논문 개요와 전체 구조
프로그램 복원에 실패한 에이전트라도 재현용 테스트나 반례를 남길 수 있습니다. 다음 에이전트가 그 기록을 읽고 문제의 범위를 좁힌다면, 두 번의 실행은 같은 문제를 처음부터 푼 두 번의 시도와 달라집니다. GitSwarm의 저자들은 이렇게 중간 작업을 남겨 다음 추론에서 확인하고, 수정하고, 합칠 수 있게 하는 방식을 누적 추론(compounding inference)이라고 부릅니다. arXiv:2610.04862v1
GitSwarm은 작업 내용을 Git 커밋으로 보존하고, 워커가 다른 분기에서 참고한 코드와 근거를 별도로 기록합니다. 연구진은 수학 증명과 프로그램 복원에서 최종 점수와 추론 토큰을 비교한 뒤, GPU가 필요한 모델 설계 실험에서도 이 구조를 시험했습니다. 최종 답안이 실제로 이전 작업을 얼마나 이어받았는지 보기 위해 의존 그래프와 실행 로그도 분석했습니다. 원문 §1
| 원문 절 | 다루는 내용 |
|---|---|
| 1. Introduction | 추론 과정에서 재사용 가능한 작업을 남겨야 하는 이유 |
| 2. GitSwarm | 공유 커밋 그래프, 워커 실행 규약, 진행 상태와 최종 후보 선택 |
| 3. Experiments | 벤치마크, GPU를 쓰는 연구 과제, 산출물 재사용과 조율 비용 |
| 4. Discussion and Limitations | 재사용을 관찰하는 것과 성능에 미친 영향을 입증하는 것의 차이 |
| 5. Conclusion | 누적 추론의 의의와 저자들이 제안한 학습 방향 |
| 부록 A–H | 관련 연구, 평가 설정, 합성 실험, 벤치마크·연구 결과, 재사용·조율 분석, 프롬프트 |
핵심 기여와 혁신성
독립 샘플링은 여러 풀이를 만든 다음 좋은 답을 고르는 데 적합합니다. 그런데 다음 에피소드가 기존 풀이에서 확보한 부분 해법이나 새 테스트를 이용하려면, 최종 후보만 보존하는 방식에 작업 기록을 넘기는 과정이 추가로 필요합니다. GitSwarm은 작업 도중 만들어진 기록도 이후에 출발점이나 근거로 선택할 수 있게 커밋 단위로 보존합니다. 이때 코드 변경을 상속하는 Git 부모와 별도 분기에서 읽은 근거를 구분합니다. 예를 들어 수정 코드는 한 분기에서 이어받으면서 다른 분기가 만든 반례를 사용해 변경 범위를 정할 수 있습니다. 원문 §1–2
실험의 또 다른 기여는 최종 점수와 작업 기록의 재사용을 각각 측정했다는 점입니다. 증명과 프로그램 복원은 모두 워커가 앞선 기록을 읽지만, 프로그램의 최종 구현은 여러 분기를 연결하는 경향이 강하고 증명에서는 이미 완성된 후보를 비교하는 데 후속 워커가 더 많이 쓰였습니다. 같은 시스템 안에서도 과제에 따라 추가 추론의 용도가 달라질 수 있습니다. 원문 §3.4–3.5
기술적 세부사항
워커는 모델이 저장소를 탐색하고 한 가지 작업을 수행하는 실행 단위입니다. 한 워커의 실행을 에피소드라고 합니다. 기본 구성에서는 모델과 행동 규약을 공유하고, 실행 하네스가 빈 슬롯에 워커를 배치합니다. 워커마다 격리된 Git 워크트리에서 시작 커밋을 고른 뒤, 기여 커밋을 제출하거나 기존 커밋을 지명하거나 자발적으로 중단합니다. 프로그램 복원과 증명에서는 과금 대상 에피소드 수로 예산을 세고, 아키텍처 연구에서는 시간과 GPU를 공유합니다. 원문 §2.3 및 §3.1
| 기록 | 예시 | 이후에 사용되는 방식 |
|---|---|---|
| Git 부모 | 실제 수정에 사용한 저장소 상태 | 동일 파일 상태에서 실험을 이어갑니다. |
| 의미적 의존성 | 다른 분기의 반례, 측정 결과, 참고 코드 | 커밋의 informed_by=에서 근거를 찾아갈 수 있습니다. |
| 진행 로그 | 수정 중인 버그, 완료 조건, 미커밋 변경 | 동료의 범위를 살피고 겹치는 작업을 조정합니다. |
| 지명 기록 | 기존 후보 SHA와 선택 이유 | 후보의 코드나 증명 파일을 바꾸지 않고 표만 집계합니다. |
수학 증명은 문제별 점수 0·1·6·7 가운데 만점 7만 완전 정답으로 집계합니다. 프로그램 복원은 과제마다 숨은 테스트에서 기준 프로그램의 동작과 일치한 비율을 먼저 구합니다. 논문에서 비교하는 평균은 과제별 점수에 같은 가중치를 줍니다. 연구 실험에서는 RMT와 Looped Transformer의 다음 토큰 교차 엔트로피 손실과 NanoChat의 바이트당 비트 수(BPB)를 사용합니다. 손실과 BPB는 모두 낮을수록 좋지만 데이터, 후보를 선택한 검증 세트, 훈련 예산이 달라서 세 연구의 수치를 한 점수로 합치지 않습니다. 부록 B.1 및 E.1
챕터별 상세 리뷰
📖 Chapter 1: Introduction
저자들은 긴 수학 증명과 실험 연구에서는 한 번의 실행이 전체 문제를 해결하기 어려워도 부분 성과가 다음 시도에 쓸모가 있다고 봅니다. 예를 들어 어떤 가설이 틀렸다는 반례는 후속 실험의 범위를 줄입니다. 이전의 추론 확장 방식은 후보를 반복 표집하거나 탐색 트리를 만들고, 일부는 이전 실행 내용을 요약해 다음 실행의 입력으로 넘깁니다. 이 논문이 검토하는 설계에서는 여러 워커가 자신의 탐색 분기를 남기고, 앞선 분기 중 무엇을 읽거나 확장할지도 각자 판단합니다. 원문 §1
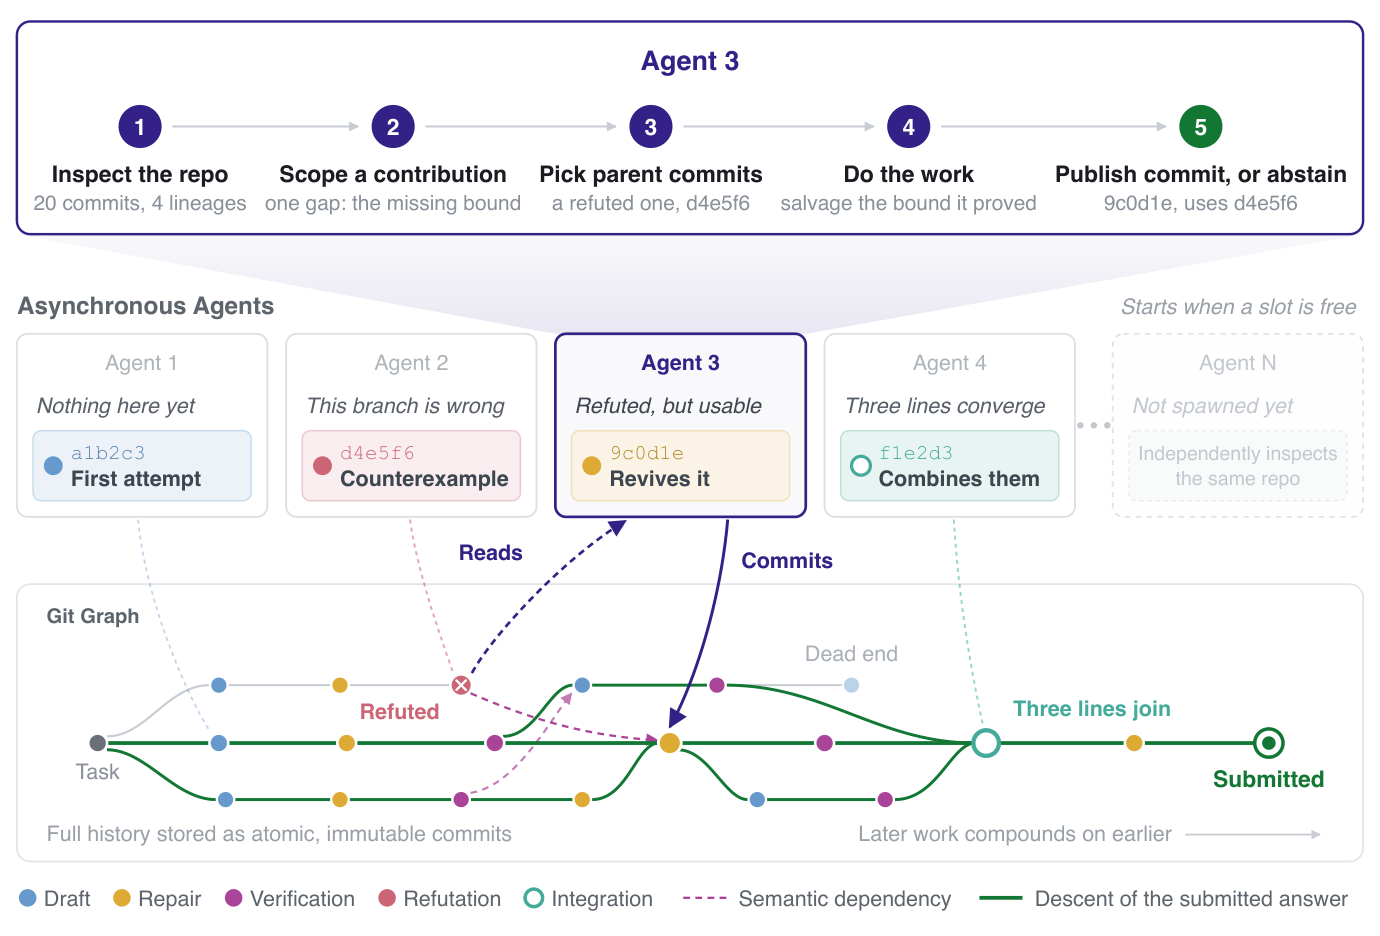
워커의 작업 순서와 비동기 실행, 교차 분기 의존성을 한 흐름으로 보여 줍니다. Shah 외, GitSwarm v1 그림 1 · PDF 2쪽 · CC BY 4.0 · 그림 영역 크롭.
그림의 세 번째 워커는 이전 시도를 반박한 커밋을 확인하고, 그 안에서 증명에 쓸 수 있는 상계를 골라 새 작업을 진행합니다. 실패 판정과 재사용 가능한 결과가 한 커밋에 함께 남아 있기 때문에 가능한 흐름입니다. 저자들은 이 동작을 Git 기반 시스템으로 구현하고, 벤치마크의 점수와 연구 과정에서 남은 의존성·산출물 기록을 함께 제시합니다. 원문 §1
📖 Chapter 2: GitSwarm
2.1 Design Principles. 누적을 위해 저자들은 세 가지 성질을 요구합니다. 지속성(persistence)은 워커가 종료된 뒤에도 결과를 남기는 성질입니다. 분기 가능성(branchability)은 같은 작업 상태에서 여러 대안을 별도로 발전시키는 능력입니다. 출처 추적(attribution)은 나중에 어떤 작업을 참고했는지 찾아갈 수 있게 합니다. 하네스는 실행과 제출을 관리하며, 기본 구성에서 워커는 시점에 따라 코드 작성, 검증, 비교 또는 합성을 스스로 선택합니다. 원문 §2.1
2.2 Shared Computation Graph. 과제 $q$마다 명세와 필요한 파일을 넣은 불변 루트 $v_0$를 만듭니다. $i$번째로 채택된 기여 커밋 $v_i$에는 실제 작업을 시작한 Git 부모 $p_i$가 하나 있습니다. 워커는 그 부모를 포함하여, 참고한 이전 커밋들의 집합 $U_i$도 informed_by=로 제출합니다. 식 (1)의 $E_t$는 $t$개의 기여가 들어온 시점의 간선 집합입니다. 앞의 항은 Git 부모, 뒤의 항은 추가로 선언한 의존성입니다. 원문 §2.2 식 (1)
예를 들어 두 번째 워커가 고친 파서에서 분기하고 네 번째 워커가 찾은 입력 사례까지 사용했다면, 새 커밋의 파일 상태는 파서 수정분을 상속합니다. 입력 사례는 informed_by= 참조로 연결됩니다. 코드 병합 없이도 두 출처에 접근할 수 있고 한편으로 각 분기의 원래 작업 상태도 남습니다. 이 간선은 워커가 신고한 연구 경로이므로, 참조한 작업이 점수를 올렸는지는 별도 실험이 필요합니다. 원문 §2.2
2.3 Asynchronous Worker Protocol. 문제 풀이 모드에서 하네스는 최대 동시 실행 수 $C$까지 워커를 채우고, 자리가 비면 새 워커를 시작합니다. 워커는 현재 저장소를 읽은 다음 격리된 워크트리에서 범위를 정합니다. 종료 행동은 새 커밋의 제출, 정확한 SHA로 기존 후보 지명, 자발적 중단 중 하나입니다. 제출 조건은 필요한 파일과 프로토콜의 충족을 검사합니다. 답안의 정오 판정은 과제별 평가기가 맡습니다. 중단은 실행 횟수를 세는 예산 $B$를 소비하지 않아 대체 워커가 실행되지만, 중단 결정에 쓴 토큰은 기록됩니다. 무효 제출과 시스템 실패는 예산에 포함됩니다. 원문 §2.3 및 부록 G.4
논문 규약을 워커 하나의 입출력 중심으로 옮긴 의사코드입니다. 예산·동시성은 문제 풀이 실행을 관리하는 하네스에 있습니다. 원문 §2.3–2.5
1
2
3
4
5
6
7
입력: 과제 명세, 현재 저장소, 대시보드, 동료의 진행 로그
후보와 진행 중인 작업을 살피고 이번 에피소드의 범위를 결정한다
기존 후보가 비교·검증 결과 가장 낫다면 후보 SHA와 이유를 지명한다
추가할 작업이 없거나 동등한 작업이 진행 중이면 자발적으로 중단한다
그 외에는 시작 커밋을 고르고 작업 범위를 알린 뒤 격리된 워크트리에서 작업한다
Git 부모와 참고한 다른 커밋을 적고 검증 가능한 기여 한 개를 제출한다
출력: 기여 커밋, 지명 기록, 또는 중단
2.4 Live Swarm State: Dashboard and In-Flight Activity. gs_dashboard는 시작 시점의 상태를 보여 주고 실행 중 새로 조회할 수 있습니다. 문제 풀이에서는 남은 예산, 실행 중인 워커, 지명 상황을 표시합니다. GPU 연구에서는 보호된 개발 점수와 해당 커밋, GPU·CPU·작업 큐와 낮은 사용률 경고를 읽습니다. 워커는 편집 전 gs_inflight에 해결하려는 빈틈, 예상 산출물, 성공·중단 조건을 적고 중간 진행을 알립니다. 동료는 공개 로그와 미커밋 변경을 읽을 수 있으며 해당 워크트리를 수정할 수 없습니다. 원문 §2.4
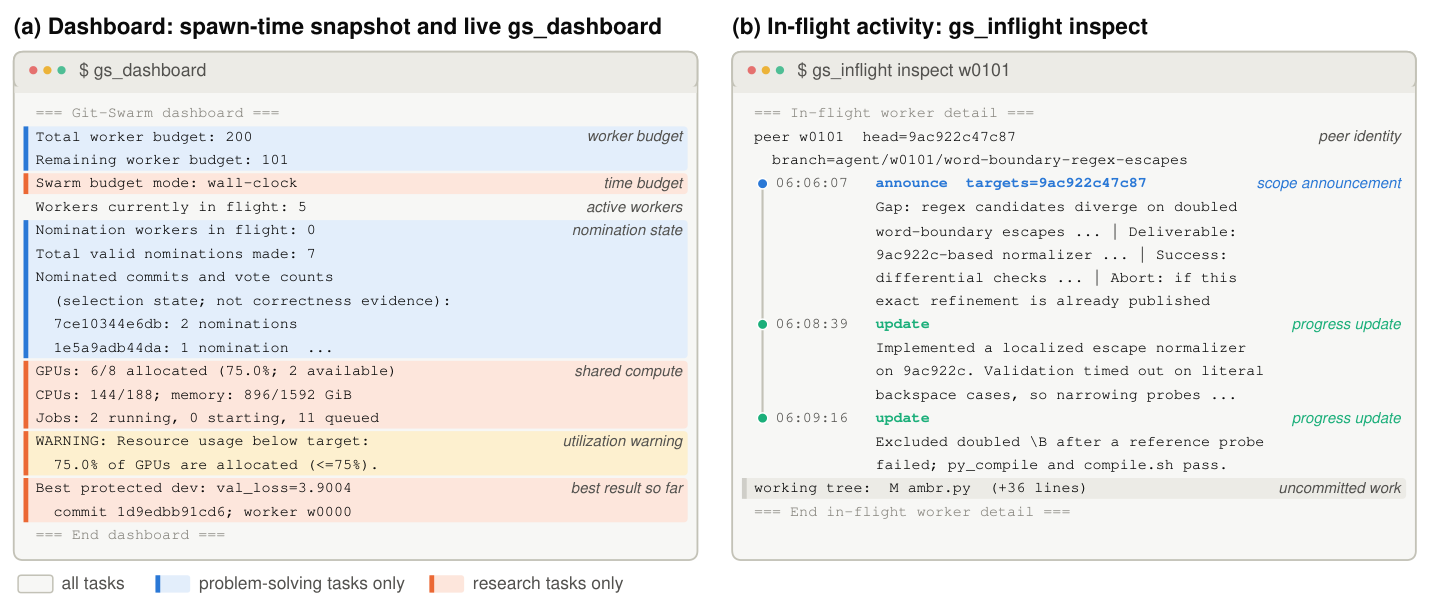
왼쪽은 과제별로 달라지는 대시보드 항목이고 오른쪽은 다른 워커가 확인한 진행 로그입니다. Shah 외, GitSwarm v1 그림 2 · PDF 5쪽 · CC BY 4.0 · 그림 영역 크롭.
2.5 Decentralized Readout. 추론 예산이 끝나면 후보별 지명 횟수를 집계하고 동률은 결정론적으로 처리합니다. 식 (2)에서 $c_i$는 $i$번째 지명 대상, $V_{\mathrm{cand}}$는 후보 커밋의 집합, $\mathbf{1}[\cdot]$은 조건을 만족하면 1인 표시 함수입니다. 선택된 $v^\star$의 파일을 제출합니다. 지명 기록은 작업을 확장하는 그래프에서 제외되므로, 늦게 받은 표 때문에 어떤 커밋의 조상 범위가 늘어나지는 않습니다. GPU 연구에서는 지명 대신 개발 검증 점수를 기준으로 모델을 고릅니다. 원문 §2.5 식 (2) 및 §3.3
📖 Chapter 3: Experiments
3.1 Experimental Setup. 증명은 IMOProofBench-Advanced 30문제를 모두 사용했습니다. 프로그램 복원은 문서와 실행 전용 기준 프로그램이 주어지며, 평가에서 기준 프로그램에 의존할 수 없는 독립 실행 파일을 제작해야 합니다. ProgramBench 전체 200개 중 언어, 난도, 테스트 수, 실행 시간으로 층화한 고정 50개를 평가에 사용했습니다. 설계 조정에 사용한 프로그램 9개는 이 평가에서 제외됐고, 개발 단계에서 본 증명 6문제는 전체 30문제 평가에 포함됐습니다. 원문 §3.1 및 부록 B
문제 풀이 GitSwarm의 동시 실행 수는 5이며, ProgramBench의 과금 대상 에피소드 예산은 100·200·300·500, 증명은 20·40·80·120·160입니다. 단일 에이전트 비교군 Forced는 같은 세션이 자연스럽게 종료할 때마다 작업을 이어가게 하고, 각 종료 지점의 후보를 평가했습니다. 토큰은 모든 모델 요청에서 합산합니다. 입력은 처음 보낸 지시와 요청마다 다시 전송한 누적 문맥을 모두 포함합니다. 출력은 새로 생성된 답과 숨은 추론 토큰을 포함합니다. 워커 예산이 같아도 한 에피소드에서 하는 작업의 길이에 따라 토큰 비용은 달라집니다. 원문 §3.1 및 부록 B.3
3.2 Benchmark Performance and Inference-Time Scaling. ProgramBench의 같은 50개 과제에서 GPT-5.5 High를 쓰는 Codex 워커의 평균은 예산 100에서 73.1%, 500에서 79.4%였습니다. 기본 추론 강도의 GPT-5.5 워커는 예산 100에서 64.6%, 300에서 71.2%였습니다. 논문의 구체적 최고 점수는 79.39%이며, 이어서 실행한 단일 Forced Codex의 최고 보고 점수는 65.12%입니다. 이 숫자는 50문제의 완전 해결률이 아닌 과제별 숨은 테스트 통과율의 평균입니다. 논문은 유사한 연산 예산의 비교로 제시하고, 그림에서는 입력·출력 토큰을 각각 표시합니다. 저장소가 커질 때 입력 토큰이 증가하며, 가장 큰 예산에서는 추가 점수 상승이 둔해졌습니다. 원문 §1 및 §3.2
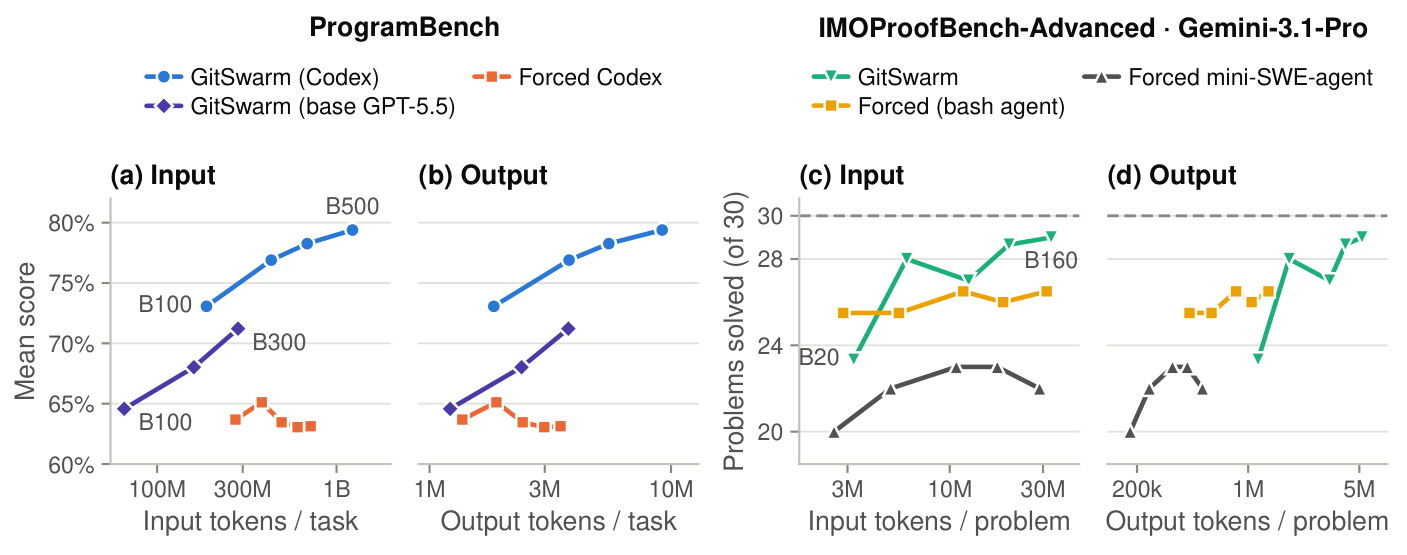
왼쪽 두 패널은 프로그램 복원, 오른쪽 두 패널은 Gemini-3.1-Pro의 증명 결과입니다. Shah 외, GitSwarm v1 그림 3 · PDF 6쪽 · CC BY 4.0 · 그림 영역 크롭.
증명에서 Codex(GPT-5.5 High) 워커는 예산 20에서 28문제, 예산 40과 80의 보고 실행에서 각각 30문제를 완전 정답으로 평가받았습니다. 30/30은 한 실행 안에서 30문제 모두 채점 기준의 만점 7을 받았다는 뜻입니다. 서론은 Codex의 만점 결과를 약 100만 미만의 출력 토큰으로 요약하고, 부록 그림 17은 문제당 평균 토큰으로 비용을 표시합니다. Gemini-3.1-Pro 비교에서 예산 20과 160의 평균은 각각 23.3과 29.0이며, 예산 80 부근에서 점수가 일시 하락합니다. 정답 판정기를 갖춘 독립 Best-of-N 비교도 더 적은 토큰으로 만점에 도달했습니다. 원문 §3.2 및 부록 그림 17
3.3 Sustained Experimental Research. 아키텍처 연구에서는 워커가 구현과 수치를 저장소에 남기고 제한된 GPU를 SLURM으로 공유합니다. 예산은 문제별 활성 시간과 GPU로 정하며, 각 후보 모델을 훈련하는 데 쓴 데이터 토큰과 워커의 추론 토큰은 별개의 비용입니다. 아래 표는 후보를 선정한 지표와 별도 평가가 있었는지를 구분합니다. 원문 §3.3 및 부록 E.1
| 연구 과제 | 기준과 GitSwarm 관찰 | 실험 조건 |
|---|---|---|
| RMT | 별도 held-out 손실 3.147 → 2.890 / 2.894 | 12워커, 72시간, 8 / 4 H200 할당. 비교한 세 모델 모두 1.3B 훈련 토큰 |
| Looped Transformer | 개발 손실 3.265 → 3.187 | 12워커·8 H200, 48시간 중 26시간 시점 보고. 반복 횟수 8. 별도 held-out 미보고 |
| NanoChat | 검증 BPB 0.993 → 0.905 | Astra 워커 20개가 GB300 16개 공유. 첫 활성 24시간, 후보당 GPU 훈련 시간 5분 |
RMT의 목표는 행렬 형태의 잔차 상태를 유지한 채 파라미터 350M 이하에서 아키텍처를 개선하는 것입니다. 원 논문 기준 모델과 두 GitSwarm 결과는 같은 1.3B 훈련 토큰을 사용합니다. 단일 에이전트 설정은 3.0B 토큰에서 2.927, Codex 설정은 10.1B 토큰에서 2.690을 기록했습니다. 8 GPU 실행에서는 여섯 변경 가운데 네 가지가 다른 분기에서 출발했습니다. 이전 토큰 한 개의 메모리를 읽는 실패 기록을 49.5시간 뒤 다른 워커가 참고하여, 여러 시점의 메모리를 섞는 모듈을 설계했습니다. 별도 seeded 실행은 독립 실행 세 개의 우승 커밋을 이어받아 약 28시간에 개발 손실 2.909를 2.898로 개선했습니다. 시작점에 이전 연구가 포함된 비교입니다. 원문 §3.3 및 부록 E.2
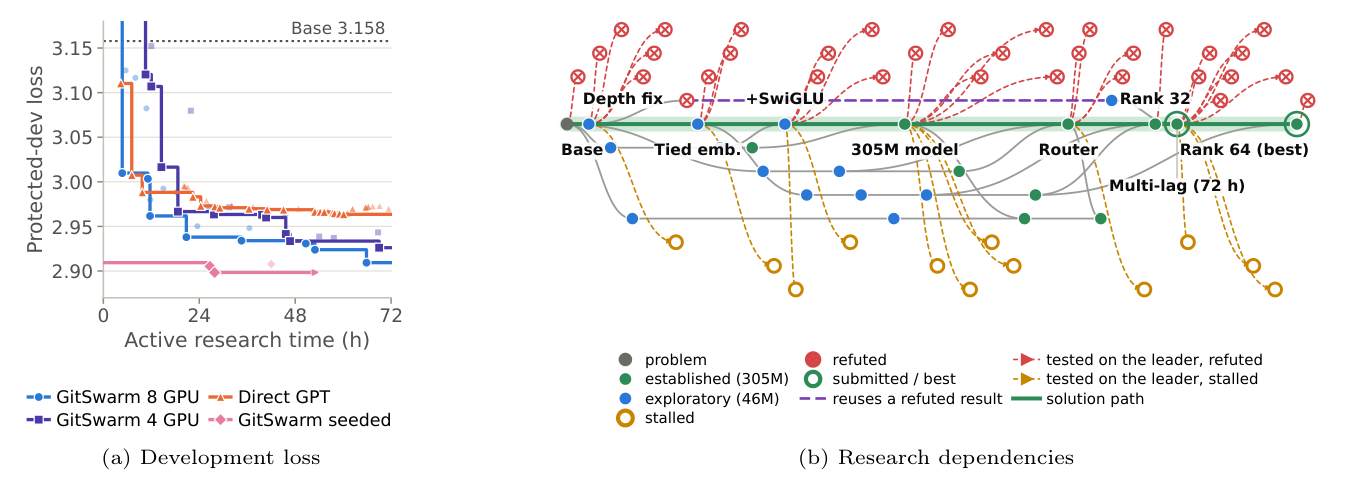
왼쪽은 RMT 개발 손실의 최솟값, 오른쪽은 8 GPU 실행의 연구 그래프입니다. Shah 외, GitSwarm v1 그림 4 · PDF 7쪽 · CC BY 4.0 · 그림 영역 크롭.
Looped Transformer의 Huginn은 같은 가중치의 코어를 여러 번 돌리며, 매 반복에서 인코딩된 입력을 어댑터로 다시 주입합니다. GitSwarm은 선형 어댑터를 게이트가 있는 순방향 신경망으로 바꿨습니다. 128개 개발 예제로 먼저 평가했을 때는 기각됐으나, 동료가 512개와 전체 4,873개 예제로 평가해 개선을 확인했습니다. 전체 평가와 비교 가능한 모델 쌍 12개 중 128개 평가는 5쌍, 512개 평가는 1쌍의 순서를 잘못 매겼습니다. 같은 파라미터 수로 맞춘 대조군의 개발 손실은 3.212였습니다. 26시간 동안 12개 계열에서 395개 아키텍처 실험을 수행했고, 부정적 아키텍처 결과의 74%는 이후 인용됐습니다. 원문 §3.3 및 부록 E.3
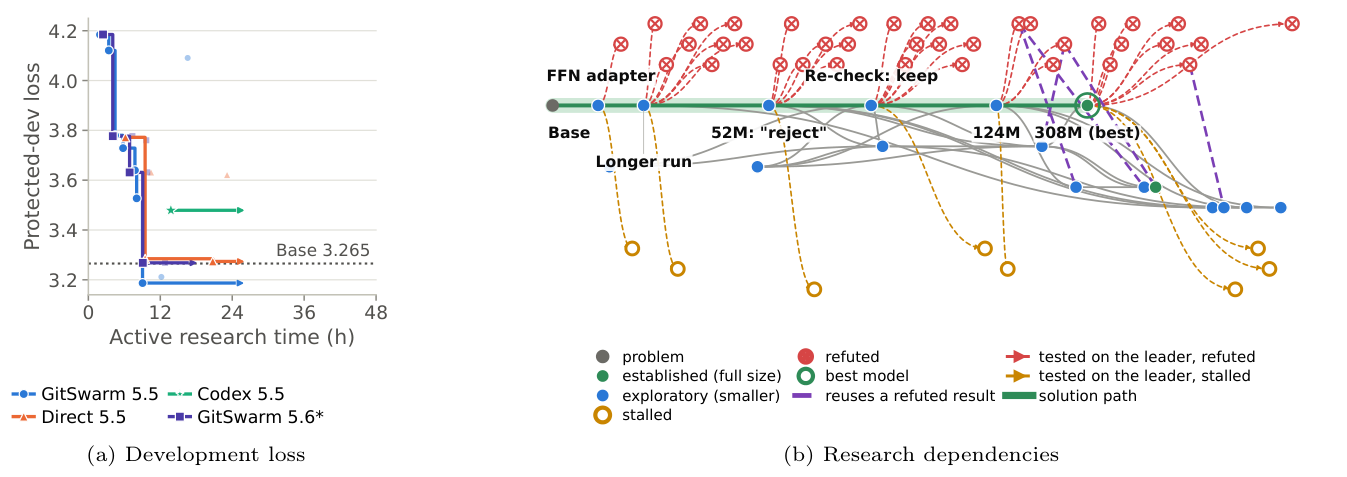
어댑터가 작은 표본에서 기각됐다가 재평가를 거쳐 채택되는 과정을 오른쪽에서 볼 수 있습니다. Shah 외, GitSwarm v1 그림 5 · PDF 8쪽 · CC BY 4.0 · 그림 영역 크롭.
NanoChat의 첫 24 활성시간 Astra·GB300 실행에서는 평가에 성공한 1,465건 가운데 최고 후보가 0.905235 BPB에 도달했습니다. 이전에 따로 저장했을 때 성능이 낮던 trigram 해시를 다른 워커가 bigram과 공유하는 테이블에 적용했고, 이후 테이블 크기를 늘린 후보가 채택됐습니다. 이때 모델은 50.3M에서 약 1.72B 파라미터로 커졌고, 증가분의 대부분은 어휘 테이블에 있습니다. 데이터·토크나이저·평가기를 고정했지만 아키텍처, 용량, 최적화, 훈련 구현을 함께 바꿀 수 있는 설계입니다. 분석된 Astra 실행에는 실험·합성과 비평·검증 역할이 3:1로 설정돼 있어, 그 실행에서의 탐색 행동은 주어진 역할 안에서 해석해야 합니다. 원문 §3.3 및 부록 E.4
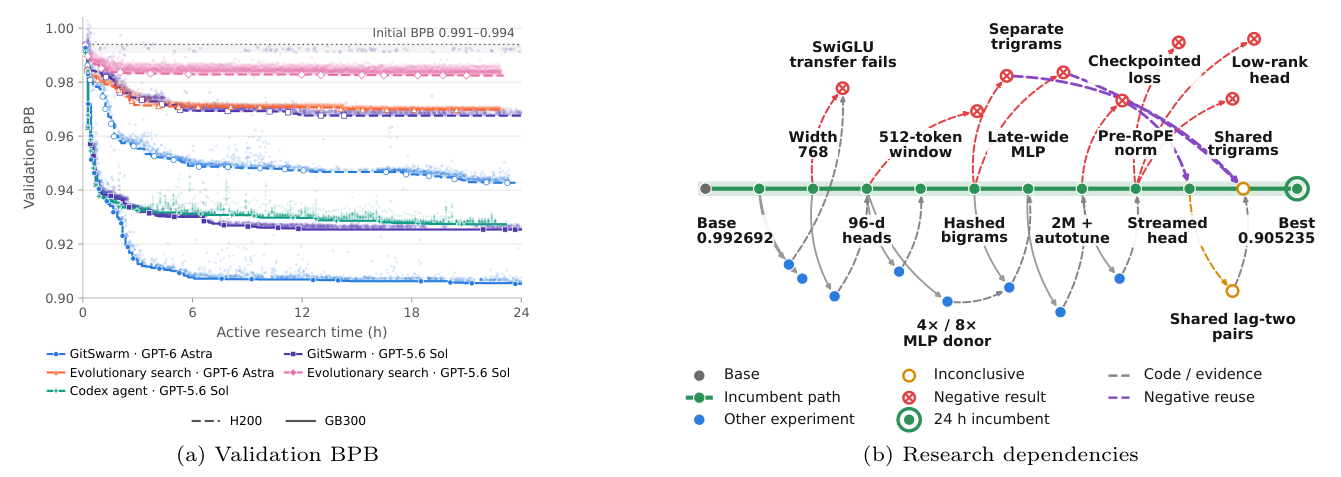
왼쪽은 첫 활성 24시간의 검증 BPB입니다. 오른쪽은 일부 의존성을 추린 그래프이며 시간축이 없습니다. Shah 외, GitSwarm v1 그림 6 · PDF 9쪽 · CC BY 4.0 · 그림 영역 크롭.
3.4 Evidence for Compounding Computation. 50개 프로그램 과제마다 네 예산으로 얻은 200개 실행과, Gemini-3.1-Pro의 증명 150개 실행이 추적 분석에 쓰였습니다. 앞선 커밋을 참조할 수 있는 에피소드 중 참조를 남긴 비율은 두 과제에서 99.9%와 96.2%입니다. 분모를 앞선 에피소드에서 발행된 기여 커밋으로 바꾸면, 적어도 한 번 후속 작업이 참조한 비율은 94.7%와 44.4%입니다. 워커가 참고 자료를 많이 읽는지와 이미 쌓인 자료 중 얼마나 두루 쓰이는지는 서로 다른 질문입니다. 원문 §3.4 및 부록 F.1
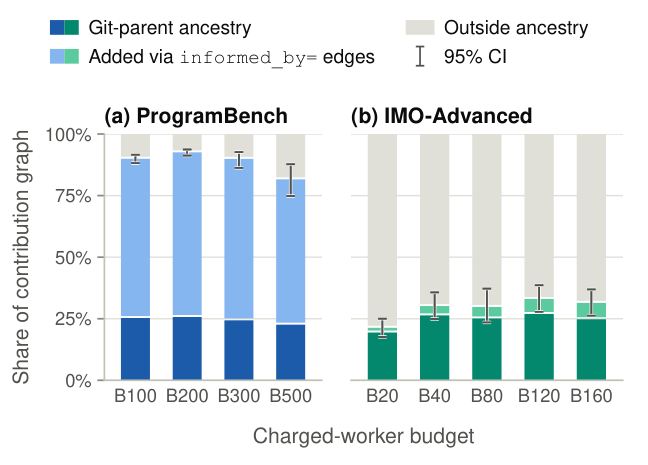
최종 커밋에 연결된 기여의 비율을 Git 부모 경로와 추가 의존성으로 나눠 그렸습니다. Shah 외, GitSwarm v1 그림 7 · PDF 9쪽 · CC BY 4.0 · 그림 영역 크롭.
최종 선택의 조상 범위는 선택 커밋에서 Git 부모와 추가 의존성을 역방향으로 따라갈 수 있는 기여의 비율입니다. 루트와 지명 기록은 제외하며 예산별로 과제에 걸쳐 평균합니다. ProgramBench의 범위는 81.6–92.6%, 증명은 21.3–33.0%였습니다. Git 부모만 따라가면 연구진이 설명한 규모는 대략 그래프의 4분의 1입니다. ProgramBench에서 다른 분기의 근거를 연결해 닿는 범위가 크게 넓어집니다. 증명에서는 먼저 만든 해법을 검증해 그대로 지명할 수 있으므로 그 검증의 작업량이 선택된 커밋의 조상 수로 나타나지 않을 수 있습니다. 원문 §3.4 및 부록 F.1
실행 로그에서 관측한 능동 재사용도 따로 셉니다. ProgramBench의 자발적 산출물 중 분석 조건을 만족하는 묶음의 79.9–82.5%는 후속 워커가 실행·응용하거나 기여의 근거로 활용했습니다. 증명에서는 계산으로 주장을 확인하는 탐침 묶음 759개 중 583개를 열었고, 그중 172개를 후속 워커가 작성자를 인용하며 실행하거나 수정했습니다. 52개는 최종 선택의 조상 안에 있는 기여로 연결됐습니다. 규약이 요구하는 추론·평가 기록의 접근률은 두 과제에서 대상 리비전 기준 약 98–99%였습니다. 이 관찰은 기존 파일이 단순히 워크트리에 복제된 경우와 구별됩니다. 원문 §3.4 및 부록 F.2
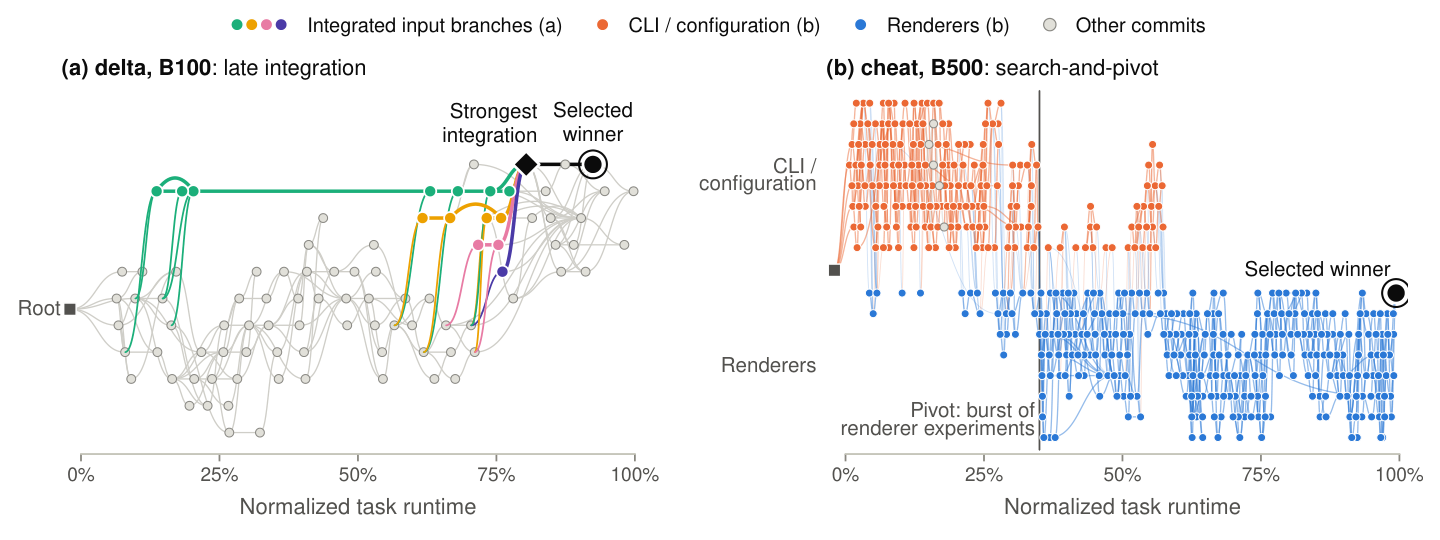
왼쪽은 delta의 후기 통합, 오른쪽은 cheat에서 렌더러로 작업 초점을 옮긴 사례입니다. Shah 외, GitSwarm v1 그림 9 · PDF 10쪽 · CC BY 4.0 · 그림 영역 크롭.
3.5 Adaptive Coordination and Design Tradeoffs. 연구진은 에피소드 로그를 사후 분류했습니다. ProgramBench에서는 초기 후보를 만든 뒤 기능 추가와 입출력 수리, 후보 합성이 종료 무렵까지 이어졌고 지명은 후반에 늘었습니다. 최종 커밋이 처음 등장한 중앙 시점은 예산별 실행 진행률의 93.1–98.0%였습니다. 증명은 중앙 시점 8.6–17.5%로 앞섰으며, 예산 20에서 160으로 커질 때 후보 선택 에피소드의 비중도 44.2%에서 69.7%로 올랐습니다. 원문 §3.5 및 부록 G.3
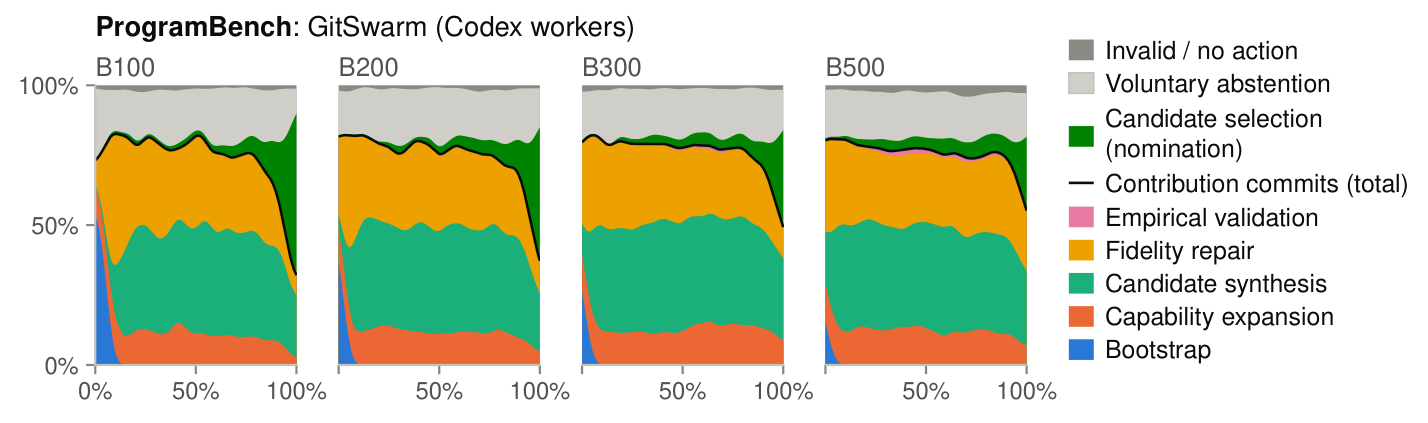
후보 생성, 기능 확장, 수리, 합성, 지명 등이 예산 소진 과정에서 차지하는 비중입니다. Shah 외, GitSwarm v1 그림 10 · PDF 11쪽 · CC BY 4.0 · 그림 영역 크롭.
프로그램 워커 약 6명 중 1명은 같은 작업이 진행 중이거나 이미 완료됐다며 중단했습니다. 증명에서는 예산별 2.7% 미만입니다. 프로그램 워커는 보통 후보 커밋 5–7개, 증명 워커는 약 3개를 직접 열었습니다. 중단은 중복 커밋이나 뒤따를 평가를 줄일 수 있지만 중단 전 쓴 추론 토큰은 지불합니다. 실제로 프로그램의 모든 자발적 중단이 차지한 토큰은 입력·출력 각각에서 대략 6–7%였습니다. 원문 §3.5 및 부록 G.4–G.5
프로그램 개발 과제 9개에서는 동일한 GPT-5.5(Medium), 예산 50, 동시 실행 5, 시드 3개를 사용해 실행·선택 방식을 바꿨습니다. ± 뒤는 시드별 과제 평균의 표본 표준편차입니다. 각 비교의 기준은 기본 비동기 실행과 분산 지명 조합입니다. 부록 Table 13
| 비교 설정 | 평균 점수 ± 표본 표준편차 | 평균 과제 시간 |
|---|---|---|
| 기본 비동기·분산 지명 | 62.06 ± 2.44% | 38.0분 |
| 5명 단위로 기다리는 동기 실행 | 63.11 ± 0.58% | 49.3분 |
| 중앙 선택자 | 64.40 ± 1.49% | 34.9분 |
| 중앙 합성자 | 58.19 ± 4.53% | 43.9분 |
중앙 선택자는 기존 후보를 고르고 합성자는 새 후보를 만든다는 차이가 있습니다. 두 대조군은 전체 50개 중 한 에피소드를 마지막 워커에게 배정했습니다. 비동기는 이 실험에서 대기 시간이 짧았고 중앙 선택의 관측 평균이 더 높았습니다. 이 개발 과제 결과는 처리 시간과 선택 방식 사이의 절충을 보여 주며, 구조별 성능의 통계적 동등성을 입증하는 검정은 제시되지 않았습니다. 원문 §3.5 및 부록 G.6
📖 Chapter 4: Discussion and Limitations
Causal attribution. 저장소와 실행 로그는 워커가 무엇을 읽고 활용했는지 보여 줍니다. 특정 기록을 숨겼을 때 최종 점수가 어떻게 바뀌는지는 이 분석에서 측정하지 않았습니다. 저자들은 같은 후보에서 출발해 남은 연산을 맞춘 다음, 이전 연구 이력에 대한 접근을 한쪽에만 주는 개입을 제안합니다. 지속성, 분기 가능성, 교차 분기 의존성 각각을 따로 평가하려면 그 속성의 유무를 바꾸는 실험이 추가로 필요합니다. 원문 §4
Evaluation scope. ProgramBench 수치는 고정 50개 과제에 해당합니다. 증명 만점은 단일 실행의 결과이며 일부 Forced·독립 샘플링 비교군도 점수 상한에 도달했습니다. RMT의 단일 에이전트와 스웜 후보는 사용한 훈련 토큰이 다릅니다. seeded RMT는 이미 만들어진 연구를 가져왔고, Looped Transformer는 작성 당시 관련 실행이 진행 중이었습니다. NanoChat은 시작 체크포인트와 GPU 할당이 설정마다 다릅니다. 연구진은 세 과제에서 각 출발점보다 개선을 보고했습니다. 원문 §4
Computational overhead. 저장소를 확인하는 입력 토큰, 채택되지 않거나 중복된 에피소드의 추론, 공유 GPU 실행의 대기와 경합에 비용이 듭니다. 저자들은 저장된 작업의 가치와 이런 비용의 균형을 보려면 전체 연산량과 실행 시간을 맞춘 더 긴 평가가 필요하다고 설명합니다. 원문 §4
📖 Chapter 5: Conclusion
GitSwarm은 비동기 워커가 여러 분기의 기록을 보존하고 중간 결과도 다음 작업의 재료로 쓸 수 있도록 설계됐습니다. 원문은 프로그램의 교차 분기 합성, 증명 후보의 비교, 처음에는 실패했던 실험의 재사용을 이 구조에서 관찰했습니다. 저자들이 제안한 후속 방향은 이런 환경에서 강화학습을 적용해, 해당 에피소드의 과제 성공 외에도 후속 워커가 쓸 수 있는 기여를 장려하는 것입니다. 원문 §5
이어지는 AI 사용 명세는 API 기반 모델이 실험 대상 워커이자 일부 의미 분석의 측정 수단이었음을 밝힙니다. 연구진은 격리된 워크트리와 인터넷 접근이 없는 실행 환경을 사용했다고 기술했으며, 프로그램 재구성과 자율 아키텍처 연구의 이중 용도를 고려해 사람이 감독하고 결과를 독립 검증할 수 있어야 한다고 설명합니다. AI Usage Statement 및 Ethics Statement
📖 Chapter A: Related Work
부록 A는 작업 상태 보존, 대안 탐색, 의존 기록, 다음 작업 결정 방식이라는 네 축으로 기존 시스템을 비교합니다. ToT·LATS는 탐색 상태와 탐색 간선을 남기고, Reflexion·ExpeL은 이후 시도에 쓸 반성과 경험을 저장합니다. MetaGPT·AutoGen에는 작업 흐름과 역할에 따른 메시지 기록이 있으며, GPTSwarm은 실행 가능한 에이전트 연산 그래프를 최적화합니다. 저장소를 쓰는 CAID와 SwarmResearch, Agora는 Git 기반 보존과 분기를 공유합니다. 표에서 GitSwarm이 강조하는 차이는 Git 부모에 더해 여러 참고 커밋을 명시적으로 기록하는 규약과 워커별 독립적 작업 선택입니다. Table 1과 Table 2는 설계 비교표입니다. 부록 A
📖 Chapter B: Experimental Setup Details
B.1–B.2. 프로그램 워커는 문서와 참조 실행을 토대로 독립 코드베이스를 구성하고, 증명 후보는 공통 채점 규약에 따라 0·1·6·7점 중 하나를 받습니다. ProgramBench의 50개 평가 과제 중 26개는 Rust, 11개는 Go, 8개는 C이고 나머지는 C++·Haskell·Java입니다. 테스트 수 5분위에서 각각 10개씩 뽑고 실행시간 사분위의 균형도 고려했습니다. 개발용 9개와 평가용 50개의 실제 목록을 원문에서 구분해 확인할 수 있습니다. 부록 B.1–B.2 및 Table 3
B.3–B.4. Forced는 자연 종료마다 기존 세션을 계속 진행시켜 중간 체크포인트를 얻습니다. 프로그램 추적은 평가 50과제의 Codex 워커 네 예산이고, 증명 추적은 점수 포화 이후에도 작업 양상이 관찰되는 Gemini-3.1-Pro 워커의 다섯 예산입니다. 따라서 증명 만점에 도달한 Codex 실행과 재사용률을 계산한 증명 코퍼스의 모델이 서로 다릅니다. 부록 B.3–B.4
📖 Chapter C: Controlled Tests of Substrate Properties
C.1 Persistence. Hidden Rulebook에서는 현재 규칙을 조회해야 선행 규칙의 ID가 드러납니다. 예를 들어 목표가 이전 결과의 3배이고 그 이전 규칙이 상수 7에 5를 더한다면, 세 레코드를 연결해 36을 구합니다. 공유 메모리 조건의 다음 워커는 앞 워커의 조회 기록을 읽어 미발견 레코드부터 조회할 수 있습니다. 평가자는 전체 정답 풀이 여부와 별개로 목표에 필요한 레코드 가운데 몇 개를 팀이 고유하게 조회했는지 셌습니다. 독립 비교군에는 합산 조회 예산을 더 줬는데도 공유 메모리의 관련 레코드 발견 비율이 높았습니다. 부록 C.1 및 그림 11–12
C.2 Branchability. Hidden Maze의 평면 기록은 이전 발걸음을 보여 주지만 시작점에서 알려진 경로를 다시 지나야 합니다. 분기형 메모리는 도달했던 끝점을 복원해 바로 그 방의 다른 출구를 탐색합니다. 동일한 방향의 방·출구 조합을 재방문한 발걸음의 비율이 낮아졌습니다. 분기형 조건에서는 프롬프트에도 복원 방법을 직접 안내했으므로 인터페이스와 안내가 함께 달라졌습니다. 부록 C.2 및 그림 13–14
C.3 Attribution. Retracted Evidence에서는 철회된 연구소가 생산한 기록에 의존하는 결론을 제외해야 합니다. 한 기록의 출처와 직전 부모가 표에 있으면 워커는 제목과 수치만 보고 전체 계보를 재구성하는 비용을 줄일 수 있습니다. 정확한 첫 제출까지 읽은 고유 문서의 비율로 비교했을 때 모든 깊이·모호성·분기 폭 설정에서 출처가 명시된 조건이 더 적게 읽었습니다. 그림 12와 그림 16의 띠는 세 시드 평균의 ±1 표준편차입니다. 부록 C.3 및 그림 16
C.4 Scope. 세 실험은 각각 관찰을 다시 찾는 비용, 이미 탐색한 경로를 재이동하는 비용, 출처 연결을 재구성하는 비용을 다룹니다. 실제 벤치마크에서 각 기능이 얼마나 성능을 올렸는지는 §4의 별도 개입이 필요한 질문으로 남습니다. 부록 C.4
📖 Chapter D: Benchmark Performance Details
그림 17은 문제당 평균 입력·출력 토큰에 대해 7점짜리 증명 수를 보여 줍니다. Gemini 점은 세 차례 채점 평균이고 수염은 채점 간 최솟값과 최댓값입니다. Forced Codex와 Forced GPT-5.5는 입력 토큰 계측이 없어 출력 패널에만 나타납니다. 이 범위는 독립적 재실행의 신뢰구간과 구분되며, 모델·도구 구성도 달라서 곡선 전체를 워커 수의 통제된 효과로 해석할 수 없습니다. 부록 D 및 그림 17
📖 Chapter E: AutoResearch: Additional Details
E.1 Common Setup. 각 연구의 시작 구현과 목표는 고정하고, 개별 워커는 모델 변형을 작성해 공유 GPU에 평가 작업을 제출합니다. 원문은 활성 시간에 따른 최상 검증값을 그리고 가능한 경우 별도 held-out 결과를 함께 보고합니다. 이 구조에서는 실험 큐와 평가 슬롯도 코드 변경만큼 작업 선택에 영향을 줍니다. 부록 E.1
E.2 Residual Matrix Transformer. RMT는 잔차 벡터를 행렬 메모리로 바꾸고 읽기 키와 쓰기 키·값으로 상태에 접근합니다. 72시간 제출의 개발 손실 2.909와 별도 held-out 2.890은 구분됩니다. 제출 모델의 다중 시차 메모리 믹서는 다른 분기의 부정 결과를 참고했고, 추가 실행에서 어텐션 랭크를 확대해 얻은 개발 손실 2.894는 72시간 제출의 평가와 별개입니다. 작은 모델에서 승격한 아이디어는 첫 72시간에 17개 중 15개가 본 크기에서 개선을 보였고 연장 실행에서는 8개 중 1개였습니다. 시드만 달리한 재실행에서 손실이 0.010 움직였다는 기록도 있습니다. 부록 E.2 및 Table 6–8
E.3 Looped Transformer. Huginn은 입력을 만드는 prelude, 공유 가중치로 반복하는 core, 결과를 읽는 coda로 나뉩니다. 반복마다 원래 입력을 주입하는 어댑터를 바꾸는 것이 이번 개선의 핵심입니다. 52M·124M·188M 규모의 실험과 파라미터 수 통제를 거쳤고, 평가 표본이 작아 순위가 흔들린 사례를 확인한 뒤 128→512→4,873 예제로 검증을 넓히는 절차가 생겼습니다. 선택된 코드의 직접 경로는 비교적 짧았지만, 측정과 대조를 포함한 선언 의존성이 89개 커밋에 걸쳐 있습니다. 부록 E.3 및 Table 9
E.4 NanoChat. Astra·GB300 기록에서 활성 23.67시간에 측정한 0.905235는 재할당 사이의 공백을 포함한 경과 시간으로는 25.15시간이었습니다. 엄격히 경과 24시간으로 자르면 0.905487이 최상입니다. 연장 실행의 0.898671은 관측 최저치로, 같은 소스의 반복은 0.899864였고 제출 규약을 충족한 최종 제출도 확인되지 않았습니다. 24시간 후보는 대형 어휘 테이블, 변경된 어텐션과 FFN, 훈련 구현을 함께 사용합니다. 별도의 검증 워커가 모은 반복 측정치로 이후 후보의 BPB와 메모리 사용량을 해석한 예도 있습니다. 부록 E.4
E.5 Findings Across Research Tasks. RMT는 별도 평가를 거친 개선, Looped Transformer는 기록된 개발 궤적의 개선, NanoChat은 다양한 초기 조건에서의 공동 탐색을 보여 줍니다. 이전 실험 기록의 영향은 최종 숫자 하나에서 알 수 없으므로, 다음 부록은 의존 기록과 실제 실행 흔적을 나눠 살핍니다. 부록 E.5
📖 Chapter F: Reuse, Artifacts, and Accumulation
F.1 Declared reuse와 조상 범위. 선택된 SHA의 Git 부모에서 시작해 그 부모가 참고한 분기까지 재귀적으로 방문합니다. 루트와 지명 기록을 뺀 기여 커밋이 분모입니다. 그림 7의 막대는 과제별 비율을 평균한 값이고, 수염은 95% 신뢰구간으로 표시됩니다. 예산이 늘어도 조상 비율이 두 벤치마크에서 일관되게 올라가지는 않았습니다. 부록 F.1 및 그림 7
F.2 산출물 소비. 원문은 파일이 만들어진 단계, 이후 파일을 실제로 연 단계, 실행하거나 바꿔 쓴 단계, 사용한 워커의 기여가 선택 해법과 연결된 단계를 구분합니다. 독립적 가치가 없는 파일은 한 논리적 묶음으로 셌고, 단순 파일 목록 조회나 작업 트리의 자동 상속은 소비로 집계하지 않았습니다. 증명 스크립트·계산 탐침과 프로그램의 차등 테스트·도구를 같은 파일 종류로 놓지 않고 도메인별로 분류했습니다. 부록 F.2 및 그림 19
F.3 협업 사례. delta 예산 100의 여러 입력 처리 분기는 끝부분에서 합쳐졌습니다. cheat 예산 500에서는 CLI와 설정 중심의 탐색 일부가 렌더러 실험으로 옮겨갔고 그쪽 계보에서 후보가 선택됐습니다. 그림 9의 가로축은 정규화한 작업 경과 시간입니다. §3.5의 워커 투입 진행률과는 다른 축입니다. 부록 F.3 및 그림 9
📖 Chapter G: Worker Activity, Coordination, and Design Tradeoffs
G.1–G.2 활동과 실행 상태. 프로그램은 기능 확장과 호환성 수리, 후보 합성을 별도 범주로 두고, 증명은 새 풀이 생성과 비판·보완의 비중을 구분합니다. 워커를 생성 순서대로 추적해 행동 범주와 조율 도구 호출을 분석하고, 정상 기여·지명·자발 중단과 무효 또는 행동 없는 종료를 따로 집계합니다. 두 과제의 어댑터가 남기는 도구 호출 기록이 달라 원시 호출 수를 곧바로 비교하기 어렵습니다. 부록 G.1–G.2
G.3–G.4 후보 선택과 중복. 프로그램 지명은 종료 가까이에 몰렸고 증명 지명은 더 일찍부터 쌓였습니다. 중복을 이유로 중단한 프로그램 워커의 검토 가능한 기록 1,421건 중 1,349건은 겹치는 작업이 실제로 완료돼 중단 근거가 타당한 것으로 분류됐습니다. 증명 쪽 확인은 언급한 커밋이나 워커 작업이 존재했는지에 초점을 둡니다. 두 검사는 서로 다른 기준을 적용하므로 증명의 수학적 동등성 판단으로 읽을 수 없습니다. 부록 G.3–G.4 및 그림 23–28
G.5–G.6 이력 탐색과 설계 비교. 프로그램 예산 100의 후반 워커는 후보 약 72개 중 여섯 개 정도를 명시적으로 열었고, 증명은 초기 이후 평균 세 개 안팎을 열었습니다. 마지막으로 개발용 9개 프로그램에 대해 동기 실행의 대기 비용과 중앙 최종 선택자의 효과를 작은 예산에서 비교합니다. 동일 구조가 더 큰 그래프에서도 현재의 조회 패턴과 지연을 유지하는지는 이 실험 범위를 벗어납니다. 부록 G.5–G.6 및 Table 13
📖 Chapter H: GitSwarm Worker Prompts
H.1–H.2 조립과 공통 규약. 시스템 프롬프트는 공통 협업 규약에 과제별 추가문과 일부 모델용 상호작용 지침을 결합합니다. 공통 규약은 저장소 상태를 살피고 좁은 범위의 기여를 고른 뒤, 다른 워커가 재사용할 재현 절차와 출처를 기록하게 합니다. 지명은 기존 후보 파일을 그대로 둔 채 SHA와 근거만 남기며, 비교 과정에서 본 후보까지 출처로 기록할 수 있습니다. 지명 개수는 후보를 찾는 데 쓰이는 상태 정보이며 검증을 대신하지 않습니다. 부록 H.1–H.2
H.3–H.5 과제와 실행 환경에 따른 차이. 프로그램 기여는 compile.sh로 독립 실행 파일을 만들 수 있어야 합니다. 증명은 주장과 근거가 드러나는 산출물을 제출합니다. 아키텍처 연구는 실험 결과를 기록하며 검증 지표로 후보를 고릅니다. Gemini용 순차 셸 사용 지침, Codex용 제출 경로 조정, 문제별 사용자 프롬프트의 실제 구성도 원문에 실려 있습니다. 부록 H.3–H.5
실험 결과 심층 분석
ProgramBench에서 최고 보고 평균의 차이는 14.27%p입니다. 이 차이는 숨은 테스트를 합산한 전체 통과율이나 50개 중 완전 해결한 문제 비율로 바꿔 읽을 수 없습니다. 과제마다 통과 비율을 계산해 같은 가중치를 줬기 때문입니다. 비교군은 모델이 종료하는 시점마다 이어서 작업하므로, 워커 수를 맞췄다는 해석도 적용되지 않습니다. 그림 3의 입력·출력 축을 각각 확인해야 하며, 이 두 최고 점수 차이에 대한 통계 검정은 제시되지 않았습니다. 원문 §1 및 §3.2
추론을 더 배분했을 때 무엇이 추가되는지는 두 벤치마크에서 달랐습니다. 프로그램은 마지막까지 선택 후보가 개선되므로, 앞선 작업의 코드와 근거가 동일 후보에 합쳐질 여지가 큽니다. 증명은 후보가 일찍 등장한 뒤 검증과 지명이 늘어납니다. 그래서 최종 커밋의 조상 범위가 얕더라도 남은 작업이 최종 선택에 정보를 제공할 수 있습니다. 반대로 참조가 많았다는 사실만으로 참조한 작업 각각의 성능 기여를 계산할 수는 없습니다. 원문 §3.4–4
연구 결과는 평가 단계와 예산을 함께 읽는 편이 정확합니다. RMT의 3.147 대비 2.890은 훈련 토큰이 같은 별도 held-out 비교입니다. 단일 Codex의 2.690은 더 많은 훈련 토큰을 사용한 결과입니다. Looped Transformer의 3.187은 개발 손실이고, NanoChat의 0.905235는 모델 용량을 넓힐 수 있는 검증 기록입니다. GPU 시간과 수량은 연구자가 후보를 탐색하는 예산이고, 훈련 토큰 수는 해당 모델을 만드는 예산입니다. 그 위에 워커 자신의 API 추론 토큰이 별도로 듭니다. 원문 §3.3 및 부록 E
기술적 함의와 응용
동일한 브랜치에서 코드를 확장하면서 다른 분기의 실험 실패를 참고하는 작업은 최종 코드를 보는 것만으로 재구성하기 어렵습니다. GitSwarm은 파일 상태와 참고한 증거를 따로 남겨, 나중 워커가 구현뿐 아니라 측정 조건과 채택 이유를 읽을 수 있게 합니다. RMT의 실패한 단일 시차 메모리와 Looped Transformer의 작게 측정해 기각된 어댑터 사례는, 후속 에이전트에게 유용한 산출물이 성공한 변경으로만 구성될 필요가 없음을 보여 줍니다. 원문 §3.3 및 §5
검토 범위. 본문 1–5와 부록 A–H의 실험 설계·핵심 결과를 다뤘습니다. 부록 B.2의 과제 식별자 전체, E.2–E.4의 모든 중간 커밋, F.2 및 G의 세부 범주표와 H.2–H.5의 전체 프롬프트는 원문에 있습니다. 원문 전체