논문 개요와 전체 구조
코딩 에이전트가 같은 모델로 같은 이슈를 받아도 결과는 달라질 수 있습니다. 한 실행에서는 의존성이 준비된 작업공간에서 패치를 작성하고 테스트까지 통과합니다. 다른 실행에서는 테스트 도구를 찾지 못하거나, 재시작 후 어디까지 작업했는지 잊거나, 실패한 테스트를 통과로 표시할 수 있습니다. Li 외의 Agent Harness Engineering: A Survey는 이 차이를 설명하기 위해 모델을 둘러싼 실행 환경, 도구, 상태, 검증, 권한을 하나의 시스템으로 살펴봅니다. 저자가 말하는 에이전트 하네스는 모델의 제안을 실제 행동으로 옮기고, 그 결과를 관찰해 다음 행동에 반영하는 장치들의 조합입니다. 저자 공개본 §1
공개 카탈로그의 171개 문서화 항목 가운데 138개 기술 산출물을 선별하고 일곱 계층에 매핑했습니다. 논문은 먼저 하네스의 범위와 조사 방법을 설명하고, 이어 계층별로 기술과 사례를 살핍니다. 후반부에서는 비용·품질·속도, 능력·통제, 계층 간 결합을 다루고 미해결 질문을 제시합니다. 부록 A는 138개 산출물의 전체 분류표, 부록 B는 대표 구현 6개의 비교표입니다. 논문 목차 · 부록 A · 부록 B
OpenReview PDF에 직접 접근할 수 없어 공동 제1저자 Chen Liu가 공개한 71쪽 PDF를 읽었습니다. 공개본 README는 같은 OpenReview 레코드를 가리킵니다. 그림과 쪽수는 이 글에 명시한 Hugging Face 리비전의 PDF를 기준으로 합니다. 고정된 저자 공개본 · 저자 공개본 README · OpenReview 레코드
| 논문 순서 | 다루는 내용 |
|---|---|
| §1–2 | 서론, 모델과 하네스의 관계, ETCLOVG 분류, 조사 방법과 집계 |
| §3–9 | 실행 환경, 도구, 컨텍스트, 작업 생애주기, 관측, 검증, 거버넌스 |
| §10–13 | 계층 공통 문제, 시스템 관점의 종합, 미해결 질문, 결론 |
| 부록 A–B | 기술 산출물 전체 매핑과 대표 하네스 구현 6개 |
핵심 기여와 혁신성
첫째, 이 논문은 “모델이 얼마나 잘하느냐”를 묻기 전에 어떤 실행 구성을 모델에 제공했는지 기록해야 한다고 주장합니다. 도구 형식이나 검증 훅을 변경한 외부 코딩 벤치마크 결과는 같은 모델에서도 결과가 달라질 수 있음을 보여 줍니다. 실행 환경이 달라졌거나 채점기에 오류가 있으면 성공률의 차이를 모델 능력에만 돌리기 어렵습니다. 저자 공개본 §1 · §8.1
둘째, 저자는 하네스 한 개의 내부 부품을 나열하는 분석에서 범위를 넓혀 서로 다른 기술 산출물을 일곱 기능 계층에 놓습니다. 이 방식으로 오케스트레이션에 필요한 체크포인트, 실패 경로를 읽는 관측 기록, 행동의 허용 여부를 정하는 정책이 각각 어떤 책임을 지는지 설명합니다. 하나의 코드 에이전트나 운영 플랫폼이 여러 책임을 함께 질 수 있어, 산출물의 분류와 시스템 구성은 구분해서 읽어야 합니다. 저자 공개본 §1–2 · §2.3
셋째, 계층을 함께 바꿀 때 생기는 효과를 설명합니다. 도구 설명을 늘리면 선택에 필요한 정보가 늘 수 있지만 입력 토큰도 늘어납니다. 실행 환경을 엄격하게 초기화하면 재현성이 좋아질 수 있지만 작업마다 시작 비용이 듭니다. 분류표의 실제 쓰임은 이런 변화가 어디에 영향을 주는지 기록하고, 전후 실험에서 무엇을 고정했는지 드러내는 데 있습니다. 마지막 문장은 분류표에 대한 리뷰의 해석입니다. 저자 공개본 §10–11
기술적 세부사항
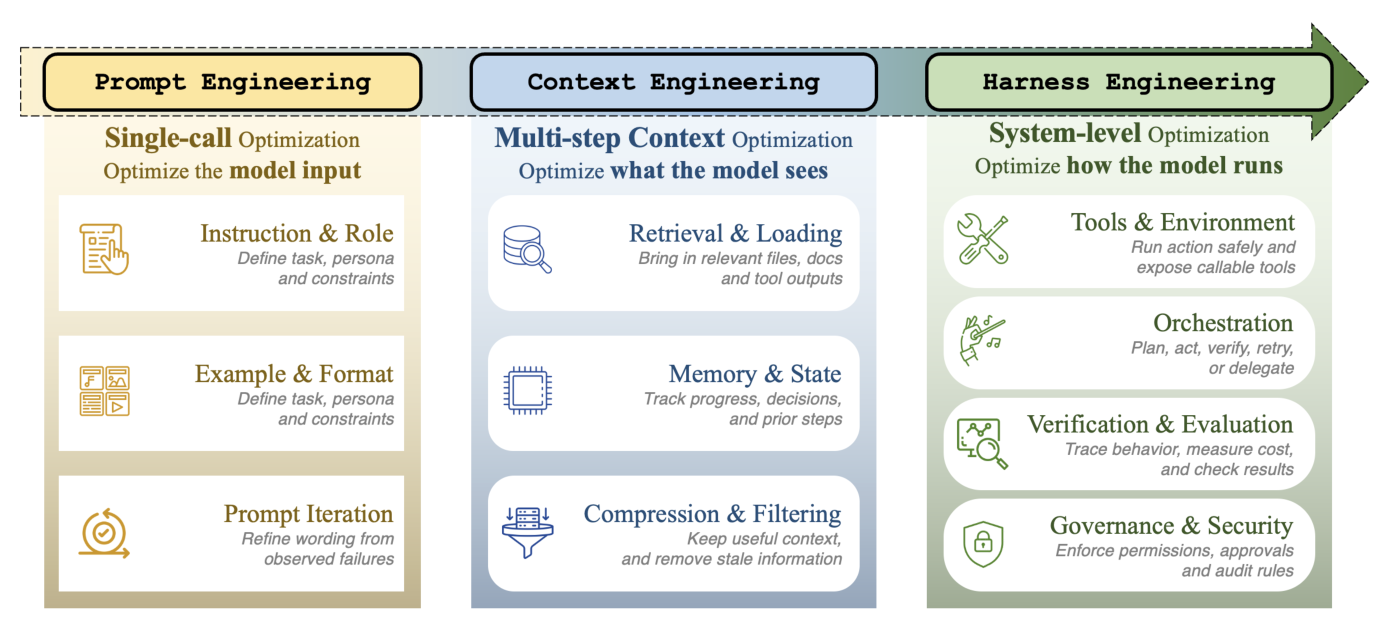
모델 호출에서 전체 실행 시스템으로 넓어지는 설계 범위. Li 외, 그림 1 · PDF 1쪽 · CC BY 4.0 · 그림 영역을 잘라 인용했습니다.
프롬프트 엔지니어링은 호출에 들어가는 지시와 예시를 작성합니다. 컨텍스트 엔지니어링은 여러 번 호출하는 동안 어떤 문서와 기록을 보여 줄지 정합니다. 하네스 엔지니어링은 그 입력을 준비하는 부분부터 도구를 실제로 호출하고, 응답을 되돌려 주고, 실패나 종료를 처리하는 부분까지 포함합니다. ETCLOVG에서 실행 환경(E), 도구(T), 컨텍스트(C), 생애주기(L)는 실행을 구성합니다. 관측(O), 검증(V), 거버넌스(G)는 여러 구성요소에 걸쳐 기록, 평가, 제약을 제공합니다. 저자 공개본 §2.2–2.3
| 계층 | 맡는 일 | 주 계층 빈도 |
|---|---|---|
| E · Execution | 에이전트의 코드와 행동이 실행될 환경 및 격리 경계 | 20 |
| T · Tooling | 도구의 설명, 발견, 호출 계약 | 12 |
| C · Context | 모델이 현재 호출에서 볼 정보와 그 정보를 위한 기억 관리 | 9 |
| L · Lifecycle | 작업의 진행 상태, 중단·재개, 에이전트 간 조율 | 47 |
| O · Observability | 실행 추적 기록, 지연, 비용, 장애 신호 | 15 |
| V · Verification | 결과 평가, 실패 귀속, 회귀 검증 | 21 |
| G · Governance | 권한, 신원, 정책 적용, 감사, 사람 승인 | 14 |
| 합계 | 산출물당 주 계층 1개 | 138 |
빈도는 산출물의 중심 기능을 기준으로 저자가 집계했습니다. 공개 근거에서 독립적인 추가 기능이 식별되면 보조 계층도 붙일 수 있습니다. 위 표는 §2.9와 부록 A 표 S1을 대조해 재구성했습니다. 이 서베이의 조사 방법과 비교에는 계층별 항목 수와 기능 매핑이 쓰입니다. 저자 공개본 §2.7–2.9 · 부록 A 표 S1
챕터별 상세 리뷰
📖 Chapter 1: Introduction
서론은 브라우저나 저장소에 들어가 여러 단계로 일하는 모델이 매 단계마다 문맥을 공급받고, 도구를 호출하고, 결과를 되돌려 받아야 한다는 문제에서 출발합니다. 저자는 코딩 분야에서 하네스 개입의 효과를 보여 주는 외부 사례를 제시합니다. 그중 Trivedy가 보고한 Terminal-Bench 2.0 실험은 GPT-5.2-Codex를 고정한 채 시스템 프롬프트를 재구성하고, 미들웨어로 컨텍스트를 주입하고, 자기 검증 훅을 추가한 뒤 52.8%에서 66.5%로 올라갔습니다. 이 수치는 세 변경을 묶은 결과입니다. 서베이 저자들은 특히 코딩 벤치마크에서 통제된 근거가 강하다고 봅니다. 저자 공개본 §1
이어서 저자는 planning, memory, tool use, safety를 따로 다룬 연구와 실행 정책·장애 복구·인계·감사를 함께 설명하는 운영 사례 사이에 용어의 간극이 있다고 짚습니다. 어떤 기능부터 하네스에 포함할지, 서로 영향을 주는 기능들을 어떻게 나눌지, 어떤 분류에 공개 근거가 많이 모여 있는지가 서론의 질문입니다. §2는 이 질문에 답하기 위한 범위와 분류 절차를 정합니다. 저자 공개본 §1
📖 Chapter 2: Background and Taxonomy
§2.1–2.2 · 단일 실행 루프에서 하네스까지
저자는 ReAct에서 추론·행동·환경 관찰이 번갈아 진행되는 기본 형태를 찾습니다. AutoGPT와 BabyAGI처럼 작업 큐와 메모리가 추가되면서 종료 시점과 상태 복구가 별도 과제가 됐습니다. 이후 도구 사용 학습, 여러 에이전트의 역할 분담, 실행 가능한 벤치마크, MCP와 A2A 같은 인터페이스가 늘어납니다. 저자가 부르는 ‘하네스로의 전환’은 운영 구성을 바꿔 성능과 신뢰성을 실험하는 흐름입니다. 저자 공개본 §2.1 · §2.1–2.2
설계 범위를 좁은 쪽부터 보면, 프롬프트는 한 호출에서 주는 지시를 정하고 컨텍스트는 다음 호출에 제공할 정보의 선택·순서·요약을 정합니다. 하네스는 그 호출을 반복할 실행 경로를 정합니다. 모델이 도구 사용을 제안하면 하네스가 실행할 권한과 환경을 판단하고, 돌아온 관찰을 다음 호출에 넣고, 검증 결과에 맞춰 재시도하거나 종료합니다. 이런 피드백 때문에 에이전트 실행을 폐루프 시스템으로 읽을 수 있습니다. 저자 공개본 §2.2
§2.3 · ETCLOVG의 일곱 계층
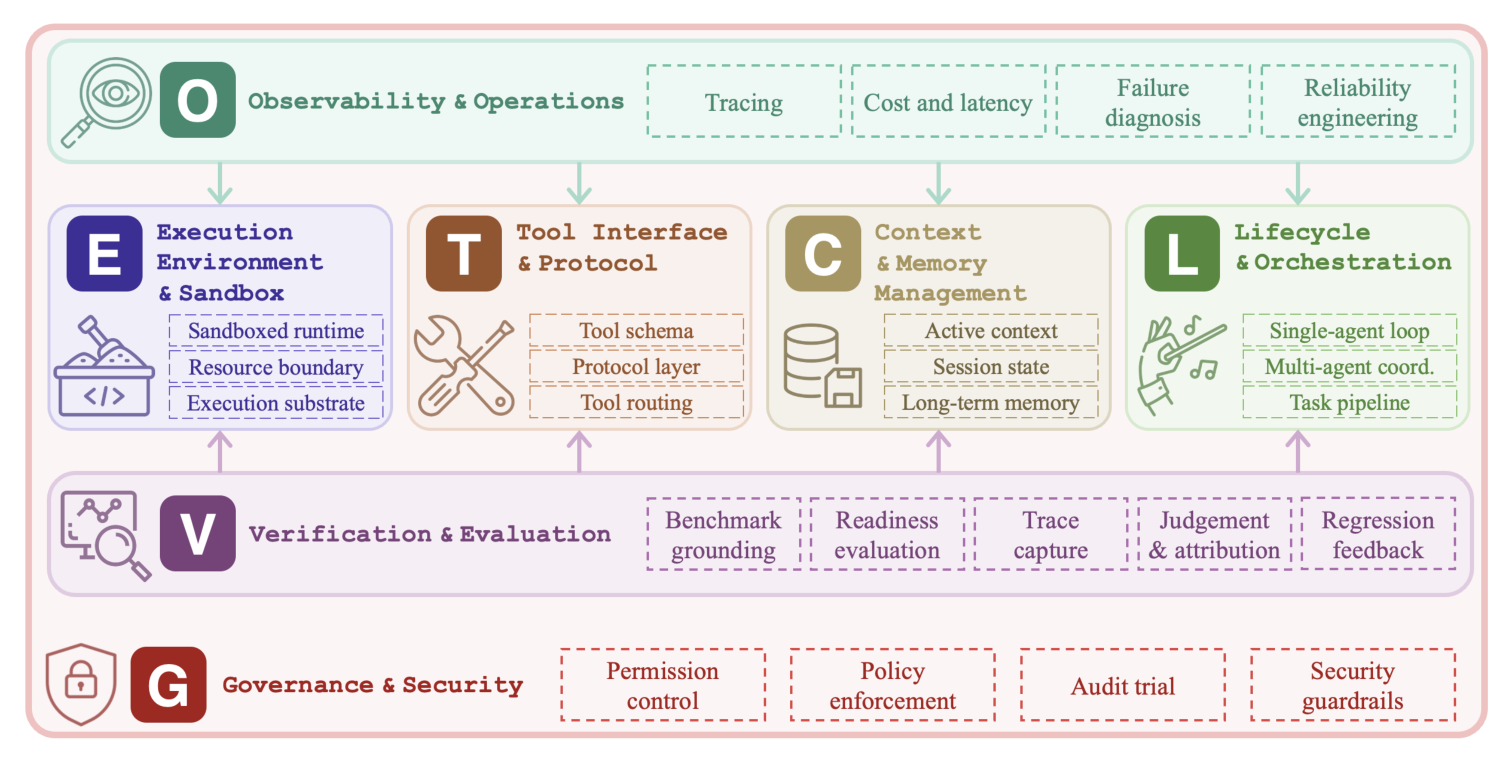
ETCLOVG 분류의 네 실행 계층과 실행 전반을 다루는 세 계층. Li 외, 그림 3 · PDF 7쪽 · CC BY 4.0 · 그림 영역을 잘라 인용했습니다.
특히 상태의 용도를 기준으로 계층의 경계가 갈립니다. 이슈 설명의 어느 부분을 다음 모델 입력에 넣을지는 C입니다. 작업 재개 전에 브랜치, 마지막 테스트 상태, 남은 작업을 복원하는 일은 L입니다. 어떤 테스트가 몇 번 호출됐고 누가 실행했는지 추적하는 일은 O에서 시작합니다. 그 기록을 근거로 실행 결과를 채점하면 V, 호출 당시 권한이나 정책 결정을 감사하면 G입니다. 같은 파일이나 이벤트가 여러 계층에 쓰이더라도 기능상 책임은 이렇게 다릅니다. 저자 공개본 §2.3 · §6.1
§2.4–2.6 · 무엇을 어떤 경로로 모았나
포함 기준은 공개 문서가 있고, 구체적인 하네스 수준 기제를 구현하거나 명세하며, 공개 근거로 최소 한 계층을 부여할 수 있다는 것입니다. 재사용 가능한 작업 조율이나 실행 가능한 평가 환경은 포함 대상입니다. 간단한 챗봇 데모, 프롬프트 모음, 모델 클라이언트 래퍼, 실행 환경이 없는 정적 데이터셋은 제외했습니다. 일반 컨테이너나 벡터 데이터베이스에도 에이전트용 실행·상태·평가와 연결되는 근거가 필요합니다. 저자 공개본 §2.4·§2.6
§2.5는 선행 서베이·벤치마크 논문, GitHub 검색, 큐레이션 목록·패키지 레지스트리, 기업 기술 블로그·릴리스 노트라는 네 수집 경로를 기술합니다. 같은 쪽 그림 5의 캡션은 출처 유형을 다섯 가지로 표기합니다. 본문에 적힌 경로를 기준으로 읽으면 ‘agent harness’, ‘LLM agent sandbox’, ‘agent governance’ 등의 검색어를 사용했고, GitHub에서는 이름·설명·README·토픽과 별 수·최근성·아카이브 여부를 검색에 활용했습니다. 이후 프로젝트명, URL, 산출물과 출처의 유형, 공개 상태, 식별 가능한 출시 연도, 분류 근거와 메타데이터를 기록했습니다. 메타데이터 스냅샷의 기준일은 2026년 5월 8일입니다. 저자 공개본 §2.5·그림 5
§2.7–2.9 · 분류 기준과 빈도 해석
주 분류 담당자 한 명이 README, 문서, 논문, 예제, 릴리스 노트와 필요한 경우 저장소 구조를 바탕으로 태그를 붙였고 저자진이 감사했습니다. 보조 태그는 문서에서 독립적 기능이 확인될 때만 부여했습니다. 예를 들어 샌드박스를 호출한다는 사실과 샌드박스 실행 기능을 제공한다는 사실은 서로 다른 코딩 근거가 됩니다. 불분명한 항목은 전수 코딩 뒤 다시 검토했고 증거가 모호하면 계층 부여를 보류했습니다. 코더 간 Cohen’s κ 등 정식 일치도 통계는 보고되지 않았습니다. 저자 공개본 §2.7 · §2.7–2.8
주 계층 빈도는 L 47, V 21, E 20 순으로 높았고 O 15, G 14, T 12, C 9가 뒤를 잇습니다. 저자는 영어 공개 자료, GitHub에 잘 드러나는 오픈소스, 코딩 에이전트에 표본이 치우쳐 있다고 밝힙니다. 코딩 에이전트 작업 흐름은 이슈·PR·테스트 환경이 공개되는 경우가 많습니다. 반면 기업 내부의 권한 서비스나 메모리 정책은 배포돼 있더라도 분류 근거가 외부에 드러나기 어렵습니다. 따라서 이 분포로 비교할 수 있는 것은 공개 기술 산출물의 주요 기능이 어떤 모습으로 제공됐는가입니다. 저자 공개본 §2.8–2.9
📖 Chapter 3: Execution Environment and Sandbox (E)
§3.1–3.2 · 격리 경계와 일곱 실행 환경
실행 환경의 역할은 에이전트가 코드를 실행할 공간을 주는 동시에, 파일·네트워크·프로세스에 대한 행동 범위를 정하는 것입니다. 평가할 때는 각 시도를 같은 초기 상태로 돌릴 수 있어야 합니다. 스냅샷이나 초기화 규칙이 다르면 같은 명령 뒤에 오는 관찰도 달라집니다. §3.2는 사용 목적에 따라 다음 일곱 유형을 제시합니다. 저자 공개본 §3.1–3.2
- 범용 관리형 샌드박스는 Daytona나 E2B처럼 일회성 실행 공간의 준비와 폐기를 API로 관리합니다.
- 컴퓨터 사용 에이전트 인프라는 OSWorld처럼 데스크톱 상태, 화면 관찰, 입력 이벤트가 있는 작업을 다룹니다.
- 코드·저장소 실행 샌드박스는 Judge0이나 Repo2Run처럼 코드 실행과 의존성 준비에 초점을 맞춥니다.
- 프레임워크 통합 런타임은 OpenHands처럼 에이전트가 쓰는 쉘·브라우저와 작업공간을 실행 인터페이스와 함께 제공합니다.
- 브라우저 평가 환경은 WebArena와 BrowserGym처럼 웹에서 실행한 행동과 그 결과를 반복해서 평가할 수 있게 합니다.
- 운영체제 수준 권한 샌드박스는 로컬 실행에서 파일·네트워크 같은 권한 경계를 좁힙니다.
- 샌드박스 추상화·훈련·평가 유형은 SWE-ReX처럼 실행 백엔드의 계약을 분리하거나 여러 평가·훈련 환경을 준비하는 기술을 묶습니다. 저자 공개본 그림 6 및 §3.2 · §3.2
§3.3–3.5 · 위협 모델과 배포 방식
프롬프트 인젝션은 웹페이지나 도구 출력에 삽입된 지시로 에이전트 행동을 바꿀 수 있습니다. 목표가 어긋난 모델이 탈출을 중간 목표로 삼는 경우도 있고, 여러 도구 사이에서 하나의 권한 경계 붕괴가 더 큰 피해를 부르는 경우도 있습니다. 저자가 인용한 SandboxEscapeBench는 중첩된 샌드박스에서 모델이 깃발을 획득하는 CTF 조건을 사용했고, Docker 기반 컨테이너의 구성에 따라 15–35% 탈출 성공률을 보고했습니다. 저자는 방어 연구들이 서로 다른 위협 모델과 평가 조건을 사용한다고 지적합니다. 저자 공개본 §3.3 · §3.3–3.5
직접 운영하면 작업공간에 가까운 곳에서 실행할 수 있고 운영 책임도 팀이 집니다. 클라우드형은 실행 슬롯을 탄력적으로 확보하지만 네트워크 왕복과 작업 데이터의 위치를 따져야 합니다. 하이브리드나 BYOC는 에이전트 로직과 실행 환경의 배치 위치를 분리할 수 있습니다. 이 절에서 저자가 정리한 선택 축은 격리 강도, 작업 환경의 충실도, 운영 규모와 비용입니다. 다음 장에서는 이 환경과 외부 능력을 연결하는 호출 계약을 살펴봅니다. 저자 공개본 §3.4–3.5
📖 Chapter 4: Tool Interface and Protocol Layer (T)
§4.1 표준. 논문 표 1은 각 표준이 어떤 경계를 가로지르는지 보여 줍니다. 모델 제공자의 함수 호출은 모델이 인자를 구조화하고 호스트가 함수를 실행하는 경계에 있습니다. OpenAPI는 HTTP 서비스의 인터페이스를 기술합니다. MCP는 호스트가 도구나 컨텍스트 자원을 발견하고 접근하는 데 쓰이고 A2A는 에이전트 간 작업 전달과 상호운용을 다룹니다. AGENTS.md 같은 저장소 수준의 파일은 작업 환경에서 지켜야 할 규칙을 버전 관리합니다. 호출 형식과 실행·승인 주체를 함께 기록하면 어느 경계에서 실패했는지 확인할 수 있습니다. 저자 공개본 §4.1 및 표 1 · 표 1
§4.2 도구 설명·발견·선택. 도구가 몇 개일 때는 설명을 모두 입력에 넣기 쉽습니다. 카탈로그가 커지면 설명과 스키마가 컨텍스트를 차지하고, 비슷한 도구 가운데 적합한 것을 고르는 문제도 생깁니다. 이름·설명·인자 스키마는 모델이 언제 어떤 도구를 불러야 하는지 알려 줍니다. MCP-Zero와 ToolRet 같은 사례는 필요한 후보를 검색해 노출하는 방식을 보여 줍니다. 저자 공개본 §4.2
§4.3 도구 사용 학습과 통합. 이 절은 모델이 도구를 선택하고 인자를 생성하도록 학습시키는 연구와, 하네스가 실제 호출과 결과를 처리하는 방식을 함께 살핍니다. Toolformer 등의 방법은 호출 행동을 학습시키고, 시스템 쪽에서는 도구 계약과 실행 환경이 정상 동작해야 구조화된 선택이 실제 행동으로 이어집니다. 검증 도구는 모델이 전제와 실행 경로를 명시하도록 만들 수도 있습니다. 저자 공개본 §4.3 · §4.3
§4.4 확장과 세션. 로그인한 브라우저나 서버 측 상태가 있는 도구는 세션을 유지하면 긴 작업을 효율적으로 이어갈 수 있습니다. 그러나 세션 핸들이 만료됐거나, 실패한 시도의 재실행이 이전 상태와 다르면 결과가 달라집니다. 여러 에이전트가 상태를 공유할 때는 호출 계약과 세션 소유권을 함께 다뤄야 합니다. 도구 응답에서 어떤 정보를 다음 호출까지 남길지는 §5의 주제입니다. 저자 공개본 §4.4
📖 Chapter 5: Context and Memory Management (C)
§5.1–5.2 컨텍스트의 설계. 모델 호출이 받을 수 있는 토큰이 많더라도 관련 정보가 입력의 어디에 있는지와 얼마나 많은 다른 정보와 섞였는지가 응답에 영향을 줍니다. 저자는 한 번의 추론에서 입력이 길거나 불균질해 필요한 정보를 활용하기 어려워지는 문제를 문헌의 context rot 사례로 설명합니다. 프롬프트 문장 작성에서 정보의 검색·선별·배치로 설계 단위가 넓어지면 컨텍스트 창을 관리해야 할 자원으로 보게 됩니다. 저자 공개본 §5.1–5.2
§5.3 활성 컨텍스트 창. 같은 도구 출력이라도 후속 판단이 바로 필요로 하는 진단은 유지하고, 다시 읽을 수 있는 대량의 원본 로그는 외부에 둘 수 있습니다. 안정적인 프롬프트 접두부를 유지하는 순서는 반복 호출의 캐시 효율에도 관계합니다. 핵심은 다음 호출에 필요한 정보 배치를 유지하면서 토큰과 비용을 통제하는 것입니다. 저자 공개본 §5.3
§5.4 중기 작업 상태. 활성 창이 리셋되더라도 파일 기반 계획표나 작업 메모에서 완료 항목, 다음 시도, 해결하지 못한 오류를 읽고 이어갈 수 있습니다. 논문은 Planning-with-Files와 Trellis를 예로 듭니다. 이 절의 파일은 다음 모델 호출에 주입할 작업 기억을 제공합니다. 같은 체크포인트가 실행을 재개하는 상태라면 §6.1의 관점에서도 다룰 수 있습니다. 저자 공개본 §5.4
§5.5 장기 기억. MemGPT는 운영체제의 가상 메모리에 빗대어 현재 창에 들어가는 정보와 외부 저장소의 정보를 오가게 합니다. Mem0는 장기 저장과 검색을 지원하는 하이브리드 방식을, A-MEM은 새로운 기억이 들어올 때 관련 기억의 연결도 갱신하는 방식을 보여 줍니다. 이어서 여러 에이전트가 확인한 사실을 공유하는 Mozilla AI의 cq와, 장기 기억을 사실·절차·경험 같은 유형과 읽기·쓰기·관리 단계로 구분하는 기존 서베이를 다룹니다. 저자 공개본 §5.5 · §5.5 · §5.5
§5.6 긴 실행의 기법. 창이 차면 이력을 압축하고, 중간 탐색은 하위 에이전트에 맡겨 전체 탐색 기록 대신 요약을 받고, 필요할 때만 도구를 로드할 수 있습니다. 요약에는 아키텍처 결정, 미해결 오류, 꼭 지켜야 할 구현 제약처럼 재개에 필요한 상태가 남아야 합니다. 도구 결과를 버리더라도 나중에 원본을 찾을 수 있게 참조를 남기는 것은 정보 손실을 줄이는 한 가지 방식입니다. 저자 공개본 §5.6 · §5.6
§5.7 컨텍스트 드리프트. Context drift는 실행이 진행되면서 모델에 보이는 작업 상태가 실제 과제 상태와 점차 벌어지는 현상입니다. 압축을 여러 번 거치면 작은 부정확성이 누적될 수 있습니다. 이미 초기 제약을 잊은 모델은 어떤 사실을 다시 검색할지 알기 어렵습니다. 저자는 신뢰할 수 있는 산출물로 상태를 재구성하는 체크포인트와 행동 이상 탐지를 논의합니다. 다음 장이 다루는 것은 그런 복구를 실행 흐름에서 언제, 어떻게 적용할지입니다. 저자 공개본 §5.7
📖 Chapter 6: Lifecycle and Orchestration (L)
§6.1 상태 관리. 상호작용 이력을 재생해 현재 상태를 복원하는 방식은 어떤 관찰이 다음 결정의 입력이 됐는지 추적하기 쉽습니다. 궤적이 길면 복원 비용이 커집니다. 파일·DB·저장소·태스크 그래프에 상태를 유지하면 중단 뒤 이어가기 쉽지만 여러 저장물 사이의 일관성이 필요합니다. 재생 가능한 이력과 영속 산출물을 함께 보존하는 혼합형도 있습니다. 저자 공개본 §6.1
§6.2 단일 에이전트 내부 루프. 입력은 현재 과제의 지시, 환경 관찰, 작업 상태입니다. 모델이 도구와 인자를 제안하면 하네스가 호출을 실행하고 그 결과를 다음 입력에 붙입니다. 종료 조건에 도달하면 반복을 끝내고 최종 출력을 반환합니다. 표 2에서 Codex CLI는 논문이 인용한 공개 자료를 바탕으로 무상태 재생에 가까운 단일 루프로, OpenCode와 Claude Code는 혼합형 단일 루프로 분류됩니다. 이 표는 조사 자료가 문서화한 실행 패턴을 비교합니다. 저자 공개본 §6.2 및 표 2
§6.3 멀티에이전트. 계층형 조율은 상위 에이전트가 하위 작업을 나누고 결과를 모읍니다. 팀형은 역할이 다른 에이전트가 협력하고, 워크플로형은 단계와 전환 규칙을 두고, 팬아웃은 독립 시도를 병렬로 실행하고, 그래프 방식은 상태·도구·에이전트 노드를 연결합니다. 예를 들어 계획·생성·평가를 나누면 평가자가 생성 결과를 검토할 수 있고, 각 작업의 입력·진행·결과를 연결하는 조율 상태가 필요해집니다. 저자 공개본 §6.3 · §6.3
§6.4 이슈에서 PR까지. 저자가 제시한 작업 실행기의 입력은 이슈나 작업 명세입니다. 실행기는 작업을 할당하고, 변경과 테스트 결과를 저장하고, 검증 분기에서 성공이면 리뷰 가능한 산출물을 넘기고 실패면 수정·재검증 경로를 시도합니다. 이 구조에서 이슈와 브랜치, 테스트, PR은 사람이 확인할 수 있는 영속 산출물이면서 다음 실행의 복구 기준이 됩니다. 논문은 Vibe Kanban, Symphony, GitHub Agentic Workflows를 전체 파이프라인의 예로 분류합니다. 다음 장은 각 단계에서 남긴 기록을 어떻게 읽는지 다룹니다. 저자 공개본 §6.4
📖 Chapter 7: Observability and Operations (O)
§7.1 추적과 모니터링. OpenTelemetry 계열 도구는 모델 호출과 도구 실행을 시간 구간인 스팬(span)으로 기록하고, 관련 스팬을 묶어 한 실행의 트레이스(trace)를 구성합니다. Langfuse나 Arize Phoenix 같은 플랫폼은 트레이스를 시각화합니다. 모델 응답 시간이 늘었을 때 전체 벽시계 시간만 보면 병목을 찾기 어렵지만, 도구 대기와 모델 호출의 시간을 나누면 어디서 느려졌는지 읽을 수 있습니다. 애플리케이션 외부에서 계측하거나 환경 상태까지 묶어 남기는 연구 사례도 소개합니다. 저자 공개본 §7.1
§7.2 에이전트 운영 플랫폼. 세션 아래에 에이전트와 도구 호출을 묶으면 어떤 에이전트가 다른 에이전트에게 작업을 넘겼고 어느 단계에서 오류가 났는지 살펴볼 수 있습니다. 논문은 AgentOps의 계층형 스팬, AgentLens의 환경 재생, 실행 경로에서 이상을 찾아 수정에 연결하는 연구들을 소개합니다. 추적을 남기는 기능에서 작업 구조를 해석하는 기능으로 범위가 넓어집니다. 저자 공개본 §7.2
§7.3 비용 추적과 최적화. 전체 토큰 수를 보면 예산을 넘겼다는 사실을 알 수 있습니다. 어느 검색 결과를 몇 차례 입력에 넣었고, 실패한 도구 호출을 몇 번 반복했는지를 보면 비용이 커진 이유도 찾을 수 있습니다. 논문은 모델 라우팅, 응답 캐싱, 토큰 예산의 조절을 소개합니다. 예산이 지나치게 낮으면 모델이 오히려 추론을 반복해 토큰을 더 소비할 수 있다는 인용 사례도 제시합니다. 저자 공개본 §7.3 · §7.3
§7.4 신뢰성. 저자가 인용한 Anthropic의 장기 코딩 사례에서는 초기화 에이전트가 기능 목록, 작업 기록, 초기화 스크립트를 만들고 후속 코딩 에이전트가 기능을 하나씩 구현하며 깨끗한 인계 상태를 남깁니다. 테스트를 하지 않고 일을 완료 처리하거나 장애가 난 작업공간을 다음 세션에 넘기는 문제에 대응한 설계입니다. 같은 절의 Managed Agents 사례는 하네스·모델, 샌드박스·도구, 영속 세션 로그를 분리해 한 부분이 실패해도 복구할 수 있게 합니다. 저자 공개본 §7.4 · §7.4
§7.5 통합 관측. 저자는 기록을 수집하는 것과 그 기록에 대한 평가를 운영하는 것 사이의 간극을 짚습니다. 실패 경로에서 회귀 사례를 추출하고, 도구·권한·컨텍스트 구성의 변경 전후를 트레이스로 비교하면 어떤 개입이 여전히 필요한지 조사할 수 있습니다. §8은 그 데이터를 실제 평가로 바꾸는 절차를 정리합니다. 저자 공개본 §7.5
📖 Chapter 8: Verification and Evaluation (V)
§8.1 작업에서 피드백까지. 평가 대상은 특정 과제에서 실행된 모델–하네스 조합입니다. 표 3은 계층마다 설정과 진단 근거를 함께 남길 것을 제안합니다. E라면 실행 이미지·의존성·초기화 정책과 설치 실패 기록이 필요하고, C라면 입력 정책과 압축 뒤 소실된 정보가 필요합니다. 아래 그림의 다섯 단계는 이 기록을 평가와 다음 수정에 연결합니다. 저자 공개본 §8.1 및 표 3
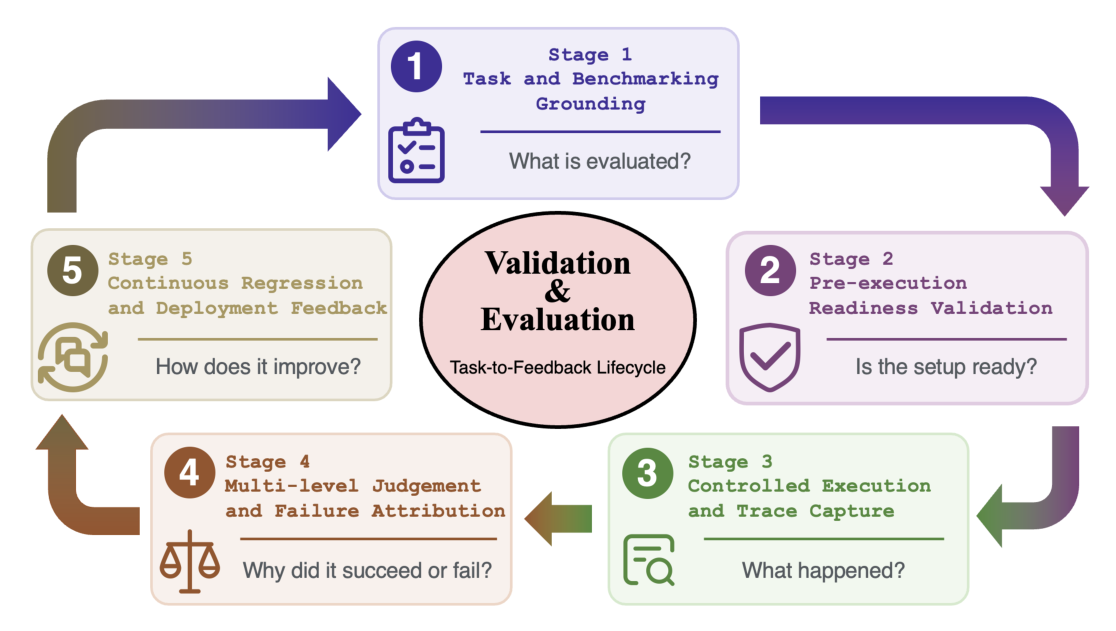
에이전트의 작업 정의에서 회귀 평가로 이어지는 다섯 단계. Li 외, 그림 12 · PDF 33쪽 · CC BY 4.0 · 그림 영역을 잘라 인용했습니다.
- §8.2 과제와 벤치마크를 정의합니다. 과제 지시 외에 초기 환경, 사용할 도구, 허용 행동, 종료와 성공의 조건이 필요합니다. SWE-bench는 실제 저장소 이슈와 실행 가능한 테스트를, Terminal-Bench는 터미널 환경과 과제별 검증기를 사용합니다. WebArena나 OSWorld는 웹·데스크톱 상태의 변화를, AgentBench·GAIA·TheAgentCompany는 여러 도구와 업무 환경에 걸친 능력을 다룹니다. 과제 유형마다 결과를 관찰하고 채점할 위치가 달라집니다. 저자 공개본 §8.2 · §8.2
- §8.3 실행 전 준비를 확인합니다. 저장소 버전과 의존성을 맞추고 샌드박스를 초기화합니다. 도구 설명·서버 연결, 컨텍스트의 초기 상태, 파일·네트워크 권한, 예산과 타임아웃도 맞춥니다. 결정적 검증기는 흔들리는 테스트와 의존성을 확인하고, LLM 평가자는 프롬프트·루브릭·모델의 버전을 기록합니다. 테스트 의존성이 깨진 상태를 먼저 발견하면 유효한 패치에서 실패가 난 것으로 해석하는 일을 줄일 수 있습니다. 저자 공개본 §8.3 · §8.3
- §8.4 통제된 실행과 추적 기록을 수집합니다. 여기서 한 롤아웃(rollout)은 과제와 모델·하네스 설정을 받아 행동·중간 관찰·최종 상태·채점 결과를 남긴 한 번의 실행입니다. 도구 호출과 상태 변화, 재시도, 지연, 비용을 같이 기록하면 같은 성공률에서 다른 실행 비용이 드러납니다. 남아 있는 비결정성은 반복 실행에서 분산을 살펴볼 수 있습니다. 저자 공개본 §8.4 · §8.4
- §8.5 결과·경로·평가자를 각각 판단합니다. 결과 평가는 테스트 통과나 최종 페이지 상태를, 경로 평가는 도구 선택·호출 순서·권한 준수를 살핍니다. 평가자 검증은 흔들리는 테스트, LLM 평가자의 순서·장황함 편향, 사람과의 판정 일관성 등을 확인합니다. 예컨대 최종 파일이 맞더라도 금지된 경로에 접근했다면 결과와 경로 평가가 갈릴 수 있습니다. 반대로 검증기가 불안정하면 실행을 실패로 귀속하기 전에 채점 단계부터 조사해야 합니다. 저자는 이 세 수준의 증거로 모델·도구·환경·컨텍스트·오케스트레이션 등의 실패 원인을 좁힙니다. 저자 공개본 §8.5 · §8.5 · §8.5
- §8.6 진단을 회귀 검증과 배포 피드백에 반영합니다. 도구 스키마와 검증기는 작은 단위에서 확인하고, 개별 판단·전체 롤아웃·다중 턴을 각각 검사합니다. 운영 트레이스에서 발견한 실패를 재현 과제로 남기고, 다음 버전의 모델뿐 아니라 도구·압축 정책·실행 이미지·권한 변경에도 평가를 돌릴 수 있습니다. 논문은 R2E-Gym처럼 검증기 신호를 학습에 사용하는 사례와 Meta-Harness처럼 하네스 구성을 탐색하는 사례까지 다룹니다. 저자 공개본 §8.6
§8.7 요약. 채점 뒤 남은 실패 경로가 다음 회귀 테스트의 입력이 될 때 평가가 실행 시스템의 개선으로 이어집니다. 특히 최종 결과가 통과하더라도 권한을 지켰는지는 별도로 판단해야 합니다. 다음 장은 그 권한의 정의와 기록을 다룹니다. 저자 공개본 §8.7
📖 Chapter 9: Governance and Security (G)
§9.1 권한과 신원. 고정 권한은 파일·네트워크 범위와 허용 명령을 미리 정합니다. Progent는 도구 이름, 인자, 환경 상태를 조건으로 검사하고, Conseca는 신뢰할 수 있는 과제 정보에서 정책을 만든 뒤 별도의 결정적 검사기로 집행합니다. 여러 에이전트가 연결되는 상황에서는 사용자 신원과 에이전트의 위임 범위를 연결해야 합니다. 논문은 OAuth와 OpenID Connect 확장 제안, 중개자가 접근 정책을 적용하는 SAGA, 원본 비밀값을 실행 계층에만 넘기는 자격 증명 저장소, 웹사이트가 확인이 필요한 행동을 표시하는 권한 매니페스트를 차례로 소개합니다. 저자 공개본 §9.1 · §9.1
§9.2 생애주기 훅. 권한은 허용 가능한 행동을 정하고, 훅은 그 검사나 승인이 실행 흐름 어디에 들어가는지 정합니다. 도구가 반환한 데이터도 다음 모델 호출이나 다른 도구로 흘러갈 수 있어, 호출 권한 검사와 데이터 흐름 검사는 별도의 지점에 놓입니다. 저자 공개본 §9.2
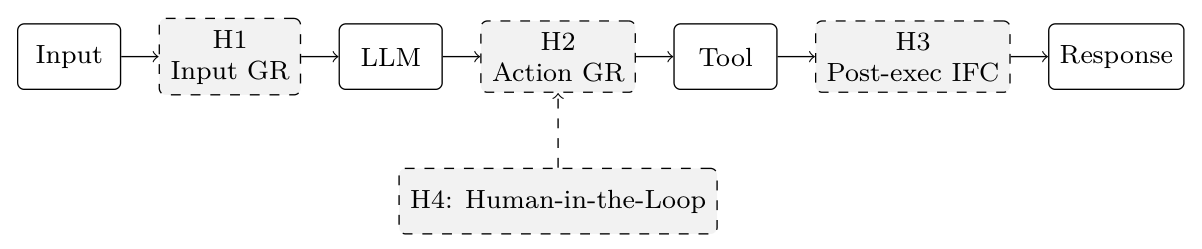
입력 검사(H1), 행동 검사(H2), 도구 출력의 정보 흐름 통제(H3), 사람 승인(H4). Li 외, 그림 14 · PDF 41쪽 · CC BY 4.0 · 그림 영역을 잘라 인용했습니다.
예를 들어 에이전트가 외부 이슈를 읽고 그 안의 지시에 따라 파일을 외부로 전송하려는 상황을 생각해 볼 수 있습니다. H1은 모델에 유입될 입력을 검사합니다. H2는 제안된 실행의 인자와 대상이 허용되는지 봅니다. H3에서는 도구가 돌려준 데이터의 출처와 권한을 추적해 어디로 흐를 수 있는지 판단합니다. H4는 영향이 큰 작업을 사용자 승인에 걸 수 있습니다. 이는 그림의 역할을 한 사례에 대응시킨 리뷰의 예시입니다. 저자 공개본 §9.2
§9.3 구성요소 강화. 논문은 지시의 우선순위를 구분하도록 모델을 훈련하는 방법, 별도 분류기로 입출력을 검사하는 방법, MCP 도구 정의의 무결성을 확인하는 방법, 여러 에이전트 사이의 정보 흐름을 제어하는 방법을 살핍니다. 버전·정의를 고정하면 승인했던 도구가 갱신되며 동작을 바꾸는 공격을 탐지하는 데 도움이 됩니다. 외부 패키지와 검색 데이터도 실행에 영향을 주므로 공급망이 평가 범위에 들어갑니다. 저자 공개본 §9.3
§9.4 선언적 규칙. 학습 단계의 헌법은 정렬 과정에서 모델이 따를 우선순위를 정합니다. 배포 단계에서는 YAML 등 사람이 읽을 수 있는 형태로 도구의 허용·차단, 위험 등급, 예산, 감사 목적지를 지정할 수 있습니다. Progent 같은 정책 언어를 쓰면 실행 시점의 도구 인자나 환경 상태까지 조건으로 삼을 수 있습니다. 저자는 배포 규칙을 서로 다른 하네스끼리 공유할 표준 스키마가 정착하지 않았다고 설명합니다. 저자 공개본 §9.4 · §9.4
§9.5 감사 인프라. 호출당 로그에 추적 식별자, 실행 주체, 도구 호출, 정책 버전과 적용 결과를 연결하면 누가 무엇을 허용했는지 살펴볼 수 있습니다. 단일 행동 감시는 호출을 즉시 차단하는 데 쓰이고, 궤적 감시는 여러 호출에 나뉜 정보 유출 같은 패턴을 볼 수 있습니다. 로그 보관은 개인정보, 비밀값, 저장 비용과 함께 고려해야 합니다. 논문은 이 절에서 위험에 따라 검사 깊이를 달리하는 AutoHarness의 정책 파이프라인도 소개합니다. 저자 공개본 §9.5
§9.6 보안 연구에서의 위치. 저자는 관련 서베이가 분류한 위협과 권한·훅·정보 흐름·감사를 연결합니다. Kim 외의 에이전트 6개 사례에서는 도구 호출을 로그에 남기는 기능과 별도로 자동 이상 탐지, 정보 흐름 통제, 신원 관리, 형식 검증이 어떻게 드러나는지 살펴봅니다. 서베이는 컨텍스트에 들어오는 정보의 출처와 변경을 통제하는 접근도 소개합니다. 저자 공개본 §9.6 및 표 4 · §9.6
§9.7 저자가 제안한 연구 주제. 표 5에 이어 논문은 정책·감사 언어 표준화, 집행 보장의 형식 검증, 적응형 정책의 신뢰성, 장기 실행 권한의 갱신·철회, 사용하기 쉬운 승인·감사 인터페이스, 학습·배포·실행 계층의 정책 합성, 공급망 전체의 검증, 완전한 방어 구성을 공통 위협 모델로 시험할 벤치마크를 제시합니다. §10은 이 거버넌스 문제를 다른 계층의 설계 선택과 연결합니다. 저자 공개본 §9.7 및 표 5 · §9.7
📖 Chapter 10: Cross-Cutting Concerns
저자는 실행 환경이 가능한 복구·조율 방식을 제한하고, 컨텍스트 초기화가 평가 재현성을 바꾸고, 권한과 감사는 모든 계층의 조치에 걸친다고 정리합니다. 비용·품질·속도를 함께 고려하면 즉시 적용할 동기 검증과 배포 뒤 수행할 오프라인 검증을 나누게 됩니다. MCP, ACP, A2A 같은 공통 인터페이스를 사용하더라도 호출 주체, 권한, 비용, 실패 기록을 상대 시스템에 이어 보내는 문제가 남습니다. 이 장에서 지목하는 공개 생태계의 접점은 도구 간 상호운용, 비용 귀속, 실패 복구, 여러 저장소의 조율, 사람과 에이전트 간 인계입니다. 저자 공개본 §10
📖 Chapter 11: Cross-Layer Synthesis
§11.1 비용·품질·속도. 매 실행에서 더 충실한 환경을 만들고, 토큰을 많이 쓰는 검증기를 호출하고, 트레이스를 모두 보관하면 각각 시작 시간·실행 비용·저장 비용이 증가합니다. 어떤 위험을 즉시 검사하고 어떤 실패를 회귀 테스트로 보내는지가 품질과 운영비를 함께 좌우합니다. 저자 공개본 §11.1
§11.2 능력·통제. 도구를 더 열면 가능한 과제가 늘고 후보를 잘못 고르거나 비신뢰 입력에 영향을 받을 여지도 커집니다. 긴 기억은 작업을 이어 주지만 기록의 출처, 오래된 내용, 개인정보의 처리까지 필요하게 만듭니다. 이 절은 에이전트가 할 수 있는 일과 실제 부여할 권한을 같은 설계 문제로 봅니다. 저자 공개본 §11.2
§11.3 하네스 결합. 도구 설명을 늘리면 컨텍스트를 차지하고 도구 선택 방식이 바뀝니다. 실행 환경이나 복구 루프를 바꾸면 같은 검증기에서도 벤치마크 결과가 달라질 수 있습니다. 감사에 사용할 호출 기록도 신원과 권한 정보가 같은 수준으로 기록될 때 증거가 됩니다. 같은 모델로 비교하더라도 하네스 전체를 구성하는 제어기가 어떻게 바뀌었는지 함께 확인해야 합니다. 저자 공개본 §11.3
§11.4–11.5 플랫폼과 연구 의제. 프레임워크가 실행 루프, 도구, 메모리 같은 구성요소를 제공하면 플랫폼은 여러 사용자와 여러 실행에 걸쳐 작업공간, 격리, 신원, 비용, 평가, 인계를 운영합니다. 저자는 모델과 함께 하네스의 변형을 비교하는 벤치마크, 트레이스에 기반한 실패 진단, 에이전트와 사람 사이의 상태 이전, 모델이 좋아질 때 필요한 제어를 재평가하는 연구를 연결해 다음 장으로 넘어갑니다. 저자 공개본 §11.4–11.5 · §11.5
📖 Chapter 12: Open Problems and Future Directions
- §12.1 안전하면서 규모를 감당하는 실행 환경. 공격 조건과 방어 지표를 맞춰 비교하고, 컨테이너·microVM·OS 권한 경계·브라우저 환경을 작업별로 조합할 필요성을 제시합니다. 대량 롤아웃에서 빠르게 초기화하는 비용과 모사 환경이 실제 실행 상태를 얼마나 충실하게 따르는지도 남은 질문입니다. 저자 공개본 §12.1
- §12.2 장기 작업에서 믿을 수 있는 상태. 요약, 검색, 망각을 거치며 현재 작업에 필요한 정보가 얼마나 사라지는지, 모델에 제공한 상태가 실제 작업 상태와 얼마나 벌어지는지를 묻습니다. 저자는 출처가 남는 기억, 모순과 오래된 정보의 표시, 영속 산출물에서 상태를 다시 복원하는 절차가 필요하다고 봅니다. 저자 공개본 §12.2
- §12.3 트레이스로 실패 진단. 최종 성공률이 같아도 원인이 모델의 추론, 도구 설명, 환경 설정, 채점기 중 어느 곳에 있는지는 경로를 읽어야 합니다. 저자는 생산 환경에서 발견한 이상 트레이스를 회귀 과제로 만들고, 경로 지표를 스팬에서 계산하는 평가를 제안합니다. 저자 공개본 §12.3
- §12.4 표준화된 인계. 인계에 텍스트 요약과 더불어 의도, 남은 제약과 예산, 권한, 산출물, 근거, 위험, 미결 결정을 포함할 수 있는 공통 계약이 필요하다고 봅니다. 실행을 넘긴 주체와 다음 실행에 책임을 지는 주체도 구분해야 합니다. 저자 공개본 §12.4
- §12.5 모델이 좋아질 때 하네스 조정. 모델과 하네스 개입을 교차 비교하면 모든 모델에 도움이 되는 조치와 특정 모델에서만 유효한 조치를 구분할 수 있습니다. 저자가 인용한 사례에서는 더 강한 모델로 바꾸면서 기존 리셋이 불필요해졌습니다. 저자는 안전·품질·지연·비용을 함께 보며 제어를 추가하거나 제거하도록 제안하고, 좁은 벤치마크에 맞춰 최적화할 때 생길 과적합을 지적합니다. 저자 공개본 §12.5 · §12.5
📖 Chapter 13: Conclusion
결론은 모델과 하네스가 실행의 신뢰성을 함께 결정한다는 관점으로 돌아옵니다. ETCLOVG는 어떤 구성요소가 어떤 책임을 맡는지 비교할 어휘를 제공하고, 공개 산출물 138개의 분류는 그 책임이 기능으로 드러나는 양상을 보여 줍니다. 저자는 영어권 공개 개발·코딩 에이전트 자료의 편향을 재차 밝히고, 기술을 묘사하는 현재 분류를 상황에 맞는 하네스 선택도 도울 수 있는 틀로 발전시키는 과제를 남깁니다. 저자 공개본 §13
📖 Chapter A: Appendix: Full Ecosystem Mapping
표 S1은 2026년 5월 8일 기준으로 검증한 카탈로그에서 학습용 읽을거리, 일반 기술 목록, 튜토리얼·핸드북 전용 항목 등을 제외하고 기술 산출물 138개를 주 계층별로 정리합니다. 각 행에는 산출물 이름, 주 계층, 카탈로그 태그, 확인 가능한 별 수가 들어갑니다. 별 수는 당시 카탈로그의 메타데이터입니다. 본문 §6의 표 2에 들어 있는 반올림 별 수는 별도로 5월 12일을 기준으로 합니다. 동반 카탈로그는 조사 대상과 근거를 탐색할 때 쓰는 자료이고, 본문의 집계는 부록 표 S1 기준입니다. 저자 공개본 부록 A 표 S1 · §6 표 2 · 동반 자료 소개
📖 Chapter B: Appendix: Reference Harness Implementations
표 S2는 부록 A에서 이어지는 대표 비교입니다. 아래 표는 저자가 공개 문서에서 근거를 확인한 계층과 그 예가 보여 주는 방식을 옮겼습니다. 각 구현의 모든 내부 기능을 확인했다는 뜻은 아닙니다. 저자 공개본 부록 B 표 S2
| 대표 구현 | 문서로 확인한 계층 | 서베이가 주목한 설계 |
|---|---|---|
| Claude Code | E·T·C·L·G | 터미널 안의 편집·디버깅·Git 작업과 명시적인 권한·격리 경계 |
| OpenCode | E·T·L | 계획·구현 역할, 하위 에이전트, 언어 서버와의 연결 |
| Codex CLI | E·T·L·V | 단일 루프에서 구조화한 프롬프트, 도구 호출 재생, 로컬 실행과 검증 피드백 |
| OpenHands | E·T·C·L·V | 샌드박스 실행, 쉘·브라우저, 작업 상태와 평가가 결합된 개방형 플랫폼 |
| SWE-agent | E·T·L·V | 명령·관찰·편집·테스트와 실행 백엔드가 함께 이루는 에이전트–컴퓨터 인터페이스 |
| Symphony | C·L·V·G | 이슈 할당·진행 상태·검증·리뷰 경계를 잇는 영속 작업 실행기 |
Codex CLI 행에서는 한 실행 루프에 명령 실행과 평가 피드백이 어떻게 이어지는지 읽을 수 있습니다. Symphony 행에서는 여러 작업에 걸쳐 할당과 상태, 검증까지 담당하는 오케스트레이션을 볼 수 있습니다. 부록 표가 둘 다 ‘코딩 에이전트 관련’이라고 묶지 않고 실행 책임의 범위를 드러내는 사례입니다. 저자 공개본 부록 B 표 S2
실험 결과 심층 분석
이 논문이 자체 집계한 결과는 공개 카탈로그 171개에서 선별한 138개 산출물의 주 계층 빈도입니다. 동일 모델을 일곱 계층의 구성별로 다시 실행한 자체 벤치마크와 빈도에 대한 신뢰구간·유의성 검정은 논문에 보고되지 않았습니다. 검색어·출처·분류 규칙과 부록 행을 대조할 수 있지만, 교차 코더 일치도와 비공개 배포에서의 빈도까지 추정할 수는 없습니다. 저자 공개본 §2.5–2.9 · §2.7–2.9 · 부록 A
본문에 소개된 정량 근거는 아래와 같이 실험의 질문과 조건이 다릅니다. 저자 공개본 §1 · §3.3 · §7.3–7.4
| 서베이가 인용한 외부 결과 | 평가 조건 | 이 조건에서 읽을 수 있는 것 |
|---|---|---|
| Trivedy (2026), 52.8% → 66.5% | GPT-5.2-Codex 고정, Terminal-Bench 2.0에서 시스템 프롬프트 재구성·컨텍스트 주입·자기 검증 훅을 함께 적용 | 해당 하네스 변경 묶음에서 13.7%포인트 차이를 보고했습니다. 각 개입의 독립 효과는 이 비교에서 분리되지 않습니다. |
| SandboxEscapeBench, 15–35% | 중첩 샌드박스 CTF, Docker 기반 컨테이너의 여러 설정 | 격리 설정에 따라 탈출 성공률이 달라졌습니다. 일반 운영에서의 발생률을 추정하는 수치와는 집계 조건이 다릅니다. |
| Anthropic (2026d), 6%포인트 차이 | 에이전트 코딩 평가의 인프라 구성을 변경한 외부 분석 | 해당 출처의 인프라 효과에 대해 서베이는 p < 0.01을 인용합니다. 이 검정은 서베이의 계층 빈도에 대한 검정과 무관합니다. |
위 결과를 한 리더보드의 개선폭으로 합치면 측정 조건이 사라집니다. 코딩 성공률은 과제·하네스 변경의 영향을, 탈출률은 위협 모델과 격리 구성의 영향을 보여 줍니다. 논문이 제안한 평가 실무는 모델 버전, 샌드박스 초기 상태, 도구와 권한, 평가자 버전을 명시한 다음 성공률·비용·지연과 실패 경로를 함께 비교하는 것입니다. 저자 공개본 §8.1 및 표 3 · §8.4–8.5
기술적 함의와 응용
리뷰의 관점에서 ETCLOVG의 실용적인 쓰임은 같은 실패를 서로 다른 구성요소의 기록과 대조할 수 있다는 점입니다. 코드 수정 에이전트가 재시작 직후 틀린 파일을 고쳤다면 먼저 상태가 누락됐는지(C), 올바른 체크포인트에서 재개했는지(L), 저장소와 권한이 그대로였는지(E·G)를 확인할 수 있습니다. 이어 호출 기록(O)으로 최초 분기점을 찾고, 그 상태와 도구 계약(T)을 고정한 회귀 과제(V)를 만들면 다음 수정에서 같은 실패가 재발하는지 확인할 수 있습니다. 이 예시는 논문의 분류와 평가 절차를 함께 적용한 리뷰의 해석입니다. 저자 공개본 §6.1 · §8.1 · §8.5–8.6
논문이 제시한 후속 과제는 맥락에 맞는 조합을 실증적으로 판단하는 일입니다. 특히 하네스 버전을 모델 버전과 함께 기록하면, 모델을 교체한 뒤에도 같은 검증과 복구 조치가 필요한지 다시 실험할 수 있습니다. 안전·비용·지연에 영향을 주는 개입을 실행 기록과 함께 점검하는 방식은 에이전트의 성능 보고와 운영 정책을 연결합니다. 저자 공개본 §11.3 · §12.5 · §13