논문 개요와 전체 구조
무음 영상에서 드러머가 북을 네 번 칩니다. 북소리를 만들어도 채가 닿는 순간보다 먼저 들리거나, 연주가 멈춘 뒤 계속 울리면 장면과 어긋납니다. MMAudio는 이처럼 영상에 맞는 소리의 종류와 소리가 나는 시점을 함께 학습합니다. 연구 대상은 영상에 붙이는 환경음과 효과음, 즉 이 논문에서 말하는 폴리(Foley)입니다.
Ho Kei Cheng 연구진은 영상·오디오·텍스트가 함께 있는 데이터와 영상 없이 소리와 설명만 있는 데이터를 하나의 생성 모델에 넣었습니다. 영상이 주어지면 CLIP으로 장면을 읽고, Synchformer로 타격이나 움직임의 시점을 포착하는 데 필요한 단서를 얻습니다. 생성할 오디오 잠재 표현은 텍스트만으로도 조건을 줄 수 있으며, 이 기능을 위해 모델을 따로 미세조정할 필요가 없습니다. 아래 내용은 2025년 4월 7일 개정된 arXiv v2를 기준으로 합니다. 논문 원문
| 원문 | 구성 |
|---|---|
| 1. Introduction | 폴리에서 의미와 시간 정렬이 필요한 이유 |
| 2. Related Works | 의미 정렬, 시간 정렬, 멀티모달 조건 부여, 멀티모달 생성 |
| 3. MMAudio | 3.1 생성과 오디오 인코딩, 3.2 모델 개요, 3.3 멀티모달 트랜스포머, 3.4 조건부 동기화, 3.5 학습과 추론 |
| 4. Experiments | 4.1 지표, 4.2 주요 결과, 4.3 제거 실험, 4.4 한계 |
| 5. Conclusion | 공동 학습과 프레임별 동기화에 대한 결론 |
| 부록 A–E | 사용자 평가, Movie Gen Audio, Greatest Hits, 결측 조건 채우기, 데이터 중복 |
| 부록 F–I | 오디오 잠재 표현, 네트워크 세부, 학습 세부, 추가 시각화 |
핵심 기여와 혁신성
영상에 효과음을 붙일 때는 장면에 어울리는 소리를 고르는 문제와 소리가 시작하고 끝나는 시점을 맞추는 문제를 함께 풀어야 합니다. 영상과 녹음이 짝을 이루는 공개 데이터는 상대적으로 적으며, 장면 밖에서 덧입힌 음악이나 대사가 포함되면 화면 속 동작과 소리의 관계를 그대로 배우기 어렵습니다. 저자들은 영상 데이터만으로 처음부터 학습하는 방법과, 사전학습된 텍스트→오디오 모델에 영상 제어 모듈을 붙이는 방법을 주요 선행 접근으로 정리합니다. §1–2
MMAudio는 공동 학습과 오디오 토큰별 동기화를 결합합니다. 공동 학습은 소리와 설명만 있는 쌍을 학습에 포함해 “북”과 북소리의 관계를 더 많은 사례에서 배울 수 있게 합니다. 토큰별 동기화는 영상의 빠른 변화를 오디오 잠재 표현과 같은 길이로 만든 뒤, 각 시점의 특징 계산에 직접 넣습니다. 학습에 쓸 수 있는 소리의 범위를 넓히는 효과와 영상 속 타이밍을 맞추는 효과는 각각의 제거 실험에서 구분해 읽을 수 있습니다. §3–4
기술적 세부사항
모델이 학습 중 맞히는 값은 오디오 잠재 공간에서 지금 어느 방향으로 얼마나 움직일지를 나타내는 속도입니다. 실제 소리를 시간–주파수 표현인 멜 스펙트로그램으로 바꿔 잠재 표현으로 압축하고, 이 표현과 가우시안 잡음 사이의 점을 만듭니다. 모델은 그 점에서 실제 소리 방향으로 가는 속도를 회귀합니다. 추론에서는 잡음에서 출발해 속도를 여러 번 계산하고, 도착한 잠재 표현을 파형으로 복원합니다. §3.1–3.2
| S-16kHz의 입력 또는 상태 | 표현 | 8초 예시 |
|---|---|---|
| CLIP 영상 특징 | 8 fps, 토큰당 1,024차원 | 64개 |
| CLIP 텍스트 특징 | 77개 토큰, 토큰당 1,024차원 | 77개 |
| Synchformer 영상 특징 | 이 길이에서 24 fps, 토큰당 768차원 | 192개 |
| VAE 오디오 잠재 표현 | 31.25 fps, 토큰당 20차원 | 250개 |
여기에서 fps는 특징 시퀀스의 초당 토큰 수입니다. 16 kHz는 최종 파형의 초당 샘플 수입니다. 8초 영상에서 추출한 Synchformer 토큰 192개를 250개로 맞추면 각 오디오 토큰마다 프레임별 조건을 붙일 수 있습니다. CLIP 영상과 텍스트는 멀티모달 어텐션에 참여하며, Synchformer 특징은 별도의 조건 경로를 통해 오디오 스트림을 조절합니다. §3.3–3.4, 부록 G.4
VGGSound에서는 생성 오디오의 분포, 오디오 품질, 영상 내용과의 의미 일치, 영상의 이벤트 시점과의 정렬을 평가합니다. AudioCaps는 텍스트만으로 10초 오디오를 만드는 평가에 쓰며, Greatest Hits에서는 라벨이 붙은 타격 시작점과 생성 오디오에서 검출한 시작점을 비교합니다. 세 데이터셋은 서로 다른 질문에 답합니다. §4, 부록 C
챕터별 상세 리뷰
📖 Chapter 1: Introduction
저자들은 비나 물 흐르는 소리처럼 장면 전반에 깔리는 환경음과, 개가 짖거나 라켓이 공에 닿을 때처럼 화면 속 사건이 일으키는 효과음을 예로 듭니다. 비 장면에 빗소리가 들리는 것은 의미 정렬입니다. 공이 라켓에 닿을 때 소리가 들리는 것은 시간 정렬입니다. 원문은 선행 연구를 인용해 사람이 조건에 따라 25 ms 정도의 어긋남을 감지할 수 있다고 설명합니다. 이 수치는 MMAudio가 달성한 오차나 실험의 판정 문턱을 뜻하지 않습니다. §1
처음부터 영상과 소리만으로 학습하면 확보할 수 있는 데이터 규모에 제약이 있습니다. 반면 사전학습된 텍스트→오디오 모델에 영상 제어 모듈을 붙이면 기존 모델의 생성 능력을 활용할 수 있지만, 이미 잡힌 표현 공간에서 영상 조건을 해석해야 하고 모델 설계도 복잡해집니다. 논문은 영상과 음성이 항상 짝을 이뤄야 한다는 제약을 풀기 위해, 없는 입력은 비워 둔 채 두 종류의 데이터로 같은 속도 예측기를 학습하는 방식을 제안합니다. §1
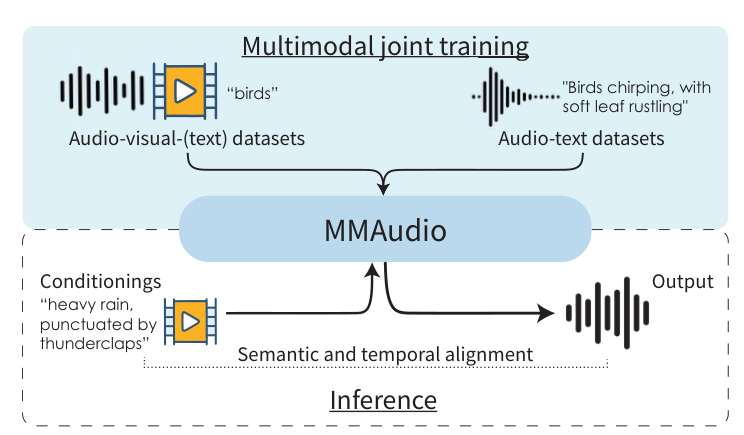
위는 두 종류의 학습 데이터, 아래는 영상·텍스트를 조건으로 하는 오디오 생성입니다. Cheng 외, Figure 1 · PDF 1쪽, 원문 크롭 · CC BY 4.0
📖 Chapter 2: Related Works
- Semantic alignment에서는 영상과 소리를 생성 또는 대조 학습으로 연결한 선행 연구를 다룹니다. MMAudio는 오디오·텍스트 쌍에도 같은 학습 구조를 사용합니다. 논문은 이 과정에서 학습한 청각 개념을 영상 조건에 활용할 수 있다고 해석합니다.
- Temporal alignment에서는 사건의 시작점, 신호 에너지, 파형 RMS 같은 요약값을 예측해 타이밍을 주는 방법을 설명합니다. MMAudio는 어긋난 영상과 소리를 탐지하도록 사전학습된 Synchformer의 시각 인코더에서 특징을 가져옵니다. V-AURA도 Synchformer를 쓰지만 논문에서 비교하는 기본 맥락 길이는 2.56초이며, MMAudio는 8–10초 생성을 다룹니다. 위치 처리에서는 고속 스트림을 서브샘플링하는 동시 연구와 달리 저속 영상의 위치 회전 주파수를 높입니다. 원문이 두 방식의 효과가 같다고 한 조건은 두 프레임률이 정수배인 경우입니다.
- Multimodal conditioning에서는 사전학습 모델에 제어 모듈을 붙이는 방식, Seeing&Hearing처럼 추론 중 정렬 점수의 기울기를 사용하는 방식, VATT와 MultiFoley의 공동 학습을 비교합니다. 원문에서 VATT는 학습 중 영상 조건을 항상 필요로 합니다. MultiFoley와 비교할 때 저자들은 시간 정렬에 쓰는 시각 특징의 해상도 차이인 8 fps와 24 fps를 강조합니다.
- Multimodal generation은 영상과 오디오를 함께 출력하는 문제입니다. MMAudio가 다루는 범위는 영상과 텍스트를 조건으로 오디오를 생성하는 문제입니다. 이 범위 덕분에 다음 장은 주어진 장면 정보가 오디오에 전달되는 경로를 구체적으로 설계할 수 있습니다. §2
📖 Chapter 3: MMAudio
3.1 Preliminaries
조건부 플로 매칭. 학습 데이터에서 소리의 잠재 표현 $x_1$과 조건 $\mathbf{C}$를 가져오고, 표준정규분포에서 같은 형태의 잡음 $x_0$을 뽑습니다. 원문 식 (2)–(3)은 그 사이를 직선으로 보간하고, 그 직선의 기울기를 정답 속도로 사용합니다.
여기서 $t$는 잡음에서 샘플로 이동하는 생성 시간입니다. 실제 영상에서 소리가 나는 초 단위 시각은 오디오 잠재 표현의 토큰 위치에 해당합니다. 예를 들어 한 잠재 좌표에서 잡음값이 2이고 실제 오디오 값이 6이면, $t=0.25$에서 모델이 받는 값은 3이고 목표 속도는 4입니다. 한 좌표를 택한 설명용 계산이며, 네트워크는 전체 오디오 잠재 시퀀스의 속도를 한꺼번에 예측합니다. §3.1, 식 (2)–(3)
원문 식 (1)은 예측한 속도와 이 목표값의 제곱 오차를 평균냅니다. 기대값은 샘플링한 $t$, 잡음 $x_0$, 그리고 데이터에서 함께 뽑은 $x_1,\mathbf{C}$에 대해 계산합니다.
추론할 때는 실제 소리에 해당하는 $x_1$이 주어지지 않습니다. 대신 학습한 속도장 $v_\theta$에 맞춰 잡음에서 출발하는 미분방정식을 수치 적분합니다. 오일러 방법의 한 단계에서는 현재 잠재 표현에 $\Delta t\,v_\theta(t,\mathbf{C},x_t)$를 더합니다. 같은 과정을 여러 번 반복하면 재생 가능한 소리로 변환할 잠재 표현에 도달합니다. §3.1, 식 (1)
오디오 인코딩. 모델은 파형을 짧은 시간 구간으로 나눠 주파수 성분을 계산하는 STFT로 멜 스펙트로그램을 얻습니다. 사전학습된 VAE가 이를 더 작은 잠재 시퀀스로 압축합니다. 생성 후에는 VAE 디코더가 멜 스펙트로그램을 복원하고, 보코더가 사람이 들을 수 있는 파형을 만듭니다. §3.1, 부록 F
3.2 Overview
처음 $N_1$개 블록은 영상·텍스트·오디오가 정보를 주고받는 멀티모달 트랜스포머입니다. 뒤의 $N_2$개 블록은 오디오 스트림만 유지해 속도를 계산합니다. 작은 16 kHz 모델에서는 각각 4개와 8개입니다. 그림 왼쪽의 별도 동기화 경로에서 만든 조건 $c_f$는 후반의 오디오 단독 블록에도 들어갑니다. 그 단계에도 영상에서 추출한 타이밍 정보는 계속 전달됩니다. §3.2, Figure 2
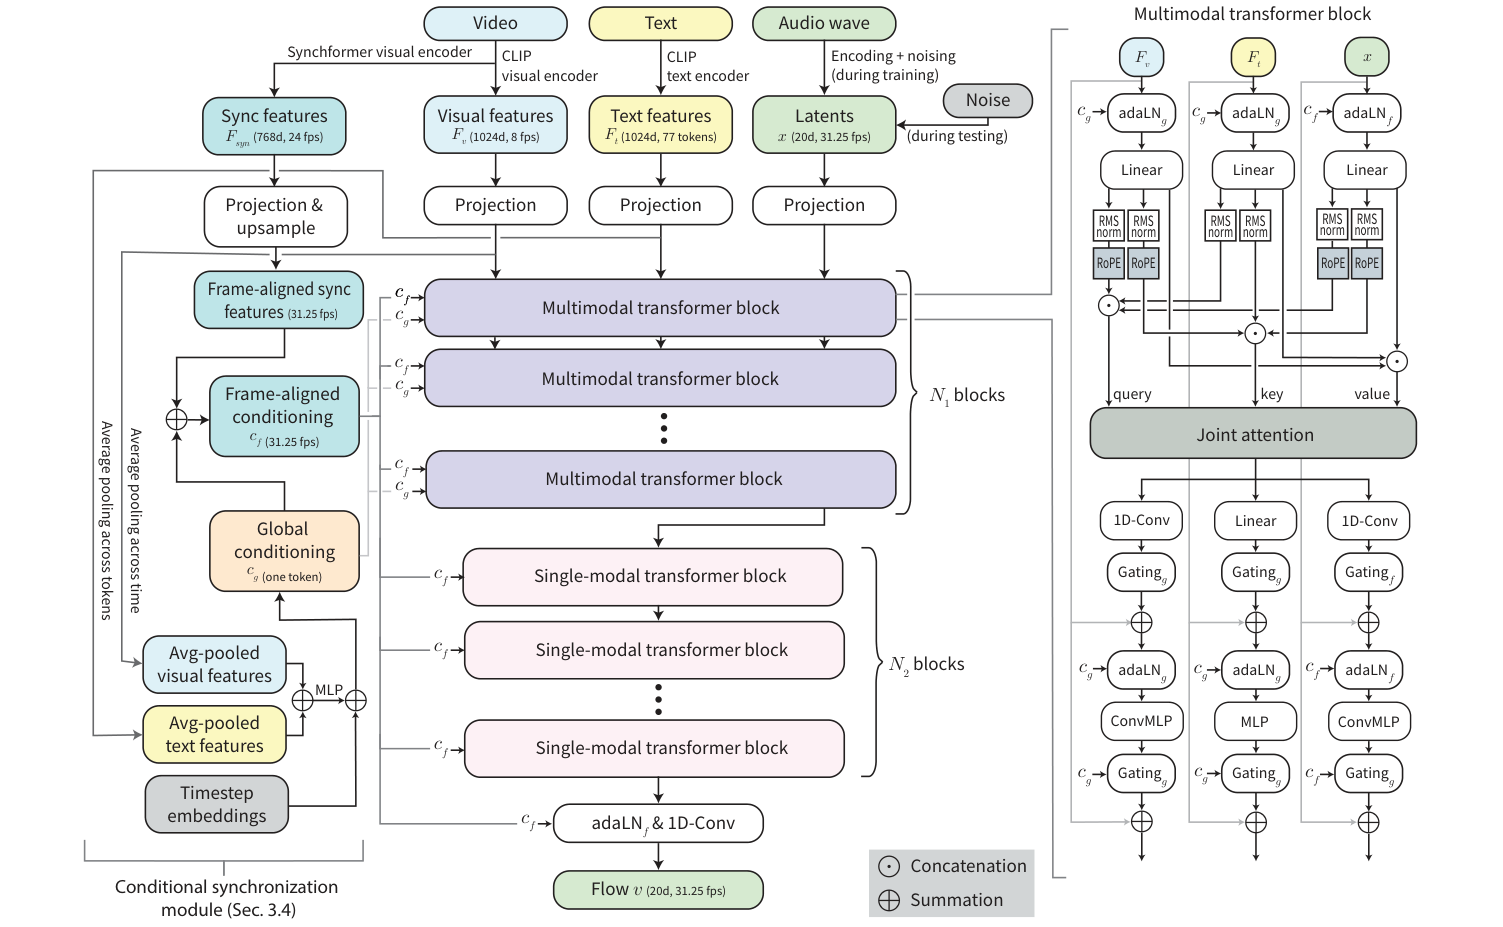
왼쪽은 속도 예측기 전체, 오른쪽은 멀티모달 트랜스포머 한 블록입니다. Cheng 외, Figure 2 · PDF 4쪽, 원문 크롭 · CC BY 4.0
3.3 Multimodal Transformer
Representations → Joint attention. 영상, 텍스트, 오디오의 토큰을 공통 은닉 차원 $h$로 사상합니다. 각 스트림의 쿼리·키·값을 시퀀스 방향으로 이어 붙여 한 번에 스케일 내적 어텐션을 구하고, 결과를 원래 길이에 따라 세 스트림으로 나눕니다. 이 구조에서 오디오 토큰은 문장이 설명하는 소리와 영상이 보여주는 물체 양쪽에 주의를 줄 수 있습니다. 후반의 오디오 전용 블록에서는 같은 계산이 오디오 자기 어텐션이 됩니다.
Aligned RoPE position embedding. 오디오와 영상의 쿼리·키에만 RoPE를 적용합니다. 각 토큰의 회전 각도를 시간에 맞추기 위해 기본 모델에서는 영상 쪽 RoPE 주파수에 $31.25/8$을 곱합니다. 영상에서 토큰 16개만큼 떨어진 두 지점의 간격은 2초이고, 같은 시간은 오디오 토큰 간격으로 62.5에 해당합니다. 숫자 16이라는 인덱스를 두 스트림에서 똑같은 시간으로 취급하면 서로 다른 순간이 가까워집니다. 텍스트의 단어 순서는 영상의 재생 축에 직접 대응하지 않으므로 이 RoPE를 적용하지 않습니다.
ConvMLP. 영상과 오디오의 MLP에 해당하는 부분에 커널 3, 패딩 1인 1차원 합성곱을 넣습니다. 현재 토큰 주변의 짧은 변화를 함께 볼 수 있는 구조입니다. 시간 순서를 공유하지 않는 텍스트 스트림에는 기존 MLP를 씁니다.
Global conditioning. 생성 시간의 푸리에 임베딩과 평균 풀링한 CLIP 영상·텍스트 특징에서 전역 조건 $c_g$를 만듭니다. 적응형 층 정규화인 adaLN은 이 조건으로 스케일과 편향을 구합니다. 원문 식 (4)의 $\mathbf{1}$은 시퀀스 길이만큼 이 값을 복제하는 열 벡터입니다. 같은 영상 안의 모든 토큰은 동일한 전역 스케일과 편향을 받습니다.
$y$는 토큰의 은닉 표현이고, $\mathbf{W}_\gamma$와 $\mathbf{W}_\beta$는 각각 스케일과 편향을 내는 MLP입니다. 이 식의 곱은 정규화된 토큰과 스케일 사이의 원소별 곱입니다. 장면 전체에 관한 조건을 반영한 뒤, 다음 절에서 토큰마다 달라지는 조건을 별도로 구성합니다. §3.3, 식 (4)
3.4 Conditional Synchronization Module
조인트 어텐션은 여러 위치의 특징을 가중합합니다. 저자들은 이 과정만으로 특정 프레임의 작은 동작에 소리를 정밀하게 맞추기 어렵다고 보았습니다. 그래서 영상과 오디오의 시차를 판별하도록 사전학습된 Synchformer의 영상 인코더에서 타이밍 단서를 추출합니다. 이 단계의 입력에는 원래 오디오가 필요하지 않습니다. 생성 모델은 768차원 동기화 특징 $F_{\mathrm{syn}}$을 ConvMLP로 가공하고, 최근접 보간으로 오디오 잠재 시퀀스에 맞춘 뒤 전역 조건을 더합니다. 예를 들어 8초 입력에서는 동기화 특징 192개를 오디오 토큰 250개에 대응시킵니다.
원문 식 (5)의 결과 $c_f$는 오디오 토큰별 조건입니다. 식 (6)에서 두 MLP $\mathbf{A}_\gamma,\mathbf{A}_\beta$가 토큰마다 스케일과 편향을 산출합니다. 같은 북 장면에서도 채가 닿는 토큰과 그 사이의 토큰에서 조건값이 달라질 수 있습니다.
$x$는 이 층에 들어온 오디오 스트림 표현입니다. $c_f$는 소리의 정답 시작점 라벨이나 파형을 직접 제공하지 않습니다. 속도 예측기가 영상의 어떤 순간에 어떤 변화를 낼지 결정할 때 사용하는 조건입니다. §3.4, 식 (5)–(6)
3.5 Training and Inference
3.5.1 Multimodal Datasets. VGGSound는 이 논문에서 영상·오디오·텍스트를 모두 제공하는 유일한 데이터셋이며, 텍스트로는 310개 클래스 이름을 사용합니다. 검증용 2천 개를 떼고 남은 약 18만 개의 10초 영상에서 처음 8초를 학습에 씁니다. 오디오·텍스트는 사람이 캡션을 달아 놓은 AudioCaps(약 128시간), Clotho(약 31시간), 메타데이터로 캡션을 만든 WavCaps(약 7,600시간)에서 가져옵니다. 논문의 8초 자르기 규칙을 적용하면 약 95만 1천 개의 쌍이 생깁니다. 영상이 없으면 CLIP 영상과 동기화 특징을 각각 학습 가능한 빈 토큰으로 채웁니다. 테스트셋 중복 제거 규칙은 부록 E에서 설명합니다.
3.5.2 Implementation Details. 기본 S-16kHz는 은닉 차원 448, 20차원 오디오 잠재 표현, 31.25 fps를 사용합니다. 학습 중에는 classifier-free guidance를 쓰기 위해 영상 조건이나 텍스트를 10% 확률로 가립니다. 영상 쪽은 두 시각 스트림의 학습 가능한 빈 토큰, 텍스트는 빈 문자열을 사용합니다. 기본 추론은 guidance 강도 4.5와 오일러 25단계입니다. 절대 위치 임베딩을 두지 않아서 추론 길이에 맞춰 토큰 수를 바꿀 수 있고, 논문은 VGGSound의 8초와 AudioCaps의 10초를 평가합니다. §3.5
다음은 학습에서 이미 배운 속도장을 쓰는 과정을 정리한 설명용 의사코드입니다. 25는 생성 시간의 적분 횟수이며, 8초 영상의 프레임 수와는 별개입니다.
1
2
3
4
5
6
7
8
9
10
11
입력: 길이, 선택적 영상, 선택적 텍스트
영상이 있으면 CLIP 영상 특징과 Synchformer 특징 추출
영상이 없으면 두 특징을 각각 학습된 빈 토큰으로 채움
텍스트가 없으면 빈 문자열 사용
길이에 맞는 오디오 잠재 모양으로 표준정규 잡음 샘플링

25번의 오일러 스텝 동안:
    현재 잠재 표현으로 조건부 속도와 무조건 속도를 계산
    guidance 강도 4.5를 적용한 속도로 현재 잠재 표현 갱신

반환: VAE 디코더와 보코더를 거친 오디오 파형
📖 Chapter 4: Experiments
4.1 Metrics
분포 일치에서는 생성·정답 오디오의 특징 분포에 대해 Fréchet Distance(FD)와 KL 거리를 계산합니다. FD의 특징 추출기는 PaSST, PANNs, VGGish입니다. PaSST와 PANNs는 전체 클립 특징을 쓰고, VGGish는 겹치지 않는 0.96초 구간을 처리합니다. 서로 다른 FD 값을 같은 척도처럼 직접 비교하기보다, 한 추출기에서 두 방법의 차이를 읽어야 합니다.
오디오 품질은 PANNs 분류기에 기반한 Inception Score(IS)로 평가합니다. 이 지표에는 원본 정답 오디오가 직접 들어가지 않습니다. 의미 정렬에서는 ImageBind 영상·오디오 특징의 평균 코사인 유사도를 IB-score로 보고합니다. 시간 정렬은 Synchformer가 예측한 시차 DeSync로 측정합니다. 이 논문은 8초 오디오에서 처음과 마지막 4.8초를 각각 잘라 점수를 평균냅니다. V-AURA 원 논문의 2.56초 평가 점수는 여기의 재평가와 설정이 다릅니다. §4.1–4.2
4.2 Main Results
Video-to-audio. VGGSound 테스트셋의 약 1만 5천 영상에서 8초 생성 결과를 비교합니다. ReWaS는 5초까지만 생성하므로 저자들은 해당 행의 정답도 5초로 잘랐습니다. V-AURA는 공식 자기회귀 코드로 8초를 생성했습니다. 아래 표는 원문 Table 1에서 비교하기 좋은 항목을 발췌했습니다. 표에 있는 시간은 H100에서 워밍업 후 배치 크기 1로 8초 샘플 한 개를 생성한 총 시간이며 디스크 입출력을 제외합니다. 파라미터 수에는 사전학습된 특징 추출기, 잠재 인코더·디코더, 보코더가 포함되지 않습니다. §4.2, Table 1
| VGGSound 모델 | FD PaSST ↓ | IB-score ↑ | DeSync ↓ | 시간 |
|---|---|---|---|---|
| Seeing&Hearing | 219.01 | 33.99 | 1.204 | 14.55초 |
| V-AURA | 218.50 | 27.64 | 0.654 | 16.55초 |
| Frieren | 106.10 | 22.78 | 0.851 | 미보고 |
| FoleyCrafter | 140.09 | 25.68 | 1.225 | 1.67초 |
| MMAudio-S-16kHz | 70.19 | 29.13 | 0.483 | 1.23초 |
| MMAudio-S-44.1kHz | 65.25 | 32.27 | 0.444 | 1.30초 |
| MMAudio-M-44.1kHz | 61.88 | 32.99 | 0.443 | 1.35초 |
| MMAudio-L-44.1kHz | 60.60 | 33.22 | 0.442 | 1.96초 |
157M과 1.23초는 S-16kHz의 조건에서 함께 성립하는 수치입니다. MMAudio 계열은 표의 시간 정렬에서 좋은 결과를 내지만, Seeing&Hearing은 추론 중 ImageBind 점수를 직접 최적화해 IB-score가 가장 높습니다. KL 두 항목은 VATT가 각각 1.48과 1.41을 얻으며, 위 발췌표 밖의 지표에서 순위가 달라질 수 있습니다. Table 1
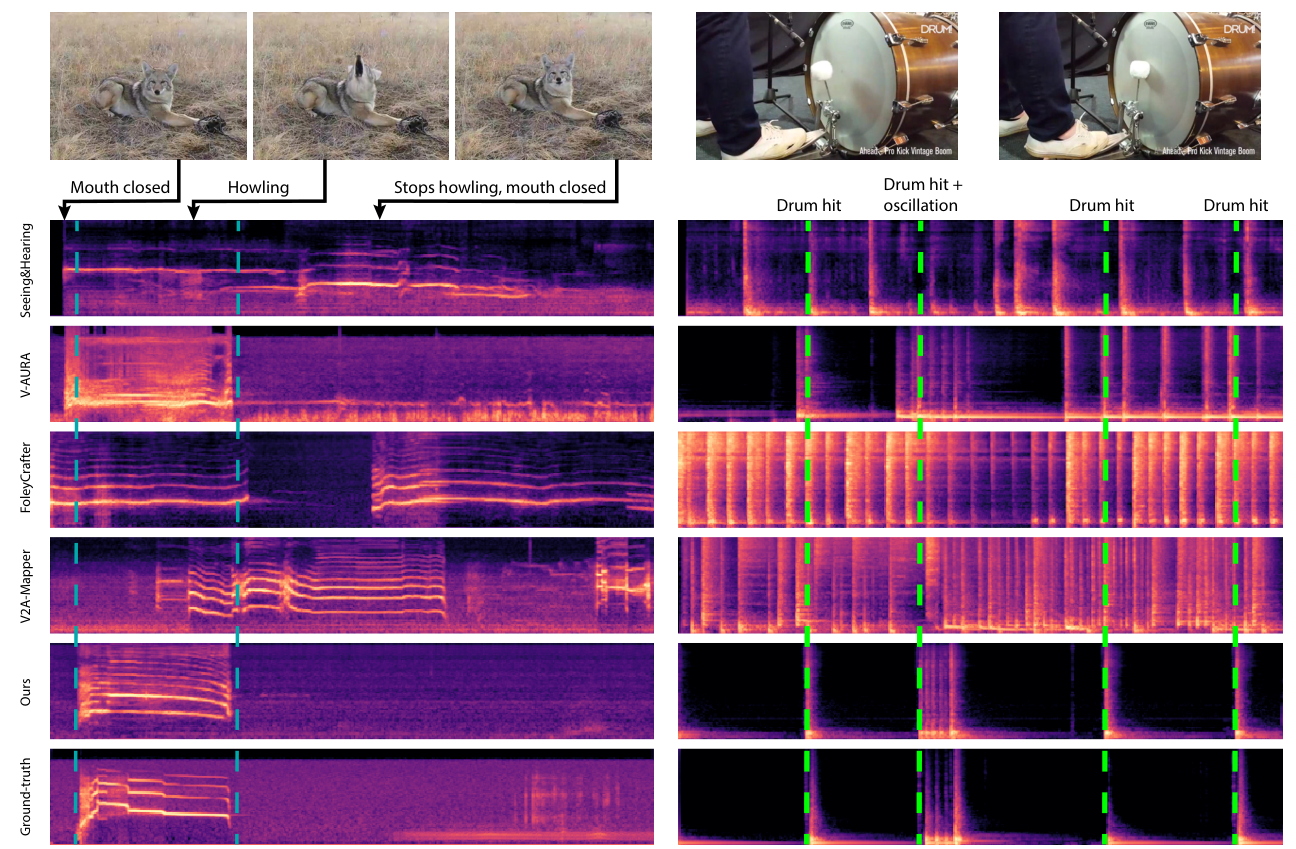
왼쪽은 동물의 울음, 오른쪽은 북 타격입니다. 점선은 영상에서 확인되는 사건의 시점을 나타냅니다. Cheng 외, Figure 3 · PDF 7쪽, 원문 크롭 · CC BY 4.0
스펙트로그램은 가로축을 따라 시간의 흐름을 보여 줍니다. 왼쪽에서 MMAudio의 밝은 주파수 띠는 동물이 울 때 나타났다가 입을 닫으면 약해집니다. 오른쪽에서 타격음은 밝은 세로선으로 보입니다. 각 행의 세로선이 점선 근처에서 생기는지, 동작이 없는 구간에서 추가 타격처럼 보이는 선이 생기는지 비교할 수 있습니다. 논문이 제시한 두 예시이며, 전체 평가셋 결과는 Table 1에 해당합니다. Figure 3, Table 1
Text-to-audio. AudioCaps 테스트셋 10초 샘플에서 별도 미세조정 없이 평가했습니다. 비교 모델의 수치는 같은 프로토콜로 공식 체크포인트를 재현한 GenAU 논문에서 가져왔으며, CLAP 기반 재순위화를 적용하지 않습니다. M-44.1kHz의 CLAP 0.351과 FD PANNs 14.38은 GenAU-Large의 0.285와 16.51보다 유리하지만, FD VGGish는 4.07 대 1.21로 불리합니다. 글 전체의 의미와 잘 맞는 소리와 0.96초 단위의 국소 분포가 같은 순위를 낼 필요는 없습니다. 저자들은 자신들의 강점이 전역적이고 의미가 일관된 소리라고 해석합니다. §4.2, Table 3
4.3 Ablations
제거 실험은 모두 S-16kHz를 기준으로 VGGSound 테스트셋에서 수행했습니다. 원문 순서대로 조건을 하나씩 바꾸면 어떤 경로가 어떤 지표에 영향을 주는지 볼 수 있습니다. §4.3, Tables 4–7
- Cross-modal alignment. 영상·오디오·클래스 이름과 오디오·텍스트를 모두 학습하는 AVT+AT의 FD PaSST/DeSync는 70.19/0.483입니다. 영상 자료의 클래스 이름을 가린 AV+AT는 72.77/0.502, 별도 오디오 자료의 캡션을 가린 AVT+A는 71.01/0.496, 별도 오디오 자료를 빼는 AVT는 77.38/0.562입니다. AV는 77.27/0.502로, 별도 오디오 자료를 쓰지 않을 때 클래스 이름만 추가해도 지표가 일관되게 개선되지는 않았습니다.
- Multimodal data. 별도 오디오·텍스트 풀을 10%, 25%, 50%, 100% 사용할 때 DeSync는 0.514, 0.505, 0.489, 0.483입니다. 이 구간에서는 두 자료 종류를 대략 1:1로 샘플링합니다. 따라서 10%와 100%는 학습 배치 안의 비율 차이가 아니라 샘플링 대상 풀의 크기 차이입니다. 오디오·텍스트를 전혀 쓰지 않았을 때는 과적합을 관찰해 학습을 일찍 종료했습니다.
- Conditional synchronization module. 동기화 특징을 빼면 DeSync가 0.973으로 올라갑니다. CLIP 영상 특징을 최근접 보간으로 24 fps까지 늘려 동기화 특징과 합친 대안은 0.490, 오디오 토큰별 조건을 주는 기본 방식은 0.483입니다. 대안의 IS는 16.70으로 기본 방식의 14.44보다 높습니다. 저자들은 영상 시퀀스가 세 배 길어진 효과일 수 있다고 제안합니다.
- RoPE embeddings. RoPE를 빼면 DeSync는 0.509, 영상의 주파수를 보정하지 않으면 0.496, 정렬하면 0.483입니다. 영상과 오디오의 시계를 맞춘 위치 표현이 추가로 도움이 됩니다.
- ConvMLP. 파라미터 수를 비슷하게 맞추기 위해 일반 MLP 대안의 은닉 차원과 층 수를 늘렸습니다. 일반 MLP의 FD PaSST/DeSync는 73.84/0.533, ConvMLP는 70.19/0.483입니다.
- Ratio between multimodal and single-modal blocks. 비슷한 파라미터 예산에서 멀티모달/오디오 전용 블록 수를 4/8, 2/13, 6/3으로 두면 DeSync가 각각 0.483, 0.487, 0.509입니다. 저자들은 오디오 전용 블록이 같은 예산에서 더 깊은 모델을 구성할 수 있게 한다고 해석합니다.
4.4 Limitations
영상 속 입 움직임이나 텍스트를 조건으로 사람의 말을 생성하도록 요청하면 알아듣기 어려운 중얼거림이 나온다고 보고합니다. 저자들은 언어, 말투, 문법이 관여하는 음성의 복잡성을 언급하며 이 모델의 목표를 일반 효과음으로 설명합니다. §4.4
📖 Chapter 5: Conclusion
저자들은 영상·오디오·텍스트 공동 학습이 공개 데이터 활용 범위를 넓히고, 프레임별 조건이 영상에 대한 시간 정렬을 개선한다고 결론짓습니다. 텍스트→오디오에도 같은 모델을 사용할 수 있었으며, 공개 모델과의 VGGSound 비교 및 제한된 Movie Gen Audio Bench 비교를 서로 다른 조건의 결과로 제시합니다. 부록에서는 이 주장을 뒷받침하는 청취 평가, 별도 동기화 벤치마크, 모델 및 데이터 세부사항을 제공합니다. §5
📖 Chapter A: User Study
저자들은 VGGSound 테스트셋에서 360p 미만 또는 사람 음성이 든 영상을 빼고 8개를 뽑았습니다. 23명의 참가자 각각이 영상별로 무작위 배치된 다섯 모델의 결과 40개를 보았고, 품질·의미·시간 정렬을 각각 1–5점으로 평가했습니다. 항목당 응답 수는 920개입니다. 동일한 참가자가 여러 모델과 영상을 평가한 구조입니다.
MMAudio-L-44.1kHz는 품질 4.14±0.77, 의미 4.52±0.74, 시간 4.46±0.80을 얻었습니다. V-AURA는 각각 3.59±1.02, 3.70±1.17, 3.65±1.16입니다. ± 뒤의 값은 응답의 표준편차이며, 비교를 위한 신뢰구간은 논문에 보고되지 않았습니다. 부록 A, Table A1
📖 Chapter B: Comparisons with Movie Gen Audio
Movie Gen Audio Bench에서 당시 공개된 527개 생성 결과를 사용했습니다. 영상 자체도 생성된 데이터라 실제 녹음에 해당하는 정답 오디오가 없습니다. 같은 영상과 오디오 프롬프트에서 MMAudio-L-44.1kHz와 Movie Gen Audio를 비교했으며, 별도의 사용자 평가는 Movie Gen Audio의 소리가 너무 작아 잘 들리지 않는 예를 제외한 5개 영상에서 진행했습니다. 참가자 23명에게서 항목당 230개 응답을 얻었습니다. 부록 B, Table A2
| 평가 항목 | MMAudio-L-44.1kHz | Movie Gen Audio |
|---|---|---|
| 주관적 오디오 품질 | 3.93±0.89 | 3.93±0.92 |
| 주관적 의미 정렬 | 4.26±0.71 | 4.36±0.74 |
| 주관적 시간 정렬 | 3.62±1.03 | 3.52±1.21 |
| IS ↑ | 8.40 | 8.40 |
| IB-score ↑ | 27.01 | 36.26 |
| CLAP ↑ | 0.4324 | 0.4409 |
| DeSync ↓ | 0.771 | 1.006 |
Figure A1에서 낮은 IB-score를 받은 구간의 격차가 큽니다. Figure A2의 수영 예에서는 MMAudio가 53.95, Movie Gen Audio가 42.74입니다. 으깬 감자를 뜨는 예에서는 10.52와 30.94입니다. 저자들은 VGGSound 학습셋에 수영 영상이 516개 있고, 제공된 라벨에 으깬 감자 영상이 없다는 점을 근거로 이런 차이를 학습 데이터가 다루는 장면의 범위와 연결합니다. 이 두 점수는 개별 예시입니다. 부록 B, Figures A1–A2
📖 Chapter C: Evaluation on the Greatest Hits Dataset
DeSync를 계산하는 예측기가 모델 조건을 추출한 것과 같은 Synchformer 계열이므로, 별도 벤치마크에서는 학습된 동기화 점수 대신 정답 타격 시점을 사용합니다. 두 방법군 모두 학습에 쓰지 않은 Greatest Hits 테스트 영상 244개의 처음 8초를 입력으로 삼았습니다. 생성 오디오에서 소리가 시작되는 시점인 onset을 검출하고 정답 이벤트와 비교합니다.
| Greatest Hits 모델 | Accuracy ↑ | AP ↑ | F1 ↑ |
|---|---|---|---|
| Seeing&Hearing | 0.1156 | 0.8342 | 0.1591 |
| V-AURA | 0.5852 | 0.8567 | 0.6441 |
| Frieren | 0.6949 | 0.7846 | 0.6550 |
| MMAudio-S-16kHz | 0.7637 | 0.9010 | 0.7928 |
| MMAudio-S-44.1kHz | 0.7150 | 0.9097 | 0.7666 |
| MMAudio-L-44.1kHz | 0.7158 | 0.9064 | 0.7535 |
Seeing&Hearing의 AP 0.8342와 F1 0.1591은 같은 출력에서 어느 값을 함께 봐야 하는지를 잘 보여 줍니다. 저자들이 설명하듯, 검출된 시작점이 아주 적어도 AP가 높게 나올 수 있습니다. Table 2의 DeSync 열은 Greatest Hits에서 측정한 수치가 아니라 VGGSound 참고값입니다. Table 2, 부록 C
📖 Chapter D: Ablations on Filling in Missing Modalities
기본 방식은 영상 쪽의 두 특징을 각각 학습 가능한 빈 표현으로 채우고, 없는 텍스트에는 빈 문자열을 사용합니다. 전부 학습 가능한 표현으로 채울 때와 0으로 채울 때도 비교했습니다. FD PaSST는 각각 70.19(기본), 70.13(모두 학습), 69.91(0)이며, DeSync는 각각 0.483, 0.494, 0.496입니다. 저자들은 세 방식에 큰 차이가 없다고 해석합니다. 이 실험은 누락 입력을 무엇으로 채울지를 비교합니다. 오디오·텍스트 데이터를 학습에 포함할지를 비교한 Table 4–5와 질문이 다릅니다. 부록 D, Table A3
📖 Chapter E: Details on Data Overlaps
게임·생활 소리 같은 여러 데이터셋이 같은 공개 영상을 재사용하기 때문에 학습과 테스트 사이에 샘플이 겹칠 수 있습니다. Table A4에서는 VGGSound 테스트 15,496개 중 132개가 AudioSet 학습에, 13개가 AudioCaps 학습에 포함돼 있음을 보고합니다. AudioCaps 테스트 975개 중 580개는 AudioSet 학습과 겹쳤습니다. 수치는 각 테스트셋을 분모로 하며, 겹치는 집합을 단순 합산하지 않습니다. 부록 E, Table A4
저자들은 VGGSound, AudioCaps, Clotho 테스트와 겹치는 항목을 학습 자료에서 제거했습니다. AVSync-15 테스트 150개 중 144개가 VGGSound 학습과 겹치므로, VGGSound로 학습한 기존 모델과 비교할 때 이 벤치마크는 사용하지 않았습니다. 영상 ID로는 다른 ID에 재업로드한 동일 영상을 제거할 수 없으며, 그 사례는 부록 H에서 다시 다룹니다. 부록 E, H
📖 Chapter F: Details on the Audio Latents
두 샘플링률은 압축 전의 주파수 설정과 압축 후의 토큰 해상도가 다릅니다. VAE는 1차원 합성곱으로 시간축을 2배 다운샘플링합니다. 예를 들어 16 kHz에서 STFT hop 256은 초당 62.5 프레임을 만들고, VAE를 지나면 31.25 토큰이 됩니다. 44.1 kHz는 hop 512로 STFT를 계산한 뒤 같은 압축률을 사용합니다.
| 파형 샘플링률 | 멜 빈 | STFT hop | 잠재 채널 | 잠재 토큰률 |
|---|---|---|---|---|
| 16 kHz | 80 | 256 | 20 | 31.25 fps |
| 44.1 kHz | 128 | 512 | 40 | 43.07 fps |
VAE의 학습 목표에는 재구성, 적대적 학습, KL 발산이 포함됩니다. 저자들은 처음 설계에서 시퀀스 끝 잠재값이 수 표준편차만큼 튀는 현상을 관찰했고, EDM2의 크기 보존 계층을 적용해 이 현상을 줄였습니다. 논문은 이 변경으로 생성 성능에 큰 차이가 나타나지 않았다고 보고합니다. 16 kHz는 Make-An-Audio 2의 BigVGAN, 44.1 kHz는 BigVGAN-v2를 보코더로 사용합니다. 부록 F, Table A5
📖 Chapter G: Network Details
G.1 Model Variants. S-16kHz와 S-44.1kHz의 트랜스포머는 은닉 차원 448, 멀티모달 4층과 오디오 전용 8층을 공유합니다. 44.1 kHz 쪽은 잠재 채널을 20에서 40으로 늘립니다. M-44.1kHz는 은닉 차원을 896으로 늘리고, L-44.1kHz는 이 폭에서 블록을 7/14개로 늘립니다. 소리의 샘플링률 변경과 본체의 폭·깊이 변경을 구별할 수 있는 구성입니다. 부록 G.1, Table A6
G.2 Projection Layers. 텍스트는 선형층과 MLP, CLIP 영상은 선형층과 커널 3인 ConvMLP로 은닉 차원에 맞춥니다. 동기화 특징과 오디오 잠재는 커널 7인 첫 합성곱과 SELU 활성화를 공통으로 사용합니다. 뒤따르는 ConvMLP는 동기화 특징에 커널 3, 오디오 잠재에 커널 7을 둡니다.
G.3 Gating. 트랜스포머의 잔차 가지에 더할 값을 조절하는 게이트에도 조건을 사용합니다. 전역 게이트는 $\mathbf{W}_g(c_g)$에서 얻은 스케일을 전 토큰에 적용합니다. 토큰별 게이트는 $\mathbf{W}_f(c_f)$에서 얻은 위치별 스케일을 씁니다. 이 게이트는 각 조각의 출력을 곱셈으로 조절하고, 앞 절의 adaLN은 정규화한 입력에 스케일과 편향을 모두 적용합니다. 부록 G.2–G.3, 식 (A1)–(A2)
G.4 Details on Synchronization Features. 영상에서 25 fps로 프레임을 얻은 뒤 16프레임 창을 8프레임마다 이동합니다. Synchformer의 영상 인코더는 창 하나에서 768차원 특징 8개를 내고, 모델은 창 안의 8개 위치에 학습된 위치 임베딩을 더한 뒤 창들을 하나의 시퀀스로 펼칩니다.
$T$는 영상 길이(초)이며, 식 (A3)에서 괄호 안은 시작 프레임이 유효한 창 개수입니다. 8초면 입력 200프레임에서 창 24개가 생기고, 각 창에서 8개를 얻어 총 192개를 만듭니다. 10초에서는 총 240개입니다. 원문의 24 fps는 이렇게 생성된 특징 개수를 영상 길이로 나눈 값으로, 두 평가 길이에서 정확히 성립합니다. 부록 G.4, 식 (A3)–(A4)
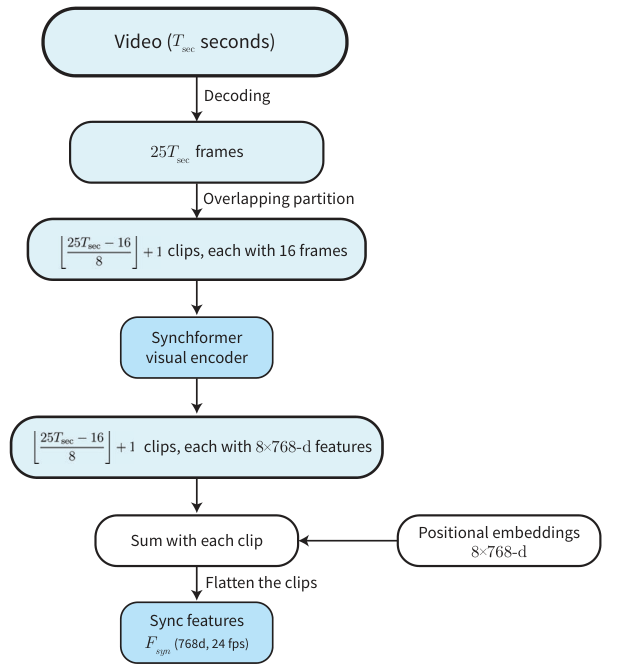
Synchformer의 영상 인코더는 겹치는 창마다 768차원 특징을 8개씩 냅니다. Cheng 외, Figure A3 · PDF 18쪽, 원문 크롭 · CC BY 4.0
G.5 Illustration of the “sum sync with visual” Ablation. Figure A4의 대안은 CLIP 영상 토큰을 8 fps에서 24 fps로 늘리고, 선형 사상한 동기화 토큰을 더해 멀티모달 블록의 시각 입력으로 보냅니다. 기본 구조에서는 8 fps CLIP 시각 입력을 유지하고 동기화 특징을 31.25 fps 오디오 토큰 쪽의 조건으로 보냅니다. 4.3절에서 비교한 두 방식은 동일한 동기화 특징을 어느 스트림에서 어떤 해상도로 사용하는지가 다릅니다. 부록 G.5, Figure A4
G.6 Visualization of Aligned RoPE. 저자들은 모든 원소를 1로 놓은 오디오 토큰 250개와 영상 토큰 64개에 RoPE를 적용하고 서로 내적했습니다. 채널 수는 64입니다. 아래 그림은 학습된 어텐션 가중치를 그린 것이 아니라, 입력 내용을 고정한 채 위치 회전만 달라질 때 내적 유사도가 어떻게 변하는지 보여 줍니다. 정렬 후에는 같은 인덱스가 아니라 같은 실제 시간에 해당하는 토큰끼리 밝은 띠를 이룹니다. 부록 G.6, 식 (A5)–(A6)
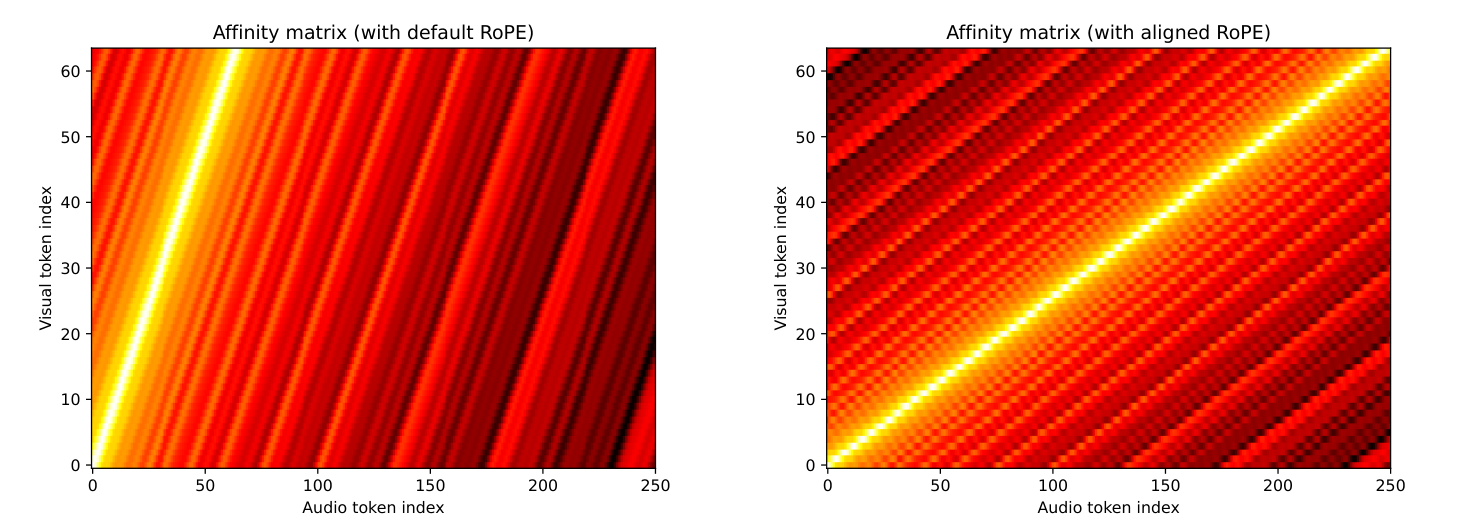
왼쪽은 기본 RoPE, 오른쪽은 정렬 RoPE의 위치별 내적입니다. Cheng 외, Figure A5 · PDF 19쪽, 원문 크롭 · CC BY 4.0
📖 Chapter H: Training Details
Training setup. 기본 설정은 AdamW, 배치 512, 1천 단계 학습률 워밍업, 30만 반복입니다. 학습률은 $10^{-4}$에서 시작해 전체 단계의 80%와 90%에서 각각 $10^{-5}$와 $10^{-6}$로 내립니다. 오디오 잠재와 시각 임베딩을 미리 계산하고 bf16 혼합 정밀도를 활용합니다. H100 기준 학습 자원은 S-16kHz 44 GPU시간, S-44.1kHz 52 GPU시간, M-44.1kHz 168 GPU시간, L-44.1kHz 304 GPU시간입니다. 부록 H, Table A7
Balancing multimodal training data. 영상 자료 약 18만 개와 오디오·텍스트 약 95만 1천 개를 그대로 섞으면 후자에 학습이 치우칠 수 있습니다. 기본 모델은 에폭마다 셔플하기 전 영상 자료를 5배로 복제해 약 1:1로 맞춥니다. 중형·대형의 영상 자료 복제 배수는 과적합을 줄이기 위해 3배로 낮췄습니다.
Duplicated videos. 저자들은 같은 영상이 다른 YouTube ID로 학습셋과 테스트셋에 올라간 사례를 식별했습니다. ID가 같은 샘플을 제거하는 부록 E의 절차로는 이 사례가 남습니다. 데이터 중복을 통제했다는 설명은 논문에 명시된 ID 비교 방식의 범위에서 읽어야 합니다. 부록 H
📖 Chapter I: Additional Visualizations
Figure A6의 골프공은 타격 시점이 뚜렷하고, 개 짖는 영상은 빠른 소리의 반복이 들리지만 생성과 원본의 개별 이벤트 위치가 정확히 같지 않습니다. Figure A7은 줄을 튕기는 동작처럼 소리의 원인을 명확히 볼 수 있는 경우와 여러 사건이 겹치는 복합 장면을 비교합니다. 논문은 복합 장면에서 원본과 다른 타이밍의 결과도 그럴듯할 수 있다고 설명합니다. 부록 I, Figures A6–A7
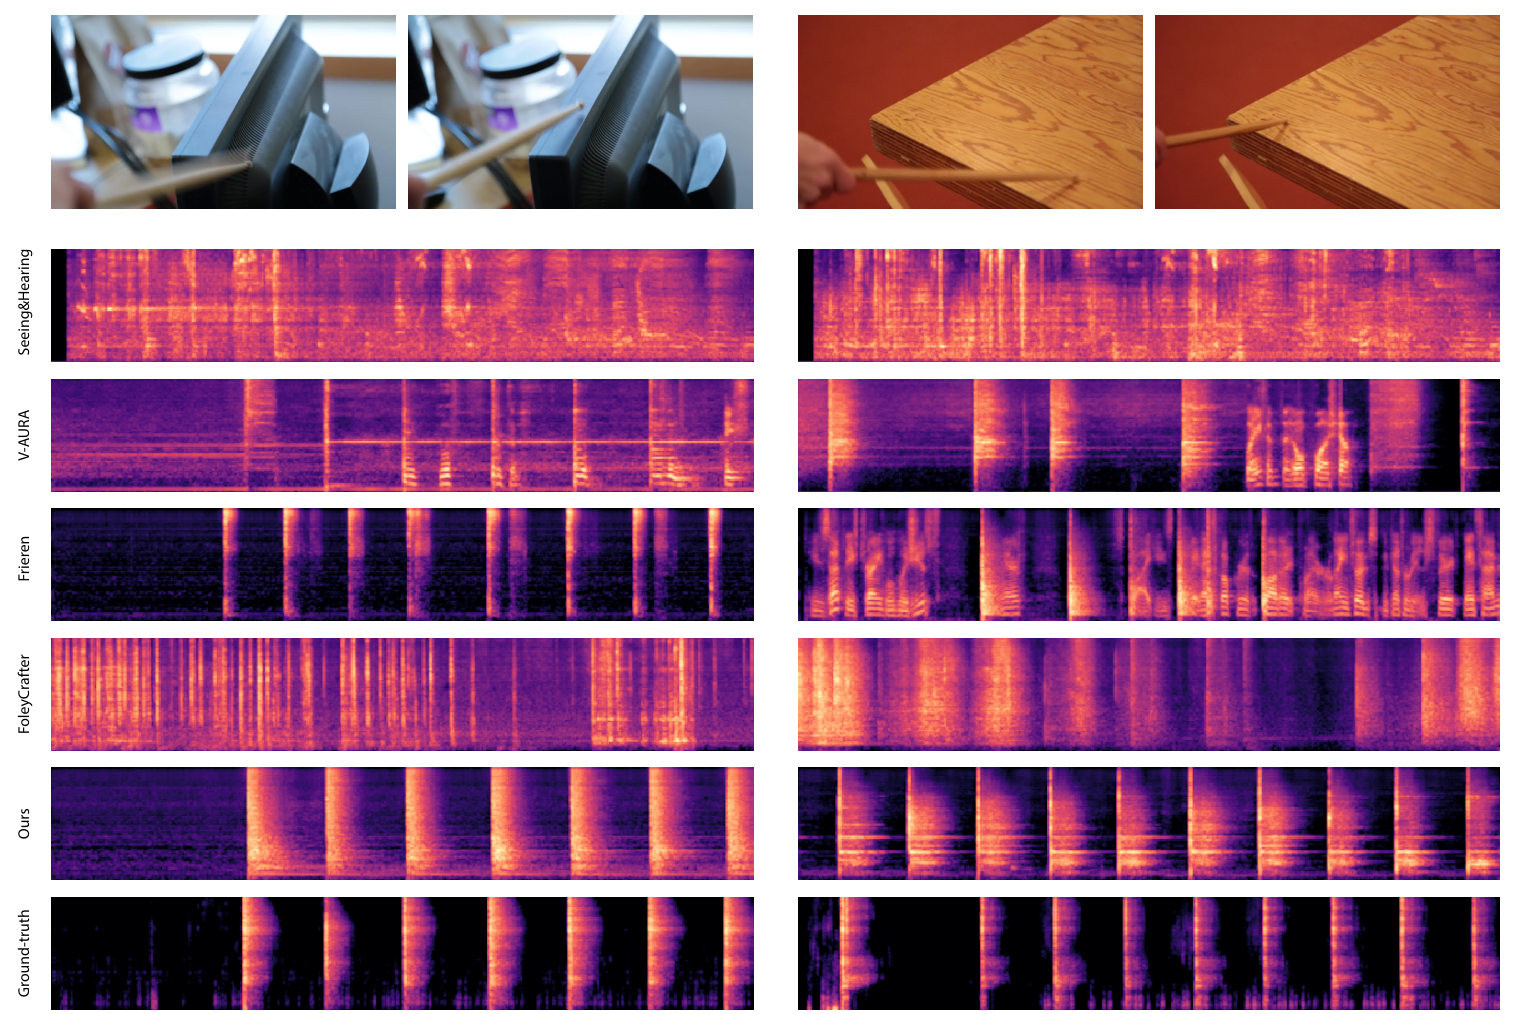
왼쪽은 기기 외장, 오른쪽은 나무판을 두드리는 장면입니다. 각 열의 아래 두 행이 MMAudio와 원본 녹음입니다. Cheng 외, Figure A8 · PDF 22쪽, 원문 크롭 · CC BY 4.0
Figure A8에서 아래 두 행의 밝은 띠가 여러 타격에서 비슷한 위치에 나타납니다. 오른쪽 예에서는 일부 띠의 폭과 색이 달라집니다. 시점 정렬 지표와 음향 분포 지표가 각기 필요한 이유를 이 비교에서 확인할 수 있습니다. 부록 I, Figure A8
실험 결과 심층 분석
공동 학습과 동기화 조건은 서로 다른 실험으로 확인할 수 있습니다. 영상·오디오·텍스트 자료에 오디오·텍스트를 더한 비교(AVT → AVT+AT)에서 FD PaSST는 77.38에서 70.19로 약 9.3% 낮아지고, IS는 12.53에서 14.44로 약 15.2% 높아집니다. DeSync는 0.562에서 0.483으로 약 14.1% 낮아집니다. 한편 동기화 특징이 없는 행과 기본 구조를 비교하면 DeSync는 0.973에서 0.483으로 약 50.4% 낮아지지만, IS는 15.05에서 14.44로 떨어집니다. 타이밍을 맞춘 효과를 오디오 지표 전반이 개선된 것으로 확대해서 읽을 수는 없습니다. Tables 4, 6
모델을 키웠을 때 어떤 지표가 움직였는지 봐야 합니다. 44.1 kHz S에서 L로 커지면 VGGSound의 FD PaSST는 65.25에서 60.60으로, IB-score는 32.27에서 33.22로 개선됩니다. 같은 비교에서 DeSync는 0.444에서 0.442로 변화 폭이 작습니다. Greatest Hits의 F1에서는 S-16kHz가 0.7928로 L-44.1kHz의 0.7535보다 높습니다. VGGSound의 모델 기반 시차와 Greatest Hits의 특정 타격 시작점은 평가하는 이벤트와 방식이 다릅니다. Tables 1–2
정량 벤치마크의 반복 실행 분산이나 유의성 검정은 논문에 보고되지 않았습니다. 청취 평가에는 평균과 표준편차가 있으며 평가 영상 수는 VGGSound 8개, Movie Gen Audio Bench 5개입니다. 저자들은 코드, 가중치, 데모를 공개하고 학습 설정과 평가 조건을 문서에 제시했습니다. 이 리뷰의 확인 범위는 arXiv v2의 원문과 공개 예시이며 별도의 생성 실험은 수행하지 않았습니다. 부록 A–B · 프로젝트
기술적 함의와 응용
MMAudio는 영상 편집에서 주변 환경음이나 특정 동작의 효과음을 만드는 데 가까운 설계입니다. 북이 어떤 소리를 내는지 학습하는 데 필요한 장면·텍스트 정보와, 채가 어느 순간에 닿는지 보여 주는 빠른 영상 특징을 함께 쓸 수 있기 때문입니다. 공개 데모에서는 같은 영상에 대해 원본과 모델별 생성 결과를 들어 보며, 음색과 타격 시점의 차이를 따로 확인할 수 있습니다. 공개 영상 예시
이 논문의 구조에서 다른 시간 조건부 생성에도 적용할 만한 부분은 조건의 시간 해상도를 출력에 맞추고, 그 조건을 출력 토큰의 계산에 직접 전달하는 방식입니다. 장면 차원의 의미는 평균 풀링된 특징과 공동 어텐션을 통해 전달되고, 빠르게 변하는 사건 정보는 토큰마다 다르게 적용됩니다. 논문이 직접 확인한 범위는 폴리와 텍스트→오디오이며, 사람의 발화를 재구성하는 용도에서는 저자들이 보고한 중얼거림 문제가 있습니다. §3.3–3.4 · §4.4