논문 개요와 전체 구조
이미지 속 막대그래프에 질문하면 멀티모달 모델은 픽셀을 토큰으로 바꾸고, 그 토큰에서 숫자와 눈금의 관계를 읽어야 합니다. 흔한 설계는 이 과정의 일부를 별도로 사전학습한 비전 트랜스포머에 맡깁니다. 그런데 이 인코더를 붙이는 순간 세 가지가 함께 바뀝니다. 이미지에 관한 지식을 미리 학습하고, 시각 토큰만 쓰는 파라미터가 생기고, 이미지가 텍스트와 만나기 전에 처리됩니다. 성능이 좋아졌다면 이 셋 중 어디에서 차이가 났을까요?
Meta FAIR와 New York University 연구진은 같은 데이터 풀에서 모델을 학습하고 모든 학습 단계의 연산량을 합산해 비교합니다. 실험 범위에서 별도 사전학습은 시각 질의응답에 일관된 이점을 주지 않았고, 시각 전용 파라미터는 시각 질의응답(VQA) 점수를 높였습니다. 그 파라미터를 공유 백본 초반으로 옮겨도 인코더를 둔 모델과 비슷한 점수에 도달했습니다. 리뷰는 2026년 11월 12일에 제출된 arXiv v1을 따릅니다. 원문 서지 · 저자 프로젝트 페이지
| 원문 절 | 내용 |
|---|---|
| 1. Introduction | 시각 인코더가 묶고 있는 세 가지 설계 선택 |
| 2. A controlled protocol for comparing multimodal recipes | 네 가지 구성, 공통 데이터, 전체 학습 연산량, 학습 일정과 평가 |
| 3. Does the vision encoder need separate pretraining? | 동일 인코더를 사전학습하는 경우와 공동 학습하는 경우 |
| 4. Does vision encoding need dedicated capacity? | 전용 인코더, 공유 백본 확장과 패치 임베딩 보강의 효과 |
| 5. Does dedicated capacity need to precede multimodal fusion? | 결합 분기의 설계, 배치와 라우팅, 인코더 대비 성능, 규모 변화 |
| 6. Vision encoding beyond lifetime compute | 사전학습 비용 제외, 언어 모델의 중간 학습, 학습·추론 시간 |
| 7. Related work | 모델 구성, 통제 연구와 모달리티 전용 모듈 |
| 8. Discussion | 실험에서 확인한 결론, 적용 범위와 후속 과제 |
| 부록 A–I | 실험 설정, 평가법, 세부 대조 실험과 벤치마크별 수치 |
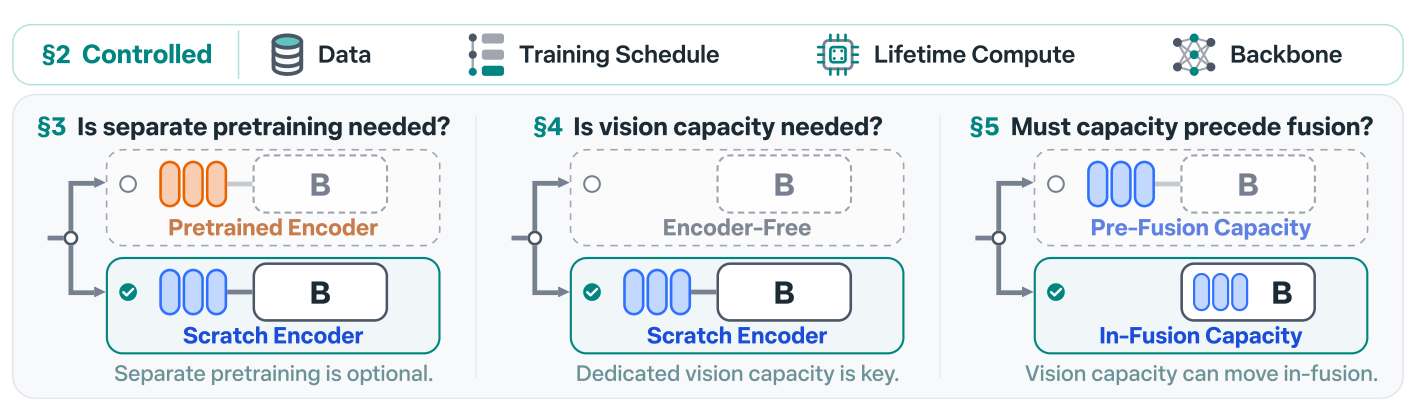
위는 공통 실험 조건입니다. 아래는 왼쪽부터 별도 사전학습, 시각 전용 파라미터, 융합 전 배치의 효과를 비교합니다. 그림 1 · Brown 외, v1 PDF 1쪽 · CC BY 4.0 · 도식 영역 크롭, 번역 없음.
핵심 기여와 혁신성
시각 인코더가 있는 공개 모델과 없는 공개 모델을 비교하면 학습 데이터, 텍스트 백본, 사전학습 예산까지 함께 달라집니다. 이 논문은 같은 27층 비전 트랜스포머(ViT)를 사전학습한 뒤 연결하는 경우와 공유 백본에 연결한 상태에서 처음부터 학습하는 경우를 먼저 비교합니다. 그런 다음 그 인코더를 빼거나 같은 시각 파라미터 예산을 공유 백본 안으로 옮깁니다. 인코더를 뺀 자리에 공유 파라미터를 늘리는 대조 실험도 둬서, 전체 모델 크기와 시각 토큰에 배정된 용량의 효과를 분리합니다. 원문 §1–2
이 설계의 또 다른 축은 비교에 적용하는 연산량입니다. 인코더가 이미지·텍스트를 별도로 학습했다면 그 비용도 최종 모델을 만드는 데 들어갔습니다. 연구진은 이 비용을 포함한 경우와, 이미 사전학습된 인코더를 확보했다고 보고 비용을 제외한 경우를 모두 실험합니다. 전자는 새로 모델을 만드는 프로젝트의 예산 배분을, 후자는 기존 인코더를 재사용할 때의 선택을 설명합니다. 원문 §2.3, §6.1
기술적 세부사항
융합 경계는 시각 토큰과 텍스트 토큰이 처음 상호작용할 수 있는 층입니다. 경계 앞의 ViT는 이미지 패치만 처리합니다. 공유 백본에서는 같은 이미지에 속한 시각 토큰들이 양방향으로 서로를 참고할 수 있고, 텍스트 토큰은 앞선 토큰에만 주의를 둡니다. 이미지가 텍스트 앞에 오므로 다음 단어를 예측할 때 시각 토큰을 읽을 수 있습니다. 손실은 텍스트의 다음 토큰 예측에만 부과합니다. 원문 §2.1
| 구성 | 별도 시각 사전학습 | 시각 전용 인코딩 용량 | 전용 연산의 위치 |
|---|---|---|---|
| Pretrained encoder | 있음 | 있음 | 융합 전 ViT |
| Scratch encoder | 없음 | 있음 | 융합 전 ViT |
| Encoder-free | 없음 | 패치 입력 투영만 사용 | 패치를 공유 백본에 직접 입력 |
| In-fusion | 없음 | 있음 | 공유 백본 초반의 시각 전용 분기 |
표는 원문 Table 1을 풀어 쓴 것입니다. 저자가 인코더 없음으로 부르는 구성도 패치를 백본 폭에 맞추는 작은 입력층은 갖고 있습니다. 여기서 비교하는 용량은 별도 ViT나 백본 내부 분기가 제공하는 규모의 시각 전용 연산입니다. 원문 Table 1
전체 학습 연산량(lifetime compute)에는 멀티모달 학습과 해당 모델이 사용한 언어·인코더 사전학습이 들어갑니다. 식 (1)의 $C_s$는 각 단계 $s$의 연산량이며, $\mathcal{S}$는 해당 구성의 학습 단계 집합입니다. 부록 A.5의 식 (6)은 이 값을 같은 크기의 텍스트 전용 모델에 해당하는 토큰 수 $H_{\mathrm{eq}}$로 바꿉니다. $c_{\mathrm{LM}}$은 그 텍스트 모델이 토큰 하나를 학습할 때 드는 FLOPs입니다.
예를 들어 1.7B 백본의 경우 $c_{\mathrm{LM}}=1.17\times10^{10}$이므로, 200B 토큰 상당량은 $2.34\times10^{21}$ FLOPs입니다. 이미지까지 처리하는 모델이 그 예산으로 실제 읽은 토큰 수는 경로별로 다를 수 있습니다. 논문의 TPP(tokens per parameter)는 $H_{\mathrm{eq}}$를 임베딩을 제외한 백본 파라미터 수로 나눈 값입니다. FLOPs 산정은 행렬 곱과 합성곱의 학습 비용을 세고 통신이나 옵티마이저 업데이트는 제외합니다. 평가용 지시 튜닝도 모든 체크포인트에 동일하게 적용하는 별도 단계로 처리합니다. 원문 식 (1), 부록 A.5
챕터별 상세 리뷰
📖 Chapter 1: Introduction
저자들은 멀티모달 학습에서 별도 시각 인코더를 고정하던 방식과, 전체 모델 학습 중 인코더도 업데이트하는 방식을 짚습니다. 이어 별도 인코더 사전학습을 생략하는 Kimi K3 계열 설계와, 패치를 공유 백본에 직접 넣는 설계를 소개합니다. 인코더를 백본과 함께 처음부터 학습하면 별도 시각 사전학습만 제거됩니다. 패치를 직접 넣는 구성에서는 전용 ViT와 융합 전 처리도 사라집니다. 이 차이가 다음 절에서 한 요소씩 바꾸는 실험으로 이어집니다. 원문 §1
📖 Chapter 2: A controlled protocol for comparing multimodal recipes
2.1 Recipes and the fusion boundary. Qwen3를 참고한 밀집 디코더 전용 Transformer를 공통 백본으로 씁니다. 주 비교에서는 1.7B와 4B 백본에 0.4B 시각 용량을 배정합니다. 융합 전 인코더는 MoonViT-V2를 참고한 27층 ViT를 거친 뒤 출력에 선형 투영을 적용합니다. Encoder-free는 선형 패치 임베딩에 RMSNorm과 학습 가능한 스칼라 게이트를 붙입니다. In-fusion은 그 패치 입력을 받아 공유 백본 초반에서 전용 연산을 수행합니다. 입력 이미지는 224×224를 14×14 패치로 나눈 256토큰입니다. 지시 튜닝과 기본 VQA 평가에서는 448×448을 1,024토큰으로 처리해 문자나 도표의 세부를 더 살립니다. 원문 §2.1
2.2 Common data. 텍스트는 Nemotron-CC v2/v2.1, 이미지·텍스트는 MetaCLIP 1.2의 영어 부분을 사용합니다. 별도 인코더 사전학습에는 원래 대체 텍스트를, 멀티모달 단계에는 Qwen2.5-VL-32B로 다시 작성한 캡션을 사용합니다. 각 구성의 멀티모달 단계는 텍스트 전용 시퀀스와 이미지·텍스트 시퀀스를 70:30으로 섞습니다. 사전학습까지 하는 구성은 같은 이미지 풀을 사용하더라도 전체 예산 중 더 많은 부분을 이미지·텍스트에 씁니다. 원문 §2.2 및 부록 A.4
2.3 Lifetime compute. 저자에게 비교 단위는 최종 체크포인트를 얻기까지의 전체 연산량입니다. 예산이 고정된 실험에서 인코더 사전학습에 15%를 쓰면 그만큼 멀티모달 단계가 줄어듭니다. 한편 토큰당 연산 비용은 아키텍처마다 달라 같은 FLOPs에서도 실제 학습 토큰 수가 달라집니다. 원문 §2.3
2.4 Training schedule. 워밍업 뒤 학습률을 고정한 실행의 중간 체크포인트에서 분기해, 각 비교 예산의 마지막 10% 구간에 학습률을 최고치의 5%까지 낮춥니다. 이 방식으로 여러 예산의 종점을 얻습니다. 주 비교는 $6.5\times10^{20}$에서 $2.9\times10^{22}$ FLOPs를 다루고, 최고 학습률은 1.7B에서 $3\times10^{-4}$, 4B에서 $2\times10^{-4}$입니다. 원문 §2.4
2.5 Evaluation. Avg. VQA는 16개 문제 세트를 일반 시각 질의, 지식, 문자 인식(OCR)·도표, 시각 중심 과제로 나누고 네 범주의 평균을 냅니다. 모든 체크포인트는 같은 Cambrian-7M 지시 튜닝을 3에폭 거칩니다. Avg. Text는 12개 벤치마크를 상식 추론, 과학 질의응답, 일반 지식, 독해로 묶고 범주 수준에서 평균합니다. 텍스트 전용 모델은 같은 전체 연산량에서 언어 점수의 기준이 됩니다. 저자들은 학습에 쓰지 않은 이미지의 캡션 손실도 별도로 추적합니다. 원문 §2.5 및 부록 B
📖 Chapter 3: Does the vision encoder need separate pretraining?
저자들은 이미지·텍스트 대조 학습인 MetaCLIP, 자기지도 학습인 WebSSL, 캡션 생성 계열인 Cap과 CapPa로 동일 인코더를 별도 사전학습합니다. 이어 대부분의 설정에서 멀티모달 학습 중 인코더까지 업데이트하고, MetaCLIP을 고정하는 설정도 둡니다. 비교하는 다른 쪽은 동일 구조의 인코더와 백본을 한 번에 무작위 초기화해 학습합니다. 원문 §3
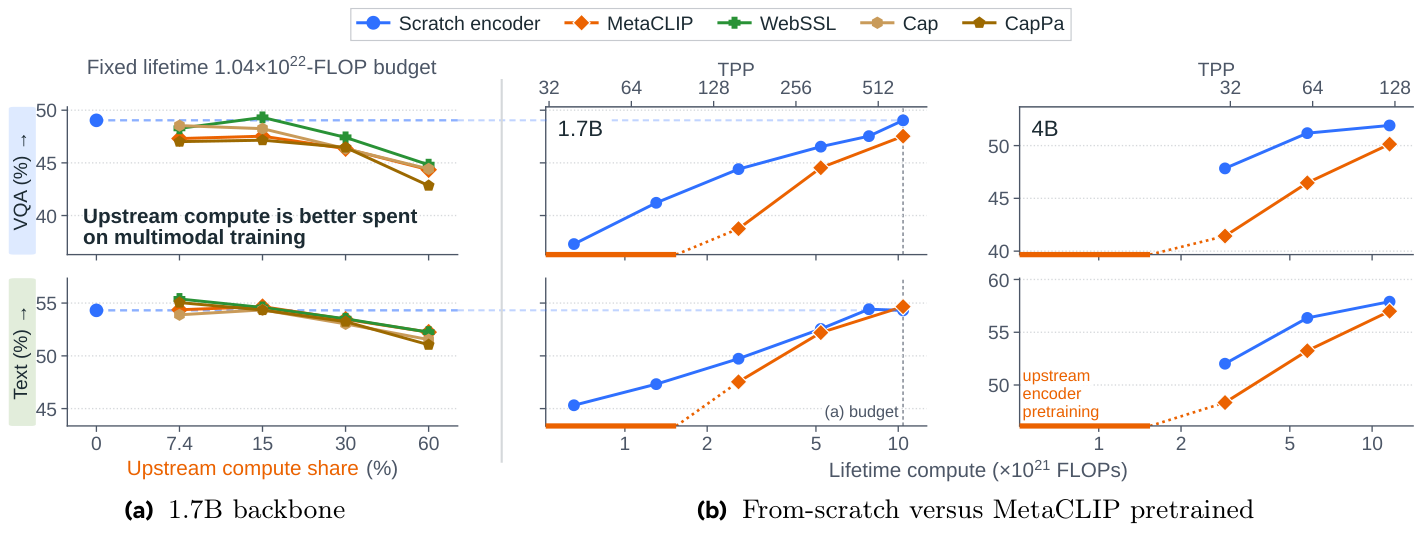
왼쪽은 사전학습 비중을 바꾼 1.7B 실험입니다. 오른쪽은 두 백본 규모에서 전체 연산량에 따른 VQA와 텍스트 점수입니다. 그림 2 · Brown 외, v1 PDF 6쪽 · CC BY 4.0 · 그래프 영역 크롭, 번역 없음.
1.7B 백본과 $1.04\times10^{22}$ FLOPs에서 사전학습 비중이 7.4% 또는 15%이면 네 목적함수 모두 공동 학습과 비슷했습니다. 그 비중이 60%까지 늘면 VQA와 텍스트 점수 모두 내려갑니다. MetaCLIP을 별도 사전학습하는 구성과의 전체 예산 비교에서도 공동 학습이 비슷하거나 높았습니다. 또한 이미지·텍스트 예제 수를 고정하고 투입 시작만 늦춘 실험에서는 첫 업데이트부터 이미지를 넣는 경우가 가장 높은 VQA 점수를 냈습니다. 이 결과를 토대로 다음 절에서는 공동 학습 인코더를 기준으로 전용 파라미터의 효과를 봅니다. 원문 그림 2, 부록 Table 11 · 이미지 투입 일정
📖 Chapter 4: Does vision encoding need dedicated capacity?
공동 학습 인코더와 Encoder-free를 같은 백본·데이터·연산량에서 비교합니다. 두 구성은 백본에서 동일한 시각 토큰 어텐션 규칙을 사용합니다. 1.7B와 4B 모두에서 Avg. Text는 비슷한 궤적을 보이지만 Avg. VQA 차이는 여러 예산에서 남습니다. 그림 3의 4.4배와 3.0배는 각각 표시된 목표 점수에서 화살표로 읽는 예시입니다. 뒤의 규모별 적합식이 보고하는 배수와는 기준점이 다릅니다. 원문 §4, 그림 3
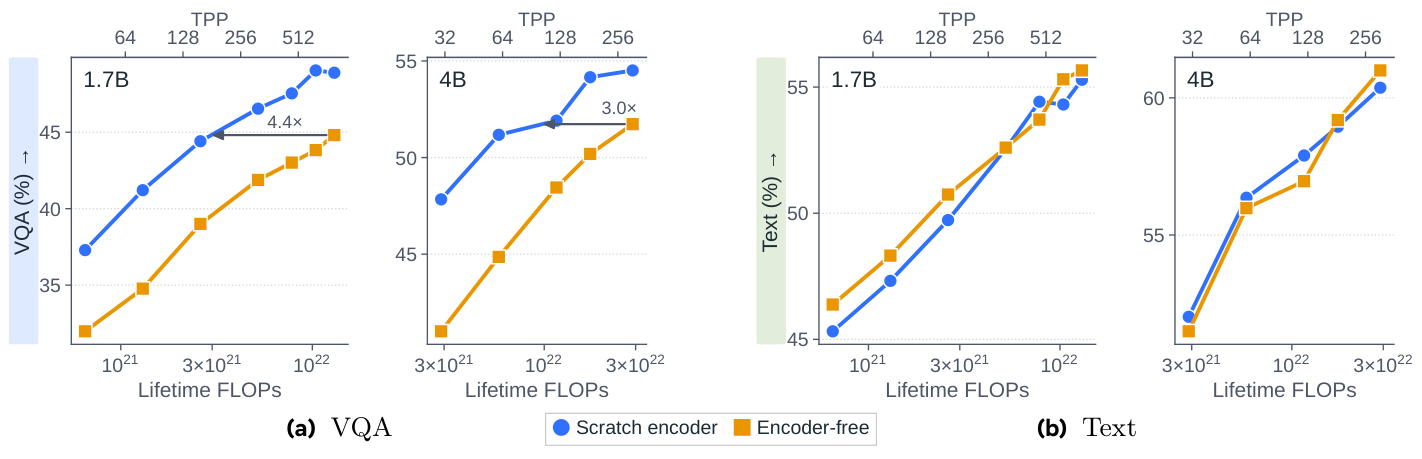
왼쪽은 Avg. VQA, 오른쪽은 Avg. Text입니다. 화살표는 표시된 VQA 점수에 Encoder-free가 도달하는 데 드는 연산량을 비교합니다. 그림 3 · Brown 외, v1 PDF 7쪽 · CC BY 4.0 · 그래프 영역 크롭, 번역 없음.
| 1.7B 백본, 전체 2.6 × 10²¹ FLOPs | Avg. VQA (%) | OCR·도표 (%) | Avg. Text (%) |
|---|---|---|---|
| 공동 학습 인코더, 시각 전용 0.4B 추가 | 44.4 | 38.2 | 49.7 |
| Encoder-free | 39.0 | 25.2 | 50.7 |
| Encoder-free, 공유 폭 확장 +0.4B | 38.6 | 29.3 | 51.3 |
| Encoder-free, 공유 깊이 확장 +0.4B | 38.7 | 26.3 | 51.2 |
| Encoder-free, 공유 폭·깊이 확장 +0.4B | 38.8 | 25.1 | 51.4 |
| Encoder-free, 2층 패치 투영 | 40.5 | 30.5 | 49.7 |
| Encoder-free, 계층형 MLP 패치 임베딩 | 35.9 | 15.3 | 50.3 |
원문 Table 2의 세 열을 발췌했습니다. 공유 폭·깊이로 0.4B를 보충하면 텍스트 점수가 오르지만 Avg. VQA는 38.6–38.8%에 머뭅니다. 224×224에서 입력 투영을 보강하는 설정도 인코더와의 차이를 닫지 못합니다. 다만 640×640을 동일한 256 시각 토큰으로 압축한 계층형 MLP는 별도 해상도 실험에서 인코더와 같은 40.2%를 기록합니다. 이 결과는 패치 처리의 표현력과 입력 해상도를 따로 읽어야 함을 보여 줍니다. 원문 Table 2 · 부록 Table 21
📖 Chapter 5: Does dedicated capacity need to precede multimodal fusion?
5.1 Moving the encoder’s capacity inside the backbone. In-fusion은 공유 층의 가중치를 그대로 쓰면서, 선택한 층에만 시각 토큰이 사용하는 분기를 추가합니다. 식 (2)의 $W_P$는 공유 어텐션 투영, $\Delta W_P$는 시각 전용 투영, $m_i$는 토큰 $i$가 이미지에서 왔으면 1이고 텍스트이면 0인 표시값입니다. $z_i$는 Q·K·V의 경우 정규화한 은닉 벡터이며, O의 경우 어텐션에서 나온 벡터입니다. Q·K·V는 질의·키·값을, O는 어텐션 결과의 출력 투영을 뜻합니다.
식 (3)의 $h_i$는 FFN에 들어오는 잔차 스트림, $N$은 정규화, $F$는 공유 FFN, $\Delta F$는 같은 정규화 결과를 읽는 시각 FFN입니다. 어텐션은 결합된 Q·K·V로 한 번 계산하고, FFN 출력은 두 경로를 더합니다. 전용 투영과 시각 FFN의 출력 투영을 0으로 초기화해 추가 분기의 초기 기여가 0이 되도록 합니다. 텍스트 전용 입력의 연산 경로는 공유 백본과 같습니다. 원문 §5.1, 식 (2)–(3)
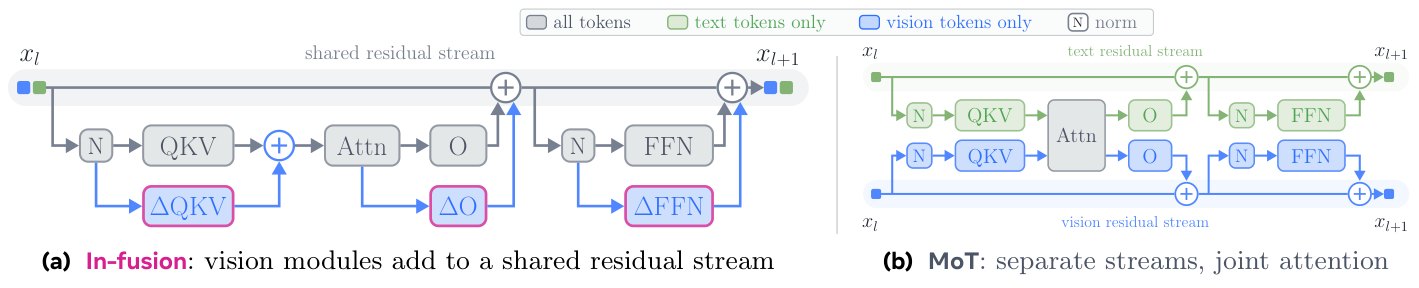
왼쪽에서 시각 토큰은 회색 공유 모듈과 파란 전용 분기를 모두 통과합니다. 오른쪽의 MoT는 모달리티별 경로를 두고 어텐션에서 상호작용합니다. 그림 4 · Brown 외, v1 PDF 8쪽 · CC BY 4.0 · 도식 영역 크롭, 번역 없음.
5.2 Where and how to add in-fusion capacity. 1.7B에서 0.4B를 유지하며 FFN 분기 배치를 바꿉니다. 첫 8층의 시각 분기는 Avg. VQA 45.0%, 전체 층에 가늘게 분산하면 39.4%, 8층을 균등하게 띄우면 37.6%, 마지막 8층에 두면 35.1%입니다. 첫 8층이라는 위치를 그대로 쓰더라도 공유 FFN을 넓힌 대조군은 40.1%, 별도 FFN을 모든 토큰에 열어 둔 대조군은 42.3%입니다. 마지막 대조군은 텍스트 토큰도 분기를 실행하므로 같은 FLOPs로 처리한 토큰 수가 더 적습니다. 저자들은 초반의 패치에 가까운 표현이 전용 연산에서 더 큰 도움을 받는다고 해석합니다. 이후 기본 In-fusion은 첫 8층에 Q·K·V·O의 전용 투영과 상대적으로 좁은 시각 FFN을 함께 둡니다. FFN만 넣은 구성과는 1.7B에서 비슷하고, 4B에서는 모든 비교 예산에서 소폭 앞섰습니다. 원문 §5.2, Table 3 및 그림 5 · 부록 E.2
5.3 Can in-fusion capacity match a pre-fusion encoder? 같은 0.4B의 전용 예산을 융합 전후에 두고 전체 학습 연산량을 맞춥니다. 1.11T 토큰 상당량까지 학습한 경우 1.7B에서 공동 학습 인코더·In-fusion·Encoder-free의 Avg. VQA는 각각 48.9·49.2·44.8%, 4B에서는 54.5·54.3·51.7%입니다. FFN-only는 각각 48.6%와 53.4%입니다. 같은 토큰 상당량이라도 백본이 다르면 FLOPs는 1.7B의 $1.30\times10^{22}$와 4B의 $2.90\times10^{22}$로 다릅니다. 원문 그림 6 · 부록 Table 26
5.4 Results hold with scale. 주 실험에서는 시각 모듈을 0.4B에 고정했고, 여기서는 0.6B에서 6.4B까지 다섯 백본 규모에 따라 모듈도 키웁니다. 저자들이 VQA에 적합한 식은 백본 크기 $N$과 토큰 상당량 $D$의 로그에 선형입니다. 캡션 손실 $L$에는 멱법칙 모형을 사용합니다. $c$는 절편, $b_1,b_2$는 로그 규모와 로그 토큰의 계수입니다. $E$는 점근 항이며 $A,B$와 $\alpha,\beta$는 크기와 토큰량에 따른 손실 감소를 표현합니다. 계수는 구성별로 따로 적합합니다. 원문 §5.4, 부록 Table 30
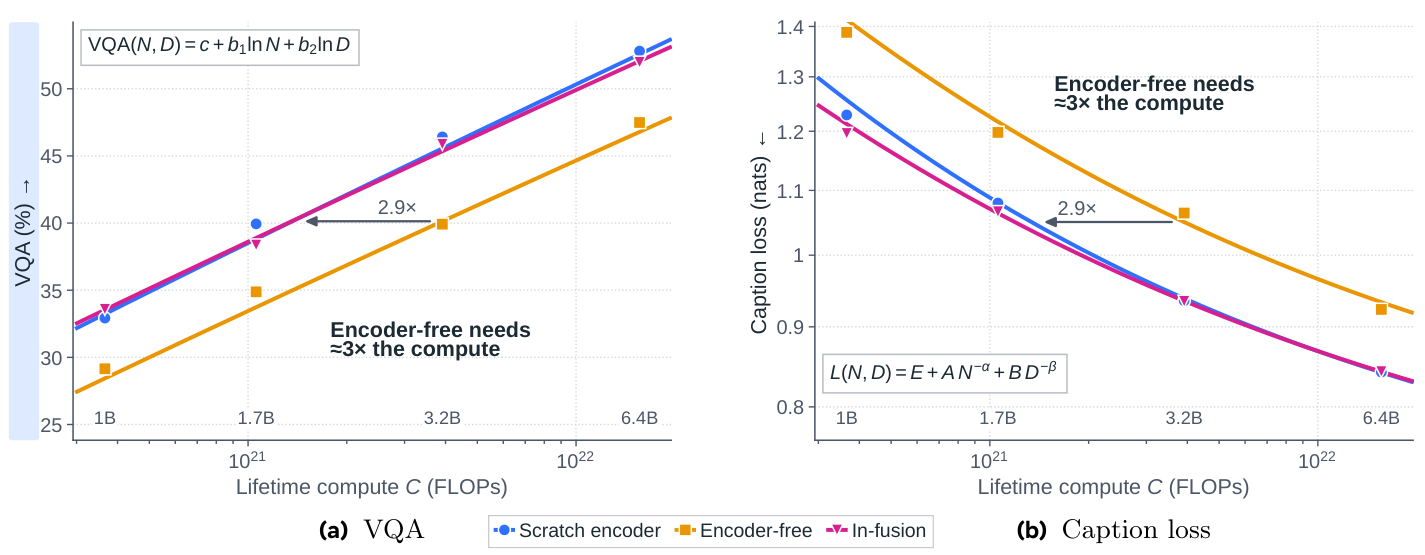
왼쪽은 VQA, 오른쪽은 캡션 손실입니다. 그림은 64 TPP인 지점을 보여 주며 적합에는 여러 규모와 TPP의 실행을 사용했습니다. 그림 7 · Brown 외, v1 PDF 10쪽 · CC BY 4.0 · 그래프 영역 크롭, 번역 없음.
1.7B–6.4B의 64 TPP 기준점을 따라 적합 곡선에서 읽으면, Encoder-free가 같은 Avg. VQA에 이르는 데 필요한 전체 연산량은 인코더 기준 2.6–3.1배입니다. In-fusion은 1.0–1.1배이며 텍스트 손실의 대응 연산량은 세 구성에서 거의 같습니다. 이 배수는 같은 점수에 도달하는 곡선상의 지점을 비교한 값입니다. 부록 Table 30
📖 Chapter 6: Vision encoding beyond lifetime compute
6.1 Zero-cost pretrained encoders. 멀티모달 학습은 1.7B 백본에서 $2.7\times10^{21}$ FLOPs로 고정하고, MetaCLIP 사전학습 연산은 비교 예산에 넣지 않습니다. 사전학습을 $1.4\times10^{21}$에서 $9.0\times10^{21}$ FLOPs로 늘리면 멀티모달 학습 전 ImageNet 선형 탐침 정확도는 80.4%에서 84.4%로 오릅니다. 같은 멀티모달 후속 학습을 마친 Avg. VQA는 가장 짧은 사전학습에서 43.2%, 가장 긴 경우에서 41.6%입니다. 공동 학습 인코더는 43.5%입니다. ImageNet 선형 탐침은 고정한 시각 표현의 분류 능력을 재고, VQA는 전체 모델이 이미지에 관한 질문에 답하는 능력을 잽니다. 두 평가의 숫자는 서로 다른 학습 시점에 측정했습니다. 원문 그림 8 · 부록 Table 18
6.2 Midtraining from pretrained language models. 연구진이 같은 텍스트 말뭉치에서 1T 토큰으로 사전학습한 1.7B 언어 모델에 시각 경로를 붙여 1.33T 토큰 상당량까지 중간 학습합니다. 실험은 MetaCLIP의 인코더 사전학습 비용을 제외합니다. Avg. VQA는 In-fusion 50.1%, 공동 학습 인코더 48.6%, 첫 8층 MoT 48.5%, 별도 사전학습 MetaCLIP 43.5%, 전체 층 MoT 43.3%, Encoder-free 39.8%입니다. 전체 층 MoT는 시각 전용 파라미터가 1.41B로 첫 8층의 0.4B보다 약 3.5배 많았습니다. Avg. Text는 모든 멀티모달 구성이 텍스트 전용 기준 57.3%의 1점 이내였습니다. 저자들은 이미 언어에 맞춰진 백본에 연결할 때, 공동 학습 인코더가 첫 업데이트부터 그 백본이 쓰기 좋은 시각 표현을 배울 수 있다고 가설을 제시합니다. 원문 §6.2, 그림 9 · 부록 Table 33
6.3 Training and inference speed. 첫 토큰 지연(TTFT)은 모델이 응답의 첫 토큰을 내놓기까지 걸리는 시간입니다. 별도 인코더가 있는 경우 백본은 이미지 표현이 나올 때까지 기다립니다. In-fusion은 백본의 초반 층에서 시각 연산을 함께 수행합니다. 저자들의 동일 추론 구현에서 H200 한 장으로, 448×448 이미지 한 장과 텍스트 256토큰을 담은 요청 16개를 동시에 처리했습니다. 구성별로 네 차례 실행해 중앙값과 전체 범위를 보고합니다. 원문 §6.3 · 부록 H.3
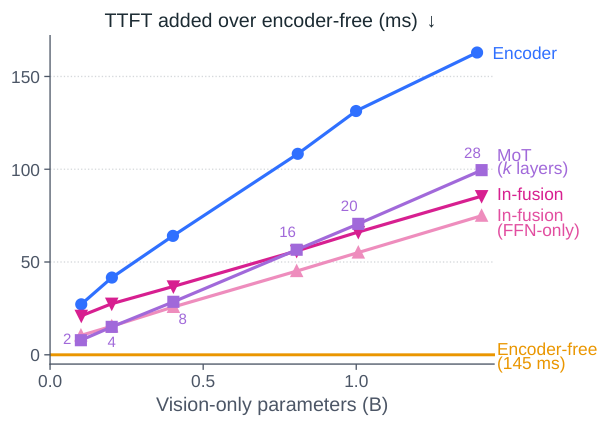
1.7B 백본에서 시각 파라미터 예산별로 Encoder-free 대비 추가된 첫 토큰 지연입니다. 그림 10 · Brown 외, v1 PDF 12쪽 · CC BY 4.0 · 그래프 영역 크롭, 번역 없음.
| 401M 시각 전용 예산 | 공동 학습 인코더 | In-fusion | In-fusion (FFN-only) |
|---|---|---|---|
| 1.7B 백본 TTFT | 210ms | 182ms (−13%) | 171ms (−18%) |
| 4B 백본 TTFT | 405ms | 381ms (−6%) | 365ms (−10%) |
부록 Table 36에서 401M 조건을 발췌했습니다. Encoder-free는 같은 요청에서 각각 146ms와 340ms이지만 VQA도 낮았습니다. 401M에서 절대 지연 감소 폭은 두 백본에서 비슷하지만, 4B는 백본 자체의 초기 입력 처리 시간이 길어 감소율이 더 작습니다. 논문은 텍스트와 이미지 요청을 연속 배치로 섞으면 In-fusion 분기의 실행이 같은 순전파에 포함되고, 별도 인코더는 이미지 요청에만 지연을 더하므로 서빙 방식에 따라 결과가 달라질 수 있다고 덧붙입니다. 부록 H.3 및 Table 36
학습 시간은 별도의 기준으로 비교합니다. H200 32장과 4B 백본에서 측정한 업데이트 시간으로 같은 $1.04\times10^{22}$ FLOPs에 도달하는 시간을 추정했습니다. Encoder-free 대비 기본 인코더는 +2.9%, In-fusion은 +0.3%, FFN-only는 −0.3%입니다. 401M 참조 인코더의 최적화 전 결과이며, 저자들은 더 작은 Base 인코더를 컴파일해 4B에서 같은 전용 파라미터의 FFN-only와 학습 시간 차이를 0.2% 이내로 줄인 사례도 보고합니다. 부록 H.2 및 Table 35
📖 Chapter 7: Related work
저자들은 먼저 사전학습한 인코더를 붙이는 방식에서 인코더 공동 학습, 패치 직결, 별도 토크나이저에 이르는 구성을 살핍니다. 앞선 통제 연구는 주로 사전학습 목표나 데이터를 바꾸거나 언어 백본을 사전학습한 상태에서 멀티모달 연산만 합산했습니다. 이 논문은 공통 이미지 풀과 최종 모델에 걸친 전체 연산량에서 사전학습 단계 자체를 따로 비교합니다. 원문 §7
이어 시각 토큰과 텍스트 토큰이 만나기 시작하는 깊이를 바꾸는 연구, 백본의 가중치를 모달리티별로 복제하는 연구, 인코더와 함께 쓰는 어댑터를 짚습니다. 이 논문의 구현은 고정된 시각 파라미터 예산을 공유 백본의 선택된 층에 덧붙여, 전용 용량이 어느 쪽에 놓였는지 비교할 수 있게 했습니다. 원문 §7
📖 Chapter 8: Discussion
저자들은 동일 예산에서 첫 8층의 시각 전용 모듈과 융합 전 인코더가 비슷한 VQA를 얻고, 동일한 수의 파라미터를 공유 경로에 주면 특히 OCR·도표에서 차이가 남았다는 결과를 묶습니다. 별도 사전학습을 한 구성에서는 VQA가 일관되게 오르지 않았습니다. 인코더와 백본을 함께 학습하는 구성에서는 시각 표현이 실제로 쓰일 언어 모델의 손실을 통해 처음부터 업데이트됩니다. 원문 §8
논문이 밝힌 범위는 별도 인코더도 멀티모달 학습과 같은 이미지 풀에서 학습했다는 점, 최대 6.4B의 밀집 백본만 비교했다는 점, 기본 멀티모달 학습에는 224×224 정지 이미지를 사용했다는 점입니다. 추가 데이터를 사용한 공개 인코더의 이점, 희소 MoE 백본, 더 높은 학습 해상도와 문자가 많은 데이터, 구성별 최적 혼합 비율, 이미지·텍스트가 교차하는 데이터나 비디오에서는 같은 결론이 성립하는지 남아 있습니다. 원문 §8의 한계와 후속 과제
참고문헌은 원문 14–20쪽에 수록되어 있습니다. 이후 부록은 공통 실험 프로토콜에서 개별 평가표까지 이어집니다. 원문 참고문헌
📖 Chapter A: Controlled protocol
A.1은 인코더가 이미지 $x$에서 만든 특징 $f_\phi(x)$를 선형 투영 $W_{\mathrm{proj}}$로 백본 폭에 맞추는 식 (4)를 제시합니다. Encoder-free의 식 (5)는 이미지 분할 결과를 $W_{\mathrm{patch}}$로 투영하고 2차원 위치값 $p_{\mathrm{2D}}$를 더한 뒤 RMSNorm과 스칼라 게이트 $g$를 적용합니다. 이 작은 입력층을 지나면 텍스트와 이미지가 같은 백본으로 들어갑니다. A.2는 인코더 크기와 형태를 비교해 27층 0.4B 구성을 주 실험의 기준으로 정합니다. A.3은 행렬 파라미터와 나머지 파라미터의 Muon·AdamW 설정, 감쇠 종점과 지시 튜닝을 설명합니다. 부록 A.1–A.3
A.4의 1.7B 혼합 비율 실험에서 90:10은 Avg. VQA 41.2%와 Avg. Text 49.3%, 70:30은 43.4%와 48.0%입니다. 이미지·텍스트 비율을 50%까지 올리면 VQA는 43.0%였습니다. 전체 비율 90:10을 고정한 별도 실험에서 첫 업데이트부터 이미지를 사용할 때 VQA가 42.5%, 예산의 25·50·75% 지점부터 사용할 때 35.0·35.1·34.4%였습니다. A.5는 사전학습·동결 인코더 비용과 토큰 상당량 산출법을 정의합니다. 동결된 인코더는 멀티모달 단계에서 역전파가 없으므로 순전파 비용만 더합니다. 부록 A.4–A.5, Table 10–12
📖 Chapter B: Evaluation
B.1은 VQA를 최대 256 출력 토큰의 greedy decoding으로 평가하며, 각 데이터셋의 처음 최대 5,000개 예제를 사용합니다. 태스크별로 정확 일치, 수치 오차를 허용하는 채점, 복수 참조 답변의 합의 점수를 사용합니다. MME-Perception은 총점을 20으로 나눈 뒤 다른 태스크와 평균합니다. B.2와 B.3은 언어 점수와 텍스트 전용 비교군을 정의합니다. B.4의 검증 캡션 손실은 학습에 쓰지 않은 이미지의 재작성 캡션 토큰당 음의 로그 우도이며, 분포 밖 비교는 COCO 사람 캡션, MetaCLIP 대체 텍스트, 스톡 이미지에서 각각 5,000장을 사용합니다. B.5는 사전학습 인코더의 패치 특징과 멀티모달 모델의 최종 시각 토큰에 각각 선형 분류기를 맞추는 ImageNet 평가를 설명합니다. 부록 B.1–B.5
📖 Chapter C: Separate encoder pretraining
C.1의 MetaCLIP은 이미지와 캡션이 맞는 쌍에 높은 유사도를 주도록 이미지→텍스트와 텍스트→이미지 대조 손실을 함께 계산합니다. 식 (7)의 온도는 유사도가 확률로 바뀔 때 분포의 뾰족함을 조절합니다. 식 (8)의 Cap은 인코더가 읽은 이미지와 앞선 캡션 토큰으로 다음 캡션 토큰을 예측합니다. 식 (9)의 CapPa는 이 손실에 0.25를, 캡션 전체를 가린 채 각 위치를 병렬 예측하는 손실에 0.75를 곱해 합칩니다. 식 (10)의 WebSSL은 DINO 자기 증류와 iBOT 마스크 패치 예측에 각각 1, KoLeo 표현 분산 정규화에 0.1을 곱합니다. 학습에 사용한 텍스트 타워, 캡션 디코더와 예측 헤드는 멀티모달 단계 전에 제거합니다. 부록 C.1, 식 (7)–(10)
C.2는 같은 사전학습 연산량에서도 ImageNet 순위가 후속 VQA의 순위와 달랐음을 보입니다. 이미지와 캡션의 구성이 맞는지 비교한 SugarCrepe에서는 구성별 종합 점수가 비슷했습니다. C.3은 멀티모달 연산을 고정한 상태의 MetaCLIP 비교이며, 가장 짧은 사전학습 체크포인트의 인코더 학습률을 0.1배로 낮춰도 Avg. VQA는 43.1%로 기본 43.2%와 비슷했습니다. 부록 C.2–C.3, Table 16–18
📖 Chapter D: Dedicated vision capacity
D.1은 인코더가 가장 크게 앞서는 과제가 OCR·도표이며, 학습을 늘리면 그 차이의 일부가 줄지만 다른 범주에도 차이가 남음을 보고합니다. D.2는 토큰 수를 맞춘 경우와 연산을 맞춘 경우를 따로 제시합니다. 토큰 수가 같고 학습률 감쇠 이전인 1.7B 실험에서 공유 FFN 0.8B를 더한 모델은 44.4%로 0.4B 전용 인코더의 44.2%에 근접하지만, 연산량은 각각 $6.3\times10^{21}$과 $4.7\times10^{21}$ FLOPs였습니다. D.3은 더 큰 패치로 640×640 이미지를 256토큰에 담은 계층형 MLP가 특히 OCR에서 개선됐음을 보여 줍니다. D.4는 선행 비교에서 낮은 인코더 학습률, 원본 대체 텍스트, 텍스트와 캡션을 섞은 검증 손실이 어떤 영향을 주는지 각각 살핍니다. 부록 D.1–D.4 · Table 20
📖 Chapter E: In-fusion vision capacity
E.1은 전용 투영이 차지하는 파라미터를 먼저 세고, 예산 안에 들도록 시각 FFN의 중간 폭을 줄입니다. E.2에서는 1.7B에서 훈련을 두 배 늘려도 시각 토큰 전용 FFN이 같은 형태의 모든 토큰용 분기보다 VQA에서 높았습니다. 또한 4B에서 실제 학습 토큰 수를 맞춘 채 최종 학습률 감쇠 전에 측정했을 때, Q·K·V·O 전용 투영만 추가한 구성은 Encoder-free보다 Avg. VQA가 +1.8점이고 95% 구간은 [1.0, 2.5]입니다. 같은 폭의 시각 FFN에 전용 투영을 더한 비교는 +1.1점 [0.4, 1.9]입니다. 부록 E.1–E.2, Table 23–25
E.3은 1.11T 토큰 상당량에서 두 백본의 범주별 점수를 제시합니다. E.4는 블록 양쪽의 시각 벡터 사이 코사인 유사도를 1에서 뺀 값과, 캡션 토큰이 시각 토큰에 할당한 어텐션 비율을 측정합니다. In-fusion에서 시각 벡터 변화는 대부분 전용 분기가 있는 초반 8개 블록에 모이고, Encoder-free에서는 초반과 중간 공유 블록에 이어집니다. 부록 E.3–E.4, Table 26 및 그림 16
📖 Chapter F: Decay, learning rate, and caption loss
F.1은 감쇠 후 종점별 점수를 제공합니다. F.2는 1.7B에서 기본 최고 학습률을 절반에서 두 배까지 바꿔도 대체로 인코더와 In-fusion의 VQA가 Encoder-free보다 높았다고 보고합니다. F.3에서 학습에 쓰지 않은 이미지의 캡션 손실과 Avg. VQA의 상관계수는 네 구성의 감쇠 후 종점을 함께 봤을 때 −0.96입니다. OCR·도표 범주의 관련성이 가장 높았습니다. 부록 F.1–F.3 · 그림 18
📖 Chapter G: Scaling ladder
규모 비교에서는 전용 분기를 백본 깊이의 약 29%에 해당하는 초반 층에 넣고, 예산은 같은 규모의 인코더와 맞춥니다. 규모가 커지면 배치와 시각 모듈도 커지므로 앞의 1.7B·4B 고정 0.4B 실험과 조건이 다릅니다. VQA 적합의 RMS 오차는 0.93점이고, 6.4B 결과를 빼고 맞춘 다음 그 규모를 예측한 평균 절대 오차는 0.95점입니다. Table 32는 별도로 학습한 1.7B·4B 실험의 캡션 손실과 적합식의 예측을 대조합니다. 부록 G, Table 28–32 · 적합 오차
📖 Chapter H: Beyond lifetime compute: midtraining and inference
H.1에서는 텍스트 비율을 처음 20B 토큰 구간에 걸쳐 100%에서 70%로 낮추고 유지합니다. 시각 경로만 학습률을 조정하면 공동 학습 인코더가 In-fusion에 가까워지고, MetaCLIP과 공동 학습 인코더의 차이도 일부 줄어듭니다. H.2는 업데이트당 학습 시간과 동일 FLOPs 도달 시간을 분리합니다. Table 35의 Encoder-free 대비 +2.9%는 공통 타이밍 창 17개에 대한 대응표본 95% 부트스트랩 구간 [+1.9%, +4.2%]을 보고합니다. In-fusion 두 구성의 구간에는 0이 포함됩니다. H.3은 첫 토큰과 출력 처리량을 측정하는 동일 추론 구현을 설명하고 여러 해상도와 시각 파라미터 예산을 비교합니다. 부록 H.1–H.3 · Table 35
📖 Chapter I: Per-benchmark results
마지막 부록은 본문의 각 그래프와 비교표에 해당하는 세부 성능을 싣습니다. 일반 시각 질의의 GQA, 지식 범주의 MMMU, OCR·도표의 ChartQA와 TextVQA처럼 각 태스크의 점수를 확인할 수 있습니다. 표에 함께 실린 캡션 손실과 텍스트 손실은 지시 튜닝 이전에 측정한 토큰당 nats이고, VQA는 지시 튜닝 후의 점수입니다. 그래프와 세부 점수의 연결표는 부록 첫 페이지에 있습니다. 부록 I
실험 결과 심층 분석
가장 큰 차이는 같은 연산으로 시각 토큰이 어떤 파라미터를 사용하는지 바꾼 비교에서 보입니다. 1.7B에서 공유 경로를 0.4B 늘리면 텍스트 과제에 쓰이는 용량도 늘어나 Avg. Text가 51.2–51.4%에 이릅니다. 반대로 공동 학습 인코더의 Avg. Text는 49.7%이지만 OCR·도표는 38.2%로 공유 확장 세 구성의 25.1–29.3%를 앞섭니다. 입력의 문자나 눈금에 민감한 과제를 따로 보면, 텍스트 평균으로는 드러나지 않던 설계 차이를 확인할 수 있습니다. 원문 Table 2
VQA 범주 평균의 차이와 불확실성은 구분할 필요가 있습니다. Table 25는 감쇠 전 4B의 실제 토큰 수를 맞춘 두 전용 투영 대조에 95% 구간을 제공합니다. Table 35는 학습 시간에 대응표본 부트스트랩 구간을, 추론 시간은 네 번 측정한 중앙값과 전체 범위를 보고합니다. Table 2와 Table 26의 대표 VQA 평균에는 신뢰구간이나 별도의 유의성 검정 결과가 보고되지 않았습니다. 따라서 1.7B 장기 비교의 49.2%와 48.9%는 실험에서 비슷한 점수로 읽는 것이 적절합니다. 부록 Table 25–26 · 부록 H.2–H.3
학습 설정과 채점 범위를 확인할 수 있도록 논문은 백본과 인코더의 구조, 데이터 혼합, 학습률과 FLOPs 산정 기준, 지시 튜닝과 개별 점수까지 제공합니다. 비교 결과를 읽을 때는 지표마다 측정 시점을 확인해야 합니다. 사전학습 직후 인코더를 고정해 측정한 ImageNet 성능, 지시 튜닝 이전의 캡션 손실, 지시 튜닝 이후의 VQA는 각각 다른 질문에 답합니다. 부록 A–C · 부록 I
기술적 함의와 응용
멀티모달 모델에 이미지를 넣는 경로를 고를 때는 파라미터를 어느 토큰에 배정할지부터 명시할 수 있습니다. 이 논문의 분기형 설계에서는 텍스트와 이미지가 같은 어텐션을 쓰면서도 이미지에는 추가 투영과 FFN을 보낼 수 있습니다. 독립 인코더를 거칠 때와 비슷한 VQA가 관찰된 동시에, 연구진의 이미지 전용 부하에서는 첫 토큰까지의 대기가 줄었습니다. 이 차이를 실제 서빙에서 해석할 때는 요청의 이미지 비중과 배치 방식, 인코더 최적화 상태가 함께 고려됩니다. 원문 §5–6
같은 데이터와 연산량에서 이 논문이 가장 일관되게 확인한 것은 시각 전용 연산의 효과입니다. 같은 크기의 시각 모듈이라면 공동 학습한 독립 ViT와 공유 백본 초반의 분기가 실험 범위에서 비슷한 시각 점수를 냈습니다. 인코더가 미리 학습한 분류 표현의 품질만으로 최종 모델의 시각 이해를 고르기 어렵다는 결과도 이 비교에서 함께 드러납니다. 원문 §8