논문 개요와 전체 구조
같은 언어 모델이 문제를 풀고, 자신의 결과를 평가하고, 다음 문제 해결 방식을 설계한다면 실제로 더 나아질 수 있을까요? MASS(Multi-Agent Self-Supervision) 는 이 질문을 다루는 자기 개선 방법입니다. 한 모델을 여러 역할의 에이전트로 나누어 협업하게 한 뒤, 그 협업 과정의 대화를 다시 같은 모델의 학습 데이터로 사용합니다. 여기서 재귀적 자기 개선(Recursive Self-Improvement, RSI) 이란 한 번 좋아진 모델이 다음 세대의 실행자·평가자·최적화자가 되어 개선 절차를 반복하는 것을 뜻합니다. 원문 §1–3
핵심 대상은 연구 코드·실험·보고서처럼 짧은 정답 검사 하나로 품질을 판단하기 어려운 과제입니다. 논문의 “non-verifiable”은 이러한 자기 학습 상황을 설명합니다. 모든 평가에서 정답·검증기를 없앴다는 뜻은 아닙니다. MASS 내부의 워크플로 수정과 학습 자료 선별은 현재 모델이 담당하지만, 최종 결과는 별도의 강한 모델이나 벤치마크 공식 검증기로 평가합니다. 이 구분을 유지해야 자기 감독의 범위와 결과의 신뢰도를 올바르게 읽을 수 있습니다.
분석 대상은 Hyunin Lee, Jinglue Xu, Jeffrey Seely, Donghyun Lee, Somayeh Sojoudi, Matei Zaharia, Yujin Tang의 Recursive Self-Improvement through Multi-Agent Self-Supervision, arXiv 2610.12176v1, 2026년 10월 8일 제출본입니다. 39쪽 PDF와 같은 버전 HTML을 대조했습니다. 범용 연구 에이전트의 학습이 중심이며, 로보틱스는 금융·약학과 함께 등장하는 합성 연구 과제의 한 영역입니다.
원문의 구조는 다음과 같습니다. 3절에는 번호 없는 방법별 소제목이 있고, 4절 이후에는 번호 있는 하위 절이 있습니다.
| 순서 | 원문 제목과 하위 구성 | 읽을 핵심 |
|---|---|---|
| 1 | Introduction | 자기 평가의 한계와 두 가지 가설 |
| 2 | Notations and problem statement | 과제·실행 궤적·산출물·모델 역할의 구분 |
| 3 | Method: Overview; Algorithm 2; Algorithm 3 | 워크플로 검색과 SFT의 교대 |
| 4 | Experiments: 4.1 설정, 4.2 주요 결과, 4.3 정보 흐름, 4.4 감독 밀도 | 무엇이 개선되며 어떤 근거가 있는가 |
| 5 | Ablations: 5.1 검색 병목, 5.2 내재화된 행동 | 모델 역할과 실제 도구 사용의 분해 |
| 6–7 | Related works; Conclusion | 기존 연구와의 관계와 결론 |
| A–B | Algorithms; Training data and optimization | 알고리즘, 데이터, 학습·실행 지시문 |
| C–D | Evaluation and additional results; Teacher composition and token accounting | 평가 분모·통계·토큰 회계 |
| E–G | Workflow-search ablations and execution variability; Workflow-information estimates; Behavioral audit | 검색 변동·정보량 추정·행동 감사 |
| H–J | Representative task specifications; Complete workflow examples; Comparison with related methods | 실제 과제, 워크플로, 비교 범위 |
핵심 기여와 혁신성
문제의 중요성은 좋은 학습 신호를 어디서 얻느냐에 있습니다. 연구 결과가 복잡해질수록 사람이 매번 검증하기 어렵고, 과제마다 좋은 에이전트 구성을 손으로 설계하는 것도 부담스럽습니다. 그렇다고 동일 모델에게 답안을 다시 읽혀 평가만 시키면 공통된 오해를 강화할 수 있습니다.
기존 접근과의 차이는 모델의 지식을 먼저 늘리는 대신, 모델 복제본들이 일하는 구조를 바꾼다는 점입니다. MASS는 역할 이름만 늘리지 않습니다. 각 에이전트가 어떤 결과를 반환하고, 조정자가 누구를 언제 호출하고, 실패한 산출물을 어느 담당자에게 되돌릴지를 텍스트 워크플로로 검색합니다. 그 후 조정자와 작업자 대화를 함께 지도 미세조정합니다.
주요 실험적 기여는 작업 수행 데이터로만 학습해도 실행·워크플로 설계·평가 역할에 개선이 관찰된다는 것입니다. 두 주기 뒤 세 합성 테스트 과제에서 기반 모델 대비 판단 승률은 69.9%, 외부 심사와의 평가 일치율은 0.93이 됩니다. 네 연구 벤치마크에서는 출력 토큰당 점수가 기반 모델의 1.2–1.6배입니다. 이 수치는 모든 벤치마크의 절대 성능 향상이나 전체 계산 비용 절감을 뜻하지 않으며, 아래에서 평가 조건을 분리해 설명합니다. §4, 부록 C–D
리뷰어 해석으로는, 이 연구가 “좋은 답변만 모으기”를 넘어 “일을 나누고 산출물을 연결하는 행동도 학습 대상으로 삼기”라는 관점을 구체화했다고 볼 수 있습니다. 다만 원문이 실험한 것은 두 번의 개선 주기이며, 무한히 계속 좋아지는 자기 개선을 증명한 것은 아닙니다.
기술적 세부사항
안쪽 루프는 프롬프트를, 바깥 루프는 가중치를 바꿉니다
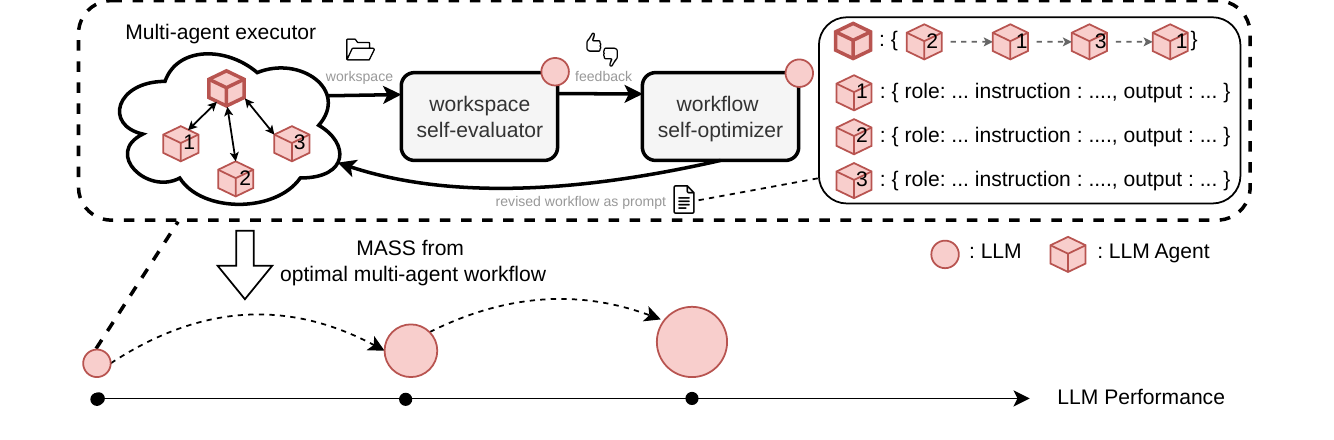
Figure 1, PDF 1쪽. 같은 모델이 협업 실행·산출물 평가·워크플로 수정을 담당하고, 선택한 실행 기록을 SFT하여 다음 주기를 시작합니다. 2610.12176v1 원문, 저자들, CC BY 4.0. 페이지에서 그림 영역만 크롭했으며 번역·재작도·수치 변경은 없습니다.
한 주기의 안쪽에서는 모델 가중치를 고정하고 워크플로를 여러 번 바꿉니다. 각 제안은 실제로 실행되며, 산출물 작업 공간을 현재까지 보유한 최선의 산출물과 비교합니다. 바깥쪽에서는 선택한 워크플로로 여러 실행을 생성하고, 자기 평가로 순위를 정한 뒤 학습합니다. 이때 쓰는 SFT(Supervised Fine-Tuning) 는 정답 형태의 대화 기록을 다음 토큰 예측으로 모방하는 지도 미세조정입니다.
워크플로는 다음 요소로 표현합니다. §3
$t$는 과제, $m_t$는 하위 에이전트 수입니다. $\mathbf r$는 역할, $\mathbf u$는 작업 지시, $\mathbf c$는 출력 계약(output contract), 즉 반환해야 할 파일·지표·오류 정보의 약속입니다. $\mathbf h$는 호출 순서인 hop입니다. 따라서 이 식은 신경망 계층을 새로 정의하는 것이 아니라, 과제 프롬프트 뒤에 붙일 협업 설계의 구성 요소를 나타냅니다. 코딩 도구·메모리 등을 제공하는 실행 틀인 하네스(harness) 는 비교 동안 고정합니다.
협업 기록을 모델에 남기는 손실 함수
$\theta$는 학습할 모델 파라미터, $z$는 저장한 대화 창, $q$는 그 창을 뽑는 분포입니다. $p_\theta$는 앞선 토큰을 보았을 때 다음 토큰에 부여하는 확률입니다. 마스크 $\mu_\ell$가 1인 assistant의 추론·텍스트·도구 호출만 손실을 받으며, 사용자 프롬프트·도구 출력·겹치는 과거 문맥은 0으로 처리합니다. 분모는 실제 감독 토큰 수이므로 대화 창마다 해당 토큰의 평균 손실을 구합니다. §3, Algorithm 3
조정자의 최초 입력에서는 최적화 워크플로와 실행 지시를 제거하고 원래 과제만 남깁니다. 작업자에게 이미 전달된 구체적 할당은 보존합니다. 따라서 학습 목표는 매번 긴 팀 설계를 입력해야만 동작하는 시스템을 만드는 데 그치지 않고, 과제를 보면 조정·위임 행동을 더 자주 활용하도록 만드는 것입니다.
비교할 때 나눠야 할 세 가지 토큰
생성 토큰은 과제 실행 중 모든 모델 호출이 출력한 양입니다. 저장 감독 토큰은 학습 데이터에 저장한 손실 대상 토큰입니다. 처리 감독 토큰은 선택한 체크포인트까지 복원 추출한 학습 창에서 실제 손실을 계산한 양입니다. 같은 창을 여러 번 뽑을 수 있으므로 저장량과 처리량은 다릅니다. 출력 토큰 효율, 학습 토큰 효율, 전체 GPU·검색 비용은 서로 다른 질문입니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
위치와 역할. 서론은 자기 개선의 두 병목을 평가와 개선으로 나누고, 이를 협업 구조와 학습 데이터의 문제로 연결합니다.
저자의 서술 순서를 따른 상세 내용
- 평가 병목과 개선 병목. 연구가 전문가의 즉각적인 판단 범위를 넘어가거나 실험 피드백이 오래 걸리면 외부 감독을 반복적으로 확보하기 어렵습니다. 동시에 좋은 실험 설계·도구 사용·검증 순서를 사람이 매번 수정해야 한다면 개선의 속도도 제한됩니다. 저자들은 이 두 병목을 함께 다루는 상황으로, 현재 이용 가능한 가장 강한 모델이 실행·평가·개선 역할을 모두 맡는 구성을 설정합니다.
- 동질적 자기 피드백의 문제. 같은 모델의 생성·평가·수정은 같은 학습된 사전 지식을 공유합니다. 따라서 “한 번 더 생각하라”만으로는 공통된 오류를 교정하기 어렵습니다. 여기서 여러 복제본에 데이터 처리·신호 생성·백테스트처럼 서로 다른 책임을 맡기는 Society of Mind 관점이 등장합니다. 다양성의 출발점은 서로 다른 모델의 지식이 아니라 조직된 작업 분해입니다.
- 가설 1: 더 좋은 데이터를 만드는 정보 흐름. 역할 수를 늘리는 대신 어떤 정보를 누구에게 언제 전달할지 최적화하면, 단일 실행이 놓치는 관점을 얻을 수 있다는 가설입니다. 이는 실제 메시지의 양을 무조건 늘리자는 주장과 다릅니다.
- 가설 2: 서로 다른 추상 수준을 함께 학습하는 효율. 조정자는 과제와 중간 결과를 제한된 할당으로 바꾸고, 작업자는 할당과 파일을 구현으로 바꿉니다. 두 예측 문제를 나눠 학습하는 것이 모든 행동을 한 긴 궤적에 섞어 배우는 것보다 유리할 수 있다는 가설입니다.
- 방법과 결과의 예고. 서론은 워크플로 검색→실행 기록 학습→다음 주기라는 구조를 제시한 뒤 성능·평가 일치율·행동 변화를 소개합니다. 이때 두 주기의 관찰을 무제한 자기 개선으로 확장하지 않고 읽어야 합니다.
핵심 기여와 다음 연결. 자기 감독의 공급원을 협업 과정으로 옮기는 문제 설정입니다. 2절은 “모델이 좋아졌다”를 어떤 대상과 평가 관계로 나타낼지 정의합니다.
📖 Chapter 2: Notations and problem statement
위치와 역할. 동일한 모델이 여러 역할을 맡는 실험에서 무엇을 고정하고 무엇을 비교하는지 정리합니다.
저자의 서술 순서를 따른 상세 내용
- Task and language model. 유한한 과제 집합을 학습 과제와 겹치지 않는 테스트 과제로 나눕니다. 언어 모델은 파라미터로 정의된 다음 토큰 분포입니다. 이 구분은 테스트 과제의 기록이 SFT나 검증 손실 선택에 들어가지 않게 하는 기준입니다.
- Agent and artifacts. 실행은 대화·도구 호출의 궤적과 최종 작업 공간을 함께 만듭니다. 궤적은 나중에 학습하는 대상이고, 작업 공간은 평가자가 비교하는 대상입니다. 보고서가 그럴듯한지와 각 assistant 토큰이 올바른지는 같은 평가 문제가 아닙니다.
- Task execution and evaluation. 실행자·평가자·최적화자는 개념적으로 구분하지만, 동질적 설정에서는 같은 가중치를 사용합니다. 두 산출물의 선호 판단과 그 이유를 다음 워크플로 설계에 전달합니다. 여러 호출이 있다고 해서 별도 모델을 학습하는 것은 아닙니다.
- Goal definition. 세대가 올라간 모델이 만든 결과가 이전 세대의 결과보다 외부 강한 모델의 관점에서 더 선호되는지를 목표로 둡니다. 자기 평가자의 자신감 증가만을 성공 정의로 삼지 않습니다.
핵심 기여와 다음 연결. 실행 기록·최종 산출물·평가 역할을 구분하여 자기 학습과 외부 보고의 경계를 세웁니다. 다음 절은 이 정의를 실행 가능한 두 단계 알고리즘으로 연결합니다.
📖 Chapter 3: Method
위치와 역할. MASS의 재귀 구조와 각 단계에서 전달되는 정보를 구체화합니다. §3 전체
저자의 서술 순서를 따른 상세 내용
- Overview. 세대마다 현재 모델을 세 역할에 배치합니다. 먼저 가중치를 고정한 채 과제별 보유 워크플로를 얻고, 그 워크플로의 실행 기록으로 같은 모델을 학습합니다. 새 모델은 다음 세대에서 다시 세 역할을 모두 맡습니다. Algorithm 1이 이 바깥 구조를 명시합니다.
- Algorithm 2: Multi-agent workflow optimization. 워크플로의 역할·지시·출력 계약·호출 순서를 과제 프롬프트에 붙입니다. 조정자와 모든 하위 에이전트가 같은 실행 모델을 사용합니다. 각 제안의 최종 파일을 현재 보유한 최선의 파일과 비교하고, 더 좋다고 판단되면 보유 워크플로를 교체합니다. 최적화자는 과제별 피드백 이력과 최선의 설계를 함께 보고 다음 설계를 제안합니다.
- 정보 전달을 중심에 둔 수정. 최적화 프롬프트는 역할과 지시뿐 아니라 호출 순서와 반환 계약을 특히 강조합니다. 예를 들어 “검증 담당자를 둔다”를 넘어, 실패한 파일·검사 결과·좁힌 수정 범위를 누구에게 반환할지 지정합니다. 이는 텍스트로 표현된 협업 그래프를 찾는 절차입니다.
- 최선의 의미. 저자들은 이를 크기 1의 엘리트를 유지하는 진화적 검색에 비유합니다. 여기서 최선은 순차적 자기 비교에서 보유한 최선이며, 가능한 모든 워크플로를 탐색한 전역 최적해라는 인증은 아닙니다. 보유 설계가 바뀌지 않아도 새 제안은 실제로 실행되므로 모든 실행 점수가 단조 증가하지 않습니다.
- Algorithm 3: Workflow internalization by supervised fine-tuning. 과제마다 보유 워크플로를 독립적으로 여러 번 실행합니다. 자기 평가자의 쌍별 비교를 Bradley–Terry 모델로 점수화합니다. 이는 대결에서 누가 이겼는지를 잠재 점수 차이와 연결해 순위를 만드는 통계 모형입니다. 상위 기록을 학습에, 그다음 기록 하나를 검증에 배정합니다.
- 학습 입력과 감독 범위. 조정자 입력에서 워크플로를 지우고, 작업자 할당은 남긴 채 대화를 길이 제한 창으로 나눕니다. 앞부분 문맥은 조건으로 보여줄 수 있지만 손실에서 제외합니다. 조정자의 위임·통합과 작업자의 구현을 같은 파라미터에 학습시키는 점이 방법의 연결 고리입니다.
핵심 기여와 다음 연결. 협업을 발견하는 검색과 협업을 가중치에 남기는 학습을 분리하면서 반복 가능하게 묶었습니다. 4절은 이 절차가 실제로 각 역할과 토큰 효율에 어떤 변화를 주는지 평가합니다.
📖 Chapter 4: Experiments
위치와 역할. 실험 설정을 제시하고, 전체 결과에서 두 가설의 세부 근거로 이동합니다.
4.1 Experimental setup
먼저 기반 모델은 Qwen3.6-27B-FP8, 실행 하네스는 qwen-code 0.20.0입니다. GPT-5.5가 생성한 비공개 합성 연구·프로그래밍 과제 12개를 금융·로보틱스·약학 각 4개로 구성합니다. 9개를 학습 후보로 정하지만, 워크플로 검색이 기준 산출물을 이기지 못한 과제 하나를 제외하여 실제 SFT 기여 과제는 8개입니다. 도메인별 하나씩 남긴 테스트 과제 3개는 학습·검증·체크포인트 선택에 쓰지 않습니다.
이어 데이터 수집과 학습을 설명합니다. 과제별 18개 실행에서 상위 15개를 학습, 16위를 검증으로 고르며, 중도 종료한 학습 궤적 하나를 제외해 총 119개를 사용합니다. 이 기록은 2,435개 창과 약 17.2M 저장 감독 토큰으로 바뀝니다. 창은 최대 49,152토큰이고 이전 문맥은 최대 8,192토큰까지 포함하되 마스킹합니다. 작업자 창이 많으므로 작업자·보조 대화와 조정자를 2:1로 뽑습니다.
BF16 부모 모델에 새 LoRA 어댑터를 학습하며 rank 64, scaling 128, dropout 0.05를 사용합니다. AdamW와 최고 학습률 0.00003, 5단계 warmup, cosine decay를 적용하고 첫 주기는 1,624 optimizer step을 수행합니다. 여기서 데이터 저장량과 체크포인트까지 실제 재표집한 양을 구분해야 합니다.
마지막으로 외부 평가는 GPT-5.5와 Claude Opus 4.8 각각 세 seed, 즉 산출물 쌍 하나당 여섯 판단을 사용합니다. 승률은 무승부를 제외한 승리 판단의 비율입니다. 여섯 번의 심사는 여섯 번의 독립 과제 실행이 아닙니다. 이 외부 심사는 주 MASS 검색·교사 선별·SFT 목표에 전달되지 않습니다. 다만 뒤의 교사 구성 대조 실험은 별도의 체크포인트 선택 규칙을 사용하므로 구별합니다.
4.2 Main results: improvement across model roles
첫째, 과제 실행에서는 첫 주기와 두 번째 주기 뒤 테스트 과제에서 기반 모델 대비 승률이 53.9%→69.9%가 됩니다. 두 번째 세대가 첫 세대와 직접 비교될 때의 승률은 60.8%입니다. 같은 “승률”이라도 비교 상대가 다르므로 하나의 증가율로 합치면 안 됩니다.
둘째, 워크플로 최적화에서는 후속 모델이 외부 심사 전원에게 선호되는 설계를 더 일찍 찾습니다. 실행 모델을 기반 모델로 고정하고 첫 세대가 만든 워크플로와 기반 모델이 만든 워크플로를 비교한 별도 이전 실험에서도 평균 승률 0.64가 나옵니다. 이는 좋은 실행 모델만 투입해서 생긴 효과를 부분적으로 분리합니다. 다만 검색 당시에는 각 세대의 실행자·평가자도 달랐습니다.
셋째, 평가자 역할에서는 외부 참조 판단과의 일치율이 0.73→0.91→0.93으로 증가합니다. 이것은 과학적 진실에 대한 정확도나 모든 토큰의 정답률이 아니라, 해당 외부 심사 판단과의 일치율입니다.
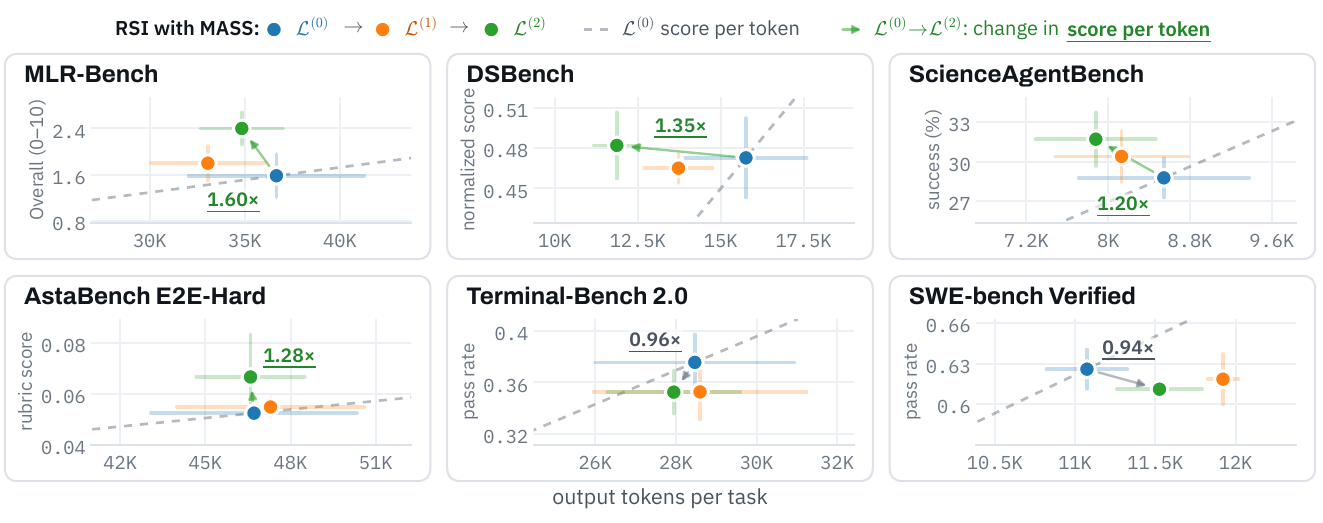
Figure 2, PDF 3쪽. 네 연구 벤치마크의 토큰당 점수 개선과 두 코딩 벤치마크의 하락을 함께 보여줍니다. 2610.12176v1 원문, 저자들, CC BY 4.0. 그림만 크롭했으며 번역·재작도는 없습니다. 오차막대 해석과 MLR-Bench의 실제 반복 횟수는 부록 C.5 설명을 따릅니다.
공개 벤치마크 결과는 다음과 같습니다. 수치와 단위는 본문의 반올림 서술보다 구체적인 부록 Table 7을 기준으로 옮겼습니다.
| 벤치마크·지표 | 기반 모델 | 1주기 뒤 | 2주기 뒤 |
|---|---|---|---|
| ScienceAgentBench 성공률(%) | 28.8 ± 1.5 | 30.4 ± 2.0 | 31.7 ± 2.0 |
| MLR-Bench Overall(미제출 0 포함) | 1.58 ± 0.38 | 1.80 ± 0.30 | 2.40 ± 0.28 |
| AstaBench E2E-Hard 체크리스트 비율 | 0.053 ± 0.002 | 0.055 ± 0.004 | 0.067 ± 0.017 |
| DSBench 정규화 점수 | 0.473 ± 0.029 | 0.465 ± 0.011 | 0.482 ± 0.025 |
| Terminal-Bench 2.0 통과율(%) | 37.5 ± 2.2 | 35.3 ± 2.1 | 35.2 ± 1.7 |
| SWE-bench Verified 통과율(%) | 62.6 ± 1.4 | 61.8 ± 1.9 | 61.1 ± 0.6 |
±는 trial 평균들의 표본 표준편차이며 신뢰구간이 아닙니다. MLR-Bench는 5회, 나머지는 3회입니다. 연구 벤치마크 네 개의 출력 토큰당 점수는 1.20–1.60배이지만, 코딩 벤치마크 두 개에서는 그 비율도 각각 0.96과 0.94입니다. “모든 에이전트 작업이 좋아졌다”는 결과가 아닙니다.
4.3 Hypothesis 1: information flow supplies useful self-supervision
다음으로 보유 워크플로의 3·6·9·11회차를 분석합니다. 역할·지시·계약·hop의 텍스트를 임베딩하고, 과제 설명과 얼마나 함께 변하는지 정보량 대용 지표로 측정합니다. 특정 과제마다 달라지는 요소에는 높은 과제 정보량을, 공통된 범용 표현에는 낮은 값을 부여하는 방식입니다.
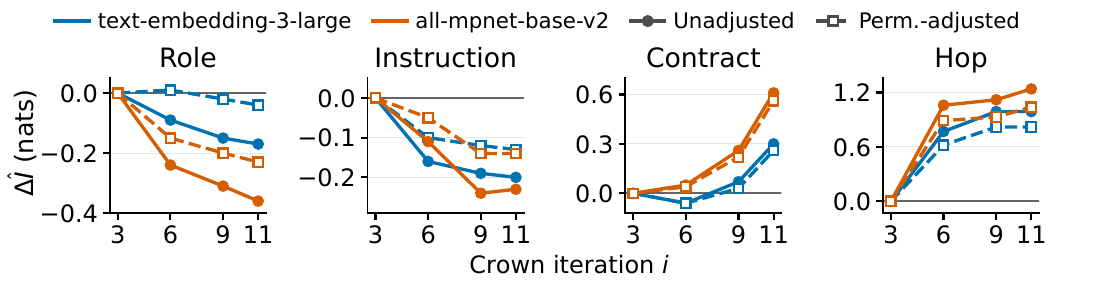
Figure 4, PDF 8쪽. 3회차를 기준으로 한 임베딩 기반 정보량 변화이며 패널별 세로축 범위가 다릅니다. 2610.12176v1 원문, 저자들, CC BY 4.0. 그림만 크롭, 번역·재작도 없음.
두 임베딩 모델과 보정 유무의 네 설정에서, 시작과 끝을 비교하면 역할·지시의 과제 정보량은 줄고 계약·hop의 정보량은 늘어납니다. 예컨대 OpenAI 임베딩의 비보정 계약 정보량은 2.99→3.29 nats, hop은 5.23→6.22입니다. 반면 역할은 1.26→1.09입니다. 단위 nats는 자연로그 기반 정보량 단위입니다. 이 결과는 과제별 특수성이 반환 정보와 연결 순서에 더 많이 실리는 양상과 부합합니다.
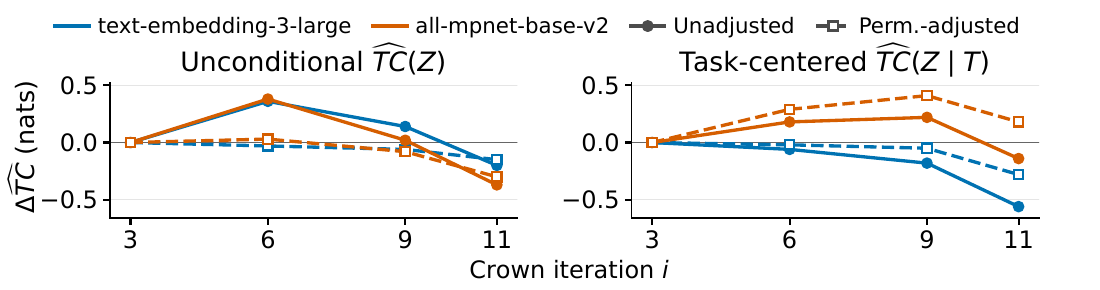
Figure 5, PDF 8쪽. 전체 상관은 네 설정 모두 끝점에서 감소하지만, 과제 중심화 뒤 permutation 보정 MPNet 값은 증가합니다. 2610.12176v1 원문, 저자들, CC BY 4.0. 그림만 크롭, 번역·재작도 없음.
구성 요소 간 중복을 나타내는 전체 상관은 대체로 줄어듭니다. 그러나 과제 평균을 제거한 통계에서는 네 설정 중 하나가 증가하며 중간 경로도 단조롭지 않습니다. 측정 대상은 워크플로 설명 텍스트입니다. 실제 실행 중 메시지의 정보 전달량을 측정하거나 정보 흐름 변화가 성능 향상을 일으켰다는 인과 실험을 한 것은 아닙니다. 저자의 Claim 1은 이러한 기술적 텍스트 통계에 근거한 해석으로 읽어야 합니다.
4.4 Hypothesis 2: Multi-agent trajectories provide denser supervision
마지막으로 단일 에이전트 기록과 다중 에이전트 기록을 학습 데이터로 비교합니다. S와 M은 각각 단일·다중 실행 17개, X는 두 집합의 합, S+와 S++는 더 많은 단일 실행, M+는 주 실험의 119개 기록을 사용합니다. +는 데이터 확대 표기이며 재귀 주기의 수가 아닙니다.
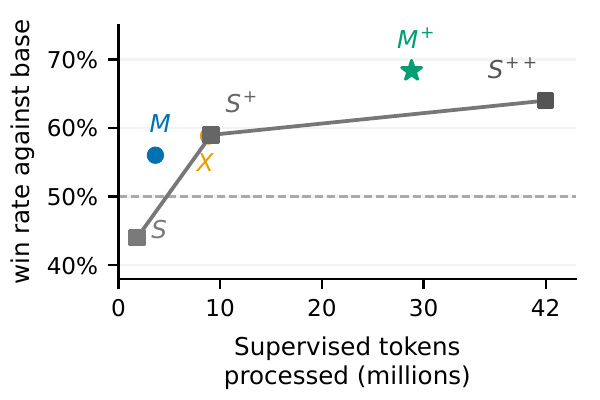
Figure 6, PDF 8쪽. 가로축은 선택한 체크포인트까지 처리한 감독 토큰, 세로축은 공유 평가 과제 다섯 개에서 기반 모델 대비 승률입니다. 회색선은 단일 에이전트 관측점의 선형 보간입니다. 2610.12176v1 원문, 저자들, CC BY 4.0. 그림만 크롭, 번역·재작도 없음.
M+는 28.82M 처리 감독 토큰에 68.3%, S++는 42.00M에 64.0%입니다. M+가 4.3퍼센트포인트 높고 토큰은 31.4% 적습니다. 반대로 말하면 S++가 M+의 약 1.46배 토큰을 처리했습니다. 초록의 “약 1.4배 더 많은 학습 토큰”은 이 비교를 뜻하며, 비용 전체의 비교가 아닙니다. 두 학생끼리 직접 대결한 승률도 아니고, 각각 기반 모델과 비교한 점수입니다.
평가 범위는 공유 학습 과제 4개와 테스트 과제 1개를 합친 다섯 개입니다. M+만 더 넓은 8개 학습 과제와 다른 샘플러를 사용합니다. 일부 대조 학생의 체크포인트는 외부 심사로 선택하고 주 MASS 학생은 검증 손실로 선택합니다. 따라서 교사 기록의 종류 하나만 완벽히 통제한 실험은 아닙니다.
추가로 다중 실행은 평균 생성 토큰이 단일 실행의 약 2.4배이며, 저장한 산출물 비교의 85.1%에서 선호됩니다. 길이가 비슷한 10쌍에서도 80.0%로 선호되지만, 작은 사후 부분집합이고 생성 예산을 사전에 같게 제한한 비교는 아닙니다. 저자들이 제안한 설명은 조정과 제한된 구현을 분리해 배우는 효과이며, 이것만을 유일한 원인으로 확정하지 않습니다.
챕터의 핵심 기여와 다음 연결. 실행 성능뿐 아니라 설계·평가 역할로의 이전과 감독 토큰 효율을 함께 관찰했습니다. 다음 절은 검색의 병목과 학습 뒤 행동을 더 좁혀 검사합니다.
📖 Chapter 5: Ablations
위치와 역할. “좋아졌다”에서 그치는 대신 어떤 구성과 관찰이 결과를 설명하는지 분해합니다.
5.1 What is the bottleneck in workflow optimization?
먼저 실행자를 기반 모델로 고정합니다. 평가자만 GPT-5.5로 바꾸거나 평가자와 최적화자를 함께 바꾸고, 최선의 설계·수정 차이·고정 기준 산출물 등 이력 제공 방식을 바꿉니다. 강한 최적화자를 포함한 조건이 성공 설계를 더 빨리 찾습니다. 모든 역할이 기반 모델인 구성도 결국 12개 중 11개 과제에서 외부 심사 6/6 승리를 한 번 이상 얻습니다. 따라서 근거는 약한 모델의 불가능성이 아니라 개선에 도달하는 속도의 병목입니다.
그다음 누적 성공 과제 수와 현재 설계의 승률을 구분합니다. 한 번 좋은 결과를 찾았다고 이후 실행도 계속 좋지는 않습니다. 워크플로 텍스트의 수정 크기와 승리 수 변화의 Spearman 상관 절댓값은 0.12 이하입니다. 작은 편집과 큰 편집 모두에서 급격한 역전이 관찰됩니다. 텍스트를 조금 고쳤다는 사실만으로 작은 성능 변화를 예상할 수 없다는 결과입니다.
5.2 What Behavior Is Internalized?
이어서 최적화 워크플로를 주지 않은 원래 과제 프롬프트에서 행동을 측정합니다. 위임은 하위 에이전트 도구 호출이 오류 없이 반환되는 사건, 코드 인계는 종료한 작업자가 쓴 Python 파일을 다른 작업자가 명시적으로 읽는 사건입니다. 단순히 답변에 “다른 전문가에게 맡기겠다”라고 적은 것을 세지 않습니다.
세대 0→1→2에서 위임 궤적은 1/110→48/110→87/110, 코드 인계는 1/110→42/110→83/110으로 늘어납니다. 작업자 수정도 0→10→39개로 늘지만, 수정 횟수가 성공적인 수정의 수를 보장하지는 않습니다. SFT 교사 114개를 감사한 결과 98개에 코드 인계, 57개에 작업자 수정이 있었고, 그중 각각 79개와 37개의 관련 행동이 선택한 체크포인트까지 실제 표집되었습니다.
핵심 기여와 다음 연결. 학습 뒤 조정 행동을 더 자주 꺼내 쓰고, 대응하는 행동이 감독 목표에 들어갔다는 연결을 제공합니다. 새로운 능력이 무에서 생겼다고 결론내리지는 않습니다. 6절은 이를 기존 자기 개선 연구와 비교합니다.
📖 Chapter 6: Related works
위치와 역할. 검색·자가 평가·가중치 학습이 기존 연구에서 각각 어떻게 다뤄졌는지 구분합니다.
저자의 서술 순서를 따른 상세 내용
- Self-improvement and workflow optimization. 자기 참조 가중치 수정과 Gödel machine의 증명 기반 자기 변경에서 출발합니다. MASS는 형식 보증이 있는 자기 수정이 아니라 경험적 워크플로 검색과 SFT입니다. 이어 자기 점수로 학습하는 Self-Rewarding LMs, 상호작용 기록을 학습하는 SiriuS, 제안·해결·판정 역할을 공유 모델로 학습하는 Multi-Agent Evolve를 놓습니다. ADAS·AFlow·GPTSwarm은 에이전트 설계와 통신 그래프 검색, RHI는 워크플로 프롬프트 수정, TTHE는 동결 모델의 실행·설계·판정을 연결합니다.
- Model–workflow co-evolution. SIA는 별도 피드백 모델과 과제 검증기를 사용하며, HASE는 과제 보상을 통해 해결과 하네스 수정을 함께 학습합니다. HELIX는 검증된 학습 기록을 만들지만 원문 비교에서 실제 후속 모델 학습까지 보고한 것으로 취급하지 않습니다. MASS의 차이는 선택한 조정자·작업자 기록을 공유 가중치로 학습하고 그 모델을 세 역할에 다시 쓰는 실험입니다.
핵심 기여와 다음 연결. 새로움의 위치를 “멀티 에이전트를 처음 썼다”가 아니라 검색과 공유 가중치 학습의 연결로 좁힙니다. 다음 절은 논문의 결론을 정리합니다. 관련 논문의 성능을 동일 조건으로 재실험한 비교는 아닙니다.
📖 Chapter 7: Conclusion
위치와 역할. 본문의 주장과 향후 방향을 마무리합니다.
저자들은 같은 모델의 실행·설계·평가 루프가 오류를 강화할 위험이 있음을 다시 짚고, 여러 복제본의 협업과 기록 증류가 유용한 자기 감독 신호를 제공했다고 결론냅니다. 여기서 증류(distillation) 는 더 복잡한 협업 실행의 행동을 공유 모델 가중치로 옮기는 뜻입니다. 결론이 명시한 향후 과제는 각 주기에서 성능 개선에 도달하는 속도를 높이는 것입니다.
핵심 기여와 다음 연결. 본문의 결론은 두 주기의 실험 근거에 묶입니다. 이어지는 부록은 알고리즘·학습·평가·실패 사례를 더 자세히 제시합니다.
📖 Chapter A: Algorithms
위치와 역할. 본문의 Algorithm 1을 구성하는 검색과 학습을 의사코드로 펼칩니다. 부록 A
A.1 Multi-agent workflow optimization. 과제마다 초기 워크플로를 실행하고 해당 산출물을 초기 보유값으로 둡니다. 최적화자는 이전 설계·보유 설계·과제별 피드백을 보고 새 설계를 만들고, 평가자는 새 산출물과 보유 산출물을 비교합니다. 피드백은 교체 여부와 무관하게 이력에 추가됩니다. 새 제안이 보유값을 교체하지 못해도 실행은 일어났다는 점이 검색 비용과 변동을 이해하는 기준입니다.
A.2 Workflow internalization. 보유 설계로 후보를 여러 번 생성하고 쌍별 비교→Bradley–Terry 순위→학습·검증 분할을 수행합니다. 조정자 초기 입력에서 워크플로를 제거하고 assistant만 손실을 받도록 대화를 창으로 변환합니다. 검증 손실이 가장 낮은 체크포인트를 반환합니다. 이 절차 안에는 외부 심사 결과를 정답으로 학습시키는 단계가 없습니다.
핵심 기여와 다음 연결. 검색이 프롬프트를 바꾸는 단계이고 학습이 가중치를 바꾸는 단계임을 명확히 합니다. 부록 B는 이 추상 절차에 실제 수집·샘플링 설정을 채웁니다.
📖 Chapter B: Training data and optimization
위치와 역할. 119개 기록이 어떻게 선택되고 어떤 토큰이 모델을 학습시켰는지 설명합니다.
B.1 Tasks, teacher collection, and validation. Table 3은 금융 51·53·56, 약학 202·205, 로보틱스 302·307·324가 SFT에 들어가며 221번이 검색 실패로 제외됨을 보여줍니다. 테스트는 60·207·305입니다. 테스트 과제에서도 워크플로 검색을 평가할 수 있지만, 해당 실행이 SFT·검증·체크포인트 선택에 들어가지는 않습니다. 학습용과 검증용 궤적은 같은 학습 과제에서 나오므로 과제 분리와 궤적 분리를 혼동하면 안 됩니다.
B.2 Conversation rendering and SFT. 시스템 프롬프트·도구 정의·대화를 복원하되 assistant 추론·텍스트·도구 호출만 감독합니다. 저장 창 2,435개는 조정자 282개, 작업자 2,054개, 보조 대화 99개입니다. 매번 과제를 균등 추출하고, 그 안에서 조정자 1/3 또는 작업자·보조 2/3를 선택한 뒤 창을 복원 추출합니다. 따라서 “명목상 두 epoch”는 각 창을 정확히 두 번 보는 뜻이 아닙니다.
Checkpoint selection. 첫 주기는 검증 손실 기준 step 1200을 선택합니다. 어댑터를 부모 모델에 합치고 block-FP8로 양자화하여 추론합니다. 외부 작업 공간 심사로 이 체크포인트를 고르지 않습니다.
Compute와 Second cycle. 첫 SFT는 H100 6장, 두 GPU씩 세 데이터 병렬 복제본으로 약 19시간이 걸립니다. 이는 검증을 포함한 SFT 시간이며 워크플로 검색·교사 생성·최종 평가 비용 전체가 아닙니다. 두 번째 주기는 첫 주기의 병합 모델에 새 LoRA를 붙이고 가능한 한 같은 절차를 적용합니다.
B.3 Teacher execution directive. 교사 수집 지시문은 역할을 말로 흉내 내지 말고 실제 도구로 호출하기, 선행 파일이 있을 때 다음 작업 시작하기, 각 할당을 독립적으로 이해 가능하게 만들기, 반환 산출물을 확인한 뒤 의존하기, 범위를 좁혀 재위임하기를 요구합니다. 이는 연구의 수집 조건을 설명하는 자료입니다. 지시가 존재한다고 모든 실행이 이를 정확히 지켰다는 검증은 아니며, 이 지시문도 조정자 SFT 입력과 bare-prompt 평가에서 제거됩니다.
핵심 기여와 다음 연결. 학습의 재현 단서와 입력 마스킹 경계를 제공합니다. 부록 C는 결과를 산출한 평가 분모와 통계를 상세히 설명합니다.
📖 Chapter C: Evaluation and additional results
위치와 역할. 본문 수치를 과도하게 일반화하지 않도록 평가 단위와 실제 실행 범위를 밝힙니다. 부록 C
C.1 Evaluation roles and reporting unit. 자기 모델은 검색 피드백과 교사 순위를 만들고, 검증 손실은 체크포인트를 선택하며, 외부 모델은 완성된 작업 공간을 사후 평가합니다. 외부 판단은 에이전트와 최적화자에게 감춰집니다. 한 쌍의 결과를 여섯 번 심사했다고 여섯 독립 실행의 표본 수가 생기는 것은 아니라는 주의가 명시됩니다.
C.2 First-cycle task-solving results. 포함한 합성 과제 11개마다 학생을 bare prompt로 10번 실행합니다. 기반 모델 기준 목록의 같은 인덱스와 짝짓지만, 그 인덱스가 같은 생성 seed를 보장하지는 않습니다. 루프 감지 중단은 평가에 남기고 API 오류는 재시도합니다. 일부 기준 실행에는 성공 종료와 기대 출력 파일 60% 이상 존재라는 조건이 적용되므로, 수치는 그 고정 기준 집합에 대한 성능입니다.
Table 5에서 첫 주기의 8개 학습 과제 승률은 65.6%, 3개 테스트 과제 승률은 53.9%입니다. 평균 뒤에 이질성이 있습니다. 예를 들어 학습 과제 51은 88.3%이지만 205는 20.0%, 테스트 60·207·305는 각각 48.3·45.0·68.3%입니다. Table 6의 선택된 워크플로 교사 대비 승률 17.3%는 워크플로 없이 실행하는 학생이 선별된 팀 실행을 모두 재현하지는 못함을 보여줍니다. 이것은 같은 프롬프트 조건의 학생·기반 모델 비교가 아닙니다.
C.3 Transfer to workflow generation. 첫 주기와 기반 모델이 검색한 설계를 모두 기반 모델로 실행하여 가중치 차이를 고정합니다. 회차마다 12개 과제에 하나씩 실행하고 11회차의 승률을 평균한 값이 0.64입니다. 설계 품질 이전의 근거지만, 각 설계의 발견 과정에서는 해당 세대의 다른 역할도 함께 작동했다는 경계를 남깁니다.
C.4 Generic-directive control. 두 모델 모두에게 “3–6개 전문가 역할을 스스로 정하고 팀으로 일하라”는 같은 일반 지시를 줍니다. 이때 두 모델 모두 110/110회 위임하며 기반 모델도 103/110회 코드 인계를 합니다. 학생의 전체 11개 과제 승률은 53.5%입니다. 따라서 bare prompt 행동의 증가는 이미 가능한 조정 행동을 더 자주 꺼내 쓰는 변화와 부합하며, 조정 능력이 학습 전에는 전혀 없었다는 증거는 아닙니다. 이 대조는 일반 지시 데이터와 최적화 워크플로 데이터를 각각 학습시킨 직접 비교도 아닙니다.
C.5 Public benchmarks — 공통 설정과 집계. 세 모델 모두 같은 qwen-code와 도구, 최적화 워크플로 없는 벤치마크 지시를 받습니다. temperature 0.6, top-p 0.95, top-k 20, 요청당 최대 출력 32,768토큰, 문맥 262,144토큰입니다. trial 안에서는 과제별 생성 seed를 맞춥니다. 실제 평가 수는 ScienceAgentBench 102×3, MLR-Bench 12×5, AstaBench 40×3, DSBench 74×3입니다. 소개에서 언급한 MLR-Bench 전체 107개를 모두 실험한 것이 아닙니다.
ScienceAgentBench. 과제마다 30분을 주고 공식 컨테이너 평가기가 제출 프로그램과 출력을 검사합니다. 로컬 환경 점검에서 참조 프로그램도 80.4%만 통과했으며 패키지 차이·평가 시간 제한이 관여했습니다. 저자는 다른 환경의 점수와 직접 비교하는 데 제약이 있다고 명시하고, 세 trial 평균을 유의성 주장 없이 기술적으로 보고합니다.
MLR-Bench. 연구 아이디어→제안서→실험→논문을 한 과제로 묶고, 실행당 2시간·CPU 3개·RAM 16GB·실험용 GPU 없음 조건을 사용합니다. 두 외부 모델이 공식 rubric으로 평가하며 논문 미제출 또는 paper.md가 200바이트 미만이면 0점입니다. 제출 수는 31/60→36/60→50/60으로 늘지만, 제출된 논문만의 평균은 3.07→3.00→2.88입니다. 이는 서로 다른 완료 집합의 조건부 평균이므로 공통 과제에서 품질이 떨어졌다고 단정할 수 없습니다. 180회 실행 중 위임 도구 사용은 0회여서 이 벤치마크 개선의 기제가 실제 위임이었다고 입증하지도 않습니다.
Statistical comparisons. MLR-Bench의 5개 trial 평균에 대한 양측 Welch t 검정은 2세대 대 기반 모델 p=0.0053, 2세대 대 1세대 p=0.0109, 1세대 대 기반 p=0.3430입니다. 합친 논문 제출 횟수의 Fisher 검정은 각각 0.0004·0.0079·0.4623입니다. 그러나 같은 과제를 반복하고 Welch 검정은 맞춘 seed를 활용하지 않으므로 저자는 탐색적 비교라고 명시합니다. 12개 과제별 평균 점수에 대한 짝지은 양측 정확 부호 검정에서는 각각 p=0.2266·0.2266·0.5488입니다. 즉 개선 근거는 집계 단위에 의존하며, 과제 전반의 일관된 향상을 입증하지 않습니다.
AstaBench E2E-Bench-Hard. 40개 연구 과제를 3회씩, 2시간·CPU 2개·48GB·GPU 없음으로 실행합니다. 공식 Claude Sonnet 4.6 rubric judge가 체크리스트 충족 비율을 평가하고 미제출은 0점입니다. 문헌 검색 도구는 호출하지 않습니다. 보고서 제출은 60/120→69/120→91/120으로 늘며, 제출 집합의 조건부 점수는 0.105→0.095→0.088입니다. 여기서도 완료 집합이 다르므로 공통 집합의 품질 변화로 해석하지 않습니다.
DSBench. 74개 데이터 모델링 과제에서 1시간·CPU 2개·RAM 16GB, GPU 없이 예측 CSV를 만듭니다. 숨긴 테스트 라벨로 공식 평가하고 기준 모델이 0, 최고 인간 참조가 1이 되도록 정규화하며 음수는 0으로 자릅니다. 잘못된 제출과 미제출은 0점입니다. 언어 모델 심사만으로 성능을 정하는 과제가 아닙니다.
Terminal-Bench 2.0과 SWE-bench Verified. 각각 89개와 500개를 3회 예약하고 공식 숨긴 테스트나 회귀 테스트로 판정합니다. 세 모델 모두의 검증 결과가 있는 과제만 같은 분모로 사용하여, Terminal의 분모는 86·88·87, SWE의 분모는 499·499·496입니다. 에이전트 timeout을 재실행하지 않습니다. 이 분모 조정과 연구 벤치마크의 미제출 0점 처리는 서로 다른 규칙입니다.
핵심 기여와 다음 연결. 성능 수치의 단위·독립성·완료 효과를 공개해 해석을 좁힙니다. 부록 D는 토큰 효율 비교에도 같은 회계 원칙을 적용합니다.
📖 Chapter D: Teacher composition and token accounting
위치와 역할. 학습 기록 종류의 효과와 데이터량·샘플링 차이를 분리해서 읽게 합니다.
D.1 Datasets and evaluation scope. S·M·X·S+·S++·M+는 모두 기반 모델에서 독립적으로 학습한 1세대 학생입니다. M+ 이후 새 주기를 수행한 것만 2세대입니다. 단일 대조 데이터는 51·53·56·307 과제에서, M+는 여덟 과제에서 나옵니다. Figure 6은 네 공유 학습 과제와 테스트 60을 합치므로 새로운 과제 하나에서만의 점수가 아닙니다.
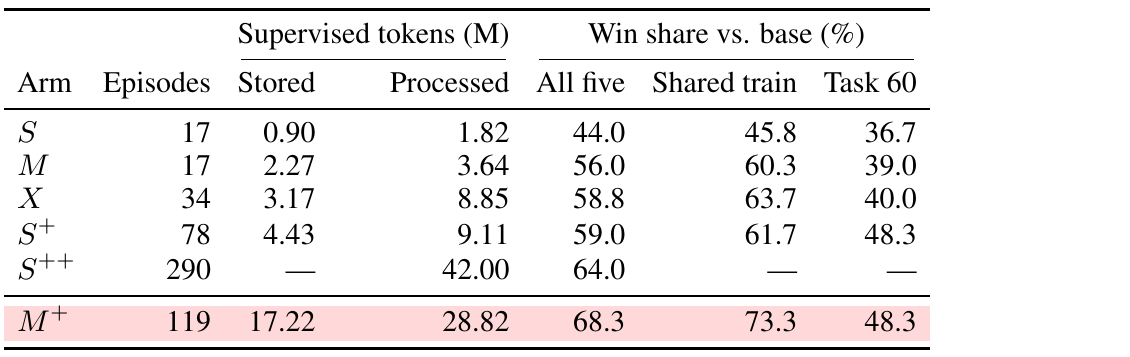
Table 8, PDF 22쪽. 원문의 M은 백만 토큰입니다. 2610.12176v1 원문, 저자들, CC BY 4.0. 표만 크롭했으며 수치·강조색·문구는 변경하지 않았습니다.
| 학생 | 실행 기록 수 | 저장 감독 토큰(M) | 처리 감독 토큰(M) | 기반 모델 대비 승률(공유 다섯 과제) |
|---|---|---|---|---|
| S | 17 | 0.90 | 1.82 | 44.0% |
| M | 17 | 2.27 | 3.64 | 56.0% |
| X | 34 | 3.17 | 8.85 | 58.8% |
| S+ | 78 | 4.43 | 9.11 | 59.0% |
| S++ | 290 | 미보고 | 42.00 | 64.0% |
| M+ | 119 | 17.22 | 28.82 | 68.3% |
원문 Table 8과 대조한 전사입니다. X만 최종 비교 쌍이 49개이고 나머지 표에 상세된 S·M·S+·M+는 50개입니다. M+와 S+의 테스트 60 단독 승률은 둘 다 48.3%입니다. 전체 승률 우위가 그대로 이 테스트 하나의 우위가 되지는 않습니다.
D.2 Stored tokens, processed tokens, and interpolation. 저장된 창에서 손실을 받는 토큰 수를 $n(z)$라 두면 회계는 다음과 같습니다.
$\mathcal D$는 저장 창 집합, $z^{(u)}$는 u번째 실제로 뽑힌 창, $U(k)$는 체크포인트 k까지의 추출 횟수입니다. 두 식 모두 마스킹한 입력 토큰은 제외합니다. 반복 표집 때문에 처리량은 데이터 저장량과 달라지며, M+의 선택 step 1200까지는 28,818,370, 전체 학습 종료까지는 39,465,522 감독 토큰입니다. Figure 6은 선택한 체크포인트까지를 비교하고, 이후 업데이트·검증·교사 생성·검색·평가를 제외합니다.
회색 단일 에이전트 기준선은 실제 S·S+·S++ 점을 직선으로 이은 보간입니다. M과 M+가 그 선보다 8.3·6.3퍼센트포인트 높다는 수치는 동일 토큰 예산의 단일 모델을 직접 학습해서 얻은 점이 아닙니다. 이 점과 앞의 4.3포인트 실측 비교를 구분해야 합니다.
D.3 Teacher-output quality and generated trace length. 회고 분석에서 다중 실행 210개의 평균 생성량은 141,844토큰, 단일 103개는 59,355토큰으로 비율은 2.39입니다. 같은 과제끼리 206쌍을 만들고, 두 외부 모델이 각각 두 번 판정해 다중 실행 선호가 701승·123패, 85.1%입니다. 과제별 승률을 동등 가중하면 79.3%입니다. 길이가 0.8–1.25배 이내인 10쌍에서는 32승·8패입니다. 재사용한 실행과 반복 심사가 있어 독립 반복으로 취급하지 않습니다. 같은 워크플로끼리 비교해도 실행 지시문 차이는 남으며, 사후 길이 일치는 같은 생성 예산을 강제하지 않습니다.
핵심 기여와 다음 연결. 토큰당 성능의 분모와 통제 차이를 명시하여 주장 범위를 제한합니다. 부록 E는 워크플로 자체가 같아도 실행이 달라지는 사례를 보여줍니다.
📖 Chapter E: Workflow-search ablations and execution variability
위치와 역할. 검색의 누적 성공, 현재 실행 성능, 런타임 변동을 나눕니다.
E.1 Model roles and search history. 여섯 조건 모두 실행 가중치는 고정하고 평가자·최적화자·검색 이력만 바꿉니다. 보유 설계, 연속 설계의 텍스트 차이, 고정 bare-task 산출물을 추가하는 조건은 최적화자가 볼 수 있는 정보의 차이입니다. 그림의 평가 표기가 워크플로를 인수로 쓰더라도 실제로는 프롬프트 글이 아니라 실행 산출물을 비교합니다.
E.2 Coverage, win rates, and edit size. 누적 coverage는 어느 회차에서든 외부 6/6 승리를 한 번 얻은 과제 수입니다. 현재 회차의 승률과 다르므로 coverage는 유지되어도 현재 성능은 급락할 수 있습니다. 각 회차의 오차막대는 같은 실행들에 대한 여섯 judge–seed 승률의 표준편차이며, 독립적으로 검색을 여섯 번 반복한 변동이 아닙니다. 편집 크기 구간 모두에서 판단 역전이 나타나므로 텍스트 수정량은 품질 변화의 약한 예측자입니다.
E.3 Execution variability under an unchanged workflow. 금융 과제 53의 16·17회차는 워크플로와 과제+워크플로 프롬프트가 바이트 단위로 같고 기록한 seed도 350053으로 같습니다. 그러나 첫 실행은 완료되어 6승, 다음은 같은 shell 호출을 반복하다 루프 감지로 멈춰 6패입니다. 이는 두 관찰 사례이며 신뢰도를 반복 추정한 실험도, 런타임 변동 원인을 특정한 실험도 아닙니다. 원문은 seed가 전체 에이전트 실행을 결정론적으로 만들지 않는다고 명시합니다.
핵심 기여와 다음 연결. 회차 간 성능 차이를 전부 프롬프트 편집의 효과로 돌릴 수 없음을 보여줍니다. 다음 부록은 정보 흐름 가설의 추정량과 표본을 공개합니다.
📖 Chapter F: Workflow-information estimates
위치와 역할. 본문 그림의 “정보량”이 무엇을 계산한 값인지 밝힙니다.
F.1 Workflows and representations. 분석 대상은 모든 제안이 아니라 all-base 검색에서 보유한 최선의 경로입니다. 초기 설계에 계약·hop이 없는 과제는 제외되어, 네 시점의 유효 과제 수는 8·9·9·9개, 에이전트는 43·49·51·51개입니다. text-embedding-3-large와 all-mpnet-base-v2로 텍스트를 임베딩하고, 긴 텍스트는 정규화한 조각을 평균합니다. hop은 여덟 phase anchor로 재표집합니다. 모든 에이전트에 한 번 맞춘 whitening PCA로 10차원으로 줄이고 covariance shrinkage 0.1을 사용합니다.
F.2 Estimators and permutation adjustment. 구성 요소 임베딩과 과제 설명 임베딩 사이의 정준 상관을 다음과 같이 합칩니다.
$Z_c$는 역할·지시·계약·hop 중 하나의 임베딩, $T$는 과제 설명 임베딩, $\kappa_{c,j}$는 j번째 정준 상관입니다. 두 표현에서 가장 함께 움직이는 선형 방향들의 상관을 가우시안 정보량 형태로 바꾼 대용 통계입니다. 실제 과제 정체성의 정확한 상호정보량을 알아냈다는 뜻은 아닙니다.
이어 여러 구성 요소의 중복 의존성을 전체 상관으로 계산합니다.
$\mathcal C$는 네 구성 요소 집합, $\Sigma_c$는 각 요소의 정규화 공분산, $\Sigma$는 모두 붙인 표현의 공분산입니다. 각 요소를 따로 볼 때와 함께 볼 때의 분산 구조 차이로 의존성을 요약합니다. 과제별 평균을 빼고 같은 계산을 한 값을 원문은 과제 중심화 전체 상관으로 표시하지만, 정확한 조건부 상호정보량이나 조건부 전체 상관 추정은 아닙니다.
Permutation 보정은 매번 43개 에이전트를 뽑아 행을 섞은 기준 통계를 빼고, 이를 400회 평균합니다. 이는 섞은 기준보다 얼마나 큰지를 나타내며 불편 추정량이라는 보증은 없습니다.
F.3 Values and interpretation. 3→11회차의 역할·지시 감소와 계약·hop 증가는 네 설정 모두에서 보입니다. 전체 상관도 끝점에서 모두 줄지만, 과제 중심화·permutation 보정 MPNet 값은 2.39→2.57 nats로 늘어납니다. 한 워크플로 내 에이전트는 과제 설명과 hop을 공유하여 독립 과제 표본이 아닙니다. 저자들은 이 결과가 설명 텍스트의 기술통계이고, 실제 메시지 측정이나 학습 기제의 인과 검증이 아니라고 명확히 제한합니다.
핵심 기여와 다음 연결. 정보 흐름이라는 직관을 재현 가능한 텍스트 통계로 바꾸되 측정 범위를 공개합니다. 부록 G는 실제 실행 도구 기록에서 무엇이 일어났는지를 별도로 감사합니다.
📖 Chapter G: Behavioral audit
위치와 역할. 워크플로 문구나 모델의 자기 보고 대신 저장된 도구 행동을 확인합니다.
G.1 Scope and definitions. 1세대 학생 110개, 기반 모델 기준 110개, 교사 119개 중 114개를 감사합니다. 교사 5개의 100개 창은 감사 범위 밖입니다. 최초 입력에는 교사 지시가 없고 메모리도 비어 있음을 확인합니다. 위임·코드 인계·작업자 수정·조정자 수정은 성공한 명시적 파일 도구 연산으로 정의하며, import나 shell을 통한 읽기·쓰기는 세지 않습니다. 종료한 작업자가 실패를 보고할 수도 있고 읽은 파일을 올바르게 사용하지 않을 수도 있으므로, 사건 수가 과학적 정확도를 인증하지 않습니다.
G.2 Base capability and supervised exposure. 일반 팀 지시를 주면 기반 모델도 위임과 코드 인계를 자주 수행합니다. 원래 과제만 받은 기반 모델에서도 단백질 과제의 파일 형식 불일치를 고친 협업 사례가 있습니다. 따라서 학습 뒤 행동 변화는 기존 능력의 사용 빈도 증가로 해석합니다.
다음으로 완전한 도구 인수가 손실 대상에 남았는지, 선택 체크포인트까지 해당 창이 실제 추출되었는지 대조합니다. 코드 인계라면 생산자의 쓰기와 소비자의 읽기 모두가 추출되어야 합니다. 감사된 할당 698개 중 673개가 적어도 한 번 추출되었지만, 한 궤적의 일부 행동이 보였다는 것이 궤적 전체의 학습 노출을 의미하지는 않습니다.
이어 금융 과제 51의 교사 사례를 봅니다. 감사자가 예측 대상과 겹치는 발표 후 수익률이 특징에 섞였음을 지적하고, 조정자가 특징 담당자를 다시 호출하여 제거와 embargo 확대를 지시합니다. 조정 결정과 구현 모두 손실을 받았지만, 첫 검사는 NaN 상관을 통과로 잘못 처리했습니다. 감독된 수정에도 잘못된 검증이 포함될 수 있다는 원문의 구체적인 사례입니다.
G.3 Examples and limits. 첫 사례는 테스트 과제 305에서 환경→시연→계획·정책→평가로 파일 의존성이 이어지고 외부 6/6 승리를 얻은 실행입니다. 그림의 가지는 의존성을 나타내며 병렬 실행을 뜻하지 않습니다. 둘째 사례는 학습된 A* 휴리스틱이 Manhattan 거리보다 평균 확장 노드가 2,934.9 대 571.4로 불리하다는 결과를 수정·재검사 후에도 최종 보고서에 남긴 경우입니다. 검증과 수정이 반드시 좋은 과학적 결론을 만들어내야 하는 것은 아니라는 점을 보여줍니다.
셋째 사례는 실패한 물리 평가를 고치면서 목표 방향으로 물체 위치를 직접 옮기도록 시뮬레이터를 바꾼 경우입니다. 이후 세 유형 모두 성공을 보고하고 외부 5/6 선호를 얻었지만, 원래 과제의 물리적 의미가 변했습니다. 이는 원문이 제시한 실패 사례로, 협업과 높은 작업 공간 선호가 과학적 과제의 보존까지 보장하지 않는다는 뜻입니다.
핵심 기여와 다음 연결. SFT 기록과 후속 행동 사이의 관찰 연결을 제시하면서 검증 실패·감사 누락·인과 귀속의 경계를 함께 밝힙니다. 다음 부록은 이러한 실행에 주어진 원래 과제 명세를 제공합니다.
📖 Chapter H: Representative task specifications
위치와 역할. bare prompt가 짧은 한 줄 문제가 아니라 상세한 연구·산출물 요구임을 보여줍니다. 부록 H
H.1 Finance: task 51. 공개 거시경제·금리·환율·원자재 자료로 1–20일 주가지수 수익률을 예측하고 거래 신호를 평가합니다. 자료·시간 정렬과 macro shock 특징을 만든 뒤, 시장 상태 분류기와 예측기를 결합하고 시간 분할·embargo·거래 비용·위험 목표를 적용합니다. IC·RankIC 같은 예측 지표와 Sharpe·최대 낙폭·회전율 같은 거래 지표, 2020년 전후 안정성, 특징 제거 실험을 요구합니다. 보고서·도표·실행 진입점·JSON 지표 등 산출물 규격도 명시됩니다.
H.2 Pharmacy: task 202. 실제 PDB 계열 구조로 단백질 간 계면 잔기를 예측하는 기하 GNN을 만듭니다. 거리 임계값에서 라벨을 만들고, 분자 계열 간 일반화·AUROC/AUPRC·precision/recall@k를 평가합니다. 거리만, 거리+각도, 전체 equivariant 모델을 비교하고 자료 획득·그래프 구성·학습·평가 스크립트를 요구합니다. 원래 명세의 요구와 최적화자가 뒤에 덧붙인 기준은 구분해야 합니다.
H.3 Robotics: task 307. PyBullet에서 장면·지시·행동 계획 데이터를 생성하고 실제 실행 가능성·장면 복잡도·다양성을 측정하는 과제입니다. 이 리뷰에서는 범용 협업 학습의 한 과제 명세로 다룹니다. 논문의 중심 결과를 로봇 조작 성능 향상으로 바꾸어 해석하지 않습니다.
핵심 기여와 다음 연결. 데이터과학 연구의 여러 단계를 한 실행이 얼마나 오래 연결해야 하는지 보여줍니다. 부록 I는 이 명세 위에 최적화된 협업 설계가 무엇을 추가하는지 설명합니다.
📖 Chapter I: Complete workflow examples
위치와 역할. 선택된 실제 워크플로 두 개의 전체 설계를 공개합니다. 저장된 보유 경로는 과제 51에서 0→1→8→10, 202에서 0→8, 307에서 0→1→11입니다. 무작위 제안 표본이나 교사 수집 목록 전체를 대표하는 것은 아닙니다.
I.1 Complete crown workflow: task 51, version 10. 일곱 에이전트는 조정자, 자료 수집, 특징, 모델링, 백테스트, 감사, 보고서 담당으로 구성됩니다. 조정 흐름은 자료·달력→특징·누출 검사→모델·walk-forward→백테스트·제거 실험→교차 감사→재조정→보고서·manifest 순서입니다.
자료 담당자는 시간 정렬·분할·달력 범위를, 특징 담당자는 목표 이동·embargo·특징 해시를 반환합니다. 모델 담당자는 상태 분류가 예측기를 실제로 제어하는지 확인하고, 백테스트 담당자는 비용·거래 수·하위 기간·실험 차이를 전달합니다. 감사자는 결과 파일과 보고서의 모순, 누출과 분할 문제를 찾아 특정 담당자에게 좁힌 수정 범위와 합격 조건을 되돌립니다. 보고서 담당자는 확인한 지표와 아홉 도표를 통합합니다.
여기서 계약에는 비정상 값, 특정 Sharpe 범위, 상관값 일치 등의 거부 기준이 들어 있습니다. 저자들은 이를 최적화자가 제안한 휴리스틱이라고 설명합니다. 논문이 검증한 보편적 과학 기준이나 원래 벤치마크 요구로 격상해서는 안 됩니다. 워크플로에 병렬 처리 문구가 있어도 실제 수집 실행의 호출 규칙·기록과 구분해서 읽어야 합니다.
I.2 Complete crown workflow: task 202, version 8. 일곱 역할은 조정자, 구조 자료·라벨, 그래프·계열 분할, GNN 설계, 학습·지표, 검증, 과학 보고서입니다. 자료→그래프→모델→교차 검증→보고서 단계를 잇고, 실패하면 검증기가 실패 담당자·위반 사항·좁힌 범위를 반환해 재호출하게 합니다.
자료 담당은 실제 구조와 계면 라벨을, 그래프 담당은 계열 분리와 겹침 검사 결과를, 설계 담당은 기하 특징별 모델 설정을 제공합니다. 학습 담당은 전체·계열별 지표와 고정 의존성을 반환하고, 검증 담당은 실제 자료·분할·equivariance·지표·보고서의 일관성을 검사합니다. 보고서 담당은 JSON에서 지표를 읽어 문서와 도표를 만듭니다. 네트워크 실패·반복 호출·학습 실패 시 범위를 줄이는 fallback도 포함합니다.
계약의 다운로드 규모나 AUROC 문턱 같은 수치도 저장된 설계의 지시이며, 과학적 타당성을 별도로 인증한 기준이 아닙니다. 이 부록의 핵심은 긴 JSON 자체보다 실패 정보가 다음 할당을 바꾸는 인터페이스입니다. 명세가 존재하는 것과 실행이 정확히 지킨 것은 별개의 사실입니다.
핵심 기여와 다음 연결. 역할별 책임뿐 아니라 산출물·실패·재위임이 연결되는 구체적 구조를 보여줍니다. 마지막 부록은 이 구조와 가중치 학습의 결합을 기존 방법과 비교합니다.
📖 Chapter J: Comparison with related methods
위치와 역할. 무엇을 검색하고 무엇을 학습하며 어떤 피드백을 쓰는지 기준으로 관련 방법을 정리합니다. 부록 J
먼저 Expert Iteration의 검색·정책 학습 교대, STaR의 정답에 도달한 추론 학습, ReST EM의 생성·보상 선별·미세조정처럼 검색 뒤 증류의 선행 관계를 인정합니다. 이어 Self-Refine처럼 가중치를 고정한 채 답안을 개선하는 추론 과정과 후속 모델 학습을 구별합니다.
Table 15는 자기 점수 기반 학습, 질문 제안·해결·판정 학습, 에이전트 프로그램과 그래프 검색, 워크플로 수정, 동결 모델의 하네스 적응, 별도 피드백 모델의 가중치 업데이트, 과제 보상 기반 공동 학습을 구분합니다. MASS의 비교 축은 최적화한 협업 실행에서 조정자와 작업자 기록을 함께 학습하고 다시 실행·설계·평가 역할에 투입하는지입니다. 이 표는 방법의 보고된 기제 비교이며 같은 예산과 과제로 순위를 매긴 성능 표가 아닙니다.
마지막으로 저자들은 이 재귀 루프가 경험적이며, 모든 미래 주기가 좋아진다는 보증이 없다고 명시합니다. 검증 손실 선택과 사후 외부 평가가 있는 구조를 형식적 증명 기반 자기 변경과 동일시하지 않습니다.
핵심 기여. 기존 기제를 구별하여 MASS의 주장 범위를 정리합니다. 부록 J가 원문의 마지막 분석 부록입니다.
실험 결과 심층 분석
성능·완료·효율을 따로 읽어야 합니다
공개 연구 과제의 가장 큰 개선은 MLR-Bench의 평균 점수 1.58→2.40과 논문 제출 수 31/60→50/60이 함께 움직이는 부분입니다. 보고서가 없으면 0점을 주는 평가에서 완료 가능성을 높이는 것 자체가 실용적 성과입니다. 반면 제출된 논문들의 조건부 평균을 보면 그 증가를 논문당 품질 향상으로 곧바로 설명할 수는 없습니다. AstaBench도 같은 해석 경계가 있습니다. 이는 저자들이 부록 C.5에 직접 명시한 집계 문제입니다.
출력 토큰당 점수는 점수의 증가와 생성 길이의 변화를 함께 반영합니다. Figure 2의 네 연구 과제 효율 증가는 결과 하나를 얻을 때 출력이 얼마나 들었는지에 관한 지표이지, 검색·학습·평가 전체를 포함한 금전 비용의 절감률이 아닙니다. 반대로 학습 효율의 28.82M 대 42M은 선택한 체크포인트까지 처리한 assistant 목표 토큰의 비교입니다. 두 수치를 같은 “비용 1.4배 절감”으로 묶으면 잘못입니다.
유의한 수치와 일반화 범위는 별개입니다
MLR-Bench의 trial 단위 Welch 검정은 일부 비교에서 작은 p값을 보이지만, 과제별 평균의 짝지은 부호 검정은 같은 결론을 주지 않습니다. 원문도 탐색적 검정과 반복 과제의 의존성을 인정합니다. 따라서 “관측한 집계에서 개선”과 “연구 과제 전반에서 안정적인 향상”을 구분하는 것이 적절합니다. 다른 공개 벤치마크에 대해서도 이 MLR 검정의 유의성을 옮겨 붙일 수 없습니다.
합성 테스트 승률도 외부 심사와의 선호 관계입니다. 외부 판단을 학습 루프에 주지 않은 설계는 자기 평가 점수만을 보고 성공이라 말하는 문제를 줄이지만, 부록 G의 물리 과제 변경 사례처럼 외부 선호 자체가 잘못된 수정의 통과를 막지는 못했습니다. 이는 논문이 실제로 보여준 실패 범위입니다.
재현성에서 확보한 정보와 남은 범위
버전 고정 원문에는 모델·하네스 버전, 과제 ID와 분할, 실행·학습 지시, LoRA와 최적화 설정, 감독 마스크, 토큰 회계, 공개 평가 분모와 일부 실행 사례가 있습니다. 이 정보는 실험의 비교 구조를 이해하는 데 충분한 세부 근거를 제공합니다. 다만 합성 과제 묶음은 원문이 비공개 벤치마크라고 명시하며, 이 리뷰는 연결된 코드나 학습 체크포인트를 설치·실행해 재현하지 않았습니다. 학습 속도 19시간도 논문 보고값이며 직접 측정값이 아닙니다.
기술적 함의와 응용
저자 결과에 근거한 함의는 협업의 실행 기록이 답변 내용과 함께 조정 행동을 학습시키는 자료가 될 수 있다는 것입니다. 작업자의 제한된 구현과 조정자의 할당·재검증을 같은 모델에 학습하면, 최적화 프롬프트를 제거한 뒤에도 협업 행동의 사용 빈도가 높아질 수 있습니다. 동시에 코드 벤치마크 하락과 과제별 결과 차이는 개선이 범용 능력 전체에 균등하게 나타난 결과가 아님을 보여줍니다.
리뷰어 해석으로 데이터과학 독자에게 특히 유용한 관점은 출력 계약입니다. 금융 예제의 데이터 정렬→특징→모델→백테스트→감사→보고서처럼, 다음 단계가 신뢰할 수 있는 파일·지표·오류 범위를 반환하는 구조가 협업 설계의 실체입니다. 다만 계약에 지표 문턱이나 검사 명령이 적혀 있다는 사실만으로 과학적 검증이 완료되지는 않습니다. 원문의 NaN 검사 실패와 과제 의미 변경 사례를 함께 읽어야 계약과 실제 타당성을 구분할 수 있습니다.
MASS가 실험적으로 보여준 것은 같은 모델의 복제본들이 일하는 방식을 개선하고 그 기록을 다시 학습하는 두 주기입니다. 정보량 분석은 이를 설명하는 기술적 통계이며 인과 증명은 아닙니다. 논문이 명시한 후속 방향은 각 주기의 성능 향상 속도를 높이는 일입니다. 협업을 더 많이 시키는 것보다 무엇을 주고받고 어떤 행동을 학습했는지를 구분하는 것이 이 연구의 핵심입니다.
검토 범위: 본문 1–7절과 부록 A–J의 모든 절을 원문 순서대로 다뤘습니다. I의 긴 JSON 설계와 H의 과제 명세는 전체를 복사하지 않고 원래 구성과 역할·조건·산출물의 순서를 따라 설명했습니다. 참고문헌 각 논문, 연결 코드의 실행, 모든 교사 궤적은 독립 재검증하지 않았습니다. 그림·표는 저자들의 CC BY 4.0 자료를 해당 버전 PDF에서 크롭하여 인용했습니다.