논문 개요와 전체 구조
LLM 에이전트가 일을 잘하는지는 모델의 지식만으로 결정되지 않습니다. 어떤 자료부터 읽는지, 언제 도구를 호출하는지, 작성한 파일을 다시 열어 검사하는지, 과거 경험을 어떻게 불러오는지가 결과를 바꿉니다. 이러한 실행 환경을 하네스(harness)라고 부릅니다. Harness²는 모델 가중치를 고정한 채 하네스를 수정하고, 수정 과정에서 얻은 경험을 다음 과제의 개선에 활용하는 연구입니다.
핵심은 두 종류의 재귀를 구분하는 데 있습니다. 과제 수준 재귀는 지금 수행하는 작업의 실행 하네스를 개선합니다. 하네싱 수준 재귀는 그 과정의 기록을 라이브러리에 남겨 다음 작업을 개선하는 데 활용합니다. 다음 과제가 이전 과제의 실행 하네스를 그대로 물려받는 것은 아닙니다. 매 과제는 공통 기본 하네스에서 시작하고, 누적된 라이브러리를 참고해 필요한 구성요소를 선택적으로 가져옵니다. 원문 §2
이 리뷰는 Ruiyao Xu, Yanfei Chen, Zhongying CuiZhu, Bhavana Dalvi Mishra, Yifei Ming, Han Yu, Rujun Han, Chen-Yu Lee, Tomas Pfister의 Harness^2: Recursive Agent Harnessing for an Open World, arXiv 2610.14224v1을 다룹니다. 최초 제출은 2026년 10월 9일 UTC입니다. DOI 10.48550/arXiv.2610.14224는 학술지 게재 DOI가 아니라 arXiv 발급 DOI입니다. 아래 설명과 수치는 이 버전의 HTML 및 37쪽 PDF를 근거로 작성했습니다.
| 구분 | 원문의 구조와 역할 |
|---|---|
| 1. Introduction | 정답 검증기가 없는 새로운 과제와 과제 간 경험 이전 문제를 제시합니다. |
| 2. Harness² | 2.1 Recursive Agent Harnessing → 2.2 Task-Level Recursion → 2.2.1 A Contrastive Improvement Step → 2.2.2 Parallel and Sequential Recursion → 2.3 Harnessing-Level Recursion 순서입니다. |
| 3. Experiments | 3.1 Experiment Setup → 3.2 Main Results 순서로 설정과 결과를 설명합니다. |
| 4. Analysis | 재귀 예산, 계산 비용, 제거 실험, 경험 이전, 동일 모델의 편집·실행, 사례를 분석합니다. |
| 5–6 | Related Work에서 연구 맥락을 정리하고 Conclusion으로 마칩니다. |
| Appendix A–D | 방법 비교 기준(A.1), 벤치마크, 베이스라인, 구현(D.1–D.3)을 제공합니다. |
| Appendix E | E.1 구성요소 기여 → E.2 경험 재사용 → E.3 모델 간 이전 → E.4 도구 신뢰도 → E.5 실제 제품 하네스 비교 → E.6 실패 분석 → E.7 정성 사례 순서입니다. |
| Appendix F–H | 명시적 한계, 향후 방향, Editor·Composer·Selector·Reflector의 Prompt 1–6을 제공합니다. |
핵심 기여와 혁신성
해결하려는 문제는 실제 업무에서 하네스를 수정할 때 정답 점수를 바로 알기 어렵다는 것입니다. 문서나 스프레드시트를 생성하는 에이전트에는 코딩 문제의 단위 테스트처럼 즉시 사용할 수 있는 검증기가 없는 경우가 많습니다. 그럼에도 실행 기록과 산출물을 보면 “파일은 만들었지만 열어보지 않았다”, “여러 파일의 수치를 맞추지 않았다”와 같은 행동상의 차이를 관찰할 수 있습니다.
기존 접근의 한계에 대한 저자의 문제의식은 두 가지입니다. 고정된 학습 과제로 미리 최적화한 하네스는 배포 후 처음 만나는 요구사항에 맞지 않을 수 있습니다. 또 한 과제에 맞춘 하네스를 다음 과제에 통째로 이어 붙이면, 특정 과제에만 맞는 수정까지 전파될 수 있습니다. 논문은 이를 현재 과제의 개선과 개선 과정 자체의 경험 축적으로 나눕니다. 원문 §1
제안 방식은 수정 후보를 일반적인 작업 절차와 도메인 전문 지식의 두 관점으로 만들고, 같은 과제를 수정 전후 하네스로 실제 수행하여 행동 차이에 근거해 조합합니다. 이후 채택한 실행 하네스뿐 아니라 어떤 수정이 무엇을 바꾸었는지를 저장합니다. 저자는 경험 재사용이나 온라인 적응 각각을 처음 제안했다고 주장하지 않습니다. 정답 피드백 없이 과제 스트림을 처리하면서 두 수준의 하네스를 함께 개선하는 결합을 강조합니다.
리뷰어 해석으로는, 개선 단위를 답변 문장이나 모델 파라미터에서 실행 절차·도구·재사용 가능한 구성요소로 넓혔다는 점이 학습 가치가 큽니다. 다만 “자기 개선”은 모델 가중치나 개선 알고리즘 전체를 스스로 다시 작성한다는 뜻이 아닙니다.
기술적 세부사항
무엇을 수정할 수 있는가
논문은 실행 하네스를 8개 파일 기반 구성요소로 분해합니다. 같은 지식이라도 매 호출마다 읽는 지시문, 필요할 때만 불러오는 skill, 결정적 계산을 수행하는 script 중 어디에 넣는지에 따라 비용과 동작이 달라집니다.
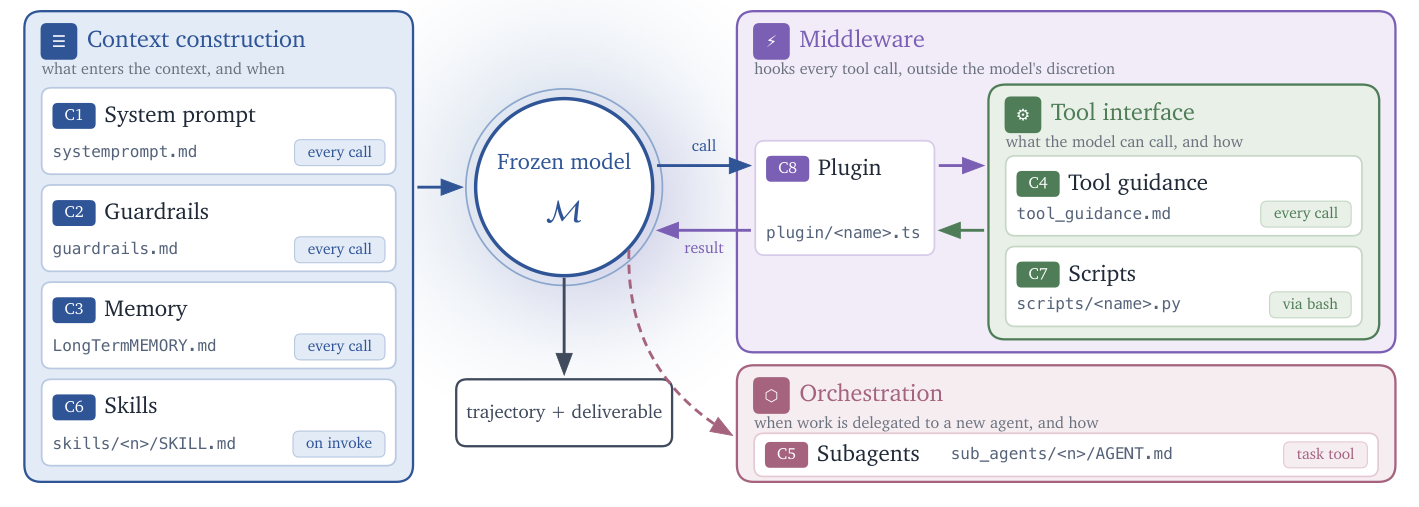
Figure 2, PDF 3쪽. 모델 바깥의 8개 편집 지점입니다. 원본 영역 크롭, 영문·구성 변경 없음. Xu 외, arXiv 2610.14224v1, 버전 고정 PDF, CC BY 4.0.
| 번호 | 구성요소 | 실행 중의 역할 |
|---|---|---|
| C1 | System prompt | 매 호출에 포함하는 역할과 상위 절차입니다. |
| C2 | Guardrails | 과제·도구와 관계없이 유지할 제약입니다. |
| C3 | Memory | 도메인 안에서 지속적으로 참고할 사실입니다. 과제별 사실과 구분합니다. |
| C4 | Tool guidance | 기존 도구를 언제, 어떻게 사용하는지 안내합니다. |
| C5 | Subagents | 독립된 문맥에서 하위 작업을 수행하고 결과를 반환합니다. |
| C6 | Skills | 특정 상황에만 불러오는 전문 절차와 관련 보조 파일입니다. |
| C7 | Scripts | 추출·변환·검사 같은 결정적 연산을 실행합니다. |
| C8 | Plugin | 도구 루프 안의 hook으로 동작하며 런타임에서 개입합니다. |
핵심 수식: 현재 실행과 다음 개선을 구분합니다
아래 식은 원문 식 (1)–(4)의 의미를 보존했습니다. Compose와 Update의 글꼴만 렌더링 호환을 위해 upright 표기로 바꾸었습니다.
식 (1)에서 $q_t$는 현재 과제, $\mathcal{H}$는 현재 실행 하네스, $\mathcal{E}$는 과제 안에서 누적된 실행·개선 기록입니다. $\mathcal{R}_t$는 이번 과제를 개선하는 동안 고정되는 개선 하네스입니다. $\Phi$는 Propose–Probe–Compose 한 단계입니다. 반환값은 새 실행 하네스 $\mathcal{H}^{\prime}$, 그 하네스로 실제 실행한 기록 $e^{\prime}$, 후보와 조합 결정까지 담은 단계 기록 $\xi$입니다. 실행 기록 $e=(\tau,y)$는 행동 궤적 $\tau$와 산출물 $y$를 함께 포함합니다. 이 식은 정답 점수를 최대화하는 학습 손실이 아니라 개선 절차의 입출력을 정의합니다.
식 (2)는 병렬 재귀입니다. $\mathcal{B}$는 기본 하네스의 참조 실행 집합, $\mathcal{P}$는 후보 하네스와 실행 기록의 집합입니다. $k$개의 Composer가 같은 전체 증거를 각각 읽고 후속 하네스를 만듭니다. 첨자 $j$는 독립적인 조합 세션입니다. 후보 답변을 단순 투표하는 식이 아니라 실행 가능한 하네스를 조합하는 식입니다.
식 (3)은 순차 재귀입니다. $r$번째 단계는 직전 하네스 $\mathcal{H}^{(r-1)}$와 그때까지의 기록 $\mathcal{E}^{(r-1)}$에서 출발합니다. 이전 수정을 유지할 수도, 고치거나 되돌릴 수도 있습니다. 병렬 방식의 $k$가 탐색 폭을 늘린다면 순차 방식의 $k$는 이어지는 개선 단계의 깊이를 늘립니다.
식 (4)의 $\mathcal{D}_t$는 한 과제의 전체 개선 기록이고 $\mathcal{H}^{\star}_t$는 최종 채택한 실행 하네스입니다. 별표는 검증된 최적해가 아니라 채택 여부를 나타냅니다. Update는 라이브러리에 하네스와 근거 있는 경험을 남깁니다. 다음 과제는 $\mathcal{H}^{\star}_t$가 아니라 공통 기본 하네스 $\mathcal{H}_0$에서 시작하되, 개선할 때 $\mathcal{R}_{t+1}$을 참고합니다. 모델 가중치, 단계별 지시문, 결정 규칙은 고정되고 라이브러리가 변합니다. 원문 §2.2–2.3
챕터별 상세 리뷰
📖 Chapter 1: Introduction
챕터의 위치와 역할: 모델 성능과 실행 환경의 관계에서 출발해 왜 두 수준의 재귀가 필요한지 질문을 세웁니다.
먼저 저자는 하네스를 prompt·memory·skills·tools·orchestration으로 설명합니다. 코딩을 넘어 사무 업무나 법률 업무로 대상이 넓어지면 어떤 문서를 근거로 삼을지, 산출물을 어떻게 점검할지 같은 요구도 다양해집니다. 이를 매번 사람이 설계하는 데 반복적인 엔지니어링이 들어간다는 것이 자동 개선의 동기입니다.
이어서 기존 개선을 배포 전 최적화와 배포 중 적응으로 나눕니다. 전자는 고정 과제나 검증 피드백으로 후보를 평가하고, 후자는 처음 만나는 과제를 수행하면서 하네스를 고칩니다. 원문이 말하는 open world는 새로운 과제와 변화하는 요구가 들어오는 설정입니다. 모든 현실 업무에 대한 무제한 일반성을 뜻하는 명칭으로 읽어서는 안 됩니다.
그다음 두 장애물을 제시합니다. 첫째, 현재 산출물이 맞는지 알려주는 정답이나 신뢰할 검증기가 없어도 수정을 결정해야 합니다. 둘째, 현재 작업에 맞춘 하네스가 다음 작업의 개선 능력을 자동으로 높여주지는 않습니다. 저자는 완성된 하네스 외에 “약점을 어떻게 찾았고 어떤 수정으로 어떤 행동이 달라졌는가”를 재사용할 수 있다고 봅니다.
마지막으로 task-level recursion과 harnessing-level recursion을 제시합니다. 전자는 현재 과제에 대한 수정·실행·조합이고 후자는 그 경험을 미래 수정에 사용하도록 저장하는 과정입니다. 세 벤치마크와 네 실행 모델–하네스 조합을 통해 평가하겠다고 예고합니다.
챕터의 핵심 기여: 현재 하네스를 잘 만드는 문제와 다음 하네스를 더 잘 고치는 문제를 분리합니다. 다음 챕터로의 연결: 이 구분을 수식과 실제 파이프라인으로 구체화합니다. §1
📖 Chapter 2: Harness²
챕터의 위치와 역할: 개선 대상, 과제 안의 탐색, 과제 사이의 지속 상태를 차례로 정의하는 방법론의 중심입니다.
2.1 Recursive Agent Harnessing
Harness Configuration and Setting에서 고정 모델과 8개 구성요소의 하네스를 정의합니다. 각 구성요소가 파일이므로 수정은 파일 diff로 표현할 수 있습니다. 모델 가중치는 바뀌지 않습니다. 과제는 순차적으로 들어오고 미래 과제는 사용할 수 없으며 완료한 과제를 다시 재생하지 않습니다. 현재 과제는 정해진 예산 안에서 여러 번 실행할 수 있습니다.
Recursive Agent Harnessing에서는 실행 하네스와 개선 하네스를 구분합니다. 실행 하네스는 실제 업무를 수행하는 시스템입니다. 개선 하네스는 Editor·Composer가 어떤 경험을 읽고 수정할지 안내합니다. 개선 하네스는 한 과제의 재귀 동안 고정되어 있고 과제 뒤에 내부 라이브러리를 갱신합니다. 현재 과제의 반복 시도와 장기 경험 축적을 혼동하지 않게 하는 경계입니다.
2.2 Task-Level Recursion
2.2.1 A Contrastive Improvement Step
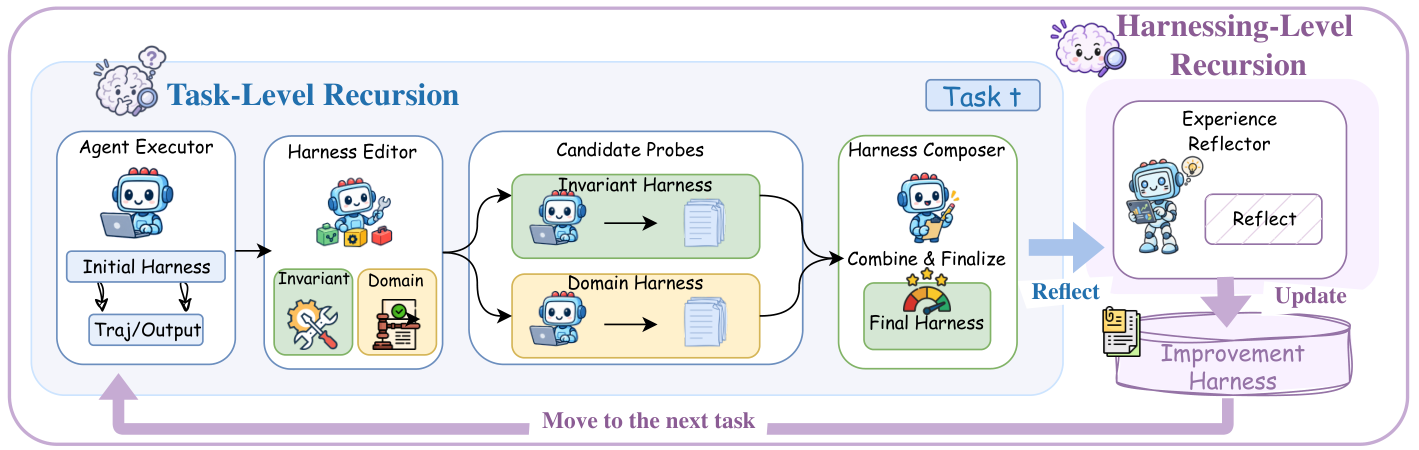
Figure 3, PDF 5쪽. 왼쪽은 현재 과제의 개선, 오른쪽은 다음 과제에 남길 경험의 갱신입니다. 원본 영역 크롭, 번역·재구성 없음. Xu 외, arXiv 2610.14224v1, PDF, CC BY 4.0.
Propose는 현재 하네스로 참조 실행을 얻습니다. 정답 예시가 아니라 현재 시스템의 행동 기록입니다. Editor는 과제, 하네스, 참조 궤적, 이전 기록과 라이브러리를 읽고 두 종류의 실행 가능한 수정안을 만듭니다.
- Invariant 후보는 도메인에 걸쳐 반복될 수 있는 작업 방식의 약점을 다룹니다. 계획, 도구 사용, 문맥 관리, 위임, 완수 확인 등이 해당합니다.
- Domain-specific 후보는 해당 업무의 지식·절차·제약을 다룹니다. 문서 종류에 맞는 구성, 근거 자료 사이의 관계, 전문적으로 빠뜨리기 쉬운 항목 등이 대상입니다.
Invariant는 파일을 바꿀 수 없다는 뜻이 아니라 도메인에 걸쳐 반복되는 절차상의 문제를 보는 관점입니다. Domain 후보는 주제 이름을 추가하는 역할보다 실제 업무에 적용하고 확인할 규칙을 구성합니다. 라이브러리를 재사용해도 과거 과제의 사실을 현재 과제의 사실로 취급해서는 안 됩니다.
Probe는 두 후보를 동일 과제와 동일 모델·환경 설정에서 실행합니다. 최종 문장뿐 아니라 어떤 자료를 읽었고 어떤 도구를 호출했으며 무엇을 만들었는지 비교합니다. 수정이 의도한 행동을 바꾸었는지, 차이가 없었는지, 퇴행했는지 대조합니다. 이는 수정의 영향에 대한 증거이며 정답을 보장하는 검증은 아닙니다. 후보들이 같은 모델 편향을 공유하고 실행에도 변동이 있기 때문입니다.
Compose는 참조 실행, 후보 파일, diff와 모든 과제 내부 실행 증거를 함께 읽습니다. 지지되는 수정을 합치거나 충돌을 수정하거나 한 후보 전체를 채택하거나 기존 하네스를 유지할 수 있습니다. 무조건 규칙을 추가하는 절차가 아닙니다. 조합한 하네스를 다시 실행하고 각 선택을 지지한 관찰까지 기록합니다. 숨겨진 점수 증가를 보고 움직이지 않습니다.
2.2.2 Parallel and Sequential Recursion
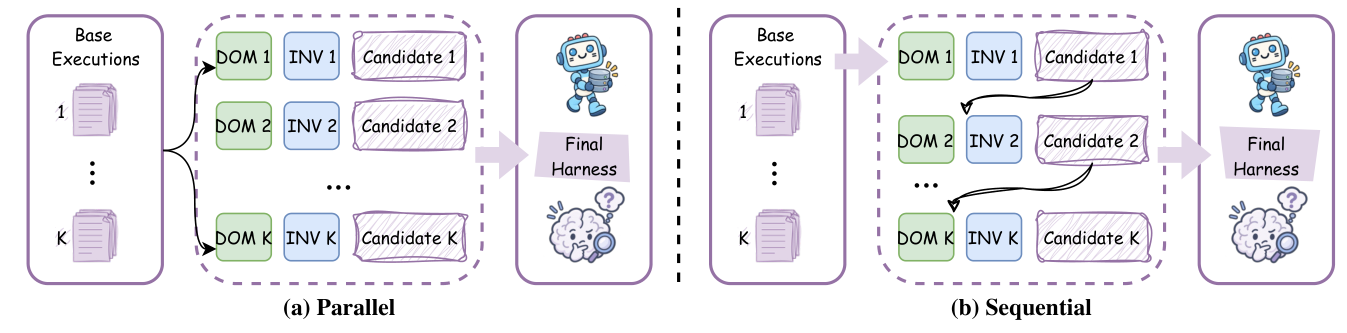
Figure 4, PDF 6쪽. (a) 병렬은 후보와 조합의 폭, (b) 순차는 개선의 깊이를 늘립니다. 원본 영역 크롭, 번역·재구성 없음. Xu 외, arXiv 2610.14224v1, PDF, CC BY 4.0.
Parallel Recursion은 기본 하네스의 참조 실행 $k$개, invariant와 domain 후보 각각 $k$개를 만듭니다. 각 후보를 실행한 뒤 $k$개 Composer가 전체 풀을 독립적으로 읽고 후속 하네스를 만듭니다. 구현은 이러한 population update를 한 번 수행합니다. 병렬 $k=5$는 5세대 진화가 아닙니다.
Sequential Recursion은 식 (3)의 개선을 $k$번 이어갑니다. 초기 기록에는 $k$개의 기본 실행이 있고 단계 뒤마다 후보와 조합 기록을 추가합니다. 이후 단계는 현재 하네스의 행동과 이전에 버린 수정까지 재검토할 수 있습니다. 이전 하네스를 무조건 보존하거나 항상 최초 하네스로 초기화하는 방식은 아닙니다.
리뷰어의 절차상 계산으로, 정상 병렬 경로의 executor rollout은 참조 $k$회 + 두 관점의 후보 probe $2k$회 + 조합 결과 $k$회로 총 $4k$회입니다. 순차도 초기 참조 $k$회와 각 단계의 두 probe·한 후속 실행을 더하면 $4k$회입니다. 이는 원문의 절차를 센 값이며 보고된 토큰 비용이나 API 청구 건수가 아닙니다. Editor·Composer·Selector·Reflector의 별도 세션, rollout 안의 여러 모델 호출, 재시도는 별개입니다. $k=1$도 기본 하네스를 한 번 실행하는 것과 비용이 같지 않습니다.
Final Selection은 $k>1$일 때 익명 산출물을 요청과 원자료에 비추어 비교하고 이미 존재하는 결과 하나를 반환합니다. 어느 하네스로 만들었는지 보지 않고 새 내용을 합성하지 않으며 하네스 수정도 추가하지 않습니다. $k=1$에서는 선택을 건너뜁니다. 최종 채택의 별표가 정답 보증이 아닌 이유입니다.
2.3 Harnessing-Level Recursion
Reflect on the Improvement Process는 과제 결과 반환 뒤 전체 개선 기록을 읽습니다. 어떤 변경이 어떤 약점을 다루었는지, 적용 조건과 행동 결과가 무엇인지 정리합니다. 산출물 선택만으로 수정의 유익성이나 다른 과제로의 이전을 판단하지 않습니다.
Update the Improvement Harness는 채택한 전체 하네스와 EXPERIENCE.md를 저장합니다. 경험에는 적용 상황·교훈·증거가 들어가며 인덱스로 필요한 항목을 찾습니다. 증거가 부족하면 새 경험 항목을 추가하지 않습니다. 실행 가능한 구성요소도 보관하므로 경험을 일반 문장으로만 남기는 방식과 다릅니다.
Reuse in Subsequent Improvement에서 다음 과제는 공통 기본 하네스에서 다시 출발합니다. 제안 단계가 필요한 파일을 복사·수정하고 현재 자료에 맞게 재검증합니다. 경험은 probe 해석과 조합에도 쓰입니다. 모델 가중치, stage instructions, decision rule은 고정이고 라이브러리만 변합니다. “개선 알고리즘 자체를 제한 없이 다시 쓰는 시스템”으로 설명하면 원문보다 강한 주장입니다.
챕터의 핵심 기여: 행동 차이를 수집하고 현재 수정과 장기 재사용 사이의 경계를 정합니다. 다음 챕터로의 연결: 서로 다른 모델과 하네스에서 작동하는지 평가합니다. §2
📖 Chapter 3: Experiments
챕터의 위치와 역할: 비교할 데이터와 점수의 의미를 정의하고 주요 결과를 제시합니다.
3.1 Experiment Setup
Benchmarks는 WorkBuddy-Bench, JobBench, Harvey의 Legal Agent Benchmark(LAB)입니다. WorkBuddy는 Code·Web·Office 산출물, JobBench는 여러 입력 문서에서 직업별 완성 산출물을 만드는 긴 작업, LAB는 법률 업무를 평가합니다. 실제 사용 분할과 채점 세부는 부록 B에 제공합니다.
세 번의 독립 실행 스트림에서 과제 순서를 섞어 평가합니다. 표 괄호는 세 실행의 표준편차(SD)입니다. WorkBuddy Avg.는 세 영역에 같은 비중을 둔 평균이며 SD는 각 실행에서 먼저 영역 평균을 낸 뒤 계산합니다. 과제 수가 다른 영역을 모두 모은 미시 평균이나 각 SD의 단순 평균이 아닙니다.
Baselines는 Base harness, ReasoningBank, Meta-Harness, Harness Scaling입니다. 각각 초기 하네스 유지, 하네스 수정 없는 과거 전략 검색, 학습·개발 분할을 사용한 오프라인 탐색, 과제 사이 상태를 잇지 않는 과제별 test-time 수정을 대표합니다.
Implementation Details의 실행자는 Gemini 3.5 Flash와 GLM-5, 초기 하네스는 OpenCode와 Codex입니다. 네 조합마다 같은 절차를 적용하고 기본 Editor는 OpenCode의 Claude Opus 4.8입니다. 주요 표의 Harness²는 $k=1$이며 + Recursion은 병렬 $k=5$의 추가 변화량입니다. 라이브러리는 각 벤치마크 스트림에서 빈 상태로 시작합니다. §3.1
3.2 Main Results
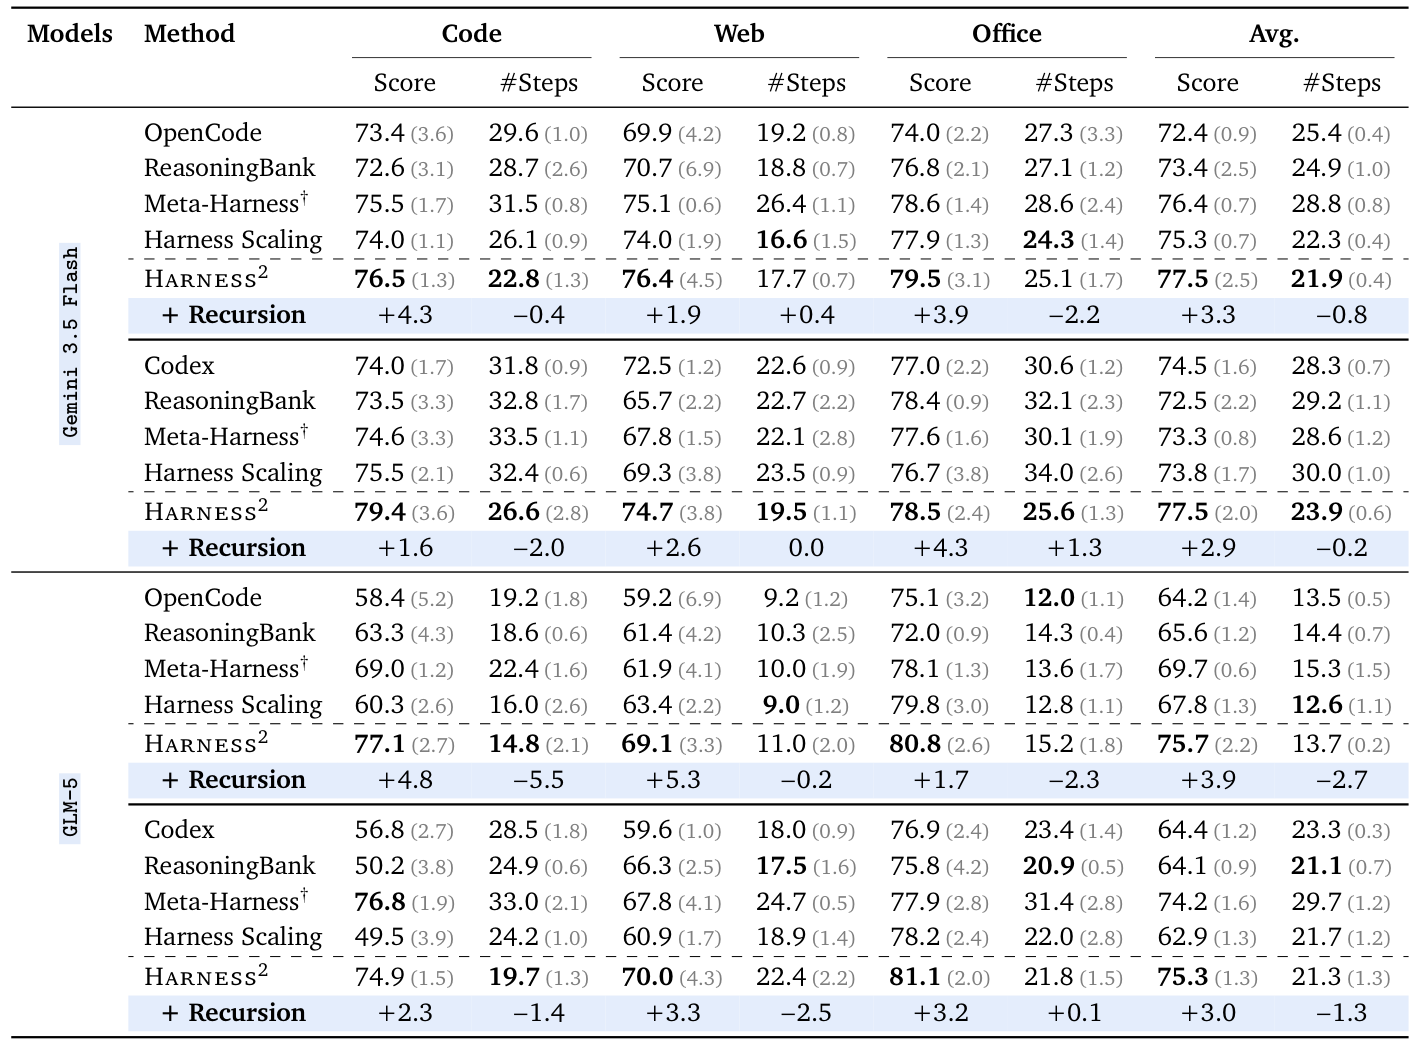
Table 1, PDF 8쪽. 괄호는 3회 실행의 SD, 파란 행은 단일 단계 대비 재귀의 변화량입니다. 표 영역 크롭, 숫자·주석 기호 변경 없음. 작은 숫자는 아래 대조표로도 제공합니다. Xu 외, arXiv 2610.14224v1, PDF, CC BY 4.0.
저자는 먼저 기본 하네스 대비 일관된 개선을 설명합니다. WorkBuddy 평균에서 GLM-5/OpenCode는 64.2→75.7로 11.5점, Gemini/OpenCode는 72.4→77.5로 5.1점 올라갑니다. JobBench 최대 단일 단계 이득 4.5점은 Gemini/OpenCode의 31.5→36.0이고, LAB 최대 11.8%p는 GLM-5/OpenCode의 59.6→71.4입니다. 벤치마크별 최대치를 같은 조합의 공통 수치처럼 묶지 않습니다.
| 실행 모델 / 초기 하네스 | WorkBuddy 평균: 기본 → 단일 단계 (SD) | 병렬 재귀의 추가 변화 → 최종 평균 | JobBench: 기본 → 단일 단계 | LAB Partial: 기본 → 단일 단계 |
|---|---|---|---|---|
| Gemini 3.5 Flash / OpenCode | 72.4 (0.9) → 77.5 (2.5) | +3.3 → 80.8 | 31.5 → 36.0 | 79.9% → 81.9% |
| Gemini 3.5 Flash / Codex | 74.5 (1.6) → 77.5 (2.0) | +2.9 → 80.4 | 33.9 → 35.3 | 71.6% → 75.6% |
| GLM-5 / OpenCode | 64.2 (1.4) → 75.7 (2.2) | +3.9 → 79.6 | 20.6 → 24.2 | 59.6% → 71.4% |
| GLM-5 / Codex | 64.4 (1.2) → 75.3 (1.3) | +3.0 → 78.3 | 23.6 → 24.8 | 58.1% → 65.9% |
Tables 1–2의 일부 재작성입니다. 최종 평균은 단일 단계 평균에 원문 변화량을 더했습니다. JobBench·LAB 열에는 SD를 생략했으며 변동이 없다는 뜻이 아닙니다. Table 1, Table 2.
다음은 상대적으로 약한 실행자의 이득입니다. 개선된 GLM-5의 WorkBuddy 평균 75.7(OpenCode), 75.3(Codex)은 해당 Gemini 기본의 72.4, 74.5를 넘습니다. 반면 JobBench 증가량은 Gemini 4.5·1.4점, GLM-5 3.6·1.2점이므로 약한 모델이 항상 더 이득을 얻는 일반 법칙은 아닙니다.
마지막으로 재귀 예산의 추가 효과를 설명합니다. 병렬 $k=5$는 단일 단계보다 WorkBuddy 평균 2.9–3.9점, JobBench 3.0–4.2점, LAB 2.6–6.7%p 높습니다. 초기 하네스 사이의 격차가 항상 줄어들지는 않습니다. 단일 단계가 모든 방법을 모든 지표에서 이기는 것도 아닙니다. LAB Gemini/Codex에서는 Meta-Harness 76.5%가 Harness² 75.6%보다 높습니다.
챕터의 핵심 기여: 기본 대비 이득은 넓게 관찰되지만 조건별 예외도 확인합니다. 다음 챕터로의 연결: 이득의 원인과 계산 비용을 분석합니다. §3.2
📖 Chapter 4: Analysis
챕터의 위치와 역할: 원문은 번호 없는 다음 여섯 소주제를 이 순서로 분석합니다.
Effect of Task-Level Recursion
WB-Code와 WB-Office에서 $k$를 1부터 5까지 늘리면 병렬·순차 모두 성능이 단조롭게 증가합니다. 병렬은 Code 76.5→80.8, Office 79.5→83.4입니다. ReasoningBank나 Harness Scaling은 증가가 더 작거나 불안정하며 Harness Scaling은 두 영역에서 $k=2$에서 3으로 갈 때 하락합니다. Harness²의 두 방식은 $k=2$에서도 표시된 모든 베이스라인의 $k=5$보다 높습니다.
병렬이 마지막 $k=5$ 지점에서는 높지만 Code의 $k=2$에서는 순차가 높습니다. 병렬 세션을 동시에 수행할 수 있어도 실제 지연 시간은 실행 자원과 rollout 길이에 좌우됩니다.
Compute–Performance Trade-off
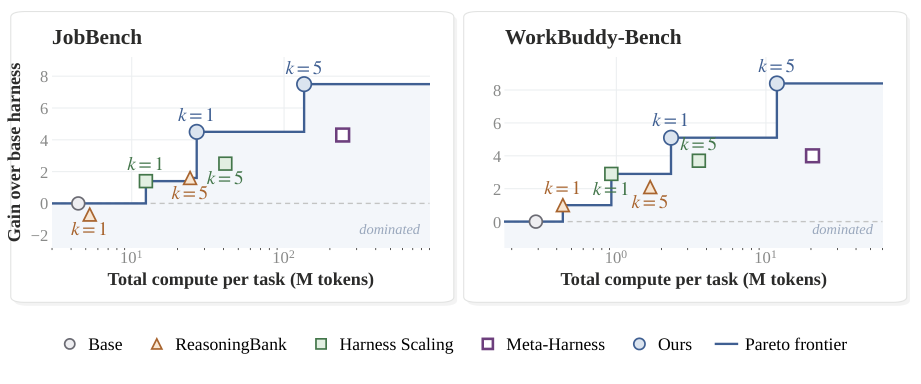
Figure 6, PDF 10쪽. 가로축은 과제당 전체 계산량(M tokens), 세로축은 기본 대비 상승입니다. 축·범례·두 패널을 보존한 크롭, 수치 재구성 없음. Xu 외, arXiv 2610.14224v1, PDF, CC BY 4.0.
최종 산출물 제출 전 사용한 실행·개선 토큰을 함께 셉니다. Gemini/OpenCode에서 $k=1→5$로 바꾸면 JobBench의 기본 대비 이득은 4.5→7.5점, WorkBuddy는 5.1→8.4점입니다. 두 Harness² 설정이 관측된 Pareto frontier에 있다는 것은 이 실험에서 같은 수준의 성능을 더 적은 계산으로 얻는 비교 설정이 없었다는 뜻입니다. 모든 모델·가격·업무의 최저 비용을 증명하지는 않습니다.
주요 표의 #Steps는 executor 세션의 모델 턴 수입니다. 최종 실행이 짧아져도 앞서 수행한 probe·편집 비용은 발생합니다. WorkBuddy Gemini/OpenCode는 평균 단계가 25.4→21.9로 줄지만 이 수치만으로 총 추론 비용 감소를 말할 수 없습니다.
Ablation Study
$k=1$, Gemini/OpenCode에서 라이브러리·관점 분리·조합을 각각 제거합니다. 라이브러리 제거는 읽기·쓰기를 모두 끕니다. scoping 제거는 같은 후보 수·예산으로 두 일반 Editor를 사용합니다. composition 제거는 두 후보를 실행한 뒤 증거상 유리한 하나를 반환합니다.
| 설정 | WorkBuddy 평균 | JobBench |
|---|---|---|
| 전체 Harness² | 77.5 | 36.0 |
| 라이브러리 없음 | 74.4 | 34.2 |
| 관점 분리 없음 | 74.6 | 32.3 |
| 조합 없음 | 75.9 | 34.1 |
원문 Table 3. 독립 제거 실험의 차이를 합산해 전체 성능을 설명할 수 없습니다.
WorkBuddy에서는 라이브러리 제거 손실 3.1점, JobBench에서는 관점 분리 제거 손실 3.7점이 가장 큽니다. 경험 저장·진단 관점·조합은 업무에 따라 다르게 기여합니다.
Analysis of Harnessing-Level Recursion
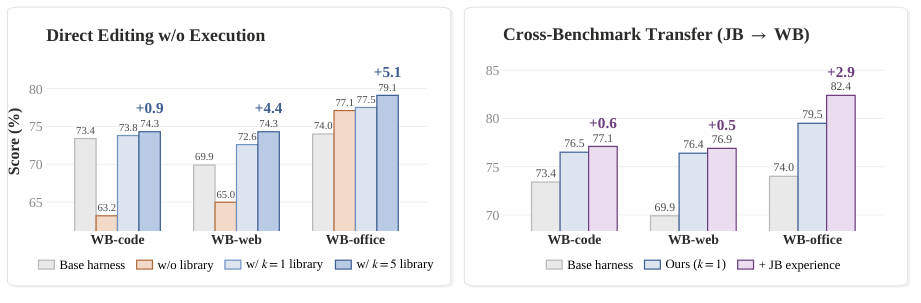
Figure 7, PDF 11쪽. 왼쪽은 추가 실행 증거 없이 직접 편집할 때의 효과, 오른쪽은 JobBench→WorkBuddy 이전입니다. 축·범례·수치·패널 보존 크롭, 번역 없음. Xu 외, arXiv 2610.14224v1, PDF, CC BY 4.0.
참조 실행·후보 probe·라이브러리 없이 직접 수정하면 Code 73.4→63.2, Web 69.9→65.0으로 떨어집니다. $k=1$에서 축적한 라이브러리는 기본 수준을 회복시키고, $k=5$ 라이브러리는 기본 대비 Code +0.9·Web +4.4·Office +5.1점의 이득을 지원합니다. 앞서 축적한 탐색 경험이 추가 probe 없는 편집에도 도움이 되는지 보는 분석입니다.
JobBench 라이브러리를 가져온 한 단계 개선은 WorkBuddy Code·Web·Office에서 각각 +0.6·+0.5·+2.9점의 추가 이득입니다. 자기 항목을 뺀 완성 라이브러리로 다시 실행한 결과는 WorkBuddy +1.9, JobBench +1.7점입니다. 후자는 나중 과제 경험도 읽는 회고 분석이므로 처음 온라인 처리할 때의 추가 성능으로 해석하지 않습니다.
Same Model as Executor and Editor
OpenCode, $k=2$에서 Editor와 executor를 같은 모델로 맞춥니다. GLM-5부터 Claude Opus 5까지 다섯 모델이 세 벤치마크 모두에서 개선됩니다. Opus 5는 WorkBuddy +3.3·JobBench +5.5점, LAB +3.0%p이며 GLM-5의 LAB 증가량은 13.7%p입니다. 이 실험은 더 강한 기본 Editor만으로 모든 이득을 설명할 수 있는지 분리하며, 모델 간 하네스 이전과도 다른 질문입니다.
Case Study
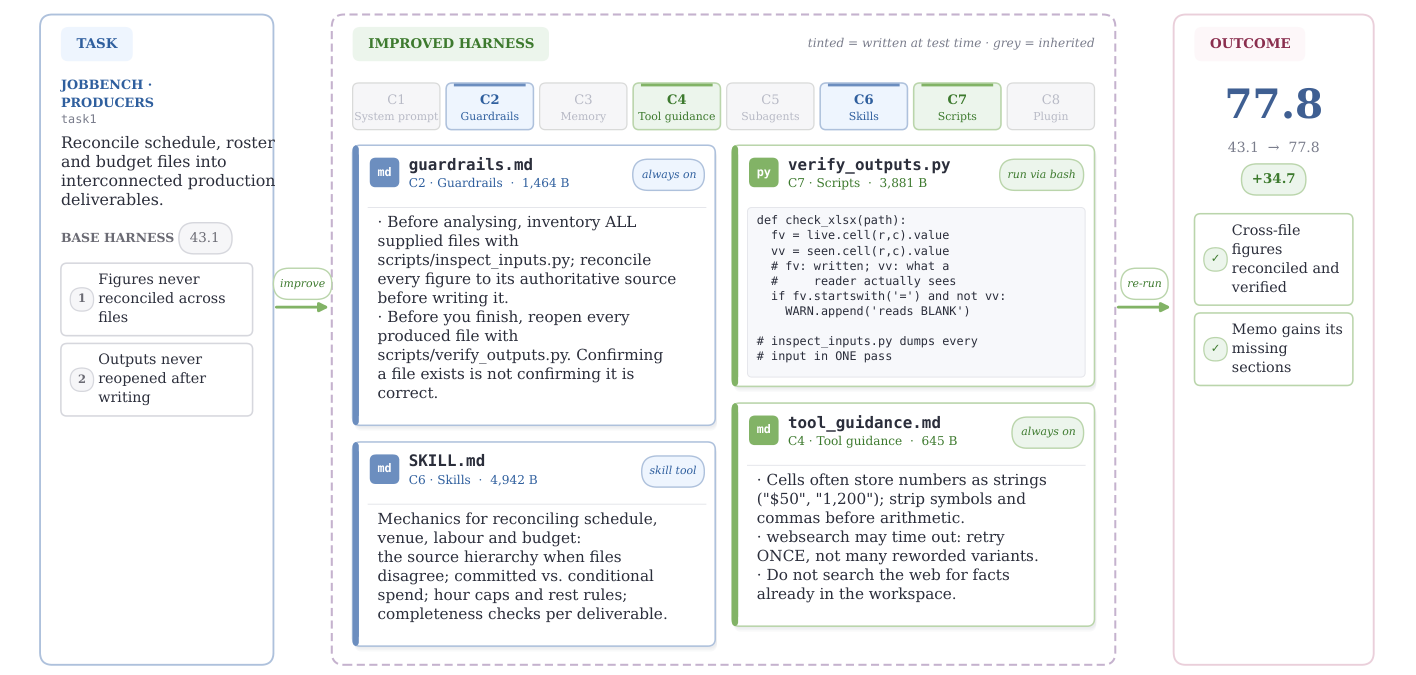
Figure 9, PDF 12쪽. 색칠한 구성요소는 test time에 작성했고 회색은 기본에서 유지했습니다. 원본 영역 크롭, 코드·수치 보존, 번역 없음. Xu 외, arXiv 2610.14224v1, PDF, CC BY 4.0.
JobBench 제작 업무의 기본 점수는 43.1입니다. 일정·인력·예산 파일의 수치를 대조하지 않았고 작성한 파일을 다시 열어 검사하지 않았습니다. 일반 절차 쪽은 모든 입력 목록화·정확한 출처 연결·검증 script로 파일 재읽기를 요구합니다. 도메인 쪽은 일정·장소·노동·예산 대조 skill과 숫자 형식 처리 tool guidance를 만듭니다.
Composer는 네 수정을 유지합니다. 재실행에서 파일 간 수치 대조와 누락한 메모 항목이 복구되어 77.8로 상승합니다. 34.7점은 이 사례의 사후 평가 차이이며 전체 평균이 아닙니다. 그림 안 코드는 원문 인용이며 이 리뷰에서 실행하거나 독립 검증하지 않았습니다.
챕터의 핵심 기여: 점수 상승을 계산량·진단·경험 저장·행동 변화로 분해합니다. 다음 챕터로의 연결: 기존 자기 개선 연구와 비교합니다. §4
📖 Chapter 5: Related Work
챕터의 위치와 역할: 재귀적 자기 개선, 하네스 최적화·진화 순서로 연구 맥락을 설명합니다.
Recursive Self-Improvement에서는 개선 대상을 구분합니다. 자기 보상 모델은 가중치, STOP은 개선 프로그램, Darwin Gödel Machine은 에이전트 코드, Hyperagents는 메타 수정 절차를 대상으로 합니다. 출력 자기 피드백이나 reflection도 배경입니다. 저자는 utility·벤치마크·검증 피드백을 사용하는 연구와 달리 Harness²가 정답 없는 새 과제 흐름에서 개선 경험을 축적한다고 설명합니다.
Harness Optimization and Evolution에서는 prompt·workflow에서 memory·skill, 완전한 실행 하네스로 대상이 확장된 흐름을 정리합니다. 배포 전 탐색, 학습한 Editor, 진단 경험 저장, 배포 중 적응, 지연된 결과 피드백을 구분합니다. 그 뒤 가중치 갱신·정답 감독 없이 현재 과제의 대조적 수정과 다음 개선을 위한 경험 갱신을 결합하는 방식으로 Harness²를 위치시킵니다.
챕터의 핵심 기여: 방법을 기억 유무나 online/offline 한 축으로만 분류하지 않게 합니다. 다음 챕터로의 연결: 본문 결론에서 결합의 의미를 요약합니다. 선행 연구 설명은 저자의 비교 요약이며 인용 논문을 모두 독립 검증한 평가는 아닙니다. §5
📖 Chapter 6: Conclusion
챕터의 위치와 역할: 두 재귀의 연결과 실험 근거를 묶습니다.
과제 수준은 대조적 개선·병렬 조합·순차 수정으로 현재 하네스를 개선하고, 하네싱 수준은 채택 하네스와 경험을 보관해 이후 수정을 돕습니다. 세 전문 벤치마크·두 실행 모델·두 초기 하네스에서 기본 대비 개선을 확인하고 제거·이전 분석이 관점 분리·조합·경험 축적의 가치를 뒷받침한다고 정리합니다.
챕터의 핵심 기여: 과제별 수정 경험을 이후 test-time 적응의 재사용 기반으로 삼습니다. 다음 내용과의 연결: 참고문헌 뒤 부록은 비교 기준·구현·추가 실험·한계·prompt를 제공합니다. §6
📖 Chapter A: Comparison of Harness Improvement Methods
챕터의 위치와 역할: 본문 관련 연구의 비교를 Table 4와 여섯 판정 기준으로 확장합니다.
A.1 Comparison Criteria
원문은 Object → Stage → Label → Streaming → Scaling → Improver Update 순서로 기준을 설명합니다.
- Object는 prompt·skill 일부, 실행 가능한 전체 하네스, 실행물을 고치는 개선 하네스를 구분합니다.
- Stage는 배포 전 최적화, 배포 중 적응, 두 단계의 결합입니다. 배포 중 정답을 쓰지 않아도 배포 전 준비에 정답을 썼을 수 있습니다.
- Label은 외부 정답·점수·verifier 결과를 개선에 사용하는지입니다. 자기 판단·실행 궤적은 외부 정답 감독으로 세지 않고 최종 평가용 라벨도 구분합니다.
- Streaming은 완료 과제를 재생하지 않는 한 번의 과제 또는 batch 흐름입니다. 현재 과제의 반복 실행은 허용하며 하나의 긴 episode만으로 이 조건이 성립하지는 않습니다.
- Scaling은 예산과 성능의 관계를 실제 연구했는지입니다. 반복 횟수를 조절할 수 있다는 사실만으로 scaling 연구가 있다고 판정하지 않습니다.
- Improver Update는 실행물 외에 편집을 생성·평가하는 지시·경험·파라미터가 지속적으로 변하는지입니다. 현재 실행물을 Editor에게 다시 보여주는 것만으로는 해당하지 않습니다. 체크 표시는 개선 장치의 존재이지 개선 능력 향상의 독립 증명이 아닙니다.
챕터의 핵심 기여: label-free나 recursive라는 이름만으로 방법을 같은 범주로 묶지 않게 합니다. 다음 챕터로의 연결: 실험의 분할과 채점 규약을 명시합니다. Appendix A
📖 Chapter B: Benchmarks
챕터의 위치와 역할: 어떤 업무를 몇 개 평가했는지, 개선 중 숨긴 정보와 최종 채점 정보를 구분합니다.
WorkBuddy-Bench 전체 Code·Web·Office는 80·70·50개이며 범주별 절반 분할의 test 40·35·25개를 평가합니다. 각 rollout은 새 컨테이너입니다. 점수는 hidden test와 파일·구조 검사 같은 결정적 검사에 LLM/VLM judge 항목을 결합한 composite verifier의 통과 비율입니다. 필요한 judge는 Gemini 3.5 Flash이고 기대값은 파이프라인 모델에게 공개하지 않습니다.
JobBench는 전체 65개 직업 과제를 31/34로 고정 분할하여 test 34개를 평가합니다. 입력 문서와 여러 산출물을 요구하며 Claude Opus 4.8이 가중 rubric으로 채점합니다. 점수는 최대 가능 가중 점수 대비 획득 점수입니다. rubric은 executor·Editor·Selector에게 보여주지 않습니다.
LAB 전체 1,251개는 24개 법률 분야와 분석·작성·검토·연구의 네 유형입니다. 논문의 모든 LAB 수치는 전체가 아니라 분야·유형·문맥 크기를 반영한 고정 test 100개에서 측정했습니다. 별도 dev 24개는 Meta-Harness만 탐색에 씁니다. Claude Sonnet 4.6이 criterion을 평가하고 Partial은 criterion 통과율입니다. 과제 100개 중 완전히 성공한 과제의 비율이 아닙니다.
Meta-Harness만 WorkBuddy·JobBench train 또는 LAB dev를 사용합니다. Harness²와 나머지 방법은 test를 빈 라이브러리·메모리에서 시작합니다. 개선에 정답을 쓰지 않는다는 말과 최종 평가에도 정답·rubric이 없다는 말은 다릅니다.
챕터의 핵심 기여: 평가 분모와 감독 정보의 경계를 공개합니다. 다음 챕터로의 연결: 같은 실행자·초기 하네스·judge 아래 베이스라인 구현을 설명합니다. Appendix B
📖 Chapter C: Baselines
챕터의 위치와 역할: 비교 방법의 실제 예산과 상태 유지 방식을 풀어 씁니다.
Best-of-k는 기본 하네스를 독립적으로 여러 번 실행하고 Harness²와 같은 선택자로 산출물 하나를 고릅니다. 점수는 공개하지 않습니다.
ReasoningBank는 같은 도메인의 과거 과제 중 embedding 유사도가 가장 높은 과제에서 기억을 최대 세 개 가져와 prompt 앞에 넣습니다. embedding은 gemini-embedding-001입니다. 과제 뒤에는 정답 없는 자기 판단으로 성공·실패를 분류하고 궤적에서 title–description–content 기억을 최대 세 개 추출합니다. $k>1$에서는 같은 기억 아래 여러 rollout, 선택, 대조적 distillation을 사용합니다. 자기 라벨은 외부 정답이 아닙니다.
Harness Scaling은 기본 rollout 하나 뒤 과제·누적 궤적·현재 트리를 읽고 수정·실행을 반복합니다. 빈 수정은 한 번 재시도합니다. scope 분리·조합·라이브러리가 없고 마지막 배포가 산출물을 못 만들면 기본 실행을 제출합니다.
Meta-Harness는 frontier에서 후보를 제안·검증한 뒤 학습 집합 전체로 평가합니다. 탐색 10회, 반복당 후보 2개, 과제당 3회 평가, 채택 margin 0.01입니다. 채택하지 않은 후보의 경험도 lessons 파일에 남기며 최종 하네스는 test 동안 고정합니다. 이 방법의 별도 오프라인 탐색 비용·감독을 test-time 적응과 구분해야 합니다.
챕터의 핵심 기여: 기억과 재귀라는 용어 뒤의 실행 절차를 드러냅니다. 다음 챕터로의 연결: Harness²의 초기 구성·실행 제한·파일 계약을 제공합니다. Appendix C
📖 Chapter D: Implementation Details
챕터의 위치와 역할: 실행 하네스가 런타임에 어떻게 장착되는지 설명합니다.
D.1 Executors and Initial Harnesses
실행자는 고정 모델을 넣은 기존 coding agent이고 초기 하네스는 기본 구성에 벤치마크 지시를 더한 것입니다. OpenCode의 system prompt·guardrails·memory·tool guidance는 상시 파일입니다. skill은 skill 도구, subagent는 task 도구, script는 shell, TypeScript plugin은 tool loop로 작동합니다. Codex는 상시 텍스트가 AGENTS.md에 들어가고 on-demand 구성의 역할은 같습니다.
stock 상시 파일에는 벤치마크 지시 외 내용이 없고 on-demand 디렉터리에는 편집 지점을 알려주는 placeholder가 있습니다. rollout은 모델 턴 200회·3,600초로 제한하고 WorkBuddy는 벤치마크 기본 timeout의 두 배를 사용합니다. 개별 rollout은 다른 과제를 기억하지 않으며 과제 간 경험은 개선 라이브러리를 통해 필요한 경우 다시 도입됩니다.
D.2 Improvement Sessions and Library Configuration
Roles에서 Editor와 Selector는 OpenCode의 Claude Opus 4.8 agentic session, high reasoning effort입니다. 증거는 prompt에 모두 붙이지 않고 작업 디렉터리 파일로 제공합니다. grader verdict·rubric·score가 있는 디렉터리는 전달을 거부하는 guard가 있습니다.
trigger 없는 skill, 컴파일되지 않는 script, 호출하지만 함께 제공하지 않은 helper처럼 유효하지 않은 트리는 검증 메시지로 한 번 재시도합니다. 다시 실패하면 단계 시작 트리를 유지하고 fallback을 기록합니다. 이는 파일 구조의 유효성 검사이며 업무 정답 검증과는 다릅니다.
Library는 벤치마크 도메인별 디렉터리입니다. 채택한 전체 트리와 EXPERIENCE.md를 보관하고 인덱스로 나열합니다. 이전 항목을 읽어도 이전 과제를 재실행하지 않습니다. 실행 파일을 prose 요약으로 대체하지 않는 것도 재사용 방식의 일부입니다.
D.3 Editable Harness Components
Table 5는 C1–C8을 활성화 시점과 역할로 묶습니다. 문맥 구성은 무엇을 언제 모델에게 넣는지, 도구 인터페이스는 어떤 연산을 어떻게 호출하는지, orchestration은 별도 문맥과 위임을 어떻게 만드는지, middleware는 모델의 선택 밖에서 tool loop에 어떻게 개입하는지입니다.
구성요소 이름보다 활성화 시점이 중요합니다. 상시 텍스트는 매 호출의 문맥을 차지하고 skill은 필요할 때만 읽습니다. subagent는 별도 추론 문맥을 추가하는 유일한 구성요소이고 plugin은 모델에게 “하라”고 말하는 대신 루프에서 강제합니다. 이는 논문 구현의 분해 기준이며 모든 runtime의 보편적인 파일 규격을 뜻하지는 않습니다.
챕터의 핵심 기여: 수정 가능한 파일과 실행·검증·저장 계약을 공개합니다. 다음 챕터로의 연결: 실제 기여와 남은 실패를 분석합니다. Appendix D
📖 Chapter E: Supplementary Experiments and Analyses
챕터의 위치와 역할: 평균 성능을 구성요소·재사용·이전·도구 사용·제품 비교·실패·사례로 세분합니다.
E.1 Contributions of Harness Components
이미 개선한 하네스에서 prompt 관련 구성, skill, script를 제거하고 다시 평가합니다. 개선을 다시 돌려 빈자리를 보상하게 하지 않습니다. 처음부터 그 구성요소 없이 개선한 경우와 다릅니다.
Gemini/OpenCode, 병렬 $k=5$의 WorkBuddy 평균은 전체 80.8, prompt 그룹 제거 79.3, skill 제거 75.5, script 제거 77.1입니다. Code·Web은 skill 제거 손실 3.6·6.9점, Office는 script 제거 손실 7.4점이 가장 큽니다. 모두 기본 72.4보다 높지만 손실을 더해 전체 이득의 원인으로 계산할 수 없습니다. Table 6
E.2 Reuse of Harnesses and Improvement Experience
What the Library Carries는 수정 파일의 비정형 반복 문구를 제외한 줄이 당시 라이브러리의 같은 구성요소에 얼마나 포함되는지 측정합니다. 채택 하네스의 5분의 1보다 많은 곳에 공통인 줄은 boilerplate로 제외합니다. 라이브러리 흔적은 LAB·WB-Office 수정 파일의 22%, JobBench 47%에서 관찰됩니다. 절반 이상 줄을 유지한 파일은 2–10%라서 광범위한 복사보다 적응이 흔하다고 설명합니다. skill·script는 각 벤치마크 수정의 대략 절반입니다. 이 수치는 성공률이 아니라 수정 파일의 출처 분석입니다.
Leave-One-Out Re-run은 스트림 뒤 자기 항목을 뺀 라이브러리로 다시 실행합니다. WorkBuddy 77.5→79.4, JobBench 36.0→37.7입니다. 나중 과제 경험도 보며 반복 실행도 차이에 기여할 수 있어 온라인 첫 처리 성능으로 보고하지 않습니다.
E.3 Transfer Across Executor Models
Gemini 3.5 Flash/OpenCode용 하네스를 추가 수정 없이 GLM-5, Gemini 3.7 Flash, Claude Opus 4.8에 적용하면 세 모델 모두 Code·Office에서 개선됩니다. GLM-5 Code는 58.5→75.8로 17.3점, Gemini 3.7 Flash는 Code +0.3·Office +6.4점, Opus 4.8은 +2.6·+1.1점입니다. 이 기준 58.5는 해당 이전 실험의 값이며 주 표의 다른 실행 58.4와 교체하지 않습니다. 이득은 모델과 영역에 따라 크게 다릅니다.
E.4 Tool-Use Reliability
Gemini/OpenCode, $k=1$에서 도구 호출 빈도와 오류율을 나눠 봅니다.
| 벤치마크 | 과제당 평균 도구 호출: 기본 → 개선 | 도구 오류율: 기본 → 개선 |
|---|---|---|
| WorkBuddy | 20.0 → 17.8 | 0.8% → 0.5% |
| JobBench | 27.4 → 32.8 | 14.4% → 9.1% |
| LAB | 20.8 → 25.2 | 2.0% → 1.6% |
원문 Table 7의 평균 호출 수·Error(%)를 대조해 재작성했습니다. 오류율을 과제 완전 실패율이나 전체 정확도로 읽지 않습니다.
JobBench 감소는 5.3%p, 상대적으로 약 36.8%입니다. 호출 수는 약 19.7% 늘어납니다. 적게 호출하는 것과 신뢰할 만하게 사용하는 것은 다릅니다. LAB도 호출은 늘지만 오류율은 내려갑니다.
E.5 Comparison with Production Harnesses
같은 Gemini 3.5 Flash를 CodeBuddy·OpenCode·Codex·Claude Code에 넣고 수정하지 않은 결과와 OpenCode에서 병렬 $k=5$로 개선한 Harness²를 비교합니다. 고정 하네스 중 Code·Office는 Claude Code, Web은 Codex가 가장 높습니다. Harness²는 영역별 최강 고정 하네스보다 4.6·5.8·4.9점 높습니다.
이 별도 비교에서 자기 OpenCode 출발점 대비 이득은 7.4·8.4·9.4점입니다. 주 Table 1에서 계산한 영역별 차이와 혼합하지 않습니다. 추가 test-time 계산을 사용하는 개선 하네스와 고정 하네스의 비교이므로 같은 비용에서 제품을 능가한다는 주장으로 확장하지 않습니다.
E.6 Failure Analysis
Figure 14는 참조보다 낮아진 아홉 결과를 세 범주로 묶습니다. 첫째는 선택 오류입니다. WB-Code는 95점 후보가 있어도 55점 결과를 고르고 LAB는 범위가 좁은 결과를 골라 54→26으로 떨어집니다. 선택 사례에서 참조와 최선 후보는 다를 수 있으므로 후보 95를 기본 점수로 읽지 않습니다.
둘째는 편집이 후보 풀 자체를 제한하는 경우입니다. literal-key 요구나 확인하지 않은 cache 가정이 전파되어 2–11점 손실을 만듭니다. 셋째는 편집·선택만으로 귀속하기 어려운 결과로 실행 변동·judge verdict 누락·평가 기준과 맞지 않는 수정입니다. 이 점수는 사후 평가이며 파이프라인은 보지 못했습니다.
저자는 coverage·precision을 더 잘 균형 잡는 선택, 공유 가정을 반박하는 probe, 편집 효과와 실행 변동을 구분하는 반복 실행을 논의합니다. 이 원인과 방향은 원문 명시 내용이며 리뷰어가 새 한계로 만든 것이 아닙니다.
E.7 Qualitative Case Studies
WorkBuddy 세 영역 → LAB → 8개 구성요소를 모두 바꾸는 JobBench 순서입니다. 각 그림은 참조 행동 → 수정 하네스 → 재실행 결과로 읽습니다.
- Figure 15, Code: 호출을 실행하지 않고 텍스트로만 출력하는 문제를 tool guidance로 다뤄 60.0→100.0입니다.
- Figure 16, Office: 잘못된 집계 단위와 key 연결에 skill로 집계 단위·파생 필드를 정하고 guardrail로 입력 읽기 전용·정제 규칙을 지정해 23.6→100.0입니다.
- Figure 17, Web: 최초 렌더 뒤 상태가 갱신되지 않아 remapping·export가 낡는 문제를 상태 재계산 skill, 오프라인 파일 열기 검사 script, 네트워크 의존 금지 guardrail로 다뤄 64.0→100.0입니다. 네트워크 금지는 이 산출물 사례의 조건이며 모든 Harness² 배포의 공통 정책이 아닙니다.
- Figure 18, LAB: Word 변경 내용 추적 계층의 markup이 텍스트 읽기에 안 보이는 문제에 본문 문자 markup skill과 redline용 guardrail을 추가해 44.4→94.5입니다.
- Figure 19, JobBench: Opus 5가 실행자와 Editor인 사회과학 조사 사례입니다. 조사만 지속하고 파일을 늦게 만드는 문제에 일정 도구 호출 수 동안 산출물이 없으면 경고하는 plugin, 큰 자료에서 인용 가능한 표를 추려 반환하는 subagent, 도메인 memory 등 8개 구성요소를 작성해 72.0→100.0입니다.
사례별 사후 점수를 평균 이득이나 성공 보장으로 일반화하지 않습니다.
챕터의 핵심 기여: 어느 구성요소를 왜 바꾸었는지와 개선이 실패하는 모습을 함께 제공합니다. 다음 챕터로의 연결: 저자가 인정한 일반적 한계를 정리합니다. Appendix E
📖 Chapter F: Limitations
챕터의 위치와 역할: 저자가 명시한 두 한계입니다.
Cost of recursive refinement는 제안·probe·조합에 추가 실행과 Editor 세션이 필요하다는 점입니다. 예산 증가로 추론 비용도 늘고 병렬화가 지연을 줄여도 계산 자체는 없어지지 않습니다. 실험은 제한된 예산 범위를 분석하며 보편적인 최적 배분을 정하지 않습니다.
Execution-based feedback는 행동 대조와 모델 판단이 실행 변동·공유 편향에 민감하다는 점입니다. 이 신호는 정확성이나 다른 과제로의 이전을 보장하지 않습니다.
챕터의 핵심 기여: 성능 향상과 correctness 보장을 분리합니다. 다음 챕터로의 연결: 저자가 제시한 방향을 설명합니다. Appendix F
📖 Chapter G: Future Directions
챕터의 위치와 역할: 저자가 명시한 두 향후 방향입니다.
Managing the improvement harness는 indexed library가 커질 때 중복 구성요소 통합, 오래된 경험 갱신, 현재 과제·증거에 맞는 검색 개선입니다. 재사용 맥락을 보존하면서 라이브러리를 간결하고 관련 있게 유지하려는 방향입니다.
Adaptive recursion은 미리 정한 재귀 형태·예산을 과제 난이도·과거 경험 관련성에 따라 배분하거나 새로운 probe가 증거를 주지 않으면 중단하는 방향입니다. 현재 이미 제공하는 자동 예산 배분 기능은 아닙니다.
챕터의 핵심 기여: 현재 구현과 미래 제안의 경계를 명확히 합니다. 다음 챕터로의 연결: 마지막 부록에서 실제 지시문을 공개합니다. Appendix G
📖 Chapter H: Prompts
챕터의 위치와 역할: 증거를 읽고 수정·조합·선택·경험 기록을 수행하는 Prompt 1–6입니다. 세션은 context/의 과제·하네스·궤적·산출물·라이브러리를 읽습니다. 벤치마크별 도구·환경·제약의 추가 블록은 코드 공개분에 둔다고 명시합니다.
Prompt 1 — Harness Editor, invariant scope는 궤적의 최초 분기를 찾아 가장 비용이 낮은 구성요소로 대응합니다. 도구 오류는 입력·timeout·권한·기능 부재·출력 미확인을 구분하고, 기계적 반복은 script, 상황별 절차는 skill, 반복적으로 무시되는 규칙은 방어적 plugin을 고려합니다. 한 번의 실수만으로 코드부터 추가하지 않고 충분한 증거와 산출물 재검사를 요구합니다.
현재 작업공간의 확인 사실과 도메인 일반 절차도 나눕니다. 과거 라이브러리 경로만 참조하고 helper를 복사하지 않으면 유효하지 않은 하네스입니다. 상시 텍스트의 문맥 비용을 고려해 trigger가 있는 skill, 결정적 script, 큰 입력에서 작은 답을 얻는 subagent, 기계적인 tool-loop 문제의 plugin을 우선합니다. skill 이름을 상시 trigger에 함께 넣고 호출 script를 제공하며 런타임 template를 깨뜨리지 않는 구조 검증 규칙도 있습니다. 요청한 열·필드·순서 등 산출물 형식을 하네스가 임의로 바꾸지 못하게 합니다.
Prompt 2 — Harness Editor, domain scope는 분석 연산·산출물 계약·전문 판단을 확인 가능한 규칙으로 만듭니다. 근거 없는 권위·식별자·표준·인용을 만들지 않고 현재 건의 사실을 다음 과제에도 맞는 영구 memory로 저장하지 않습니다. 절차·retry·경로·예산·hook은 다른 Editor에 맡겨 진단 책임을 나눕니다.
Prompt 3 — Harness Composer, parallel recursion는 기본 실행 집합과 후보의 한 번뿐인 실행을 구분합니다. 같은 모델·자료를 쓰므로 동의는 독립 증명이 아닙니다. 수정이 어느 궤적 순간을 바꾸었는지 요구하고 산출물이 없는 실행의 수정은 특별히 위험하게 취급합니다. 병합·단일 후보 채택·KEEP_BASE를 허용하며 kept/revised/dropped 결정에 관찰을 붙입니다.
Prompt 4 — Harness Composer, sequential은 현재 checkpoint와 과거 후보·궤적을 읽습니다. 거절한 수정을 나중 근거로 다시 채택하거나 더 나았던 checkpoint로 돌아갈 수 있습니다. 여기서 KEEP_BASE는 최초 하네스 복원이 아니라 현재 체크포인트 유지입니다.
Prompt 5 — Terminal aggregator는 익명 산출물을 delivery → conformance → fidelity → internal consistency → operational fitness → finish 순서로 비교합니다. 산출물 존재, 요구한 구조, 원자료 충실성, 내부 일관성, 후속 사용 가능성, 미완성 표시를 확인합니다. 길거나 세련됐다는 이유로 고르지 않고 기본 하네스 출력도 정당한 후보로 둡니다. 점수·rubric·생성 궤적은 보지 않습니다.
Prompt 6 — Experience Reflector는 채택 여부를 편집의 인과 효과와 동일시하지 않습니다. 모든 후보 diff에 구성요소·변경·관찰·판정을 적습니다. 판정은 helped, hurt, no observed effect, confounded입니다. 여러 요소를 함께 바꾸었거나 단일 rollout만 있으면 원인 귀속이 혼재되었다는 confounded를 우선합니다. 이후 cue·lesson·evidence·confidence로 경험을 최대 한 개 남기고 구체적인 재사용 근거가 없으면 NO_ENTRY로 끝냅니다.
모든 prompt는 자료 안의 명령을 실행 지시가 아닌 분석 대상으로 읽게 합니다. 후보 script·plugin도 편집 세션에서는 텍스트로 검토합니다. 이는 저자의 설계 설명이며 이 리뷰가 방어 효과를 독립 시험했다는 뜻은 아닙니다.
챕터의 핵심 기여: 경험 저장 뒤의 증거 요구·변경 범위·원인 귀속 규칙을 드러냅니다. 마지막 부록이므로 다음 챕터는 없습니다. Appendix H
실험 결과 심층 분석
개선량과 일반화 범위를 구분합니다
핵심 결과는 고정 모델·출발 하네스 대비 개선입니다. WorkBuddy GLM-5/OpenCode의 64.2→75.7은 평균 11.5점 상승이며 Code만의 점수나 과제 성공률 11.5%p가 아닙니다. LAB의 59.6%→71.4%는 criterion 통과율 11.8%p 상승이며 상대 증가율과 다릅니다. 채점 체계가 다른 세 벤치마크 숫자를 평균해 단일 성능 향상률로 만들 수 없습니다.
WorkBuddy 평균·JobBench에서는 네 조합 모두 단일 단계가 비교 방법보다 높지만 LAB Gemini/Codex의 Meta-Harness 우위는 남습니다. 제품 하네스 비교도 영역별 최강 고정 하네스가 다릅니다. 특정 조합의 개선 근거와 모든 제품·업무에서의 우월성은 구분합니다.
성능·계산·신뢰도는 별도 축입니다
주 표는 세 독립 스트림의 평균과 SD입니다. SD는 실행 간 산포이며 표준오차나 신뢰구간이 아닙니다. 본문과 해당 표에는 유의성 검정 p-value나 신뢰구간이 보고되지 않았습니다. 평균 차이가 크다는 관찰만으로 통계적 유의성을 단정하지 않습니다. + Recursion 행은 평균 차이만 제공하므로 대응하는 SD를 임의 계산하지 않습니다.
최종 실행의 #Steps, 도구 호출 수, 전체 파이프라인 토큰도 구분합니다. 오류를 줄이려 더 많이 호출할 수 있고 더 효율적인 최종 하네스를 만드는 데 여러 probe가 필요할 수 있습니다. Figure 6이 실행·개선 토큰을 함께 비교하는 이유입니다. 병렬화로 지연을 줄일 가능성과 비용 절감도 같은 말이 아닙니다.
실험 설계와 재현성의 해석
리뷰어 해석으로는, 두 실행 모델·두 초기 하네스와 다른 업무 유형의 세 벤치마크를 결합한 설계는 한 runtime에만 우연히 맞는 이득과 구분하는 데 도움이 됩니다. 동일 모델 Editor 실험은 강한 외부 Editor만의 효과인지 살피고 라이브러리·scope·composition 제거는 방법을 분해합니다. 다만 제거 결과는 상호작용을 포함하므로 독립적인 가산 기여를 추정하는 실험은 아닙니다.
분할·judge·실행 상한·예산·파일 표면·공통 prompt는 본문·부록에 공개되어 있습니다. 논문은 코드 위치로 google-research/harness2를 제시합니다. 이 리뷰는 논문 분석이며 코드·벤치마크를 설치하거나 실행하지 않았고 모델 endpoint의 동일성이나 전체 실행 로그를 독립 재현한 것으로 표시하지 않습니다. 부록 H가 코드 공개분으로 넘긴 벤치마크별 추가 prompt는 인쇄된 공통 prompt와 구분합니다.
실패 해석은 E.6·F가 명시한 선택 오류·공유 가정 전파·실행 변동·추가 계산 비용에 근거합니다. 최종 산출물이 좋았다는 사실은 모든 하네스 변경이 좋았다는 증거가 아닙니다. Prompt 6의 confounded와 NO_ENTRY는 이 간극을 라이브러리 안에 보존하려는 설계입니다.
기술적 함의와 응용
Harness²는 모델 가중치를 고정해도 실행 환경을 관찰·수정·재사용하는 별도 개선 경로를 보여줍니다. 한 과제에서 무엇을 바꿀지 찾는 능력과 다음 과제에서 더 잘 수정하도록 경험을 보관하는 능력을 구분하고 연결합니다.
리뷰어 해석으로는, 데이터과학 업무에서도 일반 절차와 도메인 지식을 나누는 관점이 유용합니다. 파일 재검사 누락은 실행 절차이고 집계 단위·자료 간 일관성은 도메인 규칙입니다. Office·JobBench 사례가 이를 산출물 수준에서 보여줍니다. 새로운 산업 도메인에 적용한 성능은 이 논문이 제공하지 않으므로 효과를 단정하지 않습니다.
원문이 제시하는 판단 기준은 구체적입니다. 결정적 반복 연산은 script, 상황별 전문 절차는 skill, 큰 입력에서 작은 결과를 얻는 일은 subagent, 반복적인 tool-loop 문제는 plugin에 배치할 수 있습니다. 선택을 추상적 좋은 습관보다 실제 궤적의 관찰에 연결하며 요청한 산출물 형식과 사실 근거는 임의 변경하지 않습니다.
저자가 제시한 다음 방향은 라이브러리 통합·갱신·검색과 적응적 재귀 예산입니다. 현재 이미 해결됐다는 뜻은 아닙니다. 이 연구를 읽는 핵심은 재귀 횟수 자체보다 수정 전후의 행동 증거와 그 증거가 허용하는 범위를 충실히 남기는 데 있습니다.
검토 범위: 본문 1–6, 부록 A–H, 식 (1)–(4), Tables 1–7·Figures 1–19의 캡션과 관련 본문, Prompt 1–6을 확인했습니다. 주요 그림 6개·Table 1을 인용했고 나머지 그림은 관련 수치·해설로 반영했습니다. 참고문헌의 모든 선행 논문, 공개 코드 실행, 벤치마크별 추가 prompt·개별 원시 궤적은 독립 검증하지 않았습니다.