논문 개요와 전체 구조
데이터베이스에 “2023년에 구매한 고객은 몇 명인가요?”라고 질문한다고 생각해 보겠습니다. 정답 SQL을 바로 쓰려면 어떤 테이블에 구매 기록이 있는지, 고객 식별자가 무엇인지, 날짜와 취소 주문을 어떻게 처리하는지 알아야 합니다. 실제 SQL 에이전트는 테이블을 찾고, 스키마와 값을 살펴보고, 시험 쿼리의 오류를 읽은 뒤 수정합니다. HarnessSQL은 이러한 탐색–실행–수정–제출 과정 자체를 학습 대상으로 삼는 연구입니다.
논문의 핵심은 도구를 추론 시점에 붙이는 데 그치지 않는다는 점입니다. 실행 가능한 데이터베이스 환경과 SQL용 하네스에서 교사 모델의 상호작용 궤적을 수집하고, 검증에 통과한 전체 궤적으로 지도 미세조정(SFT)을 수행한 다음 같은 환경에서 실행 보상을 이용한 강화학습(RL)을 이어갑니다. 하네스는 모델이 사용할 도구, 관찰할 결과, 오류 형식, 종료 규칙을 정하는 실행 체계입니다. 따라서 무엇을 학습했는지 이해하려면 모델과 데이터뿐 아니라 이 실행 체계도 함께 읽어야 합니다.
분석 대상은 2026년 10월 8일 제출된 HarnessSQL: Harness-Native Training for SQL Agents in Realistic Database Environments, arXiv:2610.12274v1입니다. HTML 원문과 24쪽 PDF를 대조했습니다. PDF 표제와 HTML에는 Haolin Yang, Jipeng Zhang, Zhiqiang Qian, Jian Xie, Shuaishuai Gong, Yike Guo, Sirui Han의 7명이 기재되어 있으나, 초록 페이지의 저자 메타데이터에는 Zhiqiang Qian이 빠져 있습니다. 이 글은 분석한 PDF 표제의 저자 목록을 사용합니다. DOI 10.48550/arXiv.2610.12274는 arXiv 식별용 DOI이며 학술지 게재 DOI를 뜻하지 않습니다.
원문의 전개 순서는 다음과 같습니다.
| 순서 | 원문 제목과 하위 구조 | 역할 |
|---|---|---|
| 1 | Introduction | 정적 SQL 학습과 실제 실행의 간극 |
| 2 | Problem Setting — 2.1 SQL agents as partially observed policies, 2.2 The Train–Deploy Mismatch | 상호작용 정책과 학습 목표의 차이 |
| 3 | Methodology — 3.1 Executable SQL Environment Construction, 3.2 SQL-Specific Harness Adaptation, 3.3 Harness-Native Post-Training | 환경·인터페이스·학습 파이프라인 |
| 4 | Experimental Setup | 데이터베이스, 모델, 벤치마크, 비교 방식 |
| 5 | Experimental Results — 5.1 Main Results, 5.2 Effect of Post-Training, 5.3 Ablation Studies | 성능과 구성 요소 분석 |
| 6 | Related Work — Text-to-SQL, 하네스, 합성 궤적 데이터 | 기존 연구와의 관계 |
| 7–8 | Limitations and Ongoing Work; Conclusion | SQLite 중심 범위와 결론 |
| A–B | DSH-SQL Harness Composition and Lifecycle; Additional Ablations and Analysis | 실행 구조·활성화 감사·행동 분석 |
| C–D | Post-training Configuration and Objectives; SFT Corpus Statistics | 학습 설정·목적함수·데이터 통계 |
| E–G | Data Integrity and Leakage Audit for Shared-Database Evaluation; Cross-Harness Evaluation; Evaluation Benchmarks | 중복 감사·비교 조건·평가 정의 |
| H–K | Data Record and Export Format; Structural Difficulty Control and Synthesized Task Examples; Verifier Checklist; Generation Diagnostics | 재현용 레코드·난도·검증·생성 통계 |
핵심 기여와 혁신성
첫째, 해결하려는 문제를 정답 SQL 생성 능력과 실행 정책의 불일치로 정의합니다. 정답 쿼리만 학습하면 오류를 만났을 때 무엇을 관찰하고 다음에 어떤 도구를 호출할지 직접 가르치기 어렵습니다. 이 문제는 스키마가 크고 여러 번의 탐색이 필요한 환경에서 특히 중요합니다.
둘째, 실행 가능한 샌드박스, 네 가지 SQL 도구, 전체 상호작용 궤적 학습을 연결합니다. 교사는 정답 검증기를 보지 못한 상태로 데이터베이스를 탐색하고, 외부 검증기가 결과와 프로토콜을 확인합니다. 모델이 직접 생성해야 하는 추론·행동 토큰과 외부 환경이 돌려주는 관찰 토큰을 구분하여 학습합니다.
셋째, 학습과 추론의 정렬 효과를 분리해 보려는 통제 비교를 제공합니다. Qwen3-8B에서 하네스 추론만 적용한 기준선은 Spider 2.0-SQLite 15.5%, 전체 궤적 SFT 후 30.4%, SFT와 RL 후 45.2%입니다. 이 세 수치는 서로 다른 학습 단계를 뜻합니다. 단순히 “하네스를 붙였더니 45.2%”라고 읽으면 논문의 기여를 잘못 이해하게 됩니다. 원문 §5, Tables 2–3
리뷰어 관점에서 이 연구의 학습 가치는 SQL 모델 순위보다 배포 환경이 학습 데이터의 구조를 결정한다는 관점에 있습니다. 다만 주 평가에는 학습과 동일한 데이터베이스가 포함되므로, 미리 본 데이터베이스의 새로운 질문 해결과 처음 보는 데이터베이스로의 전이는 구분해서 읽어야 합니다.
기술적 세부사항
상호작용을 관측·행동·궤적으로 표현하기
논문 §2는 과제를 $x=(q,\mathcal{D},h,v)$로 정의합니다. $q$는 질문, $\mathcal{D}$는 실제 데이터베이스, $h$는 하네스, $v$는 모델에게 숨겨진 실행 검증기입니다. 모델은 데이터베이스 전체를 직접 보는 대신 도구가 반환한 관찰을 이용합니다. 원문의 식 (1)–(2)는 다음과 같습니다.
$a_t$는 추론을 포함한 도구 호출 또는 제출 행동, $o_t$는 실행 결과나 오류, $T$는 에피소드의 마지막 단계, $y$는 제출 SQL입니다. 첫 식은 정답에 도달하는 중간 행동을 학습 자료에 남긴다는 뜻입니다. 두 번째 식에서 $R_{\mathrm{result}}$는 SQL 문자열의 동일성이 아니라 숨겨진 정답과 실행 결과가 동등한지 확인하고, $R_{\mathrm{protocol}}$은 읽기 전용·행동 형식·예산·종료 등의 규칙을 확인합니다. 둘 다 이진 값이므로 한쪽이 실패하면 결합 보상은 0입니다. 구체적인 실행 보상의 정규화와 타임아웃은 부록 C에서 추가로 설명합니다.
모델에게 보이는 네 가지 도구
| 도구 | 모델이 얻거나 수행하는 것 | 학습할 결정 |
|---|---|---|
sql_list_tables |
테이블 목록과 행 관련 정보 | 탐색 시작점 고르기 |
sql_schema |
DDL, 열과 예시 값 | 조인 키·값 표현 이해하기 |
sql_exec |
제한된 읽기 전용 SQL 실행과 결과·오류 | 가설을 시험하고 수정하기 |
sql_submit |
최종 SQL 제출과 에피소드 종료 | 언제 탐색을 끝낼지 결정하기 |
이것은 SQLite 합성·주 평가의 계약입니다. BIRD-Interact에서는 사용자에게 질문하기 등을 포함한 9개 연산으로 바뀝니다. 따라서 전이 실험 전체가 항상 동일한 네 도구로 수행됐다고 설명하지 않습니다. 원문 부록 A가 이 차이를 명시합니다.
SFT는 환경을 지우지 않고 손실만 마스킹합니다
원문 식 (6)의 SFT 목적은 전체 궤적에서 모델이 생성한 행동을 감독합니다.
$\theta$는 학습하는 모델 파라미터, $\pi_\theta$는 행동을 생성하는 정책, $s_t$는 앞선 상호작용 이력입니다. 오류와 조회 결과는 이 조건 문맥에 남습니다. 다만 system·user·환경 관찰 토큰에는 손실을 부여하지 않고 assistant의 추론·행동 토큰을 학습합니다. 관찰을 입력으로 활용하는 것과 관찰 자체를 생성하도록 학습하는 것은 다른 일입니다.
SFT 데이터는 79개 데이터베이스에서 확보한 2,512개 검증 궤적이며, RL에는 합성 질문–SQL 2,700개와 검증용 100개를 사용합니다. 주 모델은 Qwen3-8B와 Qwen3-14B이고, 실행 보상 RL의 기본 알고리즘은 DAPO입니다. 이진 정답 보상은 최종 결과에 주어지지만, 정책 손실은 궤적 안의 assistant 토큰에 적용됩니다. 따라서 최종 정답을 높이는 행동 연쇄를 학습하는 구성입니다. 원문 §3–4, 부록 C–D
챕터별 상세 리뷰
📖 Chapter 1: Introduction
위치와 역할: 논문의 출발점은 Text-to-SQL이라는 과제를 실제 데이터베이스 작업 방식에 맞추어 다시 보는 것입니다. 이후 문제 정의와 방법의 세 요소가 모두 이 장의 관찰에서 나옵니다.
저자는 먼저 전통적인 “질문과 스키마 → SQL” 추상화를 설명하고, Spider 2.0 같은 환경에서는 필요한 정보를 정적 프롬프트에 모두 담기 어렵다고 지적합니다. 이어 존재하지 않는 user_id 열을 참조한 SQL이 실패하고, 그 오류를 읽은 에이전트가 가설을 수정하는 흐름을 제시합니다. 같은 최종 SQL이라도 어떤 관찰과 수정 끝에 도달했는지가 실제 에이전트에는 중요하다는 설명입니다.
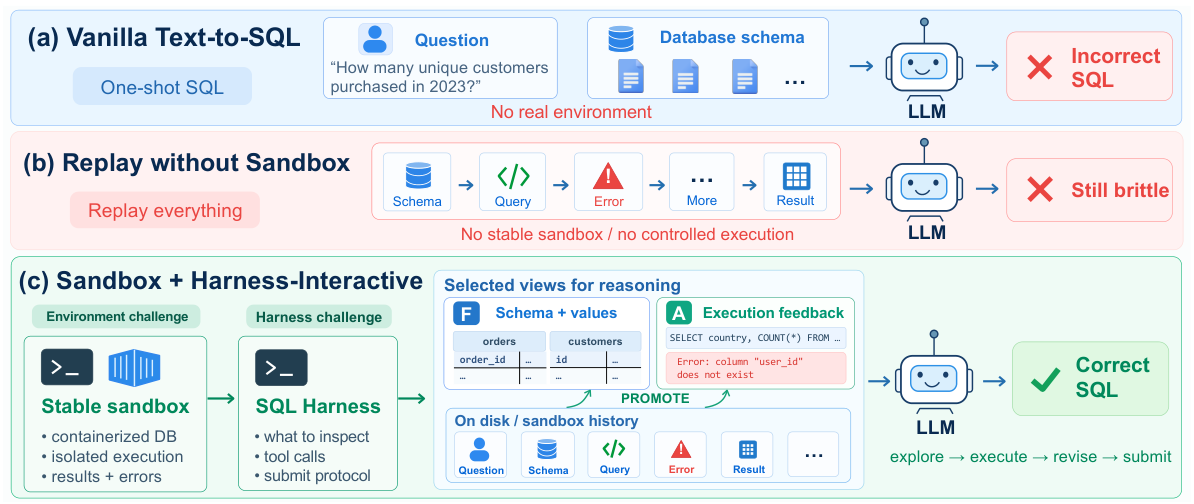
원문 Figure 1, PDF 1쪽. 원본 그림 영역을 크롭했으며 번역·수치 변경은 없습니다. 실행 환경, 관찰, 수정, 제출을 연결하는 차이를 보여줍니다. 버전 고정 PDF, CC BY 4.0.
다음으로 세 가지 요구를 순서대로 도출합니다. 환경은 실제 스키마·값·오류를 제공하며 재현 가능해야 합니다. 하네스는 가능한 행동과 종료 의미를 결정합니다. 감독 데이터는 최종 SQL뿐 아니라 탐색과 오류 복구를 포함해야 합니다. 이에 대응해 실행 환경 구축, SQL용 하네스 적응, 하네스 안에서의 후속 학습을 제안합니다.
마지막으로 두 모델 크기의 성능과 OOD 전이를 소개하고, 문제 정식화·전체 파이프라인·소형 에이전트의 성능을 기여로 정리합니다. 이 장의 기여: 정답 쿼리에서 상호작용 정책으로 관심을 확장합니다. 다음 연결: §2는 이 정책과 보상을 수식으로 정의합니다.
📖 Chapter 2: Problem Setting
위치와 역할: §1의 실행 사례를 부분 관측 정책으로 정식화하고, 기존 학습과 왜 다른지 설명합니다. 원문 §2
2.1 SQL agents as partially observed policies
저자는 질문·데이터베이스·하네스·숨겨진 검증기의 과제 튜플을 정의한 뒤, 모델이 이력에 조건화하여 행동하는 과정과 식 (1)의 궤적을 소개합니다. 관찰은 $o_t=h(\mathcal{D},a_t)$처럼 하네스에 의해 만들어지는 투영입니다. 같은 데이터베이스라도 행 제한, 오류 포맷, 시간 제한이 다르면 모델이 볼 수 있는 증거가 달라집니다. 따라서 하네스는 단순한 입출력 전달 장치로 취급되지 않습니다.
이후 식 (2)로 결과의 의미적 동등성과 프로토콜 준수를 결합합니다. 여기서 의미적 동등성은 질문의 정답을 검증하는 실행 결과 비교를 뜻합니다. SQL 문자열이 다르다고 오답이 되는 방식과 구분해야 합니다. 반대로 실행 가능한 SQL이라는 사실만으로 올바른 분석 결과가 보장되는 것도 아닙니다.
2.2 The Train–Deploy Mismatch
기존 정적 감독의 식 (3)은 다음과 같습니다.
$y^*$는 정답 SQL이고 $\mathcal{S}$는 정적 스키마 설명입니다. 이 식은 정답을 생성하는 확률을 높이지만, 실행 오류 이후의 다음 행동을 직접 감독하지 않습니다. 저자는 추론 텍스트를 덧붙이는 방식도 환경과 상호작용하지 않고 끝난다면 같은 구별이 남는다고 설명합니다.
저자의 설명 순서는 세 단계입니다. 먼저 식 (4)는 최종 SQL만을 목표로 할 때 중간 궤적을 주변화한다는 관점을 제시합니다. 이어 식 (5)는 배포된 정책이 앞선 실행 피드백에 조건화하는 폐루프 과정임을 보입니다. 마지막으로 학습이 하네스의 행동 공간을 모르면 도구 호출 형식과 종료 규칙도 맞추기 어렵다고 설명합니다. 식 (4)–(5)를 별도의 확률 추론 알고리즘으로 구현했다는 뜻은 아니며, 학습 목표의 구조 차이를 설명하기 위한 정식화입니다.
이 장의 기여: 모델·환경·프로토콜을 함께 학습 문제에 포함합니다. 다음 연결: §3은 세 간극에 대응하는 구현 절차를 설명합니다.
📖 Chapter 3: Methodology
위치와 역할: 환경 생성 → 하네스 적응 → SFT와 RL이라는 순서로 실제 학습 자료와 정책이 만들어지는 과정을 연결합니다.
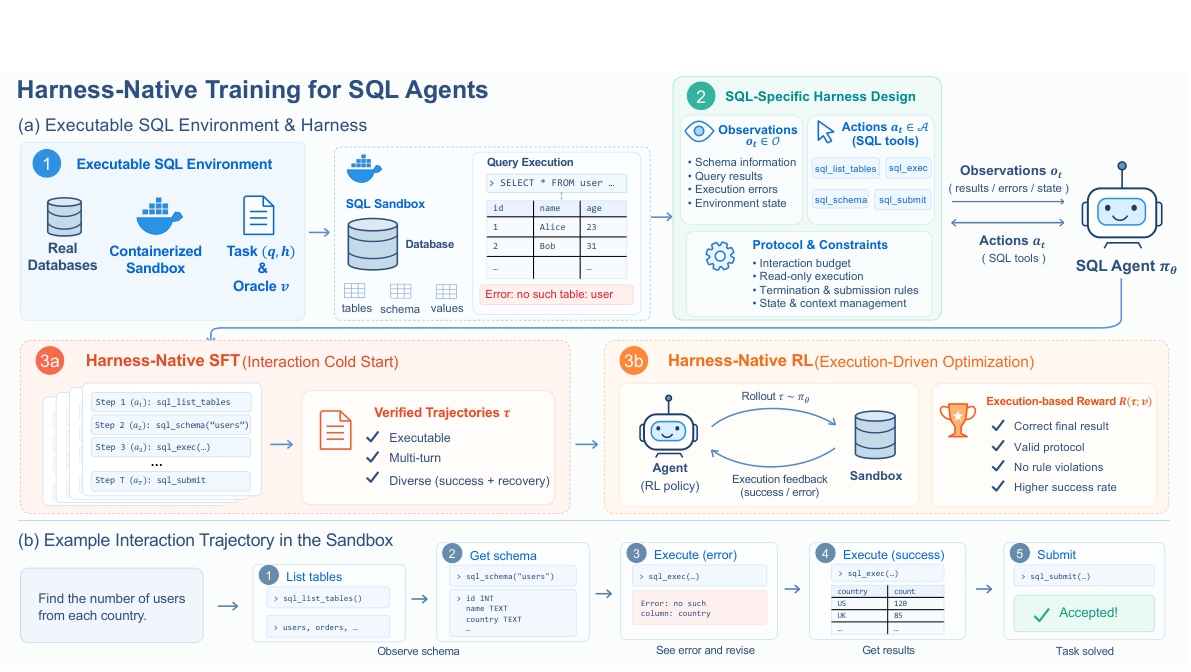
원문 Figure 2, PDF 4쪽. 전체 패널을 보존한 영역 크롭이며 번역·수치 변경은 없습니다. 위쪽은 환경과 하네스, 가운데는 SFT와 RL, 아래쪽은 오류를 거쳐 제출하는 예시입니다. 버전 고정 PDF, CC BY 4.0.
3.1 Executable SQL Environment Construction
먼저 실행 중인 데이터베이스에서 스키마, 예시 열 값, 유효한 조인 경로를 얻어 카탈로그를 만듭니다. 그런 다음 질문부터 자유롭게 생성하고 SQL을 나중에 맞추는 대신, 난도 조건에 맞는 실행 가능한 SQL을 먼저 만들고 그 결과 관계에서 질문과 검증기를 구성합니다. 이 SQL-first 접근은 생성된 과제의 정답을 실행으로 확인할 수 있게 합니다.
다음 단계는 과제마다 질문·하네스 공개 필드와 숨겨진 검증기를 분리하여 샌드박스에 넣는 것입니다. 읽기 전용, 단일 문장, 별도 자식 프로세스의 60초 제한을 적용합니다. 문법 오류, 빈 결과, 퇴화한 조인 등을 결정적 검사로 제거하고, 쿼리를 변형하는 mutation test로 결과가 실제 의미 변화에 반응하는지 확인합니다. 이 검사는 교사에게 정답을 보여 주는 절차와 다릅니다.
3.2 SQL-Specific Harness Adaptation
저자는 DSH의 공용 에이전트 기반을 사용하면서 SQL 프로파일을 특화합니다. 모델에게 네 도구를 노출하고, 셸·파일시스템·일반 코드 런타임 같은 무관한 도구는 비활성화합니다. 에이전트가 감당할 행동 공간을 데이터베이스 작업에 맞추는 설계입니다.
관찰 미들웨어는 큰 결과를 일정하게 자르고, 동일 호출이 반복되면 알림을 주며, 문맥이 길어지면 압력 조건에 따라 요약합니다. 모든 미들웨어가 매 에피소드에서 실제로 발동하는 것은 아닙니다. 이 장은 기능을 소개하고 부록 A는 실제 활성화 로그를 구분하여 제시합니다.
3.3 Harness-Native Post-Training
교사 모델은 동일한 네 도구만 사용해 데이터베이스를 탐색합니다. 숨겨진 oracle은 정책 문맥에 들어가지 않습니다. 외부에서 결과와 프로토콜을 확인하고 통과한 궤적만 보존합니다. 그 결과가 79개 DB의 2,512개 에피소드입니다.
SFT에서는 앞서 설명한 식 (6)으로 전체 궤적의 assistant 구간을 학습합니다. 실행 결과는 마스킹된 정답 토큰이지만 다음 행동의 입력 증거입니다. RL은 같은 환경에서 새 궤적을 생성하고, 최종 제출 결과에 대한 이진 실행 보상으로 DAPO 정책 업데이트를 수행합니다. 교사의 행동 복제에서 출발해 자율적인 탐색과 수정 행동을 더 최적화하는 구성입니다.
이 장의 기여: 합성 과제·교사 궤적·SFT·RL이 배포의 인터페이스를 공유하게 만듭니다. 다음 연결: §4는 이 원리를 시험한 데이터·모델·평가 조건을 고정합니다.
📖 Chapter 4: Experimental Setup
위치와 역할: 성능 수치를 해석하는 데 필요한 데이터의 출처와 비교 조건을 명시합니다. 원문 §4
저자는 먼저 79개 DB의 구성을 밝힙니다. Spider 2.0-Lite의 SQLite 30개와 Spider 2.0-DBT의 DuckDB 49개를 SQLite로 옮긴 구성이며, 후자는 스키마와 열 대응을 유지한다고 설명합니다. SFT 2,512개 궤적, RL 2,700개 합성 프롬프트와 검증용 100개가 사용됩니다. 이는 79개 모두가 평가에서 처음 등장하는 DB라는 뜻이 아닙니다. Spider 주 평가가 학습 DB를 공유한다는 사실은 부록 E에서 명시됩니다.
이어 각 과제를 독립 프로세스와 읽기 전용 DB에 연결하고, 관찰 길이와 실행 시간을 제한한다고 설명합니다. 명시적인 sql_submit 없이 끝나면 실패 처리합니다. Qwen3-8B와 14B에 전체 궤적 SFT를 한 뒤 DAPO RL을 적용하며, 자세한 학습률과 GPU 설정은 부록 C로 넘깁니다.
평가는 Spider 2.0-SQLite 135개 과제, GPT-4o 사용자 시뮬레이터를 쓰는 BIRD-Interact Mini, LiveSQLBench Base-Lite SQLite 순으로 소개합니다. 앞의 것은 도메인 내 평가이고, 뒤의 두 개는 상호작용 방식 또는 데이터베이스 분포의 전이를 살펴봅니다. 본문과 부록 G에는 뒤 두 평가의 정확한 과제 수가 제시되지 않아 이 글에서는 분모를 추정하지 않습니다.
마지막으로 범용 코딩 모델, SQL 특화 모델, 다중 에이전트 MARS-SQL을 비교군으로 둡니다. 중요한 조건은 Table 1의 기존 모델을 각자의 native 추론 프로토콜로 평가한다는 것입니다. 모든 모델을 동일한 DSH-SQL에 강제로 넣은 비교가 아닙니다. 비교의 의미는 시스템 전체의 최종 성능이고, 하네스 정렬 효과의 통제 비교는 Table 3에서 별도로 봅니다.
이 장의 기여: 모델 크기와 상호작용 패러다임이 다른 비교군의 조건을 드러냅니다. 다음 연결: §5는 최종 성능과 단계별 기여를 나누어 제시합니다.
📖 Chapter 5: Experimental Results
위치와 역할: 최종 시스템 비교, SFT·RL 단계, 설계 선택의 통제 실험 순으로 주장을 검토합니다. 원문 §5
5.1 Main Results
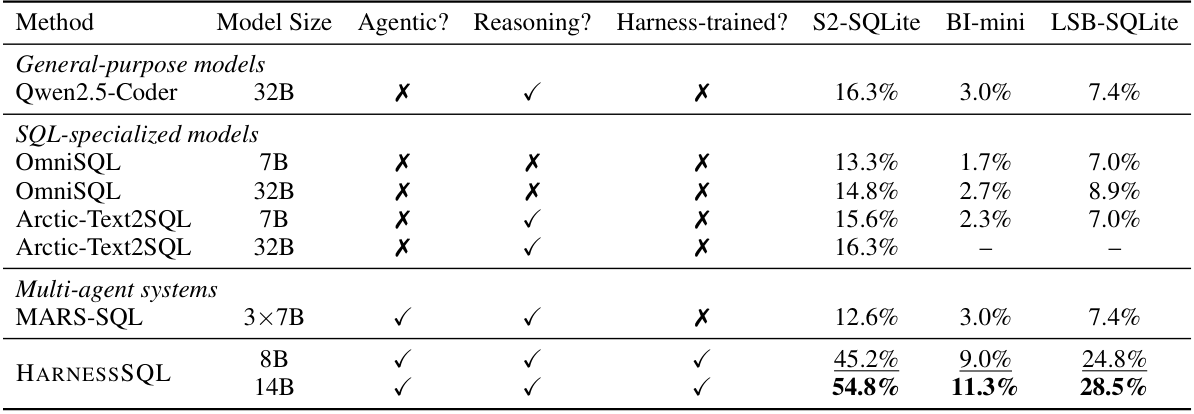
원문 Table 1, PDF 6쪽. 표 본체를 크롭했으며 수치를 변경하지 않았습니다. 기존 모델은 native 추론 방식이라는 조건을 함께 읽어야 합니다. 버전 고정 PDF, CC BY 4.0.
표의 주요 수치를 읽기 쉽게 옮기면 다음과 같습니다. —는 원문에서 결과를 보고하지 않은 셀입니다.
| 모델 | S2-SQLite | BI-mini | LSB-SQLite |
|---|---|---|---|
| Qwen2.5-Coder-32B | 16.3% | 3.0% | 7.4% |
| OmniSQL-7B | 13.3% | 1.7% | 7.0% |
| OmniSQL-32B | 14.8% | 2.7% | 8.9% |
| Arctic-Text2SQL-7B | 15.6% | 2.3% | 7.0% |
| Arctic-Text2SQL-32B | 16.3% | — | — |
| MARS-SQL, 3×7B | 12.6% | 3.0% | 7.4% |
| HarnessSQL-8B | 45.2% | 9.0% | 24.8% |
| HarnessSQL-14B | 54.8% | 11.3% | 28.5% |
저자는 먼저 S2-SQLite에서 작은 모델이 더 큰 기존 모델을 앞선다는 점을 강조합니다. 이어 BI-mini의 사용자 상호작용과 LSB-SQLite의 다른 DB 분포에서도 개선된다는 점을 해석합니다. 이 결과는 논문이 시험한 모델·평가 묶음에서의 우위입니다. 모델 크기, 감독 데이터, 추론 프로토콜을 모두 같게 맞춘 비교는 아니므로, 차이를 모델 파라미터 수나 DAPO 하나만의 효과로 돌리지 않습니다.
5.2 Effect of Post-Training
원문은 먼저 전체 궤적 감독과 직접 RL을 비교합니다. 8B는 Base 15.5% → SFT 30.4% → SFT+RL 45.2%이고, 14B는 22.2% → 37.8% → 54.8%입니다. 8B의 Direct RL은 20.0%이며 14B의 Direct RL 결과는 보고하지 않습니다.
8B에서 SFT의 증가는 14.9%p, 그 뒤 RL의 증가는 14.8%p입니다. 초기 모델에 바로 RL을 적용한 증가는 4.5%p이므로, 같은 실행 보상을 사용하더라도 출발 정책이 중요하다는 근거가 됩니다. 14B의 SFT 증가와 후속 RL 증가는 각각 15.6%p와 17.0%p입니다. 전체 증가 29.7%p와 32.6%p는 상대 개선율이 아닌 퍼센트포인트입니다.
5.3 Ablation Studies
Harness-native training and inference. 먼저 추론 환경과 학습 방식의 결합을 비교합니다.
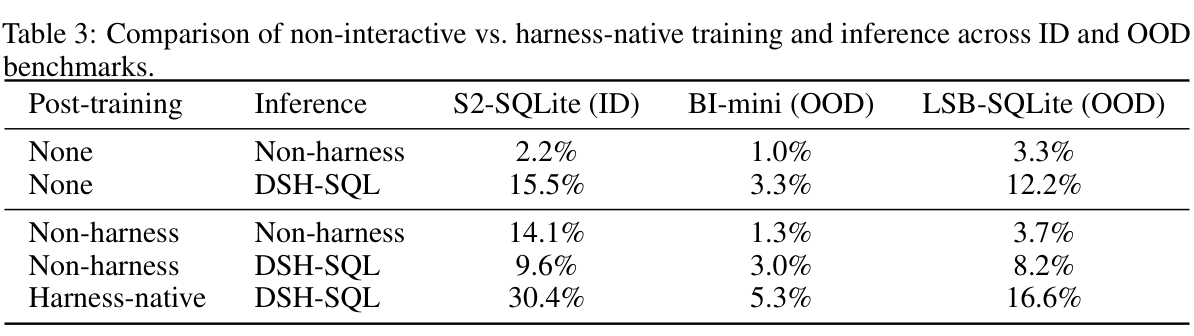
원문 Table 3, PDF 7쪽. 표 영역을 크롭했으며 번역·수치 변경은 없습니다. 버전 고정 PDF, CC BY 4.0.
| 후속 학습 | 추론 | S2-SQLite | BI-mini | LSB-SQLite |
|---|---|---|---|---|
| 없음 | Non-harness | 2.2% | 1.0% | 3.3% |
| 없음 | DSH-SQL | 15.5% | 3.3% | 12.2% |
| Non-harness | Non-harness | 14.1% | 1.3% | 3.7% |
| Non-harness | DSH-SQL | 9.6% | 3.0% | 8.2% |
| Harness-native | DSH-SQL | 30.4% | 5.3% | 16.6% |
이 표의 마지막 행은 SFT 결과이며 최종 SFT+RL 45.2%와 구별해야 합니다. 같은 DSH-SQL 추론에서 9.6%와 30.4%를 비교하면 학습 형식 정렬의 효과를 볼 수 있습니다. 한편 학습 전부터도 도구 추론이 2.2%를 15.5%로 올립니다. 저자는 도구가 유용하다는 관찰과, 그 도구에 맞는 학습이 추가로 필요하다는 주장을 분리합니다.
SFT trajectory organization. 다음으로 전체 궤적을 한 학습 예제로 묶는 방식과 각 턴을 분리하는 방식을 비교합니다. 턴 분리 방식도 이전 이력 prefix를 조건으로 받습니다. 따라서 맥락이 있는 모델과 없는 모델의 비교가 아니라 같은 에피소드를 어떤 학습 단위와 손실 구조로 조직하는가의 비교입니다.
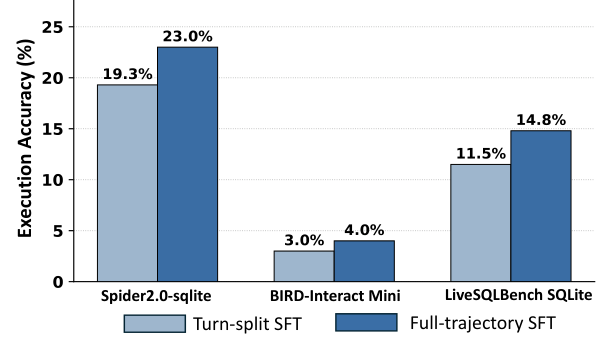
원문 Figure 3, PDF 7쪽. 축·범례·수치를 보존한 크롭이며 번역하지 않았습니다. 버전 고정 PDF, CC BY 4.0.
그림의 S2-SQLite는 19.3% → 23.0%, BI-mini는 3.0% → 4.0%, LSB-SQLite는 11.5% → 14.8%입니다. 이 그림의 full-trajectory 23.0%를 전체 코퍼스 SFT의 30.4%와 혼용하면 안 됩니다. Figure 3의 그림·설명 자체는 학습 예제 수를 명시하지 않으므로 같은 수치가 나타나는 다른 부분의 조건을 임의로 붙이지 않습니다.
Trajectory context length. 이어 SFT와 RL의 문맥 상한을 함께 8K·16K·32K로 변경합니다.
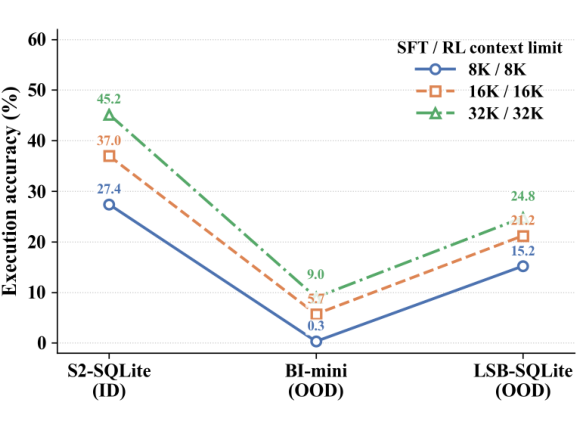
원문 Figure 4, PDF 8쪽. 축·범례·모든 데이터 지점을 보존한 영역 크롭이며 수치를 변경하지 않았습니다. 버전 고정 PDF, CC BY 4.0.
| SFT/RL 문맥 상한 | S2-SQLite | BI-mini | LSB-SQLite |
|---|---|---|---|
| 8K / 8K | 27.4% | 0.3% | 15.2% |
| 16K / 16K | 37.0% | 5.7% | 21.2% |
| 32K / 32K | 45.2% | 9.0% | 24.8% |
저자는 긴 추론·도구 결과·수정 이력을 유지할 문맥 용량이 중요하다고 해석합니다. 여기서는 SFT와 RL 상한이 동시에 달라집니다. 따라서 학습 후 추론 문맥만 늘린 효과로 바꾸어 설명하지 않습니다.
RL algorithm. 마지막으로 같은 SFT 체크포인트, 보상, 문맥·학습 예산에서 GRPO·GSPO·DAPO를 비교합니다. 세 평가의 순서로 GRPO는 40.7/8.7/23.3%, GSPO는 43.7/9.0/25.2%, DAPO는 45.2/9.0/24.8%입니다. DAPO는 S2-SQLite에서 가장 높지만 LSB-SQLite에서는 GSPO가 더 높습니다. 핵심은 이득이 단일 알고리즘에만 의존하지 않는다는 것이며, DAPO가 모든 평가에서 최고라는 결과는 아닙니다.
이 장의 기여: 하네스 추론, 하네스에 맞는 감독, 전체 궤적, 문맥 용량을 서로 구분하는 증거를 제시합니다. 다음 연결: §6은 이 기여가 기존 SQL·에이전트 연구와 어떻게 이어지는지 정리합니다.
📖 Chapter 6: Related Work
위치와 역할: 원문은 세 연구 흐름을 차례로 연결합니다. 이 절에서 언급된 연구를 모두 독립적으로 재검증한 것은 아니며, 여기서는 논문이 제시한 위치 관계를 설명합니다.
LLMs for Text-to-SQL. Spider와 BIRD의 의미 파싱에서 복잡한 업무 DB로 과제가 확장되었고, 합성 감독·실행 최적화와 추론 시점 탐색 시스템이 발전했다는 흐름입니다. 저자는 또 다른 추론 전략을 제안하는 것보다 배포 하네스 안에서 작동할 학습 데이터를 만드는 데 초점을 둡니다.
Harnesses and tool-using agents. ReAct의 추론–행동 교차, API·코드·소프트웨어 도구, 상호작용 평가를 거쳐 모델과 하네스의 조합이 중요하다는 관점을 소개합니다. HarnessSQL은 이 평가 관점을 데이터 생성·교사 rollout·후속 학습으로 확장합니다.
Synthetic instruction and agent trajectory data. 지시–응답 합성에서 개별 도구 호출, 전체 행동 궤적과 실행 검증으로 발전한 흐름을 설명합니다. 논문의 차이는 과제 생성과 결과 검증까지 목표 하네스의 계약과 연결한다는 데 있습니다.
이 장의 기여: 기존 실행 에이전트와 합성 데이터 연구를 학습 인터페이스 정렬이라는 관점으로 묶습니다. 다음 연결: §7은 현재 실험이 다루는 SQL 방언의 범위를 밝힙니다.
📖 Chapter 7: Limitations and Ongoing Work
위치와 역할: 저자가 명시한 한계와 진행 중인 연구를 제시합니다. 원문 §7
현재 연구의 중심은 SQLite입니다. 실무 벤치마크에 나타나는 PostgreSQL, Snowflake, BigQuery 등 다른 방언에서는 작은 기반 모델의 초기 능력이 더 약하고 일관성도 낮다고 설명합니다. 긴 상호작용에서는 SQL 문법뿐 아니라 DB 클라이언트, 메타데이터 명령, 실행 동작도 궤적의 일부가 되어 이 문제가 복합적으로 작용합니다.
저자가 밝힌 진행 방향은 방언별 실행 환경으로 하네스 기반 합성을 확장하여 SQLite와 다른 방언 간의 성능 격차를 줄이는 것입니다. 이 글에서는 논문이 언급하지 않은 실패 유형이나 별도의 미래 과제를 저자의 한계 목록에 추가하지 않습니다.
이 장의 기여: 실험에서 확인된 범위와 확장 중인 범위를 분리합니다. 다음 연결: §8은 그 범위 안에서 전체 결론을 정리합니다.
📖 Chapter 8: Conclusion
위치와 역할: 원문은 실행 가능한 환경, 과제에 맞는 하네스, 궤적 수준 감독이라는 세 정렬을 다시 연결합니다. 8B·14B의 단계별 개선과 OOD 결과를 근거로 하네스를 추론 wrapper뿐 아니라 학습이 재현해야 할 행동 분포의 일부로 보아야 한다고 결론짓습니다.
이어지는 Reproducibility Statement는 부록 A·C·H·J에 구성·설정·레코드·검증 정보를 제공한다고 밝힙니다. 생성 프롬프트, DB 식별자, seed, 원시 rollout, 실행 SQL, 결과 fingerprint와 선택 provenance를 기록한다고 설명하며, 최종 제출에 코드 스냅샷·데이터 manifest·실행 명령 등을 포함하겠다고 서술합니다. 초록의 코드 공개 문구와 이 향후 제공 문구를 구별해야 합니다. 이 리뷰는 연결된 저장소의 실행·학습 재현을 수행하지 않았습니다. AI use statement에는 문법 교정과 번역에 AI 보조를 사용했다는 설명이 있습니다.
이 장의 기여: 주장의 범위를 학습–실행 정렬로 수렴시킵니다. 다음 연결: 참고문헌 뒤 부록 A부터는 실행과 검증의 구체적 근거가 제시됩니다.
📖 Chapter A: DSH-SQL Harness Composition and Lifecycle
위치와 역할: 본문에서 말한 하네스의 구성과 실제 실행을 분리합니다. 공용 기반에서 상속한 기능을 논문의 새 기여로 오해하지 않게 하는 부록입니다. 원문 부록 A
System boundary. DSH-SQL은 에이전트 루프를 새로 만든 시스템이 아니라 프로파일 수준의 조합입니다. Table 5는 외부 실험 컨트롤러, 프로파일 조합, DSH 제어 평면, ReAct식 루프, SQL 환경 평면, 외부 검증기를 구별합니다. 컨트롤러는 과제별 프로세스·작업공간·DB 연결과 결과 회수를 담당합니다. DSH는 모델 요청, 세션·체크포인트, 재시도·압축, 도구 디스패치를 제공합니다. 논문이 추가한 부분은 SQL 프로파일과 어댑터, 그 계약에 맞춘 데이터·평가 파이프라인입니다. 검증기는 모델 문맥 밖에서 제출물을 재실행합니다.
Lifecycle and middleware. Cordis의 플러그인 수명주기는 서비스와 리스너의 설치·제거를 관리하고, 순서가 있는 이벤트는 에이전트 단계와 도구 실행 주변의 미들웨어로 작동합니다. 원문의 흐름은 다음 순서입니다.
system-prompt/assemble→agent/pre-step→agent/requestllm/stream→tools/pre-execute→tools/execute- SQL 도구 본체 →
tools/post-execute→tools/result
다음 외부 행동 전에 세션을 기록하고, 요청 오류 분기는 공급자 재시도와 문맥 초과 복구를 지원합니다. 실행 전에는 거부·승인 요청이 가능하고, 실행 중에는 취소와 시간 제한을 전달하며, 실행 후에는 결과를 줄이거나 수정 문맥을 주입할 수 있습니다. 이는 가능한 실행 경로의 설명이며 모든 분기가 매번 발동한다는 뜻은 아닙니다.
Composition does not imply activation. SQLite 프로파일에는 등록 82개 중 40개가 마운트되고 42개가 비활성화되어 있습니다. 마운트된 40개를 모델이 호출하는 도구 40개로 세어서는 안 됩니다. 일부는 구성 의존성이나 조건부 미들웨어입니다. 135개 과제를 담은 평가 디렉터리에 재시도 때문에 138개 세션 로그가 있었고, Table 6의 감사 단위는 이 로그입니다. 문맥 압축 22회, 큰 결과 잘라내기 1회, 반복 호출 알림 19회, SQLite 쿼리 60초 제한 발동 35회, 다중 문장 차단 2회가 기록됩니다. 마운트된 LLM retry와 output spill은 발동 0회였습니다. 또한 sql_submit 129회는 정답 129개라는 뜻이 아닙니다.
Backend-specific environment planes. SQLite는 별도 종료 가능한 자식 프로세스에서 단일 읽기 전용 쿼리를 실행합니다. PostgreSQL·BigQuery 어댑터도 있지만 보고된 SQLite 결과에는 사용되지 않았습니다. BIRD-Interact는 질의 실행, 스키마·열 의미 조회, 외부 지식 조회, 사용자 명확화, 제출을 포함한 9개 연산을 사용합니다. bird-coin 예산과 단계 전환을 유지하며 ask_user는 GPT-4o 시뮬레이터로 전달합니다. 공용 제어 평면은 유지하되 모델에게 보이는 능력 계약은 의도적으로 바뀝니다.
이 부록의 기여: 구성에 존재하는 기능, 실제 실행된 기능, 모델이 호출하는 행동을 구분할 근거를 제공합니다. 다음 연결: 부록 B는 이러한 환경에서 합성 교사의 질과 모델 행동을 분석합니다.
📖 Chapter B: Additional Ablations and Analysis
위치와 역할: 최종 정답률 뒤에 있는 합성 데이터 품질과 행동 변화를 확인합니다.
B.1 Trajectory Synthesis Configuration
Qwen3-8B와 고정된 1,000개 합성 예제 조건에서 교사와 하네스를 비교합니다. Table 7의 Base/Full DSH는 13.3%, Qwen3.5-9B 교사/DSH-SQL은 7.4%, Qwen3.6-27B 교사/Full DSH는 15.5%, 같은 27B 교사/DSH-SQL은 23.0%입니다. 교사가 약할 때는 학습 후 성능이 기준선보다 낮아질 수 있으며, 같은 강한 교사라도 하네스 특화에 따라 결과가 달라집니다.
여기서 15.5%는 강한 교사의 Full DSH 합성 데이터로 학습한 행의 값입니다. 주 실험의 8B Base/DSH-SQL 15.5%와 우연히 숫자가 같더라도 실험 행을 혼합해서는 안 됩니다. 저자는 교사의 신뢰할 수 있는 행동과 좁고 적합한 인터페이스가 함께 중요하다고 해석합니다.
B.2 Interaction Behavior Analysis
각 체크포인트에서 135개 과제에 독립 rollout 4회를 수행하여 모델당 540개 궤적을 분석합니다. 이것이 주 결과 표의 반복 평균·표준편차를 뜻하지는 않습니다. 원문 Table 8
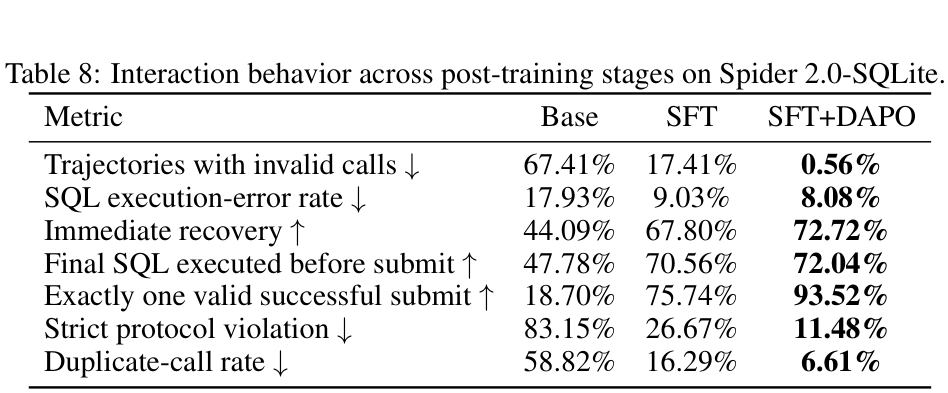
원문 Table 8, PDF 16쪽. 표 영역 크롭이며 수치를 변경하지 않았습니다. 지표마다 궤적 또는 호출·오류 등 측정 단위가 다르므로 하나의 공통 정답률로 읽지 않습니다. 버전 고정 PDF, CC BY 4.0.
| 행동 지표 | Base | SFT | SFT+DAPO |
|---|---|---|---|
| 유효하지 않은 호출을 포함한 궤적 | 67.41% | 17.41% | 0.56% |
| SQL 실행 오류율 | 17.93% | 9.03% | 8.08% |
| 즉각적인 복구 | 44.09% | 67.80% | 72.72% |
| 제출 전에 최종 SQL 실행 | 47.78% | 70.56% | 72.04% |
| 정확히 한 번의 유효하고 성공적인 제출 | 18.70% | 75.74% | 93.52% |
| 엄격한 프로토콜 위반 | 83.15% | 26.67% | 11.48% |
| 중복 호출률 | 58.82% | 16.29% | 6.61% |
저자는 SFT가 기본 프로토콜과 복구 패턴을 크게 바꾸고 RL이 종료·행동 일관성을 추가로 높인다고 해석합니다. 특히 SQL 실행 오류의 9.03→8.08% 감소보다 잘못된 호출을 포함한 궤적의 17.41→0.56% 감소가 두드러집니다. 두 지표의 분모와 의미가 다르므로 감소폭을 같은 현상으로 취급하지 않습니다. Table 8의 “성공적인 제출”도 Table 1의 정답 실행 정확도와 동일한 지표가 아닙니다.
이 부록의 기여: 최종 정답 개선과 함께 어떤 상호작용 행동이 달라졌는지 보여줍니다. 다음 연결: 부록 C는 이 정책을 학습한 설정과 목적함수를 공개합니다.
📖 Chapter C: Post-training Configuration and Objectives
위치와 역할: 본문의 SFT와 RL을 학습 길이·예산·토큰 손실 수준으로 구체화합니다. 원문 부록 C
C.1 Training configuration
SFT는 두 모델에 2,512개 전체 궤적, 최대 32,768토큰, 3 epoch와 471 optimizer update를 사용합니다. 유효 batch는 16이며 AdamW 학습률은 $10^{-5}$, cosine decay, warmup 5%, weight decay 0.01입니다. H800 GPU 8개, bfloat16, gradient checkpointing, DeepSpeed ZeRO-3를 사용합니다.
RL은 각 모델의 32K SFT 체크포인트에서 출발합니다. 150 rollout iteration, iteration당 질문 4개와 질문당 궤적 8개, rollout당 optimizer step 2회입니다. 세션 전체 32,768토큰과 단일 모델 호출의 새 생성 4,096토큰을 구분해야 합니다. trainer의 dynamic-batch 토큰 cap도 모델 문맥 창과 다른 메모리 관리 설정입니다. Adam 학습률 $10^{-6}$, actor H800 4개와 rollout H800 4개를 사용하며 entropy bonus와 유효 KL 벌점은 없습니다. 이는 단일 저사양 장치에서 수행한 학습이라는 주장이 아닙니다.
C.2 Policy optimization objectives
GRPO objective. 질문 하나에 $G=8$개 궤적을 생성하고, 각 실행 보상 $r_i$를 그룹 안에서 표준화합니다. 원문 식 (7)의 mean과 std는 수학적 의미를 유지해 upright 함수명으로 표기했습니다.
$\hat A_i$는 같은 질문의 다른 시도에 비해 해당 궤적이 얼마나 유리한지 나타내는 advantage입니다. 분모의 작은 상수는 0으로 나누는 것을 막습니다. 이 궤적 값을 손실이 있는 assistant 토큰에 전달합니다. 원문 식 (8)은 다음과 같습니다.
$\rho_{i,t}$는 같은 상태의 토큰 또는 행동에 대해 새 정책 확률을 이전 정책 확률로 나눈 중요도 비율입니다. clip은 비율을 지정 범위에 제한하며, 급격한 업데이트를 억제합니다. 기대값은 궤적과 토큰에 대한 손실 집계입니다. 저자는 설정에 reference-KL 관련 0.01 값이 전달되더라도 확인한 구현의 return broadcaster가 그 값을 실제 보상에서 빼지 않아 유효 목적에는 KL 항이 없다고 구별합니다. 하네스 프로세스 자체가 실패한 그룹은 음성 정답 예제로 쓰지 않고 그룹 단위로 제외합니다.
GSPO objective. 원문 식 (9)은 토큰별 확률 비율의 기하평균을 궤적 비율로 만듭니다.
$\mathcal T_i$는 손실을 부여하는 assistant 토큰 위치의 집합이고 $N_i$는 그 수입니다. 길이 정규화로 서로 다른 길이의 궤적 비율을 비슷한 수치 척도에 놓습니다. 환경 관찰은 상태에는 들어가지만 이 토큰 집합에는 들어가지 않습니다. 식 (10)은 GRPO의 $\rho_{i,t}$ 대신 $\sigma_i$를 사용해 궤적 전체를 함께 clip합니다. 따라서 최종 궤적 보상과 중요도 보정의 단위가 일치합니다. 이 글에서는 동일한 clip 형태를 중복 전사하는 대신 그 변경 항과 집계 단위를 설명합니다.
DAPO objective. DAPO는 토큰 비율을 유지하되 위·아래 clip 폭을 달리하고, 보상이 모두 같은 그룹을 제외하며, batch의 손실 토큰 전체에 대해 정규화합니다. 원문 식 (11)의 유효 질문 집합은 다음과 같습니다.
$\mathbb I$는 조건이 참일 때 1인 지시함수입니다. 이진 보상에서 성공과 실패가 섞여 있어야 그룹 내부 우열이 생긴다는 뜻입니다. 모두 성공하거나 모두 실패하면 표준화 advantage가 0이므로 정책 경사 신호가 생기지 않습니다. 원문 식 (12)을 같은 의미의 aligned 줄바꿈으로 옮기면 다음과 같습니다.
$\epsilon_{\mathrm{low}}$와 $\epsilon_{\mathrm{high}}$는 하한·상한 clip 반경이며, 보고된 설정은 0.20과 0.28을 사용합니다. 상한을 더 크게 두어 유리한 토큰의 확률 증가를 더 허용합니다. $\sum_iN_i$로 나누는 부분은 길이가 다른 궤적마다 같은 비중을 주기보다 손실 토큰을 합쳐 정규화하는 차이입니다. 알고리즘 비교는 공통 rollout pool에서 각 방식의 필터·집계를 적용하며, 별도의 초과 길이 shaping reward는 추가하지 않습니다.
Execution reward. 식 (13)은 제출 SQL을 30초 제한으로 재실행한 정규화 결과가 정답과 맞으면 1, 아니면 0인 종료 보상을 정의합니다. 의미상 필요한 경우 행 순서를 유지하고, 그렇지 않으면 순서에 무관한 fingerprint를 비교합니다. 공개 지시에 열 별칭이 지정되지 않은 경우 값이 맞으면 인정하지만, 공개 열 이름을 틀리거나 SQL 파싱·실행·시간 제한이 실패하면 0입니다. 도구 호출 횟수나 중간 SQL의 문법 타당성에는 부분 점수를 주지 않습니다. 이 30초 검증 제한과 SQLite 도구의 60초 자식 쿼리 제한은 원문에서 서로 다른 경로에 제시된 값입니다.
이 부록의 기여: 같은 “실행 보상 RL” 안에서도 손실 토큰·집계 단위·클리핑·실제 유효 항을 구체화합니다. 다음 연결: 부록 D는 감독 궤적에 실제 어떤 상호작용이 들어 있는지 보여줍니다.
📖 Chapter D: SFT Corpus Statistics
위치와 역할: 검증된 궤적이 실패 없는 정답 경로만을 뜻하는지 확인합니다. 원문 부록 D
Table 11의 궤적은 평균 11,793.89토큰, 에이전트 턴 중앙값 16, 평균 도구 호출 17.00회, SQL 실행 13.91회입니다. 중간 SQL 실패를 하나 이상 포함하는 궤적이 77.83%, 서로 다른 쿼리를 둘 이상 실행한 궤적이 99.92%, 실패 후 쿼리 수정이 있는 궤적이 77.71%입니다. 교사의 pass@1은 71.20%, pass@3은 83.61%이며, 이는 학생의 최종 평가 정확도와 다른 데이터 수집 지표입니다.
전체 42,704개 도구 호출과 34,936개 SQL 실행 중 실행 실패는 3,989개입니다. 그런데 그중 3,230개는 SQL 앞의 주석 때문에 읽기 전용 guard가 첫 토큰을 SELECT, WITH, EXPLAIN으로 인식하지 못하여 거부한 경우입니다. 따라서 실패를 전부 SQL 추론의 의미적 오류로 세면 원문이 제시한 현상을 왜곡합니다. 하네스가 허용하는 입력 문법과 그에 대한 복구도 학습 데이터에 들어 있습니다.
Ablation on Sanitizing Comment-Induced Execution Failures. 저자는 이 주석 거부와 후속 상호작용을 제거한 데이터를 별도로 만들어 같은 설정으로 학습합니다. 원본 궤적의 SFT는 30.4%, 정제한 궤적은 28.2%로 2.2%p 낮았습니다. 저자는 이러한 실패–복구 경험을 유지하는 것이 유용하다고 해석합니다. 이는 모든 오류나 노이즈를 무조건 보존하라는 일반 법칙이 아니라 해당 guard와 학습·평가 조건에서의 관찰입니다.
이 부록의 기여: 정답 검증을 통과한 전체 에피소드와 그 안의 실패한 중간 행동을 구분합니다. 다음 연결: 부록 E는 같은 DB에서 생성한 학습 과제와 평가 질문의 겹침을 감사합니다.
📖 Chapter E: Data Integrity and Leakage Audit for Shared-Database Evaluation
위치와 역할: 주 평가가 학습과 데이터베이스를 공유한다는 사실을 전제로, 평가 질문 자체를 복제했는지 다층으로 검사합니다. 새로운 질문에 대한 적응과 새로운 DB에 대한 전이를 구분하는 데 핵심인 부록입니다. 원문 부록 E
E.1 Exact Matching and Near-Duplicate Analysis
Spider 2.0-Lite의 SQLite 30개는 이름만 같은 것이 아니라 파일 SHA-256이 같은 DB입니다. 공식 평가 135개 질문과 합성 pool·최종 SFT subset을 비교한 결과 Task ID, 원문 질문, 정규화 질문, 같은 DB 안의 부분 문자열 포함 관계가 모두 0건입니다. 이는 DB 중복 0건이라는 뜻과 정반대입니다. DB는 공유하고 과제 중복을 검사한 설계입니다.
같은 DB의 가장 가까운 합성 질문과 비교한 token sequence ratio는 중앙값 0.0913, 최대 0.1689이고, token-set Jaccard는 중앙값 0.0971, 최대 0.1869입니다. 연속 공통 토큰의 최대 길이는 5입니다. Table 13은 Baseball, F1, IPL, Chinook, Education의 상위 유사 쌍을 수작업으로 대조하여, 같은 업무 용어를 쓰더라도 분석 대상과 목적은 다르다고 설명합니다. 예를 들어 고객·매출 용어의 공유가 같은 집계 질문의 복제를 곧바로 뜻하지는 않습니다.
E.2 Semantic Overlap Analysis
문자열 이상의 유사성은 all-MiniLM-L6-v2의 384차원 임베딩으로 비교합니다. 긴 지시는 최대 254토큰 창과 48토큰 stride로 나누고, 문서 평균 임베딩 유사도와 가장 가까운 chunk 쌍 유사도를 구합니다. 같은 DB의 합성 후보는 1,797개입니다.
135개 평가 질문에서 문서 cosine 유사도 중앙값은 0.4965, 최대 0.7122이고, 최대 chunk cosine은 중앙값 0.5241, 최대 0.7075입니다. 두 기준 모두 0.75 이상인 평가 질문은 0개입니다. 가장 가까운 IPL 사례도 생애 타격·투구 프로필과 특정 시즌 조건의 투수 cohort 집계를 구분하여 설명합니다. 이 값들은 선택한 임베딩·청크·기준 아래의 감사 결과이며 모든 가능한 의미 중복을 수학적으로 증명하는 정리는 아닙니다.
E.3 Execution Result Fingerprinting
마지막으로 동일 DB에서 실제 결과가 우연히 겹치는지 확인합니다. 공식 135개 과제의 허용 정답 CSV 328개와 비교하며, 같은 DB 쌍의 수는 전체 생성 pool 14,266개와 최종 SFT corpus 14,260개입니다. 행 순서 유지/무시와 열 이름 포함/값만 비교의 네 조건을 적용하고, NULL·부동소수점·공백·대소문자를 정규화합니다. 가장 관대한 값·무순서 비교에서도 일치가 0개였습니다.
저자는 이를 목표 과제 암기나 누수로 성능 향상을 설명하기 어렵다는 근거로 제시합니다. 리뷰어의 해석 범위는 명확합니다. 이 감사는 공유 DB에서 평가 질문·결과가 학습 과제와 겹쳤는지에 대한 증거를 강화합니다. DB의 스키마·도메인에 노출되지 않았다는 증거는 아니며, 그 노출을 금지하는 실험 설계도 아닙니다. 또한 이 글은 원시 레코드와 CSV로 감사를 재실행한 것이 아니라 논문의 보고를 대조했습니다.
이 부록의 기여: 주 결과의 일반화 단위를 “같은 DB의 새로운 질문”으로 정확하게 읽도록 합니다. 다음 연결: 부록 F는 모델을 낯선 하네스에 옮겼을 때의 비교 문제를 다룹니다.
📖 Chapter F: Cross-Harness Evaluation
위치와 역할: 본문 Table 1에서 기존 모델에 native 프로토콜을 사용한 이유를 검증합니다. 원문 부록 F
Table 15는 벤치마크와 실행 기반 채점을 고정한 뒤 기존 모델을 추가 학습 없이 DSH-SQL로 옮깁니다. Qwen2.5-Coder-32B의 S2-SQLite는 16.3→3.0%, OmniSQL-32B는 14.8→1.5%, Arctic-Text2SQL-7B는 15.6→0%입니다. BI-mini도 각각 3.0→0%, 2.7→0%, 2.3→0%로 낮아집니다. LSB-SQLite는 각각 7.4→5.6%, 8.9→0%, 7.0→1.1%입니다.
저자는 도구를 제공하기만 해서는 낯선 행동 계약에 적응하지 못할 수 있다고 해석합니다. 그러므로 Table 1은 기존 모델을 각자의 설계에 맞는 프로토콜로 비교하고, Table 3은 동일한 DSH-SQL 추론 안에서 학습 전략을 비교합니다. 동일한 평가 문제·채점기와 동일한 추론 하네스는 서로 다른 통제 조건입니다. 이 구분이 하네스를 학습해야 한다는 논문의 주장과 직접 연결됩니다.
이 부록의 기여: 모델 능력과 인터페이스 호환성을 혼합한 불리한 비교를 피하려는 근거를 제시합니다. 다음 연결: 부록 G는 각 벤치마크와 실행 정확도의 정의를 정리합니다.
📖 Chapter G: Evaluation Benchmarks
위치와 역할: 평가 문제의 성격과 결과 일치의 의미를 정리하며, 원문 내부의 서술 차이도 확인할 수 있는 부록입니다.
Spider 2.0-SQLite. 135개 과제의 복잡한 스키마·다중 테이블·업무 데이터 표현을 대상으로 사람이 개입하지 않는 탐색과 실행을 요구한다고 설명합니다. 원문 이 부록의 “135 complex database instances” 표현은 §4와 부록 E에서 말하는 135개 평가 과제와 함께 읽어야 합니다. 135개의 서로 다른 DB라는 의미로 옮기지 않습니다.
BIRD-Interact Mini. A-Interact의 GPT-4o 사용자 시뮬레이터가 불완전한 요구에 답하고 피드백을 주는 과제입니다. 사용자 명확화와 실행 탐색의 전이를 살펴보며, SQLite 합성의 네 도구와 실제 평가의 9개 연산 차이는 부록 A에 있습니다.
LiveSQLBench Base-Lite SQLite. 새롭게 갱신되는 실제 업무형 DB 과제에서 보지 못한 DB 구조와 지저분한 스키마 등으로의 전이를 살펴본다고 설명합니다. 이 글은 논문의 평가 묶음과 보고 수치를 다루며, 이후 갱신된 라이브 순위나 별도 DB를 시험한 결과를 추가하지 않습니다.
Evaluation Protocol and Tool Contract. 원문 식 (14)의 실행 정확도는 다음과 같습니다.
$D$는 평가 과제 집합, $Y_i$와 $Y_i^*$는 예측 SQL과 기준 SQL, $\mathcal D_i$는 해당 DB입니다. 실행 결과가 맞는 과제의 비율이며, 응답 누락·파싱 오류·문법 오류·시간 초과는 분모에서 제거하지 않고 오답으로 셉니다. 식의 정답 SQL 표기는 일반 정의이며, 실제 Spider 감사는 canonical gold SQL 대신 허용 CSV를 사용했다는 부록 E의 설명도 유지해야 합니다.
한편 부록 G에는 “모든 모델이 동일한 DSH-SQL 인터페이스로 평가된다”는 문장이 있으나, 이는 §4와 부록 F의 기존 모델 native 평가 설명 및 부록 A의 BIRD 9개 연산과 일치하지 않습니다. 이 리뷰는 더 구체적인 프로토콜 비교표와 backend 설명에 따라 결과를 구분하며, 모든 실험이 동일한 네 도구였다고 단정하지 않습니다. 이 차이는 원문 서술의 불일치이며 리뷰어가 새로 만든 실험 결과가 아닙니다.
이 부록의 기여: 오류를 포함하는 분모와 평가의 실행 의미를 명시합니다. 다음 연결: 부록 H는 이러한 작업을 추적하기 위한 저장 레코드를 설명합니다.
📖 Chapter H: Data Record and Export Format
위치와 역할: 합성 과제, 실행 환경, 궤적, 학습 입력의 서로 다른 레코드를 정리합니다.
과제 blueprint에는 sample·database·template 식별자, 지시, oracle SQL, 예상 열, 행 수 범위, 연산자, 의미 역할, 조인과 mutation이 들어갑니다. 환경 레코드는 방언·연결·도구 정의·권한·예산을 덧붙입니다. 궤적 레코드는 전체 메시지, 도구 인자, 관찰, 최종 SQL과 실행 결과, 검증 결과와 선택 방식을 저장합니다.
학습 export는 숨겨진 oracle 필드를 모델 문맥에서 제거하고 system·user·도구 관찰 토큰의 손실을 마스킹합니다. 따라서 사후 감사용 정답 정보가 레코드에 존재한다는 사실과 교사가 그 정답을 봤다는 주장은 동일하지 않습니다. 이 부록의 기여: 검증 가능성과 정책에 대한 정답 노출을 분리합니다. 다음 연결: 부록 I는 이 레코드의 과제를 어떤 난도로 생성하는지 설명합니다.
📖 Chapter I: Structural Difficulty Control and Synthesized Task Examples
위치와 역할: 합성 질문의 난도를 막연한 언어적 지시 대신 SQL 구조의 측정값으로 제어하는 방법과 실제 예제를 제시합니다. 원문 부록 I
I.1 Controllable structural difficulty
원문 식 (15)은 합성 SQL $z$의 구조 점수를 정의합니다.
$n_{\mathrm{tok}}$는 SQL 어휘 토큰 수입니다. 나머지 $n$ 항들은 순서대로 CTE, join, SELECT, window, 집합 연산, EXISTS, 조건부 집계, CASE, 시간 관련 구조, JSON 구조의 수를 나타내며, $d_{\mathrm{sel}}$은 SELECT의 최대 중첩 깊이입니다. 양의 부분 $[n_{\mathrm{sel}}-1]_+$는 첫 SELECT를 넘어서는 추가 SELECT 수만 반영합니다. 가중치는 생성 구조를 제어하는 점수이며 모델의 실제 성공률을 완벽히 예측한다는 주장은 아닙니다.
저자는 foundation·core·growth·stretch의 네 구간에 혼합 비율을 주고, 식 (16)으로 각 구간의 구조 점수·토큰 수의 하한과 상한, 고급 구조 계열의 최소 수를 함께 제한합니다. 범위를 벗어난 후보에는 어떤 구조가 부족하거나 과한지 피드백하여 제한된 수정으로 단순화하거나 보강합니다. 이 점수와 gate는 생성 SQL에만 적용하며 벤치마크 정답 SQL을 입력으로 사용하지 않는다고 명시합니다.
I.2 Representative synthesized task records
Example 1: core task. Airlines의 sqlite_candidate_000002는 구조 점수 15.732이며 CTE 2개, join 2개, JSON 추출, 조건부 집계, distinct count, ranking window를 결합합니다. 과제는 2017년 8월 도착 항공편의 기종별 수입과 편당 수입·비즈니스 운임 비율·매출 순위를 묻습니다. 공개 지시는 원시 값으로 순위를 결정하고 마지막 표시만 반올림하도록 구별합니다. 검증 결과는 6열·8행과 결과를 바꾸는 mutation 5개입니다.
원문 SQL의 흐름은 도착 항공편과 기종 JSON을 결합하는 CTE, 티켓 매출을 집계하는 CTE, 최종 비율·순위 계산 순입니다. 이는 단지 길이가 긴 SQL을 만드는 것보다 여러 의미 조건과 표시 규칙을 일관되게 묶는 과제라는 점을 보여줍니다. 이 리뷰는 SQL 전문을 다시 실행하거나 결과 행을 독립 검증하지 않았습니다.
Example 2: stretch task. activity DB의 dbt_score20_30_000001은 구조 점수 20.824, SQL 302토큰, window와 파생 분류의 두 고급 구조 계열을 포함합니다. activity_id left join으로 원시 이벤트를 모두 보존하고, 개체별 첫 visit page를 기준으로 이후 이벤트와 예상 출력에 포함된 이벤트·매출·비율을 집계합니다. 검증 결과는 8열·8행과 mutation 5개입니다. 첫 예제와 같은 생성–실행–검증 절차를 유지하면서 필요한 구조 조합이 달라지는 사례입니다.
원문에 정답 SQL이 실린 것은 감사 가능성을 위해서이며, rollout 시점에는 oracle·fingerprint·mutation을 숨긴다고 다시 설명합니다. 이 부록의 기여: 난도 제어 변수와 실제 합성 과제의 업무 의미를 연결합니다. 다음 연결: 부록 J는 이를 통과시킬 검증 목록을 정리합니다.
📖 Chapter J: Verifier Checklist
위치와 역할: 원문은 검증을 다음 여섯 층으로 나눕니다.
- 정적 안전성: 단일 읽기 전용 SELECT 또는 WITH이며 쓰기·DDL·attachment·다중 문장 우회를 막습니다.
- 스키마 타당성: 참조 테이블과 열이 존재하고 조인 조건과 방언 구조가 유효해야 합니다.
- 실제 실행: 지정 DB에서 query planning과 제한된 실행이 성공해야 합니다.
- 결과 품질: blueprint의 열과 행 범위를 만족하고 필요한 경우 비어 있거나 퇴화한 결과를 배제합니다.
- 일관성: 지시·프로그램·결과가 맞고 의도적인 변형이 결과를 바꾸어야 합니다.
- 궤적 프로토콜: 도구 인자·읽기 전용 접근·예산을 준수하고 최종 SQL 전체를 제출 전에 실행해야 합니다.
이 목록은 문법 검사 하나가 의미적 정답을 대신하지 않음을 보여줍니다. 모든 항목을 이 리뷰에서 재실행해 통과했다는 뜻은 아니며, 원문이 공개한 gate와 검증 계약을 설명한 것입니다. 이 부록의 기여: 검증이 데이터 생성·실행·정답·프로토콜을 함께 다룬다는 점을 명시합니다. 다음 연결: 부록 K는 마지막으로 확보한 궤적의 출처를 집계합니다.
📖 Chapter K: Generation Diagnostics
위치와 역할: 원문 마지막 부록은 과제당 교사 rollout 3회 뒤 보존한 궤적의 분포를 Table 16으로 제시합니다. Spider 2.0-Lite 출처 1,797개가 71.5%, Spider 2.0-DBT 출처 715개가 28.5%로 총 2,512개입니다.
이는 벤치마크 정답률이나 전체 생성 시도에 대한 채택률이 아닙니다. 검증을 통과하여 최종 SFT에 포함된 궤적의 구성입니다. 부록 E가 같은 DB의 의미 유사도 검사에 사용한 1,797개도 이 Lite 출처 부분과 연결해서 읽을 수 있습니다. 이 부록의 기여: 코퍼스 전체와 그 출처별 부분집합의 분모를 명확히 합니다. 여기서 원문의 본문과 부록 전개가 끝납니다.
실험 결과 심층 분석
무엇이 얼마나 좋아졌는지
S2-SQLite에서 8B의 15.5→45.2%는 29.7%p 증가이며, 14B의 22.2→54.8%는 32.6%p 증가입니다. 그중 8B SFT 14.9%p와 후속 RL 14.8%p를 나누어 보면, 정답 보상만 주는 방식과 먼저 상호작용 패턴을 감독하는 방식의 차이를 이해할 수 있습니다. Table 3의 같은 DSH-SQL 추론 비교인 non-harness 학습 9.6%와 harness-native SFT 30.4%는 논문의 핵심 가설에 더 직접적인 근거를 제공합니다.
반면 Table 1의 32B 모델과 최종 HarnessSQL 비교는 데이터와 프로토콜까지 동일하게 맞춘 단일 변수 실험은 아닙니다. 따라서 작은 모델의 시스템 전체 성능이 높다는 결과는 읽을 수 있지만 “파라미터 수만 줄였는데 좋아졌다” 또는 “DAPO만 바꾸면 같은 성능이 난다”는 결론은 지지하지 않습니다.
신뢰도와 일반화의 범위
이 v1의 주 결과 표에는 반복 평균±표준편차, 신뢰구간, 유의성 검정이 보고되어 있지 않습니다. 기록하는 seed가 있다는 재현성 설명과 반복 통계가 실제로 제시됐다는 주장은 구별해야 합니다. 부록 B.2의 4회×135개 행동 분석도 그 자체로 Table 1의 불확실성 구간을 제공하지 않습니다. 따라서 점추정 차이를 보고하되 통계적으로 유의하다고 단정하지 않습니다.
주 평가에서는 30개 SQLite DB를 학습과 공유합니다. 누수 감사는 질문·의미 유사도·실행 결과의 직접 중복을 찾지 못했다는 증거이며, 공유 스키마의 새로운 질문을 푸는 설정을 뒷받침합니다. 다른 DB·사용자 상호작용에 대한 전이는 BI-mini와 LSB-SQLite로 따로 읽어야 합니다. 이 전이 결과도 SQLite 중심이며 다른 SQL 방언의 성능까지 보장하지 않습니다.
행동 개선과 남아 있는 수치의 의미
정확한 제출 형식과 중복 호출 억제는 큰 폭으로 좋아지지만, SFT 뒤 SQL 실행 오류율은 9.03→8.08%로 더 완만하게 줄어듭니다. 이는 프로토콜을 잘 따르는 것과 업무 질문의 정답을 얻는 것이 다름을 보여줍니다. BI-mini의 9.0/11.3% 역시 비교군보다 높더라도 절대 성공률 자체를 함께 봐야 합니다. 이 해석은 보고된 결과의 실용적 의미를 읽는 것이며, 논문에 없는 새로운 실패 사례를 제시하는 것은 아닙니다.
재현에 대해서는 환경 경계·마스킹·학습률·예산·검증 목록이 비교적 구체적입니다. 동시에 원문에는 코드 공개 문구와 최종 제출 시 추가 manifest·스냅샷 제공 계획이 함께 있습니다. 이 글은 모델 학습·저장소 설치·DB 실행·누수 감사의 독립 재현을 하지 않았으므로, 논문의 수치 대조와 실행 재현을 같은 검증으로 표시하지 않습니다.
기술적 함의와 응용
데이터과학자의 관점에서 이 논문은 SQL 에이전트를 “정답 쿼리를 잘 쓰는 모델”보다 어떤 증거를 조회하고, 어떤 가설을 시험하며, 어떤 조건에서 종료하는가를 학습한 정책으로 보게 합니다. 원문이 강조하듯 모델이 실제로 받을 오류 형식과 결과 길이, 도구 이름, 제출 규칙은 학습과 무관한 주변 설정이 아닙니다. 학습 시점의 행동 분포를 만드는 요소입니다.
리뷰어의 응용 해석으로는, 스키마가 비교적 안정적이고 업무 질문이 계속 바뀌는 조직 내부 분석 환경과 특히 관련이 있습니다. 이때 같은 DB에서 합성 질문을 만드는 설계는 실험 조건과도 맞닿습니다. 다만 모델에게 숨기는 정답 필드와 사후 감사 레코드, 도구 실행 제한과 평가 검증 제한, 로그에 등록된 기능과 실제 활성화된 기능을 각각 구별해야 논문에서 무엇을 배포에 가져오는지 분명해집니다.
저자가 명시한 확장 방향은 SQLite 밖의 방언별 실행 환경입니다. 현재 결과가 뒷받침하는 결론은 실행 가능한 환경, SQL에 맞춘 인터페이스, 전체 궤적 감독과 실행 보상을 함께 정렬하면 보고된 소형 모델의 데이터베이스 상호작용을 개선할 수 있다는 것입니다. 하네스는 모델의 답을 포장하는 부분을 넘어 학습할 행동의 경계를 정의합니다.
분석 범위는 arXiv v1 본문 §1–8과 부록 A–K, 수식과 표·그림입니다. 참고문헌의 개별 연구 전체, 부록 I의 두 SQL 전문 실행, 공개 저장소·모델의 독립 재현은 수행하지 않았습니다. 주요 수식은 식 (1)–(3), (6)–(9), (11)–(12), (14)–(15)을 전사·해설했고, 식 (4)–(5), (10), (13), (16)은 원문의 의미와 변경 항·조건을 본문에서 설명했습니다.