논문 개요와 전체 구조
에이전트가 코드를 수정할 수 있다면 자신을 실행하는 도구와 지침도 바꿀 수 있습니다. 문제는 어떤 수정이 좋은지 알아내는 비용입니다. 후보를 만들 때마다 실제 문제를 풀게 하고 점수를 확인하면, 평가 문제 수와 반복 횟수에 따라 탐색 비용이 누적됩니다. SelfSearch는 자기 수정 과정에서 생긴 행동 기록을 다음 수정의 근거로 사용하고, 탐색 중에는 downstream 벤치마크의 문제나 정답 보상을 제공하지 않는 방법입니다. 여기서 downstream은 개선된 에이전트가 나중에 수행하는 소프트웨어 수정·터미널 작업을 뜻합니다. 초록·1절
하네스(harness)는 모델 주변의 도구, 지침, 실행 절차를 구성하는 소프트웨어 층입니다. 이 연구는 모델 가중치를 학습하지 않고 하네스를 바꿉니다. 긴 실행 기록이 잘려 필요한 내용을 읽지 못했다면 검색 도구를 만들고, 검색 결과를 줄이는 과정에서 일치 구간이 사라졌다면 출력 방식을 고치는 식입니다. 이렇게 발전한 도구와 수정 경험이 다음 세대로 함께 전달됩니다. reward-free는 탐색에 downstream 평가 보상을 쓰지 않는다는 뜻이며, 도구의 오류·로컬 검사 결과까지 없애거나 최종 성능 평가를 생략한다는 뜻은 아닙니다.
분석 대상은 Jungwoo Yang, Injin Kong, Yohan Jo의 SelfSearch: Reward-Free Search for Self-Improving Agents, arXiv:2609.37968v2입니다. 최초 제출일은 2026년 9월 29일, 분석 버전 수정일은 9월 30일이며 같은 버전 HTML과 20쪽 PDF를 대조했습니다. 아래 모델 이름과 추론 가격은 논문 실험에 사용된 설정입니다. 버전 고정 서지
| 원문 순서 | 내용과 역할 |
|---|---|
| 1 Introduction | 평가 기반 탐색의 비용과 자기 수정 경험이라는 대안 |
| 2 SelfSearch | 수정 에피소드 → 두 계보의 세대별 탐색 → 실행 환경 |
| 3 Experiments | 3.1 설정, 3.2 성공률·비용, 3.3 평가 기반 탐색 비교, 3.4 모델 전이, 3.5 다른 하네스 비교 |
| 4 Analysis | 4.1 기록·개선자 제거 실험, 4.2 도구의 발전 과정, 4.3 실제 과제에서 재사용 |
| 5 Related Work | 평가 기반 탐색, 자기 수정 에이전트, 수정 과정의 경험 |
| 6 Discussion → 7 Conclusion | 평가와 후보 생성의 분리, 후속 검증 방향, 결론 |
| AI Use Statement → Reproducibility Statement → References | AI 활용과 책임, 재현 정보의 위치, 참고문헌 |
| A Initial Agent and Execution Environment | 초기 에이전트, 수정 경계, 기록과 이식 |
| B Search Prompts | 공통 템플릿, 두 탐색 방향, 모델별 목표·설계 지침 |
| C Experimental Details | C.1 모델, C.2 과제·프로토콜, C.3 비교군, C.4 비용 수식 |
| D Additional Results | D.1 탐색 자원, D.2 실행 효율, D.3 하네스 비교 조건 |
| E Self-Improvement Trajectories | E.1 세대별 변화, E.2 downstream 도구 사용 |
| F Comparison of Agent Search Designs | 작업자·개선자 진화와 보상 사용의 설계 비교 |
핵심 기여와 혁신성
첫째, 자기 수정의 산출물을 코드와 경험으로 나눠 보존합니다. 기존 탐색의 주요 피드백은 후보가 과제를 얼마나 잘 풀었는지입니다. SelfSearch는 후보를 만드는 동안 어떤 파일을 읽었고, 무엇을 잘못 관찰했으며, 어떤 편집·검사를 했는지를 다음 수정의 입력으로 삼습니다. 작업을 풀어야만 개선의 근거를 얻을 수 있다는 제약을 완화하려는 접근입니다. 1–2절
둘째, 개선된 에이전트가 다음 개선도 수행합니다. 수정 대상만 바뀌고 수정하는 프로그램은 고정되는 구조와 달리, 같은 에이전트 구현이 과제 수행과 자기 수정을 맡습니다. 도구가 좋아지면 다음 수정 과정에서도 이를 사용할 수 있습니다. 두 독립 계보는 서로의 코드를 자동으로 합치는 대신 이전 세대의 기록을 공유해 필요한 변경을 선택적으로 도입합니다.
셋째, 성능만이 아니라 비용과 전이를 함께 측정합니다. 두 모델 계열과 세 벤치마크를 결합한 여섯 설정에서 최종 두 계보의 평균 성공률이 초기 에이전트보다 높았습니다. 다만 개별 계보는 모든 설정에서 개선되지 않았으며, 이 평균은 독립적인 전체 탐색 반복들의 평균도 아닙니다. 두 모델 계열 간 구현 전이와 도구 사용 분석은 개선이 어떤 실행 절차에 남았는지를 보여줍니다. 3–4절
리뷰어 관점의 학습 가치는 “최종 답의 정오”와 “행동 과정에서 드러난 소프트웨어 문제”를 다른 개선 신호로 다루는 방법입니다. 에이전트의 기록 구조, 파일 편집 인터페이스, 출력 제한, 재사용 가능한 도구 설계를 함께 공부할 수 있습니다. 이 연구의 주 평가는 코딩과 터미널 과제이며 Robotics 연구가 아닙니다.
기술적 세부사항
무엇이 바뀌고 무엇이 고정되는가
초기 에이전트는 DGM의 코딩 에이전트를 바탕으로 shell 실행과 파일 편집을 제공하고, 일반 작업·코딩·자기 수정 지침이 담긴 policy library를 추가합니다. 에이전트 저장소의 지침·도구·작업 수준 orchestration은 수정할 수 있습니다. 반면 모델 호출과 도구 실행을 진행하는 런타임은 저장소 밖에 있으며 모델, 추론 강도, 출력 제한, 실행 예산을 관리합니다. 이전 수정 기록 역시 외부에서 읽기 전용으로 제공됩니다. 따라서 에이전트 코드가 바뀌어도 평가 조건과 기록 관리의 경계는 유지됩니다. 부록 A
한 에피소드에서는 현재 에이전트가 자신의 편집 가능한 복사본을 수정합니다. 지금 실행 중인 에이전트는 그대로이고, 수정 결과가 다음 에피소드의 실행자가 됩니다. 모델 가중치는 고정되어 있으므로 강화학습의 파라미터 업데이트 식이 아니라 구현을 바꾸는 절차입니다.
두 계보와 기록 공유
capability 계보는 부족한 능력을 해결할 재사용 도구·절차에, adaptive 계보는 실패나 반대 증거를 만났을 때 접근을 수정하는 능력에 초점을 둡니다. 방향은 정성적인 지침이며 점수 함수가 아닙니다. 각 모델 설정에서 두 계보를 10세대 진행하고, 마지막 세대의 두 에이전트를 평가합니다. 탐색 중 성능이 가장 좋았던 체크포인트를 골라낸 결과가 아닙니다. 2절·Algorithm 1
평가 조건과 지표의 단위
| 구분 | GPT 설정 | DeepSeek 설정 |
|---|---|---|
| 자기 수정 모델 | gpt-5.6-sol |
deepseek-v4-pro-0813 |
| downstream 실행 모델 | gpt-5.6-luna |
deepseek-v4-flash-0731 |
| 기본 추론 강도·temperature | medium·1 | medium·1 |
| 탐색 중 호출당 출력 상한 | 8,192 tokens | 16,384 tokens |
| downstream 호출당 출력 상한 | 16,384 tokens | 16,384 tokens |
탐색 에피소드 하나의 상한은 모델 호출 513회, 도구 단계 512회, 실행 4시간이며 네트워크가 차단된 컨테이너를 사용합니다. 과제는 SWE-bench Verified 120개, SWE-bench Multilingual 60개, Terminal-Bench 2.1 전체 89개입니다. 성공률은 해결된 과제 비율이며 평균 실행 비용은 실패한 과제까지 포함한 과제당 모델 비용입니다. 뒤의 공통 성공 비용 지표는 각 에이전트 쌍이 모두 성공한 과제만 비교하므로 분모가 다릅니다. 비용식은 원문 순서대로 부록 C.4 리뷰에서 전개합니다. 3.1절·부록 C
챕터별 상세 리뷰
📖 Chapter 1: Introduction
챕터의 위치와 역할: 연구 동기에서 시작해 자기 수정 경험이 왜 별도의 개선 근거가 될 수 있는지 설명합니다. 문제를 “스스로 코드를 바꿀 수 있는가”보다 “그 과정에서 무엇을 배울 수 있는가”에 둡니다.
저자의 서술 순서를 따른 상세 내용:
1. 메타인지에서 출발합니다. 사람은 능력의 한계를 파악하고 이를 고치는 동안, 문제 자체뿐 아니라 실패에 대응하고 학습 방법을 바꾸는 경험도 얻습니다. 저자들은 코딩 가능한 LLM 에이전트도 자신을 구성하는 구현을 조사·수정하면서 비슷한 경험을 얻을 수 있는지 질문합니다. 이는 인간의 메타인지와 동일한 능력을 증명한다는 주장이 아니라 연구를 유도하는 비유입니다.
2. 기존 평가 중심 개선의 비용을 설명합니다. 후보 에이전트가 실제 작업을 수행한 결과는 유용하지만, 매 후보를 개발 집합에서 실행하면 평가 수에 따라 반복 비용이 늘어납니다. 또한 개선 방향이 평가한 과제 분포와 연결됩니다. SelfSearch가 줄이려는 것은 이 후보 생성 과정의 downstream 평가 의존성입니다.
3. 수정 과정 자체를 경험으로 재정의합니다. 수정은 새로운 코드뿐 아니라 한계를 발견하고 변경을 만들며 검증한 기록도 남깁니다. 긴 기록을 읽기 어려웠다는 경험은 검색·조회 도구를, 잘못된 편집은 수정 전 관련 코드를 확인하는 절차를 유도할 수 있습니다. 다음 세대는 개선된 구현과 이전 경험을 함께 받습니다.
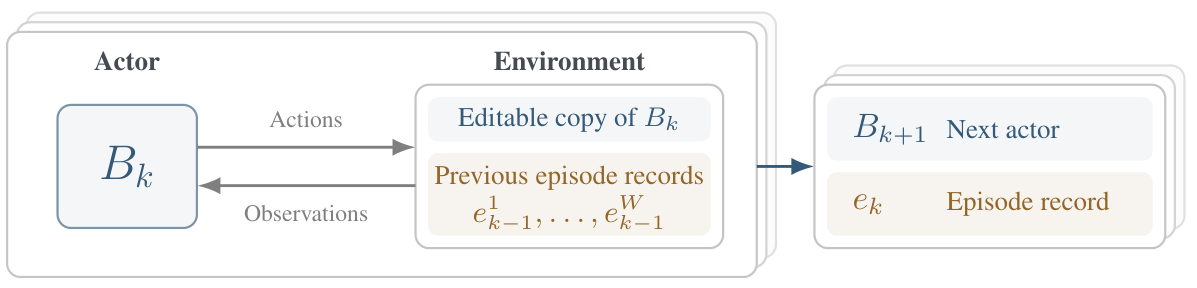
Figure 1, PDF 2쪽. 같은 버전 PDF의 그림 영역을 크롭했으며 번역·수치 변경은 없습니다. 쌓인 상자는 병렬 계보를 나타내고, 구현과 기록은 서로 다른 산출물로 다음 세대에 전달됩니다. 원문 그림
4. 보상 부재의 범위와 가설을 명확히 합니다. 탐색에는 downstream 과제·평가 결과를 제공하지 않습니다. 그러나 파일 조회, 도구 오류, 로컬 검사 결과는 사용할 수 있습니다. 저자의 가설은 생소한 코드 조사, 오류 진단, 수정 구현, 효과 확인이 자기 수정과 downstream 작업 모두에 필요하다는 것입니다. 따라서 자기 수정을 개선하는 도구가 실제 과제에도 도움이 될 수 있습니다.
5. 결과와 기여를 예고합니다. 두 모델 설정·세 벤치마크에서 최종 population mean이 개선되고, 일부 개별 에이전트의 성공률과 효율이 좋아졌으며 구현이 모델 사이에 전이됩니다. 초록의 최대 11.2 percentage points와 82.0%는 서로 다른 비교입니다. 전자는 기본 조건의 초기 에이전트 대비 개별 개선이고, 후자는 다른 하네스와 맞춘 확대 실행 조건의 결과입니다.
챕터의 핵심 기여: 자기 수정의 행동 기록을 다음 후보 생성의 근거로 사용할 수 있다는 연구 질문과 검증 가능한 범위를 설정합니다. 다음 챕터로의 연결: 2절은 이 경험을 어떤 자료구조와 세대 전환으로 전달하는지 정의합니다. 1절
📖 Chapter 2: SelfSearch
챕터의 위치와 역할: 한 번의 수정, 계보 간 정보 공유, 고정된 실행 환경을 순서대로 정의하는 방법론의 중심입니다.
저자의 서술 순서를 따른 상세 내용:
1. Self-improvement episode — 실행자와 편집 대상을 구분합니다. 초기 에이전트 $B_0$는 지침·도구·실행 로직이 담긴 저장소입니다. 에피소드 $k$에서 실행자 $B_k$는 자기 저장소의 편집 가능한 복사본과 이전 기록 $\mathcal{E}_k$를 받습니다. 이를 조사하고 변경·검증해 후속 구현을 만듭니다. 원문 식 (1)은 다음과 같습니다.
$B_k$는 현재 수정 작업을 수행하는 구현, $B_{k+1}$은 수정 결과, $e_k$는 이번 수정의 기록입니다. $\mathcal{E}_k$는 이전 에피소드 기록 모음이고 $d$는 어떤 종류의 개선을 탐색할지 정하는 정성적 지침입니다. 세미콜론은 입력 구현과 보조 입력을 구분합니다. SelfImprove는 특정 신경망 층이나 학습 손실이 아니라 기록 조사→수정→검사의 전체 절차입니다. 기록에는 추론, 도구 행동과 결과, 코드 변경이 포함됩니다. 다음 에피소드에서 후속 구현이 실행자가 되므로 도구의 변화가 자기 수정 방식에도 영향을 줍니다. 식 (1)
2. Search across generations — 두 방향이 다른 종류의 문제를 조사합니다. capability 방향은 비효율, 실패한 행동, 수행하기 어려운 연산에서 드러난 능력 부족을 찾아 재사용 도구·절차로 해결하도록 요청합니다. adaptive 방향은 행동 실패나 가정에 반하는 증거를 만났을 때 계획을 수정하는 방식에 초점을 둡니다. 방향 자체가 candidate의 성공률을 계산하거나 어느 쪽이 우수한지 채점하지 않습니다.
첫 세대에 읽을 경험을 마련하기 위해 초기 에이전트를 각 방향으로 한 번씩 실행합니다. 여기서 얻은 기록은 보존하지만 수정된 구현은 버립니다. 따라서 두 계보는 동일한 초기 구현에서 출발합니다. 이후 각 계보는 직전 세대의 두 기록을 모두 받지만 자기 구현을 따로 유지합니다. 다른 계보에서 나온 도구를 읽고 옮길 수 있으나 저장소 전체가 자동으로 합쳐지는 것은 아닙니다.
3. Algorithm 1 — 공유하는 것은 기록이고 보관하는 것은 모든 후보입니다. 계보 수 $W$, 세대 수 $K$에 대해 각 계보의 초기 구현을 동일하게 설정하고 archive를 초기화합니다. 매 세대의 수정 에피소드는 계보별로 병렬 실행합니다. 새 기록 묶음과 archive 갱신은 다음과 같습니다.
위 첨자 $w$는 계보, $\mathcal{C}$는 생성된 에이전트 보관함입니다. $\mathcal{E}_{k+1}$는 모든 과거 기록의 누적 집합이 아니라 직전 세대에서 나온 계보별 기록 묶음입니다. 전체 후보 보존과 매 에피소드 입력으로 제공하는 기록의 범위를 혼동하지 않아야 합니다. 논문 실험은 두 계보·10세대이며 최종 세대의 각 계보를 보고합니다. Algorithm 1
4. Search environment — 수정 권한과 관찰의 경계를 고정합니다. 탐색 중 downstream 벤치마크 과제와 점수는 보이지 않으며, 평가할 체크포인트를 고정한 뒤 별도로 평가합니다. 실행 루프는 편집 저장소 밖에 두어 변화한 구현을 일정한 방식으로 실행하고 기록합니다. 모델, reasoning effort, 출력·실행 예산도 런타임이 관리합니다. 에이전트는 공통 인터페이스를 호출하면서 주변 도구·지침·orchestration을 바꿀 수 있습니다.
챕터의 핵심 기여: 구현의 계승과 경험의 공유를 분리하고, 후보 생성에 downstream 보상을 사용하지 않는 탐색 절차를 정의합니다. 다음 챕터로의 연결: 3절은 이 절차로 만든 마지막 세대 구현을 실제 문제에서 평가합니다. 2절
📖 Chapter 3: Experiments
챕터의 위치와 역할: 기본 성능·실행 비용부터 평가 기반 탐색, 모델 전이, 다른 하네스 비교로 검증 범위를 넓힙니다. 비교별 과제 수와 추론 조건이 바뀌므로 이를 따로 읽어야 합니다.
저자의 서술 순서를 따른 상세 내용:
3.1 Experimental Setup
Agents and models. GPT 설정은 Sol로 자기 수정하고 Luna로 실제 작업을 수행하며, DeepSeek 설정은 Pro로 수정하고 Flash로 실행합니다. 동일 설정 안의 초기·개선 에이전트는 downstream 모델과 실행 제한이 같고 구현만 다릅니다. 자기 수정에 더 강한 모델을 사용했다는 사실과, 최종 실행 모델 가중치는 학습하지 않았다는 사실이 함께 성립합니다.
Search configuration. 두 계보를 10세대 진행한 뒤 마지막 capability·adaptive 구현을 각각 평가합니다. 모든 체크포인트는 저장하지만 downstream 점수로 최종 후보를 선택하지 않습니다. 아래에서 population mean은 이 두 계보 성공률의 산술평균이며, 여러 독립 탐색의 평균 또는 두 에이전트를 합쳐 문제를 푼 ensemble 점수가 아닙니다.
Downstream evaluation. SWE-bench Verified 120개는 저장소 이슈 수정, Multilingual 60개는 여덟 언어의 코드 수정, Terminal-Bench 2.1의 89개는 터미널 환경의 과제입니다. 세 벤치마크를 모두 동일한 “정확도 데이터셋”으로 취급하기보다 파일·도구·검증을 사용하는 수행 과제로 이해해야 합니다. 각 벤치마크의 grader가 성공 여부를 결정합니다.
Cost metrics와 Baselines. 과제당 비용은 시도한 모든 과제의 모델 비용을 나누며 탐색 비용은 제외합니다. 초기 에이전트와 두 개선 구현을 비교하고, 별도로 개발 집합 점수로 개선하는 linear·archive search와 두 메커니즘 제거 실험을 둡니다. 3.1절
3.2 Downstream Performance and Efficiency
아래는 원문 Table 1의 성공률을 모델·벤치마크별로 옮긴 것입니다. 비용은 이어지는 표로 분리했습니다.
| 실행 모델·벤치마크 | 초기 성공률 | capability | adaptive |
|---|---|---|---|
| GPT-5.6 Luna · Verified 120 | 75.0% | 77.5% | 75.0% |
| GPT-5.6 Luna · Multilingual 60 | 53.3% | 60.0% | 58.3% |
| GPT-5.6 Luna · Terminal 89 | 43.8% | 55.1% | 44.9% |
| DeepSeek V4 Flash · Verified 120 | 81.7% | 86.7% | 86.7% |
| DeepSeek V4 Flash · Multilingual 60 | 68.3% | 66.7% | 73.3% |
| DeepSeek V4 Flash · Terminal 89 | 65.2% | 73.0% | 71.9% |
평균이 좋아졌다는 주장과 모든 개체가 좋아졌다는 주장은 다릅니다. DeepSeek Multilingual의 capability는 68.3%에서 66.7%로 낮아지지만 adaptive의 개선으로 두 계보 평균은 초기보다 높습니다. GPT Verified의 adaptive는 초기와 같습니다. 가장 유리한 계보 하나만으로 “모든 조건에서 성공했다”고 설명하면 원문의 population 주장보다 강해집니다. Table 1
GPT Terminal의 표기값 차이는 55.1−43.8=11.3 percentage points이지만 초록의 최대 개선은 11.2입니다. 89개 중 49개와 39개라는 해결 수에 대응하는 차이 10/89는 약 11.24 percentage points입니다. 먼저 반올림한 두 비율을 빼는 값과 원래 해결 수에서 계산해 반올림하는 값이 다르기 때문이며 서로 다른 실험의 개선량으로 해석하지 않습니다.
| 실행 모델·벤치마크 | 초기 비용/과제 | capability | adaptive |
|---|---|---|---|
| GPT-5.6 Luna · Verified | USD 0.0096 | USD 0.0091 | USD 0.0093 |
| GPT-5.6 Luna · Multilingual | USD 0.0131 | USD 0.0135 | USD 0.0133 |
| GPT-5.6 Luna · Terminal | USD 0.0212 | USD 0.0219 | USD 0.0199 |
| DeepSeek V4 Flash · Verified | USD 0.0214 | USD 0.0169 | USD 0.0184 |
| DeepSeek V4 Flash · Multilingual | USD 0.0521 | USD 0.0321 | USD 0.0332 |
| DeepSeek V4 Flash · Terminal | USD 0.0301 | USD 0.0264 | USD 0.0250 |
Table 1의 과제당 모델 실행 비용(USD) 재작성입니다. 실패 시도를 포함하며 자기 수정 탐색 비용을 제외합니다. 원문 표
Execution efficiency. DeepSeek Terminal은 두 계보 모두 성공률을 높이면서 평균 실행 비용을 줄였습니다. 원문은 capability 12.1%, adaptive 16.9% 절감을 보고합니다. 반면 GPT capability는 성공률을 크게 높이면서 비용은 3.1% 늘었고 adaptive는 성공률을 소폭 높이면서 비용을 6.2% 줄였습니다. 표시된 비용은 반올림되어 있으므로 표시값으로 재계산한 백분율이 원문의 전체 정밀도 계산과 조금 다를 수 있습니다.
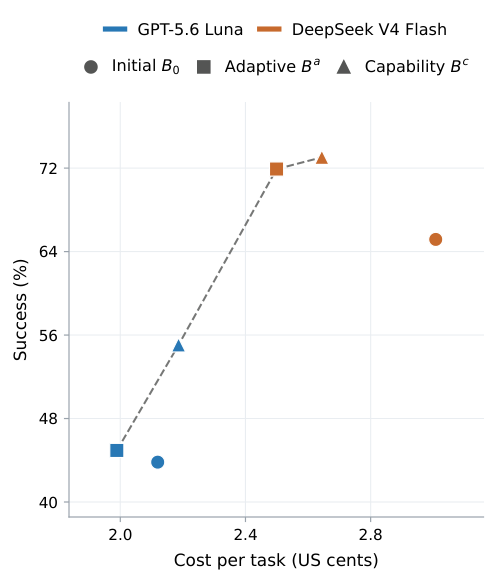
Figure 2, PDF 5쪽. 동일 버전 PDF 그림 크롭이며 축·범례와 모든 지점을 보존했습니다. 가로축은 US cents이며 위 표의 dollar와 단위가 다릅니다. 점선은 평가된 에이전트 중 성공률·비용 frontier의 점들을 연결합니다. 원문 그림
저자들은 공통 성공 집합도 별도로 비교합니다. DeepSeek adaptive의 Multilingual 성공률은 전체 60개에서 5.0 percentage points 높아졌고, 두 에이전트가 모두 성공한 39개 과제에서 비용이 38.5% 줄었습니다. 성공률 분모 60과 비용 비교 분모 39를 한 문장 안에서도 구분해야 합니다. 3.2절·Table 10
3.3 Comparison with Evaluation-Guided Search
linear·archive search는 SWE-bench 개발 과제 10개를 이용해 10회 수정합니다. 개발 점수가 가장 높은 후보를 선택하고 동률이면 최신 수정본을 고릅니다. 평가에 개발 과제를 다시 넣지 않도록 Verified 120개에서 해당 10개를 제외해 110개로 비교하며 Multilingual은 60개 그대로입니다. SelfSearch는 개발 점수 선택 없이 마지막 두 계보를 보고합니다.
| 탐색 모델·방법 | Verified 110 성공률 | Multilingual 60 성공률 | 탐색 모델 비용 |
|---|---|---|---|
| GPT · 초기 | 76.4% | 53.3% | 해당 없음 |
| GPT · linear | 77.3% | 60.0% | USD 12.35 |
| GPT · archive | 76.4% | 56.7% | USD 7.53 |
| GPT · SelfSearch capability | 78.2% | 60.0% | USD 6.52, 두 계보 전체 |
| GPT · SelfSearch adaptive | 75.5% | 58.3% | 위 비용에 포함 |
| DeepSeek · 초기 | 81.8% | 68.3% | 해당 없음 |
| DeepSeek · linear | 81.8% | 73.3% | USD 8.59 |
| DeepSeek · archive | 86.4% | 70.0% | USD 7.90 |
| DeepSeek · SelfSearch capability | 87.3% | 66.7% | USD 4.03, 두 계보 전체 |
| DeepSeek · SelfSearch adaptive | 87.3% | 73.3% | 위 비용에 포함 |
Table 2 재작성입니다. SelfSearch의 비용을 각 계보에 두 번 더하지 않습니다. 탐색 비용의 포함 범위와 비교 절차는 Table 2·부록 C.3·D.1에 제시됩니다.
GPT capability는 두 벤치마크에서 비교군과 같거나 높고 adaptive는 결과가 섞입니다. DeepSeek은 두 계보 모두 Verified에서 비교군과 같거나 높으며 adaptive는 Multilingual 최고 비교군과 같습니다. “항상 모든 비교군을 이겼다”보다 더 낮은 보고 탐색 비용에서 경쟁력 있는 후보를 만들었다는 결론이 원문에 가깝습니다.
Search cost. GPT SelfSearch는 두 비교군보다 13.4–47.2%, DeepSeek은 49.0–53.2% 비용이 낮습니다. 비교군 비용은 수정과 개발 집합 실행을, SelfSearch 비용은 자기 수정 에피소드를 포함합니다. 부록 C.3이 밝히듯 동일 총예산을 맞춘 비교는 아닙니다. 평가 기반 탐색에 절약한 비용만큼 추가 수정 기회를 준 실험으로 읽어서는 안 됩니다.
3.4 Cross-Model Transfer
다른 모델로 실행할 때 추가 탐색과 코드 변경은 하지 않습니다. GPT Sol이 만든 두 구현을 DeepSeek Flash로 실행하면 Verified 성공률은 초기 81.7%에서 capability 83.3%, adaptive 85.0%가 됩니다. 반대로 DeepSeek Pro가 만든 구현을 GPT Luna로 실행하면 초기 75.0%에서 79.2%, 76.7%가 됩니다. Table 3
이는 발견한 파일 조회·편집·도구 절차가 수정에 사용한 모델 계열에만 종속되지 않았다는 근거입니다. 평가 범위는 두 실행 모델과 Verified 집합이며 모든 모델·과제로의 보편적 이식을 확인한 것은 아닙니다.
3.5 Comparison with Other Harnesses
DeepSeek Pro로 탐색한 capability 구현을 DeepSeek Flash로 실행해 공개된 9개 하네스 비교 조건에 맞춥니다. 여기서는 xhigh 추론, 과제별 지정 시간 제한, 도구 단계 100,000회·모델 호출 100,001회를 사용합니다. 기본 Table 1의 medium 결과 73.0%와 조건이 다릅니다.
이 설정에서는 89개 중 73개, 82.0%를 해결해 공개 비교의 최고 점수인 Codex와 동률입니다. 두 하네스가 모두 푼 과제는 66개이고 각각 7개씩은 상대가 풀지 못한 과제입니다. 따라서 총점 동률을 같은 문제 해결 능력 또는 동일한 오류 패턴으로 해석하지 않습니다. USD 4.03은 그 하네스를 만든 탐색 비용이며 89개 평가 실행을 모두 포함한 총비용이 아닙니다. 다른 하네스 수치의 근거는 논문이 인용한 공개 비교이며, 이 리뷰가 해당 비교를 독립 재실행한 결과는 아닙니다. 3.5절·부록 D.3
챕터의 핵심 기여: 최종 두 계보의 성능·효율, 평가 기반 탐색 대비 비용, 모델 전이와 별도 확대 설정의 하네스 비교를 제시합니다. 다음 챕터로의 연결: 4절은 개선이 기록과 실행자 진화 중 어디서 비롯되는지, 실제로 무엇이 바뀌었는지 분석합니다.
📖 Chapter 4: Analysis
챕터의 위치와 역할: 성능 표 뒤에 있는 메커니즘을 제거 실험, 세대별 코드 변화, 실제 도구 사용 순서로 조사합니다.
저자의 서술 순서를 따른 상세 내용:
4.1 Episode Records and the Evolving Improver
Ablation setup. no-record 변형은 수정된 구현이 다음 수정도 수행하지만 이전 에피소드 기록을 받지 않습니다. 도구·지침 변경은 구현에 누적되므로 “기억이 완전히 없는 초기 에이전트”는 아닙니다. fixed-improver 변형은 이전 기록을 읽고 최신 구현을 수정하지만 매번 초기 에이전트가 편집합니다. 수정 대상은 누적되나 수정자의 도구·절차는 발전하지 않습니다. 이 구분은 경험 전달과 개선자 진화를 각각 제거하려는 설계입니다.
Results. 마지막 세대의 Verified 성공률은 다음과 같습니다.
| 방법 | GPT capability / adaptive / 평균 | DeepSeek capability / adaptive / 평균 |
|---|---|---|
| 초기 | 75.0 / 75.0 / 75.0% | 81.7 / 81.7 / 81.7% |
| 이전 기록 제외 | 75.0 / 73.3 / 74.2% | 82.5 / 85.0 / 83.8% |
| 개선자 고정 | 73.3 / 75.8 / 74.6% | 82.5 / 85.0 / 83.8% |
| 전체 SelfSearch | 77.5 / 75.0 / 76.2% | 86.7 / 86.7 / 86.7% |
Table 4 재작성입니다. 각 값과 평균은 원문 표시값이며, 독립 탐색 반복 평균이나 신뢰구간이 아닙니다. 원문 표
전체 방식의 population mean이 두 모델 설정에서 가장 높습니다. 저자들은 기록 제거로 GPT 2.1·DeepSeek 2.9 percentage points, 개선자 고정으로 1.7·2.9 points 낮아졌다고 보고합니다. 다만 GPT adaptive 개체만 보면 fixed-improver가 전체 방식보다 약간 높습니다. 구성 요소의 기여를 평균 경향으로 해석해야 하는 이유입니다.
4.2 How Improvements Develop
원문은 먼저 GPT의 10세대 변화(Table 5)를 제시합니다. 두 계보는 다른 순서로 비슷한 인터페이스를 도입하고, 후반부에는 기록을 더 잘 조사하는 도구로 발전합니다.
| 세대 | capability 계보 | adaptive 계보 |
|---|---|---|
| 1 | 정확한 문자열 치환 | 계획 수정·실패 복구 |
| 2 | 행 범위 파일 조회 | 정확한 문자열 치환 |
| 3 | 계획 수정·실패 복구 | 행 범위 파일 조회 |
| 4 | 문자 범위 파일 조회 | 시작 시 일반 지침 로드 |
| 5 | 시작 시 일반 지침 로드 | 문자 범위 파일 조회 |
| 6 | 출력 제한이 있는 텍스트 검색 | 구조화된 trajectory reader |
| 7 | 구조화된 trajectory reader | 출력 제한이 있는 텍스트 검색 |
| 8 | trajectory·diff 전체 출력 제한 | 호출·결과 ID를 포함한 기록 출력 제한 |
| 9 | 기록 필터·도구명 조회 | 페이지를 넘어 호출 인자와 결과 연결 |
| 10 | 인자를 포함한 과거 호출 매칭 | 호출·결과 연결을 포함한 기록 필터 |
Table 5의 순서와 계보를 보존해 번역했습니다. 같은 항목의 반복은 다른 계보의 변경을 가져온 경우를 포함합니다. 원문 표
GPT inspection tools. 6세대 capability가 검색 도구를, adaptive가 기록 reader를 만듭니다. 7세대에는 상대의 기록에서 이 도구를 확인해 도입합니다. adaptive는 reader로 capability의 기록을 읽고 검색 구현과 테스트를 가져옵니다. 개별 excerpt를 짧게 제한해도 여러 조각을 합치면 전체 응답이 커진다는 문제가 드러나 8세대에서 전체 출력 제한을 추가합니다. 이어 관련 이벤트 필터와 호출 인자·결과의 연결이 발전합니다.
이 흐름의 요점은 “기록을 제공하면 자동으로 좋아진다”가 아닙니다. 기록을 소비하는 과정에서 생긴 관찰 문제를 수정하고, 그 수정 도구를 다음 세대가 다시 사용하면서 더 정교하게 만든다는 구체적인 연쇄입니다.
DeepSeek search-output repair. 5세대 adaptive는 긴 검색 출력의 앞뒤만 남겼는데, 일치 텍스트가 가운데 있으면 사라질 수 있었습니다. 6세대 capability가 이 기록을 읽고 일치 지점을 중심으로 excerpt를 보여주도록 고칩니다. 7세대 adaptive는 실패를 재현하고 상대의 수정을 가져와 일치 텍스트가 보이는지 검사합니다. 뒤에서는 파일 조회·수정 시 tab과 줄바꿈을 보존하는 변경도 이루어집니다. 이는 논문이 실제 기록에서 분석한 실패·복구 사례입니다. 4.2절·부록 E.1
4.3 Downstream Use of Evolved Tools
최종 두 에이전트를 각각 269개 과제(120+60+89)에서 관찰합니다. 두 계보 평균으로 텍스트 검색을 사용한 과제 비율은 GPT 8.6%, DeepSeek 23.6%, 행 범위 조회는 40.3%, 33.8%입니다. 호출 횟수의 비율이 아니라 해당 연산을 한 번 이상 쓴 과제의 비율입니다. 상세 집계는 부록 E.2에 있습니다.
GPT trajectory reader는 downstream에서 한 번도 호출되지 않았습니다. 모든 개선 도구가 실제 작업에서 직접 쓰였다는 설명과는 다릅니다. 기록 reader는 자기 수정에 쓰이고, 그 과정에서 개선된 검색·편집 도구는 downstream에 쓰이는 역할 분화가 관찰됩니다.
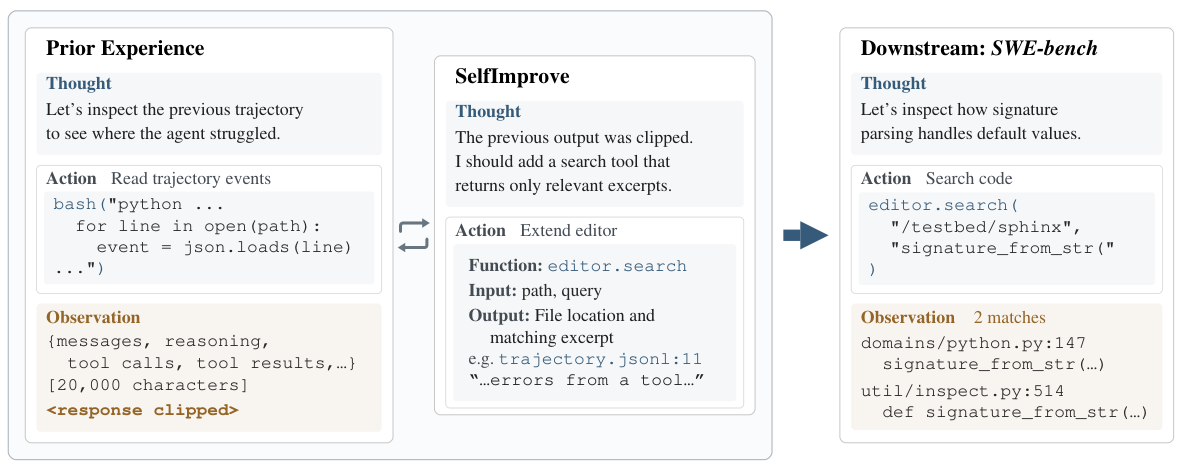
Figure 3, PDF 8쪽. 같은 버전 PDF의 전체 패널을 크롭했으며 번역·코드·수치 변경은 없습니다. 왼쪽의 잘린 기록, 가운데 검색 도구 추가, 오른쪽 실제 과제의 코드 검색으로 이어집니다. 원문 그림
그림을 왼쪽부터 읽으면 세 단계가 드러납니다. 왼쪽에서는 이전 trajectory를 길게 출력하다 응답이 잘려 필요한 오류 내용을 얻지 못합니다. 가운데에서는 파일 경로와 검색어를 입력받아 파일 위치와 일치 excerpt를 돌려주는 editor.search를 추가합니다. 오른쪽에서는 이 도구로 Sphinx 저장소의 signature_from_str( 호출을 찾아 함수와 호출 코드의 연결을 조사합니다. 잘린 기록을 읽기 위해 만든 기능이 새 과제의 코드 검증에 쓰인 것입니다.
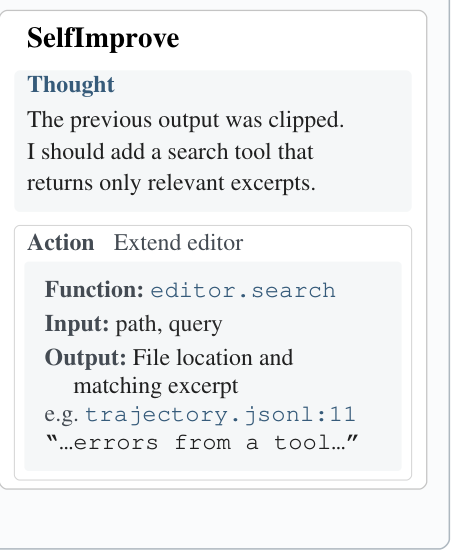
Figure 3 중앙 패널 상세, PDF 8쪽. 전체 그림을 위에 유지하면서 작은 도구 설명을 읽을 수 있도록 중앙 패널만 추가 크롭했습니다. 번역·코드 변경은 없습니다. 입력은 path·query이고 출력은 파일 위치와 일치 excerpt입니다. 원문 그림
Sphinx 사례에서 GPT capability는 함수를 수정한 뒤 검색 도구로 관련 테스트와 호출 코드를 찾고, 호출 코드를 조사하고 테스트를 실행합니다. 자기 수정 기록을 읽기 위해 만든 검색 기능이 실제 저장소의 검증에도 재사용된 사례입니다. 도구 사용률만으로 성능 개선의 모든 원인을 분리해 증명하는 것은 아니며, 논문은 제거 실험과 사례·기록 분석을 함께 제시합니다.
챕터의 핵심 기여: 이전 기록과 진화하는 개선자가 평균 성능에 기여하는 결과, 실제 변경이 발생한 경로, 도구가 downstream에서 사용되는 양상을 연결합니다. 다음 챕터로의 연결: 5절은 이 구조를 기존 에이전트 탐색·자기 수정 연구와 비교합니다. 4절
📖 Chapter 5: Related Work
챕터의 위치와 역할: 알고리즘의 차이를 세 관점으로 나누어 설명합니다. 여기서의 기존 연구 설명은 SelfSearch 원문이 정리한 범위이며 인용 논문 전체를 별도로 재현한 분석은 아닙니다.
저자의 서술 순서를 따른 상세 내용:
1. Evaluation-guided agent search. 기존 방법은 구현·workflow 변경을 제안하고 후보를 평가한 결과로 탐색을 유도합니다. archive를 유지하거나 현재 성능뿐 아니라 유용한 후손을 만들 잠재력을 고려할 수 있습니다. 여러 에이전트·과제·계보의 경험 공유 역시 기존에 있습니다. SelfSearch의 차이는 경험 공유 자체의 최초 제안보다 그 경험을 downstream 평가가 아닌 자기 수정 과정에서 얻는다는 점에 있습니다.
2. Self-modifying agents. 에이전트 코드는 과제 해결 방식과 다른 에이전트를 수정하는 방식을 모두 결정합니다. 같은 구현이 두 역할을 맡으면 도구 변경이 후속 개선 절차도 바꿉니다. 원문은 세대 간 진화와 작업 수행 중 scaffold 변경을 구분하고, SelfSearch가 저장소 전체를 편집하며 수정된 구현과 기록을 함께 전달한다고 설명합니다. 행 범위 조회·정확한 문자열 치환·제한된 검색 출력은 기존 agent–computer interface 연구에서 유용한 것으로 알려진 설계와 닮았습니다. 이 연구의 관찰은 그와 같은 기능을 자기 수정 과정에서 발견·정교화했다는 데 있습니다.
3. Experience from self-improvement. 기존에도 후보 변경 이력이나 평가 결과에서 교훈을 얻는 방법이 있습니다. SelfSearch는 편집 중의 추론·도구 호출·중간 결과를 경험으로 다룹니다. 실패한 편집, 불완전한 관찰, 긴 기록 조사 문제처럼 최종 점수만으로 알기 어려운 현상이 개선의 구체적인 입력이 됩니다.
챕터의 핵심 기여: “경험 공유”, “개선자 진화”, “downstream reward-free”라는 서로 다른 설계 축을 구분합니다. 다음 챕터로의 연결: 6절은 평가를 제거하기보다 생성과 평가를 어떻게 분리·결합할지 논의합니다. 5절
📖 Chapter 6: Discussion
챕터의 위치와 역할: 관찰 결과의 의미와 저자가 명시한 후속 검증 방향을 제시합니다. 별도의 Limitations 절은 없으며 여기의 논의를 임의의 한계 목록으로 확장하지 않습니다.
저자의 서술 순서를 따른 상세 내용:
1. 후보 생성과 평가 비용을 분리합니다. downstream 평가는 유용하지만 과제 범위와 반복 수가 늘면 비용이 커집니다. 본 실험은 자기 수정 경험으로도 경쟁력 있는 후보를 생성할 수 있음을 보였습니다. 평가·선택 비용이 사라진 것이 아니라 생성과 별도 단계로 남습니다. 사후 결과가 좋은 후보를 배포할지 결정하려면 여전히 해당 목적에 맞는 평가가 필요하다는 구조입니다.
2. 자기 수정이 드러내는 도구·절차 문제를 설명합니다. 기록은 코드 조사, 편집, 검사에서 겪은 어려움을 다음 세대가 조사할 구체적인 문제로 제공합니다. 일부 도구는 downstream에 재사용되고 trajectory reader처럼 추가 자기 수정을 돕는 도구도 있습니다. 저자들은 이런 경험이 평가 없는 수정의 근거가 된다고 해석합니다. 동시에 독립적인 여러 탐색에서 개선이 얼마나 일관되게 나타나는지 추가 연구가 필요하다고 명시합니다. 이는 이 리뷰가 새로 추측한 실패가 아니라 원문의 후속 검증 과제입니다.
3. 평가 기반 선택과의 결합을 제안합니다. 하나의 평가 기반 수정 단계를 SelfSearch 여러 세대로 확장한 뒤 결과 후보를 평가·보존할 수 있다는 아이디어를 제시합니다. 저자는 같은 총 탐색 예산에서 이 결합이 더 좋은 에이전트를 만드는지 검증할 것을 제안합니다. 현재 Table 2가 예산을 맞춘 결합 실험까지 수행했다는 뜻은 아닙니다.
챕터의 핵심 기여: reward-free 후보 생성과 평가 기반 선택을 상호 보완적인 역할로 위치시킵니다. 다음 챕터로의 연결: 7절은 입증한 범위를 간결히 정리합니다. 6절
📖 Chapter 7: Conclusion
챕터의 위치와 역할: 연구가 확인한 방법·결과를 정리하는 본문 마지막 절입니다.
저자의 서술 순서를 따른 상세 내용:
1. 방법을 다시 확인합니다. SelfSearch는 자기 수정 에피소드 기록을 이용해 다음 수정을 유도하며 탐색 중 downstream 평가를 사용하지 않습니다. 2. 결과의 단위를 유지합니다. 세 벤치마크에서 최종 population mean이 초기보다 높았고, 발견한 변경이 다른 실행 모델에도 전이됩니다. 평균 개선을 모든 개별 에이전트의 개선이나 독립 탐색 반복의 확정적 수렴으로 바꾸지 않습니다. 3. 핵심 해석을 제시합니다. 에이전트를 편집하는 과정 자체가 추가 개선을 위한 경험이 될 수 있다는 것이 결론입니다.
챕터의 핵심 기여: 모델 가중치 업데이트나 downstream 보상 없이도 구현 수정 경험을 이용하는 경로를 실증합니다. 뒤따르는 내용과의 연결: 본문 이후 AI 활용·재현성 진술과 부록이 책임 범위와 구현·평가 세부사항을 보충합니다. 7절
📖 Chapter 부가 진술: AI Use Statement → Reproducibility Statement → References
위치와 역할: 결과 해석 뒤에서 AI 활용과 재현 정보의 소재를 공개합니다. 두 진술은 본문 번호가 없는 항목으로 원문에 배치됩니다.
원문 순서에 따른 내용:
먼저 AI Use Statement는 개념 정리, 구현, 가설 정제, 실험 설계 피드백, 행동 기록 분석과 결과 해석, 문헌 탐색, 코드·그림·문장·참고문헌 편집 등에 생성형 AI를 사용했다고 밝힙니다. 합성 데이터셋 생성에는 사용하지 않았으며, 코드 시험·인용 원문 확인·실험 로그와 수치·그림 대조를 저자들이 수행하고 최종 책임을 진다고 명시합니다. 이는 AI 사용 사실의 공개와 저자 책임에 관한 진술이며 결과의 독립 재현을 대신하지 않습니다.
이어 Reproducibility Statement는 2절의 절차와 부록 A–C의 구현·프롬프트·모델·평가 과제 선택을 가리킵니다. 구현과 trajectory를 기록하면서 추론 설정과 자원 제한은 편집 저장소 밖에 유지한다는 실행 경계를 강조합니다. 뒤의 References는 비교 대상과 벤치마크의 근거를 제시합니다. 이 리뷰는 해당 목록의 모든 인용문헌을 독립적으로 읽거나 실험을 재실행했다고 주장하지 않습니다. 원문 7절 이후 진술
핵심 기여: 보조 도구 활용·검증 책임과 재현 정보를 찾을 위치를 제공합니다. 다음 내용과의 연결: 부록 A는 실제 실행 경계부터 설명합니다.
📖 Chapter Appendix A: Initial Agent and Execution Environment
챕터의 위치와 역할: “전체 저장소를 수정한다”는 표현과 고정 런타임이 공존하는 이유를 구현 수준에서 설명합니다.
저자의 서술 순서를 따른 상세 내용:
1. Initial agent and relation to DGM. 초기 구현은 DGM의 shell 실행과 파일 editor를 유지합니다. editor는 조회·생성·파일 전체 교체를 지원합니다. 여기에 일반 작업·코딩·자기 수정 지침이 담긴 편집 가능한 policy library를 더합니다. 에피소드 시작 시 policy catalog를 받고 과제에 맞는 지침과 helper tool을 불러옵니다. 자기 수정 전용 프로그램과 작업 전용 프로그램이 별개로 고정되어 있는 구조가 아닙니다.
2. Editable repository and fixed runtime. 지침·도구·policy library·과제 수준 orchestration이 수정 영역입니다. respond(message)는 에이전트 지침과 도구 정의를 이용해 저장소 밖 런타임의 모델–도구 루프를 호출합니다. 모델 호출·도구 단계 제한은 respond를 여러 번 호출해도 전체 실행에 걸쳐 적용됩니다. 따라서 호출을 나누는 것으로 실행 예산을 새로 받는 구조가 아닙니다.
3. Runtime-managed episode records. 런타임은 추론·도구 행동·결과를 저장소 밖에 기록합니다. workflow는 수정 전후 소스와 trajectory를 함께 저장하고, 다음 에피소드에 이전 기록을 읽기 전용으로 mount합니다. 수정 대상으로 쓰는 구현과 근거로 읽는 기록의 권한이 다릅니다.
4. Portability. 동일한 고정 구현을 소스 변경 없이 여러 벤치마크에 적용합니다. adapter는 과제 지시와 환경 접근을 제공하고 최종 출력을 각 evaluator에 전달합니다. 환경 준비·채점은 에이전트 저장소 밖입니다. 평가 결과를 탐색 프롬프트에 주지 않는 원칙과 별도로, 평가 자체는 외부에서 정상 수행됩니다.
챕터의 핵심 기여: 에이전트가 바꿀 수 있는 층과 조건·기록을 관리하는 층을 분리합니다. 다음 챕터로의 연결: 부록 B는 이 환경에서 무엇을 수정하라고 요청했는지 보여줍니다. 부록 A
📖 Chapter Appendix B: Search Prompts
챕터의 위치와 역할: reward-free 탐색이 무지시 상태의 자유 탐색이 아니라, 명시적 목표·실행 계약·두 탐색 방향으로 안내된 절차임을 보여줍니다. 원문의 프롬프트 전문을 재현하지 않고 블록 순서와 작동 역할을 보존해 설명합니다.
저자의 서술 순서를 따른 상세 내용:
1. 템플릿의 조합과 고정 시점. 공통 템플릿에 모델별 goal, design guidance, capability 또는 adaptive direction을 결합합니다. 시스템 지침과 policy catalog는 별도로 제공합니다. 목표·설계 문구는 pilot 탐색의 수정 기록과 코드 변경을 살피며 정제했지만 pilot 에이전트를 downstream 벤치마크에서 평가하지 않았고, 보고 실험 전에 고정했습니다. 따라서 외부 목표가 없는 탐색은 아니며, pilot 단계에서도 downstream 점수는 사용하지 않았다는 설명입니다.
2. Objective 블록. 패키지가 실행 가능하기만 한 변경보다 실제 능력·신뢰성 개선을 요구합니다. 관찰된 행동과 결과로 유지·수정·제거를 판단하고, 한 실행의 우연한 상황을 보편적 규칙으로 만들지 않도록 합니다. 문맥에서 관련 policy·도구를 고르게 하고 추가 self.respond는 반복 비용을 늘리므로 신중히 쓰게 합니다.
3. Environment 블록. 패키지는 __init__.py에서 Agent 인스턴스 agent를 export하고 agent.run(task: str)가 문자열을 반환해야 합니다. 현재 실행자는 /app/agent의 읽기 전용 구현, 수정 대상은 동일 소스로 시작하는 /workspace입니다. @tool의 이름·type annotation·docstring이 도구 schema를 정의하고 agent.tools에 등록된 도구가 모델에 노출됩니다. workspace 변경은 현재 실행이 아니라 반환할 후속 구현에 적용됩니다. 이 계약은 새 도구의 코드만 작성하고 모델에 노출하지 않는 변경을 구분하게 합니다.
4. Procedure 블록. /evidence/0, /evidence/1의 이전 수정 기록과 /evidence/index.json에 연결된 요약·수정·trajectory·snapshot을 읽습니다. 근거가 있는 중요한 한계·기회를 골라 일관된 변경 하나를 만들며, 필요한 경우 여러 구성 요소에 걸칠 수 있습니다. 편집·검사 후 간결한 설명과 결과 구현을 남깁니다. “하나의 변경”은 반드시 한 파일이라는 뜻이 아닙니다.
5. Capability → Adaptive 방향. 첫 방향은 누락된 연산을 지침만 늘려 해결하려 하기보다 실제 동작하는 재사용 기능을 선호합니다. 둘째 방향은 반대 증거를 만나 계획을 조정하되 keyword routing이나 고정 workflow로 유연성을 잃지 않도록 합니다. 이는 원문에 실제로 포함된 설계 지침입니다.
6. GPT goal → DeepSeek goal → DeepSeek design guidance. GPT는 자신을 포함한 에이전트를 개선하는 능력, DeepSeek은 그런 능력을 포함한 일반 과제 수행 능력을 목표로 합니다. DeepSeek의 추가 지침은 일반 과제의 실제 행동, 모델이 호출할 정확한 인자 형태의 검사, 과제에 비례하는 계획·검토·상태 관리, 불필요한 반복 호출 회피를 강조합니다. 두 모델이 모든 문구까지 동일한 프롬프트를 사용한 실험은 아닙니다.
챕터의 핵심 기여: 모델 호출 인터페이스와 목표가 어떤 개선을 유도했는지 재현 가능한 수준으로 공개합니다. 다음 챕터로의 연결: 부록 C는 이 프롬프트를 실행한 모델·과제·비용 정의를 구체화합니다. 부록 B
📖 Chapter Appendix C: Experimental Details
챕터의 위치와 역할: 본문 결과를 올바르게 비교하기 위한 모델 조건, 과제 분모, 비교군 선택과 비용식을 제공합니다.
저자의 서술 순서를 따른 상세 내용:
C.1 Model Configurations
탐색 모델 Sol·Pro는 medium 추론과 temperature 1을 사용하고 출력 상한은 각각 8,192·16,384 tokens입니다. 한 자기 수정 에피소드의 상한은 모델 호출 513회·도구 512단계·4시간입니다. 실제 평균 사용량이 아니라 허용 상한입니다. downstream의 Luna·Flash도 medium·temperature 1이며 호출당 최대 출력 16,384 tokens입니다. 다른 하네스 비교의 xhigh는 부록 D.3에서 별도로 정의합니다.
C.2 Evaluation Sets and Protocol
Verified 120개는 DGM small·medium의 60개와 large에서 추가로 고른 60개를 결합합니다. 추가 ID는 Table 6에 있습니다. Multilingual은 seed 42로 60개를 뽑고 언어별로 C 6, C++ 2, Go 8, Java 9, JavaScript 9, PHP 9, Ruby 8, Rust 9개입니다. ID는 Table 7에 있습니다. 두 집합을 전체 SWE-bench의 결과로 확대하지 않으며, Terminal은 버전 2.1의 89개 전체입니다.
리뷰어 관점에서 이 구성은 Python 중심 이슈 수정, 여러 언어의 저장소 수정, 터미널 작업이라는 서로 다른 환경에서 구현 변경이 재사용되는지 살피는 데 의미가 있습니다. 다만 실제 과제 ID와 표본 구성을 유지해야 같은 성공률 분모로 재현할 수 있습니다.
C.3 Evaluation-Guided Search Comparison
linear는 최신 후보를 계속 수정합니다. archive는 초기·완료 후보를 보관하며 공통 첫 수정 이후 짝수 번째 수정에서 parent를 균등 샘플링하고 홀수 번째에서는 개발 점수가 가장 높은 parent를 고릅니다. parent 선택의 동률은 가장 이른 후보, 최종 후보 선택의 동률은 가장 최신 후보를 택하므로 두 규칙을 구분해야 합니다.
편집자는 parent가 DGM small 10개 과제를 수행한 기록, 문제, trajectory, patch, 결과와 공식 테스트·출력을 받습니다. 공식 테스트는 과제 실행 이후에만 제공됩니다. 수정 중 로컬 검사도 가능하며 후보를 반환한 뒤 다시 개발 집합에서 평가합니다. 최종 선택 수정 번호는 GPT linear 8·archive 10, DeepSeek linear 6·archive 9입니다. SelfSearch는 개발 점수로 고르지 않은 10세대의 두 계보를 보고합니다.
원문은 이 비교가 budget-matched가 아니라고 명시합니다. Verified에서 개발 과제 10개를 모든 방법에서 제외하고 110개를 평가하는 것은 개발·평가 중복을 줄이는 절차이며, 동일 총 탐색 자원이나 동일 후보 선택 방식까지 맞췄다는 뜻은 아닙니다. 유효한 patch가 생긴 뒤 실행이 종료된 경우를 포함해 성공은 benchmark grader가 결정합니다. 부록 C.3
C.4 Cost Metrics and Inference Pricing
원문은 과제 $i$에서 구현 $B$의 전체 모델 실행 비용을 $c_i(B)$, 성공 지시자를 $s_i(B)\in\{0,1\}$로 정의합니다. 평가 집합 $\mathcal{T}$의 평균 비용은 식 (2)입니다.
$|\mathcal{T}|$는 시도한 과제 수이며 분자에는 성공과 실패의 비용이 모두 들어갑니다. 예를 들어 Multilingual의 분모는 60입니다. $\bar{c}$를 “성공 한 건을 얻는 데 필요한 비용”과 동일시하면 안 됩니다. 후자는 성공률까지 함께 반영하는 별도 계산이 필요하며 논문은 위 지표를 보고합니다. 식 (2)
초기 구현에 대한 평균 비용 절감률은 식 (3)입니다.
$B_0$는 초기 구현입니다. 개선 구현의 평균 비용이 초기보다 작으면 양수, 크면 음수가 됩니다. 전체 과제 집합에서 계산하므로 에이전트마다 성공·실패한 과제 구성이 달라질 수 있습니다. 식 (3)
같은 과제를 모두 성공했을 때의 효율을 비교하기 위해 공통 성공 집합을 정의합니다.
$\mathcal{S}_B$는 개선·초기 에이전트가 모두 해결한 과제만 담습니다. capability와 adaptive는 서로 다른 공통 성공 집합을 가질 수 있습니다. 식 (4)는 이 집합의 모델 비용 합으로 비교합니다.
두 합은 동일한 과제 집합을 사용하므로 과제 난도가 다른 집합을 비교하는 효과를 줄입니다. 집합 크기가 양쪽에서 같아 평균 대신 합을 사용해도 비율은 같습니다. 38.5%는 이 식으로 계산한 DeepSeek adaptive의 Multilingual 공통 성공 39개 결과입니다. 전체 60개의 평균 비용이 38.5% 줄었다거나 성공률이 38.5% 올랐다는 뜻이 아닙니다. 비용 지표들은 탐색 비용을 제외합니다. 식 (4)
논문 계산에 적용한 100만 tokens당 입력·cached input·출력 가격은 Luna USD 0.20·USD 0.02·USD 1.20, Flash USD 0.15·USD 0.003·USD 0.60입니다. 입력 가격은 uncached token에 적용합니다. 이는 논문 비용을 해석하기 위한 실험 가격이며 현재 서비스의 견적을 보장하는 안내가 아닙니다.
챕터의 핵심 기여: 성공률·비용 비교의 과제 분모와 계산 단위를 명시합니다. 다음 챕터로의 연결: 부록 D는 이 정의로 집계한 자원·비용과 확대 실행 조건을 보여줍니다. 부록 C
📖 Chapter Appendix D: Additional Results
챕터의 위치와 역할: 탐색 자원, 실제 실행 자원, 공통 성공 비용과 외부 하네스 비교의 설정을 보충합니다.
저자의 서술 순서를 따른 상세 내용:
D.1 Search Cost
| 탐색 모델 | 모델 호출 | 입력 tokens, cached 포함 | 출력 tokens | 모델 비용 |
|---|---|---|---|---|
| GPT-5.6 Sol | 281 | 5.48 million | 101.4 thousand | USD 6.52 |
| DeepSeek V4 Pro | 832 | 36.89 million | 578.7 thousand | USD 4.03 |
Table 8 재작성입니다. 초기 기록 생성과 두 계보의 10세대 탐색을 포함한 자원이며 downstream 평가를 제외합니다. 원문 표
DeepSeek의 호출·token 사용이 더 많아도 보고 비용은 더 낮습니다. 비용은 사용량뿐 아니라 모델별 가격 구조에 좌우되므로 “USD 4.03이므로 연산량도 적다”고 해석하지 않습니다. 에피소드별 상한을 전부 사용한 비용도 아니며, 최종 개별 후보 하나의 1회 실행 비용도 아닙니다.
D.2 Downstream Efficiency
Figure 4는 Verified·Multilingual의 성공률–비용 frontier를 보여주며 패널별 축 범위가 다르다고 명시합니다. Table 9는 실패를 포함한 평균 호출·입력·출력 token을 제시하고, Table 10은 공통 성공 과제 비용을 제시합니다. 이 리뷰는 Figure 4를 별도 이미지로 중복 삽입하지 않고 원문 링크와 핵심 수치를 해설합니다. Figure 4·Tables 9–10
DeepSeek Multilingual은 초기 평균 56.3호출·입력 2,451.9k·출력 25.2k에서 capability 41.3호출·1,274.1k·19.1k, adaptive 42.1호출·1,377.5k·19.7k로 바뀝니다. 같은 과제 수의 비용 감소가 호출·입출력 감소와 함께 나타납니다. 반면 GPT capability Terminal은 호출이 34.4에서 29.8로 줄지만 입력이 516.3k에서 564.0k로 늘고 비용도 소폭 증가합니다. 호출 수만으로 비용을 설명할 수 없다는 사례입니다.
공통 성공 결과는 다음과 같습니다. 절감률은 양수가 절감, 음수가 비용 증가입니다.
| 실행 모델·벤치마크 | capability 공통 과제 / 절감률 | adaptive 공통 과제 / 절감률 |
|---|---|---|
| GPT · Verified | 86개 / 8.7% | 84개 / 13.6% |
| GPT · Multilingual | 31개 / 4.1% | 32개 / 8.3% |
| GPT · Terminal | 33개 / −2.4% | 31개 / 15.2% |
| DeepSeek · Verified | 95개 / 36.1% | 95개 / 19.7% |
| DeepSeek · Multilingual | 37개 / 52.9% | 39개 / 38.5% |
| DeepSeek · Terminal | 52개 / 16.5% | 52개 / 18.6% |
Table 10의 과제 수와 절감률을 대조해 재작성했습니다. 각 열은 초기 에이전트와 해당 계보의 교집합이므로 행 안의 두 절감률도 완전히 같은 과제 집합 비교는 아닐 수 있습니다. 원문 표
DeepSeek capability는 Multilingual 공통 성공에서 52.9% 비용을 줄였으나 전체 성공률은 초기보다 낮습니다. 비용이 크게 줄었다는 사실만으로 가장 좋은 배포 후보라고 결론 내릴 수 없는 이유가 원문 결과 안에 드러납니다.
D.3 Comparison with Other Harnesses
평가는 Terminal-Bench 2.1 전체 89개, 실행 모델 DeepSeek Flash, 추론 xhigh, 과제별 지정 시간과 100,000도구 단계·100,001모델 호출 상한입니다. SelfSearch capability와 Codex는 각각 73개를 풀고 교집합 66개·각 고유 성공 7개입니다. 이 비교는 모델과 과제·실행 조건을 공개 비교에 맞춘 것이며 Table 1의 medium 결과와 직접 차이를 빼서 알고리즘 개선으로 볼 수 없습니다.
챕터의 핵심 기여: 탐색 비용과 실행 비용을 분리하고, 성공·실패 전체와 공통 성공이라는 두 집계 범위를 구체적인 수치로 보여줍니다. 다음 챕터로의 연결: 부록 E는 숫자 뒤에서 도구가 어떻게 바뀌고 사용됐는지 추가 기록을 제시합니다. 부록 D
📖 Chapter Appendix E: Self-Improvement Trajectories
챕터의 위치와 역할: 본문 사례를 세대별 변경과 연산 사용 집계로 확장합니다.
저자의 서술 순서를 따른 상세 내용:
E.1 Changes across Generations
GPT trajectory-reader sequence. adaptive가 6세대에 inspect_trajectory를 도입하고 capability가 7세대에 가져옵니다. 8세대에는 개별 excerpt 제한만으로 부족하다는 것을 발견해 전체 응답 제한과 continuation position을 추가합니다. 9세대는 이전 두 기록 조사와 필터를, 10세대는 여러 응답 페이지에 걸친 결과–원호출–인자 연결을 제공합니다. 단순한 로그 저장량 증가보다 필요한 근거를 찾아 호출 맥락과 연결하는 인터페이스가 발전합니다.
이어 Table 11은 DeepSeek의 10세대 변경을 계보별로 나열합니다.
| 세대 | capability 계보 | adaptive 계보 |
|---|---|---|
| 1 | 검색·파일 조회·정확 치환 | 검색·조회·치환·지침 |
| 2 | 검증·복구 지침 | shell 종료 상태·출력 excerpt |
| 3 | shell 종료 상태·출력 excerpt | 고유 shell capture 파일·지침 |
| 4 | 고유 shell capture 파일 | 파일 앞뒤 excerpt |
| 5 | 파일 앞뒤 excerpt | 검색 출력 제한 |
| 6 | 검색 일치 중심 excerpt | 디렉터리 목록 제한·필터 |
| 7 | 디렉터리 목록 제한·필터 | 검색 일치 중심 excerpt |
| 8 | 파일 생성·교체·조회 수정 | tab 보존·바이너리 검사 |
| 9 | tab 보존·바이너리 검사 | 파일 생성·교체·조회 수정 |
| 10 | 편집 시 줄바꿈 보존 | 편집 시 줄바꿈 보존 |
Table 11 번역입니다. 같은 변경이 다른 세대에 등장하는 것은 상대 계보 기록을 이용한 도입을 포함합니다. 원문 표
DeepSeek observation and editing sequence. 원문은 capability의 3세대 shell 출력 앞뒤 요약, 4세대 임시 파일 충돌 수정, 5–7세대 파일·검색·디렉터리 출력 처리 확장을 차례로 설명합니다. adaptive는 상대 기록을 활용해 잘린 검색에서 일치 텍스트를 보존합니다. 후반부에는 조회와 편집의 불일치를 줄이도록 tab·줄바꿈을 보존합니다. 이런 변경은 텍스트를 “더 짧게 보여주기”와 “중요한 정보를 보존하기”가 동시에 필요하다는 실제 인터페이스 문제를 드러냅니다.
E.2 Downstream Tool Use
Table 12는 각 연산을 최소 한 번 호출한 과제 비율을 세 벤치마크와 전체로 제시합니다. 같은 과제에서 여러 번 호출해도 한 번만 세며, 호출 성공 여부로 가중하지 않습니다. 전체 열은 269개 과제를 동일 가중해 합친 결과이며 크기가 다른 세 벤치마크 비율의 단순 평균이 아닙니다. shell에서 grep을 실행한 것은 새 검색 도구 사용으로 세지 않습니다.
| 모델·계보 | 텍스트 검색 | 행 범위 조회 | 정확한 문자열 치환 |
|---|---|---|---|
| GPT capability | 7.8% | 38.7% | 76.6% |
| GPT adaptive | 9.3% | 42.0% | 79.2% |
| DeepSeek capability | 21.6% | 29.0% | 72.5% |
| DeepSeek adaptive | 25.7% | 38.7% | 71.0% |
Table 12의 All 열을 재작성했습니다. 원문에는 벤치마크별 비율도 있습니다. GPT 문자 범위 조회는 capability 전체 0.4%, adaptive 0%이며 trajectory reader는 양쪽 0%입니다. DeepSeek에는 두 연산이 도입되지 않아 해당 행 자체가 없습니다. 원문 표
검색 사용은 DeepSeek의 Verified·Multilingual에서 더 자주 나타나고 Terminal에서는 capability 0%, adaptive 1.1%입니다. 작업 환경이 다르면 같은 도구의 사용 빈도도 달라집니다. 이 빈도를 “그 비율의 문제에서 검색이 성공을 일으켰다”는 인과적 성공 기여율로 읽어서는 안 됩니다. 관찰된 사용과 제거 실험은 서로 다른 종류의 근거입니다.
챕터의 핵심 기여: 수정 도구의 발전 과정을 재구성하고 연산 사용률의 집계 기준을 제공합니다. 다음 챕터로의 연결: 마지막 부록은 이런 구조를 기존 탐색 설계의 역할 분담과 비교합니다. 부록 E
📖 Chapter Appendix F: Comparison of Agent Search Designs
챕터의 위치와 역할: 기존 시스템을 단일 성능 순위가 아니라 무엇이 진화하고 어떤 피드백을 받는지의 설계 축으로 비교하는 마지막 부록입니다.
저자의 서술 순서를 따른 상세 내용:
원문은 Table 13에서 각 시스템의 설계 속성을 비교한 뒤 네 열의 의미를 정의합니다.
| 원문 비교 방법 | 작업 에이전트 진화 | 개선자 진화 | 두 역할 통합 | reward-free 탐색 |
|---|---|---|---|---|
| DGM | 해당 | 해당 없음 | 해당 없음 | 해당 없음 |
| HGM | 해당 | 해당 없음 | 해당 없음 | 해당 없음 |
| Hyperagents | 해당 | 해당 | 해당 없음 | 해당 없음 |
| SICA | 해당 | 해당 | 해당 | 해당 없음 |
| SelfSearch | 해당 | 해당 | 해당 | 해당 |
Table 13의 논문 내 정의와 비교를 재작성했습니다. “해당 없음”은 이 표의 정의에 대한 구분이며 연구의 전반적 가치나 성능이 없다는 뜻이 아닙니다. 원문 표
evolving task agent는 실제 과제를 푸는 구현이 세대 간 바뀌는지, evolving meta-agent는 수정 제안·구현 절차도 바뀌는지입니다. unified meta and task agent는 같은 에이전트가 과제 해결과 자기 수정을 맡는지, reward-free search는 수정·선택을 downstream 평가 보상으로 유도하지 않는지입니다.
원문은 DGM·HGM이 별도 진단 절차로 수정을 제안하고 Hyperagents는 편집 가능한 프로그램 안에 작업자와 meta-agent를 구분한다고 설명합니다. SelfSearch의 특징은 네 속성을 결합한 데 있으며, 표의 체크 개수 자체가 실험 성능 우위를 증명하는 것은 아닙니다.
챕터의 핵심 기여: 자기 수정 경험의 활용을 역할의 통합·진화와 평가 신호의 분리라는 설계 언어로 정리합니다. 이 부록이 원문의 마지막 분석 항목입니다. 부록 F
실험 결과 심층 분석
population mean, 최선의 개체, 독립 반복은 다른 결과입니다
여섯 모델–벤치마크 설정에서 초기보다 좋아졌다는 결과의 단위는 최종 두 계보의 평균입니다. GPT Terminal의 큰 개선은 capability 개체이며 adaptive의 증가는 작습니다. DeepSeek Multilingual에서는 capability가 낮아지고 adaptive가 높아집니다. 따라서 평균 결과는 두 탐색 방향이 항상 같은 이득을 얻었다는 증거가 아니며, 최고 개체만 보고 전체 방식의 안정성을 평가하는 것도 적절하지 않습니다. Tables 1·4
논문은 여기에 독립 탐색 반복의 신뢰구간, 성공률 차이의 유의성 검정 또는 반복별 분산을 보고하지 않습니다. 관찰된 차이와 통계적으로 확정된 개선을 구분해야 합니다. 저자도 독립 탐색 간 일관성을 후속 검증 방향으로 명시합니다.
효율을 판단하려면 성공률과 두 비용 분모를 함께 봐야 합니다
DeepSeek adaptive Multilingual은 초기보다 3개를 더 해결한 73.3%이고 공통 성공 39개에서 비용이 38.5% 줄었습니다. 전체 과제 평균 비용 USD 0.0521→USD 0.0332와 공통 성공 절감률은 서로 다른 계산입니다. capability는 공통 성공 37개에서 더 큰 52.9%를 줄였지만 전체 성공률은 낮습니다. 성공을 유지하면서 비용이 줄었는지, 전체 시도에서 얼마를 쓰는지, 더 어려운 과제를 추가로 해결하는 데 얼마가 드는지를 같은 숫자로 대체할 수 없습니다. Tables 1·10
GPT capability Terminal은 성능을 크게 높이며 평균 비용도 약간 늘었습니다. 이는 효율 개선이 반드시 모든 모델·벤치마크에서 비용 감소를 뜻하지 않음을 보여줍니다. Figure 2의 frontier는 평가된 후보들 사이의 성공률·비용 관계이며 가능한 모든 하네스의 최적 frontier를 구한 결과는 아닙니다.
저비용 후보 생성과 동일 예산 탐색 우위는 구분해야 합니다
USD 6.52·USD 4.03은 초기 기록과 두 계보 탐색을 포함하고 사후 평가를 제외한 모델 비용입니다. 비교군은 수정과 개발 집합 평가를 포함합니다. Table 2는 SelfSearch가 낮은 보고 비용으로 경쟁력 있는 구현을 만들었다는 근거를 제공합니다. 그러나 비교가 예산 매칭이 아니므로 “같은 예산에서 어떤 탐색보다 우수하다”는 결론까지 뒷받침하지 않습니다. 저자는 같은 총예산에서 평가 기반 선택과 결합하는 실험을 향후 방향으로 제시합니다. 부록 C.3·6절
82.0%도 동일하게 조건을 붙여 읽어야 합니다. 이 값은 xhigh·확대 실행 예산의 73/89이며 기본 medium 결과 73.0%와 같은 비교가 아닙니다. Codex와 총 해결 수는 같지만 공통 66·각 고유 7이므로 실제 해결 집합은 다릅니다. 이 실험의 의미는 탐색에 downstream 보상을 쓰지 않고 만든 하네스가 해당 공개 비교 조건에서 경쟁력 있었다는 데 있습니다. 부록 D.3
재현성은 절차·고정 조건·기록을 함께 요구합니다
원문은 모델 ID, 추론 설정, 프롬프트, 계보·세대 수, 평가 ID, 비용 정의와 에이전트–런타임 경계를 제공합니다. 특히 코드 변경 전후 snapshot과 도구 호출 기록을 함께 남기면 “무엇이 좋아졌는가”를 검토할 수 있습니다. 이 리뷰는 원문에 제시된 구성과 결과를 분석했으며 모델 API 실행이나 공개 아티팩트의 독립 재현을 수행하지 않았습니다. 따라서 보고된 성공률은 저자의 실험 결과입니다. Reproducibility Statement·부록 A–C
기술적 함의와 응용
저자의 주장에 따른 함의는 수정 경험과 downstream 평가가 다른 역할을 할 수 있다는 것입니다. 기록에서 발견한 관찰·편집 문제로 후보를 여러 번 개선하고, 별도 평가로 그 후보를 검증·선택할 수 있습니다. 평가가 없는 자기 수정도 유용할 수 있다는 결과가 평가의 폐기를 뜻하지는 않습니다. 6절
리뷰어 관점의 적용 해석으로는 에이전트 운영 로그를 실패 문장 모음보다 넓게 설계할 가치가 있습니다. 호출 인자와 결과의 연결, 잘림 여부, 변경 전후 코드, 검사 결과가 있어야 도구 인터페이스의 문제를 구체적으로 재구성할 수 있습니다. SelfSearch의 실제 발전은 거대한 새 추론 알고리즘보다 정확한 치환, 행 범위 조회, 일치 구간을 보존하는 검색, tab·줄바꿈 유지처럼 작업의 근거를 잃지 않는 연산에 집중됐습니다. 이 관찰은 하네스 설계에서 기록의 가독성과 편집의 정확성을 함께 다뤄야 하는 이유를 보여줍니다.
또한 개선 실행자, 편집 가능한 구현, 고정 런타임, 사후 평가를 구분하는 경계를 공부할 수 있습니다. 같은 에이전트가 자기 수정과 실제 작업을 맡더라도 모델·자원 예산·기록 관리까지 모두 편집 대상으로 둘 필요는 없습니다. 여기의 일반적 설계 해석은 논문이 산업 배포 안정성이나 범용 업무 성능까지 검증했다는 주장이 아닙니다.
이 연구는 자기 수정 경험에서 재사용 가능한 도구를 만들고, 그런 도구가 다시 자기 수정과 실제 작업을 돕는 순환을 제시합니다. 원문의 다음 검증 방향은 독립 탐색에서의 일관성과 동일 총예산 아래 평가 기반 선택과의 결합입니다. SelfSearch가 보여준 것은 정답 평가 없이도 후보를 개선할 경험을 얻는 방법이며, 그 후보의 실제 가치는 별도 평가 조건·성공 집합·비용 분모를 유지해 판단해야 합니다.
다루지 않은 세부 범위: 본문 1–7절, AI Use·Reproducibility 진술과 부록 A–F의 구조·핵심 내용을 반영했습니다. 부록 B의 프롬프트 전문, C의 Tables 6–7 전체 과제 ID, D의 Table 9 전체 자원 행, E의 Table 12 전체 벤치마크별 사용률과 모든 인용문헌의 개별 상세 리뷰는 전재하지 않았습니다. 원문 링크에서 해당 세부사항을 확인할 수 있습니다.