논문 개요와 전체 구조
보고서에 적힌 매출이 맞는지 확인하려면 문장의 자연스러움보다 원본 파일의 버전, 통화 단위, 계산 범위를 살펴야 합니다. 여러 에이전트가 같은 답을 내놓아도 모두 오래된 자료를 읽었을 수 있습니다. VeriHarness는 생성에 사용한 모델을 그대로 검증에도 사용하되, 여러 실행 결과를 비교하고 실제 작업 환경에서 근거를 찾아 결과물을 선택·수정하는 하네스입니다. 하네스(harness)는 모델 주변의 도구, 파일 접근, 실행 절차와 기억을 묶어 에이전트의 행동을 조직하는 층을 뜻합니다. 이 연구는 모델 가중치를 학습하지 않고 이 층을 바꾸어 검증 능력을 높입니다. 원문 초록·1절
핵심 질문은 “같은 모델이 자신의 오류를 어떻게 알아낼 수 있는가?”입니다. 저자들은 생성 결과의 불일치에서 비교할 대안을 얻고, 일치한 주장에서도 공통 오류와 누락을 찾아야 한다고 설명합니다. 서로 다른 결과를 조사하는 disagreement resolver와 모두가 동의한 내용을 의심하는 consensus challenger를 별도 문맥에서 실행한 뒤, 새로운 문맥의 adjudication이 증거를 종합합니다. 이는 답변을 다시 읽고 점수를 매기는 작업을 넘어, 원자료를 조회하고 계산을 재실행하는 능동적 검증입니다.
분석 대상은 2026년 10월 1일 제출된 arXiv:2610.00972v1, VeriHarness: Scaling Agentic Verification for Long-Horizon Tasks입니다. Caiqi Zhang, Rujun Han, Zifeng Wang, Zoey CuiZhu, Nigel Collier, Tomas Pfister, Chen-Yu Lee의 연구이며, 이 글은 같은 버전의 HTML과 28쪽 PDF를 기준으로 작성합니다. 논문에 등장하는 모델과 CLI 버전, 가격은 해당 실험 조건을 설명하는 값입니다. 버전 고정 서지
| 원문 순서 | 다루는 내용 |
|---|---|
| 1 Introduction | 일반 업무 결과물 검증의 어려움과 동일 모델 검증의 동기 |
| 2 Problem Formulation | 작업·실행 결과·주장·증거, 합의와 불일치의 정의 |
| 3 VeriHarness | 3.1 하네스 구성, 3.2 불일치 해소, 3.3 합의 반증, 3.4 판정과 수정 |
| 4 Experiments | 4.1 벤치마크·비교군·설정, 4.2 선택·CLI 이식·수정 결과 |
| 5 VeriHarness Can Self-Evolve | 개발 실패 피드백으로 검증 스킬 진화 |
| 6 Analysis | 구성 요소, 불일치 정도, 공유 오류, 진화 스킬 분석 |
| 7 Related Work | 출력 검증, 추론 시점 확장, 하네스와 자기 진화 |
| 8 Conclusion | 연구 결과와 검증 기록의 활용 방향 |
| Limitations → References | 저자가 밝힌 제약과 참고문헌 |
| 부록 A–D | 주장 분석, 동일 모델의 이점, 알고리즘, 상세 실험 조건 |
| 부록 E–H | 공개 실행 풀, 구성 요소 제거 실험, 런타임, 도구·18개 스킬 |
| 부록 I–K | 자기 진화 설정, 남은 공유 오류, 계산 비용 |
핵심 기여와 혁신성
첫째 기여는 검증 대상을 불일치와 합의로 나누는 원칙입니다. 후보들이 다른 값을 내놓으면 구체적인 대안을 비교할 수 있지만, 모두 같은 값을 내놓을 때는 검증할 대안부터 만들어야 합니다. APEX-Agents의 사후 주장 분석에서 합의한 값의 34%가 오답으로 판단됐고, 불일치 주장의 74%에는 정답 후보가 있었지만 최빈값이 정답인 비율은 47%였습니다. 이 수치는 특정 모델·벤치마크·주장 추출 절차의 관찰이며 모든 에이전트의 보편적 오류율은 아닙니다. 2절·부록 A
둘째 기여는 검증 절차를 환경 근거와 연결하는 범용 구조입니다. 파일·데이터·행동 기록을 조사하고, 두 조사자의 증거를 별도 판정 문맥으로 넘깁니다. 같은 도구 접근을 가진 단일 에이전트 비교군도 포함하므로, 결과 개선을 단순히 “도구를 추가했다”로 설명하지 않습니다. 3절·4절·부록 F
셋째 기여는 검증 스킬 자체의 개선입니다. 개발 작업의 채점 피드백과 실패 기록에서 일반화 가능한 확인 절차를 만들고, 별도 held-out 작업에서 성능을 측정합니다. 여기서 training-free는 모델 가중치를 학습하지 않는다는 뜻입니다. 자기 진화 과정에는 개발 데이터의 외부 채점 피드백이 사용되므로, 아무런 감독 신호 없이 스스로 정답을 알아낸다는 주장은 아닙니다. 5절·부록 I
리뷰어 관점에서 이 연구의 학습 가치는 모델의 판단과 근거 확보 절차를 분리해 설계하는 방법에 있습니다. 에이전트·하네스·데이터 검증과 직접 연결되며, 주된 평가 대상은 문서·스프레드시트·코드·다중 파일 업무입니다.
기술적 세부사항
실행 결과를 답변 한 줄보다 넓게 정의합니다
작업은 설명과 환경의 쌍 $t=(s,\mathcal{E})$입니다. 한 번의 에이전트 실행인 rollout은 $r_i=(d_i,w_i,\tau_i)$로 나타냅니다. $d_i$는 납품한 파일이나 답변, $w_i$는 종료 시점의 작업 공간 상태, $\tau_i$는 행동 기록입니다. 같은 작업을 여러 번 실행한 풀 $R$에는 이 세 정보가 함께 들어갑니다. 검증자는 결과물의 수치뿐 아니라 그 수치가 어떤 파일과 계산에서 나왔는지 추적할 수 있습니다. 2절
주장(claim)은 특정 수치, 문서 해석, 요구사항 충족 여부처럼 검증 가능한 내용입니다. 확인 작업 $\chi$를 환경에서 실행해 얻는 $e=\mathcal{E}(\chi)$가 증거입니다. 문서의 특정 절을 읽거나 합계를 다시 계산하는 것이 이에 해당합니다. 이 논문에서 말하는 외부 근거는 주로 주어진 작업 환경의 파일과 데이터이며, 실험 런타임은 네트워크가 차단된 샌드박스입니다.
엔트로피는 후보 간 차이를 측정합니다
원문 식 (1)은 주장 $p$에 대한 후보 값의 경험적 분포와 엔트로피를 정의합니다.
$N$은 실행 수, $v_{i,p}$는 실행 $i$가 주장 $p$에 대해 제시한 값, $\mathcal{V}_p$는 후보 값의 집합입니다. $\mathbf{1}$은 조건이 참이면 1인 지시함수입니다. 동등한 표현은 같은 값으로 묶고 누락도 별도의 값으로 처리합니다. 모두 같은 값을 내면 $H=0$으로 합의, 서로 다른 값이 있으면 $H\gt0$으로 불일치입니다. 이는 정답일 확률이나 모델의 신뢰도 보정값이 아닙니다. 모두 같은 오답을 내도 엔트로피는 0입니다.
도구·절차·스킬은 서로 다른 역할을 맡습니다
원문 식 (2)의 하네스는 다음 네 요소로 구성됩니다.
$M$은 생성자와 동일한 고정 모델, $\mathcal{W}$는 작업 공간, $\mathcal{T}$는 증거 수집 도구, $\Pi$는 검증 프로토콜, $\mathcal{S}$는 스킬 라이브러리입니다. 도구가 “엑셀 셀을 읽는 방법”을 제공한다면, 스킬은 “성장률에 적힌 기간과 수식이 참조하는 시작·종료 열이 같은지 확인하라”처럼 무엇을 왜 확인할지 제공합니다. 프로토콜은 이 확인 작업을 두 조사와 판정·납품으로 조직합니다. 3.1절
평가에서 지켜야 하는 정보 경계
| 단계 | 참조 정답·채점 rubric 사용 여부 | 목적 |
|---|---|---|
| 테스트 시 검증 실행 | 접근하지 않음 | 작업 설명·실행 풀·환경으로 선택 및 수정 |
| 부록 A의 사후 주장 분석 | rubric과 채점 결과 사용 | 합의·불일치와 정답 여부의 통계 계산 |
| 스킬 자기 진화의 개발 단계 | 항목별 grader 피드백 사용 | 실패에서 재사용 가능한 확인 절차 제안·선정 |
| held-out 평가 | 평가자만 점수를 확인 | 스킬의 일반화 측정, 제안자에 피드백하지 않음 |
이 경계를 구분해야 “검증자는 rubric을 보지 않는다”는 진술과 “개발 실패의 채점 피드백으로 스킬을 진화시킨다”는 진술이 모순 없이 연결됩니다. 세부 분할·차단 규칙은 원문 부록 I에서 다룹니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
챕터의 위치와 역할: 장기 작업의 생성 능력과 검증 능력을 분리하고, 왜 같은 모델로 검증을 연구하는지 설명합니다. 이후의 두 조사자 구조가 어떤 관찰에서 나왔는지 제시하는 장입니다. 원문 1절
저자의 서술 순서를 따른 상세 내용:
- 일반 업무 산출물은 전체를 판정할 단일 테스트가 부족합니다. 코드에는 단위 테스트, 수학에는 증명 검사기처럼 실행 가능한 피드백이 있지만 보고서·스프레드시트·여러 문서의 결과물은 주장별 출처와 계산, 요구사항 해석을 확인해야 합니다. 긴 실행을 잘했다고 해서 최종 산출물 전체의 정확성이 쉽게 판명되는 것은 아닙니다.
- 더 강한 판정 모델을 가정하지 않습니다. 생성자와 검증자가 동일한 모델과 도구를 사용하도록 고정합니다. 생성자가 이미 가장 강한 가용 모델인 상황을 다루면서, 더 큰 모델의 지식이 들어와서 생긴 개선과 하네스의 효과를 구분하려는 설정입니다. 검증자가 사용할 정보는 반복 실행의 후보 풀과 작업 환경입니다.
- 다수결과 읽기 중심 판정의 한계를 관찰합니다. 다수결은 자주 나온 답을 선택하고, LLM judge는 후보를 읽고 평가합니다. 저자들은 후보들이 이미 믿고 있는 내용만으로 판단할 때 모두가 공유하는 오류를 놓칠 수 있다고 설명합니다. 반대로 의견이 다르면 정답 후보가 소수 의견으로 존재할 수 있습니다.
- 두 검증 작업을 결합합니다. resolver는 경쟁하는 값을 원자료에 대조하고, challenger는 합의한 값과 빠뜨린 요구사항을 반증하려고 합니다. 두 결과는 최종 선택과 수정의 근거가 됩니다. 개발 실패에서 새로운 스킬을 축적할 수 있는지도 후속 연구 질문으로 제시합니다.
챕터의 핵심 기여: “합의하면 검증을 끝낸다”는 운영 기준 대신, 불일치를 해소하는 작업과 합의를 의심하는 작업을 모두 검증의 대상으로 세웁니다. 다음 챕터로의 연결: 2절은 후보·주장·증거와 합의의 의미를 수학적으로 정의합니다.
📖 Chapter 2: Problem Formulation
챕터의 위치와 역할: 시스템이 무엇을 입력받고 무엇을 반환하는지, 어떤 경우에 추가 조사가 필요한지 정합니다. 결과물 선택과 수정의 평가 차이도 이 정의에서 시작합니다. 원문 2절
저자의 서술 순서를 따른 상세 내용:
- Task and rollouts. 작업 설명과 환경을 함께 입력받으며, 각 실행에는 결과물·종료 상태·행동 기록이 있습니다. 결과물에는 수치뿐 아니라 계약 조항에 대한 판단, 특정 섹션이 존재한다는 요구사항 충족 주장도 포함됩니다. 따라서 검증은 최종 문장의 의미만 읽는 것보다 넓은 범위를 가집니다.
- Verification objective. 검증자는 후보 중 하나를 선택하거나 수정한 결과 $r^\star$와 확인 기록 $C$를 반환합니다. 목표는 외부 평가자의 품질 점수를 높이는 것입니다. 그러나 실행 중 평가자, 참조 정답, 채점 rubric에는 접근하지 않습니다. 모든 비교 방법은 동일한 후보 풀을 받습니다.
- Checks and evidence. 검증자는 작업, 후보, 지금까지 얻은 증거에 따라 다음 확인을 능동적으로 선택합니다. 증거가 후보를 지지할 수도, 반박할 수도, 후보에 없던 새로운 값을 확정할 수도 있습니다. 증거가 부족하면 미해결로 남깁니다. 모든 후보가 빠뜨린 항목도 작업 설명을 기준으로 확인 대상이 됩니다.
- Consensus and disputed claims. 값의 동등성을 묶어 경험적 빈도와 엔트로피를 계산합니다. 여기서 누락을 별도 값으로 두는 것은 “이 값이 다르다”와 “아예 답하지 않았다”를 함께 비교할 수 있게 합니다. 엔트로피가 높다고 오답이라는 뜻도, 낮다고 정확하다는 뜻도 아닙니다.
- Empirical observations. Figure 2는 Claude Opus 4.8의 APEX-Agents 10회 실행 풀을 분석합니다. 합의 값의 34%는 오답으로 판단됐습니다. 불일치 주장에서는 정답 후보가 존재하는 비율 74%와 최빈값이 정답인 비율 47% 사이에 차이가 있습니다. 이는 소수 대안을 환경에 대조할 여지가 있음을 보여주며, 불일치 집합의 모든 후보가 오답인 경우도 허용합니다.
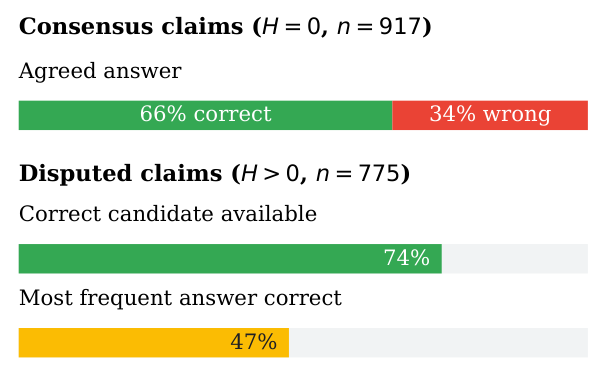
Figure 2, PDF 2쪽. 동일 버전 원문 그래프 영역만 크롭했으며 번역·수치 수정은 하지 않았습니다. 합의 주장 917개와 불일치 주장 775개는 서로 다른 분모입니다. 원문 그림
챕터의 핵심 기여: 합의와 불일치를 후보 분포의 속성으로 정의하면서, 정답 판정은 실제 근거와 별도 평가의 문제로 남깁니다. 다음 챕터로의 연결: 3절은 이 두 유형을 실제 에이전트의 조사 절차로 구현합니다.
📖 Chapter 3: VeriHarness
챕터의 위치와 역할: 두 조사자와 판정·납품을 결합한 방법론의 중심입니다. 원문은 재무 보고서 예시를 제시한 뒤 3.1–3.4절에서 구성과 판단 절차를 구체화합니다. 원문 3절
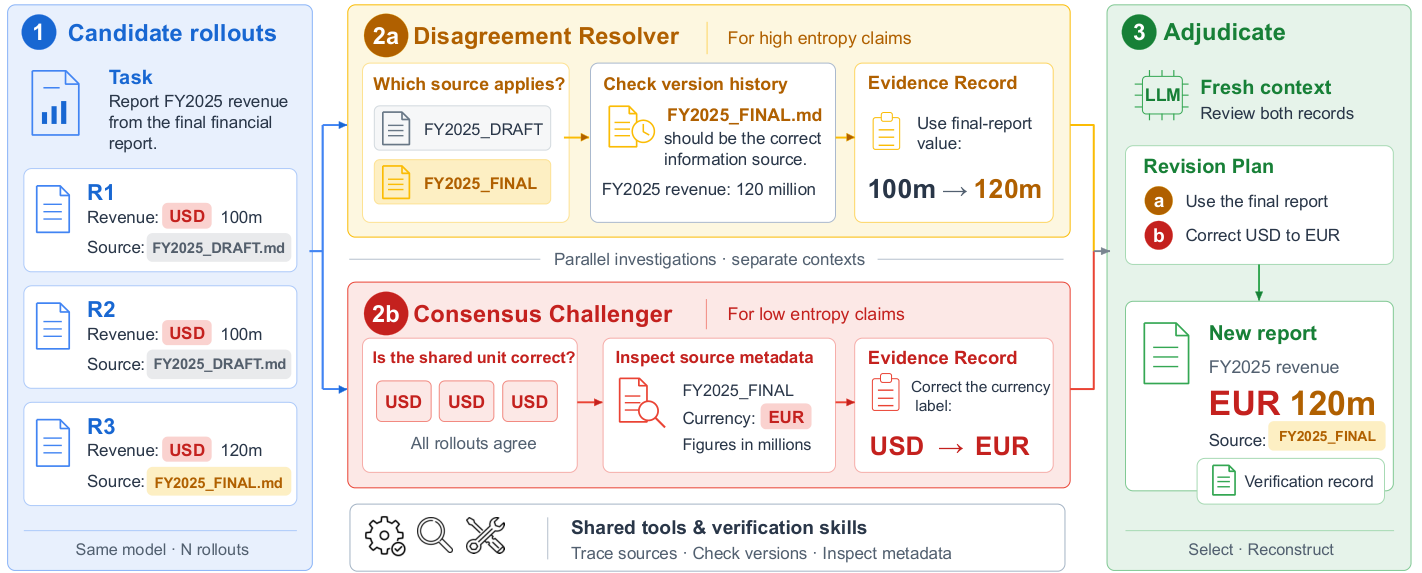
Figure 3, PDF 4쪽. 전체 도식 영역을 크롭했고 원문 패널·화살표·숫자를 보존했습니다. 번역하지 않았습니다. 원문 그림
| 단계 | 확인할 문제 | 실제 근거 | 결과에 반영하는 내용 |
|---|---|---|---|
| 후보 비교 | 100m과 120m이 다름 | 각 후보의 인용 파일 | 비교할 버전 차이를 발견 |
| Resolver | 어느 버전이 기준인가 | 최종 보고서가 초안을 대체하는 버전 이력 | 매출 120m을 지지 |
| Challenger | 모두 적은 USD가 맞는가 | 최종 원자료의 통화 EUR 메타데이터 | 공유 단위 오류를 발견 |
| Adjudication·delivery | 어떤 변경을 적용할 것인가 | 두 조사자의 독립 증거 기록 | 최종본을 기준으로 EUR120m 납품 |
Figure 3의 각 단계를 한국어로 풀어 쓴 표입니다. 원본 그림의 작은 글씨를 읽지 않아도 버전 확인과 단위 확인이 다른 작업임을 따라갈 수 있습니다.
저자의 서술 순서를 따른 상세 내용:
- 도입 예시: 수치의 불일치와 단위의 공유 오류. 세 후보 중 두 개는 초안에서 매출 100m, 하나는 최종 보고서에서 120m을 가져오고 모두 통화를 USD로 적습니다. resolver가 버전 이력을 확인하면 최종본의 120m을 지지할 수 있습니다. 그러나 이 후보를 선택하는 것만으로 USD라는 공통 오류는 사라지지 않습니다. challenger가 원본 메타데이터의 EUR를 확인한 뒤에야 EUR120m으로 고칠 수 있습니다. 그림은 방법을 설명하는 예시이며 별도의 벤치마크 실측 사례라고 해석하지 않습니다.
3.1 A General-Purpose Verification Harness
- Workspace and tools. 작업 설명·원자료와 함께 각 후보의 파일·최종 상태·행동 기록을 파일 기반 공간에 노출합니다. 검증자는 출처와 계산을 추적하고 재계산하거나 코드를 실행해 증거를 얻을 수 있습니다. 같은 모델이라도 이미 완성된 결과물의 특정 의심점에 도구 사용을 집중한다는 차이가 생깁니다.
- Verification protocol. 프로그램이 두 조사 문맥과 정보 접근 범위를 준비하고, 모델은 무엇을 확인하고 언제 멈출지 결정합니다. 절차는 문서 유형에 고정되지 않습니다. 보고서·스프레드시트·코드가 같은 구조로 처리되고, 파일 유형별 지식은 스킬에 들어갑니다.
- Verification skills. 스킬은 반복되는 실패 유형과 확인 절차를 담은 짧은 텍스트이며 선택적으로 스크립트를 포함합니다. 도구가 표를 읽는다면 스킬은 성장률의 기간, 단위, 부호, 원본 버전 등 점검할 속성을 알려줍니다. 작업별 정답을 저장하지 않으며, 4절에서는 사람이 작성한 라이브러리, 5절에서는 진화한 라이브러리를 비교합니다.
3.2 Resolving Disagreement through Evidence
- 대안을 가장 잘 가르는 확인을 고릅니다. resolver는 후보마다 다른 주장과 그 근거를 찾습니다. 현재 증거에 따른 정답 값의 믿음 분포 $b_p$는 후보가 얼마나 자주 나왔는지의 분포 $\pi_p$와 다릅니다. 원문 식 (3)은 확인의 기대 정보 이득을 표현합니다.
$\chi$는 실행할 확인, $e_{\lt k}$는 $k$번째 단계 이전의 증거, $b_p(\cdot\mid\mathcal{E}(\chi))$는 해당 확인 결과를 반영한 믿음입니다. 확인 전후 불확실성이 얼마나 줄어드는지를 뜻합니다. 구현은 이 기대값을 수치 계산하거나 확률 모델로 최적화하지 않고, 모델이 질적으로 판단합니다. 예컨대 두 후보가 서로 다른 원본 버전을 읽었다면 버전 이력을 확인하는 것이 단순 재독보다 구별력이 큽니다.
- 근거와 모순되는 후보를 제외합니다. 원문 식 (4)은 다음과 같습니다.
현재 후보 집합 $\mathcal{V}_p$에서 증거 $e$와 양립하는 값을 남깁니다. 이는 다수의 값을 자동 채택하는 규칙이 아닙니다. 모든 후보가 반박되더라도 증거가 새로운 값을 확정할 때만 새 값을 기록합니다. 그렇지 않으면 열린 문제로 남깁니다. 더 확인해도 결과가 바뀔 가능성이 낮다고 판단하면 멈추고 증거 기록 $L_{\neq}$를 남깁니다.
3.3 Challenging Consensus
- 합의에는 반박 가능성부터 만들어야 합니다. 후보들이 모두 같은 값을 말하면 비교할 다른 값이 없습니다. challenger는 작업·후보·기존 증거를 보고 어떤 확인이 중요한 공유 오류를 드러낼지 판단합니다. 식 (5)의 우선순위는 다음과 같습니다.
조건 $t,R,e_{\lt k}$는 작업, 실행 풀, 이전 증거입니다. 우선순위는 “이 확인이 합의의 실패를 드러낼 가능성”이라는 사고 기준이며, 실제로 보정된 확률값을 계산하는 알고리즘은 아닙니다. 원문은 이 역시 질적으로 판단한다고 명시합니다.
- 세 종류의 합의를 살핍니다. 합의한 값은 원입력 재계산과 단위 메타데이터로 확인하고, 합의한 해석은 지정 파일·기간·정의를 대조합니다. 합의한 누락은 작업 설명에 요구됐지만 모든 결과물이 빠뜨린 내용을 찾는 작업입니다. 누락은 결과물 안에 없으므로 먼저 점검 대상으로 드러내야 합니다. 스킬은 이처럼 겉으로 문제가 없어 보이는 결과물에서 실패 가설을 만들 지식을 제공합니다. 결과는 $L_{=}$에 남깁니다.
3.4 Adjudication and Evidence-Backed Revision
- 조사 문맥을 분리하고 판정 문맥을 새로 엽니다. 불일치가 많은 부분에 주의가 쏠려 공유 오류가 밀려나지 않도록 resolver와 challenger는 서로의 대화를 보지 않습니다. 판정자는 어느 조사자의 대화 이력도 그대로 물려받지 않고 두 기록·작업·후보를 받아 판단합니다. 발견 내용을 유지·뒤집기·미해결 처리할 수 있습니다. 식 (6)은 결과를 다음 세 요소로 정리합니다.
$\mathrm{base}$는 수정의 출발점인 후보, $\mathrm{revision\_plan}$은 근거를 붙인 변경 계획, $\mathrm{unresolved}$는 확정하지 못한 주장입니다. $A$는 새로운 문맥에서 수행하는 판정 과정입니다. 주요 요구사항에서 증거로 확인된 결함이 적은 후보를 고르되, 적절한 출발점이 없으면 $\mathrm{base}=\varnothing$도 허용합니다.
- 선택과 수정의 출력이 다릅니다. selection-only는 기존 후보를 바꾸지 않고 반환합니다. 전체 하네스는 식 (7)에 따라 계획을 적용합니다.
$r^\star$는 최종 결과, $C$는 검증 기록입니다. 빈 계획이면 출발 후보를 유지하고, 계획이 있으면 수정합니다. 출발 후보가 없으면 입력과 증거에서 새 결과물을 구성합니다. 미해결 주장은 기록에 남기며 형식이 허용하면 두 해석을 함께 제시합니다. 증거 기록은 주장→확인→증거→판정의 연결을 보존합니다.
챕터의 핵심 기여: 후보 간 차이와 후보 전체의 공통 오류에 조사 자원을 따로 배정하고, 그 결과를 추적 가능한 변경으로 연결합니다. 다음 챕터로의 연결: 4절은 기존 후보만 선택하는 능력과 결과물을 고치는 능력을 나누어 평가합니다.
📖 Chapter 4: Experiments
챕터의 위치와 역할: 실제 업무형 결과물에서 검증 설계가 유효한지 비교합니다. 먼저 데이터·모델·비교군을 정의하고, 선택 성능, CLI 이식, 근거 기반 수정의 순서로 결과를 해석합니다. 원문 4절
4.1 Setup
저자의 서술 순서를 따른 상세 내용:
- Evaluation scope. 5개 벤치마크가 보고서·워크북·코드·다중 파일을 포괄합니다. Table 1의 작업 수와 평가 특성은 다음과 같습니다.
| 벤치마크 | 작업 수 | 대표 산출물 | 평가 특성 |
|---|---|---|---|
| APEX-Agents v1.0 | 480 | 은행·법률·컨설팅 메모, 모델, 답변 | 전문가 rubric 기반 채점 |
| Workspace-Bench Lite | 100 | 문서·파일 의존성이 큰 작업 | rubric judge |
| WorkBuddy Bench | 200 | 코드 패치·오피스·웹 산출물 | 테스트·규칙·judge의 복합 검증 |
| SpreadsheetBench 2 | 321 | 비즈니스 스프레드시트 | 재계산 후 참조 워크북과 비교 |
| JobBench | 65 | 35개 사무 직종의 다중 파일 | rubric judge |
원문 Table 1을 한국어 Markdown으로 재작성했습니다. 각 작업·모델마다 10개 실행을 사용합니다. 원문 표
- Same-model comparison. Gemini 3.5 Flash와 Claude Opus 4.8을 각각 생성자·검증자로 사용하고 thinking level은 high입니다. 모델별로 모든 방법이 같은 고정 10개 실행 풀을 받습니다. 평가자는 검증자에게 공개하지 않습니다. 동일 생성 비용에서 후보를 얼마나 잘 활용하는지의 비교이지, 모든 방법의 추가 검증 비용까지 동일하게 제한한 실험은 아닙니다.
- Baselines. 다수결, best-of-N judge, 쌍대 토너먼트, LLM-as-a-Verifier와 비교합니다. 같은 작업 공간·도구는 있지만 프로토콜·스킬이 없는 agentic verifier도 둡니다. selection oracle은 채점자가 아는 점수로 각 작업의 최상 후보를 고르는 이상적 기준입니다. 수정 비교에는 풀을 종합해 새 결과물을 쓰는 aggregation과, 단일 문맥에서 환경을 조사하고 수정하는 agentic verifier + revision을 포함합니다.
- 평가 반복. 각 벤치마크의 자체 척도를 독립 검증 실행 3회에 걸쳐 평균하고 seed 간 표준편차를 표시합니다. 단일 실행 기준은 임의의 한 결과를 뽑은 값이 아니라 고정 풀의 평균입니다. Avg는 서로 다른 자체 척도의 5개 벤치마크 평균을 같은 가중치로 합친 요약값입니다.
4.2 Results
- 선택 비교. VeriHarness(select)는 두 모델×5개 벤치마크의 모든 조건에서 평가한 선택 비교군보다 높은 평균을 보입니다. Flash의 Avg는 단일 실행 47.2에서 51.6, Opus는 49.6에서 53.7입니다. 같은 환경 접근만 제공한 비교군은 각각 49.4, 51.6이므로 접근 자체보다 확인 절차와 스킬을 함께 조직하는 설계가 중요하다는 저자 해석을 뒷받침합니다.
| 모델·방법 | Avg | APEX | WSB | WorkBuddy | SB-2 | JobBench |
|---|---|---|---|---|---|---|
| Flash 단일 실행 | 47.2 | 48.1 | 56.5 | 73.2 | 27.3 | 30.9 |
| Flash 환경 접근 verifier | 49.4 | 49.0 | 60.1 | 75.1 | 30.9 | 31.8 |
| Flash VeriHarness(select) | 51.6 | 53.3 | 62.0 | 77.8 | 31.5 | 33.5 |
| Flash VeriHarness 수정 포함 | 53.4 | 54.8 | 65.4 | 78.2 | 32.2 | 36.2 |
| Flash 선택 oracle | 62.7 | 67.3 | 70.3 | 87.7 | 37.4 | 51.0 |
| Opus 단일 실행 | 49.6 | 35.8 | 60.5 | 79.0 | 30.1 | 42.8 |
| Opus 환경 접근 verifier | 51.6 | 38.1 | 63.4 | 80.9 | 31.8 | 43.9 |
| Opus VeriHarness(select) | 53.7 | 41.2 | 65.0 | 83.0 | 33.4 | 46.1 |
| Opus VeriHarness 수정 포함 | 56.1 | 47.5 | 67.3 | 83.7 | 34.3 | 47.6 |
| Opus 선택 oracle | 63.1 | 53.8 | 72.4 | 89.4 | 39.6 | 60.4 |
Table 2에서 주요 행의 평균값만 옮겼습니다. 표준편차는 아래 실험 분석에서 별도로 다룹니다. WSB는 Workspace-Bench Lite, SB-2는 SpreadsheetBench 2입니다. Avg를 전체 작업의 통합 정확도로 해석하면 안 됩니다. 원문 전체 표
- 기존 CLI로의 이식. 전용 런타임 대신 Gemini CLI·Claude Code·Codex에서 같은 지침과 스킬을 실행해도 상당한 선택 개선을 유지합니다. 다만 모든 조건에서 전용 구현과 같지는 않습니다. Opus의 JobBench는 CLI에서 단일 실행 수준으로 돌아가고, Claude Code의 SB-2도 마찬가지입니다. “아무 CLI에 텍스트를 넣으면 같은 성능”이라는 결론은 아닙니다.
- 증거 기반 수정의 추가 이득. 조사 결과의 수정 계획을 한 번 적용하면 10개 모델·벤치마크 조건 모두에서 선택보다 평균이 높아집니다. 전체 평균의 단일 실행 대비 보고된 gain은 Flash +6.2, Opus +6.4입니다. Opus의 표시 Avg 49.6과 56.1을 단순 차감하면 6.5지만, 원문 gain 행은 +6.4입니다. 표시값의 반올림 정밀도가 다르므로 이 글은 저자가 보고한 gain을 따릅니다. 후보를 근거 없이 재조합하는 aggregation보다도 높아 단순 재작성과 근거 기반 수정을 구분할 이유가 생깁니다.
챕터의 핵심 기여: 같은 생성 풀에서 선택 능력과 수정 능력을 나누고, 환경 접근·CLI 이식·수정 비교군으로 시스템의 효과를 검토합니다. 다음 챕터로의 연결: 5절은 고정된 사람 작성 스킬을 넘어 실패 피드백으로 스킬을 개선합니다.
📖 Chapter 5: VeriHarness Can Self-Evolve
챕터의 위치와 역할: 가중치를 바꾸지 않고 검증 경험을 축적할 수 있는지 시험합니다. 모델과 프로토콜, 일반 도구를 고정한 채 스킬 라이브러리만 변경합니다. 원문 5절
저자의 서술 순서를 따른 상세 내용:
- The learning loop. 대상 작업을 약 3:1의 개발·held-out으로 나눕니다. 각 라운드에서 개발 실패와 항목별 grader 피드백을 보고 후보 라이브러리를 제안합니다. 개발 점수가 기존 이상인 최고 후보를 유지합니다. held-out 점수는 기록하지만 라이브러리 선정에는 사용하지 않습니다. 테스트 검증 시에는 정답·rubric을 보지 않습니다.
- Four conditions. A는 빈 라이브러리, B는 고정한 사람 작성 라이브러리, C는 A에서 진화한 최종 라이브러리, D는 B에서 진화한 최종 라이브러리입니다. 모두 Opus로 전체 하네스와 수정을 실행합니다. A→C는 실패 학습, B와 C는 사람 지식과 학습된 지식, B→D는 사람 초기화 이후 개선을 비교합니다. Table 2 전체 벤치마크와 다른 held-out 부분집합이므로 점수를 직접 동일시하지 않습니다.
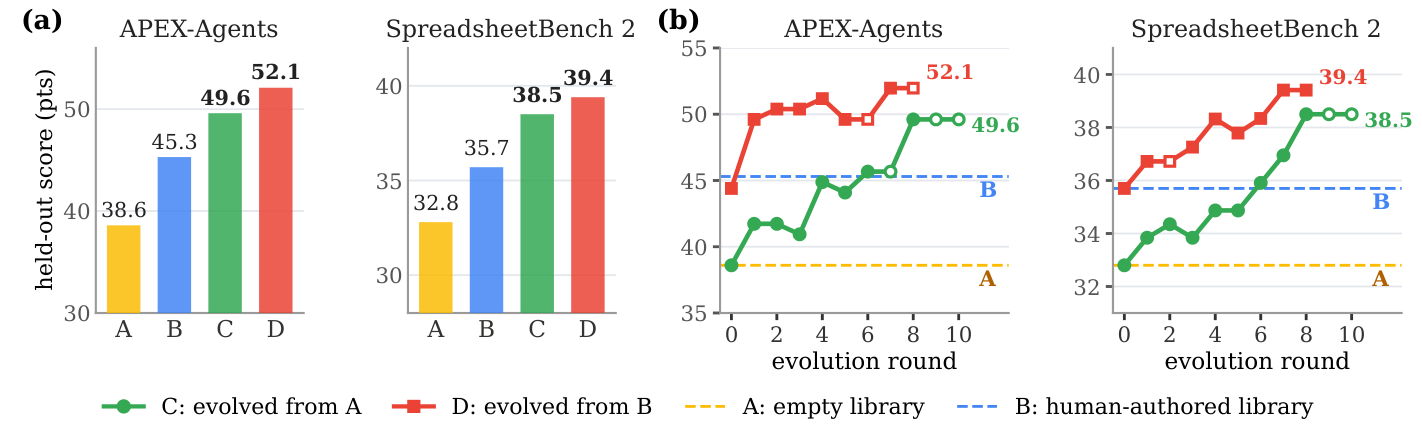
Figure 4, PDF 9쪽. (a) 최종 비교와 (b) 라운드별 궤적, 축·범례·빈 마커를 함께 크롭해 보존했습니다. 번역하지 않았습니다. 원문 그림
| 라이브러리 | APEX-Agents held-out | SpreadsheetBench 2 held-out |
|---|---|---|
| A: 빈 라이브러리 | 38.6 | 32.8 |
| B: 사람 작성 | 45.3 | 35.7 |
| C: A에서 진화 | 49.6 | 38.5 |
| D: B에서 진화 | 52.1 | 39.4 |
Figure 4(a)의 점추정치를 옮겼습니다. 각 수치는 해당 분할·완전 하네스·수정 포함 조건의 자체 척도입니다.
- Skills learned from empty. C는 A보다 APEX +11.0, SB-2 +5.7이고 B도 넘습니다. 반복된 실패에서 무엇을 점검해야 하는지 학습한 스킬이 결과물의 확인·판정·수정을 함께 개선한 결과입니다.
- Human initialization. D는 가장 높은 최종 점수이며 B 대비 각각 +6.8, +3.7입니다. D가 C의 최종 궤적 점수에 더 빨리 도달하지만, 부록 I는 후보 수가 라운드별로 달라 라운드 감소가 계산량·실시간 감소를 증명하지 않는다고 명시합니다.
- Examples. 요청된 모든 항목을 목록화하고 후보별 대응과 근거를 확인하는 스킬, 성장률 라벨의 기간과 수식 열을 대조하는 스킬이 생깁니다. 추상적 “꼼꼼히 확인하라”보다 실행 가능한 점검 절차가 되는 점이 중요합니다.
챕터의 핵심 기여: 개발 실패에서 얻은 일반 절차가 평가 분할의 보지 않은 작업에서도 도움을 줄 수 있음을 보여줍니다. 다음 챕터로의 연결: 6절은 어떤 조사와 어떤 스킬이 실제 개선을 설명하는지 분석합니다.
📖 Chapter 6: Analysis
챕터의 위치와 역할: 평균 성능을 넘어서 두 조사자의 역할, 후보의 다양성, 합의 반증의 잔여 오류, 진화 스킬의 내용을 차례로 분석합니다. 원문 6절
저자의 서술 순서를 따른 상세 내용:
- The disagreement resolver and the consensus challenger recover different errors. 부록 F의 수정 포함 실험에서 Opus의 Avg는 단일 실행 49.6, resolver만 54.3, challenger만 52.6, 전체 56.1입니다. 공유 오류는 모든 후보에 있으므로 challenger가 찾은 수정이 선택만으로 실현되지는 않습니다. 두 조사를 하나의 문맥에 합치면 55.3으로 0.8 낮아집니다. Flash도 같은 순서를 보입니다. 이 값들은 각 요소의 독립적·가산적 인과 효과를 뜻하는 것은 아니며, 구성 제거 비교에서의 결과입니다.
- Selection gains come from the pools that disagree. Opus APEX의 task-level 분석에서 합의 풀 154개는 선택 점수가 풀 평균보다 0.6 높고, 불일치 풀 262개는 6.1 높습니다. 불일치 풀 안에서는 낮은 엔트로피 +4.5, 중간 엔트로피 +7.7입니다. 이는 후보가 서로 다를 때 선택할 대안이 있다는 해석과 맞습니다. 154+262=416개 작업이라는 이 분석의 분모는 부록 A의 434개 작업·1,692개 주장과 다릅니다. 원문이 두 분석의 포함 범위를 동일하게 연결하지 않으므로 하나의 통계 집합으로 합치지 않습니다.
- Challenging consensus generally does no harm. 분석한 APEX 합의 주장에서는 모든 후보가 맞힌 주장을 challenger가 반박한 사례가 없었다고 보고합니다. 특정 분석 범위의 관찰이며 모든 업무에서 거짓 반박이 불가능하다는 보장은 아닙니다. 남겨 둔 공유 오류의 약 70%는 올바른 중간값을 확인했지만 실제 오류가 뒤 단계에 있었습니다. 검증이 생성자가 멈춘 지점에서 다시 멈추는 현상입니다.
- The evolved libraries are more specific. 4개 진화 라이브러리의 95개 확인을 수동 비교하면 5개는 사람 작성 확인의 반복, 48개는 스크립트·상수·문서 유형으로 구체화, 42개는 새 확인입니다. 서로 다른 두 벤치마크의 진화 결과에서 “풀과 재계산이 일치한다는 사실만으로 확인 완료로 보지 말라”는 절차가 함께 나타납니다. 개발 패키지의 검증 기록과 grader 결과를 함께 읽었기 때문에 검증자 자체의 맹점을 드러낼 수 있었습니다.
챕터의 핵심 기여: 불일치 해소와 공유 오류 반증이 다른 문제를 다루며, 경험에서 얻는 점검 범위가 검증의 깊이에 영향을 준다는 설명을 제공합니다. 다음 챕터로의 연결: 7절은 이 위치를 기존 검증·추론 확장·자기 진화 연구 안에서 정리합니다.
📖 Chapter 7: Related Work
챕터의 위치와 역할: 방법을 세 연구 흐름에 배치합니다. 이 절은 원문이 비교하는 관점을 설명하며, 인용된 모든 외부 연구를 독립 재검증한 문헌 조사로 제시하지 않습니다. 원문 7절
저자의 서술 순서를 따른 상세 내용:
- Verifying agent outputs. LLM judge, 학습된 verifier·process reward model, 더 세분화한 평가, 작업 공간을 조사하는 agentic verifier로 이어지는 흐름을 소개합니다. 동일 모델은 외부 피드백 없이 자기 오류를 고치기 어렵고, 자기 확인이 확증적일 수 있으며, 같은 계열의 모델 오류가 상관될 수 있다는 선행 관찰을 배경으로 둡니다. VeriHarness는 모델 학습 대신 실행 풀에서 검증 대상을 얻고 환경에서 근거를 찾는 접근이라고 위치시킵니다.
- Test-time scaling for agents. 반복 샘플링은 좋은 후보의 존재 확률을 높일 수 있지만, 그것을 찾아내는 선택 능력은 별개입니다. 투표·토너먼트·후보 융합과 달리 이 방법은 실행 가능한 전체 정답 테스트가 없는 업무에도 원자료 조사와 재계산을 가져옵니다. 모델끼리 논쟁하는 debate와 비교해서도 환경에서 관찰할 증거를 중심에 둡니다.
- Harnesses and self-evolution. 고정 모델 주변의 하네스를 실행 기록으로 진화시키거나 경험·스킬 라이브러리를 축적하는 흐름을 정리합니다. 저자들은 생성자 scaffold보다 검증자의 스킬을 진화시킨다는 점을 구분합니다. 개발·평가 분할이 겹칠 때의 과적합과 예산을 맞춘 추론 확장 비교에 대한 선행 문제를 소개하고, 자신의 held-out 분할과 개발 점수 선정 규칙을 설명합니다.
챕터의 핵심 기여: 기존 판정 점수화, 후보 융합, 생성자 하네스 진화와 구분되는 연구 대상이 무엇인지 밝힙니다. 다음 챕터로의 연결: 8절은 실험에서 확인한 결과와 검증 기록의 활용 가능성을 모읍니다.
📖 Chapter 8: Conclusion
챕터의 위치와 역할: 같은 모델·환경 근거·축적 경험의 결합이라는 주장을 다시 정리합니다. 원문 8절
저자의 서술 순서를 따른 상세 내용:
- 두 검증 작업의 결합. 생성자의 모델을 그대로 사용해 불일치를 해결하고 합의를 반증하는 하네스가 5개 업무 벤치마크·2개 모델에서 평가한 선택 비교군 중 가장 높은 점수를 보였다고 정리합니다.
- 수정과 스킬 진화. 근거 기반 수정이 단일 실행 대비 두 모델 모두 평균 6점 넘는 보고 gain을 얻고, 개발 실패에서 진화한 스킬이 held-out에서 사람 작성 라이브러리를 넘는다고 요약합니다. 더 강한 모델이 등장할 때까지 검증 능력 개선을 기다릴 필요는 없다는 것이 저자의 결론입니다.
- 기록의 향후 활용. 주장·확인·증거·판정의 연결이 생성자를 감독할 claim-level 신호가 될 수 있고, 이를 장기 작업 에이전트의 학습 데이터로 바꾸는 것을 다음 단계로 제시합니다. 이는 저자가 명시한 향후 방향이며 본 논문에서 실제로 그 학습 효과를 실험했다는 뜻은 아닙니다.
챕터의 핵심 기여: 검증 능력을 모델 크기 외의 설계 변수로 바라보는 결과를 정리합니다. 다음 내용으로의 연결: 원문은 독립 Limitations 절에서 연구 범위를 명시한 뒤 참고문헌과 부록으로 넘어갑니다.
📖 Chapter Limitations: Limitations
챕터의 위치와 역할: 저자가 본문 뒤에 별도로 밝힌 제약을 원문 순서대로 정리합니다. 이 글의 한계·향후 방향 설명은 이 절과 부록의 명시적 진술을 기준으로 합니다. 원문 Limitations
저자의 서술 순서를 따른 상세 내용:
- Cost of the rollout pool. 보고 결과는 작업당 10회 실행을 사용합니다. 모든 비교군이 같은 풀을 받아 생성 비용은 맞췄지만, 풀 생성 자체의 비용은 필요합니다. 부록 K가 별도로 계산하는 검증 비용을 전체 작업 비용이라고 읽으면 안 됩니다.
- No score for individual rollouts. 결과물과 확인 기록을 반환하며 각 실행에 하나의 스칼라 점수를 부여하지 않습니다. 여러 주장의 판정을 보정된 실행 수준 점수나 보상으로 바꾸는 것은 향후 연구로 남깁니다.
- Same-model setting. 생성자와 검증자를 같은 모델로 제한합니다. 더 강한 검증 모델의 추가 효과는 모델 간 능력 격차와 하네스 효과가 섞이므로 이 논문의 범위 밖입니다.
- Latency. 여러 턴의 조사는 실제 시간을 늘립니다. 저자들은 즉시 응답보다 품질이 중요한 보고서·워크북·패치 등의 전문 업무를 대상으로 삼는다고 설명합니다.
챕터의 핵심 기여: 생성 비용, 점수화 기능, 모델 조합, 지연 시간에 관한 결과의 적용 범위를 명확히 합니다. 다음 내용으로의 연결: 참고문헌은 근거 연구의 목록이며, 이어지는 부록 A–K는 분석·구현·재현 조건을 보충합니다. 참고문헌 각 논문의 전문은 이 리뷰의 분석 범위에 포함하지 않습니다.
📖 Chapter Appendix A: Claim-Level Analysis Protocol
챕터의 위치와 역할: Figure 2의 통계를 어떻게 만들었는지 설명합니다. 검증 실행과 rubric을 사용하는 사후 분석을 구별하는 핵심 부록입니다. 원문 부록 A
저자의 서술 순서를 따른 상세 내용:
- 분석 범위. Claude Opus 4.8의 APEX-Agents 10회 실행 풀 중 434개 작업, 1,692개 주장을 다룹니다. 이 오프라인 분석은 rubric을 읽지만 검증자는 읽지 않습니다.
- Claims and values. rubric의 각 기준을 하나의 주장으로 취급하고, Opus가 temperature 0으로 10개 답변에서 값을 추출합니다. 수치는 기준의 정밀도에서 같으면 동일, 판단은 결론이 같으면 동일하게 묶고, 응답하지 않은 항목은 absent로 둡니다. 이렇게 917개 합의 주장과 775개 불일치 주장을 얻습니다. 주장 추출 역시 모델을 이용한 절차라는 점을 인식해야 합니다.
- Correctness. 벤치마크의 항목별 pass/fail 채점을 사용합니다. 같은 값을 제시한 실행 중 다수가 기준을 통과하면 그 값을 정답으로 봅니다. 불일치의 정답 후보 존재는 적어도 하나가 통과하는지를, 최빈값 정답은 동률 최빈값에 대해 평균하여 계산합니다. 이는 인간이 모든 주장에 새로 정답 라벨을 붙인 별도 실험이 아닙니다.
챕터의 핵심 기여: 34%·74%·47%의 분모와 판정 방법을 공개합니다. 다음 부록으로의 연결: B는 같은 모델이 정보와 목표의 차이로 개선할 수 있는 이유를 정리합니다.
📖 Chapter Appendix B: Why Same-Model Verification Can Improve Outputs
챕터의 위치와 역할: 모델 가중치가 같아도 생성과 검증의 조건이 다르다는 논리를 Table 3으로 정리합니다. 원문 부록 B
저자의 서술 순서를 따른 상세 내용:
- Exposed alternatives. 여러 실행은 단일 생성이 보지 못한 경쟁 값과 해석을 명시합니다. 검증자는 막연히 오류를 찾는 대신 구체적인 차이를 조사할 수 있습니다.
- Focused checking. 완성된 결과물이 있으므로 특정 주장 확인에 주의를 집중합니다. 별도 문맥은 불일치와 합의 양쪽에 조사 공간을 남깁니다.
- Environmental evidence. 생성자와 같은 도구여도, 의심할 주장이 정해진 뒤의 조회와 재계산은 기존 실행이 놓친 정보를 드러낼 수 있습니다. 외부 근거를 새롭게 읽는다는 의미에서 단순 내적 자기 반성과 다릅니다.
- Accumulated skills. 사람의 확인 절차와 개발 실패에서 얻은 지식이 모든 후보의 누락까지 점검하도록 돕습니다. 저자들은 필요한 주장을 확인하지 않거나 이용 가능한 근거가 결론을 내리지 못하면 공통 맹점이 남을 수 있다고 덧붙입니다.
챕터의 핵심 기여: 동일 모델 개선을 신비로운 자기 교정 능력이 아니라 정보·목표·경험의 재배치로 설명합니다. 다음 부록으로의 연결: C는 이 조건을 실제 실행 알고리즘과 납품 규칙으로 연결합니다.
📖 Chapter Appendix C: Verification Procedure and Delivery Details
챕터의 위치와 역할: Algorithm 1에서 프로그램이 정하는 경계와 모델이 판단하는 내용을 분리합니다. 원문 부록 C
저자의 서술 순서를 따른 상세 내용:
- 초기화와 병렬 조사. 프로그램이 작업·실행 풀·도구·스킬을 노출하고 서로 볼 수 없는 두 문맥을 동시에 엽니다. resolver는 의미 있는 불일치가 남는 동안 정보 이득이 큰 확인을 선택해 기록하고, challenger는 확인할 가치가 있는 합의 주장을 시험해 기록합니다.
- 새 문맥의 판정. 두 증거 기록·작업·풀을 받은 새 문맥이 base, revision_plan, unresolved를 만듭니다. 납품은 이 판정 문맥에서 계속 실행하므로, 또 하나의 독립 조사 단계가 추가되는 것은 아닙니다.
- Delivery rules. 변경 계획이 없으면 base를 그대로 반환하고, 계획이 있으면 근거 있는 변경만 적용합니다. base가 없으면 입력과 증거에서 재구성합니다. 미해결 해석은 가능한 형식에서는 두 해석을 base의 해석부터 표시하고, 하나의 값만 들어가는 형식에서는 판정자가 선호한 해석을 택합니다. 어느 경우든 확인 기록에는 미해결 상태가 남습니다.
챕터의 핵심 기여: 병렬 분리 조사→새 문맥 판정→같은 문맥 납품이라는 제어 흐름과 미해결 처리 규칙을 명확히 합니다. 다음 부록으로의 연결: D는 이 절차가 어떤 벤치마크·런타임·평가 조건에서 실행됐는지 설명합니다.
📖 Chapter Appendix D: Experimental Details
챕터의 위치와 역할: 본문 표의 비교를 읽기 위해 필요한 데이터 범위, 생성 scaffold, 실행 제약, 채점 방식을 제공합니다. 원문 부록 D
저자의 서술 순서를 따른 상세 내용:
- Benchmarks. APEX는 v1.0, Workspace는 100개 Lite를 사용합니다. WorkBuddy는 코드 80·오피스 50·웹 70개를 평가하며 security 영역은 모델 API의 안전 경고가 반복돼 실행하지 않습니다. SB-2는 금융 모델링·템플릿 완성·디버깅·시각화, JobBench는 35개 사무 직종을 다룹니다. WorkBuddy 전체 영역의 성능으로 일반화하면 안 됩니다.
- Models and rollout pools. 벤치마크의 표준 도구·지침으로 모델당 작업별 10개 실행을 만듭니다. APEX는 자체 runner와 도구 서버, JobBench는 opencode, SB-2는 셸·스프레드시트 도구가 있는 자체 에이전트, WorkBuddy·Workspace는 Claude Code를 사용합니다. 한 벤치마크에서 두 모델은 같은 scaffold를 쓰고, 검증 전 풀을 고정합니다.
- Harness runtime. 전용 구현은 pi coding agent 위의 얇은 층이며 Claude 호출에는 로컬 LiteLLM proxy를 사용합니다. 원자료·후보·환경은 읽기 전용, 출력 디렉터리만 쓰기 가능하고 네트워크는 차단합니다. 스프레드시트는 셀 수준 텍스트도 제공합니다. CLI 비교 버전은 Gemini CLI 0.46.0, Claude Code 2.1.246, Codex 0.149.1입니다. 이 값은 논문 실험의 재현 조건이며 최신 사용법 안내가 아닙니다.
- Grading protocol. APEX와 JobBench rubric judge는 Gemini 3 Flash, Workspace의 agent-as-a-judge는 Opus 4.8을 쓰는 Claude Code입니다. WorkBuddy는 영역별 테스트·규칙·judge를 조합하고, SB-2는 재계산 후 참조 워크북과 셀 단위 비교합니다. judge 기반 채점에서는 base와 수정 결과를 같은 라운드에 채점한 차이를 보관된 base 점수에 더해 라운드 간 judge 변동을 통제합니다. 같은 라운드 차이를 썼다는 사실은 paired bootstrap이나 신뢰구간을 계산했다는 뜻이 아닙니다.
- Baselines. single rollout은 풀 평균이고, 다수결은 다른 후보와 가장 일관적인 실행을 선택합니다. best-of-N은 한 호출에서 전체 후보를 점수화하고, 토너먼트는 쌍대 승자를 반복 선택합니다. LLM-as-a-Verifier는 기준별 쌍대 비교를 수행합니다. 환경 접근 verifier는 같은 샌드박스·파일·검색·셸 도구가 있으나 하나의 점수화 지침만 받습니다. aggregation은 환경 접근 없이 후보·설명을 종합합니다.
- Selection and revision. 기본 비교는 기존 실행을 반환하여 선택 판단을 분리합니다. 전체 하네스는 추가 조사 없이 수정 한 번을 적용합니다. 새 결과물을 만드는 방법은 기존 후보 선택 oracle의 직접 비교 범위 밖입니다.
- Metrics. APEX는 작업 성공률, JobBench·Workspace는 평균 rubric 점수, WorkBuddy는 3개 영역의 작업 수 가중 평균, SB-2는 headline accuracy입니다. 그 위의 Avg는 벤치마크 5개를 비가중 평균합니다. 단일 실행과 oracle은 고정 풀의 기대값이므로 추가 샘플링이 필요 없습니다.
챕터의 핵심 기여: “같은 모델·같은 풀”이 의미하는 통제 범위와 지표별 해석 차이를 제공합니다. 다음 부록으로의 연결: E는 고정 풀의 공개 범위와 그 점수로 재현할 수 있는 분석을 설명합니다.
📖 Chapter Appendix E: Released Rollout Pool
챕터의 위치와 역할: 공개 자료의 내용과 재현 경로를 밝힙니다. 원문 부록 E
저자의 서술 순서를 따른 상세 내용:
- 공개 내용. 저자들은 실행 풀을 Hugging Face 데이터셋, 검증 코드를 google-research/veriharness에 공개한다고 밝힙니다. 실행별 행동 기록·납품 파일·grader 점수가 포함됩니다. 이 리뷰는 논문 분석이며 공개 레포의 코드 실행이나 데이터셋 전체 건수 감사는 하지 않았습니다.
- 재배포하지 않는 내용. 작업 설명, 입력 공간, rubric, 참조 정답은 벤치마크 원출처에서 얻어야 합니다. 실행에는 공식 task ID가 있어 연결할 수 있습니다. 따라서 공개 실행만으로 원자료가 필요한 검증을 모두 재현할 수 있다는 의미는 아닙니다.
- 풀만으로 가능한 재현. 단일 실행 평균, 선택 oracle, Figure 6의 곡선은 저장된 점수로 모델 실행 없이 계산할 수 있습니다. Figure 6은 10개 풀에서 비복원 추출한 $N$개 중 최고 점수의 기대값이며, 1이면 단일 실행, 10이면 Table 2 oracle입니다. 새로운 실행을 무제한 생성할 때의 성능 예측 곡선으로 확대해석하지 않습니다.
- 규모 표현의 경계. 초록은 약 26,000개 실행·생성 비용 10만 달러 초과를 보고합니다. Table 1의 작업 수 합계 1,166에 10회·2모델을 곱한 본문 표의 풀 규모는 23,320입니다. 두 보고 범위가 완전히 같은 집계라는 설명은 확인되지 않아, 약 26,000을 공개 데이터셋에서 직접 센 정확한 건수처럼 제시하지 않습니다.
챕터의 핵심 기여: 풀 기반 점수 분석과 환경을 필요로 하는 검증 재현의 범위를 나눕니다. 다음 부록으로의 연결: F는 두 조사·스킬·문맥 분리를 제거해 구성의 역할을 확인합니다.
📖 Chapter Appendix F: Ablation of Harness Components
챕터의 위치와 역할: 전체 하네스에서 구성 하나를 바꿀 때의 성능을 비교합니다. ablation은 특정 부분을 제거하거나 변경해 결과가 어떻게 달라지는지 보는 실험입니다. 원문 부록 F
저자의 서술 순서를 따른 상세 내용:
- 한 조사만 남깁니다. resolver-only는 불일치 기록만 판정자에 주며 합의 주장은 반증하지 않습니다. challenger-only는 합의 기록만 주고 불일치 주장은 base에 적힌 대로 남깁니다. 그 외 모델·도구·스킬·판정·납품은 유지합니다.
- 수정을 포함합니다. 합의 오류는 모든 후보가 공유하므로 후보 선택으로 바꿀 수 없습니다. challenger의 효과를 반영하려고 이 비교는 모두 수정 계획을 적용한 점수입니다. 본문 selection-only와 혼동하면 안 됩니다.
- 스킬과 문맥을 바꿉니다. without skills는 빈 라이브러리로 두 조사 절차를 실행합니다. single context는 두 조사를 하나의 문맥에서 실행해 기록을 합칩니다. 아래는 Table 4의 Avg입니다.
| 방법 | Flash Avg | Opus Avg |
|---|---|---|
| 단일 실행 | 47.2 | 49.6 |
| Resolver only | 51.5 | 54.3 |
| Challenger only | 50.0 | 52.6 |
| 스킬 없음 | 51.3 | 53.8 |
| 단일 문맥 | 52.6 | 55.3 |
| 전체 VeriHarness | 53.4 | 56.1 |
원문 Table 4를 한국어로 재작성했습니다. 3-seed 평균, 각 벤치마크 자체 척도의 비가중 평균, 수정 포함 조건입니다.
- 결과 해석. 스킬을 제거하면 모든 벤치마크에서 낮아지고 가장 큰 손실은 APEX입니다. 문맥 통합의 점수 하락은 스킬 제거보다 작지만 모든 벤치마크에서 점수가 낮아집니다. 두 역할의 보완성과 문맥 분리의 가치를 지지하지만, “resolver 효과+challenger 효과=전체 효과”처럼 단순 합산할 수는 없습니다.
챕터의 핵심 기여: 일반 도구를 공유하는 조건에서 스킬과 역할 분리가 추가 가치를 갖는 근거를 제공합니다. 다음 부록으로의 연결: G는 CLI 이식이 가능해도 별도 런타임을 제공하는 이유를 설명합니다.
📖 Chapter Appendix G: Why a Dedicated Runtime
챕터의 위치와 역할: 지침·스킬의 이식성과 실행 절차의 강제가 같지 않다는 점을 설명합니다. 원문 부록 G
저자의 서술 순서를 따른 상세 내용:
- CLI 이식의 의미. 호스트 CLI는 자신의 생성 하네스와 도구를 유지하고, 검증 프로토콜과 스킬을 지침 텍스트로 받습니다. 상당한 개선이 유지되므로 검증 설계가 특정 구현에만 묶이지는 않습니다.
- The program executes the protocol. 전용 런타임은 두 별도 문맥, 기록 전달, 새 판정 문맥, 확인 기록 동반 납품을 프로그램으로 실행합니다. CLI에서는 호스트 에이전트의 운영 루프·시스템 지침·문맥 관리가 이 절차를 얼마나 잘 수행하는지에 영향을 줍니다. Opus의 일부 CLI 조건 약화는 이 차이를 보여주는 관찰입니다.
- Explicit workspace and tool configuration. 여러 후보와 원자료를 읽기 전용으로 노출하고 출력은 하나로 제한하며, 셀 텍스트·기록·계획 파일 전달을 명시적으로 구성합니다.
- A controlled implementation. 전용 구현은 재현성과 구성 제거 실험의 통제를 돕고, CLI 결과는 프로토콜·스킬의 이식성을 보여줍니다. 두 실험의 목적이 다릅니다.
챕터의 핵심 기여: 좋은 프롬프트를 전달하는 것과 정보 경계·제어 흐름을 코드로 보장하는 것의 차이를 설명합니다. 다음 부록으로의 연결: H는 그 흐름에서 쓰는 구체적 도구와 스킬을 목록화합니다.
📖 Chapter Appendix H: Tools and Skills
챕터의 위치와 역할: 추상적인 하네스를 실제 파일 접근과 유형별 지식으로 풀어냅니다. Table 5의 구성 요약 뒤 도구, 18개 스킬, 사용 분포, 상세 목록 순으로 전개합니다. 원문 부록 H
저자의 서술 순서를 따른 상세 내용:
- Components. 작업 공간·도구는 점검할 대상에 접근하게 하고, 프로토콜은 확인 노동을 분담하며, 스킬은 확인할 속성에 대한 지식을 줍니다. 각각 접근·조직·지식이라는 다른 역할입니다.
- Tools. read·ls·find·grep으로 파일과 풀을 조사하고, bash로 스킬의 스크립트 등을 실행합니다. write·edit은 출력 디렉터리에 제한됩니다. 이는 논문 속 검증 에이전트의 기능 설명이며, 이 리뷰 작성 과정에서 대상 레포를 실행했다는 뜻은 아닙니다.
- Skills. 18개 사람 작성 스킬은 evidence 6개, resolver 4개, challenger 3개, revision 5개입니다. 짧은 텍스트와 선택적 스크립트로 구성됩니다. 도구가 추출한 텍스트만 보는 데 그치지 않고 파일 형식이 가진 구조를 근거로 읽는 방법을 포함합니다.
- Where the skills are used. Figure 7은 각 스킬의 작업당 호출률을 벤치마크별로 나눕니다. 큰 벤치마크가 호출 수를 지배하지 않도록 횟수 대신 비율을 씁니다. 호출은 문맥에 스킬 로드, 모델의 파일 읽기, 스크립트 실행을 포함합니다. 문서 포맷 증거 스킬은 폭넓게 쓰이고, spreadsheet는 SB-2에서 특히 많이 쓰입니다. 이는 사용 분포이며 호출이 많은 스킬의 독립 효과를 입증하는 실험은 아닙니다.
- The skill library. Table 6의 목록을 아래에 유형별 원문 순서로 정리합니다.
| 유형 | 원문 스킬 | 무엇을 확인·지원하는가 |
|---|---|---|
| Evidence | evidence-xlsx | 수식·캐시값 병렬 읽기, 워크북 차이, 렌더링 |
| Evidence | evidence-pdf | 열을 보존한 표, 좌표 있는 단어, 페이지 렌더 |
| Evidence | evidence-docx | 읽기 순서, 표, 변경 추적, 댓글 |
| Evidence | evidence-pptx | 슬라이드 순서의 도형·표·차트·노트·렌더 |
| Evidence | evidence-bundle | 후보가 납품한 파일과 상태의 목록 |
| Evidence | evidence-patch | 후보 패치의 빌드·테스트와 웹 페이지 브라우저 확인 |
| Resolver | resolve-answer | 어떤 원자료·조항·질문이 해석 차이를 결정하는가 |
| Resolver | resolve-bundle | 출력 계약, 개수의 기준, 열거 목록, 저장값 |
| Resolver | resolve-workbook | 메모 셀→라벨→주변 수식→작업 표현의 근거 우선순위 |
| Resolver | resolve-patch | 실행 동작→요구사항→레포 관용구→프로젝트 테스트 |
| Challenger | falsify-answer | 열지 않은 문서, 빠진 지배 조항, 잘못된 집합의 통계 |
| Challenger | falsify-bundle | 명시됐지만 쓰지 않은 파일, 빠진 세부 내역, 과한 제외 |
| Challenger | falsify-workbook | 빈 라벨 셀, 불필요한 채움, 스케일·참조·범위·검산 행 |
| Revision | repair-prose | 서술형 결과의 평가 관점, 미해결 처리, 보존할 내용 |
| Revision | repair-bundle | 오피스 묶음의 요구 범위와 다른 후보 대비 누락 |
| Revision | repair-record | 구조화 레코드의 미해결 필드와 파생 목록 완성 |
| Revision | repair-xlsx | 편집으로 깨질 항목, 재계산, 의도한 셀만 바뀌었는지 확인 |
| Revision | repair-patch | 패치 텍스트보다 작업 트리 편집, 적용·재현·기존 통과 보존 |
Table 6의 역할을 한국어로 요약했습니다. 원문은 evidence-xlsx의 dump/diff/gaps/forks/render, PDF의 render/tables/words, DOCX의 changes/text, PPTX의 render/text, bundle_inventory, patchlab/pageprobe, xlsx_recalc 등의 스크립트도 명시합니다. 이는 제공 기능의 설명이며 이 글에서 실행해 검증한 기능 목록은 아닙니다.
챕터의 핵심 기여: 증거의 형식을 보존하는 도구와 그 증거에 질문을 던지는 스킬을 구체적으로 보여줍니다. 다음 부록으로의 연결: I는 이러한 스킬이 개발 실패에서 어떻게 생성·선정되고 held-out과 격리되는지 설명합니다.
📖 Chapter Appendix I: Self-Evolution Details
챕터의 위치와 역할: 자기 진화의 정보 경계와 선정 규칙을 공개합니다. 모델 학습 없이 개선한다는 주장에 어떤 감독 신호가 필요한지 가장 세밀하게 확인할 수 있는 부록입니다. 원문 부록 I
저자의 서술 순서를 따른 상세 내용:
- Setup and split. verifier와 라이브러리 제안자는 모두 Opus 4.8입니다. 수정까지 포함한 전체 하네스를 쓰며, 고정 풀·프로토콜·도구를 유지하고 스킬만 바꿉니다. APEX 실험은 파일 납품 작업을 제외하고, SB-2는 템플릿과 금융 모델 작업을 다룹니다. 한 작업의 10개 실행은 모두 같은 분할에 넣습니다. 원본 공간·문서·워크북 템플릿을 공유하는 작업은 먼저 그룹화해 개발과 held-out 양쪽에 관련 사례가 섞이지 않게 합니다. 고정 seed와 가능한 범위의 범주 균형을 적용합니다.
- Information boundary. 사람 작성 라이브러리도 일반 문서 지식과 개발 실패만 보고 만들며 held-out 산출물·기록·점수를 보지 않습니다. held-out 점수는 평가자에게만 보이고, 제안자에게 돌려주거나 지침·스킬·후보 수·중단 결정에 쓰지 않습니다. 따라서 Figure 4의 궤적을 사후 기록했다는 사실과 그 점수로 최종 checkpoint를 골랐다는 주장은 구별됩니다.
- Learning loop. 개발 실패 패키지에는 작업·공간·고정 후보·확인 기록·수정 계획·납품물·항목별 grader 판정이 있습니다. 매 라운드 후보 라이브러리는 처음 3개, 이후 5개이며, 스크립트는 10분 제한으로 실행됩니다. 자동 필터가 task ID, benchmark 이름, 개발 파일명, 참조 정답 값을 포함하는 후보를 거부합니다. 같은 개발 작업에서 현재 라이브러리와 비교하여 가장 큰 비음수 paired gain을 가진 후보를 채택하고 모두 음수면 유지합니다. 여기서 paired gain은 동일 작업에서의 점수 차이라는 뜻이며 bootstrap 유의성 검정 결과가 아닙니다.
- 고정 종료 일정. C는 10라운드, D는 8라운드를 held-out 궤적을 보기 전에 정합니다. 마지막까지 유지된 라이브러리를 최종으로 사용합니다. 개발 점수로 채택한 뒤 held-out 점수가 떨어질 수 있고 실제 궤적에도 그런 구간이 있습니다.
- Round-by-round comparison. APEX에서 C는 최종 궤적 점수 49.6에 8라운드, D는 1라운드에 도달합니다. SB-2에서 C는 38.5에 8라운드, D는 7라운드에 39.4로 이를 넘습니다. 라운드 단축은 벤치마크에 따라 다르고 후보 수가 변하므로 계산 효율이나 경과 시간의 이점으로 단정하지 않습니다. 원문은 이 그림이 점추정치이며 통계적 유의성을 확립하지 않는다고 명시합니다.
- What the learned skills contain. 요구된 수치·열거 항목·규칙 요소를 빠짐없이 나열하고 근거를 대조하는 coverage, 비경상 항목의 효과를 워크북 관례에 맞게 역조정하는 normalization, 라벨 기간과 참조 열을 대조하는 period alignment, 공제 항목의 저장·적용 부호를 먼저 확인하는 sign conventions를 예로 듭니다. 평가 대상이 최종 산출물이므로 이득은 확인·판정·납품의 결합 효과입니다. 저자들은 평가한 분포 밖의 일반화와 개발 grader 피드백 없는 개선은 아직 확인되지 않았다고 명시합니다.
챕터의 핵심 기여: 개발 감독을 인정하면서 held-out 오염과 사후 최적 checkpoint 선택을 막는 설계를 설명합니다. 다음 부록으로의 연결: J는 스킬이 보완해야 할 잔여 공유 오류를 구체적으로 분류합니다.
📖 Chapter Appendix J: Why Shared Errors Survive
챕터의 위치와 역할: challenger가 합의 오류를 왜 그대로 두는지 확인 기록과 채점 항목을 대응시켜 분석합니다. 원문 부록 J
저자의 서술 순서를 따른 상세 내용:
- 분석 절차. Opus의 APEX 기록 중 10개 실행 모두가 공유한 주장을 다루는 행을 rubric 항목에 대응시킵니다. 같은 모델이 기록과 rubric을 읽고 연결하며, 보관된 항목별 점수로 모두 틀렸는데 challenger가 유지한 사례를 식별합니다. 이 역시 사후 분석의 rubric 사용입니다.
- 남은 오류의 분류. Table 7의 분모는 모든 공유 오류나 모든 주장이 아니라 challenger가 유지한 만장일치 오답입니다.
| 확인 대상과 실제 채점 항목의 관계 | 해당 잔여 오류에서의 비중 |
|---|---|
| 확인한 것은 입력·중간값이고 채점하는 값은 그 뒤 계산에 있음 | 70% |
| 같은 수치처럼 보이나 정의·기간·원본 버전이 다름 | 14% |
| 채점하는 값 자체의 오답을 확인 완료로 판단함 | 12% |
| 누락 또는 대응 과정의 잡음 | 4% |
원문 Table 7을 번역해 재작성했습니다. 원문 표
- 해석. 중간값이 맞았다는 사실이 최종 요구사항의 정확성을 보장하지 않는 경우가 가장 많습니다. 예를 들어 원자료 총액을 올바르게 재계산했어도 최종 산출물이 요구한 기간·정규화·분류가 뒤에서 잘못될 수 있다는 유형입니다. 이는 표의 관계를 설명하는 일반 해설이며 새로운 실측 사례나 새로운 실패율을 덧붙인 것은 아닙니다.
챕터의 핵심 기여: 검증 완료를 선언할 대상과 실제 납품 요구사항의 거리가 잔여 오류의 중심이라는 진단을 제공합니다. 다음 부록으로의 연결: K는 이러한 다단계 조사의 추가 비용을 비교합니다.
📖 Chapter Appendix K: Compute Cost
챕터의 위치와 역할: 같은 생성 풀을 쓰는 조건에서 추가 검증의 비용 대비 이득을 살핍니다. 모델 가격·캐시·추정 방식에 의존하는 실험 비용으로 읽어야 합니다. 원문 부록 K
저자의 서술 순서를 따른 상세 내용:
- Cost–gain comparison. Figure 8은 작업당 검증 계산 비용과 Table 2의 5개 벤치마크 평균 gain을 비교합니다. selection 비용은 Flash 1.44달러, Opus 3.92달러입니다. Flash는 LLM-as-a-Verifier 비용의 약 10분의 1에서 두 배가량의 gain, Opus는 해당 비교군·다수결·best-of-N의 약 절반, 토너먼트의 약 4분의 1 비용이라고 보고합니다. 이는 고정 10회 실행 생성 비용을 제외한 추가 검증 비용입니다.
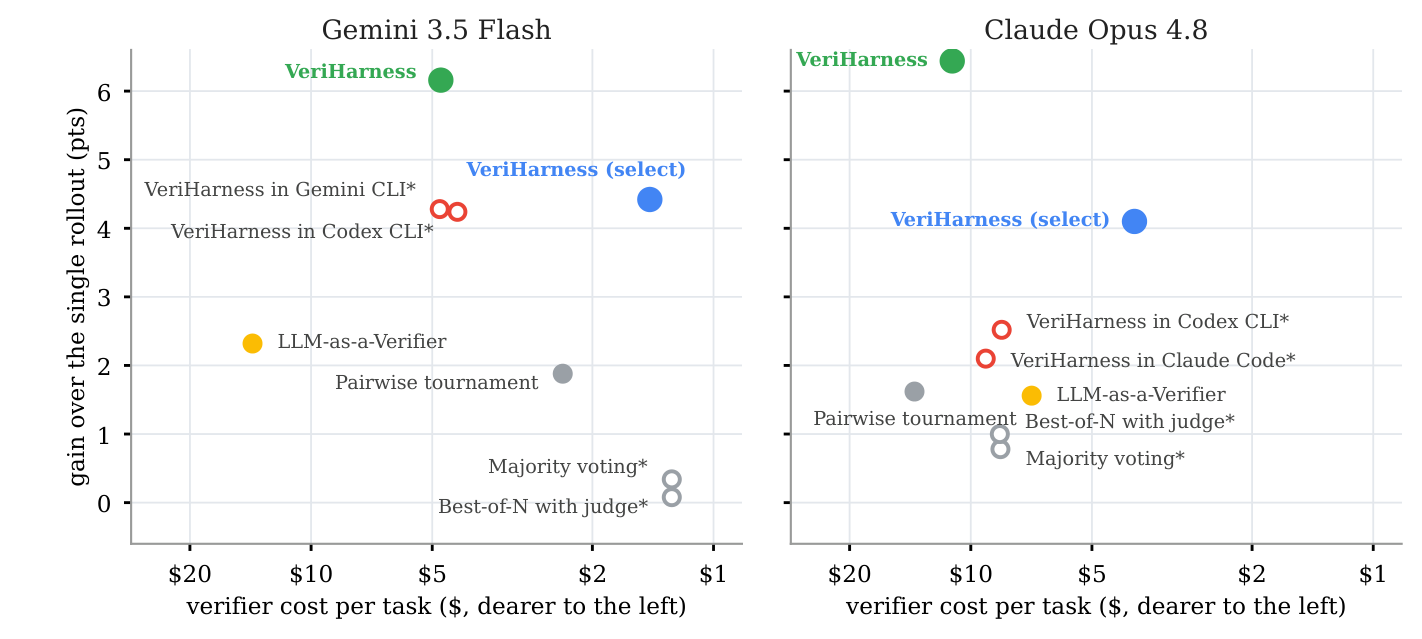
Figure 8, PDF 28쪽. 두 모델 패널, 로그 축, 마커·별표, 비용 방향을 보존한 크롭이며 번역하지 않았습니다. 빈 마커와 별표는 추정 비용입니다. 원문 그림
- 수정과 CLI의 비용. 수정 계획 적용은 선택보다 약 3배의 비용이며 더 높은 gain을 얻습니다. Flash에서 CLI 실행은 전용 런타임과 비슷한 gain에 약 3배 비용, Opus에서는 2–3배 비용에 더 낮은 gain으로 보고합니다. 전체 실행 비용·wall-clock 지연·스킬 진화 비용을 이 숫자 하나로 대표하지 않습니다.
- 캐시의 영향. 하나의 공간에서 점진적으로 턴을 이어가 입력 토큰의 86–91%가 캐시에서 제공됩니다. 캐시 토큰을 일반 입력 가격으로 계산하면 selection은 Flash 5.40달러, Opus 13.06달러로 올라갑니다. 이 재계산에서도 저자들은 비용–이득 frontier에 있다고 설명합니다. 캐시율과 가격 정책이 다른 환경에 그대로 적용되는 견적은 아닙니다.
- Metering. 비용은 토큰 수와 정가, 캐시 읽기 요율로 계산합니다. LLM-as-a-Verifier는 비교당 4회 평가합니다. 다수결·best-of-N·CLI는 실측 토큰 전체가 아니라 호출 수·문맥 크기에서 추정해 빈 마커와 별표로 구별합니다. aggregation은 자체 클라이언트를 호출해 비용을 계측하지 못했습니다. 모든 점을 같은 정밀도의 실측값으로 취급하면 안 됩니다.
챕터의 핵심 기여: 선택·수정의 효과를 추가 검증 비용과 연결하고 캐시·추정 여부를 공개합니다.
실험 결과 심층 분석
평균 개선과 실제 업무 조건을 함께 읽습니다
두 모델에서 선택만으로도 5개 벤치마크 모두 개선되며, 수정이 그 위에 더해집니다. 특히 Opus APEX는 단일 실행 35.8에서 선택 41.2, 수정 포함 47.5입니다. 수정이 선택보다 6.3 높다는 것은 후보에 있는 최선의 전체 답안을 찾는 것과 주장별 증거로 고치는 것이 다른 능력임을 보여줍니다. Flash WSB는 56.5→62.0→65.4로 같은 방향입니다. 반면 Opus WorkBuddy는 79.0→83.0→83.7로 수정 추가 폭이 작습니다. 여러 업무에서 같은 절차가 작동해도 이득의 크기는 같지 않습니다. Table 2
Avg의 +6.2·+6.4는 서로 다른 자체 점수 척도의 비가중 평균 gain입니다. 전체 작업의 통합 정답률이 그만큼 퍼센트포인트 올랐다는 표현은 부정확합니다. 개별 벤치마크의 척도와 baseline 수준을 함께 봐야 실용적 개선을 판단할 수 있습니다. selection oracle도 고정 후보 선택의 상한이지, 후보를 수정하거나 다시 만드는 모든 방법의 상한은 아닙니다.
표준편차와 유의성을 구별합니다
Table 2는 3개 검증 seed의 평균과 seed 간 표준편차를 제공합니다. 예를 들어 Opus APEX 선택은 41.2±0.7, 수정은 47.5±0.2, Flash SB-2 선택은 31.5±2.4, 수정은 32.2±0.6입니다. 평균 차이와 seed 간 변동을 함께 읽을 수 있지만 이 ±는 95% 신뢰구간이 아닙니다. 원문에 paired bootstrap 신뢰구간이나 통계적 유의성 검정 결과는 보고되지 않습니다. 수정의 평균이 모두 높다는 관찰과 모든 개별 비교가 유의하다는 주장은 구분합니다.
자기 진화 Figure 4도 다른 조건입니다. 부록 I는 점추정치만 제시하며 유의성을 확립하지 않는다고 명시합니다. 사람 초기화의 라운드상 이점은 관찰되지만, 후보 수가 3에서 5로 변하고 라운드별 비용이 다르므로 계산 효율을 입증한 결과로 쓰지 않습니다.
비교 설계가 설명하는 것과 재현 범위
고정 풀과 동일 모델을 쓰므로 더 좋은 후보가 우연히 특정 방법에만 주어진 영향을 통제합니다. 환경 접근 verifier를 포함해 접근 자체와 절차·스킬의 결합을 비교하고, aggregation 및 agentic verifier + revision으로 새 결과물 작성 자체와 근거 기반 수정도 비교합니다. 그러나 추가 검증의 호출 수·비용은 같지 않으므로 품질 표만으로 예산을 맞춘 우월성을 단정하지 않고 부록 K를 함께 봅니다.
원문은 생성 scaffold, CLI 버전, 샌드박스, 지표, judge, 스킬 목록, 스킬 진화 분할과 선정 규칙을 설명합니다. 공개 풀의 저장 점수로 평균·oracle을 재계산할 경로도 있습니다. 다만 원본 벤치마크 자료는 별도로 확보해야 하고, 이 글에서는 대상 코드·모델·전체 데이터로 재실험하지 않았습니다. 공개한다고 명시된 자료의 범위와 이 리뷰에서 직접 확인한 원문의 범위를 구분합니다.
기술적 함의와 응용
VeriHarness의 핵심 성과는 같은 모델의 생성과 검증을 서로 다른 정보 작업으로 조직했다는 점입니다. 후보 풀은 어디에서 값이 갈리는지 알려주고, 환경은 그 대안을 시험할 증거를 제공합니다. 합의한 주장은 대안이 없으므로 스킬과 요구사항에서 반박 가능성을 만들어야 합니다. 따라서 반복 샘플링, 근거 접근, 점검 절차, 최종 수정은 서로 대체 가능한 기능이 아니라 결합할 때 의미가 생기는 단계입니다.
리뷰어 해석으로는 문서 기반 데이터 분석·재무 워크북·코드 변경처럼 산출물과 원입력을 함께 보존하는 업무에서 이 분리가 유용합니다. 납품 결과만 평가하는 대신 “어떤 주장에 어떤 파일·계산을 대조했고 무엇이 미해결인가”를 남기면 사람이 검토할 근거가 구체화됩니다. 이는 논문의 구조에서 도출한 활용 관점이며 새로운 산업 성능이나 비용 절감의 실측 주장은 아닙니다.
저자가 명시한 적용 경계도 함께 유지해야 합니다. 10회 후보 생성과 다단계 검증은 비용·지연을 추가하고, 현재 하네스는 개별 실행의 보정된 스칼라 보상을 반환하지 않습니다. 더 강한 별도 검증자 조합, 평가 분포 밖의 스킬 일반화, 개발 grader 피드백 없는 진화는 이 연구에서 확인한 범위를 넘어섭니다. 검증 기록을 장기 작업 에이전트의 학습 신호로 바꾸는 것은 저자가 결론에서 제안한 향후 방향입니다.
이 리뷰는 본문 1–8절, 독립 Limitations 절, 부록 A–K의 논리와 주요 수식·표·분석을 반영했습니다. Figure 1·5·6·7과 전체 Table 2·4의 모든 비교 행을 이미지로 재현하지는 않았으며, 관련 정의·핵심 수치·조건을 해당 챕터에서 설명했습니다. 참고문헌에 실린 외부 논문 전문, 공개 코드의 구현 세부와 실제 실행, 공개 데이터셋 전체 건수는 별도 검증 범위에 포함하지 않았습니다.