논문 개요와 전체 구조
터미널 에이전트는 명령을 하나 실행할 때마다 다음에 마주할 환경을 바꿉니다. 잘못된 패키지를 설치하거나 엉뚱한 파일을 수정하면, 이후 판단이 출발하는 상태 자체가 나빠집니다. 모델이 좋은 대안을 생성할 수 있어도 첫 번째 행동을 그대로 실행하는 구조에서는 그 능력을 활용하지 못할 수 있습니다. Mid-Harness는 같은 상황에서 여러 다음 행동을 제안받고, 실제 실행 전에 비교하여 하나만 실행하는 방법입니다.
Minki Kang 외 연구진은 생성 모델과 실행 하네스(harness)를 고정하고 두 요소 사이에 후보 생성·검증 계층을 삽입합니다. 하네스는 모델 응답을 도구 호출로 해석하고, 터미널에서 실행하며, 결과를 다음 문맥에 넣는 제어 프로그램입니다. 연구는 유용한 후보가 존재하는지와 검증기가 그것을 구별할 수 있는지를 분리하여, 행동 단위의 추론 시점 연산 확대가 전체 작업 성공으로 이어지는 조건을 분석합니다. 원문 §1
주요 설정인 TMAX-9B·TerminalBench-Lite에서 기본 Pass@1은 50.00%입니다. 후보 8개와 GPT-5.6 Sol 검증기를 결합하면 68.03%, 같은 계열 모델의 쌍별 검증과 지식 증류를 사용하면 57.14%입니다. 이는 각각 추가 검증 없는 기준선, 강한 외부 검증기 참고 설정, 학습한 소형 검증기 설정입니다. 검증기를 학습한 결과를 생성기 학습 결과로 해석하지 않아야 합니다.
분석 대상은 2026년 9월 30일 제출된 arXiv:2609.39982v1, Mid-Harness: Scaling Actions Between Model and Harness for Terminal Agents입니다. 아래 그림·표 번호는 동일 버전 PDF를 기준으로 합니다. HTML 변환본이 PDF Table 2를 Figure 5로 세어 이후 번호가 달라지므로, 연결한 HTML의 표시 번호가 다를 때는 PDF 번호를 우선합니다. 버전 고정 초록 · PDF
| 원문 순서 | 내용과 하위 구조 |
|---|---|
| 1. Introduction | 행동 신뢰성, 연구 질문과 기여 |
| 2. Mid-Harness | 2.1 Scaling Actions Within a Trajectory; 2.2 Verification Mechanisms |
| 3. Experimental Setup | 작업·모델, 지표, 기준선과 연산 확대, 추론 비용 |
| 4. When Does Action Scaling Work? | 4.1 Candidate Coverage; 4.2 Candidate Width and Verification; 4.3 Verifier Distillation; 4.4 Cost for Action Scaling and Verification |
| 5. Analysis: What Still Limits Verification? | 5.1 What Distillation Improves; 5.2 Remaining Verification Challenges |
| 6. Composition and Transfer of Action Scaling | 6.1 Composition with Trajectory Scaling; 6.2 Transfer Across Models, Benchmarks, Harnesses |
| 7–8 | Related Work; Conclusion과 명시적 Limitations and Future Work |
| 후속 선언 | AI use; Ethics; Reproducibility; References |
| Appendix A | 한계와 향후 연구: 학습, 평가, 연산 배분, 범위 확장 |
| Appendix B | B.1 평가·기준선; B.2 검증 구현; B.3 증류; B.4 비용; B.5 평가 부담; B.6.1–B.6.3 프롬프트 |
| Appendix C | C.1 정밀 수치; C.2 decision-only 비용; C.3 추가 검증 연산; C.4 불확실성; C.5 작업군 |
| Appendix D | D.1·D.1.1 오프라인 진단; D.2·D.2.1 불일치 분류와 사례; D.3·D.3.1 실행 사례와 상세 추적 |
핵심 기여와 혁신성
문제의 중요성은 행동의 누적 효과에 있습니다. 완료된 답변을 여러 개 생성한 뒤 고르는 문제와 달리, 잘못된 중간 행동은 이후 관측과 선택지를 바꿉니다. Mid-Harness는 환경을 바꾸기 직전의 결정에 추가 연산을 투자합니다.
후보 다양성과 선택 능력을 함께 검증합니다. 같은 생성기에서 후보 수를 늘려도 약한 listwise 검증에서는 성공률 변화가 작습니다. 반면 같은 후보를 강한 검증기가 선택하면 더 높은 성공률을 얻습니다. 후보를 만드는 것보다 그 가치를 회수하는 능력이 병목일 수 있다는 실험입니다.
생성기·하네스 경계에서 비교 실험을 통제합니다. Listwise·pointwise·pairwise 비교 형식, 후보 수, 검증 역량과 증류를 바꾸면서 생성기는 유지합니다. LoRA 어댑터도 검증 호출에만 켭니다. 행동을 제안하는 능력과 선택하는 능력을 분리하여 개선할 수 있음을 보입니다.
전체 실행 확대와 결합할 수 있습니다. Best-of-T는 여러 완료 실행 중 하나를, Sequential Refine은 앞선 실행을 요약한 새 실행을 사용합니다. 행동 검증은 이들 실행 내부에 적용됩니다. 리뷰어 관점에서 “더 많은 실행”과 “각 실행 안에서 더 나은 결정”을 나누어 보는 실험 틀입니다. 보고된 비용은 고정 토큰 단가의 추정치로, 실제 배포 지연·전체 운영비를 직접 측정한 결과는 아닙니다. §1·§6
기술적 세부사항
생성기, 검증기, 하네스
생성기는 과제와 터미널 기록에서 가능한 다음 행동을 만듭니다. 검증기는 후보가 현재 상태에서 무엇을 바꾸고 어떤 요구사항을 해결할지 비교합니다. 하네스는 선택된 행동 하나를 실행합니다. 검증기는 후보 생성 reasoning을 받지 않고 원래 과제·실행 이력·현재 상태·후보 행동을 받습니다.
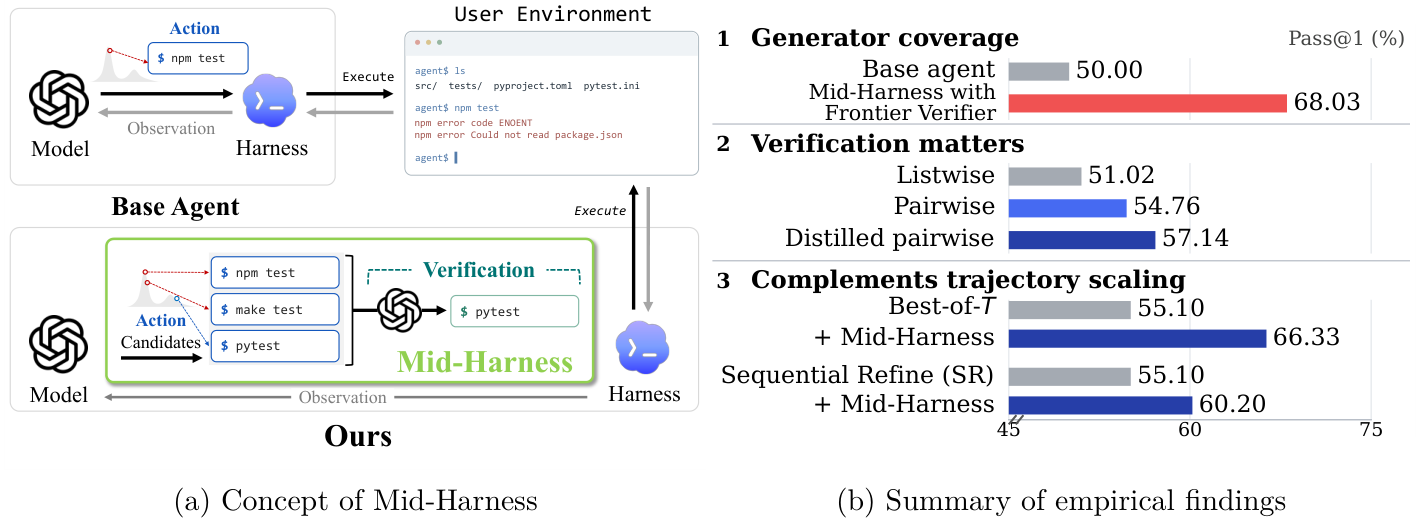
PDF Figure 1, 1쪽. 동일 버전 PDF의 전체 그림 영역 크롭이며 번역·수치 변경은 없습니다. 왼쪽은 여러 후보 중 하나만 실행하는 구조, 오른쪽은 검증과 실행 확대의 결과입니다. 원문
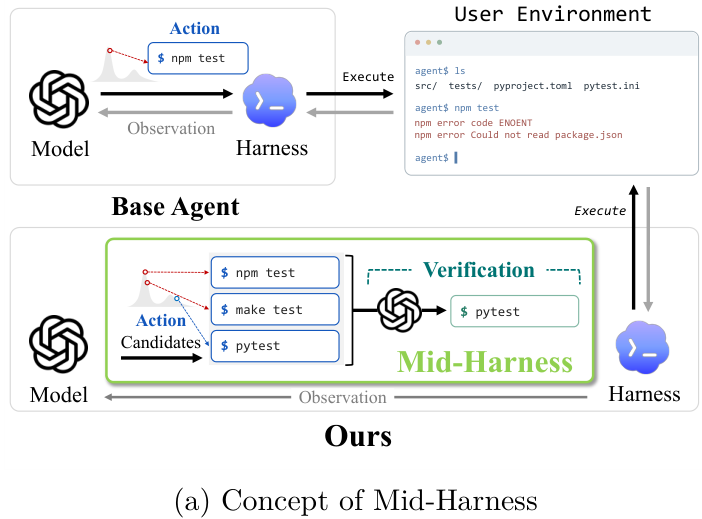
PDF Figure 1 왼쪽 패널 상세, 1쪽. 전체 그림을 위에 유지하고 원래 위치의 흐름만 크롭했습니다. 재배열·번역·수치 변경은 없습니다. 원문
그림은 npm·make·pytest 등의 대안 중 현재 프로젝트 상태에 맞는 명령을 고르는 개념을 보여줍니다. 특정 명령이 모든 프로젝트에서 우월하다는 규칙은 아닙니다. 후보를 각각 실행해 결과를 비교하는 대신, 실행 전에 하나를 선택한다는 점이 핵심입니다.
행동 선택과 최종 성공률
원문 식 (1)은 다음과 같습니다.
$h_t$는 시점 t까지의 과제·행동·관측 이력, $\pi$는 생성기, $N$은 후보 수, $\mathcal{A}_t$는 같은 이력에서 샘플링한 후보입니다. $\psi$는 검증기이고 $a_t^\star$는 실행할 행동입니다. 검증기는 후보를 수정해 새로 출력하지 않고 제안된 것 중 하나를 반환합니다.
| 비교 형식 | 선택 방식 | 판단 부담 |
|---|---|---|
| Listwise | 전체 후보를 한 번에 보고 하나 선택 | 전체 순위와 차이를 한 응답에서 해결 |
| Pointwise | 각 후보의 독립 점수 중 최고점 선택 | 목적이 다른 행동의 점수를 같은 척도로 보정 |
| Pairwise | 두 후보씩 비교한 결과를 집계 | 비교 호출은 늘지만 상대적 차이에 집중 |
전체 성능은 행동별 정답률이 아니라 과제를 끝까지 해결한 실행의 비율입니다. TerminalBench-Lite의 실제 평가 작업 98개를 각각 3번 실행하므로 Pass@1은 294개 실행의 평균 정확 성공률, Pass@3은 98개 작업 중 세 번 안에 한 번이라도 성공한 비율입니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
챕터의 위치와 역할: 긴 터미널 실행에서 실행 전 선택이 중요한 이유를 설명하고 생성과 검증을 분리하는 질문을 세웁니다.
1. 생성 능력과 안정적인 실행의 차이
동일 모델·하네스라도 확률적 생성 때문에 실행마다 결과가 달라집니다. 파일 수정·패키지 설치는 환경을 바꾸므로 다음 판단이 이전 명령의 영향에서 자유롭지 않습니다. 논문의 action reliability는 작업 완료에 도움이 되는 행동을 일관되게 생성하는 성질이며, 실제 평가는 최종 성공으로 수행합니다.
2. 추가 연산의 효과는 후보와 검증기를 함께 봐야 합니다
기존 test-time scaling은 샘플링·검증·수정으로 추론 성능을 높였습니다. 그러나 유용한 행동을 후보에 포함하는 것과 실제로 그것을 골라 실행하는 것은 별도 조건입니다. 논문은 실행 전 연산이 언제 최종 성공률을 높이는지 묻고 고정 생성기에서 두 조건을 분리합니다.
3. 강한 검증기에서 자기 검증·증류·조합으로 전개합니다
GPT-5.6 Sol을 붙여 50.00→68.03%로 오르는 결과로 활용 가능한 대안의 존재를 간접적으로 확인합니다. 이어 같은 TMAX-9B로 검증하는 자기 검증에서 비교 형식을 바꾸고, frontier 응답을 증류합니다. 마지막으로 행동 확대가 전체 실행의 병렬·순차 확대와 결합되는지 평가합니다.
핵심 기여: 좋은 대안의 생성과 그 대안의 선택을 별도로 시험합니다. 다음 챕터로의 연결: §2는 이 틀을 정확한 삽입 위치와 수식으로 정의합니다. §1
📖 Chapter 2: Mid-Harness
챕터의 위치와 역할: 기존 생성 호출을 감싸 후보 생성·검증을 넣고, 하네스의 파싱·실행·이력 갱신은 유지합니다.
2.1 Scaling Actions Within a Trajectory
1. 같은 상태에서 여러 다음 행동을 제안합니다
기본 에이전트는 현재 이력에서 행동 하나를 샘플링합니다. Mid-Harness는 같은 이력에서 여러 후보를 얻고 식 (1)로 하나를 고릅니다. 후보는 실패 원인을 진단할지 재시도할지처럼 목적도 다를 수 있습니다. 검증기는 미해결 요구사항과 비교하여 다음 상태에 유리한 행동을 선택합니다.
$o_0$는 작업 지시, 이후 $o_t$는 실제 터미널 피드백입니다. 선택된 행동과 관측만 다음 이력에 포함됩니다. 미선택 후보의 결과를 관측하거나 각각의 환경으로 분기하지 않습니다. 따라서 후보 비교는 한 환경 인스턴스에서 가능하지만 실행 효과는 관측 이력으로부터 추론해야 합니다.
2. 생성 reasoning과 검증 입력을 구분합니다
생성기는 ReAct처럼 행동 전 reasoning을 생성하지만, 후보 생성 reasoning은 검증기에 주지 않습니다. 검증기는 설명의 장황함보다 실제 후보 명령이 현재 상태에 미치는 영향을 판단합니다.
2.2 Verification Mechanisms
1. Listwise
한 호출로 모든 대안을 보지만, 목적이 다른 후보들을 구분하고 전체 순위를 같은 응답에서 결정해야 합니다. 후보가 늘면 구별 부담도 커집니다. Frontier도 비용 때문에 listwise를 사용하므로 형식 자체가 원리상 약하다고 결론 내릴 수는 없습니다.
2. Pointwise
후보별 독립 평가는 병렬화할 수 있습니다. 다만 상태 확인과 코드 수정처럼 목적이 다른 행동의 점수가 같은 척도에 놓여야 합니다. 개별적으로 그럴듯한 행동도 실제 대안에 비하면 가치가 낮을 수 있습니다.
3. Pairwise
같은 상황의 두 행동을 비교하여 점수·선호를 출력하고 여러 비교를 집계합니다. 두 대안의 상대적 차이에 집중할 수 있지만 호출이 늘어납니다. 후보 8개의 전쌍 비교는 28회이나, 기본 N=8 구현은 ring·pivot 두 단계이며 고유 후보 8개·pivot 4개에서 실제 22–25회입니다. 세부는 B.2에서 이어집니다.
핵심 기여: 후보 생성·검증·실행을 나누면서 기존 모델·서빙·하네스를 바꾸지 않습니다. 다음 챕터로의 연결: §3는 비교할 작업·성공 지표·비용을 정의합니다. §2
📖 Chapter 3: Experimental Setup
챕터의 위치와 역할: 고정 요소와 변경 요소, 성능·비용의 분모를 명확히 합니다.
1. Tasks and models
주요 생성기는 TMAX-9B, 하네스는 Vanillux2입니다. TMAX-9B는 Qwen3.5-9B에서 출발하여 합성 터미널 작업·Vanillux2로 강화학습한 모델입니다. 규모 비교는 TMAX-4B·27B를 추가합니다. 기본 생성 설정은 temperature 0.8, 최대 64단계, 문맥 65,536토큰, 단계별 출력 한도 16,384토큰입니다.
기본 검증기는 생성기와 같은 모델이지만 역할과 호출이 다릅니다. 강한 검증기 참고 실험만 GPT-5.6 Sol을 사용합니다. 검증기 증류 시 생성기 가중치는 바꾸지 않습니다.
2. Evaluation metrics
Run은 작업을 한 번 수행하는 실행, trajectory는 그 행동·관측의 연속입니다. 작업당 세 번 평가하며 완전 성공만 셉니다. 실패도 분모에 남습니다. Best-of-T는 완료된 T개 실행 중 하나를 반환하므로 반환 출력의 성공을 Pass@1로 평가하며 Pass@3은 정의하지 않습니다.
3. Baselines and compute-scaling methods
기본은 단계마다 한 행동만 생성·실행합니다. Zero-shot Mid-Harness는 추가 학습 없이 같은 모델로 검증하고, distilled는 frontier의 쌍별 응답으로 학습한 검증기를 씁니다. Best-of-T는 완료된 trajectory를 비교해 하나를 고릅니다. Sequential Refine(SR)은 앞선 실행을 요약하고 새 환경에서 재실행합니다. 행동 검증과 완료 실행 검증의 위치가 다르므로 결합할 수 있습니다.
4. Inference cost
Parallelized output tokens(POT)는 이상적인 병렬 단계에서 가장 긴 출력을 더한 디코딩 지연 proxy입니다. 전체 검증 출력은 모든 호출을 합합니다. 토큰 가격 비용은 입력·출력을 포함합니다. 이 셋을 같은 비용·시간 지표로 취급해서는 안 됩니다.
핵심 기여: 실행 횟수·출력량·입력 비용을 분리하여 비교합니다. 다음 챕터로의 연결: §4는 후보 폭·비교 방식·검증기 학습을 시험합니다. §3
📖 Chapter 4: When Does Action Scaling Work?
챕터의 위치와 역할: 후보 안의 기회, 선택 방식, 검증 학습, 비용을 분해합니다.
4.1 Candidate Coverage
1. 강한 검증기로 활용 가능한 대안을 확인합니다
Candidate coverage는 후보 안에 유용한 대안이 포함되는지입니다. 행동 gold label이 없어 직접 측정하지 못하므로 강한 검증기를 통한 trajectory 성공으로 간접 확인합니다. 고정 TMAX-9B 생성기에 GPT-5.6 Sol을 붙이면 후보 4개에서 64.63%, 8개에서 68.03% Pass@1입니다.
이는 활용 가능한 대안의 간접 증거입니다. Frontier도 완벽한 oracle이 아니므로 68.03%를 최대 달성 가능 성공률이나 정확한 coverage로 부르면 안 됩니다.
4.2 Candidate Width and Verification
1. 약한 검증에서는 폭 확대의 이득이 작습니다
Zero-shot listwise의 후보 4→8 확대는 Pass@1 49.32→51.02%, Pass@3 66.33→67.35%입니다. 후보 8개 중 처음 파싱 가능한 행동을 고르는 first-runnable proxy는 Pass@1 49.66%입니다. 후보 생성만 추가하는 것으로 선택 품질은 보장되지 않습니다.
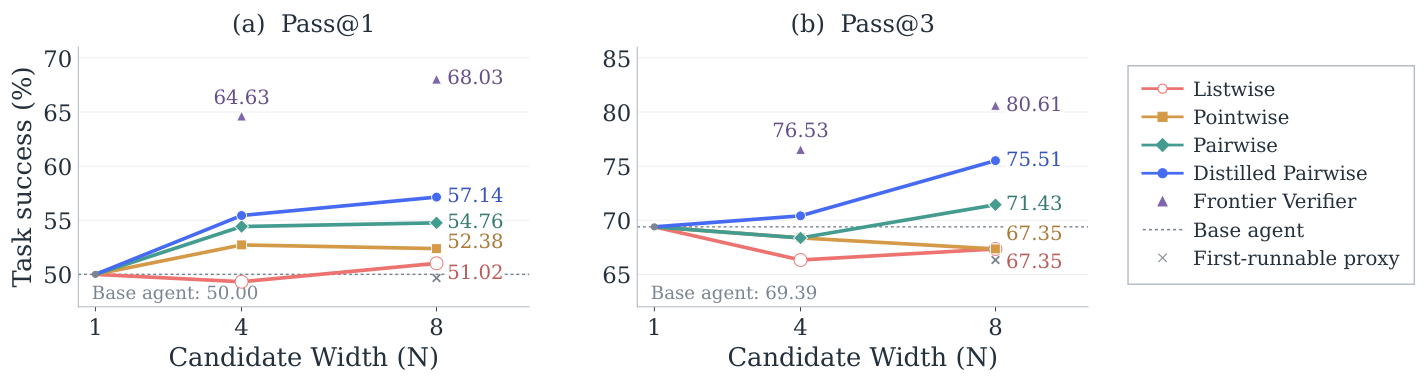
PDF Figure 2, 6쪽. 전체 패널·축·범례를 보존한 크롭입니다. 왼쪽은 평균 실행 성공률, 오른쪽은 세 번 중 성공한 작업 비율입니다. 원문
2. 평가한 자기 검증 중 pairwise가 가장 높습니다
| 검증 설정 | 후보 수 | Pass@1 | Pass@3 |
|---|---|---|---|
| 기본 에이전트 | 1 | 50.00% | 69.39% |
| First-runnable proxy | 8 | 49.66% | 66.33% |
| Zero-shot listwise | 8 | 51.02% | 67.35% |
| Zero-shot pointwise | 8 | 52.38% | 67.35% |
| Zero-shot pairwise | 8 | 54.76% | 71.43% |
| Distilled pairwise | 8 | 57.14% | 75.51% |
| GPT-5.6 Sol listwise | 8 | 68.03% | 80.61% |
PDF Table 6의 수치입니다. Pairwise가 이 자기 검증 설정에서 가장 높지만 모든 모델·작업에서 최적이라는 결과는 아닙니다. Strong listwise가 더 높은 사실도 비교 형식과 모델 역량을 함께 봐야 함을 보여줍니다.
4.3 Verifier Distillation
1. 강한 검증기의 비교 응답을 학습합니다
어려운 TMAX-15k 작업 244개에서 TMAX-9B로 732개 실행을 수집하고, 중간 상태의 후보 쌍을 GPT-5.6 Sol에 비교시킵니다. 최종 학습 입력 117,631개에서 reasoning·점수·선호를 LoRA로 학습합니다. 어댑터는 검증기에만 켭니다.
증류는 큰 모델의 행동을 작은 모델에 전달하는 학습입니다. 여기서는 정답 명령 자체보다 같은 상황의 두 후보를 어떻게 비교하는지 전달합니다. 생성기의 후보 분포를 바꾸지 않고 선택 역량을 높이는 구성입니다.
2. 검증기 격차를 일부 줄입니다
N=8에서 Pass@1은 54.76→57.14%로 2.38%p, Pass@3은 71.43→75.51%로 4.08%p 높아집니다. N=4도 각각 54.42→55.44%, 68.37→70.41%입니다. 그러나 frontier 68.03%와 distilled 57.14% 사이에는 10.89%p 차이가 남습니다.
4.4 Cost for Action Scaling and Verification
1. 비교 이득에는 출력 비용이 따릅니다
후보가 늘면 병렬 생성 중 가장 긴 출력도 길어질 수 있습니다. N=8 zero-shot pairwise 검증은 약 26.6k POT를 추가하는 반면 listwise·pointwise는 최대 1.3k입니다. 전체 검증 출력은 각각 listwise 0.6k, pointwise 7.0k, pairwise 125.7k입니다.
Pointwise는 총 출력이 많아도 병렬 단계의 최대 길이는 작을 수 있습니다. Pairwise는 ring 결과 뒤 pivot을 결정하므로 두 최대 길이가 순차적으로 더해집니다.
2. Decision-only 효과는 규모와 후보 폭에 따라 다릅니다
Reasoning·두 점수 대신 A/B 한 토큰만 출력합니다. N=8 9B의 Pass@1은 zero-shot 54.76→56.12%, distilled 57.14→59.18%로 높아지고 기준 토큰 비용은 20.9%, 24.1% 감소합니다. 그러나 4B·27B에서는 비용은 낮아져도 Pass@1이 하락하며, 9B N=4에서도 두 변형의 Pass@1은 reasoning 기반보다 낮습니다.
따라서 설명 제거가 항상 좋다는 결론은 아닙니다. 응답 형식·집계·학습 목표가 함께 바뀐 조건에서 성능과 비용의 교환관계가 달라집니다.
핵심 기여: 폭 확대와 올바른 선택을 구분하고 학습·출력 형식의 비용을 함께 분석합니다. 다음 챕터로의 연결: §5는 증류가 전달한 것과 남은 어려움을 진단합니다. §4
📖 Chapter 5: Analysis: What Still Limits Verification?
챕터의 위치와 역할: 최종 성공률을 검증기의 비교 행동과 연결합니다. 분석은 학습에서 분리한 TMAX-15k 21개 작업의 저장된 상태를 사용합니다.
5.1 What Distillation Improves
1. 교사 일치도를 두 수준에서 측정합니다
Pairwise agreement는 A/B/TIE 선호가 교사와 같은 비교의 비율입니다. Verification agreement는 상태의 여러 비교를 집계한 최고 후보가 같은 비율입니다. 후자는 실제 온라인 점수차 가중 집계와 달리 저장된 ring 비교의 단순 승수로 계산합니다.
| 지표 | Zero-shot | Distilled | 의미 |
|---|---|---|---|
| Score MAE | 2.59 | 1.05 | 교사·학생 후보 점수의 평균 절대오차 |
| Pairwise agreement | 59.01% | 74.58% | 개별 선호 일치율 |
| Verification agreement | 38.52% | 57.79% | 상태별 최고 후보 일치율 |
PDF Table 1의 결과입니다. 점수·선호가 교사에 가까워졌지만, 교사와 같은 판단을 하는 것과 행동이 실제로 옳다는 것은 다릅니다. 이는 후보 실행 없이 저장된 응답을 비교한 진단입니다.
5.2 Remaining Verification Challenges
1. 후반 상태에서도 개선되지만 일치도는 낮아집니다
공통으로 유효한 응답을 가진 1,355개 상태에서 증류 검증기는 모든 turn 구간의 일치도를 높입니다. 1–4턴은 68.13%, 17–32턴은 54.07%입니다. 후반 판단의 어려움이 남지만, 모든 작업이 후반 구간에 같은 비중으로 포함되는 것은 아닙니다.
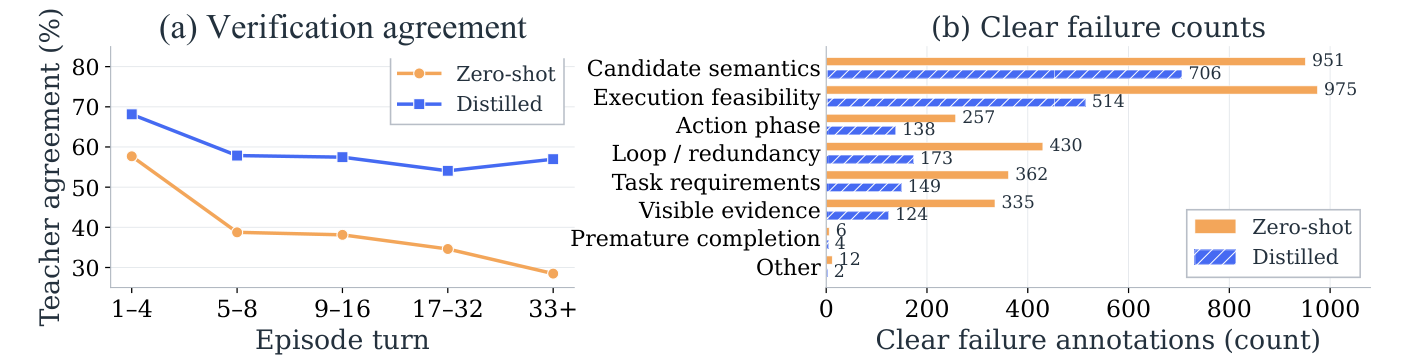
PDF Figure 4, 8쪽. 전체 패널·축·범례·수치를 보존한 크롭입니다. 오른쪽은 교사 불일치 중 추가 모델이 명확한 검증 실패로 판정한 사례로, 독립적인 행동 정답 라벨은 아닙니다. 원문
2. 명령 의미와 실행 가능성이 큰 비중을 차지합니다
GPT-5.6 Terra가 교사 불일치를 검토하고, 교사 선호가 분명하고 근거가 충분하다고 판단한 것만 오류 유형으로 분류합니다. 이 조건을 통과한 사례는 zero-shot 3,328건, distilled 1,810건입니다. 증류 후 명령 의미(candidate semantics)·실행 가능성(execution feasibility)은 1,220건, 67.4%입니다.
이는 모든 교사 불일치 수나 실제 환경 실패 횟수가 아닙니다. 핵심 어려움은 어떤 명령이 좋아 보이는지를 넘어, 명령이 현재 상태에서 정확히 무엇을 하며 끝까지 실행될지를 판단하는 데 있습니다. 상세 사례는 D.2에서 이어집니다.
핵심 기여: 교사 비교 행동의 전달을 확인하면서 행동 정답·교사 일치·실행 성공을 구분합니다. 다음 챕터로의 연결: §6는 실행 전체 확대와 다른 설정으로의 전이를 시험합니다. §5
📖 Chapter 6: Composition and Transfer of Action Scaling
챕터의 위치와 역할: 한 실행 내부의 개선을 전체 실행의 병렬·순차 확대와 결합하고 다른 모델·작업·하네스로 옮깁니다.
6.1 Composition with Trajectory Scaling
1. 병렬 확대: 각 실행을 개선한 다음 고릅니다
Best-of-3은 환경 세 개에서 완성한 실행 중 하나를 반환합니다. TMAX-9B의 기본 Best-of-3 Pass@1은 55.10%, 각 실행에 zero-shot Mid-Harness를 적용하면 61.22%, distilled를 적용하면 66.33%입니다. 환경 실행은 같은 세 번이지만 후보 생성·검증 연산은 추가됩니다.
2. 순차 확대: 이전 경험을 받은 실행에도 적용됩니다
SR 1회는 앞선 실행의 요약을 받은 새 실행입니다. 기본 Pass@1 55.10%에서, 초기·수정 실행 모두에 distilled Mid-Harness를 적용하면 60.20%가 됩니다. Pass@3은 71.43→75.51%입니다. 이전 경험이 주어져도 다음 행동 선택의 문제는 남습니다.
| 9B 설정 | Pass@1 | Pass@3 | 최종 출력당 환경 실행 수 |
|---|---|---|---|
| 기본 에이전트 | 50.00% | 69.39% | 1 |
| Best-of-3 | 55.10% | 정의하지 않음 | 3 |
| Best-of-5 | 57.14% | 정의하지 않음 | 5 |
| Best-of-7 | 59.18% | 정의하지 않음 | 7 |
| SR 1회 | 55.10% | 71.43% | 2 |
| Distilled Mid-Harness | 57.14% | 75.51% | 1 |
| Distilled + Best-of-3 | 66.33% | 정의하지 않음 | 3 |
| Distilled + SR 1회 | 60.20% | 75.51% | 2 |
PDF Table 2·7의 수치입니다. 환경 실행 수와 추가 후보·검증 호출 수는 다릅니다.
3. 성공률과 비용을 함께 비교합니다
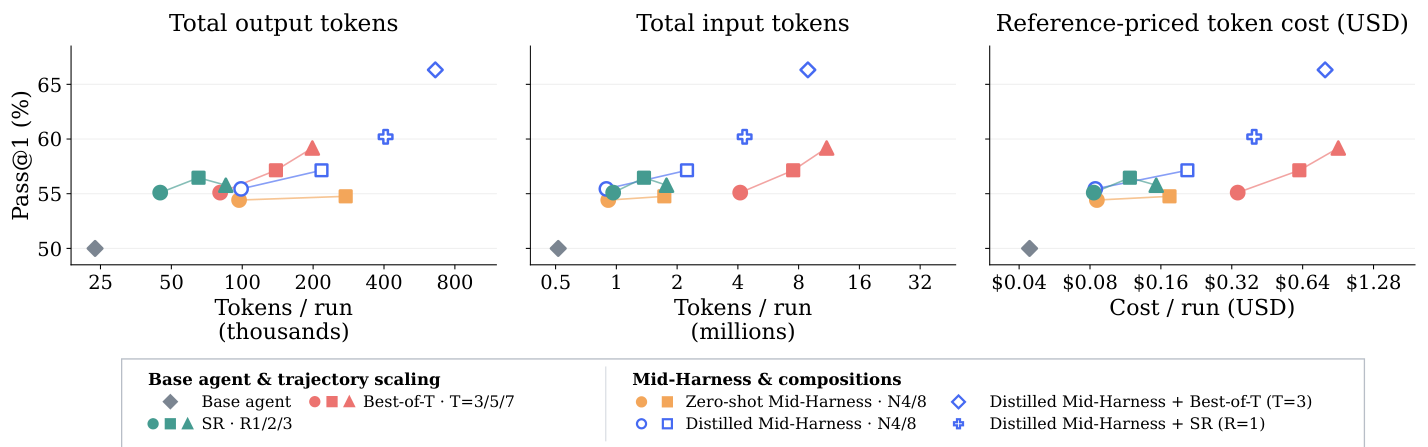
PDF Figure 5, 9쪽. 세 패널과 전체 범례를 보존한 크롭입니다. HTML에서는 Figure 6입니다. 비용은 실제 청구액이 아닌 기준 토큰 가격의 추정치입니다. 원문
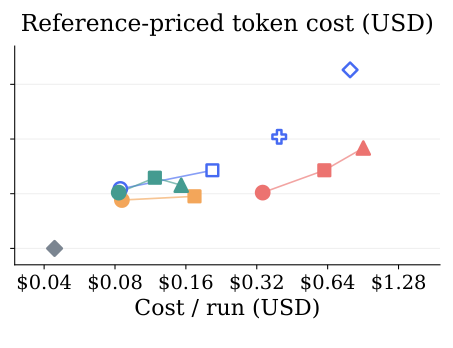
PDF Figure 5 오른쪽 비용 패널 상세, 9쪽. 오른쪽 패널만 원래 위치에서 크롭했습니다. 세로축의 Pass@1 눈금과 전체 범례는 위 전체 그림을 함께 참고합니다. 재배열·번역·수치 변경은 없습니다. 원문
SR을 1·2·3회로 늘린 성공률은 55.10·56.46·55.78%로 정체됩니다. Distilled N=8은 Best-of-5와 같은 57.14%를 약 3분의 1의 기준 토큰 비용으로 달성합니다. SR·Best-of-3 결합은 각각 60.20·66.33%로 Best-of-7의 59.18%보다 높으면서 비용은 낮습니다.
이는 검증이 무료라는 뜻이 아닙니다. 실행 횟수를 더 늘리는 대신 행동 결정과 전체 실행에 연산을 나누는 것이 이 설정에서 효율적이었다는 결과입니다.
6.2 Transfer Across Models, Benchmarks, Harnesses
1. 규모 전이
4B는 기본→zero-shot→distilled 순서로 Pass@1 38.78→41.50→43.88%, 27B는 71.09→73.13→76.19%입니다. 각 검증기는 같은 규모 생성기 backbone에서 초기화하고 pairwise 형식은 유지합니다.
2. 어려운 벤치마크
Terminal-Bench 2.1의 89개 작업에서 TMAX-9B는 21.72→27.34→26.59%입니다. 증류가 zero-shot보다 항상 좋지는 않습니다. SWE-bench Verified Mini 50개 작업은 46.67→48.00→48.67%입니다.
FeatureBench-Mini CPU 작업 23개에서 9B는 1.45→5.80→7.25%입니다. 증가해도 절대 성공률은 낮습니다. Pass@3은 zero-shot 17.39%에서 distilled 13.04%로 낮아져 두 지표가 같은 방향으로 움직이지 않습니다. 27B distilled는 Pass@1 23.19%, Pass@3 39.13%로 기본 17.39·26.09%보다 높습니다.
3. 다른 모델과 Terminus-2
Lite·Terminus-2에서 Qwen3.5-9B는 Pass@1 40.48→42.52%, Nemotron3.5 Lightning 30B는 41.16→43.20%입니다. Terminal-Bench 2.1·Terminus-2에서 Nemotron3 Ultra 550B는 50.94→56.18%입니다. 이들은 zero-shot이며 모든 모델에 증류를 적용한 실험은 아닙니다.
추가 일곱 설정에서 zero-shot은 Pass@3을 높이고 Pass@1은 같거나 높습니다. 범위가 넓은 증거지만 벤치마크 분모·추론 조건·증류 효과는 따로 보아야 합니다.
핵심 기여: 행동 검증이 다른 확대 축과 양립하고 여러 설정으로 전이됨을 보입니다. 다음 챕터로의 연결: §7는 기존 모델·하네스·검증 연구 안에서 위치를 정리합니다. §6
📖 Chapter 7: Related Work
챕터의 위치와 역할: 기존 연구와 공유하는 축과 이 논문의 통제 범위를 정리합니다.
1. Models and harnesses in terminal agents
기존 연구는 인터페이스·문맥 관리·하네스 최적화 또는 합성 작업의 지도학습·강화학습을 다룹니다. Mid-Harness는 모델·하네스를 고정한 경계에서 행동 샘플링·검증의 효과를 연구합니다.
2. Test-time scaling and process reward models
중간 추론 단계를 평가하는 process reward model(PRM), 두 답안을 비교하는 generative verifier와 연결됩니다. 차이는 행동이 외부 환경을 바꾼다는 점입니다. 실행하지 않은 명령이 현재 환경에서 어떤 결과를 낼지 판단해야 합니다.
3. Agent test-time scaling
완료 실행의 병렬 비교·순차 수정, 단계별 후보 검증, critic·patch 검증과 연결합니다. 저자는 행동 검증 자체의 최초 제안이라고 주장하지 않습니다. 동일 생성기를 검증기로 사용하는 여러 비교 형식과 넓은 터미널 작업을 체계적으로 분석한다는 위치입니다.
핵심 기여: 시스템의 새 이름보다 비교 실험의 통제·분석 범위를 차별점으로 제시합니다. 다음 챕터로의 연결: §8는 결과와 명시된 한계를 묶습니다. §7
📖 Chapter 8: Conclusion
챕터의 위치와 역할: 생성기·하네스를 고정한 행동 확대의 결과를 정리합니다.
1. 후보와 검증의 결합
같은 생성기의 유용한 대안을 활용할 수 있지만 약한 검증에서는 후보 폭 확대의 이득이 작습니다. 평가한 자기 검증 중 pairwise가 가장 높고, frontier 응답 증류가 생성기 변경 없이 성공률을 높입니다.
2. 다른 확대 축과 보완적 결합
여러 agent 설정으로 이득이 전이되며, 실행 전체 확대와 조합하면 실행 수만 늘리는 것보다 나은 비용·성공률 지점을 얻습니다. 행동 수준을 별도의 test-time compute 배분 대상으로 보는 근거입니다.
3. Limitations and Future Work
증류·frontier 간 격차와 행동 gold label 부재를 명시합니다. 더 나은 검증기 학습과 직접적인 행동 평가 논의는 A에서 이어집니다.
핵심 기여: 후보 수·검증 역량·연산 배분을 함께 고려해야 한다고 결론짓습니다. 다음 내용으로의 연결: AI 사용·윤리·재현성 선언과 참고문헌, 부록 A–D가 이어집니다. §8
📖 Chapter Statements: AI use, Ethics, Reproducibility, References
위치와 역할: AI 사용 범위, 적용 경계, 재현 정보를 제공합니다.
1. AI use statement
저자는 합성 데이터 생성·구현·방법론과 실험 피드백·정성 분석 지원·번역·그림·가독성 개선에 생성형 AI를 사용했다고 밝힙니다. 가설 제안·수정, 데이터 정리·재포맷, 결과 해석에는 사용하지 않았다고 구분합니다. AI 생성 코드는 두 저자가 확인·시험했으며 최종 산출물의 책임을 저자가 진다고 명시합니다.
2. Ethics statement
실험은 격리된 benchmark에서 수행되었습니다. 행동 신뢰성은 작업 완료 성공을 뜻하며 명령 안전성·보안의 입증은 아닙니다. 권한 제한·환경 격리·민감하거나 되돌릴 수 없는 행동의 사람 승인을 유지하고 검증은 이들을 보완해야 한다고 설명합니다.
3. Reproducibility statement와 References
검증·프롬프트는 B.2·B.6, 증류는 B.3, 평가·기준선은 B.1, 비용은 B.4, 진단은 D.1·D.2에 상세히 기술합니다. 참고문헌은 방법의 계보를 제공합니다. 이 논문의 관련 연구 서술을 이해하는 것과 인용 논문 전체를 독립 분석한 것은 구분해야 합니다.
핵심 역할: 성공률·안전성·재현성의 경계를 정합니다. 다음 내용으로의 연결: A는 남은 과제를 저자 구분에 따라 설명합니다.
📖 Chapter Appendix A: Limitations and Future Work
챕터의 위치와 역할: 본문의 한계를 네 축으로 구체화합니다.
1. Improving verifier training
Distilled 57.14%·frontier 68.03%의 격차를 해소하는 방법은 확립하지 못했습니다. 후반 상태의 낮은 일치도와 명령 의미·실행 가능성 오류를 근거로, 실제 명령 결과에서 학습하고 과제 진전·미해결 요구사항·관련 이력의 표현을 개선하는 방향을 논의합니다. 행동 효과를 예측하는 world model, 생성·검증의 공동 강화학습도 명시합니다.
2. Evaluating action verification
Gold label이 없어 검증 정확도·candidate coverage·완벽한 검증 아래의 달성 가능 성공률을 직접 측정하지 못합니다. 실행 행동이 바뀌면 이후 상태와 후보도 달라지므로, 저장 trajectory만 다시 평가해 새로운 검증기의 온라인 성능을 입증할 수 없습니다. 중간 상태 분기와 tree·beam search에는 환경 복제·복원이 필요하다고 설명합니다.
3. Allocating inference compute
생성 reasoning 설정은 고정하여 한 후보에 더 많은 reasoning을 쓰는 방법과 동등 비용으로 비교하지 않았습니다. 모든 단계에 적용한 현재 설계 대신 단계별 후보 폭·비교량을 조절하는 adaptive verification을 논의합니다. 단일 토큰·분류 head는 출력 비용을 줄이지만 4B·27B 성능 하락, 일부 usage 누락·별도 live run 때문에 형식 효과를 정밀하게 분리하기 어렵다는 조건도 명시합니다.
4. Extending beyond this study
현재는 터미널 agent·TMAX 지도 증류 중심입니다. 다른 증류·자기 증류·강화학습·탐색 학습, 외부 도구·지식, 문맥·기억 관리, 검증 rationale의 수정 피드백 활용, 효율 모델 설계, 인과·강건성 분석을 논의합니다. Computer use·robotics 전이도 향후 대상으로 언급하지만 이 논문에서 그런 환경의 성능을 입증한 것은 아닙니다.
핵심 기여: 답하지 못한 질문을 학습·평가·연산·범위로 나눕니다. 다음 챕터로의 연결: B는 실제 설정을 상세화합니다. Appendix A
📖 Chapter Appendix B: Experimental Setup and Implementation
챕터의 위치와 역할: 평가 범위·비교 구현·학습·비용·프롬프트를 재현 가능한 단위로 제공합니다.
B.1 Evaluation and Baseline Procedures
1. 실제 평가 작업 수
Lite 100개 중 sandbox 서비스 오류의 network-log-normalization·okhttp-trailers-crash를 제외하여 98개를 사용합니다. Terminal-Bench 2.1은 89개 전체, SWE-bench Verified Mini는 50개, FeatureBench-Mini는 GPU 의존 작업을 제외한 CPU 작업 23개입니다. 제외 사유와 분모가 성공률의 조건입니다.
2. 성공 지표의 정확한 정의
원문 식 (2)입니다. $M$은 작업 수, $\tau_{ij}$는 작업 i의 j번째 trajectory, $R$은 보상, $\mathbf{1}$은 조건이 참이면 1인 지시함수입니다. 부분 보상은 성공으로 세지 않습니다. Pass@3은 세 결과 중 성공이 존재하는지이며, 이를 실제로 선택하는 능력은 포함하지 않습니다.
3. Timeout, parallel, sequential, transfer 설정
로컬 서빙 속도 때문에 발생하는 timeout을 줄이기 위해 모든 실험에 agent-timeout multiplier 3을 사용합니다. Best-of-T의 9B trajectory verifier는 pivot 1개·repeat 2회·temperature 1·thinking off·출력 한도 4,096토큰입니다.
SR은 앞선 실행을 다섯 필드로 요약하고 새 환경에서 다시 실행합니다. 긴 이력을 수용하는 요약 문맥은 256K입니다. 결합 설정은 초기·수정 실행 모두에 행동 검증을 적용합니다.
Terminal-Bench 2.1의 TMAX-9B 전이는 Vanillux2·N=8·K=4를 사용합니다. Nemotron 전이는 생성 temperature 1.0·top-p 0.95·thinking on, 검증 temperature 0·thinking off 등의 별도 설정입니다. 생성 문맥 65,536·출력 16,384, 검증 문맥 61,440·출력 2,048을 사용합니다. 전이를 주요 TMAX 실험과 모든 추론 조건이 같은 비교로 해석하면 안 됩니다.
B.2 Verification Mechanisms and Hyperparameters
1. 파싱·중복 제거와 first-runnable
도구 호출 파싱에 성공한 후보만 유효하며 도구 이름·인자가 같은 후보는 첫 항목만 유지합니다. 유효 후보가 없으면 첫 샘플을, 하나뿐이면 검증 없이 그 후보를 반환합니다. First-runnable은 파싱 가능한 첫 후보를 선택할 뿐, 그 후보들 사이의 가치를 비교하지 않는 진단입니다.
2. Ring과 pivot의 두 단계
N=4는 모든 고유 후보 쌍을 한 병렬 stage에서 비교하므로 최대 6회입니다. N=8에서는 seed로 섞은 후보를 고리로 배열하고 이웃 쌍을 병렬 비교합니다. 정규화한 ring 점수의 상위 최대 4개를 pivot으로 고릅니다. 이어 non-pivot 대 모든 pivot 및 pivot끼리를 비교합니다. Ring에 이미 포함된 쌍은 방향과 무관하게 재호출하지 않습니다. 고유 후보 8개·pivot 4개에서 총 22–25회입니다.
Ring이 끝나야 pivot을 정할 수 있으므로 두 stage는 순차적입니다. Seeded priority로 동점을 풀고 A/B 방향도 seed로 정합니다. 기본 검증기 temperature 0·thinking off·문맥 61,440·출력 2,048입니다. Thinking off여도 프롬프트에 따라 rationale·점수를 출력합니다. 설명이 없는 별도 설정이 decision-only입니다.
3. 점수차 가중 승률
원문 식 (3)에서 $e$는 유효 비교, $s_{A,e},s_{B,e}$는 1–10 정수 점수, $E_i$는 후보 i가 포함된 비교 집합입니다. $p_{i,e}$는 승리 1·패배 0·무승부 1/2입니다. 점수차가 크면 가중치가 커지고 최솟값 0.1로 작은 선호도 남깁니다. 후보별 비교 횟수가 다르므로 가중치 합으로 나눕니다.
점수 6 대 6에서도 winner B를 낼 수 있으며 B에 가중치 0.1의 승리를 줍니다. 점수가 다르면서 선호가 높은 점수와 모순되면 무효입니다. 최종 동점은 ring 점수·seeded priority 순서로 풉니다. 전쌍 tournament에서는 seeded priority를 직접 사용합니다.
4. 무효 응답과 fallback
무효·누락 응답은 분자·분모에서 모두 제외하며 무승부로 세지 않습니다. 어떤 후보가 유효 incident ring 비교를 전혀 갖지 못하면 첫 유지 후보를 반환합니다. Pivot 비교 일부만 실패하면 남은 근거를 집계합니다. 정확한 재현에는 정상 비교뿐 아니라 이 규칙도 필요합니다.
Zero-shot N=4 및 Terminal-Bench 2.1의 TMAX-9B 두 설정은 검증 이력 8,000문자 제한이 있습니다. Frontier N=4는 listwise 한 호출·temperature 1.0·출력 한도 4,096이며 N=8도 listwise 한 호출입니다. 검증 역량 외에 이런 세부 조건도 보존해야 합니다.
5. Decision-only의 확률 집계
원문 식 (4)입니다. $\ell_{A,e},\ell_{B,e}$는 첫 출력 위치에서 A·B 토큰의 log-probability입니다. 두 토큰으로 정규화한 선호 확률을 후보별로 평균냅니다. Ring 평균으로 pivot을, 전체 ring·pivot 평균으로 최종 순위를 정합니다. 실패 비교는 제외하고 점수차 가중치는 쓰지 않습니다. 설명만 잘라낸 동일 알고리즘이 아니라 집계도 바뀝니다.
B.3 Verifier Training Data and Settings
1. 분할과 라벨 균형
학습 244개·분석 21개 작업은 겹치지 않습니다. 학습 입력은 A 56,274·B 56,274·TIE 5,083개로 117,631개입니다. 분석은 A·B 각각 5,019·TIE 505개로 10,543개입니다. Seed 42의 결정적 다수 라벨 downsampling으로 A/B를 균형화하고 TIE는 유지합니다. 분석 작업은 checkpoint 선택·학습 설정에 쓰지 않습니다.
2. LoRA 설정
Rank 64·alpha 128·dropout 0.05·learning rate 0.0001·2 epochs·장치별 batch size 8·gradient accumulation 1·H200 GPU 4개를 사용합니다. Attention·MLP·state-space의 입력·출력 projection 모듈을 대상으로 합니다. 주요 비교의 생성기는 원래 TMAX-9B입니다. 동일 데이터로 4B·27B 검증기도 증류합니다.
3. Decision-only 별도 corpus
학습 113,728·development 10,188개의 별도 A/B 교사 corpus를 사용합니다. A/B 균형을 맞추고 TIE는 배제하며 A나 B로 임의 변환하지 않습니다. 응답 형식·집계·학습 목표가 모두 reasoning 기반과 달라집니다.
B.4 Inference Cost Accounting
1. 검증 입력 길이
Distilled 9B·N=8·K=4의 usage 기록에서 입력 중앙값은 6,495, 90백분위는 10,380토큰입니다. 설정 한도 61,440보다 작으며 긴 입력은 주로 긴 행동 후보에서 생깁니다.
2. POT 정의
원문 식 (5)에서 $c_{t,i}$는 단계 t의 후보 i 출력 길이, $v_{t,s,j}$는 단계 t·순차 검증 stage s의 호출 j 출력 길이입니다. 병렬 stage 내부는 최장 출력을, 순차 stage 사이는 합을 취합니다. N=8 ring·pivot은 두 stage이므로 각 최대 길이를 더합니다.
이는 이상적인 병렬 디코딩 근사치로 wall-clock latency·queue·prefill·환경 실행 시간을 직접 측정하지 않습니다. 전체 검증 출력량은 병렬 최대가 아닌 모든 호출의 합입니다. 두 값은 실패를 포함한 294개 실행 평균으로 계산합니다.
3. 기준 토큰 비용
9B 기준 단가는 입력 백만 토큰당 USD 0.08·출력 USD 0.13입니다. 입력 I·출력 O의 비용은 (0.08I + 0.13O) / 1,000,000 USD입니다. 같은 행동 단계의 생성기 공통 prompt는 한 번만 세고 후보 출력은 모두 합합니다. 검증 입력은 비교마다 세며 서로 다른 단계·trajectory의 입력은 공유하지 않습니다.
Best-of-T는 T개 원 실행·trajectory 검증, SR은 원 실행·요약·해당 round까지의 새 실행을 포함합니다. 결합 시 모든 원 실행·수정 실행의 행동 검증도 셉니다. 4B 단가는 9B의 4/9배, 27B는 입력 USD 0.30·출력 USD 2.00입니다. 추가 cache 할인은 없으며 로컬 모델을 고정 단가로 비교하는 proxy입니다.
B.5 Evaluation Effort
매 trial은 새 Docker 환경과 명령 실행이 교차하는 순차 모델 호출을 요구합니다. 작업당 세 번 평가하며 기본 9B·Vanillux2에서 작업별 평균 단계 수의 중앙값은 Lite 21.0·Terminal-Bench 2.1 28.3, 실행 시간 중앙값은 7.2·10.5분입니다. 90백분위 시간은 13.3·20.0분이고 후자의 최장 작업 평균은 60분입니다.
환경 준비·최종 평가를 제외하고 timeout의 관측 시간은 포함합니다. 성공까지의 시간이나 benchmark 고유 상수는 아닙니다. Interactive 반복의 부담을 설명하면서 C.4의 불확실성 보고로 연결합니다.
B.6 Verifier Prompt Templates
1. B.6.1 Listwise Verification
원래 과제·실행 명령·현재 상태·익명화하고 섞은 후보를 받아 실제 진전이 있는 하나를 고릅니다. reason·best의 JSON을 출력하며, 실패 반복·근거 없는 완료·현재 blocker와 무관한 설치·대기를 낮게 평가합니다. 모든 요구사항이 충족되면 불필요한 추가 확인보다 완료를 선택하게 합니다.
2. B.6.2 Pointwise Verification
보지 못한 후보와 비교하지 않고 아무것도 하지 않는 것 대비 기대 가치를 0–10으로 평가합니다. 예상 다음 상태·미해결 요구사항을 설명하고 reason·predicted_next_state·score를 출력합니다. 반복은 새 필요성이 없으면 3 이하, 근거 없는 완료는 2 이하 등의 기준을 둡니다. 그럴듯한 설명만으로 8–10점을 주지 않게 합니다.
3. B.6.3 Pairwise Verification
요구사항→관측 근거→A의 다음 상태·위험→B의 다음 상태·위험→차이가 생기는 인과적 이유 순서로 비교합니다. JSON은 reasoning·scores·winner이며 reasoning은 45–160 lexical token의 한 문자열입니다. 높은 점수가 승리하며, 동점 점수에서는 미세한 A/B 선호나 실제 TIE를 허용합니다.
세 프롬프트는 문장 품질보다 진전·반복 탈출·근거 있는 완료를 강조합니다. 다만 D의 실패 사례에서는 변경을 하는 행동에 대한 선호가 필요한 진단을 밀어내는 경우도 나타납니다.
핵심 기여: 정상 비교·fallback·학습·비용·프롬프트를 구현 가능한 단위로 설명합니다. 다음 챕터로의 연결: C는 정밀 수치와 불확실성·하위군 분석을 제공합니다. Appendix B
📖 Chapter Appendix C: Additional Experiments and Results
챕터의 위치와 역할: 정밀 값, 응답 형식·추가 검증 연산, 통계와 작업군을 순서대로 분석합니다.
C.1 Numerical Performance Results
PDF Table 6·7은 행동·trajectory 확대 수치를 소수 둘째 자리까지 제공합니다. 후보 4→8에서 pointwise Pass@1은 52.72→52.38%로 낮아집니다. 폭 증가가 성공률의 단조 증가를 보장하지 않습니다.
PDF Table 8의 decision-only 비교에서 9B distilled Pass@1은 57.14→59.18%지만 Pass@3은 75.51→73.47%입니다. 4B distilled Pass@1은 43.88→41.50%, 27B는 76.19→74.15%입니다. 평균 실행 성공과 세 번 안에 성공할 작업 범위가 다르게 움직일 수 있습니다.
C.2 End-to-End Costs with Decision-Only Verification
1. 출력 감소와 총 비용 감소는 다릅니다
9B·N=8의 총 출력은 zero-shot 62.8%·distilled 44.7% 줄지만 입력 포함 비용 감소는 20.9%·24.1%입니다. 여러 쌍의 입력이 남기 때문입니다. N=4도 비용은 29.5%·20.8% 낮아지지만 Pass@1은 reasoning 기반보다 낮습니다.
| 9B 설정 | Pass@1: reasoning→decision-only | 기준 비용: reasoning→decision-only | 비용 감소 |
|---|---|---|---|
| Zero-shot | 54.76→56.12% | USD 0.174→0.138 | 20.9% |
| Distilled | 57.14→59.18% | USD 0.207→0.157 | 24.1% |
| Distilled + Best-of-3 | 66.33→65.31% | USD 0.797→0.608 | 23.7% |
| Distilled + SR 1회 | 60.20→65.99% | USD 0.399→0.309 | 22.4% |
PDF Table 9의 값입니다. 감소율은 원문 보고값으로, 반올림된 비용 칸에서 다시 계산한 값과 약간 다를 수 있습니다.
2. 조합에도 비용 절감이 이어집니다
Best-of-3 결합은 Pass@1이 1.02%p 낮아지며 비용을 23.7% 줄입니다. SR 결합은 비용 22.4%를 줄이고 Pass@1을 높입니다. 한 토큰으로 바뀐 것은 행동 검증이며 trajectory 검증·SR 요약은 원래 형식입니다. 응답 형식·집계·학습 목표의 동시 변경, usage 누락·별도 live run의 조건을 감안해야 합니다.
C.3 Additional Verifier Inference Compute
PDF Table 10은 변형별 기준선과 비교합니다. Distilled 비교마다 응답을 5개 생성하면 검증 출력은 4.99배지만 Pass@1 57.14→53.40%, Pass@3 75.51→71.43%입니다. Zero-shot thinking on은 출력 4.86배에서 Pass@1 54.76→56.12%, Pass@3 71.43% 유지입니다. Rubric scaling은 출력 2.26배에서 Pass@1 55.10%·Pass@3 72.45%입니다. 응답량 증가가 비례하는 성공률 이득을 주지는 않습니다.
C.4 Uncertainty in Comparisons against Base Agent
1. 작업 단위 paired bootstrap
각 작업에서 두 설정의 세 실행 평균 차이를 구합니다. 이 98개 paired task block을 100,000회 재표집하여 평균 차이의 percentile 95% 신뢰구간을 냅니다. 한 작업의 세 반복을 함께 보존하며 294개 실행을 독립적인 294개 작업으로 취급하지 않습니다.
| 모델·검증 | 기본 대비 Pass@1 차이 | 95% 신뢰구간 |
|---|---|---|
| 4B zero-shot | +2.72%p | [-3.06, +8.84]%p |
| 4B distilled | +5.10%p | [-0.68, +10.88]%p |
| 9B zero-shot | +4.76%p | [-0.68, +10.20]%p |
| 9B distilled | +7.14%p | [+1.36, +12.93]%p |
| 27B zero-shot | +2.04%p | [-3.74, +7.48]%p |
| 27B distilled | +5.10%p | [+0.34, +9.86]%p |
PDF Table 11입니다. 각 비교의 개별(marginal) 구간이며 여섯 비교의 simultaneous interval이 아닙니다. 9B·27B distilled만 구간 전체가 0보다 높습니다. 다른 네 구간은 0을 포함하여 해당 분석에서 양의 차이를 0과 분리하지 못합니다. 이는 개선 부재의 입증도 아닙니다.
2. 통계적 근거의 범위
표는 기본 대비 여섯 Mid-Harness 설정의 분석입니다. Frontier 68.03%·모든 조합·전이·decision-only 차이에 같은 신뢰구간을 제공한 것은 아니며 별도 p-value를 보고한 결과도 아닙니다. C.4
C.5 Mid-Harness Across Task Groups
1. 영역별 개선과 회귀
Distilled는 세 규모 모두 software engineering·machine learning·debugging·system setup에서 이득을 보입니다. Software engineering 증가폭은 4B·9B·27B에서 2.6·5.1·20.5%p입니다. Scientific computing은 4B·9B는 개선되지만 27B는 10.0%p 낮아집니다.
2. 난이도와 분모
난이도는 메타데이터의 Easy 24·Medium 42·Hard 29·Extreme 3개입니다. Hard의 distilled 증가폭은 2.3·6.9·10.3%p입니다. Extreme 3개·build/dependency 4개처럼 작은 집단의 큰 비율 변화에는 적은 분모를 함께 봐야 합니다.
3. 실행 길이와 단조 관계는 없습니다
모델별 기본 실행 shell call 중앙값으로 Short·Medium·Long을 나누고 같은 모델의 모든 설정에 같은 그룹을 적용합니다. 9B는 4–15회 33개·16–24회 32개·25–64회 33개입니다. Long의 distilled 증가폭은 4B·9B·27B에서 11.1·5.1·14.1%p지만 9B는 Medium에서 가장 큽니다. 이는 관측된 기본 agent 행동 길이로, 모델과 무관한 작업 고유 길이가 아닙니다.
핵심 기여: 좋은 평균 뒤의 비용·통계·하위군 차이를 보존합니다. 다음 챕터로의 연결: D는 점수와 실제 명령 사례로 판단 차이를 해설합니다. Appendix C
📖 Chapter Appendix D: Verifier Analysis
챕터의 위치와 역할: 점수 분포, 교사 불일치 분류, 실제 실행의 복구·실패를 구분합니다.
D.1 Offline Verifier Agreement
1. D.1.1 Score and Turn Diagnostics — 점수 통계
공통 유효 쌍 10,197개가 후보 점수 두 개씩 20,394개 관측과 점수차 10,197개를 제공합니다. 같은 후보의 반복 등장은 유지합니다. PDF Figure 10은 점수·점수차 주변분포, Figure 11은 A/B 방향을 보존한 공동 점수 분포입니다. 후자는 교사·학생 confusion matrix가 아닙니다. 점수는 상대적 rating이며 보정된 성공 확률이 아닙니다.
2. 공통 상태와 turn 필터
상태 안의 모든 비교가 두 모델 모두에서 유효해야 남깁니다. 1,624개 중 1,355개·비교 8,702개를 유지하고, 상태 269개(16.6%)는 제외합니다. 따라서 verification agreement는 상태 전체의 응답이 유효하다는 조건부 수치입니다.
1–4·5–8·9–16·17–32·33+ 구간의 상태는 182·178·388·442·165개입니다. 앞 네 구간은 각각 21개 작업, 마지막은 8개만 포함합니다. 구간별 계산은 작업 macro 평균이 아닌 상태 pooling입니다.
3. 교사 일치 집계
Pairwise는 저장 A/B/TIE가 같은지 봅니다. Verification은 저장 ring에서 선호된 후보의 승수만 세고 TIE는 어느 쪽에도 승리를 주지 않습니다. 최다 승수 동점은 원래 후보 순서의 첫 항목입니다. 온라인 식 (3)의 margin-weighted 집계와 다릅니다.
D.2 Remaining Verifier Disagreements
1. Failure categories and reference clarity
명령 의미·실행 가능성·보이는 근거 사용·행동 단계·반복·요구사항·성급한 완료 등을 분류합니다. GPT-5.6 Terra는 교사 선호가 명확하고 근거가 충분한지 먼저 확인하고 통과 사례마다 주된 범주 하나를 부여합니다.
의미·실행 가능성 사례는 zero-shot 1,926·distilled 1,220건입니다. 이는 교사 기준으로 추가 모델이 판단한 오류이며 독립적으로 입증된 실제 행동 오류·trajectory 실패가 아닙니다.
2. D.2.1 Candidate semantics: valid character arithmetic rejected as defective code
OCR prefix 네 글자와 소문자 suffix 두 글자로 토큰을 찾는 과제입니다. 18턴에서 A는 BASE·base라는 일반 prefix를, B는 OCR의 W를 출발점으로 확장 탐색합니다. B의 C 코드에는 다음이 있습니다.
1
2
token[4] = 'a' + s1;
token[5] = 'a' + s2;
D.2.1의 코드이며 s1·s2는 0–25입니다. Distilled는 'a' + s1이 s1 + 'a'에 비해 잘못됐다고 판단하여 A를 4 대 3으로 선호합니다. 그러나 두 정수 덧셈은 동등하며 해당 플랫폼에서 의도한 소문자를 만듭니다. 교사는 timeout 가능성은 인정하면서 OCR 근거가 있는 B를 2 대 5로 선호합니다. 오류는 유효한 문자 연산을 잘못된 코드로 읽은 점입니다.
3. D.2.1 Execution feasibility: a persistent launch rewarded despite a self-termination hazard
Go 음향 시뮬레이션 시험 통과와 9090 포트 HTTP 서비스 유지 과제입니다. 30턴 B는 프로세스 cmdline에 9090 또는 main.go가 있으면 종료한 뒤 nohup 실행하려 합니다. 그러나 Python 명령 자체·부모 shell에도 그 문자열이 들어갈 수 있고 자기 자신을 제외하지 않습니다. 서버 실행 전에 자신·부모를 종료할 위험이 있습니다.
Distilled는 지속 실행 의도를 높게 평가하여 5 대 7로 B를, 교사는 9 대 2로 A를 선호합니다. A에도 별도 포트 탐지 결함이 있어 완벽한 대안과의 비교는 아닙니다. 초점은 계획한 실행 단계까지 실제로 도달할 수 있느냐입니다.
D.3 Qualitative Examples of Action Verification
1. Recovery: a useful preference despite an imperfect rationale
TMAX-27B zero-shot·N=8·pivot 4의 React/TypeScript 과제에서 실제 복구 후보를 골라 Jest 3 suites·16 tests, 외부 17/17 tests를 통과합니다. 기본 세 실행은 0/3, Mid-Harness는 3/3입니다. 그러나 diagnostics.exclude에 관한 reasoning은 부정확하여 올바른 선택이 완전히 올바른 설명을 보장하지 않습니다.
2. Failure: prioritizing an edit over resolving conflicting evidence
Alias canonicalization에서는 명세·예시의 모순을 조사하는 후보보다 solver rewrite를 고릅니다. Header 이름을 canonical 후보에서 빼는 heuristic이 도입되어 11/12 tests만 통과하고 보상 0입니다. 변경을 한다는 이유로 필요한 진단을 밀어낸 사례입니다.
D.3.1 Detailed Action-Verification Traces
1. Recovery Example — 과제·후보·두 비교·결과
React 18·TypeScript 5의 typecheck·production build·Jest 통과, strict mode 유지와 test 파일 수정 금지라는 제약입니다. 28단계에서 @types/user import에 TS6137이 발생합니다.
후보 0은 별도 tsconfig.test.json을 만들지만 Jest가 쓰도록 연결하지 않습니다. 후보 2는 활성 Jest 설정의 diagnostics.exclude에 TS6137을 넣습니다. 선택된 후보 3은 diagnostics.ignoreCodes에 6137을 넣습니다. 2 대 3은 점수 3 대 9, 3 대 0은 9 대 2로 후보 3을 선호합니다.
저자는 exclude가 무효 옵션이라는 설명이 잘못됐다고 밝힙니다. Exclude는 파일 경로 filter이고 ignoreCodes가 진단 코드 filter입니다. 수정 전 suite 1개 실패·2개 통과, 이후 3개 모두·16 tests 통과, 외부 17개 통과입니다. 명령 효과의 유용성과 설명 각 문장의 정확성은 별도입니다.
2. Verifier Error — 충돌 근거·선택 rewrite·실패
solve(lines)는 대칭·추이 alias와 사전순 최소 canonical 이름을 구현해야 합니다. 예시는 {build, compile, link}의 대표로 compile을 기대하지만 명시된 규칙은 build입니다. 4단계 후보 0은 충돌을 확인하고 후보 5는 parser·alias 논리를 추적합니다.
선택된 후보 7은 alias 값에 등장하는 이름만 우선하는 전체 rewrite입니다. 7 대 5는 8 대 3, 7 대 0은 6 대 2로 수정 후보를 선호합니다. 검증기는 heuristic임을 인정하면서도 파일 변경을 진전으로 높게 평가합니다.
최종 test_03_alias_canonicalization_lexmin은 all, build, clean을 기대하지만 all, compile, clean을 얻습니다. 11/12의 부분 통과도 정확 성공에서는 실패입니다. 환경 변경을 무조건 진전으로 판단하면 필요한 모순 확인보다 잘못된 수정을 앞세울 수 있음을 보여줍니다.
핵심 기여: 교사 일치·점수·설명·실행 결과를 서로 다른 근거로 구분합니다. 부록의 마무리: 두 상세 추적으로 끝나며 본문 §5의 명령 의미·실행 가능성 문제를 구체화합니다. Appendix D
실험 결과 심층 분석
강한 검증기 참고와 소형 검증 결과는 다릅니다. 68.03%는 GPT-5.6 Sol listwise입니다. 고정 생성기와 동일 계열의 학습된 pairwise는 57.14%, 기본 대비 +7.14%p입니다. 하나의 성능으로 합치면 역량·학습·비용 조건이 사라집니다.
통계적 근거의 범위를 지켜야 합니다. Distilled 9B의 차이 신뢰구간은 [+1.36, +12.93]%p, 27B는 [+0.34, +9.86]%p입니다. 다른 네 구간은 0을 포함합니다. 모든 point estimate가 양수라는 사실과 모든 설정의 개선이 명확하다는 주장은 다릅니다. 여섯 개별 구간을 동시 보장으로 읽거나 frontier·decision-only·전이에도 같은 통계 근거가 있다고 확대해서는 안 됩니다. C.4
출력 감소율은 지연·총 비용 감소율이 아닙니다. 한 토큰 응답이어도 긴 비교 입력은 남습니다. 생성 prompt 공유 가정, 비교별 입력 계산, 고정 모델별 단가가 추정 비용을 구성합니다. POT는 이상적 병렬 디코딩 proxy로 실제 응답시간 감소율과 같지 않습니다.
평균 개선과 작업별 안정성도 다릅니다. FeatureBench 9B의 낮은 절대 성공률·distilled Pass@3 하락, scientific computing 27B 회귀는 저자가 보고한 결과입니다. 작은 작업군의 큰 변화도 작업 수를 함께 봐야 합니다.
재현에는 비교 규칙과 근거의 한계가 함께 필요합니다. 모델·프롬프트·LoRA·균형화·seed·fallback·timeout·비용이 상세히 제공됩니다. 그러나 행동 gold label이 없어 교사 일치도를 정답률로 대체할 수 없습니다. 저장 trajectory만 다시 평가해 새로운 행동이 만든 온라인 상태의 성능을 입증할 수도 없습니다.
기술적 함의와 응용
Mid-Harness의 함의는 생성 가능한 대안을 실제 행동으로 회수하는 선택 계층을 독립적으로 개선할 수 있다는 점입니다. 생성기를 다시 학습하지 않고 검증기를 학습하거나 비교 형식을 바꾸어, 모델 능력과 agent 성공률 사이의 간격을 분석합니다.
리뷰어 관점에서 터미널을 쓰는 데이터 처리·코드 수정 agent에는 다음 명령의 선택이 중요한 설계 단위가 됩니다. 미해결 요구사항·최근 실패·후보별 예상 상태 변화를 비교하는 접근입니다. 다만 데이터과학의 모든 작업에 대한 실증을 뜻하지 않으며 실제 근거는 논문의 벤치마크·설정에 있습니다.
적용 시 후보 생성 자원, 두 단계 tournament의 순차 지연, 검증 입력량과 환경 실행 비용을 함께 계산해야 합니다. 오류 사례처럼 코드 변경과 필요한 진단을 구분해야 하며, 교사 선호·그럴듯한 rationale만으로 실행 정당성을 보장해서는 안 됩니다. 윤리 선언대로 검증은 권한 제한·환경 격리·필요한 사람 승인을 보완합니다.
저자가 명시한 향후 방향은 명령 결과 학습, world model·강화학습, 적응적 후보·비교량, 더 직접적인 행동 평가 등입니다. 결과의 중심은 특정 절차가 언제나 최적이라는 데 있지 않습니다. 후보 다양성·선택 능력·전체 실행 확대·비용 배분을 각각 측정하고 조합하면 agent 성공률을 더 정밀하게 개선할 수 있다는 데 있습니다.
본문 1–8·세 선언·부록 A–D와 하위 절을 다루었습니다. 참고문헌의 개별 논문 전체를 독립 리뷰하지는 않았습니다. B.6 프롬프트 전문과 D.3.1의 긴 명령·원어 응답 전부는 전재하지 않고 원래 순서의 조건·후보·비교·결과를 해설했습니다.