논문 개요와 전체 구조
언어 모델 에이전트의 성능은 모델 가중치뿐 아니라 도구를 호출하고, 과거 관측을 보존하며, 다음 행동을 결정하는 실행 소프트웨어에도 좌우됩니다. 이 실행 소프트웨어를 하네스(harness)라고 합니다. Jingbo Yang 외의 「Learning from Research: Toward Lifelong Agent Harness Evolution」은 모델을 고정한 채 연구 문헌에서 새로운 실행 메커니즘을 찾아 하네스를 개선하는 ScholarEvolve를 제안합니다. 이 리뷰는 2026년 9월 30일 제출된 arXiv 2609.40169v1의 본문과 부록 A–D를 분석합니다.
핵심 질문은 “실패 기록을 읽는 코딩 에이전트가 이미 알고 있는 해결책의 범위를 어떻게 넓힐 것인가”입니다. ScholarEvolve는 하네스를 다섯 모듈로 분해하고, 관련 논문을 구현 가능한 방법별로 묶어 후보를 만듭니다. 이후 단일 모듈 변경과 여러 모듈의 조합을 검증셋에서 평가합니다. 새로운 논문이 들어오면 이전 최우수 하네스를 출발점으로 같은 과정을 반복하도록 설계했습니다. 데이터과학 관점에서는 모델 재학습 없이 탐색 공간을 구성하는 방법, 평가 데이터의 역할 분리, 모듈 간 상호작용을 배우기 좋은 연구입니다.
원문의 순서는 다음과 같습니다. 본문에 별도 목차가 없으므로 실제 절 제목과 부록 목차를 기준으로 정리했습니다.
| 원문 | 하위 구조 |
|---|---|
| 1 Introduction | 세 가지 탐색 문제와 연구 문헌을 통한 개선 |
| 2 Related Work | Agent harness evolution → Automated research |
| 3 Method | 3.1 Problem formulation → 3.2 Research guided modular exploration(3.2.1 모듈화, 3.2.2 연구 풀, 3.2.3 주제 모델링, 3.2.4 실행 가능한 변이) → 3.3 Module crossover and selection → 3.4 Lifelong harness evolution |
| 4 Experiments | 4.1 Experimental Setup → 4.2 Main Results → 4.3 Lifelong Evolution → 4.4 Ablation Studies → 4.5 Analysis of Harness Evolution |
| 5 Conclusion | 결론 → Acknowledgments → References |
| A Additional Experimental Details | A.1 Implementation Details → A.2 Lifelong Evolution Protocol and Results → A.3 Training and Test API Distributions → A.4 Analysis Protocol → A.5 Failure Taxonomy and Diagnostic Checks |
| B Qualitative Analysis | 의사결정 지점별 연구 메커니즘 → 상태를 고려한 실행 사례 |
| C Additional Method Details | C.1 Representative Module Implementations → C.2 Research Pool Construction and Topic Selection → C.3 Module Interfaces and Executable Checks → C.4 Crossover Diagnostics |
| D Candidates and Evolved Harnesses | D.1 Candidate Pool for Qwen3.5-27B on AppWorld → D.2 Selected Configurations and Code |
핵심 기여와 혁신성
저자들은 실행 피드백 중심의 자동 개선이 좁은 수정의 반복, 개선 에이전트의 기존 지식에 대한 의존, 실패가 관찰된 뒤에야 시작되는 적응이라는 세 문제를 갖는다고 설명합니다. 문헌을 검색하는 것만으로 이 문제들이 해결되는 것은 아닙니다. 비슷한 방법을 제안한 논문만 반복해서 구현하면 여전히 탐색이 편중되기 때문입니다. ScholarEvolve의 차별점은 모듈이라는 개입 위치와 방법 주제라는 해결 방식의 두 축으로 구현 예산을 분배한다는 데 있습니다. 원문 §1–3
첫째, 도구·문맥·스킬·메모리·워크플로에 각각 인터페이스를 부여합니다. 둘째, TopicGPT 방식의 주제 생성·정제·할당으로 중복된 메커니즘을 합치고 서로 다른 주제에서 후보를 고릅니다. 셋째, 개별 후보의 성능을 이용해 조합을 선별하되 실제 조합을 다시 실행하여 성능을 확인합니다. 넷째, 새 문헌 구간을 공급하여 같은 모델로 추가 개선이 가능한지 평가합니다. 모듈화와 자동 코드 탐색 자체를 최초로 발명했다는 주장으로 읽기보다는, 기존 탐색에 외부 연구 지식과 방법 다양성 관리를 결합한 기여로 이해하는 것이 적절합니다.
리뷰어의 해석으로는, 논문을 “정답 자료”로 사용하는 대신 검증할 가설과 구현의 공급원으로 다룬다는 점이 중요합니다. 실제로 문헌에서 유도한 후보 중 성능이 크게 하락한 것도 있습니다. 따라서 연구 기반 제안의 가치는 검증 절차와 함께 평가해야 하며, 문헌에서 왔다는 사실이 개별 구현의 효과를 보장하지 않습니다. 이 해석은 부록 D의 전체 후보 결과에 근거합니다.
기술적 세부사항
ScholarEvolve에서 변이(mutation)는 한 모듈만 교체한 실행 프로그램이며, 교차(crossover)는 모듈별 후보를 다시 조합하는 연산입니다. 챔피언(champion)은 다음 탐색의 기준으로 보존하는 최우수 하네스입니다. 연구 모델은 문헌을 분류하고 구현 청사진을 작성하며, 코딩 에이전트가 이를 호스트 하네스에 맞게 구현합니다. 작업을 실제 수행하는 모델과 이 개선용 모델은 역할이 다릅니다. “모델 고정”은 작업 백본의 가중치를 바꾸지 않는다는 의미입니다.
데이터도 역할에 따라 나눕니다. 진화셋은 실패 분석과 재사용 스킬·메모리 구축에, 검증셋은 후보 선택에, 테스트셋은 선택을 끝낸 프로그램의 최종 보고에 사용합니다. 평가 에피소드 안에서 상태가 바뀌는 것은 허용하지만, 검증·테스트 작업으로 영구 스킬 라이브러리나 메모리를 새로 구축하지 않습니다. 이 구분은 추론 중 상태 갱신과 평가 데이터의 영구 학습을 혼동하지 않게 합니다. 원문 §3.1·3.2.4
AppWorld는 API로 여러 앱의 상태를 바꾸는 작업 환경입니다. TGC는 작업 성공률, SGC는 같은 시나리오의 세 변형이 모두 성공한 비율입니다. τ²-Bench Telecom은 사용자 시뮬레이터와 도구를 통해 서비스 문제를 해결하는 환경이며, pass 지표는 반복 성공의 일관성을 측정합니다. 핵심 목적함수, 주제 생성식, 조합 예측식, 챔피언 보존식과 지표 추정식은 해당 원문 절의 논리 흐름에 맞춰 아래에서 항별로 설명합니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
이 장은 하네스 개선의 필요성을 제시하고, 실행 기록에만 의존하는 탐색에서 연구 지식으로 탐색 범위를 넓히는 문제로 이어집니다. 먼저 길고 복잡한 디지털 작업에서 도구 사용, 문맥 관리, 스킬, 메모리와 실행 흐름이 모델 출력을 지속적인 행동으로 바꾸는 역할을 설명합니다. 대규모 백본을 반복 훈련하는 비용 때문에 이 주변 프로그램의 개선이 실용적인 경로가 된다는 것이 출발점입니다.
이어 세 가지 문제를 순서대로 제시합니다. Limited exploration은 수정 권한이 넓어도 검증 라운드 추가나 다중 제안 같은 좁은 워크플로 변경만 반복할 수 있다는 문제입니다. Figure 1의 검증기 사례는 필요한 도구 호출까지 차단하는 과도한 보수성을 보여 줍니다. Limited design knowledge는 실패 원인을 보더라도 이를 해결할 기술을 개선 모델이 모를 수 있다는 문제입니다. Delayed adaptation은 이미 발생한 상호작용과 실패가 쌓여야 업데이트가 시작되는 문제입니다. 이들은 저자가 동기를 설명하기 위해 든 문제이며, 모든 기존 하네스에서 동일하게 발생한다고 실험한 결과는 아닙니다.
다음으로 숙련된 연구자가 문헌에서 해결책을 찾는 과정을 자동화합니다. 모듈별로 방법 계열을 정리하고, 중복을 줄이며, 남은 계열에 후보 예산을 배분합니다. 문헌은 백본 훈련 이후 등장한 기술도 전달할 수 있습니다. 새 논문을 주기적으로 읽는 배포 시나리오는 제안된 확장이고, 실험에서는 AppWorld와 Telecom의 모듈 탐색 및 별도 문헌 구간 실험을 평가합니다. 장의 핵심은 자동 수정의 횟수보다 수정 방향을 공급하는 지식과 탐색 구조를 바꾸는 데 있으며, 다음 장은 이를 선행 자동 설계·자동 연구와 연결합니다. 원문 §1, PDF 1–2쪽
📖 Chapter 2: Related Work
Agent harness evolution. 먼저 ADAS와 AFlow의 프로그램·워크플로 탐색을 소개한 뒤, DGM의 자기 수정과 후보 아카이브, Meta Harness의 실행 프로그램 탐색, AHE의 상세 궤적 기반 수정을 설명합니다. AgentSquare는 이미 모듈 분해와 재조합을 사용합니다. 따라서 이 논문의 위치는 모듈화 자체보다, 연구 문헌에서 추출한 메커니즘을 모듈 내부의 탐색 방향으로 조직한다는 데 있습니다.
같은 소주제의 후반부는 일반화와 지속 적응을 다룹니다. 저자들은 일부 선행 실험이 탐색에 사용한 작업에서 성능을 보고했다는 점을 지적하고, 탐색셋과 최종 평가를 분리하는 연구를 연결합니다. 경험 스트림으로 계속 수정하는 방법과 비교하면, ScholarEvolve는 새로운 논문이라는 별도의 업데이트 신호를 공급합니다. 이 선행 연구 비교는 해당 원문이 설명한 범위이며, 여기서 인용된 다른 논문들의 전체 실험을 독립 재검증한 것은 아닙니다.
Automated research. 이어 AI Scientist-v2와 AI-Researcher의 연구 자동화, AgentRxiv의 보고서 공유, Paper2Agent의 논문·코드 도구화를 설명합니다. ScholarEvolve에서는 논문이 후보 메커니즘을 제공하고, 주제 모델링이 탐색 범위를 관리하며, 작업 평가가 유효한 변경을 선택합니다. 이 장의 기여는 자동 연구를 실행 하네스 최적화의 내부 단계로 위치시키는 데 있고, 다음 장은 그 과정을 명시적인 목적함수와 선택 규칙으로 구체화합니다. 원문 §2, PDF 3쪽
📖 Chapter 3: Method
이 장은 문제 정의, 모듈별 연구 탐색, 조합 선택, 지속 진화의 순서로 전체 알고리즘을 설명합니다.
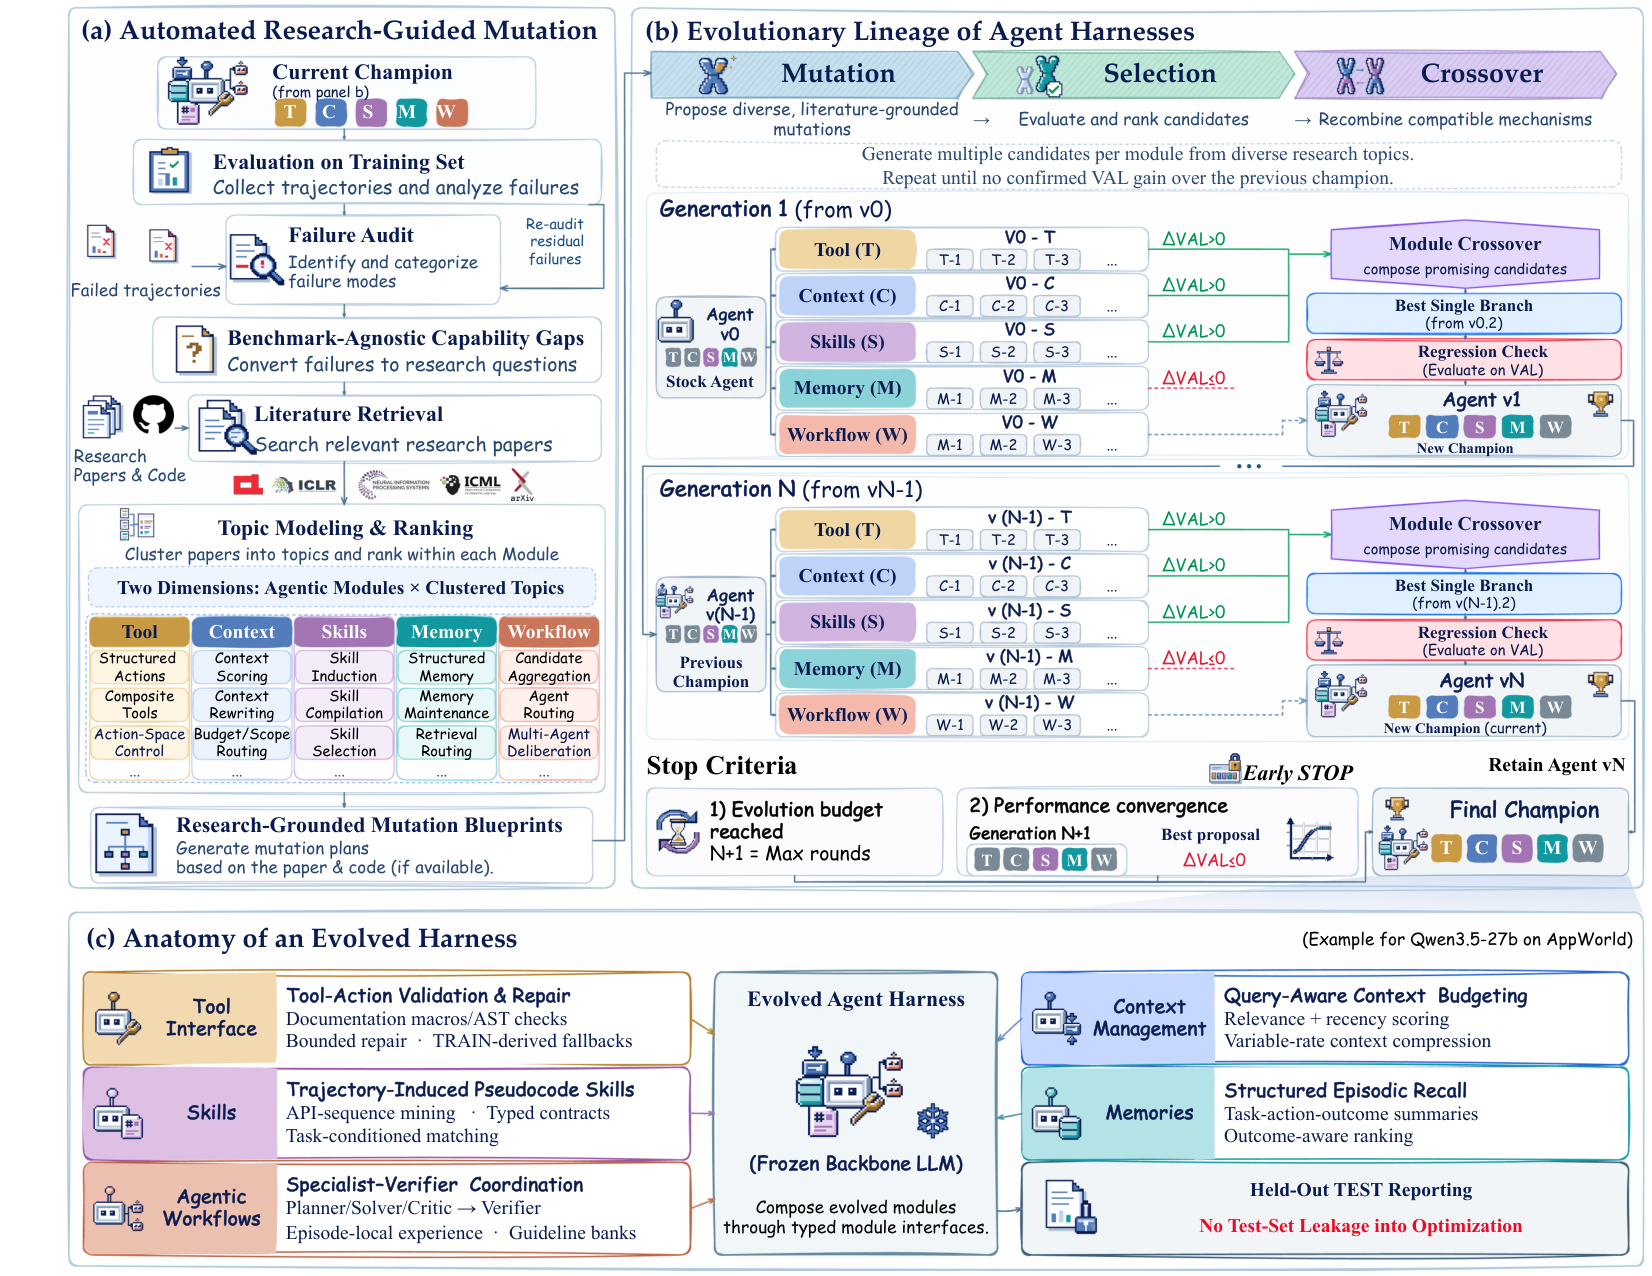
Figure 2, PDF 4쪽. 2609.40169v1 원본의 그림 영역을 크롭했습니다. 패널 (a)–(c)를 원래 배치로 유지했으며 번역·재구성하지 않았습니다. (a)는 문헌 기반 후보 생성, (b)는 세대별 평가·교차, (c)는 최종 실행 구조를 보여 줍니다.
3.1 Problem formulation
하네스는 모델 입력, 행동 실행, 상태 갱신을 관리하는 실행 프로그램입니다. 허용 가능한 프로그램 집합을 $\mathcal{H}$, 작업 백본을 $f_\theta$로 나타냅니다. 진화 동안 $\theta$는 고정합니다. 목표 작업 분포 $\mathcal{P}_{\mathrm{tar}}$와 그 유한 표본인 테스트셋을 구분하고, 진화셋 $\mathcal{D}_{\mathrm{evo}}$, 검증셋 $\mathcal{D}_{\mathrm{val}}$, 테스트셋 $\mathcal{D}_{\mathrm{test}}$이 서로 겹치지 않도록 합니다.
원문 식 (1)은 다음과 같습니다.
$x$는 작업, $\tau=(o_0,a_0,\ldots,o_T)$는 관측과 행동으로 이뤄진 상호작용 궤적입니다. $p_\theta(\cdot\mid H,x)$는 고정 모델이 특정 하네스와 작업 아래 생성하는 궤적 분포이고, $R(x,\tau)$는 그 궤적의 보상입니다. 안쪽 기대값은 같은 작업에서 실행의 변동을, 바깥쪽 기대값은 작업 분포 전체를 평균합니다. $H^\star$는 기대 보상을 최대화하는 프로그램입니다. 실제 검색은 이 이상적인 분포를 직접 알 수 없으므로 진화·검증 표본과 고정 예산을 사용합니다. 테스트셋을 목표 분포 그 자체로 취급하지 않는 점이 명확합니다. 원문 §3.1, 식 (1)
3.2 Research guided modular exploration
3.2.1 Structuring the code space into modules. 하네스를 $H=\mathrm{Compose}(m_1,\ldots,m_5)$로 나타냅니다. 도구 인터페이스는 사용 가능한 행동과 실행 가능한 호출로의 변환을, 문맥 관리는 입력의 선택·압축·순서를 맡습니다. 스킬은 재사용 절차의 유도·검색·정리를, 메모리는 경험의 형성·검색·통합을 담당합니다. 워크플로는 작업 분해, 역할 조정과 위임을 다룹니다.
스킬은 “어떤 순서로 수행할 것인가”라는 절차이고, 메모리는 “비슷한 상황에서 무엇을 했고 어떤 결과였는가”라는 경험이라는 차이가 있습니다. 둘의 출력은 문맥 관리로 전달됩니다. 긴 스킬을 검색하면 문맥 예산에 영향을 주므로 모듈들이 완전히 독립인 것은 아닙니다. 단일 변이는 다른 네 모듈을 고정해 한 변경의 효과를 측정하고, 이후 조합 평가에서 상호작용을 확인합니다.
3.2.2 Constructing the research pool. 진화셋에서 수집한 궤적을 감사하여 환경 문제와 에이전트 문제를 구분합니다. 반복되는 에이전트 문제에서 관측·행동 근거를 보존하고, 특정 벤치마크의 필드 이름이나 도메인 개체를 일반적인 능력 공백으로 추상화합니다. 그런 뒤 모듈마다 넓은 능력 질의와 좁은 메커니즘 질의를 만들고, 검색·중복 제거를 거쳐 제목과 초록의 풀을 구성합니다. 실패 기록은 연구 질문의 출발점이고 문헌은 가능한 해결 방법의 공급원입니다.
3.2.3 Topic modeling for orthogonal exploration. 여기서 “직교”는 선형대수의 내적이 0이라는 뜻이 아니라, 의도한 동작이 가능한 한 겹치지 않는 의미적 방법 계열을 뜻합니다. TopicGPT에 따라 주제 생성, 정제, 논문 할당을 수행합니다. 원문 식 (2)은 다음과 같습니다.
$j$는 모듈, $b$는 문헌 배치의 순서, $B_{j,b}$는 그 배치의 논문들입니다. $d_j$는 모듈의 책임을 기술한 설명이고, $\mathcal{T}_j^{(b)}$는 배치 $b$까지 누적한 주제 집합입니다. 초기 집합은 비어 있습니다. 연구 모델 $\phi$의 생성 연산 $G_\phi$는 기존 주제에 맞는 방법을 재사용하고 빠진 방법을 새로 추가합니다. $B_j$는 전체 배치 수이며, 정제 연산 $F_\phi$는 동의어나 겹치는 분류를 합치고 지나치게 세부적인 변형과 모호한 주제를 정리합니다. 예를 들어 시연 검색과 지식 검색은 개입 방식이 같으면 외부 문맥 검색으로 합칠 수 있습니다. 원문 식 (2)
논문마다 초록의 근거 구절과 순서 있는 주제 목록을 부여합니다. 여러 방법을 가진 논문은 복수 라벨을 갖되 첫 번째 유효 라벨을 대표 주제로 삼아 선택 클러스터를 결정합니다. 현재 하네스·백본에 이미 있는 메커니즘은 선별 대상에서 제외합니다. 남은 비어 있지 않은 클러스터를 크기순으로 정렬하고, 한 클러스터로 돌아오기 전에 다른 클러스터를 모두 방문하는 순환 선택을 수행합니다. 모듈 예산 $K_j$와 남은 주제 집합 $\mathcal{T}_j^+$에 대해 서로 다른 주제의 커버리지는 $\min(K_j,|\mathcal{T}_j^+|)$입니다. 클러스터 안에서는 검색 순서를 유지하므로 “주제 다양성”과 “그 안의 논문 순위”는 별도의 결정입니다.
3.2.4 From research mechanisms to executable mutations. 선택된 논문의 방법·부록과 가용한 공식 코드를 연구 에이전트가 읽고 변이 청사진을 만듭니다. 청사진은 원래 메커니즘과 가정, 대상 인터페이스, 필요한 상태와 산출물, 실행 연산, 보조 모델 호출 및 종료 조건을 포함합니다. 원 방법과 호스트 환경에 맞춘 변형을 구분하고 출처를 남깁니다. 이는 ScholarEvolve 내부 절차에 대한 설명이며, 이 리뷰가 후보 논문들의 전문이나 공식 코드를 모두 읽었다는 뜻은 아닙니다.
코딩 에이전트는 한 모듈을 $m_j^{(p)}$로 바꾸고 나머지를 유지합니다. 측정 전에 import 가능 여부, 인터페이스, 영구 산출물의 생성·재로딩, 유효 행동 생성을 확인합니다. 오류는 정해진 수리 예산 안에서 고칩니다. 진화셋으로만 구축한 영구 스킬·메모리는 검증과 테스트에서 고정하고, 현재 에피소드의 관측에 따른 지역 상태 변화는 허용합니다. 원문 §3.2
3.3 Module crossover and selection
세대 $g$의 챔피언 $H_g$를 기준 하네스 $H^{(0)}$로 삼습니다. 작업 $i$의 평균 보상 $\bar r_i(H)$를 이용해 후보 $p$로 모듈 $j$만 바꾼 이득을 $g_{j,p}(i)=\bar r_i(H_j^{(p)})-\bar r_i(H^{(0)})$로 계산합니다. 조합 $c=(c_1,\ldots,c_5)$는 위치마다 하나의 구현을 지정합니다. $c_j=0$은 원래 모듈을 유지한다는 뜻이며 해당 이득은 0입니다. 식 (3)은 조합 후보의 우선순위를 정합니다.
$|\mathcal{D}_{\mathrm{val}}|$은 검증 작업 수, 안쪽 합은 선택한 다섯 모듈의 단독 이득, 바깥쪽 합과 분모는 작업 평균입니다. 이미 측정한 값을 재사용하므로 순위 산정에 새 실행은 필요하지 않습니다. 다만 이 덧셈값은 실제 조합 성능이 아닙니다. 후보를 좁힌 뒤 완성 하네스를 실행하여 공동 이득을 측정합니다. 원래 모듈을 남기는 선택지도 있으므로 단독으로 좋은 변경이라도 조합에서는 제외할 수 있습니다. 원문 식 (3)
평가한 단일 변이와 교차 후보 가운데 검증 평균 보상이 가장 높은 것을 $\widetilde H_g$라 합니다. 작업별 차이를 짝지어 부트스트랩한 이득 구간의 하한 $L_\alpha$로 새 챔피언을 보존합니다. 부트스트랩은 관측 표본을 재추출하여 불확실성을 추정하는 절차입니다.
식 (4)의 명목 신뢰수준은 $1-\alpha$입니다. 이득의 하한이 양수일 때만 갱신하고 그렇지 않으면 이전 챔피언을 유지합니다. 실행 가능한 후보가 없을 때도 이전 것을 보존합니다. 단일 변이도 후보에 포함하므로 유용한 한 가지 변경만으로 전진할 수 있습니다. 확인된 개선이 없는 세대가 $s_{\mathrm{stop}}$회 연속 나오거나 예산이 소진되면 현재 주기를 끝냅니다. 주실험의 $s_{\mathrm{stop}}=1$은 A.1에 명시되어 있습니다. 식의 일반 신뢰수준과 부록 D의 후보별 90% 구간, A.3의 하위집단 95% 구간을 같은 대상으로 혼동해서는 안 됩니다. 원문 식 (4)
3.4 Lifelong harness evolution
한 탐색 주기가 수렴해도 새 논문이 들어오면 보존한 챔피언에서 새 주기를 시작합니다. 이미 구현된 방법을 걸러내고 필요하면 진화셋 궤적으로 연구 질문을 갱신합니다. 문헌은 변이 방향, 교차는 모듈 조합, 검증셋은 적합도 신호를 제공합니다. 가중치는 계속 고정하지만 코드와 영구 산출물에는 이전 개선이 남습니다.
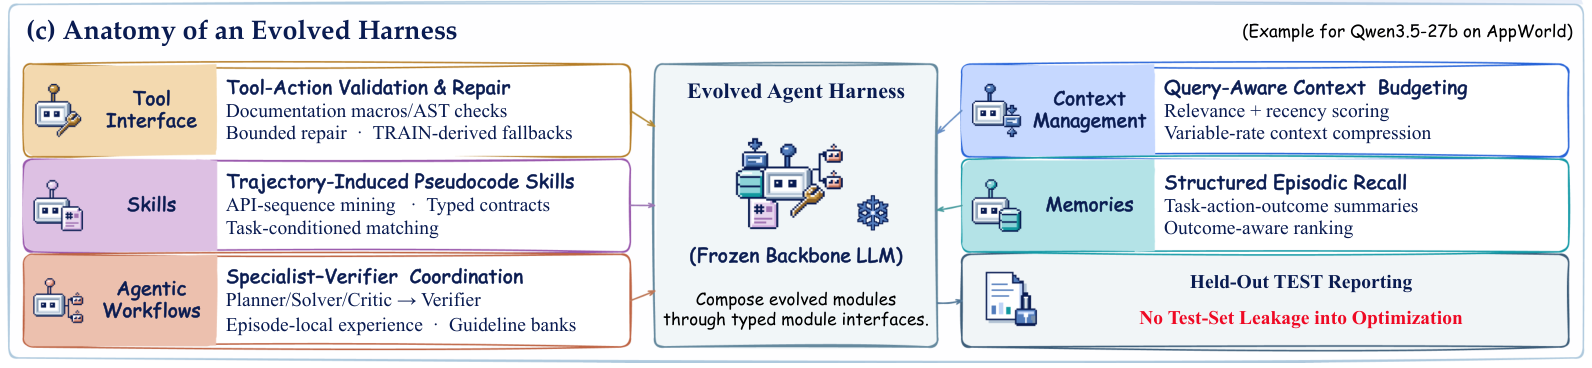
Figure 2(c), PDF 4쪽. 2609.40169v1의 하단 패널만 추가 크롭했으며 번역·재구성하지 않았습니다. 전체 그림에서 작은 글자를 읽기 위한 상세 발췌입니다.
그림의 다섯 모듈은 각각 행동 형식과 수리, 질의에 맞춘 문맥 예산, 반복 API 절차, 과거 작업·행동·결과, 전문 역할과 검증을 맡습니다. 이 장의 핵심은 연구 지식의 주입부터 실행 가능한 변경과 선택까지 이어지는 연결이며, 다음 장은 이 연결이 실제 작업 성공으로 이어지는지 평가합니다. 원문 §3.4
📖 Chapter 4: Experiments
4.1 Experimental Setup
원문은 먼저 평가 환경과 데이터를 정의합니다. AppWorld의 진화셋은 학습 작업 90개, 검증셋은 개발 작업 57개입니다. 테스트는 Normal 168개와 Challenge 417개로 분리합니다. Challenge에는 진화·검증셋에 없던 Amazon 또는 Gmail API를 필요로 하는 작업이 포함됩니다. SGC는 같은 시나리오의 세 변형이 모두 성공해야 하므로 개별 작업 성공률인 TGC보다 엄격합니다.
Telecom에서는 계층화한 경험 작업 250개를 진화셋으로, 공식 학습 분할 74개를 검증셋으로, 공식 테스트 40개를 최종 평가로 사용합니다. 여기서 pass의 $k\in\{1,2,3,4\}$는 지정한 k개 실행이 모두 성공할 확률을 나타냅니다. 흔히 코드 생성에서 사용하는 “k번 중 한 번이라도 성공”의 pass@k와 방향이 다릅니다. 각 실행 묶음에는 작업별 내부 시도 네 번이 있으며, 집계식은 A.1에서 설명합니다.
두 작업 백본은 Qwen3.5-27B와 GPT-5.4-mini입니다. 초기 하네스 및 실행 피드백으로 수정하는 Meta Harness와 비교합니다. 주실험의 두 진화 방법 모두 Codex를 통한 GPT-5.4를 사용하며, 각 설정에서 같은 할당 탐색 실행 예산을 받습니다. 최종 수치는 세 번의 독립 평가 실행에 대한 평균±표준편차입니다. “같은 할당 실행 예산”은 같은 전체 토큰 비용이나 실행 시간을 입증하는 문장은 아닙니다. 원문 §4.1
4.2 Main Results
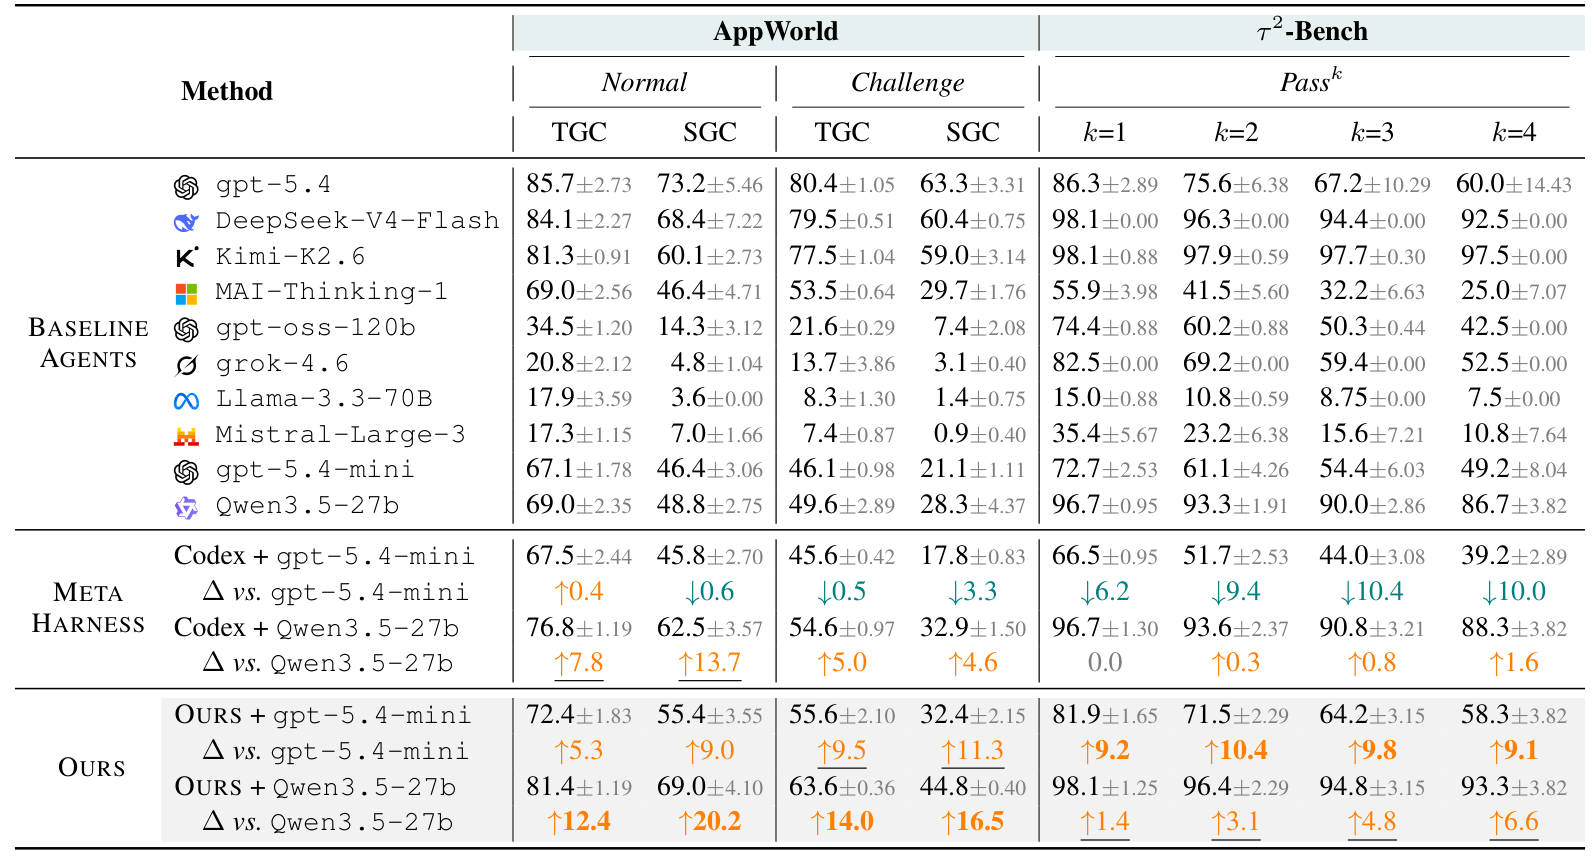
Table 1, PDF 8쪽. 2609.40169v1의 표 영역을 크롭했습니다. 수치·단위·행·열을 유지했으며 번역하지 않았습니다. 아래 표는 두 진화 대상 백본의 핵심 행을 원문과 대조해 옮긴 것입니다.
먼저 저자들은 모든 보고 지표에서의 개선을 제시합니다. AppWorld의 주요 수치는 다음과 같습니다. 모두 % 단위의 평균±표준편차이며 초기, Meta, Scholar는 각각 초기 하네스, Meta Harness, ScholarEvolve입니다.
| 작업 백본·하네스 | Normal TGC | Normal SGC | Challenge TGC | Challenge SGC |
|---|---|---|---|---|
| Qwen 초기 | 69.0±2.35 | 48.8±2.75 | 49.6±2.89 | 28.3±4.37 |
| Qwen Meta | 76.8±1.19 | 62.5±3.57 | 54.6±0.97 | 32.9±1.50 |
| Qwen Scholar | 81.4±1.19 | 69.0±4.10 | 63.6±0.36 | 44.8±0.40 |
| Mini 초기 | 67.1±1.78 | 46.4±3.06 | 46.1±0.98 | 21.1±1.11 |
| Mini Meta | 67.5±2.44 | 45.8±2.70 | 45.6±0.42 | 17.8±0.83 |
| Mini Scholar | 72.4±1.83 | 55.4±3.55 | 55.6±2.10 | 32.4±2.15 |
Qwen의 Normal TGC는 12.4%p, SGC는 20.2%p 증가합니다. Challenge에서는 TGC 14.0%p, SGC 16.5%p 증가합니다. Mini의 Challenge TGC는 9.5%p 높아집니다. 같은 백본의 Meta Harness와 비교한 Challenge TGC 차이는 Qwen 9.0%p, Mini 10.0%p입니다. 성능 변화의 단위는 비율의 상대 증가율이 아닌 퍼센트포인트입니다.
| 작업 백본·하네스 | Telecom pass¹ | pass² | pass³ | pass⁴ |
|---|---|---|---|---|
| Qwen 초기 | 96.7±0.95 | 93.3±1.91 | 90.0±2.86 | 86.7±3.82 |
| Qwen Meta | 96.7±1.30 | 93.6±2.37 | 90.8±3.21 | 88.3±3.82 |
| Qwen Scholar | 98.1±1.25 | 96.4±2.29 | 94.8±3.15 | 93.3±3.82 |
| Mini 초기 | 72.7±2.53 | 61.1±4.26 | 54.4±6.03 | 49.2±8.04 |
| Mini Meta | 66.5±0.95 | 51.7±2.53 | 44.0±3.08 | 39.2±2.89 |
| Mini Scholar | 81.9±1.65 | 71.5±2.29 | 64.2±3.15 | 58.3±3.82 |
Telecom에서 Mini의 pass¹는 9.2%p, pass⁴는 9.1%p 개선됩니다. 초기 점수가 높은 Qwen에서도 pass¹ 1.4%p, pass⁴ 6.6%p의 변화가 보고됩니다. 반복해서 모두 성공해야 하는 지표에서의 변화가 단일 시도 평균 이상의 정보를 제공합니다.
다음 소주제는 보지 못한 앱으로의 일반화입니다. Normal에서 만든 코드와 영구 산출물을 Challenge에 그대로 적용합니다. 마지막으로 저자들은 모델 간 격차를 설명합니다. Qwen의 Normal TGC 81.4%는 초기 Kimi-K2.6의 81.3%와 비슷하고, 초기 GPT-5.4의 85.7%와의 차이는 16.7%p에서 4.3%p로 줄어 약 74%를 메웁니다. 이는 해당 벤치마크·하네스 조건의 비교이며 모델 전반의 능력 동등성을 뜻하지 않습니다. 원문 §4.2·Table 1
4.3 Lifelong Evolution
새 논문을 세 발표 구간에 나누어 공급하며 Qwen 백본, 진화 궤적, 유도 산출물을 고정합니다. 매 라운드는 현재 하네스의 다섯 모듈을 모두 탐색합니다. Figure 3 왼쪽은 검증셋에서 고른 세대별 최우수 하네스를 Normal 테스트에 적용한 결과이고, 오른쪽은 별도로 주실험의 작업별 성공 횟수 변화를 보여 줍니다. 같은 그림 안에서도 두 분석의 프로토콜이 다릅니다.
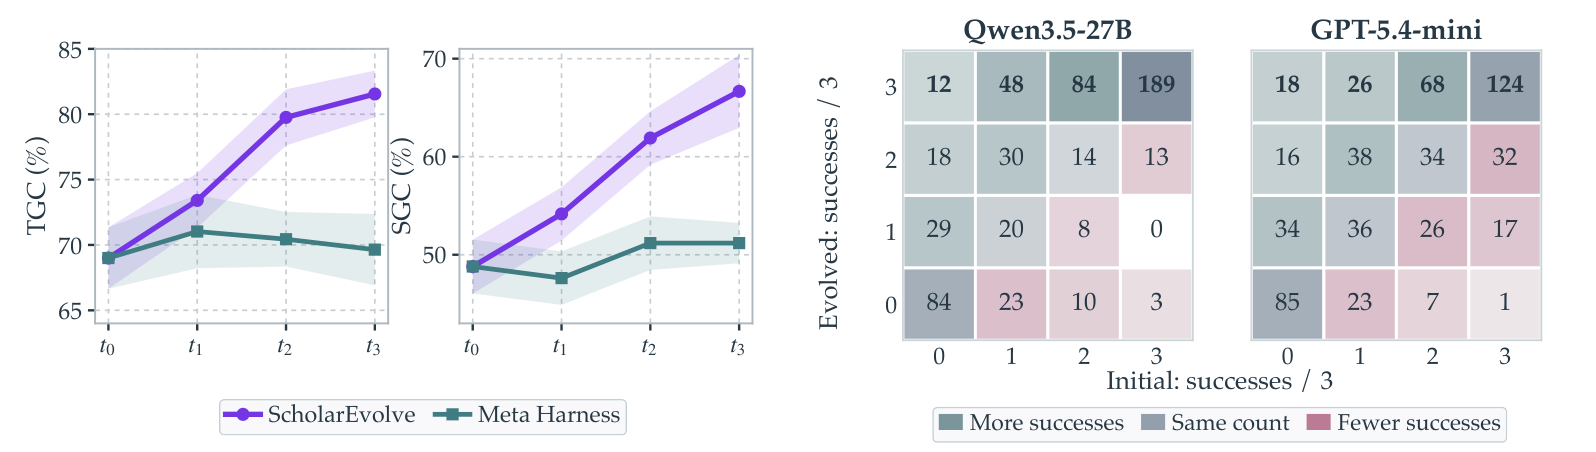
Figure 3, PDF 8쪽. 2609.40169v1의 그림 영역을 크롭했습니다. 축·범례·패널과 원 수치를 유지했으며 번역하지 않았습니다. 왼쪽 띠는 한 표준편차이고, 오른쪽 각 백본의 작업 수는 Normal과 Challenge를 합친 585개입니다.
세대별 TGC는 69.00→73.41→79.76→81.55%, SGC는 48.80→54.17→61.91→66.67%입니다. 최종 Meta Harness는 각각 69.64%, 51.19%여서 차이는 약 11.9%p와 15.5%p입니다. 이 결과를 Table 1의 81.4%·69.0%와 합쳐 하나의 실험처럼 해석하면 안 됩니다. 발표 구간, 후보 예산과 구현 모델이 별도인 실험이며 자세한 조건은 A.2에 있습니다. 원문 §4.3·Table 5
4.4 Ablation Studies
Contributions of the search design. Table 2는 요소를 차례로 추가 제거하는 누적 제거 실험입니다. 먼저 같은 선별 풀과 논문 예산에서 주제 순환 선택을 관련성 순위로 바꾸고, 다음에는 모듈별 변이·재조합을 하네스 전체 공동 수정으로 바꾸며, 마지막에는 연구 지침도 제거해 Meta Harness에 도달합니다.
| 누적 설정 | Qwen TGC / SGC | Mini TGC / SGC |
|---|---|---|
| 전체 ScholarEvolve | 81.4 / 69.0 | 72.4 / 55.4 |
| 추가로 주제 선택 제거 | 80.0 / 66.7 | 69.8 / 50.0 |
| 추가로 모듈별 변이 제거 | 78.6 / 64.9 | 69.3 / 48.8 |
| 추가로 연구 지침 제거 | 76.8 / 62.5 | 67.5 / 45.8 |
가독성을 위해 평균만 옮겼으며 원문은 각 셀의 표준편차도 보고합니다. 첫 제거의 TGC·SGC 차이는 Qwen 1.4·2.3%p, Mini 2.6·5.4%p입니다. 이는 주제 할당과 메커니즘 선별을 이미 마친 풀 안에서의 선택 정책 효과입니다. 뒤 단계 차이는 앞 요소가 제거된 조건에서 관측되므로, 완전한 시스템에 대한 각 구성요소의 독립 효과로 단정하지 않습니다.
Module interactions under crossover. Table 3은 테스트가 아닌 개발셋 57개 작업·세 실행에서 구성 모듈과 조합을 비교합니다. Qwen의 초기 TGC·SGC는 67.8·43.9%, 조합은 84.8·73.7%입니다. Mini는 66.1·47.3%에서 77.2·59.6%가 됩니다. Qwen은 다섯 모듈, Mini는 스킬·메모리·워크플로를 조합하고 다른 둘은 유지합니다.
Qwen의 최고 단독 TGC는 메모리 81.3%, 최고 단독 SGC는 워크플로 61.4%입니다. 조합은 지표별 최고 단독값보다 각각 3.5·12.3%p 높습니다. Mini도 각각 4.7·7.0%p 높습니다. 한편 단독 TGC 75.4%인 스킬 대신 73.7%인 스킬을 쓰자 조합 TGC가 80.7%에서 84.8%로 올랐습니다. A.1은 이 개발셋 조합의 스킬이 Table 1 주실험의 스킬과 다르고 다른 네 모듈은 같다고 명시합니다. 단독 순위로 최종 조합을 정할 수 없다는 근거이지만, 84.8%를 최종 테스트 성능으로 제시할 근거는 아닙니다. 원문 §4.4·Tables 2–3
4.5 Analysis of Harness Evolution
Generalization to broader API requirements. 공식 참조 풀이의 서로 다른 API 수로 Challenge를 묶습니다. 학습 작업의 76.7%는 최대 아홉 API를, 전체 최대는 열두 API를 사용합니다. 이 학습 분포에서 정한 경계에 따른 세 집단은 각각 168·147·102개 작업입니다. Qwen의 TGC 차이는 13.1·18.4·9.5%p, Mini는 5.4·15.9·7.2%p입니다. 참조 풀이의 API 폭을 측정한 것이므로 에이전트 실행 길이와 같지 않습니다. 열두 API를 넘는 집단의 불확실성은 A.3에서 별도로 다룹니다.
Residual failures after evolution. Qwen의 초기·최종 실패 에피소드 1,336개를 감사하여 다섯 실패 계열·열여섯 하위유형으로 정리합니다. Figure 4는 최종 실패 549개에서 근거가 확보된 미해결 라벨 580개를 요약합니다. 한 에피소드에 여러 라벨이 붙을 수 있습니다. 잘못된 응답 형식은 492→206개로 줄었지만, 제약 위반은 91→89개, 불완전 검색은 77→70개로 변화가 작습니다. 저자들은 요구사항 추적과 증거 커버리지가 계속 남는 문제라고 명시합니다. 이 실패 분포는 Qwen AppWorld의 해당 실행 집단에 대한 결과입니다.
Evolution expands task coverage and reliability. 두 테스트 분할을 합친 585개 작업에서 세 번 중 성공 횟수가 증가한 작업은 Qwen 221개, 감소한 것은 57개입니다. Mini는 증가 200개, 감소 106개입니다. 증가 집단 중 초기부터 간헐적으로 성공하던 작업의 비중은 Qwen 73.3%, Mini 66.0%입니다. Qwen이 세 번 모두 성공한 작업은 205→333개로 늘어납니다. 따라서 평균 개선에는 새 작업 해결뿐 아니라 기존의 불안정한 성공을 안정화하는 변화도 포함됩니다. 이 장은 성능 상승, 조합 상호작용과 남은 실패를 연결하고, 다음 장은 그 결론을 정리합니다. 원문 §4.5
📖 Chapter 5: Conclusion
결론은 고정 백본 주위에서 문헌을 배우며 하네스를 진화시키는 프레임워크, 모듈과 주제별 탐색, 조합의 직접 평가를 다시 정리합니다. AppWorld와 Telecom의 두 백본에서 성능이 개선되고 보지 못한 앱으로 전이되며, 새 문헌 구간으로 추가 개선이 가능했다는 것이 저자의 결론입니다. 요구사항 추적과 증거 커버리지는 열린 문제로 명시합니다. 원문 §5, PDF 9–10쪽
이어 Acknowledgments는 UCSB 팀에 대한 NSF 지원을 기록하고, References는 관련 연구와 후보 메커니즘의 서지를 제공합니다. 참고문헌 목록의 위치와 연결은 확인했으나 그 목록의 모든 논문을 읽거나 각각의 주장을 독립 확인하지는 않았습니다. 본문 결론 뒤에는 부록 목차와 A–D가 이어지며, 실험과 구현을 해석하는 데 필요한 세부 조건을 순서대로 보완합니다.
📖 Chapter A: Additional Experimental Details
A.1 Implementation Details
Task environments and data. AppWorld는 공식 최소 프롬프트와 벤치마크 지침을 사용하고 에피소드당 환경 단계 100회를 허용합니다. 시나리오의 변형은 분할 간에 함께 묶습니다. Telecom 경험 풀은 기본 컬렉션을 제외한 전체 작업 컬렉션에서 시드 2026으로 계층 추출한 250개이며, 서비스 문제 18개·모바일 데이터 60개·MMS 172개입니다. 환경은 주 정책과 기술지원 매뉴얼을 사용하며 대화 단계 200회, 오류 10회, 시뮬레이션 시드 300을 적용합니다. 사용자 시뮬레이터는 high reasoning effort의 GPT-5.2입니다.
Model configuration. 모델 호출당 최대 완성 길이는 65,536토큰이고 Mini는 low reasoning effort입니다. 주실험 Qwen은 vLLM 0.27.1, tensor parallelism 4, temperature 0, thinking 활성화로 서비스합니다. Telecom 서버 문맥 한도는 262,144토큰입니다. AppWorld의 저장 요청에는 low reasoning effort가 있지만 Qwen 템플릿은 이를 무시하고 기본 thinking을 유지한다고 설명합니다. 따라서 요청 필드 하나만 보고 실제 추론 모드를 판단해서는 안 됩니다. 같은 벤치마크·백본에서 초기·진화 하네스의 모델 설정과 환경 제한은 같습니다.
Search and artifact construction. 주실험의 연구 선택은 GPT-5.4 medium reasoning effort, 코드 생성은 Codex GPT-5.4입니다. AppWorld는 모듈당 논문 유도 후보 네 개, 총 스무 개를 요청하고 Telecom은 세 개씩 총 열다섯 개를 요청합니다. 단일 후보 측정 후 조합을 순위화합니다. AppWorld 초기 개발 측정은 세 실행이고 Mini 최종 후보는 아홉 실행으로 추가 확인합니다. Telecom 개발 측정은 작업별 내부 시도 네 번입니다. 성공한 진화 궤적으로 만든 스킬과 메모리는 평가에서 고정하며 Normal·Challenge에는 같은 AppWorld 구현과 산출물을 사용합니다. 한 세대에 확인된 이득이 없으면 주기를 멈춥니다.
Metric aggregation. Normal은 56개 시나리오, Challenge는 139개이며 각각 시나리오당 세 작업입니다. Telecom에서 한 실행의 작업 $i$가 내부 네 시도 중 $s_i$번 성공했다면 원문이 서술한 추정량은 다음과 같습니다.
이 식은 원문 A.1의 집계 절차를 한 식으로 정리한 것이며 별도의 원문 식 번호는 없습니다. $s_i$는 성공 횟수, $\binom{s_i}{k}$는 성공한 시도에서 k개를 고르는 조합 수, $\binom{4}{k}$는 전체 네 시도에서 k개를 고르는 수입니다. $s_i<k$이면 기여를 0으로 처리합니다. 작업 40개의 평균을 각 실행에서 먼저 계산한 뒤 세 실행의 평균과 표준편차를 보고합니다. 예를 들어 k=4에서는 네 번 모두 성공한 작업만 기여합니다. 이 정의 때문에 k가 커질수록 성공 일관성 기준이 엄격해집니다.
Ablation controls. Qwen의 저장된 선별 풀에는 모듈–논문 기록 1,956개가 있습니다. 한 논문이 여러 모듈에 들어갈 수 있으므로 서로 다른 논문 1,956편으로 바꾸어 표현하지 않습니다. 주제 선택 제거 시 상위 주제 할당과 메커니즘 선별은 고정합니다. 개발셋 조합 분석은 같은 57작업·세 실행의 정확한 구성요소끼리 비교하며, 앞서 설명한 Qwen 스킬 차이를 명시합니다. 원문 A.1, PDF 16쪽
A.2 Lifelong Evolution Protocol and Results
라운드마다 해당 발표 구간에서 모듈당 최대 한 논문을 고릅니다. 개별 변이 최대 다섯 개와 조합 최대 네 개를 개발셋 57작업에서 평가하고, 최우수 하네스에는 총 세 번의 개발 평가를 제공합니다. 세 세대의 선택을 모두 동결한 뒤 Normal 테스트 168작업을 평가합니다.
발표 구간은 2025년 12월까지, 2026년 1–4월, 2026년 5–8월의 서로 겹치지 않는 세 구간입니다. arXiv 최초 제출일을 기준으로 현재 인덱스에서 재구성했습니다. 따라서 당시 실시간 서비스에서 새 논문을 받아 수개월간 운영했다는 실증으로 읽지 않습니다. 모델 가중치·저장 진화 궤적·유도 산출물은 고정하고, 연구 선택은 GPT-5.4, 구현은 Codex GPT-5.5를 사용하며 둘 다 medium reasoning effort입니다. 주실험의 구현 모델과 구분해야 합니다.
| 지표·방법 | t₀ | t₁ | t₂ | t₃ |
|---|---|---|---|---|
| TGC ScholarEvolve | 69.00±2.35 | 73.41±2.09 | 79.76±2.15 | 81.55±1.79 |
| TGC Meta Harness | 69.00±2.35 | 71.03±2.81 | 70.44±2.09 | 69.64±2.73 |
| SGC ScholarEvolve | 48.80±2.75 | 54.17±2.72 | 61.91±2.73 | 66.67±3.72 |
| SGC Meta Harness | 48.80±2.75 | 47.62±2.73 | 51.19±2.73 | 51.19±2.06 |
단위는 %입니다. 표는 세대마다 찾은 최우수 하네스를 보여 주며, 테스트가 선택 신호가 되지 않도록 모든 선택을 먼저 고정합니다. 원문 A.2·Table 5, PDF 17쪽
A.3 Training and Test API Distributions
Figure 5의 API 수에는 참조 풀이의 helper API도 포함합니다. 중앙값은 Train 8, Normal 8.5, Challenge 10으로 증가하고 Challenge의 24.5%가 학습 최대인 열두 API를 넘습니다. 검증셋의 최대는 열 API입니다. 학습의 제3사분위수 아홉과 최대 열둘로 경계를 정하므로 테스트 이득을 보고 유리한 분할을 고른 것이 아닙니다.
Table 4의 하위집단 이득 구간은 저장된 세 실행에 조건을 두고 시나리오를 짝지어 20,000회 재표집한 95% 부트스트랩 구간입니다. 시드는 20260922이고 시나리오의 세 변형을 함께 보존합니다. 열두 API 초과 집단에서 Qwen 이득 9.5%p의 구간은 [-0.7, 19.6]%p, Mini 이득 7.2%p는 [0.3, 14.1]%p입니다. Qwen의 평균은 양수이지만 구간에 0이 포함됩니다. 따라서 두 모델 모두 이 집단에서 통계적으로 확인된 양의 이득이라고 일괄 서술할 수 없습니다. 원문 A.3, PDF 17–18쪽
A.4 Analysis Protocol
분석은 Table 1의 최종 구성을 사용하고 원래 성공 비트에서 재계산합니다. 다른 하위집단 구간은 시드 20260905로 20,000회 짝지은 클러스터 부트스트랩을 수행합니다. AppWorld는 시나리오 전체를, Telecom은 작업 전체를 재표집합니다. 구간은 저장된 실행에 조건부인 탐색적 비교입니다. 실행 인덱스를 같은 난수 시드의 대응쌍으로 가정하지 않습니다. Figure 6에는 모든 585작업을 포함하고 공식 작업 ID와 다섯 난도·구조 메타데이터 필드를 대조합니다.
Reliability transitions. Qwen의 성공 횟수 증가·동일·감소 작업 수는 Normal 57·102·9, Challenge 164·205·48입니다. Mini는 각각 44·94·30과 156·185·76입니다. Qwen의 세 번 모두 성공한 작업은 Normal 86→123, Challenge 119→210이고 Mini는 85→96, 89→140입니다. Qwen에서 새로 일관된 성공을 보인 작업 중 Normal 40개 중 39개, Challenge 104개 중 93개는 초기에도 한두 번 성공한 작업입니다. 이는 안정화가 평균 개선의 큰 부분임을 구체화합니다.
Recovery after execution errors. 명시적인 Execution failed. Traceback: 표지가 있으면 실행 오류로 식별합니다. Qwen Normal에서 오류를 겪은 최종 하네스 에피소드 249개 중 180개는 결국 성공합니다. 조건부 성공률은 초기 176/273=64.5%에서 최종 180/249=72.3%로 바뀝니다. Challenge는 405/903=44.9%에서 518/865=59.9%입니다. 두 하네스가 오류를 겪은 작업은 같지 않을 수 있으므로 이는 관측된 궤적의 조건부 통계이며, 오류 뒤 복구 능력에 대한 무작위 대응 실험은 아닙니다. 원문 A.4, PDF 18–19쪽
A.5 Failure Taxonomy and Diagnostic Checks
먼저 감사 범위를 고정합니다. Qwen의 초기·최종 하네스 각각 Normal 504에피소드와 Challenge 1,251에피소드, 즉 작업당 세 실행을 대상으로 합니다. 원래 평가 결과는 바꾸지 않고 API 요청·실행 상태의 저장 해시와 작업별 성공 수를 확인합니다. 공개 참조 답과 평가 정의는 사후 진단에만 사용합니다.
Hierarchical behavior coding. 실패 1,336에피소드에는 초기 787개와 최종 549개가 포함되며 396작업에 걸쳐 있습니다. 서로 다른 시나리오의 50에피소드로 보정하고 14개 표적 재검토로 경계를 다듬은 뒤 정의를 동결합니다. 주석 모델은 OpenRouter를 통한 Muse Spark 1.3 Contributor, temperature 0, medium reasoning effort입니다. 작업·기본 지침·실행 코드·관측·참조 평가를 제공하되 모델·하네스 이름, 비교 집단, 실행 번호와 성능 차이는 숨깁니다. 자격증명·식별 필드는 에피소드 안에서 일관된 가명으로 바꾸고, 실제 실행 단계는 자르지 않습니다.
두 번째 패스는 전체 입력과 첫 초안, 재구성한 완료·응답 검사를 보고 라벨과 복구 상태를 다시 판단합니다. 같은 모델을 쓰며 첫 패스 초안을 보므로 독립된 사람 평가자 간 합의로 해석하지 않습니다. 지역 검사는 근거 인용·단계 번호·완료 신호를 대조하고 수정 이유를 보존합니다. 주소 가명화로 생긴 별칭 차이가 잘못된 위치로 오인되지 않도록 관계도 재확인합니다.
실패 계열의 순서와 하위유형은 다음과 같습니다.
| 계열 | 하위유형 |
|---|---|
| Retrieval & grounding | 불완전 검색, 개체 혼동, 근거 없는 추론 |
| Goal & reasoning | 요구사항 누락, 제약 위반, 잘못된 도출 |
| Action & state | 목표와 동작의 불일치, 선행조건 누락, 의도하지 않은 상태 변경, 잘못된 도구 호출 |
| Monitoring & recovery | 효과 없는 복구, 진전 없는 반복, 성급한 완료, 예산 소진 |
| Response delivery | 잘못된 답, 잘못된 응답 형식 |
각 문제는 미해결·복구·불확실로 구분하고 근거 강도와 신뢰도를 기록합니다. 근거가 확보된 미해결 빈도에는 중간 이상 신뢰도와 직접 관측 또는 검증된 참조 비교가 필요합니다. 에피소드가 다른 문제로 실패했더라도 수정된 도구 호출은 복구로 남깁니다. 단계 예산이 끝났다는 이유만으로 요구사항 누락을 붙이지 않습니다.
Coverage and descriptive comparisons. 후보 열일곱 하위유형 중 답 누락은 관측되지 않아 최종 열여섯 유형에서 빠집니다. 근거 있는 미해결 행동 라벨이 없는 실패는 218개로 초기 97개·최종 121개이며, 그 불확실성을 유지합니다. 따라서 580라벨을 최종 실패 549개의 완전한 원인 분해로 취급할 수 없습니다. Table 6의 복구 열도 성공 에피소드 전체가 아니라 실패 에피소드 집단 안에서 복구된 발생 수입니다.
처음 세 번 모두 실패하고 초기 응답 형식 문제가 있던 작업은 111개 중 54개가 최소 한 번 성공하게 됩니다. 초기 제약 위반 작업은 42개 중 16개입니다. 집단은 중복 가능하고 다른 문제도 함께 존재하므로 한 라벨이 수정되어 성공했다는 인과 분해는 아닙니다.
Completion and answer diagnostics. 별도의 상호배타적인 끝점 진단은 순서대로 첫 실패를 기록합니다. ① 완료 신호 부재, ② 참조 답이 null인 행동 작업의 응답 계약 위반, ③ 답이 필요한 작업의 응답 비교 실패, ④ 완료·응답이 허용되었지만 목표 상태 미달입니다. 숫자 허용오차, 순서 없는 목록, 허용 인용문과 반환 코드 집합 등 공개 비교 규칙을 적용합니다. 성공 에피소드는 재구성 검사도 통과합니다.
전체 에피소드를 분모로 삼을 때 실패 총수는 Normal 156→94, Challenge 631→455입니다. 순서별 끝점 빈도는 Normal (1,84,15,56)→(0,29,8,57), Challenge (10,407,11,203)→(10,177,17,251)입니다. Challenge의 마지막 상태 미달 빈도가 늘어도 앞선 응답 검사를 통과하면서 뒤의 실패가 새로 드러날 수 있습니다. 저자들은 실행 변화와 처음 기록되는 실패의 변화가 함께 섞인다고 설명합니다. 전체 행동 라벨과 이 순차 진단은 다른 관점을 제공합니다. 이 부록은 평가 수치를 해석할 분모와 관측 범위를 제공하며, 다음 부록은 두 상태 사례로 실행 메커니즘을 구체화합니다. 원문 A.5·Tables 6·Figures 7–8, PDF 19–21쪽
📖 Chapter B: Qualitative Analysis
Research introduces choices at different decision points. Figure 9는 Qwen 후보들을 에이전트가 무엇을 보는지, 어떻게 추론하는지, 어떻게 행동하는지에 따라 배치합니다. 문맥 후보는 정보량 기반 선택과 문맥 구간 간 관계를 고려한 선택을, 메모리 후보는 해결 에피소드 검색과 제한된 코드북 압축을 포함합니다. 스킬 후보는 선행조건 검사와 반복 API 순서의 의사코드화를 제공합니다. 워크플로 후보는 추론 전략 라우팅과 전문 역할 제안 집계를, 도구 후보는 구조화된 행동과 API 탐색 계획을 다룹니다. 그림의 대안들은 모두 동시에 활성화한 최종 구성이라는 뜻이 아니라 선택·재조합 대상입니다.
State-aware execution turns some repeated failures into successes. 작업 9126bf0_3은 기존 객체를 갱신해야 하는데 초기 하네스가 새 객체를 만든 사례입니다. 최종 하네스는 원 객체를 찾아 수정합니다. 작업 20c1328_3은 장바구니의 기존 항목이 의도하지 않게 주문에 포함되는 사례로, 최종 하네스는 기존 상태를 비운 뒤 요청한 동작을 수행합니다. 두 사례 모두 초기 세 번 실패에서 최종 세 번 성공으로 바뀌며 각 하네스의 세 궤적을 모두 확인했다고 명시합니다.
이 사례는 객체 식별과 행동 선행조건의 중요성을 설명하지만 전체 빈도의 대용은 아닙니다. 두 하네스 모두 세 번 실패한 Challenge 작업 71개 중 35개는 최종 실행에도 최소 한 번 잘못된 최종 응답을 보입니다. 저자들은 상태 검사와 인터페이스 강제의 추가 개선을 이 잔여 관측과 연결합니다. 이 부록의 역할은 성능 변화가 실행에서 어떤 차이로 나타나는지 보여 주는 것이며, 다음 부록은 이를 구현 인터페이스와 검색 절차로 이어 갑니다. 원문 B, PDF 21–22쪽
📖 Chapter C: Additional Method Details
C.1 Representative Module Implementations
원문은 다섯 모듈을 차례로 구체화합니다. Tool interface의 AppWorld 예시는 문서 조회 매크로를 실제 API 설명 출력 호출로 확장합니다. Python 행동을 추출하고 문법·문장 구조를 검사하며 제한된 정규화와 문서 질의를 통한 복구를 지원합니다. Context management는 질의 관련성과 최신성으로 구간에 점수를 매기고 최소 할당을 예약한 뒤 남은 문자 예산을 배분합니다. 질의 중심 구절을 추출하고 원래 시간순을 복원하며 호스트 정책은 보존합니다.
Skills는 성공 궤적에서 반복 API 부분수열을 채굴하고 입력·출력·적용 단서·호출 순서·경험적 지지 횟수가 있는 의사코드로 만듭니다. 실행 시 어휘 트리거와 지지 횟수로 절차를 고릅니다. Memories의 Telecom 예시는 개체 프로필·시간·작업 속성·궤적 요약을 가진 장면 기록을 만들고 개체 일치 및 가중 속성·어휘 겹침으로 검색합니다. Agentic workflows의 AppWorld 예시는 planner·solver·critic의 제안을 verifier가 선택하고, 최근 관측과 오류 조건부 재시도 지침을 제한된 에피소드 내부 저장소로 유지합니다. 최종 출력은 하나의 제안과 합산 모델 사용량입니다. 원문 C.1, PDF 22–23쪽
C.2 Research Pool Construction and Topic Selection
Failure audit and capability abstraction. 감사가 있으면 관측 원인별로 실패를 묶고 추론 시 변경으로 개선할 수 있다고 판단한 반복 에이전트 문제를 우선합니다. 연구 질문에서 벤치마크 이름·도메인 개체·도구·필드명을 제거합니다. 앞선 관측을 잊는 문제는 문맥 선택·상태 추적·메모리 검색이라는 여러 개입으로 연결될 수 있습니다.
Module specific query construction. 같은 능력 공백 설명을 모듈 책임·인터페이스·현재 동작과 함께 제공하고, 넓은 능력 용어와 좁은 방법 용어를 교차 배치합니다. 문맥 압축, 궤적 검색, 스킬 발견 같은 짧은 연구 용어를 사용합니다. 모듈별 질의는 감사 없이 연구를 수집할 때도 지원됩니다.
Retrieval and pool construction. arXiv에서 제목·초록·링크를 수집합니다. 모듈 안에서는 정규화한 제목으로 중복을 제거하고 초록 없는 항목을 제외합니다. 서로 다른 모듈 풀에 같은 논문이 남을 수 있습니다. 구현 예산은 수집 시점이 아니라 주제 체계 구성 뒤에 적용합니다.
Mechanism taxonomy and evidence assignment. 배치별 제목·초록과 누적 주제 체계를 함께 읽어 짧은 메커니즘 이름과 한 문장 설명을 만듭니다. 구현 가능한 언어 모델 에이전트 메커니즘에 초점을 맞추고 서베이·독립 벤치마크·같은 용어의 무관한 사용을 제외합니다. 정제 뒤 고정된 체계에 초록 근거와 순서 있는 라벨을 할당하며, 파서가 인정한 첫 라벨이 선택 클러스터를 정합니다.
Mechanism screening and candidate allocation. 현재 모듈과 백본의 능력 설명에 비춰 빠진 메커니즘을 추가하는지와 그 이유를 기록합니다. 이미 포함된 주제는 제거하고 클러스터 크기순·순환 선택으로 후보를 배분합니다. 주제 설명·병합 이력·할당 근거·선별 이유·선택 논문 ID를 보존합니다. 따라서 문헌 수집의 폭과 구현 예산의 다양성 제어를 구분합니다. 원문 C.2, PDF 23쪽
C.3 Module Interfaces and Executable Checks
메모리는 근거, 스킬은 절차를 반환하고 문맥 관리가 이를 모델 입력에 배치합니다. 워크플로는 전달받은 입력을 각 호출의 접두부로 유지하고 필요하면 일시적 숙고를 덧붙입니다. 행동 제안은 도구 인터페이스로 넘어갑니다. 공유 에피소드 상태를 읽을 수 있지만 출력 계약으로 책임 경계를 유지합니다.
실행 전 점검은 import·인터페이스·영구 산출물 생성과 재로딩·통제된 모델 응답으로 유효 행동 생성 여부를 확인합니다. 성공 진화 궤적으로 만든 각 산출물은 원 작업의 provenance를 함께 저장하고 검증·테스트 동안 고정합니다. 이는 코드가 실행 가능하다는 점검과 성능이 좋은지 측정하는 평가를 구분한 설계입니다. 원문 C.3, PDF 24쪽
C.4 Crossover Diagnostics
원문 식 (5)은 실제 조합 이득과 단독 이득 합산 예측 사이의 차이를 정의합니다.
$H_c$는 완성된 조합 하네스, $H^{(0)}$는 기준, $\Delta(c)$는 검증 작업별 평균 보상 차이입니다. $\widehat\Delta(c)$는 식 (3)의 덧셈 예측이고 $\varepsilon(c)$는 그 잔차입니다. 보상의 상한 때문에 합산 예측이 가능한 이득을 넘을 수 있으며, 잔차에는 모듈 상호작용·보상 상한·평가 변동이 함께 들어갑니다. 잔차 전부를 순수한 시너지로 해석하지 않습니다.
실측 이득으로 조합의 순위를 정하고 강한 개별 후보의 부분집합도 평가하여 유용한 포함·제외를 찾습니다. 선택된 코드와 고정 산출물은 재사용 가능한 하네스가 됩니다. 지속 진화에서도 식 (4)의 보존 규칙을 적용하고 테스트 전에 구성을 동결합니다. 이 부록은 모듈 경계를 실제 실행과 선택으로 연결하며, 마지막 부록은 전체 후보와 선택 구현을 공개합니다. 원문 C.4, 식 (5), PDF 24쪽
📖 Chapter D: Candidates and Evolved Harnesses
D.1 Candidate Pool for Qwen3.5-27B on AppWorld
Table 7은 주실험의 Qwen AppWorld 후보 스무 개를 모두 보여 줍니다. 각 모듈의 네 후보는 네 가지 서로 다른 주제에서 나옵니다. 개발셋 57작업·세 실행에서 초기 하네스 대비 단독 TGC 차이를 계산하고 90% 짝지은 작업 부트스트랩 구간을 보고합니다. 후보 열일곱 개의 평균 차이가 양수이고 여덟 개는 구간 전체가 0보다 큽니다. 나머지 세 후보는 크게 하락하여 최종 구성에서 빠집니다.
| 모듈 | 원문의 후보 순서: 출처 방법과 단독 TGC 차이(%p) |
|---|---|
| Tool interface | Budget-constrained tool learning +2.9 → CheMatAgent +1.2 → ToolACE-R +4.7 → RefTool +1.8 |
| Context | Compression without MLPs -45.6 → ICPC -43.3 → Prompt compression limits +7.0 → Prompt-SAW +4.1 |
| Skills | RL with skill library +2.9 → Group of Skills +0.6 → Skill Drift Is Contract Violation +5.8 → Skill-as-Pseudocode +7.6 |
| Memories | Oracle Agent Memory +13.5 → Memory bank compression +4.1 → Episodic-memory prompting +9.9 → CoEvo-Mem -67.8 |
| Workflow | Perceptual self-reflection +8.8 → CodeMonkeys +8.2 → RTTC +4.1 → TMAS +9.4 |
최종 Qwen AppWorld 구성의 다섯 후보는 ToolACE-R, Prompt compression limits, Skill-as-Pseudocode, Oracle Agent Memory, TMAS입니다. 각각의 90% 구간은 [-0.6,+9.9], [+1.8,+12.3], [+1.2,+14.0], [+8.2,+19.3], [+3.5,+15.8]%p입니다. ToolACE-R의 단독 구간은 0을 포함하지만 최종 선택은 조합 평가도 사용합니다. 표의 W/L은 초기보다 작업 평균 보상이 높은/낮은 작업 수이지 실행별 승패 수가 아닙니다.
크게 하락한 문맥 두 후보의 구간은 [-53.8,-36.8], [-52.0,-34.5]%p이고 메모리 후보 CoEvo-Mem은 [-75.4,-60.2]%p입니다. 이는 해당 하네스에 적용한 후보 구현의 결과입니다. 원래 연구 방법 전체의 무효나 특정 실패 메커니즘을 입증하는 표가 아니므로 원문에 없는 하락 원인을 만들어 설명하지 않습니다. 원문 D.1·Table 7, PDF 25쪽
D.2 Selected Configurations and Code
먼저 Table 8은 네 가지 최종 설정의 출처 논문과 할당 주제를 모듈 순서대로 보여 줍니다. Mini AppWorld는 도구·문맥의 초기 구현을 유지하므로 모든 모듈을 교체해야 개선된다는 설계가 아닙니다.
| 모듈 | AppWorld Qwen | AppWorld Mini | Telecom Qwen | Telecom Mini |
|---|---|---|---|---|
| Tool interface | ToolACE-R | 초기 유지 | Lower Privileges Suffice | Interactive Semantic Parsing |
| Context | Prompt compression limits | 초기 유지 | Diable | Measure Before You Manage |
| Skills | Skill-as-Pseudocode | Skill Drift Is Contract Violation | Procedural KG Extraction | Procedural Knowledge at Scale |
| Memories | Oracle Agent Memory | CoEvo-Mem | CAST | MemRL |
| Workflow | TMAS | Plan-and-Solve | Textual-to-Visual Self-Verification | Same-Model Self-Verification |
같은 CoEvo-Mem 출처라도 Qwen AppWorld 후보에서는 크게 하락하고 Mini AppWorld의 최종 메모리에는 선택됩니다. 표에 기록된 주제도 각각 Adaptive Memory Optimization과 Adaptive Retrieval Control입니다. 따라서 출처 이름만으로 서로 다른 백본·구현·조합을 동일한 처치로 간주하면 안 됩니다.
이어 PDF 26–30쪽은 최종 Qwen AppWorld의 다섯 모듈 코드 일부를 같은 순서로 제공합니다. 생략된 줄을 표시한 발췌이므로 완전한 실행 코드로 취급하지 않습니다.
Tool interface: ToolACE-R (Structured API Actions). tool-p3.py는 DOC_ACTION <app> 또는 <app>.<api>를 Python 문서 조회로 확장합니다. act는 후보 코드를 제한된 횟수만큼 정제하고 유효하면 반환하며 마지막에는 fallback을 사용합니다. _is_effectful_python은 AST, 즉 코드를 트리로 표현한 추상 구문 구조를 파싱하고 빈 코드·문법 오류·효과 없는 단순 표현을 걸러냅니다. 이 검사가 모든 실행 의미나 목표 충족을 증명하는 것은 아닙니다. 발췌의 의미는 실행 형식 검사와 행동 생성의 경계에 있습니다.
Context management: Prompt compression limits (Budget and Scope Routing). cont-p3.py는 task instruction에서 질의 어휘를 추출하고 문맥 구간에 관련성+최신성 점수를 줍니다. 호스트 정책의 문자 수를 먼저 계산하고 남은 예산을 메모리·스킬·이력 구간에 배분합니다. 압축한 구간은 원래 순서대로 추가합니다. 다만 예산이 없거나 정책 자체가 한도 이상이면 정책과 이력을 그대로 반환하는 분기도 보입니다. 따라서 모든 분기에서 무조건 엄격한 문자 상한을 강제한다고 요약하지 않습니다.
Skills: Skill-as-Pseudocode (Skill Compilation). skil-p4.py의 절차 텍스트에는 task instruction과 current observation 입력, Python action 출력, 적용 어휘, 성공 학습 에피소드의 지지 횟수가 들어갑니다. 성공 궤적의 API 부분수열을 길이별로 세되 같은 에피소드 안에서는 중복 지지 횟수를 더하지 않습니다. 실행 시 어휘 겹침에 지지 횟수 보너스를 더합니다. 보너스의 발췌식은 min(0.25, support / 100.0)이므로 자주 나온 패턴이 무한히 우세해지는 구조는 아닙니다.
Memories: Oracle Agent Memory (Structured Memory Architecture). memo-p1.py는 작업 지침, API 행동, 출력의 앞부분과 결과를 제한된 길이로 요약하여 고정 JSON 저장소로 남깁니다. 회상은 작업 어휘와 저장 어휘의 Jaccard 유사도, 보상 보너스, 완료 보너스를 사용합니다. Jaccard는 두 집합의 합집합 대비 교집합 비율입니다. 코드의 보상 보너스 상한은 0.15, 완료 보너스는 0.05입니다. 파일 설명이 원 연구의 메모리 생애주기를 “lightweight version”으로 구현한다고 명시하므로, 원 논문의 모든 구조를 그대로 복제했다고 주장하지 않습니다.
Agentic workflows: TMAS (Multi-Agent Deliberation). agen-p4.py는 planner·solver·critic 역할의 후보를 만들고 verifier에게 지금 실행 가능하며 중복되지 않고 작업을 진전시킬 행동을 고르게 합니다. 전달받은 메시지를 각 역할 호출의 앞부분에 보존하며, 이전 관측과 재시도 지침을 에피소드 내부 공유 메모리로 덧붙입니다. 모든 호출의 사용량을 합산합니다. 선택 결과에서 코드를 추출하지 못하면 개별 후보에서 추출 가능한 코드를 찾는 fallback도 보입니다.
이 마지막 부록의 기여는 “문헌을 배웠다”는 표현을 구체적인 적응 코드와 출처로 연결하는 데 있습니다. 원래 논문을 바탕으로 한 메커니즘과 호스트에 맞춘 경량 구현을 구분하면, 같은 문헌에서도 여러 실제 변경이 나올 수 있음을 이해할 수 있습니다. 원문 D.2·Table 8 및 코드 발췌, PDF 25–30쪽
실험 결과 심층 분석
가장 직접적인 성과는 고정 백본의 작업 성공률과 반복 성공 일관성이 함께 개선되었다는 점입니다. Qwen의 Challenge TGC 49.6→63.6%와 SGC 28.3→44.8%는 보지 못한 앱을 포함하는 분할에서 얻은 결과이며, Mini Telecom의 pass¹ 72.7→81.9%와 pass⁴ 49.2→58.3%는 대화형 도구 작업에서 보고됩니다. 모든 실험을 하나의 평균 향상으로 합치기보다 초기 난도·성공 기준·백본별 여지를 함께 읽어야 합니다. Table 1
베이스라인 비교에서는 탐색용 모델과 할당 실행 예산을 맞춘 점이 중요합니다. Mini의 Meta Harness는 Telecom과 Challenge의 여러 지표에서 초기보다 낮아집니다. 따라서 자동 수정이나 더 복잡한 실행 흐름 자체가 개선을 보장하지 않습니다. 주제 선택, 모듈별 변이와 연구 지침을 차례로 제거할 때의 하락은 제안한 설계를 뒷받침하지만, 누적 실험의 각 차이를 독립적이고 가산적인 기여율로 해석해서는 안 됩니다. 개발셋의 강한 단독 후보가 가장 좋은 조합을 만들지 않았다는 결과는 실제 조합 평가의 필요성을 더 직접적으로 보여 줍니다.
통계 정보는 대상마다 다릅니다. 주실험 Table 1은 세 실행의 평균±표준편차를 보고하며 각 최종 방법 차이에 대한 p값이나 별도의 전체 테스트 신뢰구간은 표에 보고되지 않았습니다. 반면 개별 개발 후보에는 90% 짝지은 작업 부트스트랩 구간이 있고, API 하위집단에는 95% 시나리오 부트스트랩 구간이 있습니다. Qwen의 학습 최대 초과 API 집단은 평균 +9.5%p여도 구간이 0을 포함합니다. 이러한 불확실성을 보존해야 평균 향상을 모든 하위집단에서 확인된 효과로 과장하지 않습니다.
실패 분석의 강점은 전체 실행 집단과 라벨의 근거를 연결하고 불확실한 경우를 남긴다는 데 있습니다. 다만 이것은 Qwen AppWorld의 사후 진단이며, 행동 라벨은 중복되고 218실패에는 근거 있는 미해결 라벨이 없습니다. 응답 형식 감소는 분명하게 보고되지만 제약 위반과 증거 누락은 계속 남습니다. 순차 끝점 검사에서 후반 실패가 늘어나는 현상은 앞선 검사 통과로 드러나는 실패의 변화도 포함하므로, 곧바로 상태 처리 능력의 악화라고 해석할 수 없습니다. 원문 A.5
재현성 판단에서는 공개된 분할·서버 설정·후보 수·문헌 구간·집계식·코드 발췌를 유용한 근거로 볼 수 있습니다. 원문은 ScholarEvolve 코드 주소를 제공하지만, 이 리뷰는 해당 저장소의 별도 커밋을 내려받아 실행하거나 결과를 재현하지 않았습니다. 주실험과 지속 진화 실험의 구현 모델, 평가용 구성과 개발셋 조합의 스킬 차이도 재현 시 구분해야 할 조건입니다.
기술적 함의와 응용
저자의 주장으로는 연구 문헌이 고정 모델의 기존 지식 밖에서 새로운 하네스 개선 방향을 공급할 수 있고, 새 출판물이 다음 탐색 주기의 시작점이 될 수 있습니다. 제시된 실험은 세 문헌 구간에서 추가 개선이 가능함을 보여 줍니다. 저자들이 결론과 실패 분석에서 명시한 남은 문제는 요구사항 추적, 증거 커버리지, 상태 검사와 인터페이스 강제입니다. 이 범위를 넘어 새로운 한계나 향후 연구 과제를 저자의 주장으로 덧붙이지 않습니다.
리뷰어의 해석으로는 이 연구의 응용 가치는 특정 최종 모듈의 복제보다 문헌 근거→구현 가설→단독 평가→조합 평가→보존이라는 과정에 있습니다. 예를 들어 여러 앱을 다루는 업무 에이전트에는 행동 전 상태 확인, 문서 조회와 실행 형식 검사, 성공 경험의 절차화라는 분리된 개입 지점이 있습니다. Telecom에서는 구조화한 대화 상태와 경험 검색을 별도 모듈로 다룹니다. 실제로 유효한 변경은 백본과 환경에 따라 달랐으므로 이 예시는 실험에서 관측된 구현 방향의 해설이며 다른 산업 환경의 효과를 보장하지 않습니다.
데이터과학자가 얻을 수 있는 핵심은 모델 능력과 시스템이 전달하는 능력을 구분하고, 탐색 다양성과 평가 누수를 함께 관리하며, 개별 구성요소의 점수 대신 실제 결합 프로그램을 측정하는 관점입니다. ScholarEvolve는 새로운 지식을 코드로 받아들이면서도 그 유용성을 작업 성능으로 판단하는 연구 기반 하네스 진화의 한 사례를 제시합니다.
원문 검토 범위는 PDF 30쪽 전체와 동일 v1 HTML의 본문·부록 A–D입니다. 모든 번호 절과 부록 소절을 반영했으며, 표의 비핵심 세부 셀·그림 1·4–9·생략 표시된 코드 전체를 본문에 모두 재수록하지는 않았습니다. 참고문헌의 개별 원문, 공개 저장소의 전체 코드, 독립 재실행 결과는 이번 검토 범위에 포함되지 않습니다.