논문 개요와 전체 구조
언어 모델 에이전트의 행동은 모델 가중치만으로 결정되지 않습니다. 어떤 문맥을 모델에 전달하고, 언제 도구를 실행하며, 그 결과를 다음 호출에 어떻게 연결하는지 정하는 실행 프로그램도 성능에 영향을 줍니다. 이 논문은 그 프로그램을 하네스(harness) 라고 부르고, 실행 피드백을 읽어 하네스를 수정하는 능력을 학습합니다. 문제 풀이 모델인 solver는 고정한 채, 별도의 수정 제안 모델인 proposer를 학습한다는 점이 출발점입니다.
Alvin Zhang 외 연구진의 「Harness Learning Enables Generalizable Test-Time Adaptation」은 이를 실행 가능한 프로그램에 대한 메타학습으로 정식화합니다. 메타학습은 여러 경험에서 새로운 과제에 적응하는 절차 자체를 학습하는 접근입니다. 바깥 학습 루프에서는 proposer의 가중치를 갱신하고, 안쪽 적응 루프에서는 하네스 코드를 갱신합니다. 테스트 시점에는 proposer와 solver가 모두 고정됩니다. 따라서 테스트 시점의 적응은 가중치 공간(weight space)의 미세조정이 아니라 하네스 공간(harness space)의 프로그램 수정으로 이루어집니다. 이 글은 arXiv:2609.35738v1의 전체 HTML과 같은 버전의 36쪽 PDF를 분석합니다.
평가는 합성 추론 과제 Reasoning Gym과 다중 홉 질의응답(multi-hop QA)으로 이루어집니다. 다중 홉 QA는 여러 문서의 정보를 연결해야 답할 수 있는 문제입니다. 핵심 질문은 수정 능력이 미학습 과제로 이전되는지, 한 번 수정하는 능력을 배운 모델이 여러 번 수정해도 유용한지, 여러 수정 상태를 직접 학습하면 더 좋아지는지입니다. 원문의 전개는 다음과 같습니다.
| 원문 순서 | 절과 소절 | 역할 |
|---|---|---|
| 1 | Introduction | 문제와 세 가지 기여를 제시합니다. |
| 2 | Related Work: Harness optimization → Meta-learning | 기존 최적화와 학습된 적응 절차의 관계를 정리합니다. |
| 3 | Preliminaries: 3.1 Harness → 3.2 Reinforcement learning with verifiable rewards | 실행 프로그램과 검증 가능한 보상, GRPO를 정의합니다. |
| 4 | Harness Learning as Meta-Learning: 4.1 Tasks, harnesses, and execution feedback → 4.2 Harness adaptation and the meta-learning objective → 4.3 Training the proposer | 피드백·선택·평가를 분리하고 학습 목적을 설명합니다. |
| 5 | Experiments: 5.1 Experimental setup → 5.2 Learning transferable revisions on Reasoning Gym → 5.3 Adapting retrieval workflows on unseen QA benchmarks → 5.4 Effect of training on revision sequences | 과제 이전, 반복 수정, 다단계 학습의 효과를 검증합니다. |
| 6 | Analysis and Discussion: 6.1 Training improves proposal reliability → 6.2 Qualitative analysis of learned harnesses → 6.3 Repeated revision | 실패율과 생성 구조, 반복 개선의 양상을 해석합니다. |
| 7 | Conclusion | 결과와 저자가 명시한 연구 범위를 정리합니다. |
| 후속 자료 | Acknowledgment → References | 연구 지원과 인용 문헌을 기록합니다. |
| 부록 A | Extended Related Work | 동시대 하네스 학습, 자기 개선, 지속학습을 비교합니다. |
| 부록 B | Reasoning Gym Training and Evaluation: B.1 Evaluation protocol → B.2 SFT corpus and training → B.3 Single-step RL → B.4 Multistep RL → B.5 Training curves | 추론 실험의 학습·평가 조건을 명시합니다. |
| 부록 C | Additional Reasoning Gym Results and Analyses: C.1 Single-step results → C.2 Multistep results → C.3 Training variants → C.4 Harness composition | 집계·실패 처리·학습 변형·도구 조합을 분석합니다. |
| 부록 D | Multi-Hop QA Training and Evaluation: D.1 Datasets and retrieval → D.2 RL training → D.3 Multistep evaluation → D.4 Single-step evaluation | 검색 코퍼스와 QA의 예산·선택 규칙을 설명합니다. |
| 부록 E | Implementation Details: E.1 Structured harness revision → E.2 Execution feedback → E.3 Composition directives | 코드 수정 인터페이스와 보고서·지시문을 설명합니다. |
| 부록 F | Limitations and Future Work | 교사·초기화, proposer의 도구 사용, 공동 학습과 긴 과제를 논의합니다. |
HTML과 PDF의 부록 번호에는 차이가 있습니다. 이 글의 부록 표 링크는 HTML 번호를 기준으로 하며, 달라지는 지점에서는 PDF 번호도 병기합니다. 예를 들어 QA 독립 수정 결과는 HTML Table 24, PDF Table 23입니다. 이는 다른 버전의 결과를 섞은 것이 아니라 같은 v1의 표시 번호 차이입니다.
핵심 기여와 혁신성
첫째 기여는 실행 결과에서 적응 규칙을 학습하는 문제 설정 입니다. 하네스 검색은 좋은 코드를 발견할 수 있지만, 새 과제에서도 유용한 수정을 반복적으로 제안할 수 있는지는 별개의 질문입니다. 논문은 현재 코드와 실패 보고서를 입력받는 proposer를 강화학습하여 이 질문을 다룹니다. 실행 가능한 제어 흐름, 도구 인터페이스, 모델 호출 순서를 바꿀 수 있으므로, 수정 대상은 단순한 답안 문장보다 넓습니다. 원문 §1·§4
둘째 기여는 학습에서 제외한 과제 계열로의 이전 평가 입니다. Reasoning Gym에서는 SFT와 RL 양쪽에서 제외한 계열을, QA에서는 HotpotQA로 학습한 proposer를 MuSiQue와 2WikiMultihopQA에서 평가합니다. 주 그림의 21개 미학습 추론 계열에서 단일 수정 평균은 Base 0.32, SFT 0.49, Single-step RL 0.62입니다. 다만 이 집계는 어려운 5개 계열을 제외하며, 전체 26개 미학습 계열의 평균은 각각 0.282, 0.415, 0.528입니다. 따라서 0.62를 전체 미학습 계열의 평균으로 읽어서는 안 됩니다. 원문 §5.2·부록 B.1·Table 9
셋째 기여는 단일 수정 학습과 반복 적응을 구분한 실험 입니다. 특히 QA의 Single-step RL은 seed 하네스를 부모로 둔 입력만 학습하지만, 테스트에서는 자기 수정으로 바뀐 중간 하네스를 다시 개선합니다. 반면 여러 수정 상태에서 학습하는 Multistep RL은 일관되게 더 좋지 않았습니다. 저자들의 결과는 반복 적응의 유용성을 뒷받침하지만, 다단계 학습 자체의 우월성을 입증하는 결과는 아닙니다. 리뷰어 관점에서는 모델의 정적 문제 풀이 점수와 별도로, 피드백을 받아 실행 구조를 개선하는 능력을 평가하게 한다는 점이 주요 의미입니다. 원문 §5.3–§6.3
기술적 세부사항
무엇이 학습되고 무엇이 바뀌는가
solver는 실제 질문을 풉니다. proposer는 solver의 답을 직접 대신 작성하는 것이 아니라, 그 solver를 호출하는 프로그램의 수정을 생성합니다. 학습 시에는 proposer의 파라미터 $\theta$만 바뀌고 solver는 고정됩니다. 테스트 시에는 두 모델의 파라미터가 모두 고정된 채 하네스 $h_0,h_1,\ldots,h_T$가 달라집니다. 여기서 $T$는 수정 라운드 수입니다. 이런 구분은 성능 개선을 solver 가중치 변화와 분리해 해석하게 합니다.
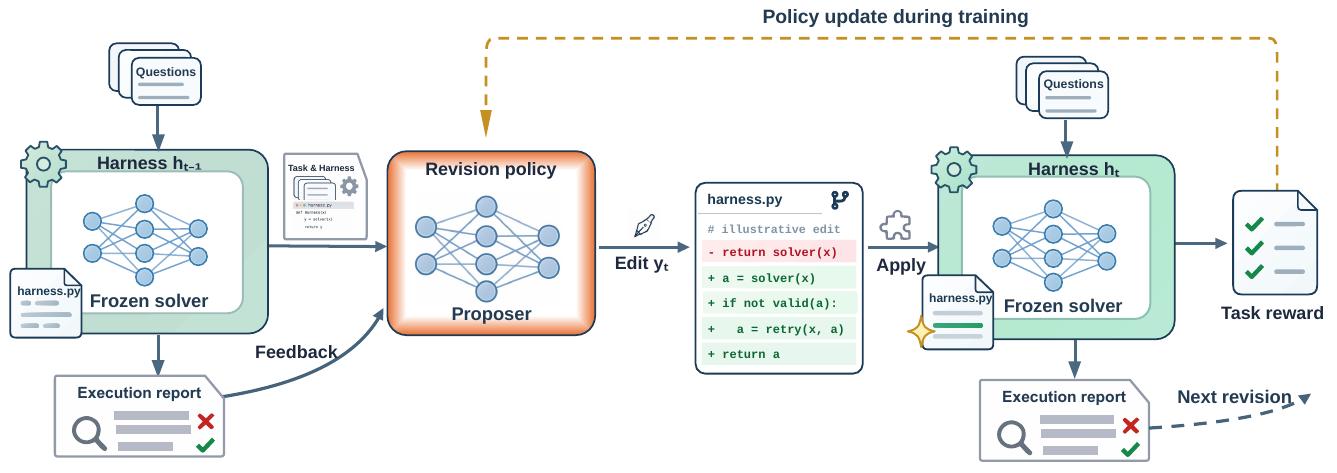
원문 Figure 1, PDF p.2. 2609.35738v1, CC BY 4.0. 그림 영역을 크롭했으며 번역·재배열하지 않았습니다. 점선의 정책 갱신은 학습에만 해당하고, 하단 피드백은 다음 하네스 수정으로 이어집니다.
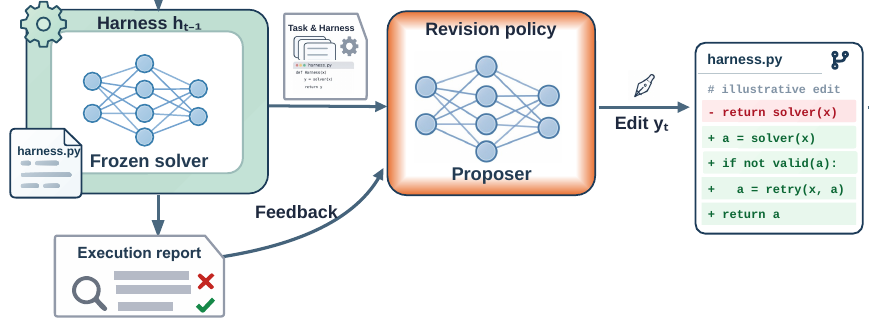
Figure 1 상세 크롭, PDF p.2, 동일 출처·라이선스. 이 부분은 실행 보고서에서 코드를 수정하는 연결을 보여 줍니다. 예시 편집은 답을 검증하고 필요하면 재시도하는 흐름을 추가합니다.
보상, 평가 집합, 메타학습 목적
원문 식 (1)의 검증 가능한 보상 강화학습 목표는 다음과 같습니다.
$x$는 수정 문맥이며 과제 설명·부모 하네스·실행 보고서를 포함합니다. $y$는 proposer가 생성한 토큰열, $\pi_\theta$는 그 생성 정책, $r$은 수정 후 실행 성과와 유효성 보상입니다. $\mathcal{D}$는 이런 수정 문맥의 분포입니다. 즉 정답을 닮은 코드보다, 실제로 실행해 좋은 결과를 내는 편집의 기대 보상을 높입니다. 원문 식 (1)
하네스 자체의 품질은 질문 집합 $Q$의 평균 점수로 측정합니다.
$\mathrm{score}(h,q)$는 하네스 $h$를 질문 $q$에 실행한 관측 채점값이며 범위는 0–1입니다. Reasoning Gym은 부분 점수를 포함할 수 있고, QA는 정규화 exact match를 사용합니다. 확률적으로 동작하는 solver에서는 같은 하네스의 점수도 실행에 따라 달라질 수 있습니다. $Q^{\mathrm{fb}}$는 보고서 작성용, $Q^{\mathrm{score}}$는 후보 보상·선택용, $Q^{\mathrm{eval}}$는 숨겨 둔 평가용 집합입니다. 학습에서는 피드백과 보상 질문을 분리하고, 테스트 평가 질문은 적응 피드백과 후보 선택에 쓰지 않습니다. Reasoning Gym 테스트에서는 개발 질문이 피드백과 선택을 겸할 수 있습니다. 원문 식 (3)·§4.1
한 라운드의 적응은 원문 식 (4)와 같습니다.
$G$는 라운드당 후보 수입니다. Apply는 편집을 파싱하고 현재 코드에 적용하며, Select는 실행 점수와 유지 규칙에 따라 다음 부모를 정합니다. 이 선택 규칙은 두 평가에서 다릅니다. Reasoning Gym은 라운드당 1개 후보를 생성하고 개발 점수가 엄격히 개선될 때만 승격합니다. QA는 8개 후보 중 최고를 택하며, 부모보다 점수가 낮아도 다음 하네스로 진행합니다. 따라서 반복 곡선의 성격을 방법 이름만으로 같다고 가정할 수 없습니다.
바깥 루프가 지향하는 최종 목표는 적응이 끝난 하네스의 평가 성능입니다.
$h_T$는 현재 proposer가 만들어 낸 전체 적응 절차의 결과이고, 기대값은 과제·질문·수정·실행의 변동을 포함합니다. 실제 학습은 이 최종 목적을 직접 최적화하는 대신 각 후보의 즉시 성과 $r_i=J(h_i';Q^{\mathrm{score}})+v_i$를 사용합니다. $v_i$는 편집 및 실행의 유효성 보상입니다. 여러 상태를 학습해도 라운드를 가로지르는 지연 보상을 할당하는 것은 아닙니다. 원문 식 (5)–(6)·§4.3
GRPO가 편집을 학습하는 방식
GRPO(Group Relative Policy Optimization)는 동일 문맥에서 생성한 후보끼리 보상을 비교합니다. 원문의 그룹 정규화 이점은 다음과 같습니다.
$\delta$는 분모를 안정화하는 항이며, 평균보다 높은 보상을 낸 편집은 양의 이점을 받습니다. 각 토큰의 새 정책 확률을 이전 정책 확률로 나눈 비율 $\omega_{i,k}(\theta)$에 이 이점을 곱하되, 너무 큰 정책 변화를 clip으로 제한합니다. 원문 식 (2)를 길이 기준 정규화와 토큰별 항으로 나누어 쓰면 다음과 같습니다.
$k$는 후보 안의 토큰 위치이며 $y_{i,\lt k}$는 앞선 토큰들입니다. $\epsilon$은 clip 범위이고 분모는 그룹 전체 응답 토큰 수입니다. $\ell_{i,k}$는 가독성을 위해 이 글에서 붙인 중간 기호이며 원문 식의 min 항과 같습니다. 원문 operatorname의 mean·std·clip·score·Apply·Select는 동일 의미의 직립체 mathrm로 표기했습니다. 원문 §3.2·식 (2)
챕터별 상세 리뷰
📖 Chapter 1: Introduction
이 장은 모델을 고정해도 프로그램을 바꾸면 행동이 달라진다는 관찰에서 시작합니다. 하네스는 문맥 구성과 도구 접근, 실행 순서를 정하므로, 모델의 기존 능력을 사용하게 하는 방식 자체가 적응 대상이 됩니다. 문제는 한 과제에서 성공한 수정을 찾는 것뿐 아니라, 실행 피드백을 활용하는 수정 절차가 새로운 과제에도 이전되는지입니다.
저자는 이어 외부 루프에서 proposer를 학습하고 내부 루프에서 하네스를 고치는 메타학습 관점을 도입합니다. 과제 설명·현재 코드·보고서에서 편집을 생성하고, 실제 수정 프로그램의 점수를 보상으로 사용하는 흐름입니다. SFT(Supervised Fine-Tuning, 감독 미세조정)는 선택 가능한 초기화 단계이며, 테스트에서는 같은 proposer를 여러 라운드 재사용합니다.
마지막으로 기여를 실행 하네스의 학습된 테스트 적응, 미학습 과제 이전, 반복 수정의 세 항목으로 제시합니다. 추론과 QA를 함께 쓰는 이유는 최소한의 단일 호출 프로그램을 확장하는 경우와, 이미 검색 구조를 갖춘 프로그램을 개선하는 경우를 모두 보기 위해서입니다. 이 장의 역할은 점수 향상과 적응 능력의 이전을 하나의 연구 질문으로 연결하는 데 있으며, 다음 장은 이 질문을 기존 하네스 최적화·메타학습과 비교합니다. 원문 §1
📖 Chapter 2: Related Work
Harness optimization
저자는 먼저 언어 모델 파이프라인과 워크플로를 자동 최적화하는 계열을 소개하고, 실행 피드백으로 프로그램을 수정하는 하네스 연구로 범위를 좁힙니다. 동시대 Harness-R1은 고정 solver와 SFT 후 RL이라는 유사한 학습 절차를 사용하며, JIT-Agent는 과제 조건부 생성·수리·진화를 학습합니다. 따라서 이 논문은 하네스 편집을 학습했다는 사실만을 독점적 기여로 내세우지 않습니다. 현재 하네스의 반복 수정이 학습에서 제외한 과제 계열에서도 성능을 높이는지에 분석의 초점을 둡니다.
Meta-learning
메타학습은 초기 상태나 적응 절차를 경험에서 배웁니다. 저자는 공유 워크플로 초기화나 하네스 진화 청사진과 비교하여, 이 연구에서 적응되는 객체가 실행 코드이고 학습된 규칙이 proposer임을 명확히 합니다. 코드 수준 적응은 제어 흐름과 도구 인터페이스, 호출 순서를 이산적으로 바꿀 수 있습니다. TTHE도 모델을 고정해 코드를 적응시키지만, 저자 설명에 따르면 라벨 없는 실행 흔적을 피드백으로 쓰며 이 논문은 채점된 개발 질문을 사용합니다. 이 비교는 다음 장의 하네스 정의와 강화학습 표기를 위한 배경이며, 확장 비교는 부록 A에 이어집니다. 여기서 인용된 관련 논문들을 모두 별도로 분석한 것은 아닙니다. 원문 §2
📖 Chapter 3: Preliminaries
3.1 Harness
하네스는 모델 호출을 감싸는 실행 프로그램입니다. 단순한 프롬프트 문자열을 넘어 호출 시점, 도구 요청 실행, 환경 관측을 다음 문맥에 넣는 방식까지 담당합니다. 코딩 에이전트라면 파일 탐색·편집·테스트 도구를 노출하고 결과를 모델에 돌려주는 프로그램이 여기에 해당합니다. 이 정의는 하네스를 바꿔도 모델 파라미터는 고정할 수 있다는 연구의 조건을 분명히 합니다.
3.2 Reinforcement learning with verifiable rewards
검증 가능한 보상은 프로그램 채점기가 응답이나 실행 결과를 평가하는 설정입니다. proposer의 출력 토큰열이 편집 코드이므로, 보상은 코드의 표면적 유사도가 아니라 실행 이후 얻습니다. 이 장은 먼저 기대 보상 최대화를 식 (1)로 정의한 뒤, 같은 문맥의 여러 응답 사이 상대적 보상으로 학습하는 GRPO와 식 (2)를 설명합니다.
GRPO의 핵심은 모든 후보에 절대적인 정답 편집을 제공하지 않아도, 같은 조건에서 더 잘 실행된 편집에 높은 이점을 줄 수 있다는 점입니다. 토큰별 중요도 비율과 clip은 정책 업데이트를 제한하고, 그룹 전체 응답 길이에 대한 정규화가 적용됩니다. 다만 이 단계는 최종 적응 궤적의 목적을 아직 정의하지 않습니다. 다음 장에서 그 보상이 어떤 하네스·질문 집합에서 만들어지는지 연결합니다. 원문 §3
📖 Chapter 4: Harness Learning as Meta-Learning
4.1 Tasks, harnesses, and execution feedback
이 절은 적응의 단위를 질문 하나가 아니라 과제로 둡니다. Reasoning Gym의 maze나 sudoku처럼 생성기·채점기를 공유하는 계열이 과제이며, QA에서는 HotpotQA 같은 벤치마크가 과제입니다. 같은 하네스는 해당 과제의 여러 질문에 적용됩니다. solver는 고정되어 표기에서 생략하고, 프로그램의 질은 식 (3)의 평균 관측 점수로 정의합니다.
그다음 실행 흔적과 성과를 요약한 실행 보고서를 도입합니다. 보고서는 실패 여부뿐 아니라 실제로 어떤 호출과 중간 결과가 발생했는지 알려 줍니다. 마지막으로 보고서용·후보 선택용·최종 평가용 질문의 역할을 분리합니다. 테스트 평가 질문은 적응 중 피드백이나 선택과 겹치지 않지만, 개발 질문은 프로토콜에 따라 피드백과 선택을 겸할 수 있습니다. 이 구분이 없으면 피드백을 본 문제를 잘 푼 것과 새로운 문제를 잘 푼 것을 혼동하게 됩니다.
4.2 Harness adaptation and the meta-learning objective
각 라운드에서 proposer는 현재 하네스와 보고서를 받아 $G$개 편집을 생성합니다. Apply가 편집을 적용하고 Select가 다음 하네스를 결정합니다. 구조화된 편집은 기존 코드의 구간을 찾고 대체 코드를 제시하는 방식입니다. 파싱·적용에 실패한 편집과 적용되었으나 성능이 낮은 편집은 같은 사건이 아닙니다.
저자는 여기서 Reasoning Gym과 QA의 선택 규칙을 예로 듭니다. 전자는 개선이 있을 때만 부모를 대체하고, 후자는 8개 후보 중 최고로 전진하므로 부모보다 나쁜 후보가 선택될 수도 있습니다. 선택된 하네스의 다음 실행이 다음 라운드 입력을 만듭니다. 이 내부 루프의 최종 평가 점수를 높이는 것이 식 (5)의 외부 목적입니다.
마지막으로 실제 구현은 각 수정의 즉시 성과를 최종 목적의 대리 목표로 사용한다고 밝힙니다. 따라서 Multistep RL의 여러 상태 학습과 장기 보상 최적화는 구별해야 합니다. 상태 분포는 바뀌지만 보상은 각 후보 자체의 실행 결과에 귀속됩니다.
4.3 Training the proposer
먼저 선택적 SFT 초기화입니다. 교사가 seed와 실행 보고서를 받아 편집을 생성하고, seed를 개선하며 품질 검사를 통과한 응답을 보존합니다. 이는 proposer가 자신의 실행 결과로 배우기 전에 성공적인 편집 형태를 익히게 합니다.
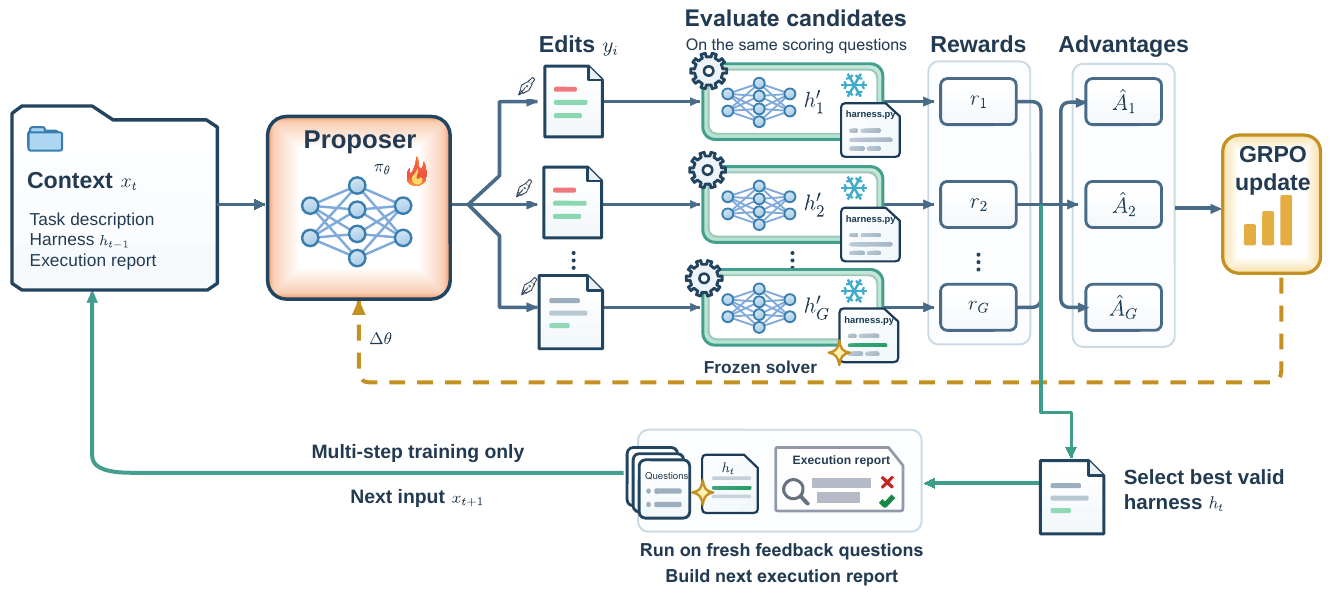
원문 Figure 2, PDF p.5. 2609.35738v1, CC BY 4.0. 그림 영역 크롭, 번역·재배열 없음. 주황 점선은 proposer 갱신, 초록 흐름은 다단계 상태 학습에서 다음 보고서를 만드는 경로입니다.
이어서 RL은 한 문맥의 후보들을 공통 scoring 질문에서 실행합니다. 이 질문은 입력 보고서를 만든 질문과 분리됩니다. task 점수에 유효성 보상을 더한 식 (6)으로 그룹 이점을 계산하며, 편집 실패 시 Reasoning Gym은 실패 전까지 획득한 유효성 점수만 받습니다. 명시적으로 변경하지 않겠다고 응답하면 부모를 실행해 점수를 구합니다.
마지막은 successive revision states입니다. Single-step training은 각 부모·보고서를 독립 문맥으로 취급합니다. Reasoning Gym의 Single-step RL에도 seed 외에 더 강한 부모가 포함되므로, 이름을 모든 입력이 seed라는 뜻으로 해석해서는 안 됩니다. 다단계 상태 학습은 선택한 후보의 보고서를 새로 생성해 문맥을 확장합니다. Reasoning Gym은 오프라인 단계 사이에서 상태를 갱신하고, QA는 온라인 수정 실행으로 상태를 만듭니다. 두 학습 결과 모두 테스트에서는 반복 수정할 수 있습니다. 이 장은 학습과 추론의 축을 분리해 다음 장의 비교를 해석할 기반을 제공합니다. 원문 §4
📖 Chapter 5: Experiments
5.1 Experimental setup
실험은 미학습 과제 이전, 한 번 이후의 추가 개선, 수정 시퀀스 학습의 이득을 차례로 묻습니다. 두 설정의 proposer는 별도로 학습합니다. Reasoning Gym은 Qwen3.5-4B proposer와 solver를 사용하고, Qwen3.6-35B-A3B 교사의 수정으로 SFT한 뒤 RL합니다. QA는 Qwen3-4B proposer와 Qwen3-8B solver를 사용하며 교사 SFT 없이 Base에서 RL합니다.
Seed는 수정 전 코드이고 Base는 학습 전 proposer가 만든 수정입니다. SFT·Single-step RL·Multistep RL은 학습 구성의 이름입니다. 평가를 한 라운드로 할지 여러 라운드로 할지는 별도의 축입니다. Reasoning Gym의 canonical은 표준 문제 형식이고 format-varied는 같은 과제를 다른 형식으로 제시합니다. QA의 주요 측정값은 숨긴 test 질문의 exact match입니다. 이 설정은 이후 두 도메인의 결과를 같은 숫자 척도로 무리하게 합치지 않게 합니다. 원문 Table 1
5.2 Learning transferable revisions on Reasoning Gym
Generalization of individual revisions. 저자는 먼저 후보를 고르기 전 평균 품질을 비교합니다. 주 집계의 21개 미학습 계열에서 Base 0.32가 RL 이후 0.62가 되므로, 이 개선은 최고 후보만 고르는 효과에 의존하지 않습니다. RL 평균은 seed 위에 있고 Base·SFT 평균은 seed 아래입니다. 그러나 부록 B.1에 명시된 대로 26개 미학습 계열 가운데 knight_swap, letter_jumble, modulo_grid, sokoban, ab를 제외한 결과입니다. 전체 집계는 뒤의 부록 리뷰에서 함께 확인합니다.
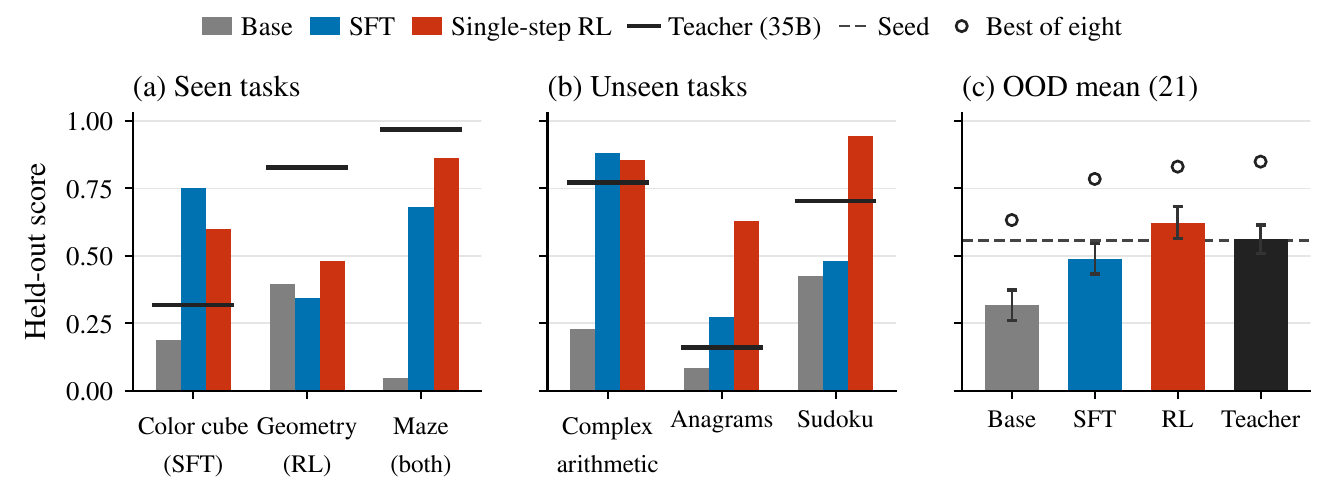
원문 Figure 3, PDF p.6. 2609.35738v1, CC BY 4.0. 전체 그림 영역 크롭, 번역·재배열 없음. 막대는 8개 시도 평균, 검은 선은 교사, 원은 held-out 점수로 선택한 oracle best-of-eight입니다.
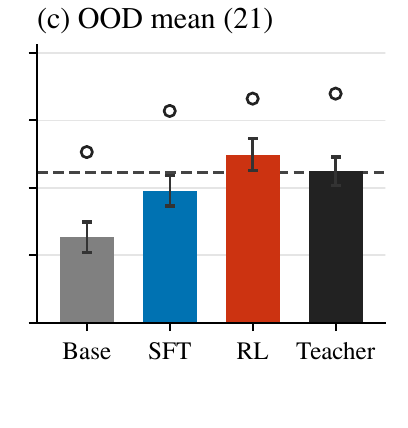
Figure 3(c) 상세 크롭, PDF p.6, 동일 출처·라이선스. 색상은 회색 Base, 파랑 SFT, 빨강 RL, 짙은 회색 Teacher입니다. 오차 막대는 계열 간 한 표준오차이고 점선은 seed입니다. 원으로 표시한 최고 후보는 숨긴 평가 점수를 본 뒤 고른 값입니다.
Comparison with the teacher. 같은 21개 계열에서 학습된 4B proposer의 평균 0.62는 교사 0.56보다 높지만, oracle best-of-eight는 RL 0.83, 교사 0.85로 교사가 높습니다. 학습은 후보 분포의 평균을 높였으며 최고 가능 후보에 대한 우열은 다릅니다. 고정 Python tool loop의 같은 집계 0.69도 RL 평균 0.62보다 높으므로 모든 기준선을 능가했다고 말할 수 없습니다.
Gains across revision rounds. format-varied 문제에서는 Single-step RL이 다섯 라운드 이득의 대부분을 첫 수정에서 얻고, SFT는 더 점진적으로 향상됩니다. canonical에서는 둘의 개선 일정이 유사합니다. 그림의 최종점은 개발 집합으로 고른 하네스를 별도 held-out 질문에서 평가한 값입니다.
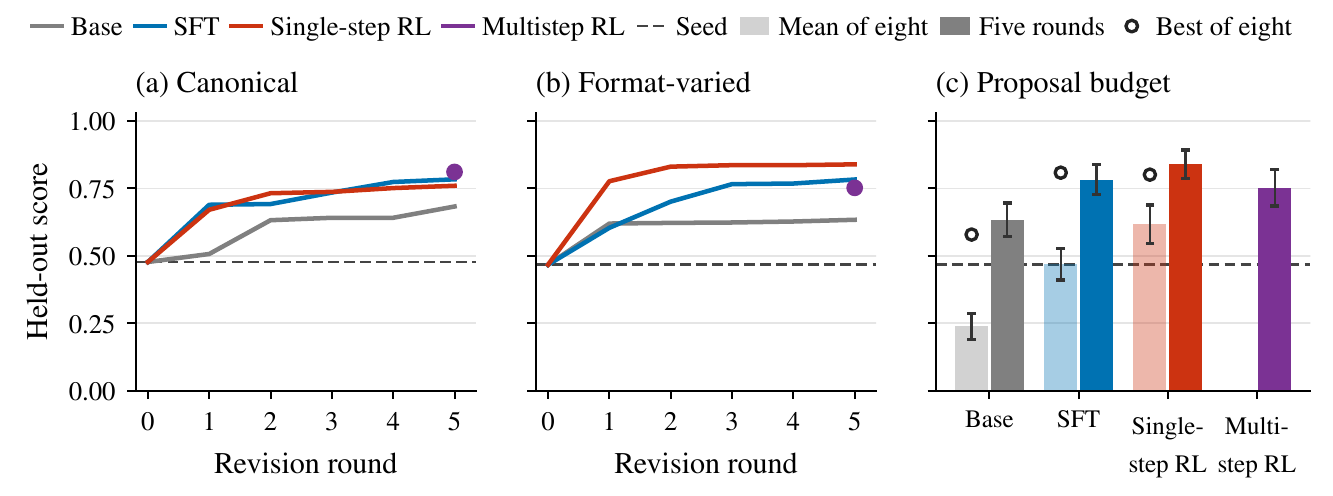
원문 Figure 4, PDF p.7. 2609.35738v1, CC BY 4.0. 전체 그림 영역 크롭, 번역·재배열 없음. (a,b)는 개발 점수로 유지한 하네스의 held-out 성능, (c)는 독립 평균·oracle과 순차 수정의 비교입니다.
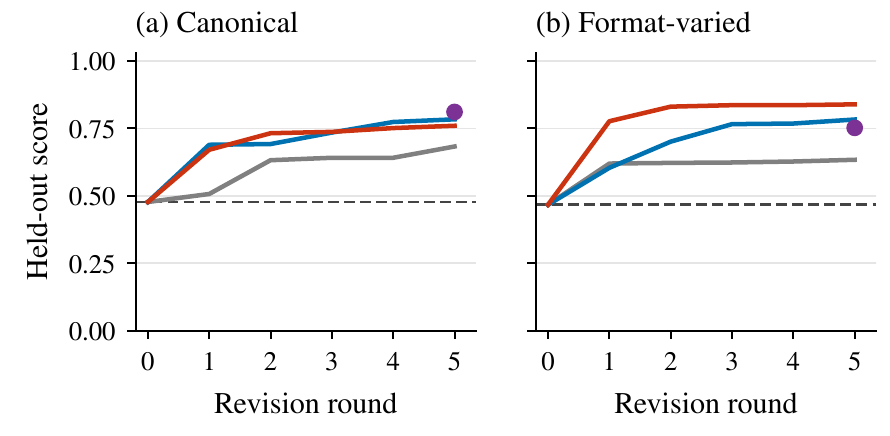
Figure 4(a,b) 상세 크롭, PDF p.7, 동일 출처·라이선스. 회색 Base, 파랑 SFT, 빨강 Single-step RL, 보라 최종점 Multistep RL입니다. 전체 그림의 (c)와 범례도 위에 함께 보존했습니다.
Sequential versus independent revision. 다섯 순차 제안으로 유지한 하네스는 여덟 독립 제안의 평균을 넘고 oracle best-of-eight에 접근하거나 이를 넘습니다. 다만 부록 B.1은 두 프로토콜의 지시문·보고서·부모·선택 방식도 다르다고 명시합니다. 이 비교는 실제 수정 프로토콜의 결과이며 피드백 자체의 효과만 분리한 실험은 아닙니다. 원문 §5.2
5.3 Adapting retrieval workflows on unseen QA benchmarks
Progress over successive revisions. QA에서는 두 RL proposer가 첫 라운드 이후에도 개선되며 세 벤치마크에서 모두 Base보다 높게 끝납니다. Base는 HotpotQA와 MuSiQue에서 seed보다 낮게 끝납니다. 첫 수정이 열 라운드 전체 이득에서 차지하는 비중은 약 1/3–2/3로, Reasoning Gym보다 여러 라운드에 걸쳐 이득이 누적됩니다.
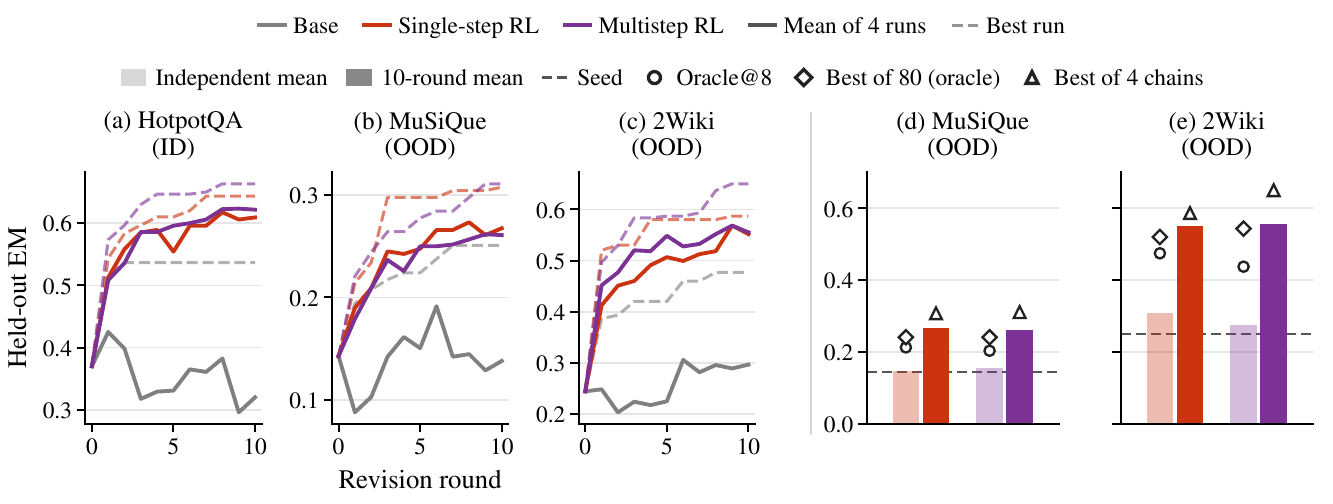
원문 Figure 5, PDF p.8. 2609.35738v1, CC BY 4.0. 전체 그림 영역 크롭, 번역·재배열 없음. (a–c) 실선은 4회 실행 평균, 점선은 실행들에서 지금까지 도달한 최고 held-out 점수입니다. (d,e)에는 독립 후보 평균과 열 라운드 최종 평균을 함께 표시합니다.
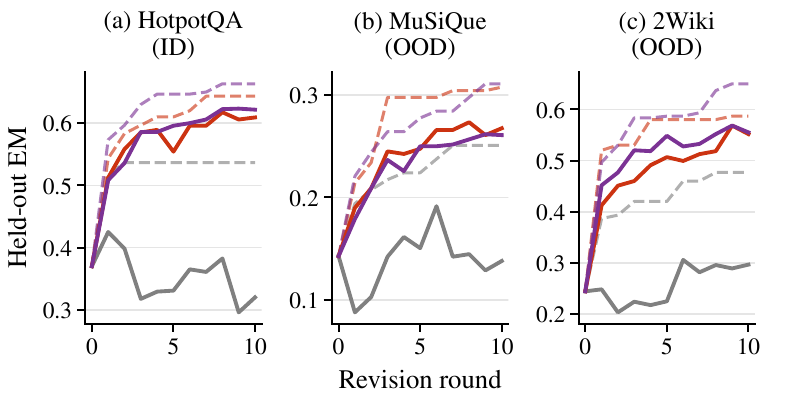
Figure 5(a–c) 상세 크롭, PDF p.8, 동일 출처·라이선스. 회색은 Base, 빨강은 Single-step RL, 보라는 Multistep RL입니다. 실선의 평균과 점선의 최고값은 서로 다른 통계입니다.
Sequential versus independent revision. MuSiQue의 Single-step RL 독립 수정 평균은 정확히 0.1467이고 독립 평가 seed는 0.1438입니다. 반면 열 라운드 뒤 평균은 본문에서 약 0.27로 보고합니다. 두 미학습 벤치마크 모두 RL의 최종 실행 평균이 독립 후보 80개의 oracle 최고보다 높습니다. 이는 작은 독립 평균 개선만으로 반복 적응 능력을 판단하면 중요한 효과를 놓칠 수 있음을 보여 줍니다.
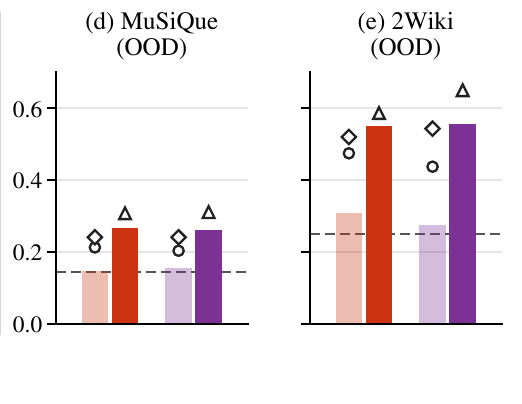
Figure 5(d,e) 상세 크롭, PDF p.8, 동일 출처·라이선스. 빨강은 Single-step RL, 보라는 Multistep RL이며, 옅은 막대는 독립 80개 평균, 진한 막대는 열 라운드 실행 4회의 최종 평균입니다. 원은 Oracle@8, 마름모는 독립 80개 최고, 삼각형은 4개 수정 사슬의 전 라운드 최고입니다. 범례 전체는 위의 원본 그림에 보존했습니다.
여기서 예산을 정확히 구분해야 합니다. 순차 실행 하나는 10라운드×8후보=80개를 사용하므로 독립 풀 80개와 제안 수가 같습니다. 그러나 최종 평균은 그런 실행 4회의 통계이며 전체 320개 후보를 사용합니다. 전체 실행 중 최고값은 이 320개와 여러 라운드의 test 측정을 거친 값이므로 독립 80개 최고와 예산이 맞지 않습니다. 독립 수정은 seed 보고서 네 개를 공유하고 순차 수정은 중간 하네스의 새 피드백을 얻습니다. 총 계산량·피드백도 통제된 비교가 아닙니다. 원문 §5.3·부록 D.4
5.4 Effect of training on revision sequences
Reasoning Gym에서 Multistep RL은 canonical 최종점에서는 Single-step RL보다 높지만 format-varied에서는 낮습니다. QA의 두 구성은 거의 같은 최종 성능에 도달합니다. 고정된 후속 상태를 사용한 추가 학습도 일관된 이득을 보이지 않습니다. 저자의 결론은 단일 수정 학습에서도 반복 개선이 나타날 수 있다는 것입니다. 다단계 상태를 학습했다는 사실만으로 더 강한 장기 적응 정책이라고 판단하지 않습니다. 다음 장은 결과를 제안 신뢰성과 프로그램 구조의 변화로 설명합니다. 원문 §5.4
📖 Chapter 6: Analysis and Discussion
6.1 Training improves proposal reliability
이 절은 실행 가능한 하네스를 만들지 못하거나 개발 점수가 0인 후보의 비율을 비교합니다. 두 경우를 합산한 신뢰성 지표이므로, 0점이라는 사실이 코드 무효를 뜻하지는 않습니다. Reasoning Gym의 별도 OOD 진단 집합 5계열·40후보에서 이 비율은 Base 38%, SFT 35%, RL 8%입니다. 주 성능 집계의 21개 계열과 진단 집합을 혼동해서는 안 됩니다.
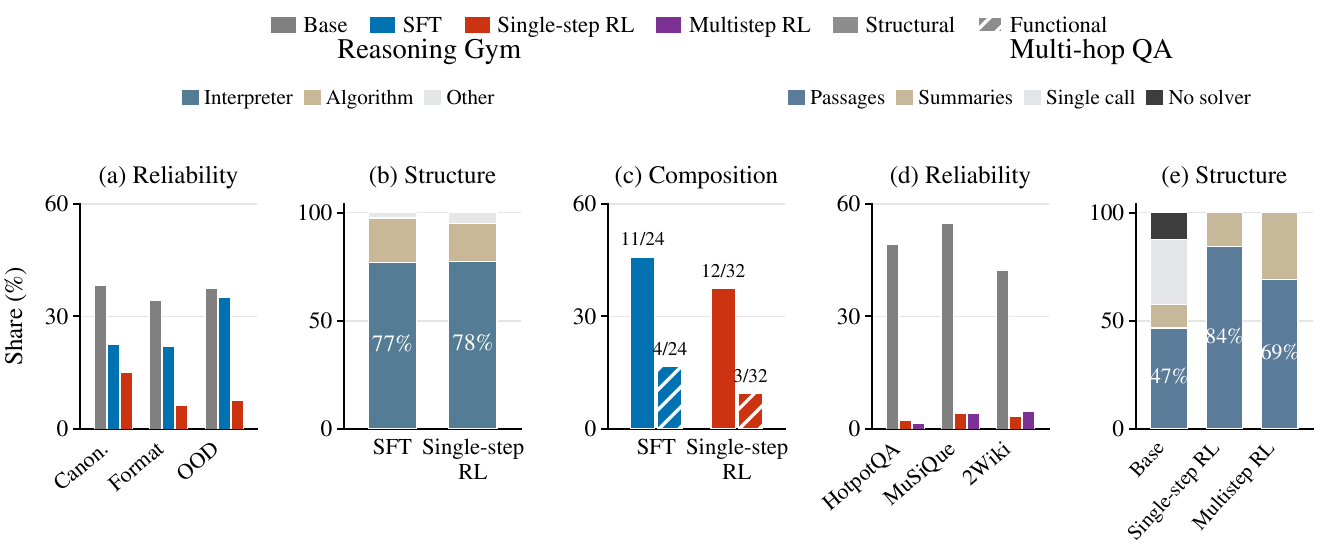
원문 Figure 6, PDF p.9. 2609.35738v1, CC BY 4.0. 전체 그림 영역 크롭, 번역·재배열 없음. (a–c)는 Reasoning Gym 신뢰성·구조·조합, (d,e)는 QA 신뢰성·유지된 하네스 구조입니다.
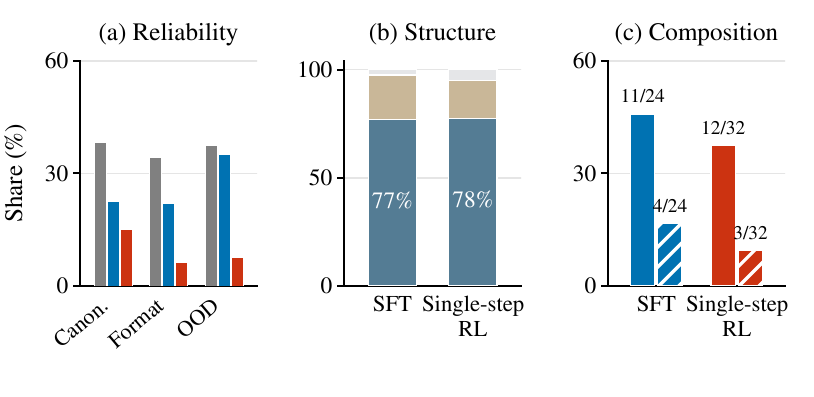
Figure 6(a–c) 상세 크롭, PDF p.9, 동일 출처·라이선스. 조합 막대의 실색은 구조적 조합, 빗금은 답에 기여한 기능적 조합입니다. 비율의 분모는 패널과 실험별로 다릅니다.
QA의 진단도 벤치마크·방법별 320개 후보를 대상으로 RL 이후 실패 또는 0점 비율의 큰 감소를 보여 줍니다. 저자는 더 많은 유효 후보가 반복 선택의 진전을 도울 수 있다고 해석합니다. 이는 후보 신뢰성의 변화에 관한 분석이며, 모든 점수 이득을 이 요인 하나로 설명하는 인과 분해는 아닙니다. 원문 §6.1·Table 10
6.2 Qualitative analysis of learned harnesses
먼저 Reasoning Gym에서는 SFT와 RL이 주로 interpreter loop를 생성합니다. solver가 계산을 코드로 작성하면 런타임이 실행하고 결과를 돌려주는 구조입니다. 교사 SFT 자료에서도 432개 중 207개, 약 48%가 이런 구조였으며, 별도 미학습 계열 감사에서는 SFT 39개 중 30개, RL 40개 중 31개로 가장 흔했습니다.
다음으로 helper 조합 지시가 있어도 기능적 기여는 구조적 통합보다 드뭅니다. 예컨대 한 감사에서 SFT는 구조적 11/24, 기능적 4/24이고 RL은 12/32, 3/32입니다. 올바른 알고리즘이 있어도 문제 파싱, 도구 메시지, 답 추출이 실패하면 최종 답에 기여하지 못합니다. 이 관찰은 알고리즘 생성과 그 알고리즘을 실제 풀이에 연결하는 능력을 구분합니다.
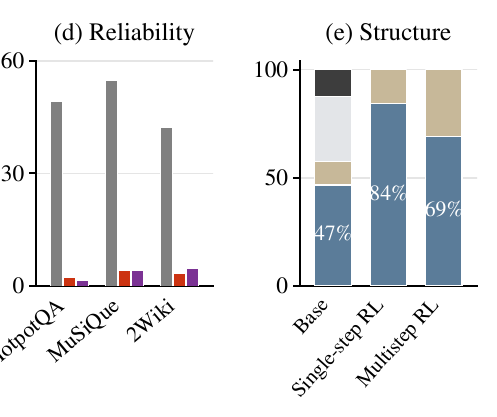
Figure 6(d,e) 상세 크롭, PDF p.9, 동일 출처·라이선스. (e)는 세 벤치마크의 유지된 하네스를 합친 방법별 120개 감사입니다. Passages는 원문 단락, Summaries는 solver 요약에서 답하는 다중 홉 구조이며 나머지는 단일 호출 또는 solver 제거입니다. 색상 범례 전체는 위 원본 그림에 있습니다.
마지막으로 QA에서 RL은 다중 홉 검색 구조를 보존하며 Base는 때때로 단일 호출로 축소하거나 solver를 없앱니다. 흔한 RL 편집은 첫 홉 요약을 다음 검색어 생성에는 쓰되, 최종 답변에는 검색된 원문 단락을 직접 제공합니다. 검색어 구성에 필요한 정보와 정답 근거를 분리하는 수정입니다. 다른 편집은 세 번째 검색 홉을 추가하거나, 초안 답이 검색 단락에 없으면 추가 검색합니다. 원문 Figure 7과 HTML Figure 15(PDF Figure 12)는 이런 변경을 보여 줍니다. 원문 §6.2
6.3 Repeated revision
저자는 먼저 seed 구조의 차이가 반복 개선 양상과 관련될 수 있다고 설명합니다. Reasoning Gym은 첫 수정에서 interpreter를 추가하며 큰 이득을 얻는 경우가 많습니다. helper가 정확해도 주변 인터페이스에서 기여가 막힐 수 있습니다. 반면 QA의 seed에는 이미 검색 워크플로가 있어, 검색 깊이·근거 접근·재검색 조건을 순차적으로 수정할 여지가 있습니다. 다만 학습과 선택 절차도 다르므로 차이를 seed만으로 귀속하지 않습니다.
이어서 반복 수정은 정책이 스스로 바꾼 문맥에서도 유용한지 시험한다고 설명합니다. QA Single-step RL은 학습 중 seed만 보지만 테스트에서는 수정된 프로그램과 새 보고서를 개선합니다. 따라서 결과는 미학습 벤치마크 이전과 함께 중간 적응 문맥으로의 이전을 시사합니다.
마지막으로 저자는 현재 시퀀스 학습이 부모·보고서 분포를 바꾸지만 보상은 즉시 수정에 둔다고 재확인합니다. 라운드 간 기여를 배분하는 학습의 효과는 이 실험에서 결정되지 않았습니다. 이 문단은 관측된 이득을 과도한 장기 최적화 주장으로 넓히지 않도록 경계를 정합니다. 이어지는 결론은 입증된 결과와 명시적 연구 방향을 모읍니다. 원문 §6.3
📖 Chapter 7: Conclusion
결론은 학습된 proposer가 고정 solver의 프로그램을 실행 피드백으로 적응시키며, 테스트에서는 두 모델 모두 고정된다는 정의를 다시 제시합니다. 주요 근거는 미학습 Reasoning Gym 계열의 단일 수정 평균 개선, QA의 벤치마크 이전, 단일 수정 학습 정책의 반복 개선입니다. 이 세 결과를 함께 읽으면 과제 성능과 수정 능력이 서로 다른 평가 축임을 이해할 수 있습니다.
저자는 이어 지정된 수정 프롬프트, 고정 solver, 하나의 Reasoning Gym 교사라는 설정을 밝히고 부록 F의 방향으로 연결합니다. 이 글도 한계·향후 연구는 그 명시된 범위에 한정합니다. 본문 이후의 Acknowledgment는 계산 자원과 연구 지원을, References는 관련 문헌을 기록합니다. 이들은 추가 실험 결과가 아니며, 다음 부록 A가 관련 연구의 세부 비교를 확장합니다. 원문 §7
📖 Chapter A: Extended Related Work
Harness optimization and learned editors. 부록은 DSPy·AFlow의 파이프라인·코드 워크플로 최적화에서 출발해 실행 피드백 편집, 실패 집계, 실행 중 외부 상태 관리로 범위를 넓힙니다. WHALE은 더 강한 proposer의 하네스 최적화와 모델 가중치 갱신을 번갈아 수행하는 방법으로 소개됩니다. 이 연구는 solver 가중치를 고정하기 때문에 그 결합과는 분석 대상이 다릅니다.
Comparison with contemporary work. 이어 Table 2의 세 동시대 접근을 비교합니다. Harness-R1은 교사 시연 후 GRPO를 사용하고, 동일 벤치마크 내 서로 다른 인스턴스 및 미학습 target 모델 이전을 평가합니다. 반면 이 논문은 전체 추론 계열과 QA 벤치마크를 학습에서 제외하고, 학습 중 feedback 질문과 scoring 질문도 분리합니다. Harness-R1의 피드백 배치 재실행 및 개별 patch 생성과, 이 논문의 같은 하네스 반복 수정은 비교해야 할 절차가 다릅니다.
그다음 JIT-Agent는 teacher SFT·실행 기반 DPO·지도 수리·Evo-GDPO를 결합하고 확장되는 아카이브에서 과제 인스턴스별 하네스를 진화시키는 접근으로 정리됩니다. 이 논문은 현재 하네스를 같은 계열의 여러 인스턴스로 평가하며 갱신합니다. 마지막 Ornith는 하네스 생성과 문제 풀이, 더 나아가 과제 생성까지 공동 학습합니다. 여기서는 proposer만 학습하므로 solver가 바뀌어 생긴 효과와 분리됩니다. 이 비교는 공유 아이디어와 평가 범위의 차이를 설명하며, 다른 방법의 성능을 직접 재평가한 결과는 아닙니다.
Meta-learning. MAML의 초기화 학습, RL²의 정책 내 적응, 공유 워크플로 초기화와 청사진 진화, 탐색·반성 이력을 사용하는 메타 RL을 차례로 연결합니다. 본 논문은 프로그램과 피드백에서 코드 수정으로 가는 규칙을 배우며 즉시 보상을 최종 품질의 탐욕적 대리로 쓴다는 점을 재확인합니다.
Self-improvement. 출력 수정과 언어적 반성, 코드 변경 제안 프로그램의 개선, 후보 아카이브의 코드 진화, 고정 모델의 unlabeled trace 기반 하네스 적응을 먼저 소개합니다. 이어 STaR·Self-Rewarding Language Models·SEAL·SIA처럼 가중치 갱신을 포함하는 계열과 구분합니다. 자기 개선이라는 같은 이름 아래에서도 바뀌는 대상이 답안·기억·코드·가중치로 다르다는 설명입니다.
Evaluation of harness evolution. 이후 solver 능력, 피드백, 탐색 예산이 평가 해석을 바꾼다고 정리합니다. 평균 제안 점수·oracle 최고·순차 수정 점수를 나누고, 개발과 held-out을 분리하며, 미학습 과제 이전을 평가하는 이유가 여기에 있습니다. Continual learning agents. 마지막으로 장기 텍스트 게임, 파라미터 기억 보존, 실행 가능한 기술·세계 모델 축적을 연결하고, 하네스 학습을 모델 호출과 도구 사용을 조직하는 프로그램의 적응으로 위치시킵니다. 이 부록은 개념적 비교를 마치고, B에서 실제 추론 실험 프로토콜로 넘어갑니다. 원문 부록 A
📖 Chapter B: Reasoning Gym Training and Evaluation
B.1 Evaluation protocol
계열마다 개발 25문제와 held-out 75문제를 분리합니다. 단일 평가는 seed의 고정 보고서에서 독립 수정 8개를 만들고, 반복 평가는 라운드당 후보 1개로 다섯 라운드 진행합니다. 편집 파싱은 최종 답변에서만 하고, 실패 시 오류 피드백을 주며 제안당 최대 3회 시도, 시도당 32,768토큰을 허용합니다. 반복 평가의 승격 규칙은 식 (7)입니다.
$h_t^\star$는 t라운드 뒤 유지한 하네스입니다. 개발 평균이 같거나 낮으면 부모를 유지하고, 매 라운드 유지한 코드의 held-out 점수를 따로 측정합니다. 모든 시도와 0점 후보를 통계에 포함하며 seed 자체는 제안 개수에서 제외합니다. 실패 편집과 선언된 no-change 제안은 부모 점수를 유지합니다. 이는 RL 학습의 실패 보상 규칙과도, QA의 실패 0점 규칙과도 구분해야 합니다.
주 그림은 전체 26개 OOD 계열 중 알고리즘 하네스로 접근하기 어려웠던 5개를 제외합니다. 제외된 계열은 knight_swap, letter_jumble, modulo_grid, sokoban, ab입니다. 전체 26개 평균은 Base 0.282, SFT 0.415, RL 0.528, 교사 0.501로 보고됩니다. seed는 solver 한 번 호출 후 답을 추출하고, 공통 tool-loop 기준선은 최대 다섯 턴 Python 실행을 제공합니다. 교사는 같은 수정·채점 절차와 같은 보고서를 받습니다.
불확실성은 계열 내 반복 실행을 먼저 평균한 후 계열 간 한 표준오차로 집계합니다. 계열별 곡선의 음영은 반복 실행의 범위입니다. 단일·순차 평가의 제안 수, 분기 지시문, 보고서 재생성, 부모 선택이 다르므로 피드백만의 효과를 고립시키지 않습니다. 조합 실험의 구조적 기준은 helper가 solver 도구 루프에 통합되는지이며, 기능적 기준은 helper가 답에 기여하는지까지 요구합니다. 원문 부록 B.1·Table 3
B.2 SFT corpus and training
SFT는 21개 계열의 첫 라운드 교사 수정으로 구성합니다. RL의 5계열은 codeio, maze, rotten_oranges, simple_geometry, tower_of_hanoi이며 SFT와 maze·tower_of_hanoi가 겹칩니다. 미학습 평가는 두 단계에 등장한 계열을 모두 제외합니다. 교사는 개발 점수·결과 개수와 최대 여덟 실패 사례의 질문·흔적을 보고 solve(model, question) 인터페이스를 보존하는 Python 코드를 수정합니다.
한 수집 문맥에서 8개를 제안하고 1–6개를 보존하며 총 432개를 얻었습니다. 수용 조건은 다음과 같습니다.
즉 seed보다 최소 0.08 높고 절대 점수도 최소 0.40이어야 합니다. 답안 반복, 중복 코드, 출력 인터페이스 위반을 검사합니다. 논문은 Claude Opus 5 검토자가 개발·held-out·format-varied 문제에서 재실행하고 oracle 접근·기억·채점기 악용을 점검했다고 기록합니다. held-out 질문 텍스트는 SFT 자료에 들어가지 않습니다. 다만 검토 단계에서 held-out 실행을 사용했다는 원문 절차를 숨기지 않아야 합니다.
207개, 약 48%가 interpreter loop입니다. 일부 수집에서는 Python 실행 도구를 주라는 지시를 넣었지만 SFT 학습 프롬프트에서는 그 지시를 뺍니다. LoRA는 rank와 scaling 모두 32, 학습률 $10^{-4}$, 32,768토큰 문맥, cosine decay와 10% warmup을 사용합니다. 계열이 겹치지 않는 4-fold 교차검증의 최적 epoch 중앙값으로 기간을 정해 전체 자료에서 약 2.9 epoch 학습 후 adapter를 병합합니다. 저자가 명시한 자료 범위는 단일 교사·첫 수정·interpreter와 직접 알고리즘 중심이며, 부록 F의 초기화 논의로 이어집니다. 원문 부록 B.2·Tables 4–5
B.3 Single-step RL
고정 문맥 풀 640개 중 seed 부모가 440개, 더 강한 부모가 200개입니다. tower_of_hanoi와 codeio는 각각 seed 100개·강한 부모 100개, rotten_oranges와 simple_geometry는 seed 100개씩, maze는 seed 40개입니다. feedback과 reward 질문은 같은 계열이지만 seed를 달리해 분리합니다.
Reasoning Gym의 유효성 항은 식 (8)과 같습니다.
첫 항은 응답 편집 파싱, 둘째는 하네스로 적용·로드 가능한 상태, 셋째는 scoring 시도가 완료된 비율입니다. 모든 질문을 실행하지만 전부 오답인 하네스도 유효성 보상 0.30을 받습니다. task 점수는 부분 점수를 포함한 평균으로 별도 가산됩니다. 실패 편집은 실패 전 유효성 점수만 받고 no-change는 부모를 실행합니다.
문맥당 후보 8개, 업데이트당 문맥 40개, 학습률 $10^{-6}$로 640문맥을 한 번 소비해 총 16업데이트를 수행합니다. 주 결과는 update 10 checkpoint이며 later는 update 16입니다. KL penalty와 entropy bonus는 없습니다. proposer temperature 0.6, prompt/response 한도 12,288/16,384토큰입니다. solver는 non-thinking Qwen3.5-4B, temperature 0.7이며 최소 설정 응답 예산 32,768토큰, scoring 25문제, 문제당 300초 제한을 사용합니다. 보고된 checkpoint와 마지막 checkpoint가 다르므로 표의 later를 별도 방법으로 오독하지 않습니다. 원문 부록 B.3·Tables 6–7
B.4 Multistep RL
오프라인 두 단계로 successive 상태를 학습합니다. Single-step RL update 10에서 시작해 개선 여지가 있는 저장 부모 62개로 9업데이트를 합니다. 각 부모를 최소 0.01 개선한 최고 후보로 갱신하고, 같은 25개 canonical 개발 질문에서 보고서를 다시 만든 뒤 그 계열 최고 점수보다 최소 0.10 낮은 상태를 남깁니다. 두 번째 단계는 이전 수정 실행에서 얻은 상태를 주로 포함한 246개로 15업데이트하며 최종 checkpoint를 보고합니다.
각 상태는 결과 개수와 최대 여덟 실패 인스턴스를 포함하고 모든 후보가 그 문맥의 scoring 질문을 공유합니다. 여러 단계라는 이름에도 각 편집은 전체 응답 예산과 즉시 보상을 받습니다. 고정된 후속 상태를 쓰는 별도 C.3 실험과, 온라인으로 상태를 만드는 QA 설정은 다릅니다. 원문 부록 B.4·Table 8
B.5 Training curves
Figure 8은 GRPO 업데이트별 비평활화 보상, task score, 유효성 기준선과 rollout 결과를 보여 줍니다. 표시된 한 표준오차와 보고 checkpoint 위치를 함께 읽어야 합니다. 저자는 한 배치에 여러 과제 계열이 섞이는 문맥 분포 때문에 분산이 크다고 설명합니다. 학습 곡선을 통해 최종 점수만으로 보이지 않는 실행 유효성과 task 보상의 구성을 확인하고, 부록 C의 추가 평가로 이어갑니다. 원문 부록 B.5·Figure 8
📖 Chapter C: Additional Reasoning Gym Results and Analyses
C.1 Single-step results
먼저 Figure 9와 Table 9는 학습 노출별 단일 수정을 정리합니다. 표에는 모든 평가 계열과 본 비교 제외 여부가 있고, 평균과 oracle best-of-eight, 고정 tool-loop를 나란히 둡니다. 교사 결과가 있는 비교 집합 27계열에서는 RL 평균 0.600, 교사 0.567입니다. 이 수치는 21 OOD 평균과 대상이 다릅니다.
다음 Table 10은 실패 편집과 개발 0점 하네스를 나눕니다. canonical 15계열에서 Base 120개 중 실패 1·0점 45, RL은 실패 0·0점 18입니다. format-varied 12계열에서는 Base 96개 중 4·29, RL 0·6입니다. 별도 OOD 5계열에서는 Base 40개 중 0·15, RL 0·3입니다. 따라서 학습은 코드 편집 가능성뿐 아니라 적용된 코드가 실제 task 점수를 내는 비율도 바꿉니다.
Sensitivity to failed-edit scoring. 실패 편집에 부모 점수 유지·0점·통계 제외를 적용한 Table 11은 11개 format-varied 및 19개 OOD 계열의 별도 집계입니다. OOD에서 RL은 세 규칙 모두 0.501이고 교사는 각각 0.471·0.447·0.472로, 이 비교에서는 실패 처리 방식에 관계없이 RL 평균이 높습니다. 그러나 0점 하네스 자체를 제외하면 성공한 사례만 조건부로 보는 지표가 되어 순위가 뒤집힐 수 있습니다. 주 결과는 0점을 포함합니다. 같은 19계열에서 교사 152개 중 30개, RL 152개 중 19개가 0점입니다. 원문 부록 C.1
C.2 Multistep results
각 문제 형식에서 기존 12계열에 미학습 12계열을 더해 24계열을 평가합니다. 추가 계열은 이전 단일 수정 성능도 고려해 선택됩니다. 첫 여섯은 RL>SFT>Base, RL best-of-eight가 고정 tool-loop에 도달, seed에 개선 여지가 있다는 조건을 사용하고, 나머지 여섯은 두 학습 proposer가 Base보다 높다는 조건으로 완화합니다. canonical과 format-varied의 계열 목록은 다릅니다. 따라서 무작위로 뽑은 동일 계열군의 반복 실험이라고 표현할 수 없습니다.
Table 13은 24계열의 다섯 수정 후 held-out 성능이며, 계열 내 반복 실행을 먼저 평균합니다. canonical은 Base 0.593, SFT 0.698, Single-step RL 0.699, Multistep RL 0.701입니다. format-varied는 각각 0.498, 0.688, 0.725, 0.649입니다. Base 대비 paired gain과 표준오차도 보고합니다. 이때 paired는 같은 계열에서 방법 간 차이를 구했다는 뜻입니다.
이어서 Figure 10은 학습 노출별 held-out 곡선, Tables 14–15는 round 1·5에서 개발 집합으로 선택한 하네스의 개발 점수 를 제시합니다. PDF에서는 두 표가 Table 14와 그 continued 패널입니다. 예를 들어 canonical의 개발 평균과 Table 13의 held-out 평균은 다른 질문 집합의 통계입니다. Figure 11–14는 계열별 개발 곡선을 원래/추가 계열과 canonical/format-varied 순서로 보여 줍니다. PDF에서는 모두 Figure 11의 연속 패널(p.25–28)입니다. 추가 계열은 방법당 한 실행이고 원래 계열에는 반복 실행 범위 음영이 있습니다. 원문 부록 C.2·Table 13
C.3 Training variants
먼저 composition-prompt RL은 helper 도구를 요청하는 지시문과 600문맥 풀을 사용합니다. harder-task RL은 7계열·694문맥과 다른 유효성 항, 구조적 조합 보상을 사용합니다. 두 구성은 SFT에서 시작하고 후보 8개·학습률 $10^{-6}$·KL 없음은 같지만 업데이트당 20문맥으로 주 학습의 40개와 다릅니다. 자료·프롬프트·보상이 함께 변할 수 있으므로 어느 하나만의 효과로 해석하지 않습니다. 설정은 HTML Table 16, PDF Table 15입니다.
harder-task 보상 식 (9)은 다음과 같습니다.
$Q$는 scoring 집합이고 $C(h')$는 구조적 조합 검사를 통과하면 1인 지시변수입니다. 그러나 기록된 rollout은 이 검사를 하나도 통과하지 못해 조합 bonus가 실제로 지급되지 않았습니다. 따라서 이 실행은 더 어려운 자료 풀과 유효성 항 변경의 결합 효과를 측정합니다.
이어서 학습 변형의 단일 및 반복 결과를 비교합니다. harder-task는 11개 format-varied 단일 평가에서 0.600으로 주 RL의 해당 평가 실행들 0.576·0.506보다 높지만, 반복 수정 후 두 개발 형식에서는 주 RL보다 낮습니다. 19계열 결과에는 harder-task 학습 계열도 들어 있어 순수 OOD라고 부를 수 없습니다. HTML Table 17(PDF Table 16)은 단일 열은 75개 held-out, round-five 열은 원래 12계열·25개 개발 질문의 최고 제안 점수임을 명시합니다.
Later-round training states. 마지막으로 SFT 수정 사슬에서 가져온 고정 465문맥은 첫 라운드 240, 후속 155, seed에 머문 실행 70개입니다. SFT에서 학습해 update 16을 평가한 round-five 개발 점수는 0.615로 Single-step RL 0.660보다 낮습니다. paired 차이는 $-0.045\pm0.048$의 한 표준오차이며, 2–5라운드 이득도 유사해 이 구성에서 후속 상태 학습의 이득을 지지하지 않습니다. 원문 부록 C.3
C.4 Harness composition
구조적 조합과 기능적 조합을 다시 나누어 실제 생성물을 감사합니다. 지시문 없는 미학습 평가에서는 SFT와 RL 모두 구조적·기능적 조합이 0이며 interpreter가 우세합니다. helper 지시문을 넣은 한 비교에서 구조적 통합 11/24·12/32에 비해 기능적 기여는 4/24·3/32입니다. 표의 여러 감사 그룹은 별도 평가이므로 분모가 다른 행을 하나의 연속 실험처럼 합치지 않습니다. HTML Table 18, PDF Table 17입니다.
다음 지시문 유무 비교는 일관되지 않습니다. 11계열 held-out 점수에서 Single-step RL은 0.506→0.461로 낮아지고 composition-prompt RL은 0.526→0.559로 높아집니다. 결정적 helper에 solver fallback을 요구하는 guarded 지시에서는 160개 중 158개가 직접 알고리즘 해법이었고 조합 기준을 통과한 것은 없습니다. 지시의 의도와 실제 실행 구조는 별도로 확인해야 합니다. 이 비교는 HTML Table 19, PDF Table 18입니다.
Composition rewards. 이어 식 (10)은 기본 보상에 도구 사용 proxy와 구조적 지시변수를 더합니다.
$F(h')$는 각 scoring 시도의 task 점수에 도구 결과가 solver에 도달했는지의 지시변수를 곱한 값의 평균이며, 구조 검사에 실패하면 0입니다. $C$는 구조적 통합, $w_{\mathrm f},w_{\mathrm s}$는 그 보상 가중치입니다. tool-use reward는 (0.3,0), combined reward는 (1.0,0.15)를 씁니다. 도구 결과가 전달되는 proxy와 helper가 실제 답에 기여했다는 기능적 감사는 같은 측정이 아닙니다.
tool-use reward에서 조합 루프는 초기 25/40에서 checkpoint 14의 1/40으로 감소합니다. combined checkpoint 12는 16/40을 유지하지만 round-five 개발 점수는 0.624로 Single-step RL 0.660보다 낮습니다. 표의 보상 probe는 항별 효과를 고립시키지 않습니다. 마지막 실패 검사는 올바른 maze BFS, sudoku backtracking, count_primes sieve 주변에서 목표 표식 누락, 풀리지 않은 격자 반환, 잘못된 도구 메시지를 찾습니다. 이 결과는 HTML Tables 20–21, PDF Tables 19–20이며, 생성된 계산 모듈의 정확성만으로 전체 파이프라인의 성공을 보장할 수 없다는 실제 관측을 제공합니다. 다음 부록은 이미 검색 구조가 있는 QA로 이동합니다. 원문 부록 C.4
📖 Chapter D: Multi-Hop QA Training and Evaluation
D.1 Datasets and retrieval
HotpotQA는 full-wiki 523만 Wikipedia 초록을 검색합니다. train split에서 학습 2,000·개발 500·test 300문제를 겹치지 않게 뽑습니다. MuSiQue와 2Wiki는 원래 개발 split의 지원·방해 단락을 모아 제목과 텍스트로 중복 제거한 코퍼스를 사용합니다. 따라서 세 벤치마크가 모두 같은 전 위키 검색 환경인 것은 아닙니다.
MuSiQue-Ans는 질문당 제공 단락 20개를 모은 21,100단락 코퍼스와 개발 500·test 299문제를 사용하고 홉 수로 층화합니다. 2Wiki는 질문당 10개를 모은 54,957단락, 개발 500·test 300문제를 사용하고 질문 유형으로 층화합니다. 개발·test 질문과 학습 2,000문제는 분리됩니다. 정답 비교는 소문자화·구두점·관사·중복 공백 제거를 포함한 normalized exact match이며, MuSiQue와 2Wiki는 정답 alias 중 하나와 일치해도 정답입니다. 이 조건은 HTML Table 22, PDF Table 21에 있습니다. 원문 부록 D.1
D.2 RL training
QA는 교사 시연 없이 Base에서 시작합니다. 문맥마다 부모를 6개 feedback 질문에서 실행해 호출·검색·최종 답·정오·지원 문서 검색 여부를 보고하고, 별도 64개 scoring 질문을 공통 후보 평가에 씁니다. 두 집합은 같은 2,000문제 풀에서 뽑지만 해당 문맥에서는 겹치지 않습니다. proposer는 짧은 진단과 Python 코드블록 하나로 응답합니다.
QA의 식 (11)은 다음과 같습니다.
유효 후보는 코드블록이 파싱되고 run을 정의하며 200줄 이하이고 scoring 실행을 완료해야 합니다. 질문별 예외나 호출 예산 초과는 평균 $J$ 안에서 오답으로 계산하며 별도의 부분 실행 bonus는 없습니다. Reasoning Gym의 0.05·0.10·0.15 유효성 구성과 같지 않습니다.
Single-step RL. 320문맥 모두 seed 부모이며, 문맥마다 다른 feedback·scoring draw를 사용합니다. 4문맥씩 총 80업데이트를 한 번 수행한 마지막 checkpoint를 보고합니다. Multistep RL. 32개 수정 실행을 정책이 전진시키며, 각 실행을 10번 방문해 역시 320문맥·80업데이트를 만듭니다. 이전 문맥의 최고 scoring exact match 후보가 다음 부모이며 모두 실행 실패하면 부모를 유지합니다. 다른 조건을 공유하므로 이 QA 비교는 부모 상태 출처를 구분하도록 설계됩니다.
공통 설정은 Qwen3-4B thinking proposer, temperature/top-p 1.0/1.0, 후보 8개, 학습률 $10^{-6}$, clip ratio 0.2, token-mean loss, KL 계수 $10^{-3}$입니다. prompt/response 한도는 10,240/8,192토큰입니다. solver는 non-thinking Qwen3-8B로 2,048토큰 응답과 16,384토큰 문맥, 질문당 solver·검색 각각 12회 예산입니다. BM25 검색을 쓰며 solver 호출 120초, scoring 실행 900초 제한입니다. 조건 표는 HTML Table 23, PDF Table 22입니다. 원문 부록 D.2
D.3 Multistep evaluation
모든 벤치마크의 seed는 두 번 retrieve-and-summarize한 뒤 요약에서 답합니다. 각 proposer는 seed에서 독립 실행 4회를 시작해 10라운드 진행합니다. 라운드마다 실행별 6개 feedback 질문을 개발 풀에서 뽑고, 그 라운드의 모든 feedback과 겹치지 않는 64개 scoring 질문을 4회 실행이 공유합니다. 라운드 사이에는 개발 질문이 다시 나올 수 있습니다. 각 라운드의 무작위 draw는 방법 간 같게 합니다.
각 실행은 후보 8개의 scoring 최고를 택하며 부모보다 낮아도 진행합니다. 파싱 실패, run 없음, 200줄 초과, scoring 실행 실패는 0점입니다. 8개 모두 실패할 때만 부모를 유지합니다. 매 라운드 4개 현재 하네스를 전체 test에서 평가해 평균을 보고합니다. Figure 5의 점선은 지금까지 모든 실행에서 얻은 최고 test 점수로 평균 곡선과 다릅니다.
Sampling and execution. 평가 proposer 응답 예산은 10,240토큰으로 학습의 8,192와 다릅니다. temperature 1.0과 thinking은 같으며 scoring 600초, test 1,800초 제한, 검색당 최대 20단락입니다. 원문의 QA 코드 도식은 원문 단락 직접 답변, 세 번째 홉, 초안 답 검증 후 재검색의 편집을 보여 줍니다. HTML Figure 15, PDF Figure 12(p.34)입니다. 이 절은 숨긴 test를 후보 선택에 쓰지 않는 실제 반복 적응 규칙을 정의합니다. 원문 부록 D.3
D.4 Single-step evaluation
Proposal generation and scoring. 각 데이터셋·RL checkpoint에서 첫 라운드의 네 보고서마다 20개를 뽑아 seed 독립 수정 80개를 만듭니다. 동일 프로그램은 실행을 공유하되 80개 모두 통계에 포함하고, 파싱·컴파일 실패는 0점입니다. 보고 항목은 선택 전 평균, seed를 엄격히 넘는 비율, 실패율입니다. Oracle@8은 80개 중 여덟 개를 비복원 균등 추출했을 때의 최고 held-out 점수의 기대값이고 Best-of-80은 풀 전체 최고입니다.
두 oracle은 test 점수로 후보를 선택합니다. 따라서 생성 후보의 잠재적 품질을 설명하는 진단이며 배포 가능한 선택 규칙이 아닙니다. 예를 들어 MuSiQue Single-step RL의 평균 0.1467, Oracle@8 0.2126, Best-of-80 0.2408은 각각 다른 질문에 답합니다. 높은 최고 후보가 항상 손에 들어온다는 뜻은 아닙니다.
Comparison with successive revision. 순차 1회는 80후보로 독립 풀과 개수가 같지만 4회 평균·최고에는 총 320후보가 쓰입니다. 순차는 중간 하네스 보고서를 계속 얻고 독립은 네 seed 보고서를 공유합니다. 또한 seed 성능은 독립·순차 평가에서 별도로 측정하며 Figure 5 막대 패널의 seed 점선은 독립 평가 기준입니다. 이 절은 제안 수 일치와 완전한 예산 일치를 구분하도록 명시합니다. 결과 표는 HTML Table 24, PDF Table 23(p.34)입니다. 다음 부록은 보고서와 코드 인터페이스를 설명합니다. 원문 부록 D.4
📖 Chapter E: Implementation Details
E.1 Structured harness revision
Reasoning Gym의 도식적 프롬프트는 과제 계열·설정, 현재 소스·개발 점수, 실행 보고서 순으로 입력을 제공합니다. proposer는 실패를 진단하고, 답을 하드코딩하지 않으며, 진입점을 보존하는 SEARCH/REPLACE 편집을 제시합니다. 예상 수정 효과·퇴행 가능성의 설명과 change manifest도 요구합니다. 이 인용은 전체 운영 프롬프트가 아니라 schematic excerpt임을 원문이 명시합니다.
편집은 현재 소스와 맞아야 하고 결과 프로그램이 파싱되어야 합니다. 변경하지 않으면 no-change를 선언하며, 잘못된 응답에는 검증 피드백을 주어 정해진 시도 예산 안에서 재시도합니다. 이 절은 proposer의 출력이 자유로운 설계 설명으로 끝나지 않고 적용 가능한 코드 변경으로 연결되는 방식을 보여 줍니다. QA의 코드블록 인터페이스는 D.2–D.3의 별도 조건을 따릅니다.
E.2 Execution feedback
Reasoning Gym 보고서는 개발 점수·인스턴스 결과, 실패 trace, 이전 수정 이후 변화, 유지된 하네스의 이력을 포함합니다. 독립 제안은 같은 부모·보고서를 바탕으로 하며 분기 지시가 서로 다른 실패 원인을 향하게 합니다. 순차 수정은 유지한 하네스에서 새 피드백을 얻습니다. 이 차이도 단일·순차 비교의 조건입니다.
successive-state 학습의 보고서는 최대 $K$개 성공·$K$개 실패 질문과 하네스 답·기대 답·결과를 제공합니다. QA는 실행별 여섯 개발 질문의 trace, 정오, gold 답, 지원 문서의 검색·누락 정보를 제공합니다. 따라서 여기서 테스트 적응은 아무 정답 정보 없이 이루어지는 절차가 아니라, 평가 test와 분리한 채점된 개발 피드백을 쓰는 절차입니다.
E.3 Composition directives
표준 수정 요청에 재사용 가능한 계산 helper를 solver 도구 루프에 통합하라는 지시를 추가합니다. 더 제한적인 버전은 범용 interpreter 대신 과제별 helper와 결과 검증을 요구합니다. 지시문은 원하는 구조를 말할 뿐이며 실제 구조·기능은 C.4의 감사로 확인합니다. 이 부록은 프롬프트와 결과 측정 사이의 간격을 명확히 하고, 마지막 F에서 저자가 밝힌 학습 범위로 연결됩니다. 원문 부록 E
📖 Chapter F: Limitations and Future Work
Teacher capability and proposer initialization
Reasoning Gym의 SFT는 단일 35B 교사가 만든 설계에 제한됩니다. 저자는 더 강한 교사가 다양한 하네스와 다단계 수정 시연을 제공할 수 있다고 제안합니다. 또 하네스 설계·수정 지식을 이미 학습한 모델에서 RL을 시작하는 방향을 명시합니다. QA는 이미 시연 없는 direct RL을 쓰지만, 더 나은 초기 지식이 탐색과 이전을 개선하는지는 열린 질문으로 남깁니다.
Agentic training of the proposer
현재 proposer는 정해진 수정 프롬프트와 외부에서 만든 실행 보고서를 받으며, 편집 전 코드 검사나 테스트를 스스로 선택하지 않습니다. 저자는 도구를 사용하는 하네스 안에서 proposer를 학습하여 코드 검사·표적 테스트·후보 비교와 그 관측에 따른 수정을 선택하게 하는 방향을 설명합니다. 이는 코드 편집 생성에서 무엇을 조사할지의 선택까지 학습 범위를 넓히려는 제안이며, 현 실험에서 검증된 기능은 아닙니다.
Joint training and longer-horizon tasks
solver를 고정했으므로 하네스 생성 능력과 사용 능력의 공동 강화는 이 연구에서 시험하지 않습니다. 저자는 proposer와 solver를 공동 최적화하되 미학습 계열 이전이라는 목적을 유지하는 확장을 제안합니다. solver가 변할 때도 수정 기술이 이전되는지, 더 긴 도구 사용과 중간 의사결정 과제에서 유효한지가 명시된 질문입니다. 이 부록으로 원문 순서에 따른 상세 리뷰를 마칩니다. 원문 부록 F
실험 결과 심층 분석
평균 제안 품질과 최고 후보 품질
아래는 원문 Table 9와 부록 B.1의 집계를 대조한 값입니다. 21 OOD 행은 주 그림에 쓰인 계열, 26 OOD 행은 제외한 다섯 어려운 계열까지 포함합니다. 점수는 0–1이며 평균은 모든 시도·0점 하네스를 포함합니다.
| 집계·통계 | Base | SFT | Single-step RL | 35B Teacher | 고정 tool loop |
|---|---|---|---|---|---|
| 21 OOD, 8제안 평균 | 0.32 | 0.49 | 0.62 | 0.56 | 0.69 |
| 21 OOD, oracle best-of-eight | 0.63 | 0.78 | 0.83 | 0.85 | 해당 없음 |
| 전체 26 OOD, 제안 평균 | 0.282 | 0.415 | 0.528 | 0.501 | 해당 집계 별도 보고 없음 |
원문 Table 9·부록 B.1. 고정 tool loop는 제안 생성 방법이 아니라 공통 실행 기준선입니다. 21개 평균에서 RL은 Base보다 0.30 높지만 tool loop보다는 0.07 낮습니다. 교사 대비 평균은 높고 oracle 최고는 낮습니다. 이 결과를 평균적 수정 신뢰성의 향상으로 읽는 것은 타당하지만, 모든 형태의 하네스 설계에서 교사를 능가했다는 결론으로 넓혀서는 안 됩니다.
다섯 라운드의 held-out 성능
다음 표는 주 그림의 15 OOD가 아니라 각 형식별 24계열로 확장한 Table 13입니다. 증가량은 같은 계열에서 Base를 뺀 paired 차이의 평균±한 표준오차이며, 표의 반올림 때문에 점수 차와 마지막 자리가 다를 수 있습니다.
| 방법 | Canonical score | Base 대비 증가 | Format-varied score | Base 대비 증가 |
|---|---|---|---|---|
| Base | 0.593 | — | 0.498 | — |
| SFT | 0.698 | 0.105±0.030 | 0.688 | 0.189±0.058 |
| Single-step RL | 0.699 | 0.106±0.044 | 0.725 | 0.226±0.051 |
| Multistep RL | 0.701 | 0.109±0.038 | 0.649 | 0.150±0.051 |
원문 Table 13. canonical의 학습 방법 간 점수는 가깝고 format-varied에서는 Single-step RL이 가장 높습니다. 추가 계열은 이전 성능 조건을 참고해 선택되었고 두 형식의 목록도 다르므로, 이 숫자를 모든 Reasoning Gym 과제에 대한 무조건적 기대 성능으로 일반화하지 않습니다. 개발 점수를 보여 주는 Tables 14–15와 이 held-out 표를 합치지 않는 것도 중요합니다.
QA 독립 수정의 정확한 조건
아래는 HTML Table 24, PDF Table 23(p.34)의 80개 독립 제안을 옮긴 것입니다. Seed와 Mean·Oracle은 exact match이고, > seed와 Failed는 후보 비율입니다.
| 데이터셋 | 학습 | Seed | Mean | Oracle@8 | Best-of-80 | > seed | Failed |
|---|---|---|---|---|---|---|---|
| HotpotQA | Single-step RL | 0.3900 | 0.4105 | 0.5399 | 0.5800 | 71.3% | 1.3% |
| HotpotQA | Multistep RL | 0.3900 | 0.4131 | 0.5209 | 0.5833 | 77.5% | 1.3% |
| MuSiQue | Single-step RL | 0.1438 | 0.1467 | 0.2126 | 0.2408 | 58.8% | 5.0% |
| MuSiQue | Multistep RL | 0.1438 | 0.1551 | 0.2034 | 0.2408 | 67.5% | 2.5% |
| 2WikiMultihopQA | Single-step RL | 0.2500 | 0.3090 | 0.4746 | 0.5200 | 67.5% | 1.3% |
| 2WikiMultihopQA | Multistep RL | 0.2500 | 0.2748 | 0.4374 | 0.5433 | 58.8% | 0.0% |
원문 Table 24. MuSiQue는 299 test 질문, 다른 두 데이터셋은 300개입니다. 독립 후보 평균은 MuSiQue에서 작게 개선되지만 순차 최종 평균은 약 0.27로 더 높습니다. 이 차이는 현재 하네스에서 얻은 피드백을 이어 쓰는 적응의 중요성을 보여 줍니다. 동시에 독립 80개와 순차 4회 총 320개, 서로 다른 보고서 배분을 고려해야 합니다. Oracle 최고를 숨긴 평가 점수로 고른다는 점 때문에 운영 선택 성능으로 해석할 수도 없습니다.
신뢰도와 실제 실행의 의미
Reasoning Gym은 계열 간 한 표준오차, paired 증가량의 표준오차, 계열 내 실행 범위를 보고합니다. 따라서 불확실성 정보를 전혀 보고하지 않았다고 쓰는 것은 부정확합니다. 다만 본문에 사용한 비교에 대한 p값과 신뢰구간은 논문에 보고되지 않았습니다. QA의 주 곡선은 독립 실행 4회의 평균과 최고 궤적을 보여 주며, 그 평균 곡선의 신뢰구간이나 유의성 검정은 제시하지 않습니다. 관측 점수 차와 통계적 유의성을 구분해야 합니다.
실행 실패 처리도 성능 정의의 일부입니다. Reasoning Gym 평가에서는 실패 편집·no-change에 부모 점수를 유지하되 적용된 0점 하네스는 그대로 포함합니다. QA는 파싱·컴파일 및 유효 실행 조건을 통과하지 못한 후보에 0점을 주며, 반복 선택은 8개 모두 실패할 때만 부모를 유지합니다. 학습 보상의 유효성 항도 서로 다릅니다. 따라서 두 도메인의 실패율이나 평균을 단일한 지표인 것처럼 합쳐서는 안 됩니다. 저자가 보고한 helper 실패는 문제 파싱·도구 통신·답 추출의 구체적 사례이며, 그 외 실패 원인을 추정해서 추가하지 않습니다.
재현성 측면에서 논문은 모델, 자료 분할, 후보·라운드 수, 학습률·예산·타임아웃, report와 편집 인터페이스를 상세히 제공합니다. 이 글에서는 원문에 있는 조건을 확인했으며 학습을 재실행하지 않았습니다. 별도 코드 저장소의 공개·실행 상태를 확인한 것처럼 주장하지 않습니다.
기술적 함의와 응용
저자들의 결과는 고정 모델을 둘러싼 실행 프로그램도 경험에서 학습한 적응 규칙의 대상이 될 수 있음을 보여 줍니다. 학습된 것은 특정 과제의 최종 하네스 하나만이 아니라, 현재 코드와 관측을 다음 코드로 바꾸는 proposer입니다. Reasoning Gym의 계열 이전과 HotpotQA→MuSiQue·2Wiki 이전은 그 절차가 학습 경계를 넘어 유용할 수 있다는 근거입니다. 단일 수정 학습 정책이 바뀐 중간 하네스에서도 개선을 이어 가는 결과는 과제 이전과 상태 이전을 함께 평가할 필요를 보여 줍니다.
리뷰어의 해석으로는 검색 기반 에이전트의 개선을 검토할 때, 검색어를 만드는 요약과 답변의 근거를 분리한 QA 편집이 구체적인 설계 사례가 됩니다. 요약은 다음 검색을 안내하고, 원문 단락은 최종 답의 근거로 제공합니다. 반면 합성 추론의 helper 감사는 계산 알고리즘이 맞는지뿐 아니라 입력 파싱·도구 전달·출력 추출이 연결되는지 확인해야 함을 보여 줍니다. 두 사례 모두 모델 교체 없이 정보와 계산의 흐름을 바꿔 성과를 개선하는 하네스 적응의 의미를 설명합니다.
응용 범위는 원문의 조건 안에서 읽어야 합니다. 적응에는 채점된 개발 피드백이 제공되고, solver와 후보 예산·실행 제한이 정해져 있습니다. 실제로 사용할 후보는 개발 점수로 선택하며, held-out oracle은 연구용 진단입니다. 이 논문은 이러한 설정에서 학습된 수정의 이전과 반복 개선을 보였고, 다단계 상태 학습의 이득은 설정에 따라 달랐습니다. 교사 다양성, 도구를 사용하는 proposer, proposer–solver 공동 학습과 긴 도구 사용 과제는 부록 F에서 저자가 명시한 후속 연구 범위입니다.
원문 본문 1–7과 부록 A–F의 모든 소절을 위 순서대로 다루었습니다. 부록의 전체 계열별 표와 모든 곡선을 이미지로 재게시하지는 않았으며, 집계 조건·핵심 수치·실패 처리·조합 감사의 역할을 설명하고 해당 원문 표·절로 연결했습니다. 인용 참고문헌 전체의 개별 원문 검토와 모델 학습 재현은 이 리뷰의 수행 범위에 포함하지 않습니다.