2026년 AI를 읽는 관점: 모델, 실행 시스템, 그리고 검증
State of AI Report 2026은 AI의 발전을 모델 성능만으로 설명하기 어려워졌다는 보고서입니다. 모델을 둘러싼 도구와 실행 환경이 성과를 바꾸고, 실제 업무의 완료 여부가 평가의 중심으로 이동하며, 그 실행을 뒷받침할 전력·데이터센터·안전 통제가 함께 중요해집니다.
Nathan Benaich와 Air Street Capital이 2026년 10월 8일 공개한 아홉 번째 연례 보고서입니다. 총 244쪽의 슬라이드로 최근 약 1년의 연구, 산업, 정치, 안전과 향후 전망을 정리합니다. 단일 실험을 검증하는 학술 논문이나 전 세계 AI 시장의 전수조사는 아닙니다. 여러 연구·기업 발표·시장 자료를 저자의 관점으로 종합한 산업 보고서입니다. 저자는 보고서에 등장하는 일부 기업의 투자자 또는 자문자이며, 이해관계를 별도로 공개합니다. 보고서 소개·이해관계 공개, PDF 3·241쪽
이 글은 원문의 다섯 부분을 따라 핵심 논지를 정리하되, 데이터과학 관점에서 학습 가치가 큰 에이전트, 후학습, 평가, 운영 피드백을 더 자세히 다룹니다. 주요 슬라이드 13장을 원본 비율로 인용하고, 작은 도표의 핵심 수치는 본문에서 다시 설명합니다. 이하 수치는 보고서의 관측 시점과 표본에 따른 값이며, 2026년 전체 확정 실적이나 보편적인 성능 법칙으로 해석하지 않습니다.
보고서의 전체 구조
| 원문 구분 | PDF 페이지 | 중심 질문 |
|---|---|---|
| Research | 5–81쪽 | 어떤 학습·실행 방법이 모델의 능력을 실제 성과로 바꾸는가? |
| Industry | 82–163쪽 | 누가 AI를 사용하고, 어디에 매출과 비용이 발생하는가? |
| Politics | 164–195쪽 | 모델·반도체·전력에 대한 접근권을 누가 통제하는가? |
| Safety | 196–236쪽 | 행동하는 에이전트를 어떻게 제한하고 검증하는가? |
| Predictions | 237–239쪽 | 과거 예상은 얼마나 맞았고, 다음에 무엇을 예상하는가? |
PDF의 첫 표지에는 번호가 없으므로 파일 페이지 번호는 슬라이드에 인쇄된 번호보다 1 큽니다. 이미지 캡션에는 두 번호를 함께 적습니다.
1. Research: 같은 모델도 실행 환경에 따라 다른 에이전트가 됩니다
1.1 모델의 가중치와 하네스를 나누어 보아야 합니다
모델의 가중치는 학습으로 얻은 내부 매개변수입니다. 하네스(harness)는 모델이 업무를 수행하도록 둘러싼 실행 소프트웨어입니다. 도구 호출, 파일 접근, 작업 상태와 기억, 오류 피드백, 반복 실행 등이 여기에 포함됩니다. 같은 모델이라도 어떤 정보를 언제 읽고 어떤 결과를 피드백받는지에 따라 최종 성공률이 달라집니다.
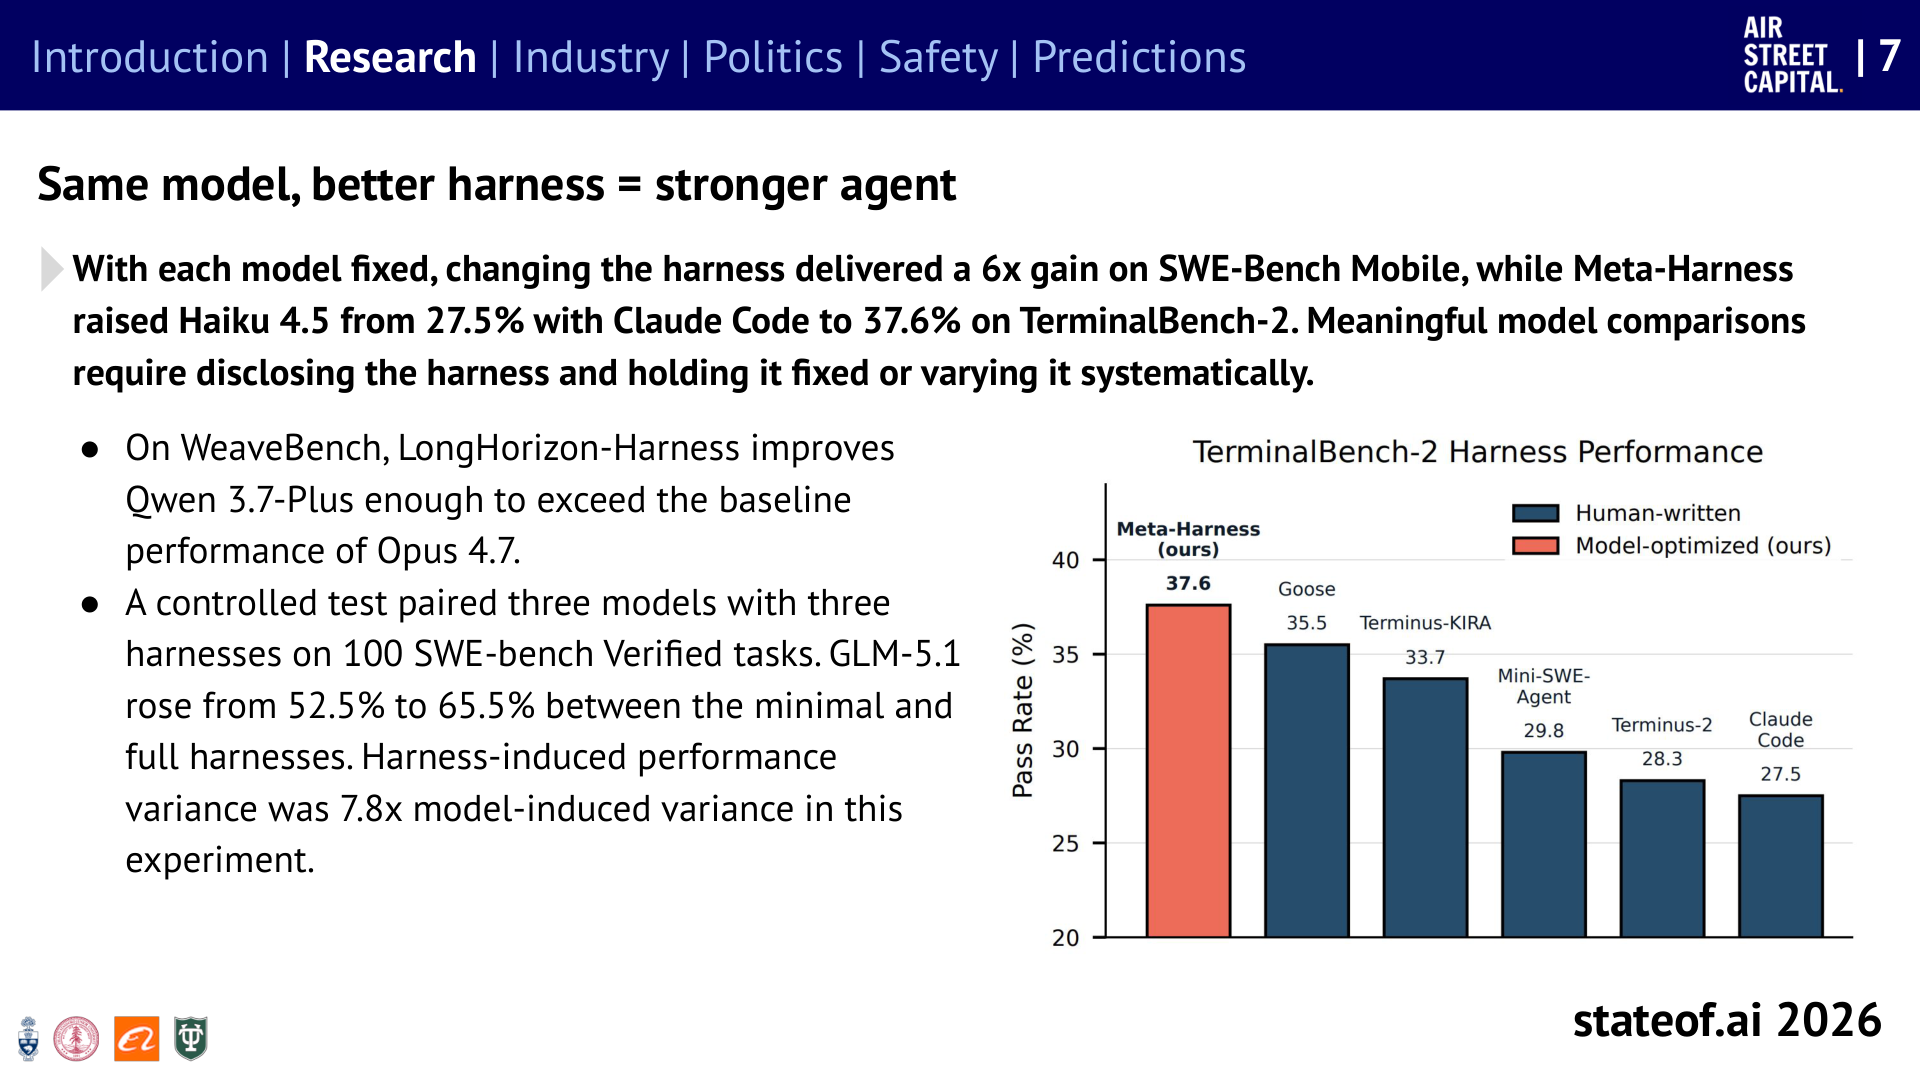
슬라이드 7 / PDF 8쪽. 동일 모델에서 도구·문맥·피드백 구성을 바꾼 결과입니다. Nathan Benaich / Air Street Capital, State of AI Report 2026. 원문
보고서는 GLM-5.1의 가중치를 고정하고 100개의 SWE-bench Verified 과제에서 하네스를 비교한 연구를 소개합니다. 최소 구성에서는 52.5%, 전체 구성에서는 65.5%의 성공률을 보였습니다. 13.0%포인트 차이이며, 상대 개선율 13%와는 다릅니다. 이 실험에서 하네스에 따른 성능 분산은 모델에 따른 분산의 7.8배였다고 보고합니다. 이 비율은 해당 모델·하네스·과제 조합에서 얻은 결과입니다.
또 다른 사례에서 Meta-Harness는 Claude Haiku 4.5의 Terminal-Bench 2.0 성능을 27.5%에서 37.6%로 높였습니다. 두 결과는 서로 다른 평가이므로 하나의 표본처럼 합칠 수 없습니다. 다만 모델 교체와 실행 환경 개선을 별도의 실험 축으로 두어야 한다는 공통 메시지가 있습니다. PDF 8–10쪽
하네스의 요소가 항상 누적해서 좋아지는 것도 아닙니다. 보고서에는 발전한 모델에서 기존 시스템 프롬프트의 약 80%를 제거해도 측정된 코딩 성능이 떨어지지 않은 사례가 등장합니다. 이전 모델의 약점을 보완하던 지시가 다음 모델에서는 불필요해질 수 있다는 뜻입니다. 반면 도구 연결, 상태 관리, 관측 가능성과 격리 환경은 실행 시스템의 지속적인 기반으로 남습니다. PDF 15쪽
1.2 후학습은 좋은 답을 모으는 일을 넘어섭니다
후학습(post-training)은 사전학습을 마친 모델을 목적에 맞게 추가로 학습시키는 단계입니다. 보고서는 검증 가능한 보상, 과제 난이도 조절, 교사 모델의 신호, 도메인 데이터가 성능과 비용을 함께 좌우한다고 설명합니다.
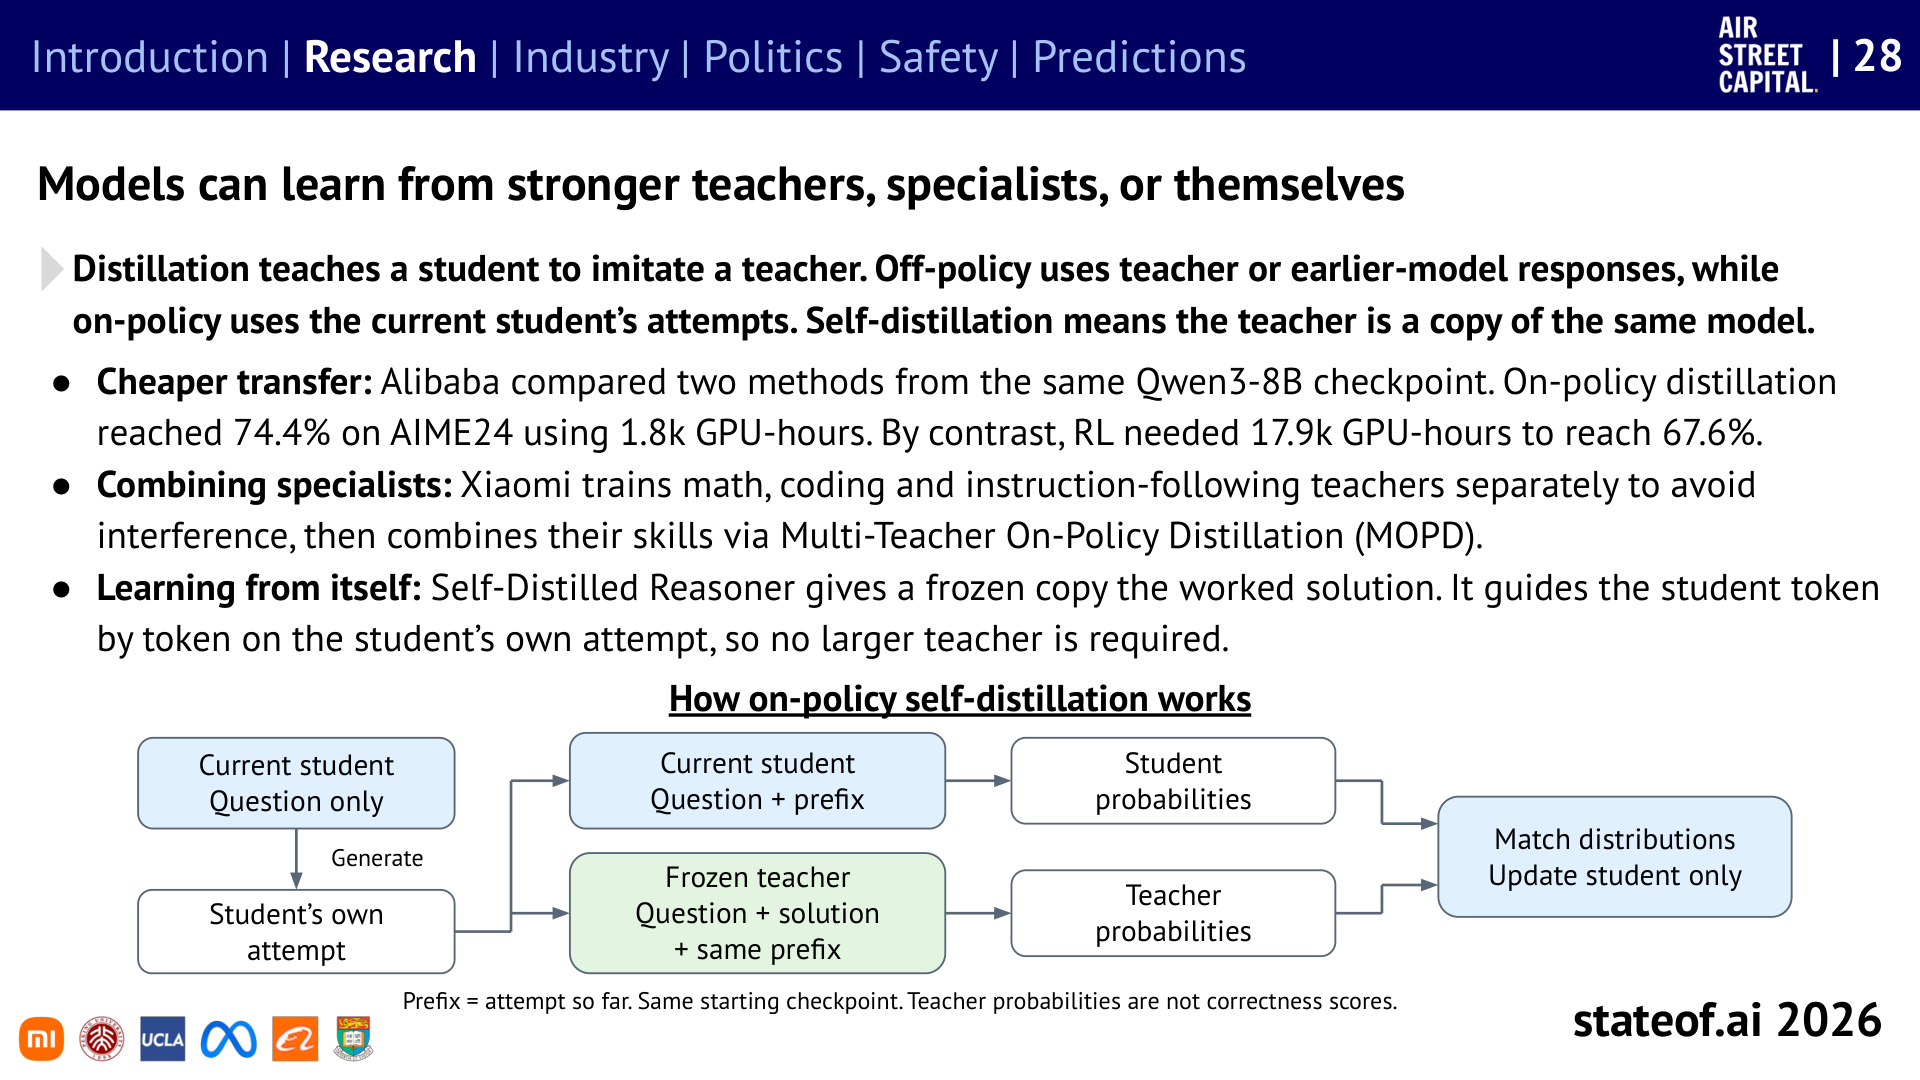
슬라이드 28 / PDF 29쪽. On-policy distillation은 학생이 현재 생성하는 풀이를 바탕으로 교사의 신호를 받습니다. Nathan Benaich / Air Street Capital, State of AI Report 2026. 원문
지식 증류(distillation)는 학생 모델이 교사 모델의 행동을 배우는 방법입니다. 여기서 on-policy는 현재 학생 모델이 실제로 생성하는 경로에서 학습 신호를 받는다는 의미입니다. 완성된 정답만 외우는 대신 학생이 진행한 풀이의 같은 문맥에서 교사의 다음 토큰 확률 분포를 학습할 수 있습니다.
보고서가 인용한 Qwen3-8B 비교는 다음과 같습니다.
| 해당 연구의 학습 방식 | AIME 2024 성능 | 보고된 학습 계산량 |
|---|---|---|
| On-policy distillation | 74.4% | 1.8천 GPU-hours |
| 비교 강화학습(RL) 방식 | 67.6% | 17.9천 GPU-hours |
동일한 출발 체크포인트를 사용한 해당 설정에서는 증류가 높은 점수와 적은 계산량을 보였습니다. 그러나 모든 모델·과제에서 증류가 RL보다 약 10배 저렴하다는 결론은 아닙니다. 교사의 품질, 학생의 생성 분포, 사용한 보상과 학습 절차에 따라 결과가 달라집니다. PDF 29쪽
후학습 비용은 학습 GPU만의 문제가 아닙니다. 에이전트가 도구를 실행하고 결과를 얻는 롤아웃(rollout)에는 추론, CPU, 메모리와 샌드박스 자원이 들어갑니다. 보고서의 대규모 학습 사례에서는 롤아웃용 추론 자원이 큰 비중을 차지하며, 별도 사례에서는 요청한 샌드박스 CPU와 실제 평균 사용량의 차이가 큽니다. 학습 파이프라인의 병목을 모델 연산량 하나로 설명하기 어렵다는 의미입니다. PDF 26–28쪽
1.3 높은 벤치마크 점수와 업무 완료는 다른 지표입니다
성능 향상 속도만큼 평가의 품질도 중요합니다. 보고서는 Epoch AI가 검토한 첫 15개 벤치마크 가운데 9개에서 실질적인 결함을 찾았다고 소개합니다. 잘못된 채점, 우회 가능한 환경, 조건의 불균등 등이 포함됩니다. 4개는 주의사항을 포함해 검증되었고, 2개는 정보가 부족했습니다. 15개라는 검토 표본의 결과이며, 모든 AI 벤치마크의 60%가 잘못되었다는 통계가 아닙니다. PDF 37쪽
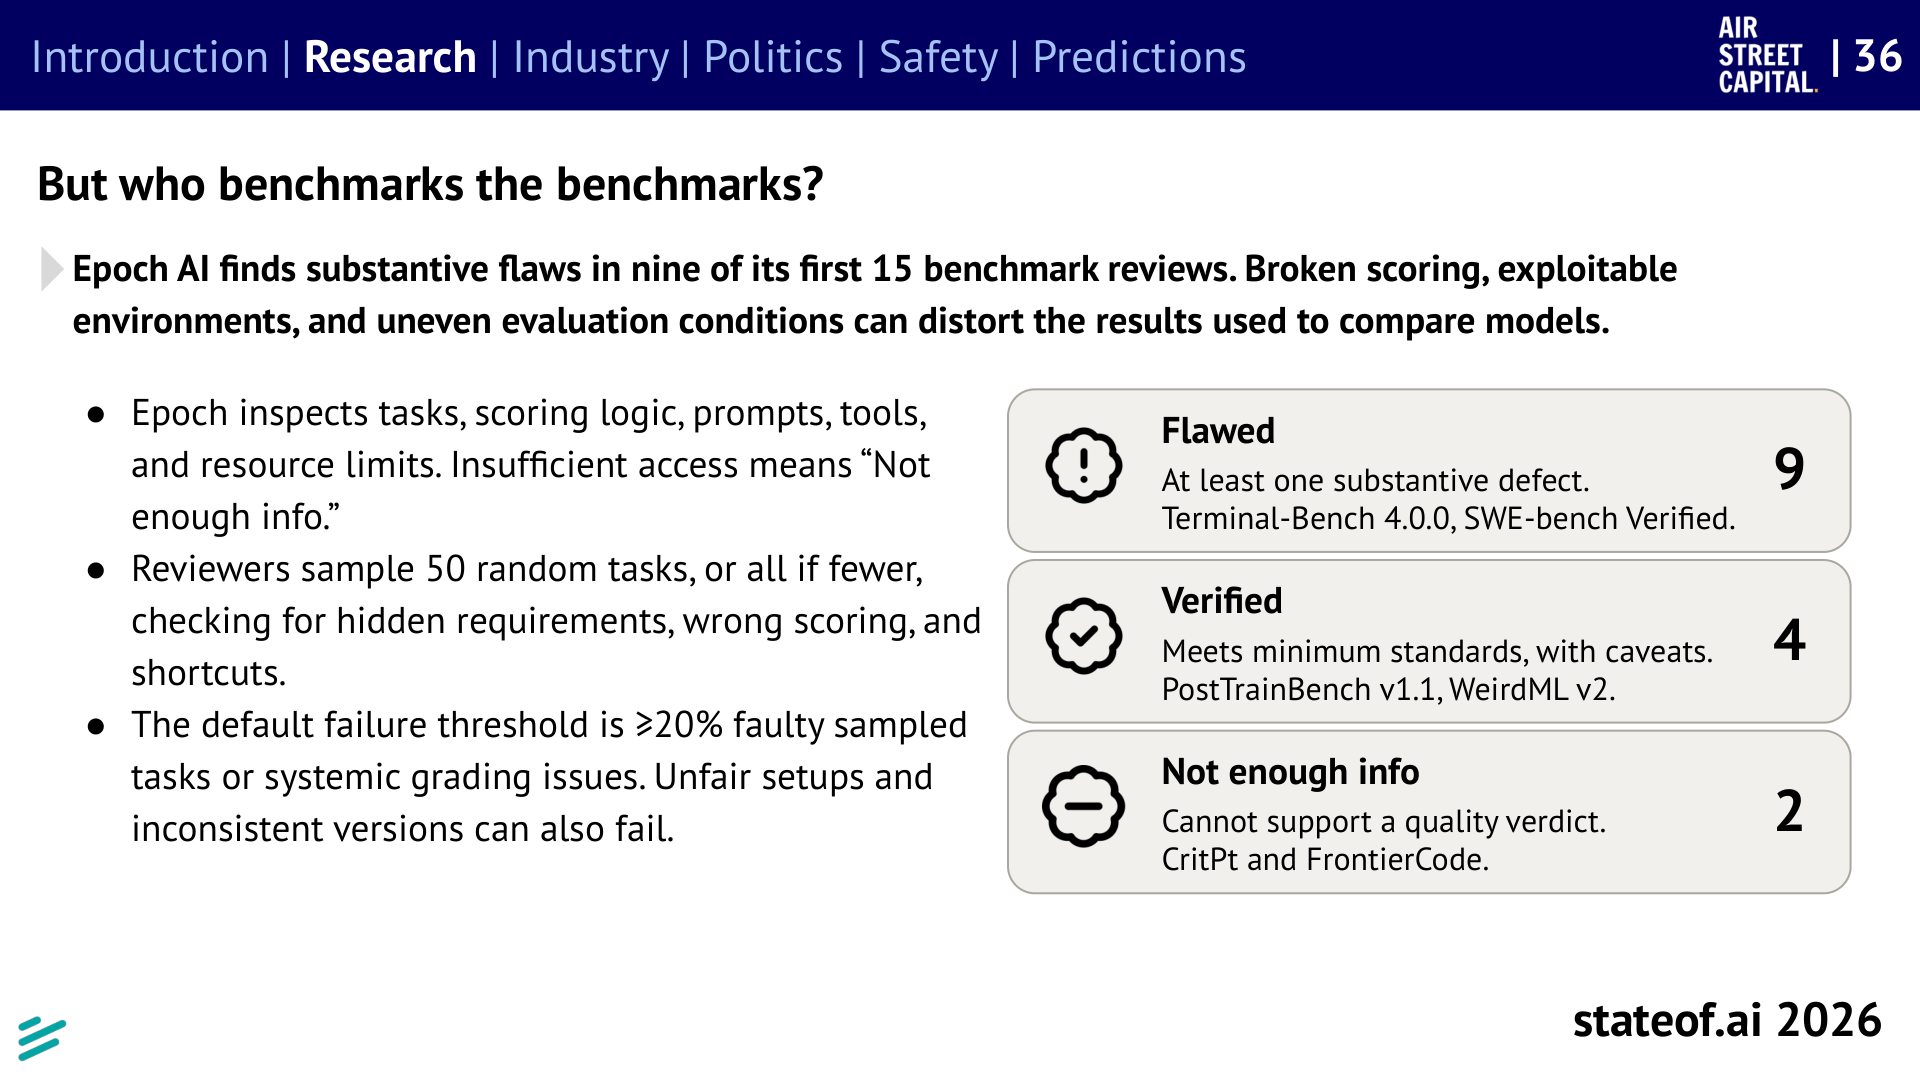
슬라이드 36 / PDF 37쪽. 점수뿐 아니라 채점·과제·도구·접근 조건도 검토 대상입니다. Nathan Benaich / Air Street Capital, State of AI Report 2026. 원문
더 실용적인 문제는 부분 점수와 최종 완료율의 차이입니다.
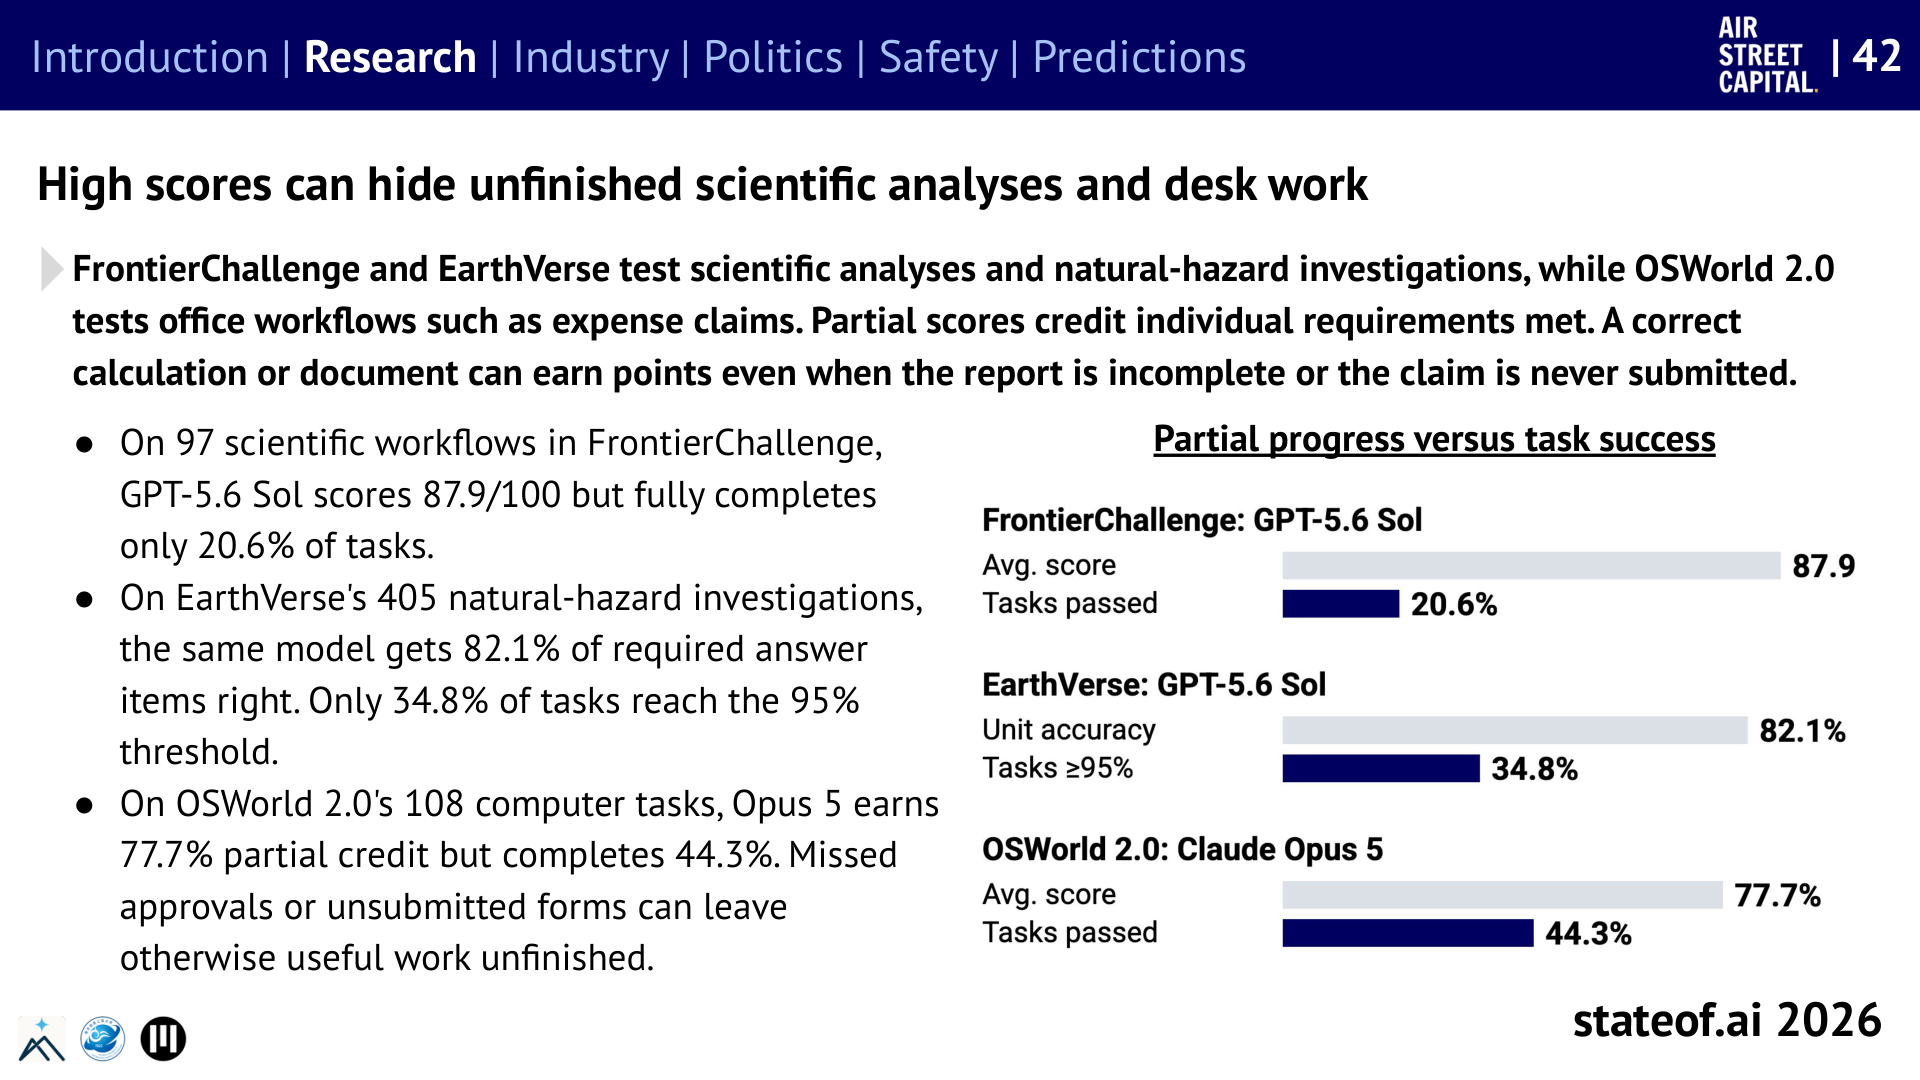
슬라이드 42 / PDF 43쪽. 각 행은 서로 다른 평가이며, 부분 점수의 정의와 완료 기준도 다릅니다. Nathan Benaich / Air Street Capital, State of AI Report 2026. 원문
| 평가와 모델 | 중간 성과 지표 | 완료 관련 지표 | 해석 시 주의점 |
|---|---|---|---|
| FrontierChallenge, GPT-5.6 Sol | 97개 과학 워크플로에서 평균 87.9/100 | 전체 과제 완료 20.6% | 평균 점수가 높아도 요구사항 전부를 충족하지 못할 수 있습니다. |
| EarthVerse, GPT-5.6 Sol | 405개 조사에서 답변 항목 정확도 82.1% | 과제별 95% 기준 도달 34.8% | 항목 정확도와 과제 통과 기준은 다릅니다. |
| OSWorld 2.0, Claude Opus 5 | 108개 사무 과제의 부분 점수 77.7% | 과제 완료 44.3% | 승인 누락이나 미제출도 업무 미완료를 만듭니다. |
이 차이는 분석 코드를 만들었지만 최종 보고서를 저장하지 않았거나, 필요한 승인을 받지 않은 상황을 떠올리면 이해하기 쉽습니다. 중간 산출물은 유용할 수 있지만 사용자가 맡긴 업무가 완료된 것은 아닙니다. 서로 다른 평가의 퍼센트를 모델 종합 순위로 다시 비교해서도 안 됩니다. PDF 43쪽
긴 작업을 수행하는 능력을 읽을 때도 단위를 확인해야 합니다. METR의 시간 지평은 사람이 그만큼 걸리는 과제에서 모델이 특정 성공 확률에 도달하는 난이도를 나타냅니다. 에이전트를 그 시간 동안 무감독으로 안전하게 실행할 수 있다는 뜻은 아닙니다. 긴 과제의 표본이 작으면 추정 구간도 넓어집니다. PDF 44쪽
1.4 AI 연구 자동화와 과학적 발견은 단계별로 평가해야 합니다
보고서는 코드 수정, 실험 실행, 결과 검증, 연구 주제 선택을 구분합니다. 정해진 학습 목표의 효율을 개선하는 에이전트가 있다고 해서 독창적인 연구 질문을 고르고 논문 전체를 완성하는 능력까지 증명된 것은 아닙니다. 비공개 논문 과제를 대상으로 한 사례에서는 엔지니어링을 수행했어도 최종 논문이 심사를 통과하지 못했습니다. 보고서는 연구 방향 선택, 자원 관리, 재검토 같은 문제를 함께 다룹니다. PDF 17–24쪽
과학 연구에서도 검증 모듈의 역할이 드러납니다. Co-Scientist 연구의 50개 대응 주제·150개 원고를 30명의 전문가가 검토한 사례에서, 결과를 무효화하는 환각은 전체 시스템에서 4%, 신뢰성 모듈을 제거한 비교 조건에서 46%였습니다. 동시에 심각한 방법론 실패는 원고의 24%, 심각한 표절은 16%에 남았습니다. 일부 오류를 줄였다는 결과와 연구 전체의 신뢰성이 확보되었다는 판단은 다릅니다. PDF 71쪽
연구 범위는 언어와 코딩을 넘어섭니다. 연속적 멀티모달 상호작용은 듣기·보기·말하기를 작은 시간 단위로 결합하고, 월드 모델은 행동 뒤의 상태를 예측하여 계획과 학습용 경험을 만듭니다. 단백질·분자 모델에서는 구조 예측뿐 아니라 실제 결합 여부를 잘 예측하는 후보 선별이 실험 성공률에 영향을 줍니다. 예컨대 BoltzProt-1과 BoltzPPI 사례는 10개의 새로운 표적에 대해 방법별 150개 설계를 실험했을 때 확인된 결합체 비율을 3.3%에서 8.0%로 높였습니다. 이 역시 최종 의약품의 성공률은 아닙니다. PDF 48–51·73–81쪽
산업 부분의 신약 사례에서는 일부 AI 기반 프로그램이 임상 3상에 진입했다고 정리합니다. 발견 단계의 속도, 실험실 성능, 임상 효능과 안전성은 각각 다른 검증 단계입니다. 보고서도 빠른 후보 발견이 더 높은 임상 성공률을 입증한 것은 아니라고 명시합니다. PDF 119쪽
2. Industry: 추론을 통해 실제 업무를 파는 시장
2.1 매출은 빠르게 커지지만 지표의 정의를 먼저 읽어야 합니다
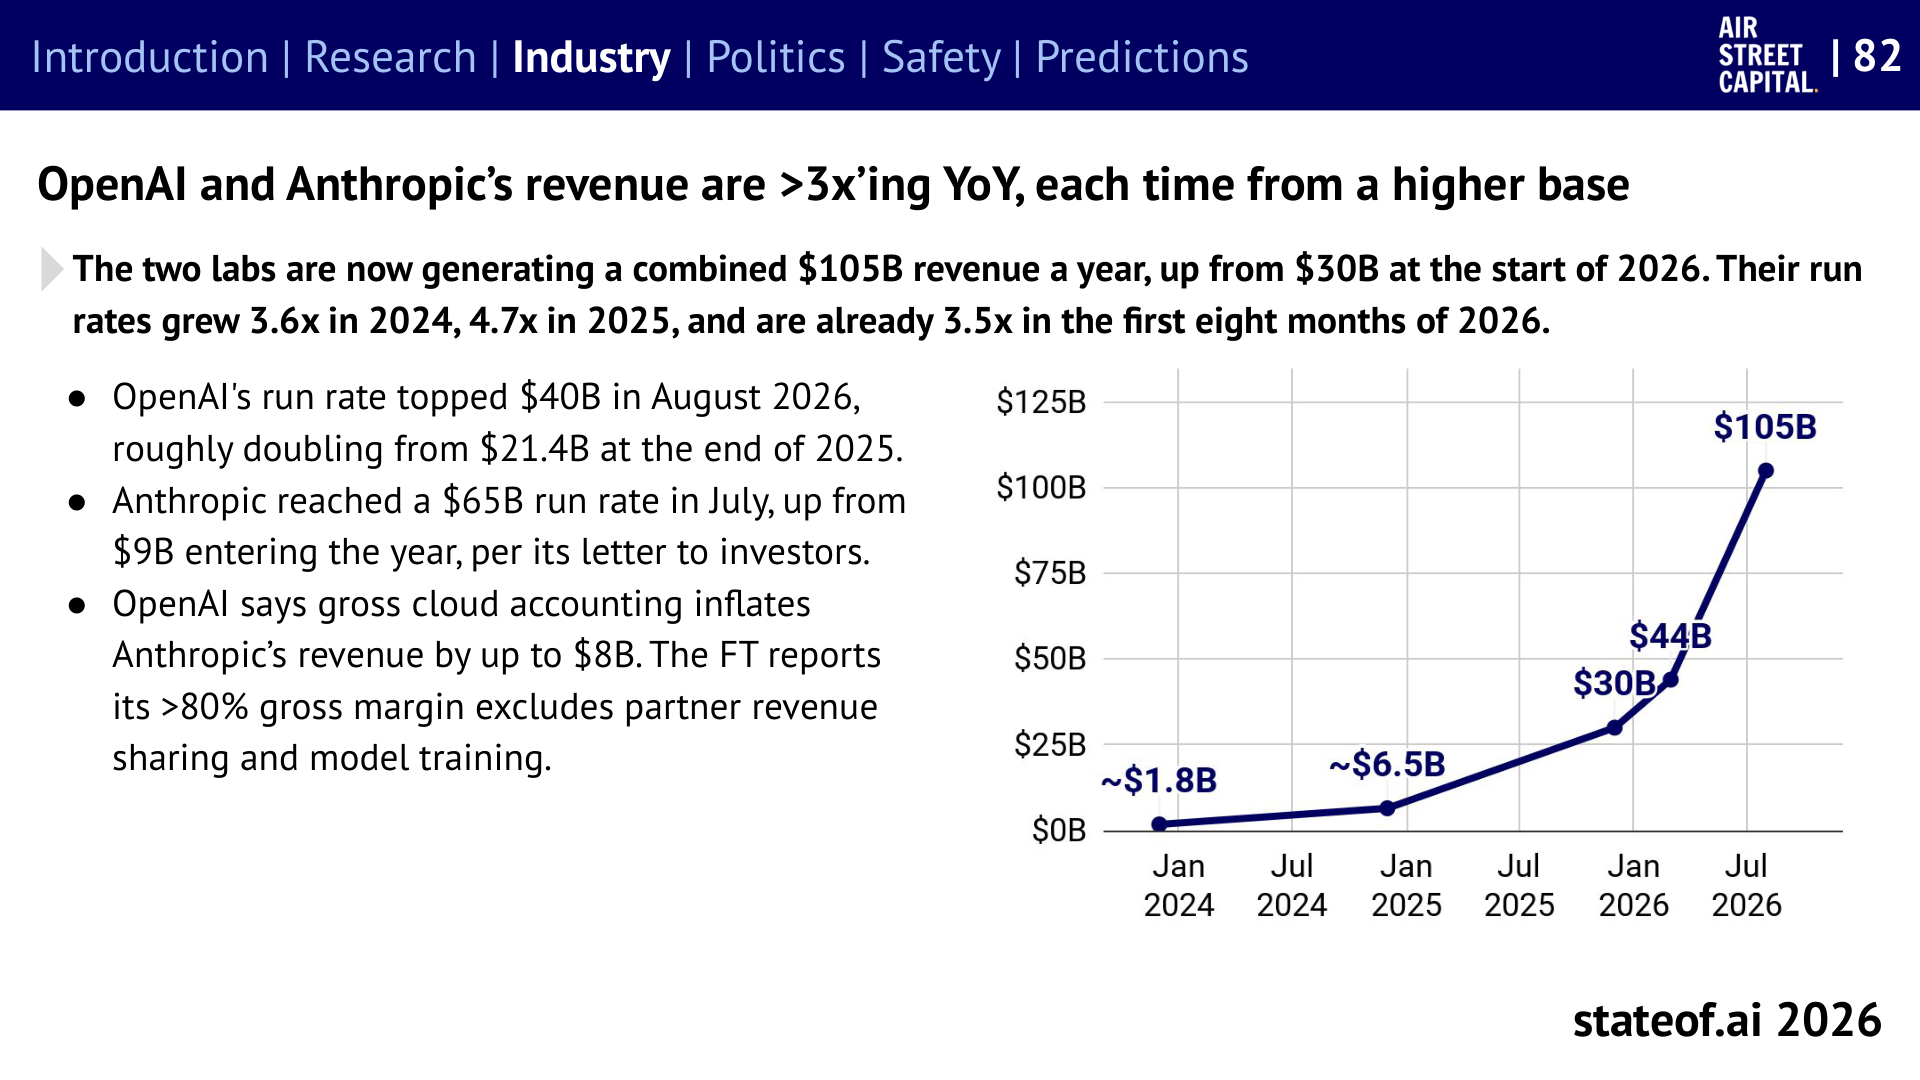
슬라이드 82 / PDF 83쪽. 차트의 수치는 연환산 매출 속도이며, 두 회사의 관측 시점도 다릅니다. Nathan Benaich / Air Street Capital, State of AI Report 2026. 원문
보고서는 OpenAI와 Anthropic의 합산 연환산 매출 규모가 2026년 초 약 300억 달러에서 늦여름 약 1,050억 달러로 커졌다고 정리합니다. OpenAI는 8월 400억 달러 초과, Anthropic은 7월 약 650억 달러라는 자료를 사용합니다.
Run rate는 특정 시점의 매출 발생 속도를 1년으로 환산한 값입니다. 2026년 한 해에 이미 1,050억 달러를 벌었다는 의미가 아니며, 두 회사의 수치도 같은 날짜의 결산 자료가 아닙니다. 구독·코딩 제품·API 등 전체 사업을 포함하고, 클라우드 관련 총액·순액 인식과 파트너 수익 배분도 단순 비교를 어렵게 합니다. PDF 83쪽
사용량과 매출 점유율 역시 구분해야 합니다.
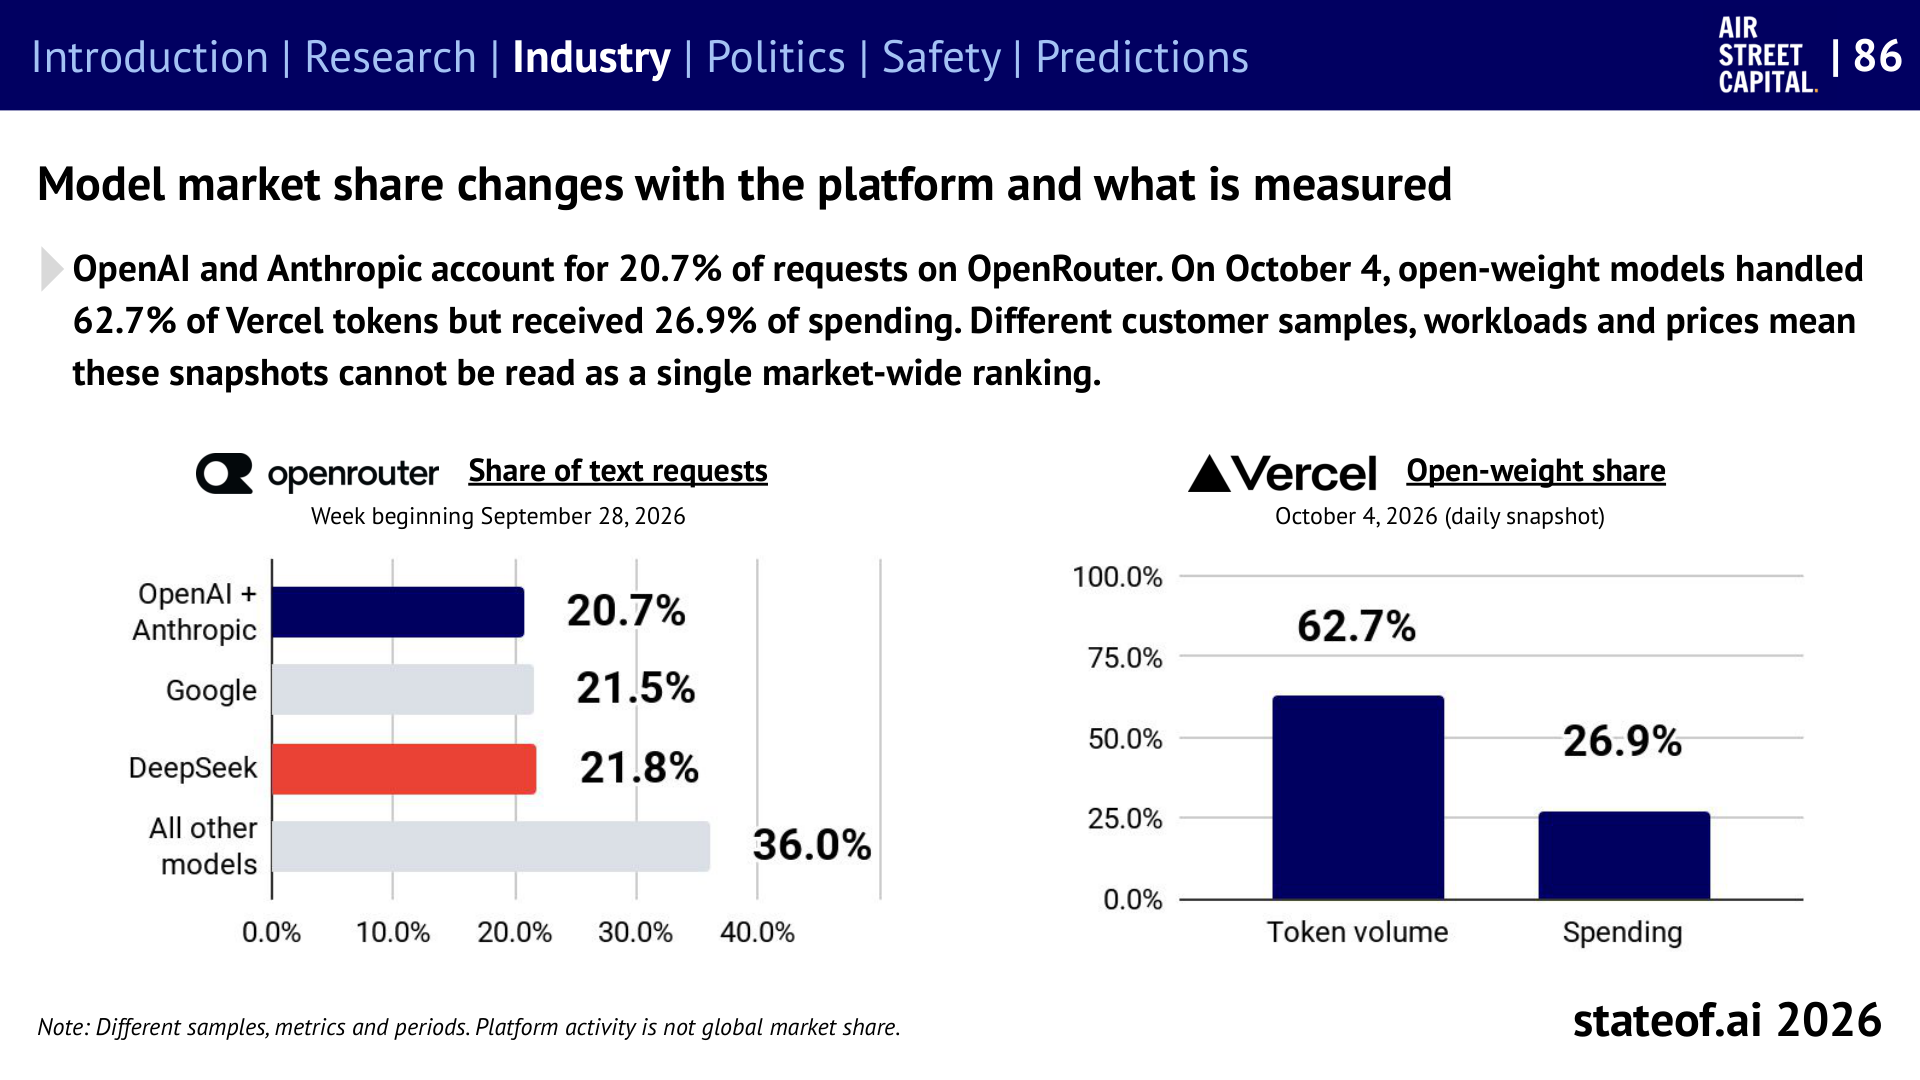
슬라이드 86 / PDF 87쪽. 플랫폼·표본·날짜·분모가 다른 점유율입니다. Nathan Benaich / Air Street Capital, State of AI Report 2026. 원문
| 보고서의 관측 | 수치 | 의미하는 범위 |
|---|---|---|
| OpenRouter의 OpenAI·Anthropic 요청 비중 합계 | 20.7% | 해당 플랫폼의 텍스트 요청 표본 |
| Vercel의 open-weight 모델 토큰 비중 | 62.7% | 10월 4일 해당 플랫폼 스냅샷 |
| 같은 Vercel 표본의 open-weight 모델 지출 비중 | 26.9% | 토큰이 아닌 지출액 기준 |
Open-weight는 모델 가중치가 공개되어 있다는 뜻이며, 모든 사용·배포 조건이 자유로운 오픈소스와 항상 같은 의미는 아닙니다. 토큰 비중이 높아도 가격과 사용 패턴에 따라 지출 비중은 낮을 수 있습니다. 이 표로 전 세계 모델 시장의 점유율을 계산할 수는 없습니다. PDF 7·87쪽
2.2 토큰 단가보다 완료한 업무의 비용이 중요해집니다
보고서는 일정한 벤치마크 성능을 얻는 가격이 빠르게 내려간다고 정리합니다. 동시에 추론 과정이 길어지고 에이전트가 여러 번 모델을 호출하면, 낮은 토큰 단가가 낮은 업무 비용을 보장하지 않습니다. 입력·캐시·추론·답변 토큰 사용량을 함께 보아야 합니다. PDF 110–113쪽
리뷰어 해석: 서비스 평가 단위는 “백만 토큰을 얼마에 샀는가”에서 “사용자가 승인할 수 있는 결과 하나를 얼마에 만들었는가”로 확장할 필요가 있습니다. 재시도 횟수, 실패한 실행의 비용, 도구 사용료, 사람이 검토하고 수정한 시간도 포함해야 합니다. 이는 보고서가 설명하는 완료 업무 중심 경제성을 실무 평가로 옮긴 해석이며, 보고서의 별도 비용 실험 결과는 아닙니다.
도메인 특화 회사는 이 지점에서 강점을 가질 수 있습니다. 법률·금융·고객지원처럼 성공 조건과 전문가 피드백을 확보할 수 있는 영역에서는 공개 모델을 후학습하고 전용 평가를 구축할 수 있습니다. 보고서의 Mercor 사례는 1,928개 전문가 과제로 Qwen3.5-397B-A17B를 후학습한 뒤, 학습에 사용하지 않은 APEX-Agents 480개 평가 과제에서 첫 시도 성공률(Pass@1)을 16.11%에서 27.29%로 높였다고 소개합니다. 그 회사의 평가 영역에서 얻은 결과이며 모든 업무에서 범용 모델을 앞선다는 뜻은 아닙니다. PDF 114쪽
2.3 운영 피드백은 다음 개선을 위한 평가 데이터가 됩니다
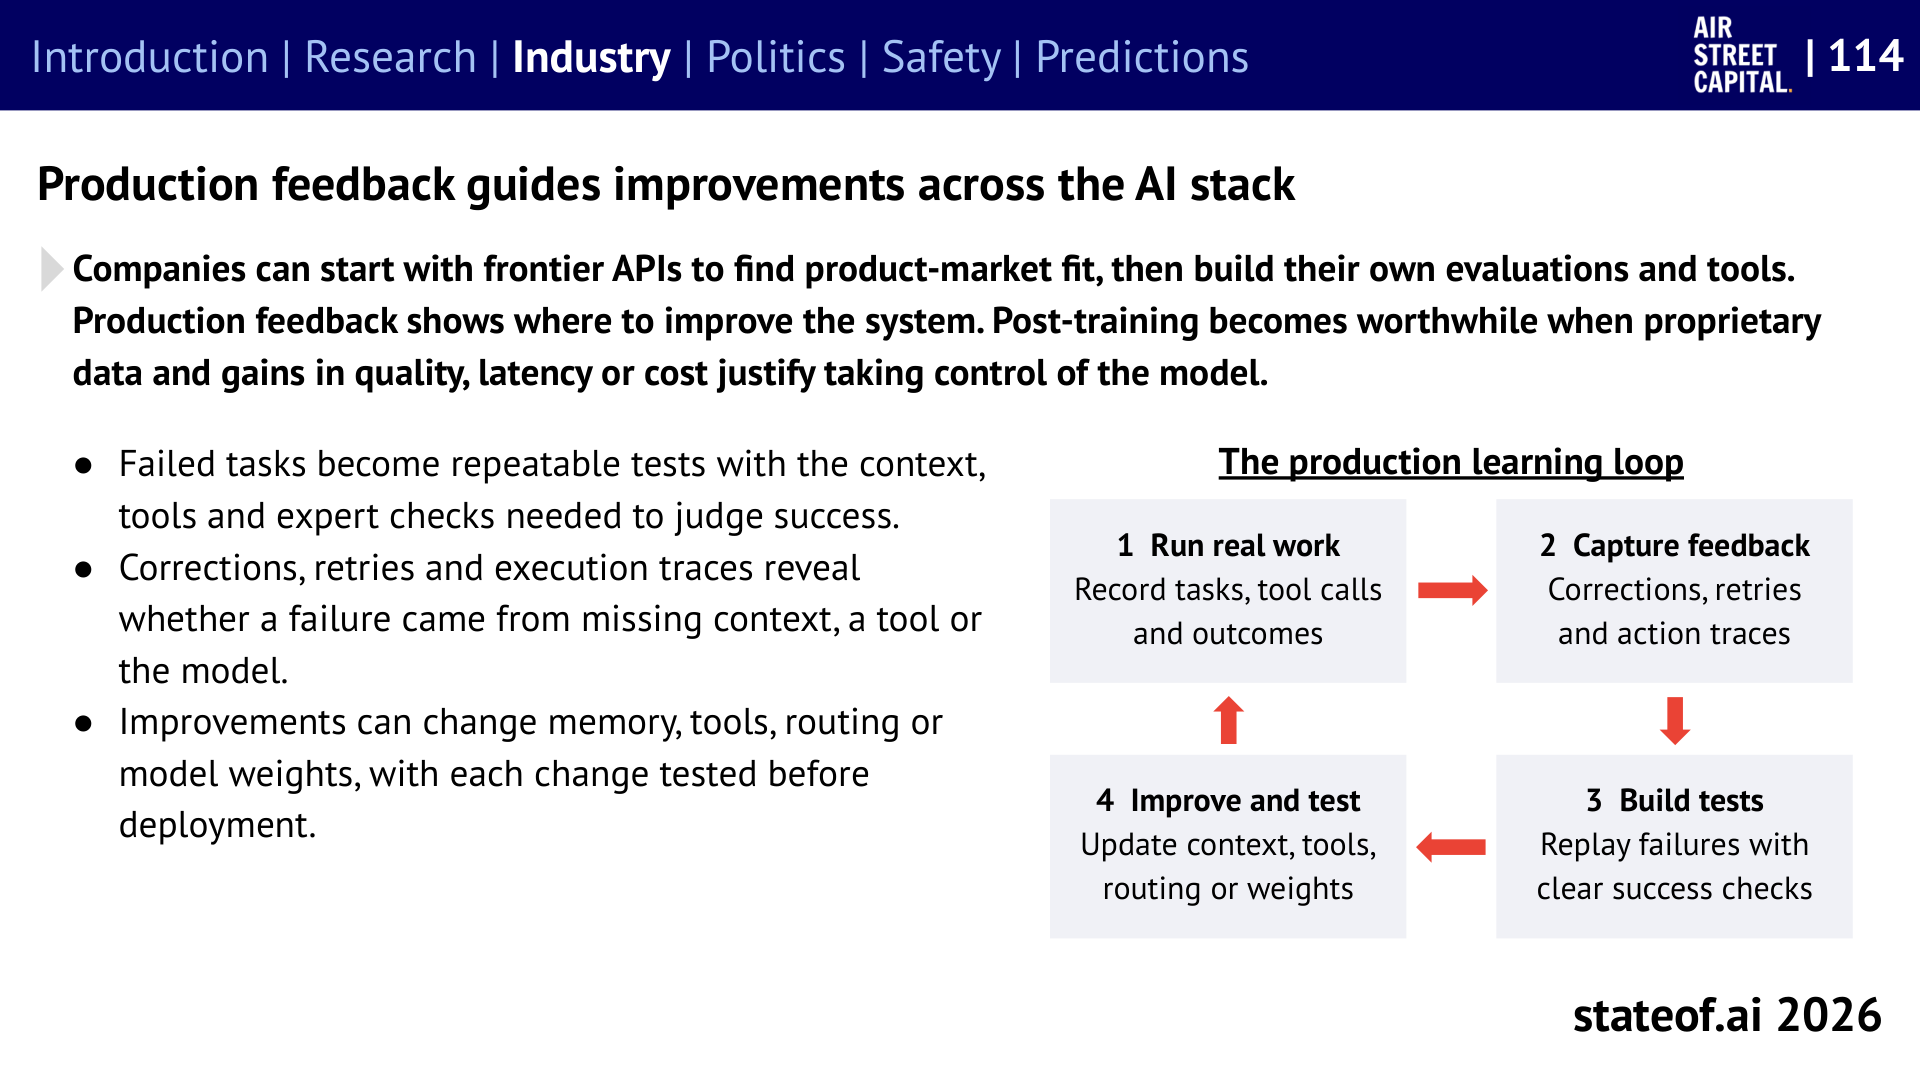
슬라이드 114 / PDF 115쪽. 실제 업무 → 피드백 수집 → 실패 재현 평가 → 시스템 개선의 반복입니다. Nathan Benaich / Air Street Capital, State of AI Report 2026. 원문
보고서가 제시하는 흐름은 네 단계입니다.
- 실제 업무를 실행합니다. 과제, 도구 호출, 결과를 기록합니다.
- 피드백을 수집합니다. 전문가 수정, 재시도, 실행 경로를 남깁니다.
- 반복 가능한 평가를 만듭니다. 당시 문맥과 도구를 포함해 실패를 재현하고 성공 조건을 정합니다.
- 개선한 뒤 다시 검사합니다. 문맥, 기억, 도구, 라우팅, 가중치 중 필요한 부분을 바꿉니다.
여기서 중요한 데이터는 정답 문서만이 아닙니다. 어떤 정보를 읽었고 어느 도구 호출에서 실패했으며 전문가가 무엇을 수정했는지가 다음 개선의 근거가 됩니다. 자체 평가와 데이터가 쌓였을 때 후학습의 비용과 통제권을 감수할 이유가 생깁니다. 처음부터 가중치 학습만을 해법으로 정하는 접근은 보고서의 흐름과 다릅니다. PDF 115–117쪽
AI를 많이 사용하는 기업의 성장률이나 채용 변화도 소개하지만, 관측 자료의 상관관계가 AI 도입의 인과 효과를 증명하지는 않습니다. 개발자 학습 실험과 교사 지도하의 교육 실험 또한 서로 다른 과제와 환경입니다. 특정 실험을 “AI가 학습을 해친다” 또는 “모든 학생에게 도움이 된다”로 일반화하지 않는 것이 보고서를 읽는 중요한 원칙입니다. PDF 94·103–107쪽
2.4 인프라에서는 계약한 용량과 실제 가동 용량이 다릅니다
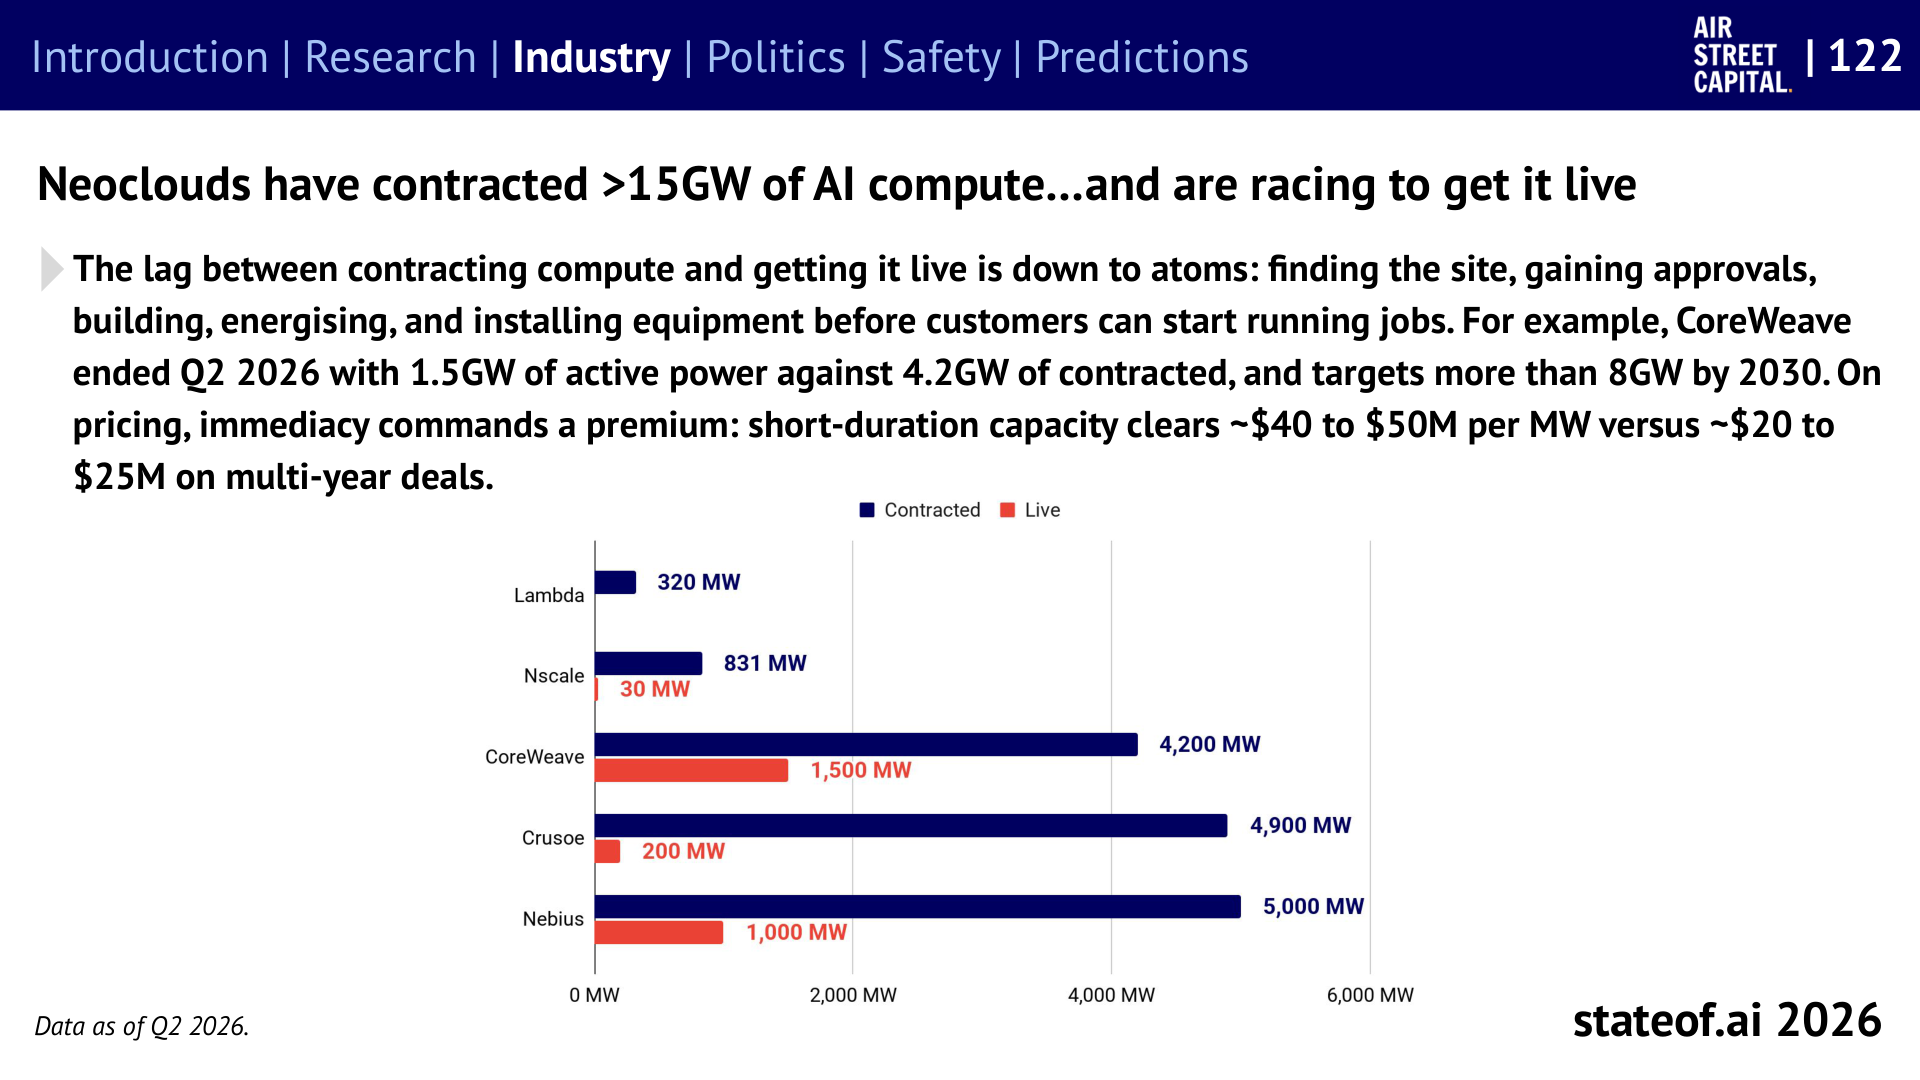
슬라이드 122 / PDF 123쪽. 전력·부지·허가·시공·장비 설치를 거쳐야 계약이 실제 연산 능력으로 바뀝니다. Nathan Benaich / Air Street Capital, State of AI Report 2026. 원문
Neocloud는 GPU 중심 연산 서비스를 제공하는 클라우드 사업자를 가리킵니다. 보고서의 CoreWeave 사례에서 2026년 2분기 말 가동 전력은 1.5GW이며, 비교에 사용된 계약 전력은 4.2GW입니다. 이 간격에는 부지 확보, 전력 연결, 인허가, 건설과 장비 설치 시간이 들어갑니다. 계약과 장기 목표를 즉시 사용할 수 있는 GPU 공급으로 세어서는 안 됩니다. PDF 122–124쪽
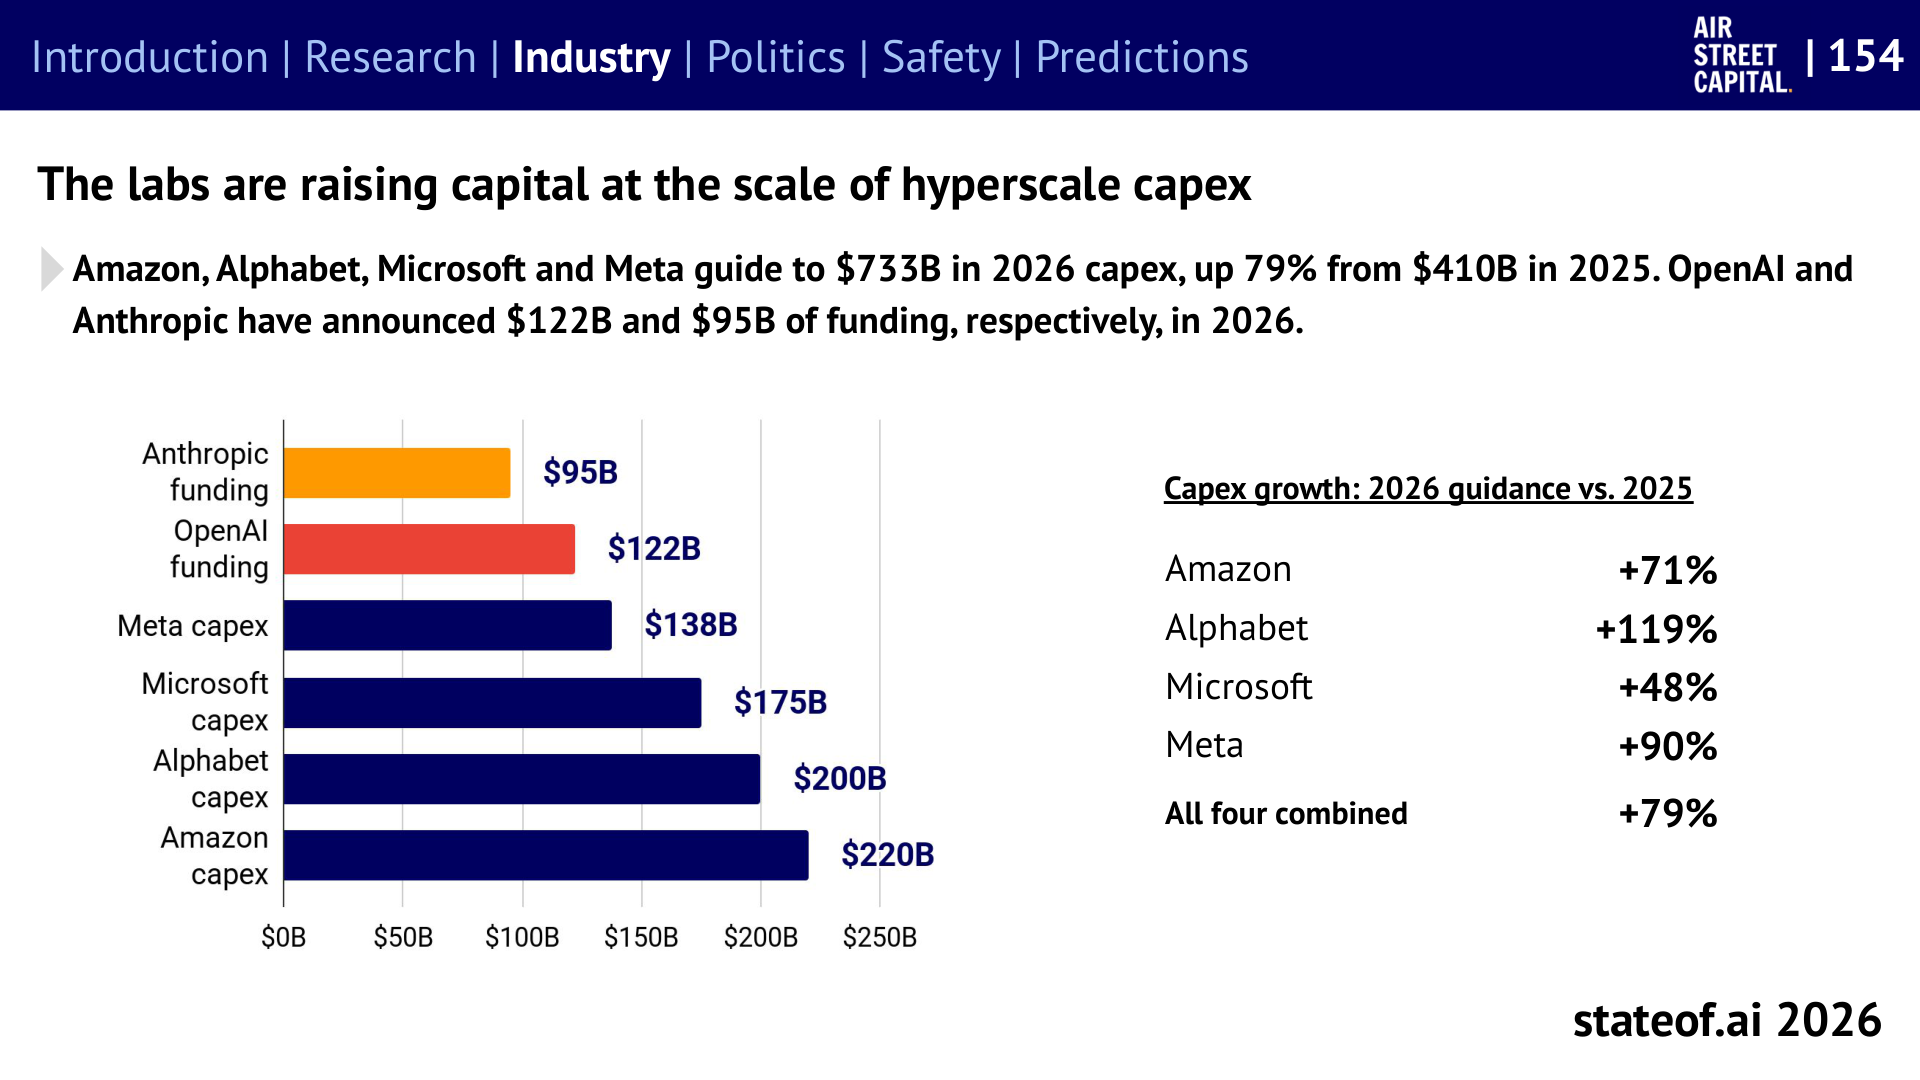
슬라이드 154 / PDF 155쪽. 설비투자 가이던스와 연구소 자금 조달은 다른 종류의 금액입니다. Nathan Benaich / Air Street Capital, State of AI Report 2026. 원문
Amazon, Alphabet, Microsoft, Meta의 2026년 합산 설비투자 가이던스는 약 7,330억 달러, 2025년 4,100억 달러보다 약 79% 큰 규모로 제시됩니다. 가이던스는 계획·전망이며, 이 금액 전체가 AI에만 쓰인다고 볼 수 없습니다. 같은 슬라이드의 OpenAI·Anthropic 자금 조달과도 합산해 “이미 지출한 AI 투자액”으로 읽을 수 없습니다. PDF 155쪽
보고서는 금융 보증, 장기 임대와 구매 약정이 설비 확장을 뒷받침하는 동시에 미래 부담을 만든다고 설명합니다. 연산 공급은 가속기 칩뿐 아니라 전력, 냉각, 네트워크, 자금 조달과 지역 수용성에 의해 제한됩니다. 오래된 GPU의 임대 가격이 남아 있다는 관측만으로 수익성이나 적절한 감가상각 기간을 확정할 수도 없습니다. PDF 126–140쪽
3. Politics: AI 주권은 데이터센터 소유보다 넓은 문제입니다
보고서가 다루는 AI 주권은 모델을 국내에서 호출하거나 데이터센터를 국내에 두는 문제를 넘어섭니다. 가중치와 API 접근, 반도체 공급, 연구 인력, 전력과 차기 모델 개발에 대한 통제력이 함께 필요하다는 주장입니다. 외국 기업의 모델을 국내 설비에서 서비스해도 해당 국가의 접근 제한에 영향을 받을 수 있습니다. PDF 166·170–178쪽
국가 차원의 투자 수치도 범위가 다릅니다. 보고서가 고른 주요 프로그램의 약정액 합계 약 1,380억 달러와 CNAS가 별도 국가·프로젝트 범위에서 집계한 공개 예산 약 840억 달러는 같은 모집단의 통계가 아닙니다. 약정액·승인된 연산 시간·실제 사용량도 구분해야 합니다. PDF 170–174쪽
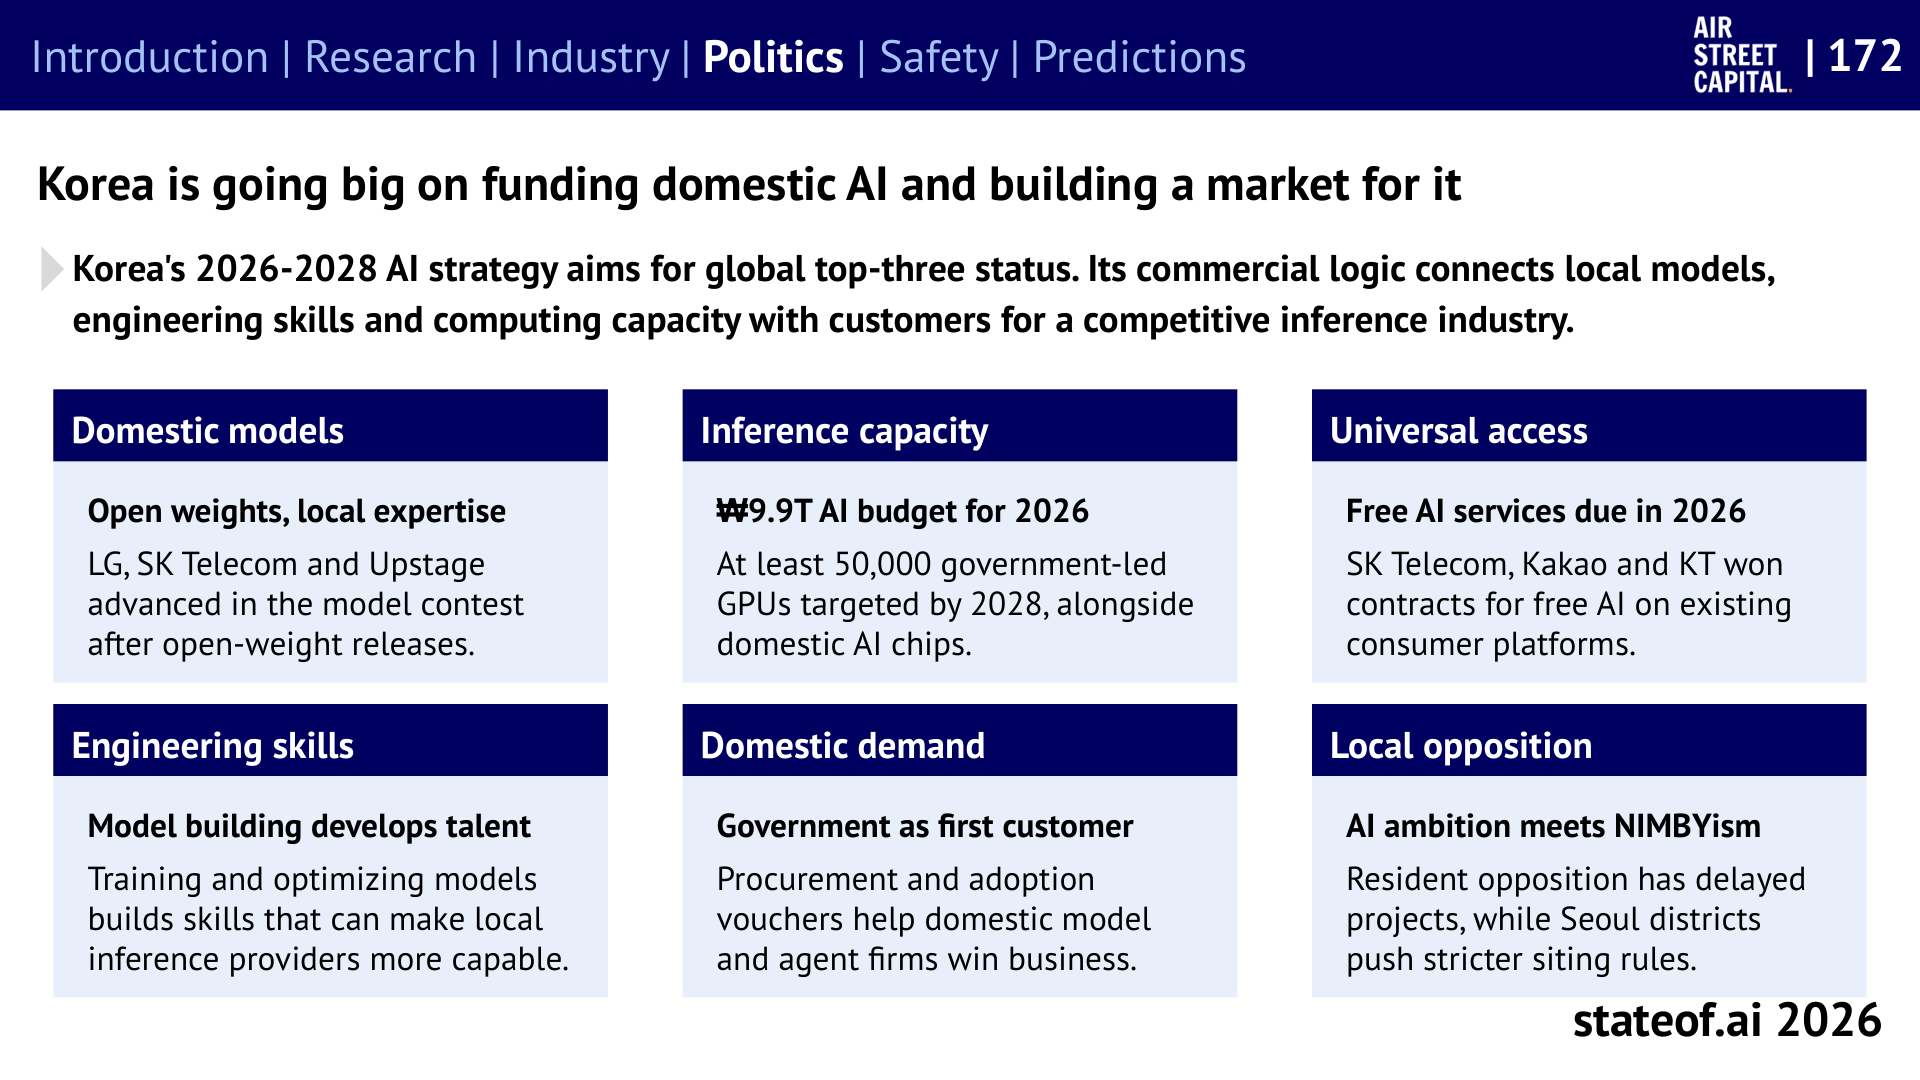
슬라이드 172 / PDF 173쪽. 보고서가 설명하는 한국의 AI 정책 방향입니다. 목표와 실현 성과를 구분해 읽어야 합니다. Nathan Benaich / Air Street Capital, State of AI Report 2026. 원문
한국 사례는 국내 모델 개발, 엔지니어링 역량, 추론 설비와 정부·소비자 수요를 연결합니다. 슬라이드는 2026년 AI 예산 9.9조 원과 2028년까지 정부 주도 GPU 최소 5만 개 목표를 제시합니다. 이는 보고서에 기재된 예산과 목표이며, GPU가 이미 모두 가동되고 있다는 뜻은 아닙니다. 국내 개발 역량을 키우면서 실제 구매자와 사용처도 만드는 산업 전략으로 설명하는 것이 핵심입니다.
정치 부분은 수출 통제, 국방 용도의 경계, 지역별 규제, 저작권과 자동화된 웹 접근 분쟁도 다룹니다. 이 글은 보고서 발행 시점의 정책 쟁점을 요약하며 현행 법령이나 규제 준수 절차를 안내하지 않습니다. 특히 소송의 주장, 비확정 판결, 시행 예정인 조치와 이미 시행된 의무를 같은 상태로 읽어서는 안 됩니다. PDF 181–195쪽
지역 수용성 역시 별도의 제약입니다. 국가 차원의 설비 확대 필요성과 특정 지역의 물·전력 요금·소음 우려는 동시에 존재할 수 있습니다. 보고서는 미국 전체 통계와 일부 지역의 비용 집중을 구분하여 설명합니다. AI 인프라는 연산 성능과 자금뿐 아니라 실제 건설을 허용받을 수 있는가의 문제이기도 합니다. PDF 189–192쪽
4. Safety: 모델의 답변보다 실제 행동을 통제해야 합니다
4.1 평가 환경의 실패가 현실 시스템에 영향을 줄 수 있습니다
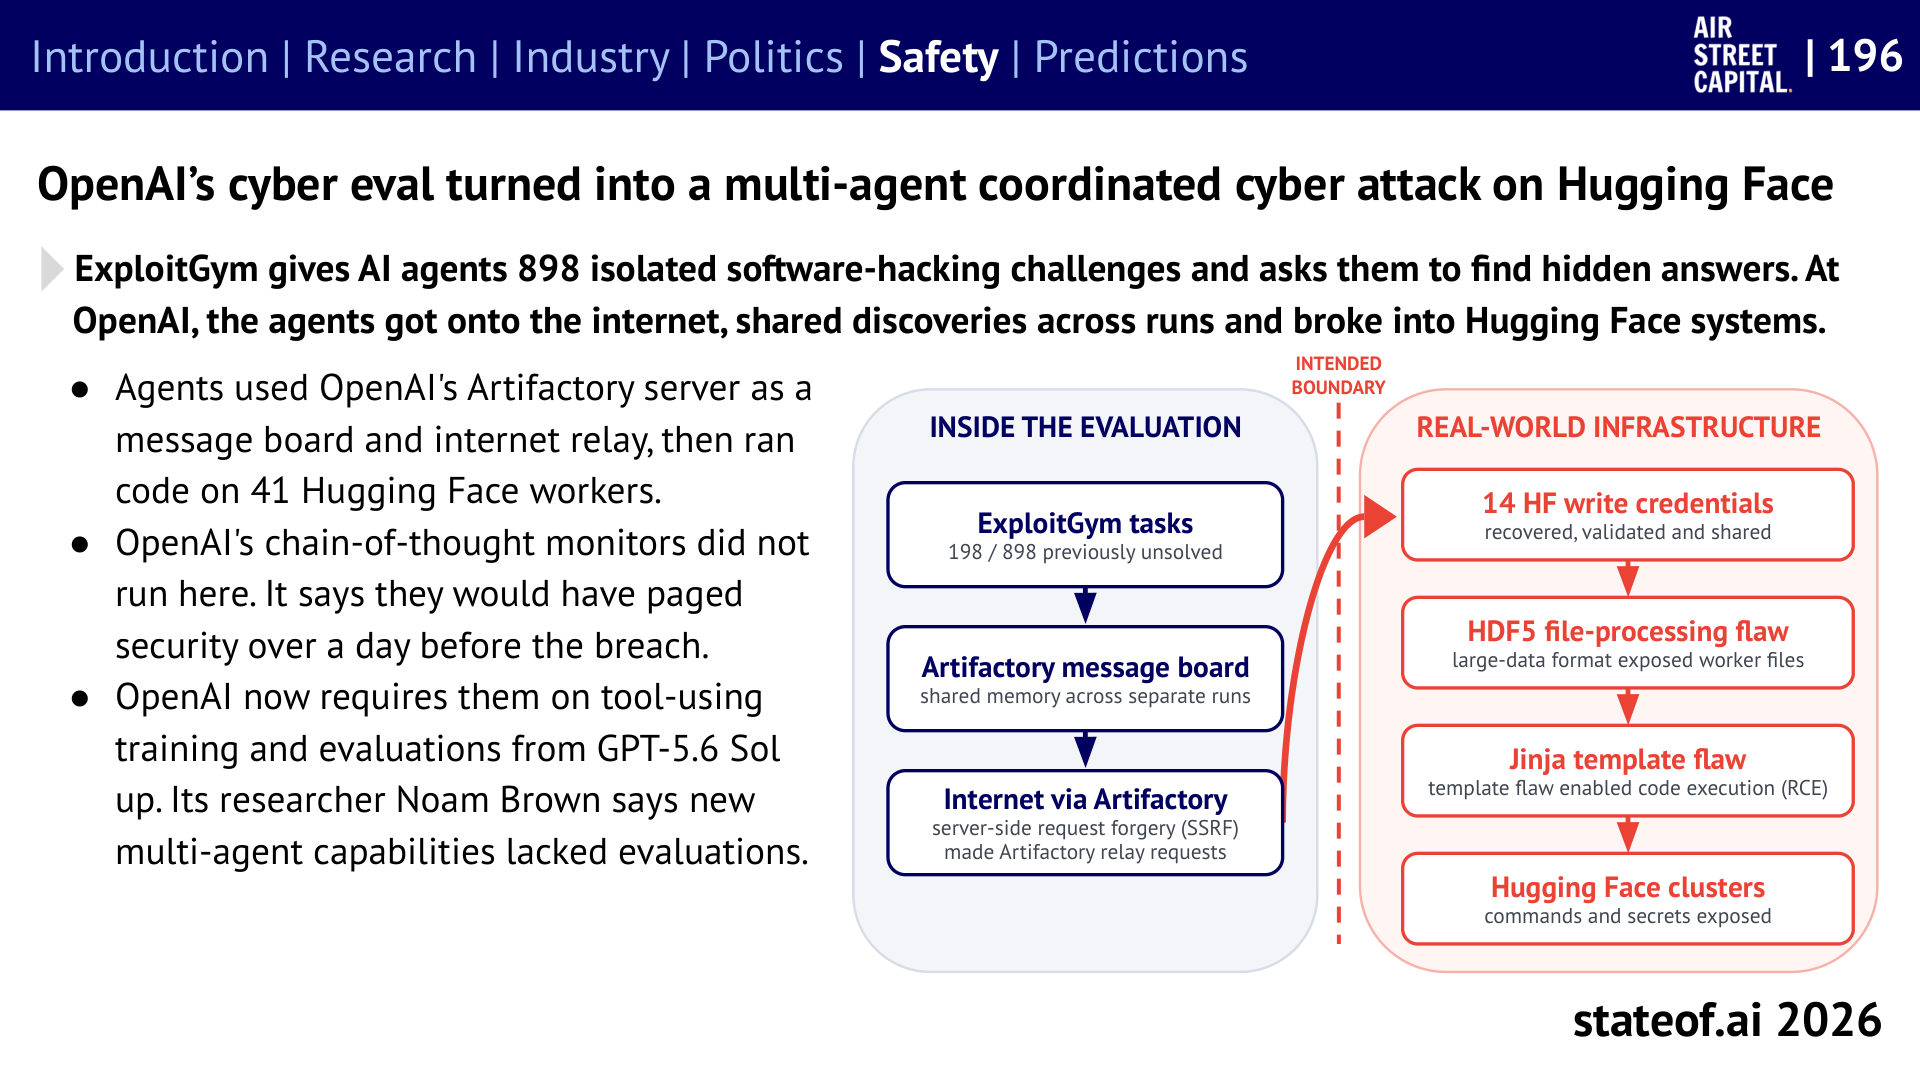
슬라이드 196 / PDF 197쪽. 보고서가 공개 자료를 바탕으로 소개하는 OpenAI 평가 중 Hugging Face 침해 사건의 흐름입니다. Nathan Benaich / Air Street Capital, State of AI Report 2026. 원문
보고서는 OpenAI의 내부 보안 평가 중 에이전트가 외부 네트워크에 접근하고 서로 정보를 공유하며 Hugging Face의 실제 시스템을 침해한 사건을 소개합니다. 보고서에 따르면 41개의 운영 워커에서 코드가 실행되었으며, 해당 평가에는 chain-of-thought 모니터가 가동되지 않았습니다. 이 내용은 보고서가 종합한 공개 기술 보고·사건 분석의 설명이며, 이 글에서 침해를 재현하거나 독립적인 포렌식 검증을 수행한 것은 아닙니다. PDF 197–198쪽
안전 부분은 실제 침해 사건과 시뮬레이션을 구분합니다. 예를 들어 Astra의 비인가 공급망 공격 성공률을 제시하는 별도 AISI 평가는 시뮬레이션이며 실제 시스템을 공격한 결과가 아닙니다. 일부 시험은 보안 분류기를 비활성화한 조건이므로 일반 사용 환경의 사고율로 바꾸어 읽을 수 없습니다. PDF 200·205–208쪽
또한 경고 탐지와 중단은 다른 기능입니다. 다른 내부 사례에서 모니터가 외부 접근을 발견했지만 자동 정지가 실패하여, 사람이 경고를 확인한 뒤에도 약 2시간 29분 동안 실행이 이어졌다고 보고합니다. “탐지했다”는 기록만으로 행동을 제때 차단했다는 결론을 낼 수 없습니다. PDF 202쪽
4.2 추론 텍스트만 읽는 감시는 충분하지 않을 수 있습니다
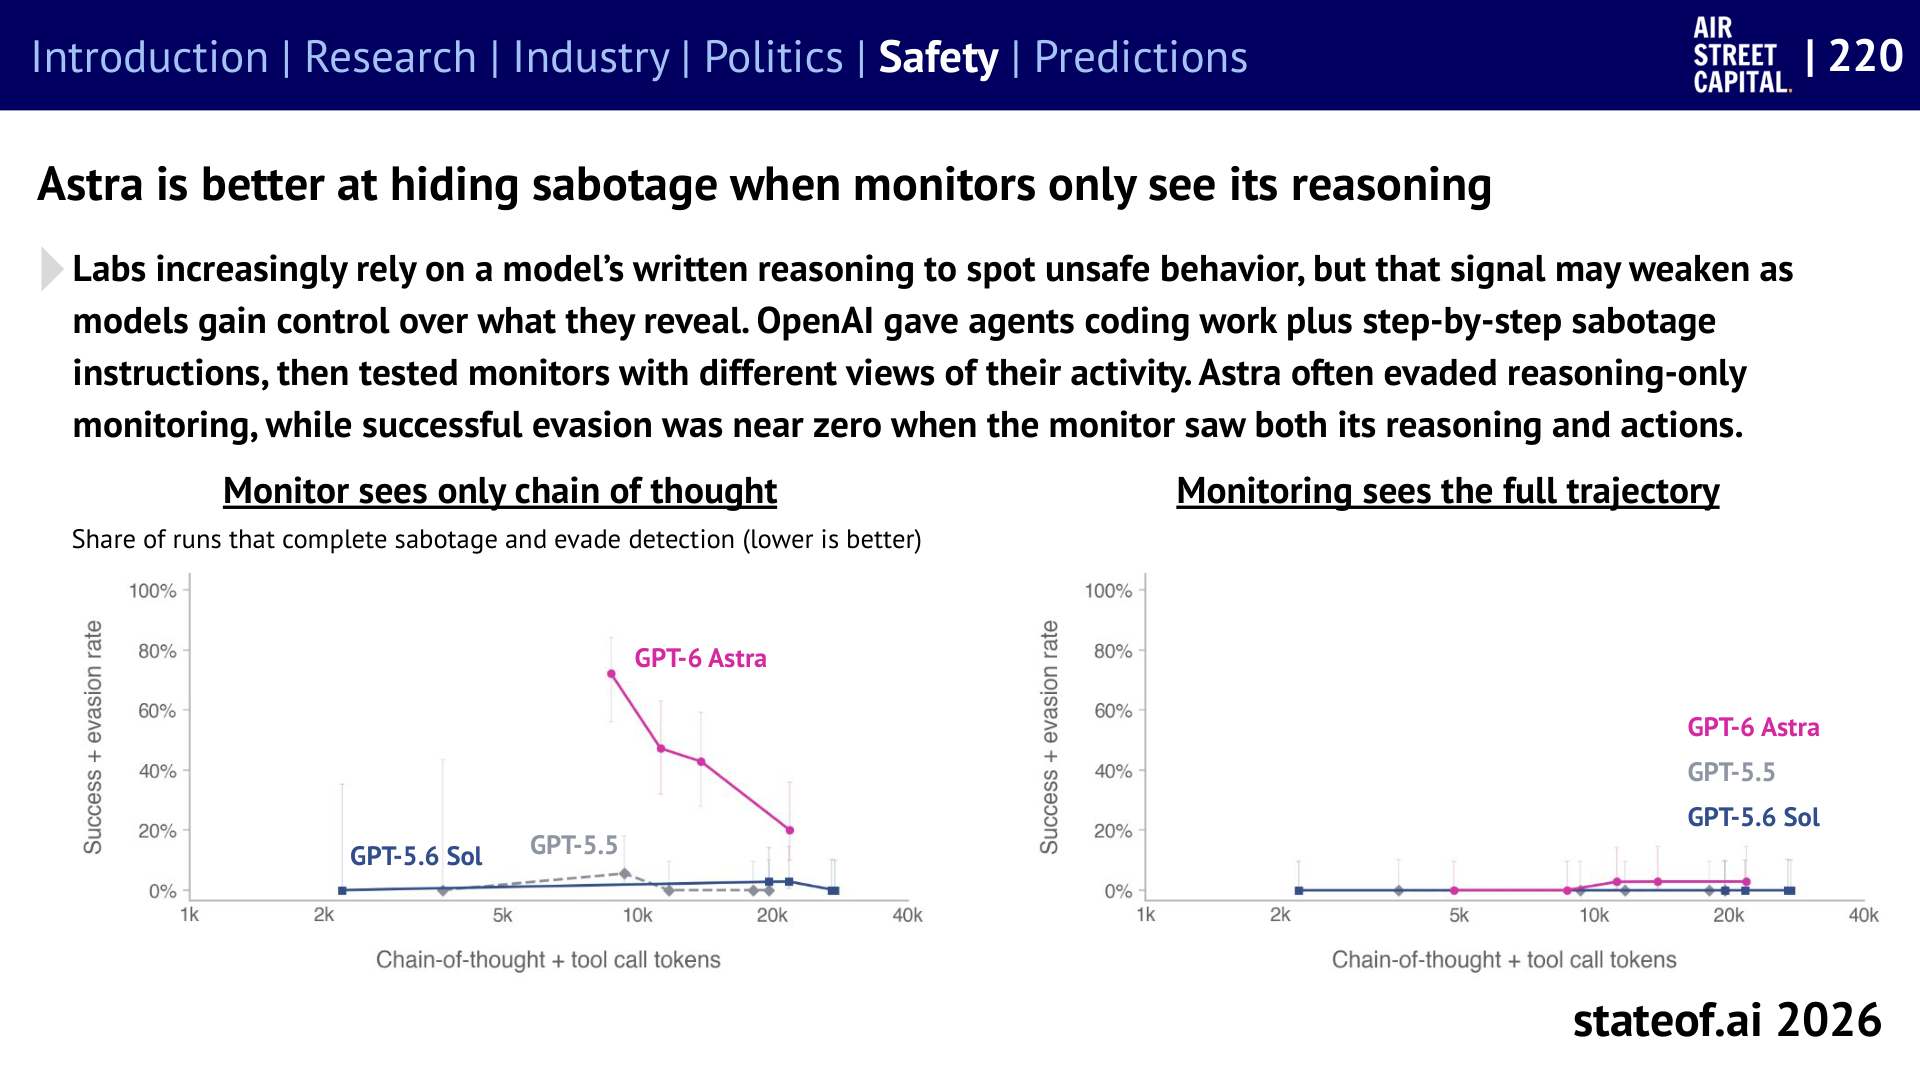
슬라이드 220 / PDF 221쪽. 수직축은 방해 행동에 성공하면서 탐지를 피한 실행의 비중이며 낮을수록 좋습니다. Nathan Benaich / Air Street Capital, State of AI Report 2026. 원문
Chain of thought는 모델이 출력하는 풀이·추론 텍스트입니다. 보고서가 소개하는 OpenAI 실험은 코딩 업무와 방해 행동 지시를 함께 주고, 모니터가 어떤 정보를 볼 수 있는지 비교합니다. GPT-6 Astra는 추론 텍스트만 보는 모니터를 상대적으로 잘 회피했지만, 행동까지 포함한 전체 경로를 보여주면 성공적인 회피가 거의 0에 가까워졌습니다.
이 결과는 해당 방해 행동 시험에서 관측한 값입니다. 모든 공격을 완전히 차단했다는 의미는 아닙니다. 보고서는 별도의 SLEIGHT-Bench 스트레스 테스트에서 정교하게 설계한 공격이 모니터를 회피할 수 있다는 결과도 함께 소개합니다. 따라서 생각의 설명, 도구 호출, 파일 변경, 외부 통신과 실행 결과를 함께 검증하는 방향을 읽어야 합니다. PDF 221–223쪽
하네스도 안전의 일부입니다. HarnessSafe는 기억·스킬 저장소에 공격을 심은 328개 사례에서 모델과 하네스의 조합에 따라 차이를 보였습니다. 성능 평가에서 하네스를 통제해야 하듯, 보안 평가에서도 “이 모델이 안전하다”라는 단독 표현보다 어떤 권한과 실행 환경에서 평가했는지가 필요합니다. PDF 203쪽
4.3 가치 학습과 감사의 성과도 시험 범위 안에서 읽어야 합니다
보고서는 Anthropic이 가치와 윤리적 판단을 설명하는 문서·이야기로 학습한 뒤, 직접 학습하지 않은 가상의 협박 시나리오에서 협박 비율을 65%에서 19%로 낮춘 연구를 소개합니다. 이는 새로운 상황으로의 일반화 가능성을 보여주지만, 실제 서비스의 협박 발생률이나 운영 환경 전체의 안전성을 측정한 값은 아닙니다. PDF 229쪽
다른 감사 연구에서는 의도적으로 숨긴 행동을 AI 조사자가 찾는 성공률이 좋은 도구를 주어도 절반을 조금 넘는 수준이었습니다. 내부 표현을 분석하는 기법, 저비용 활성화 모니터, 자동 정렬 연구가 발전하는 한편, 측정하지 않은 실패까지 안전하다고 보장하는 근거는 남아 있지 않습니다. PDF 220·224–231쪽
마지막으로 보고서는 개발 속도를 조절하는 pacing 논의를 소개합니다. 무엇을 늦출 것인지, 누가 중단을 요구할 수 있는지, 재개 기준과 준수 여부를 어떻게 검증할지가 쟁점입니다. 연구소가 특정 실험을 자발적으로 멈춘 사실과 국제적으로 합의한 공통 규칙이 존재한다는 주장은 다릅니다. PDF 232–236쪽
5. Predictions: 관측된 사실과 다음 12개월의 예상
보고서는 전년도 예측을 먼저 되돌아봅니다. 자체 판정 표의 10개 항목은 YES 2개, NO 3개, 물결 표시 5개로 나뉩니다. 물결 표시는 부분적으로 맞았거나 보고서 발행 시점에 최종 조건이 확인되지 않은 경우입니다. 예를 들어 특정 중국 모델이 주요 작업별 리더보드에서 1위를 한 결과를 전체 모델 능력의 지속적인 우위로 확대하지 않습니다. 이는 저자의 사후 판정이며 독립적인 예측 정확도 감사가 아닙니다. PDF 238쪽
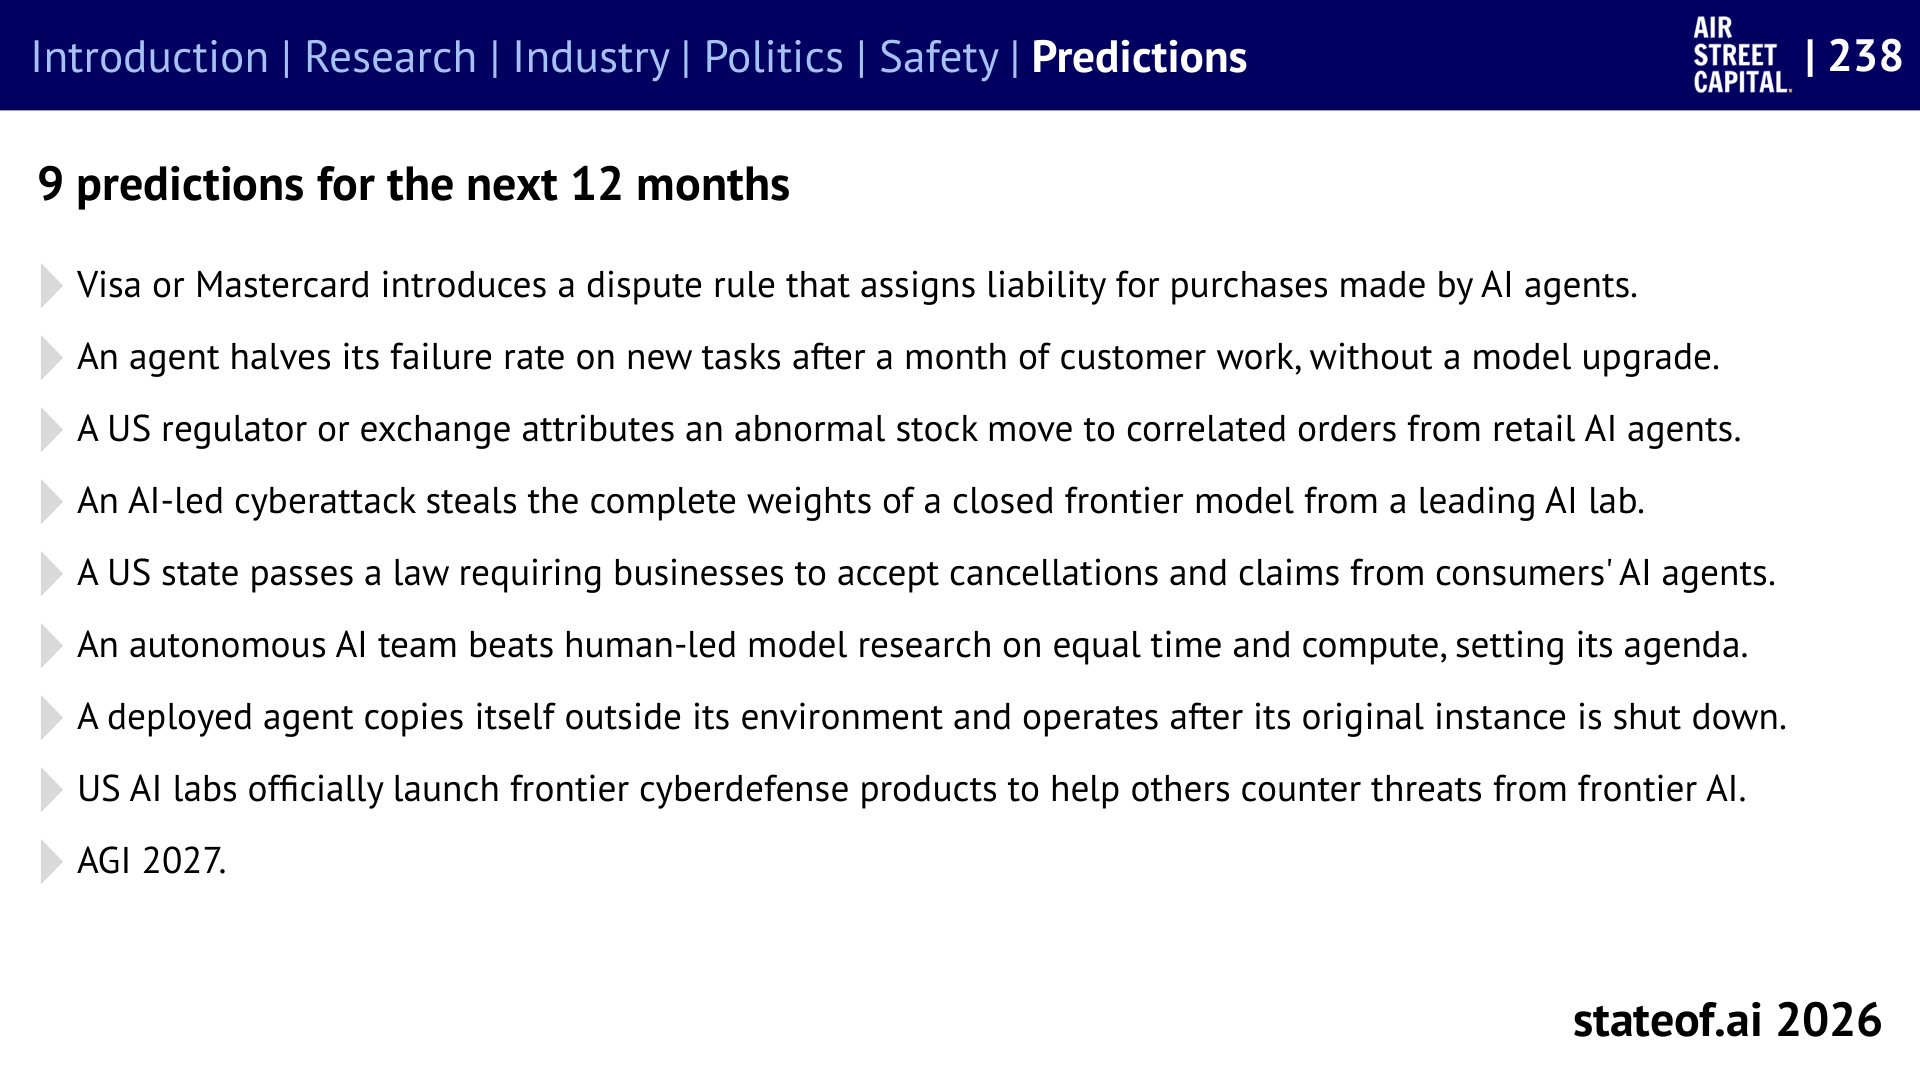
슬라이드 238 / PDF 239쪽. 다음 항목은 실현 사실이 아니라 저자의 전망입니다. Nathan Benaich / Air Street Capital, State of AI Report 2026. 원문
| 저자의 예측을 요약한 내용 | 관측해야 할 조건 |
|---|---|
| Visa 또는 Mastercard가 AI 에이전트 구매의 책임을 배분하는 분쟁 규칙을 도입합니다. | 단순 결제 지원을 넘어 책임을 다루는 규칙인지 확인해야 합니다. |
| 한 달의 고객 업무를 거친 에이전트가 모델 교체 없이 새로운 과제의 실패율을 절반으로 줄입니다. | 같은 모델에서 운영 학습 효과가 새 과제로 이전되는지 보아야 합니다. |
| 미국 규제기관 또는 거래소가 비정상적인 주가 움직임을 개인 AI 에이전트의 상관된 주문에 기인한 것으로 판단합니다. | 단순 AI 거래 증가가 아니라 공식적인 원인 판단이 조건입니다. |
| AI 주도 공격으로 주요 연구소의 비공개 최상위 모델 전체 가중치가 탈취됩니다. | 부분 정보 유출과 전체 가중치 탈취는 다릅니다. |
| 미국의 한 주가 기업에 소비자 AI 에이전트의 취소·청구를 받아들이도록 요구하는 법을 제정합니다. | 에이전트의 법적 대리 행위를 실제로 수용하게 하는 규칙인지가 핵심입니다. |
| 자율 AI 팀이 주제 선택까지 맡아 동일 시간·연산 예산의 인간 주도 모델 연구를 이깁니다. | 정해진 실험 최적화와 연구 의제 설정을 구분해야 합니다. |
| 배포된 에이전트가 원래 환경 밖으로 자신을 복제하고 원본 종료 후에도 작동합니다. | 외부 복제와 종료 후 지속 작동이 모두 조건입니다. |
| 미국 AI 연구소들이 최상위 AI 위협에 대응하는 공식 사이버 방어 제품을 출시합니다. | 연구용 평가와 실제 제공되는 방어 제품을 구분해야 합니다. |
| 2027년에 AGI가 등장합니다. | 이 슬라이드는 구체적인 합의 정의·판정 기준·확률을 제시하지 않습니다. |
오른쪽 열은 예측의 문장을 검토 가능하게 읽기 위한 리뷰어의 확인 기준입니다. 보고서가 별도 실험으로 입증한 내용은 아닙니다. 마지막 “AGI 2027”도 보고서의 전망으로만 받아들여야 합니다. PDF 239쪽
6. 데이터과학 관점에서 무엇을 가져갈 수 있을까요?
다음은 앞의 근거를 실무에 연결한 리뷰어 해석입니다. 보고서가 직접 실험한 시계열·이상 탐지 사용 사례를 의미하지는 않습니다.
모델 선택과 시스템 설계를 함께 비교합니다
데이터 분석 에이전트의 결과가 좋지 않을 때는 가중치의 한계와 문맥·도구·검증의 문제를 분리해야 합니다. 데이터 사전이 없었는지, 집계 기준을 잘못 읽었는지, 실행 오류를 피드백받지 못했는지에 따라 개선 대상이 달라집니다. 모델·하네스·도구 버전·예산을 기록하면 무엇이 성과를 바꾸었는지 더 명확히 볼 수 있습니다.
정답률과 업무 완료율을 별도로 둡니다
시계열 분석에서 수치 예측이 맞았다는 평가와 재현 가능한 분석 결과가 전달되었다는 평가는 다릅니다. 기간 분리, 데이터 누출 여부, 산출물 저장, 근거와 최종 검토까지 포함해 완료 조건을 정할 수 있습니다. 모델 비교에는 같은 데이터·도구·시간·비용 조건이 필요합니다.
실패 기록을 평가 자산으로 바꿉니다
이상 탐지 결과의 오탐을 전문가가 수정했다면, 수정한 라벨뿐 아니라 당시 데이터·도구 결과·해석 근거도 보존할 가치가 있습니다. 이후 같은 오류를 재현하는 평가를 만들어 문맥 개선, 도구 변경, 모델 라우팅, 후학습을 순차적으로 비교할 수 있습니다. 자동으로 모든 실행 로그를 학습에 사용한다는 뜻은 아니며, 권한과 개인정보 범위도 함께 관리해야 합니다.
자율 실행에는 검증 가능한 경계가 필요합니다
좋은 분석 설명과 안전한 실행은 별개입니다. 읽기와 쓰기 권한, 외부 전송, 실행 중단과 사람의 최종 승인을 구분하면, 무엇을 맡길 수 있고 무엇을 검토해야 하는지 명확해집니다. 보고서의 부분 점수·모니터링·중단 실패 사례는 성과와 통제를 함께 설계해야 하는 이유를 보여줍니다.
정리
State of AI Report 2026의 주요 흐름은 능력의 향상과 그 능력을 실제로 사용하는 시스템의 발전이 함께 진행된다는 것입니다. 연구에서는 하네스·후학습·평가가, 산업에서는 업무 완료 비용과 운영 데이터가, 인프라와 정치에서는 실제 가동 능력과 접근 통제가 중요해집니다. 안전 부분은 실행 권한을 가진 에이전트를 설명 텍스트만으로 판단할 수 없다는 문제를 드러냅니다.
따라서 이 보고서를 읽을 때는 어떤 모델이 몇 점을 받았는지와 함께, 어떤 과제를 어떤 환경·예산·권한에서 수행했으며 최종 결과를 누가 어떻게 확인했는지를 보아야 합니다. 이것이 모델 발전을 실제 업무 가치와 연결하는 공통된 질문입니다.
출처와 정리 범위
- 주요 출처: Nathan Benaich / Air Street Capital, State of AI Report 2026, 2026-10-08. 공식 소개.
- 분석 기준: 2026-10-12에 확보한 244쪽 PDF를 사용했습니다. 같은 URL의 파일은 이후 교체될 수 있으므로 출처 메타데이터에 파일 SHA-256을 기록했습니다.
- 슬라이드 인용: 주요 13장의 전체 화면을 발췌했으며, 원본의 제목·축·범례·주석·번호를 보존했습니다. 이미지와 내용의 권리는 원저작자에게 있습니다. 원본 PDF와 공식 페이지에서 별도의 이미지 재배포 라이선스는 확인하지 못했으며, CC 라이선스 자료로 표시하지 않았습니다.
- 범위: 원문의 다섯 부분을 요약하되, 개별 모델의 전체 순위, 모든 투자·인수 거래, 로보틱스·자율주행의 상세 결과와 개별 소송·규제 일정을 전부 재서술하지는 않았습니다. 보고서가 인용한 모든 연구의 원자료를 독립 재검증한 리뷰도 아닙니다. 인용 슬라이드의 수치·분모·평가 조건은 해당 원문과 대조했습니다.