논문 개요와 전체 구조
Thinking Before Thinking: Scaling Agentic Inference Through Meta-Reasoning은 에이전트가 문제를 푸는 능력과, 무엇을 다음에 계산할지 결정하는 능력을 분리해 연구합니다. 증명을 새로 시도할지, 유망한 풀이의 보조정리를 검증할지, 이미 얻은 답을 제출할지는 서로 다른 계산 선택입니다. 저자들은 이러한 선택도 한 번의 즉흥적인 모델 응답에 맡기지 않고, 기억을 조회하고 대안을 비교하는 별도의 에이전트 과정으로 구성합니다.
제안하는 Meta-Reasoning Agent에서 작업자(worker)는 풀이·검증·코드 구현을 수행하고, 컨트롤러(controller)는 진행 상태를 평가한 뒤 다음 작업과 전달할 문맥을 고릅니다. 핵심은 Assess → Propose → Evaluate → Dispatch의 네 단계, 매 주기 다시 쓰는 압축 상태, 원문 산출물을 보관하는 영구 메모리입니다. 컨트롤러의 호출도 작업자와 같은 예산에서 차감하므로, 제어에 쓴 계산은 최종 결과로 그 비용을 보상해야 합니다. 원문 초록·§1
이 리뷰는 arXiv:2609.38147v1, 2026년 9월 29일 17:57:25 UTC 제출본을 분석합니다. PDF 표지의 문서 날짜는 9월 30일로, arXiv 제출 시각과 구분합니다. 저자는 Paras Dahal 외 11명이며 소속은 Meta Superintelligence Labs입니다. 연구의 중심은 범용 추론과 프로그램 재구성입니다. 모델 이름과 성능은 이 버전의 실험 보고를 기준으로 읽어야 합니다.
원문에는 본문 8개 장과 부록 A–I가 있습니다. 아래는 실제 섹션 순서를 따른 구조입니다.
| 원문 위치 | 제목과 내부 구성 | 읽을 때 확인할 내용 |
|---|---|---|
| 1 | Introduction | 실행 제어를 독립된 추론 문제로 보는 동기 |
| 2 | Related Work | 추론 시 계산, 학습된 오케스트레이션, 메타인지, 기억, 실행 진단 |
| 3 | Agentic Meta-Reasoning — 3.1 Memory, State, and Worker Context; 3.2 Actions over the Run; 3.3 The Control Cycle; 3.4 Recording the Artifact Graph; 3.5 Direct Control and the Cost of Deliberation | 작업자 인터페이스, 네 단계 제어, 그래프, 예산 |
| 4 | Diagnosing Agentic Inference Through Artifact Graphs — 4.1 예산 사용; 4.2 정답 발견·인식·제출; 4.3 구조적 선택 기준선 | 최종 점수를 계산 과정의 진단으로 분해 |
| 5 | Experimental Setup — 5.1 Tasks; 5.2 Comparisons; 5.3 Models and Budgets; 5.4 Measurements | 벤치마크별 채점과 비교 조건 |
| 6 | Experimental Results — 6.1 주요 성능; 6.2 예산 확장; 6.3 추가 계산의 구조; 6.4 정답 발견과 선택; 6.5 기억과 상태 크기 | 어떤 개선이 어떤 조건에서 나타나는지 |
| 7 | Discussion and Limitations — 7.1 에이전트 역량; 7.2 메타추론의 에이전트성; 7.3 한계 | 제어 비용, 체스 실패 사례, 모델 의존성 |
| 8 | Conclusion | 실행을 지휘하는 능력의 의미 |
| References | 참고문헌 | 연구 계보를 연결하는 인용 목록 |
| A | Scope of the Evidence | 구성요소 인과효과·비용·일반화에 대한 경계 |
| B | Meta-Reasoning Agent Prompts — B.1 Assess; B.2 Propose; B.3 Evaluate; B.4 Dispatch | 네 단계의 실제 입력·출력·종료 지침 |
| C | Direct Control Agent Prompts — C.1 System prompt; C.2 Budget | 누적 대화 기반 비교군과 강제 종료 |
| D | Worker Prompts | 두 시스템이 공유하는 작업자 계약 |
| E | Artifact Memory | 식별자·제목 인덱스·본문 조회·작업자 문맥 |
| F | Tools | 동일한 작업자 호출 도구와 서로 다른 종료·메모리 인터페이스 |
| G | Implementation details: ProgramBench — G.1 Task prompt; G.2 Read-only git tool | 공유 파일시스템, 관찰 기반 재구현, 커밋 조회 |
| H | Implementation details: Recursive Language Model (RLM) | 제한 Python 환경과 예외 셀, 예산 계수 |
| I | Implementation details: Claude Code and Codex | headless 실행과 동일 컨테이너 도구 경로 |
핵심 기여와 혁신성
문제의 중요성은 장기 실행의 계산 배분에 있습니다. 추론 예산이 늘어도 잘못된 풀이를 계속 고치거나, 정확한 답을 얻고도 다른 답을 제출하면 성능은 좋아지지 않습니다. 저자들은 문제 자체를 푸는 object-level 작업과, 그 작업을 모니터링하고 조절하는 meta-level 제어를 구분합니다. 여기서 메타추론은 모델이 자신의 생각을 설명한다는 뜻보다, 외부에 쌓인 실제 산출물을 근거로 다음 계산을 결정한다는 뜻에 가깝습니다.
기존 접근과의 차이는 실행 중 계산 구조를 만드는 방법에 있습니다. 고정된 샘플 수·검증 횟수·탐색 트리는 문제를 보기 전에 계산 형태를 정합니다. 일반 에이전트는 실행 중 이를 바꾸지만, 제어 판단을 누적 이력 위의 한 번의 응답에서 내리는 경우가 많습니다. 이 논문은 컨트롤러가 먼저 상태를 재평가하고, 대안을 만들고, 비용을 따져, 필요한 산출물만 작업자에게 전달하도록 설계합니다. 새로운 컨트롤러를 학습하거나 작업별 하네스를 탐색하는 연구와도 구분됩니다. §2–3
기술적 독창성은 제어와 기록을 연결한 데 있습니다. 작업자가 이전 산출물을 입력으로 받아 새 산출물을 만들면 의존성 간선을 기록합니다. 이 artifact graph를 통해 계산이 독립 시도에 쓰였는지, 검증·수정·합성에 재사용됐는지, 정답은 있었으나 제출에 실패했는지를 분석합니다. 최종 정확도 하나로는 보이지 않는 생성과 선택의 차이를 계량화하는 장치입니다.
실험이 뒷받침하는 범위는 결합된 제어 설계의 효과입니다. 가장 큰 명목 호출 예산에서 4개 벤치마크 × 3개 모델의 12개 대응 비교 모두 점 추정치가 높았습니다. 그러나 단계 분리·상태 압축·메모리 접근을 동시에 바꾸었으므로, 어느 요소가 얼마만큼 기여했는지는 분리하지 못합니다. 저자도 부록 A에서 이를 명시합니다. 아래의 시스템 설계 해석은 이 경계를 유지합니다. §6.1·부록 A
기술적 세부사항
세 가지 저장·실행 단위를 구분하기
메모리는 작업자의 원문 출력과 컨트롤러의 메모를 식별자와 함께 보관합니다. 상태는 지금 무엇이 확인됐고 무엇이 미해결인지 매 주기 다시 쓴 짧은 판단입니다. 작업자 문맥은 컨트롤러가 해당 작업에 필요하다고 고른 산출물 본문입니다. 전체 기억이 상태에 복사되는 것도, 상태가 작업자에게 그대로 전달되는 것도 아닙니다. 이 구분이 장기 이력을 보존하면서 매번 모든 내용을 읽지 않는 구조를 만듭니다.
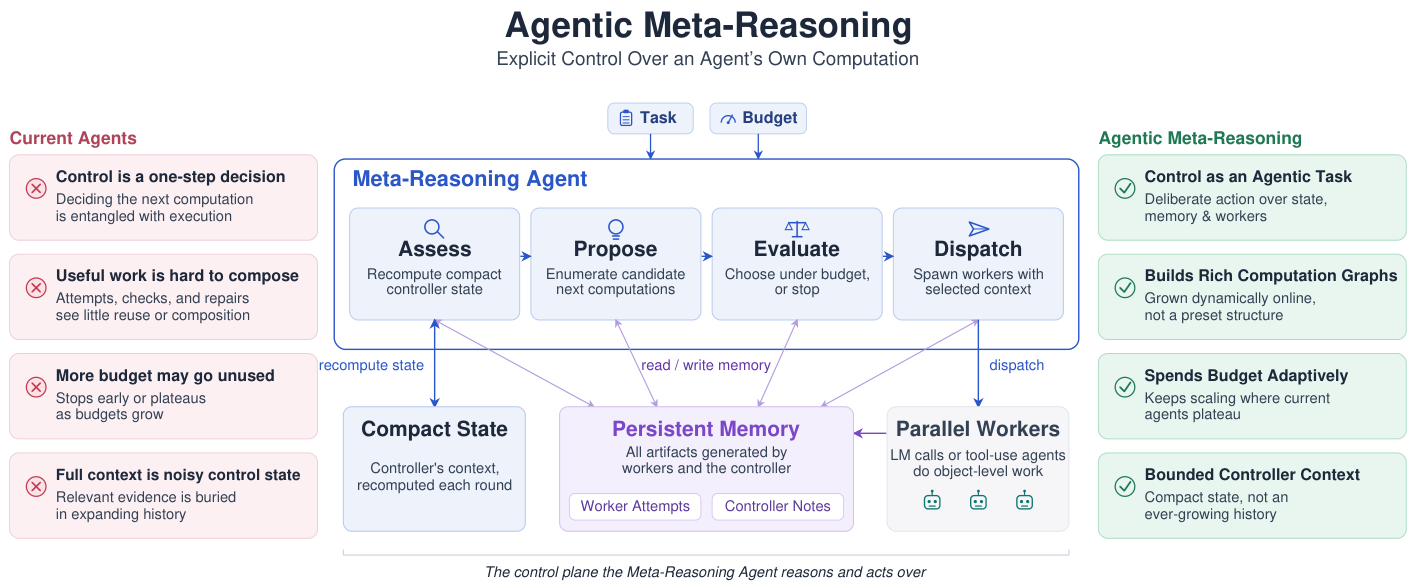
원문 Figure 1, PDF 1쪽, v1. 그림 영역만 크롭했으며 번역·재배열·수치 변경은 하지 않았습니다. 중앙은 제어 순환, 아래는 상태·메모리·작업자, 양옆은 기존 설계와 제안 설계의 대비입니다. 버전 고정 원문
네 단계의 책임과 예산
Assess는 새 산출물을 반영해 판단을 갱신합니다. Propose는 가능한 다음 작업을 넓게 제안하며 남은 예산을 명시적으로 받지 않습니다. Evaluate는 이때의 남은 예산과 제안을 함께 보고 무엇이 가치 있는지 정성적으로 평가합니다. Dispatch는 이를 실제 작업자 지시와 문맥 목록 또는 종료 호출로 바꿉니다. 비용을 고려하는 단계와 대안을 만드는 단계를 분리한 설계입니다.
작업자는 추론 벤치마크에서 도구 없는 단일 모델 호출이고, ProgramBench에서는 여러 번 호출하며 셸 도구를 쓰는 코딩 에이전트입니다. 따라서 작업자 한 명과 모델 호출 한 번을 항상 같은 단위로 세면 안 됩니다. 호출 예산은 컨트롤러의 조사·메모리 사용 과정과 모든 병렬 작업자 호출을 합산합니다. 동일한 명목 호출 예산이 동일한 토큰 수·지연 시간·FLOPs를 뜻하지 않는다는 점이 비교의 전제입니다. §3.3·3.5·5.3
점수와 진단의 연결
본문 성능은 각 벤치마크의 고유 지표로 보고합니다. 증명은 부분 점수를 정규화하고, ARC와 LongCoT는 정답 정확도, ProgramBench는 문제별 숨겨진 테스트 통과 비율의 평균입니다. 중간 답안에 정오 라벨을 붙일 수 있는 세 추론 벤치마크에서만 coverage·monitoring·selection을 분석합니다. ProgramBench의 중간 구현에는 대응 채점 프로토콜이 없어 같은 진단을 적용하지 않습니다. 다음 장별 리뷰에서는 인터페이스와 진단 수식을 원문 전개 순서대로 풀이합니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
챕터의 위치와 역할: 문제를 직접 푸는 계산뿐 아니라, 계산의 방향을 정하는 판단에도 별도의 추론이 필요하다는 연구 질문을 세웁니다.
저자의 서술 순서를 따른 상세 내용:
- 검증되지 않은 보조정리를 가진 수학 에이전트의 선택으로 시작합니다. 보조정리를 증명할지, 현재 논증을 다른 작업자에게 검사시킬지, 새로운 접근으로 돌아갈지는 계산량과 후속 작업 모두를 바꿉니다. 잘못된 선택은 해당 호출을 낭비하는 데서 끝나지 않고, 실행 전체가 잘못된 경로를 따라가게 만들 수 있습니다.
- 메타인지적 제어의 대상을 확장합니다. 단일 호출에서는 자신의 사고 사슬이 제어 대상이라면, 에이전트에서는 지금까지 만들어 놓은 풀이·비평·부분 구현이 대상입니다. 무엇을 믿을지, 어디에 이어 붙일지, 언제 멈출지가 문제 해결의 일부가 됩니다.
- 메타추론을 에이전트 과정으로 제안합니다. 컨트롤러는 과거 작업을 다시 읽거나 검증을 위임한 다음 판단할 수 있습니다. 작업자는 문제 수준의 계산을 맡고, 컨트롤러는 압축 상태와 영구 메모리 위에서 네 단계로 다음 계산을 고릅니다. 모든 제어 비용을 같은 예산에서 계산한다는 조건도 여기서 소개합니다.
- 결과와 진단의 방향을 예고합니다. 네 벤치마크와 세 모델을 비교하고, 그래프를 통해 이전 작업의 재사용과 정답 후보의 존재 여부를 분석합니다. 12개 주요 대응 비교의 양의 차이는 주 예산 설정에서의 결과이며, 모든 작은 예산까지 항상 우세하다는 뜻은 아닙니다.
챕터의 핵심 기여: 계산 방향을 정하는 능력을 작업자 역량과 구분되는 에이전트 역량으로 정의합니다.
다음 챕터로의 연결: 이 주장을 기존 추론 시 계산·오케스트레이션·기억 연구의 맥락에 배치합니다. 원문 §1
📖 Chapter 2: Related Work
챕터의 위치와 역할: 제안의 차별점을 다섯 연구 흐름에서 순서대로 설명합니다. 아래 내용은 이 논문이 인용 연구를 정리한 방식이며, 모든 참고문헌을 독립 재검토한 결과는 아닙니다.
저자의 서술 순서를 따른 상세 내용:
- Test-time computation and agentic harnesses. 하나의 추론 경로를 길게 만들거나, 독립 샘플을 고르거나, 비평과 수정을 반복하거나, 미리 정한 탐색 구조를 사용하는 방법을 먼저 설명합니다. 이런 방법은 계산을 늘리는 효과를 보여 주지만 샘플·분기·검증 구조를 미리 정합니다. 에이전트 하네스는 환경 행동과 피드백으로 방향을 바꾸지만, 중간 산출물이 많아질수록 제어 문맥이 혼잡해집니다. 저자들은 실행을 온라인 artifact graph 구성으로 보는 관점을 제시합니다.
- Learned and optimized orchestration. 통신 구조를 학습하는 GPTSwarm, 다중 에이전트 조정, Meta-Harness와 Fugu 같은 하네스·오케스트레이터 최적화, 자동 하네스 생성·편집 연구를 연결합니다. 본 논문의 선택은 새로운 조정기를 학습하거나 특정 과제의 하네스를 탐색하는 대신, 실행 중의 제어 메커니즘을 구조화해 비교하는 것입니다.
- Metacognitive control of inference. 계산 가치에 따른 예산 배분, 자신이 아는 정도에 대한 신호, 검증과 재시도, 도구 호출과 종료 판단을 다룬 연구를 설명합니다. 차이는 제어 대상이 단일 사고 사슬·도구 실행·종료 규칙에 머물지 않고, 영구 산출물 위에서 성장하는 외부 계산이라는 점입니다.
- Memory and context as control. MemGPT, A-MEM, Mem0, ACE, CoALA, RLM, PRO-LONG을 통해 기억과 문맥 선택을 연결합니다. 여기서 메모리는 수동 저장소만이 아닙니다. 무엇을 읽고 메모할지, 어떤 과거 작업을 새 작업자에게 보여 줄지를 정하면서 이후 계산이 활용할 근거를 바꿉니다.
- Diagnosing agent runs. 정답 생성과 선택을 분리한 연구, 탐색 궤적 분석, 에이전트 실패 분류와 진단 연구를 소개합니다. 이 논문은 계산 사용량·그래프 구조·coverage·monitoring·selection을 같은 artifact graph와 연결합니다.
챕터의 핵심 기여: 제어·기억·실행 진단을 하나의 계산 과정으로 묶는 연구 위치를 설명합니다.
다음 챕터로의 연결: 이 관점을 상태, 도구, 순환, 예산의 구체적 정의로 전환합니다. 원문 §2
📖 Chapter 3: Agentic Meta-Reasoning
챕터의 위치와 역할: 논문의 핵심 설계입니다. 기억과 상태를 정의하고, 가능한 행동을 제시한 다음, 네 단계 순환과 기록·예산 규칙을 설명합니다.
저자의 서술 순서를 따른 상세 내용:
3.1 Memory, State, and Worker Context
Artifact는 저장된 산출물입니다. 작업자의 풀이·비평뿐 아니라 컨트롤러가 자신을 위해 쓴 메모도 포함합니다. 과제 $x$를 푸는 제어 주기 $t$에서 전체 산출물 집합을 $M_t$, 현재 압축 상태를 $s_t$로 둡니다. 상태는 매번 다시 쓰지만 참조한 원문 산출물은 메모리에 남습니다.
작업자에게 전달하는 인터페이스는 다음과 같습니다.
$W$는 작업자 실행, $g$는 컨트롤러가 작성한 작업 지시, $C\subseteq M_t$는 선택한 과거 산출물 집합, $y$는 반환 산출물입니다. 보조정리 검증이라면 $g$가 검증 범위를 지정하고 $C$가 기존 증명과 관련 비평을 제공합니다. 작업자는 컨트롤러의 비공개 상태나 숙고 과정 전체를 받지 않습니다.
이 표기는 입출력 인터페이스이지 순수 함수의 결정론적 정의가 아닙니다. 코딩 작업자는 $C$에 기록되지 않은 파일을 읽거나 환경을 수정할 수 있고 출력에도 확률성이 있습니다. 환경 상태와 난수는 식에서 생략되며, 기록하는 것은 컨트롤러가 명시적으로 선택한 산출물 문맥입니다. 뒤의 그래프도 이 경계를 따릅니다.
3.2 Actions over the Run
원문은 먼저 Read and write를 소개합니다. Read(I)는 식별자 목록에 해당하는 산출물을 읽고, Write(u)는 새 내용을 식별자와 함께 저장합니다. “이 증명은 잘못된 가정을 사용했다”는 메모는 문제 답을 직접 진전시키지 않더라도, 이후 판단의 근거를 조직하는 인식적 행동입니다.
다음은 Run workers입니다. 컨트롤러가 $k$개의 작업자에게 각기 다른 지시와 문맥을 주면 다음과 같이 표현됩니다.
$i$는 작업자 번호입니다. 모든 작업자가 같은 과제 $x$를 받지만, 지시 $g_i$와 문맥 $C_i$에 따라 새로운 시도·특정 결함 수정·여러 결과 합성을 수행합니다. 반환된 산출물과 입력 산출물의 식별자를 함께 저장합니다. 별도의 고정 역할 목록이 각 작업의 종류를 결정하는 구조는 아닙니다.
마지막은 Stop and select입니다. Stop은 이미 메모리에 있는 $y^\star$를 최종 답으로 고릅니다. 반드시 최신 결과일 필요는 없습니다. 다만 이 시스템에서 새 답을 제출하려면 작업자가 먼저 그것을 만들어 저장해야 합니다. 컨트롤러가 종료 순간 새 답을 직접 지어내는 동작과 구분됩니다.
3.3 The Control Cycle
네 단계는 순서대로 진행하지만, 각 단계 자체가 도구 조회와 여러 모델 호출을 할 수 있는 에이전트 과정입니다. “네 단계”가 항상 “정확히 네 번의 총 호출”을 뜻하지는 않습니다.
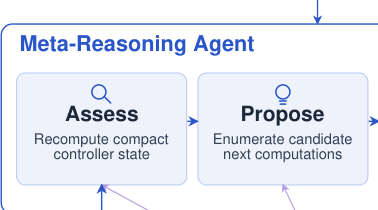
Figure 1 중앙 왼쪽 상세, PDF 1쪽, v1. 원문 영역만 크롭했습니다. Assess는 상태를 다시 쓰고 Propose는 다음 계산 후보를 열거합니다. 전체 연결은 위 개요 그림에서 확인할 수 있습니다. 원문
Assess: What have we learned? 단계는 이전 판단과 새 결과를 통합합니다.
$s_{t-1}$는 이전 상태, $\Delta M_t$는 직전 작업자 묶음에서 새로 생긴 산출물입니다. 세미콜론 뒤의 $M_t$는 전체 원문이 프롬프트에 복사된다는 뜻이 아니라, 필요하면 조회할 수 있는 기억에 접근한다는 뜻입니다. 무엇이 믿을 만하고 어떤 보조정리가 미검증인지 등을 갱신합니다.
Propose: What could we do next? 단계는 다음 계산 후보를 만듭니다.
$\mathcal{A}_t$는 가능한 작업들의 집합입니다. 이 단계는 남은 예산을 명시적으로 받지 않으므로 비싼 대안도 후보에 들어올 수 있습니다. “무엇을 해 볼 수 있는가”와 “지금 그것을 감당할 만한가”를 분리합니다.
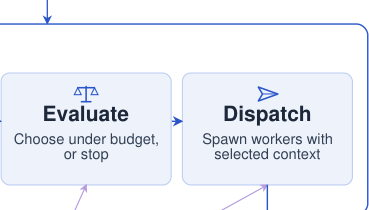
Figure 1 중앙 오른쪽 상세, PDF 1쪽, v1. 원문 영역만 크롭했습니다. Evaluate는 예산 아래에서 선택하고 Dispatch는 지시와 문맥을 작업자에게 전달합니다. 원문
Evaluate: Which option is worth its cost? 단계는 계산 가치와 비용을 비교합니다.
$b_t^{\mathrm{eval}}$은 앞 단계 비용이 이미 차감된 평가 시작 시점의 예산, $\tilde a_t$는 선택한 제안입니다. 불확실한 보조정리가 전체 증명을 좌우한다면 새로운 증명 전체를 만드는 것보다 그 부분을 검사하는 편이 가치 있을 수 있습니다. 그러나 이 평가는 프롬프트에 의한 정성적 판단입니다. 정확한 최적화 문제의 해나 학습된 계산 가치 추정기를 사용했다고 해석하면 안 됩니다.
Dispatch: What should the worker receive? 단계는 선택을 실행 가능한 행동으로 변환합니다.
$a_t$는 실제 작업자 실행 또는 종료 행동입니다. 검증 작업에는 기존 증명과 비평을 전달하고, 새로운 시도에는 과거 산출물을 전혀 주지 않을 수도 있습니다. 문맥 선택 자체가 어떤 계산을 할지 정하는 일의 일부입니다. 종료라면 이미 있는 답을 선택하고, 실행이라면 새 결과가 다음 주기의 Assess에 들어갑니다. 부록 B의 구현 지침에서는 여러 추천 작업을 하나의 작업자 호출 묶음으로 변환합니다.
3.4 Recording the Artifact Graph
산출물을 노드로 놓고, 이전 산출물을 작업자 입력으로 제공했을 때 간선을 기록합니다.
$G=(V,E)$에서 $V$는 산출물, $E$는 기록된 의존성, $C_j$는 $y_j$ 생성에 제공한 과거 문맥입니다. 증명에서 비평으로, 증명과 비평에서 수정안으로 연결하면 수정안은 두 입력 간선을 가집니다. 입력 산출물이 출력보다 먼저 존재하므로 그래프는 방향 비순환 그래프(DAG)가 됩니다.
입력 문맥이 없는 노드는 새로운 시도의 뿌리이고, 여러 후속 작업은 분기, 여러 입력은 합성을 보여 줍니다. 다만 이 그래프는 컨트롤러가 전달한 의존성만 기록합니다. 공유 파일시스템이나 작업자가 따로 읽은 내용 등 모든 정보 경로를 포착한 완전한 인과 그래프는 아닙니다. 원문의 전체 artifact 정의에는 컨트롤러 메모도 포함되지만, 후속 worker-artifact topology의 노드 통계는 작업자 출력에 한정됩니다.
3.5 Direct Control and the Cost of Deliberation
Direct Control Agent는 같은 작업자를 호출하고 이전 산출물을 작업자 문맥으로 선택할 수 있지만, 단계와 압축 상태 대신 전체 누적 대화 위에서 한 번에 다음 행동을 고릅니다. 이 비교는 결합된 제어 설계를 평가합니다. 단계 분리만의 효과를 분리한 ablation은 아닙니다.
예산은 다음과 같이 차감합니다.
$B$는 최초 명목 호출 예산, $b_t$는 주기 시작 시 남은 예산, $c_t$는 그 주기의 모든 컨트롤러 호출, $w_t$는 모든 작업자 호출 합계입니다. 코딩 작업자 내부의 여러 호출과 병렬 작업자 각각의 호출도 포함합니다. 예산이 다했는데 종료하지 않으면 이용 가능한 답을 강제로 제출합니다.
본문은 두 시스템의 공통 행동 인터페이스를 강조하지만, 실제 도구 계약은 완전히 같지 않습니다. 부록 F에서 Direct Control은 finish(result)로 텍스트를 직접 넘기고, Meta-Reasoning은 finish(memory_id)로 기존 작업자 산출물을 고릅니다. 명시적 read_memory·write_memory도 Meta-Reasoning에 제공되고, Direct Control은 원문 출력이 누적 이력에 남습니다. 따라서 “메모리와 종료 방식까지 모두 같은 상태에서 단계만 바꾸었다”고 요약해서는 안 됩니다.
챕터의 핵심 기여: 기억·상태·작업자 문맥을 나누고, 다음 계산과 종료를 명시적인 제어 과정으로 만듭니다.
다음 챕터로의 연결: 이렇게 기록한 그래프에서 예산 사용과 정답 발견·선택을 어떻게 측정할지 정의합니다. 원문 §3
📖 Chapter 4: Diagnosing Agentic Inference Through Artifact Graphs
챕터의 위치와 역할: 정답을 한 번도 만들지 못한 실행과, 정답이 있었지만 제출하지 않은 실행을 구분합니다. 아래 진단은 중간 후보를 독립적으로 채점할 수 있는 경우에 성립합니다.
저자의 서술 순서를 따른 상세 내용:
4.1 What Did the Agent Do with Its Budget?
Did it use the available calls? 항목에서 예산 이용률을 정의합니다.
$N_{\mathrm{ctrl}}$와 $N_{\mathrm{work}}$는 각각 실제 컨트롤러·작업자 호출 수, $B$는 허용량입니다. 이용률이 높다는 사실만으로 좋은 시스템이라고 할 수 없습니다. 이미 정답이 확실하면 일찍 멈추는 것이 합리적이고, 끝까지 계산해도 결과가 나빠질 수 있습니다. 그래서 성능 곡선과 함께 읽습니다.
Did later work build on earlier work? 항목에서는 노드·간선 수, 뿌리와 후손, 평균·최대 fan-in, 깊이와 너비를 셉니다. Fan-in은 노드에 들어오는 의존성 간선 수입니다. 깊이는 뿌리에서 해당 노드까지의 최장 경로를 간선 수로 재며 뿌리는 0입니다. 너비는 같은 깊이에 있는 노드 수의 최댓값입니다. 계산량의 증가와 과거 결과를 이용하는 구조의 증가를 구분할 수 있습니다.
What information did the controller reuse? 항목은 어떤 작업자 출력과 자체 메모를 저장·조회했는지, 어느 단계가 조회했는지, 상태 크기는 어떻게 변했는지 봅니다. 메모리를 많이 썼다는 집계뿐 아니라, 실제 다시 읽은 내용과 읽지 않은 내용을 나누는 진단입니다.
4.2 Did the Agent Find and Submit a Correct Answer?
채점 가능한 풀이 산출물 집합을 $V_{\mathrm{sol}}$, 후보 $y$의 정오 라벨을 $\ell(y)\in\{0,1\}$로 둡니다. 제출 답안도 반드시 이 집합에 포함합니다. 정답 후보가 존재하는 사건을 $\mathcal C$, 제출이 정답인 사건을 $\mathcal S$로 두면 $\mathcal S\subseteq\mathcal C$이므로 다음 분해가 성립합니다.
첫 항은 정답을 발견할 확률, 둘째 항은 정답이 있는 실행에서 그것을 제출할 확률입니다. 인과효과를 분해한 식이 아니라 사건의 포함 관계에 따른 확률 항등식입니다.
Coverage: Did a correct answer appear? 항목은 중간 후보 중 하나라도 맞으면 해당 실행을 성공으로 셉니다.
$k$는 컨트롤러와 작업자를 모두 포함한 누적 호출 체크포인트이고, $V_{\mathrm{sol},\leq k}$는 그때까지 생성한 풀이 집합입니다. 이미 있는 답을 완벽하게 고를 수 있는 선택기의 도달 가능한 성공률로 읽을 수 있습니다. 여기의 binary correctness는 IMO 본 성능 표의 부분 점수 정규화와 다른 지표입니다.
Monitoring: Could the agent recognize correct work? 항목은 정답의 존재를 아는 신호를 봅니다. 작업자는 HIGH·MEDIUM·LOW confidence를, Meta-Reasoning의 Assess는 후보 판정을 제공합니다. 평가할 신호를 $r(y)$, 정답 후보와 오답 후보를 각각 $Y^+$, $Y^-$로 두면 다음과 같습니다.
정답의 평가가 오답보다 높을 확률에 동률의 절반을 더합니다. 0.5는 이 순위 판별에서의 우연 수준입니다. 이것은 자신의 답의 정오를 판단하는 Type-2 AUC이며, 자신감 수치가 실제 정답 확률과 맞는지 평가하는 calibration 지표는 아닙니다. Direct Control에는 대응하는 컨트롤러 판정 신호가 없어 동일 비교를 계산하지 않습니다.
Selection: Did it submit a correct answer it had found? 항목은 다음 조건부 확률입니다.
정답을 만들지 못한 실패는 coverage-bound, 정답이 있었는데 제출하지 못한 실패는 selection-bound입니다. 전자는 탐색이나 문제 해결 과정, 후자는 평가·검증·최종 확정 과정을 살펴볼 근거가 됩니다. 이 분류 자체가 특정 수정 방법의 효능을 입증하지는 않습니다.
4.3 Does Selection Improve on a Structural Baseline?
저자들은 실행 그래프에서 가장 깊은 terminal artifact들을 convergence frontier라고 부릅니다.
$L(G)$는 후속 간선이 없는 말단 노드들, $d(y)$는 최장 의존 경로 길이입니다. 모든 말단 노드가 아니라 가장 깊은 말단 노드만 남깁니다. 후보 정오 라벨이 있으면 이 집합에서 균등하게 하나를 고를 때의 정답 확률은 다음과 같습니다.
분모는 frontier 후보 수이고 분자는 그중 정답 수입니다. 최종 제출 $y^\star$가 이 기준선보다 얼마나 나은지를, 정답 후보가 존재한 실행에 한정해 평균냅니다.
Frontier selection gain(FSG) 값이 양수라면 해당 실행의 frontier에서 무작위 선택하는 것보다 실제 제출이 낫다는 뜻입니다. 최종 답이 frontier에 있어야 하는 것은 아니므로, 더 얕은 올바른 답을 골라도 이득이 생길 수 있습니다. 비교군마다 자신의 그래프에서 만든 기준선을 쓰며, FSG 자체를 최종 정확도나 동일 후보 집합의 직접 비교와 혼동하면 안 됩니다.
챕터의 핵심 기여: 계산 사용, 정답 생성, 정오 판별, 제출 선택을 서로 다른 측정 대상으로 만듭니다.
다음 챕터로의 연결: 어떤 과제에서 이 진단을 적용하고 무엇을 채점하는지 실험 설정으로 구체화합니다. 원문 §4
📖 Chapter 5: Experimental Setup
챕터의 위치와 역할: 두 실행 환경과 네 벤치마크, 비교군, 모델과 호출 예산, 측정 범위를 정합니다.
저자의 서술 순서를 따른 상세 내용:
5.1 Tasks
| 원문 순서 | 과제 수와 성격 | 최종 성능 지표 |
|---|---|---|
| IMO ProofBench-Advanced | 어려운 증명 문제 30개 | 풀이별 0·1·6·7점을 합산하고 최대 총점 대비 백분율로 정규화 |
| ARC-AGI-2 | 색 격자의 숨은 변환을 추론하는 문제 120개 | 테스트 입력의 출력 격자 exact match 정확도 |
| LongCoT-mini | 논리·컴퓨터과학·화학·체스·수학의 장기 추론 문제 507개 | 분야별 결정론적 검증기의 정답 정확도 |
| ProgramBench | 문서와 실행만 가능한 참조 프로그램으로 코드를 재구성하는 문제 200개 | 각 문제의 숨겨진 테스트 통과 비율을 평균한 값 |
IMO에서 94.6이라는 수치는 “문제의 94.6%를 완전히 증명했다”는 뜻이 아닙니다. ProgramBench에서 71.5라는 수치도 “200개 중 71.5%를 완전히 재구현했다”는 뜻이 아닙니다. 서로 다른 분모와 부분 점수 방식을 유지해야 합니다. 세 추론 벤치마크의 작업자는 외부 도구를 쓰지 않는 단일 모델 호출이고, ProgramBench 작업자는 파일 탐색·명령 실행·테스트가 가능한 코딩 에이전트입니다.
5.2 Comparisons
첫 비교는 Meta-reasoning versus direct control입니다. 같은 모델과 작업자를 사용하면서 컨트롤러의 압축 상태·단계·메모리 접근을 바꿉니다. 두 컨트롤러 모두 이 실험을 위해 fine-tuning하지 않습니다.
다음 Recursive Language Model은 문제를 Python 변수에 두고, 코드로 문맥을 다루며 하위 모델을 호출합니다. 재귀 호출에는 자식 인스턴스의 자체 턴도 포함됩니다. 다만 이 논문의 추론 벤치마크에는 코드 실행 능력이 없는 비교군과 맞추기 위해 제한된 workspace를 사용했고, Opus 4.8의 LongCoT-mini 한 셀만 full Python 예외입니다. 부록 H를 빼고 일반적인 RLM 전체의 성능으로 확대하면 안 됩니다.
마지막 Coding agents는 ProgramBench에서 mini-SWE Agent를 세 모델 모두에, Codex를 GPT-5.5에, Claude Code를 Opus 4.8에 비교합니다. 같은 컨테이너를 사용하지만, 각 도구의 실행 경로를 제한한 실제 구성은 부록 I에 적혀 있습니다. 이는 평가한 구성의 end-to-end 기준점입니다.
5.3 Models and Budgets
모델은 Gemini 3.1 Pro, GPT-5.5, Opus 4.8입니다. 추론 벤치마크의 명목 예산은 문제당 25·50·100호출, ProgramBench는 400·800·1200호출입니다. 주 비교는 각각 가장 큰 100과 1200호출을 사용합니다.
모든 컨트롤러·작업자 호출을 합산하고 병렬 묶음도 각 호출을 따로 셉니다. 외부 비교군에도 같은 계수와 예산 알림을 추가합니다. 조기 종료는 허용되므로 동일 허용량에서도 실제 사용량은 다릅니다. 예산 감시는 제어 주기 사이에서 이루어져 이미 시작한 작업자가 끝날 때 약간 초과할 수 있다는 실행상 특성은 결과 장에서 설명합니다.
5.4 Measurements
주 결과는 각 과제의 고유 채점 지표이고, 예산 sweep은 허용량 증가에 따른 점수와 실제 사용량을 봅니다. 추가로 그래프 구조, 메모리 읽기·쓰기, 컨트롤러 상태 크기를 측정합니다. Meta-Reasoning은 단계별 메모리 사용량도 보고합니다.
Coverage·monitoring·selection·FSG는 세 추론 벤치마크의 중간 풀이에만 적용합니다. ProgramBench 중간 구현의 정오를 같은 방식으로 독립 채점하는 프로토콜이 없기 때문입니다. 그래프 구조를 분석했다는 것과 모든 그래프 노드의 정답 여부를 분석했다는 것은 다른 주장입니다.
챕터의 핵심 기여: 호출 예산이라는 공통 제약 아래에서도 과제별 채점과 분석 가능한 범위를 분명하게 구분합니다.
다음 챕터로의 연결: 설정된 조건에서 최종 성능부터 계산 구조·기억 사용까지 차례로 분석합니다. 원문 §5
📖 Chapter 6: Experimental Results
챕터의 위치와 역할: 성능 개선을 먼저 보고하고, 예산을 어떻게 사용했는지, 무엇을 만들었는지, 정답을 어떻게 골랐는지, 이력을 어떻게 유지했는지 순서대로 설명합니다.
저자의 서술 순서를 따른 상세 내용:
6.1 Meta-Reasoning Improves Performance Across Tasks and Models
아래는 원문 Table 1 전체 비교 행을 옮긴 표입니다. 수치는 모두 백분율이지만 열별 의미는 다릅니다. IMO는 정규화된 증명 점수, ARC·LongCoT는 정확도, ProgramBench는 평균 문제별 테스트 통과율입니다. —는 비교가 보고되지 않았다는 뜻입니다.
| 모델 | 시스템 | IMO | ARC-AGI-2 | LongCoT-mini | ProgramBench |
|---|---|---|---|---|---|
| Gemini 3.1 Pro | RLM | 73.3 | 76.7 | 46.5 | — |
| Gemini 3.1 Pro | mini-SWE Agent | — | — | — | 42.0 |
| Gemini 3.1 Pro | Direct Control Agent | 82.7 | 77.5 | 53.5 | 46.9 |
| Gemini 3.1 Pro | Meta-Reasoning Agent | 91.3 | 84.2 | 62.7 | 48.7 |
| GPT-5.5 | RLM | 86.2 | 73.3 | 63.3 | — |
| GPT-5.5 | mini-SWE Agent | — | — | — | 57.6 |
| GPT-5.5 | Codex | — | — | — | 58.0 |
| GPT-5.5 | Direct Control Agent | 93.3 | 75.8 | 64.7 | 63.7 |
| GPT-5.5 | Meta-Reasoning Agent | 94.6 | 79.2 | 65.1 | 71.5 |
| Opus 4.8 | RLM | 68.1 | 66.7 | 64.3* | — |
| Opus 4.8 | mini-SWE Agent | — | — | — | 64.7 |
| Opus 4.8 | Claude Code | — | — | — | 65.5 |
| Opus 4.8 | Direct Control Agent | 78.0 | 77.5 | 65.3 | 65.3 |
| Opus 4.8 | Meta-Reasoning Agent | 80.2 | 80.0 | 66.5 | 67.2 |
원문 Table 1, PDF 11쪽, v1과 대조했습니다. 명목 예산은 추론 100호출, ProgramBench 1200호출이며 컨트롤러를 포함합니다. 별표는 Opus 4.8/LongCoT-mini의 full-Python RLM 예외로, 다른 RLM 8개 셀은 제한 workspace입니다. 원문 표
주 예산에서 대응 비교 12개 모두 Meta-Reasoning의 점 추정치가 더 높습니다. 세 모델 평균 개선은 IMO 4.0점, ARC 4.2점, LongCoT 3.6점입니다. ProgramBench 평균은 표에서 계산하면 약 3.8점입니다. 가장 큰 개별 대응 차이는 Gemini의 LongCoT 53.5 → 62.7, +9.2%p이고, GPT-5.5의 ProgramBench는 63.7 → 71.5, +7.8%p입니다.
외부 비교군과는 GPT-5.5/ProgramBench에서 Codex 58.0 대비 71.5로 +13.5%p, Opus 4.8에서는 Claude Code 65.5 대비 67.2로 +1.7%p입니다. mini-SWE Agent 대비 차이는 세 모델에 따라 2.5–13.9%p입니다. 외부 시스템 비교는 전체 실행 구성의 비교이고, Direct Control 비교가 제어 방식 변경에 더 가까운 대응 비교입니다. 어느 쪽도 동일 토큰 비용에서의 우세를 보여 주는 표는 아닙니다.
6.2 Meta-Reasoning Keeps Improving as the Budget Grows
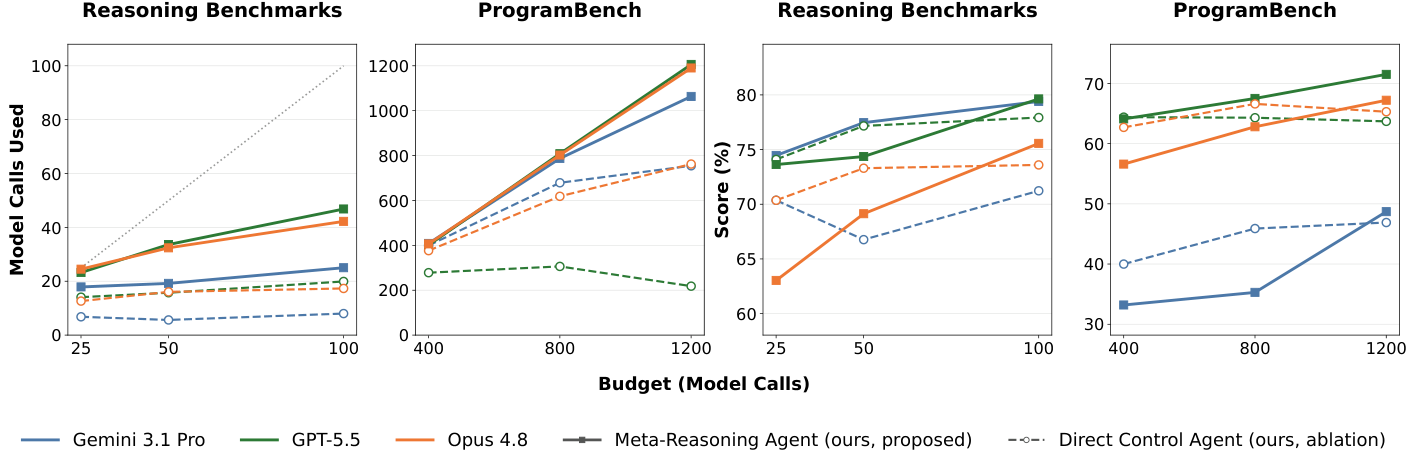
원문 Figure 3 전체, PDF 10쪽, v1. 그림 영역만 크롭했습니다. 왼쪽 두 패널은 실제 호출 수, 오른쪽 두 패널은 점수이며 색은 모델, 실선·사각형은 Meta-Reasoning, 점선·빈 원은 Direct Control입니다. 축·범례를 보존했습니다. 원문
원문은 먼저 허용량이 실제 사용으로 이어지는가를 봅니다. GPT-5.5의 Direct Control은 ProgramBench 1200허용량에서 약 18%만 사용합니다. Meta-Reasoning은 같은 설정에서 모델별 약 89–101%를 사용합니다. 101%는 새로운 예산 정의가 아니라, 예산 아래에서 시작한 작업자가 주기 사이의 감시 전에 완료되며 조금 넘는 실행 방식 때문입니다.
다음은 추가 사용이 결과를 바꾸는가입니다. GPT-5.5/ProgramBench에서 Meta-Reasoning은 예산 400 → 1200에 따라 64.1 → 71.5로 오르지만 Direct Control은 대체로 64 근처에 머뭅니다. 추론 세 벤치마크를 합친 곡선도 시험한 범위에서 비슷한 대비를 보입니다. 다만 합산 곡선을 각 개별 과제가 모든 구간에서 단조 개선한다는 뜻으로 확대하면 안 됩니다.
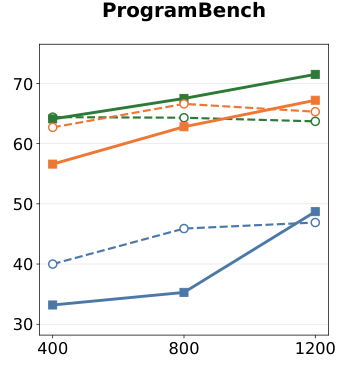
Figure 3 마지막 패널 상세, PDF 10쪽, v1. 원문 패널만 크롭했습니다. 가로축은 명목 호출 예산, 세로축은 평균 문제별 테스트 통과율입니다. 파랑은 Gemini 3.1 Pro, 초록은 GPT-5.5, 주황은 Opus 4.8이며 선·마커 의미는 전체 그림과 같습니다. 전역 범례는 전체 그림에 보존했습니다. 원문
조기 종료만이 설명은 아닙니다. Opus Direct Control은 실제 호출이 376 → 768로 대략 두 배가 되지만 점수는 62.7 → 65.3이고 중간 예산에서 최고입니다. 계속 일한다는 사실보다 어떤 일을 추가하는지가 중요하다는 관찰입니다.
작은 예산의 역전도 보고합니다. Opus/ProgramBench 400호출에서 Meta-Reasoning 56.6은 Direct Control 62.7보다 6.1%p 낮습니다. 1200호출에서는 67.2 대 65.3으로 앞섭니다. GPT-5.5도 가장 작은 ProgramBench 허용량에서는 약간 뒤집니다. 단계 제어의 비용이 충분한 실행 길이에서 회수된다는 해석과 맞지만, 모든 예산에서 추천되는 방식은 아닙니다.
6.3 What computation does the additional budget produce?
원문은 먼저 작업자 산출물과 재사용 간선을 봅니다. 주 예산의 세 추론 과제 모두에서 Meta-Reasoning이 더 많은 산출물을 만들고, 의존성 증가는 더 큽니다. Gemini/IMO에서는 산출물이 대략 두 배, 기록된 의존성의 규모가 약 한 차수 커지는 양상입니다. 이는 원문이 제시한 근사 설명이며, 정확한 원자료 수치로 바꾸어 단정하지 않습니다.
Figure 4는 ProgramBench의 노드·간선·깊이·너비가 예산에 따라 어떻게 바뀌는지 보여 줍니다. GPT-5.5의 Meta-Reasoning은 400 → 1200에서 노드가 2.5배 이상, 간선이 거의 4배가 됩니다. Direct Control은 대응하는 성장을 보이지 않습니다. 다만 더 큰 그래프만으로 품질의 인과 원인을 식별하는 것은 아닙니다.
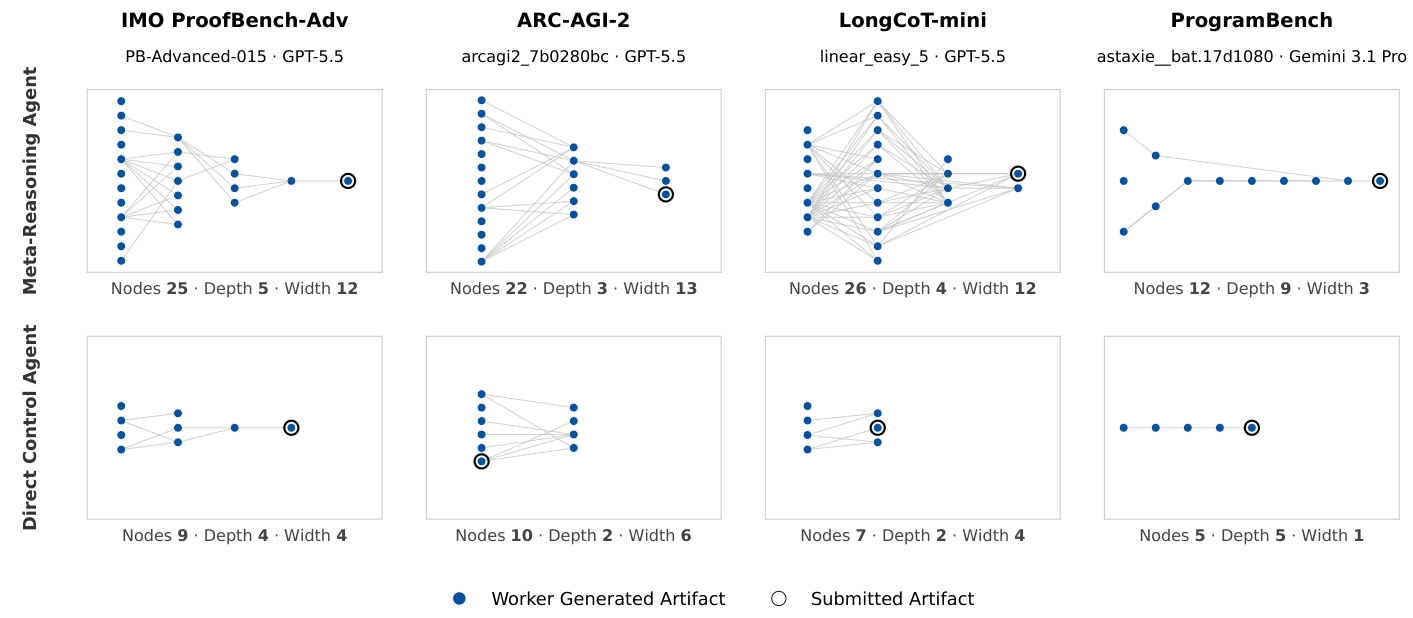
원문 Figure 5 전체, PDF 13쪽, v1. 그림 영역만 크롭했습니다. 위는 Meta-Reasoning, 아래는 Direct Control이며 원으로 둘러싼 노드는 최종 제출 산출물입니다. 간선은 선택해 전달한 문맥 의존성입니다. 원문
Figure 5의 ARC 대응 실행에서 Direct Control은 독립 시도 6개와 1-hop 후속 4개를 만듭니다. Meta-Reasoning은 더 많은 독립 시도를 출발점으로 삼고 과거 결과를 연결하며 최종 깊이의 후보 3개에 도달합니다. 탐색과 재사용이 같은 실행에 공존하는 사례입니다.
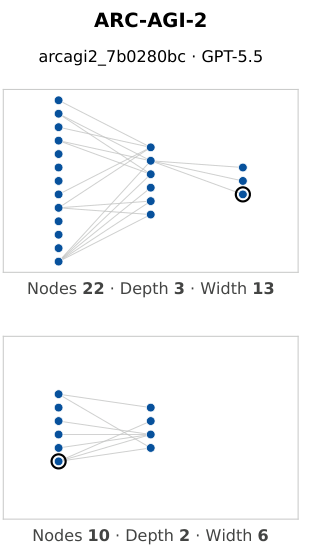
Figure 5 ARC-AGI-2 열 상세, PDF 13쪽, v1. 원문 열만 크롭했습니다. GPT-5.5의 같은 문제에서 위 Meta-Reasoning 그래프는 노드 22·깊이 3·너비 13, 아래 Direct Control은 노드 10·깊이 2·너비 6입니다. 파란 점은 작업자 산출물, 원 표시는 최종 제출 산출물입니다. 이 한 사례를 평균 그래프 통계로 읽어서는 안 됩니다. 원문
Direct Control도 이전 산출물을 선택해 작업자에게 전달할 수 있으므로 원리적으로 이런 의존성을 만들 수 있습니다. 관찰된 차이는 그 기능을 실제로 어떻게 사용했는지에 있습니다. 공유 환경의 모든 정보 이동이 간선으로 기록되는 것은 아니라는 §3.4의 조건을 다시 적용해야 합니다.
6.4 Finding Correct Answers Is Only Part of the Problem
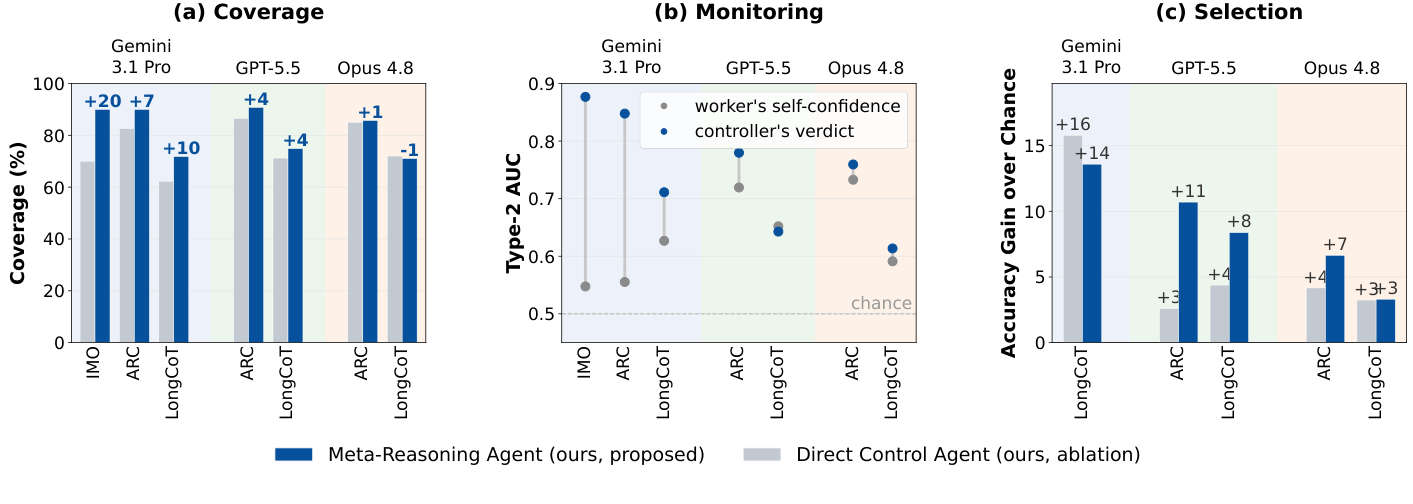
원문 Figure 6 전체, PDF 14쪽, v1. 그림 영역만 크롭했으며 세 패널과 범례를 보존했습니다. (a)는 coverage, (b)는 monitoring, (c)는 frontier selection gain입니다. IMO coverage는 부분 점수와 다른 이진 정오 기준입니다. 원문
Correct answers appear in more runs. 대부분의 평가 설정에서 coverage가 높아집니다. Gemini에서는 IMO +20%p, LongCoT +10%p가 큽니다. ARC는 세 모델 모두 개선하며, Opus의 LongCoT는 거의 같습니다. Figure 6(a)의 Opus/LongCoT 표시는 약 −1%p여서 모든 셀의 coverage가 증가했다는 주장은 맞지 않습니다. 최종 부분 점수·정확도가 올랐다는 사실과 정답 후보가 존재한 실행 비율은 구분됩니다.
The controller often judges quality better than worker confidence does. Gemini/IMO에서 작업자 confidence의 Type-2 AUC는 0.55, 컨트롤러 판정은 0.88입니다. 정답 후보를 오답보다 높게 두는 능력이 상당히 다릅니다. Gemini/ARC에서도 차이가 크지만, GPT-5.5·Opus에서는 더 작고 GPT-5.5/LongCoT에서는 거의 없습니다.
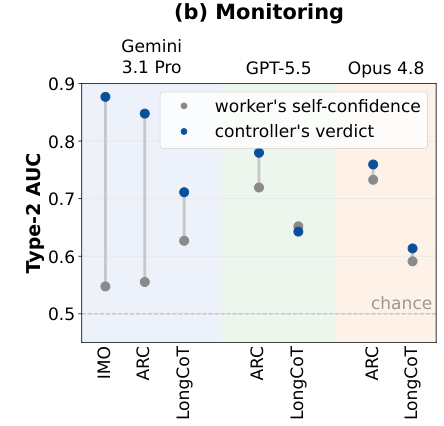
Figure 6(b) 상세, PDF 14쪽, v1. 원문 패널만 크롭했습니다. 회색은 작업자 자기 confidence, 파랑은 Meta-Reasoning 컨트롤러 판정입니다. 0.5 기준선은 순위 판별의 우연 수준이며 보정된 정답 확률이 아닙니다. Direct Control의 컨트롤러 verdict 비교는 없습니다. 원문
The final choice improves in some settings, but not all. ARC와 LongCoT의 해당 실행 집계에서 약 83%는 deepest terminal artifact에서 답을 제출합니다. 그러나 대략 4분의 3의 실행에서는 그 frontier에 후보가 여러 개여서 여전히 선택 문제가 남습니다. GPT-5.5/ARC의 FSG는 Meta-Reasoning +11%p, Direct Control +3%p입니다. Opus/ARC와 GPT-5.5/LongCoT도 제안법이 높지만, Opus/LongCoT는 거의 같고 Gemini/LongCoT는 Direct Control이 약간 높습니다.
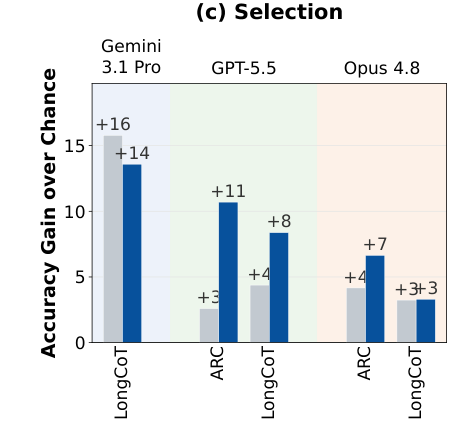
Figure 6(c) 상세, PDF 14쪽, v1. 원문 패널만 크롭했습니다. 회색은 Direct Control, 파랑은 Meta-Reasoning입니다. 정답이 존재한 실행에 조건을 둔 FSG이므로 최종 전체 정확도와 다릅니다. 모델별 자신의 frontier 기준선에서 계산한 값이며, 전역 색 범례는 전체 그림에 보존했습니다. 원문
이 순서는 중요한 해석을 만듭니다. 정답이 더 자주 생기고, 정오를 잘 순위화하는 신호가 있어도, 그 신호가 최종 제출을 모든 설정에서 균일하게 개선하는 것은 아닙니다. 좋은 후보를 만드는 계산과 좋은 후보를 고르는 계산을 따로 봐야 합니다.
6.5 Can control retain useful history without replaying it all?
원문은 먼저 어떤 기억을 다시 읽는지 봅니다. ARC와 LongCoT에서 적어도 한 번 명시적으로 조회된 산출물만 대상으로 하면, 컨트롤러 자체 메모는 평균 4.4–9.8회, 작업자 산출물은 1.9–3.3회 읽힙니다. 전체 메모의 평균이라고 바꾸면 안 됩니다. 많은 산출물은 다시 읽히지 않았고, 소수의 메모가 반복해서 조직적 참조점으로 사용됩니다.
Figure 7의 단계별 분석에서 쓰기는 모든 모델에서 읽기보다 많습니다. Assess는 새 산출물 본문을 입력으로 받기 때문에 꾸준히 쓰지만 과거 산출물을 명시적으로 읽는 경우는 거의 없습니다. 읽기의 대부분은 Propose와 Evaluate에 집중됩니다. 모델별 사용 방식도 다릅니다. Gemini는 가볍게, GPT-5.5는 더 자주 사용하며, Opus는 이후에 다시 읽지 않는 메모도 많이 씁니다.
Figure 8은 제어 결정 사이에 유지하는 표현의 문자 수를 로그 축으로 보여 줍니다. 가장 긴 Opus/IMO Direct Control 이력은 100만 문자를 넘고, Meta-Reasoning 상태는 대체로 수천–수만 문자입니다. 추론 과제에서는 상태가 실행 중 줄어들기도 합니다. ProgramBench는 저장소 내용을 계속 파악해야 하므로 제안법의 상태도 커지고 격차는 수 배 수준으로 좁아집니다.
이 수치는 전체 입력 토큰 수가 아닙니다. 조회한 산출물과 단계 내부 대화가 추가되므로 실제 판단 문맥의 하한에 가깝습니다. “작은 상태 때문에 성능이 올랐다”는 설명도 아직 가설입니다. 저자는 긴 문맥에서 정보 찾기가 어려워지는 현상이 관련 있을 수 있으나, 이를 직접 검증하거나 상태 압축만 제거하는 ablation을 수행하지 않았다고 밝힙니다.
챕터의 핵심 기여: 주 예산의 점수 향상과 함께 실제 계산 사용·재사용 구조·coverage·평가 신호·기억 접근을 관찰하되, 최종 선택과 낮은 예산에서는 균일하지 않은 결과를 보입니다.
다음 챕터로의 연결: 이러한 관찰이 에이전트 역량에 대해 무엇을 말하고 무엇을 입증하지 못하는지 논의합니다. 원문 §6
📖 Chapter 7: Discussion and Limitations
챕터의 위치와 역할: 설계의 의미를 해석하고 저자가 명시한 비용·실패 사례·모델 의존성을 제시합니다.
저자의 서술 순서를 따른 상세 내용:
7.1 Meta-Reasoning Is Part of Agent Capability
저자들은 같은 작업자 모델을 유지하면서 제어 방식을 바꿨을 때 결과가 달라진다는 점에서, 긴 과제 성능을 작업자 모델의 속성만으로 볼 수 없다고 주장합니다. 실행을 지휘하는 능력도 별도로 측정하고 개선할 수 있는 역량입니다. 이 주장은 주 예산의 대응 결과에 근거하며, 실제로 비교에서 동시에 바뀐 세부 요소는 부록 A와 F의 범위 안에서 해석합니다.
7.2 Meta-Reasoning Is Itself an Agentic Process
메타 수준의 일도 여러 단계, 전용 도구, 하위 작업이 필요한 활동이라고 설명합니다. 이전 산출물을 찾아 읽고, 중요한 사실을 메모하고, 반복해서 참조하며, 정오 판정을 기록하는 행동은 답을 직접 만드는 일과 다른 인식적 행동입니다. 외부 기억은 결과를 보관하는 곳이면서 다음 판단이 사용할 근거를 구성하는 장치입니다.
저자들은 제안한 네 단계가 이 활동을 조직하는 한 가지 방식이라고 말합니다. 논문이 지지하는 것은 기능의 분리이며, 모든 과제에서 이 네 단계 각각이 필수라고 실증한 것은 아닙니다.
7.3 Limitations
Costs and failure modes. 단계 제어에는 추가 계산이 들고, 작은 예산의 역전 때문에 항상 우세하지 않습니다. 잘못된 평가가 압축 상태에 들어가면 이후에도 전파될 수 있습니다. 다시 읽지 않은 좋은 부분 풀이를 잃을 수도 있으며, 압축 상태에는 손실이 있어 나중에 중요해진 정보를 기억 조회로 되살려야 합니다.
논문이 명시한 실패 사례는 LongCoT-mini의 체스 부분집합입니다. 다른 분야에서의 향상과 달리 이 분야는 Direct Control보다 낮았습니다. 일부 궤적의 예비 관찰은 이미 맞는 답을 추가 검사·설명으로 흔드는 비생산적 재고를 가리킵니다. 저자는 완전한 분석과 목표를 정한 개입을 향후 작업으로 남깁니다. 이것을 확정된 실패 원인이나 모든 재검증의 해로움으로 단정하지 않습니다.
Model dependence. Gemini는 추론 벤치마크, GPT-5.5는 ProgramBench에서 특히 큰 이득을 보이고 Opus는 주 비교에서 더 작지만 양의 이득을 보입니다. 모델이 컨트롤러로 행동하는 방식, 과제 난도, 프롬프트, 작업자 역량이 함께 작용하는 결과입니다. 모델 이름만으로 제어 능력의 일반적인 서열을 매긴 실험은 아닙니다.
챕터의 핵심 기여: 저자가 직접 제시한 위험과 관찰 사례를 성능 주장과 함께 제한합니다.
다음 챕터로의 연결: 제어와 작업 수행을 함께 에이전트 능력으로 보는 결론으로 이어집니다. 원문 §7
📖 Chapter 8: Conclusion
챕터의 위치와 역할: 실행에 계산을 더 줄수록 그 계산을 어떻게 사용할지 고르는 문제가 커진다는 처음의 논지를 회수합니다.
저자의 서술 순서를 따른 상세 내용:
- 추론 시 계산이 늘면 다음 작업의 선택지도 늘어난다고 정리합니다.
- 네 벤치마크와 세 모델에서 주 예산의 대응 비교가 개선됐고, 시험한 예산 범위에서 Direct Control이 정체하는 동안 제안법이 더 개선되는 양상을 요약합니다.
- 더 많은 예산 사용, 과거 작업을 조합하는 계산, 정답 후보의 높은 coverage, 작업자 confidence보다 나은 일부 판정 신호, 실행 길이와 분리된 압축 상태를 진단 결과로 묶습니다.
- 문제를 잘 푸는 능력과 어떤 계산이 가치 있는지 판단하는 능력이 함께 에이전트 성능을 결정한다고 결론 내립니다.
챕터의 핵심 기여: 제어 자체를 추론 계산의 한 부분으로 취급하는 관점을 정리합니다.
뒤 자료와의 연결: 본문 결론 뒤에는 참고문헌과 부록이 이어지며, 부록은 근거의 범위와 실제 프롬프트·도구·비교군 설정을 공개합니다. 원문 §8
References의 역할
참고문헌은 추론 시 계산·에이전트 기억·메타인지·실행 진단·벤치마크 계보를 연결합니다. 위 관련 연구 요약은 본 논문이 해당 연구를 설명한 방식에 근거합니다. 모든 인용 논문의 원문·실험을 독립 검증했다고 주장하지 않습니다.
📖 Chapter A: Scope of the Evidence
챕터의 위치와 역할: 본문 결과에서 도출할 수 있는 결론의 경계를 세 항목으로 명시합니다.
저자의 서술 순서를 따른 상세 내용:
- Combined design rather than component-level attribution. 대응 비교는 압축 상태, 에이전트 단계, 컨트롤러 기억 접근을 함께 바꿉니다. 결합 설계의 가치는 평가하지만 각 단계의 필요성과 독립 인과효과는 식별하지 않습니다. 저자가 제시한 후속 검증은 단계 제거, 상태만의 효과, 메모리 인터페이스 ablation입니다.
- Resource matching. 호출은 해석하기 쉬운 예산 단위지만 입력·출력 길이와 실행 시간이 다릅니다. 실제 사용하는 허용량의 비율도 각 시스템이 스스로 다르게 선택합니다. 따라서 동일 토큰 비용·지연·실제 계산량에서 효율을 비교한 결과가 아닙니다.
- Evaluation breadth and uncertainty. 세 frontier 모델과 네 벤치마크, 그중 30문제의 작은 증명 집합을 다룹니다. 주 비교의 양의 점 추정치가 모든 차이의 통계적 유의성이나 약한 모델·다른 과제·훨씬 긴 실행에 대한 일반화를 보장하지 않습니다. 외부 에이전트 비교는 평가한 버전과 구성에 한정됩니다.
챕터의 핵심 기여: “전체 설계가 더 높은 점수를 보였다”와 “각 구성요소가 원인이며 더 저렴하다”를 구분합니다.
다음 챕터로의 연결: 이 결합 설계를 실제로 만드는 단계별 프롬프트를 제시합니다. 원문 부록 A
📖 Chapter B: Meta-Reasoning Agent Prompts
챕터의 위치와 역할: 추상적인 네 단계에 어떤 입력·책임·출력 구조를 부여했는지 공개합니다. 추론용 텍스트 과제와 ProgramBench의 프롬프트를 구분해야 합니다.
저자의 서술 순서를 따른 상세 내용:
B.1 Assess
먼저 Assess의 입력 조립을 설명합니다. Assess의 각 턴은 단계 간 동일하게 유지되는 과제, 식별자·제목만 담은 메모리 인덱스, 이전 상태, 새 산출물 본문을 받습니다. 추론에서는 새 풀이, ProgramBench에서는 작업한 브랜치·구현·참조 프로그램에서 배운 점·빌드·미완료 항목을 담은 작업자 종료 보고서입니다.
텍스트 과제 프롬프트는 요약보다 비판적 평가를 요구합니다. 새 후보별 접근, 논리의 결함, 증거와의 일치, 답안 형식을 살피고 LIKELY_CORRECT, HAS_GAPS, FUNDAMENTALLY_FLAWED 중 판정을 남깁니다. 이어 전체 후보에 대한 종합 상태, 종료 권고, 미해결 질문을 작성합니다. 후보 간 답의 일치가 독립적으로 타당한 추론 때문인지 공통의 잘못된 가정 때문인지도 구분합니다.
종료 권고는 모든 단계가 읽혔고 논리적 비약·누락·형식 문제가 없을 때만 하며 기본값은 계속 진행입니다. 하지만 Assess의 권고는 Evaluate가 따를 명령이 아니라 하나의 입력입니다. 원문은 작업자 자기 confidence의 과신을 경계합니다.
ProgramBench 프롬프트는 판정과 종료 신호 대신 증거가 달린 사실 상태를 유지합니다. 순서는 implemented → broken → unverified → unexplored → dead_ends입니다. 구현했다고 말한 것과 테스트·커밋·실행 흔적이 있는 것을 구분하고, 새 증거가 생기면 항목을 중복 추가하지 않고 맞는 분류로 옮깁니다. 과거에도 여전히 참인 내용은 유지하며, 출처를 댈 수 없는 주장은 넣지 않습니다.
컨트롤러가 직접 셸 실행으로 확인하는 것은 허용하지 않고 실행·수정·런타임 검증은 작업자로 제안하게 합니다. 커밋된 코드의 읽기 전용 검사는 git 도구로 할 수 있습니다. 이 책임 분리가 “보고서를 읽었으니 검증됐다”는 성급한 상태 갱신을 막도록 의도되어 있습니다.
B.2 Propose
입력은 과제, 메모리 인덱스, 현재 Assess 상태입니다. 남은 예산은 넣지 않습니다. 프롬프트는 몇 개의 안전한 선택지로 스스로 좁히지 말고 가능한 다음 행동을 넓게 제안하도록 요구합니다.
텍스트 과제에서는 새로운 접근, 결함의 표적 수정, 독립 검증, 공통 주장에 대한 반례 찾기, 부분 결과 합성, 종료 등을 후보로 만듭니다. 각 행동은 무엇을 달성하고 왜 시도할 가치가 있으며 어떤 가정과 과거 후보를 이용하는지 설명합니다. 고정된 메뉴는 아닙니다.
ProgramBench도 같은 구조지만, 미구현 기능, 실패한 빌드·출력, 미탐색 플래그·경계 사례, 수정하지 않는 검증 작업 등을 다룹니다. 구현·수정·검증·탐색을 별개의 후속 작업으로 제안할 수 있게 하는 지침입니다.
B.3 Evaluate
입력은 과제·메모리·상태·제안·예산입니다. 부록은 명시적인 예산 블록을 받는 단계가 Evaluate뿐이라고 설명합니다. 텍스트 과제에서 작업자 한 명은 한 호출이고, 기본 네 단계 숙고도 최소 네 호출의 부담임을 상기시킵니다. 단, 본문처럼 단계 중 도구 사용과 추가 턴이 있으면 컨트롤러 비용은 그보다 커질 수 있습니다.
텍스트 행동은 기대 이득, 1명 또는 여러 작업자의 비용, 남은 예산에서 정당화되는지를 평가해 HIGH·MEDIUM·LOW value로 등급을 매깁니다. 동률이면 미해결 질문을 더 많이 푸는 행동, 작업자 호출당 기대 이득, 후보 다양성 순서로 우선합니다. 추천은 행동 ID·문맥 ID 목록·병렬 작업자 수를 가진 YAML 목록입니다.
텍스트 과제의 종료는 Assess가 유망하다고 봤으며 관련 미해결 질문이 없고, 제안된 추가 작업의 가치가 낮고, 최종 정오를 확신할 때에만 권고합니다. Assess를 그대로 승인하는 과정이 아니라 별도 판단입니다.
ProgramBench는 원자적 행동을 같은 하위 시스템·자연스러운 작업 순서로 묶어서 한 작업자에게 주도록 합니다. 공유 파일을 수정하는 구현·수정·리팩터링은 작업자 한 명, 읽기 중심 조사·검증은 유익할 때 병렬로 합니다. 공유 파일시스템에서 두 코딩 작업자가 같은 실행 파일·빌드 스크립트를 덮어쓸 수 있기 때문입니다. 실제로 파일을 쓰는 테스트 작업도 이 공유 상태 조건을 함께 읽어야 합니다.
평가 우선순위는 테스트 통과 범위를 늘리는 데 있습니다. 이미 맞는 코드의 정리보다 알려진 실패, 미검증 기능, 미구현 기능을 해결하는 작업에 가치를 둡니다. 추천 지시에 구체 파일·명령·성공 조건을 가진 독립적인 작업자 지시를 포함하도록 요구합니다.
ProgramBench의 종료 조건은 미탐색 항목에 더 추적할 가치가 없고, 해결할 수 있는 알려진 실패가 없으며, 미검증 구현이 없고, 추가 제안도 낮은 가치일 때입니다. 특히 구현한 작업자와 별개의 검증 위임을 요구합니다. 이는 프롬프트가 요구하는 절차이며, 모든 실행이 그 절차를 완벽히 준수했다는 별도 감사 결과를 논문이 보고한 것은 아닙니다.
B.4 Dispatch
입력은 과제·메모리·선택된 Evaluate 출력입니다. 이 단계는 추천을 도구 호출로 번역합니다. 첫 추천이 STOP이면 지정된 memory_id를 제출합니다. 그렇지 않으면 추천별 작업자 수를 합치고, 각 작업자에게 줄 지시와 메모리 ID 목록을 같은 길이의 배열로 만들어 한 번의 run_workers 묶음을 실행합니다.
텍스트 답안은 저장된 작업자 본문을 그대로 제출하므로 제목·confidence 표기까지 함께 들어갑니다. 필요한 답안 형식이 깨졌다면 컨트롤러가 즉석에서 고치는 대신 마지막 정리 작업자를 실행해 새 산출물을 제출하도록 합니다.
ProgramBench는 추천의 subagent_prompt가 있으면 그대로 전달합니다. 작업자는 숙고 과정과 YAML 전체를 보지 않으므로, 행동 ID만 전달하면 충분한 작업 설명이 되지 않습니다. 구체 파일·동작·성공 조건을 가진 200–500자 정도의 독립 지시를 목표로 합니다. 추천이 비었거나 잘못됐을 때는 원래 과제에 문맥 없이 작업자 한 명을 실행하는 fallback도 명시합니다. 이는 정지 방지 동작이지 잘못된 추천을 완전히 복원하는 절차는 아닙니다.
챕터의 핵심 기여: 단계 분리를 이름만 붙이는 것이 아니라 서로 다른 정보·출력·종료 책임으로 구현합니다.
다음 챕터로의 연결: 같은 작업자를 쓰는 Direct Control의 실제 프롬프트를 비교 대상으로 공개합니다. 원문 부록 B
📖 Chapter C: Direct Control Agent Prompts
챕터의 위치와 역할: 단계가 없는 비교군도 충분한 작업자 선택과 문맥 재사용 기능을 받았음을 설명합니다.
저자의 서술 순서를 따른 상세 내용:
C.1 System prompt
Direct Control은 하나의 시스템 프롬프트와 과제 메시지로 시작해, 도구 호출·결과가 같은 대화 목록에 쌓이는 방식입니다. 매 행동에서 현재까지의 이력을 보고 다음 작업자 묶음 또는 종료를 고릅니다.
텍스트 프롬프트는 정확하고 완결된 답과 엄격한 형식을 요구합니다. run_workers는 1–32명, 작업자별 지시, 이전 출력 ID 목록을 받아 새로운 각도·수정·검증·합성을 수행할 수 있습니다. 후보들이 같은 답에 동의해도 공통의 상류 오류일 수 있으며, 일부 증거만 설명하는 후보는 충분하지 않다는 주의도 제공합니다. 따라서 검증·합성 자체를 못 하는 허약한 비교군으로 묘사해서는 안 됩니다.
ProgramBench 프롬프트는 관찰만으로 원래 프로그램을 새로 구현하는 목표와 공유 workspace를 설명합니다. 코딩 작업자는 여러 턴을 사용하고, 파일 충돌 위험 때문에 독립 모듈·브랜치가 아니라면 한 명씩 실행하도록 권합니다. 종료 때 채점하는 것은 설명 텍스트가 아니라 compile.sh와 실행 파일이 있는 workspace입니다.
C.2 Budget
프롬프트 끝에 총 허용량과 작업자 비용의 의미를 붙입니다. 실행 중에는 허용량의 10%를 사용할 때마다 사용·잔여량 메시지를 추가하고, 90%에서 한 번 종료를 요구합니다. 텍스트 과제에서 예산 내에 끝내지 않으면 최신 작업자 출력을 강제로 제출할 수 있어, 컨트롤러가 선호한 후보와 달라질 수 있습니다. ProgramBench는 현재 구현으로 종료하도록 요구합니다.
챕터의 핵심 기여: 전체 누적 이력을 사용하는 직접 제어에도 재시도·수정·검증·문맥 선택과 예산 인식을 제공합니다.
다음 챕터로의 연결: 두 컨트롤러가 공통으로 호출하는 작업자 프롬프트를 정의합니다. 원문 부록 C
📖 Chapter D: Worker Prompts
챕터의 위치와 역할: 비교군과 제안법이 동일하게 사용하는 object-level 작업자 계약을 보여 줍니다.
저자의 서술 순서를 따른 상세 내용:
- 작업자 입력의 세 부분은 원래 과제, 컨트롤러가 고른 산출물의 전체 본문, 작업별 steering 지시입니다. 컨트롤러의 상태와 숙고 자체는 보지 않습니다. 과거 풀이·보고서는 도움이 되는 문맥이지만 정답으로 간주하지 말고 비판적으로 읽도록 합니다.
- 텍스트 작업자는 추론과 정당화를 제시하고 요구 형식의 단일 최종 답에 확정합니다. 첫 줄에 접근법 제목, 마지막 비어 있지 않은 줄에 HIGH·MEDIUM·LOW confidence를 남깁니다. 자신감 표기는 이후 오케스트레이션과 monitoring 진단에 쓰입니다. 이것이 confidence의 정확성을 보장하는 것은 아닙니다.
- ProgramBench 작업자는 셸로 탐색·문서 확인·구현·빌드·테스트합니다. 반환 전에 변경을 커밋하고, 소스나 빌드 스크립트를 수정했다면 마지막 수정 이후 다시 빌드해 실제 종료 코드를 보고하도록 요구합니다. 보고에는 브랜치, 구체 구현, 참조 동작에서 배운 점, 빌드 결과, 남은 미완료 항목과 confidence가 들어갑니다.
- 형식과 진단의 연결에서 제목 또는 커밋 메시지가 메모리 인덱스의 제목이 됩니다. 본문을 조회하기 전 컨트롤러가 보는 정보입니다. confidence는 작업자의 자기 판단과 컨트롤러 판정을 비교하는 신호가 됩니다.
챕터의 핵심 기여: 작업자 입력을 통제하고 원문 출력·자기 판단을 구조적으로 기록합니다. 여기의 커밋 지침은 논문의 실험 환경 설명이며, 블로그 작성 과정에 실행하는 지침이 아닙니다.
다음 챕터로의 연결: 이 결과가 어떤 ID와 제목·본문 형태로 보관되는지 메모리 구조로 이어집니다. 원문 부록 D
📖 Chapter E: Artifact Memory
챕터의 위치와 역할: 압축 상태와 원문 보존을 동시에 가능하게 하는 메모리 표현을 설명합니다.
저자의 서술 순서를 따른 상세 내용:
- 엔트리 생성과 식별자: 각 산출물은 ID·제목·본문을 갖습니다.
{round}_{worker}방식이어서2_1은 세 번째 라운드의 두 번째 작업자입니다. 작업자 반환 또는 컨트롤러의write_memory로 새 엔트리가 생깁니다. 텍스트 제목은 작업자의 제목 줄, 코딩 과제 제목은 커밋 메시지에서 얻습니다. - The index: 모든 단계가 받는
{memory}에는 ID와 제목만 나열하고 본문은 생략합니다. 따라서 메모리가 커져도 전체 본문을 상태에 넣을 필요는 없습니다. 예시에는 작업자 풀이와 “기저 사례가 미증명”이라는 컨트롤러 메모가 같은 인덱스에 공존합니다. - A retrieved body:
read_memory로 본문을 가져옵니다. 없는 ID는 호출 전체를 실패시키는 대신NOT FOUND를 반환합니다. 정확한 ID를 유지하라는 앞선 지침과 연결됩니다. - The worker view: 작업자에게는 선택한 산출물의 전체 본문을 메모리 경계로 감싸 전달합니다. 기본적으로 ID는 주지 않아 작업자가 이전 산출물을 그 ID로 다시 인용하는 구조는 아닙니다.
챕터의 핵심 기여: 짧은 인덱스로 보관 위치를 알고, 필요할 때 원문을 읽고, 작업자에게 선택적으로 전달하는 경로를 구체화합니다.
다음 챕터로의 연결: 이 경로를 실제 도구 스키마와 종료 호출에 연결합니다. 원문 부록 E
📖 Chapter F: Tools
챕터의 위치와 역할: 본문의 추상적 행동을 실제 함수 인터페이스 수준으로 확인합니다. 대응 비교의 구현 차이를 읽는 데 특히 중요합니다.
저자의 서술 순서를 따른 상세 내용:
run_workers: 두 에이전트의 스키마는 동일합니다. 작업자 수, 작업자별 과거 문맥 ID 배열, 작업자별 지시 배열을 받습니다. 설명에는 1–32명과 첫 라운드 이후 문맥 지정을 요구하는 내용이 있지만, 스키마의 필수 필드는num_repeats입니다. 자연어 사용 지침과 구조적 필수 필드 검증을 같은 것으로 취급하지 않습니다.finish: Direct Control은 전체 답 문자열인result를 받습니다. Meta-Reasoning은 이미 존재하는 작업자 산출물의memory_id를 받으며 새 ID나 즉석 답안을 만들지 못합니다. 이는 최종 답이 저장 후보에 포함돼야 한다는 진단 조건과 연결됩니다. ProgramBench에서는 어느 쪽도 보고서 문장 자체를 채점하지 않고 workspace를 평가합니다.read_memory와write_memory: 네 Meta-Reasoning 단계 모두에 제공됩니다. 읽기는 ID 배열, 쓰기는 제목·본문 엔트리 배열을 받습니다. Direct Control에는 명시적 도구를 주지 않으며, 생성된 산출물 본문이 누적 대화에 남기 때문입니다.- 과제별 도구 범위: 세 텍스트 벤치마크에서 컨트롤러가 받는 도구는 이 범위입니다. ProgramBench에서는 두 컨트롤러 모두 추가로 읽기 전용 git 도구를 받습니다.
챕터의 핵심 기여: 공통 작업자와 문맥 전달은 유지하지만, 메모리를 읽는 방식과 종료 인터페이스는 다르다는 실제 계약을 공개합니다.
다음 챕터로의 연결: 프로그램 재구성에서 파일과 커밋, 평가 대상이 어떻게 결합되는지 설명합니다. 원문 부록 F
📖 Chapter G: Implementation details: ProgramBench
챕터의 위치와 역할: 텍스트 풀이와 달리 결과물이 공유 파일시스템에 남는 코딩 환경의 실행 규칙을 설명합니다.
저자의 서술 순서를 따른 상세 내용:
작업자는 셸을 쓰는 다중 턴 에이전트이고 반환 전에 커밋합니다. 커밋 제목이 메모리 산출물 제목이 되므로 인덱스는 커밋 로그와 연결됩니다. 종료 채점은 compile.sh와 그것이 만드는 실행 파일이 있는 workspace 상태에 적용됩니다. 과거 보고서의 ID를 고른다고 자동으로 과거 커밋으로 rollback한다는 설명은 아닙니다.
G.1 Task prompt
모든 ProgramBench 시스템은 같은 구성 과제 설명을 받습니다. 문서와 실행 가능한 참조 프로그램의 일반 인터페이스를 관찰해 독립적인 코드를 작성해야 합니다. 원래 소스를 온라인·레지스트리·저장소에서 가져오거나, 원본 바이너리를 감싸거나 복사해 제출하거나, 원본을 역어셈블·디컴파일·추적하는 우회는 금지합니다. 허용된 것은 CLI·표준 입력/출력으로 참조를 실행하고 제공 문서를 읽는 행동입니다.
네트워크와 패키지 레지스트리 접근은 없고 기본 이미지의 도구와 패키지를 사용합니다. 빌드 스크립트는 workspace 루트의 실행 파일을 만들어야 하며, 원본 백업 executable_orig를 보존합니다. 참조 파일을 실수로 훼손했을 때 복구하는 도구도 제공합니다. 이 조건들은 모델이 기억한 원래 프로젝트를 가져오는 문제와, 관찰한 동작을 재구성하는 문제를 구분합니다.
G.2 Read-only git tool
두 컨트롤러는 작업자의 서술 보고만 믿는 대신 커밋된 코드를 읽을 수 있습니다. log, show, diff, blame, cat-file 같은 읽기 전용 하위 명령을 허용하고 쓰기·셸 우회를 거부합니다. 출력은 8000문자로 잘라 필요하면 통계나 파일 필터로 좁힙니다.
mini-SWE Agent·Claude Code·Codex는 제어와 작업이 한 에이전트에 있어 컨테이너에 직접 접근하므로 별도 컨트롤러 git 도구를 받지 않습니다. 제안법과 Direct Control의 컨트롤러는 코드를 읽을 수 있지만 수정·실행 검증은 작업자에게 맡깁니다. 이는 비교 시스템의 역할 분리에 따른 인터페이스 차이입니다.
챕터의 핵심 기여: 메모리 보고, 커밋 근거, 실제 파일 상태를 구분해 장기 재구현을 실행합니다.
다음 챕터로의 연결: 텍스트 과제 비교군인 RLM의 실행 능력과 예산을 어떻게 맞췄는지 공개합니다. 원문 부록 G
📖 Chapter H: Implementation details: Recursive Language Model (RLM)
챕터의 위치와 역할: 비교한 RLM이 어떤 구성인지, 원래 구현에서 무엇을 바꾸었는지 설명합니다.
저자의 서술 순서를 따른 상세 내용:
먼저 저자들의 참조 구현과 기본 프롬프트를 사용하고, 벤치마크 검증기가 읽을 최종 답 형식을 덧붙였다고 밝힙니다. 이어 두 비교 목적의 변경을 설명합니다.
Restricted workspace. 원래 full Python REPL에서는 하위 모델 분해 대신 Python 자체로 문제를 풀 수 있습니다. 제안법과 Direct Control은 세 추론 벤치마크에서 코드 실행을 못 하고, Python 내부 계산은 모델 호출 계수에도 안 들어가므로 비교 능력과 비용이 달라집니다. 처음에는 각 코드 블록에 하위 모델 호출을 강제했지만, 형식적인 호출을 넣고 문제는 코드로 푸는 행동이 생겼다고 보고합니다.
이에 AST allowlist로 실행 전 문법을 검사하는 제한 workspace로 바꿉니다. 변수 저장·인덱싱·슬라이싱·리터럴·f-string·문자열 조작·연결·동등성·포함 검사·출력과 제공 모델 호출 함수 등을 허용합니다. 루프·컴프리헨션·생성기·함수 및 클래스 정의·람다·import·산술·비트 연산·대소 비교·일부 제어 구문 등은 거부합니다. 문맥을 다루는 코디네이션은 유지하면서 실제 문제 계산을 모델 호출로 보내려는 설계입니다. 본문은 이 제한을 사전에 프롬프트에 알립니다.
Full-Python run for Opus 4.8 on LongCoT-mini. 제한 환경의 Opus가 분해 대신 계속 workspace 계산을 시도해 이 셀만 unrestricted 결과를 보고합니다. Table 1의 64.3(별표) 값이 그것입니다. 다른 8개 RLM 셀은 제한 환경입니다. 따라서 별표 셀과 나머지를 같은 실행 능력으로 묶거나, 제한 RLM 결과를 정규 full Python RLM 전체의 결과라고 부르면 안 됩니다.
Budget awareness. 참조 구현에는 호출 예산 인식이 없어 재귀 깊이와 무관하게 모든 모델 호출을 같은 허용량으로 계수합니다. 10% 구간마다 알리고 90%에서 최종 제출을 요구합니다. 종료 방식은 finish가 아니라 answer 사전의 내용과 준비 상태를 설정하는 형태이므로 강제 종료 안내도 이를 따릅니다.
챕터의 핵심 기여: 외부 비교군의 도구 능력·공짜 계산·예산 계수를 명시하며 단일 예외도 표시합니다.
다음 챕터로의 연결: 코딩 외부 비교군의 실제 컨테이너 접근 구성으로 이어집니다. 원문 부록 H
📖 Chapter I: Implementation details: Claude Code and Codex
챕터의 위치와 역할: 제품 이름만으로 비교를 오해하지 않도록 headless 코딩 에이전트의 실행 설정을 밝힙니다.
저자의 서술 순서를 따른 상세 내용:
- Claude Code는
claude -p, Codex는codex exec로 실행합니다. 두 시스템은 같은 문제별 컨테이너에 단일 MCP 도구container_bash로 접근합니다. - 이 도구는 논문 작업자가 사용하는 셸 핸들러를 재사용하므로 출력 잘림, 메모리 제한, 복구 동작이 같습니다. 두 제품의 기본 도구는 꺼 모든 채점 대상 행동이 이 경로를 지나게 합니다.
- Claude Code는 내장 도구를 끄고 해당 MCP만 허용합니다. Codex는 자체 셸이 채점 파일을 쓸 수 없도록
--sandbox read-only로 실행하고 MCP 도구를 호출별 승인합니다. 파일 수정은 컨테이너 셸 명령과 heredoc을 통해 이루어집니다. - 허용량과 턴마다 한 호출이 든다는 정보를 시스템 프롬프트에 넣고, 사용량 10% 구간마다 다음 도구 결과 앞에 예산을 표시합니다.
챕터의 핵심 기여: 외부 시스템의 기본 사용 경험 전체가 아니라, 같은 컨테이너와 제한된 도구 경로에서 평가한 구성임을 분명히 합니다.
전체 리뷰와의 연결: 마지막 부록이므로 별도의 다음 장은 없습니다. 이 설정을 바탕으로 주 결과의 실용적 의미와 일반화 범위를 다시 평가할 수 있습니다. 원문 부록 I
실험 결과 심층 분석
개선 폭은 모델·과제별로 읽어야 합니다
주 예산에서 Direct Control 대비 차이를 모으면 다음과 같습니다. 이는 원문 Table 1에서 리뷰어가 뺄셈한 %p 차이이며 추가 실험값이 아닙니다.
| 모델 | IMO 정규화 점수 | ARC 정확도 | LongCoT 정확도 | ProgramBench 평균 테스트 통과율 |
|---|---|---|---|---|
| Gemini 3.1 Pro | +8.6 | +6.7 | +9.2 | +1.8 |
| GPT-5.5 | +1.3 | +3.4 | +0.4 | +7.8 |
| Opus 4.8 | +2.2 | +2.5 | +1.2 | +1.9 |
GPT-5.5/LongCoT의 0.4%p와 Gemini/LongCoT의 9.2%p는 같은 개선 폭이 아닙니다. 모델별 분포가 다른데 전체 평균만 읽으면 어떤 작업에서 제어에 투자할 가치가 컸는지 사라집니다. GPT-5.5/ProgramBench는 대응 비교 +7.8%p와 Codex 구성 대비 +13.5%p를 함께 보되, 전자는 제어 설계에 더 가까운 비교, 후자는 전체 시스템 구성의 비교라는 차이를 유지해야 합니다.
실험 설계가 분리해 주는 것과 함께 바꾸는 것
동일 작업자와 명목 호출 예산은 단순히 더 강한 모델이나 더 큰 허용량을 줬기 때문이라는 설명을 제한합니다. 컨트롤러 호출까지 과금한 것도 제어 비용을 숨기지 않는 설계입니다. 그러나 실제 사용량과 호출 길이가 다르고, 압축 상태·단계·메모리 접근·종료 계약이 함께 달라집니다. 따라서 결과는 동일 명목 호출 제약 아래에서 평가한 전체 제어 설계의 점수입니다. 토큰당 효율·지연·비용 우세나 네 단계 각각의 인과효과로 읽을 수 없습니다. 부록 A·F
통계적 신뢰도와 정답 진단
논문은 이 성능 차이에 대한 신뢰구간과 유의성 검정을 보고하지 않습니다. 30문제의 증명 집합, 모델별 다른 차이, 낮은 예산의 역전을 고려하면 12개 양의 점 추정치라는 일관성과 모든 개별 차이의 유의성을 구분해야 합니다. 저자도 부록 A에서 양의 점 추정치가 유의성과 일반화를 보장하지 않는다고 명시합니다.
Coverage 개선과 높은 Type-2 AUC는 “올바른 후보를 만들고 알아보는 과정”의 관찰 증거입니다. 하지만 FSG가 모든 설정에서 더 높지 않고, 체스에서는 추가 재고가 이미 맞는 답을 흔든 예비 사례도 있습니다. 이를 함께 읽으면 좋은 컨트롤러는 더 많은 검증을 무조건 수행하는 시스템이 아니라, 어떤 검증과 제출이 가치 있는지 결정하는 시스템이어야 한다는 원문의 문제의식이 드러납니다.
재현성 평가
원문은 과제 수·채점 지표·예산 sweep·단계 및 작업자 프롬프트·메모리와 도구 스키마·RLM 변경·코딩 컨테이너 경로를 공개합니다. 설계와 비교 범위를 이해하는 데 구체적인 정보입니다. 다만 이 리뷰에서는 하네스 코드, 원시 실행 궤적, 모델 호출이나 벤치마크를 독립 실행하지 않았습니다. 논문에 제시된 설정이 실제 모든 실행에서 어떻게 준수됐는지까지 검증했다고 주장하지 않습니다. 공식 구현·데이터 공개 여부도 읽은 원문 범위를 넘어 추정하지 않습니다.
기술적 함의와 응용
원문이 뒷받침하는 함의는 에이전트의 성능을 작업자 모델만으로 설명하기 어렵다는 것입니다. 같은 작업자라도 무엇을 새로 시도하고, 어떤 부분을 검증하며, 무엇을 재사용하고, 언제 제출하는지에 따라 결과가 달라집니다. 이 논문은 이런 결정을 영구 산출물 위의 명시적인 계산으로 만들고, 그 실행을 그래프로 진단하는 방법을 제시합니다.
리뷰어의 응용 해석으로는 장기 분석·코드 수정 시스템에서 작업 결과와 진행 판단을 분리해 보관하는 설계가 유용한 사고 틀입니다. 작업자의 “완료했습니다”라는 보고, 커밋된 실제 변경, 별도 검증의 결과를 같은 사실로 취급하지 않는 부록 B·G의 계약이 특히 중요합니다. 문제를 발견했을 때 새로운 시도·특정 수정·독립 검증·기존 답 제출 중 무엇을 선택할지 명시적으로 비교할 수 있습니다. 이는 논문이 해당 산업 시스템에서 성능을 입증했다는 뜻은 아닙니다.
실제 적용을 해석할 때에는 원문이 밝힌 비용과 실패 경계를 함께 가져와야 합니다. 네 단계 자체의 호출 부담이 있고, 작은 예산에서는 직접 제어보다 낮을 수 있으며, 손실된 상태나 잘못된 평가가 다음 작업에 전파될 수 있습니다. 공유 코드 환경에서는 병렬 수보다 소유권과 검증 경로가 먼저이고, 정답 후보를 확보한 이후에도 추가 작업이 답을 흔들 수 있습니다. 더 오래 실행하는 것과 더 좋은 계산을 수행하는 것은 같은 조건이 아닙니다.
저자들이 명시한 향후 방향은 구성요소별 ablation과 체스 실패의 완전한 분석·목표 개입입니다. 이를 넘어 새로운 한계나 연구 과제를 원문의 주장으로 추가하지 않습니다. 이 연구의 핵심은 계산량 확장에 계산을 지휘하는 능력을 포함시키고, 정답을 찾는 것과 고르는 것을 서로 다른 검증 대상으로 만든 데 있습니다.
분석 범위와 생략한 세부 내용
본문 1–8과 부록 A–I를 모두 반영했으며, 원문 Figures 1·3·5·6의 전체 그림과 관련 상세 영역을 인용했습니다. Figure 2는 Table 1 전체 수치로 대조했고, Figures 4·7·8은 본문의 해당 순서에서 축·통계·해석 범위를 설명했으나 이미지로 재수록하지 않았습니다. 긴 프롬프트와 도구 JSON은 전문을 복제하지 않고 입력·출력·판정·종료 조건을 설명했습니다. 참고문헌 전체 원문과 개별 실행 궤적의 독립 재현은 분석 범위에 포함하지 않았습니다.