논문 개요와 전체 구조
Mixture of Self-Improving Branches for Agent Harness Optimization은 LLM 에이전트를 둘러싼 하네스(harness)를 자동으로 개선할 때, 후보 코드뿐 아니라 후보를 평가하는 개발 문제의 구성과 다음 후보를 만드는 지침까지 함께 바꾸는 연구입니다. 하네스는 모델에 전달할 검색 자료, 사용 가능한 도구, 실행 순서, 검증과 종료 조건을 정하는 프로그램입니다. 따라서 같은 모델도 어떤 하네스에서 실행되는지에 따라 다른 문제 해결 능력을 보일 수 있습니다. 이 논문은 모델의 가중치를 학습하는 대신, 하네스를 작성하고 평가하는 탐색 과정 자체를 적응적으로 구성합니다. 분석 대상은 2026년 9월 29일 제출된 arXiv:2609.37834v1 원문입니다.
저자들은 Meta-Harness의 고정 개발 집합과 고정 제안 지침을 출발점으로 삼아, 서로 다른 개발 부분집합·후보 이력·지침을 가진 탐색 분기(branch)를 만듭니다. 분기마다 잘 해결하는 문제를 비교해 개발 문제의 소속을 바꾸고, 해당 분기의 실행 기록으로 제안 지침을 갱신합니다. 탐색 종료 후에는 각 분기의 개발 성적이 가장 좋은 하네스인 헤드(head)를 남기고, 새 문제를 실행하기 전에 라우터(router)가 헤드 하나를 선택합니다. 수학과 소프트웨어 에이전트라는 평가 범위에서, 서로 보완적인 하네스를 발견하는 과정과 이를 실제 입력에 배치하는 과정을 함께 살펴볼 수 있다는 점이 학습 가치입니다.
논문에서 가장 큰 개선은 Math–Gemini의 46.0%→62.0%입니다. 이는 16.0%p 상승이자 베이스라인 대비 34.8%의 상대 향상입니다. 다만 다른 세 설정의 개선 폭은 더 작고, 라우터가 모든 설정에서 더 강한 헤드를 넘지는 않습니다. 또한 탐색 토큰 예산은 동일하지 않습니다. 따라서 개발 데이터만 사용한 배치 결과, 테스트 결과를 사후에 보고 고른 후보의 성적, 두 헤드가 풀 수 있는 문제의 합집합을 구분해서 읽어야 합니다. 원문 §4.2–4.6, §5
원문의 본문과 부록은 다음 순서로 구성됩니다. 본문의 굵은 문단 제목도 아래 상세 리뷰에서 같은 순서로 설명합니다.
| 구분 | 원문 제목과 하위 구조 |
|---|---|
| 1 | Introduction |
| 2 | Related Work: Self-evolving agents and harnesses → Diversity through adaptive search inputs → Evolving guidance from search experience → Deploying evolved harnesses |
| 3 | Branching Search with Evolving Objectives and Policies: Overview → Branch-local search and proposal generation → Development-driven trajectory evolution → Branch-specific proposal adaptation → Development-informed routing → Full search and deployment pipeline |
| 4 | Experiments: 4.1 Experimental Setup → 4.2 Performance of Development-Selected Systems → 4.3 How Branches Develop Different Search Trajectories → 4.4 Router Analysis → 4.5 Method Ablation Studies → 4.6 Test Performance Analysis |
| 5 | Conclusion, 이어서 AI use statement와 References |
| A | Token Accounting |
| B | Development-Set Changes and Head Selection: B.1 Subset Histories Across Settings → B.2 How Subset Changes Redirect Head Selection |
| C | Proposal-Guidance Updates: C.1 Full Update Prompts(수학, Terminal-Bench 2.0) → C.2 Concrete Gradient-Update Examples |
| D | Router Analysis: D.1 Router Instructions → D.2 Router Context and Prompt Ablations |
| E | Discovered Harness Mechanisms: E.1 Math–Gemini → E.2 Math–Sonnet → E.3 Terminal-Bench 2.0 → E.4 SWE-bench Lite |
핵심 기여와 혁신성
하네스 탐색에서 중요한 문제는 평균 점수가 가장 높은 후보를 계속 발전시키는 동안, 다른 문제를 풀 수 있는 후보의 장점이 충분히 발전하지 못할 수 있다는 것입니다. 저자들은 같은 개발 문제와 같은 제안 지침을 반복 사용하는 방식이 탐색을 한 경로로 유도할 수 있다고 설명합니다. 이는 이 논문이 제시하는 연구 동기이며, 모든 고정 개발 집합 기반 탐색이 반드시 국소 최적점에 빠진다는 증명은 아닙니다. 원문 §1–2
첫 번째 기여는 후보를 채점하는 문제의 구성 자체를 분기별로 진화시키는 방법입니다. 각 분기의 상위 후보들이 어떤 문제를 더 잘 푸는지 비교하고, 상대적 우위가 있는 분기에 그 문제를 남깁니다. 새로운 보상 함수를 설계하지 않아도, 평균 보상을 계산하는 사례 집합이 바뀌면 선호되는 후보와 후속 탐색의 출발점이 바뀔 수 있습니다. 두 번째 기여는 분기별 제안 지침의 갱신입니다. 지침은 해당 분기의 성공과 실패를 기록하고 다음에 어떤 변화를 시도할지 안내하며, 분기별 목표 변화와 함께 작동합니다. 원문 §3
세 번째 기여는 개발 데이터로 선택한 전문가를 실행 전에 라우팅하는 배치 방식입니다. 서로 다른 개발 부분집합에서 얻은 평균 점수를 직접 비교해 전역 최고 후보를 정하는 대신, 분기별 헤드를 모두 유지하고 문제마다 하나를 고릅니다. 네 번째 기여는 수학 두 모델, Terminal-Bench 2.0, SWE-bench Lite에서 이 전체 구성을 평가했다는 점입니다. 리뷰어의 해석으로는, 이 연구의 독창성은 분기를 여러 개 실행한다는 사실보다 문제 소속과 제안 지침을 서로 맞물리게 갱신하고, 그 결과를 개발 정보만 사용하는 배치 체계로 연결한다는 데 있습니다. 논문은 이 설정에서의 성능 향상을 보여 주며, 동일 비용에서의 우월성까지 확립하지는 않습니다. 원문 §4–5
기술적 세부사항
이 방법에서 역할은 세 가지로 나뉩니다. 행동 모델은 실제 수학 풀이 또는 코딩 작업을 수행하는 LLM입니다. 제안자는 과거 하네스 코드·점수·실행 궤적을 읽고 새 하네스 코드를 작성하는 LLM이며, 논문은 Claude Opus 4.6을 사용합니다. 라우터는 탐색이 끝난 뒤 새 문제를 어느 헤드에 보낼지 고르며 행동 모델을 사용합니다. 제안 지침의 갱신도 같은 제안자가 담당하므로, 여기서 자기 개선은 모델 가중치 갱신이 아니라 실행 가능한 하네스와 외부 지침의 변화입니다. 원문 §3
분기별 상위 후보 집합을 프런티어(frontier)라고 부릅니다. 한 문제를 푸는 프런티어 후보의 수가 커버리지 투표이며, 소유권 마진은 다른 분기보다 최소 몇 표 앞서야 문제를 독점적으로 남길지 정합니다. 모든 분기의 모든 프런티어 후보가 푸는 문제는 전체 탐색에서 제거합니다. 어느 분기도 충분히 앞서지 않으면 기존 소속을 유지합니다. 기본값은 분기 2개, 반복 20회, 프런티어 크기 5개, 소유권 마진 2표이며, 개발 부분집합은 매 반복, 제안 지침은 5회마다 갱신합니다. 중요한 목적식과 판단식은 아래 Chapter 3에서 항별로 해설합니다. 원문 §3, §4.1
평가는 검색 가능한 풀이 코퍼스를 이용하는 올림피아드 수학, 터미널 작업 완료, GitHub 이슈 해결로 구성됩니다. 수학은 정답률, 터미널은 작업별 검사를 통과한 비율, SWE-bench는 테스트로 확인한 이슈 해결률을 보고합니다. 이진 성공률이 같더라도 문제 수와 작업 성격은 다르므로 지표를 단순한 공통 난이도 척도로 해석해서는 안 됩니다. 또한 학습 사례로 제공되는 전문가 출력은 개발 문제에 대한 과거 출력입니다. 새 테스트 문제에서 두 전문가를 먼저 실행한 뒤 정답을 고르는 구조가 아닙니다. 원문 §4.1, 부록 D.1
챕터별 상세 리뷰
📖 Chapter 1: Introduction
이 장은 하네스를 최적화하는 이유에서 출발해, 고정된 평가 대상과 제안 지침을 함께 적응시켜야 한다는 질문으로 이어집니다. 먼저 검색, 도구 인터페이스, 제어 흐름이 모델이 받는 정보와 실행 가능한 행동, 검증·수정 시점을 결정한다고 설명합니다. 모델 자체의 성능만으로 에이전트 능력을 설명하기 어려운 이유입니다. 이어 기존 연구의 추론·피드백 기법과 자동 워크플로 설계를 소개하고, 코드·점수·실행 기록을 읽어 하네스를 반복 수정하는 Meta-Harness를 실용적인 재귀적 자기 개선(RSI)의 사례로 위치시킵니다.
저자들은 다음으로 고정 개발 집합이 가진 선택상의 문제를 제시합니다. 현재 선두 후보가 풀지 못하는 문제를 해결하는 후보도 전체 평균이 낮으면 후속 개선의 중심에 서지 못할 수 있습니다. 고정 제안 지침 역시 탐색 중 새롭게 드러난 강점과 미해결 실패에 맞추어 우선순위를 명시적으로 바꾸지 않습니다. 여기서 연구 질문은 개발 부분집합과 제안 지침을 분기마다 적응시키면 상호 보완적인 하네스와 더 나은 배치 성능을 얻을 수 있는지입니다.
해결책은 사전에 수학 분야나 작업 유형을 나누는 것이 아니라, 탐색 중 관찰한 해결 능력으로 문제 소속을 바꾸는 것입니다. 여러 선두 후보가 한 문제를 얼마나 자주 푸는지 비교해 유리한 분기에 남기고, 모두가 푸는 문제는 제거합니다. 이어 분기별 지침에 도움이 된 수정, 반복 실패, 남아 있는 문제를 기록합니다. 따라서 한 분기는 외부 풀이의 구체적 증거를 이용하는 방향으로, 다른 분기는 풀이 구성과 검증 구조를 바꾸는 방향으로 발전할 수 있습니다.
마지막으로 저자들은 배치 선택의 문제를 연결합니다. 서로 다른 개발 부분집합에서 얻은 점수는 곧바로 비교할 수 없고, 테스트 점수로 최고 하네스를 고르는 방식은 새 문제를 푸는 시점에 사용할 수 없습니다. 이에 각 분기의 개발 최고 헤드를 유지하고 실행 전에 입력별로 라우팅합니다. 이 장의 네 기여는 동적 개발 부분집합, 분기별 제안 적응, 배치 가능한 전문가 라우팅, 네 평가 설정에서의 성능 향상입니다. 다음 장은 각각을 기존 자기 진화·다양성 탐색·지침 최적화·라우팅 연구와 비교합니다. 원문 §1
📖 Chapter 2: Related Work
Self-evolving agents and harnesses. 저자들은 실행 프로그램과 워크플로를 최적화 대상으로 삼는 자동 에이전트 설계에서 시작합니다. Meta-Harness는 영속 파일시스템의 구현·점수·실행 기록을 제안자가 살펴보게 하는 기본 탐색 틀이며 주요 비교 대상입니다. Self-Harness는 실패 패턴에 맞춘 수정과 회귀 검사를 사용하고, 다른 연구들은 온라인 적응이나 구성요소의 공동 진화를 탐구합니다. 이 논문의 차별점은 그러한 진화를 어떤 방향으로 이끌지에 있습니다. 분기 간 프런티어 커버리지를 비교해 개발 집합을 바꾸므로, 어떤 후보가 선택되고 확장되는지도 달라집니다.
Diversity through adaptive search inputs. 이어 novelty search와 quality-diversity search처럼 다양한 후보를 보관하는 계보를 설명합니다. AlphaEvolve의 대안 프로그램 데이터베이스나 AgenticGEO의 행동 셀은 후보를 평가하고 유지하는 방식으로 다양성을 장려합니다. 반면 이 논문은 후보를 만드는 데 영향을 주는 평가 사례 집합을 바꿉니다. 과제별 성공 보상 자체는 유지하지만 평균을 계산하는 문제가 달라져 분기별 목표가 달라진다는 구분입니다. 리뷰어의 해석으로는 이는 다양성을 최종 후보의 분포만으로 관리하지 않고, 후보가 성장하는 평가 환경에 반영하는 접근입니다.
Evolving guidance from search experience. 세 번째 문단은 실행 피드백을 이용하는 프롬프트·프로그램 최적화와 탐색 경험을 지침으로 정리하는 연구를 연결합니다. DREvo가 과거 증거를 탐색 방향으로 정리하고 SkillOpt가 점수가 있는 롤아웃으로 외부 스킬 지침을 갱신한다는 맥락에서, 저자들은 분기별 성공과 미해결 실패를 별도의 제안 우선순위로 바꿉니다. 여기서 중요한 것은 모든 분기에 하나의 전역 교훈을 동일하게 적용하는 것이 아니라, 달라지는 개발 목표에 맞추어 로컬 지침을 유지한다는 점입니다.
Deploying evolved harnesses. 마지막 문단은 탐색 문제와 최종 평가 문제가 겹칠 때 일반화 성능을 과대평가할 수 있다는 선행 연구의 문제의식으로 이동합니다. 저자들은 개발 데이터만으로 하네스를 고르고 별도 테스트에서 성적을 보고합니다. 분기별 개발 점수의 직접 비교가 어렵기 때문에 입력별 모델 선택과 전문가 라우팅의 원리를 사용합니다. 이 라우팅은 모델 내부 토큰 라우팅과 같은 더 넓은 전문가 선택 계보에 놓이지만, 이 논문의 선택 단위는 실행 가능한 하네스입니다. 이 장은 관련 연구의 위치를 정리하며 다음 장의 목적식·문제 소속 갱신·배치 절차를 준비합니다. 인용된 선행 논문의 원문 전체를 별도로 검토한 것은 아닙니다. 원문 §2
📖 Chapter 3: Branching Search with Evolving Objectives and Policies
Overview. 이 장은 탐색과 배치를 하나의 절차로 정의합니다. 탐색 중에는 여러 분기가 각자의 개발 부분집합과 제안 지침을 바꾸며 새 하네스를 생성합니다. 배치 시에는 라우터가 새 입력을 한 분기의 전문가로 보냅니다. 그림 1의 상단은 지침 수정, 가운데는 후보 생성과 평가, 오른쪽은 사례 소속 판정, 하단은 배치 시 선택을 나타냅니다.
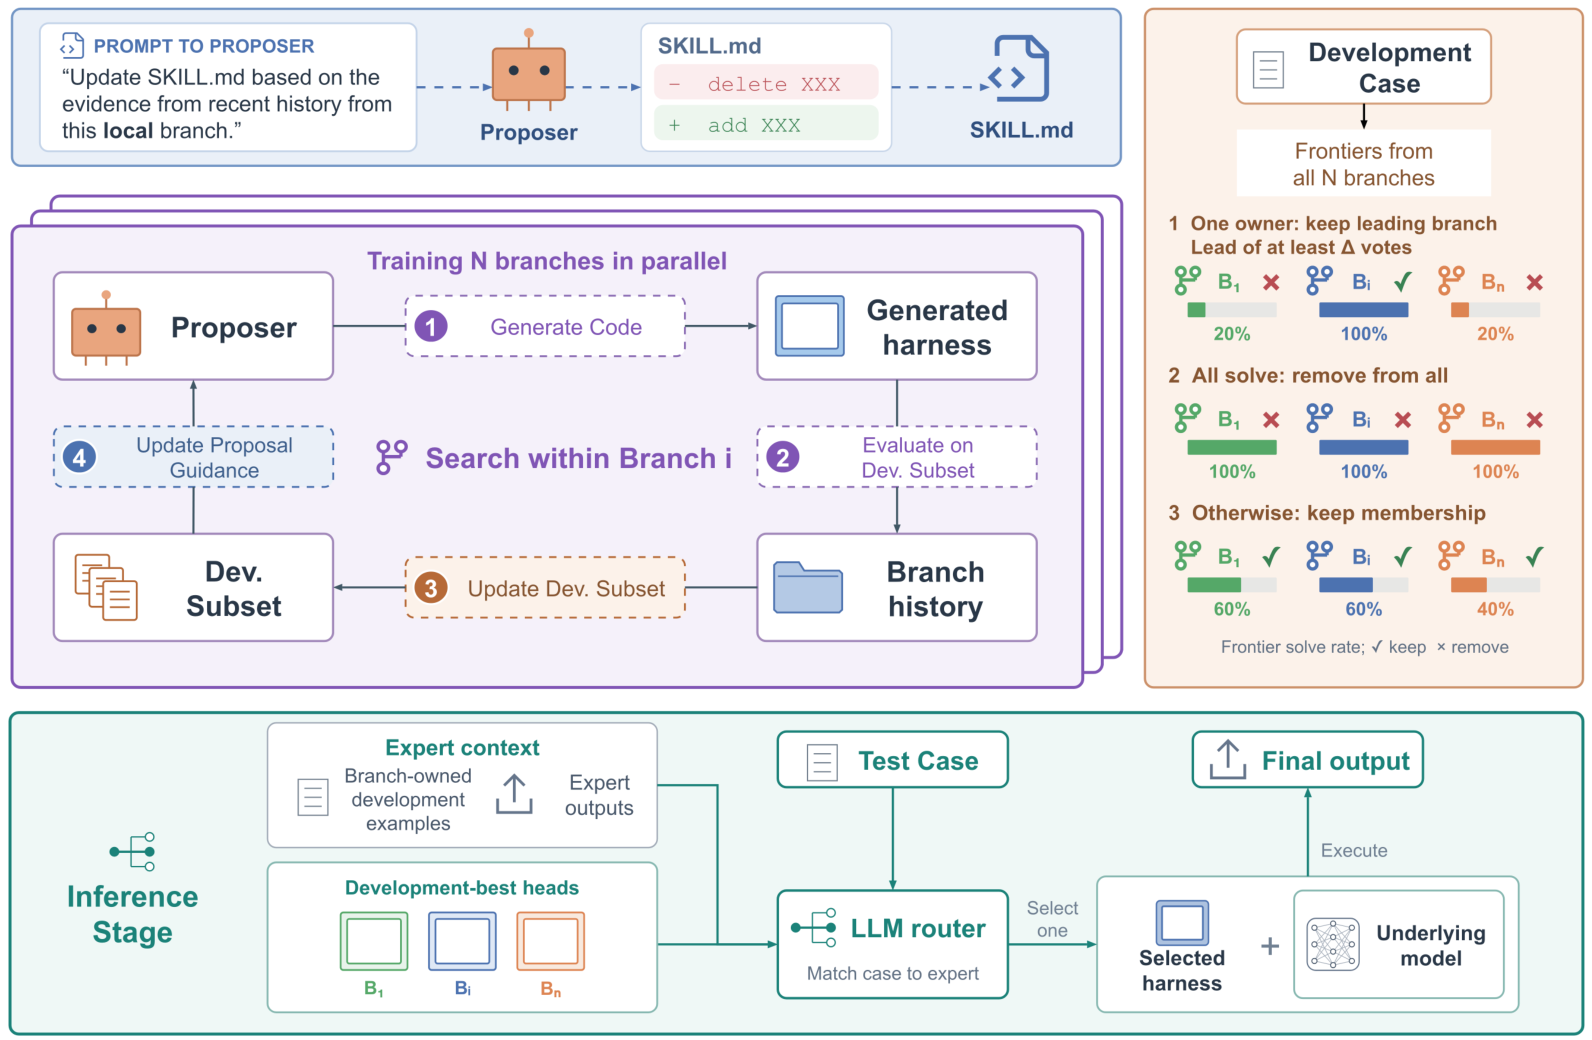
그림 1. 원문 Figure 1, PDF 3쪽. 2609.37834v1 PDF에서 그림 영역만 크롭했으며, 원본의 모든 패널·범례·문구를 보존했습니다. 번역·재배열 없이 인용합니다. 원문 라이선스는 CC BY 4.0입니다. 전체 구조를 확인한 뒤 아래 상세 패널에서 분기 내부 흐름과 소속 규칙을 읽을 수 있습니다.
Branch-local search and proposal generation. 하네스를 $H$, 행동 모델을 $M$, 코드 제안자를 $P$로 둡니다. 전체 개발 집합 $\mathcal X$ 중 반복 $t$에서 분기 $b$가 평가하는 부분집합은 $\mathcal X_b^t$입니다. 해당 분기의 후보 집합 $\{H\}_b^t$, 소스·점수·실행 궤적을 담는 파일시스템 $\mathcal D_b^t$, SKILL.md에 저장되는 제안 지침 $S_b^t$가 분기의 상태를 이룹니다. 모든 분기는 같은 시드 하네스, 전체 개발 집합, 초기 지침에서 시작합니다. 처음부터 다른 작업 유형을 강제하는 방식이 아닙니다.
원문 식 (1)에서 $f_M(H,x)$는 모델 $M$을 하네스 $H$로 문제 $x$에 실행한 궤적이며, $r$는 그 실행의 과제 보상입니다. 기댓값은 실행의 확률성을 대상으로 합니다. 분모는 현재 분기에 남은 사례 수이므로, 같은 코드라도 부분집합이 바뀌면 목적값이 달라질 수 있습니다. 논문은 관찰 보상의 평균으로 이 목적값을 추정하고, 가장 높은 후보를 헤드 $\widehat H_b^t$로 선택합니다. 기댓값 표기가 모든 실험에서 충분한 반복 추정이나 신뢰구간을 제공했다는 뜻은 아닙니다.
매 반복 제안자는 기존 후보와 현재 개발 점수의 쌍을 읽습니다. 그 뒤 로컬 파일시스템의 실행 기록과 산출물 중 무엇을 조사할지 정하고, 지침을 따라 새 코드와 설계 근거를 작성합니다. 새 하네스는 현재 부분집합에서 평가되며 구현·점수·실행 기록이 이후 제안에 사용할 증거로 추가됩니다. 따라서 제안자는 텍스트 프롬프트만 고치는 것이 아니라 검색 경로, 풀이 결합, 도구 루프, 종료 제어 같은 프로그램 수준의 변화를 만들 수 있습니다.
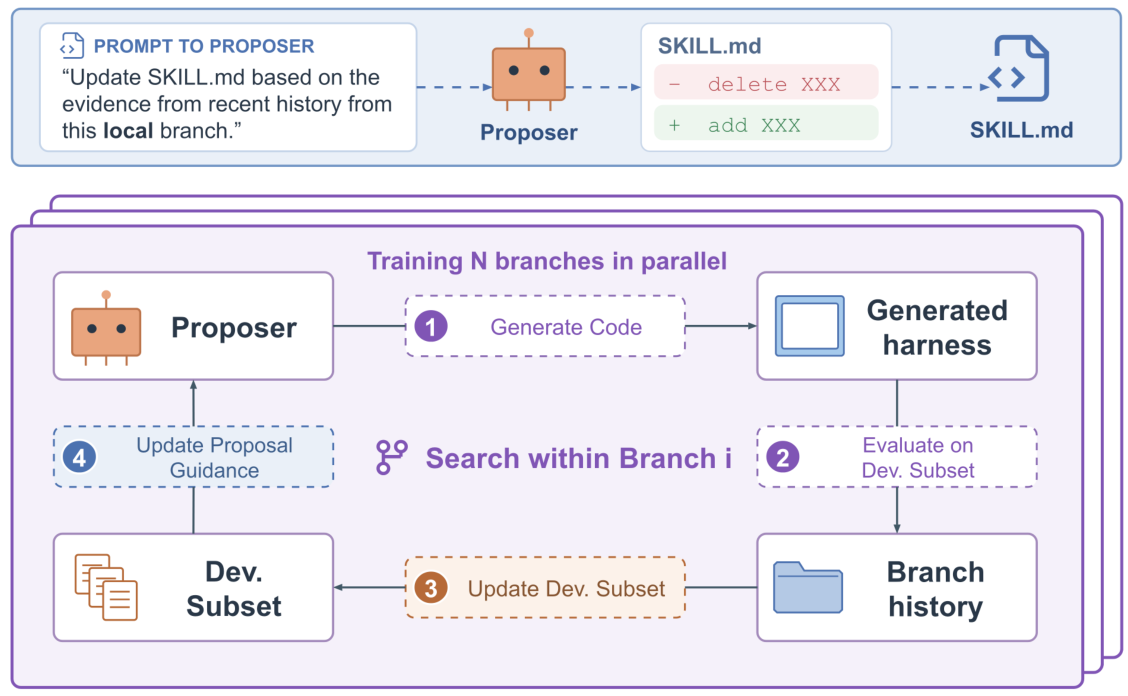
그림 1 상세. 원문 Figure 1의 왼쪽과 상단, PDF 3쪽을 크롭했습니다. 같은 그림의 분기 내부 흐름을 확대해 읽기 위한 인용이며, 패널 안의 요소를 변경하지 않았습니다. 고정 버전 출처
Development-driven trajectory evolution. 다음으로 개발 부분집합이 후보를 선호하는 기준을 바꾼다는 점을 형식화합니다. 각 분기의 프런티어 $\mathcal F_b^t$는 현재 부분집합 평균 보상으로 정렬한 상위 $q$개 하네스입니다. 코드가 그대로여도 평가 집합이 바뀌면 순위와 프런티어 구성은 달라질 수 있습니다. 한 문제에 대한 분기별 커버리지 투표는 다음과 같습니다.
원문 식 (2)의 $\mathbb 1$은 후보가 문제를 풀면 1, 그렇지 않으면 0인 지시함수입니다. $c_b^t(x)$는 한 헤드의 단일 성공 여부가 아니라 상위 후보 집합 중 성공한 후보 수를 셉니다. 이를 이용하는 판정에는 우선순위가 있습니다. 모든 분기에서 모든 프런티어 후보가 성공한 문제를 먼저 전체 부분집합에서 제거합니다. 어느 한 분기의 후보들이 모두 성공했다는 이유만으로 전체 삭제하지는 않습니다.
그 밖의 문제는 다음 소유권 조건으로 비교합니다.
왼쪽은 분기 $b$의 성공 표 수에서 다른 분기 중 가장 큰 표 수를 뺀 값이며, $\Delta$는 최소 우위입니다. 기본 $q=5$, $\Delta=2$에서는 두 분기의 성공 후보 수가 최소 2개 차이 나야 합니다. 조건을 만족한 분기에 문제를 남기고 다른 분기에서 제거합니다. 어느 분기도 조건을 만족하지 않으면 기존 소속을 유지합니다. 남은 문제를 매번 모든 분기에 재배분하거나, 아무도 풀지 못하는 문제를 무조건 삭제하는 규칙이 아닙니다.
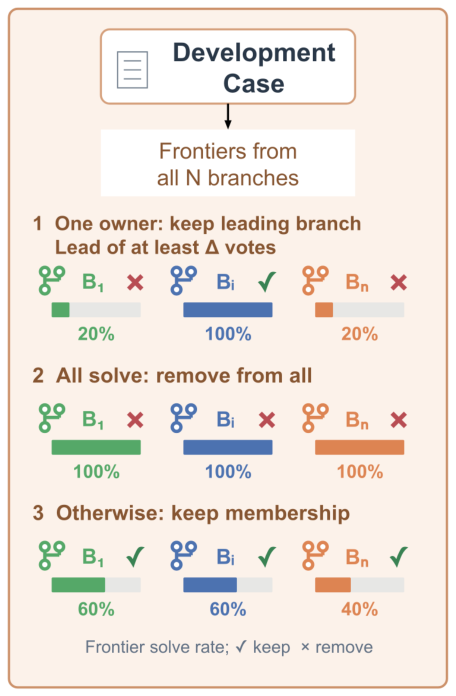
그림 1 상세. 원문 Figure 1의 오른쪽 소속 판정 패널, PDF 3쪽을 그대로 크롭했습니다. 그림의 퍼센트는 프런티어 성공 비율을 나타내며, 소유권 마진은 본문의 투표 수 차이로 정의됩니다. 고정 버전 출처
이 규칙은 각 분기가 이미 드러낸 상대적 강점을 계속 발전시킬 기회를 만듭니다. 저자들은 사전에 정한 작업 분류 없이도 서로 다른 탐색 목표를 만들 수 있다고 설명합니다. 다만 개발 부분집합이 다르므로 한 분기의 높은 평균 점수를 다른 분기의 낮은 평균보다 우월한 전체 성능으로 바로 해석해서는 안 됩니다. 평가 분모와 포함된 문제가 서로 다르기 때문입니다.
Branch-specific proposal adaptation. 개발 목표가 달라지면 공통 초기 지침이 각 분기의 남은 문제를 충분히 안내하지 못할 수 있습니다. 이에 같은 제안자 $P$가 최근 탐색 기록과 현재 지침을 읽어 $S_b^t$를 수정합니다. 부록 C.1의 프롬프트는 같은 개발 단계 안에서 후보를 비교하고, 한 구현의 성공·실패와 여러 구현에서 반복된 증거를 구분하도록 요구합니다. 개발 집합 갱신이 어떤 능력에 보상을 주는지 바꾼다면, 지침 갱신은 그 로컬 경험을 다음 시도의 우선순위로 바꿉니다. 여기서 optimizer update는 모델 가중치 최적화를 뜻하지 않습니다.
Development-informed routing. 탐색 종료 후 각 분기는 최종 부분집합에서 평균 보상이 가장 높은 헤드를 남깁니다. 라우팅 사례는 최종 헤드 중 정확히 하나만 해결한 개발 문제에서 만들며, 성공한 헤드가 정답 라벨입니다. 라우터는 전문가 소스 코드, 그 개발 사례, 두 전문가가 해당 개발 사례에서 낸 출력을 문맥으로 받습니다. 이어 GEPA로 라우팅 지침을 최적화합니다. GEPA는 이 문맥에서 개발 피드백으로 지침을 진화시키는 프롬프트 최적화 도구이며, 이 논문에서는 성공 헤드 라벨을 가진 개발 자료를 사용합니다.
새 입력에서는 라우터가 문제를 보고 전문가 하나를 실행 전에 선택합니다. 새 문제에 대한 전문가 출력이나 정오답 피드백은 이 선택의 입력이 아닙니다. 따라서 개발 사례의 전문가 출력이 문맥에 포함된다는 사실과 테스트 문제의 두 출력을 미리 관찰한다는 주장을 혼동하면 안 됩니다. 두 전문가의 실제 테스트 성공 여부를 알고 고르는 오라클은 비교용 상한일 뿐 배치 알고리즘이 아닙니다.
Full search and deployment pipeline. Algorithm 1은 앞선 구성요소를 실행 순서로 묶습니다. 시드 하네스를 평가해 기록을 복제한 뒤 모든 분기를 초기화합니다. 각 반복에서 분기들은 병렬로 후보를 하나씩 생성·평가하고 후보 집합과 이력을 확장합니다. 각 분기에 최소 $q$개 후보가 모인 후 개발 갱신 주기 $C_p$에 맞추어 프런티어 비교와 부분집합 가지치기를 수행합니다. 제안 지침은 $C_s$마다 수정합니다. 두 갱신이 같은 반복에 예정되면 개발 부분집합을 먼저, 지침을 나중에 바꾸고 다음 반복에서 두 갱신 상태를 사용합니다. $N$회 탐색이 끝나면 최종 헤드와 개발 증거로 라우터를 구성합니다.
이 장의 핵심은 평가 집합, 후보 순위, 제안 지침이 연결된 상태 전이라는 점입니다. 원문 알고리즘 전체를 그대로 옮기는 대신 위 순서로 읽으면, 어떤 갱신이 무엇을 바꾸는지와 라우터가 언제 만들어지는지 명확해집니다. 다음 장은 이 구성이 실제 배치 성능과 서로 다른 탐색 궤적을 만드는지 평가합니다. 원문 §3, 식 (1)–(2), Algorithm 1
📖 Chapter 4: Experiments
이 장은 개발 데이터로 선택한 시스템의 배치 성능부터 제시한 뒤, 분기 궤적과 상보성, 라우터, 구성요소 제거 실험, 사후 테스트 최고 후보 분석으로 이동합니다. 이 순서를 지키는 이유는 배치 가능한 결과와 진단용 분석의 평가 질문이 다르기 때문입니다. 이하 Math–Gemini와 Math–Sonnet은 수학 벤치마크의 행동 모델을 구분하는 표기입니다.
4.1 Experimental Setup
Mathematical reasoning. Meta-Harness의 검색 증강 수학 설정을 따르며, 하네스는 50만 개가 넘는 문제의 풀이 코퍼스에서 자료를 검색할 수 있습니다. 개발 문제는 250개, 별도 IMO 수준 테스트 문제는 200개입니다. Gemini 3 Flash와 Claude Sonnet 4.5를 행동 모델로 각각 평가합니다. BM25는 질의와 문서 사이의 어휘 기반 관련성을 계산하는 검색 방법이며, 이 실험에서는 전체 코퍼스 또는 기하 문제로 제한한 코퍼스에서 참고 풀이를 찾는 고정 기준선으로 사용됩니다. 수학 정확도는 검색 능력과 검색된 풀이를 사용하는 제어 구조가 결합된 결과입니다.
Terminal-Bench 2.0. 실제적인 소프트웨어 환경에서 긴 작업을 수행하는 에이전트를 평가합니다. 총 88개 작업을 무작위로 개발 30개와 테스트 58개로 나누고, 행동 모델은 Claude Sonnet 4.5로 고정합니다. 작업별 검사로 완료 여부를 판정합니다. 한 문제의 성공 차이는 약 1.72%p이므로, 뒤의 1.7%p 차이를 여러 문제에서의 큰 우위처럼 읽지 않아야 합니다.
SWE-bench Lite. GitHub 이슈, 저장소 스냅샷, 실행 가능한 테스트를 묶은 300개 작업을 개발 50개와 테스트 250개로 무작위 분할합니다. 행동 모델은 Claude Sonnet 4.5이며 생성 패치를 벤치마크 테스트로 평가합니다. 테스트 한 문제는 0.4%p에 해당합니다. 이 설정에서 이슈 해결률은 에이전트가 그 테스트 조건을 만족한 비율입니다.
Baselines. 수학의 고정 기준선은 no-memory, few-shot, BM25-all, BM25-geometry입니다. 각각 참고 기억 없이 풀기, 예시를 제공한 프롬프팅, 전체 코퍼스 검색, 기하 코퍼스 검색에 해당합니다. Terminal-Bench는 Terminus 2와 Terminus-KIRA, SWE-bench는 수정하지 않은 mini-swe-agent와 비교합니다. 자동 탐색 기준선 Meta-Harness는 개발 집합과 제안 지침을 고정합니다. 이처럼 고정 하네스와 탐색 하네스를 모두 비교하므로, 하네스 탐색 자체의 이점과 분기 적응을 추가한 차이를 구분할 수 있습니다.
Implementation details. 기본적으로 Meta-Harness는 전체 개발 집합에서 하네스 하나를 선택하고, 제안법은 분기별 최종 개발 부분집합에서 선택한 헤드들을 기본 라우터로 결합합니다. 분기 수 $B=2$, 반복 수 $N=20$, 프런티어 크기 $q=5$, 소유권 마진 $\Delta=2$이며 분기당 매 반복 후보 하나를 생성합니다. 개발 갱신은 $C_p=1$, 지침 갱신은 $C_s=5$입니다. 따라서 동일한 20회 반복이라는 표현이 동일한 후보 수나 동일한 전체 토큰 예산을 뜻하지 않습니다. 실제 토큰 사용량은 부록 A가 별도로 보고합니다. 원문 §4.1
4.2 Performance of Development-Selected Systems
원문 Table 1은 테스트 결과로 하네스를 선택하지 않은 배치 성능을 비교합니다. 아래 표는 네 설정을 가로로 배치한 원문 수치를 그대로 옮겼습니다. 대시는 해당 설정의 기준선으로 보고하지 않았다는 뜻입니다.
| 방법 | Math–Gemini 정확도 | Math–Sonnet 정확도 | Terminal-Bench 완료율 | SWE-bench 해결률 |
|---|---|---|---|---|
| No-memory | 34.0% | 24.5% | — | — |
| Few-shot | 40.0% | 23.0% | — | — |
| BM25-all | 40.5% | 25.0% | — | — |
| BM25-geometry | 46.5% | 27.0% | — | — |
| Terminus 2 | — | — | 34.5% | — |
| Terminus-KIRA | — | — | 43.1% | — |
| mini-swe-agent | — | — | — | 62.8% |
| Meta-Harness | 46.0% | 29.0% | 44.8% | 63.6% |
| 제안법: 개발 선택 헤드+라우터 | 62.0% | 30.5% | 50.0% | 66.0% |
출처: 원문 Table 1, PDF 6쪽. 고정 버전 PDF
제안법은 각 설정의 가장 강한 고정 기준선보다 높습니다. 상대 향상은 BM25-geometry 대비 수학에서 33.3%와 13.0%, Terminus-KIRA 대비 16.0%, mini-swe-agent 대비 5.1%입니다. 다만 Math–Gemini에서는 개발 선택 Meta-Harness 46.0%가 고정 BM25-geometry 46.5%보다 낮다는 사실도 표에 남아 있습니다. 자동 탐색을 실행했다는 이유만으로 모든 고정 기준선을 항상 넘는다고 일반화할 수는 없습니다.
Meta-Harness 대비 차이는 차례로 16.0%p, 1.5%p, 5.2%p, 2.4%p입니다. 논문이 보고하는 상대 향상 34.8%, 5.2%, 11.6%, 3.8%는 이 차이를 해당 Meta-Harness 점수로 나눈 값입니다. 저자들은 수학과 코딩 모두에서의 상승을 적용 가능성의 근거로 해석합니다. 가장 큰 상승은 Math–Gemini에 집중되므로, 네 설정에서 모두 같은 규모의 효과를 얻었다고 요약해서는 안 됩니다. 원문 §4.2
4.3 How Branches Develop Different Search Trajectories
이 절은 Math–Gemini의 탐색을 구체적으로 살펴본 뒤 네 설정의 최종 헤드 상보성으로 확장합니다. 분기 1은 제안 답이 문제의 조건을 만족하는지 직접 확인하고, 필요한 논증 유형에 따라 경로를 정하는 방향으로 발전합니다. 분기 2는 JSON 형식 제약을 완화한 자유로운 유도, 구성과 필요조건을 분리하는 two-sided closure, 두 풀이가 합의해도 공통 오류를 점검하는 agreement challenge로 발전합니다. 같은 시드에서 출발한 분기들이 검증과 구성에 다른 중점을 둔다는 사례입니다.
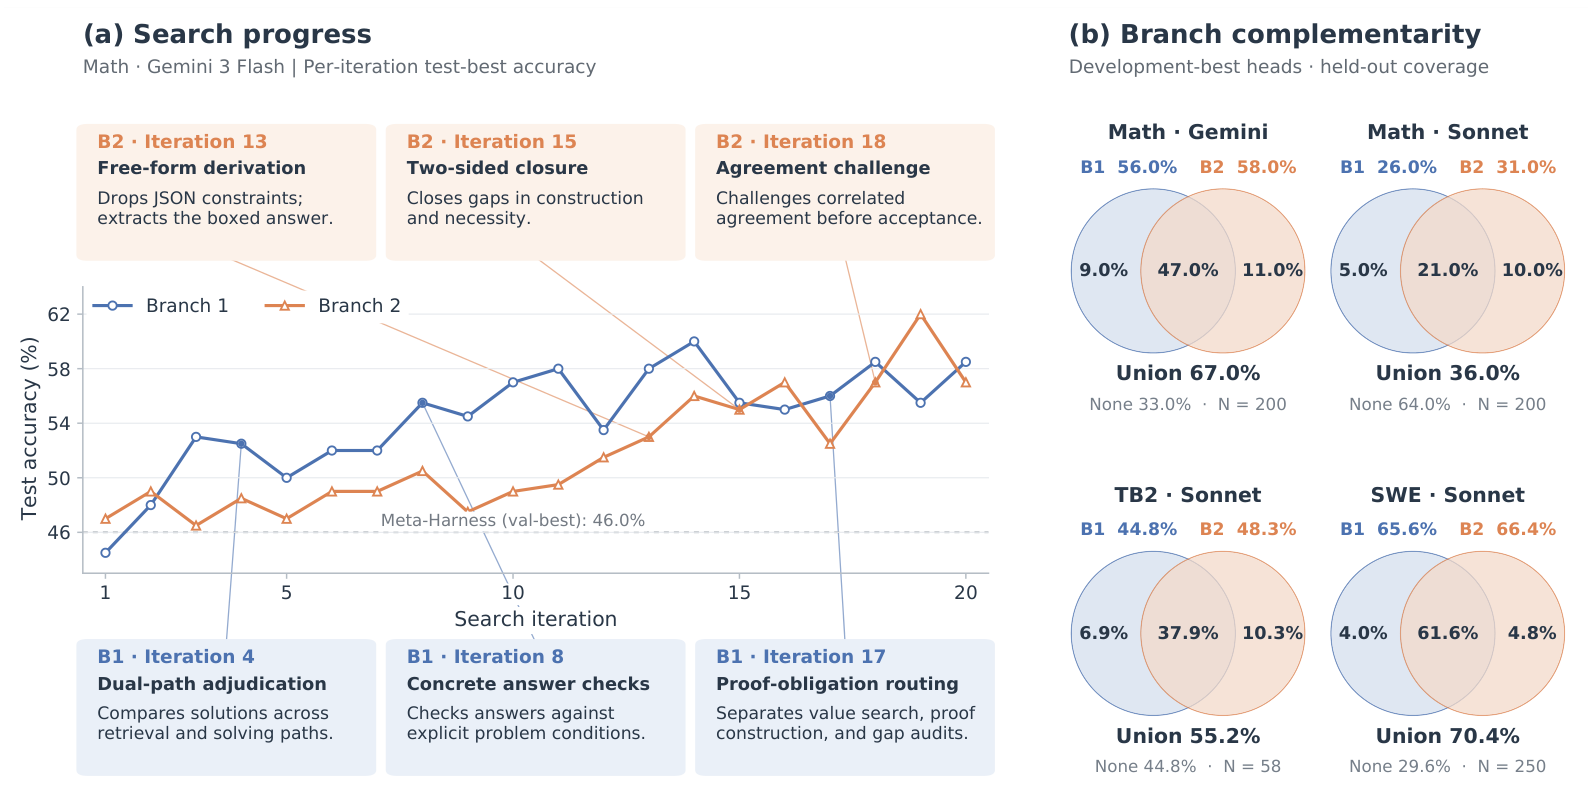
그림 2. 원문 Figure 2, PDF 7쪽의 전체 그림을 크롭했습니다. 왼쪽은 반복별 test-best 진단, 오른쪽은 개발 선택 헤드의 테스트 커버리지입니다. 축·범례·모든 패널을 보존했으며, 벤 다이어그램 면적은 원문에서 도식적 표현이라고 명시합니다. 고정 버전 출처
구체적인 전환은 반복 13에서 발생합니다. 분기 2가 개발 사례 4개를 제거해 부분집합이 44개에서 40개로 줄었고, 같은 반복에 자유 형식 유도 하네스가 기하 검색 기반 헤드를 대체합니다. 이후 후보는 자유 형식 유도에 점진적 보완과 양면 논증을 연결합니다. 반복 15 후의 지침에서도 차이가 드러납니다. 분기 1은 검색된 풀이에서 구체적 재료를 추출하는 방향, 분기 2는 유도 구조를 재설계하는 방향을 우선합니다. 원문은 기록된 전환과 후속 설계의 연결을 보여 주며, 이 사건 하나만으로 이후 테스트 향상의 인과 효과를 분리해 증명하지는 않습니다.
분기 1의 검증 사례는 십진 표기가 모두 1인 양의 정수를 같은 형태의 정수로 보내는 실수계수 다항식의 전체 집합을 찾는 문제입니다. 답의 한 계열을 발견하는 것과 가능한 모든 답을 빠짐없이 포함하는 것은 다릅니다. 두 후보가 다항식 형태에는 합의했지만 매개변수의 음수 허용 여부에 이견을 보이자, 하네스는 제외된 다음 예를 검사합니다.
원문 §4.3의 이 다항식은 $k$자리 repunit, 즉 모든 자릿수가 1인 수를 $2k-1$자리 repunit으로 보냅니다. $x$는 입력 repunit이고 $k$는 그 자릿수입니다. 저자들은 이 반례가 불필요한 매개변수 제한을 드러내 더 넓고 올바른 답 계열을 유지하게 했다고 설명합니다. 이 사례는 정답 후보의 형식적 합의만으로는 놓칠 수 있는 답 범위 누락을 구체적 검사가 복구한 예입니다.
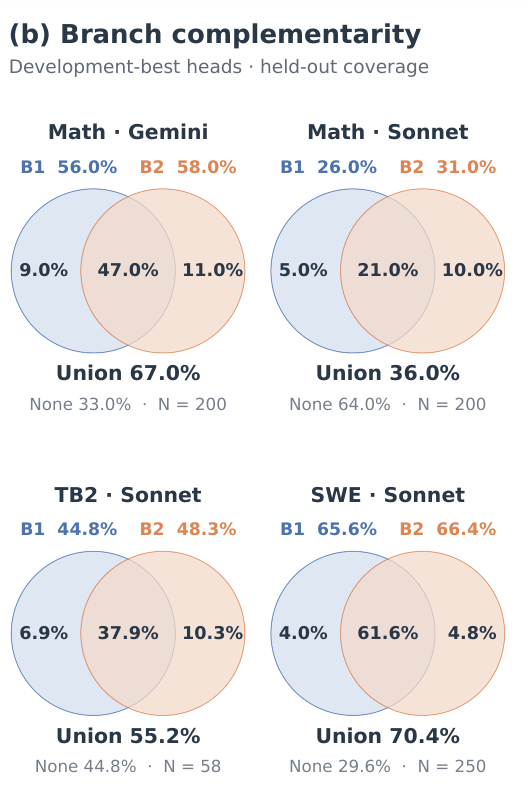
그림 2 상세. 원문 Figure 2(b), PDF 7쪽을 크롭했습니다. 각 비율의 분모는 해당 전체 테스트 집합이며 두 원의 면적은 정확한 비례를 뜻하지 않습니다. 이 합집합은 배치 라우터의 성적이 아니라 성공 전문가를 항상 아는 오라클 상한입니다. 고정 버전 출처
Math–Gemini에서 헤드 1만 푼 비율은 9.0%, 둘 다 푼 비율은 47.0%, 헤드 2만 푼 비율은 11.0%이므로 합집합은 67.0%입니다. Math–Sonnet은 5.0%·21.0%·10.0%로 합집합 36.0%, Terminal-Bench는 6.9%·37.9%·10.3%로 합집합 55.2%, SWE-bench는 4.0%·61.6%·4.8%로 합집합 70.4%입니다. 원문 표기에는 반올림이 적용됩니다. 네 설정 모두 각 헤드만 푸는 문제가 있고, 합집합은 더 강한 단일 헤드보다 4.0–9.0%p 높습니다. 상보성을 확인했다는 사실과 라우터가 그 상보성을 모두 활용했다는 사실은 구분해야 합니다. 원문 §4.3, Figure 2
4.4 Router Analysis
원문 Table 2는 헤드를 각각 실행했을 때와 기본 라우터를 적용했을 때를 비교합니다. 헤드는 개발 데이터로 선택되었으며, 어느 헤드가 테스트에서 더 강한지는 아래 결과를 본 뒤 알게 되는 비교 정보입니다.
| 구성 | Math–Gemini | Math–Sonnet | Terminal-Bench | SWE-bench |
|---|---|---|---|---|
| 헤드 1만 실행 | 56.0% | 26.0% | 44.8% | 65.6% |
| 헤드 2만 실행 | 58.0% | 31.0% | 48.3% | 66.4% |
| 기본 라우터 | 62.0% | 30.5% | 50.0% | 66.0% |
출처: 원문 Table 2, PDF 8쪽. 고정 버전 PDF
라우터는 더 강한 헤드보다 Math–Gemini에서 4.0%p, Terminal-Bench에서 1.7%p 높습니다. 반대로 Math–Sonnet에서는 0.5%p, SWE-bench에서는 0.4%p 낮으며 각각 테스트 한 문제에 해당합니다. 테스트 피드백 없이 더 강한 헤드에 근접하거나 이를 넘는다는 것이 저자들의 해석이고, 항상 최고 헤드를 능가한다는 주장은 아닙니다.
합집합과 비교하면 라우팅은 4.4–5.5%p 낮습니다. Math–Gemini에서 헤드 1 독점 성공 18개 중 12개, 헤드 2 독점 성공 22개 중 18개를 올바르게 활용해 독점 성공 40개 중 30개, 즉 75.0%를 회수합니다. 놓친 10개가 테스트 200개 기준 5.0%p의 격차를 설명합니다. 라우터가 이미 존재하는 해법을 고르지 못한 경우와 어떤 헤드도 풀지 못한 경우를 구분해 볼 수 있는 분석입니다.
이어서 전문가 코드만 제공, 코드와 독점 개발 사례 제공, 코드·사례·전문가 출력 제공의 세 문맥 구성을 GEPA 사용 여부와 교차 비교합니다. GEPA 없이 사례에 출력을 추가하면 Math–Gemini는 57.0%→59.5%이지만 Terminal-Bench는 48.3%→46.6%입니다. 추가 문맥의 효과는 설정에 따라 다릅니다. GEPA는 평균적으로 작은 이득을 주며 전체 문맥에서 이점이 가장 크다고 보고하지만, 개별 설정에서 모두 좋아지는 것은 아닙니다. 부록 D가 전체 수치를 제공합니다. 원문 §4.4, Table 2, 부록 D.2
4.5 Method Ablation Studies
More frequent development updates improve performance. 먼저 개발 부분집합 갱신 주기를 바꿉니다. Math–Gemini의 기본 라우팅 성적은 매 5회 갱신 53.0%, 매 3회 56.0%, 매 반복 62.0%입니다. 갱신 사이에는 기존 부분집합으로 계속 후보를 제안하므로, 느린 갱신에서는 새로 관찰한 분기 차이가 목표에 반영되기까지 더 많은 제안이 진행됩니다. 저자들은 적시에 전문화하는 것이 도움이 되는 방향과 일치한다고 해석합니다. 동시에 이 총괄 성적만으로 갱신 빈도가 발견 메커니즘의 다양성을 어떻게 바꾸었는지는 입증하지 못한다고 명시합니다.
Combining development updates and proposal adaptation performs best. 다음은 개발 가지치기와 제안 지침 갱신을 켜고 끄는 네 조합입니다. 아래 수치는 모두 개발 선택 헤드와 기본 라우터를 사용한 Math–Gemini 정확도입니다.
| 개발 가지치기 | 제안 지침 갱신 없음 | 제안 지침 갱신 있음 |
|---|---|---|
| 없음 | 51.0% | 50.0% |
| 있음 | 54.0% | 62.0% |
출처: 원문 Table 3(b), PDF 8쪽. 갱신 주기 실험은 같은 쪽 Table 3(a)입니다. 고정 버전 PDF
가지치기가 없으면 두 분기는 같은 개발 집합에서 독립적으로 탐색하는 Meta-Harness에 해당하며 지침만 고정 또는 갱신됩니다. 따라서 둘 다 끈 51.0%도 단일 Meta-Harness 46.0%와 같은 구성은 아닙니다. 위 표에서 지침 갱신만 추가하면 51.0%→50.0%이고, 가지치기가 있을 때 추가하면 54.0%→62.0%입니다. 저자들은 서로 다른 개발 과제가 생길 때 제안 적응의 효용이 커진다고 해석합니다. 이는 해당 Math–Gemini 구성의 제거 실험 근거이며, 모든 모델·과제에서의 독립적 또는 통계적으로 유의한 상호작용을 확정하는 결과는 아닙니다. 원문 §4.5
4.6 Test Performance Analysis
마지막 실험은 개발 순위와 테스트 성적의 차이를 사후 분석합니다. 제안법은 각 분기의 최종 개발 점수 상위 5개씩 총 10개, Meta-Harness는 전체 개발 점수 상위 10개를 추립니다. 그런 다음 이 풀에서 테스트 정확도가 가장 높은 단일 하네스를 보고합니다. 이 test-best 선택은 배치 시 사용할 수 없는 테스트 결과를 활용하므로, Table 1의 개발 선택 시스템과 평가 목적이 다릅니다.
| 사후 test-best 단일 하네스 | Math–Gemini | Math–Sonnet | Terminal-Bench | SWE-bench |
|---|---|---|---|---|
| Meta-Harness 상위 10개 풀 | 49.0% | 32.5% | 46.6% | 63.6% |
| 제안법 분기별 상위 5개 풀 | 58.0% | 32.5% | 50.0% | 66.4% |
출처: 원문 Table 4, PDF 9쪽. 고정 버전 PDF
Meta-Harness의 Math–Gemini는 개발 선택 46.0%에서 test-best 49.0%, Math–Sonnet은 29.0%에서 32.5%로 높아집니다. 이는 개발 순위의 불완전성과 테스트 기반 선택의 낙관성을 함께 드러냅니다. 제안법의 test-best는 세 설정에서 Meta-Harness의 test-best보다 높고 Math–Sonnet에서는 같습니다. 저자들은 평가한 구성에서 분기 탐색이 강한 후보를 발견하는 데 유효하다는 근거로 봅니다.
Math–Gemini의 기본 라우터 62.0%는 해당 풀의 test-best 단일 하네스 58.0%보다 높습니다. 여러 전문가의 해결 집합이 다르므로 그중 한 개의 최고 점수가 입력별 선택 시스템의 상한은 아닙니다. 그림 2 왼쪽의 반복별 test-best 선도 진단용이고, 이 절의 최종 개발 순위 상위 후보 풀과 선택 범위가 같다고 가정하면 안 됩니다. 발견된 test-best 하네스의 내부 실행은 부록 E가 설명합니다. 이 장은 배치 성능, 상보성, 구성요소 효과, 사후 후보 품질을 차례로 분리해 보여 주며 다음 결론의 근거 범위를 정합니다. 원문 §4.6
📖 Chapter 5: Conclusion
저자들은 개발 사례 소속과 분기별 제안 지침을 함께 진화시키는 탐색을 제안했다고 정리합니다. 프런티어 간 커버리지 비교가 헤드를 선택하는 목적을 바꾸고, 별도 스킬 문서가 다음 제안의 우선순위를 보존합니다. 기록된 헤드 교체는 탐색이 다른 하네스 계열로 이동하는 과정을 보여 줍니다. 네 설정에서 개발 선택 헤드와 라우터를 결합한 시스템이 개발 선택 Meta-Harness보다 높은 테스트 성적을 얻었다는 것이 결론의 중심입니다.
한계는 이 장에서 저자들이 명시한 범위로 읽어야 합니다. 전체 토큰 사용량이 같지 않고 반복 평가가 제한되어 효율과 신뢰성에 관한 결론이 제약됩니다. 라우팅은 두 설정에서 더 강한 단일 헤드보다 약간 낮습니다. 구성요소 제거 실험은 결합 설계를 지지하지만, 각각의 궤적 변화가 이후 테스트 향상을 일으켰다는 인과성을 입증하지는 않습니다. 논문은 이보다 넓은 실패 범주나 향후 과제를 명시적으로 제시하지 않으므로 여기에 별도 연구 의제를 덧붙이지 않습니다. 원문 §5
결론 다음의 AI use statement는 실험 시스템 구현, 설계 피드백, 궤적·메커니즘 분석과 결과 해석, 원고 작성·수정, 문헌 정리, 그림과 코드에 생성형 AI 도구를 사용했다고 밝힙니다. 핵심 방법론 개발과 연구 가설 제안에는 사용하지 않았다고 설명하며 최종 산출물의 책임을 저자들에게 둡니다. 이어지는 References는 본문의 선행 연구 근거 목록입니다. 본 리뷰는 이 목록 전체의 독립 검증을 주장하지 않습니다. 본문은 여기서 끝나고, 다음 부록은 비용·탐색 이력·지침·라우터·발견 하네스의 구현 설명을 보충합니다.
📖 Chapter A: Token Accounting
부록 A는 성능 표만으로 알 수 없는 탐색 비용을 나눕니다. 세 비용 설정에서 행동 모델은 Claude Sonnet 4.5, 하네스 작성자는 Claude Opus 4.6입니다. 작업 해결 토큰은 기록된 평가 호출의 입력·출력을 합산하고 캐시된 입력을 한 번 포함합니다. 하네스 작성 토큰은 제안 세션의 비캐시 입력, 캐시 읽기, 캐시 생성, 출력을 합산합니다. 총량은 두 구성요소의 합입니다. 아래 단위는 모두 백만 토큰입니다.
| 벤치마크 | Meta 작업 해결 | Meta 하네스 작성 | Meta 총량 | 제안법 작업 해결 | 제안법 하네스 작성 | 제안법 총량 |
|---|---|---|---|---|---|---|
| Math–Sonnet | 11.10 | 68.82 | 79.92 | 13.40 | 159.50 | 172.90 |
| Terminal-Bench 2.0 | 2,086.10 | 280.70 | 2,366.80 | 3,564.60 | 436.79 | 4,001.39 |
| SWE-bench Lite | 1,814.60 | 92.57 | 1,907.17 | 2,726.70 | 224.78 | 2,951.48 |
출처: 원문 Table 5, PDF 13쪽. 수학 행의 원문 표기는 Math이며, 표 캡션의 행동 모델 조건을 따라 여기서는 Math–Sonnet으로 명시했습니다. 고정 버전 PDF
원문은 분기가 2개여도 개발 가지치기로 후속 평가 사례를 줄여, 작업 해결 토큰 배율이 각각 1.21배·1.71배·1.50배라고 설명합니다. 이 세 값은 작업 해결 부분만의 배율입니다. 총량을 나눈 리뷰어 계산은 각각 약 2.16배·1.69배·1.55배입니다. Math–Sonnet에서는 작성 토큰이 68.82→159.50으로 커지므로 작업 해결 비용만으로 총 탐색 비용을 설명하기 어렵습니다. 이는 토큰 집계이며 통화 비용, 지연 시간, 실제 배치 문제 한 개의 비용과 동일한 지표가 아닙니다.
이 부록은 제안법의 성능 향상을 동일 토큰 예산에서의 비교로 읽지 않도록 합니다. 특히 Math–Gemini의 62.0%를 이 표의 수학 비용과 결합해 효율 수치를 계산하면 행동 모델 조건이 섞입니다. 저자들이 제공한 비용은 Sonnet 설정이라는 범위를 유지해야 합니다. 다음 부록은 비용을 줄이는 개발 부분집합 변화가 동시에 탐색의 방향을 어떻게 바꾸는지 보여 줍니다. 원문 부록 A
📖 Chapter B: Development-Set Changes and Head Selection
B.1 Subset Histories Across Settings
그림 3은 네 설정에서 개발 부분집합이 줄고 분기별로 갈라지는 과정을 추적합니다. 각 분기의 활성 집합은 공통 사례와 그 분기만 유지하는 사례를 합친 것입니다. 갱신에는 분기마다 후보 5개가 필요하므로 보통 반복 5부터 시작합니다. Math–Sonnet은 반복 3에서 후보가 생성되지 않아 반복 6부터 시작했다고 보고합니다. 따라서 기본 갱신 주기가 매 반복이라는 설명은 시작 조건 없이 첫 반복부터 가지치기했다는 뜻이 아닙니다.
네 설정에서 공통 사례가 줄고 분기 독점 사례가 늘어납니다. SWE-bench에서는 반복 5부터 20까지 양쪽에서 제거된 사례가 19개로 유지되는 동안, 공통 사례는 30→24개, 분기별 독점 사례는 1→7개가 됩니다. 즉 전체 유지 사례의 합집합이 더 작아지지 않아도 사례 소속의 변화로 전문화가 진행될 수 있습니다. 원문 그림의 채워진 구간은 정확한 사례 수를 표시하지만 너비에는 $\log(1+n)$ 스케일을 사용합니다. $n$은 해당 구간 사례 수이므로, 육안으로 본 너비 차이를 원래 개수 차이에 비례한다고 읽어서는 안 됩니다. 원문 부록 B.1, Figure 3, PDF 14쪽
B.2 How Subset Changes Redirect Head Selection
이 절은 Math–Gemini 분기 2의 반복 13 전환을 더 자세히 기록합니다. 반복 8–12에서 부분집합은 58→44개로 줄었지만 기하 검색 기반 두 솔버 하네스가 계속 헤드였습니다. 반복 13에서 사례 4개가 더 빠지고 freeform_derivation_dual이 헤드가 됩니다. 새 후보는 검색 경로, 기하 코퍼스 선택, 조건부 판정을 보존하면서 유도를 JSON 필드 안에 쓰게 하던 제약을 없앱니다. 일반적인 수학 서술과 LaTeX로 유도하고 최종 답은 따로 추출합니다. 설계 근거는 남은 개발 실패와, 풀이 절차를 더 강제했던 이전 시도가 좋지 않았다는 로컬 증거를 연결합니다.
반복 14 기록에서 자유 형식 헤드는 남은 40개 중 8개를 풀고 이전 점진적 보완 후보는 7개를 풉니다. 새 freeform_progressive는 두 후보의 장점을 결합해 초기 유도의 약한 단계를 찾고 관련 예시를 검색한 뒤 JSON 제약 없이 다시 풉니다. 반복 15에서는 이것이 헤드가 되고 two_sided_closure의 출발점이 됩니다. 기록된 불완전 논증에 대응해 도달 가능한 답을 구성하는 경로와 모든 답이 만족해야 할 필요조건을 세우는 경로를 분리합니다.
이후 반복 17에서는 검색 문제를 먼저 시도해 기준 풀이의 피드백을 얻는 rehearsal이 양면 구조에 추가됩니다. 반복 18에서는 구성과 필요조건의 답이 같아도 구체적 도전을 수행해 두 경로의 공통 오류를 겨냥합니다. 반복 19의 gap_directed_construction은 불일치 때 판정 전에 빠진 구성을 직접 시도하도록 확장합니다. 검색, 예행 풀이, 양면 유도, 합의 검사를 계승한다는 설계 근거도 기록됩니다.
이 이력은 부분집합 변화, 헤드 교체, 이후 후보의 설계 의존성을 연결합니다. 리뷰어의 해석으로는 “자유롭게 추론시키면 좋아진다”는 단일 프롬프트 교훈보다, 바뀐 평가 대상에서 새 부모가 선택되고 후속 설계가 그 부모의 장치를 이어 간다는 탐색 설명이 더 중요합니다. 다음 부록은 이러한 로컬 경험을 제안 지침으로 바꾸는 규칙과 실제 수정 내용을 제시합니다. 원문 부록 B.2
📖 Chapter C: Proposal-Guidance Updates
이 부록은 제안 지침의 갱신을 추상적인 자기 개선이라는 말에서 실제 편집 규칙으로 옮깁니다. 같은 제안자 Claude Opus 4.6이 분기별 SKILL.md를 읽고 최근 완료 반복의 증거로 수정하며, gradient.json에 근거와 변경 사항을 구조화합니다. 이 파일 이름의 gradient는 외부 지침 수정 기록이며, 모델 파라미터의 미분을 계산했다는 뜻은 아닙니다.
C.1 Full Update Prompts
Mathematical reasoning — Update instructions. 수학용 프롬프트는 공급된 반복 요약을 모두 읽되 더 오래된 진화 이력을 찾지 않도록 합니다. 검증 정확도를 증거로 쓰고 같은 검증 단계 안에서 비교하며, 단계가 다른 점수는 참고로만 다룹니다. 수정 가능한 파일은 지정된 분기의 지침과 변경 기록 두 개뿐입니다. 에이전트, 검증 데이터, 벤치마크 출력, 소스 파일을 고치지 않으며 반복당 후보 하나라는 계약을 유지합니다. 문제 본문·정답·사례 ID·검증 집합에 특화된 규칙을 지침에 넣지 말라는 제약도 있습니다.
판단의 강도 역시 제한합니다. 각 점수는 한 구현의 증거이고 검색 또는 추론 접근 전체를 증명하는 것이 아니며, 강한 주장은 공급된 최소 두 반복에서 서로 다른 구현의 증거가 일치할 때 사용하도록 합니다. 누락 평가는 누락 데이터로 처리합니다. 절차는 후보 결과 비교 → 후보별 사실과 잠정 가설 분리 → 최신 검증 단계의 증거에 더 큰 비중 부여 → 탐색을 닫지 않는 다음 구간 목표 하나 설정 → 근거와 변경 내역 기록 후 지침 적용의 순서입니다. gradient.json에는 완료 반복, 분기 ID, 목표, 비어 있지 않은 근거와 스킬 변경 목록을 요구합니다.
Terminal-Bench 2.0 — Update instructions. 터미널용 프롬프트도 같은 구조를 따르되 증거 지표는 검증 통과율입니다. 검증 작업 목록과 벤치마크 출력, 소스를 고치지 않으며 작업 지시, 기대 출력, 특정 작업의 해법 단계를 지침에 넣지 않도록 합니다. 특정 에이전트 구현의 결과를 scaffold 계열 전체에 대한 증명으로 확장하지 않는다는 표현이 수학용의 검색·추론 접근 제약에 대응합니다. 두 프롬프트 모두 성공 사례를 재사용하는 활용과 증거에 맞춘 새로운 탐색을 함께 유지하려는 규칙입니다. 부록 C.1에 별도의 SWE-bench용 전체 프롬프트는 제시되지 않으며, SWE-bench 지침 수정 예시는 다음 절에 나옵니다. 원문 부록 C.1, PDF 14–15쪽
C.2 Concrete Gradient-Update Examples
원문 Figures 4–7은 회색 문맥, 빨간 삭제, 초록 추가로 지침의 차이를 보여 줍니다. 이 절의 내용은 그 분기에서 당시 관찰한 로컬 증거와 지침입니다. 이를 모든 수학 또는 코딩 작업에 적용되는 일반 법칙으로 읽지 않는 것이 C.1의 판단 규칙과도 맞습니다.
Figure 4: Math–Gemini, iteration 15. 분기 1은 기존의 헤드 기반 검증·작업 유형 라우팅·답 규격 점검 우선순위에서, 검색 풀이의 구체적 정보를 추출하고 이전하는 방향으로 이동합니다. 패턴 추출, 근거 사실, 기준 정답 이전이 해당 구간의 양의 커버리지 변화와 반복 13·15의 헤드 교체를 만들었다는 기록을 반영합니다. 자체 생성 대안들을 판정하는 네 설계가 각 반복에서 낮았다는 관찰은 그 계열 전체의 영구 금지보다 검색된 증거를 이용하는 다른 메커니즘으로 재시도하라는 경고가 됩니다. 평균뿐 아니라 커버리지와 합집합도 비교하고, 새 단계의 식별자만 있고 점수가 갱신되지 않았다면 단계 간 정확도 비교를 하지 말라는 주의도 추가합니다. 재서술·요약 오버레이는 항상 적용하는 대신 표적 또는 조건부 개입으로 검토하도록 바뀝니다.
같은 그림의 분기 2는 정체된 헤드와 커버리지라는 이전 설명을 삭제하고, 반복 13·14·15의 헤드 전진과 자유 형식·점진적 유도·양면 논증의 로컬 성과를 기록합니다. 반복 실패 뒤 기존 헤드에서 벗어나라는 지침도 수정해, 이번 구간의 헤드 기반 제안이 실제로 연속 교체를 만들었으므로 그 선택지를 유지하되 과거 강한 후보와 메커니즘 결합도 고려하게 합니다. 약한 검색 선택·조회 변형의 실패가 검색 전체를 배제하지는 않으며, 재시도할 때 자료나 질의와 이전 구현의 문제를 분명히 바꾸도록 합니다. 저장된 개발 사례에서 비어 있지 않은 파싱 가능한 답이 반환되는지 확인하는 프로토타입 검사도 추가됩니다.
Figure 5: Math–Sonnet, iteration 5. 분기 1은 기하 전용 BM25를 로컬 기반으로 삼고, 두 경로의 독립 풀이가 일치하면 바로 반환하고 불일치하면 판정하는 구조를 우선합니다. 지침은 연속 검증이 올바른 답을 과도하게 수정할 위험을 기록하고, 판정자·경로 간 추론 다양성·검색 재정렬과 질의 재작성에 주의를 돌립니다. 분기 2는 전체 추론을 보는 비판적 판정을 보존하며, 기하·전체 코퍼스의 중복 제거된 이중 검색을 우선합니다. 참고 풀이를 기법 힌트로 잘라 넣었던 시도의 퇴행을 근거로 풀이 맥락을 보존하고, 경로 수를 늘리거나 검색 상수를 폭넓게 조정하기보다 판정 구조와 각 경로의 추론을 바꾸도록 합니다. 두 분기가 같은 모델에서도 다른 검색 교훈을 유지한다는 예입니다.
Figure 6: Terminal-Bench 2.0, iteration 5. 분기 1은 삭제 방지 프롬프트 수정과 남은 단계 예산 인식을 유지합니다. 포괄적인 검증·프로세스 체크리스트 선호는 최소한의 표적 변경으로 바뀝니다. 기다리는 시간 상한을 300초로 늘린 시도에 대한 부정적 기록을 남기고 기존 60초를 유지하며, 프롬프트 위주 수정에서 도구·실행 논리·문맥과 관찰 처리의 구조적 변화로 옮겨 가도록 합니다. 분기 2는 완료 전 검증의 로컬 효용을 기록하지만 공격적 개입과 검증 문구에 대한 민감성도 함께 보존합니다. 광범위한 검증 루프 변형을 계속하기보다 어려운 작업에 직교하는 다른 메커니즘을 탐색하라는 지침입니다. 여기의 duration cap은 원문 터미널 실험 하네스 설정이지 모든 도구의 공통 권장 대기 시간이 아닙니다.
Figure 7: SWE-bench Lite, iteration 5. 분기 1은 best-of-N을 최고 가치 방향으로 보던 문구를 경계 대상으로 바꿉니다. 복수 시도와 테스트 선택의 추가 비용이 해당 난도에서 보상되지 않았고, 문맥 잘라내기·요약이 추론 연속성을 해친 로컬 관찰을 기록합니다. 테스트로 제출을 제어하는 기제를 우선하고 회귀 검사와 해결 집합이 보완적이라는 점을 다음 조합의 근거로 삼으며, 베이스라인과 가까운 최소 수정을 강조합니다. 분기 2는 다섯 메커니즘의 성적이 31개 중 4–5개 해결로 비슷해 잡음이 큰 증거로 취급해야 한다고 기록합니다. 31개 중 21개가 계속 미해결이라는 관찰로, 편집 루프 변형보다 문제 위치 찾기와 검색을 우선하는 방향으로 이동합니다. reasoning_high와 예산 분할의 단일 관찰은 잠정적 판단으로 남깁니다.
이 절은 지침 갱신이 짧은 성공 규칙을 무조건 축적하는 것이 아니라, 기존 우선순위를 삭제·수정하고 증거의 강도까지 기록하는 과정임을 보여 줍니다. 원문 그림의 일부 유지 문구에는 복수 후보 구현을 지시하는 표현이 보이지만, 본문 §4.1과 C.1의 실행 계약은 분기당 반복 하나의 후보라고 명시합니다. 본 리뷰의 후보 수 설명은 이 명시적 실험 조건을 따릅니다. 다음 부록은 이러한 탐색으로 나온 전문가를 실제 문제에 배정하는 라우터 입력과 제거 실험을 제시합니다. 원문 부록 C.2, Figures 4–7, PDF 16–17쪽
📖 Chapter D: Router Analysis
D.1 Router Instructions
라우터의 전체 입력은 최적화된 라우팅 지침, 출력 계약, 두 전문가의 이름과 소스 코드, 독점 개발 사례별 두 출력과 승자, 마지막으로 새 문제의 순서입니다. 출력 계약은 choice와 reason이라는 정확히 두 필드의 JSON 객체입니다. choice는 expert_1 또는 expert_2여야 하며 reason은 짧은 증거 기반 이유입니다. JSON 바깥 텍스트는 반환하지 않게 합니다. 이 계약은 라우터가 문제를 직접 푸는 역할보다 실행할 전문가를 선택하는 역할에 집중하도록 합니다.
개발 예시 블록은 문제, 전문가 1의 출력, 전문가 2의 출력, 어느 전문가만 풀었는지를 담습니다. 수학에서는 풀이를, Terminal-Bench와 SWE-bench에서는 최종 행동을 제공합니다. 이 출력들은 예시 개발 문제의 결과이며 맨 마지막 새 문제에 대한 전문가 출력은 템플릿에 없습니다. 전문가 구현 코드와 과거 성공 유형을 보고 새 입력의 적합성을 판단하는 구조입니다. 따라서 “전문가 출력을 보는 라우터”라는 짧은 표현은 개발 사례와 새 입력을 분명히 구분해 사용해야 합니다. 원문 부록 D.1, PDF 15·18쪽
D.2 Router Context and Prompt Ablations
모든 구성은 전문가 소스 코드를 받으며 실행 전 선택을 유지합니다. 차이는 독점 개발 사례와 그 전문가 출력을 추가하는지, GEPA로 라우팅 지침을 최적화하는지입니다. 아래는 원문 Table 6 전체 수치입니다. “사례”는 독점 개발 사례, “출력”은 해당 개발 사례에 대한 두 전문가의 응답입니다.
| 사례 | 출력 | GEPA | Math–Gemini | Math–Sonnet | Terminal-Bench | SWE-bench |
|---|---|---|---|---|---|---|
| 있음 | 있음 | 사용 | 62.0% | 30.5% | 50.0% | 66.0% |
| 있음 | 있음 | 없음 | 59.5% | 29.0% | 46.6% | 66.4% |
| 있음 | 없음 | 사용 | 57.0% | 31.0% | 48.3% | 66.4% |
| 있음 | 없음 | 없음 | 57.0% | 30.0% | 48.3% | 66.4% |
| 없음 | 없음 | 사용 | 59.5% | 30.5% | 48.3% | 66.0% |
| 없음 | 없음 | 없음 | 60.5% | 30.5% | 46.6% | 66.4% |
출처: 원문 Table 6, PDF 19쪽. 고정 버전 PDF
저자들은 먼저 GEPA 없는 구성을 비교합니다. 코드만에서 사례를 추가하면 Math–Gemini 60.5%→57.0%, Math–Sonnet 30.5%→30.0%, Terminal-Bench 46.6%→48.3%입니다. 여기에 전문가 출력을 추가하면 Math–Gemini 59.5%로 올라가지만 Math–Sonnet과 Terminal-Bench는 각각 29.0%와 46.6%로 내려갑니다. SWE-bench는 세 구성 모두 66.4%입니다. 문맥을 더 많이 제공한다고 항상 선택이 개선되는 것은 아니라는 결과입니다.
다음으로 전체 문맥에서 GEPA를 적용하면 59.5%→62.0%, 29.0%→30.5%, 46.6%→50.0%로 올라가지만 SWE-bench는 66.4%→66.0%로 내려갑니다. 저자들은 세 문맥 구성 모두에서 벤치마크 평균의 작은 이득을 보고하며 전체 문맥의 이점이 가장 크다고 설명합니다. 개별 점수에는 무변화와 하락도 있으므로 평균 해석을 각 설정의 일관된 향상으로 바꾸면 안 됩니다. Table 1의 기본 시스템은 첫 행의 전체 문맥+GEPA 구성입니다. 다음 부록은 라우터 구성과 별개로 사후 test-best 하네스의 실행 장치를 설명합니다. 원문 부록 D.2
📖 Chapter E: Discovered Harness Mechanisms
부록 E의 하네스는 §4.6에서 정의한 개발 순위 상위 10개 후보 풀 중 test-best로 사후 선택한 단일 하네스입니다. 개발 선택 라우터의 구성요소가 항상 여기의 하네스와 같다고 가정하지 않습니다. 저자들은 각 하네스의 실행 순서와 직전 설계에서 달라진 핵심 장치를 설명합니다.
E.1 Math–Gemini: Construction Before Adjudication
Overview. gap_directed_construction은 개발 순위 후보 풀에서 테스트 58.0%를 기록합니다. 도달 가능한 답을 구성하는 작업과 다른 답이 불가능한 이유를 세우는 작업을 분리하고, 두 논증의 관계에 따라 다음 계산을 고릅니다.
1. Retrieve and rehearse. 문제의 계획을 만들고 계획과 문제 본문으로 BM25 검색을 수행합니다. 적절한 기준 풀이가 있으면 그 검색 문제를 먼저 시도하고 기준 풀이와 비교해 목표 문제를 위한 보정 메모를 만듭니다. 검색 풀이를 정적으로 읽는 데서 끝나지 않고 자신의 풀이와 기준 사이의 차이를 다음 유도 문맥에 넣는 단계입니다.
2. Construct and constrain. 두 솔버는 계획, 검색 예시, 보정 메모를 공유합니다. 한쪽은 실제로 가능한 답을 구성하고 검사하며, 다른 쪽은 답이 반드시 만족해야 하는 필요조건을 유도합니다. 이는 같은 지시로 두 번 풀어 다수결하는 방식과 다르게 논증의 역할을 나눕니다.
3. Resolve agreement or disagreement. 정규화한 답이 같으면 추가 호출로 공통 답에 도전합니다. 다르면 두 답의 간극을 겨냥한 명시적 구성 또는 구체적 검사를 먼저 시도하고, 마지막 호출이 문제를 판정합니다. 핵심 변경은 불일치한 풀이를 바로 판정자에게 넘기기 전에 구성 증거를 공급하는 것입니다. 이 실행 설명은 왜 분기 2가 구성과 필요성, 합의 오류 검사로 발전했는지를 앞선 이력과 연결합니다. 원문 부록 E.1
E.2 Math–Sonnet: Cleaned Retrieval with Answer Grounding
Overview. clean_retrieval_answer_grounded는 테스트 32.5%를 기록합니다. 검색에 조건화된 두 풀이 경로와 조건부 비판을 사용하며, 주된 변경점은 검색된 풀이를 모델 문맥에 넣기 전에 정리하는 방식입니다.
1. Retrieve complementary references. 한 경로는 기하 예시를 검색하고, 다른 경로는 전체 코퍼스에서 중복되지 않는 예시를 가져옵니다. 서로 다른 참고 자료가 두 풀이 경로의 문맥을 구성합니다.
2. Clean and ground the examples. 추론 태그를 제거하고, 가능하면 태그된 추론을 문장 경계에서 잘라내며, 풀이 하나를 4,000자로 제한합니다. 코퍼스에 저장된 기준 답도 덧붙입니다. 여기의 정답 근거는 검색 자료의 기준 답이며, 새 테스트 문제의 정답을 제공하는 것이 아닙니다.
3. Solve and critique. 두 경로가 계획·풀이·검증의 구조화된 지시를 따릅니다. 정규화한 답이 일치하면 바로 반환하고, 불일치하면 세 번째 호출이 두 추론을 비판해 최종 답을 냅니다. 기존 두 번 또는 세 번의 솔버 호출 구조를 유지하면서 입력 자료를 바꾼다는 점이 기여입니다. E.1처럼 합의 때도 추가 도전하는 구조와 구분됩니다. 원문 부록 E.2
E.3 Terminal-Bench 2.0: Verification Once Before Completion
Overview. verification_once_gate는 작업 완료율 50.0%를 기록합니다. 검증이 추가된 Terminus-KIRA 에이전트의 종료 검사 방식을 바꿉니다.
1. Execute the task. 에이전트는 기존 도구 사용 루프로 터미널과 상호작용합니다. 2. Request verification once. 처음 완료 신호를 내면 검증 프롬프트를 보여 주고, 이미 보여 주었다는 상태를 기록합니다. 3. Allow subsequent completion. 이후의 완료 신호는 같은 게이트를 통과해 실행을 끝낼 수 있습니다. 에이전트가 검증 뒤 다시 도구를 쓰더라도 상태가 유지되므로 검증 게이트가 반복해서 열리지 않습니다.
핵심은 검증을 단순히 늘리는 것이 아니라 완료 전 검증을 한 번만 요구하는 제어 흐름입니다. 프롬프트 문구와 함께 상태 플래그가 종료 동작을 정한다는 설명이므로, “한 번 검증하면 모든 터미널 작업에 충분하다”는 일반 원칙으로 확장할 수는 없습니다. 원문 부록 E.3
E.4 SWE-bench Lite: Issue-Guided Localization Before Editing
Overview. test_aware_edit는 이슈 해결률 66.4%를 기록하며 구조화된 편집 에이전트의 첫 모델 행동 전에 위치 찾기 단계를 추가합니다. 1. Extract issue identifiers. 이슈에서 클래스명, 함수명, Python 파일 경로, 예외 이름을 최대 8개 식별자로 추출합니다.
2. Assemble repository context. Python 파일에서 식별자를 검색하고 소스와 테스트 파일을 구분해 일치 수로 순위를 매깁니다. 상위 소스 파일 2개와 테스트 파일 1개를 읽으며, 소스는 파일당 4,000자, 테스트는 3,000자로 제한해 첫 사용자 메시지에 넣습니다. 유용한 일치가 없으면 추가 문맥을 제공하지 않습니다. 따라서 검색 실패 때에도 기존 편집 루프로 진행할 수 있습니다.
3. Run the editing loop. 이후 기존 도구로 편집합니다. 문자열 치환은 유일한 일치를 요구하며 결과 diff를 반환합니다. 검색된 저장소 테스트는 편집 전에 기대 동작의 예를 제공하는 역할입니다. 이는 새 문제의 평가 정답을 외부에서 가져오는 것이 아니라 주어진 저장소 안의 관련 문맥을 앞당겨 공급하는 장치입니다.
이 마지막 부록은 성능이 오른 하네스가 하나의 공통 프롬프트로 수렴하지 않았음을 보여 줍니다. 수학에서는 검색 문맥 정리와 논증 제어, 터미널에서는 종료 상태, 이슈 수정에서는 초기 위치 찾기가 중요 변경점으로 나타납니다. 이는 원문이 기술한 발견 사례의 요약이며, 모든 개선의 원인이 이 장치 하나라고 독립적으로 검증한 결과는 아닙니다. 원문 부록 E.4
실험 결과 심층 분석
주요 성과는 개발 정보만으로 하네스와 라우터를 구성한 시스템이 네 설정에서 개발 선택 Meta-Harness보다 높은 테스트 성적을 얻었다는 점입니다. 상대 향상을 읽을 때는 기준값과 절대 차이를 함께 보아야 합니다. 아래 차이와 상대값은 원문 Table 1 수치로 계산하며 상대값은 논문 보고와 일치합니다.
| 설정과 테스트 분모 | Meta-Harness→기본 라우터 | 절대 차이 | 상대 향상 |
|---|---|---|---|
| Math–Gemini, 200문제 | 46.0%→62.0% | +16.0%p | +34.8% |
| Math–Sonnet, 200문제 | 29.0%→30.5% | +1.5%p | +5.2% |
| Terminal-Bench, 58작업 | 44.8%→50.0% | +5.2%p | +11.6% |
| SWE-bench, 250이슈 | 63.6%→66.0% | +2.4%p | +3.8% |
Terminal-Bench의 표 수치는 소수 첫째 자리로 반올림되어 있으므로, 표시된 비율의 차이와 원래 성공 개수에서 계산한 차이를 혼동하지 않아야 합니다. 성능 격차의 크기도 테스트 한 문제의 단위와 함께 봐야 합니다. 유의성 검정·신뢰구간은 논문에 보고되지 않았습니다. 저자들도 제한된 반복 평가가 신뢰성 판단을 제약한다고 밝히므로, 이 표의 상승을 통계적으로 유의하다고 서술할 근거는 없습니다. 원문 Tables 1–2, §5
분기 상보성은 두 헤드의 합집합이 각 단일 헤드보다 크다는 근거로 확인됩니다. 그러나 배치에서 중요한 것은 그 합집합 자체보다 실행 전에 올바른 헤드를 고르는 성적입니다. 라우터는 Math–Gemini와 Terminal-Bench에서 더 강한 헤드를 넘고, Math–Sonnet과 SWE-bench에서는 한 문제씩 낮습니다. 또한 오라클 합집합에는 도달하지 못합니다. 따라서 “분기가 보완적이다”, “라우터가 그 보완성을 일부 회수한다”, “라우터가 항상 더 강한 헤드보다 높다”는 서로 다른 명제이며, 마지막 명제는 이 결과가 지지하지 않습니다. 원문 §4.3–4.4, Figure 2, Table 2
제거 실험은 Math–Gemini에서 개발 가지치기와 지침 갱신을 함께 쓸 때 62.0%로 가장 높다는 결과를 줍니다. 지침 갱신만 켠 50.0%와 둘 다 끈 51.0%의 비교는 지침 적응만으로 항상 향상하지는 않는다는 점을 보여 줍니다. 이 구성 비교와 분기 2의 계승 기록은 논문의 설계 설명을 뒷받침하지만, 각 헤드 교체의 개별 인과 효과를 측정한 실험으로 바꿔 읽을 수 없습니다. 원문 §4.5, §5
비용과 재현성의 경계도 분명합니다. 부록 A의 총 토큰은 제안법이 더 많으며 동일 비용 비교가 아닙니다. 논문에는 분할 크기, 행동 모델과 제안자, 분기 수·반복 수·갱신 주기, 소속 규칙, 갱신 프롬프트, 라우터 템플릿, 발견 하네스 실행 설명이 제공됩니다. 본 리뷰는 지정된 v1 HTML·PDF를 대조한 분석이며 실험 코드를 실행하거나 독립 재현을 수행하지 않았습니다. 공개 코드 저장소의 완전성도 별도로 감사하지 않았으므로, 이 설명만으로 동일 점수가 재현되었다고 주장하지 않습니다.
기술적 함의와 응용
저자들이 제시하는 중심 함의는 탐색 목적과 제안 정책을 함께 적응시키고, 개발 정보에 기반한 라우팅으로 결과를 배치한다는 것입니다. 후보 코드만 바꾸는 대신 어떤 사례가 선택 압력을 만드는지, 어떤 로컬 경험이 다음 제안을 안내하는지까지 설계 대상으로 삼습니다. 평가한 네 설정에서 이 결합이 유효했고, 각 분기는 서로 다른 문제를 푸는 전문가를 남겼습니다. 원문 §5
리뷰어의 해석으로는 이 방법은 하네스 탐색을 세 개의 연결된 결정으로 이해하게 합니다. 먼저 해결 여부가 비교 가능한 개발 문제에서 분기별 상대 강점을 식별하고, 다음으로 그 문제에서 나온 증거를 제안 지침에 반영하며, 마지막으로 새 문제에서 어느 전문가를 실행할지 선택합니다. 수학의 검색·논증 제어와 코딩의 종료·위치 찾기라는 다른 장치가 같은 탐색 틀 안에서 발견되었다는 점은, 특정 추론 프롬프트보다 평가와 제어 구조를 함께 공부할 필요성을 보여 줍니다.
실제 활용을 해석할 때도 원문의 조건을 유지해야 합니다. 서로 다른 부분집합의 평균 점수만으로 전문가의 전역 순위를 정할 수 없고, 개발 사례의 출력은 새 입력의 정답 피드백과 구분해야 합니다. 성능 개선과 함께 하네스 작성·평가 토큰이 늘었으며, 라우팅이 더 강한 헤드에 미치지 못한 설정도 있습니다. 이 연구가 제공하는 결과는 적응하는 탐색과 개발 기반 배치의 구체적 가능성이고, 비용 효율성·반복 신뢰성·개별 변화의 인과성에 관한 범위는 저자들이 결론에서 명시한 한계 안에 있습니다.