논문 개요와 전체 구조
장시간 동작하는 에이전트는 검색 결과, 실행 로그, 중간 계획과 실패한 시도를 계속 축적합니다. 문제는 문맥 창의 크기만이 아닙니다. 다음 모델 호출에 어떤 정보를 남기고, 이미 끝난 작업의 기록을 언제 지우며, 여러 에이전트의 진행 상황을 어떻게 유지할지가 함께 중요해집니다.
Rulin Shao 등의 Context Language Models(CLMs)는 이 문맥 관리 자체를 언어모델의 능력으로 다룹니다. 현재 문맥을 수정 가능한 파일로 노출하고, 모델이 일반적인 프로그래밍 도구로 그 파일을 편집하면 다음 호출의 입력에도 반영합니다. 고정된 요약 함수를 호출하는 수준을 넘어, 필요한 관리 절차를 모델이 실행 중에 만들고 재사용하게 합니다. 논문은 기존 모델을 훈련 없이 사용하는 실험, 문장과 스킬 문서를 통한 행동 조정, 강화학습, 서빙 캐시 최적화를 연결합니다.
이 리뷰의 대상은 2026년 9월 29일 제출된 arXiv:2609.37725v1입니다. 고정 버전 HTML과 27쪽 PDF를 함께 대조했습니다. PDF와 HTML 변환본의 일부 그림 번호가 달라, 아래 그림 번호와 페이지는 PDF 기준으로 표기합니다. 논문에서 공개한 코드 링크는 소개하되, 이 글은 해당 구현을 실행하여 재현한 결과가 아닙니다.
| 원문 순서 | 구성과 역할 |
|---|---|
| 1. Introduction | 문맥 관리의 자율성, 연구 범위와 주요 결과 |
| 2. Related Work | 하네스 정책, 제한된 관리 도구, RLM과의 차이 |
| 3. Pilot Study with ContextBench | 문맥 관리만 분리하여 측정하는 네 가지 합성 과제 |
| 4. Context Language Models | 4.1 정의·파일 구현 → 4.2 in-context learning·RL → 4.3 Suffix Cache Reuse |
| 5. Results | 5.1 zero-shot: 5.1.1 코딩·심층 검색, 5.1.2 열린 발견 문제 → 5.2 학습 → 5.3 서빙 |
| 6. Discussion and Future Work | 편집 가능한 문맥의 안전성과 저자가 제시한 후속 방향 |
| References | 본문에서 비교한 선행 연구의 서지 |
| Appendix A | 관련 연구의 세부 비교 |
| Appendix B | Suffix Cache Reuse 구현·민감도·남은 서빙 병목 |
| Appendix C | Prefix-reuse FLOPs 계산식 |
| Appendix D | ContextBench 생성·채점·방법별 지침 |
| Appendix E | 벤치마크·steering·evolution·RL 실험 설정 |
| Appendix F | 모델 크기·수학 최적화·128K·evolution·RL 추가 결과 |
| Appendix G | 모델의 문맥 길이 인식 진단 |
핵심 기여와 혁신성
문제의 중요성은 오래 동작하는 에이전트에서 문맥 관리가 정확도와 비용을 동시에 결정한다는 데 있습니다. 긴 입력을 계속 보존하면 계산이 늘어나고, 일괄 요약으로 줄이면 나중에 필요한 세부 정보가 사라질 수 있습니다. 저자는 이 선택을 외부 하네스에만 맡길 필요가 있는지 질문합니다.
기존 접근의 제약은 모델이 관리 결정을 일부 내리더라도 실제 동작의 종류는 사람이 미리 정한다는 점입니다. 요약·오프로딩·검색·분기 등의 도구는 유용하지만, 특정 구간의 정보를 지우고 다른 구간을 정확히 갱신하는 절차를 새로 구성하는 자유는 제한됩니다. RLM은 큰 입력을 외부 변수에서 읽는 방법을 제공하지만, 읽은 뒤 계속 자라는 실제 대화 문맥의 편집은 별개의 문제입니다.
해결책의 독창성은 세 요소를 연결한 데 있습니다. 첫째, 현재 문맥 자체를 파일로 다루어 임의 편집을 허용합니다. 둘째, 그 편집 전략을 자연어 스킬의 진화와 모델 가중치의 강화학습 양쪽으로 개선합니다. 셋째, 중간 편집이 캐시 재계산을 늘릴 수 있다는 점을 비용 지표에 포함하고, 살아남은 뒷부분의 캐시를 재사용하는 SCR을 별도로 제안합니다. 근거: 1·4절
리뷰어 해석으로는 에이전트의 실행 환경과 모델 학습을 함께 이해하는 데 가치가 있습니다. 같은 모델에서도 문맥을 구성하는 방식이 성능을 바꿀 수 있고, 토큰을 적게 남기는 것과 실제 추론 계산을 줄이는 것은 다를 수 있음을 보여주기 때문입니다. 다만 CLM의 자율성이 모든 모델과 모든 과제에서 우월하다는 결론으로 확대해서는 안 됩니다. 원문은 작은 모델의 초기 성능 저하와 조건별 subagent 효과 차이도 보고합니다.
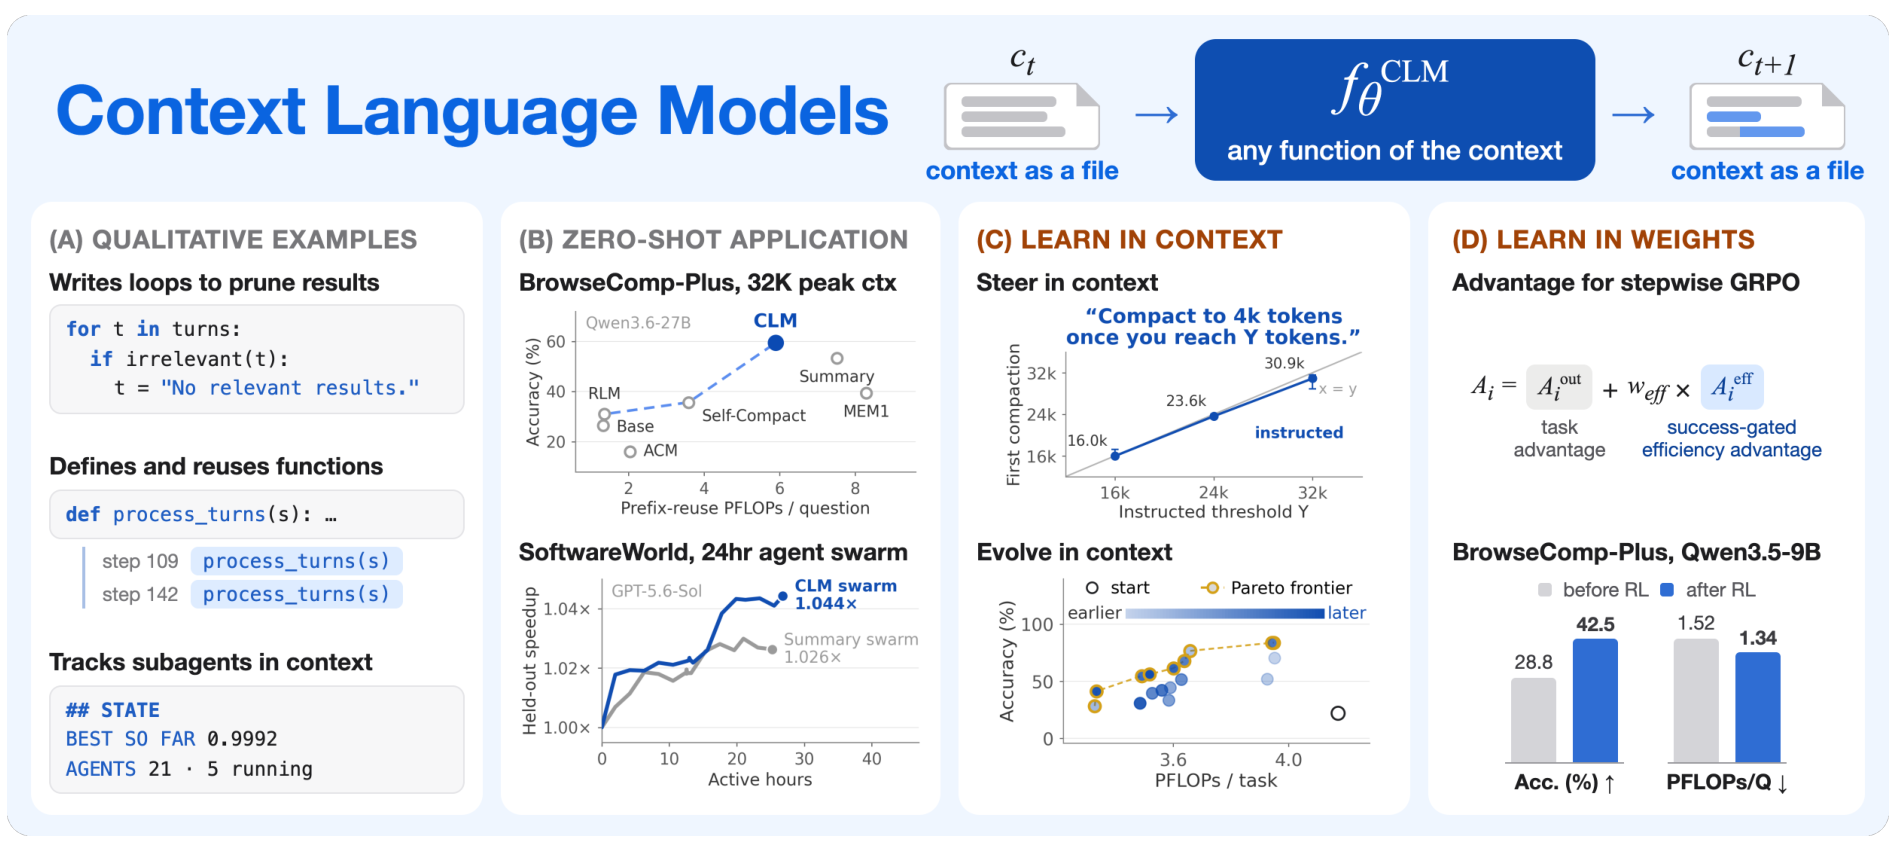
PDF Figure 1, 2쪽. CLM의 파일 기반 문맥 전환, 훈련 없는 적용, 자연어 스킬 학습과 강화학습을 연결한 개요입니다. 원문 그림 영역만 크롭했으며 번역·수치 변경은 하지 않았습니다. 고정 버전 원문, CC BY 4.0.
기술적 세부사항
문맥 전환을 바꾸는 모델
원문 식 (1)·(2)는 일반 LM과 CLM의 차이를 다음과 같이 표현합니다.
$c_t$는 $t$번째 턴의 현재 문맥, $\theta$는 모델 파라미터, $\oplus$는 문자열 또는 토큰열의 연결입니다. 첫 식은 현재 문맥 뒤에 생성 결과를 붙입니다. 둘째 식의 $f^{\mathrm{CLM}}_\theta$는 모델이 제어하는 임의의 문맥 변환입니다. 이전 문장을 삭제하거나, 중간 상태를 바꾸거나, 여러 기록을 짧은 메모로 교체하는 것도 허용합니다. 이 정의는 Transformer 내부 연산을 교체한다는 뜻이 아니라 호출 사이의 입력 상태를 모델이 구성한다는 뜻입니다.
구현에서는 시스템 프롬프트에 live context 파일의 경로를 제공하고, Bash 등의 도구로 편집한 내용을 다음 호출에 동기화합니다. 편집하지 않으면 기본적으로 새 출력을 덧붙입니다. 여러 live context 파일을 각각의 모델 호출과 연결하면 agent swarm과 subagent로 확장할 수 있습니다. 일반적인 메모 파일은 다시 읽어야 입력에 들어오지만, live context 파일은 그 자체가 다음 호출의 입력을 지정한다는 점이 다릅니다.
길이보다 캐시를 포함한 계산량
문맥 중간을 수정하면 표준 prefix cache는 최초 불일치 이후의 토큰을 다시 처리합니다. 따라서 문맥이 짧아졌어도 편집 위치에 따라 계산량이 증가할 수 있습니다. 원문은 이를 반영하는 prefix-reuse FLOPs를 사용합니다.
Prefill은 입력 문맥을 처리하는 계산이고, decode는 새 토큰을 생성하는 계산입니다. 첫 항에는 편집 때문에 다시 읽어야 하는 문맥의 뒷부분도 들어갑니다. 논문 본문의 일반 성능 비교는 표준 prefix caching을 가정한 이 비용을 사용하며, SCR을 적용해 얻은 추가 절감은 따로 보고합니다. FLOPs, API 지출, 실행 시간은 서로 다른 지표입니다.
진단·실제 과제·학습의 평가 축
| 평가 축 | 대상 | 무엇을 측정하는가 |
|---|---|---|
| 문맥 관리 진단 | ContextBench 네 가지 합성 과제 | 중요한 정보의 정확한 보존·갱신·오프로딩·검색 |
| 코딩·심층 검색 | TerminalBench 2.1, TBLite, BrowseComp-Plus | verifier 또는 judge로 판정한 성공률과 계산량 |
| 열린 발견 | 수학 최적화, EdgeBench-10, Software World | 탐색 최고 점수, 저장소 개선 점수, 보지 못한 downstream 성능 |
| 문맥 내 학습 | 자연어 steering, 스킬 evolution | 관리 행동의 변화와 정확도·비용 Pareto 개선 |
| 가중치 학습 | OpenResearcher로 RL, BrowseComp-Plus 평가 | 성공률과 prefix-reuse FLOPs의 동시 개선 |
| 서빙 | Qwen3.6-27B의 SGLang·SCR 비교 | 정확도를 유지하면서 줄어든 재-prefill 계산 |
이 축을 분리해서 읽어야 합니다. 합성 과제의 정확도는 범용 코딩 능력과 같지 않고, 수학 탐색의 best-of-run은 반복 실행 평균과 같지 않습니다. 다음 장별 리뷰에서 원문이 각 평가를 어떤 순서와 설정으로 연결하는지 살펴봅니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
챕터의 위치와 역할: 문맥을 모델 밖에서 관리하던 관행을 문제로 제시하고, 진단·설계·학습·서빙을 하나의 연구 질문으로 묶습니다.
저자의 서술 순서를 따른 상세 내용:
- 현재 문맥 관리의 주체: 저자는 수작업 하네스와 오프라인으로 최적화된 하네스를 먼저 설명합니다. 최근 방법은 압축 시점 등을 모델에게 맡기지만, 사용할 수 있는 동작은 미리 정의되어 있습니다. CLM은 관리 동작의 선택뿐 아니라 절차의 구성까지 모델에 맡기자는 제안입니다.
- 문맥을 파일로 만드는 구현: live context를 저장 공간에 반영하고, 모델이 파일을 쓰면 다음 호출에 동기화합니다. 기본 덧붙이기를 유지하면서 필요할 때 편집할 수 있습니다. 여러 문맥 파일을 유지하면 각각을 별도 에이전트와 연결할 수 있다는 확장도 여기서 제시합니다.
- 효율의 역설과 서빙 설계: 중간 편집이 prefix cache를 무효화한다는 문제가 뒤따릅니다. 저자는 이 재계산을 빼고 비용을 유리하게 계산하지 않고, prefix-reuse FLOPs로 포함합니다. 이후 SCR은 그 재계산을 줄이는 별도의 서버 설계입니다.
- 연구 결과의 범위: ContextBench에서 출발하여 코딩·심층 검색, 수학 탐색, 12시간 저장소 개선, 24시간 다중 저장소 실험으로 확장합니다. 마지막으로 자연어 지침 진화와 RL이 문맥 관리 자체를 학습 가능한 대상으로 만든다고 설명합니다. 성능 수치의 조건은 5절과 부록 E에서 구체화됩니다.
챕터의 핵심 기여: 문맥 관리의 자율성을 기능 추가가 아니라 모델의 meta-capability로 정의합니다. 다음 챕터로의 연결: 이 자율성이 선행 연구의 도구 제어와 어떻게 다른지 비교합니다. 1절
📖 Chapter 2: Related Work
챕터의 위치와 역할: CLM이 주장하는 새로운 부분을 기존 방법의 범위와 대조합니다.
저자의 서술 순서를 따른 상세 내용:
- From harness-defined to action-based context management: 고정 길이 임계값에서 요약하는 방식에서 시작해, AutoCompact·Self-Compact처럼 압축 시점을 모델이 선택하는 방식, ACM처럼 오프로딩·검색을 제공하는 방식, Sculptor처럼 문맥 조각을 선택하는 방식으로 설명을 전개합니다. 모델의 자유는 커지지만 동작 공간은 사람이 정의합니다. CLM은 일반적인 파일 편집을 통해 이 공간을 넓힙니다.
- Context as a REPL variable: RLM은 긴 입력을 REPL 변수로 두고 필요한 부분을 읽어 옵니다. 저자는 이것을 무엇을 읽을지의 문제로 구분합니다. 읽은 결과와 후속 대화는 여전히 live context에 쌓이므로, 이를 언제 지우고 다시 구성할지의 문제는 남습니다. CLM은 그 live context에 직접 쓰기 권한을 줍니다.
- 상세 비교의 이관: 관련 연구의 RL·캐시·외부 메모리 비교는 부록 A로 이어집니다. 본문은 RLM을 대체 불가능한 경쟁자라고 단정하지 않으며, 부록은 입력을 외부에 보관하는 RLM과 내부 문맥을 관리하는 CLM이 상보적일 수 있다고 명시합니다.
챕터의 핵심 기여: 입력 접근과 현재 문맥 갱신을 분리하여 비교 기준을 정합니다. 다음 챕터로의 연결: 그 차이가 단순한 관리 과제에서 어떻게 드러나는지 진단합니다. 2절
📖 Chapter 3: Pilot Study with ContextBench: A Diagnostic for Context Management
챕터의 위치와 역할: 일반 지식이나 복잡한 추론을 최소화하고 문맥 관리 능력을 분리합니다.
저자의 서술 순서를 따른 상세 내용:
- 네 가지 진단 과제: Needle Retention은 중요 문자열을 그대로 남기는 능력을, Sudoku Sketchpad는 보드의 일부 셀과 버전을 제자리 갱신하는 능력을 봅니다. KV Store와 Log Triage는 대량 값을 밖에 저장했다가 정확히 회수하는 능력을 봅니다. Sudoku는 퍼즐을 새로 푸는 시험이 아니라 주어진 이동을 정확히 반영하는 시험입니다.
- 방법과 압력의 비교: GPT-5.4, 32K 문맥 한도에서 입력량/문맥 한도인 context pressure를 변화시킵니다. Base, Summary, Context Folding, RLM, Self-Compact, ACM과 CLM을 비교합니다. 그림의 과제별 압력 범위는 다르며 최대 24배에 이릅니다.
- 실패의 의미: 저자가 관찰한 요약 기반 방법은 중요한 문자열을 잃거나 잘못 만들 수 있습니다. 제자리 갱신이 유연하지 않으면 작은 셀 변경에도 보드 전체를 재생성해야 합니다. 파일에 데이터를 옮길 수 있는 도구가 있어도 현재 문맥에서 즉시 제거할 수 없다면 과거 입력이 계속 자리를 차지합니다.
- 해석의 범위: 이 진단은 실제 심층 검색이나 코딩을 대체하지 않습니다. 관리해야 할 답은 문맥 창 안에 담을 수 있게 설계하고, 방법별 도구 사용 지침을 제공하여 문맥 관리의 차이를 드러내려는 구성입니다. 생성·채점 규칙은 부록 D에서 확인할 수 있습니다.
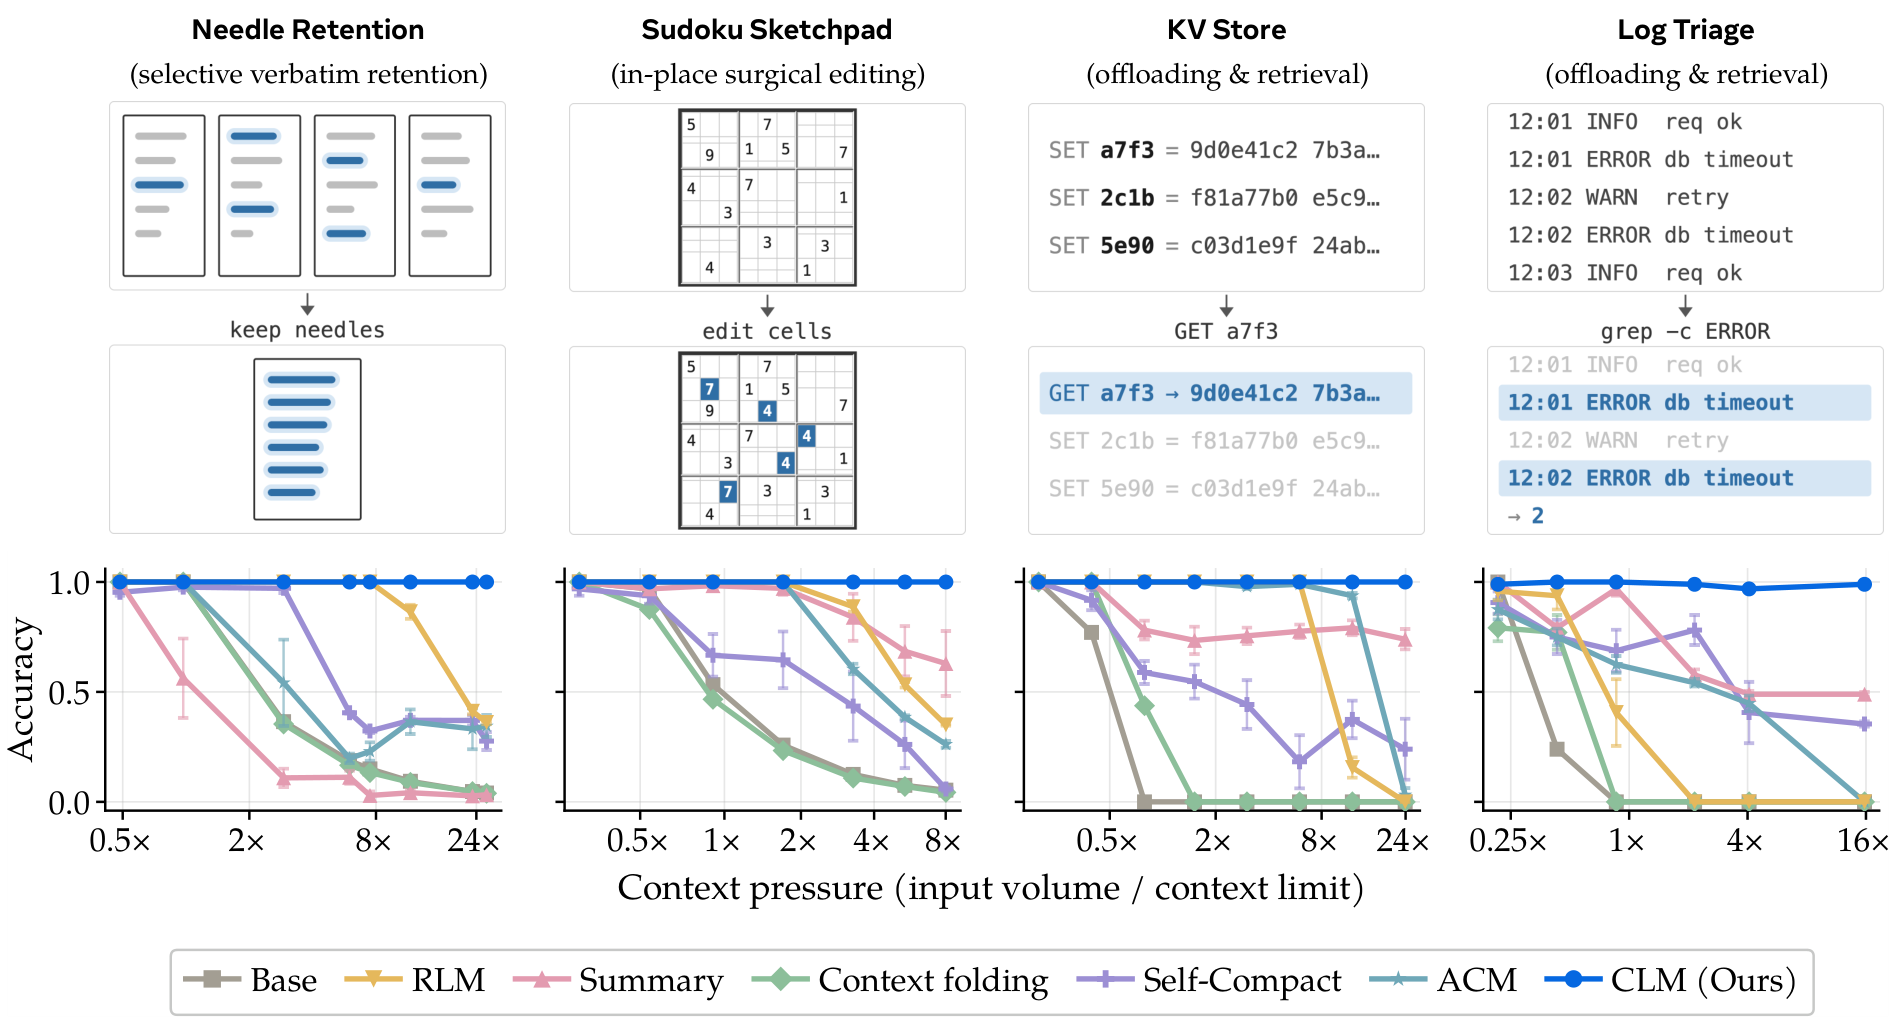
PDF Figure 2, 4쪽. 위는 과제의 관리 동작, 아래는 입력 압력에 따른 정확도입니다. 모든 과제를 동일한 현실 업무의 성공률로 해석하지 않습니다. 그림 영역만 크롭했으며 축·범례와 패널을 보존했습니다. 고정 버전 원문, CC BY 4.0.
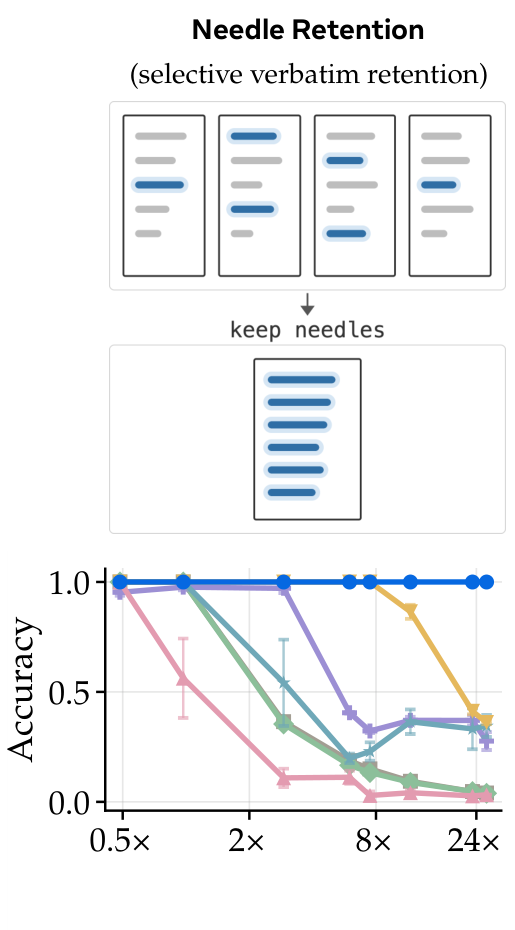
PDF Figure 2의 왼쪽 Needle Retention 패널 확대, 4쪽. 가로축은 문맥 압력, 세로축은 정확도이며 파란 원형 선이 CLM입니다. 전체 방법의 범례는 위의 전체 그림에 보존되어 있습니다. 모바일에서 과제 동작과 곡선을 살펴볼 수 있도록 해당 패널만 추가 크롭했으며, 수치·배치·색은 바꾸지 않았습니다. 원문, CC BY 4.0.
챕터의 핵심 기여: 관리 도구의 존재와 실시간 문맥 편집의 자유가 같지 않음을 보여줍니다. 다음 챕터로의 연결: 이를 일반화한 CLM의 상태 전환과 학습 방식을 정의합니다. 3절
📖 Chapter 4: Context Language Models (CLMs)
챕터의 위치와 역할: 모델의 권한, 학습 목표, 계산 비용과 캐시 구현의 관계를 정식화합니다.
4.1 Formal Definition and Implementation with Context as a File
첫째, 식 (1)·(2)는 덧붙이기만 하는 전환을 일반적인 문맥 변환으로 확장합니다. 기존 하네스의 관리 함수도 이 정의 안에 포함되지만, CLM은 함수를 미리 고정하지 않고 모델이 계획 속에서 또는 재사용 함수로 정의할 수 있게 합니다.
둘째, 구현은 live context 파일과 다음 모델 입력의 동기화입니다. 파일 경로를 알려 주는 것만으로 일반 메모 파일이 CLM이 되는 것은 아닙니다. 파일의 변경이 실제 호출 입력에 반영되어야 합니다. 여러 에이전트에서는 각각의 파일을 해당 서버 호출과 연결하고, subagent는 추가 파일 생성·삭제로 초기화·종료할 수 있습니다.
셋째, PDF Figure 3의 실제 실행 예시는 관리 전략이 다양함을 보여줍니다. 에이전트 상태를 기록하는 scoreboard를 163번 제자리 갱신하면서 6–8K 토큰을 유지한 사례, notes 역할을 만든 사례, 불필요한 검색 결과를 반복문으로 지운 사례가 있습니다. compact_turns 함수를 정의하고 37번 호출한 사례는 한 번의 요약보다 재사용 가능한 절차에 가깝습니다. 이들은 zero-shot 평가에서 수집한 정성적 사례이지, 모든 실행의 평균 행동은 아닙니다.
넷째, 저자는 비용에 편집 후 재-prefill을 포함합니다. 문맥의 앞을 자주 고치면 짧아진 입력이라는 이점이 캐시 손실로 상쇄될 수 있습니다. 따라서 편집 횟수나 삭제 토큰량만으로 효율을 평가하지 않습니다.
4.2 In-Context Learning and Reinforcement Learning for CLMs
Steering에서는 자연어 지침 또는 스킬 $s$를 추가해 문맥 전환을 $f^{\mathrm{CLM}}_\theta(c_t;s)$로 조건화합니다. 가중치나 하네스 코드를 바꾸지 않고도 특정 길이에서 압축하거나, 하위 질문이 끝날 때만 압축하도록 행동을 조정할 수 있습니다.
Evolution은 그 지침을 평가 피드백으로 개선합니다. 원문 식 (5)는 다음 목적을 둡니다.
$x$는 과제, $\mathcal D$는 과제 분포, $\tau(x;s)$는 지침 $s$로 만든 전체 실행 궤적, $R$은 궤적 수준 보상입니다. train split의 실행을 proposer가 읽고 후보 스킬을 만든 뒤 development split으로 다음 지침을 선택합니다. 최종 지침을 정한 뒤 held-out test에서 평가합니다. 강한 외부 모델이 지침을 제안하는 assisted evolution과 같은 모델이 양쪽 역할을 맡는 self-evolution을 구분합니다.
RL에서는 문맥을 고치면 최종 대화에 예전 입력이 남아 있지 않을 수 있다는 문제가 있습니다. 각 생성 구간을 그 구간이 실제 생성될 때의 입력과 함께 보존하고, 전체 궤적의 결과 advantage를 각 구간에 배분하는 stepwise GRPO를 사용합니다. 문맥 편집을 미분하는 접근은 아닙니다.
효율 보상은 성공 궤적 안에서만 비교합니다. 원문 식 (6)의 표기를 렌더링에 맞게 옮기면 다음과 같습니다.
$\mathcal G_g^+$는 rollout 그룹 $g$에서 성공한 궤적 집합이고, 여기의 $c_i$는 문맥이 아니라 궤적 $i$의 prefix-reuse FLOPs입니다. $\bar c_g$는 성공 궤적의 평균 비용입니다. 성공 평균보다 저렴하면 양수, 비싸면 음수이며 $\mathrm{clip}$은 값을 -1에서 1 사이로 제한합니다. 성공 궤적이 두 개 미만이면 비교가 불충분하므로 효율 advantage를 모두 0으로 둡니다.
$A_i^{\mathrm{out}}$는 결과 보상의 advantage, $w_{\mathrm{eff}}$는 효율 신호의 가중치입니다. 이 방식은 실패한 실행이 적은 계산을 썼다는 이유만으로 보너스를 받지 않게 합니다. 저자는 편집 빈도나 삭제량을 직접 보상하면 불필요한 편집이나 중요한 정보 삭제를 유도할 수 있어 이 목표를 택했다고 설명합니다.
4.3 (More) Efficient CLM Serving with Suffix Cache Reuse
문맥 $[A\,B\,C]$에서 $B$를 $B'$로 바꾸면 표준 서빙은 공통 접두사 $A$만 재사용하고 $B'$와 $C$를 다시 처리합니다. SCR은 바뀌지 않은 $C$의 캐시도 보존하여 새로 들어온 $B'$와 추가 토큰만 처리합니다.
중요한 조건은 $C$의 캐시가 이전 문맥을 반영한 stale state라는 점입니다. SCR은 완전한 재계산과 수학적으로 동일하지 않습니다. 저자는 과거 정보가 캐시에 남는 것이 일부 경우 도움이 될 수도 있다고 설명하지만, 논문이 검증한 것은 측정된 과제에서의 성능 보존입니다. 새 문맥의 모든 토큰을 정확히 다시 계산한다는 주장으로 바꾸어서는 안 됩니다.
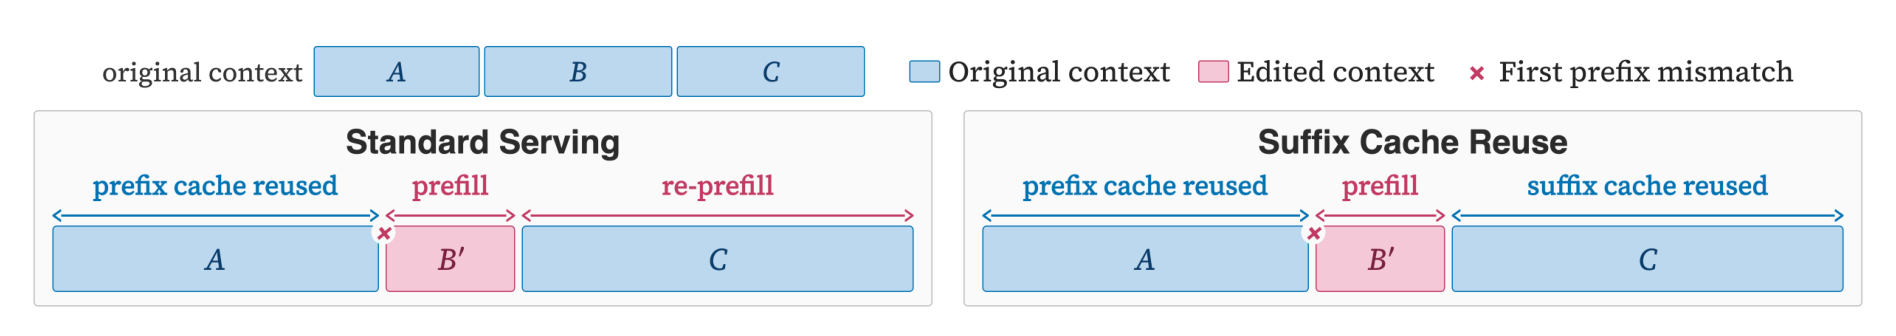
PDF Figure 4, 6쪽. 표준 서빙은 B′와 C를 다시 처리하고 SCR은 살아남은 C의 기존 캐시를 재사용합니다. 원문 그림 영역만 크롭했으며 의미를 바꾸지 않았습니다. 고정 버전 원문, CC BY 4.0.
챕터의 핵심 기여: 편집 권한, 지침·가중치 학습, 실제 캐시 비용을 함께 정의합니다. 다음 챕터로의 연결: 이 설계가 서로 다른 길이의 에이전트 업무에서 어떤 결과를 만드는지 확인합니다. 4절
📖 Chapter 5: Results
챕터의 위치와 역할: 추가 훈련 없는 효과, 전략 학습의 효과, 서버 최적화의 효과를 순서대로 분리합니다.
5.1 Evaluating CLMs Zero-Shot on Long-Horizon Agentic Tasks
5.1.1 Coding and Deep Research Tasks
저자는 코딩의 TerminalBench 2.1·TBLite와 심층 검색의 BrowseComp-Plus를 먼저 평가합니다. Mini-SWE-Agent 기반에서 MEM1, Self-Compact, ACM, RLM 등을 비교하며, 이 실험의 방법들은 추가 훈련 없이 적용합니다. 따라서 여기서 zero-shot은 답을 생성할 때 모든 방법을 처음 본다는 뜻보다 비교를 위한 별도 post-training을 하지 않았다는 의미로 읽어야 합니다.
Qwen3.6-27B의 BrowseComp-Plus 정확도는 CLM 59.4%입니다. 가장 강한 baseline인 Codex-style Summary보다 11.4% 상대 개선이며 11.4%p가 아닙니다. prefix-reuse FLOPs는 Summary보다 21.5%, MEM1보다 28.9% 적습니다. TerminalBench 2.1에서는 strongest baseline과 정확도를 맞추면서 계산량을 약 70% 수준으로 낮추고, TBLite에서는 73.7% 대 67.0%로 6.7%p 높으면서 계산량은 약 91% 수준입니다.
본문·그림은 32K 문맥 실험으로 설명하지만, 부록 E에는 BrowseComp-Plus의 세부 예산 23,560토큰이 적혀 있습니다. 코딩의 턴 한도도 PDF Figure 5 캡션은 100턴, 부록 E는 64턴으로 다릅니다. 이 차이를 하나로 추정하여 합치지 않고, 재현 시 확인할 원문 내부 설정 차이로 남깁니다.
5.1.2 Open Discovery Problems
첫째, 수학 최적화는 원의 배치, min-max/min-distance, Erdős overlap, Heilbronn 문제를 다룹니다. Claude 4.6 Sonnet, 32K, 최대 100회 평가 또는 5시간에서 OpenEvolve(OE), Mini-SWE-Agent proposer를 붙인 OE-Agent, CLM 및 subagent CLM을 비교합니다. 원문 Table 1은 각 방법의 한 번 실행에서 얻은 최고 점수입니다.
| 방법 | Circle packing ↑ | Heilbronn ↑ | Min-max/min-dist ↑ | Erdős overlap ↓ |
|---|---|---|---|---|
| OE | 2.541 | 0.03127 | 0.07690 | 0.38123 |
| OE-Agent | 2.525 | 0.03053 | 0.07724 | 0.38167 |
| CLM | 2.618 | 0.03653 | 0.07758 | 0.38094 |
| CLM + subagents | 2.636 | 0.03617 | 0.07758 | 0.38109 |
PDF Table 1, 7쪽을 전사했습니다. ↑는 클수록, ↓는 작을수록 좋습니다. 원문.
CLM 계열이 네 문제에서 최고값을 얻지만 subagent 변형이 모든 열에서 가장 좋은 것은 아닙니다. Heilbronn의 16.8% 상대 개선과 circle packing의 약 3.0% 개선은 일반 CLM과 OE의 비교입니다. 최고값 한 번을 보고 안정적인 반복 성능을 단정하지 않습니다.
둘째, EdgeBench-10은 공개 실행 가능 과제 중 10개에서 12시간 동안 저장소를 개선합니다. 과제마다 세 seed 중 최고 점수를 사용합니다. Qwen3.6-27B에서 CLM은 44.6점·179 PFLOPs/실행, Summary는 42.3점·437 PFLOPs/실행입니다. 2.3점 상승, 약 5.4% 상대 상승과 약 59% 계산 절감으로 구분할 수 있습니다. subagent CLM은 44.2점·181 PFLOPs여서 이 설정에서는 추가 이득이 작습니다. Claude 4.6 Sonnet에서는 CLM 51.0, subagent 50.4, Summary 42.3입니다.
셋째, Software World에서는 여섯 에이전트가 상호 의존하는 여섯 Python 저장소를 24시간 이상 최적화합니다. 직접 보지 못한 네 downstream package의 17개 CPU benchmark에서 실행 명령 수 기준 기하평균 speedup을 봅니다. 같은 API 지출에서 CLM swarm은 초기 release 대비 downstream speedup 개선량이 Summary swarm보다 65% 큽니다. 이는 정확도 65%p 상승이나 모든 패키지의 실행 시간 65% 감소를 뜻하지 않습니다. 외부 패키지에 개선이 전달되는지를 평가한다는 점이 단일 저장소 실험과 다릅니다.
5.2 Learning Better Context-Management Strategies in Context or in Weights
먼저 자연어 steering을 평가합니다. 특정 토큰 수를 넘을 때 압축하기, 하위 질문 경계에서 압축하기, 편집 전에 백업하기의 세 행동을 각각 한 문장으로 유도합니다. 행동 변화는 모델 가중치나 하네스 수정 없이 나타납니다. 이 실험은 무지침 대조군과 같은 질문을 비교하고 paired difference에 BCa bootstrap 신뢰구간을 사용합니다. 세 행동의 표본·예산은 부록 E에서 구분됩니다.
다음은 스킬 evolution입니다. assisted 조건에서는 Qwen3.6-27B가 실행하고 Claude Fable 5.1이 지침을 제안합니다. self 조건에서는 Opus 5가 실행과 제안을 모두 맡습니다. PDF Figure 8은 KV Store에서 정확도·비용 Pareto frontier가 개선되는 모습을 보여줍니다. 다른 과제와 held-out 결과는 부록 F로 이어집니다. 개발 집합의 frontier를 최종 test 성능이라고 바꾸어 읽지 않는 것이 중요합니다.
마지막은 RL입니다. Qwen3.5-9B를 OpenResearcher로 post-training하고 held-out BrowseComp-Plus에서 평가합니다. Table 2의 CLM 정확도는 28.8%에서 42.5%로 13.7%p, 상대적으로 47.6% 상승합니다. 비용은 질문당 1.52에서 1.34 PFLOPs로 약 11.8% 감소합니다. 학습된 Summary는 42.1%·2.19 PFLOPs입니다. 학습된 CLM의 정확도는 0.4%p 높고 계산은 약 38.8% 적지만, 0.4%p 차이만으로 통계적 우위를 주장하지 않습니다.
| 방법 | 학습 전 정확도 | 학습 후 정확도 | 학습 전 PFLOPs/질문 | 학습 후 PFLOPs/질문 |
|---|---|---|---|---|
| Summary | 34.7% | 42.1% | 4.01 | 2.19 |
| CLM | 28.8% | 42.5% | 1.52 | 1.34 |
PDF Table 2, 9쪽. checkpoint는 별도 validation 집합에서 선택했습니다. 원문.
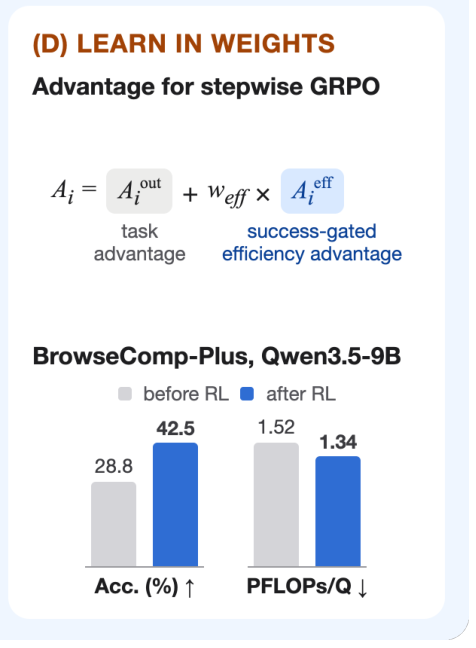
PDF Figure 1(d) 확대, 2쪽. 위는 결과 advantage와 성공 조건 효율 advantage의 결합, 아래는 Qwen3.5-9B의 학습 전후 정확도와 질문당 PFLOPs입니다. 앞서 실은 전체 개요에서 해당 패널만 추가 크롭했으며, 회색은 학습 전·파란색은 학습 후를 뜻합니다. 수치·배치·색은 바꾸지 않았습니다. 원문, CC BY 4.0.
5.3 (More) Efficient Serving with Suffix Cache Reuse
Qwen3.6-27B의 BrowseComp-Plus 서빙 비교에서 Standard SGLang과 SCR의 정확도는 모두 60.2%입니다. 그림의 질문당 계산량은 10.98에서 7.14 PFLOPs로 줄어 약 35% 감소합니다. 이는 앞선 zero-shot 비교의 59.4% 결과와 별도 서빙 실험이므로 숫자를 동일 실행의 결과처럼 합치지 않습니다.
전체 prompt token 분해에서는 SCR이 추가 재사용한 토큰이 7.8%이며, 실제 편집 직후 요청에서는 28.2%입니다. 이전 reasoning token이 chat template에서 제거될 때에도 표준 prefix cache가 끊길 수 있어, 이 최적화는 CLM의 명시적 파일 편집에만 국한되지 않습니다. 자세한 원인 분해는 부록 B에서 이어집니다.
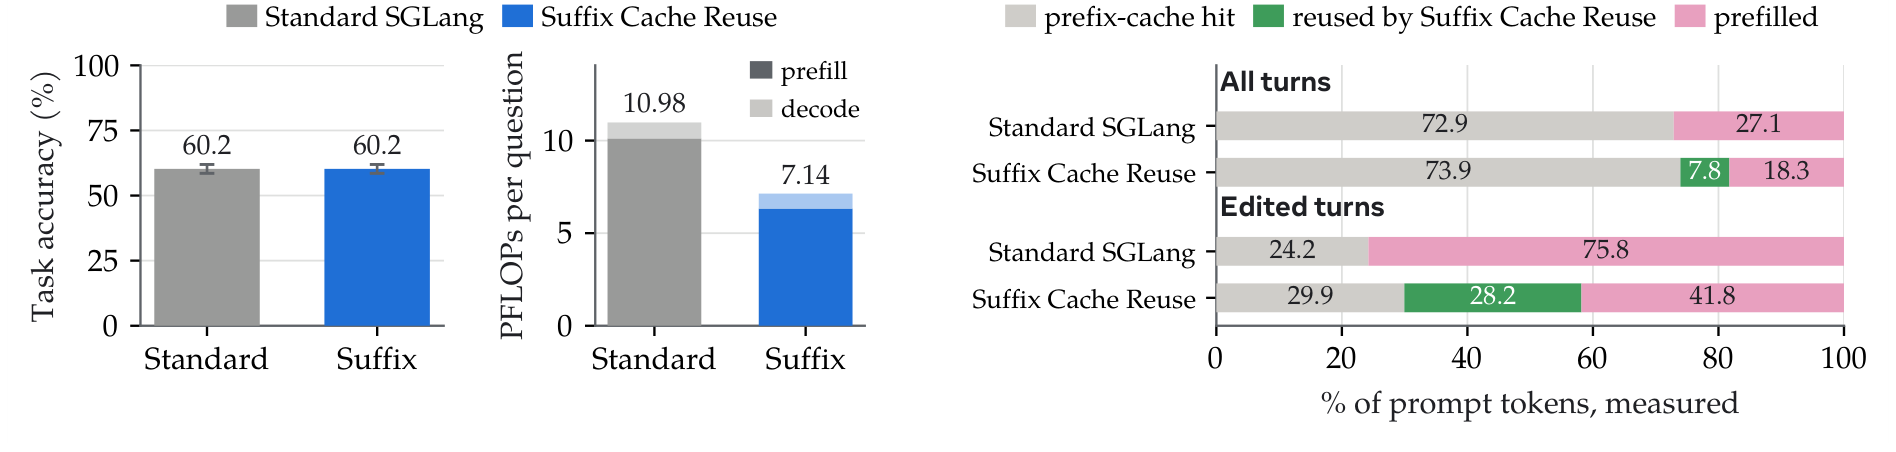
PDF Figure 9, 9쪽. 두 방법 정확도 60.2%, 질문당 10.98→7.14 PFLOPs와 token 처리 분해를 보여줍니다. 원문 그림만 크롭했으며 축·단위·범례를 보존했습니다. HTML에서는 Figure 11로 표시됩니다. 고정 버전 원문, CC BY 4.0.
챕터의 핵심 기여: 문맥 편집만으로 얻는 효과, 관리 전략을 학습한 효과, 서버 캐시 개선 효과를 분리하여 제시합니다. 다음 챕터로의 연결: 입력을 직접 수정할 권한이 갖는 안전성과 후속 연구를 논의합니다. 5절
📖 Chapter 6: Discussion and Future Work
챕터의 위치와 역할: 제안 방식의 권한 확대가 가져오는 안전 문제와 저자가 실제로 제시한 후속 방향을 정리합니다.
저자의 서술 순서를 따른 상세 내용:
- Safety implications of a model-editable context: 편집 가능한 문맥은 prompt injection 또는 모델이 스스로 만든 지침이 여러 턴에 걸쳐 남는 통로가 될 수 있습니다. 저자는 compaction summary에 비인가 지침이 삽입된 선행 사례를 인용합니다. CLM 자체에서 새로운 공격 성공률을 측정한 결과를 제시한 것은 아닙니다. 새 공격 표면을 특성화하고, 유연성을 유지하면서 문맥의 무결성을 보장하는 방어를 연구해야 한다고 명시합니다.
- Future directions: scaling CLM RL and distilling existing harnesses into CLMs: 더 큰 RL 학습으로 관리 전략을 탐색하고, 기존 하네스의 절차를 CLM 행동으로 옮겨 가중치에 내재화하는 방향을 제안합니다. 저자의 관점에서 하네스는 문맥을 구성·갱신하는 절차적 기억으로 볼 수 있습니다. 이를 흡수하는 파이프라인은 후속 방향이며 본 논문의 완료된 결과는 아닙니다.
- Acknowledgments와 References: 본문은 감사와 지원 내역, 참고문헌으로 마무리됩니다. 이 리뷰는 인용 문헌 전체의 원문을 별도 검증했다고 주장하지 않습니다.
챕터의 핵심 기여: 효율과 자율성의 확대를 안전성의 완료로 오해하지 않게 합니다. 다음 내용으로의 연결: 이후 부록 A~G가 관련 연구, 구현, 비용식과 실험 세부 근거를 제공합니다. 6절
📖 Chapter A: Extended Related Work
챕터의 위치와 역할: 본문 2절의 비교를 관리 주체·행동 공간·학습·캐시·메모리 축으로 확장합니다.
저자의 서술 순서를 따른 상세 내용:
- Harness-scheduled context management: Cursor·Codex·Terminus2의 길이 임계값 기반 compaction과, 매 턴 정보를 결합하는 MEM1을 설명합니다. Composer·CompactionRL 등의 훈련은 이 절차 안에서 유용한 정보를 보존하는 능력을 개선하지만, 업데이트 시점과 절차는 하네스가 지정합니다.
- Model control within a constrained action space: Self-Compact·AutoCompact의 압축 시점 선택, ACM·AgeMem의 관리 도구, Context Folding·AgentFold의 분기와 접기, Sculptor의 조각별 연산을 정리합니다. 훈련으로 도구 사용을 개선하더라도 연산의 종류는 인터페이스에 묶입니다.
- Model-controlled context through meta optimization: Meta-Harness·AutoMem·Meta Context Engineering은 평가 궤적으로 재사용 절차를 개선합니다. CLM의 skill evolution도 유용한 문맥 관리 절차를 개선한다는 목표를 공유하되, live context를 편집하는 모델의 지침으로 표현합니다.
- Context as a variable in the environment: RLM이 외부화하는 것은 큰 입력이고, CLM이 편집하는 것은 실행 중 누적되는 현재 문맥입니다. 필요한 입력을 늦게 가져오는 방식과, 가져온 뒤의 정보를 관리하는 방식은 함께 사용할 수 있습니다.
- Non-prefix KV cache reuse: Prompt Cache의 모듈 재사용, CacheBlend·EPIC의 문서 조각 재사용, PIE의 코드 편집 뒤 캐시 이동, Memento의 요약 캐시 유지와 SCR을 비교합니다. SCR은 이 재사용 원리를 live context 편집과 hybrid architecture에 적용합니다. 이 선행 연구의 설명은 본 논문이 제공한 비교 범위입니다.
- Reinforcement learning for context management: 과거 생성 구간의 입력을 보존하여 학습해야 하는 이유를 ReSum·Sculptor와 연결합니다. 단순 문맥 길이가 아니라 편집이 유발하는 재계산까지 비용으로 삼는 것이 CLM 효율 보상의 차이입니다.
- Success-conditioned efficiency objectives: 정답인 응답에만 길이 비용을 주는 선행 연구와 목적이 닮았지만, CLM은 길이 대신 궤적 전체 FLOPs를 사용합니다. 따라서 적게 출력해도 입력 재계산이 많으면 비싼 실행으로 평가될 수 있습니다.
- Context management and external memory: 외부 메모리는 현재 문맥 밖의 정보를 보관하고, 문맥 관리는 각 호출에 실제 보일 정보를 결정합니다. live context 파일도 파일이지만 역할상 모델 입력이며, 다른 파일은 읽어 올 때만 문맥에 들어오는 외부 메모리입니다. 저장 형식이 같다고 같은 기능인 것은 아닙니다.
챕터의 핵심 기여: CLM이 기존 memory·RLM·prompt optimization과 공유하는 부분과 다른 부분을 구분합니다. 다음 챕터로의 연결: 이어서 suffix 캐시 재사용을 구체적으로 구현합니다. 부록 A
📖 Chapter B: Suffix Cache Reuse
챕터의 위치와 역할: 본문 4.3절의 단순한 그림을 실제 캐시 저장·위치 이동·hybrid state 처리로 구체화합니다.
저자의 서술 순서를 따른 상세 내용:
- Background: radix tree and prefix cache reuse in SGLang: SGLang은 토큰열을 radix tree로 저장하고 가장 긴 공통 접두사의 KV cache를 재사용합니다. 최초 불일치 이후에는 재사용을 멈춥니다. hybrid model의 linear-attention state는 토큰별 KV가 아니라 고정 크기 recurrent state여서 checkpoint가 있는 지점에서만 재개할 수 있습니다.
- Implementation for standard full attention layers: 새 prompt와 직전 prompt를 diff하여 남은 구간을 찾고, 가장 긴 구간부터 최대 $K$개를 이동합니다. key의 rotary position을 새 위치로 다시 회전시키고, 새로 들어온 구간과 연결합니다. 이동된 cache는 session 전용 slot에 보관하여 공유 radix tree를 오염시키지 않습니다. slot을 확보할 수 없으면 표준 재-prefill로 돌아갑니다. 위치 보정이 이전 prefix의 영향을 지우지는 않으므로 근사입니다.
- Implementation for linear-attention layers: Qwen3.6-27B는 64층 중 48층이 linear attention, 16층이 full attention입니다. linear 층은 토큰별 cache를 옮길 수 없어 편집 전 recurrent state snapshot에서 계속합니다. 따라서 삽입 구간은 그 linear 층에서 완전히 재계산되지 않지만 full-attention 층에서는 재계산되며, 그 출력이 후속 linear 층에 영향을 줄 수 있습니다.
- Multiple surviving post-edit spans: 한 번에 많은 구간을 옮기면 오래된 상태의 근사가 겹칠 수 있어 $K$를 제한합니다. 64개 BrowseComp-Plus 질문에서 $K\in\{1,2,3,6,12,64\}$를 비교했고, 효율 이득은 대체로 6에서 포화되어 기본값을 6으로 둡니다. PDF Figure 11은 질문 간 ±1 standard error를 표시하고 일부 반복 실행도 보여줍니다. 이 소규모 결과에서 성능 저하가 관찰되지 않았다는 것을 임의의 편집에 대한 안전 보장으로 확대하지 않습니다.
- Stripped reasoning tokens in chat endpoints: chat template이 과거 reasoning block을 제거하면 에이전트가 직접 문맥을 편집하지 않아도 이후 token의 prefix가 달라집니다. 전체 prompt token 중 SCR 추가 재사용 7.8%의 5.3%p는 reasoning stripping, 2.5%p는 나머지 문맥 편집에서 옵니다. 따라서 35% 계산 절감을 모두 CLM 파일 편집의 효과라고 설명하면 안 됩니다.
- A common serving bottleneck and future improvement space: 남는 중복 prefill 상당 부분은 unchanged suffix보다 unchanged prefix에 있습니다. hybrid model에서 recurrent state를 요청 경계에만 저장해 중간 분기점 가까이에서 재개할 수 없는 현재 SGLang 구현의 문제라고 저자는 설명합니다. message boundary처럼 더 촘촘한 위치에 state를 두는 것은 원문이 제안한 개선 방향입니다.
챕터의 핵심 기여: SCR의 절감 원인과 근사 조건, 실패 시 fallback과 남은 병목을 공개합니다. 다음 챕터로의 연결: 캐시를 고려한 비용 계산을 식으로 정리합니다. 부록 B
📖 Chapter C: Prefix-Reuse FLOPs Computation
챕터의 위치와 역할: 단순 토큰 수가 포착하지 못하는 입력 재계산을 정량화합니다.
저자의 서술 순서를 따른 상세 내용:
- 입력·출력·재사용 길이 정의: 턴 $t$의 prompt 길이는 $P_t$, 생성 길이는 $G_t$, 재사용 가능한 leading prefix는 $R_t$입니다. 새로 처리할 입력은 $U_t=P_t-R_t$입니다. 출력은 생성 시 decode된 뒤, 다음 prompt에 들어오면 cache 조건에 따라 prefill될 수 있습니다.
- 모델별 상수: 식 (7)은 MLP·full-attention projection·Gated DeltaNet projection의 token당 비용 $C_{\mathrm{token}}$을 합칩니다. 층 수, hidden width, MLP width, query/KV head 수와 차원을 사용하고 multiply-add를 2 FLOPs로 셉니다. 식 (8)은 full-attention의 query–key pair당 비용 $C_{\mathrm{attn}}=4L_{\mathrm{attn}}h_qd_h$를 정의합니다. 여기서 $L_{\mathrm{attn}}$는 full-attention 층 수, $h_q$는 query head 수, $d_h$는 head 차원입니다.
- 턴과 궤적 비용: 원문 식 (9)는 다음과 같습니다.
첫 항은 처리한 입력과 출력 token의 선형 연산입니다. 대괄호의 첫 항은 prefill 중 attention, 나머지 두 항은 decode가 이전 prompt 및 생성 이력에 attention하는 비용입니다. $T$는 전체 턴 수입니다. 같은 $P_t$에서도 $R_t$가 작아지면 재계산이 커지므로 편집 위치가 효율에 중요합니다.
4. 생략 항과 해석: 원문 계산은 embedding·output layer, DeltaNet recurrent update, normalization·activation·softmax 등을 생략합니다. 따라서 측정된 wall-clock time이나 GPU 전력의 직접 대체값이 아니라, 동일 모델·계산 규칙에서 방법을 비교하는 이론적 지표입니다. 5. Example: Qwen3.6-27B: 64층, hidden size 5,120, MLP width 17,408을 대입하면 token당 약 $48.70\times10^9$ FLOPs, query–key pair당 약 $3.93\times10^5$ FLOPs입니다. 입력 20,000·출력 500의 설명용 가상 길이에서 prefix 18,000이면 $1.41\times10^{14}$, prefix 10,000이면 $5.74\times10^{14}$, 재사용 0이면 $10.81\times10^{14}$ FLOPs입니다. 마지막은 첫 경우의 약 7.7배이며 실제 benchmark 실행에서 추출한 세 사례가 아닙니다.
챕터의 핵심 기여: 짧게 쓰기·적게 출력하기·캐시를 잘 보존하기를 구분할 계산 근거를 제공합니다. 다음 챕터로의 연결: 이후 합성 진단의 생성과 채점 규칙을 설명합니다. 부록 C
📖 Chapter D: ContextBench
챕터의 위치와 역할: 합성 benchmark가 무엇을 시험하고 무엇을 미리 통제했는지 밝힙니다.
저자의 서술 순서를 따른 상세 내용:
- Design and examples of ContextBench tasks: 입력은 operation의 연속이며 매 operation이 새 user message로 live context에 들어옵니다. 에이전트는 현재 operation을 처리한 뒤
echo READY_FOR_NEXT_OP로 다음 입력을 받습니다. 하네스가 입력을 먼저 잘라 숨기지 못하게 하여, 문맥에 들어온 정보를 어떻게 처리하는지 평가합니다. - 해결 가능성과 압력: 32,768 token 중 응답용 2,048을 제외한 30,720을 사용합니다. 한 operation은 사용 가능 공간의 1/5, 반드시 보존할 전체 정보는 1/2 안에 들어가도록 각각 10% 여유를 둡니다. 따라서 창보다 큰 답을 요구해 실패시키려는 설계가 아닙니다. 압력은 에피소드 총입력/o200k 기준 32,768이며, 1배 미만의 통제 조건도 둡니다.
- 과제별 세부 채점: Needle은 chunk마다 2–8개 핵심 줄과 140개 filler 줄을 주고 마지막 context에 원문 그대로 남은 비율을 봅니다. Sudoku는 16×16 보드의 이동마다 정확한 version을 요구합니다. KV Store는 100개 SET씩 입력하고 24개 GET의 값을 정확히 비교합니다. Log Triage는 14–54줄씩 들어오는 서비스 로그에서 24개 조회·개수 질문을 채점합니다. 파일에만 있는 답은 점수를 받지 못하고 실제 context에서 확인합니다.
- Detailed instructions for isolated context-management diagnostics: 모든 방법에 같은 과제 지침과, 해당 방법의 도구를 사용하기 위한 비슷한 수준의 상세 skill을 제공합니다. 부록 Table 4는 기작 설명 → batch 처리 → query 응답 → 처리 확인의 네 종류 지침을 나란히 보여줍니다. CLM에만 명시적 사용법을 알려 주어 생기는 차이를 줄이려는 통제입니다. 방법별 기능 자체가 같아지는 것은 아니므로 그 기능 차이가 측정 대상입니다.
챕터의 핵심 기여: 정확성 평가와 관리 도구 사용 안내를 공개해 진단의 타당성을 설명합니다. 다음 챕터로의 연결: 실제 benchmark와 학습의 모델·예산·seed 조건을 정리합니다. 부록 D
📖 Chapter E: Experimental Configurations
챕터의 위치와 역할: 본문의 성능 수치를 재현할 때 필요한 실행·채점·학습 조건을 제공합니다.
저자의 서술 순서를 따른 상세 내용:
- 공통 baseline 규칙: Summary는 예산 75%에서 압축하고, Self-Compact는 37%를 넘으면 두 턴마다 점검합니다. RLM·ACM은 공개 구현을, MEM1은 저자 재구현을 사용합니다. CLM은 한도 2,048 token 전에 편집 reminder를 받습니다. 별도 언급이 없으면 o200k로 token budget을 계산하고 같은 base LM으로 비교합니다. 따라서 모델이 환경 정보 없이 길이를 완벽히 스스로 아는 실험은 아닙니다.
- ContextBench: GPT-5.4 API, 32,768 budget·2,048 reserve입니다. level당 네 seed를 사용하고 일부 level은 분산을 줄이기 위해 여덟 seed입니다.
- TerminalBench 2.1: 89개 과제를 verifier pass/fail로 평가합니다. Qwen은 thinking을 활성화한 vLLM, 호출당 최대 4,096 생성 token, 32,000 budget을 사용합니다. 부록의 한도는 64턴, 명령당 180초, 과제 기본 시간의 4배입니다. 종료 원인과 무관하게 마지막 container 상태를 채점합니다.
- TBLite: 호출당 최대 생성 2,048, budget 32,000이며 턴·시간 제한은 TB2.1과 같습니다. 정확도는 verifier reward 평균입니다.
- BrowseComp-Plus: 고정 corpus의 830개 전체 질문을 사용합니다. 검색은 상위 10개·각 512 token snippet, 문서 reader는 8,192 token으로 제한합니다. vLLM thinking, temperature 0.7, top-p 0.95, 호출당 최대 4,096 생성 token, budget 23,560·100턴입니다. CLM 편집 턴은 턴 수에서 제외하며, 예산 초과 시 마지막 턴을 되돌려 최대 여섯 번 재시도합니다. Qwen3.5-27B judge가 정답·완전성을 판정하며 미응답은 오답입니다.
- Math optimization problems: 문제별 방법당 한 실행입니다. 최대 100회 evaluator 제출 또는 5시간입니다. OE는 population 60·island 네 개, OE-Agent proposer는 후보당 25턴, subagent CLM은 최대 다섯 subagent·각 40턴입니다. 문제별 목적함수 방향을 Table 1과 함께 읽어야 합니다.
- EdgeBench-10: 공개 실행 가능 48개 중 10개이며 조합 최적화, graph classification, 취약점 분석, 테스트 데이터 생성, 게임 등으로 구성됩니다. 네트워크 없는 container에서 12시간·세 seed, 0–100 judge score를 사용합니다. 실행 점수는 최고 제출과 마지막 저장소 평가 중 높은 값입니다. 32K와 128K 예산 실험이 있고 턴 제한은 없습니다. 비용에는 subagent 계산도 포함합니다. 동시 subagent 수는 본문 최대 다섯과 달리 이 부록에는 최대 여섯으로 적혀 있습니다.
- Software World: requests·urllib3와 네 downstream package를 여섯 agent가 병렬 개선합니다. 별도의 보지 못한 네 package에서 17개 CPU 과제를 평가하며 깨진 benchmark는 speedup 1.0으로 셉니다. Pi harness의 GPT-5.6-Sol·272K context, 비용은 누적 USD입니다. 이 실험 비용을 앞의 prefix-reuse PFLOPs와 직접 합산할 수 없습니다.
- In-context steering: Claude 4.6 Sonnet, reminder 없는 CLM에서 같은 질문을 무지침 조건과 비교합니다. threshold는 긴 질문 30개·48K budget, boundary는 네 질문 연결 세션 189개/조건, backup은 200개 질문 중 91개 paired analysis입니다. 각기 첫 압축 시점, 경계 두 턴 이내 압축 비율, 편집 전 전체 복사 비율을 보고 paired BCa bootstrap interval을 사용합니다. 성능 정확도 검정과 관리 행동 검정을 구분합니다.
- In-context evolution: 후보 skill은 train 여섯 instance에서 시작하여 frontier 이상의 정확도이면 12개를 더 평가하고, task별 development 102개에서 선택합니다. assisted test는 archive를 고정한 뒤 102개·세 seed로 한 번 평가합니다. proposer 네 개가 병렬로 성공·실패 궤적을 읽으며 다섯 번 연속 개선이 없으면 lineage를 멈춥니다. frontier는 정확도와 비용으로 정하고, development accuracy가 1 SE 안에서 비슷하면 비용을 봅니다. Qwen 비용은 예산 안에 끝난 실행의 FLOPs, Opus 비용은 USD입니다.
- Reinforcement learning: OpenResearcher prompt 3,040개로 70 step을 학습합니다. step당 prompt 여덟 개·각 rollout 32개, 학습률 $10^{-6}$, KL coefficient 0.01입니다. CLM은 28K budget·2,048 reserve·최대 80턴으로 편집 턴을 제외하고, Summary는 28,672에서 압축·최대 100턴입니다. 효율 가중치 0.25는 CLM의 context-management token에 적용합니다. policy용 H200 16개, rollout용 48개를 사용하고, OpenResearcher validation 500개에서 checkpoint를 골라 BrowseComp-Plus 830개를 평가합니다. validation과 test를 구분하는 절차가 명시됩니다.
챕터의 핵심 기여: 같은 모델이라는 통제뿐 아니라 방법별 reminder·retry·편집 턴 처리도 결과 해석에 필요함을 드러냅니다. 다음 챕터로의 연결: 기본 설정 밖의 모델 크기·예산·학습 결과를 비교합니다. 부록 E
📖 Chapter F: Supplementary Results
챕터의 위치와 역할: 본문 결과가 모델 크기와 예산에 따라 달라지는 양상을 보완합니다.
저자의 서술 순서를 따른 상세 내용:
- TerminalBench 2.1, TBLite and BrowseComp-Plus with models of different sizes: Qwen3.6-27B는 세 benchmark의 Pareto frontier에 놓이고 BCP 59.4%를 얻습니다. 이 부록의 별도 zero-shot Qwen3.5-9B 비교는 BCP CLM 39.9%·Summary 37.7%입니다. 이는 Table 2의 RL 전 28.8%·34.7%와 같은 설정으로 취급하지 않습니다. TB2.1에서 작은 모델은 평균 1.4회 편집하며 절반의 과제에서는 편집하지 않습니다. 큰 모델은 평균 2.6회 편집합니다. peak context 중앙값은 작은 모델 30.2K, 큰 모델 17.6K입니다. 저자는 자유를 활용할 능력에 따라 이득이 커진다고 해석합니다.
- Math optimization problems: PDF Figure 18은 평가 횟수에 따른 best-so-far, 개별 후보의 점, 마지막 점수 범위를 함께 제시합니다. 이를 통해 최종 최고값뿐 아니라 탐색 진행을 볼 수 있습니다. 방법별 한 실행이라는 조건은 유지됩니다.
- EdgeBench-10 with a 128K context budget: 128K에서 subagent CLM은 50.2점·219 PFLOPs, 단일 CLM은 47.3점·142 PFLOPs, Summary는 47.8점·222 PFLOPs입니다. 32K에서 이득이 작던 subagent가 더 큰 예산에서 점수를 높입니다. 그러나 단일 CLM보다 계산은 더 들기 때문에 정확도와 효율을 분리하여 비교해야 합니다. Base는 초기 두 시간 안에 개선이 멈추고 관리 방법들은 12시간 동안 계속 개선합니다.
- In-context evolution: assisted development accuracy는 Needle 97.6→100.0%, Sudoku 45.3→65.8%, KV 22.3→83.8%, Log 0.0→100.0%입니다. held-out KV test는 38.3→74.2%, 즉 35.9%p입니다. development의 큰 상승폭을 held-out 결과로 소개하지 않습니다. self-evolution의 Opus 5 초기 정확도는 94–100%이며 정확도를 유지·개선하면서 비용을 줄이는 결과도 보고합니다.
- Reinforcement learning: PDF Figure 21은 70 step까지 정확도와 FLOPs, 두 지표의 관계를 학습 진행에 따라 표시합니다. CLM·Summary에 FLOPs reward를 넣고 뺀 ablation을 보여주며, 효율 신호가 뚜렷한 정확도 손실 없이 비용을 낮추는 경향을 보고합니다. checkpoint 선택 절차는 부록 E를 따릅니다.
챕터의 핵심 기여: 자율성의 이득이 모델의 관리 능력과 문맥 예산에 의존함을 보여줍니다. 다음 챕터로의 연결: 모델이 언제 관리해야 하는지 판단할 기본 능력인 문맥 길이 인식을 점검합니다. 부록 F
📖 Chapter G: Analysis on the Context Length Awareness of Existing LMs
챕터의 위치와 역할: 모델이 스스로 문맥을 관리하려면 소비한 예산을 얼마나 잘 아는지 진단합니다.
저자의 서술 순서를 따른 상세 내용:
- 진단의 필요성: 길이를 잘 모르면 잦은 외부 개입에 의존하고, 편집 후에도 낡거나 중복된 정보가 남을 수 있다고 설명합니다. 따라서 문맥 편집 권한과 정확한 길이 인식은 다른 능력입니다.
- 추정값과 실제값 비교: 길이가 다른 50개 입력에 대해 현재 token 수를 추정하게 하고 provider가 보고한 실제 길이와 비교합니다. 무힌트와 입력 25%·50%·75% 지점의 token-count anchor 조건을 비교하며 mean absolute error(MAE)를 보고합니다. 힌트가 추정 지점에 가까울수록 더 도움이 됩니다.
- 관찰과 해석의 구분: 긴 문맥에서 6.2K·9.8K·10.4K 같은 반복적인 구간값을 예측하는 경향을 관찰합니다. 학습에서 본 token-counting pattern의 영향일 수 있다는 설명은 저자의 추측입니다. Claude 4.6 Sonnet의 과소추정 경향과 비교 모델 중 GPT-5.4의 더 좋은 정렬도 보고합니다.
- 저자가 제시한 방향: 현재 모델의 긴 문맥 길이 인식은 제한적이며 환경 힌트가 도움을 줍니다. 향후 CLM 훈련에 이 신호를 포함할 수 있다고 제안합니다. 본 실험에서 reminder를 쓰는 이유가 이 결과와 연결됩니다.
챕터의 핵심 기여: 모델에게 제어권을 주었다는 사실만으로 예산 인식까지 해결된 것은 아님을 명확히 합니다. 원문은 이 부록에서 끝나며, 이어지는 새로운 챕터는 없습니다. 부록 G
실험 결과 심층 분석
성능 차이는 단위와 비교 대상을 함께 읽어야 합니다
| 핵심 결과 | 실제 비교와 조건 | 해석의 경계 |
|---|---|---|
| BCP 59.4%, 11.4% 상대 개선 | Qwen3.6-27B zero-shot, strongest Summary 대비 | 11.4%p 상승이 아닙니다 |
| TBLite 73.7% 대 67.0% | 같은 base model의 verifier 평가 | 6.7%p 차이이며 비용도 함께 봅니다 |
| EdgeBench 44.6 대 42.3 | 10개 과제·12시간·best-of-three | 반복 평균이나 전체 48개 과제 결과가 아닙니다 |
| RL 28.8→42.5% | Qwen3.5-9B, 별도 validation으로 checkpoint 선택 | 13.7%p/47.6% 상대 상승을 구분합니다 |
| KV test 38.3→74.2% | assisted skill evolution, archive 고정 뒤 test | development 22.3→83.8%와 구분합니다 |
| SCR 10.98→7.14 PFLOPs | 별도 BCP 서버 실험, 정확도 양쪽 60.2% | 벽시계 지연·API 비용 35% 감소를 뜻하지 않습니다 |
실험 설계가 답하는 질문
ContextBench는 필요한 정보를 창 안에 보관할 수 있게 만들고, 방법별 skill을 제공하여 관리 기작을 비교합니다. 실제 benchmark는 그 관리 차이가 코딩·검색과 오래 지속되는 탐색으로 전달되는지 봅니다. Software World의 unseen downstream 평가, evolution의 개발·test 분리, RL의 별도 validation checkpoint 선택은 각각 직접 최적화한 대상 바깥으로 결과가 전달되는가를 확인하는 장치입니다.
반대로 비용의 분모를 섞으면 결과가 달라 보입니다. 일반 benchmark는 prefix-reuse FLOPs, Software World는 누적 USD, self-evolution은 gateway USD를 씁니다. EdgeBench 점수는 best-of-three이지만 비용은 trial당 평균이며, 수학 문제는 best-of-run입니다. 이 지표는 서로 동일한 통계량이 아닙니다.
통계적 신뢰도와 관찰된 실패
통계적 근거가 전혀 없는 논문은 아닙니다. steering은 paired BCa bootstrap interval을, SCR의 소규모 $K$ 민감도는 질문 간 ±1 SE와 일부 반복 실행을 보고합니다. ContextBench는 seed를 여러 개 사용합니다. 그러나 모든 본문 성능 차이에 대한 유의성 검정이 보고된 것은 아니며, Table 2의 0.4%p 차이 등을 유의한 우위로 표현하지 않습니다. 수학 문제의 한 실행 최고값 역시 반복 분산에 대한 검정이 아닙니다.
저자가 제시한 실패·조건 차이는 관리 전략의 적용 범위를 설명합니다. 요약은 문자열을 잃거나 잘못 생성할 수 있고, 작은 모델은 문맥을 충분히 편집하지 않거나 RL 전 Summary보다 낮은 성능을 보일 수 있습니다. subagent의 효용은 32K와 128K에서 다릅니다. SCR은 이전 상태를 재사용하는 근사이며, 성능 보존 관찰은 평가 범위 안의 결과입니다. 이 내용은 원문 3·5절과 부록 B·F에 근거합니다.
재현성에서 확인할 정보
원문은 모델, serving engine, budget, seed, judge, 학습 하이퍼파라미터와 공개 코드 위치를 제공합니다. 동시에 본문 그림과 부록의 코딩 100/64턴, BCP 32K/23,560 token, EdgeBench subagent 다섯/여섯 표기가 다릅니다. 이 리뷰는 어느 쪽이 실제 실행 설정인지 임의로 확정하지 않았습니다. 코드 실행으로 이 차이를 해결하거나 결과를 재현했다고도 주장하지 않습니다. 재현성 평가는 공개된 정보의 범위와 이러한 원문 내 차이를 함께 기록하는 수준입니다.
기술적 함의와 응용
원문이 보여준 성과는 문맥을 직접 편집하는 범용 인터페이스가 여러 관리 전략을 담을 수 있고, 그 전략을 자연어와 가중치 학습 양쪽으로 개선할 수 있다는 것입니다. 특정 task의 고정된 요약 절차를 늘리는 대신 모델이 유지할 상태와 처리 절차를 선택하게 했고, 계산 비용에는 그 선택이 일으키는 캐시 손실까지 포함했습니다.
리뷰어 해석으로는 긴 검색·코딩 작업을 설계할 때 세 층을 나누어 이해하는 데 도움이 됩니다. 무엇을 보존할지 결정하는 관리 정책, 그 결정을 실제 다음 입력에 반영하는 실행 환경, 편집된 입력을 효율적으로 처리하는 서빙 엔진입니다. 외부 메모리에 결과를 저장하는 것만으로 live context가 줄지는 않고, 문맥을 줄이는 것만으로 서버 재계산이 줄지도 않습니다. CLM은 이 세 층의 연결을 구체적으로 보여주는 사례입니다.
실제 적용에 관한 원문의 고려사항은 편집 가능한 문맥의 무결성, 현재 모델의 길이 인식, SCR의 근사와 hybrid cache 제약입니다. 미래 방향도 저자가 명시한 범위로 한정됩니다. RL 규모 확대, 기존 하네스 절차의 CLM 내재화, 문맥 편집 공격 표면과 방어, recurrent-state checkpoint의 세분화, 길이 인식 신호의 학습입니다. 이들은 후속 과제이며 이미 해결된 기능으로 소개하지 않습니다.
CLM의 핵심은 큰 창을 제공하는 데서 끝나지 않습니다. 모델이 다음 호출에서 무엇을 볼지를 직접 구성하고, 그 관리 전략의 성능과 실제 계산 효과를 함께 학습·평가한다는 데 있습니다.
분석 범위: v1의 본문 1~6절과 부록 A~G의 모든 소제목을 원래 순서로 다루었습니다. 참고문헌 원문 전체, 공개 코드의 실행, 개별 rollout·skill의 모든 문자열, 모든 추가 그래프의 개별 점과 학습 체크포인트의 독립 재현은 이 리뷰에 포함하지 않았습니다. 인용 그림은 PDF 원본을 크롭했으며, 다른 표와 그래프는 본문에서 명시한 수치와 조건을 중심으로 설명했습니다.