논문 개요와 전체 구조
금융 보고서를 잘 쓰는 일은 과거의 사실을 많이 찾는 일보다 어렵습니다. 분석가는 기업·산업·정책 사이의 관계를 연결하고, 당시 알려진 정보로 이후 전개를 판단해야 합니다. 미래에 공개된 기사를 검색해 과거 시점의 보고서를 작성한다면, 문장은 설득력 있어도 평가에는 미래 정보 누출이 섞입니다. FinanceHarness는 금융 조사 에이전트의 실행 구조와 시간 제약을 가진 평가 환경을 함께 설계한 연구입니다.
논문은 두 대상을 구분합니다. FinanceGym은 질문마다 자료 접근 기준일을 정하고, 기준일 이전의 사실 종합과 이후 사건에 대한 판단을 따로 평가하는 벤치마크입니다. FinanceHarness는 이 환경에서 검색·읽기·계산·인용·보고서 완성을 수행하는 계층형 실행 체계입니다. harness는 모델을 감싸는 도구와 실행 규칙의 묶음이며, 새로운 언어모델의 이름이 아닙니다. 동일 Qwen3.6-27B에서 검색만 사용한 점수 25.3%가 전체 harness에서는 32.4%로 높아집니다. 여기서 점수는 투자 수익률이나 정답률이 아니라 질문별 루브릭의 정규화 평균입니다. 원문 v2, §1·§6.2
이 리뷰는 2026년 7월 30일 최초 제출되고 8월 7일 수정된 arXiv:2607.27853v2의 HTML과 55쪽 PDF를 읽었습니다. PDF 표지에는 8월 6일이 인쇄되어 있지만 버전의 arXiv 수정일과 구분합니다. 저자는 Yijia Xiao, Rujun Han, Yanfei Chen, Zifeng Wang, Ke Jiang, Zhongying CuiZhu, Vishy Tirumalashetty, Wei Wang, Burak Gokturk, Tomas Pfister, Chen-Yu Lee로, 원문 표지에서 11명을 확인했습니다. 아래 설명은 레포의 구현 리뷰와 별도로 논문의 데이터 구축·평가·실험을 중심으로 합니다.
원문 구조는 다음과 같습니다. 챕터별 상세 리뷰에서도 이 순서를 유지합니다.
| 순서 | 원문 섹션과 하위 구조 | 주요 역할 |
|---|---|---|
| 1 | Introduction | 금융 조사와 시간 제약 평가의 필요성 |
| 2 | Related Work: Financial benchmarks → Research agents → Deep-research evaluation | 기존 벤치마크·에이전트와의 차이 |
| 3 | FinanceGym Construction: 3.1 PIT sandbox → 3.2 Situation-driven construction → 3.3 Evaluation Contract | 검색 환경·상황 기반 질문 생성·평가 계약 |
| 4 | FinanceHarness: 4.1 Expert-guided Harness Design → 4.2 Evaluation and Optimization | 실행 계층과 학습 환경의 일치 |
| 5 | Experimental Setup: 5.1 Dataset → 5.2 Baselines → 5.3 Protocol | 비교군과 블라인드 채점 조건 |
| 6 | Results and Analysis: Cost-quality Frontier → 6.1 Performance → 6.2 Training | 전체 결과·설계 효과·GRPO |
| 7 | Conclusion | 결과의 종합 |
| 후속 | Limitations → References | 명시적 한계와 참고문헌 |
| A | FinanceHarness Ablation Breakdowns | 주제·추론·산업·상황별 절제 실험 |
| B | Cross-Backbone Harness Evaluation | 11개 구성요소 과제의 모델 간 평가 |
| C | Additional Analysis: C.1 Tool shift → C.2 Pre/Post → C.3 Trade-offs → C.4 Axes | 결과 해석의 경계 |
| D | Case-Study Reports: D.1 Industry → D.2 DCF → D.3 Risk → D.4 Comparables → D.5 Derivatives → D.6 Fixed Income | 생성 보고서의 구체적 사례 |
| E | Case-Study Trajectories: E.1 Industry → E.2 DCF | 보고서 뒤의 도구 호출 과정 |
핵심 기여와 혁신성
문제의 중요성은 평가 시점에 있습니다. 일반적인 장문 조사 평가는 현재 웹의 정보를 종합하는 능력을 측정합니다. 금융 분석에서는 “그때 알 수 있었던 것”과 “나중에 확인된 것”을 분리해야 과거 정보 정리 능력과 전망 능력을 구별할 수 있습니다. 원문은 이를 point-in-time(PIT), 즉 특정 시점까지 이용 가능한 정보로 제한하는 계약으로 정의합니다.
기존 접근의 한계는 과업 단위와 평가 조건에 있습니다. 금융 NLP 벤치마크의 감성 분석·개체 인식·공시 질의응답은 유용하지만 산업 관계와 미래 판단을 포함한 분석가형 보고서 전체를 측정하지는 않습니다. 일반 deep research 평가도 대부분 질문별 출판일 제한과 기준일 전후 루브릭을 함께 제공하지 않습니다. 이는 원문의 비교 관점이며 기존 과제가 무가치하다는 뜻은 아닙니다. §2, Table 1
해결책의 독창성은 상황 기반 데이터 생성과 실행·평가·학습의 계약 공유입니다. 금융 개체 그래프에서 관계·시간 흐름·서로 충돌하는 관측을 찾아 질문을 생성하고, 질문마다 투자 논지와 전후 시점 평가 기준을 연결합니다. 동일 검색 API·문서 접근 규칙·인용 요건을 평가와 강화학습에 사용해, 도구가 바뀌면서 모델의 학습 경험이 어긋나는 문제를 직접 다룹니다.
파급효과에 대한 리뷰어 해석은 평가 설계의 이동 가능성입니다. 시계열·정책·산업 전망을 다루는 데이터과학 과제에서도 자료의 출판일, 예측 기준일, 사후 확인 신호를 별도 필드로 보존하면 “잘 검색한 결과”와 “당시 근거로 잘 판단한 결과”를 구별하는 데 도움이 됩니다. 논문이 이러한 다른 분야에서 성능을 실험했다는 뜻은 아닙니다.
기술적 세부사항
시간 제약 검색과 질문의 평가 단위
검색 서버는 문서의 실제 출판일이 질문의 cutoff date 이하인 자료만 반환합니다. cutoff는 보고서에 사용할 수 있는 정보의 경계입니다. post-cutoff 루브릭이 있다는 것은 에이전트에게 미래 자료를 보여준다는 의미가 아닙니다. 에이전트는 질문과 기준일만 받고, 채점자는 기준일 이후의 확인 자료를 이용해 전망이 어떤 수준으로 충족되는지 평가합니다. 누출이 탐지된 실행은 낮은 점수로 남기는 대신 무효화합니다. §3.3
핵심 수식: 기준일 선정과 점수의 분모
원문 식 (1)은 상황에 관련된 후보 날짜를 선정합니다. 표시 폭을 줄이기 위해 곱을 두 줄로 나누되 의미는 그대로 유지했습니다.
$d$는 후보 날짜, $v(d)$는 이벤트 양, $e(d)$는 개체 다양성, $r(d)$는 관계 엔트로피입니다. $z$는 후보 날짜들에 대한 z-score이며 식에서 직접 z-score가 적용되는 항은 이벤트 양입니다. 사건이 많은 날짜를 선호하면서, 하나의 기업이나 관계 유형에 치우친 배치의 영향을 다양성 항으로 조절합니다. 관계 엔트로피를 10으로 나누는 배율도 원문 그대로입니다. 이 식은 모델의 예측 정확도를 직접 최적화하는 손실함수가 아닙니다. §3.2, 식 (1)
원문 식 (2)의 Outcome은 두 단계 평균입니다.
위 식의 $U_q$는 원문의 긴 분수를 나누어 적기 위해 이 리뷰에서 붙인 보조 기호입니다. $Q$는 평가 질문 집합, $\mathcal R(q)$는 질문 $q$의 루브릭 항목 집합, $c$는 개별 평가 기준입니다. $\mathrm{score}(q,c)$는 0~4점이며 분모의 4는 항목당 최대점수입니다. 먼저 각 질문의 획득 점수를 그 질문의 최대점수로 나누고, 질문별 결과를 동일 가중치로 평균합니다. 따라서 루브릭이 많은 질문이 전체 점수를 독점하지 않습니다. 백분율로 보고할 때는 이 값을 100배 합니다. §3.3, 식 (2)
실험에서 무엇을 고정했는가
공통 PIT 검색 인프라 위에서 모델만 바꾸는 비교와, 동일 모델 위에서 실행 절차를 바꾸는 비교를 나눕니다. Qwen3.6-27B 고정 절제 실험은 검색만 → 단순 harness → 전체 harness → GRPO 학습 순서입니다. 이 비교가 설계 기여를 판단하는 가장 직접적인 근거입니다. 다른 모델이나 다른 scaffold 간 순위는 같은 목적의 절제 실험과 구분해야 합니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
챕터의 위치와 역할: 금융 조사에 일반 deep research 체계를 그대로 적용하기 어려운 이유를 제시하고, 이후의 환경 구축과 harness 설계를 하나의 문제로 연결합니다.
저자의 서술 순서를 따른 상세 내용:
- 일반 deep research의 발전: 검색과 다단계 추론으로 여러 출처의 장문 보고서를 만드는 에이전트가 널리 사용되고 있다는 배경에서 시작합니다. 여기서 필요한 능력은 단일 문장의 질의응답을 넘어 검색·합성·인용을 반복하는 조사입니다.
- 금융 분석의 추가 요구: 원문은 반도체 기업을 조사하는 분석가를 예로 듭니다. 과거 실적만 정리해서는 충분하지 않고 경쟁사 상황, 수요, 거시 조건과 향후 전개를 연결해야 합니다. 이 때문에 분야 도구와 분석 절차를 제공하는 실행 체계가 필요합니다.
- 기존 평가의 빈틈: 과거·현재 상황에 답하는 조사 벤치마크와 분리된 금융 NLP 과제는 기준일 이후 판단을 가진 보고서 전체의 품질을 측정하기 어렵다고 설명합니다. 사후 정보를 끌어와 전망을 맞히는 지름길을 차단해야 합니다.
- 해결 구도: 출판일을 가진 대규모 코퍼스와 검색 제어, 금융 개체 그래프를 이용한 질문·루브릭, 전문 실무 지식을 반영한 harness를 차례로 제시합니다. 평가와 환경 내 최적화가 같은 계약을 공유한다는 점을 강조합니다.
- 기여의 요약: 400개 전문가 검토 질문의 FinanceGym, 이를 실행하는 FinanceHarness, 여러 모델·시스템의 벤치마킹을 제시합니다. 서론의 “모든 시스템 40% 미만” 문장은 §6 Figure 5의 Opus-5 결합 44.9%와 일치하지 않습니다. 이 리뷰는 고정 모델 비교에는 Table 4를, 확장 모델 비용 비교에는 Figure 5와 그 설명을 각각 사용합니다.
챕터의 핵심 기여는 시간 경계를 검색 편의 기능이 아니라 연구 평가의 필수 조건으로 제시한 것입니다. 다음 챕터로의 연결은 금융 벤치마크·연구 에이전트·장문 평가가 각각 어디까지 이 요구를 충족했는지 비교하는 흐름입니다. §1
📖 Chapter 2: Related Work
챕터의 위치와 역할: 기존 연구를 금융 문제, 실행 구조, 평가 방법의 세 축으로 분리해 FinanceGym과 FinanceHarness의 위치를 정합니다.
저자의 서술 순서를 따른 상세 내용:
- Financial benchmarks: 감성 분석과 개체 인식, SEC 공시 QA, 금융 특화 LLM 평가를 먼저 설명합니다. FinanceGym은 개체·산업·사건·시간을 연결하는 장문 보고서를 목표로 하며, 기준일 이전 근거와 이후 결과를 두 층의 루브릭으로 분리합니다. Table 1은 장문, 고정 코퍼스에 의한 재현성, 질문별 PIT, 루브릭, 외부 확인 가능성으로 비교합니다.
- Research agents: RAG와 ReAct를 바탕으로 조사 정책이 어디에 존재하는지 구분합니다. TTD-DR·GPT-Researcher·STORM 등은 코드 scaffold에 조율 절차를 넣고, Tongyi-DR·MiroThinker 등은 도구 호출 궤적 학습을 모델에 반영합니다. 금융 에이전트의 기존 거래 의사결정 연구와 달리 이 논문은 분석가형 보고서 생성에 초점을 둡니다.
- Deep-research evaluation: 장문·인용 중심 평가와 풍부한 루브릭이 늘었지만, live web 또는 하나의 전역 스냅샷을 쓰는 경우 질문별 정보 경계가 없다고 설명합니다. LLM-as-judge는 규모를 늘릴 수 있으나 역사적 사실의 검색과 미래 판단의 충족 정도를 항목별로 귀속해야 합니다.
- Table 1의 비교 해석: FinanceBench는 같은 금융 분야지만 단문 QA이고, BrowseComp-Plus와 DeepResearchGym은 고정 코퍼스의 이점이 있지만 질문별 cutoff를 적용하지 않습니다. DeepScholar-Bench는 PIT 축에서 가깝지만 arXiv 색인의 변화에 연결됩니다. 여러 금융 요구를 한 평가에 결합했다는 것이 원문의 주장입니다.
챕터의 핵심 기여는 모델의 능력, scaffold의 기여, 도구 분포 변화가 다른 비교라는 관점을 마련한 것입니다. 다음 챕터로의 연결은 이 구분을 실제로 실험할 수 있는 검색 환경과 데이터 생성 절차입니다. §2, Table 1
📖 Chapter 3: FinanceGym Construction
챕터의 위치와 역할: 논문의 중심 데이터 설계입니다. 검색 환경을 정의하고, 그 환경에서 질문을 생성한 뒤, 최종 보고서 평가 계약을 정합니다.
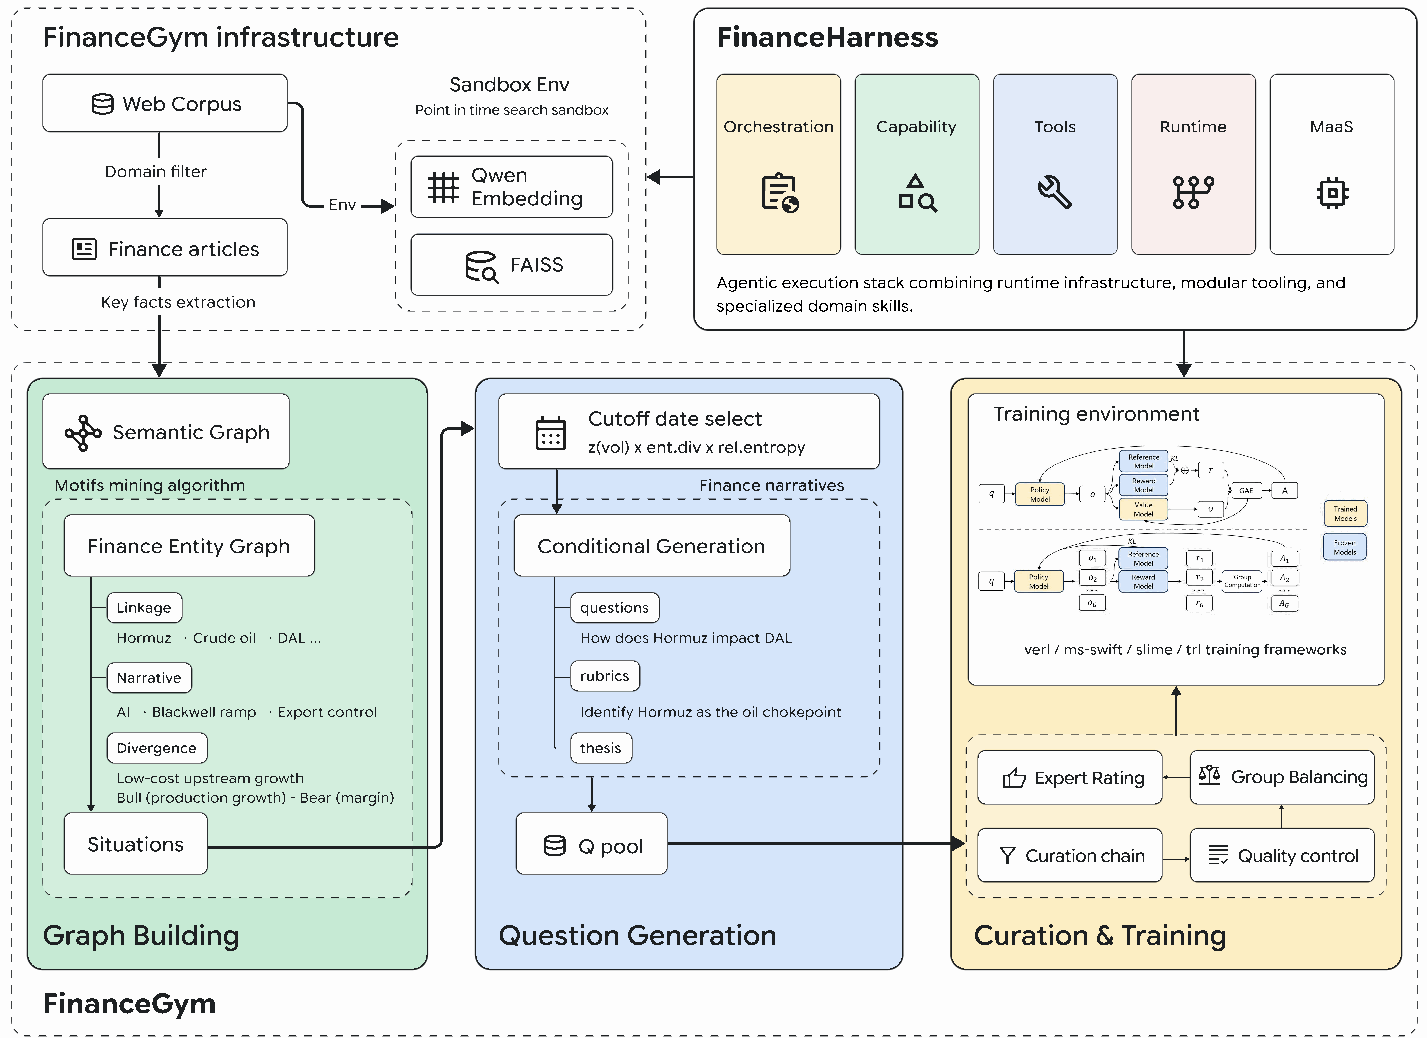
Figure 1, PDF 4쪽. 웹 기사 필터링, FAISS와 PIT 저장소, 금융 개체 그래프와 상황 추출, 기준일 선정, 질문 생성, 큐레이션·균형화·전문가 검토를 연결합니다. 원문 그림 영역을 크롭했으며 패널을 재배열하거나 번역하지 않았습니다. 원문 v2
3.1 Point-in-Time Financial Search Sandbox
Source corpus에서 수천 개 공개 웹 도메인의 기사를 수집합니다. htmldate로 출판일을 추출하고 trafilatura로 본문을 정리하며, 정규화된 메타데이터를 남깁니다. 1억 건 이상의 기사를 포함해 정제된 공시만 제공하는 과제보다 실제 웹 검색의 잡음과 폭을 보존하려는 설계입니다. 코퍼스는 내부 개발·평가 환경이며 공개 질문과 분리됩니다.
Embedding and storage에서는 Qwen3-Embedding-4B의 정규화된 dense vector를 사용합니다. 벡터 색인과 전체 본문 저장소를 분리하여 먼저 후보를 검색하고, 필요한 자료의 본문을 읽어 인용할 수 있게 합니다. Search server는 FAISS IVF-SQ8 색인을 API로 제공하며 기준일 이후 자료를 막습니다. 검색과 읽기는 가능하지만 live web으로 우회할 수 없는 환경이 headline 실험의 조건입니다.
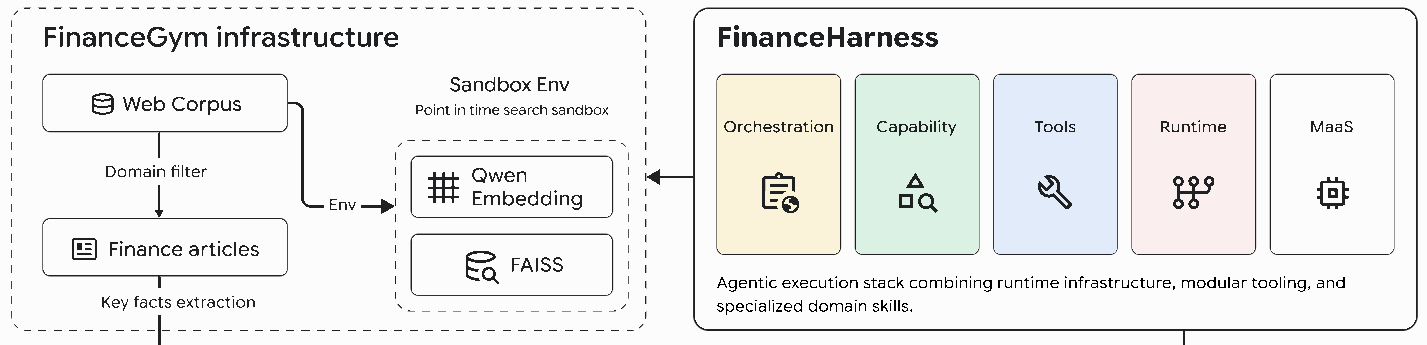
Figure 1 상단 상세, PDF 4쪽. 작은 라벨을 읽을 수 있도록 원본의 상단 영역을 추가 크롭했습니다. 전체 그림의 대체물이 아닌 상세 보기입니다. 원문 v2
이 설계에서 날짜는 단순 정렬 키가 아닙니다. 같은 질의라도 질문별 cutoff에 따라 이용 가능한 문서 집합이 달라집니다. 출판일 메타데이터를 검색 접근 제어까지 연결한다는 점이 PIT의 작동 원리입니다.
3.2 FinanceGym: Situation-Driven Benchmark Construction
Finance graph construction에서는 금융 관련 자료를 먼저 걸러 Gemini-3.5-Flash의 구조화 JSON 출력으로 개체-관계 삼중항을 뽑습니다. 간선에는 시작 개체·관계·끝 개체뿐 아니라 국소 문맥, URL, 출판일을 보존합니다. 원시 간선 574만 개에서 일반적이거나 잘못된 노드를 제거한 작업 그래프는 437만 간선, 111만 개체, 120만 원문 기사를 갖습니다. 기사 수와 전체 검색 코퍼스의 1억 건 이상은 서로 다른 단계의 규모입니다.
Situation mining에서는 넓은 주제로 묶기보다 분석가가 질문을 발견하는 상황을 찾습니다. 첫째, 서로 다른 범주의 개체와 사건을 잇는 linkage에서 다단계 관계 경로를 찾습니다. 둘째, 연결이 많은 개체를 중심으로 사건의 시간적 서사를 만듭니다. 셋째, 상향·하향 평가나 실적 기대의 충족·미달처럼 서로 충돌하는 관측을 찾습니다. 특정 대형 기업의 반복 표집을 제한하는 entity budget으로 표본 집중을 제어합니다.
Publication-date cutoff selection and unconstrained generation에서는 앞서 설명한 식 (1)로 기준일을 선택합니다. 상황과 날짜를 전달받은 LLM은 분석가형 질문, 참조 투자 논지, 두 층 루브릭을 생성합니다. 프롬프트에 주제·산업·추론 taxonomy를 미리 주지 않는 것이 unconstrained generation의 의미입니다. 질문을 만든 후 분류하기 때문에 미리 정한 주제 틀로 질문을 유도하지 않으려는 접근입니다.
Bottom-up taxonomy에서는 생성된 질문을 배치 단위로 분류하고, 원시 분류를 topic·sector·reasoning type의 세 축으로 통합합니다. Figure 2는 400개 질문의 주제와 산업을 두 겹 sunburst로, 추론 유형을 donut으로 표시합니다. taxonomy는 생성 프롬프트의 제한이 아니라 결과의 균형과 보고에 사용됩니다.
Quality filtering and balancing에서는 실현 가능성, 기관 실무 관련성, 일관성, 근거 충실성, 축별·날짜별 균형의 LLM 품질 게이트를 적용합니다. 29,669개 자유 생성 결과에서 2,078개 publication pool을 얻고, 정수 선형계획(ILP)으로 축별·월별 제약을 만족하면서 품질을 높이는 500개 부분집합을 선택합니다. 단순히 많이 생성한 다음 처음 500개를 고른 과정이 아닙니다.
Expert annotation에서는 외부 전문 데이터 업체의 검토자가 질문의 실현 가능성과 명료성을 평가하고, 각 루브릭의 실행 가능 여부와 이유를 적습니다. 질문당 전문가 작업은 약 1.2시간이며, 검토된 500개 중 411개가 통과해 약 82%입니다. 이 값은 전문가가 모든 모델 답변을 맞다고 판단한 비율도, 최종 400개의 모델 성공률도 아닙니다. 이후 균형화를 거친 최종 데이터는 400개 질문과 2,464개 루브릭, 9개 주제, 11개 원시 산업을 합친 9개 leaf, 6개 추론 유형, 12개 월별 cutoff bucket으로 구성됩니다. Figure 3은 검토 가능성과 명료성 분포, Figure 4는 기준일의 월별 분포를 보여줍니다.
Release policy에서는 각 질문이 공개 정보로 답할 수 있고 분석 대상이 명확한지 확인하며, 개인 정보와 원문 저작물을 질문에 누출하지 않는지 확인합니다. underlying corpus는 공개하지 않고 질문과 제출 코드를 공개합니다. 루브릭은 점수 무결성을 위해 비공개 leaderboard에 둡니다. 따라서 공개 질문·코드만으로 내부 검색 코퍼스와 채점 전체를 동일하게 재구성할 수 있다고 말할 수는 없습니다.
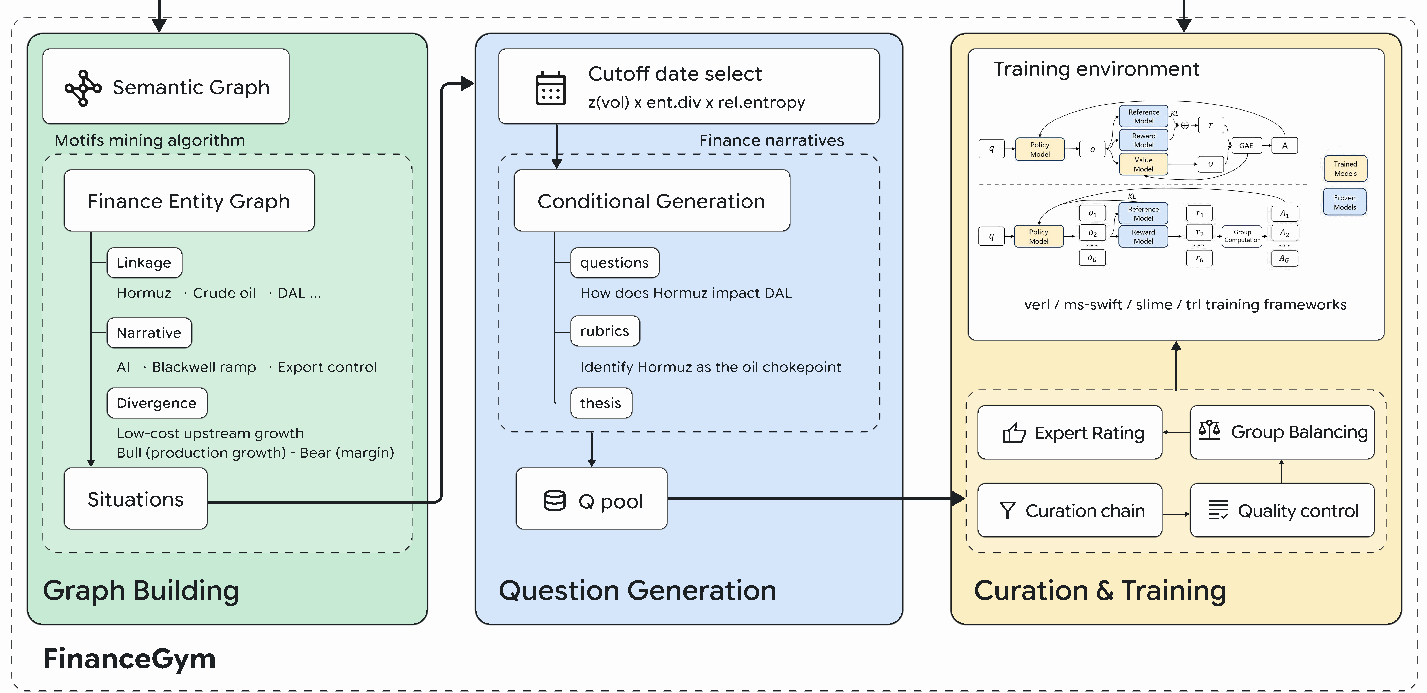
Figure 1 하단 상세, PDF 4쪽. 그래프 구축, 질문 생성, 큐레이션과 학습 패널을 원래 배치대로 크롭했습니다. 연결선과 패널명을 보존했습니다. 원문 v2
3.3 Evaluation Contract
Rubric-based scoring은 0~4점의 다섯 수준으로 평가합니다. 0은 다루지 않음, 1은 언급, 2는 부분 충족, 3은 실질적인 설명, 4는 충분한 근거 연결입니다. judge는 질문·논지·기준일·평가 기준·인용 URL을 포함한 보고서를 봅니다. 검증된 루브릭을 적용하는 역할이며, 매번 새로운 평가 기준을 발명하는 역할이 아닙니다.
Outcome은 질문별 최대 점수로 정규화한 뒤 질문들에 동일 가중치로 평균합니다. 기준 유형·주제·산업·추론·날짜별로 분해한 결과도 같은 방식을 사용합니다. Point-in-time protocol은 검색 결과의 출판일이 cutoff 이하인지 서버에서 통제하고, 에이전트의 live web 접근을 막습니다. pre-cutoff는 당시 근거의 검색과 종합, post-cutoff는 나중에 확인할 수 있는 전개를 당시 분석이 얼마나 다루었는지 평가합니다. 누출은 실행 무효 사유입니다.
챕터의 핵심 기여는 질문 생성부터 접근 제어와 평가 분모까지 하나의 계약으로 묶었다는 점입니다. 다음 챕터로의 연결은 이 계약을 실제 보고서 작성과 학습에서 실행하는 harness입니다. §3
📖 Chapter 4: FinanceHarness
챕터의 위치와 역할: 앞에서 정의한 검색·평가 환경에 에이전트의 행동 구조를 연결합니다. 전문 지식을 긴 기본 프롬프트 하나에 모두 넣는 대신 계층과 필요 시 로딩으로 분리합니다.
4.1 Expert-guided Harness Design
Model and serving layer는 조사 조율 모델과 긴 문서에서 근거를 뽑는 가벼운 reader를 제공합니다. runtime은 요청·응답 계약만 보므로 로컬 serving이나 폐쇄형 SDK로 backbone을 바꿔도 조율 로직을 바꿀 필요가 없도록 설계합니다.
Runtime layer는 제한된 에이전트 루프, 응답 파싱과 도구 dispatch, schema 검사, tier 로딩, 프롬프트 mode, 복구, 도구·skill registry를 소유합니다. 원문은 이 계층 자체에는 모델 지능이 없다고 설명합니다. 담당하는 것은 schema 준수, 도구 출력의 연결, 인용 확정, 실행 예산 같은 불변조건입니다. 언어모델이 계획을 제안하고 runtime이 실제 실행 계약을 강제하는 구조로 이해할 수 있습니다.
Tool surface는 세 층입니다. 항상 로딩되는 core tier는 검색·읽기·인용·보고서 완성을 지원합니다. deferred tier는 작은 catalog로 먼저 보이고 모델이 특정 도구 family를 선택하면 전체 schema를 로딩합니다. extension tier는 MCP나 CLI 기반 connector로 유료 데이터나 내부 시스템을 연결합니다. 이 확장 가능성과 headline 실험의 PIT 환경은 구분해야 합니다. 확장 도구가 있다고 실험에서 모든 live data를 자유롭게 사용한 것은 아닙니다.
Modes and skills는 같은 도구 surface 위에서 프롬프트를 바꿉니다. research mode는 웹 근거 조사, analytical mode는 데이터·계산, automatic mode는 선택을 강조합니다. mode를 바꿔도 registry를 일관되게 유지하므로 이전 궤적에서 사용하던 도구가 갑자기 사라지지 않습니다. skill은 도구와 전문 문맥을 선언한 재사용 워크플로이며, 고정 이름 비교가 아니라 설명을 바탕으로 선택합니다.
Grounding and robustness에서는 직접 호출과 skill 로딩을 모두 허용합니다. 읽은 출처에서 번호 인용을 구성하고, 초안에서 인용 도구가 빠지면 인용을 보완하며, 근거와 연결하지 못한 주장을 완화하거나 귀속하도록 가벼운 grounding review를 수행합니다. 일시적 모델 실패, 잘못된 호출, 문맥 예산, 출력 잘림을 복구하되 평가 계약 자체는 바꾸지 않습니다.
Operational guardrails는 비용과 최종 점수를 구분하게 합니다. URL pre-fetch로 비싼 읽기 전에 문서 ID를 검사합니다. 이를 끄면 visit 오류율이 2.1%에서 39.4%로 늘지만 최종 점수는 크게 바뀌지 않았다고 보고합니다. backbone의 자기 수정이 보고서 점수를 회복해도 궤적 비용은 커질 수 있습니다. 검색량이 많을수록 낮은 점수가 나타나는 상관은 어려운 질문에서 검색이 늘어난 효과로 해석하며, 검색 cap의 주된 목적을 비용 통제로 설명합니다. 원문은 이 운영 수치의 상세 표를 본문에 제공하지 않으므로 최종 Outcome 차이와 같은 통계 검정 결과로 취급하지 않습니다.
4.2 Evaluation and Optimization
도구 호출은 PIT FAISS 서버로 직접 이어지고, 벤치마크 judge는 학습 reward의 구성요소로도 사용됩니다. backbone만 바꾸면 검색 API, 문서 fetch, 인용 요구, 평가 기준은 고정됩니다. 이는 다른 도구 stack에서 학습한 조사 모델이 평가 환경으로 이동할 때 생기는 분포 차이를 줄이려는 설계입니다. 부록 D의 보고서와 E의 도구 궤적으로 실행 예를 제공하지만, 그 live-web 사례를 headline PIT 실험과 섞지 않습니다.
챕터의 핵심 기여는 금융 전문가의 절차를 도구·skill·runtime 계약으로 표현하고 모델 layer와 분리한 것입니다. 다음 챕터로의 연결은 이 체계를 어떤 데이터와 비교군으로 평가했는지 설명하는 실험 설정입니다. §4
📖 Chapter 5: Experimental Setup
챕터의 위치와 역할: 데이터 생성 규모, 실제 headline 평가 집합, 비교군, judge의 정보 범위를 명확히 합니다.
5.1 Benchmark Dataset
먼저 publication pool 2,078개와 ILP subset 500개를 구분하고, 전문가 검토 후의 400개를 FinanceGym의 headline 평가 대상으로 정의합니다. 루브릭 2,464개는 질문당 평균 6.16개입니다. 의료·바이오, 기술·반도체, 소비재, 금융, 부동산, 에너지, 산업·운송, 거시·정책, 원자재, 암호자산, 채권의 원시 산업 분류를 사용하고 일부를 합칩니다. 산업 수 11과 최종 leaf 수 9가 함께 등장하는 이유입니다.
5.2 Agent Baselines
Fine-tuned open-weight는 조사 루프를 모델 학습에 넣은 Tongyi-DR, OpenResearcher, MiroThinker입니다. Foundation model with search tool은 검색 도구와 final-answer 도구를 가진 고정 30-step ReAct wrapper에 9개 backbone을 바꿔 넣는 비교입니다. 오픈웨이트 비교에는 Qwen3.6-27B의 FinanceHarness도 함께 보고하지만, 이것이 최소 wrapper와 동일한 실행 절차라는 뜻은 아닙니다.
Agentic search systems는 TTD-DR, GPT-Researcher, STORM, OpenClaw, deepagents입니다. 이 다섯 시스템에는 Gemini-3-Flash를 공통 backbone으로 사용합니다. 같은 검색 환경에서 최소 ReAct와 engineered scaffold를 비교하고, wrapper 안에서는 모델 교체 효과를 볼 수 있습니다.
사전 학습 조사 모델의 live-web 도구는 corpus-backed 도구로 대체합니다. Search는 FAISS+PIT, Visit은 SQLite의 문서 레코드 접근에 대응합니다. 이 통제는 모든 시스템이 같은 자료를 보게 하지만, 모델이 학습했던 Serper·Jina의 출력과 상호작용 방식까지 동일하게 만들지는 않습니다. 저자는 이 점을 분포 전이 분석으로 분리합니다.
5.3 Evaluation Protocol
각 agent는 500개 ILP subset 전체에서 한 번 실행합니다. 이후 전문가 검토 400개 질문의 항목별 judge 결과를 골라 headline 점수를 집계하며, 나머지를 포함한 500개 실행은 보조 진단에 남깁니다. 실행 500개와 headline 400개를 서로 다른 실험이라고 단정하거나 같은 분모로 혼용해서는 안 됩니다.
에이전트는 질문 텍스트와 cutoff만 받습니다. 참조 논지·루브릭·지원 근거는 숨깁니다. judge인 Gemini-3.5-Flash는 baseline backbone Gemini-3-Flash와 이름·역할이 다릅니다. judge는 질문·논지·채점 대상 항목·기준일 전후 간선 근거·보고서와 URL을 보고 채점합니다. headline은 질문 단위 bootstrap 1,000회의 표준오차를 보고합니다. 에이전트 반복 실행의 분산과 혼동해서는 안 됩니다.
챕터의 핵심 기여는 동일 검색 인프라 위에서 비교의 통제 요소를 나누고, blind agent와 evidence-aware judge의 정보 범위를 분리한 것입니다. 다음 챕터로의 연결은 이 조건에서 관측된 결과입니다. §5
📖 Chapter 6: Results and Analysis
챕터의 위치와 역할: 비용과 품질을 먼저 비교하고, 모델·scaffold·시간 이후 판단의 영향을 분석한 뒤 환경 내 학습 결과를 제시합니다.
Cost-quality Frontier
Figure 5는 질문당 추정 비용과 전체 루브릭 점수의 관계를 그립니다. 가로축은 log scale이며 오른쪽이 더 저렴합니다. FinanceHarness를 여러 backbone과 결합한 점들이 포함되어, Table 2의 Qwen3.6-27B 구성 하나와 범위가 다릅니다. §6 본문은 Opus-5 결합의 최고 전체 점수를 44.9%로 보고합니다. 비용 축의 값을 여기서 새로 추정하거나 모든 환경의 운영 비용으로 일반화하지 않습니다.
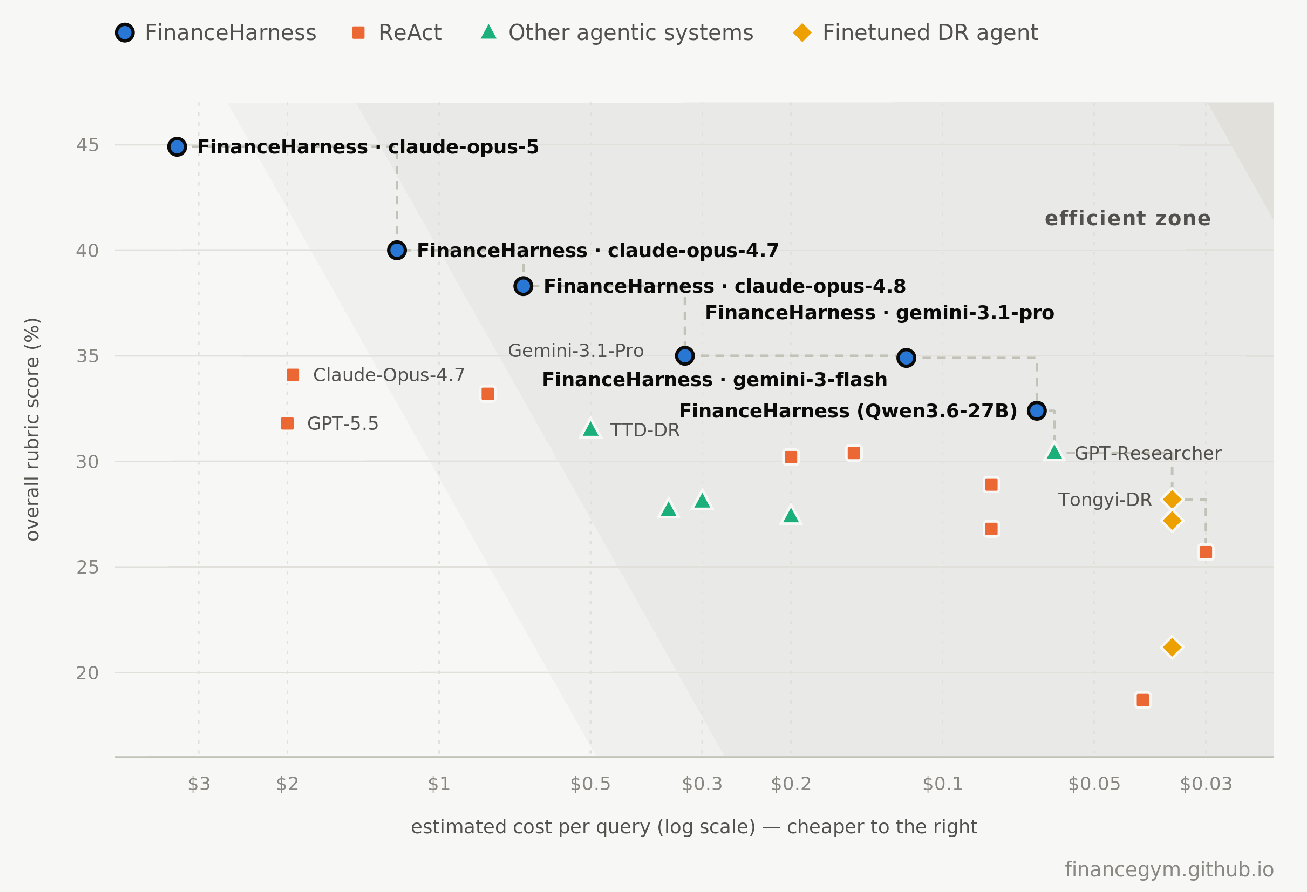
Figure 5, PDF 11쪽. 전체 루브릭 점수와 질문당 추정 비용의 frontier입니다. 그림 영역을 크롭했고 범례·축·log scale 방향·모델 라벨을 보존했습니다. Opus-5 조합은 Table 2의 표 행과 별도 범위입니다. 원문 v2
다음 표는 원문 Table 2에서 비교 목적이 분명한 행을 발췌했습니다. 전체 18행을 모두 전사한 표가 아닙니다. Pre/Post는 기준일 전후 루브릭 점수이며, SE는 Overall의 bootstrap 표준오차입니다.
| 원문 비교군 / 시스템 | Overall (%) | Pre-cutoff (%) | Post-cutoff (%) | SE (%p) |
|---|---|---|---|---|
| 학습된 오픈웨이트 / Tongyi-DR | 28.2 | 39.7 | 10.7 | 0.8 |
| 에이전트 시스템 / TTD-DR | 31.5 | 45.5 | 9.8 | 0.7 |
| 에이전트 시스템 / GPT-Researcher | 30.4 | 42.2 | 12.0 | 0.8 |
| 오픈웨이트 / FinanceHarness, Qwen3.6-27B | 32.4 | 45.7 | 11.8 | 0.8 |
| 오픈웨이트 검색 / GLM-5 | 30.4 | 44.7 | 8.5 | 0.9 |
| 폐쇄형 검색 / Claude-Opus-4.7 | 34.1 | 50.1 | 9.9 | 0.8 |
| 폐쇄형 검색 / Gemini-3.1-Pro | 33.2 | 46.8 | 12.8 | 0.7 |
| 폐쇄형 검색 / GPT-5.5 | 31.8 | 47.5 | 8.0 | 0.7 |
| 폐쇄형 검색 / Gemini-3-Flash | 30.2 | 43.7 | 9.8 | 0.7 |
Table 2 발췌·한국어 열 해설. 원문 Table 2, PDF 12쪽
원문의 범위 표현은 완전히 일치하지 않습니다. §6은 23 baselines, 결론은 17 baselines와 FinanceHarness, Table 2는 실제 18개 시스템 행을 갖습니다. 서론·결론의 “모두 40% 미만”은 Figure 5의 44.9%와 맞지 않습니다. Figure 5에 확장 harness 조합이 포함되어 있음을 확인할 수 있지만, 이것만으로 각 문장의 시스템 수를 저자 대신 재정의하지는 않습니다. 따라서 순위와 SE는 Table 2, 동일 backbone의 개선은 Table 4, 확장 비용·품질 주장은 Figure 5에 한정해 해석합니다.
6.1 What Drives Performance
동일 검색 wrapper 안에서 backbone을 바꾸었을 때의 점수 폭이 Gemini-3-Flash를 둘러싼 engineered scaffold 간 차이보다 큽니다. 예를 들어 Table 2에서 gpt-oss-120b는 18.7%, Claude-Opus-4.7은 34.1%인 반면, 다섯 agentic 시스템은 27.4~31.5%에 모입니다. 저자는 모델 능력이 여전히 강한 제약이지만, 과업에 맞는 절차가 추가 근거의 확보와 조직화를 돕는다고 해석합니다.
학습된 조사 모델의 점수가 일반 검색 backbone보다 낮은 경우는 도구·보고 형식 전이와 함께 해석합니다. 전문 조사 학습을 했다는 사실만으로 새로운 PIT 도구와 인용 민감 평가에서 우위를 보장하지 않는다는 것입니다. Table 3은 주제별로 같은 경향을 분해하고, Figure 6은 모델 규모와 점수를 비교합니다. FinanceHarness의 27B 구성은 더 큰 오픈웨이트 모델과 경쟁하지만, 모델 크기와 점수의 관계는 느슨하다고 설명합니다.
전후 시점 차이는 여러 시스템에서 유지됩니다. FinanceHarness의 pre-cutoff 45.7%와 post-cutoff 11.8%는 역사적 근거 정리와 미래 판단의 난도가 다름을 보여줍니다. 다만 Outcome을 pre/post 단순 평균으로 다시 계산해서는 안 됩니다. 원문 점수는 질문별 해당 루브릭의 분모와 평균 구조를 따릅니다.
6.2 In-Environment Training
FinanceGym과 독립적으로 기계 큐레이션한 172개 학습 instance를 생성하고 GRPO로 추가 학습합니다. 사람이 참여하지 않은 학습 집합이며 평가 데이터 400개와 구분합니다. rollout과 평가의 검색 도구 및 보고서 형식은 같습니다. 보상은 생성 기준에 대한 rubric-style 평가 0.6과 보고서의 일관성·grounding·궤적 품질 judge 0.4를 결합합니다. 원문이 일반 GRPO 손실의 상세 식을 제시하지 않으므로 이 리뷰에서도 별도 손실함수를 만들어 덧붙이지 않습니다.
| Qwen3.6-27B 고정 구성 | Total (%) | Pre-cutoff (%) | Post-cutoff (%) |
|---|---|---|---|
| Vanilla: 검색만 | 25.3 | 36.1 | 8.7 |
| Naive harness | 29.6 | 41.8 | 10.7 |
| 전체 Harness, 학습 전 | 32.4 | 45.7 | 11.8 |
| RFT: GRPO 추가 학습 | 32.8 | 46.2 | 12.1 |
Table 4 전사. §6.2, Table 4
검색만에서 전체 harness로 7.1%p 개선하고, GRPO는 그 뒤 0.4%p를 추가합니다. 저자도 GRPO를 headline 성과보다 refinement로 설명하며 더 넓은 trained-policy sweep을 향후 작업으로 명시합니다. 검색·실행 절차의 개선과 소규모 추가 학습의 개선을 동일한 성과로 묶지 않는 것이 중요합니다.
챕터의 핵심 기여는 고정 backbone의 단계별 절제로 harness 효과를 분리하면서, post-cutoff의 낮은 점수와 비용을 함께 드러낸 것입니다. 다음 챕터로의 연결은 평가·도구·최적화의 환경 공유라는 중심 결론입니다. §6
📖 Chapter 7: Conclusion
챕터의 위치와 역할: FinanceGym의 PIT 검색·전후 루브릭과 FinanceHarness의 실행·최적화를 함께 요약합니다.
저자의 서술 순서를 따른 상세 내용는 먼저 400개 질문과 2,464개 항목의 환경을 다시 정리하고, 다음으로 전후 시점 점수 차이가 더 강한 검색만으로 금융 조사를 해결하기 어렵다는 점을 시사한다고 설명합니다. 마지막으로 동일 Qwen3.6-27B의 25.3%→32.4% 개선과 이후 0.4%p 추가 학습을 연결합니다. 앞서 고지한 시스템 수·40% 경계의 불일치는 이 결론의 문장을 전체 확장 실험으로 일반화할 때 주의해야 할 원문 내부 문제입니다.
챕터의 핵심 기여는 평가·도구 사용·최적화가 시간 통제된 같은 환경을 공유해야 한다는 주장입니다. 다음 내용으로의 연결은 코퍼스와 도구 분포에 관한 명시적 한계 및 세부 분석입니다. §7
📖 Chapter Limitations: Limitations
위치와 역할: 결과가 의미하는 평가 범위를 명시합니다. 저자가 직접 적은 두 항목만 정리합니다.
- Corpus scope: 자체 수집한 2025년 영어 웹 코퍼스이므로 비영어 자료, 유료 전문 데이터, 구조화 공시의 coverage가 제한됩니다. 이는 모든 금융 자료가 완비된 환경에서의 결과가 아니라는 경계입니다.
- Tool-distribution shift: 전문 조사 모델을 학습 당시 live-web stack이 아닌 corpus-backed 검색기에 연결했으므로 분포 밖 평가입니다. 점수는 통제 PIT 인터페이스로의 전이 결과로 읽어야 합니다.
핵심 기여는 모델 자체의 일반 능력과 이 환경에서의 수행을 구별하는 해석 기준입니다. 원문의 References는 이러한 배경과 도구·모델의 인용 목록이며, 이 리뷰에서 모든 인용 논문을 개별 검토한 것은 아닙니다. 이후 부록은 본문의 절제 결과와 사례를 확장합니다. Limitations
📖 Chapter Appendix A: FinanceHarness Ablation Breakdowns
위치와 역할: Table 4의 평균 개선이 어떤 유형에 분포하는지 Table 5~8에서 분해합니다. 모든 구성의 backbone은 Qwen3.6-27B이고 평가 계약도 같습니다.
저자의 서술 순서를 따른 상세 내용:
- 주제별 Table 5: 기업 경쟁전략, 거시·규제 정책, 사건 기반 재구조화, 가치평가·sentiment divergence, 산업 주제, 소유·지배구조, 기관 자금·미시구조, 분석가 consensus, 자산배분 순으로 나열합니다. 사건 기반 재구조화는 Vanilla 30.9→Harness 39.1→RFT 39.3%, 기관 자금·미시구조는 20.2→25.9→26.1%입니다. 개선량과 도달 수준을 함께 보는 것이 필요합니다.
- 추론별 Table 6: 인과 분석, 예측, 효과 평가, 위험, 비교, 정량 분석 순입니다. 위험 평가는 31.4→39.5→39.9%이며, 인과는 23.4→29.8→30.1%, 비교는 23.2→29.7→30.2%로 낮습니다. harness가 모든 추론 유형의 어려움을 같은 수준으로 해소한 것은 아닙니다.
- 산업별 Table 7: 의료·바이오, 기술·반도체, 소비재, 산업·운송, 에너지·원자재, 부동산, 금융, 거시·금리, 암호자산 순입니다. 의료·바이오는 Harness 39.8%, 암호자산은 24.0%, 거시·금리는 26.9%입니다. RFT에서도 각각 40.1%, 25.1%, 27.6%로 취약 영역의 순서가 크게 바뀌지 않습니다.
- 상황별 Table 8: multihop path, temporal narrative, 분석가 의견 충돌, 목표 가격 차이, 성과 차이, 전략 포트폴리오 전환, 소유권 변동 순입니다. Harness에서 multihop 33.7%, temporal narrative 30.7%, 목표 가격 차이 28.2%, 소유권 변동 40.1%입니다. 목표 가격 차이는 RFT에서도 28.2%이며 모든 개별 셀이 반드시 엄격히 상승하는 것은 아닙니다.
핵심 기여는 대부분의 이득이 harness 구성에서 나오고 추가 학습의 증가가 작다는 주장을 여러 축에서 뒷받침하는 것입니다. 다음 부록으로의 연결은 평균 보고서 평가와 별도로 도구 구성요소가 실제로 작동하는지 확인하는 평가입니다. 부록 A
📖 Chapter Appendix B: Cross-Backbone Harness Evaluation
위치와 역할: 동일 harness를 여러 backbone에 연결했을 때 구성요소의 실행과 근거 연결을 평가합니다. FinanceGym의 Outcome과 다른 시험입니다.
저자의 서술 순서를 따른 상세 내용:
- Coverage suite: 가치평가·위험·상대가치·시장 데이터·집중/광범위 조사·자동 routing·세 skill·계획 등 11개 과제를 셀당 3회 실행합니다. Qwen3.6-27B, Gemini-3.5-Flash, GPT-5.5에 같은 harness를 사용합니다. Gemini-3.5-Flash와 GPT-5.5의 dual-LLM judge가 faithfulness·grounding·coherence·completeness를 1~5점으로 평가합니다. grounding은 문헌 인용뿐 아니라 조회·계산한 구조화 도구 데이터도 인정합니다.
- 모델별 Table 9: GPT-5.5는 4.36/4.47/4.92/4.98, Qwen3.6-27B는 4.02/4.20/4.68/4.76, Gemini-3.5-Flash는 3.85/3.97/4.78/5.00입니다. 열 순서는 위 네 기준과 같습니다. 일관성과 완결성은 높은 수준에 모이지만 충실성과 근거 연결은 더 잘 구별됩니다. 이 점수를 400개 질문의 rubric 백분율로 환산하지 않습니다.
- 규칙 기반 동작 확인: data routing 95.8%, golden-answer 계산 90.9%, tool coverage 0.99, skill hit 0.94, unknown-tool 오류 0을 보고합니다. 후속 대화의 이전 문맥 사용,
/compact에서 금액 보전, 불명확한 질문의 clarification도 세 backbone이 통과했다고 서술합니다. - 구성요소별 Table 10: Risk의 faithfulness/grounding은 4.53/4.61, Market은 4.39/4.56, Relative valuation은 3.25/3.33입니다. 상대가치 도구가 작은 peer set을 반환할 때 약한 backbone이 사전 지식으로 표를 메우고 judge가 근거 없는 셀을 감점했다고 명시합니다. 이는 저자가 제시한 구체적 실패 양상입니다.
핵심 기여는 보고서 점수가 높은지와 필요한 구성요소를 호출하고 근거를 보존하는지가 다른 시험임을 보여준다는 점입니다. 다음 부록으로의 연결은 분포 변화와 시간 이후 판단의 실패를 더 자세히 해석하는 단계입니다. 부록 B
📖 Chapter Appendix C: Additional Analysis
위치와 역할: 단순 시스템 순위에서 벗어나 결과를 읽는 조건을 정리합니다.
C.1 Tool-Distribution Shift
저자는 전문 조사 오픈웨이트 모델의 낮은 점수를 일반 능력의 열세 대신 도구 분포 전이로 해석합니다. live-web 검색과 페이지 추출을 학습한 모델을 고정 문서 레코드와 PIT 검색으로 옮기면 상호작용과 보고서 형식이 달라집니다. 특히 4점 anchor는 정확하고 구체적이며 출처로 뒷받침되는 주장을 요구합니다. TTD-DR·GPT-Researcher는 출처 귀속 보고서를 명시적으로 요구하지만, 학습 모델은 더 매끈한 답변형 문장과 약한 inline attribution을 출력하는 경우가 있다고 설명합니다.
따라서 “모델이 금융 지식을 모른다”와 “새 평가 인터페이스에서 요구하는 근거 표현에 맞지 않는다”를 구분합니다. 이는 저자의 해석이며, 원문이 해당 원인을 독립 인과 실험으로 모두 분리했다고 주장하지 않습니다.
C.2 Pre-cutoff and Post-cutoff Remain Different Failure Modes
좋은 검색·읽기·인용은 pre-cutoff에 효과적이지만 post-cutoff는 강한 시스템에서도 좁은 낮은 범위에 남습니다. GRPO 이후에도 약 46% 대 12%라는 간격을 강조합니다. 역사적 사실 회수와 사후에 확인되는 전개를 당시 판단으로 연결하는 능력이 다르기 때문이라는 해석입니다. 미래 자료를 더 검색하면 이 문제가 해결된다는 결론은 PIT 계약을 깨는 것이므로 논문의 목표와 맞지 않습니다.
C.3 Agentic-system Trade-offs
TTD-DR은 계획·검색·초안·비평·수정을 반복하며 높은 점수를 얻지만 반복 비용도 있습니다. GPT-Researcher는 조금 낮은 점수의 더 가벼운 절차입니다. STORM과 deepagents의 기본 구성 방식은 구체적이고 출처 기반 금융 주장을 보상하는 평가에 항상 맞지는 않는다고 설명합니다. 이 비교는 과업과 orchestration의 적합성에 대한 증거이며 에이전트 framework의 보편 순위가 아닙니다.
C.4 Per-Axis Breakdowns
Table 11은 11개 원시 산업을 9개 leaf로 합친 산업별 점수를, Table 12는 여섯 추론 유형별 점수를 시스템 그룹별로 제시합니다. Energy는 에너지+원자재, Macro는 거시·정책+채권입니다. Table 11에서 FinanceHarness의 의료39.8·암호자산24.0% 차이를, Table 12에서 위험39.5·인과29.8·비교29.7% 차이를 확인할 수 있습니다. Table 3의 주제별 결과와 함께 총점이 감추는 영역 차이를 보여줍니다. 색과 bold/underline은 각 panel·열 내부 상대 비교이므로 서로 다른 panel의 색 농도를 절대 점수처럼 읽지 않습니다.
핵심 기여는 전이, 미래 판단, 실행 비용, 유형별 어려움을 분리하는 것입니다. 다음 부록으로의 연결은 이런 체계가 실제로 어떤 보고서를 만들었는지 확인하는 사례입니다. 부록 C
📖 Chapter Appendix D: FinanceHarness Case-Study Reports
위치와 역할: 부록 B의 구성요소 평가에서 생성한 여섯 보고서를 질문→인용 보고서→출처 순으로 제시합니다. 이들은 live-web 실행이며 PIT FinanceGym headline 결과에 포함되지 않습니다. 원문도 생성된 금융 주장을 독립 검증하지 않았다고 명시합니다. 아래 수치는 해당 보고서의 출력 내용이며 이 리뷰가 현실의 기업 가치나 거래 판단을 확인한 값이 아닙니다.
D.1 Industry Deep Research
질문은 AI 가속기에서 출발해 수요가 연결되는 산업·공급자를 찾고, 재무 특성과 지속 가능성을 비교하라는 것입니다. 보고서는 먼저 silicon chain과 physical-infrastructure chain을 나누고, 수요 배경 및 재무 스냅샷을 제시합니다. 이후 원래 순서대로 가속기·맞춤 실리콘 → HBM·메모리 → foundry·첨단 패키징 → 제조 장비 → 서버·rack → networking·광학 → 전력·냉각 → 건설·전력망 연결 → 발전 → 데이터센터 부동산을 설명합니다.
각 층에서는 대표 기업, AI 수요와의 연결, 재무 지표와 positioning을 붙입니다. 예를 들어 서버 조립의 높은 매출 증가가 희소 기술의 높은 마진과 같지 않다는 식으로 매출 노출과 경제적 가치 포착을 나눕니다. 마지막에는 보고서가 매력적이라고 판단한 영역을 지속성·가치평가·기술 희소성·물리적 제약별로 비교하고, hyperscaler 자본수익, 효율화와 대체, 고객 집중, 공급 과잉, 지정학, 전력 제약, 기술 전환, 가치평가 압축을 위험으로 정리합니다. 이는 생성 보고서의 분석 구성에 대한 요약이며, 특정 기업을 이 리뷰가 추천하는 내용이 아닙니다.
D.2 Valuation Compute Seam
질문은 Microsoft의 최신 회계연도 자료에서 5년 unlevered DCF를 만들고, 명시적 가정·시장 입력으로 WACC를 계산하며, terminal growth 2.5%와 민감도 표를 제시하라는 것입니다. 보고서는 가치평가 결과를 먼저 내고 FY2025 기초 자료, forecast 가정, 현금흐름, WACC, 기업가치→주주가치 연결, 민감도 순으로 설명합니다.
현금흐름의 핵심 관계를 표시 폭에 맞춰 나누면 다음과 같습니다. 원문의 D.2 보고서에서 제시한 식입니다.
$\mathrm{EBIT}$는 이자·세전 영업이익, $\tau$는 적용 세율, $\mathrm{D\&A}$는 감가·상각, $\mathrm{Capex}$는 자본지출, $\Delta\mathrm{NWC}$는 순운전자본 증가입니다. EBIT의 세후 금액에서 현금 유출인 투자·운전자본을 빼고 비현금 비용을 더해 자금 조달 구조와 분리된 현금흐름을 만듭니다. $\tau$는 긴 영문 세율 라벨을 대신해 정의한 기호입니다.
보고서는 WACC 11.5986%, terminal growth 2.5%, 주당 가치 233.19달러, terminal value의 기업가치 비중 71.03%를 출력합니다. WACC ±2%p, 장기 성장1.5~3.5%의 표는 179~340달러 범위를 보여줍니다. 중심값과 민감도를 함께 제시해 계산 결과가 명시적 가정에 종속됨을 드러냅니다. peer beta는 관측 equity beta의 동일 가중 평균으로, 개별 beta를 unlever/relever하지 않았다고 보고서가 밝힙니다.
D.3 Risk Analytics
질문은 TSLA·SPY의 2023-01-03~2025-12-31 조정 종가로 VaR·변동성·beta·상관을 계산하라고 요청합니다. 출력은 먼저 데이터와 convention을 적고, VaR→연율 변동성→beta→상관→분포 진단으로 진행합니다. 가장 중요한 조건은 실제 도구가 임의 시작·종료일을 받지 못해 5년 preset을 사용했다는 명시적 불일치입니다. 실제 범위는 2026-07-24에서 약 5년 전까지이며 가격1,255개·일간 단순수익률1,254개입니다.
보고서는 100만 달러 long position의 일간 historical VaR를 95%에서58,000달러, 99%에서95,000달러, normal-parametric를 각각61,000·86,000달러로 출력합니다. 역사적 방법은 경험적 하위 꼬리 분위수를 이용하고, 정규 방법은 일간 표준편차에 양의 꼬리 손실 계수1.645·2.326을 곱합니다. 원문 보고서의 $z_{1-\alpha}$ 라벨과 양수 값은 통상 하위 분위수의 부호 표기와 혼동될 수 있어, 여기서는 양의 손실 크기를 표시하는 계수라는 적용 의미를 풀었습니다.
beta2.02, 상관0.58, 초과 첨도3.04도 해당 실행의 출력입니다. 원문은 꼬리가 두꺼워 99% 정규 VaR가 역사적 값보다 작다고 해석합니다. 이 사례는 숫자를 계산했는지뿐 아니라 요청 데이터 구간을 실제로 만족했는지를 읽어야 함을 보여줍니다. 구간 불일치는 원문에 명시된 사례이며 새로운 실패 사례를 만들어 덧붙인 것이 아닙니다.
D.4 Relative Comparables
Alphabet을 META·MSFT·AMZN·AAPL과 비교하는 질문입니다. 보고서는 요약, 데이터·추정 시각, 가치배수와 재무 특성, 비영업·비경상 조정, peer-median 내재 가치, 비교 조건, 결론 순서입니다. 보고된 GAAP 이익의 투자 지분 평가손익을 조정한 뒤 trailing P/E 16.39배→34.28배로 해석이 달라지고, forward P/E 22.21배는 peer median21.71배와 비교합니다.
핵심은 같은 “저평가”라는 말도 분모가 GAAP 이익인지 정규화 이익인지, trailing인지 forward인지에 따라 달라진다는 설명 구조입니다. 사업 모델·자본지출·순현금·규제 조건의 차이도 보고서가 비교 한계로 적습니다. 원문 생성 보고서의 기업 수치·회계 조정 자체를 별도 공시와 대조한 분석은 이 리뷰 범위가 아닙니다.
D.5 Derivatives
질문은 AAPL 유럽형 call·put의 Black–Scholes 가격과 Greeks, put-call parity를 계산하도록 합니다. 입력은 현물225달러, 행사가230달러, 만기90일, 변동성28%, 연속복리 금리4.25%, 연속 배당수익률0.45%입니다. 보고서는 먼저 가격·delta·gamma·vega·theta·rho를 표로 내고 parity를 확인합니다. call11.1610달러, put14.0128달러는 입력 조건에 대한 이론 가격 출력입니다.
$C$와 $P$는 call·put 가격, $S$는 현물, $K$는 행사가, $q$는 연속 배당수익률, $r$는 연속복리 무위험 금리, $T$는 연 단위 잔존 만기입니다. $T=90/365$로 변환해 할인된 현물·행사가 차이와 옵션가격 차이를 비교합니다. 보고서는 잔차를 주당 약 0.00003달러로 제시해 반올림 범위의 일치를 확인합니다. 숫자 결과를 현실 시장가격과 같다고 주장하는 사례는 아닙니다.
D.6 Fixed Income
질문은 만기2032-11-15의 미 국채4.125% note를 결제일2026-07-27, 액면100달러, 반기 coupon, 수익률4.35%에서 분석하라는 것입니다. 보고서는 채권 조건·경과이자, 가격·duration·convexity, ±50bp shock과 정확한 재가격, 관측 해석 순으로 갑니다.
보고서는 clean price 98.7379, accrued interest 0.8183, dirty price 99.5562, modified duration 5.64, convexity 37.0을 제시합니다. 경과이자는 해당 반기184일 중73일을 반영합니다. 가격 변화의 2차 근사는 다음과 같습니다.
$P$는 기준 가격, $\Delta P$는 변화, $D_{\mathrm{mod}}$는 수정 duration, $\Delta y$는 소수 단위 수익률 변화, $\mathcal C$는 convexity입니다. 옵션의 call 기호와 구별하기 위해 원문 보고서의 convexity $C$를 여기서는 $\mathcal C$로 적었습니다. 첫 항은 금리 변화의 1차 영향, 둘째 항은 곡률의 2차 보정이며 ±50bp는 ±0.005를 대입합니다. 원문 보고서는 duration만 쓰면 가격을 약0.046달러 낮게 추정하고, convexity를 더하면 이 사례에서 정확 재가격과 약0.0001달러 차이로 접근한다고 제시합니다.
부록의 핵심 기여는 논문이 제공하는 실행 표면을 실제 질문·계산·인용 형식으로 보여주는 것입니다. 다음 부록으로의 연결은 이 출력들이 어떤 도구 호출 순서로 만들어졌는지 확인하는 과정입니다. 부록 D
📖 Chapter Appendix E: FinanceHarness Case-Study Trajectories
위치와 역할: D.1과 D.2의 완성된 보고서 뒤에 있는 round-by-round 행동을 공개합니다. 이 궤적도 live-web 사례이며 PIT headline 실험과 분리됩니다.
E.1 Industry Deep Research
R1은 산업 층·대표 기업·수요·재무 비교·종합의 네 단계 계획을 만듭니다. R2는 industry-analysis skill을 로딩하고, R3은 여러 기업 그룹의 data_equity_comps를 묶어서 호출합니다. R4는 계획의 첫 단계가 끝났다는 1/4 완료 상태를 기록하고 조사 단계를 이어갑니다. R5~R15는 기업 IR·산업 자료·전력 보고서·hyperscaler 투자 및 전력 계약 관련 검색을 반복하며 분석 범위를 넓힙니다. 이때 단순 회사 나열 대신 산업 수요와 자료의 근거를 연결합니다.
R16에서는 NVIDIA·TSMC·Micron·Broadcom·ASML·Dell·Vertiv·Quanta·IEA·Equinix·Alphabet·CNBC의 페이지를 visit해 실제 실적·수요·capacity·backlog·위험을 읽습니다. R17~R20은 특정 실적과 서버·network·광학 기업의 상세를 보충하고, R21에서 관련 페이지를 다시 읽습니다. R22~R23은 TSMC의 AI 수요·첨단 공정·패키징·투자·해외 확장 조건을 확인합니다. R24에서 계획3/4 완료, R25에서75.2/81.615×100의 비중 계산, R26에서4/4 완료를 기록합니다. R27~R28은 전력·network·HBM의 직접 노출을 추가 검색·읽기로 확인합니다.
이 순서는 구조화 데이터 호출→광범위 검색→원문 읽기→빈 근거 보충→계산→계획 상태 갱신을 보여줍니다. 원문 궤적에는 긴 schema와 결과 일부를 … more로 접은 표시가 있어 모든 내부 응답의 원시 로그가 공개된 것은 아닙니다. 이 리뷰는 round의 존재와 행동을 확인했지만 각 외부 시장 데이터 출력의 현실 정확성까지 검증한 보고서는 아닙니다.
E.2 Valuation Compute Seam
R1은 Microsoft의 재무자료, 시장·peer beta, 영업 가정, 기업→주주가치, 민감도, 보고서의 여섯 단계 계획을 만듭니다. R2는 dcf-valuation skill을 불러 필요한 데이터와 계산 도구의 schema를 로딩하고 기초 재무자료를 검색합니다. 이 단계가 deferred tool의 로딩이 실제 계산 전에 어떻게 붙는지 보여줍니다.
R3에서 공식 재무자료를 읽고 MSFT·ORCL·GOOGL·AMZN·AAPL의 데이터 및 국채 금리를 조회합니다. R4~R5는 CRM·ADBE·IBM 및 운전자본·현금흐름 자료를 보충합니다. R6은 매출 대비 EBIT·세율·D&A·capex 비율을 계산해 가정의 기초를 만듭니다. R7에서 compute_valuation_wacc에 무위험 금리0.0468, risk premium0.05, beta1.406, 부채비용0.0518, 세율0.176296, D/E0.015194를 전달하고, R8은 자본비용과 부채·자기자본 weight의 관계를 계산합니다.
R9는 예상 매출과 영업 항목을 계산하고, R10에서 5년 FCF schedule, discount rate0.115986, terminal growth0.025, net debt−66.819, shares7.465를 DCF 도구에 전달합니다. 이어 discount rate와 성장률 grid로 민감도를 계산합니다. 단위가 billion dollars인 cash flow·순부채·주식 수를 맞춰 주당 가치로 이어지는 경로가 드러납니다. 음의 순부채는 순현금이므로 기업가치에서 차감할 때 주주가치를 늘립니다.
부록의 핵심 기여는 숫자가 보고서에 나타나는 마지막 문장뿐 아니라 자료 조회→가정→계산 도구→민감도라는 흐름을 볼 수 있게 한 것입니다. 마지막 부록이므로 원문에 없는 다음 챕터를 설정하지 않습니다. 부록 E
실험 결과 심층 분석
개선의 크기와 평가 맥락
가장 직접적인 설계 비교는 Table 4입니다. 동일27B 모델의 25.3→29.6→32.4→32.8% 경로에서 검색만→전체 harness의 증가7.1%p가 추가 GRPO의0.4%p보다 큽니다. 7.1/25.3을 계산한 상대 증가는 약28.1%지만, 이 값은 리뷰어의 산술 비교이며 원문이 보고한 별도 지표는 아닙니다. post-cutoff는8.7→11.8→12.1%로 개선해도 pre-cutoff36.1→45.7→46.2%에 비해 낮습니다.
Table 2의 FinanceHarness32.4%와 TTD-DR31.5% 차이는0.9%p이지만 모델·절차가 다른 비교입니다. 반면 Table 4는 backbone을 고정하므로 harness 설계의 설명에 적합합니다. Table 2의 Overall을 투자 성과·정확한 예측 비율·항목 성공률로 해석해서는 안 됩니다.
통계적 신뢰도와 반복 실행
논문은 질문 단위 bootstrap1,000회의 표준오차(SE)를 보고합니다. 예를 들어 FinanceHarness32.4±0.8은 표준오차 표기이며 자동으로95% 신뢰구간을 뜻하지 않습니다. 모델 간 paired 차이의 신뢰구간이나 유의성 검정은 보고되지 않았습니다. 각 agent의 benchmark 실행은 한 번이므로 실행 seed·재시도의 변동을 이 SE가 모두 포괄한다고 주장할 수도 없습니다. GRPO0.4%p 증가를 유의한 개선이라고 단정하지 않습니다.
실용적 의미와 재현 범위
URL ID 검사를 끄면 visit 오류2.1→39.4%로 악화해도 최종 점수는 크게 움직이지 않는 사례는, 보고서 점수만 보면 실행 낭비를 놓칠 수 있음을 보여줍니다. 부록 B의 상대가치 표에 사전 지식으로 근거 없는 peer 셀을 채우는 행동, D.3의 요청 구간과 실제 조회 구간 불일치도 저자가 공개한 구체적 경계입니다.
공개 질문·제출 코드와 harness 구조는 읽을 수 있지만 내부 검색 코퍼스와 비공개 루브릭은 공개되지 않습니다. 따라서 같은 corpus·judge 입력을 완전히 재현했다고 말할 수는 없습니다. 부록 B의11과제×3회 평가, D/E의 live-web 예시, 400질문의 PIT headline은 규모·자료 접근·점수척도가 다르므로 서로의 성능을 대체하지 않습니다. 원문의 모델·시스템 수 및40% 경계 불일치는 앞의 §6 리뷰에 명시했으며, 확인된 표와 Figure별 범위를 유지했습니다.
기술적 함의와 응용
이 논문의 기술적 성과는 금융용 도구를 많이 붙였다는 점에만 있지 않습니다. 언제 공개된 정보를 읽을 수 있는가, 모델은 무엇을 보고 행동하는가, judge는 무엇으로 판단하는가, 학습 reward는 어느 환경에서 만들어지는가를 한 계약으로 연결합니다. 보고서 생성과 평가의 시간 기준을 일치시키는 것이 핵심입니다.
리뷰어 관점에서 데이터과학자가 배울 부분은 세 가지입니다. 첫째, cutoff와 사후 검증 정보를 분리한 데이터 설계는 시간 누출을 드러내는 데 유용합니다. 둘째, 같은 모델을 고정한 실행 절차 절제는 framework 이름 간 순위보다 설계의 효과를 이해하기 쉽습니다. 셋째, 인용·schema·도구 결과 연결·실행 예산은 최종 문장의 자연스러움과 별도로 검수할 수 있는 시스템 조건입니다. 이 일반화는 해석이며 다른 도메인의 검증 결과가 아닙니다.
저자는 더 넓은 trained-policy sweep을 향후 작업으로 남깁니다. 코퍼스 범위와 도구 분포 전이라는 명시적 한계 안에서, 현재 결과는 강한 검색만으로 미래 판단의 루브릭을 충분히 충족하지 못하며 과업에 맞는 harness가 같은 모델의 근거 수집과 보고서 구성을 개선할 수 있음을 보여줍니다.
분석 범위: 본문1~7, Limitations, 부록A~E의 모든 하위 섹션 순서를 반영했습니다. Table 2·3·5~12의 모든 셀, D의 여섯 생성 보고서의 모든 기업별 재무 행·출처 항목, E의 접힌 schema·도구 출력 전문은 전사하지 않았습니다. 원문의 핵심 비교와 명시된 사례를 해설했으며, 참고문헌 전체의 개별 논문과 live-web 사례의 외부 재무자료를 모두 독립 검증한 것으로 표현하지 않습니다.