논문 개요와 전체 구조
LLM이 상품 리뷰에 별점 4점을 부여하면서 95%의 확률을 제시했다고 해도, 그 확률이 실제 정답 빈도와 맞는다는 뜻은 아닙니다. 문장의 의미는 잘 파악하면서도 항상 한 단계 높은 점수를 주거나, 극단적인 감정을 중립으로 압축할 수 있습니다. CORDIAL은 이러한 순서형 평가를 잡음이 섞인 측정으로 보고, 소수의 정답 라벨로 측정 채널을 보정하는 연구입니다. LLM의 가중치를 다시 학습하는 대신 출력 확률이 실제 라벨 분포로 변환되는 방식을 학습합니다.
핵심은 다섯 매개변수로 온도, 등급 이동, 척도 확대·축소, 집중도, 사전분포 대비 신뢰 강도를 표현하는 것입니다. 이를 Bayesian 추정과 여러 보정기의 stacking에 연결합니다. 논문은 작은 라벨 예산에서의 이점뿐 아니라, 라벨이 충분해지면 더 유연한 Dirichlet calibration이 앞서는 구간도 분석합니다. 데이터과학 관점에서는 정확도와 확률 품질의 차이, 구조적 가정과 표본 효율 사이의 교환관계를 함께 살펴볼 수 있습니다. 원문 초록·§1
이 리뷰는 Xiangwei Wang, Peng Wang, Saman Halgamuge의 arXiv:2609.29807v1, 2026년 9월 24일 제출본을 대상으로 합니다. PDF는 총 5페이지이며 별도 부록은 없습니다. PDF와 HTML의 마지막 번호가 달라 아래에서는 PDF 순서를 기준으로 정리합니다. PDF의 §5는 참고문헌, §6은 윤리 준수이며 HTML에서는 참고문헌이 무번호이고 윤리 준수가 §5로 표시됩니다.
| 원문 구조 | 내용과 역할 |
|---|---|
| §1 Introduction | 순서형 출력의 왜곡, 기존 보정법과의 관계, 세 가지 기여 |
| §2 CORDIAL: Structured Channels | §2.1 잡음 측정 → §2.2 scalar 제약 → §2.3 affine 채널·순서 보장 → §2.4 Bayesian 추정 → §2.5 stacking → §2.6 교차점 → §2.7 확장 |
| §3 Experiments | 데이터·reader·프로토콜 → §3.1 소수 라벨·표본 증가·다른 모델·in-context 비교 → §3.2 사전분포·모델 결합·개인화 |
| §4 Conclusion | 순서형 잡음 센서 관점과 확장 요약 |
| §5 References | 이론·보정법·데이터·모델 관련 참고문헌 23개 |
| §6 Compliance with Ethical Standards | 공개 데이터와 식별자 재사용, 신규 참여자 모집·개입 없음 |
핵심 기여와 혁신성
문제의 출발점은 순서가 있는 클래스 사이의 방향성 있는 오류입니다. 1점과 2점은 1점과 5점보다 가깝습니다. 그러나 단일 신뢰 계수로 모델 출력을 전체 라벨 분포에 섞는 방법은 이러한 인접 관계를 활용해 확률을 옮기지 못합니다. 반대로 모든 등급 간 이동을 자유롭게 학습하면 적은 라벨에 비해 매개변수가 많아집니다.
저자는 이 사이에서 affine 변환과 이산 Gaussian 형태를 사용합니다. 분포의 형태를 유지하는 mixture 채널과 평균 위치를 중심으로 다시 구성하는 location 채널을 제안하고, 고정된 채널이 1차 확률적 순서를 보존함을 증명합니다. 소수 라벨의 추정 불확실성을 줄이기 위해 하나의 최적 추정치 대신 posterior 평균을 사용합니다. 다섯 매개변수는 기본 채널의 수이며, 최종 CORDIAL ensemble 전체가 다섯 매개변수라는 뜻은 아닙니다.
또 다른 기여는 구조적 제약이 유리한 표본 규모를 근사적으로 설명하는 것입니다. 낮은 차원의 구조는 추정 오차를 줄이지만 실제 채널을 완전히 표현하지 못할 수 있습니다. 실험은 이 장점과 표현력의 비용을 동시에 보여줍니다. 리뷰어의 해석으로, 이 연구의 가치는 범용 LLM의 성능 순위를 새로 정하는 데보다 고정된 LLM의 평가 점수를 적은 정답으로 통계적으로 활용하는 방법에 있습니다. 원문 §1–2
기술적 세부사항
전체 흐름은 텍스트 → 동결된 LLM의 선택지 logits → 구조화된 확률 채널 네 개와 logit 보정기 세 개 → out-of-fold 예측으로 학습한 가중 결합입니다. LLM 자체의 재학습과 보정기 학습을 구분해야 합니다. 실험의 라벨 예산은 후자에 사용되는 정답 텍스트 수입니다.
| 요소 | 의미와 작동 위치 |
|---|---|
| Temperature | logits의 포화를 완화해 입력 분포의 확신 정도를 조절합니다. |
| Offset·gain | 순서형 척도의 체계적 이동과 압축·확대를 보정합니다. |
| Concentration | 보정된 등급 주변으로 확률이 퍼지는 정도를 정합니다. |
| Strength | 채널 출력과 평활화된 라벨 빈도 분포를 섞는 비율입니다. |
| Bayesian posterior 평균 | 적은 라벨에서 채널 추정치의 불확실성을 예측에 반영합니다. |
| Stacking | 보정기별 out-of-fold 예측을 이용해 최종 혼합 가중치를 학습합니다. |
실험은 Amazon 별점 5단계와 CMU-MOSEI 전사문 감정 7단계에 적용됩니다. MOSEI를 사용하지만 이 논문에서 reader에 입력하는 자료는 영상 자체가 아닌 전사 텍스트입니다. 주요 평가는 정답 클래스 확률에 대한 negative log-likelihood(NLL)와 순서형 누적확률의 품질을 평가하는 ranked probability score(RPS)이며 낮을수록 좋습니다. 정확도는 보조적으로 비교합니다. 핵심 수식과 평가 조건은 원문 순서를 유지한 다음 절에서 해설합니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
챕터의 위치와 역할: 언어 이해가 가능하다는 사실과 출력 확률이 올바른 통계량이라는 주장을 분리하고, 적은 라벨에서 무엇을 학습할 것인지 정합니다.
첫째, 저자는 LLM의 순서형 출력을 유용하지만 왜곡될 수 있는 측정으로 규정합니다. 왜곡에는 일정한 방향의 별점 오차, 지나치게 넓거나 좁은 분포, 실제보다 높은 확신이 포함됩니다. 논문은 post-training과 calibration의 관계를 기존 연구를 통해 동기화하지만, 그 모든 모델과 과제를 이 논문에서 새로 검증한 것은 아닙니다.
둘째, scalar 신뢰도와 자유로운 행렬 사이의 대안을 제시합니다. 등급이 $K$개일 때 일반적인 행 확률행렬은 $K(K-1)$개의 자유도를 사용하고, 논문이 비교하는 Dirichlet calibrator의 매개변수 수는 $K(K+1)$입니다. 라벨이 수십 개뿐인 환경에서 이 자유도는 추정 부담이 됩니다. CORDIAL은 등급 간 오류를 일정한 이동·축척·폭으로 설명할 수 있다는 구조를 부여합니다.
셋째, 기여를 채널과 순서 보장, 표본 수 교차점, posterior 기반 확장의 세 부분으로 정리합니다. 마지막 관련 연구 단락은 temperature·vector·Dirichlet scaling, 라벨 없는 contextual·batch calibration, 학습 중 ordinal-aware loss, noisy observer의 confusion matrix, ordinal regression, 전문가 확률을 관측 자료로 취급하는 pooling을 차례로 연결합니다. CORDIAL은 동결된 reader의 출력을 사후 보정한다는 위치에 놓입니다.
챕터의 핵심 기여는 확률 오차를 단순 과신으로 한정하지 않고 순서형 측정의 구조적 왜곡으로 표현한 것입니다. 다음 장은 이 관점을 채널 수식으로 구체화합니다. §1
📖 Chapter 2: CORDIAL: Structured Channels
챕터의 위치와 역할: 입력 측정의 정의에서 시작해 식별 가능한 왜곡, Bayesian 추정, ensemble, 표본 규모의 해석, 확장 적용까지 방법론을 순차적으로 구성합니다.
2.1 LLM outputs as noisy ordinal measurements
텍스트 $x$에 대해 LLM은 순서형 선택지 $y\in\{0,\ldots,K-1\}$의 next-token logits $\ell(x)$를 반환합니다. 관측된 출력 등급 $y$와 실제 정답 $z$를 구별합니다. 원문 식 (1)은 다음과 같습니다.
$\tau$는 온도이며 $T(z\mid y)$는 모델이 등급 $y$를 읽었을 때 실제 라벨 $z$로 전달하는 확률입니다. 각 $y$에 대해 $z$ 방향으로 합이 1인 채널이므로 출력도 확률분포입니다. 정답이 있는 소수 텍스트로 채널을 추정하고 LLM은 고정합니다. 원문에서 보정 전 최대 softmax 확률의 평균은 0.92–0.96으로, 상당히 포화되어 있어 온도도 채널의 일부로 취급합니다.
2.2 Why a scalar reliability is not enough
기존 scalar 채널은 확률 $\beta$로 reader를 믿고 나머지는 라벨 사전분포 $\pi$로 되돌립니다.
두 번째 식은 사전분포 대비 차이의 방향을 유지한 채 크기만 바꾼다는 뜻입니다. reader가 등급 $y$에 완전히 포화되어 있지만 정답은 바로 다음 등급 $y+1$이면, 정답에 주는 확률은 $(1-\beta)\pi(y+1)\leq\pi(y+1)$입니다. 따라서 reader의 방향성 있는 오류를 이용해 그 인접 등급을 강화하지 못합니다. Remark 1은 이러한 특정 scalar 혼합의 제약을 증명하며 모든 calibration 방법의 불가능성을 말하지 않습니다.
2.3 An affine channel with interpretable parameters
먼저 실제 등급 축 위의 정규화된 Gaussian profile을 정의합니다. 연속 정규분포를 그대로 사용하는 것이 아니라 유한한 등급들에서 확률 합을 1로 맞춥니다.
원문 식 (2)의 $c$는 중심이며 정수일 필요가 없습니다. $\kappa>0$는 집중도로, 커질수록 중심에 가까운 등급에 확률이 모입니다. 분모는 가능한 모든 등급 $v$에 대한 합입니다. 이 profile에 affine 중심을 적용하는 두 형식이 식 (3)·(4)입니다.
$d$는 척도의 이동량, 양수인 $s$는 gain입니다. $s>1$이면 압축된 척도를 펼치고 $s<1$이면 과장된 척도를 줄입니다. $\rho$는 채널과 평활화된 라벨 빈도 $\pi$의 혼합 강도입니다. 온도까지 포함하면 기본 매개변수는 $\phi=(\tau,d,s,\kappa,\rho)$입니다.
Mixture 형식은 각 원래 등급의 확률을 이동·분산시킨 다음 더하므로 입력 분포의 형태를 활용합니다. Location 형식은 입력 평균 $m(x)$을 먼저 계산해 하나의 중심을 만듭니다. 논문은 이를 평균 후 반올림한 라벨에 어울리는 단봉형 형식으로 설명합니다. 엄밀하게는 $G$ 항이 단봉형이며, 임의의 $\pi$를 섞은 최종 분포 전체의 단봉성을 별도로 증명하는 것은 아닙니다. Mixture에서 $d=0,s=1,\kappa\to\infty$이면 앞의 scalar 채널로 돌아갑니다.
그다음 vector-scaled reading을 추가합니다. 입력 $\ell/\tau$ 대신 $e^\epsilon\odot\ell/\tau+b$를 사용하며, 클래스마다 배율과 절편을 두어 $2K$개 매개변수가 더해집니다. 따라서 이 변형은 기본 다섯 매개변수 채널보다 큽니다.
Proposition 1의 순서 보장은 평균값의 정렬보다 강한 1차 확률적 순서를 대상으로 합니다.
$q_2$가 더 높은 등급 쪽에 놓이면 모든 절단점 $t$에서 낮은 등급까지 누적한 확률은 더 작습니다. 동일한 고정 채널, 양의 gain과 concentration, 동일한 사전분포·혼합비를 적용하면 두 형식 모두 이 순서를 보존합니다.
증명은 세 단계입니다. 먼저 중심이 오른쪽으로 움직일 때 profile의 likelihood ratio가 등급에 따라 증가합니다.
다음으로 mixture에서는 중심 $sy+d$가 $y$에 따라 증가하므로 누적분포의 평균도 순서를 유지합니다. Location에서는 입력 평균의 순서가 양의 affine 변환을 거쳐 그대로 보존됩니다. 마지막으로 동일한 $\pi$와 혼합하거나 동일한 posterior로 평균해도 순서가 유지됩니다. 다만 posterior predictive에는 posterior가 지지하는 모든 온도에서 입력 reading의 순서가 유지된다는 조건이 붙습니다. 완전히 포화된 순서형 등급들은 이 조건을 충족합니다.
이 명제를 자유로운 vector scaling과 다른 보정기를 포함한 최종 7개 구성원 stack의 전역 단조성 보장으로 확대하면 안 됩니다. 실제 §3.1도 최종 방법에서 순서 역전이 완전히 사라진다고 보고하지 않습니다. §2.1–2.3, Proposition 1
2.4 Bayesian estimation from few labels
소수 라벨에서는 최적점 하나도 크게 흔들릴 수 있습니다. 저자는 $(\log\tau,d,\log s,\log\kappa,\mathrm{logit}\rho)$에 독립 Gaussian prior를 둡니다. 원래 척도의 중심은 온도 2, 이동 0, gain 1, concentration 4, strength 0.95이며 변환된 좌표의 표준편차는 순서대로 1, 1, 0.5, 1.5, 2입니다. 로그와 logit 변환은 양수·확률 범위 제약에 맞추기 위한 좌표입니다.
Vector 변형은 $\epsilon\sim\mathcal N(0,0.5^2)$, $b\sim\mathcal N(0,1)$ prior로 과도한 클래스별 변형을 억제합니다. Posterior mode 부근의 Laplace 근사를 만든 뒤 공분산을 $1.5^2$배 확장하고, 300개 draw에 importance weight를 적용하여 예측 확률을 평균합니다. 이는 정확한 posterior 적분을 계산했다는 의미가 아니라 명시된 근사 절차입니다. 두 채널 형식과 두 reading 형태의 조합으로 채널 네 개가 만들어집니다.
2.5 Stacking with logit-space calibrators
네 채널에 temperature scaling, vector scaling, centered logits 기반 proportional-odds regression을 더합니다. 이 ordinal regression의 stack 내부 L2 penalty는 $100/n$입니다. 최종 식 (5)는 다음과 같습니다.
$\hat p_m$은 각 구성원의 예측이고 $\omega_m$은 혼합 가중치입니다. 라벨 $n$개를 네 fold로 나누어 out-of-fold log-likelihood를 구하고, Dirichlet(1) prior 아래 EM으로 가중치를 구합니다. 라벨이 8개보다 적으면 동일 가중치를 씁니다. 채널 형태와 prior 선택에는 calibration pool의 validation 텍스트를 사용합니다.
원문은 채널 없는 logit stack(LS), Bayesian scalar 채널을 더한 stack, 자유로운 전체 행렬 채널을 더한 stack도 비교합니다. 전체 행렬에는 교차검증된 KL penalty로 scalar 채널 쪽으로 수축시키는 장치가 있습니다. 구성원 수를 늘려서 좋아진 것인지, 구조를 부여해서 좋아진 것인지를 구별하려는 비교입니다.
2.6 When does structure pay?
구조화된 family가 가장 좋은 자유형 보정기를 따라가지 못하는 기대 log loss 차이를 $\delta$라고 정의합니다. 구조화된 모델의 매개변수 수는 $d_s=5$, 자유형은 $d_u$입니다. 잘못 지정된 모델도 포함하는 최대우도 추정의 정규 조건 아래, 추정에 따른 초과 손실을 대략 $d/(2n)$으로 보아 다음 교차 규모를 얻습니다.
원문 식 (6)은 자유형 모델이 더 많은 매개변수를 추정하며 치르는 비용이 구조화 family의 근사 손실보다 클 때 구조가 유리하다는 설명입니다. $\delta$가 작으면 구조가 더 오래 유리할 수 있고, 크면 자유형으로 넘어가는 시점이 빨라집니다. 유한 표본 성능의 보장 경계가 아니라 교차점 규모를 설명하는 근사식입니다. 원문도 고차항과 shrinkage가 실제 교차점을 바꾼다고 명시하며, 완성된 Bayesian stack의 정확한 위험식을 도출한 것은 아닙니다.
2.7 What a five-parameter posterior enables
첫 번째 확장은 학습된 prior입니다. 다른 데이터셋의 전체 calibration pool과 각 reader에서 채널을 맞추고, $d$와 $\log\kappa$를 척도 길이 $K-1$ 기준 단위로 표현합니다. 다른 과제에서 추정한 값의 평균을 prior 중심으로 쓰고 표준편차는 다음 식을 사용합니다.
$v$는 다른 과제 추정치들의 분산이고 $\sigma_0$는 기본 표준편차입니다. 과제 간 일치도가 높으면 더 집중된 prior를 사용하되 원래 설정보다 넓어지지 않도록 합니다. 이 과정은 평가 대상 과제의 정답을 무제한으로 가져오는 것이 아니라 다른 과제에서 보정 매개변수의 통계를 학습하는 empirical Bayes입니다.
두 번째는 여러 reader의 결합입니다. $R$개 LLM 각각에 앞의 stack을 만들고, 그 예측들과 multi-reader location 채널을 두 번째 out-of-fold stack에서 결합합니다. 공통 중심에는 $s\sum_r w_rm_r(x)+d$를 사용합니다. $m_r(x)$는 각 reader의 평균 등급, $w_r$는 합이 1인 가중치이며 reader마다 온도가 있습니다. 이 추가 채널의 매개변수 수는 $2R+3$이고 기본 단일-reader 방식처럼 Bayesian 추정합니다.
세 번째는 개인화입니다. 사용자 $u$의 반복 텍스트가 있으면 population 예측을 $\Delta_u$만큼 이동시키고 척도 끝에서는 자릅니다. $s=\rho=1$, $\kappa\to\infty$로 둔 shift 채널입니다. 이전 정답 텍스트의 likelihood에 이차 penalty $\Delta_u^2/(2\sigma^2)$를 적용하고 $\sigma$는 사용자 간 교차검증으로 정합니다. Remark 1의 scalar reliability가 증거의 크기만 바꾸는 데 비해, shift는 사용자별 방향성 있는 평가 차이를 표현합니다.
챕터의 핵심 기여는 구조·불확실성·ensemble을 하나의 보정 절차로 연결한 것입니다. 다음 장에서는 각 요소의 효용을 소수 라벨과 큰 라벨 예산, 여러 모델, 개인화에서 나누어 측정합니다. §2.4–2.7
📖 Chapter 3: Experiments
챕터의 위치와 역할: 평가 데이터를 먼저 정의하고 소수 라벨에서의 성능, 구조의 비용이 드러나는 교차점, posterior를 활용한 확장을 순서대로 검증합니다.
Benchmarks → Readers → Methods and protocol
Amazon Reviews 2023의 Digital Music, All Beauty, Software 각 도메인에는 단일 리뷰 사용자의 calibration 2,000개, report 4,000개 리뷰가 있습니다. 별도로 최소 8개 리뷰가 있는 반복 사용자 400명을 사용하며 사용자당 최대 16개를 시간순으로 다룹니다. 별점은 1–5의 5단계입니다. CMU-MOSEI는 평균 감정 점수 −3–3을 7단계로 반올림합니다. Train·validation 18,135개 전사 segment를 calibration pool로, test의 675개 영상에서 나온 4,653개 segment를 report pool로 사용합니다.
Reader는 동결된 Qwen2.5-Instruct 3B·7B·14B와 Llama-3.1-8B-Instruct입니다. 주 reader인 7B의 최빈 예측 정확도는 Music 75%, Beauty 66%, Software 68%, MOSEI 32%입니다. 그러나 정확도만으로는 확률의 포화와 방향성 오차를 표현할 수 없으므로 NLL·RPS를 함께 봅니다.
모든 보정기는 같은 라벨 예산과 20개 추출 subset을 사용합니다. 예산은 5개부터 2,000개까지이며 확률에는 $10^{-4}$의 바닥값을 둡니다. 단독 ordinal regression은 L2 penalty를 교차검증하고, Dirichlet calibration은 off-diagonal 및 intercept penalty를 교차검증합니다. 따라서 stack 내부 고정 penalty ordinal regression과 단독 비교 방법을 구별해야 합니다. Label-free batch calibration은 원래 NLL을 낮추지 못했다고 보고합니다.
95% paired bootstrap interval은 report 항목과 라벨 subset을 대상으로 10,000번 재추출하여 구합니다. 차이의 구간이 0을 제외할 때 원문은 차이가 “resolved”되었다고 표현합니다. CORDIAL 보정기 적합 시간은 CPU 한 코어에서 7–30초, 예측은 텍스트당 0.2ms입니다. 이는 동결 LLM의 텍스트 추론 비용까지 포함한 전체 시스템 비용으로 읽어서는 안 됩니다.
3.1 Few labels: structure beats size
주 7B reader에서 5–100개의 라벨을 사용할 때 네 benchmark 모두 가장 낮은 평균 NLL을 보고합니다. 비교는 Table 1의 여덟 보정기(CORDIAL 포함)와 stack 내부 고정 penalty ordinal regression을 대상으로 합니다. 보정 전 Raw LLM은 표에 있지만 학습된 보정기 개수와 혼동하지 않아야 합니다.
아래는 원문 Table 1의 $n=20$ 열입니다. 모든 값은 같은 7B reader, 20개 라벨 subset의 평균 test NLL이며 낮을수록 좋습니다. Table 1, PDF 3쪽
| 방법 | Music | Beauty | Software | MOSEI |
|---|---|---|---|---|
| Raw LLM | 1.339 | 2.052 | 2.093 | 5.806 |
| Temperature | 0.693 | 0.766 | 0.792 | 1.682 |
| Vector scaling | 0.907 | 0.953 | 1.023 | 1.729 |
| Ordinal regression | 0.787 | 0.789 | 1.028 | 1.540 |
| Dirichlet | 0.982 | 1.181 | 1.308 | 2.020 |
| Logit stack (LS) | 0.519 | 0.654 | 0.742 | 1.383 |
| LS + scalar channel | 0.504 | 0.662 | 0.749 | 1.395 |
| LS + full channel | 0.528 | 0.659 | 0.748 | 1.397 |
| CORDIAL | 0.473 | 0.596 | 0.718 | 1.330 |
CORDIAL의 20개 라벨 결과는 LS가 28–54개, Dirichlet calibration이 79–132개를 사용할 때의 수준에 해당한다고 보고합니다. LS 대비 NLL 개선은 본문에서 Music 0.046, Beauty 0.057, Software 0.024, MOSEI 0.053 nats입니다. Beauty의 반올림된 표 값을 직접 빼면 0.058이므로 본문 보고치와 0.001 차이가 있습니다. 반올림 전 결과는 제공되지 않아 여기서는 표 자체와 본문 보고를 구분합니다.
100개 라벨에서는 LS 대비 이득이 0.002–0.016으로 줄어듭니다. Software의 20개 초과 예산을 제외하고 해당 비교의 구간이 0을 제외한다고 보고합니다. Scalar·full 채널 추가만으로는 20개 라벨에서 LS 대비 NLL 변화가 −0.015~+0.014에 그치며, CORDIAL은 이들보다 0.031–0.067 낮고 구간도 0을 제외합니다. 저자는 이를 구성원 추가 자체보다 구조가 중요하다는 근거로 해석합니다.
Posterior 평균은 라벨 10개 이하에서 mode 사용 대비 최대 0.134 nats 개선하며, 100개부터는 이득이 없다고 보고합니다. RPS도 20개에서 LS 대비 0.008–0.017 개선하지만 정확도는 LS와 비슷합니다. 따라서 성능 주장은 “더 많은 문장을 맞힌다”보다 “정답 가능성을 더 적절하게 배분한다”에 가깝습니다.
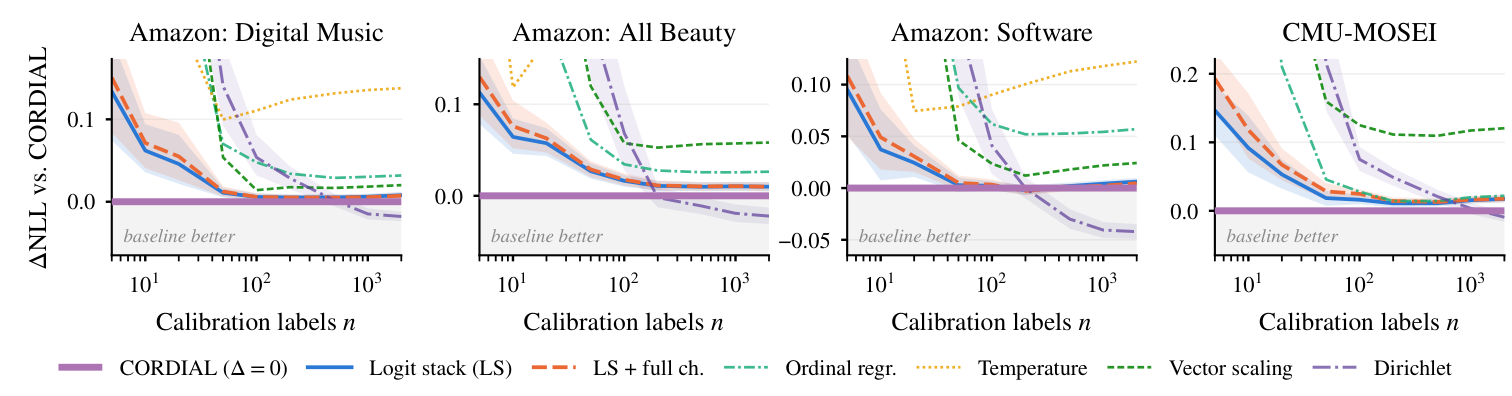
Figure 1. 7B reader, 20개 라벨 subset 평균. 세 강력한 기준 방법에는 paired 95% bootstrap 구간이 표시됩니다. PDF 4쪽, 2609.29807v1에서 그래프 영역을 크롭했으며 축·범례·수치를 수정하거나 번역하지 않았습니다.
세로축은 기준 방법 NLL에서 CORDIAL NLL을 뺀 값입니다. 0보다 높으면 CORDIAL이 낫고, 음수면 기준 방법이 낫습니다. 가로축은 로그 척도의 라벨 수입니다. 일부 곡선은 패널 범위를 넘어 잘렸다는 원문 캡션의 조건도 함께 읽어야 합니다. 왼쪽 소수 라벨 구간의 차이는 크지만 오른쪽에서는 줄거나 부호가 바뀝니다.
다음으로 reader의 예측 등급별 실제 분포를 확인합니다. 원문은 네 benchmark에서 class-weighted KL이 CORDIAL 0.06–0.17, LS 0.10–0.22, Dirichlet 0.31–0.55, Raw 0.32–1.97이라고 보고합니다. 아래 Figure 2에는 그중 Music와 MOSEI 두 데이터셋만 제시되며, 비교열의 표기는 LS + full입니다. 본문의 LS 요약 범위와 그림의 LS + full 개별 숫자를 같은 것으로 합치면 안 됩니다.
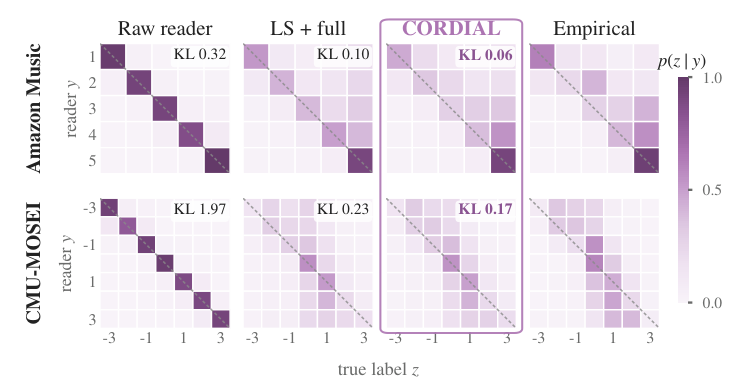
Figure 2. 행은 reader 등급, 열은 실제 라벨이며 점선은 두 값이 같은 위치입니다. 20개 라벨·20개 subset 평균입니다. PDF 4쪽, 2609.29807v1에서 그림 영역을 크롭했으며 원문 표기를 유지했습니다.
Raw reader는 대각선에 거의 모든 확률을 몰아줍니다. 경험 분포에서 Amazon Music의 실제 라벨은 더 높은 쪽으로, MOSEI는 중립 쪽으로 이동합니다. CORDIAL은 이러한 이동과 확산을 반영합니다. 그림에 표시된 Music의 KL은 Raw 0.32, LS + full 0.10, CORDIAL 0.06이며 MOSEI는 1.97, 0.23, 0.17입니다.
순서 일관성 검사에서는 포화된 인접 등급의 누적확률이 0.05를 초과해 역전되는지를 봅니다. 20개 라벨 적합에서 vector scaling은 45–80%, Dirichlet은 45–70%의 fit에 역전이 있었고 CORDIAL은 최대 10%입니다. 기본 temperature-reading 채널의 이론적 순서 보장과 최종 stack의 경험적 역전율은 서로 다른 주장입니다.
The crossover. 이어지는 단락은 많은 라벨에서 자유형 보정기가 추월하는 시점을 다룹니다. Table 1의 200개 라벨 열에서도 모든 과제가 CORDIAL 우위는 아닙니다.
| 방법, 라벨 200개 | Music | Beauty | Software | MOSEI |
|---|---|---|---|---|
| Dirichlet | 0.449 | 0.539 | 0.663 | 1.221 |
| LS | 0.426 | 0.551 | 0.661 | 1.183 |
| LS + full | 0.426 | 0.552 | 0.660 | 1.186 |
| CORDIAL | 0.420 | 0.541 | 0.663 | 1.172 |
이 표는 Table 1의 네 방법을 발췌한 것이며, 굵은 값은 원문 전체 방법에서도 해당 열의 최솟값입니다. Beauty는 Dirichlet, Software는 LS + full의 평균이 더 낮습니다. 작은 평균 차이를 곧바로 통계적으로 확정된 우위로 해석하지는 않습니다.
Dirichlet이 CORDIAL보다 낮은 NLL을 보이며 paired interval도 0을 제외하는 첫 예산은 Music 1,000, Beauty 500, Software 500, MOSEI 2,000개입니다. 2,000개에서의 이득은 각각 0.018, 0.022, 0.042, 0.009 nats입니다. 큰 표본의 손실 차이를 $\delta$의 plug-in 추정치로 쓰면 식 (6)의 예측 교차점은 700, 565, 297, 2,746개이며 관측 교차점과 두 배 이내입니다. 이는 거친 규모 설명의 적합성을 보여주며 미래 데이터에서 정확한 예산을 보장하지 않습니다.
저자는 affine family 밖의 알려진 채널로도 확인합니다. 근사 차이 0.001–0.09에서 최대우도 초과 손실이 $d/(2n)$ 형태를 따르며, 네 매개변수 채널에서는 유효 $d\approx4$, full matrix에서는 $1.1\text{–}1.3\,K(K-1)$ 수준입니다. 실제 추월은 shrinkage가 없으면 $1.2\text{–}2.7\,n^\star$, 있으면 $0.2\text{–}1.3\,n^\star$에서 발생합니다. 이 합성 비교의 네 매개변수를 본문의 기본 다섯 매개변수 설정과 동일시하지 않습니다.
Reader size and family. 3B·14B·Llama를 사용하는 5–100개 라벨 조건에서는 60개 중 56개에서 가장 좋고 나머지 네 개에서 열세는 최대 0.006입니다. 주 7B의 20개 조건을 합쳐 초록의 80개 중 76개가 됩니다. 이는 비교한 조건의 개수이며 임의 과제에서 95% 확률로 승리한다는 통계량은 아닙니다. 다른 reader의 20개 라벨 조건에서 LS 대비 이득은 0.012–0.086이며 구간이 0을 제외합니다.
In-context examples. 같은 20–100개 정답을 7B의 in-context demonstration으로 사용할 때 정확도는 CORDIAL 대비 −0.06~+0.02 범위지만 NLL은 2.3–3.3배 높습니다. 동일한 라벨을 prompt에 넣는 것과 출력 채널을 학습하는 것은 확률 품질에서 다른 결과를 낸다는 비교입니다. §3.1
3.2 What the posterior buys
A learned prior. 다른 데이터셋에서 학습한 prior는 12개 Amazon reader–domain 조합에서 라벨 5·10·20·50·100개일 때 평균 NLL을 각각 0.017·0.016·0.011·0.006·0.003 낮춥니다. 각 예산에서 9개 또는 10개 조합의 개선 구간이 0을 제외하고 확정된 손실은 없습니다. 그러나 Amazon만으로 prior를 만든 MOSEI에서는 라벨 10개 이하에서 0.009–0.011 손해를 보고, 20–50개에서는 0.013–0.015 개선됩니다. 다른 과제의 prior가 항상 이롭지는 않다는 실제 보고 사례입니다.
Several readers. 네 reader 결합은 5–500개 라벨의 28개 조건 모두에서 7B 단독보다 0.008–0.090 낮은 NLL을 기록하고, 교차검증으로 선택한 단일 reader보다도 모두 좋습니다. 같은 결합에서 채널을 제거한 방법보다 27개 조건에서 좋으며 20개 라벨의 이득은 0.011–0.043입니다. 이 예산에서 reading들을 이어 붙인 Dirichlet calibration은 0.55–1.5 nats 뒤처집니다.
그렇지만 MOSEI의 10–20개 라벨 조건에서는 Llama 단독이 결합보다 0.018–0.030 더 좋습니다. 교차검증으로 선택한 reader와 사후 관찰한 특정 reader를 구분해야 앞의 문장과 모순되지 않습니다. 추가 multi-reader 채널 자체의 이득도 최대 0.006으로 제한적입니다. 모든 모델을 결합하면 언제나 가장 좋은 개별 모델을 이긴다고 주장할 수 없습니다.
Across users. 1,000개 라벨로 적합한 population 모델 위에 사용자별 shift를 적용합니다. 해당 사용자의 이전 텍스트가 11개 이상 있을 때 NLL 이득은 Music 0.100, Beauty 0.046, Software 0.044, MOSEI 0.048이며 모두 구간이 0을 제외합니다. 전체 텍스트를 합친 비교에서도 사용자별 reliability보다 0.013–0.041, 사용자별 temperature보다 0.004–0.016 좋습니다. Random-intercept ordinal regression과 비교하면 Amazon에서는 0.021–0.029 좋고 MOSEI에서는 비슷합니다. 이 개인화 결과는 20개 라벨 단일-reader 실험과 다른 학습 조건입니다.
챕터의 핵심 기여는 소수 라벨의 장점을 정확도·확률 품질·구조·posterior로 나누어 확인하면서, 큰 표본과 전이·결합의 예외를 함께 제시한 점입니다. 다음 결론은 이 결과를 잡음 센서 관점으로 다시 묶습니다. §3.2
📖 Chapter 4: Conclusion
챕터의 위치와 역할: LLM의 순서형 출력에 있는 offset, gain, concentration의 체계적 오차를 정리합니다. 저자는 다섯 매개변수 Bayesian 채널이 소수 라벨에서 이러한 왜곡을 보정하고, 학습된 prior·여러 reader·사용자별 적응으로 이어진다고 결론짓습니다.
이 결론의 핵심은 LLM의 의미 이해 능력을 버리지 않고 측정 오차를 별도로 다루는 것입니다. 원문 결론은 별도의 미래 연구 목록을 제시하지 않으므로 임의의 확장 과제를 저자의 제안으로 추가하지 않습니다. 뒤에는 참고문헌과 윤리 준수 문장이 이어집니다. §4
📖 Chapter 5: References
챕터의 위치와 역할: 앞의 이론과 실험 구성의 출처를 제공합니다. PDF §5에는 23개 참고문헌이 있으며, 보정법·ordinal regression·noisy observer·확률적 순서·오지정 모델의 최대우도 이론·데이터셋·LLM 기술 보고서를 포함합니다. 이 절의 역할은 새로운 실험 결과를 추가하는 것이 아니라 본문의 위치와 가정을 뒷받침하는 것입니다.
본 리뷰는 이 논문의 인용 관계와 사용 목적을 확인했으며 23개 문헌의 원문을 모두 독립 재검증한 것은 아닙니다. 다음 윤리 절은 데이터 사용 방식을 명시합니다. PDF 5쪽
📖 Chapter 6: Compliance with Ethical Standards
챕터의 위치와 역할: 데이터 수집과 참여자 관련 범위를 분명히 합니다. 연구는 Amazon Reviews 2023과 CMU-MOSEI 전사문이라는 공개 데이터셋을 재사용하고, 데이터셋에 있는 사용자·화자 식별자를 사용합니다. 새로운 참여자 모집이나 개입은 없다고 명시합니다.
핵심은 개인화 실험이 새로 사용자를 모집해 평가를 수집한 실험이 아니라 기존 공개 데이터와 식별자에 기반한다는 점입니다. 이 문장만으로 별도의 윤리 심의 승인이나 모든 개인정보 문제가 검증되었다고 확대 해석하지 않습니다. 원문은 여기에서 끝나며 별도 부록은 없습니다. PDF §6, 5쪽
실험 결과 심층 분석
작은 라벨 예산의 개선과 큰 표본의 역전은 함께 읽어야 합니다. 20개 라벨에서 CORDIAL은 표의 네 데이터셋 모두 최저 NLL을 보이지만, 200개에서는 Beauty와 Software에서 이미 다른 방법의 평균이 더 낮습니다. 500–2,000개 구간에서는 Dirichlet의 우위가 paired interval 기준으로도 확인됩니다. 이는 구조가 주는 낮은 추정 분산과 구조 밖의 분포를 표현하지 못하는 근사 차이 사이의 교환관계라는 원문의 설명과 맞습니다.
실험 설계의 강점은 같은 라벨 subset과 구조 제거 비교입니다. LS에 scalar·full 채널을 추가하는 비교는 ensemble 크기 증가만으로 결과를 설명하기 어렵게 만듭니다. Posterior 평균과 mode 비교는 소수 라벨 이득의 또 다른 원천을 확인합니다. NLL과 RPS가 함께 개선되고 정확도는 비슷하다는 결과는 개선이 확률 할당에 있다는 해석을 뒷받침합니다. 반면 분류 정확도의 대폭 향상이나 LLM 자체의 새로운 언어 능력을 입증한 결과는 아닙니다.
통계적 신뢰도는 원문이 제시한 방식 안에서 판단합니다. 이 논문에는 20개 subset, 10,000회 paired bootstrap, 95% 구간이라는 불확실성 평가가 있습니다. 다만 본문의 모든 평균값에 개별 구간 숫자가 제시된 것은 아닙니다. 특히 Table 1의 작은 차이 자체를 구간이 0을 제외한다는 주장으로 바꾸지 않습니다. “76/80” 역시 조건별 평균 성능 집계이지 독립적인 80회 임상적 성공률과 같은 수치가 아닙니다.
재현성 측면에서는 데이터 분할 규모, reader, 라벨 예산, 주요 prior, posterior 근사 draw 수, stacking fold와 비교법의 penalty 전략이 보고되어 있습니다. 그러나 확보한 5페이지 v1과 HTML에는 실행 가능한 전체 코드, 정확한 prompt 전문, 모든 세부 실험 설정을 담은 별도 부록이 없습니다. 따라서 원문만으로 공개 구현의 실행 결과까지 재현했다고 말할 수는 없습니다. 이는 확인한 자료의 범위이며, 코드가 어디에도 존재하지 않는다는 단정은 아닙니다.
기술적 함의와 응용
리뷰어의 해석으로, CORDIAL은 LLM 점수를 데이터 분석에 넣기 전에 무엇을 보정해야 하는가를 구체적으로 보여줍니다. Confidence를 낮추는 것만으로는 점수의 체계적 이동을 바로잡을 수 없고, 순서형 구조를 활용하면 많은 라벨 없이도 그러한 이동을 표현할 수 있습니다. 동시에 prior 전이의 손실 사례와 여러 reader 결합의 예외가 있으므로 적용할 데이터에서 라벨 예산과 확률 품질을 함께 확인해야 한다는 의미를 갖습니다.
직접 실험한 적용 범위는 상품 별점과 전사문 감정의 순서형 분포입니다. 다른 평가 척도에 대한 관심은 이 방법의 해석 가능성에서 나올 수 있지만, 해당 분야의 성능이 이 논문으로 검증된 것은 아닙니다. 최종적으로 이 연구는 동결 LLM의 출력도 신뢰 가능한 확률로 사용하려면 측정 구조, 작은 표본의 불확실성, 충분한 표본에서의 표현력을 함께 고려해야 함을 보여줍니다.
검토 범위: arXiv:2609.29807v1의 본문 §1–4, 참고문헌, 윤리 준수, 식 (1)–(6), Proposition 1의 증명, Table 1, Figure 1–2를 반영했습니다. PDF에는 별도 부록이 없습니다. 참고문헌 전체의 독립 리뷰와 원문에 없는 구현 실행은 수행하지 않았습니다.