논문 개요와 전체 구조
검색 증강 생성(Retrieval-Augmented Generation, RAG)에서 검색한 문서를 읽고 답을 다시 쓰면 정확도가 올라갈 수 있습니다. 그러나 이미 맞는 답을 엉뚱한 답으로 바꾸는 경우도 있습니다. Return or Revise?는 질문에 대한 초안과 검색 결과가 준비된 시점에, 초안을 그대로 반환할지 아니면 근거를 반영해 수정할지를 학습하는 연구입니다. 관심 대상은 검색 여부가 아니라 이미 확보한 근거로 특정 수정기를 실행했을 때의 효과입니다.
저자 Nicholas Kashani Motlagh, Tim Anderson, Jeremy Gwinnup, Grant Erdmann은 초안과 수정 답변을 같은 판정기로 채점해 수정의 이득과 손해를 함께 관측합니다. 이 차이를 recoverability라고 정의하고, 수정 답변을 생성하기 전에 예측합니다. 실험은 단문 개방형 질의응답 25,870개와 세 검색 설정을 중심으로 진행됩니다. 본 리뷰는 2026년 9월 24일자 arXiv:2609.30087v1의 HTML과 25쪽 PDF를 분석합니다. 제출일은 RSS 발표 묶음의 날짜와 구분합니다. 버전 고정 원문
원문은 별도의 정식 목차 대신 다음 섹션 구조를 갖습니다. 상세 리뷰에서도 이 순서를 유지합니다.
- Introduction: 수정 결정의 문제와 세 가지 기여.
- Paired Outcomes for the Revision Decision: 평균 정확도의 한계, 쌍을 이룬 결과, 결정 규칙과 oracle gap, 수정 설정, 인접 문제.
- Predicting Revision Effect: 입력 정보, 모델 계열, 기준선, 학습 목표를 맞춘 비교.
- Experimental Setup: 검색 설정, 데이터와 평가, 오프라인 감독과 온라인 결정.
- Results: 5.1 Repair와 Harm → 5.2 학습 정책 → 5.3 학습 목표 비교 → 5.4 입력·모델 비교 → 5.5 강건성 → 5.6 선택 가능한 답변의 영향.
- Related Work: confidence·adaptive RAG, retrieval utility, revision·conflicting evidence.
- Discussion: 목표·정보·검색 개선·행동 집합·효용의 의미.
- Conclusion.
- 번호 없는 Limitations → Ethical Considerations → Acknowledgments → References.
- Appendix A: Supporting Analyses, A.1~A.13의 보조 실험.
- Appendix B: Reproducibility Details.
- Appendix C: Artifacts, Prompts, and Determinism, C.1 Prompt Templates.
핵심 기여와 혁신성
첫째, 평균 정확도의 상승을 오답을 고친 비율과 정답을 망친 비율로 분해합니다. 두 수정기가 똑같이 3 percentage points(pp)를 개선하더라도, 하나는 3%를 고치고 아무 답도 망치지 않을 수 있고 다른 하나는 13%를 고치고 10%를 망칠 수 있습니다. 후자에는 수정 여부를 고르는 정책의 가치가 훨씬 큽니다.
둘째, “현재 답이 맞는가”와 “이 수정이 도움이 되는가”를 학습 목표로 분리하고, 동일한 backbone·LoRA 설정·학습 예산·시드 조건에서 비교합니다. 결과 차이를 예측하는 발상 자체는 model routing과 cascade 연구에 존재합니다. 이 논문의 기여는 이를 초안에 조건화된 검색 기반 수정에 적용해 무엇이 추가로 좋아지는지, 어떤 입력이 필요한지 측정한 데 있습니다.
셋째, 수정 정책의 성능만 보고 결론내리지 않고, 초안을 보지 않는 standard RAG 답변을 대안으로 넣습니다. Llama에서는 standard RAG 자체의 평균 정확도가 수정 답변보다 낮아도, 초안과 조합했을 때 더 좋은 선택지가 됩니다. 리뷰어 해석: 좋은 대안은 평균 성능이 높은 답변뿐 아니라 기존 답변이 틀리는 곳에서 맞는 답변이라는 점을 실험으로 공부할 수 있습니다. 원문 §1, §5.6
기술적 세부사항
관측 결과와 사전 예측을 구분하기
질문을 $q$, 관측된 초안을 $a_d$, 검색기·검색 질의·근거 프롬프트·수정기를 묶은 설정을 $I$라고 합니다. 이 설정으로 생성한 수정 답변은 $a_I$입니다. 동일한 정답 별칭 집합과 의미 동등성 판정기로 두 답을 평가한 이진 정오 라벨이 각각 $z_d$, $z_I$입니다. 원문 §2의 정의는 다음과 같습니다.
$r_I=+1$이면 오답을 정답으로 바꾼 repair, $-1$이면 정답을 오답으로 바꾼 harm입니다. $0$에는 정답 유지와 오답 유지가 함께 포함됩니다. $x$는 수정 생성 전에 관측 가능한 입력입니다. 조건부 기대값 $\Delta_I(x)$는 그러한 입력에서 예상되는 수정의 순효과이며, 같은 정의를 확률로 쓰면 다음과 같습니다.
실제 분류 모델은 repair·harm·tie의 softmax 출력을 학습하고 repair 확률에서 harm 확률을 뺀 점수를 사용합니다. 개발 집합에서 최종 답변 정확도를 최대화하는 임계값을 고른 뒤, 테스트에서는 고정합니다. 이 출력 확률은 보정된 확률이라고 주장하지 않습니다. 초안 correctness 모델은 초안이 맞을 확률이 임계값보다 낮을 때 수정합니다. 두 정책은 같은 두 답변 중 하나를 고릅니다.
오프라인에서는 모든 사례의 수정 답변을 생성하므로 두 선택의 결과를 모두 채점할 수 있습니다. 온라인 정책 입력에는 수정 답변·정답·판정 결과가 없습니다. 따라서 라벨을 직접 관측할 수 있다는 사실과 실제 결정 시점에서 효과를 예측해야 한다는 사실이 양립합니다. 원문 §2–4
평가 단위와 상한
항상 반환·항상 수정·학습 정책·oracle을 비교합니다. Oracle은 두 답 중 하나라도 맞으면 정답을 고르는, 운영 시 사용할 수 없는 평가 상한입니다. 본 실험에서는 항상 수정이 더 좋은 고정 행동이어서, oracle과 항상 수정 사이 차이는 harm 비율과 같습니다. 원문 정의를 정리하면 다음과 같습니다.
분자는 정책이 항상 수정보다 얻은 정확도 증가이고, 분모는 두 행동만으로 얻을 수 있는 남은 정확도 증가입니다. 모든 정확도는 같은 단위로 넣어야 합니다. 이 비율은 전체 오류의 감소율도, 수정이 성공한 확률도 아닙니다. 선택 가능한 답이 바뀌면 oracle도 바뀝니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
챕터의 위치와 역할: 질문에 답하는 RAG와, 이미 존재하는 답을 재검토하는 시스템의 결정 문제를 구분합니다. 논문의 출발점은 “검색 결과가 있다”는 사실만으로 수정을 정당화할 수 없다는 것입니다.
먼저 저자는 초안 confidence가 답하는 질문을 한정합니다. 초안이 맞다면 유지되거나 망가질 수 있고, 틀리다면 고쳐지거나 계속 틀릴 수 있습니다. 초안의 정오를 안다고 수정 결과까지 알 수는 없습니다. 결정 시점에는 초안과 검색 근거가 있지만 아직 수정 답변이 디코딩되지 않았습니다.
이어서 오프라인에서 두 답변을 함께 채점하는 설계를 제시합니다. 생성기는 근거 없이 초안을 만들고, 수정기는 질문·초안·검색 근거를 받아 수정 답변을 만듭니다. Figure 1은 두 정오 라벨을 교차시킨 네 가지 결과를 보여 줍니다.
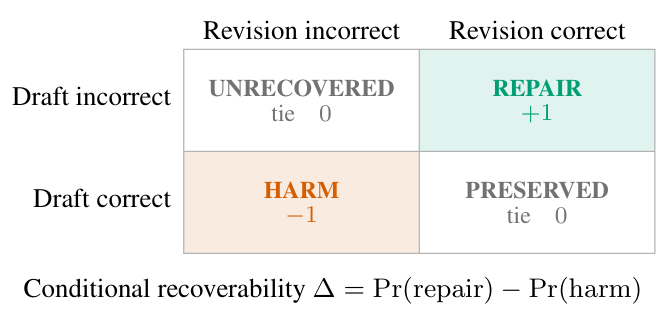
원문 Figure 1, PDF 2쪽. 그림 영역만 크롭했으며 내용과 색상은 수정하거나 번역하지 않았습니다. 2609.30087v1 PDF
그림에서 초안 confidence는 행을 구분하지만, 수정할 가치가 있는지는 어느 열로 이동하는지에 달려 있습니다. Figure 2의 실제 사례는 이를 구체화합니다. 노래 작곡가를 묻는 질문에서는 문서가 정답을 직접 제공해 잘못된 초안이 교정됩니다. 반면 Henry VIII의 두 번째 아내를 묻는 질문에서는 문서에 Anne Boleyn이라는 올바른 정보가 있는데도 수정기가 Anne of Cleves로 바꿉니다. 근거에 정답이 포함되는 것과 수정기가 올바른 사실을 선택하는 것은 별개입니다.
마지막으로 저자는 네 질문을 제시합니다. 수정은 얼마나 고치고 망치는가, 쌍 결과 예측은 correctness 예측보다 나은가, 어떤 입력과 모델이 필요한가, standard RAG라는 다른 답이 있으면 결론이 유지되는가입니다. 이어 paired 평가, matched 학습 목표 비교, 행동 집합 비교를 기여로 정리합니다.
핵심 기여와 연결: 정답 신뢰도에서 수정 효과로 질문을 옮기고, 다음 장에서 이를 수학적 평가 대상으로 정의합니다. 원문 §1
📖 Chapter 2: Paired Outcomes for the Revision Decision
챕터의 위치와 역할: 문제 제기를 라벨·의사결정 규칙·평가 상한으로 연결합니다.
Limits of aggregate accuracy에서는 같은 순이득을 만드는 서로 다른 repair/harm 조합을 먼저 비교합니다. 평균 정확도만으로는 기존 정답을 보전하는 능력을 알 수 없다는 논리입니다. Paired outcome에서는 앞서 설명한 $r_I$와 $\Delta_I(x)$를 정의합니다. 기존 행동 로그에서 한 선택의 결과만 관측되는 문제와 달리, 여기서는 오프라인에서 두 결과를 모두 생성하고 같은 판정기로 측정합니다. 다만 라벨은 특정 수정기·근거·판정기에 종속됩니다.
Decision rule and oracle gap은 효과 예측값에 개발 집합 임계값을 적용합니다. Oracle은 미래 수정 결과를 아는 이상적인 선택자입니다. 항상 수정이 더 나은 고정 행동인 현재 실험에서는, 수정 때문에 잃은 정답을 모두 보전하면 그 상한에 도달하므로 gap이 harm 비율과 정확히 대응합니다. 이 등식은 모든 시스템에 무조건 적용되는 법칙이 아니라 현재 두 행동과 우세한 고정 행동의 조건에 따른 결과입니다.
Revision setups는 효과에 설정 $I$를 붙여야 하는 이유를 강조합니다. 같은 초안도 검색 문서나 수정 프롬프트가 다르면 다른 전이를 보입니다. Neighboring decisions에서는 selective prediction은 현재 답의 신뢰 여부, adaptive RAG는 검색 여부·방식, retrieval utility는 근거를 넣은 새 답의 이득을 다룬다고 구분합니다. 본 연구는 확보된 근거를 고정한 채 관측된 초안을 수정할지 결정합니다.
핵심 기여와 연결: recoverability가 범용적인 “고칠 수 있음” 점수가 아니라 특정 수정 동작의 조건부 순효과임을 확정합니다. 다음 장은 이 효과를 어떤 입력과 모델로 예측하는지 설명합니다. 원문 §2
📖 Chapter 3: Predicting Revision Effect
챕터의 위치와 역할: 정책의 정보 범위와 비교 실험의 공정성을 설계합니다.
Information inputs는 질문만, 질문과 초안, 질문·초안·지시문·검색 문서 다섯 개가 들어 있는 전체 프롬프트의 세 수준입니다. 모든 입력은 수정 답변의 첫 토큰 직전에서 끝납니다. 정답이나 생성 후 판정 결과를 넣지 않는 것은, 평가 때만 가능한 정보를 정책이 사용하는 누출을 막기 위한 조건입니다.
Model classes는 frozen final state에 적용하는 Ridge, Linear, MLP와 모든 frozen token state를 attention pooling하는 모델, 그리고 입력 전체를 읽고 LoRA로 적응하는 모델로 구성됩니다. Ridge는 부호 있는 차이를 회귀하고, 분류기는 repair·harm·tie를 예측합니다. 모델은 답을 생성하는 수정기가 아니라, 정해진 답변 후보 사이에서 행동을 선택하는 점수 함수입니다.
Baselines는 학습한 초안 correctness, retrieval utility 예측을 이 문제에 맞게 바꾼 Tian-style 회귀, 모델에게 초안의 정오를 물어 얻는 verbalized confidence입니다. Tian-style은 원 연구의 QPP·QualT5 구성 요소를 재현한 것이 아닙니다. 따라서 이 비교를 원래 retrieval-utility 방법 전체에 대한 우월성으로 확대할 수 없습니다. 질문과 초안만 보는 verbalized confidence는 검색 설정별 점수 자체가 달라지지 않으며, 임계값만 설정별로 고릅니다.
Matched training targets에서는 전체 프롬프트를 읽는 두 LoRA 모델의 backbone·adapter·optimizer·예산·시드를 맞춥니다. 하나는 초안 correctness, 하나는 paired outcome을 학습합니다. 다만 출력 head와 checkpoint 선택 기준은 목표에 맞게 다릅니다. 완전히 동일한 학습 절차에서 라벨 한 가지 값만 바꾼 비교라고 표현하지 않는 것이 정확합니다.
핵심 기여와 연결: 점수의 목표, 가용 정보, 모델 용량을 분리해 읽을 수 있는 비교 구조를 만듭니다. 다음 장은 이 정책들이 선택하는 실제 답변과 데이터·통계 절차를 고정합니다. 원문 §3
📖 Chapter 4: Experimental Setup
챕터의 위치와 역할: 결과 숫자의 분모와 불확실성이 무엇을 뜻하는지 정합니다.
Revision setups는 DPR, BM25, BM25→MonoT5입니다. 같은 Wikipedia passage 집합에서 다섯 개의 제목·문단 쌍을 반환하며, 근거 프롬프트와 수정기는 공유합니다. 따라서 검색 설정 비교에서는 검색 결과가 주된 차이입니다. 재정렬 설정은 BM25 후보 100개를 가져와 MonoT5로 상위 다섯 개를 남깁니다.
Data and evaluation에서는 NQ-Open과 TriviaQA로 학습 134,847개, 개발 14,966개를 구성합니다. 테스트 25,870개는 NQ-Open 3,610개, TriviaQA 7,993개, PopQA 14,267개입니다. PopQA는 학습·개발에 사용하지 않으며 전체 테스트의 약 55.1%를 차지합니다. 주 생성기와 수정기는 Llama 3.1 8B Instruct이고, 주 판정기는 Llama 3.3 70B입니다. 추가 생성기/수정기 계열은 GPT-OSS-20B와 OLMo 3 7B, 두 번째 판정기는 GPT-OSS-120B입니다.
학습 시드 세 개를 바꾸되 질문·초안·수정 답변·판정 라벨·분할·프롬프트·초매개변수는 고정합니다. 표의 평균±SD는 정책 학습 시드 간 표본 표준편차입니다. 유의 표시인 dagger는 대응하는 세 실행의 차이로 양측 paired t-test를 수행해 p<0.05인 경우이며, 다중 비교 보정은 없습니다. 95% 구간은 각 데이터셋 내부에서 테스트 사례를 10,000번 paired bootstrap한 결과입니다. 테스트 사례의 불확실성과 학습 시드 변동은 서로 다른 축입니다.
Offline supervision and online decisions에서는 모든 split에 수정 답변을 미리 생성해 감독과 평가에 사용합니다. 그러나 정책은 이 결과를 입력으로 보지 않고, 온라인에서는 반환 또는 수정 호출 중 하나를 결정합니다. 수정 호출 수가 감소하더라도 정책 추론 자체의 비용이 있으므로, 행동 비율을 시스템 지연시간 개선율로 읽어서는 안 됩니다.
핵심 기여와 연결: 동일한 답변 후보와 테스트 사례를 공유하는 비교 조건을 확정합니다. 다음 장의 수치는 이 조건을 유지한 정책 비교입니다. 원문 §4
📖 Chapter 5: Results
챕터의 위치와 역할: 수정 자체의 손익에서 시작해 정책, 목표, 정보, 강건성, 행동 집합 순으로 결론의 범위를 넓힙니다.
5.1 Measured Repair and Harm
DPR은 전체 초안의 9.32%를 고치고 3.05%를 망칩니다. BM25와 재정렬 설정에서는 repair가 각각 10.58%, 13.42%로 증가하지만 harm은 3.33%, 3.06%입니다. 항상 수정의 정확도는 항상 반환 47.38%보다 6.27~10.37pp 높습니다. 즉 수정 자체는 평균적으로 유익하면서도 선택적으로 막을 손해를 남깁니다.
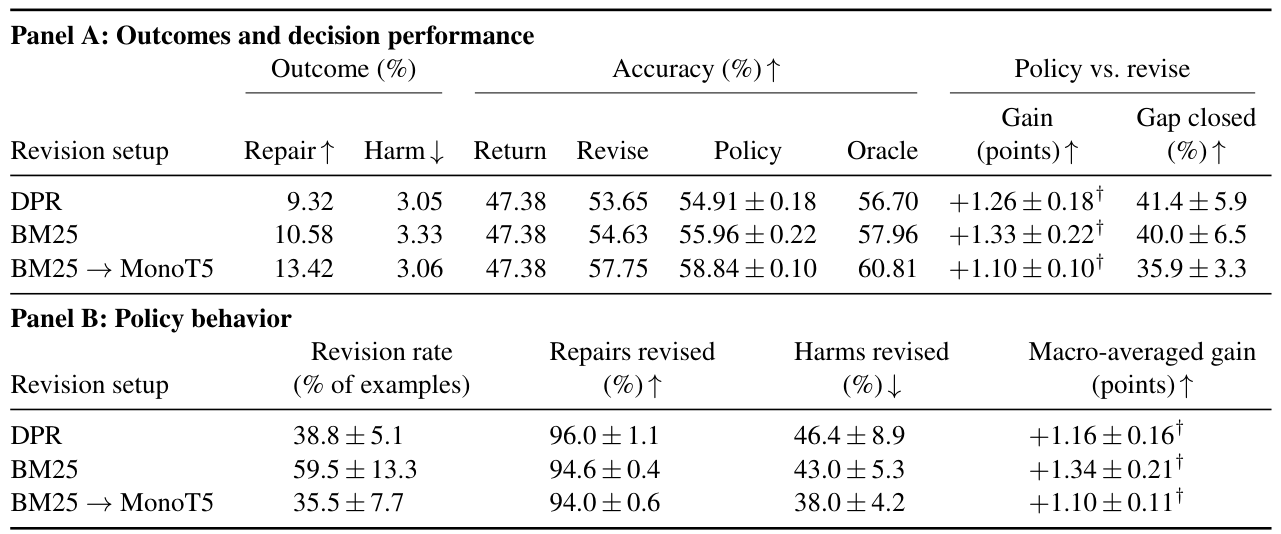
원문 Table 1의 Panel A·B, PDF 6쪽. 표 영역 원본 크롭이며 수치·단위·기호를 보존했습니다. ±는 세 정책 학습 시드의 SD이고 dagger는 원문 run-level 검정입니다. 2609.30087v1 PDF
재정렬로 repair가 늘어도 harm이 줄지는 않습니다. 정답 별칭이 어느 검색 문단에도 없는 정답 초안에서는 훼손 비율이 DPR 16.5%, 재정렬 21.1%입니다. 이 조건부 비율의 분모는 전체 질문이 아니라 해당 조건을 만족하는 정답 초안입니다. 나머지 사례에는 수정기가 원래 답을 그대로 반환해 정오가 변하지 않는 tie가 많습니다.
5.2 The Learned Policy
전체 프롬프트 LoRA 정책은 항상 수정보다 1.10~1.33pp 높은 정확도를 내고 oracle gap의 35.9~41.4%를 메웁니다. 전체 사례 중 실제 수정하는 비율은 35.5~59.5%입니다. 가능한 repair의 94.0~96.0%를 실행하는 대신, 발생 가능한 harm도 38.0~46.4% 실행합니다. 마지막 두 비율은 각각 모든 repair 사례, 모든 harm 사례를 분모로 합니다. “수정한 답의 46%가 틀린다”는 뜻이 아닙니다.
아홉 설정·시드 조합에서 정확도 이득은 0.98~1.53pp로 비교적 안정적이지만 수정 비율은 29.9~74.4%로 넓습니다. BM25의 수정 비율이 높은 시드는 추가 호출을 해도 답변 문자열이 그대로인 경우가 많았습니다. 따라서 정확도 곡선이 평평한 구간에서는 비슷한 정확도를 내는 정책도 실행량이 크게 달라질 수 있습니다. Tian-style 기준선은 거의 모든 사례를 수정해 항상 수정과 비슷하므로, 다음 절의 matched correctness가 더 강한 비교 대상입니다.
5.3 Paired Outcome versus Draft Correctness
같은 수정 비율에서 paired 목표와 correctness 목표의 정확도 차이를 그리면, paired 목표의 곡선 아래 면적이 아홉 학습 조합 모두에서 큽니다. Figure 3의 세 검색 설정에서 면적 차이는 각각 0.79±0.06, 0.98±0.12, 0.97±0.06 accuracy points입니다. 낮은 수정 비율에서 분리가 크고, 개별 곡선의 최대 차이는 1.37~3.06pp입니다. 이것은 정책이 자기 개발 임계값에서 얻는 차이와 다른 지표입니다.
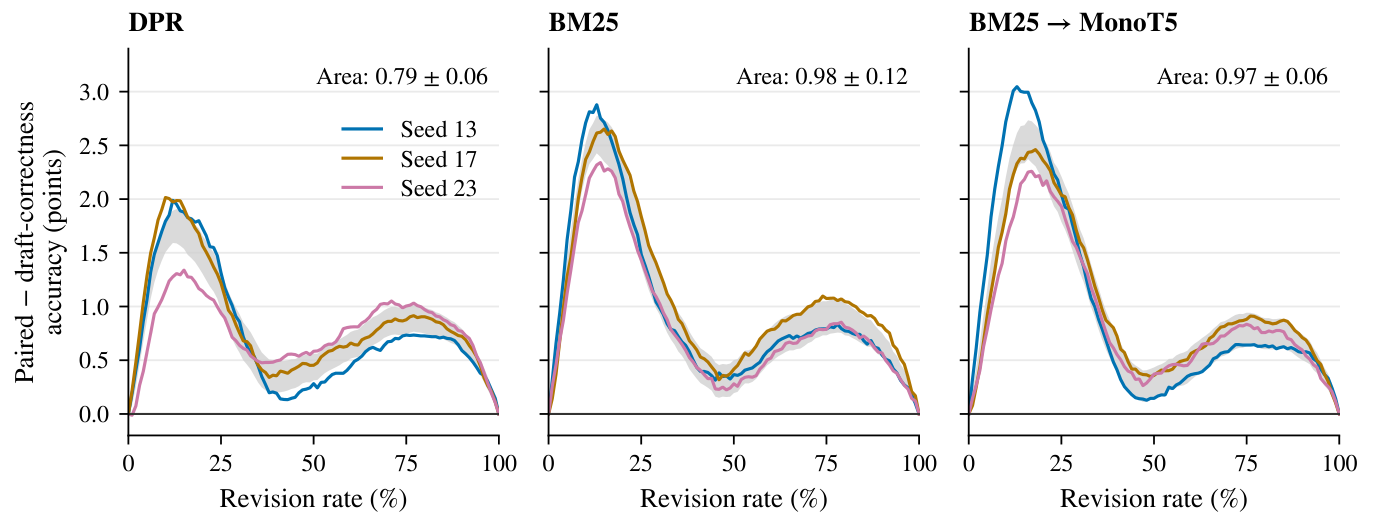
원문 Figure 3, PDF 6쪽. 세 패널·축·범례·음영을 보존한 원본 크롭입니다. 선은 학습 시드이며 회색 영역은 고정된 시드 평균에 대한 테스트 사례 bootstrap 95% 구간입니다. 2609.30087v1 PDF
각 정책의 개발 선택 임계값에서는 paired 목표의 평균 이득이 DPR 0.68pp, BM25 0.23pp, 재정렬 0.33pp입니다. 학습 실행 수준에서 유의한 것은 DPR뿐입니다. BM25는 한 시드에서 음의 차이를 보였고 재정렬은 세 시드 모두 양수지만 p=0.058입니다. correctness만으로도 항상 수정 대비 0.58~1.11pp를 얻으므로, paired 목표의 기여는 이미 유효한 confidence 정책을 개선하는 정도로 해석해야 합니다.
저자는 verbalized confidence가 항상 수정보다 0.03~0.09pp 정도만 개선한다고 덧붙인 뒤, 별도의 네 학습 목표 비교를 소개합니다. 이 별도 실험에서는 각 행동의 correctness를 예측하는 두 head가 repair/harm/tie 세 분류보다 평균 0.13pp 높습니다. 이는 특정 세 분류 구현만이 정답이라는 주장이 아니라 수정 결과를 감독 신호에 포함하는 여러 방식이 가능함을 보여 줍니다.
5.4 Inputs and Model Classes
질문만으로는 어떤 모델 계열도 거의 이득을 얻지 못합니다. 초안을 추가하면 각 설정의 최고 모델이 gap의 6.8~12.1%를 메웁니다. 큰 변화는 전체 근거 프롬프트를 읽는 LoRA에서 나타나며, 단일 시드 실험에서 32.1~41.0%를 메웁니다. 반면 전체 프롬프트를 쓰는 frozen-feature 모델의 최고값은 13.5%입니다.
이 비교는 입력과 모델 학습 방식이 함께 달라지므로, 저자는 같은 LoRA recipe를 고정한 입력 제거 실험을 추가합니다. 근거를 마스킹하거나 다른 질문의 근거로 바꾸면 항상 수정 대비 이득은 0.18~0.25pp로 줄고, 초안을 제거하면 0.56~0.69pp로 줄어듭니다. Remaining errors는 주제상 유사하지만 다른 인물·시기·대상을 설명하는 문서가 그럴듯한 잘못된 수정으로 이어지는 경우를 설명합니다. 전체 근거를 읽을 수 있다는 것만으로 질문과 근거의 정확한 대응을 항상 판별하는 것은 아닙니다.
5.5 Robustness
학습에 쓰지 않은 PopQA가 테스트의 절반 이상이라는 점을 확인하기 위해 데이터셋별 결과와 세 데이터셋 동등 가중 평균을 제시합니다. 세 시드의 macro gain은 1.10~1.34pp로 pooled gain과 비슷합니다. 단일 시드의 아홉 데이터셋·검색 조합에서도 정책은 항상 수정보다 높지만, DPR/NQ-Open의 gap closed는 14.6%로 약합니다. 학습 사례가 많다는 이유만으로 해당 분포에서 선택 문제가 쉬워지지는 않았습니다.
추가 모델 계열과 두 판정기로 재평가하면, 주 판정기 기준 항상 수정 대비 이득은 0.12~2.74pp입니다. GPT-OSS-20B는 정답을 망치는 비율이 작아 oracle gap도 작고, 정책이 gap을 메우는 비율도 Llama보다 낮습니다. 두 번째 판정기에서는 GPT-OSS-20B의 세 설정 중 재정렬만 run-level 유의성을 유지합니다. Llama와 OLMo는 두 판정기 모두에서 모든 설정의 이득이 유의합니다.
이어 독립적인 단일 평가자가 480쌍을 blind labeling한 진단을 제시합니다. 불확실 답을 제외한 470쌍에서 repair 8.5%, harm 5.7%, 순이득 2.8pp의 95% 구간은 −0.6~6.1pp입니다. 이는 전체 테스트 집합의 대표 비율 추정이나 1pp 미만 정책 차이에 대한 독립 검증이 아닙니다. A.10은 표본 구성과 제외 기준을 자세히 설명합니다.
5.6 Sensitivity to the Available Answers
이번에는 초안을 반환하는 행동, 초안을 수정하는 행동, 초안 없이 질문과 근거로 새 답을 생성하는 standard RAG 행동을 비교합니다. 하나의 per-action 모델이 세 행동 각각의 correctness logit을 학습하고, 같은 checkpoint에서 허용되는 행동만 바꿔 가장 큰 logit을 고릅니다. 이때 standard RAG 생성 비용은 비교에 포함하지 않습니다.
동일한 per-action 모델에서 {Return, Revise}를 {Return, RAG}로 바꾸면 Llama 정확도가 DPR 2.05pp, BM25 1.95pp, 재정렬 2.10pp 상승합니다. 별도 paired 정책과 비교한 2.17~2.37pp와 구별해야 합니다. 후자는 행동뿐 아니라 학습 목표도 달라지는 비교입니다. Llama에서 고정 standard RAG는 고정 revision보다 약하지만 초안의 오류와 덜 겹치는 오류를 만들어 조합 가치가 높습니다.
세 번째 행동으로 revision을 추가하면 평균 변화는 −0.15, +0.00, −0.12pp이며 유의한 개선을 확인하지 못했습니다. 그렇다고 revision만 맞는 질문이 없는 것은 아닙니다. 그런 질문은 설정별 181, 222, 323개이고 oracle을 0.70, 0.86, 1.25pp 높입니다. 학습 정책이 이 고유 승리를 잡는 비율은 아홉 fit에서 7~24%뿐이고, 새로운 revision 선택이 기존 정답을 망치는 경우도 생깁니다. Table 5는 고유 정답 포착, 이진 선택 오류 교정, 해로운 전환의 합으로 순변화를 설명합니다.
OLMo에서도 return-or-RAG가 동일 모델의 return-or-revise보다 약 4.0~4.6pp 높습니다. 이 계열에서는 standard RAG 자체도 revision보다 높아 Llama와 다른 양상을 보입니다. GPT-OSS-20B에는 standard RAG 답변을 생성하지 않아 이 행동 집합 실험을 수행하지 않았습니다.
마지막 Sensitivity of the action comparison에서는 보수적인 유지 프롬프트를 중립적인 유지·교체 프롬프트로 바꿉니다. 수정 답변 자체는 약해지지만 oracle은 올라가므로, 평균 정확도와 보완성의 차이가 다시 나타납니다. 두 번째 judge로 같은 결정을 재채점해도 return-or-RAG 우위와 paired 목표의 양의 평균 차이는 유지됩니다.
핵심 기여와 연결: 두 답 사이 효과 예측은 유용하지만, 수정 행동의 가치는 다른 답이 추가되는 순간 다시 평가해야 합니다. 다음 장은 이 결론을 기존 confidence·routing·revision 연구와 연결합니다. 원문 §5
📖 Chapter 6: Related Work
챕터의 위치와 역할: 유사한 결과 차이 예측 방법들과 본 논문의 결정 시점이 어떻게 다른지 정리합니다.
Confidence and adaptive RAG에서는 selective prediction과 adaptive retrieval을 먼저 설명합니다. 이전 연구들은 검색 전이나 생성 중 검색 여부를 고르는 경우가 많습니다. 본 연구는 이미 초안과 문서가 고정된 시점의 수정 실행을 다룹니다. Self-RAG·Adaptive-RAG는 생성기나 검색 파이프라인까지 바꾸므로 고정 답변 비교의 기준선으로 다시 실행하지 않았습니다. RASER의 recoverability는 검색 경로를 바꾸는 escalation 효과인 반면, 여기서는 검색 근거를 고정한 수정 효과입니다.
Retrieval utility는 근거를 넣기 전후 답변 품질 차이의 예측, learning to defer, 모델 cascade와 routing의 쌍 감독을 연결합니다. 저자는 이 아이디어를 처음 제안했다고 주장하지 않습니다. 두 번째 모델이 질문에 새로 답하는 cascade와 달리, 여기서 두 번째 답변은 첫 답변을 조건으로 수정한 결과라는 점이 핵심 구별입니다.
Revision and conflicting evidence는 피드백에 따른 수정과 내부 지식·외부 근거 충돌을 다룹니다. 본 연구는 이 문제에 matched target 비교와 동일 scorer의 행동 집합 비교를 함께 적용합니다. 두 답을 모두 오프라인에서 만들 수 있다는 점에서 관측되지 않은 반사실 결과를 추정해야 하는 일반적인 인과 추론 문제와도 다릅니다.
핵심 기여와 연결: 선행 개념의 조합과 실험상 차별점을 분리합니다. 다음 장은 그 차별점이 시스템 설계에 무엇을 말해 주는지 논의합니다. 원문 §6
📖 Chapter 7: Discussion
챕터의 위치와 역할: 실험에서 확인한 효과의 크기와 적용 범위를 정리합니다.
What the paired target adds는 correctness만으로 이미 얻는 이득이 상당하며 paired 목표는 이를 0.23~0.68pp 더 개선한다는 점을 다시 강조합니다. 수정 결과를 예측하는 정보는 유용하지만, 세 분류 head만이 유일하거나 항상 최선인 표현은 아닙니다.
Where the useful signal comes from은 질문·초안·근거·수정기의 관계를 읽는 능력을 핵심으로 봅니다. 입력 제거 실험상 현재 질문에 맞는 근거가 대부분의 이득을 설명하고, 초안도 일부를 설명합니다. Better retrieval does not remove the decision에서는 더 많은 repair가 생겨도 harm이 사라지지 않고 정책의 추가 이득이 비례해 커지지 않음을 짚습니다.
The action set determines the value of revision은 조건부 효과 $\Delta_I(x)$ 자체와 다른 답변이 있는 상황에서 revision의 선택 가치를 구분합니다. standard RAG를 추가해도 초안 대비 revision의 효과 정의는 그대로이지만, revision이 이겨야 하는 대안은 달라집니다.
From accuracy to decision utility는 원문이 제시한 확장 방향입니다. 현재 정확도 목적함수는 repair의 +1과 harm의 −1을 대칭으로 셉니다. 실제 배치에서 정답 훼손에 더 큰 비용을 부여하거나 지연·연산 비용, abstention, 사람 escalation을 고려하려면 행동별 효용을 정의하고 개발 집합에서 운용점을 고른 뒤 전이 여부를 검증해야 합니다. 본 논문은 이 효용 실험을 수행한 것은 아닙니다.
핵심 기여와 연결: 정확도상의 선택 문제와 비용·위험상의 선택 문제를 분리하고 결론으로 이어집니다. 원문 §7
📖 Chapter 8: Conclusion
챕터의 위치와 역할: 연구 질문에 대한 답을 짧게 회수합니다. 오프라인 paired grading은 repair·harm과 상한을 드러내고, 효과 예측은 matched correctness보다 좋은 순위를 학습합니다. 전체 근거 프롬프트를 읽는 적응 모델에서 큰 이득이 나타납니다. 그러나 standard RAG까지 선택 가능하면 revision의 추가 이득은 유의하지 않습니다.
핵심 기여와 연결: 수정 여부는 가용 대안에 대한 상대적 결정이며, 모든 답변을 오프라인 평가하면 이를 학습·비교 가능한 문제로 바꿀 수 있다는 결론입니다. 이어 번호 없는 제한·윤리·감사·참고문헌이 배치되고 그 뒤에 부록이 옵니다. 원문 §8
📖 Chapter: Limitations → Ethical Considerations → Acknowledgments → References
챕터의 위치와 역할: 본문 결론의 적용 한계와 연구 조건을 명시하는 번호 없는 부분입니다. 아래 한계는 저자가 원문에서 직접 제시한 것만 정리합니다.
Limitations의 첫 범위는 단문 open-domain QA, 세 검색 설정, 세 생성기/수정기 계열입니다. 장문·multi-hop·특정 도메인·고위험 상황을 테스트하지 않았고, 초안과 수정에 같은 checkpoint를 사용합니다. 모든 설정이 하나의 Wikipedia corpus에서 다섯 문서를 사용하며, 더 큰 모델·다른 수정기·다른 corpus·배포된 파이프라인·사람의 수정은 평가하지 않았습니다. PopQA의 높은 테스트 비중에 따른 분포 차이 우려도 남습니다.
두 번째는 비교의 통제 범위입니다. frozen 모델과 LoRA는 적응·파라미터 수·최적화가 함께 달라지고, matched target도 head와 선택 규칙은 다릅니다. 입력 ablation은 각각 재학습하므로 이미 학습된 정책 내부에서 어떤 입력을 실제 사용하는지 직접 증명하는 실험은 아닙니다. calibrated confidence와 semantic uncertainty를 폭넓게 조사하지 않았습니다.
세 번째는 불확실성입니다. 입력·모델 격자 등 일부 분석은 한 시드이고, 세 학습 실행만으로는 run-level 검정력이 낮습니다. 시드는 정책 학습만 바꾸므로 생성 및 judge sampling 변동을 반영하지 않습니다. 단일 평가자의 진단으로 평가자 간 신뢰도를 추정하거나 작은 정책 이득을 독립 검증할 수 없습니다. 저자는 특히 비유의한 세 번째 행동 이득이 동등성 검정 결과는 아니며, shared per-action checkpoint의 선택 목적이 각 이진 정책에 따로 최적화한 목적과 다를 수 있다고 밝힙니다.
Ethical Considerations에서는 평균 정확도 연구가 배포 준비 상태를 보장하지 않는다고 명시합니다. 놓친 repair와 실행한 harm 모두 중요하고, 실제 적용에는 도메인별 정오 기준·근거 범위 확인·사람 escalation·모든 행동 검증이 필요합니다. Wikipedia 근거가 오래되거나 불균등하면 평균적으로 좋은 정책도 근거가 빈약한 질문에서 체계적으로 수정을 억제할 수 있습니다.
Acknowledgments는 피드백·데이터 라벨링 기여와 연구 지원을 밝힙니다. References는 앞서 연결한 QA·RAG·routing·self-correction·판정 연구의 서지 목록입니다. 본 리뷰는 인용 논문 전체를 독립적으로 재검증한 것으로 주장하지 않습니다.
핵심 기여와 연결: 결과를 일반화할 수 있는 범위를 한정하고, 이후 부록이 실험 recipe와 추가 근거를 제공하도록 연결합니다. 원문 PDF의 결론 이후 부분
📖 Chapter A: Supporting Analyses
챕터의 위치와 역할: 본문의 결론을 뒷받침하는 모델 설정·진단·통제 실험을 A.1~A.13 순서로 제공합니다.
A.1 Decision-Model Recipes
Table 6은 세 입력×다섯 모델×세 검색 설정의 45개 fit을 설명합니다. Ridge는 4,097개, Linear는 12,291개, MLP는 약 106만 개, LoRA는 약 4,196만 개 학습 파라미터를 갖습니다. Llama LoRA는 rank 16, scale 32, dropout 0.05로 attention·MLP projection을 적응하고 분류 head를 학습합니다. 학습률 10⁻⁴, 한 epoch, 유효 batch 64, BF16, AdamW, weight decay 0.01, cosine decay, warmup 0.03, gradient clipping 1.0을 사용합니다. 입력 제한은 Llama 4,096, OLMo 8,192토큰이며 넘친 입력은 자르지 않고 거부합니다. 테스트에서는 제한을 넘는 입력이 없었습니다.
뒤의 Matched comparator and per-action model은 선택 절차를 명확히 합니다. correctness는 개발 Brier score, paired 모델은 부호 있는 효과의 개발 MSE로 checkpoint를 고릅니다. Per-action 모델은 세 sigmoid/BCE head를 쓰고 세 행동 argmax 정확도로 checkpoint를 선택합니다. 제한된 행동 집합에도 같은 checkpoint를 적용하고 다시 학습하거나 임계값을 고르지 않습니다. 동률은 return, standard RAG, revision 순으로 처리합니다.
A.2 Verbalized Confidence Baseline
Adapter 없는 Llama가 질문과 자신의 초안을 보고 true/false 한 단어를 출력하도록 합니다. 두 응답의 상대 확률로 confidence를 만들고 개발 집합으로 수정 임계값을 고릅니다. 테스트의 85.3~93.1%를 수정하며 항상 수정 대비 이득은 DPR +0.027pp, BM25 +0.089pp, 재정렬 +0.035pp입니다. DPR의 95% 구간 −0.015~+0.070pp는 0을 포함합니다. 모델의 언어화된 자신감과 특정 수정의 성공 가능성이 다른 신호임을 보여 주는 약한 기준선입니다.
A.3 Analysis of Harmful Revisions
먼저 Figure 2의 두 사례에서는 정책이 repair를 실행하고 harm을 차단해 모두 올바르게 처리했다고 밝힙니다. 이어 Golden State Warriors의 첫 우승 연도를 묻는데 최근 팀을 다룬 문서를 따라 1947을 2015로 바꾸거나, The Terminal을 The Terminator와 혼동한 근거를 따라 답을 바꾸는 실패를 설명합니다.
Table 7은 이런 패턴과 harm의 연관성을 전체 사례에서 측정합니다. 수정 답의 문자열이 근거에 있는 harm은 설정별 78.3~86.0%입니다. PopQA의 lexical mismatch는 수정 답이 근거에 있고, 문서 제목이 질문 대상과 일치하지 않으며, 정답 별칭도 없는 경우입니다. 이 조건에 해당하는 정답 초안의 harm은 82.2~87.5%지만, 이는 해당 조건부 진단이지 전체 harm 비율이 아닙니다. 정답 별칭을 쓰는 이 사후 분석은 정책 입력이나 임계값 선택에 사용하지 않았습니다.
A.4 Retrieval-Utility Baseline
Tian-style은 21개 engineered feature와 절편, 총 22개 계수의 회귀입니다. 전체 프롬프트의 검색·문맥·초안 특징을 사용하지만 LoRA 약 4,200만 학습 파라미터와 용량이 크게 다릅니다. 수정 비율 93.8~94.4%, 정확도 53.70/54.72/57.80%로 항상 수정과 가깝습니다. LoRA 우위 1.04~1.25pp를 이 약한 기준선의 범위에서 해석해야 합니다.
A.5 Additional Matched Training Targets
Table 9는 본문 Table 1과 별도로 다시 학습한 네 목표를 비교합니다. 세 분류, 두 correctness head, scalar utility regression, tie-aware preference이며, 마지막 목표는 harm/tie/repair를 0/½/1로 표현합니다. 두 head는 세 분류보다 아홉 셀 평균 0.13pp 높고, 두 방식 모두 회귀·preference보다 평균 정확도가 높습니다.
저자는 정확한 조건부 기대 차이만 추정할 수 있다면 scalar도 결정에 충분하다고 설명합니다. 따라서 이 표는 scalar 목표가 필요한 정보를 본질적으로 잃는다는 증거가 아니라 실제 학습 recipe의 성능 순서입니다. 같은 테스트 데이터를 공유하는 아홉 셀을 아홉 독립 데이터셋의 재현으로 간주하지 않습니다.
A.6 Complete Input and Model Comparison
Table 10은 Figure 4의 45개 셀을 모두 제공합니다. 각 셀은 seed 13으로 독립 학습하고 개발 집합에서 선택한 결과입니다. 예를 들어 전체 근거 입력 DPR에서 Ridge의 gap closed는 7.7%, LoRA는 35.8%입니다. BM25에서는 Linear가 13.5%, LoRA가 41.0%입니다. 질문만으로는 일부 값이 음수여서 항상 수정보다 나쁘기도 합니다. 이 표의 단일 실행값을 본문 세 시드 평균과 섞지 않아야 합니다.
A.7 Controlled Input Ablations
전체 프롬프트의 근거를 neutral token으로 마스킹하되 길이를 유지하거나, 같은 데이터셋·split·검색 설정의 다른 사례 근거로 교체합니다. 초안 제거 실험도 수행합니다. 모든 경우 수정 답변과 paired 라벨은 그대로여서 선택해야 할 두 답변은 바뀌지 않습니다. 학습·개발·테스트 입력을 함께 변경해 재학습합니다.
근거 교란에서 얻는 작은 이득과 비교해, 질문에 대응하는 근거가 중요하다는 해석을 뒷받침합니다. 초안 제거의 감소는 DPR·재정렬에서 run-level 유의하지만 BM25에서는 표시가 없습니다. 단일 실행에서 문단 제목만 남기면 정확도가 0.41~0.89pp 낮아지고, 문서 순서 뒤집기·섞기는 최대 0.18pp만 바꿉니다. 두 학습 시드 간 최대 차이 0.43pp와 함께 제시해 작은 순서 효과의 규모를 가늠하게 합니다.
A.8 Results by Dataset
Table 12는 NQ-Open·TriviaQA·PopQA 각각의 repair/harm, 반환·수정·RAG·정책·oracle 정확도를 한 시드에서 비교합니다. Llama의 아홉 조합 모두 고정 revision이 고정 RAG보다 높습니다. DPR/NQ-Open의 policy 58.86%와 revision 58.25%, DPR/PopQA의 policy 37.37%와 revision 36.22%는 같은 정책도 데이터셋에 따라 추가 이득과 남은 상한이 다름을 보여 줍니다. 데이터셋별 임계값 재조정은 하지 않았습니다.
A.9 Additional Robustness Checks
Operating points의 Table 13은 모델·검색·judge 조합마다 oracle gap과 gain, gap closed를 풀어 보여 줍니다. GPT-OSS-20B의 주 judge gap은 1.24~1.64pp로 Llama의 3.05~3.33pp보다 작습니다. 작은 추가 정확도만 보고 정책이 항상 열등하다고 판단하기 전에 개선 가능한 상한부터 봐야 합니다.
Judge agreement의 Table 14는 같은 답변에 대한 판정기 일치를 측정합니다. 답변 단위 정오 일치는 96.46~96.74%지만 harm의 유지 비율은 85.7~86.7%로 네 결과 중 가장 낮습니다. 주 judge의 harm이 두 번째 judge에서 unrecovered가 되는 경우가 많다는 것은, 수정의 정오보다 원래 초안이 정말 맞았는지에 이견이 생긴다는 뜻입니다. 두 번째 judge는 전반적으로 엄격해도 harm 자체는 더 많이 찾습니다.
A.10 Single-Annotator Human Diagnostic
비저자 평가자 한 명에게 초안·수정 여부, 쌍 관계, judge와 metadata를 숨긴 960개 답변을 제시합니다. NQ-Open·TriviaQA·PopQA 각각 160쌍이고 DPR·BM25의 각 셀에서 80쌍을 뽑아 같은 질문이 중복되지 않게 합니다. 평가자는 14개 답에 unsure를 표시했습니다.
양쪽 라벨이 확정된 470쌍에서 사람 기준 반환 47.9%, 수정 50.6%입니다. 데이터셋 균등 진단 표본이므로 전체 테스트 가중치와 다릅니다. TriviaQA의 순이득은 −2.6pp지만 구간 −8.9~+3.8pp는 0을 포함합니다. 사람과 주 judge의 three-way 일치는 94.5%, Cohen’s κ는 0.78입니다. 라벨 간 repair↔harm 직접 전환은 없고 주로 tie와의 차이였습니다. 평가자 한 명이라는 제약과 정책 미세 차이 검증이 아니라는 범위를 유지합니다.
A.11 Action Sets by Dataset
Table 16은 Llama와 OLMo의 행동 집합 비교를 각 데이터셋에 그대로 적용합니다. 같은 모델·checkpoint·답변·라벨을 유지하고 허용 head만 제한합니다. Llama에서 return-or-RAG의 return-or-revise 대비 이득은 아홉 데이터셋·설정 조합에서 1.75~3.83pp이고 모두 run-level 유의합니다. OLMo의 최소 slice 이득은 약 3.4pp입니다. 세 번째 행동의 효과는 같은 정도로 뒷받침되지 않습니다. 표의 차이 SD는 독립 추정치의 SD를 빼서 얻은 것이 아니라 시드별 대응 차이의 SD입니다.
A.12 Policy Contrasts Under a Second Judge
Table 17은 checkpoint·threshold·선택 행동을 바꾸지 않고 GPT-OSS-120B로 다시 채점합니다. Paired−correctness는 +0.38~+0.75pp, return-or-RAG−return-or-revise는 +2.04~+2.23pp이고 각 평균의 사례 bootstrap 구간은 양수입니다. 세 번째 revision 추가는 −0.12~+0.01pp입니다.
DPR·재정렬에서 세 번째 행동의 손실은 사례 bootstrap 구간상 음수이지만 세 학습 실행 검정에서는 유의하지 않습니다. 두 검정이 다른 불확실성을 평가하므로 모순은 아닙니다. Return-or-RAG 학습 정책과 return-or-revise oracle의 차이는 주 judge에서 작은 양수지만 두 번째 judge의 구간은 모두 0을 포함합니다. 서로 다른 행동 집합의 상한과 실제 정책을 비교하는 데에도 판정기 민감성이 있습니다.
A.13 Neutral Revision Prompt
기본 프롬프트는 증거가 불충분·무관·모호·충돌이면 초안을 유지합니다. 중립 버전은 근거가 더 지지하는 답이 있으면 바꾸도록 합니다. 같은 Llama 테스트 사례에서 neutral revision 정확도는 52.74/54.06/57.45%로 원래보다 낮지만, return-or-revise oracle은 57.22/58.38/61.21%로 높아집니다. 더 공격적인 수정이 평균적으로는 나빠도 초안과 다른 곳에서 맞을 수 있습니다.
이 실험은 neutral revision selector를 새로 학습하지 않았습니다. 따라서 높아진 oracle을 실제 정책 이득으로 제시할 수 없습니다. neutral oracle과 기존 학습 return-or-RAG 평균의 차이 구간도 0을 포함합니다.
핵심 기여와 연결: A.1~A.13은 recipe, 목표, 입력, 데이터, 판정기, 프롬프트의 영향을 단계적으로 분해합니다. 다음 부록은 분할과 실패 처리처럼 숫자를 재현할 때 필요한 세부 조건을 정리합니다. 원문 Appendix A
📖 Chapter B: Reproducibility Details
챕터의 위치와 역할: 실험 프로토콜에서 결과를 바꿀 수 있는 세부사항을 명시합니다.
Splits는 학습 NQ-Open 79,029·TriviaQA 55,818, 개발 8,896·6,070, 테스트 3,610·7,993·PopQA 14,267개를 제시합니다. Training seeds는 13, 17, 23이며 단일 실행 분석은 seed 13입니다. Retrieval and prompts는 다음 Appendix C의 공개 자원·revision·프롬프트로 연결합니다.
States는 frozen feature를 추출하는 토큰 위치를 구분합니다. 질문만일 때는 질문 입력 끝, 질문+초안일 때는 근거 직전, 전체 프롬프트일 때는 수정 첫 토큰 직전입니다. 모두 Llama의 final RMS normalization을 사용합니다. 같은 “마지막 hidden state”라는 표현도 어떤 입력 범위의 끝인지를 고정해야 합니다.
Probability features는 정규화한 answer probability를 다음처럼 정의합니다.
$m$은 파싱된 답변 문자열 토큰 수, $a_t$는 해당 위치 토큰, $a_{\lt t}$는 앞선 토큰, $x$는 조건 입력입니다. 토큰 log probability의 평균에 지수를 취하므로 길이 전체의 단순 확률 곱이 아니라 기하평균 확률입니다. 문맥 특징도 근거 토큰 span에 같은 방식을 사용합니다. 정확한 프롬프트를 teacher forcing해 계산하며 답을 다시 생성하지 않습니다.
Invalid generations and judge parses는 모든 정확도 계산에 25,870개를 유지하고 invalid·ambiguous를 실패로 셉니다. 주 judge의 초안에는 invalid 8개, revision의 DPR/BM25/재정렬에는 invalid·ambiguous가 각각 6/1, 5/0, 3/1개입니다. 파싱 답변 span이 없는 학습·개발·테스트의 초안 7개도 버리지 않고 Tian-style answer probability를 0으로 둡니다.
핵심 기여와 연결: 입력 경계, 분모, 파싱 실패를 명시해 성공한 사례만 남기는 평가를 방지합니다. 마지막 부록은 자원과 프롬프트의 구체적 구현 조건으로 이어집니다. 원문 Appendix B
📖 Chapter C: Artifacts, Prompts, and Determinism
챕터의 위치와 역할: 독립 구현에 필요한 자원·환경·생성 조건을 기록하는 마지막 부록입니다.
Artifacts and availability에서 저자는 upstream 데이터·passage·모델은 공개되어 있지만, 실험 코드·생성 답변 corpus·학습 정책·row-level 평가 출력은 공개하지 않았다고 명시합니다. 따라서 이 리뷰는 공개 실행 코드의 재현 성공을 주장하지 않습니다. 데이터셋 고유 식별자의 SHA-1 첫 여덟 자리 값을 이용해 원 학습 split의 약 10%를 개발 집합으로 배정하는 규칙, 원 평가 split의 사용 방식, 모델 commit revision은 원문에 제시되어 있습니다.
DPR과 BM25는 같은 WikiDPR 100-word passage collection을 사용합니다. DPR 질문 입력은 256토큰에서 자르고, BM25는 Lucene analyzer와 기본 BM25 설정을 사용합니다. 생성기·판정기 checkpoint는 revision으로 고정하며, 원문 환경은 vLLM 0.25.1, Transformers 5.5.4, PyTorch 2.11.0 등으로 기재되어 있습니다. 이는 저자가 보고한 재현 환경이며 본 리뷰에서 해당 환경을 설치·실행한 것은 아닙니다.
Compute budget은 H200 기준 전체 실험을 한 번 재현하는 비용을 약 900 GPU-hours로 추정합니다. 세 학습 시드는 같은 생성 답변과 판정 결과를 공유합니다. Determinism은 Llama·OLMo의 greedy generation과 GPT-OSS의 temperature 1.0, top_p 1.0, seed 13 sampling을 구분합니다. 주 Llama judge는 greedy, 두 번째 GPT-OSS judge는 해당 sampling 설정을 사용하며 두 판정기 모두 로컬 서빙입니다.
C.1 Prompt Templates
원문은 실제 user-message template을 Draft → Standard RAG → Candidate revision → Neutral revision → Evidence block → Semantic-equivalence judge → P(true) → Validity handling 순서로 제공합니다.
Draft는 질문과 내부 지식만으로 짧은 답을 내고, Standard RAG는 초안을 보지 않고 근거로 답합니다. Candidate revision은 초안을 유지할 조건을 강하게 명시하며, Neutral revision은 근거가 가장 잘 지지하는 답으로 유지·교체하도록 바꿉니다. Evidence block은 다섯 문서의 제목과 전문을 순위 순으로 넣고 별도 문자 수 cap을 두지 않습니다.
Judge는 정답 별칭과 후보 답을 JSON 값으로 받아 equivalent/not_equivalent/ambiguous/invalid 중 하나를 반환합니다. 별칭·약어·동등한 엔터티는 허용하지만 관련만 있는 답·부분 일치·더 넓거나 좁은 답에는 점수를 주지 않습니다. P(true)는 질문과 초안에 대한 true/false 응답을 요구합니다. 마지막으로 한 줄 Final answer: 형식을 결정적으로 파싱하고 잘리거나 잘못된 형식·모호한 답은 오답 처리합니다.
핵심 기여: 프롬프트의 보수성이 행동 후보의 성질을 만들고, 파싱·판정 규칙까지 결과 라벨에 영향을 준다는 점을 명시합니다. 이것이 원문의 마지막 부록이며 이후 별도 실험 장은 없습니다. 원문 Appendix C
실험 결과 심층 분석
세 종류의 개선을 구분하기
아래는 원문 Tables 1·2·4의 서로 다른 비교를 함께 읽기 위해 정리한 표입니다. 정확도 차이는 모두 percentage points이며, 괄호 설명처럼 비교 조건을 구분합니다.
| 비교 | DPR | BM25 | BM25→MonoT5 |
|---|---|---|---|
| Paired 정책 − 항상 수정, 세 시드 평균 | +1.26 | +1.33 | +1.10 |
| Paired 정책 − matched correctness 정책, 각자 개발 임계값 | +0.68 | +0.23 | +0.33 |
| Return-or-RAG − Return-or-Revise, 같은 per-action 모델 | +2.05 | +1.95 | +2.10 |
| 세 행동 − Return-or-RAG, 같은 per-action 모델 | −0.15 | +0.00 | −0.12 |
첫 행은 수정 여부를 선택하는 전체 정책의 가치, 둘째는 학습 목표를 paired로 바꾸는 추가 가치, 셋째는 선택 가능한 답변을 바꾸는 가치입니다. 모두 “제안 방법의 개선”으로 한데 합치면 어떤 설계가 실제 차이를 만들었는지 놓칩니다. 셋째 행의 차이가 더 크다는 사실은 본 실험에서 행동 집합의 보완성을 확인하는 일이 목표 함수 미세 개선보다 큰 차이를 만들었다는 리뷰어 해석을 뒷받침합니다. 다른 작업에서도 같은 크기일 것이라는 일반화는 하지 않습니다. 원문 Tables 1·2·4
통계적 신뢰도와 실용적 중요성
항상 수정 대비 정책 이득은 세 검색 설정 모두 run-level 유의합니다. 반면 matched correctness 대비 이득은 DPR만 유의하며 재정렬의 p=0.058을 “거의 유의하니 유의”로 처리하지 않습니다. Figure 3의 면적 우위는 순위 품질에 대한 증거이고, 선택된 단일 임계값의 차이에 대한 검정을 대체하지 않습니다.
0.23~0.68pp는 작은 평균 차이지만 전체 질문에서 repair와 harm을 따로 추적하게 만드는 학습 목표의 의미가 있습니다. 동시에 정책의 추론 비용, 수정 호출 비용, 잘못된 수정의 업무상 손실을 측정하지 않았으므로 곧바로 운영 비용 절감으로 환산할 수 없습니다. 저자가 §7에서 효용을 별도로 정의해야 한다고 한 이유입니다.
인간 진단과 두 번째 judge는 자동 라벨에 대한 추가 근거입니다. 그러나 480쌍의 단일 평가자 검사는 전체 정책의 작은 이득을 검증하는 실험이 아니고, 세 학습 시드 역시 생성·판정 샘플링 전체의 변동을 담지 않습니다. 세 번째 행동의 비유의 개선도 revision이 모든 상황에서 무가치하다는 증명이 아닙니다. 원문이 보고한 고유 revision 정답과 oracle 상승은 그보다 좁은 결론을 요구합니다.
기술적 함의와 응용
리뷰어 해석: RAG 파이프라인을 평가할 때 최종 정확도 한 개만 저장하기보다 초안과 각 후속 행동의 정오를 같은 기준으로 저장하면, 어떤 행동이 무엇을 고치고 무엇을 망치는지 볼 수 있습니다. 이 논문에서 중요한 학습 단위는 질문의 난이도만이 아니라 현재 초안, 실제 검색 근거, 고정된 수정기의 조합입니다.
답변 후보를 늘릴 때에도 각 후보의 단독 정확도만 비교해서는 충분하지 않습니다. Llama standard RAG처럼 단독 정확도는 낮아도 기존 답과 보완적인 후보가 더 유용할 수 있습니다. 반대로 새 행동이 고유 정답을 제공해 oracle을 높여도, 학습 정책이 그것을 알아보고 해로운 전환을 피하지 못하면 실제 정확도는 오르지 않습니다.
저자가 제시한 응용상의 고려사항은 정확도에서 행동별 효용으로의 확장입니다. 정답 훼손에 대한 비대칭 비용, 지연·연산 비용, 답변 보류와 사람 escalation을 반영하려면 그 목적에 맞는 평가를 새로 해야 합니다. 현재 결과는 단문 open-domain QA와 지정된 모델·검색·프롬프트 조건에서 얻은 것입니다. 수정 효과를 학습할 가치는 있지만, 그 가치는 함께 선택할 수 있는 답변과 목적함수 안에서 판단해야 합니다.
분석 범위: 본문 8개 섹션, 번호 없는 제한·윤리·감사·참고문헌의 역할, Appendix A.1~A.13·B·C/C.1을 반영했습니다. 부록의 모든 표 셀·checkpoint SHA·프롬프트 전문·참고문헌 항목을 재전재하지는 않았습니다. Tables 1·2·4의 주요 수치와 이미지 인용은 고정 버전 PDF와 대조했으며, 저자의 비공개 실험 산출물을 확보하거나 실험을 재실행한 것은 아닙니다.