최근 JEV라는 모델이 공개되면서 BERT 계열 인코더와의 비교가 다시 활발해졌고, 덕분에 BERT에 대한 관심도 한 번 더 올라갔습니다. 생성형 LLM이 대세가 된 지금도 분류·검색·라우팅처럼 “빠르고 정확하게 이해하는” 문제에서는 인코더 모델이 여전히 자주 언급됩니다. 그런데 막상 “BERT는 GPT와 학습 방식이 정확히 어떻게 다르지? 입력과 출력은 뭐고 loss는 어디에 걸리지?”라는 질문을 받으면 바로 답하기가 쉽지 않았습니다.
그래서 이번 기회에 BERT를 중심으로, 그 뿌리인 2017년의 Transformer와 같은 시기에 나온 GPT, BART, T5까지 근본 모델들을 처음부터 다시 정리해 보았습니다.
각 모델은 아래 다섯 가지 관점으로 정리합니다.
- 모델 정보: 발표 시점, 저자·기관, 크기, 학습 데이터
- 핵심 특징과 Contribution: 이전 연구와 비교해 무엇을 바꿨는가
- 푸는 문제: 어떤 태스크를 어떤 형태로 푸는가
- 학습 방식: 입력(IN)과 출력(OUT), 정답(label), loss가 걸리는 위치
- 샘플과 코드: 실제 입출력 예시와 PyTorch·Hugging Face 스니펫
그림은 모두 원 논문의 그림입니다. arXiv 소스에 포함된 원본 그림 파일을 쓰거나 PDF에서 그림 영역만 잘라 왔고, 그림 안의 글자는 번역하지 않았습니다.
전체 지도 먼저 보기
| 모델 | 연도·기관 | 구조 | 사전학습 목표 | 대표 용도 |
|---|---|---|---|---|
| Transformer | 2017, Google | Encoder–Decoder | (사전학습 없음) 번역 데이터로 바로 학습 | 기계번역 |
| BERT | 2018, Google | Encoder only | Masked LM + Next Sentence Prediction | 분류, 추출형 QA, NER, 임베딩 |
| GPT (1/2/3) | 2018~2020, OpenAI | Decoder only | 다음 토큰 예측 (Causal LM) | 생성, few-shot, 범용 LLM |
| BART | 2019, Facebook AI | Encoder–Decoder | 노이즈가 섞인 문서 → 원문 복원 | 요약, 생성, 분류 |
| T5 | 2019, Google | Encoder–Decoder | Span corruption (가린 span만 생성) | 모든 태스크를 text-to-text로 |
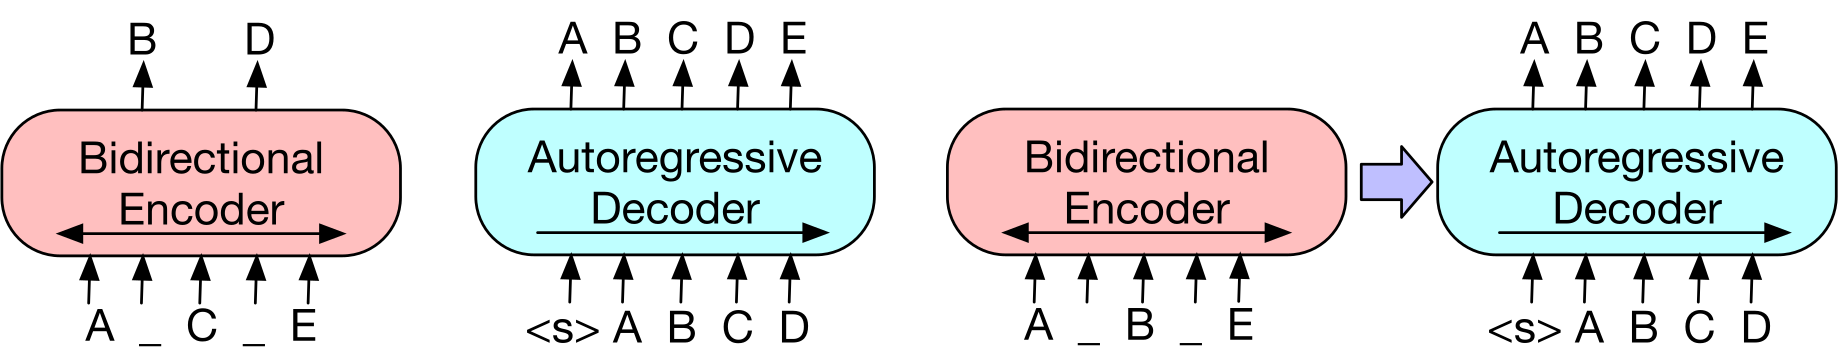
BART 논문 Figure 1. 왼쪽부터 (a) BERT: 양방향 인코더가 가려진 토큰(B, D)을 제자리에서 맞힘, (b) GPT: 자기회귀 디코더가 왼쪽만 보고 다음 토큰을 맞힘, (c) BART: 손상된 입력을 양방향 인코더로 읽고 자기회귀 디코더가 원문 전체를 생성. T5와 원래 Transformer도 (c)와 같은 Encoder–Decoder 구조입니다. 세 하위 그림을 원문 배치대로 한 장으로 이어 붙였습니다. 원문
이 그림 한 장이 글 전체의 지도입니다. 인코더만 쓰는 BERT, 디코더만 쓰는 GPT, 둘을 모두 쓰는 Transformer·BART·T5로 나뉩니다. 이후의 모든 차이는 결국 “각 위치의 토큰이 어느 토큰을 볼 수 있는가(어텐션 마스크)”와 “loss를 어느 위치에 거는가” 두 가지로 설명됩니다.
1. 트랜스포머 (Transformer)
1.1 모델 정보
| 항목 | 내용 |
|---|---|
| 논문 | Attention Is All You Need (Vaswani et al., NeurIPS 2017) |
| 기관 | Google Brain, Google Research |
| 구조 | Encoder 6층 + Decoder 6층 |
| 크기 | Base: $d_{model}=512$, 8 heads, FFN 2048, 약 65M / Big: $d_{model}=1024$, 16 heads, FFN 4096, 약 213M |
| 데이터 | WMT 2014 영어–독일어(약 450만 문장 쌍), 영어–프랑스어(약 3,600만 문장 쌍) |
| 학습 | P100 GPU 8장. Base 10만 step 약 12시간, Big 30만 step 약 3.5일 |
1.2 핵심 특징과 Contribution
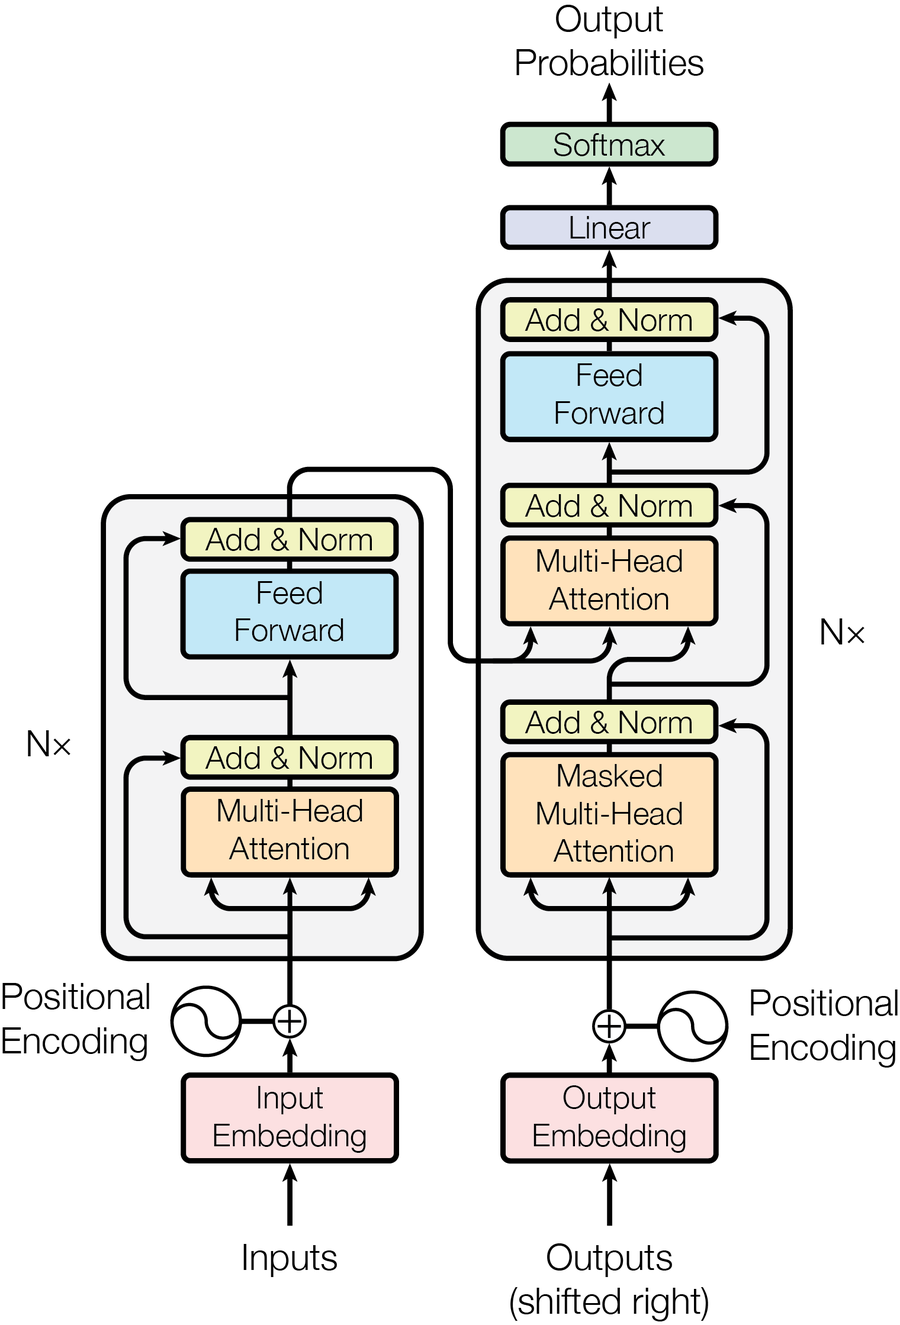
Transformer 논문 Figure 1. 왼쪽 N× 블록이 Encoder, 오른쪽 N× 블록이 Decoder입니다. 원문
1) RNN과 CNN 없이 어텐션만으로 seq2seq를 구성했습니다. 이전 번역 모델(RNN seq2seq + attention)은 토큰을 순서대로 하나씩 처리해야 해서 학습 병렬화가 어려웠습니다. Transformer는 self-attention으로 모든 토큰 쌍의 관계를 한 번의 행렬 연산으로 계산합니다. 그래서 학습 시간이 크게 줄었고, 멀리 떨어진 토큰 사이 경로 길이도 $O(1)$이 되었습니다.
2) Scaled Dot-Product Attention과 Multi-Head Attention
$\sqrt{d_k}$로 나누는 이유는 차원이 커질수록 내적 값의 분산이 커져서 softmax가 한쪽으로 쏠리고 gradient가 작아지기 때문입니다. Multi-head는 서로 다른 projection으로 어텐션을 여러 번 나누어 계산한 뒤 이어 붙여서, 여러 종류의 관계(문법, 지시어, 의미 등)를 동시에 볼 수 있게 합니다.
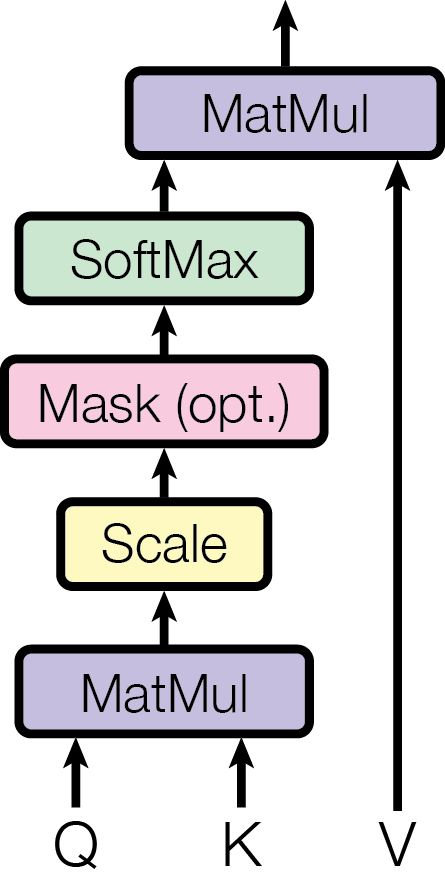
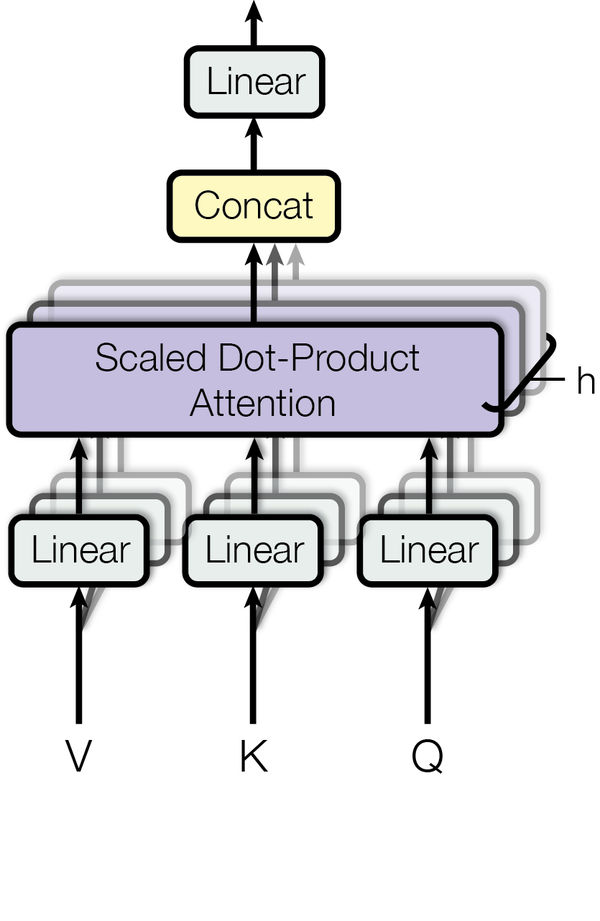
Transformer 논문 Figure 2. 왼쪽은 Scaled Dot-Product Attention, 오른쪽은 이를 h개 병렬로 수행하는 Multi-Head Attention입니다. 원문
3) 세 종류의 어텐션을 씁니다.
| 위치 | Query | Key/Value | 마스크 |
|---|---|---|---|
| Encoder self-attention | 원문 | 원문 | 없음 (양방향) |
| Decoder masked self-attention | 번역문 | 번역문 | Causal (자기 왼쪽만) |
| Decoder cross-attention | 번역문 | Encoder 출력 | 없음 |
4) Positional Encoding. 어텐션 자체에는 순서 개념이 없으므로 sin/cos 함수로 위치 정보를 더해 줍니다.
5) 결과. WMT14 영어→독일어에서 BLEU 28.4를 기록해 앙상블을 포함한 기존 최고 결과보다 2 BLEU 이상 높았고, 영어→프랑스어에서는 단일 모델로 41.8을 기록했습니다. 학습 비용은 기존 모델들보다 훨씬 적었습니다.
1.3 푸는 문제
원 논문의 주된 문제는 기계번역이었습니다. 추가로 영어 구문 분석(constituency parsing)에도 적용해서 번역 외 태스크로 일반화된다는 것을 보였습니다. 이 논문에는 “대규모 사전학습 후 파인튜닝”이라는 개념이 없습니다. 태스크 데이터로 처음부터 끝까지(E2E) 한 번에 학습합니다.
1.4 학습 방식: Teacher Forcing으로 E2E 학습
1
2
3
원문 (Encoder 입력)  : 나는 사과를 먹었다
Decoder 입력         : <s>  I    ate   an    apple          ← 정답을 오른쪽으로 한 칸 민 것
Decoder 정답 (label) : I    ate  an    apple </s>           ← 각 위치의 "다음 토큰"
- IN: 원문 토큰 → Encoder, 정답 번역문을 한 칸 민 것 → Decoder
- OUT: Decoder 각 위치마다 vocab 전체에 대한 다음 토큰 확률분포
- Loss: Decoder의 모든 위치에서 계산한 cross-entropy 합. 논문에서는 label smoothing $\epsilon_{ls}=0.1$을 적용했습니다.
loss는 Decoder 끝에만 있습니다. 하지만 gradient가 cross-attention을 통해 Encoder까지 흘러가므로 Encoder와 Decoder가 함께 학습됩니다. 또 Decoder에 모델 자신의 예측 대신 정답 토큰을 넣는 teacher forcing과 causal mask 덕분에, 번역문의 모든 위치를 한 번의 forward pass로 병렬 학습할 수 있습니다.
학습률은 warmup 후에 감소하는 스케줄을 썼습니다(warmup 4,000 step, Adam $\beta_2=0.98$).
1.5 코드로 보기
두 단계로 봅니다. (1) Transformer의 핵심 연산인 어텐션 함수를 직접 구현해서 마스크가 어떻게 작동하는지 확인하고, (2) PyTorch의 nn.Transformer로 teacher forcing 학습 한 step을 돌려 봅니다.
(1) Scaled dot-product attention과 마스크
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
import math
import torch
import torch.nn.functional as F

def scaled_dot_product_attention(q, k, v, mask=None):
    # q, k, v: (batch, heads, seq_len, d_k)
    scores = q @ k.transpose(-2, -1) / math.sqrt(q.size(-1))   # (B, H, T_q, T_k)
    if mask is not None:
        scores = scores.masked_fill(mask == 0, float("-inf"))  # 볼 수 없는 위치는 -inf
    attn = F.softmax(scores, dim=-1)                           # 행(Query)마다 합이 1
    return attn @ v, attn                                      # (B, H, T_q, d_k)

torch.manual_seed(0)
x = torch.randn(1, 1, 4, 8)                  # B=1, H=1, 토큰 4개, d_k=8 (self-attention이라 q=k=v=x)

_, a_enc = scaled_dot_product_attention(x, x, x)                                 # (a) Encoder: 마스크 없음
causal = torch.tril(torch.ones(4, 4))                                            # 아래 삼각형만 1
_, a_dec = scaled_dot_product_attention(x, x, x, causal)                         # (b) Decoder: causal mask
pad = torch.tensor([1, 1, 1, 0]).view(1, 1, 1, 4)                                # 4번째 토큰이 <pad>
_, a_pad = scaled_dot_product_attention(x, x, x, pad)                            # (c) Encoder: padding mask
print(a_enc[0, 0].round(decimals=2), a_dec[0, 0].round(decimals=2), a_pad[0, 0].round(decimals=2), sep="\n")
한 줄씩 보기
q @ k.transpose(-2, -1):q는 (B, H, T_q, d_k),k를 전치하면 (B, H, d_k, T_k)이므로 결과는 (B, H, T_q, T_k)입니다.scores[b, h, i, j]는 i번째 토큰(Query)이 j번째 토큰(Key)을 얼마나 볼지를 나타내는 점수입니다. 행은 “보는 쪽”, 열은 “보이는 쪽”입니다./ math.sqrt(q.size(-1)): d_k가 클수록 내적 값이 커져서 softmax가 한 칸으로 쏠립니다. 이를 막기 위해 나눕니다.masked_fill(mask == 0, -inf): mask가 0인 칸을 -∞로 바꾸면 softmax에서exp(-∞) = 0이 되어 가중치가 정확히 0이 됩니다. 0을 곱하지 않고 -∞를 넣는 이유는, 가린 칸을 뺀 나머지 칸끼리 합이 다시 1이 되도록 정규화하기 위해서입니다.attn @ v: 각 Query 토큰의 출력은 Value 벡터들을 attn 비율로 가중평균한 것입니다.
실행 결과: 같은 입력에 마스크만 바꾼 어텐션 행렬 (행 = 보는 토큰, 열 = 보이는 토큰)
1
2
3
4
5
(a) Encoder, 마스크 없음          (b) Decoder, causal mask          (c) Encoder, padding mask
[[0.77, 0.07, 0.02, 0.13],       [[1.00, 0.00, 0.00, 0.00],       [[0.89, 0.09, 0.03, 0.00],
 [0.16, 0.42, 0.06, 0.36],        [0.27, 0.73, 0.00, 0.00],        [0.25, 0.65, 0.10, 0.00],
 [0.01, 0.01, 0.98, 0.00],        [0.01, 0.01, 0.98, 0.00],        [0.01, 0.01, 0.98, 0.00],
 [0.17, 0.23, 0.01, 0.58]]        [0.17, 0.23, 0.01, 0.58]]        [0.41, 0.55, 0.03, 0.00]]
- (a) 모든 토큰이 모든 토큰을 봅니다(양방향).
- (b) 위쪽 삼각형이 0입니다. 2번째 행은 (a)에서
0.16, 0.42였지만 (b)에서는0.27, 0.73입니다. 가려진 칸이 빠지고 남은 칸끼리 재정규화된 것입니다. 마지막 행은 원래 전부 볼 수 있으므로 (a)와 같습니다. - (c) 모든 행에서 4번째 열(
<pad>)이 0입니다.
Encoder에는 마스크가 필요 없나? causal mask는 필요 없지만 padding mask는 필요합니다. 배치 안의 문장 길이를 맞추려고 짧은 문장 뒤를 <pad>로 채우는데, 이를 가리지 않으면 같은 문장이라도 배치에서 옆에 어떤 문장이 있느냐에 따라 표현이 달라집니다.
| 어텐션 | Q | K, V | causal mask | padding mask |
|---|---|---|---|---|
| Encoder self-attn | 원문 | 원문 | ✗ | ✓ (원문 pad) |
| Decoder masked self-attn | 번역문 | 번역문 | ✓ | ✓ (번역문 pad) |
| Decoder cross-attn | 번역문 | Encoder 출력 | ✗ | ✓ (원문 pad) |
cross-attention에 causal mask가 없는 이유는 원문이 이미 전부 주어져 있어서 가릴 “미래”가 없기 때문입니다.
마스크 모양과 broadcasting. causal mask는 (T, T)이고 모든 배치와 head에 같으므로 (B, H, T, T)로 자동 broadcast됩니다. padding mask는 문장마다 다르고 열(Key)만 가리면 되므로 (B, 1, 1, T_k) 모양으로 만듭니다. Decoder에서는 둘을 곱해서(causal * pad) 둘 다 1인 칸만 볼 수 있게 합니다.
pad 토큰 자신의 행은 가리지 않습니다. (c)의 4번째 행처럼 pad 위치에서도 출력이 계산되지만, 이 위치는 loss에서 제외되고 다른 토큰이 보지도 않으므로 결과에 영향이 없습니다. 반대로 한 행 전체를 -∞로 가리면 softmax가 0/0이 되어 NaN이 나옵니다.
(2) nn.Transformer로 teacher forcing 학습 한 step
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
import torch
import torch.nn as nn

VOCAB, D_MODEL, PAD, BOS = 8000, 512, 0, 1

class Seq2SeqTransformer(nn.Module):
    def __init__(self):
        super().__init__()
        self.src_emb = nn.Embedding(VOCAB, D_MODEL)   # 원문 토큰 id → 512차원 벡터
        self.tgt_emb = nn.Embedding(VOCAB, D_MODEL)   # 번역문 토큰 id → 512차원 벡터
        self.pos = nn.Embedding(512, D_MODEL)         # 위치 0~511 → 512차원 벡터 (간단히 learned position 사용)
        self.transformer = nn.Transformer(d_model=D_MODEL, nhead=8,
                                          num_encoder_layers=6, num_decoder_layers=6,
                                          dim_feedforward=2048, batch_first=True)
        self.lm_head = nn.Linear(D_MODEL, VOCAB)      # 512차원 → 단어 8000개의 점수

    def embed(self, emb, ids):
        pos = torch.arange(ids.size(1), device=ids.device)
        return emb(ids) + self.pos(pos)

    def forward(self, src, tgt_in):
        T = tgt_in.size(1)
        tgt_mask = torch.triu(torch.ones(T, T, dtype=torch.bool), diagonal=1)   # True = 가림 (대각선 위 = 미래)
        h = self.transformer(self.embed(self.src_emb, src), self.embed(self.tgt_emb, tgt_in),
                             tgt_mask=tgt_mask,                       # Decoder causal mask
                             src_key_padding_mask=(src == PAD),       # Encoder self-attn: 원문 pad 가림
                             tgt_key_padding_mask=(tgt_in == PAD),    # Decoder self-attn: 번역문 pad 가림
                             memory_key_padding_mask=(src == PAD))    # Cross-attn: 원문 pad 가림
        return self.lm_head(h)                                        # (B, T_tgt, VOCAB)

model = Seq2SeqTransformer()
criterion = nn.CrossEntropyLoss(ignore_index=PAD, label_smoothing=0.1)

src = torch.randint(2, VOCAB, (2, 10))           # 원문 (0=PAD, 1=BOS를 피해 2부터 랜덤 id)
tgt = torch.randint(2, VOCAB, (2, 8))            # 정답 번역문 (끝에 </s> 포함이라고 가정)
tgt_in = torch.cat([torch.full((2, 1), BOS), tgt[:, :-1]], dim=1)   # 오른쪽으로 한 칸 shift

logits = model(src, tgt_in)
loss = criterion(logits.reshape(-1, VOCAB), tgt.reshape(-1))        # 모든 target 위치에서 CE
loss.backward()                                                     # Encoder까지 gradient 전달
print(logits.shape, loss.item())   # torch.Size([2, 8, 8000]) 약 9.1~9.3 (랜덤 초기화라 실행마다 조금 다름)
전체 흐름과 텐서 모양
1
2
3
4
5
6
7
src (2,10) ──src_emb+pos──▶ (2,10,512) ──▶ Encoder ×6 ──▶ memory (2,10,512)
                                                              │ cross-attn
tgt_in (2,8) ──tgt_emb+pos──▶ (2,8,512) ──▶ Decoder ×6 ◀──────┘
                                                │
                                         h (2,8,512) ──lm_head──▶ logits (2,8,8000)
                                                                        │
                                          tgt (2,8) ─────────────▶ CrossEntropy ──▶ loss (스칼라)
__init__: 부품 다섯 개
nn.Transformer안에는 Encoder/Decoder 층만 들어 있습니다(어텐션, FFN, LayerNorm). 토큰 임베딩, 위치 정보, 출력층(lm_head)은 직접 만들어 붙여야 합니다.batch_first=True로 두면 텐서 모양이 (B, T, D)입니다. 기본값은 (T, B, D)라서 헷갈리기 쉽습니다.nhead=8이면 head 하나당 d_k = 512 / 8 = 64입니다.
embed: 토큰 임베딩 + 위치 임베딩. torch.arange(T)로 [0, 1, …, T−1]을 만들고 위치 임베딩을 꺼내 더합니다. (B, T, 512) + (T, 512)는 broadcast되어 배치마다 같은 위치 벡터가 더해집니다. 어텐션 자체는 순서를 모르기 때문에 “몇 번째 토큰인지”를 벡터에 넣어 주는 것입니다.
forward: 마스크 규약에 주의. PyTorch nn.Transformer는 True = 가림입니다. 위 (1)의 직접 구현(mask == 0이면 가림, 즉 1 = 볼 수 있음)과 반대입니다.
| 인자 | 모양 | 적용 위치 | 의미 |
|---|---|---|---|
tgt_mask |
(T_tgt, T_tgt) | Decoder self-attn | 미래 토큰 가림 (causal) |
src_key_padding_mask |
(B, T_src) | Encoder self-attn | 원문 <pad> 열 가림 |
tgt_key_padding_mask |
(B, T_tgt) | Decoder self-attn | 번역문 <pad> 열 가림 |
memory_key_padding_mask |
(B, T_src) | Cross-attn | Decoder가 원문 <pad>를 보지 않게 가림 |
src == PAD는 pad 위치가 True인 bool 텐서이므로 그대로 “가림” 표시가 됩니다. memory_key_padding_mask를 빼먹으면 Decoder가 cross-attention에서 원문의 pad를 보게 되니 주의해야 합니다.
데이터와 teacher forcing shift. 실제 단어로 바꿔 보면 이렇습니다.
1
2
3
4
5
tgt    (정답) :  I     ate   an    apple  </s>
tgt_in (입력) :  <s>   I     ate   an     apple     ← 앞에 BOS를 붙이고 정답의 마지막 토큰은 뺌
               위치 0이 보는 것: <s>               → 맞혀야 할 것: I
               위치 1이 보는 것: <s> I             → 맞혀야 할 것: ate
               위치 4가 보는 것: <s> I ate an apple → 맞혀야 할 것: </s>
tgt[:, :-1]에서 마지막 토큰을 빼는 이유는tgt_in과tgt의 길이를 같게(8) 맞추기 위해서입니다.</s>는 입력으로 넣을 필요가 없습니다.- causal mask 덕분에 위치 1은 자기 정답(
ate)이 들어 있는 위치 2를 볼 수 없습니다. 그래서 8개 위치를 한 번의 forward로 동시에 학습해도 정답이 새지 않습니다.
loss 계산
CrossEntropyLoss는 (N, C) 점수와 (N,) 정답을 받습니다. 그래서 (2, 8, 8000) → (16, 8000), (2, 8) → (16,)으로 펴서 16개 위치를 16개 분류 문제처럼 다룹니다.ignore_index=PAD: 정답이 PAD인 위치를 평균에서 뺍니다. Hugging Face의-100과 같은 역할입니다.label_smoothing=0.1: 정답 분포를 one-hot 대신 “정답 클래스 0.9 + 0.1/8000, 나머지 7999개는 0.1/8000씩”으로 만듭니다. 모델이 과하게 확신하지 않도록 하는 장치이고, 논문도 0.1을 썼습니다.- 값이 맞는지 확인하는 법: 학습 전 모델은 8000개 중에서 거의 균등하게 찍으므로 loss ≈ ln(8000) ≈ 8.99 근처여야 합니다. 실행하면 약 9.1~9.3이 나오는데, label smoothing 때문에 조금 더 높습니다. 처음 loss가 ln(V)보다 훨씬 크면 초기화나 입력에 문제가 있다는 신호입니다.
backward와 실제 학습 루프. loss.backward()는 lm_head → Decoder → cross-attention → Encoder → 임베딩까지 gradient를 계산합니다. loss는 Decoder 끝에만 있지만 Encoder가 cross-attention으로 연결되어 함께 학습되는 것, 이것이 E2E 학습입니다. 위 코드는 한 step만 보여 주므로, 실제로 학습하려면 optimizer와 루프가 필요합니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
opt = torch.optim.Adam(model.parameters(), lr=1.0, betas=(0.9, 0.98), eps=1e-9)   # 논문 설정
warmup = 4000
sched = torch.optim.lr_scheduler.LambdaLR(                                          # 1.4절의 warmup 스케줄
    opt, lambda s: D_MODEL**-0.5 * min((s + 1)**-0.5, (s + 1) * warmup**-1.5))

for src, tgt in loader:
    tgt_in = torch.cat([torch.full((tgt.size(0), 1), BOS), tgt[:, :-1]], dim=1)
    logits = model(src, tgt_in)
    loss = criterion(logits.reshape(-1, VOCAB), tgt.reshape(-1))
    opt.zero_grad()      # 이전 step의 gradient 초기화 (안 하면 누적됨)
    loss.backward()
    opt.step()           # 파라미터 업데이트
    sched.step()         # 학습률 업데이트 (lr=1.0에 LambdaLR 값이 곱해져 실제 학습률이 됨)
원 논문과 다른 점. 설명을 위해 단순화한 부분입니다. 핵심인 어텐션 3종, 마스크, teacher forcing, loss는 논문과 같습니다.
| 이 코드 | 논문 | |
|---|---|---|
| 위치 정보 | 학습되는 임베딩 | sin/cos 고정 |
| 임베딩 스케일 | 그대로 | 임베딩에 √d_model을 곱함 |
| 가중치 공유 | 없음 | 두 임베딩과 출력층의 가중치를 공유 |
| LayerNorm 위치 | Post-LN (nn.Transformer 기본값) |
Post-LN (같음) |
2. 구글의 BERT
2.1 모델 정보
| 항목 | 내용 |
|---|---|
| 논문 | BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding (Devlin et al., NAACL 2019, arXiv 2018.10) |
| 기관 | Google AI Language |
| 구조 | Transformer Encoder only |
| 크기 | Base: 12층, hidden 768, 12 heads, 110M / Large: 24층, hidden 1024, 16 heads, 340M |
| 데이터 | BooksCorpus (8억 단어) + 영어 Wikipedia (25억 단어) |
| 토크나이저 | WordPiece, vocab 30,000 |
| 학습 | batch 256 시퀀스 × 512 토큰, 100만 step (약 33억 단어 코퍼스 기준 40 epoch) |
2.2 핵심 특징과 Contribution
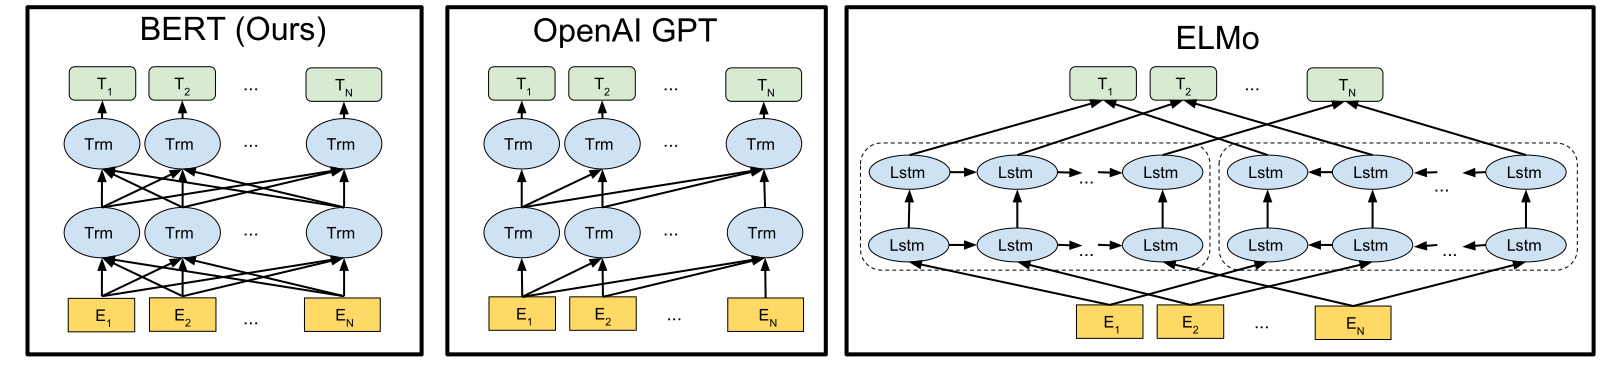
BERT 논문 Figure 3. BERT는 모든 층에서 양방향, GPT는 왼쪽→오른쪽 단방향, ELMo는 독립적으로 학습한 두 방향 LSTM의 출력을 이어 붙입니다. 원문
1) 깊은 양방향(Deep Bidirectional) 표현. GPT-1은 왼쪽 문맥만 보고, ELMo는 왼쪽→오른쪽 LM과 오른쪽→왼쪽 LM을 따로 학습한 뒤 이어 붙이는(shallow) 방식이었습니다. BERT는 모든 층에서 양쪽 문맥을 동시에 봅니다. 그런데 그냥 양방향 LM을 학습하면 정답 단어를 스스로 보게 되는 정보 누설이 생깁니다. 이를 막기 위해 제안한 것이 Masked LM입니다.
2) 사전학습 → 파인튜닝 패러다임의 정착. 태스크마다 복잡한 아키텍처를 새로 설계하지 않고, 사전학습된 BERT 위에 출력층 하나만 추가해서 전체를 파인튜닝합니다.
3) 결과. 11개 NLP 태스크에서 SOTA를 달성했습니다. GLUE 80.5(+7.7%p), MultiNLI 86.7%, SQuAD v1.1 F1 93.2, SQuAD v2.0 F1 83.1입니다.
2.3 학습 방식: MLM과 NSP
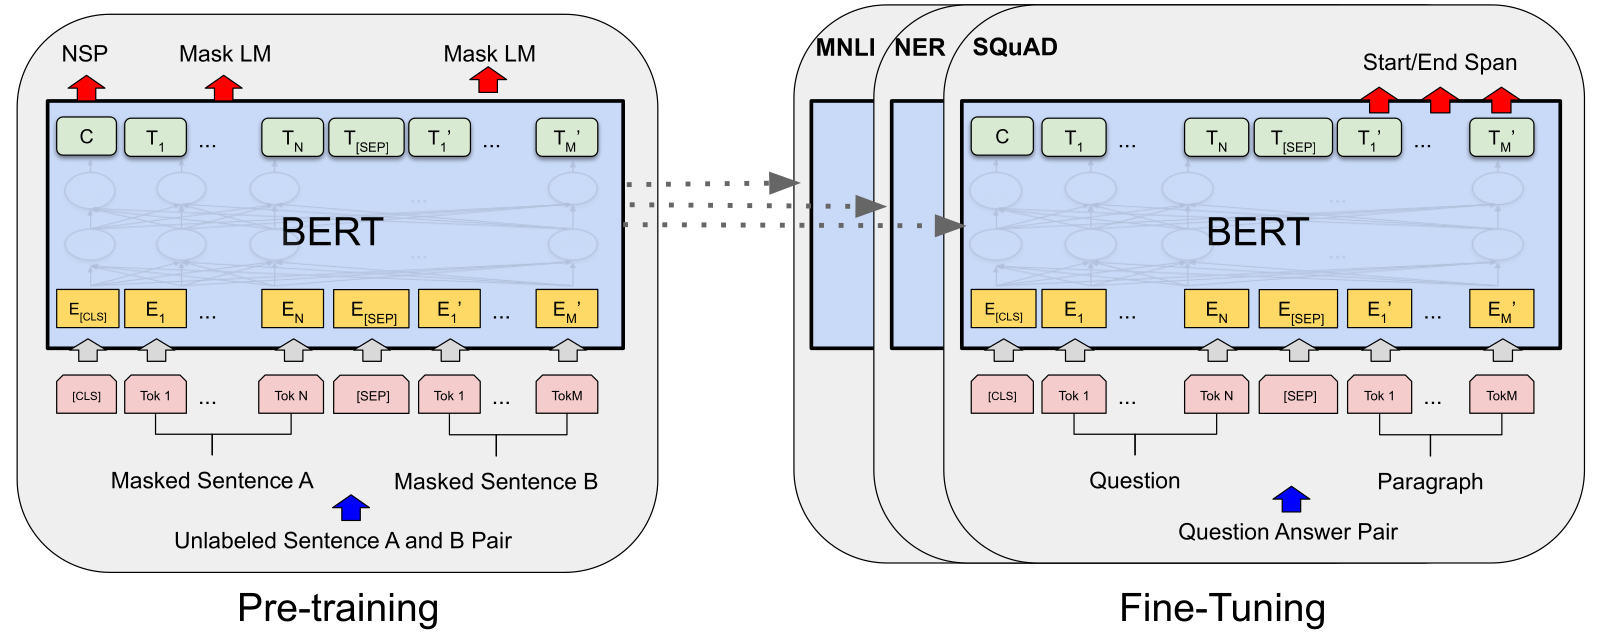
BERT 논문 Figure 1. 왼쪽은 NSP와 Mask LM으로 하는 사전학습, 오른쪽은 같은 가중치에서 시작해 태스크별로 하는 파인튜닝입니다. 원문
입력(IN): 두 문장(segment)을 [CLS] A [SEP] B [SEP] 형태로 이어 붙이고, 세 임베딩을 더해서 넣습니다.
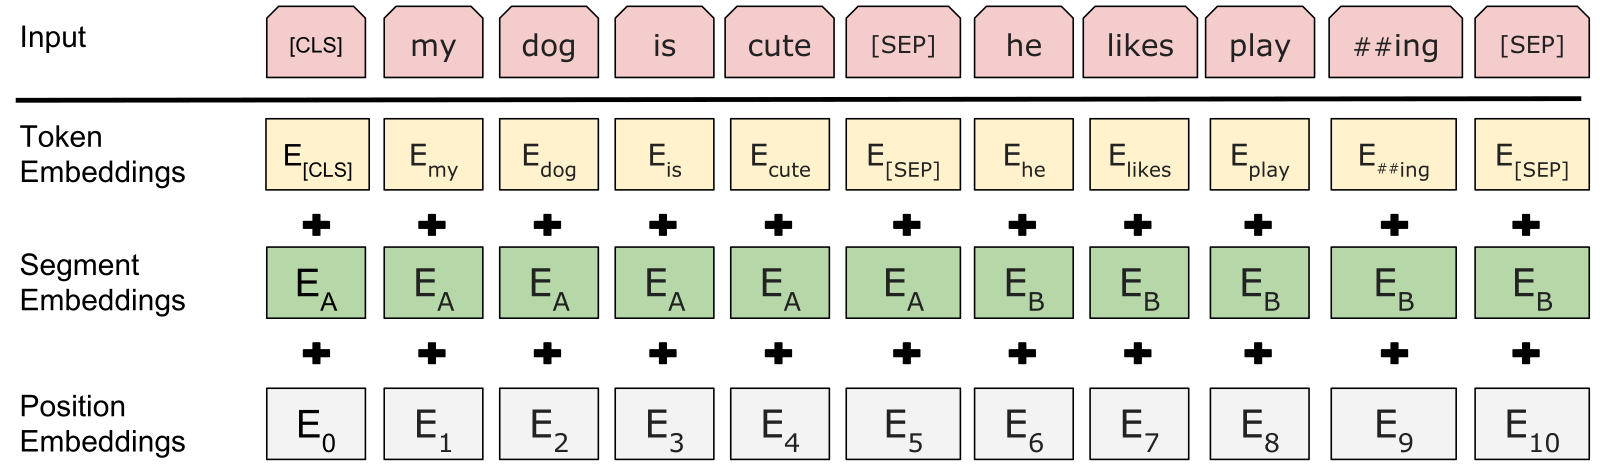
BERT 논문 Figure 2. 입력 임베딩 = Token + Segment + Position 임베딩입니다. 원문
출력(OUT): 토큰마다 하나씩 나오는 문맥 벡터(hidden state) $T_i \in \mathbb{R}^{H}$입니다. BERT 자체에는 “생성” 단계가 없습니다. 이 벡터 위에 작은 head를 붙여서 loss를 계산합니다.
(1) Masked Language Model (MLM)
- 입력 토큰의 15%를 예측 대상으로 고릅니다.
- 고른 토큰 중 80%는
[MASK], 10%는 랜덤 토큰, 10%는 원래 토큰 그대로 둡니다. 파인튜닝 때는[MASK]가 나오지 않으므로, 사전학습과 파인튜닝 입력 분포의 차이를 줄이려는 장치입니다. - 선택된 위치의 출력 벡터를 vocab 크기의 분류기에 넣어 원래 토큰을 맞힙니다. loss는 선택된 15% 위치에서만 계산합니다.
1
2
3
4
5
원문     : my dog is hairy
입력     : [CLS] my dog is [MASK] [SEP]      (80%)
           [CLS] my dog is apple  [SEP]      (10%, 랜덤 토큰)
           [CLS] my dog is hairy  [SEP]      (10%, 그대로)
정답     : 4번째 위치 → "hairy"                (나머지 위치는 loss 없음)
(2) Next Sentence Prediction (NSP)
- 50%는 실제로 이어지는 문장 B(
IsNext), 50%는 코퍼스에서 뽑은 랜덤 문장(NotNext)을 넣습니다. [CLS]위치의 출력 $C$로 이진 분류를 합니다. QA나 NLI처럼 두 문장 관계가 중요한 태스크를 위해 넣은 목표입니다.- 이후 RoBERTa(2019)가 NSP를 빼도 성능이 떨어지지 않거나 오히려 좋아진다고 보고해서, 이후 모델들은 대부분 NSP를 쓰지 않습니다.
여기서 $\mathcal{M}$은 마스킹 대상으로 고른 위치 집합이고, $\tilde{x}$는 손상된 입력입니다. 라벨이 원문에서 자동으로 만들어지므로 사람이 라벨을 달 필요가 없는 self-supervised 학습입니다.
2.4 코드로 보기
세 단계로 봅니다. (1) MLM의 80/10/10 마스킹을 직접 구현하고, (2) 학습된 MLM head가 빈칸을 어떻게 채우는지 확인한 뒤, (3) loss가 어느 위치에서 계산되는지 숫자로 봅니다.
(1) 80/10/10 마스킹 직접 구현
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
import torch

def mask_tokens(input_ids, tokenizer, mlm_prob=0.15):
    labels = input_ids.clone()
    prob = torch.full(labels.shape, mlm_prob)
    special = torch.tensor(tokenizer.get_special_tokens_mask(labels.tolist(), already_has_special_tokens=True),
                           dtype=torch.bool)
    prob.masked_fill_(special, 0.0)                       # [CLS], [SEP]는 마스킹 제외
    masked = torch.bernoulli(prob).bool()
    labels[~masked] = -100                                # 선택되지 않은 위치는 loss 제외

    replace = torch.bernoulli(torch.full(labels.shape, 0.8)).bool() & masked
    input_ids[replace] = tokenizer.mask_token_id          # 80% → [MASK]

    rand = torch.bernoulli(torch.full(labels.shape, 0.5)).bool() & masked & ~replace
    input_ids[rand] = torch.randint(len(tokenizer), labels.shape)[rand]   # 10% → 랜덤 토큰
    return input_ids, labels                              # 나머지 10%는 원래 토큰 그대로
한 줄씩 보기
labels = input_ids.clone(): 마스킹하기 전 원문을 정답으로 복사해 둡니다. 이후input_ids는 제자리에서(in-place) 바뀌므로, 호출할 때도.clone()한 텐서를 넘기는 것이 안전합니다.prob = torch.full(..., 0.15): 토큰마다 “예측 대상으로 뽑힐 확률” 0.15를 채운 텐서입니다.get_special_tokens_mask(...):[CLS],[SEP]위치를 1로 표시합니다. 이 위치의 확률을 0으로 만들어 마스킹 대상에서 뺍니다.torch.bernoulli(prob): 위치마다 확률 0.15로 동전을 던져 1(선택)/0을 뽑습니다. 결과masked가 예측 대상 15%입니다.labels[~masked] = -100: 선택되지 않은 위치의 정답을 -100으로 지웁니다. 이 위치는 loss에서 빠집니다.replace = bernoulli(0.8) & masked: 선택된 위치 중 80%를 골라[MASK]로 바꿉니다.rand = bernoulli(0.5) & masked & ~replace:[MASK]가 되지 않은 나머지 20% 중 절반을 골라 랜덤 토큰으로 바꿉니다. 전체 기준으로는 0.2 × 0.5 = 10%입니다.- 남은 10%는 원래 토큰 그대로 둡니다. 하지만
labels에는 정답이 남아 있으므로 여전히 예측 대상입니다.
| 선택된 15% 안에서 | 확률 | 입력 | 정답 |
|---|---|---|---|
[MASK]로 치환 |
0.8 | [MASK] |
원래 토큰 |
| 랜덤 토큰으로 치환 | 0.2 × 0.5 = 0.1 | 아무 토큰 | 원래 토큰 |
| 그대로 | 0.1 | 원래 토큰 | 원래 토큰 |
실무에서는 transformers.DataCollatorForLanguageModeling(tokenizer, mlm_probability=0.15)가 배치 단위로 같은 일을 해 줍니다.
(2) 빈칸 채우기: MLM head가 하는 일
pipeline("fill-mask", ...) 한 줄로도 되지만, 안에서 무슨 일이 일어나는지 직접 풀어 쓰면 이렇습니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
import torch
from transformers import AutoTokenizer, BertForMaskedLM

tok = AutoTokenizer.from_pretrained("google-bert/bert-base-uncased")
model = BertForMaskedLM.from_pretrained("google-bert/bert-base-uncased")

enc = tok("The capital of France is [MASK].", return_tensors="pt")
print(tok.convert_ids_to_tokens(enc.input_ids[0]))
# ['[CLS]', 'the', 'capital', 'of', 'france', 'is', '[MASK]', '.', '[SEP]']

with torch.no_grad():
    logits = model(**enc).logits                              # (1, 9, 30522): 9개 위치 × vocab
mask_pos = (enc.input_ids[0] == tok.mask_token_id).nonzero().item()   # 6
probs = logits[0, mask_pos].softmax(-1)                        # [MASK] 위치의 분포만 꺼냄
top = probs.topk(3)
for p, i in zip(top.values, top.indices):
    print(f"{tok.decode([i]):>6s} {p:.3f}")
# paris 0.417 / lille 0.071 / lyon 0.063
- 토크나이저: 소문자로 바꾸고(uncased) 앞뒤에
[CLS],[SEP]를 붙입니다.[MASK]는 특수 토큰 하나(id 103)로 인식됩니다. with torch.no_grad(): 추론만 하므로 gradient 계산을 끕니다. 메모리와 시간이 절약됩니다.logits(1, 9, 30522): BERT는 모든 위치에서 vocab 30,522개에 대한 점수를 냅니다. 이 중 필요한 것은[MASK]위치(6번)의 점수뿐입니다.- MLM head의 구조: Encoder 출력(768차원) → Linear + GELU + LayerNorm → Linear(768 → 30,522)입니다. 마지막 Linear의 가중치는 입력 단어 임베딩과 같은 행렬을 공유합니다(weight tying). “입력에서 단어를 벡터로 바꾸는 표”를 거꾸로 써서 벡터를 단어 점수로 바꾸는 셈입니다.
softmax→topk: 점수를 확률로 바꾸고 상위 3개를 봅니다. 문맥상 수도가 와야 하므로paris가 41.7%로 가장 높고, 프랑스 도시들이 뒤를 잇습니다.
(3) MLM loss 계산
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
import torch
from transformers import AutoTokenizer, BertForMaskedLM

tok = AutoTokenizer.from_pretrained("google-bert/bert-base-uncased")
model = BertForMaskedLM.from_pretrained("google-bert/bert-base-uncased")

torch.manual_seed(0)
enc = tok("my dog is hairy and he likes to play fetch in the park every morning", return_tensors="pt")
input_ids, labels = mask_tokens(enc.input_ids[0].clone(), tok)
print(tok.decode(input_ids))
# [CLS] my [MASK] [MASK] hairy and he likes to play fetch in [MASK] park every morning [SEP]
out = model(input_ids=input_ids[None], attention_mask=enc.attention_mask, labels=labels[None])
print(out.logits.shape)   # torch.Size([1, 17, 30522]): 모든 위치에서 vocab 분포가 나오지만
print(out.loss)           # loss는 labels != -100 인 위치(마스킹된 3개 위치)에서만 계산 → 약 1.40
# 주의: 문장이 너무 짧으면 한 토큰도 선택되지 않아 loss가 nan이 될 수 있습니다.
이 실행에서는 17개 토큰 중 3개가 선택되었고, 세 개 모두 80% 규칙에 따라 [MASK]가 되었습니다.
| 위치 | 원래 토큰 | 입력 | labels |
|---|---|---|---|
| 2 | dog |
[MASK] |
3899 (dog) |
| 3 | is |
[MASK] |
2003 (is) |
| 12 | the |
[MASK] |
1996 (the) |
| 나머지 14개 | – | 원래 토큰 | -100 |
input_ids[None]: (17,) 텐서 앞에 배치 차원을 붙여 (1, 17)로 만듭니다. 모델은 항상 배치 단위로 받습니다.labels를 함께 넘기면 모델이 내부에서 cross-entropy를 계산해out.loss로 돌려줍니다. 직접 계산하면 다음과 같고, 값이 정확히 같습니다(1.3979).
1
2
3
import torch.nn.functional as F
manual = F.cross_entropy(out.logits.view(-1, out.logits.size(-1)),   # (17, 30522)
                         labels.view(-1), ignore_index=-100)         # (17,) 중 -100이 아닌 3개만 평균
- 즉 loss는 17개 위치가 아니라 3개 위치의 평균입니다. BERT가 “15% 위치에서만 학습 신호를 얻는다”는 말이 이 뜻입니다.
- 짧은 문장에서는 확률적으로 아무 위치도 선택되지 않을 수 있습니다. 그러면 평균을 낼 위치가 0개라서
nan이 나옵니다. 실제 학습에서는 512토큰 길이로 묶어서 쓰기 때문에 이런 일이 거의 없습니다.
3. BERT로 풀 수 있는 다양한 문제들
BERT는 출력층만 바꿔서 거의 모든 이해(NLU) 태스크를 풉니다. 논문 Figure 4에 네 가지 유형이 정리되어 있습니다.
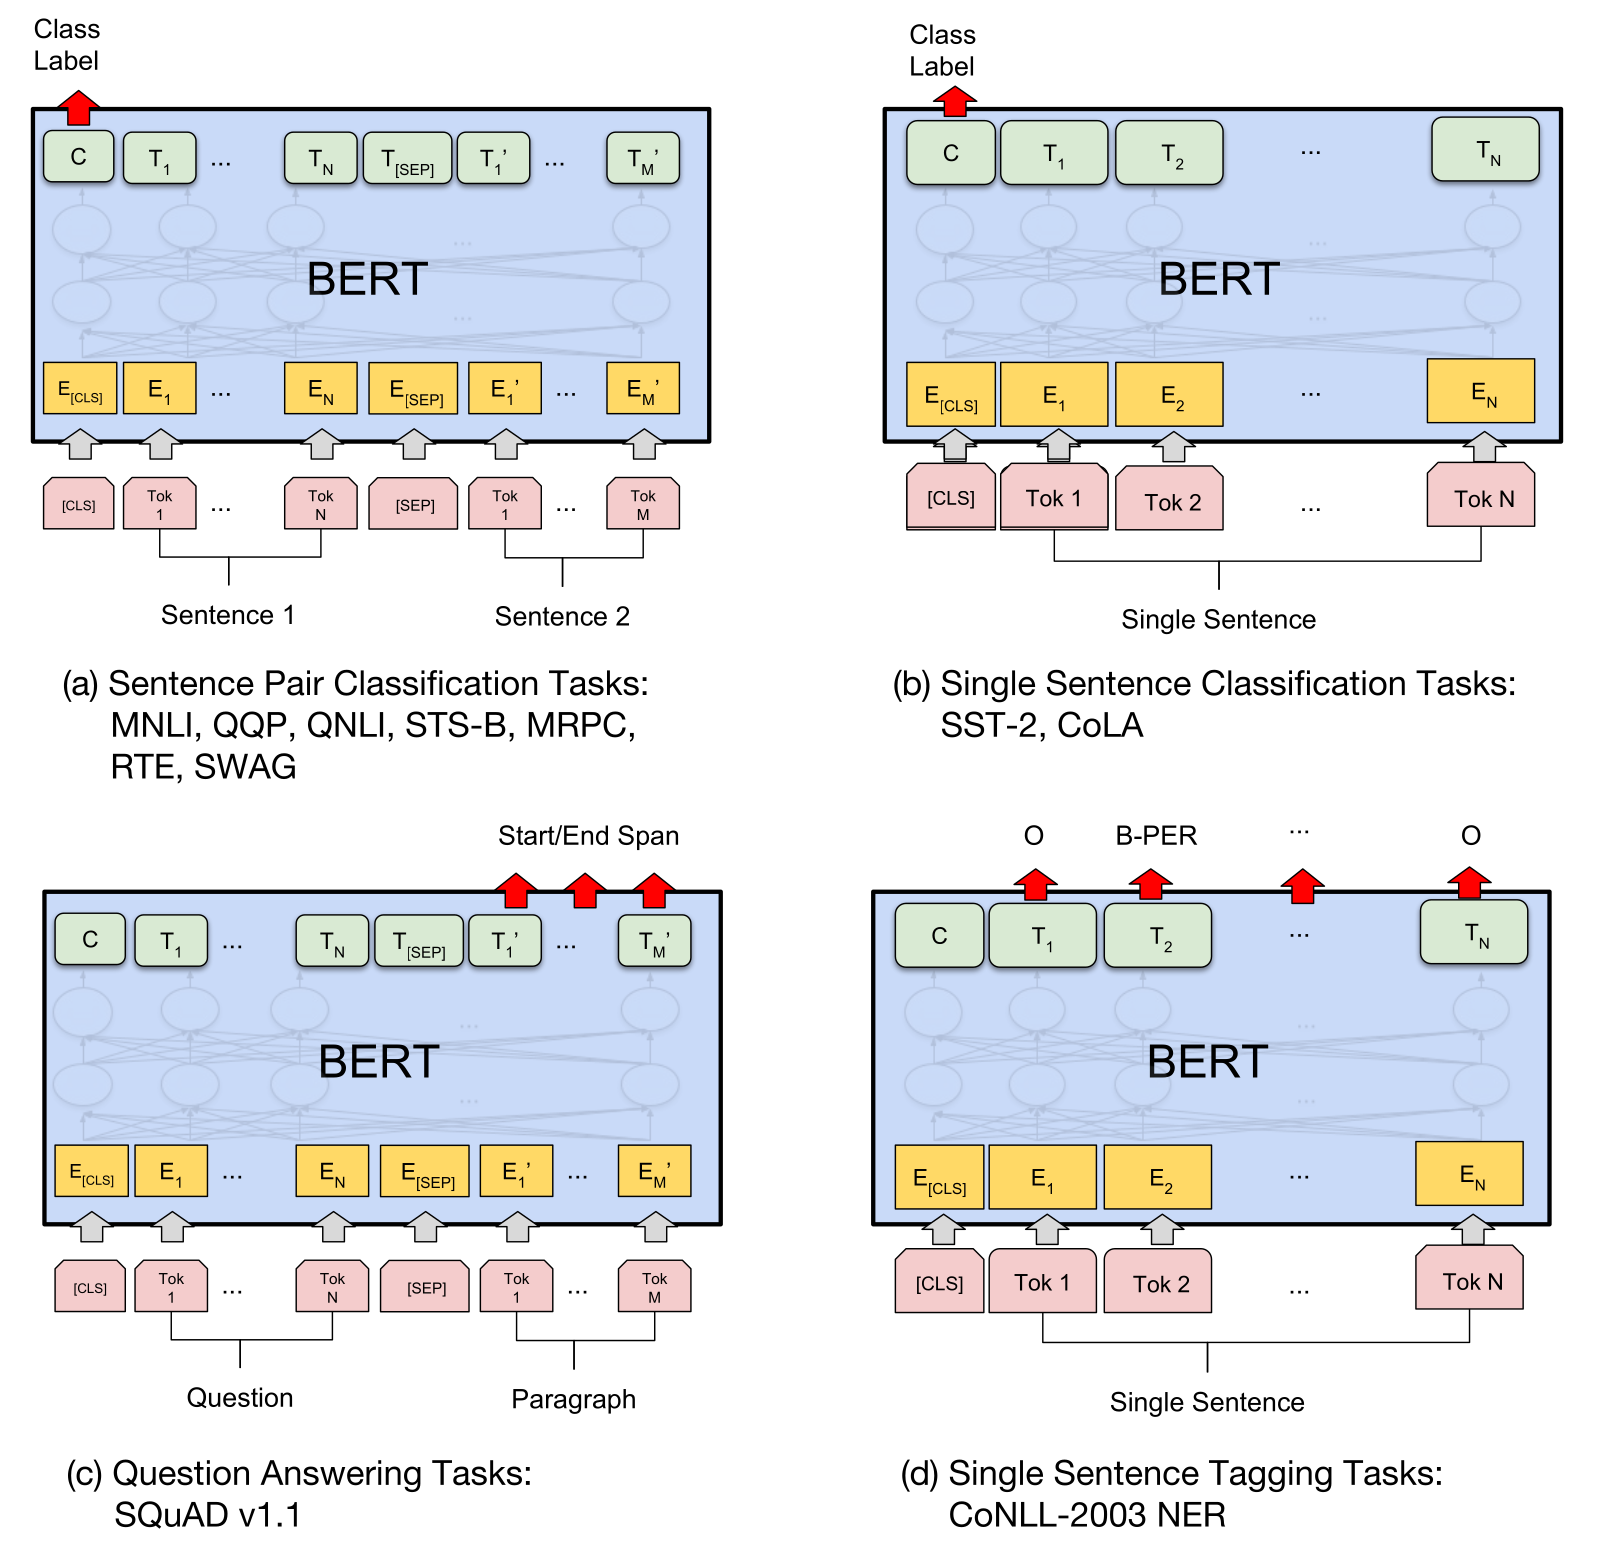
BERT 논문 Figure 4. (a) 문장쌍 분류, (b) 단일 문장 분류, (c) 질의응답, (d) 단일 문장 태깅입니다. 원문
| 유형 | 예시 데이터셋 | 입력 | 사용하는 출력 | 추가하는 head |
|---|---|---|---|---|
| (a) 문장쌍 분류 | MNLI, QQP, QNLI, STS-B, MRPC, RTE, SWAG | [CLS] 문장1 [SEP] 문장2 [SEP] |
[CLS] 벡터 $C$ |
Linear → 클래스 수 (STS-B는 회귀 1개) |
| (b) 단일 문장 분류 | SST-2, CoLA | [CLS] 문장 [SEP] |
[CLS] 벡터 $C$ |
Linear → 클래스 수 |
| (c) 추출형 QA | SQuAD v1.1/v2.0 | [CLS] 질문 [SEP] 문단 [SEP] |
문단 토큰 벡터 $T_i$ | 시작 벡터 $S$, 끝 벡터 $E$ |
| (d) 토큰 태깅 | CoNLL-2003 NER | [CLS] 문장 [SEP] |
각 토큰 벡터 $T_i$ | Linear → 태그 수 (B-PER, O 등) |
추출형 QA에서는 토큰 $i$가 정답의 시작일 확률을 $P_i = \mathrm{softmax}_i(S \cdot T_i)$로 계산하고, 끝 위치도 같은 방식으로 구합니다. 정답은 $S \cdot T_i + E \cdot T_j$가 최대인 $(i, j),\ j \ge i$ 구간입니다. 답을 생성하지 않고 문단에서 구간을 찾아 뽑는다는 점이 핵심입니다.
예시
| 태스크 | 입력 | 출력 |
|---|---|---|
| 감성 분류 (SST-2) | [CLS] this movie was surprisingly good [SEP] |
positive |
| 자연어 추론 (MNLI) | [CLS] A man is playing guitar. [SEP] A person plays music. [SEP] |
entailment |
| 추출형 QA (SQuAD) | [CLS] Where is the Eiffel Tower? [SEP] The Eiffel Tower is in Paris ... [SEP] |
start=Paris, end=Paris |
| NER | [CLS] Steve Jobs founded Apple [SEP] |
B-PER I-PER O B-ORG |
코드로 보기
네 유형 모두 같은 BERT 본체 위에 head만 다르게 붙입니다. Hugging Face에서는 AutoModelFor... 클래스 이름이 곧 “어떤 head를 붙였는가”를 뜻합니다.
(a)/(b) 문장 분류: AutoModelForSequenceClassification
1
2
3
4
5
6
7
8
9
10
11
12
13
14
import torch
from transformers import AutoTokenizer, AutoModelForSequenceClassification

tok = AutoTokenizer.from_pretrained("google-bert/bert-base-uncased")
clf = AutoModelForSequenceClassification.from_pretrained("google-bert/bert-base-uncased", num_labels=3)

enc = tok("A man is playing guitar.", "A person plays music.", return_tensors="pt")  # 문장쌍
print(tok.convert_ids_to_tokens(enc.input_ids[0]))
# ['[CLS]', 'a', 'man', 'is', 'playing', 'guitar', '.', '[SEP]', 'a', 'person', 'plays', 'music', '.', '[SEP]']
print(enc.token_type_ids[0].tolist())
# [0, 0, 0, 0, 0, 0, 0, 0, 1, 1, 1, 1, 1, 1]      ← 문장 A는 0, 문장 B는 1 (Segment embedding)

out = clf(**enc, labels=torch.tensor([0]))       # 0 = entailment 라고 가정
print(out.logits.shape, out.loss)                # torch.Size([1, 3]) — 파인튜닝 전이라 무작위 예측
- 입력: 토크나이저에 문장을 두 개 넘기면
[CLS] A [SEP] B [SEP]형태로 이어 붙이고,token_type_ids로 A(0)와 B(1)를 구분해 줍니다. 단일 문장 분류(SST-2)는 문장을 하나만 넘기면 됩니다. - head 구조:
[CLS]위치의 출력(768차원) → pooler(Linear 768→768 + tanh) → dropout → classifier(Linear 768→3)입니다. pooler는 사전학습 때 NSP용으로 학습된 층이고, classifier는 새로 만들어진 층입니다. - 경고 메시지: 모델을 불러올 때 “Some weights … are newly initialized” 경고가 나오는데 정상입니다. classifier가 랜덤 초기화 상태라는 뜻이고, 파인튜닝으로 학습해야 합니다.
- loss:
labels를 넘기면num_labels > 1일 때 cross-entropy를 계산합니다.num_labels=1로 두면 STS-B 같은 회귀로 보고 MSE를 계산합니다. - 출력:
logits(1, 3) →argmax가 예측 클래스입니다. 문장 하나에 점수 3개가 나옵니다.
(c) 추출형 QA: AutoModelForQuestionAnswering
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
from transformers import AutoModelForQuestionAnswering

name = "distilbert/distilbert-base-cased-distilled-squad"   # SQuAD로 파인튜닝된 모델
qa_tok = AutoTokenizer.from_pretrained(name)
qa = AutoModelForQuestionAnswering.from_pretrained(name)

enc = qa_tok("Where is the Eiffel Tower?",
             "The Eiffel Tower is a wrought-iron lattice tower in Paris, France.", return_tensors="pt")
with torch.no_grad():
    out = qa(**enc)
print(out.start_logits.shape)                               # torch.Size([1, 28]): 토큰마다 "시작점 점수"
start, end = out.start_logits.argmax(-1).item(), out.end_logits.argmax(-1).item()
print(start, end, qa_tok.decode(enc.input_ids[0, start:end + 1]))   # 23 25 Paris, France

# 학습할 때: 정답 구간의 토큰 위치를 넘기면 loss = (CE(start) + CE(end)) / 2
out = qa(**enc, start_positions=torch.tensor([23]), end_positions=torch.tensor([23]))
print(out.loss)                                             # 약 1.21
- head 구조: 토큰마다 Linear(768 → 2)를 적용해 시작점 점수와 끝점 점수 두 개를 냅니다. 그래서
start_logits,end_logits가 각각 (1, 28), 즉 토큰 28개 각각의 점수입니다. - 예측: 시작점 점수가 가장 높은 토큰(23번
Paris)부터 끝점 점수가 가장 높은 토큰(25번France)까지를 잘라Paris, France를 답으로 냅니다. 답을 생성하지 않고 문단에서 잘라 옵니다. - 학습: 정답 문자 위치(
answer_start)를 토큰 위치로 바꿔(7.2절)start_positions,end_positions로 넘깁니다. 시작점 분류 CE와 끝점 분류 CE의 평균이 loss입니다. 위 예에서 정답을Paris(23~23)로 주면 모델은 25를 끝점으로 골랐기 때문에 loss가 약 1.21로 나옵니다. - 실무 후처리: 위 코드는 시작과 끝을 따로
argmax하는 가장 단순한 방법입니다. 실제로는 “끝 ≥ 시작”, “질문이 아니라 문단 안의 토큰”, “답 길이 제한” 조건을 만족하는 (시작, 끝) 조합 중 점수 합이 가장 높은 것을 고릅니다. 예전에는pipeline("question-answering")이 이 처리를 해 줬지만, transformers 5.x에서는 이 pipeline이 빠져 있어 직접 호출하는 방식으로 적었습니다.
(d) 토큰 태깅(NER): AutoModelForTokenClassification
1
2
3
4
5
6
7
8
9
10
11
12
from transformers import AutoModelForTokenClassification

name = "dslim/bert-base-NER"                      # CoNLL-2003으로 파인튜닝된 모델
ner_tok = AutoTokenizer.from_pretrained(name)
ner = AutoModelForTokenClassification.from_pretrained(name)

enc = ner_tok("Steve Jobs founded Apple in California.", return_tensors="pt")
with torch.no_grad():
    logits = ner(**enc).logits                    # (1, 10, 9): 토큰 10개 × 태그 9종
pred = logits[0].argmax(-1)                       # 토큰마다 가장 점수가 높은 태그
for t, p in zip(ner_tok.convert_ids_to_tokens(enc.input_ids[0]), pred):
    print(f"{t:>12s}  {ner.config.id2label[p.item()]}")
1
2
3
4
5
6
7
8
9
10
       [CLS]  O
       Steve  B-PER
         Job  I-PER
         ##s  I-PER
     founded  O
       Apple  B-ORG
          in  O
  California  B-LOC
           .  O
       [SEP]  O
- head 구조: 토큰마다 Linear(768 → 9)를 적용합니다. 태그 9종은
O와 PER/ORG/LOC/MISC 각각의B-(시작),I-(내부)입니다. - 서브워드:
Jobs가Job,##s로 잘렸고 둘 다I-PER로 예측되었습니다. 태그는 단어 단위인데 BERT는 서브워드 단위로 보기 때문에, 학습할 때는 보통 첫 서브워드에만 태그를 주고 나머지는 -100으로 둡니다(7.2절). - 엔티티로 묶기:
B-PER+I-PER+I-PER→Steve Jobs(PER)처럼 이어진 태그를 하나의 엔티티로 합치는 후처리가 필요합니다.pipeline("ner", aggregation_strategy="simple")이 이 작업을 해 줍니다.
BERT가 잘 못하는 것: 자유로운 텍스트 생성입니다. 학습할 때 항상 오른쪽 문맥까지 보고 예측했기 때문에, 오른쪽이 비어 있는 상태에서 왼쪽부터 한 토큰씩 이어 쓰는 상황은 학습 분포와 다릅니다. 그래서 요약·번역·대화에는 GPT나 BART, T5 계열을 씁니다. 반대로 문장 임베딩과 검색(Sentence-BERT, 각종 retriever 인코더), 분류, 추출 문제에서는 지금도 인코더 계열이 효율적입니다.
4. OpenAI의 GPT
4.1 모델 정보
| 항목 | GPT-1 (2018.06) | GPT-2 (2019.02) | GPT-3 (2020.05) |
|---|---|---|---|
| 논문 | Improving Language Understanding by Generative Pre-Training | Language Models are Unsupervised Multitask Learners | Language Models are Few-Shot Learners |
| 구조 | Decoder only, 12층, 768, 12 heads | 최대 48층, 1600 | 96층, 12288, 96 heads |
| 크기 | 117M | 최대 1.5B | 최대 175B |
| 문맥 길이 | 512 | 1024 | 2048 |
| 데이터 | BooksCorpus (미출판 도서 7,000여 권) | WebText (약 800만 문서, 40GB) | Common Crawl(필터링) 등 약 3,000억 토큰 학습 |
| 사용 방식 | 사전학습 → 파인튜닝 | Zero-shot | In-context (few-shot) |
4.2 핵심 특징과 Contribution
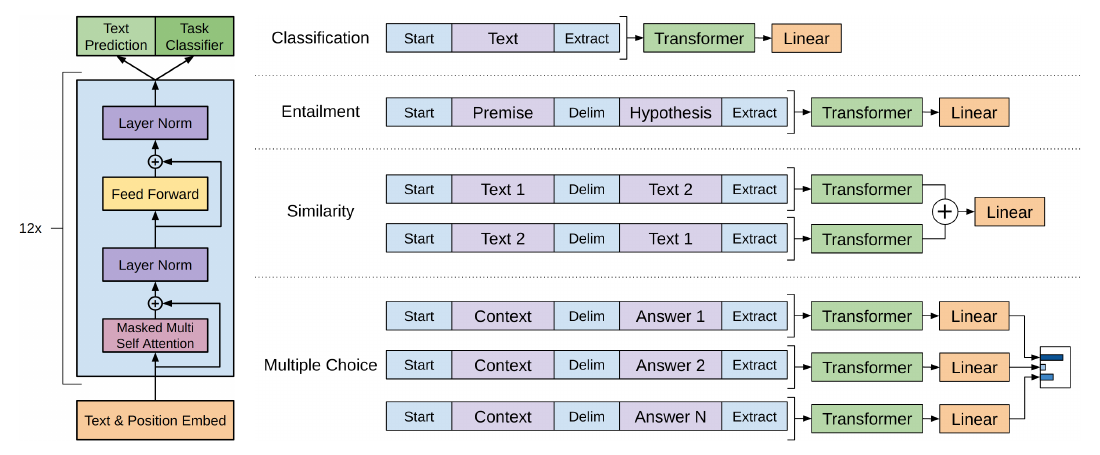
GPT-1 논문 Figure 1. 왼쪽은 12층 Transformer Decoder(cross-attention 없음, Masked Multi Self Attention만 있음), 오른쪽은 태스크별 입력을 하나의 토큰 시퀀스로 바꾸는 방법입니다. 원문 PDF 4쪽
GPT-1: 생성형 사전학습 + 판별형 파인튜닝. 라벨 없는 텍스트로 LM을 사전학습하고 태스크별로 파인튜닝하는 방식을 Transformer에서 처음으로 보였습니다(BERT보다 4개월 먼저 나왔습니다). 구조를 태스크마다 바꾸지 않고, 위 그림처럼 입력을 Start … Delim … Extract 형태의 한 시퀀스로 변환하는 방식으로 여러 태스크를 풀었습니다. 파인튜닝할 때는 LM loss를 보조 loss로 함께 사용했습니다.
($\mathcal{L}_1$: LM loss, $\mathcal{L}_2$: 태스크 분류 loss)
GPT-2: 파인튜닝 없이 zero-shot. 모델과 데이터를 키우면 LM이 번역·요약·QA 같은 태스크를 별도 학습 없이 어느 정도 수행한다는 것을 보였습니다. 예를 들어 요약은 문서 뒤에 TL;DR:을 붙이는 방식입니다. 구조적으로는 LayerNorm을 각 sub-block의 입력 쪽으로 옮긴 Pre-LN을 썼고, byte-level BPE(vocab 50,257)를 도입했습니다.
GPT-3: In-context learning과 스케일링. 175B까지 키우자 프롬프트 안에 예시 몇 개만 넣어도(gradient 업데이트 없이) 새 태스크를 수행하는 능력이 뚜렷해졌습니다.
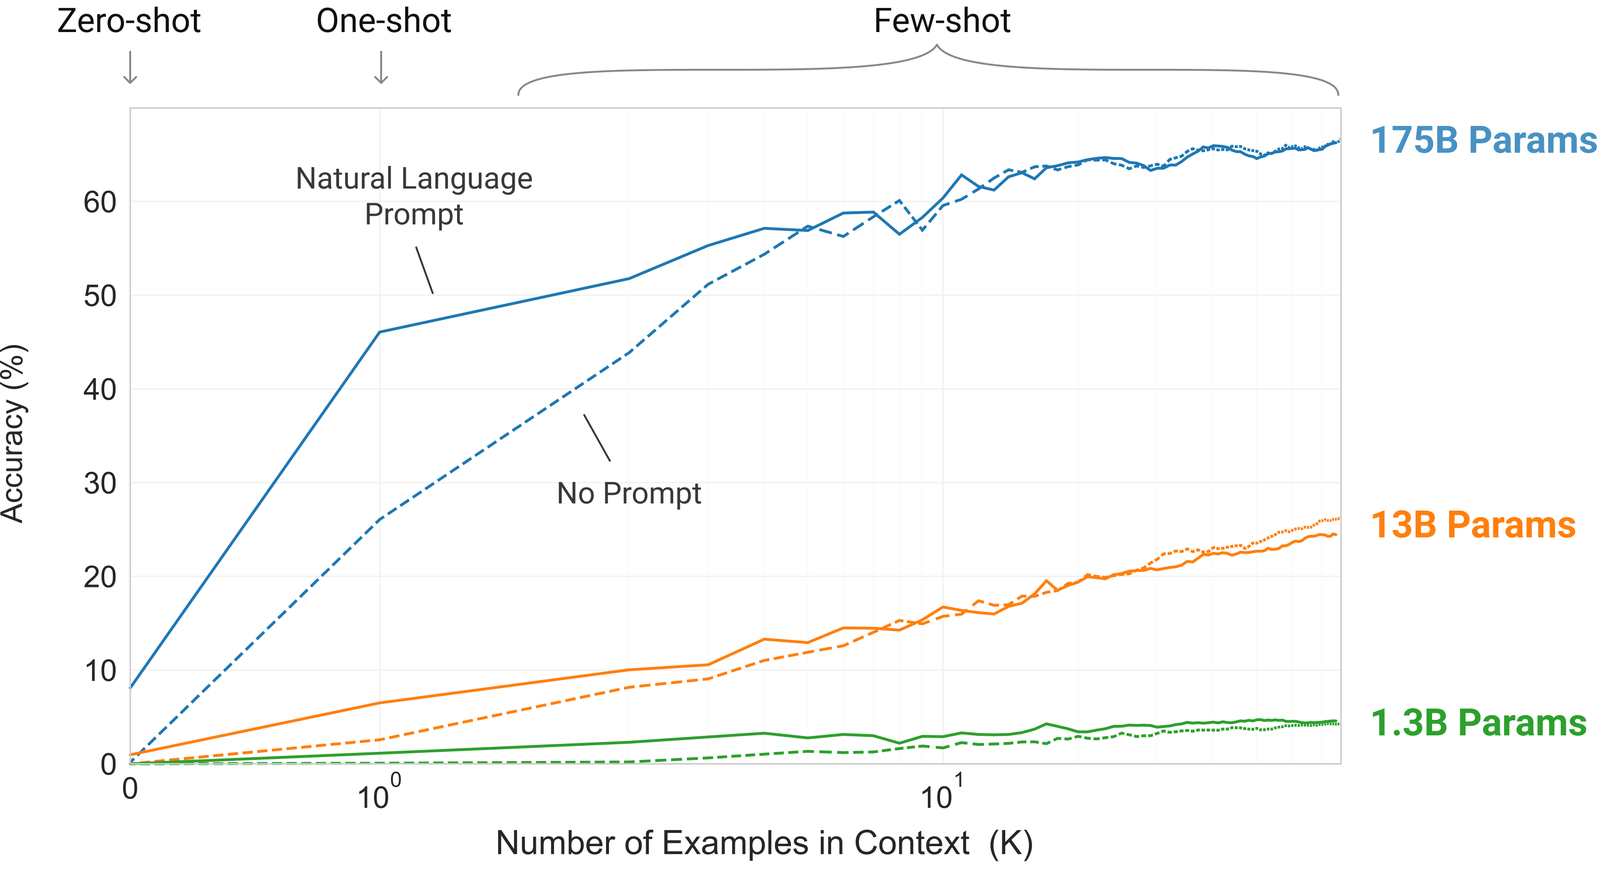
GPT-3 논문 Figure 1.1. 사전학습(outer loop) 동안 하나의 시퀀스 안에 반복되는 패턴을 학습하면서, 추론 시 문맥 안에서 태스크를 파악하는 능력(inner loop)이 생긴다는 해석입니다. 원문
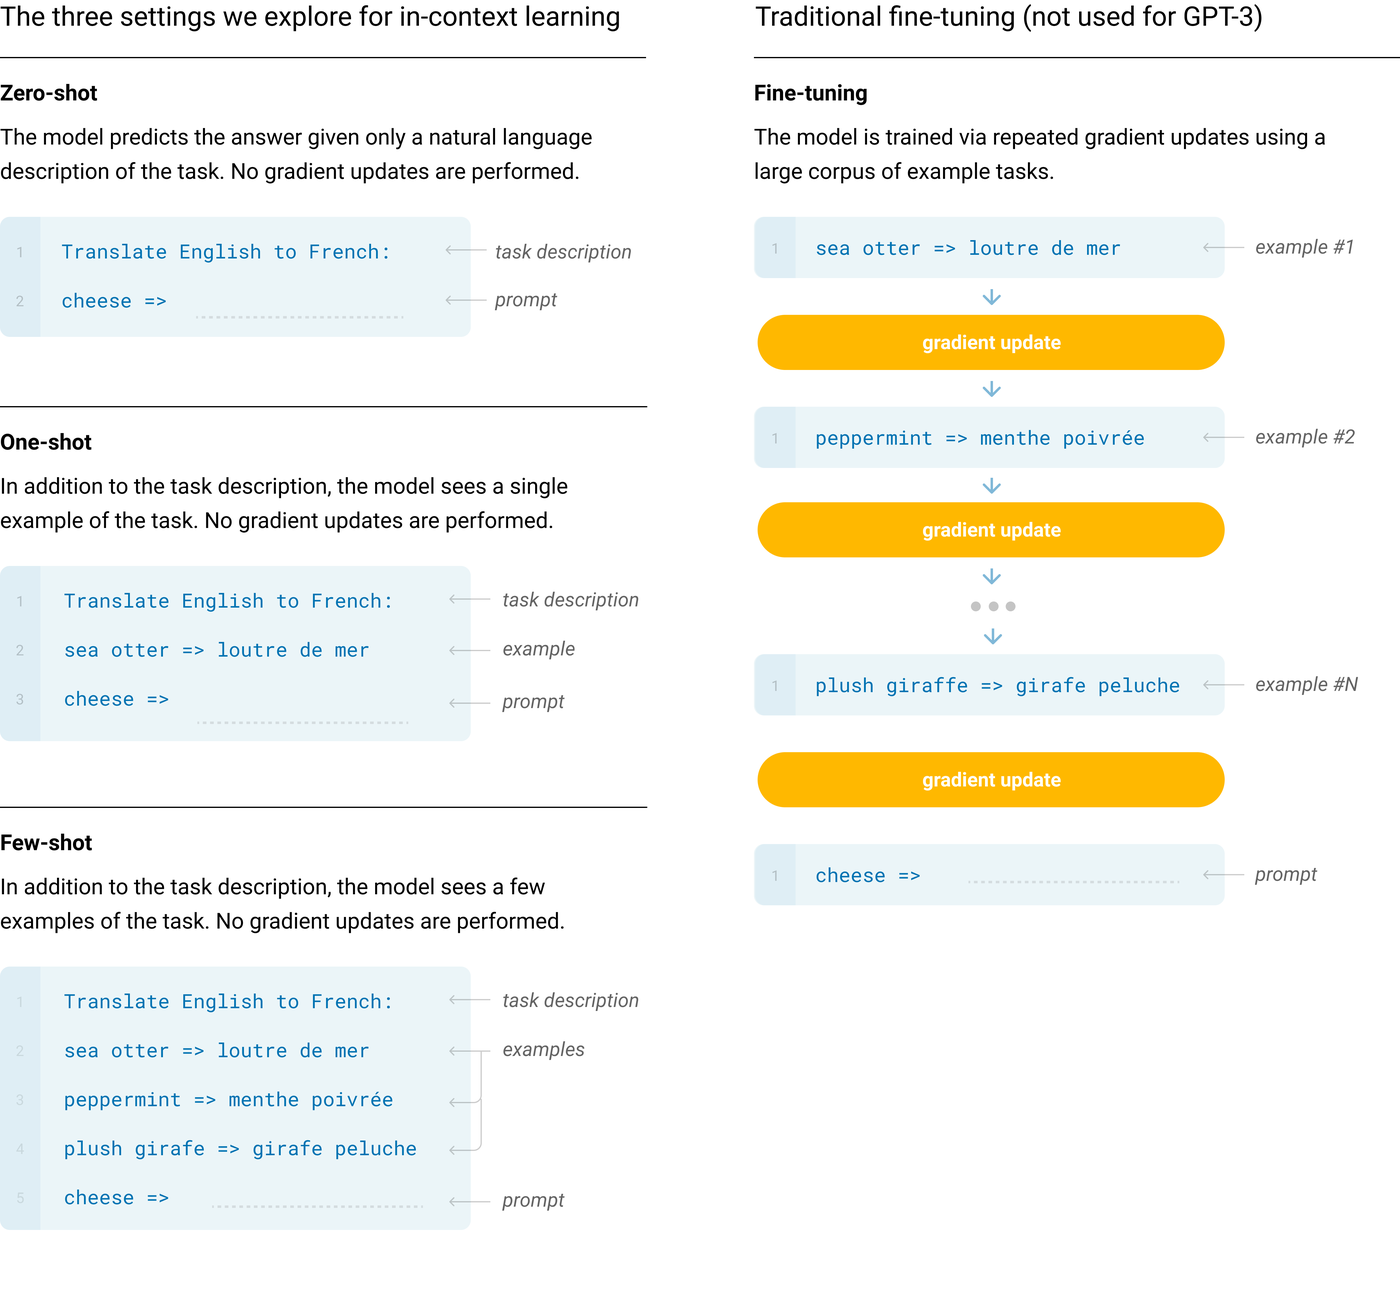
GPT-3 논문 Figure 2.1. 왼쪽 세 가지(zero/one/few-shot)는 가중치를 업데이트하지 않고 프롬프트만 바꿉니다. 오른쪽 전통적 파인튜닝은 GPT-3에서 사용하지 않았습니다. 원문
그 이후: InstructGPT (2022). 사전학습만 한 LM은 “다음 토큰 이어쓰기”에 최적화되어 있어서 지시를 잘 따르지 않습니다. InstructGPT는 SFT(지시–응답 쌍으로 지도학습) → Reward Model 학습 → PPO 강화학습(RLHF)의 3단계로 이를 정렬했습니다. 사람 평가에서 1.3B InstructGPT의 응답이 175B GPT-3보다 더 선호되었고, 이 방식이 ChatGPT의 기반이 되었습니다.
4.3 푸는 문제
- GPT-1: 파인튜닝으로 NLI, QA/상식추론(RACE, Story Cloze), 문장 유사도, 분류. 12개 중 9개 태스크에서 SOTA를 달성했습니다.
- GPT-2/3: 모든 문제를 “텍스트 이어쓰기”로 풉니다. 번역, 요약, QA, 산술, 코드 등 프롬프트로 표현할 수 있는 모든 태스크가 대상입니다.
4.4 학습 방식: 다음 토큰 예측 (Causal LM)
1
2
입력 (IN)     :  나는    사과를   먹었다    .
정답 (label)  :  사과를  먹었다   .        <eos>        ← 입력을 왼쪽으로 한 칸 민 것
- IN: 토큰 시퀀스 하나. Token embedding + Position embedding입니다. Segment embedding과 Encoder는 없습니다.
- OUT: 모든 위치에서 다음 토큰의 vocab 분포
- 정답: 별도로 만들 필요가 없습니다. 입력 자체를 한 칸 민 것이 라벨입니다.
- Causal mask: 각 위치는 자기 자신과 왼쪽만 볼 수 있습니다. 그래서 정답(오른쪽 토큰)을 미리 볼 수 없고, 동시에 모든 위치를 한 번에 병렬로 학습할 수 있습니다.
BERT는 전체 토큰의 15% 위치에서만 loss를 얻지만, GPT는 100% 위치에서 loss를 얻습니다. 같은 데이터에서 학습 신호를 더 많이 뽑아낼 수 있다는 뜻입니다.
| 단계 | 데이터 | loss 위치 |
|---|---|---|
| Pretraining | 대규모 웹 텍스트 (라벨 없음) | 모든 토큰 |
| SFT (instruction tuning) | (프롬프트, 응답) 쌍을 한 시퀀스로 이어 붙임 | 보통 응답 토큰만 (프롬프트 부분은 -100으로 제외) |
| RLHF / DPO | 사람 선호 데이터 | 보상 모델 점수 또는 선호 쌍 기반 목표 |
4.5 코드로 보기
세 단계로 봅니다. (1) “입력을 한 칸 민 것이 정답”이 코드에서 어떻게 구현되는지, (2) SFT에서 프롬프트를 loss에서 빼는 방법, (3) 생성할 때 다음 토큰을 고르는 방법입니다.
(1) 다음 토큰 예측 loss: shift를 직접 구현
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
import torch
import torch.nn.functional as F
from transformers import AutoTokenizer, AutoModelForCausalLM

tok = AutoTokenizer.from_pretrained("openai-community/gpt2")
model = AutoModelForCausalLM.from_pretrained("openai-community/gpt2")

ids = tok("The quick brown fox jumps over the lazy dog", return_tensors="pt").input_ids   # (1, 9)
logits = model(ids).logits                        # (1, 9, 50257): 모든 위치에서 다음 토큰 분포

# 위치 t의 출력으로 t+1번째 토큰을 맞힌다 → logits는 마지막 제외, 라벨은 첫 토큰 제외
loss = F.cross_entropy(logits[:, :-1].reshape(-1, logits.size(-1)), ids[:, 1:].reshape(-1))

# Hugging Face는 labels=input_ids만 넘기면 내부에서 같은 shift를 해 줍니다
assert torch.allclose(loss, model(ids, labels=ids).loss, atol=1e-5)
print(loss.item())                                # 약 5.43
- 토큰화: 9개 토큰
The,Ġquick,Ġbrown,Ġfox,Ġjumps,Ġover,Ġthe,Ġlazy,Ġdog가 나옵니다.Ġ는 GPT-2의 byte-level BPE에서 앞에 공백이 있다는 표시입니다. logits(1, 9, 50257): causal mask 덕분에 위치 t의 출력은 0~t번 토큰만 보고 만든 “다음 토큰” 분포입니다.- shift: 위치 0~7의 출력(
logits[:, :-1])이 토큰 1~8(ids[:, 1:])을 맞히도록 짝을 맞춥니다. 마지막 위치(8번Ġdog)의 출력은 정답(10번째 토큰)이 없으므로 버립니다.
| 출력 위치 | 0 | 1 | 2 | … | 7 | 8 |
|---|---|---|---|---|---|---|
| 이 위치까지 본 것 | The |
The quick |
The quick brown |
… | … the lazy |
… lazy dog |
| 맞혀야 할 토큰 | Ġquick |
Ġbrown |
Ġfox |
… | Ġdog |
(없음, 버림) |
- loss: 8개 위치 CE의 평균 약 5.43입니다. vocab 50,257개 중에서 무작위로 찍으면 ln(50257) ≈ 10.8이 나오므로, 사전학습된 GPT-2가 이 문장을 꽤 잘 예측한다는 뜻입니다.
- HF 규약:
labels=ids를 그대로 넘기면 모델이 내부에서 위와 같은 shift를 합니다.assert는 두 값이 같은지 확인하는 줄입니다. 그래서 GPT 계열에서는labels를 따로 밀어서 만들 필요가 없습니다.
(2) SFT: 프롬프트 부분은 loss에서 제외
1
2
3
4
5
6
7
8
prompt = "Q: What is the capital of France?\nA:"
answer = " Paris.<|endoftext|>"
p_ids = tok(prompt).input_ids                            # 12개 토큰
a_ids = tok(answer).input_ids                            # 3개 토큰: ' Paris', '.', <|endoftext|>

input_ids = torch.tensor([p_ids + a_ids])                # (1, 15): 프롬프트 + 응답을 한 시퀀스로
labels = torch.tensor([[-100] * len(p_ids) + a_ids])     # 프롬프트 위치는 -100 → CE에서 무시
loss = model(input_ids, labels=labels).loss              # 응답 토큰에서만 loss 계산
- 입력: 프롬프트와 응답을 그냥 이어 붙입니다. GPT에는 Encoder가 없으므로 질문도 같은 시퀀스 안에서 self-attention으로 읽습니다.
- labels: 입력과 같은 길이(15)로 만들고, 프롬프트 12칸을 -100으로 채웁니다. 모델 안에서 한 칸 shift가 일어나므로, 실제로는 위치 11(
:), 12(ĠParis), 13(.)의 출력이 각각ĠParis,.,<|endoftext|>를 맞히는 3개 위치에서만 loss가 계산됩니다(7.3절 표 참고). - 왜 프롬프트를 빼나: 모델이 배워야 할 것은 “질문이 오면 이렇게 답한다”이지 “사용자 질문을 생성하는 법”이 아니기 때문입니다. 응답 끝의
<|endoftext|>까지 정답에 넣어야 모델이 답을 끝내는 법도 배웁니다. - 배치로 학습할 때 길이를 맞추는 padding 위치도
labels = -100,attention_mask = 0으로 둡니다. GPT-2에는 pad 토큰이 없어서 보통tok.pad_token = tok.eos_token으로 지정합니다.
(3) 생성: 다음 토큰은 어떻게 고르나
1
2
3
4
inputs = tok("Once upon a time", return_tensors="pt")
out = model.generate(**inputs, max_new_tokens=30, do_sample=True, top_p=0.9, temperature=0.8,
                     pad_token_id=tok.eos_token_id)
print(tok.decode(out[0], skip_special_tokens=True))
generate()는 “마지막 위치의 분포에서 토큰 하나 고르기 → 입력 뒤에 붙이기”를 max_new_tokens번 반복합니다(반복 구조는 8절에서 직접 구현합니다). 한 step에서 토큰을 고르는 과정을 풀어 쓰면 이렇습니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
ids = tok("Once upon a time", return_tensors="pt").input_ids
with torch.no_grad():
    logits = model(ids).logits[:, -1, :]         # (1, 50257): 마지막 위치의 분포만 사용

logits = logits / 0.8                             # temperature: 1보다 작으면 분포가 뾰족해짐
probs = logits.softmax(-1)
sorted_p, sorted_idx = probs.sort(descending=True)
cum = sorted_p.cumsum(-1)
keep = (cum - sorted_p) < 0.9                     # 누적확률이 0.9에 도달하기 전까지의 후보만 유지
print("후보 수:", keep.sum().item(), "/", probs.size(-1))   # 후보 수: 10 / 50257
sorted_p = sorted_p * keep
sorted_p = sorted_p / sorted_p.sum()              # 남은 후보끼리 다시 합이 1이 되게
next_id = sorted_idx.gather(-1, torch.multinomial(sorted_p, 1))   # 확률에 비례해서 하나 뽑기
[:, -1, :]: 생성에 필요한 것은 마지막 위치의 분포뿐입니다. 앞 위치들의 출력은 학습 때만 쓰입니다.- temperature: logits를 T로 나눕니다. T < 1이면 높은 점수가 더 도드라져서 보수적인 출력이, T > 1이면 분포가 평평해져서 다양한 출력이 나옵니다.
- top-p (nucleus): 확률이 높은 순으로 정렬해서 누적확률이 p(0.9)에 도달할 때까지만 후보로 남깁니다. 위 예에서는 50,257개 중 10개만 남았습니다. 이상한 저확률 토큰이 뽑히는 것을 막습니다.
multinomial: 남은 후보 중에서 확률에 비례해 하나를 샘플링합니다.do_sample=False(기본값)이면 대신argmax로 가장 높은 것 하나를 고르는 greedy 방식이 됩니다.pad_token_id=tok.eos_token_id: GPT-2에는 pad 토큰이 없어서 지정하지 않으면 경고가 나옵니다. 배치 생성할 때 길이를 맞출 토큰으로 eos를 쓰겠다는 뜻입니다.
5. BART와 T5
BERT(양방향 인코더)는 이해에 강하고, GPT(단방향 디코더)는 생성에 강합니다. 둘을 합치면 어떨까?라는 질문에 대한 2019년의 두 가지 답이 BART와 T5입니다. 둘 다 원래 Transformer와 같은 Encoder–Decoder 구조에 노이즈 제거(denoising) 사전학습을 결합했습니다.
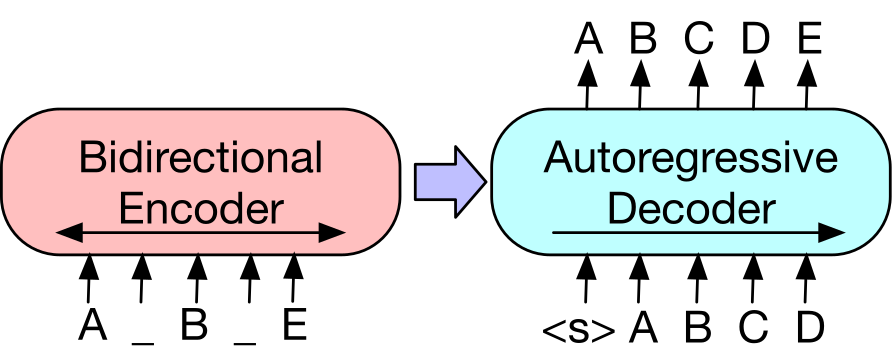
BART 논문 Figure 1(c). 글 맨 앞 그림의 오른쪽 부분입니다. (a) BERT는 가린 토큰을 서로 독립적으로 예측하므로 생성에 약하고, (b) GPT는 왼쪽 문맥만 봅니다. (c) BART는 손상된 문서를 양방향 인코더로 읽고, 자기회귀 디코더로 원문 전체를 복원합니다. 원문
5.1 BART
| 항목 | 내용 |
|---|---|
| 논문 | BART: Denoising Sequence-to-Sequence Pre-training for NLG, Translation, and Comprehension (Lewis et al., ACL 2020, arXiv 2019.10) |
| 기관 | Facebook AI |
| 구조 | Encoder–Decoder. Base 6+6층(약 140M), Large 12+12층, hidden 1024(약 400M) |
| 데이터 | RoBERTa와 같은 160GB (뉴스, 책, 스토리, 웹 텍스트) |
| 학습 | batch 8,000, 50만 step |
핵심 아이디어: 어떤 노이즈든 넣고 원문을 복원한다. Encoder에 넣는 입력은 자유롭게 망가뜨려도 됩니다. Decoder는 항상 원래 문서 전체를 생성합니다. 논문에서는 다섯 가지 노이즈를 비교했습니다.
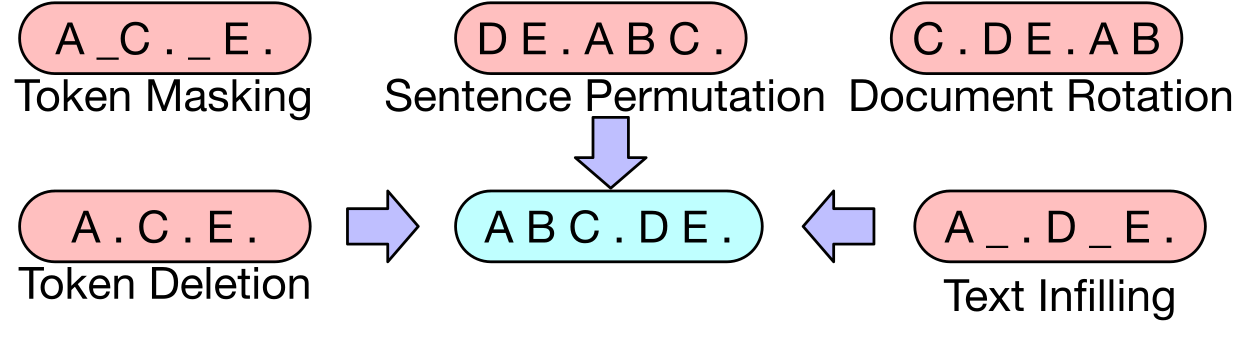
BART 논문 Figure 2. 원문 ABC.DE.에 적용한 노이즈 변환입니다. 원문
| 노이즈 | 방식 |
|---|---|
| Token Masking | BERT처럼 토큰을 [MASK]로 치환 |
| Token Deletion | 토큰을 삭제. 모델이 어느 위치가 빠졌는지도 알아내야 함 |
| Text Infilling | Poisson($\lambda=3$) 길이의 span을 [MASK] 하나로 치환 (길이 0인 span 포함). 모델이 몇 토큰이 빠졌는지도 예측해야 함 |
| Sentence Permutation | 문장 순서를 섞음 |
| Document Rotation | 임의의 토큰에서 문서가 시작되도록 회전 |
최종 모델은 Text Infilling(토큰의 30%) + Sentence Permutation 조합을 썼습니다.
Q. 입력을 이렇게 망가뜨리면 문장의 의미나 형식이 달라져서 문제가 되지 않나요?
입력이 망가지는 것은 맞습니다. 하지만 BART는 일부러 입력을 망가뜨리고, 뒤에 있는 디코더가 원문을 복원하게 합니다. 핵심은 망가지는 것은 입력뿐이고, 정답은 항상 원문이라는 점입니다.
1
2
3
원문 (정답)    : A B C . D E .
Encoder 입력   : A _ . D _ E .      ← 여기만 망가짐 (span 하나 → [MASK] 하나, 길이 0인 span도 가능)
Decoder 정답   : A B C . D E .      ← loss는 항상 온전한 원문에 걸림
- loss가 원문 전체에 걸립니다. 그래서 모델이 망가진 문장을 출력하도록 학습될 일은 없고, 오히려 “망가진 입력 → 올바른 문장”으로 고치는 법을 배웁니다.
- 디코더는 자기회귀라서 출력 길이가 입력 길이에 묶여 있지 않습니다.
[MASK]하나가 원래 3토큰이었든 0토큰이었든, 디코더가 필요한 만큼 생성하면 됩니다. - BERT에서는 이것이 불가능합니다. BERT는 마스크 1개가 토큰 1개에 대응해야 하므로, 몇 토큰이 빠졌는지가 입력에 그대로 드러납니다. BART의 Text Infilling은 몇 개가 빠졌는지까지 모델이 추론해야 하는 더 어려운 과제이고, 이것이 생성 능력에 도움이 됩니다.
- Sentence Permutation도 같은 원리입니다. 섞인 문장을 원래 순서로 복원해야 하므로 문장 사이의 흐름(담화 구조)을 배웁니다.
그래도 주의할 점
- 변환 종류에 따라 효과가 크게 다릅니다. 논문 비교(Table 1)에서 Text Infilling이 가장 일관되게 좋았고, Token Deletion도 생성 태스크에서 좋았습니다. 반면 Document Rotation이나 Sentence Permutation은 단독으로 쓰면 성능이 낮았습니다. 그래서 최종 모델은 Text Infilling + Sentence Permutation 조합을 씁니다.
- 가리는 정도는 하이퍼파라미터입니다. 너무 많이 가리면 복원할 근거가 사라져서 정답이 사실상 추측이 되고 학습 신호가 약해집니다(일반적인 denoising 목표의 성질에 대한 해석입니다). 논문은 토큰의 30%, span 길이 Poisson($\lambda=3$)을 사용했습니다.
- 빈칸의 정답이 여러 개일 수 있습니다.
No <mask> in Syria에는 그럴듯한 답이 많지만 정답 텍스트는 하나뿐입니다. 하지만 이것은 GPT의 다음 토큰 예측에도 똑같이 있는 불확실성입니다. 모델은 가능한 후보들에 확률을 나눠 주는 식으로 학습하므로 치명적이지 않습니다. - 사전학습과 파인튜닝 사이의 입력 분포 차이. 파인튜닝 입력은 깨끗한 문장이라 사전학습 입력과 분포가 다릅니다. BERT의
[MASK]문제와 같은 종류입니다. 다만 사전학습에서도 토큰 대부분(약 70%)은 가려지지 않은 채 들어가고, 실제로 BART는 파인튜닝 후 요약·QA·GLUE에서 좋은 성능을 보였으므로 실무에서는 큰 문제가 되지 않았습니다.
T5와의 차이도 여기서 나옵니다. T5는 가린 span만(<X> for inviting <Y> last <Z>) 생성하므로 학습 비용은 적지만, 디코더가 문장 전체를 다시 쓰는 연습은 덜 합니다. BART는 원문 전체를 다시 쓰기 때문에 비용이 크지만, 요약처럼 문장 전체를 새로 생성하는 태스크에 특히 강했습니다.
Contribution과 결과
- 생성 태스크에서 강했습니다. CNN/DailyMail, XSum 요약에서 기존 대비 최대 6 ROUGE 향상, 생성형 QA와 대화에서도 SOTA를 달성했습니다.
- 이해 태스크(GLUE, SQuAD)에서는 RoBERTa와 비슷한 수준을 유지했습니다. 즉 생성 능력을 얻으면서 이해 능력을 잃지 않았습니다.
- 번역에서는 BART 앞에 새 소스 인코더를 붙이는 방식으로, 타깃 언어만으로 사전학습해도 back-translation 대비 1.1 BLEU 향상을 보였습니다.
분류는 어떻게 푸나? 같은 입력을 Encoder와 Decoder 양쪽에 넣고, Decoder 마지막 토큰의 hidden state를 분류기에 넣습니다. 마지막 토큰은 causal mask 아래에서도 전체 입력을 볼 수 있기 때문입니다(BERT의 [CLS] 역할).
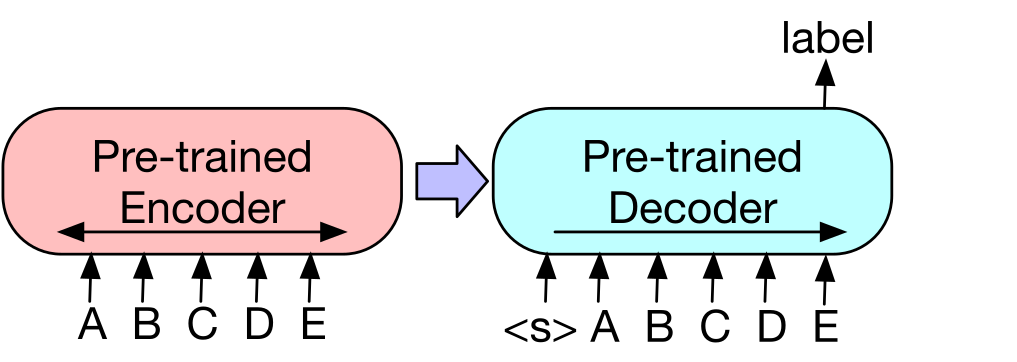
BART 논문 Figure 3(a). 분류 태스크에서는 Decoder 마지막 위치의 표현을 사용합니다. 원문
코드로 보기
(1) 사전학습 loss가 어떻게 계산되는지, (2) 사전학습만 한 BART가 빈칸을 어떻게 채우는지, (3) 요약으로 파인튜닝한 BART를 쓰는 방법을 차례로 봅니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
from transformers import AutoTokenizer, BartForConditionalGeneration

tok = AutoTokenizer.from_pretrained("facebook/bart-large")
model = BartForConditionalGeneration.from_pretrained("facebook/bart-large")

# 1) 사전학습 loss: 손상된 입력 → 원문 "전체"가 정답
noised   = tok("UN Chief Says There Is No <mask> in Syria", return_tensors="pt").input_ids
original = tok("UN Chief Says There Is No Plan to Stop Chemical Weapons in Syria", return_tensors="pt").input_ids
out = model(input_ids=noised, labels=original)
print(out.logits.shape, out.loss)   # torch.Size([1, 15, 50265]) 약 1.88

# 2) Text infilling: <mask> 하나가 여러 토큰으로 복원되고, 문장 전체가 다시 생성됨
gen = model.generate(noised, forced_bos_token_id=0, max_new_tokens=20)
print(tok.batch_decode(gen, skip_special_tokens=True))
# ['UN Chief Says There Is No Plan to Stop Chemical Weapons in Syria']
1) 사전학습 loss
- Encoder 입력 (
noised, 11토큰):<s> UN ĠChief ĠSays ĠThere ĠIs ĠNo <mask> Ġin ĠSyria </s>. 원래 5토큰(Plan to Stop Chemical Weapons)이던 구간이<mask>하나로 줄어 있습니다. - 정답 (
original, 15토큰): 원문 전체입니다. 가려진 부분만이 아니라 멀쩡했던UN Chief Says …까지 전부 정답에 들어갑니다. T5와 가장 다른 점입니다. - Decoder 입력:
labels만 넘기면 모델이 내부에서 오른쪽으로 한 칸 밀어 만듭니다. BART는 시작 토큰으로</s>(id 2)를 쓰므로</s> <s> UN ĠChief … ĠSyria가 됩니다. - loss:
logits(1, 15, 50265)의 15개 위치 전부에서 계산한 CE 평균입니다. 모델은 “몇 개가 빠졌는지”(여기서는 5개)까지 스스로 판단해서 원문 길이만큼 생성해야 합니다.
2) 빈칸 채우기 생성
generate()는 Encoder를 한 번 돌리고, Decoder를 한 토큰씩 반복합니다(8절).forced_bos_token_id=0: 첫 생성 토큰을<s>(id 0)로 강제합니다. 사전학습 때 Decoder 출력이 항상<s>로 시작했기 때문에(위 정답 참고), 이 형식을 맞춰 줘야 정상적으로 이어 씁니다.- 왜 직접 넘기나: Hub의
facebook/bart-large설정 파일(config.json)에는forced_bos_token_id=0,num_beams=4같은 생성 옵션이 들어 있습니다. 그런데 transformers 5.x는 모델 설정 파일에 적힌 생성 옵션을 자동으로 적용하지 않아서, 필요한 값은generate()에 직접 넘깁니다. - 결과:
<mask>하나 자리에Plan to Stop Chemical Weapons5토큰이 생성되었습니다. BERT였다면[MASK]하나에 토큰 하나만 채울 수 있습니다.
1
2
3
4
5
6
7
8
9
10
11
# 3) 요약: CNN/DailyMail로 파인튜닝한 BART. Encoder가 기사를 읽고 Decoder가 요약을 beam search로 생성
sum_tok = AutoTokenizer.from_pretrained("facebook/bart-large-cnn")
summarizer = BartForConditionalGeneration.from_pretrained("facebook/bart-large-cnn")
long_article = ("The Transformer architecture, introduced in 2017, replaced recurrence with self-attention. "
                "It enabled highly parallel training and became the basis of BERT, GPT and T5. These models now "
                "power search, translation and chat assistants used by millions of people every day.")
inputs = sum_tok(long_article, return_tensors="pt", truncation=True)
summary_ids = summarizer.generate(**inputs, num_beams=4, min_length=10, max_length=40)
print(sum_tok.decode(summary_ids[0], skip_special_tokens=True))
# The Transformer architecture, introduced in 2017, replaced recurrence with self-attention.
# It enabled highly parallel training and became the basis of BERT, GPT and T5.
3) 요약 모델 쓰기
- 모델:
bart-large-cnn은 사전학습된 BART를 CNN/DailyMail 뉴스 요약 데이터(기사 → 하이라이트 문장)로 파인튜닝한 것입니다. 구조는 같고 가중치만 다릅니다. truncation=True: 입력이 모델 최대 길이(1,024토큰)를 넘으면 잘라냅니다.num_beams=4: beam search입니다. 매 step에서 확률이 높은 후보 시퀀스 4개를 동시에 유지하다가 최종 점수가 가장 높은 것을 고릅니다. 요약처럼 “그럴듯한 정답”이 비교적 정해진 태스크에서 greedy보다 안정적입니다.min_length,max_length: 생성 길이를 토큰 수로 제한합니다. Hub 설정의 기본값은 뉴스 기사 길이에 맞춰 최소 56, 최대 142토큰이라서, 짧은 예시 글에 맞게 줄였습니다.- 결과 해석: 원문의 앞 두 문장을 거의 그대로 가져왔습니다. CNN/DailyMail 요약 정답이 기사 문장과 많이 겹치기 때문에, 이 데이터로 학습한 모델은 원문 문장을 골라 붙이는 경향이 있습니다.
5.2 T5
| 항목 | 내용 |
|---|---|
| 논문 | Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer (Raffel et al., JMLR 2020, arXiv 2019.10) |
| 기관 | |
| 구조 | Encoder–Decoder. Small 60M / Base 220M / Large 770M / 3B / 11B |
| 데이터 | C4 (Colossal Clean Crawled Corpus). Common Crawl을 정제한 약 750GB |
| 토크나이저 | SentencePiece, vocab 32,000 |
| 특징 | Relative position bias, bias 없는 LayerNorm(RMSNorm 형태), Pre-LN |
핵심 아이디어 1: 모든 문제를 Text-to-Text로. 번역, 요약, 분류, 회귀까지 입력도 텍스트, 출력도 텍스트로 통일하고, 태스크는 입력 앞의 prefix로 구분합니다. 그래서 모델, loss, 디코딩 방식이 모든 태스크에서 같습니다.
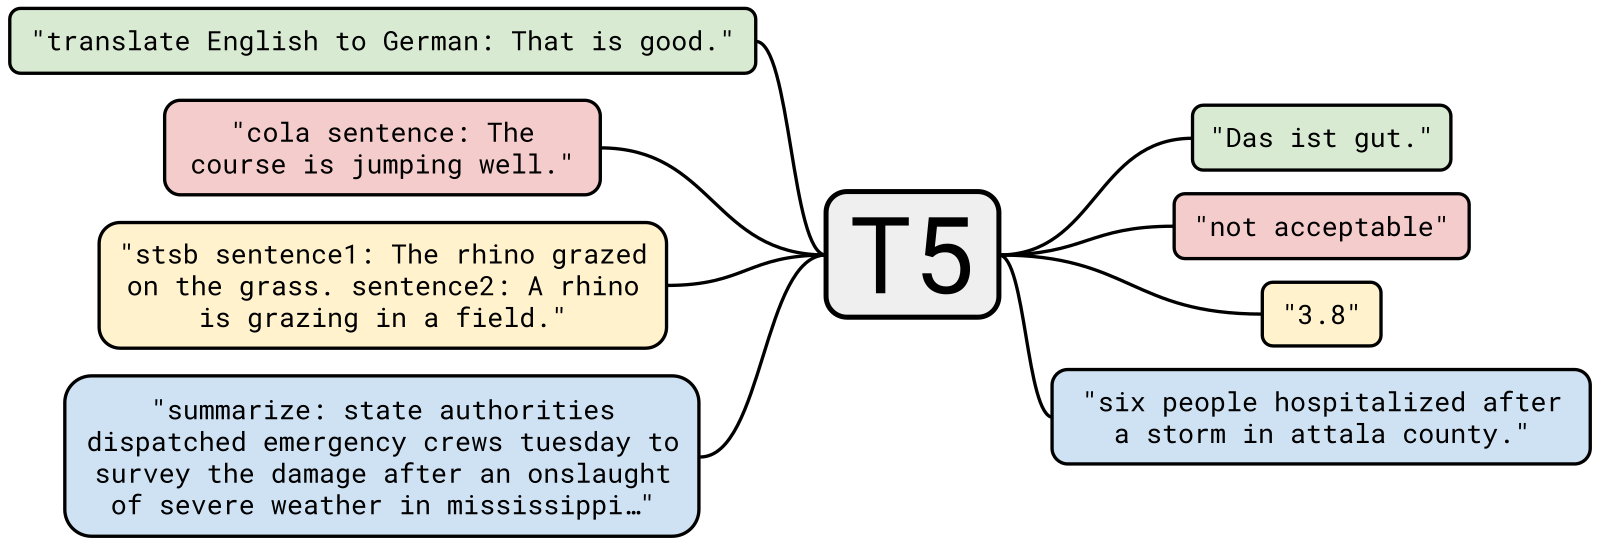
T5 논문 Figure 1. 번역, 문법성 판정(CoLA), 문장 유사도 회귀(STS-B), 요약을 모두 같은 모델이 텍스트로 입력받고 텍스트로 출력합니다. 원문
| 태스크 | Encoder 입력 | Decoder 출력 |
|---|---|---|
| 번역 | translate English to German: That is good. |
Das ist gut. |
| 문법성 분류 (CoLA) | cola sentence: The course is jumping well. |
not acceptable |
| 유사도 회귀 (STS-B) | stsb sentence1: The rhino grazed on the grass. sentence2: A rhino is grazing in a field. |
3.8 (0.2 단위로 반올림한 점수를 문자열로 출력) |
| 요약 | summarize: state authorities dispatched emergency crews tuesday to ... |
six people hospitalized after a storm in attala county. |
핵심 아이디어 2: Span Corruption 사전학습. BERT의 MLM을 Encoder–Decoder에 맞게 바꾼 목표입니다.
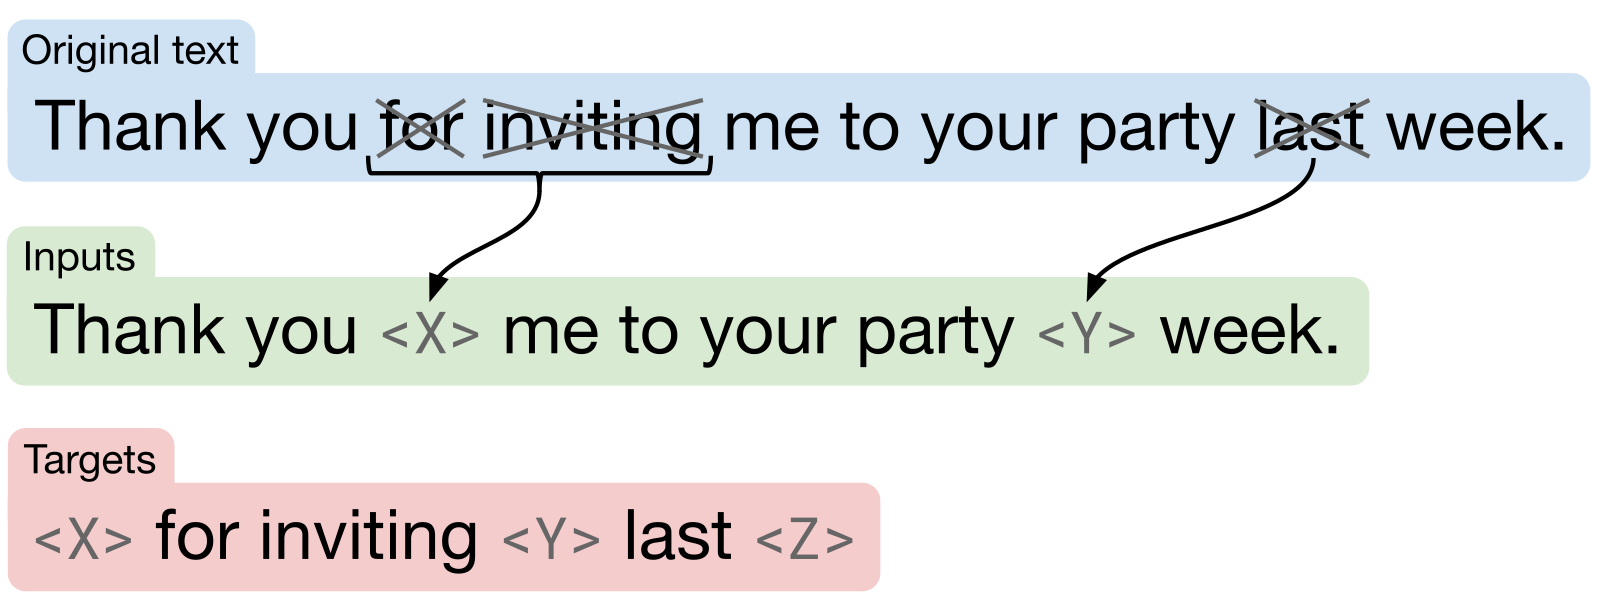
T5 논문 Figure 2. 가린 span 하나를 sentinel 토큰 하나(<X>, <Y>)로 치환하고, 타깃은 sentinel과 가린 내용만 이어 붙인 것입니다. 원문
- 토큰의 15%를 가리되, 평균 길이 3의 연속 span 단위로 가립니다.
- span 하나는 고유한 sentinel 토큰 하나(
<extra_id_0>,<extra_id_1>, …)로 바뀝니다. - Decoder는 원문 전체가 아니라 가린 부분만
sentinel + 내용형태로 생성하고, 마지막 sentinel로 끝냅니다.
BART vs T5, 비슷해 보이지만 다른 점
| BART | T5 | |
|---|---|---|
| 마스크 토큰 | 모든 span에 같은 [MASK] |
span마다 다른 sentinel |
| Decoder 타깃 | 원문 전체 복원 | 가린 span만 생성 |
| 타깃 길이 | 길다 (원문 길이) | 짧다 (원문의 약 15%) → 학습 비용이 적음 |
| 다운스트림 형식 | 태스크별 head(분류) 또는 생성 | 전부 텍스트 생성 (prefix로 구분) |
Contribution: 체계적인 비교 연구. T5 논문은 새 모델 하나를 제안하는 데 그치지 않고, 구조(Encoder–Decoder vs LM vs Prefix LM, 6.1절 참고), 사전학습 목표(LM, BERT식, deshuffling, span corruption 등), 데이터셋, 전이 학습 전략, 스케일을 같은 조건에서 비교한 대규모 실험 보고서입니다. 결론은 “Encoder–Decoder + span corruption + 대규모 정제 데이터 + 큰 모델”이 가장 좋았다는 것이고, 11B 모델로 GLUE, SuperGLUE(89.3, 사람 89.8), SQuAD, CNN/DM에서 SOTA를 기록했습니다.
후속 모델: T5 v1.1(GeGLU, C4만 사용해 사전학습), mT5(101개 언어), Flan-T5(1,800여 개 태스크로 instruction tuning), UL2(여러 denoising 목표 혼합).
코드로 보기
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
import torch
from transformers import AutoTokenizer, T5ForConditionalGeneration

tok = AutoTokenizer.from_pretrained("google-t5/t5-small")
model = T5ForConditionalGeneration.from_pretrained("google-t5/t5-small")

# 1) Span corruption 사전학습 loss: labels만 넘기면 decoder_input_ids는 내부에서 shift해서 만듦
inp = tok("Thank you <extra_id_0> me to your party <extra_id_1> week.", return_tensors="pt").input_ids
tgt = tok("<extra_id_0> for inviting <extra_id_1> last <extra_id_2>", return_tensors="pt").input_ids
out = model(input_ids=inp, labels=tgt)
print(out.logits.shape, out.loss)   # torch.Size([1, 7, 32128]) 약 3.10

# 2) 다운스트림도 text-to-text: prefix만 바꾸면 됨
for text in ["translate English to German: That is good.",
             "cola sentence: The course is jumping well.",
             "summarize: The Transformer replaces recurrence with attention, making training highly parallel."]:
    ids = tok(text, return_tensors="pt").input_ids
    print(tok.decode(model.generate(ids, max_new_tokens=30)[0], skip_special_tokens=True))
# Das ist gut.
# acceptable     ← 정답은 "unacceptable". 가장 작은 t5-small은 이렇게 틀리기도 합니다.
# Transformer replaces recurrence with attention, making training highly parallel.
1) Span corruption loss: 텐서로 보기
| 토큰 | |
|---|---|
| Encoder 입력 (11개) | ▁Thank ▁you <extra_id_0> ▁me ▁to ▁your ▁party <extra_id_1> ▁week . </s> |
labels (7개) |
<extra_id_0> ▁for ▁inviting <extra_id_1> ▁last <extra_id_2> </s> |
decoder_input_ids (자동 생성) |
<pad> <extra_id_0> ▁for ▁inviting <extra_id_1> ▁last <extra_id_2> |
- sentinel 토큰:
<extra_id_0>,<extra_id_1>, …은 vocab 끝쪽에 미리 만들어 둔 특수 토큰입니다(id 32099, 32098, … 순으로 거꾸로 매겨짐).▁는 SentencePiece에서 “앞에 공백이 있음”을 뜻합니다. labels: 가린 두 구간(for inviting,last)만 sentinel과 함께 나열하고, 마지막 sentinel(<extra_id_2>)과</s>로 끝냅니다. BART와 달리 멀쩡한 부분(Thank you,me to your party)은 정답에 없습니다. 그래서 target이 7토큰으로 짧고 학습 비용이 적습니다.decoder_input_ids:labels를 오른쪽으로 한 칸 밀고 맨 앞에 시작 토큰을 넣습니다. T5는 시작 토큰으로<pad>(id 0)를 씁니다. 위치 t의 입력을 보고labels[t]를 맞히도록 짝이 맞춰집니다.- loss:
logits(1, 7, 32128)의 7개 위치 CE 평균입니다. vocab이 토크나이저의 32,100개(일반 토큰 32,000 + sentinel 100)보다 조금 큰 32,128인 것은 임베딩 행렬에 여유분을 둔 것으로, 남는 id는 쓰이지 않습니다.
2) Text-to-text 추론
- prefix가 태스크 지정자입니다. 모델 구조, 가중치, 호출 방법은 세 경우 모두 같고 입력 문자열 앞부분만 다릅니다. 공개된 T5 체크포인트는 사전학습 중에 이런 지도학습 태스크를 섞어서 학습했기 때문에 prefix를 알아듣습니다.
generate()기본값: 따로 지정하지 않으면 greedy(매 step 최고 확률 토큰)로 생성합니다.max_new_tokens=30은 최대 30토큰까지만 생성하라는 뜻이고, 그 전에</s>가 나오면 멈춥니다.- CoLA 결과:
The course is jumping well.은 문법적으로 어색한 문장이라 정답은unacceptable인데, t5-small은acceptable이라고 답했습니다. 60M짜리 가장 작은 모델이라 틀릴 수 있습니다. 출력이 클래스 이름을 텍스트로 생성한 것이라는 점을 보면 됩니다.
6. 인코더와 디코더가 문제를 학습하는 방식의 차이
지금까지 본 모델들의 학습 방식은 어텐션 마스크 모양과 loss를 거는 위치로 정리할 수 있습니다.
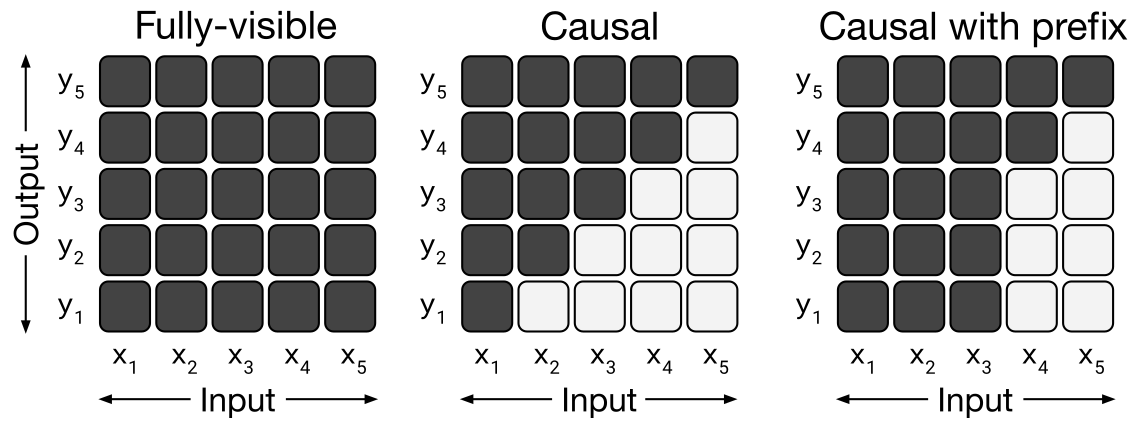
T5 논문 Figure 3. 진한 칸이 “출력 위치 $y_i$가 입력 위치 $x_j$를 볼 수 있음”을 뜻합니다. Fully-visible은 인코더(BERT), Causal은 디코더(GPT), Causal with prefix는 Prefix LM입니다. 원문
| 인코더 계열 (BERT) | 디코더 계열 (GPT) | 인코더–디코더 (Transformer, BART, T5) | |
|---|---|---|---|
| 어텐션 | Fully-visible (양방향) | Causal (왼쪽만) | Enc: 양방향 / Dec: causal + cross-attn |
| 입력 | 일부가 가려진 문장 | 원문 그대로 | Enc: 원문 또는 손상된 문장 / Dec: 타깃을 한 칸 shift |
| 예측 대상 | 가려진 위치의 원래 토큰 | 모든 위치의 다음 토큰 | 타깃 시퀀스의 다음 토큰 |
| loss 위치 | 마스킹된 약 15% | 전체 토큰 | 타깃(Decoder) 전체 |
| 라벨 생성 | 마스킹 전 원문 | 입력을 한 칸 shift | 원문 / 가린 span / 태스크 정답 |
| 학습 신호 밀도 | 낮음 | 높음 | 중간 (T5는 타깃이 짧음) |
| 사전학습–사용 괴리 | [MASK]는 파인튜닝에 없음 |
거의 없음 (학습도 사용도 다음 토큰 예측) | 적음 |
세 가지 마스크를 직접 만들어 보기
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
import torch

T, prefix_len = 5, 3

fully_visible = torch.ones(T, T)                 # BERT: 모두 볼 수 있음
causal = torch.tril(torch.ones(T, T))            # GPT: 자기 자신과 왼쪽만
prefix_lm = causal.clone()
prefix_lm[:, :prefix_len] = 1                    # Prefix LM: prefix 구간은 양방향, 이후는 causal

print(prefix_lm)
# tensor([[1., 1., 1., 0., 0.],
#         [1., 1., 1., 0., 0.],
#         [1., 1., 1., 0., 0.],
#         [1., 1., 1., 1., 0.],
#         [1., 1., 1., 1., 1.]])
왜 이 차이가 중요한가
- 양방향 = 정보 누설 위험. 양방향 어텐션에서 “다음 토큰 맞히기”를 하면 정답이 입력에 그대로 보입니다. 그래서 BERT는 정답을 가리는(MASK) 방식을 택했고, 그 대가로 전체 토큰 중 일부에서만 학습 신호를 얻습니다.
- Causal = 누설 없음 + 전 위치 학습. 오른쪽을 가려 두면 모든 위치에서 동시에 “다음 토큰”을 맞히는 문제를 낼 수 있습니다. 데이터 효율이 좋고 구조가 단순해서 스케일을 키우기 쉽습니다. 오늘날 LLM이 대부분 디코더 전용인 이유 중 하나입니다.
- 인코더–디코더 = 입력과 출력의 역할 분리. 입력(원문)은 양방향으로 충분히 이해하고, 출력은 causal하게 생성합니다. 입력과 출력이 명확히 구분되는 번역·요약에 자연스럽게 맞습니다.
6.1 Prefix LM: 읽기는 양방향, 쓰기는 causal
위 Figure 3의 세 번째 마스크(Causal with prefix)를 쓰는 구조가 Prefix LM입니다. T5 논문은 세 가지 구조를 같은 조건에서 비교했습니다.
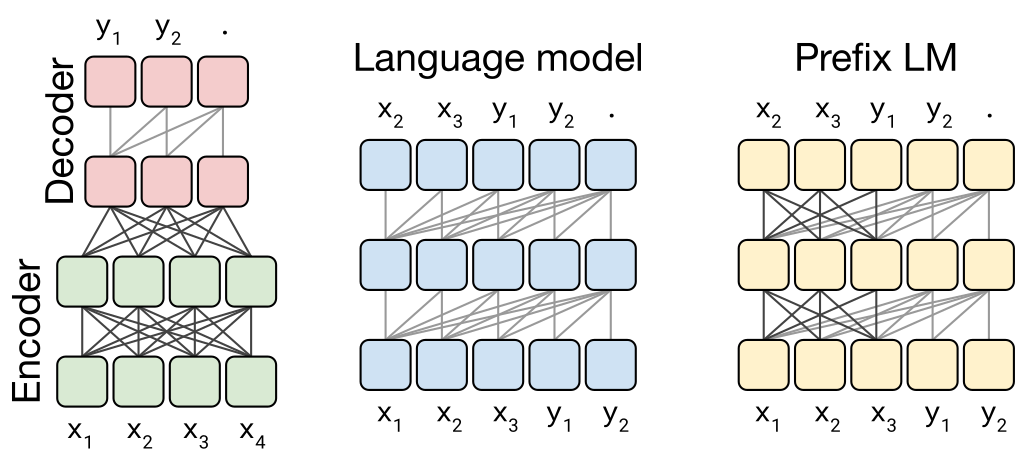
T5 논문 Figure 4. 왼쪽부터 Encoder–Decoder(Transformer, BART, T5), Language model(GPT), Prefix LM입니다. 선의 연결이 곧 어텐션 마스크입니다. Prefix LM에서는 아래쪽 x1 x2 x3끼리 모두 연결되어 있고(양방향), y1 y2는 prefix 전체와 자기 왼쪽만 봅니다. 원문
Prefix LM은 Decoder 하나만 쓰면서 어텐션 마스크만 바꿔서, 입력(prefix)은 인코더처럼 양방향으로 읽고 출력(target)은 GPT처럼 causal하게 생성하는 구조입니다. Encoder–Decoder를 파라미터를 공유하는 한 스택 안에 합쳐 놓은 형태라고 볼 수 있습니다. 위 코드의 prefix_lm 행렬이 바로 이 마스크입니다. GPT의 causal mask에서 왼쪽 위 prefix 블록만 전부 1로 채운 것입니다.
1
2
3
4
5
6
          x1  x2  x3 | y1  y2
x1         ✓   ✓   ✓ |  ✗   ✗     ← prefix끼리는 서로 다 봄 (양방향)
x2         ✓   ✓   ✓ |  ✗   ✗
x3         ✓   ✓   ✓ |  ✗   ✗
y1         ✓   ✓   ✓ |  ✓   ✗     ← target은 prefix 전체 + 자기 왼쪽만 (causal)
y2         ✓   ✓   ✓ |  ✓   ✓
학습 방식. prefix와 target을 한 시퀀스로 이어 붙이고, loss는 target 위치에서만 계산합니다(prefix 위치의 라벨은 -100). 7.3절의 GPT SFT와 같은 라벨 구성입니다. 차이는 SFT가 프롬프트를 causal하게 읽고, Prefix LM은 프롬프트를 양방향으로 읽는다는 점 하나입니다. T5 논문의 사전학습 실험에서는 라벨 없는 텍스트를 임의 지점에서 잘라 앞부분을 prefix, 뒷부분을 target으로 썼습니다.
1
2
3
시퀀스 : translate English to German: That is good.  |  Das ist gut. </s>
         └──────────── prefix (양방향) ─────────────┘   └─ target (causal) ─┘
labels : -100 ... -100                                  Das  ist  gut. </s>
| Encoder–Decoder | Language model (GPT) | Prefix LM | |
|---|---|---|---|
| Transformer 스택 | 2개 (Enc, Dec) | 1개 | 1개 |
| 입력(prefix) 부분 | 양방향 (Encoder) | 왼쪽만 | 양방향 |
| 출력(target) 부분 | causal + cross-attention | causal | causal (prefix 전체 + 자기 왼쪽) |
| 입력을 참조하는 방법 | cross-attention | 같은 시퀀스의 self-attention | 같은 시퀀스의 self-attention |
Prefix LM = BERT인가? 아닙니다. 양방향인 것은 prefix 구간뿐이고, prefix에는 맞힐 정답(loss)이 없습니다. BERT는 시퀀스 전체를 양방향으로 보면서 그 안의 빈칸을 제자리에서 맞히고, 정보 누설을 막으려고 정답을 [MASK]로 가립니다. Prefix LM은 가리는 대신 정답이 있는 target 구간을 causal로 막아서 누설을 피합니다. 그래서 Prefix LM은 BERT와 “읽는 방식”만 같고, 학습 목표와 용도(생성)는 GPT·T5 쪽입니다. 굳이 비유하면 BERT처럼 읽고(prefix) GPT처럼 쓰는(target) 구조이고, 구조적으로는 Encoder–Decoder에 가장 가깝습니다.
T5 논문의 결론과 그 이후. T5 실험에서는 Encoder–Decoder가 가장 좋았고, Prefix LM은 그보다 조금 낮았으며, 순수 causal LM이 가장 낮았습니다. 입력을 양방향으로 보는 것이 분명히 도움이 된다는 뜻이고, 그래서 T5는 Encoder–Decoder를 택했습니다. 이후 UniLM(2019)은 한 모델에서 마스크만 바꿔 양방향·단방향·seq2seq(Prefix LM)를 함께 학습했고, UL2(2022)는 여러 denoising 목표 중 하나로 Prefix LM을 썼습니다. 다만 지금의 채팅 LLM은 대부분 순수 causal LM입니다. 모든 토큰에서 loss를 얻는 쪽이 학습 효율이 높고, 멀티턴 대화에서는 prefix 경계가 계속 뒤로 밀리기 때문입니다. Prefix LM에서는 새 턴이 오면 앞부분의 표현까지 바뀌어야 해서, 앞 토큰의 KV cache를 그대로 이어 쓰기 어렵습니다.
7. 학습·검증 데이터 샘플과 loss 계산 디테일
앞에서 “loss를 어디에 거는가”를 말로 설명했습니다. 이 절에서는 원천 데이터 한 줄이 실제 배치 텐서가 되고, 그 텐서에서 loss 숫자 하나가 나오기까지의 과정을 모델 계열별로 따라가 봅니다. 표의 토큰은 모두 실제 토크나이저(bert-base-uncased, bert-base-cased, gpt2, t5-small)로 뽑은 결과입니다.
7.1 공통 규칙: 위치별 Cross-Entropy와 -100
세 계열 모두 loss 계산 방식은 같습니다. 모델은 위치마다 vocab 크기의 점수(logit)를 내고, 정답이 있는 위치에서만 cross-entropy를 계산해 평균을 냅니다.
| 텐서 | 모양 | 의미 |
|---|---|---|
input_ids |
(B, T) | 모델에 들어가는 토큰 id |
attention_mask |
(B, T) | 1 = 실제 토큰, 0 = padding (어텐션에서 제외) |
logits |
(B, T, V) | 위치마다 vocab V개에 대한 점수 |
labels |
(B, T) | 위치마다 정답 토큰 id. -100이면 loss에서 제외 |
$N$은 라벨이 -100이 아닌 위치의 개수입니다. 즉 시퀀스 단위가 아니라 토큰 단위 평균입니다. 계열별 차이는 결국 labels의 어느 칸에 정답을 넣고 어느 칸을 -100으로 비우는가뿐입니다.
위치 하나에서의 계산 예시. vocab이 [Paris, Lyon, Rome] 세 개라고 하고, 어떤 위치의 logit이 [2.0, 1.0, 0.1], 정답이 Paris라고 해 봅시다.
1
2
softmax([2.0, 1.0, 0.1]) = [0.659, 0.242, 0.099]
loss = -log(0.659) = 0.417
정답 확률이 1에 가까워질수록 loss는 0에 가까워지고, 정답 확률이 낮을수록 loss가 커집니다.
1
2
3
4
5
6
7
8
9
import torch
import torch.nn.functional as F

logits = torch.tensor([[2.0, 1.0, 0.1]])            # (위치 1개, V=3)
print(F.cross_entropy(logits, torch.tensor([0])))   # tensor(0.4170)

# 실제 모델에서는 (B, T, V) → (B*T, V)로 펴고, -100 위치는 자동으로 제외
def token_ce(logits, labels):
    return F.cross_entropy(logits.reshape(-1, logits.size(-1)), labels.reshape(-1), ignore_index=-100)
검증(validation)은 두 가지로 봅니다.
- Validation loss: 학습과 똑같이 정답을 넣고(teacher forcing) gradient 없이 loss만 계산합니다. 언어모델에서는 이것을 Perplexity = exp(loss)로 바꿔서 보고하기도 합니다. “매 위치에서 평균적으로 몇 개의 후보 사이에서 헷갈리는가”로 해석할 수 있습니다.
- 태스크 지표: 실제로 예측(분류는 argmax, 생성은
generate)을 한 뒤 정답과 비교합니다. Accuracy, F1, Exact Match, BLEU, ROUGE 등이 여기에 해당합니다.
생성 모델에서는 두 값이 다르게 움직일 수 있습니다. validation loss는 정답 prefix를 보면서 다음 토큰을 맞히는 점수이고, 실제 생성은 자기가 만든 prefix 위에서 이어 쓰기 때문입니다(exposure bias). 그래서 생성 모델은 loss와 생성 지표를 함께 봅니다.
7.2 인코더 (BERT)
(1) 사전학습 데이터: 라벨 없는 원문
1
2
3
4
5
6
# 원천 데이터: 한 줄에 한 문장, 문서 사이는 빈 줄
my dog is hairy
he likes to play

the stock market fell sharply today
...
같은 문서에서 연속된 두 문장(IsNext) 또는 다른 문서의 문장(NotNext)을 뽑아 한 샘플을 만들고, 15%를 마스킹합니다. 아래는 hairy와 play가 선택된 경우입니다. hairy는 80% 규칙에 따라 [MASK]가 됐고, play는 10% 규칙에 따라 원래 토큰 그대로 남았지만 예측 대상입니다.
| 위치 | 원래 토큰 | input_ids (마스킹 후) |
token_type_ids |
labels |
|---|---|---|---|---|
| 0 | [CLS] |
[CLS] (101) |
0 | -100 |
| 1 | my |
my |
0 | -100 |
| 2 | dog |
dog |
0 | -100 |
| 3 | is |
is |
0 | -100 |
| 4 | hairy |
[MASK] (103) |
0 | 15892 (hairy) |
| 5 | [SEP] |
[SEP] (102) |
0 | -100 |
| 6 | he |
he |
1 | -100 |
| 7 | likes |
likes |
1 | -100 |
| 8 | to |
to |
1 | -100 |
| 9 | play |
play (그대로) |
1 | 2377 (play) |
| 10 | [SEP] |
[SEP] |
1 | -100 |
next_sentence_label = 0 (Hugging Face 규약에서 0이 IsNext)
- MLM loss:
logits(1, 11, 30522) 중 위치 4와 9의 두 칸에서만 CE를 계산해 평균합니다. - NSP loss: 위치 0(
[CLS])의 출력을 2-class 분류기에 넣어 CE를 계산합니다. - 전체 loss = MLM loss + NSP loss
- 검증: 따로 떼어 둔 문서에 같은 마스킹을 적용해 MLM loss(또는 마스크 위치 정확도)와 NSP 정확도를 봅니다. 사전학습 모델의 최종 품질은 결국 다운스트림 태스크 성능으로 평가합니다.
(2) 파인튜닝 데이터: 태스크별 라벨
1
2
3
4
5
6
7
8
9
10
11
// 문장 분류 (SST-2) — train.jsonl / valid.jsonl 같은 형식
{"sentence": "a gripping, funny and genuinely moving film", "label": 1}
{"sentence": "the plot is a mess and the acting is worse",   "label": 0}

// NER (CoNLL-2003 형식) — 단어 단위 태그
{"tokens": ["Euisuk", "Chung", "works", "at", "Google"], "ner_tags": ["B-PER", "I-PER", "O", "O", "B-ORG"]}

// 추출형 QA (SQuAD 형식) — 정답은 문단 안의 문자 위치
{"question": "Where is the Eiffel Tower?",
 "context": "The Eiffel Tower is a wrought-iron lattice tower in Paris, France.",
 "answers": {"text": ["Paris"], "answer_start": [52]}}
| 태스크 | labels 모양 |
loss | 검증 지표 |
|---|---|---|---|
| 문장 분류 | (B,) 문장당 정수 1개 | [CLS] logits (B, C)에 CE |
Accuracy, F1 (MNLI는 accuracy, STS-B는 Pearson/Spearman) |
| NER | (B, T) 토큰마다 태그 id | 태그가 있는 토큰 위치에서 CE | 엔티티 단위 F1 (seqeval) |
| 추출형 QA | start_positions (B,), end_positions (B,) |
(CE(start) + CE(end)) / 2 | Exact Match, F1 |
NER에서 서브워드 정렬. 태그는 단어 단위인데 BERT는 서브워드 단위로 자르므로, 각 단어의 첫 서브워드에만 태그를 주고 나머지와 특수 토큰은 -100으로 둡니다.
| 토큰 | [CLS] |
E |
##ui |
##su |
##k |
Chung |
works |
at |
Google |
[SEP] |
|---|---|---|---|---|---|---|---|---|---|---|
| word_id | – | 0 | 0 | 0 | 0 | 1 | 2 | 3 | 4 | – |
labels |
-100 | B-PER | -100 | -100 | -100 | I-PER | O | O | B-ORG | -100 |
QA에서 문자 위치를 토큰 위치로 변환. answer_start: 52는 문자 위치입니다. offset_mapping으로 토큰 위치로 바꾸면 [CLS] Where is the E ##iff ##el Tower ? [SEP] The E ##iff ##el Tower is a wrought - iron lattice tower in Paris , France . [SEP]에서 Paris는 23번 토큰이므로 start_positions = end_positions = 23이 됩니다.
7.3 디코더 (GPT)
(1) 사전학습 데이터: 문서를 이어 붙여 고정 길이로 자르기 (packing)
1
2
{"text": "I like cats."}
{"text": "Paris is in France."}
문서를 토큰화하고 문서 끝에 <|endoftext|>(아래 표에서는 <eos>)를 붙여 하나로 이어 붙인 뒤 길이 L 블록으로 자릅니다. padding이 없어 계산 낭비가 없습니다. 아래는 L = 5인 예입니다(남는 토큰은 버리거나 다음 배치로 넘깁니다).
1
2
3
이어 붙인 토큰: I | Ġlike | Ġcats | . | <eos> | Paris | Ġis | Ġin | ĠFrance | . | <eos>
블록 1        : I  Ġlike  Ġcats  .  <eos>
블록 2        : Paris  Ġis  Ġin  ĠFrance  .
블록 1의 input_ids와 labels는 같은 값입니다. 한 칸 shift는 모델(또는 loss 함수) 안에서 합니다.
| 위치 t | 0 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|---|
| 입력 토큰 | I |
Ġlike |
Ġcats |
. |
<eos> |
| 이 위치의 출력이 맞혀야 할 토큰 | Ġlike |
Ġcats |
. |
<eos> |
(없음) |
- 블록 길이가 L이면 L − 1개 위치에서 loss가 나옵니다. 배치 전체로는 B × (L − 1)개 위치의 평균입니다.
- 검증: 학습에 쓰지 않은 텍스트로 같은 loss를 계산하고 PPL로 봅니다. 예를 들어 GPT-2 small에
The capital of France is Paris.(7토큰 → 6개 위치)를 넣으면 평균 loss ≈ 3.80, PPL ≈ 44.6이 나옵니다.
(2) SFT 데이터: 대화 → 템플릿 → 프롬프트 마스킹
1
2
{"messages": [{"role": "user", "content": "What is the capital of France?"},
              {"role": "assistant", "content": "Paris."}]}
채팅 템플릿으로 한 시퀀스로 만든 뒤, 사용자 발화(프롬프트) 부분의 라벨은 -100으로 둡니다. 아래는 간단한 Q: … A: 템플릿을 GPT-2 토크나이저로 자른 결과입니다.
| 위치 | 0–11 | 12 | 13 | 14 |
|---|---|---|---|---|
| 입력 토큰 | Q : ĠWhat Ġis Ġthe Ġcapital Ġof ĠFrance ? Ċ A : |
ĠParis |
. |
<eos> |
labels |
-100 × 12 | 6342 | 13 | 50256 |
shift 후에는 위치 11(:), 12(ĠParis), 13(.)의 출력이 각각 ĠParis, ., <eos>를 맞히는 3개 위치에서만 loss가 계산됩니다. 모델은 질문을 읽기는 하지만, 질문을 생성하도록 학습되지는 않습니다.
- 배치 안의 길이를 맞추는 padding 위치도
labels = -100,attention_mask = 0입니다. GPT-2에는 pad 토큰이 없어서 보통pad_token = eos_token으로 둡니다. - 검증: 응답 토큰 기준 validation loss와 함께, 실제로 생성한 답을 정답과 비교합니다(Exact Match, 사람 평가, LLM-as-a-judge 등).
7.4 인코더–디코더 (T5, BART)
(1) 사전학습 데이터: 5.2절의 span corruption 예시가 그대로 한 샘플입니다(inputs는 Encoder로, targets는 labels로).
(2) 파인튜닝 데이터: source / target 쌍
1
2
3
// train.jsonl / valid.jsonl
{"source": "summarize: The cat sat on the mat all day.", "target": "A cat rested."}
{"source": "translate English to German: That is good.", "target": "Das ist gut."}
| 토큰 (t5-small) | |
|---|---|
Encoder input_ids |
▁summarize : ▁The ▁cat ▁ s at ▁on ▁the ▁mat ▁all ▁day . </s> |
labels |
▁A ▁cat ▁reste d . </s> |
labels만 넘기면 모델이 내부에서 오른쪽으로 한 칸 밀어 decoder_input_ids를 만듭니다. T5는 시작 토큰으로 <pad>를 씁니다.
| Decoder 위치 t | 0 | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|---|
decoder_input_ids |
<pad> |
▁A |
▁cat |
▁reste |
d |
. |
labels (이 위치의 정답) |
▁A |
▁cat |
▁reste |
d |
. |
</s> |
- GPT와 달리 입력과 라벨의 위치가 이미 맞춰져 있습니다(shift를 decoder 입력 쪽에서 했기 때문). 위치 t의 logits를
labels[t]와 바로 비교합니다. - loss는 target의 6개 위치 평균입니다. Encoder 입력 토큰에는 loss가 없습니다.
- 배치 안에서 target 길이가 다르면
labels의 padding을-100으로 바꿔야 합니다. 토크나이저는 pad id(T5는 0)로 채우므로,DataCollatorForSeq2Seq를 쓰거나 직접 바꿔 줍니다. - 검증: (a) teacher forcing으로 계산한 validation loss, (b)
generate()(보통 beam search)로 만든 출력을 reference와 비교한 ROUGE(요약), BLEU(번역), Exact Match(QA)를 함께 봅니다.
7.5 한눈에 비교
| 인코더 (BERT) | 디코더 (GPT) | 인코더–디코더 (T5) | |
|---|---|---|---|
| 사전학습 원천 샘플 | my dog is hairy / he likes to play |
{"text": "I like cats."} |
{"text": "Thank you for inviting me ..."} |
| 모델 입력 | 마스킹된 문장쌍 | 이어 붙인 블록 | Enc: 손상 문장 / Dec: shift된 target |
labels |
마스킹 위치만 원래 토큰, 나머지 -100 | input_ids와 동일 (내부 shift) |
sentinel + 가린 span |
| loss가 계산되는 위치 | 약 15% + [CLS](NSP) |
블록의 L − 1개 전부 | target 전체 |
| 파인튜닝 원천 샘플 | {"sentence", "label"} |
{"messages": [...]} |
{"source", "target"} |
| 파인튜닝 loss 위치 | [CLS] 1개 / 토큰별 태그 / start·end |
응답 토큰만 | target 전체 |
| 주요 검증 지표 | Accuracy, F1, EM | Val loss, PPL, 생성 품질 | Val loss, ROUGE, BLEU, EM |
세 계열에 모두 쓸 수 있는 검증 루프
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
import math
import torch

@torch.no_grad()
def evaluate(model, loader, causal_lm=False):
    """토큰 가중 평균 validation loss와 perplexity."""
    model.eval()
    total_loss, total_tokens = 0.0, 0
    for batch in loader:                          # batch: input_ids, attention_mask, labels (+ 필요한 키)
        out = model(**batch)                      # labels를 넘기면 out.loss = 위 수식의 토큰 평균 CE
        labels = batch["labels"][:, 1:] if causal_lm else batch["labels"]   # 디코더는 내부 shift로 첫 라벨이 빠짐
        n = (labels != -100).sum().item()         # 실제로 loss에 들어간 토큰 수
        total_loss += out.loss.item() * n         # 배치별 평균 → 토큰 수로 가중해서 합산
        total_tokens += n
    loss = total_loss / total_tokens
    return loss, math.exp(loss)                   # (val loss, perplexity)
배치마다 유효 토큰 수가 다르기 때문에 out.loss를 단순 평균하면 안 되고 토큰 수로 가중해야 정확합니다. gradient accumulation을 할 때도 같은 이유로 주의가 필요합니다.
8. 인코더와 디코더가 문제를 푸는 방식의 차이
학습이 끝난 뒤 추론할 때 문제를 푸는 방식도 다릅니다.
| 인코더 (BERT) | 디코더 (GPT) | 인코더–디코더 (T5, BART) | |
|---|---|---|---|
| forward 횟수 | 1회 | 생성 토큰 수만큼 반복 | Encoder 1회 + Decoder 반복 |
| 출력 형태 | 위치별 벡터 → head (클래스, 태그, span 위치) | 텍스트 (한 토큰씩) | 텍스트 (한 토큰씩) |
| 답의 공간 | 미리 정한 라벨 집합 또는 입력 안의 구간 | 열린 vocab 시퀀스 | 열린 vocab 시퀀스 |
| 새 태스크 적용 | head를 붙여 파인튜닝 | 프롬프트만 바꿈 (few-shot) 또는 SFT | prefix/지시문 + 파인튜닝 |
| 대표 문제 | 분류, NER, 추출형 QA, 임베딩·검색 | 대화, 코드, 범용 생성, 추론 | 번역, 요약, 생성형 QA |
| 속도 | 빠름 (병렬, 한 번) | 출력 길이에 비례 (KV cache로 가속) | 중간 |
인코더: 한 번의 forward로 끝
1
2
3
4
5
6
7
8
9
10
import torch
from transformers import AutoTokenizer, AutoModelForSequenceClassification

name = "distilbert/distilbert-base-uncased-finetuned-sst-2-english"
tok = AutoTokenizer.from_pretrained(name)
model = AutoModelForSequenceClassification.from_pretrained(name)

with torch.no_grad():
    logits = model(**tok("this movie was surprisingly good", return_tensors="pt")).logits   # (1, 2)
print(model.config.id2label[logits.argmax(-1).item()])   # POSITIVE — forward 한 번 + argmax
- 문장 전체를 한 번에 넣고 한 번 계산하면
[CLS]위치에서 클래스 점수 2개(NEGATIVE, POSITIVE)가 나옵니다. 반복이 없으므로 출력 길이와 관계없이 비용이 일정합니다. id2label은 클래스 번호를 이름으로 바꾸는 표입니다. 파인튜닝할 때 모델 설정에 저장해 둔 값입니다.
디코더: 한 토큰씩 반복 + KV cache
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

tok = AutoTokenizer.from_pretrained("openai-community/gpt2")
model = AutoModelForCausalLM.from_pretrained("openai-community/gpt2")

ids = tok("The capital of France is", return_tensors="pt").input_ids
past = None
with torch.no_grad():
    for _ in range(10):
        # 첫 step은 프롬프트 전체, 이후에는 새 토큰 하나만 넣고 앞 토큰의 K/V는 cache에서 재사용
        out = model(input_ids=ids if past is None else ids[:, -1:], past_key_values=past, use_cache=True)
        past = out.past_key_values
        next_id = out.logits[:, -1, :].argmax(-1, keepdim=True)   # 마지막 위치의 분포만 사용 (greedy)
        ids = torch.cat([ids, next_id], dim=-1)
        if next_id.item() == tok.eos_token_id:
            break
print(tok.decode(ids[0]))
# The capital of France is the capital of the French Republic, and the capital
# (GPT-2 small + greedy라 반복적인 출력이 나옵니다)
- 첫 step: 프롬프트 5토큰을 전부 넣습니다. 이때 각 층의 어텐션이 계산한 Key와 Value가
past_key_values에 저장됩니다. GPT-2 small은 12개 층마다 K, V가 각각 (배치 1, head 12, 토큰 5, 64차원) 모양으로 쌓입니다. - 두 번째 step부터:
ids[:, -1:], 즉 방금 만든 토큰 하나만 넣습니다. 새 토큰의 Query는 cache에 저장된 앞 토큰들의 K, V와 어텐션을 계산하고, 자기 K, V를 cache 뒤에 추가합니다. - 왜 가능한가: causal mask 때문에 앞 토큰의 표현은 뒤에 어떤 토큰이 오든 바뀌지 않습니다. 그래서 한 번 계산한 K, V를 계속 재사용할 수 있습니다. cache가 없으면 매 step 전체 시퀀스를 처음부터 다시 계산해야 합니다.
argmax: greedy decoding입니다. GPT-2 small에 greedy를 쓰면 위처럼 같은 말을 반복하기 쉬워서, 실제로는 4.5절의 샘플링이나 반복 억제 옵션을 함께 씁니다.- 종료 조건:
<|endoftext|>(eos)가 나오거나 최대 step 수에 도달하면 멈춥니다.
인코더–디코더: Encoder는 한 번, Decoder는 반복
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
import torch
from transformers import AutoTokenizer, T5ForConditionalGeneration

tok = AutoTokenizer.from_pretrained("google-t5/t5-small")
model = T5ForConditionalGeneration.from_pretrained("google-t5/t5-small")

enc_in = tok("translate English to German: That is good.", return_tensors="pt")
with torch.no_grad():
    enc_out = model.get_encoder()(**enc_in)                      # 원문은 한 번만 인코딩
    dec_ids = torch.tensor([[model.config.decoder_start_token_id]])
    for _ in range(20):
        out = model(encoder_outputs=enc_out, attention_mask=enc_in.attention_mask,
                    decoder_input_ids=dec_ids)                   # Decoder는 cross-attn으로 enc_out 참조
        next_id = out.logits[:, -1].argmax(-1, keepdim=True)
        dec_ids = torch.cat([dec_ids, next_id], dim=-1)
        if next_id.item() == tok.eos_token_id:
            break
print(tok.decode(dec_ids[0], skip_special_tokens=True))          # Das ist gut.
get_encoder(): Encoder만 떼어서 원문을 한 번 인코딩합니다. 결과enc_out은 원문 토큰마다의 벡터이고, 반복하는 동안 계속 재사용합니다.decoder_start_token_id: T5는<pad>(id 0)로 Decoder를 시작합니다. 학습 때decoder_input_ids맨 앞에 넣었던 토큰과 같습니다(5.2절).encoder_outputs=enc_out: 이미 계산한 Encoder 출력을 넘기면 모델이 Encoder를 다시 돌리지 않고 Decoder만 계산합니다.attention_mask는 cross-attention에서 원문의 pad를 가리는 데 쓰입니다.- 반복: 매 step Decoder 입력 전체(
dec_ids)를 넣고 마지막 위치의 분포에서 다음 토큰을 고릅니다.</s>가 나오면 멈춥니다.
(설명을 위해 Decoder 쪽 KV cache는 생략했습니다. 실제로는 model.generate()가 cache와 beam search를 모두 처리해 줍니다.)
디코딩 전략 요약
| 전략 | 방식 | 특징 |
|---|---|---|
| Greedy | 매 step 최고 확률 토큰 선택 | 빠르지만 반복적인 출력이 나오기 쉬움 |
| Beam search | 상위 k개 후보 시퀀스를 유지 | 번역·요약처럼 정답이 비교적 정해진 태스크에 적합 |
| Top-k / Top-p 샘플링 | 상위 k개 또는 누적확률 p 안에서 샘플링 | 다양하고 자연스러운 생성, 대화·창작에 적합 |
| Temperature | softmax 전에 logits를 T로 나눔 | T < 1이면 보수적, T > 1이면 다양한 출력 |
정리
| Transformer | BERT | GPT | BART | T5 | |
|---|---|---|---|---|---|
| 구조 | Enc–Dec | Enc | Dec | Enc–Dec | Enc–Dec |
| 한 줄 요약 | 어텐션만으로 seq2seq | 가려진 단어를 양방향으로 맞히기 | 다음 단어 맞히기를 스케일업 | 망가진 문서를 통째로 복원 | 가린 span만 생성, 모든 태스크를 text-to-text로 |
| 핵심 기여 | Self-attention, 병렬 학습 | Deep bidirectional, 사전학습–파인튜닝 정착 | 생성형 사전학습, zero/few-shot, ICL | 임의 노이즈 denoising seq2seq | 통합 프레임워크, 대규모 체계적 비교, C4 |
| 입력 → 출력 | 원문 → 번역문 | 마스크된 문장 → 위치별 벡터 | 텍스트 → 다음 토큰 | 손상 문서 → 원문 | 손상 문장 → sentinel + span |
| loss 위치 | Decoder 전체 | 마스크 위치(15%) + [CLS] |
전체 토큰 | Decoder 전체(원문 길이) | Decoder 전체(짧은 타깃) |
| 강점 | 번역 | 분류, 추출, 임베딩 | 생성, 범용 | 요약, 생성 | 멀티태스크, 생성 |
정리하면 다음과 같습니다.
- Transformer가 뼈대를 만들었습니다(Encoder + Decoder + attention).
- BERT는 Encoder만 떼어서 “이해”를 위한 사전학습 방법(MLM)을 만들었습니다.
- GPT는 Decoder만 떼어서 “다음 토큰 예측” 하나로 스케일을 키웠고, 이것이 지금의 LLM으로 이어졌습니다.
- BART와 T5는 다시 Encoder–Decoder로 돌아가 두 장점을 합쳤습니다.
스스로 점검해 볼 질문
- BERT가 양방향 어텐션에서 “다음 토큰 예측”을 쓸 수 없는 이유는 무엇이고, MLM은 이를 어떻게 피하나요? 그 대가는 무엇인가요?
- Transformer 학습에서 teacher forcing과 causal mask가 없으면 학습 속도와 정보 누설 측면에서 각각 무엇이 달라지나요?
- 같은 문장
Thank you for inviting me to your party last week.에 대해 BERT, BART, T5 각각의 Encoder 입력과 정답(label)을 직접 써 보세요. - BART는 분류 문제에서 왜 Decoder의 마지막 토큰 표현을 쓰나요? 첫 토큰을 쓰면 어떤 문제가 생기나요?
- GPT의 SFT에서 프롬프트 토큰을 loss에서 제외하는 이유는 무엇일까요?
- 추론 비용 관점에서 분류 문제를 BERT로 풀 때와 GPT에 프롬프트로 풀 때 어떤 차이가 있나요?
- 7.3절의 SFT 샘플에서 loss가 계산되는 위치는 몇 개이고, 각 위치의 출력은 어떤 토큰을 맞혀야 하나요? T5의 같은 태스크 샘플과 비교하면 shift가 어디서 일어나나요?
- BART는 입력을 크게 망가뜨려도 왜 학습이 무너지지 않나요? 반대로 가리는 비율을 90%로 올리면 어떤 일이 생길까요?
참고 문헌
- Vaswani et al., Attention Is All You Need, NeurIPS 2017.
- Devlin et al., BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding, NAACL 2019.
- Radford et al., Improving Language Understanding by Generative Pre-Training, OpenAI 2018.
- Radford et al., Language Models are Unsupervised Multitask Learners, OpenAI 2019.
- Brown et al., Language Models are Few-Shot Learners, NeurIPS 2020.
- Ouyang et al., Training language models to follow instructions with human feedback, NeurIPS 2022.
- Lewis et al., BART: Denoising Sequence-to-Sequence Pre-training for Natural Language Generation, Translation, and Comprehension, ACL 2020.
- Raffel et al., Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer, JMLR 2020.
- Liu et al., RoBERTa: A Robustly Optimized BERT Pretraining Approach, 2019.