논문 개요와 전체 구조
시계열 이상탐지에서는 정상 데이터보다 이상 데이터의 확보가 어렵습니다. 발전량이나 교통량을 오래 관측해도 장애·급격한 변화 사례는 적을 수 있고, 심전도처럼 이상 형태가 다양한 데이터에서는 몇 개의 사례만으로 전체 분포를 배우기 어렵습니다. CAST는 주변의 정상 문맥과 생성하려는 이상 형태를 서로 다른 조건으로 제공해, 이상 구간을 합성하는 방법입니다. 생성한 데이터가 원본과 비슷한지뿐 아니라, 그 데이터로 학습한 검출기가 실제 이상을 잘 찾는지까지 평가합니다.
핵심 구성은 VQ-VAE로 얻은 이산적 이상 구조 표현, rectified flow matching 생성기, 그리고 정상·이상 데이터를 활용하는 두 단계 학습입니다. 처음에는 정상 문맥을 별도로 제공하지 않고 잠재 표현과 전체 신호의 대응을 배우고, 이후에는 정상 문맥을 유지하면서 이상 구간을 생성하도록 미세조정합니다. 같은 문맥에서도 다른 이상 형태를 만들고, 같은 이상 구조를 다른 문맥에 맞춰 변형하는 것이 연구의 중심입니다. 시계열의 희소한 이상 사례, 생성 모델의 조건 설계, 합성 데이터의 학습 효용을 함께 다룬다는 점에서 데이터과학 관점의 학습 가치가 있습니다.
이 리뷰는 arXiv 2609.27825v1의 본문과 부록을 포함한 24쪽을 기준으로 합니다. 초록 페이지의 제출일 표기는 2026년 8월 19일이며, 이번 수집에서 관측한 RSS 발표 묶음은 2026년 9월 24일입니다. 두 날짜를 같은 의미로 취급하지 않습니다. 원문은 심사 중인 preprint로 표시되어 있습니다. 저자의 포괄적인 성능 주장과 개별 표의 예외는 아래에서 구분합니다. 버전 고정 원문
원문의 구조는 다음과 같습니다.
| 순서 | 원문 구성 | 읽을 때의 중심 질문 |
|---|---|---|
| 1 | Introduction | 왜 정상 문맥만으로는 이상 형태를 충분히 제어하기 어려운가? |
| 2 | Preliminaries: 2.1 VQ-VAE, 2.2 Rectified Flow Matching | 이산 표현과 연속 생성 과정을 어떻게 결합하는가? |
| 3 | Method: 3.1 확률 모델링, 3.2 두 단계 학습, 3.3 조건부 생성 | 문맥과 이상 구조가 학습·추론에 각각 어디로 들어가는가? |
| 4 | Experiments: 설정, 주요 결과, ablation, 정성 분석 | 생성 충실도와 실제 검출 효용이 함께 좋아지는가? |
| 5 | Related Works: 이상 생성, 이상탐지, 일반 시계열 생성 | CAST가 기존 계열에서 바꾼 설계는 무엇인가? |
| 6 | Conclusion | 실험에서 얻은 결론과 저자가 제시한 확장은 무엇인가? |
| 후속 | Acknowledgment, References | 연구 지원과 인용 문헌의 범위는 무엇인가? |
| A–C | Datasets, More Implementation Details, Anomaly Detector Implementation Details | 데이터와 비교 모델·검출기는 어떻게 구성했는가? |
| D | Theoretical Analysis | 구조 표현을 조건으로 추가하는 이유를 어떻게 설명하는가? |
| E | More Experiment results | 단순 증강·다변량 ECG·잠재 공간 분석은 무엇을 보완하는가? |
| F–G | Limitations, Impact Statement | 저자가 명시한 한계와 영향 범위는 무엇인가? |
핵심 기여와 혁신성
첫째, 데이터 부족과 형태의 다양성을 별개의 문제로 다룹니다. 이상 데이터가 적다는 문제는 정상 데이터를 함께 사용해 완화할 수 있지만, 동일한 정상 문맥에 여러 종류의 이상이 나타나는 현상은 데이터량만 늘린다고 해결되지 않습니다. 저자는 문맥만 조건으로 제공하면 서로 다른 형태가 평균화될 수 있다는 문제의식을 제시합니다. 이 설명은 CAST의 설계 동기이며, 모든 문맥 조건부 생성기가 반드시 단봉 분포만 표현한다는 일반적인 수학 정리로 읽어서는 안 됩니다.
둘째, 이상 구조를 명시적인 생성 조건으로 만듭니다. VQ-VAE가 실제 이상 사례에서 추출한 잠재 코드를 생성기에 전달합니다. 문맥은 이상이 놓이는 정상 동작을, 잠재 코드는 이상 형태를 지정하는 역할을 맡습니다. 추론 시에는 관측된 이상에서 얻은 표현과 정상 데이터에서 가져온 문맥을 조합합니다. 따라서 기본 절차는 아무 이상 사례도 보지 않는 무조건적 신종 이상 생성과는 구별됩니다.
셋째, 표현을 사용할 준비를 한 뒤 문맥 조건부 생성으로 전환합니다. 정상·이상 혼합 데이터에서 잠재 코드와 시간적 패턴의 대응을 먼저 배운 후, 이상 데이터에서 문맥과 구조를 함께 조건으로 사용하는 방식입니다. 구조 조건만 추가했을 때보다 사전학습과 결합했을 때 효과가 커지는 ablation이 이 설계의 실험적 근거입니다.
넷째, 생성 평가를 검출 학습으로 연결합니다. 다섯 데이터셋에서 생성 오차와 분포 지표를 비교하고, 일곱 검출기를 합성 데이터로 학습한 뒤 실제 데이터에서 F1을 측정합니다. 데이터셋별 검출기 평균 F1은 모두 CAST가 가장 높지만, 개별 지표·검출기에는 예외가 있습니다. 기여를 이해할 때는 이 평균적 효용과 모든 조건에서의 우위를 구분해야 합니다. §1, §3–4
기술적 세부사항
CAST의 입력은 길이 $T$, 채널 수 $C$인 시계열과 이상 위치를 표시한 이진 마스크입니다. 마스크가 1인 위치가 생성할 이상 구간이며, 나머지 관측값은 정상 문맥으로 사용합니다. 문맥 전체를 새로 합성하는 것보다, 정상 문맥과 일관된 이상 부분을 채우는 문제로 정식화합니다.
VQ-VAE는 연속적인 입력을 코드북의 이산 항목으로 바꿉니다. 구현에서는 코드북 크기가 500이고, 한 시계열을 임베딩 차원 8의 코드 네 개로 나타냅니다. 생성기는 FlowTS에 기반한 encoder–decoder Transformer로, encoder와 decoder가 각각 4개 층이고 hidden dimension은 64, attention head는 4개입니다. 연속 시간과 이상 구조 표현은 adaptive normalization으로 주입합니다. 부록 B, PDF 15쪽
학습의 핵심은 노이즈에서 데이터로 이동하는 속도장을 회귀하는 것입니다. 학습 시간 $t$는 시계열 자체의 관측 시각이 아니라, 노이즈 상태에서 완성된 데이터 상태로 이동하는 생성 과정의 진행도입니다. 이 구분을 놓치면 시계열의 시간축과 flow의 시간축을 혼동하기 쉽습니다. 핵심 수식과 구현 흐름은 원문 순서에 따라 다음 챕터 리뷰에서 연결합니다.
평가는 서로 다른 세 층위로 구성됩니다. MSE·MAE는 이상 구간의 점별 오차, FID·KID·MMD는 분포 유사성, 검출 F1은 생성 데이터를 학습에 사용했을 때의 효용입니다. 앞의 두 층위에서 작은 값이 좋고, F1에서는 큰 값이 좋습니다. 낮은 생성 오차가 어떤 검출기에서도 높은 F1을 보장하는 관계는 아니므로, 세 층위를 함께 읽어야 합니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
챕터의 위치와 역할: 정상 시계열 생성이 활발히 연구되어 온 배경에서 출발해, 왜 이상 시계열 생성에는 다른 조건 설계가 필요한지 설명합니다.
저자의 서술 순서를 따른 상세 내용: 먼저 시계열 생성이 시뮬레이션·데이터 증강·표현 학습을 지원한다는 맥락을 소개합니다. 정상 데이터는 장기 관측으로 풍부하게 쌓일 수 있지만, 이상 데이터는 드물고 수집 비용이 높습니다. 저자는 이런 상황에서 정상 신호를 더 만드는 것의 한계효용보다, 관측하기 어려운 이상을 합성하는 가치에 주목합니다.
이어서 희소한 이상 사례만으로 생성기를 학습하면 과적합 위험이 커진다는 문제를 제시합니다. C-GATS의 VAE 기반 사전학습–미세조정 접근은 정상 데이터를 활용할 수 있음을 보여 준 선행 사례입니다. CAST는 이 발상을 이어받되, 그것만으로 이상 형태의 다양성이 충분히 설명되지는 않는다고 봅니다.
다음 논점은 비슷한 정상 문맥에서 서로 다른 이상이 나타날 수 있다는 점입니다. 예컨대 문맥을 지정해도 이상 구간의 구체적인 모양을 결정하는 요인이 모두 관측되지는 않을 수 있습니다. 저자는 잠재 공간에 단순한 무작위 변형을 주는 방식과, 이상 구조를 명시적으로 조건화하는 방식을 구분합니다. Figure 1에서는 실제 이상에서 구조 표현을 추출하고 정상 문맥과 함께 생성기에 전달하는 전체 개념을 보여 줍니다.
마지막으로 CAST의 세 기여를 정리합니다. 두 가지 문제의 구분, 문맥·구조 조건부 생성과 두 단계 학습, 그리고 다양한 실제 데이터에 대한 생성·검출 실험입니다. 이 단계의 “일관된 우수성”이라는 표현은 뒤의 표에서 적용 범위를 확인할 저자 주장입니다.
챕터의 핵심 기여: 데이터 수량과 형태 조건을 분리해 생각하도록 문제를 재구성합니다. 다음 챕터로의 연결: 이산 구조 표현과 연속적인 시계열 생성에 필요한 두 구성 요소를 정의합니다. §1
📖 Chapter 2: Preliminaries
챕터의 위치와 역할: VQ-VAE와 rectified flow matching의 기본 연산을 제시해, 이후 CAST의 조건부 생성 수식을 이해할 기반을 마련합니다.
2.1 Vector Quantized Variational Autoencoder
VQ-VAE의 encoder는 입력 $x$를 연속 잠재 표현 $z_e$로 변환합니다. quantizer는 학습 가능한 코드북에서 가장 가까운 항목을 선택하고, decoder는 선택된 표현에서 입력을 복원합니다.
$e_k$는 코드북의 $k$번째 벡터이고, $z_q$는 양자화된 표현입니다. 가장 가까운 벡터를 고른다는 점에서 구조를 유한한 코드 집합으로 표현합니다. 학습 손실은 다음 세 항으로 구성됩니다.
첫 항은 신호 복원 오차입니다. 두 번째 항은 encoder 출력을 향해 코드북 벡터를 학습시키고, 세 번째 commitment 항은 encoder 표현이 선택한 코드에서 지나치게 벗어나지 않도록 합니다. $\mathrm{sg}$는 해당 값의 역전파를 멈추는 stop-gradient이며, $\beta$는 commitment 항의 가중치입니다. CAST에서는 이렇게 학습한 표현을 생성기에 전달하는 구조 조건으로 사용합니다.
2.2 Rectified Flow Matching
rectified flow는 단순한 분포의 표본 $x_0$을 실제 데이터 $x_1$로 운반하는 속도장 $v_\theta$를 학습합니다. 생성은 다음 미분방정식을 적분하는 과정입니다.
학습에서는 두 끝점을 선형으로 연결한 경로와 그 미분을 사용합니다.
$t=0$은 노이즈 쪽, $t=1$은 데이터 쪽 끝점입니다. $v_t^*$는 특정 노이즈–데이터 표본 쌍의 목표 속도이며, 모델은 여러 쌍에서 이 속도를 예측하도록 학습합니다. 이 목적함수는 생성 결과를 한 번에 직접 회귀하는 방식과 달리, 중간 상태에서 어느 방향으로 이동할지를 학습합니다.
챕터의 핵심 기여: 코드북 기반 조건 표현과 속도 회귀 기반 생성이라는 두 역할을 분명히 합니다. 다음 챕터로의 연결: 두 구성 요소에 정상 문맥과 이상 마스크를 결합합니다. §2
📖 Chapter 3: Method
챕터의 위치와 역할: 문제를 확률적으로 정의한 뒤, 사전학습·미세조정·추론에 이 정의를 구현합니다.
3.1 Probabilistic Modeling
저자는 다변량 시계열 $X\in\mathbb R^{T\times C}$와 시간축 이진 마스크 $M\in\{0,1\}^T$를 사용합니다. 마스크는 채널에 걸쳐 적용되며, 원소별 곱 $\circ$로 이상 구간과 정상 문맥을 나눕니다.
마스크 밖의 이상 구간 표현과 마스크 안의 정상 문맥 표현은 각각 0이 됩니다. 전체 시계열을 두 부분으로 나눈 표기이며, 구간 길이가 다른 텐서를 단순히 이어 붙이는 정의가 아닙니다.
문맥만 사용하는 모델은 $p(X_{\mathrm{ano}}\mid X_{\mathrm{ctx}})$를 학습합니다. CAST는 문맥만으로 설명되지 않는 이상 구조를 이상적인 잠재 변수 $Z$로 나타내고, 다음 혼합 형태로 문제를 표현합니다.
원문의 혼합 가중치는 $p(z)$로 표기되어 있습니다. 실제 모델이 관측할 수 없는 oracle 구조 $Z$를 직접 받는 것은 아닙니다. VQ-VAE로 추론한 표현 $U$를 대신 사용해 $p_\theta(X_{\mathrm{ano}}\mid X_{\mathrm{ctx}},U)$를 학습합니다. 이 차이는 부록 D의 이론에서 다시 중요해집니다. §3.1
3.2 Pretraining-Finetuning Strategy
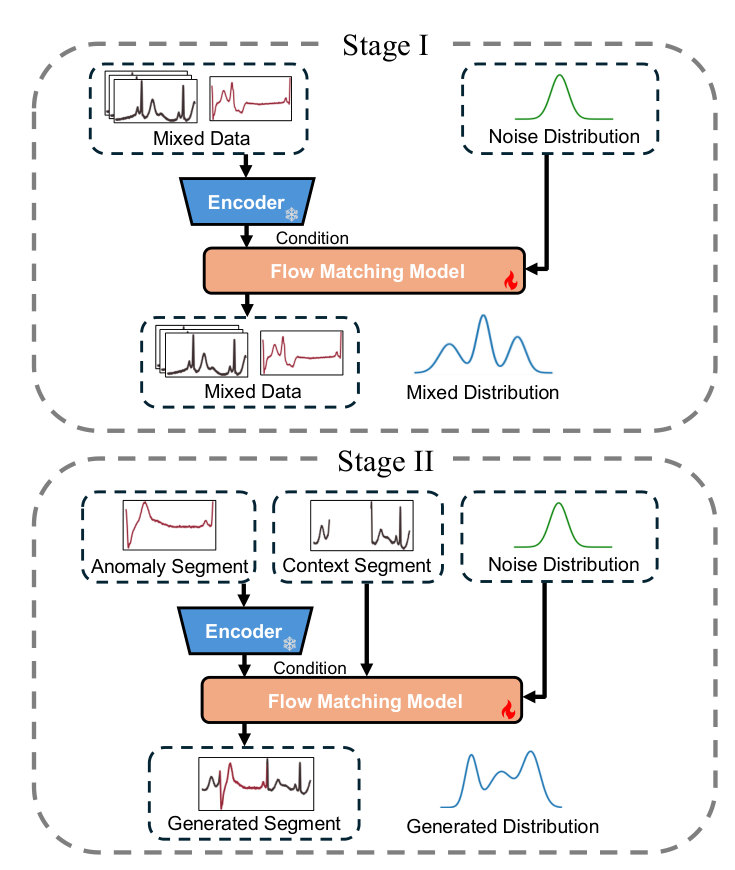
Figure 2, PDF 4쪽. 원문 그림 영역을 크롭했으며 내부 글자는 번역하지 않았습니다. 2609.27825v1 원문
Stage I: Context-unaware Pretraining. 먼저 VQ-VAE를 학습하고, 그 표현 $U$를 조건으로 전체 신호 분포 $p_\theta(X\mid U)$를 배웁니다. 중요한 점은 정상 데이터만으로 사전학습하는 절차가 아니라 정상·이상 혼합 데이터를 사용하는 절차라는 것입니다. “context-unaware”도 아무 조건이 없다는 뜻이 아닙니다. 정상 문맥을 별도 조건으로 사용하지 않을 뿐, 잠재 표현은 계속 입력됩니다. 이 단계의 목적은 충분한 데이터에서 구조 코드와 일관된 시간 패턴의 대응을 먼저 형성하는 것입니다.
Stage II: Context-aware Finetuning. 이후에는 정상 문맥과 구조 표현을 함께 제공해 이상 구간의 조건부 분포를 학습합니다. 정상 문맥에 맞는 세부 변형을 하면서도, 구조 코드가 지정하는 형태를 유지하도록 목적을 좁힙니다. 두 단계는 전체 신호의 패턴을 배우는 문제와, 주어진 문맥 안의 이상 부분을 만드는 문제를 순차적으로 연결합니다. §3.2
3.3 Context- and Anomaly Structure-Conditional Generation
조건부 속도장은 $v_\theta(X_t,U,X_{\mathrm{ctx}},t)$입니다. 학습 경로는 정상 문맥을 그대로 더하고, 이상 구간에만 노이즈와 실제 이상 신호를 보간합니다.
$X_0$은 노이즈 표본, $Y$는 목표 속도입니다. 마스크가 0인 정상 위치에서는 $X_t$가 정상 문맥에 머무르고 목표 속도는 0입니다. 마스크가 1인 위치에서는 노이즈가 실제 이상 신호로 이동합니다. 저자가 제시한 목적함수는 다음과 같습니다.
여기에는 서술과 수식 사이에서 확인해야 할 차이가 있습니다. 본문은 이상 구간에서만 손실을 계산한다고 설명하지만, 표시된 식과 Algorithm 1의 손실에는 잔차 전체에 마스크를 곱하는 연산이 명시되어 있지 않습니다. 목표 $Y$가 마스킹되었다는 사실만으로 정상 구간의 예측 속도 오차가 손실에서 제외되지는 않습니다. 위 식을 임의로 수정하지 않았으며, 공개된 표기만으로 실제 구현의 손실 마스킹을 확정하지 않습니다.
추론에서는 실제 이상 사례에서 구조 표현을 얻고, 정상 데이터에서 문맥과 생성할 위치를 고릅니다. 초기 상태를 $X_{\mathrm{ctx}}+\varepsilon\circ M$으로 놓고 $t=0$부터 $1$까지 ODE를 적분합니다. 저자의 의도는 정상 문맥을 보존하는 생성이지만, Algorithm 2에는 적분 중 정상 구간을 매 단계 다시 고정하는 절차도 별도로 적혀 있지 않습니다. 설명된 목적과 의사코드에서 직접 확인되는 연산을 구분할 필요가 있습니다.
또한 Algorithm 1은 $u=E(x_{\mathrm{ano}})$를 사용하지만, Algorithm 2는 이상 구간 $\tilde{x}_{\mathrm{ano}}$를 만든 다음 $u=E(\tilde{x})$라고 표기합니다. §3.3의 “이상 구간에서 표현 추출”이라는 설명과 입력 표기가 다릅니다. 이것을 리뷰어가 하나의 구현으로 통일하지 않고 원문의 모호성으로 남깁니다. §3.3 및 Algorithm 1–2, PDF 16쪽
챕터의 핵심 기여: 정상 문맥과 구조 코드를 결합하는 학습 경로를 제시합니다. 다음 챕터로의 연결: 이 조건 설계가 생성 충실도와 검출 학습에 어떤 차이를 만드는지 평가합니다.
📖 Chapter 4: Experiments
챕터의 위치와 역할: 전체 모델 비교에서 시작해 구성 요소의 효과와 생성 제어의 정성적 증거를 순차적으로 제시합니다.
4.1 Experimental Setup
주 실험은 MIT-DB, SVDB, QTDB의 세 ECG 데이터셋과 PV 발전량, Metro 교통량의 다섯 데이터셋을 사용합니다. 저자는 전자를 강한 이상, 후자를 약한 이상 설정으로 구분합니다. 이런 분류는 이 논문의 실험 맥락이며 모든 ECG·발전량 데이터에 대한 보편적 정의는 아닙니다.
비교 대상은 이상 생성용 GenIAS·C-GATS와 일반 시계열 생성용 Diffusion-TS·FlowTS·TimeVAE입니다. 일반 생성 모델도 CAST와 같은 마스크·문맥·데이터 분할을 사용하도록 이상 구간 채우기 문제에 맞춰 조정합니다. GenIAS와 C-GATS는 저자가 원 논문의 설계와 설정을 따라 재구현했습니다. 따라서 비교 결과는 이 논문의 재현·적응된 설정에 대한 결과입니다.
생성 평가의 MSE·MAE는 이상 구간에서만 계산합니다. 정상 구간의 많은 위치가 일치해 전체 오차가 작아지는 효과와 구별하기 위한 선택입니다. 검출 평가는 합성 이상을 이용해 학습한 모델을 실제 테스트 데이터에 적용하는 방식이며, Random Forest, CatBoost, Robust-TAD, TCN, MOMENT, OneFitsAll, LTSM의 일곱 모델을 사용합니다. 별도 언급이 없으면 다섯 번 실행한 평균을 보고합니다. §4.1
4.2 Main Results
Table 1의 생성 결과는 대체로 CAST에 유리하지만 세부 지표의 예외가 있습니다. 아래 표는 단위를 실제 값으로 환산해 주요 비교를 정리한 것입니다. 모든 값은 작을수록 좋습니다.
| 데이터·지표 | CAST | 비교 대상 | 해석 |
|---|---|---|---|
| MIT-DB MSE | 0.0029 | C-GATS 0.0045 | 해당 지표의 차선 대비 약 35.6% 감소 |
| SVDB MSE | 0.0043 | Diffusion-TS 0.0091 | 해당 지표의 차선 대비 약 52.7% 감소 |
| QTDB MSE | 0.0022 | FlowTS 0.0037 | 점별 오차는 CAST가 낮음 |
| QTDB FID | 0.64 | C-GATS 0.56 | 분포 지표에서는 C-GATS가 더 낮음 |
| PV MSE | 0.033 | TimeVAE 0.030 | MSE의 최저값은 TimeVAE |
| PV MAE | 0.088 | TimeVAE 0.120 | 같은 비교에서도 MAE의 순위는 다름 |
| Metro MSE | 0.014 | C-GATS 0.018 | CAST가 더 낮음 |
원문 Table 1, PDF 5쪽을 재작성했습니다. 상대 감소율은 표의 값에서 리뷰어가 계산했습니다. 원문 표
QTDB KID 역시 CAST 0.00023, C-GATS −0.00064로 C-GATS의 표 값이 더 낮습니다. 저자는 KID·MMD의 음수가 유한 표본 추정 오차로 생길 수 있으며 0에 가까운 값으로 해석해야 한다고 설명합니다. Metro KID에서 CAST의 음수 값 −0.00708을 보고 “실제 분포 거리가 0보다 작다”거나 더 큰 음수 자체에 특별한 의미가 있다고 해석해서는 안 됩니다. 본문 §4.2의 “CMMD” 표기와 달리 Table 1의 지표 이름은 MMD입니다.
검출 성능은 데이터셋별 일곱 검출기의 평균 F1에서 비교하면 CAST가 모두 가장 높습니다.
| 데이터셋 | CAST 평균 F1 | 가장 높은 비교 모델 평균 F1 | 절대 차이 |
|---|---|---|---|
| MIT-DB | 0.832 | Diffusion-TS 0.730 | +0.102 |
| SVDB | 0.935 | FlowTS 0.773 | +0.162 |
| QTDB | 0.896 | FlowTS 0.839 | +0.057 |
| PV | 0.321 | FlowTS·C-GATS 0.178 | +0.143 |
| Metro | 0.575 | FlowTS 0.528 | +0.047 |
원문 Table 2, PDF 7쪽의 보고된 평균을 재작성했습니다. 차이는 반올림된 평균값 간 차이이며 F1의 절대 단위입니다. 원문 표
개별 검출기에서는 결과가 달라집니다. MIT-DB의 TCN은 CAST 0.653보다 C-GATS 0.707이 높고, QTDB의 OneFitsAll은 CAST 0.975보다 FlowTS 0.977이 높습니다. PV에서는 MOMENT의 FlowTS 0.392가 CAST 0.369보다 높고, LTSM의 C-GATS 0.472가 CAST 0.420보다 높습니다. PV의 TCN도 GenIAS 0.075, CAST 0.070입니다. Metro에서는 Random Forest와 OneFitsAll의 FlowTS, CatBoost의 Diffusion-TS가 CAST를 앞섭니다. 따라서 “모든 검출기에서 최상”이라는 식으로 평균 결과를 확대하면 표와 맞지 않습니다.
4.3 Ablation Study
저자는 이상 구조 조건 ASC와 문맥 비인지 사전학습 CUP를 분리해 비교합니다.
| 설정 | ASC | CUP | MSE ↓ | MAE ↓ | F1 ↑ |
|---|---|---|---|---|---|
| (a) 기본 생성기 | 없음 | 없음 | 0.023 | 0.080 | 0.595 |
| (b) 구조 조건만 추가 | 있음 | 없음 | 0.040 | 0.080 | 0.599 |
| (c) 사전학습만 추가 | 없음 | 있음 | 0.021 | 0.072 | 0.686 |
| (d) 전체 CAST | 있음 | 있음 | 0.011 | 0.053 | 0.711 |
원문 Table 3, PDF 6쪽을 재작성했습니다. 원문 표
(a)→(b)에서는 구조 조건을 추가해도 MSE가 0.023에서 0.040으로 악화되고, MAE는 같으며, F1은 0.004만 증가합니다. 저자는 적은 이상 데이터로 직접 학습하면 이산 구조 표현을 활용하기 어렵다고 해석합니다. (a)→(c)는 정상 데이터를 활용하는 사전학습이 세 지표를 개선하는 비교입니다. (c)→(d)는 이미 사전학습한 생성기에 구조 조건을 더했을 때 MSE 0.021→0.011, F1 0.686→0.711의 추가 개선이 나타나는 비교입니다.
이 실험은 두 구성 요소를 따로 점수화하기보다 사전학습이 구조 조건의 활용을 도울 수 있다는 상호 보완성을 보여 줍니다. 단, Table 3과 해당 설명에서 데이터셋별 세부 집계 방식은 명확히 제시되지 않습니다. 이를 임의로 특정 데이터셋의 결과나 다섯 데이터셋 평균으로 이름 붙이지 않습니다.
4.4 Qualitative Analysis
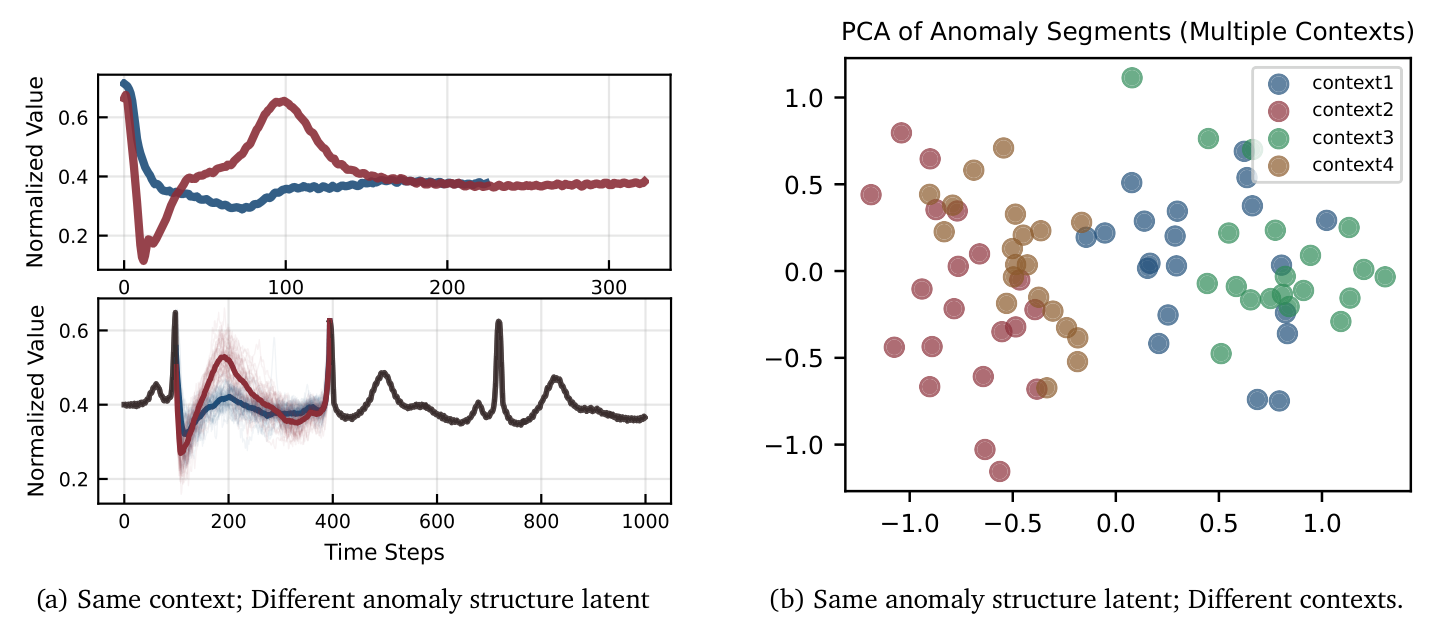
Figure 3, PDF 8쪽. 원문 그림 영역을 크롭했으며 내부 글자는 번역하지 않았습니다. 2609.27825v1 원문
Figure 3a는 정상 문맥을 고정하고 구조 코드를 바꿉니다. 뚜렷하게 상승했다가 하강하는 모양과 더 평평한 형태가 다른 생성 결과로 이어집니다. 저자는 주어진 이상 구간을 그대로 복사하는 대신, 형태적 특성을 유지하면서 주변 문맥에 맞추는 사례로 설명합니다.
Figure 3b는 구조 코드를 고정하고 문맥을 바꾼 결과를 PCA로 시각화합니다. 문맥별로 다른 군집이 나타나므로, 구조 코드만 사용하고 문맥을 무시하는 동작과는 다른 정성적 증거입니다. 이 그림만으로 잠재 변수의 통계적 독립성이나 완전한 disentanglement가 증명되는 것은 아닙니다.
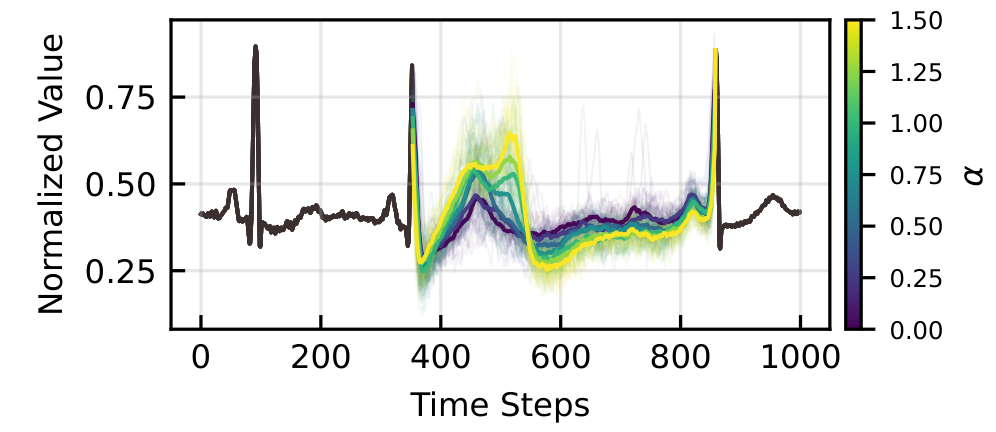
Figure 4, PDF 8쪽. 원문 그림 영역을 크롭했으며 내부 글자는 번역하지 않았습니다. 2609.27825v1 원문
다음 Figure 4는 두 구조 표현을 선형 조합합니다.
$u_0,u_1$은 관측된 두 이상에서 얻은 잠재 표현입니다. $0\le\alpha\le1$은 두 표현 사이의 보간이며, 1.25와 1.5는 선분 밖으로 확장한 외삽입니다. 코드북 항목은 이산적으로 선택되지만, 선택된 벡터의 선형 조합 자체는 연속적입니다. 원문의 곡선은 이런 조작에 따라 형태가 점진적으로 바뀌는 사례를 보여 줍니다. 저자는 이를 새로운 형태를 합성할 잠재력으로 해석하지만, 미관측 이상 유형 전체에 대한 정량적 검증으로 제시하지는 않습니다.
챕터의 핵심 기여: 성능 표, 구성 요소 비교, 조건 조작 사례를 서로 보완적인 근거로 제시합니다. 다음 챕터로의 연결: 기존 이상 생성·검출·일반 생성 연구와의 관계를 정리합니다. §4
📖 Chapter 5: Related Works
챕터의 위치와 역할: 세 연구 계열을 순서대로 검토하며 CAST의 위치를 설명합니다.
5.1 Time Series Anomaly Generation
먼저 규칙 기반 이상 주입을 다룹니다. 이런 방법은 단순하고 효율적이지만, 저자는 실제 이상 분포의 복잡성과 다양성을 충분히 담기 어렵다고 설명합니다. 이어 GAN 기반 방법이 주로 이상탐지의 보조 과정으로 생성기를 활용했고 세밀한 제어가 부족하다는 맥락을 제시합니다. 마지막으로 VAE 기반 GenIAS와 C-GATS의 잠재 교란·사전학습 전략을 소개합니다. CAST의 차별점은 이 전략에 명시적인 구조 조건과 flow 기반 생성기를 결합하는 데 있습니다.
5.2 Time Series Anomaly Detection
저자는 비지도·준지도·지도 이상탐지를 구분합니다. 비지도 방법은 전역·국소 분포에서 벗어나는 관측을 찾고, 준지도 방법은 정상 동작을 학습한 뒤 테스트의 차이를 이용합니다. 지도 방법은 정상·이상 라벨을 사용할 수 있지만 이상 라벨 부족에 제약을 받습니다.
표현 학습, 시계열 foundation model, LLM 기반 방법도 풍부한 표현력을 제공할 수 있으나, 지도 검출을 학습하는 데이터의 희소성까지 자동으로 제거하지는 않습니다. CAST는 검출기 자체를 대체하기보다, 이런 모델을 학습시킬 이상 데이터를 공급하는 위치에 놓입니다.
5.3 General Time Series Generation
마지막으로 VAE·GAN에서 diffusion·flow matching으로 이어지는 생성 연구를 정리합니다. VAE 계열의 시간적 분해와 잠재 동역학, GAN 계열의 분포 정합과 시간적 제약, diffusion 계열의 조건 설계와 여러 구조를 차례로 언급합니다. 저자는 diffusion의 계산 비용에 비해 flow matching을 효율적 대안으로 소개하지만, 이 장 자체에서 CAST의 추론 속도를 직접 측정한 비교표를 제시하지는 않습니다. 다단계 추론의 비용은 부록 F에서 다시 다룹니다.
챕터의 핵심 기여: 생성기 설계와 검출기 학습 데이터 문제를 연결합니다. 다음 챕터로의 연결: 이를 바탕으로 논문의 결론과 확장 방향을 요약합니다. 이 리뷰는 관련 연구들의 원문 전체를 별도로 검증한 서베이가 아니라, CAST가 제시한 연구 맥락을 설명합니다. §5
📖 Chapter 6: Conclusion
챕터의 위치와 역할: 이상 데이터 부족과 형태 다양성이라는 출발점으로 돌아가, 두 단계 학습과 이중 조건의 의미를 정리합니다.
저자는 정상 데이터를 활용하는 학습 전략과 정상 문맥·이상 구조를 함께 조건화하는 생성기를 핵심으로 요약합니다. 결론에는 비교 모델 대비 MSE 26% 감소, MAE 17% 감소, F1 16% 증가라는 수치가 제시됩니다. 그러나 이 문장에는 어느 비교 모델과 어떤 집계식을 사용했는지 명확한 설명이 붙어 있지 않습니다. 따라서 이 리뷰는 이를 저자가 결론에서 보고한 요약 수치로만 기록하고, 개별 데이터셋·검출기에 적용되는 수치로 사용하지 않습니다. 구체적인 비교는 Table 1–2의 조건이 명확한 값으로 수행합니다.
이어 저자는 추가 데이터 모달리티 통합과 downstream task 응용을 향후 방향으로 명시합니다. 잠재 표현을 연속적으로 조작했을 때 형태가 일관되게 변하는 정성 결과도 다시 언급합니다. 이것은 관측 패턴의 유연한 재조합 가능성에 대한 주장입니다.
챕터의 핵심 기여: 데이터 활용 전략과 제어 가능한 합성이라는 두 축을 결론으로 연결합니다. 다음 부분으로의 연결: 감사의 글·참고문헌 이후 부록에서 데이터, 구현, 이론, 추가 실험, 한계를 보충합니다. §6, PDF 10쪽
감사의 글은 NIH의 부분 지원을 명시하고, 연구자의 견해가 지원 기관의 공식 입장을 나타내지 않는다고 설명합니다. References는 본문 이후 PDF 11–13쪽에 배치됩니다. 인용 논문의 목록 전체를 개별 리뷰로 확장하지는 않습니다.
📖 Chapter A: Datasets
부록의 위치와 역할: 본문에서 사용한 다섯 데이터셋의 공개 출처와 입력 크기를 구체화합니다.
| 데이터셋 | 채널 수 | 시퀀스 길이 | 최소 이상 길이 | 최대 이상 길이 |
|---|---|---|---|---|
| MIT-DB | 2 | 1000 | 180 | 800 |
| QT-DB | 2 | 600 | 80 | 450 |
| SV-DB | 2 | 800 | 30 | 360 |
| PV | 1 | 200 | 20 | 144 |
| Metro | 1 | 72 | 24 | 24 |
원문 Table 4, PDF 14쪽을 재작성했습니다. 길이는 표본 시점 수입니다. 원문 표와 데이터 링크
세 ECG 데이터는 PhysioNet, PV는 Sheffield PVLive와 NIST의 공개 자료, Metro는 UCI 데이터 링크를 제공합니다. Table 4의 “Dimension”은 채널 수이며, 데이터셋의 표본 개수를 뜻하지 않습니다. Metro는 이상 길이가 24로 고정되고 다른 데이터는 구간 길이가 달라집니다. 이런 차이는 생성기가 다루는 문맥·이상 비율의 차이를 이해하는 데 도움이 됩니다.
핵심 기여: 실제 입력 규모를 분명히 합니다. 다음 부록으로의 연결: 이 입력을 처리하는 생성기와 비교 모델의 구현을 설명합니다.
📖 Chapter B: More Implementation Details
부록의 위치와 역할: 전체 모델 구조, 학습 예산, 비교 모델 구현, 학습·추론 의사코드를 제시합니다.
먼저 모든 실험을 48GB 메모리의 NVIDIA RTX A6000에서 실행할 수 있고 각 방법의 학습이 24시간 미만이라고 보고합니다. 이는 저자의 실행 환경 보고이며, 이 리뷰에서 직접 실행해 확인한 처리량은 아닙니다.
CAST는 FlowTS를 바탕으로 한 encoder–decoder Transformer입니다. 연속 시간은 임베딩 후 adaptive normalization을 통해 각 block의 hidden representation을 조절하고, 이상 구조 표현도 adaptive normalization으로 주입합니다. 문맥은 입력 마스킹과 부패된 구간을 대상으로 하는 학습이라는 설명으로 제공됩니다. VQ-VAE는 정상·이상 혼합 구간에서 학습하고, 코드북 500개·표현 길이 4·임베딩 차원 8을 사용합니다. flow Transformer는 encoder 4층, decoder 4층, hidden dimension 64, head 4개, feed-forward 확장 비율 4입니다.
다음으로 CAST는 최대 100 epoch 사전학습과 최대 500 epoch 미세조정을 수행하며 early stopping을 사용한다고 설명합니다. 비교 모델은 최대 2000 epoch와 early stopping을 사용합니다. 모든 모델의 optimizer는 Adam이고 초기 학습률은 $10^{-4}$입니다. training loss를 감시하는 ReduceLROnPlateau로 한 epoch 동안 $10^{-4}$보다 큰 개선이 없으면 학습률에 0.8을 곱하며, 하한은 $10^{-5}$입니다. 최대 epoch가 같지 않으므로 “모든 모델이 동일한 학습 횟수를 사용했다”고 표현하면 정확하지 않습니다.
비교 모델 세부 사항도 이어집니다. FlowTS·Diffusion-TS는 CAST와 같은 Transformer 층 수·hidden 크기를 사용합니다. TimeVAE는 50·100·200 channel의 convolutional encoder와 차원 64의 잠재 공간을 사용하고, level·3차 다항 trend·seasonal·residual 요소로 복원합니다. KL 항 가중치는 $10^{-4}$입니다. GenIAS 재구현도 같은 encoder 계열과 잠재 차원을 사용하며, 교란 범위 관련 설정은 $\delta_{\min}=0.01$, $\delta_{\max}=0.02$, prior scale은 0.5, perturbation loss 가중치는 0.1입니다. C-GATS는 1D ResNet 계열 VAE로, 길이 8·차원 64의 잠재 시퀀스를 사용합니다.
Algorithm 1은 이상 시계열과 마스크를 뽑아 이상 부분·문맥·구조 코드를 만들고, 노이즈와 시간 표본으로 flow의 목표 속도를 계산하는 순서입니다. Algorithm 2는 이상 사례의 구조 표현, 정상 데이터에서 뽑은 문맥, 사전 정의된 마스크 분포를 조합해 ODE를 적분합니다. §3에서 지적한 손실 마스크와 encoder 입력 표기의 차이는 이 의사코드에도 그대로 존재합니다. Algorithm 1의 입력·초기화 줄에 사전학습 checkpoint 로딩이 명시되지는 않지만, §3.2는 사전학습 후 미세조정이라는 절차를 분명히 설명합니다.
핵심 기여: 모델 규모와 학습 절차를 이해할 구체적인 설정을 제공합니다. 코드 공개는 “논문 승인 후 공개”로 적혀 있으므로, 원문만으로 CAST의 공개 코드를 이미 재현했다고 주장할 수는 없습니다. 다음 부록으로의 연결: 생성 데이터의 효용을 측정하는 검출기의 구조와 학습법을 설명합니다. 부록 B, PDF 14–16쪽
📖 Chapter C: Anomaly Detector Implementation Details
부록의 위치와 역할: 합성 데이터 평가에 쓰는 검출기들이 어떤 입력·학습 방식을 갖는지 구체화합니다. 공통 과제는 시계열의 각 시점에 이진 이상 라벨을 예측하는 point-wise detection이며, 서로 다른 seed로 다섯 번 반복한 평균을 보고합니다.
Random Forest는 각 시점의 주변 $2w+1$ 길이 window를 사용하고 경계에서는 reflection padding을 적용합니다. 원시 값, 채널별 평균, 표준편차, 1차 시간 차분의 평균을 합쳐 특징 벡터로 만듭니다. 트리 수는 300, 깊이 제한은 없고, 최소 leaf sample은 10이며 class weight를 균형화합니다. CatBoost는 같은 특징 추출을 사용하고, 500회 boosting, 깊이 8, 학습률 0.05, Logloss 목적함수와 자동 class balancing을 적용합니다.
Robust-TAD는 U-Net 형태의 1D convolutional network로 설명됩니다. encoder channel은 16·32·64·128·256이며, downsampling 후 대칭적인 decoder와 skip connection으로 시간 해상도를 복원합니다. 이상 비율을 반영한 weighted binary cross-entropy, Adam, validation loss 기반 scheduling·early stopping을 사용합니다. TCN은 dilation이 지수적으로 커지는 causal convolution 6층, kernel 3, hidden 128을 사용하고 1×1 convolution으로 시점별 logit을 만듭니다.
MOMENT는 pretrained backbone을 고정한 linear probing 설정입니다. 입력을 길이 512로 resample하고 patch embedding에 MLP head를 붙여 시점별 예측을 합니다. 이 결과를 MOMENT 전체를 end-to-end로 미세조정한 성능으로 해석하면 안 됩니다.
OneFitsAll은 stride 1의 patch 입력을 pretrained GPT-2의 앞 여섯 층에 전달합니다. layer normalization과 MLP parameter만 조정하고 나머지는 고정하며, validation F1에 따라 scheduling·early stopping을 수행합니다. LTSM은 sample별 정규화, 채널별 overlapping patch, pretrained Transformer 일부 층을 사용하고, 채널 표현을 집계한 후 선형 head로 시점별 logit을 만듭니다. 학습은 binary cross-entropy와 HuggingFace Trainer를 사용합니다.
핵심 기여: 모델 계열뿐 아니라 입력 특징과 tuning 범위가 다른 평가자들을 사용했음을 보여 줍니다. 다음 부록으로의 연결: 경험적 성능과 별개로, 구조 조건 추가가 이상적인 학습 목적함수에 어떤 영향을 주는지 설명합니다. 부록 C, PDF 16–17쪽
📖 Chapter D: Theoretical Analysis
부록의 위치와 역할: 저자는 이 이론을 새로운 포괄적 이론적 기여보다 조건 설계의 직관을 설명하는 분석으로 명시합니다. 실제 유한 데이터로 학습한 모델의 성능 보장과는 구분해야 합니다.
표기와 최적 속도장
목표 속도를 $Y=X_1-X_0$, 보간 상태와 문맥을 합친 관측 정보를 $W_t=(X_t,X_{\mathrm{ctx}})$로 둡니다. 이 부록에서는 이상 부분의 상태 공간으로 문제를 기술하므로 본문의 마스크 표기를 반복하지 않습니다. 제곱오차를 최소화하는 population 수준의 속도장은 조건부 평균입니다.
여기서 $C$는 일반적인 추가 조건이며, 앞서 시계열의 채널 수를 표시한 $C$와는 이 부록에서의 역할이 다릅니다. $\mathrm{Var}$는 벡터가 조건부 평균에서 벗어나는 제곱 거리의 조건부 기댓값입니다. 최적 손실은 주어진 조건으로도 설명되지 않는 속도의 불확실성을 나타냅니다.
Assumption D.1과 D.2
D.1은 oracle 구조 $Z$와 관측 정보 $W_t$를 알면, 추론 표현 $U$가 $Y$에 관한 추가 정보를 주지 않는다고 가정합니다. 즉 이상적인 구조가 충분한 설명을 담고 있다는 oracle sufficiency입니다. D.2는 $m_t(w,z)=\mathbb E[Y\mid W_t=w,Z=z]$가 $z$에 대해 Lipschitz 연속이라는 가정입니다. 구조가 조금 달라질 때 최적 속도도 무한히 급격하게 달라지지 않는다는 조건이며, 그 변화율 상한이 $L$입니다.
Lemma D.3: 구조 조건을 추가한 최적 위험
원문은 다음의 정확한 분해를 제시합니다.
$v^*$는 문맥과 중간 상태만 사용하는 최적 속도장, $v_u^*$는 구조 표현까지 사용하는 최적 속도장입니다. 빼는 항은 음수가 될 수 없는 분산입니다. 따라서 추가 조건이 주어졌을 때 이상적인 최적 목적함수는 커지지 않습니다. 증명은 조건부 전체 분산 법칙으로 $\mathrm{Var}(Y\mid W_t)$를 두 항으로 나누고, 기댓값과 시간 적분을 취하는 순서입니다.
이 결과는 ASC만 추가한 실제 모델의 MSE가 악화된 Table 3과 모순되지 않습니다. 정리는 population minimizer를 비교하고, Table 3은 제한된 데이터·모델·최적화로 얻은 경험적 결과입니다. 조건을 더 받으면 활용 가능한 정보가 늘어난다는 명제와, 학습한 모델이 그 정보를 잘 사용한다는 명제는 서로 다릅니다.
Theorem D.4: oracle 구조와 추론 표현의 차이
D.1과 D.2 아래에서 원문은 다음 상한을 도출합니다.
$v_z^*$는 oracle 구조를 받는 최적 속도장입니다. 우변의 추가 항은 관측 정보와 추론 표현을 알고도 남는 oracle 구조의 불확실성입니다. $U$가 구조를 잘 설명해 이 분산이 작아지면, oracle 조건에 비해 추가로 남는 위험의 상한도 작아집니다.
증명은 먼저 D.1과 전체 분산 법칙으로 oracle 최적 위험과 추가 조건부 분산을 분리합니다. 다음으로 조건부 평균의 제곱오차 최소화 성질을 사용하고, $\hat Z=\mathbb E[Z\mid W_t,U]$를 대입한 비교 함수를 구성합니다. 마지막으로 D.2의 Lipschitz 조건을 적용해 추가 분산을 $L^2\mathbb E[\mathrm{Var}(Z\mid W_t,U)]$로 제한합니다. 이것이 식 D.5–D.19의 전개입니다.
핵심 기여: 좋은 구조 표현이 왜 조건부 생성에 도움이 될 수 있는지 설명합니다. 실제 VQ-VAE가 두 가정을 만족한다거나, 실험 F1이 특정 양만큼 오른다는 보장을 제시하는 정리는 아닙니다. 다음 부록으로의 연결: 조건 설계에 관한 실험적 분석을 추가로 제시합니다. 부록 D, PDF 17–20쪽
📖 Chapter E: More Experiment results
부록의 위치와 역할: 단순 증강 비교, 추가 ECG 데이터, 잠재 공간 진단, GenIAS 변형 실험을 원문 순서대로 제시합니다.
Comparison with Simple Baselines. Figure 5는 Copy-and-Paste와 Gaussian Noise Injection을 포함한 간단한 증강과 비교하며, 다섯 실행의 F1 평균·표준편차를 표시합니다. CatBoost·OneFitsAll·Random Forest에서는 여러 증강 방법이 비슷하게 높은 성능을 보이고, TCN·MOMENT·Robust-TAD에서는 CAST의 우위가 더 뚜렷하다는 것이 저자의 해석입니다. 복잡한 생성기가 항상 단순 증강보다 같은 정도로 유리하다는 결론보다, 평가자에 따라 생성 품질 차이를 활용하는 정도가 다르다는 관찰이 중요합니다.
Results on Noisier Dataset. 이어 12-lead ECG인 INCART를 추가합니다. Table 5에서 CAST는 Random Forest 0.479, OneFitsAll 0.917, 평균 0.698을 보이며, Diffusion-TS의 평균은 0.5865입니다. 다만 원문 표 제목에는 “FID”와 “Higher is better”가 함께 적혀 있고, 본문은 F1 결과라고 설명하며 열도 검출기 이름입니다. 이 리뷰의 수치 설명은 본문 문맥상 검출 F1로 제시된 결과를 따르되, 캡션의 지표 표기가 불일치한다는 점을 명시합니다.
Qualitative Analysis on VQVAE. Figure 6은 학습한 VQ-VAE 잠재 공간의 이웃과 무작위로 선택한 시계열을 비교합니다. 잠재 이웃은 형태가 더 비슷하고 무작위 표본은 더 다양한 패턴을 보입니다. 저자는 이웃 안에서도 남는 세부 차이를 들어, 잠재 표현만으로 모든 형태가 완전히 결정되는 것은 아니라고 설명합니다. 이는 구조를 요약한 표현과 문맥에 맞춘 세부 생성의 역할을 구분하는 정성 근거입니다.
Additional analysis on GenIAS. 마지막으로 명시적인 anomaly-aware modeling을 더한 GenIAS 변형을 비교합니다. Table 6은 LTSM을 제외한 여섯 검출기의 평균이며, Table 2의 일곱 검출기 평균과 직접 같은 분모로 비교하면 안 됩니다. Modified/Original 평균은 MIT-DB 0.6387/0.5578, SVDB 0.6503/0.4790, QTDB 0.4612/0.3773, PV 0.0991/0.0780, Metro 0.0902/0.1105입니다. 대부분의 데이터에서 개선되지만 Metro 평균은 낮아집니다.
이 표의 PV Original MOMENT 값은 0.223으로, Table 2의 GenIAS MOMENT 0.233과 다릅니다. 서로 다른 값을 임의로 통일하지 않았습니다. 저자는 이 실험을 방법 간 순위를 정하기 위한 직접 비교가 아니라, 이상을 명시적으로 모델링하는 효과를 이해하기 위한 통제 분석으로 위치시킵니다.
핵심 기여: 평균 성능만으로 드러나지 않는 평가자 의존성과 구조 표현의 의미를 보완합니다. 다음 부록으로의 연결: 저자가 명시한 방법의 한계와 향후 방향을 다룹니다. 부록 E, PDF 21–23쪽
📖 Chapter F: Limitations
부록의 위치와 역할: 저자가 직접 인정한 두 가지 한계를 제시합니다.
첫째는 추론 효율입니다. flow matching을 사용하더라도 현재 CAST는 여러 단계의 추론에 의존합니다. 실제 이상 생성 시스템이 엄격한 지연 요구를 갖는 경우를 고려해, 저자는 더 발전된 단일 단계 생성 패러다임을 향후 방향으로 언급합니다. 논문에는 이 방향의 구현이나 속도 개선 결과가 제시되어 있지 않습니다.
둘째는 이론의 범위입니다. 부록 D는 설계 직관을 제공하는 분석이며, 시계열의 조건부 이상 생성을 포괄하는 이론적 기반이라고 주장하지 않습니다. 저자는 더 깊은 이론적 이해를 향후 연구로 남깁니다.
핵심 기여: 실험적 유용성과 이론·배포 범위를 구분합니다. 다음 부록으로의 연결: 연구의 사회적 영향에 관한 저자 입장을 설명합니다. 부록 F, PDF 23쪽
📖 Chapter G: Impact Statement
부록의 위치와 역할: 이상 시계열 생성 연구의 응용과 영향에 대한 저자 입장을 밝힙니다.
저자는 시스템 모니터링과 고장 진단 등 안전이 중요한 분야의 잠재적 응용을 언급합니다. 동시에 즉각적인 부정적 사회·윤리 영향을 예상하지 않으며 일반적인 머신러닝 연구의 고려 사항을 넘어서는 추가 우려를 식별하지 않았다고 서술합니다. 이는 논문 저자의 영향 평가 진술이며, 실제 응용의 안전성이나 위험 부재를 별도의 실험으로 검증한 결과는 아닙니다.
핵심 기여: 기술 결과와 연구자가 주장하는 영향 범위를 구분할 근거를 제공합니다. 이 부록이 원문의 마지막 부분입니다. 부록 G, PDF 24쪽
실험 결과 심층 분석
가장 강한 실험적 메시지는 평균적인 downstream utility의 개선입니다. Table 2에서 데이터셋별 검출기 평균 F1은 다섯 데이터셋 모두 CAST가 가장 높습니다. 예를 들어 MIT-DB는 차선 평균 0.730에서 0.832로 0.102 증가하고, SVDB는 0.773에서 0.935로 0.162 증가합니다. 이는 비교적 다양한 검출 방식에 쓸 수 있는 학습 데이터를 만든다는 주장에 근거를 제공합니다. 다만 평균이 낮은 PV에서 CAST도 0.321이므로, 상대적인 개선만으로 실제 운용 수준의 검출 정확도가 확보되었다고 말할 수는 없습니다.
생성 오차와 검출 효용은 동일한 목표가 아닙니다. PV에서는 TimeVAE의 MSE가 CAST보다 낮지만, 평균 검출 F1은 CAST 0.321, TimeVAE 0.145입니다. 이 결과는 점별 복원 오차의 순위만으로 합성 데이터의 학습 가치를 정할 수 없다는 사례입니다. MSE는 큰 오차에 더 큰 가중치를 주고, MAE와 분포 지표는 다른 측면을 측정합니다. 단, 이 표만으로 두 모델의 어떤 내부 특성이 F1 차이를 일으켰는지 인과적으로 확정할 수는 없습니다.
구성 요소의 효과는 조합을 봐야 합니다. ASC 단독은 Table 3에서 안정적인 개선을 보이지 않았지만 CUP와 결합하면 가장 좋은 세 지표가 나옵니다. 구조 표현을 입력으로 추가하는 것과, 생성기가 그 입력을 활용하도록 학습하는 것은 별개의 문제라는 해석입니다. 이는 부록 D의 population 수준 결과를 실제 학습과 연결할 때도 중요한 구분입니다.
통계적 신뢰도는 보고 범위 안에서 판단해야 합니다. 본문은 다섯 실행의 평균을 제시하고 Figure 5에는 표준편차가 포함되지만, Table 1–3의 주요 수치에 대한 신뢰구간이나 유의성 검정 결과는 보고되지 않았습니다. 따라서 0.002처럼 작은 F1 차이를 통계적으로 확정적인 우열이라고 표현하지 않습니다. 여러 검출기에서 평균 개선이 반복된다는 경험적 일관성과, 각 차이의 통계적 유의성은 서로 다른 근거입니다.
재현성은 구조·하이퍼파라미터를 확인할 수 있는 수준과 완전 재현을 구분합니다. 부록은 모델 크기, 코드북, optimizer, 학습률, 학습 epoch와 검출기 구성을 제공합니다. 반면 데이터 분할의 구체적인 표본 수·비율, Table 3의 집계 범위, FID·KID 특징 추출기의 세부 정의 등은 공개 원문만으로 확정하기 어렵습니다. 손실 마스크와 encoder 입력의 표기 차이도 남습니다. 이는 원문에서 확인할 수 있는 정보의 경계를 밝히는 것이며, CAST의 실제 코드가 잘못되었다고 판정하는 근거는 아닙니다. 논문은 코드 공개를 승인 이후로 예고합니다.
기술적 함의와 응용
CAST가 보여 주는 중요한 설계 원리는 생성 환경을 지정하는 조건과 생성 대상의 형태를 지정하는 조건을 나누는 것입니다. 시계열의 정상 문맥은 그대로 두고 이상 구조 표현을 바꿀 수 있다면, 데이터 증강을 단순한 노이즈 추가보다 세밀한 조작으로 다룰 수 있습니다. 이 논문에서는 ECG·발전량·교통량의 결과와 조건 조작 그림이 그 가능성을 뒷받침합니다.
데이터과학 관점에서는 생성기를 평가하는 방법도 핵심입니다. 점별 오차, 분포 유사성, 실제 데이터에서의 검출 성능을 함께 보면, 보기 비슷한 신호와 학습에 유용한 신호가 완전히 같은 개념이 아님을 확인할 수 있습니다. 검출기의 입력 특징과 학습 방식에 따라 합성 데이터의 가치가 다르다는 결과는, 생성 모델의 평균 순위를 개별 분석 파이프라인에 그대로 옮기지 않아야 한다는 실험 해석으로 이어집니다.
저자가 명시한 향후 방향은 추가 모달리티 통합, downstream 응용 확장, 단일 단계 생성, 더 깊은 이론적 이해입니다. 현재 결과의 중심은 관측된 이상 구조와 정상 문맥을 조합하는 생성이며, 잠재 보간의 정성적 가능성을 보지 못한 모든 이상 유형에 대한 보장으로 확대하지 않습니다. CAST의 기여는 희소한 이상 데이터를 활용하는 학습 절차와, 구조를 조건으로 삼는 생성 설계를 결합하고 그 효용을 실제 검출 학습으로 연결한 데 있습니다.
분석 범위는 본문 §1–6, 감사의 글·참고문헌의 역할, 부록 A–G 전체입니다. 부록 D의 증명은 주요 등식과 논리 전개를 설명했으며 D.5–D.19의 중간 대수식을 모두 전사하지는 않았습니다. Figure 5–6은 원문 설명과 도표의 역할을 요약했고 모든 시각화 점의 값을 추출하지 않았습니다. 인용 문헌 전체의 독립 검증이나 저자 코드를 실행한 실험 재현은 수행하지 않았습니다.