논문 개요와 전체 구조
문서 이미지를 텍스트·HTML 표·LaTeX 수식으로 바꾸는 생성형 OCR에서는 결과가 길수록 토큰을 하나씩 출력하는 시간이 늘어납니다. GravityOCR는 여러 토큰의 초안을 병렬로 만들되, 출력 확정은 자기회귀 모델이 담당하도록 구성합니다. 하나의 모델이 attention 패턴을 바꾸어 block diffusion drafter와 autoregressive(AR) verifier를 번갈아 수행하므로 별도 초안 모델이나 예측 head를 추가하지 않습니다.
이 논문을 읽을 핵심 이유는 diffusion의 병렬성과 AR의 순차적 정합성을 결합하는 구체적인 방법, 그리고 알고리즘의 병렬성이 실제 서비스 속도로 바뀌는 조건을 함께 보여주기 때문입니다. 보고된 3.94배는 문서 영역의 토큰 생성만 측정한 속도이며, 레이아웃 분석부터 결과 조립까지 포함한 전체 페이지 처리 가속은 같은 checkpoint의 AR 대비 1.32배입니다. 서로 다른 측정 범위를 구분해야 실용적 성과를 정확히 이해할 수 있습니다.
분석 대상은 Dohyun Kim 외 6인의 arXiv:2609.26638v1이며, 원문 제출일은 2026년 9월 22일입니다. RSS 발표일인 9월 23일과 구분합니다. 아래 내용은 PDF 28쪽의 본문과 부록 A–F를 기준으로 합니다.
| 원문 순서 | 구성과 역할 |
|---|---|
| 1. Introduction | 병렬 토큰 확정에서 발생하는 누락·중복 문제와 제안의 동기 |
| 2. Preliminaries | OCR 과제 정의 → block diffusion → speculative decoding |
| 3. Method | 3.1 공유 drafter/verifier 학습 → 3.2 self-speculative decoding → 3.3 AR 경로 강화학습 |
| 4. Experiments | 4.1 설정 → 4.2 주 결과 → 4.3 효율 → 4.4 AR loss → 4.5 강화학습 |
| 5. Related Work | 문서 VLM → diffusion 언어모델 → AR–diffusion hybrid → 강화학습 |
| 6. Conclusion | 품질·속도·공유 파라미터 관점의 결론 |
| References | 본문에 인용된 선행 연구의 서지 목록 |
| Appendix A–C | 학습 설정 → 디코딩·동등성 검증 → 속도 측정 규약 |
| Appendix D–F | 추가 실험 → 강화학습 세부사항 → 정성적 출력 사례 |
핵심 기여와 혁신성
OCR 출력은 이미지의 글자와 구조에 강하게 제약되므로 열린 주제의 문장 생성보다 병렬 예측에 유리합니다. 그러나 표의 닫는 태그, 수식의 괄호, 문장 내 읽기 순서처럼 앞 토큰과의 일관성도 필요합니다. 논문은 여러 위치의 확률이 높다는 사실만으로 동시에 확정하면, 각 위치가 다른 위치에서 실제 선택된 토큰을 보지 못한 채 결정된다는 문제를 지적합니다.
GravityOCR의 해결책은 예측과 확정의 역할 분리입니다. pretrained GLM-OCR를 AR와 block diffusion 목적함수로 공동 학습하고, diffusion이 제안한 블록에서 AR 예측과 연속으로 일치하는 가장 긴 접두부만 채택합니다. 초안 오류는 채택 길이를 줄일 수 있지만, exact arithmetic의 greedy decoding에서는 동일 checkpoint의 AR 출력을 바꾸지 않습니다. 실제 bf16 계산에서의 일치율은 별도의 실험 결과로 다룹니다.
또 하나의 기여는 AR 경로에서 GRPO를 적용한다는 점입니다. 확산 과정 전체의 확률을 추정하는 문제를 풀기보다, 최종 출력의 기준인 AR 경로의 정확한 확률 분해를 이용합니다. 공유 파라미터를 업데이트하므로 drafter도 함께 바뀌며, 실험에서는 OmniDocBench Overall이 94.92에서 95.16으로 개선되면서 TPF가 9.61에서 9.68로 유지됩니다. 리뷰어 관점에서 이는 모델 전체를 완전히 새로운 생성 방식으로 바꾸지 않고, 병렬 제안·인과적 검증·기존 강화학습을 결합하는 설계 사례입니다. 원문 §1, §3, §4.5
기술적 세부사항
입력은 문서 영역 이미지와 과제 prompt이며, 출력은 해당 영역의 직렬화된 텍스트입니다. 전체 문서는 PP-DocLayout-V3로 영역을 나눈 뒤 각 영역을 인식하고 다시 조립합니다. GravityOCR가 변경하는 부분은 영역 인식 모델이고, 레이아웃 검출·조립 pipeline은 유지합니다. 기본 block 크기는 32입니다.
학습에서는 하나의 정답 응답을 clean stream과 상보적으로 마스킹한 두 corrupted stream으로 구성합니다. 이미지와 prompt는 공유하며 손상시키지 않습니다. clean stream은 causal next-token loss, corrupted stream은 마스킹된 정답 복원 loss를 받습니다. 추론에서는 여러 denoising step을 수행하는 대신 한 번의 diffusion forward로 블록 초안을 만들고, 한 번의 causal forward로 검증합니다. 자세한 attention·cache 규칙과 수식은 아래 원문 순서의 챕터 분석에서 설명합니다.
| 평가 대상 | 데이터와 지표 | 해석 시 확인할 조건 |
|---|---|---|
| 문서 전체 인식 | OmniDocBench v1.6, 1,651쪽; Text·TEDS·CDM·Order·Overall | 품질은 전체 평가셋, 주요 속도 평가는 영어 부분집합 |
| 표 인식 | PubTabNet validation 9,115개; TEDS·TEDS-struct | 셀 내용과 구조를 함께 보는 점수와 구조만 보는 점수를 구분 |
| 수식 인식 | UniMER-Test; CDM | RL reward의 LaTeX 문자열 유사도와 다른 지표 |
| 영역 처리 효율 | 영어 OmniDocBench 정답 경계 crop 8,922개 | batch 1; decode-only와 vision·prefill 포함 시간을 분리 |
| 페이지 처리 효율 | OmniDocBench 100쪽 부분집합 | H100 한 대; 한 페이지씩 처리하되 페이지 내부 영역 요청은 병렬 가능 |
실험 수치는 모두 논문 저자가 측정한 값입니다. 이 리뷰에서는 모델 학습이나 benchmark를 별도로 재실행하지 않았습니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
챕터의 위치와 역할: 연구의 출발점은 OCR 인식률 자체보다 긴 출력의 순차적 디코딩 비용입니다. 저자는 생성형 문서 파서가 텍스트뿐 아니라 HTML과 LaTeX까지 출력하면서 AR의 토큰 단위 의존성이 지연 시간과 처리량을 제한한다고 설명합니다.
첫 번째 논점은 이미지에 근거한 병렬 생성의 가능성입니다. 입력 이미지가 이미 답의 많은 부분을 결정하므로, masked diffusion으로 여러 위치를 복원할 수 있습니다. 이어서 저자는 이 직관이 출력의 순차적 정합성까지 보장하지는 않는다고 지적합니다. 원문 Figure 2에서는 confidence threshold 0.7로 여러 위치를 먼저 확정한 결과, 중간 단어 vehicles가 빠지거나 the가 중복됩니다. 이는 논문이 실제로 제시한 실패 사례이며 모든 diffusion 모델에 대한 일반적 실패율을 뜻하지 않습니다.
이 문제에서 공유 AR–diffusion 모델로 논리가 이어집니다. diffusion은 제안하고 AR는 연속 일치 구간만 확정합니다. 두 경로가 vision encoder·decoder·LM head를 공유하므로 별도 drafter를 운영할 필요가 없습니다. 마지막으로 저자는 OCR reward를 AR 경로에 적용하는 GRPO와 SGLang 구현을 기여로 묶습니다.
챕터의 핵심 기여: 병렬 예측의 확신도와 완성된 출력의 정합성을 구별하고, 검증을 도입할 이유를 구체적 OCR 오류로 설명합니다. 다음 챕터로의 연결: 이를 수학적으로 기술하기 위해 AR likelihood, block diffusion, speculative decoding의 기본 개념을 정의합니다. §1, PDF 1–3쪽
📖 Chapter 2: Preliminaries
챕터의 위치와 역할: 서로 다른 생성 경로를 같은 OCR 과제로 표현하는 기준을 마련합니다.
Task Formulation. 이미지 $I$와 prompt $c$에서 길이 $N$인 정답 토큰열 $\mathbf y$를 생성합니다. 원문 식 (1)–(2)는 다음과 같습니다.
$\theta$는 모델 파라미터이고, $\mathbf y_{\lt i}$는 현재 토큰보다 앞선 정답 토큰입니다. 각 위치의 확률을 곱해 전체 응답의 확률을 만들고, 그 음의 로그 합을 최소화합니다. 학습 시 이전 정답을 주는 방식과 달리 추론 시에는 이전 출력이 정해져야 다음 토큰을 생성할 수 있습니다.
Block Diffusion. 응답을 최대 $B$개 토큰의 연속 블록으로 나눕니다. 블록 사이는 왼쪽에서 오른쪽으로 진행하지만 현재 블록 안에서는 양방향 attention을 허용합니다. 원문 식 (3)은 다음과 같습니다.
$b$는 블록 번호, $t$는 noise level, $\mathcal M_t^{(b)}$는 마스킹한 위치 집합입니다. $\mathbf y_t^{(b)}$는 일부 토큰이 mask로 바뀐 현재 블록이고, $\mathbf y^{(\lt b)}$는 앞서 완성된 블록입니다. $w(t)$는 noise level별 loss 가중치이며 실제 학습에서는 1로 둡니다. 합산 대상은 마스킹된 위치이고, 기대값은 블록·noise·mask의 변동을 평균화한다는 뜻입니다.
기본적인 직접 diffusion 추론은 전체 mask 블록에서 시작해 여러 step 동안 선택한 토큰을 고정하고 남은 위치를 다시 예측합니다. 완성된 이전 블록은 바뀌지 않으므로 KV cache를 재사용할 수 있습니다.
Speculative Decoding. drafter가 미래 토큰들을 제안하고 AR 모델이 한 번에 평가합니다. greedy 방식에서는 AR top-1과 연속으로 일치한 토큰만 채택합니다. 원문은 stochastic 방식의 표준 acceptance–rejection도 소개하지만, 이 연구의 출력 동등성 논의는 top-1 검증을 기준으로 합니다.
챕터의 핵심 기여: 병렬 복원과 인과적 검증을 함께 설명할 공통 표기를 제공합니다. 다음 챕터로의 연결: 두 목적함수와 attention 패턴을 한 모델에서 어떻게 구현하는지로 넘어갑니다. §2, PDF 3–4쪽
📖 Chapter 3: Method
챕터의 위치와 역할: 학습, 추론, 강화학습을 차례로 연결하는 논문의 중심입니다.
3.1 Learning a Shared Block-Diffusion Drafter and AR Verifier
AR-to-Diffusion Conversion. pretrained AR OCR 모델에 학습 가능한 mask token embedding을 추가합니다. vision encoder, language decoder, LM head를 모두 공유하고 별도 예측 head를 만들지 않습니다. 같은 파라미터를 사용해도 attention과 입력이 다르면 예측 분포는 달라질 수 있으므로, 파라미터 공유 자체가 초안과 검증 결과의 일치를 보장하는 것은 아닙니다.
Joint AR–Diffusion Training. 하나의 응답에서 clean stream 하나와 corrupted stream 둘을 만듭니다. 블록마다 $t\sim U(0,1)$을 뽑고 각 토큰을 확률 $t$로 가립니다. 두 번째 corrupted stream은 첫 번째의 마스크를 반전시킵니다. 두 stream의 마스킹 비율은 기댓값 기준 $t$와 $1-t$이며, 각 응답 토큰은 둘 중 정확히 한 stream에서 복원 학습을 받습니다.
clean stream은 자신의 이전 토큰만 봅니다. corrupted stream의 현재 블록은 같은 corrupted block 전체와 이전 clean response block을 볼 수 있지만, 현재·미래 clean block은 볼 수 없습니다. 따라서 정답 전체를 한 forward에 함께 넣는 학습에서도 현재 블록 정답을 직접 참조하지 않도록 attention을 제한합니다. 예측 위치는 두 경로 모두 한 칸 이동한 logit, 즉 위치 $i-1$에서 토큰 $y_i$를 예측하는 convention을 따릅니다.
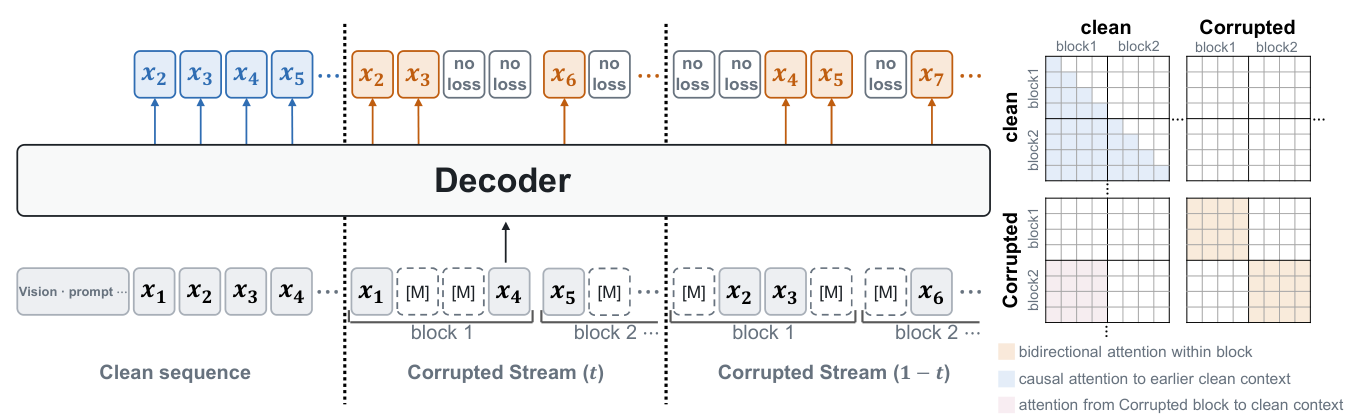
원문 Figure 3, PDF 5쪽. 2609.26638v1 원문의 그림 영역을 크롭했습니다. 그림 내부 번역·수치 변경은 없습니다. 오른쪽 attention 패턴이 현재 clean 정답으로부터의 누설을 차단하는 핵심입니다.
Training Objective. 원문 식 (4)는 두 loss의 결합을 나타냅니다.
$\lambda$는 denoising 목적의 상대적 비중입니다. 실제 구현에서는 AR loss를 supervised clean token 수로 평균하고, diffusion loss를 두 corrupted stream의 masked target 전체로 평균합니다. 그 합을 $1+\lambda$로 나누므로 기본 설정 $\lambda=1$에서는 두 목적에 각각 0.5를 부여합니다. 식의 합과 구현의 평균·정규화를 구분해야 학습률과 loss 규모를 재현할 수 있습니다.
3.2 Self-Speculative Decoding
한 round는 마지막 확정 토큰 $x_0$와 $B$개의 mask에서 시작합니다. 경계 위치는 causal attention을 사용해 다음 AR 토큰 $a_0$를 예측하고, mask 위치들은 병렬 초안 $d_{1:B}$를 만듭니다. $a_0$는 이미 인과적 AR 예측이므로 바로 확정합니다. 초안은 confidence threshold나 반복 unmasking 없이 한 번에 제안합니다.
검증 forward는 $[a_0,d_{1:B}]$를 causal attention으로 읽어 $a_{1:B+1}$을 출력합니다. 첫 위치부터 $d_j=a_j$인 동안만 채택하고, 첫 불일치 이후의 초안은 버립니다. 연속 일치 길이를 $A$라고 하면 이번 round의 확정 출력은 다음과 같이 정리할 수 있습니다. 이 표기는 원문 §3.2와 부록 B.2의 절차를 모아 쓴 것입니다.
$a_0$와 마지막 $a_{A+1}$는 검증된 AR 예측이며, 가운데 $A$개는 AR 예측과 일치한 초안입니다. 종료 조건에 도달해 잘리는 경우를 제외하면 두 forward로 2개에서 $B+2$개까지 확정합니다. 기본 $B=32$에서 최대 34개입니다. 이 최대치와 실제 평균을 혼동하면 안 됩니다.
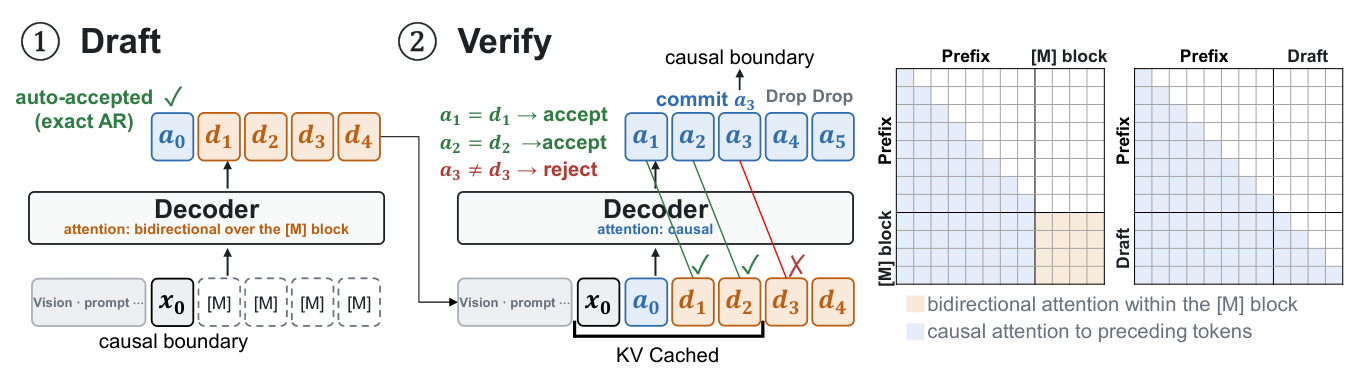
원문 Figure 4, PDF 6쪽. 고정 버전 원문의 그림 영역 크롭이며 내부 번역·변형은 없습니다. 검증은 토큰 채택뿐 아니라 다음 round가 읽을 causal KV state 작성까지 수행합니다.
3.3 RL on the AR Path
저자는 token likelihood와 완성된 OCR 품질 사이의 차이에서 강화학습의 필요성을 설명합니다. text reward는 normalized edit similarity, table reward는 구조와 셀 내용의 조합, formula reward는 정규화한 LaTeX의 유사도와 형식 검사입니다. 모두 0과 1 사이에 있으며 CDM 자체를 reward로 계산하지 않습니다.
여러 denoising trajectory를 갖는 diffusion에서 sequence likelihood를 구하려면 trajectory를 고려해야 합니다. GravityOCR에서는 최종 출력의 기준이 AR verifier이므로 AR factorization을 그대로 사용해 GRPO를 적용합니다. 같은 입력에 대한 출력 집단의 상대적 reward로 advantage를 계산하고 causal token log-probability로 모델 전체를 업데이트합니다. diffusion-specific RL loss는 없으며, drafter는 공유 파라미터를 통해 간접적으로 바뀝니다. 따라서 drafter–verifier 일치가 유지되는지는 후속 실험에서 확인해야 합니다.
챕터의 핵심 기여: 공유 학습으로 두 모드를 만들고, 검증을 통해 출력 확정과 cache 정합성을 유지하며, AR likelihood를 이용해 OCR reward를 학습하는 닫힌 절차를 제시합니다. 다음 챕터로의 연결: 이 조합의 인식 품질·실제 속도·각 구성 요소의 역할을 실험합니다. §3, PDF 4–7쪽
📖 Chapter 4: Experiments
챕터의 위치와 역할: 실험 조건을 먼저 정의한 뒤 종합 성능, 디코딩 효율, AR loss, 강화학습 순으로 설계를 분해합니다.
4.1 Setup
Model and Training. GLM-OCR에서 시작해 vision encoder와 decoder를 함께 40,000 step 학습합니다. 약 26B forward token은 순수한 텍스트 정답 수가 아니라 vision token과 세 응답 stream을 포함한 계산량 집계입니다. 기본 결과는 이후 500 step의 GRPO까지 수행한 checkpoint입니다.
Training Data. 최초 pool은 공개 데이터 중심의 영역 12.3M개입니다. DocGenome, Docmatix, PubTables-1M, FinTabNet, SynthTabNet, PubTabNet, RVL-CDIP, DocLayNet, UniMER training split을 이용합니다. text 6.49M, table 2.90M, formula 2.89M에서 table·formula를 각각 2.16M으로 고정 seed subsampling하여 약 10.8M개와 60/20/20 비율을 만듭니다. 대부분 영어이며, 정답은 대체로 base GLM-OCR 전사입니다. 단, 원래 셀 annotation이 있는 table crop은 평가 markup으로 변환한 정답을 사용하고, 이는 table stream의 약 39%입니다.
full-page 자료의 영역은 추론과 같은 detector로 자르고, 표·수식 전용 자료는 전체 crop을 씁니다. 별도 내부 validation은 1,000쪽·4,614 crop입니다. 저자는 document ID, text shingle, table cell, formula string으로 OmniDocBench 중복이 없음을 검사했다고 명시합니다. 이 서술은 저자의 데이터 검사 보고이며, 본 리뷰의 독립 데이터 감사 결과는 아닙니다.
Benchmarks and Metrics. OmniDocBench의 Overall은 세 인식 축을 평균하고 reading-order 지표는 별도로 보고합니다. 따라서 Order를 Overall의 네 번째 동일 가중 항으로 해석하면 안 됩니다. 표는 TEDS와 TEDS-struct, 수식은 CDM으로 추가 평가합니다.
Baselines. 같은 계열에서는 base AR·MTP와 GravityOCR의 AR·직접 diffusion·self-speculation을 비교합니다. 다른 계열 모델은 공개 구현으로 재측정하지만 inference stack은 각 공식 구현을 따릅니다. 동일 GPU라는 조건만으로 동일 backend 비교가 되는 것은 아닙니다.
Efficiency Measurement. 원문 식 (5)는 다음과 같습니다.
분자는 확정된 출력 토큰 수이며, 분모는 GravityOCR에서 draft forward와 verify forward를 각각 센 합입니다. vision·prompt prefill은 제외합니다. AR는 정의상 TPF 1이고, round당 accepted draft token에는 경계 예측과 verifier의 추가 토큰을 포함하지 않습니다. 따라서 평균 accepted draft token 17.4와 TPF 9.7은 서로 다른 양입니다.
4.2 Main Results
OmniDocBench. GravityOCR의 Overall 95.16은 base GLM-OCR 95.48보다 0.32점 낮습니다. Text는 둘 다 표시 정밀도에서 0.040이고, TEDS는 0.934→0.928, CDM은 0.970→0.967입니다. 외부 모델 중 MinerU2.5-Pro 95.57, HunyuanOCR-1.5 95.52보다도 낮으므로 정확도 1위라는 주장은 하지 않습니다.
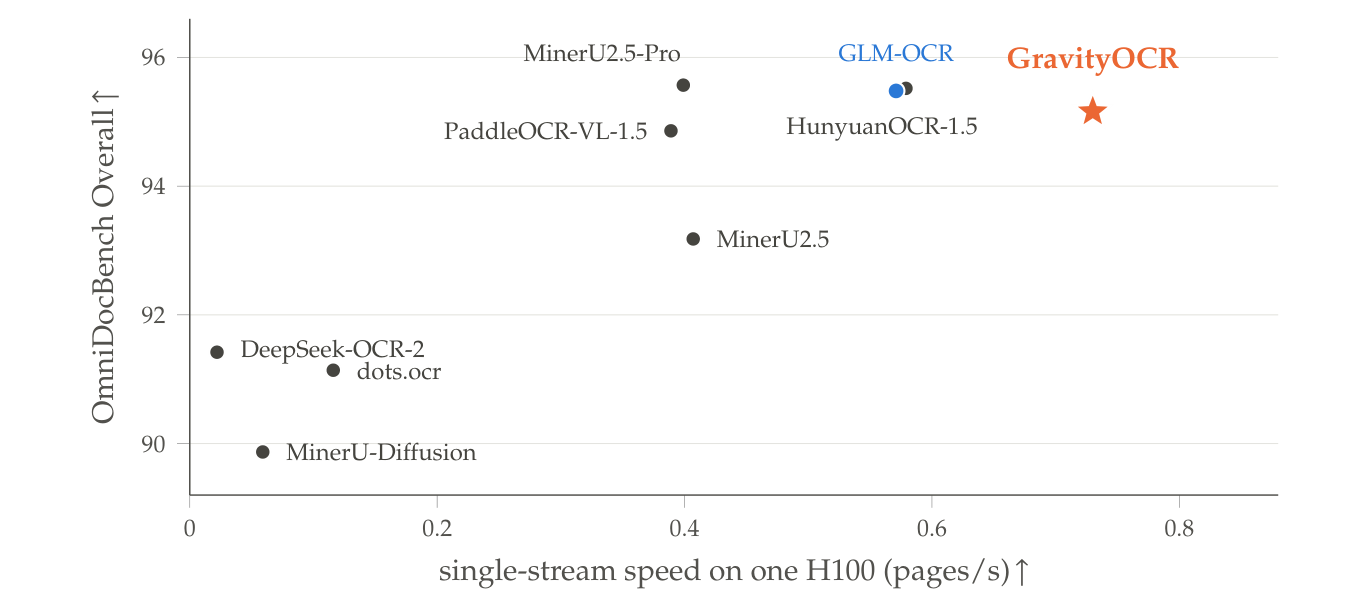
원문 Figure 1, PDF 2쪽. 고정 버전 원문의 그림 영역 크롭이며 내부 번역·수치 변경은 없습니다. 각 축의 평가셋은 시스템 간 동일하지만, 정확도 축과 속도 축 자체의 데이터 범위는 서로 다릅니다.
Page Processing Speed. 원문 Table 1에서 필요한 같은 계열 비교를 재구성하면 다음과 같습니다. 품질은 전체 평가셋, 속도는 100쪽 부분집합의 전체 pipeline 측정입니다.
| 모델·디코딩 | Overall ↑ | TPF ↑ | 전체 pipeline tok/s ↑ | pages/s ↑ |
|---|---|---|---|---|
| GLM-OCR base AR | 95.48 | 1.0 | 807 | 0.571 |
| GLM-OCR base MTP | 95.48 | 3.7† | 667 | 0.472 |
| GravityOCR AR | 95.16 | 1.0 | 794 | 0.554 |
| GravityOCR self-spec | 95.16 | 9.7 | 1,047 | 0.730 |
† MTP의 TPF는 base-model verification 횟수만 세며 보조 drafting 계산은 제외합니다. GravityOCR의 9.7과 같은 계산 예산을 뜻하지 않습니다. backend도 base MTP는 vLLM, 나머지 이 표의 AR/self-spec은 SGLang입니다.
self-spec의 0.730/0.554는 같은 checkpoint AR 대비 약 1.32배입니다. base AR와 비교한 비율은 약 1.28배로 다릅니다. MTP는 TPF가 1보다 높아도 실제 페이지 처리에서는 base AR보다 느립니다. 저자는 이를 통해 forward 수 절감이 wall-clock 개선으로 자동 변환되지는 않음을 보여줍니다.
Table and Formula Recognition. PubTabNet에서는 base 대비 TEDS 0.803→0.871, 구조만의 점수 0.858→0.916으로 개선됩니다. UniMER CDM은 0.963→0.962로 거의 유지됩니다. 따라서 OmniDocBench에서 약간의 손실이 있다는 사실과 별도 표 benchmark의 개선을 함께 읽어야 합니다. Table 1–2, PDF 9–10쪽
4.3 Decoding Efficiency
Inference Backend and Measurement Scope. 같은 checkpoint와 동일 영역 입력을 쓰는 Table 3은 decode-only와 vision·prefill을 포함하는 region end-to-end를 분리합니다.
| Backend | AR decode-only tok/s | Self-spec decode-only tok/s | decode 가속 | 영역 전체 AR → self-spec tok/s | 영역 전체 가속 |
|---|---|---|---|---|---|
| Transformers | 53 | 293 | 5.53배 | 51 → 161 | 3.20배 |
| SGLang | 777 | 3,057 | 3.94배 | 486 → 844 | 1.74배 |
표는 원문 Table 3의 반올림 수치와 원문 가속 배율을 그대로 옮겼습니다. Transformers eager reference는 kernel launch overhead의 비중이 커 블록 처리의 상대 이득이 큽니다. SGLang은 AR 자체가 빨라졌으며 처리 토큰 수에 따라 forward 비용도 증가합니다. 또 decode가 짧아질수록 고정적인 vision·prefill 비용의 비중이 커져 전체 가속은 작아집니다.
Direct Block-Diffusion vs. Self-Speculative Decoding. direct diffusion은 confidence threshold를 낮추어 더 많이 병렬 확정하면 품질이 떨어지는 경향을 보입니다. 약 10 TPF에서 direct diffusion Overall은 92.53, self-speculation은 9.7 TPF에서 95.16입니다. 단, direct diffusion TPF는 별도 cache-write forward를 빼므로 두 값을 같은 실제 연산량으로 해석하지 않습니다.
Throughput Scaling with Batch Size. Figure 6은 RL 전 checkpoint, layout-detected crop, 다른 요청 스케줄로 측정합니다. batch 1에서 1.85배였던 이득은 batch 64에서 AR 1,642 tok/s, self-spec 1,857 tok/s로 1.13배까지 줄어듭니다. 이 1.85배가 최종 checkpoint의 Table 3 값 1.74배와 다른 것은 조건이 다르기 때문입니다. 동시 요청이 많으면 AR도 GPU를 더 잘 활용한다는 것이 저자의 해석입니다.
Decoding Efficiency by Output Type. text 7,019개는 평균 73 token, accepted draft 15.0, TPF 8.5, 가속 1.54배입니다. formula 1,660개는 95 token, 18.9, 10.5, 1.82배이며, table 243개는 872 token, 25.0, 13.5, 3.36배입니다. 저자는 표의 구조적 제약과 긴 출력이 높은 acceptance 및 낮은 고정비 비중에 연결될 수 있다고 해석합니다. §4.3, Table 3–4
4.4 Effect of the AR Loss
Table 5는 최종 40k+GRPO가 아니라 10k 학습 checkpoint끼리의 ablation입니다. AR loss를 쓰면 Overall 95.02·TPF 6.75, 제거하면 93.64·6.96입니다. 초기 모델이 AR이므로 loss를 빼도 causal verification은 가능하지만 인식 품질은 낮아집니다. 비슷한 drafting 효율에서 verifier 정확도를 유지하는 것이 AR supervision의 역할이라는 해석을 지지합니다.
4.5 RL on the AR Path
self-speculation의 Overall은 94.92→95.16, TPF는 9.61→9.68입니다. 이는 RL 후 품질 향상과 drafter 효율 유지가 동시에 관찰되었다는 결과입니다. direct diffusion은 threshold 0.7에서 −0.11점, 0.9에서 −0.01점, 0.95에서 +2.91점, 0.99에서 +0.34점으로, 모든 설정에서 동일하게 개선된 것은 아닙니다. 특히 0.95의 큰 변화는 부록 D에서 수식 실패 사례의 감소로 분석합니다.
챕터의 핵심 기여: 같은 checkpoint 비교와 다른 모델 비교, 품질과 속도, AR loss와 GRPO 효과를 분리해 보고합니다. 다음 챕터로의 연결: 이 설계가 기존 문서 모델과 hybrid 생성 연구의 어느 위치에 있는지 정리합니다. §4.4–4.5, PDF 13쪽
📖 Chapter 5: Related Work
챕터의 위치와 역할: 앞서 측정한 성과가 어떤 선행 연구 계열을 결합한 것인지 설명합니다. 아래 비교는 이 논문의 관련 연구 서술을 정리한 것이며 인용된 모든 논문의 독립 리뷰는 아닙니다.
Document Parsing VLMs. Nougat·olmOCR에서 최근 OCR 특화 VLM으로 이어지는 흐름은 시각 표현, 학습 데이터, 문서 pipeline을 개선하면서 AR 출력을 유지했습니다. 디코딩 가속에서는 GLM-OCR의 MTP head, HunyuanOCR-1.5의 별도 DFlash drafter, HSD의 영역·페이지 수준 검증을 구분합니다. GravityOCR의 차이는 동일 파라미터를 두 모드로 사용한다는 데 있습니다.
Diffusion Language Models. discrete denoising, LLaDA·Dream, Block Diffusion, cache-aware Fast-dLLM, 상보적 마스킹을 쓰는 Fast-dLLM v2 순서로 기반 연구를 설명합니다. 이어 DODO와 MinerU-Diffusion의 OCR 적용을 소개하고, 직접 병렬 확정의 품질과 효율 사이에서 AR 검증을 유지할 동기를 다시 연결합니다.
AR–Diffusion Hybrid Models. SDAR, Fast-dVLM, Nemotron-Labs-Diffusion, TiDAR는 AR checkpoint를 diffusion 또는 복수 모드로 확장하는 관련 계열입니다. 한편 전용 diffusion drafter를 학습하거나 기존 모델을 초안 생성기로 쓰는 연구, 왼쪽부터의 acceptance와 drafter를 정렬하는 연구를 별도로 설명합니다. GravityOCR는 이 중 공유 모델 접근에 속하므로 hybrid 생성 자체를 처음 제안했다고 읽으면 안 됩니다.
Reinforcement Learning for Diffusion Language Models. trajectory likelihood를 근사하거나 step-level gradient를 구하는 연구와 달리 이 논문은 남아 있는 causal factorization을 사용합니다. 저자의 표현대로 확산 RL의 확률 추정 문제를 해결한 것이 아니라 해당 문제를 피하는 구성입니다.
챕터의 핵심 기여: 새 요소를 독립적인 생성 패러다임보다 OCR에 맞춘 공유 모델·검증·RL의 결합으로 위치시킵니다. 다음 챕터로의 연결: 이 범위에서 결론을 제시합니다. §5, PDF 13–15쪽
📖 Chapter 6: Conclusion
챕터의 위치와 역할: 공동 학습으로 만든 diffusion drafter와 AR verifier가 별도 모델 없이 OCR를 가속한다는 주장을 회수합니다. 저자는 AR-path GRPO의 94.92→95.16 개선, base 95.48에 가까운 품질, SGLang의 region decode-only 3.94배와 page end-to-end 1.32배를 다시 제시합니다.
챕터의 핵심 기여: 품질을 대체로 유지하며 공유 파라미터로 병렬 제안과 검증을 수행할 수 있다는 결론입니다. 별도 미래 연구 목록은 제시하지 않습니다. 다음 내용으로의 연결: References 뒤의 부록이 학습 설정·동등성·측정 범위·보상과 정성 사례를 구체화합니다. §6, PDF 15쪽
📖 Chapter References: References
위치와 역할: 원문 PDF 16–19쪽은 앞서 인용한 문서 파싱, diffusion, speculative decoding, GRPO, 데이터셋과 serving 시스템의 서지 목록입니다. 이 리뷰에서는 본문 주장 이해에 필요한 연구 관계를 Chapter 5에서 설명했으며, 참고문헌 목록의 원문들을 모두 검증했다고 주장하지 않습니다. 다음 부록부터는 GravityOCR 자체의 실험을 재현·해석하는 세부사항이 이어집니다.
📖 Chapter A: Training Details
부록의 위치와 역할: 공동 학습의 계산량과 학습 목표가 실제로 구현되는 방식을 구체화합니다.
Table 7의 설정은 H100 16대·2개 node, 40,000 step, warmup 500 이후 선형 감소입니다. AdamW의 두 beta는 0.9·0.999, weight decay는 없으며 peak learning rate는 decoder $2\times10^{-5}$, vision encoder $2\times10^{-6}$입니다. bf16, ZeRO stage 2, gradient clipping 1.0을 사용하고 모든 파라미터를 학습합니다. mask embedding은 기존 embedding 통계에 맞춘 정규분포로 초기화합니다.
Shared-prefix packing. GPU당 packed row 하나, GPU 16개, gradient accumulation 4입니다. row당 forward token 예산은 10,240이고 response cap은 3,072입니다. 비용은 image·prompt를 한 번, 응답을 세 번 세므로 단순 원문 길이로 packing하면 안 됩니다. first-fit와 carry-over를 사용해 보통 한 row에 문서 sample 21–30개를 넣습니다. 따라서 row 단위 batch와 sample 수를 동일시할 수 없습니다.
EOS block fill. 정답 응답 끝에 정확히 $B$개의 EOS를 추가해 block 정렬이 길이 정보를 노출하지 않도록 합니다. diffusion은 EOS 모두에 supervision을 주지만 AR는 첫 EOS만 학습합니다. 저자는 이 제한이 없으면 AR가 EOS를 과도하게 예측하여 Overall이 4점 넘게 떨어진다고 보고합니다.
핵심 기여와 연결: mask token 하나의 추가라는 작은 구조 변경에도, stream accounting과 EOS supervision이 중요함을 보여줍니다. 다음 부록은 inference cache와 출력 동등성을 다룹니다. Appendix A, PDF 20쪽
📖 Chapter B: Decoding Details and Equality Testing
부록의 위치와 역할: 도식으로 이해한 디코딩을 실제 cache 상태 전이와 유한 정밀도 검증까지 확장합니다.
B.1 Direct Block-Diffusion Decoding. 현재 블록을 mask로 초기화한 뒤 threshold 이상인 위치를 고정합니다. 그 조건을 만족하는 위치가 없으면 가장 확신하는 한 위치를 확정합니다. 완성된 블록 뒤에는 별도의 cache-write forward가 필요하며, 이 pass는 토큰 검증·교체를 하지 않습니다. EOS가 있는 블록을 완성하면 첫 EOS에서 잘라 종료합니다.
B.2 Self-Speculative Decoding and KV-Cache Update. 원문은 여섯 단계를 제시합니다. 먼저 cache에는 마지막 boundary token을 제외한 확정 토큰의 causal state가 있습니다. draft forward에서 boundary의 causal state를 쓰고, mask window로 초안을 생성합니다. verify forward는 mask 위치의 KV slot을 재사용하되 bidirectional state를 causal state로 덮어씁니다. 이어 연속 일치 초안과 다음 AR 토큰을 확정하고, 거부된 suffix의 state를 해제합니다. 마지막 AR 예측 토큰은 다음 round의 boundary가 되어 그때 KV state를 얻습니다.
이 과정의 핵심은 다음 round까지 남는 cache는 모두 causal state라는 불변 조건입니다. 검증 forward가 accepted prefix의 cache를 동시에 만들기 때문에 direct diffusion과 같은 추가 cache-write pass가 필요하지 않습니다. 전체 초안이 맞으면 bonus token까지, stop condition이 나타나면 그 지점까지만 확정합니다.
B.3 AR-Equivalence and Equality Testing. exact arithmetic에서는 boundary 예측도 causal하고, accepted draft도 causal top-1과 같으며, 마지막 토큰도 verifier 예측입니다. round를 따라 귀납적으로 동일 checkpoint의 greedy AR 출력과 같다는 설명입니다. 이는 원래 GLM-OCR checkpoint와의 출력 동등성을 뜻하지 않습니다.
실측은 final GRPO checkpoint, SGLang, block 32, greedy, repetition penalty 1.0, output cap 없음, 영어 crop 8,922개입니다. 문자열이 완전히 같은 crop은 96.6%였습니다. 첫 분기 위치의 top-two logit margin 중앙값은 0.14 nats이고, 저자는 AR와 verify의 서로 다른 bf16 attention kernel에서 거의 같은 점수의 argmax가 뒤집히는 현상과 일관된 결과라고 설명합니다. 305개 첫 분기를 fp32로 다시 평가하면 AR token과 일치한 경우 228개, self-spec token과 일치한 경우 77개였으며 65개 위치의 margin은 0.05 nats보다 작았습니다. 이 검사로 bf16 출력이 항상 동일하다고 주장할 수는 없습니다.
핵심 기여와 연결: 이론적 동등성, cache 정합성, 실제 문자열 일치율을 구분합니다. 다음 부록은 속도 측정에서 무엇을 포함하고 제외했는지 정의합니다. Appendix B, PDF 20–21쪽
📖 Chapter C: Speed-Measurement Protocol and Profiles
부록의 위치와 역할: 서로 다른 speedup 수치의 측정 경계를 해명합니다. 모든 속도 표와 Figure 6은 H100 한 대, full resolution, 자연 EOS 종료, 같은 node의 다른 job 없음이라는 조건입니다.
What each speed table measures. Table 1은 페이지 단위 wall-clock입니다. GLM 계열에서는 layout에 페이지당 112–146ms가 들고, crop·recognition·markdown assembly를 포함합니다. 한 페이지씩 입력하지만 그 안의 약 18개 영역 요청은 동시에 보냅니다. MinerU는 자체 두 단계 pipeline과 약 1.3초의 무거운 layout을 사용하고, full-page 모델은 단일 요청으로 처리합니다. 따라서 model-level decoder 비교와 system-level 페이지 비교를 구분합니다.
RL 전의 별도 concurrency 실험에서는 영역 요청을 순차 처리하면 self-spec/AR가 0.420/0.273 pages/s로 1.54배, 약 18개를 함께 보내면 0.781/0.581로 1.34배입니다. 동일한 한 페이지라도 내부 요청 스케줄이 이득을 바꿉니다.
Table 3은 정답 annotation 경계 crop 8,922개를 하나씩 직접 입력하며 layout·page assembly가 없습니다. 여기서 end-to-end는 vision+prefill+decode입니다. Figure 6은 RL 전 checkpoint와 영어 755쪽의 layout-detected crop을 쓰고, layout은 미리 실행해 시간에서 제외합니다. 충분히 채운 client queue와 server의 running-request cap으로 batch 효과를 측정합니다.
Forward-count accounting. MTP·DFlash는 보조 drafter 계산을 TPF에서 빼고 base verification만 셉니다. GravityOCR는 두 full-model forward를 모두 셉니다. 직접 diffusion은 토큰을 확정한 forward만 세고 prefill·완성 블록 cache-write를 뺍니다. 같은 TPF 축의 그림도 이 accounting 차이를 함께 읽어야 합니다.
핵심 기여와 연결: 속도는 decode·request·page 중 어느 경계를 측정했는지, backend와 concurrency가 무엇인지에 의존함을 명시합니다. 다음 부록은 길이와 draft schedule 등 변수를 더 세분합니다. Appendix C, PDF 22쪽
📖 Chapter D: Additional Results
부록의 위치와 역할: 평균 수치 뒤의 출력 길이·draft 전략·학습 마스킹·특이한 RL 결과를 원문 순서대로 분석합니다.
Speedup by Output Length. Table 8에서 128 token 미만 7,257 crop의 accepted draft는 14.8, TPF 8.4, 전체 영역 가속 1.43배입니다. 128–511은 1,496개·18.1·10.1·2.02배, 512–1023은 92개·18.4·10.2·2.76배, 1024 이상은 77개·23.9·12.9·3.68배입니다. 긴 출력에서는 decode가 전체 시간에서 차지하는 비중과 draft acceptance가 함께 늘어납니다. 저자는 표가 특히 빨라지는 현상의 상당 부분도 길이 효과로 설명합니다. 가장 긴 구간이 77개인 점도 평균 해석에 포함해야 합니다.
Draft Schedule. 400개 영어 crop에서 draft-side threshold로 여러 denoising step을 쓰게 만들면 round당 채택 토큰은 늘어납니다. 그러나 추가 token보다 추가 forward 비용이 커져 TPF는 감소합니다. 최종 배포가 one-shot draft를 쓰는 이유입니다. 여기서 draft를 다듬는 threshold와 직접 diffusion에서 출력 자체를 확정하는 threshold는 역할이 다릅니다.
Direct-Diffusion Quality. GRPO 후 direct diffusion은 threshold를 높일수록 품질이 오르고 병렬성이 떨어집니다. 가장 높은 품질의 직접 diffusion 설정도 self-spec보다 Overall과 TPF 모두 낮습니다. 이는 해당 sweep의 보고 결과입니다.
Mask Schedule. all-mask와 uniform partial masking을 같은 학습 조건으로 비교하면 all-mask는 여섯 checkpoint 모두 TPF가 낮고, 품질도 여섯 중 다섯에서 낮습니다. 10k 시점에는 all-mask 94.86·6.66, uniform 95.02·6.75입니다. one-shot inference에서 전부 mask를 쓴다고 해서 학습도 전부 mask로 고정하는 것이 낫지는 않았습니다.
The threshold 0.95 Gap After GRPO. direct diffusion에서 +2.91점 개선이 유독 컸던 이유를 원문은 formula 결과로 추적합니다. 수식 2,352개 중 CDM 0인 출력이 GRPO 전 116개에서 이후 37개로 감소했습니다. 이 조건의 실패 감소가 pre-GRPO threshold 곡선의 비단조성에도 연결됩니다.
핵심 기여와 연결: 평균 속도의 구성과 구체적인 실패 변화를 보여줍니다. 다음 부록은 이 RL 업데이트를 만든 reward와 sampling을 명시합니다. Appendix D, PDF 22–24쪽
📖 Chapter E: RL Details
부록의 위치와 역할: AR-path GRPO가 무엇을 보상하고 어떤 데이터로 학습했는지를 재현 가능한 수준으로 설명합니다.
Optimization. 40k 공동 학습 checkpoint에서 LoRA 없이 전체 모델을 fine-tuning합니다. step당 prompt 24개·각 28 rollout으로 총 672 completion을 생성합니다. group 안에서 advantage를 표준화하고 token-level loss를 사용합니다. clipping 범위의 계수는 아래쪽 0.2, 위쪽 0.28이며 초기 checkpoint의 frozen copy에 대한 KL penalty 계수는 $10^{-3}$입니다. learning rate $3\times10^{-6}$, cosine decay, 8-bit AdamW, bf16, gradient clipping 1.0을 사용합니다. 500 step 결과는 prompt pool의 약 1.6 epoch에 해당합니다. 길이 제한으로 잘린 completion은 loss에서 제외합니다.
Rollouts. causal AR policy에서 temperature 1.0, nucleus truncation 없음, 최대 completion 8,448 token으로 sampling합니다. colocated vLLM을 사용하고 학습 framework에서 causal log-probability를 다시 계산하며 두 kernel 사이의 token-level importance-sampling correction을 적용합니다. 강화학습 rollout이 곧 self-speculative inference와 동일한 sampling 경로인 것은 아닙니다.
Rewards. 먼저 예측과 정답을 공식 scorer와 같은 markup 규칙으로 정규화합니다. plain text는 normalized Levenshtein similarity를 씁니다. 표의 기본 reward는 다음과 같습니다. 원문의 clip 연산은 upright 함수 표기로 옮겼습니다.
$\mathrm{TEDS}_s$는 구조만의 TEDS, $s_{\mathrm{cell}}$은 읽기 순서로 이어 붙인 셀 문자열의 normalized edit similarity입니다. $p_{\mathrm{row}}$는 정답 행 수보다 많거나 적은 정도에 대한 penalty로, 두 방향 각각 최대 0.35입니다. 정규화 분모는 정답 행 수와 4 중 큰 값입니다. $p_{\mathrm{loop}}$는 허용된 횟수를 넘는 행 반복의 비율 $f$로 계산하며, 반복이 없으면 0, 있으면 $\min(1,0.30+0.70f)$입니다. 반복 허용 기준은 행 key별로 3과 정답 반복 횟수+1 중 큰 값입니다.
그 다음 행 수·열 수가 정답과 일치할 때 각각 0.05의 bonus를 합산해 $r\leftarrow r+b(1-r)$로 보정합니다. 닫히지 않은 table tag는 0점이며, 파싱할 수 없는 표는 단순 edit similarity의 0.15배를 줍니다. 보상에는 인식 내용뿐 아니라 출력의 구조적 유효성을 반영합니다.
수식 reward는 다음과 같습니다.
$\hat y$와 $y$는 예측과 정답 LaTeX, $\mathrm{sim}$은 normalized Levenshtein similarity입니다. $\mathrm{canon}$은 수학 delimiter를 제거하고 \dfrac·\tfrac를 \frac로 통일하며 \left·\right, spacing command, 공백과 중괄호를 제거합니다. $v$는 정답에서는 통과하지만 예측에서는 실패하는 형식 검사 수입니다. 검사 대상은 left/right·중괄호·begin/end의 균형과 escape되지 않은 dollar 기호의 짝입니다. 한 항목 실패할 때마다 0.3배로 감점되며, 렌더링 기반 CDM 자체는 reward로 사용하지 않습니다.
마지막으로 모든 reward에 퇴행적 반복을 줄이는 guard를 곱합니다.
$\rho_8$은 distinct 8-gram 비율이며 공백 구분 token이 16개 이상일 때만 계산하고, 짧으면 1입니다. $L_{\mathrm{run}}$은 같은 문자가 연속된 최대 길이입니다. 문자열의 과도한 반복이 높은 보상을 얻지 않도록 두 신호 중 작은 값을 사용합니다.
Prompt pool. 7,723개 crop 중 table 92%, text 6%, formula 2%입니다. table·formula의 정답은 원래 annotation이고 text는 teacher 전사입니다. benchmark 이미지는 없으며 PubTabNet은 train split만 사용합니다. prompt당 사전 rollout 8개로 reward variance가 0인 항목을 제거하고, 어렵고 긴 표 쪽으로 채굴했습니다. reference 길이 중앙값은 약 1,900자입니다. 따라서 이 RL 결과를 균등한 세 과제 데이터로 얻은 결과라고 설명하면 안 됩니다.
핵심 기여와 연결: token likelihood 이후에 무엇을 개선하도록 학습했는지 구체화합니다. 마지막 부록은 실제 출력에서 초안의 채택과 거부가 어떻게 나타나는지 보여줍니다. Appendix E, PDF 24–25쪽
📖 Chapter F: Qualitative Examples
부록의 위치와 역할: final GRPO checkpoint의 text, formula, table crop을 순서대로 제시합니다. Figure 8은 text, Figure 9는 LaTeX와 렌더링, Figure 10은 HTML과 렌더링입니다. 색은 토큰 확정 round를 나타내고 빨간 표시가 draft를 거부해 AR token으로 바꾼 위치입니다.
원문 Figure 8의 52 token text는 3 round, Figure 9의 105 token formula는 5 round, Figure 10의 214 token table은 8 round 사례입니다. round는 draft와 verify의 forward 두 번이므로 round 수를 forward 수라고 부르면 안 됩니다. EOS도 확정한 round의 색으로 표시합니다. 저자는 이 부록에 제시한 crop들의 self-spec 출력이 같은 가중치의 greedy AR와 byte-identical하다고 명시합니다. 선택된 사례의 일치는 부록 B의 전체 crop 일치율 96.6%를 대체하지 않습니다.
부록의 핵심 기여: 병렬 제안과 부분 거부가 직렬화된 실제 출력에 어떻게 대응하는지 보여줍니다. 이 부록이 원문의 마지막 분석 자료입니다. Appendix F, PDF 25–28쪽
실험 결과 심층 분석
가장 직접적인 가속 근거는 동일한 GravityOCR checkpoint에서 AR와 self-speculation을 바꾼 비교입니다. SGLang의 region decode-only 777→3,057 tok/s는 생성 단계의 개선이고, vision·prefill을 더하면 486→844 tok/s로 이득이 줄어듭니다. 페이지 pipeline에서는 0.554→0.730 pages/s입니다. 이를 하나의 “OCR가 3.94배 빠르다”는 문장으로 합치면 사용자가 실제 경험할 처리 속도를 과장하게 됩니다.
품질 보전도 두 종류의 비교가 있습니다. 같은 adapted checkpoint의 AR와 self-speculation은 공식 집계 표에서 모두 95.16이지만, bf16 출력 문자열은 전부 같지는 않습니다. 반면 원래 GLM-OCR와 GravityOCR는 학습된 가중치부터 다르며 95.48→95.16의 손실이 있습니다. exact-arithmetic 출력 동등성은 첫 번째 비교에 관한 이론이지, base 모델의 인식률을 수학적으로 보전한다는 주장이 아닙니다.
표 인식의 개선은 별도 PubTabNet 결과로 확인됩니다. 그러나 전체 adaptation, 학습 데이터, table 중심 GRPO pool이 함께 존재하므로 0.803→0.871을 GRPO 하나의 효과로 단정하지 않습니다. GRPO 단독 전후 근거는 Table 6의 Overall +0.24점과 TPF 유지입니다. AR loss ablation도 10k checkpoint 조건에 국한해 해석합니다.
원문에는 핵심 성능 차이에 대한 통계적 유의성 검정이나 신뢰구간이 보고되지 않았습니다. 따라서 작은 Overall 변화가 통계적으로 유의하다고 주장하지 않습니다. 속도는 backend·요청 단위·동시성·출력 길이를 세분해 제시하여 실용적 조건을 분석할 수 있지만, 논문에 없는 다른 GPU나 한국어 문서의 속도로 확장하지 않습니다. 특히 학습 corpus가 주로 영어이고 속도 평가도 영어 부분집합이라는 조건은 원문이 명시합니다.
재현성 측면에서 학습 hyperparameter, stream 구성, loss normalization, EOS 처리, cache 갱신, reward 계수, speed protocol을 부록에 구체적으로 제공한다는 점이 유용합니다. 원문 첫 페이지에는 코드·문서와 model weight 링크도 제시되어 있습니다. 이 리뷰는 해당 구현의 실행 재현까지 확인한 것은 아니며, 제공된 논문 설명과 수치를 분석한 결과입니다.
기술적 함의와 응용
이 연구가 보여주는 중요한 설계 원리는 병렬 예측이 최종 출력 결정권을 가질 필요는 없다는 것입니다. GravityOCR에서는 diffusion이 여러 가능 위치를 저렴한 round 수로 제안하고, causal AR가 실제 채택할 구간을 결정합니다. 저자가 보고한 직접 diffusion의 누락·중복 사례는 이 분리가 필요한 이유이며, 검증된 초안의 길이는 속도 이득을 결정하는 변수입니다.
리뷰어의 해석으로, 데이터과학 관점에서 특히 배울 부분은 지표의 측정 경계를 끝까지 유지하는 태도입니다. TPF가 높아져도 forward당 비용, vision encoding, prefill, layout, 요청 동시성에 따라 페이지 처리 이득은 달라집니다. 짧은 text가 많은 workload와 긴 구조화 table이 많은 workload에 같은 가속 배율을 적용할 수 없는 이유가 실험으로 드러납니다.
강화학습 측면에서는 공유 파라미터와 명확한 causal likelihood가 갖는 실용성이 나타납니다. diffusion trajectory의 확률 추정을 새로 해결하지 않고도 최종 출력의 기준 경로에 구조·내용 보상을 적용할 수 있었습니다. 다만 drafter의 효율이 계속 유지된다는 것은 공유 구조만으로 보장된 결론이 아니라 이 논문의 GRPO 조건에서 확인한 결과입니다.
GravityOCR는 원래 모델의 품질과 실제 계산 정밀도에 대한 조건을 남겨 두면서, 한 모델 안에서 block drafting과 AR verification을 결합해 문서 OCR를 가속한 사례입니다. 논문은 별도의 미래 연구 목록을 제시하지 않으므로 이를 임의로 추가하지 않습니다.
검토 범위: 본문 1–6절과 부록 A–F의 모든 하위 주제를 반영했습니다. 참고문헌의 각 논문을 독립적으로 재검토하지 않았으며, 외부 parser 전체 행·mask schedule의 모든 중간 checkpoint·정성 그림의 모든 원시 출력 문자열은 전사하지 않았습니다. 본문에 재구성한 표와 수식은 고정 버전 원문을 기준으로 합니다.