논문 개요와 전체 구조
TabPFN-3는 합성 표 데이터로 사전학습한 모델에 실제 학습 표를 문맥으로 제공하여 새로운 행을 예측하는 tabular foundation model입니다. 이 기술 보고서의 중심 질문은 이 방식의 성능을 유지하면서 학습 행을 100만 개까지 늘리고, 반복 예측의 메모리와 지연 시간을 줄일 수 있는가입니다. 답은 행을 먼저 고정 차원으로 압축하는 아키텍처, 전체 데이터의 통계를 보존하는 chunking, 작은 KV cache, 더 다양한 합성 사전분포의 결합입니다.
이 글은 Prior Labs Team의 2026년 5월 28일 arXiv v2, 총 83쪽을 분석합니다. PDF 표지의 보고서 날짜인 5월 12일과 버전 수정일을 구분합니다. 기존 TabPFN v2의 단순한 설정 변경을 설명하는 문서가 아니라, TabPFN-3 본체와 여러 확장 모델의 설계·평가·배포 범위를 함께 제시한 보고서입니다. 원문과 버전 이력
모델 이름부터 구분해야 결과를 올바르게 읽을 수 있습니다.
| 이름 | 이 보고서에서의 역할 | 결과를 읽을 때의 경계 |
|---|---|---|
| TabPFN-3 | 숫자·범주형 표의 분류·회귀 모델 | 공개 가중치의 기본 모델이며, 추정기 앙상블 설정에 따라 비용이 달라집니다. |
| TabPFN-3-Plus | 텍스트 열을 직접 처리하는 확장 | API·기업 배포 모델의 결과를 기본 모델에 그대로 귀속할 수 없습니다. |
| TabPFN-3-Plus (Thinking) | Plus에 추가 추론 계산을 적용 | 그림의 TabPFN-3-Thinking과 같은 이름이며, 내부 알고리즘 전체가 보고서에 기술되어 있지는 않습니다. |
| TabPFN-TS-3 | 합성 시계열로 미세조정한 별도 checkpoint | 일반 표 모델의 시계열 zero-shot 결과와 구별합니다. |
| TabPFN-REL | TabPFN-3를 사용하는 관계형 예측 모델 | 관계형 foundation model과 개별 과제에 학습한 supervised 모델을 나누어 비교합니다. |
원문의 전개 순서는 다음과 같습니다. 본문 리뷰에서도 이 순서를 유지합니다.
- Introduction
- TabPFN-3: Architecture → Many-class Decoder → Preprocessing → Inference Optimization(Row-Chunking, KV-cache, Distillation, Compilation/FlashAttention-3, Interpretability) → Synthetic Prior → Plus and Thinking mode
- Experimental Results: Public Tabular Benchmarks(TabArena, TALENT, TabSTAR) → Internal Benchmarks(Large Data, Many-Class, Many Features, Quantile Regression) → Time-Series Forecasting → Relational Data → Causal Inference → Embeddings
- Adoption: Community → Enterprise → Platform → Research Adoption
- License and Availability
- References
- Appendix A–I: Contributors → Acknowledgements → Architectural Hyperparameters → Prior visualizations → Experimental results details → Internal benchmark details → Inference time details → Time-series results → Use Case Overview
핵심 기여와 혁신성
기존 TabPFN-2 계열은 행 방향과 특징 방향 attention을 반복하면서 셀 수준의 관계를 표현했습니다. 그러나 행과 열이 동시에 증가하면 중간 활성값과 캐시가 커집니다. TabPFN-3는 열의 분포를 이해한 뒤 각 행의 특징을 압축하고, 압축된 행들 사이에서 문맥 학습을 수행하는 세 단계로 계산을 분리합니다. 이 전체 틀은 TabICL 계열의 설계를 계승하며, 보고서는 그 위에 many-class decoder, 직교 초기화 label embedding, chunking, test-side multi-query attention을 추가했다고 설명합니다. 모든 구조를 새로 발명했다고 읽어서는 안 됩니다. §2.1, Figure 5
두 번째 기여는 모델 정확도뿐 아니라 동일한 학습 표로 여러 번 예측하는 비용을 설계의 중심에 놓았다는 점입니다. 전체 학습 표를 요약하는 상태를 한 번 계산한 뒤 나누어 처리하고, 학습 측 key/value를 재사용합니다. 이로써 원문이 제시하는 100만 행의 단일 GPU 실행과 반복 예측 가속이 연결됩니다. 다만 100만 행·2만 특징을 동시에 검증한 결과는 아닙니다. 보고서의 성능 검증 범위는 100만 행×200특징, 10만 행×2,000특징, 1,000행×2만 특징이라는 서로 다른 영역입니다. Figure 4
세 번째 기여는 사전분포와 downstream 확장의 폭입니다. 다양한 인과 그래프와 함수, 범주형·공간·시간·분포 이동 구조를 합성 데이터에 포함하고 8조 개 초과의 토큰으로 사전학습했습니다. 이는 데이터셋 개수나 실제 관측 행 수가 아닙니다. Thinking은 추가 추론 계산을 통해 성능을 더 높이며, 시계열·관계형·텍스트 표에도 확장을 제시합니다. 리뷰어 관점에서 의미 있는 변화는 “작은 표의 빠른 분류기”가 반복 추론과 여러 구조화 데이터 업무를 지원하는 공통 기반으로 확장되었다는 점입니다. 이 해석은 각 실험의 성공 범위 안에서 이해해야 합니다.
기술적 세부사항
입력에서 예측까지
입력 표를 $X\in\mathbb{R}^{N\times F}$라고 하겠습니다. 여기서 $N$은 행 수, $F$는 특징 수이며, 원문 그림의 열 수 기호 $C$와 클래스 수 기호를 혼동하지 않도록 이 글에서는 특징 수를 $F$로 표기합니다. 학습 행에는 관측 label이 있고, 테스트 행의 label은 예측 대상입니다.
각 특징을 순환 이동한 이웃 특징들과 세 개씩 묶어 embedding하고 결측 신호를 함께 제공합니다. Stage 1은 특징별로 128개 inducing point를 사용해 열의 분포를 표현합니다. Stage 2는 행마다 네 개의 CLS token에 특징 정보를 모은 뒤 연결합니다. 기본 차원 128을 네 번 연결하므로 ICL 입력 행 벡터는 512차원입니다. Stage 3의 24개 Transformer block에서 학습 행은 서로 attention하고, 테스트 행은 학습 행을 참조합니다. §2.1, Appendix C
분류를 label retrieval로 바꾸는 수식
§2.2의 decoder는 테스트 행과 학습 행의 유사도를 attention 가중치로 바꾸고 학습 label을 가중 평균합니다.
$m$은 테스트 행, $n$은 학습 행, $h$는 attention head입니다. $q_m^{(h)}$와 $k_n^{(h)}$는 학습한 투영으로 만든 query와 key이고, $D_h$는 head 차원입니다. $y_n$은 학습 행의 one-hot label이며 $p_m$은 클래스 확률 벡터입니다. 클래스 이름 자체를 출력 뉴런의 고정 위치에 연결하는 대신, 비슷한 문맥의 학습 행이 가진 label을 모읍니다. 마지막에는 확률을 clipping한 뒤 로그를 취해 logit으로 변환합니다. 원문의 compact 식이며, 실제 attention에는 길이에 따른 QASSMax 조정도 적용된다는 설명이 함께 있습니다. §2.2
이 식의 decoder parameter 수는 클래스 수와 독립적이지만 공개 checkpoint는 최대 160개 클래스를 지원합니다. 학습된 label embedding과 decoder에 공급되는 one-hot tensor에 상한이 있기 때문입니다. 수식 수준의 확장성과 현재 모델의 지원 범위를 분리해야 합니다.
합성 사전의 인과 구조
Figure 9는 각 변수의 값을 부모 변수와 잡음으로 만드는 구조방정식을 사용합니다.
$X_i$는 합성 데이터의 한 변수, $\mathrm{pa}(X_i)$는 DAG에서 그 변수의 직접 부모들, $f_i$는 부모 값을 결합하는 함수, $\varepsilon_i$는 해당 노드의 잡음입니다. 그래프의 위상 순서에 따라 부모를 먼저 계산한 뒤 자식으로 값을 전파합니다. 마지막에 일부 변수를 특징과 target으로 선택하고 나머지는 관측되지 않는 변수로 남깁니다. 합성 데이터의 구조를 다양화하는 수식이지, 실제 사용자의 표에서 인과 그래프를 자동으로 식별했다는 뜻은 아닙니다. §2.5, Figure 9
서로 다른 실험 수치를 합산하는 방식
내부 benchmark의 식 (1)은 각 dataset·fold에서 모델 집합 $\mathcal B$의 점수를 min–max 정규화합니다.
$s^{(b)}_m$은 모델 $b$의 원래 지표 $m$ 값입니다. 손실처럼 작을수록 좋으면 계산 뒤 $1-\widetilde{s}^{(b)}_m$으로 뒤집습니다. 따라서 그림의 Normalized ROC-AUC 1.00은 실제 ROC-AUC가 1.00이라는 뜻이 아니라, 비교 집합에서 최고 정규화 점수를 얻었다는 뜻입니다. 비교 모델 집합이 바뀌면 정규화 기준도 달라질 수 있습니다. Appendix F.1
챕터별 상세 리뷰
📖 Chapter 1: Introduction
챕터의 위치와 역할: 표 데이터 예측의 발전 과정과 v3가 해결하려는 사용상 병목을 연결합니다.
원문은 임상 위험 예측, 신용 평가, 예방 정비, 과학 관측처럼 표가 핵심 입력인 문제에서 출발합니다. 그 다음 gradient-boosted tree가 오랫동안 기본 선택지였으며, 작은·중간 크기 표의 benchmark에서는 tabular foundation model이 강한 예측기로 등장했다고 설명합니다. 이 주장은 해당 benchmark 범위의 변화이며 모든 산업 표 데이터에서 트리가 대체되었다는 선언은 아닙니다.
이어 v1은 약 1,000행의 깨끗한 수치형 분류 문제, v2는 1만 행·범주형·결측·이상치, 2.5는 10만 행·2,000특징으로 범위를 넓혔다고 정리합니다. 이 흐름에서 v3의 요구사항은 100만 행, 작은 메모리, 빠른 반복 예측, 다수 클래스, 예측분포, downstream 확장입니다. 원문은 사용자와 커뮤니티의 피드백이 이러한 선택에 영향을 주었다고 명시합니다.
핵심 기여: 성능 개선의 목적을 대규모 표와 실제 반복 추론에 연결합니다. 다음 챕터로의 연결: 이러한 요구를 충족하는 구조·사전·추론 기법을 §2에서 순서대로 설명합니다.
📖 Chapter 2: TabPFN-3
챕터의 위치와 역할: 모델이 어떻게 표를 처리하고 어느 단계에서 계산량을 줄이는지 설명하는 기술적 중심부입니다. 원문 §2
2.1 Architecture: 열 이해, 행 압축, 행 간 문맥 학습
저자는 먼저 v1의 행 embedding, v2 계열의 반복적인 행·특징 attention을 비교한 뒤 TabICL의 두 단계 행 압축 설계를 도입합니다. 특징을 순환 이동한 이웃들과 triplet으로 묶고 선형 투영하며, 학습 행에는 target-aware embedding을 더합니다. 그 뒤 세 단계를 적용합니다.
- Feature distribution embedding: 특징 열별로 독립적인 inducing-point attention을 사용합니다. 전체 행 사이의 완전 attention 대신 작은 대표 상태를 통해 분포 정보를 수집합니다.
- Feature aggregation: 각 행의 특징 embedding과 학습 가능한 CLS token이 비인과 attention으로 정보를 교환합니다. CLS 네 개를 연결하면 특징 수와 독립적인 크기의 행 표현을 얻습니다.
- In-context learning: 학습 행끼리의 관계를 형성하고 테스트 행이 학습 행을 참조하여 예측합니다. 이 단계의 sequence 길이는 특징 수가 아니라 행 수에 비례합니다.
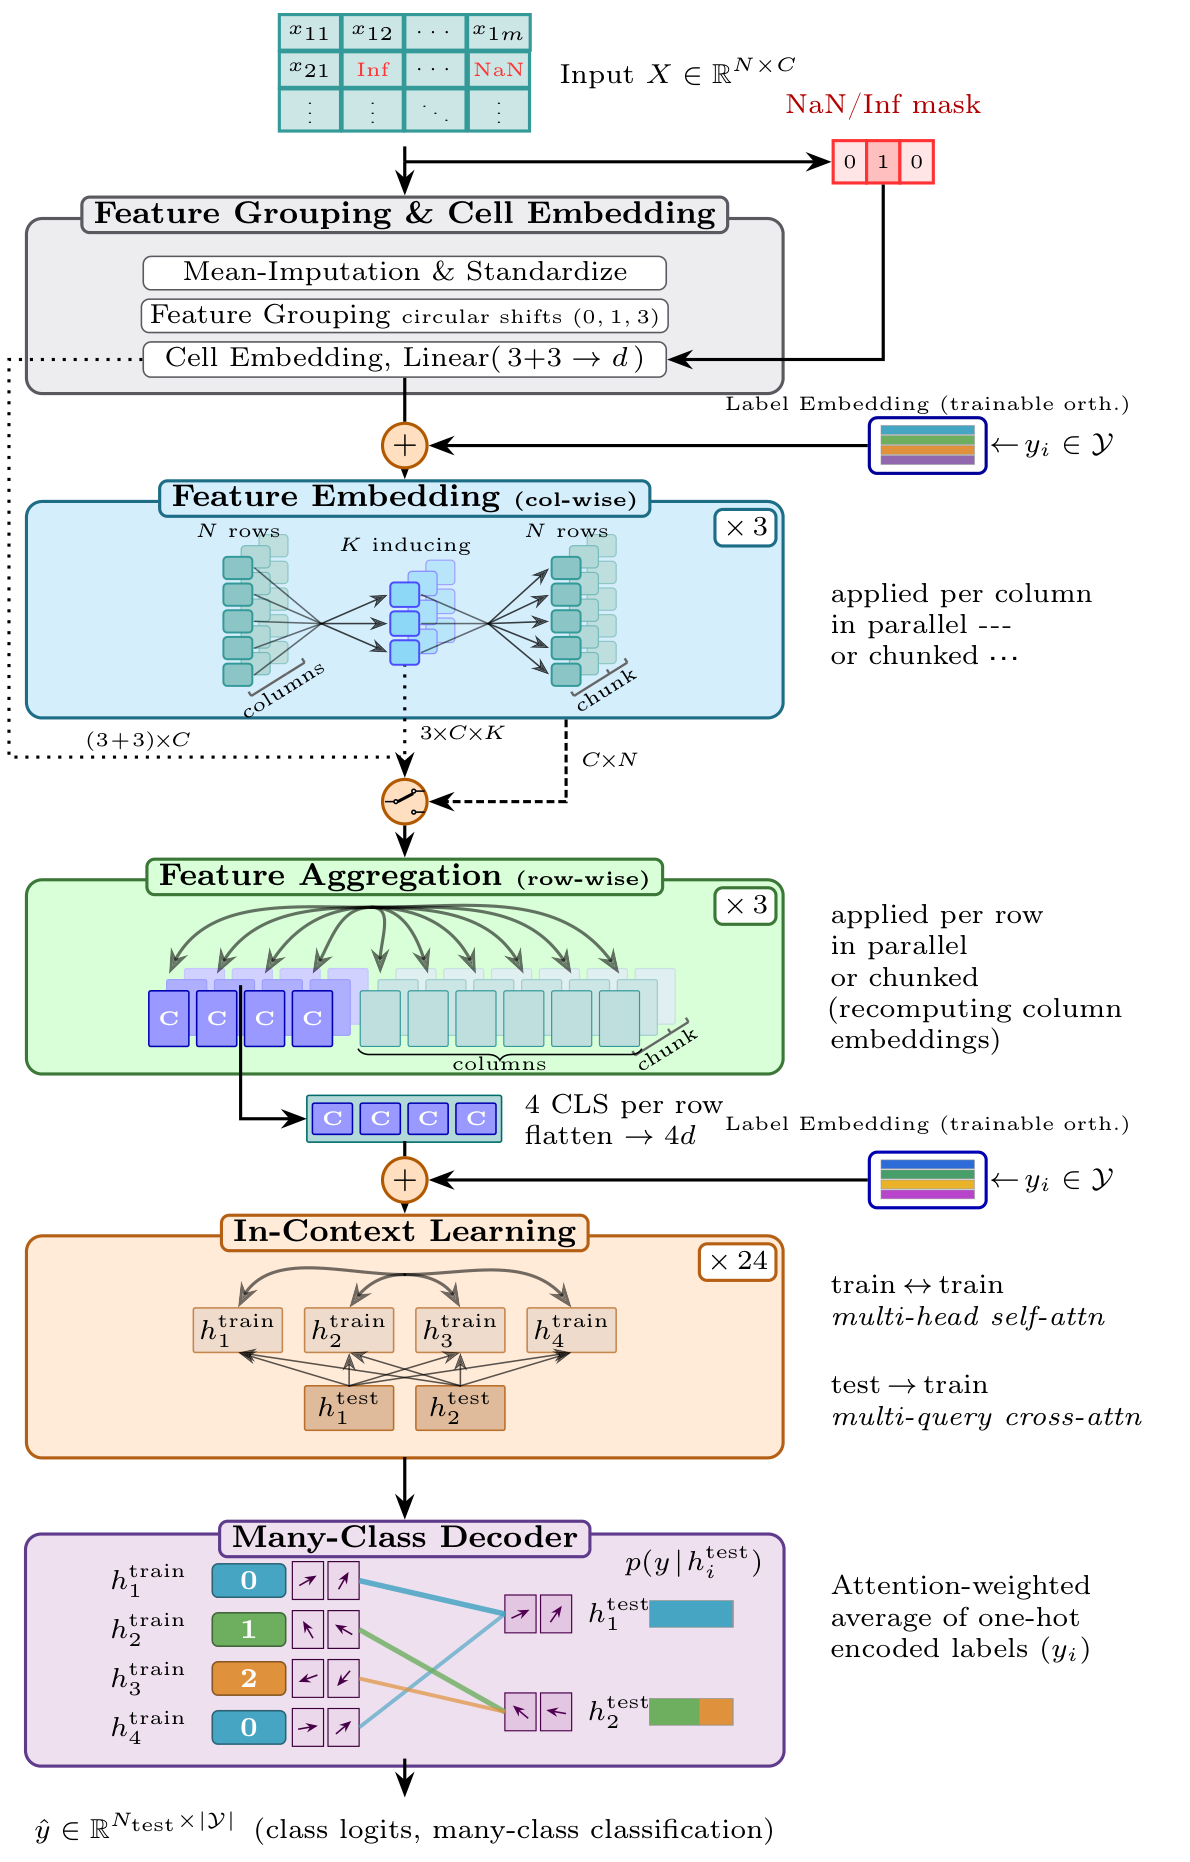
Figure 5, PDF 6쪽. arXiv 2605.13986v2의 원문 그림을 크롭했으며, 그림 내부의 표기와 수치는 번역·변경하지 않았습니다.
원문은 이 구조 위의 변경점을 many-class decoder, row-chunking, test-side multi-query attention, 직교 분해로 초기화한 label embedding, RMSNorm, 결측 indicator 순으로 제시합니다. 직교 label embedding은 학습 시작 시 클래스 표현을 충분히 분리하는 역할이며, 고정된 one-hot class output을 그대로 늘리는 방식과 다릅니다. 결측 셀은 값과 이진 결측 신호를 함께 embedding합니다. Figure 5에 평균 대치·표준화가 있으므로 “아무 대치도 하지 않는다”기보다 대치된 수치와 결측 여부를 구별할 수 있다고 이해하는 편이 정확합니다.
2.2 Many-class Decoder: 고정 output head에서 문맥 label의 검색으로
이어서 저자는 앞서 제시한 attention 가중 평균 식을 통해 분류 head를 설명합니다. 학습 행의 최종 embedding이 key, 테스트 embedding이 query, 학습 행의 one-hot label이 value가 됩니다. 클래스 인덱스를 재명명하면 예측 확률의 인덱스도 함께 바뀌는 permutation equivariance를 갖도록 설계한 것입니다.
그러나 클래스 개수에 비모수적이라는 설명 뒤에 checkpoint의 실제 상한이 등장합니다. 열 encoder와 ICL Transformer에 쓰는 학습 가능한 label embedding 두 개, decoder의 one-hot value tensor가 사전학습 시 160개 클래스에 맞추어져 있습니다. 상한을 늘리려면 이 학습 설계도 함께 바꾸어야 합니다. Appendix C에 따르면 retrieval decoder는 6개 head, head당 64차원을 사용합니다. “임의의 클래스 수”라는 서두의 구조적 설명을 현재 가중치로 무제한 분류할 수 있다는 의미로 읽지 않습니다.
2.3 Preprocessing: 서로 다른 표 변환을 사용하는 앙상블
다음은 여러 estimator가 서로 다른 데이터 순열·특징 변환에 따라 예측한 뒤 결합하는 절차입니다. robust scaling과 soft clipping, quantile transformation, standard scaling을 조합하고 일부 estimator에는 SVD 성분을 추가합니다. 이 보고서에서 estimator는 매번 새 Transformer를 지도학습한다는 뜻이 아니라, 서로 다른 입력 변환을 통해 같은 계열의 예측을 여러 번 얻는 단위입니다.
특징 선택은 round-robin 방식으로 coverage를 높이고, 10만 행을 넘는 경우에는 작은 부분표에 학습한 가벼운 tree의 Gini importance를 이용합니다. 따라서 “downstream에서 어떤 모델도 학습하지 않는다”는 강한 표현은 전처리 전체를 설명하지 못합니다. quantile normalization 등을 GPU에서 처리해 전처리 시간도 줄입니다. 필요에 따라 decision threshold tuning과 temperature scaling을 제공한다는 설명이 이어집니다.
2.4 Inference Optimization: 각 비용을 다른 방법으로 줄이기
2.4.1 Row-Chunking. 압축 전 단계는 행×특징×embedding 차원의 활성값을 만들기 때문에 메모리가 먼저 부족해질 수 있습니다. 단순히 행을 잘라 별개의 작은 표처럼 실행하면 열 분포 요약도 달라집니다. 이를 피하려고 전체 학습 행에서 inducing state를 먼저 구하되 독립적인 열 방향을 나누어 계산합니다. 이후 행을 일정 크기의 chunk로 흘려보내면서 같은 inducing state를 재사용하고 최종 행 embedding을 연결합니다. 저자는 이를 나누지 않은 계산과 동등한 방식이라고 설명합니다. 학습·테스트 행의 합이 2,048보다 클 때 chunking을 활성화합니다.
이 방법은 행 간 ICL attention 자체를 선형 시간으로 바꾸지 않습니다. 원문은 특징을 압축한 뒤에도 ICL의 행 attention이 행 수의 제곱에 비례하며, 기존 방식에 있던 특징 수의 선형 인자를 제거한다고 설명합니다. Figure 6의 메모리 감소와 속도 향상을 구분해야 하는 이유입니다.
2.4.2 Fast Inference with a Small KV-cache. 캐시는 열 분포 embedder의 inducing state, ICL 각 block의 학습 측 key/value, many-class decoder용 최종 학습 embedding을 보관합니다. 대부분의 큰 항이 행×특징 대신 행 수에 비례합니다. 학습 행끼리는 8개 KV head를 유지하지만 테스트가 학습 행에 접근할 때는 KV head 하나를 사용하여 해당 캐시 비용을 줄입니다.
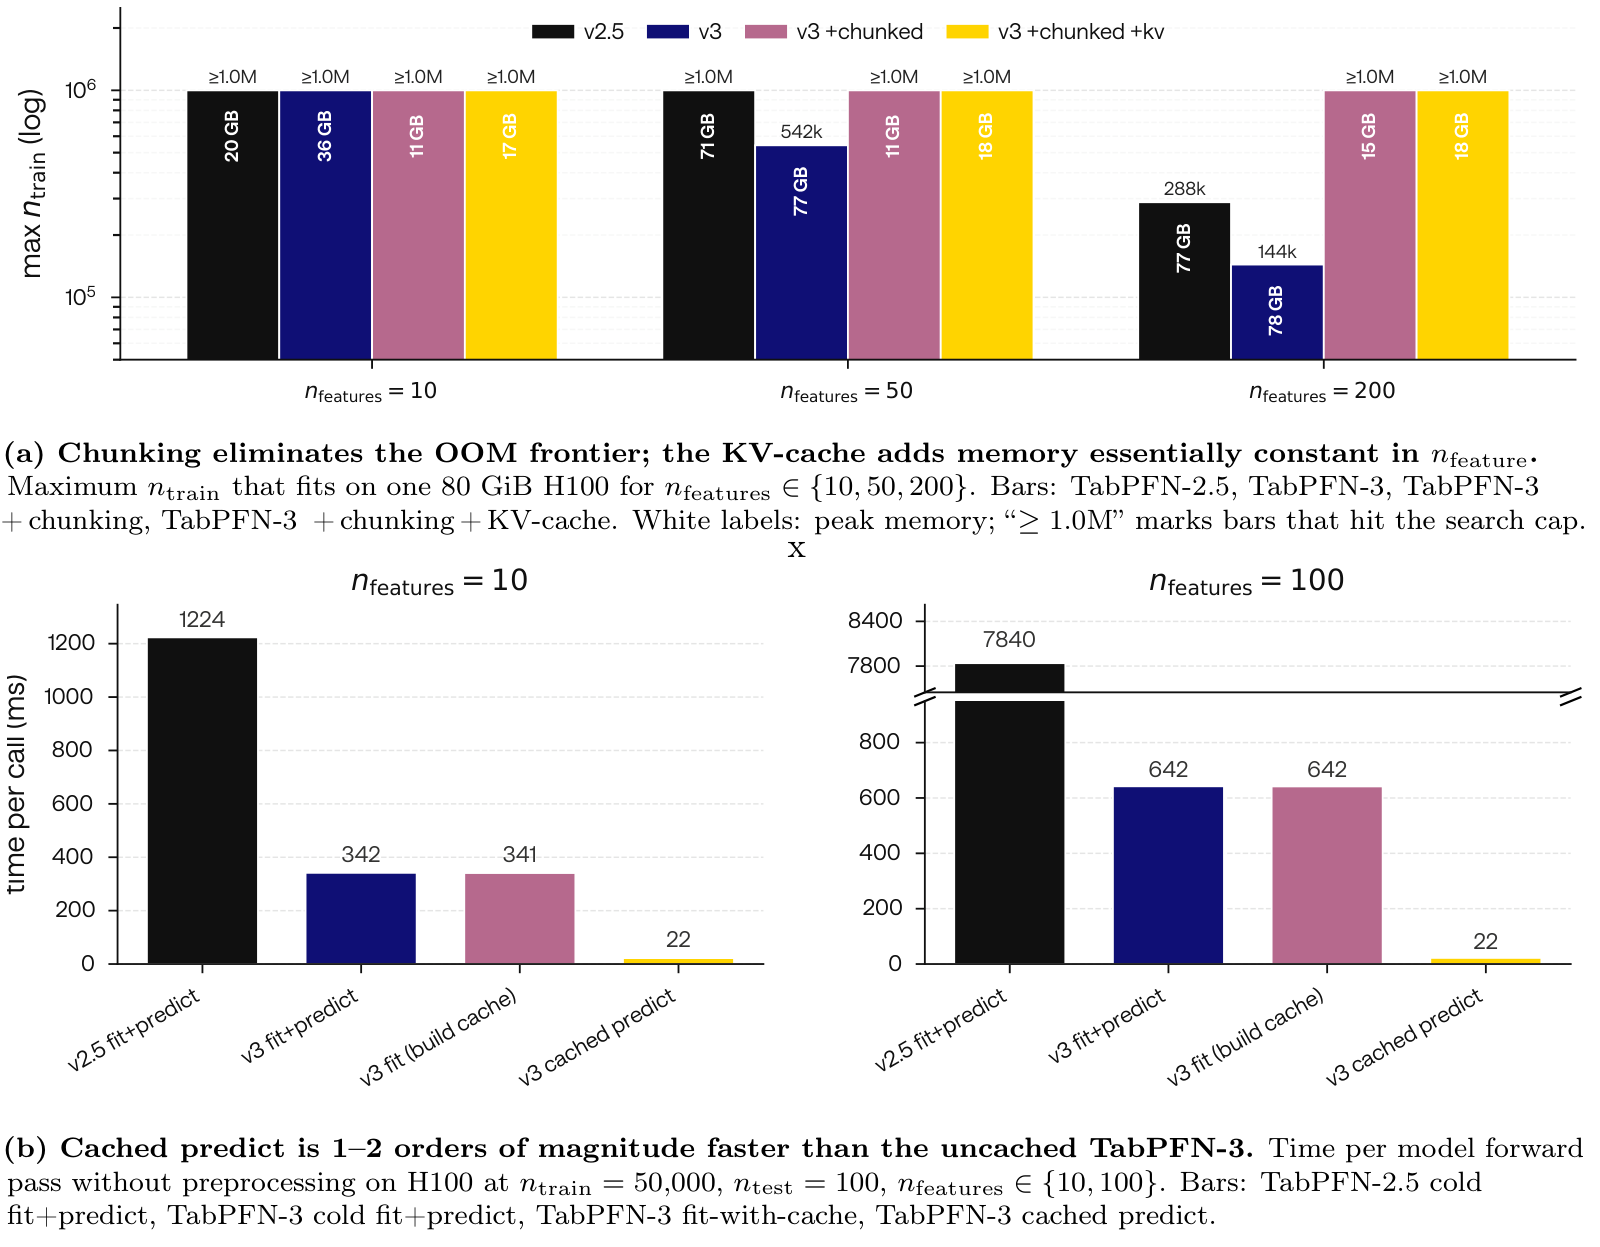
Figure 7, PDF 9쪽. 동일 버전 원문을 크롭한 그림입니다. 단일 estimator이며 전처리 시간은 제외합니다.
100만 행에서 estimator당 KV cache 약 7GiB이며 기본 설정은 8개 estimator입니다. 이는 전체 실행의 최고 GPU 메모리가 7GiB라는 뜻이 아닙니다. Figure 7b의 5만 학습 행·100개 테스트 행 조건에서 10특징은 cold fit+predict 342ms, cached predict 22ms이고, 100특징은 각각 642ms와 22ms입니다. H100의 단일 estimator forward만 측정한 값입니다. 100만 행에서는 cache를 만드는 fit 자체가 약 107초이므로, “100만 행을 처음부터 1초 미만에 처리한다”고 설명할 수 없습니다.
2.4.3 Model Distillation. CPU 지연 시간이나 사용 가능한 모델 유형에 제약이 있으면 특정 데이터셋에 맞춘 MLP 또는 tree ensemble로 지식을 증류합니다. 이 결과물은 TabPFN 본체처럼 새로운 표를 문맥으로 처리하는 범용 모델이 아니라 해당 데이터셋용 모델입니다. 원문은 표준 MLP·tree 수준의 sub-millisecond latency와 대부분의 성능 유지를 설명합니다.
2.4.4 Compilation and FlashAttention-3. torch.compile은 dispatch와 attention 이외 경로를 묶고, FlashAttention-3는 H100과 같은 Hopper GPU의 큰 attention 계산을 가속합니다. MI-250x에서 최대 1.58배, H100의 100만 행에서 약 1.5–1.7배라는 서로 다른 조건의 결과입니다. 두 배율을 임의로 곱해 전체 모델의 보편적 속도 향상으로 제시하지 않습니다.
2.4.5 Improved interpretability. SHAP 계열 설명은 같은 학습 표로 여러 특징 coalition을 반복 평가하므로 캐시의 효과가 큽니다. 원문은 20만 행·500특징에서도 테스트 행 하나의 설명을 1.08초에 계산하고, 큰 표에서 120배 이상의 개선을 보고합니다. Appendix G.2의 실험은 RTX Pro 6000 Blackwell, 1,024개 coalition, 10회 반복 조건입니다. 앞의 H100 일반 예측 측정과는 다른 실험입니다.
2.5 Synthetic Prior: 어떤 종류의 표를 미리 경험하게 할 것인가
원문은 합성 데이터의 폭과 실제 표에 존재하는 구조를 함께 확보한다는 원칙을 제시합니다. Figure 9의 순서는 dataset 크기 등 hyperparameter 샘플링, DAG 생성, 위상 순서에 따른 구조방정식 계산, 특징·target 선택, 후처리입니다. 이 과정에서 관측되지 않는 변수도 남으므로 단순한 독립 특징 생성보다 풍부한 관계를 만들 수 있습니다.
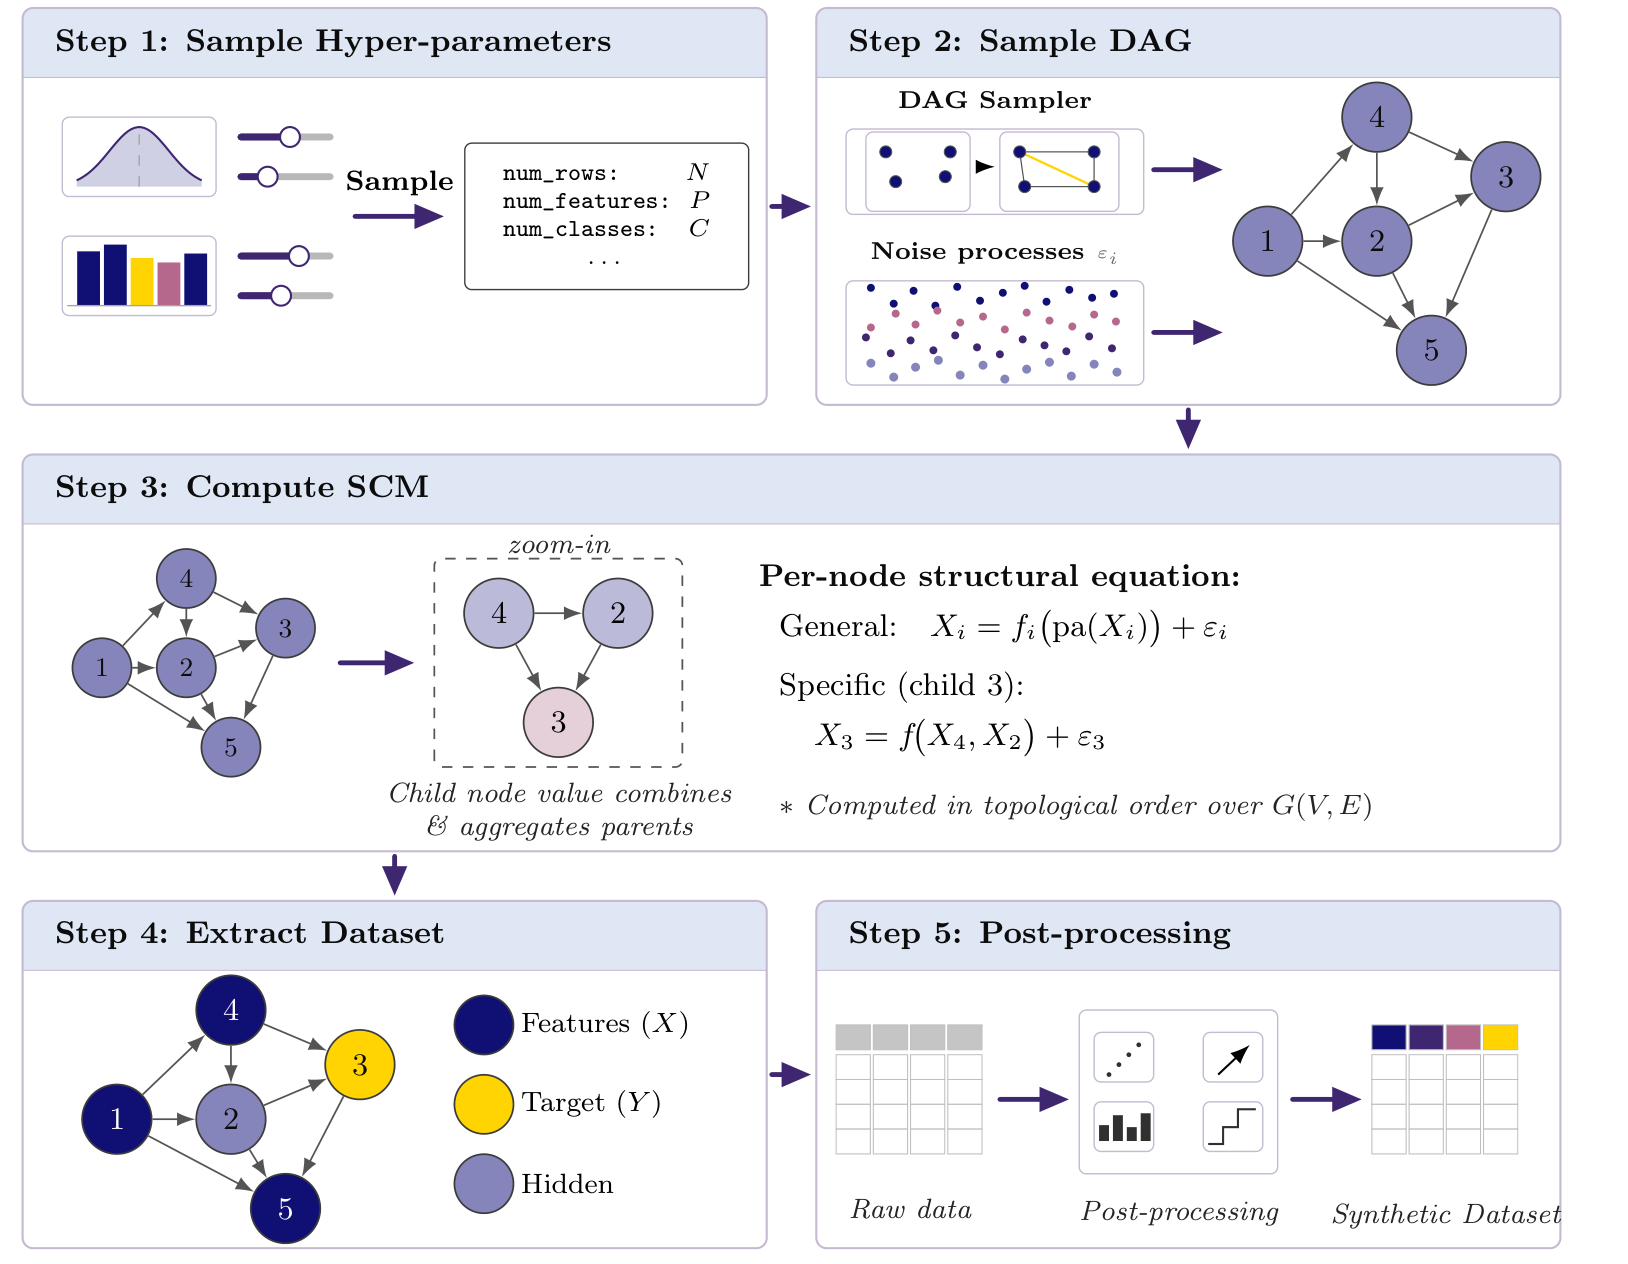
Figure 9, PDF 11쪽. 동일 버전 원문을 크롭했으며 원문 구조와 표기를 보존했습니다.
변경 사항은 원문 순서대로 여덟 가지입니다. 첫째, 그래프 샘플링 알고리즘을 넓힙니다. 둘째, 부모 변수의 값을 결합하는 함수 종류를 늘립니다. 셋째, 범주형 변수 생성을 더 표현력 있게 바꿉니다. 넷째, 이전 2.5가 어려워한 고주파 진동에 대응하도록 sinusoidal activation을 개선합니다. 다섯째, 위도·경도나 센서 격자 같은 공간 관계를 표현하는 activation을 추가합니다. 여섯째, 많은 클래스를 지원하는 decoder에 맞추어 many-class 학습 과제를 구성합니다. 일곱째, 시간 순서와 변수의 시간적 의존성을 위한 discrete-time Dynamic SCM을 도입합니다. 여덟째, interpolation뿐 아니라 extrapolation과 분포 이동을 다루는 과제를 추가합니다.
저자는 최종 모델의 학습 토큰 수를 8조 개 초과로 보고합니다. 다만 이 절은 각 sampler·combiner의 전체 구현과 확률 분포를 재현 가능한 수준으로 모두 명세하지 않습니다. 따라서 합성 prior의 방향과 예시는 이해할 수 있지만, 보고서만으로 동일한 사전학습 분포와 checkpoint를 그대로 재구성할 수 있다고 주장하지 않습니다.
2.6 TabPFN-3-Plus and Thinking mode
마지막으로 공개 기본 모델과 API·기업용 확장을 나눕니다. Plus는 문자열 열을 외부에서 미리 고정 embedding으로 바꾸도록 요구하지 않고 숫자·범주형 특징과 함께 처리한다고 설명합니다. Thinking은 여기에 추가 추론 계산을 사용합니다. 저자는 LLM, 인터넷 검색, 다른 모델을 사용하지 않고 TabPFN만으로 성능을 얻는다고 강조합니다.
보고서에는 Thinking의 구체적인 탐색 공간, 반복 제어, 후보 결합 알고리즘을 완전히 재현할 명세가 없습니다. 따라서 언어 모델의 chain-of-thought처럼 사고 문장을 생성한다거나 특정 search 알고리즘을 쓴다고 추정하지 않습니다. 또한 “실제 데이터를 사용하지 않는다”는 설명을 사용자가 제공하는 실제 문맥 표까지 필요 없다는 뜻으로 확장하지 않습니다.
핵심 기여: 행 압축·캐시·prior·추론 계산을 결합하여 성능과 처리 비용을 함께 다루는 설계를 보여줍니다. 다음 챕터로의 연결: §3은 각 기능이 어떤 데이터와 평가 조건에서 효과를 내는지 검증합니다.
📖 Chapter 3: Experimental Results
챕터의 위치와 역할: 공개 benchmark에서 시작해 내부 stress test, 시계열, 관계형 데이터, 인과 추정, embedding으로 평가 범위를 넓힙니다. 원문 §3
3.1 Public Tabular Benchmarks
3.1.1 TabArena. 1,053개 후보에서 고른 51개 데이터셋, 총 816개 task·split의 결과를 사용합니다. 비교 대상에는 tree, deep tabular model, 다른 foundation model, AutoGluon이 포함됩니다. 본문은 기본 TabPFN-3의 단일 forward 성능과 Thinking의 추가 개선을 강조하고, 이어 시간–성능 Pareto curve, 10,000–100,000행의 큰 데이터 subset 순서로 설명합니다.
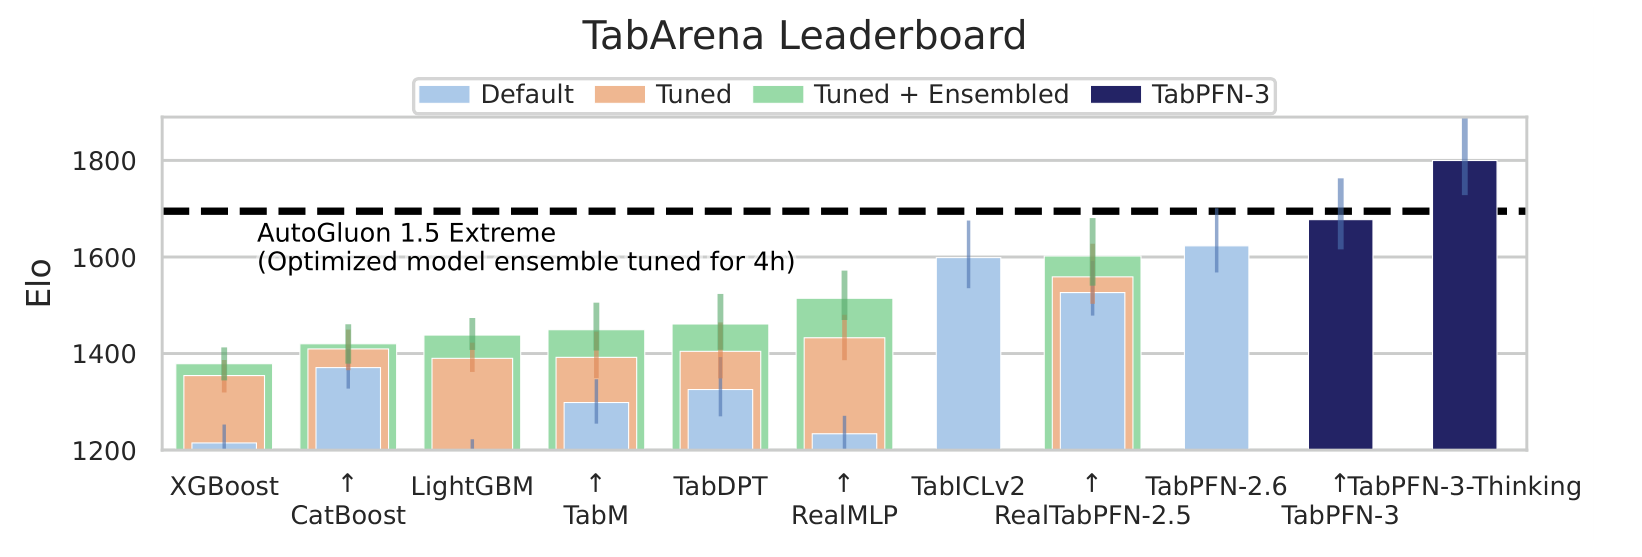
Figure 10, PDF 13쪽. 동일 버전 원문을 크롭했습니다. Thinking은 Plus의 추가 추론 계산 모드이며, 전체 수치 대조는 Appendix Table 8을 함께 사용합니다.
여기서는 홍보성 요약 문구보다 실제 수치와 집계 방식을 함께 읽는 것이 중요합니다. Appendix Table 8의 전체 Elo는 Thinking 1,800, AutoGluon 1.5 extreme(4h) 1,695, 기본 TabPFN-3 1,677입니다. 기본 모델이 “모든 모델을 능가한다”는 본문 표현과 달리, 이 전체 Elo 집계에서 AutoGluon보다 높지는 않습니다. 반면 pairwise matrix에서 기본 모델의 AutoGluon 상대 승률은 56%입니다. Elo와 특정 상대 승률은 다른 집계이므로 동일한 순서를 보장하지 않습니다.
15개 큰 데이터셋 subset에서는 Thinking이 AutoGluon보다 약 220 Elo 높고 상대 승률은 82%로 보고됩니다. 이는 전체 51개에서의 Thinking 승률 69%와 구별해야 합니다. 본문의 기존 RealTabPFN-2.5 tuned+ensembled 대비 “72 Elo 증가”도 Table 8의 1,677−1,602=75와 일치하지 않으므로, 이 글의 정밀 비교는 표에 적힌 값에 따릅니다.
3.1.2 TALENT. 원래 300개에서 TabPFN-2·TabICLv2 개발에 사용한 26개를 제외한 274개를 평가합니다. 전체 평균 rank는 3.75이며 분류·회귀 각 유형에서도 최상위입니다. 이 rank는 오류율 3.75%가 아니라 데이터셋별 순위를 평균한 값입니다. 일부 기존 모델이 실행에 실패하거나 지원 클래스 수를 넘긴 셀은 KNN 점수로 대체하였고 그림에 표시합니다. 이 때문에 순위 비교에는 순수 성능뿐 아니라 지원 범위가 함께 반영됩니다.
3.1.3 TabSTAR. 텍스트 열이 있는 50개 데이터셋을 평가합니다. Plus·Thinking은 텍스트를 사용하며 기본 TabPFN-3는 숫자·범주형만 사용하는 그룹입니다. 따라서 “기본 TabPFN-3가 텍스트를 이해해서 전체 1위”라고 해석하면 안 됩니다. 원문에서 전체 선두는 Plus 계열이고, 기본 모델은 텍스트를 제외한 비교군 중 가장 좋은 결과를 보입니다. Appendix E.4는 15개 분류·35개 회귀, 모델당 5회 실행, 실행당 최대 10만 예제로 조건을 구체화합니다.
3.2 Internal Benchmarks
3.2.1 Large Data. 내부 benchmark는 10만–100만 학습 행, 최대 200특징의 13개 데이터셋입니다. 분류 9개는 IID split이고 회귀 4개는 시간 순서로 과거에서 미래를 예측합니다. 기본 TabPFN-3는 default·8시간 tuned tree와 TabICLv2보다 높은 집계 점수를 보입니다. Thinking preview는 분류에서만 평가했으며, 보고서 작성 당시 temporal dataset을 지원하지 않아 회귀에는 넣지 못했습니다.
100만 행까지 가능한 데이터만 골라 10만·25만·50만·100만 행으로 줄여 보는 scaling 실험은 분류 1개+회귀 3개입니다. 각 크기에서 3회 반복하고 테스트셋을 고정했으며 95% bootstrap band를 제시합니다. 13개 전체 평가와 이 네 개의 scaling 곡선을 같은 분모로 설명하지 않습니다. 큰 행과 많은 특징을 동시에 가지면 이른 특징 압축이 병목이 될 수 있다고 저자가 명시하여, 고차원·적은 표본 문제를 다음 별도 실험으로 분리합니다.
3.2.2 Many-Class Classification. 실제 회귀 target을 불균등한 quantile bin으로 바꾸어 최대 100개 클래스를 구성한 9개 데이터셋을 사용합니다. 클래스 이름을 무작위로 치환하여 숫자 label의 순서 자체를 활용하지 못하게 합니다. 정규화 ROC-AUC는 TabPFN-3 1.00, TabICLv2 0.89, TabPFN-2.5 0.83이며 뒤의 두 모델은 many-class wrapper를 사용합니다. 실제 100-class 데이터의 보조 확인은 TALENT 네 개이며 이 중 세 개가 같은 식물 데이터 family입니다. 합성 문제와 실제 데이터의 근거를 분리합니다.
3.2.3 Many Features. 여섯 개 분류 데이터셋은 Figure 18 기준 102–322개 표본과 1,117–22,215개 특징, 2–4개 클래스를 가집니다. 생의학·유전자 발현 유형이 중심입니다. 기본 estimator는 최대 200특징을 보므로 큰 raw feature space 전체를 한 번에 압축한다고 이해하면 안 됩니다. 16개·32개 estimator로 feature coverage를 늘릴수록 성능이 개선됩니다.
동일 estimator 수에서는 RealTabPFN-2.5가 약간 더 좋을 수 있다고 저자가 인정합니다. 원문이 제시한 설명은 이전 모델이 estimator당 500특징을 보고, 반복적인 행·특징 attention이 선택된 subset의 정보를 더 잘 활용할 수 있다는 가설입니다. 이는 검증된 단일 원인이 아니라 저자의 해석입니다.
3.2.4 Quantile Regression. 회귀 head는 5,000개 bucket의 bar distribution을 출력하고 그 누적분포를 역변환해 quantile을 읽습니다. quantile마다 전체 모델을 다시 학습하지 않습니다. 비교 대상은 quantile linear regression, XGBoost, random forest, TabICLv2이며, Appendix F.4에는 tuned AutoGluon도 포함됩니다. pinball loss의 정규화 점수는 거의 1이고 평균 순위는 최상위입니다.
수치 재현과 관련된 원문의 불일치가 있습니다. 본문·Figure 19·Appendix F.4 모두 “10개 quantile”이라고 쓰지만 제시한 집합 $\{0.1,0.2,\ldots,0.9\}$은 9개입니다. 보고서만으로 누락된 quantile이 무엇인지 확정할 수 없어 임의로 보완하지 않습니다. 또한 좋은 pinball loss는 여러 quantile의 예측 품질 근거이며, 그 사실만으로 모든 조건부 구간에서 calibration이 완벽하다고 결론내리지 않습니다.
3.3 Time-Series Forecasting
시계열은 합성 시계열로 미세조정한 TabPFN-TS-3 checkpoint로 평가합니다. fev-bench 100개 task, 최대 32,000개 과거 time step을 문맥으로 사용합니다. SQL은 확률적 예측, MASE는 점 예측의 평가 축이며, skill score는 Seasonal Naive 기준으로 얼마나 개선했는지 나타내는 별도 집계입니다.
| 모델 | SQL skill | MASE skill | 보고된 runtime |
|---|---|---|---|
| Chronos-2 | 47.3% | 35.5% | 0.8초 |
| TabPFN-TS-3 | 43.1% | 30.6% | 234.6초 |
| TiRex | 42.6% | 30.0% | 0.2초 |
| TimesFM-2.5 | 42.2% | 30.2% | 1.9초 |
| TabPFN-v2-TS | 39.6% | 27.6% | 88.9초 |
Table 1·Table 17의 값을 옮겼습니다. runtime은 이 시계열 benchmark의 보고값이며, H100 캐시 실험의 개별 행 지연 시간과 비교하는 수치가 아닙니다.
TabPFN-TS-3는 두 skill score에서 2위지만 win rate 기준으로는 4위입니다. 두 평균 skill에서 전작보다 좋지만 실행 시간은 이 표에서 더 큽니다. 이전 외부 평가의 TabPFN-TS MASE skill 28.8과 저자 재실행 27.6도 구별하여 위 표에는 같은 비교 cohort의 27.6을 썼습니다.
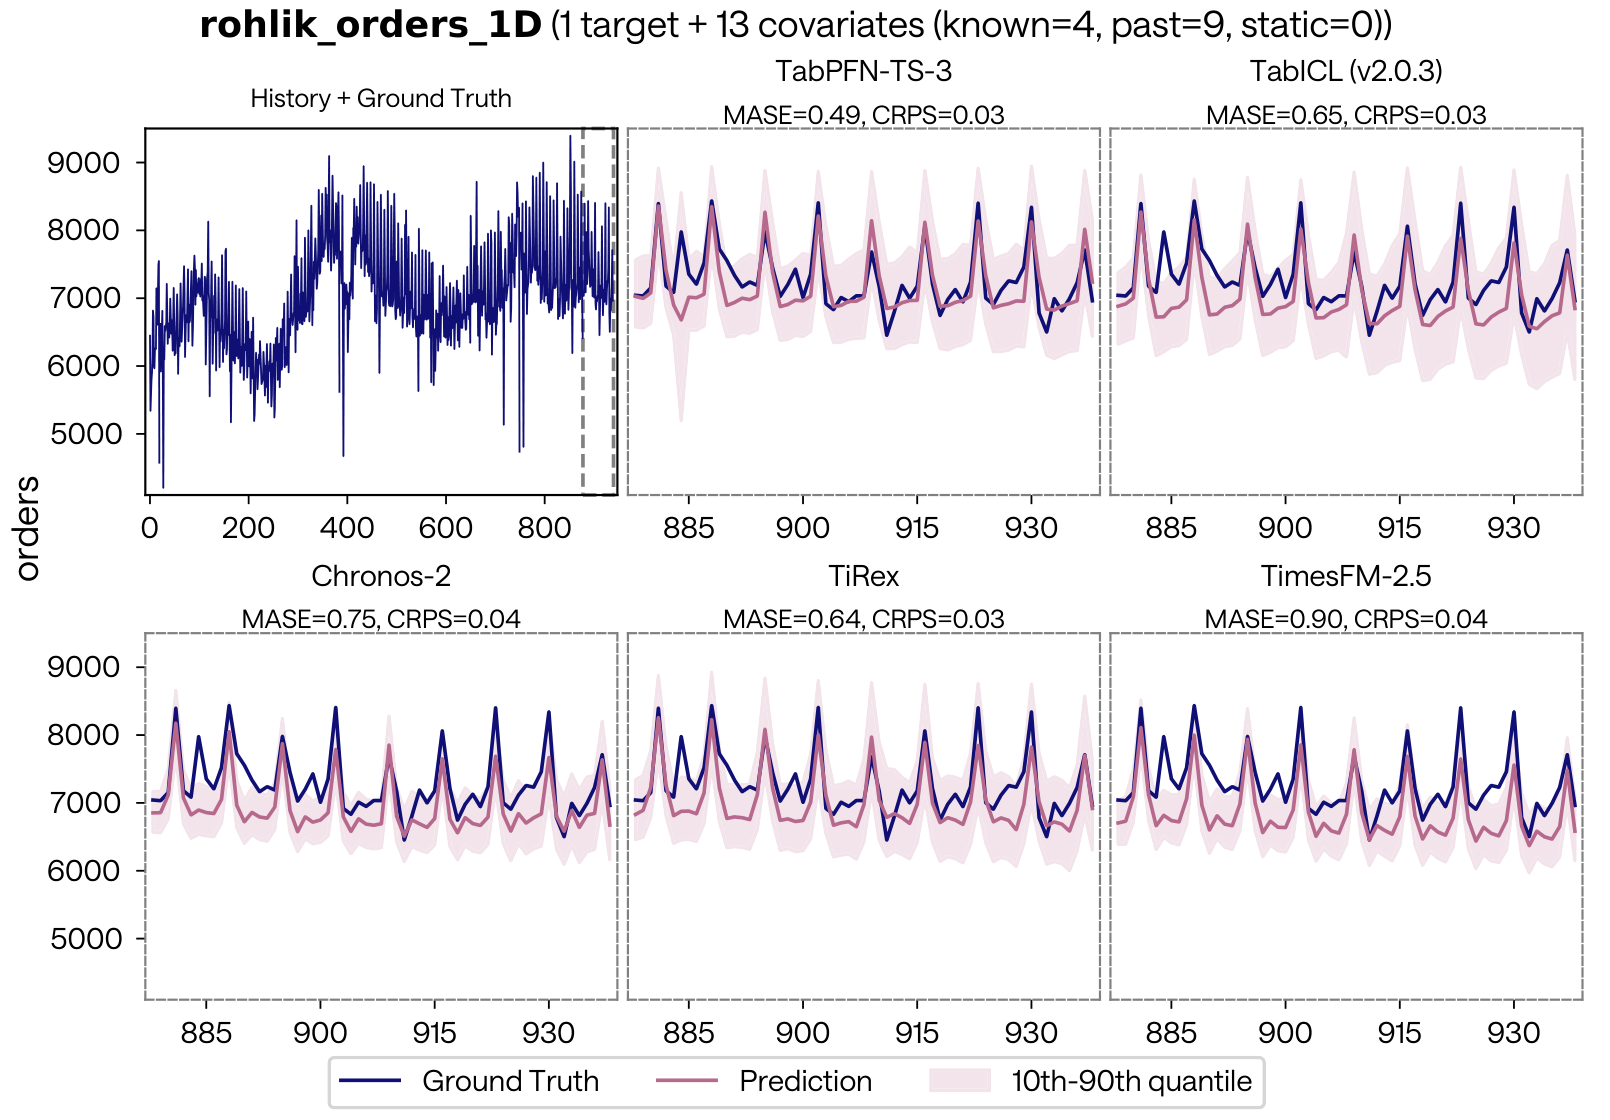
Figure 20, PDF 19쪽. 동일 버전 원문을 크롭했습니다. 하나의 주문량 task에 대한 정성 예시로, 전체 100개 task의 우열을 대신하지 않습니다.
원문은 합성 사전학습이 특정 실제 시계열의 사전학습 유입을 피한다는 점을 강조합니다. 표의 leakage flag는 TimesFM-2.5 10%, Moirai-2.0 28% 등으로 제시되지만, 이것이 해당 모델의 모든 점수가 오염되어 무효라는 뜻은 아닙니다. 합성 사전학습이라는 속성과 실제 데이터의 시간 분할을 올바르게 적용하는 문제도 별개입니다.
3.4 Relational Data
관계형 데이터는 여러 테이블을 foreign key로 연결한 상태에서 특정 entity의 label을 예측합니다. 저자는 전용 supervised graph model, relational foundation model, 관계형 DB를 표로 펼쳐 TFM을 쓰는 RDBLearn을 먼저 구분합니다. RelBenchV1 평가에서는 정해진 test timestamp에서 DB를 잘라 feature와 문맥을 구성합니다.
TabPFN-REL은 분류 12개·회귀 9개 task에서 foundation model 중 선두입니다. 그러나 개별 task에 맞추어 학습한 RelGNN의 집계 성능은 더 높습니다. “관계형 데이터 전체 모델 중 최고”라는 축약은 부정확합니다. RDBLearn의 기본 튜닝 절차 대신 TabPFN-3 backend를 고정한 방식도 개선됩니다.
비교에는 두 가지 조건이 붙습니다. KumoRFMv1·RTzero 일부 결과는 평가 프로토콜이 다를 수 있고 재실행이 불가능해 저자 보고값을 사용했습니다. 또 이 절의 결과는 전체 학습을 마치지 않은 20260417_<TASK_TYPE> 초기 checkpoint로 얻었으며 binary·multiclass 모델을 나누었습니다. 현재 최종 checkpoint의 결과를 직접 측정한 것으로 설명하지 않습니다.
3.5 Causal Inference
원문은 TabPFN을 T/X/S meta-learner의 예측기로 사용하여 scikit-uplift benchmark의 QINI-score를 비교합니다. 여기서 목표는 개입 효과가 클 사람을 잘 순위화하는 것이며, 관측된 treatment와 outcome으로 평가합니다. TabPFN-3의 S·T learner가 상위에 있고 2.5 대비 개선됩니다. 반면 RealCause에서는 2.5보다 약간 나빠졌다고 명시합니다. 표 예측기의 개선이 모든 인과 추정 benchmark의 일관된 개선을 보장하지 않는 사례입니다.
3.6 Embeddings
마지막 실험은 cross-validation fold에서 테스트 부분의 행 embedding만 수집하는 방식입니다. Stage 3 ICL의 출력을 모아 PCA로 2차원에 투영하면 원래 입력의 PCA보다 class별 구조가 뚜렷한 정성 예시를 얻습니다. 각 행을 자신의 label을 가진 학습 행으로 넣어 embedding하는 대신 held-out 행으로 처리하는 것이 방법의 핵심입니다. Figure 22는 세 개 분류 데이터의 시각화이며 모든 downstream embedding task의 정량적 우위를 검증한 결과는 아닙니다.
핵심 기여: 대규모 표, 다수 클래스, 예측분포, 시계열·관계형 등 서로 다른 요구를 분리해 평가합니다. 다음 챕터로의 연결: §4는 이 기능들이 쓰이는 생태계와 실제 적용 맥락을 제시합니다.
📖 Chapter 4: Adoption
챕터의 위치와 역할: 성능 benchmark 이후 TabPFN 계열의 활용 생태계를 소개합니다. 여기의 도입 수치는 보고서 작성 시점의 저자 집계입니다. 원문 §4
4.1 Community and Open-Source Ecosystem. 저자는 PyPI 다운로드 320만 회 초과, Nature 논문 인용 1,000건 초과, Discord 사용자 2,000명 초과를 제시합니다. 다운로드·인용 통계의 접근 시점은 2026년 5월 8일입니다. 이 수치를 리뷰 작성 시점의 실시간 통계로 갱신한 것은 아닙니다. tabpfn-extensions에는 설명, 합성 데이터 생성, 결측 대치, 특징 선택, 생존 분석, 조건부 무작위화 검정 같은 확장이 있다고 설명합니다.
4.2 Enterprise Engagements. 이어 철도 예방 정비, 금융의 CPU 기반 distilled model, proteomic liquid biopsy 사례를 듭니다. 철도 사례의 약 40% RMSE 감소는 해당 기업의 기존 baseline 대비 초기 적용 결과로 인용된 값입니다. 이 보고서의 통제된 공통 benchmark에서 확인한 40% 평균 개선이 아닙니다. 금융 사례의 예정된 사용과 실제 배포 사례도 구별합니다.
4.3 Platform Availability. PyPI, managed API, AWS·Azure, Databricks integration 순으로 제공 경로를 설명합니다. 이 절에는 보고서 이후 v3의 marketplace 제공이 뒤따른다는 문구도 있어, 당시 모든 채널에 v3가 이미 배포되었다고 읽지 않습니다.
4.4 Research Adoption Across Domains. 저자는 의료·생명과학 98편, 제조·산업 41편, 에너지·유틸리티 24편, 금융 7편, 기타 32편이라는 범주별 집계를 제시합니다. 대체로 관측 비용이 높거나 표본이 적고 이질적인 데이터라는 공통점이 있습니다. 다만 본문의 범주별 숫자 합과 Appendix I의 “201개” 서술은 일치하지 않으므로, 이를 독립적인 정확한 총계로 재산출하지 않습니다.
핵심 기여: 연구 모델을 둘러싼 응용 범위를 보여줍니다. 다음 챕터로의 연결: 넓은 이용 가능성과 실제 사용 허용 조건은 별개이므로 §5에서 라이선스 경계를 설명합니다.
📖 Chapter 5: License and Availability
챕터의 위치와 역할: 공개 가중치, 연구·평가, 상업적 배포의 접근 범위를 구분합니다. 원문 §5
보고서가 기술하는 TABPFN-3.0 License v1.0은 학술 연구와 테스트, 내부 평가·benchmarking을 허용하지만 모델·파생물·출력의 상업적 또는 production 사용을 제한합니다. 원문에는 고객 산출물, 수익 제품, 내부 상업적 의사결정에 출력 사용, 조달 결정을 위한 competitive benchmarking 등이 제한 예시로 나옵니다. 따라서 저자가 사용하는 “open-source”라는 표현을 모든 상업적 사용이 자유로운 일반적인 허용 라이선스와 동일시하면 안 됩니다. 여기서는 보고서에 적힌 조건을 요약하며, 현재 라이선스의 법적 적용을 별도로 판정하지 않습니다.
상업용 enterprise license는 API, VPC, on-prem 등 배포를 지원하고 별도의 고속 엔진, 지원, integration, Plus·Thinking을 포함한다고 설명합니다. 이 때문에 기본 모델의 공개 여부, 텍스트·Thinking 기능의 공개 여부, 재현 가능한 평가 범위를 각각 구분해야 합니다.
핵심 기여: 동일한 모델 family라도 실제 접근 가능한 기능과 사용 조건이 다름을 밝힙니다. 다음 부분으로의 연결: 참고문헌과 부록은 기술·평가 세부사항의 근거를 보완합니다.
📖 Chapter References: 참고문헌의 역할
PDF 25–45쪽에는 benchmark, 기반 아키텍처, 확장 연구, 응용 사례의 참고문헌이 이어집니다. 이 리뷰는 TabPFN-3 보고서에 제시된 인용의 역할과 실험 연결을 설명하며, 인용된 모든 논문의 원문을 별도로 읽거나 기업 사례의 결과를 독립적으로 재현했다고 주장하지 않습니다. 뒤따르는 부록 A–I를 보고서의 논리 순서대로 읽습니다.
📖 Chapter Appendix A–B: Contributors · Acknowledgements
역할: 기술·제품 기여와 계산 자원 지원의 출처를 밝힙니다. A는 Model Development & Deployment, Distribution & Product, Operations, Scientific Advisors 순으로 구성되며 기여 당시 Prior Labs 소속과 입사일 순서의 저자 배열을 설명합니다. scientific advisor가 IP에 기여하지 않았다는 문구도 있습니다. B는 EuroHPC와 LUMI 계산 자원 지원을 명시합니다. 이 부분을 모델의 성능 증거로 사용하지는 않습니다. 다음 C에서 재현에 필요한 구조 수치가 제시됩니다.
📖 Chapter Appendix C: Architectural Hyperparameters
역할: 본문의 설계를 실제 차원과 layer 수로 구체화합니다. Table 2–7의 순서를 따르면 feature embedding은 128차원·3개 block·8개 head·128개 inducing point입니다. Feature aggregation 역시 3개 block·8개 head이며 CLS token 네 개와 RoPE를 사용합니다. ICL은 512차원·24개 block·8개 query head이고 학습 측 KV head 8개와 테스트 측 1개를 구분합니다.
분류 decoder는 최대 160개 클래스·6개 head·head 차원 64입니다. 회귀 decoder는 512→1,024→5,000의 2-layer MLP와 GELU를 사용하여 bar distribution의 bucket 출력을 만듭니다. 공유 feed-forward 배율은 2이며 query-aware softmax scaling MLP의 hidden dimension은 64입니다. Figure 4의 총 parameter 수는 분류 약 5,300만, 회귀 약 5,800만으로 제시됩니다. 같은 계열이라도 output head가 달라 크기가 다릅니다.
핵심 기여와 연결: 세 단계의 추상 설명을 구체적인 모델 크기와 연결합니다. 다음 D는 이 모델이 학습하는 합성 표의 예시를 보여줍니다.
📖 Chapter Appendix D: Prior visualizations
역할: prior의 다양성을 그림으로 보충합니다. Figure 23은 DAG 샘플, Figure 24는 새로운 combiner의 2차원 함수 예시, Figure 25는 네 공변량의 class별 분포, Figure 26은 선형·지수·계단 함수와 잡음 유무에 따른 외삽 예시를 차례로 제시합니다.
Figure 26은 out-of-distribution-compatible preprocessing을 사용한 TabPFN-3와 CatBoost의 비교입니다. 따라서 모든 default 설정에서 동일한 외삽이 보장된다고 읽지 않습니다. 이 그림은 prior의 설계 의도를 이해하는 정성 자료이며, 광범위한 분포 이동에 대한 평균 성능 표는 아닙니다. 다음 E는 공개 benchmark와 확장 결과의 세부 평가로 돌아갑니다.
📖 Chapter Appendix E: Experimental results details
역할: 본문 실험의 지표·프로토콜·세부 분모를 설명합니다. Appendix E
E.1 Details on Causal Inference Results. QINI는 무작위 대조 실험 데이터에서 개인을 treatment effect 순으로 정렬했을 때의 효용을 측정하는 관점입니다. 실제 개별 인과 효과의 정답 없이 treatment·outcome으로 평가한다는 장점을 설명합니다. S/T learner가 좋은 QINI를 보이지만 작은 표본 중심 RealCause에서는 악화된다는 본문의 예외를 다시 확인합니다.
E.2 Detailed TabArena Results. E.2.1은 Elo와 Improvability를 정의합니다. Elo는 pairwise 성능 비교를 rating으로 바꾸며 400점 차이가 대략 10:1의 기대 승산에 해당합니다. random forest default를 1,000점으로 보정하고 200회 bootstrap으로 95% 신뢰구간을 얻습니다. binary classification은 ROC-AUC, multiclass는 log-loss, regression은 RMSE를 사용합니다.
Improvability는 dataset별 현재 오류에서 최선 오류까지 얼마나 줄일 여지가 있는지를 계산합니다.
$\mathrm{err}_i$는 해당 모델의 오류, $\mathrm{best\_err}_i$는 그 dataset의 비교 모델 중 최선 오류입니다. 0%면 이미 비교군 최선이고 값이 클수록 개선 여지가 큽니다. 전체 결과는 이를 dataset들에 걸쳐 평균합니다. 앞서 내부 benchmark에 사용한 정규화 score와는 방향과 정의가 다릅니다.
E.2.2는 공식 fit 시간 측정에 8-fold bagging으로 CV score를 만들고 전체 학습 표로 refit하는 과정을 따른다고 명시합니다. 따라서 “한 forward로 예측 가능”과 benchmark fit 시간에 무엇이 들어가는지를 분리해야 합니다. 기존 foundation model의 cached baseline은 H200, TabPFN-3·Thinking은 RTX 6000에서 측정되어 동일 하드웨어 비교가 아닙니다. E.2.3은 1,000샘플당 총 train+predict 시간의 중앙값과 Improvability의 Pareto curve를 설명하고, tuning ensemble trajectory는 20회 샘플링 평균임을 밝힙니다. E.2.4의 Table 8–12는 전체·medium·small·classification·regression 다섯 view의 leaderboard입니다.
E.3 Details on TALENT benchmark results. E.3.1은 64% train·16% validation·20% test split과 분류 accuracy·회귀 RMSE를 설명합니다. E.3.2는 binary·multiclass·regression별 평균 rank를 나누고, 10-class 한계를 넘는 일부 기존 모델의 12개 multiclass task에 KNN 점수를 대입했음을 표시합니다. E.3.3은 네 개의 100-class 실데이터 중 세 개가 식물 margin/shape/texture 변형임을 밝힙니다. E.3.4는 큰 행 subset 14개의 목록과 평균 rank를 제시합니다. 표의 Samples 열은 전체 샘플 수인 경우가 있으므로 이를 곧바로 학습 행 수와 동일시하지 않습니다. E.3.5는 dataset·split별 rank를 평균하고 2,000회 bootstrap으로 구간을 구하는 절차를 설명합니다.
E.4 Details on TabSTAR Text-Tabular Benchmark results. 중복·이용 불가 dataset을 제거한 50개 중 분류 15개와 회귀 35개입니다. 원래 TabSTAR의 14개 분류 집계에서 Spotify Genres를 회귀로 잘못 처리했던 것을 고쳤다는 각주가 있습니다. Figure 31·32는 이 두 task type을 분리하고 Plus·Thinking의 개선을 보여줍니다.
E.5 Per-dataset results on RelBenchV1. Table 14·15는 회귀와 분류의 task별 값 및 집계를 제시합니다. 회귀는 LightGBM MAE로 나누므로 작은 값이 좋으며, 분류는 ROC-AUC가 클수록 좋습니다. 본문 Figure 21의 서로 다른 y축 방향을 읽는 근거입니다. 원문에 표시한 프로토콜 차이와 초기 checkpoint 조건은 이 표에도 그대로 적용됩니다.
핵심 기여와 연결: 각 aggregate result가 어떻게 계산되었는지 밝혀 서로 다른 leaderboard를 혼동하지 않게 합니다. F는 내부 stress test의 생성과 유의성 검정을 자세히 다룹니다.
📖 Chapter Appendix F: Additional Details on Internal Benchmarks
역할: 내부 benchmark의 점수 변환, 데이터 생성, 통계적 비교를 설명합니다. Appendix F
F.1 Methodology. 앞서 제시한 min–max 정규화는 dataset·fold마다 적용하며 default와 tuned 모델을 별개 비교 대상으로 취급합니다. 유의성은 Friedman test 뒤 Conover post hoc 분석을 유의수준 0.05에서 수행하고 critical difference(CD) diagram으로 표시합니다. 가로선으로 연결된 방법은 해당 분석에서 유의한 차이를 확인하지 못한 집단입니다.
F.2 Large Data Benchmark Details. 의료·고객·보험·금융·물리의 분류와 판매·기후·배달·전자상거래 회귀를 설명하며, 회귀 네 개 모두 과거→미래 split입니다. Figure 33·34는 성능 순위가 좋아도 모든 tuned tree와 유의하게 다르지는 않음을 보여줍니다. 분류에서 기본 TabPFN-3와 8시간 tuned XGBoost·CatBoost의 차이는 유의하지 않습니다. 특히 회귀의 기본 TabPFN-3 평균 rank는 2.25지만 8시간 tuned 세 tree 및 default CatBoost와의 차이는 유의하지 않습니다. 분류 Figure 33은 그림 본체의 기본 TabPFN-3 rank 2.67과 캡션의 “first, 2.11”이 불일치합니다. Thinking preview의 추가를 반영한 그림과 이전 설명이 섞인 것인지 보고서만으로 확정할 수 없어, 이 글은 캡션의 수치를 확정값으로 채택하지 않습니다.
F.3 Synthetic Many-Class Benchmark Construction. 회귀 target의 quantile bin 간격을 Dirichlet(5.0)으로 흔들어 class imbalance를 만듭니다. 표본이 10개 미만인 bin은 가까운 이웃과 합친 뒤 class label을 무작위로 치환합니다. 고유 target 값이 너무 적거나 특정 값에 질량이 몰리는 네 개의 회귀 dataset을 제외한 아홉 개가 남습니다. 최종 클래스 수의 중앙값은 95, 최대/최소 class 크기 비율의 중앙값은 9.9배입니다. 최초 100개 bin과 최종 실제 클래스 수는 같지 않을 수 있습니다.
F.4 Quantile Regression: Critical Difference Diagram. Figure 35에서 TabPFN-3의 평균 rank는 1.31이고 Quantile TabICLv2는 2.00입니다. 둘 사이의 차이는 이 검정에서 유의하지 않으며 나머지 비교군과는 유의하다고 보고합니다. 최상위 평균 rank와 모든 상대에 대한 유의한 우위를 구분해야 합니다. 앞서 설명한 quantile 개수 불일치도 여기의 캡션에 반복됩니다.
F.5 Synthetic Many Class: Critical Difference Diagram. Figure 36에서 기본 모델은 평균 rank 1.00이며 모든 비교군보다 유의하게 앞선다고 보고합니다. 이 강한 결과의 모집단은 회귀 문제를 변환한 아홉 개 many-class benchmark입니다. 모든 실제 다중 클래스 문제로 통계적 결론을 확대하지 않습니다.
핵심 기여와 연결: 성능 차이, 표본 구성, 통계적 유의성의 경계를 구체화합니다. G에서는 정확도가 아닌 실행 비용 측정으로 넘어갑니다.
📖 Chapter Appendix G: Supplementary Inference Time Details
역할: 속도 개선이 어떤 하드웨어와 크기에서 생기는지 분해합니다. Appendix G
G.1 Compilation and FlashAttention-3. torch.compile(dynamic=True)는 전처리·grouping, column chunk, row chunk의 세 hot path를 대상으로 합니다. 작은 특징 수에서는 dispatch 비용 감소가 작고 특징 수가 커질수록 이득이 커집니다. 반대로 충분히 큰 행 수에서 attention이 지배하면 compilation의 추가 효과가 작아집니다. FlashAttention-3도 항상 빠르지 않습니다. H100에서 학습 행 1,000개 이하의 작은 경우에는 SDPA가 약 10–15% 더 빠르고, 100만 행에서는 FA3가 약 1.49–1.73배 빠릅니다. 비Hopper GPU는 SDPA로 fallback한다는 조건을 명시합니다.
G.2 Interpretability: SHAP-Value Computation. 같은 fit을 수많은 forward에서 재사용하므로 KV cache의 이점이 설명 계산에서 증폭됩니다. Figure 38은 표 크기별 speedup과 행 하나를 설명하는 절대 시간을 함께 보여줍니다. 1,024개 coalition이라는 계산 예산과 10회 반복, RTX Pro 6000 Blackwell 조건을 유지해야 재현 가능한 비교가 됩니다.
핵심 기여와 연결: 실행 가속을 보편적인 단일 배율로 요약하지 않고 실제 병목에 연결합니다. H는 시계열 평가의 전체 결과를 보충합니다.
📖 Chapter Appendix H: Detailed Time-Series Forecasting Results on fev-bench
역할: Table 1의 축약 leaderboard를 전체 비교군과 task별 근거로 확장합니다. 순서는 전체 SQL·MASE leaderboard(Table 17), 추가 정성 예측 사례, 모델 간 pairwise 비교(Figure 45), task별 SQL 결과(Table 18)입니다. Appendix H
전체 표에는 foundation model 외 통계·supervised baseline도 포함됩니다. TabICL-v2는 tabicl[forecast] 2.0.3과 fev-bench 0.7.0으로 저자들이 얻은 결과이며, 당시 공식 fev-bench 결과 저장소에는 없다는 각주가 붙습니다. 모든 행이 동일한 외부 leaderboard에서 그대로 복사된 결과는 아닙니다.
추가 예시는 history, 미래 ground truth, 예측과 10–90% quantile 구간, 공변량을 함께 보여줍니다. 이는 오차가 어느 구간에서 생기는지 이해하는 자료이지만 잘 보이는 예시만으로 전체 rank를 정당화하지 않습니다. Figure 45는 모델 쌍별 skill score와 bootstrap 95% 신뢰구간을 표시하며, 구간이 0을 포함하는 셀을 별도로 표시합니다. 이것은 win-rate 표가 아닙니다. Table 18은 leakage·실행 실패 대체 처리 뒤의 task별 SQL을 싣고 큰 값 일부는 지면상 상한 처리합니다. 전체 skill, pairwise skill, win rate는 서로 구별해서 읽어야 합니다. 긴 문맥을 사용하는 설정과 234.6초의 보고 runtime 역시 정확도 결과와 함께 유지해야 합니다.
핵심 기여와 연결: 평균 수치 뒤의 task별 다양성을 보여줍니다. 마지막 I는 새 평가가 아니라 TabPFN 계열의 기존 응용 문헌을 정리합니다.
📖 Chapter Appendix I: TabPFN Use Case Overview
역할: 저자들이 수집한 기존 TabPFN 응용 목록을 도메인별로 제시합니다. Highlights 이후 Healthcare and Life Sciences, Financial Services·Banking·Insurance, Energy and Utilities, Industrial and Manufacturing, Other Industries 순으로 이어집니다. 진단·예후·분자 특성·재료·금융·환경 예측 등 다양한 표 기반 문제를 포함합니다. Appendix I
이 목록은 이전 TabPFN 모델을 사용한 연구도 포함합니다. 따라서 모두가 TabPFN-3를 사용했다거나 v3가 이 각각의 응용에서 개선을 재검증했다는 뜻은 아닙니다. 또한 논문 내부의 응용 요약을 별도 원문까지 전수 검증한 것으로 취급하지 않습니다. 본문 도입 사례의 폭을 이해하는 자료로 읽는 것이 적절합니다.
핵심 기여: 기술 보고서의 적용 맥락을 관련 문헌과 연결하며 부록을 마무리합니다.
실험 결과 심층 분석
가장 중요한 결과는 하나의 “몇 % 개선”이 아니라, 정확도·지원 범위·추론 비용의 비교 축을 분리한 개선입니다. 특히 다음 네 가지 구분이 필요합니다.
첫째, 기본 모델과 Thinking의 성능은 다릅니다. 전체 TabArena Table 8에서 기본 모델 1,677 Elo는 AutoGluon 1,695보다 낮고, Thinking 1,800은 높습니다. Thinking의 Improvability 4.7%, AutoGluon 5.7%, 기본 모델 6.9%도 같은 방향입니다. 반면 기본 모델은 비교적 짧은 시간에 강한 성능을 제공합니다. 본문이 강조하는 최고 성능과 빠른 기본 실행을 한 모델의 한 설정처럼 합치면 안 됩니다.
둘째, 속도의 분모를 확인해야 합니다. Table 8의 1,000샘플당 train·predict 시간은 Thinking 37.69·3.26초, AutoGluon 289.07·4.03초, 기본 모델 2.31·0.74초입니다. 이 표를 단순 합산한 값만으로 본문의 “10배 이상 빠름”을 그대로 복원할 수는 없습니다. Figure 11은 총 시간의 중앙값을 사용하고 측정 하드웨어도 서로 다르기 때문입니다. 따라서 정확한 조건 없이 보편적인 10배 속도 향상으로 반복하지 않습니다. 또한 캐시된 22ms의 단일 forward와 benchmark 전체 fit·전처리·ensemble 시간은 비교 대상이 다릅니다. Table 8, Appendix E.2
셋째, 좋은 rank와 통계적 유의성은 다릅니다. 원문은 Figure 4에서 이전 모델과의 Wilcoxon 검정 $p<0.0001$, Elo·TALENT의 bootstrap 신뢰구간, 내부 실험의 Friedman–Conover 검정을 제시합니다. 따라서 통계 분석이 전혀 없다고 할 수 없습니다. 그러나 large-data의 tuned tree 비교 일부와 quantile의 TabICLv2 비교는 유의하지 않다고 명시합니다. 이 경우 “일관된 집계 우위”와 “모든 상대에 유의한 우위”를 구별합니다.
넷째, 확장 영역의 결과를 일반 표 모델의 주장과 섞지 않습니다. 시계열은 전용 미세조정 checkpoint이며 skill 2위와 win-rate 4위를 함께 기록합니다. 관계형은 foundation model 중 우위이고 RelGNN이 더 강합니다. 텍스트 표는 Plus가 텍스트를 사용하지만 공개 기본 모델은 그렇지 않습니다. many-feature에서는 estimator 예산에 따라 이전 모델이 더 나을 수 있고, 인과 추정의 RealCause에서는 성능이 약화됩니다. 모두 원문이 제시한 조건 또는 예외입니다.
재현성 측면에서 구조의 차원·layer 수, 여러 benchmark의 split·지표, 정규화·검정 절차, 버전·초기 checkpoint 식별자는 제공됩니다. 반면 Thinking의 완전한 내부 절차와 합성 prior의 전체 샘플링 구현은 보고서만으로 재구성하기 어렵습니다. 본 리뷰는 모델을 실행하거나 저자 실험을 재현하지 않았으며, 원문 수치와 조건을 대조한 분석입니다.
기술적 함의와 응용
데이터과학자의 관점에서 이 보고서가 보여주는 변화는 표 예측기의 선택을 데이터셋당 학습 시간만으로 판단하기 어려워졌다는 점입니다. 행 압축과 KV cache는 같은 학습 표로 예측을 반복하는 서비스에서 비용 구조를 바꾸고, 설명 기법처럼 같은 모델을 수백·수천 번 호출하는 작업에도 영향을 줍니다. 이는 §2.4·Appendix G의 결과를 바탕으로 한 리뷰어 해석입니다. 초기 fit 비용, estimator 수, 전처리, 실제 GPU를 포함한 전체 비용으로 판단해야 그 의미가 유지됩니다.
합성 사전분포는 단순히 실제 학습 데이터가 부족할 때 쓰는 대체재를 넘어, 어떤 구조에 일반화하도록 모델을 만들지 결정하는 설계 수단으로 제시됩니다. 시간·공간·분포 이동·범주형 관계를 prior에 추가하고 여러 응용의 기반으로 재사용한다는 점이 연결됩니다. 다만 시계열과 관계형의 성과는 각각 전용 checkpoint와 별도 시스템·평가 프로토콜을 거친 결과이며, 모든 구조화 데이터에 동일한 모델을 그대로 넣으면 같은 효과가 난다는 증거는 아닙니다.
TabPFN-3의 성과는 대규모 행 처리, 예측분포, 많은 클래스, 반복 추론 비용을 하나의 모델 계열에서 함께 발전시킨 데 있습니다. 그 성과를 정확히 이해하려면 공개 기본 모델과 Plus·Thinking, 전체 benchmark와 특정 subset, 정규화 점수와 원래 지표, 통계적 유의성과 실용적인 시간 절약을 끝까지 구분해야 합니다.
분석 범위: 본문 §1–5와 부록 A–I의 구조·주요 방법·실험 조건을 반영했습니다. Table 8–18의 모든 dataset별 수치를 전사하거나, Appendix I의 응용 논문들을 개별 원문까지 검토하지는 않았습니다. Thinking 내부 구현, prior 전체 생성 코드, 실제 배포 라이선스의 현재 상태를 독립적으로 검증한 리뷰도 아닙니다. 원문에 확인되지 않은 추가 한계나 향후 연구 과제는 제안하지 않았습니다.