논문 개요와 전체 구조
TabPFN v2는 학습 데이터와 예측할 행을 함께 입력받아, 새 데이터셋마다 신경망을 미세조정하지 않고 정형 데이터의 분류·회귀를 수행하는 foundation model입니다. 그렇다면 열의 개수와 의미가 매번 바뀌는데도 어떻게 작동하며, 내부 표현을 별도의 모델에 사용할 수 있을까요? 입력이 너무 넓거나 길고 클래스가 많아지면, 이미 학습된 모델을 그대로 활용할 방법은 무엇일까요?
Han-Jia Ye, Si-Yang Liu, Wei-Lun Chao의 A Closer Look at TabPFN v2: Understanding Its Strengths and Extending Its Capabilities는 이 세 질문을 실험으로 분석합니다. 이 글은 2025년 6월 11일 수정된 arXiv:2502.17361v2를 기준으로 합니다. Accurate predictions on small data with a tabular foundation model이라는 Nature 논문이 TabPFN v2 자체를 제안했다면, 여기서 다루는 논문은 공개된 TabPFN v2의 동작을 분석하고 적용 범위를 확장한 별도의 후속 연구입니다. 새로운 사전학습 모델이나 아키텍처를 제안하는 연구로 읽으면 기여의 초점이 달라집니다. 원문 초록·서론
분석의 중심은 무작위 열 토큰에서 안정적인 관계가 형성되는 과정, 학습·테스트 행의 역할을 맞춘 특징 추출, 그리고 열·클래스·행을 나누는 추론 시 분할 정복입니다. 아래의 절·그림·표 번호는 v2 PDF를 따릅니다. HTML 변환본과 번호가 다른 곳이 있어 PDF를 기준으로 통일했습니다.
| 원문 순서 | 제목과 하위 구조 | 논리적 역할 |
|---|---|---|
| 1 | Introduction | 분석할 세 가지 질문과 기여를 설정합니다. |
| 2 | Related Work | 정형 데이터 학습, foundation model, TabPFN 변형의 계보를 정리합니다. |
| 3 | Background | 표의 행·열·레이블과 v1/v2의 입력·예측 구조를 정의합니다. |
| 4 | Comprehensive Evaluation of TabPFN v2 — 4.1 Setups, 4.2 Strengths, 4.3 Limitations | 일반적 강점과 범위 밖의 성능 저하를 확인합니다. |
| 5 | How Does TabPFN v2 Effectively Handle Data Heterogeneity? — 5.1 Mechanisms, 5.2 Attribute Token Learning | 랜덤 토큰과 attention을 통해 이질성 대응을 분석합니다. |
| 6 | TabPFN v2 Can Be Transformed into an Effective Feature Encoder — 6.1 Naive Extraction, 6.2 Leave-one-fold-out, 6.3 Validation | 특징 추출의 역할 불일치를 교정합니다. |
| 7 | Improving TabPFN v2 via Test-Time Divide-and-Conquer — 7.1 High Dimension, 7.2 More Than 10 Classes, 7.3 Large-Scale | 세 가지 규모 제약에 서로 다른 분해 전략을 적용합니다. |
| 8 | Conclusion | 분석과 확장의 기여를 정리합니다. |
| 뒤따르는 자료 | References, Appendix A–E | 평가 설정, 변형 구현, 특징 추출, 모듈·메타특징 분석, 세부 수치를 제공합니다. |
핵심 기여와 혁신성
첫째, 열의 의미를 미리 알아야만 전이할 수 있는 것은 아니라는 실험적 설명을 제시합니다. 기존 토큰 기반 접근은 열 이름의 의미 임베딩이나 데이터셋별 학습 가능한 토큰에 의존할 수 있습니다. TabPFN v2는 무작위 섭동으로 열을 구분하고, 문맥에 주어진 데이터의 값과 레이블을 이용해 관계를 형성합니다. 저자들은 층별 토큰 시각화와 attention의 반복 실행 안정성을 근거로, 속성 토큰 학습이 추론 안에 내재화되었다고 해석합니다. 이는 관찰에 기반한 메커니즘 분석이며, 모든 데이터셋에 대한 수학적 증명은 아닙니다. §5
둘째, 예측기에서 특징 추출기로 전환할 때 생기는 역할 불일치를 해결합니다. 정답 레이블을 가진 학습 행과 더미 레이블을 가진 테스트 행에서 같은 위치의 출력 토큰을 뽑아도 같은 의미의 표현이 되지는 않습니다. 학습 행 역시 레이블을 가린 query 역할로 처리하는 leave-one-fold-out 방식은 이 차이를 줄이며, 추출 특징 위의 선형 분류기가 원래 TabPFN v2에 근접한 성능을 보이게 합니다. §6
셋째, 사전학습 가중치를 다시 학습하지 않고 어려운 문제를 작은 문제로 나눕니다. 고차원 입력에는 열 부분집합 앙상블, 많은 클래스에는 십진수 분해와 레이블 매핑 순열, 큰 데이터에는 support/query 특징 추출이나 트리 기반 지역 분할을 적용합니다. 여기서 ‘재학습하지 않는다’는 말은 TabPFN backbone에 관한 설명입니다. 선형 모델과 결정 트리를 추가로 학습하는 변형까지 학습 비용이 전혀 없는 것은 아닙니다. §7
리뷰어 관점에서 세 기여를 묶는 핵심은 입력의 역할과 문제의 단위를 바꾸어 사전학습된 추론 능력을 활용한다는 점입니다. 표 전체를 한 번에 처리할 수 있는지만 보는 대신, 어떤 문맥을 주고 어떤 출력 표현을 얻을지를 분석 대상으로 삼습니다.
기술적 세부사항
표의 학습 집합은 $\mathcal D=\{(\mathbf x_i,y_i)\}_{i=1}^{N}$입니다. $N$은 행 수, $d$는 열 수, $\mathbf x_i\in\mathbb R^d$는 한 행입니다. 분류에서 $y_i$는 클래스이며, 회귀에서는 수치입니다. 논문은 범주형 열이 있으면 ordinal 또는 one-hot encoding을 거쳐 수치로 표현한다고 설정합니다. 테스트 행 $\mathbf x_*$는 학습 집합과 같은 분포에서 왔다고 가정합니다. §3
v2에서는 각 열의 값과 레이블이 각각 토큰이 됩니다. 단일 테스트 행까지 넣은 문맥은 개념적으로 다음 크기입니다.
$N+1$은 학습 행과 테스트 행, $d+1$은 속성과 레이블, $k$는 토큰 차원입니다. 행 방향 attention은 사례 사이의 정보를, 열 방향 attention은 속성 사이의 정보를 교환합니다. 마지막에는 테스트 행의 더미 레이블에 대응하는 출력 토큰을 예측에 사용합니다. 이 표기는 §3의 설명을 따른 것으로, 실제 체크포인트의 feature grouping과 같은 구현 세부사항을 모두 펼친 메모리 사용량 공식은 아닙니다.
이 논문의 결과를 읽을 때는 실험 단위를 분리해야 합니다.
| 분석 | 데이터와 비교 조건 | 보고 지표 |
|---|---|---|
| 기본 예측 성능 | 300개 후보에서 체크포인트 선택용 27개를 제외한 273개; 학습/검증/테스트 64/16/20%; 15 seeds | 분류 accuracy, 회귀 RMSE, 순위, PAMA |
| 특징 추출 | tiny benchmark의 분류 29개; 검증 집합으로 결합 층 선택 | 선형 분류기의 accuracy와 평균 순위 |
| 고차원 확장 | 속성 2,000개 이상인 분류 18개 | 평균 accuracy |
| 다중 클래스 확장 | 클래스 10개 초과인 분류 12개 | 평균 accuracy |
| 대규모 확장 | 행 수×열 수가 1,000,000을 넘는 18개; 모든 방법 기본 하이퍼파라미터 | accuracy/RMSE에 따른 평균 순위 |
기본 비교에서 TabPFN v2는 추가 튜닝을 하지 않고, 비교 모델은 Optuna 100 trials와 검증 성능에 따른 early stopping을 사용합니다. 따라서 튜닝된 기존 모델과 튜닝 없이 전이하는 모델의 예측 성능을 비교한 설계이며, 모든 방법에 같은 총 연산 시간을 준 실험은 아닙니다. 큰 데이터 실험은 비용 때문에 기본값을 사용하므로 해당 결과를 그대로 튜닝된 모델 간 비교라고 옮기면 안 됩니다. §4.1–4.3
챕터별 상세 리뷰
📖 Chapter 1: Introduction
챕터의 위치와 역할. 서론은 정형 데이터가 foundation model에 어려운 이유부터 출발합니다. 의료·금융·과학 데이터는 활용 범위가 넓지만, 데이터셋마다 열 수와 의미가 다릅니다. 작은 데이터셋에서 개별 모델을 처음부터 학습하면 하이퍼파라미터 선택에 민감하고 일반화에 사용할 사례가 부족합니다.
저자의 서술 순서를 따른 상세 내용. 먼저 이런 수요에 TabPFN v2의 in-context learning을 연결합니다. 모델은 레이블이 있는 행들과 레이블이 없는 테스트 행을 함께 처리하여, 새 태스크에 별도의 미세조정을 하지 않고 예측합니다. 저자들이 다음으로 제시하는 질문은 ‘왜 잘 되는가’와 ‘권장 범위를 벗어나면 어떻게 하는가’입니다. 여기서 인용하는 기존 권장 범위는 샘플 10,000개, 차원 500개, 클래스 10개 이하입니다.
이어서 세 관찰을 순서대로 제시합니다. 무작위 열 토큰으로 시작해도 속성 관계를 추론한다는 점, 학습·테스트 역할을 맞추면 유용한 특징 추출기가 된다는 점, 추론 시 분할 정복이 적용 범위를 넓힌다는 점입니다. 특히 첫 관찰은 별도 열 임베딩을 학습하는 절차를 없애면서도 데이터셋의 통계적 구조를 활용할 수 있다는 주장입니다.
마지막 Remark는 연구의 성격을 제한합니다. 새 아키텍처나 사전학습 방식이 기여가 아니라, 이미 공개된 모델의 분석과 원리 있는 확장이 기여입니다. 각주에서도 학습 데이터와 학습 recipe가 공개되지 않았다는 배경 아래 공개된 사전학습 모델의 성질에 초점을 맞춘다고 밝힙니다. 이 글 역시 사전학습을 재현했다는 주장 없이 해당 체크포인트의 분석 결과를 다룹니다.
핵심 기여와 다음 연결. 세 질문을 분리해 이후 논문의 뼈대를 만듭니다. 다음 장은 각각의 질문이 기존 정형 데이터 연구와 어떻게 이어지는지 설명합니다. §1
📖 Chapter 2: Related Work
챕터의 위치와 역할. 관련 연구는 단순 모델 목록보다, 데이터 표현과 전이 방식의 선택지를 정리하는 역할을 합니다.
Learning with Tabular Data. 저자들은 먼저 XGBoost·LightGBM·CatBoost 같은 트리 모델과 딥러닝 모델을 비교하는 흐름을 소개합니다. 딥러닝은 원래 수치 벡터를 직접 처리하는 계열과, 속성을 토큰으로 바꿔 상호작용을 학습하는 계열로 구분됩니다. 이는 뒤에서 v2의 토큰화가 기존 방법과 어떻게 다른지 설명할 준비입니다.
Tabular foundation models. 다음에는 데이터셋 사이의 열 공간·차원·레이블 분포 차이를 다룹니다. 열 이름과 값을 문장으로 만들어 언어 모델에 넣거나, 열의 의미 임베딩을 미리 계산하는 방법이 있습니다. 그러나 개인정보 제약이나 기술 비용, 의미를 쉽게 서술하기 어려운 측정값 때문에 열 이름의 의미를 활용하지 못하는 경우도 있습니다. 이때 주변 사례와의 유사도로 공통 공간을 만드는 접근이나, 문맥 자체를 조건으로 예측하는 TabPFN 계열이 대안이 됩니다. 저자들은 v1의 고정 차원 padding과 v2의 속성 tokenizer 차이도 여기서 짚습니다.
Variants of TabPFN. 마지막에는 합성 데이터 사전학습에서 출발한 TabPFN이 생성·이상 탐지·시계열 등으로 응용되고, context 크기, 검색, 미세조정, 앙상블, 사전학습 개선으로 확장된 흐름을 소개합니다. 초기 변형 상당수는 v1의 분류 제약을 물려받았고, v2는 회귀와 더 큰 context를 지원합니다. 따라서 이 논문은 v2의 분석과 사후 확장을 대상으로 정합니다.
핵심 기여와 다음 연결. 열 이름의 의미가 없더라도 전이가 가능한가라는 질문을 선명하게 만듭니다. 다음 장은 이를 논하기 위한 표기와 입력 구조를 고정합니다. §2
📖 Chapter 3: Background
챕터의 위치와 역할. 단일 표의 감독학습 문제에서 시작하여 v1, v2 순으로 구조가 어떻게 바뀌었는지 설명합니다.
단일 데이터셋의 학습 문제. 행 $\mathbf x_i$와 레이블 $y_i$의 집합을 이용해 새 행의 레이블을 예측합니다. 분류는 유한한 클래스 집합, 회귀는 연속적인 값을 출력합니다. 서로 다른 표에서는 $d$가 달라질 수 있으므로, 고정된 열 벡터 의미를 전제로 하는 모델의 전이가 어렵습니다.
v1의 표현. 원래 TabPFN은 학습·테스트 행을 고정 차원으로 zero-padding한 뒤, 행 벡터와 레이블을 각각 같은 토큰 차원으로 선형 사영합니다. 레이블이 있는 행에서는 두 임베딩을 합치고 테스트 행에는 입력 임베딩을 사용하여, 전체를 $N+1$개 토큰의 문맥으로 처리합니다. Transformer는 문맥 길이 변화에 대응하지만, 열의 처리 방식은 고정 차원 표현에 묶여 있습니다.
v2의 표현. v2는 한 행을 속성별 토큰과 레이블 토큰으로 나눕니다. 테스트 행에는 학습 레이블의 평균 같은 더미 레이블을 사용합니다. 속성 방향과 사례 방향 self-attention을 번갈아 적용한 뒤, 테스트 레이블 위치의 출력 토큰을 MLP에 전달합니다. 이 장은 분류의 10-class logit과 회귀의 예측 출력을 개념적으로 설명합니다. 원 모델의 회귀 분포 표현 등 모든 세부 구현을 새롭게 유도하는 장은 아닙니다.
저자들은 이어서 합성 structural causal model 데이터로 사전학습하고 실제 데이터로 체크포인트를 선택한다는 배경을 정리합니다. 특히 무작위 토큰의 사용은 기존 논문의 보충자료와 코드에 설명된 세부사항이었다고 밝힙니다. 후속 분석 논문의 역할은 이 설계를 새 발명으로 제시하는 것이 아니라, 실제 동작과 함의를 해석하는 데 있습니다.
핵심 기여와 다음 연결. 입력의 행·열·레이블 축을 분리함으로써 이후의 토큰 분석과 특징 추출 문제를 이해할 틀을 제공합니다. 다음 장에서는 이 구조가 실제로 어느 데이터 범위에서 강한지 먼저 검증합니다. §3 및 Figure 1
📖 Chapter 4: Comprehensive Evaluation of TabPFN v2
챕터의 위치와 역할. 내부 메커니즘을 설명하기 전에 강점과 제약을 경험적으로 확인합니다. 결과가 좋아지는 조건만으로 메커니즘을 설명하지 않도록, 범위 밖의 데이터도 별도로 평가합니다.
4.1 Setups
출발점인 300개 데이터셋은 이진 분류 120개, 다중 클래스 분류 80개, 회귀 100개로 구성됩니다. 저자들은 중복 버전과 잘못된 레이블 같은 문제를 다룬 기존 벤치마크를 사용하고, TabPFN v2 체크포인트 선택에 사용된 27개를 제외하여 본문 핵심 비교를 273개로 제한합니다.
각 데이터셋을 무작위로 64% 학습, 16% 검증, 20% 테스트로 나누고 15 seeds의 평균을 보고합니다. 분류 accuracy와 회귀 RMSE는 방향이 반대이므로, 서로 다른 태스크를 한데 비교할 때는 순위와 최고 성능 달성 비율을 사용합니다. 클래스가 10개를 초과하면 기본 비교의 TabPFN v2에는 기존 ECOC, 즉 여러 하위 분류 결과로 클래스를 표현하는 Error-Correcting Output Codes 전략을 사용합니다.
4.2 Empirical Results: Strengths of TabPFN v2
저자들은 기존 정형 데이터 방법들과 비교하고, 유의수준 0.05의 Wilcoxon-Holm 검정 결과를 Figure 1에 제시합니다. 이 그림과 최고 성능 달성 비율 PAMA를 함께 읽어야 합니다. 평균 순위는 여러 데이터셋에서 일관되게 상위권에 있는지를, PAMA는 실제로 1위를 얻은 비율을 보여줍니다.
Figure 2에서 TabPFN v2의 PAMA는 26.02%, ModernNCA는 11.79%, TabM은 9.78%입니다. 26.02%는 평균 accuracy나 기존 모델 대비 개선율이 아닙니다. 273개 비교 데이터셋 중 해당 방법이 최고 결과를 얻은 비율입니다. 나머지 데이터셋에서도 모두 실패했다는 뜻은 아니며, 최고가 아니라는 사실만 나타냅니다.
4.3 Empirical Results: Limitations of TabPFN v2
이후 저자들은 고차원 18개, 대규모 18개, 클래스 10개 초과 12개를 살펴봅니다. 고차원은 $d\geq 2{,}000$, 큰 데이터는 $N\times d\gt1{,}000{,}000$으로 구분합니다. 고차원에서는 기본 TabPFN v2가 단순 Logistic Regression보다 낮은 순위를, 큰 데이터에서는 CatBoost·RealMLP보다 낮은 순위를 보입니다. 다중 클래스에서도 기존 ECOC 확장이 충분한 accuracy를 내지 못합니다.
Table 1의 순위는 그 표에 포함된 다섯 방법 사이에서 계산되었습니다. 예컨대 큰 데이터의 TabPFN v2 3.97과 CatBoost 1.89를, 더 많은 변형이 포함된 Figure 5의 순위와 같은 분모로 비교하면 안 됩니다. 저자들은 계산 복잡도뿐 아니라 작은 합성 태스크 중심 사전학습과 복잡한 실제 데이터 사이의 불일치도 원인일 수 있다고 가설로 제시합니다. 사전학습 분포 불일치가 실제 원인이라는 통제 실험 결과로 확정하지는 않습니다.
핵심 기여와 다음 연결. 소·중규모의 강한 일반화와 세 가지 적용 범위 제약을 함께 설정합니다. 다음 두 장은 강점의 표현 구조를 분석하고, 7장은 여기서 확인한 제약을 해결합니다. §4, Table 1, Figures 1–2
📖 Chapter 5: How Does TabPFN v2 Effectively Handle Data Heterogeneity?
챕터의 위치와 역할. 열 개수와 의미가 다른 데이터셋에 하나의 모델을 적용할 수 있는 이유를 tokenizer와 층별 표현에서 찾습니다.
5.1 Diving into TabPFN v2’s Mechanisms for Heterogeneous Input
저자들은 먼저 토큰화 자체가 열 개수 변화를 다루는 방법임을 설명합니다. 각 열을 고정 차원 벡터로 바꾸면 Transformer는 토큰 수가 달라도 처리할 수 있습니다. 문제는 새 데이터셋의 토큰을 어떻게 정하느냐입니다. 미리 정한 의미 임베딩은 열 의미가 알려져 있어야 하고, 데이터셋별 학습 토큰은 추가 최적화를 요구합니다.
v2는 공유 벡터와 무작위 섭동을 결합합니다. 원문 식 (1)의 요소를 풀어 쓰면 다음과 같습니다.
$x_i^j$는 $i$번째 행의 $j$번째 속성값, $\mathbf u\in\mathbb R^k$는 모든 속성에서 공유하는 학습된 벡터입니다. 속성값에 $\mathbf u$를 곱해 같은 차원의 토큰으로 올립니다. $\mathbf p_j\in\mathbb R^{k'}$는 무작위 벡터, $\mathbf W\in\mathbb R^{k\times k'}$는 학습된 사영 행렬이며, $\mathbf r_j$는 열을 서로 구분하는 섭동입니다. 위의 $\mathbf e_{ij}$는 항을 설명하기 위해 붙인 이름이며, 원문은 전체 행 표현을 다음과 같이 제시합니다.
마지막 $\widetilde{\mathbf y}_i$는 레이블 토큰입니다. 식은 토큰들을 열로 놓은 표기이고, 앞의 3차원 문맥 표현은 축 배치 관점에서 읽으면 됩니다. 중요한 점은 같은 열의 무작위 식별자는 여러 행에서 일관되게 사용된다는 것입니다. 각 셀마다 독립적으로 다른 의미를 주는 방식이 아니므로, 모델은 행들에 걸친 한 열의 분포와 다른 열·레이블과의 관계를 추적할 수 있습니다.
5.2 TabPFN v2 Internalizes Attribute Token Learning
저자들은 churn과 bank를 대상으로 세 순서의 분석을 수행합니다. 먼저 입력과 3·6·9·12층의 속성 토큰을 PCA로 투영합니다. 처음에는 무작위로 흩어진 열 표현이 층을 지나면서 더 구조화되고, bank의 job·education·balance처럼 의미상 관련된 속성들이 가까워지는 사례를 보여줍니다.
다음으로 head와 학습 행에 대해 평균한 속성 간 attention을 봅니다. 초기 층에서는 레이블 토큰을 강하게 참조하고, 중간 층에서는 여러 속성으로 정보가 퍼지며, 후반에는 관련 속성에 attention이 집중되는 패턴을 설명합니다. ‘초기에 태스크 신호를 흡수하고 후반에 유용한 속성 관계를 형성한다’는 부분은 관찰에 대한 저자 해석입니다.
마지막으로 무작위 초기화를 바꾼 10회 실행의 attention 지도 간 cosine similarity와 변동을 계산합니다. 첫 층을 제외하면 attention 패턴이 안정적으로 나타납니다. 시작 좌표가 달라도 관계 구조는 비슷해질 수 있다는 근거입니다. 단, 이 실험은 attention 관계의 안정성을 보여주는 것이지, 서로 다른 실행의 모든 임베딩 좌표가 동일하다는 주장은 아닙니다.
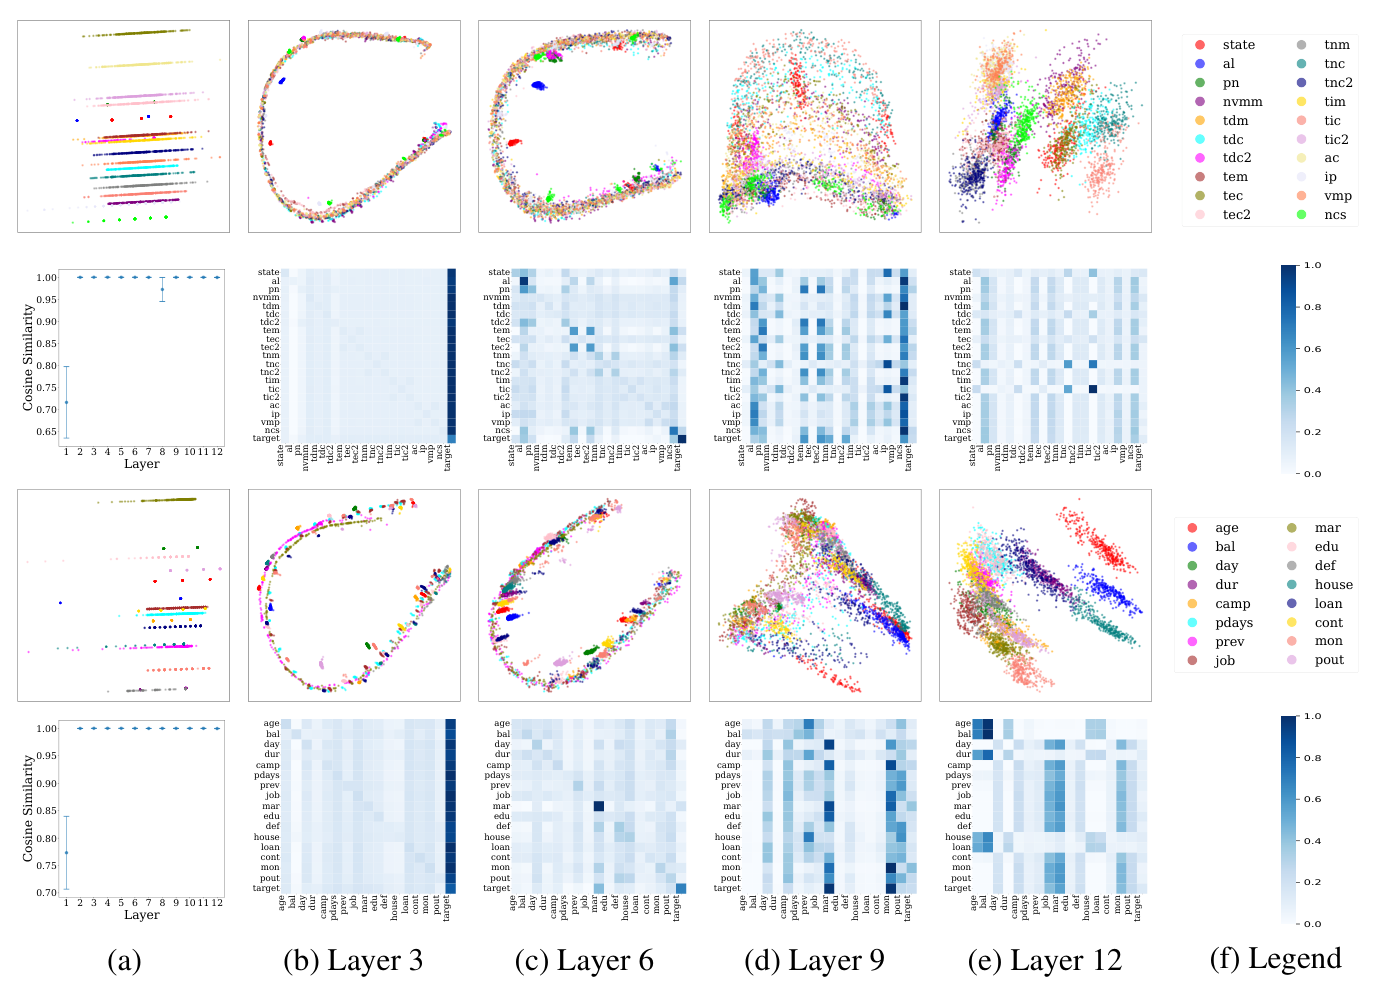
Figure 3, PDF 7쪽. v2 원문의 그림 영역을 크롭했으며, 그림 내부 영문·수치는 번역하거나 변경하지 않았습니다. 한국어 해설만 덧붙였습니다. 버전 고정 출처
그림을 읽을 때 놓치기 쉬운 조건은 부록 A에 있습니다. 기본 공개 체크포인트는 feature grouping size가 2이지만, Figure 3 분석은 개별 속성을 보기 위해 group size=1인 수정 체크포인트를 사용했습니다. 따라서 그림을 기본 체크포인트의 개별 열 토큰을 그대로 관찰한 결과라고 설명해서는 안 됩니다.
핵심 기여와 다음 연결. 저자들은 랜덤 토큰을 열을 구분하는 식별자, in-context learning을 관계를 복원하는 과정으로 해석합니다. 다음 장은 열 토큰에서 행 전체의 특징 표현으로 분석 단위를 옮깁니다. §5 및 식 (1), 분석 체크포인트 조건
📖 Chapter 6: TabPFN v2 Can Be Transformed into an Effective Feature Encoder
챕터의 위치와 역할. 잘 예측하는 모델이 반드시 쉽게 재사용할 수 있는 특징 추출기인 것은 아니라는 문제에서 시작합니다. 학습 행과 테스트 행의 표현을 같은 방식으로 얻는 절차가 필요합니다.
6.1 Naive Feature Extraction Fails
테스트 행의 예측은 더미 레이블 위치의 출력 토큰에서 나오므로, 이 토큰을 그 행의 임베딩으로 해석할 수 있습니다. 자연스러운 첫 시도는 학습 행에서도 레이블 위치의 출력 토큰을 추출하는 것입니다.
그러나 학습 행의 레이블 토큰에는 실제 정답이, 테스트 행에는 더미 레이블이 들어갑니다. 같은 Transformer를 통과했다는 사실만으로 이 출력들이 같은 역할의 특징이라고 볼 수 없습니다. Figure 4(b)의 학습·테스트 분포 차이와 낮은 선형 분류 정확도는 이 역할 불일치를 보여줍니다. churn에서는 raw feature의 선형 분류 accuracy가 0.8600인데 naive 임베딩에서는 0.5650으로 떨어집니다.
6.2 Leave-one-fold-out Feature Extraction
저자들은 실제 레이블을 제공하는 행을 support $S$, 레이블을 가리고 표현을 뽑는 행을 query $Q$로 구분합니다. 학습 행의 임베딩을 테스트 행과 맞추려면 그 행도 query에 넣어야 합니다. 반면 너무 많은 학습 행을 query로 옮기면 support의 감독 정보가 줄어듭니다.
해법은 학습 집합을 10 folds 등 여러 묶음으로 나누는 것입니다. 각 회차에서 한 fold는 더미 레이블을 가진 query, 나머지는 실제 레이블을 가진 support가 됩니다. 모든 fold에 반복하면 각 학습 행은 자기 정답을 입력받지 않는 query 상태에서 임베딩을 얻게 됩니다. 테스트 행도 더미 레이블의 query이므로, 학습·테스트의 입력 역할이 맞춰집니다.
이 절차는 감독학습 정보를 제거하는 것이 아닙니다. query의 자기 레이블을 가리는 동안 다른 support 행의 레이블을 이용합니다. 따라서 비지도 특징 추출이나 정답 레이블과 무관한 범용 임베딩으로 부르면 잘못입니다. 또한 fold별 support와 테스트에 사용하는 support가 완전히 같다는 뜻이 아니라, 저자의 표현대로 더 비교 가능한 임베딩을 만드는 전략입니다.
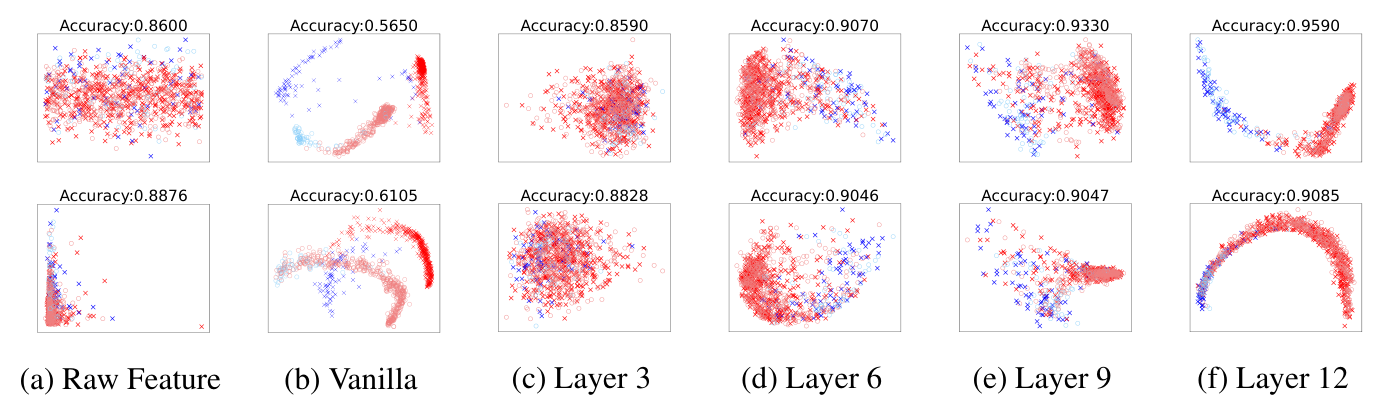
Figure 4, PDF 8쪽. 원문 그림 영역 크롭이며 영문·좌표·정확도 수치는 보존했습니다. 짙은 십자는 학습, 옅은 원은 테스트 사례입니다. 버전 고정 출처
churn의 12층 특징 위 선형 분류 accuracy는 0.9590, bank는 0.9085입니다. 이 값은 해당 시각화에 사용한 실험의 결과이며, 29개 데이터셋 전체 평균이나 TabPFN v2 자체의 accuracy로 바꾸어 읽으면 안 됩니다.
6.3 Validation of Embedding Quality
다음으로 tiny benchmark의 분류 29개에서 추출 특징 위에 Logistic Regression을 학습하여 검증합니다. Table 2의 평균 순위는 다음과 같습니다.
| 표현 또는 예측 방식 | 평균 순위, 낮을수록 좋음 |
|---|---|
| TabPFN v2 자체 예측 | 2.69 |
| Naive/Vanilla 특징 | 5.97 |
| Leave-one-fold-out, 6층 | 4.28 |
| Leave-one-fold-out, 9층 | 4.00 |
| Leave-one-fold-out, 12층 | 2.12 |
| 검증 성능으로 선택한 최대 3개 층 결합 | 1.94 |
PDF Table 2, 9쪽의 수치를 재작성했습니다. Combined는 12개 층 중 최대 3개를 선택·연결합니다. 출처
원래 예측기와 비슷하거나 더 좋은 평균 순위는 유용한 표현이 형성되었음을 뒷받침합니다. 다만 Combined에는 검증 집합을 이용한 층 선택과 선형 모델 학습이 추가됩니다. 원래 예측기와 전혀 같은 추론 절차나 계산 비용의 비교는 아닙니다. 평균 순위 1.94를 accuracy 1.94%나 오차 개선율로 해석해서도 안 됩니다.
핵심 기여와 다음 연결. 특징의 품질만큼 ‘그 특징을 어떤 역할로 추출했는가’가 중요함을 보입니다. 다음 장은 이 특징 추출 능력과 문제 분할을 이용해 입력 규모 제약을 줄입니다. §6
📖 Chapter 7: Improving TabPFN v2 via Test-Time Divide-and-Conquer
챕터의 위치와 역할. 4장의 세 제약을 같은 순서, 즉 많은 열 → 많은 클래스 → 많은 행으로 다룹니다. 저자들은 Chain-of-Thought에 영감을 받은 분해라고 설명하지만, 여기서 실제로 수행하는 연산은 언어적 추론문 생성이 아니라 하위 정형 태스크를 구성하고 예측을 합치는 과정입니다.
7.1 High Dimension Datasets
열 방향 attention의 제곱 복잡도에 대응하기 위해 원래 속성 집합에서 작은 부분집합을 무작위로 뽑습니다. 각 부분집합에 독립적으로 TabPFN v2를 적용한 뒤, 회귀에서는 평균, 분류에서는 다수결로 모읍니다. 저자들이 실험에 사용한 설정은 다음과 같습니다.
$d$는 원래 열 수, $d'$는 각 하위문제의 열 수, $m$은 부분집합 수입니다. 천장 함수는 비율을 올림하여 정수 개수로 만듭니다. 이 식은 추출 횟수를 정하는 설정이며, 무작위 부분집합이 서로 겹치지 않거나 모든 열을 정확히 한 번 포함한다는 보장은 아닙니다.
18개 고차원 분류 데이터에서 기본 v2의 평균 accuracy는 85.25%, PCA 기반 변형은 87.29%, 열 부분집합 앙상블은 89.73%입니다. Logistic Regression은 89.36%, RealMLP는 88.83%입니다. 확장판이 이 비교의 최고 평균을 얻지만, Logistic Regression과의 차이는 0.37 percentage points입니다. 사전학습 모델의 범위를 회복한다는 결과와 모든 기존 방법에 큰 격차로 앞선다는 주장은 구분해야 합니다.
7.2 Multi-Class Problems with More Than 10 Classes
레이블을 여러 자리의 십진 표현으로 바꾸면 각 자리의 예측은 최대 10개 클래스 문제입니다. 필요한 자리 수는 원문에서 다음과 같이 정합니다.
$C$는 클래스 수, $t$는 자리 수입니다. 클래스 식별자를 십진 코드에 매핑한 뒤 각 자리의 예측을 조합하여 원래 클래스를 복원합니다. 부록의 15클래스 예에서는 십의 자리 0·1, 일의 자리 0–9의 하위문제를 사용합니다. 저자들은 기본 십진 분해를 TabPFN v2-DPT로 부르며, 관련 선행연구에서도 제시된 전략임을 명시합니다.
문제는 코드가 임의의 관계를 만든다는 점입니다. 같은 자릿값을 가진 클래스끼리 묶여도 실제 의미는 관련이 없을 수 있습니다. 확장판은 클래스와 십진 코드의 대응을 $\sqrt C$회 무작위로 바꿔 여러 그룹 구성을 만들고 예측을 앙상블합니다. 부록 B에서는 공정한 비교를 위해 기본 DPT 역시 자리별 앙상블 수를 늘려 총 예측 횟수를 맞춘다고 설명합니다. 따라서 개선을 단순히 모델 호출 수 증가의 효과로만 설명하지 않도록 비교군이 설계되었습니다.
12개 데이터셋에서 평균 accuracy는 DPT 65.67%, ECOC 66.69%, 순열 앙상블 70.93%입니다. 비교 방법 전체에서 최고는 RealMLP의 72.51%이고, 확장판은 두 번째입니다. TabPFN의 제한을 완화했다는 주장과 전체 최고 성능이라는 주장을 분리하는 중요한 결과입니다.
7.3 Large-Scale Datasets
첫 전략 SQ는 전체 학습 행 중 10,000개를 support로 뽑고, 나머지 학습 행과 테스트 행을 query로 처리합니다. query의 임베딩을 추출해 새 특징 데이터셋을 만들고 그 위에 선형 예측기를 학습합니다. 본문은 분류의 Logistic Regression을 중심으로 서술하며, 전체 결과 표에는 회귀 태스크도 포함됩니다. 이 과정을 4회 반복해 예측을 합칩니다. 샘플을 10,000개만 남기고 나머지 학습 데이터를 버리는 bagging과 달리, 나머지 행을 특징 기반 학습에 사용한다는 것이 요점입니다.
두 번째 DF는 얕은 결정 트리로 문제 공간을 나눕니다. 전체 학습 데이터에서 60%를 비복원 추출한 부분집합 32개를 만들고, 각 부분집합에 최소 내부 노드 분할 샘플 수를 10,000으로 설정한 트리를 학습합니다. 테스트 행은 트리를 따라 leaf로 이동하고, 해당 지역의 사례를 문맥으로 사용하는 TabPFN v2로 예측합니다. 32개 모델의 출력을 모아 최종 결과를 얻습니다. 이 숫자는 내부 노드의 분할 조건이며, 논문이 모든 leaf의 실제 크기 분포를 따로 표로 보인 것은 아닙니다.
비교군에는 10,000개 학습 행을 네 번 무작위 추출하는 bagging(B), KMeans prototype과 가까운 10,000개를 선택하는 방식(K), 단일 트리 분할(DT)이 포함됩니다. Figure 5의 13개 방법 비교에서 평균 순위는 기본 v2 9.64, B 8.19, SQ 7.00, DF 4.35입니다. CatBoost 3.06, RealMLP 3.72, ModernNCA 3.80은 여전히 DF보다 앞섭니다. 개선은 뚜렷하지만 대규모 태스크의 우위가 완전히 뒤집힌 결과는 아닙니다.
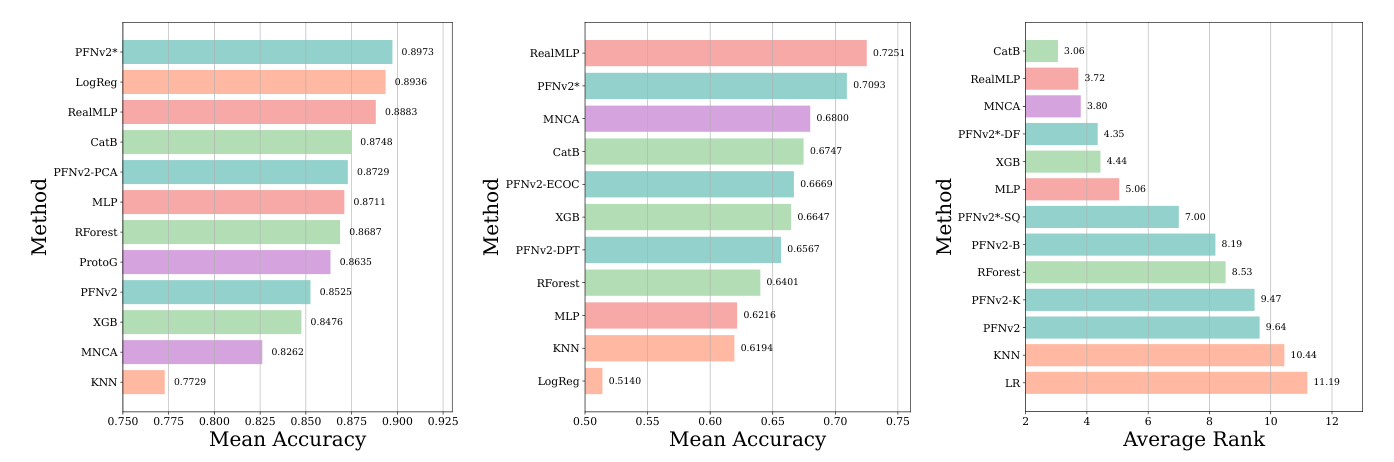
Figure 5, PDF 10쪽. 원문 그림 영역 크롭이며 수치·범례는 수정하지 않았습니다. 왼쪽·가운데는 accuracy가 높을수록 좋고, 오른쪽은 평균 순위가 낮을수록 좋습니다. 버전 고정 출처
핵심 기여와 다음 연결. 고정된 backbone도 하위문제의 구성에 따라 활용 범위가 달라짐을 보여줍니다. 다음 장은 이 확장 결과를 앞선 표현 분석과 묶어 결론을 제시합니다. §7 및 Figure 5
📖 Chapter 8: Conclusion
챕터의 위치와 역할. 결론은 속성 관계 추론, 특징 추출, 분할 정복이라는 세 기여를 다시 연결합니다.
저자들은 무작위 입력 토큰으로부터 사전 정의된 의미나 데이터셋별 속성 표현 학습 없이 관계를 추론할 수 있다고 정리합니다. 이어서 leave-one-fold-out으로 얻은 특징이 시각화·진단 분석 같은 용도에도 모델을 활용할 수 있게 한다고 설명합니다. 마지막으로 backbone 재학습 없이 큰 차원·많은 클래스·큰 데이터에 대한 활용 범위를 늘렸다는 점을 강조합니다.
이 장은 새로운 실험이나 별도의 구체적 향후 연구 목록을 추가하지 않습니다. 따라서 결론에서 제시하지 않은 연구 과제를 저자의 제안처럼 확장하지 않습니다.
핵심 기여와 뒤따르는 자료. 본문은 여기서 끝납니다. 뒤에는 References와 부록 A–E가 이어지며, 주장에 사용한 설정과 수치의 세부 근거를 제공합니다. §8
📖 Chapter References: References
참고문헌은 본문 뒤, 부록 앞에 위치합니다. 기존 TabPFN v1과 Nature의 v2 원논문, 정형 데이터 벤치마크, 비교 모델, 십진 분해와 test-time scaling의 관련 연구를 구분하는 역할입니다. 특히 Nature 원논문은 참고문헌 [29]이고, 이 리뷰의 대상인 후속 분석 논문 자체와 동일 문헌이 아닙니다. 이 리뷰는 본문이 인용한 모든 선행 논문을 독립적으로 재검증한 문헌 조사가 아니며, 인용 목록을 그대로 반복하지 않습니다. 다음 부록부터는 현재 논문의 추가 실험 자료로 돌아갑니다. References
📖 Chapter Appendix A: Evaluation Details
위치와 역할. 부록 A는 결과를 해석하는 데 필요한 계산 환경, 데이터셋, 비교 모델, 분석 체크포인트를 보완합니다.
저자들은 NVIDIA RTX 6000 Ada 4개와 Intel Xeon Platinum 8352V CPU 2개를 사용했다고 명시합니다. 고차원 18개 데이터셋은 scikit-feature 자료에서 선택했으며, Table 3에는 행·열·클래스 수가 제시됩니다. 50행·4,434열의 GLIOMA처럼 샘플이 적고 열이 많은 문제부터 7,000행·5,000열의 gisette까지 포함됩니다. 따라서 고차원 평균 결과는 모든 데이터가 충분한 학습 행을 가졌다는 상황을 뜻하지 않습니다.
대규모 Table 4는 BNG(credit-a)·Higgs 같은 백만 행 문제와 1천만 행의 Airlines_DepDelay, 상대적으로 행은 적어도 열이 많은 UJIndoorLoc 등을 함께 보여줍니다. 이는 큰 데이터의 판정이 단순 행 수 하나가 아니라 행×열 기준임을 이해하는 데 도움이 됩니다. 이어 Tables 5–6은 bank·churn의 약어를 풀어 Figure 3의 열 관계를 읽을 수 있게 합니다.
비교 방법은 고전 모델, 트리, MLP 변형, 특수 구조, 토큰 기반, 정규화 기반, 트리 모방, 문맥 기반 순으로 분류합니다. 마지막 Remark는 앞서 강조한 Figure 3의 group size=1 체크포인트 조건을 설명합니다. 기본 모델과 분석용 변형의 차이를 재현 설정에 포함해야 한다는 점에서 중요한 부록입니다.
핵심 기여와 다음 연결. 평가 대상의 범위와 구현 조건을 구체화합니다. 다음 부록은 확장 전략의 비교군을 어떻게 만들었는지 다룹니다. Appendix A, Tables 3–6
📖 Chapter Appendix B: Details of Comparison Baselines
위치와 역할. 7장의 세 확장 문제를 같은 순서로 다시 방문하면서 구현 조건과 비교 공정성을 명확히 합니다.
High-Dimensional Classification. PCA 비교군은 입력을 500차원으로 줄이고, 서로 다른 PCA 사영을 사용한 결과를 bagging합니다. 이는 원래 열 중 일부를 선택하는 제안 방법과, 원래 열을 섞은 축으로 사영하는 비교군의 차이를 드러냅니다. 두 방법 모두 작은 입력을 만들지만 보존하는 정보의 방식은 다릅니다.
Many-Class Classification. ECOC는 공식 extensions의 구현을 이용합니다. DPT는 클래스 코드를 자리별로 예측하고 다시 조합합니다. 제안 방법은 매핑을 바꾸어 인위적 클래스 묶음의 영향을 분산합니다. 이때 DPT에도 자리별 $\sqrt C$ 앙상블을 적용해 호출 횟수를 맞춥니다. 본문의 $\sqrt C$는 저자의 표기이며, 모든 클래스 수에서 정수가 되는 것은 아니므로 이 리뷰에서 임의의 반올림 규칙을 추가하지 않습니다.
Large-Scale Tasks. DT는 한 개의 얕은 트리, B는 네 번의 무작위 support 추출, K는 KMeans 기반 대표 support 선택입니다. DF는 32개 부분집합에 DT를 적용하는 forest 확장입니다. 예측 결합은 태스크에 따라 투표 또는 평균으로 수행합니다. 따라서 DF는 단순히 같은 10,000개 문맥을 여러 번 반복하는 앙상블과 달리, 트리가 정한 서로 다른 지역을 활용합니다.
핵심 기여와 다음 연결. 이름이 비슷한 여러 v2 변형의 차이를 입력 구성과 앙상블 단위로 구분합니다. 다음 부록은 특징 추출의 추가 데이터와 감독 신호의 역할을 확인합니다. Appendix B
📖 Chapter Appendix C: Additional Feature Extraction Results
위치와 역할. 본문 6장의 주장을 다른 데이터셋과 비지도 대안으로 보강합니다.
C.1 Additional Results for Figure 4
Figure 6은 website_phishing의 3클래스와 KDD의 이진 분류를 추가합니다. 원래 특징, naive 방식, 층별 leave-one-fold-out 표현을 같은 학습·테스트 표시 방식으로 비교합니다. 두 데이터만 보인 본문 시각화에서 더 나아가지만, 여전히 시각화의 역할은 특정 데이터에서 표현의 구조를 보여주는 것입니다. 전체 데이터셋 성능은 별도의 선형 분류 평가와 함께 판단해야 합니다.
C.2 Comparison Between Supervised and Unsupervised Feature Extraction
첫 비지도 대안 Dummy는 모든 행의 pseudo-target을 0으로 두고 회귀 모델의 출력 토큰을 추출합니다. 두 번째 Permute는 각 속성을 차례로 pseudo-target으로 두고 나머지 속성으로 그 값을 예측하게 합니다. 이름의 ‘Permute’를 무조건 행을 무작위로 섞는 것으로 해석하면 안 됩니다. 여기서는 어느 열을 목표로 삼는지 바꾸어 가며 얻은 특징을 연결하는 절차가 설명되어 있습니다.
원문이 제시하는 연결식은 다음과 같습니다.
$n$은 행 수, $d$는 원래 열 수, $h$는 한 번 추출한 임베딩 차원입니다. $\mathbf E^{(j)}\in\mathbb R^{n\times h}$는 $j$번째 속성을 목표로 삼았을 때의 임베딩이고, $\mathrm{concat}$은 이들을 특징 축으로 이어 붙입니다. 실제 태스크의 정답 레이블을 사용하지 않으면서 속성 간 예측 관계를 담으려는 방식입니다.
Table 7의 평균 순위는 TabPFN v2 2.66, Vanilla 5.72, Dummy 4.90, Permute 3.69, 감독 방식 Ours 2.16, Combined 1.88입니다. 이 값은 Table 2와 비교 방법 구성이 달라 별도로 계산된 순위입니다. 순위 숫자가 조금 다르다는 이유만으로 같은 평가표의 오기로 합치면 안 됩니다.
저자들은 감독 방식의 특징 추출은 클래스 구분을, 비지도 방식은 특징 분포의 포괄을 지향한다고 해석합니다. 실제 레이블을 특징 생성 단계부터 이용하는지, 이후 선형 분류 단계에서만 이용하는지가 다릅니다. 따라서 비지도 방법의 낮은 분류 점수가 모든 비지도 활용 목적에서 열등함을 뜻하지는 않습니다.
핵심 기여와 다음 연결. 좋은 분류 임베딩의 형성에 support 레이블이 중요한 역할을 함을 보입니다. 다음 부록은 전처리·앙상블과 데이터셋 수준의 성질로 분석 범위를 확장합니다. Appendix C, Table 7, Figures 6–7
📖 Chapter Appendix D: Influence of Key Modules and Meta-Feature Analysis
위치와 역할. 개별 행과 토큰 수준을 넘어, 파이프라인 구성과 데이터셋 성질이 성능과 어떤 관계를 갖는지 봅니다. 원문은 세 소주제를 다음 순서로 설명합니다.
Feature engineering. 다양한 전처리 중 fingerprint feature와 polynomial feature를 추가하는 선택의 영향을 비교합니다. 해당 벤치마크에서는 이들을 사용하지 않아도 모델 성능이 강하고 개선 효과는 크지 않다고 보고합니다. Figure 8은 정규화한 accuracy/$R^2$ 점수를 사용합니다. 이는 본문 회귀 비교의 RMSE와 다른 그림용 지표입니다. 검토한 두 기능의 효과가 제한적이라는 결과를 ‘모든 전처리를 제거해도 된다’는 주장으로 확대하지 않아야 합니다.
Model ensemble. 입력을 여러 방식으로 변형하고 예측을 결합하는 post hoc ensemble 크기를 2·4·8·16으로 바꿉니다. Figure 9의 상대 개선 표시는 차례로 0.20%, 0.30%, 0.33%, 0.34%이며, 분포를 box plot으로 제시합니다. 저자들은 앙상블이 도움이 되지만 기본 모델이 이미 강하므로 추가 이득이 제한적이라고 해석합니다. 여기의 상대 개선율은 accuracy의 percentage-point 차이와 같지 않습니다. 또 열 순서 변화에 대한 둔감성을 설명하는 등변성 관련 해석을 덧붙입니다.
Meta-Feature Analysis. 이 분석은 본문 주 비교의 273개와 달리 300개 데이터셋을 사용합니다. TabPFN v2의 평균 순위 6.31을 기준으로 각 데이터셋을 Good/Bad로 나누고, 메타특징에서 이 라벨을 예측하는 깊이 3의 결정 트리를 만듭니다. Table 8에는 행·열 수, 분포 통계, 클래스 비율, 속성·타깃 엔트로피, 공분산, 상호정보량 등이 설명됩니다.
Figure 10의 뿌리는 행 수 24,350.5에서 갈립니다. 작은 쪽에서는 속성과 클래스의 평균 joint entropy 3.028, 더 작은 행 수 4,862 등이 분기로 등장합니다. 큰 쪽에서는 특징별 IQR의 표준편차와 클래스 중심 간 거리인 gravity 등이 사용됩니다. 이 트리는 해당 벤치마크에서 Good/Bad를 설명한 경험적 분할입니다. 24,350행이 모델의 보장된 입력 한계이거나, threshold만 보면 새 태스크 성능을 확정할 수 있다는 뜻은 아닙니다.
핵심 기여와 다음 연결. 성능을 backbone만의 효과로 읽지 않도록 구성 요소와 데이터 특성의 역할을 나누어 보여줍니다. 다음 부록은 이 모든 분석의 데이터셋별 수치를 모읍니다. Appendix D, Figures 8–10
📖 Chapter Appendix E: Detailed Results
위치와 역할. 마지막 부록은 평균 결과 뒤에 있는 데이터셋별 변동을 드러냅니다. Table 9부터 13까지의 순서대로 읽으면 본문 실험 전체를 다시 추적할 수 있습니다.
Table 9 — 기본 예측 성능. 분류 accuracy와 회귀 RMSE의 평균·표준편차를 데이터별로 제시합니다. 본문 주요 순위 비교는 체크포인트 선택용 27개를 제외한 273개라는 설명을 따릅니다. 한편 PDF의 Table 9 제목은 300개 결과라고 쓰며, 표 안에는 ada_prior·allbp 등 제외 목록에 든 이름도 나타납니다. 따라서 이 리뷰는 Table 9 전체 행을 그대로 273개 집계의 구성으로 간주하지 않습니다. 데이터별 표와 본문 집계 대상의 구분을 유지합니다.
Table 10 — 고차원 결과. 평균 89.73%만 보면 보이지 않는 차이가 있습니다. BASEHOCK은 기본 v2 69.09%에서 확장판 97.36%로 크게 오르지만, PCMAC은 92.70% → 90.14%, colon은 81.54% → 79.49%입니다. 이는 원문 표에 보고된 개별 결과로, 평균 개선이 모든 데이터셋의 개선을 뜻하지 않음을 보여줍니다. 고차원에서 선형 분류기도 강하다는 본문의 관찰 역시 평균 89.36%로 확인됩니다.
Table 11 — 많은 클래스 결과. 100-plants-shape에서는 ECOC 63.38%에 비해 확장판이 79.52%이지만, letter에서는 ECOC 97.78%, 확장판 97.57%입니다. RealMLP는 kropt·kr-vs-k에서 높은 값을 보여 전체 평균에서 앞섭니다. 태스크 분해가 특히 도움이 되는 문제와 이미 기존 전략이 강한 문제를 구별하게 합니다.
Table 12 — 큰 데이터 결과. 분류와 회귀를 함께 싣되, 회귀 행에는 배율이 표시됩니다. 이를 무시한 원시 숫자 평균은 의미가 없습니다. 분류 사례인 covertype은 기본 v2 83.54%, DF 97.44%인 반면 Fashion-MNIST는 기본 68.40%, SQ에 대응하는 표의 PFNv2* 86.26%, DF 78.82%입니다. 한 확장 전략이 모든 데이터 형태에 동일하게 유리한 것은 아닙니다. 이 비교는 원문이 보고한 결과의 범위를 설명하며, 별도 실행으로 재현한 수치가 아닙니다.
Table 13 — 층별 특징 추출. 29개 분류 데이터의 원 모델, naive, 비지도, 6·9·12층, Combined 결과와 선택된 층을 제시합니다. 예를 들어 website_phishing의 12층 특징은 91.88%, 원 모델은 90.77%입니다. 반면 Combined가 항상 마지막 층보다 좋은 것은 아니며, KDD에서는 12층 81.23%, Combined 79.94%입니다. 검증 집합에서 고른 조합의 테스트 결과이므로, 테스트 최적 조합을 사후 선택한 것처럼 읽으면 안 됩니다.
핵심 기여. 집계값, 데이터별 성능, 선택 조건을 함께 볼 수 있게 합니다. 본문 1–8과 부록 A–E의 구조는 모두 다루었으며, 개별 표의 모든 행과 참고문헌 83편의 내용을 전재하지는 않았습니다. 여기서 원문 순서에 따른 상세 리뷰를 마칩니다. Appendix E 및 Tables 9–13
실험 결과 심층 분석
수치에서 가장 먼저 구분해야 할 것은 비교 대상과 단위입니다. 다음 표는 원문 결과를 같은 조건 안에서만 계산한 변화입니다.
| 조건 | 기본 또는 비교 방법 | 제안 확장 | 해석 |
|---|---|---|---|
| 고차원 분류 18개, 평균 accuracy | v2 85.25% | 열 부분집합 89.73% | +4.48 percentage points; Logistic Regression 89.36%보다 0.37 points 높습니다. |
| 10클래스 초과 12개, 평균 accuracy | ECOC 66.69% | 매핑 순열 70.93% | +4.24 points; RealMLP 72.51%보다는 낮습니다. |
| 동일 다중 클래스 조건 | 호출 수를 맞춘 DPT 65.67% | 매핑 순열 70.93% | +5.26 points; 매핑 다양화의 비교 근거입니다. |
| 큰 데이터 18개, 13개 방법 사이 평균 순위 | v2 9.64 | DF 4.35 | 순위가 좋아집니다. accuracy 5.29 points 개선으로 해석할 수 없습니다. |
Figures 5와 Tables 10–12에 근거해 재작성했습니다. percentage-point 차이는 해당 표의 값으로 계산했습니다. Figure 5, Tables 10–11
통계적 근거의 범위. 기본 273개 비교에는 Wilcoxon-Holm, 유의수준 0.05가 명시되어 있으며, 15 seeds 평균과 Table 9의 표준편차도 제공됩니다. 그러나 위 확장별 평균 accuracy 차이 전체에 대해 각각의 신뢰구간이나 대응 p-value가 보고된 것은 아닙니다. 따라서 이 리뷰는 모든 확장 간 차이를 ‘통계적으로 유의하다’고 확정하지 않습니다. 평균 순위와 accuracy, seed 표준편차와 평균의 신뢰구간도 서로 대체하지 않습니다.
메커니즘 분석이 보여주는 것. Figure 3은 무작위 열 토큰에도 attention 관계가 반복 실행에서 안정적이라는 관찰입니다. Figure 4와 Table 2는 역할을 맞춘 특징으로 선형 분류가 가능하다는 정량 근거입니다. 전자는 열 관계에 대한 관찰, 후자는 실제 예측에 유용한 행 표현에 대한 평가로 서로 다른 분석 단위를 보완합니다. attention 지도가 안정적이라는 이유만으로 모든 속성의 인과적 의미를 학습했다고 결론내리지는 않습니다.
원문이 명시한 제약과 실패 조건. 기본 v2의 고차원·대규모 성능 저하, 많은 클래스에 대한 ECOC의 부족한 성능, naive 특징 추출의 역할 불일치, 십진 코드의 인위적 클래스 상관이 이 논문에서 직접 다룬 문제입니다. 확장은 이를 완화하지만 RealMLP나 CatBoost가 앞서는 조건도 남아 있습니다. 데이터별 표에 나타난 성능 감소는 해당 조건의 결과로만 기술했으며, 논문에 없는 새로운 실패 원인을 붙이지 않았습니다.
재현성. 분할 비율, trials, seeds, 하드웨어, 데이터 목록, 확장별 support·앙상블 설정과 분석용 체크포인트 정보를 제공한다는 점은 재현에 도움이 됩니다. 다만 공개 모델의 사전학습 자체를 재현하는 연구는 아니며, 본문과 부록에 있는 모든 축약 구현 설명을 완전한 실행 명세로 간주할 수는 없습니다. 이 리뷰에서는 모델·코드·실험을 실행하지 않았고, 원문 수치와 설정을 대조했습니다. 특히 SQ의 본문 설명은 분류기를 중심으로 하면서 결과 표는 회귀도 포함하므로, 회귀 구현의 추가 세부사항을 추정해 채우지 않았습니다.
기술적 함의와 응용
데이터과학 관점에서 가장 유용한 메시지는 예측 모델의 재사용 단위가 가중치에만 있지 않다는 점입니다. 이 논문은 같은 사전학습 모델이라도 행의 역할, 열의 부분집합, 레이블 코드, 지역 문맥을 바꾸면 다른 활용이 가능함을 보여줍니다. 아래의 해석은 원문 결과를 실무적 관점으로 연결한 리뷰어 해석입니다.
특징 추출에서는 일반적인 신경망의 hidden state를 가져오는 관행을 그대로 적용하기 어렵습니다. in-context 모델에서 입력에 실제 레이블이 포함되었다면 그 행은 다른 정보를 가진 상태입니다. leave-one-fold-out은 이 정보 조건을 맞추는 장치이며, 이후 시각화나 선형 분류의 성능을 해석할 때도 감독 신호가 어디에 들어갔는지 추적해야 합니다.
확장 방법을 볼 때는 병목 축을 구별하는 것이 중요합니다. 열이 많으면 작은 속성 부분집합, 클래스가 많으면 출력 문제의 분해, 행이 많으면 support의 제한과 지역적 문맥 구성을 사용합니다. 이들은 같은 이름의 단일 ‘더 큰 TabPFN’이 아니라, 서로 다른 제약에 대응하는 방식입니다. 추가 선형 모델·트리 학습과 반복 추론이 있으므로 ‘backbone 미세조정 불필요’와 ‘추가 계산 불필요’를 구분해야 합니다.
마지막으로 이 논문의 해석은 강한 평균 성능과 조건별 예외를 함께 보는 데 가치가 있습니다. 작은 표에서의 성공을 모든 규모로 일반화하지 않고, 고차원에서의 선형 모델 경쟁력과 큰 데이터에서의 트리·MLP 우위를 유지한 채 확장의 효과를 측정합니다. TabPFN v2를 이해한다는 것은 하나의 최고 점수를 외우는 것보다, 어떤 문맥에서 어떤 표현이 만들어지고 어떤 분해가 적용 범위를 넓히는지를 이해하는 일에 가깝습니다.