논문 개요와 전체 구조
TabPFN v2는 새로운 표 데이터셋을 받았을 때 어떤 예측기를 학습할 것인지 자체를 미리 학습한 모델입니다. 수많은 합성 데이터셋에서 예측 문제를 풀도록 Transformer를 사전학습하고, 실제 사용 시에는 정답이 있는 학습 행과 정답이 없는 질의 행을 문맥으로 전달합니다. 일반적인 사용 과정에서 모델 가중치를 다시 최적화하지 않아도 새 데이터의 예측을 생성하는 in-context learning(ICL, 문맥 내 학습)이 핵심입니다.
이 글은 Noah Hollmann 등 8인이 발표한 Accurate predictions on small data with a tabular foundation model의 2025년 1월 8일 Nature 온라인 출판 정본을 분석합니다. 논문 자체는 모델을 TabPFN이라고 부르며, 이전 초기 연구와 구분하기 위해 이 글에서는 TabPFN v2라고 표기합니다. 정식 명칭은 Tabular Prior-data Fitted Network입니다. 2023년의 초기 소규모 분류 전용 TabPFN 연구와 구분해야 하며, 여기서는 회귀·범주형 변수·결측치·더 큰 표를 다루는 후속 모델이 대상입니다. Nature 정본
논문의 중심 실험 범위는 최대 10,000개 표본, 500개 특징이며 분류는 최대 10개 클래스입니다. 분류 29개와 회귀 28개 데이터셋에서 비교하고, 다른 벤치마크와 Kaggle 실험으로 범위를 보충합니다. 초록의 “2.8초”는 거대한 사전학습을 끝내는 시간이 아니라 이미 사전학습한 모델로 새로운 분류 과제에 적합하고 예측하는 평균 시간입니다.
원문은 번호가 붙은 전형적인 머신러닝 학회 목차 대신 다음 순서로 전개됩니다. 아래 챕터 번호는 리뷰에서 부여한 탐색용 번호입니다.
| 원문 순서 | 섹션과 하위 구성 | 역할 |
|---|---|---|
| 1 | Main | 표 데이터의 이질성과 작은 데이터 문제 |
| 2 | Principled in-context learning | 합성 과제에서 예측 알고리즘을 학습하는 원리 |
| 3 | An architecture designed for tables | 행·열 attention과 학습 상태 캐시 |
| 4 | Synthetic data based on causal models | 데이터셋 분포를 만드는 생성 prior |
| 5 | Qualitative analysis | 함수 근사와 예측분포의 정성적 확인 |
| 6 | Quantitative analysis → Comparison with state-of-the-art baselines → Evaluating diverse data attributes → Comparison with tuned ensemble methods | 정확도·시간·강건성·앙상블 평가 |
| 7 | Foundation model with interpretability | 밀도·생성·표현·미세조정·SHAP |
| 8 | Conclusion | 연구 결론과 저자가 명시한 확장 방향 |
| 9 | Methods: User guide → Details on the neural architecture → Details on the causal generative process → Training details → Inference details → TabPFN (PHE) → Foundation model abilities → Detailed evaluation protocol | 방법과 평가를 재구성할 세부 정보 |
| 10 | Data availability, Code availability | 데이터·코드의 공개 범위 |
| 11 | Extended Data Figures 1–4 | 추가 속성·벤치마크·설명·전이 실험 |
| 12 | Extended Data Tables 1–6 | 집계 점수·대상 목록·탐색 공간·Kaggle 결과 |
| 13 | Supplementary Tables 1–6 | 데이터셋별 원점수와 개발 데이터 목록 |
핵심 기여와 혁신성
표 데이터는 같은 숫자와 같은 열 위치라도 데이터셋마다 뜻이 바뀝니다. 한 표의 첫 번째 열이 나이라면 다른 표에서는 온도일 수 있습니다. 하나의 공통 어휘나 이미지 패턴을 대규모로 재사용하는 것과 달리, 표 학습은 작은 개별 과제의 함수 관계를 새로 추정해야 합니다. 저자는 이 문제를 다양한 표를 생성하는 분포를 설계하고 그 분포에서 학습 절차를 신경망으로 근사하는 문제로 바꿉니다.
첫 번째 기여는 PFN의 적용 범위를 실제 데이터과학 과제에 가깝게 확장한 점입니다. 원문이 이전 버전에 비해 강조하는 변화는 더 큰 데이터, 회귀, 범주형 변수와 결측치 지원, 불필요한 특징과 이상치에 대한 강건성입니다. 두 번째는 표의 두 축을 직접 처리하고 학습 행의 상태를 재사용하는 아키텍처입니다. 세 번째는 구조적 인과 모형(structural causal model, SCM)을 이용해 다양한 함수 관계와 데이터 문제를 합성하는 prior입니다. 이 세 요소가 결합되어 새 과제의 최적화 비용을 사전학습 단계로 옮깁니다. 본문 ICL·아키텍처·prior 설명
실험 기여는 빠른 기본 설정뿐 아니라 충분히 튜닝한 트리 모델 및 AutoGluon과 비교한 것입니다. 다만 “모든 표 문제에서 최고”, “어떠한 연산도 없이 학습”, “인과관계를 알아내는 모델”로 읽어서는 안 됩니다. 이 논문이 직접 보여주는 것은 정해진 소규모 벤치마크에서의 예측 성능과 시간 이점이며, SCM은 사전학습 과제 생성 방식입니다. 실제 입력 표의 인과 그래프를 복원하거나 개입 효과를 추정했다는 실험은 아닙니다.
리뷰어 관점에서 가장 큰 의미는 “표마다 모델을 처음부터 훈련하는 것” 외에 “여러 과제를 통해 배운 추론 절차에 새 표를 입력하는 것”을 강력한 선택지로 만들었다는 데 있습니다. 생성·밀도 추정·임베딩도 같은 조건부 예측 능력에서 파생됩니다.
기술적 세부사항
먼저 서로 다른 세 종류의 계산을 구분할 필요가 있습니다.
| 단계 | 입력과 계산 | 가중치 업데이트 |
|---|---|---|
| 사전학습 | 합성 데이터셋을 반복 생성하고 숨긴 정답의 확률을 높임 | 수행합니다 |
| 일반적인 새 과제 예측 | 실제 학습 행·정답과 질의 특징을 Transformer 문맥으로 전달 | 수행하지 않습니다 |
| 선택적 미세조정 | 관련 과제에 맞게 사전학습 가중치를 추가 학습 | 수행합니다 |
PFN의 예측 대상은 학습 데이터가 주어진 뒤 새 표본의 정답에 대한 조건부 분포입니다. 논문 Principled in-context learning의 표기를 정리하면 다음과 같습니다.
$\mathbf X_{\mathrm{train}}$은 학습 특징 행렬, $\mathbf y_{\mathrm{train}}$은 학습 정답, $\mathbf X_{\mathrm{test}}$는 질의 특징입니다. PFN은 합성 데이터 prior가 정하는 Bayesian posterior predictive distribution, 즉 가능한 데이터 생성 설명들을 관측된 학습 표에 비추어 반영한 예측분포를 근사하도록 학습합니다. 이 해석은 설계한 prior에 대한 근사이며 모든 실제 데이터에 대한 정확한 Bayesian 추론을 보장한다는 뜻은 아닙니다.
입력은 셀 또는 작은 특징 묶음을 임베딩으로 바꾸고, 같은 행의 특징끼리 정보를 교환한 뒤 같은 특징의 여러 행 사이에서 정보를 교환합니다. 학습 행의 표현은 질의 행의 영향을 받지 않도록 attention을 제한하여 캐시할 수 있습니다. 회귀 출력은 단일 실수 대신 구간별 밀도를 표현하는 분포입니다. 사전학습 손실, prior의 생성식, 확률 보정과 밀도 분해는 아래 Methods 리뷰에서 원문의 순서대로 설명합니다.
평가는 ROC AUC와 accuracy, 회귀의 음의 RMSE와 결정계수 $R^2$를 사용합니다. 데이터셋마다 점수 범위가 달라 먼저 데이터셋 내부에서 정규화한 다음 평균을 냅니다. 따라서 정규화 ROC AUC 0.939는 실제 ROC AUC 93.9%와 다릅니다. 이 구분은 결과를 이해하는 데 아키텍처만큼 중요합니다.
챕터별 상세 리뷰
📖 Chapter 1: Main
위치와 역할: 도입부는 수작업 알고리즘 구성요소를 학습된 구성요소로 바꾸어 온 AI의 흐름을 표 예측 문제와 연결합니다. 이후 ICL을 학습 알고리즘의 설계 방식으로 도입할 배경입니다.
저자는 먼저 컴퓨터 비전의 수작업 특징, 자연어의 문법 규칙, 게임의 전문가 전략이 학습으로 대체된 사례를 듭니다. 이어 표 데이터가 텍스트·이미지와 다른 이유를 설명합니다. 동일한 숫자가 약물의 화학 성질일 수도 있고 재료의 열적 성질일 수도 있으므로, 데이터셋 간의 공유 구조가 쉽게 드러나지 않습니다. 논문 작성 시점 OpenML 데이터의 76%가 10,000행보다 작다는 관찰은 작은 표가 예외적 사례가 아니라 중요한 연구 대상임을 뒷받침합니다.
다음으로 한 표 안에서도 이진·범주·순서·정수·실수 변수, 다른 척도, 결측, 클래스 불균형, 무관한 열, 이상치가 공존한다고 설명합니다. 저자가 비교 대상으로 삼는 트리 모델은 이러한 문제에서 강했지만, 다른 과제로 지식을 이전하거나 미분 가능한 신경망 시스템과 결합하는 측면에서는 다른 접근이 필요하다고 논지를 전개합니다.
도입부의 성능 주장은 최대 10,000개 표본과 500개 특징의 실험 범위에 붙어 있습니다. 뒤에서 나오는 더 큰 표의 메모리 처리 가능성과 이 범위의 정확도 검증을 같은 것으로 읽지 않아야 합니다. 핵심 기여는 표 데이터의 이질성을 전제로 학습 절차의 사전학습이라는 문제를 세운 점이며, 다음 절은 그 절차가 무엇을 학습하는지 구체화합니다.
📖 Chapter 2: Principled in-context learning
위치와 역할: 초기 TabPFN에서 발전한 부분을 정리하고, 데이터 생성·사전학습·실제 예측이라는 세 단계로 방법을 설명합니다.
저자는 먼저 ICL이 문맥의 예제에서 과제 규칙을 추론하는 메커니즘이며, PFN은 복잡한 예측 알고리즘도 이 방식으로 근사할 수 있다고 설명합니다. 이전 TabPFN은 적용 가능성의 초기 실증이었고, 이번 모델은 규모를 확대하면서 회귀·범주·결측·이상치 문제를 다룹니다. 이 논문에서 “50배 큰 데이터셋”이라는 개선 표현은 초기 모델과의 비교 문맥에 있으며, 모든 차원의 처리 비용이 50배 줄었다는 뜻은 아닙니다.
첫 단계에서는 합성 표와 해당 표의 예측 문제를 만듭니다. 일부 행의 정답을 숨겨 학습 행과 질의 행을 구성합니다. 두 번째 단계에서는 공개된 정답과 특징을 보고 숨긴 정답을 예측하도록 Transformer를 학습합니다. 세 번째 단계에서는 새로운 실제 표를 같은 형식으로 전달합니다. 새 표의 데이터가 네트워크 가중치를 갱신하는 대신 forward 계산의 문맥이 된다는 것이 일반적인 지도학습과의 차이입니다.
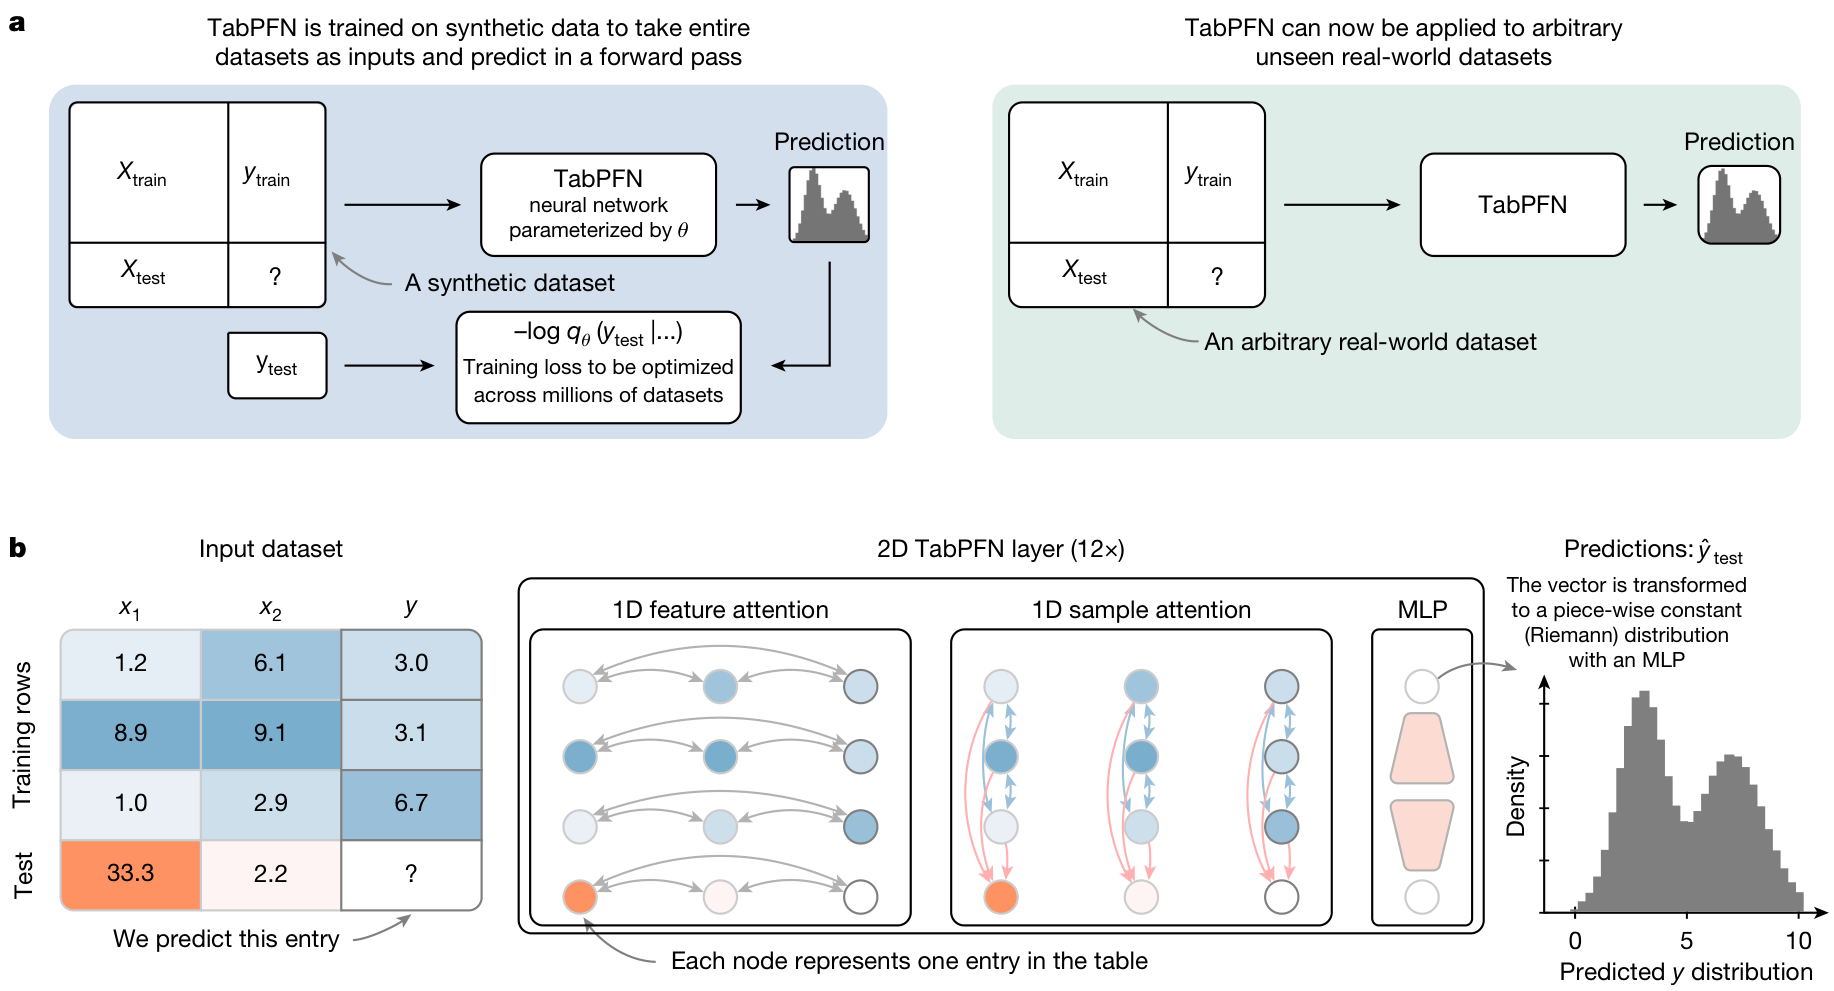
그림 1. 원문 Figure 1, PDF 2쪽. Hollmann et al., Nature (2025), 원문, CC BY 4.0. 그림 영역을 크롭했으며 그림 내부는 번역하지 않았습니다.
그림의 위쪽은 개발 과정에서 한 번 수행하는 합성 과제 학습과 사용 시점의 실제 표 입력을 구분합니다. 아래쪽은 행과 열 정보를 교환하여 질의 정답을 예측하는 구조입니다. 같은 입력 형식으로 여러 과제를 해결하므로, 학습된 것은 특정 데이터셋의 회귀계수보다는 문맥에서 예측기를 구성하는 계산 규칙에 가깝습니다.
이 절의 마지막은 Bayesian 해석으로 연결됩니다. 합성 데이터가 정의한 prior를 많이 관찰하며 적절한 예측 손실을 줄이면 해당 prior의 사후 예측분포를 근사한다는 설명입니다. 핵심 기여는 경험적으로 작동하는 ICL과 명시적인 데이터셋 분포를 연결한 점입니다. 다음 절은 표 구조를 활용하여 이 계산을 가능하게 하는 네트워크를 설명합니다.
📖 Chapter 3: An architecture designed for tables
위치와 역할: 표를 하나의 긴 시퀀스로 다루는 문제와, 새 질의마다 학습 표를 다시 계산하는 문제를 차례로 해결합니다.
첫째, 표의 각 셀에 표현을 할당합니다. 같은 표본 안에서는 특징 간 attention으로 변수의 조합을 파악하고, 같은 특징을 따라서는 표본 간 attention으로 관측 예제와 질의의 관계를 파악합니다. 표의 두 축을 분리해 처리하므로 행과 열 수가 달라지는 입력을 다루기 용이합니다. 다만 이 절의 순서 불변성에 대한 큰 그림과 달리, Methods는 실제 모델이 완전히 permutation invariant하지 않아 특징·클래스 순서를 섞은 작은 앙상블로 순서 영향을 줄인다고 명시합니다. 실사용 결과를 완전한 수학적 불변성으로 설명해서는 안 됩니다.
둘째, 학습 행의 상태를 캐시해 fit와 predict를 분리합니다. 10,000개 학습 행과 10개 특징 조건에서 핵심 추론 계산은 CPU 약 32초에서 0.1초로 줄어 약 300배, GPU에서는 약 6배 빨라집니다. 특징이 100개이면 CPU 약 800배, GPU 약 30배라는 수치가 제시됩니다. 이 측정은 전처리와 앙상블을 제외한 core inference이므로 다른 절의 전체 예측 지연과 직접 합쳐서는 안 됩니다.
셋째, half-precision layer normalization, FlashAttention, activation checkpointing, 상태의 순차 계산으로 메모리 요구량을 줄입니다. 저자는 셀당 1,000바이트 미만으로 줄여 H100 한 장에서 5천만 셀을 다룰 수 있다고 설명합니다. 예로 든 500만 행×10개 특징은 계산 자원 측면의 처리 가능성이지, 그 규모에서 우수한 예측 정확도를 검증한 결과가 아닙니다.
마지막으로 회귀에서 구간별 상수 밀도 형태의 출력분포를 사용합니다. 평균 하나에 정보를 압축하지 않으므로 두 봉우리를 갖는 다봉분포도 표현할 수 있습니다. 핵심 기여는 표 구조·학습 상태 재사용·확률적 회귀 출력을 하나의 모델에 결합한 점입니다. 다음 절은 이 모델에 어떤 과제를 보여주는지 설명합니다.
📖 Chapter 4: Synthetic data based on causal models
위치와 역할: 모델의 일반화 능력을 결정하는 합성 과제 분포, 즉 prior의 설계 철학을 소개합니다.
생성기는 우선 표 크기, 특징 수, 난도 같은 상위 하이퍼파라미터를 뽑고 방향성 비순환 그래프(DAG)를 만듭니다. 루트에 잡음을 넣고 연결을 따라 값을 전파합니다. 연결에는 작은 신경망, 범주화, 의사결정나무 등 서로 다른 변환이 사용되며 잡음이 추가됩니다. 그다음 그래프에서 특징과 정답에 해당할 위치를 선택해 중간 표현을 추출합니다.
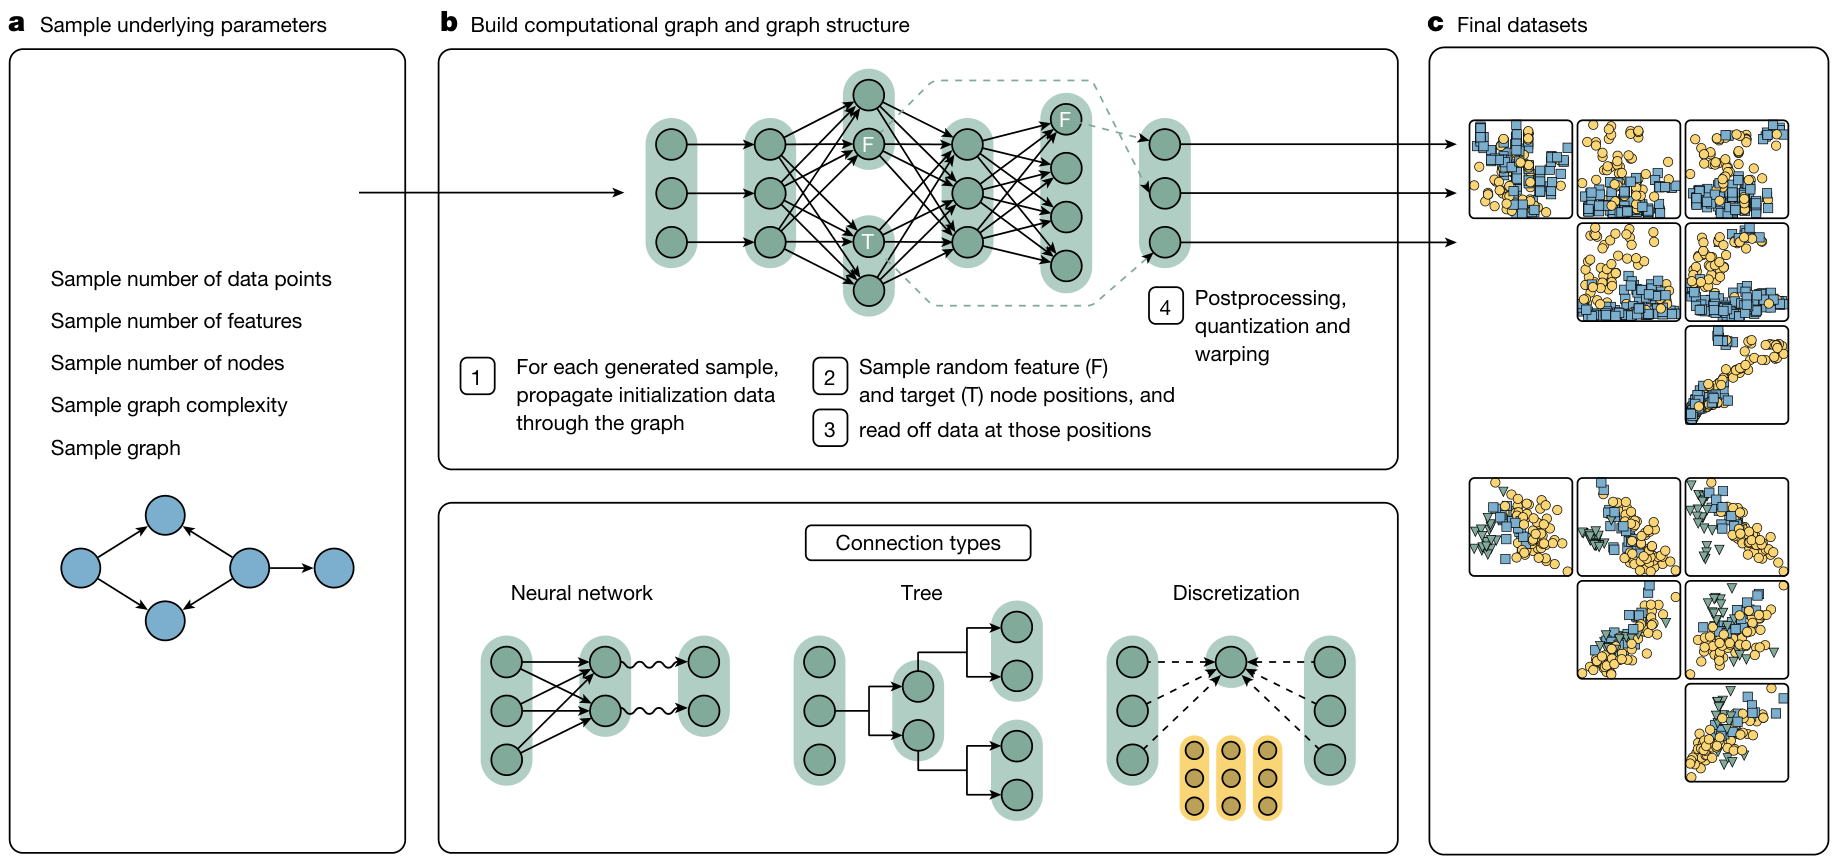
그림 2. 원문 Figure 2, PDF 3쪽. Hollmann et al., Nature (2025), 원문, CC BY 4.0. 그림 영역 크롭, 그림 내부 번역 없음.
그림에서 F와 T는 생성 그래프에서 선택한 특징·정답 위치입니다. 최종 표는 그래프 전체를 보여주지 않고 그 일부 관측만 제공합니다. 따라서 PFN은 다양한 숨은 생성 구조 아래에서 관측된 표로 예측하는 과제를 학습합니다. 이는 실제 데이터의 인과구조를 알려주거나 복원하는 기능과 구별됩니다.
저자는 이어 결측, 비선형 왜곡, 양자화 등을 생성 과정에 넣으면 모델이 그러한 문제를 처리하는 전략도 학습한다고 설명합니다. 본문에서 약 1억 개라고 개괄하는 합성 데이터셋 수는 Methods에서 모델당 약 1.3억 개로 구체화됩니다. 실제 공개 표를 직접 사전학습 데이터로 수집하지 않는 방식이라는 주장과, 실제 개발 데이터로 prior 및 설정을 선택했다는 사실은 함께 읽어야 합니다.
핵심 기여는 단순한 랜덤 숫자 생성이 아니라, 서로 다른 예측 관계와 데이터 문제를 체계적으로 만들어 학습 알고리즘의 성향을 설계하는 점입니다. 다음 절은 이 prior를 학습한 모델이 어떤 함수를 표현하는지 살펴봅니다.
📖 Chapter 5: Qualitative analysis
위치와 역할: 대규모 평균 점수에 앞서, 간단한 함수와 출력분포를 통해 모델의 작동 성향을 보여줍니다.
Figure 3a에서는 한 특징과 한 정답의 관계를 여러 toy function으로 바꿉니다. 선형 Ridge는 선형 관계에 적합하고, MLP는 급격한 계단형 함수에서 어려움을 보이며, CatBoost는 구간별 상수 함수로 근사합니다. 저자는 TabPFN이 매끄러운 함수와 비매끄러운 함수 모두를 기본 설정에서 다룬다고 설명합니다. 이 관찰은 뒤의 User guide가 매우 비매끄러운 회귀 데이터에서 다른 방법이 유리할 수 있다고 밝히는 것과 함께 이해해야 합니다. 제한된 toy 사례의 성공이 모든 형태에서의 우위를 보장하지 않습니다.
Figure 3b의 이중 슬릿 예시는 출력분포의 의미를 구체화합니다. 1,000개 광자 위치를 관측한 뒤 여러 봉우리를 갖는 밝기 패턴의 분포를 추정합니다. TabPFN의 계산은 1.2초이며, CatBoost 기본 설정에서 여러 분위수 예측을 이용해 분포를 재구성하는 비교는 169.3초입니다. 저자는 낮은 밀도 영역의 표현과 인공적인 흔적 측면에서 TabPFN이 더 낫다고 정성적으로 평가합니다. 이 숫자는 이중 슬릿 예제의 조건이며 전체 회귀 벤치마크 평균 시간과 다릅니다.
핵심 기여는 “회귀값을 잘 맞힌다”와 “조건부 분포를 표현한다”의 차이를 보여주는 것입니다. 다음 절은 이러한 성질이 실제 여러 표에서도 성능과 시간 이점으로 이어지는지 검증합니다.
📖 Chapter 6: Quantitative analysis
위치와 역할: 평가 대상을 소개한 뒤, 단일 방법 비교, 데이터 속성 변화, 튜닝 앙상블 비교의 순서로 주장을 확장합니다.
평가 대상과 공통 조건
주 평가에는 AutoML Benchmark에서 조건을 만족하는 분류 29개 데이터셋을 사용합니다. 회귀는 AutoML의 16개에 OpenML-CTR23의 적합한 데이터셋을 합쳐 중복을 제거한 28개입니다. 범위는 표본 10,000개·특징 500개·분류 클래스 10개 이내입니다. 트리 계열뿐 아니라 선형 모델, SVM, MLP를 포함하여 서로 다른 inductive bias를 비교합니다.
각 방법은 같은 데이터 분할을 사용하며, 학습 90%·테스트 10%의 분할과 seed를 바꿔 10회 평가합니다. 하이퍼파라미터 탐색은 별도의 5-fold cross-validation으로 수행하고 30초부터 4시간까지 예산을 바꿉니다. 모든 방법에 CPU 8코어를 제공하고 TabPFN은 RTX 2080 Ti를 추가로 사용합니다. GPU 자원의 차이는 명시되어 있으며, 강한 baseline에도 GPU를 제공하는 추가 실험은 Extended Data Figure 2d에 있습니다.
Comparison with state-of-the-art baselines
Figure 4는 기본 설정과 4시간 튜닝 결과를 나눕니다. 아래는 본문이 설명하는 데이터셋별 정규화 후 평균한 점수입니다. 회귀 열은 음의 RMSE를 기준으로 높을수록 좋게 표현한 점수입니다.
| 조건 | 지표 | TabPFN | CatBoost | 점수 차이 |
|---|---|---|---|---|
| 기본 설정 | 정규화 ROC AUC | 0.939 | 0.752 | 0.187 |
| 튜닝 | 정규화 ROC AUC | 0.952 | 0.822 | 0.130 |
| 기본 설정 | 정규화 음의 RMSE | 0.923 | 0.872 | 0.051 |
| 튜닝 | 정규화 음의 RMSE | 0.968 | 0.875 | 0.093 |
원문 Figure 4와 해당 본문에서 재작성했습니다. 원점수 AUC 또는 실제 단위의 RMSE 표가 아닙니다.
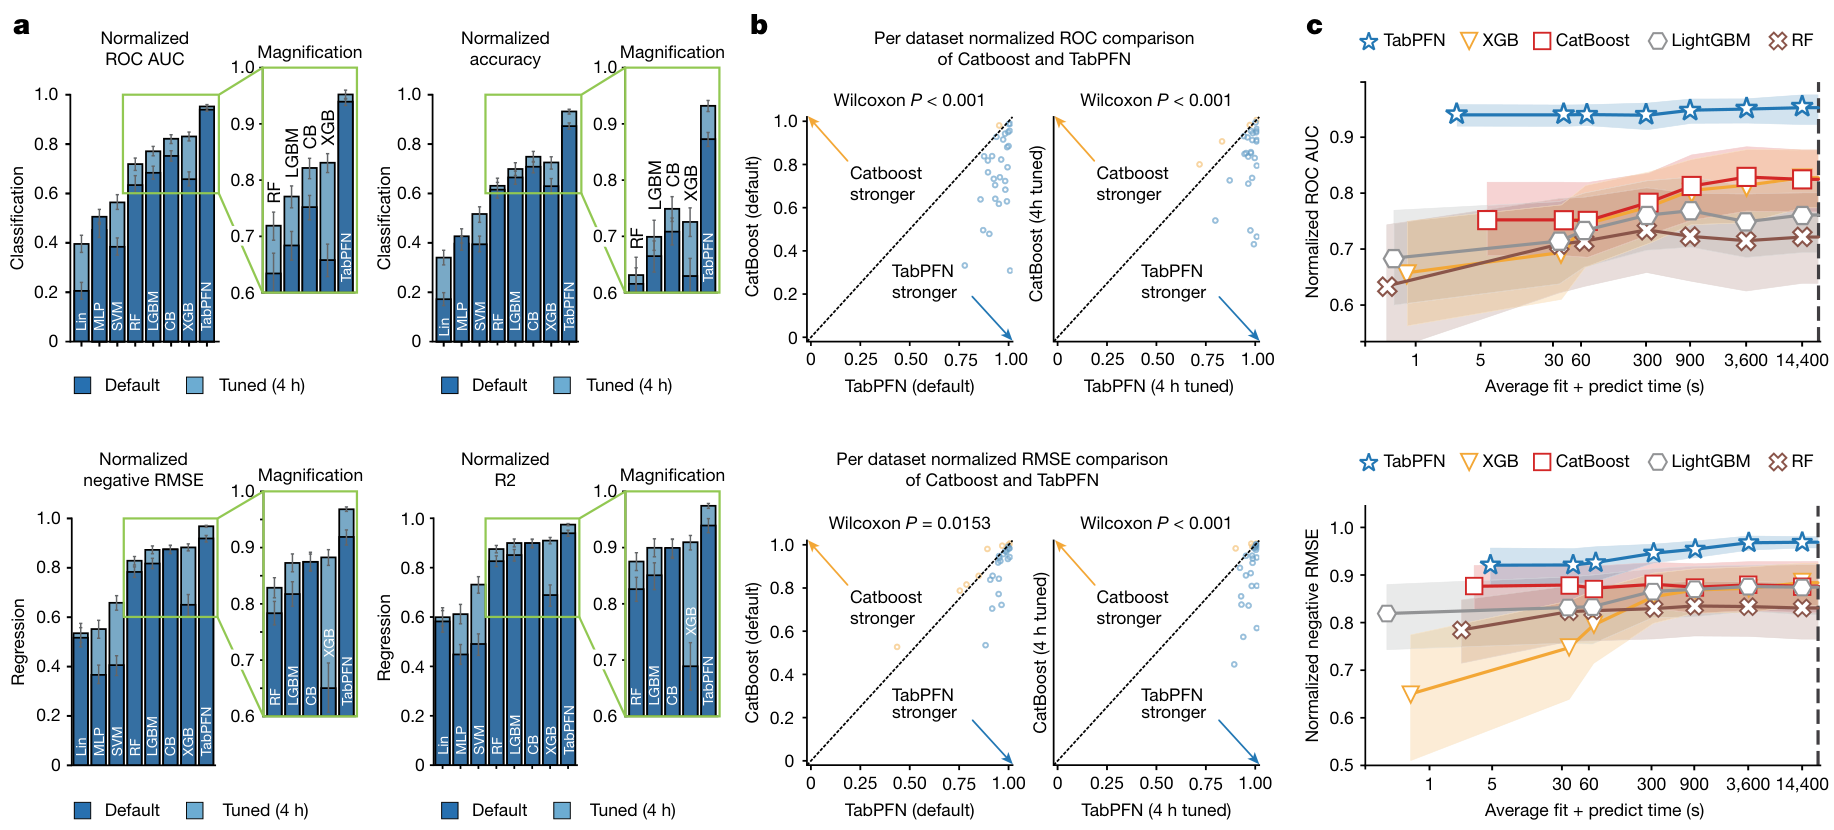
그림 3. 원문 Figure 4, PDF 5쪽. Hollmann et al., Nature (2025), 원문, CC BY 4.0. 원문 그림 영역 크롭, 번역 없음. 오차 구간은 95% 신뢰구간입니다.
패널 a는 평균적인 상대 성능, b는 개별 데이터셋의 우열, c는 시간 예산에 따른 성능입니다. b의 점들이 모두 TabPFN 쪽에 있지는 않으므로, 평균 우위를 개별 데이터셋의 승리 보장으로 읽지 않아야 합니다. c의 기본 설정 평균은 분류 2.8초, 회귀 4.8초이며, 개별 baseline에 4시간 튜닝을 허용한 경우보다도 좋은 결과라는 것이 저자의 주장입니다. 약 5,140배와 3,000배는 이 시간 예산 비교에서 나옵니다.
Evaluating diverse data attributes
Figure 5a는 원래 특징을 무작위로 섞어 무정보 특징을 추가하고, 셀마다 2% 확률로 값을 임의 배수로 바꾸어 이상치를 주입합니다. 또 학습 행이나 특징을 제거합니다. 이러한 변형에서도 TabPFN의 상대 성능이 유지되며, 저자는 절반의 학습 표본으로 다음으로 좋은 방법의 전체 표본 성능에 도달한다고 설명합니다. 이는 해당 변형 실험의 집계 결과이지 개별 과제의 필요 표본 수를 정확히 절반으로 줄인다는 법칙은 아닙니다.
Figure 5b는 범주형 변수와 결측의 존재, 표본 수, 특징 수로 데이터셋을 나눕니다. 표본 수와 특징 수의 하위 집단은 데이터셋의 약 3분의 1씩 들어가도록 구성합니다. 특정 집단에서 성능이 크게 무너지지 않았다는 관찰은 평가 범위 내의 강건성 근거입니다. 저자도 이 결과를 10,000표본·500특징 밖으로의 확장성 증거로 해석하지 말라고 명시합니다.
Comparison with tuned ensemble methods
AutoGluon 1.0은 여러 종류의 모델과 stacking·튜닝·post hoc ensembling을 결합하므로 단일 모델 비교와 별도로 다룹니다. TabPFN (PHE)는 TabPFN 설정들만으로 후보를 구성하고 검증 예측을 바탕으로 가중 앙상블을 만듭니다.
분류에서는 기본 TabPFN의 2.8초 결과가 AutoGluon에 최대 4시간을 허용한 결과보다 좋습니다. 정규화 ROC AUC는 기본 TabPFN 0.939, AutoGluon 0.914, TabPFN PHE 0.971입니다. 회귀에서는 같은 결론을 기본 설정에 그대로 적용하지 않습니다. 저자는 최소 300초 예산의 TabPFN PHE가 4시간 AutoGluon보다 좋은 결과를 얻는다고 보고하며, 이때 시간 예산 비율이 48배입니다.
핵심 기여는 정확도·계산 시간·데이터 변화·AutoML 비교를 구분해 작은 표에서의 유용성을 보여준 점입니다. 다음 절은 지도 예측 이외에 사전학습 모델을 어떻게 재사용하는지 설명합니다.
📖 Chapter 7: Foundation model with interpretability
위치와 역할: 조건부 예측을 여러 방식으로 활용하여 foundation model의 성질을 개념 증명합니다.
첫 순서는 밀도 추정입니다. 정답 열만 예측하는 대신 특징 열도 차례로 예측하여 수치형 특징의 확률밀도나 범주형 특징의 확률질량을 얻습니다. Figure 6a는 German Credit 데이터를 이용한 예시이며, 낮은 밀도의 관측을 찾아 이상 탐지에 활용할 수 있다는 동기를 제시합니다. 이어 Figure 6b는 이렇게 얻은 조건부 분포에서 샘플링해 실제 표와 유사한 합성 행을 만드는 예시입니다. 논문이 개인정보 보호형 공유를 응용 가능성으로 언급하더라도, 이 결과 자체를 differential privacy 보장으로 바꾸어 읽지는 않습니다.
다음은 재사용 가능한 표현입니다. mfeat-factors의 손글씨 숫자 표에서 마지막 층의 정답 열 표현을 임베딩으로 추출하고, 첫 두 주성분에 투영했을 때 원시 특징보다 클래스가 분리되는 모습을 제시합니다. 이는 시각적 표현 품질의 예시이며 모든 downstream task의 향상을 측정한 실험은 아닙니다.
그다음 관련 과제에 대한 미세조정을 다룹니다. 서로 offset이 다른 2차원 sine curve 과제에서 미세조정한 뒤 다른 과제로 전이합니다. 50회 분석에서 분포가 유사할수록 더 좋은 전이를 보였으며, 정답 관계가 크게 달라지는 경우에도 전이가 관찰됩니다. 마지막으로 SHAP을 통해 특징 기여를 설명하며, 선형 모델의 단순함과 정확도, CatBoost의 복잡한 패턴, TabPFN의 예측력과 비교적 단순한 패턴을 정성적으로 비교합니다.
핵심 기여는 예측분포와 내부 표현의 재사용 가능성을 보여주는 데 있습니다. 실제 임상·산업 시스템에서 각각의 응용을 검증했다는 주장과는 구분됩니다. 다음 Conclusion은 이 결과를 연구 방향으로 묶습니다.
📖 Chapter 8: Conclusion
위치와 역할: 작은 표에서 학습된 학습 알고리즘이 경쟁력을 갖는다는 결론과 저자가 직접 제안한 후속 과제를 제시합니다.
결론은 합성 데이터와 ICL을 통해 사람이 직접 설계하던 표 예측 알고리즘을 학습할 수 있다는 데 초점을 둡니다. 우수한 성능의 범위는 다시 10,000개 표본과 500개 특징 이내로 명시됩니다. 저자가 제시한 향후 방향은 더 큰 데이터로의 확장, data drift 대응, 관련 표 과제 사이의 미세조정, 이론적 기반 분석입니다. 이어 시계열·멀티모달 데이터 및 ECG·신경영상·유전체와 같은 특화 데이터에 맞는 prior를 언급합니다.
이 가운데 시계열은 이 논문에서 전용 시계열 모델의 성능이 입증되었다는 의미가 아닙니다. 특화 prior의 향후 연구 대상으로 명시된 것입니다. 결론의 핵심은 예측 알고리즘을 데이터 생성 분포와 함께 설계할 수 있다는 방향성입니다. 다음 Methods는 앞선 설명을 구현·평가 수준의 세부사항으로 풀어냅니다.
📖 Chapter 9: Methods
위치와 역할: 실무 적용 조건에서 시작해 아키텍처, prior, 학습, 추론, 앙상블, 생성적 활용, 평가 순서로 상세 근거를 제공합니다. 아래 소제목도 원문의 순서를 따릅니다.
User guide
When to use TabPFN. 저자는 작은·중간 규모 표에서 강점을 설명하면서, 더 큰 데이터나 매우 비매끄러운 회귀 데이터에서는 CatBoost·XGBoost·AutoGluon이 더 좋을 가능성이 있다고 명시합니다. 특징 공학, 데이터 정리, 문제 정의에서 데이터과학자의 역할이 사라지는 것은 아니며 빠른 적합이 반복 실험을 도와준다는 위치입니다.
Limitations of TabPFN. 원문이 열거한 한계는 최적화된 CatBoost 등에 비해 추론이 느릴 수 있다는 점, 데이터 크기에 선형으로 증가하는 메모리 때문에 매우 큰 표에서 부담이 생긴다는 점, 10,000표본·500특징 밖의 확장성은 추가 연구가 필요하다는 점입니다.
Computational and time requirements. 새 과제에 대한 계산은 소비자용 GPU 사용을 권하며, CPU 대비 1–3자릿수의 속도 차이를 설명합니다. 하지만 실시간 단건 추론에 최적화된 모델은 아닙니다. 10,000행×10열 학습 데이터 조건에서 한 표본 예측은 GPU 0.2초, GPU 없이 0.6초인 반면 기본 CatBoost는 0.0002초입니다. 앞서 설명한 캐시 실험의 core inference와 달리 이 절은 사용 관점의 지연을 보여줍니다.
Data preparation. 입력은 NumPy 행렬 같은 표 형식이며 결측 처리, 범주 인코딩, 특징 정규화를 수행합니다. 도메인 지식에 따른 특징 변환·조합·제거는 여전히 도움이 될 수 있습니다. 원문은 내부 전처리 후 특징과 정답이 대략 정규분포에 가까운 형태일 때를 염두에 둡니다. Hyperparameter tuning에서는 추가 예산이 있을 때 HPO나 PHE로 전처리·출력 처리 설정을 탐색할 수 있다고 설명합니다.
Details on the neural architecture
범주형 값을 정수로 변환하고 특징별 학습 평균·표준편차로 z-normalization을 수행합니다. 그 값을 선형 인코더로 임베딩합니다. 각 층은 특징 간 attention, 표본 간 attention, MLP 순서이며 각 하위 층에 residual addition과 half-precision layer normalization이 붙습니다. 후보 아키텍처 중에는 한 토큰에 두 특징을 묶는 구성이 있으며, 기본 모델도 이 구성을 사용합니다.
질의 표본끼리 attention하지 않고 학습 표본만 보도록 제한합니다. 학습 표현도 질의 집합에 영향을 받지 않으므로 학습 표의 key/value를 저장할 수 있습니다. 같은 통계를 가진 서로 다른 특징을 구분하기 위해 무작위 특징 임베딩을 더합니다. 캐시 메모리를 줄일 때는 학습 표본 간 attention은 전체 key/value를 사용하되, 질의에서 학습 표본으로 향하는 attention에서는 특별한 multi-query 변형을 사용해 셀당 하나의 key/value 쌍만 보관합니다.
원문은 표본 수를 $n$, 특징 수를 $m$으로 놓고 계산 요구량의 축별 이차 증가를 $O(n^2+m^2)$, 메모리 요구량을 $O(nm)$로 기술합니다. 이 표기는 실제 wall-clock 시간을 바로 산출하는 비용식이 아니라 원문이 제시한 규모 의존성 설명으로 읽습니다. 셀의 결측 여부는 별도 입력으로 표시하고 원래 값은 0으로 채워 인코딩합니다. “0이라는 관측값”과 “결측을 채운 0”을 분리하는 입력 설계입니다.
Details on the causal generative process
SCM은 각 노드의 값이 부모 노드와 잡음의 함수로 정해지는 생성 모형입니다. 원문의 구조식을 옮기면 다음과 같습니다.
$z_i$는 노드 값, $\mathrm{PA}_{\mathcal G}(i)$는 그래프 $\mathcal G$에서 해당 노드의 직접 부모 집합, $f_i$는 결정적 변환, $\epsilon_i$는 잡음입니다. 생성 시에는 부모부터 순서대로 값을 계산하면 됩니다. 여러 그래프·변환·잡음 설정을 뽑아 만든 과제를 학습하는 것은 그 하이퍼파라미터 공간에 걸친 예측을 암묵적으로 근사하게 합니다.
Graph structure sampling. growing network with redirection 방식으로 DAG를 생성하고 하나의 연결 성분 또는 서로 떨어진 여러 부분 그래프를 사용합니다. 정답과 연결되지 않은 부분에서 특징을 선택하면 무관한 예측변수가 생깁니다. 노드 수는 log-uniform, redirection 확률 관련 값은 gamma 분포에서 뽑아 구조 다양성을 만듭니다.
Computational edge mappings. 각 노드의 표본은 벡터입니다. 변환에는 무작위 작은 신경망, 범주 이산화, 의사결정나무, 잡음 주입이 사용됩니다. 신경망은 선형 변환 뒤 identity·log·sigmoid·절댓값·sine·tanh·rank·제곱·거듭제곱·smooth ReLU·step·modulo 같은 활성함수를 적용합니다. 범주형은 무작위 대표 벡터와 가까운 범주의 인덱스로 바꾸고, 그 범주를 다시 연속 벡터에 임베딩해 이후 계산으로 전달합니다. 트리 연결은 무작위 특징·임곗값으로 국소 규칙을 만들며, Gaussian 잡음으로 불확실성을 더합니다.
Initialization data sampling. 루트의 입력은 정규분포, 균등분포 또는 둘의 혼합에서 생성합니다. 일부 과제에서는 표본을 독립적으로 만들지 않고 prototype의 가중합으로 만들어 의존성을 조절합니다. 원문 식 (1)은 다음과 같습니다.
$n$은 표본 수, $\rho$는 prototype 비율, $M$은 prototype 수, $x_j^{*}$는 기준 입력 벡터, $\alpha_{ij}$는 i번째 입력을 구성하는 가중치입니다. 여러 입력이 같은 prototype을 공유하면 표본 사이에 관계가 생깁니다. 저자는 온도 하이퍼파라미터가 가중치의 집중도를 조절한다고 설명합니다.
Post-processing. Kumaraswamy warping으로 특징을 비선형 왜곡하고, 연속값을 임의 개수의 구간으로 양자화하며, 결측을 주입합니다. 상세히 정의된 결측 주입은 각 값을 데이터와 독립적으로 가리는 MCAR(missing completely at random) 방식입니다. 본문의 다양한 결측 문제에 대한 일반적인 설명을 MNAR 생성까지 구현했다는 주장으로 확대하지 않습니다.
Target generation. 회귀는 후처리하지 않은 연속 특징을 정답으로, 분류는 최대 10개 값을 갖는 범주 특징을 정답으로 고릅니다. 따라서 native 분류 출력은 최대 10개 클래스입니다. 더 많은 클래스는 사전학습 범위를 바꾸거나 one-vs-one·one-vs-rest·ECOC 같은 방법으로 확장할 수 있다고 원문이 설명하지만, 여기서 그 확장 성능을 검증한 것은 아닙니다.
Training details
합성 표에서 정답을 숨긴 부분을 예측하고 그 확률의 음의 로그를 최소화합니다. 원문 손실식을 기호를 정리해 옮기면 다음과 같습니다.
$p(D)$는 합성 표를 뽑는 prior, $D_{\mathrm{train}}$은 정답이 공개된 문맥, $q_\theta$는 가중치 $\theta$를 가진 PFN의 출력분포입니다. $\mathbb E$는 다양한 과제에 대한 평균입니다. 한 표에서만 손실을 줄이지 않고 표의 생성 구조까지 바뀌는 과제들에서 숨긴 정답의 확률을 높이는 것이 중요합니다. 원문은 이 목적이 선택한 prior에 대한 Bayesian 사후 예측분포 근사로 이어진다고 설명합니다.
최종 모델은 약 200만 step, step당 64개 데이터셋으로 학습하여 모델당 약 1.3억 합성 데이터셋을 사용합니다. 한 번의 학습은 RTX 2080 Ti 8개가 있는 노드에서 약 2주입니다. 데이터셋당 학습 표본은 최대 2,048개에서 뽑고 검증 표본은 128개로 고정합니다. 특징 수는 beta 분포를 1–160 범위로 변환해 뽑으며, 큰 특징 수에서 표본 수를 줄여 총 셀 수가 75,000보다 작게 유지되도록 합니다.
이 설정과 실제 평가의 10,000표본·500특징을 비교하면, 모델이 학습 중 본 표 크기보다 큰 입력으로도 적용되었음을 이해할 수 있습니다. 다만 앞서의 실험 범위를 넘어 일반화 범위를 무한히 확대하지 않습니다. prior 하이퍼파라미터는 실제 개발 데이터에서의 성능을 이용한 탐색으로 정하고, 최적화에는 Adam, linear warmup, cosine annealing을 사용합니다.
Inference details
실제 추론은 동일 모델의 작은 앙상블을 기본으로 합니다. 특징 순서를 섞고 분류에서는 정답 클래스 인덱스도 섞어 순서 영향을 완화합니다. 전처리 후보는 quantile 변환과 원본 특징의 병합, 낮은 cardinality 범주의 인덱스 섞기, SVD 표현 추가, 이상치 처리, Yeo–Johnson 변환, one-hot encoding입니다. HPO·PHE에서는 log·exponential·KDI 변환 등도 탐색합니다.
확률 보정은 원문 식 (2)의 temperature softmax로 설명됩니다.
$z_i$는 클래스 i의 logit, $T$는 온도이며 기본값은 0.9입니다. 모든 logit을 동일 온도로 나누므로 순위보다는 확률의 집중도를 조절합니다. 확률값의 해석을 바꾸는 단계이므로 ROC AUC와 보정 지표의 개선을 같은 것으로 보아서는 안 됩니다.
선택적 다항 특징은 원문 식 (3)처럼 기존 특징의 곱을 추가합니다.
$\mathcal S$는 무작위로 고른 최대 50개 특징 쌍이고, $f_{ij}$는 상호작용 특징입니다. 이 옵션은 기본적으로 꺼져 있습니다. 중복 표본을 구분하는 무작위 row identifier 특징을 더하며, estimator별 비복원 표본 추출 옵션도 있으나 기본값은 비활성입니다.
Regression details. 사전학습 정답을 평균 0·표준편차 1로 정규화하고, prior에서 뽑은 정답 분포의 1/5,000 분위수를 이용해 출력 구간 경계를 정합니다. 실제 입력 정답도 같은 척도로 변환하고, 예측 뒤 경계를 역변환해 원래 단위의 분포로 돌려놓습니다. 단조 변환은 누적분포상의 경계 위치를 보존하므로 이러한 처리가 가능하다는 설명입니다. 전체 실수 범위를 덮는 양끝 half-normal 부분에는 원문이 별도 단서를 붙입니다.
Data grouping based on random forest. 이질적인 데이터는 무작위 트리로 작은 그룹으로 나누고 각 leaf의 학습 표에 TabPFN을 적용할 수 있습니다. 질의는 트리를 따라 대응하는 leaf의 TabPFN으로 전달됩니다. leaf의 최소 크기는 500–2,000으로 설정합니다. 이 구성은 HPO 또는 PHE에서만 사용하며 기본 설정의 필수 요소는 아닙니다.
TabPFN (PHE)
PHE는 post hoc ensembling입니다. 미리 정한 TabPFN 설정 portfolio를 holdout 검증으로 순차 평가하고, 시간 예산이 남으면 새 분할로 평가를 반복합니다. 검증 예측에 greedy ensemble selection을 25회 적용해 산술평균의 가중치를 정합니다. 가중치가 0인 모델은 제거하고 남은 모델을 전체 학습 표에 다시 적합합니다.
핵심은 “튜닝된 TabPFN 한 개”와 “여러 설정의 가중 조합”이 다르다는 점입니다. 작은 기본 앙상블과도 다릅니다. 저자는 희소한 가중치가 만들어지면 불필요한 구성원을 제거하여 다른 앙상블 방식보다 추론 효율에도 도움이 될 수 있다고 설명합니다. AutoGluon은 여러 알고리즘을 결합하지만 이 PHE의 후보는 TabPFN 설정이라는 차이가 있습니다.
Foundation model abilities
Density estimation. 결합분포를 특징별 조건부 분포와 최종 정답 조건부 분포로 분해합니다. 원문 식 (4)와 (5)의 논리는 다음과 같습니다.
$\mathcal D$는 관측 표, $d$는 특징 수, $\mathbf x_{\lt j}$는 현재 특징보다 앞선 특징들입니다. 두 번째 식의 $\mathcal D_{:,\lt j}$는 원문이 표시한 앞선 특징의 조건 문맥이며, 예측할 j번째 특징은 해당 단계의 목표 열로 취급합니다. 연속 열이면 회귀 PFN, 범주 열이면 분류 PFN을 사용하여 각 조건부 예측을 구성합니다. 첫 식의 확률 연쇄법칙은 정확한 등식이고, 두 번째 줄의 PFN 대입은 근사입니다.
모델의 근사 때문에 특징 순서가 밀도 추정에 영향을 줄 수 있어 실험에서는 24개 순열의 출력을 평균합니다. 입력 특징이 없는 첫 번째 예측을 기술적으로 처리할 수 없어 정보가 없는 무작위 잡음 특징을 문맥으로 사용합니다. 각 조건부 밀도를 계산할 수 있으므로 새 표본의 likelihood를 평가할 수 있습니다.
Synthetic data generation. 같은 분해 순서로 각 특징을 샘플링하고 마지막 정답을 샘플링하면 새로운 행을 생성합니다. 밀도 추정과 생성이 별개의 사전학습 모델을 필요로 하는 것이 아니라 같은 조건부 예측 기능의 두 사용 방식입니다. Embeddings는 마지막 층의 정답 열 표현을 가져오는 방법입니다. 입력 특징에서 임베딩 공간으로의 변환은 해당 학습 문맥을 이용해 만들어진 표현으로 이해해야 합니다.
Detailed evaluation protocol
Default configuration of TabPFN. 이 절은 기본 설정을 분류 4-way, 회귀 8-way 앙상블이라고 설명합니다. 그러나 Extended Data Table 5는 configuration당 평균 예측 수의 기본값을 두 과제 모두 8로 기재합니다. 이 리뷰는 두 기재가 다르다는 점을 보존하며 실제 구현의 횟수를 독자적으로 확정하지 않습니다. 어느 쪽이든 “기본 결과 전체가 아무 전처리 없는 단 한 번의 호출”이라는 해석은 맞지 않습니다.
Baselines, Tabular dataset benchmarks. 앞서의 트리·선형·SVM·MLP 외에 집계표와 보충표에는 KNN 비교도 포함됩니다. 주 벤치마크는 분류 29개·회귀 28개, 추가 검증은 Grinsztajn의 범주형 포함 7개와 수치형 15개, 필터링한 TabZilla 102개, Kaggle 5개 과제입니다. TabZilla에서는 중복과 클래스당 표본 5개 미만의 데이터셋을 제거합니다. 원래 benchmark 전체 개수와 실제로 평가한 개수를 구분해야 합니다.
Development datasets. prior·모델·전처리 설정은 별도의 개발 데이터셋으로 선택합니다. 저자는 테스트와 겹치지 않도록 선정했다고 설명하고 Supplementary Tables 5–6에 목록과 검사 기준을 공개합니다. 그러므로 합성 사전학습이라는 말은 실제 표가 모델 개발에 전혀 쓰이지 않았다는 의미가 아닙니다.
Metrics and cross-validation. 각 데이터셋에서 10회 결과를 평균하고, 해당 데이터셋의 방법들 중 최저·최고 성능을 기준으로 선형 정규화한 뒤 데이터셋 간 집계를 합니다. ROC AUC·RMSE를 탐색 목적함수로 삼았기 때문에 accuracy 등 보조 지표에서의 결과 해석에는 그 선택을 반영해야 합니다. 그림의 구간은 95% 신뢰구간이며, 방법 쌍 비교에는 양측 Wilcoxon signed-rank 검정이 제시됩니다. 튜닝 시간 안에 하나의 교차검증도 끝나지 않으면 기본 설정을 사용하는 규칙도 명시합니다.
이 챕터의 핵심 기여는 모델 하나의 가중치뿐 아니라 입력 처리·추론 조합·검증 절차를 포함한 전체 예측 방법을 설명한 것입니다. 이어지는 공개 범위 정보는 어느 부분을 직접 재현할 수 있는지 판단하게 합니다.
📖 Chapter 10: Data availability and Code availability
위치와 역할: 방법 설명에서 실험 재현의 자료로 연결하는 부분입니다.
평가 데이터는 OpenML 또는 Kaggle에서 공개되며, 저자는 다운로드·평가 스크립트에 데이터셋 ID와 분할·처리 절차를 제공한다고 설명합니다. 코드와 모델 관련 자료는 논문 코드 아카이브에 연결되어 있습니다.
중요한 범위 구분은 합성 사전학습 데이터를 생성하는 코드는 모델과 함께 공개하지 않았다고 논문이 명시한다는 점입니다. 공개 모델을 사용한 예측 실험과 모델을 처음부터 재학습하는 일은 재현에 필요한 자료가 다릅니다. 이 리뷰는 원문에 제시된 공개 범위를 설명하며 저장소 설치·코드 실행 또는 독립 재학습을 수행했다는 의미는 아닙니다.
핵심 기여는 평가의 추적 가능한 진입점과 재현 범위를 제공한 것입니다. 다음 확장 자료는 본문 집계가 담지 못한 조건별 근거를 보충합니다.
📖 Chapter 11: Extended Data Figures 1–4
위치와 역할: 네 그림은 데이터 속성, 추가 벤치마크, 설명가능성, 미세조정의 순서로 본문의 주장을 확장합니다. 확장 자료
Extended Data Figure 1은 이진·다중 분류, 클래스 균형, 특징/표본 비율, 회귀 정답의 이상치 유무를 나누어 비교합니다. 정답에 이상치가 있는 집단에서 눈에 띄는 차이가 보이지만 저자는 신뢰구간이 겹친다고 설명합니다. 이 그림에서 모든 속성의 영향이 통계적으로 같다고 결론 내리거나, 겹친 구간만으로 유의성 여부를 새로 판단하지 않습니다.
Extended Data Figure 2는 Grinsztajn 7개·15개 및 TabZilla 102개에서 성능 대 시간 곡선을 비교합니다. TabZilla 곡선은 최대 3,600초까지이며 다른 패널의 14,400초와 예산이 다릅니다. 마지막 패널은 CPU와 CPU+GPU 자원을 비교해 주요 baseline에 GPU를 주어도 이 소규모 분류 벤치마크의 결과가 뚜렷하게 개선되지 않았다는 근거를 제시합니다. 이를 모든 규모에서 baseline GPU가 무익하다는 주장으로 일반화하지 않습니다.
Extended Data Figure 3는 신용 관련 변수들의 SHAP 관계를 Logistic Regression·TabPFN·CatBoost에서 비교합니다. 저자는 TabPFN이 높은 예측력과 비교적 단순한 특징 관계를 함께 얻는다고 해석합니다. 그림은 세 변수의 패턴을 보여주는 정성적 비교이며, 모델 전체의 설명가능성을 하나의 정량 점수로 검증한 결과는 아닙니다.
Extended Data Figure 4는 offset이 다른 2차원 sine curve 과제에 대한 50회 미세조정 실험입니다. 학습·테스트 손실과 accuracy·ROC AUC가 함께 제시됩니다. offset이 작아 과제가 비슷할수록 전이가 좋고, offset이 π여서 테스트 정답 관계가 뒤집힌 경우에도 전이가 가능하다는 설명입니다. 관련 과제를 통해 가중치를 적응시키는 능력을 보여주지만 실제 의료 데이터 전이에 대한 확증 실험은 아닙니다.
핵심 기여는 본문 평균 성능에서 빠지기 쉬운 조건과 확장 기능의 증거 수준을 드러내는 데 있습니다. 다음 표들은 구체적인 점수와 평가 설정을 확인하게 합니다.
📖 Chapter 12: Extended Data Tables 1–6
위치와 역할: PDF 18–23쪽의 표는 성능 집계, 실험 대상, 하이퍼파라미터, 외부 대회 평가 순서로 구성됩니다.
Extended Data Table 1은 분류 29개 데이터셋의 정규화 점수, 원점수 평균, 승리 횟수, 시간을 나란히 제시합니다. 기본 TabPFN의 정규화 ROC AUC 0.939와 원점수 평균 0.929는 서로 다른 값입니다. CatBoost 기본 설정은 각각 0.752와 0.920입니다. 따라서 정규화 점수 차이 0.187을 실제 평균 AUC 0.187 상승으로 옮길 수 없습니다. 이 표에는 accuracy, F1, cross-entropy, expected calibration error도 있지만 최적화 목표는 ROC AUC입니다.
Extended Data Table 2는 회귀 28개 데이터셋을 같은 방식으로 집계합니다. 표에서는 정규화 RMSE를 낮을수록 좋은 오차 방향으로 기록하여 기본 TabPFN은 0.077, 기본 CatBoost는 0.128입니다. 본문의 Figure 4는 반대 방향의 0.923과 0.872로 표현합니다. 숫자가 다르더라도 같은 비교의 방향 변환이라는 점을 확인해야 합니다. 원래 단위가 다른 회귀 데이터셋의 개별 RMSE는 Supplementary Table 2에서 확인할 수 있습니다.
Extended Data Tables 3–4는 주 분류·회귀 데이터셋의 이름, OpenML ID, 도메인, 특징 수, 표본 수, 범주형 특징 수를 제공합니다. 금융·건강·환경·제조 등 서로 다른 도메인을 포함하는 이유는 하나의 특정 표 구조에만 맞는 방법인지 확인하기 위해서입니다. 숫자 특징만 있는 표부터 많은 범주 특징이 있는 표까지 포함하지만, 앞서 명시한 크기 제한 안에서의 다양성입니다.
Extended Data Table 5는 TabPFN과 baseline의 탐색 공간입니다. TabPFN은 전처리, 온도, row identifier, 표본 추출, 모델 후보 등을 탐색합니다. 분류 6개·회귀 5개 모델 후보를 언급하고, random-forest 전처리의 기본값은 비활성입니다. 기본 ensemble 횟수의 기재는 앞서 설명한 Methods와의 차이가 있으므로, 재현할 때는 해당 코드 아카이브와 함께 확인할 항목으로 남깁니다.
Extended Data Table 6은 Tabular Playground Series Season 3에서 조건에 맞는 5개 대회의 private score를 5개 seed로 평균한 결과입니다.
| 대회 | 지표와 좋은 방향 | CatBoost 기본 | TabPFN 기본 |
|---|---|---|---|
| Episode 3 | ROC AUC ↑ | 0.841 | 0.868 |
| Episode 5 | Quadratic weighted kappa ↑ | 0.528 | 0.559 |
| Episode 9 | RMSE ↓ | 12.506 | 12.238 |
| Episode 22 | Micro-averaged F1 ↑ | 0.722 | 0.737 |
| Episode 26 | Log loss ↓ | 0.435 | 0.432 |
Extended Data Table 6, PDF 23쪽을 재작성했습니다. Episode 5는 ordinal regression을 분류 또는 회귀로 풀어 각 방법에서 더 좋은 쪽을 선택했으며, CatBoost는 회귀, TabPFN은 분류를 사용했습니다.
이 비교는 원시 대회 데이터에서의 기본 모델 비교입니다. 저자가 명시하듯 도메인 지식, 데이터 정리, 특수 특징 공학, 후처리, 고급 앙상블을 사용하는 Kaggle 참가자의 완성된 파이프라인과 비교한 것이 아닙니다. 핵심 기여는 성능 주장을 수치와 조건으로 추적할 수 있게 한 점이며, 다음 보충표는 개별 데이터셋 수준으로 내려갑니다.
📖 Chapter 13: Supplementary Tables 1–6
위치와 역할: 별도 PDF 두 개는 원점수와 개발 데이터 목록을 제공하여 정규화 집계와 모델 선택 과정을 보완합니다. Tables 1–4, Tables 5–6
Supplementary Table 1은 주 분류 벤치마크의 4시간 예산 결과를 데이터셋별 ROC AUC 평균·표준편차로 제공합니다. 예를 들어 philippine에서 TabPFN PHE는 0.9751±0.0050, CatBoost는 0.8681±0.0158입니다. 반면 car처럼 여러 방법이 모두 1.0000에 도달한 과제도 있습니다. 이처럼 과제별 절대적인 개선 폭은 집계 점수 하나보다 다양합니다. 여기의 ±는 표가 정의한 표준편차이며 본문 그림의 95% 신뢰구간과 다릅니다.
Supplementary Table 2는 주 회귀 벤치마크의 4시간 결과를 음의 RMSE로 제공합니다. 값이 0에 가까울수록 좋습니다. airfoil_self_noise에서 튜닝 TabPFN은 −0.8598±0.1254, CatBoost는 −1.0953±0.1700으로 나타납니다. 반대로 energy_efficiency에서는 튜닝 TabPFN −0.3563±0.0642와 CatBoost −0.2617±0.0730이므로 해당 과제는 CatBoost가 더 좋은 평균 오차를 보입니다. 원문 표의 관측을 읽은 것이며 개별 차이에 대한 추가 유의성 검정을 수행한 것은 아닙니다.
Supplementary Table 3은 Grinsztajn 벤치마크의 4시간 결과입니다. 특징 구성을 달리한 데이터셋과 task ID를 함께 제공하므로 이름만으로 실험을 합치지 않도록 해야 합니다. Supplementary Table 4는 TabZilla의 1시간 결과로, 다른 세 보충표의 4시간과 예산이 다릅니다. 이것이 확장 그림의 시간축 차이와 대응합니다.
Supplementary Tables 5–6는 각각 분류·회귀 개발 데이터의 OpenML ID와 크기·변수 유형을 제공합니다. 첫 10,000행 사용, 특징 수 등의 제한, 이름과 표본·특징·결측 메타데이터를 통한 중복 점검 기준을 설명합니다. 목록의 역할은 실제 표가 최종 모델의 가중치 사전학습용 합성 데이터와는 다른 용도로, 개발 중 설정 선택에 사용되었음을 드러내는 것입니다. 이름이나 다른 ID의 유사성만으로 독립성 또는 누수를 이 리뷰에서 별도 확정하지 않습니다.
핵심 기여는 논문의 평균 결과를 실제 데이터셋별 크기·점수·분산·설정 선택 자료로 되짚을 수 있게 한 점입니다. 이것으로 학술 본문과 실험 보충자료의 전개가 마무리됩니다.
실험 결과 심층 분석
첫째, 가장 강한 결과는 소규모 분류의 빠른 기본 설정입니다. 데이터셋별 정규화 ROC AUC에서 0.939라는 결과가 기본 CatBoost 0.752뿐 아니라 4시간 AutoGluon 0.914보다 높습니다. 하지만 정규화는 각 데이터셋 안의 상대적 위치를 비교하는 연산입니다. Extended Data Table 1의 실제 ROC AUC 평균은 기본 TabPFN 0.929, 기본 CatBoost 0.920이므로 정규화 차이를 원점수의 퍼센트포인트 개선으로 인용하면 과장됩니다.
둘째, 회귀는 분류와 분리해서 해석해야 합니다. 개별 모델 비교에서 기본 TabPFN은 강하지만 AutoGluon과의 비교에서는 튜닝·앙상블의 역할이 더 큽니다. 분류 2.8초 대 4시간, 개별 회귀 baseline 대비 4.8초 대 4시간, 회귀 AutoGluon 대비 PHE 300초 대 4시간은 서로 다른 주장입니다. 또한 사전학습의 8 GPU·약 2주 비용은 이 새 과제 시간에 포함되지 않습니다. 사용자가 이미 학습된 모델을 재사용하는 상황의 비용과 모델 개발 비용을 구분한 결과입니다.
셋째, 이 논문은 통계적 근거를 제공합니다. Figure 4b의 TabPFN·CatBoost 비교에서 분류 기본·튜닝은 각각 양측 Wilcoxon $P\lt0.001$, 회귀 기본은 $P=0.0153$, 회귀 튜닝은 $P\lt0.001$로 표시됩니다. 그림의 95% 신뢰구간과 반복 분할도 결과의 변동성을 보여줍니다. 다만 이는 해당 데이터셋 집합의 비교이며, 모든 개별 데이터셋에서의 유의한 개선을 뜻하지 않습니다. 보충표의 평균±표준편차만으로 별도의 유의성을 추정하지 않습니다. Figure 4
넷째, 평가 설계는 특정 유형의 benchmark에만 의존하지 않도록 추가 benchmark와 Kaggle을 사용하고, GPU를 baseline에도 제공하는 조건을 보충했다는 장점이 있습니다. 원문이 제한한 데이터 크기, 자유로운 텍스트 열을 포함하지 않는 benchmark 구성, 목적 지표별 튜닝, 개발 데이터의 사용까지 함께 기록해야 이 결과의 적용 범위를 판단할 수 있습니다. 원문이 명시한 실패·제약은 실시간 단건 지연, 큰 데이터의 메모리 부담, 큰 표와 매우 비매끄러운 회귀에서 다른 방법이 유리할 수 있다는 점입니다.
재현성 측면에서는 데이터 ID·분할·탐색 공간·원점수와 공개 모델이 유용한 근거입니다. 반면 합성 데이터 생성 코드의 미공개는 원문이 직접 밝힌 사실이며, 처음부터 같은 사전학습을 재현하는 것과 공개 체크포인트로 결과를 재평가하는 일을 구분해야 합니다. 기본 앙상블 횟수의 문서 간 기재 차이도 숨기지 않고 확인 범위로 남깁니다.
기술적 함의와 응용
TabPFN v2의 핵심 변화는 데이터과학에서 “학습”이라고 부르는 과정 일부를 사전학습된 계산으로 바꾸었다는 것입니다. 사용자는 작은 표의 학습 행과 정답을 전달하고, 모델은 합성 과제에서 배운 예측 규칙을 문맥에 적용합니다. 문제에 맞는 prior, 표를 다루는 아키텍처, 실제 추론 파이프라인이 함께 성능을 만든다는 점이 단순히 Transformer를 표에 적용했다는 설명보다 정확합니다.
리뷰어의 해석으로는, 이 접근은 특징 공학과 검증 설계를 유지하면서 작은 표의 baseline을 빠르게 확보하고 다양한 문제 정의를 반복하는 작업에 특히 의미가 있습니다. 반대로 적합이 빠르다는 이유만으로 실시간 요청의 지연도 가장 낮다고 기대할 수는 없습니다. 논문이 별도로 측정한 단건 추론과 메모리 조건이 그 구분을 보여줍니다.
밀도·합성·임베딩·미세조정은 같은 조건부 예측 엔진의 활용 범위를 넓힙니다. 다만 본문의 생성·전이 결과는 개념 증명이고, 저자가 명시한 시계열·멀티모달·분포 변화 대응은 향후 방향입니다. 이 논문의 성과는 검증된 작은 표 범위에서 ICL 기반 예측이 강한 대안임을 보여주고, 학습 알고리즘을 합성 과제의 분포로 설계하는 구체적인 방법을 제시했다는 데 있습니다.
검토 범위: Nature 정본의 Main부터 Methods 전체 하위 절, Data/Code availability, Extended Data Figures 1–4 및 Tables 1–6, 별도 Supplementary Tables 1–6을 반영했습니다. 표의 모든 데이터셋 행과 탐색 공간의 모든 후보값을 본문에 전사하지는 않았으며, 참고문헌 73편을 각각 독립적으로 검토하거나 공개 코드·모델을 실행해 수치를 재현하지 않았습니다. 이 리뷰의 버전 기준은 2025년 Nature 출판 정본이며 이후 소프트웨어 릴리스의 기능을 섞지 않았습니다.