논문 개요와 전체 구조
작은 정형 데이터로 분류기를 만들 때는 대개 모델을 고르고, 하이퍼파라미터를 탐색하고, 학습을 반복합니다. TabPFN은 이 절차 자체를 미리 학습한 Transformer에 맡깁니다. 새로운 데이터셋의 관측된 행과 정답, 예측할 행을 함께 입력하면 모델 가중치를 갱신하지 않고 클래스 확률을 출력합니다. 개별 데이터셋에 대한 학습은 입력 문맥 안에서 일어나며, 그 학습 규칙은 합성 데이터로 수행한 사전학습에 담겨 있습니다.
Noah Hollmann, Samuel Müller, Katharina Eggensperger, Frank Hutter의 ICLR 2023 논문을 arXiv 2207.01848v6, 2023년 9월 16일 수정본으로 읽습니다. 이 글은 작은 데이터의 분류를 다루는 원 논문의 리뷰이며, 이후 이름이 같은 모델의 성능이나 지원 범위를 섞지 않습니다. 중심 실험의 대상은 학습 표본 최대 1,000개, 특성 최대 100개, 클래스 최대 10개인 문제이며, 특히 결측값이 없는 수치형 데이터에서 강점을 보입니다. 논문 원문
핵심 질문은 “Transformer가 정형 데이터에서도 좋은가”보다 구체적입니다. 데이터가 만들어지는 과정에 대한 사전 가정을 합성 데이터 생성기로 표현하고, 그 가정에 따른 Bayesian 예측을 미리 근사할 수 있는가를 묻습니다. 이 질문을 따라가려면 빠른 추론 결과뿐 아니라 어떤 사전분포를 학습했는지, 평가 시간에 어떤 비용이 포함되는지 함께 읽어야 합니다.
원문에는 별도 목차가 없으므로 실제 절과 부록을 기준으로 구조를 정리합니다.
| 원문 순서 | 내용과 역할 |
|---|---|
| 1. Introduction | 정형 데이터 학습 절차를 사전학습된 예측기로 바꾸는 문제 제기 |
| 2. Background on Prior-Data Fitted Networks (PFNs) | Posterior Predictive Distribution, Synthetic Prior-fitting, Real-World Inference, Architecture, Tabular Data |
| 3. The TabPFN: A PFN Fitted on a New Prior for Tabular Data | 모델 변경, 사전학습 규모, 추론과 앙상블 |
| 4. A Prior for Tabular Data | 4.1 Fundamentally Probabilistic Models → 4.2 Simplicity → 4.3 SCM Prior → 4.4 BNN Prior → 4.5 Multi-Class Prediction |
| 5. Experiments | 5.1 Evaluation on Toy Problems → 5.2 Evaluation on Tabular ML Tasks |
| 6–8 | Conclusions & Future Work → Ethics Statements → Reproducibility |
| Acknowledgments, References | 연구 지원과 참고문헌 |
| A. Limitations | 크기, 자료형, 불필요 특성, 순수 예측 시간의 제약 |
| B. Additional Results | B.1 Detailed Tabular Results → B.2 Results on the OpenML-AutoML Benchmark → B.3 In-depth Analysis of Model Biases(B.3.1 불규칙 패턴, B.3.2 불필요 특성, B.3.3 특성 공간 회전) → B.4 사전분포 ablation → B.5 확장 벤치마크 |
| C. Details of the TabPFN Prior | C.1 SCM Prior → C.2 Tabular Data Refinements(C.2.1 전처리, C.2.2 상관 특성, C.2.3 불규칙 함수, C.2.4 NaN, C.2.5 범주형, C.2.6 선행 PFN과 차이) |
| D. Details of the Prior-Data Fitted Network Algorithm | Algorithm 1의 학습 절차 |
| E. Setup of Our Method | E.1 Transformer 하이퍼파라미터 → E.2 구조 변경 → E.3 학습 → E.4 사전분포 하이퍼파라미터 |
| F. Details for Tabular Experiments | F.1 하드웨어 → F.2 베이스라인 → F.3 데이터셋 → F.4 크기 일반화 → F.5 시간 비교 |
핵심 기여와 혁신성
정형 데이터는 특성마다 의미와 척도가 다르고, 적은 표본으로 일반화해야 하는 경우가 많습니다. 원문이 출발하는 당시의 문제는 이런 환경에서 딥러닝이 트리 기반 모델에 일관된 우위를 보이지 못하고, AutoML이 좋은 결과를 내더라도 탐색 비용을 요구한다는 점입니다. TabPFN은 개별 데이터셋마다 최적화하는 비용을 여러 문제에 재사용할 수 있는 오프라인 학습 비용으로 옮깁니다. §1–3
독창성의 중심은 PFN이라는 기존 아이디어를 정형 분류에 맞는 사전분포와 결합한 데 있습니다. Structural Causal Model(SCM, 구조적 인과 모형)과 Bayesian Neural Network(BNN, Bayesian 신경망)에서 생성한 문제를 섞고, 간단한 구조에 높은 확률을 줍니다. 모델은 실제 데이터에서 인과 그래프 하나를 찾아내는 대신, 여러 생성 가설을 고려한 예측 확률을 직접 근사합니다. 저자들은 이를 인과 추론 자체와 명확히 구분합니다. §4.3
실험적으로는 결측값 없는 수치형 OpenML-CC18 데이터셋 18개에서, 짧은 실행 시간으로 강한 AutoML과 경쟁하는 결과를 제시합니다. 다만 모든 데이터셋·지표에서 최고라는 주장은 아닙니다. 리뷰어의 해석으로는 이 연구의 더 넓은 의미가 학습 알고리즘의 귀납 편향을 데이터 생성 과정으로 설계하는 방법을 구체적으로 보여준 데 있습니다. 어떤 문제를 합성하고 얼마나 자주 보여주는지가, 실제 데이터에서 어떤 해법을 선호할지를 결정합니다.
기술적 세부사항
예측하려는 것은 하나의 최적 모델이 아니라 예측 분포입니다
원문 식 (1)은 관측 데이터와 양립하는 생성 가설들을 합쳐 예측하는 Bayesian 관점을 제시합니다.
$D$는 관측한 학습 데이터, $x$는 새 입력, $y$는 그 클래스입니다. $\Phi$는 가능한 생성 가설의 공간이고, $\phi$는 특정 SCM이나 BNN 같은 하나의 가설입니다. $p(\phi)$는 데이터를 보기 전의 선호, $p(D\mid\phi)$는 그 가설이 관측 데이터를 설명하는 정도, $p(y\mid x,\phi)$는 해당 가설의 예측입니다. 비례 기호는 정규화 상수가 생략됐음을 나타냅니다. 실제 적용에서 모든 가설을 명시적으로 적분하는 대신, TabPFN이 이 결과인 사후 예측 분포(PPD)를 근사합니다. §2, 식 (1)
합성 문제의 정답을 맞히며 예측 규칙을 학습합니다
사전분포에서 데이터셋을 뽑고 일부 정답을 가린 뒤, 나머지 데이터로 가린 정답을 예측하도록 학습합니다. 원문 식 (2)는 하나의 테스트 표본에 대해 다음과 같습니다.
$p(D)$는 합성 데이터셋의 분포이며, $D_{\mathrm{train}}$은 정답을 보여주는 문맥입니다. $q_\theta$는 가중치 $\theta$를 가진 PFN의 클래스 확률 출력입니다. 기대값은 여러 합성 문제에 걸친 평균을 뜻하고, 음의 로그 확률은 정답에 낮은 확률을 주면 크게 벌점화합니다. 이 목적함수로 사전학습할 때는 가중치를 갱신하지만, 실제 새 데이터셋을 입력할 때는 같은 가중치로 순전파만 수행합니다. 따라서 “추가 학습이 없다”는 말은 관측 데이터를 무시한다는 뜻이 아니라, 관측 데이터가 가중치 대신 문맥으로 예측을 바꾼다는 뜻입니다. §2, 식 (2)
행 사이 attention과 서로 다른 세 가지 순서 개념
각 학습 행의 특성과 레이블이 하나의 토큰으로 인코딩됩니다. 학습 토큰은 서로를 참조하고, 테스트 토큰은 학습 토큰만 참조합니다. 행을 집합으로 취급하는 것, 특성 열의 인덱스를 순환 이동하는 것, 여러 특성을 선형 결합하는 공간 회전은 서로 다릅니다. 앞의 것은 입력 표본의 순서, 두 번째는 앙상블 전처리, 세 번째는 부록의 귀납 편향 분석에 해당합니다. 이 구분이 없으면 “회전에 강하다”는 결과를 잘못 해석하기 쉽습니다. Figure 1, C.2.6, B.3.3
평가는 주로 ROC AUC를 사용하며, 다중 클래스에서는 one-vs-one(OVO) 방식을 적용합니다. 정확도는 최종 클래스 선택, cross-entropy(CE)는 정답에 부여한 확률을 평가하므로 AUC 순위와 일치할 필요가 없습니다. 학습·튜닝·예측을 합한 시간을 비교한다는 점도, 이미 학습된 분류기의 순수 예측 시간과 구분해야 합니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
위치와 역할. 서론은 정형 데이터에서 GBDT가 강한 현실을 제시한 다음, 기존 학습 절차를 바꿀 수 있다는 주장으로 이동합니다. 문제는 단순히 신경망의 구조를 개선하는 것이 아니라, 새 데이터가 주어질 때 반복하는 모델 적합 과정을 없애는 것입니다.
먼저 저자들은 이미지·언어와 달리 정형 분류에서는 짧은 학습 시간과 견고성을 갖춘 GBDT가 널리 사용된다고 설명합니다. 이어 새 데이터셋마다 처음부터 모델을 적합하는 대신, 인위적으로 만든 분류 문제를 풀도록 훈련된 Transformer를 한 번 실행하자는 대안을 제시합니다. 데이터셋을 입력받아 예측을 출력하는 모델이라는 관점에서는, 모델이 분류 함수 하나뿐 아니라 분류기를 구성하는 절차를 학습한 셈입니다.
다음으로 PFN을 소개하며 귀납 편향의 표현 방식을 설명합니다. 보통의 모델에서는 정규화 항이나 트리 깊이 같은 구현 가능한 제약을 통해 선호를 넣습니다. PFN에서는 원하는 특성을 가진 데이터 생성 알고리즘으로 선호를 표현할 수 있습니다. 이 논문은 그 구체적 선택으로 SCM과 BNN, 그리고 작은 구조에 대한 선호를 내놓습니다.
서론 후반은 이 설계를 실험 주장에 연결합니다. 최대 1,000개 학습 표본과 100개 수치 특성, 10개 클래스의 범위에서 성능과 속도를 평가하고, 다른 방법과 다른 데이터셋에서 강점을 보이는 예측 특성이 앙상블에 도움이 될 수 있다고 설명합니다. 코드와 사전학습 모델 공개는 새로운 접근을 외부에서 검토할 수 있게 하는 장치로 제시됩니다.
핵심 기여와 연결. 서론의 기여는 “어떤 모델을 학습할까”를 “어떤 데이터 생성 가정을 학습시킬까”로 넓힌 문제 설정입니다. 다음 절은 이를 뒷받침하는 PFN의 확률적 목표를 정의합니다. §1
📖 Chapter 2: Background on Prior-Data Fitted Networks (PFNs)
위치와 역할. 이 절은 TabPFN의 새 기여와 선행 PFN의 기본 원리를 구분합니다. 사후 예측 분포 → 합성 사전학습 → 실제 추론 → 구조 → 기존 정형 데이터 적용의 순서로 전개됩니다.
The Posterior Predictive Distribution for Supervised Learning. 먼저 생성 가설과 데이터의 관계를 정의합니다. SCM 하나가 주어지면 그 구조와 메커니즘에서 여러 표본을 생성할 수 있습니다. 실제 문제에서는 그 생성 가설을 알 수 없으므로, 관측한 학습 데이터를 설명하는 정도에 따라 가설을 가중해 새 레이블의 분포를 구합니다. 앞서 해설한 식 (1)은 이 가중 평균을 적분으로 표현합니다. 예측의 불확실성은 단일 모델의 출력 변동뿐 아니라 가능한 생성 과정에 대한 불확실성과 연결됩니다.
Synthetic Prior-fitting. 그 적분 결과를 매번 계산하는 대신 합성 문제를 반복해서 풉니다. 먼저 사전분포에서 가설을 뽑고, 그 가설로 데이터셋을 생성한 뒤, 관측 부분과 예측 부분으로 나눕니다. 원문이 사용하는 데이터셋 분포는 다음과 같습니다.
$p(\phi)$에서 생성 메커니즘을 뽑고 그 조건부 분포 $p(D\mid\phi)$에서 데이터셋을 뽑는 두 단계 표본추출입니다. 같은 메커니즘을 공유하는 한 데이터셋 안에서 정답을 가리는 것이 중요합니다. 서로 무관한 문제의 행을 섞는 것이 아니라, 관측된 행으로 그 문제의 규칙을 추정하는 능력을 학습합니다. 식 (2)의 cross-entropy 최소화가 해당 사전분포의 PPD 근사로 이어진다는 이론적 배경은 선행 PFN 연구에 근거합니다.
Real-World Inference. 실제 데이터에서는 학습 표본과 새 특성을 함께 넣고 클래스 확률을 받습니다. 온라인 단계에서 gradient descent를 하지 않지만, 학습 데이터의 내용이 바뀌면 attention을 통한 계산과 출력도 바뀝니다. 저자들은 이를 in-context learning이라고 부릅니다. 여기서 문맥은 자연어 프롬프트가 아니라 레이블을 포함한 정형 데이터의 집합입니다.
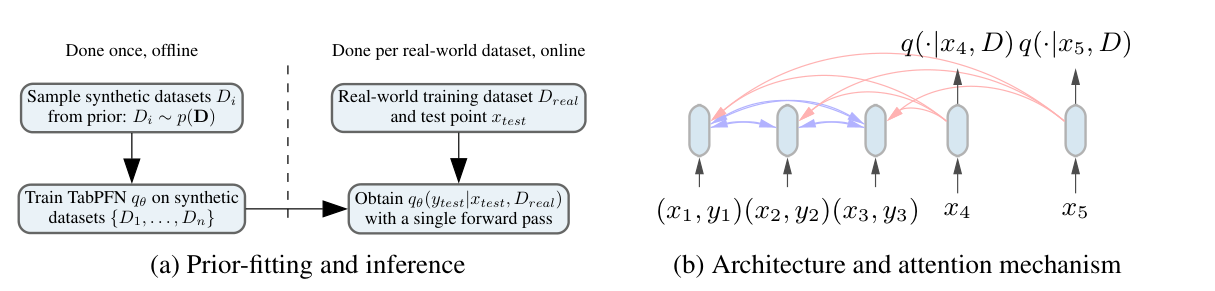
Figure 1, PDF 3쪽. 왼쪽은 오프라인 사전학습과 온라인 예측, 오른쪽은 학습·테스트 토큰의 attention을 보여줍니다. 2207.01848v6 원문의 그림 영역을 크롭했으며 내부 표기와 색상은 변경하지 않았습니다. 캡션은 한국어로 해설했습니다.
Architecture. 각 행의 특성 벡터와 레이블을 토큰화하고, 가변 길이의 학습 집합과 질의 집합을 처리합니다. 그림에서 테스트 행끼리 직접 정보를 교환하지 않는 구조는 여러 질의를 한꺼번에 계산하면서도 각 질의를 학습 집합에 조건화하는 방식을 보여줍니다.
Tabular Data. 마지막으로 기존 PFN은 30개 학습 표본을 가진 작고 균형적인 이진 분류 문제를 다뤘다고 설명합니다. 본 연구는 표본 수뿐 아니라 클래스 수와 불균형까지 확장합니다. 핵심 기여와 연결. 이 절은 학습과 추론의 의미를 재정의하고, 다음 절에서 어느 부분을 TabPFN에 맞게 바꿨는지 읽을 기준을 제공합니다. §2
📖 Chapter 3: The TabPFN: A PFN Fitted on a New Prior for Tabular Data
위치와 역할. PFN이라는 일반 틀을 실제 모델로 구체화합니다. 저자들은 attention mask 변경과 특성 수가 다른 데이터에 대한 zero-padding을 먼저 제시합니다. 전자는 불필요한 attention 계산을 줄이고, 후자는 고정 크기 인코더로 가변 특성 수를 받게 합니다.
그다음 학습 규모를 밝힙니다. 12층 Transformer를 512개 합성 데이터셋씩 18,000번 학습했으며, RTX 2080 Ti 8개에서 20시간이 걸렸습니다. 이 비용은 실제 사용자가 새 데이터셋을 넣을 때마다 내는 비용이 아닙니다. 반대로 제목의 짧은 시간만 보고 사전학습 자체도 가볍다고 해석해서는 안 됩니다.
추론 설명에서는 두 설정을 구분합니다. 하나는 한 번의 순전파이고, 다른 하나는 데이터 표현을 달리한 최대 32회 순전파의 앙상블입니다. 앙상블 구성원은 특성 열과 클래스 레이블의 인덱스를 순환 이동하고, power transformation 사용 여부를 바꿉니다. 각 구성원은 별도로 학습한 모델이 아니라 같은 모델에 서로 다른 표현을 입력한 예측입니다. 클래스 인덱스를 바꾼 결과는 원래 클래스 의미에 맞춰 해석해야 합니다.
핵심 기여와 연결. 구조 개선과 사전학습으로 공통 예측기를 만들되, 단일 실행과 앙상블의 계산비용을 분리합니다. 다음 절은 이 모델이 학습한 데이터 분포가 왜 정형 데이터에 적합하다고 보았는지 설명합니다. §3
📖 Chapter 4: A Prior for Tabular Data
위치와 역할. 이 절이 방법론의 중심입니다. 모델이 PPD를 근사하므로, 어떤 데이터셋에 높은 사전확률을 주는지가 예측 행동을 결정합니다. 저자들은 확률적 하이퍼파라미터 → 단순성 → SCM → BNN → 다중 클래스 생성의 순서로 설계를 쌓습니다.
4.1 Fundamentally Probabilistic Models. 일반적인 하이퍼파라미터 탐색은 적절한 층 수나 활성함수의 한 조합을 선택합니다. PFN은 합성 데이터 생성 단계에서 이 값들을 분포로 두어, 여러 구조와 가중치에 대한 예측을 함께 고려하도록 학습합니다. SCM과 BNN이라는 서로 다른 생성 모형까지 혼합합니다. 다만 이 주장은 사전분포 안에서 적분하려는 목표를 뜻하며, 실제 Transformer가 무한한 가설 전체를 정확하게 계산한다는 뜻은 아닙니다.
4.2 Simplicity. 저자들은 Occam의 면도날과 연결해, 복잡한 설명보다 간단한 설명을 우선하는 사전분포를 구성합니다. 여기서 간단함은 추상적 미덕이 아니라 노드와 파라미터가 적은 그래프라는 구체적 기준입니다. 어떤 표현 체계를 선택하느냐에 따라 단순성의 의미도 달라진다고 명시합니다. 따라서 “모든 종류의 단순한 함수”를 보편적으로 선호한다고 확대해서 읽을 수는 없습니다.
4.3 SCM Prior. 구조적 인과 모형은 각 변수를 직접 원인과 잡음으로 계산합니다.
$G$는 방향성 비순환 그래프(DAG), $\mathrm{PA}_G(i)$는 노드 $i$의 부모 집합입니다. $z_i$는 해당 노드의 값, $f_i$는 결정론적 메커니즘, $\epsilon_i$는 잡음입니다. 그래프를 따라 이 식을 계산하면 서로 의존하는 여러 변수를 생성할 수 있습니다. §4.3
저자들은 먼저 기존 인과 접근과의 차이를 설명합니다. 관측 자료만으로는 하나의 인과 그래프를 식별하기 어려울 수 있습니다. TabPFN은 그래프를 명시적으로 출력하거나 개입 효과를 추정하지 않고, SCM이 데이터를 생성한다는 가정 아래 관측 기반 예측을 직접 수행합니다. 원문의 “rung 1.5”라는 표현도 이 중간적 관점을 설명하기 위한 것이며, 인과 식별을 달성했다는 실험 결과가 아닙니다.
생성 과정은 다음으로 이어집니다. 하나의 SCM을 뽑고 그 안의 일부 노드를 입력 특성, 다른 하나를 타깃으로 선택합니다. 이후 같은 그래프에 서로 다른 잡음을 주며 여러 행을 생성합니다. 선택하지 않은 노드는 잠재 변수로 남습니다. 특성과 타깃의 위치가 고정되지 않으므로 타깃이 어떤 특성의 원인이거나 결과인 관계도 포함할 수 있습니다.
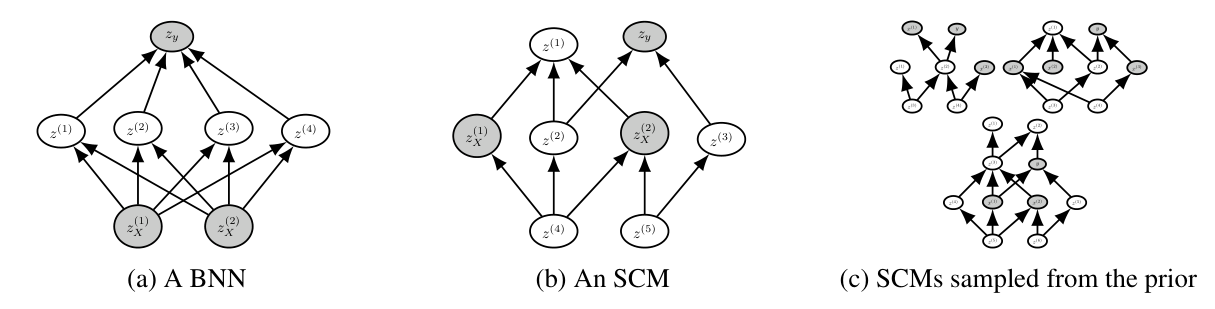
Figure 2, PDF 4쪽. 입력에서 출력으로 진행하는 BNN과, 그래프의 여러 위치에서 특성·타깃을 관측하는 SCM을 비교합니다. 2207.01848v6 원문의 그림 영역을 크롭했으며 내부 표기와 색상은 변경하지 않았습니다. 캡션은 한국어로 해설했습니다.
4.4 BNN Prior. BNN에서는 신경망 구조와 가중치를 먼저 뽑습니다. 각 입력을 뽑아 잡음이 포함된 네트워크에 통과시키고 출력을 타깃으로 사용합니다. 학습 시 SCM과 BNN에서 데이터셋을 뽑을 확률은 각각 1/2입니다. 두 종류의 문제를 섞었다는 사실과, 혼합이 순수 SCM보다 반드시 우월하다는 주장은 다릅니다. 부록 B.4의 ablation은 이 차이를 따로 확인합니다.
4.5 Multi-Class Prediction. 앞의 생성기는 연속 타깃을 내므로, 분류 문제로 바꾸는 단계가 필요합니다. 클래스 수를 뽑고, 생성된 연속 타깃 중에서 클래스 경계들을 뽑은 뒤 구간을 클래스로 대응시킵니다. 원문의 구간 배정 규칙은 다음과 같습니다.
$\hat y_i$는 연속 타깃, $B_j$는 표본추출한 경계이며, 지시함수는 타깃보다 작은 경계의 개수를 셉니다. 클래스가 세 개라면 경계 두 개가 세 구간을 만듭니다. 구간마다 표본 수가 다를 수 있으므로 불균형 분류도 생깁니다. 마지막에는 클래스 레이블을 섞어 숫자 순서가 타깃의 연속적 순서를 그대로 뜻하지 않게 합니다.
핵심 기여와 연결. 사전분포는 “랜덤한 표”가 아니라, 생성 구조·복잡도·변수 관계·분류 경계에 대한 선택을 담고 있습니다. 다음 절은 이 가정이 실제 데이터의 성능과 계산시간으로 이어지는지 평가합니다. §4
📖 Chapter 5: Experiments
위치와 역할. 저자들은 이해하기 쉬운 저차원 결정 경계부터 시작해, 실제 정형 데이터의 정량 비교로 확장합니다.
5.1 Evaluation on Toy Problems. Figure 4는 moons, circles, iris와 wine의 일부 특성·클래스를 이용해 결정 경계를 비교합니다. TabPFN은 곡선 구조를 따라 매끄러운 경계를 만들며, moons에서는 관측에서 멀리 떨어진 영역에 큰 불확실성을 보입니다. 저자들은 이를 직관적인 예측으로 해석합니다. 이 그림은 모델의 행동을 보여주는 정성적 증거이고, 별도의 calibration 지표를 대체하지는 않습니다.
5.2 Evaluation on Tabular ML Tasks — Datasets. OpenML-CC18에서 전체 표본 최대 2,000개, 특성 최대 100개, 클래스 최대 10개 조건을 적용해 30개 데이터셋을 고릅니다. 그중 수치형이며 결측값이 없는 18개가 본문 중심 평가이고, 나머지 12개는 범주형 특성이나 결측값이 있습니다. 전체 표본 제한 2,000개와 학습 표본 제한 1,000개는 50:50 분할 때문에 함께 성립합니다.
Baselines. KNN과 Logistic Regression, XGBoost·LightGBM·CatBoost, AutoGluon과 Auto-sklearn 2.0을 비교합니다. 일반 모델은 랜덤한 하이퍼파라미터를 5-fold 교차검증으로 평가하고, 시간 예산이나 최대 10,000개 조합에 도달하면 선택한 설정으로 전체 학습 부분을 다시 적합합니다. 딥러닝 비교에는 Regularization Cocktails와 SAINT도 포함합니다. 각 방법이 처리할 수 있는 입력 형식에 맞춰 인코딩·정규화·결측 처리 등을 사용합니다.
Evaluation Protocol. 각 데이터셋에서 다섯 개 시드로 학습·테스트를 절반씩 나눕니다. 동일 시드에서는 방법들이 같은 분할을 사용합니다. 평균 AUC만 보지 않고 데이터셋별 순위와 승리 수도 집계합니다. 시간 예산은 30, 60, 300, 900, 3,600초이며, Figure 5의 동일 예산 비교에서는 요청 시간의 두 배를 넘긴 방법을 제외합니다. Auto-sklearn 2.0의 다중 클래스와 Cocktails는 AUC 대신 CE를 최적화하므로, 모든 베이스라인의 최적화 목적이 완전히 동일하다고 말할 수는 없습니다.
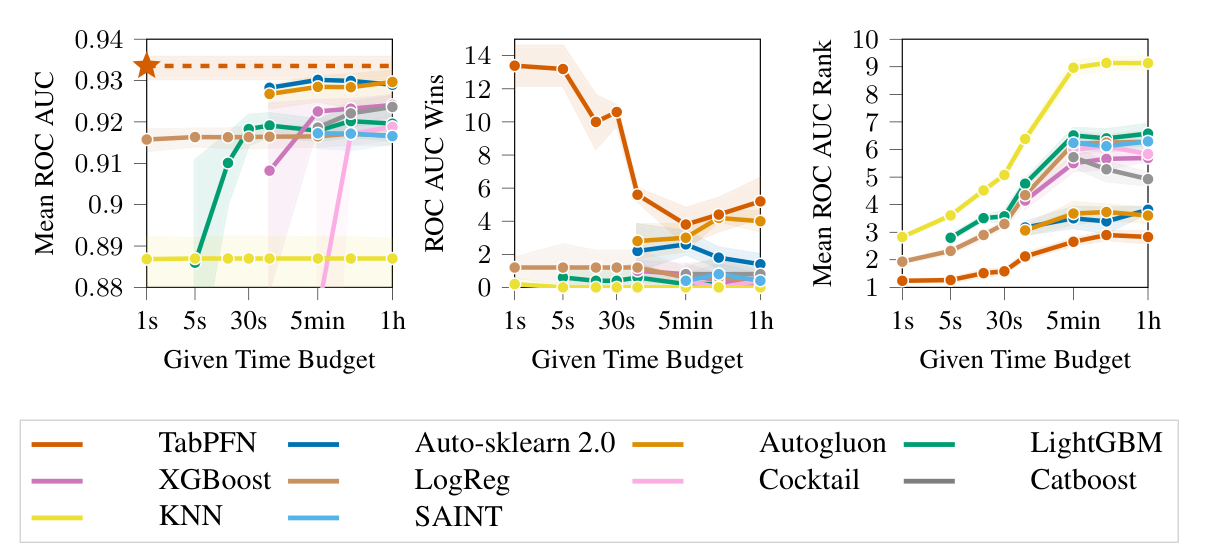
Figure 5, PDF 7쪽. 평균 ROC AUC, 승리 수, 평균 순위를 시간 예산에 따라 비교합니다. 음영은 원문이 다섯 분할에 대해 제시한 95% 신뢰구간이며, 붉은 별은 GPU에서 약 0.62초가 든 32회 표현 앙상블입니다. 2207.01848v6 원문의 그림 영역을 크롭했으며 축·범례·수치를 변경하지 않았습니다. 캡션은 한국어로 해설했습니다.
Results. 결과의 핵심은 제한된 수치형 문제군에서의 시간 대비 예측 성능입니다. Table 1에서 32회 앙상블 TabPFN의 평균 AUC는 0.934, AutoGluon은 0.930입니다. 그러나 정확도는 각각 0.879와 0.881, CE는 0.716과 0.714이므로 모든 집계 지표를 TabPFN이 이겼다는 결론은 맞지 않습니다. 단일 순전파 설정도 AUC 0.932로 강하며, CPU 평균 1.301초와 GPU 평균 0.0519초가 보고됩니다.
저자들은 이어 개별 데이터셋에서의 예외를 명시합니다. 기본 설정의 베이스라인보다 못한 데이터도 있고, 범주형·결측값이 있으면 대체로 강점이 줄어듭니다. 따라서 전체 집계에서 좋은 결과를 보인 것과 새로운 한 데이터셋에서 반드시 이기는 것은 별개입니다.
OpenML-AutoML Benchmark. 별도 평가에서는 공개된 공식 평가 스크립트와 기존 베이스라인 결과를 활용합니다. 평균 CPU 시간 약 4.4초로 평가하며, 이 결과는 논문의 자체 실험 코드나 특정 분할에만 의존하는지 점검하는 역할을 합니다. 데이터셋 일부가 앞선 평가와 겹치므로 완전히 독립된 새로운 문제군이라고 보아서는 안 됩니다.
In-depth Analysis, Ensembling, Model Generalization. 마지막 세 주제는 부록의 분석을 예고합니다. 단순한 SCM 설명을 선호하는지, 불필요한 특성과 회전에 어떻게 반응하는지 확인합니다. 다른 방법과 데이터셋별 성능의 상관이 낮다는 관찰에 따라 TabPFN과 AutoGluon 확률을 평균하고, 추가 성능을 제시합니다. 또한 사전학습 데이터셋의 크기가 1,024로 고정됐음에도 최대 5,000개 학습 표본을 제공했을 때 성능이 개선되는지 살펴봅니다. 이는 더 긴 입력에 대한 실증적 일반화이며 무제한 크기를 지원한다는 의미는 아닙니다.
핵심 기여와 연결. 실험은 빠른 실행과 경쟁력 있는 예측을 함께 보여주되, 적용 범위와 지표별 차이를 드러냅니다. 다음 절은 이 결과를 바탕으로 저자들이 인정한 제약과 연구 방향을 정리합니다. §5
📖 Chapter 6: Conclusions & Future Work
위치와 역할. 결론은 하나의 Transformer로 AutoML의 일부 역할을 빠르게 수행했다는 성과에서 시작해, 해결되지 않은 문제로 이동합니다. 이 절의 미래 과제는 저자들이 직접 적은 범위를 따릅니다.
먼저 작은 데이터에서 수분에서 한 시간의 AutoML과 경쟁하는 빠른 예측을 강조합니다. 이어 Transformer의 확장성, 범주형 특성, 결측값, 중요하지 않은 특성에 대한 견고성을 개선 대상으로 제시합니다. 이 항목들은 부록의 측정 결과와 연결됩니다.
그다음 AutoML 통합과 추가 시간에 따른 앙상블, 데이터셋별 사전분포 선택, 비정형 데이터와 회귀로의 확장을 언급합니다. 분포 밖 견고성, 공정성, 적대적 예제, 설명가능성도 연구 대상으로 나열합니다. 마지막으로 빠른 예측이 탐색적 데이터 분석·특성 공학·능동학습에 줄 가능성과, SCM 분포를 이용한 개입·반사실 추정의 후속 연구를 제안합니다. 현재 모델이 이 기능들을 이미 제공한다고 해석하면 안 됩니다.
핵심 기여와 연결. 성과를 재진술하면서 적용 경계를 저자 자신의 언어로 한정합니다. 다음 절은 계산비용 감소의 사회적 의미와 책임 있는 활용 문제를 다룹니다. §6
📖 Chapter 7: Ethics Statements
위치와 역할. 저자들은 계산시간 감소가 비용과 접근성, 탄소 배출 측면에 줄 수 있는 긍정적 효과를 설명합니다. 큰 계산 자원을 쓰기 어려운 연구자와 학생에게도 분류 모델을 쉽게 적용할 수 있다는 관점입니다.
이어 적용이 쉬워지면 머신러닝 사용 자체가 늘어날 수 있다고 지적합니다. 의료나 업무 효율 같은 활용 가능성을 언급하면서도, 계산 지속가능성 외에 공정성·적대적 견고성·설명가능성·감사가 필요하다고 씁니다. 이 절은 윤리 지표를 실험으로 검증한 결과가 아니라 저자의 영향 평가입니다. 탄소 배출량을 직접 계측한 수치도 여기에는 제시되지 않습니다.
핵심 기여와 연결. 빠른 계산을 사회적 편익과 연결하되 신뢰성 평가가 끝났다고 주장하지 않습니다. 다음 절은 외부 연구자가 결과를 재현할 수 있도록 제공한 자료를 소개합니다. §7
📖 Chapter 8: Reproducibility
위치와 역할. 이 절은 Code release → Application to public benchmarks → Availability of datasets → Online resources → Details of training procedures 순으로 재현성 자원을 설명합니다.
저자들은 코드·사전학습 모델·재현 노트북을 공개한다고 밝히고, OpenML-CC18과 OpenML-AutoML이라는 공개 벤치마크를 사용했다고 설명합니다. OpenML-AutoML에서는 공식 스크립트와 이미 공개된 베이스라인 결과를 사용한 점이 추가적인 점검 장치입니다. 데이터 다운로드 절차, scikit-learn 형태의 사용 인터페이스를 체험하는 노트북, 179개 테스트·검증 데이터셋의 평가와 그림을 재현하는 노트북, 두 개의 온라인 데모를 안내합니다.
마지막으로 학습 설정과 베이스라인 하이퍼파라미터를 부록 표에 연결합니다. 리뷰어의 판단으로는 모델 설명뿐 아니라 분할·비교 환경·검색 공간까지 제시한 점이 재현에 도움이 됩니다. 다만 이 리뷰는 해당 버전 PDF를 분석한 것이며, 연결된 현재 코드로 모든 실험을 재실행했다고 주장하지 않습니다.
핵심 기여와 연결. 재현을 위한 자료의 위치와 역할을 명시합니다. 뒤의 Acknowledgments는 연구 지원을, References는 PFN·Transformer·인과 모형·정형 데이터 모델·통계 비교의 선행 근거를 기록합니다. 참고문헌 목록은 확인했으나 각 인용 논문을 모두 별도로 검토한 것은 아닙니다. 이후 부록은 본문에서 간략히 다룬 한계와 실험·구현 세부사항을 보완합니다. §8 및 후속 항목
📖 Chapter A: Limitations
위치와 역할. 부록의 첫 절은 본문의 성과를 사용할 때 필요한 경계를 명시합니다. 저자들은 먼저 Transformer의 시간·메모리 사용이 학습 표본 수에 대해 이차적으로 증가한다고 설명합니다. 효율적 attention 계열을 통합할 가능성을 언급하지만 본 모델에서 그 문제가 해결됐다는 뜻은 아닙니다.
다음으로 이 논문이 학습한 모델은 특성 100개, 클래스 10개를 넘는 데이터셋을 직접 처리할 수 없다고 밝힙니다. 숫자를 단순한 벤치마크 선택 조건으로만 이해하면 지원 범위를 잘못 판단하게 됩니다. 반면 표본 수는 입력 길이가 가변이며, 별도 실험에서 사전학습보다 긴 문맥을 평가했습니다. 제한의 성격이 서로 다릅니다.
범주형·결측값 데이터에서는 대체로 성능이 낮고, 사전분포에서 충분히 고려하지 않은 불필요 특성을 추가하면 성능이 떨어진다는 점도 적습니다. 마지막으로 TabPFN은 적합과 예측을 함께 수행하므로, 이미 학습된 베이스라인의 순수 예측만 비교하면 베이스라인이 더 빠를 수 있다고 명시합니다.
핵심 기여와 연결. “빠른 분류”가 적용되는 비용과 자료형의 범위를 분리합니다. 다음 부록은 이 경계들을 실제 데이터와 통제 실험으로 보여줍니다. Appendix A
📖 Chapter B: Additional Results
위치와 역할. 이 부록은 평균 성능 뒤에 숨은 조건과 편향을 분석합니다. 데이터 종류별 성능 → 외부 평가 절차 → 귀납 편향 → 사전분포 ablation → 확장 데이터셋과 통계검정 순서입니다.
B.1 Detailed Tabular Results. Figure 6은 범주형 특성 유무, 결측값 유무, 이진·다중 클래스에 따라 성능을 나눕니다. 수치형이고 결측값이 없을 때 강점이 크며, 이진과 다중 클래스는 비교적 비슷하게 처리한다고 관찰합니다. Figure 7과 Table 2는 조건에 맞는 30개 데이터셋 전체를 보여줍니다. 이때 평균 AUC는 TabPFN 0.894, AutoGluon 0.895로, 본문의 18개 수치형 결과와 순서가 달라집니다. 범위를 넓힌 결과를 분리해 보여주는 이유가 여기에 있습니다.
B.2 Results on the OpenML-AutoML Benchmark. 저자들은 다섯 개 소규모 데이터셋을 공식 절차로 평가합니다. 기존 실험의 50:50 분할·다섯 반복과 달리 여기서는 10-fold 교차검증으로 90:10 분할을 사용합니다. 데이터셋 중 세 개가 CC18 테스트에, Australian은 개발용 검증에 이미 포함돼 있다고 밝힙니다. 이 평가는 데이터의 완전한 독립성보다 분할·평가 코드·비교 결과가 달라도 관찰이 유지되는지 확인하는 데 의미가 있습니다. Table 3의 평균 CPU 시간은 4.374초, 정확도 0.794, CE 0.449이며, AutoGluon의 해당 값은 3,182초, 0.793, 0.454입니다. 원문의 Table 3 제목은 ROC AUC라고 쓰지만 행에는 다중 클래스의 음의 CE도 포함되어 있어, 모든 값을 AUC로 읽지 않아야 합니다.
B.3 In-depth Analysis of Model Biases. 비교 대상은 TabPFN, LightGBM, 은닉 차원 100의 기본 MLP입니다. 저자들은 이 부분이 충분히 튜닝한 모델 사이의 절대 우열 평가가 아니라 질적 행동 분석임을 밝힙니다.
B.3.1 Fitting Irregular Patterns. Figure 8은 랜덤 SCM의 은닉 유닛 수로 생성 복잡도를 바꾸고 학습 표본 수도 바꾸며 training-set CE를 측정합니다. TabPFN은 간단한 설명을 선호하지만 표본이 많아지면 더 복잡한 함수를 적합할 수 있다고 해석합니다. 이는 단순성 선호가 관측 증거와 무관하게 고정된 평활화 규칙이라는 뜻은 아닙니다. 또한 학습 집합의 CE를 본 실험이므로 일반화 성능 표와 구분해야 합니다.
B.3.2 Robustness to Uninformative Features. 기존 특성을 복사한 뒤 행 사이 값을 섞어 정보가 없는 특성을 추가합니다. TabPFN과 MLP는 LightGBM보다 성능 저하가 큽니다. 반대 실험에서는 Random Forest 중요도에 따라 덜 중요한 특성부터 제거합니다. MLP는 일부 제거가 도움이 되고, TabPFN과 GBDT는 일정 구간에서 변화가 작다가 중요 정보까지 빠지면 악화됩니다. 추가 특성으로 모델의 100개 제한을 넘지 않도록, 추가 실험은 50개 이하 특성의 이진 분류 데이터로 한정합니다. 통제한 입력 범위까지 결과의 일부입니다.
B.3.3 Invariance to Feature Rotation. 여기서 회전은 열 순서를 바꾸는 것이 아니라 특성 공간에 회전 행렬을 적용하는 연산입니다. MLP는 거의 영향을 받지 않고 LightGBM은 크게 악화되며, TabPFN은 그 사이의 행동을 보입니다. 저자들은 불필요 특성에 대한 약점과 상대적인 회전 불변성을 연결하고, 사전분포에 그런 특성을 더 포함하는 방향을 제안합니다. 이 이론적 연결은 원문이 인용한 선행 연구에 기반합니다.
B.4 Ablation on the Selection of Prior Models. 본 모델보다 적은 계산량으로 학습한 비교에서 평균 AUC는 BNN 0.865±0.007, SCM 0.881±0.002, SCM+BNN 0.883±0.003입니다. CE는 각각 0.811±0.009, 0.771±0.006, 0.776±0.009입니다. SCM을 도입한 효과는 보이지만 혼합이 순수 SCM보다 일관되게 우월하다고 말할 수는 없습니다. 원문도 두 설정의 차이가 크지 않다고 설명합니다. 이 표의 수치를 최종 모델의 Table 1 수치와 직접 맞비교해서는 안 됩니다.
B.5 Extended Analysis on a Larger Benchmark of Datasets. 개발에 사용했던 추가 검증 데이터셋 149개를 대상으로 기본값 모델과 한 시간 튜닝한 모델을 더 넓게 비교합니다. Figure 13은 수치형·무결측 65개와 범주형 또는 결측값 84개로 구분합니다. 원래 개발 목록 150개 중 flags는 충분한 분할 생성이 어려워 제외됐습니다. 이 149개는 사전분포 설계에도 활용된 meta-validation이며, 전부 미사용 테스트라고 부를 수 없습니다.
통계 분석은 데이터셋별 성능을 비교 단위로 삼아 Wilcoxon 검정과 Holm–Bonferroni 다중 비교 보정, 유의수준 0.05를 사용합니다. Figure 14의 빠른 실행군에서 수치형·무결측 데이터에 대해 TabPFN의 유의한 우위를 보고합니다. 긴 실행군의 개별 쌍 비교와 다중 비교 보정 후 그림의 결과는 구분해서 서술하며, 이를 “모든 AutoML을 유의하게 능가”로 바꾸지 않습니다.
이후 저자들은 좋은 결과만으로 끝내지 않고 개별 사례를 제시합니다. collins에서는 불필요 특성이 상대적 약점의 원인이라고 분석하고, 중요한 특성 다섯 개만 사용한 별도 분석도 제공합니다. 집계에는 원래의 낮은 성능을 그대로 넣었다고 밝힙니다. sensory의 범주형 특성, meta의 결측값 사례 다음에는 Touch2와 vehicle, PizzaCutter1과 arsenic-female-bladder의 강한 결과를 소개합니다. 마지막에는 수치형 pm10에서의 낮은 결과와 범주형 monks-problem2에서의 좋은 결과를 함께 제시해, 데이터 유형만으로 모든 사례를 단정할 수 없다고 정리합니다.
핵심 기여와 연결. 부록 B는 적용 조건, 통계적 근거, 예외를 통해 중심 주장을 정교하게 만듭니다. 다음 부록은 이 행동의 원천인 생성 사전분포를 재현 가능한 절차로 풀어냅니다. Appendix B
📖 Chapter C: Details of the TabPFN Prior
위치와 역할. 본문에서 개념적으로 설명한 사전분포를 실제 표본추출 과정으로 구체화합니다. SCM 생성 이후 정형 데이터의 특성을 반영한 수정들을 순서대로 다룹니다.
C.1 SCM Prior. 먼저 MLP 모양의 층별 DAG를 만듭니다. 층 수와 은닉 노드 수를 뽑고, 간선 가중치를 뽑고, 일부 간선을 제거합니다. 그중 특성 노드와 타깃 노드를 선택하고 잡음의 분포도 상위 분포에서 뽑습니다. 이 단계에서 한 데이터셋의 생성 규칙이 정해집니다. 그 뒤 각 행마다 새 잡음을 뽑아 그래프를 계산하고 관측 노드의 값을 읽습니다.
여기서 $E_{ij}$는 원문이 계산식에 사용한 간선 가중치 표기, $a$는 활성함수입니다. 부모 노드들의 가중합에 잡음을 더한 뒤 비선형 함수를 적용합니다. 활성함수는 데이터셋마다 Tanh, LeakyReLU, ELU, Identity 중 하나를 고릅니다. 그래프·가중치·잡음 분포는 데이터셋 단위로 공유되고, 잡음의 실현값은 행마다 달라집니다. 이 구분이 있어야 같은 모집단의 여러 관측치가 생성됩니다.
C.2.1 Preprocessing. 합성 학습 입력을 평균 0, 분산 1로 정규화하고 실제 입력에도 같은 처리를 적용합니다. 지수적으로 스케일이 달라지는 자료에 대응하기 위해 추론 시 Yeo–Johnson power transform을 활용합니다. 정규화 통계와 power transform 등은 학습 표본만으로 계산하며, 전처리 시간은 보고한 추론 시간에 포함합니다.
C.2.2 Correlated Features. SCM 자체가 다양한 상관을 생성하지만, 가까운 열끼리 관련이 많은 데이터도 표현하려고 blockwise feature sampling을 도입합니다. 층별 네트워크에서 인접한 노드 묶음을 특성으로 선택하면 관련 특성이 가까운 순서에 놓일 수 있습니다. Figure 20은 실제 PC4 데이터와 합성 데이터의 상관행렬을 비교합니다. 모든 실제 상관구조를 복원한다는 보장이 아니라, 생성기가 그런 구조를 만들 수 있음을 보여주는 예시입니다.
C.2.3 Generating Irregular Functions. 입력 특성별 가중치 배율을 뽑아 영향력 차이를 강화합니다. 그래프 연결을 희소하게 하거나 블록 단위로 제거해 일부 변수 집단의 상호작용을 강하게 만들며, 노드별 잡음의 평균과 표준편차도 다르게 합니다. 입력 분포는 Gaussian, Zipfian, Multivariate Distribution의 혼합으로 설명됩니다. 넓은 네트워크의 평균화 효과 때문에 모든 특성이 비슷하게 기여하는 상황을 줄이려는 구성입니다.
C.2.4 NaN Handling. 특별한 결측 처리 구조는 없으며 테스트 시 NaN을 0으로 바꾼다고 적습니다. 이 간단한 처리를, 결측 메커니즘 자체를 학습하는 방법으로 해석하지 않아야 합니다.
C.2.5 Categorical Features. 연속 특성을 구간화해 범주형 특성을 만들고 일부에서는 범주 순서를 섞습니다. 원문은 prior-fitting 중 범주형 특성 확률 20%를 사용했다고 명시합니다. 범주형을 생성기에 전혀 넣지 않은 것은 아니지만, 중심 개발 목표가 수치형 데이터였고 실제 범주형 성능의 약점도 보고됐다는 두 사실을 함께 읽어야 합니다.
C.2.6 Differences to Prior Work on PFNs for Tabular Data. 원문은 불균형·다중 클래스 확장, 전처리, 여러 전처리의 앙상블, attention 비용 감소, 새 SCM prior를 순서대로 정리합니다. 특성 수 $k$, 클래스 수 $j$라면 가능한 순환 이동과 power transform의 조합은 최대 $2kj$이며, 지정한 앙상블 크기가 더 커도 같은 조합을 계속 늘리지 않습니다. 또한 특성 인덱스의 순환 이동은 공간 회전이 아니라는 각주를 명시합니다.
핵심 기여와 연결. 생성 사전분포가 구조·잡음·자료형·전처리의 결합임을 보여줍니다. 다음 부록은 그 분포를 학습에 연결하는 PFN 알고리즘을 정리합니다. Appendix C
📖 Chapter D: Details of the Prior-Data Fitted Network Algorithm
위치와 역할. Algorithm 1은 선행 PFN의 prior-fitting을 짧은 절차로 제시합니다. 입력은 표본추출 가능한 데이터셋 사전분포와 반복 횟수이며, 출력은 PPD를 근사하는 신경망입니다.
먼저 신경망을 초기화합니다. 각 반복에서 문맥 데이터와 여러 예측 대상의 정답을 포함하는 합성 데이터셋을 뽑습니다. 예측 대상 각각에 대한 음의 로그 확률을 더해 확률적 손실을 계산하고, 그 gradient로 모델을 갱신합니다.
$m$은 이번 문제에서 예측할 표본 수, $D$는 레이블을 보여주는 문맥, $(x_i,y_i)$는 정답을 가린 평가 부분입니다. 합은 한 합성 문제의 여러 예측 항을 모으며, 여러 생성 문제에서 이 단계를 반복해 식 (2)의 기대 손실을 근사합니다. 이 gradient 갱신은 사전학습 알고리즘 안에만 있으며 실제 새 데이터의 추론 과정에 추가되는 단계가 아닙니다.
핵심 기여와 연결. 높은 수준의 Bayesian 목표와 통상적인 신경망 최적화가 어떻게 연결되는지 보입니다. 다음 부록은 실제 사용한 네트워크 크기와 최적화 설정을 제공합니다. Appendix D, Algorithm 1
📖 Chapter E: Setup of Our Method
위치와 역할. E.1–E.4는 모델 크기, 구조 변경, 학습량, 사전분포 설정의 순서로 구현 조건을 설명합니다.
E.1 Transformer Hyperparameters. 12층, 임베딩 크기 512, feed-forward 은닉 크기 1,024, attention head 4개를 사용합니다. 파라미터 수는 25.82M입니다. Adam, 선형 warmup, cosine annealing을 사용하며, 학습률 후보 0.001·0.0003·0.0001 중 마지막 학습 손실이 낮은 것을 택했습니다. 이는 실제 데이터셋마다 하이퍼파라미터 튜닝을 하지 않는다는 주장과 모순되지 않습니다. 모델 개발 단계의 선택과 사용자 데이터셋에 대한 온라인 선택이 다르기 때문입니다.
E.2 PFN Architecture Adaptations — Attention Adaption. 학습 표본끼리의 self-attention과 질의에서 학습 표본으로의 cross-attention을 가중치를 공유하는 두 모듈로 나눕니다. 기존에는 질의가 자기 자신에도 attention할 수 있었지만 이를 제거하며, 현재 질의의 정보는 residual branch로 흐릅니다. 원문 식 (3)과 (4)의 mask가 보여주는 변경입니다. 학습 표본 수를 $n$, 테스트 표본 수를 $m$이라 하면 비교하는 attention 행렬 규모는 다음처럼 줄어듭니다.
왼쪽은 모든 토큰 조합을 가진 행렬, 오른쪽은 학습-학습과 테스트-학습의 조합만 계산한 크기입니다. 테스트-테스트 조합을 없애는 이점이 있지만 학습 표본 사이의 $n^2$ 항은 남습니다. 따라서 이 개선이 큰 학습 집합의 이차 비용까지 제거하는 것은 아닙니다.
Flexible Encoder. 특성 수를 최대 100개까지 변화시키며 학습합니다. 특성이 $k$개이고 최대가 $K$이면 부족한 차원을 0으로 채우고 특성을 $K/k$로 스케일링한다고 원문에 설명합니다. 이를 통해 입력 차원은 고정된 인코더와 실제 데이터의 가변 특성 수를 연결합니다.
E.3 TabPFN Training. 18,000 step × 512개 데이터셋으로 총 9,216,000개 합성 데이터셋을 사용했습니다. 각각은 1,024개 표본을 가지고, 학습 문맥과 예측 부분의 분할 위치를 균일하게 뽑습니다. 따라서 1,024개가 언제나 전부 관측된 학습 문맥이라는 뜻은 아닙니다. 원문은 약 1,000만 데이터셋 부근에서 학습 곡선이 평탄해지고, 다양한 생성 문제 때문에 잡음도 컸다고 보고합니다.
E.4 Prior Hyperparameters. 사전분포의 설계는 단순성 원칙과 개발용 검증 데이터의 클래스 분포·상관 등 관찰을 바탕으로 했습니다. 검증 데이터에서 동작을 평가하며 개발했다고 명시합니다. 실제 데이터로 모델 가중치를 지도학습하지 않았다는 사실과, 실제 데이터의 특성이 설계 과정에 전혀 쓰이지 않았다는 주장은 다릅니다. Table 5는 층 수·노드 수·잡음·가중치 척도를 상위 분포에서 뽑는 설정을 제공합니다. 로그 스케일 분포에서 평균과 표준편차를 뽑고 절단 정규분포를 거친 뒤 필요한 경우 반올림·최솟값 이동을 적용하는 방식도 정의합니다.
핵심 기여와 연결. 빠른 예측을 가능하게 한 사전 계산과 구조를 구체적으로 밝힙니다. 마지막 부록은 비교 실험의 하드웨어와 데이터 선택, 비용 계산을 보충합니다. Appendix E
📖 Chapter F: Details for Tabular Experiments
위치와 역할. 이 부록은 실험 재현에 필요한 조건을 하드웨어 → 베이스라인 → 데이터 → 크기 일반화 → 시간의 순서로 정리합니다.
F.1 Hardware Setup. 평가에는 Intel Xeon Gold 6242 2.80GHz의 CPU 하나와 최대 6GB RAM을 사용하며, TabPFN의 GPU 평가에는 RTX 2080 Ti를 추가합니다. CPU와 GPU 시간을 같은 숫자인 것처럼 섞지 않아야 하는 이유입니다.
F.2 Baselines. Table 6은 각 방법의 검색 공간을 제공합니다. CatBoost와 XGBoost는 기존 연구의 범위를 활용하되 일부를 수정했고, XGBoost에는 별도의 탐색 공간도 시도했으나 주 비교에 쓰인 범위보다 결과가 낮았다고 설명합니다. KNN·Gaussian Process·Logistic Regression은 scikit-learn 구현과 정의한 검색 공간을 사용합니다. 범주형 특성 위치를 지원하는 모델에는 그 정보를 전달하고, 일부 모델은 MinMax scaling을 적용합니다. Figure 21은 Auto-sklearn의 최종 앙상블 구성 가중치를 보여주어, 그 결과가 단일 분류기의 성능이 아니라는 점을 보충합니다.
F.3 Used Datasets. 네 종류의 데이터 집합을 구분합니다. 첫째는 CC18의 크기 조건을 만족하는 30개 meta-test입니다. 둘째는 사전분포 개발을 위한 150개 meta-validation으로, 테스트와 같은 데이터 및 크기·특성·클래스 수가 같은 중복 의심 항목을 수동 점검해 제외했다고 설명합니다. FOREX와 일부 인공 생성 데이터도 제외했습니다. 셋째는 10-fold 평가에서 학습 부분이 약 1,000개 이하가 되도록 전체 표본 최대 1,111개를 고른 OpenML-AutoML 부분집합입니다. 넷째는 긴 입력 일반화를 위한 큰 데이터셋 18개입니다. Tables 7–11은 각 목록과 OpenML 식별자 등을 제공합니다.
F.4 Model Generalization. 큰 데이터셋 실험에서도 모델 입력 제한은 유지합니다. 특성이 100개보다 많으면 처음 100개로 제한하고, 클래스가 10개를 넘으면 처음 10개 클래스 밖의 표본을 제거합니다. 본문은 각 데이터셋에서 10,000개를 선택하고, 테스트 5,000개와 최대 5,000개 학습 표본을 사용했다고 설명합니다. Figure 10의 입력 길이 일반화가 원래 대규모 데이터 전체에 대한 무제한 적용 실험은 아니라는 점을 보여줍니다.
F.5 Details on Time Comparisons. 시간은 튜닝·적합·예측의 합이며, 모든 방법의 일회성 개발 비용은 제외합니다. TabPFN의 prior-fitting뿐 아니라 AutoML의 메타학습과 수작업 알고리즘 개발도 제외하는 기준입니다. 저자들은 이런 비용이 사용자에게 매번 발생하지 않고 반복 사용에 걸쳐 분산된다는 이유를 제시합니다. 이는 온라인 사용비용 비교로 읽을 수 있지만, 전체 생애주기의 에너지나 총비용을 직접 비교한 표는 아닙니다.
핵심 기여. 마지막 부록은 성능 숫자를 재현하고 해석할 실험 경계를 완성합니다. 데이터가 독립적인지, 어떤 전처리와 계산 자원이 허용되는지, 일회성 비용을 어디까지 계산하는지가 최종 주장을 이해하는 조건임을 보여줍니다. Appendix F
실험 결과 심층 분석
AUC의 작은 차이와 시간의 큰 차이를 분리해야 합니다
다음은 원문 Table 1에서 핵심 비교만 옮긴 표입니다. 대상은 수치형·무결측 CC18 18개 데이터셋, 50:50 분할 다섯 번, 베이스라인 요청 예산 60분입니다. ±는 원문 표의 표준편차이며 신뢰구간이나 p-value가 아닙니다. 시간은 튜닝·적합·예측의 합입니다. Table 1, PDF 8쪽
| 방법 | 평균 ROC AUC OVO | 평균 정확도 | 평균 CE ↓ | CPU 시간(초) | GPU 시간(초) |
|---|---|---|---|---|---|
| CatBoost | 0.924±0.011 | 0.864±0.011 | 0.747±0.029 | 3,746 | — |
| Auto-sklearn 2.0 | 0.929±0.0096 | 0.870±0.014 | 0.813±0.073 | 3,601 | — |
| AutoGluon | 0.930±0.0091 | 0.881±0.010 | 0.714±0.014 | 3,077 | — |
| TabPFN 단일 실행(n.e.) | 0.932±0.0088 | 0.873±0.0095 | 0.727±0.021 | 1.301 | 0.0519 |
| TabPFN 32회 앙상블 | 0.934±0.0086 | 0.879±0.0089 | 0.716±0.019 | 37.59 | 0.6172 |
| TabPFN + AutoGluon | 0.934±0.0084 | 0.886±0.0094 | 0.711±0.014 | 3,109 | 3,077 |
마지막 행의 GPU 열은 AutoGluon까지 전부 GPU로 실행했다는 뜻이 아니라, TabPFN의 GPU 계산을 결합했을 때 원문이 보고한 전체 시간입니다. 앙상블해도 AutoGluon의 긴 처리시간은 남습니다.
TabPFN 32회 앙상블과 AutoGluon의 평균 AUC 차이는 0.004입니다. 그 차이 자체보다, 경쟁력 있는 예측을 내는 데 필요한 온라인 계산량이 크게 다르다는 것이 핵심입니다. 반대로 정확도와 CE는 AutoGluon이 조금 좋으므로 모든 지표의 승리로 묶을 수 없습니다. 확률 평균 앙상블은 정확도 0.886과 CE 0.711로 개선되지만, 빠른 단독 TabPFN의 시간과 같지는 않습니다.
논문의 CPU 230배·GPU 5,700배 주장은 §5.2에서 단일 실행 TabPFN과 약 5분 예산의 강한 베이스라인을 비교한 표현입니다. 이를 32회 앙상블의 CPU 시간 37.59초에 붙이거나, 모든 경우를 한 시간 대비 속도 향상으로 설명하면 조건이 바뀝니다. 또한 원문은 모델이 이미 메모리에 있다고 가정하며, 적재에는 당시 약 0.2초가 더 필요했다고 적습니다. “1초”는 하드웨어·설정·비용 범위를 함께 읽어야 하는 제목입니다.
실험 설계가 지지하는 범위
같은 데이터 분할을 모든 방법에 적용하고, 여러 예산과 AUC·순위·승리 수를 함께 본 점은 비교의 타당성을 높입니다. 공개 벤치마크를 크기 조건으로 선택한 점도 선택 과정을 확인하기 쉽게 합니다. 다만 가장 좋은 중심 결과는 사전분포 개발이 겨냥한 수치형·무결측 부분집합의 결과입니다. 범주형·결측값을 포함한 30개에서는 TabPFN 평균 AUC 0.894와 AutoGluon 0.895로 집계가 달라집니다. Table 2
통계적 유의성은 표의 소수점 차이에서 추정하지 않습니다. 원문 B.5의 Wilcoxon 검정, Holm–Bonferroni 보정, 0.05 유의수준 및 Figure 14가 실제 근거입니다. 저자들이 보고한 수치형·무결측의 빠른 비교군 결과와, 긴 예산에서 AutoML과의 경쟁적 성능을 구분해야 합니다. 각 셀의 모든 쌍에 대한 p-value는 이 리뷰에서 재계산하지 않았습니다.
원문 표기의 불일치와 재현 범위
v6에는 보고 범위를 읽을 때 주의할 표기가 있습니다. 초록은 추가 수치형 데이터 67개를 언급하지만, B.5의 확장 평가와 Figure 13은 검증 데이터 149개를 65개 수치형·무결측과 나머지 84개로 나눕니다. 이 글은 상세 확장 분석에 그 부록의 숫자를 사용하며 두 숫자가 동일한 집합이라고 단정하지 않습니다. 또한 OpenML-AutoML 결과 Table 3에는 eucalyptus가 있으나 목록 Table 10의 대응 위치에는 wine이 들어 있습니다. 따라서 다섯 데이터셋 목록이 두 표에서 완전히 일치한다고 쓰지 않습니다. 초록, Figure 13, Table 3, Table 10
이런 표기 차이를 모델의 성능 결함으로 확대하지는 않습니다. 다만 표본 목록을 그대로 재현하려면 원문이 안내한 평가 자료와 대조해야 하는 지점입니다. 이 글에서 수행한 것은 논문 근거의 대조이며, 전체 학습과 벤치마크 재실행은 아닙니다.
기술적 함의와 응용
리뷰어의 해석으로, TabPFN은 데이터과학에서 익숙한 학습·검증·튜닝의 경계를 다시 생각하게 합니다. 모델 가중치는 고정되어 있어도, 레이블을 가진 데이터셋을 문맥으로 받아 새로운 문제에 적응할 수 있습니다. 이 능력은 언어 프롬프트에 한정된 현상이 아니라 합성 문제 분포를 통해 의도적으로 학습할 수 있는 계산입니다.
또 하나의 의미는 사전분포가 실용적 설계 도구가 된다는 점입니다. SCM이 성능에 기여했다는 ablation, 불필요 특성에 대한 약점, 수치형·범주형 사이 차이는 모두 생성 문제의 분포와 실제 문제의 관계를 보여줍니다. “어떤 네트워크를 쓸까”뿐 아니라 “어떤 데이터 생성 상황을 반복해서 경험하게 할까”가 모델 개발의 중요한 질문이 됩니다. 이는 본문의 방법과 부록 결과를 연결한 해석이며, 임의의 사전분포가 실제 데이터에서 잘 작동한다는 보장은 아닙니다.
실제 활용을 논문의 범위에서 보면 작은 수치형 분류 문제를 빠르게 평가하거나, 다른 모델의 확률 예측과 결합하는 사용이 직접적인 근거를 갖습니다. 반면 회귀, 큰 특성 수, 인과 개입 효과 추정 등은 이 논문이 달성한 결과로 포함하지 않습니다. 저자들이 명시한 향후 방향에는 이런 확장과 신뢰성 평가가 들어가지만, 현재 실험의 성과와는 구분됩니다.
TabPFN의 성과는 작은 정형 데이터에서 사전학습된 추론 절차가 반복적인 모델 적합을 상당 부분 대체할 수 있음을 보여준 데 있습니다. 그 성과의 크기는 빠른 실행뿐 아니라 사전분포, 입력 조건, 평가 지표와 비용의 정의를 함께 읽을 때 정확히 드러납니다.
검토 범위. v6 PDF 37쪽의 본문 1–8절, Acknowledgments·References, 부록 A–F를 원래 순서로 반영했습니다. 그림은 Figure 1·2·5를 인용했습니다. 모든 베이스라인 하이퍼파라미터 범위와 Tables 7–11의 데이터셋별 행, 모든 그림의 수치를 글에 전부 재전사하지는 않았으며 관련 부록의 역할과 조건을 설명했습니다. 참고문헌 개별 원문과 현재 구현 전체의 실행 검증은 이 리뷰의 범위에 포함하지 않습니다.