논문 개요와 전체 구조
GroupKV는 긴 문맥을 처리하는 확산 대규모 언어 모델(diffusion large language model, dLLM)의 Key–Value(KV) 캐시를 CPU와 GPU 사이에서 효율적으로 관리하는 추론 시스템입니다. 확산 언어 모델은 마스크가 포함된 토큰들을 반복적으로 갱신하면서 문장을 생성합니다. 여러 토큰을 함께 처리할 수 있지만, 긴 입력의 KV를 GPU에 보관하기 어렵고 CPU로 옮겨 두면 데이터를 다시 가져오는 시간이 병목이 됩니다. 이 논문은 연속된 문맥 토큰을 작은 그룹으로 묶어 필요한 영역만 가져오고, 다음 계층에서 쓸 데이터를 현재 계층의 계산과 겹쳐 전송하는 방법을 제안합니다.
핵심 질문은 “어떤 문맥을 남길 것인가”와 “언제 가져올 것인가”를 함께 해결할 수 있는지입니다. GroupKV는 같은 생성 블록 안의 토큰들이 비슷한 문맥 영역을 참조하고, 인접 계층에서도 중요한 영역이 상당 부분 유지된다는 관찰을 활용합니다. 여기에 오래된 캐시 항목을 선택적으로 고치는 절차와 입력 처리 단계의 임시 메모리를 줄이는 스트리밍 프리필을 결합합니다. 따라서 이 논문은 모델의 학습 방법보다 정확도·GPU 메모리·전송·계산을 조율하는 런타임 설계를 이해하는 데 가치가 있습니다. 원문 초록 및 §1
검토 대상은 Jinhao Wang, Zhexin Hu, Kangjie Zhou, Xin Zhou, Fangfang Liu의 arXiv:2609.17573v1입니다. 초록 페이지의 제출일은 2026년 7월 30일이며, 이번 정기 수집에서 확인한 RSS 발표일 2026년 9월 17일과 구분해야 합니다. 아래 설명은 이 고정 버전의 본문·수식·표·그림에 근거합니다. 원문은 다음 순서로 구성되며 별도 부록은 없습니다. 버전 고정 서지
- Introduction
- Related Work: 확산·장문맥 언어 모델 → 자기회귀 모델의 KV 최적화 → 확산 모델의 KV 최적화
- Observations: 3.1 Intra-block Locality Enables Group-level Retrieval → 3.2 Inter-layer Consistency in Attention Saliency
- GroupKV Design: 4.1 Group-Level Selection and Hierarchical KV Access → 4.2 Predictive Compact-Buffer Scheduling → 4.3 Dynamic Group Update and Selective Repair → 4.4 Throughput-Oriented Streaming Prefilling → 4.5 Runtime Budgets and Deployment Policy
- Evaluation: 5.1 Experimental Setup → 5.2 Accuracy Evaluation → 5.3 Efficiency Evaluation → 5.4 Ablation Studies → 5.5 Batch-size Scalability
- Conclusion, 이어서 References
핵심 기여와 혁신성
문제의 출발점은 KV를 CPU로 오프로딩(offloading, GPU 밖의 메모리에 보관)하면 용량 제약은 완화되지만 CPU–GPU 전송이 새로운 병목이 된다는 점입니다. 확산 모델은 생성 위치를 반복해서 수정하고 전체 시퀀스를 주기적으로 다시 계산합니다. 과거 토큰을 유지한 채 뒤에 새 토큰만 추가하는 자기회귀 방식과 달라, 무거운 토큰별 인덱스나 군집 구조를 오래 재사용하기 어렵습니다. 또한 미리 가져온 데이터가 실제 계산 전에 낡아질 수 있습니다. §1
저자들의 해결책은 세 부분으로 연결됩니다. 첫째, 연속 그룹의 평균 키로 중요도를 먼저 계산해 전체 토큰 키를 스캔하는 부담을 줄입니다. 둘째, 현재 계층에서 고른 그룹을 다음 계층의 예측 정보로 삼아 데이터 이동을 계산과 중첩합니다. 셋째, 생성 토큰 갱신으로 유효하지 않게 된 캐시 항목만 고쳐 이 비동기 실행의 일관성을 유지합니다. 프리필의 임시 텐서 메모리 절감은 이 디코딩 경로가 긴 입력에서도 시작될 수 있도록 돕습니다. §4
리뷰어의 해석으로는, 독창성의 중심이 그룹 평균 자체보다는 확산 모델의 동적인 KV 수명에 맞춰 선택 단위·전송 일정·캐시 수정을 함께 설계했다는 데 있습니다. 논문이 보고한 최대 48배는 RTX 4090에서 처리 가능한 문맥 길이가 Fast-dLLM의 2K에서 96K로 늘어난 비교이며, 최대 3.73배는 A100의 32K에서 특정 오프로딩 기준선 대비 종단 간 처리량의 비율입니다. 두 숫자는 서로 다른 평가 축이고 모든 환경에서의 속도 향상을 뜻하지 않습니다. Table 7–8
기술적 세부사항
KV 캐시는 어텐션에서 문맥 토큰을 참조하는 키(key)와, 그 토큰이 전달할 정보를 담는 값(value)을 저장합니다. 질의(query)는 현재 계산할 토큰이 찾는 정보를 나타냅니다. GroupKV에서는 먼저 여러 키를 요약한 그룹 키에 질의를 대조하고, 선택된 그룹의 원래 KV를 CPU에서 GPU로 복구합니다. 이후 복구한 후보 토큰 중 일부를 다시 골라 값 쪽 어텐션 계산을 수행합니다. 즉, 그룹 요약은 실제 값 벡터를 대체하지 않습니다.
| 조절 변수 | 의미 | 주로 영향을 주는 비용 | 기본값 |
|---|---|---|---|
| $g$ | 연속 그룹당 토큰 수 | 그룹 키 수와 중요도 계산 | 8 |
| $k_g$ | 그룹 검색 예산 | 가져올 KV의 양과 GPU 버퍼 크기 | 20% |
| $k_2$ | 복구된 후보 중 세부 계산에 남길 비율 | 값 쪽 어텐션 계산 | 0.50 |
위 설정은 본문의 top-k 검색 예산과 §4.5의 표기를 연결한 것입니다. $k_2=0.50$은 전체 문맥의 절반을 전송한다는 뜻이 아니라, 먼저 가져온 후보에서 다시 계산할 항목을 거르는 비율입니다. 이 단계는 거친 그룹 선택으로 이미 이루어진 전송량을 바꾸지 않습니다. §4.2 및 §4.5
런타임은 CPU에 원래 KV와 그룹 키를 유지하고, GPU에는 필요한 희소 KV를 담는 두 개의 작은 버퍼를 번갈아 사용합니다. 하나를 계산 스트림이 소비하는 동안 다른 하나를 프리페치(prefetch, 사용 전 미리 가져오기) 스트림이 채웁니다. 전송에는 고정된 호스트 메모리(pinned host memory)를 사용합니다. 생성 토큰이 바뀌면 CPU 쪽 관련 요약을 갱신하고, GPU의 실제 사용 직전에 해당 위치의 낡은 항목을 수정합니다. §4.2–4.3
평가는 장문맥 이해를 보는 LongBench, 문맥 길이에 따른 검색·추론 과제를 보는 RULER, 긴 입력 속 단일 정답 정보 검색을 보는 Needle In A Haystack(NIAH)로 구성됩니다. 정확도와 별도로 프리필 시작부터 반복 디코딩·토큰 갱신 완료까지의 종단 간 생성 처리량을 측정합니다. 구성요소 제거 실험에서는 프리필 이후의 디코딩 처리량을 측정하므로 두 값을 같은 지표로 읽으면 안 됩니다. 중요한 수식은 다음 장에서 원문의 순서에 맞춰 설명합니다. §5.1
챕터별 상세 리뷰
📖 Chapter 1: Introduction
이 장은 확산 모델의 생성 특성에서 출발해 긴 문맥의 시스템 병목을 도출하고, GroupKV의 구성요소가 필요한 이유를 차례로 설명합니다. 자기회귀 언어 모델이 정해진 좌우 순서로 토큰을 하나씩 생성하는 것과 달리, dLLM은 반복적인 잡음 제거 과정으로 여러 생성 위치를 갱신합니다. 이 과정은 병렬 디코딩, 양방향 의존성, 빈 구간 채우기에 적합하지만, KV의 재사용 가능성을 별도로 다루어야 합니다.
저자들은 먼저 문맥 길이와 배치 크기에 따라 KV 메모리가 증가한다는 점을 지적합니다. 전체 KV를 GPU에 두는 방식은 GPU 메모리(VRAM) 용량에 막히고, CPU로 옮기는 방식은 훨씬 긴 문맥을 다룰 수 있지만 반복적인 전송 비용을 지불합니다. 원문 Figure 2는 이처럼 용량 병목이 데이터 이동 병목으로 바뀌는 상황을 설명합니다. 이어 확산 모델에서는 인접 잡음 제거 단계의 KV가 비슷해 근사 재사용이 가능하지만, 전체 시퀀스 재계산과 생성 슬롯의 국소적 덮어쓰기로 관리가 복잡해진다고 설명합니다. §1
그다음 저자들은 토큰 단위 접근의 두 문제를 연결합니다. 모든 키를 GPU에 가져와 중요도를 계산한 뒤 필요한 값만 불러오면, 키와 값의 크기가 비슷한 상황에서 키가 차지하는 절반을 줄이지 못합니다. 이 조건에서는 KV 압축 비율의 구조적 상한이 대략 2배입니다. 또한 하나의 생성 블록 안에 여러 질의 토큰이 있으므로, 토큰별 선택의 합집합이 커지면 희소 선택의 이득이 사라질 수 있습니다. 이 2배 설명은 전체 키를 계속 요구하는 선택 방식에 대한 것이며, 모든 KV 압축 기법의 일반적 한계는 아닙니다.
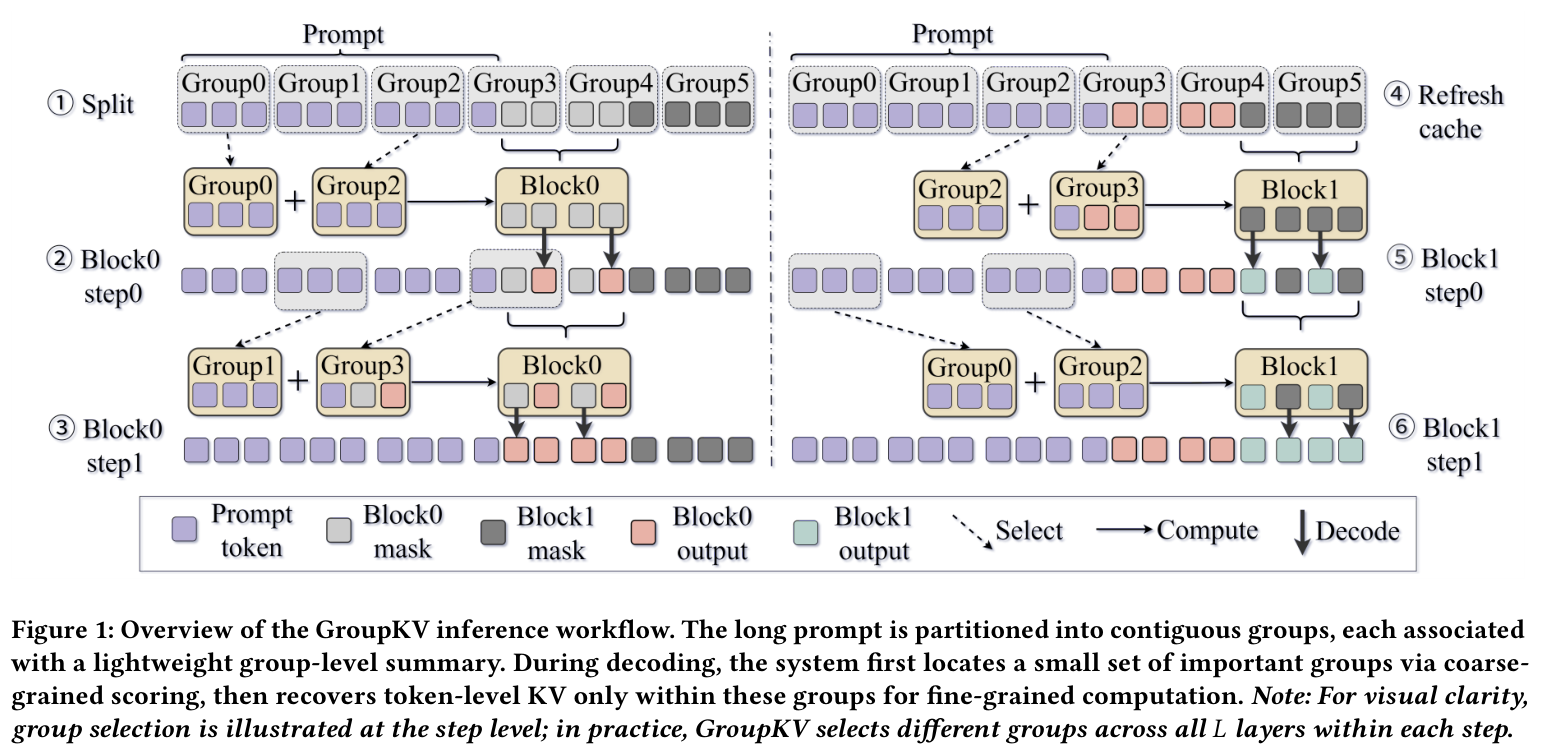
Figure 1, PDF 2쪽. GroupKV v1 원문의 그림과 영문 캡션 영역을 크롭했습니다. 그림 안 문구는 번역하지 않았습니다.
Figure 1에서 점선은 그룹 선택, 가로 실선 화살표는 계산, 아래쪽 화살표는 토큰 디코딩을 나타냅니다. 첫 블록을 갱신한 뒤 캐시를 새로 만들고 다음 블록으로 넘어가는 흐름은 KV가 고정된 과거 기록이 아님을 보여 줍니다. 그림에서는 이해를 돕기 위해 단계별로 그룹을 표시하지만, 실제로는 같은 단계의 모든 계층에서 서로 다른 그룹이 선택될 수 있습니다. 그림의 간단한 그룹 크기를 기본 실험값 $g=8$과 혼동해서도 안 됩니다.
이 장의 마지막 논리는 희소성과 일정 관리의 결합입니다. 필요한 그룹을 줄여도, 각 계층이 계산 직전에 데이터를 기다리면 지연은 남습니다. 저자들은 인접 계층의 그룹 중요도가 비슷하다는 관찰로 다음 계층의 전송을 앞당기고, 동시에 생성 위치 갱신으로 생기는 낡은 항목을 고칩니다. 이 장의 기여는 문제를 “KV 압축” 하나로 축소하지 않고, 선택·전송·일관성의 공동 설계로 정식화한 것입니다. 다음 장은 기존 연구가 이 문제의 어느 부분을 다루었는지 비교합니다.
📖 Chapter 2: Related Work
이 장은 Diffusion Language Models and Long-Context Diffusion Language Models, KV Cache Optimization for Autoregressive Models, KV Cache Optimization for Diffusion Language Models 순서로 연구 맥락을 정리합니다. 첫 부분에서는 이산 확산 모델에서 LLaDA, Dream, 블록 단위 확산 생성으로 이어지는 발전을 설명합니다. 긴 문맥 확장 사례로는 학습 없이 위치 표현을 외삽하는 LongLLaDA와, 후속 학습 및 확산 특화 방식으로 128K 문맥을 지원하는 UltraLLaDA를 소개합니다. 여기서 GroupKV가 해결하려는 것은 모델이 긴 문맥을 표현할 수 있게 하는 학습 문제와 구분되는, 그 문맥을 메모리 제약 안에서 실행하는 문제입니다. §2
두 번째 부분은 자기회귀 모델의 KV 최적화를 다시 나눕니다. StreamingLLM, H2O, SnapKV 등은 어텐션의 특성을 활용해 활성 KV 일부를 유지합니다. RetrievalAttention, MagicPIG, ShadowKV 등은 전체 또는 외부에 보관된 기록에서 관련 항목을 검색하거나 복원합니다. 논문은 이 구조들이 단방향·추가 전용 디코딩에서 반복적으로 재사용된다는 점에 주목합니다. 계층적 선택이라는 공통점이 있는 HISA에 대해서도, 확산 모델의 오프로딩·계층 간 프리페치·동적 캐시 일관성을 다루지 않는다고 구분합니다.
이어지는 오프로딩 계열에서는 FlexGen을 이종 메모리 관리 방식으로, InfiniGen을 가중치 투영과 일부 키 경로를 통해 토큰 선택 비용을 줄이는 방식으로 소개합니다. GroupKV의 차이는 연속 그룹 요약을 가볍게 갱신하고, 확산 토큰의 수정에 맞춰 프리페치된 항목을 고친다는 점입니다. 이는 원문의 비교 관점이며, 인용된 모든 연구를 이 리뷰에서 독립적으로 재평가했다는 의미는 아닙니다.
마지막 부분은 dLLM-Cache, dKV-Cache, Fast-dLLM이 근사 KV 재사용을 통해 확산 모델을 가속하는 흐름을 설명합니다. 이후 Sparse-dLLM과 d²Cache는 주로 계산 가속에, MaskKV는 GPU 내부 KV 퇴거에 초점을 맞춘다고 정리합니다. GroupKV는 CPU 오프로딩을 기본으로 삼아 메모리가 부족한 긴 문맥·큰 배치를 겨냥합니다. 이 장은 관련 연구와의 차이를 KV의 수명과 배치 위치로 정리하며, 다음 장에서 왜 그룹이라는 단위가 효과적인지 관찰 근거를 제시합니다.
📖 Chapter 3: Observations
이 장은 그룹 선택과 계층 간 예측이라는 두 설계 가정의 경험적 근거를 제공합니다. 저자들은 별도 명시가 없는 통계를 평가한 데이터셋과 문맥 길이에 걸쳐 평균했다고 설명합니다. 따라서 아래 중첩률은 개별 요청이나 모든 계층에서 그대로 보장되는 값이 아닙니다. §3
3.1 Intra-block Locality Enables Group-level Retrieval
먼저 생성 블록 전체가 접근해야 할 문맥은 블록 안 각 토큰이 접근하는 문맥의 합집합입니다. 원문 식 (1)은 다음과 같습니다.
$B$는 한 번의 디코딩 반복에서 처리하는 생성 토큰 블록이고, $j$는 그 안의 토큰입니다. $\Omega_j$는 토큰 $j$가 접근하는 문맥 위치 집합, $\Omega_B$는 블록 전체에 필요한 위치 집합입니다. 서로 겹치지 않는 문맥을 선택한다면 합집합이 전체 문맥에 가까워질 수 있습니다. 반대로 선택 영역이 많이 겹치면 블록 전체에도 작은 후보 집합을 사용할 수 있습니다. 식 (1)
Table 2는 top-k를 20%로 설정했을 때 UltraLLaDA의 Jaccard 값 0.7442, Overlap 값 0.8428, LLaDA-8B의 Jaccard 값 0.7308, Overlap 값 0.8318을 보고합니다. Jaccard는 집합의 교집합을 합집합과 비교하는 중첩 지표입니다. 원문의 Overlap 열은 별도 지표로 제시되며, 이 절에 정규화 정의가 따로 적혀 있지 않아 Jaccard와 같은 분모라고 가정하지 않습니다. 두 모델 모두 높은 공유 경향을 보인다는 것이 저자의 관찰입니다. Table 2
저자들은 중요한 토큰들이 연속된 일부 구간에 집중된다는 공간적 국소성도 관찰합니다. 원문 식 (2)는 이를 다음처럼 나타냅니다.
$T_K(B)$는 블록 $B$와 가장 관련된 상위 $K$개 문맥 토큰의 집합입니다. 여기서 대문자 $K$는 선택 개수이며, KV의 key 자체를 뜻하는 표기와 문맥상 구분합니다. $R$은 해당 토큰들을 덮는 연속 구간의 수이고, $a_r,b_r$는 $r$번째 구간의 시작·끝 위치입니다. 이 표현의 역할은 중요한 위치들이 적은 수의 연속 구간에 모여 있을 때 그룹 단위 복구가 적합하다는 점을 설명하는 것입니다. 식 (2)
이를 이용해 문맥 길이를 $S$, 그룹 크기를 $g$라고 두고, 문맥을 $M=\lceil S/g\rceil$개의 연속 그룹으로 나눕니다. $m$번째 그룹은 $G_m=\{(m-1)g+1,\ldots,\min(mg,S)\}$이므로 마지막 그룹에는 $g$보다 적은 토큰이 들어갈 수도 있습니다. 그룹 키는 원문 식 (3)의 평균 풀링으로 만듭니다.
$k_i$는 회전 위치 임베딩(Rotary Position Embedding, RoPE)을 적용한 문맥 토큰 $i$의 키이고, $|G_m|$은 실제 그룹의 토큰 수입니다. $k_m^g$는 그룹을 대표하는 하나의 키 벡터입니다. 위치가 반영된 키들을 평균하므로 별도의 복잡한 군집이나 인덱스를 만들지 않고 그룹 요약을 구할 수 있습니다. 이것이 저자들이 갱신 비용을 낮게 유지하는 근거입니다. 식 (3)
블록의 질의들과 이 그룹 키를 내적한 뒤 평균하면 그룹 중요도인 식 (4)를 얻습니다.
$q$는 생성 블록의 토큰에 대응하는 질의 벡터, $q^\top k_m^g$는 그 질의와 그룹 키의 내적, $t_m$은 블록 전체 관점의 그룹 점수입니다. 여기서 $q\in B$는 블록 내 토큰의 질의들을 순회한다는 원문의 표기입니다. 이 점수로 그룹들을 정렬하고 상위 그룹의 원래 KV만 복구합니다. 식 (4)
이어 저자들은 상위 $p\%$의 토큰이 중요하다면 확장 계수 $c$를 적용한 상위 $c\cdot p\%$의 그룹을 가져오는 방식으로 설명합니다. 그룹 경계를 포함하다 보면 중요하지 않은 주변 토큰도 함께 가져옵니다. 원문 식 (5)는 중요한 구간을 덮기 위해 필요한 그룹 수를 제한합니다.
$L_r$은 $r$번째 중요 구간의 길이이고, $G_{\mathrm{need}}$는 모든 중요 구간을 덮는 데 필요한 그룹 수입니다. $\lceil L_r/g\rceil$는 구간 길이를 그룹 단위로 환산한 항이며, 추가된 1은 구간 경계와 그룹 경계가 맞지 않을 때의 확장을 고려합니다. 중요한 구간 수가 적으면 경계 때문에 더 읽는 비용도 제한된다는 것이 이 식의 활용 방식입니다. 다만 이 식은 구간을 덮는 비용의 상한을 설명하며, 평균 키로 선택한 그룹이 항상 모든 중요 토큰을 찾는다는 보장은 아닙니다. 식 (5)
마지막으로 저자들은 경계 확장으로 추가된 주변 토큰의 어텐션 점수가 대체로 낮아, 소프트맥스 정규화 후 출력 기여도도 작다고 해석합니다. 이 절은 그룹 단위 선택이 세밀한 토큰 선택에 가까운 충실도를 유지하면서 연속 메모리 접근을 가능하게 한다는 근거를 세웁니다.
3.2 Inter-layer Consistency in Attention Saliency
다음 관찰은 동일 디코딩 반복 안에서 인접 계층의 중요 문맥이 상당 부분 겹친다는 점입니다. top-k가 20%일 때 Table 3의 인접 계층 재현율은 UltraLLaDA에서 토큰 단위 0.8210, 그룹 단위 0.8806이고, LLaDA-8B에서는 각각 0.8021과 0.8610입니다. 그룹 단위의 증가분은 0.0596과 0.0589입니다. 여기서 재현율은 인접 계층의 중요한 선택을 얼마나 다시 포함하는지 보는 지표이며, 벤치마크 정답률과는 다릅니다. Table 3
저자들은 여러 계층에 걸쳐 상위 토큰의 약 11%가 지속해서 중요하다는 관찰도 덧붙입니다. 이 수치는 여러 계층에서 계속 유지되는 토큰 비중을 가리키며, 바로 인접한 두 계층의 그룹 재현율 0.8806과 같은 통계가 아닙니다. 전체적으로 현재 계층의 그룹 선택은 다음 계층에서 무엇을 가져올지 예측하는 사전 정보가 될 수 있습니다. 이 장의 기여는 블록 내 공유와 계층 간 공유를 각각 측정했다는 점이며, 다음 장은 두 관찰을 실제 전송 경로로 구현합니다.
📖 Chapter 4: GroupKV Design
이 장은 각 소절에서 문제를 먼저 제시한 뒤 대응 설계를 설명합니다. 전송할 데이터의 양을 줄이는 것부터 시작해 전송 시점, 캐시 유효성, 프리필 메모리, 배포 정책으로 범위를 넓힙니다. §4
4.1 Group-Level Selection and Hierarchical KV Access
첫 문제는 반복적으로 바뀌는 생성 위치 때문에 토큰 수준의 복잡한 선택 구조를 유지하는 비용이 발생한다는 것입니다. 전체 키에 의존하는 주문형 선택은 값을 읽기 전에 키부터 읽어야 하므로, 대략 2배라는 앞선 압축 상한도 남습니다. GroupKV는 프리필에서 각 계층의 그룹 요약을 만든 후, 디코딩에서는 상위 그룹만 고르고 그 안의 토큰별 KV를 복구합니다. 따라서 첫 선택 단계가 전체 토큰 키를 요구하지 않습니다.
저자들은 원문 식 (6)에서 계층당 전송량을 항목 수로 근사합니다.
$N_{\text{ctx}}$는 문맥 토큰 수, $g$는 그룹당 토큰 수, $f$는 복구하는 토큰 비율입니다. 첫 항은 거친 선택에 쓰는 그룹 키의 수이고, 두 번째 항은 선택 영역의 토큰별 키와 값 두 종류를 가져오는 양입니다. 비교 대상인 일반적인 전체 KV 오프로딩은 약 $2N_{\text{ctx}}$개 항목을 전송합니다. 벡터 차원과 자료형이 같은 조건을 공통으로 두고 개수를 비교하는 근사이므로, 식 자체의 단위를 바이트로 읽지 않아야 합니다. 식 (6)
원문 식 (7)의 전송량 감소 비율은 다음과 같습니다.
분자는 전체 KV 전송량, 분모는 GroupKV의 그룹 키와 선택된 KV 전송량입니다. 기본값 $g=8$, $f=0.2$를 대입하면 $2/(0.125+0.4)\approx3.81$입니다. 이는 계층당 이론적 데이터 이동량 감소 비율입니다. 계산·동기화·프리필 등 전체 시간을 측정한 처리량 향상과 같지 않으며, 실제 GPU 메모리 전체가 3.81배 줄어든다는 뜻도 아닙니다. 식 (7)
이어서 Algorithm 1은 프리필의 순서를 제시합니다. 각 계층에서 스트리밍 방식으로 블록의 순전파와 KV 생성을 수행하고, 토큰 키로 그룹 키를 만든 뒤 KV와 그룹 키를 CPU로 옮깁니다. 이 절은 다음 단계가 사용할 자료 구조를 정의하며, 프리필의 임시 메모리를 줄이는 구체적 이유는 §4.4에서 다시 다룹니다.
4.2 Predictive Compact-Buffer Scheduling
그룹만 선택해도 각 계층이 선택 완료 → CPU 읽기 → GPU 어텐션을 순차 수행하면 호스트에서 GPU로의 전송(Host-to-Device, H2D)이 계산의 임계 경로에 남습니다. GroupKV는 현재 계층에서 계산하는 동안 다음 계층의 후보 데이터를 준비합니다. 계산 스트림은 이미 준비된 작은 KV 버퍼로 토큰 중요도, 어텐션, 순방향 신경망(Feed-Forward Network, FFN)을 계산합니다. 프리페치 스트림은 현재 계층 입력과 그룹 키로 중요한 그룹을 선택하고, 같은 그룹 위치에 해당하는 다음 계층의 KV를 가져옵니다. 현재 계층의 KV 벡터를 다음 계층에서 그대로 쓰는 방식이 아닙니다. §4.2
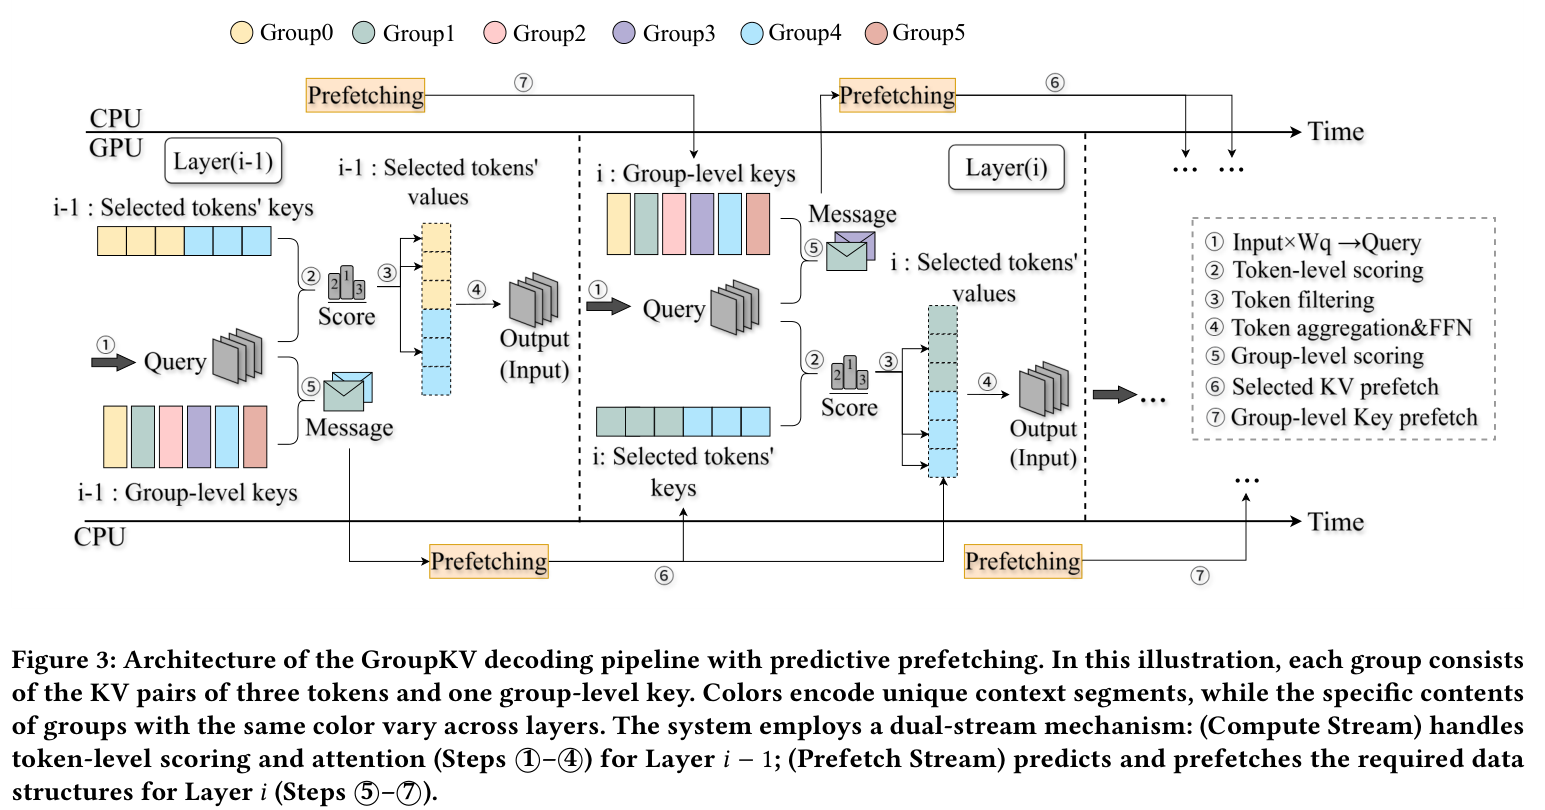
Figure 3, PDF 3쪽. GroupKV v1 원문의 파이프라인과 영문 캡션 영역을 크롭했습니다. 색상 범례와 단계 번호를 유지했으며 그림 안 문구는 번역하지 않았습니다.
Figure 3의 ①~④는 질의 생성, 토큰 점수 계산, 토큰 선택, 어텐션 집계와 FFN 계산입니다. ⑤~⑦은 그룹 점수 계산과 선택 KV·그룹 키 프리페치를 보여 줍니다. 같은 색은 같은 문맥 구간을 가리키지만 계층마다 그 구간의 KV 내용은 다릅니다. 그림은 그룹당 세 토큰을 그린 예시이며 실제 기본 설정의 여덟 토큰과 구분합니다. 이처럼 어느 계층의 어떤 데이터가 이동하는지 나누어 읽어야 파이프라인의 의미가 드러납니다.
Algorithm 2는 두 버퍼를 계층 번호의 홀짝에 따라 교대로 사용하는 과정을 설명합니다. 한 버퍼에는 현재 계층의 후보 KV와 그룹 키가 준비되어 있고, 다른 버퍼에는 다음 계층의 데이터를 모읍니다. 의사코드의 후보 용량은 검색 예산과 문맥 길이의 곱을 올림한 값으로 설정됩니다. 이때 버퍼 차원의 배치 크기 표기와 §3의 생성 블록 표기는 문맥이 다르므로, 물리적 버퍼의 요청 수와 한 요청 안에서 갱신하는 토큰 블록을 혼동하지 않아야 합니다.
후보 KV가 도착하면 계층 내부의 세부 선택(intra-layer refinement)을 수행합니다. 복구된 키에 질의를 대조해 상위 기여 토큰만 값 쪽 어텐션에 남기는 과정입니다. 원문 Figure 4는 전체 KV 프리페치, 계산을 막는 주문형 읽기, 예측 프리페치, 여기에 세부 선택을 더한 경우를 순서대로 비교합니다. 마지막 추가 단계는 계산량을 줄이지만, 앞서 결정된 그룹 단위 전송량을 더 줄이는 단계는 아닙니다. 이 절의 기여는 희소 KV 복구를 두 버퍼의 생산자–소비자 파이프라인으로 조직한 점입니다.
4.3 Dynamic Group Update and Selective Repair
이 절은 속도 최적화에 앞서 필요한 캐시 일관성 문제를 다룹니다. 확산 디코딩에서는 생성할 위치를 마스크 토큰으로 미리 확보한 후 같은 위치를 반복적으로 바꿉니다. 안정적인 프롬프트만 포함한 그룹은 현재 생성 블록 안에서 요약을 재사용할 수 있지만, 생성 슬롯과 겹치는 그룹은 변경된 키를 반영해야 합니다. 특히 프리페치 시점과 실제 어텐션 시점 사이에 해당 위치가 바뀌면, GPU 버퍼에 낡은 KV가 남을 수 있습니다. 저자들은 이를 수정하지 않으면 오래된 표현을 참조해 일관성 없는 출력이 생기므로, 수정 절차를 정확성의 필수 조건으로 설명합니다. §4.3
CPU-side group refresh에서는 변경된 토큰의 KV와 그 토큰이 속한 그룹 키만 갱신합니다. 바뀌지 않은 그룹의 요약은 재사용하며, 평균 풀링 덕분에 해당 그룹의 요약 갱신은 가볍게 수행됩니다. 별도로 주기적인 전체 시퀀스 프리필은 모든 KV를 새로 계산해 이후 디코딩의 일관성을 맞춥니다. 따라서 “그룹은 계속 불변”이나 “모든 단계에서 전체 그룹을 재구축”이라는 설명은 모두 원문의 설계와 다릅니다.
GPU-side selective repair에서는 프리페치한 각 KV 항목에 원래 토큰 위치를 기록합니다. 어텐션 커널이 버퍼를 사용하기 직전, 현재 잡음 제거 반복에서 갱신된 위치가 버퍼 안에 있는지 확인하고 해당 슬롯만 최신 CPU KV로 덮어씁니다. 그룹 전체나 계층 전체를 다시 읽지 않습니다. 이에 따라 수정 비용은 전체 문맥 길이보다 실제로 맞닥뜨린 낡은 항목 수에 따라 증가하고, 안정적인 프롬프트 그룹에는 GPU 쪽 수정이 필요하지 않습니다.
이 메커니즘이 보장하려는 것은 선택해 온 항목의 최신성입니다. 희소 선택 자체가 전체 어텐션과 정확히 동일한 결과를 낸다는 뜻은 아닙니다. 이 구분은 정확도–효율 절충을 해석할 때 중요합니다. 또한 논문은 이 수정 절차의 필요성을 설명하지만, 이를 제거했을 때의 정량적 정확도 표를 별도로 보고하지 않습니다.
4.4 Throughput-Oriented Streaming Prefilling
다음 문제는 디코딩 전에 발생하는 메모리 피크입니다. 디코딩은 적은 토큰을 처리하지만 프리필은 긴 시퀀스 전체를 입력으로 받습니다. 저자들은 dLLM의 전체 위치에 대한 로짓(logit, 어휘별 예측 점수) 계산, RoPE 중간 텐서, FFN 활성값 등 수명이 짧은 임시 자료가 메모리 피크를 키운다고 설명합니다. GPU에 들어가는 KV를 줄여도 이 단계에서 메모리가 부족하면 긴 문맥 추론을 시작할 수 없습니다. §4.4
GroupKV는 로짓 투영, RoPE 계산, FFN 중간값을 시퀀스 차원의 작은 청크 단위로 처리합니다. 한 청크의 결과를 기록한 뒤 임시 버퍼를 다음 청크에 재사용하여, 해당 중간 메모리가 전체 문맥 길이 $S$보다 청크 길이 $S_{\mathrm{blk}}$에 주로 좌우되도록 합니다. 원문은 이 처리가 모델의 의미를 유지한다고 설명합니다. 여기서 줄어드는 것은 명시된 임시 활성값의 피크이며, 전체 추론 메모리가 문맥 길이와 무관해진다는 뜻은 아닙니다.
저자들은 이 프리필 최적화와 디코딩의 그룹 희소성·예측 프리페치·캐시 수정을 구분합니다. 스트리밍 프리필만으로는 디코딩 KV의 크기나 CPU–GPU 전송량이 줄지 않습니다. 이 구분이 이후 Table 9에서 모든 변형에 스트리밍 프리필을 적용하는 실험 설계의 근거가 됩니다.
4.5 Runtime Budgets and Deployment Policy
마지막 설계 소절은 세 조절 변수를 배포 관점에서 정리합니다. 그룹 크기 $g$는 요약의 해상도와 그룹 점수 계산 비용을, 검색 예산 $k_g$는 CPU–GPU 전송량과 작은 KV 버퍼의 크기를, 세부 선택 예산 $k_2$는 이미 복구한 KV에서 수행할 계산량을 조절합니다. 더 세밀한 그룹이나 큰 검색 예산은 문맥을 포함할 가능성을 높일 수 있지만 전송·메모리 비용도 증가하고, 큰 세부 선택 예산은 더 많은 후보를 계산하는 대신 처리량을 낮춥니다. 실제 정확도 관계는 뒤의 표처럼 모델별로 확인해야 합니다. §4.5
저자들은 짧은 문맥이나 작은 배치에서는 오프라인 프로파일링 결과로 계층적 필터링을 우회할 수 있다고 설명합니다. 오프로딩 부담이 큰 경우에 그룹 선택과 프리페치를 활성화하는 정책입니다. 이 장의 전체 기여는 하나의 고정 압축률을 제시하는 데 그치지 않고 전송과 계산을 서로 다른 예산으로 제어한 것입니다. 다음 장은 이 제어가 정확도와 메모리·처리량에 어떤 영향을 주는지 검증합니다.
📖 Chapter 5: Evaluation
이 장은 실험 조건을 먼저 정의하고, 정확도 → 효율 → 구성요소 및 예산의 영향 → 배치 확장성 순서로 평가합니다. 보고된 수치를 비교할 때는 모델 백본, GPU, 문맥 길이, 전송 방식, 프리필 포함 여부를 함께 보아야 합니다. §5
5.1 Experimental Setup
Models and Baselines. 기반 모델은 원래의 LLaDA와 장문맥 모델 UltraLLaDA입니다. 기준선은 전체 어텐션 방식의 UltraLLaDA·Fast-dLLM, FlexGen 방식의 KV offload + sparse와 KV pipeline + sparse, 같은 dLLM 조건에서 다시 구현한 InfiniGen 방식으로 나눕니다. 따라서 “InfiniGen과 비교”는 원래 자기회귀 구현을 그대로 실행한 결과가 아니라, 논문의 확산 모델 조건에 맞춘 구현과의 비교입니다.
Benchmarks. LongBench는 단일·다중 문서 질의응답, 요약, 소수 예제 학습, 코드 완성을 포함한 7개 하위 과제(MFQA, NQA, 2WQA, QMS, TQA, SAM, LCC)를 평가합니다. RULER는 4K~32K에서 다단계 추론·변수 추적·검색을, NIAH는 4K~128K에서 하나의 정답 정보를 찾는 능력을 평가합니다. LongBench의 Avg.는 원문이 제시한 과제 점수의 평균이고, NIAH의 정확도 백분율과 동일한 지표로 취급하지 않습니다.
Platform. A100 환경은 A100-80G PCIe GPU와 Intel Xeon Silver 4214 CPU 두 개, 총 24코어·48스레드, DDR4 호스트 메모리 1.5TB를 사용합니다. RTX 4090 환경은 24GB GDDR6X와 PCIe 4.0 ×16을 사용하는 워크스테이션입니다. 두 환경의 운영체제는 Ubuntu 22.04, CUDA는 12.2, GCC는 9.5이며 CPU 오프로딩에는 고정 호스트 메모리를 사용합니다. 24GB GPU에서 긴 문맥을 실행했다는 설명은 GPU 메모리만을 뜻하며, CPU 메모리와 전송 경로가 사라진다는 의미가 아닙니다.
Default Configuration. 저자들은 $g\in\{4,8\}$, 검색 예산 10·20·30·40%, $k_2\in\{0.25,0.50,0.75\}$를 살펴보고 $g=8$, 20%, 0.50을 기본값으로 선택합니다. Metrics. 달리 명시하지 않은 처리량·메모리 실험은 배치 크기 1이며, Table 7·8은 프리필부터 토큰 갱신 완료까지 포함합니다. 구성요소 실험의 Table 9는 프리필 이후 디코딩을 측정하고 GPU 메모리는 GiB로 표시합니다. §5.1
5.2 Accuracy Evaluation
LongBench. Table 4의 평균을 재구성하면 다음과 같습니다. 전체 어텐션 원모델과 Fast-dLLM을 별도 열로 놓아 비교 대상의 차이를 드러냈습니다.
| 백본 | 전체 어텐션 원모델 | Fast-dLLM | InfiniGen 방식 | GroupKV |
|---|---|---|---|---|
| LLaDA | 33.10 | 33.38 | 30.57 | 32.73 |
| UltraLLaDA | 36.61 | 38.26 | 34.92 | 37.43 |
원문 Table 4의 평균 점수를 재작성했습니다.
GroupKV는 LLaDA 원모델보다 0.37점 낮고 UltraLLaDA 원모델보다 0.82점 높습니다. 그러나 Fast-dLLM과 비교하면 각각 0.65점, 0.83점 낮습니다. 따라서 “정확도를 유지하면서 항상 개선한다”는 식의 단정은 적절하지 않습니다. 세부 과제에서도 LLaDA의 LCC는 원모델 71.05에서 GroupKV 66.13으로 낮아지고, UltraLLaDA의 NQA는 12.18에서 17.12로 높아지는 등 차이가 섞여 있습니다. 저자들은 UltraLLaDA의 평균 개선을 방해 문맥을 걸러내는 약한 정규화 효과로 해석하지만, 이를 별도의 인과적 검증 결과로 제시하지는 않습니다.
RULER. Table 5의 문맥 길이별 평균은 아래와 같습니다.
| 문맥 길이 | UltraLLaDA | Fast-dLLM | GroupKV |
|---|---|---|---|
| 4K | 75.66 | 77.92 | 75.25 |
| 8K | 71.48 | 74.86 | 72.21 |
| 16K | 68.46 | OOM | 70.22 |
| 32K | 62.70 | OOM | 62.81 |
원문 Table 5의 평균 점수를 재작성했습니다. OOM은 메모리 부족(out-of-memory)으로 실행하지 못했다는 뜻입니다.
16K와 32K에서는 GroupKV가 Fast-dLLM이 실행되지 않는 길이에서 결과를 내며, UltraLLaDA보다 평균이 각각 1.76점과 0.11점 높습니다. 하지만 4K에서는 UltraLLaDA보다도 낮고, 세부 과제의 모든 항목이 개선되는 것은 아닙니다. 예를 들어 32K의 변수 추적 vt 열은 UltraLLaDA 97.89, GroupKV 93.68입니다. OOM은 정답률 0으로 환산하지 않고 실행 가능성의 별도 결과로 읽어야 합니다.
NIAH Retrieval Sanity Check. Table 6은 4K·8K·16K·32K·64K·128K에서 각각 98·98·99·100·99·95%의 단일 정보 검색 정확도를 보고하며 평균은 98.17%입니다. 이는 매우 긴 문맥에서도 검색 대상이 대거 소실되지는 않는다는 점을 점검합니다. 다만 128K 단일 정보 검색 95%를 같은 길이의 모든 문서 이해·추론 능력으로 확대할 수는 없습니다. Table 6에는 GroupKV의 행만 제시됩니다. Table 6
Comparison with InfiniGen. 같은 dLLM 조건에서 구현한 InfiniGen 방식과의 LongBench 차이는 LLaDA에서 32.73−30.57=2.16점, UltraLLaDA에서 37.43−34.92=2.51점입니다. 저자들은 평가 조건 안에서 그룹 단위 선택이 토큰 단위 추정보다 과제에 필요한 문맥을 안정적으로 포함한다고 해석합니다. 이 비교는 다음 소절의 처리량 비교와 함께 보아야 합니다.
5.3 Efficiency Evaluation
Throughput on A100-80G. Table 7의 단위는 생성 토큰/초(tok/s)입니다. 희소 방법들은 GroupKV와 같은 희소 비율을 사용합니다.
| 방법 | 4K | 8K | 16K | 32K | 64K | 128K |
|---|---|---|---|---|---|---|
| UltraLLaDA | 2.51 | 1.12 | 0.48 | OOM | OOM | OOM |
| Fast-dLLM | 23.55 | 11.83 | OOM | OOM | OOM | OOM |
| KV offload + sparse | 4.32 | 1.96 | 1.07 | 0.48 | 0.27 | 0.12 |
| KV pipeline + sparse | 5.33 | 2.57 | 1.33 | 0.69 | 0.34 | 0.15 |
| InfiniGen 방식 | 8.21 | 4.68 | 2.18 | 1.33 | 0.79 | 0.31 |
| GroupKV | 10.64 | 5.91 | 2.84 | 1.79 | 0.99 | 0.39 |
원문 Table 7을 재작성했습니다. A100-80G, 배치 크기 1, 프리필을 포함한 종단 간 처리량입니다.
GroupKV는 표의 오프로딩 방식 가운데 모든 길이에서 가장 높은 처리량을 보입니다. 최대 3.73배라는 주장은 32K에서 KV offload + sparse의 0.48 tok/s를 분모로 삼은 1.79/0.48≈3.73과 대응합니다. 같은 길이에서 KV pipeline + sparse를 분모로 삼으면 약 2.59배이며, InfiniGen 방식을 분모로 삼으면 약 1.35배입니다. 논문이 보고한 InfiniGen 방식 대비 전 구간 향상 범위는 약 1.25~1.35배입니다. 비교 대상을 생략하면 큰 폭의 속도 향상이 무엇을 뜻하는지 달라집니다.
또한 4K에서는 Fast-dLLM 23.55 tok/s가 GroupKV 10.64 tok/s보다 높고, 8K에서도 11.83 대 5.91로 Fast-dLLM이 빠릅니다. 전체 KV가 GPU에 들어가는 짧은 구간에서는 계산 가속만으로 유리할 수 있다는 결과입니다. 반면 이 표에서 Fast-dLLM은 16K부터 OOM이고 GroupKV는 128K까지 실행됩니다. 효율의 핵심은 모든 구간의 최단 지연이 아니라, 전송이 지배적인 긴 문맥에서의 실행 가능성과 오프로딩 처리량입니다.
Throughput on RTX 4090-24G. Table 8에서는 Fast-dLLM이 1K에서 30.46, 2K에서 15.90 tok/s이고 4K부터 OOM입니다. GroupKV는 각각 30.66, 18.62 tok/s를 기록하며, 4K·8K·16K·32K·64K·96K에서도 10.25·5.78·2.76·1.33·0.59·0.35 tok/s로 실행됩니다. 보고된 최대 처리 가능 문맥의 비율은 96K/2K=48입니다. 이는 해당 표의 테스트 범위에서 관측한 문맥 길이 비교이며 48배의 처리량이나 언어 이해 성능 개선이 아닙니다. Table 8
Remark on Short-Context Scenarios. 저자들은 가용 VRAM과 입력 길이를 미리 만든 조회표에 대조하는 디스패처(dispatcher, 실행 경로 선택기)를 설명합니다. 짧은 문맥은 Fast-dLLM에 보내고, 그 방식이 메모리 한계에 도달하면 GroupKV로 전환하는 접근입니다. 이 결합 시스템이 짧은 구간에서 Fast-dLLM의 처리량을 따른다는 설명과 Table 7의 GroupKV 단독 행을 구분해야 합니다. 논문의 배포 관점은 두 방식을 상호 보완적으로 사용하는 것입니다.
5.4 Ablation Studies
Component Ablation. 이 실험은 32K·64K의 실제 장문맥 압력에서 구성요소의 역할을 구분합니다. 모든 변형에 스트리밍 프리필을 적용해 프리필의 임시 메모리 피크가 비교를 지배하지 않게 하고, 프리필 이후 디코딩 처리량과 피크 GPU 메모리를 측정합니다.
| 문맥 | 구성요소의 누적 추가 | 피크 디코딩 VRAM (GiB) | 디코딩 처리량 (tok/s) |
|---|---|---|---|
| 32K | Fast-dLLM + 스트리밍 프리필 | 38.62 | 4.68 |
| 32K | + KV 파이프라인 | 17.91 | 0.70 |
| 32K | + 그룹 희소성 | 15.87 | 1.08 |
| 32K | + 예측 프리페치 | 16.00 | 1.79 |
| 64K | Fast-dLLM + 스트리밍 프리필 | OOM | OOM |
| 64K | + KV 파이프라인 | 20.88 | 0.36 |
| 64K | + 그룹 희소성 | 16.28 | 0.60 |
| 64K | + 예측 프리페치 | 16.53 | 0.99 |
원문 Table 9 오른쪽을 재작성했습니다. A100-80G, 배치 크기 1이며 Table 7의 종단 간 처리량과 측정 구간이 다릅니다.
32K에서 단순 KV 파이프라인은 메모리를 크게 줄이지만 처리량도 4.68에서 0.70 tok/s로 낮아집니다. 오프로딩으로 실행에 필요한 GPU 용량을 줄여도 전송 대기가 남으면 속도는 손해를 볼 수 있다는 결과입니다. 그룹 희소성은 전송할 양을 줄여 1.08 tok/s로 회복하고, 예측 프리페치는 같은 그룹 희소 예산에서 전송 일정을 바꿔 1.79 tok/s까지 높입니다. 이때 메모리 증가는 15.87→16.00 GiB로 작습니다. 저자들은 전체 계층 KV가 아니라 다음 계층의 희소 작업 집합만 이중 버퍼에 추가되기 때문이라고 설명합니다.
64K에서도 그룹 희소성에 예측 프리페치를 더하면 0.60→0.99 tok/s, 16.28→16.53 GiB가 됩니다. 이 비교는 전송량을 줄이는 효과와 전송을 계산에 겹치는 효과가 다름을 보여 줍니다. 다만 Table 9는 누적 구성 실험이며, §4.3의 selective repair를 독립적으로 제거한 정확도·성능 수치는 제공하지 않습니다.
Group Size g and Retrieval Budget top-k. Table 9 왼쪽에서 LLaDA의 $g=8$은 예산 10·20·30·40%에 대해 32.22·32.73·33.05·33.27점으로 증가합니다. 같은 예산의 $g=4$ 값 31.29·31.95·32.66·32.96보다 높습니다. 그러나 UltraLLaDA에서는 단조로운 관계가 아닙니다. $g=8$의 점수는 36.22·37.43·38.02·38.01이고, $g=4$는 36.75·38.27·37.90·37.25입니다. 특히 예산 20%에서는 작은 그룹이 더 높은 점수를 냅니다.
따라서 저자들이 선택한 $g=8$, 20%는 정확도만 최대화한 설정이 아니라 요약 크기·선택 비용·처리량을 고려한 기본 절충점으로 이해해야 합니다. 검색 예산을 늘리거나 그룹을 세밀하게 하면 점수가 항상 높아진다는 규칙으로 표를 일반화할 수 없습니다.
Intra-layer Refinement Budget k₂. Table 10은 UltraLLaDA, A100-80G에서 세부 선택 비율만 바꾼 결과입니다.
| $k_2$ | LongBench 평균 | 32K 처리량 (tok/s) | 64K 처리량 (tok/s) |
|---|---|---|---|
| 0.25 | 36.89 | 1.90 | 1.08 |
| 0.50, 기본값 | 37.43 | 1.79 | 0.99 |
| 0.75 | 37.72 | 1.42 | 0.71 |
원문 Table 10의 값을 재작성했습니다.
0.25로 줄이면 기본값보다 LongBench가 0.54점 낮아지는 대신 처리량은 32K에서 6.4%, 64K에서 8.9% 증가합니다. 0.75로 늘리면 정확도 평균은 0.29점 높아지지만 처리량은 각각 20.4%, 28.7% 감소합니다. 이 결과는 같은 그룹 후보를 가져온 뒤에도 계산에 남길 토큰 수로 별도의 정확도–효율 절충을 만들 수 있음을 보여 줍니다. 저자들은 이를 근거로 0.50을 기본 운영점으로 선택합니다.
5.5 Batch-size Scalability
마지막으로 A100-80G에서 기본 설정을 유지한 채 LLaDA와 UltraLLaDA의 배치 크기를 바꾸고 합산 생성 처리량을 측정합니다. Figure 5와 본문은 배치를 늘리면 처리량이 증가하다가 메모리 용량 또는 호스트–장치 전송 포화에 도달한다고 설명합니다. 이는 앞선 배치 1의 결과를 넘어 여러 장문맥 요청을 함께 처리할 수 있음을 뒷받침합니다. 다만 합산 처리량 증가는 각 요청의 지연 감소와 같은 지표가 아닙니다. §5.5 및 Figure 5
이 장의 핵심 기여는 정확도만이나 단일 GPU 속도만 보고하지 않고, 실행 가능한 문맥 범위·오프로딩 처리량·구성요소별 역할·예산 조절·배치 확장성을 연결해 보여 준 것입니다. 다음 결론은 이 결과를 오프로딩 부담이 큰 장문맥 실행이라는 적용 범위로 정리합니다.
📖 Chapter 6: Conclusion
저자들은 블록 안의 공간적 국소성과 계층 간 일관성을 활용해, 그룹 단위 계층적 KV 관리와 예측 프리페치를 결합했다고 정리합니다. 최대 48배의 처리 가능 문맥 확장과 최대 3.73배의 오프로딩 조건 처리량 개선은 앞의 서로 다른 실험을 요약한 결과입니다. 결론 역시 호스트–장치 KV 전송이 추론 지연을 지배하는 장문맥 환경에서 이점이 가장 크다고 명시합니다. §6
원문이 직접 제시한 향후 연구는 문맥 길이, 배치 크기, 하드웨어, dLLM 아키텍처에 따라 정확도와 효율의 균형을 잡는 적응적 예산 선택입니다. 이는 현재 기본값을 모든 환경의 최적값으로 간주하지 않는 방향입니다. 본문 뒤에는 References가 이어지며 별도 부록은 없습니다. 이 리뷰는 원문의 관련 연구 설명을 바탕으로 인용 연구의 위치를 정리했으며, 참고문헌에 실린 모든 논문을 별도로 읽거나 재현한 것은 아닙니다.
실험 결과 심층 분석
이 논문의 가장 강한 시스템 결과는 “메모리에 들어간다”와 “들어오는 동안 얼마나 기다리는가”를 별도로 개선했다는 점입니다. Table 8의 RTX 4090 결과는 24GB GPU에서 문맥 길이를 2K에서 96K까지 확장한 실행 가능성의 결과입니다. Table 9는 CPU 오프로딩만 적용하면 메모리는 절약되어도 디코딩 처리량이 낮아지고, 이후 그룹 선택과 예측 프리페치로 회복된다는 과정을 보여 줍니다. 모델 가중치와 임시 활성값을 포함한 GPU 메모리 전체의 압축률을 식 (7)의 KV 전송량 비율로 대체할 수는 없습니다.
비교의 분모에 따라서도 결론은 달라집니다. A100의 32K에서 GroupKV 1.79 tok/s는 단순 희소 오프로딩 0.48 tok/s 대비 약 3.73배지만, 계층 간 토큰 선택을 활용하는 InfiniGen 방식 1.33 tok/s 대비 약 1.35배입니다. A100의 4K·8K에서는 GPU에 KV를 유지하는 Fast-dLLM이 더 빠릅니다. 따라서 실용적인 해석은 “항상 빠른 추론 엔진”보다 GPU 상주가 어려워진 구간에서 전송을 줄이고 겹치는 런타임에 가깝습니다. Table 7–9
정확도 결과에는 상승과 하락이 함께 있습니다. UltraLLaDA 원모델 대비 LongBench 평균 0.82점 상승은 흥미롭지만, 같은 백본의 Fast-dLLM보다 0.83점 낮고 LLaDA 원모델보다는 0.37점 낮습니다. RULER도 문맥 길이와 하위 과제에 따라 방향이 다릅니다. 반복 실행의 분산, 신뢰구간, 통계적 유의성 검정은 논문에 보고되지 않았습니다. 따라서 이 차이들은 관측된 점수 차이로 기술해야 하며, 작은 차이가 통계적으로 유의하다고 주장할 수 없습니다. 이 정보 부재를 곧바로 방법의 결함으로 단정하지도 않습니다. Table 4–6
재현 관점에서는 하드웨어, CUDA·컴파일러, 고정 호스트 메모리, 기본 예산, 비교 방식, 처리량 측정 구간이 명시되어 있어 실험의 핵심 조건을 파악할 수 있습니다. 반면 고정 v1 본문에서는 GroupKV 전용 공개 구현 URL을 확인하지 못했으므로 코드가 공개되었다고 단정하지 않습니다. 또한 PDF의 배치 확장 그래프는 추세 수준으로 반영했으며, 개별 데이터 점을 임의로 수치화하지 않았습니다. 이 리뷰에서 새로 실행한 벤치마크는 없습니다.
기술적 함의와 응용
저자들이 직접 제시한 적용 범위는 GPU 메모리가 제한되고 CPU–GPU KV 전송이 큰 비용을 차지하는 장문맥 확산 언어 모델 추론입니다. 짧은 문맥에서는 Fast-dLLM 같은 경로를 사용하고, 메모리 제약이 커지면 GroupKV로 전환한다는 정책이 이 범위를 명확히 합니다. 긴 문서 이해나 여러 문서를 참조하는 과제는 LongBench·RULER가 포함한 평가 영역이며, NIAH의 128K 결과는 그보다 좁은 단일 정보 검색을 점검합니다. §5.1–5.3
리뷰어의 해석으로는, 이 연구가 제공하는 일반적인 시스템 관점은 선택 해상도와 데이터 수명을 함께 고려해야 한다는 점입니다. 그룹 평균은 세밀한 표현을 줄이는 대신 관리 비용을 낮추고, 원래 KV를 남겨 둔 채 필요한 범위만 복구합니다. 계층 간 유사성은 전송 예측에 쓰되, 생성 단계에서 실제로 바뀐 항목의 최신성은 별도의 선택적 수정으로 유지합니다. 이 관점은 설계를 이해하는 해석이며 다른 모델이나 하드웨어에서도 같은 개선 폭이 검증되었다는 주장은 아닙니다.
GroupKV의 결과는 정확도를 고정한 채 모든 비용을 없앤 사례가 아니라, 검색·계산 예산으로 정확도와 효율을 조절하면서 긴 문맥의 실행 범위를 넓힌 사례입니다. 그룹 선택은 가져오는 양을, 프리페치는 기다리는 시간을, 선택적 수정은 데이터의 최신성을, 스트리밍 프리필은 시작 단계의 임시 메모리를 담당합니다. 이 네 역할을 구분하면 최대 문맥 길이, 처리량, 벤치마크 점수라는 서로 다른 성과가 하나의 런타임에서 어떻게 연결되는지 이해할 수 있습니다.