논문 개요와 전체 구조
기업 업무용 AI Agent에 도구를 연결할 때는 흔히 문서 읽기, 파일 검색, 메시지 전송과 같은 기능을 각각의 함수로 제공합니다. 그런데 모델이 이미 셸 명령과 프로그램 작성에 익숙하다면, 이런 개별 도구 대신 셸 하나를 주는 편이 더 효과적일 수 있을까요? Is Bash All You Need?는 같은 모델과 업무를 유지하면서 행동 인터페이스를 다섯 가지로 바꾸어 이 질문을 검증합니다. 여기서 Harness는 모델의 반복 실행, 도구 호출, 세션 상태와 종료를 관리하는 실행 틀을 뜻합니다.
연구는 소프트웨어 회사 업무를 모사하는 TheAgentCompany의 174개 과제와 금융·컨설팅·법률 업무를 다루는 APEX-Agents의 480개 과제를 사용합니다. Opus-4.8과 GPT-5.5를 각각 다섯 인터페이스로 평가하여, 답의 품질뿐 아니라 토큰 사용량, 추정 추론 비용, 실행 시간과 행동 양식을 비교합니다. 핵심 관찰은 셸만 제공한 Bash가 셸 없는 두 인터페이스보다 네 개 벤치마크·모델 조합 모두에서 높은 점수를 얻었다는 것입니다. 다만 모든 셀에서 최저 비용·최단 시간을 달성했다거나, 일반적인 보안 조건에서도 셸이 우월하다는 결과는 아닙니다. 원문 §1·Table 1
분석 대상은 Hazel Mak, Susheel Suresh, Sahil Bhatnagar, Barry Wang, Chhaya Methani, Alejandro Gutierrez Munoz의 arXiv:2609.11999v1이며, 제출일은 2026년 9월 10일입니다. 이 글은 버전이 고정된 HTML과 PDF를 기준으로 작성했습니다. 새 모델을 제안하는 논문보다는, Agent를 둘러싼 인터페이스 설계를 어떻게 비교할지 배우는 실험 연구에 가깝습니다.
원문은 다음 순서로 전개됩니다.
- Introduction: 기업 업무에서 도구 인터페이스를 비교해야 하는 이유
- Related Work: 함수 호출에서 실행 가능한 행동으로의 확장, 셸 에이전트와 도구 합성, 함수 호출을 넘어선 평가
- Method: 다섯 인터페이스와 통제 조건
- Experiment Setup: 4.1 TheAgentCompany, 4.2 APEX-Agents
- Results: 5.1 핵심 결과, 5.2 도구 사용, 5.3 과제 복잡도별 대응 비교, 5.4 Bash 효율, 5.5 도구 합성, 5.6 Programmatic Tool Calling
- Discussion: 품질·비용·권한에 따른 선택과 적용 범위
- Acknowledgments·References: 감사의 글과 참고문헌
- Appendix A — Harness and Prompts
- Appendix B — Benchmark Details: B.1 TheAgentCompany, B.2 APEX-Agents
- Appendix C — Additional Results: C.1 분야별 점수, C.2 대응 점수 차이, C.3 셸 실행 세부사항, C.4 합성 도구와 재사용, C.5 실패 유형
핵심 기여와 혁신성
이 논문이 다루는 문제는 모델의 지식이나 추론 능력만으로 Agent의 성능을 설명할 수 없다는 데서 출발합니다. 같은 모델이라도 개별 함수를 반복해서 호출하는지, 셸 안에서 여러 작업을 묶는지, 승인된 함수들을 프로그램으로 조합하는지에 따라 행동의 표현력과 모델에 되돌아오는 문맥의 양이 달라집니다. 기업 업무에서는 그 차이가 문서 작성, 데이터 대조, 여러 서비스 간 상태 변경과 같은 최종 산출물에 영향을 줄 수 있습니다.
기존 함수 호출 평가가 함수명과 인자의 정확성을 확인하는 데 유용하다면, 이 연구는 업무 전체의 결과를 비교 단위로 옮깁니다. 저자가 내세우는 기여는 셸 자체나 도구 합성의 발명이 아니라, 직접 도구 호출·프로그램 기반 호출·셸 실행을 두 기업 업무 환경에서 통제하여 비교한 데 있습니다. 코드 에이전트에서 유용했던 실행 방식이 비코딩 업무에서도 효과적인지 확인한다는 맥락입니다. 원문 §1–3
리뷰어 관점에서 중요한 점은 성능이 높은 인터페이스를 찾는 것과 그 원인을 단정하는 것을 구분한다는 것입니다. 논문은 도구 호출 수, 반복 호출, 셸 명령의 조합, 재사용 도구와 토큰 사용을 함께 분석합니다. 이 자료는 가능한 작동 경로를 설명하지만, 각 요소의 독립적인 인과 효과를 모두 분리한 실험은 아닙니다. 따라서 “셸을 주면 언제나 성공한다”보다 “우리 업무에서 행동 인터페이스를 별도 실험 변수로 취급해야 한다”는 시사점이 더 견고합니다.
기술적 세부사항
다섯 가지 인터페이스
| 인터페이스 | 모델에 제공하는 행동 수단 | 실험이 확인하는 차이 |
|---|---|---|
| Tool-only | 이름·설명·인자 형식이 정해진 typed tool catalog | 개별 함수 호출만으로 업무를 수행하는 기준선 |
| Bash+Tool | 셸과 같은 typed catalog | 셸이 있을 때 개별 도구를 추가하는 효과 |
| Bash | 셸만 제공 | 범용 실행 수단만으로 업무를 구성하는 효과 |
| Bash+Synthesis | 셸과 지속되는 도구 저장 디렉터리 | 앞선 과제에서 만든 도구를 뒤 과제에서 재사용하는 효과 |
| PTC | typed catalog 위의 제한된 Python 프로그램 | 셸 없이 승인된 함수 호출을 프로그램으로 조합하는 효과 |
PTC는 Programmatic Tool Calling의 약자입니다. 모델이 Python으로 반복·분기·호출 연결을 작성할 수 있지만, 환경에 작용하는 경로는 catalog의 함수로 제한됩니다. 반면 Bash는 범용 코드 실행을 허용합니다. 같은 Python 문법을 사용할 수 있다는 이유만으로 두 인터페이스의 행동 가능 범위가 같아지는 것은 아닙니다. 원문 §3
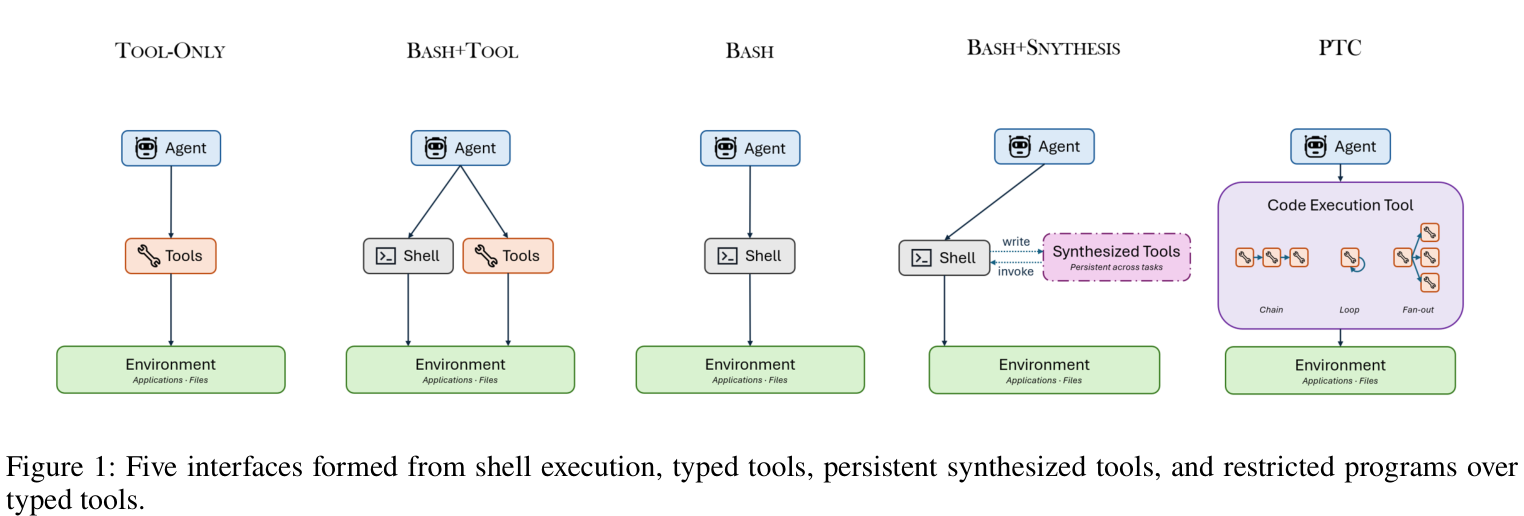
원문 Figure 1, PDF 2쪽. 다섯 인터페이스의 구성을 보여주는 그림을 크롭했습니다. 그림의 영문 표기는 번역하거나 수정하지 않았습니다. 버전 고정 PDF
점수·비용·행동 지표를 읽는 방법
TheAgentCompany의 Score는 업무 체크포인트의 노력 가중 달성률이며, APEX-Agents의 Score는 rubric 기준을 충족한 비율의 평균입니다. Pass rate는 두 환경 모두 완전히 해결한 과제의 비율입니다. 부분적으로 유용한 산출물을 만든 것과 모든 요구를 충족한 것을 분리하는 지표입니다.
Table 1의 Input에는 Cache-read가 이미 포함되어 있습니다. Total은 Input과 Output의 합이므로 Cache-read를 다시 더하면 이중 집계가 됩니다. 토큰 수는 과제당 평균이며, 도구 호출의 인자·반환값만 센 Table 2의 Tool tokens와 다릅니다. 추론 비용은 논문이 사용한 GitHub Copilot 정가 기준의 추정치이고, 실제 청구 내역이나 전체 운영비를 뜻하지 않습니다. 실행 시간은 과제당 평균 wall-clock입니다. 원문 Table 1·2
논문은 새로운 최적화 목적함수나 학습 알고리즘을 제안하지 않습니다. 핵심은 인터페이스 절제 실험과 통계량의 정의이므로, 원문에 없는 학습 수식을 추가하지 않습니다. 아래 점수 차이에서 pp는 퍼센트포인트를 뜻하며 상대 개선율과 구분합니다. 95% bootstrap 신뢰구간은 관측 과제에서 추정한 불확실성을 보여주며, 0을 포함하는 구간을 동등성의 증거로 해석하지 않습니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
챕터의 위치와 역할: 셸 기반 코드 에이전트의 경험을 기업 업무 전체로 확장할 수 있는지 문제를 설정합니다.
저자의 서술 순서를 따른 상세 내용:
- 셸을 행동 언어로 쓰는 모델: 저자는 최신 모델이 Bash를 자연스러운 실행 수단으로 학습했다는 배경을 제시하고, 셸만 노출하는 mini-SWE-agent와 스스로 도구를 만드는 Live-SWE-agent를 사례로 듭니다. 이는 비교를 시작하는 동기이며, 해당 시스템의 결과를 이 논문의 결과와 직접 합치지는 않습니다.
- 제품의 인터페이스 선택과 근거의 공백: typed catalog를 프로그램으로 호출하는 방식과 셸 기반 orchestration이 함께 쓰이지만, 기업 업무에서 둘을 같은 조건으로 비교한 근거가 제한적이라고 설명합니다. 개별 함수 호출 성공률만으로는 실제 업무에 필요한 여러 행동의 조합을 판단하기 어렵다는 문제로 이어집니다.
- 두 벤치마크·다섯 인터페이스의 비교: TheAgentCompany와 APEX-Agents에서 Bash, Tool-only, Bash+Tool, Bash+Synthesis, PTC를 비교합니다. 서론은 Bash의 높은 점수와 낮은 토큰 사용, 추가 도구의 뚜렷하지 않은 점수 이득, PTC의 토큰 절감이라는 결과를 먼저 요약합니다.
챕터의 핵심 기여는 실행 인터페이스 자체를 비교 변수로 설정하는 것입니다. 다음 챕터와의 연결은 그 변수가 함수 호출, 코드 행동, 도구 합성 연구와 어떻게 이어지는지 정리하는 데 있습니다. 원문 §1
📖 Chapter 2: Related Work
챕터의 위치와 역할: 다섯 인터페이스를 임의의 제품 조합이 아니라 기존 연구에서 발전해 온 행동 표현 방식으로 위치시킵니다.
저자의 서술 순서를 따른 상세 내용:
- From tool calls to executable actions: typed function calling은 외부 함수의 정해진 기능을 호출합니다. 이를 실행 가능한 코드로 확장하면 여러 행동과 제어 흐름을 한 프로그램 안에 표현할 수 있습니다. PTC는 이 중 환경 행동을 고정된 catalog로 제한하는 경우입니다. 논문의 비교는 직접 호출, catalog에 제한된 프로그램, 범용 셸을 구분합니다.
- Shell-based agents and tool synthesis: SWE-agent의 특화 인터페이스, mini-SWE-agent의 셸, Live-SWE-agent의 도구 생성, Agentless의 고정 workflow를 차례로 연결합니다. 재사용 가능한 도구를 저장하는 접근은 반복 탐색을 줄일 수 있지만, 셸만으로 충분한 상황에서도 추가 가치가 있는지는 별도 검증이 필요합니다. 이것이 Bash+Synthesis 실험의 배경입니다.
- Evaluation beyond function calling: 고객 서비스, 웹, 데스크톱, 기업 업무 벤치마크를 언급한 뒤, 동시기 BFCL 부분집합의 프로그램 호출 비교와 이 연구를 구분합니다. 이 논문의 평가 단위는 개별 함수 호출 정답이 아니라 여러 전문 역할에 걸친 업무 결과입니다.
챕터의 핵심 기여는 연구 범위를 함수 호출 능력에서 업무 완수로 옮기는 이유를 설명하는 것입니다. 다음 챕터에서는 실제로 어떤 행동 경로를 허용하고 통제했는지 정의합니다. 참고문헌의 개별 성능은 이 리뷰에서 독립 재검증한 결과가 아닙니다. 원문 §2
📖 Chapter 3: Method
챕터의 위치와 역할: 비교 대상의 차이를 명확히 하여 이후 숫자가 무엇의 효과인지 읽을 수 있게 합니다.
저자의 서술 순서를 따른 상세 내용:
- 행동 능력과 허용 범위: 셸은 임의 코드를 실행할 수 있어 여러 작업을 한 번에 수행할 수 있지만 실행·접근 제어가 필요합니다. curated catalog는 배포자가 승인한 함수만 노출하는 대신 개별 호출의 부담이 있습니다. PTC는 승인된 함수를 프로그램으로 연결하여 그 부담을 줄이려는 절충안입니다. 이 설명은 설계상의 구분이며, 보안 사고율을 실험으로 측정했다는 뜻은 아닙니다.
- 공통 조건과 인터페이스별 조건: 모델, 과제 문구, 기본 프롬프트, 종료 기준을 같게 두고 인터페이스를 바꿉니다. 다만 synthesis와 PTC에는 해당 방식을 사용하도록 하는 추가 지침이 들어갑니다. 완전히 동일한 문자열 프롬프트라고 표현하면 실제 통제 조건을 과장하게 됩니다.
- Bash·Tool-only·Bash+Tool: 각각 셸만, catalog만, 둘 다 제공합니다. 특히 Bash+Tool과 Bash의 비교는 “도구를 많이 제공할수록 좋아지는가”를 직접 확인합니다.
- Bash+Synthesis: 과제를 순차 실행하면서 지속 디렉터리에 재사용 도구를 만들고 뒤 과제에서 호출하도록 장려합니다. 도구 작성은 강제하지 않습니다. 지속되는 도구 라이브러리가 실험 처치의 일부이므로, 매 과제를 완전히 독립된 도구 집합에서 시작하는 조건과는 다릅니다.
- PTC: 제한된 Python runtime에 catalog를 일반 함수처럼 노출합니다. 셸이나 다른 환경 행동 채널은 주지 않습니다. 반복문으로 호출을 묶을 수 있지만 catalog가 제공하지 않은 기능까지 직접 실행할 수는 없습니다.
챕터의 핵심 기여는 인터페이스를 단순 UI가 아닌 행동 표현력·허용 범위·상태 유지 방식의 조합으로 정의하는 것입니다. 다음 챕터는 이 조건들을 실제 기업 업무 환경에 연결합니다. 원문 §3
📖 Chapter 4: Experiment Setup
챕터의 위치와 역할: 비교의 환경, 과제 수, 모델과 평가 기준을 제시합니다. 두 모델 모두 인터페이스 간에는 provider 기본 reasoning 수준을 유지합니다.
저자의 서술 순서를 따른 상세 내용:
- 4.1 TheAgentCompany: 네 개 자체 호스팅 서비스와 로컬 workspace, RocketChat으로 연락하는 17명의 가상 동료를 포함하는 회사 환경입니다. 코딩과 사무 업무가 함께 존재합니다. 원래 벤치마크에 LLM용 typed catalog가 없으므로 연구진은 174개 평가 과제에 맞추어 서비스 도구 54개와 파일 작업 도구 6개, 총 60개를 구성합니다. 여기서 catalog가 연구진의 설계물이라는 사실은 결과 해석에 중요합니다.
- 동료 시뮬레이션과 일관된 수정: 가상 동료는 GPT-5로 고정합니다. 메시지 누락, 너무 이른 대화 종료, 오래된 상태가 남는 결함을 수정하여 모든 인터페이스에 동일하게 적용합니다. 최종 채점은 벤치마크의 Python checkpoint evaluator를 사용합니다.
- 4.2 APEX-Agents: 투자은행, 경영 컨설팅, 기업 법률의 총 480개 과제를 평가합니다. 공유 파일을 읽어 답하거나 문서·스프레드시트·발표자료를 생성·편집합니다. 2026년 6월 Archipelago snapshot의 MCP 서버 9개를 사용하며, 이후 11개 서버 버전은 사용하지 않습니다. 유료 금융 데이터 API 의존을 피하기 위한 선택입니다.
- APEX의 도구와 평가: application 도구 20개를 유지하고 code-execution 서버를 workspace에 대한 제한된 Unix 셸로 사용합니다. 최종 답변과 workspace 파일 변경을 읽는 Archipelago 파생 LLM judge가 rubric 기준을 평가합니다. 자동 실행 체크포인트를 쓰는 TheAgentCompany와 평가 방식이 같지 않으므로, 두 벤치마크의 절대 점수를 동일 척도로 취급하지 않습니다.
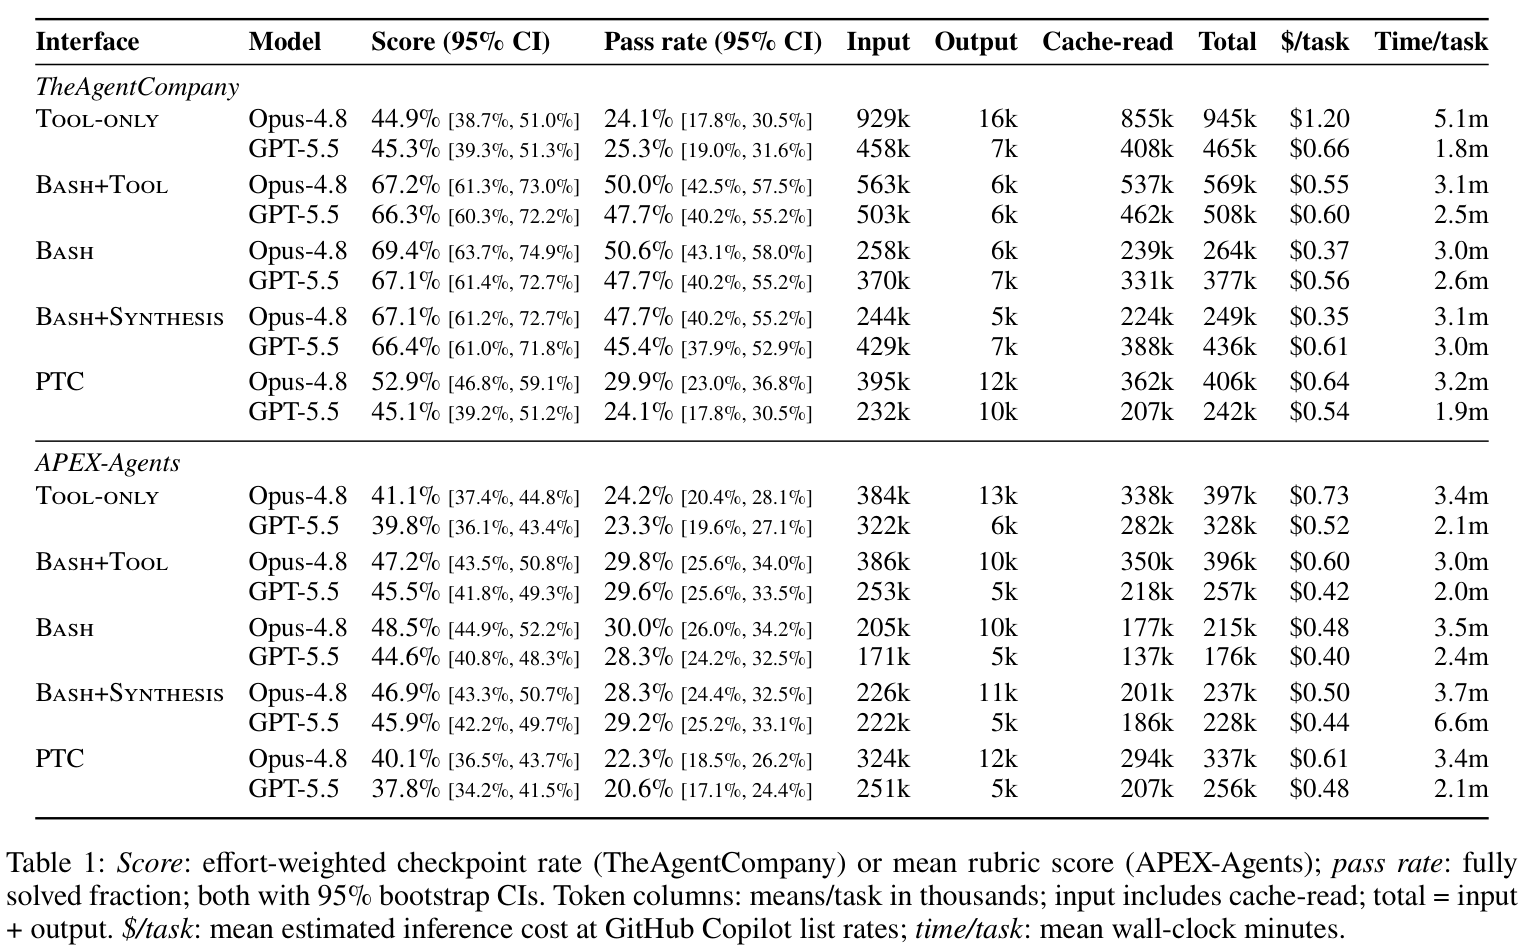
원문 Table 1, PDF 3쪽. 표 전체와 원문 캡션을 포함하여 크롭했습니다. Input은 Cache-read를 포함하고, Total은 Input과 Output의 합입니다. 버전 고정 PDF
챕터의 핵심 기여는 인터페이스 비교를 재해석할 때 필요한 환경 조건을 제시하는 것입니다. 다음 챕터는 이 조건에서 얻은 품질과 행동 자료를 순서대로 분석합니다. 원문 §4
📖 Chapter 5: Results
챕터의 위치와 역할: 최종 품질에서 출발하여 호출 양식, 복잡도, 셸의 조합 능력, 합성 도구와 PTC의 효율로 분석 범위를 좁혀 갑니다.
저자의 서술 순서를 따른 상세 내용:
5.1 Core Outcomes
Bash는 네 벤치마크·모델 조합 모두에서 Tool-only와 PTC보다 높은 점수를 보입니다. Tool-only 대비 Bash의 주요 수치를 원문 Table 1에서 옮기면 다음과 같습니다. 토큰은 과제당 평균이며 k는 천 토큰입니다.
| 환경·모델 | Score: Tool-only → Bash | Pass rate: Tool-only → Bash | Total tokens: Tool-only → Bash | 추정 비용: Tool-only → Bash |
|---|---|---|---|---|
| TheAgentCompany·Opus-4.8 | 44.9% → 69.4% | 24.1% → 50.6% | 945k → 264k | USD 1.20 → USD 0.37 |
| TheAgentCompany·GPT-5.5 | 45.3% → 67.1% | 25.3% → 47.7% | 465k → 377k | USD 0.66 → USD 0.56 |
| APEX-Agents·Opus-4.8 | 41.1% → 48.5% | 24.2% → 30.0% | 397k → 215k | USD 0.73 → USD 0.48 |
| APEX-Agents·GPT-5.5 | 39.8% → 44.6% | 23.3% → 28.3% | 328k → 176k | USD 0.52 → USD 0.40 |
TheAgentCompany에서 차이가 더 크다는 점은 소프트웨어·서비스 간 업무에서 유연한 실행이 도움이 될 수 있다는 저자의 해석과 연결됩니다. APEX에서도 점수는 높지만 개선 폭이 작고 완전 해결률은 30% 안팎입니다. 인터페이스 개선이 전문 분야 추론의 어려움을 모두 해결한 것은 아닙니다.
PTC는 Tool-only보다 일관되게 적은 토큰을 쓰지만 점수가 개선되는 것은 TheAgentCompany의 Opus-4.8에서 두드러집니다. Bash에 typed tool이나 합성 도구를 추가해도 대응 비교에서 검출 가능한 pooled 점수 향상이 없습니다. 토큰이 줄어드는 추가 도구의 예외는 TheAgentCompany의 Opus-4.8 Bash+Synthesis입니다. 또한 TheAgentCompany의 GPT-5.5에서 PTC 비용은 USD 0.54로 Bash의 USD 0.56보다 조금 낮습니다. 따라서 저자의 전체적 효율 결론을 모든 개별 셀의 최소 비용 주장으로 확대하지 않아야 합니다. 원문 §5.1·Table 1
5.2 Tool Use
이 절은 높은 점수가 더 많은 호출 때문인지 살펴봅니다. Table 2의 호출 수와 Tool tokens는 과제당 중앙값입니다. TheAgentCompany에서 Tool-only는 14.0회·19.6k tool tokens, Bash는 12.8회·9.0k입니다. 호출 수 감소보다 토큰 감소가 크며, 절반 이하가 된 것은 tool tokens입니다. APEX에서는 각각 13.0회·15.6k와 7.5회·10.4k입니다.
호출 성공률은 TheAgentCompany에서 Tool-only 93.3%, Bash 92.1%, APEX에서는 90.9%와 91.1%로 비슷합니다. 즉 Bash의 높은 최종 점수를 개별 호출의 성공률 향상만으로 설명하기 어렵습니다. PTC는 TheAgentCompany 65.2%, APEX 86.2%로 가장 낮은 호출 성공률을 보입니다. 저자는 프로그램 안에서 여러 호출과 중간 실패를 조율하는 어려움이 작용할 가능성을 제시합니다.
동일 도구·인자를 정확히 반복한 비율은 TheAgentCompany의 Tool-only 16.2%에 비해 Bash가 0.3%입니다. 다만 셸이나 프로그램 내부 반복은 한 번의 외부 호출로 묶일 수 있습니다. 지표가 내부 연산을 제외하고 Agent에 반환되는 결과를 기준으로 센다는 점을 고려해야 합니다. 낮은 외부 반복률을 실제 연산의 반복이 사라졌다는 의미로 읽지 않습니다. 원문 §5.2·Table 2
5.3 Paired Performance by Task Complexity
저자는 Tool-only 호출 수의 두 모델 평균을 과제 복잡도의 대리 지표로 사용하고, 같은 과제·모델에서 Bash 또는 PTC가 Tool-only보다 얻은 점수 차이를 비교합니다. TheAgentCompany에서는 Bash의 이득이 중간 호출 수 구간에서 가장 크며 PTC의 이득은 작고 고르지 않습니다. APEX에서는 호출 수가 많은 구간에서 두 방식의 이득이 커지고, PTC의 평균 차이도 양수가 됩니다.
저자는 두 가지 제한을 명시합니다. PTC의 신뢰구간은 대부분 구간에서 0을 포함하므로 일관된 향상의 근거가 제한적입니다. 또한 높은 Tool-only 호출 수는 과제 자체의 난도뿐 아니라 인터페이스의 비효율을 반영할 수 있습니다. 예산 한계로 잘린 호출 수는 하한이라는 점도 Figure 4에 표시됩니다. 따라서 이 그래프를 “복잡한 업무일수록 PTC가 반드시 유리하다”는 법칙으로 사용하지 않습니다. 원문 §5.3·Figure 4
5.4 Bash Efficiency
셸은 한 번의 호출에 여러 정적 명령과 프로그램을 담을 수 있습니다. Table 3에서 Bash의 조합 표식이 있는 호출 비율은 TheAgentCompany 94.3%, APEX 96.5%입니다. TheAgentCompany는 호출당 명령 중앙값 4.0개·코드 2줄, APEX는 1.5개·12줄로 서로 다른 실행 양식을 보입니다. 앞쪽은 텍스트 도구와 HTTP 호출을 조합하는 양식이, 뒤쪽은 긴 내장 프로그램을 실행하는 양식이 두드러집니다.
Bash+Tool은 셸 사용을 줄이지만 남은 셸 호출의 신뢰성을 개선하지는 않습니다. 셸 실패율은 TheAgentCompany에서 Bash 7.9%, Bash+Tool 10.8%, APEX에서 4.4%와 9.3%입니다. 단, 셸을 쓰는 과제·호출의 구성이 달라질 수 있으므로 특정 인터페이스가 개별 명령을 본질적으로 더 불안정하게 만든다는 인과적 결론까지는 아닙니다.
Bash+Synthesis의 코드 줄 수 중앙값은 각각 1줄과 5줄로 가장 짧습니다. 이는 반복 코드를 도구 뒤에 감싸는 실용적 효과와 일치합니다. 그렇다고 짧은 호출이 곧 낮은 전체 토큰 비용이나 높은 최종 점수를 보장하지는 않습니다. 또한 Composed·Loop는 소스 문자열의 표식으로 분류되며 실제 실행 횟수가 아닙니다. 원문 §5.4·Table 3
5.5 Tool Synthesis
TheAgentCompany에서 Opus-4.8은 21개 도구를 만들고 19개를 호출했으며, 12개를 후속 과제에서 재사용합니다. GPT-5.5는 12개를 만들고 10개를 호출하며 6개를 후속 과제에서 재사용합니다. APEX에서는 Opus-4.8이 32개 중 29개 호출·14개 후속 재사용, GPT-5.5가 10개 모두 호출·후속 재사용입니다. 재사용 비율의 분모는 생성된 도구 수입니다.
도구가 실제로 쓰였다는 사실과 품질이 향상되었다는 사실은 별개입니다. Opus-4.8의 재사용 호출 성공률은 새 inline 코드와 비슷하지만 GPT-5.5에서는 재사용 쪽이 낮습니다. APEX의 GPT-5.5는 재사용 80.1%, 새 코드 86.2%이며, 부록은 이 차이가 인자 거절에 민감하다고 설명합니다.
합성 도구를 호출한 과제만 분리해 Bash와 대응 비교해도 평균 점수 이득은 검출되지 않습니다. TheAgentCompany의 해당 228개 과제·모델 쌍은 평균 −0.6pp와 +1.1k total tokens, APEX의 559개 쌍은 +0.1pp와 +63.0k입니다. 이는 관찰된 부분집합 비교이므로 재사용 행위 자체의 무작위 처치 효과로 읽지 않습니다. 도구 합성의 확인된 이점은 코드 포장과 재사용 가능성이며, 이 실험의 점수 향상으로 바로 연결되지는 않습니다. 원문 §5.5·Tables 4–5
5.6 Programmatic Tool Calling
PTC는 한 프로그램 실행에 여러 typed call을 묶습니다. Table 6의 과제별 typed call/PTC 실행 비율은 두 벤치마크 모두 2.0이며, Tool-only 대비 Agent에 보이는 호출 수 차이는 각각 −4.0회와 −3.0회입니다. 호출 압축 자체는 비교적 작지만 토큰 절감은 큽니다.
TheAgentCompany에서 uncached input은 97.6k, cache-read는 86.8k 줄고 output은 0.2k 늘어납니다. APEX에서는 각각 45.4k, 44.0k, 0.4k 감소합니다. 저자는 프로그램 내부에서 중간 결과를 처리하고 필요한 출력만 반환하면 후속 모델 호출에 실리는 문맥이 줄어들 수 있다고 해석합니다. 이 설명은 토큰 로그와 부합하는 가능한 기전이며, 중간 출력 필터링만의 효과를 독립적으로 측정한 결과는 아닙니다. 원문 §5.6·Table 6
챕터의 핵심 기여는 최종 점수의 차이를 호출·문맥·코드 조합·재사용이라는 관찰 가능한 행동과 연결한 것입니다. 다음 챕터는 이러한 관찰을 실제 배포의 선택 조건으로 정리합니다.
📖 Chapter 6: Discussion
챕터의 위치와 역할: 실험의 전체적 결론을 권한과 업무 조건에 맞는 선택으로 바꿉니다.
저자의 서술 순서를 따른 상세 내용:
- 단순한 scaffold의 성과: 연구 범위에서는 셸만 있는 인터페이스가 전체적으로 높은 품질과 좋은 비용 효율을 보이며, typed catalog나 지속 합성 라이브러리를 더해도 일관된 품질 이득은 없습니다. 이는 해당 모델·벤치마크의 결과이지 도구 라이브러리의 일반적 무용성을 뜻하지 않습니다.
- 실행 허용 범위에 따른 선택: 저자는 임의 실행을 격리할 수 있는 환경에서는 셸을, 승인된 catalog로 행동을 제한해야 하는 환경에서는 PTC를 고려할 수 있다고 제안합니다. 논문은 그 선택의 품질·토큰 측면 근거를 주지만, 보안 통제의 효과를 같은 척도로 평가하지 않습니다.
- 모델과 업무의 조합: 셸 기반 코딩·서비스 간 업무에서는 Opus-4.8, 직접 typed call의 토큰 효율에서는 GPT-5.5가 유리한 양상을 설명합니다. 문서 중심 분석과 PTC에서는 더 높은 점수와 더 낮은 토큰 사용 사이의 선택이 남습니다. 저자는 이후 모델 버전으로 이러한 권고가 그대로 이어지지 않을 수 있다고 명시합니다.
- 기업 내부 평가: 플랫폼이 여러 인터페이스를 선택 가능하게 하고, 권한과 사람 검토 조건을 고정한 채 실제 업무에서 A/B 평가할 것을 제안합니다. 사용자 요구 충족, 수동 수정량, 비용, 운영 실패를 함께 비교하여 필요한 조건을 만족하는 가장 단순한 인터페이스를 찾는 방향입니다.
챕터의 핵심 기여는 보편적인 “Bash만 쓰라”는 결론 대신 품질·비용·권한을 함께 보는 선택 조건을 남기는 것입니다. 본문은 여기서 마무리되며, 감사의 글과 참고문헌 이후 부록이 실행·평가 조건을 보완합니다. 원문 §6
📖 Chapter A: Harness and Prompts
챕터의 위치와 역할: 본문의 통제 실험이 어떤 공통 실행 틀 위에서 이루어졌는지 설명합니다.
다섯 인터페이스의 system prompt는 벤치마크 분야에 맞는 identity 문단과 과제 문구를 공유하고 도구 목록이 달라집니다. 합성·PTC만 추가 지침을 갖습니다. 합성은 반복 단계를 매개변수화된 명령으로 묶도록 장려하지만 도구 생성 자체를 의무화하지 않습니다.
GitHub Copilot SDK는 agent loop를 제공하지만 기본 도구 집합과 system prompt는 연구진의 설정으로 교체됩니다. 따라서 이 실험을 제품 기본 설정 전체의 비교로 이해해서는 안 됩니다. 핵심 기여는 공통 loop와 연구진이 바꾼 부분을 구분하는 데 있으며, 다음 부록은 각 환경에서 실제 catalog와 권한 경계를 구체화합니다. 원문 Appendix A
📖 Chapter B: Benchmark Details
챕터의 위치와 역할: 점수에 영향을 줄 수 있는 환경 구현, typed catalog와 평가 경계를 공개합니다.
저자의 서술 순서를 따른 상세 내용:
- B.1 TheAgentCompany의 업무와 catalog: ownCloud의 이력서를 RocketChat 채용 요건과 비교하거나 Plane 이슈를 GitLab과 동기화하는 업무가 예시입니다. 도구는 workspace 파일 조작과 RocketChat·ownCloud·GitLab·Plane의 과제 관련 API를 다룹니다. Table 7의 60개 catalog는 과제 관련 기능을 위한 것이며 셸로 접근 가능한 모든 endpoint를 덮지 않습니다. 따라서 인터페이스 문법만 바꾸고 행동 공간이 완전히 같았다고 가정하면 안 됩니다.
- 동료 상태와 shortcut 차단: 누락된 채널 메시지를 다음 차례에 복구하고, 답이 필요한 동안 thread가 닫히지 않게 하며, 과제 간 Redis를 초기화합니다. 개발 과정에서는 셸 Agent가 공개 evaluator 코드에서 정답을 읽거나 가상 동료 파일을 직접 읽는 reward hacking이 관찰되었습니다. 보고된 실행에서는 평가 저장소로의 네트워크 접근 차단과 동료 정보 암호화를 적용했습니다. 이는 저자가 명시한 개발 중 실패와 완화 조치이지, 보고된 점수가 모두 그 shortcut으로 얻어졌다는 뜻은 아닙니다.
- B.2 APEX-Agents의 snapshot: 33개 scenario world에서 세 전문 분야가 같은 수의 과제를 갖습니다. 2026년 6월 5일 Archipelago revision을 고정하고 도구명·설명·JSON schema와 환경 이미지 식별자를 기록합니다. 7월 16일 추가된 FMP·EDGAR SEC 연동은 사용하지 않습니다. 비셸 서버 8개의 도구 20개와 셸 서버 하나가 결합된 설정입니다.
- 셸 제한과 채점: 셸은 Python만 허용하는 방식이 아니라 filesystem 제한, 환경변수 정리, 실행 제한을 적용한 Unix
sh -c입니다. APEX 점수는 rubric 충족 비율, 통과는 전 기준 충족입니다. 공개 leaderboard는 최대 reasoning과 최신 snapshot을 사용하지만 여기서는 provider 기본 reasoning과 고정 snapshot을 쓰므로 절대 점수를 직접 비교할 수 없습니다.
챕터의 핵심 기여는 행동 공간과 evaluator 접근을 포함한 구체적인 실험 경계를 드러내는 것입니다. 다음 부록은 집계 점수의 불확실성과 행동 통계의 측정 한계를 추가합니다. 원문 Appendix B
📖 Chapter C: Additional Results
챕터의 위치와 역할: 본문의 평균 결과를 분야·과제 대응 차이·명령 패턴·재사용·실패 원인으로 세분화합니다.
저자의 서술 순서를 따른 상세 내용:
- C.1 Scores by Domain: 두 모델을 합친 분야별 결과에서 Bash ≥ Bash+Tool ≥ Tool-only 순서가 나타납니다. 소프트웨어 엔지니어링의 분리가 가장 크고 Corporate Law는 다섯 인터페이스가 가장 가깝습니다. TheAgentCompany의 작은 분야 bm·ml·qa·research는 effort weighting으로 other에 묶습니다. 분야별 표본 크기와 가중 방식을 함께 보아야 합니다.
- C.2 Paired Score Differences: 같은 과제·모델 쌍의 차이를 먼저 구한 뒤 각 쌍에 같은 가중치를 줍니다. TheAgentCompany는 174×2=348쌍, APEX는 480×2=960쌍입니다. Bash−Tool-only는 각각 +24.6pp [20.6, 29.0], +6.2pp [3.6, 8.7]입니다. Bash−PTC도 +21.2pp [17.0, 25.5], +7.7pp [5.2, 10.2]로 두 구간 모두 0보다 큽니다.
- 추가 도구의 불확실성: Bash+Tool−Bash는 −0.6pp [−3.0, 1.9]와 −0.2pp [−2.4, 1.9], Bash+Synthesis−Bash는 −1.6pp [−3.6, 0.3]와 −0.2pp [−2.4, 2.0]입니다. 이는 관측된 평균 차이의 구간이지 두 방식이 정확히 같다는 증명이 아닙니다. TheAgentCompany의 Table 1은 effort-weighted score이고 Table 9는 과제·모델 쌍의 동일 가중 평균이므로, Table 1의 모델별 차이를 단순 평균한 값과 Table 9가 일치할 필요는 없습니다.
- C.3 Shell Execution Details: APEX에서 GPT-5.5는 Opus-4.8보다 heredoc을 더 많이 쓰고 논리 연결 표식은 덜 사용합니다. Table 10의 명령 수는 정적 heuristic으로 센 값이며 내장 코드와 loop iteration을 제외합니다. 한편 style 비율은 내장 코드를 포함한 소스 표식으로 계산하므로 실제 동작 횟수와 다릅니다. Table 11은 filesystem, text processing, HTTP, embedded program 등 실행 파일 계열의 분류 사전입니다.
- Repair 지표의 한계: 실패 바로 다음 셸 호출의 첫 명령이 같을 때만 retry로 셉니다. 중간에 다른 호출이 끼어 나중에 돌아온 경우는 놓칩니다. 저자가 든
python → pwd → python도 실행 파일로 돌아온 기록이며 수정 성공이 확인되었다는 뜻은 아닙니다. 이를 “오류 복구 성공률”로 이름 붙이면 과장입니다. - C.4 Synthesized Tools and Reuse: TheAgentCompany의
owncloud_dav.py, RocketChat helper, APEX의extract_text.py와 문서·시트 도구처럼 실제로 만들어진 도구를 분류합니다. Table 12의 Uses는 raw 호출 수가 아니라 서로 다른 호출 과제·모델 쌍의 수입니다. 예컨대extract_text.py의 254는 254번 호출했다는 뜻이 아닙니다. 직접 대응되는 typed tool이 없는 합성 도구도 존재합니다. - 재사용 측정의 경계: 같은 경로를 덮어쓰면 한 도구로 세며, 이전 과제에서 생성·호출된 도구를 이후 호출했을 때 cross-task reuse로 분류합니다. 일시적·삭제된 도구는 놓칠 수 있습니다. GPT-5.5 APEX의 재사용 성공률은 인자 거절을 제외하면 새 코드와 작은 차이만 남습니다. 이 민감도 분석도 whole-call 결과를 보는 것이지 도구 함수 몸체의 신뢰성을 분리 측정하지 않습니다.
- C.5 Failure Types: LLM judge가 만점 미만 trajectory마다 하나의 실패 원인을 배정합니다. Figure 7은 실패 trajectory만을 분모로 하여 14개 범주의 비율을 보여줍니다. APEX는 요구사항 누락, 분야 규칙 오해, 숫자·형식 오류가 공통적입니다. TheAgentCompany는 산출물 미완성, 검증 생략, 추정값 사용, 잘못된 검색·전달, 환경·접근 오류가 더 다양합니다. 셸 인터페이스는 검증 없이 완료를 선언하는 실패가 두드러지고 PTC는 최종 메시지 잘림의 비중이 가장 높습니다. 실패 내부 구성비와 전체 실패율을 혼동하지 않습니다.
챕터의 핵심 기여는 평균 점수의 방향을 유지하면서도, 집계 방식과 proxy 지표의 해석 범위를 좁혀 주는 데 있습니다. 원문의 실질적인 추가 분석은 이 부록에서 끝납니다. 원문 Appendix C
실험 결과 심층 분석
점수 개선과 완전 해결은 함께 보아야 합니다
가장 직접적인 근거는 Table 9의 동일 과제·모델 대응 비교입니다. Bash의 Tool-only 대비 점수 차이는 두 벤치마크 모두 양수이며 95% bootstrap 구간이 0을 넘습니다. 동시에 Table 1에서 TheAgentCompany Opus-4.8의 완전 해결률은 24.1%에서 50.6%로 증가하지만 APEX에서는 24.2%에서 30.0%로 증가합니다. 인터페이스 개선이 소프트웨어·서비스 간 실행에서는 크게 작용해도, 전문 분야 판단의 어려움은 상당 부분 남는다는 해석이 가능합니다. 이는 저자의 분야·실패 분석과 연결되는 리뷰어 해석입니다.
추가 도구의 효과는 더 조심스럽게 읽어야 합니다. 신뢰구간이 0을 포함한다는 것은 여기서 뚜렷한 평균 이득을 검출하지 못했다는 의미입니다. 재사용 도구의 모든 장기적 효용을 부정하거나 동등성을 입증한 결과로 확대하지 않습니다. 논문은 bootstrap 구간을 제공하지만, 이를 별도의 동등성 검정이나 보고되지 않은 p값으로 바꾸어 제시하지 않습니다. 원문 Table 9
토큰이 적다고 더 빨리 끝나는 것은 아닙니다
TheAgentCompany의 GPT-5.5는 Tool-only에서 1.8분, Bash에서 2.6분입니다. APEX의 Opus-4.8도 3.4분에서 3.5분으로 늘어납니다. Bash가 두 경우 모두 토큰과 추정 추론 비용을 줄였어도 wall-clock은 더 짧지 않습니다. APEX GPT-5.5의 Bash+Synthesis는 6.6분으로 Bash 2.4분보다 길기도 합니다. 따라서 이 연구의 “효율”을 토큰·가격·시간 중 무엇으로 말하는지 명시해야 합니다.
또한 Table 2의 도구 토큰 중앙값은 실제 과금 토큰과 다릅니다. 모델이 반복해서 읽는 전체 대화, 캐시 적용과 중간 결과 처리 방식이 Table 1의 total token에 영향을 줍니다. PTC가 호출 수를 어느 정도만 줄이고도 uncached·cache-read 토큰을 크게 줄였다는 사실은 도구 결과를 모델 문맥으로 가져오는 방식을 설계 대상으로 볼 이유를 제공합니다. 원문 Tables 1·2·6
실험의 강점과 적용 범위
같은 과제·모델을 맞춘 비교, 공통 harness와 종료 조건, 두 종류의 기업 업무, 점수와 운영 지표의 동시 보고가 장점입니다. 반면 원문이 밝힌 대로 TheAgentCompany catalog는 모든 shell endpoint와 같지 않으며, 복잡도·repair·reuse 지표는 관찰 가능한 대리값입니다. 이 실험을 행동 권한까지 완전히 같게 맞춘 순수 문법 비교로 해석하기보다, 실제로 구성한 다섯 인터페이스의 비교로 읽는 편이 정확합니다.
재현성 측면에서 원문은 catalog, snapshot, prompt 차이, coworker 수정, 평가 정의를 제시합니다. 이 리뷰는 그 설명과 원문 결과를 대조했으며 논문의 전체 실행을 재현하거나 참고문헌 시스템을 모두 검증하지는 않았습니다. 특히 공개 APEX leaderboard와는 reasoning·서버 버전이 달라 순위 비교에 사용할 수 없습니다. 원문 Appendices A–B
기술적 함의와 응용
이 연구를 Agent 설계에 연결하면, 먼저 도구 수를 늘리는 것보다 어떤 행동을 한 번에 표현할 수 있고 어떤 중간 결과가 모델 문맥에 남는지를 살펴볼 필요가 있습니다. 셸은 유틸리티와 프로그램을 결합하고, PTC는 승인된 함수 안에서 제어 흐름과 중간 데이터 처리를 표현합니다. 둘은 토큰 효율에 도움을 줄 수 있지만 실행 가능한 행동의 경계가 다릅니다.
데이터과학자의 관점에서는 최종 점수 하나보다 과제별 대응 차이, 완전 해결률, 캐시를 포함한 사용량, 실행 시간, 실패 유형을 함께 기록하는 평가 설계가 특히 유용합니다. 가령 데이터 추출·문서 생성 workflow에서는 호출 자체가 성공해도 숫자나 요구사항이 틀릴 수 있습니다. 이 논문의 APEX 실패 분석은 실행 인터페이스 개선과 업무 지식·검증의 개선을 구분하여 볼 근거를 제공합니다.
저자가 제안하는 후속 적용은 권한과 사람 검토 조건을 유지한 내부 A/B 평가입니다. 이는 셸을 무조건 열라는 권고가 아니라, 범용 실행을 허용할 수 있는지와 실제 산출물의 품질·수정 부담·비용을 함께 확인하자는 제안입니다. 이 논문의 가장 강한 메시지는 “Bash가 전부다”라는 제목의 일반화보다, 현재 업무에 필요한 가장 단순한 인터페이스를 실험으로 선택하라는 데 있습니다. 원문 Discussion
분석 범위: 본문 1–6절과 부록 A–C의 모든 소절을 원문 순서대로 반영했습니다. 감사의 글과 참고문헌은 위치와 역할만 표시했으며, 전체 참고문헌의 독립 리뷰, Table 7·8·11·12의 모든 도구명·명령 분류 행 전사, 실행 trajectory별 재채점은 수행하지 않았습니다. 핵심 그림과 Table 1은 원문에서 인용했고, 나머지 표·그래프는 해당 설명과 출처 링크로 연결했습니다.