논문 개요와 전체 구조
GPU-CFR는 불완전정보 게임의 균형 전략을 계산하는 Counterfactual Regret Minimization(CFR)의 실행 방식을 바꾸는 시스템 연구입니다. 포커처럼 상대의 정보를 알 수 없는 게임에서는 하나의 관측에 여러 실제 상태가 대응합니다. CFR는 이 상태들을 반복해서 순회하며 행동별 후회값을 누적합니다. GPU-CFR는 게임이 고정되어 있는 동안 트리 구조와 데이터 의존성도 바뀌지 않는다는 점을 이용해, 게임을 한 번만 평탄한 배열과 정적 실행 순서로 컴파일합니다.
Boning Li와 Longbo Huang의 arXiv 2609.11923v1을 대상으로 분석합니다. 제목의 80배는 동일한 A100에서 기존 GPU 구현인 Kim(2026)과 비교한 8개 게임의 반복 시간 중 최대 개선 폭을 가리킵니다. 모든 게임이나 전체 초기화 시간을 포함한 실행에서 80배라는 뜻은 아닙니다. 가장 작은 두 게임에서는 LiteEFG CPU 구현이 더 빠르고, 별도 대규모 포커 실험에서는 Kim의 GPU 구현이 더 빠릅니다. 연구의 핵심은 이러한 조건까지 포함해 표현 변환의 효과와 실행 호출 비용의 효과를 나누어 설명한다는 점입니다. 원문 §1, §7
원문은 본문 1–8절, References, 그리고 부록 역할을 하는 9–17절 순서입니다. 아래 리뷰도 이 순서를 보전합니다.
| 원문 위치 | 제목과 하위 구성 | 역할 |
|---|---|---|
| 1 | Introduction | GPU에서 CFR가 느렸던 이유와 연구 질문 |
| 2 | Related Work: CFR 계열, 근사화, 시스템 | 실행 계층의 기여를 기존 알고리즘과 구분 |
| 3 | Preliminaries | 게임·정보집합·후회·평균 전략·exploitability 정의 |
| 4 | Compiling CFR onto Accelerators: 4.1 표현, 4.2 고정 데이터 흐름, 4.3 CUDA graph, 4.4 검증 | 핵심 설계 |
| 5 | The Compiled Iteration, Formally: 세 연산자, 계산 의미, 평균 누적의 정밀도 | 정확성 및 실행 단계 수 정식화 |
| 6 | Experimental Setup | 세 실험군·백엔드·공유 게임·측정 프로토콜 |
| 7 | Results: 속도, 원인, 시간 대비 품질, 갱신 규칙·순서, 반복 재풀이 | 주 실험 |
| 8 → References | Conclusion → References | 결론과 인용 문헌 |
| 9 | HUNL Subgame Construction | 포커 게임 정의와 외부 재구성 |
| 10 | Benchmark Protocol and Environment | 하드웨어·시간·정밀도·재현 기록 |
| 11 | Correctness Test Inventory | 검증 항목과 GPU 수치 변동 |
| 12 | Additional Results; 12.1 Cross-implementation check of the update-rule study | 수명주기·메모리·분산·외부 규칙 비교 |
| 13 | Poker Head-to-Heads and the Value-Agreement Certificate | 동일 게임 비교와 가치 일치 검사 |
| 14 | Kernel-Level Profile and Alternative Execution Models | 프로파일·범용 컴파일러·직접 융합 커널 |
| 15 | Compiler Passes and Memory Plan | 실제 컴파일 단계와 재사용 계약 |
| 16 | Proofs: 16.1–16.4 네 명제 | chance folding·dual lane·깊이 스케줄·평균 누적 증명 |
| 17 | Future Work | 저자가 명시한 확장 방향 |
핵심 기여와 혁신성
해결하려는 문제는 반복마다 같은 구조를 다시 해석하는 비용입니다. 일반 게임 인터페이스를 따라 노드별로 분기하고 작은 수치 연산을 실행하면 GPU 커널 하나의 계산 시간보다 Python/PyTorch의 디스패치와 커널 실행 요청 비용이 커집니다. GPU에 계산을 옮기는 것만으로는 이 비용이 사라지지 않습니다.
저자들은 게임을 컴파일할 때 카드 배분 같은 외생적 무작위 사건인 chance의 확률을 말단 보상에 접어 넣고, 같은 깊이의 간선을 묶으며, 두 플레이어의 도달 확률을 하나의 연속 버퍼에서 갱신합니다. 두 명이 겨루는 노리밋 텍사스 홀덤(heads-up no-limit Texas hold’em, HUNL)의 turn 하위 게임에서 최적화 전 참조 구현의 Aten 연산 1,742개가 96개로 줄어듭니다. Aten은 PyTorch가 텐서 연산을 실제 실행 경로로 전달하는 연산 계층입니다. 이어 고정된 주소·형상·순서를 CUDA graph로 기록해 반복별 디스패치를 줄입니다. 전자는 실행할 작업의 조직을 바꾸고, 후자는 그 작업을 제출하는 비용을 줄입니다. 원문 §4, Table 2
독창성은 새로운 후회 최소화 수식을 제안하는 데 있지 않습니다. CFR·CFR+·DCFR·PCFR+가 공유하는 반복 계산을 정적인 프로그램으로 다루고, 원래 알고리즘과 일치하는지 별도로 검사한다는 데 있습니다. 리뷰어 관점에서 이 설계는 게임 풀이뿐 아니라 구조는 고정되고 수치만 변하는 반복 계산에서 무엇을 미리 계산할 수 있는가를 구체적으로 보여줍니다. 다만 다른 분야에 같은 성능 배수가 보장된다는 실험은 아닙니다.
기술적 세부사항
대상은 유한한 두 플레이어 제로섬 완전기억(perfect-recall) 확장형 게임입니다. 완전기억은 각 플레이어가 자신의 과거 정보와 행동을 잊지 않는다는 가정입니다. 전체 게임 트리를 사용할 수 있고 같은 구조에서 많은 반복을 수행하는 상황을 다룹니다. Monte Carlo CFR처럼 매번 순회 경로 자체를 표본추출하는 경우로 구현 범위를 확장하지 않습니다. 원문 §3, §17
평가 지표인 exploitability는 상대 전략이 고정됐을 때 각 플레이어가 최적 반응으로 얻을 수 있는 추가 이익을 합한 NashConv의 절반입니다.
$\sigma$는 두 플레이어의 전략 조합, $u_i$는 플레이어 $i$의 기대 보상, $\sigma_i'$는 그 플레이어가 바꿀 수 있는 전략입니다. 값이 작을수록 상대에게 이용당할 여지가 작습니다. 게임별 보상의 단위가 다르므로 서로 다른 게임의 절대 수치를 직접 순위화하지 않습니다. 이 연구는 정확한 best response로 이 지표를 계산하며, 승률이나 신경망 예측 정확도를 사용하지 않습니다. 원문 식 (1)
실행은 정보집합·행동별 regret matching → 두 도달 확률의 전방 전파 → 가치의 역방향 전파 → 후회와 평균 전략 누적 순서입니다. 데이터는 노드, 간선, 정보집합별 슬롯의 평탄한 배열로 구성합니다. 고정된 인덱스로 원소를 읽는 gather와 지정 위치에 쓰거나 합치는 scatter가 중심 연산이며, CUDA graph는 이 연산들을 하나의 거대한 연산으로 수학적으로 합치는 것이 아니라 실행 순서를 기록하고 재생합니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
챕터의 위치와 역할: 포커 균형 계산이라는 응용에서 출발해, 왜 계산량이 큰데도 GPU가 충분히 유리하지 않았는지를 실행 모델의 문제로 좁힙니다.
먼저 저자들은 CFR가 정확한 균형 계산, 근사 알고리즘의 기준선, 온라인 subgame re-solving의 내부 루프라는 점을 설명합니다. 실시간 게임 에이전트는 수초의 행동 예산 안에서 큰 하위 트리를 반복해서 풀어야 하므로, 한 반복의 시간이 실제로 계산할 수 있는 전략 품질을 제한합니다. 여기서 tabular는 후회와 전략을 신경망으로 근사하지 않고 정보집합별 표에 보관한다는 뜻입니다.
이어서 일반 인터페이스 기반 트리 순회가 노드 종류 분기, 포인터 추적, 작은 gather/scatter를 반복한다는 점을 지적합니다. 기존 Kim 구현도 깊이별 희소 행렬 연산으로 병렬화하지만, 해당 CuPy·cuSPARSE 실행 경로는 논문의 실험 환경에서 graph capture가 되지 않았습니다. 저자들은 이 문제를 알고리즘 고유의 비용과 표현상의 비용으로 나누어 질문합니다.
마지막으로 게임을 한 번 컴파일해 모든 반복에서 재사용하는 설계를 제시합니다. 연구 질문은 의미를 보전한 정적 데이터 흐름 구성, 표현과 graph replay의 기여 분리, 실제 품질 및 재풀이 시간으로의 연결입니다. 핵심 기여는 GPU 사용 여부보다 실행 계획의 고정 가능성을 문제의 중심에 둔 것입니다. 다음 챕터로의 연결은 이 작업이 기존 CFR 개선 및 근사화와 어느 계층에서 다른지를 정리하는 것입니다. 원문 §1
📖 Chapter 2: Related Work
챕터의 위치와 역할: 기존 연구를 후회 갱신 알고리즘, 계산할 게임을 줄이는 근사화, 실제 실행 시스템 순서로 나누어 기여의 범위를 설정합니다.
The CFR family and exact equilibrium solving. CFR+는 누적 후회를 0 이상으로 제한하고 평균 전략에 선형 가중치를 사용합니다. DCFR는 누적량을 할인하고, predictive/optimistic 계열은 다음 전략을 정할 때 예측 항을 활용합니다. 저자들은 동시 갱신과 교대 갱신도 품질을 바꾸는 독립 축임을 강조합니다. GPU-CFR는 이러한 규칙을 대체하지 않고 공통 실행 계층을 제공합니다.
Scaling CFR by approximation. 원문은 표본추출, abstraction, pruning, 신경망 근사 순서로 전체 트리를 줄이거나 방문량을 줄이는 방법을 설명합니다. GPU-CFR의 현재 대상은 그렇게 선택된 트리가 완전히 주어져 반복 실행되는 구간입니다. 따라서 근사화와 결합할 여지는 있지만, 논문에서 모든 근사 알고리즘과의 종단 간 결합을 실험한 것은 아닙니다.
Systems and frameworks for game solving. OpenSpiel은 넓은 게임 지원과 참조 구현, LiteEFG는 단일 스레드 C++ 기반 컴파일 실행, PokerRL은 포커 hand range를 이용한 특화 표현으로 설명합니다. 기존 병렬 CFR가 순회 자체를 나누는 데 초점을 맞췄다면, 이 연구는 그 순회가 사용하는 표현을 바꿉니다. CPU 비교군의 병렬성도 별도의 CFR 전용 스레드 코드가 아니라 PyTorch 연산 내부의 병렬 풀에서 얻습니다.
핵심 기여는 시스템 개선과 알고리즘 개선을 구분하는 비교 틀입니다. 다음 챕터로의 연결은 서로 같은 알고리즘을 실행한다고 말하기 위해 필요한 게임과 CFR의 정의입니다. 원문 §2
📖 Chapter 3: Preliminaries
챕터의 위치와 역할: 뒤의 배열과 연산자가 어떤 게임 이론적 양을 나타내는지 정의합니다.
첫째, history는 루트에서 현재까지의 모든 행동을 포함한 실제 상태이고, information set은 플레이어가 관측으로 구분할 수 없는 history의 묶음입니다. 원문의 States는 chance 노드를 제외하고 말단을 포함한 상태 수입니다. Infosets는 말단을 포함한 비chance history에 대해 두 플레이어 각각의 정보집합을 세는 방식입니다. 따라서 일반적인 의사결정 노드 수와 동일한 지표라고 읽으면 안 됩니다.
둘째, 도달 확률은 플레이어 1, 플레이어 2, chance의 기여로 분해됩니다. Counterfactual reach는 해당 플레이어 자신의 기여만 제외합니다. 어떤 정보집합에 도달했을 때 특정 행동을 택했다면 얻을 가치와 현재 전략의 가치를 비교해 후회를 계산합니다. 원문의 식 (3)–(4)는 다음 관계를 사용합니다.
$I$는 정보집합, $A(I)$는 허용 행동, $h$는 그 정보집합의 실제 history, $z$는 말단입니다. $\pi^\sigma(h\cdot a,z)$는 해당 행동 이후 말단까지의 전략에 따른 도달 확률입니다. 첫 합은 관측상 같은 여러 실제 상태를 통합하고, 두 번째 식은 그중 현재 혼합 전략이 얻는 가치를 계산합니다. 후회 누적은 선택하지 않은 행동이 현재 전략보다 얼마나 유리했는지를 기억합니다.
셋째, 다음 전략은 양의 누적 후회에 비례하게 정하고, 합이 0이면 균등 전략을 사용합니다. 평균 전략은 자신의 정보집합 도달 확률을 함께 가중해 누적합니다.
$R_+=\max(R,0)$이고 $w_t=1$은 균일 평균, $w_t=t$는 선형 평균입니다. 마지막의 비례 기호는 행동 확률로 다시 정규화해야 한다는 뜻입니다. CFR+는 다음 전략을 계산할 때만 양수를 고르는 데서 더 나아가, 갱신된 후회 누적량 자체를 0 이상으로 제한합니다.
원문은 표준 CFR의 평균 전략이 내시 균형으로 수렴하는 속도를 $O(1/\sqrt{T})$로 설명합니다. 내시 균형은 상대의 전략이 고정됐을 때 어느 플레이어도 혼자 전략을 바꿔 더 높은 보상을 얻을 수 없는 상태입니다. 이 수렴 논의의 대상은 평균 전략이며, 매 반복의 현재 전략 자체가 같은 방식으로 수렴한다는 진술과 구별해야 합니다.
끝으로 동시 갱신은 하나의 전략 프로파일에서 두 플레이어의 후회를 계산하고, 교대 갱신은 첫 플레이어의 변경이 두 번째 플레이어에게 보입니다. 교대 방식의 한 iteration은 플레이어별 half-update를 수행하므로 대략 두 배의 작업입니다. 핵심 기여는 비교에서 고정해야 할 의미를 명시하는 데 있습니다. 다음 챕터로의 연결은 이 순서를 바꾸지 않고 배열 연산으로 옮기는 방법입니다. 원문 §3, 식 (3)–(5)
📖 Chapter 4: Compiling CFR onto Accelerators
챕터의 위치와 역할: 게임의 의미를 보존하면서 반복 시점에 수행할 구조 처리를 제거하는 핵심 설계입니다.
4.1 Compiled game representation
게임을 한 번 순회해 부모가 자식보다 먼저 오도록 노드 번호를 부여합니다. 노드 배열에는 소유자·깊이·말단 보상을, 간선 배열에는 부모·자식·정보집합 행동 슬롯을 저장합니다. 슬롯은 동일한 정보집합의 같은 행동이 공유하는 인덱스입니다. 정보집합마다 행동 수가 달라도 슬롯 오프셋과 구간 합으로 regret matching을 수행할 수 있으므로 가변 길이 객체를 반복해서 탐색하지 않습니다.
후회·평균 전략·중간 도달 확률·가치 버퍼는 미리 할당합니다. 정수 인덱스와 수치 버퍼의 크기는 노드·간선·행동 슬롯 수에 대해 선형으로 증가합니다. Figure 2의 예시는 게임 트리 → 깊이별 배열과 보상 템플릿 → 반복 실행의 구분을 보여줍니다. 트리에서 동일 깊이에 있는 간선이 배열의 한 실행 블록으로 모이고, 말단 보상은 뒤로 전파할 초기값이 됩니다. 원문 §4.1
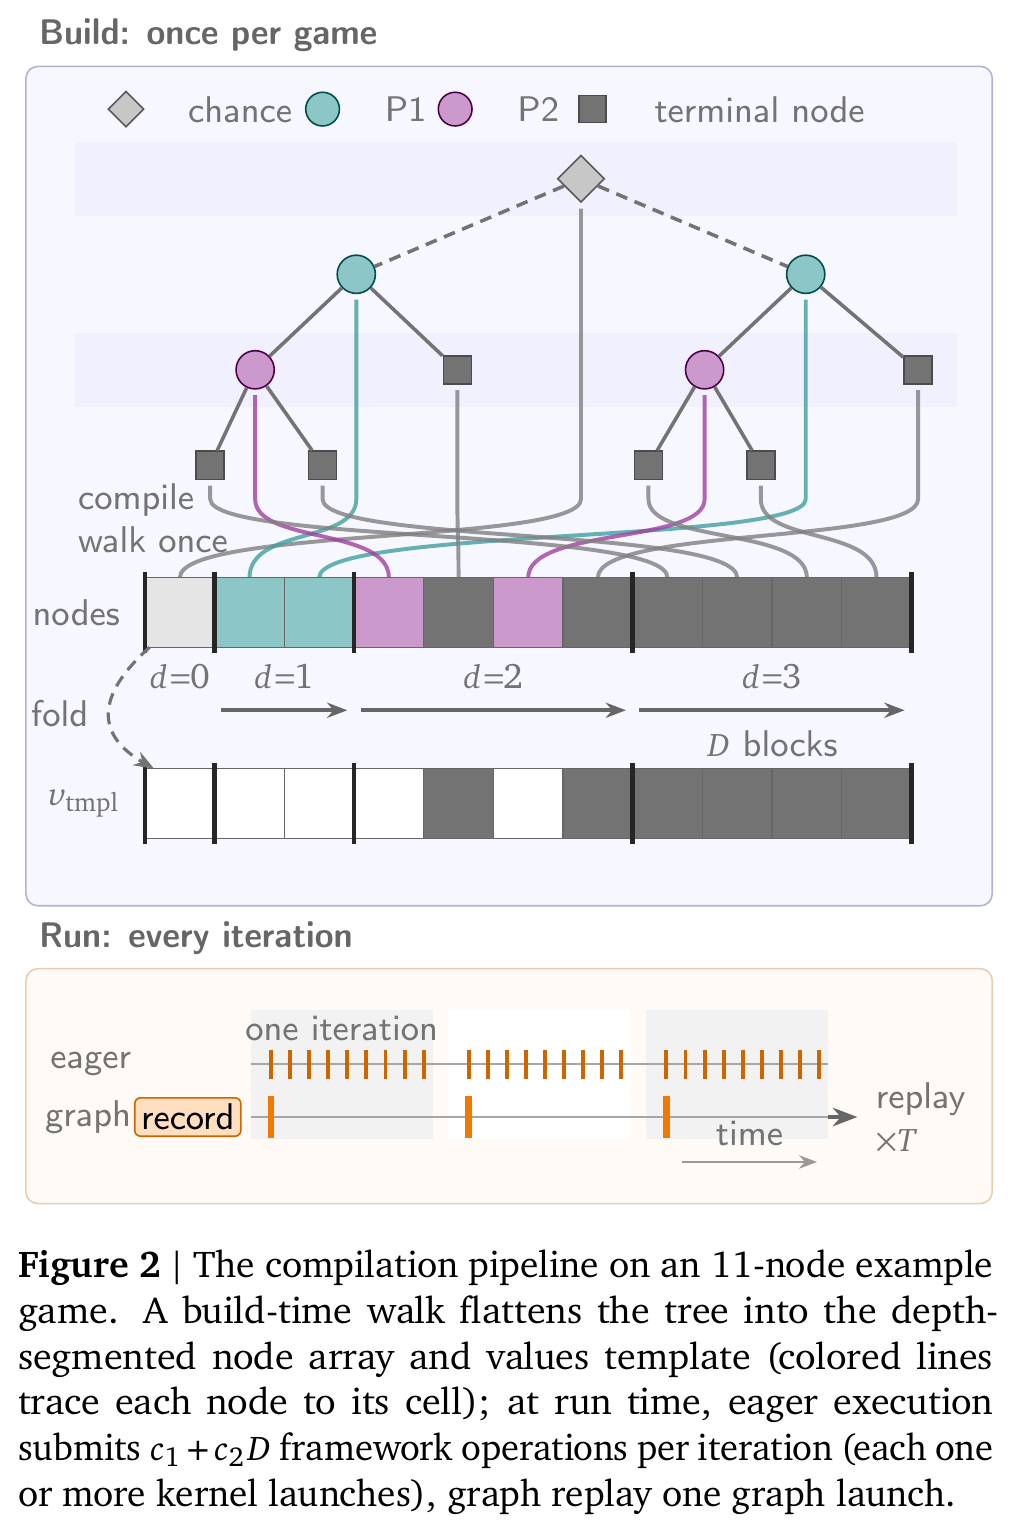
Figure 2. 11개 노드 게임의 컴파일 파이프라인. 원문 v1 PDF 6쪽에서 그림과 영어 캡션을 함께 크롭했습니다. 그림 내부는 번역·재구성하지 않았습니다.
4.2 One iteration as a fixed dataflow
(a) Static chance folding. 루트에서 말단까지 chance 확률의 곱은 전략과 무관하므로, 말단 보상에 미리 곱합니다.
$\pi_c(h)$는 루트부터 해당 노드까지 chance 확률만 곱한 값입니다. 매 반복의 역방향 계산을 이 템플릿에서 시작하고, 동적 순회에서 chance 간선의 승수는 1로 둡니다. 그러면 확률이 사라지는 것이 아니라 말단에 한 번만 들어갑니다. 가치 버퍼에는 이미 chance 가중치가 포함되어 있으므로 후회를 계산할 때 다시 곱하지 않습니다. 원문 식 (6)
(b) Depth-level execution blocks. 전방 도달 확률은 부모 결과를 알아야 자식을 계산할 수 있습니다. 같은 깊이의 간선을 모으면 서로 의존하지 않는 작업을 한 번에 실행할 수 있고, 깊이 순서만 유지하면 됩니다. 역방향 가치 계산은 같은 블록을 반대 순서로 사용합니다. 한 자식에는 부모가 하나이므로 전방 scatter는 덮어쓰기를 사용할 수 있습니다. 반면 여러 자식의 값을 한 부모로 더하는 역방향 단계는 index_add가 필요합니다.
(c) Sentinel slot and dual-lane reach buffer. 각 플레이어의 도달 확률은 자기 행동에서는 자기 전략 확률을 곱하고, 상대나 chance의 행동에서는 그대로 전달해야 합니다. 전략 벡터 끝에 항상 1인 sentinel 슬롯을 두고, 컴파일 시점에 실제 행동 슬롯 또는 sentinel을 가리키게 만듭니다. 두 플레이어의 도달 확률을 길이 $2N$의 버퍼에 연속 배치하면 같은 gather·곱셈·scatter가 두 lane을 함께 전진시킵니다.
후회 기여는 플레이어별 부호와 상대 도달 확률을 사용합니다.
$e=(h,a,h')$는 결정 간선, $q$는 해당 정보집합·행동 슬롯입니다. 가치가 플레이어 1 관점으로 저장되므로 $s(e)$는 플레이어 1이면 +1, 플레이어 2이면 −1입니다. 여기의 $\pi_{-i}$는 상대 lane의 플레이어 도달 확률만 뜻합니다. 앞 절의 일반 counterfactual reach와 달리 chance 확률은 이미 $v$ 안에 있습니다. 같은 슬롯을 공유하는 history들의 기여를 더하면 정보집합 수준의 후회가 됩니다. 원문 식 (8)
Algorithm 1은 개념적으로 깊이별 가치·후회 갱신을 보여주지만 실제 구현은 모든 가치가 완성된 뒤 후회 scatter를 한 번 평탄하게 수행합니다. 평균 전략 누적도 같은 결정 간선 인덱스를 활용합니다. 깊이에 비례하는 것은 전방·역방향 pass이고, 나머지는 고정 수의 연산입니다. HUNL turn은 100개 참조 실행 블록에서 8개 깊이 블록으로 줄어듭니다.
4.3 CUDA-graph execution
형상·인덱스·주소가 고정되었으므로 한 반복의 커널 순서를 기록할 수 있습니다. 단, 선형 평균의 반복 가중치는 매번 바뀝니다. 이를 host의 Python 숫자가 아니라 device의 0차원 텐서에 보관하고 graph 내부에서 증가시킵니다. batch 시작 시 host가 정확한 시작 번호를 채웁니다. float32 카운터의 연속 정수 표현은 $2^{24}$까지 정확하며, 이는 평균 전략의 float64 누적과 별개의 문제입니다.
warmup도 실제 전략을 바꾸는 반복이므로 전체 iteration 예산에 포함합니다. 포인터가 바뀐 버퍼를 재생하면 오래된 메모리에 접근하므로, 캡처 당시의 영속 버퍼 주소를 검사합니다. capture 실패 시 한 번 경고하고 같은 eager 경로로 복귀합니다. graph replay는 새 수학 알고리즘이 아니라 동일 커널의 제출 방식 변경입니다. 원문 §4.3
4.4 Layered verification
검증은 동일 프로세스의 eager/graph 비교, 최적화 전 참조 구현 비교, 독립 solver와 best-response oracle 비교로 나뉩니다. 모든 기기·프로세스의 결과가 항상 bitwise 동일하다는 주장은 아닙니다. CPU의 고정 reduction 순서에서는 8개 게임의 22회 float32 반복 후 후회 최대 차이가 0이고, GPU의 독립 실행에서는 scatter 합산 순서가 달라질 수 있습니다.
또한 기계 부하에 영향을 덜 받는 Aten 연산 수를 성능 회귀 기준으로 사용합니다. 핵심 기여는 정확성, 실행 중 안전성, 성능을 각각 다른 검사로 다룬 것입니다. 다음 챕터로의 연결은 이러한 구현을 세 연산자와 네 명제로 정식화하는 것입니다. 원문 §4.4
📖 Chapter 5: The Compiled Iteration, Formally
챕터의 위치와 역할: 앞의 구현 직관을 연산자 합성과 증명 가능한 성질로 바꿉니다.
Three indexed operators. 부모 깊이가 같은 간선 집합을 $B_\ell$로 두고, 전방 연산자 $\mathrm F$, 역방향 가치 연산자 $\mathrm B$, 후회 연산자 $\mathrm R$를 정의합니다. $\mathrm F$는 부모 도달 확률과 인덱스로 읽은 전략 확률을 곱해 자식 위치에 대입합니다. $\mathrm B$는 자식 가치를 전략 가중합해 부모에 누적하고, $\mathrm R$는 결정 간선의 차이를 정보집합 행동 슬롯에 누적합니다. 식 (11)은 대입이고 식 (12)–(13)은 합산이라는 차이가 중요합니다. 트리의 유일한 부모 성질이 전방 버퍼를 매번 지우지 않아도 되는 근거입니다.
What the operators compute. 명제 1은 chance folding 후에도 chance 가중 continuation value가 정확하다는 것, 명제 2는 sentinel을 통한 dual-lane 업데이트가 경우별 원래 정의와 같다는 것입니다. 명제 3은 의존하는 연속 간선을 같은 그룹에 넣을 수 없는 스케줄 중 깊이별 스케줄이 최소 그룹 수를 가진다는 것입니다. 모든 가능한 GPU 알고리즘의 전역 실행 시간이 최소라는 주장은 아닙니다.
연산 호출 수는 $c_1+c_2D$ 형태입니다. $D$는 간선이 존재하는 깊이 수이며, 실제 Table 2의 CFR+ 연산 수는 $8D+32$와 맞습니다. 노드 수가 커져도 연산 호출 수보다 각 배치의 폭이 커진다는 설명입니다. 배치 폭과 메모리 접근 비용까지 상수가 된다는 의미는 아닙니다. 원문 §5
The averaging horizon. 선형 평균은 다음과 같이 누적합니다.
$x_t$는 해당 슬롯의 자기 도달 확률과 전략 확률의 곱에 대응하는 0–1 값이고, $p$는 유효 가수 비트 수, ulp는 해당 크기에서 인접한 표현 가능 수의 간격입니다. 명제는 이상적인 합이 $\Theta(T^2)$로 증가하고 현재 $x_T$가 양의 상수 이상이라는 조건을 둡니다. 합의 크기에 비해 새 증가량의 해상도가 떨어지는 규모가 $2^p$ 수준이라는 뜻이며, 정확히 그 반복에서 모든 슬롯이 영구 정지한다는 뜻은 아닙니다. GPU-CFR가 모든 규칙의 평균 전략 누적을 float64로 유지하는 근거입니다.
핵심 기여는 구조적 정확성과 수치 표현의 범위를 함께 명시한 것입니다. 다음 챕터로의 연결은 실제 게임과 측정 조건입니다. 원문 명제 4·식 (15)
📖 Chapter 6: Experimental Setup
챕터의 위치와 역할: 어떤 비교가 실행 표현을 비교하고 어떤 비교가 서로 다른 라이브러리 기본 설정을 비교하는지 정합니다.
Three evaluation suites. 주 timing/regression 실험은 OpenSpiel의 공개 게임 6개와 자체 HUNL subgame 2개입니다. Kuhn, Dark Hex 2×2, HUNL river, Leduc, Goofspiel-5, HUNL turn, Liar’s Dice, Battleship이 포함되며 Infosets는 54–275,983입니다. 별도의 규칙 실험은 12개 게임에서 네 규칙과 두 갱신 순서를 비교합니다. 포커 확장 실험은 공개된 Libratus endgame 등을 사용합니다.
Backends. GPU-CFR eager/graph와 Kim은 같은 A100을 사용합니다. 주 GPU 비교는 CFR+, 동시 갱신, 선형 평균, float32를 맞춥니다. 같은 컴파일 데이터 흐름의 CPU arm은 물리 코어 8개, LiteEFG는 단일 스레드 C++입니다. LiteEFG의 주 표는 vanilla CFR·동시 갱신·균일 평균·float64여서 GPU-CFR와 모든 의미가 같지 않습니다. OpenSpiel은 Python·교대 갱신·균일 평균의 vanilla CFR입니다.
Shared game representations. 공개 게임을 백엔드별 형식으로 변환하고, 자체 포커와 Libratus 트리는 하나의 체크섬이 있는 export를 외부 구현에도 전달합니다. 노드 수만 같은지보다 행동·정보집합 의미와 가치가 일치하는지도 검사합니다.
Protocol. GPU steady-state는 50회 warmup 이후 1,000회의 CUDA event 시간입니다. 트리 구축과 graph capture는 별도 표에 둡니다. OpenSpiel은 200회를 실행해 반복당 시간으로 보고합니다. 따라서 표의 ms/iteration에 구축·평가 시간을 더했다고 해석하면 안 됩니다. 핵심 기여는 시스템과 수렴의 비교 조건을 드러내는 것입니다. 다음 챕터로의 연결은 이 조건 아래의 결과입니다. 원문 §6, Table 8
📖 Chapter 7: Results
챕터의 위치와 역할: 속도 자체에서 시작해 원인, 품질, 알고리즘 축, 반복 재사용으로 결과를 넓힙니다.
Cross-framework timing. Table 3의 주요 행을 ms/iteration 단위로 옮기면 다음과 같습니다. 낮을수록 빠릅니다.
| 게임 | GPU-CFR graph, A100 | GPU-CFR eager, A100 | 같은 데이터 흐름 CPU 8 threads | Kim, A100 | LiteEFG, CPU 1 thread |
|---|---|---|---|---|---|
| Kuhn | 0.113 | 0.401 | 0.177 | 9.057 | 0.008 |
| Dark Hex 2×2 | 0.174 | 0.536 | 0.243 | 11.691 | 0.065 |
| HUNL river | 0.210 | 0.411 | 1.697 | 9.642 | 16.857 |
| Leduc | 0.304 | 0.738 | 0.612 | 12.860 | 1.233 |
| Goofspiel-5 | 0.245 | 0.591 | 0.765 | 13.180 | 3.375 |
| HUNL turn | 0.397 | 0.617 | 5.360 | 11.893 | 102.160 |
| Liar’s Dice | 0.556 | 0.933 | 4.378 | 16.545 | 102.880 |
| Battleship | 0.380 | 0.688 | 3.138 | 14.393 | 80.952 |
출처는 원문 Table 3이며, LiteEFG는 앞 절에서 설명한 다른 규칙·평균·정밀도 조건입니다. 가장 작은 두 게임은 CPU가 이깁니다. Kim 대비 graph의 개선은 29.8–80.4배, 중앙값 44.1배이며, eager만으로도 17.4–23.5배입니다. CPU에서 같은 표현을 실행해도 기존 GPU 기준선보다 2.2–51.1배 빠르다는 결과는 개선을 GPU 하드웨어만으로 설명하기 어렵게 합니다.
Where the speed comes from. Figure 4의 HUNL turn ablation은 같은 프로세스·스택에서 참조 eager → 컴파일 eager → graph를 비교합니다. 연산 수는 약 18배, 첫 단계 시간은 약 19배 감소하고, graph가 약 1.6배를 추가해 전체 약 29배가 됩니다. 이는 위 표의 서로 다른 구현 간 최대 80.4배와 구별해야 하는 실험입니다.
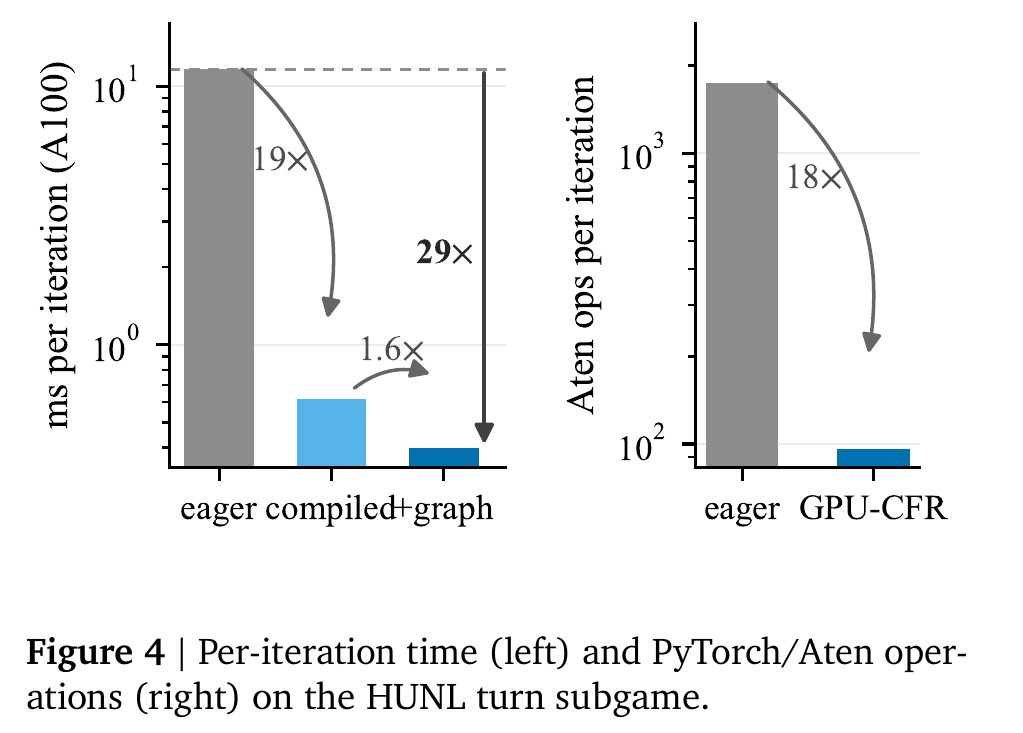
Figure 4. 왼쪽은 A100의 반복당 시간(ms), 오른쪽은 반복당 Aten 연산 수이며 두 세로축 모두 로그 눈금입니다. 원문 v1 PDF 13쪽에서 두 패널과 영어 캡션을 함께 크롭했고, 축·수치·표시는 변경하지 않았습니다.
깊이를 거의 유지하며 hand range를 4개에서 24개로 늘린 Figure 5에서는 상태 수가 37.9배, 반복 시간은 2.95배 증가합니다. 추가 데이터가 배치를 넓히는 동안 순차적인 깊이 단계는 거의 같기 때문입니다. 다만 §14의 하드웨어 카운터는 대역폭을 모두 활용하는 상태가 아님을 보여줍니다.
Quality against wall-clock. Figure 8은 학습 시간 대비 exploitability를 그립니다. 0.1–30초의 여섯 checkpoint와 백엔드별 독립 프로세스 10개를 사용합니다. 선은 중앙값, band는 프로세스 전체 범위입니다. Table 5는 Kim의 30초 중앙 exploitability의 10배·3배·1.5배를 기준으로 임계값을 정한 뒤, checkpoint 사이를 log–log 보간해 최초 도달 시간을 추정합니다. 이 값은 직접 측정한 연속적인 정확한 crossing 시점이 아닙니다.
예를 들어 HUNL turn에서 임계값 0.0111의 도달 시간은 GPU-CFR 0.978초 [0.976, 0.983], Kim 17.821초 [17.639, 18.008]로 중앙값 비율 18.213배입니다. 괄호는 독립 프로세스 10개에 대한 10,000회 bootstrap의 95% 구간입니다. 모든 게임·임계값의 보고 범위는 약 3.8–44배이며, 두 matched arm에서 각각 적어도 8/10개 프로세스가 도달한 행만 포함합니다. 원문 Table 5
Update rule and update order. 12개 게임×4개 규칙×2개 순서의 96칸을 동일 CPU 엔진에서 비교합니다. 같은 보고 iteration 수에서 교대 갱신이 48쌍 중 44쌍에서 더 낮은 exploitability를 보입니다. 대략 두 배의 플레이어 업데이트 비용을 반영해도 41쌍에서 낫습니다. 동시 갱신에서는 PCFR+가 12개 중 11개를 선도하고, 교대 갱신에서는 PCFR+와 DCFR가 6개씩 선도합니다. 규칙의 순위가 갱신 순서와 상호작용한다는 결과이지, 한 규칙이 언제나 가장 좋다는 결론이 아닙니다.
Repeated solves of one tree. 구축 비용은 한 번 지불하고 같은 topology에서 재사용할 수 있습니다. 주 HUNL turn 사례는 전체 초기화 비용까지 첫 1,000회 solve 안에서 기존 구현보다 유리하다고 보고합니다. 그러나 별도 Libratus endgame 4에서는 Kim이 더 빠릅니다. Table 7의 200회 training-call 시간은 GPU-CFR 3.184초, Kim 2.374초, LiteEFG 2,771.135초입니다. 약 3,610만 States가 대부분 말단인 구조에서는 sequence-form 대비 깊이별 실행의 이점이 줄어듭니다. 이 표는 GPU-CFR timing이 두 실행의 중앙값이고 외부 baseline은 단일 실행이며, 품질 지표는 가장 빠른 실행에서 가져옵니다.
핵심 기여는 headline 수치를 적용 범위·원인·품질·예외까지 연결한 것입니다. 다음 챕터로의 연결은 이러한 결과에 기반한 본문 결론입니다. 원문 §7
📖 Chapter 8: Conclusion
챕터의 위치와 역할: 본문의 기여를 컴파일 가능한 정적 게임 구조라는 관점에서 다시 묶습니다.
저자들은 평탄한 배열, chance folding, 깊이별 스케줄, 분기 없는 간선을 통해 CFR 반복을 64–152개 텐서 연산으로 표현한 결과를 강조합니다. 균형 계산을 호출하는 온라인 re-solving·abstraction·neural CFR의 내부 루프에 활용할 수 있다는 전망과 함께 코드·게임 명세·벤치마크 스크립트를 공개했다고 밝힙니다. 이 리뷰는 논문에 기재된 공개 위치를 확인 대상으로 기록하며, 구현 설치나 성능 재현을 직접 수행했다는 뜻은 아닙니다.
핵심 기여는 갱신 규칙과 실행 표현의 분리입니다. 다음 부분으로의 연결은 References 뒤에서 실제 포커 구성, 세부 측정, 증명으로 본문의 주장을 뒷받침하는 것입니다. 원문 §8
📖 References: 인용 문헌의 위치
References는 CFR·CFR+·DCFR·predictive CFR, 게임 추상화·subgame solving, OpenSpiel·LiteEFG·GPU 실행과 관련된 선행 연구를 나열합니다. 본 리뷰는 앞 절의 분류를 이해하는 데 필요한 인용 관계를 반영했으며, 목록의 모든 논문을 별도로 읽거나 재평가하지 않았습니다. 원문 순서대로 이어지는 9–17절은 본문에서 생략된 실험 조건과 증명을 제공하는 상세 자료입니다.
📖 Chapter 9: HUNL Subgame Construction
챕터의 위치와 역할: “같은 포커 게임을 풀었다”는 비교의 기반을 명시합니다.
The two native subgames → Background. 저자들은 no-limit hold’em의 river와 turn 하위 게임을 정의한 뒤, subgame solving과 온라인 re-solving이 왜 같은 구조의 반복 계산을 필요로 하는지 설명합니다. 두 게임 모두 정확한 7-card hand 평가를 사용하고 작은 사례의 완전열거로 검사합니다.
River subgame. 고정 board는 Ks Js Th 7d 2c, pot은 20, stack은 100입니다. 플레이어당 후보 hand 100개 중 카드가 겹치지 않는 9,161개 deal을 균등하게 사용합니다. 한 betting street에서 check/bet/fold/call을 허용하고, bet 크기는 pot의 0.5배와 1배이며 raise는 없습니다. 이는 무제한 실제 포커 전체가 아니라 정해진 행동 추상화입니다. 3,000 Infosets와 137,415 States가 나옵니다.
Turn subgame. board는 Ks Js Th 7d, 플레이어당 hand 12개, 기본 seed의 유효 deal은 131개이며 river 카드 44개를 전부 다룹니다. turn과 river에서 베팅하고 all-in 뒤 river betting은 생략합니다. river fold에는 이전에 투입한 칩을 반영하는 sunk-cost 보상 정의가 적용됩니다. 그 결과가 83,040 Infosets, 433,610 States, 깊이 블록 8개입니다.
Analytic anchors → Best-response oracle. 최강 hand만 보유한 river 사례의 이론적 값은 half-pot인 +10이고, 구현의 chance 이산화에서는 완전열거 값 +10.000033을 검사합니다. quads 사례는 모든 river에서 이기므로 +10으로 수렴하며 1,000회 후 exploitability가 0.001보다 낮습니다. 독립 재귀 oracle은 작은 게임의 순수 전략 완전열거로 먼저 검사하고, 실제 평가기와 허용오차를 비교합니다.
External reconstruction → Scope. OpenSpiel universal_poker로 river를 재구성할 때 all-in과 pot-size bet의 중복 제거, 카드 인코딩 순서, 행동 순열을 맞춥니다. chance root를 포함한 137,416 nodes와 모든 말단 보상이 일치합니다. turn에서는 하나의 chips-behind 설정으로 양쪽 street의 all-in 중복을 동시에 맞출 수 없어 외부 재구성을 하지 않습니다. 원문이 명시한 범위 제한입니다. 외부 baseline의 turn·Libratus 비교는 이 재구성과 별개로 공유 export를 사용합니다.
핵심 기여는 게임 이름 대신 행동·보상·정보 구조까지 비교 대상을 고정한 것입니다. 다음 챕터로의 연결은 그 게임을 어느 환경에서 어떻게 계측했는지입니다. 원문 §9
📖 Chapter 10: Benchmark Protocol and Environment
챕터의 위치와 역할: 측정값의 분모와 실행 환경을 재현 가능한 수준으로 구분합니다.
Hardware and software. A100 80GB PCIe, 두 Intel Xeon Gold 6348, 256GB 메모리, PyTorch 1.13.1+cu117·CUDA 11.7·Python 3.9.16이 기본 환경입니다. CPU arm은 한 NUMA node의 물리 코어 8개에 고정하고 SMT sibling을 제외합니다. 공유 host의 다른 부하는 존재하므로 시작 전후 load를 기록하고 별도의 고정 코어·GPU queue에서 측정합니다.
Timing rules. steady-state는 50회 warmup 뒤 51–1050회 반복을 측정합니다. training-call은 이미 solver를 구성한 뒤 호출에 들어가는 세 번의 eager warmup과 capture를 포함하고, 호출 종료 시 device synchronize로 계산 완료를 확인합니다. 게임 명세 생성·컴파일·solver 생성 및 exploitability 평가는 제외합니다. GPU-CFR와 자체 CPU timing은 20회, baseline과 vanilla control은 10회 독립 프로세스의 중앙값입니다. 본문 배수는 반올림 전 중앙값으로 산출하므로 표의 소수점 수로 나누면 끝자리가 달라질 수 있습니다.
Operation and memory counters → Solve protocol. Aten은 dispatcher interception으로 세고, 메모리는 allocated/reserved를 구분해 MiB로 보고합니다. 주 protocol은 CFR+·동시 갱신·선형 평균·float32·seed 0입니다. 규칙별 1,000회 비교는 의도적으로 CPU에서 수행해 GPU의 합산 순서 차이가 규칙 순위를 흐리지 않도록 합니다.
Conversion validation → Reproduction. 구조 개수와 작은 게임의 수렴·알려진 값을 확인합니다. 원문은 환경·부하·게임 크기·dtype가 있는 JSONL, 그림과 표 생성기, benchmark driver와 테스트를 재현 자료로 설명합니다. 리뷰어는 논문상 제공 정보의 범위를 평가했으며 이 환경을 구축하거나 24.2시간의 측정 campaign을 재실행하지 않았습니다.
핵심 기여는 steady-state, 첫 호출, 전체 구축, 평가 시간을 섞지 않는 측정 계약입니다. 다음 챕터로의 연결은 이 속도로 얻은 수치가 맞는지에 대한 검사입니다. 원문 §10
📖 Chapter 11: Correctness Test Inventory
챕터의 위치와 역할: 구현 정확성과 반복 실행의 수치 변동을 분리합니다. 원문은 총 499개 테스트를 보고합니다.
Reference-oracle parity → Independent reference solver. 최적화 전 solver를 보존하고 CFR/CFR+와 균일/선형 평균의 조합을 검사합니다. CPU float64는 절대오차 $10^{-12}$, 별도 Python 참조 solver의 작은 HUNL 비교는 $10^{-9}$ 조건입니다. Table 2의 8개 큰 게임에서는 22회 float32 반복의 후회 차이가 0입니다. 이들은 범위와 허용오차가 다른 검사입니다.
Structural invariants → CUDA-graph path. 전방 scatter 목적지가 루트를 제외한 각 lane을 정확히 한 번 덮는지, 나누어 호출한 반복과 한 번에 실행한 반복이 같은지 검사합니다. 0회 호출, root-terminal·all-chance 게임, capture 실패 시 한 번 경고하는 fallback, 포인터 교체를 replay 전에 거부하는 동작도 포함합니다.
Seed-invariance audit. 동일 seed 20회와 서로 다른 seed 4회를 섞어 비교합니다. CPU는 모든 쌍이 동일합니다. GPU에서는 seed 차이와 동일 seed 내 합산 순서 차이를 분포로 비교하고, 10,626개 relabeling의 정확 permutation 검정을 사용합니다. 8개 게임 모두 유의수준 0.05에서 차이를 검출하지 못했으며 최소 p값은 0.15입니다. 이는 “seed가 같으므로 GPU 출력이 bitwise 같다”는 주장과 다릅니다. 서로 다른 개수의 pair에서 최대값만 비교했던 초기 감사 기준의 문제도 원문이 설명합니다.
How far reduction-order noise propagates. Leduc·HUNL river의 네 규칙·두 순서, 각 8회 GPU 실행에서는 1,000회 float32 뒤 exploitability 범위가 중앙값 대비 0.004%–65%, 16칸 중앙값은 3.5%입니다. Leduc float64·8,000회에서 더 큰 상대 변동도 보고합니다. 후회가 0 근처일 때 반올림 차이가 clipping과 재정규화를 거쳐 전략 support를 다르게 만들 수 있기 때문입니다. 단순히 float64로 바꾸면 모든 경로가 같아진다고 보지 않습니다.
Performance gates → Evaluator and game-level checks. 연산 수를 $40+10D$ 이내로 제한하는 검사는 머신 부하와 무관한 회귀 기준입니다. 평가기는 재귀 best response와 알려진 게임 값으로 따로 검사합니다. 핵심 기여는 수학적 동등성, 동일 실행 경로의 일치, 독립 GPU 실행의 변동을 구분한 것입니다. 다음 챕터로의 연결은 세부 자원·반복 분산·다른 구현의 결과입니다. 원문 §11
📖 Chapter 12: Additional Results
챕터의 위치와 역할: headline 반복 시간 밖에서 사용자가 실제로 지불하는 비용을 보여줍니다.
Solver lifecycle. Table 9는 HUNL turn의 명세 생성 2.925초, 컴파일·solver 생성 1.305초를 분리합니다. solver를 재사용한 1/10/100번의 1,000회 solve 누적 시간은 4.942/8.537/44.462초입니다. 매번 재구축하는 모델 추정은 4.943/49.425/494.250초입니다. 재사용 쪽은 측정값, rebuild 쪽은 모델 추정값이라는 차이를 유지해야 합니다. 두 번째 solve부터 reset과 payoff·root-range 갱신을 수행합니다.
Peak GPU memory. Table 10의 HUNL turn은 peak allocated 183MiB, reserved 236MiB입니다. Table 9의 capture 이후 solver 수명주기 측정은 112MiB/162MiB로 다른 측정 범위를 가집니다. 특히 큰 endgame의 평가용 float64 트리까지 포함한 benchmark process와 solver 단독 메모리를 섞으면 안 됩니다.
Timing dispersion → Kim precision. Table 11의 graph timing은 20회 독립 프로세스에서 최대 상대 IQR과 전체 범위가 각각 약 1%이고, eager는 host scheduling에 더 민감합니다. Kim의 Leduc·Liar’s Dice에서 float64와 float32 시간이 비슷한 현상도 계산 정밀도보다 launch가 지배하는 해석과 연결합니다.
12.1 Cross-implementation check of the update-rule study
다른 구현에서 규칙 순위가 재현되는지 확인합니다. 양쪽에 유일한 최소값이 있는 비교 10개는 모두 winner가 일치하고, 동률이 있는 2개는 제외합니다. uniform·linear·last-iterate scoring이 섞이므로 절대 exploitability를 구현 간 그대로 비교하지 않고 각 구현·게임·순서 안의 순위를 비교합니다.
LiteEFG: both arms. LiteEFG의 vanilla는 동시 갱신, 나머지 세 규칙은 교대 갱신이므로 주 GPU-CFR와 두 축이 동시에 맞는 preset이 없습니다. 교대 CFR+ preset은 반복당 1.28–1.47배 더 비싸지만 동일 iteration에서 더 낮은 gap에 도달할 수 있습니다. 규칙 변경과 순서 변경을 동시에 한 결과를 한쪽 효과로 귀속하지 않습니다. Measurement provenance는 이를 같은 측정 campaign과 실행별 기록에 연결합니다.
핵심 기여는 구축·재사용·메모리·변동을 따로 보여주는 것입니다. 다음 챕터로의 연결은 더 큰 포커 트리에서 외부 solver가 같은 게임을 풀었는지 확인하는 방법입니다. 원문 §12
📖 Chapter 13: Poker Head-to-Heads and the Value-Agreement Certificate
챕터의 위치와 역할: 자체 생성 게임을 외부 solver에 전달할 때 생길 수 있는 의미 차이를 검사합니다.
Exporting our trees. 컴파일 표현을 LiteEFG의 범용 extensive-form 텍스트 형식으로 streaming export하고, Kim은 별도 interpreter의 adapter로 같은 체크섬 파일을 읽습니다. 자식 노드의 고유 이름을 행동 label로 사용하면 동일 정보집합의 행동이 노드별로 갈라지는 오류가 생깁니다. 원문은 이 오류가 Kuhn의 player별 sequence 수를 13에서 25로 늘리고 겉보기 gap을 과도하게 개선했다고 설명합니다. 각 정보집합에서 일관된 행동 순서를 확인한 뒤 행동 위치를 label로 써서 해결합니다.
Structural equivalence. Kuhn·Leduc의 sequence 수와 결과를 비교하고, river 및 endgame 4의 sequence 수도 compiler와 baseline 사이에서 일치시킵니다. 트리 모양만 같아도 전략 공간은 달라질 수 있다는 점을 검사에 반영합니다.
The certificate that scales: comparing on the value. 제로섬 게임의 균형 가치는 하나이므로, 각 전략의 best-response gap으로 추정 가치가 벗어날 수 있는 범위를 제한합니다.
여기서 $i,j$는 플레이어가 아니라 두 백엔드의 결과를 가리킵니다. $v_i$는 그 백엔드 평균 전략의 플레이어 0 기대 보상이고, 각 NashConv는 해당 프로파일의 두 best-response 이익 합입니다. 같은 게임에서 올바른 평가를 했다면 만족해야 하는 부등식입니다. 리뷰어 해석으로, 이 조건의 통과만으로 임의의 두 게임이 동일하다는 충분조건이 되는 것은 아닙니다. 구조·행동 변환 검사와 함께 해석해야 하며, 원문에서 발견한 adapter 오류를 잡는 일관성 검사로 유용합니다. 원문 식 (16)
Gaps agree once the variant is matched. river에서 CFR+·교대 갱신·선형 평균·float64로 맞춘 8,000회 결과는 GPU-CFR $1.27\times10^{-5}$, LiteEFG $1.25\times10^{-5}$이고, game value는 약 $3\times10^{-8}$ 차이입니다. 앞 표의 품질 차이에 갱신 순서가 섞였다는 해석을 뒷받침합니다.
The river subgame, three ways. Table 13은 각 native CFR+ preset의 1,000/8,000회 실행을 비교합니다. 1,000회 training-call은 GPU-CFR 0.315초, Kim 9.699초, LiteEFG 28.134초입니다. LiteEFG는 교대 갱신·float64이므로 gap의 우열을 동일 알고리즘의 성능으로 해석하지 않습니다. 세 backend의 value spread는 반복 증가에 따라 약 $1.02\times10^{-3}$에서 $8.58\times10^{-5}$로 줄어듭니다.
Libratus endgame 4. 약 3,610만 노드의 2.42GB 파일에서 GPU-CFR는 load 165.889초와 컴파일·solver 생성 124.751초를 먼저 지불합니다. benchmark process는 평가 트리를 포함해 peak allocated 14.4GiB, solver만은 약 8.9GiB입니다. 매우 큰 게임에서도 첫 반복 이전 비용과 메모리는 상당합니다. 주 timing suite의 80배가 이 terminal-heavy 구조로 이어지지 않고 Kim이 더 빠른 결과를 앞서 Table 7에서 확인했습니다.
Endgame 3. 약 9,317만 노드의 export가 6GB를 넘고 loading 비용이 커지므로 외부 baseline과의 직접 비교는 수행하지 않았다고 원문이 명시합니다. 핵심 기여는 같은 게임과 같은 알고리즘의 조건을 따로 검사한 것입니다. 다음 챕터로의 연결은 실제 커널 수준에서 남은 비용입니다. 원문 §13
📖 Chapter 14: Kernel-Level Profile and Alternative Execution Models
챕터의 위치와 역할: 실행 시간 단축의 원인을 profiler로 확인하고 대안 구현을 비교합니다.
What one iteration launches. HUNL turn의 96 Aten 연산은 eager에서 87커널과 87 host launch로 나타납니다. graph 경로는 같은 solver 연산에 카운터 및 프레임워크 random-state refresh가 더해져 Table 14에서 90커널·3 host submission입니다. 따라서 “graph launch 하나”를 “GPU에서 실행되는 커널이 하나” 또는 “host submission이 문자 그대로 하나뿐”으로 해석하면 안 됩니다. 측정 window의 GPU busy 비율은 32%에서 94%로 증가합니다.
하드웨어 카운터의 DRAM traffic은 반복당 129MB이며, unprofiled 0.397ms로 나눈 값은 약 325GB/s, peak의 17%입니다. solver 배열만 센 bytes-moved 모델의 대역폭과 다른 지표입니다. 커널 절반가량은 block 수가 A100의 SM 수보다 적으므로 큰 처리량보다는 작은 grid의 지연시간이 남은 비용을 설명합니다.
More iterations per graph. graph 하나에 1·10·100개 반복을 넣어도 HUNL turn은 0.397·0.391·0.391ms로 큰 추가 이득이 없습니다. 이미 launch 비용을 충분히 줄였기 때문입니다.
A generic compiler on the same dataflow. PyTorch 2.5.1에서도 표현 변환과 graph의 개선 순서는 유지됩니다. torch.compile default는 turn에서 약 0.357ms로 graph 경로보다 빠르지만, Leduc에서는 0.415ms로 느립니다. 첫 컴파일 수초와 reduction 재배치에 따른 부동소수점 차이가 있고, 테스트한 설정에서 핵심 gather/scatter의 launch가 전반적으로 융합되지 않았습니다. 범용 compiler가 게임→정적 데이터 흐름 변환 자체를 대신한 실험은 아닙니다.
Graph capture of the prior GPU baseline → CPU thread scaling. 논문의 CuPy 경로는 작은 Kuhn부터 sparse product capture가 실패하고 반복 중 host-to-device 전송도 문제입니다. 이 결과를 모든 버전의 cuSPARSE가 영구적으로 capture 불가하다는 일반 명제로 확대하지 않습니다. CPU 1–28개 물리 코어 sweep은 작은 깊이별 연산의 intra-op 병렬성이 일찍 포화함을 보여줍니다.
Hand-fused kernels. Triton으로 깊이별 전방·역방향 pass와 슬롯 업데이트를 직접 융합하면 실행 수를 $2D+5$로 줄입니다. Table 16의 HUNL turn은 compiled graph 0.400ms에서 fused graph 0.193ms로 2.075배 개선됩니다. 다섯 게임에서 graph 위에 추가한 융합 이득은 약 1.985–2.533배입니다. 따라서 정적 데이터 흐름과 graph는 중요한 개선이지만 커널 수준의 모든 개선을 소진한 것은 아니라는 원문 자체의 실험 결과입니다.
핵심 기여는 dispatcher 호출·host launch·실제 커널·GPU busy·대역폭을 구분한 것입니다. 다음 챕터로의 연결은 이런 실행을 생성하는 compiler와 메모리 계약입니다. 원문 §14
📖 Chapter 15: Compiler Passes and Memory Plan
챕터의 위치와 역할: 앞의 표현이 실제로 만들어지는 순서와 재풀이 시 수정할 수 있는 항목을 명시합니다.
Algorithm 2의 논리적 순서는 게임 구조 검사 → 정보집합 슬롯 배치 → 노드 배열 → 간선 배열 → 깊이별 안정 정렬 → chance folding → lane별 인덱스 생성 → 메모리 계획 → 규칙별 hook 연결 → warmup·capture·replay입니다. 구조 검사에는 유일한 부모, 정보집합 소유자와 행동 목록의 일치, chance 확률의 존재가 포함됩니다. 정렬을 포함한 시간은 $O(N+E\log E)$, host 저장은 $O(N+E)$로 설명합니다.
Planning scope. 메모리 계획은 예상 버퍼 크기가 budget에 들어오는지 표시하는 지표입니다. 원문 구현은 그 판단과 무관하게 build를 진행하고 일부 누적 벡터는 계획보다 먼저 할당합니다. 이를 메모리 부족을 사전 차단하는 보장으로 설명하면 안 됩니다.
Input representation. native game·OpenSpiel·파일 converter는 노드와 정보집합 및 chance 확률 map의 동일 GameSpec을 만듭니다. 그 아래의 pass를 공유하므로 입력 converter가 의미를 잘 보전했는지가 중요한 경계입니다.
Mutable and immutable fields. 인덱스는 고정하지만 말단 payoff와 root chance distribution은 제자리에서 바꿀 수 있습니다. 원문은 아래쪽 chance product와 root 소유 정보를 남겨 값 템플릿을 다시 계산합니다. reset()은 누적 후회·평균 전략·예측 버퍼와 카운터를 같은 주소에서 초기화합니다. topology를 바꾸지 않는 이 갱신들은 기존 graph를 계속 쓸 수 있게 합니다. 임의의 중간 chance 구조 변경까지 같은 계약에 포함하지 않습니다.
Update rules share one schedule. 규칙 차이는 슬롯 벡터의 할인·clamp·prediction hook에 들어갑니다. CFR+ 대비 Aten 증감은 vanilla −1, PCFR+ +13, DCFR +29이며 Leduc와 HUNL turn에서 같습니다. 트리 깊이에 비례하는 $8D$ 부분은 공유합니다. 핵심 기여는 재사용 가능한 구조와 변경 가능한 수치를 명확히 나눈 것입니다. 다음 챕터로의 연결은 이 구조의 정확성과 표현 정밀도를 증명하는 것입니다. 원문 §15
📖 Chapter 16: Proofs
챕터의 위치와 역할: 유한 트리와 유일한 부모라는 가정 아래 네 명제의 근거를 순서대로 제시합니다.
16.1 Proposition 1: folded chance is exact
말단에서 시작해 높이에 대한 귀납법을 사용합니다. 말단은 이미 전체 chance 곱을 포함한 payoff 템플릿입니다. 비말단에서는 자식들이 최종값을 얻은 뒤 합칩니다. chance 노드는 승수 1을 쓰며 chance 기여는 자식 값 안에 있고, 결정 노드는 자신의 전략 확률을 곱합니다. 자식별 말단 집합은 서로 겹치지 않는 분할이므로 모든 말단 기여가 정확히 한 번 합쳐집니다. chance 확률을 동적으로 또 곱하면 두 번 반영된다는 실패 조건도 증명 뒤에 설명합니다.
16.2 Proposition 2: the dual-lane update is exact
자기 결정 간선이면 인덱스가 실제 전략 슬롯을, 그 외면 값 1인 sentinel을 가리킨다는 두 경우를 나눕니다. 각각 원래의 곱셈과 복사 정의에 해당하므로 결과가 같습니다. 두 lane은 서로 겹치지 않는 버퍼 영역이며, 한 자식으로 들어오는 간선이 하나라서 scatter 대입의 경합이 없습니다. 이전 깊이에서 부모 값이 만들어졌다는 점이 오래된 scratch를 읽지 않는 근거입니다.
16.3 Proposition 3: the depth schedule is shortest
부모→자식으로 이어지는 두 간선은 서로 다른 순서 그룹에 있어야 합니다. 가장 깊은 간선에서 루트로 올라가면 길이 $D$의 의존 사슬이 있으므로 어떤 dependency-respecting 스케줄도 적어도 $D$그룹을 필요로 합니다. 깊이별 묶음이 정확히 그 수를 달성합니다. 연산 수의 상수항과 깊이 비례항은 그룹별 고정 연산과 나머지 고정 작업을 합해 얻습니다.
16.4 Proposition 4: the averaging horizon
크기가 $2^k\leq S\lt2^{k+1}$인 정상 범위의 부동소수점 수에서 간격은 $2^{k-p+1}$입니다. 합이 $T^2$ 차수로 커질 때 간격은 $T^2 2^{-p}$ 차수가 되고 새 증가량은 $T$ 차수이므로 앞의 식 (15)를 얻습니다. 실제 반올림 누적량의 다음 큰 표현 가능 수까지 간격을 $g_T$라 하면, 아래 조건에서 새 증가량이 흡수됩니다.
$\widehat S$는 실제 저장된 누적량, $\widehat\delta_T$는 실제 덧셈에 들어가는 증가량, $\mathrm{fl}$은 round-to-nearest 반올림입니다. 정확히 중간인 경우는 tie-breaking 규칙을 따릅니다. 한 번 흡수되어도 뒤의 더 큰 증가량이 반영될 수 있으므로 영구 정지로 단정하지 않습니다. subnormal과 overflow는 이 정상 범위의 점근 논증 밖입니다. 균일 평균도 finite-resolution 문제를 가지므로 float64 누적을 모든 규칙에 사용한다는 결론으로 이어집니다.
핵심 기여는 구조적 불변식과 수치적 적용 범위를 분리한 것입니다. 다음 챕터로의 연결은 현재 정적 트리 설계를 넘어서는 저자의 확장 방향입니다. 원문 §16
📖 Chapter 17: Future Work
챕터의 위치와 역할: 본문과 증명 뒤에서 저자가 명시적으로 제안하는 응용 및 미해결 설계 문제를 정리합니다.
원문의 순서는 실시간 subgame re-solving, 후보 abstraction을 평가하는 반복 풀이, 토너먼트 stack 구성별 continuation 계산, 평가기의 exact best response와 value decomposition, equilibrium 전략을 조회하는 solver-guided language agent입니다. 같은 구조를 재사용하는 짧은 반복 풀이에서 컴파일 비용을 나누어 부담할 수 있다는 연결입니다. 이 응용들의 종단 간 배포 성능이 본 논문에서 모두 검증됐다는 의미는 아닙니다.
마지막으로 두 명보다 많은 플레이어와, 순회가 더 이상 정적이지 않은 Monte Carlo CFR로 compiler를 확장하는 문제를 주요 open design question으로 명시합니다. 이는 현재 실험의 완성 기능이 아니라 저자가 제시한 후속 과제입니다. 원문이 말하는 graph의 이점은 앞 절의 계약에 따라 캡처한 반복 본체를 재생하는 것으로 이해해야 하며, 임의 길이의 전체 solve가 언제나 물리적 launch 하나라는 보장은 아닙니다.
챕터의 핵심 기여는 적용 전망과 현재 구현 범위를 구분하는 것입니다. 이 절이 원문의 마지막 본문이므로 다음 챕터 연결은 없습니다. 원문 §17
실험 결과 심층 분석
가장 설득력 있는 비교는 같은 A100, 같은 CFR+·동시 갱신·선형 평균·float32인 Kim과 GPU-CFR입니다. 29.8–80.4배의 반복 시간 차이에 eager/graph ablation과 kernel profile이 더해져, 단순한 GPU 사용 효과보다 표현과 호출 구조가 중요한 원인임을 뒷받침합니다. 반면 LiteEFG의 14–258배는 실제 라이브러리 설정의 비용 비교로 유용하지만 정밀도·평균 방식·규칙까지 완전히 통제한 단일 변수 실험은 아닙니다.
실용적 품질과 통계적 신뢰도는 별개로 읽어야 합니다. Table 5는 같은 품질 기준에 도달하는 시간을 비교하고 독립 프로세스 bootstrap 구간을 보고합니다. 보고된 두 arm의 구간이 겹치지 않는 것은 그 조건에서 시간 차이가 분명하다는 근거입니다. 다만 threshold가 Kim의 30초 결과에 상대적으로 정의되고 checkpoint 보간을 사용하므로, 임의의 서비스 품질 목표에서 똑같은 배수가 나온다고 확장하지 않습니다. 이 timing 차이에 대한 별도의 p값 검정은 해당 표에 보고되지 않았습니다. §11의 permutation p값은 seed 효과 감사에 관한 다른 검정입니다.
범위의 양 끝이 설계의 성격을 설명합니다. 아주 작은 게임은 고정 GPU 비용 때문에 C++ CPU가 빠릅니다. 큰 terminal-heavy endgame에서는 sequence-form 표현의 Kim이 더 빠릅니다. 즉 노드 수 하나만으로 승패가 결정되지 않고 깊이, 정보집합·말단의 비율, 연산별 배치 폭이 중요합니다. 이는 논문이 직접 보고한 예외와 profiler 해석에 기반한 비교입니다.
재현성 자료와 직접 재현 여부도 구분합니다. 원문은 499개 테스트, 독립 oracle, 분석 가능한 poker anchor, 실행별 JSONL, 생성 스크립트, dtype·warmup·thread pinning을 제공한다고 설명합니다. CPU bitwise 검사와 GPU 변동 감사가 별개로 있다는 점은 근거가 강합니다. 이번 리뷰에서는 버전 고정 HTML과 PDF를 대조했으며, 대상 구현을 설치·실행하거나 논문의 측정 campaign을 재현하지 않았습니다.
기술적 함의와 응용
리뷰어 관점에서 GPU-CFR의 가장 중요한 교훈은 반복의 불변 구조를 먼저 드러내야 가속기 도구를 제대로 적용할 수 있다는 것입니다. chance 확률, 인덱스, 버퍼 주소, 깊이 의존성을 고정하면 일반 텐서 연산과 CUDA graph가 유효한 실행 대상이 됩니다. torch.compile이나 직접 작성한 Triton 커널의 효과를 해석할 때도 그 앞의 게임 표현 변환이 선행됐다는 점을 유지해야 합니다.
운영 관점에서는 같은 topology에 대한 반복 재풀이가 핵심입니다. payoff와 root range를 제자리에서 바꾸고 graph를 재사용할 때 초기 구축 비용을 분산할 수 있습니다. 반대로 새로운 거대 트리를 매번 읽고 구성하는 비용까지 반복당 0.397ms에 포함되는 것은 아닙니다. 저자가 제시한 온라인 re-solving과 abstraction 평가 등의 응용은 이 재사용 조건과 함께 읽을 때 의미가 분명해집니다.
이 연구는 CFR의 갱신 수식과 GPU 실행 계획을 분리하고, 어느 단계에서 시간을 절약했는지를 연산 수·커널·품질·수명주기로 연결합니다. 주 결과는 정적 두 플레이어 제로섬 완전기억 게임의 실험 범위에서 해석해야 하며, 다인 게임과 표본추출 CFR는 원문이 남겨 둔 설계 과제입니다.
분석 범위: 원문 1–17절과 References의 위치, 4.1–4.4·12.1·16.1–16.4의 하위 구조를 반영했습니다. Table 1–18과 두 Algorithm의 역할을 분석하되 모든 표의 모든 셀·세부 테스트 입력·증명의 중간 전개를 전부 전사하지는 않았습니다. 인용된 선행 논문 전체와 공개 코드의 실제 실행 결과는 별도로 검증하지 않았습니다. 원문 HTML의 일부 그림 교차참조 번호는 PDF 캡션으로 대조했습니다.