논문 개요와 전체 구조
SenseNova-U1.5는 이미지를 이해하는 모델과 이미지를 만드는 모델을 하나의 멀티모달 계산 구조 안에서 학습하는 연구입니다. 기존 시각 인코더와 Variational Autoencoder(VAE)를 연결하는 대신, RGB 픽셀과 텍스트에서 직접 출발합니다. 핵심은 모든 파라미터를 공유하는 데 있지 않습니다. 이해와 생성의 계산을 구분하면서도 같은 attention 안에서 정보가 전달되도록 설계합니다.
이번 버전은 두 지점을 집중적으로 바꿉니다. 첫째, 시각 토큰을 각각 독립적인 패치로 복원하던 출력을 공간적으로 연결된 디코더로 교체합니다. 둘째, 미학·문자·인포그래픽·편집을 각각 강화학습한 뒤 학생 모델의 생성 경로 위에서 전문가를 증류합니다. 논문이 부르는 “8B-MoT”의 구성표는 이해·생성 파라미터를 각각 8.2B / 8.2B로 표시합니다. 따라서 이 명칭을 전체 시스템의 모든 파라미터 합계가 8B라는 뜻으로 읽어서는 안 됩니다. 원문 §3.1·Table 1
이 리뷰는 2026년 9월 10일 제출된 arXiv:2609.11929v1의 HTML과 35쪽 PDF를 기준으로 합니다. 원문 목차는 다음과 같으며 별도 부록은 없습니다.
| 원문 순서 | 섹션과 소절 |
|---|---|
| 1 | Introduction |
| 2 | Related Works: Native Multimodal Unified Models → Reinforcement Learning for Diffusion Models → On-Policy Distillation for Unified Models |
| 3 | Methodology: Model architecture → Training Procedure → Reward Modeling |
| 4 | Data Construction: Image Generation Data → Image Editing Data → Interleaved Data → RL Training Data |
| 5 | Experiments: General Understanding → Image Generation → Image Editing → Interleaved Generation |
| 6 | Conclusion |
| 7 | Contributors |
| 마지막 | References |
핵심 기여와 혁신성
저자들이 해결하려는 문제는 “의미를 잘 이해하는 표현”과 “픽셀을 잘 복원하는 표현”이 분리돼 있다는 점입니다. 전자는 추상화를, 후자는 세부 묘사를 중심으로 학습되므로 이해·추론·생성을 오갈 때 별도 표현 변환이 필요합니다. SenseNova-U 계열은 이를 픽셀과 언어의 공동 학습으로 다루며, U1.5는 그 안의 공간 복원과 능력 통합을 개선합니다.
공간 디코더는 인접한 토큰 영역의 색·질감·기하를 출력 전에 함께 조정합니다. 전문가별 강화학습과 on-policy distillation은 서로 다른 보상 점수를 무리하게 더하는 대신 각 능력의 최적화 조건을 유지하면서 결과를 하나의 모델로 옮깁니다. 학습 데이터도 고해상도·긴 문자·복잡한 편집 지시를 중심으로 확장합니다.
저자들은 이를 이해에서 배운 구조적 지식이 시각적 계획과 생성에 전달되는 사례로 해석합니다. 리뷰어 관점에서 주목할 부분은 이러한 전달을 최종 이미지 품질뿐 아니라 생성 중간 결과를 이용하는 추론 과제에서도 평가했다는 점입니다. 다만 각 개선의 독립적인 기여도를 모두 분리한 ablation 결과로 받아들일 수는 없습니다. 이 논문의 주된 실험은 완성된 시스템의 벤치마크 비교입니다. 원문 §1
기술적 세부사항
입력은 두 합성곱 투영을 거쳐 한 토큰당 32×32 픽셀 영역으로 묶입니다. 이해와 생성은 같은 시퀀스에서 상호작용하지만 attention projection, normalization, feedforward module은 토큰 종류에 따라 별도로 선택됩니다. 생성 토큰은 앞선 깨끗한 이미지·텍스트를 읽을 수 있고, 깨끗한 문맥은 노이즈가 섞인 생성 상태를 읽지 못합니다.
출력은 토큰 배열을 2차원 특징 맵으로 복원한 뒤 Pixel Shuffle을 2배, 2배, 8배 적용합니다. 사이에 3×3 합성곱을 넣어 패치 경계에서 이웃 정보를 주고받습니다. 해상도별 노이즈 조건은 4096×4096을 기준으로 확장됩니다. “encoder-free”는 입력 투영 자체가 없다는 뜻이 아니라, 별도로 사전학습된 외부 시각 인코더에 의존하지 않는다는 뜻입니다.
학습 신호는 언어의 autoregressive loss, RGB 공간의 flow-matching loss, LPIPS 지각 손실입니다. 이후 네 전문가가 서로 다른 보상과 샘플링 조건으로 학습되고, 학생이 직접 방문한 노이즈 상태에서 전문가의 velocity field를 모방합니다. 실제 수식과 항의 의미는 아래 §3 순서에 맞춰 풀이합니다.
평가는 이해, 일반 생성, 문자 생성, 인포그래픽, 편집, 이미지·텍스트 교차 생성으로 나뉩니다. 표의 수치는 서로 다른 지표이므로 한 평균으로 합치지 않습니다. 특히 prompt enhancement(PE: 입력 지시 보강)와 chain-of-thought(CoT: 이미지 출력 전 명시적 추론)를 사용한 결과를 기본 조건과 구별해야 합니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
챕터의 위치와 역할: 이미지 생성의 목표가 단일 그림 합성에서 다국어 타이포그래피, 고밀도 디자인, 다중 참조 편집으로 넓어졌다는 문제 설정에서 출발합니다.
먼저 저자들은 시각 인코더와 VAE가 각기 다른 표현 공간을 만든다는 구조적 구분을 설명합니다. 이해는 의미를 추상화하고 생성은 픽셀 충실도를 추구하기 때문에, 여러 형태의 시각 작업을 한 계산 흐름으로 연결하기 어렵다는 주장입니다.
이어서 이전 SenseNova-U1의 경량 인터페이스를 짚습니다. 각 시각 토큰을 독립적인 RGB 패치로 바꾸면 계산은 간단해지지만 마지막 이미지 복원 단계에서 인접 패치가 정보를 교환하지 못합니다. 저자들이 명시한 증상은 경계 이음새, 질감 불연속, 고해상도에서의 기하 불일치입니다. U1.5는 토큰을 2차원 특징장으로 바꾸고 공간 합성곱으로 공동 복원합니다.
그다음 논리는 최적화로 넘어갑니다. 미학, 두 언어의 문자, 인포그래픽, 편집은 보상과 rollout 조건이 다릅니다. 저자들은 하나의 정책에 여러 보상을 동시에 적용할 때 목표가 얽힐 수 있다고 설명하고, 전문화 후 통합하는 학습을 제안합니다. 학생 자체 경로에서 전문가를 증류하는 이유는 실제 학생이 방문하는 상태에 감독을 제공하기 위해서입니다.
마지막으로 32×32 영역당 한 시각 토큰이라는 압축을 유지하면서 이해와 생성의 능력이 상호작용할 수 있다는 주장을 제시합니다. 구조화된 지시에 대한 일반화를 이해 능력의 생성 전이로 해석하지만, 이는 뒤의 벤치마크를 통해 검토할 연구 주장입니다.
핵심 기여와 다음 연결: 공간 복원과 능력 통합이라는 두 연구 축을 설정하고, 다음 장에서 각각을 뒷받침하는 선행 연구를 배치합니다. 원문 §1
📖 Chapter 2: Related Works
챕터의 위치와 역할: 제안 방법이 어디서 이어지는지 native 모델, 생성 강화학습, on-policy 증류 순서로 정리합니다.
2.1 Native Multimodal Unified Models. 외부 인코더 없이 이미지 입력을 처리하는 VLM 흐름과 픽셀을 직접 생성하는 흐름을 먼저 연결합니다. 이후 이산 토큰의 autoregression으로 통합하는 방법과 연속적인 픽셀 모델링 방법을 구별합니다. SenseNova-U 계열은 NEO-unify를 기반으로 후자에 위치합니다. 이 구분은 모든 통합 모델이 같은 토큰화 방식이나 생성 목적함수를 사용하는 것은 아니라는 점을 분명히 합니다.
2.2 Reinforcement Learning for Diffusion Models. 언어의 RLHF·PPO에서 GRPO·DAPO로 이어지는 상대적 보상 최적화를 소개한 뒤, diffusion과 flow 모델의 온라인 강화학습으로 논의를 옮깁니다. 결정론적인 ODE만으로는 탐색 다양성이 제한되므로 확률적 rollout이 필요하다는 맥락에서 CPS와 Precise를 소개합니다. 이후 보상 과최적화를 억제하는 GRPO-Guard와 작업별 보상으로 연결합니다. U1.5가 전문가마다 다른 샘플러를 쓰는 배경입니다.
2.3 On-Policy Distillation for Unified Models. 일반 증류의 교사 데이터와 학생 실제 생성 상태 사이에 분포 차이가 생긴다는 문제를 설명합니다. 학생 경로에 교사 감독을 제공하는 OPD, 여러 전문가를 합치는 MOPD, 생성 모델의 velocity·transition 증류가 차례로 등장합니다. U1.5는 네 외부 전문가를 유지하고 샘플의 능력 종류에 따라 하나의 교사를 선택하는 hard routing을 사용합니다. 교사마다 조건·guidance·해상도 정책을 보존하는 것이 차별점입니다.
핵심 기여와 다음 연결: 모델 통합과 파라미터의 무조건적 공유를 구별하고, 생성 강화학습 및 전문가 증류가 필요한 이유를 방법 장으로 넘깁니다. 인용된 선행 논문 각각을 이 리뷰에서 독립 검증한 것은 아닙니다. 원문 §2
📖 Chapter 3: Methodology
챕터의 위치와 역할: 입력과 출력의 구조, 다섯 단계 학습, 보상 설계를 순서대로 제시하는 중심 장입니다.
3.1 Model architecture
Near-Lossless Visual Interface. 원시 이미지나 노이즈 입력을 GELU가 붙은 두 합성곱 투영으로 16배와 2배 다운샘플링합니다. 2차원 sinusoidal 위치 임베딩으로 좌표를 보존하고 이미지 블록을 특수 토큰으로 구분합니다. 텍스트와 이미지는 같은 hidden space로 투영됩니다. “near-lossless”는 저자들의 인터페이스 명칭이며, 토큰화가 수학적으로 완전 가역이라는 증명을 뜻하지 않습니다.
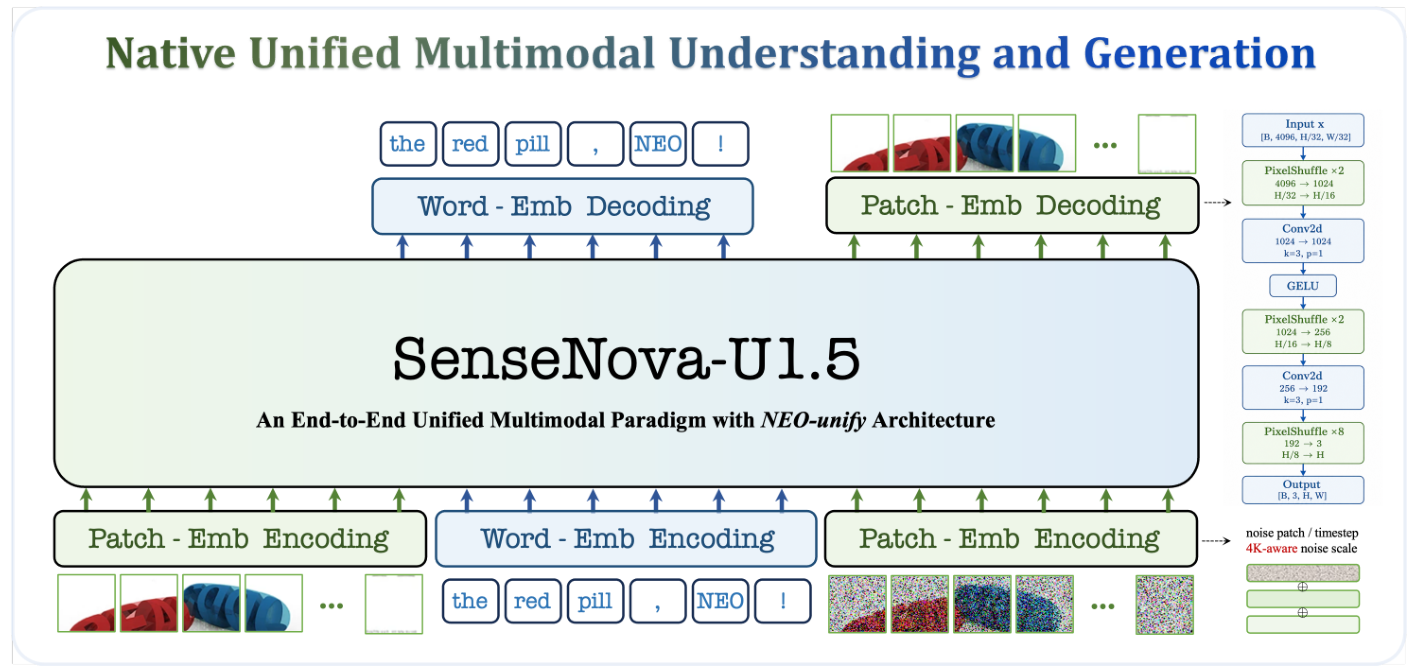
Figure 3, PDF 7쪽. 2609.11929v1 원본 PDF에서 그림 영역만 크롭했으며 원문 표기와 수치는 변경하거나 번역하지 않았습니다.
그림 오른쪽의 복원 경로는 32×32 패치 토큰이 곧 독립적인 최종 패치일 필요가 없음을 보여줍니다. backbone 출력을 배치·토큰·채널 배열에서 배치·채널·높이·너비 배열로 복원하고, Pixel Shuffle의 2×2×8 확대와 사이의 3×3 합성곱을 통해 인접 영역을 함께 결정합니다. 큰 시각 토큰의 계산 이점과 픽셀 경계의 연속성을 서로 다른 단계에서 다룹니다.
해상도 조건은 다음과 같습니다.
여기서 H와 W는 이미지 높이·너비, σ_R은 해당 해상도의 노이즈 크기, σ_max는 4096×4096 기준값입니다. τ_t는 diffusion 시간 임베딩이며 NSEmb는 정규화한 노이즈 크기를 인코딩하는 sinusoidal MLP입니다. 모델에는 “지금 어느 시간의 노이즈인가”와 “어떤 해상도에 대응하는 노이즈인가”를 함께 제공합니다. 원문 §3.1
Native Mixture-of-Transformers. 텍스트는 앞선 문맥만 읽고, 같은 깨끗한 이미지 블록 안에서는 양방향 attention을 허용합니다. 생성 이미지 블록도 내부적으로 양방향이며 앞선 깨끗한 문맥에 접근합니다. 반대 방향은 마스킹합니다. 이해와 생성의 attention projection·normalization·feedforward는 별도이므로 “공유 attention”을 “모든 가중치 공유”로 오해하면 안 됩니다. Table 1은 42개 층, hidden size 4,096, Q/KV head 32/8, 이해/생성 각각 8.2B를 명시합니다.
Unified Training Objectives. 원문 식 (1)은 정답 텍스트 토큰의 조건부 음의 로그우도입니다.
N은 정답 토큰 수, x_n은 n번째 정답 토큰, x_{<n}은 이전 토큰, c는 앞선 멀티모달 문맥입니다. 정답을 순서대로 예측하도록 언어·이해 분기를 감독합니다.
시각 생성에서는 정답 이미지 x와 표준 정규 노이즈 ε를 섞고, 모델이 깨끗한 종착점 x̂_θ를 예측합니다. 원문 식 (2)–(4)는 다음과 같습니다.
t는 0에서 1로 진행하는 경로 시간입니다. z_t는 중간 노이즈 상태이고, v_θ와 v★는 각각 예측 종착점과 정답 종착점으로 향하는 velocity입니다. 이 식은 픽셀 공간에서 두 velocity의 제곱 오차를 줄입니다. 분모가 있으므로 종착점 t=1을 식에 그대로 대입하는 계산과 구분해야 합니다. 본문은 이 경계의 구현 처리를 상세히 제시하지 않습니다.
식 (5)–(6)은 지각 손실과 전체 가중합입니다.
LPIPS는 특징 공간에서 예측 이미지와 정답의 지각적 차이를 감독합니다. 세 λ는 각 손실의 가중치입니다. 따라서 VAE 없이 RGB를 생성한다는 설명과, 학습 때 특징 기반 지각 손실을 쓴다는 설명은 양립합니다. 원문 식 (1)–(6)
3.2 Training Procedure
Stage 1: Generation Pre-Training. 사전학습된 이해 분기를 고정하고 생성 분기를 무작위 초기화합니다. 처음에는 256²–1024² 해상도에서 180K step, 이어 512²–4096²에서 100K step을 학습합니다. 마지막 185K step에서는 텍스트→이미지 60%, 편집 30%, 교차 이미지·텍스트 10%를 사용합니다. 이 마지막 phase부터 가중치 0.1의 LPIPS를 추가합니다. 순서는 생성 능력의 기본 학습, 고해상도 확장, 생성 작업의 다양화입니다.
Stage 2: Unified Mid-Training. 두 분기를 공동 최적화합니다. 문장·멀티모달 이해 30%, 텍스트→이미지 40%, 편집 20%, 교차 데이터 10%이며, 80K step과 최대 32,768 토큰을 사용합니다. 이해·flow·지각 손실 가중치는 0.1:1:0.1입니다. 생성에 큰 가중치를 두면서 기존 이해 능력을 함께 학습합니다.
Stage 3: Unified Supervised Fine-Tuning. 고품질 지시 데이터로 10.5K step을 학습하고 학습률을 2×10⁻⁵에서 0으로 cosine decay합니다. 원문 본문은 작업 구성을 Stage 2와 유사하다고 설명합니다. 다만 Table 2의 Stage 3 비율은 0.30·0.40·0.30·0.10으로 합계가 1.10입니다. 이 리뷰는 이를 임의로 100%로 재정규화하지 않습니다. 정확한 sampling 비율을 재현하려면 원문 표의 확인이 필요합니다. 원문 Table 2·§3.2
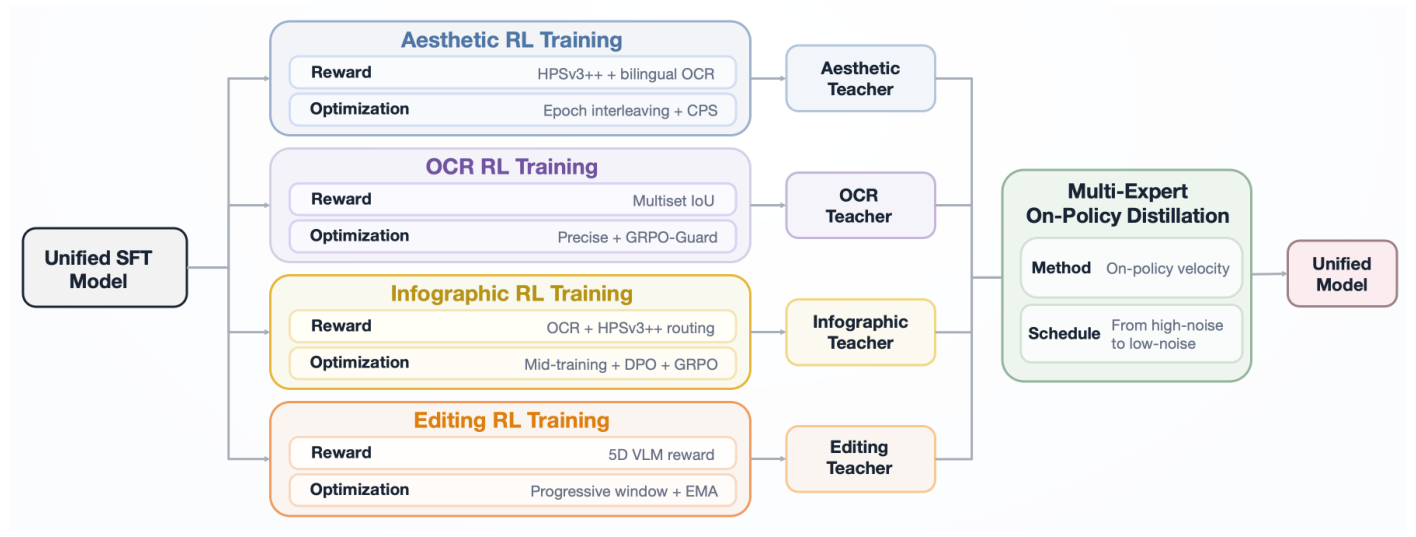
Figure 4, PDF 10쪽. 2609.11929v1 원본 PDF의 그림 영역을 크롭했습니다. 영문 표기·연결 관계를 보존했으며 번역이나 재구성은 하지 않았습니다.
Stage 4: Multi-Expert Reinforcement Learning. 그림처럼 SFT 모델에서 전문가를 나누되, 본문의 설명은 미학 → OCR → 편집 → 인포그래픽 순서입니다.
미학 전문가는 HPSv3++ 미학 데이터와 OCR 데이터를 epoch 단위로 교대로 학습합니다. 한 프롬프트당 16개 후보, 30-step 경로, guidance 4.0, timestep shift 3을 쓰고 CPS의 η는 0.7입니다. 처음 10개 step 안에서 연속된 5개 step을 선택해 초기 구조 형성을 최적화합니다. KL 계수는 0.01이며 마지막 생성 Transformer block·출력 head·출력 normalization을 고정해 보상으로 인한 과도한 변화를 줄입니다.
OCR 전문가는 영어 단어와 중국어 문자의 정확도에 집중합니다. 후보 수와 경로 길이는 같지만 Precise의 η=1.5와 GRPO-Guard를 사용하며 KL 계수는 0.02입니다. 이는 서로 다른 전문가의 탐색과 규제를 하나의 공통 설정으로 합치지 않았다는 구체적인 예입니다.
편집 전문가는 바꿀 내용과 남길 내용을 함께 평가합니다. 학습률 4×10⁻⁵, KL 0.01, rollout 24, noise scale 0.7과 EMA를 사용합니다. 저자들은 과도한 확률적 교란이 잔여 노이즈와 artifact를 만들 수 있어 SDE 기반 trajectory sampling을 피한다고 설명합니다. 최적화 창은 의미를 만드는 초기 구간에서 질감을 다듬는 후기 구간으로 이동합니다.
인포그래픽 전문가는 고품질 데이터로 별도 mid-training을 거친 다음, OCR 강화학습 → 선호 쌍 DPO → OCR·미학 교대 강화학습을 수행합니다. DPO는 학습률 5×10⁻⁶, β=10이며 1–20번째 step 중 하나를 사용합니다. 마지막 단계도 OCR과 미학 점수를 더하지 않고 데이터 종류에 따라 선택합니다. 해당 GRPO 단계의 CFG는 보상 평가용 rollout에 적용하고 정책 목적함수는 conditional prediction으로 계산합니다.
Stage 5: Multi-Expert On-Policy Distillation. 학생이 만든 중간 상태에서 해당 작업의 고정 교사가 velocity를 제공합니다. 원문 번호 없는 OPD 식은 다음과 같습니다.
m은 작업별 교사, c는 텍스트 또는 텍스트·이미지 조건입니다. x̂_{θ,t}는 여기서는 학생이 생성한 경로상의 상태를 가리킵니다. sg는 stop-gradient로, 앞선 전체 샘플링 경로로 역전파하지 않습니다. 교사와 학생은 같은 상태·같은 시간·같은 조건에서 비교됩니다. 완성된 교사 이미지에만 맞추는 증류와 구별되는 지점입니다.
교사에 질문할 경로 위치도 학습 중 바뀝니다.
n은 현재 epoch, N은 전체 epoch 수입니다. Beta(2,5)에서 Beta(5,2) 쪽으로 이동해 초기 고노이즈 구조에서 후기 저노이즈 세부와 문자로 감독 중심을 옮깁니다. 두 종류의 작업 모두 30-step 결정론적 ODE를 사용하되 경로당 한 시점을 조회하고 그 뒤 불필요한 경로는 계산하지 않습니다.
증류에서는 미학·OCR·인포그래픽에 CFG 4, 편집에 1을 사용합니다. 생성은 1024²부터 4096²까지 선택한 목표 면적과 여러 종횡비를 조합하고 32 배수로 반올림합니다. 편집 해상도는 원본 이미지에 맞춥니다. 총 800 optimizer step, global batch 128, 분야당 25,600 샘플을 사용하며 이해 분기·마지막 생성 3개 층·출력 head는 고정합니다. 원문 §3.2
3.3 Reward Modeling
Aesthetic Reward. HPSv3++가 구도·시각 충실도·의미 정합성·스타일 및 사람의 선호를 평가합니다. 저자들은 학습 중 생성 분포가 바뀌는 상황에 적합한 보상이라고 설명합니다.
OCR Reward. 프롬프트에서 목표 문자를 추출하고 생성 이미지에 PaddleOCR를 적용합니다. 대소문자·문장부호·공백을 정규화한 뒤 영어는 단어, 중국어는 문자로 나눕니다. 원문 식 (7)은 중복 개수를 보존하는 multiset IoU입니다.
g_u와 o_u는 각 토큰 u의 목표·인식 횟수입니다. 시간 t와 혼동하지 않도록 여기서는 원문의 토큰 인덱스 t를 u로 표기했습니다. 분자는 일치한 횟수, 분모는 합집합 횟수이므로 누락·중복·잘못 추가된 문자 모두 점수에 영향을 줍니다. 읽기 순서가 불안정한 조밀한 배치에서도 사용하도록 설계했습니다. 점수 하나가 문자의 위치·스타일 전부를 평가한다는 뜻은 아닙니다.
Infographic Reward. 전용 보상 모델을 새로 만들지 않습니다. 식 (8)은 초기 OCR 보상만 사용하는 단계를, 식 (9)는 프롬프트가 OCR 종류이면 OCR 보상, 미학 종류이면 HPSv3++를 선택하는 단계를 정의합니다. 서로 단위와 의미가 다른 두 점수를 합산하거나 상호 정규화하지 않는 것이 핵심입니다.
Editing Reward. VLM이 지시 충족, 편집 실행 품질, 전체 시각 품질, 필요할 때 문자 편집, 비편집 영역 보존을 평가합니다. 여러 하위 차원이 있으면 그 안에서도 최솟값을 택하고, 정규화 후 식 (10)으로 합칩니다.
각 R은 앞서 나열한 차원의 점수입니다. 문자 수정 요청이 없으면 R_text를 제외하고, 요청된 변화가 보이지 않으면 실행 점수를 0으로 만듭니다. 평균을 사용하면 잘 그린 이미지가 지시 불이행을 상쇄할 수 있지만, 최솟값은 가장 약한 차원을 드러냅니다.
핵심 기여와 다음 연결: 공간 복원·작업별 강화학습·학생 경로 증류가 구체적인 계산과 학습 조건으로 연결됩니다. 다음 장은 이 조건을 지탱하는 데이터의 구성과 필터링을 설명합니다. 원문 §3.3
📖 Chapter 4: Data Construction
챕터의 위치와 역할: 데이터 양뿐 아니라 어떤 시각 능력을 위해 자료를 확대하고 정제했는지 설명합니다. Figure 5는 네 종류의 데이터 분포를 제시합니다.
4.1 Image Generation Data. 이전 버전 대비 78개 출처에서 약 59M개의 이미지·텍스트 쌍을 추가합니다. 논문은 “유효 학습량”의 약 88.2%가 1024², 64.4%가 2048²를 초과한다고 적습니다. 이는 고유 원본 파일 수의 비율이라고 바꿔 쓸 수 없습니다. 자세한 캡션·짧은 설명·의미 태그를 함께 구성하고 중국어·영어 문자와 실제 이미지의 일치 여부를 확인합니다. 희귀 개념·복잡한 레이아웃은 합성 데이터로 보완하며 실제·합성 자료 모두 품질·지시 일치·문자·레이아웃·다양성 필터를 거칩니다.
4.2 Image Editing Data. 약 38M 예제로 일반 편집, 인포그래픽 편집, 참조 조건 편집, 공간 제어 편집을 다룹니다. 복잡한 요청에는 대상 영역·속성·공간 제약·보존할 내용을 명시한 구조화 지시와 CoT 예제를 사용합니다. 본문은 일반 편집 약 43%, 공간 제어 인포그래픽 편집 약 42%, 참조 조건 약 15%를 보고합니다. 참조 예제는 최대 10개의 이미지를 포함하며 정체성·시점·포즈·기하·조명 정보를 다룹니다. bounding box나 시각 표식으로 지역적 제어를 제공하고, 수정 대상뿐 아니라 남겨야 하는 내용의 보존도 정제 기준에 포함합니다.
4.3 Interleaved Data. 생활 절차·이야기 등의 궤적 약 44%, 인포그래픽 약 29%, 영상 유래 시퀀스 약 19%, 명시적 중간 추론을 붙인 자료 약 8%입니다. 이를 각각 별도 작업으로 두지 않고 텍스트·이미지 상태가 번갈아 등장하는 공통 trajectory 형식으로 바꿉니다. 이 자료는 국소 이미지·문장 대응뿐 아니라 장기 의미 일관성, 시간적 변화, 여러 단계의 생성까지 감독합니다. 필터링 단위도 개별 이미지에서 전체 궤적의 언어·시각·교차 일관성으로 확장됩니다.
4.4 RL Training Data. 미학에는 약 280K 프롬프트를 구성하고 후보 간 보상 차이가 약한 그룹은 제거합니다. 상대적 보상을 학습할 때 후보 간 구별이 가능한 자료를 남기는 설계입니다. OCR은 중국어·영어 균형을 갖춘 약 60K 프롬프트이며, 약 20K 짧은 지시와 이를 확장한 약 40K 긴 지시를 포함합니다. 인포그래픽의 DPO에는 약 120K 선호 쌍을 사용합니다.
편집 강화학습은 약 120K 예제이고 지역 편집 80%, 전체 편집 20%입니다. 손상·중복·저해상도 자료 제거 → 지시에 등장하는 대상과 수정 결과의 정합성 확인 → 원본·편집본 양쪽 품질 평가 순서로 정제합니다. 학습 해상도는 512²–2048²이며 언어와 지시 길이도 균형을 조정합니다. 전체 생성 사전학습의 4K 범위와 이 편집 RL 범위를 구별해야 합니다.
핵심 기여와 다음 연결: 고해상도와 긴 지시를 단순히 추론 옵션으로 추가한 것이 아니라 실제 데이터 분포와 감독 형식을 바꿨음을 보여줍니다. 다음 장은 이러한 능력을 서로 다른 평가축으로 측정합니다. 원문 §4
📖 Chapter 5: Experiments
챕터의 위치와 역할: 일반 이해를 먼저 확인한 후 생성, 편집, 교차 생성과 생성 보조 추론으로 범위를 넓힙니다. 아래 비교는 모두 원문 표의 보고값이며 외부 순위의 현재 상태를 의미하지 않습니다.
5.1 General Understanding
Multimodal Understanding. Table 3은 STEM·VQA·OCR·환각·시각 추론을 평가합니다. U1.5는 MathVista mini 85.85로 U1의 84.20보다 높지만 MMMU는 73.86 대 74.78, OCRBench-v2는 59.07 대 61.30으로 낮습니다. 따라서 “이해 능력 유지”라는 전체 메시지를 “모든 이해 과제의 개선”으로 바꿔 읽지 않습니다. 일부 비교 모델 결과의 별표는 VLMEvalKit 재현값이라는 표 주석도 있습니다.
Language Understanding. MMLU-Pro는 86.67, C-Eval은 90.41이며 IFEval은 U1 91.13에서 U1.5 93.35로 높아집니다. 반면 MMLU-Redux는 87.61에서 86.33입니다. 언어와 시각 생성의 공동 학습 후 여러 지표가 유지되거나 개선됐다는 관찰과 개별 지표의 증감을 함께 봐야 합니다. 원문 Table 3
5.2 Image Generation
General Generation. 논문은 Qwen-Image-Bench → GenEval → GenEval2 → OneIG-Bench → DPG-Bench 순서로 설명합니다. Qwen-Image-Bench의 영어·중국어 점수는 PE를 사용할 때 60.22·60.13입니다. 이는 입력 보강을 포함한 조건입니다. GenEval은 객체 수·색·위치·속성 결합을 나눠 평가하며 U1.5 전체 0.92, U1 0.91입니다. 특히 속성 결합은 0.76에서 0.81로 증가하지만 색상은 둘 다 0.92입니다.
GenEval2는 더 복잡한 속성·수량·행동 제약에서 PE 효과를 평가합니다. OneIG-Bench는 영어·중국어의 정합성·추론·스타일·문자 등 여러 축을 나눠 봅니다. DPG-Bench는 조밀한 지시의 entity·attribute·relation 등을 평가하고 전체 88.11을 보고합니다. 이 서로 다른 벤치마크의 “overall”은 같은 단위가 아닙니다. 원문 Tables 4–10
Text-centric Generation. CVTG-2K에서 평균은 0.948로 U1의 0.940보다 높습니다. 네 영역 word accuracy는 0.944→0.955, 다섯 영역은 0.936→0.954입니다. 그러나 두 영역은 0.945→0.933, 세 영역은 0.954→0.941로 낮아지고 CLIPScore도 0.825→0.819입니다. 개선은 특히 복잡한 다중 영역에 집중된 결과로 읽는 편이 정확합니다. LongText-Bench는 영어 0.979→0.988, 중국어 0.962→0.989를 보고해 두 언어 모두 긴 문자 생성이 개선됩니다. 원문 Tables 11–12
Complex Infographic Generation. IGenBench는 구성·인코딩·순서·마크·주석·축·범례·차트·제목·장식을 세분합니다. U1.5의 질문 단위 Q-ACC는 기본 0.62, PE 0.76이며 이미지 단위 I-ACC는 0.08·0.17입니다. U1은 각각 0.51·0.04입니다. 한 이미지의 여러 요구를 함께 충족하는 어려움은 질문 단위 점수와 이미지 단위 점수의 차이에서 드러납니다. Nano-Banana-Pro의 0.90·0.49에는 미치지 못하며 원문도 강한 폐쇄형 모델과의 차이를 명시합니다. BizGenEval은 easy·hard 및 지식·레이아웃·속성·문자 관련 상업 콘텐츠 생성으로 논의를 이어갑니다. 원문 Tables 13–14
Reasoning-centric Generation. WISE는 문화·시간·공간·생물·물리·화학 지식을 요구합니다. U1.5는 기본 0.70, CoT 0.81입니다. 특히 문화 0.66→0.82, 생물 0.69→0.80, 화학 0.66→0.76입니다. 이 비교는 모델 버전 차이가 아니라 같은 U1.5의 추론 조건 차이입니다. 원문은 이를 세계 지식에 기반한 이미지 생성에서 명시적 추론의 이점으로 해석합니다. 원문 Table 15
5.3 Image Editing
General Editing. ImgEdit → GEdit-Bench → WeEdit → OmniRef-Bench 순서입니다. ImgEdit 전체 점수는 U1 3.90에서 U1.5 4.59로 증가합니다. 삽입·변경·추출·교체·제거·배경·스타일·복합·행동 편집을 나눠 평가하며, 복합 편집은 3.03→4.36입니다. 모든 열에서 다른 모델보다 높다는 뜻은 아닙니다.
GEdit-Bench 영어·중국어 전체 점수는 8.26·8.24입니다. 공개 모델 비교에서는 높은 결과이지만, 표의 GPT-Image-2는 8.73·8.76입니다. 원문 서술의 “strongest overall”은 이 전체 표를 기준으로 무조건적인 1위라고 옮기지 않습니다. 영어 semantic consistency는 9.15, perceptual quality는 7.79이므로 의미 충실도와 시각적 품질을 구분할 수 있습니다. 원문 Tables 16–17
WeEdit은 지시 이행·글자 선명도·배경 보존을 함께 요구합니다. 저자들은 번역 및 추론이 필요한 편집은 여전히 상대적으로 어렵다고 명시합니다. OmniRef-Bench는 객관적 평가와 MLLM 평가를 구분하고 스타일·배경·대상·포즈의 일관성을 측정합니다. 참조를 활용하는 것과 수정하지 않을 부분을 보존하는 것을 동시에 확인하는 평가입니다. 원문 Tables 18–19·§5.3
Reasoning-centric Editing. RISEBench는 시간·인과·공간·논리적 결과를 먼저 추론해야 하는 편집을 다룹니다. U1.5 기본 overall은 33.6, CoT는 38.6입니다. 인과는 37.8→52.2, 논리는 10.6→20.0으로 높아지지만 공간은 49.0→42.0으로 낮아집니다. 원문도 공간 편집의 이점이 일관적이지 않다고 설명합니다. 따라서 CoT를 모든 편집에 대한 일률적인 개선 수단으로 제시하지 않습니다. 원문 Table 20
5.4 Interleaved Generation
Interleaved Generation. OpenING은 결과의 완결성·품질·풍부함·정확성·사람 정렬·이미지 텍스트 일관성·다단계 일관성을 평가합니다. CoT 조건에서 U1.5 전체 9.18, U1-SFT 9.07입니다. 특히 이미지·텍스트 일관성은 9.58입니다. GPT-4o+DALL-E3처럼 결합된 파이프라인과의 비교도 포함되므로 개별 이미지 생성기 순위표로 읽지 않습니다.
VBVR-Pro-Bench는 생성으로 시각적 추론을 수행하는 평가입니다. U1.5의 교차 생성 overall은 68.2%, in-domain은 67.6%, out-of-domain은 68.9%입니다. VBVR-SenseNova-U1 overall 40.8%와 비교되지만 이는 표에 명시된 이전 모델의 특정 설정입니다. 같은 교차 생성 범주의 Nano-Banana-Pro overall 56.4%, GPT-Image-2 50.7%보다 높습니다. 다만 U1.5가 모든 세부 열에서 최고는 아닙니다. 예를 들어 out-of-domain 추상화는 69.8로 Nano-Banana-Pro의 75.1보다 낮습니다. 원문 Tables 21–22
Unified Reasoning. Uni-MMMU-GaU는 generation-aided understanding, RealUnify-GEU는 generation-enhanced understanding을 평가합니다. Table 23의 RealUnify 평균은 U1-SFT 47.5에서 U1.5 56.3으로 증가합니다. 정신적 재구성·추적·주의 집중·탐색을 나누며 추적은 63.0→84.0입니다.
반대로 Uni-MMMU 평균은 35.0에서 29.6으로 낮아집니다. Jigsaw-T 86.0, Maze-T 17.3, Sliding-T 0.0, Geometry-T 15.0이며 이전 모델도 Sliding-T는 0.0입니다. 원문이 “competitive”라고 표현하더라도 이 수치 감소는 그대로 밝혀야 합니다. 생성이 이해를 돕는다는 가능성을 보여주는 결과와 모든 생성 보조 추론 과제가 개선됐다는 주장은 구별됩니다. 원문 Table 23
핵심 기여와 다음 연결: 한 모델의 능력을 여러 조건과 지표에서 평가하고, 생성 품질을 넘어 이미지 생성이 추론 과정의 일부가 될 수 있음을 탐색합니다. 다음 장은 이 관찰을 native 통합의 의미로 정리합니다.
📖 Chapter 6: Conclusion
챕터의 위치와 역할: 별도 지각·생성 파이프라인을 연결하는 대신 공통 계산 기반에서 이해와 생성을 학습한다는 출발점으로 돌아옵니다.
저자들은 고품질 생성·편집·교차 생성·추론 과제가 compact native representation에서 함께 작동한다는 결과를 요약합니다. 이후 아키텍처 단순화 자체보다 능력 간 상호작용에 의미를 둡니다. 추론이 생성과 변환을 돕고, 생성이 다시 시각 문제를 푸는 중간 과정이 될 수 있다는 관점입니다.
이는 저자들의 연구적 해석입니다. 통합이 자동으로 모든 과제의 우위를 보장한다는 결론은 아닙니다. 원문에는 별도 미래 과제 목록이 없으므로 이 리뷰도 임의의 로드맵을 추가하지 않습니다.
핵심 기여와 다음 연결: 지각·추론·생성을 공통된 시각 지능의 다른 작동 형태로 해석하며 기술 논의를 끝냅니다. 이어지는 장은 새로운 실험이 아니라 연구 기여자 기록입니다. 원문 §6
📖 Chapter 7: Contributors
챕터의 위치와 역할: 연구 기여를 역할별로 기록합니다. Project Sponsor and Advisor, Senior Project Lead, Project Lead, Core Contributor, Contributor, Acknowledgement 순서이며 각 범주 안에서 이름을 정렬합니다.
Project Lead는 Haiwen Diao와 Jiahao Wang입니다. 감사의 글은 데이터 준비·모델 평가·인프라·아키텍처 분석·토론 지원을 구분합니다. 이 장에 새 알고리즘이나 실험 결론은 없습니다.
핵심 기여와 뒤따르는 자료: 결과의 기술적 주장을 추가하는 대신 협업의 출처를 기록합니다. 다음 References는 인용 자료 목록이며 별도 부록은 없습니다. 인명 전체와 164개 참고문헌의 개별 내용은 재서술하지 않습니다. 원문 §7
실험 결과 심층 분석
결과를 판단할 때는 버전 개선, 추론 조건 변경, 서로 다른 평가 과제를 분리하는 것이 중요합니다.
| 비교 | 보고값 | 해석 범위 |
|---|---|---|
| GenEval, U1 → U1.5 | 0.91 → 0.92 | 전체 개선은 0.01이며 속성 결합의 변화가 더 큽니다. |
| ImgEdit, U1 → U1.5 | 3.90 → 4.59 | 같은 벤치마크의 overall 0.69 상승입니다. 정확도 %로 바꾸지 않습니다. |
| IGenBench U1.5, 기본 → PE | Q-ACC 0.62 → 0.76 | 모델 변경이 아닌 입력 보강 포함 효과입니다. |
| WISE U1.5, 기본 → CoT | 0.70 → 0.81 | 명시적 추론을 포함하는 평가 조건의 차이입니다. |
| RealUnify, U1-SFT → U1.5 | 47.5 → 56.3 | 생성 보조 이해 중 이 과제군에서 향상합니다. |
| Uni-MMMU, U1-SFT → U1.5 | 35.0 → 29.6 | 다른 생성 보조 이해 과제에서는 하락합니다. |
이 비교에서 가장 실용적인 관찰은 조밀한 문자·복합 편집·지식 기반 생성의 개선이 동일한 방식으로 나타나지 않는다는 점입니다. 예컨대 문자 영역 수가 많을 때의 CVTG 개선과 적을 때의 감소, RISEBench의 인과 개선과 공간 감소를 함께 확인해야 실제 사용 과제에 맞는 판단이 가능합니다. 원문 Tables 6, 11, 13, 15, 16, 20, 23
실험은 다양한 벤치마크를 다루지만 표에는 반복 실행의 신뢰구간이나 유의성 검정이 보고되지 않았습니다. 따라서 작은 차이를 통계적으로 유의하다고 단정하지 않습니다. 또한 외부 모델 결과에는 서로 다른 파라미터 표기, 재현값, PE·CoT 및 파이프라인 조건이 섞여 있습니다. 공개 모델이라는 표의 분류는 이 원문이 사용하는 분류이며 모든 라이선스·공개 범위를 별도로 감사한 결과가 아닙니다.
재현에 필요한 학습 단계·일부 하이퍼파라미터·보상·데이터 구성이 상당히 제시되지만, Table 2 Stage 3 비율의 합계 불일치는 그대로 남습니다. 초록은 SFT·RL·OPD 학습 코드를 공개할 예정이라고 적습니다. 이 리뷰는 원문 밖의 코드 배포 완료나 학습 데이터 전체 공개를 확인했다고 주장하지 않습니다.
기술적 함의와 응용
저자들이 제시하는 방향은 이미지를 최종 출력에만 두지 않고 이해와 추론의 중간 표현으로 사용하는 것입니다. 공간 디코더는 작은 토큰 수를 유지하면서 출력의 지역적 연속성을 다루고, 전문가 증류는 작업마다 다른 최적화 조건을 단일 학생으로 통합합니다. 구조와 학습 전략을 함께 봐야 하는 연구입니다.
리뷰어 관점에서 인포그래픽·문자 편집·참조 기반 제작은 이 설계를 이해하기 좋은 응용 맥락입니다. 원하는 내용의 생성과 기존 내용의 보존을 따로 평가하고, PE·CoT의 유무도 결과와 함께 기록해야 합니다. 이는 논문이 보고하지 않은 산업 성능을 예측하는 주장이 아니라, 제시된 평가축을 실제 요구 사항에 대응시키는 해석입니다.
SenseNova-U1.5의 결과는 native 통합의 가능성과 과제별 차이를 동시에 보여줍니다. 생성·편집 및 일부 생성 보조 추론의 개선이 확인되지만 모든 이해 지표가 상승하지는 않습니다. 이 논문을 읽는 핵심은 통합 모델이라는 명칭보다 어떤 정보를 공유하고, 무엇을 별도로 최적화하며, 어떤 조건에서 효과를 측정했는가를 따라가는 데 있습니다.
분석 범위: 본문 1–7장과 모든 번호 있는 소절을 원래 순서대로 반영했습니다. 별도 부록은 없으며, Figure 1–2의 개별 생성 예시 전체, Figure 5의 모든 세부 데이터 범주, Tables 3–23의 모든 모델·세부 열, 참고문헌 164편의 독립 검토는 포함하지 않았습니다. 핵심 수식은 원문 번호와 함께 해설했고 식 (8)–(9)의 보상 분기는 문장으로 설명했습니다.