논문 개요와 전체 구조
에이전트가 예전 대화를 기억하게 만들 때 흔히 원문을 요약하거나, 중요한 사실만 추출하거나, 관계를 그래프로 연결합니다. 그런데 정리한 기억을 읽게 한 에이전트가 원래 대화를 검색한 에이전트보다 더 자주 틀린다면, 그 정리는 어떤 가치를 만든 것일까요? Memory Tax는 기억 시스템의 성능을 다른 기억 시스템과 비교하는 데서 한 걸음 더 들어가, 원문을 직접 검색하는 기준선에 무엇을 더하고 무엇을 잃었는지 묻습니다.
여기서 memory benefit은 단순 검색이 틀린 문제를 기억 시스템이 맞힌 이익이고, memory tax는 단순 검색이 맞힌 문제를 기억 시스템이 틀린 손실입니다. 이 tax는 API 요금이나 저장 공간을 뜻하지 않습니다. 원문을 가공하면서 생기는 정답 기회의 손실입니다. 실제 토큰 비용·호출 횟수·실행 시간은 별도 지표로 측정합니다. 기억이 정보를 잘 정리해 주는 효과와, 같은 과정에서 근거를 지우거나 찾기 어렵게 하는 효과를 함께 보는 것이 논문의 출발점입니다. §1–2
이 리뷰는 Xuan He 외 10명의 2026년 10월 25일 arXiv:2610.34073v1, 36쪽 PDF와 같은 버전 HTML을 읽었습니다. HTML에는 설계 개선 실험 표가 누락되고 일부 그림·표의 참조 번호가 어긋나 있어, 아래 번호와 수치는 PDF 기준으로 통일했습니다. 중심 평가는 개인 에이전트의 대화 기억이며, 경험 기억과 비디오 세계 모델은 관점의 확장을 확인하는 후속 실험입니다. 고정 버전 원문
| 원문 순서 | 다루는 내용 |
|---|---|
| 1 Introduction | 기억의 순가치를 원문 검색과 비교해야 하는 이유 |
| 2 Preliminary | 이력 → 기억 구축 → 검색 → 답변의 공통 틀 |
| 3 Experiments | 3.1 설정, 3.2 성능·비용 결과 |
| 4 Memory Tax | 4.1 이익과 손실, 4.2 충실도, 4.3 접근성, 4.4 백본 강건성, 4.5 벤치마크의 개선 여지 |
| 5 Generalizing Memory Tax | 5.1 경험 기억, 5.2 세계 모델 기억 |
| 6 Design Implications | 6.1 원문 복구 경로, 6.2 검색 경험의 재기억, 6.3 미래 수요 모델링 |
| 7 Related Works | 장기 기억 설계와 기존 실증 연구 |
| 8 Conclusion · Limitations | 결론과 저자가 밝힌 적용 범위 |
| Appendix A | A.1 데이터, A.2 기준선, A.3 지표, A.4 구현, A.5 추가 설명 |
| Appendix B | B.1 RAG 구성 제거 실험, B.2 기존 논문의 RAG, B.3 기억 시스템 설정 검증 |
| Appendix C | C.1 정답 집합, C.2 충실도, C.3 접근성, C.4 강건성, C.5 평가 여지, C.6 일반화 |
| Appendix D | D.1 이익 사례, D.2 충실도 손실, D.3 접근성 손실, D.4 같은 메커니즘의 양면성 |
| Appendix E · F | E.1–E.3 전체 성능·비용, F.1 답변 프롬프트, F.2 채점 프롬프트 |
핵심 기여와 혁신성
장기 기억은 단순히 더 많은 문장을 저장하는 기능이 아닙니다. 무엇을 사실로 뽑을지, 어떤 시점을 붙일지, 어떤 정보를 합칠지 결정합니다. 이 결정이 검색을 쉽게 할 수도 있지만, 이후 질문에 필요한 구체적 조건을 버릴 수도 있습니다. 논문은 기억의 복잡도와 최종 정답률 사이에 원문 대비 순가치라는 비교 축을 둡니다. §1
기존 접근의 한계에 대한 저자의 주장은, 여러 기억 연구가 다른 기억 시스템과의 비교에 집중하면서 단순 검색의 설정과 성능을 충분히 드러내지 않았다는 것입니다. 이 논문의 RAG 기준선은 검색 모델 하나만 붙인 구성이 아닙니다. 대화 경계를 고려한 청크, BM25와 임베딩 검색의 결합, 재정렬을 사용합니다. 저자는 이를 표준적인 검색 구성으로 보고, 기억 구축의 추가 이득을 평가하는 출발점으로 삼습니다. Appendix B.1–B.2
독창적인 부분은 전체 점수를 질문별 두 집합으로 분해하고, 손실의 경로를 충실도·접근성·백본 변화에 대한 강건성으로 나누어 추적한 점입니다. 원문 근거를 직접 넣는 실험과 정답에 대응하는 기억 단위를 직접 넣는 실험을 비교해, 검색 실패와 기억 구축 중 손실을 구별하려고 합니다. 이로써 “기억을 넣었더니 낮아졌다”에서 멈추지 않고 어느 과정에서 무엇을 잃었는지 살펴봅니다. §4
리뷰어 관점에서 이 연구의 실용적 의미는 기억 시스템을 없애자는 결론에 있지 않습니다. 기억이 새로 맞힌 질문과 원래 맞힐 수 있었는데 놓친 질문을 함께 보면, 평균 점수만으로는 보이지 않는 변경의 효과를 확인할 수 있습니다. 실제로 기억이 더 높은 점수를 낸 조건도 논문에 존재합니다. 아래에서는 그 예외와 비교 조건을 함께 다룹니다.
기술적 세부사항
원문 §2는 기억 시스템을 다음과 같이 표현합니다. 식 번호가 붙은 새로운 알고리즘이 아니라, 서로 다른 시스템을 비교하기 위한 공통 표기입니다. §2
$H$는 과거 메시지·관찰 등의 이력, $I$는 기억을 만드는 과정, $M$은 그 결과인 기억 저장소입니다. 질문 $q$가 오면 검색 함수 $R$이 관련 문맥 $C$를 돌려주고, 생성 모델 $G$가 답 $\hat y$를 만듭니다. 단순 RAG는 원문을 최소한으로 청크화해 검색하므로, 여기서는 별도 기억 가공의 순가치를 재는 비교 기준이 됩니다.
질문별 비교를 명확히 하기 위해 저자의 설명을 지시함수로 다시 쓰면 다음과 같습니다. 아래 식은 리뷰어가 원문의 집합 비교를 수식화한 표현이며, 논문의 별도 번호식이 아닙니다. §4.1, Figure 2
$N$은 같은 평가 질문 수이며 $m_i$와 $r_i$는 각각 기억 시스템과 RAG의 정오 판정입니다. 둘 다 맞힌 질문과 둘 다 틀린 질문은 차이에서 상쇄됩니다. 따라서 tax는 그 시스템의 전체 오답률과 다르며, 어떤 RAG를 기준으로 삼았는지에 따라 바뀝니다. Table 1의 괄호는 RAG 2회 검색 대비 전체 점수 차이이고, §4의 질문별 tax 분석은 RAG 1회 검색 기준이라는 차이도 구별해야 합니다.
평가의 또 다른 조정 변수는 Retrieval Scope, 줄여서 RS입니다. 기억 단위 크기가 다르면 같은 top-k라도 모델이 읽는 정보량이 달라집니다. 저자의 정의를 요약하면, RS는 검색부터 답변까지 모델이 본 기억 단위의 토큰 수를 해당 시스템의 검색 가능한 전체 저장소 토큰 수로 나눈 비율입니다. 최종 답변 문맥에 남지 않았더라도 검색 도중 LLM이 읽은 단위는 포함합니다. 모든 시스템에 같은 절대 토큰 수를 주었다는 뜻은 아닙니다. Appendix A.4
| 비교 요소 | 논문의 설정 |
|---|---|
| 주 평가 | LongMemEval-s, PersonaMem-v2 20% 표본, MINT-Eval 10% 표본 |
| 백본 | Qwen3.5-4B, Qwen3.6-27B, GPT-5.6 Luna(low) |
| 검색 임베딩·재정렬 | Qwen3-Embedding-0.6B · 사용하는 경우 Qwen3-Reranker-0.6B |
| 주 성능 지표 | Qwen3.6-27B 판정기의 정답률(%); 객관식은 우선 선택지 정확 일치 |
| 비용 지표 | 구축·유지·추론 토큰, 단일 동시성 환산 시간, LLM 호출, 기억 저장량 |
| 기억 시스템 11개 | 평면 저장 3개, 계층·생애주기 3개, 그래프 3개, 학습 정책 2개 |
챕터별 상세 리뷰
📖 Chapter 1: Introduction
첫 장은 장기 기억 설계가 다양해졌지만, 원래 대화를 바로 검색하는 방법보다 얼마나 나아졌는지는 분리해서 평가하기 어렵다는 문제를 제기합니다. 기억을 쓰는 시스템끼리만 비교하면, 원문 검색만으로 얻을 수 있는 성능과 기억 가공의 추가 가치를 구별하기 어렵습니다. §1
저자는 개인 에이전트 대화 기억부터 여러 백본과 벤치마크를 비교합니다. 많은 기억 시스템이 RAG보다 낮은 전체 점수를 보이지만, 질문별로 보면 기억만 맞히는 문제도 있습니다. 여기서 기억의 이익과 tax라는 두 측면을 도입합니다. 정보를 요약하거나 선호를 추출하는 행위는 목적 있는 변환이지만, 동시에 원래 증거를 바꾸는 과정이기도 합니다.
이후 논리의 순서는 구축 중 정보가 남았는지, 남은 정보를 찾을 수 있는지, 모델이 바뀌어도 같은 기억을 활용할 수 있는지를 살피는 것입니다. 벤치마크가 원문 검색에 유리하면 추가 이득의 여지는 작아지고 같은 손실도 더 눈에 띕니다. 이 관점을 경험 기억과 세계 모델 기억으로 확장한 뒤, 새로운 대형 아키텍처 대신 기존 시스템에 적용할 수 있는 조정을 제안합니다. 이 장의 기여는 평가 질문을 “기억의 절대 성능”에서 “원문 검색 대비 가공의 순가치”로 옮기는 데 있습니다.
📖 Chapter 2: Preliminary
이 장은 앞서 소개한 $I$·$R$·$G$의 공통 틀을 정의합니다. 원문 이력에는 사용자와 에이전트의 메시지, 관찰 및 다른 콘텐츠가 섞일 수 있습니다. 이를 지속적 저장소로 바꾸고, 현재 질문에 필요한 기억 단위를 골라 답변하는 흐름은 같지만 저장 형태는 요약문·사실·구조화 레코드·에피소드 등으로 달라집니다. §2
비교 기준인 RAG는 원문 이력을 최소한으로 가공해 직접 검색합니다. 이것도 넓은 의미에서 과거 정보에 접근하는 장치이지만, 논문에서는 별도 기억 구축의 효과를 구별하기 위한 기준선으로 취급합니다. 따라서 “memory-free baseline”이라는 표현을 과거 정보가 전혀 없다는 뜻으로 읽으면 안 됩니다. 과거 정보를 안 주는 조건은 별도의 No Context입니다. 다음 장은 이 기준선과 기억 시스템을 같은 평가 틀에 놓습니다.
📖 Chapter 3: Experiments
3.1 Setup: 무엇을 같은 조건으로 비교했을까요
LongMemEval-s는 대화 이력의 사실을 다시 묻고, PersonaMem-v2는 암묵적 성향과 선호를 4지선다로 평가하며, MINT-Eval은 여러 대상·변화가 섞인 이력을 다룹니다. PersonaMem-v2와 MINT-Eval은 비용 때문에 질문 유형별 층화 표본을 사용합니다. GPT-5.6 Luna의 LongMemEval-s 실험도 전체 500개 중 100개 표본입니다. 전체 데이터와 표본의 차이는 Appendix A에서 더 구체화합니다. §3.1, Appendix A.1
기억 시스템은 A-Mem·SimpleMem·MemOS의 평면 저장, MemoryOS·LightMem·OpenViking의 계층 및 생애주기 관리, HippoRAG2·MAGMA·PlugMem의 그래프, Mem-T·Memory-R2의 학습 정책으로 나눕니다. 학습 정책 계열은 배포된 자체 정책 모델을 유지하고 최종 QA 모델만 공통 백본으로 교체합니다. 단순히 모든 구성 요소를 같은 백본으로 바꾼 실험은 아닙니다.
RAG는 1회 검색과 2회 검색을 모두 평가합니다. 2회 검색에서는 첫 검색 결과가 충분한지 백본이 확인하고, 부족하면 추가 질의를 만들어 남은 풀에서 검색합니다. No Context·Full Context·Gold Context도 구분해 제공합니다. Gold Context는 정답 근거만 주는 oracle 조건으로, 실제 사용 시 정답 근거를 알고 있다는 가정은 하지 않습니다.
기억 단위의 크기 차이를 줄이기 위해 각 시스템의 top-k를 RS 기준으로 조정합니다. 대체로 기본 설정보다 넓게 검색하도록 조정하되, OpenViking처럼 단위 수가 적고 각 단위가 큰 시스템에는 고정 top-k 예외를 둡니다. 이 조정은 절대 추론 토큰 예산을 완전히 같게 맞추는 장치가 아닙니다.
3.2 Results: RAG가 강하지만 예외도 있습니다
Table 1에서 Qwen3.6-27B의 LongMemEval-s 점수는 RAG 1회 77.6%, 2회 81.4%입니다. A-Mem은 79.4%로 RAG 1회보다 높고, RAG 2회보다는 2.0%p 낮습니다. 따라서 비교 기준을 생략한 “A-Mem이 RAG보다 나쁘다”는 표현은 정확하지 않습니다. PersonaMem-v2의 MemOS는 50.2%로 RAG 2회 48.7%보다 높고, MINT-Eval의 GPT-5.6 Luna 조건에서는 Mem-T 38.4%, PlugMem 37.8%가 RAG 2회 34.5%보다 높습니다. PDF Table 1, p.3
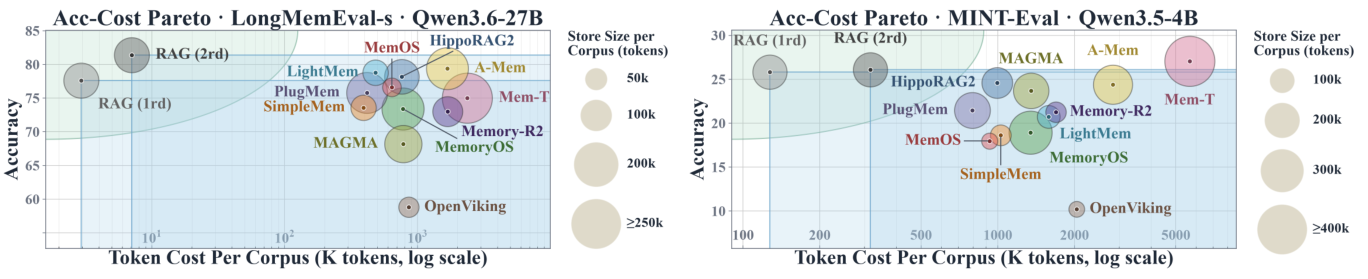
Figure 1. 왼쪽은 LongMemEval-s·Qwen3.6-27B, 오른쪽은 MINT-Eval·Qwen3.5-4B의 정확도와 코퍼스당 토큰 비용입니다. 버블 크기는 저장량입니다. Xuan He et al., v1 PDF p.3, CC BY 4.0, 그림 영역 크롭·라벨 변경 없음.
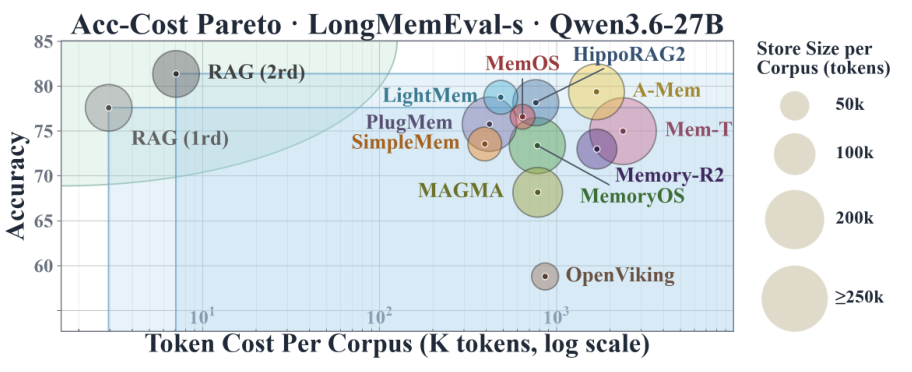
Figure 1 상세. 왼쪽 LongMemEval-s·Qwen3.6-27B 패널만 크롭했습니다. 가로축은 로그 토큰 비용, 세로축은 정확도, 버블 범례는 저장량입니다. Xuan He et al., v1 PDF p.3, CC BY 4.0, 내용·라벨 변경 없음.
Figure 1의 가로축은 로그 척도이고, 세로축은 정답률입니다. 비용이 큰 기억 시스템이 항상 더 정확하지 않으며, 저장량이 큰 버블도 높은 점수를 보장하지 않습니다. 이 결과가 다음 장의 질문을 만듭니다. 추가 비용을 썼다는 사실과 별개로, 원문 검색이 맞힐 수 있었던 문제를 어디에서 놓쳤을까요?
📖 Chapter 4: Memory Tax
4.1 Overview: 이익과 손실은 같은 시스템 안에 공존합니다
저자는 질문별 정오 판정의 교집합과 차집합을 비교합니다. 아래 Figure 2의 파란 부분은 기억만 맞힌 질문, 붉은 부분은 RAG만 맞힌 질문입니다. 전체 성능 차이만 보면 작은 변화처럼 보여도, 그 안에서는 서로 다른 많은 질문이 바뀔 수 있습니다. §4.1, PDF Figure 2
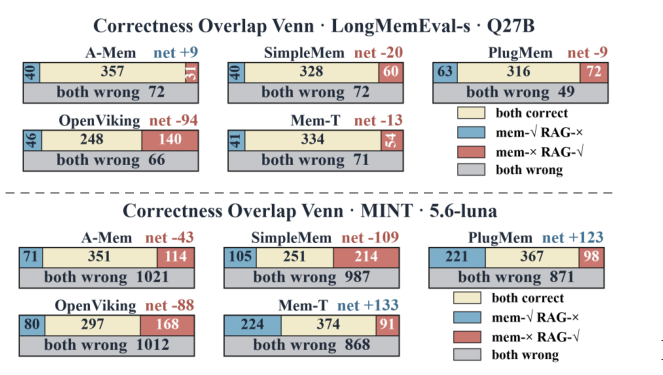
Figure 2. 위는 LongMemEval-s·Qwen3.6-27B, 아래는 MINT-Eval·GPT-5.6 Luna의 질문별 정답 집합입니다. 비교 기준은 RAG 1회 검색입니다. Xuan He et al., v1 PDF p.4, CC BY 4.0, 그림 영역 크롭·라벨 변경 없음.
LongMemEval-s·Qwen3.6-27B에서 A-Mem은 RAG만 맞힌 31개를 놓치는 대신 RAG가 틀린 40개를 맞힙니다. 순증은 9개로 500개 질문의 1.8%p입니다. SimpleMem은 이익 40개와 tax 60개로 순감 20개입니다. MINT-Eval·GPT-5.6 Luna에서는 PlugMem의 이익 221개가 tax 98개보다 커 순증 123개입니다. 기억의 효용을 부정하기보다 어떤 질문을 구하고 어떤 질문을 잃었는지 함께 보자는 해석이 적합합니다.
4.2 Faithfulness: 저장 단계에서 근거가 남았을까요
충실도는 원래 사실이 기억으로 바뀐 뒤에도 보존되는지를 뜻합니다. 저자는 정답 근거가 있는 원문 턴을 gold raw turn, 이에 대응하는 기억 단위를 gold memory unit으로 정의합니다. 원문 근거만 주는 QA와 정답 기억 단위만 주는 QA를 비교하면, 검색 오류를 제거한 뒤에도 남는 차이를 볼 수 있습니다. §4.2, Appendix C.2
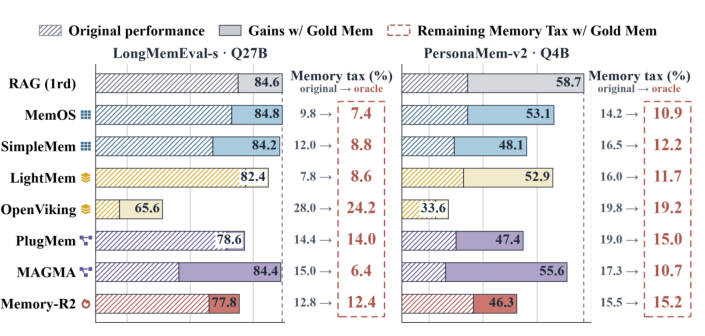
Figure 3. 정답 기억 단위를 직접 넣었을 때의 정확도와 남은 memory tax입니다. 왼쪽·오른쪽은 서로 다른 데이터와 백본 조건입니다. Xuan He et al., v1 PDF p.4, CC BY 4.0, 그림 영역 크롭·라벨 변경 없음.
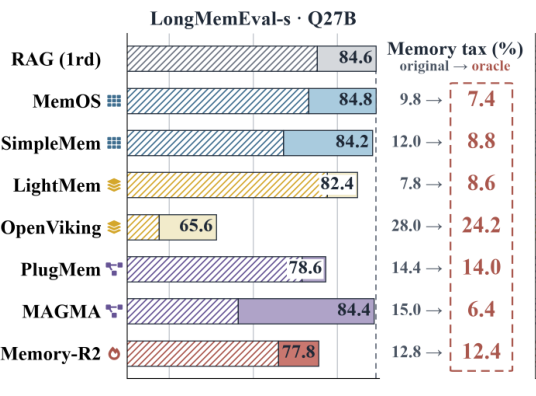
Figure 3 상세. 왼쪽 LongMemEval-s·Qwen3.6-27B 패널만 크롭했습니다. 빗금은 실제 검색 성능, 이어진 색 영역은 gold 기억 제공 시 이득, 붉은 점선 상자는 남은 tax입니다. 공통 범례는 위 전체 그림에 있습니다. Xuan He et al., v1 PDF p.4, CC BY 4.0, 내용·라벨 변경 없음.
여기서 Figure 3의 RAG 행에 표시된 84.6%는 gold 원문 턴을 직접 제공한 oracle 조건의 정확도입니다. Table 1의 RAG 1회 77.6%는 실제 검색을 거친 정확도이므로, 둘은 입력 조건부터 다릅니다. 별도로 gold 기반 진단에서는 근거가 없는 질문을 제외하므로 평가 질문 집합도 확인해야 합니다. gold 기억을 주어도 남는 tax는 구축 과정에서 생긴 손실을 보여 주고, 실제 검색보다 성능이 크게 회복되는 부분은 근거가 남았는데 접근하기 어려웠을 가능성을 보여 줍니다.
미시적으로는 세 벤치마크의 원문 턴 500개를 표본 추출해 기억 단위와 비교합니다. Table 2에서 “정보 손실 없음”의 비율은 MemoryOS 98.4%, MAGMA 93.6%, MemOS 85.8%, OpenViking 39.4%입니다. OpenViking은 대응 기억 단위가 없는 비율도 38.0%입니다. 이 비율은 표본 원문 정보의 보존 판정이며 QA 정답률이나 전체 데이터의 정보 보존율과 동일하지 않습니다. PDF Table 2
4.3 Accessibility: 남아 있는 근거를 찾을 수 있을까요
접근성 분석은 정보가 남았다는 사실만으로 충분하지 않다는 점을 다룹니다. 이미 검색한 단위를 풀에서 제외하면서 검색을 반복하고, 정답에 필요한 모든 기억 단위가 몇 회 만에 모이는지 기록합니다. 구축 중 사라진 근거는 검색 불가능으로 표시합니다. 이 반복 재생은 진단 실험이며, Table 1의 모든 시스템에 같은 횟수의 추가 검색을 부여한 결과가 아닙니다. §4.3, Appendix C.3
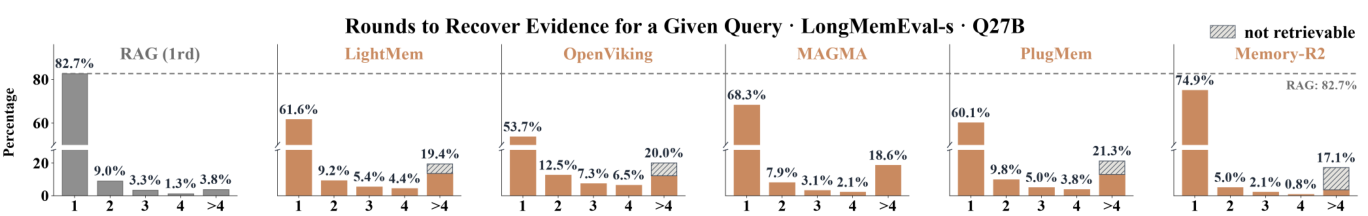
Figure 4. LongMemEval-s·Qwen3.6-27B에서 근거 전체를 회수하는 데 필요한 검색 회차입니다. 빗금은 검색 불가능한 경우를 나타냅니다. Xuan He et al., v1 PDF p.5, CC BY 4.0, 그림 영역 크롭·라벨 변경 없음.
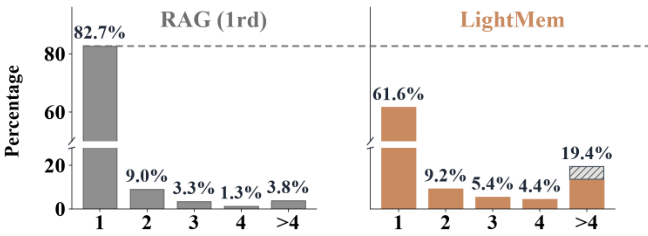
Figure 4 상세. RAG와 LightMem의 첫 두 패널만 크롭했습니다. 가로축은 검색 회차, 세로축은 질문 비율이며 빗금은 검색 불가능한 경우입니다. Xuan He et al., v1 PDF p.5, CC BY 4.0, 내용·라벨 변경 없음.
이 조건에서 첫 회차에 모든 근거가 모인 비율은 RAG 82.7%, LightMem 61.6%, OpenViking 53.7%, MAGMA 68.3%, PlugMem 60.1%, Memory-R2 74.9%입니다. 기억 단위가 여러 조각으로 분산되거나, 긴 프로필 속에 희석되거나, 질문과 다른 표현으로 바뀌면 관련 근거가 뒤쪽 회차로 밀릴 수 있습니다.
저자는 같은 근거의 원문 표현과 기억 표현이 질문과 이루는 임베딩 유사도도 비교합니다. Figure 5는 재표현 전후의 분포 이동과 개별 차이를 보여 줍니다. 그러나 서로 다른 저장소의 절대 유사도는 곧바로 비교할 수 없고, 모든 시스템이 임베딩 점수만으로 검색하지도 않습니다. 따라서 이 그림은 접근성 변화의 보조 신호로 해석합니다.
4.4 Robustness: 기억을 만든 모델과 읽는 모델이 달라질 때
장기 운영에서는 기억을 구축한 모델과 나중에 답변하는 모델이 다를 수 있습니다. 저자는 세 백본으로 각각 기억을 만들고, 각 기억을 세 QA 백본으로 읽는 조합을 비교합니다. 구축 모델을 바꾸면 같은 이력에서 다른 기억이 나올 수 있고, 구축 기억을 고정해도 QA 백본 변화에 따른 점수 하락이 RAG보다 큰 시스템이 존재합니다. §4.4, PDF Figure 6, Appendix C.4
RAG는 인덱스 구축에 LLM을 쓰지 않아 QA 모델 변화만 영향을 주는 기준입니다. 반면 기억 시스템은 구축과 활용 양쪽에서 모델 의존성이 생깁니다. 저자가 말하는 tax는 한 번의 점수 손실뿐 아니라, 백본 변경에 대한 추가 민감성으로도 관찰됩니다. 모든 기억 시스템이 모든 변경에서 더 불안정하다고 일반화하지는 않습니다.
4.5 Benchmark Headroom: 추가 이득을 낼 여지가 얼마나 남았을까요
다음으로 초점이 시스템 내부에서 평가 과제로 이동합니다. 저자는 No Memory, 희귀 단어를 이용하는 IDF-keyword, 임베딩 검색, 하이브리드 RAG를 더 넓은 기억 벤치마크에서 비교합니다. 간단한 검색만으로 이미 많은 문제를 맞힌다면, 복잡한 기억이 새로 맞힐 수 있는 질문은 줄어듭니다. 조금의 정보 손실도 전체 차이에서 크게 드러날 수 있습니다. §4.5, Appendix C.5
Qwen3.6-27B 조건의 PDF Table 16에서 IDF-keyword는 LoCoMo 58.8%, EverMemBench-MCQ 68.2%이고, 하이브리드 RAG는 각각 75.3%, 82.7%입니다. 반면 MINT-Eval의 하이브리드 RAG는 28.6%여서 모든 벤치마크가 같은 난이도인 것은 아닙니다. 검색에 우호적인 과제도 현실적으로 의미가 있으며, 저자는 이를 없애기보다 RAG 결과를 함께 제시해 추가 개선의 여지를 분명히 하자고 제안합니다.
📖 Chapter 5: Generalizing Memory Tax
5.1 Experiential Memory: 과거 작업 경험을 다시 사용할 때
경험 기억은 예전 대화의 사실 대신 과거 작업 궤적을 다음 작업의 안내로 사용합니다. Qwen3.5-4B를 백본으로 ALFWorld·WebShop·Mind2Web·BigCodeBench·AppWorld·τ²-Bench를 평가합니다. 학습 또는 개발 분할에서 경험을 쌓고, 테스트에서는 기억을 고정합니다. ReAct 기반 No Memory와 과거 작업 설명이 유사한 궤적을 검색하는 RAG에 Mem-p·ReasoningBank·G-Memory·SkillPro를 비교합니다. §5.1, Appendix C.6.1
도메인마다 결과가 달라집니다. WebShop에서는 No Memory 45.9점, RAG 38.4점, Mem-p 44.5점입니다. Mem-p가 RAG보다 높다고 해서 이 조건에서 기억 없는 에이전트까지 이겼다는 뜻은 아닙니다. τ²-Bench에서는 RAG 69.0%에 대해 G-Memory 78.0%이지만 ReasoningBank는 51.0%입니다. 경험을 가공하는 방식의 가치도 과제와 표현에 따라 달라집니다. 세부 지표·분모는 Appendix C에서 구별합니다. PDF Table 17, p.24
5.2 World-Model Memory: 지난 장면을 유지할 때
세계 모델에서는 과거 환경 상태를 보존해 긴 비디오의 장면과 시간적 일관성을 유지합니다. 이 논문은 과거 프레임을 직접 검색해 다시 넣는 I3DM, raw KV의 WorldKV, 학습된 KV의 ReWorld, 시각 잠재표현의 MagicWorld·FramePack, 기억 토큰의 HyDRA를 비교합니다. Context-as-Memory와 MemoBench에서 재방문하거나 물체가 다시 나타날 때 상태를 얼마나 유지하는지 측정합니다. §5.2, PDF Table 3
| 방법 | 기억 형태 | C-as-M SSIM↑ | C-as-M 1−LPIPS↑ | MemoBench SSIM↑ | MemoBench 1−LPIPS↑ |
|---|---|---|---|---|---|
| I3DM | 과거 프레임 직접 검색 | .560 | .704 | .430 | .476 |
| WorldKV | raw KV | .372 | .459 | .379 | .420 |
| ReWorld | 학습된 KV | .378 | .510 | .387 | .422 |
| MagicWorld | 시각 잠재표현 | .388 | .341 | .433 | .412 |
| FramePack | 시각 잠재표현 | .217 | .312 | .279 | .303 |
| HyDRA | 기억 토큰 | .320 | .319 | .355 | .326 |
출처: v1 PDF Table 3, p.7을 수치 변경 없이 재작성했습니다. SSIM은 구조 유사도, LPIPS는 지각적 차이 지표이며, 여기서는 1에서 LPIPS를 뺀 값을 써 두 열 모두 높을수록 좋습니다.
직접 프레임 검색은 여러 지표에서 강하지만 모든 셀에서 1위는 아닙니다. MemoBench SSIM은 MagicWorld .433이 I3DM .430보다 조금 높습니다. 저자의 결론은 잠재표현·캐시 기반 기억이 단순 대안보다 일관되게 우수하지 않다는 것이며, 특정 저장 표현이 보편적으로 열등하다는 증명은 아닙니다. 이 장은 원문을 변환하면서 얻는 것과 잃는 것을 따지는 관점을 다른 매체로 확장합니다.
📖 Chapter 6: Design Implications
6.1 Memory Construction: 변환을 되돌릴 경로를 남깁니다
기억을 만들 때 미래의 모든 질문을 예측하기 어렵다면, 어떤 변환도 손실을 완전히 막기 어렵습니다. 저자는 구축된 기억이 부족할 때 원문으로 돌아갈 수 있는 가벼운 경로를 남기자고 제안합니다. 개념 검증에서는 기존 기억 검색과 원문 검색을 함께 수행하고, 결과를 합쳐 재정렬한 뒤 QA에 넣습니다. 새 기억 아키텍처를 만든 실험은 아닙니다. §6.1, PDF Table 4 p.8
| Qwen3.6-27B 조건 | LongMemEval-s 정확도 / tax(%) | PersonaMem-v2 정확도 / tax(%) |
|---|---|---|
| SimpleMem | 73.6 / 12.0 | 46.7 / 11.2 |
| SimpleMem + 원문 보강 | 82.8 / 5.2 | 49.6 / 7.2 |
| MemoryOS | 73.4 / 11.4 | 48.2 / 17.1 |
| MemoryOS + 원문 보강 | 76.4 / 7.8 | 53.0 / 8.5 |
| Mem-T | 75.0 / 10.8 | 42.1 / 15.2 |
| Mem-T + 원문 보강 | 80.0 / 5.2 | 49.0 / 8.7 |
출처: v1 PDF Table 4의 원문 보강(src-aug) 행을 재작성했습니다. 정확도와 tax는 서로 다른 값입니다. 이 표의 개선은 원문 보강이라는 변경을 적용한 조건의 결과입니다.
SimpleMem의 LongMemEval-s 정확도는 9.2%p 올라가고 tax는 6.8%p 줄어듭니다. 기억 가공의 이익을 유지하면서 원문 근거를 다시 가져올 수 있다는 것이 이 제안의 핵심입니다.
6.2 Memory Access: 어떻게 찾았는지도 기억합니다
두 번째 제안은 과거 질문과 찾아낸 근거를 기억 저장소의 추가 입력으로 넣는 것입니다. 이전 질문에서 여러 번 찾아야 했던 근거라면, 비슷한 정보 수요가 다음에 왔을 때 더 직접적으로 접근하도록 합니다. 저자는 이를 “기억하는 방식을 기억하는” 재귀적 연결로 설명하며, 개별 질문 안의 추가 검색과 질문 사이의 경험 축적을 구별합니다. §6.2
PDF Table 4에서 recursive 조건의 PersonaMem-v2 정확도/tax는 SimpleMem 46.8/12.1, MemoryOS 49.1/16.4, Mem-T 45.7/13.6입니다. 개선이 모든 지표에 일관적인 것은 아닙니다. SimpleMem의 정확도는 46.7%에서 46.8%로 조금 오르지만 tax는 11.2%에서 12.1%로 커집니다. 이익과 손실을 함께 측정해야 하는 이유가 설계 개선 표 안에서도 드러납니다. LongMemEval-s는 코퍼스당 질문이 하나이므로 질문 사이 메커니즘을 적용하지 않아 N/A로 표시합니다.
6.3 Future Direction and Beyond Memory Operations: 미래에 필요할 정보를 추정합니다
마지막 제안은 실험으로 입증한 새로운 모델이 아니라 저자가 명시한 향후 방향입니다. 질문 전에 기억을 만드는 ahead-of-time 방식은 어떤 정보가 나중에 필요한지 모른 채 비용을 쓰고, 질문을 받은 뒤 가공하는 just-in-time 방식은 수요를 알 수 있지만 사용자 응답 지연을 늘립니다. 저자는 과거 관심·습관·접근 패턴으로 미래 수요의 사전분포를 추정하는 중간 지점을 제시합니다. §6.3
이 관점에서 기억은 과거 정보를 잘 압축하는 문제이면서, 앞으로 어떤 과거 정보가 관련될지 추정하는 암묵적 추천 문제이기도 합니다. 논문은 이 방향을 개인 에이전트의 실제 사용 환경에서 탐색할 대상으로 남깁니다. 앞의 원문 보강 실험과 동일한 수준의 실증 결과로 읽어서는 안 됩니다.
📖 Chapter 7: Related Works
첫 번째 묶음은 장기 기억의 저장 형태와 제어 방식을 정리합니다. 평면적인 메모, 단기·장기 계층, 파일시스템 트리, 관계 그래프가 있고, 기억을 쓰고 갱신하는 규칙도 미리 정한 harness·LLM의 동적 결정·학습 정책으로 나뉩니다. 같은 저장 형태라도 누가 언제 수정하는지에 따라 동작이 달라진다는 설명입니다. §7
두 번째 묶음은 기억 시스템의 성능·비용·시간 사용을 분석한 실증 연구입니다. 저자는 기존 연구가 설계와 경험적 동작을 특징짓는 데 초점을 두었다면, 이 논문은 원문 검색 대비 기억 가공 자체의 이익과 손실을 분해한다는 차이를 강조합니다. 여기서는 논문이 정리한 관계를 설명했으며, 참고문헌 전체를 독립적으로 다시 검토한 것은 아닙니다. 다음 결론은 이 비교 축을 전체 결과에 다시 연결합니다.
📖 Chapter 8: Conclusion
결론은 세 벤치마크에서 많은 기억 방법이 RAG보다 낮은 점수를 보인다는 관찰, 그 안에도 기억만 맞히는 질문이 있다는 분해, 충실도·접근성·강건성 및 평가 조건의 영향을 다시 연결합니다. 기억은 유익한 정보 조직이면서 유해한 변형일 수도 있으므로, 최종 점수와 함께 순가치를 살펴야 한다는 주장입니다. §8
바로 뒤의 번호 없는 Limitations에서 저자는 기준선이 대표적 선택이지 전수 목록은 아니며, 공식 설정을 따르더라도 시스템별 추가 튜닝으로 성능이 좋아질 수 있다고 밝힙니다. 평가는 주로 정적·오프라인·영어 환경이어서 질문과 기억 갱신이 교차하는 장기 실제 운영, 다국어 상호작용은 충분히 다루지 않았습니다. 비용 제한으로 더 강한 frontier 모델은 포함하지 못했고 일부 데이터는 층화 표본입니다. 전모달·잠재·파라미터 기억으로의 확장도 향후 과제로 남깁니다. PDF p.9
이 한계 고지 뒤에는 참고문헌과 재현·진단을 위한 부록이 이어집니다. 부록은 주장의 비교 조건을 확인하는 데 필요한 자료이므로 다음 순서대로 살펴봅니다.
📖 Chapter A: Experiment Details
A.1 Benchmark Details
데이터 규모는 PDF Table 5에 정리됩니다. LongMemEval-s는 코퍼스 500개·질문 500개이며 코퍼스당 약 50개 세션에서 근거를 찾습니다. GPT-5.6 Luna에는 질문 유형별로 뽑은 100개 코퍼스만 사용합니다. PersonaMem-v2는 128k-token 변형에서 200개 코퍼스 중 40개를 골라 934문항을 평가합니다. MINT-Eval은 595개 코퍼스 중 60개를 골라 1,557문항을 평가합니다. Appendix A.1
| 데이터 | 평가 코퍼스 | 질문 수 | 코퍼스당 토큰 중앙값 | 답변 형태 |
|---|---|---|---|---|
| LongMemEval-s | 500 | 500 | 약 115k | 짧은 답 |
| PersonaMem-v2 표본 | 40 | 934 | 약 123k | 4지선다 |
| MINT-Eval 표본 | 60 | 1,557 | 약 139k | 짧은 답 |
MINT-Eval은 다중 턴 대화 10코퍼스·690문항, 상태 추적 10·563, GitHub 커밋 20·154, 위키 수정 20·150으로 구성됩니다. 코퍼스의 길이와 질문 수가 서로 달라 전체 정확도가 어떤 하위 과제에 의해 좌우되는지 확인해야 합니다. 위 토큰 수는 중앙값이며 이후 넓은 벤치마크 표의 평균 길이와 같은 통계가 아닙니다.
A.2 Baseline Details
No Context는 질문만, Full Context는 시간순 원문 전체를 넣되 문맥 창을 넘으면 오래된 부분부터 자릅니다. Gold Context는 답을 뒷받침하는 원문 근거만 주는 oracle입니다. MINT-Eval은 검증된 gold가 일부 문항에만 있어 주 결과의 Gold Context 행을 생략합니다.
RAG 청크는 세션 경계를 넘지 않습니다. 짧은 턴을 약 1,024자로 합치고 마지막 턴을 중첩시키며, 긴 턴은 따로 유지합니다. 8,192자를 넘는 턴은 8,192자 창과 1,024자 중첩으로 나눕니다. 여기서 단위는 토큰이 아니라 문자입니다. 각 청크에 세션 날짜·시간을 붙입니다. BM25와 임베딩 검색이 각각 top-k를 돌려주고, 중복 제거한 합집합을 재정렬해 top-k를 최종 문맥으로 줍니다. 2회 검색은 첫 결과가 불충분할 때 후속 질의로 검색합니다. Appendix A.2
평면·계층·그래프라는 저장 형태와 학습된 정책이라는 제어 방식은 분류 축이 완전히 같지는 않습니다. 예컨대 학습 정책 Mem-T는 계층 저장을, Memory-R2는 평면 저장을 사용합니다. 둘의 자체 정책 모델은 각각 Qwen3-4B와 Qwen2.5-7B-Instruct로 유지합니다.
A.3 Evaluation Metrics
일반 QA는 정답과 의미가 맞는지 Qwen3.6-27B 판정기가 채점합니다. F1·BLEU처럼 표면 단어 중복에 민감한 지표는 피합니다. 객관식은 선택지를 파싱해 정확 일치를 적용하고, 파싱하기 어려운 응답만 판정기로 보냅니다. PDF Table 6의 사람 판정 일치율은 LongMemEval-s 95.1%, PersonaMem-v2 100.0%, MINT-Eval 97.3%입니다. 객관식 100%는 선택지 일치 조건의 결과이며 일반 자유 응답 판정의 완벽함을 뜻하지 않습니다. Appendix A.3
비용은 구축·유지·QA의 입력 및 출력 토큰을 합산합니다. 실행 시간은 서로 다른 동시성을 단일 동시성 상당 시간으로 환산하고, 호출 수는 엔드포인트 부하와 별개로 셉니다. 저장량은 구축 뒤 기억 단위 토큰 수의 코퍼스 평균입니다. 실제 사용자 요청 한 건의 지연, 전체 구축 시간, 토큰 비용을 서로 대체해서 읽지 않아야 합니다.
A.4 Implementation
RS는 검색 도중 LLM이 기억을 읽는 경우까지 포함합니다. 검색과 무관한 메타데이터는 분자·분모에서 제외하고, Qwen3.6-27B 토크나이저로 셉니다. 단순 쿼리 재작성처럼 검색 문서를 읽지 않는 호출은 기억 노출량을 늘리는 경우와 구별합니다. Appendix A.4
Qwen 백본은 NVIDIA H20에서 로컬 서빙하고 온도 0·top-p 1·추론 비활성화로 실행합니다. GPT-5.6 Luna는 API의 기본 샘플링과 low reasoning을 사용합니다. 임베딩과 재정렬 모델을 통일하되 특정 기억 시스템이 원래 재정렬을 쓰지 않는 경우까지 모두 같은 검색 파이프라인으로 바꾸었다는 뜻은 아닙니다.
A.5 More Explanations
PersonaMem-v2에서는 GPT-5.6 Luna가 Qwen3.6-27B보다 낮은 경우가 많습니다. 저자의 사례 점검에서는 개인화 선택지와 거의 같은 일반 선택지가 있을 때 Luna가 일반 선택지를 선호하는 패턴이 관찰됩니다. 저자는 민감한 정보나 고정관념을 피하려는 응답 성향과의 상호작용으로 설명하며, 모델의 일반 능력 저하로 단정하지 않습니다. 이어 MINT-Eval의 gold 문맥이 약 절반의 질문에만 있다는 이유를 다시 명시합니다. 다음 부록은 이 비교 설정이 특정 기억 시스템을 부당하게 불리하게 하지 않았는지 확인합니다.
📖 Chapter B: Configuration Validation
B.1 Ablations on RAG Baseline
RAG의 강한 결과가 하나의 유리한 구성에서만 나온 것인지 보기 위해 청크 방식, 검색 방식, 임베딩, 재정렬을 하나씩 바꿉니다. 기본 1,024자 버퍼와 512자 버퍼·턴 단위·고정 길이 스트리밍 청크를 비교하고, 하이브리드 검색과 BM25 단독·임베딩 단독을 구별합니다. 임베딩은 MiniLM부터 NV-Embed-v2까지, 재정렬은 BGE·Jina·Qwen 계열을 바꾸되 나머지 조건은 유지합니다. Appendix B.1, PDF Table 7
LongMemEval-s·Qwen3.6-27B에서 기본 77.6%에 비해 턴 단위는 76.6%, 스트리밍 청크는 69.4%, BM25 단독은 68.2%, 임베딩 단독은 72.6%입니다. 대부분의 구성에서 경쟁력을 유지하지만, 대화 경계를 자르거나 검색 채널을 하나로 줄이는 변경에는 점수가 낮아집니다. 따라서 “어떤 RAG든 똑같다”가 아니라, 충분히 명시한 검색 기준선과 비교해야 한다는 근거로 읽습니다.
B.2 RAG Implementation in Prior Works
저자는 평가한 기억 기준선과 추가 주요 논문을 다시 살펴, 원래 RAG 시스템인 HippoRAG2 등을 제외하면 RAG 결과를 제시한 경우가 LightMem·PlugMem·Mem-T 세 곳이라고 정리합니다. LightMem은 턴 청크와 MiniLM 검색을 사용하지만 검색 예산 등의 설정을 명시하지 않았고, PlugMem은 NV-Embed-v2 top-10, Mem-T는 BGE-M3 top-5를 사용하되 청크 전략이 명확하지 않았다고 설명합니다. Appendix B.2
이 검토 범위에서 저자가 내리는 결론은 기억 구축의 추가 가치를 평가할 때 검색 기준선의 잠재력을 충분히 확인해야 한다는 것입니다. 모든 기억 연구 전체에 대한 전수 조사나, 각 이전 논문의 모든 실험을 다시 실행했다는 주장과 구별합니다.
B.3 Memory Baseline Config Offset Validation
공통 QA·판정·임베딩 설정은 기억 메커니즘과 무관한 혼입을 줄이기 위한 조정입니다. top-k는 RS 때문에 대부분 커지지만, 일부에서는 작아집니다. 저자는 이 영향도 따로 확인합니다. LongMemEval-s·Qwen3.6-27B의 HippoRAG2는 기본 top-5 68.2%에서 조정 top-10 78.2%이고, PersonaMem-v2·Qwen3.5-4B의 SimpleMem은 기본 top-25 37.5%에 비해 조정 top-10 34.7%입니다. 조정이 언제나 모든 시스템에 유리했다는 식으로 단순화할 수 없습니다. PDF Tables 8–9
시스템별 조정은 다섯 가지입니다. MemOS는 기존 임베딩에 맞춘 임계값·MMR 후처리를 끄고 cosine 재정렬을 켭니다. SimpleMem은 다른 세션이 한 창에 묶이지 않도록 입력 창을 40발화에서 10발화로 바꿉니다. LightMem은 사용자 발화만이 아니라 에이전트 발화도 포함합니다. Mem-T는 정책 모델이 검색을 마친 뒤 답변하기 전에 멈추고 공통 QA 모델이 답합니다. Memory-R2는 두 구축 단계의 출력 상한을 학습 길이인 4,096토큰으로 높여 잘림을 줄입니다. Appendix B.3
PDF Table 11에서 LightMem의 LongMemEval-s·Qwen3.6-27B는 사용자만 입력할 때 70.6%, 양쪽 발화를 입력할 때 78.8%입니다. 이는 공통 조건으로 맞추는 구체적 변경이 결과에 영향을 준다는 증거입니다. 이후 분석은 이렇게 명시한 평가 설정의 결과를 대상으로 합니다.
📖 Chapter C: Analysis Details
C.1 Overview
PDF Figures 10–12는 세 주 벤치마크에서 Qwen3.5-4B와 Qwen3.6-27B별 정답 집합을 확장해 보여 줍니다. 본문의 작은 예시만으로 모든 조합을 대표하지 않고, 각각의 이익과 tax가 함께 존재하는지 확인하는 자료입니다. Appendix C.1
C.2 Memory Tax — Faithfulness
먼저 gold 근거의 분모를 명시합니다. LongMemEval-s는 500문항 중 479개에 gold 턴이 있고 나머지 21개는 답변 유보 문항입니다. PersonaMem-v2는 934개 중 836개이며, 나머지 98개는 질문 자체에 민감 정보가 있어 별도 기억이 필요 없는 경우입니다. MINT-Eval은 1,557개 중 765개에 검증된 gold 단계가 있습니다. gold 기반 분석은 근거 없는 문항을 제외합니다. PDF Table 12
원문과 기억의 매핑은 한 원문 턴이 단일 기억으로 이어지는 경우, 여러 후보 기억으로 이어지는 경우, 정보가 사라져 대응 단위가 없는 경우로 나눕니다. 필요한 경우 GPT-5.6 Terra와 Claude Sonnet 5가 독립적으로 선택하고 드문 불일치는 사람이 조정합니다. A-Mem·MemoryOS·HippoRAG2·MAGMA는 결정적인 일대일 매핑을 사용할 수 있습니다. 따라서 gold 기억의 구성도 평가 절차의 일부입니다.
표본 인적 점검에서 잘못 추가하거나 빠뜨리는 선택이 있음을 PDF Table 14에 보고합니다. 예컨대 LongMemEval-s의 SimpleMem 매핑 점검은 올바름 92.2%, 불필요한 단위 포함 5.8%, 필요한 단위 누락 2.0%입니다. 원문 사실 보존을 판정하는 별도 500턴 점검에서는 일대다 대응 단위를 LLM으로 먼저 걸러내지 않고 모두 사람에게 보여 줍니다. 단위 선택 정확도와 내용 보존 정확도는 서로 다른 검사입니다.
Oracle 비교는 구축 손실과 검색 손실을 분리하는 도구입니다. MAGMA·LightMem처럼 gold 기억을 주면 원문 gold 성능에 가까워지는 경우에는, 근거를 없앤 것만으로 실제 QA 성능 하락을 설명하기 어렵습니다. 이 결과가 다음 접근성 분석의 동기입니다.
C.3 Memory Tax — Accessibility
저자는 검색 메커니즘을 점수 기반 ranking, 키워드·메타데이터 matching, 그래프 이웃 등의 expansion, 프로필을 항상 문맥에 두는 persistence로 나눕니다. 한 시스템이 여러 방식을 함께 쓸 수 있으므로 저장 형태만 보고 검색 동작을 판단하지 않습니다. PDF Table 15
검색 반복 재생은 이미 찾은 단위를 제거하며 모든 gold가 모일 때까지 진행합니다. 저장 상태만으로 재생 가능한 경우와 그래프 확장·LLM 질의 수정 때문에 검색을 다시 실행해야 하는 경우를 구별합니다. 유사도 변화 분석에서는 원문 턴 하나가 여러 기억 단위에 대응할 때 중앙값 유사도를 사용합니다. 저장소 간 절대 유사도의 직접 비교를 피하고, 같은 근거의 표현이 질문에 얼마나 가까워졌는지 살피는 보조 분석입니다.
C.4 Memory Tax — Robustness
각 구축 모델의 기억을 각 QA 모델로 읽으며, 검색이 LLM에 의존하지 않으면 검색 단위를 고정합니다. LLM이 검색에 관여하는 경우에는 새 QA 모델로 검색을 다시 재생합니다. PDF Figure 15는 같은 구축 모델에서 강한 QA 모델을 약한 QA 모델로 바꿨을 때의 점수 하락을 RAG의 하락과 비교합니다. Appendix C.4
따라서 이 그림은 저장 내용만 다른 단일 요인의 실험으로 일괄 해석할 수 없습니다. 어떤 시스템에서는 QA 모델 변화가 검색 과정에도 영향을 주도록 설계되어 있고, 그 포함 범위를 저자가 명시합니다.
C.5 Benchmark Headroom Further Exposes the Memory Tax
LoCoMo부터 RealMem·EverMemBench·AMA-Bench 및 다중모달 Mem-Gallery·WorldMemArena까지 범위를 넓힙니다. IDF-keyword는 질문에서 IDF가 높은 단어 두 개를 고르고, 두 단어를 모두 포함하는 청크를 먼저, 하나만 포함하는 청크를 나중에 선택하며 같은 층에서는 균등 표본을 뽑습니다. 단순한 단어 일치 검색도 어떤 과제에서는 강한 기준이 된다는 점을 시험합니다. Appendix C.5, PDF Table 16
평가 방식이 공식 설정과 다른 부분도 있습니다. 일부 벤치마크는 비용 때문에 유형 분포를 대략 보존한 표본을 사용하고, LoCoMo의 답변 유보 범주는 제외합니다. ES-MemEval은 결정적 정답이 있는 QA 과제만 사용합니다. 다중모달 데이터의 이미지는 Qwen3.6-27B가 약 200토큰 캡션으로 바꾼 뒤 텍스트 검색을 합니다. 그러므로 이 결과를 원래 다중모달 시스템 전체의 성능과 바로 등치하지 않습니다.
C.6 Generalizing Memory Tax
C.6.1 Experiential Memory는 경험 축적/테스트 개수를 각각 ALFWorld 300/134, WebShop 1,000/500, Mind2Web 1,009/1,341, BigCodeBench 992/148, AppWorld 147/585, τ²-Bench 178/100으로 명시합니다. RAG는 작업 시작 때 설명이 유사한 과거 작업 top-2의 원시 궤적을 넣습니다. Mem-p는 절차, ReasoningBank는 성공·실패의 전략, G-Memory는 계층 그래프, SkillPro는 피드백으로 다듬는 스킬 풀을 사용합니다. Appendix C.6.1
ALFWorld는 성공률, WebShop은 과제 점수, Mind2Web은 단계 성공률, BigCodeBench는 pass@1, AppWorld는 전체 관련 테스트를 통과해야 하는 Task Goal Completion, τ²-Bench는 pass^1입니다. 서로 다른 지표를 하나의 동일한 정확도로 합치지 않습니다. BigCodeBench는 한 번 생성하는 과제이고, Mind2Web은 정답 궤적의 단계별 오프라인 평가여서 에이전트가 정한 평균 단계 수가 없습니다. 토큰 비용은 경험 라이브러리 구축 비용을 테스트 작업에 나누어 포함합니다.
C.6.2 World-Model Memory는 Context-as-Memory의 60개 표본에서 네 비디오 구간을 생성해 카메라가 원래 위치로 돌아왔을 때를 비교합니다. MemoBench는 25%인 90개 표본에서 물리적으로 변한 물체가 화면 밖으로 나갔다 돌아왔을 때 상태 보존을 확인합니다. PSNR·SSIM·1−LPIPS를 사용하고, 모든 방법은 H100에서 추론 50단계로 실행합니다. Appendix C.6.2, PDF Table 18
예컨대 C-as-M의 I3DM PSNR은 19.8, ReWorld는 14.1이고, MemoBench에서는 각각 14.4와 12.9입니다. 원문 프레임 재주입을 유력한 대조군으로 놓아야 한다는 관찰은 있지만, 서로 다른 생성 시스템의 비교를 기억 표현 하나의 인과 효과로 확대하지 않는 것이 적절합니다. 다음 부록은 추상적인 진단을 실제 질문 사례로 연결합니다.
📖 Chapter D: Case Studies
D.1 Memory Benefit
저자는 기억이 RAG를 이긴 사례를 여섯 가지로 분류합니다. 원자적 사실 추출은 불필요한 긴 청크를 줄이고, 다중 홉 연결은 여러 세션의 사실을 함께 가져오며, 암묵적 선호 노출은 스쳐 지나간 취향을 명시합니다. 시간 기준 고정은 상대 날짜를 절대 시점에 연결하고, 명시적 잊기는 철회 요청을 반영하며, 이종 입력 처리는 코드 diff 등을 자연어 기록으로 바꿉니다. Appendix D.1, PDF Figures 18–19
대표적으로 “새집에 제안하기 전 집을 몇 채 보았나”라는 질문에서 Memory-R2는 각 방문을 별도 사실로 저장해 정답 4를 답하고, RAG는 같은 타운하우스에 대한 청크가 상위를 차지해 1이라고 답합니다. 코드 diff 사례에서는 tabulate가 처음 추가된 다음 커밋 당시 spotipy 버전을 묻습니다. MemOS와 Memory-R2가 커밋 사건을 날짜별 문장으로 정리해 2.12.0을 답하고, RAG는 필요한 최초 커밋을 가져오지 못합니다. 이 사례들은 구조화가 실제로 유익한 조건을 보여 줍니다.
D.2 Memory Tax — Faithfulness
다음 사례는 같은 추출·일반화가 어떤 근거를 없애는지 보여 줍니다. 택시 요금 원문에는 약 60달러라는 수치가 있는데, 어떤 기억은 “비용 효율적인 교통수단을 선호한다”는 일반 성향만 남깁니다. 후속 질문이 기차와 택시의 절감액을 묻는다면 일반 성향만으로는 계산할 수 없습니다. Appendix D.2, PDF Figures 20–23
“가족의 결혼 압박에 대한 정보를 잊어 달라”는 요청을 압박을 느낀다는 새 사실로 저장하는 경우도 있습니다. 다른 예에서는 “백팩이 1월 20일 도착했다”가 “1월 20일 사용을 시작했다”로 바뀝니다. 문장이 자연스럽더라도 사건 종류가 바뀌면 후속 날짜 계산의 근거가 달라집니다. 정보 손실의 정도는 전체 누락뿐 아니라 의미의 일부 변형까지 포함합니다.
D.3 Memory Tax — Accessibility
접근성 사례는 필요한 사실이 실제로 남았는지부터 확인합니다. 자전거 수리 원문에 체인 25달러와 조명 40달러가 함께 있지만, LightMem에서는 여러 단위로 나뉘어 조명은 1회차, 체인은 4회차에 검색됩니다. 지출 합계를 묻는 질문은 두 금액을 모두 필요로 합니다. 원문이 보존되었다는 사실만으로 첫 검색의 답변 성공이 보장되지 않는 이유입니다. Appendix D.3, PDF Figure 24
희석 사례에서는 편도 통근 45분이라는 한 줄이 59줄 프로필 안에 들어갑니다. 재표현 사례에서는 “평소 오후 6시에 체육관에 간다”가 회의 일정 중심의 표현으로 바뀌며, 먼저 검색된 예전 오후 7시 기록과 경쟁합니다. 저자는 분절·희석·재표현을 반복해서 관찰한 패턴으로 제시하며, 임베딩 유사도 진단을 이런 사례와 연결합니다.
D.4 Direct Examples for the Double-edged Memory Mechanisms
마지막 사례 묶음은 같은 메커니즘의 성공과 실패를 짝지어 비교합니다. 사실 추출은 방문 수 계산을 돕지만 500포인트가 5달러 할인이라는 관계에서 금액을 빼먹을 수 있습니다. 다중 홉 연결은 가족 나이 평균 59.6을 구하도록 돕지만, 잘못 연결한 날짜 추론의 결론만 전달해 3주를 6주로 답하게 할 수 있습니다. Appendix D.4, PDF Figures 25–26
| 같은 처리 | 이익 사례 | tax 사례 |
|---|---|---|
| 암묵적 선호 추출 | 간접적으로 드러난 취향을 추천에 반영 | 실제 60달러 구매를 제안에 있던 10–20달러 예산으로 일반화 |
| 상대 시점의 절대화 | 울타리 수리와 발굽 손질의 선후 관계 정리 | 목격 사건과 산책을 분리한 뒤 세션 날짜를 붙여 기간 오답 |
| 명시적 잊기 | 과학 다큐 취향 철회에 맞춰 다른 추천 | 잊어 달라는 수집 취향을 다시 긍정 사실로 기록 |
| 코드 diff의 문장화 | 의존성 추가·변경 순서를 검색 가능하게 만듦 | 실제 2016년 커밋을 임시 날짜 2024년으로 요약 |
이 표는 원문의 사례를 한국어로 축약한 것이며 새로운 실행 결과가 아닙니다. 핵심은 좋은 기억 연산과 나쁜 기억 연산을 이름만으로 나누기 어렵다는 점입니다. 같은 연산의 이익과 손실을 후속 질문의 요구와 함께 봐야 합니다.
📖 Chapter E: Full Results
E.1 Full Results of LongMemEval-s
PDF Table 19와 Figure 27은 GPT-5.6 Luna의 100코퍼스 표본에 대해 구축·유지·추론 토큰, 오프라인 구축·온라인 QA 시간, 호출 수와 저장량을 분리합니다. 점수는 벤치마크 단위, 표의 비용은 전체 코퍼스 합계, 산점도는 코퍼스 평균이라는 집계 차이를 명시합니다. Appendix E.1
이 표에서 RAG 2회의 정확도는 90.0%, 추론 토큰은 총 0.65M입니다. A-Mem은 84.0%이고 구축 29.3M·유지 145.0M·추론 0.44M입니다. A-Mem의 온라인 QA 시간은 3.2분으로 RAG 2회의 7.7분보다 짧지만, 오프라인 구축은 각각 117.0시간과 0.11시간입니다. 이것은 전체 표본의 단일 동시성 환산 시간이며 한 사용자 질문의 실측 지연으로 바꾸어 말하지 않습니다.
E.2 Full Results of PersonaMem-v2
PDF Table 20과 Figure 28은 Qwen3.6-27B·40코퍼스 표본입니다. MemOS는 정확도 50.2%로 RAG 2회 48.7%보다 높지만, 구축 토큰 44.8M과 추론 1.31M을 사용합니다. RAG 2회는 추론 7.68M이며 별도 LLM 구축 토큰은 없습니다. 즉 더 높은 초기 처리 비용과 더 작은 QA 토큰 비용을 함께 볼 수 있습니다. Appendix E.2
Mem-T는 정확도 42.1%, 추론 61.0M, 온라인 QA 6,807.9분입니다. 한 숫자만으로 효율을 판단하기보다, 어떤 단계의 비용과 어떤 정확도를 교환했는지 분리해 읽도록 만든 자료입니다.
E.3 Full Results of MINT-Eval
PDF Table 21과 Figure 29는 Qwen3.5-4B·60코퍼스 표본입니다. RAG 2회는 26.1%, Mem-T는 27.0%로 후자가 0.9%p 높습니다. Mem-T의 토큰은 구축 54.0M·유지 199.2M·추론 86.6M이며, RAG 2회 추론은 19.0M입니다. 작은 점수 이득도 존재하지만 어떤 비용을 동반하는지 함께 확인할 수 있습니다. Appendix E.3
이 부록은 모든 시스템을 무조건 비효율적이라고 정리하기 위한 자료가 아닙니다. 오프라인 구축·온라인 응답·저장량을 구분했을 때 시스템마다 다른 교환관계가 있음을 보여 줍니다. 마지막 부록은 이 점수를 만든 답변 및 채점 지시를 공개합니다.
📖 Chapter F: Prompt Templates
F.1 QA Prompts
일반 QA 프롬프트는 날짜·기간을 구체적으로 답하고, 상대 시점은 현재 질문 날짜를 기준으로 해석하며, 변한 정보는 질문이 과거를 지정하지 않는 한 최신 기억을 우선하도록 합니다. 여러 대화의 근거를 결합하고, 정보가 없으면 없다고 말하라는 규칙도 포함합니다. 기억 블록과 선택적 사용자 프로필, 현재 날짜, 질문을 구분해 전달합니다. Appendix F.1, PDF Tables 22–24
정답이 하나로 정해지지 않는 선호 질문에서는 사용자의 취향을 충분히 반영하도록 하며, 일반 QA의 정보 부재 규칙은 제거합니다. 객관식은 네 선택지 중 해당 사용자에게 가장 맞는 답을 한 글자로만 내도록 합니다. 세 종류의 문제에 같은 출력 규칙을 무조건 적용하지 않는 설계입니다.
F.2 LLM-as-Judge Prompts
일반 짧은 답 채점은 의미가 같은 표현을 정답으로 인정하고, 시간 표현을 같은 날짜·기간으로 바꾸어 비교하며, 일부 반올림 차이도 허용합니다. 선호 자유 응답은 원하는 개인화 응답의 기준을 만족하는지 보고, 모든 기준을 빠짐없이 재현할 필요 없이 개인 정보를 올바르게 떠올려 활용하면 정답으로 봅니다. Appendix F.2, PDF Tables 25–27
객관식의 예외 채점은 답이 선택지 글자로 파싱되지 않을 때 실제로 하나의 정답 선택지에 확정했는지를 판단합니다. 빈 답·거절·여러 선택지 사이의 유보·그럴듯하지만 선택하지 않은 답은 오답입니다. 이 부록까지 보면 본문의 정확도는 단순 단어 일치율이 아니라, 문제 유형에 맞춘 답변·채점 규약의 결과라는 점이 명확해집니다.
실험 결과 심층 분석
전체 결과를 읽는 첫 기준은 RAG 1회와 2회를 구별하는 것입니다. Qwen3.6-27B의 LongMemEval-s에서 A-Mem 79.4%는 RAG 1회 77.6%보다 1.8%p 높고, RAG 2회 81.4%보다 2.0%p 낮습니다. 1회 기준의 질문별 이익 40개와 tax 31개는 앞의 1.8%p 차이와 맞습니다. 이 분해는 tax를 최종 점수 차이와 혼동하지 않게 합니다. PDF Table 1·Figure 2
두 번째는 과제에 따라 결론의 강도가 달라진다는 것입니다. LongMemEval-s·GPT-5.6 Luna에서는 RAG 2회가 90.0%로 모든 평가 기억 시스템보다 높습니다. 반면 PersonaMem-v2·Qwen3.6-27B의 MemOS와 MINT-Eval·GPT-5.6 Luna의 Mem-T·PlugMem은 RAG 2회보다 높습니다. 기억이 도움이 될 만한 추론·선호·경험 정리가 있는 조건을 평균 결론으로 지우지 않아야 합니다. PDF Table 1
세 번째는 정보 보존과 답변 성공을 별도 측정했다는 것입니다. MemoryOS의 표본 정보 보존 판정이 98.4%라고 해서 QA가 98.4%가 되는 것은 아닙니다. 남은 근거가 첫 검색에 모이지 않거나, 백본이 활용하지 못할 수 있습니다. gold 기억을 직접 넣는 진단, 반복 검색 재생, 백본 교차 실험을 연결해야 손실이 발생하는 경로를 구별할 수 있습니다. §4.2–4.4
네 번째는 개선안도 benefit와 tax를 모두 봐야 한다는 것입니다. 원문 보강은 PDF Table 4의 세 시스템·두 벤치마크에서 정확도를 높이고 tax를 줄입니다. 재귀적 기억은 일부 개선을 보이지만 SimpleMem의 PersonaMem-v2에서는 tax가 오히려 커집니다. 정확도의 상승만으로 모든 질문 유형의 근거 접근이 개선되었다고 결론 내릴 수 없습니다. PDF Table 4
통계적 유의성 검정이나 성능 차이에 대한 신뢰구간은 논문에 보고되지 않았습니다. 판정기와 사람의 일치율을 제공한 것은 유용하지만, 그것이 시스템 간 작은 점수 차이의 통계적 유의성을 입증하지는 않습니다. 일부 데이터의 층화 표본, 시스템별 설정 조정, 정적·영어 중심 환경은 저자가 명시한 해석 범위입니다. 이 리뷰에서 추가 실험을 실행하거나 논문의 결과를 재현한 것은 아닙니다.
기술적 함의와 응용
이 연구에서 배울 가장 직접적인 관점은 기억을 데이터 변환으로 보는 것입니다. 더 짧게 정리하고 더 많은 관계를 붙이는 일은 후속 질문에 유익할 수 있지만, 구체적 금액·시점·철회 조건을 없앨 수도 있습니다. 저자가 제시한 원문 복구 경로는 가공된 기억과 원문을 둘 중 하나만 선택하는 구조에서 벗어나게 합니다. §6.1
리뷰어의 해석으로는 개인화 에이전트나 대화 이력 검색을 평가할 때, 최종 정답률과 함께 원문 검색 기준의 질문별 이익·손실을 보면 변경의 성격을 더 잘 설명할 수 있습니다. “기억이 개선되었다”는 말을 어떤 질문이 새로 해결됐고 어떤 질문이 더 이상 해결되지 않았는지로 풀어 쓸 수 있기 때문입니다. 이것은 논문 밖의 새로운 성능 주장이 아니라, 저자의 비교 관점을 실제 결과 해석에 적용한 설명입니다.
논문은 기억의 형태가 복잡하다는 이유만으로 가치를 부여하지 않습니다. 원문 정보의 보존, 필요한 순간의 접근, 모델 변경 뒤의 활용, 그리고 비교 과제의 개선 여지를 함께 봅니다. 기억은 과거를 다시 쓰는 과정이며, 그 과정에서 생긴 이익과 손실의 균형이 실제 순가치입니다.