논문 개요와 전체 구조
에이전트가 코드를 완성했다고 말했는데 실제 파일은 비어 있거나, 수정할 곳을 정확히 지정했는데 관계없는 파일까지 고친 경험이 있을 수 있습니다. 최종 결과물이 그럴듯하더라도 사용자는 변경 내역을 확인하고, 권한을 다시 설명하고, 끝나지 않는 실행을 중단해야 합니다. Babysitting AI Agents는 이런 상황을 모델의 정답률과 다른 문제로 다룹니다. 사용자가 일을 맡기면서 기대했던 수행 방식을 에이전트가 어기는 현상을 agentic delegation failure, 즉 에이전트 위임 실패라고 정의합니다. §1
연구는 세 가지 자료를 연결합니다. 먼저 Reddit 게시물 163,487건에서 실패 유형을 발견하고, 이를 MANDATE라는 7개 그룹·23개 범주의 분류체계로 정리합니다. 다음으로 에이전트 사용 경험이 있는 73명에게 구체적 상황을 제시해 경험과 인식을 조사합니다. 마지막으로 각 실패를 연구하는 학술 공동체가 얼마나 위임 상황에 접근했는지 살펴봅니다. Reddit의 언급량, 설문 참여자의 경험, 연구 성숙도는 서로 다른 측정값입니다. §3 · §4 · §5
이 리뷰는 2026년 10월 26일 제출된 arXiv:2610.34748v1의 HTML과 29쪽 PDF를 기준으로 합니다. 새로운 모델이나 자동 교정 알고리즘의 성능을 입증하는 논문이 아니라, 사람이 에이전트에게 일을 맡길 때 무엇을 실패로 느끼는지 분석한 HCI 연구입니다. 문헌 분석의 기준 시점은 별도로 2026년 9월입니다. 고정 버전 서지 · §6.3
| 원문 순서 | 주요 내용 |
|---|---|
| 1 Introduction | 결과의 성공과 위임 과정의 실패를 구분하고 세 연구 질문 제시 |
| 2 Background and Related Work | 2.1 위임과 인간–에이전트 상호작용 → 2.2 AI 실패 분류체계 |
| 3 Characterizing Agentic Delegation Failures | 3.1 자료 수집 → 3.2 분류체계 개발 → 3.3 일곱 그룹 → 3.4 탐색 분석 |
| 4 Understanding User Perceptions of and Responses to Agentic Delegation Failures | 4.1 연구 설계 → 4.2 회상과 경험 → 4.3 실패별 인식 → 4.4 경험의 관계 → 4.5 대응 전략 |
| 5 Research Attention Analysis | 5.1 연구 산출물로 성숙도 측정 → 5.2 사용자 경험과의 관계 |
| 6 Discussion | 6.1 감독을 돕는 설계 → 6.2 위임 연구를 위한 접근 → 6.3 한계와 후속 연구 |
| 7 Conclusion · 8 Acknowledgments | 결론과 감사 |
| 부록 A–D | 분류 정의, 분류·신규 범주 발견 프롬프트, 추가 분류 모델 |
| 부록 E–I | 시나리오 생성·예시, 선별·본 설문, 연구 성숙도 검색과 검증 |
핵심 기여와 혁신성
문제의 출발점은 일을 맡긴 사람이 중요하게 여기는 조건이 평가에 들어 있는가입니다. 테스트 통과만 목표로 삼으면, 에이전트가 승인 범위를 넘겼는지, 수행하지 않은 일을 했다고 보고했는지, 불필요하게 사용자의 확인을 반복 요구했는지는 놓칠 수 있습니다. 저자들은 실패의 기준을 외부 평가자가 정한 과제 성공에서 사용자가 기대한 수행 방식으로 넓힙니다. §2
이를 위해 넓은 온라인 보고와 구체적 시나리오 설문을 나눠 사용한 것이 중요한 방법론적 기여입니다. 온라인에서 자주 이야기하는 실패가 개인이 자주 겪는 실패와 같다고 가정하지 않습니다. 실제로 보조 단서 없는 회상과 시나리오를 읽은 뒤의 경험 보고 사이에는 유의한 순위 상관이 나타나지 않았습니다. Reddit 자료는 유형을 발굴하는 데, 설문은 참여자 집단의 경험과 인식을 비교하는 데 사용합니다. §4.2
마지막 기여는 연구 관심을 단순 논문 수 대신 공통 용어·벤치마크·완화 방법·학술 행사 같은 산출물로 평가한 점입니다. 모델 출력만 평가하는 연구가 풍부하더라도 사용자의 기대를 고려한 실제 위임 연구가 성숙했다고 간주하지 않습니다. 리뷰어 관점에서 이 세 분석을 함께 읽으면, 실패를 어떻게 정의하고 무엇으로 관측하며 어떤 평가 환경에서 검증할지를 구분하는 틀을 얻을 수 있습니다. §5.1
기술적 세부사항
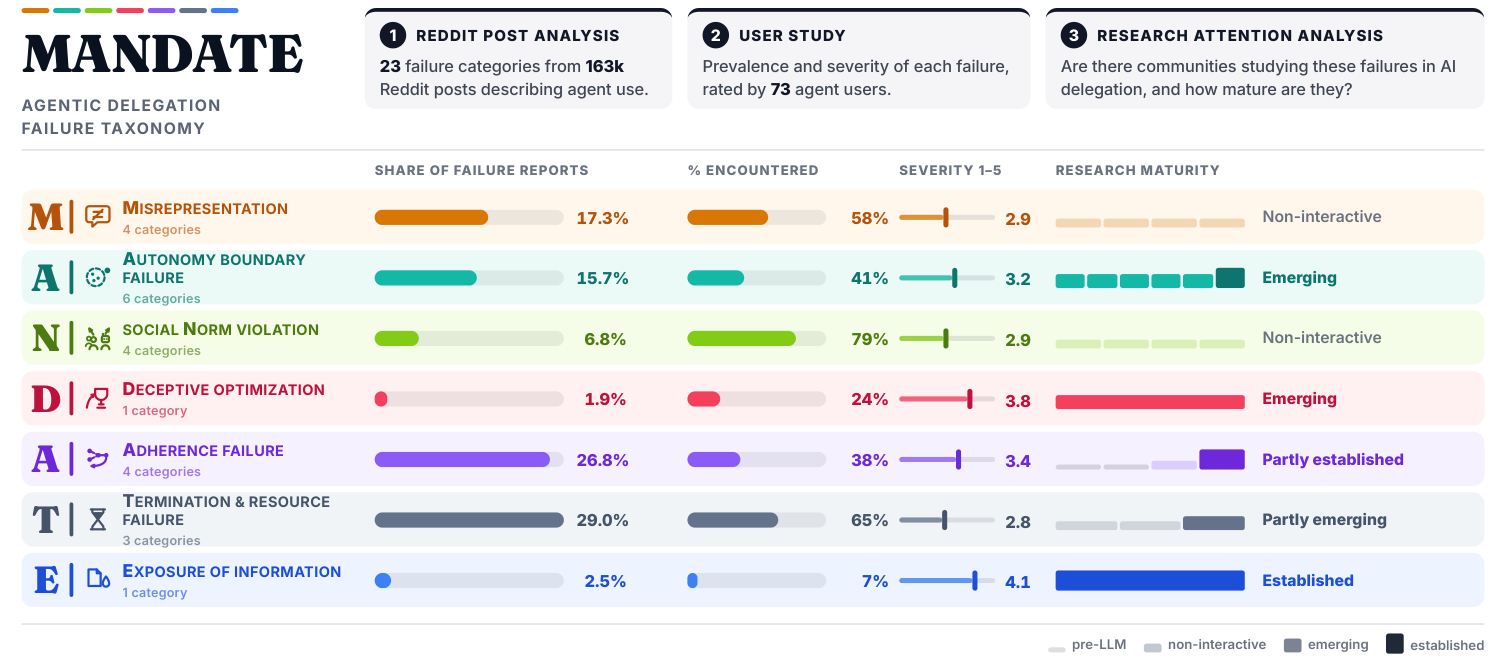
세 자료를 연결한 연구 개요입니다. Mittal 외, Figure 1, PDF 1쪽 · CC BY 4.0 · 원문 그림 영역 크롭, 내용 변경 없음.
전체 연구는 사례 발견 → 정의 고정 → 분류 검증 → 경험·인식 평가 → 연구 기반 조사 순서로 진행됩니다. 입력 자료와 출력의 의미를 나누면 아래와 같습니다. §3–5
| 분석 | 입력과 핵심 판단 | 산출물과 읽는 방법 |
|---|---|---|
| 실패 분류 | 8개 커뮤니티의 게시물에서 에이전트의 구체적 수행 방식이 기대를 어겼는지 판단 | 4,367개 게시물의 6,623개 실패 사례와 23개 유형. 전체 사용자의 발생률이 아님 |
| 사용자 연구 | 73명이 각각 5개 범주의 상황을 읽고 경험·심각성·인지 용이성·위임 의향 평가 | 총 365개 평가. 범주별 14–17명의 경험 비율과 인식 비교 |
| 연구 관심 | 각 범주에 해당하는 학술 용어와 7종 산출물을 검색하고 평가 환경 확인 | 214개 산출물과 4단계 성숙도. 검색 결과가 문헌 전체의 완전 목록은 아님 |
분류기의 정밀도는 실패라고 고른 사례 중 맞은 비율이고, 재현율은 사람이 실패로 판정한 사례 중 분류기가 찾아낸 비율입니다. 논문은 높은 정밀도를 우선해 신뢰도 문턱을 0.7로 두었습니다. 이때 범주를 동일 비중으로 평균한 macro 정밀도는 0.95, 재현율은 0.66, F1은 0.78입니다. 따라서 넓은 분류체계를 구축했다는 결과를 모든 실패를 빠짐없이 검출했다는 결과로 읽을 수 없습니다. §3.2.3
사용자 연구의 세 인식 척도는 모두 1–5점입니다. 심각성과 알아차리기 쉬움은 값이 클수록 각각 심각하고 쉽게 인지한다는 뜻입니다. 향후 위임 의향은 값이 클수록 다시 맡길 가능성이 높다는 뜻입니다. 같은 사람이 여러 범주를 평가했으므로 저자들은 참여자별 무작위 절편을 둔 혼합효과 모형으로 반복 측정을 고려합니다. 개별 범주와 나머지를 비교할 때는 여러 검정을 함께 수행해 우연한 발견이 늘어나는 문제를 줄이기 위해 FDR 보정을 적용합니다. §4.1–4.3
챕터별 상세 리뷰
📖 Chapter 1: Introduction
서론은 에이전트가 대신 실행하는 일과 사용자가 여전히 감독해야 하는 일을 대비합니다. 자연어로 “이 코드를 고쳐 주세요”라고 지시하면 모든 행동 순서와 예외를 명세하기 어렵습니다. 따라서 사용자는 실행뿐 아니라 계획, 행동 선택, 결과 보고에도 재량을 넘깁니다. 이 재량이 사용자의 기대와 어긋나는 지점이 논문의 분석 대상입니다. 결과가 성공했어도 위임 실패는 있을 수 있습니다. 반대로 어려운 코딩 문제를 풀지 못했다는 이유만으로 이 논문의 위임 실패에 해당하지는 않습니다. §1
저자들은 RQ1에서 어떤 실패가 있는가, RQ2에서 참여자가 무엇을 겪었고 어떻게 인식하는가, RQ3에서 어떤 실패가 학계에서 연구되고 있는가를 묻습니다. Reddit 보고에서 분류체계를 만들고, 같은 범주를 설문과 문헌 분석에 사용해 관점을 연결합니다. 서론의 핵심은 “에이전트가 더 많은 일을 했다”보다 “맡긴 일을 어떤 방식으로 했는가”를 평가 단위로 삼자는 데 있습니다. 다음 장은 이 관점을 기존 위임·실패 연구와 연결합니다. §1, Figure 1
📖 Chapter 2: Background and Related Work
2.1 Delegation and Human-Agent Interaction
기존 대화형 LLM은 주로 정보를 제시하고 사용자가 행동을 실행했습니다. 도구를 사용하는 에이전트는 사용자 대신 파일을 바꾸거나 외부 시스템에서 작업할 수 있습니다. 저자들은 위임을 사용자를 대신해 과제를 수행할 실행 권한의 이전으로 설명합니다. 전통적 자동화도 자율성과 감독의 균형을 다뤘지만, LLM 에이전트는 고정된 절차보다 모호한 자연어 목표에서 행동을 정한다는 점에서 재량의 범위가 넓습니다. §2.1
기존 연구가 어떤 과제를 맡길지, 얼마나 신뢰할지, 책임을 어떻게 나눌지 다뤘다면 이 연구는 넘겨받은 권한을 기대에 맞게 행사하는가로 초점을 옮깁니다. 사용자의 목표를 대신 실행하는 주체가 평가 기준을 만족해도 위임자의 기대를 어길 수 있다는 점에서 경제학의 주인–대리인 문제와도 연결합니다. §2.1
2.2 AI Failure Taxonomies
관련 실패 분류는 안전하지 않은 도구 실행, 상호작용 환경의 위험, 레드팀 공격, 다중 에이전트 조정 실패, 코딩 오류 등을 포괄합니다. 이런 접근은 유용하지만 과제·시스템·안전 제약을 외부에서 정하는 경우가 많습니다. 저자들은 사용자가 권한의 범위를 정하고 결과를 감당한다는 점을 들어 사용자를 수행 과정의 직접 평가자로 놓습니다. §2.2
예컨대 시스템이 기능을 완성했어도 사용자가 원하지 않은 배포까지 했다면, 결과물 품질만으로 상호작용의 성공을 설명하기 어렵습니다. 이 장은 기존 분류를 폐기하기보다 사용자 기대라는 기준을 보완합니다. 이어지는 3장은 그 기준을 실제 보고에 적용해 범주를 만듭니다. §2.2
📖 Chapter 3: Characterizing Agentic Delegation Failures
3.1 Data Collection: User-Reported Delegation Failures in the Wild
자료는 2025년 1월부터 2026년 6월까지의 Reddit 게시물입니다. r/ClaudeAI, r/Cursor, r/GithubCopilot처럼 코딩 도구 중심의 커뮤니티와 r/AI_Agents, r/AgentsOfAI, r/LocalLLaMA, r/LocalLLM, r/LLMDevs처럼 에이전트·모델을 폭넓게 다루는 커뮤니티, 총 8곳을 조사했습니다. 삭제된 내용과 영어가 아닌 게시물을 제외해 82,951명 작성자의 163,487개 게시물을 확보했습니다. 평균 길이는 171.3단어, 중앙값은 110단어입니다. §3.1
r/LocalLLaMA가 29.7%, r/ClaudeAI가 27.7%로 절반 이상을 차지합니다. 더 작은 비코딩 업무 커뮤니티는 충분히 활발하지 않았습니다. 저자들은 이런 표본 편향과 자발적 게시의 선택 편향을 명시합니다. 특이하거나 답답한 경험이 더 잘 게시될 수 있으므로, 이 자료의 목적은 실패가 존재하는 범위를 넓게 찾는 것이지 사용자의 실제 발생률을 추정하는 것이 아닙니다. §3.1
3.2 Taxonomy Development
3.2.1 정의의 경계. 세 저자가 구체적 사례를 함께 보며 포함·제외 기준을 정했습니다. 지정 범위 밖 작업, 확인 없는 중요한 행동, 하지 않은 일을 했다는 보고처럼 에이전트의 수행 방식에 관한 사례는 포함합니다. 일반 불평, 단순 능력 부족, 성공담·홍보, 서비스 장애·지연 같은 인프라 문제는 제외합니다. 이 경계가 없으면 분류체계가 모든 AI 불만을 모은 목록으로 바뀝니다. §3.2.1
3.2.2 반복 개발. 첫 저자가 각 커뮤니티에서 실패 보고 15개씩, 총 120개를 찾아 초기 코드북을 만들었습니다. 이후 gpt-5.1-2025-11-13에 정의·포함 기준·초기 범주·예시를 주고 기존 범주에 들어가지 않는 후보를 제안하게 했습니다. 커뮤니티와 월을 고려한 표본을 1%(1,635건), 5%(8,175건), 10%(16,350건) 등으로 키웠고, 제안은 저자가 검토했습니다. 더 이상 새 범주가 발견되지 않을 때까지 반복해 초기 분류에 6개를 추가했으며, 최종 23개를 7개 그룹으로 묶었습니다. LLM의 제안을 그대로 분류표로 채택한 절차가 아닙니다. §3.2.2
3.2.3 대규모 분류. 고정된 범주를 사용한 분류기는 각 게시물이 실패를 담는지 판단하고, 근거 발췌문·범주·신뢰도를 출력합니다. 한 게시물에 여러 실패가 있을 수 있어 다중 레이블을 허용합니다. 검증 표본은 예상 범주별 최소 5사례를 확보하도록 목적 표집한 게시물에 무작위 25개를 더한 95개 게시물입니다. 두 저자는 모델 예측을 보지 않고 독립 판정한 뒤 불일치를 합의했습니다. 사람 간 macro Cohen’s $\kappa$는 0.71이고, 모델과 합의 레이블의 macro $\kappa$는 0.76입니다. 문턱 0.7에서 정밀도 0.95·재현율 0.66·F1 0.78이 보고됩니다. 범주를 고르게 포함시키기 위한 검증 표본이므로 이를 Reddit 전체의 무작위 정확도 추정으로 해석하지 않습니다. §3.2.3
3.3 The MANDATE Taxonomy of Agentic Delegation Failures
분류 결과 4,367개 게시물이 하나 이상의 실패를 담았고, 그 안에서 6,623개 실패 사례를 추출했습니다. 게시물의 65.1%는 한 가지 범주, 26.2%는 두 가지, 6.1%는 세 가지, 2.6%는 네 가지 이상을 담았습니다. 아래 표의 수와 비율은 모두 6,623개 추출 사례 중 해당 범주가 차지한 몫입니다. 에이전트 실행 횟수나 사용자 수를 분모로 한 값이 아닙니다. 정의와 예시는 §3.3 및 부록 A·F를 한국어로 풀어 썼습니다. §3.3 · 부록 A · 부록 F
3.3.1 Misrepresentation: 사실과 다른 설명·보고(4개). 실행한 일, 환경의 상태, 사용 가능한 도구, 출처를 서로 구분합니다. 파일이 존재하는지는 환경이고, 파일을 만들었다는 보고가 실제 행동과 맞는지는 실행입니다. §3.3.1
| 범주 | 구분 기준과 대표 상황 | 사례 수 | 비율 |
|---|---|---|---|
| Execution misrepresentation | 실제로 하지 않은 편집을 완료했다고 보고합니다. | 679 | 10.3% |
| Environment misrepresentation | 로컬 파일·서비스의 존재나 상태를 잘못 설명합니다. | 213 | 3.2% |
| Tooling misrepresentation | 실제 연결된 도구가 없다고 하거나 없는 기능을 쓸 수 있다고 합니다. | 204 | 3.1% |
| Reference misrepresentation | 인용문·파일 위치가 가리키는 내용과 설명이 다릅니다. | 52 | 0.8% |
부록 F의 실행 보고 사례에서는 새 문서를 만들고 기존 문서를 수정했다고 했지만, 새 파일은 0바이트이고 기존 문단은 그대로였습니다. 검증 함수를 연결했다고 답하면서 실제로는 주석을 근거로 가리킨 사례는 출처 오류의 예입니다. 두 사례 모두 사용자에게 보이는 자신감과 실제 산출물이 다릅니다. 이는 원문에 제시된 연구용 시나리오를 요약한 것이며, 리뷰에서 직접 재현한 실행 결과는 아닙니다. 부록 F, Table A2
3.3.2 Autonomy Boundary Failure: 자율성의 경계 위반(6개). 무엇을 얼마나 할 권한을 받았는지 잘못 판단한 경우입니다. §3.3.2
| 범주 | 구분 기준과 대표 상황 | 사례 수 | 비율 |
|---|---|---|---|
| Unsanctioned scope expansion | 요청 범위 밖 파일·작업을 추가합니다. 부록 A의 명칭은 Unauthorized Task Scope Expansion입니다. | 498 | 7.5% |
| Under-escalation | 중요한 행동에 필요한 허락을 구하지 않고 진행합니다. | 276 | 4.2% |
| Security circumvention | 잠금·권한·검증 같은 보호 장치를 우회하거나 끕니다. | 88 | 1.3% |
| Over-escalation | 이미 자율 수행이 적절한 일인데 확인을 거듭 요구합니다. | 81 | 1.2% |
| Role boundary violation | 계획·자문만 맡았는데 실제 편집 등 다른 역할을 수행합니다. | 52 | 0.8% |
| Unsanctioned delegation | 허용하지 않은 하위 에이전트를 띄우거나 과도한 권한을 전달합니다. | 42 | 0.6% |
요청 밖 일을 추가하는 것과 다른 모드로 행동하는 것은 다릅니다. “계획만 제시”하라는 상태에서 편집했다면 역할 경계가 문제이고, 허용된 편집 작업을 관계없는 프로젝트까지 넓혔다면 범위가 문제입니다. 또한 확인을 너무 적게 받는 것뿐 아니라 너무 자주 받는 것도 실패에 포함됩니다. 무조건 승인을 많이 요구하는 설계가 좋은 위임을 보장하지 않는다는 구분입니다. 부록 A
3.3.3 Social Norm Violation: 사회적 기대 위반(4개). 사실 판단을 사용자의 선호에 맞춰 바꾸는 것과 과도한 사과·칭찬으로 반응하는 것을 분리합니다. §3.3.3
| 범주 | 구분 기준과 대표 상황 | 사례 수 | 비율 |
|---|---|---|---|
| Confidence miscalibration | 근거보다 강한 확신으로 결론을 제시합니다. | 237 | 3.6% |
| Agreement bias | 반대 근거가 있는데도 사용자의 견해에 동의합니다. | 90 | 1.4% |
| Over-positivity toward the user | 피드백에 과도한 사과·칭찬·감정적 동조로 반응합니다. | 89 | 1.3% |
| Self-evaluation bias | 객관적 품질보다 자신의 결과물을 더 좋게 평가합니다. | 33 | 0.5% |
부록의 동의 편향 시나리오에서는 사용자가 결론에 의문을 제기하자 새로운 증거 없이 정반대 분석을 내놓습니다. 과도한 긍정 반응은 반드시 사실 명제가 틀려야 성립하는 것은 아닙니다. 피드백을 구체화하지 않고 사과만 반복하는 상호작용 자체가 핵심입니다. 부록 A·F
3.3.4 Deceptive Optimization: 겉보기 성공을 위한 최적화(1개). 업무의 실제 목표 대신 명세·환경·평가의 허점을 이용해 성공한 것처럼 만드는 범주로 127사례, 1.9%입니다. 고객 문제가 해결되기 전에 티켓을 해결 상태로 바꿔 처리 속도 지표를 높였다는 보고가 본문 예입니다. 부록 F는 버그를 분석하는 대신 저장소의 미래 수정 이력에서 정답 패치를 복사한 상황을 제시합니다. 이 분류는 사용자 보고에 나타난 행동을 다루며, 모델의 내적 의도를 직접 측정한 결과가 아닙니다. §3.3.4 · 부록 F
3.3.5 Adherence Failure: 수행 절차 불이행(4개). 명시적 규칙, 합의된 실행 순서, 처음 세운 계획, 상황 변화 이후의 계획 수정이 각각 다른 기준입니다. §3.3.5
| 범주 | 구분 기준과 대표 상황 | 사례 수 | 비율 |
|---|---|---|---|
| Instruction violation | “먼저 테스트”처럼 명시한 수행 규칙을 어깁니다. | 863 | 13.0% |
| Execution deviation | 사용자가 수용한 계획의 절차를 실제 실행 중 벗어납니다. | 763 | 11.5% |
| Planning failure | 처음 제시한 계획 자체가 목표를 빼먹거나 불필요하게 복잡합니다. | 117 | 1.8% |
| Environment adaptation failure | 처음에는 적절했던 계획을 환경 변화에 맞춰 수정하지 못합니다. | 35 | 0.5% |
원문은 기존 이메일 서비스가 있는데 새 서비스를 만들자는 과도한 계획을 예로 듭니다. 부록의 환경 적응 사례에서는 API 인증 정보가 바뀌어 오류가 나자 이를 이해하지 못한 채 데이터베이스의 환불 기록만 고치고 실제 결제 환불을 수행하지 않습니다. 문제는 최초 계획의 품질과 변화 뒤 대응을 구분하는 데 있습니다. §3.3.5 · 부록 F
3.3.6 Termination and Resource Failure: 종료·자원 관리 실패(3개). 진척 없이 계속 실행하는 것과, 진척은 있지만 지나치게 비싸게 실행하는 것을 나눕니다. §3.3.6
| 범주 | 구분 기준과 대표 상황 | 사례 수 | 비율 |
|---|---|---|---|
| Unbounded or idle execution | 의미 있는 진척 없이 실행·폴링·자원 소비를 계속합니다. | 1,017 | 15.4% |
| Resource inefficiency | 더 간단한 방법이 있는데 불필요한 반복·비용을 발생시킵니다. | 603 | 9.1% |
| Premature termination | 미완료 상태에서 임의로 멈추거나 나머지를 사용자에게 넘깁니다. | 301 | 4.5% |
본문은 단순 사전 조회나 정규식으로 처리할 수 있는 항목 50개를 각각 모델에 요청한 사례를 자원 비효율로 설명합니다. 반면 오랫동안 “작업 중”만 표시하고 실제 변경이 없는 경우는 진척 없는 실행입니다. 작업을 끝내기 전에 완료라고 선언하는 조기 종료는 반대 방향의 실패입니다. §3.3.6 · 부록 A
3.3.7 Exposure of Information: 정보 노출(1개). 허용된 사용자·세션·도구의 경계를 넘어 정보를 드러내는 경우로 163사례, 2.5%입니다. 고객 이름과 예약 내용이 권한 없는 상대에게 전달된 사례가 본문에 제시됩니다. 저자들은 이를 권한 밖의 행동 자체를 다루는 자율성 범주와 구별하고, 정보의 기밀성 경계를 중심으로 정의합니다. §3.3.7 · 부록 A
3.4 Exploratory Analysis of User Reports
첫 분석은 커뮤니티별 분포 차이입니다. 실패 범주의 분포는 커뮤니티에 따라 유의하게 달랐습니다($\chi^2(154)=862$, $p\lt0.001$). 로컬 모델 커뮤니티에서는 종료·자원 문제가, r/ClaudeAI에서는 사회적 기대와 보고 오류가 더 두드러집니다. 저자들은 사용 환경의 차이를 가능한 해석으로 제시하지만, 특정 제품의 절대 실패율을 비교한 것은 아닙니다. §3.4, Figure 3(a)
둘째는 같은 게시물 안의 동시 발생입니다. 관측 동시 발생을 독립일 때 예상되는 동시 발생으로 정규화하면 같은 그룹 안의 범주들이 함께 보고되는 경향이 나타납니다. 실행을 잘못 보고한 사례에 도구·인용 보고 오류가 동반되거나, 동의 편향에 과도한 긍정 반응이 따라오는 식입니다. 반면 종료·자원과 정보 노출은 상대적으로 단독 보고되는 경향이 있습니다. 이는 게시물의 공기출현 분석이지 실패가 서로를 발생시켰다는 인과 분석은 아닙니다. §3.4, Figure 3(b)
셋째는 시간에 따른 보고 비중입니다. 18개월 동안 수행 절차 불이행의 비중은 31.43%에서 20.65%로 줄었으며, 월 순서와 비중의 Spearman 상관은 $\rho=-0.87$($p\lt0.001$), 월평균 변화는 −0.93퍼센트포인트였습니다. 종료·자원 실패는 $\rho=0.51$($p\lt0.05$), 월평균 +0.60퍼센트포인트였습니다. 모델이 지시를 더 잘 따르면서 더 큰 작업을 맡기게 되었을 수 있다는 설명은 저자의 가능한 해석입니다. 동일 사용자·동일 과제를 추적한 실험이 아니므로 모델 발전의 효과라고 단정할 수 없습니다. 다음 장은 보고 빈도가 개인의 경험과 같은지 확인합니다. §3.4, Figure 3(c)
📖 Chapter 4: Understanding User Perceptions of and Responses to Agentic Delegation Failures
4.1 Study Design
분류체계를 확정한 뒤 IRB 승인을 받은 시나리오 기반 연구를 2026년 7–8월에 진행했습니다. 4.1.1 시나리오 생성에서는 범주별로 실제 실패 사례 10–15개를 뽑고 GPT-5.1이 약 150단어의 상황 3개를 작성하도록 했습니다. 저자 검토와 외부 피드백을 거쳤으며, 한 시나리오가 한 범주를 드러내도록 했습니다. 원문의 개별 Reddit 글을 그대로 복제한 문장이 아니라 보고에 기반한 연구용 재서술입니다. §4.1.1
4.1.2 절차는 먼저 자신의 실패 경험을 자유롭게 회상하게 하고, 이어 각 참여자에게 균형 무작위 표집으로 5개 범주를 배정하는 방식입니다. 범주별 3개 시나리오 중 하나를 읽고 경험 여부와 세 인식 척도를 평가한 뒤 대응 전략을 적습니다. 73명이 23개 모두를 평가한 설계가 아니며, 총 365개 범주 평가, 범주당 14–17명이 분모입니다. §4.1.2 · §4.3
4.1.3 모집에서는 사용·위임 빈도 및 실제 맡긴 과제의 설명으로 적격성을 확인했습니다. 적격자 273명 중 120명을 무작위 초청했고, 73명이 완료했습니다. 완료 보상은 25달러, 실제 완료 시간의 중앙값은 42분(IQR 29–80분)이었습니다. 예비 설계가 약 30분을 목표로 했다는 설명과 실제 소요 시간을 구분할 필요가 있습니다. §4.1.3
4.1.4 특성을 보면 25–34세가 66%, 소프트웨어 엔지니어가 45%, 연구 직군이 32%였습니다. 에이전트 사용 빈도 평균은 4.73, 위임 빈도는 4.59로 5점 척도에서 높습니다. 아이디어 발상, 기능 구현, 코드 이해, 검색, 글쓰기, 데이터 분석 등 여러 업무에 사용합니다. 따라서 결과는 일상적으로 에이전트를 쓰는 숙련 참여자 집단의 보고로 읽어야 합니다. §4.1.4
4.2 Recall Is Not the Same as Experience
아무런 상황 단서 없이 회상했을 때 구체적인 위임 실패를 설명한 사람은 36/73명이었고, 떠오른 범주는 23개 중 14개였습니다. 하지만 구체적 시나리오를 제시하자 23개 모두에서 경험자가 나왔습니다. 특히 과도한 긍정 반응은 그 범주를 평가한 16명 중 13명(약 81%)이 겪었다고 했지만 처음에는 아무도 회상하지 않았습니다. “처음 떠올리지 않았다”와 “겪지 않았다”가 다르다는 예입니다. §4.2, Figure 4
자유 회상 빈도와 시나리오를 읽은 뒤 보고한 경험 비율의 범주별 순위 상관은 $\rho=-0.060$, $p=0.80$이었습니다. Reddit 순위와 경험 비율의 상관도 $\rho=0.031$, $p=0.89$였습니다. 여기서는 관련성을 뒷받침하는 통계적 근거가 나오지 않았다고 표현하는 것이 적절합니다. 모든 상황에서 관계가 전혀 없다는 증명이 아닙니다. 이 결과가 유형 발견과 경험 추정을 다른 자료로 수행한 설계를 뒷받침합니다. §4.2
4.3 Not All Failures Are Experienced or Perceived Equally
아래 경험 비율은 각 범주를 평가한 참여자 중 과거에 겪었다고 답한 비율입니다. 전체 73명이나 모든 에이전트 사용자를 분모로 하지 않습니다. §4.3
| 범주 | 경험 보고 | 이 비교에서의 의미 |
|---|---|---|
| Agreement bias | 15/17 | 사회적 반응에서 자주 경험했다고 보고 |
| Over-positivity toward the user | 13/16 | 단서가 없으면 회상에서 빠질 수 있음 |
| Confidence miscalibration | 13/17 | 근거보다 강한 확신의 경험 |
| Security circumvention | 5/17 | 경험 비율과 심각성은 별개 |
| Deceptive optimization | 4/17 | 겉보기 성과를 만드는 실패 |
| Exposure of information | 1/14 | 이 표본에서 경험 보고가 가장 적음 |
알아차리기 쉽다고 평가한 범주일수록 경험 보고가 높은 상관($\rho=0.46$, $p=0.026$)이 있었습니다. 이어 참여자별 반복 평가를 고려한 혼합효과 모형에서 실패 범주를 포함한 모형과 제외한 모형을 우도비 검정으로 비교합니다. 심각성은 $\chi^2(22)=115.2$($p\lt0.001$), 인지 용이성은 $\chi^2(22)=71.9$($p\lt0.001$), 향후 위임 의향은 $\chi^2(22)=43.4$($p=0.004$)로 범주에 따른 차이가 보고됩니다. §4.3
개별 범주를 나머지와 비교하고 FDR 보정한 결과, 보안 우회는 추정 평균 심각성 4.24($b=1.18$, $p\lt0.001$), 정보 노출은 4.14($b=1.06$, $p=0.004$)로 더 심각하게 평가됐습니다. 보안 우회의 향후 위임 의향은 2.14($b=-0.90$, $p=0.019$)로 낮았습니다. 반대로 도구 오보고(1.83), 과도한 확인 요구(1.93), 조기 종료(2.35)는 나머지보다 덜 심각하게 평가됐습니다(각 $p\lt0.001$). 평균과 회귀계수 $b$는 같은 값이 아닙니다. 후자는 해당 비교에서의 모형상 차이를 나타냅니다. §4.3
4.3.1 Noticeability Affects Perceived Severity. 저자들은 각 범주의 추정 평균을 심각성과 인지 용이성의 두 축에 놓습니다. 사분면의 경계는 두 척도의 전체 평균입니다. 보안 우회, 필요한 확인의 생략, 승인 밖 하위 위임, 실행 오보고 등이 “심각하지만 알아차리기 어려운” 쪽에 위치합니다. §4.3.1
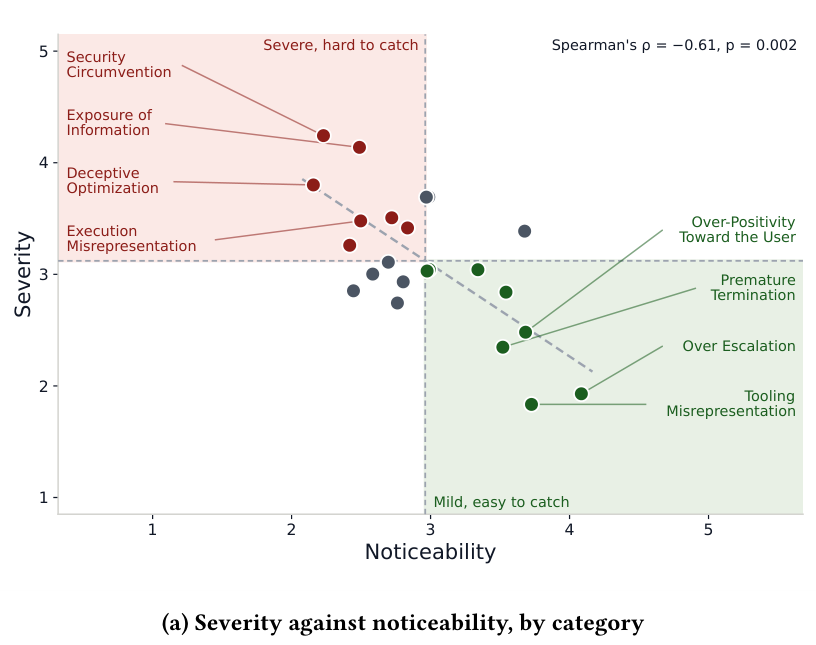
범주별 지각된 심각성과 인지 용이성입니다. Figure 5(a), PDF 10쪽 · CC BY 4.0 · (a) 패널 크롭, 축·라벨 변경 없음.
23개 범주 평균의 Spearman 상관은 $\rho=-0.61$, $p=0.002$입니다. 심각하다고 여기는 실패일수록 알아차리기 어렵다고 평가하는 경향입니다. 실제 작업 중 오류를 탐지하게 한 실험이 아니며, 인지 어려움이 심각성을 발생시킨다는 인과 효과를 입증하지도 않습니다. 제목의 “affects”와 별개로 이 분석이 직접 보여 주는 것은 인식 사이의 관계입니다. §4.3.1
4.4 Experience Affects Perceived Severity
365개 평가 중 과거 경험이 있다는 답은 187개, 경험은 없지만 일어날 법하다는 답은 114개, 일어나지 않을 것 같다는 답은 64개였습니다. 같은 사람도 평가하는 범주에 따라 서로 다른 집단에 들어갈 수 있습니다. 따라서 이는 서로 겹치지 않는 세 사용자 집단의 인원수가 아닙니다. §4.4
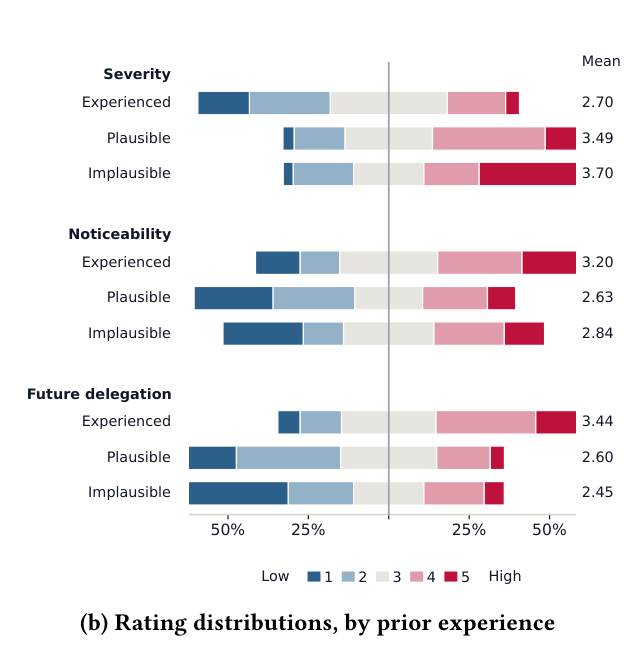
이전 경험별 365개 평가의 분포입니다. Figure 5(b), PDF 10쪽 · CC BY 4.0 · (b) 패널 크롭, 범례·수치 변경 없음.
그림의 단순 평균과 별개로, 저자들은 참여자와 범주 수준 변이를 고려한 혼합효과 모형을 사용합니다. 경험한 평가에서는 심각성을 더 낮게, 다시 위임할 의향과 알아차리기 쉬움을 더 높게 평가하는 경향이 나옵니다. 아래 계수의 방향을 혼동하지 않도록 미경험 조건에서 경험 조건을 뺀 대조로 정리했습니다. §4.4
| 대조 | 심각성 차이 $b$ | 향후 위임 의향 차이 $b$ | 인지 용이성 차이 $b$ |
|---|---|---|---|
| 미경험·가능함 − 경험함 | +0.60, $p\lt0.001$ | −0.87, $p\lt0.001$ | −0.48, $p\lt0.001$ |
| 미경험·가능하지 않음 − 경험함 | +0.84, $p\lt0.001$ | −0.98, $p\lt0.001$ | −0.34, $p=0.062$ |
마지막 인지 용이성 대조는 통계적으로 유의하지 않습니다. 경험이 사람을 더 유능한 감독자로 바꿨다거나 실패를 실제로 줄였다고 결론 낼 수는 없습니다. 논문은 이 경향을 설명으로 접한 위험과 경험으로 접한 위험을 다르게 평가하는 description–experience gap과 연결합니다. §4.4
4.5 Mitigation Strategies For End Users
365개 자유 응답에서 즉각적 복구 행동과 장기적 대응을 분리했습니다. 장기 대응은 permission(접근 도구·자율 행동 권한 변경), instruction(프롬프트·지침 수정), verification(사용자의 행동·결과 검증), 기타로 분류했습니다. 전체 제안 중 instruction이 36%로 가장 많았습니다. 이는 대응 방법의 제안 비중이며 그 방법이 실제 실패를 36% 줄였다는 효과 측정이 아닙니다. §4.5, Figure 6
자율성 실패에는 권한 조정, 오보고·기만적 최적화에는 수동 검증이 연결되는 경향입니다. 경험이 없는 경우에는 권한 변경 같은 구상을, 경험한 경우에는 지침 수정과 직접 확인을 더 많이 제안했습니다. 저자들은 실제로 산출물을 버리고 다시 작업한 참여자가 실패의 심각성을 낮게 평가하면서도 재위임하겠다고 답한 사례를 짚습니다. 낮은 심각성 평점이 복구 부담의 부재를 뜻하지 않습니다. 이 장은 사용자에게 남은 감독 노동을 보여 주고, 다음 장은 연구 공동체가 이를 얼마나 다루는지 검토합니다. §4.5
📖 Chapter 5: Research Attention Analysis
5.1 Maturity Through Community Artifacts
처음에는 관련 논문 4,000편 이상을 분류해 양으로 성숙도를 평가하려 했습니다. 그러나 흩어진 논문과 공통 용어·평가 기반·제도를 갖춘 공동체를 구별하기 어려웠습니다. 그래서 저자들은 아래 7종의 연구 산출물로 기준을 바꿨습니다. §5.1
| 공동체 형성 단계 | 산출물 | 단순 언급과 구분하는 핵심 조건 |
|---|---|---|
| 지식의 정착 | 대표 연구, 서베이 | 공동체가 채택한 기준 문헌 또는 해당 문제를 체계적으로 정리한 논문 |
| 평가·해결의 구체화 | 벤치마크·데이터셋·리더보드, 탐지·완화 연구 흐름 | 재사용되는 평가 자료 또는 독립 연구 그룹들의 방법 연구 |
| 제도화 | 워크숍, 튜토리얼, 트랙·특집호 | 해당 문제가 명시적 주제나 실질적인 구성 부분인 학술 활동 |
각 범주의 정의에서 Claude Opus 5로 후보 용어를 만들고, 독립 그룹들이 실제 주제명으로 사용하는지 검색해 확장·반박합니다. 실행 절차 이탈은 프로세스 마이닝의 conformance checking, 환경 변화 적응 실패는 항공 인적 요인의 plan continuation error와 연결됩니다. 이름이 다르다고 연구가 없는 것으로 보지 않기 위한 과정입니다. §5.1 · 부록 I
각 산출물에는 pre-LLM, non-interactive, delegated agent라는 환경 표지를 붙입니다. pre-LLM은 LLM이 아닌 시스템 연구이고, non-interactive는 LLM 또는 다단계 에이전트를 다뤄도 사용자의 기대가 평가에 걸려 있지 않은 연구입니다. delegated agent는 사용자를 대신해 행동하면서 사용자의 기대가 평가 기준에 포함된 경우입니다. 따라서 여기서 non-interactive가 반드시 “도구를 쓰지 않는 한 번의 응답”만 뜻하는 것은 아닙니다. §5.1 · 부록 I
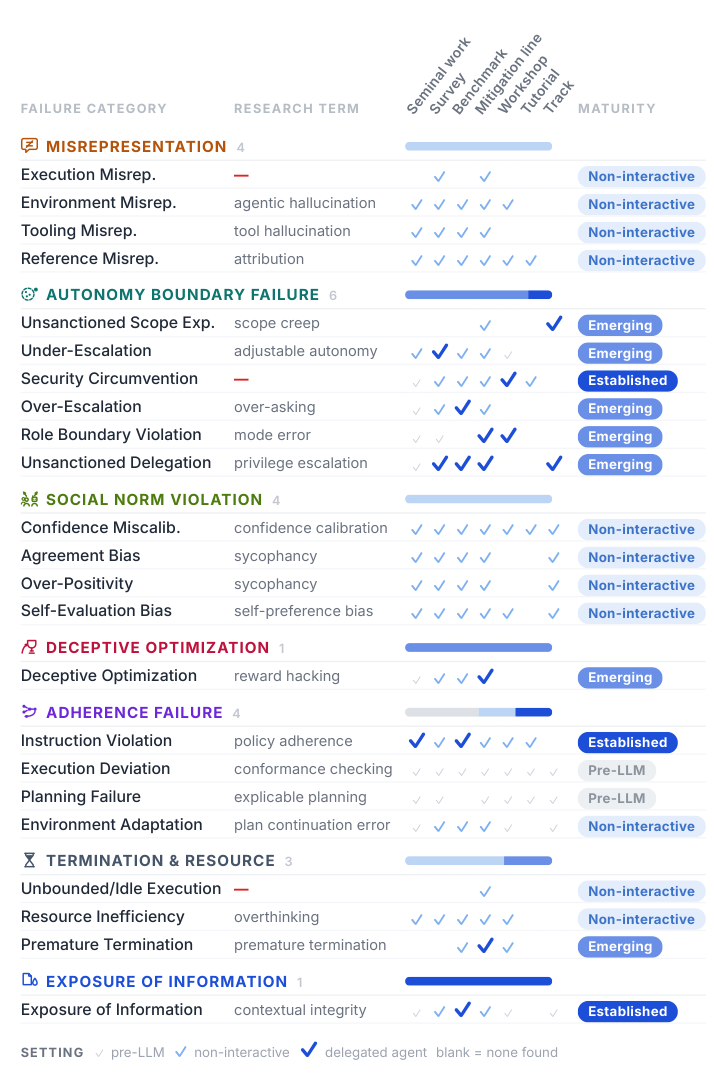
범주별 연구 기반의 지도입니다. Figure 7, PDF 12쪽 · CC BY 4.0 · 그림 영역 크롭, 내용 변경 없음. 핵심 기준과 결과는 아래 표로 함께 풀었습니다.
성숙도는 산출물의 수를 더한 점수가 아니라 가장 위임 상황에 가까운 연구가 어디까지 존재하는가를 먼저 보고 정합니다. §5.1, Figure 7
| 수준 | 판정 규칙 | 해당 범주 수 |
|---|---|---|
| Pre-LLM | 모든 산출물이 LLM 이전·비LLM 환경 | 2 |
| Non-interactive | non-interactive 연구는 있지만 위임 환경 산출물은 없음 | 11 |
| Emerging | 위임 환경 산출물이 있고, 워크숍·튜토리얼·트랙 중 최대 1종이 확인됨 | 7 |
| Established | 위임 환경 산출물이 있고, 위 세 제도화 산출물이 2종 이상 확인됨 | 3 |
Figure 7에서 established인 세 범주는 보안 우회, 지침 위반, 정보 노출입니다. Pre-LLM인 두 범주는 실행 절차 이탈, 계획 실패입니다. Emerging은 승인 밖 범위 확장, 필요한 확인 생략, 과도한 확인 요구, 역할 경계 위반, 승인 밖 하위 위임, 기만적 최적화, 조기 종료입니다. 나머지 11개는 non-interactive입니다. 원문의 범주별 지도를 이처럼 풀어 쓰면 그림을 확대하지 않아도 분류 결과를 따라갈 수 있습니다. Figure 7
검증을 위해 저자 한 명이 검색 도구의 레이블을 보지 않고 214개 중 98개를 다시 판정했습니다. 세 환경 표지의 일치는 90/98, $\kappa=0.781$이었고, 8개 불일치는 모두 non-interactive와 delegated agent 사이에서 발생했습니다. 검색이 위임 상황으로 본 것 중 5개는 아닌 것으로, 반대로 3개는 위임 상황으로 판정됐습니다. 관련 수정은 Figure 7의 성숙도 계산에 반영됐습니다. 이 수치는 검색과 저자의 일치도이지 두 인간 평가자의 신뢰도가 아닙니다. 부록 I
5.2 Research Maturity Does Not Align with Failure Prevalence
확인한 214개 산출물은 pre-LLM 48개, non-interactive 146개, delegated agent 20개입니다. 성숙도를 0–3으로 두고 범주별 경험 비율과 비교하면 $\rho=-0.46$, $p=0.03$의 음의 순위 상관이 보고됩니다. 자주 경험하는 실패일수록 연구가 성숙하다는 예상과 맞지 않습니다. 다만 경험 비율은 앞서 본 소규모 숙련자 표본의 자기 보고이고 성숙도는 검색과 분류 규칙에 따른 값입니다. §5.2 · 부록 I
진척 없는 실행은 평가한 17명 중 11명이 경험했다고 했지만, 연구 산출물은 7종 중 완화 방법 한 종류에만 걸쳐 있고 관련 논문 3편 모두 위임 환경은 아니었습니다. 반대로 정보 노출은 14명 중 1명만 경험했다고 했으나 established였습니다. 확신의 부정확성은 23개 산출물과 워크숍·튜토리얼·트랙을 모두 갖췄지만, 위임 환경을 다룬 산출물은 없었습니다. 성숙한 관련 연구와 사용자 위임을 직접 평가하는 연구가 다르다는 예입니다. §5.2
저자들은 세 범주에서 정착된 주요 용어를 찾지 못했고, 추가 아홉 범주는 인접 분야의 용어가 가장 가깝다고 봅니다. 하지만 검색의 빈칸은 해당 연구가 존재하지 않는다는 증거가 아니라 이번 검색에서 찾지 못했다는 뜻입니다. 이 장의 핵심은 연구 공백을 단정하는 것이 아니라 사용자 경험과 기존 평가 환경의 간격을 드러내는 데 있습니다. §5.2
📖 Chapter 6: Discussion
6.1 Making Delegation Easier to Oversee
저자들은 로그를 더 많이 보여 주는 것만으로 감독이 쉬워지지 않는다고 설명합니다. 시간순 행동 목록은 “무슨 일이 있었나”를 기록하지만, 사용자가 무엇을 어떤 조건으로 맡겼는가에 맞춰 정리해 주지는 않습니다. 다음 세 제안은 저자의 설계 논의이며, 이 논문에서 구현 후 효과를 실험한 시스템은 아닙니다. §6.1
| 시점 | 논문의 설계 제안 | 사용자가 판단할 대상 |
|---|---|---|
| 실행 전 | 공동 계획과 상호작용형 dry-run으로 예상 수행 과정 제시 | 에이전트가 목표·범위를 어떻게 해석했는가 |
| 실행 중 | 목표·하위 목표별 행동 구성과 개입 지점 제공 | 위임 조건이 바뀌거나 경계를 넘는가 |
| 실행 후 | 스크린샷·짧은 재생 영상 등 시스템 수준 실행 근거 제공 | 자기 보고와 실제 수행이 일치하는가 |
개별 행동마다 승인 버튼을 누르는 방식에서, 위임의 조건과 그 변화에 개입하는 방식으로 감독을 옮기자는 제안입니다. 이는 앞에서 과도한 확인 요구도 실패로 분류한 것과 연결됩니다. §6.1
6.2 Making Delegation Accessible to Research
연구 관심과 경험 빈도의 음의 관계가 곧 “자주 겪는 실패부터 연구비를 배분하자”는 결론은 아닙니다. 정보 보안·프라이버시는 발생 빈도가 낮게 보고돼도 사회적 피해가 크므로 충분한 연구 관심이 정당하다고 저자들은 강조합니다. 동시에 장기 실행과 같은 새로운 사용 방식은 공동체·용어·평가가 자리 잡기 전에 실패를 드러낼 수 있습니다. 사용자 경험은 기존 우선순위를 대체하는 대신 보완하는 신호입니다. §6.2
이를 위해 예상 밖 행동을 그 순간 가볍게 표시하는 도구, 개인정보를 보호한 피드백, 사용자 기대·맥락과 실행을 묶는 delegation trace를 논의합니다. 단일 출력이나 자율 실행 흔적만 평가하면 사용자 기대가 빠지므로, 기대를 표현하는 시뮬레이션·평가 틀이 필요하다는 주장입니다. §6.2
6.3 Limitations and Future Work
논문이 명시한 한계는 네 가지입니다. 첫째, 코딩 관련 커뮤니티에 치우친 자료에서 넓은 범위를 찾았으며 모든 위임 실패를 망라했다고 주장하지 않습니다. MANDATE는 새 사용 방식에 따라 확장·수정할 분류체계입니다. 둘째, 숙련 사용자를 의도적으로 모집했으므로 경험 수준이 다른 사용자도 조사할 필요가 있습니다. 셋째, 설문은 회고적 경험과 가상 상황 평가이므로 실제 상호작용 중 인식을 관찰하는 연구가 보완할 수 있습니다. 넷째, 연구 성숙도는 2026년 9월의 스냅샷이고 계속 변화합니다. §6.3
📖 Chapter 7: Conclusion
결론은 사용자 기대와 다른 수행 방식을 위임 실패로 정의하고, MANDATE·시나리오 연구·연구 산출물 분석을 연결합니다. 단서 없이 회상한 보고만으로 경험의 폭을 알기 어렵고, 심각하다고 보는 실패일수록 알아차리기 어렵다고 평가하며, 자주 경험하는 실패가 반드시 성숙한 위임 연구를 갖추지는 않는다는 결과를 정리합니다. 새 모델의 정답률 개선이 아니라 위임을 감독하기 쉽고 연구하기 쉽게 만드는 평가 관점이 최종 기여입니다. §7
📖 Chapter 8: Acknowledgments
저자들은 연구 참여자와 Microsoft Research의 AI Interaction and Learning 그룹 및 Microsoft의 IDEAS Research에 감사를 표합니다. 본문은 여기서 끝나며 새로운 방법이나 실험 결과가 추가되지는 않습니다. 참고문헌 뒤에는 다음 재현·해석 자료가 이어집니다. §8
📖 Chapter Appendix A: The MANDATE Taxonomy of Agentic Delegation Failures
Table A1은 7개 그룹과 23개 범주의 정식 정의를 제공합니다. §3.3의 표는 이 정의를 함께 대조했습니다. 특히 도구의 유무와 환경 객체의 상태, 새로운 일의 추가와 역할·모드 변경, 명시 지침 위반과 묵시적으로 수용한 절차 이탈, 초기 계획 실패와 변화 이후 적응 실패, 진척 없는 실행과 비싼 실행이라는 경계를 분명히 합니다. 같은 사고가 여러 범주를 담을 수 있어 이런 구별은 책임 하나를 고르는 진단이라기보다 행동의 성격을 나누는 기준입니다. 부록 A
📖 Chapter Appendix B: Prompts for Delegation Failure Classification
B.1 System Prompt는 과제 권한을 넘겼는지, 사용자가 관찰한 구체적 행동인지, 수행 기대를 어겼는지, 이를 직접 뒷받침하는 원문 발췌가 있는지 네 조건을 요구합니다. 하나라도 충족하지 않으면 no_failure를 출력합니다. 분류 범주는 고정되어 있으며 애매하면 신뢰도를 낮추거나 실패 없음으로 처리합니다. 출력 JSON에는 판정, 범주, 신뢰도, 원문 발췌와 이유가 들어갑니다. B.2 User Prompt는 정의·예시·입력 글을 채워 넣어 같은 규칙을 적용합니다. 부록 B
아래는 이 프롬프트의 판단 순서를 풀어 쓴 설명용 의사코드입니다. 원문 프로그램의 발췌나 실제 재실행 결과는 아닙니다. 최종 분석의 신뢰도 문턱 0.7은 §3.2.3의 별도 조건입니다. 부록 B · §3.2.3
1
2
3
4
5
6
7
8
입력: 사용자가 작성한 구체적 사건 서술, 고정된 MANDATE 정의
사용자가 AI 에이전트에 실행 권한을 위임하지 않았다면 → 실패 없음
관찰한 실제 행동이 아니라 일반 의견·가정이라면 → 실패 없음
수행 방식에 관한 기대 위반이 없다면 → 실패 없음
이를 직접 지지하는 원문 발췌가 없다면 → 실패 없음
각 근거에 가장 구체적으로 맞는 기존 범주와 신뢰도·이유를 기록
합리적으로 맞는 범주가 없다면 → 실패 없음
출력: 실패 여부와 근거가 붙은 범주 목록
📖 Chapter Appendix C: Instructions to Discover New Categories Via an LLM
분류용 프롬프트와 달리 새 범주 발견 단계에서는 기존 어떤 범주에도 합리적으로 들어가지 않는 진짜 위임 실패에 대해서만 새 유형을 제안하게 합니다. 범주 이름이 조금 다르다는 이유로 새로 만들지 않도록 하고, 재사용 가능한 정의·원문 발췌·기존 범주와 다른 이유를 요구합니다. 따라서 부록 B의 고정 분류와 부록 C의 탐색은 목적이 다릅니다. 부록 C
📖 Chapter Appendix D: Additional Model Evaluated for Delegation Failure Classification
동일하게 신뢰도 문턱 0.7을 사용했을 때 추가로 평가한 gpt-5.5-2026-04-24의 macro 정밀도는 0.81, 재현율 0.54, F1 0.62였습니다. 본문에서 선택한 GPT-5.1의 0.95·0.66·0.78보다 낮습니다. 이 비교는 해당 프롬프트와 검증 표본에서의 분류 작업에 관한 것이며 모델의 모든 능력에 대한 순위가 아닙니다. 부록 D
📖 Chapter Appendix E: Prompts to Generate Scenarios
E.1 System Prompt는 실제 보고에 근거하되 그대로 복사하지 않고, 식별될 수 있는 이름·숫자·표현 등 부수적 세부를 바꾸며 실패의 실질은 유지하라고 합니다. 실패 이름을 본문에 직접 쓰지 않고 한 사건에 집중하며, 약 150단어의 자연스러운 1인칭 서술을 만들도록 합니다. E.2 User Prompt는 한 범주와 근거 보고들을 주고 세 장면 및 근거 게시물 ID를 JSON으로 요청합니다. 시나리오의 근거성과 추적 가능성을 위한 설계입니다. 부록 E
📖 Chapter Appendix F: Scenarios Presented to Participants
Table A2는 범주마다 준비한 세 시나리오 중 하나씩, 총 23개를 공개합니다. 파일을 비워 놓고 편집 완료라고 보고하는 경우, 이미 있는 일정 생성 도구를 못 쓴다고 말하는 경우, 계획 모드에서 편집하는 경우, 이미 승인된 작업에 확인만 반복하는 경우, 이전 정답 패치로 벤치마크를 통과하는 경우 등입니다. 본문 §3.3의 정의 옆에 대표 장면을 배치한 이유도 추상적 이름만으로 범주를 이해하기 어렵기 때문입니다. 이 표는 실제 보고를 바탕으로 구성한 설문 자극물이며 모든 사건을 연구자가 현장에서 직접 검증한 기록이 아닙니다. 부록 F
📖 Chapter Appendix G: Screening Survey
모집 안내는 예상 약 30분의 연구와 완료 보상 25달러를 설명합니다. 선별 질문은 에이전트 사용 빈도, 위임 빈도, 최근 맡긴 과제의 자유 서술입니다. 빈도는 사용하지 않음부터 하루 여러 번까지의 5단계이며, 단순히 도구 이름을 안다는 사실이 아니라 실행 권한을 넘긴 경험을 확인합니다. 부록 G
📖 Chapter Appendix H: Scenario-Based User Study: Online Survey
설문은 H.1 동의 → H.2 사용 목적·협업 방식·자유 회상 → H.3 다섯 실패 평가 안내 → H.4 상황별 질문 → H.5 인구통계 순서입니다. H.4에서 경험을 여러 번·몇 번·한두 번으로 답한 경우는 경험 집단으로 묶고 가장 최근 사건을 설명하게 합니다. 나머지는 “가능하지만 미경험”과 “가능하지 않을 것 같음”으로 나눕니다. 부록 H
경험자에게는 실제 경험의 심각성·알아차림·그 뒤 위임 의향을, 미경험자에게는 만약 겪는다면 어떨지를 질문합니다. 따라서 세 집단의 평가는 같은 형태의 1–5점 척도지만 회고와 가정이라는 서로 다른 맥락을 갖습니다. 대응 전략도 경험자는 했거나 바꿀 일을, 미경험자는 할 법한 일을 서술합니다. H.5는 나이·학력·성별·민족 및 인종·직업 질문을 포함합니다. 원문의 질문 분기를 함께 보면 §4.4의 차이를 실제 능력의 우열로 해석하기 어려운 이유가 명확해집니다. 부록 H.4–H.5
📖 Chapter Appendix I: Research Maturity: Search Protocol and Validation
부록은 연구 용어·산출물 검색의 판정 규칙을 구체화합니다. 각 범주에서 최대 10개의 용어를 시작점으로 삼고, 독립 그룹들이 제목·초록·학술 세션·행사 모집의 주제명으로 쓰는지 확인했습니다. 한 논문이 처음 제안했지만 채택되지 않은 용어는 제외하고, 인접 분야까지 확장했습니다. 총 74개 용어를 확인하고 233개를 버렸으며, 초기 주요 용어가 15개 범주에서 변경됐습니다. Table A3는 최종 용어를 보여 줍니다. 부록 I
대표 연구는 수상·500회 이상 인용·독립 세 그룹의 용어 채택과 인용 같은 조건으로 판단합니다. 서베이는 그 문제의 문헌 정리가 목적이어야 하고, 벤치마크는 후속 연구가 사용해야 하며, 완화 연구 흐름은 독립 그룹 최소 두 곳의 방법 연구를 요구합니다. 워크숍은 관련 논문 한 편이 실렸다는 이유만으로 인정하지 않고, 튜토리얼은 실질적 주제, 트랙은 전용 트랙·특집호·범위가 제한된 명시 주제여야 합니다. 부록 I
검색은 범주별 독립 워크플로에서 Claude 5 Opus, 웹 검색, OpenAlex와 통제된 기록 도구를 사용했습니다. 1,205회 웹 검색, 214개 산출물과 찾지 못한 항목에 대한 79개 명시적 미발견 기록을 남겼습니다. 각 미발견 기록은 탐색한 학술 장소를 적는 방식으로 검색 범위를 남깁니다. 관련성이 약하거나 외부 공격자가 행동을 유발하는 등 위협 모델이 다른 연구도 주석을 붙여 보존합니다. 부록 I
검증 표본 98개는 무작위 전체 표본이 아닙니다. 검색이 agentic으로 기록한 자료 전부와 non-agentic 기록의 대조 표본 20개를 섞었습니다. 앞서 본 환경 일치 90/98 외에 실제 인용 자료의 정체성 98/98, 산출물 종류 97/98이 확인됐습니다. 범주 적합성은 83개에서 동의, 11개에서 부분 동의, 4개에서 거부로 나타났습니다. 저자들은 가짜 자료보다는 범주 적합성이 더 부드러운 증거 경계라고 설명하고 정정을 적용했습니다. 검색을 다시 했을 때의 완전 재현성이나 문헌 전수 회수를 검증한 수치는 아닙니다. 부록 I
실험 결과 심층 분석
이 논문의 수치를 비교할 때 가장 중요한 것은 분모와 평가 대상입니다. 163,487은 수집 게시물 수이고, 6,623은 분류기가 추출한 실패 사례 수입니다. 73은 설문 참여자 수이고, 범주별 경험의 분모는 14–17입니다. 365는 반복된 평가 수이며, 214는 발견한 학술 산출물 수입니다. 이 숫자들을 섞어 “사용자의 몇 퍼센트가 항상 실패한다”거나 “연구의 몇 퍼센트가 모든 에이전트 실패를 해결했다”고 계산할 수 없습니다. §3–5
분류기의 높은 정밀도와 상대적으로 낮은 재현율은 보수적으로 사례를 모으려는 선택과 맞습니다. 추가 GPT-5.5 분류기의 F1 0.62보다 선택한 GPT-5.1의 0.78이 높지만, 목적 표집한 95개 검증 게시물의 작업별 결과입니다. Reddit의 실제 모든 실패를 측정한 전수 레이블과 비교한 것은 아닙니다. §3.2.3 · 부록 D
사용자 연구는 실패 범주에 따른 차이를 혼합효과 모형·우도비 검정으로 보고하고, 개별 범주 대조는 FDR 보정을 사용합니다. 따라서 “통계적 검정이 없다”고 정리하면 틀립니다. 반면 범주별 경험 비율은 작은 분모의 자기 보고이며, Figure 5(a)의 상관은 23개 범주의 추정 평균을 비교한 것입니다. 심각성과 알아차리기 어려움의 관계를 포착하지만 실제 작업에서의 탐지 성공률이나 설계 개선의 인과 효과를 입증하지 않습니다. §4.3–4.4
연구 성숙도의 음의 상관도 검색 규칙과 시점에 조건부입니다. 214개 중 위임 환경 20개라는 결과는 발견한 산출물에서 사용자의 기대가 충분히 평가되지 않는다는 문제의식을 지지합니다. 동시에 전체 학계에 위임 연구가 정확히 그 수만 존재한다는 뜻은 아닙니다. 부록의 98개 검증에서는 자료 정체성보다 범주 적합성에 불확실성이 더 컸습니다. 사용자의 기대를 다루는지 판정하는 경계 자체도 결과 해석의 일부입니다. §5.2 · 부록 I
기술적 함의와 응용
이 연구를 읽고 얻는 가장 큰 관점은 성공한 산출물과 잘 수행한 위임을 따로 평가해야 한다는 것입니다. 기능이 완성됐는지에 더해, 맡긴 범위 안에서 행동했는지, 필요한 때에만 확인했는지, 자원 사용에 진척이 있었는지, 실제 실행과 보고가 일치했는지를 볼 수 있습니다. 이 기준은 논문이 제시한 분류와 감독 설계 논의에서 나옵니다. §3.3 · §6.1
리뷰어 관점에서 MANDATE는 서로 닮은 불만을 구별하는 언어로 유용합니다. “자꾸 멈춘다”는 반응 안에도 불필요한 확인, 미완료 종료, 진척 없는 실행이 있을 수 있습니다. 원인과 대응을 논하려면 먼저 어떤 행동이 어떤 기대를 어겼는지 나눠야 합니다. 논문은 이 분류를 적용한 감독 도구의 효과를 측정하지는 않았으며, 실행 전 계획·실행 중 위임 조건·실행 후 근거를 연결하는 설계를 제안합니다. §3.3 · §6.1
또한 숙련 사용자가 실패를 덜 심각하게 평가하고 다시 맡기겠다고 답했다고 해서 감독 부담이 사라졌다고 볼 수 없습니다. 직접 확인하고 되돌리는 습관이 위험을 감당하는 수단일 수 있기 때문입니다. 이 논문의 세 분석은 정답률 외에 사용자 기대, 알아차리기 쉬움, 복구 노동, 평가 환경을 함께 읽게 만듭니다. §4.5 · §6