논문 개요와 전체 구조
코딩 에이전트가 함수 하나를 고쳤는데, 그 함수를 부르는 코드와 설정 파일, 테스트는 그대로라면 작업이 끝났다고 보기 어렵습니다. 저장소가 커질수록 에이전트는 여러 파일에 흩어진 상태와 의존성을 다시 읽고 연결해야 합니다. HERMES는 이 부담을 하나의 긴 대화에 모으는 대신, 각 파일에 그 파일을 읽고 수정하는 추론 역할을 붙입니다. 논문은 이 단위를 Dev-Primitive, 즉 개발 구성요소에 결합된 실행 가능한 추론 인터페이스라고 부릅니다. §1
Dev-Primitive는 파일 자체가 학습되거나 스스로 실행되는 프로그램으로 바뀐다는 뜻이 아닙니다. 모델 호출이 담당 파일의 현재 내용과 지역 목표를 받아 수정안과 메시지를 내놓는 구조입니다. HERMES는 필요한 구성요소만 활성화하고, 구성요소끼리 요구사항을 전달하게 한 뒤, 실제 실행 결과를 진단해 다음 수정 대상을 고릅니다. 논문의 중심 기여와 주 평가는 소프트웨어 이슈 해결·저장소 마이그레이션·터미널·DevOps 작업입니다. §3 · 부록 F.5
이 리뷰는 2026년 10월 6일 제출된 arXiv:2610.07832v1, HTML 원문과 30쪽 PDF를 기준으로 합니다. 초록의 평균 성능 개선 “12.4%”는 본문에서 기본 GPT-5.6 Sol medium 구성의 네 지표 평균 12.4퍼센트포인트로 설명합니다. 아래에서는 상대 증가율과 구별해 pp로 표기하고, 작은 모델을 쓰는 구성의 비용도 활성화·실제 수정·진단에 어떤 모델을 배정했는지와 함께 읽겠습니다. 고정 버전 서지 · §1
| 원문 순서 | 역할과 내부 구성 |
|---|---|
| 1 Introduction | 긴 작업에서 흩어진 프로그램 상태를 유지하는 문제와 제안 |
| 2 Related Work | 소프트웨어 에이전트, 긴 작업 평가, 재사용 가능한 능력과의 차이 |
| 3 Methodology | 3.1 개요 → 3.2 Dev-Primitives → 3.3 활성화·협업·실행·진단 |
| 4 Experiments | 4.1 설정 → 4.2 주요 결과 → 4.3 역할별 모델 규모 → 4.4 구성요소 선택 → 4.5 제거 실험 |
| 5 Conclusion | 구성요소에 붙인 추론 역할과 하네스 설계의 의미 |
| A–C | 확장 관련 연구, 구성요소 명세, 프롬프트 템플릿 |
| D–F | 전체 실행 알고리즘, 사용 모델, 실행·평가·제거 실험 세부 조건 |
| G–I | 중앙 편집기 대조 실험, Django 실행 사례, 명시된 한계 |
핵심 기여와 혁신성
첫 번째 기여는 추론의 단위를 저장소의 변경 가능한 산출물에 맞춘 것입니다. 기존 역할 분담이 기획자·개발자·테스터처럼 설계자가 정한 조직을 중심으로 움직였다면, 여기서는 소스·설정·테스트 파일이 책임의 경계가 됩니다. 파일의 동작을 잘 아는 역할이 자신의 변경 때문에 다른 파일에 필요한 조건을 직접 전달합니다. 저자들은 이를 재사용 가능한 일반 스킬이나 외부 도구를 감싼 인터페이스와 구분합니다. §2 · 부록 A
두 번째는 이 단위를 저장소 규모에서 운용하는 동적 활성화와 실행 근거 기반 진단입니다. 모든 파일에 매번 모델을 호출하지 않고 이슈와 의존성을 읽어 작업 대상을 좁힙니다. 실행이 실패하면 “계속 고쳐라”는 신호 대신 실패 근거, 관련 구성요소, 다음 수정 지침을 돌려줍니다. 구성요소별 편집이 전체 동작으로 이어지도록 만드는 연결 장치입니다. §3.3
세 번째는 역할을 분리한 상태에서 강한 모델을 어디에 배정할 것인지를 실험한 점입니다. Qwen3-8B가 모든 역할을 맡는 경우와, 파일 수정은 Qwen3-8B가 맡되 활성화·진단을 더 강한 모델이 맡는 경우를 나눕니다. 따라서 “8B 모델이 대형 모델과 같아졌다”는 결과가 아니라, 어느 역할에 추론 자원을 배분했을 때 성능과 비용의 균형이 달라지는지를 보여 줍니다. §4.3
리뷰어 관점에서 이 연구의 읽을거리는 에이전트를 더 많이 호출했다는 사실보다 수정의 책임, 메시지의 목적지, 실행 실패의 귀속을 함께 설계했다는 점에 있습니다. 저자들은 같은 구성요소를 보여 주는 중앙 편집기와 추론 예산을 맞춘 대조군도 추가해, 이 설명을 단순한 파일 탐색 효과나 추가 호출량과 구분하려고 합니다. 부록 G
기술적 세부사항
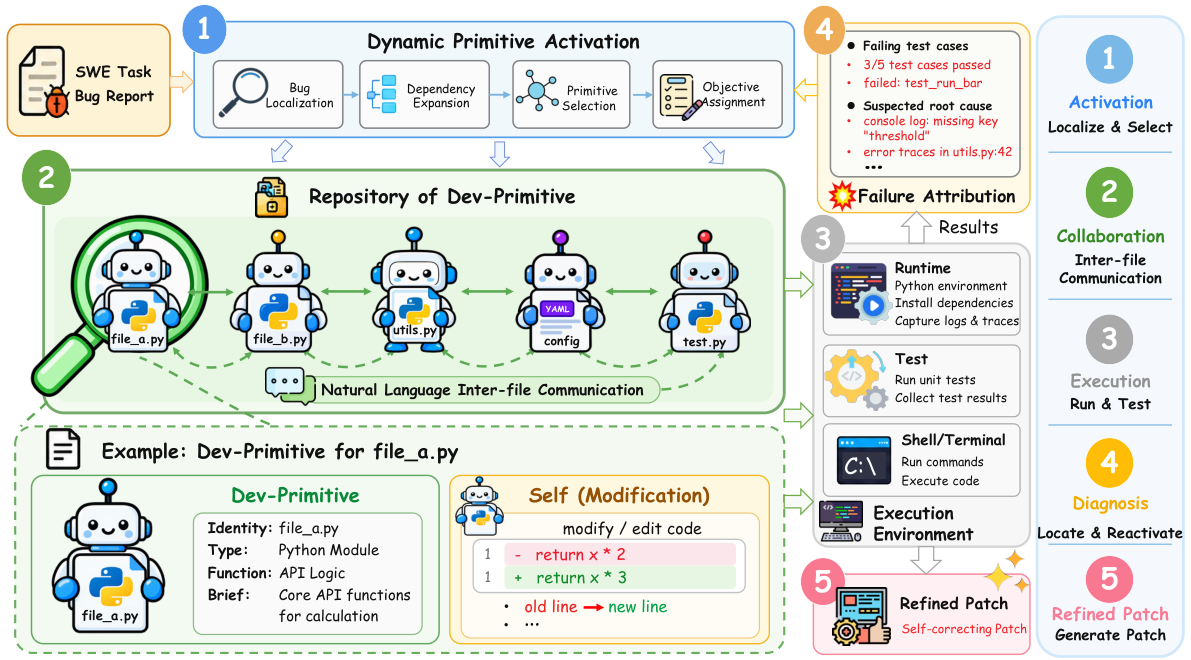
HERMES의 활성화·협업·실행·진단 흐름입니다. Jin 외, Figure 1, PDF 3쪽 · CC BY 4.0 · 원문 그림 영역 크롭, 내용 변경 없음.
입력은 이슈와 현재 저장소입니다. 활성화 모듈은 파일을 찾아 지역 목표를 배정하고, 각 Dev-Primitive는 담당 산출물을 수정하거나 필요한 정보만 제공합니다. 메시지는 관련 구성요소에만 전달됩니다. 이후 쉘·테스트·런타임·로그를 관찰하고, 진단 모듈이 그 근거를 다음 계획에 연결합니다. 그림 오른쪽의 최종 패치는 이 과정을 통과한 산출물이며, 숨겨진 벤치마크 평가가 미리 알려 준 정답은 아닙니다. §3 · 부록 F.1
원문 식 (1)의 핵심은 다음과 같습니다.
$a_i$는 담당 파일 등 현재 산출물, $x_i$는 그 구성요소에 배정된 목표, $\mathcal C_i$는 다른 구성요소에서 온 메시지입니다. $P_i$는 이 입력을 모델 $\mathcal M$에 전달해 필요하면 바뀐 산출물 $a_i'$와 다른 구성요소에 보낼 메시지 $m_i$를 반환합니다. 점검만 필요하면 산출물은 그대로입니다. 파일을 선택했다는 사실과 그 파일을 수정했다는 사실은 다릅니다. §3.2, 식 (1)
평가에서는 성공률뿐 아니라 비용·시간과 선택된 파일의 적절성도 확인합니다. 기본 수정 예산은 최초 실행 뒤 최대 세 번의 추가 수정입니다. B=0도 최초 계획·협업·실행·진단을 한 번 수행하므로, 실행이나 진단을 없앤 조건과 혼동하면 안 됩니다. 해결 중에 보는 테스트와 최종 채점용 숨겨진 테스트도 분리합니다. 부록 B.5 · 부록 F.1·F.6
챕터별 상세 리뷰
📖 Chapter 1: Introduction
서론은 소프트웨어 에이전트가 터미널을 사용할 수 있어도 긴 작업에 취약한 이유에서 출발합니다. 하나는 대화 이력이 계속 늘면서 필요한 정보가 흐려지는 문제이고, 다른 하나는 실제 프로그램 상태가 소스·설정·테스트·의존성에 분산된 문제입니다. 이력을 압축해도 호출자와 피호출자 사이에 새로 생긴 계약까지 자동으로 일치하지는 않습니다. §1
저자들은 이 두 번째 문제를 “각 구성요소가 자신의 책임을 설명하고 다른 구성요소와 요구사항을 교환할 수 있는가”라는 질문으로 바꿉니다. Dev-Primitive는 현재 구현을 읽는 모델을 산출물에 결합하고, 그 산출물을 바꿀 수 있는 지역 역할을 제공합니다. HERMES는 여기에 필요한 구성요소를 고르는 활성화와 실패를 구성요소에 연결하는 진단을 더합니다.
서론은 기본 GPT-5.6 Sol medium 구성의 네 벤치마크 지표 평균 개선을 12.4pp로 요약하고, 강한 활성화·진단 모델과 Qwen3-8B 수정 역할을 결합했을 때 균일한 GPT-5.6 Sol 구성과의 격차가 최대 4.5pp라고 보고합니다. 이 요약은 모든 백본에서 같은 폭으로 개선된다거나 작은 모델만으로 달성한 결과라는 뜻이 아닙니다. 뒤의 실험 장은 같은 모델·추론 강도 안에서 하네스를 비교하고, 역할별 모델 배정을 별도로 분해합니다. §1 · §4.2–4.3
서론의 기여는 코드 산출물과 추론 역할을 묶는 문제 정의입니다. 다음 장은 이 단위가 기존 역할 기반 에이전트와 어떤 점에서 다른지 설명합니다.
📖 Chapter 2: Related Work
소프트웨어 에이전트와 긴 작업 평가. SWE-agent·OpenHands·CodeAct처럼 저장소를 읽고 실행하는 방식, Agentless·AutoCodeRover처럼 탐색과 수리를 명시적 단계로 구성하는 방식, 설계자가 정한 역할이나 파일 담당자를 중앙에서 조정하는 방식을 먼저 정리합니다. 이어 단일 이슈 해결을 넘어 저장소 전체 마이그레이션과 여러 단계의 개발 작업을 평가하게 된 배경을 설명합니다. §2
재사용 가능한 모듈형 능력. 저장소 작업 궤적에서 행동을 학습하는 연구와, 추론 절차·스킬·도구를 명시적으로 모듈화하는 연구를 구분합니다. 이들은 여러 과제에 가져다 쓸 수 있는 능력을 단위로 삼는다는 공통점이 있습니다.
차이를 만드는 경계. Dev-Primitive는 일반 능력보다 특정한 변경 가능 산출물에 묶입니다. 논문이 강조하는 차이는 파일 담당자의 존재 자체가 아니라, 저장소가 추론 단위를 정하고 구현을 읽다가 발견한 요구가 관련 구성요소로 직접 흘러간다는 점입니다. 중앙 에이전트가 모든 상태와 메시지를 다시 해석해 중계하는 구조와 구분합니다. 이것이 다음 장의 지역 수정과 의존성 기반 협업을 이해하는 출발점입니다. §2 · 부록 A
📖 Chapter 3: Methodology
3.1 Overview
전체 과정은 선택 → 협업과 수정 → 실행 → 진단 → 필요한 부분만 재선택하는 반복입니다. 실패를 관찰하는 것만으로는 어느 파일을 바꿔야 할지 알 수 없으므로 진단 모듈이 필요합니다. 반대로 좋은 진단이 있어도 관련 파일을 빠뜨리면 지역 수정만 반복할 수 있어 활성화가 필요합니다. 두 메커니즘은 Dev-Primitive의 기본 기능과 분리되어 있습니다. §3.1
3.2 Dev-Primitives
각 구성요소는 자신이 소유한 산출물에 대해 지역 추론과 수정을 수행하고, 다른 구성요소에 영향을 주는 정보는 자연어 메시지로 전달합니다. 메시지에는 인터페이스 변경, 입력·출력에 대한 가정, 설정 조건, 의존성 변경, 테스트가 확인해야 할 동작 등이 들어갑니다. 모든 담당자에게 일괄 방송하는 방식이 아니라 현재 추론이 지목한 수신자에게 보냅니다. §3.2
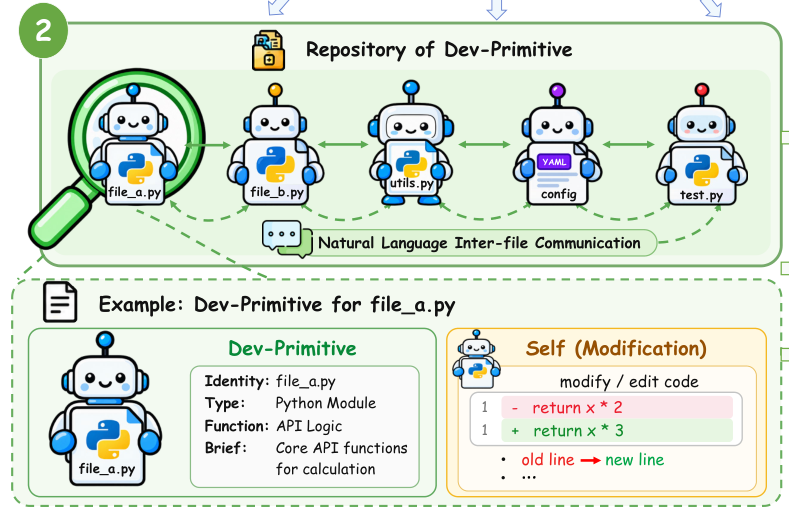
파일별 메시지 교환과 지역 수정 부분을 자세히 본 모습입니다. Jin 외, Figure 1 부분, PDF 3쪽 · CC BY 4.0 · 같은 그림의 협업·수정 영역 크롭.
그림의 file_a.py 예시는 담당 구현을 바꾸는 동작을 도식화한 것입니다. 중요한 규칙은 다른 담당자의 파일을 직접 고치는 대신 필요한 조건을 전달한다는 점입니다. 메시지가 현재 라운드가 끝나기 전에 수신자의 문맥에 들어가므로, 수신자는 그 조건을 반영해 자신의 수정을 다시 조정할 수 있습니다. 따라서 협업은 고정된 전체 회의 단계가 아니라 지역 작업 도중 일어나는 정보 교환입니다. §3.2 · 부록 F.5
3.3 Harness Engineering via Modular Executable Dev-Primitives
Dynamic Primitive Activation. 활성화 모듈은 이슈를 분석하고 구현 위치를 찾은 다음, 호출자·피호출자·설정·테스트로 의존성을 확장합니다. 원문에서 저장소를 입력으로 쓴다는 것은 전체 내용을 한 프롬프트에 이어 붙인다는 뜻이 아닙니다. 필요한 구조와 파일을 읽으면서 계획을 구성합니다. §3.3 · 부록 B.1
$q$는 이슈, $\mathcal R$은 저장소에 대한 접근, $\mathcal A$는 선택된 구성요소 집합입니다. 계획 $\Pi$는 각 구성요소의 인덱스와 지역 목표를 짝짓습니다. 위 식은 원문 §3.3과 부록 식 (2)의 ACTIVATE를 같은 의미의 직립 글자로 표기한 것입니다. 선택하지 않은 구성요소는 모델 호출을 받지 않습니다.
Dev-Primitive Collaboration. 활성화된 담당자들이 각자의 파일을 수정하고, 그 수정이 요구하는 조건을 전달합니다. 한 문맥에 모든 변경 파일을 모아야 한다는 전제가 사라집니다. 다만 파일별 수정이 서로 맞는지는 이어지는 실제 실행에서 확인해야 합니다.
Execution Environment. 수정된 저장소에 대해 명령·테스트·런타임을 실행합니다. 결과에는 종료 코드, 빌드 상태, 실패 테스트, 예외와 로그가 포함됩니다. 이는 모델이 “이 코드면 통과할 것”이라고 예측하는 것과 다릅니다. 또한 이 실행 환경에는 최종 채점에만 쓰는 숨겨진 평가 테스트가 포함되지 않습니다. §3.3 · 부록 F.1
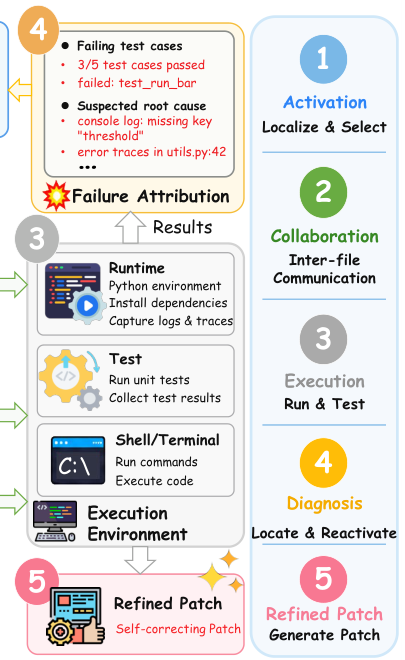
실행 결과와 실패 귀속, 재활성화의 연결입니다. Jin 외, Figure 1 부분, PDF 3쪽 · CC BY 4.0 · 같은 그림의 실행·진단 영역 크롭.
Bug Diagnosis. 진단은 이슈·현재 계획·수정된 저장소·실행 관측을 받아 통과 또는 실패를 반환합니다. 실패하면 관측된 증거, 의심되는 원인과 관련 구성요소, 수정 지침을 구조화합니다. 이 진단 모듈은 파일을 직접 편집하지 않고 활성화 모듈에 피드백을 돌려줍니다. 실패한 테스트나 컴파일을 모델의 판단만으로 성공으로 뒤집을 수 없습니다. §3.3 · 부록 B.4
$e$는 실패 근거, $c$는 의심 원인과 관련 구성요소, $u$는 다음 수정 지침입니다. 갱신된 저장소 $\mathcal R'$와 이전 계획을 함께 보기 때문에 이미 잘된 수정을 보존하면서 목표를 바꾸거나, 담당자를 빼거나, 새 구성요소를 추가할 수 있습니다. 이 식은 실패를 다음 편집의 위치로 바꾸는 연결을 나타냅니다. 방법 장은 이 반복을 정의하고, 실험 장은 각 부분이 성능과 비용에 어떤 차이를 만드는지 확인합니다.
📖 Chapter 4: Experiments
4.1 Experimental Setup
네 벤치마크는 같은 종류의 성공률을 측정하지 않습니다. SWE-bench Verified는 500개 이슈의 해결 비율, SWE Refactor Bench는 20개 저장소 마이그레이션의 복합 점수, Terminal-Bench 4.0은 66개 실행 과제에서 다섯 번 실행의 해결률, DevOps-Gym은 네 작업 범주의 성공률과 그 단순 평균을 사용합니다. §4.1 · 부록 F.7
기본 설정은 가능한 경우 추론 강도 medium, 최초 실행 후 추가 수정 예산 3입니다. 각 표의 직접 대조는 모델과 추론 강도를 맞추고 하네스를 바꿉니다. 다만 모든 기준선을 저자들이 새로 실행한 것은 아닙니다. 정확히 맞는 공개 설정은 보고값을 사용하고, 없는 설정은 동일 스냅샷과 평가 절차로 보완 실행합니다. 본문이 먼저 제시한 일곱 백본 외에도, 전체 결과표와 부록 E에는 더 넓은 비교 모델이 실립니다. §4.1 · 부록 E·F.8
4.2 Main Results
SWE-bench Verified. 표 1에서 GPT-5.6 Sol은 mini-SWE-agent의 96.2%에서 HERMES의 97.0%로 0.8pp 오릅니다. 반면 GPT-5 Mini는 60.8%에서 80.2%로 19.4pp 오릅니다. Claude Opus 5는 97.0%로 동률입니다. 이미 높은 기준선과 아직 여지가 큰 기준선에서 개선 폭이 다릅니다. §4.2, 표 1
효율도 따로 봐야 합니다. GPT-5.6 Sol의 과제당 비용은 1.15달러에서 1.80달러, 평균 시간은 182.37초에서 205.34초로 늘어납니다. Claude Sonnet 5에서는 79.6%에서 85.8%로 오르면서 시간이 962.37초에서 824.63초로 줄지만 비용은 1.49달러에서 2.10달러로 증가합니다. 하네스의 성능 개선과 비용·시간 감소가 항상 함께 일어나지는 않습니다.
SWE Refactor Bench. 파일 여러 개의 일관된 변경이 필요한 마이그레이션에서 차이가 큽니다. GPT-5.6 Sol medium은 Codex의 복합 점수 6.5에서 31.0으로 24.5pp 오르지만 과제당 비용은 6.0달러에서 24.8달러가 됩니다. high 비교는 19.0에서 36.5로 17.5pp이며 비용은 7.7달러에서 39.6달러로 늘어납니다. 이는 20개 과제 중 31%를 완전히 해결했다는 뜻이 아니라 벤치마크 복합 점수의 값입니다. 표 2
Terminal-Bench 4.0. GPT-5.6 Sol medium은 33.0±3.4%에서 51.8±2.2%로 오릅니다. 여기의 ±는 다섯 번 실행 사이의 표준편차입니다. 같은 비교에서 전체 토큰은 3.6B에서 6.8B, 비용은 약 1.9천 달러에서 3.4천 달러로 증가합니다. Claude Sonnet 5 medium은 10.6%에서 35.8%로 개선되면서 토큰은 15.9B에서 13.4B, 비용은 7.1천 달러에서 5.8천 달러로 감소합니다. 이 예외를 전체 모델의 일반적 비용 감소로 확대할 수는 없습니다. 표 3
DevOps-Gym. GPT-5.6 Sol은 Codex 대비 네 범주 평균이 49.89%에서 55.41%로 5.52pp 오릅니다. 빌드 77.78→83.33, 모니터링 38.24→44.12, 이슈 해결 40.97→46.13, 테스트 생성 42.58→48.06으로 분산되어 나타나는 개선입니다. 비교 하네스를 mini-SWE-agent로 바꾸면 같은 HERMES 결과의 기준선이 달라져 평균 차이도 7.52pp가 됩니다. 표 4
| 기본 GPT-5.6 Sol medium 비교 | 기준 하네스 | 기준 점수 | HERMES | 차이 |
|---|---|---|---|---|
| SWE-bench Verified, 해결률 | mini-SWE-agent | 96.20 | 97.00 | +0.80pp |
| SWE Refactor Bench, 복합 점수 | Codex | 6.5 | 31.0 | +24.5pp |
| Terminal-Bench 4.0, 해결률 | Codex | 33.0 | 51.8 | +18.8pp |
| DevOps-Gym, 네 범주 평균 | Codex | 49.89 | 55.41 | +5.52pp |
표 1–4에서 뽑은 동일 기본 모델의 비교입니다. 서로 다른 평가 지표이므로 한 과제의 통합 성공률처럼 읽지 않습니다. 저자의 12.4pp 요약은 이 기본 GPT-5.6 Sol medium 구성의 네 지표 차이, 즉 0.80·24.5·18.8·5.52pp를 평균한 값입니다. 모든 모델의 평균이나 하나의 통합 해결률은 아닙니다. §1 · §4.2
관련 다중 에이전트 프레임워크. 표 5의 SWE-bench에서 MAGIS 13.9, HERMES 36.6, NL2Repo-Bench에서 CodeTeam의 prompting 34.6·SFT 42.3, HERMES 44.9를 제시합니다. 이는 각 연구의 원래 평가 설정에서 가져온 참고 비교입니다. 앞의 같은 백본·추론 강도 하네스 대조표와 같은 통제 조건으로 해석하지 않습니다. 표 5
4.3 Scaling LLMs Across HERMES Components
이 절은 세 역할의 모델을 별도로 바꿉니다. 파일 수정 역할을 Qwen3-8B로 고정하고 진단만 강화하거나, 활성화만 강화하거나, 두 역할을 함께 강화합니다. Terminal-Bench에서 모든 역할이 Qwen3-8B이면 27.6%이고, 진단만 GPT-5.5로 바꾸면 46.1%, 활성화만 GPT-5.5로 바꾸면 36.7%입니다. 이 조건에서는 진단에 강한 모델을 넣은 개선이 더 큽니다. 표 6
| 활성화 / 파일별 수정 / 진단 | Terminal 해결률 | 전체 추론 비용 |
|---|---|---|
| Qwen3-8B / Qwen3-8B / Qwen3-8B | 27.6% | 0.70천 달러 |
| Qwen3-8B / Qwen3-8B / GPT-5.5 | 46.1% | 1.56천 달러 |
| GPT-5.6 Sol / Qwen3-8B / GPT-5.5 | 49.7% | 2.13천 달러 |
| GPT-5.6 Sol / Qwen3-8B / GPT-5.6 Sol | 50.6% | 2.51천 달러 |
| GPT-5.6 Sol / GPT-5.6 Sol / GPT-5.6 Sol | 51.8% | 3.40천 달러 |
표 7의 역할별 배정과 비용입니다. §4.3, 표 7
초록의 26.2% 비용 감소는 활성화와 진단을 모두 GPT-5.6 Sol로 유지하고 파일 수정만 Qwen3-8B로 바꾼 구성입니다. 이 구성은 Terminal에서 1.2pp 낮고, 네 벤치마크 전체에서 균일한 Sol 구성과의 차이는 1.2–4.5pp입니다. 최대 4.5pp는 Refactor 복합 점수 31.0과 26.5의 차이입니다. 표 6–7
반면 본문이 추가로 설명하는 37.4% 비용 감소는 진단도 GPT-5.5로 낮춘 2.13천 달러 구성입니다. Terminal 해결률은 49.7%로 Sol 전체 구성보다 2.1pp 낮습니다. 두 비용 감소율은 서로 다른 구성의 결과이므로 한 문장에 섞으면 안 됩니다. 49.7→50.6의 0.9pp를 회복하는 데 0.38천 달러, 다시 50.6→51.8의 1.2pp를 회복하는 데 0.89천 달러가 추가됩니다. §4.3
4.4 Dev-Primitive Selection Quality
선택 품질은 실행 결과와 별개로, 참조 구성요소 집합을 얼마나 찾아냈는지를 측정합니다. 표 8의 GPT-5.6 Sol에서 재현율·정밀도·고유 활성 구성요소 수는 SWE-bench 95.4%·72.6%·4.7개, Refactor 83.3%·68.4%·12.6개, Terminal 84.5%·64.9%·6.8개, DevOps 85.7%·70.3%·5.4개입니다. DevOps의 파일 수준 측정에서는 모니터링 과제를 제외합니다. 표 8
해결된 과제의 선택 재현율은 실패 과제보다 16.5–24.7pp 높습니다. 다만 이것은 선택과 성공 사이의 연관을 보여 주는 분해이며 독립적인 인과 효과 실험은 아닙니다. 또한 참조 패치와 다른 경로로 올바른 수정을 만들 수도 있습니다. 부록 H의 Django 사례가 그 예이므로, 참조 파일과 겹치지 않는 선택을 모두 잘못이라고 단정할 수 없습니다. 지표의 구체적 분모와 집계는 부록 F.4에서 설명합니다. §4.4
4.5 Ablation Study
제거 실험은 다른 조건을 유지하고 통신, 필요 시 활성화, 실행 피드백, 진단 피드백을 하나씩 끕니다. 아래는 표 9의 GPT-5.6 Sol 결과입니다. §4.5
| 구성 | SWE-bench | Refactor | Terminal | DevOps |
|---|---|---|---|---|
| HERMES 전체 | 97.0 | 31.0 | 51.8 | 55.41 |
| 구성요소 간 통신 없음 | 94.2 | 23.5 | 46.1 | 50.34 |
| 필요 시 활성화 없음 | 95.8 | 28.0 | 49.4 | 53.26 |
| 실행 피드백 없음 | 93.8 | 21.5 | 43.6 | 48.17 |
| 진단 피드백 없음 | 92.6 | 20.0 | 41.2 | 46.73 |
네 열은 각각 해결률·복합 점수·해결률·범주 평균입니다. 진단 제거의 하락이 이 네 제거 조건 중 가장 크고, 통신 제거는 SWE-bench의 2.8pp보다 Refactor의 7.5pp, Terminal의 5.7pp에서 더 큽니다. 파일 간 일관성이 필요한 작업에서 직접 요구를 전달하는 역할을 살펴볼 근거입니다. 표 9
이 표에는 중앙 편집기 대조군이 없습니다. Dev-Primitive를 중앙 편집기로 교체한 실험은 부록 G의 별도 표 13–14에 있습니다. 또한 필요 시 활성화를 끈다는 것은 저장소의 모든 파일을 전부 깨운다는 뜻이 아닙니다. 최초 분석에서 식별한 구성요소를 계속 활성 상태로 유지하는 조건입니다. 세부 통제 조건은 부록 F.6에서 다시 짚겠습니다.
수정 예산을 3에서 5로 늘리면 어느 벤치마크에서도 0.9pp를 넘는 추가 개선이 나오지 않습니다. 저자들은 이 결과를 바탕으로 기본 예산을 3으로 정합니다. 이 절은 어떤 구성요소와 반복 단계가 기여하는지 분해하며, 결론은 전체 설계의 의미로 돌아갑니다. 부록 F.3
📖 Chapter 5: Conclusion
결론은 산출물에 결합한 지역 추론, 동적 활성화, 실제 실행, 진단에 따른 재수정의 조합을 다시 정리합니다. 기본 Sol medium의 네 지표 평균 12.4pp 개선과 작은 수정 모델을 강한 활성화·진단 모델과 결합한 결과를 하네스 설계의 중요성을 보여 주는 근거로 제시합니다. 세 역할의 조합을 바꾸는 결과이므로 모델 자체의 학습 능력이 새로 획득됐다는 주장과는 구분됩니다. §5
본문은 여기서 끝납니다. 이어지는 부록은 관련 연구의 경계, 실행 가능한 명세와 실험 통제 조건, 실제 궤적과 한계를 차례로 보충합니다.
📖 Chapter A: Extended Related Work
부록 A는 본문 2장의 세 흐름을 더 상세히 나눕니다. 먼저 소프트웨어 에이전트 구조, 다음으로 긴 작업 평가와 상태 유지 문제, 이어 궤적 학습·재사용 가능한 능력·도구 인터페이스를 정리한 뒤 차이를 설명합니다. 특히 Tool Primitives가 외부 도구를 자연어 인터페이스로 감싸는 것과, Dev-Primitives가 변경 가능한 저장소 산출물에 결합하는 것을 구별합니다. 부록 A
핵심은 중앙 역할이 파일 담당자에게 일을 나눠 줬다는 사실만으로 같은 설계가 되지는 않는다는 점입니다. 저자들의 정의에서는 현재 구현을 읽으며 발견한 조건이 저장소 의존성을 따라 직접 전달되고, 산출물이 바뀌면 그 역할이 보는 상태도 함께 바뀝니다. 다음 부록은 이 구분을 활성화·협업·진단의 입출력 명세로 구체화합니다.
📖 Chapter B: Detailed Component Specifications
B.1 Dynamic Primitive Activation
활성화는 이슈 분석, 구성요소 위치 찾기, 의존성 분석, 지역 작업 분해, 편집 계획의 순서로 정의됩니다. 계획에는 선택한 파일뿐 아니라 그 파일에 무엇을 확인·수정시킬지가 들어갑니다. 다음 반복에서는 새 실행 근거에 따라 목표를 조정하고 성공한 수정을 유지하며, 불필요해진 구성요소는 빼고 새로 드러난 의존성은 추가합니다. 부록 B.1
B.2 Dev-Primitives
담당 산출물, 지역 목표, 들어온 메시지를 받아 필요하면 산출물을 바꾸고 관련 요구를 내보냅니다. 참여가 수정의 의무를 뜻하지는 않습니다. 현재 구현이 다른 파일의 변경에 중요한 조건을 제공한다면 파일을 그대로 두고도 협업에 기여할 수 있습니다.
B.3 Execution Environment
실행 관측은 쉘, 테스트, 런타임, 추적 정보로 구성됩니다. 저장소 스냅샷과 해당 벤치마크의 의존성·환경에서 실제 명령을 실행해 독립적으로 수정한 구성요소가 함께 작동하는지 확인합니다. 이 중 테스트는 해결 중 접근 가능한 테스트이며, 숨겨진 채점기를 피드백 채널로 사용하지 않습니다.
B.4 Bug Diagnosis
진단은 실패 근거, 원인으로 의심되는 구성요소·상호작용, 목표와 구현의 불일치, 누락된 구성요소와 다음 지침을 반환합니다. 진단 역할은 파일을 고치는 편집기가 아닙니다. 명령이나 테스트가 명확하게 실패했는데도 말로 성공을 선언할 수 없다는 제약이 이 단계의 중요한 경계입니다.
B.5 Revision and Termination
통과하거나 예산을 소진하면 반복을 멈춥니다. 원문은 최초 실행 다음의 추가 수정 횟수를 예산으로 정의합니다. 따라서 기본 예산 3은 최초 시도까지 포함해 최대 네 번의 계획·협업·실행·진단을 허용합니다. 다음 부록의 프롬프트는 이 책임과 금지 조건을 모델에 어떻게 전달하는지 보여 줍니다. 부록 B.5
📖 Chapter C: Prompt Templates
C.1 Activation Prompt
활성화 프롬프트는 이슈·구조·관련 구현·이전 계획·진단 피드백을 받아 PLAN 또는 REPLAN을 작성하게 합니다. 각 구성요소 항목에 경로, 목표, 의존성, 메시지 대상, inspect | modify | validate의 예상 행동을 기록하고, 실행할 검증 절차도 별도 목록으로 내놓습니다. 이 역할에는 파일을 직접 수정하지 말라는 제약이 있습니다. 부록 C.1
C.2 Dev-Primitive Prompt
담당자 프롬프트는 맡은 파일에 필요한 부분만 수정하고, 다른 담당자의 파일을 직접 고치지 않으며, 확인할 수 없는 구성요소의 세부사항을 지어내지 않도록 합니다. 출력에는 modify 또는 no_change, 지역 변경 설명, 수정 산출물, 보낼 메시지와 검증 메모가 포함됩니다. 이것은 “모든 담당자가 무언가 바꿔야 한다”는 압박을 줄이는 명시적 인터페이스입니다.
C.3 Inter-Primitive Communication Format
메시지는 source, target, type, message, required_action으로 구성됩니다. 유형은 인터페이스·의존성·동작·테스트·설정 중 하나이며, 수신자에게 필요한 정보만 전달합니다. 수신자는 이번 협업 라운드가 끝나기 전에 이를 반영해 자신의 수정을 조정할 수 있습니다. 메시지 목적지가 드러나므로 전체 대화에 같은 내용을 축적하는 방식과 다릅니다.
C.4 Diagnosis Prompt
진단 프롬프트는 원래 이슈를 충족했는지와 새 회귀가 있는지 함께 보게 합니다. PASS에는 실행 근거와 요약, FAIL에는 실패 증거, 의심 원인, 누락 구성요소, 수정 지침을 담습니다. 실패를 보고해도 성공한 부분은 보존하도록 요구합니다. 부록 D는 이 명세를 한 반복 알고리즘으로 연결합니다. 부록 C.4
📖 Chapter D: End-to-End Execution Flow
알고리즘 1의 입력은 이슈·저장소·Dev-Primitive 집합·수정 예산이고 출력은 수정된 저장소 또는 구조화된 실패 보고입니다. 최초 계획 뒤 협업·수정·실행·진단을 수행하고, 실패하면 예산을 확인한 뒤 이전 계획과 피드백으로 다시 활성화합니다. 성공한 변경은 새 근거가 반박하지 않는 한 유지합니다. 부록 D, 알고리즘 1
다음은 원문 알고리즘을 읽기 쉽게 다시 쓴 설명용 의사코드이며 실제 공개 구현이나 실행 결과가 아닙니다.
1
2
3
4
5
6
7
8
9
10
11
plan = activate(issue, repository)
for revision in range(budget + 1):  # 최초 실행 + 추가 수정 예산
    edits = collaborate(plan, repository)
    repository = apply_edits(repository, edits)
    observation = execute_visible_checks(repository)
    verdict, feedback = diagnose(issue, plan, repository, observation)
    if verdict == "pass":
        return repository
    if revision == budget:
        return failure_report(issue, repository, observation)
    plan = activate(issue, repository, plan, feedback)
execute_visible_checks는 과제 해결 중 접근 가능한 실행 검사를 나타냅니다. 숨겨진 평가 결과를 받아 수정하는 경로는 없습니다. pass 역시 해결 중 근거에 따른 종료 판단이며 최종 벤치마크 점수와는 다른 단계입니다. 이 구분은 뒤의 Django 사례에서 중요해집니다.
📖 Chapter E: Backbone Models
부록 E의 표 10은 본문의 주요 백본뿐 아니라 각 벤치마크의 추가 비교 모델을 열거하고, 역할별 모델 배정·제거 실험에 쓰인 모델을 구분합니다. Qwen3-8B는 NVIDIA A40에서 Ollama로 제공하며 온도 0.6, top-p 0.95, top-k 20과 32K 문맥 창을 사용합니다. 다른 모델은 공식 API로 접근합니다. 부록 E
따라서 작은 모델과 API 모델 사이의 차이를 파라미터 수 하나만으로 설명할 수는 없습니다. 논문은 이 배포 설정을 명시하며 마지막 한계 절에서도 모델 갱신과 배포 조건에 따라 결과가 달라질 수 있다고 적습니다. 다음 부록은 모델 배정보다 더 세부적인 실행·채점 조건을 정리합니다.
📖 Chapter F: Implementation and Evaluation Details
F.1 Execution Isolation and Settings
활성화는 사전 계산한 호출 그래프를 조회하는 고정 검색기가 아니라, 모델이 구조와 후보 파일을 읽고 의존성을 확장하는 호출 체인입니다. 진단 역시 이슈·계획·수정된 상태·실행 관측을 읽는 모델 호출입니다. 두 역할과 각 Dev-Primitive의 모델을 다르게 배정할 수 있습니다. 부록 F.1
해결 과정에는 저장소에 있는 테스트, 빌드·린터·타입 검사, 런타임과 재현 스크립트가 허용됩니다. SWE-bench의 FAIL_TO_PASS·PASS_TO_PASS를 포함한 평가 테스트와 다른 벤치마크의 채점기는 종료 후 점수 계산에만 사용됩니다. 명확한 실행 실패를 모델 판단이 뒤집을 수 없다는 조건도 다시 확인합니다.
F.2 Complete Component Ablation
표 11은 표 9의 제거 실험을 Claude Sonnet 5와 Qwen3-8B까지 확장합니다. Sonnet의 Refactor는 전체 22.0에서 통신 제거 16.5, 실행 피드백 제거 14.5, 진단 제거 13.0으로 내려갑니다. Qwen의 Terminal은 전체 27.6에서 각각 23.0·20.9·19.1로 내려갑니다. 같은 경향이 다른 백본에도 나타나는지를 보여 주는 자료이며, 각 모델의 절대 점수가 동일하다는 의미는 아닙니다. 부록 F.2, 표 11
F.3 Revision Budget
| 추가 수정 예산 | SWE-bench | Refactor | Terminal | DevOps |
|---|---|---|---|---|
| 0 | 92.2 | 18.5 | 39.7 | 45.91 |
| 1 | 94.6 | 24.0 | 45.2 | 50.17 |
| 2 | 96.4 | 28.5 | 48.8 | 53.72 |
| 3 | 97.0 | 31.0 | 51.8 | 55.41 |
| 5 | 97.2 | 31.5 | 52.7 | 55.88 |
GPT-5.6 Sol의 수정 예산 실험 표 12에서 발췌했습니다. 부록 F.3
0→3의 차이는 Refactor 12.5pp, Terminal 12.1pp지만, 3→5의 추가 개선은 각각 0.5pp·0.9pp입니다. “수정을 세 번 더 허용한다”는 예산 정의를 먼저 확인해야 최초 실행만 수행하는 조건과 비교할 수 있습니다.
F.4 Dev-Primitive Selection Protocol
참조 집합은 SWE-bench에서는 개발자 패치의 변경 파일, Refactor에서는 과제 명세와 채점 산출물이 지목하는 구성요소, Terminal에서는 오라클 풀이가 접근·변경한 산출물, DevOps에서는 모니터링을 제외한 참조 산출물입니다. 이는 선택 품질을 사후 평가하기 위한 기준이며, 활성화 단계에 정답 파일을 미리 제공한다는 뜻이 아닙니다. 부록 F.4
$\mathcal G$는 참조 구성요소, $\mathcal A$는 계획과 수정 라운드 전체에서 활성화된 구성요소 집합입니다. 재현율은 필요한 참조 파일을 얼마나 찾았는지, 정밀도는 선택한 파일 중 참조와 겹치는 비율을 뜻합니다. 두 지표와 해결·실패별 지표는 벤치마크 안에서 구성요소 단위로 micro-average합니다. Refactor의 해결·실패 분해에서는 복합 점수가 0보다 큰 과제를 “해결”로 분류합니다. 이를 완전한 마이그레이션 성공률과 같게 읽지 않습니다.
F.5 Dev-Primitive Runtime
담당자는 같은 과제의 수정 라운드 사이에 현재 파일 내용과 관련 메시지를 유지합니다. 모델의 내부 은닉 상태를 호출 사이에 보존하는 것은 아닙니다. 다시 호출할 때 갱신된 산출물·목표·관련 문맥을 전달합니다. 메시지는 중앙 모델이 해석·필터링·재작성하지 않고 지정 수신자의 문맥에 원문 그대로 들어갑니다. 부록 F.5
필요한 새 소스·테스트·설정 파일을 만들면 이후 그것도 Dev-Primitive로 등록할 수 있습니다. 임시 출력·캐시·로그·실행 중 프로세스와 일시적 상태는 구성요소가 아니라 실행 관측입니다. 기본 세분화 단위는 파일이며, 일반 저장소 형태가 아닌 Terminal 과제도 독립적으로 읽고 바꿀 수 있는 지속적 파일 산출물을 이 단위로 다룹니다.
F.6 Ablation Settings
통신 제거는 담당자의 지역 추론·수정을 유지하고 직접 메시지만 막습니다. 필요 시 활성화 제거는 최초에 식별한 담당자를 계속 활성 상태로 두는 조건으로, 모든 저장소 파일을 깨우는 실험이 아닙니다. 실행 피드백 제거는 진단이 실행 출력 대신 정적 점검으로 다음 수정을 판단하게 합니다. 부록 F.6
진단 피드백 제거는 실행 자체와 원시 출력을 유지하되 전담 진단의 구조화된 피드백을 없애고, 활성화 모듈이 원시 결과를 직접 읽게 합니다. 추가 수정은 여전히 허용되므로 B=0과 다릅니다. 이 정의를 구분해야 “검사 없음”, “진단 없음”, “재시도 없음”을 같은 실험으로 착각하지 않습니다.
F.7 Benchmark-Specific Evaluation Protocol
SWE-bench는 500개 사람 검증 과제의 최종 해결 비율을 측정합니다. Refactor는 20개 마이그레이션의 복합 점수를 사용하고, Terminal은 66개 과제를 다섯 번 실행해 평균과 표준편차를 냅니다. Terminal의 토큰과 비용은 전체 평가 궤적의 합입니다. DevOps는 빌드·설정, 모니터링, 이슈 해결, 테스트 생성의 성공률을 각각 내고 단순 평균합니다. 이처럼 분모와 점수 정의가 다르므로 네 열을 동일 지표로 합쳐 해석하면 안 됩니다. 부록 F.7
F.8 Baseline Provenance
기준선은 공개 보고값과 통제 실행을 함께 사용합니다. 맞는 모델·하네스·추론 강도·벤치마크 버전의 공개 결과가 있으면 가져오고, 부족한 직접 대조 조건은 같은 환경에서 실행합니다. 모든 HERMES 결과는 저자의 구현에서 얻었으며 비용에는 활성화·파일별 수정·진단의 전체 호출이 포함됩니다. 이 절은 비교 설정의 맞춤과 데이터 획득 경로를 설명합니다. 다음 부록은 Dev-Primitive 자체의 효과를 더 좁은 대조 실험으로 확인합니다. 부록 F.8
📖 Chapter G: Additional Analysis of Dev-Primitives
Dev-Primitives vs. a Centralized Editor. 표 13은 활성화가 고른 동일한 구성요소 집합을 중앙 편집기에 모두 주고 공동 수정하게 합니다. 활성화·실행·진단·수정 예산과 GPT-5.6 Sol medium은 그대로 둡니다. 중앙 편집기의 점수는 SWE-bench 93.4, Refactor 16.8, Terminal 38.8, DevOps 44.21로 HERMES의 97.0·31.0·51.8·55.41보다 낮습니다. 파일 위치를 더 잘 찾아서 생긴 차이만으로는 설명되지 않는 대조입니다. 다만 중앙 편집기는 토큰을 10–14%, 비용을 11–16% 덜 씁니다. 부록 G, 표 13
Controls for Compute and Context Capacity. 추가 추론량을 맞춘 표 14에서는 Terminal 중앙 편집기에 여러 수정 후보를 생성하게 합니다. 5.9B 토큰·2.90천 달러·38.8%에서 6.7B·3.35천 달러·45.5%로 오르지만, HERMES의 6.8B·3.40천 달러·51.8%보다 6.3pp 낮습니다. 저자들은 예산 차이가 격차 일부를 설명하지만 전부 설명하지는 못한다고 해석합니다. 이 표에 별도의 문맥 용량 확장 실험 수치를 제시한 것으로 읽지는 않습니다. 표 14
Efficiency of On-Demand Activation. 표 8의 고유 활성 파일 수와 표 15의 모델 호출 수는 다릅니다. 같은 파일 담당자를 통신·추가 수정 때문에 여러 번 호출할 수 있기 때문입니다.
| 벤치마크 | HERMES 평균 담당자 호출 | 필요 시 활성화 제거 | 제거 시 상대 비용 |
|---|---|---|---|
| SWE-bench | 9.6 | 28.7 | 1.61배 |
| Refactor | 25.1 | 64.3 | 1.88배 |
| Terminal | 14.2 | 39.6 | 1.73배 |
| DevOps | 11.7 | 33.2 | 1.67배 |
반복 호출을 모두 센 표 15의 결과입니다. 부록 G
이 대조군은 최초에 식별한 담당자를 계속 켜 두며, 활성화 메커니즘 전체나 위치 찾기 기능을 없앤 조건이 아닙니다. 필요 시 호출은 비용뿐 아니라 더 이상 필요하지 않은 구성요소의 개입을 줄이는 역할로 설명됩니다.
Run-to-Run Variation on SWE Refactor Bench. 20개 과제의 작은 평가 집합에서 기본 Sol 구성을 세 번 실행한 복합 점수는 29.5·32.0·31.5이며, 저자는 31.0±1.3으로 보고합니다. 이 분산 표시는 개별 궤적이 전체 점수에 영향을 주는 정도를 드러냅니다. 여러 기준선의 차이에 대한 유의성 검정을 대체하는 값은 아닙니다. 다음 부록은 숫자를 넘어 실제 구성요소와 메시지를 따라갑니다. 부록 G
📖 Chapter H: Case Study: A Complete HERMES Trajectory with Qwen3-8B
사례는 SWE-bench Verified의 django__django-13512입니다. JSONField의 비ASCII 문자가 Django 관리자 화면에서 원래 문자 대신 유니코드 이스케이프 형태로 보이는 문제를 다룹니다. 전체 모델을 Qwen3-8B로 둔 기본 예산 3의 성공 궤적입니다. 부록 H
Planning and activation. 최초 계획은 수정할 구성요소 네 개와 점검할 구성요소 두 개를 고릅니다.
| 역할 | 구성요소 | 최초 목표 |
|---|---|---|
| 수정 | db/models/fields/json.py |
JSONField 값 준비에서 비ASCII 문자 유지 |
| 수정 | forms/fields.py |
prepare_value의 문자 보존 |
| 수정 | forms/utils.py |
폼의 JSON 출력에서 ASCII 이스케이프 방지 |
| 수정 | core/serializers/json.py |
코어 직렬화의 문자 보존 |
| 점검 | forms/widgets.py |
렌더링 경로의 관련 조건 전달 |
| 점검 | utils/encoding.py |
공유 인코딩 조건 전달 |
부록 H의 표 16을 한국어로 옮겼습니다. 저장소 경로 앞의 공통 django/는 원문 표와 같이 생략했습니다. 표 16
Collaboration. 여섯 담당자는 15개의 지향성 메시지를 교환합니다. 위젯 담당자는 폼 필드 담당자에게 ensure_ascii=False를 써서 렌더링 시 문자를 유지하라는 조건을 전달하고, 모델 필드와 인코딩 담당자는 직렬화 담당자에게 동작 일관성을 요구합니다. 원문은 이 사례의 통신이 대체로 이미 선택한 방향을 확인·명시하는 역할이었다고 설명합니다. 메시지가 없었다면 반드시 실패했을 것이라는 새 주장을 덧붙이지 않습니다. 표 17
Local modification. 실제 수정된 파일은 여섯 개가 아니라 네 개입니다. 아래 한 줄은 원문이 제시한 forms/fields.py의 prepare_value 수정 내용을 옮긴 것으로, 새로운 실행 예제를 만든 것이 아닙니다.
1
json.dumps(value, ensure_ascii=False, cls=self.encoder)
출처: 부록 H의 Local modification · Jin 외, CC BY 4.0 · 원문 코드 발췌. 다른 세 수정 담당자도 각자의 JSON 처리 위치에 문자 보존 조건을 적용합니다. 두 점검 담당자는 파일을 바꾸지 않습니다.
Execution and diagnosis decision. 해결 중 접근 가능한 회귀 검사 407개는 수정 전과 같은 성공 종료 상태를 반환합니다. 그러나 자동 생성한 재현 시도 세 개는 Django 설정 단계에서 종료되어 실제 문제 동작에 도달하지 못했고 버려집니다. 따라서 진단에 전달된 것은 성공한 회귀 검사와 변경 내용·원래 이슈이지, 문제 재현이 실패에서 성공으로 바뀌었다는 믿을 만한 실행 신호가 아닙니다. 진단은 첫 라운드에 PASS를 반환해 추가 수정은 수행하지 않습니다. 부록 H
Held-out outcome. 종료 후 벤치마크 평가에서는 숨겨진 테스트 35개가 모두 통과하고 resolved=True가 됩니다. 저자 패치는 django/contrib/admin/utils.py와 django/forms/fields.py를 고치지만 HERMES는 전자를 활성화하지 않고 더 아래의 JSONField·직렬화 경로에서 같은 문자 보존 조건을 만족시킵니다. 즉, 실행 중 진단 통과와 최종 숨겨진 평가 통과는 별개 근거이며, 참조 패치 파일과의 겹침도 올바른 수리의 모든 경로를 포괄하지 않습니다. 이 사례는 4.4절 선택 지표의 해석 범위를 구체적으로 보여 줍니다. 부록 H
📖 Chapter I: Limitations
저자들이 명시한 한계는 추가 모델 호출·실행·반복 진단에 따른 비용과 지연, 이미 높은 기준선에서 작아지는 개선, 관련 구성요소 선택과 유익한 실행 피드백에 대한 의존입니다. 빠뜨린 의존성이나 빈약한 런타임 신호는 복구를 제한할 수 있습니다. 기본 단위를 파일로 정했고 네 소프트웨어 벤치마크에서 평가했다는 범위도 명시합니다. 부록 I
더 세밀한 단위와 더 넓은 소프트웨어 작업은 저자가 후속 대상으로 적은 항목입니다. Qwen3-8B의 로컬 Ollama 설정과 다른 모델의 공식 API 접근 차이, 배포 설정·모델 갱신에 따른 변동 가능성도 함께 적습니다. 이 부록은 모델·실행 환경·측정 범위를 고정한 연구 결과를 어디까지 해석할 수 있는지 설명하며 원문을 마무리합니다.
실험 결과 심층 분석
결과는 같은 모델로 하네스를 바꾼 차이, 역할별 모델 배정을 바꾼 차이, 기능을 제거한 차이로 나누어 읽는 것이 유용합니다. 첫 비교는 HERMES가 특정 모델의 능력을 소프트웨어 작업에 어떻게 연결하는지, 두 번째는 비용을 어디에 배분할지, 세 번째는 어떤 연결이 기여했는지를 다룹니다. 중앙 편집기를 같은 파일 집합과 거의 같은 추론 예산으로 비교한 부록 G는 이 세 번째 질문을 더 좁게 검사합니다. §4 · 부록 G
기본 Sol medium의 네 지표 평균 12.4pp보다 구체적인 판단에는 개별 지표가 중요합니다. SWE-bench의 기본 Sol 개선은 0.8pp인 반면 Refactor 복합 점수는 24.5pp 오릅니다. 추가 협업이 언제나 같은 이득을 주는 것도, 비용을 절감하는 것도 아닙니다. Terminal의 작은 수정 모델 구성은 전체 Sol보다 낮은 점수로 비용을 줄인 절충이며, 작은 모델만을 사용한 27.6%와 강한 활성화·진단을 붙인 50.6%를 같은 결과로 부를 수 없습니다. 표 1–7
불확실성 표기도 통일된 종류가 아닙니다. SWE-bench 표 1의 ±는 500개 인스턴스에 대한 표준오차이고, Terminal 표 3은 다섯 실행의 표준편차입니다. Refactor의 31.0±1.3은 세 반복의 변동입니다. 이 논문에는 직접 대조 차이에 대한 별도의 유의성 검정이나 신뢰구간이 보고되지 않았습니다. 따라서 보고된 성능 차이와 통계적으로 유의하다는 주장을 구분합니다. 표 1 · 표 3 · 부록 G
재현성에 대해서는 프롬프트 템플릿, 반복 예산, 모델 배정, 샘플링·문맥 설정, 비용 집계 범위, 숨겨진 평가와의 격리를 확인할 수 있습니다. 이 리뷰는 고정 원문의 명세와 결과를 분석했으며 HERMES를 직접 실행하거나 결과를 재현한 것은 아닙니다. 인용된 각 외부 기준선의 원 논문과 현재 리더보드를 모두 재감사한 것으로도 표현하지 않습니다. 부록 C–F
기술적 함의와 응용
HERMES에서 배울 설계 원칙은 변경의 책임을 산출물에 붙이고, 그 변경이 다른 산출물에 요구하는 조건을 명시적으로 전달하는 것입니다. 파일 목록을 잘 고르는 것만으로 협업이 완성되지는 않고, 많은 모델 호출만으로 올바른 실행 결과가 보장되지도 않습니다. 원문은 같은 파일을 주는 중앙 편집기 대조와 실행·진단 제거 실험으로 이 차이를 확인합니다. 부록 G · §4.5
리뷰어 해석으로, 이 구조는 저장소 전체를 한 번에 잘 이해하는 모델에 모든 책임을 몰아주는 설계와 다른 자원 배분 방식을 제공합니다. 파일별 수정은 작은 모델이 수행하되 범위를 정하고 실패를 귀속하는 역할에 강한 모델을 배정할 수 있습니다. 다만 실제 적용의 비용 판단에는 최종 정확도뿐 아니라 활성화·통신·진단의 전체 호출과 검증 환경을 함께 포함해야 합니다. 이 조건은 논문의 비용 집계와 역할별 모델 실험에서 직접 드러납니다. §4.3 · 부록 F.8
Django 사례는 마지막 경계도 보여 줍니다. 회귀 검사가 통과했다는 사실, 진단이 종료를 승인했다는 사실, 숨겨진 과제 평가가 통과했다는 사실은 각각 별도의 근거입니다. HERMES의 핵심은 이들을 섞는 데 있지 않고, 지역 변경을 실제 실행과 연결하고 그 결과를 다음 책임자에게 돌려주는 하네스를 구성한 데 있습니다. 부록 H