논문 개요와 전체 구조
에이전트가 웹 검색을 반복하다 작업을 끝내지 못했다고 가정해 보겠습니다. 같은 세션에서 “이미 찾은 자료를 정리하고 다른 도구를 써 보라”고 알려 주면 다음 시도는 나아질 수 있습니다. 그러나 새 세션에서 같은 실수를 피하려면 그때의 교훈을 다시 전달해야 합니다. 이 논문은 실패한 실행을 돌아보고 만든 교정 예제를 작은 모델 어댑터에 학습해, 이후에도 꺼내 쓸 수 있게 하는 Self-Direction을 제안합니다. 원문 §1
여기서 교훈은 정답 문장을 저장한 메모와 다릅니다. 모델은 자신이 어떤 절차를 잘못 적용했는지 살펴보고, 관련 상황에 적용할 instruction–response 예제를 합성합니다. 그 예제로 저랭크 어댑터 하나를 학습하고 작업 설명을 검색 키로 등록합니다. 최초 실행은 항상 원래 모델로 하고, 실패했을 때만 저장한 어댑터를 찾거나 새로 학습합니다. 이 순서가 즉시 복구와 이후 재사용, 원래 능력 보존을 연결합니다. §3.3 · 부록 F
리뷰 기준은 2026년 10월 22일 제출된 arXiv v1의 HTML과 42쪽 PDF입니다. 원문 그림의 번호와 쪽수는 PDF 캡션을 기준으로 표시했습니다. 고정 버전 서지 · 고정 PDF
| 원문 순서 | 다루는 질문 |
|---|---|
| §1–2 | 실패에서 배운 내용을 어디에 보관할 것인가 |
| §3 | 교정 비교 실험과 Self-Direction 학습·검색·재시도 루프 |
| §4 | 세 영역의 성능, 반복 실패, 기존 능력 보존, 새 과제 전이 |
| §5 | 결론과 명시된 한계 |
| 부록 A–E | 관련 연구 확장, 브라우저 평가, 상세 결과, 강한 기반 모델, 모듈화 분석 |
| 부록 F–J | 실행·학습 설정, 프롬프트, 전이 사례, 합성 예제, SVD 초기화 |
핵심 기여와 혁신성
저자들이 다루는 문제는 현재 과제의 복구가 다음 과제의 학습으로 이어지지 않는다는 점입니다. 텍스트 반성은 빠르게 만들 수 있지만 문맥에서 검색·선택해야 하고, 모든 이력을 넣으면 입력 길이가 커집니다. 전체 모델을 미세조정하면 경험이 가중치에 남지만, 학습 비용과 기존 파라미터에 미치는 영향을 함께 관리해야 합니다. Self-Direction은 실패 하나마다 별도의 LoRA 교훈을 두고 필요할 때 선택하는 방식으로 이 간극을 다룹니다. §1–2
독창성은 LoRA 자체보다 검증된 실패를 개입 시점으로 삼고, 자기 반성에서 나온 교훈을 분리된 어댑터로 누적하는 운영 루프에 있습니다. 같은 기반 모델이 작업 수행과 예제 합성에 사용되며, 정답이나 숨은 테스트를 반성 입력으로 전달하지 않습니다. 논문은 즉시 성공률뿐 아니라 같은 실패의 재발 방지와 새로운 과제에서의 재사용을 따로 평가합니다. §3.3 · §4.2–4.4 · 부록 F.2
기술적 세부사항
어댑터는 큰 가중치 행렬에 작은 저랭크 수정량을 더합니다. Self-Direction은 기반 모델과 기존 교훈을 고정하고 새 어댑터의 한 인자만 학습합니다. 라이브러리에는 어댑터와 원래 과제 설명의 문장 임베딩을 함께 저장합니다. 이 임베딩은 텍스트의 의미를 벡터로 나타낸 값이며, 새로 실패한 과제와 유사한 교훈을 찾는 데 쓰입니다. 선택 임계값보다 충분히 가까운 항목이 없고 라이브러리에 자리가 남아 있으면 새 교훈을 만듭니다. §3.3 · 부록 F.5·J
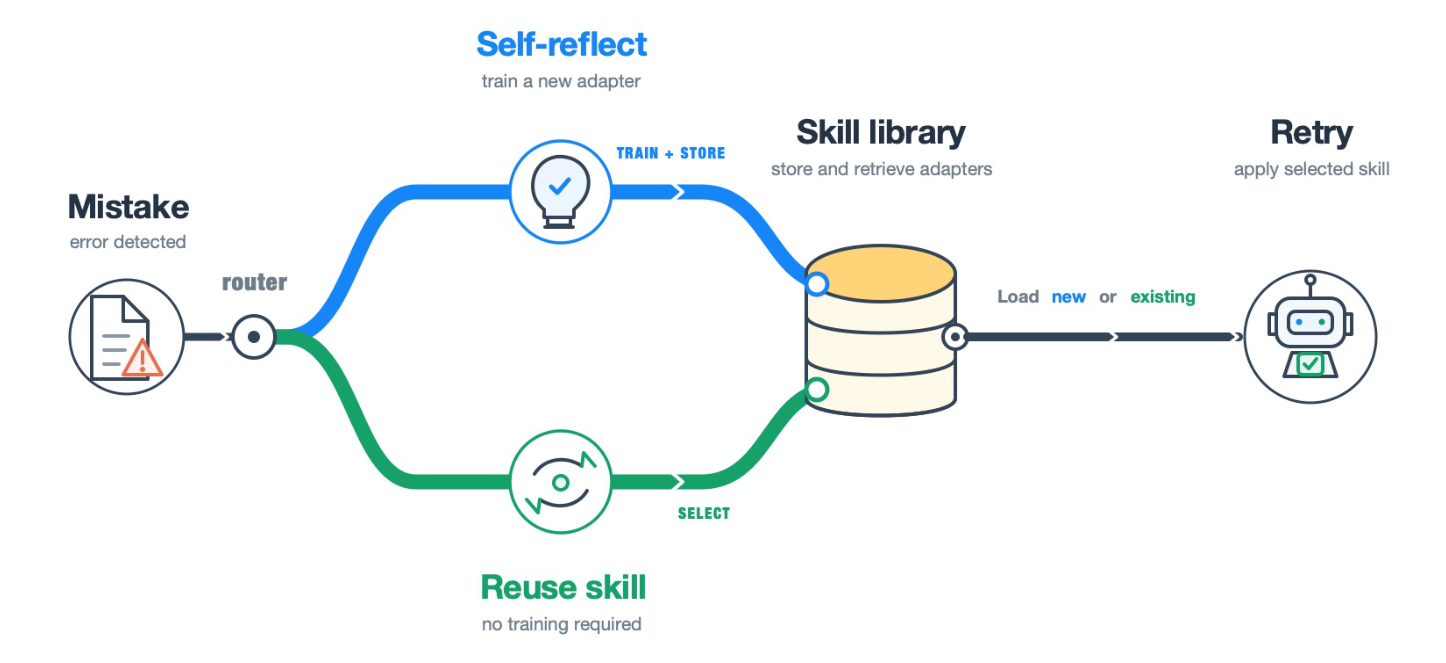
위쪽은 자기 반성과 새 어댑터 학습, 아래쪽은 기존 교훈 재사용 경로입니다. Kansal 외, 그림 3 · PDF 5쪽, 원문 크롭 · CC BY 4.0
이 설계는 “새 파라미터를 학습해도 원래 가중치를 덮어쓰지 않는다”는 저장상의 성질과, “선택된 어댑터가 이후 과제의 출력을 해치지 않는다”는 경험적 문제를 구분해야 이해할 수 있습니다. 잘못 연결된 어댑터는 성능을 낮출 수 있습니다. 그래서 논문은 검색 임계값, 실패 뒤에만 개입하는 순서, 어댑터를 내린 뒤의 기반 모델 재시도를 함께 분석합니다. §4.3 · 부록 E.1·C.8
챕터별 상세 리뷰
📖 Chapter 1: Introduction
서론은 같은 실수를 다시 고치는 비용에서 출발합니다. 긴 작업에는 도구 사용과 판단이 여러 번 필요하고, 한 번의 반성이 현재 세션을 고쳐도 다음 세션의 행동을 바꿨는지는 별개의 문제입니다. 저자들은 교훈을 문맥·하네스·가중치에 보관하는 접근을 비교하며 지속적인 개선에 필요한 조건을 제시합니다. 하네스는 모델을 호출하고 도구·문맥·상태를 관리하는 실행 구조를 뜻합니다. §1
이어서 Self-Direction의 세 주장을 소개합니다. GAIA·Claw-Eval·Terminal-Bench 2.1에서 실패 복구를 개선하고, 같은 과제의 반복 조우에서도 교정을 더 자주 유지하며, 제한된 교훈 라이브러리를 관련 새 과제에 재사용할 수 있다는 것입니다. 이후 장은 이 세 종류의 결과를 각각 다른 실험으로 확인합니다. §1, PDF 2–3쪽
📖 Chapter 2: Related Work
문맥에 남긴 교훈. Reflexion·ExpeL·CLIN 등은 반성이나 절차를 외부 메모리에서 찾아 입력에 넣습니다. 모델을 갱신하지 않아 빠르게 적용할 수 있지만, 필요한 경험을 매번 선택하고 제한된 문맥 안에서 전달해야 합니다. 논문은 텍스트 길이와 프롬프트 구성에 민감한 점을 기존 연구와 연결합니다. §2
하네스에 남긴 교훈. 프롬프트·도구·메모리·실행 코드를 바꾸는 연구는 같은 모델이 더 효과적으로 일하도록 돕습니다. 이 논문은 실패를 계기로 삼는 점을 공유하면서 교정 내용을 정책 파라미터에 모듈로 저장하는 방향을 택합니다. 가중치에 남긴 교훈을 다루는 마지막 부분에서는 전체 미세조정, 실패 자료 학습, Test-Time Training과 비교합니다. Self-Direction의 구분점은 확인된 실패에 반응하고, 더 강한 외부 교사 없이 예제를 생성하며, 교훈을 이후 검색할 수 있게 남기는 조합입니다. §2
📖 Chapter 3: Learning from Mistakes
3.1 Existing Paradigms for Repairing Mistakes
같은 실패를 복구하는 네 방식을 비교합니다. 기반 모델에서 독립적으로 다시 뽑는 resampling은 성공 기회를 늘립니다. 반성을 문맥에 넣으면 다음 행동을 안내합니다. 반성을 가중치에 학습하면 어댑터를 다시 불러 쓸 수 있습니다. Skills.md 방식은 여러 반성을 공유 Markdown 파일에 요약해 넣고 다음 작업의 입력에 사용합니다. 비교의 축은 현재 복구에 쓰인 경험이 어디에 남아 이후 행동에 관여하는가입니다. §3.1
3.2 Experimental Setup and Evaluation on GAIA
주 실험의 기반 모델은 Qwen3.6-27B이고, 도구의 실행 결과를 관찰한 뒤 다음 행동을 정하는 ReAct 루프를 사용합니다. GAIA 검증 과제는 165개로 난이도 1·2·3이 각각 53·86·26개입니다. 웹 검색·가져오기, Python, 셸, 파일 도구를 사용할 수 있고 최종 짧은 답을 참조와 대조합니다. Claw-Eval은 행동 로그·상태·산출물과 평가자를 함께 쓰며, Terminal-Bench는 새 컨테이너에서 종료 후 숨은 테스트로 검증합니다. 최종 문장만 맞으면 되는지와 행동까지 맞아야 하는지가 벤치마크마다 다릅니다. §3.2
평가에서는 pass@k와 $\mathrm{pass}^{k}$를 구분합니다. 앞의 값은 독립 실행 k번 중 한 번 이상 성공한 과제 비율이고, 뒤의 값은 k번 모두 성공한 비율입니다. 여러 번 시도해 풀 수 있는 범위와 매번 안정적으로 푸는 정도를 나누어 보는 것입니다. §3.2
| GAIA, 동일 초기 실행에서 시작 | 성공률 |
|---|---|
| 최초 기반 모델 | 38.8% · 64/165 |
| 기반 모델 pass@3 | 49.7% |
| 문맥에 반성 삽입 | 45.5% |
| Skills.md에 반성 누적 | 53.3% |
| Self-Direction 전체 루프 | 55.8% · 92/165 |
표는 PDF 그림 2와 부록 C.9에서 대조했습니다. Self-Direction은 최초 실패 101개 중 어댑터로 21개, 기반 모델 fallback으로 7개를 추가 해결했습니다. 따라서 17.0%포인트 개선 전체를 어댑터 한 번의 효과로 해석하면 안 됩니다. 부록 C.2의 100단계 실행은 더 긴 순차 예산을 준 참고 비교입니다. PDF 4쪽, 그림 2 · 부록 C.2·C.9
3.3 The Self-Direction Loop
실패가 확인되면 같은 모델이 궤적을 읽어 절차적 instruction–response 예제를 최대 24개 합성합니다. 도구를 어떤 순서로 쓰고 무엇을 확인해야 하는지 가르치는 짧은 예제이며, 과제 환경에서 끝까지 다시 실행한 rollout과 구분됩니다. 적어도 유효 예제 8개가 있어야 학습을 시작합니다. 더 강한 외부 모델이 교정 답안을 제공하는 구조는 사용하지 않습니다. §3.3 · 부록 F.2
학습할 행렬의 오른쪽 특이벡터에서 LoRA의 인자 $A$를 초기화해 고정하고, 0에서 출발하는 $B_i$만 최적화합니다. 기반 모델은 그대로 두고 새 교훈 i에 해당하는 수정량만 학습합니다. 왜 이 초기화가 업데이트를 작게 제한하는지는 부록 J에서 수식으로 설명합니다. §3.3
저장한 교훈을 재사용할 때는 all-MiniLM-L6-v2의 과제 설명 임베딩을 비교합니다. 일치도가 임계값 $\tau$보다 낮으면 새 교훈 학습을 검토합니다. 어댑터 재시도가 실패하면 이를 완전히 내리고 기반 모델로 한 번 더 시도합니다. 아래는 부록 F.5의 흐름을 정리한 설명용 의사코드입니다. §3.3 · PDF 33쪽
1
2
3
4
5
6
7
8
9
입력: 최초 기반 모델 실행이 실패한 과제와 궤적, 교훈 라이브러리
가장 유사한 과제 설명의 교훈을 검색
교훈이 없거나 유사도가 임계값보다 낮으면:
    라이브러리 용량이 남아 있으면 반성·예제 합성·새 어댑터 학습
    용량이 가득 차 있으면 새 학습 생략
사용할 교훈이 있으면 어댑터를 올려 새 환경에서 재시도
어댑터를 내림
아직 실패했다면 원래 모델과 재시도 지시로 마지막 실행
출력: 최종 성공 여부, 저장된 교훈
📖 Chapter 4: Results
4.1 Self-Direction Repairs Mistakes Across Various Task Types
Claw-Eval 161개와 Terminal-Bench 89개를 각각 세 번 독립 실행했습니다. Claw-Eval의 평균 성공률은 64.4±3.6%에서 73.3±2.8%로, Terminal-Bench는 51.7±4.1%에서 65.5±0.6%로 올랐습니다. ±는 실행 간 표본 표준편차이며 신뢰구간과 구분됩니다. GAIA의 17.0%포인트 개선과 함께 과제 영역이 달라도 교정 루프가 추가 성공을 만든 결과입니다. §4.1 · PDF 7쪽
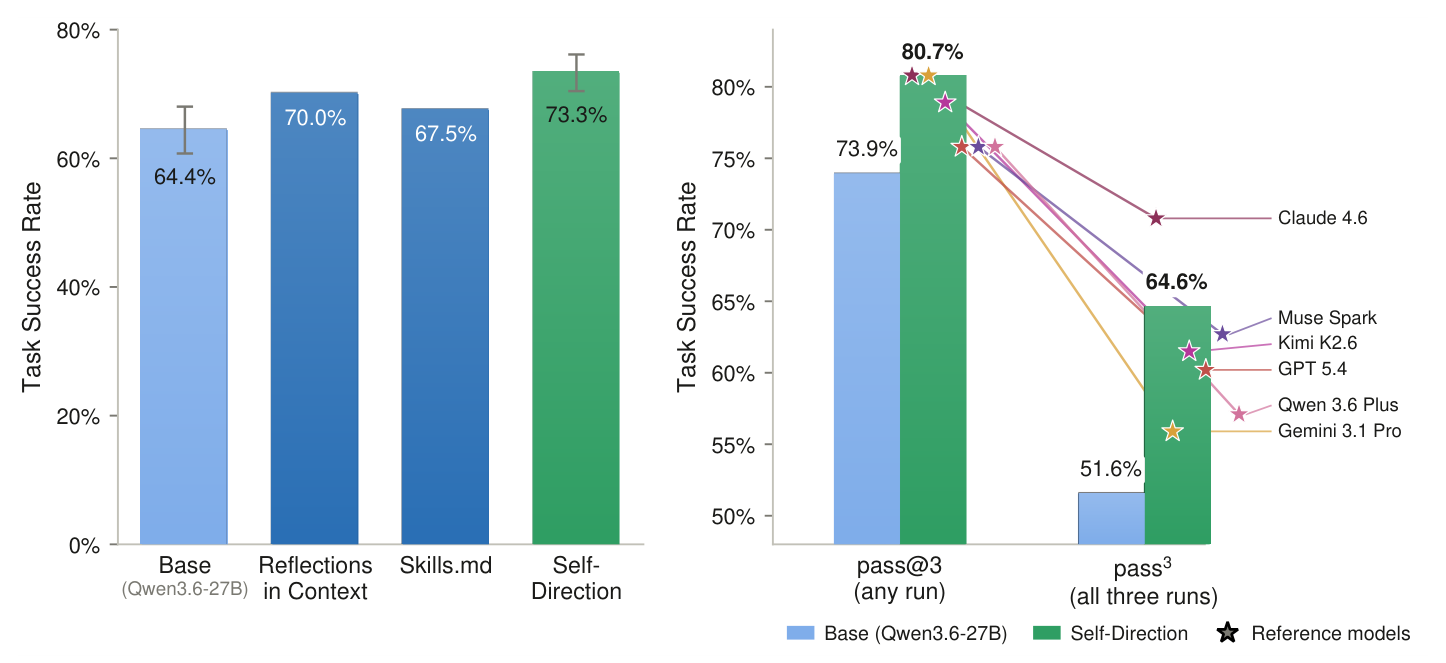
왼쪽은 평균 성공률, 오른쪽은 한 번 이상 성공한 pass@3과 세 번 모두 성공한 pass³입니다. 별 표시는 외부 보고 시스템의 참고값입니다. Kansal 외, 그림 4 · PDF 7쪽, 원문 크롭 · CC BY 4.0
공식 벤치마크의 프런티어 모델 수치도 함께 놓지만, 프롬프트·도구·종료 조건·재시도 정책이 다른 시스템의 보고값입니다. 저자들은 부록 C.3에서 이 점을 명시합니다. 같은 기반 모델과 하네스 안에서 교정 루프를 추가한 비교와, 외부 시스템의 점수를 나란히 보는 비교를 구별해야 합니다. §4.1 · 부록 C.3
4.2 Learned Lessons Prevent Repeated Mistakes
GAIA 101개, Terminal-Bench 44개, Claw-Eval 40개의 과거 실패 185개를 다시 만나는 실험입니다. 각 조우에서 두 방식 모두 최대 두 번의 전체 실행을 받습니다. 모든 조우에서 성공한 실패의 비율을 mistakes avoided, 첫 조우에서 고친 것 중 이후에도 계속 성공한 비율을 corrections preserved로 계산합니다. 아래 표는 원문 표 1의 통합 행입니다. §4.2 · PDF 9쪽, 표 1
| 세 번 조우까지의 지표 | 기반 모델 재시도 | Self-Direction |
|---|---|---|
| 세 번 모두 해결한 과거 실패 비율 | 9.7% | 18.9% |
| 첫 교정 성공 중 두 번째까지 유지 | 52.4% | 76.9% |
| 첫 교정 성공 중 세 번째까지 유지 | 42.9% | 67.3% |
18.9%는 전체 185개가 분모이고, 67.3%는 첫 조우의 교정 성공이 분모입니다. 후자를 전체 과제 성공률로 읽으면 의미가 달라집니다. 별도로 매 실행마다 전체 학습 루프를 새로 실행한 Terminal-Bench 세 번 캠페인에서는 pass@3이 64.0%→74.2%, pass³가 34.8%→57.3%였습니다. 그 캠페인과 하나의 저장된 교훈을 반복 활용하는 실험은 학습·실행 단위가 다릅니다. §4.2 · PDF 8쪽, 그림 5
4.3 Self-Direction Learns New Lessons Without Impacting Existing Capabilities
보존을 위한 첫 장치는 최초 시도를 언제나 수정되지 않은 기반 모델에 맡기는 것입니다. 이미 성공한 작업에 어댑터를 미리 적용하지 않습니다. 둘째는 기반 모델과 기존 어댑터의 파라미터를 고정하는 구조입니다. 이 상태에서 새 어댑터 학습은 기존 저장값을 덮어쓰지 않습니다. §4.3
그러나 재시도에서 어떤 교훈을 고르느냐는 여전히 중요합니다. $\tau=1$이면 같은 과제에 해당하는 교훈만 재사용하고, 더 작은 임계값이면 비슷한 새 과제에서도 고를 수 있습니다. 부록 C.8은 다른 벤치마크의 교훈이 잘못 검색되지 않을 임계값과, 이를 낮췄을 때 실제 복구 성능을 별도로 살펴봅니다. 논문은 매우 낮은 임계값에서 도움이 되거나 해가 되는 전이가 나타날 수 있다고 보고합니다. §4.3 · 부록 C.8
4.4 Learned Lessons Transfer to Unseen Tasks Across Difficulties and Types
세 전이 실험은 라이브러리를 언제 학습하고 무엇을 고정했는지가 다릅니다. 첫째는 GAIA 165개를 섞어 순차로 만나며 처음부터 라이브러리를 채우는 배포 흐름입니다. 용량을 어댑터 세 개로 제한한 설정에서 성공률은 36.4%→52.7%였고, 저장 라이브러리는 약 256MB입니다. 이 초기 성공률은 앞의 진단 GAIA 실행 38.8%와 같은 실행으로 취급하지 않습니다. §4.4 · 부록 C.1·C.7
둘째는 쉬운 Level 1 실패에서 학습한 어댑터 28개를 고정하고, 보지 않은 Level 2 과제 86개를 평가하는 실험입니다. 초기 35개 성공에 9개 복구를 더해 40.7%→51.2%가 됐습니다. 셋째는 Claw-Eval operations 과제에서 만든 어댑터 세 개만 고정해 새 workflow 과제 24개에 사용합니다. 초기 18개 성공 후 남은 6개 중 3개를 복구해 75.0%→87.5%가 됐습니다. 뒤의 두 실험은 평가 과제에서 새 교훈을 학습하지 않았습니다. §4.4 · PDF 17쪽, 표 3
📖 Chapter 5: Conclusion
저자들은 경험을 분리된 가중치 교훈으로 누적하는 방식이 지속적인 자기 개선, 개인화, 특화, 보안 취약점 패치 등에 활용될 가능성을 제시합니다. 어떤 교훈을 텍스트·하네스·가중치에 보관할지 선택하고 여러 교훈을 합성하는 문제를 후속 방향으로 듭니다. §5
명시된 한계는 실패 감지와 자원입니다. 자체 평가·평가자·사용자 등으로 실수가 확인돼야 루프가 시작됩니다. 학습에는 추론 외 GPU와 저장 공간이 더 필요하며, 가중치 교훈은 모델에 종속됩니다. 텍스트 반성은 다른 모델로 옮기고 사람이 읽기 쉽다는 장점이 있습니다. 저자들은 충분한 학습 자원이 생길 때까지 텍스트 교훈을 저장해 둘 수도 있다고 설명합니다. §5, Limitations
📖 Chapter A: Expanded Related Work
부록은 본문과 같은 순서로 문맥·하네스·가중치 기반 교훈을 확장합니다. 문맥 방식에는 자기 비평, 반성 기반 프롬프트 최적화, 스킬 메모리 갱신 등을 놓습니다. 하네스 방식에는 에이전트 코드나 구성의 자동 탐색·수정·누적을 놓습니다. 이 비교에서 저자들은 Self-Direction을 모든 저장 매체의 대체물로 두기보다 정책 수준의 교훈을 추가하는 방식으로 위치시킵니다. 부록 A
가중치 기반 비교에서는 PiSSA와의 차이를 설명합니다. PiSSA는 주요 특이 성분을 학습 대상으로 삼고 원래 가중치를 잔여분으로 재구성합니다. Self-Direction은 원래 행렬을 그대로 둔 채 고정된 스펙트럼 인자에 새 계수만 학습합니다. 또 외부 정답·참조 패치를 교사에게 줄 때의 정보 비대칭과, 매 에피소드 뒤 폐기하는 Test-Time Training을 비교해 실패 조건부 영속 라이브러리의 범위를 설명합니다. 부록 A
📖 Chapter B: Additional Browser and Computer-Use Benchmarks
B.1 MiniWoB++
브라우저 실험은 화면 픽셀 대신 안정된 요소 식별자가 포함된 접근성 트리를 줍니다. 기본 모델의 성능이 이미 포화된 과제는 제외하고, 소셜미디어 다중 선택·접기 UI·이메일 두 유형에서 각 25개씩 평가했습니다. 초기 성공은 42/100, 기반 모델 세 번 중 한 번 이상 성공은 55/100, Self-Direction 전체 루프는 54/100입니다. 이 설정에서는 기반 모델 pass@3보다 높은 성공을 보인 것이 아니라 비슷한 범위에 도달하면서 교훈을 남긴 결과입니다. 부록 B.1, 표 2
📖 Chapter C: Expanded Results Across Benchmarks
C.1–C.2 · 전이와 GAIA 난이도별 복구
표 3은 본문의 세 전이 설정을 한곳에 모읍니다. 이어 GAIA를 난이도별로 나누면 초기 25/53→최종 35/53, 31/86→46/86, 8/26→11/26입니다. 세 수준에서 모두 추가 성공이 생겼습니다. 그림 6은 50단계와 100단계 예산, 실패 궤적 삽입, 반성, Skills.md, 어댑터 비교를 펼치지만 더 긴 예산을 준 실험을 동일 실행 비용 비교로 간주하지 않습니다. 부록 C.1–C.2
C.3–C.4 · 세 번과 여덟 번의 독립 실행
Claw-Eval 161개에서 세 번의 평균은 앞의 73.3%이고, pass@3은 80.7%, pass³는 64.6%입니다. Terminal-Bench는 여덟 번의 더 큰 캠페인도 실행했습니다. 이때 초기 평균은 51.8%, 최종은 64.0%로 본문의 세 번 평균 65.5%와 집계 범위가 다릅니다. 89개 중 여덟 번 모두 성공한 과제는 23개에서 43개로 늘었고, 처음부터 8/8 성공하던 23개는 계속 성공했습니다. 부록 C.3–C.4
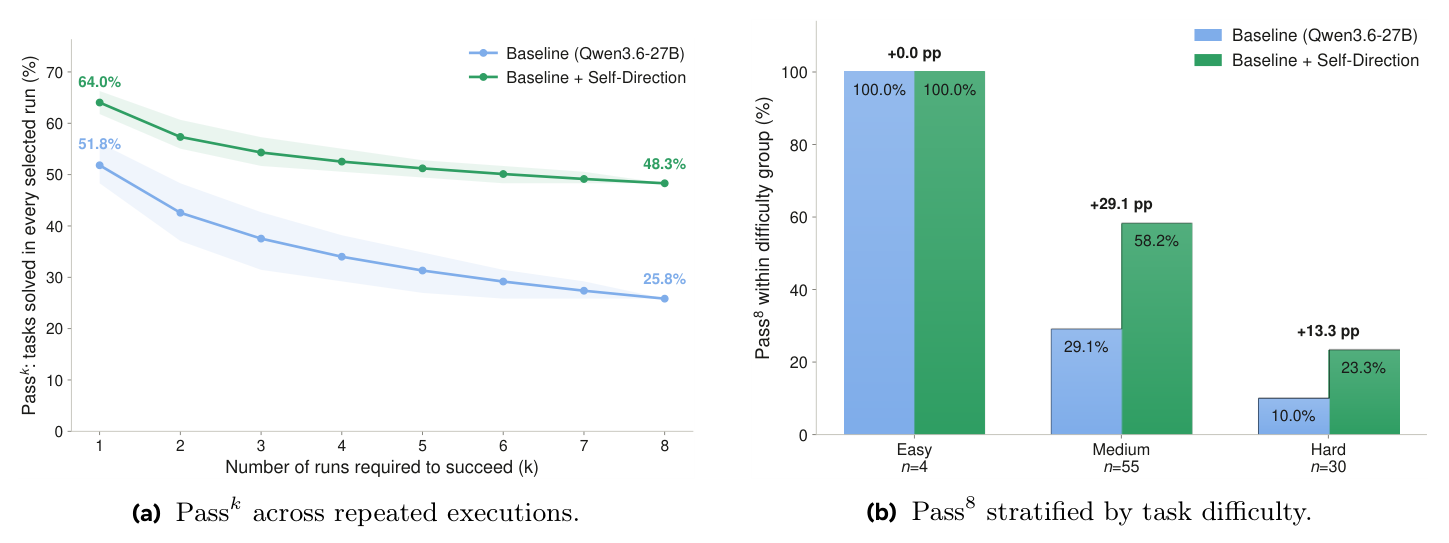
왼쪽은 k번 모두 성공한 과제 비율이며 띠는 실행 부분집합의 최솟값·최댓값입니다. 오른쪽은 난이도별 pass⁸입니다. Kansal 외, 그림 9 · PDF 24쪽, 원문 크롭 · CC BY 4.0
여덟 실행 모두에서 새 학습 루프를 수행했으므로, 이 캠페인 자체가 기반 모델과 총 연산량을 맞춘 반복 교훈 보존 시험은 아닙니다. 저장된 교훈 재조우 시험은 §4.2에서 별도로 수행합니다. 추가 Qwen3.5-9B 결과는 23/89의 최초 성공에서 최종 31/89로 늘었습니다. 부록 C.4, 표 4
C.5 · 난이도·범주·실행 구조별 결과
Claw-Eval의 Workflow 47개에서는 평균 78.7%→87.9%, pass³ 61.7%→78.7%였습니다. 여러 서비스에 걸친 60개에서는 평균 80.6%→91.1%였습니다. 서비스 수·상태 변경·안전 중심 여부는 각각의 이진 속성이므로 속성 행들을 서로 배타적인 과제 분류처럼 합산하면 안 됩니다. PDF 19쪽, 표 5
Terminal-Bench의 쉬운 4개는 원래부터 모두 성공했고, 보통 55개의 평균은 62.4%→78.2%, 어려운 30개는 25.6%→37.8%였습니다. 데이터 과학·시스템 관리 등 여러 범주의 결과도 보고하지만, 저자들은 5개 미만의 작은 범주는 기술적으로 읽도록 명시합니다. PDF 20쪽, 표 6
C.6 · 과제 환경 실행 횟수 통제
GAIA는 평균 2.10 rollout으로 55.8%에 도달했고 기반 모델 pass@6과 같은 성공률을 냈습니다. Terminal-Bench 예시 실행은 평균 1.90 rollout에서 66.3%, Claw-Eval은 1.54 rollout에서 75.8%였습니다. 이 rollout 수는 과제 환경에서 에이전트를 실행한 횟수이며 반성·예제 합성·어댑터 최적화 비용을 포함하지 않습니다. 본문 평균과 개별 예시 실행을 구별해야 합니다. 원문의 Terminal-Bench 기반 pass@3은 부록 C.6 본문에 65.3%, 그림 10(b) 라벨에 64.0%로 다르게 적혀 있습니다. 이 글에서는 둘을 하나의 수치로 통일하지 않았습니다. 부록 C.6 · PDF 24쪽, 그림 10
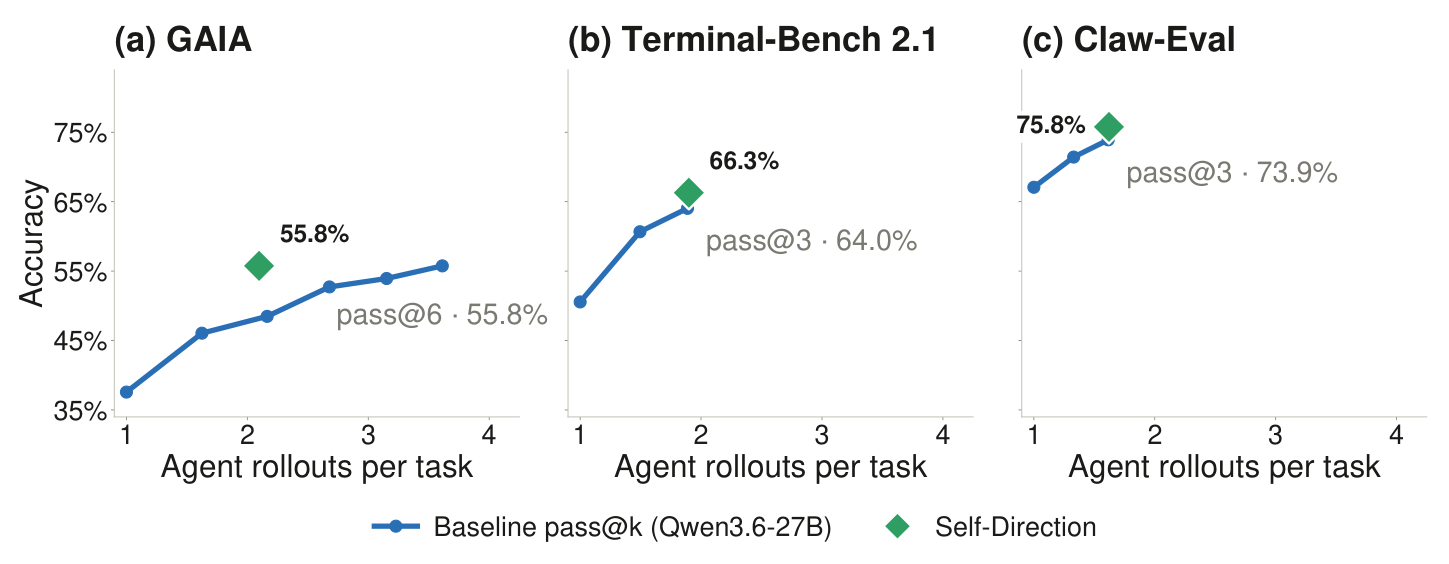
세 패널은 과제 환경 rollout만 비교합니다. 반성·합성·학습 비용은 별도 측정했습니다. Kansal 외, 그림 10 · PDF 24쪽, 원문 크롭 · CC BY 4.0
C.7–C.8 · 라이브러리 크기와 검색 경계
배포 흐름에서 3·6·12개 어댑터 라이브러리를 만들었을 때 저장 크기는 각각 약 256·383·895MiB였습니다. 기존 교훈을 골라 새 학습을 피한 초기 실패의 비율은 97.1·93.5·88.7%였고, 각각의 성공적 재사용은 18/102·7/86·16/94였습니다. 학습을 피했다는 비율과 재사용 성공률은 서로 다른 지표입니다. PDF 25쪽, 그림 11
표 7은 벤치마크 간 과제 설명의 최대 유사도와 이를 넘는 임계값을 제시합니다. 전체 최대 유사도 0.546을 넘는 $\tau=0.55$에서는 조사한 370건 중 타 도메인 교훈을 불러온 경우가 0건이었습니다. 이는 관찰한 과제에서 교차 검색을 차단한 결과이며, 모든 새 과제에 같은 임계값이 안전하다는 보장은 아닙니다. 실제 타 도메인 어댑터를 적용하는 낮은 임계값 실험에서는 도움이 되거나 성능이 낮아지는 경우가 함께 나타났습니다. 부록 C.8, 표 7·그림 12
C.9 · GAIA 통계 검정
분석 단위는 실행 횟수가 아니라 개별 GAIA 과제입니다. 최초 성공 여부 $B_i$와 전체 루프의 최종 성공 여부 $S_i$를 0·1로 두고 차이 $D_i=S_i-B_i$를 구합니다. 165개 중 64개는 둘 다 성공, 28개는 루프 후 새 성공, 73개는 둘 다 실패했습니다. 부록 C.9
$s_D$는 165개 차이의 표본 표준편차입니다. 저자의 짝지은 t 검정은 t(164)=5.79, 양측 p=3.50×10⁻⁸이고 정확도 개선의 95% 신뢰구간은 [11.2, 22.8]%포인트입니다. 이 검정과 구간은 GAIA의 초기 실행 대 전체 루프 비교에 대응합니다. 부록 C.9, PDF 21쪽
📖 Chapter D: Self-Direction with a Stronger Base Model
같은 과제 집합에서 Qwen3.8-27B로 기반 모델을 바꿔도 추가 복구가 관찰됐습니다. GAIA 59.4%→75.8%, Claw-Eval 64.6%→76.4%, Terminal-Bench 55.1%→73.0%입니다. 본문 주 모델의 세 번 평균과 바로 합쳐 읽지 않고 이 부록의 해당 실행 결과로 읽습니다. 저자들은 같은 계열의 능력 수준이 다른 두 모델에서 유용성을 확인했다고 설명하고, 더 넓은 모델 계열·규모로의 일반화는 후속 방향으로 남깁니다. 부록 D, 그림 13
📖 Chapter E: Why Self-Direction Uses Modular In-Weight Lessons
E.1 Lesson Specificity and Recovery
GAIA 초기 실패를 복구한 비율은 전체 루프 27.7%, 가우시안 초기화의 동적 LoRA 22.2%, 실패 경험을 하나로 모은 LoRA rank 16에서 16.7%, rank 64에서 14.6%였습니다. 가장 유사하지 않은 어댑터를 의도적으로 고르면 9.6%로 내려갔습니다. 단순히 파라미터를 더 넣는 효과보다 교훈과 실패의 정합성이 중요하다는 것이 저자 해석입니다. 부록 E.1, 그림 14
E.2 Why Not Place Every Lesson in Context?
101개 GAIA 실패에서 얻은 교정 예제 2,428개는 instruction–response만 약 362k토큰, 형식과 rationale까지 합치면 약 410k토큰입니다. 원문 전체 실패 궤적은 2.72M토큰이고 교훈까지 합치면 3.13M토큰입니다. 모델의 기본 문맥 262,144토큰과 비교해 전체 이력이 얼마나 커지는지 계산한 용량 분석입니다. 부록 E.2, 표 8
이 결과는 모든 텍스트 교훈을 매번 넣기 어렵다는 뜻으로 읽어야 합니다. 필요한 일부를 검색·요약하는 Skills.md 방식도 본문에서 복구에 도움이 됐습니다. Self-Direction 역시 모든 어댑터를 동시에 넣지 않고 검색으로 하나를 고릅니다. 부록 E.2
📖 Chapter F: Agent Execution and Training Hyperparameters
F.1 Agent Generation and ReAct Execution
생성 temperature 0.6, top-p 0.95, 턴당 최대 새 토큰 16,384를 공통으로 씁니다. 최대 ReAct 단계는 GAIA·Claw-Eval 50, Terminal-Bench 100이고 도구 호출 상한은 모두 100입니다. 초기·어댑터·fallback의 생성 설정은 같습니다. 턴마다 적용되는 생성 토큰 상한과 과제 전체의 행동 예산은 단위가 다릅니다. 부록 F.1, 표 9
F.2 Adapter Synthesis and Training
교정 예제 8–24개, rank 16, LoRA scaling α=16, dropout 0.05, 학습률 5×10⁻⁴, 2 epoch를 사용합니다. 장치당 배치 1에 gradient accumulation 8이며 BF16과 gradient checkpointing을 사용합니다. 반성에 남기는 궤적은 최대 24단계입니다. rationale은 분석용으로 보관하지만 학습 손실에는 넣지 않습니다. 부록 F.2–F.3, 표 10
실패 이유는 종료 신호·응답 존재 여부·검증기의 이진 결과로 정규화합니다. step/tool budget과 최종 응답 없음은 attention의 q_proj, v_proj를, 오답·실행 예외는 MLP의 down_proj를 대상으로 합니다. 관찰한 실제 저장 라벨은 step_budget, wrong_answer, exception뿐이었고 정답·점수·루브릭·숨은 테스트 출력·자유 형식 평가자 피드백은 들어 있지 않았습니다. 저자는 이를 행동 원인에 따른 가벼운 위치 사전지식으로 설명하며 기능이 각 모듈에 완전히 분리돼 있다고 주장하지 않습니다. 부록 F.2, Information boundary · 표 11
F.3 Adapter Training and Compute Requirements
H200 한 장에서 측정한 GAIA 46·Claw-Eval 39·Terminal-Bench 45개, 총 130개 실패의 평균 합성 시간은 6.76분, 최적화는 80.9초, 생성·직렬화까지의 전체 구성 시간은 8.16분이었습니다. 최초 과제 실행과 후속 재시도는 이 시간에 포함하지 않습니다. “약 1.5분 학습”을 교훈 전체 준비 시간으로 쓰면 반성·합성 비용이 빠집니다. 부록 F.3, 표 12
| 실패별 대상 | 학습 파라미터 | 기반 모델 대비 | 전체 어댑터 가중치 파일 |
|---|---|---|---|
| attention q/v | 3.41M | 0.013% | 23.0MiB |
| MLP down | 5.24M | 0.0195% | 88.0MiB |
기반 모델은 26.90B 파라미터입니다. 파일에는 학습하지 않는 SVD 인자도 들어가므로 “학습 파라미터 0.02%”와 저장 크기의 비율은 다릅니다. 토크나이저 19.1MiB를 중복 포함한 실제 디렉터리는 42.1–107.1MiB였고 라이브러리에서 토크나이저는 공유할 수 있습니다. 평균 GPU 에너지는 교훈당 30.4Wh이며 호스트·스토리지·데이터센터 비용은 제외했습니다. 부록 F.3
최적화 연산량 추정은 기반 모델 파라미터 $N=26.90\mathrm{B}$와 두 epoch의 토큰 제시량 $D=7{,}244$를 써서 약 $4ND$, 0.78PFLOPs로 계산합니다. 이는 하드웨어 카운터 측정이 아니라 분석적 근사입니다. PDF 32쪽
F.4–F.5 · 같은 도구 인터페이스와 전체 루프
세 시도는 같은 도구를 받습니다. Terminal-Bench 재시도마다 새 컨테이너를 써 이전 파일 변경이 다음 시도로 새지 않도록 하고, GAIA는 같은 첨부 자료를 사용할 수 있습니다. 반성도 해당 실행에서 쓸 수 있었던 도구를 보고 예제를 만듭니다. 부록 F.5의 의사코드는 유사도·라이브러리 용량·어댑터 해제와 기반 모델 fallback을 명시해 이 절차를 연결합니다. 부록 F.4–F.5
📖 Chapter G: Prompt Templates
G.1–G.2 · 실행과 실패 반성
실행 프롬프트는 한 턴에 도구 하나를 호출하고 결과를 본 뒤 다음 판단을 하며, 필요한 상태를 검증한 뒤 종료하도록 지시합니다. 반성 프롬프트는 과제·범주형 실패 이유·사용 가능한 도구·압축 궤적을 받아 JSON 예제를 만듭니다. 답 자체를 기억시키는 대신 도구 선택, 관찰 해석, 잘못된 행동 복구, 종료 기준을 가르치도록 구성합니다. 부록 G.1–G.2
G.3–G.4 · 벤치마크별 제약과 fallback
GAIA는 마지막 짧은 답의 형식을, Claw-Eval은 도구·로그·산출물의 근거를, Terminal-Bench는 저장소와 서비스 상태 검증을 강조합니다. 숨은 테스트·정답을 찾거나 추정하지 않도록 하고, MiniWoB++는 시드마다 바뀌는 요소 번호를 암기하지 말고 역할·이름으로 찾게 합니다. fallback은 어댑터를 내린 기반 모델에 다시 시도하라는 짧은 접미사를 줍니다. 반성 예제나 어댑터 출력을 그 입력에 넣지 않습니다. 부록 G.3–G.4
📖 Chapter H: Qualitative Analysis of Forward Transfer
H.1 Transfer Within an Online GAIA Stream
과제 순서가 섞인 흐름에서 이전 과제의 어댑터만 검색합니다. 세 임계값 설정을 합쳐 후속 실패 282건에 기존 교훈을 골랐고 41건에서 어댑터 재시도가 성공했습니다. 그중 30건은 난이도 수준을 넘어선 전이였습니다. 논문 표 14의 ORCID 출판물 집계→위키백과 수정 이력 계산 사례는 주제가 달라도 페이지를 끝까지 순회하고 날짜를 제한한 뒤 개수를 검증하는 절차를 공유합니다. 부록 H.1, 표 14
이 ORCID 어댑터는 자기 원래 과제의 어댑터 재시도에는 실패했지만 가장 관대한 검색 설정에서 이후 14개를 복구했습니다. 원래 과제의 한 번 성공만으로 다른 과제의 유용성을 모두 설명하기 어렵다는 관찰입니다. 스프레드시트에서 이미지 속 수치 통계로 넘어간 예는 자료 형식보다 추출·중간값 확인·계산·출력 검증의 공통 절차를 보여 줍니다. 부록 H.1
H.2 Cross-Category Transfer on Claw-Eval
operations 교훈 세 개를 고정한 24개 workflow 평가에서 복구한 세 사례를 설명합니다. 일정·태스크 상태 감사 교훈은 주간 회의 추적과 여러 프로젝트 진척 보고로, 월말 조정 교훈은 이메일·태스크·회의록 간 불일치 확인으로 전이됐습니다. 이는 저자가 제시한 성공 사례의 절차적 해석이며, 모든 교훈의 일반적인 작동 원리를 입증한 실험과는 범위가 다릅니다. 부록 H.2, 표 15
📖 Chapter I: Qualitative Examples of Failure-Conditioned Self-Direction
GAIA 오디오 레시피 과제에서는 재료의 수식어와 출력 형식을 놓친 뒤, 녹취→요청 구간 분리→단위 제거→정렬→형식 검증 예제를 만들었습니다. Claw-Eval 기술 조사에서는 검색만 반복하다 보고서를 끝내지 못한 뒤, 실패 시 검색어 변경·권위 있는 원문 접근·요구 항목별 근거 배치·작성 시간 확보를 가르쳤습니다. Terminal-Bench의 Git/SSH 배포 사례는 설정이 된 것으로 가정하지 않고 실제 clone–commit–push–fetch 경로와 반환 페이지를 검증하는 예제로 바뀌었습니다. 세 사례 모두 어댑터 재시도가 평가를 통과했습니다. 부록 I
부록은 성공 궤적을 처음부터 새로 수집하는 대신 실패가 드러낸 절차를 짧은 교정 예제로 바꾸는 과정을 보여 줍니다. 정답 참조는 평가에 사용되지만 반성 입력에는 제공하지 않았다는 정보 경계는 부록 F.2와 함께 확인해야 합니다. 부록 I · 부록 F.2
📖 Chapter J: Benefits of SVD Initialization
기반 가중치 $W$의 큰 에너지를 가진 오른쪽 특이 부분공간에서 rank 16 인자 $A$를 구해 고정합니다. 교훈 i는 그 입력 방향을 이용해 새 출력 방향으로 연결하는 $B_i$만 학습합니다. 초기 $B_i=0$이므로 학습 전 어댑터의 수정량은 정확히 0입니다. 원문의 관계식은 다음과 같습니다. 부록 J
교정 데이터 $D_i=\{(u_j,v_j)\}_{j=1}^{N_i}$에서 $u_j$는 지시, $v_j$는 절차적 응답입니다. 원문 학습 목표를 두 줄로 나누면 아래와 같습니다. 부록 J
$\theta$는 고정 기반 파라미터, $\phi_i$는 새 어댑터에서 학습하는 B 인자입니다. 예제 응답의 확률을 높이는 교차엔트로피 학습이며, 실제 최적화는 2 epoch의 설정을 따릅니다. 저자들은 선택한 부분공간이 같은 차원의 무작위 공간보다 약 16–22배의 기반 가중치 에너지를 담는다고 보고합니다. 학습한 출력 방향은 대체로 새로운 방향이어서 단순히 기반 가중치를 더 크게 만드는 업데이트로 설명하지 않습니다. 부록 J
실험 결과 심층 분석
이 논문의 결과는 세 단위로 읽어야 합니다. 즉시 복구는 최초 실행 뒤 어댑터와 fallback까지의 전체 루프를 봅니다. 교정 유지 실험은 같은 과거 실패를 재조우하며 이미 저장한 교훈을 봅니다. 새 과제 전이는 시점 이전의 라이브러리를 쓰거나 별도 학습 과제에서 만든 라이브러리를 고정해 보지 않은 과제의 복구를 봅니다. 숫자들이 모두 정확도라 해도 학습과 평가에서 허용한 경험의 범위가 다릅니다. §4.1–4.4
GAIA의 95% 신뢰구간은 과제별 짝지은 초기 대 최종 결과에 붙습니다. Claw-Eval·Terminal-Bench의 주 ±값은 세 번 실행의 표준편차이고, 외부 프런티어 모델은 다른 하네스의 보고 점수입니다. 과제 환경 실행 횟수를 맞춘 그림 10에는 GPU 학습과 합성 비용이 빠져 있어, 전체 비용 판단에는 H200의 평균 교훈 준비 8.16분과 저장량을 함께 봐야 합니다. 부록 C.9 · 부록 F.3
기술적 함의와 응용
Self-Direction은 실패 로그를 다음 행동의 조건으로만 쓰는 데서 더 나아가, 필요할 때 연결할 수 있는 파라미터 모듈로 남깁니다. 리뷰의 관점에서 실무적 질문은 교훈을 얼마나 많이 모았는가와 함께, 언제 실패로 판정했고 어떤 과제에 어떤 교훈을 연결했는가입니다. 기반 모델 저장값을 보존하는 구조, 검색 임계값에 따른 적용 범위, 어댑터를 내린 fallback이 각각 다른 역할을 맡기 때문입니다. §3.3·4.3 · 부록 F.5
논문은 교훈을 텍스트·하네스·가중치 중 어느 매체에 둘지와 여러 교훈의 합성을 후속 문제로 제시합니다. 현재 결과는 Qwen 계열의 정해진 도구·평가·학습 환경에서 나온 것이며, 실패 검출과 추가 학습 자원이 필요하다는 저자의 한계와 함께 읽을 수 있습니다. §5 · 부록 D
검토 범위. 본문 1–5장과 부록 A–J를 다뤘습니다. 참고문헌에 인용된 모든 연구의 원문, 전체 프롬프트와 로그의 완전 전사, 별도의 모델 학습·실행 재현은 포함하지 않았습니다. 그림은 동일 PDF의 실제 번호와 쪽수를 대조해 크롭했습니다.