논문 개요와 전체 구조
도구를 쓰는 LLM 에이전트는 검색 결과나 계산값을 받아 답변을 작성합니다. 서버가 오류를 내거나, 예상과 다른 타입을 보내거나, 형식은 정상인데 값이 틀린 결과를 돌려줄 수도 있습니다. 에이전트가 답변을 작성하고 종료했더라도 작업에 필요한 근거를 얻었는지는 따로 확인해야 합니다. 저자들은 에이전트와 서버 사이에서 MCP(Model Context Protocol) 도구 호출을 가로채는 MCP-Injector를 만들어 이 차이를 실험했습니다. 논문 §1
공개 MCP 저장소 1,774곳에서 수집하고 필터링한 스레드 57,240개로 장애 유형과 지속성의 스트레스 프로필을 구성했습니다. 이 조건의 작업 완료 점수는 10점 만점에 평균 8.08에서 3.23으로 내려갔습니다. gpt-oss-20B와 120B를 비교한 결과, 장애가 없을 때의 점수를 얼마나 유지했는지 나타내는 비율에서 120B의 우위는 검출되지 않았습니다. 이 결과는 두 모델, 세 실행 스택, 단일 서버 과제 25개, 영구 장애 비중이 큰 프로필에 관한 것입니다. 논문 §§4–6
| 원문 순서 | 내용 |
|---|---|
| §§1–2 | 도구 호출 경계의 문제와 장애 정의 |
| §§3–4 | 프록시와 오류 연산자, 공개 보고에서 프로필을 얻는 과정 |
| §§5–6 | 전체 요인 실험과 품질·스택·모델 크기 비교 |
| §§7–10 | 타당도, 사회적 영향, 관련 연구, 결론 |
| 부록 A–C | 프로필 산출, 프록시 영향, 실제 주입 검증 |
| 부록 D–H | 결과 상세, 실패 사례, 스택 구현, 호출 행동, 과제별 차이 |
| 부록 I–J 및 체크리스트 | 실행 환경, 재현 자료, 라이선스, 연구 공개 항목 |
arXiv v1 제출일은 2026년 10월 23일입니다. 이 버전의 HTML과 35쪽 PDF가 검토 기준입니다. arXiv 서지 및 제출 이력 · 고정 PDF
핵심 기여와 혁신성
- 도구가 실패하는 위치를 실험 변수로 만들었습니다. MCP 호출 경계에서는 잘못된 결과도 정상 JSON처럼 전달될 수 있습니다. 프록시는 에이전트가 실제로 받는 응답 값·오류·지연을 조작하면서 기존 클라이언트와 도구 구현을 그대로 연결합니다. 논문 §3
- 실패 유형과 지속성을 함께 정합니다. 같은 오류라도 이후 호출마다 돌아오는지, 한 호출에 그치는지에 따라 재시도의 결과가 달라집니다. 공개 장애 보고에서 얻은 18개 규칙을 사용하고, 규칙의 선택 가중치와 실제 실행 중 발동 비중을 각각 확인합니다. 논문 §4 · 부록 C
- 실행 종료, 답변 품질, 도구 근거를 별도로 측정합니다. 대부분 실행이 종료하는 상황에도 품질이 크게 떨어졌고, 도구를 호출하지 않은 그럴듯한 답변에 점수가 붙기도 했습니다. 이를 통해 정상 조건에서의 능력과 장애 조건에서 유지되는 품질을 따로 비교할 수 있습니다. 논문 §§5–6
기술적 세부사항
MCP는 클라이언트가 이름과 인자를 지정해 서버 도구를 호출하고 결과나 오류를 받는 규약입니다. 프록시는 에이전트 쪽에서 MCP 서버로, 실제 도구 쪽에서 MCP 클라이언트로 동작합니다. 도구 이름·인자·문맥을 관찰하고, 프로필·지속 상태·시드 기반 난수에서 연산자를 결정합니다. 요청을 보내기 전에 오류를 합성하거나, 실제 서버 응답을 받아 내용을 바꿀 수 있습니다. 발동한 주입 사건은 구조화 로그에 남습니다. 논문 §3.1과 그림 1
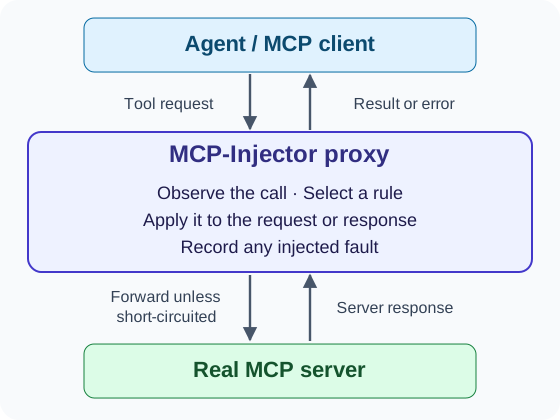
요청과 결과가 프록시를 지나는 위치입니다. 리뷰어 작성, 논문 그림 1 및 §3.1, PDF 3쪽 기반
Proxy-off는 프록시 자체를 제거한 기준선, OP0는 내용을 바꾸지 않는 프록시, OPP는 18개 규칙의 장애 프로필이 활성화된 프록시입니다. Proxy-off와 OP0를 비교해 프록시 자체의 영향을 확인하고, OP0와 OPP를 비교해 같은 프록시에서 장애를 켰을 때 달라진 결과를 측정합니다. 스택·모델·과제·시드를 맞춘 각 쌍의 OPP 점수에서 OP0 점수를 빼면 품질 변화량을 얻습니다. 논문 §5.2 · 부록 B
완료율은 시간 제한, 반복 상한, 미처리 예외 때문에 중단되지 않고 실행이 끝난 비율입니다. 작업 완료 점수는 도구 선택과 계획, 과제 이행을 포함하는 0~10점 품질 척도입니다. 논문은 주 분석에서 OPP 미완료를 0점으로 반영하고 양쪽 조건에서 완료된 셀도 따로 비교합니다. 완료 실행의 답변마다 LLM 심사 모델을 다섯 번 실행하고 중앙값을 취했습니다. 논문 §5.3–5.4 · 부록 D
챕터별 상세 리뷰
📖 Chapter 1: Introduction
도구의 스키마와 서비스 상태, 통신 방식은 에이전트 품질에 관여합니다. 정상 도구를 전제로 평가하면 형식은 맞지만 틀린 값을 그대로 사용하거나, 같은 오류에 반복 호출을 보내는 에이전트의 행동을 측정하기 어렵습니다. 저자들은 네트워크 계층보다 MCP 도구 호출 경계에 가까운 실험을 구성합니다. 공개 장애 보고로 만든 프로필, 이를 적용하는 미들웨어, 같은 과제를 조건별로 반복하는 실험이 연구의 세 부분입니다. 논문 §1
📖 Chapter 2: Background and Definitions
호출의 요청과 결과 또는 오류가 관찰 경계입니다. 예상과 달라진 서비스 상태가 failure이고, 이를 일으킨 버그·설정 오류·의존 서비스의 중단이 fault입니다. 서버의 내부 원인을 재현하지 않고도 에이전트가 관찰하는 현상을 인터페이스에서 만들어 후속 판단을 조사할 수 있습니다. MCP의 프롬프트·리소스·스트리밍과 보안 공격은 실험 범위 밖입니다. 논문 §2
내용 실패는 도착한 값이나 형식이 잘못된 경우이고, 시간 실패는 결과가 지나치게 늦거나 도착하지 않는 경우입니다. 시간에 따른 지속성은 한 번 발동하고 해소되는 일시적(transient), 정상과 실패가 섞여 나타나는 간헐적(intermittent), 활성화 이후 매번 나타나는 영구적(permanent)으로 나눕니다. 다음 절은 이 구분을 호출별 스케줄로 옮깁니다. 논문 §2
📖 Chapter 3: MCP-Injector
3.1 Architecture
프록시는 MCP 클라이언트 라이브러리의 호출 훅을 가로챕니다. 요청 단계에서는 지연·무응답·합성 오류를 만들 수 있고, 결과 단계에서는 실제 응답의 내용이나 타입을 바꿉니다. 이 구성을 사용하면 실제 서버 권한을 변경하지 않고도 에이전트가 권한 오류를 받고 다른 도구를 택하는지 볼 수 있습니다. 논문 §3.1
3.2 Fault API
설정은 무엇을 바꿀지 정하는 연산자, 얼마나 지속할지 정하는 스케줄, 어느 도구 호출에 적용할지 정하는 범위를 분리합니다. 다음 표는 원문 연산자의 동작입니다. 논문 표 1
| 연산자 | 호출 경계에서 관찰되는 동작 |
|---|---|
| OP0 | 요청과 결과를 그대로 통과 |
| OP1 | 문자의 일부를 바꾸는 작은 내용 오류 |
| OP2 | 단어 수준의 치환으로 의미상 잘못된 결과 생성 |
| OP3 | 예상 스키마에 맞지 않는 타입으로 강제 변환 |
| OP4 | 구조화된 MCP 오류 반환 |
| OP5 | 반환 전 인위적 지연 |
| OP6 | 호출을 대기 상태에 두어 응답을 보내지 않음 |
영구 규칙은 한 번 활성화되면 범위가 맞는 호출마다 발동합니다. 일시 규칙은 한 호출에 적용하고 초기화하며 이 실험에서는 선택된 호출에 확실히 적용됩니다. 간헐 규칙은 상태를 유지하는 동안 호출마다 설정 확률로 발동하고, 해제 확률에 따라 새 규칙을 뽑습니다. 시드와 호출 이력이 같으면 주입 결정은 재현됩니다. 모델이 고른 호출 이력이나 평가 모델의 점수는 달라질 수 있습니다. 논문 §3.2 · 부록 A
📖 Chapter 4: Fault Profile Methodology
저자들은 2025년 9월 MCP Market과 Awesome MCP Servers에서 공개 저장소 1,774곳을 선정했습니다. 이슈·PR과 연결된 활동을 시간순으로 묶어 103,166개 스레드를 얻었습니다. 키워드로 분할하고 교차 링크 중복, 빌드 관련 항목, 비영어 자료를 제거하자 57,240개가 남았습니다. gpt-4o-2024-08-06을 temperature 0과 고정 JSON 스키마로 사용해 장애 유형과 지속성을 분류했습니다. 층화 추출한 117개를 두 연구자가 독립 표기하고 세 번째 연구자가 불일치를 조정했습니다. 코언 카파는 유형 0.93, 지속성 0.80입니다. 논문 §4와 그림 2
57,240개 가운데 비장애 분류는 42,411개였습니다. 유형과 지속성이 모두 정해진 13,824개가 다음 표와 가중치의 분모를 이룹니다. 불확실하다고 분류된 유형이나 지속성은 제외했습니다. 논문 표 2 · 부록 A 표 3
| 실패 유형 | 간헐 | 영구 | 일시 |
|---|---|---|---|
| 응답 지연 | 51 | 157 | 1 |
| 명시적 오류 | 669 | 9,075 | 97 |
| 잘못된 값 | 155 | 1,733 | 1 |
| 잘못된 형식·타입 | 47 | 511 | 1 |
| 작은 내용 오류 | 15 | 177 | 0 |
| 무응답 | 167 | 963 | 4 |
| 합계 | 1,104 | 12,616 | 104 |
영구 장애는 가중치의 91.3%이며, 영구적 명시 오류 항목 하나가 약 65.6%입니다. 이 수치는 이슈에서 관찰한 실패 양상의 상대 빈도입니다. 전체 정상 호출 수를 관찰하지 않았고 공개 이슈에서 재현하기 쉬운 장애가 과대표집될 수 있으므로, 저자들은 스트레스 프로필로 해석합니다. 주입 시 30초 지연, 간헐 규칙 해제 확률, 내용 변형 강도는 고정 설정값입니다. 논문 §4 · 부록 A
📖 Chapter 5: Experimental Protocol
5.1 Benchmark and Task Set
MCP-Bench의 과제 생성 절차을 사용했습니다. 연결을 시도한 서버 28개 중 연결된 25개에서 과제 25개를 만들었습니다. 에이전트에는 일상 언어로 작성한 요청을 주고, 세부 요구사항은 채점 참조에만 사용합니다. 무관한 서버는 넣지 않았습니다. 한 서버가 여러 도구를 제공하므로 단일 서버 과제도 여러 호출을 요구할 수 있습니다. 논문 §5.1
5.2 Experimental Factors
백본은 gpt-oss-20B와 120B입니다. 배포된 MXFP4 정밀도, 16,000토큰의 문맥창, 기본 디코딩 설정을 사용했습니다. 세 스택은 MCPBench의 여러 라운드에 걸친 계획·실행, OpenAI Agents SDK, LangChain/LangGraph입니다. 입력 프롬프트, 도구 스키마, 문맥 예산과 시간 제한은 공통으로 두었습니다. 백본 2종 × 스택 3종 × 조건 3종 × 과제 25개 × 시드 3개로 총 1,350개 셀을 구성했습니다. OPP에 450개, OPP의 각 모델에 225개, 모델·스택 조합에 75개가 배정됩니다. 논문 §5.2 · 부록 D 표 4
5.3 Execution and Run Policy
최종 정책은 과제당 3,000초입니다. 반복 상한은 MCPBench 40라운드, OpenAI SDK 40턴, LangChain 25슈퍼스텝으로 단위와 상한이 다릅니다. 시간 초과, 반복 상한 소진, 처리되지 않은 예외는 시스템 실패입니다. 초기 캠페인의 일부 정상 조건 실행은 더 엄격한 상한에 도달하기 전에 완료됐으므로 최종 표에 남겼습니다. 모든 OPP 셀과 보고된 미완료에는 최종 정책을 적용했습니다. 논문 §5.3 · 부록 I
5.4 Metrics
품질 루브릭은 과제 이행, 근거, 도구 선택·적절성, 인자 정확도 등을 평가합니다. 시스템 결과는 시간 초과와 처리되지 않은 오류를 집계합니다. 시간 지표는 실행에 사용된 전체·에이전트 내부·평가 시간으로 나눕니다. 완료 실행은 gpt-4o-mini-2024-07-18이 루브릭 항목 순서를 섞어 다섯 번 채점하고 중앙값을 사용했습니다. 논문 §5.3–5.4
📖 Chapter 6: Results
6.1 Calibrated Faults Cause Severe, Pervasive Quality Degradation
450쌍의 OP0와 OPP를 비교한 결과, 작업 완료 점수는 평균 8.08 → 3.23이었습니다. 차이는 −4.85점이고 짝지은 95% 신뢰구간은 [−5.22, −4.48]입니다. 모델·스택별 완료율은 OPP에서도 약 88~97%를 보였지만, 가장 흔한 결과는 450개 OPP 셀의 56%를 차지한 부분 성능 저하였습니다. 두 조건에서 모두 완료한 쌍에서도 점수는 8.26에서 3.53으로 57% 하락했습니다. 논문 §6.1과 그림 3 · §10 · 부록 D
완료한 답변 중 과제 이행 점수 4 이상이면서 도구 적절성 2 미만인 셀을 도구 우회로 분류했습니다. OPP 27개(6.0%), OP0 21개, Proxy-off 16개가 해당합니다. OpenAI 스택에서는 OP0 3개에서 OPP 9개로 늘었으며 짝지은 정확 McNemar 검정의 p값은 0.07이었습니다. OPP 도구 우회 27개 중 17개는 도구를 호출하지 않았습니다. 논문 §6.1
단위 변환 과제의 한 셀은 도구를 한 번도 부르지 않고 이행 9.8점, 완료 9.3점, 도구 적절성 1.2점을 받았습니다. 도구 적절성이 2 미만인 답변의 이행 점수를 0점으로 반영하면, 일반 과제 이행에서 관찰한 58% 하락이 63%로 커집니다. 도구가 필요한 업무에서 실행 성공과 근거 확보를 함께 확인할 이유입니다. 논문 §6.1 · 부록 D 표 5
6.2 Agent Stacks Shape Fault Response
OPP 완료율은 LangChain 94.7~97.3%, MCPBench 90.7~94.7%, OpenAI SDK 88.0~94.7%였습니다. 스택별 과제 점수 유지율의 중앙값도 LangChain이 가장 높았습니다. 과제를 무작위 절편으로 둔 모형에서 LangChain 대비 추가 하락은 MCPBench −0.93점(95% 신뢰구간 [−1.86, −0.01], p=0.048), OpenAI SDK −0.84점([−1.77, 0.08], p=0.074)이었습니다. 다중 비교 보정은 적용하지 않았고, 스택별 주입량도 달랐습니다. 저자들은 이 결과를 스택의 역할을 시사하는 근거로 해석합니다. 논문 §6.2와 그림 4 · 부록 D 표 4
실패 뒤 MCPBench는 계획할 도구 목록을 다시 만들어 다른 도구를 호출하는 경우가 가장 많았습니다. LangChain과 OpenAI SDK는 도구 루프를 끝내고 텍스트로 답하는 비중이 각 스택에서 가장 높았습니다. 종료를 표현하고 오류를 모델에 전하는 방식이 레퍼런스 구현마다 달랐습니다. 논문 §6.2 · 부록 F·G
6.3 Scale Does Not Purchase Fault Tolerance
같은 스택·모델·과제·시드 셀의 작업 완료 점수로 유지율을 계산합니다. 아래 식은 원문의 비율을 기호로 나타낸 것입니다. 논문 §6.3
분자는 장애 주입 상태의 점수, 분모는 같은 프록시가 장애를 주입하지 않을 때의 점수입니다. 1은 점수 유지, 1보다 작은 값은 점수 하락을 뜻합니다. 미완료를 0점으로 처리한 유지율 모형에서 모델 크기 계수는 −0.009, 95% 신뢰구간은 [−0.39, 0.37], p=0.96이었습니다. 신뢰구간에는 개선과 악화가 모두 포함됩니다. 논문 §6.3
OPP 완료율은 20B 95.6%, 120B 91.1%였습니다. 20B에서 120B를 뺀 차이는 약 4.4%포인트(95% 신뢰구간 [−0.2, 9.3], Fisher 정확 검정 p=0.088)입니다. 120B는 OP0에서도 완료율이 낮았습니다. OP0 대비 OPP의 짝지은 완료율 하락은 120B −5.8%포인트, 20B −3.6%포인트이고, 두 하락 폭 차이의 95% 신뢰구간은 [−3.0, 7.5]입니다. OPP에서 완료한 실행의 점수는 120B 3.68, 20B 3.26으로 완료율과 다른 순서를 보였습니다. 논문 §6.3 · 부록 D 표 4
120B는 OPP 셀당 평균 주입 4.6회(20B 3.9회), OP0 출력 평균 2,063토큰(20B 1,711토큰)을 기록했습니다. 저자들은 장애 노출, 공동 16K 문맥창 안의 긴 출력, 스택의 호출량 차이를 가능한 설명으로 검토합니다. 실험에서는 이런 요인들을 따로 개입해 인과 효과를 식별하지 않았습니다. 논문 §6.3 · §7
📖 Chapter 7: Limitations
- 구성 타당도. 반복 중앙값으로 채점 변동성을 줄였고, 일부 도구 미사용 답변에도 점수가 부여됩니다. 공개 보고 편향도 프로필에 남습니다. 내용 연산자에는 스키마 변경, 잘린 페이로드, 일부 결과 누락이 없습니다.
- 내적 타당도. 스택별 오류 처리와 호출량이 동시에 다릅니다. 두 백본의 공통 문맥창 제약, 55개의 무주입 셀, 조건별 시드 3개는 크기·노출·드문 상호작용의 해석에 관여합니다.
- 외적 타당도. 단일 모델 계열과 서빙 설정, 25개의 단일 서버 과제에 대한 결과입니다. 장애를 주입하지 않은 OP0에서 대다수 과제가 완료됐습니다. 간헐·일시 장애는 실제 주입 1,905건 중 9건이었습니다. 다중 서버, 긴 과제, 복수 에이전트와 인간 개입은 실험 범위 밖입니다. 논문 §7
📖 Chapter 8: Broader impacts
프록시는 배포 전 재현 가능한 장애 테스트에 쓰입니다. 동시에 MCP 호출 경로에 접근한 공격자가 오류·지연·무응답·변형 결과를 악용할 수 있습니다. 저자들은 기본 연산자로 OP0를 두고, 주입 응답에 구별용 헤더를 붙이며, 문서를 스테이징 사용에 한정하는 방안을 명시했습니다. 프로필의 용도는 공개 장애 보고를 반영한 스트레스 시험입니다. 논문 §8
📖 Chapter 9: Related work
저자들은 정상 도구를 가정하는 벤치마크, 모델 내부의 인자 오류를 보는 평가, 적대적 위협 연구를 차례로 검토합니다. 가까운 연구로는 시간 초과·요청 한도·스키마 변경을 시험한 ReliabilityBench를 듭니다. MCP-Injector는 공개 MCP 보고에서 가중치를 정하고 여러 지속성을 모델링해, 기존 에이전트와 도구 사이에 프록시로 연결합니다. 논문 §9
고전적 결함 주입과 카오스 엔지니어링은 하드웨어·OS·API·분산 인프라에 장애를 만들어 복원력을 조사합니다. 이 논문은 도구 응답의 의미와 구조를 해석하는 MCP 경계의 실패를 다룹니다. MCP 생태계의 실패·위협을 분류하는 연구와 모델의 자기 수정 접근에는 실제로 주입하고 기록하는 실험 조건을 더합니다. 논문 §9
📖 Chapter 10: Conclusion
저자들은 영구 장애가 주를 이루는 조건에서 부분 성능 저하가 흔했고, 품질 점수가 크게 하락했다고 정리합니다. 스택별 오류 대응의 역할을 시사하는 결과도 얻었습니다. 비교한 두 gpt-oss 백본에서 큰 모델의 유지율 우위는 검출되지 않았습니다. 저자가 명시한 후속 방향은 다중 서버 오케스트레이션, 더 긴 과제, 장애를 고려하는 계획입니다. 논문 §10
📖 Chapter A: Fault Profile Calibration Details
여섯 연산자와 세 지속성 조합마다 하나의 규칙이 있습니다. 식 (1)에서 분자 $n_{m,p}$는 실패 유형 $m$과 지속성 $p$가 모두 확인된 스레드 수입니다. 분모 $N$은 해당 조건을 만족해 주입할 수 있는 13,824개입니다. 영구적 명시 오류는 9,075개이므로 9,075를 13,824로 나눈 약 0.6565의 가중치를 갖습니다. 이 가중치는 새 규칙을 뽑을 때 적용됩니다. 부록 A 식 (1)·표 3
간헐 장애의 활성 확률 $a$를 정할 때 저자들은 두 상태를 오가는 이상적인 스케줄의 정상상태 장애 비율을 사용했습니다. 식 (2)의 $\mathrm{INT}$와 $\mathrm{PERM}$은 같은 장애 유형의 간헐·영구 보고 수입니다. 해제 확률 $d$는 0.3으로 고정했습니다. 첫 식을 $a$에 대해 풀면 두 번째 식을 얻습니다. 지연의 경우 $0.3 \times 51/157$로 약 0.0975입니다. 부록 A 식 (2)
실제 구현은 간헐 규칙을 보유하는 동안 각 호출에 독립적으로 확률 $a$를 적용하며, 이후 호출마다 확률 $d$로 해제합니다. 평균 보유 길이는 $1 + 1/d$, 약 4.3호출입니다. 따라서 위 분수로 설정값을 정했더라도 발동 빈도는 상태 보유 중의 독립 시행과 호출 이력에 좌우됩니다. 일시적 규칙은 한 번 발동하고, 영구적 규칙은 매번 발동합니다. OP5는 HTTP 전송 제한 60초보다 짧은 30초 지연을, OP1·OP2는 단어별 변형 확률 0.08과 0.35를 사용합니다. OP1 변형 강도는 0.05이며 OP3·OP4·OP6에는 추가 조정값이 없습니다. 부록 A
📖 Chapter B: Proxy Non-Intrusiveness: Full Analysis
동일한 스택·모델에서 과제·시드를 짝지어 Proxy-off와 OP0를 비교했습니다. 조합 6개와 종합 점수 3개의 윌콕슨 부호순위 검정 18개에서 본페로니 보정 후 논문이 유의하다고 보고한 결과는 없습니다. 가장 작은 보정 p값은 반올림 0.050이고, 평균 점수 차이의 최대 절댓값은 0.55점입니다. 호출당 프록시 오버헤드는 약 0.1~0.5초로 추정했습니다. 이 검사는 현 실험에서 계측 영향이 체계적으로 나타나는지 확인하며, 사전에 정한 동등성 마진에 대한 검정까지 보고한 것은 아닙니다. 부록 B와 그림 5
📖 Chapter C: Injection Fidelity: Full Analysis
선택한 규칙과 발동한 사건의 비중. 450개 OPP 셀 중 395개에서 한 번 이상 주입됐고, 총 1,905개 사건이 기록됐습니다. 가중치에서는 영구적 규칙이 91.3%였고 사건 로그에서는 99.5%였습니다. 영구적 OP2는 가중치 12.5%에서 사건 비중 28.9%로 늘었습니다. 영구 규칙을 한 번 뽑으면 이어지는 호출에도 발동하므로, 호출이 길게 이어진 실행은 같은 규칙의 사건을 여러 번 보탭니다. 간헐적 규칙은 가중치에서 8.0%였지만 실제 주입은 6건이었습니다. 영구·일시 사건에 한해 실행별 첫 발동 항목을 비교한 검정은 391개 실행에서 몬테카를로 p=0.22였습니다. 부록 C와 그림 6
무주입과 노출. 주입 0건인 55개 OPP 셀 중 29개는 도구를 호출하지 않았고, 26개는 간헐 규칙이 한 번도 발동하지 않았습니다. 55개를 제외하면 평균 작업 완료 점수 하락은 60%에서 67%로 커집니다. 한 번 이상 장애를 받은 셀의 점수는 OPP 2.72점과 대응 OP0 8.15점이고, 무주입 셀은 OPP 6.93점과 OP0 7.61점입니다. 무주입 여부는 에이전트 행동에도 의존하므로 무작위로 배정한 대조군과 구분해야 합니다. 부록 C
사건 수와 품질. 한 번 이상 장애를 받고 완료한 366개만 넣은 모형에서 추가 사건 한 건당 작업 완료 점수 계수는 +0.06점이고 95% 신뢰구간은 [−0.004, 0.12]입니다. 무주입 셀을 포함해도 +0.01점([−0.05, 0.07])이었습니다. 답변을 부분적으로 만드는 동안 더 오래 도구를 사용한 실행에는 더 많은 사건이 기록될 수 있습니다. 저자들은 노출 여부와 저하의 관계를 보고하고, 사건 수만으로 기울기를 해석할 근거는 확보하지 못했습니다. 부록 C
📖 Chapter D: Supplementary Analyses of Fault Impact
표 4는 완료율을 모델·스택·프록시 조건별로 보고합니다. 모델별 통합 행에서 조건당 225개 셀을 사용하며, 각 스택으로 나누면 75개입니다. 아래는 모델별 통합 행을 옮겼습니다. 신뢰구간은 Wilson 95%입니다. 부록 D 표 4
| 백본 | Proxy-off | OP0 | OPP |
|---|---|---|---|
| 20B | 98.7% | 99.1% | 95.6% [92.0, 97.6] |
| 120B | 96.0% | 96.9% | 91.1% [86.7, 94.2] |
표 5의 채점 지표 9개와 도구 적절성 기준을 적용한 보조 점수입니다. 원문의 변화율과 평균 표시 자릿수를 따랐습니다. 부록 D 표 5
| 지표 | OP0 | OPP | 하락률 |
|---|---|---|---|
| 작업 완료 | 8.08 | 3.23 | 60% |
| 도구 선택 | 8.10 | 3.36 | 59% |
| 계획 효과 | 7.51 | 2.49 | 67% |
| 과제 이행 | 8.07 | 3.37 | 58% |
| 근거 포함 과제 이행 | 7.70 | 2.83 | 63% |
| 근거 연결 | 8.09 | 3.10 | 62% |
| 도구 적절성 | 8.21 | 3.81 | 54% |
| 매개변수 정확도 | 8.00 | 2.91 | 64% |
| 의존성 인식 | 7.94 | 2.75 | 65% |
| 병렬화 효과 | 7.08 | 2.23 | 68% |
과제별로 작업 완료 점수 하락은 unit_converter 19%, national_parks 82%, game_trends 97%였습니다. 원문의 히트맵은 과제 하나에서도 지표별 감소 폭이 다름을 보여 줍니다. 두 조건에서 모두 완료한 쌍의 57% 하락과 여섯 행동 범주의 예시는 각각 미완료 처리와 실패 내용의 영향을 확인하는 자료입니다. 부록 D와 그림 7
📖 Chapter E: Failure Mode Case Studies
저자들은 LangChain·120B·OPP 사례를 여섯 범주로 설명합니다. 아래 사례는 경로의 차이를 보여 주는 사례 기록입니다. 부록 E
| 행동 범주 | 사례 |
|---|---|
| 미완료 | car_price_evaluator는 연속 권한 오류 뒤 평가할 답변 없이 끝났습니다. |
| 도구 우회 | openapi_explorer는 지정 도구의 성공적인 조회 없이 기억에 의존해 API를 비교했습니다. |
| 적응적 하락 | google_maps는 도구 사용 불가를 알리고 대안을 제시했으나 도구 근거 점수를 얻지 못했습니다. |
| 완료 후 실패 | bibliomantic은 텍스트로 응답을 끝냈으나 작업 관련 내용이 없어 전 지표가 0이었습니다. |
| 부분 하락 | fruityvice는 일부 조회 결과에 모델 지식을 섞어 답변을 만들었고 근거 점수는 낮았습니다. |
| 영향이 적음 | huge_icons의 핵심 호출은 해당 장애에 영향을 받지 않아 작업 완료 점수 10점을 얻었습니다. |
일부 사례에서 모델은 장애를 파라미터나 응답 형식 문제로 추정해 작은 변경을 반복했습니다. 도구 불가를 밝혀도 현재 루브릭에서 낮은 점수를 받을 수 있어, 저자들은 적응적인 실패 보고와 근거 없는 답변을 분별할 평가의 필요성을 짚습니다. 부록 E
📖 Chapter F: Agent Stack Orchestration Details
MCPBench는 각 라운드에 계속 여부와 도구 호출 목록을 JSON으로 정하고 목록의 호출을 병렬 실행합니다. 오류는 누적 정보 버퍼로 돌아가 다음 계획 입력이 됩니다. OpenAI Agents SDK는 한 메시지 루프에서 도구 결과 메시지를 붙이고, MCP 오류를 구조화된 오류 결과로 전달합니다. LangChain은 LangGraph의 모델·도구 노드를 번갈아 실행하고 미들웨어에서 예외를 도구 메시지로 반환합니다. 두 메시지 기반 스택에서는 모델이 추가 호출 없는 텍스트를 내면 루프가 종료됩니다. 세 스택 모두 다음 도구를 재시도하거나 바꾸는 결정은 모델이 내립니다. 부록 F 표 6
📖 Chapter G: Behavioral Adaptation: Reasoning Traces and Retry Loops
저자들은 장애 직후 다음 도구 호출이 같으면 재시도, 다르면 전환, 추가 호출 없이 완료하면 대체 응답, 추가 호출 없이 미완료면 타임아웃으로 분류했습니다. 이 기준으로 분류한 장애 인접 호출 1,302건에서 MCPBench는 전환 68%, LangChain은 대체 응답 44%, OpenAI SDK는 대체 응답 49%였습니다. 이 분류의 집계 단위는 호출입니다. §6의 시스템 미완료는 전체 셀을 셉니다. 이 절의 장애 인접 호출 분류에는 타임아웃이 관찰되지 않았습니다. 부록 G와 그림 8
동일한 실패 도구에 연속 세 번 이상 요청한 실행은 38개였고, MCPBench 25개, LangChain 7개, OpenAI SDK 6개였습니다. 저자들이 확인한 MCPBench·120B 계획 기록에서 모델은 인자나 형식을 추정했지만 영구 장애인지 일시 장애인지 구별하지 않았습니다. 한 과학 계산 과제는 22회 호출 중 12회 연속 재시도를 남겼습니다. 부록 G
📖 Chapter H: Task-Domain Sensitivity
과제별로 의존성 분석에 등장하는 서로 다른 도구 호출을 세어 깊이 6~29를 얻고, 여섯 도메인으로도 분류했습니다. 과제별 점수 유지율 중앙값과 깊이의 스피어만 상관은 0.29(p=0.17, 과제 25개)입니다. 깊이와 평균 주입량의 상관은 0.47(p=0.02)이었고, 주입량을 고려한 부분 상관은 0.35(p=0.09)였습니다. 깊이가 저하를 유발했다는 결론을 논문은 내리지 않습니다. 부록 H와 그림 9
업무 유형별 중앙값은 상태를 다루는 금융 과제 0.04(2개), 개발 도구 0.05(4개), 실시간 API 0.06(4개), 상태 없는 검색 0.18(8개), 순수 계산 0.60(2개), 여러 단계의 순차 작업 0.61(5개)입니다. 크루스칼–왈리스 검정 p=0.08이므로 유형별 차이는 기술 통계로 읽는 것이 적절합니다. 부록 H
📖 Chapter I: Reproducibility Details
두 모델은 M3 Ultra와 통합 메모리 96GB를 갖춘 Mac Studio에서 LM Studio 0.3.39로 실행됐습니다. 캠페인 다섯 라운드 중 처음 두 번은 과제 한도 1,500초와 20라운드를 사용했고 이후 최종 정책을 적용했습니다. 최종 결과의 정상 조건 셀 875개는 초기 제한에 도달하기 전에 완료했습니다. 정상 조건의 나머지 25개, 모든 OPP 셀, 보고된 미완료 51개는 최종 제한으로 실행했습니다. 총 캠페인은 재실행 포함 약 237시간이며, 보고 셀 1,350개에는 에이전트 약 58시간과 채점 API 약 18시간이 들었습니다. 부록 I
📖 Chapter J: Licenses of Used Assets
저자들은 MCP-Bench와 gpt-oss 백본의 Apache 2.0, OpenAI Agents SDK와 LangChain/LangGraph의 MIT, 각 MCP 서버의 원래 라이선스를 명시했습니다. 저자 산출물은 코드에 Apache 2.0, 프로필·과제 결과·주입 로그·분류 결과 등 데이터에 CC BY 4.0을 적용합니다. GitHub 원문 스레드 전문은 재배포하지 않습니다. 이 글의 호출 흐름 그림은 PDF 3쪽을 바탕으로 직접 그렸습니다. 부록 J · 공개 연구 산출물
📖 Chapter Checklist: NeurIPS Paper Checklist
체크리스트는 주장과 한계의 범위, 실험과 통계 보고, 계산 비용, 라이선스, 사회적 영향 및 LLM 사용을 정리합니다. LLM은 에이전트 백본과 평가 기준 채점, 공개 이슈 분류에 사용됐습니다. 이 절과 부록의 설정·산출물은 추후 결과를 대조하거나 재실행할 때의 자료입니다. 논문 PDF 25–35쪽
실험 결과 심층 분석
완료율과 품질에 분모를 붙이면 결과가 달라 보입니다. 전체 OPP 셀 450개 중 420개가 완료했습니다. 주 분석의 평균은 OPP 미완료에 0점을 부여하고, 두 조건 모두 완료한 셀만 고른 분석은 완료 가능한 과제로 범위를 좁힙니다. 평균 하락률이 각각 60%, 57%라는 점은 저하가 종료 실패에만 집중되지 않았음을 보여 줍니다. 원문의 아홉 품질 지표는 짝지은 윌콕슨 검정에서 Benjamini–Hochberg 보정 후 모두 p<0.001이었습니다. 논문 §6.1 · 부록 D 표 4·5
스택 간 차이와 모델 크기 비교는 별개의 추정입니다. 스택 분석의 추가 하락 −0.93점과 −0.84점은 LangChain과의 조건 상호작용으로, 주입량을 맞춘 실험값이 아닙니다. 백본 분석에서는 각 모델의 평소 점수 대비 유지율과 완료율 하락 폭을 따로 살폈습니다. OPP 완료율 차이 4.4%포인트에는 정상 조건에서 이미 존재한 완료율 격차가 포함됩니다. 120B의 완료 응답에 더 높은 점수가 나타난 것은 살아남은 실행 집합의 품질에 관한 결과입니다. 논문 §6.2–6.3
기술적 함의와 응용
도구가 실패할 때에도 에이전트는 텍스트를 반환할 수 있습니다. 시스템의 종료 상태, 사용할 수 있었던 도구 근거, 사용자에게 전달한 답변 품질을 각각 기록하면, 권한이 없는 도구에 계속 요청한 경우와 조회 실패를 설명하고 답변을 마친 경우가 같은 숫자로 합쳐지는 문제를 줄일 수 있습니다. 이 구분은 논문의 완료율·품질·근거 점수에서 얻는 설계상의 해석입니다. 논문 §5.4–6.1
저자들의 평가 설계는 정상 동작, 프록시 통과, 장애 프로필을 분리하고 각 실행에 선택한 조건과 발동 사건을 연결합니다. 모델과 오케스트레이션을 함께 비교하는 운영 시험에서 어떤 설정이 같았고 어디에서 호출이 달라졌는지 재구성할 수 있습니다. 논문은 이 방식을 다중 서버·장시간 과제와 장애를 고려하는 계획에 확장할 방향을 제시합니다. 부록 C · 논문 §10
검토 범위. 모델·채점기·프록시를 재실행하지 않았습니다. 원문 도표 전체와 로그 전문은 옮기지 않았고, 비교에 필요한 표와 대표 사례를 추려 원문 수치와 대조했습니다.