논문 개요와 전체 구조
분류 모델이 정답에 거의 100%의 확률을 줄 때도 교차 엔트로피가 돌려줘야 할 기울기는 작지만 남아 있습니다. 문제는 컴퓨터에 저장된 정답 확률이 정확히 1로 반올림되면, 다른 클래스의 기울기가 남아 있는 동안 정답 쪽 기울기만 0이 될 수 있다는 점입니다. 교사 모델의 확률을 따라가는 지식 증류에서는 반대로 학생과 교사가 같아도 미세한 기울기가 남을 수 있습니다. 두 경우 모두 학습에 전달되는 신호가 달라집니다. 원문 초록과 §1
Google DeepMind의 Jonathan T. Barron, Dan Gnanapragasam, Michael Tschannen은 log-softmax와 교차 엔트로피의 계산 순서를 바꿔 이 문제를 다룹니다. 먼저 정답이 하나인 분류와 교사 분포를 따르는 증류에서 반올림 오류가 생기는 지점을 분석합니다. 이어 나머지 연산을 학습시키는 소규모 실험에서 기울기 오류가 Adam 계열 옵티마이저와 만나 손실 급등이나 학생 모델의 이탈로 이어지는 과정을 살펴봅니다. 원문은 2026년 10월 22일 최초 제출됐으며, 이 글은 10월 29일 공개된 v3를 따릅니다. arXiv 서지와 버전 이력
| 원문 절 | 다루는 내용 |
|---|---|
| 1. Introduction | 최대 로짓으로 이동한 기존 계산에 남는 두 가지 오류 |
| 2. Softmax Collapse | 한 클래스가 압도적일 때 사라지는 기울기와 음수 합을 보전하는 구현 |
| 3. Softmax Cancellation | 학생·교사 확률을 빼기 전에 로짓 차이를 처리하는 증류 손실 |
| 4. The Slingshot Mechanism | 정밀도 경계를 넘나드는 기울기가 Adam의 업데이트를 키우는 과정 |
| 5. Margin Equilibria | 가중치 감쇠와 Adam의 ϵ가 형성하는 마진 균형 |
| 6. Grokking Across Precisions and Benchmarks | 정밀도, 기준 구현, 나머지 연산 과제별 비교 |
| 7. Soft-Target Distillation | 학생을 교사와 동일하게 초기화한 뒤 발생하는 변화 |
| 8. Conclusion 및 정오표 | 적용 범위와 이전 버전 예제의 마스킹 오류 |
핵심 기여와 혁신성
소프트맥스는 로짓, 즉 확률로 변환하기 전 모델의 점수에 지수 함수를 적용합니다. 모든 점수에서 최댓값을 빼면 지수가 너무 커지는 오버플로를 피할 수 있습니다. 그래도 분모에서 1에 극히 작은 수를 더할 때 작은 항이 사라집니다. Prieto 등이 Softmax Collapse라고 이름 붙인 이 현상에서 저자들은 정답 확률을 계산한 뒤 1을 빼는 대신, 정답 외의 확률 질량으로 정답 기울기를 복원합니다. 높은 정밀도로 내부 계산을 올리거나 확률 변환 함수를 바꾸지 않고도 같은 목적함수를 평가할 수 있습니다. 원문 §1–2
또 다른 기여는 증류에서 학생과 교사의 차이를 확률로 변환하기 전에 꺼내는 구현입니다. 작은 입력에서 정밀도를 유지하는 log1p와 expm1을 써서 두 로짓 벡터가 가까울 때의 기울기를 살립니다. 저자들은 두 변경을 통해 관찰된 Slingshot 손실 급등과 Adam의 마진 균형을 구분하고, 동일한 교사에서 시작한 학생이 수치 오차 때문에 움직일 수 있음을 확인합니다. 원문 §3–5 및 §7
기술적 세부사항
교차 엔트로피는 목표 분포 $\mathbf p$에서 확률 질량이 큰 클래스의 log-softmax에 더 큰 가중치를 주는 손실입니다. 예측 분포를 $\mathbf q$라 하면 각 로짓의 기울기는 식 (1) 다음에 나오는 $\mathbf q-\mathbf p$입니다. 두 분포의 합은 각각 1이므로 기울기의 합은 수학적으로 0입니다. 모든 로짓에 같은 상수를 더해도 확률이 그대로라는 사실을 기울기 합으로 확인할 수 있습니다. 원문 §1
| 입력과 조건 | 오차가 생기는 연산 | 논문의 안정화 방법 |
|---|---|---|
| 정수 정답 라벨과 정답에 높은 확신을 보이는 로짓 | 거의 1인 정답 확률을 반올림한 후 1을 뺍니다. | 정답 외의 지수 항을 따로 모으고 log1p로 손실을 계산합니다. |
| 학생·교사의 로짓이 가까운 소프트 타깃 | 거의 같은 두 확률을 따로 계산해 뺍니다. | 로짓 차이를 중심화하고 expm1으로 확률 차이를 계산합니다. |
실험에서는 나머지 연산의 입력 쌍 일부를 학습에 쓰고 나머지에서 일반화를 측정합니다. 학습 데이터를 이미 맞힌 모델이 테스트에서도 한참 뒤에 높은 정확도에 도달하는 현상이 그로킹(grokking)입니다. 저자들은 정답 로짓과 나머지 로짓이 얼마나 벌어졌는지 나타내는 마진, 학습 손실, 테스트 정확도로 이 과정을 추적합니다. 증류에서는 교사 분포와 학생 분포 사이의 KL 발산을 따로 봅니다. 확률분포가 같으면 KL은 0이며, 클래스 예측 정답률은 그대로인 단계에서도 확률분포의 변화를 감지할 수 있습니다. 원문 §4, §6–7
챕터별 상세 리뷰
📖 Chapter 1: Introduction
클래스가 $K$개라면 $z_k$는 클래스 $k$의 로짓입니다. 기존 계산은 최대 로짓만큼 전체 점수를 옮긴 뒤 정규화합니다. 식 (1)에서 $\tilde z_k$는 옮긴 점수이고, 지수 항을 모두 더한 분모가 각 클래스 확률의 크기를 결정합니다.
정답 $t$가 최대 로짓일 때는 $\exp(\tilde z_t)=1$입니다. 나머지 클래스의 지수 항 합은 식 (2)의 마진 $m$을 사용해 $\exp(-m)$으로 쓸 수 있습니다. 마진이 크다는 말은 정답 로짓이 다른 로짓 하나보다 높다는 뜻을 넘어, 다른 클래스 전체의 로그 합보다 높다는 뜻입니다.
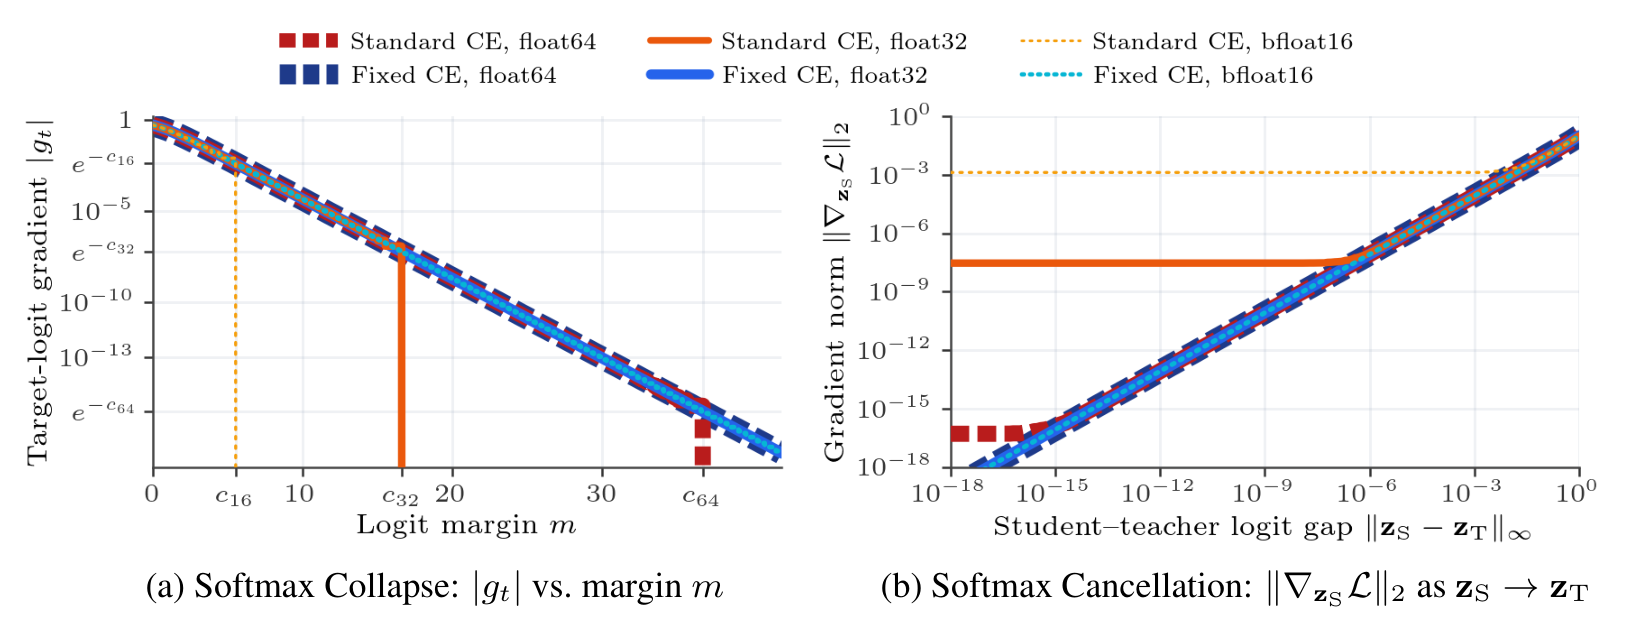
왼쪽 (a)는 정답 기울기의 정밀도 절벽, 오른쪽 (b)는 증류 기울기에 남는 오차를 보여 줍니다. 그림 1 · Barron 외, v3 PDF 1쪽 · CC BY 4.0, 그래프 영역 크롭.
왼쪽에서 표준 구현의 급락은 bf16 약 5.5, fp32 약 16.6, fp64 약 36.7에서 생깁니다. 정답 항에 더해진 작은 수가 반올림으로 버려지는 경계입니다. 1과 그다음 표현 가능한 수 사이 간격의 절반보다 보정 항이 작아질 때 1로 반올림되므로, 작은 수 자체가 0으로 언더플로되는 경계보다 훨씬 먼저 나타납니다. 오른쪽은 학생과 교사의 확률을 각각 계산할 때 생기는 잔여 오차가 로짓 차이를 계속 줄여도 남는 모습을 보여 줍니다. 논문은 이 두 형태를 각각 식 (3)과 식 (9)의 계산 변경으로 풉니다. 원문 그림 1과 식 (2)
📖 Chapter 2: Softmax Collapse
정답 분류의 손실을 미분하면 정답의 경우 $q_t-1$, 다른 클래스의 경우 $q_j$입니다. 식 (3)은 정답 기울기의 두 동치 표현을 나란히 놓습니다. 첫 번째는 분모가 1로 반올림되는 순간 0이 되고, 두 번째는 분자에 작은 항이 남아 같은 순간에도 음수입니다.
정답 외의 지수 항은 분자에서 직접 평가하므로 해당 크기를 표현할 수 있는 동안 양수입니다. 따라서 표준 방식에서 정답 기울기만 지워지면 식 (4)처럼 합이 양수가 됩니다. 원문은 소프트맥스 확률 자체를 미분할 때도 비슷한 문제가 발생하며, 최대 클래스 확률의 미분에서 같은 작은 차이가 사라질 수 있다고 설명합니다. 원문 §2, 식 (3)–(4)
아래는 원문에 나온 세 로짓을 같은 fp32로 두고 식 (3)의 계산 차이를 확인하는 NumPy 예제입니다. 첫 줄은 분모에서 작은 항을 잃어 손실과 정답 기울기가 모두 0인 경우입니다. 두 번째는 정답 기울기를 다른 두 클래스의 기울기 합의 음수와 일치시킵니다. 원문의 JAX 예제는 이 원리를 자동 미분 경로에 적용합니다. 원문 §2, fp32 예제
1
2
3
4
5
6
7
8
9
10
import numpy as np

logits = np.array([9.0, -9.0, -9.0], dtype=np.float32)  # 정답 인덱스는 0
rivals = np.exp(logits[1:] - logits[0])
r = rivals.sum()
one = np.float32(1.0)
denominator = one + r

print(np.log(denominator), one / denominator - one)
print(np.log1p(r), -r / denominator, rivals / denominator)
위 예제의 두 번째 출력에서 손실은 약 3.046 × 10⁻⁸, 정답 기울기는 −3.046 × 10⁻⁸, 비정답 기울기는 각각 1.523 × 10⁻⁸입니다.
정답을 모르는 log-softmax에서는 최대 로짓 인덱스 $i_{\max}$를 기준으로 사용합니다. 식 (5)에서 해당 항만 상수 0으로 놓고 지수의 합에서 제외합니다. 나머지 지수 항의 합을 $r$이라 하면 log-softmax는 옮긴 로짓에서 $\log(1+r)$을 뺀 값입니다. 구현은 log1p(r)로 평가하고, softmax가 필요하면 이 출력에 지수 함수를 적용합니다. 원문은 최대 항을 따로 계산하는 방식에 Blanchard 등의 연구를 인용합니다. 원문 §2, 식 (5)
유한한 최댓값이 있는 로짓에서 정답이 주어지는 교차 엔트로피는 $t$를 기준으로 옮깁니다. 정답이 최대인지는 따로 찾을 필요가 없습니다. 식 (6)의 손실은 $\mathrm{softplus}(-m)=\log(1+\exp(-m))$입니다. v3 코드에서는 $b=\max(0,\max_{j\ne t}(z_j-z_t))$를 사용해 지수 입력이 양수가 되지 않게 합니다. $s$에 정답 외의 옮긴 지수 항을 모으면 아래 계산이 됩니다. $b=0$인 높은 확신 구간에서는 log1p(s)가 작은 손실을 보전합니다.
정답 자리를 상수로 마스킹하면 $z_t$는 오직 다른 클래스와의 차이에만 들어갑니다. 각 비정답 항의 미분은 $\exp(z_j-z_t-\mathcal L)$이고, $z_t$로 미분할 때 이 항들이 반대 부호로 합해집니다. 즉 식 (7)의 $g_t=-\sum_{j\ne t}g_j$가 별도의 기울기 보정 없이 자동 미분에서 나옵니다. 첫째 오류를 바로잡은 뒤 저자들은 정답이 확률분포로 주어지는 경우를 다룹니다. 원문 §2, 식 (6)–(7)과 JAX 구현
📖 Chapter 3: Softmax Cancellation
지식 증류에서는 교사의 로짓 $\mathbf z_T$가 분포 $\mathbf p$를 만들고 학생의 로짓 $\mathbf z_S$가 분포 $\mathbf q$를 만듭니다. 식 (8)에서 학생 기울기는 여전히 $q_k-p_k$입니다. 그러나 약간 다른 두 로짓을 먼저 확률로 바꿔 반올림하면 차이가 줄어들거나 부호가 바뀝니다. 교사 쪽 softmax와 학생 역전파의 exp(log_softmax)가 서로 다른 연산 순서를 쓰면 같은 로짓에서도 두 확률의 마지막 자릿수가 다를 수 있습니다. 원문 §3, 식 (8)
이를 피하기 위해 식 (9)는 원본 로짓에서 차이 $\delta_k=z_{S,k}-z_{T,k}$를 먼저 얻습니다. 교사 확률로 가중 평균을 내서 빼면 $d_k$의 교사 가중 평균은 0입니다. 어떤 클래스에 대해서도 로짓이 동일하게 움직이는 성분은 이 단계에서 사라집니다. 다음으로 로그 확률비 $s_k$를 구해, 확률비에서 1을 뺀 값을 $p_k$에 곱하는 식으로 차이를 되돌립니다.
여기서 expm1(x)는 $e^x-1$을, log1p(x)는 $\log(1+x)$를 작은 $x$에서 정밀하게 계산합니다. $s_k=\log(q_k/p_k)$이므로 $u_k$는 이론상 $q_k-p_k$입니다. 원문은 $\lvert s_k\rvert\ge1$이면 직접 $q_k-p_k$를 택합니다. 교사 확률이 0으로 반올림된 항의 expm1 결과가 넘칠 때 $0\times\infty$가 들어가는 것을 막는 분기입니다. 마지막으로 $g_k=u_k-q_k\sum_i u_i$로 남은 기울기 합의 오차를 제거합니다. 원문 §3, 식 (9) 및 코드
1
2
3
4
5
6
7
8
입력: 학생 로짓 z_S, 고정 교사의 로짓 z_T
p, q = 교사와 학생의 확률
delta = z_S - z_T
d = delta - 교사 확률로 가중 평균한 delta
s = d - log1p(교사 확률로 가중 평균한 expm1(d))
각 클래스의 u = |s| < 1이면 p * expm1(s), 그 외에는 q - p
학생 쪽 기울기 = u - q * sum(u)
출력: 순전파는 교차 엔트로피, 학생 역전파에는 위 기울기를 사용
이 의사코드에서 순전파는 $-\sum_k p_k\log q_k$입니다. 논문의 JAX 예제는 stop_gradient로 이 항의 학생 방향 미분을 차단하고, 순전파 값이 0이면서 지정한 학생 기울기를 내는 항을 더합니다. 교사가 고정된 증류의 손실 값과 학생 쪽 역전파를 따로 구현한 셈입니다. 원문 §3, JAX 구현
원문의 fp32 예제에서 교사 로짓은 [2, 1, 0], 학생 로짓은 여기에 [-1e-7, 1e-7, 0]을 더한 값입니다. 표준 기울기의 두 번째 항은 약 $1.452\times10^{-8}$이지만 수정안과 fp64 기준은 약 $4.144\times10^{-8}$입니다. 세 번째 항은 표준에서 $-1.123\times10^{-9}$, 수정안에서 $+4.513\times10^{-9}$로 부호부터 다릅니다. 동일한 로짓을 입력하면 $\delta_k$부터 0이어서 학생 기울기도 0이 됩니다. 원문 §3, fp32 증류 예제
📖 Chapter 4: The Slingshot Mechanism
Slingshot은 훈련 정답을 이미 맞히는 모델의 손실이 0 근처에서 평평하다가 갑자기 뛰는 현상입니다. Thilak 등이 이를 관찰했고, 후속 연구가 저정밀 연산과 연결했습니다. 저자들이 분석한 AdamW의 좌표별 업데이트에서 $\hat M_i$와 $\hat V_i$는 각각 가중치 기울기와 기울기 제곱의 편향 보정 이동평균입니다. $\eta$는 학습률, $\epsilon$은 분모에 더하는 상수, $\lambda$는 가중치 감쇠 강도입니다. 원문 §4
- 학습 데이터의 로짓 마진이 차츰 커져서 배치의 모든 예시가 정밀도 절벽 위로 올라갑니다. 표준 교차 엔트로피에서는 정답 로짓 기울기가 0이 되고, 매개변수 수준에서도 기울기가 매우 작아져 $\hat V_i$가 감소합니다.
- 가중치 감쇠나 정답 외에 남은 업데이트가 일부 예시를 절벽 아래로 끌어옵니다. 정답 쪽 기울기가 다시 생깁니다.
- 재등장한 기울기는 작은 $\sqrt{\hat V_i}+\epsilon$을 분모로 만나 큰 업데이트와 손실 급등을 일으킵니다. 수정 손실에서는 정답 기울기가 절벽에서 끊기지 않으므로 분자와 분모가 함께 부드럽게 줄어듭니다.
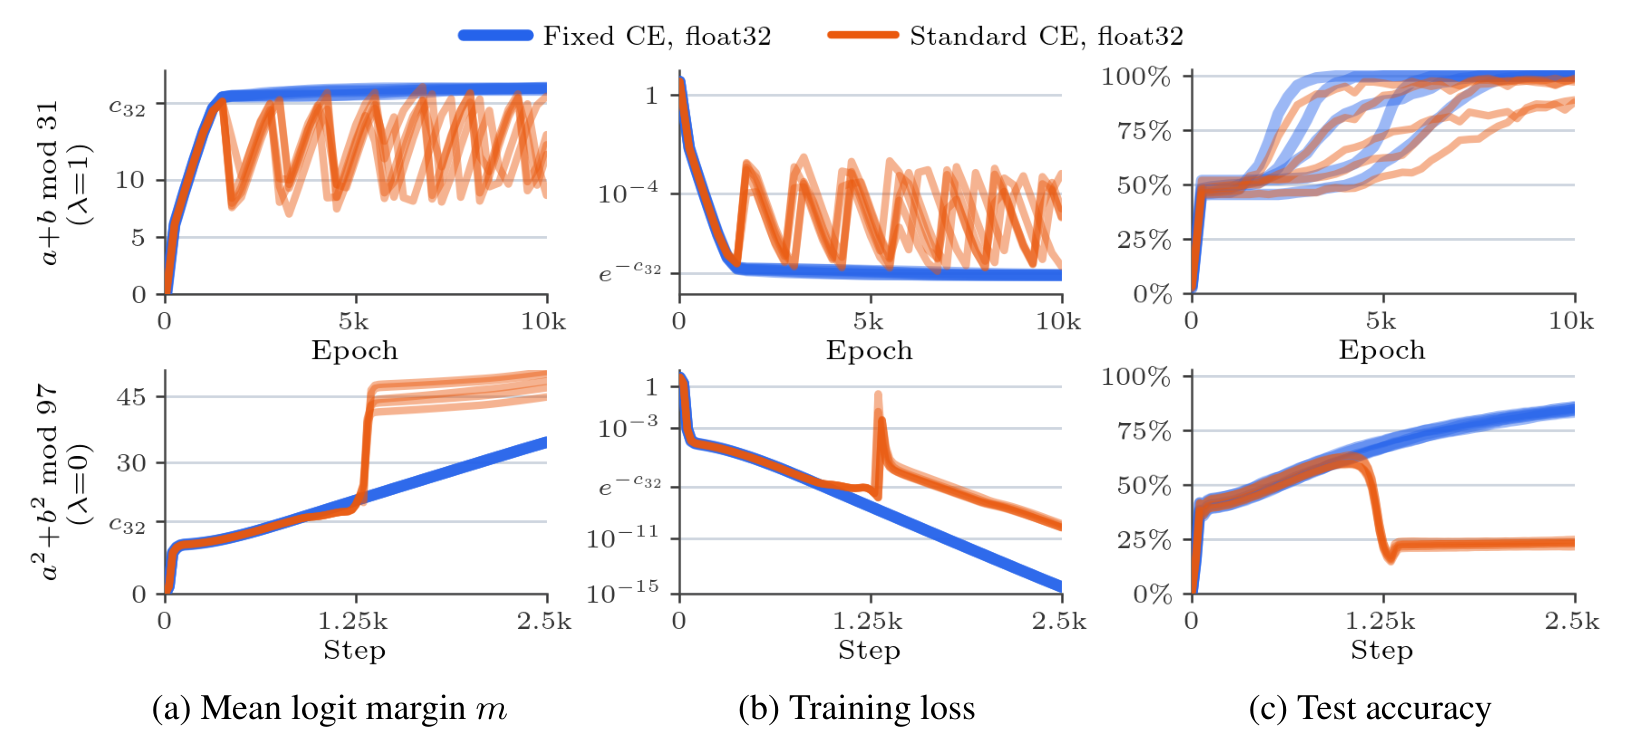
각 행의 왼쪽부터 마진, 학습 손실, 테스트 정확도입니다. 위는 감쇠가 있는 덧셈, 아래는 감쇠가 없는 제곱합입니다. 그림 2 · Barron 외, v3 PDF 5쪽 · CC BY 4.0, 그래프 영역 크롭.
저자들은 가중치 노름을 어떻게 제어하느냐에 따라 급등과 일반화의 관계가 달랐다고 설명합니다. 출력층 앞에 LayerNorm이 있고 가중치 감쇠가 없으면, 슬링샷이 앞단 노름을 키워 유효 학습률을 낮출 수 있습니다. 반면 감쇠가 있는 $(a+b)\bmod31$에서는 수정 방식이 다섯 시드 모두에서 더 빨리 그로킹에 도달했습니다. LayerNorm도 감쇠도 없는 $(a^2+b^2)\bmod97$에서는 fp32 표준 손실의 정확도가 약 1,250 스텝에서 61%에서 23%로 떨어졌고, 수정 손실은 85%까지 올라갔습니다. 원문은 같은 유형의 $(a^3+b)\bmod97$에서 60%에서 21%로 떨어진 사례도 보고합니다. 원문 §4 및 그림 2
📖 Chapter 5: Margin Equilibria
마진이 표준 fp32 절벽 16.6을 지나도 수정 손실에서 계속 훈련할 수 있습니다. 다만 감쇠가 있던 그림 2의 위쪽에서는 18 부근에서 마진이 평평해집니다. 저자들은 이를 계산 정밀도가 아니라 감쇠와 정규화된 업데이트가 이루는 균형으로 설명합니다. 매개변수 이동이 멈춘 점에서 각 좌표의 기울기 $G_i=\partial\mathcal L/\partial\theta_i$가 일정하면 $\hat M_i=G_i$, $\sqrt{\hat V_i}=\lvert G_i\rvert$로 놓을 수 있습니다.
식 (10)의 정상점에는 학습률이나 두 이동평균의 감쇠율이 남지 않습니다. 논문은 이 형태의 정상점을 RMSProp과 LaProp에도 연결합니다. $\epsilon=0$이면 0이 아닌 기울기를 자기 절댓값으로 나누므로 크기가 1입니다. 양의 ϵ에서는 기울기 크기가 ϵ보다 작아질 때 정규화 항이 $G_i/\epsilon$에 가까워집니다. 이 작은 업데이트가 반대 방향의 감쇠와 만나면 $\lvert G_i\rvert\approx\epsilon\lambda\lvert\theta_i\rvert$가 됩니다. 암기 이후 기울기 크기가 대략 $e^{-m}$에 비례한다는 분석을 붙이면 식 (11)의 근사 $m^\star(\epsilon)\approx\log(1/\epsilon)$가 나옵니다. 새 절벽값이 아니라 ϵ에 따라 균형 마진이 어떻게 이동하는지를 나타냅니다. 원문 §5, 식 (10)–(11) 및 그림 3
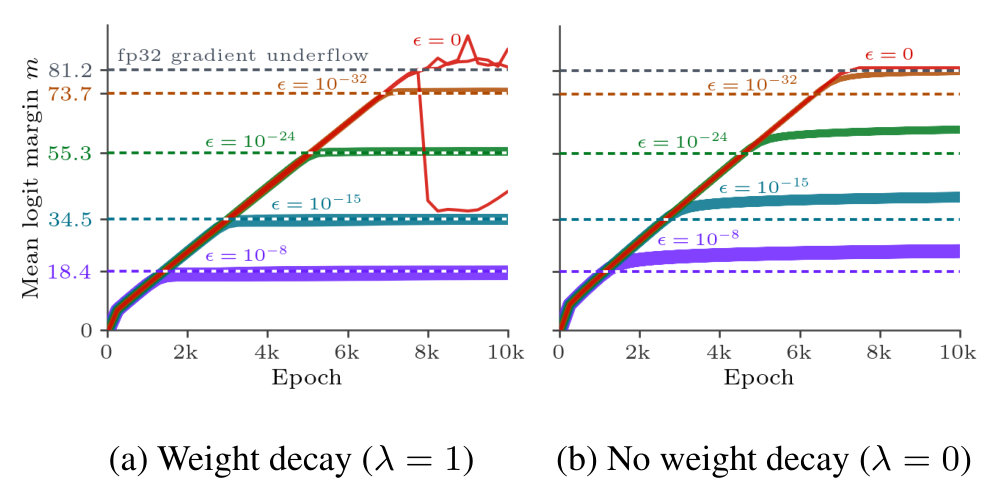
왼쪽은 감쇠가 있을 때 나타나는 ϵ별 마진 균형, 오른쪽은 감쇠를 제거한 뒤 예측선 위로 계속 올라가는 마진입니다. 그림 4 · Barron 외, v3 PDF 6쪽 · CC BY 4.0, 그래프 영역 크롭.
예를 들어 $\epsilon=10^{-8}$의 균형 예측값은 약 18.4입니다. fp32 표준 손실은 그보다 먼저 16.6 근처에 닿습니다. ϵ를 $10^{-7}$ 이상으로 두면 균형 마진의 예측값이 16.1 이하로 내려가 표준 구현도 그 앞에서 정착할 수 있습니다. 저자들은 더 작은 기울기에 접근할 때 제곱 자체가 언더플로되는 영향을 피하려고 그림 4의 LaProp에서는 2차 모멘트의 제곱근을 직접 갱신했습니다. 감쇠가 있고 ϵ가 양수인 조건에서는 예측값 근처에 도달했고, ϵ가 0인 조건에서는 마진 약 81.2에서 기울기가 언더플로됐습니다. 감쇠가 없으면 양의 ϵ가 업데이트를 줄여도 마진은 예측 높이를 지나 계속 커졌습니다. 원문 §5, 그림 4
📖 Chapter 6: Grokking Across Precisions and Benchmarks
대표 실험의 모델은 LayerNorm이 없는 1층·4헤드·폭 64 ReLU 트랜스포머입니다. 가능한 $(a+b)\bmod31$ 입력 쌍의 50%를 학습에 쓰고, AdamW로 10,000 에폭 동안 전체 배치를 학습했습니다. 학습률은 $10^{-3}$, 모멘트 계수는 0.9와 0.98, 가중치 감쇠는 1입니다. 비교 축은 손실 구현, 손실에서 로짓을 처리하는 정밀도인 bf16·fp32·fp64, 그리고 옵티마이저 ϵ입니다. 원문 §6
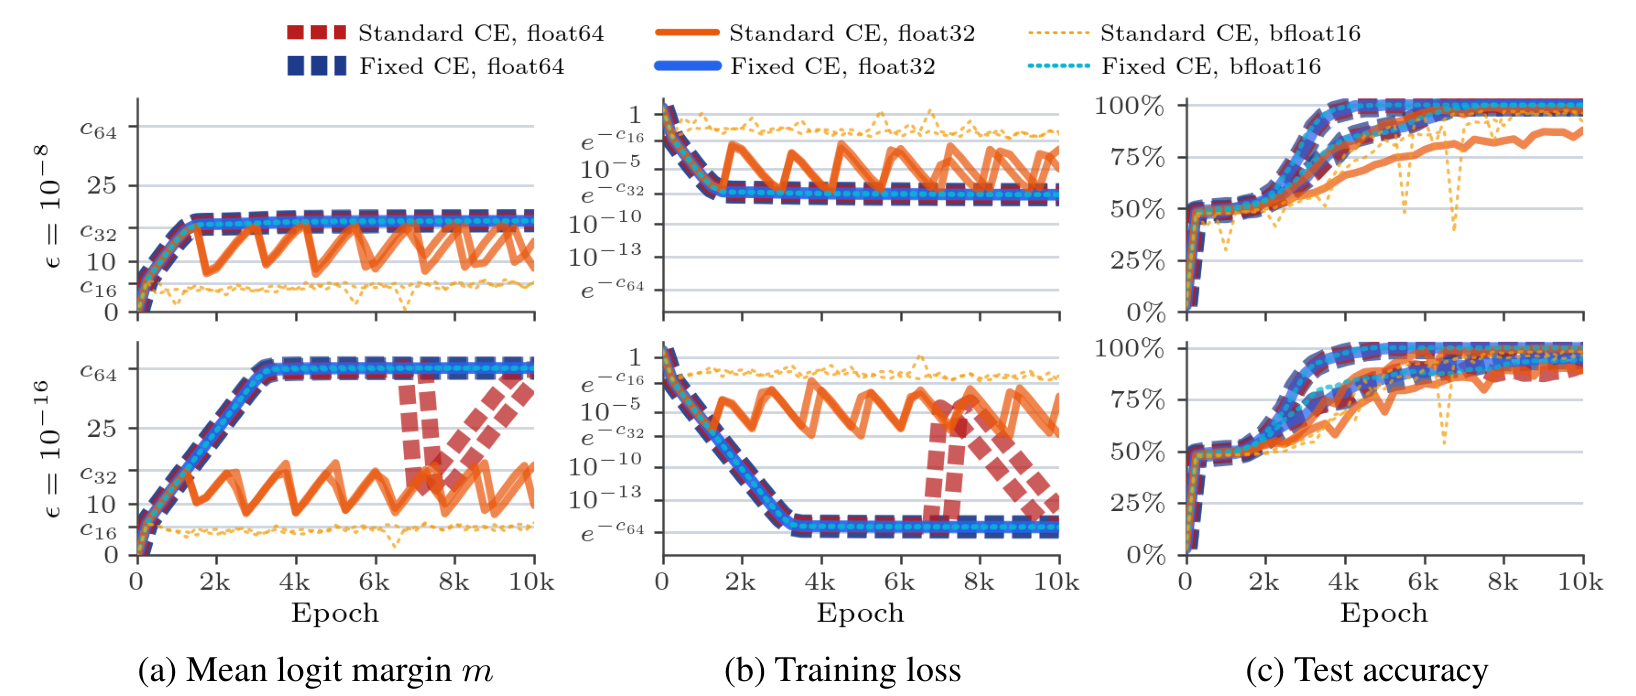
덧셈 실험에서 위쪽은 기본 ϵ 설정, 아래쪽은 fp64 절벽도 넘는 작은 ϵ 설정입니다. 다섯 시드 중 두 시드의 궤적입니다. 그림 5 · Barron 외, v3 PDF 7쪽 · CC BY 4.0, 그래프 영역 크롭.
$\epsilon=10^{-8}$에서 일반 bf16 손실의 마진은 약 5.5 부근에 머물렀고, 일반 fp32 손실은 약 16.6에 닿으며 반복해서 급등했습니다. 수정 손실은 두 경계를 지나 세 정밀도 모두 테스트 정확도 평균을 표의 반올림 기준 100.0%까지 올렸습니다. $\epsilon=10^{-16}$의 균형 예측값은 36.8로 fp64 절벽 36.7보다 높습니다. 이때 표준 fp64에서도 급등이 나타났습니다. 원문 §6 및 그림 5
원문의 표 1은 아래와 같습니다. 각 셀의 앞쪽은 테스트 정확도(%), 뒤쪽은 최종 마진입니다. 각 조건에 무작위 시드 3–5개를 사용했습니다. 원문 표 1
| 손실과 로짓 정밀도 | ϵ = 10⁻⁸ 정확도 / 마진 | ϵ = 10⁻¹² 정확도 / 마진 | ϵ = 10⁻¹⁶ 정확도 / 마진 |
|---|---|---|---|
| fp32 수정 CE | 100.0 ± 0.0 / 17.9 | 99.6 ± 0.7 / 27.4 | 99.0 ± 2.3 / 36.8 |
| fp32 표준 CE | 94.3 ± 5.4 / 13.0 | 96.4 ± 5.1 / 15.1 | 96.5 ± 4.3 / 12.7 |
| bf16 수정 CE | 100.0 ± 0.1 / 17.9 | 99.8 ± 0.2 / 27.4 | 98.9 ± 2.4 / 36.8 |
| bf16 표준 CE | 93.3 ± 7.4 / 5.1 | 94.9 ± 4.9 / 5.6 | 94.2 ± 8.3 / 5.8 |
| fp64 수정 CE | 100.0 ± 0.0 / 17.9 | 99.5 ± 1.1 / 27.4 | 99.0 ± 2.0 / 36.8 |
| fp64 표준 CE | 100.0 ± 0.0 / 17.9 | 100.0 ± 0.1 / 27.4 | 97.2 ± 3.2 / 30.1 |
| fp32 Zero-sum Proj. | 97.9 ± 3.2 / 17.0 | 48.9 ± 2.6 / 18.9 | 49.3 ± 2.5 / 18.9 |
| fp32 StableMax | 97.3 ± 4.7 / 3200 | 95.6 ± 2.0 / 5661 | 97.3 ± 4.3 / 6313 |
| fp64 StableMax | 97.4 ± 4.2 / 3170 | 96.7 ± 5.3 / 21252 | 95.6 ± 2.7 / 2322 |
Liu 등의 Zero-sum Proj.는 로짓 기울기 각각에서 평균을 뺍니다. 이 방식은 급등을 없애지만, 이미 정답 항이 0인 상황에서 평균만 빼면 정답 항으로 돌아가는 것은 비정답 합의 $1/K$만큼입니다. 이 실험에서는 마진이 약 18에 머물렀고 두 작은 ϵ에서 정확도가 50% 아래였습니다. Prieto 등의 StableMax는 지수 함수를 입력이 0 이상이면 $x+1$, 음수이면 $1/(1-x)$인 함수로 바꿉니다. 이 실험의 최종 마진은 수천에서 2만 이상까지 커졌고 테스트 정확도는 수정 CE보다 낮았습니다. 원문 §6, 표 1
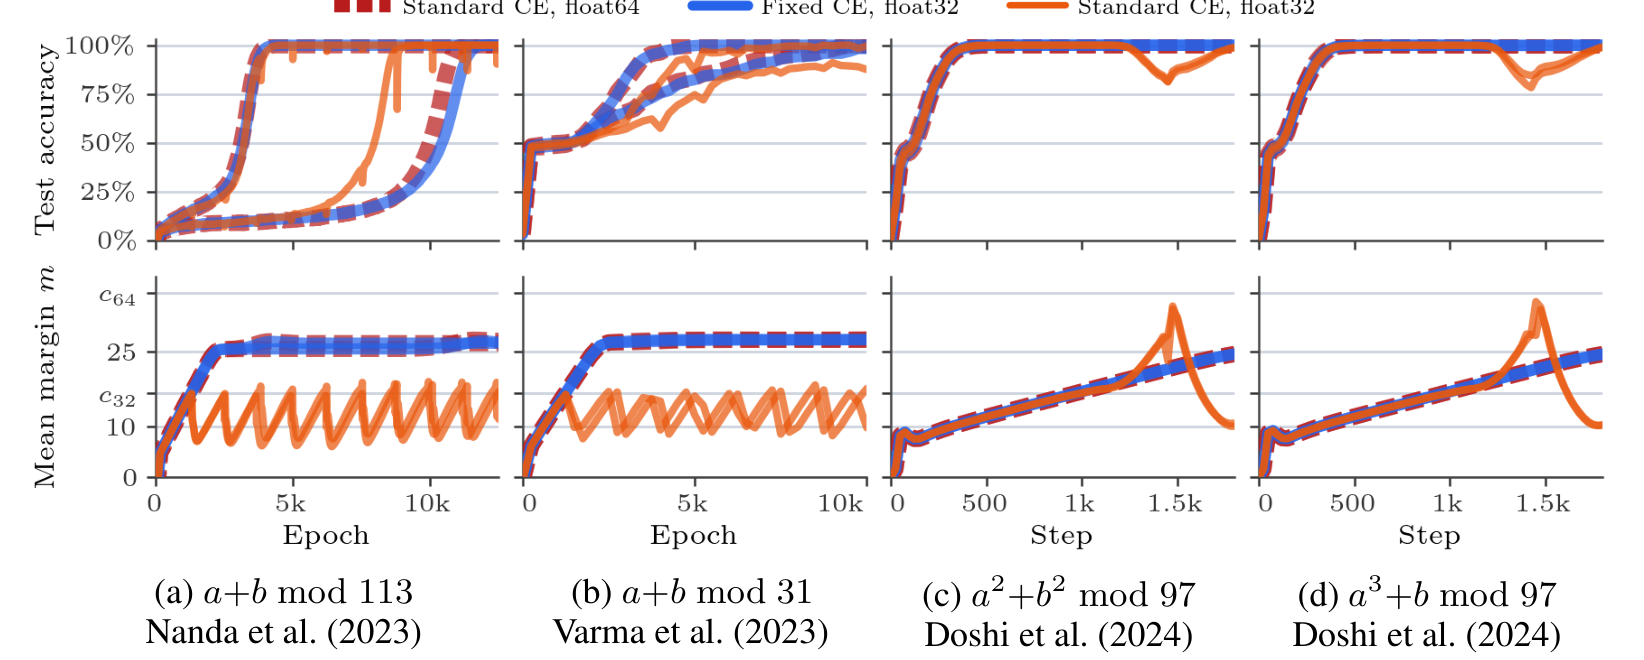
위는 테스트 정확도, 아래는 로짓 마진입니다. 왼쪽 두 열은 덧셈 트랜스포머, 오른쪽 두 열은 다항식 MLP입니다. 그림 6 · Barron 외, v3 PDF 8쪽 · CC BY 4.0, 그래프 영역 크롭.
저자들은 ϵ를 $10^{-12}$로 고정해 네 과제에서 같은 현상을 확인했습니다. 덧셈의 두 법수는 113과 31로, 한 층 트랜스포머와 감쇠 1을 사용했습니다. 법수가 97인 제곱합과 세제곱 덧셈은 2층 MLP와 감쇠 0.2를 사용했습니다. 표준 fp32는 각 과제에서 절벽에 닿자 급등했고 수정 fp32는 표준 fp64에 가까운 학습 궤적을 보이며 테스트 정확도 100%에 도달했습니다. 이 비교는 서로 다른 모듈러 산술 문제와 두 모델 형태 내에서의 관찰입니다. 원문 §6과 그림 6
📖 Chapter 7: Soft-Target Distillation
교사와 학생이 같은 로짓을 내면 분류에서처럼 정확도가 높을 뿐 아니라 이론상 학생 기울기 자체가 0입니다. 저자들은 $(a+b)\bmod53$에서 정확도 100%에 도달한 2층 ReLU MLP 교사의 fp32 가중치를 학생의 초기값으로 복사했습니다. 50% 학습 분할에서 Adam으로 전체 배치 2,000 스텝을 돌렸으며 학습률은 $2\times10^{-3}$, 모멘트 계수는 0.9와 0.98, 가중치 감쇠는 0, ϵ는 $10^{-8}$입니다. 온도는 4로 설정했습니다. 로짓을 4로 나눠 교사 분포를 부드럽게 유지하고, 스케일된 마진을 bf16 절벽보다 낮추기 위해서입니다. 원문 §7
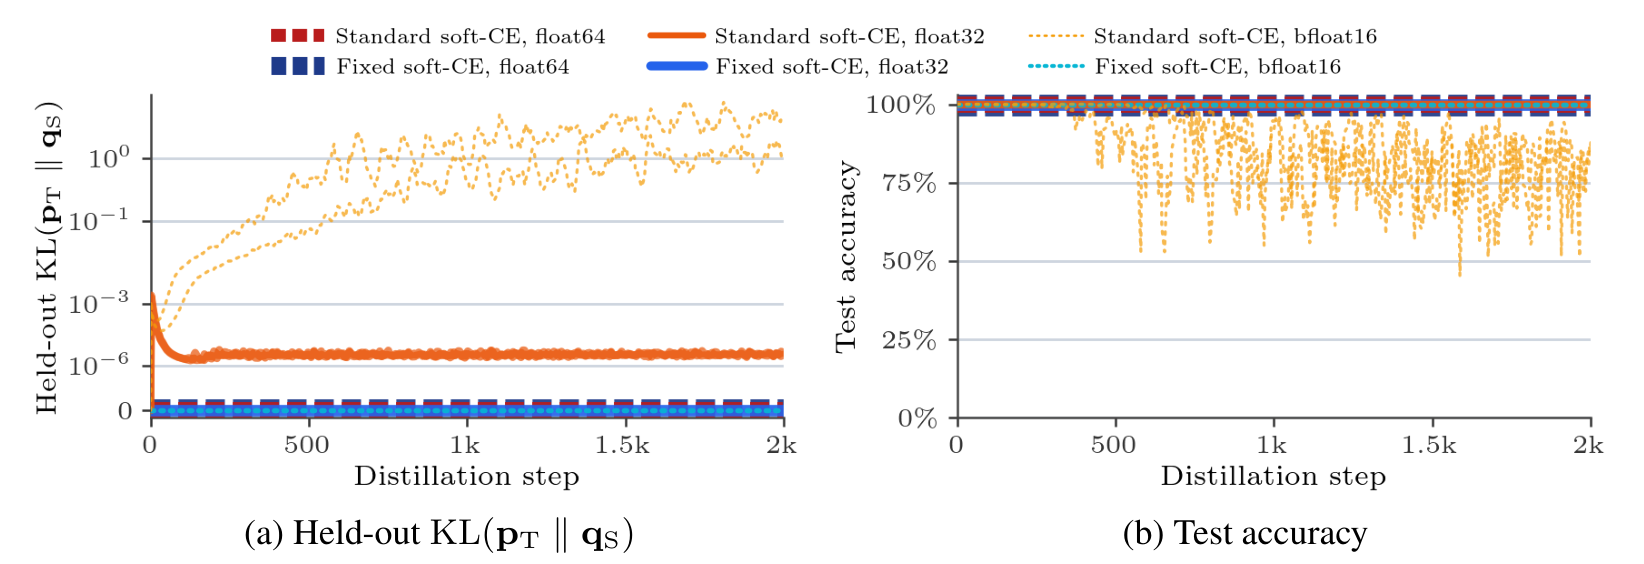
왼쪽 (a)는 별도 데이터에서 교사와 학생의 KL 발산, 오른쪽 (b)는 학생 정확도입니다. 세 시드 중 두 시드를 표시했습니다. 그림 7 · Barron 외, v3 PDF 8쪽 · CC BY 4.0, 그래프 영역 크롭.
표준 손실의 잔여 기울기는 bf16에서 약 $10^{-3}$, fp32에서 약 $10^{-8}$, fp64에서 약 $10^{-17}$였습니다. bf16에서는 Adam이 이 오차를 학습 신호처럼 증폭했고 학생이 교사에서 멀어지며 정확도도 떨어졌습니다. fp32에서는 초기 KL 급등 후 약 $10^{-6}$의 바닥값이 남았고, fp64에서는 업데이트가 저장된 fp32 가중치를 바꿀 만큼 크지 않았습니다. 수정 손실은 세 정밀도에서 학생을 KL 0, 정확도 100%에 유지했습니다. 원문 §7과 그림 7
📖 Chapter 8: Conclusion
저자들은 두 오류의 공통점을 함수의 출력에서 작은 차이를 복원하려다 정밀도를 잃는 데서 찾습니다. 정답 확률이 반올림되기 전에 다른 클래스의 질량을 꺼내거나, 학생과 교사의 로짓 차이를 로그 공간에서 먼저 처리하면 같은 손실이 필요한 기울기를 돌려줄 수 있습니다. 논문이 점검한 극단적으로 큰 마진과 거의 같은 학생·교사 로짓은 일반적인 대규모 학습에서는 드문 조건이라고 저자들은 덧붙입니다. 원문 §8
v3 정오표. 이전 버전의 공개 코드에는 인과적 어텐션 마스킹처럼 하나를 제외한 로짓이 사실상 음의 무한대일 때 NaN 기울기가 생기는 문제가 있었습니다. 합 $s$가 0이 된 경우 softplus(log(s))는 순전파 값이 0이어도 자동 미분이 log(0)을 통과합니다. 최신 코드는 log1p(s)에서 직접 작은 합을 처리합니다. 저자들은 논문 수치에 쓰인 내부 코드에는 이 오류가 없었다고 설명합니다. 원문 끝에는 감사의 글, 이 정오표와 참고문헌이 이어집니다. v3 PDF 8–10쪽
실험 결과 심층 분석
표 1에서 정확도만 읽으면 $\epsilon=10^{-16}$인 fp32에서 표준 96.5%, 수정 99.0%라는 차이가 보입니다. 같은 조건의 최종 마진은 12.7과 36.8입니다. 여기에는 앞의 정확도 차이보다 더 직접적인 원인 검증이 들어 있습니다. 낮은 정밀도의 표준 구현은 예측된 균형 높이까지 가지 못했고, 수정 구현은 fp32와 fp64에서 동일하게 36.8에 도달했습니다. 반대로 $\epsilon=10^{-12}$인 fp64에서는 마진이 양쪽 모두 27.4이고 표의 정확도 평균은 표준 쪽이 100.0%, 수정 쪽이 99.5%입니다. 당시 균형 높이가 fp64 절벽 아래라는 설명과 맞습니다. 원문 표 1
그림 2의 급등과 그림 7의 증류 이탈은 같은 옵티마이저 분모가 다른 상황에서 어떻게 작용하는지 보여 줍니다. 전자에서는 사라졌다 돌아온 기울기가 이전 스텝의 작은 2차 모멘트와 만납니다. 후자에서는 초기 2차 모멘트가 작은 상태에서 반올림으로 남은 기울기가 그대로 업데이트에 들어갑니다. 정확도는 큰 변화만 보여 주는 반면, 손실·마진·KL에는 그보다 앞선 수치 변화가 드러납니다. 원문 그림 2 · 그림 7
표 1의 ± 값은 원문 표기를 따랐습니다. 신뢰구간이나 유의성 검정은 원문에 보고되지 않았으며, 표는 조건별 3–5개 시드의 결과를 제공합니다. §2–3에는 핵심 손실의 JAX 코드와 수치 예제가 실려 있고, §6–7에는 모델 형태, 배치 방식, 정밀도와 주요 학습 설정이 나옵니다. 논문은 실험에 내부 구현을 사용했다고 명시합니다. 원문 §6–7과 정오표
기술적 함의와 응용
이 연구의 분류 실험에서 가장 직접적인 차이는 정답 쪽 미분이 끊기는 마진을 넘어 학습할 때 나타납니다. 비정답 확률이 표현 가능한데도 정답 기울기가 0이라면, 같은 크기로 반대쪽을 당기는 신호가 사라집니다. 옵티마이저가 그 기울기를 얼마나 확대할지는 해당 실행의 ϵ와 이동평균에 달려 있습니다. 그래서 저자들은 정밀도를 올리는 비교와 별도로 손실 공식을 바꾸는 실험을 수행했습니다. 원문 §4–6
증류에서는 학생이 교사와 거의 같아진 시점의 기울기가 같은 역할을 합니다. 이때 논문의 구현은 교사 확률 외에 교사 로짓을 입력으로 받습니다. 두 예측을 확률로 저장한 뒤에는 차이를 계산할 로짓 정보가 이미 사라질 수 있기 때문입니다. 분류에서는 전체 비정답 질량을, 증류에서는 확률로 변환하기 전의 두 모델 차이를 중간 계산에서 살려 두는 것이 논문이 보여 준 두 해법입니다. 원문 §3 및 §7