논문 개요와 전체 구조
문자 분류 모델에게 비슷한 글자 두 종류와 그날 정한 번호를 보여 주고, 세 번째 글자의 번호를 묻는다고 해 보겠습니다. 모델은 지금 받은 예시에서 규칙을 읽을 수 있습니다. 같은 글자에 언제나 같은 번호가 붙는 환경이라면 학습 중 가중치에 저장한 대응도 쓸 수 있습니다. Ferdinand Kapl, Kaitlin Maile, Stefan Bauer, Johannes von Oswald는 트랜스포머의 깊이를 만드는 방식이 이 두 풀이의 획득과 유지에 어떤 영향을 주는지 살펴봅니다. 2026년 10월 22일 제출된 arXiv v1을 기준으로 읽었습니다. arXiv v1
비교 대상은 처음부터 전체 깊이로 학습한 dense 모델, 얕게 시작해 학습 중 층을 복제한 성장 모델, 같은 층을 한 번의 순전파에서 여러 번 호출하는 루프 모델입니다. 자연어 실험에서는 뒤쪽 토큰의 예측 손실과 프롬프트 예시를 활용하는 능력을 각각 측정합니다. 이어 합성 언어와 문자 분류에서 문맥에만 들어 있는 규칙을 시험하고, 어텐션 헤드의 복제 계보 및 개입 결과를 추적합니다. 원문 1절
| 순서 | 원문의 질문 |
|---|---|
| 1 Introduction | 깊이를 만드는 방식에 따라 문맥을 쓰는 법이 달라지는가? |
| 2 Related Work | 네트워크 성장, 층 반복, 문맥 내 학습 연구가 각각 무엇을 밝혔는가? |
| 3 In-Context Learning of Depth-Grown and Looped Models | 3.1 모델과 지표 → 3.2 자연어 → 3.3 RegBench → 3.4 Omniglot |
| 4 Growing and Looping Increase Reliance on Induction Heads | 4.1 학습 중 헤드 추적 → 4.2 최종 모델의 헤드 개입 |
| 5 Conclusion | 실험이 뒷받침하는 주장과 저자의 가능한 설명은 무엇인가? |
| 부록 A–F | 사전학습 조건 → 자연어 평가 → RegBench → Omniglot → 헤드 추적·중간층 판독 → 평균 개입 |
핵심 기여와 혁신성
문제가 달라지면 프롬프트 안에서 예시를 활용하는 능력과 가중치에 익힌 지식을 사용하는 능력의 비중도 달라집니다. 일반 벤치마크 점수가 올라도 어떤 풀이가 개선됐는지 알아내려면 평가에 별도의 대조가 필요합니다. 이 논문은 학습 초기에 언제 문맥 풀이가 나타나는가, 가중치로도 풀 수 있는 조건에서 그 풀이가 얼마나 유지되는가, 최종 모델에서 어느 헤드의 출력에 얼마나 의존하는가를 서로 다른 실험으로 묻습니다. 원문 1–3절
깊이 성장과 루프의 공통점은 이미 존재하는 층의 계산을 다른 깊이 위치에서도 사용한다는 점입니다. 성장 쪽에는 복제 전후의 계보가 있고, 루프 쪽에는 동일한 가중치로 이뤄지는 별개의 호출이 있습니다. 저자들은 성장에서 초기 induction 헤드가 실제로 복제돼 여러 층에 남는 것을 추적하고, 두 방식에서 induction 순위가 높은 헤드들을 개입했을 때 대조 모델보다 후반 토큰과 few-shot F1에 더 큰 변화가 나타나는 조건을 확인합니다. 이 절차 덕분에 최종 정확도, 학습 시점, 헤드의 관련성을 따로 읽을 수 있습니다. 원문 4절
기술적 세부사항
깊이와 가중치 개수. 한 층을 두 번 호출하면 가중치 집합은 하나이고 순전파에는 두 층에 해당하는 계산이 생깁니다. 루프 표기에서 $p$는 앞부분, $b$는 공유 블록의 길이, $r$은 적용 횟수, $c$는 뒷부분입니다. 식의 왼쪽은 순전파 중 층 적용 횟수, 오른쪽은 독립 가중치를 가진 층의 수입니다. 레이어 수는 임베딩을 포함한 전체 모델의 파라미터 수와 별개입니다. 원문 3.1절·부록 A.2
세 가지 관찰 단위. 자연어의 다음 토큰 예측은 실제 다음 토큰에 얼마나 높은 확률을 주는지 봅니다. RegBench는 새 문법에 맞는 가능한 다음 기호들의 분포를 봅니다. Omniglot은 새 클래스의 문맥 속 라벨을 알아맞히는 검정과 오래전 학습한 라벨을 회상하는 검정을 나눕니다. 프롬프트 내 예시로 과제 자체를 푸는 능력이 궁금하다면 자연어의 위치별 토큰 손실과 별개로 GSM8K 정확도나 19개 과제의 F1을 읽어야 합니다. 원문 3절·부록 B–E
헤드 진단과 개입. Prefix matching score(PS)는 반복된 임의 토큰열에서 이전에 같은 토큰 뒤에 붙었던 위치를 어텐션이 얼마나 보는지 측정합니다. Function-vector score(FV)는 예시 라벨을 섞어 놓은 프롬프트에 해당 과제의 정상 헤드 출력 평균을 넣었을 때 정답 첫 토큰의 확률이 얼마나 회복되는지 측정합니다. 최종 평균 제거 실험에서는 반대로 선정된 헤드의 그때그때 출력을 고정된 평균으로 바꿔, 원래 모델에 비해 성능이 얼마나 바뀌는지 봅니다. 원문 4절·부록 E.1, F.1
챕터별 상세 리뷰
📖 Chapter 1: Introduction
저자들이 첫머리에서 구분하는 것은 깊이를 얻는 과정입니다. 성장 모델은 얕은 신경망을 먼저 학습한 뒤 층을 복제합니다. 루프 모델은 한 순전파 안에서 공유 층에 중간 표현을 다시 넣습니다. 두 모델에서 비슷한 반복 계산이 나타날 수 있다는 앞선 관찰에서 출발해, 그 계산이 새 문맥을 쓰는 방식도 바꾸는지 질문합니다.
문맥 내 학습(in-context learning, ICL)은 모델의 가중치를 갱신하지 않고도 해당 입력에 포함된 정보를 사용하는 능력입니다. 가중치 내 학습(in-weights learning, IWL)은 이전 훈련에서 지속되는 대응을 가중치에 익히는 능력입니다. 문장 뒤편의 다음 토큰 예측이 쉬워지는 현상과 예시를 보고 새 과제를 푸는 현상도 따로 검정합니다. 저자들은 360M–3B의 언어 모델, 문법 학습, 이미지 분류, 그리고 헤드 개입을 순서대로 연결합니다. 원문 1절
📖 Chapter 2: Related Work
Grown Models. 먼저 작은 모델에서 시작하는 학습 절감 전략을 층 복제, 학습된 크기 변환, 함수를 보존하는 확장으로 나눠 짚습니다. MIDAS는 미리 정의된 블록 중 중앙에 가까운 블록을 복제합니다. LIDAS는 과거에 만들어진 블록의 경계와 관계없이 현재 네트워크의 한가운데에 있는 층을 고릅니다. 어느 위치를 복제하느냐에 따라 나중에 크게 기여하는 층의 배치가 달라질 수 있다는 배경입니다.
Looped Models. Universal Transformer, 번역용 반복 스태킹, ALBERT와 같은 파라미터 공유 연구에서 출발해, 층별 어댑터나 전문가 혼합(MoE)으로 표현력을 늘리거나 반복 횟수로 추론 연산을 조절하는 연구를 소개합니다. 기존 사전학습 모델에 반복 구조를 도입하는 연구도 함께 다룹니다. 이 논문에서는 지정한 순전파 깊이에서 공유 블록을 반복하는 모델을 사용합니다.
In-Context Learning. 문맥에서 처음 보는 함수나 문법을 추정하는 실험, 같은 클래스가 한 입력에 몰려 나타나는 데이터의 효과, 그리고 학습 중 고정 대응을 익히면서 ICL이 약해지는 현상을 연결합니다. Induction 헤드는 토큰 반복 패턴을 복사하는 메커니즘과 연관되고, FV 헤드는 예시로부터 과제 표현을 전달하는 것으로 연구돼 왔습니다. 이런 배경에서 3절은 행동을 시험하고 4절은 특정 헤드의 진단과 개입을 구분합니다. 원문 2절
📖 Chapter 3: In-Context Learning of Depth-Grown and Looped Models
3.1 Models and Evaluation Measures
Dense 모델의 층은 처음부터 각각 독립적입니다. 성장 모델은 네 층에서 출발해 성장 시점마다 네 층을 붙입니다. 층의 가중치와 옵티마이저의 1·2차 모멘트를 함께 복제하고, 새 층과 원래 층은 이후 각자 업데이트됩니다. 루프는 같은 블록이 여러 위치에서 받는 기울기를 동일한 파라미터에 누적합니다. 3B 비교의 LIDAS는 최종 36층이고, Loop 10–8×2–10은 10층을 지난 다음 8층을 두 번 적용하고 10층을 더 지나므로 36회 적용에 고유한 층 28개(약 2.45B 파라미터)를 씁니다. 원문 3.1절·부록 A
3B 세 모델은 1,000억 토큰의 데이터와 순서, 42,400회의 옵티마이저 업데이트, 최종 추론 FLOPs가 같습니다. 훈련 FLOPs는 LIDAS가 얕은 시기를 거쳐 3B에서 약 26%, 360M·1.7B에서 각각 약 22% 절약하는 것으로 추산됩니다. 루프 모델은 같은 유효 깊이에서 고유 파라미터 수를 줄입니다. 논문의 ‘3B’는 비교 집단을 정의하는 dense 모델의 크기입니다. 원문 3.1절·부록 A
3.2 Context Use in Language Models
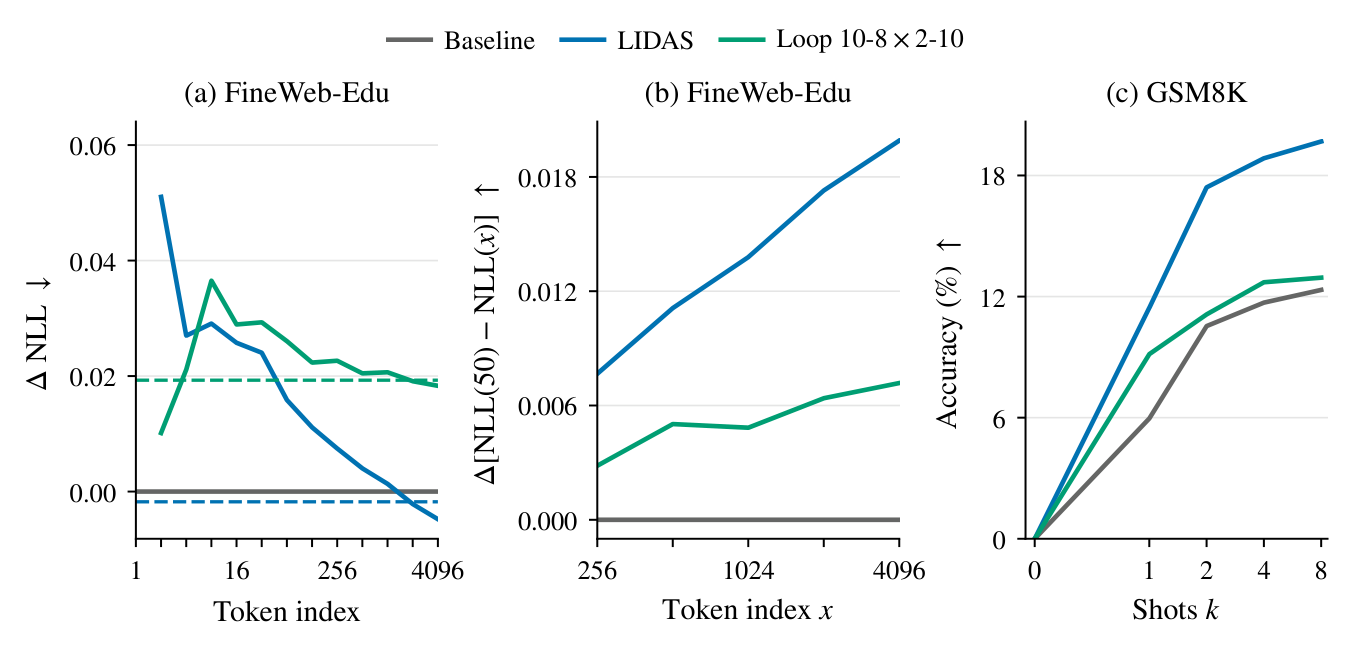
그림 1. FineWeb-Edu의 위치별 손실과 초기 대비 개선 폭, GSM8K의 예시 수별 정확도입니다. Ferdinand Kapl 외, arXiv v1 PDF 4쪽, CC BY 4.0. PDF 영역 크롭, 번역 없음.
그림 1(a)는 같은 위치 구간에서 각 모델의 NLL과 dense NLL을 비교합니다. 성장과 루프 모델은 초반 예측 손실이 높고, 차이는 첫 8토큰 이내에서 특히 큽니다. LIDAS는 약 1,000번째 토큰 부근에서 dense 수준에 도달한 뒤 뒤쪽 구간과 전체 위치 평균에서 더 낮은 손실을 보입니다. 루프는 최장 문맥까지 손실이 dense보다 높습니다. 그림 1(b)에서는 초기 40–60 위치에서 각 후반 구간까지 모델 내부의 손실 감소 폭을 구하고 dense의 감소 폭을 뺍니다. 이 도표에서는 LIDAS와 루프가 모두 양수입니다. 두 그림을 함께 보면 루프의 손실이 더 많이 줄면서도 여전히 높게 남는 상황을 볼 수 있습니다. 원문 3.2절·부록 B.2
(c)의 GSM8K는 풀이를 생성한 뒤 최종 답을 추출해 정확히 일치하는지 봅니다. 3B에서 루프 곡선은 예시가 주어지는 범위에서 dense보다 높지만 8-shot에서는 차이가 작아집니다. 그림상 8-shot은 dense 약 12%, LIDAS 약 20%, 루프 약 13%입니다. LIDAS와 dense 간 격차는 약 7%p로 읽힙니다. 0-shot에서는 그래프상 모두 0% 부근입니다. 객관식 5과제·생성 3과제를 나눈 부록 평가에서는 3B LIDAS가 두 집합에서 앞서고, 루프의 이점은 생성 과제에 집중됩니다. 원문 3.2절·그림 1, 9
3.3 In-Context Learning Languages: RegBench Dataset
RegBench에서 한 입력에 들어 있는 여러 문자열은 하나의 결정적 유한 오토마톤(DFA)에서 뽑습니다. DFA를 상태와 상태 사이의 기호 붙은 화살표로 생각하면 됩니다. 현재 상태에서 화살표를 따라갈 수 있는 기호가 다음에 올 수 있는 기호입니다. 테스트는 처음 보는 DFA로 이뤄져 있으므로 모델은 현재 입력 안의 문자열에서 규칙을 짐작해야 합니다. 원문 실험은 dense 12층, 공유 2층을 6회 적용하는 Loop 2×6, 깊이 3층에서 시작하는 성장 모델을 비교합니다. 원문 3.3절·부록 C.1
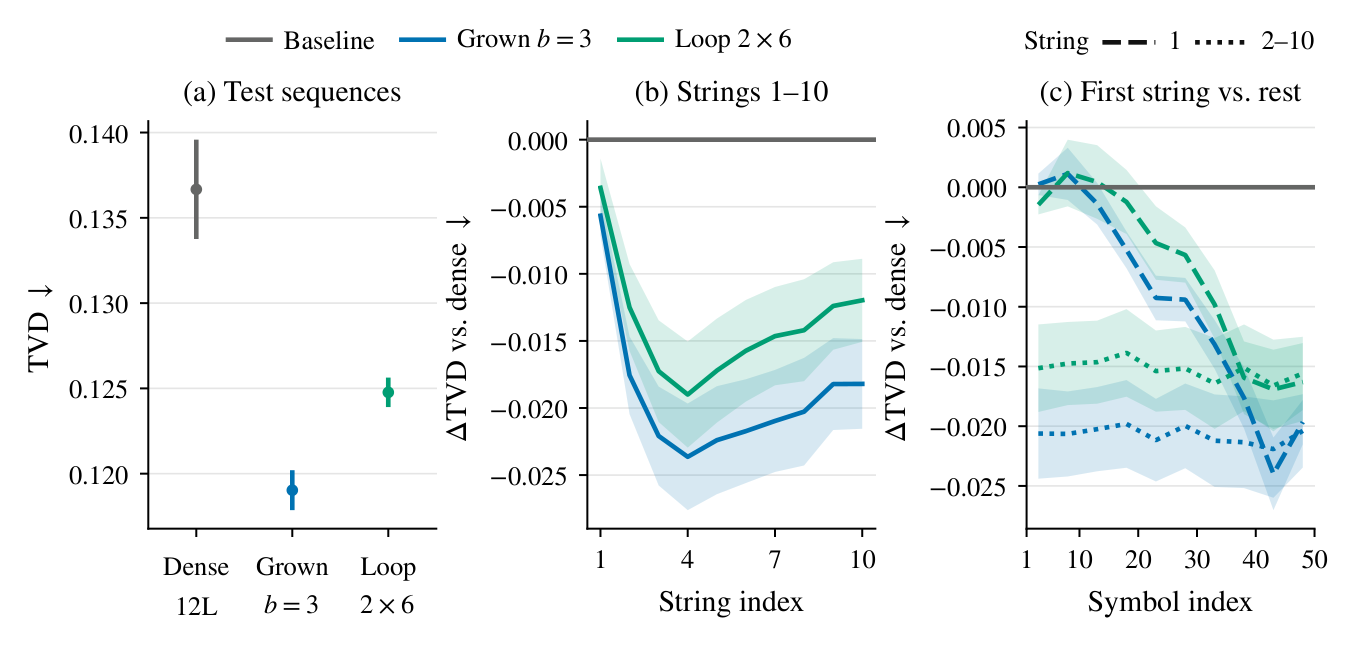
그림 2. (a)는 테스트 전체의 TVD, (b)는 문자열 번호에 따른 차이, (c)는 첫 문자열과 그 이후 문자열의 기호 위치별 차이입니다. Ferdinand Kapl 외, arXiv v1 PDF 5쪽, CC BY 4.0. PDF 영역 크롭, 번역 없음.
전체 TVD는 그림에서 dense 약 0.137, 성장 약 0.119, 루프 약 0.125입니다. 격차는 네 번째 문자열 전후에서 최대에 가깝습니다. 첫 문자열 안에서도 약 15개 기호를 보고 나면 성장과 루프가 앞섭니다. 뒤이은 문자열에서는 각 문자열 안에서 기호를 더 읽더라도 dense 대비 이점이 대체로 평탄하게 유지됩니다. 이 비교에서 세 모델의 유효 깊이는 12층이고, 검증으로 뽑힌 루프 폭은 256, 다른 두 모델 폭은 128입니다. 원문 그림 2·부록 C.2–C.4
3.4 In-Context and In-Weights Learning: Omniglot
Omniglot에서 한 입력은 여덟 개 이미지–라벨 쌍과 질의 이미지 하나로 이뤄집니다. 학습에서 항상 같은 글자 종류에 같은 번호를 붙이고, 질의 종류의 사진을 예시에 여러 장 넣으면 현재 예시를 읽는 풀이와 학습 중 익힌 대응을 쓰는 풀이가 모두 정답을 맞힐 수 있습니다. 평가는 두 풀이를 갈라 보도록 구성합니다. ICL 검정에는 학습에서 뺀 글자와 입력마다 다시 정한 번호를 쓰고, IWL 검정에는 학습한 글자와 고정 번호를 쓰되 질의 종류가 예시에 들어오지 않도록 합니다. 원문 3.4절·부록 D
설명용으로 모양 A와 B를 쓴 예를 들어 보겠습니다. 어떤 입력이 A의 예시에 0, B에 1을 붙였다면 질의 A의 답은 0입니다. 다음 입력에서 같은 A에 1, B에 0을 붙이면 답은 1로 바뀝니다. 두 입력의 질의에는 예시와 다른 사진을 씁니다. 이 조건에서는 모양을 알아본 뒤 번호를 현재 예시에서 읽어야 합니다. 고정 라벨 검정에서 A의 번호를 항상 57로 두고 A 사진을 예시에서 빼면, 질의 A를 맞히는 모델은 학습 중 익힌 57을 불러와야 합니다. 숫자와 글자는 설명을 위한 예시입니다. 원문 부록 D.2–D.3
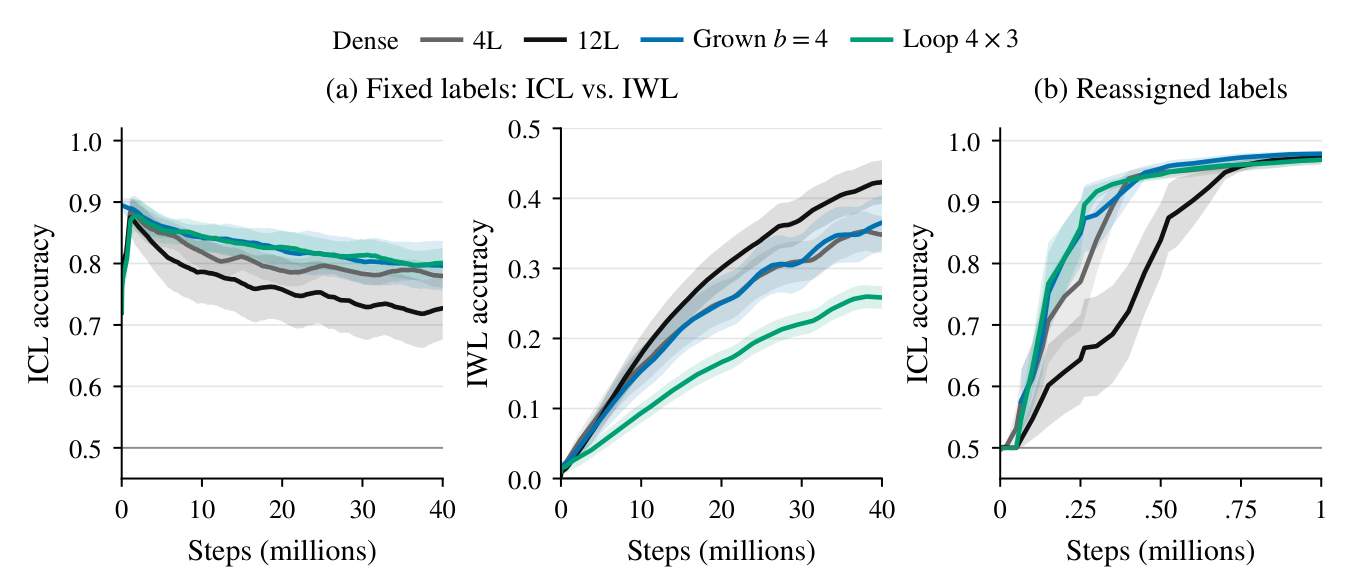
그림 3. (a)는 고정 라벨 훈련에서 분리 측정한 ICL과 IWL, (b)는 시퀀스마다 라벨을 재할당하는 훈련에서의 ICL입니다. Ferdinand Kapl 외, arXiv v1 PDF 6쪽, CC BY 4.0. PDF 영역 크롭, 번역 없음.
고정 라벨 조건에서 ICL은 먼저 올라간 뒤 점차 약해지고, IWL은 올라갑니다. 4→8→12층 LIDAS와 Loop 4×3은 dense 12층보다 ICL을 더 유지하며 IWL은 더 낮습니다. 성장 모델의 두 곡선은 복제 전 출발점을 공유한 dense 4층과 비슷합니다. 루프는 성장 모델과 비슷한 ICL을 보이며 IWL은 더 낮습니다. 입력마다 라벨을 재할당하는 ICL-only 훈련은 두 클래스의 네 장씩을 예시로 넣습니다. 성장, 루프, dense 4층의 ICL이 dense 12층보다 먼저 나타나지만 100만 스텝 무렵에는 네 모델이 모두 100%에 가까워집니다. 두 번째 조건에서 나타나는 차이는 학습 시점과 곡선입니다. 원문 3.4절·부록 D.3
📖 Chapter 4: Growing and Looping Increase Reliance on Induction Heads
4.1 Depth Growth Propagates Early Induction Heads
반복열 X Y Z X Y Z에서 두 번째 X를 처리하는 헤드가 첫 번째 X 바로 다음의 Y에 주의를 주면 PS가 올라갑니다. 앞쪽 순서가 반복되는 문맥에서 다음 토큰을 끌어올 수 있는 패턴입니다. 논문은 서로 다른 임의 토큰 50개를 두 번 붙인 긴 반복열로 이 동작을 진단합니다. FV는 과제의 올바른 헤드 출력을 라벨을 섞은 문맥에 주입해 정답의 첫 토큰 확률 회복을 측정합니다. 이 두 점수는 헤드 선정에 쓰이고, 성능 효과는 4.2절에서 따로 측정합니다. 원문 4.1절·부록 E.1
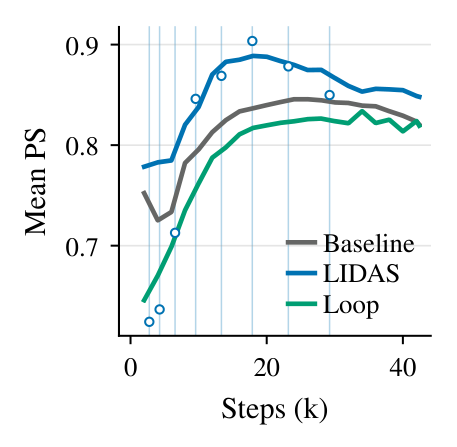
그림 4. 체크포인트마다 고른 PS 상위 2%의 평균입니다. 세로선은 성장 시점, 빈 원은 복제 직후 추가 학습 전 점수입니다. Ferdinand Kapl 외, arXiv v1 PDF 7쪽, CC BY 4.0. PDF 영역 크롭, 번역 없음.
평균 그림에서는 LIDAS가 복제 직후 점수가 떨어졌다가 회복하며, 최종 PS는 dense보다 높습니다. 루프의 최종 평균은 dense와 가깝습니다. 여기서 시점마다 선정하는 헤드 구성은 달라질 수 있습니다. 저자들은 그림 5에서 최종 상위 12개를 고정하고, 이들이 어떤 이전 층에서 왔는지 복제 지도를 역으로 따라갑니다. 원문 4.1절·부록 E.2
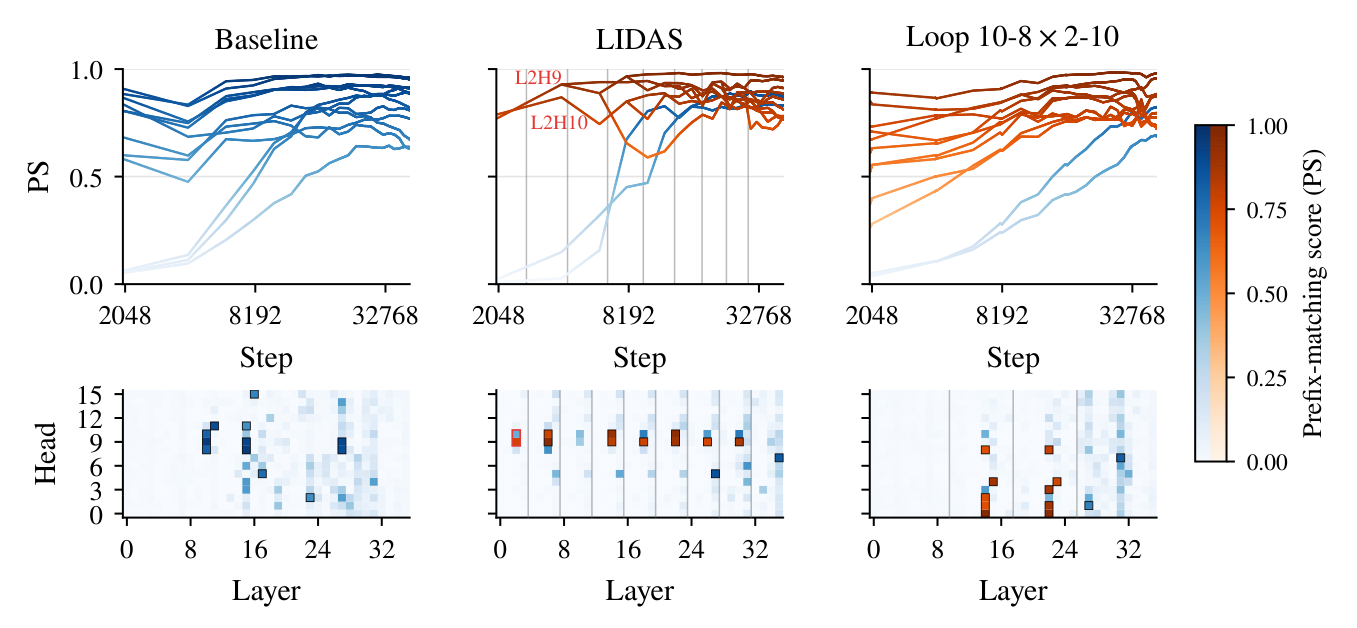
그림 5. 위는 최종 PS 상위 헤드의 학습 이력, 아래는 전체 헤드의 최종 점수입니다. Ferdinand Kapl 외, arXiv v1 PDF 8쪽, CC BY 4.0. PDF 영역 크롭, 번역 없음.
LIDAS의 최종 12개 헤드는 최초 네 층 모델의 네 조상에서 왔습니다. 그중 첫 성장 전에 이미 PS가 높았던 L2H9와 L2H10에서 10개가 나왔습니다. 인덱스는 0부터 셉니다. 원래 L2H10의 점수는 높았지만 최종 상위 12개 밖이고 그 복제본 세 개가 상위에 들었습니다. 강한 헤드는 같은 헤드 인덱스에서 4층 간격의 배수로 재등장합니다. 루프에서도 반복 블록의 두 적용에 걸쳐 8층 간격 패턴이 보입니다. 이 경우는 한 헤드의 두 적용을 별도로 센 것입니다. FV 역시 반복되는 배치가 보이지만 더 늦게 발달합니다. 원문 4.1절·부록 E.2
4.2 Induction Heads Contribute More to Context Use
최종 모델에서 PS 또는 FV로 헤드를 정렬한 뒤 정해진 수만큼의 출력을 평균 활성값으로 바꾸는 평균 제거(mean ablation)를 시행합니다. PS로 제거할 때는 FV 상위 2%를 후보에서 먼저 빼고, FV로 제거할 때는 PS 상위 2%를 뺍니다. 이 설계는 두 점수가 모두 높은 극상위 헤드가 결과를 이끄는 정도를 줄입니다. 예를 들어 3B의 576개 적용에서 9% 실험은 반대 점수 최상위 11개를 후보군에서 뺀 상태에서 전체의 9%인 51개 적용을 교체합니다. 선정 규칙의 분모는 제외 전 576개입니다. 원문 4.2절·부록 F.1
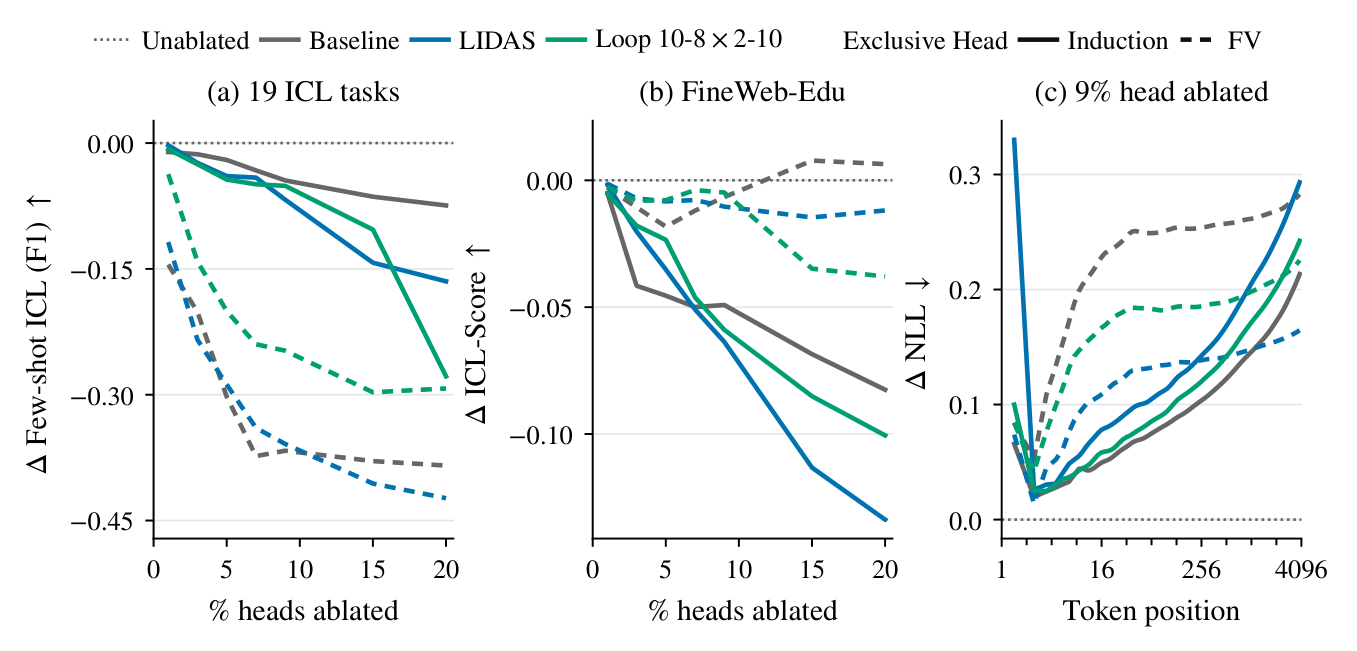
그림 6. 왼쪽과 가운데는 개입 전후의 19과제 F1과 ICL 점수 차이, 오른쪽은 9% 개입의 위치별 NLL 증가입니다. Ferdinand Kapl 외, arXiv v1 PDF 9쪽, CC BY 4.0. PDF 영역 크롭, 번역 없음.
few-shot F1은 세 모델 모두 FV에 개입했을 때 더 크게 떨어집니다. 토큰 손실 기반 ICL 점수는 PS 순위 쪽에 개입했을 때 더 크게 줄어듭니다. 개입하는 비율이 커지면 PS 개입이 성장·루프 모델의 두 점수를 dense보다 더 많이 떨어뜨립니다. 9%에서 초반 몇 토큰을 지나면 FV 개입의 NLL 증가가 먼저 커지고 이후 완만해집니다. PS 개입의 영향은 뒤로 갈수록 커져서 성장과 루프의 마지막 구간에서는 각각의 FV 개입 효과를 앞섭니다. Dense에서는 후반에도 FV 개입 효과가 더 큽니다. 이 분석은 각 모델 자체의 무개입 결과를 기준으로 삼습니다. 원문 4.2절·그림 6
📖 Chapter 5: Conclusion
논문의 결론은 층 계산의 재사용이 문맥에 기대는 풀이의 발달 및 유지와 관련된다는 것입니다. 자연어 위치 손실과 GSM8K에서의 관찰, 처음 보는 DFA에 대한 적응, Omniglot의 재할당 및 고정 라벨 조건을 연결해 제시합니다. 메커니즘에서는 성장 모델의 헤드 계보와 두 구조의 평균 제거 결과를 합쳐, 계산을 재사용할 때 PS 순위가 높은 헤드들의 기여가 커짐을 논의합니다. 과제 F1에서는 FV가 계속 큰 역할을 합니다.
저자들이 제안한 설명은 초기의 문맥 의존적 계산을 복제하거나 반복 적용하면, 가중치가 고정 대응을 익히는 동안에도 문맥 풀이가 더 오래 유지될 수 있다는 것입니다. 이 설명은 두 구조와 Omniglot 결과를 잇는 가설입니다. 이어지는 재현성 설명은 공개 데이터와 Nanotron 등 공개 구현을 토대로 했다고 밝혔으며, 설정 및 평가 절차는 부록에 제시합니다. 원문 결론·재현성 진술
📖 Chapter A: Language Model Training and Configurations
A.1 Training Setup
언어 모델은 decoder-only, pre-RMSNorm, SwiGLU 구조에 입력과 출력 임베딩을 공유하고, 편향·드롭아웃·Q/K 정규화를 사용하지 않습니다. 360M·1.7B는 SmolLM 계열 혼합 데이터와 cosmo2 토크나이저를 쓰며, 3B는 SmolLM3 레시피와 토크나이저를 사용합니다. 3B는 36,040스텝에 수학·코드·합성 추론을 강화한 혼합으로 바꾸고 학습률의 선형 감소를 시작합니다. 문서 경계를 넘는 어텐션을 막고 4층마다 한 층에서 RoPE(회전 위치 임베딩)를 생략합니다. 세 크기 모두 AdamW를 쓰고 2,000스텝을 선형 워밍업합니다. 360M 루프에는 나머지 모델의 Attention 출력·MLP down projection에 적용한 초기 스케일을 생략하는 별도 조건이 있습니다. 원문 표 1·부록 A.1
| Dense 기준 크기 | 최종 유효 깊이 | 고유 층 수가 다른 비교 모델 | 최종 학습 스텝 | 학습 토큰 | 기본 문맥 |
|---|---|---|---|---|---|
| 360M | 32 | Loop 4–12×2–4, 20층, 약 244M | 200,000 | 209.7B | 2,048 |
| 1.7B | 24 | Loop 4–8×2–4, 16층, 약 1.17B | 200,000 | 419.4B | 2,048 |
| 3B | 36 | Loop 10–8×2–10, 28층, 약 2.45B | 42,400 | 100.0B | 4,096 |
표는 원문 표 1과 부록 A.2의 값을 모아 재구성했습니다. 모델 크기별 데이터·토크나이저·예산 차이를 염두에 두고 각 행에서 같은 크기 집단의 dense 기준과 비교합니다. 원문 부록 A.1–A.2
A.2 Growing and Looping
LIDAS가 8층을 12층으로 확장하는 원문 예에서는 가운데의 층 2–5를 복사합니다. 복사 직후 두 묶음은 같은 초기 상태를 가지며, 이후에는 각자 업데이트됩니다. 아래 숫자는 새 스택의 각 위치에 어느 옛 층의 상태가 들어가는지 나타냅니다. 원문 부록 A.2
1
2
3
성장 전   0 1 2 3 4 5         6 7
성장 후   0 1 2 3 4 5 2 3 4 5 6 7
                     └─ 복제 ─┘
Prop-1 일정은 성장 단계별 깊이에 비례해 학습 스텝을 나눕니다. 부록 A.2의 식에서 $b$는 성장 한 번에 추가하는 층 수, $K=L/b$는 전체 단계 수, $i$는 깊이 $ib$인 단계, $T_{\mathrm{prop}}$는 그 비례 배분에 쓰이는 예산입니다. 학습률 감소 구간은 최종 깊이에 도달한 뒤 이어 붙입니다. 360M·1.7B의 배분 예산은 첫 워밍업을 포함한 170,000스텝입니다. 3B는 첫 2,000스텝 워밍업도 비례 계산에서 빼므로 34,040스텝을 배분합니다. 성장 시 전체 스텝과 학습률 스케줄은 이어갑니다. 1.7B MIDAS는 24,285스텝의 LIDAS 8층 체크포인트에서 분기하며, 3B에는 MIDAS 실행이 없습니다. 루프는 앞뒤 층을 한 번씩 통과하며 공유 블록만 반복합니다. 원문 부록 A.2
A.3 Checkpoints and Comparison Scope
최종 체크포인트는 360M·1.7B에서 200,000, 3B에서 42,400스텝입니다. 1.7B·3B의 궤적은 대체로 2,000스텝 간격, 360M dense·성장은 10,000스텝 간격에 성장 경계 저장점을 더합니다. 성장 경계에는 복제 전 학습된 체크포인트와 복제만 끝낸 직후 체크포인트가 같은 스텝에 있습니다. 후자가 그림의 빈 원입니다. 부록의 초록색 Loop는 모델 크기별로 위 표의 각기 다른 아키텍처를 가리킵니다. 언어 모델의 각 비교군은 훈련 시드 하나로 실행됐습니다. 원문 부록 A.3
📖 Chapter B: Context Use in Language Models
B.1 General Benchmark Evaluations
OLMES 비교는 모든 모델에 고정 예시 5개와 최대 2,048토큰을 사용합니다. 정답 문자 대신 후보 답변 텍스트가 뒤따를 점수를 매깁니다. 과제에 따라 문자 길이로 나누거나 문맥을 주지 않은 후보의 로그 가능도로 보정합니다. MMLU는 57개 과목의 테스트 14,042문항을 쓰며, 정확도는 과목에 균등 가중합니다. 예시 수를 바꾸는 뒤의 실험과 평가 설계가 다릅니다. 원문 부록 B.1
| 크기·모델 | 9개 객관식 평균 | MMLU |
|---|---|---|
| 360M Dense / MIDAS / LIDAS / Loop | 54.69 / 56.00 / 57.10 / 54.21 | 34.67 / 34.11 / 34.09 / 33.69 |
| 1.7B Dense / MIDAS / LIDAS / Loop | 62.97 / 64.61 / 64.69 / 63.25 | 40.12 / 40.43 / 40.86 / 39.89 |
| 3B Dense / LIDAS / Loop | 61.33 / 62.89 / 60.53 | 39.15 / 39.28 / 38.32 |
원문 표 2의 정확도(%)를 재구성했습니다. 3B 루프는 GSM8K에서는 dense를 앞서는 구간이 있으나, 이 표의 두 열에서는 각각 0.80%p, 0.83%p 아래입니다. 360M에서는 LIDAS가 9개 과제 평균에서 앞서고 MMLU는 dense가 앞섭니다. 원문 표 2
B.2 Token Loss and the ICL Score
FineWeb-Edu-dedup에서 긴 문서 10,000개를 고정합니다. 모델의 기본 문맥 길이 $C$보다 한 토큰 더 남겨 $C$번의 다음 토큰 예측을 만들고, 매 문서에서 문맥을 새로 시작합니다. 원문 식 (1)의 $\ell_j$는 앞 토큰들을 보고 정답 토큰 $x_j$에 부여한 확률의 음의 로그입니다. 값이 작을수록 정답 확률이 높고, 문서 평균 $\bar\ell_j$는 nat 단위입니다. 원문 부록 B.2, 식 (1)
그림의 구간은 1–2, 3–4, 5–8처럼 길이가 커집니다. 그림 1(a)의 실선은 각 구간의 손실 차이입니다. 점선은 식 (2)의 전체 위치 평균으로, 구간 수에 동일 가중치를 주는 대신 원시 토큰 위치를 각각 셉니다. $m$은 비교 모델, $\mathrm{base}$는 같은 크기의 dense입니다. 원문 부록 B.2, 식 (2)
학습 궤적과 개입에 쓰는 고정 ICL 점수는 식 (3)입니다. 초기 및 후기 창은 각각 21개 위치로 구성됩니다. 차이가 커지는 이유는 초기 손실이 올라가거나 후기 손실이 내려가거나, 두 창이 서로 다른 정도로 바뀌었기 때문일 수 있습니다. 예를 들어 초기→후기 손실이 dense에서 2.20→2.00, 다른 모델에서 2.40→2.10이면 ICL 점수는 각각 0.20, 0.30이지만 뒤쪽 절대 손실은 dense가 더 낮습니다. 이 값들은 지표 설명을 위한 예시입니다. 원문 부록 B.2, 식 (3)
식 (4)는 초기 창을 그대로 두고 후기 창을 $W_x=\{x/2+1,\ldots,x\}$로 바꿉니다. $E_m$을 모델 $m$의 초기 창 평균이라 두면, 아래처럼 두 모델의 초기→후기 감소 차이를 구합니다. 예를 들어 그림 1(b)의 $x=512$는 257–512 위치 구간으로, 식 (3)의 490–510 창과 다릅니다. 3B는 4,096까지, 나머지 크기는 2,048까지 추적합니다. 원문 부록 B.2, 식 (4)·그림 7
B.3 Few-Shot Scaling on Downstream Tasks
GSM8K에서 360M·1.7B는 예시 0·1·2·4개, 3B는 8개까지를 시험합니다. 입력을 다시 토큰화해 잘리지 않는 범위에서 비교하며, 세 번의 예시 선택 시드로 평균을 냅니다. 추가 5개 객관식과 3개 생성 과제는 크기별로 0·1·2·4·8개의 예시를 사용합니다. 생성 집합은 QA-Wikidata, Operators, Repeat-Copy-Logic의 정답 일치율을 평균합니다. 객관식은 과제 $t$의 정확도 $a_t$를 해당 과제의 무작위 정답률 $c_t$로 보정하고 집합 $\mathcal T$ 안에서 균등 평균합니다. 예를 들어 4지선다 정확도 0.55라면 해당 과제의 보정값은 40점입니다. 원문 부록 B.3, 식 (5), 그림 8–10
B.4 In-Context Graph Tracing
3×3 또는 4×4 격자의 각 칸에 한 토큰짜리 명사 하나를 붙입니다. 모델은 칸을 옮겨 다닌 무작위 경로를 공백으로 이어 붙인 토큰열로 보고, 현재 칸과 인접한 모든 칸의 단어에 부여한 다음 토큰 확률의 합으로 평가받습니다. 200회 시행마다 단어 배치와 경로를 새로 만들고, 같은 크기의 모델들에 같은 시행을 제공합니다. 참고 곡선 두 개는 현재 칸에서 출발하는 이동을 문맥에서 한 번 또는 두 번 본 위치의 비율입니다. 이미 본 연결을 재사용할 수 있는 시점을 보여 줍니다. 원문 부록 B.4·그림 11
📖 Chapter C: RegBench: Setup and Additional Results
C.1 Task and Data
오토마톤마다 상태 4–12개, 어휘 기호 4–18개, 상태당 전이 1–3개로 생성 후보를 구성합니다. 같은 오토마톤에서 길이 1–49인 문자열 10–19개를 뽑아 | 기호로 연결합니다. 오토마톤 단위로 학습 40,000개, 검증·테스트 각 500개의 시퀀스로 나눕니다. 교차 엔트로피 학습과 검증에서는 구분자 및 패딩을 정답 위치에서 마스킹합니다. 원문 부록 C.1
C.2 Models, Optimization, and Selection
비교군은 GPT-2 스타일 pre-LayerNorm, 학습 가능한 위치 임베딩, 두 개의 어텐션 헤드를 갖습니다. 모두 같은 데이터를 쓰고 AdamW로 250,000스텝을 수행합니다. 폭 64·128·256, 최대 학습률 두 값, 가중치 감쇠 두 값을 탐색해 검증 손실이 낮은 설정을 고릅니다. 성장 체크포인트는 전체 12층에 도달한 뒤의 후보 중 선택하며, 선정한 설정은 시드 4개로 반복합니다. 본문에는 평균 검증 손실에서 고른 3층 출발 prop-3이 실립니다. Prop-1·2·3은 깊이의 1·2·3제곱에 각각 비례해 성장 단계에 스텝을 배정합니다. 루프 폭 256과 다른 모델 폭 128의 차이가 있으므로 연산량을 맞춘 비교로 읽을 수는 없습니다. 원문 부록 C.2
C.3 Metrics and Position Decomposition
$p(v)$는 모델이 기호 $v$에 주는 확률이고, $q(v)$는 가능한 다음 기호에 확률을 균등 배분한 목표 분포입니다. 총변동거리(TVD)는 각각의 기호 확률이 얼마나 다른지를 더해 2로 나눕니다. DFA 정확도는 모델이 가장 높은 확률을 준 기호가 가능한 후보인지 봅니다. 예를 들어 가능한 기호 둘에 목표 확률을 0.5씩 줄 때 모델이 0.8과 0.2를 주면 최대 확률 기호는 적법하지만 TVD는 0.3입니다. 본문 그림의 위치 비교는 500개 테스트 입력이 모두 포함하는 문자열 1–10을 쓰고, 부록은 전체 문자열 1–19를 씁니다. 두 지표의 구분자 처리와 학습 마스크는 다릅니다. TVD는 구분자 정답 위치도 포함하고 목표 분포에서 구분자에 0을 줍니다. DFA 정확도는 구분자 정답 위치를 뺍니다. 원문 부록 C.3
C.4 Results Across Configurations
그림 12는 dense, 루프, 성장 3개 설정의 전체 TVD와 DFA 정확도, 문자열 및 기호 위치별 차이를 함께 보여 줍니다. Loop 2×6은 문자열 18·19에서 TVD가 dense보다 커지기도 합니다. 18번째 문자열을 포함하는 입력은 500개 중 102개(20.4%), 19번째는 54개(10.8%)입니다. 뒤쪽 구간을 전체 평균과 비교할 때 표본을 함께 보는 이유입니다. 위치별 차이 밴드는 각 모델의 시드별 통계량 표준오차를 독립으로 합친 값입니다. 원문 부록 C.3–C.4·그림 12
📖 Chapter D: Omniglot Setup
D.1 Data, Sequence Format, and Architecture
원래 Omniglot 분할을 합쳐 클래스 1,623개와 클래스당 흑백 이미지 20장을 구성합니다. 10개 클래스는 평가를 위해 통째로 빼고, 1,613개가 훈련에 들어갑니다. 한 입력에서 같은 클래스가 여러 차례 나와도 사진은 각각 다릅니다. 이미지와 라벨을 번갈아 배열하고 마지막에 질의 이미지를 두어 17토큰을 만듭니다. 함께 학습하는 작은 ResNet으로 이미지를 임베딩한 뒤, 폭 64의 인과적 Transformer에 넣습니다. 손실은 마지막 질의에서만 적용합니다. LIDAS는 50,000스텝까지 dense 4층과 동일한 궤적을 공유한 뒤 8층으로 성장하고, 100,000스텝에 12층이 됩니다. 루프의 반복 대상은 Transformer 블록입니다. 원문 부록 D.1
D.2 Training Distributions and Optimization
고정 라벨 훈련은 두 종류의 글자에서 사진을 각각 세 장, 전체 클래스에서 추가로 두 장 뽑아 순서를 섞습니다. 질의는 두 종류 가운데 하나의 새로운 사진입니다. ICL-only 쪽에서는 두 종류에서 네 장씩 뽑고 0과 1의 배정을 입력마다 무작위로 결정합니다. 데이터만 바꾼 비교라 ICL-only에서도 모델 출력은 1,623개입니다. 두 조건 모두 Adam(배치 32)을 사용합니다. 아래 식 (6)의 $t$는 훈련 스텝이며, 두 항의 최솟값을 택해 4,000스텝까지 선형으로 올린 뒤 역제곱근으로 내립니다. 고정 라벨은 4개 시드로 4,000만 스텝, ICL-only는 8개 시드로 100만 스텝 비교입니다. 원문 부록 D.2, 식 (6)
D.3 Evaluation: ICL and IWL
ICL 검정은 학습에서 뺀 10개 클래스의 새 라벨을 맞히며 출력 0과 1만 비교하므로 무작위 정답률이 1/2입니다. IWL 검정은 훈련 클래스가 질의에 나오고 같은 클래스는 문맥에 없으며, 전체 출력 1,623개 중 정답을 고릅니다. 이 출력 전체에서 균등 추측한다면 1/1,623입니다. IWL 검정은 고정 라벨 실험에서만 이뤄집니다. 각 시점에서 같은 평가 시퀀스를 사용하며, 고정 라벨은 검정당 10,000개, ICL-only는 2,000개입니다. 그림의 이동평균 폭은 순서대로 51개, 3개 체크포인트이고, 본문에서 말하는 끝점이나 발생 임계값은 평활화하지 않은 평가를 씁니다. 원문 부록 D.3
📖 Chapter E: Induction-Head Development and Readouts
E.1 Measures and Aggregate Training Trajectories
PS는 문서 시작 토큰 뒤에 서로 다른 50개 토큰을 두 번 잇는 시퀀스 1,000개에서 구합니다. 반복 구간의 각 위치에서 앞선 동일 토큰 다음의 위치가 받는 어텐션 확률을 평균합니다. 마지막 위치의 목표는 순환해서 첫 토큰입니다. FV 진단은 별도의 29개 과제에서 과제당 10-shot 정상 프롬프트 100개 및 라벨을 섞은 프롬프트 100개를 사용합니다. 어텐션 출력 투영 직전 헤드 출력을 측정하며, 잘못된 프롬프트의 마지막 위치에 해당 헤드의 정상 과제 평균을 대입합니다.
few-shot 행동 시험은 FV 진단에 쓴 29개 과제와 겹치지 않는 19개 과제를 10-shot으로 평가합니다. 과제별 질의 100개에서 최대 5개 토큰을 탐욕 생성한 뒤, 소문자화 및 구두점·영어 관사 제거를 거친 답을 정답과 비교해 토큰 중첩 F1을 냅니다. 문서 토큰 손실, 표준 과제의 정답 일치율, 이 F1은 각각 다른 평가입니다.
3B의 궤적에서 초기 복제 직후 PS와 FV가 모두 낮아졌다가 다시 올라갑니다. 마지막에 LIDAS의 PS는 dense보다 높고 FV는 더 낮으며, 루프의 PS는 dense와 가깝고 FV는 조금 높습니다. 성장 모델의 19과제 F1은 초반에 뒤처졌다가 마지막에 앞섭니다. 별개로 세 모델 모두 훈련 중 초기 토큰 예측이 후반보다 많이 좋아지면서 차이로 정의한 ICL 점수는 내려갑니다. 최종 ICL 점수는 성장·루프 모델이 dense보다 높습니다. 원문 부록 E.1·그림 13
E.2 Final-Head Identities, Lineages, and Locations
최종 상위 2%의 집합은 PS와 FV 각각 고릅니다. 전체 깊이에서 크기별로 10개, 16개, 12개의 헤드가 해당합니다. 성장 모델은 실제 복제 지도를 거슬러 올라가며, 루프 모델은 헤드가 적용되는 위치를 구분합니다. 저자들은 단계 안에서 로그 스텝의 삼각 가중치로 궤적을 평활화하되 단계 끝점과 최종 값은 유지합니다. 3B LIDAS의 최종 FV 상위 12개는 여덟 조상에서 나왔고, L3H13에서 두 개, L3H15에서 네 개가 나왔습니다. 부록 그림 15–18은 크기별 궤적과 최종 점수 행렬을 짝지어 보여 줍니다. 원문 부록 E.2·그림 14–18
E.3 Per-Layer Readouts
정해진 깊이까지만 실행해 중간 표현에서 정답을 얼마나 읽을 수 있는지 봅니다. Logit lens는 마지막 층용 정규화와 어휘 투영을 중간층에 그대로 사용합니다. Tuned lens는 중간 표현 $h$를 $h+W_lh+b_l$로 변환하고 같은 투영을 적용합니다. 여기서 $l$은 중간 종료 깊이, $W_l$과 $b_l$은 층별로 학습하는 행렬과 편향입니다. 모델 본체를 고정하고 최종 모델의 다음 토큰 분포에 가깝도록 250스텝 동안 변환을 학습합니다. 변환을 0으로 두면 logit lens가 되고, 전체 깊이 종료는 원래 모델과 같습니다. 그림 19의 F1은 이렇게 읽을 수 있는 예측의 수준을 보여 줍니다. 부록 F에서는 특정 헤드 출력에 개입해 과제 성능의 변화를 측정합니다. 원문 부록 E.3·그림 19
📖 Chapter F: Attention-Head Ablations
F.1 Head Selection and Mean Ablation
최종 체크포인트에서 전체 적용의 1·3·5·7·9·15·20%를 선택합니다. 교차 제외 외에도 일반 PS·FV 정렬, 무작위 집합, 두 점수를 각각 0 이상으로 제한하고 최댓값으로 나눈 뒤 기하평균을 취한 결합 정렬을 비교합니다. 제거하는 헤드의 출력 조각을 어텐션 출력 투영 바로 전에 평균으로 대체합니다. 루프의 선택과 개입 단위는 공유 가중치 자체가 아니라 적용 위치입니다. 원문 부록 F.1
F.2 Measurements and Plotted Summaries
19과제 F1에서는 FV 진단에 사용한 29개 과제의 정상 마지막 위치 활성값을 평균으로 삼습니다. 프롬프트 끝과 이후 생성 순전파마다 마지막 위치에 적용합니다. FineWeb-Edu에서는 자연어에서 얻은 평균 활성값을 모든 위치에 씁니다. 각 위치의 NLL 증가는 같은 모델·같은 문서에서 개입 후 손실에서 개입 전 손실을 뺀 값입니다. 원문 식 (7)은 고정된 초기·후기 위치 창으로 계산한 점수의 개입 전후 차이입니다. 후기 손실이 초기 손실보다 더 많이 커지면 점수가 감소합니다. 원문 부록 F.2, 식 (7)
그림 20은 크기별 점수 변화, 그림 21은 7·9·15·20%에서 위치별 NLL 증가를 비교합니다. 그림 22는 개입 후 절대 점수를 보여 주고, 무작위 선택에 대한 표준오차를 F1은 3개, ICL 점수는 16개 헤드 집합에서 구합니다. 그림 6(c)의 위치 곡선은 로그 구간 집계 및 추가 평활화를 거치지만, 고정 창의 점수는 개별 위치 손실에서 계산됩니다. 원문 부록 F.2·그림 20–22
실험 결과 심층 분석
| 실험 | 변동을 보여 주는 단위 | 비교의 범위 |
|---|---|---|
| 360M·1.7B·3B 언어 모델 | 학습군별 훈련 시드 1개. Few-shot 밴드는 예시 선택 시드 3개 | 같은 크기 집단의 데이터와 스텝 및 최종 추론 연산 대응. 학습 총 FLOPs와 고유 가중치까지 맞춘 비교는 아님 |
| RegBench | 검증으로 고른 설정마다 훈련 시드 4개 | 데이터·스텝·유효 깊이 대응. 폭·연산량 차이 있음 |
| Omniglot | 고정 라벨 4개, ICL-only 8개 훈련 시드 | 같은 입력 형식·폭·옵티마이저. 유효 깊이 4층과 12층을 함께 비교 |
| 그래프 및 무작위 헤드 비교 | 그래프 시행 200회, 대조 헤드 집합 F1 3개·ICL 점수 16개 | 평가 시행·헤드 선택의 변동이며 언어 모델 재훈련에 따른 변동은 별개 |
주요 곡선과 막대는 이 표에 적힌 단위로 평균 또는 표준오차를 보고합니다. 주요 비교에 대한 통계적 유의성 검정과 신뢰구간은 논문에 보고되지 않았습니다. 특히 초반의 높은 손실이 ICL 점수 차이에 기여할 수 있고, RegBench의 검증 선정 폭 차이는 구조 차이와 함께 읽어야 합니다. 원문 부록 A.3, B.2–B.4, C.2–C.3, D.3, F
Omniglot의 dense 4층은 결과 해석의 기준을 하나 더 줍니다. LIDAS와 4층 모델은 성장 전까지 같은 실행이므로, 성장 뒤에도 고정 라벨 조건의 곡선이 비슷하다는 사실은 얕게 학습할 때 형성된 거동이 성장 뒤에 일부 유지된다는 저자의 설명과 들어맞습니다. ICL-only에서는 4층 dense도 먼저 학습하므로, 앞당겨진 시점이 복제나 가중치 공유에서만 나타나는 현상이라고 읽을 수는 없습니다. 원문 3.4절·부록 D.1
3B 루프의 최종 PS 평균은 dense와 가깝지만, PS 순위에 따라 헤드들을 함께 바꾸면 후반 예측의 변화는 dense보다 큽니다. 순위용 점수는 임의 토큰 반복에서 측정했고 개입 후 성능은 자연어 또는 19과제에서 측정했기 때문에, 두 결과는 각각 다른 현상을 보여 줍니다. FV 개입과 PS 개입의 비교도 겹치는 최상위 일부를 제외한 헤드 묶음의 효과입니다. 원문의 데이터와 부록에 있는 교체 방식 및 시드 범위에서 읽을 수 있는 기여입니다. 원문 그림 4·6, 부록 E.1·F.1
기술적 함의와 응용
이 연구는 모델이 문맥을 잘 활용한다는 관찰을 평가 목적에 맞게 구체화합니다. 긴 문서의 토큰 예측을 비교할 때는 위치별 절대 NLL과 초기 대비 감소를 함께 읽을 수 있습니다. 예시를 통해 과제 해결이 개선되는지가 궁금하면 예시 수를 바꿔 성능이 얼마나 달라지는지 확인할 수 있습니다. 입력마다 달라지는 라벨은 학습 중 고정된 대응을 회상하는 성능과 새 문맥에 적응하는 성능을 분리합니다. 같은 3B 루프가 이 측정들에서 서로 다른 결과를 보인다는 점이 구분의 실제 사례입니다. 원문 3절·부록 B
아키텍처 측면에서 LIDAS와 루프는 각각 언제 전체 깊이의 계산을 지불하는지, 같은 순전파 깊이를 몇 개의 독립 파라미터로 구현하는지에 대한 선택입니다. 이 논문의 최종 추론 FLOPs 대응 비교에서는 루프의 약 2.45B 고유 파라미터와 36회 층 적용을 함께 읽어야 합니다. 메커니즘 분석에서는 현재 입력 안의 반복을 따라가는 헤드와 예시가 규정하는 과제를 복원하는 헤드의 기여가 평가에 따라 달라집니다. 두 종류의 증거를 나란히 제시함으로써, 깊이를 만드는 방식이 최종 점수뿐 아니라 그 점수를 내는 계산에도 연결됨을 보여 줍니다. 원문 결론·부록 A.2 및 F