논문 개요와 전체 구조
연구 에이전트가 세션을 종료하는 순간에도 실험은 끝나지 않을 수 있습니다. 시도한 방법이 여러 개라면 다음 세션은 어느 구현이 어떤 결과를 냈는지, 실패한 접근을 언제 다시 검토할지부터 파악해야 합니다. Épi는 실행 기록과 실험 상태를 세션 밖에 저장하고, 같은 검증 기준 아래 대안을 비교하며 여러 세션에 걸쳐 연구를 이어가는 에이전트입니다. 논문에 보고된 연구에서 모델 가중치는 고정되어 있고, 누적된 증거와 기억을 바탕으로 방법과 코드를 바꿉니다. 원문 §1–3
저자들은 문헌·레지스트리의 기준값을 개선한 구성 100건과 수치적 경계 20건을 보고합니다. 지정된 분할 그래프 계열에서 Tuza 추측을 증명한 결과는 별도로 제시합니다. 알고리즘 설계용 경량 설정 Épi-turbo는 FrontierOR 30개 과제에서 동일 모델과 추론 강도의 Codex와 비교합니다. 구성 하나를 제출하는 일, 최적값의 상한이나 하한을 증명하는 일, 처음 보는 입력에도 작동할 프로그램을 제출하는 일은 서로 다른 검증을 요구합니다. 원문 §4–6
| 원문 순서 | 다루는 내용 |
|---|---|
| §1 Introduction | 연구 연속성, 경험 학습, 대안 탐색과 되돌리기 |
| §2 Research Setting | 문제와 증거, 캠페인과 세션 |
| §3 The Épi Research Loop | 캠페인별 평가 환경과 분기·기억·독립 검토 |
| §4 Experimental Results | 집계 방법, 구성 기록, 수치적 경계 기록 |
| §5 Case Studies | 패킹, Cohn–Elkies, n-퀸, MAX-4-CUT, Spencer, 물 네트워크, Tuza |
| §6 Épi-turbo | 경량 설정, FrontierOR 프로토콜, 결과, 사례 |
| §7–9 | 관련 연구, 사람이 이해할 수 있는 연구 산출물, 결론 |
| Acknowledgements, References | 연구 피드백과 인용 문헌 |
| 부록 A, B | 수치적 경계 12계열과 Tuza 증명, 추가 구성 기록 |
핵심 기여와 혁신성
실험을 반복할수록 방법을 자유롭게 변경하는 권한과 결과의 채점 규칙을 고정하는 권한의 경계가 중요해집니다. 예를 들어 패킹에서 좌표를 이동하는 방식은 여러 가지일 수 있지만, 겹침 허용 오차나 정규화 방식까지 가지마다 다르면 더 좋은 수치가 곧 더 좋은 패킹을 뜻하지 않습니다. Épi는 제출 형식, 타당성 조건, 목적함수, 정규화, 비교 기준값을 정한 뒤 탐색을 시작합니다. 원문 §2.1과 §3.1
프로그램 탐색과 장기 상태 보존은 선행 연구에도 등장합니다. Épi는 한 캠페인의 대안 구현을 버전별로 보존하고, 이전 사례에서 얻은 교훈과 실패 이유를 현재 탐색에 불러오며, 별도 모델이 근거와 다음 연구 방향을 검토하도록 구성합니다. 검토 모델이 판단하는 것은 연구 방향의 타당성입니다. 제출물이 제약을 만족하는지와 개선량 기준을 넘는지는 독립 실행되는 검증기가 결정합니다. 원문 §1과 §3.2
기록 갱신의 의의는 검증 가능한 산출물에 있습니다. Cohn–Elkies 사례는 더 정확한 부동소수점 추정치를 얻는 데서 그치지 않고, 해당 선형계획의 최적값과 실제 패킹 밀도 사이에 차이가 있음을 증명합니다. Tuza 사례에서는 유한 그래프들의 증명서에 임의 중복도를 다루는 수학적 환원을 결합합니다. 원문 §5.2와 §5.7
기술적 세부사항
평가 규칙과 채택 조건
원문의 ruler는 여러 실험을 같은 조건으로 비교하는 평가 규칙입니다. 최소화에서 $x$는 후보 산출물, $V(x)\in\{0,1\}$은 검증기가 내린 타당성 판정, $f(x)$는 목적함수 값, $b$는 기준값입니다. $\delta$는 기록으로 셀 최소 개선량입니다. $\delta>0$이면 경계값과 같은 개선도 채택합니다. 원문 §2.1 식 (1)
$\delta=0$으로 설정한 과제에서는 동률을 제외하기 위해 $\Delta(x)>0$을 요구합니다. 타당성 허용 오차는 기하 제약 등에서 계산 오차를 다룰 때 쓰이고, 개선량 기준은 의미 있는 변화의 크기를 정합니다. 엄밀한 경계값은 정확 산술이나 바깥쪽 반올림으로 보호합니다. 하한을 내림하고 상한을 올림하면 표시 자릿수를 줄인 뒤에도 증명의 방향이 유지됩니다. 원문 §2.1
논문의 34개 오각형 예에서는 입력이 단위 변 길이의 정오각형 중심 좌표와 회전각입니다. 검증기가 삼각형 안에 들어가는지와 오각형끼리 겹치지 않는지를 검사하고, 삼각형 변 길이로 개선량을 계산합니다. 아래는 이 절차를 식 (1)에 맞춰 옮긴 설명용 의사코드입니다. 실제 채택 임계값은 사례 설명에 제시되지 않습니다. 원문 §2.1과 §5.1
1
2
3
4
5
6
입력: 후보 배치 x, 기준 삼각형 변 길이 b, 개선량 기준 δ
x가 포함·비겹침 조건을 위반하면 → 기각
Δ ← b − 후보 삼각형의 변 길이
δ가 양수이면 Δ ≥ δ, δ가 0이면 Δ > 0인지 확인
조건을 충족하면 → 배치 좌표·회전각·측정값과 비교 기준을 남김
그 밖의 경우 → 현재 기록 유지
연구 대상별 검증 단위
| 주장 | 에이전트가 제출하는 자료 | 검증하는 내용 |
|---|---|---|
| 더 작은 삼각형 안에 패킹할 수 있습니다 | 중심 좌표와 회전각 | 포함 여부, 겹침 여부, 같은 정규화에서의 변 길이 |
| 최적값의 하한이 더 높습니다 | 쌍대 벡터 또는 별도 증명서 | 정확 산술이나 오차가 제어된 경계 계산 |
| 특정 그래프 계열에서 부등식이 성립합니다 | 유한 증명서와 수학적 환원 | 각 유한 증명서의 타당성과 전체 계열로의 확장 근거 |
| 새 입력에서도 효율적으로 풉니다 | 실행 가능한 독립 프로그램 | 비공개 입력에서 해의 품질과 실행 시간 |
챕터별 상세 리뷰
📖 Chapter 1: Introduction
이 장은 실행 가능한 평가를 사용하는 프로그램 탐색에서 출발해, 세션 하나를 넘는 연구에 필요한 세 가지 능력을 정리합니다.
- 연구 연속성. 실행 중인 작업, 코드, 중간 결과와 의사결정 이유가 다음 세션에 이어져야 합니다. 과거 상호작용 전체를 읽히기 어려워질수록 당장 필요한 상태와 재사용할 경험을 구별해 가져오는 메모리가 필요합니다.
- 실험 경험에서 학습. 좋은 점수만 남기면 무엇이 개선을 만들었는지 판단하기 어렵습니다. 다음 실험에 교훈을 적용하려면 어떤 조건에서 효과가 있었고 어느 산출물이 그 근거인지 함께 기록해야 합니다.
- 대안 탐색과 되돌리기. 하나의 방법에 일찍 고정되면 나중에 새로운 증거가 생겨도 확인할 대안이 줄어듭니다. 구현과 증거를 분기별로 남기면 같은 기준 아래 비교하고 이전 상태에서 다른 방향을 시도할 수 있습니다.
저자들은 세 가지 능력을 계층형 기억, 버전 관리된 분기, 독립 검토를 갖춘 구조로 묶습니다. 다음 장은 이 구조가 무엇을 제출하고 어떤 조건에서 개선을 인정하는지 정의합니다. 원문 §1
📖 Chapter 2: Research Setting
2.1 Problems and Evidence
과제 설정자는 연구 질문, 초기 문헌이나 자료, 계산 예산을 제공합니다. 에이전트는 그 범위에서 방법을 설계하고 실행합니다. 평가 규칙에는 적법한 산출물 형식과 타당성 검사를 포함합니다. 예를 들어 패킹 좌표를 검증할 때는 기하 제약을, 수치 경계를 제시할 때는 유리수나 반올림 방향까지 확인합니다. 정리의 경우 최종 주장을 유한 검사와 연결하는 증명도 함께 있어야 합니다. 원문 §2.1
2.2 Campaigns and Sessions
캠페인은 한 질문에 대한 전체 조사이며 여러 세션과 병행 실험을 포함할 수 있습니다. 세션은 현재 증거를 읽고 코드를 고치며 다음 실험을 결정하는 유한 문맥입니다. 실험 상태는 이 문맥 바깥에 저장되므로 다음 세션에서 진행 상황을 복구할 수 있습니다. 이 구분 덕분에 다음 장에서 고정된 캠페인 평가와 세션을 넘는 방법 개선을 함께 설명할 수 있습니다. 원문 §2.2
📖 Chapter 3: The Épi Research Loop
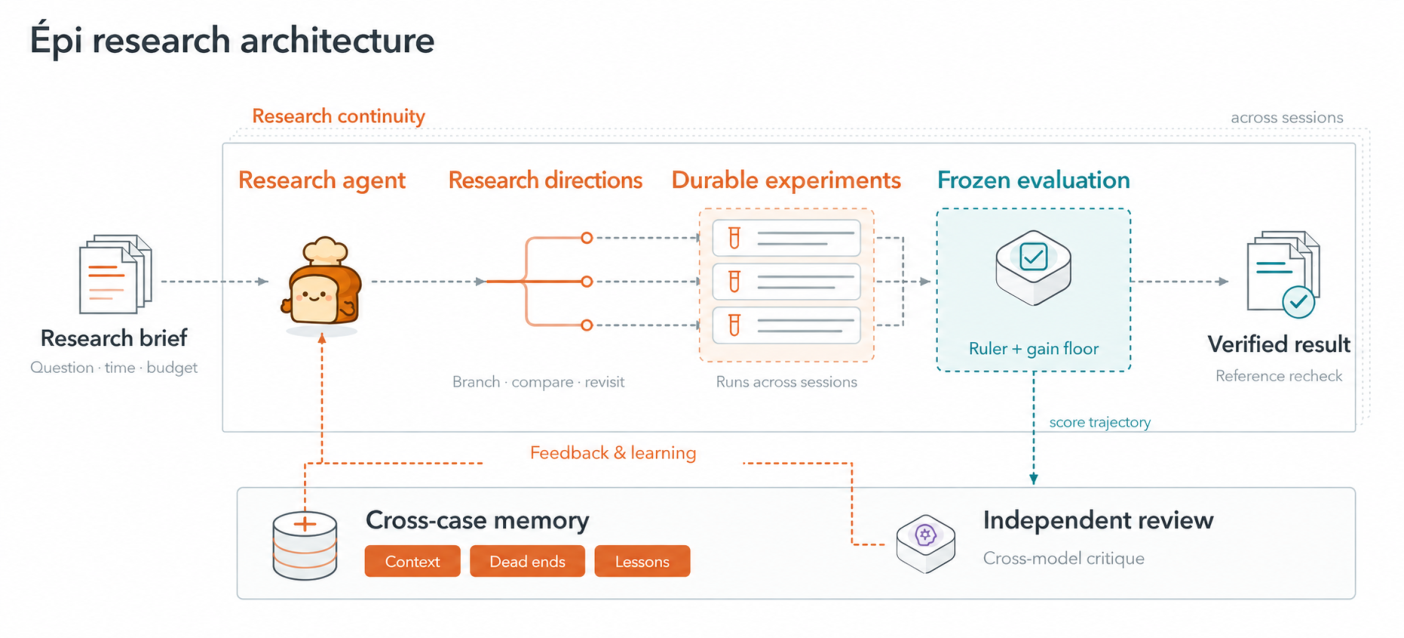
그림 1. 분기·실험·검증 경로와 기억·독립 검토의 피드백을 보여 줍니다. Yue Huang 외, CC BY 4.0. 고정 버전 PDF 4쪽의 그림 영역을 잘라냈으며 번역하지 않았습니다.
3.1 Evolving Research Environments
탐색 전 채점기가 둔 기준값을 재현하는지, 제출 검증이 예상대로 작동하는지 확인하고 설정을 고정합니다. 한 캠페인의 모든 분기는 그 조건에서 평가됩니다. 검증된 개선이 다음 연구의 기준값이 되거나, 수치 추정에서 엄밀한 증명서가 필요한 과제로 넘어갈 때는 다음 캠페인에서 새 표현과 검증 조건을 정의할 수 있습니다. 이렇게 변화 범위를 캠페인 사이로 제한하면 같은 캠페인의 분기들은 일관된 기준에서 비교됩니다. 원문 §3.1
3.2 Self-improving Research Agents
- 분기와 되돌리기. 각 분기에 코드·테스트·연구 노트를 보존하고, 저장된 커밋으로 돌아가 다른 방향을 시작할 수 있습니다. 패킹에서는 기존 배치의 좌표를 정교하게 다듬는 분기와 접촉 패턴 자체를 바꾸는 분기를 따로 시험할 수 있습니다. 중단한 분기는 왜 중단했는지와 함께 보관합니다.
- 계층형 기억. 단기 기록은 진행 중인 연구의 일부를 이어받을 때 쓰고, 장기 기록은 다른 연구에도 적용할 수 있는 교훈과 실패 이유를 저장합니다. 코드와 원자료는 영속 파일시스템에 두며, 세션 인수인계에는 현재 상태와 다음 행동을 적습니다. 다음 세션이 기억 항목을 검색하고 참조된 파일을 필요한 만큼 읽습니다.
- 독립 검토. 연구 모델과 다른 모델에 시도한 방법, 검색한 교훈, 점수 추이, 비교 기준, 자원 소모를 제공합니다. 그 모델은 어떤 결론이 증거로 뒷받침되는지와 어디를 더 탐색할지 검토합니다. 제출물의 타당성과 개선량 판정은 격리된 검증기의 역할입니다. 두 경로의 기록을 보존하면 최종 점수와 별개로 그 실험을 택한 이유를 읽을 수 있습니다.
- 연구 투명성. 대안 구현, 실험 결과, 이후 선택을 이끈 평가를 함께 남깁니다. 예를 들어 재사용 교훈에 동의하기 어려우면 당시 커밋과 실패 사례를 따라가 교훈의 적용 조건을 살필 수 있습니다.
- 실행 지원. Breadboard가 격리 환경, 세션을 넘는 장시간 실행, 상태와 결과의 저장, 고정 검증기 실행을 담당합니다. 이 인프라가 이후 세션에서 실행을 재개할 수 있는 상태를 유지합니다.
이 장의 구조는 연구 방향을 평가하는 판단과 결과를 채택하는 검사를 별도로 남길 수 있게 합니다. 다음 장은 결과군과 기록을 세는 단위를 정의합니다. 원문 §3.2
📖 Chapter 4: Experimental Results
4.1 Setup and Counting
저자들은 여러 날에 걸쳐 GPT-5.6 Sol과 GPT-6-Astra를 사용했으며, 문제별로 계산 예산을 정했습니다. 기록 비교는 2026년 9월 16일까지 공개된 문헌과 레지스트리의 동일 문제·정규화 기준을 대상으로 합니다. 인스턴스나 매개변수 설정마다 최종 개선 하나를 세므로 같은 설정을 여러 번 개선해도 1건입니다. 두 끝점을 개선한 포위 구간도 구간 하나로 셉니다. 원문 §4.1
4.2 Construction Records
구성 100건의 구성비는 아래와 같습니다. 가장 많은 두 집단은 사분원 안 원 패킹과 4차원 구 패킹입니다. 저자들은 패킹 외 구성 세 건의 원래 목적함수와 기준값도 부록 B에 함께 둡니다. 원문 §4.2와 그림 2
| 구성 종류 | 기록 건수 |
|---|---|
| 사분원 안 원 패킹 | 46 |
| 4차원 구 패킹 | 36 |
| 정오각형 패킹 | 9 |
| 반원 안 원 패킹 | 5 |
| 팔각형 안 원 패킹 | 1 |
| 차량 경로, 자기상관, Zhang–Zagier 구성 | 각각 1 |
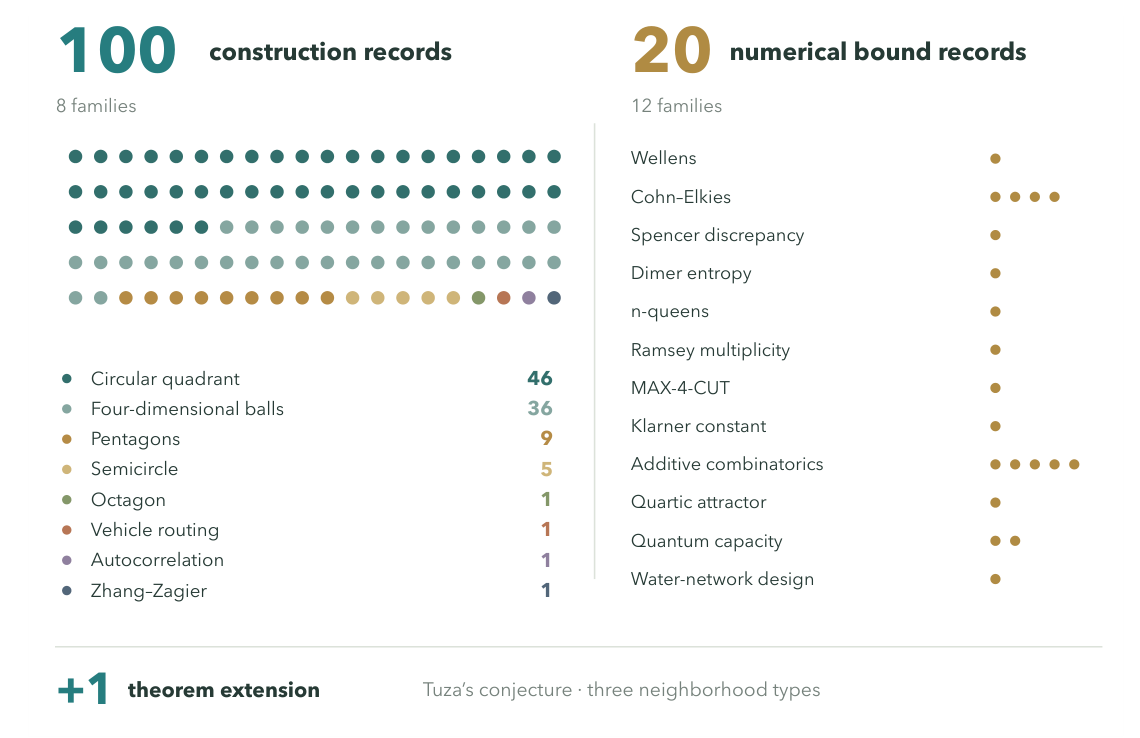
그림 2. 점 하나가 최종 기록 한 건이며 Tuza 정리 확장은 별도입니다. Yue Huang 외, CC BY 4.0. 고정 버전 PDF 6쪽에서 잘라냈으며 번역하지 않았습니다.
4.3 Numerical Bound Records
12계열에서 서로 다른 설정을 세어 수치 경계 20건이 나옵니다. Cohn–Elkies의 네 차원, $B_h[g]$의 다섯 계수, 양자 잡음의 두 채널이 각각 별도 설정입니다. Wellens 수량과 Klarner 상수의 상한은 내려가고, Spencer 상수와 Waterund36 최적값의 하한은 올라갑니다. 구간 기록은 기준 구간보다 좁아집니다. 어떤 쪽의 경계를 개선했는지 확인해야 표의 숫자 차이를 읽을 수 있습니다. 다음 장은 각 경계를 뒷받침하는 구체적인 증거를 사례로 보여 줍니다. 원문 §4.3과 표 1
📖 Chapter 5: Case Studies
5.1 Refining a Published Packing
단위 변 길이의 정오각형 34개를 정삼각형 하나에 넣고, 겹침과 바깥 돌출 없이 정삼각형의 변을 줄이는 문제입니다. 저자들은 기존 배치의 중심과 회전각을 함께 조정했습니다. 변 길이는 12.98141에서 12.97563735803487로 약 0.0445% 감소했습니다. 논문의 원 패킹 예에서는 반대로 고정 용기 안에서 원의 공통 반지름을 늘립니다. 원문 §5.1과 부록 B
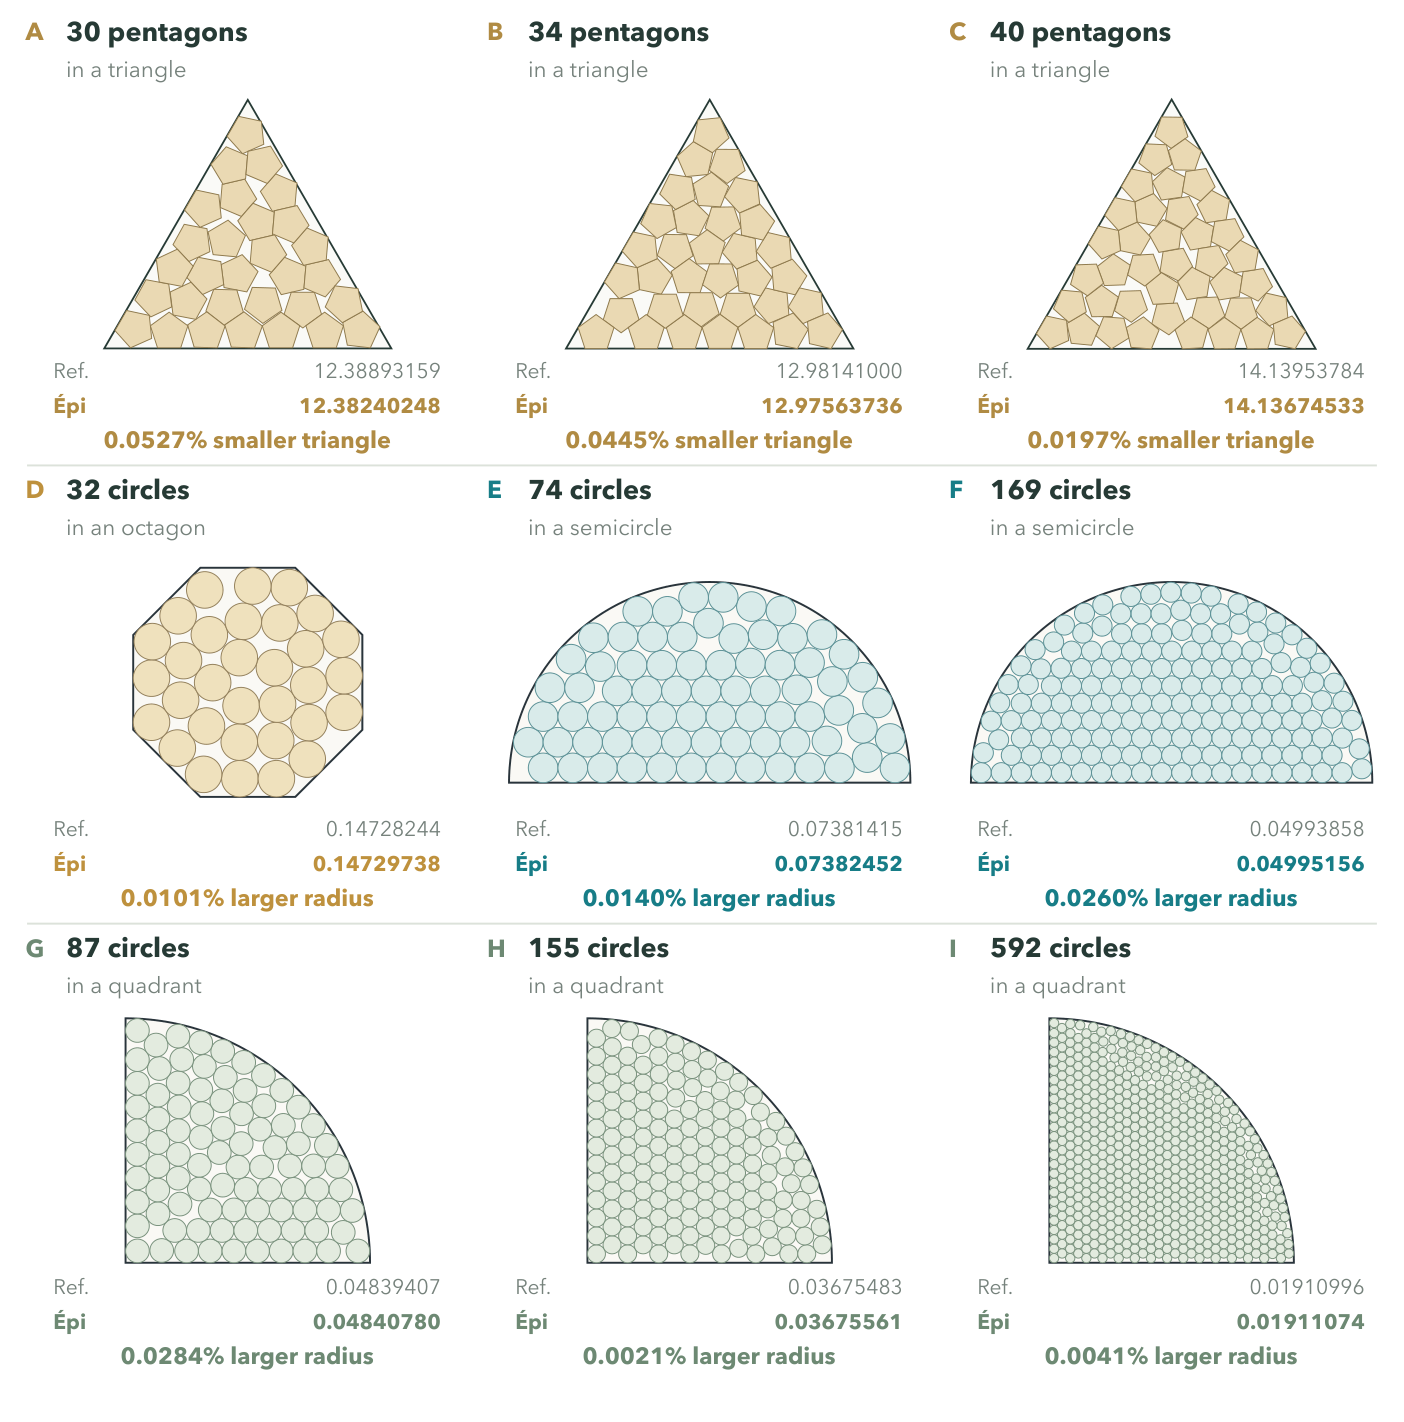
그림 3. 아홉 가지 최종 배치를 같은 설정의 과거 기준값과 비교합니다. Yue Huang 외, CC BY 4.0. 고정 버전 PDF 8쪽에서 잘라냈으며 번역하지 않았습니다.
5.2 Separating the Cohn–Elkies Bound from Packing Density
$\rho_d$는 $d$차원 실제 구 패킹의 최적 중심 밀도이고, $C_d$는 같은 정규화에서 Cohn–Elkies 선형계획으로 얻을 수 있는 가장 좋은 상한입니다. 유한 문제로 환원한 뒤 정확히 검증한 쌍대 벡터는 $C_d$의 하한 $L_d$를 제공합니다. 독립적인 3점 기법의 패킹 상한 $U_d$와 비교해 다음 관계를 세울 수 있습니다. 원문 §5.2 식 (2)
| 차원 | 이전 쌍대 하한 | Épi 쌍대 하한 $L_d$ | 알려진 패킹 상한 $U_d$ |
|---|---|---|---|
| 9 | 1/20 | 0.058044329039 | 표에 없음 |
| 10 | 1/24 | 0.056433853144 | 0.05623600 |
| 11 | 1/24 | 0.057731808202 | 0.05664550 |
| 13 | 1/28 | 0.066440082613 | 표에 없음 |
같은 중심 밀도 척도로 하한은 내림, 상한은 올림했습니다. 10차원에서 약 0.35%, 11차원에서 약 1.92% 차이가 있으며, 이때 차이의 분모는 $U_d$입니다. 부등식은 10·11차원에서 해당 선형계획을 정확히 최적화해도 실제 최적 중심 밀도에 도달할 수 없음을 보입니다. 9·13차원의 성과는 강화된 쌍대 하한입니다. 원문 표 2와 그림 4
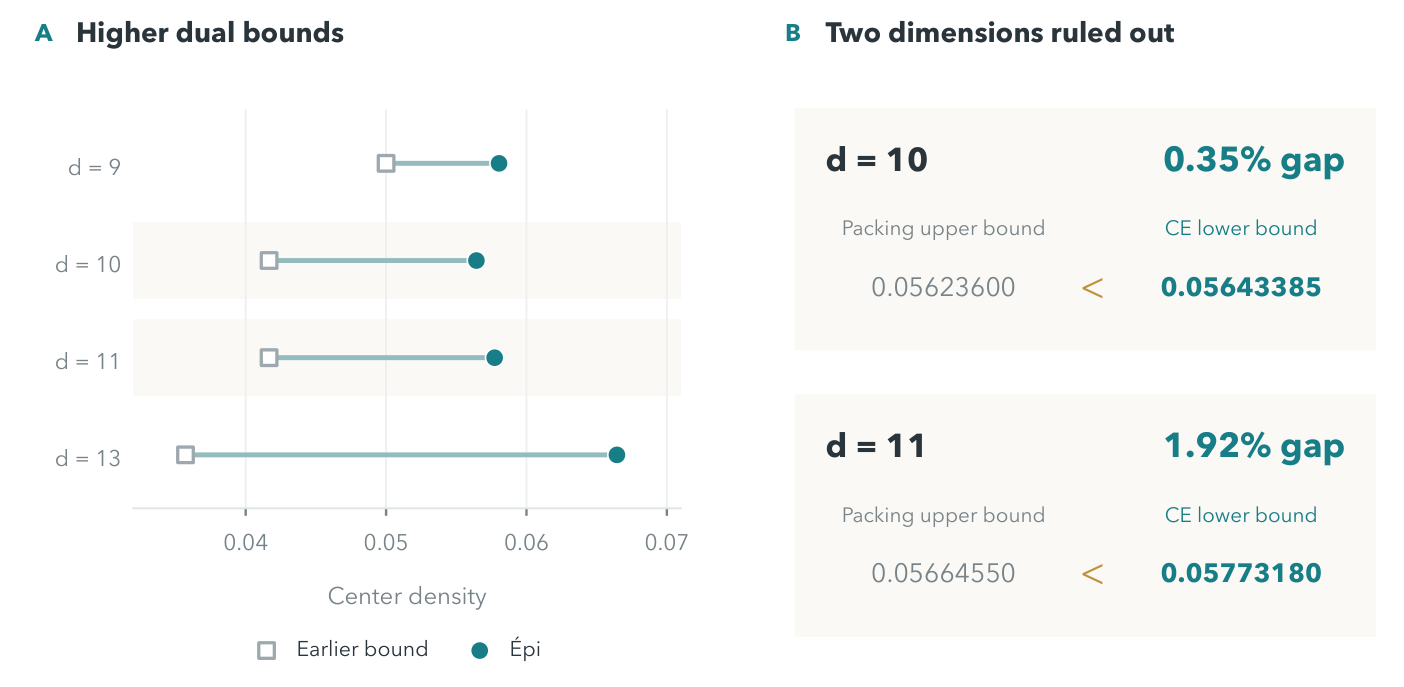
그림 4. 왼쪽은 네 차원의 쌍대 하한 변화, 오른쪽은 10·11차원의 두 경계 비교입니다. Yue Huang 외, CC BY 4.0. 고정 버전 PDF 9쪽에서 잘라냈으며 번역하지 않았습니다.
5.3 Narrowing the Interval for the n-Queens Constant
$Q(n)$은 $n\times n$ 체스판에 서로 공격하지 않는 퀸 $n$개를 놓는 경우의 수입니다. 식 (3)의 $\alpha$는 큰 체스판에서 이 수의 점근적 증가율을 결정합니다. $o(1)$은 $n$이 증가하면 0으로 수렴하는 항입니다. 원문 §5.3 식 (3)–(4)
기존 구간은 $[1.944000752,\,1.944001082]$입니다. 폭을 $3.30\times10^{-7}$에서 약 $3.94\times10^{-9}$로 줄였으므로 폭의 비는 약 84입니다. 하한과 상한은 계산 비용이 달라 각기 다른 해상도에서 찾았고, 보존된 두 증명서를 통해 양쪽을 별도로 검사할 수 있습니다. 원문 §5.3과 부록 A.5
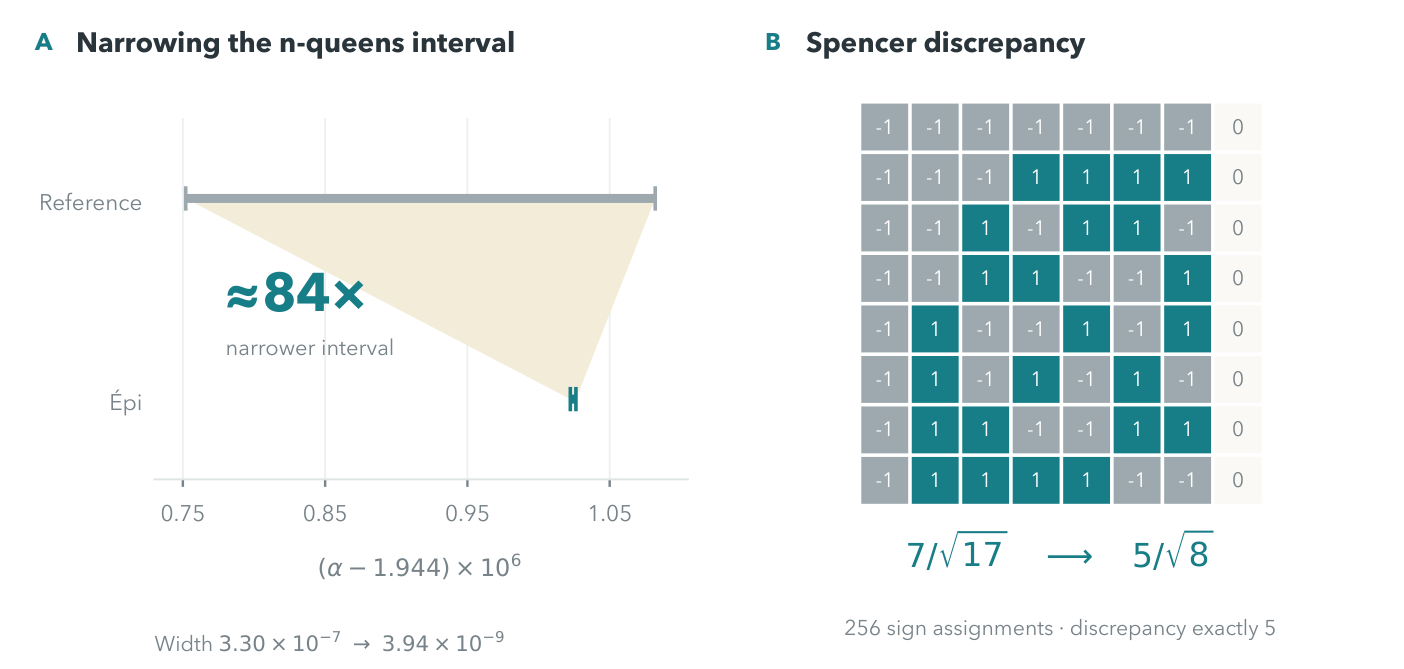
그림 5. 왼쪽은 n-퀸 상수 구간, 오른쪽은 Spencer 하한을 뒷받침하는 행렬입니다. Yue Huang 외, CC BY 4.0. 고정 버전 PDF 10쪽에서 잘라냈으며 번역하지 않았습니다.
5.4 Optimizing a Formulation: MAX-4-CUT
MAX-4-CUT은 정점을 네 색에 배정해 서로 다른 색을 잇는 간선의 가중치 합을 최대화합니다. 저자들은 난해성 증명에 쓰인 작은 구성 요소인 가젯의 구조와 관련 배정을 고정하고, 간선 가중치만 다시 최적화했습니다. 정해진 색 배정에서 목적값은 간선 가중치의 선형 합이므로, 비율의 한쪽을 정규화한 뒤 제약을 포함한 선형계획으로 다른 쪽을 조정할 수 있습니다. 정수 가중치 간선 목록에서 기존 $195581/198140$이던 난해성 비율을 $84931/86101$로 낮췄습니다. 이 가젯을 기존 환원에 넣어 개선된 난해성 경계를 얻습니다. 원문 §5.4 식 (5)와 부록 A.7
5.5 A Finite Construction for the Spencer Constant
각 원소의 절댓값이 1 이하인 정사각행렬 $A$에서 열마다 부호를 정합니다. $\varepsilon$은 부호 벡터이고 $\|A\varepsilon\|_\infty$는 부호 적용 뒤 행합의 최대 절댓값입니다. 아래 식은 그 최대 절댓값을 가장 작게 만드는 부호를 찾습니다. 원문 §5.5와 부록 A.3
그림 5 오른쪽의 $8\times8$ 행렬에 부호 $2^8=256$가지를 모두 적용하면 최대 절댓값이 5 또는 7입니다. 최솟값은 5이고, 크기 $n=8$로 정규화하면 보편 상수의 하한은 $5/\sqrt{8}$입니다. 과거 하한 $7/\sqrt{17}$보다 높습니다. 공개된 행렬 자체가 확인 가능한 근거입니다. 원문 §5.5
5.6 Certifying Near-Optimal Water-Network Design
Waterund36은 비선형 유량·농도 제약 아래 물 사용 네트워크의 비용을 최소화합니다. 이미 알려진 타당한 비용 662.8070384와 기존 전역 하한 655.5441707의 간격을, 하한을 662.80702839로 올려 약 0.00001001까지 줄였습니다. 모든 원래 타당해를 포함하는 완화 문제에서 특정 비용 이하가 불가능함을 유리수 부등식으로 증명했기 때문에, 기존 네트워크 비용이 최적값에 매우 가깝다는 결론을 낼 수 있습니다. 원문 §5.6과 부록 A.12
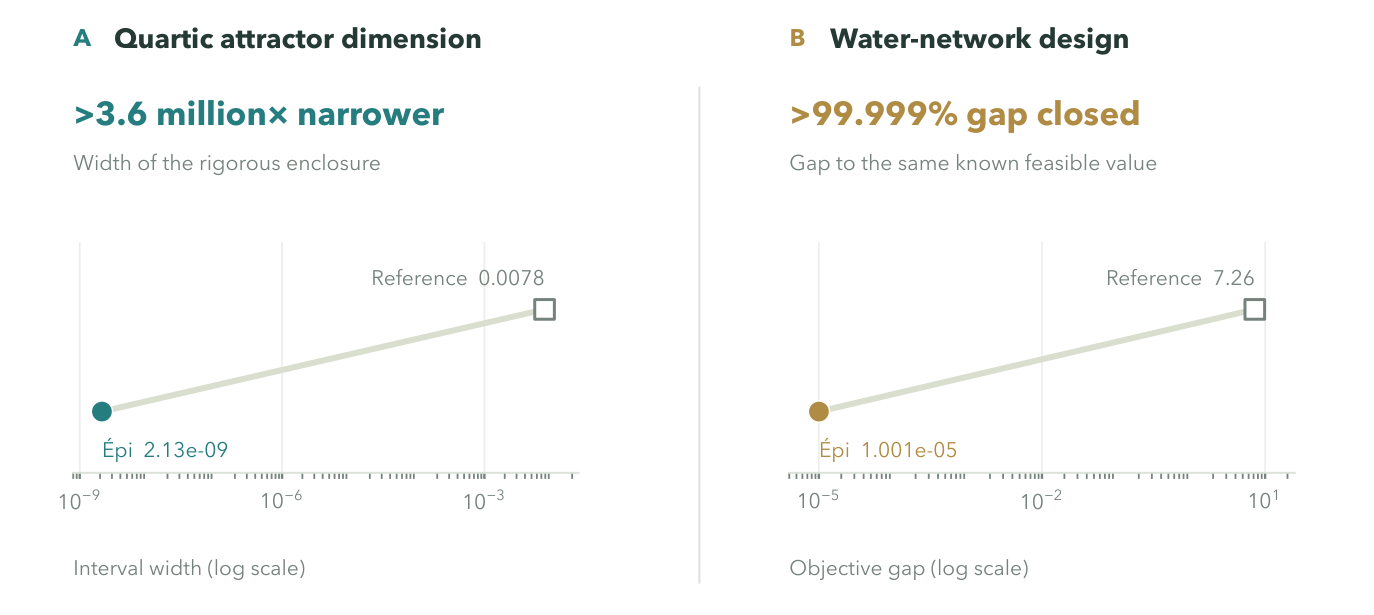
그림 6. 왼쪽은 엄밀한 차원 구간의 폭, 오른쪽은 같은 타당해 비용까지의 간격입니다. Yue Huang 외, CC BY 4.0. 고정 버전 PDF 11쪽에서 잘라냈으며 번역하지 않았습니다.
5.7 From Numerical Optimization to Proof: Tuza’s Conjecture
- 패킹과 덮개. $\nu_\triangle(G)$는 서로 간선을 공유하지 않는 삼각형의 최대 개수입니다. $\tau_\triangle(G)$는 모든 삼각형과 적어도 한 간선을 공유하는 간선 집합의 최소 크기입니다. 최대 패킹에 속한 삼각형의 세 간선을 모두 덮개로 잡으면 $\tau_\triangle\le3\nu_\triangle$가 따라옵니다. Tuza 추측의 계수는 2이고 $K_4$에서 실제로 이 계수에 도달합니다.
- 분할 그래프와 선행 정리. 분할 그래프의 정점 집합을 클릭 $C$와 독립 집합 $I$로 나눕니다. 원문은 이웃 집합이 포함 관계로 정렬되는 threshold graph와 $K_8$이 없는 chordal graph의 선행 결과를 구분합니다. 이 논문의 클릭 부분에는 8개 정점이 있습니다.
- 이웃 유형과 확장. $x\in I$에서 클릭 쪽 이웃이 둘 이상이면, 그 이웃 중 두 정점이 $x$와 삼각형을 이룹니다. 같은 클릭 이웃 집합을 가진 정점끼리 한 유형입니다. 정리 1은 지정된 분할에서 $G[C]=K_8$이고 이런 활성 이웃 집합이 최대 세 종류인 유한 단순 그래프에 적용됩니다. 각 유형의 정점 수는 임의입니다. 정확히 세 유형인 872개 대표 프로필 가운데 35개는 threshold graph 정리, 추가 277개는 Zeng의 최대 컷 기준으로 처리합니다. 남은 560개는 18,444개 중복도 상자의 증명서로 검사합니다. 두 유형 이하의 경우에는 선행 정리를 사용합니다.
이 증명의 범위는 그래프 조건으로 결정되며, 상자 집합의 검사 결과를 임의의 중복도로 확장하는 논리는 부록 A.13에 있습니다. 다음 장은 완성된 수학 증명서 대신 실행 프로그램을 제출하는 과제로 넘어갑니다. 원문 §5.7 식 (6), 정리 1 및 부록 A.13
📖 Chapter 6: Épi-turbo: Fast, Low-cost Algorithm Design
6.1 Purpose and Design
- 공통 기반. 고정 평가 규칙, 장기 상태, 분기, 교훈 기억을 유지합니다. 종료 조건과 모델 비용 사용을 짧은 알고리즘 설계 과제에 맞춥니다.
- 과제 지시. 품질과 실행 시간의 채점 규칙, 비공개 평가 입력이 사용된다는 사실을 에이전트에게 알립니다. 프로그램이 제한 시간의 상당 부분을 소비했는지 피드백합니다. 과제별 풀이법은 제공하지 않습니다.
- 모델 호출. 짧은 실험은 세션 내 제한 시간을 두고 실행합니다. 세션을 넘는 작업은 실행 인프라에 넘기고 결과가 다음 결정을 바꿀 때 진행 상황을 확인합니다.
- 연속 세션. 가능한 한 한 세션으로 진행합니다. 세션 전환 시 최고 후보와 다음 행동을 인계하며, 더 실행해도 검증 점수가 개선되지 않으면 캠페인을 끝냅니다.
- 예산 제어. 호출 전 최대 비용을 예약하고, 마지막 작업에도 예산을 남깁니다. 모델 호출을 적게 한 것과 개발 시간·최종 프로그램 실행 시간을 줄인 것은 별개의 측정값입니다.
- 선택 구성. 아래 비교에서 독립 검토 모델과 추가 검증은 껐습니다. 고정 평가기는 계속 사용했습니다.
6.2 Benchmark and Protocol
문헌 기반 운영연구 과제 180개로 이루어진 FrontierOR에서 두 시스템 모두 처음 접하는 30개를 선택했습니다. 공식 난도 순서를 따르면서 기준값이 신뢰하기 어려운 과제를 제외했습니다. 최종 표본은 공식 hard split 13개와 난도 순위 51–70 구간 17개입니다. 양쪽 모두 GPT-6-Astra에 같은 추론 강도를 적용했고, 시스템마다 과제당 모델 예산 20달러와 과제별 1회 실행 조건을 적용했습니다. 프로그램은 외부 최적화 솔버를 호출할 수 없습니다. 원문 §6.2
개발 입력 두 개의 평가 결과를 에이전트에 공개합니다. 개발 점수가 가장 높은 프로그램을 고른 뒤 별도 입력 네 개를 한 번씩 실행하며, 입력당 한 시간까지 허용합니다. 점수는 기준 해와의 차이를 반영하는 품질 항과 기준 솔버 대비 실행 시간을 반영하는 속도 항을 사용합니다. 해가 기준값의 1% 범위에 들어올 때만 속도 항이 계산에 들어갑니다. 기준 해 자체가 약할 수 있어 두 프로그램의 목적값도 같은 입력에서 직접 비교합니다. 원문 §6.2
6.3 Results
| 항목 | Épi-turbo | Codex |
|---|---|---|
| 30개 과제의 벤치마크 점수 합계 | 53.96 | 51.21 |
| 점수가 더 높은 과제 수 | 18 | 12 |
| 평균 품질 항 | 1.030 | 1.032 |
| 평균 속도 항 | 0.784 | 0.675 |
| 목적값이 더 좋은 입력 수 | 18 | 61 |
| 상대 해보다 1% 넘게 나쁜 입력 수 | 29 | 10 |
| 타당하지 않은 해 수 | 1 | 0 |
| 과제당 평균 모델 비용 | 7.30달러 | 11.35달러 |
| 과제당 개발 시간 중앙값 | 22분 | 37분 |
| 평가 입력별 프로그램 실행 시간 중앙값 | 2.9초 | 9.3초 |
목적값 직접 비교는 120개 평가 입력 중 두 해가 비교 가능한 119개를 분모로 하며, 40개에서 목적값이 같습니다. 과제 점수 차이는 30개 중 10개에서 0.01 미만입니다. Épi-turbo는 27개 과제에서 모델 비용이 낮고, 15개에서는 비용과 점수 양쪽에서 앞섰습니다. hard split 합계는 22.33 대 20.30으로 약 10% 높았고, 순위 51–70 구간은 31.64 대 30.91이었습니다. Épi-turbo 프로그램은 비교에서 30분을 넘긴 평가 실행이 없었으며, Codex 프로그램은 7개 과제에 걸쳐 120번 중 17번에서 30분을 넘겼습니다. 원문 §6.3, 표 3과 4
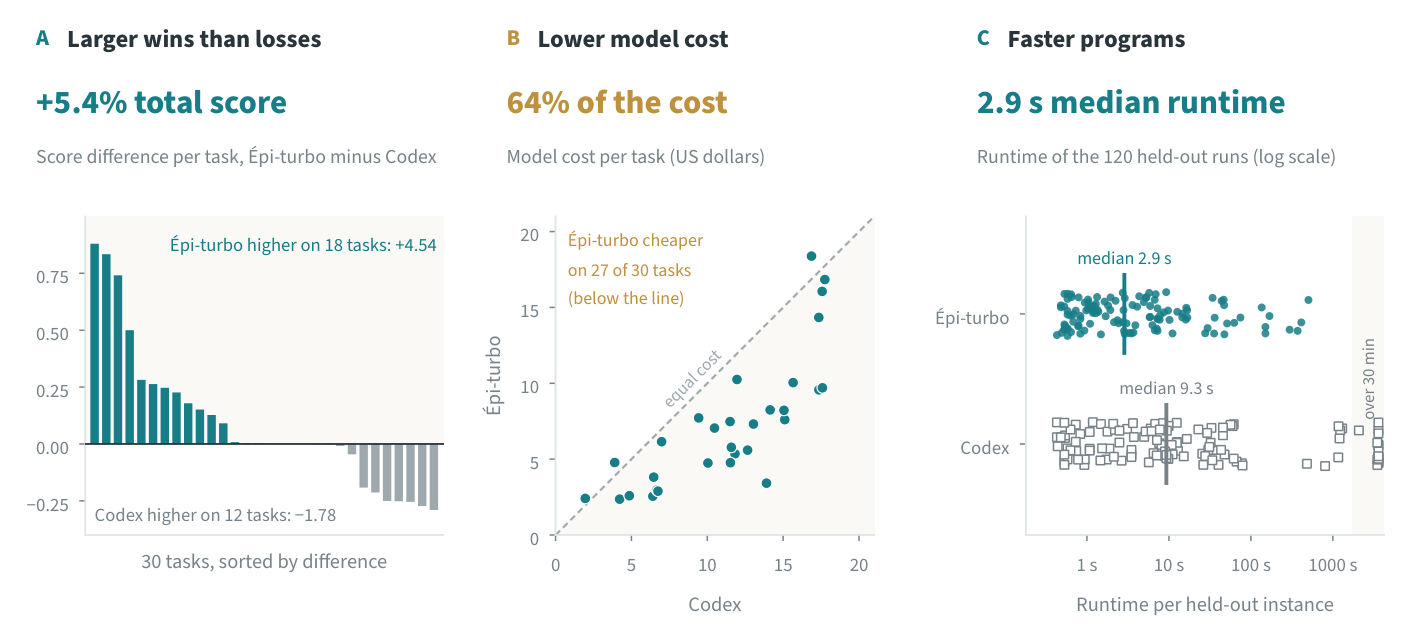
그림 7. A는 과제별 점수 차이, B는 모델 비용, C는 평가 실행 시간입니다. Yue Huang 외, CC BY 4.0. 고정 버전 PDF 14쪽에서 잘라냈으며 번역하지 않았습니다.
6.4 Selected Cases
- 클릭 차단. Épi-turbo는 네 평가 입력에서 각각 17초 미만에 풉니다. 한 입력에서 목적값 8 대 20이었고, Codex는 네 입력 중 세 개에서 20–60분을 사용했습니다. 품질과 속도 양쪽이 벤치마크 점수 차이에 기여합니다.
- 생산 계획. 한 최소화 입력에서 Codex 해는 기준값보다 1.19%, Épi-turbo 해는 0.89% 높았습니다. 1% 경계를 넘은 쪽에는 속도 점수가 붙지 않습니다. 같은 사례에서 실행 속도 차이도 2–7배였습니다.
- 최대 클릭. Épi-turbo는 네 입력에서 기준값과 같은 크기의 클릭을 찾았습니다. Codex는 한 입력에서 5% 낮은 값을 냈고, 다른 입력에서는 기준 솔버보다 느린 34초가 걸려 속도 항이 줄었습니다.
- 차량 경로. 양쪽 모두 기준값을 5–17% 능가했습니다. Codex가 세 입력에서 목적값을 최대 2.6% 더 개선했으나, 세 입력에서 주어진 한 시간을 썼습니다. Épi-turbo의 실행은 최대 36초였습니다. 점수 격차가 어떤 방식으로 발생하는지 보여 주는 사례입니다.
표 5는 Épi-turbo 점수 차이가 큰 과제 열 개를 골라 품질·속도·비용을 제시합니다. 이 장은 수학 구성의 탐색과 알고리즘 설계가 실행 가능한 산출물과 재평가를 공유한다는 점을 보여 줍니다. 다음 장은 이런 연구 방식의 선행 접근을 비교합니다. 원문 §6.4와 표 5
📖 Chapter 7: Related work
첫 비교 축은 다음 실험의 선택입니다. AI Scientist-v2는 트리 탐색으로 대안을 찾고 Co-Scientist는 모델이 생성한 비판으로 가설을 다듬습니다. InternAgent-1.5는 생성과 검증을 연결하고 AIRA2는 비동기 실험과 일관된 평가를 다룹니다. 다음 축은 상태의 보존입니다. Kosmos는 문헌·데이터 분석을 공유 상태로 묶고 ScienceFlow는 재개할 수 있는 실행 상태를 남깁니다. AgentRxiv와 AutoKD는 보고서 또는 수용한 지식 그래프를 통해 연구 간에 결과를 전달합니다. 마지막 축은 실행 가능한 탐색입니다. FunSearch와 AlphaEvolve는 프로그램 점수를 사용하고, SimpleTES와 Dream-RSI는 실행 기록을 각각 재사용하거나 재생합니다. TTT-Discover는 테스트 시 가중치를 조정합니다. Épi의 보고된 캠페인은 분기 이력과 저장된 교훈으로 다음 실험을 바꿉니다. 다음 장은 이러한 기록이 사람이 읽을 수 있는 설명이 되는 조건을 다룹니다. 원문 §7
📖 Chapter 8: Autonomous Research for Human Understanding
저자들이 원하는 산출물에는 개선된 숫자뿐 아니라 그 수치가 왜 성립하는지 설명하는 공식화와 증명서가 들어갑니다. Cohn–Elkies는 방법 자체의 경계를 식 (2)의 부등식으로 보여 줍니다. MAX-4-CUT은 고정 구조에 대한 선형계획을 제시해 어떤 과정으로 가중치를 바꿀 수 있는지 드러냅니다. Tuza에서는 한 상자의 유한 검사가 무한한 중복도 범위에 적용되는 조건을 분리합니다. 다음 장은 이러한 종류의 산출물을 알고리즘 평가와 함께 정리합니다. 원문 §8
📖 Chapter 9: Conclusion
논문은 지속적인 실행 상태와 검증 가능한 평가를 결합해 수학 결과와 실행 프로그램을 얻는 작업 방식을 제시합니다. 수학 캠페인에서 나온 구성과 증명서는 후속 검사의 대상으로, Épi-turbo에서 제출된 프로그램은 비공개 인스턴스에서 품질과 실행 시간을 평가할 대상으로 남습니다. 결론 뒤에는 감사의 글과 참고문헌이 나오고, 부록은 경계값과 증명서를 자세히 기술합니다. 원문 §9
📖 Chapter 후속 항목: Acknowledgements · References
저자들은 수학 사례에 피드백을 준 연구자들에게 감사를 표합니다. 참고문헌은 이 글에서 구분한 세 종류의 근거를 연결합니다. 패킹·경계 문제의 비교 기준과 정리, FrontierOR의 평가 설계와 비교 도구, 실험 상태를 저장하는 연구 에이전트의 선행 방식입니다. 원문은 신규 구성과 증명서의 확인 경로로 별도 결과 저장소를 인용합니다. 원문 참고문헌 · 논문이 연결한 결과 저장소
📖 Chapter A: Mathematical Results and Supporting Evidence
부록 A는 수치 결과 12계열의 정확한 경계와 이를 재검사할 증거를 정리하고, 마지막으로 본문 정리 1의 유한 환원을 설명합니다.
| 원문 순서 | 결과와 확인 근거 |
|---|---|
| A.1 Relevant Variables of Boolean Functions | 관련 변수 수와 함수 차수의 관계를 제어하는 Wellens의 $D_\infty$ 상한이 4.3935에서 4.3654674227로 낮아집니다. 차수 1–48 각각에서 정확한 비실현성 증명서와 유리수 타당해를 보존합니다. |
| A.2 Cohn–Elkies Linear Programming | 차원별 쌍대 벡터와 정확한 경계식을 제공합니다. 10·11차원은 독립적인 3점 패킹 상한과 비교하여 실제 밀도와의 분리를 증명합니다. |
| A.3 Spencer Discrepancy Constant | $8\times8$ 행렬의 256개 부호 조합을 검사해 discrepancy가 5임을 확인합니다. |
| A.4 Dimer Entropy in Three Dimensions | 정육면체 격자 완전 매칭의 한 자리당 엔트로피 상한을 0.452130에서 0.452010으로 낮춥니다. 양의 정수 벡터가 전이 연산자 부등식을 만족하며, 계산한 로그값은 상한 방향으로 올림합니다. |
| A.5 The n-Queens Constant | 하한 쪽 해상도는 65,536, 상한 쪽은 4,096입니다. 타당성의 유리수 검사와 방향 반올림으로 식 (4)의 두 끝점을 얻습니다. |
| A.6 Ramsey Multiplicity c₄,₅ | 128정점 공개 그래프의 기준값 $2129191/2^{28}$과 비교해 1,024정점 구성에서 상한 $4427841832181/2^{49}$을 얻습니다. 그래프와 여그래프를 정확히 열거해 두 색의 서로 다른 크기 클릭을 셉니다. |
| A.7 MAX-4-CUT Hardness | 정수 간선 가중치로 정확한 비율을 복원하고 기존 난해성 환원에 가젯을 대입합니다. |
| A.8 Polyomino Growth | 폴리오미노 개수의 증가율 $\lambda$는 4.5238에서 4.29569 이하로 강화됩니다. 1,186개 이웃 유형에 대한 점화 관계와 이를 만족하는 유리수 상해를 확인합니다. |
| A.9 Additive Combinatorics | 같은 정수를 원소 합으로 나타내는 순서 없는 표현이 최대 $g$개인 $B_h[g]$ 집합의 크기 상한 계수를 개선합니다. 유리수 코사인 커널의 최솟값을 전 정의역에서 구간 산술로 인증합니다. |
| A.10 Quartic Feigenbaum Attractor Dimension | 하우스도르프 차원을 $[0.6425750638035370,\,0.6425750659339700]$에 가둡니다. 폭은 $2.130433\times10^{-9}$이며 전 정의역의 pressure 부등식을 별도 구현이 확인합니다. |
| A.11 Quantum-Capacity Thresholds | 40큐비트에서 X–Z의 $p=0.1198803$, Two-Pauli의 $p=0.1193415$에 대해 양의 coherent information을 증명합니다. 구간 스펙트럼 계산으로 해당 잡음 설정에서 양자 용량이 양수임을 확인합니다. |
| A.12 Water-Network Design | 원래 연속 비선형 문제를 포함하는 유계 완화에 정확한 목적값 절단을 적용해, 그 조건 아래 제약들이 양립할 수 없음을 보입니다. |
A.9에서 $N$은 원소의 범위를 정하고 $h$는 합에 쓰인 원소 수입니다. $g\ge2$일 때 선행 정식화의 점근 상한은 아래와 같습니다. $o_N(1)$은 $N$을 늘릴 때 0으로 가는 항입니다. 같은 $h,g,N$에서 $C_h$가 작을수록 상한이 가까워집니다. 원문 부록 A.9와 표 6
| $h$ | 문헌의 계수 | Épi 계수 |
|---|---|---|
| 3 | 14.3 | 14.287390218082 |
| 4 | 71.49 | 70.289552594834 |
| 5 | 413.07 | 408.104453996958 |
| 6 | 2774.16 | 2749.492485514635 |
| 7 | 21294.74 | 21149.189776156220 |
A.12의 완화에는 $Ax\le b$와 변수 범위 $L\le x\le U$가 있습니다. 각 부등식에 0 이하의 승수 $y$를 곱하면 $y^\top Ax\ge y^\top b$가 됩니다. 목적 벡터 $c$에서 이 항을 빼 남은 선형식을 변수별 범위에서 최소화하면 모든 타당한 $x$의 목적값에 다음 하한이 적용됩니다. 등식 행의 승수는 어느 부호든 가능합니다. 이 부등식으로 경계를 전파하며 가정한 비용 이하에서 모순을 증명합니다. 원문 부록 A.12
A.13 Tuza’s Conjecture: Proof for Three Neighborhood Types
유한 환원. 클릭의 간선이 $\binom82=28$개이고 모든 삼각형이 클릭 간선을 하나 이상 사용하므로, 패킹에 들어가는 삼각형 수는 최대 28입니다. 독립 정점 유형의 중복을 각각 28개로 잘라도 패킹을 재배치할 수 있습니다. 전체 클릭 간선으로 덮개를 만들 수 있고, 절단된 그래프의 최소 덮개 크기가 28 미만이라면 28개 남은 각 유형에서 덮개가 건드리지 않은 정점을 하나 이상 찾을 수 있습니다. 그런 정점을 포함한 삼각형은 클릭 쪽 간선으로 이미 덮이므로 같은 유형의 복사본을 더해도 덮개가 유효합니다. 원문 부록 A.13
완전성과 증명서. 한 상자가 성분별로 $\ell\le m\le u$인 중복도 벡터들을 대표합니다. $F_u$는 상한 중복도 그래프의 모든 삼각형을 덮는 간선 집합이고, $P_\ell$은 하한 중복도 그래프에서 찾은 간선 비공유 삼각형 집합입니다. 복사본을 더하면 작은 그래프는 부분그래프로 남습니다. 따라서 큰 그래프의 덮개는 중간 그래프에도 유효하고, 작은 그래프의 패킹은 중간 그래프에도 남습니다. 저장된 두 증명서가 가운데 부등식을 만족하면 상자 전체에 다음 연결이 성립합니다. 원문 부록 A.13
별도 검사기가 560개 프로필과 18,444개 상자에서 상한 그래프의 삼각형 덮개, 하한 그래프의 패킹, 크기 부등식, 정수 중복도 범위 전체의 커버리지를 검사했습니다. 이 검사에 중복도 절단 논리를 결합해야 정리 1이 임의 중복도에 적용됩니다. 다음 부록은 논문의 구성 기록을 마저 설명합니다. 원문 부록 A.13
📖 Chapter B: Additional Construction Results
이 부록은 34개 정오각형 패킹의 변 길이와 세 비패킹 결과의 비교 기준을 제시합니다. 배치 좌표의 전체 정밀도는 공개 산출물이 보존합니다.
| 최소화 대상 | 보관된 비교값 | Épi |
|---|---|---|
| XL-n1048-k237 차량 경로 | 380107 | 380092 |
| 부호 있는 최대값 기준 자기상관 | 1.4515718639 | 1.4508066395 |
| Zhang–Zagier $c_{82}$ | 0.2536331090 | 0.2535744749 |
- 차량 경로. 238개 경로로 고객 1,047명을 방문하고 차량 적재 용량 128을 지킵니다. 인스턴스에서 정의한 유클리드 거리 반올림 방식으로 전체 길이를 계산합니다.
- 자기상관. $a_1,\dots,a_n$은 부호가 있는 계단 함수 값이며 $a*a$는 이산 자기합성곱입니다. 그 합성곱의 최댓값을 먼저 구하고 절댓값을 취한 뒤 아래 식으로 정규화합니다. 각 항에 먼저 절댓값을 취하는 변형에서는 분자가 달라질 수 있습니다.
- Zhang–Zagier. 보관된 $c_{82}$ 기준과 비교하며, 최종 구성에는 Arb 기반 수치 증명서가 붙습니다.
차량의 경로 목록, 자기상관 목적함수, 수치 증명서까지 보존하면 숫자를 다른 인스턴스나 정규화로 잘못 비교할 가능성을 줄일 수 있습니다. 원문 부록 B 및 표 7
실험 결과 심층 분석
기록 120건은 기준 문헌을 갱신한 결과 수입니다. 구성과 수치적 경계를 합쳤으며, 97개는 기하 패킹 구성입니다. 논문은 같은 설정의 중간 기록을 합산하지 않고 Tuza 정리 확장을 별도로 표시합니다. 유한 구성의 좌표를 검사하는 일과 정리의 전체 범위를 증명하는 일을 같은 통계 단위로 해석할 수 없습니다. 이 리뷰는 원문의 수치·규칙·증명서 설명을 대조했으며 공개 증명 검사기는 실행하지 않았습니다. 원문 §4와 부록 A–B
FrontierOR 점수 차이는 실행 시간과 해 품질의 결합에서 나옵니다. 점수 합계의 상대 차이는 $(53.96-51.21)/51.21\approx 5.4\%$이고, 평균 모델 비용의 비는 $7.30/11.35\approx64\%$입니다. 두 모델 설정과 사용 가능 예산이 같았고 실제 지출은 달랐습니다. 평균 품질 항은 비슷했으며, 같은 입력의 목적값에서 Codex가 더 좋은 경우는 61개, Épi-turbo가 더 좋은 경우는 18개였습니다. Épi-turbo가 앞선 항목은 평균 속도 항과 실행 시간입니다. 실제로 오래 탐색하고 얻은 해를 중시하는 평가라면 품질과 시간의 가중치를 읽어야 이 표를 적용할 수 있습니다. 원문 §6.2–6.3
저자들은 과제·시스템당 1회 실행했으며 통계적 유의성을 보고하지 않았습니다. 프로그램의 타당하지 않은 해 한 건, 두 시스템 간 1% 이상 목적값 차이의 빈도, 17건의 장시간 실행도 표에 남아 있습니다. §6.3은 Épi-turbo가 진 12개 과제의 손실 합을 1.79로 쓰고 그림 7A는 1.78로 표기합니다. 두 값의 차이 원인은 원문에 제시되지 않았으며, 전체 비교는 표 3의 53.96과 51.21을 사용했습니다. 원문 §6.3, 표 3, 그림 7
기술적 함의와 응용
Épi의 저자들은 구성이나 증명서가 사람에게도 검토 가능한 연구 결과를 남긴다는 점을 강조합니다. 리뷰 관점에서, 캠페인의 코드·평가 규칙·목적값·제출물을 함께 남겨야 실험을 되돌아봤을 때 개선의 출처를 확인할 수 있습니다. 패킹에서처럼 목적값이 정밀하게 수치화되면 좌표와 검증 기준을 따라 재검사할 수 있고, Tuza처럼 증명 범위가 넓은 경우에는 계산 검사를 전체 주장과 연결하는 별도 환원이 필요합니다. 원문 §5, §8
운영연구 과제에서는 프로그램 하나를 생성한 뒤 재사용하기 때문에 개발 비용과 프로그램 실행 비용을 따로 봐야 합니다. 예를 들어 차량 경로 사례에서 더 좋은 목적값이 필요한지, 주어진 시간 안에 타당한 해를 빠르게 얻는 편이 중요한지에 따라 같은 표에서 봐야 할 열이 달라집니다. FrontierOR 결과는 이 선택을 읽을 수 있도록 모델 비용, 품질, 속도를 각각 제시합니다. 원문 §6.3–6.4
검토 범위
원문 본문과 부록의 결과 및 검증 구조를 다뤘습니다. 부록 A에서 인용한 각 선행 정리의 독립적인 재증명, 개별 패킹 97건의 좌표 전사, 공개된 증명서의 재실행은 이번 검토 범위에 포함하지 않았습니다. 고정 버전 원문