논문 개요와 전체 구조
숫자로 된 신경망 가중치만 보여 주면, 대규모 언어 모델(LLM)은 그 신경망이 무엇을 분류하는지 알아낼 수 있을까요? 이 논문은 가중치에서 수치적 특징을 읽는 능력과 그 특징에 올바른 의미를 부여하는 능력을 구분합니다. 출력층에서 함께 움직이는 부류를 찾더라도, 그것이 비행기인지 새인지 맞히는 일은 별개의 문제입니다. 유명 데이터셋의 이름을 맞힌 결과만으로 두 능력을 모두 입증했다고 볼 수 있는지 실험합니다.
검토 대상은 Nazmus Sakib Ahmed의 Can an LLM Actually Reason and Program about Neural Network’s Weights or is it just memorization on steroids? Exploring “Weight-Space Programming”, arXiv:2611.08070v1입니다. v1 원문 제출일은 2026년 11월 5일이며, 이 글은 해당 버전의 HTML 전체와 23쪽 PDF를 분석했습니다. 논문이 시험한 대상은 Claude Opus 5.5 한 모델, xhigh effort, 도구 없는 약 12만 5천 파라미터 이미지 분류 신경망 읽기입니다. 아래 실험 수치는 저자 보고값이며, 리뷰어가 학습이나 LLM 질의를 재실행한 결과가 아닙니다. 버전·저자·제출 이력, 실험 설정
원래 Weight-Space Programming 연구는 가중치 읽기·쓰기·수정을 포괄합니다. 이 논문은 다른 모델과 과제로 읽기를 감사한 탐색적 연구이며, 원래 연구의 GPT-6 Astra 쓰기·수정 성과 전체를 재현하거나 반증한 논문은 아닙니다. 원 연구의 맥락은 원문 블로그 리뷰, 공개 실험 기록과 코드의 범위는 관련 저장소 리뷰에서 별도로 다룹니다.
원문의 실제 전개 순서는 다음과 같습니다. 번호 없는 공개 고지와 참고문헌도 원래 위치를 유지해 상세 리뷰에 반영합니다.
| 원문 순서 | 절과 소절 |
|---|---|
| 1. Introduction | 문제 제기, Contributions, Scope |
| 2. Related Work | 2.1 활성값·회로 해석 → 2.2 가중치 직접 읽기 → 2.3 LLM 해석기 → 2.4 가중치 편집·최적화 → 2.5 학습 데이터 정보 → 2.6 연구 위치 |
| 3. Background: Weight-Space Programming | 읽기·쓰기·수정의 기존 주장과 실험 조건 |
| 4. Experimental Setup | 4.1 신경망·훈련 → 4.2 데이터 → 4.3 프롬프트 → 4.4 격리 → 4.5 검증·채점 |
| 5. Results | 5.1 CIFAR-10·레이블 순서 → 5.2 덜 익숙한 데이터 → 5.3 구조 비교 → 5.4 SAT-6 정확도 비교 → 5.5 가중치 추적 여부 → 5.6 증거 종합 |
| 6. Discussion | 6.1 두 읽기 수준 → 6.2 순열 대조의 의미 → 6.3 선행 연구와 관계 → 6.4 확신도 → 6.5 함의 |
| 7–9 | Limitations → Future Work → Conclusion |
| 공개 고지 | AI Use Disclosure → Data and Code Availability |
| 부록 A–C | Full Results → The Prompts → Scoring Rules and Verification |
| References | 인용 연구 목록 |
핵심 기여와 혁신성
가중치를 이해한다는 주장을 평가하려면, 정답이 나온 이유를 가려야 합니다. 신경망 내부 계산을 따라가서 정답을 얻었을 수도 있고, 입력 크기·출력 수·몇 가지 통계에서 익숙한 데이터셋을 떠올렸을 수도 있습니다. 저자는 후자의 가능성을 국소적 산술과 사전 지식의 결합으로 설명하고, 이를 분리할 대조 조건을 만듭니다. 여기서 사전 지식은 해석 대상 신경망의 학습 데이터와 구별되는, 해석기 LLM이 이미 알고 있는 데이터셋·프레임워크 관행을 뜻합니다. §1, §6.1
기여는 세 가지입니다. 첫째, 가중치 전부를 텍스트로 주고 도구·기억·실행을 막은 통제된 읽기 과제를 구성합니다. 둘째, 출력 레이블 재배열, 가중치 셔플, 덜 익숙한 데이터셋, 특이한 채널 수, 학습 정확도 비교를 통해 정답 데이터셋 추측의 근거를 점검합니다. 셋째, 응답에 인용된 수치를 실제 파라미터와 대조하여 “계산은 맞지만 해석은 틀린” 사례를 분리합니다. 인용값 전부나 모든 주장을 검사했다는 뜻은 아닙니다.
가장 선명한 결과는 재배열된 CIFAR-10입니다. LLM은 새 출력 군집 {2, 4, 5, 7}을 찾았지만, 이름은 익숙한 표준 순서대로 붙였습니다. 저자가 확인한 9개의 클래스 쌍 해석은 모두 틀렸습니다. 수치 구조를 읽는 성공과 의미 대응의 실패가 한 응답 안에 공존합니다. 이 관찰의 파급효과는 “LLM은 가중치를 전혀 읽지 못한다”는 결론보다, 벤치마크 정답과 그 정답을 정당화하는 증거를 나누어 평가해야 한다는 방법론적 교훈에 있습니다. 다만 대부분 조건이 한 번씩이므로 일반적 성공률을 추정하는 자료는 아닙니다. §5.1, §7
기술적 세부사항
이 연구의 해석 대상은 CNN(합성곱 신경망)입니다. 작은 필터가 이미지의 국소 영역을 처리하고, 뒤의 층이 특징을 결합해 각 클래스의 점수를 만듭니다. 실험자는 이 신경망을 먼저 학습한 다음, 층의 계산식과 가중치·정규화 통계 전체를 텍스트로 바꾸어 LLM에게 줍니다. LLM이 받는 것은 실제 이미지나 실행 결과가 아닙니다.
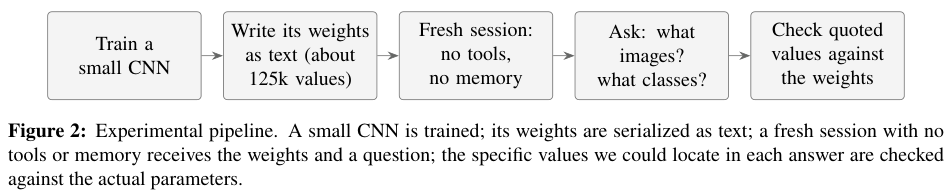
원문 Figure 2, PDF 6쪽. 고정 버전 PDF의 그림·캡션 영역을 크롭했으며 번역·수치 변경은 없습니다. 마지막 단계는 응답에서 찾아 확인할 수 있었던 특정 값의 대조이며, 응답 전체의 진실성 보증은 아닙니다.
분석할 때는 네 종류의 수치를 나누어야 합니다.
| 수치 | 무엇을 평가하는가 | 혼동하면 안 되는 것 |
|---|---|---|
| 신경망 test accuracy | 해당 CNN이 실제 테스트 이미지를 분류한 비율 | LLM의 해석 정답률이 아닙니다. |
| 인용값 대조 | 응답에서 집어낸 수치가 실제 파라미터와 일치하는가 | 그 수치에 붙인 클래스 의미까지 맞았다는 뜻은 아닙니다. |
| 클래스 in position / any position | 클래스 이름과 출력 위치를 함께 맞혔는가 / 위치와 무관하게 이름이 포함됐는가 | 4/6 any position을 4개 출력 해석 성공으로 바꾸면 안 됩니다. |
| 응답 확신도 | LLM이 스스로 제시한 0–100% | 반복 실험으로 보정된 정답 확률이 아닙니다. |
중요 계산식은 부록 B의 batch normalization(배치 정규화)입니다. 평가 시 각 채널 값을 저장된 평균·분산으로 표준화한 뒤, 학습된 크기·이동 파라미터를 적용합니다. 원문 Listing 1의 계산을 기호로 옮기면 다음과 같습니다.
$a$는 해당 채널의 정규화 전 값, $\mu_{\mathrm{run}}$과 $v_{\mathrm{run}}$은 훈련 중 누적한 평균·분산입니다. $\gamma$와 $\beta$는 학습되는 배율·편향이며, 0.00001은 분모의 수치적 안정을 위한 상수입니다. 통계와 기본 설정을 알면 학습 상태를 추론할 수 있지만, 이 식만으로 채널이 “나무”를 뜻한다고 결정할 수는 없습니다. 부록 B, Listing 1
논문에는 새 학습 목적함수나 최적화 알고리즘을 제안하는 번호 붙은 핵심 식이 없습니다. 중심은 정상 분류 기능을 유지한 출력 재배열과 기능을 훼손하는 셔플 등 실험 설계이며, 산술과 의미의 관계를 실제 관찰로 평가합니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
도입부는 가중치 읽기가 왜 흥미로운지에서 출발합니다. 프로그램을 읽듯 신경망의 숫자를 해석할 수 있다면, 데이터나 실행 없이도 내부 기능을 설명할 가능성이 열립니다. 그러나 잘 알려진 작은 이미지 분류 신경망은 입력 크기, 클래스 수, 출력층의 패턴만으로 정체를 추측하기 쉬울 수 있습니다. 따라서 정답 이름을 말하는 능력과 입력부터 출력까지 계산을 이해하는 능력을 구별해야 합니다.
저자는 가중치 흐름 추적(weight-flow tracing)을 여러 층의 변환을 따라가며 특징이 최종 출력으로 연결되는 과정을 읽는 것으로 다룹니다. 이에 비해 국소적 읽기는 첫 층의 색상 가중치나 마지막 층의 부호·상관관계처럼 낮은 차원의 요약을 얻는 일입니다. 이 연구의 가설은 국소적 읽기가 실제로 일어나면서도, 그 빈 곳을 유명 데이터셋의 관습적 이름이 메울 수 있다는 것입니다.
Contributions는 통제된 질의 환경, 이를 시험할 대조군, 수치와 의미를 분리한 검증입니다. Scope는 이 결과를 Claude Opus 5.5의 제한된 조건에 한정합니다. 신경망을 따라가는 직접적인 순전파 문제를 풀게 한 실험은 아직 없으며, 일반 LLM의 영구적인 불가능성을 주장하지 않습니다. 이 경계를 세운 뒤 관련 연구를 통해 정확히 어떤 능력과 비교하는지 정리합니다. §1
📖 Chapter 2: Related Work
2.1 Interpretability from activations and circuits. 기계적 해석 가능성 연구는 내부 활성값, 즉 입력을 통과시켰을 때 각 유닛이 내는 값과 이들을 잇는 회로를 조사합니다. 비전 회로, Transformer 회로, 희소 사전 학습, attribution graph 등이 여기에 속합니다. 본 논문은 실행과 활성값 접근을 제거하므로, 이들 기법과 동일한 문제를 푸는 설정이 아닙니다.
2.2 Reading weights directly. WeightWatcher의 행렬 스펙트럼 분석, 가중치 공간의 등변 모델, 가중치 표현 학습·생성 연구를 살펴봅니다. 이들은 가중치에 정보가 있다는 근거이지만, 별도 학습이나 구조 제약·탐색을 쓰는 접근입니다. 작은 덧셈 Transformer를 비교하는 AdderBoard도 소개합니다. 저자의 질문은 가중치 전용 훈련을 받지 않은 범용 LLM이 처음 본 네트워크를 읽을 수 있는지입니다.
2.3 LLMs as interpreters. 뉴런을 자연어로 설명하는 연구와 Activation Oracles, 자연어 autoencoder, Weight Oracles, 가중치 차이를 설명하는 튜닝을 구분합니다. 특히 Weight Oracles는 전용 커리큘럼과 외부 계산을 사용하며, 작은 Transformer 시뮬레이션에서 최대 99% holdout accuracy를 보고한 선행 연구로 인용됩니다. 이는 해당 연구의 결과이며 본 논문 Claude의 성능이 아닙니다. 전문가로 추가 훈련한 모델의 능력을 범용 모델의 도구 없는 능력으로 옮길 수 없다는 것이 이 소절의 역할입니다.
2.4 Editing and optimization in weight space. ROME·MEMIT의 사실 편집, 거절 행동의 방향, HyperNetworks, 역전파 없이 최적화하는 MeZO 등을 소개합니다. 가중치를 조작해 기능을 바꿀 수 있다는 사실과, 가중치만 보고 그 의미를 자연어로 복원한다는 주장은 구분됩니다. 본 실험이 읽기를 분리하는 이유입니다.
2.5 What models reveal about their training data. Membership inference는 특정 사례의 학습 포함 여부를, property inference는 데이터의 집계 특성을, dataset inference는 출처 데이터셋을 추론합니다. 이 경우 정보가 들어 있는 주체는 해석 대상 모델입니다. 저자의 가설은 추가로 해석기 LLM의 데이터셋 사전 지식이 답의 의미를 공급할 수 있다는 것입니다. 정확한 추측이 나왔다고 해서 어느 정보 경로가 작동했는지는 바로 알 수 없습니다.
2.6 Positioning. 연구는 다른 모델과 통제된 이미지 과제로 WSP의 읽기 주장을 감사하는 방법론적 탐색이라고 위치를 정합니다. 이 장은 모든 가중치 해석 연구를 부정하는 대신, 훈련·도구·관찰 조건을 맞추어 비교해야 한다는 기준을 세우며 다음 장의 원 연구 설명으로 이어집니다. §2.1–2.6
📖 Chapter 3: Background: Weight-Space Programming
저자는 Takehi 등의 WSP를 자연어 명세를 중심으로 범용 LLM이 신경망 가중치를 직접 읽고 쓰는 접근으로 소개합니다. 읽기에서는 정책 신경망의 게임, 확산 모델의 생성 도형, 작은 언어 모델의 언어를 알아내는 사례가 나옵니다. 어느 언어 모델이 아첨 성향을 가졌는지는 가중치만으로 구별하지 못했고, attention 패턴 접근 후 구별한 사례도 함께 적습니다.
쓰기에서는 작은 게임 정책을 처음부터 구성하고 약 150만 파라미터 규모의 Go 정책도 작성한 결과를 소개합니다. 수정에서는 제어망 가중치의 3.5%를 고친 사례와, Qwen3.5-0.8B 가중치 중 131,072개, 약 0.016%를 수정하여 MATH-500이 7.9%에서 48.1%가 됐다는 원 연구 보고를 인용합니다. 이 숫자들은 이 감사 논문이 다시 수행한 편집 실험이 아닙니다.
이어 조건 차이를 짚습니다. 원래 게임 과제는 입력 채널이 에이전트·움직이는 물체·보상·장애물·이전 프레임 중 무엇인지를 알려 주고, 첫 층 가중치는 격자 위치와 직접 대응했습니다. 이는 숫자에 의미를 붙일 기준점을 제공합니다. 본 실험은 입력을 빨강·초록·파랑으로만 설명하고 클래스 이름을 숨깁니다. 원 연구의 여러 실험은 Python 환경이나 순전파 예산을 제공했지만, 본 연구는 둘 다 제공하지 않습니다. 다만 원래 게임 읽기 실험에는 그러한 도구가 없었다는 예외도 보존합니다.
이 장의 결론은 읽기 실패만으로 편집 결과의 존재를 부정할 수 없다는 것입니다. 편집 성공이 이해인지 탐색인지 따로 평가해야 한다는 문제를 제기하지만, 어느 쪽인지 본 실험이 결정하지는 않습니다. 이 차이를 전제로 다음 장이 실제 감사 조건을 명세합니다. §3
📖 Chapter 4: Experimental Setup
4.1 Networks and training: 서로 다른 폭의 작은 CNN
세 신경망은 모두 3×3 합성곱 → ReLU → 2×2 최대 풀링 → 배치 정규화 블록 세 개를 거친 뒤, 전결합층·ReLU·dropout과 최종 출력층으로 이어집니다. 합성곱은 주변 픽셀을 결합하고, ReLU는 음수를 0으로 만들며, 풀링은 공간 크기를 줄입니다. Dropout은 훈련 중 일부 값을 무작위로 제거하는 정규화로, 비율은 0.3이며 평가 시에는 꺼집니다.
| 구조 | 세 합성곱층의 채널 수 | 마지막 은닉층 크기 | 설계 의도 |
|---|---|---|---|
| Model 1 | 16, 32, 64 | 100 | 익숙한 폭의 기준 구조 |
| Model 2 | 13, 33, 77 | 78 | 덜 전형적인 폭 |
| Random | 62, 68, 25 | 175 | 8·10의 배수가 없는 폭을 조건부 무작위 탐색 |
Random은 아무 구조나 고른 것이 아닙니다. Model 1과 같은 127,318 파라미터를 갖는 833개 크기 조합 중 seed를 고정한 탐색으로 선택했습니다. 출력 수가 데이터셋마다 달라 전체 훈련 파라미터 수는 123,782–127,318개입니다. 특이한 폭이 있어도 입력 32×32와 출력 클래스 수 등 다른 단서는 남아 있습니다.
훈련은 PyTorch·Adam, 학습률 $10^{-3}$, batch size 128, seed 0을 사용합니다. 검증 손실이 3회 정체하면 학습률을 절반으로, 10회 개선되지 않으면 조기 종료하며 최대 100 epoch입니다. 검증 손실이 가장 작은 checkpoint를 보관하고 테스트는 최종 평가에 씁니다. 이 조건은 LLM 추론 설정과 별개인, 해석 대상 CNN의 학습 설정입니다.
CIFAR-10에는 표준 정규화 상수를 사용합니다. KMNIST는 28×28 회색조 문자를 32×32로 영 패딩한 뒤 같은 채널을 세 번 복사하고, 패딩된 훈련 데이터에서 구한 평균·표준편차로 정규화합니다. 나머지는 종횡비를 보존하지 않고 bilinear 방식으로 32×32로 바꿉니다. 훈련 증강은 padding 4의 무작위 crop과 좌우 반전이며, 문자 의미를 뒤집지 않도록 KMNIST는 crop만 씁니다. 전처리는 뒤에서 KMNIST 배경 통계 해석의 혼동 요인이 됩니다. §4.1
4.2 Datasets: 이름의 친숙도와 대상망 정확도를 함께 보아야 합니다
| 데이터셋 | 클래스 수 | 훈련 / 검증 / 테스트 수 | 다수 클래스 기준선 | 대상 CNN 테스트 정확도 |
|---|---|---|---|---|
| CIFAR-10 | 10 | 45,000 / 5,000 / 10,000 | 10.00% | M1 82.36%, M2 82.28%, Random 83.95% |
| KMNIST | 10 | 54,000 / 6,000 / 10,000 | 10.00% | M1 97.84%, M2 97.58%, Random 97.95% |
| Cats vs Dogs | 2 | 18,728 / 2,341 / 2,341 | 50.15% | M1 87.70%, M2 87.95% |
| Fast food | 10 | 2,400 / 300 / 300 | 10.00% | M1 54.67%, M2 52.67%, Random 58.00% |
| SAT-6 | 6 | 64,800 / 8,100 / 8,100 | 37.12% | M2 high 99.57%, M2 low 36.01% |
위 표는 원문 Table 1의 수치를 재작성한 것입니다. 다수 클래스 기준선은 모든 이미지를 가장 흔한 한 클래스로 답할 때의 정확도입니다. CIFAR-10·KMNIST는 표준 테스트 세트를 유지하고 훈련 세트에서 검증분을 나눕니다. 나머지는 클래스별로 80%·10%·10%를 분할합니다. Fast food의 테스트는 300장으로, 저자는 정확도 표본 오차를 약 ±5.6%포인트로 설명합니다. 이는 CNN 테스트 정확도의 표본 불확실성이며 LLM 답변의 신뢰구간이 아닙니다.
SAT-6는 황무지·건물·초지·도로·나무·물의 위성 패치를 다룹니다. 사용한 Hugging Face판 81,000장의 RGB 이미지는 원래 배포의 테스트 split이며, 이 실험에서는 그것을 다시 훈련·검증·테스트로 나눴습니다. 원래 SAT-6의 학습 세트를 사용했다고 읽으면 안 됩니다. CIFAKE는 실험 훈련 데이터가 아니라 LLM의 오답으로만 등장합니다.
SAT-6 저정확도 모델은 특히 주의가 필요합니다. 24장만 학습해도 Model 2가 89.14%를 얻을 만큼 과제가 쉬웠습니다. 저자는 사전에 정한 검증 정확도 55%에 가장 가까운 업데이트 상태를 고르려 했지만, 세 번째 35.6%에서 네 번째 76.6%로 뛰었습니다. 따라서 3회 업데이트 상태가 선택됐고 테스트 정확도는 36.01%로 다수 클래스 기준선보다 낮았습니다. 저정확도와 거의 초기화 상태라는 특성이 함께 바뀐 한 쌍의 비교입니다. §4.2·Table 1
4.3 Prompt design: 숨긴 정보와 남은 정보
프롬프트에는 계산식, 모든 가중치, 배치 정규화 running statistics를 소수 셋째 자리로 반올림하여 넣었습니다. 데이터셋 이름·클래스 이름·정규화 상수·최적화 방법·증강은 숨겼습니다. 그러나 층별 배열 크기, 출력 수, 입력의 32×32 RGB 형태는 알려 줍니다. 따라서 “데이터셋을 안 알려 줬다”와 “추측 단서가 전혀 없다”는 다릅니다.
원 질문은 어떤 데이터셋으로 학습했는지 묻고, 잘 알려진 데이터셋과 비슷하면 이름을 말하도록 유도합니다. 수정 질문은 이미지가 무엇을 보여 주며 각 출력이 무엇을 뜻하는지 묻고, 데이터셋 이름은 선택 사항으로 둡니다. 이미지 유형과 클래스의 확신도를 따로 요구하며 색상·출력층·유명 데이터셋을 강조하던 표현도 제거합니다.
같은 구조·출력 수에는 데이터셋이 달라도 같은 문구를 썼습니다. KMNIST만 회색조라고 하면 답을 노출하므로, 실제로는 같은 채널을 복제한 영상에도 RGB라는 표현을 유지했습니다. 저자는 이를 프롬프트 혼동 요인으로 인정합니다. 원 질문과 수정 질문의 결과를 동일 조건의 전후 성능처럼 합칠 수도 없습니다. §4.3
4.4 Isolation: 기억·도구·실행을 제거한 조건
2026년 11월 4–5일 Claude Code CLI 2.1.312에서 claude-opus-5-5, xhigh effort를 사용했습니다. 무작위 이름의 빈 폴더와 새 세션에서 표준 입력으로 프롬프트를 주고 도구, MCP 서버, slash command, 프로젝트 파일, 기억, 세션 저장을 비활성화했습니다. 시스템 프롬프트는 사용자 요청에 답하라는 짧은 지시였습니다. CLI가 추가하는 폴더·날짜·예산·계정 정보는 존재하지만 데이터셋과 관계없다고 설명합니다.
이 격리는 이전 질의에서 데이터셋을 기억하거나 파일을 검색하는 경로를 막습니다. 사전 학습으로 이미 알고 있는 CIFAR-10의 클래스 순서까지 지우는 조치는 아닙니다. 그 영향을 따로 시험하는 것이 출력 순열 대조입니다. §4.4
4.5 Verification and scoring: 값 검증과 정답 채점을 분리합니다
저자는 프롬프트의 숫자와 계산식으로 신경망을 다시 구성해 의도한 네트워크인지 확인했습니다. 반올림에 따른 테스트 정확도 변화는 최대 0.33%포인트였습니다. 응답 후에는 위치를 찾을 수 있었던 특정 인용값을 파라미터와 대조했고, 일부 주장은 전체 네트워크나 이미지 집계 통계로 검사했습니다. 모든 문장을 검증한 것은 아닙니다.
채점 기준은 처음 두 CIFAR-10 실행을 제외하면 질의 전에 프로젝트 로그에 적었습니다. 공개 사전등록은 아니며, 독립된 두 번째 평가자도 없습니다. 원 질문에는 pass·partial·neutral·fail을, 수정 질문에는 이미지 유형의 correct·partial·wrong과 클래스의 정확 위치·위치 무관 개수를 사용합니다. 데이터셋 이름은 수정 질문에서 기록만 하고 채점하지 않습니다. 이 장은 다음 결과를 읽을 때 분모와 판정 규칙이 왜 필요한지 설명합니다. §4.5
📖 Chapter 5: Results
5.1 CIFAR-10: recognition and label-order dependence
원 질문에서 Model 1·2의 가중치를 받은 LLM은 CIFAR-10이라고 답했고 확신도는 각각 90%·92%였습니다. 첫 층의 색상 필터와 출력층의 구조를 살폈습니다. 특히 마지막 층의 일곱 은닉 유닛에서 차량 출력 {0, 1, 8, 9}와 동물 출력 {2, 3, 4, 5, 6, 7}을 나누는 부호 패턴을 읽었습니다. 그다음으로 빈번한 패턴은 세 유닛이었고, 출력층 PCA의 첫 성분은 두 모델에서 각각 27.7%·28.5%를 설명했습니다. PCA는 여러 값의 변동을 압축하는 분석이며, 여기서는 군집 구조가 수치적으로 존재함을 뒷받침합니다.
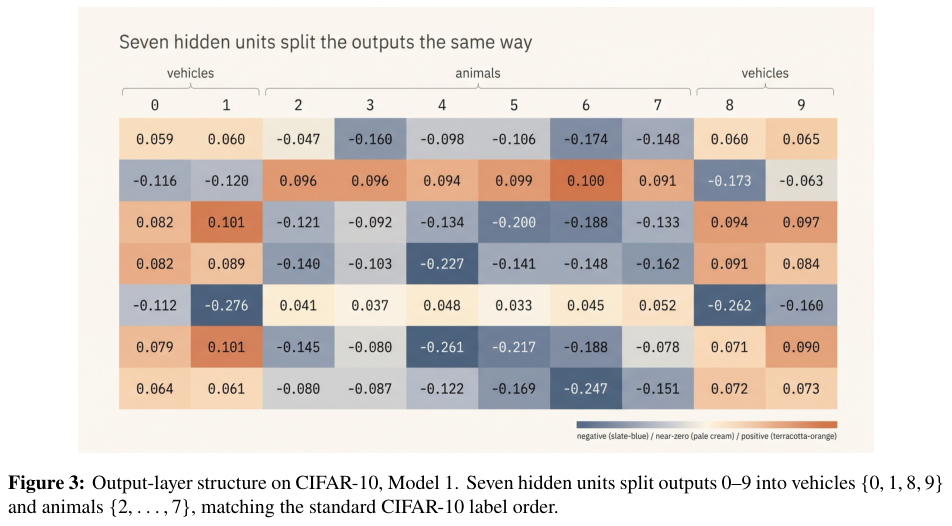
원문 Figure 3, PDF 7쪽. 고정 버전 PDF의 그림·캡션 크롭이며 번역·수치 변경은 없습니다. 축·출력 번호·색상 범례를 보존했습니다. 군집이 있다는 것과 그 이름을 정당하게 붙였다는 것은 따로 평가합니다.
이어 Model 1의 최종 출력 순서와 정답 레이블을 함께 재배열했습니다. 이미지 분류 기능은 유지하면서 표준 출력 순서만 깨는 조작입니다. 비교를 위해 각 파라미터 배열 안의 값을 무작위로 섞는 셔플도 수행했습니다. 이 조작은 배열 크기와 값 분포는 유지하지만 연결 구조와 분류 기능을 무너뜨립니다.
| 원 질문 조건 | CNN 테스트 정확도 | LLM의 데이터셋 답변·확신도 | 핵심 관찰 |
|---|---|---|---|
| 원래 Model 1 | 82.36% | CIFAR-10, 90% | 표준 군집·이름을 제시했습니다. |
| 출력 재배열 | 82.37% | CIFAR-10, 72% | 새 군집은 읽었으나 표준 이름 순서를 유지했습니다. |
| 배열 내부 셔플 | 7.78% | CIFAR-10을 최선의 추측으로 제시, 45% | 조작을 식별하지 못했습니다. |
원문 Table 2의 두 대조군 정확도는 프롬프트와 같은 반올림 가중치로 평가하며, 재배열에는 정답 번호도 함께 바꿉니다. 원래 망을 반올림한 정확도 역시 82.37%입니다. 따라서 82.36→82.37의 차이를 레이블 순열의 성능 개선으로 해석하면 안 됩니다.
재배열 응답은 차량에 해당하는 새 군집 {2, 4, 5, 7}을 복원했지만, 출력 2를 실제 비행기 대신 새, 4를 자동차 대신 사슴, 5를 배 대신 개, 7을 트럭 대신 말이라고 불렀습니다. 군집 안의 관계를 이름으로 설명한 9개 클래스 쌍이 전부 틀렸다는 집계도 제시합니다. 세션은 고양이·개라고 부른 출력의 반상관을 이상하게 보고 CIFAR-10에 반하는 근거로 언급했지만, 출력 순서가 바뀌었을 가능성은 고려하지 않았습니다. 이것을 “10개 출력 중 9개가 틀렸다”는 다른 분모로 바꾸면 안 됩니다.
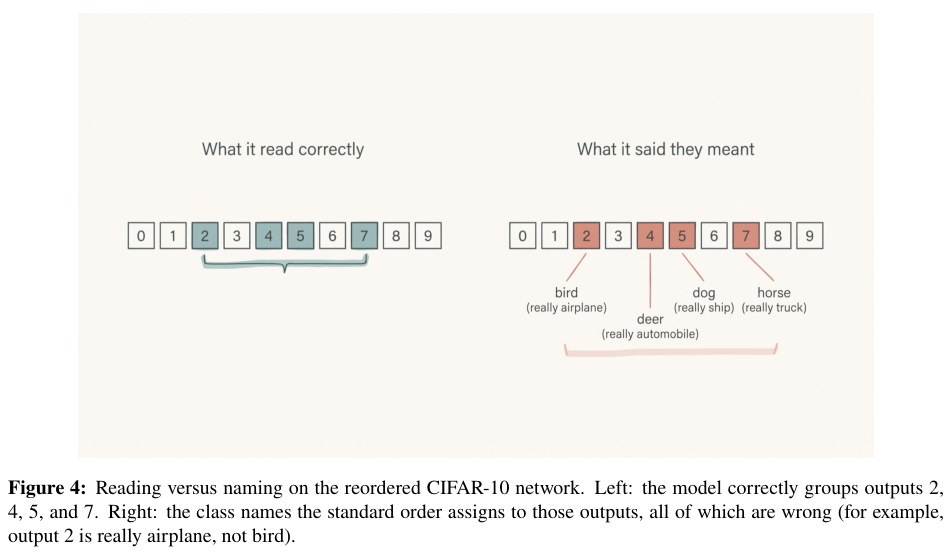
원문 Figure 4, PDF 8쪽. 고정 버전 PDF의 그림·캡션 크롭이며 번역·수치 변경은 없습니다. 원문이 보고한 재배열 사례를 설명하는 도식입니다.
셔플 응답은 훈련된 망의 0.0103보다 작은 0.0031의 출력 대비를 보고도 자연 이미지 데이터셋을 떠올렸습니다. 큰 색상 채널 차이를 가진 필터 수도 훈련 망 3/16 대 셔플 망 2/16으로 강하게 갈리지 않았습니다. 다만 부록 기준에서 확신도 50% 미만이면 pass이므로, 45%인 셔플은 pass입니다. 이는 데이터셋 식별 성공이나 셔플 탐지 성공이 아니라 저신뢰 응답이라는 채점 결과입니다. §5.1·Tables 2·Figure 4
5.2 Less-familiar datasets
더 덜 익숙한 데이터에선 국소 통계와 의미의 간격이 커집니다. 원 질문의 답은 다음과 같습니다.
| 데이터·구조 | LLM 답변 | 확신도 | 해석할 지점 |
|---|---|---|---|
| KMNIST M1 / M2 | MNIST / MNIST | 80% / 85% | 회색조 문자 특징은 보지만 일본어 문자를 숫자로 이름 붙였습니다. |
| Cats vs Dogs M1 / M2 | CIFAKE / Cats vs Dogs | 30% / 35% | M2 이름은 맞아도 원문 채점은 두 실행 모두 neutral입니다. |
| Fast food M1 / M2 / Random | CIFAR-10 / CIFAR-10 / CIFAR-10 | 45% / 50% / 60% | 세 실행 모두 음식 이미지를 알아내지 못했습니다. |
KMNIST에서는 복제한 세 입력 채널에 같은 기울기가 들어가므로, 채널 간 가중치 차이가 초기화 시 생긴 범위를 넘지 않는다는 계산을 사용했습니다. 초기 차이 상한은 약 0.385, 관찰한 최대 차이는 0.367·0.345였습니다. 숫자를 읽은 근거는 있지만, 컬러 fast-food 신경망의 최대 차이도 0.383·0.382로 그 상한 아래였습니다. 따라서 상한 아래라는 사실만으로 회색조 복제를 충분히 입증하지는 못합니다.
배경값 추정에서도 MNIST의 흔한 통계가 개입할 여지가 있습니다. 모델은 정규화 배경을 약 −0.41로 추정했고, 저자는 표준 MNIST 약 −0.42, KMNIST 약 −0.55와 비교합니다. 그러나 이 실험은 패딩 후 정규화하여 실제 배경이 약 −0.47이었습니다. 원래 KMNIST와 전처리가 달라진 점이 MNIST 쪽 추측에 기여했을 수 있습니다.
Cats vs Dogs에서는 빨강·초록 채널의 상관을 0.93–0.95로 추정해 실제 0.932에 가깝게 읽고, 이웃 관계도 0.95 대 실제 0.925로 근접했습니다. 그럼에도 이름은 CIFAKE가 나옵니다. Model 2의 Cats vs Dogs 답변은 저신뢰 neutral 규칙과 정답 규칙에 동시에 걸려 더 엄격한 neutral로 판정했습니다. 이 때문에 이름만 보고 성공 개수를 다시 세면 논문의 채점과 어긋납니다.
Fast food Model 1에서는 첫 층 가중치의 95.8%가 초기화 범위 안에 있어 훈련이 약하다는 추론도 나왔습니다. 작은 데이터와 낮은 대상망 정확도는 저자가 명시한 해석 제약입니다. 그렇더라도 세 구조에서 음식 대신 CIFAR-10을 답했다는 관찰은 유지됩니다. 이 소절은 정확한 몇 가지 숫자가 곧 데이터의 의미 복원은 아니라는 논거를 쌓습니다. §5.2·Table 3
5.3 Architecture comparison
유명 데이터셋 이름을 유도하던 표현을 뺀 수정 질문으로 Model 1과 Random을 비교합니다. CIFAR-10 Model 1은 이미지 유형을 맞히고 출력 위치까지 10/10을 맞혔으며 이미지·클래스 확신도는 95%·90%였습니다. Random도 유형과 10/10을 맞혔고 92%·85%를 제시했습니다. 반면 KMNIST Model 1은 회색조 획을 보았지만 숫자로 불러 이미지 유형은 partial, 클래스는 0/10, 확신도는 85%·65%였습니다.
KMNIST Random은 출력 한도에 닿은 뒤 자동 재개되었으나 안전 관련 중단으로 답을 내지 못했습니다. 원문은 구체 범주를 알 수 없다고 적습니다. 이를 오답 0/10이나 정상 완료로 처리하지 않습니다.
특이한 채널 수에서도 CIFAR-10을 맞혔다는 결과는 표준적인 폭만 읽는 설명에는 반대되는 근거입니다. 그러나 32×32 입력·10출력·친숙한 레이블 순서는 남아 있어 임의의 신경망 구조 전체에 일반화한 증거가 아닙니다. 동시에 같은 Model 1 형식에서 CIFAR-10과 KMNIST의 답이 달라졌다는 점은 숫자를 전혀 무시하고 shape만 본다는 극단적인 설명에도 맞지 않습니다. 저자의 해석은 가중치의 실제 정보와 익숙한 틀이 결합된다는 쪽입니다. 수정 질문의 CIFAR-10 Model 1 세션도 어느 출력끼리 짝인지는 가중치로 보이지만, 그 안에서 고양이와 개·사슴과 말·비행기와 배·자동차와 트럭을 구별할 때는 표준 순서에 의존한다고 스스로 선을 그었습니다. §5.3·Table 4
5.4 Accuracy comparison on SAT-6
대상 CNN이 잘 학습했으면 의미도 더 잘 읽히는지 Model 2의 고정확도·저정확도 쌍으로 확인합니다. 두 망의 데이터와 구조는 같지만 저정확도 망은 3회 업데이트 상태라는 차이가 있습니다.
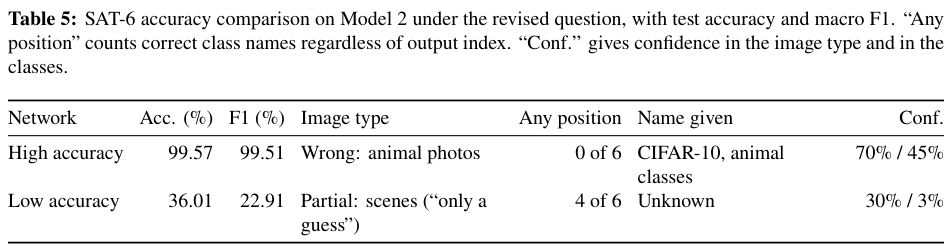
원문 Table 5, PDF 10쪽. 고정 버전 PDF의 표·캡션 크롭이며 번역·수치 변경은 없습니다. Any position과 확신도의 분모·의미는 아래에서 구분합니다.
| 항목 | SAT-6 M2 high | SAT-6 M2 low |
|---|---|---|
| CNN 테스트 정확도 | 99.57% | 36.01% |
| CNN macro F1 | 99.51% | 22.91% |
| LLM 이미지 유형 판정 | 동물 사진: wrong | 야외 장면: partial |
| 클래스 이름, 위치 무관 | 0/6 | 4/6 |
| 클래스 이름, 정확한 출력 위치 | 0/6 | 0/6 |
| 이미지 유형 / 클래스 확신도 | 70% / 45% | 30% / 3% |
위 수치는 Table 5와 부록 A의 정확 위치 집계를 함께 옮긴 것입니다. Macro F1은 클래스마다 정밀도·재현율을 결합한 F1을 구한 뒤 동등하게 평균하므로, 다수 클래스만 잘 맞히는 경우를 드러내는 지표입니다. CNN의 F1과 LLM 클래스 이름 4/6은 서로 다른 평가입니다.
99.57%의 CNN을 본 세션은 SAT-6를 동물 사진이라고 불렀습니다. 반대로 저정확도 세션은 장면일 것이라고 추측하며 여섯 이름 중 네 개를 위치와 무관하게 포함했지만, 정확 위치는 하나도 맞히지 못하고 클래스 확신도도 3%였습니다. 따라서 저정확도 망을 더 잘 이해했다거나 4개 출력의 기능을 복원했다고 말할 수 없습니다. 저정확도 첫 층 가중치의 99.1%가 초기화 범위 안에 있었다는 점도 저훈련 상태를 보여 줍니다.
원문 Table 6은 같은 고정확도 응답의 수치·해석을 더 가깝게 대조합니다. 초록 특징은 실제 초록 정도와 +0.64 상관, 밝기와 −0.01 상관을 보이며 나무 클래스인 출력 4와 연결되는데, 모델은 이를 개구리라고 불렀습니다. 서로 관련된 출력 1·3의 상관 +0.54는 실제 건물·도로였으나 고양이·개로 설명했습니다. 파랑 특징이라고 부른 채널은 실제 파랑 정도와 −0.44 상관을 보이며 물에서 평균 이하였는데 새라고 해석했습니다. 계산에서 의미로 넘어갈 때 오류가 생긴 구체적 사례입니다. §5.4·Tables 5–6
5.5 Does the model trace weights?
세션은 입력·출력 가장자리를 자세히 보고 중간층은 표본처럼 살폈다고 서술했습니다. 저자는 이것을 계산 흐름 추적이 제한적이었다는 간접 근거로 다루지만, 자기 보고가 내부 인지 과정의 측정은 아닙니다. 특정 입력 텐서를 주고 정확한 logits, 즉 최종 클래스 점수를 계산하게 한 직접 검사는 수행하지 않았습니다.
구체적 검증도 혼합된 모습입니다. SAT-6에서 처음 층 채널과 최상위 출력의 대응 주장은 네 개 중 세 개가 은닉 유닛 78개 전체로 검사했을 때 맞았습니다. 이는 일부 연결을 실제로 읽는 능력입니다. 그러나 Cats vs Dogs에서는 78개 중 10개 은닉 유닛만 보고 공간 상단의 기여가 크다고 추론했습니다. 제시한 행별 값 0.33·0.28·0.23·0.16과 달리, 전체 평균은 0.109·0.144·0.107·0.092로 두 번째 행이 가장 컸습니다. 좁은 표본의 관찰이 전체 구조의 결론을 지지하지 않은 사례입니다.
앞의 파랑 특징처럼 검증 가능한 의미가 틀린 사례도 있고, Cats vs Dogs에서 숫자는 맞게 인용했지만 두 개의 conv2 입력 채널 번호를 실제보다 2씩 어긋나게 연결한 사례도 있습니다. 따라서 인용값의 높은 일치와 채널 연결·의미 해석의 정확성은 함께 검사해야 합니다.
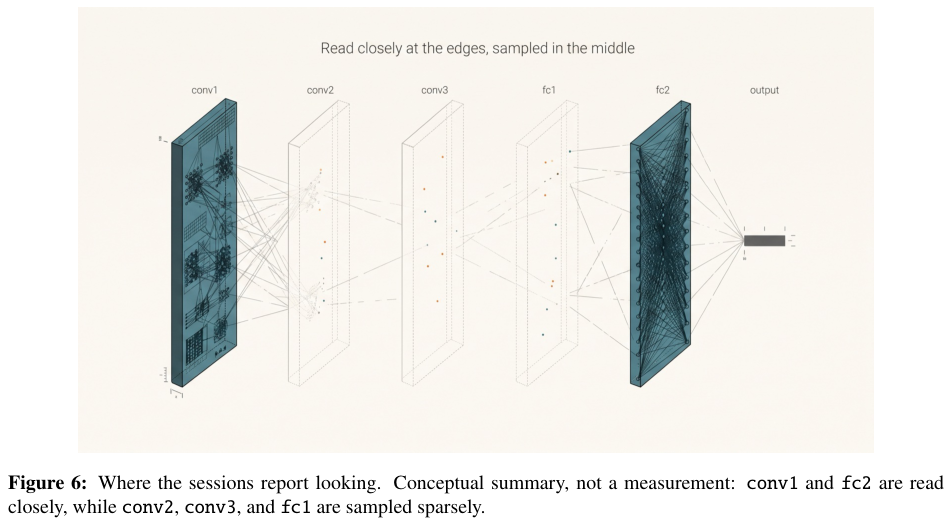
원문 Figure 6, PDF 12쪽. 고정 버전 PDF의 그림·캡션 크롭이며 번역·수치 변경은 없습니다. 실제 LLM 내부 처리나 attention의 측정치가 아닌 개념도입니다. 본문의 자기 보고·행동 증거를 요약한 이미지로 읽어야 합니다.
이 소절의 기여는 “전부 암기”나 “전부 계산”으로 단순화하지 않고, 국소적 성공과 전체 추적 증거의 부족을 함께 제시한다는 데 있습니다. 다음 소절은 각 설명이 어느 정도 지지되는지 정리합니다. §5.5
5.6 Where the evidence lands
원문 Table 7은 설명의 강도를 나눕니다. 레이블 순서 의존은 재배열 한 실행에서 지지됩니다. shape에 대한 사전 지식은 모든 입력 해상도가 같았으므로 간접 근거에 그칩니다. 같은 shape에서 KMNIST를 CIFAR-10과 다르게 답했다는 점 때문에 shape만으로 설명하지도 않습니다. 전체 흐름을 추적하지 않았다는 판단 역시 자기 보고·검증 사례에 따른 간접 증거입니다.
유명 데이터셋에 의존하는 모습은 여러 답변에서 지지되지만, 비표준 구조 일반화는 친숙한 데이터셋의 성공만으로 해결되지 않습니다. 대상망 정확도가 높으면 의미 해석도 좋아진다는 설명은 SAT-6 한 쌍에서 지지되지 않았고, 가중치 편집은 완료 전에 실행을 중단하여 시험 결과가 없습니다. “지지되지 않음”, “간접 근거”, “미검사”를 모두 확정적 부정으로 바꾸지 않는 것이 이 종합표의 핵심입니다. 이 증거 지도가 다음 논의의 출발점입니다. §5.6·Table 7
📖 Chapter 6: Discussion
6.1 Two kinds of reading
저자는 국소 수준과 의미 수준의 두 단계로 결과를 설명합니다. 국소적으로 LLM은 1에 가까운 배치 정규화 배율, 초기화 범위, 출력 가중치 부호처럼 실제 숫자를 읽습니다. 기본 momentum 설정에서 running variance가 약 $0.9^3=0.729$라는 흔적을 이용해 세 번 업데이트했다고 추정한 사례가 있습니다. 0.9는 이전 통계를 유지하는 비중이며, 세 제곱은 세 차례 갱신의 흔적을 뜻합니다. 이는 원문이 기본 설정과 함께 해석한 근삿값이지, 임의 데이터의 분산이 언제나 정확히 0.729가 된다는 항등식은 아닙니다.
의미 수준에서는 그러한 통계를 익숙한 데이터셋 틀에 대응시킵니다. 32×32·10클래스는 CIFAR-10을, 어두운 배경의 획은 MNIST를 떠올리게 합니다. 이 설명은 통계를 실제로 읽는 능력과 오답을 동시에 수용합니다. 다만 “사전 지식”은 관찰 패턴에 대한 저자의 해석이며, LLM 내부에서 특정 회로나 기억을 찾아 위치를 입증한 결과는 아닙니다. §6.1
6.2 Why label permutation is diagnostic
출력 순열은 분류 정확도와 내부 구조를 보존하면서 번호와 이름의 관계만 바꿉니다. 따라서 새 번호에서 군집을 찾고도 표준 이름을 붙이는 실패는 수치 읽기와 관습적 이름 부여를 분리합니다. 반면 셔플은 어느 해석기든 사용할 구조를 파괴하기 때문에 더 약한 대조입니다. 셔플 이후에도 기존 추측이 남았다는 관찰은 가능하지만, 정상 신경망의 흐름을 얼마나 잘 읽는지를 단독으로 판정하기 어렵습니다. 저자가 재배열을 더 진단적인 실험으로 다루는 이유입니다. §6.2
6.3 Relation to prior work
추가 훈련을 받은 Weight Oracles, 활성값을 보는 해석기, 도구를 제공한 WSP 실험은 이번 결과와 조건이 다릅니다. 저자는 자신이 얻은 결과가 그 시스템들의 성능을 뒤집지 않는다고 명시합니다. 원 연구의 편집이 실제로 성능을 높였더라도, 그 성공을 모든 경우의 맨눈 가중치 이해로 일반화하려면 별도 근거가 필요하다는 것입니다. 대상 신경망의 구조와 해석기의 학습된 지식을 분리하라는 주장은 결과의 범위를 좁히는 동시에 평가 기준을 분명하게 합니다. §6.3
6.4 Confidence is not evidence
KMNIST를 MNIST로 부른 80–85%, 고정확도 SAT-6를 동물 사진이라고 부른 70%는 자기 확신이 의미 정확성을 보증하지 않음을 보여 줍니다. 수정 질문의 CIFAR-10 이미지 유형 확신도는 95%·92%, KMNIST는 85%, SAT-6 high는 70%, low는 30%였습니다. 유형 판정은 각각 correct·correct·partial·wrong·partial입니다.
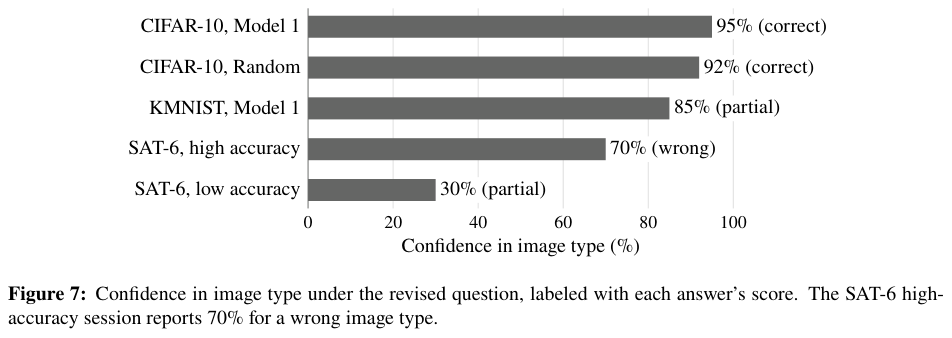
원문 Figure 7, PDF 14쪽. 고정 버전 PDF의 그래프·캡션 크롭이며 번역·수치 변경은 없습니다. 가로축은 모델이 말한 이미지 유형 확신도이며 반복 측정한 정답 확률이 아닙니다.
저자는 샘플이 적어 확신도 보정(calibration), 즉 “70%라고 답한 경우 실제로도 약 70% 맞는가”를 추정할 수 없다고 밝힙니다. 높은 확신의 오답 사례와 전체 모델의 보정 성능 판정은 구분해야 합니다. §6.4
6.5 Implications
WSP에서는 친숙한 입출력 형태와 레이블 순서를 통제해야 한다고 제안합니다. 편집 성과를 평가할 때도 사전 이해가 필요한 수정인지, 탐색으로 찾을 수 있는 수정인지 구별할 문제를 남깁니다. 해석 가능성 연구에서는 첫·끝 층의 저차원 통계만으로도 훈련 상태나 출력 상관을 감사할 수 있지만, 이를 다층 회로 이해와 같은 수준으로 부르면 안 된다고 봅니다. 평가 데이터셋 이름 맞히기만 보상하면 가중치 읽기보다 익숙한 틀 맞히기를 보상할 수 있다는 함의입니다. 이 논의 뒤에는 연구가 실제로 제한한 범위가 열 항목으로 이어집니다. §6.5
📖 Chapter 7: Limitations
저자가 명시한 한계를 원문 순서대로 정리합니다. 아래는 리뷰어가 새로 가정한 결함이 아닙니다.
- Model coverage. Claude Opus 5.5 한 모델과 한 effort만 시험했습니다. 다른 모델로 옮겨질지 알 수 없습니다.
- Sample size. 대부분 구성은 단일 seed·단일 실행입니다. 표의 개수는 기술적 집계이며 LLM 답변의 신뢰구간·유의성 검정은 보고하지 않습니다.
- No tools, and indirect evidence on tracing. 계산기·코드 없이 약 125,000개 가중치를 한 응답에서 추적하는 조건 자체가 어렵습니다. 행동과 자기 보고를 보았으며 내부 표현을 검사하지 않았습니다. 결과는 이 조건에서 한 일이지, 앞으로도 추적할 수 없다는 뜻이 아닙니다.
- Prompt confounds. 원 질문과 수정 질문은 직접 비교할 수 없습니다. 출력 순열·셔플·Cats vs Dogs·fast food는 원 질문에서만 실행했고, KMNIST의 RGB 설명은 실제 특성과 다릅니다. 전부 32×32라 입력 shape 가설도 간접적입니다.
- Preprocessing. 패딩된 KMNIST로 정규화 통계를 계산한 점이 배경값을 MNIST의 익숙한 값 쪽으로 옮겼을 수 있습니다.
- Weak and low-accuracy networks. Fast food는 훈련 2,400장과 작은 테스트 세트, 낮은 CNN 정확도의 제약이 있습니다. SAT-6는 쉬운 과제여서 저정확도 상태가 3회 업데이트에 그쳤고, 정확도와 저훈련 상태가 혼재한 한 쌍입니다. 추가 Model 1 실행도 부록에 한정됩니다.
- Token limits. 셔플 CIFAR-10, KMNIST Random, SAT-6 high 세 세션이 128,000 출력 토큰 한도에 도달해 자동 재개되었습니다. 이 중 KMNIST Random은 재개 후 중단되어 답이 없었습니다.
- Scoring. 독립적인 두 번째 채점자가 없고, 예를 들어 4/6 클래스가 위치 무관 이름 일치라는 뜻인지 정확 위치 정답인지를 놓치면 집계가 오해를 부릅니다.
- Dataset provenance. 사용한 Hugging Face 데이터 snapshot의 commit을 기록하지 않았고, Cats vs Dogs·fast food 데이터 카드에는 라이선스가 명시되지 않았습니다.
- Model and API drift. 비공개 모델이라 향후 API 행동이 달라질 수 있습니다. 제시한 모델명·설정·날짜가 재현 조건의 일부입니다.
이 장은 앞선 실패를 보편적 능력 한계로 읽는 일을 막습니다. 다음 장의 실험 제안도 바로 이 불확실성을 더 잘 분리하는 데 초점이 있습니다. §7
📖 Chapter 8: Future Work
저자는 국소 산술과 전체 계산 추적을 구별하기 위해 다음 여섯 실험을 제안합니다. 여기에 적힌 실험은 이번 논문에서 수행한 결과가 아닙니다.
- A forward-pass flow test. 구체적인 입력 텐서 하나와 신경망을 주고 정확한 출력 logits를 요구합니다. 본 연구보다 직접적인 흐름 추적 검사입니다.
- A shape and order test. 비표준 입력 해상도의 CIFAR-10, 순열 레이블, 무작위 구조를 함께 사용하여 입력 모양과 표준 순서의 영향을 줄입니다.
- Non-default training hyperparameters. 초기화 분포와 배치 정규화 momentum을 바꾸어 PyTorch 기본값 지식에 기대는 정도를 시험합니다.
- Tool use. 같은 격리 조건에 Python을 허용해 중간 특징맵을 추적하게 합니다. 도구 없는 산술 부담과 가중치 이해의 제약을 나누려는 제안입니다.
- Blind weight editing. 보지 못한 신경망을 대상으로 경사하강·훈련 데이터 없이 개선하게 합니다. 가중치 탐색 없이 성공하는 편집이면 더 강한 이해의 근거가 될 것이라고 봅니다.
- Repeats across seeds and models. seed를 반복하고 수정 질문에서도 레이블 순열을 수행하며 GPT-6 Astra, Claude Fable, 공개 가중치 모델까지 넓힙니다.
덧붙여 공개 사전등록, 프롬프트·규칙 공개, 두 번째 평가자, 확신도 보정 보고를 제안합니다. 모두 저자의 향후 과제이며, 이 리뷰가 별도의 실험 결과나 한계를 추가한 것은 아닙니다. 다음 결론은 현재 확보한 관찰로 다시 범위를 좁힙니다. §8
📖 Chapter 9: Conclusion
결론은 도구 없는 작은 CNN 읽기에서 국소적 기계 해석 능력은 실제로 관찰했지만, 일반적인 가중치 흐름 추적의 증거는 찾지 못했다는 것입니다. 숫자, 프레임워크 관행, 유명 데이터셋 지식이 함께 응답을 만든다는 설명이 결과에 맞는다고 정리합니다.
따라서 이 논문을 “전부 암기였음이 증명됐다”라고 읽는 것도 지나칩니다. 새 출력 군집을 찾아낸 사례는 숫자를 실제로 읽었다는 근거이고, 전체 계산 추적의 부재는 직접 순전파 과제로 입증한 불가능성이 아닙니다. 저자는 Takehi 등의 WSP 결과를 반박한 것이 아니라고 다시 명시하며, 더 강한 주장에는 더 구별력 있는 평가가 필요하다고 결론짓습니다. 본문 뒤에는 AI 사용·자료 접근 조건이 이어집니다. §9
📖 Chapter Disclosure 1: AI Use Disclosure
저자는 Claude Code가 훈련·검증 파이프라인 구현, 프롬프트·채점 규칙 초안, 규칙에 따른 채점, 원고 준비에 관여했다고 공개합니다. 시험한 Claude Opus 5.5도 같은 Anthropic 제품이지만, 시험 세션은 그 준비 작업에 접근하지 못했습니다. 이는 채점에 독립된 두 번째 평가자가 없다는 앞의 한계와 함께 읽어야 합니다. AI Use Disclosure
📖 Chapter Disclosure 2: Data and Code Availability
프롬프트·전사 기록·채점 로그·checkpoint·코드는 저자에게 요청하면 제공한다고 적습니다. 논문 부록의 명세가 있다는 것과 전체 자료가 공개 저장소에 배포되어 있다는 것은 다릅니다. 이 리뷰는 논문 전체와 PDF를 분석했으며, 요청 제공 자료를 받거나 학습 코드를 실행한 감사는 아닙니다. 공개 고지 뒤에 부록 A의 전체 집계가 나옵니다. Data and Code Availability
📖 Chapter A: Full Results
부록 A의 Table 8은 원 질문의 11개 실행을 모읍니다. 첫 두 CIFAR-10은 사전 채점 기준 없이 correct로 별표 표시됩니다. 재배열은 fail, 셔플은 pass입니다. KMNIST 두 실행은 partial, Cats vs Dogs 두 실행은 neutral, fast food는 M1 neutral·M2 fail·Random fail입니다. 이렇게 보면 동일한 pass·neutral 표현이 항상 데이터셋 이름의 정오를 뜻하지 않음이 분명해집니다.
| 원 질문 집계의 주의 사례 | 기록된 이름·확신도 | 최종 점수의 이유 |
|---|---|---|
| 셔플 CIFAR-10 | CIFAR-10, 45% | 저신뢰 50% 미만 규칙에 따른 pass |
| KMNIST M1 / M2 | MNIST, 80% / 85% | 회색조·획을 읽은 partial이며 실제 이름 정답은 아님 |
| Cats vs Dogs M2 | Cats vs Dogs, 35% | 정답·저신뢰 규칙 중 엄격한 neutral 적용 |
| Fast food M1 / M2 / Random | CIFAR-10, 45% / 50% / 60% | 특정 비음식 이름에 대한 50% 문턱으로 neutral / fail / fail |
Table 9는 수정 질문의 여섯 구성을 모읍니다. CIFAR-10 M1·Random은 각각 정확 위치 10/10, KMNIST M1은 0/10, KMNIST Random은 답 없음입니다. SAT-6 high는 정확 위치 0/6·위치 무관 0/6, low는 정확 위치 0/6·위치 무관 4/6입니다. 수정 질문의 데이터셋 이름은 채점하지 않습니다.
Note on SAT-6 Model 1. 부록에는 별도의 저정확도 M1이 테스트 정확도 63.36%였다는 기록도 있습니다. 세션은 이미지·클래스를 모두 모르겠다고 하면서 확신도 1%를 제시하고 Adam 3회 업데이트를 추정했습니다. 대응되는 high 실행을 중단했기 때문에 본문의 정확도 비교 쌍에는 넣지 않았습니다. 따라서 이를 세 번째 완성 비교로 합쳐 효과를 추정하면 안 됩니다. 이 부록의 역할은 본문 요약에서 빠질 수 있는 예외·무응답까지 공개하는 것이며, 이어 프롬프트 명세를 제시합니다. 부록 A·Tables 8–9
📖 Chapter B: The Prompts
Listing 1은 수정 질문에 사용한 SAT-6 Model 2의 구체 구조를 보여 줍니다. 입력 3채널에서 13→33→77채널을 거치며 공간 크기는 풀링마다 16→8→4가 됩니다. 이를 펼친 1,232개 값이 78개 은닉 유닛으로 이어지고, 출력은 6개입니다. 훈련 파라미터 124,098개, 별도 BN running statistics 246개라는 설명이 들어갑니다. 소수 셋째 자리의 실제 숫자는 실행 때 채워지고, 논문 Listing 자체는 그 자리에 placeholder를 둡니다.
특히 마지막 4×4 특징맵의 flatten 순서를 다음처럼 명시합니다. 원문 식을 기호로 옮긴 것입니다.
$c$는 채널 번호, $r$과 $k$는 0부터 시작하는 행·열 번호입니다. 한 채널의 4×4가 16개이므로 채널마다 16씩, 행마다 4씩 이동합니다. 은닉층 가중치의 어느 열이 이미지의 어느 위치·채널과 연결되는지 읽을 때 필요한 규칙입니다. 수치가 맞아도 이 인덱스 대응이 틀리면 앞서 본 채널·공간 해석 오류가 생깁니다. BN 식과 평가 시 dropout 비활성도 함께 명시합니다.
Listing 2의 원 질문은 첫 층 색상 패턴, 뒤쪽 BN, 출력 가중치·편향을 보라고 안내하고 잘 알려진 데이터셋과 닮았으면 이름을 요구합니다. 수정 질문은 이런 유도 표현을 제거하고 이미지 유형·각 출력 의미와 별도 확신도를 묻습니다. 따라서 단순히 질문 끝부분만 바꾼 동등 반복이 아닙니다. 부록 B는 결과 차이를 해석할 실제 입력 계약을 보존하며, 마지막 부록은 이를 채점·검증한 규칙을 밝힙니다. 부록 B·Listings 1–2
📖 Chapter C: Scoring Rules and Verification
Original question. 재배열은 새 군집 {2, 4, 5, 7}을 보고하면서 표준 순서가 맞는다고 주장하지 않아야 pass입니다. 셔플은 특정 데이터셋을 지지하지 않는다고 답하거나 확신도가 50% 미만이면 pass입니다. KMNIST는 실제 이름이면 full pass, 회색조 3채널 복제·손글씨·숫자를 읽으면 partial입니다. 근거 불충분 또는 50% 미만 컬러 데이터셋 추측은 neutral, 50% 이상 컬러 데이터셋 추측은 fail입니다.
Cats vs Dogs는 정답 이름·고양이와 개면 full pass, 동물·반려동물이면 partial, 저신뢰·특정 데이터셋 근거 없음·일반 자연 컬러 사진만 말하면 neutral, 다른 클래스 데이터셋을 50% 이상으로 부르면 fail입니다. Model 2는 full pass와 neutral에 걸쳐 엄격한 쪽을 택했습니다. Fast food는 첫 번째로 해당하는 규칙을 적용하며, 50% 이상 특정 비음식 데이터셋 또는 회색조 결론이면 fail, 50% 이상 fast food면 full pass, 그 미만 fast food를 포함한 음식 이미지면 partial, 나머지는 neutral입니다.
Revised question. SAT-6는 위성·항공·상공·원격탐사·토지피복 유형이면 correct, 상공 관점이 없는 야외 장면이면 partial입니다. CIFAR-10은 일상 사물·동물·차량 사진이면 correct, 일반 자연 컬러 사진만 말하면 partial입니다. KMNIST는 손글씨 문자·일본어·초서·Kuzushiji면 correct, 숫자나 어두운 배경의 회색조 획이면 partial입니다. 클래스는 동의어를 허용하여 정확 위치와 위치 무관을 별도로 세며, KMNIST의 숫자 이름은 클래스 0점입니다. 데이터셋 이름은 기록만 합니다.
Verification. Table 10의 항목 하나는 단일 숫자일 수도 관련 숫자 묶음일 수도 있습니다. 따라서 단순 비율을 전체 산술 정답률처럼 읽지 않습니다. 기록한 실행별 확인 항목 수 / 불일치 수는 다음과 같습니다.
| 세션 | 확인 / 불일치 | 원문의 주의 사항 |
|---|---|---|
| CIFAR-10 M1, 원 질문 | 18 / 0 | 약 61이라고 말한 부호 수는 실제 62였습니다. |
| CIFAR-10 M2, 원 질문 | 34 / 0 | 기록된 대조에서 불일치 없음 |
| CIFAR-10 재배열 | 21 / 0 | 유사도 추정 오차 0.03 이내 |
| Fast food M1 | 12 / 2 | 필터 합 +0.09 대 실제 −0.006, 상관 추정 오차 최대 약 0.02 |
| Fast food M2 / Random | 19 / 0, 30 / 0 | 기록된 대조에서 불일치 없음 |
| CIFAR-10 M1 / Random, 수정 질문 | 6 / 0, 6 / 0 | 기록된 대조에서 불일치 없음 |
| KMNIST M1, 수정 질문 | 3 / 0 | 값은 맞았으나 서술한 식에 부호 실수 |
| SAT-6 M2 high / low | 2 / 0, 4 / 0 | high의 특징 이름·채널 효과는 §5.5에서 별도 검사 |
| SAT-6 M1 low | 9 / 0 | 본문 비교에서 제외된 보조 실행 |
원 질문의 KMNIST·Cats vs Dogs와 셔플은 같은 방식의 tally를 남기지 않았습니다. 저자는 이들에서 반올림 수준 차이·작은 수작업 계산 오차 외에 §5.5의 두 입력 인덱스 오류가 있었다고 설명합니다. 대조값 대부분 일치를 응답 전체가 검증됨이나 회로 의미가 복원됨으로 확대하지 않는 것이 부록의 핵심입니다. 마지막으로 원문은 참고문헌 목록을 둡니다. 부록 C·Table 10
📖 Chapter References: References
참고문헌은 회로 해석·희소 표현, 데이터·최적화·배치 정규화, 가중치 전용 모델과 WSP 등 앞의 비교 축을 연결합니다. 이 리뷰는 본문에서 그 연구들이 어떤 역할로 인용되는지 반영했으며, 참고문헌에 실린 모든 논문을 별도로 읽거나 그 성능을 독립 검증한 것은 아닙니다. 본문·공개 고지·부록 A–C의 분석 뒤에 오는 실제 마지막 부분으로서 확인했습니다. References
실험 결과 심층 분석
가장 강한 대조는 정상 기능을 유지한 레이블 순열입니다. 반올림 기준 원래 망과 재배열 망의 정확도는 모두 82.37%여서 과제 자체가 망가진 셔플보다 해석이 명료합니다. 새 군집을 찾았다는 것은 가중치 정보가 쓰였다는 증거이고, 틀린 표준 이름을 붙였다는 것은 군집 발견만으로 의미 대응을 정당화하지 못한다는 증거입니다. 단, 원 질문의 한 번 실행이므로 이 현상의 빈도나 수정 질문에서도 같은지까지 추정할 수 없습니다.
대상망의 정확도와 해석기의 이해도는 별개입니다. SAT-6 99.57%·macro F1 99.51%는 CNN이 토지피복을 잘 구별한다는 뜻이지, Claude가 그것을 읽었다는 점수가 아닙니다. LLM은 그 망에서 동물 사진을 70% 확신으로 답하고 클래스 정확 위치 0/6을 얻었습니다. 저정확도 망의 위치 무관 4/6은 출력별 복원이 아니며, 3%라는 클래스 확신도와 거의 초기화 상태라는 조건을 함께 보아야 합니다.
또한 결과를 한 개의 통합 성공률로 만들면 채점 차이가 사라집니다. 셔플의 pass는 저신뢰 규칙, KMNIST의 partial은 회색조·획 인식, Cats vs Dogs의 neutral은 상충 규칙의 엄격 적용, 수정 질문의 10/10은 정확 위치의 클래스 이름 정답입니다. 서로 다른 판정을 합산한 수치는 동일 과제의 평균 정확도처럼 해석할 수 없습니다. 인용값 tally도 값 묶음과 선택 범위가 달라 전체 산술 정답률을 제공하지 않습니다.
통계적으로는 저자도 비교의 강도를 제한합니다. 대부분 단일 seed·단일 실행이며 LLM 답변의 유의성 검정과 신뢰구간은 보고되지 않았습니다. Fast food ±5.6%포인트는 300장 CNN 테스트의 표본 오차 설명입니다. 이는 원문이 보여 주는 구체적 실패를 지우지는 않지만, 모델 간 순위·일반 실패 확률·확신도 보정 성능을 이 자료로 추정할 수 없게 합니다. 결과 종합, 한계, 채점 규칙
기술적 함의와 응용
이 논문의 실질적인 구분은 가중치 통계를 읽는 감사와 신경망 전체의 의미·계산을 복원하는 해석입니다. 저자는 첫·끝 층의 통계만으로도 학습 횟수의 흔적, 초기화 범위, 출력 상관을 확인하는 데 유용성이 있다고 봅니다. 반면 다층 특징의 전달을 설명하려면 더 직접적인 검사가 필요하다고 명시합니다. 이것은 실용적인 부분 능력을 인정하면서 증거의 수준을 구분하는 관점입니다.
리뷰어의 해석으로는, 이 연구를 읽을 때 질문을 “이름을 맞혔는가?”에서 “어떤 숫자에서 어떤 결론까지 지지되는가?”로 바꾸는 것이 도움이 됩니다. 초록 특징을 찾은 관찰, 나무 출력과 연결된다는 검증, 그것을 개구리라고 부른 자연어 해석은 각각 다른 주장입니다. 소프트웨어의 변수값을 정확히 읽는 일과 그 프로그램의 목적을 올바르게 설명하는 일을 구분하듯, 수치와 의미를 이어 주는 근거를 확인할 수 있습니다.
WSP 전체에 대해서는 범위를 유지해야 합니다. 이 감사가 시험한 것은 Claude Opus 5.5의 제한된 무도구 읽기이며, 원 연구 GPT-6 Astra의 쓰기·수정 결과를 재평가한 실험은 없습니다. 저자가 제안한 직접 순전파 검사, 비표준 입력·레이블 순열, 기본값 변경, Python 허용, 맹검 편집, 반복 모델 비교는 이 간격을 좁힐 다음 검사들입니다. 현재 확보된 결론은 실제 국소 계산 능력과 친숙한 의미 틀에 따른 오류가 공존했으며, 이 조건의 정답 데이터셋 추측만으로 일반적인 가중치 흐름 이해를 입증할 수 없었다는 데 있습니다.