논문 개요와 전체 구조
도구를 쓰는 AI 에이전트가 좋은 답을 내려면, 먼저 어떤 도구가 필요한지 알아야 합니다. 검색·예약·분석 API가 수천 개를 넘어가면 설명서를 모두 언어 모델에 넣을 수 없습니다. 검색기로 후보를 줄일 수는 있지만, 질문과 비슷한 설명을 찾는 일과 여러 요구사항을 빠짐없이 충족하는 도구 집합을 정하는 일은 다릅니다. 이 논문은 그 선택 작업을 작은 언어 모델에 학습시키면, 새로운 도구 목록이나 검색기를 만나도 재학습 없이 사용할 수 있는지 살펴봅니다. 초록·§1
Zhaoyi Zhou 외 6명은 Qwen3-1.7B·4B·8B에 지도 미세조정(SFT)과 강화학습(RL)을 적용합니다. 요청을 하위 단계로 나누는 Plan, 단계별로 후보를 찾는 Retrieve, 후보 중 필요한 도구를 고르는 Select를 연결하고, 같은 모델이 Plan과 Select를 맡습니다. ToolBench G3에서 8B 모델의 도구 집합 일치 성공률은 41.5%로, 비교한 Llama-4-Maverick의 가장 높은 결과 30.6%보다 높았습니다. 그러나 이는 실제 API 실행이나 최종 업무 완수율이 아니며, 학습된 모델과 학습 없이 프롬프트로 동작하는 대형 모델의 비교입니다. §3–4
이 글은 arXiv:2610.31483v1의 본문과 부록 전체를 기준으로 합니다. 원문은 2026년 10월 22일 16:07:49 UTC에 제출되었고 PDF는 19쪽입니다. 블로그 작성일과 원문 제출일은 구분합니다. 원문 구조는 1 Introduction → 2 Related Work → 3 Method → 4 Experiments → 5 Conclusion → Acknowledgments → References → 부록 A Experiment Details → B Links to Models, Benchmarks, and Software → C Artifact Use and Release → D Prompt Templates입니다. Method의 워크플로·SFT 데이터·RL 보상, Experiments의 성공률·도메인 전이·검색기 전이·ablation, 부록의 실행 조건까지 아래에서 같은 순서로 따라갑니다. 고정 HTML · 고정 PDF
핵심 기여와 혁신성
이 연구가 다루는 병목은 대형 모델의 일반적인 문제 해결 능력보다 도구 호출 앞단에서 반복되는 선택 절차입니다. 선택기가 순위를 매기는 데서 멈추지 않고, 최종적으로 사용할 집합에 책임을 지게 한다는 점이 중요합니다. §1·§4.1
- 작은 모델의 전문화: 교사 모델이 만든 계획·선택 예제로 출력 형식을 먼저 익히고, 검색 결과를 이용한 계획 보상과 정답 도구 일치 보상으로 개선합니다. 대형 모델을 호출하는 기존 절차를 소형 모델의 학습 대상으로 바꿉니다.
- 도구 도메인과 검색기의 분리: ToolBench G3에서 학습한 동일 체크포인트를 G2·Gorilla·CRAFT·TaskBench에 적용하고, BM25를 COLT로 바꾸는 실험도 별도로 수행합니다. 무엇이 전이되는지 두 축으로 나눕니다.
- 순위보다 엄격한 평가: 정답 도구가 후보에 포함되기만 하면 되는 검색 평가와 달리, 필요한 도구를 하나라도 놓치거나 불필요한 도구를 추가하면 실패로 셉니다.
- 구성 요소별 진단: 계획 모델 교체, 후보 수 변화, 검색 1위 고정 선택, SFT 생략을 비교하여 성능이 어디에서 나오는지 확인합니다. §3·§4.4
다만 전이가 모든 환경에서 최상이라는 결론은 아닙니다. TaskBench에서는 분해하지 않는 Maverick의 Search-R1 방식이 더 높았습니다. 또 공개된 기반 모델을 학습했다는 사실과, 논문의 학습 결과물이 공개되었다는 사실은 다릅니다. 부록 C는 파생 데이터·학습 체크포인트·코드가 공개되지 않았다고 명시합니다. §4.2 · 부록 C
기술적 세부사항
처음에는 세 단계의 입력과 출력을 구분하면 이해하기 쉽습니다. 이 논문에서 도구는 개별 API입니다. ToolBench의 상위 서비스 묶음을 뜻하는 tool 용어와 구별합니다. §1의 각주
| 단계 | 입력과 역할 | 출력 |
|---|---|---|
| Plan | 사용자 요청을 한 가지 능력씩 요구하는 짧은 하위 단계로 나눕니다. | 순서 있는 하위 단계 목록 |
| Retrieve | 각 하위 단계의 텍스트로 외부 검색기에 한 번 질의합니다. | 점수가 임계값을 넘는 상위 K개 후보의 설명 |
| Select | 같은 소형 모델이 현재 하위 단계와 후보 설명을 읽습니다. | 그 단계를 해결할 도구 하나의 ID |
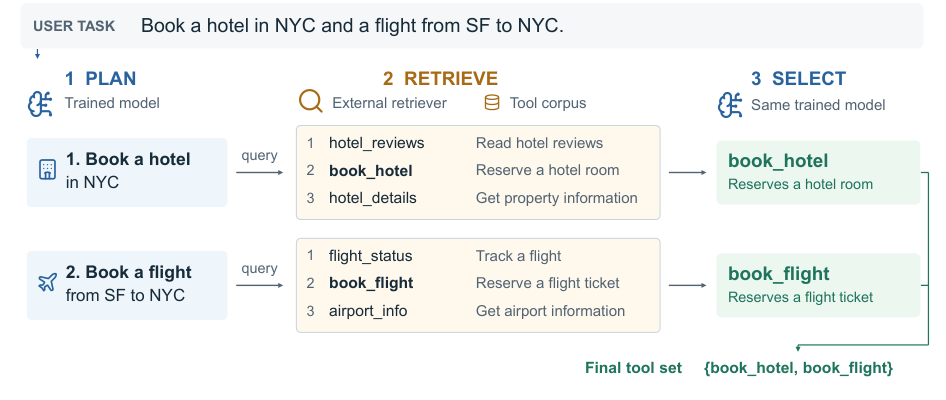
Figure 1, PDF 2쪽. 원본 도식 영역 크롭이며 번역·수치·화살표 변경은 없습니다. 호텔 예약과 항공 예약을 따로 검색한 뒤 최종 도구 집합으로 합칩니다. 원본
BM25는 단어 일치와 빈도에 기반한 검색기이므로 새 도구 목록에 별도 학습 없이 적용할 수 있습니다. 기본 설정은 점수 임계값 3, 후보 최대 15개입니다. Select가 도구 하나를 고르고 나면 모든 하위 단계의 선택을 집합 합집합으로 모읍니다. 원문 알고리즘은 하위 단계마다 도구 하나로 해결할 수 있고, 다른 단계의 실행 결과를 필요로 하지 않는 독립적인 요청을 전제로 합니다. 따라서 이 그림의 선을 실제 예약 실행의 데이터 흐름으로 해석해서는 안 됩니다. §3.1·Algorithm 1
학습도 두 역할을 구분합니다. SFT는 교사가 작성한 짧은 이유와 JSON 행동을 따라 하게 하고, RL은 Plan에 검색 기반 보상을, Select에 단일 정답 도구 일치 보상을 줍니다. 평가는 하위 단계 하나의 정답률이 아니라, 최종 선택 집합이 해당 요청의 gold 집합과 정확히 같은지를 봅니다. 이 차이가 아래 수식과 실험을 읽는 기준입니다. §3.2–3.3
챕터별 상세 리뷰
📖 Chapter 1: Introduction
첫 장은 전체 도구 설명을 문맥에 넣는 방식의 확장성 문제에서 출발합니다. 공개 도구 말뭉치에는 만 개가 넘는 API가 있고, 기업 환경에는 별도 도구도 추가됩니다. 단어 일치형 BM25와 임베딩 기반 dense retriever는 후보 목록을 만드는 데 유용하지만, 여러 요구가 섞인 요청에서 어떤 후보들이 실제로 필요한지 최종 결정하지는 않습니다. §1
이에 대한 기존 대응은 LLM이 검색기를 메타 도구로 사용하며 계획·검색·선택을 제어하는 방식입니다. 저자들은 매번 대형 상용 모델에 맡기던 이 하위 절차를 작은 공개 기반 모델에 학습시키자는 질문으로 논의를 바꿉니다. 핵심은 익숙한 도구 목록의 ID를 외우는 것이 아니라, 요청 분해와 도구 설명 대조 능력을 익히는 데 있습니다. §1
전이 가능성은 두 문제로 나뉩니다. 첫째, 다른 도메인의 도구 목록으로 옮겨도 사용할 수 있어야 합니다. 둘째, 도구 이름의 정확 일치가 중요한 목록과 의미적 유사성이 중요한 목록에 맞춰 검색기를 바꿔도 모델을 다시 학습하지 않아야 합니다. Figure 2는 G3·BM25에서 학습한 Qwen3의 Plan·Select를 유지하고 두 환경만 바꾸는 구상을 보여 줍니다. §1·Figure 2
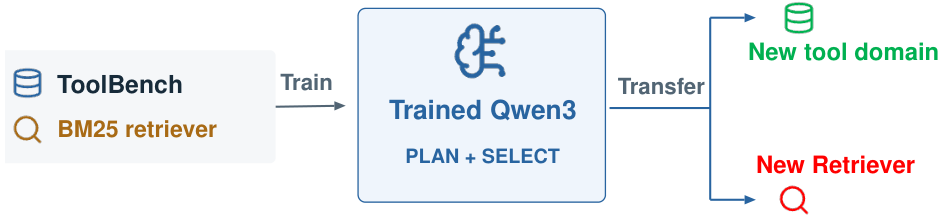
Figure 2, PDF 3쪽. 원본 영역 크롭, 번역 없음. 전이는 도구 도메인 변경과 검색기 변경의 두 축입니다. 원본
여기서 전체 문제의 규모와 주 실험의 규모를 혼동하지 않아야 합니다. 만 개 이상이라는 설명은 문제의 배경이고, 주 학습·평가 G3의 도구 수는 1,419개입니다. 11,474개 도구를 가진 G2는 별도 전이 실험입니다. 첫 장은 이 두 전이 축을 기여로 제시하고, 다음 장은 기존 접근과의 관계를 정리합니다. §4·부록 A.1
📖 Chapter 2: Related Work
Tool retrievers. 기존 도구 검색 연구는 도구 설명을 한 번 검색하거나, 도구를 토큰으로 표현하거나, 계층을 이용해 순위를 정하는 등 여러 접근을 사용합니다. ToolRet은 일반 정보 검색 인코더의 도구 도메인 전이가 쉽지 않음을 다루고, COLT는 query–tool–scene 그래프로 완전성을 개선하며, 어떤 연구는 요청별 반환 개수를 조절합니다. 이 논문은 그런 검색기를 모두 대체하기보다, 반환한 후보를 읽고 선택하는 정책을 연구합니다. §2
LLM-assisted retrieval. LLM은 문서를 확장하거나 질의를 고쳐 한 번 검색할 수도 있고, 여러 턴에 걸쳐 검색기를 운영할 수도 있습니다. 저자들의 워크플로는 하위 단계별로 검색하는 후자에 가깝습니다. 차이는 대형 모델의 프롬프트 조정에 그치지 않고, 작은 모델 자체에 계획·선택 행동을 학습시킨다는 점입니다. §2
Action generalization in RL. 일반적인 강화학습은 고정된 행동 집합을 가정하지만, 이 문제의 행동인 도구는 배포 시 바뀔 수 있습니다. 이전 연구는 행동 표현을 따로 학습하거나 행동 정보를 이용해 새로운 행동으로 일반화했습니다. 여기서는 검색된 도구의 설명이 행동을 표현하고, LLM이 이를 읽어 바뀌는 후보 집합 위에서 정책을 수행합니다. 새 ID 자체보다 설명과 요구 능력의 대응을 이용하는 관점입니다. §2
RL-trained LLM agents. 관련 연구에는 검색부터 실행까지 학습하는 에이전트, 검색 결과로 query rewriting 선호를 만드는 방법, 도구 보상 설계 연구가 있습니다. 저자들은 이들과 달리 도구 선택의 도메인·검색기 전이에 초점을 맞춘다고 구분합니다. 관련 문헌의 개별 성능을 이 논문의 점수와 직접 합산한 비교는 아닙니다. 이 장은 이어지는 방법의 범위를 도구 선택에 고정하는 역할을 합니다. §2
📖 Chapter 3: Method
이 장은 사용자 요청에서 필요한 도구 부분집합을 고르는 문제를 정의한 뒤, 워크플로 → 지도 데이터 구성 → 강화학습 순으로 설명합니다. 도구별 전문 검색기를 학습하기보다, 하나의 작은 정책 모델이 목록에 독립적인 BM25를 사용하게 만듭니다. §3
3.1. The tool-selection workflow
Plan은 사용자 요청을 하나의 능력을 요구하는 짧은 하위 단계들로 분해합니다. 호텔과 항공편 예약을 같은 문장으로 검색하면 서로의 단어가 검색에 섞일 수 있으므로 따로 질의할 단위를 만듭니다. 이 단계에는 도구 전체 설명이 들어가지 않습니다. §3.1
Retrieve는 각 하위 단계 텍스트로 모든 도구 설명을 점수화하고, 임계값을 넘는 도구만 남긴 뒤 상위 K개로 제한합니다. 기본 BM25에서는 임계값 3, K=15입니다. 단계를 나눈 뒤에도 다시 여러 검색 질의를 생성하는 것이 아니라, 그 하위 단계 문장으로 한 번 검색한다는 점이 반복 검색 baseline과 다릅니다. §3.1
Select는 현재 하위 단계와 후보의 설명을 보고 도구 하나를 고릅니다. Algorithm 1은 후보가 비면 그 단계를 건너뛰며, 후보 밖의 ID가 최종 집합에 들어가지 않도록 후보 집합과 교집합한 결과를 누적합니다. 여러 단계에서 같은 도구를 골라도 마지막에는 집합으로 합쳐집니다. 누락된 gold가 있으면 최종 평가에서 실패할 수 있지만, 이 알고리즘 자체에 누락을 보고 계획을 다시 만드는 반복은 없습니다. Algorithm 1
Plan과 Select는 서로 다른 모델이 아니라 같은 모델에 서로 다른 프롬프트를 주는 역할 구분입니다. 매 호출은 구조화된 상태에서 다시 만든 단일 요청이며, 이전 대화 전체가 계속 쌓이지 않습니다. Select에서는 도구 설명을 최대 K개만 읽습니다. 원문은 호출 문맥이 목록 크기·계획 길이에 따라 계속 증가하지 않는다고 설명하지만, 이것이 총 호출 수나 전체 문서의 길이가 항상 같다는 뜻은 아닙니다. 단계 수가 늘면 Select 호출도 늘어납니다. §3.1·부록 D
전제도 분명합니다. 각 하위 단계는 정확히 한 도구로 해결할 수 있어야 하고, 다른 단계의 출력을 받아야 하는 의존성이 없어야 합니다. 따라서 항공편 검색 결과의 특정 ID를 예약 API 인수에 넣는 실제 실행 체인까지 검증한 방법으로 확대할 수 없습니다. 도구 선택과 실행을 분리하는 것이 이 장의 출발점입니다. §3.1
3.2. Data Curation for Supervised Fine-Tuning
처음부터 RL을 하면 기반 모델이 워크플로를 성공적으로 끝내는 빈도가 낮아 학습 시작이 느립니다. 저자들은 Llama-4-Maverick을 교사로 사용해 먼저 SFT 예제를 만듭니다. 원문 순서는 gold 정제 → 계획 분해 → 이유 생성 → 미세조정입니다. §3.2
Gold tool filtering. ToolBench의 정답 도구는 참고 실행 궤적에서 얻기 때문에 요청에 명시되지 않은 도구나 중복에 가까운 도구를 포함할 수 있습니다. 먼저 요청과 도구 문서가 내용 단어를 공유하면 결정적 규칙으로 유지합니다. 남은 쌍은 교사가 기능의 동의어나 바꿔 쓴 표현이 요청에 있는지 판단합니다. 의도는 요청만으로 식별할 수 없는 도구를 학습시키지 않는 것입니다. 다만 이 정제된 gold는 학습뿐 아니라 G3·G2 평가에도 적용되므로, 점수의 기준이 원래 공개 gold와 동일하다고 설명해서는 안 됩니다. §3.2·부록 A.1
Plan decomposition. 교사는 남은 gold를 보면서 요청을 각 도구와 연결되는 하위 단계로 나눕니다. 관련은 있어도 실제로 필요하지 않다고 판단한 도구는 사용하지 않을 수 있고, 이렇게 쓰이지 않은 gold를 추가로 제거합니다. 따라서 정답 집합과 계획 예제는 별개로 존재하는 완전히 독립된 주석이 아니라, 이 구성 절차에서 함께 정해집니다. §3.2
Reasoning generation. SFT에는 행동뿐 아니라 짧은 이유도 제공합니다. Plan 이유를 만들 때는 요청과 이미 생성한 하위 단계만 주고, gold를 보았던 분해 단계의 이유를 그대로 재사용하지 않습니다. gold 도구 정보가 Plan 입력에 없는 내용을 이유로 새어 들어가는 것을 피하기 위해서입니다. Select 이유는 검색된 후보 중 해당 gold를 고르는 설명입니다. 후보 밖 도구를 언급하거나 후보 인덱스를 누설하는 이유는 검사하여 재생성합니다. §3.2
Fine-tuning. 최종 예제는 프롬프트와 reasoning + action의 쌍이며, 행동은 JSON입니다. 모델은 Plan과 Select 양쪽의 사고 패턴·출력 형식을 익힙니다. 부록 A.1에 따르면 짧은 학습 이유는 <think>…</think> 안에 배치됩니다. 이는 기반 Qwen3의 제한 없는 native thinking을 그대로 켠 조건과 다르며, 평가 설정도 부록에서 구별합니다. 이 단계의 역할은 아래 RL에 유효한 시작점을 주는 것입니다. §3.2·부록 A.1
3.3. Reinforcement Learning
SFT 뒤에는 GRPO를 이용해 더 학습합니다. 안정성을 위해 Plan과 Select의 학습을 분리하고, Select를 학습할 때에는 현재 모델이 만든 계획 대신 교사의 고품질 하위 단계를 사용합니다. 각각이 별도 보상을 받는 단일 stateless LLM 호출이 되므로 표준 GRPO로 학습할 수 있습니다. 이 절의 실험은 전체 장기 실행 궤적의 성공 보상을 그대로 역전파하는 end-to-end 도구 실행 학습과 구별됩니다. §3.3
Plan reward. 좋은 계획은 모든 gold 도구를 높은 순위로 검색하고, 불필요한 하위 단계를 만들지 않아야 합니다. 요청의 gold 도구 수를 N, 생성한 하위 단계 수를 n이라고 하겠습니다. 단계 i로 검색한 순위 목록을 순서대로 살펴보고, 아직 어떤 단계에도 대응하지 않은 gold 중 처음 발견한 도구 하나를 그 단계와 연결합니다. 다음 단계로 이동할 때에는 이미 대응한 gold를 다시 사용하지 않습니다. 이는 순서대로 수행하는 탐욕적 고유 대응이며 전체 조합에서 최적의 대응을 찾는 알고리즘이 아닙니다. §3.3
이렇게 대응한 단계 수가 n_cov이면 원문의 precision은 다음과 같습니다. 원문 precision 식
$n_{\mathrm{cov}}$는 서로 다른 gold에 대응한 하위 단계 수이고, 분모 $n$은 생성한 모든 하위 단계 수입니다. 따라서 정답 도구를 새로 찾지 못하는 중복·무관 단계가 많으면 값이 낮아집니다. 단순히 계획을 길게 써 보상을 늘리지 못하게 하는 항입니다.
recall은 정답 도구를 찾았는지만 세지 않고 검색 순위를 반영합니다. 대응한 j번째 단계에서 gold 도구가 나타난 순위를 $\rho_j$라 하면 다음과 같습니다. 원문 recall 식
$N$은 gold 도구 수입니다. 순위는 1부터 세므로 1위는 1, 2위는 1/2, 3위는 1/3만큼 기여합니다. 따라서 이름은 recall이지만 일반적인 이진 포함률과는 다릅니다. 모든 gold를 검색했더라도 순위가 낮으면 1보다 작습니다. 계획 문장이 검색기에서 필요한 도구를 상위로 올리도록 유도하는 보상입니다.
계획 보상은 이 precision과 rank-weighted recall의 조화평균인 F1입니다. 원문은 다음처럼 씁니다. 원문 Plan 보상 식
F1의 역할은 한쪽만 좋은 계획에 높은 점수를 주지 않는 것입니다. 짧지만 필요한 도구를 놓치는 계획은 recall에서, 도구를 찾으려 너무 많은 불필요한 단계를 내는 계획은 precision에서 손해를 봅니다. 다만 이 보상은 해당 검색기에서의 순위에 의존합니다. 검색기 전이는 학습 목표만으로 보장되는 성질이 아니라 이후 실험에서 확인할 대상입니다. §3.3·§4.3
Select reward. 각 하위 단계의 단일 gold 도구를 g라고 하면, 보상은 정확히 그 도구 하나만 골랐을 때 1입니다. 원문 Select 보상 식
$\mathbf{1}[\cdot]$은 괄호 안 조건이 참이면 1, 거짓이면 0인 지시함수입니다. $\{g\}$는 gold 하나로 이루어진 집합이므로, g와 함께 다른 도구를 추가해도 보상은 0입니다. 이는 하위 단계의 선택 보상이고, 최종 평가는 모든 단계의 합집합에 대해 수행한다는 점을 다시 구별해야 합니다. 이 장은 계획 문장과 최종 선택에 서로 다른 학습 신호를 준 뒤, 다음 장에서 두 단계가 결합된 결과를 평가합니다. §3.3·§4.1
📖 Chapter 4: Experiments
실험 질문은 세 가지입니다. 작은 학습 모델이 큰 비학습 모델과 비교해 얼마나 잘 고르는가, 다른 도구 도메인으로 전이되는가, 학습 때와 다른 검색기에서도 동작하는가입니다. 학습은 ToolBench G3에만 한정되며, 원래 학습 split은 21,361개 요청과 1,419개 API를 포함합니다. 정제 뒤 실제 학습 자료의 수는 부록 A.2가 따로 설명합니다. §4
4.1. Tool Selection Success Rate
G3 테스트에서는 정제 후 2,124개 요청을 평가합니다. 성공은 최종 선택 도구 ID 집합이 gold 집합과 정확히 일치하는 경우입니다. 정답이 후보 상위 K개 안에 있는지만 보는 Recall@K·NDCG@K나 completeness와 다릅니다. 필요한 도구 누락과 불필요한 도구 추가 모두 실패이며, 파싱할 수 없는 행동도 실패입니다. API 인수 생성·호출 실행·실제 예약 완료는 이 점수에 포함되지 않습니다. §4.1·부록 A.3
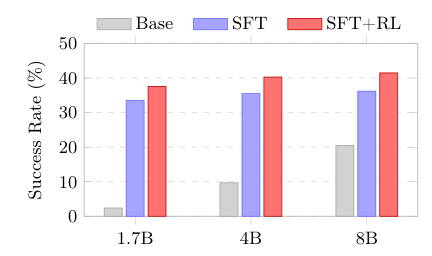
Figure 3, PDF 6쪽. 원본 그래프 영역 크롭, 번역 없음. 세 규모 모두 같은 Plan–Retrieve–Select를 사용하며, 학습 단계에 따른 차이를 보여 줍니다. 원본
기반 모델의 성능은 낮지만 SFT 뒤에는 세 규모 모두 성공률이 30%를 넘고 RL 뒤 더 높아집니다. 8B는 SFT 36.2%에서 SFT+RL 41.5%로 5.3퍼센트포인트 높아집니다. 이는 상대 증가율 5.3%라는 뜻이 아닙니다. 아래는 Table 1을 전사한 결과입니다. §4.1·Table 1
| 모델·프로토콜 | G3 exact-match 성공률 |
|---|---|
| Maverick · ReAct | 28.4% |
| Maverick · 계층 탐색 | 8.6% |
| Maverick · Search-R1 방식 | 30.6% |
| Maverick · 논문 워크플로 | 10.1% |
| Qwen3-1.7B · SFT+RL | 37.6% |
| Qwen3-4B · SFT+RL | 40.3% |
| Qwen3-8B · SFT+RL | 41.5% |
Maverick은 동일 모델이라도 프로토콜에 따라 8.6–30.6%로 크게 달라집니다. ReAct는 먼저 분해한 뒤 하위 단계마다 새 질의를 만들고, 검색 결과를 보며 최대 네 번 검색할 수 있습니다. 계층 탐색은 검색기 없이 ToolBench의 category → tool → API 트리를 내려가며 자기 점검 뒤 다시 들어갑니다. Search-R1 방식은 요청을 나누지 않고 한 reasoning 흐름에서 검색과 추론을 섞습니다. 마지막 비교는 Maverick을 논문의 Plan·Select 프롬프트에 그대로 넣은 것입니다. §4.1·부록 A.3
Maverick의 가장 높은 30.6%보다 8B 학습 모델의 41.5%가 10.9퍼센트포인트 높습니다. 하지만 이를 “작은 모델은 일반적으로 큰 모델보다 낫다”로 바꾸면 안 됩니다. 하나는 해당 절차에 SFT·RL을 거친 모델이고, 다른 하나는 학습 없이 프롬프트로 사용하는 모델입니다. 또한 Maverick은 총 402B·활성 17B인 MoE이며, 8B 모델과 총 파라미터 수 비율만으로 실제 호출 비용·지연 비율을 계산할 수 없습니다. 부록 A.1
동일 Maverick에서는 ReAct 28.4%가 논문 워크플로 10.1%보다 18.3퍼센트포인트 높습니다. 본문은 이를 대략 18% 차이로 서술하지만 여기서는 점수 차이를 명확히 적었습니다. 반복 검색은 하위 단계당 최대 다섯 번의 모델 호출을 사용할 수 있어 한 번 선택하는 경로와 상호작용 예산도 다릅니다. 이는 워크플로·모델·학습의 조합이 중요함을 보여 주며, 비용을 직접 측정한 실험은 아닙니다. §4.1
4.2. Transferability across Benchmarks
저자들은 도구 도메인 변화 정도와 요청당 도구 개수를 함께 바꿔 봅니다. G2는 같은 RapidAPI 계열이지만 도구가 11,474개로 많고 G3와의 도구 공유가 약 9%인 목록입니다. Gorilla와 CRAFT는 전혀 다른 저장소·도메인이며 정답이 하나이므로 Plan을 생략하고 Select의 전이를 평가합니다. TaskBench는 도메인 밖의 여러 도구 요청으로 Plan과 Select를 함께 평가합니다. “모든 외부 benchmark에서 전체 파이프라인을 똑같이 실행했다”는 뜻은 아닙니다. §4.2
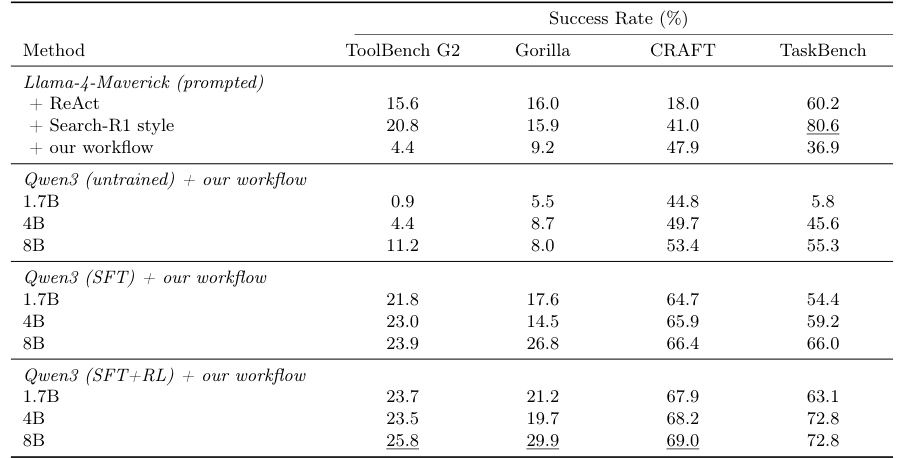
Table 2, PDF 8쪽. 원본 표 영역 크롭, 번역 없음. 열마다 도구 목록·요청 개수·Plan 사용 여부가 다르며 모든 값은 성공률(%)입니다. 작은 화면에서도 비교할 수 있도록 전체 수치를 아래에 전사했습니다. 원본
| 모델·학습·워크플로 | G2 | Gorilla | CRAFT | TaskBench |
|---|---|---|---|---|
| Maverick · ReAct | 15.6 | 16.0 | 18.0 | 60.2 |
| Maverick · Search-R1 | 20.8 | 15.9 | 41.0 | 80.6 |
| Maverick · 논문 워크플로 | 4.4 | 9.2 | 47.9 | 36.9 |
| Qwen3-1.7B · Base | 0.9 | 5.5 | 44.8 | 5.8 |
| Qwen3-4B · Base | 4.4 | 8.7 | 49.7 | 45.6 |
| Qwen3-8B · Base | 11.2 | 8.0 | 53.4 | 55.3 |
| Qwen3-1.7B · SFT | 21.8 | 17.6 | 64.7 | 54.4 |
| Qwen3-4B · SFT | 23.0 | 14.5 | 65.9 | 59.2 |
| Qwen3-8B · SFT | 23.9 | 26.8 | 66.4 | 66.0 |
| Qwen3-1.7B · SFT+RL | 23.7 | 21.2 | 67.9 | 63.1 |
| Qwen3-4B · SFT+RL | 23.5 | 19.7 | 68.2 | 72.8 |
| Qwen3-8B · SFT+RL | 25.8 | 29.9 | 69.0 | 72.8 |
G2의 8B 학습 모델은 25.8%로 가장 높은 Maverick baseline 20.8%보다 높지만, 자신의 G3 41.5%보다는 낮습니다. 더 크고 대부분 새로운 도구 목록이 검색에 방해 후보를 늘리고 gold 순위를 낮춘다는 것이 저자들의 해석입니다. 다만 약 9%의 도구가 공유되므로 G2를 완전히 새로운 도구만의 실험이라고 부를 수는 없습니다. §4.2·부록 A.1
단일 도구 벤치마크에서 8B는 Gorilla 29.9%, CRAFT 69.0%를 기록합니다. 여기서는 새로운 도구 설명을 읽는 Select 능력의 전이가 관찰됩니다. 반면 TaskBench 최고 baseline은 Maverick·Search-R1의 80.6%이며, 학습 모델의 최고 72.8%보다 7.8퍼센트포인트 높습니다. 원문은 약 8pp 차이로 설명하며, 도메인 지식을 필요로 하는 계획 분해가 영향을 줄 수 있다고 해석합니다. 분해를 포함한 ReAct와 논문 워크플로보다는 작은 학습 모델이 높지만, 모든 전이 설정에서 최고라는 주장은 아닙니다. §4.2
또한 TaskBench는 세 source 합계 103개 요청이고, 각 source의 23–40개 도구만 따로 검색합니다. Gorilla·CRAFT도 source별 목록을 따로 사용합니다. 표의 열 점수를 “하나의 거대한 혼합 도구 집합에서 동일 난도로 평가한 점수”로 이해해서는 안 됩니다. 부록 A.1·Table 3
4.3. Transferability to new retrievers
이번에는 모델·프롬프트·평가 split을 유지하고 Retrieve의 BM25를 COLT로 바꿉니다. COLT는 ToolBench G3 학습 split에 맞춰 훈련한 Contriever 계열 인코더와 graph-propagated 도구 임베딩을 사용하는 dense retriever입니다. 선택 모델을 다시 학습하지 않지만, 검색기 자체가 해당 도메인에 특화되어 있다는 사실은 남습니다. §4.3·부록 A.1
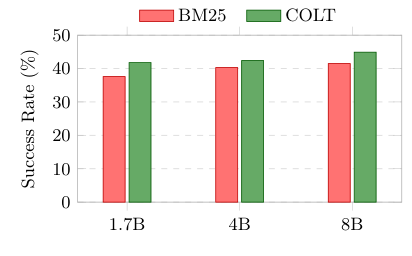
Figure 4, PDF 8쪽. 원본 그래프 영역 크롭, 번역 없음. 막대의 정확한 수치 라벨이 없으므로 그래프에서 숫자를 추정해 표로 만들지 않았습니다. 원본
세 규모 모두 COLT에서 더 높은 성공률을 얻습니다. 이는 모델이 다른 검색기의 더 좋은 후보를 이용할 수 있다는 결과입니다. 그러나 점수 척도가 달라 임계값도 BM25의 3에서 COLT의 0.6으로 변경합니다. 후보 상한 K=15는 유지합니다. 따라서 “검색기 이름만 바꾸고 모든 수치 설정을 그대로 뒀다”가 아니라, 같은 검색 결과 인터페이스에 맞춰 임계값을 조정한 전이입니다. 부록 A.3의 Retriever swap
BM25로 학습한 이유도 중요합니다. 도메인 전이 실험이 이미 대상 도메인에 맞춘 강한 dense retriever에 의존하지 않도록 하기 위해서입니다. 이 절은 선택 모델과 검색기의 역할을 분리하고, 다음 ablation은 그 안의 Plan·Select·후보 수·학습 순서를 나눠 봅니다. §4.3
4.4. Ablations
모든 ablation은 G3 테스트와 8B 설정을 사용합니다. PDF의 Figure 5는 네 패널 (a)–(d)로 구성됩니다. 실험 HTML은 subfigure를 별도 Figure 5–8 및 Figure 9로 중복 표기하므로, 여기서는 실제 PDF Figure 5(a–d)를 기준으로 설명합니다. §4.4·PDF 9쪽
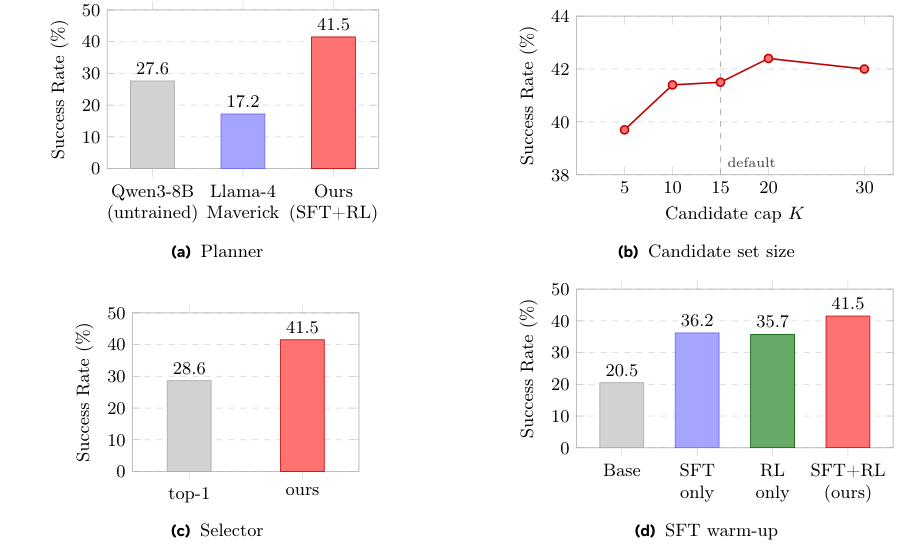
Figure 5(a–d), PDF 9쪽. 원본 네 패널을 원래 배치로 크롭했으며 번역·수치 변경은 없습니다. 각 패널의 조건과 주요 수치를 아래에서 설명합니다. 원본
Planner. Retrieve와 Select를 고정하고 계획 모델만 바꾸면, 학습된 계획기는 41.5%, 학습하지 않은 Qwen3-8B 계획기는 27.6%, Maverick 계획기는 17.2%입니다. 이 통제에서는 더 큰 기반 모델로 교체하는 것보다 해당 절차에 맞춘 계획 학습이 낫습니다. 하지만 이는 고정된 downstream 선택기에 연결한 결과이며, 각 계획기에 전체 파이프라인을 별도로 최적화한 비교는 아닙니다. Figure 5(a)·§4.4
Candidate set size. 후보 상한 K를 5·10·15·20·30으로 바꿉니다. 성공률은 K=20까지 높아지다가 30에서 더 높아지지 않습니다. 후보가 많으면 gold를 포함할 가능성이 늘지만 방해 후보도 늘어납니다. 저자들은 문맥 소비와 성능의 균형으로 학습·평가 기본값 15를 택했다고 설명합니다. 그래프의 세로축은 약 38–44% 범위로 잘려 있으므로 작은 높이 차이를 큰 배수 효과로 읽으면 안 됩니다. Figure 5(b)·§4.4
Selector. 학습된 Select를 없애고 각 하위 단계의 BM25 1위를 그대로 고르면 28.6%입니다. 학습된 선택기를 쓰는 41.5%와의 차이는 12.9퍼센트포인트입니다. 검색 순위 1위가 하위 단계에 실제 필요한 도구와 다를 수 있어, 후보 설명을 비교하는 선택 자체가 기여한다는 결과입니다. 이는 다른 검색기까지 포함한 모든 1위 선택 전략의 한계를 일반화한 실험은 아닙니다. Figure 5(c)
SFT warm-up. 8B Base 20.5%, SFT만 36.2%, RL만 35.7%, SFT+RL 41.5%입니다. Base도 성공률이 0은 아니므로 RL만으로 시작할 수는 있지만, 교사 예제로 초기화한 뒤 RL을 하는 쪽이 이 설정에서 가장 높습니다. SFT가 논리적으로 없으면 학습이 불가능하다는 결론이 아니라, 이 recipe에서 유용한 준비 단계라는 결과입니다. Base·RL-only의 native thinking은 꺼져 있고 SFT 계열은 학습된 짧은 이유를 사용한다는 부록 조건도 함께 읽어야 합니다. Figure 5(d)·부록 A.1
이 장은 소형 모델의 전문화와 전이를 보여 주는 동시에 TaskBench 예외와 구성 요소별 차이를 남깁니다. 수치는 단일 실행 결과이며, 반복 시 한두 요청의 차이는 있지만 신뢰구간·통계적 유의성 검정은 보고되지 않았습니다. 따라서 40.3%와 41.5% 같은 작은 차이를 유의한 규모 효과로 단정하지 않습니다. 부록 A.3
📖 Chapter 5: Conclusion
마지막 본문은 대규모 도구 목록에서의 선택이 에이전트 도구 호출에 반복적으로 필요한 하위 작업이라고 정리합니다. 교사의 궤적으로 SFT를 한 뒤, 검색 기반 계획 보상과 정확 일치 선택 보상으로 RL을 하면 1.7B–8B Qwen3가 G3의 prompted Maverick보다 높은 점수를 낼 수 있다는 것이 결론입니다. “추가 인간 주석이 없다”는 설명도 이미 주어진 gold 도구 집합을 사용한다는 조건을 포함합니다. 주석 자체가 전혀 필요 없다는 뜻은 아닙니다. §5
저자들은 요청 분해와 설명 기반 선택이 특정 목록에만 묶이지 않기 때문에 같은 체크포인트가 새 도메인·검색기로 전이될 수 있다고 설명합니다. 끝으로 작은 LLM의 도구 선택에 대한 추가 연구를 기대한다고 적습니다. 별도 한계 장이나 구체적인 미래 연구 목록을 제시하지 않으므로, 이 리뷰도 새로운 연구 과제를 저자의 제안처럼 덧붙이지 않습니다. §5
📖 Chapter Acknowledgments: Acknowledgments
감사의 글은 Tal Lancewicki의 논의·피드백과 NSF Grant CCF-2106778의 부분 지원을 밝힙니다. 이는 연구 지원의 고지이며 방법이나 성능을 뒷받침하는 추가 실험은 아닙니다. 뒤의 참고문헌은 앞서 언급한 도구 검색·강화학습·모델·벤치마크의 근거를 연결합니다. Acknowledgments
📖 Chapter References: References
참고문헌은 BM25·COLT·도구 검색, 행동 일반화, GRPO와 LLM 에이전트 학습, Qwen3·Maverick·추론 및 학습 소프트웨어 등 이 논문의 위치를 구성합니다. 이 리뷰가 인용 문헌 전체를 각각 재검증한 것은 아닙니다. 실험 수치는 본 논문의 표·그림과 부록을 기준으로 설명하며, 이후 부록 A의 구현·평가 조건을 통해 해석 범위를 구체화합니다. References
📖 Chapter Appendix A: Experiment Details
A.1. Models and Benchmarks
Trained models. Qwen3-1.7B·4B·8B의 동일 모델이 Plan과 Select를 수행합니다. SFT 타깃은 짧은 교사 이유를 <think> 블록에 넣고 JSON 행동을 뒤에 둡니다. SFT·SFT+RL은 학습·평가 때 thinking을 활성화하지만, 이는 학습된 짧은 과제별 이유입니다. 반면 Base·학습하지 않은 계획기·Base에서 시작하는 RL-only는 native thinking을 끕니다. 원문은 기반 모델의 생각 블록이 생성 예산을 소진하고 행동을 내지 못하는 일이 잦았기 때문이라고 설명합니다. 따라서 학습 전후 비교에는 가중치뿐 아니라 이 출력 모드의 차이도 있습니다. A.1
Teacher and baseline model. Maverick은 128개 expert를 가진 MoE로 총 402B, 활성 17B 파라미터입니다. gold 정제·계획·이유 생성의 교사이며 네 baseline의 prompted 모델이기도 합니다. “402B를 8B로 대체했다”는 표현은 총 파라미터 비교로는 맞지만, 실제 활성 계산량이나 학습비·호출비를 같은 비율로 줄였다는 측정은 아닙니다. A.1
Retrievers. BM25는 bm25s의 Lucene 점수 변형, k1=1.8, b=1.0, 영어 불용어 제거와 stemming 없음으로 구성합니다. 도구·API 이름, 설명, 인수 필드를 직렬화한 문서를 색인합니다. 같은 구성을 계획 보상·SFT 데이터 생성·평가에 사용합니다. COLT는 G3 학습 split에서 훈련한 공개 Contriever 체크포인트와 그래프 전파 도구 임베딩을 사용하며 내적 유사도를 반환합니다. A.1
Benchmarks. Table 3의 실제 평가 모집단은 아래와 같습니다. “도구 수 범위”가 있는 열은 source별로 따로 검색한 목록의 크기이며, 여러 source를 합친 단일 검색 목록이 아닙니다. Table 3, PDF 16쪽
| 평가 | 요청 수 | 검색 대상 도구 수 | gold | BM25 임계값 / K |
|---|---|---|---|---|
| ToolBench G3 | 2,124 | 1,419 | 여러 도구 | 3 / 15 |
| ToolBench G2 | 7,238 | 11,474 | 여러 도구 | 3 / 15 |
| Gorilla, 3개 source | 598 | 43–907 | 1개 | 3 / 20 |
| CRAFT, 3개 source | 654 | 180–525 | 1개 | 2 / 20 |
| TaskBench, 3개 source | 103 | 23–40 | 여러 도구 | 0 / 15 |
G3 원래 테스트 2,373개 중 2,124개(89.5%), G2 원래 8,250개 중 7,238개(87.7%)가 gold 정제를 통과했습니다. Gorilla·CRAFT·TaskBench는 원래 gold를 정제하지 않고 평가합니다. 따라서 모든 benchmark가 동일한 방식으로 정답을 다시 만들었다고 볼 수 없습니다. A.1
Gorilla는 huggingface·pytorch·tensor의 세 source에서 각각 500·43·55개 요청을 사용합니다. CRAFT는 math-algebra·tabmwp·vqa에서 280·174·200개입니다. TaskBench는 daily·multimedia·huggingface의 합계 103개 요청이며 평균 gold 도구 수가 2.6개입니다. 세 benchmark는 ToolRet 패키징을 사용하되 각 source의 원래 도구 목록으로 제한합니다. 모든 요청·도구 문서는 영어입니다. A.1
이 설정은 도메인 전이가 실제로 무엇을 뜻하는지 구체화합니다. G2는 대부분 새로운 도구가 있는 같은 서비스 생태계이고, 다른 세 benchmark는 도메인·표현이 다르지만 corpus 크기·요청당 도구 수도 다릅니다. 이 차이를 지운 평균 하나보다 각 열의 조건을 유지해야 결과를 이해할 수 있습니다. 논문에 명시되지 않은 source별 집계 가중을 새로 가정해 점수를 재계산하지 않습니다.
A.2. Training
Training data. G3 학습 split의 21,361개 요청에는 57,836개의 요청–gold 쌍, 요청당 평균 2.71개 gold가 있습니다. 첫 정제는 54,695쌍(94.6%)을 남기고, 계획 분해는 불필요하다고 판단한 gold 1,928개를 추가로 제거합니다. gold가 하나도 남지 않거나 교사가 출력 검사를 세 번 통과하지 못하는 등의 이유로 1,268개 요청(5.9%)을 버려 20,093개 정제 학습 요청이 남습니다. A.2
SFT 자료에는 Plan 예제 19,841개와 Select 예제 38,293개가 있습니다. 요청 119개와 거기서 나온 SFT 예제 783개는 개발 중 검증용으로 떼어 둡니다. 요청 수·gold 쌍 수·SFT 예제 수는 서로 다른 단위입니다. RL 프롬프트도 같은 정제 요청에서 만들며 Plan은 요청당 하나, Select는 교사 하위 단계당 하나입니다. A.2
Supervised fine-tuning. LLaMA-Factory와 DeepSpeed ZeRO-3를 사용해 bf16으로 전체 파라미터를 학습합니다. Reinforcement learning. SFT 체크포인트에서 VeRL의 GRPO와 vLLM rollout을 사용합니다. 세 모델 규모에 같은 하이퍼파라미터를 사용합니다. A.2·Table 4
| 항목 | SFT | RL, GRPO |
|---|---|---|
| 학습 파라미터 | 전체 | 전체 |
| AdamW 학습률 | 10⁻⁵ | 10⁻⁶ |
| 학습률 일정 | cosine, 3% linear warm-up | constant |
| 학습 길이 | 3 epochs | 300 steps |
| 유효 batch | 128 sequences | 64 prompts |
| 프롬프트당 rollout | 해당 없음 | 16 |
| sampling temperature | 표에 별도 값 없음 | 0.9 |
| KL 계수 | 해당 없음 | 0.001 |
| batch당 update | 표에 별도 값 없음 | 1 |
| 최대 길이 | 4,096, packed | prompt 4,096 / completion 4,096 |
| 하드웨어 | A100 8개 | A100 8개 |
훈련 temperature 0.9와 평가의 greedy decoding은 다른 조건입니다. 하드웨어 개수와 학습 step을 알 수 있어도 총 학습시간·금전 비용을 임의로 계산할 수는 없습니다. Table 4
Software versions. 학습은 VeRL e52747a4(v0.8.0+147 commits), vLLM 0.11.0, PyTorch 2.8.0·CUDA 12.8, Transformers 4.56.1, DeepSpeed 0.18.4, FlashAttention 2.8.1입니다. 평가는 별도 환경의 vLLM 0.22.1, PyTorch 2.11.0, Transformers 5.10.2, bm25s 0.3.9, COLT 인코더용 sentence-transformers 5.5.1을 사용합니다. 논문은 모든 보고 점수가 이 평가 환경에서 나왔다고 밝힙니다. 학습·평가 환경을 하나의 버전 목록으로 합치지 않는 것이 재현 조건을 보존합니다. A.2
A.3. Evaluation
Metric. 모든 결과는 최종 도구 집합 exact match입니다. 모델은 temperature 0으로 탐욕적으로 생성하며, 논문 워크플로는 호출당 최대 2,048개 새 토큰, 계획당 최대 8개 하위 단계를 허용합니다. 결과는 단일 실행이며 비결정적 배치 추론으로 같은 체크포인트를 반복해도 한두 요청이 달라질 수 있습니다. 그 관찰이 신뢰구간이나 정식 검정을 대신하지는 않습니다. A.3
ToolBench G3 evaluation. 주 결과·ablation은 같은 G3 테스트와 전체 G3 도구 목록을 사용합니다. 기본값은 BM25, 임계값 3, K=15입니다. 후보 수 실험만 K=5·10·15·20·30을 바꾸고 다른 조건은 유지합니다. A.3
Llama-4-Maverick baselines. 본문은 네 프로토콜을 모두 few-shot으로 설명하지만, 상세 부록은 논문 워크플로에 넣은 Maverick에는 few-shot 예제가 없다고 명시합니다. 이 리뷰는 구체적인 부록 A.3의 설정을 따르며, 본문과의 서술 차이를 남깁니다. 다른 세 프로토콜은 최대 1,024개 새 토큰, 논문 워크플로의 Maverick은 2,048개입니다. §4.1 · A.3
ReAct는 예제 두 개로 최대 다섯 단계까지 분해한 뒤, 단계마다 검색 이력과 최신 top-10 후보를 봅니다. 최대 네 검색 안에서 다시 검색·도구 선택·건너뛰기를 고릅니다. 계층 탐색은 최대 세 category, category당 여섯 tool, tool당 15개 API를 고르고 API 설명은 200자로 자르며 자기 점검을 한 번 수행합니다. G3의 taxonomy는 36 category·241 tool, G2는 49 category·3,391 tool입니다. 이 상위 tool 수는 앞서 개별 API를 세는 1,419·11,474와 다른 계층입니다. A.3
Search-R1 방식은 분해 없이 <think>·<search>·<answer>를 섞고, 검색당 BM25 top-10과 최대 여섯 검색을 사용합니다. 프롬프트에는 세 턴짜리 예제 하나가 들어갑니다. </search>에서 생성을 중단해 실제 검색 결과를 넣으므로 모델이 검색 결과를 스스로 꾸며 생성하지 않게 합니다. 프로토콜마다 분해 상한·후보 수·검색 횟수·토큰 예산이 다르다는 조건을 유지해야 Table 1을 동일 계산 예산의 순위표로 오해하지 않습니다. A.3
Transfer benchmark evaluations. 전이 평가에는 앞 Table 3의 benchmark별 임계값·K를 사용합니다. Retriever swap. COLT 전이에서는 유사도 척도에 맞춰 임계값 0.6, K=15를 사용하고 체크포인트·프롬프트는 유지합니다. 이 부록은 워크플로를 비교할 때 모델 이름뿐 아니라 입력·생성·검색 정책도 함께 고정해야 한다는 점을 구체적으로 보여 줍니다. A.3
📖 Chapter Appendix B: Links to Models, Benchmarks, and Software
Table 5는 사용한 기반 모델·검색기·benchmark·학습 소프트웨어의 공개 위치와 라이선스를 나열합니다. Qwen3 세 모델은 Apache-2.0, Maverick은 Llama 4 Community License입니다. bm25s는 MIT, ToolBench·Gorilla·ToolRet 패키징은 Apache-2.0, TaskBench는 MIT로 기재합니다. COLT 체크포인트와 CRAFT에는 Unspecified라고 적으며, 이는 원문이 조사한 공개 위치에 라이선스가 명시되지 않았다는 뜻입니다. 이 리뷰가 새로 법적 사용 허가를 판정한 것은 아닙니다. 부록 B·Table 5
학습·추론 소프트웨어로 나열한 LLaMA-Factory·VeRL·vLLM도 각각 Apache-2.0입니다. 이 공개 링크 목록의 역할은 기존에 사용한 자원을 식별하는 데 있습니다. 다음 부록이 설명하듯, Table 5의 기반 모델 주소를 논문에서 새로 학습한 체크포인트의 다운로드 주소로 오해하면 안 됩니다. 부록 B
📖 Chapter Appendix C: Artifact Use and Release
Use of existing artifacts. 저자들은 기존 모델·데이터·소프트웨어를 비상업 연구에 사용하며, 라이선스가 명시되지 않은 자원은 연구 평가에만 사용하고 재배포하지 않는다고 밝힙니다. COLT는 검색기 교체 실험에서만 사용합니다. 자료는 영어 도구 설명과 benchmark 저자가 만든 합성 사용자 요청이며, 이 연구가 사람에게서 새 데이터를 수집하지는 않았다고 적습니다. 이는 저자들의 사용 범위 고지입니다. 부록 C
Created artifacts. 새로 만든 것은 정제 gold·교사 SFT 궤적, 학습된 Qwen3 체크포인트, 학습·평가 코드입니다. 교사 SFT 자료는 Maverick으로 생성했기 때문에 학습 체크포인트를 Llama 출력의 파생물로 설명합니다. 원문은 이 파생 산출물 가운데 공개된 것은 없으며 보고한 실험에만 사용한다고 명시합니다. 따라서 기반 Qwen3가 공개되어 있다는 이유로 이 연구의 recipe를 그대로 내려받아 실행할 수 있다고 소개할 수는 없습니다. 부록 C
의도된 용도는 도구 선택 연구이며, 중대한 결과를 낳는 행동을 실제 실행하는 에이전트 배포용으로 검증되지 않았습니다. 프롬프트·하이퍼파라미터·소프트웨어 버전·자료 통계를 논문에 제공한다는 설명은 있지만, 미공개 파생 자료·가중치·코드가 있는 상황에서 완전한 재현을 직접 확인했다고 말할 수는 없습니다. 이 구분은 결과의 가치를 부정하는 대신, 독자가 실제로 확보할 수 있는 것과 논문이 보고하는 것을 분리합니다. 부록 C
📖 Chapter Appendix D: Prompt Templates
마지막 부록은 평가에 사용한 두 프롬프트를 공개합니다. 모든 호출은 system 하나와 user 하나로 이루어지며, 구조화된 상태를 매번 다시 렌더링합니다. 대화 기록이 누적되는 메모리형 에이전트와 다릅니다. 중괄호 placeholder는 런타임이 채우는 자리이며, 실제 도구 실행 명령이 아닙니다. 부록 D
Plan. system은 사용자 과제를 순서 있는 하위 단계로 분해하고 짧은 이유 뒤 JSON 객체를 출력하도록 요구합니다. user에는 User task: {query}만 넣습니다. 행동 구조는 name이 PLAN, substeps가 text 항목들의 배열입니다. 도구 전체 목록이나 gold는 이 평가 프롬프트에 들어가지 않습니다. 부록 D의 Plan
Select. system은 하위 단계를 해결하는 ID를 후보 목록에서 고르고, 이유 뒤 name: SELECT와 ids 배열을 출력하도록 합니다. 문구는 id(s) 및 배열 형식을 허용하지만, 본문의 방법 전제와 선택 보상은 정답 도구 하나만 고르는 것입니다. user에는 원래 요청을 복구하는 선택적인 User task 줄, 현재 Sub-step, 개수와 ID·문서를 붙인 후보 목록이 들어갑니다. 부록 D의 Select
이 선택적 원래 요청 줄은 §3.1의 “현재 단계와 후보만 본다”는 간략 설명을 보완합니다. 계획에서 떨어져 나간 질의 세부사항을 Select에 다시 제공할 수 있다는 뜻이며, 호출이 stateless라는 성질과 모순되지 않습니다. 도구 문서 전체가 들어가는 단계는 Select뿐입니다. 부록 D는 이처럼 논문의 알고리즘이 실제 모델 입출력에서 어떤 형태를 갖는지로 설명을 마무리합니다.
실험 결과 심층 분석
가장 분명한 결과는 고정된 선택 절차에 대한 학습이 강한 prompted 모델과 경쟁할 수 있다는 점입니다. G3에서 8B의 41.5%는 최고 Maverick baseline 30.6%보다 높고, 같은 8B에서 SFT에 RL을 추가한 차이는 5.3퍼센트포인트입니다. 그러나 trained 대 untrained, native thinking과 학습된 이유, 검색·토큰 예산이 함께 다릅니다. “같은 계산량에서 모델 크기만 줄여 이겼다”는 실험으로 요약하지 않는 것이 정확합니다. Table 1·Figure 5·부록 A
전이에서는 결과의 강도가 다릅니다. 단일 도구 Gorilla·CRAFT는 Select의 설명 대조 능력을 확인하고, 다중 도구 G2·TaskBench는 계획까지 포함합니다. 특히 TaskBench에서 Search-R1이 더 높다는 예외는 분해가 모든 도메인에 최적인 것은 아니라는 저자의 해석과 연결됩니다. 열마다 corpus 크기·요청 수·임계값이 다르므로 69.0%와 72.8%를 같은 난도의 성능으로 단순 비교해서는 안 됩니다. §4.2·Table 3
보상 설계도 결과와 잘 연결됩니다. Plan은 단순한 gold 포함률이 아니라 고유 대응과 역순위를 반영하고, Select는 후보를 읽고 하나를 확정합니다. 실제로 학습 선택기가 BM25 1위 고정보다 12.9퍼센트포인트 높았습니다. 다만 Plan·Select를 별도 학습하고 Select에는 교사 계획을 준다는 조건을 유지해야, 이 결과를 실제 도구 실행 전체를 RL로 최적화한 것으로 오해하지 않습니다. §3.3·§4.4
평가 신뢰도에는 원문이 제공한 범위가 있습니다. gold 정제의 비율과 단일 실행, 비결정적 추론에 따른 한두 요청 차이는 공개하지만, 신뢰구간·유의성 검정·실측 비용·실측 지연은 보고하지 않습니다. 이 정보 부재를 곧바로 방법의 결함으로 단정할 수는 없으며, 관찰된 점수 차이와 통계적으로 검증한 개선을 구분하는 근거로 사용해야 합니다. 파생 자료·코드·학습 가중치 미공개도 독립 재현을 수행한 것처럼 설명하지 않는 이유입니다. 부록 A.3·C
기술적 함의와 응용
이 논문에서 배울 설계 관점은 에이전트 전체를 한 모델에 모두 맡기는 대신, 반복되는 도구 선택이라는 하위 능력을 따로 정의하고 평가할 수 있다는 것입니다. 리뷰어의 해석으로는, 후보 검색과 최종 선택을 나누면 검색기의 Recall@K가 좋아진 것과 실제 사용할 집합이 맞아진 것을 분리하여 볼 수 있습니다. 같은 모델 이름보다 어떤 입력·정답·상호작용 정책을 사용하는지가 비교의 핵심이라는 점도 드러납니다. §3–4
다른 도구 목록으로 이동할 때에는 설명을 읽는 능력의 전이와, 실제로 정답을 검색 후보 안에 넣는 능력을 함께 봐야 합니다. COLT 교체 결과는 더 좋은 검색 후보가 같은 선택기에 도움이 될 수 있음을 보여 주고, TaskBench의 예외는 계획 분해의 적합성도 중요함을 보여 줍니다. 이는 원문 실험의 해석이며, 특정 산업에 곧바로 배포해도 된다는 권고는 아닙니다. §4.2–4.3
마지막으로 도구를 정확히 고르는 일과 그 도구로 올바른 행동을 실행하는 일은 이어져 있지만 같은 평가는 아닙니다. 원문이 검증한 것은 주어진 영어 요청과 도구 설명에서 gold 집합을 맞추는 능력입니다. 독립 하위 단계 가정, 정제된 gold, benchmark별 검색 목록, 미공개 파생 산출물이라는 조건을 함께 읽으면, 이 연구는 작은 모델의 전문화가 어디까지 유효했는지와 어떤 근거로 전이를 주장하는지를 명확히 보여 줍니다. §3.1·부록 A·C