논문 개요와 전체 구조
흐릿한 동영상에서 창틀이나 글자 같은 작은 구조를 선명하게 만들려면, 개별 프레임의 디테일과 시간에 따른 일관성을 함께 복원해야 합니다. 대형 생성 모델은 그럴듯한 디테일을 합성할 수 있지만, 영상 전체를 처리하면 비용이 커집니다. RelayVSR은 대형 모델이 일정 간격의 키프레임에서만 참조 정보를 만들고, 경량 모델이 그 정보와 저해상도 영상으로 모든 프레임을 복원하는 4배 영상 초해상도 시스템입니다. 원문 §1
이 방식에서 키프레임의 색이나 질감이 틀리면 그 오차가 같은 참조를 읽는 여러 프레임으로 퍼집니다. 저자들은 경량 모델을 고정하고, 키프레임과 최종 영상 양쪽을 채점해 대형 모델을 보정합니다. 201프레임을 대상으로 한 단일 A100 80GB의 1080p 실험에서, 15프레임 간격의 양끝 참조 설정은 29.29 FPS, 13.82 GB의 최대 할당 메모리, 0.327초의 첫 출력 모델 계산 시간을 기록했습니다. 이 시간은 미래 프레임을 기다리는 시간과 모델 밖의 처리를 제외합니다. 아래에서는 2026년 9월 29일 제출된 arXiv v1의 보고값을 사용합니다. 버전 정보 · 원문 §4.3 및 Table 2
| 원문 순서 | 다루는 질문 |
|---|---|
| 1. Introduction | 대형 생성 모델을 모든 프레임에 호출하는 비용을 어떻게 줄이는가 |
| 2. Related Work | 현실 영상 초해상도, 참조 활용, 확산 모델의 선호 최적화와 어떻게 연결되는가 |
| 3. Method | 키프레임을 만드는 방법, 두 메모리의 결합, 영상 품질을 반영하는 보상 |
| 4. Experiments | 복원 품질, 계산 효율, 참조 간격, 메모리와 보상의 기여 |
| 5. Conclusion | 시스템이 달성한 품질과 효율, 향후 개선 방향 |
| Appendix A–D | 학습식·어텐션 구현, 학습 설정, 추가 결과·사용자 평가, 한계 |
핵심 기여와 혁신성
생성 비용을 참조 프레임에 집중합니다. 확산 모델을 한 번의 추론으로 증류해도 매 프레임을 대형 모델에 넣으면 총비용은 큽니다. RelayVSR은 대형 모델이 만든 잠재 표현을 인접 구간에서 재사용합니다. 경량 모델은 현재 저해상도 프레임에서 구도와 움직임에 대한 단서를 받고, 참조로부터 세부 특징을 보완합니다. 원문 §3.1
참조에서 얻는 세부 특징과 최근 영상 문맥을 각각 보관합니다. 키프레임은 같은 구간에서 반복 사용되므로 레이어별 키와 값을 한 번 계산해 저장합니다. 최근 프레임은 새 프레임이 들어올 때마다 갱신합니다. 현재 프레임의 쿼리는 두 메모리를 동시에 읽습니다. 원문 §3.2
경량 모델이 참조를 실제로 어떻게 쓰는지 학습에 반영합니다. 키프레임이 단독으로 선명해 보여도 후속 프레임에서 색이 흔들리거나 질감이 퍼질 수 있습니다. VARO는 키프레임 품질과 경량 모델이 복원한 전체 영상의 품질을 함께 점수화하고, 그 점수로 대형 생성 모델을 업데이트합니다. 원문 §3.3
기술적 세부사항
LR은 저해상도 입력, HR은 학습 시 고해상도 정답, SR은 복원 결과입니다. 참조 잠재 표현(latent)은 픽셀 대신 모델 내부의 압축된 격자에 담긴 특징입니다. 대형 모델은 참조를 이 격자 형태로 바로 넘기고, 경량 모델은 키프레임 위치를 포함해 모든 프레임의 RGB 출력을 만듭니다. 원문 §3.1–3.2
| 구성 | 프레임을 처리하는 단위 | 남겨 두는 정보 |
|---|---|---|
| Wan2.2 기반 참조 생성기 | 간격 Δ마다 선택한 키프레임 | 다음 키프레임 생성에 사용할 최근 참조의 KV |
| Dual-Memory Video Transformer | 입력 영상의 각 프레임 | 참조 KV와 최근 영상 KV |
| VARO | 학습 중 같은 입력에서 생성한 후보 참조 시퀀스 | 고정 경량 모델의 출력에 대한 보상, 직접 디코딩한 참조 보상 |
첫 키프레임 모드에서는 구간 시작의 참조와 현재까지 들어온 LR 프레임을 사용합니다. 양끝 모드는 다음 키프레임도 읽으므로 구간 내 프레임의 미래 문맥이 늘어납니다. 예를 들어 입력이 30 FPS이고 간격이 15프레임이면, 구간 시작에서는 오른쪽 끝을 받을 때까지 최대 0.5초를 기다립니다. 대형 모델 호출 빈도, 계산 FPS, 입력 대기가 품질과 지연에 각각 영향을 줍니다. 원문 §3.1 · 원문 §4.3
챕터별 상세 리뷰
📖 Chapter 1: Introduction
저자들은 생성형 초해상도의 비용을 먼저 두 부분으로 나눕니다. 반복적인 노이즈 제거 단계는 한 번의 추론으로 증류할 수 있습니다. 희소 어텐션과 가벼운 디코더는 그 한 번의 연산을 줄입니다. 그래도 영상의 시공간 토큰 전부를 대형 모델이 처리하면 출력 해상도와 프레임 수에 따라 비용이 늘어납니다. RelayVSR은 참조가 필요한 프레임만 대형 모델이 처리하도록 연산을 배분합니다.
이 배분에서는 참조에 섞인 작은 오류도 공유됩니다. 논문은 키프레임의 품질을 최적화하는 목표와 전체 영상이 좋아지는 목표 사이의 차이를 협업 격차라고 부릅니다. 이를 줄이기 위해 최종 영상에서 계산한 보상을 다시 참조 생성기에 전달합니다. 원문 §1
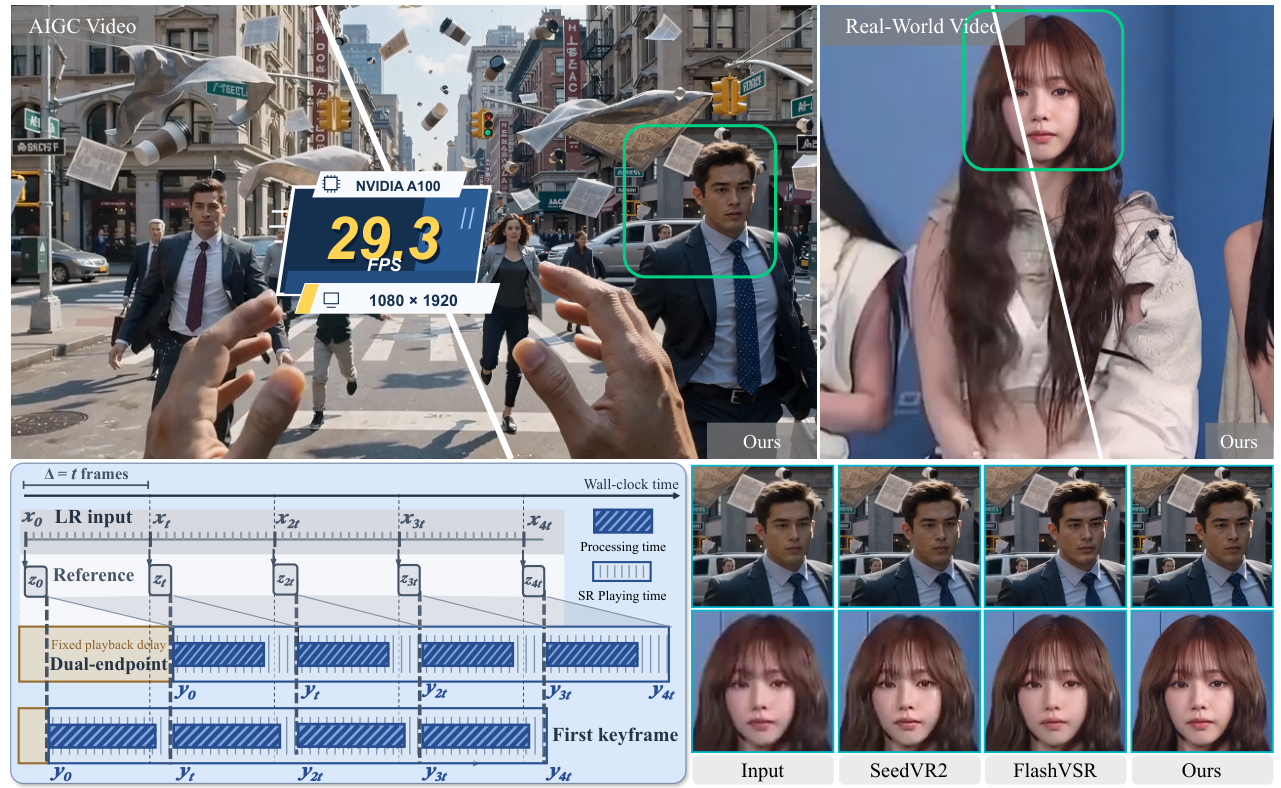
Figure 1. 왼쪽 아래 일정에서 양끝 참조의 재생 시작이 지연됩니다. 29.3 FPS 배지는 양끝 참조, 간격 15, A100 80GB의 모델 처리량입니다. 원문 PDF 2쪽의 그림 영역을 발췌했습니다.
📖 Chapter 2: Related Work
2.1 현실 영상 초해상도. 기존 방식은 인접 프레임을 정렬하고 특징을 모읍니다. 생성형 접근은 학습된 영상의 사전 지식을 사용해 세부 질감을 합성합니다. FlashVSR은 지역 희소 어텐션과 경량 디코더, SwiftVR은 이동 윈도와 경량 오토인코더, Stream-DiffVSR은 인과적인 시간 안내로 계산을 줄입니다. PS-SR은 노이즈 제거 단계별로 큰 모델과 작은 모델을 나눕니다. RelayVSR은 그 역할 분담을 영상에서 선택한 프레임과 나머지 프레임 처리에 적용합니다.
2.2 참조 기반 복원. RefVSR 계열은 별도 카메라에서 고품질 참조를 얻습니다. DAM-VSR과 SparkVSR은 저해상도 입력에서 생성한 참조로 영상 확산 모델을 안내합니다. RelayVSR은 같은 입력에서 참조를 만들고 이를 경량 모델이 재사용하는 경로를 구성합니다.
2.3 선호 최적화. DDPO, Diffusion-DPO, DiffusionNFT는 생성 모델이 기존 학습 목표에 더해 보상이나 선호를 반영하는 방법입니다. 저자들이 비교하는 이미지 SR 연구는 생성한 이미지 자체를 채점합니다. RelayVSR에서는 그 잠재 표현을 읽는 경량 모델의 최종 영상도 채점 대상에 추가됩니다. 원문 §2.1–2.3
📖 Chapter 3: Method
세 구성 요소의 역할은 Figure 2에 나타납니다. 위쪽은 큰 모델의 잠재 표현 적응과 단일 스텝 증류입니다. 왼쪽 아래는 경량 모델의 두 메모리이고, 오른쪽 아래는 영상과 참조에서 얻는 두 보상입니다. 원문 §3
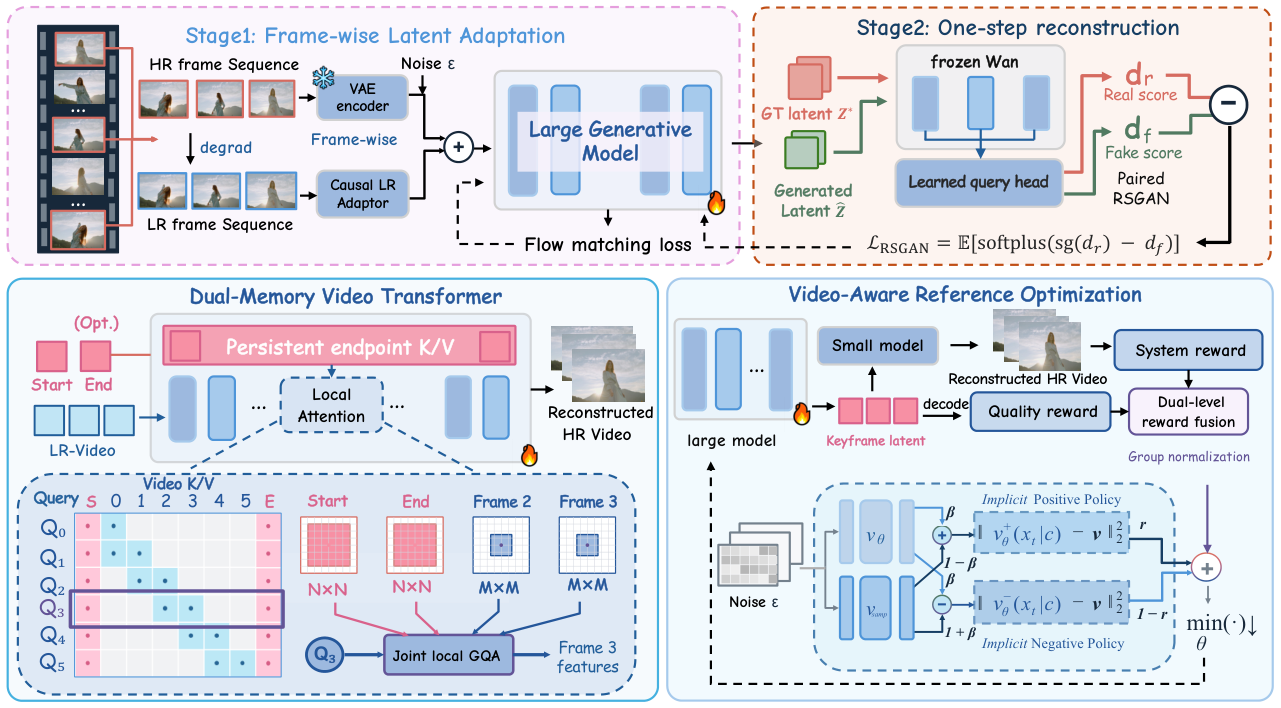
Figure 2. VARO 단계에서는 대형 생성 모델을 갱신하고 경량 복원 모델을 고정합니다. 원문 PDF 4쪽의 그림 영역을 발췌했습니다.
3.1 Sparse Generative Relay
첫 참조는 첫 프레임이고, 이후 Δ프레임마다 참조를 생성합니다. 학습 첫 단계에서 동결한 VAE 인코더로 HR 키프레임을 각각 인코딩해 정답 잠재 표현을 만듭니다. LR 프로젝션을 학습하고 Wan2.2에 LoRA를 붙여, 노이즈에서 그 잠재 표현으로 이동하는 흐름을 맞춥니다. 시간 어텐션은 현재와 제한된 수의 과거 키프레임을 봅니다. 두 번째 단계는 잠재 표현의 재구성 오차와 상대 판별 점수를 함께 써서 생성기를 한 번의 실행으로 증류합니다.
실행 시 생성기는 LR 키프레임, 샘플링 노이즈, 이전 생성기의 KV 캐시를 받아 새로운 참조와 캐시를 돌려줍니다. 경량 모델은 구간의 왼쪽 참조를 사용하며, 양끝 모드에서는 오른쪽 참조가 도착한 뒤 함께 읽습니다. 경량 모델이 현재 LR 프레임도 받으므로 구간 중간에서 움직임을 추적할 단서가 남아 있습니다. 원문 §3.1
3.2 Dual-Memory Video Transformer
LR 인코더와 참조 투영 층은 두 입력을 같은 특징 차원의 토큰으로 바꿉니다. 참조 토큰은 각 참조 내부에서 독립적으로 처리해 레이어별 키·값을 지속 참조 메모리에 저장합니다. 롤링 영상 메모리는 최근 처리 프레임의 키·값을 저장하고 매 프레임 갱신합니다. 이 두 메모리와 현재 프레임 특징을 한 어텐션에서 읽습니다.
식 (1)에서 현재 프레임의 쿼리 $Q_t$는 어떤 위치의 정보를 읽을지 결정합니다. $K_t^r,V_t^r$는 선택된 참조의 키와 값, $K_t^v,V_t^v$는 최근 영상과 현재 프레임의 키와 값입니다. 대괄호 안 세미콜론은 토큰을 이어 붙인다는 뜻입니다. 하나의 소프트맥스가 두 종류의 정보를 함께 가중합니다. 참조는 시간상 더 멀 수 있으므로 더 넓은 공간 이웃을 읽습니다.
출력 헤드는 PixelShuffle로 목표 해상도의 RGB 잔차를 만들고, 이를 바이큐빅으로 키운 LR 영상에 더합니다. 학습은 HR 키프레임의 잠재 표현을 조건으로 사용하며, 모든 출력 프레임의 L1 오차와 LPIPS를 줄입니다. 오른쪽 참조를 확률적으로 빼 같은 경량 모델이 두 모드를 지원하도록 합니다. 원문 §3.2 및 식 (1)
3.3 Video-Aware Reference Optimization
경량 모델은 정답 HR 참조로 학습하지만 추론에서는 대형 모델이 생성한 참조를 봅니다. VARO는 생성된 참조를 고정 경량 모델에 넣고 복원한 영상 $\hat Y$와, 같은 참조를 동결 VAE로 직접 디코딩한 키프레임을 각각 채점합니다. 영상 보상에는 키프레임 위치를 포함한 RGB 오차, DOVER++ 기술 품질, 일부 프레임의 MUSIQ, 연속 프레임의 광학 흐름 기반 워핑 오차가 들어갑니다. 참조 보상은 키프레임 정답과의 RGB 차이, 모든 참조의 MUSIQ, 연속된 참조 사이의 워핑 오차를 사용합니다. 워핑은 움직임을 고려해 한 프레임을 다른 시점에 맞춰 보는 계산입니다.
식 (2)의 $Y$는 HR 영상, $Y_{\mathcal K}$는 정답 HR 키프레임, $\hat Z$는 생성된 참조 시퀀스입니다. 물결표는 서로 단위가 다른 보상 점수의 크기를 정규화한 결과이며, 두 λ는 영상과 참조의 상대적 비중입니다. 영상 보상에는 참조를 사용한 모든 출력의 결과가 반영됩니다.
식 (3)은 DiffusionNFT의 목표입니다. 같은 영상에서 만든 후보들의 보상을 정규화해 $r\in[0,1]$로 바꿉니다. 후보 참조 잠재 표현을 $u=\hat Z$, 새 가우시안 노이즈를 $\epsilon$이라 하면 목표 속도는 $v=\epsilon-u$입니다. $v_\theta^\pm=v_{\mathrm{samp}}\pm\beta(v_\theta-v_{\mathrm{samp}})$는 고정된 샘플링 정책 예측을 기준으로 현재 생성기의 예측 방향 또는 그 반대 방향으로 이동한 값입니다. 보상이 큰 후보에서는 양의 항이 더 큰 비중을 갖고, 낮은 후보에서는 음의 항의 비중이 커집니다. 이 학습 뒤에도 실행은 키프레임당 한 번의 생성으로 유지됩니다. 원문 §3.3 및 식 (2)–(3)
📖 Chapter 4: Experiments
4.1 실험 설정
대형 모델은 Wan2.2-TI2V-5B, 경량 모델은 31.9M 파라미터입니다. 학습 자료는 약 50만 영상과 100만 이미지로, 대형 모델의 75K 흐름 매칭과 5K GAN 증류, 경량 모델의 60K 학습 뒤 VARO를 적용합니다. 합성 REDS30·UDM10·YouHQ40의 LR 입력은 학습과 같은 RealBasicVSR 열화 파이프라인에서 만듭니다. 실제 VideoLQ에는 픽셀 단위 HR 정답이 없으며, LongVSR60은 약 1,000프레임의 단일 쇼트로 장시간 복원을 살핍니다.
PSNR·SSIM은 정답과의 픽셀 충실도와 구조 유사도를, LPIPS는 특징 공간의 지각 거리를 비교합니다. NIQE, MUSIQ, CLIP-IQA, DOVER는 HR 정답이 없어도 평가할 수 있는 품질 지표입니다. FlashVSR은 논문 전체에서 Tiny v1.1 변형입니다. 원문 §4.1
4.2 기존 방법과의 품질 비교
| 평가셋·지표 | FlashVSR-Tiny | RelayVSR |
|---|---|---|
| REDS30 DOVER ↑ | 0.3477 | 0.4010 |
| UDM10 SSIM ↑ | 0.7008 | 0.7545 |
| YouHQ40 LPIPS ↓ | 0.2742 | 0.2569 |
| YouHQ40 DOVER ↑ | 0.6916 | 0.7313 |
| VideoLQ MUSIQ ↑ | 50.73 | 51.26 |
| VideoLQ DOVER ↑ | 0.5339 | 0.5488 |
| VideoLQ NIQE ↓ | 3.9488 | 4.4729 |
| VideoLQ CLIP-IQA ↑ | 0.3623 | 0.3458 |
Table 1에서 고른 항목입니다. 합성 세 세트에서 RelayVSR은 FlashVSR보다 PSNR·SSIM·LPIPS가 모두 개선되지만, 전체 비교군 중 PSNR 최고는 다른 모델들이 차지합니다. 실제 VideoLQ에서도 MUSIQ와 DOVER는 RelayVSR이, NIQE와 CLIP-IQA는 FlashVSR이 더 좋습니다. 수치는 키프레임만 골라 채점한 값이 아니라 복원 영상의 평가입니다.
Figure 3은 말의 얼굴과 마구, 사람의 얼굴과 번호판, 생성 영상의 자전거와 잎을 비교합니다. Figure 4는 참조 위치 00·15 사이에 있는 03·05·08·10·13의 건물 영역을 나란히 놓습니다. 여기서는 창틀과 지붕 경계가 중간 프레임에도 유지되는 모습을 확인할 수 있습니다. 원문 §4.2 및 Table 1
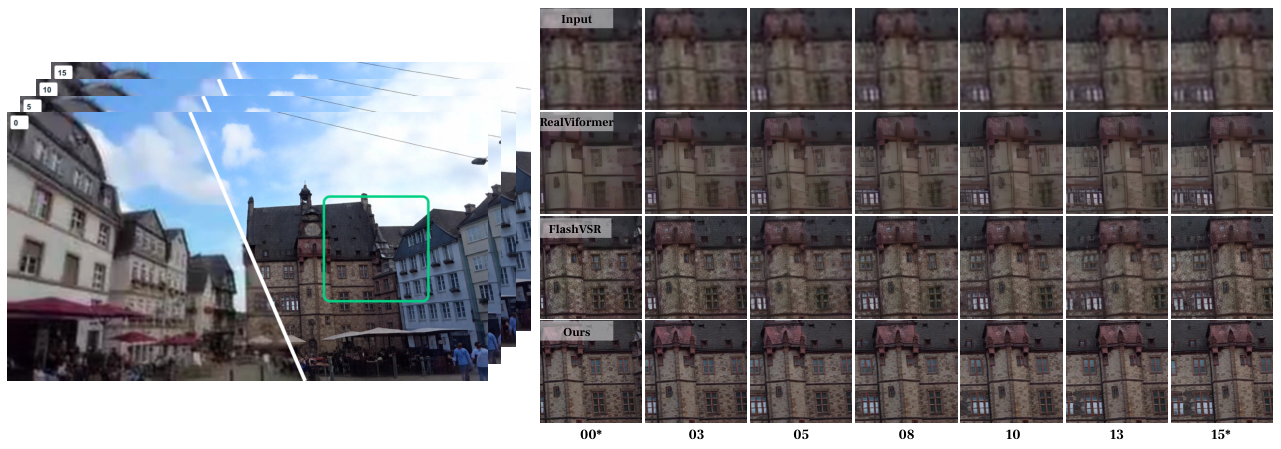
Figure 4. 별표는 대형 모델이 참조를 만든 프레임입니다. 원문 PDF 8쪽의 그림 영역을 발췌했습니다.
4.3 계산 효율과 품질의 절충
| 1080p 설정 | 모델 FPS ↑ | 최대 할당 메모리 GB ↓ | 첫 출력 모델 시간 초 ↓ |
|---|---|---|---|
| DOVE | 0.56 | 41.08 | 356.801 |
| SeedVR2-3B | 0.79 | 73.89 | 255.199 |
| Stream-DiffVSR | 0.85 | 25.92 | 0.705 |
| SwiftVR | 23.48 | 31.36 | 1.107 |
| FlashVSR-Tiny | 7.80 | 24.45 | 2.830 |
| RelayVSR 첫 키프레임, Δ=15 | 35.89 | 13.72 | 0.183 |
| RelayVSR 양끝 참조, Δ=15 | 29.29 | 13.82 | 0.327 |
Table 2는 A100 80GB에서 201프레임을 1080×1920으로 복원한 결과입니다. 양끝 모드는 FlashVSR-Tiny 대비 모델 처리량이 약 3.76배이고, 최고 할당 메모리는 약 43.5% 적습니다. 첫 키프레임 모드는 미래 입력 대기가 없고, 양끝 모드는 계산 시간 외에 오른쪽 참조가 들어올 때까지 기다립니다.
양끝 모드에서 Δ를 5에서 15로 늘리면 FPS는 18.10에서 29.29로 증가하고, UDM10의 LPIPS는 0.2115에서 0.2171로 올라가며 DOVER는 0.5530에서 0.5448로 내려갑니다. Δ를 25까지 늘리면 34.13 FPS, LPIPS 0.2370, DOVER 0.5140입니다. 저자들은 이 절충에서 Δ=15 양끝 참조를 주요 비교 설정으로 사용했습니다. 원문 §4.3, Table 2 및 Figure 5
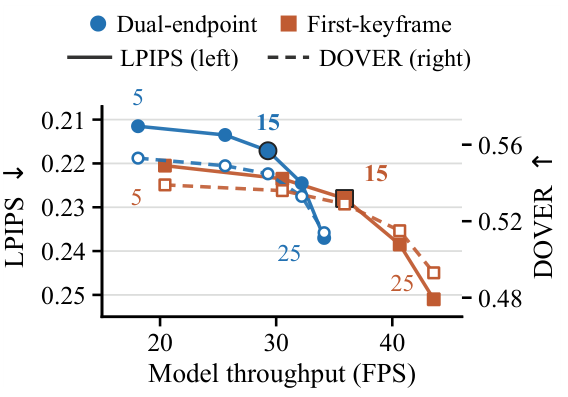
Figure 5. 실선은 LPIPS, 점선은 DOVER이고 축은 각각 왼쪽과 오른쪽입니다. 원문 PDF 8쪽의 그래프 영역을 발췌했습니다.
4.4 메모리와 보상의 기여
| 참조 메모리 | 영상 메모리 | MUSIQ ↑ | DOVER ↑ | MS ↑ |
|---|---|---|---|---|
| 없음 | 사용 | 56.80 | 0.4760 | 0.9911 |
| 사용 | 없음 | 63.65 | 0.5110 | 0.9769 |
| 사용 | 사용 | 63.72 | 0.5290 | 0.9830 |
VARO 이전의 UDM10 결과입니다. 참조를 추가하면 프레임의 지각 품질과 영상 품질 점수가 오릅니다. 참조만 있을 때보다 영상 메모리를 같이 쓰면 움직임 매끄러움(MS)이 0.9769에서 0.9830으로 오르지만, 영상 메모리만 쓴 설정의 0.9911보다는 낮습니다. 디테일과 매끄러움이 서로 다른 성질임을 보여 줍니다.
| VARO 보상 | 전체 프레임 MUSIQ ↑ | 키프레임 MUSIQ ↑ | DOVER ↑ | MS ↑ |
|---|---|---|---|---|
| 후학습 없음 | 63.72 | 64.05 | 0.5290 | 0.9830 |
| 참조 보상만 | 64.20 | 64.95 | 0.5355 | 0.9838 |
| 시스템 보상만 | 64.86 | 64.42 | 0.5400 | 0.9851 |
| 두 보상 결합 | 65.32 | 65.18 | 0.5448 | 0.9900 |
같은 단일 스텝 생성기에서 시작하고 경량 모델을 고정합니다. 참조 보상만 사용한 설정이 시스템 보상만 사용한 설정보다 키프레임 MUSIQ는 높습니다. 반면 시스템 보상만으로 전체 프레임 MUSIQ와 DOVER가 더 많이 오릅니다. 두 보상을 합쳤을 때 표의 네 지표가 모두 가장 높습니다. 원문 §4.4, Tables 3–4
📖 Chapter 5: Conclusion
큰 모델의 계산을 드문 참조에 할당하고, 작은 모델이 참조와 시간 정보를 유지하며 복원합니다. 본문의 결론은 그 비용 분담이 합성·실제 데이터에서 경쟁력 있는 지각 품질을 내면서 처리량을 높였다는 것입니다. 저자들은 장면의 변화에 따라 참조 배치를 바꾸는 방향을 제안합니다. 참고문헌 뒤의 부록은 손실식과 구현, 해상도별 효율 및 사용자 평가를 보완합니다. 원문 §5
📖 Chapter A: Additional Method Details
A.1 참조 생성. 식 (4)–(5)의 흐름 매칭은 정답 잠재 표현 $Z^\star$와 노이즈 $\epsilon$ 사이를 시간 $\tau$에 따라 보간합니다. $c$에는 투영한 LR 키프레임과 사용 가능한 시간 문맥이 들어갑니다. 모델은 노이즈 방향으로의 변화율을 예측합니다.
식 (6)의 증류는 판별기의 진짜 로짓과 생성 로짓의 차이에 시그모이드 $\sigma$를 취합니다.
식 (7)은 생성기가 잠재 표현을 복원하면서 상대 판별 점수를 개선하도록 합니다. 판별기는 고정 Wan 특징을 읽는 학습 가능한 풀링 헤드를 사용하고, 입력 특징에 대한 기울기에 R1 규제를 적용합니다.
$\lambda_{\mathrm{adv}}$와 $\gamma_{\mathrm{R1}}$는 각각 생성기의 상대 판별 손실과 판별기의 특징 공간 규제 비중입니다. 부록의 설정에서는 각각 0.1과 1,000입니다.
A.2 이중 메모리 어텐션. LR 인코더가 입력 격자를 가로세로 4분의 1로 줄이고, 4배 HR 키프레임을 VAE가 공간 스트라이드 16으로 인코딩하므로 두 토큰 격자가 일치합니다. 참조의 KV에 왼쪽·오른쪽 역할을 새기지 않아 이전 구간의 오른쪽 참조를 다음 구간의 왼쪽 참조로 재사용합니다. 하나의 grouped-query attention 소프트맥스를 사용하지만 참조와 영상의 KV 투영은 분리합니다. 참조에는 공간 RoPE, 영상에는 현재 시점 대비 상대 시간 위치를 적용합니다. 영상 창에 현재 프레임이 포함되므로 창 크기가 두 프레임일 때 이전 한 프레임의 KV를 읽습니다.
A.3 보상 성분. 식 (8)의 $q_{\ell,m}$는 높을수록 좋도록 보정한 성분이고 $w_{\ell,m}$는 음수가 아닌 가중치입니다. L과 W는 각각 RGB L1과 흐름 기반 워핑 오차에 음수를 붙인 값, D는 DOVER++ 기술 점수, M은 MUSIQ입니다.
시스템 보상은 참조 갱신 경계를 포함한 연속 출력 프레임을 보고, 참조 보상은 시간상 떨어진 인접 키프레임을 비교합니다. 원문 Appendix A
📖 Chapter B: Training Details
B.1 모델 구성. 동결된 Wan2.2-TI2V-5B에 rank 512 LoRA와 LR 프로젝션을 붙이며, 이 부분의 학습 가능 파라미터 수는 1.32B입니다. 생성기의 시간 창은 키프레임 4개입니다. 경량 모델은 폭 512의 10개 블록이며, 영상 공간 창은 24×24, 참조 창은 48×48 토큰입니다. 참조와 영상의 시간 거리 차이를 창 크기에 반영합니다.
B.2 기본 학습. 흐름 매칭, GAN 증류, 경량 VSR 학습은 모두 16개 GPU와 BF16 계산을 사용합니다. 첫 두 단계의 HR 크롭은 704×1280, 경량 모델은 1024×1536입니다. 경량 모델의 목표는 모든 프레임의 L1과 0.1배 LPIPS이며, 오른쪽 참조 제거 확률은 0.25입니다.
B.3 VARO 설정. 46프레임 구간의 1·16·31·46번째를 참조로 삼아 양끝이 있는 세 구간을 만듭니다. 입력 클립당 4개 후보, 업데이트당 2개 클립으로 총 8개 후보 영상에 점수를 매깁니다. 고정 통계로 보상 성분을 표준화한 뒤 클립 내 후보 평균을 빼고 배치 전체의 표준편차로 나눕니다. 이를 클리핑하고 0–1로 옮겨 식 (3)의 가중치를 구합니다. 2,000번 업데이트하며 시스템과 참조의 수준 가중치는 1.00과 0.25입니다. 원문 Appendix B 및 Tables 5–7
📖 Chapter C: Additional Results and Analysis
C.1 해상도와 참조 간격. 720p부터 2160p까지 201프레임에 대해, 워밍업 뒤 CUDA 이벤트로 두 모델의 계산 시간을 측정합니다. 입력·출력, 전처리, 그 바깥의 전송은 제외합니다. Δ=15의 2160p에서 양끝 모드는 8.23 FPS와 24.25 GB, 첫 키프레임 모드는 10.05 FPS와 23.86 GB입니다. FlashVSR은 1.302 FPS와 67.99 GB, SwiftVR은 5.773 FPS와 65.26 GB였습니다. 간격을 5에서 25로 늘리면 2160p 양끝 모드는 4.91에서 9.69 FPS, 첫 키프레임 모드는 5.55에서 12.39 FPS로 변합니다. 간격별 수치는 설정당 세 번의 시간 측정에 기반합니다.
C.2 추가 영상 비교. Figure 6은 번호판을 00과 15 사이에서 추적하고, Figures 7–8은 배경 글자, 얼굴, 산호, 털, 잎에 가린 차 등 여섯 장면의 대응 크롭을 보여 줍니다. 앞의 비교에서는 참조 사이의 지속성을, 뒤의 비교에서는 다양한 단일 프레임에서의 복원 형태를 볼 수 있습니다.
C.3 LongVSR60. 약 1,000프레임인 실제 영상 30개와 AI 생성 영상 30개입니다. NIQE·MUSIQ·CLIP-IQA는 영상당 균등 추출한 100프레임에 계산합니다. 시간 보조 지표 SC·BC는 DINO·CLIP 특징으로 피사체와 배경의 일관성을, MS는 보간 결과로 움직임의 매끄러움을 평가합니다. RelayVSR의 DOVER는 0.5911로 FlashVSR의 0.5895보다 높고, FlashVSR은 NIQE·MUSIQ·CLIP-IQA에서 앞섭니다.
C.4 사용자 평가. 참가자 12명이 VideoLQ와 LongVSR60에서 고른 36개 영상의 무작위 A/B 쌍을 평가했습니다. LR 입력과 두 출력을 같은 해상도·프레임률로 동기 재생하고, 전반적 품질, LR에서 확인 가능한 내용의 충실도, 시간 안정성을 각각 골랐습니다. GSB는 RelayVSR이 낫다는 응답 G와 비교군이 낫다는 응답 B의 차이를, 비슷하다는 응답 S까지 포함한 총응답으로 나눈 뒤 100을 곱한 값입니다. FlashVSR 상대 점수는 전체 품질 −3.3%, 충실도 +9.0%, 안정성 +17.0%입니다. DOVE 상대 점수는 전체 품질 +53.6%, 충실도 −8.9%, 안정성 −8.7%로 평가 축에 따라 방향이 달랐습니다. 원문 Appendix C 및 Tables 8–11
📖 Chapter D: Limitations and Future Work
고정 간격은 장면 변화에 적응하지 않고, 양끝 참조에는 미래 입력 대기가 있습니다. 생성 참조의 질감이나 색 오류가 여러 프레임으로 전달될 수 있으므로 저자들은 추론 중 참조 신뢰도에 따라 참조를 읽거나 갱신하는 방법을 제안합니다. 드물게 호출하더라도 큰 생성 모델은 메모리에 부담을 줍니다. 하드웨어 측정은 A100에서 했으며, 저자들은 압축과 더 작은 참조 생성기를 자원이 제한된 환경을 위한 방향으로 제시합니다. 원문 Appendix D
실험 결과 심층 분석
29.29 FPS를 읽을 때는 처리량과 재생 시작 지연을 구분해야 합니다. 30 FPS 입력에서 오른쪽 참조를 받을 때까지 최대 0.500초를 기다릴 수 있고, 0.327초는 모델 계산으로 첫 출력을 얻은 시간입니다. 둘을 함께 고려해야 실제 서비스의 지연을 평가할 수 있습니다. 논문의 모델 FPS는 입력 대기와 영상 입출력을 포함한 서비스 처리량을 측정한 값이 아닙니다. 2160p의 양끝 모드는 같은 GPU에서 8.23 FPS로 내려가므로, 1080p 결과를 더 높은 해상도에 그대로 적용할 수도 없습니다. 원문 §4.3 · 원문 Appendix C.1
참조 품질과 영상 품질은 다른 실험으로 확인합니다. Table 4에서 키프레임 MUSIQ가 좋은 단일 보상 설정과 전체 영상 DOVER가 좋은 단일 보상 설정이 다릅니다. 두 보상의 결합 효과는 동일 초기화의 UDM10 양끝 설정에서 관찰됐습니다. 사용자 평가에서는 FlashVSR 대비 전반적 품질이 −3.3%의 GSB를 기록하는 동안 시간 안정성은 +17.0%였으며, GSB는 정확도나 유의 확률이 아닙니다. 주요 품질 표와 사용자 평가에 신뢰구간이나 유의성 검정은 보고되지 않았습니다. 원문 Table 4 · 원문 Appendix C.4
기술적 함의와 응용
RelayVSR은 생성 모델의 출력이 다른 모델의 입력으로 쓰이는 경우, 참조가 만들어내는 최종 결과까지 학습 목표에 넣는 설계를 보여 줍니다. 영상에서 같은 참조를 여러 프레임이 공유하면 좋은 디테일과 오류가 모두 반복될 수 있습니다. 참조 갱신 간격, 최근 영상 메모리, 전체 영상 보상이 이 전달 경로의 서로 다른 부분을 조절합니다. 공개 저장소는 구현을 살펴볼 출발점을 제공하며, 이 글의 수치는 논문 보고값에 근거합니다. 논문 결론 · RelayVSR 저장소