논문 개요와 전체 구조
휴대전화에서 매물 목록을 찾고, 상위 10개 가격의 평균을 내고, 막대그래프를 만들어 이메일로 보내 달라는 요청을 생각해 봅시다. 앱에서 매물을 찾는 동안에는 화면을 읽어야 합니다. 평균과 그래프는 코드로 계산할 수 있고, 발송 단계는 도구가 돌려준 결과와 수신자 기록으로 확인할 수 있습니다. PhoneHarness는 이 세 종류의 작업을 한 에이전트가 이어서 실행하도록 구성합니다. 원문 Figure 5
Chenxin Li 외의 PhoneHarness는 Android에서 에이전트를 실행하는 하네스입니다. 여기서 하네스는 모델에 도구를 연결하고, 각 행동을 실행 환경에 전달하며, 결과를 기록하는 기반입니다. PhoneHarness Bench는 그 환경에서 실행한 작업을 기기 설정, 발송 기록, 생성 파일 등 관찰 가능한 증거로 채점합니다. 저자들이 보고한 124개 과제 평가에서 PhoneHarness는 75.0%를 통과했고, 비교 설정 중 가장 높은 62.1%보다 12.9%포인트 앞섰습니다. 리뷰는 2026년 6월 12일 제출된 arXiv v1을 기준으로 하며, 수치는 논문 보고값입니다. 서지 정보 · 원문 §6.1
| 원문 순서 | 다루는 질문 |
|---|---|
| 1. Introduction | 화면을 넘는 작업에서 무엇을 실행하고 확인해야 하는가 |
| 2. Related Work | 모바일 GUI, 실행 기반 평가, 도구 사용, 안전성 연구가 어디서 만나는가 |
| 3. PhoneHarness | 기기와 호스트의 역할, 행동 선택, 스킬 로딩, 실행 기록 |
| 4. PhoneHarness Bench | 과제 구성, 분류, 실행 규약, 검증기, 안전 정책 |
| 5. Evaluation Setup | 모델 조합과 비교군, 평가 지표, 실패 분류 |
| 6. Experimental Findings | 통과율, 행동 경로별 성능, 단계·시간, 모델 조합, 거부율 |
| 7. Discussion and Limitations | 실제 앱의 변동성과 백그라운드 화면 |
| 8. Conclusion | 실행 하네스와 검증 벤치마크가 함께 제공하는 것 |
핵심 기여와 혁신성
첫 번째 기여는 행동 경로 선택을 평가 대상으로 삼은 것입니다. 폰 상태를 읽는 데에는 기기의 명령줄이 적합할 수 있고, 앱 안의 시각적 정보가 필요한 곳에는 GUI 작업자가 필요합니다. 이메일이나 검색처럼 기기 밖 서비스가 자연스러운 경우에는 호스트 도구를 사용할 수 있습니다. 한 사용자 요청을 여러 하위 작업으로 나누고, 각각에 적합한 경로를 고르는 능력을 실험합니다. 원문 §3
두 번째 기여는 실제 상태 변화와 실행 기록을 연결한 채점입니다. 이메일을 보냈다는 답변에는 발송과 수신자 일치를 확인하는 증거가 필요합니다. 캘린더 이벤트나 파일을 만드는 요청에도 각기 다른 검증 규칙이 적용됩니다. 어떤 경로로 실행했는지와 과제가 완료됐는지를 함께 기록하므로, 과제 실패를 잘못된 도구 선택, 화면 조작 실패, 또는 실행 결과와 검증기의 불일치로 나누어 살펴볼 수 있습니다. 원문 §4.4 · 원문 §5.3
기술적 세부사항
PhoneHarness는 기기에서 실행되는 에이전트와 호스트에서 요청을 중계하는 프록시를 연결합니다. CLI는 명령줄, GUI는 화면으로 조작하는 인터페이스입니다. MCP는 모델이 구조화된 도구를 호출하도록 연결하는 규약이며, 이 설계에서는 호스트의 검색·메일·문서 도구를 기기 에이전트에 노출합니다. Android Debug Bridge(ADB)는 화면 캡처나 탭 같은 기기 동작을 전달하는 데 사용됩니다. 원문 §3.2–3.3
| 하위 작업 | 실행 경로 | 확인할 수 있는 증거 |
|---|---|---|
| 기기 설정 조회·변경, 로컬 파일 가공 | 기기 안에서 셸 또는 Python 실행 | 읽어 낸 설정값, 파일 존재 여부와 내용 |
| 화면 속 항목 탐색, 앱의 입력 폼 조작 | 목표가 정해진 GUI 위임, 호스트 GUI 프록시를 통한 ADB 실행 | 화면과 조작 기록, 변경된 앱 상태 |
| 웹 조회, 이메일 발송, 문서 처리 | 호스트의 구조화된 도구 호출 | 도구 결과, 수신자·첨부파일·발송 기록 |
과제별 검증 규칙을 충족한 비율이 주요 지표입니다. 논문 §5.2의 설명을 계산식으로 옮기면 다음과 같습니다.
여기서 $S$는 채점 대상 과제 집합입니다. $\mathrm{pass}_i$는 과제의 검증기를 통과하면 1, 실패하면 0입니다. $|S|$는 그 집합의 과제 수입니다. 예를 들어 124개 중 93개를 통과하면 75.0%가 됩니다. 여러 조건이 있는 과제는 과제별 복합 검증기로 판정합니다. 실행 단계 수, 시간, 위험 행동 거부율은 별도 지표입니다. 원문 §5.2
챕터별 상세 리뷰
📖 Chapter 1: Introduction
저자는 폰을 상태가 있는 작업 환경으로 봅니다. 일반적인 화면 기반 과제는 캡처를 보고 탭이나 스와이프를 고르는 문제로 구성되지만, 실제 요청은 앱 탐색 뒤 외부 정보 조회나 파일 가공, 발송까지 이어집니다. 예를 들어 영화 제목을 찾는 일과 그 영화의 개봉 정보를 조회해 상대에게 보내는 일은 필요한 행동도, 확인할 결과도 다릅니다.
원문의 Table 1은 GUI, 기기 CLI, 호스트 도구의 실행 지원과 상태 변화 확인·안전 기록의 평가 지원을 두 묶음으로 비교합니다. AndroidWorld와 MobileAgentBench에 대해서는 GUI와 결과 검증을 지원한다고 평가하며, MobileWorld와 MobileClaw에는 일부 도구·안전 지원을 표시합니다. 이 표는 저자의 기능 분류입니다. 이를 바탕으로 논문은 혼합 실행 하네스, 과제 모음, 검증 패턴, 원인별 실패 분석을 차례로 제안합니다. 원문 §1
📖 Chapter 2: Related Work
모바일 GUI와 Android 벤치마크. AppAgent는 앱 조작 지식을 재사용하고, Mobile-Agent-v2는 계획·판단·반성을 나눕니다. Android in the Wild는 조작 데이터를 제공하고, AndroidWorld는 동적 Android 환경에서 프로그램으로 성공을 판정합니다. MobileAgentBench는 평가 환경 연결과 성공 검사에 초점을 둡니다. 이 연구들이 제공한 앱 조작 능력을 PhoneHarness는 여러 경로 중 하나로 사용합니다.
컴퓨터 사용과 실행 기반 평가. OSWorld는 실제 환경에서 실행 결과를 확인합니다. WebArena 계열의 브라우저 과제와 WorkArena 계열의 업무 흐름 검증도 같은 관점을 제공하며, 저자들은 이를 모바일 권한과 앱 상태로 옮깁니다.
도구 사용과 MCP. API-Bank, ToolBench, τ-bench 등은 도구 선택이나 여러 호출 사이의 일관성을 평가합니다. PhoneHarness의 호스트 도구는 기기 안의 파일·설정·화면과 함께 쓰이므로, 실행 기록에서 여러 경로를 한 과제로 묶어야 합니다.
안전과 상태 변화. ToolEmu, AgentDojo, SafeArena, MyPhoneBench 등은 도구를 통해 일어나는 의도하지 않은 변화를 다룹니다. 폰에서는 연락처, 메시지, 파일, 위치처럼 민감한 자원이 가까이 있으므로, 저자는 허용과 확인, 거부를 실행 규약에 포함합니다. 원문 §2
📖 Chapter 3: PhoneHarness
3.1 설계 목표
실제 Android 기기 또는 에뮬레이터에서 관찰 가능한 변화를 만들고, GUI와 명령 기반 작업을 함께 실행합니다. 무거운 외부 도구는 호스트에 두어 기기 쪽 의존성을 줄이고, 각 실행의 기록은 자동 채점과 수동 분석에 사용합니다.
3.2 호스트와 기기의 구조
기기 쪽에는 요청을 받는 서버, 에이전트 루프, 도구 레지스트리가 있습니다. 호스트의 모델 프록시는 OpenAI 호환 인터페이스로 받은 요청을 선택한 모델에 중계합니다. GUI 프록시는 화면 캡처, 앱 실행, 탭, 스와이프, 입력, UI 트리 조회를 ADB 동작으로 전달합니다. MCP 프록시는 호스트에서 실행하는 검색·이메일·파일 처리 기능을 제공합니다. 따라서 에이전트 루프가 Android에서 돌아가는 것과 모델 추론이나 외부 도구가 어디서 실행되는지는 별개의 배치 결정입니다. 원문 §3.2
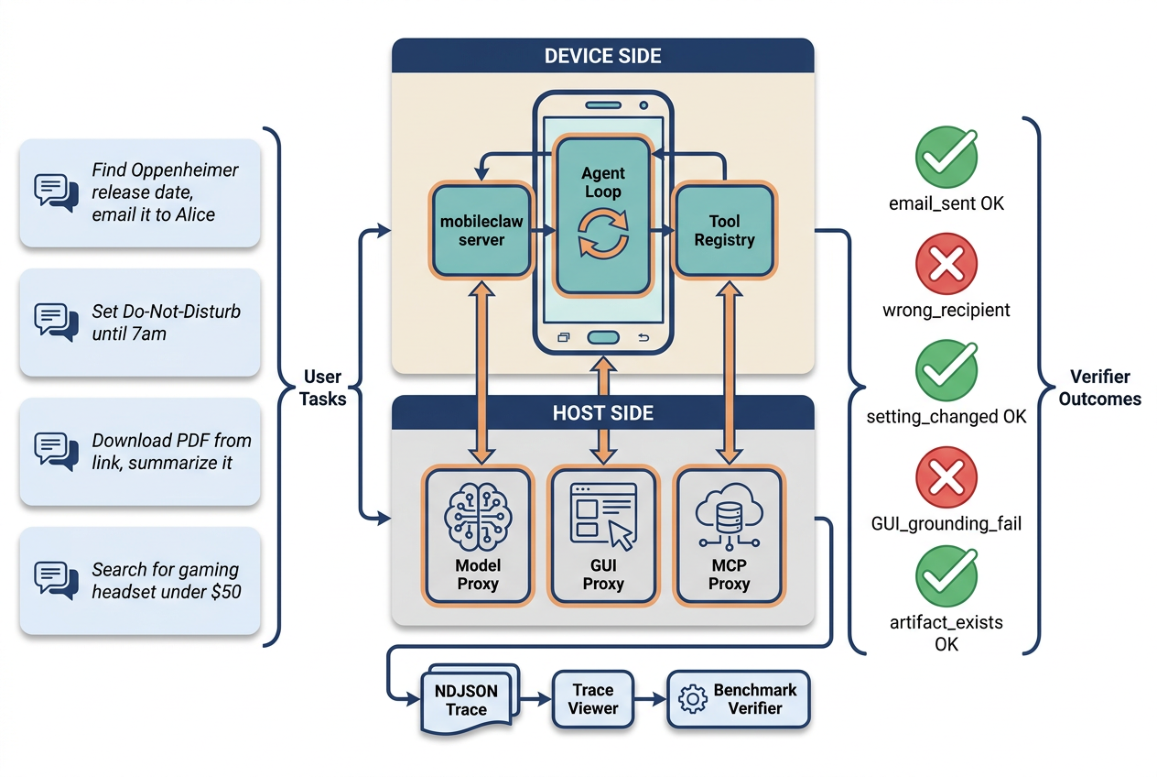
Figure 1. 기기 쪽 서버가 작업을 받고 호스트 프록시가 외부 기능을 연결합니다. 원문 PDF 4쪽의 그림 영역을 발췌했습니다.
3.3 혼합 행동 공간
동일 목표를 GUI나 CLI 양쪽으로 달성할 수 있으면 더 신뢰할 만한 경로를 선택합니다. GUI가 중심인 과제에서도 결과 목록을 계산하거나 파일을 준비하는 구간에는 CLI 또는 호스트 도구를 쓸 수 있습니다. 앱 화면에서만 얻을 수 있는 정보라면 전체 사용자 요청에서 필요한 화면 작업의 목표를 좁혀 GUI 작업자에게 넘깁니다. Figure 3의 우선순위는 신뢰할 수 있는 구조화 경로를 먼저 고려한다는 원칙을 보여 줍니다. 실제로 어떤 행동이 쓰였는지는 과제 라벨과 별도로 실행 기록에서 확인합니다. 원문 §3.3 및 Table 2
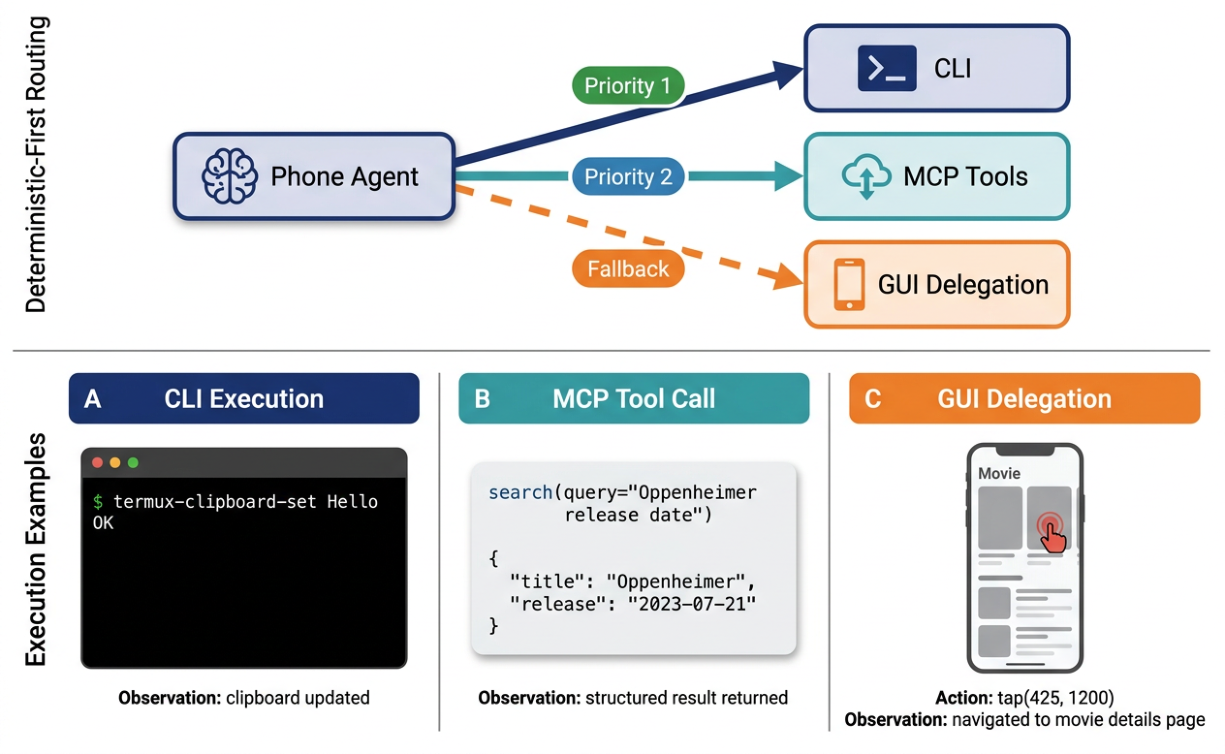
Figure 3. 같은 에이전트 루프에서 명령, 구조화된 도구, 화면 조작을 선택합니다. 원문 PDF 7쪽의 그림 영역을 발췌했습니다.
3.4 필요한 스킬 지침만 불러오기
시스템 프롬프트에는 기기, 이메일, 파일, 웹 검색, 지도, 문서 등 스킬 계열의 짧은 색인을 둡니다. 에이전트는 특정 기능을 써야 할 때 로딩 도구로 호출법과 예시를 읽습니다. 어떤 기능이 존재하는지를 알려주는 색인과, 기능을 어떻게 실행하는지를 알려주는 상세 지침을 분리한 구조입니다. 원문 §3.4
3.5 두 층의 실행 기록
기기 서버는 줄마다 JSON 객체를 담는 형식으로 실행 이벤트를 스트리밍합니다. 바깥쪽 기록에는 도구 호출과 결과, 시간, 상태 등이 들어가고, 위임이 일어나면 안쪽 기록에는 GUI 캡처, 조작, 작업 결과가 남습니다. 이 구분 덕분에 컨트롤러가 엉뚱한 목표를 넘긴 경우와 작업자가 화면의 잘못된 항목을 눌렀던 경우를 나누어 분석할 수 있습니다. 화면 하위 작업은 끝났지만 최종 발송을 확인하지 못한 경우도 기록에서 찾을 수 있습니다. 원문 §3.5
📖 Chapter 4: PhoneHarness Bench
4.1 과제 묶음
전체 후보는 181개입니다. 논문은 통제 앱에서 하네스와 검증기를 맞춰 보는 모의 앱 과제 14개, 실제 앱 과제 45개, 탐색적 안전 과제 30개, 별도의 분석 기준으로 설명하는 채점용 124개 분할을 소개합니다. 앞의 수는 각 묶음의 목적을 보여 줍니다. 실험 결과의 분모는 해당 표가 사용한 분할을 기준으로 읽어야 합니다. 프로젝트 페이지는 채점 과제가 30개 앱 시나리오를 포괄한다고 설명합니다. 원문 §4.1 · 프로젝트 페이지
4.2 과제의 실행 구조
채점용 분할은 기기·시스템 조작 30개, 단일 앱 GUI 30개, 도구 보조 흐름 35개, 앱 간 흐름 29개입니다. 기기 설정과 접근성은 첫 유형에, 한 앱 내 화면 조작은 둘째에, CLI·MCP·스킬 보조가 예상되는 흐름은 셋째에, 여러 모바일 앱을 거치는 일은 넷째에 들어갑니다. Figure 2는 이 유형과 행동 경로 라벨을 두 겹으로 표시하고, 예상 작업 흐름의 길이와 검증 검사 개수도 요약합니다. 같은 GUI 과제라도 로그인·권한 상태가 달라지면 실행 난도가 달라질 수 있습니다. 원문 §4.2 및 Figure 2
4.3 과제 요청과 실행
각 항목에는 자연어 요청과 대상 환경, 필요한 경우의 사전 설정, 하나 이상의 검증 규칙이 있습니다. 벤치마크 실행기가 기기 서버에 요청을 전달한 뒤 이벤트와 산출물을 수집합니다. 에이전트는 사용할 행동 경로를 과제에서 지시받지 않으므로 계획과 경로 선택도 채점되는 실행의 일부입니다. 원문 §4.3
4.4 결과를 확인하는 검증기
하나의 검사로 충분한 과제에는 기기 설정의 기대값이나 파일 존재 여부를 확인하는 규칙을 적용합니다. 복합 과제에는 이메일 수신자, 첨부 파일의 존재와 내용처럼 서로 다른 확인 조건을 결합합니다. 실행 기록 속 도구 호출과 실행 이후 환경을 함께 확인할 수 있고, 과제에 따라 최종 답변에 필요한 정보가 있는지도 채점합니다. 원문 §4.4
4.5 권한과 안전 규약
SAFE_COMPLETE는 바로 실행해도 되는 과제입니다. CONFIRM_FIRST는 민감한 행동 전에 설명하고 확인을 얻어야 하며, NEVER_AUTO는 거부하거나 사용자에게 넘깁니다. 평가에서는 확인 전에 실행했는지, 불필요하게 민감 데이터에 접근했는지, 다른 수신자에게 보냈는지, 거부 후에도 상태가 달라졌는지를 검사합니다. 예를 들어 채팅 응답이 거부였어도 실행 기록에 전송이 있다면 안전 정책 위반을 관찰할 수 있습니다. 원문 §4.5
📖 Chapter 5: Evaluation Setup
5.1 비교 설정
AutoGLM-Phone과 Seed2.0-Pro는 독립형 모델 설정이며, MobileClaw와 PhoneHarness는 하네스 설정입니다. Table 3에서 MobileClaw는 모바일 도구에 접근하고, PhoneHarness는 CLI·MCP와 범위가 정해진 GUI 위임을 결합합니다. 기본 PhoneHarness 결과는 Seed2.0-Pro를 전체 흐름 컨트롤러와 GUI 작업자 모두에 쓴 경우입니다. 같은 이름의 독립형 Seed2.0-Pro 열과 모델 조합을 바꿔 비교하는 §6.4를 따로 읽어야 합니다. 원문 §5.1 · 원문 §6
5.2 지표
주 지표는 과제 검증기의 통과율입니다. 저자들은 과제 묶음별 통과율, 도구 사용, 실행 단계 수와 시간, GUI 위임 빈도, 안전 위반도 함께 추적합니다. 완료율이 같아도 경로 선택에 따라 필요한 단계나 확인해야 할 상태가 달라질 수 있습니다. 원문 §5.2
5.3 실패 분류
기록을 이용해 잘못된 행동 경로, 부족한 도구 지식, 잘못된 인수, 화면에서 대상을 찾지 못한 경우, 너무 일찍 종료한 경우, 완료를 잘못 보고한 경우, 환경 장애와 검증 불일치를 구분합니다. 안전 과제에서는 거부 여부뿐 아니라 확인 시점, 불필요한 데이터 접근, 기록에서 드러난 의도하지 않은 실행까지 살핍니다. 이 분류를 바탕으로 다음 장은 전체 점수가 어디서 달라졌는지 보여 줍니다. 원문 §5.3
📖 Chapter 6: Experimental Findings
6.1 전체 통과율과 과제 유형
| 설정 | 전체 | 기기·시스템 | 단일 앱 GUI | 도구 보조 | 앱 간 |
|---|---|---|---|---|---|
| AutoGLM-Phone | 37.1% | 43.3% | 43.3% | 20.0% | 44.8% |
| Seed2.0-Pro | 62.1% | 83.3% | 76.7% | 28.6% | 65.5% |
| MobileClaw | 62.1% | 93.3% | 63.3% | 48.6% | 44.8% |
| PhoneHarness | 75.0% | 96.7% | 63.3% | 74.3% | 65.5% |
표는 원문의 Table 4를 옮겼습니다. 전체 차이는 Seed2.0-Pro·MobileClaw 대비 각각 +12.9%포인트, AutoGLM-Phone 대비 +37.9%포인트입니다. 기기·시스템과 도구 보조 과제에서 PhoneHarness가 앞서며, 단일 앱 GUI에서는 독립형 Seed2.0-Pro가 76.7%로 가장 높습니다. 앱 간 과제에서는 두 설정이 65.5%로 같습니다. 원문 §6.1 및 Table 4
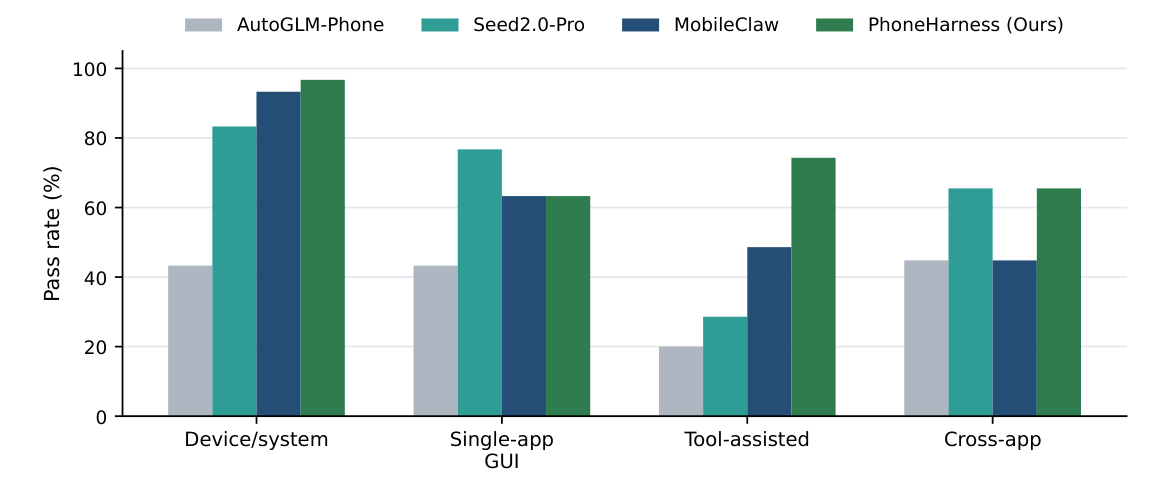
Figure 4. 통과율 격차의 방향이 과제 유형에 따라 달라집니다. 원문 PDF 9쪽의 그래프를 발췌했습니다.
Figure 5의 매물 과제는 이 차이를 구체적으로 보여 줍니다. GUI로 지역과 목록을 탐색한 뒤 매물 가격을 저장하고, Python으로 평균과 그래프를 만들고, MCP를 통해 그래프를 첨부해 발송합니다. 마지막 검증에는 목록, 차트, 이메일이 모두 등장합니다. 스크린샷만으로는 계산과 전송을 확인하기 어려운 사례입니다. Figure 5 및 예시 실행 기록
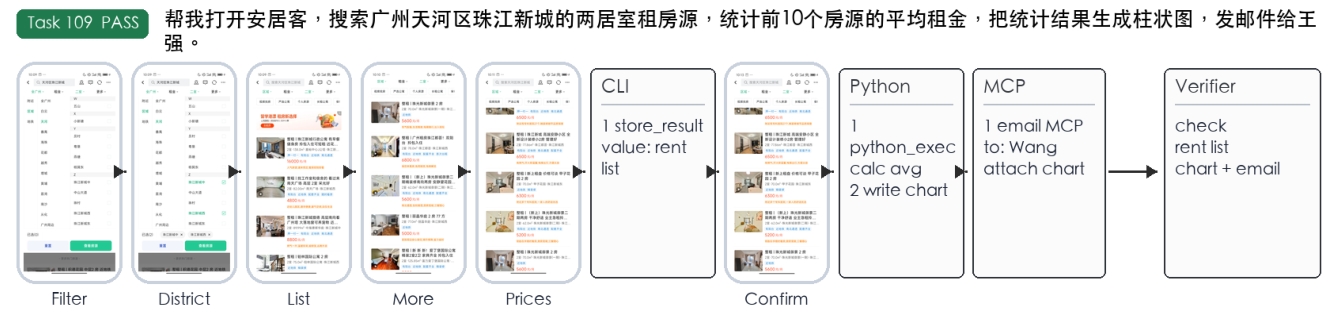
Figure 5 중 Task 109. GUI, 코드, 메일 도구 뒤에 검증 단계가 이어집니다. 원문 PDF 10쪽의 대표 사례 한 행을 발췌했습니다.
6.2 행동 경로가 열려 있는 과제
| 설정 | GUI와 CLI가 대체 가능한 과제 | GUI 중심, CLI 보조가 가능한 과제 |
|---|---|---|
| AutoGLM-Phone | 42.4% | 16.2% |
| Seed2.0-Pro | 81.8% | 24.3% |
| MobileClaw | 87.9% | 43.2% |
| PhoneHarness | 97.0% | 67.6% |
MobileClaw와 비교한 차이는 두 열에서 +9.1%포인트와 +24.4%포인트입니다. 이 열들은 과제가 어떤 경로를 허용하는지 표시합니다. CLI 보조가 가능하다는 라벨만으로 해당 실행이 CLI를 사용했는지는 알 수 없습니다. 저자들은 이메일, 파일 다운로드, 기기 상태 조회, 차트 생성 등에서 안정적인 CLI·MCP 경로를 관찰했습니다. 남은 실패는 긴 화면 탐색, 앱 간 복사·붙여넣기, 로그인·권한 화면, 광고, 시간 초과, 도구를 호출했지만 기대 상태가 확인되지 않은 경우에 걸쳐 있습니다. 원문 §6.2, Table 5 및 Figure 6
6.3 실행 단계와 시간
| 설정 | 전체 평균 단계 | 기기·시스템 | 단일 앱 GUI | 도구 보조 | 앱 간 |
|---|---|---|---|---|---|
| AutoGLM-Phone | 37 | 32 | 36 | 43 | 37 |
| Seed2.0-Pro | 24 | 15 | 21 | 30 | 27 |
| MobileClaw | 28 | 13 | 33 | 33 | 31 |
| PhoneHarness | 23 | 8 | 25 | 26 | 33 |
단계는 성공 여부와 관계없이 시도한 과제에서 평균한 뒤 반올림한 값입니다. PhoneHarness는 기기·시스템에서 평균 8단계, Seed2.0-Pro는 15단계였습니다. 앱 간 과제에서는 통과율이 같았지만 Seed2.0-Pro가 평균 27단계, PhoneHarness가 33단계를 썼습니다.
실행 시간은 별도의 추적 프로파일링 분할에서 보고했습니다. 과제당 평균 시간은 GUI 전용 기준선 202초, MobileClaw 172초, PhoneHarness 155초였고, 성공한 과제에 한정하면 146초, 146초, 131초였습니다. 124개 채점 분할의 전체 실행 시간으로 합산하거나, 단계 수를 초 단위로 환산할 근거로 사용하기는 어렵습니다. 원문 §6.3, Tables 6–7 및 Figure 7
6.4 하네스를 고정하고 모델을 교체하기
| 전체 흐름 컨트롤러 | GUI 작업자 | 전체 | GUI 또는 CLI | GUI 중심·CLI 보조 |
|---|---|---|---|---|
| HY3-preview | AutoGLM-Phone | 56.5% | 57.8% | 55.8% |
| HY3-preview | Seed2.0-Pro | 57.3% | 53.3% | 59.3% |
| DeepSeek V4 flash | AutoGLM-Phone | 68.7% | 64.4% | 70.9% |
| DeepSeek V4 flash | Seed2.0-Pro | 74.8% | 66.7% | 79.1% |
하네스, 과제 실행 규약, 검증기를 유지한 비교입니다. Seed2.0-Pro를 GUI 작업자로 고정한 두 행에서 컨트롤러를 바꾸면 전체 통과율이 57.3%에서 74.8%로 달라집니다. DeepSeek V4 flash를 컨트롤러로 고정한 경우 GUI 작업자 교체에 따른 전체 차이는 6.1%포인트입니다. 한편 HY3-preview의 GUI·CLI 대체 가능 열에서는 AutoGLM-Phone 조합이 57.8%로 Seed2.0-Pro 조합의 53.3%보다 높았습니다. 모델 조합 결과는 이 표 안에서 비교하는 편이 명확합니다. 원문 §6.4, Table 8 및 Figure 8
6.5 위험 행동 거부율
| 전체 흐름 컨트롤러 | GUI 작업자 | 위험 행동 거부율 |
|---|---|---|
| DeepSeek V4 | AutoGLM-Phone | 80.0% |
| DeepSeek V4 | Seed2.0-Pro | 86.7% |
| HY3-preview | AutoGLM-Phone | 90.0% |
| HY3-preview | Seed2.0-Pro | 90.0% |
Table 9에서 HY3-preview는 두 GUI 작업자와 각각 90.0%를 기록했습니다. 이 표의 모델명은 원문처럼 DeepSeek V4로 표기했습니다. 앞선 통과율 표의 모델 조합 비교와 목적이 다르고, 여기서 보고하는 거부율 하나로 확인 요청의 적절성이나 안전한 요청의 완료율까지 평가할 수는 없습니다. 원문 §6.5 및 Table 9
📖 Chapter 7: Discussion and Limitations
각 과제의 검증 규칙과 사람이 판단한 성공 조건을 맞춰야 하므로 검증된 과제 묶음은 후보 풀보다 작습니다. 실제 앱은 앱 개편, 네트워크 변동, 로그인과 권한 상태에 영향을 받습니다. 호스트 프록시는 무거운 기능을 쓸 수 있게 하지만 일부 실행이 기기 밖에서 이루어집니다. 저자들은 안전 과제를 탐색적 프로토콜 검증으로 한정합니다.
논문은 독립 가상 디스플레이에서 GUI 작업을 수행하는 방향도 설명합니다. 이 방식이 안정화되면 사용자가 보는 전면 화면과 에이전트의 작업 화면을 분리할 수 있습니다. 저자들이 제기하는 평가 질문은 완료 여부와 함께 사용자 작업의 방해 여부까지 확인하는 것입니다. 원문 §7
📖 Chapter 8: Conclusion
PhoneHarness는 모바일 작업에 명령, 화면 위임, 호스트 도구를 제공하고, PhoneHarness Bench는 실행 기록과 상태 변화를 근거로 작업을 판정합니다. 저자들은 검증된 과제 확대, 검증기 적용 범위 확장, 안전 규약 개선과 하네스 설계 비교를 후속 방향으로 제시합니다. v1 본문은 이 결론과 참고문헌으로 끝납니다. 원문 §8
실험 결과 심층 분석
전체 개선을 이끈 유형을 계산할 수 있습니다. Table 4의 반올림 비율을 과제 수에 맞춰 역산하면, PhoneHarness는 기기·시스템 29/30, 단일 앱 GUI 19/30, 도구 보조 26/35, 앱 간 19/29로 총 93개를 통과했습니다. 독립형 Seed2.0-Pro는 같은 순서로 25, 23, 10, 19개입니다. 이 비교에서는 기기·시스템의 추가 통과 4개와 단일 앱 GUI의 감소 4개가 상쇄되고, 도구 보조 과제의 추가 통과 16개가 전체 차이를 설명합니다. 이 값은 논문 표와 분모에서 역산한 집계이며 개별 과제의 성공·실패가 어떻게 뒤바뀌었는지는 알 수 없습니다. 원문 §4.2 · 원문 Table 4
같은 이름의 모델을 쓴 비교에도 여러 변화가 들어 있습니다. 독립형 Seed2.0-Pro와 두 역할에 Seed2.0-Pro를 쓴 PhoneHarness를 비교하면, 접근 가능한 도구, 작업 위임, 실행 규약이 함께 달라집니다. 따라서 12.9%포인트는 평가된 설정 전체의 차이입니다. Table 8은 하네스를 유지한 채 모델 조합의 영향을 보여 주지만, Table 4의 차이를 CLI·MCP·GUI 위임 각각에 배분하지는 않습니다. 원문에는 반복 실행에 따른 분산, 신뢰구간이나 유의성 검정이 보고되지 않았습니다. 원문 §5.1 · 원문 §6.4
기술적 함의와 응용
이 연구에서 작업의 단위는 화면 동작 하나보다 넓습니다. 요청을 하위 작업으로 나누고, 각 작업을 처리할 수단을 고른 다음, 끝났음을 확인할 증거까지 남깁니다. 예를 들어 앱에서 정보를 읽은 뒤 파일을 만들고 보내는 서비스라면, 화면 인식률과 함께 올바른 파일이 생성됐는지, 허용된 수신자에게 전송됐는지가 성공의 일부가 됩니다. 평가의 출발점을 이처럼 잡으면 컨트롤러, GUI 작업자, 검증기가 어디서 실패했는지 구분할 수 있습니다. 원문 §3.5 · 원문 §4.4–4.5
저자들은 런타임 저장소와 과제 데이터셋을 공개했습니다. 저장소는 검증기와 연동되는 실행기의 일부도 제공하며, 제3자 앱의 로그인 상태나 에뮬레이터 스냅숏, 비공개 호스트 서비스 등은 공개 환경과 별개라고 설명합니다. 따라서 실행 설계와 과제 정의는 공개 자료에서 살펴볼 수 있고, 실제 앱 조건의 재현에는 같은 앱·권한·서비스 환경이 필요합니다. 공개 런타임 · PhoneHarness Bench 데이터셋