논문 개요와 전체 구조
장기 대화형 AI의 기억을 만들 때는 대화를 요약하고, 사실을 추출하고, 서로 연결하고, 오래된 값을 갱신하는 과정이 자주 등장합니다. 이 논문은 그 과정에 앞서 “원래 대화를 잘 검색해서 읽히는 방법을 충분히 강한 기준선으로 평가했는가?”를 묻습니다. 원문 기록을 보존한 Raw-RAG는 평가한 일곱 가지 벤치마크·모델 조합 중 여섯 가지에서 비교 대상 메모리 시스템보다 높은 점수를 냈습니다. 다만 이 순위에서 Full-context는 제외되며, 모든 차이에 대한 통계적 유의성이 입증된 것은 아닙니다. 초록·§4.2
여기서 기억은 사람의 기억을 모사한 신경망 구조가 아니라, 과거 대화를 저장하고 질문에 필요한 부분을 다시 제공하는 외부 시스템을 뜻합니다. RAG는 검색 증강 생성의 약자로, 질문에 관련된 문서를 찾아 언어 모델의 입력에 넣는 방식입니다. 이 논문의 Raw-RAG는 검색된 원문을 읽고 현재 상태를 추론하는 일을 답변 모델에 맡깁니다. 연구 범위는 주로 이미 수집된 대화에 대한 오프라인 질문 응답입니다. 실시간 행동, 실제 데이터 삭제, 저장 공간 제한까지 해결했다는 뜻은 아닙니다. §1, §6
| 서지 항목 | 내용 |
|---|---|
| 제목 | Is Complex Agentic Memory Always Needed? Naive RAG Is Stronger Than We Thought |
| 저자 | Zhengye Bao, Shengtao Zhang, Haokai Zhang, Shiqi Lou, Muning Wen, Minnan Luo |
| 검토 버전 | arXiv:2610.30755v1, PDF 62쪽 |
| 원문 제출일 | 2026년 10월 22일 UTC — 이 글의 작성일과 구분합니다 |
| 원문 | 고정 HTML, 고정 PDF |
원문은 1 Introduction → 2 Related Work → 3 The RAW-RAG → 4 RAG Is Stronger Than We Thought → 5 Why Is Raw-RAG Enough in Most Cases? → 6 Limitations and Conclusion 순서로 전개됩니다. 이후 Acknowledgments와 References가 나오고, 부록 A는 전체 결과, B는 방법, C는 진단·통계, D는 구현·재현, E는 기존 RAG 평가 검토, F는 추가 한계, G는 프롬프트를 제시합니다. 아래 상세 리뷰도 이 순서를 따릅니다. 원문 전체 구조
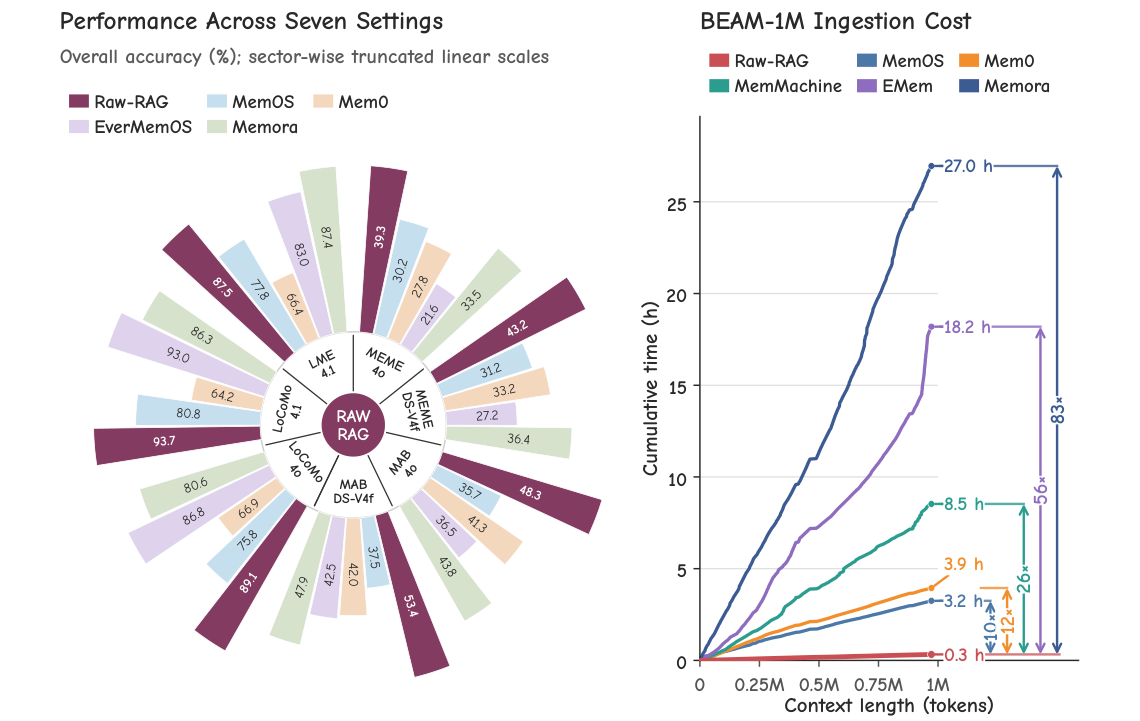
Figure 1, PDF 1쪽. 원본 도표 영역 크롭이며 번역·수치 변경은 없습니다. 왼쪽은 설정마다 원점이 잘린 선형 축을 사용하므로 막대 길이의 비율을 그대로 비교하면 안 됩니다. 실제 점수는 아래 표로 확인합니다. 원본
핵심 기여와 혁신성
이 연구의 핵심은 새로운 기억 모듈보다 비교 기준과 진단을 다시 세운 데 있습니다.
- 원문 보존 + 충분한 검색 후보 + 재순위화로 구성한 단순한 기준선을 제시합니다. 요약이나 그래프를 추가하기 전에 이 기준선을 이겨야 한다는 문제 제기입니다. §3
- 정답률을 근거가 도착했는지와 도착한 근거를 활용했는지로 나눕니다. Raw-RAG의 강점은 항상 가장 뛰어난 조건부 답변 능력이 아니라, 필요한 근거를 더 자주 제공한다는 점에 있습니다. §5.1
- 정답 값뿐 아니라 시간 순서·의존 관계·상태 변화의 경로가 남아 있는지를 측정합니다. “값을 찾았다”와 “그 값이 지금 유효한 이유를 설명할 근거를 찾았다”를 구별합니다. §5.2
- 저장된 전체 기억에서 정답 정보를 이용해 근거를 골라 주는 진단을 통해, 일반 검색에서 놓친 정보와 저장 표현 자체가 복구하기 어려운 정보를 살펴봅니다. 이 진단은 실서비스 검색기가 아니며, 순수한 정보 손실의 인과효과도 아닙니다. §5.3·부록 C.5
따라서 논문의 결론은 모든 에이전트 메모리를 폐기하자는 주장이 아닙니다. 평가한 장기 대화 과제에서는 복잡성을 추가하기 전에 원문 기반 RAG가 제공하는 근거 접근성을 엄격히 비교해야 한다는 주장입니다. §6.2
기술적 세부사항
처음 읽을 때는 세 역할을 구분하면 이해가 쉽습니다. 임베딩 검색기는 질문과 비슷한 기록을 넓게 모으고, 재순위화기는 질문·기록을 함께 읽어 순서를 정밀하게 정합니다. 답변 모델인 reader는 최종 근거를 읽어 답을 만듭니다. 메모리 시스템이 같은 답변 모델을 사용하더라도, 앞의 두 단계가 제공하는 자료가 다르면 결과가 달라질 수 있습니다. 부록 B.1
| 용어 | 이 논문에서의 뜻 |
|---|---|
| 원문 보존 | 시각·화자·발화와 제공된 이미지 캡션 텍스트를 남깁니다. 이미지 자체를 새로 이해하는 멀티모달 실험은 아닙니다. |
| 청크 | 긴 기록을 검색하기 위해 나눈 텍스트 창입니다. 기본 길이는 256토큰, 중첩은 32토큰입니다. |
| Coverage | 해당 질문을 풀기에 충분한 근거가 검색된 질문의 비율입니다. |
| Utilization | 충분한 근거가 있다고 판정된 질문들 안에서의 정답률입니다. 시스템마다 조건부 질문 집합이 다릅니다. |
| Native retrieval | 각 시스템의 원래 검색·답변 경로입니다. |
| Complete-store 진단 | 내보낸 저장 기억 전체에서 정답 정보를 활용해 근거를 선택하는 별도 실험입니다. |
Raw-RAG의 검색을 수식으로 쓰면 다음과 같습니다. 원문의 식 (2), (3)에 대응하며, 함수 이름의 표기만 동일 의미의 직립체로 옮겼습니다. 부록 B.1, 식 (2)–(3)
$H$는 사용 가능한 대화 이력, $c$는 원문 청크, $q$는 질문입니다. $e$는 텍스트를 벡터로 바꾸는 임베딩 인코더이며 코사인 유사도로 128개 후보 $D_q$를 찾습니다. $r(q,c)$는 재순위화 점수로, 그중 15개 $S_q$를 선택합니다. 두 식에는 학습 손실이나 확률 정규화 분모가 없습니다. 각 단계에서 높은 점수의 항목을 고르는 연산입니다. 부록 B.1
선택 뒤에는 일부 평가에서 청크와 겹치는 원래 발화 전체로 문맥을 확장합니다. 그러므로 15개 청크를 선택했다는 사실이 답변 입력이 15×256토큰이라는 뜻은 아닙니다. 기본 방법, 5,000토큰 통제, 정답 기반 진단은 별개 조건으로 읽어야 합니다. 부록 B.1–B.3
챕터별 상세 리뷰
📖 Chapter 1: Introduction
첫 장은 장기 대화의 이력이 모델의 문맥 창을 넘을 때, 어떤 기억 관리가 실제로 필요한지 질문합니다. 기존 시스템은 추출·요약·갱신·통합·그래프 구성 등으로 기억을 정리합니다. 저자들은 동적인 대화라면 반드시 저장 단계에서 상태를 갱신해야 하는지, 혹은 원문과 현재 질문을 받은 reader가 변화 이력을 해석할 수 있는지부터 점검합니다. §1
첫 번째 예비 실험은 Mem0의 쓰기 명령과 실제 저장 변화를 구별합니다. 이 감사에는 Mem0 classic 1.0.11을 사용합니다. LoCoMo 10개 대화에서 나온 33,902개 쓰기 판단 중 UPDATE·DELETE 제안은 4.39%였지만 실제 저장 텍스트가 바뀌거나 삭제된 비율은 1.90%였습니다. LongMemEval 500개 사례에서는 428,858개 판단 중 각각 2.46%, 1.34%였습니다. 제안에는 중복되거나 형식이 맞지 않는 동작도 있으므로 두 비율을 혼용하면 안 됩니다. Figure 2·부록 C.2
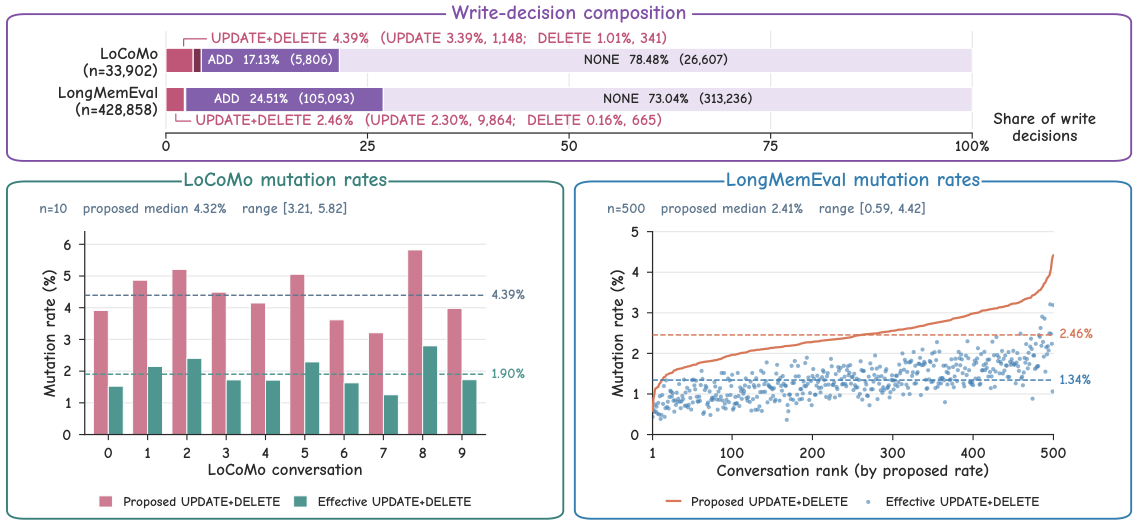
Figure 2, PDF 2쪽. 원본 영역 크롭, 번역 없음. 위는 모든 판단의 분포, 아래는 대화·사례별 비율입니다. 점선은 전체 판단 수로 가중한 평균입니다. 원본
UPDATE를 ADD로, DELETE를 NONE으로 바꾼 ADD/NONE 정책에서는 LoCoMo 전체 점수가 67.36에서 69.42로 2.06퍼센트포인트 올랐습니다. 다중 홉은 63.24→64.66, 시간 질문은 49.74→53.06, 개방형은 53.47→60.42, 단일 홉은 77.05→78.28이었습니다. 이는 이 버전·과제에서 갱신 연산이 반드시 이익을 주지는 않았다는 관찰입니다. 실제 서비스의 삭제 의무를 무시해도 된다는 실험이 아닙니다. 이 예비 실험 점수를 이후 비교표의 다른 Mem0 구성과 합쳐서도 안 됩니다. Table 1·부록 C.2
두 번째 예비 실험은 필요한 원래 세션을 이미 알고 있다고 가정한 MEME phase-visible source oracle입니다. 질문 시점까지 보이는 정답 근거 세션을 시간순으로 제공하고 토큰 상한을 두지 않습니다. Raw-RAG의 실제 검색 결과가 아닙니다. GPT-4o-mini, DeepSeek-V4-Flash, Qwen3.5-35B-A3B의 전체 점수는 각각 50.50, 85.48, 70.25였습니다. 특히 cascade는 1.83, 82.32, 39.63으로 큰 차이를 보였습니다. 검색 문제를 제거해도 reader가 상태·의존성을 해석하는 능력은 다릅니다. Table 2·부록 C.2
이 표의 Abs에는 값을 알려 주지 않는 의존성 유효성 지시문이 추가됩니다. 따라서 전체 점수도 그 과제별 조건을 합친 값입니다. 첫 장은 이 두 실험을 통해 저장 시점의 복잡성만을 정확도의 원인으로 가정하기 어렵다는 동기를 마련하고, 다음 장에서 비교 대상의 범위를 정리합니다. 부록 G.11
📖 Chapter 2: Related Work
2.1 Agentic memory systems는 기억을 저장하고 찾아오는 여러 설계를 검토합니다. 추출한 사실을 갱신하는 방식, 사건·에피소드·프로필로 정리하는 방식, 구조나 그래프를 이용하는 방식, 질문 시 검색을 반복하는 방식이 서로 다릅니다. 원문을 유지하면서 파생 표현을 함께 저장하는 시스템도 있으므로, 에이전트 메모리를 모두 “원문을 버리는 요약기”로 부르는 것은 부정확합니다. §2.1
Raw-RAG가 분리하려는 것은 근거에 접근하는 문제와 질의 시점의 탐색 제어 문제입니다. 원문을 보존하면서 세션·시간 문맥이나 반복 검색을 더하는 동시기 연구도 논의하지만, 이 논문 자체는 고정된 검색·재순위화 기준선을 평가합니다. 따라서 추가적인 에이전트 탐색 정책의 모든 장점을 실험적으로 배제한 연구는 아닙니다. §2.1
2.2 Retrieval-augmented generation은 임베딩 기반 후보 검색과 cross-encoder 재순위화를 연결합니다. 전자는 넓은 후보 집합을 저렴하게 만들고, 후자는 질문·후보를 함께 읽어 더 정밀하게 정렬합니다. 장문 기억 평가에서는 무엇을 저장했는지뿐 아니라 청크 크기, 검색 깊이, 시간 단서, reader에 실제로 들어간 근거의 양이 비교를 바꾼다는 관점입니다. §2.2
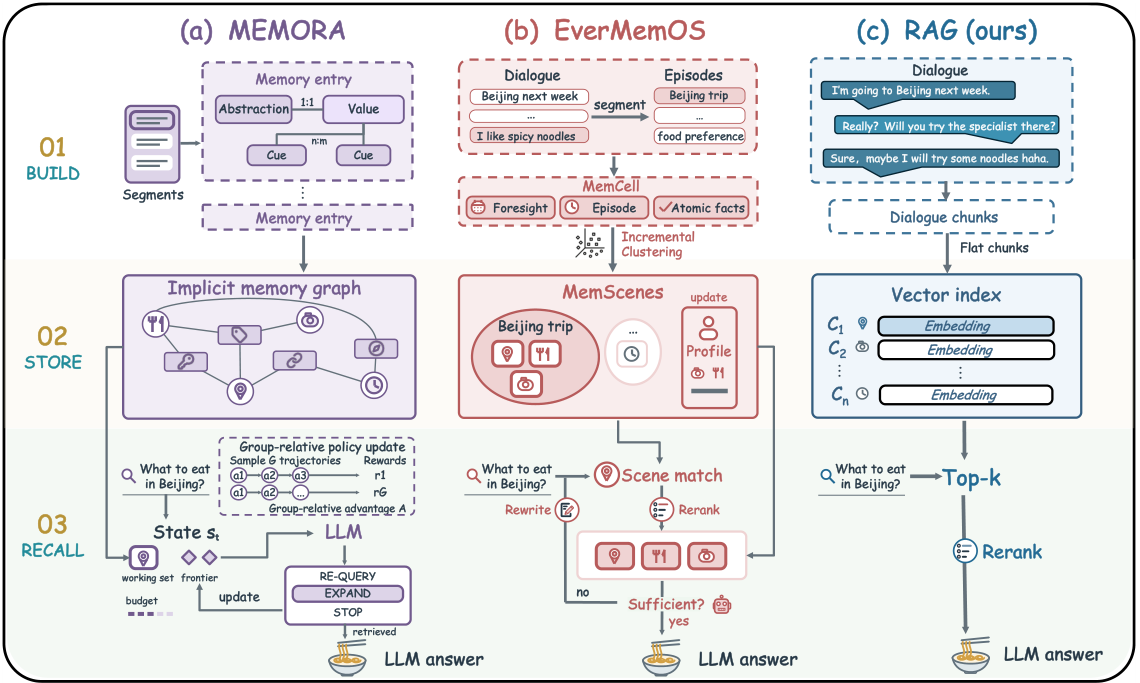
Figure 3, PDF 4쪽. 세 시스템의 흐름을 원래 배치 그대로 크롭했습니다. 번역·도식 재구성은 없습니다. 왼쪽부터 Memora, EverMemOS, Raw-RAG입니다. 원본
이 장의 역할은 복잡한 시스템의 내부를 상세 재현하는 것이 아니라, 동일한 장기 기억 문제에도 서로 다른 구축·저장·회수 선택이 존재함을 보여 주는 것입니다. 다음 장은 그중 가장 단순한 원문 기반 경로를 명시합니다.
📖 Chapter 3: The RAW-RAG
Raw-RAG는 대화의 시각·화자·내용과 주어진 이미지 캡션을 직렬화하고, 길이 256토큰·중첩 32토큰으로 나눠 대화별 평면 벡터 인덱스에 저장합니다. “Raw”의 뜻은 이 출처 텍스트를 보존한다는 것입니다. 이미지를 새로 인식하거나 감각 정보를 원형 그대로 저장했다는 뜻은 아닙니다. §3·부록 B.1
질문은 임베딩 검색에서 그대로 사용합니다. 128개 후보를 찾고 재순위화하여 15개를 reader에 전달합니다. 검색 과정에 기억용 사실 추출·요약·그래프 생성·내용 갱신 LLM 호출은 없습니다. 다만 임베딩과 재순위화, 최종 답변 생성은 여전히 필요합니다. “기억 관리용 LLM 호출이 없다”와 “추론 비용이 없다”는 서로 다른 주장입니다. §3·부록 D.3.1
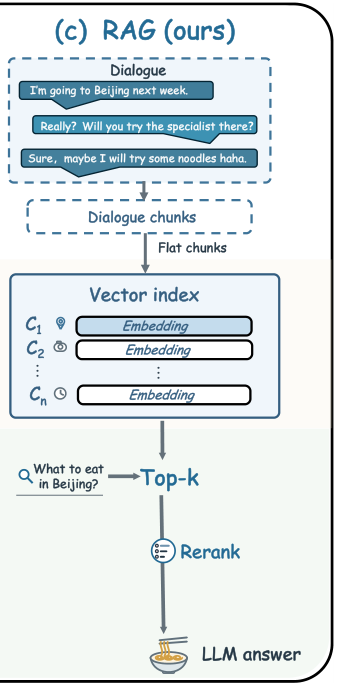
Figure 3 오른쪽 패널 상세, PDF 4쪽. 전체 그림을 위에 보존하고 Raw-RAG 패널을 별도로 크롭했습니다. 원문 문구·화살표를 변경하지 않았습니다. 원본
이 설계는 기억을 미리 현재 상태로 압축하기보다, 질문 시점에 원래 발화와 변화 이력을 reader가 해석하게 만듭니다. 시간순 표시, 발화 전체 확장, 과제별 입력 정책은 결과를 재현할 때 필요한 요소이며 부록 B에서 보완됩니다. 이어지는 4장은 이 경로의 경쟁력과 각 요소의 영향을 평가합니다.
📖 Chapter 4: RAG Is Stronger Than We Thought
4.1 Benchmarks and baselines — 무엇을 비교했는가. 주 평가에는 네 벤치마크를 사용합니다. LoCoMo는 10개 대화의 비적대적 질문 1,540개, LongMemEval-S는 500개 질문입니다. MEME는 100개 에피소드의 단계별 질문 1,188개로 회상·집계·추적·삭제·연쇄 갱신·무효화 후 응답을 다룹니다. MemoryAgentBench는 14개 출처의 2,071개 질문으로 정확한 검색, 테스트 시 학습, 장거리 이해, 충돌 해결을 평가합니다. §4.1·부록 D.1
LoCoMo의 reader 두 가지, LongMemEval의 한 가지, MEME와 MemoryAgentBench의 각 두 가지를 합쳐 일곱 설정입니다. 벤치마크가 일곱 개라는 뜻은 아닙니다. 비교에는 Mem0·MemOS·Memora·EverMemOS·MemMachine 등 여러 메모리 시스템과 Full-context가 포함됩니다. 표에는 기존 발표 결과와 연구진의 재평가가 함께 있으므로, 모든 baseline을 하나의 동일한 실행 환경에서 새로 돌린 통제 실험으로 이해해서는 안 됩니다. 검색 모델 계열을 맞춘 세부 비교는 부록 A가 구분합니다. §4.1·부록 A.1–A.2
4.2 Main results — 여섯 설정에서의 우위와 예외. 아래는 실제 Table 3·4에서 핵심 점수를 전사한 것입니다. 점수는 각 벤치마크의 공식 집계 단위이며, 마지막 열은 Full-context를 제외한 가장 높은 비교 메모리 점수와의 차이입니다. Table 3, Table 4
| 설정 | Raw-RAG | 가장 높은 비교 메모리 | 차이, 퍼센트포인트 |
|---|---|---|---|
| LoCoMo · GPT-4o-mini | 89.07 | MemMachine 88.12 | +0.95 |
| LoCoMo · GPT-4.1-mini | 93.70 | EverMemOS 93.05 | +0.65 |
| LongMemEval-S · GPT-4.1-mini | 87.53 | Memora 87.40 | +0.13 |
| MEME · GPT-4o-mini | 39.30 | MemMachine 37.06 | +2.24 |
| MEME · DeepSeek-V4-Flash | 43.19 | MemMachine 44.71 | −1.52 |
| MemoryAgentBench · GPT-4o-mini | 48.32 | Memora 43.84 | +4.48 |
| MemoryAgentBench · DeepSeek-V4-Flash | 53.41 | Memora 47.88 | +5.53 |
예외인 MEME·DeepSeek에서는 MemMachine이 Raw-RAG보다 높습니다. 같은 설정의 Full-context는 63.17로 Raw-RAG보다 19.98퍼센트포인트 높습니다. 반대로 MEME·GPT-4o-mini의 Full-context는 29.31로 Raw-RAG의 39.30보다 낮습니다. 긴 문맥을 모두 주면 항상 최선이라는 결론도, 간단한 검색이 모든 모델에서 최선이라는 결론도 나오지 않습니다. Table 4
또한 0.13퍼센트포인트의 차이를 유의한 개선이라고 부를 수는 없습니다. 주 비교 일곱 설정의 모든 기존 시스템에 대해 질문별 짝지은 결과와 신뢰구간이 제공되는 것은 아닙니다. “점 추정 순위에서 여섯 번 높았다”가 이 표에서 직접 읽을 수 있는 범위입니다. 부록 A.1–A.2·C.6
4.3 RQ1 — 검색 설정은 얼마나 중요한가. MemoryAgentBench·GPT-4o-mini에서 재순위화기를 제거하면 전체 점수는 48.32→44.40으로 3.92퍼센트포인트 하락하며, 짝지은 95% 구간은 [−5.80, −2.06]입니다. 반면 청크 길이를 128·512·1,024토큰으로 바꾼 전체 점수 차이의 구간은 모두 0을 포함합니다. 이 범위에서는 세밀한 청크 길이 하나보다 충분한 후보와 재순위화가 더 뚜렷한 요인이었습니다. Table 5·부록 A.4.1
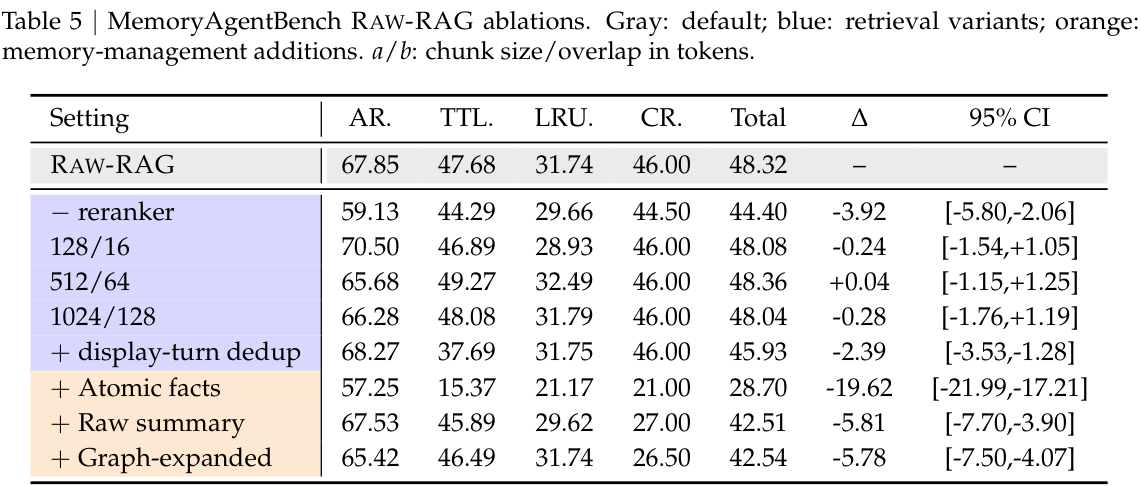
Table 5, PDF 7쪽. 원본 표 영역 크롭, 번역 없음. 표의 핵심 수치는 아래에 함께 전사합니다. 원문 HTML 본문의 일부 참조번호가 이 표를 Table 6으로 가리키지만, 이 글은 실제 PDF caption의 Table 5를 사용합니다. 원본
| 조건 | 전체 점수 | 기본 대비 차이 | 짝지은 95% 구간 |
|---|---|---|---|
| 기본 Raw-RAG | 48.32 | — | — |
| 재순위화 제거 | 44.40 | −3.92 | [−5.80, −2.06] |
| 청크 128 / 중첩 16 | 48.08 | −0.24 | [−1.54, +1.05] |
| 청크 512 / 중첩 64 | 48.36 | +0.04 | [−1.15, +1.25] |
| 청크 1,024 / 중첩 128 | 48.04 | −0.28 | [−1.76, +1.19] |
| 표시 단계 발화 중복 제거 | 45.93 | −2.39 | [−3.53, −1.28] |
| 원자적 사실 추출 | 28.70 | −19.62 | [−21.99, −17.21] |
| 원문 + 요약 | 42.51 | −5.81 | [−7.70, −3.90] |
| 그래프로 후보 확장 | 42.54 | −5.78 | [−7.50, −4.07] |
최종 청크 수를 늘리는 것도 단조롭게 유리하지 않았습니다. 1개에서는 36.59, 15개에서는 48.32, 120개에서는 33.74였습니다. 5–60개 범위는 기본값과 전체 점수 차이가 1.3퍼센트포인트 이내였고, 전체 차이 구간은 0을 포함합니다. 다만 능력별 효과는 달라 60개의 장거리 이해 개선은 별도로 관찰됩니다. Figure 4·Table 19
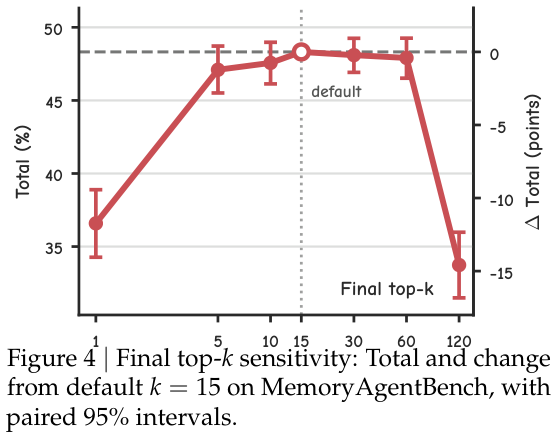
Figure 4, PDF 7쪽. 원본 그래프와 caption 영역 크롭, 번역 없음. 왼쪽 축은 전체 점수, 오른쪽 축은 기본 15개 대비 차이이며 오차막대는 짝지은 95% 구간입니다. 일부 HTML 본문 참조의 Figure 6 대신 실제 PDF 번호를 따릅니다. 원본
RQ2 — 기억 관리를 추가하면 좋아지는가. 평가한 세 변형은 모두 전체 점수를 낮췄습니다. 원자적 사실 추출은 특히 테스트 시 학습을 47.68→15.37로 낮췄습니다. 그러나 세 변형의 의미는 다릅니다. 사실 추출은 원문을 대체하지만, 요약 변형은 원문에 요약을 덧붙이고, 그래프 변형은 원문 노드를 유지하며 검색 후보를 확장합니다. 따라서 모든 하락을 “요약 때문에 원문이 없어졌다”로 설명할 수 없습니다. 정보량·형식·예제 연결·후보 경쟁이 함께 바뀔 수 있습니다. §4.3·부록 C.3·F
RQ3 — 효율은 어떠한가. MEME 10개 에피소드·110개 질문에서 Raw-RAG는 저장이 검색 가능해질 때까지 50.32초, 검색 255.59초로 합계 305.91초였습니다. EMem의 합계는 1,561.97초, EverMemOS는 9,301.48초로, 해당 조건의 합계 비율은 약 5.1배·30.4배입니다. 이 측정은 답변 생성과 평가를 제외합니다. 외부 작업자 하나와 각 시스템의 고유 내부 병렬성을 사용한 API·네트워크·재시도 포함 wall-clock 시간이지, 알고리즘 복잡도나 완전한 요청 처리 시간의 비율이 아닙니다. Table 6·부록 D.6
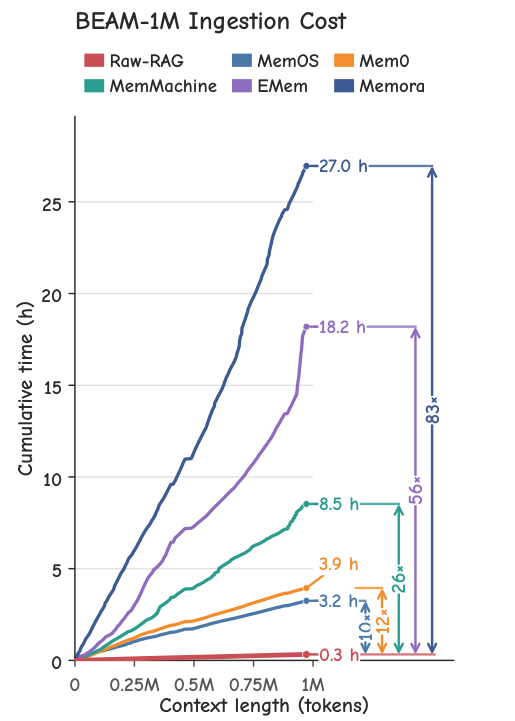
Figure 1 오른쪽 패널 상세, PDF 1쪽. 원본 영역 크롭, 번역 없음. 축·범례·종료 지점과 배수 표기를 보존했습니다. 원본
확장성 측정은 1,710개 메시지·거의 백만 토큰의 동일한 BEAM 대화 하나를 여섯 시스템에 순차 입력한 것입니다. 완료 시 Raw-RAG는 약 0.33시간, MemOS는 3.25시간, Memora는 26.95시간이었습니다. 대화 하나의 ingestion 측정이므로 다수 대화에서의 평균 정확도나 상용 서비스 처리량 실험으로 확대해서는 안 됩니다. 4장은 경쟁력 있는 점수와 낮은 구축 비용을 확인하고, 5장은 그 이유를 근거 단위로 분석합니다. 부록 A.6·D.6
📖 Chapter 5: Why Is Raw-RAG Enough in Most Cases?
5.1 Raw-RAG offsets lower utilization with high coverage. 저자들은 답변 실패를 근거가 부족한 경우와 근거를 가지고도 활용하지 못한 경우로 나눕니다. 시스템 $s$의 질문 $i$에 대해 충분한 근거가 있으면 $C_{is}=1$, 없으면 0으로 두고, 평가된 답변 점수를 $Y_{is}\in[0,1]$로 놓아 다음을 계산합니다. 이 점수에는 여러 judge 판단의 평균도 들어갈 수 있어 항상 이진 정답 라벨인 것은 아닙니다. §5.1·부록 C.1, 식 (4)
첫 분모 $N$은 평가 질문 수입니다. 두 번째 분모는 그 시스템에서 충분한 근거가 있다고 판단된 질문 수입니다. 따라서 활용률이 높은 두 시스템을 비교하더라도 같은 질문들에서 reader를 통제해 비교한 것은 아닙니다. 또한 $\widehat{C}_s\widehat{U}_s$는 충분한 근거 집합이 전체 질문 점수에 기여한 부분입니다. 부족 판정 집합에서도 정답이 나올 수 있으며, 벤치마크 공식 전체 점수는 질문별 단순 평균과 다른 macro 가중을 사용할 수 있습니다. 두 값을 곱해 본문의 Overall이라고 제시하면 안 됩니다. 부록 C.1·D.5
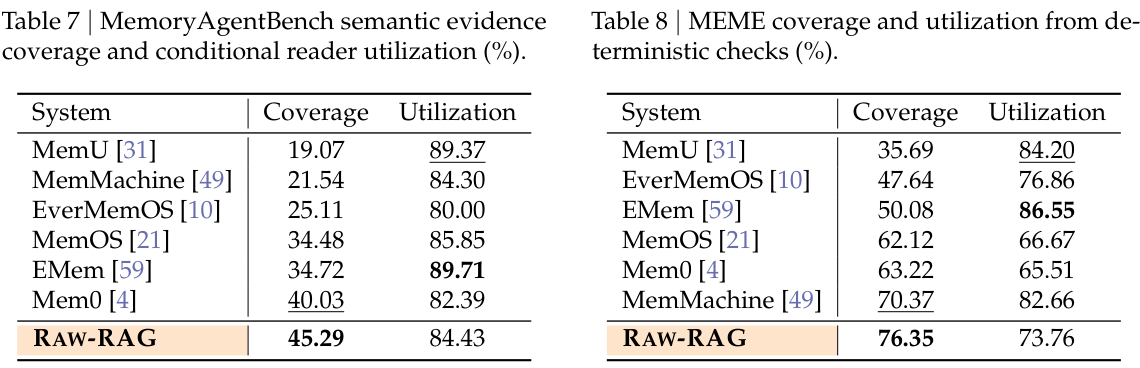
Tables 7–8, PDF 8쪽. 나란한 원본 표 영역을 그대로 크롭했으며 번역은 없습니다. 왼쪽은 의미적 충분성 판정, 오른쪽은 MEME의 결정적 검사 기반 결과입니다. 원본
| 시스템 | MemoryAgentBench coverage | MemoryAgentBench utilization | MEME coverage | MEME utilization |
|---|---|---|---|---|
| MemU | 19.07% | 89.37% | 35.69% | 84.20% |
| MemMachine | 21.54% | 84.30% | 70.37% | 82.66% |
| EverMemOS | 25.11% | 80.00% | 47.64% | 76.86% |
| MemOS | 34.48% | 85.85% | 62.12% | 66.67% |
| EMem | 34.72% | 89.71% | 50.08% | 86.55% |
| Mem0 | 40.03% | 82.39% | 63.22% | 65.51% |
| Raw-RAG | 45.29% | 84.43% | 76.35% | 73.76% |
Raw-RAG는 두 평가에서 근거 도달률이 가장 높지만 활용률이 가장 높지는 않습니다. 특히 MEME에서는 충분한 자료가 있다고 판정된 뒤에도 실패가 적지 않습니다. 따라서 근거를 더 찾는 개선과 reader가 상태를 해석하는 개선을 구별해야 한다는 것이 첫 번째 finding입니다. Tables 7–8
5.2 Raw history preserves the paths needed for reasoning. 추적과 연쇄 갱신의 after-state 질문에서는 정답 값의 존재와 완전한 추론 경로의 존재를 함께 판정합니다. 추적에는 값들의 시간 순서가, 연쇄 갱신에는 대상 값과 의존 규칙·상위 상태의 변화가 연결되어 있어야 합니다. 삭제·무효화 질문의 오래된 값은 현재 정답이 아니므로 이 중첩 결과·경로 비교에서 제외합니다. §5.2·부록 G.10
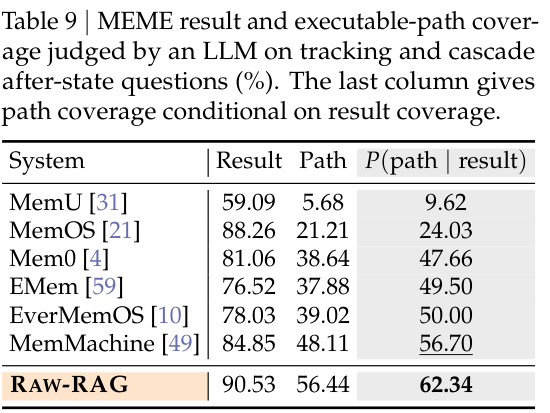
Table 9, PDF 9쪽. 원본 표·caption 크롭, 번역 없음. 마지막 열은 결과 값이 있는 경우에 경로도 있는 조건부 비율입니다. 원본
Raw-RAG는 결과 coverage 90.53%, 경로 coverage 56.44%, 결과가 있을 때 경로가 있을 비율 62.34%였습니다. MemMachine은 84.85%·48.11%·56.70%, MemU는 59.09%·5.68%·9.62%였습니다. 이는 정답 문자열만 남기는 것과 상태를 재구성할 관계를 함께 남기는 것이 다름을 보여 줍니다. Raw-RAG 역시 결과를 찾은 경우의 약 37.66%에서는 완전한 경로를 확보하지 못했습니다. Table 9
5.3 Preserving raw evidence supports downstream recovery. 다음 질문은 실패한 근거가 저장소 어딘가에 남아 있는지입니다. 저자들은 동일 MEME 질문에서 세 조건을 비교합니다. N은 각 시스템의 기본 검색, C는 내보낸 phase-visible 기억 전체에 대한 정답 기반 선택, R은 원래의 주석된 근거 세션을 정답 정보로 선택하는 raw-evidence 대조군입니다. C·R에는 값 자체를 알려 주지 않는 과제 정책과 명목 5,000토큰 예산을 적용합니다. §5.3·부록 C.5
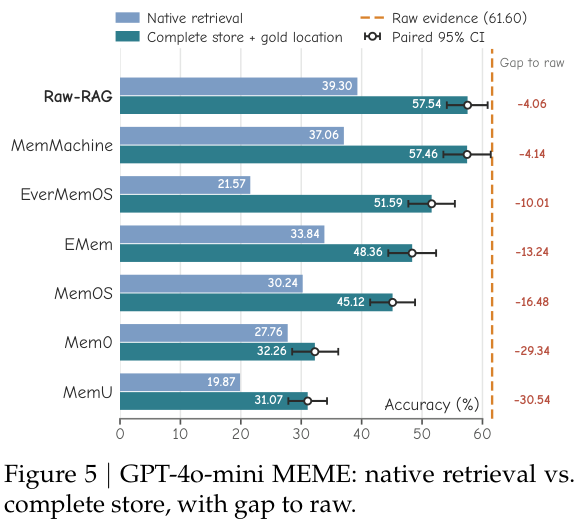
Figure 5, PDF 9쪽. 원본 그래프와 caption 크롭, 번역 없음. 주황 점선은 raw-evidence 대조군 61.60이며, 청록 막대는 전체 기억을 모두 그대로 입력한 것이 아니라 정답 기반으로 선택·포장한 결과입니다. 일부 HTML 참조의 Figure 9 대신 실제 PDF 번호를 사용합니다. 원본
| 시스템 | N: 기본 검색 | C: 전체 저장소 진단 | R−C: raw 대조군과의 차이 |
|---|---|---|---|
| Raw-RAG | 39.30 | 57.54 | 4.06 |
| MemMachine | 37.06 | 57.46 | 4.14 |
| EverMemOS | 21.57 | 51.59 | 10.01 |
| EMem | 33.84 | 48.36 | 13.24 |
| MemOS | 30.24 | 45.12 | 16.48 |
| Mem0 | 27.76 | 32.26 | 29.34 |
| MemU | 19.87 | 31.07 | 30.54 |
점수는 GPT-4o-mini·MEME의 과제 6종 macro 점수이며, R은 공통 61.60입니다. Table 29
모든 시스템은 N보다 C에서 높아지고, 원문 대화를 유지하는 Raw-RAG·MemMachine이 R에 가장 가깝습니다. 정보 보존의 중요성과 일치하는 결과입니다. 그러나 N→C는 검색 접근뿐 아니라 지시문·근거 조립을 바꾸고, C→R은 표현과 포장 방식도 바꿉니다. 선택기는 정답 값까지 이용합니다. 따라서 차이를 그대로 ingestion 단계의 정보 손실량, 순수 검색 개선량, 실서비스에서 달성 가능한 개선량으로 해석할 수는 없습니다. Raw-RAG에도 4.06의 잔여 차이가 있어 근거 위치·조립의 영향이 가능하다는 점을 저자들이 명시합니다. §5.3·부록 C.5
📖 Chapter 6: Limitations and Conclusion
6.1 Limitations and future work는 결과의 적용 범위를 제한합니다. 평가는 주로 대화 질문 응답이며, 실시간 상호작용이나 제한된 저장 공간을 가진 장기 운영을 충분히 다루지 않습니다. reader 능력에 따라 성능이 달라지며, 원문 저장이 계속 늘면 공간·검색 부담도 커집니다. 원문 저장은 개인정보 보호 문제도 제기합니다. 저자들이 명시한 미래 과제는 더 긴 이력·다양한 모델에 대한 평가, 명시적 개인정보·삭제 제약의 반영, 구조화·압축 기억이 정확도·지연·계산 비용에서 유리한 조건의 확인입니다. 약한 reader를 돕거나 질문마다 반복되는 상태 추론을 줄이는 데 사전 상태 관리가 유리한지도 추가 평가 대상으로 제시합니다. 이 글은 이를 새로운 미래 과제로 덧붙이지 않고 저자들이 명시한 범위로 읽습니다. §6.1·부록 F
6.2 Conclusion은 복잡한 기억 관리의 필요성을 전제로 삼지 말고 강한 원문 RAG와 비교하자는 결론입니다. 충분한 원문 근거와 관계 경로를 보존하면 reader가 상태를 재구성할 여지가 남습니다. 반면 자료가 사라지거나 관계가 끊기면 검색과 추론을 강화해도 되살리기 어려울 수 있습니다. 다만 저장소 진단의 잔여 차이는 정보 손실의 순수 측정값이 아니라는 조건도 함께 유지해야 합니다. §6.2·§5.3
📖 Chapter Acknowledgments: Acknowledgments
이 부분은 연구 결과가 아니라 지원 주체를 밝힙니다. 중국 교육부의 기초·융합 분야 계획, 중국 국가자연과학기금과 산시성 연구 지원 등이 명시됩니다. 방법이나 성능의 추가 근거로 사용하지 않습니다. Acknowledgments
📖 Chapter References: References
참고문헌은 에이전트 메모리 시스템, 검색·재순위화, 장문 문맥과 기억 평가의 출처를 연결합니다. 앞 장의 관련 연구 설명과 뒤 부록 E의 기존 baseline 설정 검토를 뒷받침하는 역할입니다. 이 리뷰의 수치와 실험 조건은 인용된 다른 논문의 결과를 임의로 섞지 않고, 본 논문 v1이 실제 보고하고 구분한 표를 기준으로 설명합니다. References
📖 Chapter Appendix A: Experimental Settings and Complete Results
부록 A는 본문의 종합 순위를 재현 가능한 조건으로 펼칩니다. 점수 하나를 인용할 때 검색 모델 계열, reader, 평가 프롬프트, 질문 집합을 함께 읽어야 하는 이유가 이 부록에 집중되어 있습니다. 부록 A
A.1. LoCoMo results
A.1.1 Text-embedding-3-small setting은 text-embedding-3-small과 Cohere Rerank 3.5 계열을 구분한 비교입니다. Raw-RAG의 GPT-4o-mini·GPT-4.1-mini 점수는 89.07·93.70입니다. 기존 발표 수치와 이번 평가 수치를 출처별로 유지하므로 모든 행이 동일 실행의 산물은 아닙니다. Table 10
A.1.2 Qwen3 retrieval setting에서는 Qwen3-Embedding-4B·Qwen3-Reranker-4B를 사용하며 같은 reader 순서로 89.13·94.55를 보고합니다. 앞의 89.07·93.70과 검색기가 다릅니다. 두 행의 차이만으로 모든 baseline 대비 추가 개선이 입증됐다고 말할 수는 없습니다. Table 11
A.1.3 Short-answer evaluation은 최종 답을 가장 짧은 구절로 제한합니다. 구조화된 추론 지시를 유지하면서 마지막 답변 길이를 바꾸고, 같은 생성 답변을 LLM judge·F1·BLEU-1로 평가합니다. 이때 text-embedding 계열 Raw-RAG의 judge 점수는 85.78·90.87로 일반 답변 조건과 다릅니다. 어휘 겹침 지표는 짧은 정답과 표현 방식에 민감하므로 judge와 같은 성질의 점수로 읽으면 안 됩니다. Tables 12–14
부록은 기존 Mem0 발표의 Overall 66.88과, 보고된 범주 점수를 질문 수 841·282·321·96으로 가중한 62.14가 일치하지 않는다고 밝힙니다. 질문별 원자료가 없어 기존 보고값을 임의로 고치지 않았습니다. 이 불일치를 숨기지 않는 것이 발표값을 포함한 비교표를 읽는 중요한 조건입니다. A.1.3
A.2. LongMemEval-S results
A.2.1–A.2.2는 GPT-4.1-mini reader 아래 검색 모델 계열을 분리합니다. 500문항 기준 text-embedding 계열은 87.53, Qwen3 계열은 89.93입니다. Tables 15–16
A.2.3 Non-abstention evaluation은 답할 수 없는 질문 30개를 제외한 470문항을 사용합니다. 제외한 질문은 단일 세션 사용자 6개, 다중 세션 12개, 지식 갱신 6개, 시간 추론 6개입니다. 답변과 judge 결과를 재사용하여 이 부분집합의 분모로 다시 계산합니다. Table 17·식 (1)
$y_{ir}$는 질문 $i$의 $r$번째 judge가 준 0·1 점수입니다. 분모의 3은 동일 답변에 대한 세 번의 독립 판단입니다. text-embedding 계열은 1,238/1,410=87.80%, Qwen3 계열은 1,277/1,410=90.57%입니다. 앞의 500문항 점수와 질문 집합이 다릅니다. 별도 5,000토큰 통제의 470문항 점수 90.14%도 같은 조건이 아닙니다. Table 17
A.3. PersonaMem-v2 results
추가 평가인 PersonaMem-v2는 32k 길이 대화의 5,000개 객관식 질문, GPT-4.1-mini reader, Qwen3 검색 계열을 사용합니다. Raw-RAG는 사전에 주어진 persona profile을 쓰지 않고 사용자·assistant 발화를 검색합니다. 2,481/5,000=49.62%로 일곱 시스템 중 세 번째이며, MemOS는 50.72%, EverMemOS는 53.25%입니다. Raw-RAG가 각 시나리오에서 1위인 것도 아닙니다. 이는 본문의 네 주 벤치마크·일곱 설정에 포함되지 않는 별도 결과이며 유의성 검정도 보고되지 않습니다. A.3·Table 18
A.4. Ablation studies
A.4.1 Retrieval and memory ablations는 Table 5와 최종 검색 깊이 Table 19를 확장합니다. 기본 15개 대비 1개는 −11.73퍼센트포인트, 120개는 −14.57퍼센트포인트이며 두 95% 구간 모두 0을 포함하지 않습니다. 반면 5·10·30·60개의 전체 차이는 뚜렷하지 않습니다. 60개에서 장거리 이해는 +2.22이며 Holm 보정 p=0.025였습니다. 전체 효과와 능력별 효과를 구별할 필요가 있습니다. 검정에는 출처별 층화 짝지은 bootstrap 20,000회를 사용합니다. A.4.1·Table 19
A.4.2 Evidence-length analysis는 “같은 top-k”가 “같은 입력량”이 아님을 정량화합니다. reader 근거의 서식까지 포함하되 질문은 제외한 토큰 수입니다. Table 20
| 평가 | 평균 토큰 | 최대 토큰 | 5,000토큰 초과 질문 |
|---|---|---|---|
| LoCoMo | 4,778.8 | 5,177 | 41 / 1,540 |
| LongMemEval-S | 11,355.6 | 27,375 | 500 / 500 |
| MEME | 11,986.1 | 42,490 | 1,188 / 1,188 |
| MemoryAgentBench | 3,915.8 | 4,262 | 0 / 2,071 |
A.4.3 Cross-system budget control은 MemoryAgentBench의 여섯 시스템에 5,000토큰 상한을 적용합니다. 검색 결과는 고정하고, 원래 순서의 온전한 항목을 앞에서부터 넣으며 첫 항목조차 너무 길 때만 잘라 넣는 통제입니다. 여기의 Mem0·MemOS는 이전 hosted 결과여서 본문 local 구성과 같지 않습니다. 84개 시스템·출처 셀 중 44개를 다시 실행하고 40개는 재사용했으며, 5,545개 문맥이 짧아졌고 1,479개는 첫 항목을 잘랐습니다. A.4.3·Tables 21–22
Raw-RAG는 원래 최대 길이가 4,262여서 48.32가 그대로이고, 비교 중 가장 높은 Mem0 hosted는 44.74입니다. 다른 다섯 baseline의 전체 점수는 줄어듭니다. 그러나 상한에 맞춰 재튜닝하지 않았고 관련 정보가 잘릴 수 있으므로, 이 통제는 최적의 동등 예산 시스템을 모두 재구축한 실험이 아닙니다. Table 22
A.4.4 Raw-RAG budget sensitivity는 다른 실험입니다. LoCoMo·LongMemEval·MEME에서 5,000토큰을 넘으면 전체 발화 확장을 끄고, 선택한 15개 청크는 유지합니다. 실제로 청크 본문을 추가 절단할 필요는 없었습니다. 세 평가의 3,228개 답변·판정을 새로 생성했으며 LoCoMo는 89.07→89.42, LongMemEval은 87.53→89.20, MEME는 39.30→38.21이었습니다. Tables 23–24
LoCoMo에서는 근거가 바뀐 41문항이 전체 점수 변화에 기여한 몫이 약 +0.065퍼센트포인트인 반면, 근거가 동일한 1,499문항의 기여가 약 +0.281이었습니다. 따라서 소폭 상승을 근거 절단의 효과라고 단정할 수 없습니다. reader·judge의 변동도 함께 들어갔으며 동등성이나 유의성 검정은 보고되지 않습니다. A.4.4
A.5. Diagnostic analyses
A.5.1 Coverage and utilization는 본문 표에 분모·신뢰구간·전체 및 쌍별 검정을 보충합니다. Raw-RAG의 MemoryAgentBench coverage는 938/2,071=45.29%, 95% 구간 [43.65, 46.93]이며, utilization은 792/938=84.43%, [82.15, 86.66]입니다. MEME는 각각 907/1,188=76.35%, [74.32, 78.31], 669/907=73.76%, [70.98, 76.44]입니다. Table 26
일곱 시스템의 21개 쌍에 Holm 보정을 적용했을 때 MemoryAgentBench coverage는 20쌍, utilization은 7쌍에서 차이가 확인됩니다. MEME는 각각 19쌍·17쌍입니다. Table 27·28은 유의하지 않은 쌍도 함께 보여 줍니다. 이 검정은 이 진단 라벨과 조건부 활용률에 대한 것이며, 본문 일곱 설정의 모든 순위 차이를 대신 검정한 결과는 아닙니다. Tables 25·27–28
A.5.2 Complete-store evaluation은 N·C·R 차이에 에피소드 단위의 짝지은 구간을 붙입니다. 예를 들어 Raw-RAG의 C−N=18.24는 [14.78, 21.65], R−C=4.06은 [0.74, 7.50]입니다. MemMachine의 대응 값은 +20.40 [17.30, 23.40], 4.14 [0.23, 8.07]입니다. C가 기본 검색보다 높은 것은 관찰되지만, 실험이 바꾼 여러 요소 가운데 하나의 인과효과로 분해하지는 못합니다. Table 29
5,000토큰 상한을 없애도 raw 대조군 61.60은 그대로입니다. 원래 해당 근거가 모두 들어갔기 때문입니다. 저장소 조건의 점수는 MemMachine 54.02, EverMemOS 51.19, EMem 48.19, MemOS 44.58, Raw-RAG 53.85, MemU 32.55, Mem0 32.22입니다. raw 대조군과의 차이 7.58–29.38퍼센트포인트는 관찰된 출력에 대한 각 95% 구간에서 0보다 큽니다. 이 점별 구간에는 다중 비교 보정이 없으며, 모든 재구축·reader 변동을 포괄하지 않습니다. Table 30·C.6
상한 제거가 MemMachine을 −3.44 [−6.49, −0.37] 낮춘 주 분석도 조심해서 읽어야 합니다. 공급자 필터로 빈 응답이 된 사례들을 제외한 민감도 분석에서는 MemMachine 변화가 −2.61 [−5.56, +0.36]이 되어 0을 포함하고, 일곱 시스템 모두 상한 제거 효과 구간이 0을 포함합니다. 따라서 “긴 문맥이 반드시 유의하게 해롭다”는 일반 명제로 옮기지 않습니다. 원문은 native·진단의 judge 반복 수 차이, seed가 보존되지 않은 bootstrap 재실행의 미세 차이도 밝힙니다. A.5.2
마지막 Table 31은 원래 근거 세션 oracle과 정답 기반 선택·포장 raw 대조군을 구별합니다. 전자의 GPT-4o-mini 50.50과 후자의 61.60은 같은 입력·정책을 사용한 점수가 아닙니다. “정답 근거를 다 줬을 때의 점수”라는 표현 하나로 합치면 안 됩니다. Table 31
A.6. Efficiency and scalability
MemoryAgentBench에서는 정확도 평가의 14개 출처 전체가 아니라, 함께 측정한 비충돌 해결 출처 11개를 사용합니다. 원자적 사실·요약·그래프 변형의 기억 관리용 LLM 입력·출력 사용량은 각각 약 4,630만·2,160만·1억 930만 토큰이었습니다. 호출 수는 40,248·32,144·33,748회입니다. 저장·검색 합계는 약 8.80·2.87·4.33시간이고, Raw-RAG는 718.4초, 약 12분이었습니다. Raw-RAG의 해당 기억 관리 LLM 호출은 0회이지만 임베딩·재순위화 호출과 최종 답변 비용까지 0이라는 뜻은 아닙니다. Table 32
이 부록은 짧은 답변·다른 검색기·다른 질문 분모·예산 통제·추가 벤치마크가 본문의 점수와 어떻게 연결되는지 분리합니다. 다음 부록은 이 가운데 기본 Raw-RAG가 실제로 만드는 입력을 정의합니다.
📖 Chapter Appendix B: Raw-RAG: Method Details
B.1. Indexing and evidence assembly
각 메시지는 대화 식별자, 화자, 시각, 텍스트를 보존하며 누락 시각은 unknown으로 표시합니다. 256토큰 창은 224토큰 간격으로 이동하고, 인접 창은 32토큰을 공유합니다. 임베딩과 원문을 함께 보관하여 검색 점수만 남기고 내용을 잃지 않도록 합니다. 앞의 식 (2)·(3)은 이 창들을 대상으로 계산합니다. B.1
검색 뒤의 표시 정책은 평가별로 다릅니다. 일반 대화에서는 선택한 창과 겹치는 원래 발화를 복원하며, 같은 발화가 여러 선택 창에 걸리면 기본적으로 중복이 남습니다. MEME는 질문 단계에서 보이는 자료만 사용하고 선택 후 시간순으로 표시합니다. MemoryAgentBench는 전체 발화 확장을 하지 않으며, FactConsolidation의 두 출처는 원래 사실 하나를 메시지·청크 하나로 취급해 serial number의 새로움 순서를 보존합니다. 한 가지 청킹 규칙을 모든 출처에 기계적으로 적용한 것은 아닙니다. B.1
B.2. Query construction
검색 질의는 원래 질문을 그대로 사용합니다. Qwen3 재순위화에는 질문·문서 관련성을 판단하는 공식 yes/no chat template을 사용하되 질의를 생성·확장하지 않습니다. 상대 시점이나 과제별 출력 지시를 reader 입력에 추가하는 것과 검색 query를 바꾸는 것은 구분합니다. LongMemEval의 질문 시각, MemoryAgentBench의 분류·추천·충돌 해결 지시, PersonaMem의 개인화 알림은 이 차이를 보여 줍니다. B.2·G.1
B.3. Context-length policies
기본 Raw-RAG에는 추가 근거 상한이나 head–tail 절단을 적용하지 않습니다. 일곱 주 설정의 저장된 조립 근거와 실제 요청 근거가 같음을 확인했으며 생성 오류는 기록되지 않았습니다. 공급자 길이 오류가 나면 같은 입력으로 세 번 재시도한 뒤 실패로 점수화하는 정책입니다. B.3
이 정책은 비교 시스템의 정책과도 다릅니다. SimpleMem·Memora의 일부 경로는 100k 근거 prefix 상한을, local Full-context는 128k 요청 예산에서 출력 4,096토큰과 여유 256토큰을 남기는 head–tail 절단을 사용합니다. 별도 5k 통제나 complete-store 진단을 기본 Raw-RAG 자체의 규칙으로 소개해서는 안 됩니다. 부록 B는 짧은 방법 설명만으로는 드러나지 않는 실제 입력량과 실패 처리까지 고정합니다. B.3
📖 Chapter Appendix C: Diagnostic Procedures and Statistical Methods
C.1. Coverage, utilization, and path retention
Coverage는 단순히 정답 문자열이 보이는지와 같지 않습니다. MEME의 정확 회상은 대상 값, 집계는 모든 대상 값, 추적은 값들의 시간 순서, 삭제는 대상을 특정한 삭제 사건이 필요합니다. 연쇄 갱신은 새 대상 값·의존 규칙·변화를 일으킨 상위 상태가 연결되어야 하고, 무효화 후 응답에서는 예전 값과 규칙·그 값을 무효로 만든 변화가 있어야 합니다. C.1
MemoryAgentBench의 의미적 충분성 평가와 MEME의 결정적 검사는 측정 도구가 다릅니다. 경로 비교에는 별도 LLM joint 판정도 사용합니다. 서로 다른 판정 도구를 통과한 45.29%와 76.35%를 같은 난도의 절대 척도로 비교하지 않습니다. 식 (4)의 조건부 분모와 경로의 정의는 5장의 해석을 지탱하는 핵심입니다. C.1·G.9–G.10
C.2. Write-policy and evidence controls
Mem0 감사는 모델이 제안한 명령, 시스템이 돌려준 동작, 실제 저장된 이전·이후 레코드를 분리합니다. UPDATE·DELETE라는 이름이 나왔다고 모두 유효한 변화가 아닙니다. 실제 레코드의 텍스트가 달라지거나 사라졌을 때만 effective mutation으로 셉니다. C.2
같은 절은 예비 source oracle이 질문 시점까지의 주석된 근거 세션을 그대로 주는 조건임을 설명합니다. 정답 기반으로 청크를 고르고 5k에 포장하는 complete-store raw 대조군과 다릅니다. Abs의 추가 지시는 의존성이 깨진 과거 값을 현재 값으로 답하지 말라는 규칙일 뿐 정답 엔터티 값은 제공하지 않습니다. C.2·G.11
C.3. Memory-management ablations
원자적 사실 변형은 256토큰 창마다 최대 여섯 사실을 추출하며, 사실은 28단어 미만, 인용은 12단어 미만, 엔터티 이름은 최대 다섯 개로 제한합니다. 화자·시각·순서·serial number를 보존하라는 지시가 있지만 중요도가 낮다고 선택되지 않은 예제나 연결 맥락은 사라질 수 있습니다. 추출 사실이 원문을 대체합니다. C.3·G.2
요약 변형은 summary·key events·entities·time order·conflicts/updates 다섯 필드를 만들고 원문에 덧붙입니다. 그래프 변형은 새 창과 이전 창 중 임베딩 상위 10개를 비교해 실제 연결을 LLM이 판정하며, 무방향 간선을 추가합니다. 질의 시 32개 seed의 모든 1-hop 이웃을 후보로 확장하고 다시 상위 15개 원문을 고릅니다. reader에 그래프 설명을 추가하지는 않습니다. C.3
세 변형은 GPT-4o-mini-2024-07-18, temperature 0, JSON 형식 검사를 사용하고 잘못된 형식은 재시도 후 중단합니다. 저자들은 이 조건에서의 하락을 보고하지만, 해당 추출 프롬프트와 선택·형식 제한을 넘어 모든 사실 추출이나 그래프 검색이 나쁘다고 증명한 것은 아닙니다. C.3·F
C.4. Context-budget interventions
MemoryAgentBench의 시스템 간 통제는 고정된 검색 결과의 prefix를 잘라 길이를 맞춥니다. Raw-RAG의 세 벤치마크 민감도는 발화 확장을 끄되 선택한 창을 보존합니다. 전자는 여러 시스템의 독립적인 결과를 동일 상한에 넣는 실험이고, 후자는 하나의 시스템이 더 짧은 근거로 동작하는지 보는 실험입니다. 둘을 합쳐 “모든 시스템을 최적으로 5k에 맞췄다”고 설명하면 통제의 범위를 벗어납니다. C.4
C.5. Complete-store and oracle evaluations
저장소 진단의 첫 단계는 각 시스템이 실제로 남긴 자료를 내보내는 것입니다. Mem0는 저장 텍스트이며 별도 엔터티 그래프는 포함하지 않고, MemOS는 세분화된 기억·선호·도구·기술 기록, MemU는 항목·범주 요약, EMem은 EDU, EverMemOS는 에피소드·사실, MemMachine은 episodic·semantic·working summary, Raw-RAG는 전체 원문 창을 사용합니다. 어떤 시스템의 “전체 저장소”를 원래 대화 transcript 전체로 바꾸어 주지 않습니다. Table 33
시간 가시성도 완벽히 동일한 방식은 아닙니다. EMem은 before·after의 실제 스냅샷 200개를 사용합니다. 다른 시스템은 최종 저장소를 provenance 시각으로 걸러 쓰므로 이미 덮어쓰거나 삭제한 항목을 되살릴 수 없고, 남아 있는 항목이 나중에 개정되었을 가능성도 있습니다. MemMachine은 불명확한 provenance에 보수적인 범위를 적용하며, Mem0의 생성 시각만으로 수정 이력을 완전히 복원할 수는 없습니다. C.5·Table 33
정답 기반 선택기는 정규화한 gold 구절의 일치와 질문 단어 겹침을 사용합니다. 원문 식 (5)의 점수는 다음과 같습니다. C.5, 식 (5)
$m$은 기억 항목, $H(m)$은 그 항목에서 일치한 gold 구절, $Q$는 질문의 단어 집합입니다. 첫 항은 일치한 gold 구절에 기본 4와 길이에 따른 최대 4의 보너스를 줍니다. 두 번째 항은 질문 단어의 포함 비율에 2를 곱하며, 분모 $\max(1,|Q|)$는 빈 질문 단어 집합에서 0으로 나누는 것을 막습니다. 임베딩 유사도 점수가 아닙니다. 실제 질문 시 알 수 없는 expected answer가 선택에 사용되므로 배포 가능한 검색 기준선은 아닙니다. C.5
근거 포장도 표현별로 다릅니다. 일반 항목은 들어가지 않는 항목을 건너뛰고 첫 항목만 필요한 경우 자르며, Raw-RAG는 원문 청크를 시간순으로 넣습니다. EMem은 EDU를 과제별로 압축하고 raw 대조군은 주석 근거 세션을 시간순으로 넣습니다. 두 대조군에는 값 없는 동일 과제 정책을 넣지만, 정보 범위·표현·배치는 같지 않습니다. 따라서 이 실험의 C−N·R−C는 여러 조작이 묶인 진단 차이입니다. MEME Abs에서는 근거가 부족해서 불확실하다고 답해도 정답으로 인정될 수 있어, 올바른 답변 하나가 의존 경로 복원의 성공을 뜻하지는 않는다는 경계도 있습니다. C.5·G.12
C.6. Statistical inference
Coverage·utilization의 불확실성은 MemoryAgentBench에서 출처별 층화 짝지은 bootstrap 50,000회, MEME에서 에피소드 전체를 묶은 50,000회로 추정합니다. MEME의 before·after 질문과 채점 gate가 같은 에피소드에 속하므로 개별 질문을 독립으로 무작위 재표집하는 것과 다릅니다. 일곱 시스템의 21쌍에는 지표별 Holm 보정을 적용합니다. Coverage의 전체·쌍별 이산 검정과 utilization의 조건부 검정도 구분합니다. C.6
검색 ablation은 20,000회 출처 층화 재표집으로 공식 계층 가중을 다시 계산하고, complete-store는 20,000회 에피소드 단위 재표집에서 여섯 과제 macro와 gate를 다시 적용합니다. 후자의 구간은 점별이며 다중 비교 보정이 없습니다. 일부 기존 결과는 질문별 판단이 없어 동일 검정을 할 수 없고, 원래 bootstrap seed가 보존되지 않은 결과의 재실행 구간에는 작은 차이가 있습니다. 이 불확실성은 고정된 저장 결과·reader 응답·진단 라벨에 조건부이며, 모델·저장소를 매번 다시 만드는 전체 확률적 변동을 포함하지 않습니다. C.6·A.5.2
부록 C의 기여는 진단을 강하게 보이게 만드는 데 있지 않습니다. 무엇을 분모로 삼았고 무엇을 바꾸었으며 어디까지 추론할 수 있는지 명시하여, 결과를 실제로 검토할 수 있게 만듭니다.
📖 Chapter Appendix D: Experimental Implementation and Reproducibility
D.1. Benchmark descriptions
D.1.1 LoCoMo는 단일 홉 841개, 다중 홉 282개, 시간 추론 321개, 개방형 96개를 포함하며 adversarial 범주는 제외합니다. D.1.2 LongMemEval-S는 단일 세션 사용자·assistant·선호, 다중 세션, 지식 갱신, 시간 추론의 여섯 유형을 구분합니다. 이 분포 때문에 유형별 점수를 단순 평균하면 공식 전체 점수와 달라집니다. D.1.1–D.1.2
D.1.3 MEME는 과제 사건 전후에 질문하고, 기억이 무엇을 유지·갱신·삭제했는지 평가합니다. before 질문은 삭제·연쇄 갱신·무효화에서 모델이 이전 정보를 알고 있었는지를 확인하는 gate로 사용됩니다. 삭제의 성공은 답변에서 삭제를 인정하고 예전 값을 드러내지 않는다는 뜻입니다. 디스크·벡터 DB·백업에서 실제 값이 물리적으로 삭제됐는지를 검증하지는 않습니다. D.1.3
D.1.4 MemoryAgentBench의 정확한 검색은 LongMemEval·EventQA·RULER, 테스트 시 학습은 다섯 ICL 분류 출처와 ReDial, 장거리 이해는 DetectiveQA·InfBench, 충돌 해결은 FactConsolidation 단일·다중 홉을 사용합니다. ICL은 문맥의 예제로 라벨 대응을 배우는 능력입니다. 원자적 사실로 대체하면 예제 형식·대응 관계가 바뀔 수 있다는 후속 해석이 이 구성에서 나옵니다. 충돌 해결에서는 큰 serial number의 사실이 최신이라는 규칙을 따릅니다. D.1.4
D.1.5 PersonaMem-v2는 주어진 보기 중 개인화된 답을 고르는 추가 실험이며 Raw-RAG에는 persona profile을 주지 않습니다. D.1.6 BEAM ingestion workload는 단일 긴 대화를 저장할 때의 비용을 보는 별도 작업입니다. 이 둘을 본문 네 벤치마크의 정확도 비교에 조용히 합산하지 않습니다. D.1.5–D.1.6
D.2. Evaluation workflow
실험은 ingestion → retrieval → answer generation → judgment의 네 단계를 분리합니다. 대화와 질문 식별자로 저장물·근거·답변·판정을 연결하고, 가능한 경우 질문 날짜 이후의 자료를 가립니다. 시각이 없으면 유지하므로 unknown 자료가 완벽히 과거 자료임을 보장하지는 않습니다. 여러 출처가 섞이거나 수정된 기억은 metadata 필터만으로 정확한 과거 상태를 복원하지 못할 수 있습니다. 이 절은 결과를 하나의 정답률 파일보다 추적 가능한 단계별 산출물로 보는 관점입니다. D.2
D.3. Baseline configurations
비교 시스템의 내부가 서로 달라, 이름과 top-k만 맞춰서는 같은 실험이 되지 않습니다. 원문 순서대로 주요 구현 선택을 정리하면 다음과 같습니다. D.3.1–D.3.10
| 소절·시스템 | 실제 비교에서 중요한 구성 |
|---|---|
| D.3.1 Raw-RAG | 대화별 인덱스, 임베딩 후보 128개·재순위화 15개. 인덱싱·검색·답변 단계의 동시성은 각각 다르게 설정합니다. |
| D.3.2 EverMemOS | MemCell·에피소드·사실·프로필과 lexical/dense 검색, 정제·충분성 검사를 사용하며 최종 상위 10개를 제공합니다. |
| D.3.3 MemOS | local 2.0.23의 세분화 추출과 동기 쓰기, 기억 상위 20개와 선호·MMR 재순위화를 사용합니다. 일부 ICL에는 원문 예제 청크를 보충합니다. |
| D.3.4 EMem / EMem-G | 시각을 붙인 EDU 기반 저장과 별도 graph/PageRank 변형을 구분합니다. 기본 10개, MEME·MemoryAgentBench는 20개를 사용하는 설정이 있습니다. |
| D.3.5 SimpleMem | LoCoMo에서 직접 평가하며 40개 메시지 창·중첩 2개, semantic·keyword·structured 검색과 계획·반성을 결합합니다. 근거 상한은 100k입니다. |
| D.3.6 MemU | 1.5.1의 profile·event·knowledge·behavior 항목, 의도 라우팅·충분성 검사와 최종 20개 또는 MemoryAgentBench 10개를 사용합니다. |
| D.3.7 MemMachine | 0.3.4의 episodic·semantic·working memory를 함께 쓰며 두 검색 계열에서 각각 상위 20개를 검색합니다. 시각 없는 semantic 항목은 날짜 필터를 우회할 수 있습니다. |
| D.3.8 Mem0 | 본문·근거 진단의 2.0.11과 쓰기 감사의 classic 1.0.11을 구별합니다. 정체성별 상위 20개, 시간순 쓰기와 긴 메시지 처리 정책이 있습니다. |
| D.3.9 Memora | cue·BM25·episodic 검색을 최대 다섯 단계의 정책으로 탐색하며 원문 value·연결 episode를 유지합니다. 최종 근거 상한은 100k입니다. |
| D.3.10 Full-context | 검색 인덱스를 만들지 않고 시점에 맞는 기록을 제공합니다. local 요청이 길면 출력·여유 토큰을 남긴 head–tail 절단을 적용합니다. |
이 구성들은 공식·기존 평가에 맞추기 위한 차이도 포함합니다. 일부 시스템에는 ICL 원문 예제 보충이나 과제별 검색 깊이 변경이 있으므로 “복잡한 시스템은 모두 원문을 버렸기 때문에 졌다”는 설명은 성립하지 않습니다. 데이터셋·시스템마다 원문 보존 방식과 답변 경로가 다르다는 점이 오히려 진단 실험을 필요하게 만듭니다. D.3
D.4. Experimental controls
출처 이력과 질문·응답 식별자, 실제 reader 근거와 채점 범위를 보존하고 범위·요청 오류를 기록합니다. baseline 점수에는 기존 발표값이 포함되므로, 직접 대조 가능한 출력이 있는 부분과 없는 부분을 구분합니다. 같은 계열의 검색기·reader라고 해도 입력 서식·저장 정책·근거 길이까지 자동으로 동일해지는 것은 아닙니다. D.4
D.5. Scoring and benchmark-level summaries
특히 MemoryAgentBench는 전체 2,071개 질문의 정답 수를 한 번에 나누는 평가가 아닙니다. 원문 식 (6)은 테스트 시 학습 TTL 내부의 다섯 ICL 출처 평균과 ReDial을 절반씩 합친 뒤, 네 능력을 다시 같은 비중으로 평균합니다. D.5, 식 (6)
분모 5는 ICL 출처 수, 2는 ICL 평균과 ReDial의 동등 가중, 4는 네 능력의 동등 가중입니다. 질문이 많은 출처가 무조건 전체 점수를 지배하지 않도록 하는 계층 평균입니다. MEME 역시 after-stage 여섯 과제 macro와 일부 과제의 before gate를 사용합니다. 따라서 coverage 표의 질문 가중 평균, capability 점수, 공식 Overall은 서로 다른 집계 단위입니다. D.5
D.6. Latency measurement
저장 요청을 보낸 시점만 재면 비동기 시스템이 유리해질 수 있습니다. 저자들은 검색 가능한 상태까지를 add-to-ready로 측정하고, 외부 conversation/search 작업자는 하나로 고정하되 시스템 고유의 내부 병렬성은 유지합니다. MemMachine의 일반 정확도 경로에서 쓰는 고정 대기와 달리, 시간 측정에서는 큐가 비어 준비될 때까지를 확인합니다. BEAM에서는 semantic 처리 완료 장벽을 확인하며 1초 간격으로 상태를 확인하고 1시간 제한을 둡니다. D.6
이 시간에는 로컬 저장, 원격 API, 네트워크, 재시도와 준비 대기가 들어갑니다. 답변 생성·judge는 제외합니다. 그러므로 Figure 1과 Table 6의 시간 차이를 곧바로 사용자 응답 지연 전체나 토큰 비용의 동일 배수 차이로 바꾸지 않습니다. D.6
D.7. Computational environment
실험 호스트는 i9-13900HX, RAM 16GiB, RTX 5070 Ti Laptop 12GB, 1TB NVMe, Windows 11 환경입니다. 주요 언어 모델 추론은 원격 API이며 일부 MemU 연산 등은 로컬 자원을 사용합니다. 시스템별 Python 환경·확인 가능한 의존성 버전을 나열하지만 일부 과거 실행의 패키지 세부 버전은 복원할 수 없다고 밝힙니다. “같은 GPU에서 모델을 전부 직접 실행한 실험”으로 읽지 않는 것이 중요합니다. 부록 D는 이처럼 비용·점수의 실행 조건을 설명한 뒤, 기존 연구의 비교 설정으로 논의를 넓힙니다. D.7
📖 Chapter Appendix E: Review of Prior RAG Evaluations
E.1 Review scope는 기존 연구 14편에서 보고한 RAG 기준선의 청크·검색 깊이·재순위화 설정을 검토합니다. 이는 논문 간 정확도 수치를 같은 조건으로 재실행한 메타 실험이 아니라, 공개된 구성의 차이를 점검한 문헌 분석입니다. 설정만으로 성능 격차의 인과적 원인을 계산할 수는 없습니다. E.1·Table 34
E.2 Comparative analysis에서는 Mem0의 작은 검색 깊이, Nemori·RecMem의 큰 청크, Memora의 제한된 검색 수, xMemory·LoCoMo 등의 cross-encoder 부재, SeCom의 짧은 turn 단위, SGMem·PREMem의 turn·session별 근거량 차이를 살펴봅니다. Memobase의 일부 구성은 독립 RAG 점수라기보다 보고된 설정 자체이며 LightMem은 세부 조건이 충분히 명시되지 않습니다. 이런 항목을 모두 동일한 “약한 RAG 실험” 점수로 묶을 수는 없습니다. E.2
반대 사례도 중요합니다. LongMemEval은 이미 폭넓은 검색 튜닝을 수행했고, MemoryAgentBench도 청크 크기·검색 개수를 여러 값으로 평가했습니다. 저자들이 추가로 지적하는 것은 넓은 후보군과 cross-encoder 재순위화의 결합 등입니다. “이전 연구는 아무도 RAG를 튜닝하지 않았다”가 이 검토의 결론은 아닙니다. Table 34
E.3 Synthesis는 청크 크기·최종 개수·재순위화를 함께 검토하고 reader 근거 예산을 맞추는 평가가 필요하다고 정리합니다. 이 부록은 자신의 기준선이 유용한 이유를 설명하면서도, 다른 논문의 보고 차이를 새 통제 실험의 결과처럼 바꾸지 않는 역할을 합니다. E.3
📖 Chapter Appendix F: Extended Discussion and Limitations
추가 논의는 질문 응답 정확도와 운영 가능한 기억의 요구사항이 다름을 먼저 강조합니다. 실제 시스템은 권위 있는 현재 상태를 유지하고 도구·행동을 실행하거나, 데이터를 물리적으로 지워야 할 수 있습니다. 원문을 모두 보존한 뒤 질문 시 추론하는 방식이 이 요구를 자동으로 충족하지는 않습니다. 부록 F
reader가 약하거나 같은 상태를 반복해서 계산해야 하면 원문 재해석의 비용·안정성도 달라질 수 있습니다. 원자적 사실 변형의 ICL 하락은 사실 손실 외에도 예제 토큰 감소, 입력 형식 변화, 대응 관계와 경계 손상, reader와의 부조화로 설명될 수 있습니다. 현 실험은 이 원인들을 완전히 분리하지 않습니다. 요약·그래프 변형은 원문을 남기므로 하락을 내용 삭제만으로 설명할 수도 없습니다. 부록 F
저장 규모가 커지면 원문 인덱스도 커지고, 고정 검색 예산은 의미적으로 약하게 연결되거나 넓게 흩어진 근거를 놓칠 수 있습니다. 겹치는 창은 중복을 만들며, 원격 모델은 버전·서비스 조건이 바뀌고 temperature 0에서도 완전한 결정성을 보장하지 않습니다. 더 긴 온라인 상호작용, 저장 공간 제한, 멀티모달 환경에서는 다른 설계가 유리할 가능성이 있다는 것이 저자들이 명시한 적용 경계입니다. 부록 F
📖 Chapter Appendix G: Prompt Templates
마지막 부록은 검색기·기억 변형·reader·judge의 실제 지시문을 싣습니다. 전문을 복사하기보다 각 프롬프트가 무엇을 보게 하고, 무엇을 판단하며, 어떤 실패 처리를 하는지 순서대로 확인하는 것이 재현에 더 중요합니다. 원문은 LoCoMo judge에서 채점과 관계없는 짧은 aside만 생략하고 채점 기준과 출력 요구는 유지했다고 밝힙니다. 부록 G
G.1. Qwen3 reranker
공식 chat template에 질문·후보 창을 넣고, 질문에 관련된 정보를 포함하는지 yes/no로 평가합니다. 후보 창은 발화 전체 확장 이전입니다. 따라서 재순위화가 본 입력과 최종 reader 입력은 다를 수 있습니다. G.1
G.2. Memory-management variants
세 변형은 유효한 JSON 하나만 출력하는 공통 system 지시를 사용합니다. 사실 추출은 여섯 사실·단어 수 제한과 화자·시각·serial 보존을, 요약은 다섯 구조화 필드와 원문 대체 금지를, 그래프는 단순 주제 유사성이 아닌 공동 추론에 유용한 실제 관계만 연결하도록 요구합니다. 즉 원문이 사라지는 변형과 남는 변형의 차이는 프롬프트 자체에 명시되어 있습니다. G.2
G.3. LoCoMo LLM judge
judge는 질문·gold answer·생성 답변을 보고 의미가 맞으면 CORRECT로 평가하며 날짜의 다른 표기도 허용합니다. 실제 파서는 JSON의 label을 찾아 대문자로 정규화한 뒤 정확히 CORRECT인 경우만 1을 줍니다. 유효 JSON 주변의 설명은 허용하지만 맨몸의 CORRECT 문자열, 잘못된 JSON, 빈 응답, 요청 예외는 0입니다. 형식 수리 재시도 없이 같은 고정 답변을 세 번 판단합니다. G.3
과거 기록에는 이진 점수만 있고 judge 원문·파싱·요청 상태가 없어 0점의 원인을 분리할 수 없습니다. 네 Raw-RAG 조건에서 각 4,620개 판단 슬롯, 합계 18,480개가 모두 존재하지만, 형식 실패가 0회라는 뜻은 아닙니다. text-embedding 조건의 0점은 reader 순서로 505·291개, Qwen3는 502·252개이며 형식 실패 수는 각각 0부터 해당 0점 수 사이입니다. 논문은 이 불확실성을 그대로 남깁니다. G.3
G.4. LoCoMo reader
reader는 관련 기억 추출, 세부 정보 확인, 기억 간 연결, 상대 시각 계산, 모순 확인, 세부 검증, 최종 답변의 구조를 요구받습니다. 특정 이름·숫자·빈도·고유명사를 보존하도록 지시하며 FINAL ANSWER: 뒤를 채점 대상으로 추출합니다. 별도 system 메시지 없이 단일 user 메시지를 사용합니다. 짧은 답변 변형은 이 구조를 유지하고 마지막 답을 가장 짧은 span으로 바꾸며, 몇 가지 표현·화살표 표기도 수정합니다. G.4
G.5. LongMemEval reader
독립 LongMemEval은 LoCoMo와 같은 구조화 지시를 사용하되 질문 날짜가 있으면 그 날짜를 현재로 해석하고 이후 기억을 사용하지 말라고 덧붙입니다. 이것은 reader의 날짜 해석 지시이며, 검색 질의를 새 문장으로 확장하는 과정은 아닙니다. MemoryAgentBench 안에 들어간 LongMemEval 출처는 다른 G.7 템플릿을 사용합니다. G.5
G.6. MEME reader
주 MEME reader는 제공 문맥만 사용하고, 정보가 없으면 없다고 말하며, 값만 짧게 답하도록 요구받습니다. 예비 Abs oracle의 의존성 지시와 complete-store의 과제 정책은 별도 추가 조건입니다. 주 결과와 진단의 지시문을 같다고 가정하면 안 됩니다. G.6
G.7. MemoryAgentBench reader
공통 system 메시지에는 기억과 질의에 따라 답하라는 지시가 들어가고, user 메시지는 출처별 여덟 템플릿 중 하나와 평가 당시 현재 시각을 포함합니다. 정확 검색은 짧은 답·다음 사건·문서 기반 QA를, 테스트 시 학습은 숫자 라벨 분류와 영화 20개 추천을, 장거리 이해는 엄격한 QA 형식과 책 요약을 사용합니다. 충돌 해결은 현실 지식 대신 제공된 synthetic 사실만 따르고 큰 serial number의 최신 사실을 고르게 합니다. 이 차이는 같은 reader여도 과제별 출력·집계가 다른 이유입니다. G.7
G.8. PersonaMem-v2 reader
원래 요청, 관련 선호를 기억하라는 알림, 고정된 순서의 보기, 최종 문자 선택 지시를 한 user 메시지에 넣습니다. 검색에는 알림을 덧붙이기 전 원래 요청만 사용합니다. 객관식 49.62%를 자유 형식 장기 기억 QA와 동일한 척도로 비교하지 않는 이유이기도 합니다. G.8
G.9. Semantic sufficiency judge
DeepSeek-V4-Flash는 질문·gold answer·선택된 근거 excerpt를 보고 외부 상식 없이 정답을 도출할 수 있는지 JSON으로 판정합니다. 시스템 이름과 reader의 실제 답은 보여 주지 않습니다. 다만 excerpt 선택 자체는 gold 값의 첫 대소문자 무시 일치를 사용합니다. 길이가 3자 미만인 값은 제외하고 일치 주변 앞뒤 최대 900자를 모아 9,000자로 자르며, 일치가 없으면 문맥의 첫 9,000자를 씁니다. 따라서 이는 그 선택된 excerpt에 대한 충분성 측정이며, 무제한 전체 문맥에 대한 완전한 판정이라고 부르면 안 됩니다. G.9
G.10. Result and path assessment
경로 평가는 이와 달리 전체 formatted context를 문자 상한 없이 사용합니다. judge에게 hidden-gold contract를 주되 그 계약은 요구사항이지 근거가 아니라고 명시하고, 문맥에 실제로 값·시간 순서·삭제 대상·의존 규칙·상위 변화·연결이 있는지 함께 판단합니다. “예전 값이 검색되지 않았다”는 사실은 삭제의 증거가 아닙니다. 결과·경로 비교 전에는 경로 양성인데 결과 음성인 행이 없는지도 확인합니다. 두 라벨은 같은 joint 판단에서 나오며 Tr-after·Cas-after만 중첩 비교에 사용합니다. G.10
G.11. Dependency-validity control
의존하던 사실이 나중에 바뀌면 이전의 종속 값은 현재 답으로 쓰지 말고, 새로운 값이 명시되지 않았다면 정보가 없다고 답하라는 지시입니다. 값을 노출하지 않는 규칙이지만 reader 행동을 바꾸는 추가 지시인 것은 맞습니다. Table 2의 Abs와 Overall을 읽을 때 이 조건을 함께 붙여야 합니다. G.11
G.12. Complete-store task policy
이 정책은 질문 단계·과제 종류·대상 엔터티 식별자를 주며, 시간순 로그에서 나중의 유효한 갱신을 우선하도록 합니다. 분기는 before 상태, cascade, absence, deletion, tracking, aggregation, exact recall 순으로 적용됩니다. before에서는 아직 일어나지 않은 조건부 변화를 적용하지 않고, deletion에서는 삭제를 인정하며 예전 값을 노출하지 않습니다. 정책 토큰도 5,000토큰 예산에 포함됩니다. G.12
이 블록은 근거 뒤에 붙지만 원문 문구에는 “evidence below”가 그대로 남아 있다는 세부사항도 부록이 공개합니다. 값 없는 정책이라도 과제 종류·대상과 상태 전이 의미를 reader에 추가로 알려 줍니다. 선택 단계는 gold를 사용하고 reader 정책은 gold 값을 사용하지 않는다는 구분이 complete-store 실험의 해석을 완성합니다. G.12·C.5
실험 결과 심층 분석
이 논문에서 가장 설득력 있는 결과는 순위 한 줄보다 방법을 바꾸는 실험과 근거를 진단하는 실험을 함께 제시했다는 점입니다. MemoryAgentBench에서 재순위화 제거의 −3.92와 기억 변형의 −5.78~−19.62는 해당 조건의 짝지은 구간으로 뒷받침됩니다. 반면 청크 128~1,024토큰의 전체 차이는 뚜렷하지 않습니다. 무엇이 성능에 민감한지에 대해 서로 다른 강도의 근거를 제공합니다. Table 5·C.6
다만 사실 추출 하락을 정보 손실 하나로 환원하면 설명이 지나치게 단순해집니다. 이 변형은 원문 길이와 ICL 예제 형식·대응 관계를 함께 바꾸고, 원문+요약과 그래프 변형은 원문을 유지하면서도 하락했습니다. 논문 자체가 토큰 수·형식·reader 부조화 등 가능한 요인을 구분하지 못한다고 밝힙니다. 원문을 보존하는 것이 유리하다는 관찰과, 보존 여부만이 유일한 원인이라는 증명은 다릅니다. 부록 C.3·F
Coverage·utilization은 문제를 진단하는 데 유용하지만 “모델이 아는 것”의 절대 측정은 아닙니다. 판정 방식과 excerpt 선택이 있고, utilization은 시스템별 조건부 집합을 사용합니다. MEME 경로 판정은 전체 문맥과 hidden-gold 요구사항을 쓰는 별도 도구입니다. 점수가 다루는 대상이 충분한 근거인지, 정답 값인지, 경로인지, 최종 답인지 구분해야 분석을 재사용할 수 있습니다. 부록 C.1·G.9–G.10
Complete-store의 N→C 상승과 C→R 잔여 차이는 정보 보존을 조사할 실마리를 주지만, 실제 제품이 정답 없이 같은 선택을 할 수 있다는 의미는 아닙니다. 저장소의 시점 복원·표현·포장과 reader 정책이 함께 바뀌고, 상한 제거의 민감도와 공급자 필터 영향도 존재합니다. 이 조건을 유지하면 결과는 강한 진단이며, 조건을 생략하면 과장된 인과 주장으로 바뀝니다. 부록 C.5·A.5.2
마지막으로 시간 결과는 기억 구축·검색 경로의 부담을 명확히 드러내지만, 답변 생성·평가 비용과 저장 크기 증가를 전부 합친 제품 총비용은 아닙니다. 단일 장문 입력의 확장성, 10개 MEME 에피소드의 시스템 간 비교, 11개 MemoryAgentBench 출처의 변형 비교를 각각의 모집단과 실행 조건 안에서 읽는 것이 적절합니다. 부록 A.6·D.6
기술적 함의와 응용
이 연구에서 실무로 가져갈 수 있는 첫 번째 질문은 “어떤 기억 모듈을 붙일까?”보다 “원래 근거가 제대로 도착하는가?”입니다. 이 글의 해석으로는, 장기 대화 QA를 평가할 때 원문 보존, 충분한 후보 검색, 재순위화, 실제 reader 입력량을 명시한 기준선을 먼저 두는 것이 비교를 읽기 쉽게 만듭니다. 이는 저자들이 제시한 기준선·통제의 학습 포인트이며 모든 제품의 최종 설계 처방은 아닙니다. §3·부록 E.3
다음으로 정답 점수 하나와 함께 근거의 충분성·시간 순서·의존 경로를 살펴볼 수 있습니다. 충분한 근거가 없는 실패에는 검색·저장 표현을, 근거가 있는데도 틀리는 실패에는 상태 해석과 reader를 살펴보는 식입니다. 다만 이 구분을 수치화하려면 시스템마다 실제로 전달된 문맥과 판정 조건을 기록해야 합니다. 본문의 utilization을 reader의 고정 능력 점수로 그대로 가져오면 안 됩니다. §5.1–5.2
끝으로 원문 보존과 운영상 기억 관리는 함께 설계할 대상입니다. 권위 있는 현재 상태, 도구 실행, 물리적 삭제, 제한된 저장 공간이 필요한 시스템에서는 오프라인 QA 성능만으로 선택할 수 없습니다. 이 논문이 제공하는 출발점은 복잡성을 없애라는 명령이 아니라, 복잡성이 얻는 이익과 잃는 근거·비용을 강한 기준선 위에서 설명하라는 요구입니다. §6·부록 F