논문 개요와 전체 구조
Jens Lehmann과 Sahar Vahdati의 Can LLMs Improve Their Own Harness? A Controlled Study on ARC-AGI-3는 언어 모델이 자신을 둘러싼 실행 소프트웨어를 만들고, 실행 기록을 보고 수정하며, 그 수정으로 새로운 과제에서 더 좋은 성능을 얻을 수 있는지 조사합니다. 여기서 하네스(harness)는 모델의 관찰 표현, 기억, 도구, 행동 선택, 실패 복구와 추론 예산을 조직하는 실행 프로그램입니다. 모델 가중치는 고정하고 이 프로그램만 바꾸므로, 모델을 학습시키는 능력과 모델을 사용하는 시스템을 개선하는 능력을 구분할 수 있습니다. 이 리뷰는 arXiv 2610.30499v1 원문과 동일 버전 PDF를 기준으로 합니다.
저자들은 ARC-AGI-3의 공개 게임 25개를 개발용 5개와 수정 과정에 피드백을 주지 않는 평가용 20개로 나누었습니다. 9개 모델·추론 노력 조건에서 독립적으로 3회씩 하네스를 만들고, 각 하네스를 두 번 수정했습니다. 따라서 독립 계보(lineage)는 27개, 동결된 스냅샷은 81개이며, 각 스냅샷의 25게임 평가를 합치면 2,025회입니다. 핵심 결과는 개발 점수의 평균 향상 +8.42점에 비해 holdout 향상은 +2.80점이고, 후자의 95% bootstrap 구간은 [−1.44, 7.35]라는 점입니다. 이는 관측된 평균 이득과 그 불확실성을 함께 보고해야 하는 결과입니다. §4–5
논문은 번호가 있는 본문 1–9절 뒤에 AI 사용·재현성 진술과 참고문헌을 두고, 부록 A–G로 실험과 감사 근거를 확장합니다. 아래 구조와 챕터별 설명은 이 순서를 따릅니다.
| 순서 | 원문 제목과 내부 구조 | 역할 |
|---|---|---|
| 1 | Introduction | 하네스 구성 능력과 자기개선 능력의 차이를 제기합니다. |
| 2 | Harness Adaptation as a Capability | 두 실행 루프, 적응 격차, 성능·비용 평가를 정의합니다. |
| 3 | Related Work | 자기수정, 자동 에이전트 설계, 개선 평가, ARC 하네스를 연결합니다. |
| 4 | Experimental Design → 4.1 ARC-AGI-3: An Interactive Reasoning Challenge → 4.2 Autonomous construction and revision | 게임, 두 하네스, 생성·수정·평가 절차를 설명합니다. |
| 5 | Quantitative Results | 전이, 비용, 실행 변동을 보고합니다. |
| 6 | What Models Build and How They Revise → 6.1 What harness designs emerge, and how do they change? → 6.2 Which revision behaviors accompany held-out improvement? | 구조 변화와 결과를 가린 과정 코딩을 분석합니다. |
| 7–9 | Discussion → Limitations → Conclusion | 결과의 의미와 명시적 해석 범위를 정리합니다. |
| 후속 진술 | AI Use Statement → Reproducibility Statement → References | AI 사용 책임과 재현 자료를 밝힙니다. |
| A–C | Full Experimental Protocol → Minimal Starting Prompt → Related-System Comparison | 통제 조건, 프롬프트, 선행 시스템 비교를 제공합니다. |
| D | Additional Quantitative Results → D.1 Fixed-harness execution variance | 전체 궤적, 비용, 선택, 반복 실행·게임 민감도를 보완합니다. |
| E–G | Harness and Strategy Audit → Capability Codebook and Sampling → Campaign Integrity and Recovery Audit | 소스 변경, 코딩 신뢰도, 복구·보존 감사를 제공합니다. |
핵심 기여와 혁신성
문제의 중요성은 에이전트 성능이 모델 자체에만 귀속되지 않는다는 데 있습니다. 인간 개발자가 오류를 읽고 표현·기억·도구를 바꾸면 시스템은 좋아질 수 있지만, 그 결과만으로 시스템이 스스로 개선했다고 보기는 어렵습니다. 저자들은 이미 강한 인간 주도 하네스가 존재하는 ARC-AGI-3를 사용해, 같은 종류의 설계 일을 모델에 맡겼을 때 무엇이 가능한지 묻습니다. 기존 시스템의 점수는 가능한 성능의 참고이며, 인간 주도 여부의 인과효과를 분리한 대조군은 아닙니다. §1, §7
첫째 기여는 하네스 적응 격차를 명시한 것입니다. 피드백을 제공한 과제에서 개선됐다는 사실과 피드백을 제공하지 않은 과제에서도 개선됐다는 사실을 별도로 측정합니다. 둘째는 가장 좋은 후보 하나만 보여주는 대신, 독립적으로 구성한 모든 계보와 예정된 두 후손을 모두 평가한 설계입니다. 이 방식은 생성 성공, 인터페이스 복구, 실질적 소스 변경, 일반화된 성능 개선을 서로 혼동하지 않게 합니다. 셋째는 54개 수정 에피소드를 결과가 보이지 않는 상태로 두 번 코딩하고, 코딩 일치도까지 공개한 과정 분석입니다. §1–2, §6.2
리뷰어 관점에서 이 연구의 학습 가치는 새로운 최고 점수보다 개선을 검증하는 실험 단위에 있습니다. 이전 시스템을 보존하고, 동일한 모델·실행 조건에서 후손과 짝지어 비교하며, 비용과 실패까지 함께 기록하는 방식은 에이전트 평가를 이해하는 구체적인 사례가 됩니다. 다만 본 연구는 고정된 게임 분할과 두 번의 수정에 대한 결과이며, 장기적인 재귀적 능력 가속을 입증하지는 않습니다. 이 경계는 저자들도 명시합니다. §7–8
기술적 세부사항
모델은 같지만, 코딩 하네스와 과제 하네스는 다릅니다
원문은 시스템을 $S_t=(M,H_t)$로 나타냅니다. $M$은 고정된 사전학습 모델 프로필이고 $H_t$는 단계 $t$의 실행 가능한 게임 하네스입니다. 게임을 푸는 내부 루프에서는 $H_t$가 관찰 이력을 행동으로 바꿉니다. 소프트웨어를 고치는 외부 루프에서는 같은 모델이 고정된 범용 코딩 부트스트랩 $H_{\mathrm{boot}}$를 통해 파일을 읽고 수정합니다. 이 연구에서 부트스트랩은 OpenCode이며, 생성되는 게임 하네스 자체와 구분해야 합니다. §2
$U$는 수정 절차이고, $E_t^{\mathrm{dev}}$는 개발 게임에서 얻은 추적 기록·점수·행동·비용 묶음입니다. $H_{\mathrm{boot}}$를 고정하기 때문에 이 식은 코딩 도구 자체가 재귀적으로 바뀌는 실험을 뜻하지 않습니다. 각 계보는 초기 $H_0$, 첫 수정 $H_1$, 둘째 수정 $H_2$를 남깁니다.
적응 격차와 평균의 분모
$J_{\mathcal D}(H_t;M)$은 과제 분포에서의 기대 효용이며, 실험에서는 게임별 RHAE의 산술평균으로 추정합니다. 개발 평균의 분모는 5게임, holdout 평균의 분모는 20게임입니다. 계보별 단계 차이를 계산하고 27계보에 대해 평균내므로, 2,025개 게임 평가를 모두 독립 표본으로 취급하는 분석이 아닙니다. §2, 부록 D
$G_t>0$이면 개발 게임의 향상이 holdout 향상보다 큽니다. 최종 단계에서는 8.42−2.80=5.62점입니다. 이 차이는 원래 개발·평가 점수의 절대 격차가 아니라 각 분할에서 초기 대비 얼마나 변했는지의 차이입니다.
$C_{\mathrm{run}}$은 과제당 실행 추론 비용, $C_{\mathrm{outer}}$는 해당 단계까지 구성·수정하는 데 든 누적 추론 비용입니다. 음수는 비용이 낮을수록 좋다는 방향을 나타냅니다. 실제 Pareto 비교는 holdout 성능과 게임당 배포 추론 비용의 두 축을 사용하며 외부 루프 지출은 별도 집계합니다.
RHAE는 완주와 행동 효율을 함께 봅니다
Relative Human Action Efficiency는 인간 행동 수 기준에 상대적인 효율을 나타내는 게임 점수입니다. 부록 A에서 레벨 $\ell$의 인간 기준 행동 수를 $b_\ell$, 시스템 행동 수를 $a_\ell$로 둡니다. $5b_\ell$ 행동 예산 안에 완료한 레벨은 다음 점수를 받고, 그 밖의 레벨은 0점입니다.
적은 행동으로 풀수록 첫 항이 커지지만 레벨별 상한은 115입니다. 뒤 레벨일수록 가중치 $w_\ell$가 큽니다. 총 $L$개 레벨 중 완료한 연속 앞부분을 $C$라고 하면 게임 점수는 다음과 같습니다. 부록 A, PDF 15쪽
첫 항은 가중 행동 효율, 둘째 항은 가중 완료율에 따른 상한입니다. 따라서 일부 레벨을 매우 빠르게 해결해도 미완료 부분의 점수를 대신 얻을 수 없습니다. 행동 수가 줄었다는 사실만으로 효율 향상이라고 결론 내릴 수 없는 이유도 여기에 있습니다. 일찍 중단한 시스템 역시 적은 행동을 사용할 수 있기 때문입니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
첫 절은 “모델의 능력”을 실제 실행 시스템으로 확장하는 문제 제기입니다. 관찰을 어떻게 보여주고, 무엇을 기억하며, 언제 도구와 모델을 부를지 결정하는 프로그램은 시스템 행동에 직접 관여합니다. 저자들은 낯선 상황에서 유용한 기술을 효율적으로 얻는 일반지능의 관점에서, 이 프로그램을 인간 엔지니어만 개선한다면 적응 능력의 일부가 계속 인간에게 남는다고 설명합니다.
이어서 모델 가중치 변경과 하네스 변경을 상호 보완적인 경로로 구분합니다. 하네스는 새 도구 접근, 영속 기억, 여러 모델 호출의 조직을 제공할 수 있습니다. ARC-AGI-3에서는 인간이 방향을 잡은 시스템들이 높은 점수를 보고했으므로, 현재 모델로도 강한 실행 설계가 가능한 환경에서 자율적인 설계·수정 능력을 시험할 수 있습니다. 서론의 단순 벤치마크 하네스 Sol 38.3점과 Claude Code 기반 42.83점은 각각 인용 연구의 조건을 가진 수치이며, 이 논문의 27계보 실험 결과와 같은 표본으로 합치지 않습니다. §1
마지막으로 저자들은 완전한 하네스를 구성한 뒤 자신의 실행 피드백으로 두 번 수정하는 질문을 고정 계보 프로토콜로 바꿉니다. 가장 우수한 후손만 선별해 성과를 제시하기보다 모든 예정 스냅샷을 평가합니다. 이 절의 기여는 구성 능력과 개선 능력을 별개로 측정해야 한다는 평가 문제를 명확히 한 것이며, 다음 절에서 이를 수학적으로 정의합니다.
📖 Chapter 2: Harness Adaptation as a Capability
이 절은 고정 모델 $M$, 수정 대상 $H_t$, 고정 코딩 부트스트랩 $H_{\mathrm{boot}}$의 관계를 먼저 정의합니다. 외부 루프의 모델이 파일·개발 도구를 사용해 게임 하네스를 바꾸고, 내부 루프의 같은 모델이 그 게임 하네스 안에서 환경과 상호작용합니다. MAML·RL²·AdA처럼 제공된 신경 구조와 학습 절차 안에서 적응하는 연구와 달리, 여기서는 사전학습 가중치를 바꾸지 않고 실행 소프트웨어를 구성·수정합니다. §2
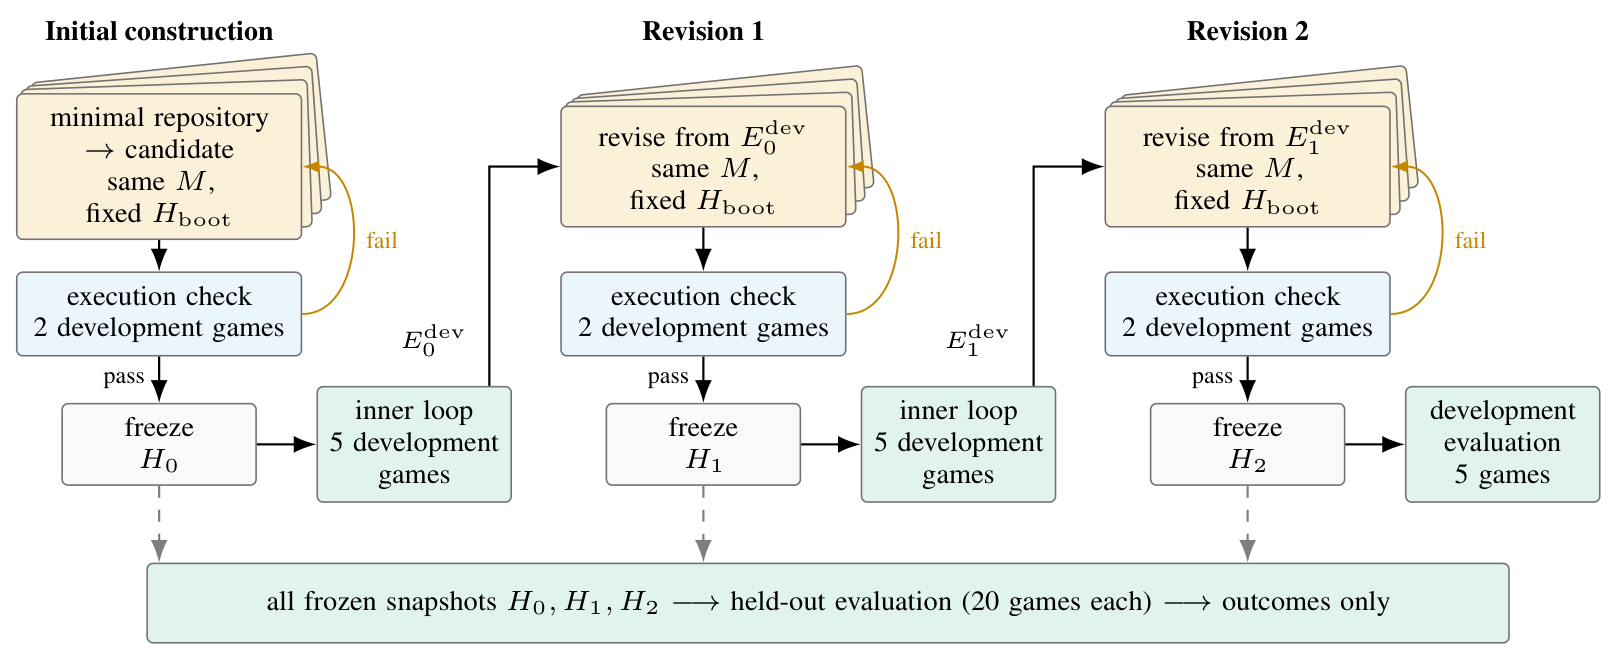
Figure 1, v1 PDF 3쪽. 그림 영역을 크롭했으며 번역·재배열·수치 변경은 없습니다. 두 개발 게임의 실행 검사를 통과한 후보가 동결되고, 5게임 개발 평가는 다음 수정의 근거가 됩니다. 최종 20게임 holdout 화살표는 결과만 산출하며 수정으로 되돌아가지 않습니다.
저자들은 네 능력을 순서대로 분리합니다. 실행 가능한 하네스 구성, 인터페이스·수명주기 실패 복구, 실행 근거를 구체적 수정에 연결하는 능력, 그리고 피드백에서 제외된 과제를 개선하는 수정 선택 능력입니다. 앞의 세 가지가 네 번째를 보장하지 않습니다. 기존 동작을 보존하고 근거가 약할 때 수정을 채택하지 않는 능력도 적응에 포함됩니다.
이어 앞서 정의한 $G_t$로 개발 향상과 전이 향상의 차이를 측정하고, 성능·배포 비용·개발 비용을 공동 평가합니다. Figure 1에서 $H_2$도 개발 게임을 실행하지만 그 결과는 추가 수정을 만들지 않습니다. 이 구분은 “평가했다”와 “학습 피드백으로 사용했다”를 분리합니다. 이 절의 핵심은 평가할 대상을 개별 모델 응답에서 완전한 모델·하네스 시스템으로 옮긴 것이며, 다음 절은 기존 최적화 연구와의 차이를 설명합니다.
📖 Chapter 3: Related Work
첫 소주제인 LLM self-refinement and program optimization에서는 Self-Refine·Reflexion·CRITIC을 응답이나 정책의 수정으로, OPRO·PromptBreeder를 지시문 탐색으로, DSPy·MIPRO·TextGrad·GEPA를 선언된 언어 모델 프로그램 안의 모듈 최적화로 배치합니다. 저자들의 비교축은 결과가 좋은가만이 아니라, 사람이 미리 정한 산출물 스키마나 계산 그래프 중 무엇을 수정할 수 있는가입니다. §3
두 번째 Automated agent and harness design은 최적화 함수·에이전트 코드·워크플로에서 완전한 코딩 에이전트 저장소와 실행 하네스 소스로 범위를 넓힙니다. Meta-Harness와 AHE처럼 점수와 추적 기록으로 하네스를 탐색하는 연구가 이미 있으므로, 본 연구의 차별점은 하네스 수정이라는 아이디어 자체를 처음 제안하는 데 있지 않습니다. 독립 구성된 계보를 예정된 두 번의 수정까지 모두 추적해 최초 능력과 후속 이득·퇴행을 함께 관찰하는 것이 중심입니다.
세 번째 Evaluating autonomous improvement는 변경 완료와 실제 향상이 다를 수 있다는 선행 결과를 다룹니다. SEAGym, Terminal-Bench 기반 진화, HarnessOpt-Bench의 검증 점수 낙관성을 본 논문의 개발·holdout 분리와 연결합니다. 네 번째 Harness design for ARC-AGI-3는 EWM·OPINE-World·PRO-LONG·Tycho 등의 인간 주도 하네스, 게임 중 실행 작업공간을 수정하지만 재사용 하네스는 고정하는 Workspace Optimization을 구분합니다.
이 절의 기여는 “무엇을 바꾸는가, 어떤 선택 절차를 쓰는가, 어떤 과제가 피드백에서 제외되는가”라는 비교축을 확립하는 것입니다. 인용 논문 전체를 이 리뷰에서 재검증한 것은 아니며, 각 연구의 위치는 이 논문이 제시한 비교에 근거합니다. 다음 절에서는 이 비교축을 실제 실험의 통제 조건으로 구체화합니다.
📖 Chapter 4: Experimental Design
4.1 ARC-AGI-3: An Interactive Reasoning Challenge
ARC-AGI-3는 정적인 입력·출력 변환이 아니라 낯선 격자 세계에서 연속 행동을 선택하는 문제입니다. 에이전트는 하나 이상의 64×64 색 격자, 게임 상태, 레벨 진행도, 사용 가능한 행동을 받습니다. 방향 입력, 게임 전용 입력, 좌표 클릭, undo 중 어떤 인터페이스가 제공되는지는 게임마다 다르며, 객체 의미·행동 효과·완료 조건은 알려주지 않습니다. 따라서 관찰하고 개입한 뒤 결과를 비교해 규칙을 알아내야 합니다. §4.1
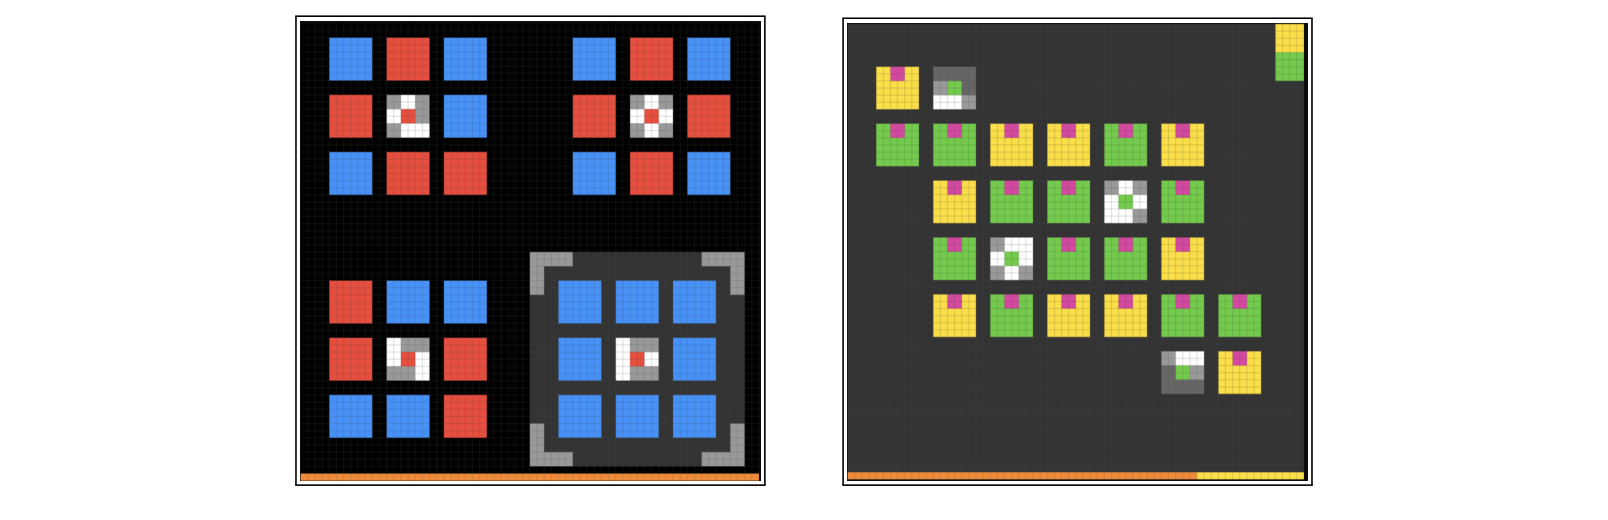
Figure 2, v1 PDF 5쪽. 원문 그림 크롭이며 번역하지 않았습니다. 왼쪽은 Level 1, 오른쪽은 Level 7입니다. 작은 패턴 타일은 기준 색과 같아야 하거나 달라야 하는 이웃을 지정하고, 클릭은 색을 순환시킵니다. 후반에는 여러 타일을 함께 바꾸는 제어가 등장합니다.
저자들은 이 화면을 이미지 그대로, 기호 격자, 객체 요약, 전이 차이 또는 이들의 조합으로 모델에 전달할 수 있다고 설명합니다. 행동 하나와 행동 묶음 중 무엇을 요청할지, 발견한 정책을 코드로 실행할지, 계산을 재사용할지도 하네스가 정합니다. RHAE 외에 행동·완료 레벨·종료 상태·모델 추론 비용을 기록하는 이유는 이러한 설계가 점수뿐 아니라 실행 양상도 바꾸기 때문입니다.
4.2 Autonomous construction and revision
Two harnesses, one model. 각 조건은 모델과 reasoning effort를 묶은 프로필이며, 코딩과 게임 실행에 같은 프로필을 사용합니다. OpenCode는 파일 조회·편집·명령 실행 도구를 제공하는 고정 부트스트랩입니다. 별도로 모델은 Python과 과학 라이브러리, 게임 인터페이스 문서, 모델 호출 클라이언트, 가격 문서를 가진 샌드박스에서 run.sh를 구현합니다. 문제 해결 구조는 지정되지 않으며, 결정적 코드와 모델 추론의 역할도 생성 하네스가 결정합니다.
코딩 세션에는 실제 평가기의 게임·모델 게이트웨이가 노출되지 않습니다. 모델은 로컬 검사와 mock 테스트를 할 수 있고, 종단 간 시험은 컨트롤러의 두 개발 게임 smoke qualification으로 수행합니다. 이 검사는 정상 실행과 상호작용을 확인하는 제한된 자격 검사입니다. 실패하면 같은 모델이 로그를 받아 최대 10주기 복구할 수 있지만, 통과에 RHAE 점수 임계값은 없습니다. 그러므로 자격 통과는 문제 해결 성능의 통과 판정이 아닙니다. §4.2
초기 자격 하네스는 5개 개발 게임을 실행합니다. 첫 수정은 부모 소스·추적·점수·행동·비용의 고정 묶음을 받으며, 생성 파일을 바꾸거나 부모를 유지할 수 있습니다. 같은 절차로 두 번째 수정을 만듭니다. 단계 사이에 인간의 코드 편집이나 자연어 지침은 들어가지 않습니다.
Held-out evaluation. 모든 동결본은 개발 5게임과 holdout 20게임에서 평가됩니다. 후자는 구성·수정·선택의 피드백이 되지 않습니다. 주 비교는 세 단계를 모두 마친 계보에서 초기 대비 둘째 수정의 평균 holdout RHAE 변화이며, 구성 실패는 전체 계획 실행에 대해 따로 보고하도록 설계했습니다. 관측 코호트에서는 27개 모두 세 단계를 마쳤습니다. 동일 행동을 로컬과 공식 서비스에 재생해 점수·진행도 일치를 확인합니다.
Conditions and uncertainty. 7개 모델 계열에 9개 모델·노력 조건, 조건당 3회 독립 구성입니다. 전체 계보를 bootstrap해 단계 간 짝을 보존하며, 조건 간 비교는 기술통계입니다. 이 절의 기여는 수정 대상, 자격 기준, 피드백 경계, 통계 단위를 동시에 고정한 것입니다. 다음 절은 이렇게 생성된 모든 계보에서 실제 전이와 비용이 어떻게 달라졌는지 보여줍니다.
📖 Chapter 5: Quantitative Results
저자들은 먼저 실행 자체의 변동을 제시합니다. 동일한 최종 하네스 하나를 같은 holdout 20게임에서 10회 평가했을 때 표본 표준편차는 3.99점입니다. 모두 해당 계보의 초기 점수보다 높았으므로 그 사례의 큰 향상은 반복되지만, 수점 정도의 단일 관측 차이는 신중하게 읽어야 합니다. 이 진단은 모든 하네스의 잡음을 대표하는 추정이 아닙니다. §5, 부록 D.1
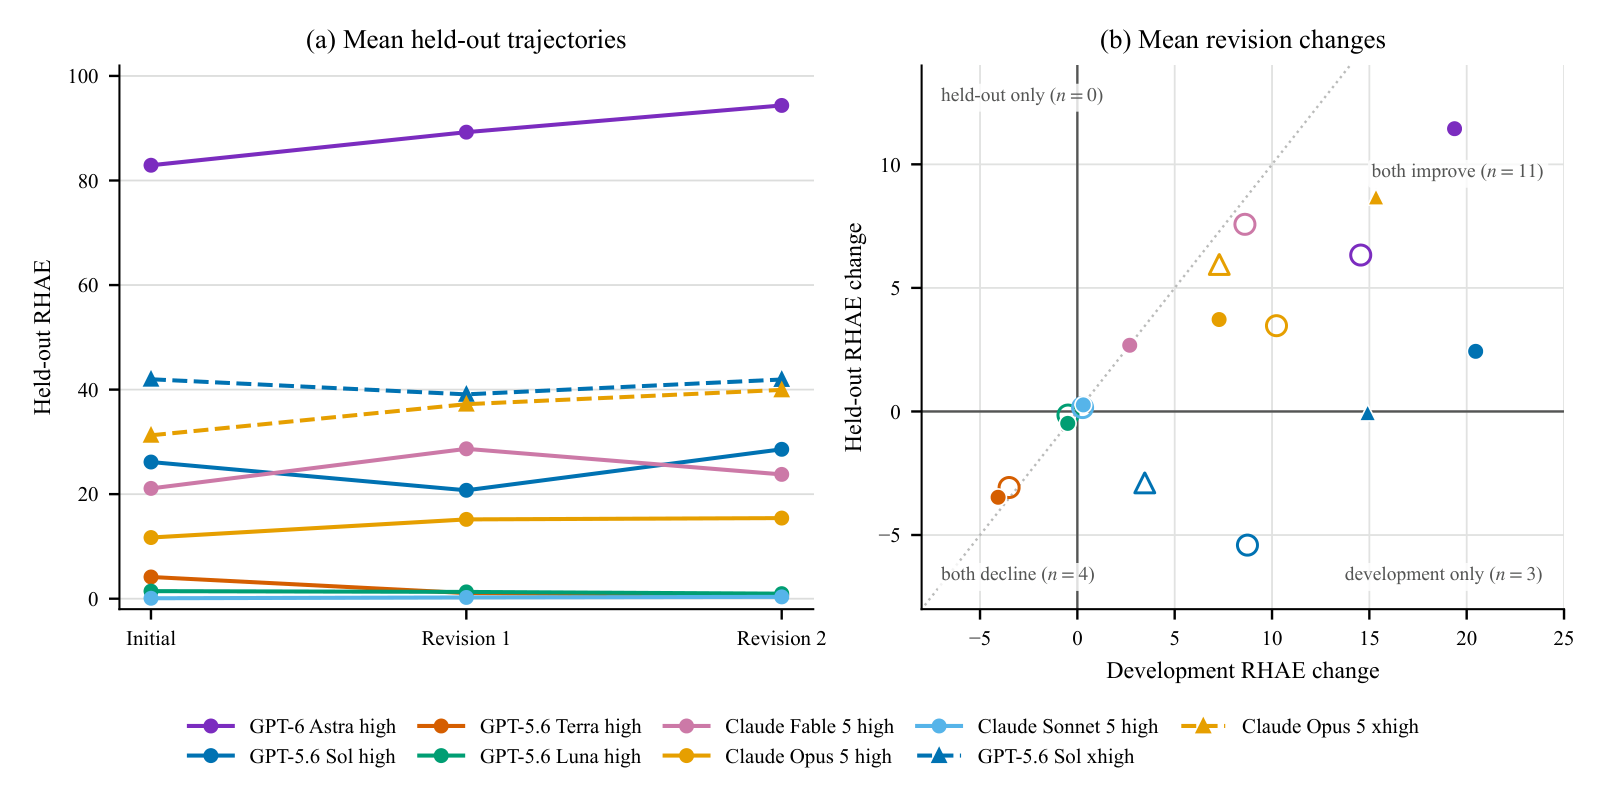
Figure 3 전체, v1 PDF 6쪽. 원문 영역 크롭, 번역 없음. (a)는 조건별 3계보 평균, (b)는 초기 대비 첫째·둘째 수정 변화입니다. 높은 추론 노력은 삼각형으로 표시됩니다.
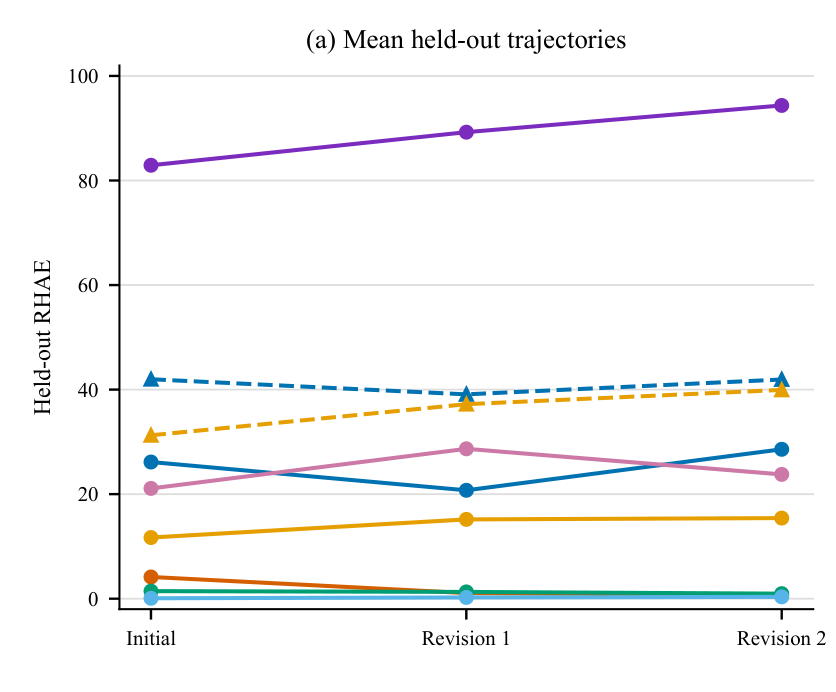
Figure 3(a) 상세 크롭, 같은 PDF 6쪽입니다. 패널 축과 점을 보존했으며 범례는 위 전체 그림과 공통입니다. 초기 성능부터 조건 간 차이가 크므로, 최종 점수와 수정으로 얻은 변화량을 구분해야 합니다.
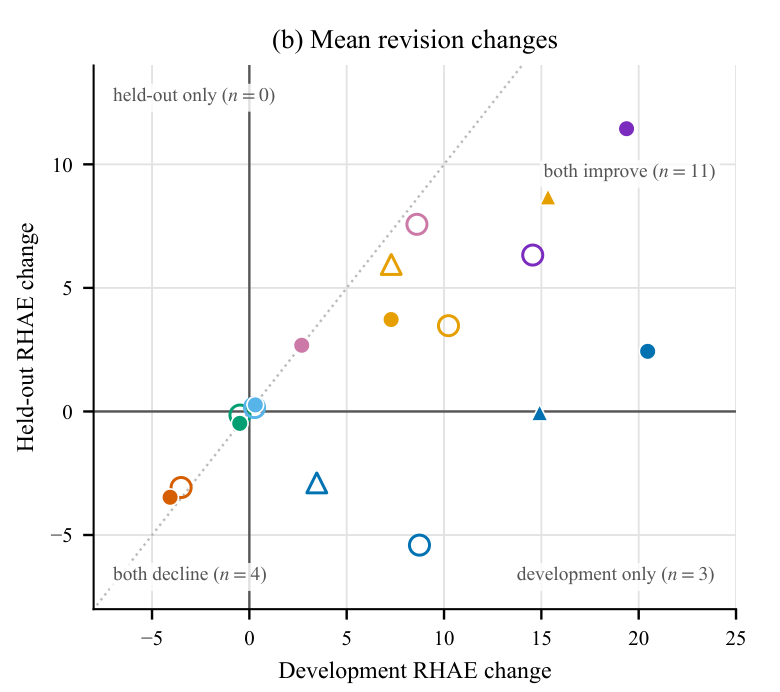
Figure 3(b) 상세 크롭, 같은 PDF 6쪽입니다. 가로축은 개발 변화, 세로축은 holdout 변화이며 빈 점과 찬 점은 각각 첫째·둘째 수정입니다. 18점은 9조건×2수정의 평균 점들로, 54개 개별 수정의 개수를 뜻하지 않습니다. 우하단의 3점은 개발만 좋아지고 holdout은 낮아진 조건·단계 평균입니다.
Held-out gains vary substantially across lineages. 최종 개발 향상은 +8.42점, holdout 향상은 +2.80점이며 후자의 95% 구간은 [−1.44, 7.35]입니다. 엄격한 부호 기준에서는 15계보 향상, 12계보 하락, 동률 0이며 양측 부호검정은 p=.70입니다. ±5점 안을 미결정으로 두면 9향상·3하락·15미결정입니다. 저자들은 이 수를 “수정이 기대 성능을 떨어뜨릴 확률”로 해석하지 않고, 관측된 평가 모음의 결과로 한정합니다.
게임별로 27계보를 평균내면 13게임이 향상되고 7게임이 하락합니다. 가장 큰 평균 이득은 +20.44점, 가장 큰 하락은 −15.03점입니다. 따라서 작은 전체 평균 이득과 특정 게임의 큰 퇴행이 함께 존재합니다.
Development gains overstate transfer. 적응 격차의 평균은 5.62점, 95% 구간은 [1.78, 9.77]입니다. 최종 holdout 평균 이득의 구간이 0을 포함한다는 사실과, 개발 향상이 holdout 향상을 초과하는 격차의 구간이 양수라는 사실은 다른 주장입니다. 개발 점수가 가장 높은 스냅샷을 고르는 사후 진단은 초기 대비 holdout +4.53점, 구간 [0.81, 8.68]을 얻지만 게임당 비용은 9.15달러로, 무조건 최종본을 배포할 때의 7.57달러보다 높습니다. 이 선택 규칙의 사전 명시 실험은 수행되지 않았습니다.
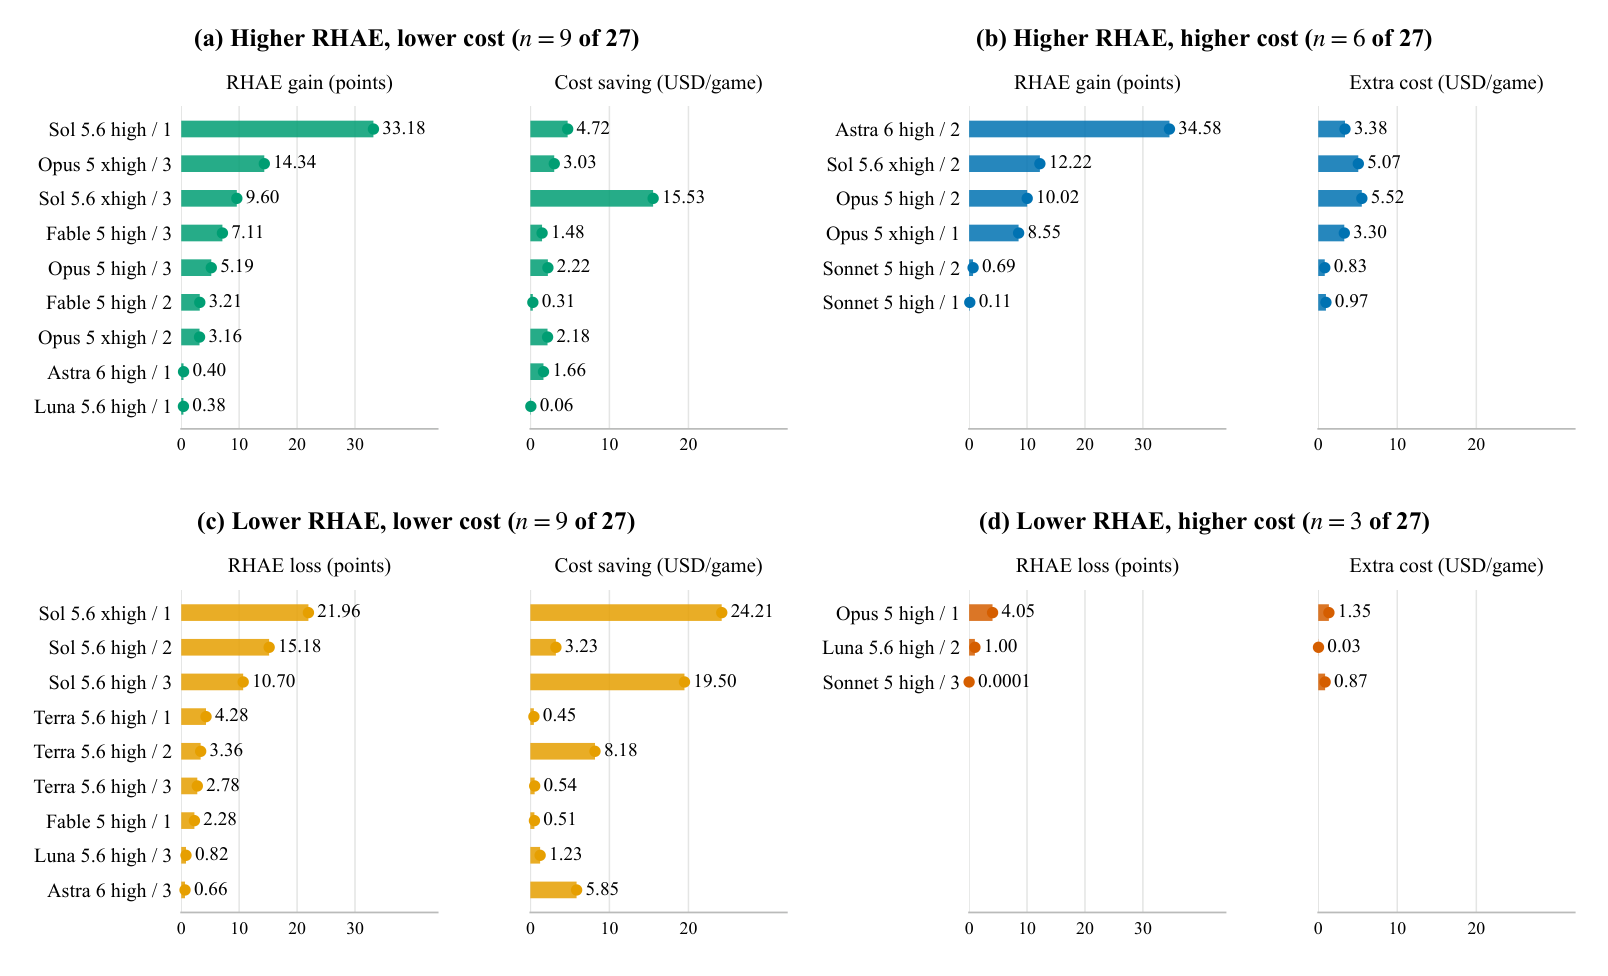
Figure 4 전체, v1 PDF 7쪽. 원문 영역 크롭, 번역 없음. 행은 조건·반복 실행이며, 각 범주 안의 두 막대는 RHAE 변화 크기와 게임당 달러 비용 변화 크기입니다. 패널마다 증가·감소 방향을 제목으로 명시하므로 부호를 혼동하지 않아야 합니다.
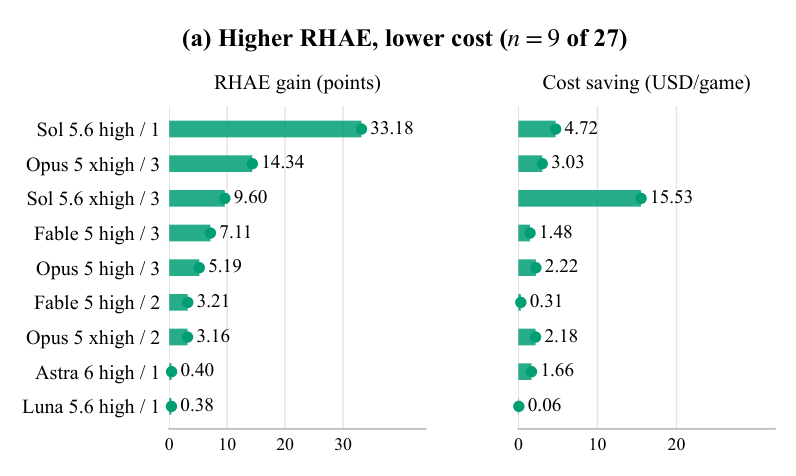
Figure 4(a) 상세 크롭, 같은 PDF 7쪽입니다. 점수 상승과 비용 하락을 동시에 달성한 9/27계보를 보여줍니다. 번역·수치 변경은 없습니다.
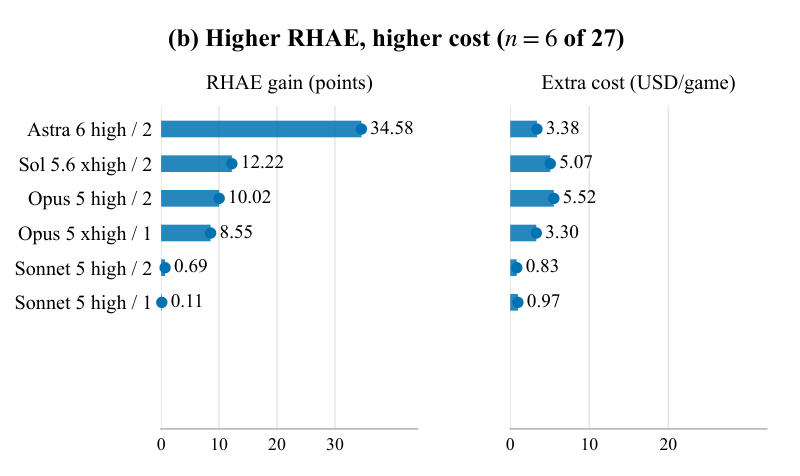
Figure 4(b) 상세 크롭, 같은 PDF 7쪽입니다. 6/27계보는 더 높은 추론 지출과 함께 점수가 올랐습니다. 번역·수치 변경은 없습니다.
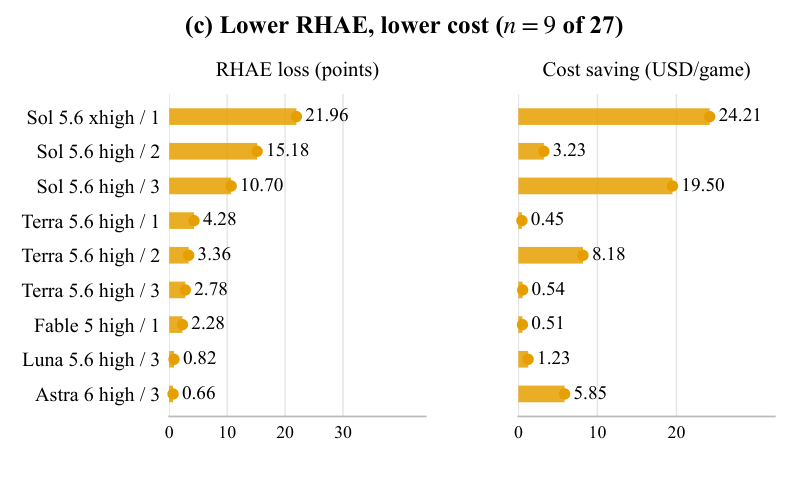
Figure 4(c) 상세 크롭, 같은 PDF 7쪽입니다. 비용이 낮아진 후손 중 절반인 9계보는 성능도 하락했습니다. 번역·수치 변경은 없습니다.
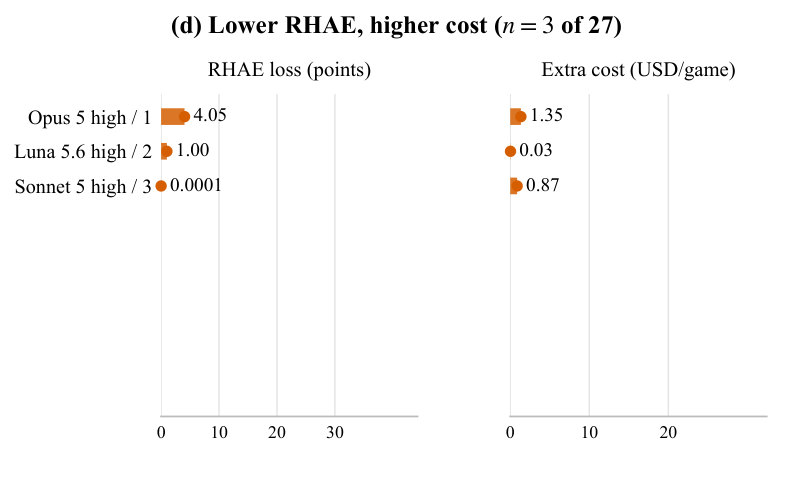
Figure 4(d) 상세 크롭, 같은 PDF 7쪽입니다. 3/27계보는 두 축 모두 악화되었습니다. 네 상세 그림은 원문의 공통 선형 축과 단위를 유지합니다.
Half of the cheaper final harnesses also improve performance. 배포 비용은 각 스냅샷의 holdout 20게임에 대한 논리적 추론 비용 평균이며, 선택된 실행 안에서 재생된 응답도 가격을 부여합니다. 9계보는 점수·비용 Pareto 개선, 6계보는 점수·비용 동반 증가, 9계보는 비용·점수 동반 감소, 3계보는 둘 다 악화입니다. 비용 변화 평균 −2.72달러와 중앙값 −0.54달러의 차이는 절감 폭이 균등하지 않음을 보여줍니다.
전체 실험은 고정 출판 가격표 기준 최소 18,129.27달러의 추론에 해당합니다. 이 절의 기여는 점수 하나의 개선 여부를 전이·실행 변동·배포 비용·구성 비용으로 분해한 것입니다. 다음 절은 어떤 하네스가 만들어졌으며 수정 과정에서 어떤 행동이 관찰됐는지를 분석합니다.
📖 Chapter 6: What Models Build and How They Revise
6.1 What harness designs emerge, and how do they change?
모델은 단순 직접 제어기뿐 아니라 휴리스틱 우선 시스템, 전략가·실행기 혼합, 지속 매뉴얼, 명시적 세계모델, 재생 시스템, 결정적 계획기, 추론 예산 관리기 등을 만들었습니다. 같은 조건의 반복 실행에서도 구조가 달라집니다. 이 다양성은 초기 프롬프트가 해결 구조를 지정하지 않은 실험의 관측 결과입니다. §6.1
저자들의 사후 구조 감사는 Preserve를 현재 정책의 복구·조정, Extend를 같은 의사결정 루프 안에서 능력 추가, Reorient를 제어 우선순위·맥락 지속성·재생·행동 또는 추론 스케줄의 실질적 변경, Replace를 하네스 계열 교체로 정의합니다. 결과를 볼 수 있는 구조 분류이며, 다음 6.2절의 결과를 가린 능력 코딩과는 별개입니다.
첫 수정의 Preserve/Extend/Reorient는 1/4/22, 둘째 수정은 3/12/12입니다. Replace는 없습니다. 기억·지각·배치·재생·자원 할당을 상당히 재조직해도 넓은 하네스 계열은 유지됐습니다. Sol-high의 한 수정은 행동 예산과 비효율적인 기억 사용, 관찰 표현을 바꾸며 RHAE 29.24→53.56을 얻었지만, Sol-xhigh의 다른 계보는 호출·맥락 구조를 바꾸며 43.95→21.99로 낮아졌습니다. 코드가 실제로 많이 바뀌었다는 것과 개선에 성공했다는 것은 서로 다른 증거입니다.
6.2 Which revision behaviors accompany held-out improvement?
Corpus and codebook. 54개 부모→후손 에피소드에는 70개 updater 세션이 포함됩니다. 코딩 패킷은 당시 피드백, 시간 순서 메시지·도구 사건, 정확한 선택 시스템 diff, 근접 테스트·smoke 결과를 담습니다. 모델·조건 이름, 계보 식별자, 미래 단계, 수정 후 개발·holdout 결과는 가립니다. 코드는 근거 사용, 계획과 실행 변경, 검증, 결과 후 적응을 측정합니다. §6.2
Blinding and reliability. GPT-5.6 Sol xhigh가 동결된 코드북으로 패킷을 두 번 독립 코딩했으며, 합의 라벨을 고정한 뒤 결과와 연결했습니다. 이는 독립 인간 평가자와의 일치를 확인한 절차가 아닙니다. 저자들은 일치율, 순서형 범주의 차이를 반영하는 가중 Cohen κ, 명목 불일치를 반영하는 Krippendorff α를 함께 보고합니다. Scope κ=.96, 결과 후 Adapt=.84, Plan=.70은 탐색 기준 .67을 넘지만 Plan은 27패킷에서 계획 구간이 없으므로 결과 연관 해석에서 제외합니다. Probe=.66, Diag=.35, Protect=.47, Meta=.29도 기준 미달입니다.
Do broader edits accompany larger gains? 모든 에피소드가 항목별 개발 근거를 읽었고, 최종 diff는 최소 한 개의 적격 근거 기반 문제를 대상으로 했으며, 선택된 후손은 근접 운용 검사를 통과했습니다. 이 공통적인 과정 성공에도 holdout 결과는 달랐습니다. 넓은 수정은 즉시 부모 대비 평균 +3.75점, 범위를 제한한 수정은 −0.20점이지만, 비교 구간은 0을 포함합니다. 따라서 “큰 재작성이 더 좋다”는 규칙으로 일반화할 근거는 없습니다.
How do reactive revision episodes differ? 36에피소드는 최종 결과를 변경과 연결한 뒤 넘겼으며 평균 변화 +2.48점입니다. 18에피소드는 결과를 보고 추가 편집·되돌리기·테스트·범위 변경·기준 기반 중단을 했고 평균 −0.76점입니다. 차이 −3.24점의 구간 역시 0을 포함합니다. 부모 성능, 복구 노력, 시도한 변경이 함께 다르므로 추가 복구가 유해하거나 유익하다는 인과결론을 내리지 않습니다.
이 절의 핵심은 수정 과정을 평가 가능한 관측 변수로 바꾸되, 코딩 신뢰도와 결측을 통과한 변수만 결과에 연결하는 것입니다. 다음 논의는 구성·수정이 활발하다는 사실과 안정적인 향상이 확보되지 않았다는 사실을 함께 해석합니다.
📖 Chapter 7: Discussion
Construction strength does not ensure consistent improvement. 저자들은 큰 이득의 계보와 유용한 평균 향상 가능성을 인정하면서도, 개발 향상이 holdout으로 일관되게 이전되지 않는다고 해석합니다. 여기서 신뢰성이란 새로운 과제에서 반복적으로 이득을 얻고 기존 능력을 보존하는 능력입니다. 단일 관측의 하락이 곧 기대 성능에 대한 확정적 손실을 뜻하지 않는다는 경계도 유지합니다. §7
A gap to human-steered harnesses remains. 같은 Opus 5 xhigh에서 Tycho는 모든 공개 게임 100점을 보고한 반면 본 연구의 최종 holdout 평균은 39.95입니다. 같은 개발 5게임을 지정했더라도 Tycho는 전체 공개 25게임을 정책 선택에 사용했습니다. Sol의 max와 본 연구 high/xhigh는 노력 라벨도 다릅니다. 저자들은 이를 더 강한 하네스가 가능하다는 여지로 읽으며, 인간 주도의 순수 효과나 동등한 효율을 입증한 비교로 보지 않습니다.
Abstention is part of adaptation. 부모 보존이 허용됐지만 모든 계보가 구현을 바꿨습니다. 저자들은 수정을 만드는 일과 배포할지 결정하는 일을 분리하고, 보존한 기준 시스템과 비교해 교체를 정당화하지 못하면 거절·되돌리기를 해야 한다고 주장합니다. 사후 개발 점수 선택 진단과 RRSI의 예산·잡음·비용을 고려한 채택 규칙을 이 논의의 근거로 사용합니다.
Implications for autonomous improvement. 하네스 변경은 고정 가중치가 수행하는 방식을 바꾸며 모델 학습을 보완합니다. 저자들은 모델 개선과 하네스 개선이 상호 작용할 가능성을 논의하지만, 지속적인 가속이나 그 위험에 관한 주장은 더 긴 실행, 넓은 과제, 스스로 바뀔 수 있는 updater를 필요로 한다고 명시합니다. 이 절의 기여는 현재 결과에서 가능한 주장과 추가 조건이 필요한 주장을 분리한 것이며, 다음 절은 연구가 직접 밝힌 한계를 모읍니다.
📖 Chapter 8: Limitations
첫째, 연구는 하나의 벤치마크·하나의 피드백 분할·두 번의 수정만 사용합니다. 다른 과제와 더 긴 개선 연속에서의 행동은 열려 있습니다. 게임이 공개되어 있으므로 일부 모델이 학습 중 접했을 가능성도 저자들이 명시합니다. 여기서 holdout은 수정 과정의 피드백에서 제외됨을 뜻하며, 사전학습 데이터에서 전혀 본 적 없는 게임임을 뜻하지 않습니다. §8
둘째, 조건당 3회로는 작은 모델 차이에 불확실성이 남고, 고정 하네스도 실행마다 달라집니다. 모든 평가를 반복하지 않았으므로 개별 이득·하락의 일부는 실행 변동일 수 있습니다. 셋째, 추론 지출이 서로 달라 점수와 비용을 함께 보여주더라도 모델 능력·하네스 설계·지출의 효과를 독립적으로 분해하지는 못합니다.
넷째, 수정 행동은 두 LLM 코딩 패스로 평가했으며 독립 인간 코딩과의 일치를 측정하지 않았습니다. 요약 실행 기록은 맥락·사건 순서를 잃을 수 있어 신뢰도나 관측 범위가 부족한 라벨을 제외합니다. 에피소드마다 출발 하네스와 고칠 문제가 다르므로 연관은 인과효과가 아닙니다. 이 절은 결과 해석의 명시적 경계를 제공하며, 다음 결론이 과도하게 확장되지 않도록 합니다.
📖 Chapter 9: Conclusion
저자들은 고정 모델 가중치에서도 시스템이 실행 소프트웨어를 상당한 수준으로 자율 구성할 수 있다고 결론짓습니다. 다만 실행 경험을 holdout 향상으로 전환하는 능력은 덜 안정적입니다. 개발 향상과 더 낮은 추론 비용이 holdout 퇴행과 공존하며, 더 저렴해진 최종 하네스의 절반은 성능을 잃었습니다. §9
따라서 좋은 모델·하네스 시스템을 갖는 것과 그 시스템이 자율적으로 자신을 개선할 수 있는 것은 구분해야 합니다. 결론의 중심 과제는 기존 강점을 보존하면서 여러 과제의 능력을 누적하는 것입니다. 이는 저자들의 논문 내 결론이며, 이 리뷰에서 새로운 연구 과제를 덧붙인 것이 아닙니다.
📖 Chapter AI Use Statement: AI Use Statement
저자들은 언어 모델 보조가 실험 인프라 구현, 코드·방법론 검토, 문헌 탐색, 해석 점검, 원고 편집, 결과를 가린 정성 코딩을 지원했다고 밝힙니다. 초기 아이디어, 프로토콜·데이터 선택, 분석·주장 검증과 최종 원고에 대한 책임은 저자들에게 있다고 명시합니다. 이 진술은 특히 앞선 두 코딩 패스의 성격을 이해하는 근거입니다. AI Use Statement, PDF 10쪽
📖 Chapter Reproducibility Statement: Reproducibility Statement
재현성 진술은 부록 A–B의 프로토콜·프롬프트, C의 비교, D–F의 추가 결과·전략 감사·코딩 방법을 연결합니다. 부록 G와 부속 자료에는 정리된 프레임워크, 동결 프롬프트·분할, 선택 소스 스냅샷, 분석표, 결정적 재현 스크립트, 체크섬 manifest가 포함된다고 설명합니다. 본 리뷰는 논문 HTML·PDF를 분석했으며, 이 부속 압축파일을 실행하거나 독립적으로 실험을 재현하지 않았습니다. Reproducibility Statement, PDF 10쪽
📖 Chapter References: References
참고문헌은 자기수정·프롬프트 최적화·에이전트 설계·일반지능 측정·자원 합리성·정성 코딩 신뢰도·ARC 시스템을 연결합니다. 이 리뷰에서의 역할은 저자들이 어떤 개념적·실험적 계보 위에 연구를 놓았는지 확인하는 것입니다. 인용 연구의 수치는 본 논문이 제시한 조건과 함께 설명했으며, 참고문헌 전체를 별도로 읽거나 재현했다고 주장하지 않습니다. 본문 뒤 참고문헌을 거쳐 다음 부록은 본 연구 자체의 운용 세부사항으로 돌아갑니다. References, PDF 10–13쪽
📖 Chapter Appendix A: Full Experimental Protocol
Repository boundary. 시작 저장소는 과제 계약, 로컬 엔진·통제 모델 클라이언트, 가격 문서, 진입점 계약을 제공합니다. 해결 아키텍처·게임 규칙·예제·재사용 정책은 주지 않습니다. 생성 시스템에는 인터넷, 게임 간 상태, 다른 게임 인스턴스 접근이 없습니다. 부트스트랩 OpenCode의 바이너리·어댑터 지문도 기록하며, 코딩과 별개로 결과를 가린 주석 작업에는 Codex를 사용했다고 설명합니다. 부록 A
Development split. 캠페인 전에 무작위 선택한 개발 게임은 tr87, vc33, r11l, bp35, ft09입니다. 나머지 공개 20게임이 피드백 holdout입니다. 자격 검사 2게임은 개발 분할에서 클릭·키보드 인터페이스를 시험하도록 선택했습니다.
Stage lifecycle. 단계마다 선택 후보 하나를 둡니다. 자격 검사는 게임당 예산에 산입되는 행동 50회, 완료 레벨 2개 또는 승리에서 멈추며, 각 게임에서 예산에 산입되는 행동·정상 종료·등록된 중단 경계를 요구합니다. 여기서 계상 행동은 게임의 행동 예산에 산입되는 입력이며 모델 추론의 달러 과금과 별개입니다. 점수 문턱은 없습니다. 실패 시 최대 10복구 주기를 허용하고, 실패 복구·보고서 마무리 시도도 감사 원장에 남깁니다.
Hosted replay. 생성 정책은 로컬 엔진과만 상호작용합니다. 컨트롤러가 행동·관찰 추적을 동결한 뒤 로컬 재생과 짧은 공식 scorecard 검증을 수행합니다. 공식 서비스의 반응이 생성 정책의 행동을 바꾸는 경로는 없습니다. 관찰·점수 일치를 요구하되, 부록 G의 좁은 시각 잡음 예외를 명시합니다.
Construction replacement policy. 구성 교체는 모델 생성 행동 바깥의 컨트롤러·전송·호스팅 실패에만 허용합니다. 문법 오류, 잘못된 프로토콜, 복구 예산 고갈, 자격 실패는 모델·하네스 결과로 남깁니다. 보존된 연구 코호트의 모든 계획 구성은 초기 자격 시스템을 만들었습니다.
| 모델 프로필 | 노력 | 공시 맥락 창 | 게임 응답 출력 상한 |
|---|---|---|---|
| GPT-6 Astra | high | 1.05M | 64K |
| GPT-5.6 Sol | high | 1.05M | 120K |
| GPT-5.6 Terra | high | 1.05M | 120K |
| GPT-5.6 Luna | high | 1.05M | 120K |
| Claude Fable 5 | high | 1.00M | 120K |
| Claude Opus 5 | high | 1.00M | 120K |
| Claude Sonnet 5 | high | 1.00M | 120K |
| GPT-5.6 Sol | xhigh | 1.05M | 120K |
| Claude Opus 5 | xhigh | 1.00M | 120K |
원문 Table 1, PDF 14쪽의 전사입니다. 모델 명칭·창·상한은 논문의 고정 실험 조건이며 현재 서비스 사양을 안내하는 표가 아닙니다.
Resource bounds. 코딩과 게임 세션은 각각 24시간, 작업공간·스냅샷은 1GiB, 모델 호출 재시도 예산은 3,600초입니다. 코딩 출력 상한은 GPT-5.6·Claude 128K, Astra 64K입니다. 게임 전체에 공통 달러 총액·모델 호출 수 상한은 없으며, 지출을 측정하고 경제적인 사용을 지시합니다. 동일 절차가 동일 지출을 뜻하지 않는 중요한 조건입니다.
RHAE definition. 마지막은 앞서 기술적 세부사항에서 전사한 레벨 점수·가중 게임 점수 식입니다. 사람 기준은 숨겨져 있고, 미완료 레벨은 0이며 가중 완료율이 총점을 제한합니다. 이 부록의 기여는 허용된 자율성과 고정된 통제 경계를 명시한 것입니다. 다음 부록은 이 자유도가 실제 시작 프롬프트에 어떻게 반영되는지 보여줍니다.
📖 Chapter Appendix B: Minimal Starting Prompt
프롬프트는 자율적으로 완전한 시스템을 구현·시험·문서화하고 사람에게 입력을 요청하지 말라고 지시합니다. 목표는 높은 RHAE를 우선하되 추론을 경제적으로 사용하는 것이며, 의미 있는 RHAE 향상을 합리적으로 기대할 때 추가 추론을 쓰도록 합니다. 같은 점수라면 적은 게임 행동을 선호합니다. 부록 B
실행 때는 현재 게임 하나만 받고 그 실행의 관찰로 규칙을 추론해야 합니다. Python 3.12, 인터넷·다른 게임 접근 금지, 제공된 llm_client.py만을 통한 지정 모델 호출, 읽기 전용 제공 파일, 비대화형 ./run.sh --game <game-id> --out-dir <directory> 진입점을 명시합니다. 모델 표시 이름과 노력 설정만 치환하며, 시각 표현·기억·계획·게임별 규칙은 정하지 않습니다. 이 부록은 다양한 하네스가 인간의 미리 정한 해결 설계에서 나온 것인지 판별하는 근거이며, 다음 비교표는 수정 자유도와 평가 절차를 선행 시스템에 대비합니다.
📖 Chapter Appendix C: Related-System Comparison
Table 2는 수정 산출물, 일정, 최종 근거, 본 연구와의 차이를 비교합니다. STOP은 최적화 함수, ADAS는 코드 정의 에이전트 함수, AFlow·GEPA는 워크플로·프롬프트를 다룹니다. SICA·DGM은 완전한 코딩 에이전트 코드와 archive 탐색, Meta-Harness·AHE는 여러 차례 점수·추적 탐색 후 선택된 하네스에 초점을 둡니다. RRSI는 20–40라운드의 정규화 제안·채택을 실험하며, HarnessCompass는 최소 Bash 하네스의 5라운드 이후 손대지 않은 450과제를 평가합니다. 부록 C, Table 2
HUIB·SEAGym·Rethinking은 기술·프롬프트·기억·초기 하네스의 사용과 퇴행·예산 배분을, HarnessOpt-Bench는 신뢰 실행 아래 후보 탐색·최종 지명을, Workspace Optimization은 게임 안에서의 구조화 작업공간 복구를 다룹니다. HUIB가 유용한 업데이트를 만드는 능력과 업데이트된 산출물을 사용하는 능력을 분리한다면, 본 연구는 한 모델 프로필이 두 역할을 맡습니다.
표의 strict test는 테스트 과제가 제안·채택·중단·후보 선택에 영향을 주지 않는 조건을 뜻합니다. 본 연구는 정확히 두 수정의 모든 스냅샷을 평가하고, 자격을 갖춘 후손 사이에서 성능으로 선택하지 않습니다. 이 부록의 기여는 최종 점수를 서로 다른 탐색·선택 절차와 혼동하지 않게 하는 것입니다. 다음 부록은 이 프로토콜로 얻은 수치를 모두 펼칩니다.
📖 Chapter Appendix D: Additional Quantitative Results
먼저 Table 3은 27계보의 전체 점수·비용 궤적을 제시합니다. 세 궤적은 최종 종합 보고서 조립이 실패했기 때문에 불변 게임별 토큰 원장에서 비용을 직접 복구했다고 명시합니다. 이는 해당 하네스 평가가 실패했다는 뜻과 구분해야 합니다. 부록 D
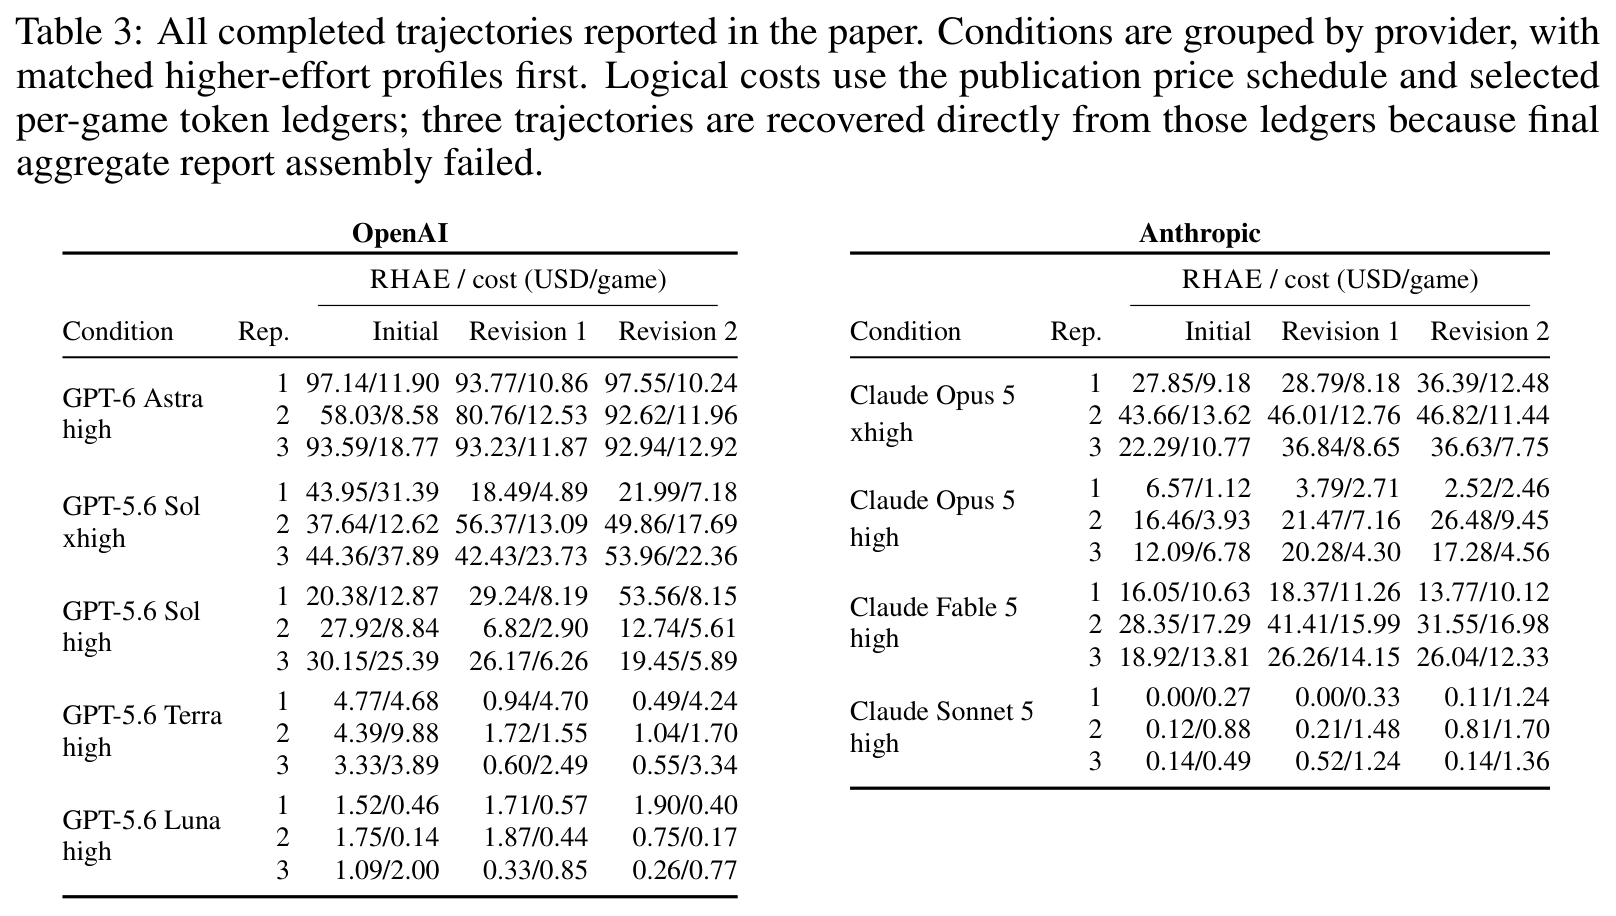
Table 3, v1 PDF 16쪽. 표·캡션 영역 크롭, 번역 없음. 작은 숫자는 다음 전사표에서 확인할 수 있습니다. 각 셀은 RHAE / USD·게임⁻¹이며 비용은 논리적 추론 비용입니다.
| 조건 | 반복 | 초기 | 수정 1 | 수정 2 |
|---|---|---|---|---|
| Astra high | 1 | 97.14 / 11.90 | 93.77 / 10.86 | 97.55 / 10.24 |
| Astra high | 2 | 58.03 / 8.58 | 80.76 / 12.53 | 92.62 / 11.96 |
| Astra high | 3 | 93.59 / 18.77 | 93.23 / 11.87 | 92.94 / 12.92 |
| Sol xhigh | 1 | 43.95 / 31.39 | 18.49 / 4.89 | 21.99 / 7.18 |
| Sol xhigh | 2 | 37.64 / 12.62 | 56.37 / 13.09 | 49.86 / 17.69 |
| Sol xhigh | 3 | 44.36 / 37.89 | 42.43 / 23.73 | 53.96 / 22.36 |
| Sol high | 1 | 20.38 / 12.87 | 29.24 / 8.19 | 53.56 / 8.15 |
| Sol high | 2 | 27.92 / 8.84 | 6.82 / 2.90 | 12.74 / 5.61 |
| Sol high | 3 | 30.15 / 25.39 | 26.17 / 6.26 | 19.45 / 5.89 |
| Terra high | 1 | 4.77 / 4.68 | 0.94 / 4.70 | 0.49 / 4.24 |
| Terra high | 2 | 4.39 / 9.88 | 1.72 / 1.55 | 1.04 / 1.70 |
| Terra high | 3 | 3.33 / 3.89 | 0.60 / 2.49 | 0.55 / 3.34 |
| Luna high | 1 | 1.52 / 0.46 | 1.71 / 0.57 | 1.90 / 0.40 |
| Luna high | 2 | 1.75 / 0.14 | 1.87 / 0.44 | 0.75 / 0.17 |
| Luna high | 3 | 1.09 / 2.00 | 0.33 / 0.85 | 0.26 / 0.77 |
| Opus xhigh | 1 | 27.85 / 9.18 | 28.79 / 8.18 | 36.39 / 12.48 |
| Opus xhigh | 2 | 43.66 / 13.62 | 46.01 / 12.76 | 46.82 / 11.44 |
| Opus xhigh | 3 | 22.29 / 10.77 | 36.84 / 8.65 | 36.63 / 7.75 |
| Opus high | 1 | 6.57 / 1.12 | 3.79 / 2.71 | 2.52 / 2.46 |
| Opus high | 2 | 16.46 / 3.93 | 21.47 / 7.16 | 26.48 / 9.45 |
| Opus high | 3 | 12.09 / 6.78 | 20.28 / 4.30 | 17.28 / 4.56 |
| Fable high | 1 | 16.05 / 10.63 | 18.37 / 11.26 | 13.77 / 10.12 |
| Fable high | 2 | 28.35 / 17.29 | 41.41 / 15.99 | 31.55 / 16.98 |
| Fable high | 3 | 18.92 / 13.81 | 26.26 / 14.15 | 26.04 / 12.33 |
| Sonnet high | 1 | 0.00 / 0.27 | 0.00 / 0.33 | 0.11 / 1.24 |
| Sonnet high | 2 | 0.12 / 0.88 | 0.21 / 1.48 | 0.81 / 1.70 |
| Sonnet high | 3 | 0.14 / 0.49 | 0.52 / 1.24 | 0.14 / 1.36 |
Construction and qualification outcomes. 81단계 중 원 후보가 바로 자격을 얻은 것은 46단계, smoke 복구 후보를 선택한 것은 35단계입니다. 초기 holdout 평균은 24.54이고 범위는 0–97.14입니다. 모든 구성의 실행 성공과 초기 문제 해결 수준의 큰 차이가 동시에 드러납니다.
Uncertainty estimation. 백분위 구간은 seed 20260902와 고정 가명 계보 순서를 사용한 100,000회 whole-lineage bootstrap입니다. 재표집한 계보의 모든 단계·게임을 함께 유지해 짝비교를 보존합니다. 구간은 관측 연구 풀과 고정 게임 분할에 조건부이며, 새 게임이나 다른 개발 분할에 대한 불확실성을 측정하지 않습니다.
Cost accounting. 달러는 불변 토큰 원장에 2026년 9월 13일 고정한 제공사 표준 API 정가를 적용해 재계산합니다. 지역·marketplace 할증은 제외하고 당시 프로필·해시도 보존합니다. 인프라·인간 노동·지연시간·에너지는 측정 대상이 아닙니다. Table 4의 조건당 3계보 평균은 Sol high 26.15→28.58(+2.43), Sol xhigh 41.98→41.94(−0.05), Opus high 11.71→15.43(+3.72), Opus xhigh 31.27→39.95(+8.68)입니다. 노력 수준 차이는 기술적 비교이며 인과적 효과 추정이 아닙니다.
Development-based checkpoint selection. 개발 점수가 같으면 이른 스냅샷을 선택합니다. 사후 선택은 초기/수정1/수정2를 9/6/12계보에서 고릅니다. 최종본 일괄 배포보다 holdout +1.72점이며 구간은 [0.38, 3.67]입니다. 그러나 외부 루프의 구성·선택 지출은 아래 배포 비용에서 제외됩니다.
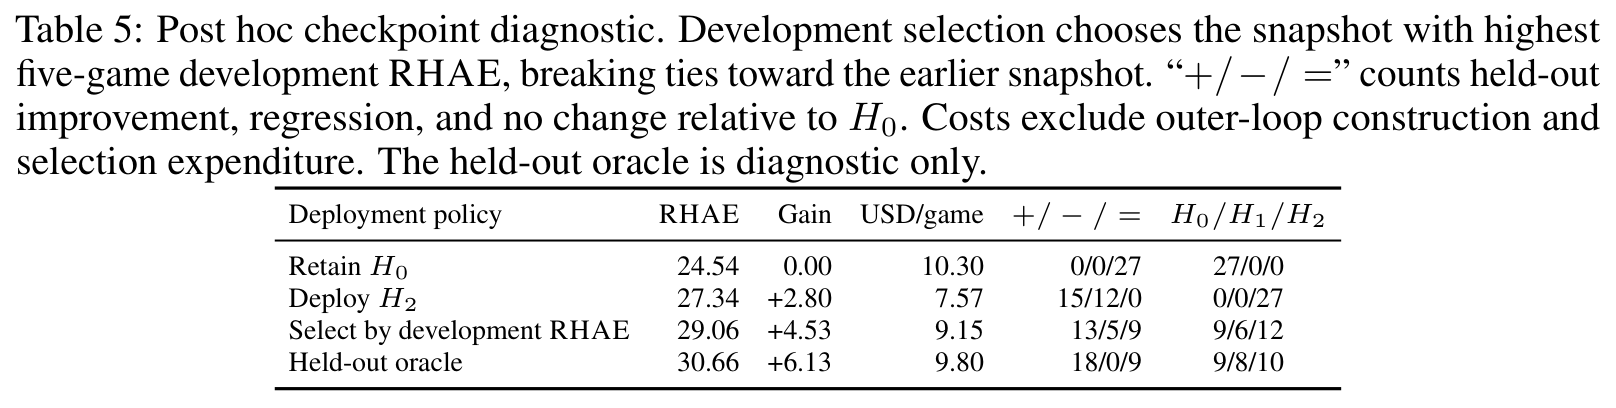
Table 5, v1 PDF 17쪽. 표·캡션 크롭, 번역 없음. 아래 표를 원문과 대조했습니다.
| 배포 정책 | holdout RHAE | 초기 대비 | USD/게임 | 향상/하락/동률 | 초기/수정1/수정2 선택 |
|---|---|---|---|---|---|
| 초기 유지 | 24.54 | 0.00 | 10.30 | 0/0/27 | 27/0/0 |
| 수정 2 배포 | 27.34 | +2.80 | 7.57 | 15/12/0 | 0/0/27 |
| 개발 RHAE 선택 | 29.06 | +4.53 | 9.15 | 13/5/9 | 9/6/12 |
| holdout 오라클 | 30.66 | +6.13 | 9.80 | 18/0/9 | 9/8/10 |
오라클은 holdout 정답 결과로 선택하는 진단적 상한 비교이며 실험의 실제 수정·배포 정책이 아닙니다. Table 6의 평균 비용은 초기/수정1/수정2 10.30달러/7.15달러/7.57,달러 중앙값은 9.18달러/6.26달러/7.18달러입니다. Table 7의 Pareto 개선은 초기→수정1, 수정1→수정2, 초기→수정2에서 각각 6/6/9계보입니다.
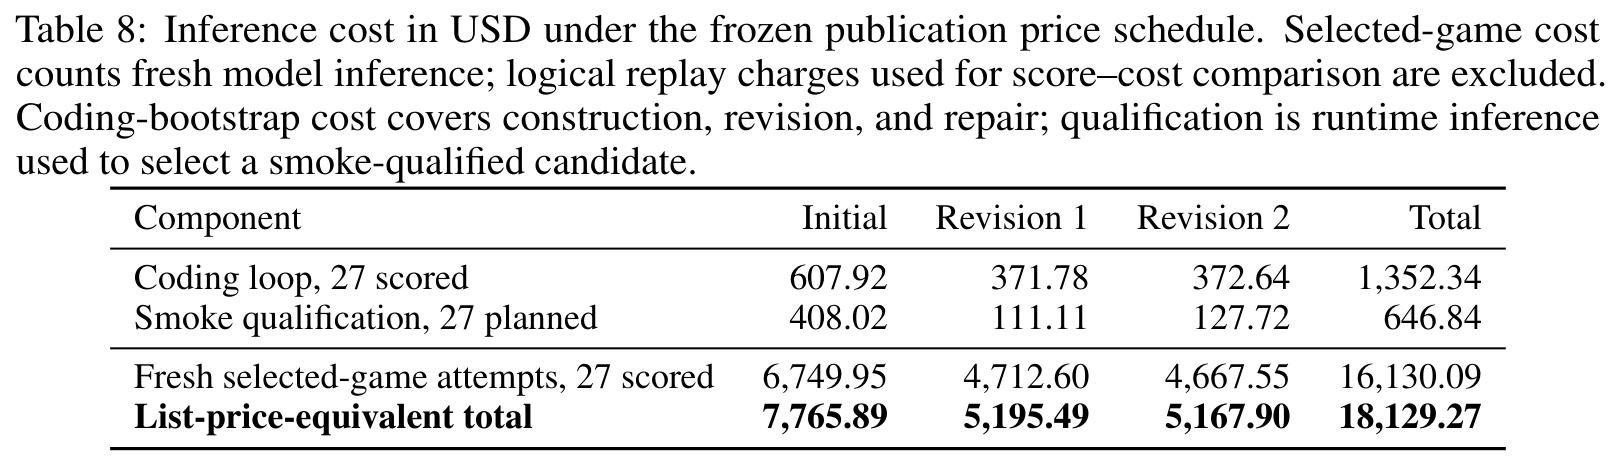
Table 8, v1 PDF 18쪽. 표·캡션 크롭, 번역 없음. 선택 게임 지출은 새 추론만 집계하며, 비교용 논리적 replay 요금과 구분됩니다.
| 지출 구성(USD) | 초기 | 수정 1 | 수정 2 | 합계 |
|---|---|---|---|---|
| 구성·수정·복구 코딩 | 607.92 | 371.78 | 372.64 | 1,352.34 |
| smoke 자격 검사 | 408.02 | 111.11 | 127.72 | 646.84 |
| 선택된 게임 시도의 새 추론 | 6,749.95 | 4,712.60 | 4,667.55 | 16,130.09 |
| 정가 환산 하한 합계 | 7,765.89 | 5,195.49 | 5,167.90 | 18,129.27 |
캠페인은 두 머신에서 적어도 5주간 진행됐습니다. 미선택 게임 시도의 복구 overhead, 코딩 미해결 요청 3개, 자격 미해결 요청 7개와 별도 제공사 요청 1개를 추정해 채우지 않으므로 총액은 하한입니다. 반올림된 표 항목의 합과 표시 총액에 작은 차이가 있을 수 있어 원문 보고값을 유지했습니다.
Human-steered reference systems. Tycho는 Sol max와 Opus 5 xhigh에서 25게임 모두 100.00, VISTA·AVO는 Opus 5에서 100.00, Retrodict는 Sol max 99.86을 보고합니다. VISTA의 별도 Sol-max는 98.27입니다. Opus 비교는 모델 버전·노력이 맞고 같은 20게임에서도 격차가 있지만, Tycho는 Opus 4.8로 25공개 게임 전체에서 네 정책을 선택합니다. Retrodict도 모든 공개 게임에서 이전 개발 시도를 보고합니다. 비용의 가격 날짜·집계 규칙도 달라 직접 효율 동등성을 주장하지 않습니다.
서론의 범용 코딩 에이전트 비교 역시 인용 연구 내부 조건입니다. Schema는 같은 Opus 4.8/Fable 5 조합에서 Claude Code 42.83 대 세계모델 하네스 98.98을, Twin은 모델·파일 연결·샌드박스를 고정해 Codex+Sol 61.1 대 세계모델 하네스 93.3을 보고하지만 강한 하네스는 추론도 더 사용합니다. 본 실험의 순위표로 합치지 않는 이유입니다.
Table 9의 실용 문턱 민감도는 변화의 절댓값이 문턱 이하일 때 미결정으로 둡니다. 문턱 0/1/5점에서 향상은 15/11/9, 하락은 12/8/3, 미결정은 0/8/15, 비용 하락까지 필요한 Pareto 개선은 9/7/5입니다.
D.1 Fixed-harness execution variance
캠페인 후 Sol-high 반복1의 최종본을 사후 선택하고 원 평가 1회와 새 추론 9회를 비교했습니다. 원 평가는 2026년 8월, 추가는 9월입니다. 하네스·컨트롤러·모델 프로필·배포·환경 지문은 같지만 노출되지 않은 제공사 변경 가능성은 배제하지 못합니다. 추가 실행에는 구성·수정·복구·체크포인트 선택·공식 replay가 없습니다. 부록 D.1
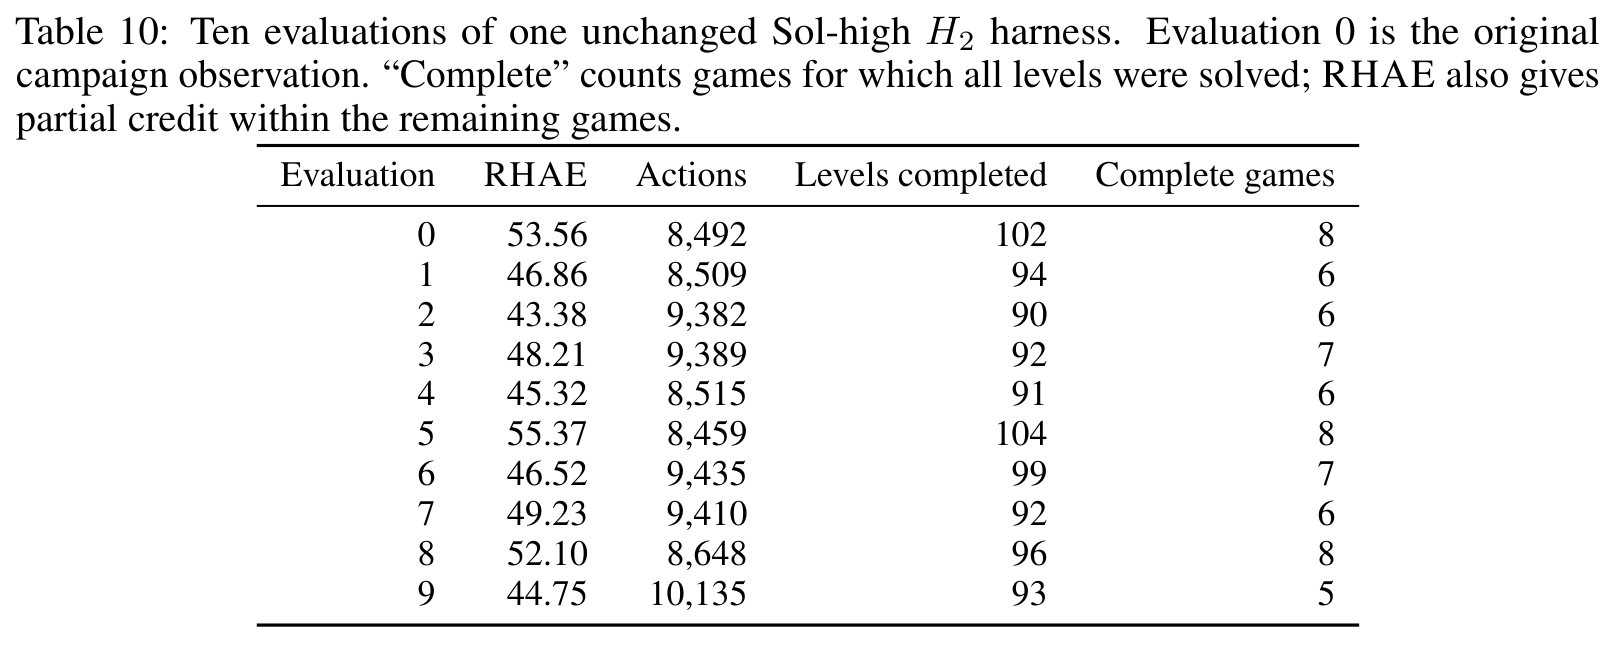
Table 10, v1 PDF 19쪽. 표·캡션 크롭, 번역 없음. 핵심 RHAE 열은 53.56, 46.86, 43.38, 48.21, 45.32, 55.37, 46.52, 49.23, 52.10, 44.75입니다.
10회 평균은 48.53, 표본 표준편차 3.99, 범위 43.38–55.37, 두 평가의 평균 절대 차이는 4.73입니다. 추가 9회만의 평균·표준편차는 47.97·3.79입니다. 원 53.56은 두 번째로 높고 전체 평균보다 5.03점 높지만, 모두 초기 20.38점보다 높습니다. 이 최종 관측 하나만 10회 평균으로 바꾸면 전체 평균 향상은 +2.80→+2.62가 됩니다. 이는 나머지 계보의 오차를 보정한 결과가 아니라 기계적 민감도 점검입니다.
게임별 표준편차 중앙값은 18.78점이며 sb26 30.76, m0r0 28.33, tn36 27.13이 큽니다. 20게임 평균이 변동을 완화하지만 한 하네스의 3.99점을 모든 시스템의 보편 잡음 문턱으로 쓸 수는 없습니다. 추가 200개 평가·게임 행의 지출은 Table 8에서 제외됩니다.
Weighting and game sensitivity. 조건마다 3계보이므로 계보·조건 동일 가중 평균 향상은 모두 +2.80이며 7모델 계열에 동일 가중치를 주면 +2.55입니다. 조건 층화 bootstrap 구간은 [−1.12, 7.01]로 여전히 결론적이지 않습니다. 조건 하나씩 제외하면 +1.72–+3.59입니다. 개발 요약에서 r11l만 제외하면 격차는 5.62→3.02, 다른 게임을 제외하면 4.68–7.84지만, 실제 수정은 원래 다섯 게임을 사용했으므로 다른 분할을 실험한 것은 아닙니다.
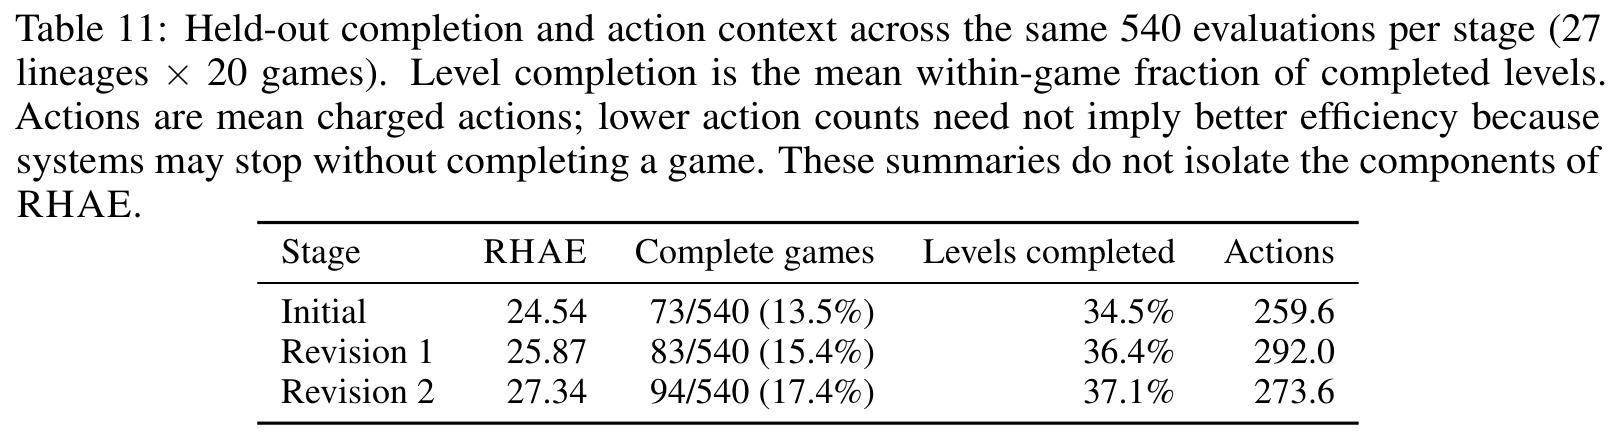
Table 11, v1 PDF 20쪽. 표·캡션 크롭, 번역 없음. 분모 540은 27계보×20holdout 게임입니다.
| 단계 | RHAE | 완전 완료 게임 | 평균 레벨 완료율 | 평균 계상 행동 |
|---|---|---|---|---|
| 초기 | 24.54 | 73/540 (13.5%) | 34.5% | 259.6 |
| 수정 1 | 25.87 | 83/540 (15.4%) | 36.4% | 292.0 |
| 수정 2 | 27.34 | 94/540 (17.4%) | 37.1% | 273.6 |
Table 12는 게임별 변화도 제공합니다. 큰 상승 lp85의 +20.44점에는 완료율 +29.6%p, 레벨 완료율 +13.0%p가, 큰 하락 sb26의 −15.03점에는 −18.5%p·−13.0%p가 동반됩니다. 전체 레벨 완료 증가가 점수 향상과 함께 나타나지만 이 요약만으로 RHAE의 각 구성요소 효과를 분리하지 않습니다. 이 부록의 기여는 평균 결과를 분모·불확실성·비용 회계·실행 변동으로 점검한 것이며, 다음 부록은 소프트웨어 변경 자체를 확인합니다.
📖 Chapter Appendix E: Harness and Strategy Audit
감사는 27계보의 모든 선택 스냅샷, 정확한 diff, updater 기록, 관련 smoke 복구 산출물을 읽습니다. Figure 5의 생성 Python 줄 수는 모델 작성 소스·테스트를 포함하고 제공된 llm_client.py는 제외합니다. 모든 계보의 코드가 초기보다 최종에 커졌고 중앙값은 2,161→2,604→2,912줄, 초기 대비 최종 평균 증가는 1,052줄입니다. 부록 E
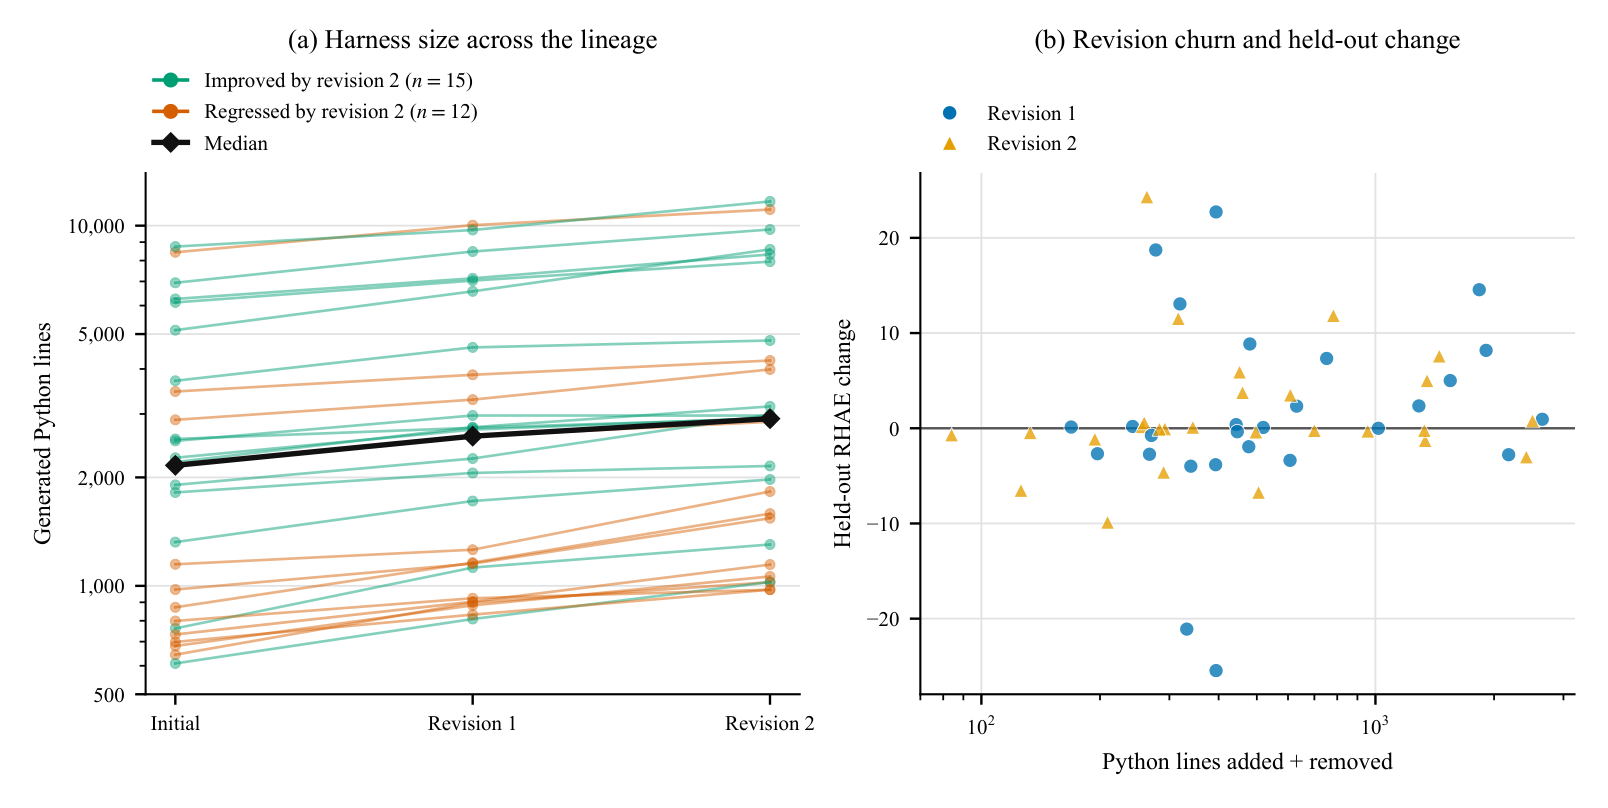
Figure 5 전체, v1 PDF 21쪽. 그림 크롭, 번역 없음. (a)는 로그 축 코드 크기와 단계 중앙값, (b)는 추가+삭제 줄 수와 즉시 holdout 변화를 보여줍니다.
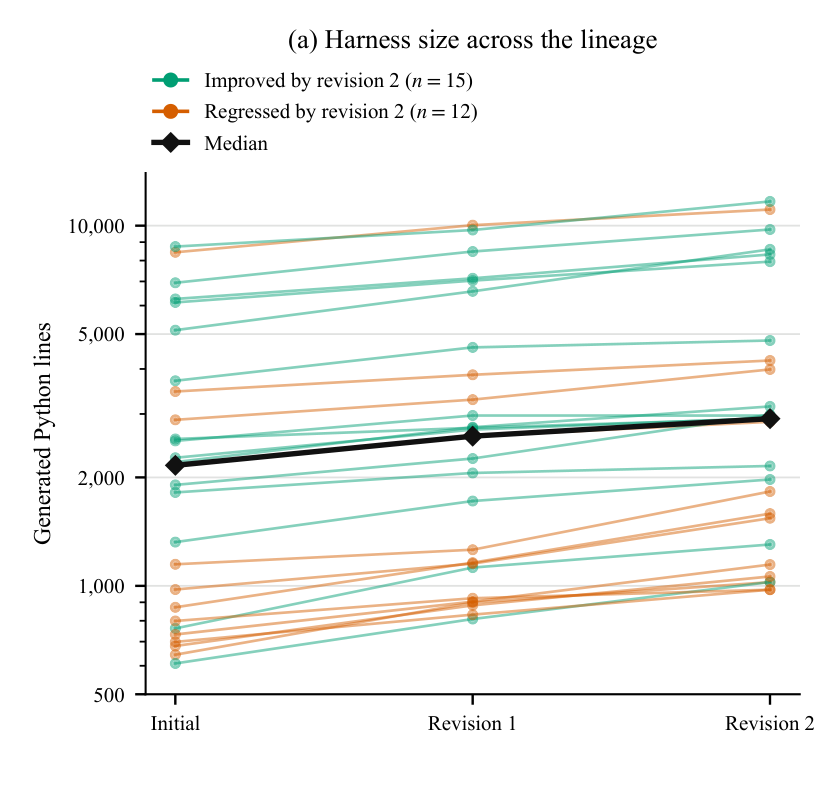
Figure 5(a) 상세 크롭, 같은 PDF 21쪽입니다. 초록·주황은 최종 관측 향상·하락이고 검은 선은 단계 중앙값입니다. 코드 증가는 두 결과 모두에서 나타납니다.
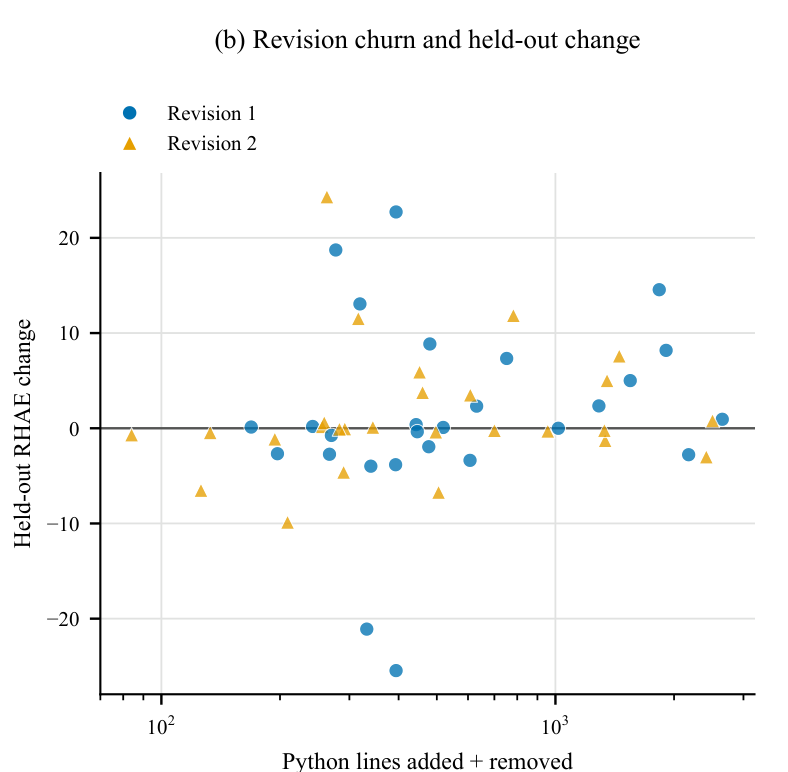
Figure 5(b) 상세 크롭, 같은 PDF 21쪽입니다. 각 점은 선택된 부모→후손 diff이며 가로축은 추가·삭제 줄의 합입니다. 작은 변경과 큰 변경이 모두 0선 양쪽에 있으므로 수정 규모가 개선을 인증하지 않습니다.
First revisions reorganize; second revisions diversify. Table 13은 조건별, Table 14는 27반복 각각의 Preserve/Extend/Reorient 경로를 제시합니다. 첫 수정은 맥락 유지·재생 흐름·모델 호출 간격·배치·예산의 재조직이 대부분이며, 둘째는 능력 확장과 재지향이 각각 12개입니다. 개발자가 “점진적”이라 표현해도 실제로 모델을 부르는 시점과 희소 행동·달러 배분이 달라질 수 있습니다.
Replicates disagree within the same condition. Sol-high의 세 반복은 모두 Reorient→Extend인데도 최종 변화가 +33.18에서 −15.18점까지 다릅니다. Fable·Luna·Sonnet·Sol-xhigh는 같은 조건 안에서 구조 경로도 섞입니다. Opus-high·xhigh는 매 단계 Reorient인데도 이득과 퇴행을 모두 포함합니다. 따라서 거친 전략 라벨은 개선 여부를 보증하지 않습니다.
An evidence-linked improvement. 사후 사례 T001은 수정1에서 세 개발 게임이 자체 100의사결정 제한을 소진하고 캐시 쓰기에 비해 읽기가 적다는 피드백을 사용했습니다. 수정2는 내부 한도를 120으로 높이고 명시 캐시 쓰기를 없애며 애니메이션을 고려한 관찰, 객체 기하, 완료 레벨 기억을 더했습니다. 수정 전 계획에 변경이 나오고 기록상 17개 로컬 테스트가 통과했으며 복구 없이 자격을 얻었습니다. RHAE는 29.24→53.56, 비용은 8.19달러→8.15달러입니다. 여러 요소가 함께 바뀌어 특정 요소의 인과효과를 분리한 것은 아닙니다.
Cost reduction with performance loss. 사후 사례 T007은 첫 수정에서 응답 ID 연결·이력 압축을 독립 호출과 제한 노트북·최근 결과로 대체했습니다. 두 수정 전체에서 holdout은 43.95→21.99, 비용은 31.39달러→7.18,달러 개발은 37.11→31.73이며 둘째 수정은 점수를 일부 회복했습니다. 맥락 상실이 원인이라는 설명은 검증되지 않았습니다. 이 부록은 추적 가능한 근거→변경→결과 사례를 제공하되 원인 분리를 주장하지 않으며, 다음은 이런 과정을 더 체계적으로 코딩하는 절차입니다.
📖 Chapter Appendix F: Capability Codebook and Sampling
Evidence boundary and units. 54에피소드의 메시지·도구·소스·diff·테스트·고정 피드백·smoke·게임 추적을 사용하지만 제공사가 숨긴 사고과정은 인지의 근거로 취급하지 않습니다. 직접 기록 사건과 재현 가능한 근거→편집→테스트 연결은 코딩할 수 있지만, 잠재적 믿음·이해에 대한 추정은 정량 코딩에서 제외합니다. 독립 단위는 완전한 계보이며 사건·게임·단계는 그 안에 중첩됩니다. 부록 F
Codebook organization. 코드북은 근거 접근·진단·가설 구별 탐색, 실행 계획·피드백 범위·편집 정합·변경 범위, 기존 시스템 보호·검증·근접 결과, 결과 후 적응·자원 할당의 순서입니다. Table 15의 질문은 “근거를 읽었는가”에서 “결과가 다음 행동을 실제로 바꿨는가”까지 이어집니다.
Codebook refinement and consensus. 초기 맹검 보정에서 시간 기준의 모호함을 발견하고 편집 전·결과 후 기준만 강화했습니다. 모든 패킷은 결과 연결을 열기 전에 동결 v2로 다시 코딩했습니다. 합의는 정확 일치를 유지하고 순서형 불일치에는 근거가 있는 더 낮은 수준을, 누락 구간에는 누락을 유지하는 보수 규칙입니다.
Ordinal episode coding. 12변수는 Evid, Diag, Probe, Plan, Cov, Align, Scope, Protect, Verify, Result, Adapt, Meta입니다. 순차 코드는 관련 행동 전에 보이는 근거만 인정합니다. 마지막 요약은 앞선 진단·예측·계획을 새로 만들어낼 수 없습니다. 의무 최종 smoke 통과는 Result에 반영되지만, 실패가 복구·재자격으로 연결됐을 때만 Verify를 높입니다.
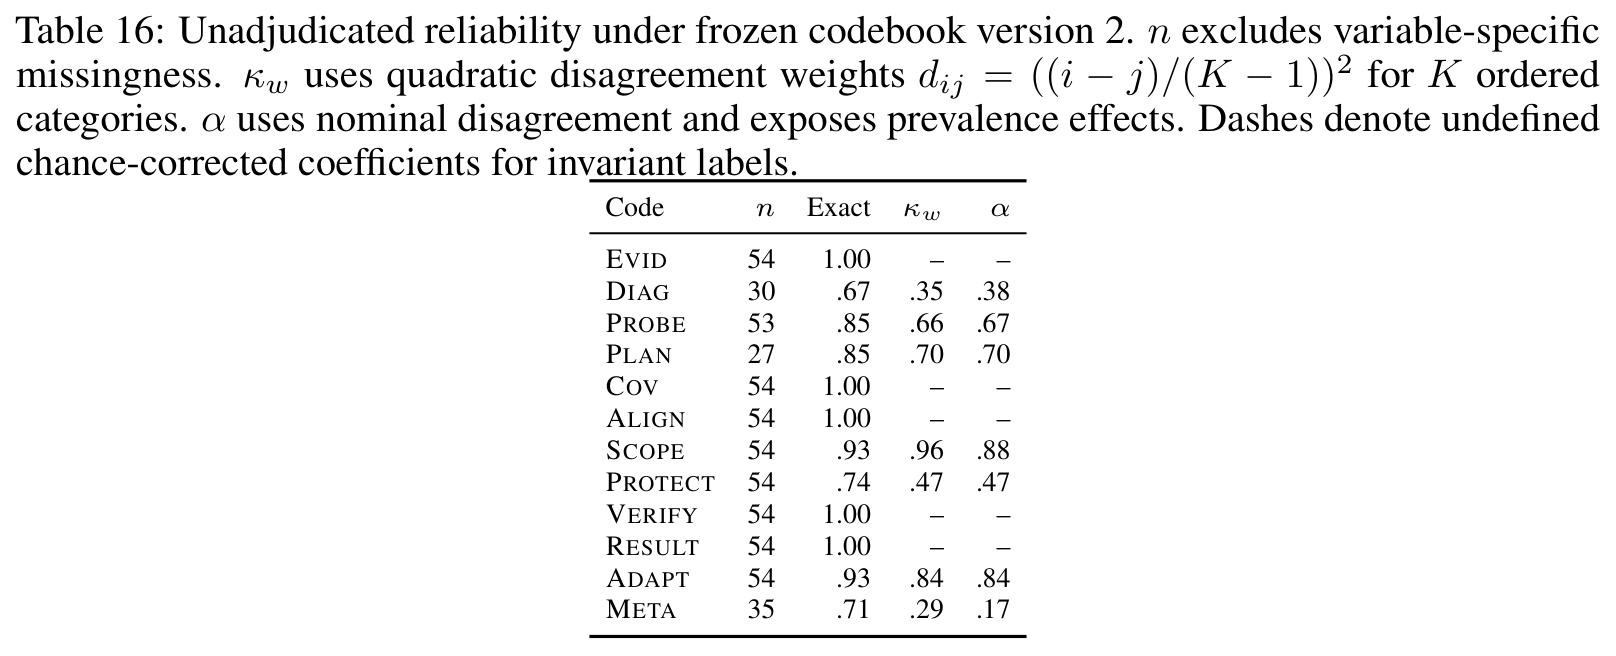
Table 16, v1 PDF 23쪽. 표·캡션 크롭, 번역 없음. —는 모든 라벨이 같아 우연 보정 계수가 정의되지 않는 경우입니다.
| 코드 | 관측 n | 정확 일치 | 가중 κ | α |
|---|---|---|---|---|
| Evid | 54 | 1.00 | — | — |
| Diag | 30 | .67 | .35 | .38 |
| Probe | 53 | .85 | .66 | .67 |
| Plan | 27 | .85 | .70 | .70 |
| Cov | 54 | 1.00 | — | — |
| Align | 54 | 1.00 | — | — |
| Scope | 54 | .93 | .96 | .88 |
| Protect | 54 | .74 | .47 | .47 |
| Verify | 54 | 1.00 | — | — |
| Result | 54 | 1.00 | — | — |
| Adapt | 54 | .93 | .84 | .84 |
| Meta | 35 | .71 | .29 | .17 |
가중 κ의 불일치 가중치는 다음과 같습니다. $i,j$는 두 코더의 순서형 범주, $K$는 범주 수이며 차이가 클수록 더 큰 불일치로 계산합니다. α는 명목 불일치를 사용하므로 같은 계수로 혼동하지 않습니다.
Outcome linkage. 코더 파일·합의 라벨을 해시로 고정한 뒤 비공개 에피소드 키를 열고 즉시 부모→후손 holdout 변화와 연결합니다. 탐색 포함 기준은 κ≥.67이며, 구간은 계보 재표집, p값은 두 단계 결과 프로필 전체를 계보 사이에 순열해 단계를 보존합니다. 연관별 재표집·순열은 각각 결정적 seed로 10,000회입니다. 다중 비교 보정은 없고, 조건 간 교환가능성도 위반될 수 있으므로 p값이 교란을 제거하지는 않습니다.
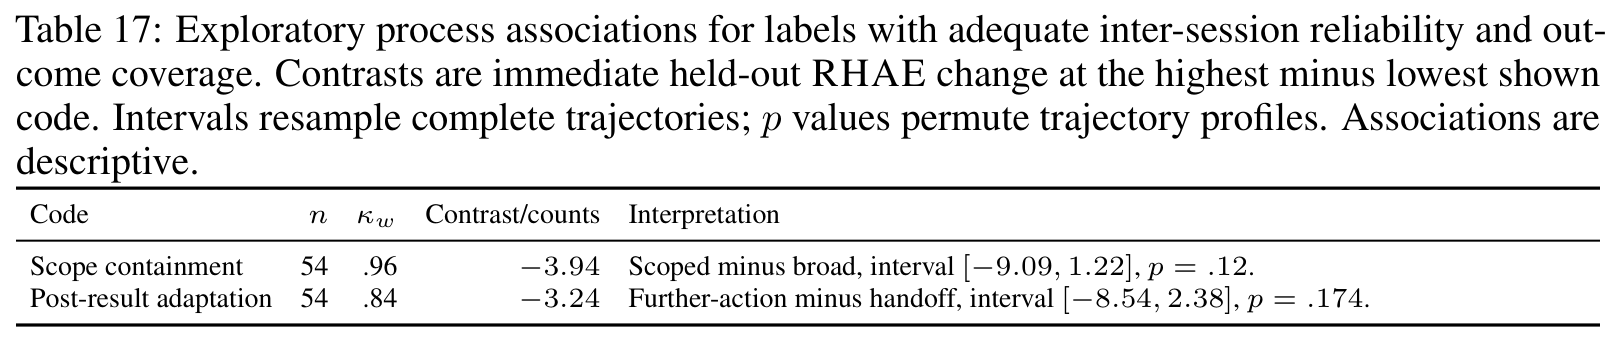
Table 17, v1 PDF 24쪽. 표·캡션 크롭, 번역 없음. 두 대비 모두 즉시 부모→후손 RHAE 변화에 관한 기술적 연관입니다.
| 대비 | n | 가중 κ | 평균 변화 차이 | bootstrap 구간 | p |
|---|---|---|---|---|---|
| 제한 범위 − 넓은 수정 | 54 | .96 | −3.94 | [−9.09, 1.22] | .12 |
| 추가 결과 기반 행동 − 넘김 | 54 | .84 | −3.24 | [−8.54, 2.38] | .174 |
Planning-label missingness. 계획 구간은 27개에서 관측되고 27개에서 없습니다. 누락 패킷은 평균 실행 파일 9.22개·추가 1,147줄을, 관측 패킷은 3.74개·414줄을 바꿨습니다. Opus-high·xhigh·Sonnet은 전부 누락, Astra·Luna·Terra는 전부 관측이며 단계별 누락은 13/14로 비슷합니다. 관측 하위집합의 높은 일치도가 계획과 성과의 관계를 정당화하지 않는 이유입니다.
Reactive-episode context. 추가 반응 행동이 있는 에피소드는 부모 점수가 평균 32.94로 다른 집단 21.33보다 높고 updater 세션도 1.67 대 1.11입니다. 두 수정의 적응 라벨이 다른 10계보 중 8개에서 반응적 수정의 변화가 더 낮았지만, 문제의 어려움과 복구 자체의 효과는 분리되지 않습니다. 이 부록의 기여는 신뢰도·결측·선택·결과 연결을 명시해 과정 해석을 제한한 것이며, 마지막 부록은 실행 기록의 보존과 복구를 감사합니다.
📖 Chapter Appendix G: Campaign Integrity and Recovery Audit
사후 소스 감사는 프롬프트·피드백·자격 검사·게임 인터페이스·점수·자원 통제가 캠페인 동안 같았다고 보고합니다. 실행 지원 코드 변경은 운용 복구·출처 관리에 해당하며 change log를 제공합니다. Table 18은 81원본 스냅샷과 1,985파일의 지문·개수, 2,025평가의 스냅샷·모델·환경·출력 상한 일치, 조건별 프롬프트와 공통 자원 프로필, 81호스팅 검증의 25게임 점수 일치, 54패킷·코딩 근거 보존을 확인했다고 보고합니다. 이는 원 기록의 일관성과 보존 감사이며 독립 실험 재실행은 아닙니다. 부록 G
Execution recovery. 구성 교체와 동일 동결본의 평가 복구는 다릅니다. 호환 journal이 있으면 이어서 실행하지만 replay 부모 없는 새 실행도 가능해 새 모델 응답을 만들 수 있습니다. 162평가 suite의 2,025슬롯에 2,130시도가 기록됐고 63슬롯은 복수 시도입니다. 슬롯마다 깨끗한 시도 하나가 선택됐으며 여러 정상 완료 점수 중 높은 것을 골랐다는 기록은 없습니다. 나머지 105시도는 제공사 인프라 실패 49, blocked 11, 결과 이유 없는 미완료 45입니다. 21슬롯에 fresh restart가 있고 선택 시도 중 17개가 그것입니다. resource-stop 기록은 없지만 모든 중단 원인을 완전히 확정한 분류도 아닙니다.
Recovery costs. 최종 게임 풀이 비용은 선택된 시도의 새 추론과 replay 추론을 포함합니다. 프로그램 비용 하한은 새 선택 게임 추론·관측 코딩·자격 검사를 합하지만 미선택 시도 복구 지출과 미해결 요청은 채우지 않습니다. 운용 복구 계량이 고정 출판 가격표로 완전히 대조되지 않았으므로 총 캠페인 청구액으로 읽을 수 없습니다.
Bounded frame exception. lf52의 seed가 고정되지 않은 시각 잡음에 대해 좁은 frame hash 예외를 허용합니다. 상태·레벨 완료·가용 행동은 일치해야 하며, 정확한 조건·기대 및 실제 해시를 보존합니다. 호스팅·로컬 모두 213사건, 전부 lf52이고 81호스팅 검증 모두 점수 일치를 보고합니다. 점수 기준을 느슨하게 만든 예외가 아닙니다.
Auditable process examples. 결과를 보지 않고 패킷 ID·라벨의 고정 규칙으로 세 발췌를 선택해 일치·불일치·근거 누락을 예시합니다. 시간 순 근거 위치·라벨·이유·합의 규칙·압축 표시를 남기지만 완전한 대화록이나 인간 검증을 뜻하지 않습니다.
Artifact availability. 저자들은 이 arXiv 버전의 ancillary file인 harness-adaptation-review-artifact.zip에 프레임워크, 고정 프롬프트·분할·조건·가격 메타데이터, 81익명 소스본, 원본·공개복사본 지문, 계보·게임 표, 코더·합의 근거, 세 코딩 예시, 두 수정 사례, 무결성·복구 감사, 매뉴얼, 결정적 분석, 체크섬 manifest를 제공한다고 명시합니다. 본 리뷰는 그 제공 내역에 대한 원문 진술을 확인한 범위이며 압축파일의 자체 검증을 수행하지 않았습니다. 마지막 부록의 기여는 성능 결과가 어떤 실행·선택·복구 기록에 기대는지 추적 가능하게 한 데 있습니다.
실험 결과 심층 분석
주 결과의 대조 기준은 각 계보의 자율 구성 초기본입니다. 인간 주도 시스템의 100점은 다른 개발·선택 절차에서 가능한 성능을 보여주는 참고입니다. 초기→최종의 27쌍 비교는 동일 모델 프로필 안에서 일어나지만, 서로 다른 하네스가 쓰는 추론 총액은 같지 않습니다. 따라서 최종 점수 차이를 모델 능력 또는 수정 알고리즘 하나의 순수 효과로 해석하지 않습니다.
| 분석 대상 | 원문 결과 | 해석 범위 |
|---|---|---|
| 개발 평균 향상 | +8.42 RHAE | 피드백 5게임에서의 변화입니다. |
| holdout 평균 향상 | +2.80, 95% [−1.44, 7.35] | 고정 20게임·관측 27계보에서 0이득과 양의 이득 모두와 양립합니다. |
| 적응 격차 | +5.62, 95% [1.78, 9.77] | 개발 향상이 holdout 향상을 초과합니다. |
| 엄격 부호 결과 | 15향상/12하락, p=.70 | 관측 부호의 불균형에서 유의한 우세를 보이지 않습니다. |
| ±5점 민감도 | 9향상/3하락/15미결정 | 작은 변화의 해석이 문턱에 민감합니다. |
| 점수·비용 Pareto 개선 | 9/27 | 나머지 비용 절감 9계보는 성능도 낮아졌습니다. |
| 개발 기반 사후 선택 | +4.53, 95% [0.81, 8.68] | 실제 사전 명시 선택 정책의 성능으로 확정하지 않습니다. |
수치는 §5와 부록 D에 근거합니다. 평균 향상 구간과 부호검정은 질문이 다릅니다. 전자는 평균 변화의 크기를, 후자는 양·음 관측의 불균형을 다룹니다. 어느 쪽도 개별 하네스의 기대 성능이 실제로 개선·퇴행했는지 모두 판정하지는 않습니다. 고정 하네스 반복 실행과 원래 모든 스냅샷의 단회 평가를 함께 봐야 합니다.
비용에서는 평균 수준과 변화량을 구분해야 합니다. Table 6의 표시 평균 10.30달러→7.57달러만 빼면 2.73달러이지만, 본문이 보고한 비반올림 쌍별 평균 변화는 −2.72달러입니다. 중앙값 변화 −0.54달러 역시 단계별 중앙값 9.18달러와 7.18달러의 차이가 아닙니다. 이처럼 각 계보의 차이를 먼저 계산한 통계와 이미 반올림·집계한 숫자의 차이를 혼동하지 않는 것이 중요합니다. 이는 원문 수치를 해석하는 리뷰어의 설명입니다.
과정 분석에서 근거 접근·테스트 통과는 모든 에피소드가 만족해 성과를 구분하는 변수가 되지 못했습니다. 신뢰도를 통과한 Scope와 Adapt의 대비도 구간이 0을 포함하며, 계획은 결측이 조건·변경 크기와 관련됩니다. 그러므로 정성 기록은 어떤 변화가 있었는지 설명하지만 “이 행동을 하면 반드시 더 잘 개선한다”는 처방으로 바뀌지 않습니다. §6.2, 부록 F
기술적 함의와 응용
저자들의 핵심 주장은 자율적인 구성, 근거 기반 수정, 일반화되는 채택을 별도로 평가해야 한다는 것입니다. 이 연구에서 실행 가능한 구성과 의미 있는 코드 변경은 충분히 관찰되지만, 개발 향상만으로 새 과제의 향상을 보장하지 못합니다. 최종본이 더 저렴해져도 실제로 적게 해결한 결과일 수 있으므로, 점수·완료·행동·추론 비용을 함께 남겨야 합니다. §7–9
리뷰어 해석으로는, 이 프로토콜은 운영 에이전트의 프롬프트·기억·도구 제어를 바꿀 때도 평가 설계를 생각하게 하는 사례입니다. 보존된 부모 시스템, 수정에 쓰지 않은 평가 과제, 변경별 비용 원장, 실행 변동 진단이 있어야 변경의 실질적 이득을 설명할 수 있습니다. 다만 실제 업무 환경으로의 성능 전이는 이 논문이 시험한 결과가 아니며, 여기서는 평가 원리를 이해하는 응용 관점으로만 제시합니다.
저자들이 논의한 장기 개선의 관점에서도 중요한 것은 새 코드를 계속 생산하는 양이 아니라, 기존 능력을 지키며 유용한 변화가 누적되는가입니다. 고정 가중치와 고정 코딩 부트스트랩 아래의 두 번 수정 실험은 이 질문을 측정 가능한 형태로 만들었고, 그 결과는 자율 하네스 구성의 가능성과 안정적인 전이 사이의 간격을 함께 드러냅니다.
분석 범위는 v1 HTML의 본문 1–9절, 두 후속 진술, 참고문헌의 구조, 부록 A–G와 동일 버전 PDF 25쪽입니다. 부속 압축파일 실행·독립 재현·참고문헌 전체의 개별 재검증은 수행하지 않았습니다. 논문 바깥 arXiv 오류 신고 안내는 논문 챕터에 포함하지 않았습니다.