논문 개요와 전체 구조
Memento는 배포된 대규모 언어 모델(Large Language Model, LLM) 에이전트가 경험을 쌓으며 개선되는 방법을 다룹니다. Huichi Zhou 등의 질문은 명확합니다. 새로운 경험이 생길 때마다 기반 LLM을 다시 미세조정하지 않고도 에이전트의 문제 해결 방식을 바꿀 수 있을까요? 저자들은 과거의 문제·계획·성공 여부를 외부 사례 저장소에 남기고, 다음 문제를 계획할 때 이를 검색하는 사례 기반 추론(Case-Based Reasoning, CBR)을 제안합니다. 이 리뷰는 2025년 8월 25일 수정된 arXiv:2508.16153v2의 본문과 부록을 기준으로 합니다. 논문 v2, 서지 정보
논문 제목에서 미세조정하지 않는 대상은 기반 LLM입니다. 비모수 메모리에서는 사례를 추가하고 유사도로 검색하며, 모수 메모리에서는 사례의 유용성을 예측하는 별도 신경망도 학습합니다. 따라서 모든 매개변수를 고정한 시스템이라는 뜻으로 읽으면 핵심을 놓치게 됩니다. 논문은 이 구조를 메모리 기반 마르코프 의사결정 과정(Memory-Based Markov Decision Process, M-MDP)으로 정식화하고, 계획자와 도구 실행자를 분리한 심층 조사 에이전트로 구현합니다. §3–4
평가는 장기 도구 사용의 GAIA, 웹 질의응답 묶음인 DeepResearcher, 사실 질문의 SimpleQA, 전문 지식 추론의 Humanity’s Last Exam(HLE)을 포괄합니다. GAIA 검증 87.88%는 세 번의 반복과 사례 축적을 포함하는 Pass@3이며, 테스트 79.40%는 검증 단계에서 구축한 사례 저장소를 사용한 결과입니다. DeepResearcher의 보고 평균은 F1 66.6%, PM 80.4%입니다. 이 숫자들은 평가 모드·사용 모델·집계 방식과 함께 읽어야 하며, 원문 내부의 집계 및 순위 표기 차이도 아래에서 구분합니다. §5
원문의 구조는 다음과 같습니다. References 뒤에 부록 A와 B가 이어집니다.
| 순서 | 원문 장과 소절 |
|---|---|
| 1 | Introduction |
| 2 | Related Work — 2.1 Continual-learning in LLM Agent Systems, 2.2 Tool-augmented LLM, 2.3 Agent Memory Mechanism |
| 3 | Methodology: Memory-Based MDP with Case-based Reasoning Policy — M-MDP 정의, CBR 정책, Soft Q-learning, 상태 유사도 기반 추정, Algorithm 1 |
| 4 | Implementation: Deep Research Agent — 4.1 Framework, 4.2 Case Memory Management, 4.3 Tool Usage |
| 5 | Experiments — 5.1 Datasets, 5.2 Evaluation Metrics, 5.3 Model Configurations, 5.4 Experimental Results, 5.5 Ablation Studies |
| 5.5 내부 | 5.5.1 Hyper-parameter Selection, 5.5.2 Component-wise Analysis, 5.5.3 Continual Learning Ability Boosted by Parametric and Non-Parametric CBR, 5.5.4 Generalisation across Tasks |
| 6 | Discussion and Analysis — 6.1 The Number of Tokens per Task, 6.2 Statistics of MCP Tools, 6.3 The Impact of Fast and Slow Think Mode |
| 7 | Conclusion |
| 이후 | References, Appendix A: Derivation of the Optimal Policy in Soft-Q Learning, Appendix B: Analysis of Memory Mechanisms |
핵심 기여와 혁신성
장시간 실행되는 에이전트는 계획, 검색, 파일 해석, 계산을 거치며 성공과 실패를 경험합니다. 그러나 고정된 작업 흐름만 사용하면 다음 작업에 이 경험을 반영하기 어렵고, 기반 모델을 계속 학습시키는 방법은 상호작용 데이터 수집과 매개변수 갱신을 요구합니다. 저자들은 이 두 접근 사이에서 과거 경험을 선택하는 정책을 개선하는 경로를 제시합니다. 외부 지식을 검색하는 정적 RAG와 비교할 때, 여기서 검색되는 것은 문서만이 아니라 특정 문제에 사용한 계획과 결과가 연결된 사례입니다. §1–2
첫째 기여는 기억을 의사결정 상태에 포함하는 정식화입니다. LLM의 행동 분포를 고정하더라도 검색 정책과 사례 저장소가 바뀌면 전체 에이전트 정책이 바뀝니다. 둘째는 사례 선택을 최대 엔트로피 강화학습의 문제로 다루고, 일반적인 다단계 유도와 심층 조사용 단일 단계 구현을 연결했다는 점입니다. 셋째는 사례 메모리, 하위 과제 메모리, 도구 메모리를 분리한 계획자–실행자 시스템과 구성요소 제거 실험입니다. 이 실험은 도구 연결, 명시적 계획, CBR의 기여를 구분하여 보여줍니다. §3–5
리뷰어의 관점에서 배울 지점은 “학습”의 단위를 모델 가중치에서 에이전트의 경험 선택으로 넓혀 볼 수 있다는 데 있습니다. 다만 이 해석이 기반 모델 차이와 도구 구성을 제거한 보편적 성능 우위를 뜻하지는 않습니다. 논문의 주요 비교에는 다른 기반 모델을 사용하는 외부 결과가 함께 포함됩니다.
기술적 세부사항
전체 시스템을 이해하려면 세 종류의 기억과 두 종류의 갱신을 구분해야 합니다.
| 구성요소 | 보관하는 내용 | 사용 시점과 역할 |
|---|---|---|
| Case Memory | 완료한 과제의 상태·계획·보상 | 새 계획을 만들 때 과거 사례를 검색합니다. |
| Subtask Memory | 현재 작업의 하위 과제와 실행 결과 | 계획자와 실행자가 진행 상황을 공유합니다. |
| Tool Memory | 하위 과제별 도구 호출과 응답 | 실행자가 같은 하위 과제 안에서 도구 사용 이력을 참조합니다. |
| 비모수 CBR | 동결된 인코더로 표현한 사례 상태 | 코사인 유사도로 상위 K개 사례를 선택합니다. |
| 모수 CBR | 사례 저장소와 별도 Q 신경망 | 성공 보상으로 신경망을 갱신하고 Q값 상위 K개를 선택합니다. |
이 표는 §4.1–4.2를 정리한 것입니다. 여기서 모수라는 표현은 검색을 위한 신경망을 뜻하며 기반 LLM 미세조정과 구별됩니다. 기본 계획자는 GPT-4.1, 실행자는 GAIA에서 o3, 나머지 평가에서 o4-mini입니다. 이미지·영상·음성 처리에도 별도 모델과 서비스가 사용됩니다. 따라서 Memento는 하나의 LLM 이름보다 기억과 계획, 실행을 결합한 시스템으로 이해하는 편이 정확합니다.
메모리는 “이전 문제와 얼마나 비슷한가”와 “이전 사례가 현재 문제 해결에 얼마나 도움이 되는가”라는 서로 다른 기준으로 읽을 수 있습니다. 전자는 비모수 유사도 검색이며, 후자는 보상으로 학습하는 Q값 검색입니다. 일반 다단계 이론의 Q값은 미래 보상까지 반영하지만, 실제 심층 조사 계획자의 모수 구현은 단일 단계로 단순화하여 성공 여부를 예측합니다. 주요 수식과 이 차이는 다음 장별 리뷰에서 순서대로 설명합니다. 식 (7), (13)–(16)
챕터별 상세 리뷰
📖 Chapter 1: Introduction
이 장은 LLM 에이전트의 적응 문제를 정의하고, 왜 경험을 외부에 저장하는지 설명합니다. 저자들은 에이전트를 목표에 따라 환경과 반복적으로 상호작용하는 시스템으로 소개합니다. 단일 프롬프트에 응답하는 모델과 달리, 에이전트는 도구 호출과 중간 판단을 여러 차례 수행하므로 작업 과정 자체가 다음 행동의 학습 자료가 될 수 있습니다. §1
논리의 출발점은 고정 작업 흐름과 기반 LLM 학습 사이의 비용 차이입니다. 고정된 반성·추론 절차는 특정 과제에 맞추기 쉽지만 배포 후의 변화에 적응하는 데 제약이 있습니다. 반대로 지도 미세조정이나 강화학습으로 LLM을 갱신하려면 상호작용 궤적을 만들고 모델을 최적화해야 합니다. 저자들이 해결하려는 것은 모델의 모든 지식을 다시 학습하는 문제가 아니라, 환경에서 얻은 경험을 다음 문제 해결에 반영하는 문제입니다.
이어서 인간 기억을 동기로 제시합니다. 경험을 일화적 흔적으로 부호화하고, 통합·보상·유사 사례 회상을 통해 재사용한다는 설명입니다. 이는 설계의 영감이며, 제안 시스템이 인간의 기억 생리 기전을 그대로 구현했다는 실증 주장은 아닙니다. 컴퓨터 시스템에서는 성공과 실패를 포함한 과거 궤적을 저장하고, 구조적으로 유사한 새 과제의 계획에 활용하는 CBR로 구체화됩니다.
마지막으로 계획자, 도구 실행자, 성장하는 Case Bank라는 세 구성요소를 소개하고 네 평가 묶음의 결과를 예고합니다. 이 장의 기여는 “기반 모델이 고정되어도 에이전트는 바뀔 수 있다”는 문제 설정입니다. 다음 장은 이 설정을 기존 지속학습·도구·메모리 연구와 연결합니다.
📖 Chapter 2: Related Work
이 장은 지속학습, 도구 확장, 메모리라는 순서로 Memento의 위치를 설명합니다. 아래의 선행연구 설명은 Memento 저자들이 제시한 분류이며, 인용 논문 전부를 별도로 재검증한 비교는 아닙니다. §2
2.1 Continual-learning in LLM Agent Systems
저자들은 지속학습을 모수 접근과 비모수 접근으로 나눕니다. 모수 접근은 기반 모델을 강화학습 또는 지도학습으로 바꾸며, 계산량과 데이터 수집 부담, 파국적 망각의 위험을 논의합니다. 파국적 망각은 새 내용을 학습하면서 이전 능력을 잃는 현상입니다. 특히 장기 과제에서는 학습 데이터 한 건을 얻기 위한 상호작용 자체가 길다는 점을 강조합니다.
비모수 접근에서는 LLM을 고정하고 외부 기억으로 프롬프트 구성 방식을 바꿉니다. 이때 일화 기억은 성공과 실패를 함께 담는 경험의 단위입니다. 저자들은 CBR의 유산을 끌어오고, 정적인 문서 집합을 검색하는 전형적 RAG와 경험이 지속적으로 갱신되는 사례 저장소를 구분합니다. 리뷰어의 해석으로는 이 구분의 중심은 검색 알고리즘의 이름보다 저장되는 정보와 갱신되는 시점입니다.
2.2 Tool-augmented LLM
다음으로 도구 사용과 다중 에이전트 조정을 다룹니다. 생성 과정에 도구 호출을 넣는 프롬프트 방식에서 출발하여 AutoGen, OWL, DeerFlow 같은 조정 체계와, 도구 호출을 학습하는 지도학습·강화학습 계열을 소개합니다. 저자들이 강조하는 병목은 도구가 존재하는지보다 긴 과제에서 언제 어떤 도구를 사용하도록 계획하느냐입니다.
Memento는 이 문제를 메모리를 가진 계획자의 의사결정으로 다룹니다. 이전 과제의 계획과 결과를 참고하게 함으로써, 실행자가 개별 도구를 조합하기 전에 상위 수준의 전략을 제공하려는 접근입니다. 이 절은 뒤의 계획자–실행자 분리가 단순한 역할 이름의 구분이 아니라 장기 도구 사용 문제에 대한 설계 선택임을 설명합니다.
2.3 Agent Memory Mechanism
저자들은 반성 프롬프트, Kaggle 풀이 재사용, 공유 지식 저장소, 망각과 삭제, 기억의 연결망, 요약·태그 부여, 경험에서 규칙이나 작업 흐름을 추출하는 연구를 순서대로 검토합니다. MemoryBank와 SAGE의 망각 방식, Mem0의 ADD·UPDATE·DELETE·NOOP, A-MEM의 연결 구조, MemInsight의 의미 보강, ExpeL·AutoGuide·Agent Workflow Memory의 경험 압축을 서로 다른 설계 축으로 소개합니다.
사례를 무작정 추가하면 검색 비용과 불필요한 정보가 유용성을 압도하는 swamping 문제가 발생할 수 있다는 논의도 포함됩니다. 그에 대한 Memento의 차별점은 일화적 사례 저장소에서 신경 사례 선택 정책을 학습하도록 계획 문제를 M-MDP로 기술한 데 있습니다. 이 장의 기여는 관련 연구를 기억의 저장·선택·유지 관점에서 정리한 것이며, 다음 장은 그 선택을 수학적으로 정의합니다.
📖 Chapter 3: Methodology: Memory-Based MDP with Case-based Reasoning Policy
이 장은 개념적 중심입니다. 먼저 상태·행동·전이·보상·할인율을 가진 MDP에 메모리 공간을 추가합니다. 상태와 행동은 자연어의 유한 길이 문자열이며, 사례 저장소에는 과거의 상태, 행동, 보상이 들어갑니다. 메모리 기반이라는 말은 현재 입력만이 아니라 어떤 사례가 축적되었는지도 행동을 결정한다는 뜻입니다. §3
M-MDP와 CBR 정책: 정의 3.1–3.2, 식 (1)–(2)
시점 t의 사례는 상태 $s_t$, 행동 $a_t$, 보상 $r_t$로 구성됩니다. 검색 정책 $\mu$가 현재 상태와 사례 저장소 $M_t$를 보고 사례 $c_t$를 고르면, 동결된 LLM이 그 사례와 현재 상태를 조건으로 행동을 생성합니다. 전체 정책은 다음과 같습니다.
이는 원문 식 (1)입니다. $\pi$는 전체 에이전트의 행동 확률, $\mu$는 사례 선택 확률, $p_{\mathrm{LLM}}$은 선택된 사례를 참조한 LLM의 행동 확률입니다. 모든 사례에 대해 선택 확률과 조건부 행동 확률의 곱을 더합니다. 이 분해 덕분에 LLM은 고정되어도 검색 정책과 메모리가 달라지면 전체 행동 분포가 달라집니다.
식 (2)는 전체 궤적을 Retrieve → Reuse & Revise → Evaluation → Retain → Transition으로 분해합니다. 검색 후 사례를 재사용·수정하고, 보상을 평가하고, 새 사례를 저장한 다음 다음 상태로 이동합니다. 보상과 기억 갱신은 지시함수로 표현되어 결정적 연산으로 취급됩니다. 저자들은 보상 및 메모리 갱신이 확률적인 경우를 향후 연구로 남긴다고 명시합니다. 이 부분은 사례 선택과 환경의 평가·전이가 서로 다른 역할임을 보여줍니다.
Soft Q-Learning for CBR Agent: 식 (3)–(8)
이어서 저자들은 LLM을 고정한 채 검색 정책을 최적화합니다. 검색 정책의 행동은 도구 호출 자체가 아니라 참고할 사례 하나를 고르는 것입니다. 식 (3)은 보상에 사례 선택 분포의 엔트로피를 더합니다. 엔트로피는 선택이 한 사례에 집중되는 정도의 반대편에 있는 다양성 척도이며, 계수 $\alpha$가 보상과 다양성의 균형을 조절합니다.
식 (4)–(6)은 상태와 메모리의 가치, 사례를 선택했을 때의 Q값, 상태·메모리 방문 분포에 대한 목적함수를 연결합니다. Q값은 선택한 사례를 사용해 LLM이 행동했을 때의 즉시 보상과 할인된 미래 가치를 포함합니다. 할인율 $\gamma\in[0,1)$는 먼 미래의 보상에 주는 가중치입니다. 검색이 생성 모델을 바꾸지 않고도 보상에 영향을 주는 경로가 이 정의에 드러납니다.
원문 식 (7)의 최적 검색 정책입니다. $Q^{*}$는 최적 Q값이며, 분모는 모든 후보의 지수값을 합하여 확률의 합을 1로 만듭니다. $\alpha$가 작을수록 높은 Q값에 선택이 집중됩니다. 이는 가치가 높은 사례를 선호하면서도 선택의 다양성을 남기는 softmax 형태입니다. 부록 A가 라그랑주 승수로 이 식을 유도합니다.
식 (8)은 시간차 학습(Temporal-Difference learning, TD)으로 Q값을 갱신합니다. 현재 추정과 “즉시 보상 + 다음 상태의 soft 가치”의 차이를 줄이는 방식입니다. 다만 v2 식 (8)은 합의 첨자와 합 내부 사례 첨자가 다르고, 식 (10)의 지수 내부 온도 표기도 식 (7)과 그대로 대응하지 않습니다. 여기서는 이를 임의로 수정한 재구현식을 제시하지 않으며, 원문이 제시하는 학습 방향과 실제 단일 단계 구현을 구분합니다.
Enhance Q-Learning Based on State Similarity: 식 (9)–(11)
자연어 상태와 사례를 입력으로 Q함수 전체를 처음부터 학습하는 어려움에 대응하여, 저자들은 일화 제어(Episodic Control, EC)의 아이디어를 사용합니다. 별도의 일화 메모리 $\mathcal D$는 상태·선택한 사례·Q값을 저장합니다. 같은 사례를 선택했던 과거 상태 중 현재 상태와 가까운 기록에 큰 가중치를 주어 Q값을 추정합니다.
원문 식 (9)입니다. $\mathcal D_c$는 검색 사례가 c였던 과거 기록의 부분집합이며, $k_\theta$는 현재 상태와 과거 상태 사이의 학습 가능한 유사도 커널입니다. 분자에는 과거 Q값과 유사도가 곱해지고 분모는 가중치를 정규화합니다. 따라서 모든 기록을 균등하게 평균내는 방식이 아니라, 유사한 상태에서 관찰한 가치를 더 많이 반영하는 방식입니다. 학습되는 대상은 이 커널의 매개변수 $\theta$이며 기반 LLM이 아닙니다.
식 (10)은 이 추정값에 TD 손실을 적용하고, 안정된 목표값을 만들기 위한 타깃 커널 $\bar\theta$를 둡니다. 식 (11)의 기울기는 TD 오차에, 각 과거 Q값이 현재 가중평균에서 얼마나 벗어나는지와 커널 로그의 기울기를 결합합니다. 즉 현재 예측 오차를 줄이는 데 도움이 되는 과거 경험의 가중치를 조정합니다. 이는 사례 저장소 자체와, 그 사례를 사용했던 상태·가치 기록을 구분해야 이해할 수 있습니다.
Algorithm 1: 읽기와 쓰기의 학습 루프
Algorithm 1은 빈 사례 저장소, 일화 메모리, 재생 버퍼에서 시작하는 일반 절차를 제시합니다. 사례 검색, LLM 행동 생성, 실행과 보상 관찰, 새 사례 저장, 전이와 Q기록 저장, 미니배치 손실 갱신의 순서입니다. 타깃 네트워크는 주기적으로 $\bar\theta\leftarrow\beta\bar\theta+(1-\beta)\theta$로 갱신됩니다. $\beta$는 과거 타깃을 유지하는 비중입니다. 알고리즘에서 타깃 갱신 주기를 나타내는 K와 뒤에서 검색 개수를 나타내는 K는 맥락이 다른 기호입니다.
이 장의 핵심 기여는 CBR의 검색·수정·저장을 강화학습 관점에서 연결한 것입니다. 다만 일반 알고리즘이 초기 메모리를 빈 집합으로 두면서 첫 사례를 어떻게 공급하는지에 관한 구체적 분기까지 설명하지는 않습니다. 다음 장은 이 일반 다단계 구성을 실제 조사 계획자에 맞추어 단순화합니다.
📖 Chapter 4: Implementation: Deep Research Agent
이 장은 이론을 실제로 어떤 모듈에 적용하는지 설명합니다. Memento는 사례 기반 계획과 도구 기반 실행을 번갈아 수행합니다. 특히 일반 이론의 다단계 TD 학습과 실제 계획자의 단일 단계 성공 예측을 같은 것으로 읽지 않는 것이 중요합니다. §4
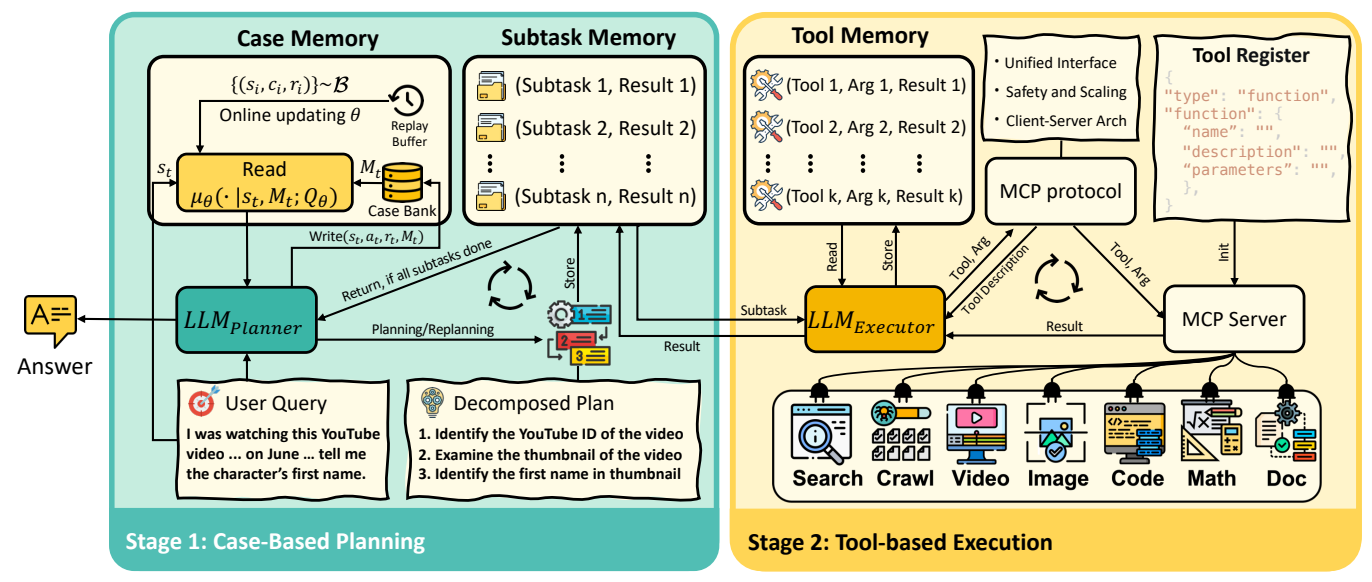
원문 Figure 3, PDF 8쪽. Memento v2 PDF에서 그림 영역만 크롭했습니다. 원문 영문·연결·비율을 보존했으며 번역하지 않았습니다. 왼쪽의 사례 선택 학습과 오른쪽의 도구 실행이 하위 과제와 결과를 주고받습니다.
4.1 Framework
먼저 계획자는 과제 지시와 검색된 K개 사례를 함께 받아 하위 과제를 만듭니다. 각 사례의 상태는 과제, 행동은 계획, 보상은 성공 여부에 대응합니다. 검색된 과거 계획이 새 과제의 정답을 직접 대신하는 것이 아니라, LLM이 새 계획을 만들 때 참고하는 문맥을 구성합니다. 하위 과제 메모리는 생성한 과제와 실행 결과를 기록하여 두 역할을 연결합니다.
실행자는 하나의 하위 과제를 독립적인 실행 에피소드로 처리합니다. 해당 과제의 도구 메모리를 참조하고, 도구를 더 호출할지 결과를 반환할지 판단합니다. 실행 결과가 돌아오면 계획자는 작업 완료 여부를 평가하고, 미완료라면 누적된 실행 이력을 바탕으로 다시 계획합니다. 사례 메모리에 새 경험을 쓰는 것은 이 구현 설명에서는 전체 과제가 완료된 뒤입니다. 형식적인 식 (12)의 매 시점 Write와 실제 도구 호출마다 장기 사례를 남긴다는 주장을 혼동해서는 안 됩니다.
Model Context Protocol(MCP)은 실행자와 여러 도구 서버 사이의 공통 인터페이스입니다. 도구 이름과 인수, 결과 전달을 같은 연결 방식으로 다루어 다양한 도구 조합을 지원합니다. Figure 3에서 계획자의 Read/Write와 실행자의 도구 Read/Store는 같은 기억에 대한 연산이 아닙니다. 앞의 것은 과제 간 경험 재사용, 뒤의 것은 현재 하위 과제 안의 실행 이력입니다.
4.2 Case Memory Management
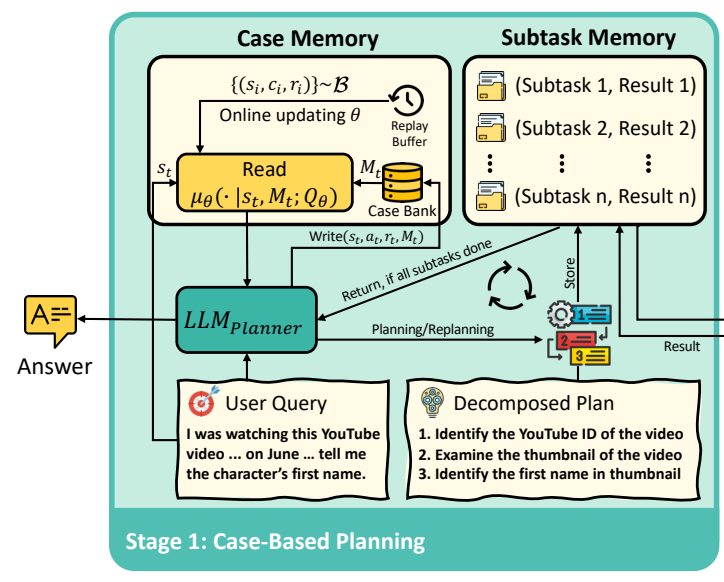
원문 Figure 3의 계획 영역 상세 발췌, PDF 8쪽. Memento v2 PDF에서 왼쪽 영역을 크롭했으며 번역·재배열하지 않았습니다. Case Bank의 사례를 Read하여 계획하고, 완료한 경험은 Write하며, Subtask Memory에는 현재 하위 과제와 결과를 남깁니다.
Memory Storage. 사례 저장소는 상태·행동·보상 튜플을 계속 추가합니다.
원문 식 (12)입니다. $M_t$는 이전 사례 집합이고, 오른쪽의 새 튜플이 관찰된 경험입니다. 상태만 동결된 텍스트 인코더로 벡터화하며 행동과 보상은 원래 형태로 보관합니다. 상태 벡터는 검색을 위한 표현이고, 계획의 원문과 성공·실패 정보는 계획자에게 제공할 경험의 내용입니다. 실패를 포함하는 이유는 성공 경로뿐 아니라 이전 실수도 참고하게 하기 위해서입니다.
Non-Parametric Memory Retrieval. 비모수 방식은 다음과 같이 상태 표현의 코사인 유사도로 상위 K개 사례를 찾습니다.
원문 식 (13)의 enc와 sim을 동일 의미의 직립 글꼴로 적었습니다. $\mathrm{enc}$는 사전학습된 텍스트 인코더, $\mathrm{sim}$은 코사인 유사도이며, TopK는 점수가 높은 K개를 반환합니다. 새 사례를 추가하면 후보 집합이 바뀌므로 검색망을 학습하지 않아도 다음 프롬프트는 달라질 수 있습니다. “비모수”는 기억이 정적이라는 뜻이 아닙니다.
Parametric Memory Retrieval. 모수 방식에서는 새 사례를 쓸 때 Q신경망도 학습합니다. 심층 조사에서 CBR은 계획에 적용되므로 저자들은 계획 선택을 단일 단계로 단순화합니다. 미래 Q값을 다시 목표에 넣는 부트스트래핑이 사라지고, 식 (14)의 제곱오차 $\mathbb E[(Q(s,c;\theta)-r)^2]$로 현재 사례의 성공 보상을 예측합니다.
보상이 0 또는 1이므로 최종 구현에서는 이진 교차 엔트로피를 사용합니다.
원문 식 (15)입니다. $Q(s,c;\theta)$는 현재 상태 s에 사례 c가 좋은 참고가 되어 성공할 확률로 해석됩니다. 성공 표본은 첫 항이, 실패 표본은 둘째 항이 낮아지도록 학습합니다. 저자들은 경계 부근의 학습 신호와 수치 안정성을 이유로 제곱오차 대신 이 손실을 택했다고 설명합니다. 일반 다단계 이론의 Q값과 달리 여기의 Q는 정규화된 성공 확률입니다.
읽기 설명에서는 식 (7)의 분포에서 사례를 표집할 수 있다고 먼저 설명하지만, 실제 Read 연산은 무작위성을 줄이기 위해 다음의 결정적 상위 K개 선택을 사용합니다.
원문 식 (16)입니다. 이 방식에서 변화하는 것은 사례 집합과 사례 유용성 신경망이며, 계획·실행 LLM은 미세조정하지 않습니다. 이 절의 핵심은 메모리의 쓰기와 읽기를 분리하고, 쓰기 때 일어난 학습이 다음 읽기의 우선순위를 바꾸도록 만든 것입니다.
4.3 Tool Usage
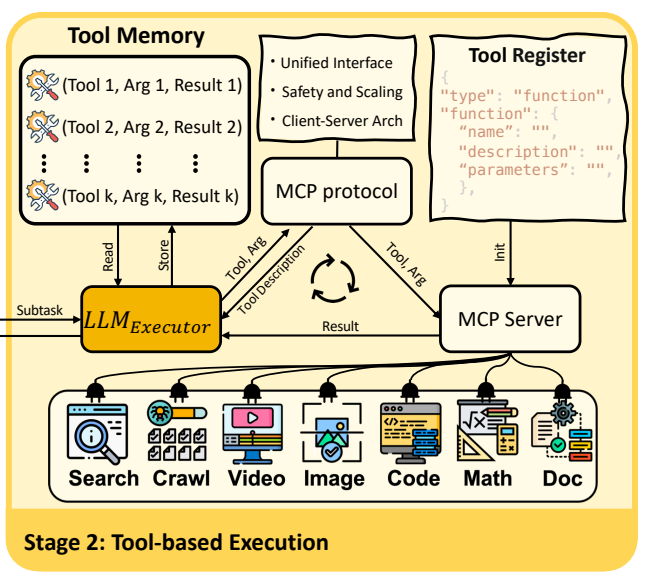
원문 Figure 3의 실행 영역 상세 발췌, PDF 8쪽. Memento v2 PDF에서 오른쪽 영역을 크롭했으며 번역·재배열하지 않았습니다. 실행자는 하위 과제의 Tool Memory를 읽고 호출 결과를 저장하며 MCP를 통해 도구 설명·인수·응답을 주고받습니다.
도구는 외부 정보 획득, 이질적·다중모달 정보 처리, 추론과 계산 순서로 소개됩니다. 먼저 searxng가 Google·Bing·DuckDuckGo·Brave 등의 검색 결과를 모으고 의미 유사도로 후보를 재정렬합니다. Crawl4AI는 선택된 웹 페이지의 본문을 가져옵니다. 검색은 후보 발견, 크롤링은 세부 근거 수집의 역할을 맡습니다.
다음으로 이미지는 시각언어 모델의 설명, 음성은 인식 결과, 발표자료는 슬라이드와 이미지 설명, 스프레드시트는 행 중심 표현으로 바뀝니다. 압축파일 해제, JSON·XML 구조 해석, Word의 Markdown 변환, 영상 요약도 포함되며, PDF 등에는 Chunkr AI 또는 텍스트 파싱을 대체 경로로 사용합니다. 에이전트는 서로 다른 형식의 자료를 언어 모델이 사용할 수 있는 관찰로 통일해 받습니다.
마지막으로 Code 도구는 지속되는 작업 디렉터리에서 파일 작성과 셸·Python 실행, 결과 확인을 지원하고 Math 도구는 기본 산술을 담당합니다. 원문은 코드 실행을 샌드박스와 허용 목록으로 제한한다고 설명합니다. 이는 저자들의 도구 설계 설명이며, 본 리뷰에서 해당 실행 환경의 보안을 시험한 결과는 아닙니다. 이 장은 기억이 실제 과제 수행을 바꾸는 접점을 설명하고, 다음 장은 그 효과를 벤치마크별로 평가합니다.
📖 Chapter 5: Experiments
이 장은 데이터셋 → 지표 → 모델 설정 → 주요 결과 → 절제 실험의 순서로 전개됩니다. Memento의 효과를 이해하려면 기반 모델, 도구 연결, 계획 유무, CBR 유무, 반복 평가를 각각 분리해야 합니다. §5
5.1 Datasets
GAIA는 답이 명확하지만 도구와 자율 계획이 필요한 질문으로 설명됩니다. Level 1은 대략 다섯 단계와 단일 도구, Level 2는 5–10단계와 여러 도구, Level 3은 최대 50단계의 긴 수행과 제한 없는 도구 사용을 요구하는 난이도 구분입니다. 원문은 전체 450개, 검증 150개, 테스트 300개라고 서술합니다. 다만 Table 2의 정확도에서 실제 평가 문항 수와 정답 개수를 이 분모로 재구성할 수 있는 세부 내역을 제시하지 않으므로, 이 리뷰는 별도의 실제 분모를 추정하지 않습니다.
DeepResearcher 묶음은 NQ, TriviaQA(TQ), HotpotQA, 2Wiki, MusiQue, Bamboogle, PopQA로 구성됩니다. Bamboogle만 125개이고 나머지는 각각 512개이므로, 원문에 기재된 크기의 합은 3,197개입니다. 단일 사실 회상과 여러 근거를 결합하는 질의응답이 함께 들어 있습니다. SimpleQA는 4,330개의 사실 질문, HLE는 여러 학문 분야의 2,500개 질문으로 설명됩니다. 데이터셋 전체의 설명과 각 표에 실제 사용한 평가 표본의 상세 내역은 같은 정보가 아닙니다.
5.2 Evaluation Metrics
GAIA는 정규화한 예측 답과 정답의 완전 일치율인 Exact Match(EM)를 사용합니다. 원문은 소문자화, 구두점과 관사 제거, 공백 정규화를 설명합니다. 이 지표는 짧은 최종 답의 정확성을 판단하며, 중간 계획의 품질을 직접 점수화하는 지표는 아닙니다.
다른 세 묶음에는 macro-F1과 Partial Match(PM)를 보고합니다. F1은 정밀도와 재현율을 결합하는 지표이지만, 본문에는 세부 토큰화와 정규화 식이 따로 전개되지 않습니다. PM은 생성 답과 정답의 부분적인 의미 일치를 평가하는 점수이며, GPT-4o-mini와 DeepResearcher와 같은 평가 프롬프트를 사용한다고 설명합니다. 따라서 PM을 GAIA의 엄격한 EM과 같은 성공률로 합쳐 읽어서는 안 됩니다. SimpleQA와 HLE의 외부 리더보드 비교도 이 평가 설명과 함께 읽어야 합니다.
5.3 Model Configurations
계획자는 GPT-4.1, 실행자는 GAIA에서 o3, 다른 데이터셋에서 o4-mini입니다. 이미지 처리는 GPT-4o, 영상은 Gemini 2.5 Pro, 음성은 Assembly AI를 사용합니다. 비모수 검색은 SimCSE 문장 표현과 코사인 유사도를 사용하고, 모수 검색은 SimCSE 표현을 초기화한 뒤 2층 다층 퍼셉트론(MLP)으로 Q값을 계산합니다. 기반 LLM을 고정한다는 사실과 이 MLP를 학습한다는 사실이 동시에 성립합니다.
기억 저장의 중복을 줄이기 위해 각 궤적의 마지막 단계의 상태·행동·보상만 사례 메모리에 쓴다고 명시합니다. 최종 상태가 앞선 상태의 정보를 포함하기 때문이라는 설명입니다. 이 설정은 모든 도구 호출 기록을 독립적인 장기 사례로 저장하는 방식과 다릅니다.
제거 실험의 이름도 정의합니다. Offline Executor는 계획자·사례 메모리·외부 도구를 제거한 실행자만을 뜻합니다. Online Executor는 같은 실행자에 실시간 검색과 MCP 도구를 다시 연결합니다. Memento w/o CBR은 계획 체계는 유지하되 일화적 사례 메모리를 끕니다. 이 구분을 바탕으로 뒤의 차이를 해석해야 합니다.
5.4 Experimental Results
DeepResearcher. Table 1은 프롬프트 방식, 학습 방식, Memento를 비교합니다. 비교 시스템의 결과는 DeepResearcher 논문에서 인용하며 그 기반 모델은 Qwen2.5-7B입니다. Memento는 GPT-4.1과 o4-mini를 결합하므로, 이 표는 동일 기반 모델에서 기억만 바꾼 실험이 아닙니다.
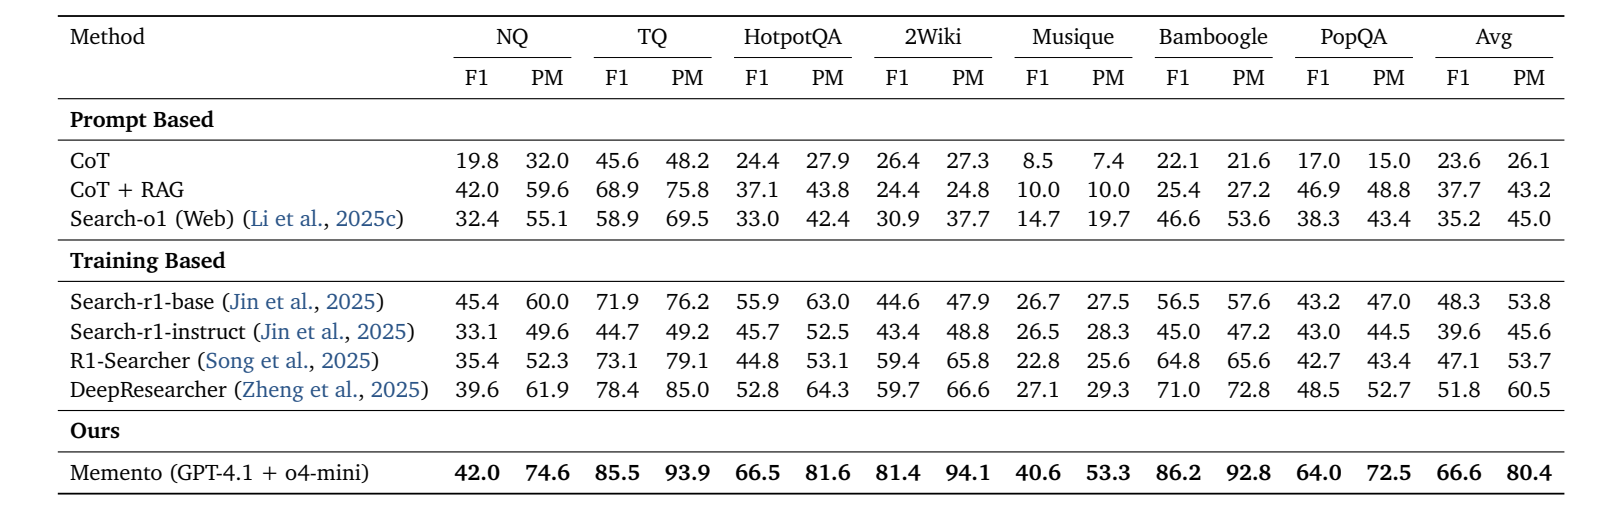
원문 Table 1, PDF 12쪽. Memento v2 PDF에서 표 영역을 크롭했으며 영문·수치·열 순서를 보존했습니다. 번역하지 않았습니다. 아래 표는 같은 결과를 읽기 쉽도록 일부 재작성한 것입니다.
| 데이터셋 | Memento F1 (%) | Memento PM (%) | DeepResearcher F1 (%) | DeepResearcher PM (%) |
|---|---|---|---|---|
| NQ | 42.0 | 74.6 | 39.6 | 61.9 |
| TQ | 85.5 | 93.9 | 78.4 | 85.0 |
| HotpotQA | 66.5 | 81.6 | 52.8 | 64.3 |
| 2Wiki | 81.4 | 94.1 | 59.7 | 66.6 |
| MusiQue | 40.6 | 53.3 | 27.1 | 29.3 |
| Bamboogle | 86.2 | 92.8 | 71.0 | 72.8 |
| PopQA | 64.0 | 72.5 | 48.5 | 52.7 |
| 원문 Avg | 66.6 | 80.4 | 51.8 | 60.5 |
Memento의 보고 Avg는 DeepResearcher보다 F1 14.8%p, PM 19.9%p 높습니다. 다만 Table 1 캡션은 문항 수에 따른 가중평균이라고 설명하는 반면, Memento의 66.6/80.4는 제시된 일곱 행의 단순평균과 일치합니다. 기재된 크기 512·125로 가중하면 반올림된 행 기준 약 64.23/78.90이 됩니다. 후자는 리뷰어가 집계 방식을 확인하기 위해 계산한 값이며 논문 보고 성능을 대체하지 않습니다. 원문만으로 이 불일치의 원인은 확정할 수 없습니다. Table 1
GAIA (Validation & Test). 검증에서는 빈 메모리에서 시작해 세 번 반복하며 성공과 실패 궤적을 저장합니다. 그 결과가 GPT-4.1 계획자·o3 실행자의 Pass@3 87.88%입니다. 테스트는 검증에서 쌓은 사례 저장소만 사용하여 79.40%를 얻었다고 설명합니다. 검증 반복 중 얻은 경험을 같은 검증 분포에서 사용하는 설정과, 테스트 정답을 사용하여 사례를 새로 학습하는 설정은 구분되어야 합니다. 본문은 후자를 했다고 보고하지 않습니다.
| GAIA 평가 | 전체 (%) | Level 1 (%) | Level 2 (%) | Level 3 (%) |
|---|---|---|---|---|
| 검증, Pass@3 | 87.88 | 96.23 | 90.70 | 61.54 |
| 테스트, 검증 사례 저장소 사용 | 79.40 | 90.32 | 75.47 | 71.43 |
출처는 원문 Table 2입니다. 이 표의 캡션은 리더보드 시점을 2025년 6월 26일로 기재합니다. 본문은 테스트 4위라고 서술하지만, 표의 테스트 행에서는 80.40, 79.73 다음에 Memento 79.40이 배치되어 있습니다. 따라서 이 리뷰는 순위를 현재 사실로 제시하지 않고 v2의 보고 점수와 평가 조건을 사용합니다. 원문이 명시한 어려움은 긴 추론과 고도화된 도구 조정이 필요한 Level 3 과제입니다. §5.4, Table 2
Humanity’s Last Exam (HLE). 원문은 GPT-4.1 계획자와 도구를 연결한 o4-mini 실행자로 PM 24.4%를 보고합니다. Figure 4에서는 GPT-5 25.32%, Gemini-2.5-Pro 21.64%, o3-high 20.32%, o4-mini-high 18.08%와 나란히 제시합니다. 외부 HLE 결과는 공식 웹사이트에서 가져왔다고 명시되어 있습니다. 서로의 채점기와 도구·실행 예산을 통제한 새 실험이라고 볼 근거는 없으므로, 이 도표의 순위를 동일 조건의 모델 우위로 확대하지 않습니다.
SimpleQA. 같은 계획자와 o4-mini 실행자의 PM은 95.0%입니다. 본문은 이를 accuracy라고도 부르지만, 초록과 Table 5(b), §5.2의 평가 체계를 함께 보면 이 리뷰에서는 PM으로 표기하는 것이 일관됩니다. Figure 4의 WebSailor 93.5%, WebDancer 90.5% 등은 WebSailor에서 인용한 비교 결과입니다. 높은 사실 질의응답 점수는 이 평가 묶음에서의 성과이며, 모든 응용에서의 오류 부재를 뜻하지 않습니다.
5.5 Ablation Studies
5.5.1 Hyper-parameter Selection
검색 사례가 늘면 문맥 비용이 증가하고 관련 없는 사례가 잡음을 만들 수 있습니다. Table 3은 K=0, 1, 2, 4, 8, 16, 32를 비교합니다. 절의 문장 목록에는 K=1이 빠져 있지만 실제 표에는 존재합니다. K=0의 평균 F1/PM은 59.9/72.2, K=1은 63.6/77.9, K=4는 64.5/78.5이며, K=32는 63.9/78.1입니다.
이 실험 안에서는 K=4가 가장 높고 그 이후 이득이 포화되거나 감소합니다. 저자들은 소수의 질 좋은 사례와 선별의 중요성으로 해석합니다. 다만 Table 3의 K=4 평균 64.5/78.5는 Table 1의 66.6/80.4와 동일하지 않습니다. 두 표를 하나의 동일 실행 결과처럼 합치지 않습니다. 원문은 그 차이를 재현할 수 있는 실행별 상세 기록을 별도로 제공하지 않습니다. §5.5.1, Table 3
5.5.2 Component-wise Analysis
Table 5는 각 셀을 F1/PM으로 보고합니다. 아래는 그 평균 열을 원문과 대조하여 옮긴 것입니다.
| 설정 | HLE F1/PM (%) | SimpleQA F1/PM (%) | DeepResearcher F1/PM (%) |
|---|---|---|---|
| Offline Executor | 6.4 / 8.7 | 19.7 / 21.5 | 48.8 / 62.8 |
| Online Executor | 11.2 / 15.8 | 48.5 / 84.8 | 30.8 / 60.7 |
| Memento w/o CBR | 22.2 / 17.4 | 81.0 / 89.7 | 59.9 / 72.2 |
| Memento | 26.7 / 24.4 | 84.7 / 95.0 | 66.6 / 80.4 |
외부 도구만 연결하는 효과는 일관되게 양수이지 않습니다. SimpleQA에서는 F1 28.8%p, PM 63.3%p 증가하지만, DeepResearcher에서는 F1 18.0%p, PM 2.1%p 감소합니다. 그 다음 명시적 계획을 추가하면 세 묶음 모두 개선됩니다. Online Executor에서 w/o CBR로의 변화는 각각 HLE 11.0/1.6%p, SimpleQA 32.5/4.9%p, DeepResearcher 29.1/11.5%p입니다.
마지막 CBR의 추가 이득은 HLE 4.5/7.0%p, SimpleQA 3.7/5.3%p, DeepResearcher 6.7/8.2%p입니다. 특히 사례 검색의 기여를 살펴볼 때는 외부 시스템과 비교한 Table 1보다 계획자·실행자 구성을 유지한 이 마지막 비교가 더 직접적인 근거가 됩니다.
저자들은 HLE의 전문 영역에서 기반 모델의 도메인 지식이 충분하지 않으면 도구와 계획만으로 정답을 안정적으로 만들기 어렵다고 설명합니다. 또한 DeepResearcher에서 도구 연결 후 점수가 떨어진 것을 데이터 오염과 내부 지식의 영향으로 해석합니다. 이는 저자의 해석이며, 표의 성능 하락만으로 특정 학습 데이터에 특정 평가 문항이 포함되었음을 직접 증명한 것은 아닙니다. §5.5.2, Table 5
5.5.3 Continual Learning Ability Boosted by Parametric and Non-Parametric CBR
Figure 1(c)와 Table 4는 같은 DeepResearcher 환경에서 반복이 늘어날 때의 변화를 비교합니다. 원문의 축은 Accuracy(%)이며, 표는 반복별 성능으로 제시됩니다. 이 계열을 Table 1의 평균 F1로 다시 이름 붙이지 않습니다.
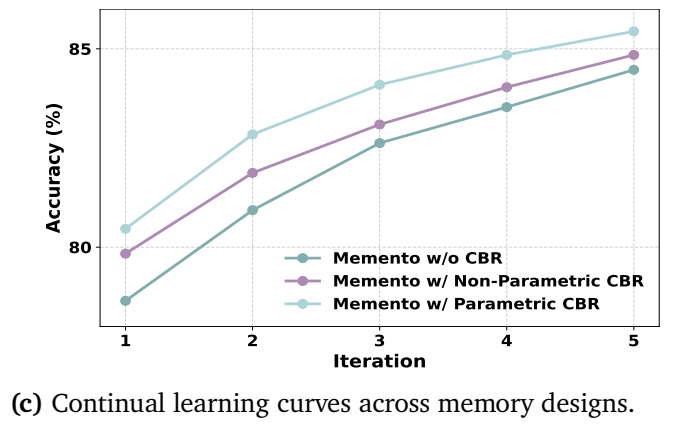
원문 Figure 1(c), PDF 1쪽. Memento v2 PDF의 해당 패널을 크롭했습니다. 반복 축, 정확도 축, 범례, 패널명을 보존했으며 번역하지 않았습니다.
| 설정 | 반복 1 (%) | 반복 2 (%) | 반복 3 (%) | 반복 4 (%) | 반복 5 (%) |
|---|---|---|---|---|---|
| w/o CBR | 78.65 | 80.93 | 82.62 | 83.53 | 84.47 |
| 비모수 CBR | 79.84 | 81.87 | 83.09 | 84.03 | 84.85 |
| 모수 CBR | 80.46 | 82.84 | 84.10 | 84.85 | 85.44 |
Table 4에서 모수 CBR은 모든 반복에서 가장 높고, 비모수 CBR도 w/o CBR보다 높습니다. 다만 CBR을 제거한 설정 역시 반복에 따라 상승하므로, 모든 상승분을 메모리 학습의 단독 효과로 해석할 수는 없습니다. 다섯 번째 반복의 차이는 모수 CBR 대 w/o CBR 0.97%p, 비모수 CBR 대 w/o CBR 0.38%p입니다. 이는 초기 반복의 차이보다 작습니다.
저자들은 약 3천 개 학습 데이터의 유한 환경에서 사례 저장소가 빨리 포화되고, 추가 반복에 새롭게 등장하는 잠재적 실패 사례가 줄어든다고 설명합니다. 그래서 더 많은 반복의 이득이 작아지며 곡선의 성능 하락 전환점을 찾기 어렵다고 명시합니다. 이 실험은 유한 데이터에서의 빠른 수렴을 보여주며, 무한히 새로운 과제가 들어오는 환경을 직접 측정한 결과로 바꾸어 읽을 수는 없습니다. §5.5.3, Table 4
5.5.4 Generalisation across Tasks
분포 밖(Out-of-Distribution, OOD) 평가에서는 NQ, TQ, HotpotQA, 2Wiki로 사례 저장소를 구축하고, 질문 양식과 정보 분포가 다른 MusiQue, Bamboogle, PopQA를 평가합니다. 추론 때마다 학습 측 저장소에서 관련 사례 네 개를 검색합니다. GAIA 검증의 세 번 반복과는 다른 프로토콜입니다.
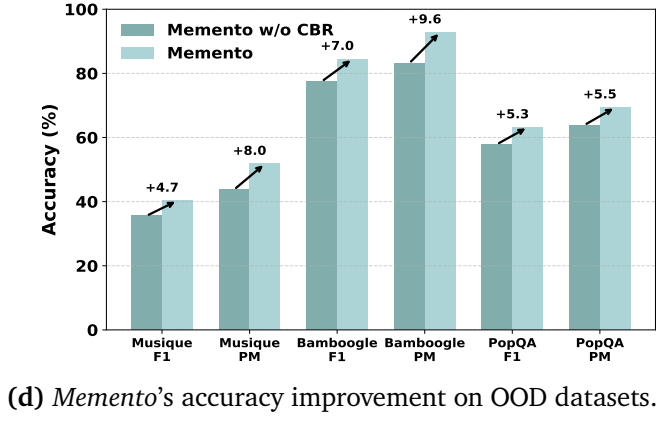
원문 Figure 1(d), PDF 1쪽. Memento v2 PDF의 해당 패널을 크롭했습니다. 축·범례·데이터셋과 F1/PM 구분·증가 화살표를 보존했으며 번역하지 않았습니다.
그림의 증가 폭은 MusiQue에서 F1 +4.7%p·PM +8.0%p, Bamboogle에서 +7.0%p·+9.6%p, PopQA에서 +5.3%p·+5.5%p입니다. 초록의 “4.7–9.6”은 이 지표별 절대 증가 폭의 범위입니다. 세 데이터셋의 모든 지표가 같은 폭으로 개선되거나 상대 개선율이 그 범위라는 뜻은 아닙니다.
이 절의 근거는 한 데이터셋에서 얻은 계획 경험을 다른 데이터셋에 가져가도 이득이 있었다는 점입니다. 다만 이름이 다른 데이터셋으로 나눴다는 사실과 내용 수준의 중복이 전혀 없다는 보장은 구별해야 합니다. 이 v2는 문항·웹 문서 수준의 중복 감사 절차를 상세히 제시하지 않습니다. 이 장의 결과는 다음 장에서 실제 도구 호출, 문맥 비용, 계획자의 역할과 연결됩니다. §5.5.4
📖 Chapter 6: Discussion and Analysis
이 장은 성능을 실제 실행 양상과 연결합니다. 원문 6.1의 제목은 토큰 수이지만 실제 문단과 Figure 5는 도구 사용을 다루며, 6.2의 제목은 MCP 도구 통계이지만 실제 문단과 Figure 6은 토큰과 비용을 다룹니다. 아래에서는 원래 절 순서를 유지하면서 실제 내용을 설명합니다. §6
6.1 The Number of Tokens per Task
Figure 5는 난이도별 과제 유형의 평균 횟수를 보여줍니다. 코드, 검색, 크롤링이 주요 비중을 차지하고 난이도가 높을수록 이들의 사용이 증가합니다. 저자들은 어려운 과제에서 도구를 더 많이 호출하는 것뿐 아니라, 앞선 도구의 관찰을 해석하고 결합하는 내부 추론의 중요성이 커진다고 해석합니다.
이 논의의 의미는 도구 개수와 문제 해결 능력을 동일시하지 않는 데 있습니다. 실행자가 가져온 여러 페이지와 계산 결과가 최종 답으로 이어지려면 계획과 근거 통합이 필요합니다. Table 5에서 도구만 연결한 설정과 계획을 추가한 설정의 차이는 이 해석을 읽는 배경입니다. 다만 도구 호출 횟수와 추론량 사이의 인과 효과를 따로 분리한 실험으로 제시되지는 않습니다.
6.2 Statistics of MCP Tools
Figure 6의 비용 분석은 GAIA 검증에서 난이도별로 각각 10개 과제를 무작위 표집했다고 설명합니다. 본문이 제시하는 과제당 평균 토큰은 다음과 같습니다.
| GAIA 난이도 | 입력 토큰 | 출력 토큰 |
|---|---|---|
| Level 1 | 약 26,000 | 약 4,700 |
| Level 2 | 약 48,000 | 약 6,900 |
| Level 3 | 약 121,000 | 약 9,800 |
난이도가 올라갈수록 입력 증가가 출력 증가보다 큽니다. 저자들은 최종 답은 짧더라도 관찰, 계획, 도구 출력, 중간 추론이 누적되면서 입력 문맥이 커진다고 설명합니다. “LLM 미세조정을 하지 않는다”는 설명은 이 추론 비용이 사라진다는 뜻이 아닙니다.
Figure 6에는 Avg Cost 보조축도 있지만, 본문은 통화·과금 구성·캐시 할인 여부를 충분히 풀어 설명하지 않습니다. 이 리뷰는 그 축을 현재 API 요금이나 전체 시스템 운영비로 환산하지 않습니다. 사례 생성의 전체 비용, Q신경망 학습 시간·자원, 검색·크롤링 서비스 비용을 합친 비용 비교도 별도로 보고되지 않았습니다. 이는 원문의 비용 자료가 어디까지 뒷받침하는지에 관한 범위 설명입니다.
6.3 The Impact of Fast and Slow Think Mode
Table 6은 GAIA 검증의 Pass@1입니다. GPT-4.1 계획자와 o3 실행자는 70.91%, o3 계획자와 o3 실행자는 63.03%입니다. 실행자를 고정한 이 비교에서 차이는 7.88%p입니다. Qwen3-32B 계획자를 사용하고 실행자를 o4-mini로 고정하면 Fast는 53.94%, Slow는 40.61%로 13.33%p 차이가 납니다. 이를 Pass@3의 87.88%와 같은 평가 모드로 나란히 비교해서는 안 됩니다.
저자들은 실행 흔적에서 o3 계획자가 계획을 만들지 않고 바로 답하거나, 지나치게 긴 계획과 복잡한 하나의 추론 사슬을 만들어 실행자를 혼란스럽게 하는 경우를 관찰했다고 설명합니다. 빠른 계획자는 하위 과제를 간결하게 나누는 역할에 더 적합했다고 해석합니다. 본문에는 o4-mini 실행자 조건의 추가 차이도 서술되지만 Table 6에 해당 GPT-4.1/o3 두 행이 모두 제시되어 있지는 않으므로, 여기서는 표로 확인되는 비교만 수치화합니다.
이 결과는 숙고가 일반적으로 해롭다는 주장이 아닙니다. 이 시스템에서 계획자의 역할과 출력 구조가 실행자와 잘 맞는지가 중요했다는 실험입니다. 이 장의 기여는 기억의 성능 이득을 추론·도구·문맥 비용 및 역할 분담과 함께 해석한 것이며, 다음 장은 전체 결론을 제시합니다.
📖 Chapter 7: Conclusion
저자들은 기반 모델 가중치를 갱신하지 않고도 사례 메모리로 에이전트가 적응하는 Memento를 정리합니다. M-MDP라는 형식화, 계획자–실행자 구조, 과거 궤적의 저장과 검색이 논문의 중심입니다. GAIA, DeepResearcher, SimpleQA 등의 성과와 모수·비모수 CBR의 이득, 소수 사례 선별의 중요성을 결론에 다시 연결합니다. §7
결론의 “모델 가중치 갱신 없음”은 앞선 구현과 함께 읽어야 합니다. 동결되는 것은 기반 LLM이고, 모수 사례 선택기는 학습됩니다. 저자들이 명시한 향후 방향은 메모리 기반 MDP를 이용한 심층 조사 연구이며, 구체적으로 나열되지 않은 새로운 과제를 저자 제안으로 덧붙이지 않습니다. 본문 결론 뒤에는 참고문헌, 정책 유도, 메모리 방식 비교가 이어집니다.
📖 Chapter References: References
참고문헌은 CBR의 고전적 기반, 일화 기억과 제어, 최대 엔트로피 강화학습, LLM 도구 사용·메모리·질의응답 평가를 연결합니다. 본문의 수식 유도에는 soft Q-learning과 episodic control 계열이, 시스템 설명에는 계획·도구·메모리 연구가, 평가에는 각 벤치마크와 외부 비교 결과의 출처가 사용됩니다. References
이 리뷰는 참고문헌 목록과 본문의 인용 역할을 확인했으며, 인용 논문 전체를 독립적으로 읽은 것으로 주장하지 않습니다. 따라서 선행연구의 세부 성능이나 한계는 Memento가 실제 설명한 범위를 넘어 추가하지 않았습니다. 다음 부록 A는 본문에서 생략한 검색 정책의 수학적 유도를 제공합니다.
📖 Chapter Appendix A: Derivation of the Optimal Policy in Soft-Q Learning
부록 A는 먼저 식 (17)–(19)에서 soft 가치와 Q값, 방문 분포에 대한 기대 목적함수를 다시 제시합니다. 그 다음 상태와 메모리를 고정하고 사례 선택 확률의 합이 1이라는 조건을 붙입니다. $\mu_c=\mu(c\mid s,M)$, $Q_c=Q^\pi(s,M,c)$로 줄여 쓰면 라그랑주 목적함수는 다음과 같습니다. Appendix A
원문 식 (20)입니다. 첫 항은 가치가 높은 사례를 선택하는 이득이고, 둘째 항은 엔트로피 보너스이며, 셋째 항의 $\lambda$는 확률 합의 제약을 강제하는 승수입니다. 선택 확률에 대해 미분하면 식 (21)–(22)를 얻습니다.
모든 사례에 공통인 승수 부분을 정규화 상수로 묶으면, 확률은 $\exp(Q_c/\alpha)$에 비례합니다. 이를 합이 1이 되도록 나누고 최적 Q값으로 쓰면 식 (23), 즉 본문의 식 (7)이 됩니다. 이 유도는 보상만 최대화하는 선택에 엔트로피를 더하면 왜 softmax가 나오는지를 설명합니다. 원문은 $\alpha\rightarrow0$에서 표준 Q-learning에 가까워진다고 덧붙입니다.
이 부록은 고정된 상태·메모리에서 검색 확률을 최적화한 형태를 보여줍니다. 실제 Memento 구현에서 상위 K개를 사용하는 식 (16)까지 확률 표집과 동일하다고 증명하는 부분은 아닙니다. 다음 부록은 이론과 구현에 등장한 여러 메모리를 읽기·쓰기·기울기 관점에서 비교합니다.
📖 Chapter Appendix B: Analysis of Memory Mechanisms
부록 B와 Table 7은 표 기반 Q-learning → deep Q-learning → neural episodic control → 실제 비모수·모수 메모리의 순서로 비교합니다. 핵심은 “메모리가 있다”는 공통점보다 어디에 값을 저장하고 무엇을 학습하는지입니다. Appendix B
| 방식 | Q값 표현 | 읽기 | 쓰기와 학습 |
|---|---|---|---|
| 표 기반 Q-learning | 개별 Q테이블 | 직접 조회 | TD로 해당 항목 갱신 |
| Deep Q-learning | 신경망 | 식 (7)의 정책 | 식 (24)의 TD 손실로 Q신경망 갱신 |
| Neural Episodic Control | 기록된 Q값의 커널 추정 | 식 (7)의 정책 | 기록 추가와 식 (10)의 커널 갱신 |
| §4 비모수 메모리 | 별도 Q함수 없음 | 식 (13)의 유사도 TopK | 식 (12)의 사례 추가 |
| §4 모수 메모리 | 성공 확률 신경망 | 식 (16)의 Q값 TopK | 식 (15)의 교차 엔트로피 학습 |
원문 Table 7의 의미를 한국어로 정리한 표입니다. Deep Q-learning은 공유 매개변수로 새 상태에 일반화할 수 있지만, 근사 오차가 매개변수 전반으로 퍼져 최적화 불안정성과 큰 데이터 요구를 낳을 수 있다고 저자들은 설명합니다. 이 점이 과거 Q값에 학습된 커널을 적용하는 EC 방식의 동기가 됩니다. EC에서 학습하는 것은 과거 값들을 조합하는 가중치 구조입니다.
식 (24)–(25)는 타깃 Q신경망을 둔 TD 손실과 그 기울기를 보여줍니다. 일반적으로 잔차와 현재 Q값의 기울기를 곱해 예측을 조정하는 형태입니다. 원문 식 (24)의 soft 목표 표기는 앞서 언급한 온도 표기 차이가 있어, 이 리뷰는 이를 일관된 구현 사양으로 재작성하지 않습니다.
마지막으로 단일 단계 계획에서는 미래 가치를 부트스트래핑하지 않으므로 직접 신경망으로 성공 확률을 학습할 수 있다고 설명합니다. 식 (26)은 교차 엔트로피 손실의 기울기입니다.
$Q-r$는 성공 확률 예측의 오차이고, 분모는 확률 표현에 대해 교차 엔트로피를 미분할 때 생기는 항입니다. 여기에 Q신경망의 매개변수 기울기를 곱합니다. 부록은 마지막으로 실제 모수 Read가 정책 표집 대신 TopK를 사용한다는 점을 재확인합니다. 이 비교를 통해 논문에 등장한 세 수준, 즉 일반 soft Q 이론, 커널 기반 일화 제어, 단일 단계 신경 사례 선택을 구분할 수 있습니다.
실험 결과 심층 분석
가장 직접적인 CBR 근거는 동일한 계획·실행 틀 안에서 메모리를 제거한 Table 5입니다. DeepResearcher에서 F1 59.9→66.6, PM 72.2→80.4로 올라가며, HLE와 SimpleQA에서도 추가 이득이 있습니다. 반면 Table 1에서 학습 기반 DeepResearcher의 51.8/60.5보다 Memento의 66.6/80.4가 높다는 결과는 기반 모델까지 다른 시스템 비교입니다. 따라서 전체 시스템의 성과와 기억만의 효과를 서로 다른 근거로 읽어야 합니다. Table 1, Table 5
평가 모드도 결론을 바꿉니다. GAIA 검증 Pass@3은 같은 검증 환경에서 사례를 세 번 축적하는 성과이고, Table 6의 Pass@1 70.91%는 단일 시도 계획자 비교입니다. 테스트 79.40%는 검증 사례 저장소를 이전한 평가입니다. OOD 실험은 네 학습 데이터셋에서 구축한 저장소를 다른 세 데이터셋으로 이전합니다. 반복·누적 경험·이전 평가를 하나의 독립적 단일 시도 점수로 환원할 수 없습니다. §5.4–5.5, Table 6
통계적 유의성 검정, 신뢰구간, 여러 무작위 시드에 대한 분산은 논문에 보고되지 않았습니다. 따라서 특히 다섯 번째 반복의 0.38%p·0.97%p 차이를 통계적으로 확정된 우위라고 표현하지 않습니다. Table 1의 가중평균 캡션과 실제 행 평균의 차이, Table 3과 Table 1의 점수 차이, 학습 곡선에서 w/o CBR도 상승하는 현상은 보고된 결과의 해석 범위를 제한하는 확인 필요 정보이며, 리뷰어가 새로 발견한 알고리즘 실패 사례로 단정할 내용은 아닙니다.
재현성 측면에서 원문은 모델 역할, 검색 표현, Q망의 층수, 최종 궤적 저장, 검색 개수 실험, OOD 학습·평가 분리, GAIA 반복 방식을 제공합니다. 그러나 평가 문항의 온라인 처리 순서, 반복 간 캐시와 중복 사례 처리, 모든 모델 호출 설정, Q망 학습의 전체 하이퍼파라미터와 총 학습 비용을 이 v2 본문만으로 확정할 수는 없습니다. 코드 링크는 논문에 제공되지만, 이 리뷰는 링크된 최신 코드를 실행하거나 특정 커밋과 논문 결과를 대조하지 않았습니다. §3–6
원문은 DeepResearcher의 데이터 오염 가능성을 논의합니다. 이를 판단할 때는 기반 LLM의 사전학습 노출, 웹 검색을 통한 평가 답안 노출, 평가 중 사례 저장소에 들어가는 경험을 구별해야 합니다. 논문이 명시한 것은 GAIA 검증 경험의 축적과 테스트로의 이전, OOD의 데이터셋 분리입니다. 질문·정답의 문서 수준 중복이나 검색 결과 누출이 없음을 검증한 감사 결과는 보고되지 않았으므로, “오염 없음”과 “누출 확인” 어느 쪽도 이 리뷰에서 추가로 선언하지 않습니다.
기술적 함의와 응용
Memento의 기술적 의미는 기반 LLM의 지식과 에이전트가 축적한 경험을 분리하여 다룬 데 있습니다. 같은 모델을 사용하더라도 어떤 과거 계획을 보여주고 어떤 실패를 상기시키는지에 따라 전체 정책이 바뀝니다. 리뷰어의 해석으로는 이 구조가 조사 업무의 반복 수행에서 학습 대상을 설계할 때 유용한 관점을 제공합니다. 지속학습을 논의할 때 사례 추가만 하는지, 검색기를 학습하는지, 모델 자체를 갱신하는지 명시할 수 있기 때문입니다.
실제 응용을 읽는 또 하나의 관점은 역할과 비용입니다. 도구를 연결하는 것만으로 항상 성능이 오르지는 않았고, 명시적인 계획이 큰 차이를 만들었습니다. 계획자는 간결한 하위 과제를 만들고 실행자는 이를 수행하는 분업이 중요했으며, 어려운 과제에서는 출력보다 입력 문맥의 증가가 컸습니다. 이 결과는 기반 LLM 미세조정을 생략하는 이점과, 경험 생성·추론·도구 사용에 필요한 비용을 함께 살펴야 한다는 의미로 해석할 수 있습니다. §5.5.2, §6
저자가 명시한 범위에서 남아 있는 문제는 Level 3의 긴 추론과 도구 조정, HLE 전문 영역에서의 기반 지식 부족, 유한한 사례 환경에서의 빠른 포화입니다. 확률적인 보상·메모리 갱신과 메모리 기반 MDP를 이용한 심층 조사 연구는 원문이 언급한 향후 방향입니다. 논문이 보여준 중심 성과는 동결된 LLM 위에 갱신되는 경험과 선택 정책을 결합하여 에이전트의 행동을 개선할 수 있다는 점이며, 그 성과는 반복 평가와 데이터셋 분리, 사용 모델, 지표 조건 안에서 해석해야 합니다.
분석 범위: v2 본문 §1–7, References의 인용 역할, Appendix A–B를 반영했습니다. 모든 참고문헌의 전문, 공개 코드의 실행·커밋별 구현, 현재 리더보드와 서비스 가격은 분석하지 않았습니다. 원문 그림과 표는 arXiv v2에 표시된 CC BY 4.0 조건에 따라 출처를 밝히고 크롭하여 인용했습니다.