논문 개요와 전체 구조
사용자의 대화 이력을 기억하는 AI Agent를 만들 때에는 먼저 무엇을 저장할지 결정해야 합니다. 중요한 사실을 추출해 별도 메모리로 보관할 수도 있고, 원문을 그대로 둔 채 질문이 들어올 때마다 필요한 부분을 찾아 읽을 수도 있습니다. MemoryTax는 모델이 강해져도 미리 설계한 메모리 시스템이 유리한지를 묻는 짧은 실증 연구입니다. 여기서 메모리는 모델 가중치에 학습된 지식이 아니라, 대화 이후 별도 저장소에 남겨 다음 질문에 활용하는 정보를 뜻합니다.
Zedong Peng은 LoCoMo의 대화 한 개에서 전체 문맥 입력, BM25, Mem0, Zep, 그리고 Pi·Codex·Claude Code를 비교합니다. 논문의 중심 주장은 약한 모델에서는 사실 추출이 도움이 될 수 있지만, 강한 모델에서는 원문 검색과 도구 사용이 더 나은 정확도·비용 조합을 만들 수 있다는 것입니다. 그러나 이를 모든 장기 메모리 문제의 결론으로 받아들이면 안 됩니다. 대화 하나, 조합당 한 번의 채택 실행, 에이전트에만 제공된 사진 캡션이라는 조건이 결과 해석의 핵심입니다.
이 리뷰는 MemoryTax v1 원문을 기준으로 작성했습니다. 제출일은 2026년 10월 21일이며, 분석일은 2026년 10월 31일 KST입니다. 모델명·버전·달러 비용은 이 논문의 실험 기록을 가리키며, 현재 서비스 가격이나 일반적인 모델 순위를 뜻하지 않습니다. 출처는 분석 대상의 버전이 고정된 arXiv 주소로 연결합니다.
| 원문 순서 | 역할 |
|---|---|
| 1. Introduction | 사전 메모리 설계와 질문 이후 원문 검색의 대비 |
| 2. Setup | 데이터, 일곱 방법, 세 모델, 캡션 조건, 측정 정의 |
| 3. Agent memory is a costly patch for a weak model | 모델별 성능과 메모리 구축비의 관계 |
| 4. Agent memory has a ceiling | 저장소 작성 모델과 답변 모델을 분리한 실험 |
| 5. With Claude Opus 5.5, Pi tops the frontier | Pi의 비용·정확도와 오답 키·사진 캡션의 영향 |
| 6. Discussion and limitations | 저자가 명시한 해석 범위와 후속 방향 |
| References | 본문 논증의 참고문헌, 부록보다 앞에 위치 |
| Appendix A. Full results | 전체 성능·비용 표, 작성자/독자 교차표, 사진 근거별 결과 |
| Appendix B. Protocols | 저장·검색·컨테이너·재시도 조건 |
| Appendix C. Prompts | 답변·에이전트·채점 프롬프트 |
핵심 기여와 혁신성
첫째, 이 연구는 메모리 방식의 비교에 기반 모델의 능력과 메모리 구축 비용을 함께 넣습니다. 약한 모델에서 도움이 된 압축이 더 강한 모델에서도 유리한지는 별도 문제입니다. 실제로 Mem0는 GPT-4o-mini에서 전체 문맥보다 높은 정답률을 보였지만, GPT-6 Luna에서는 낮았고 Claude Opus 5.5에서는 같았습니다.
둘째, 메모리를 쓰는 모델과 읽는 모델을 분리합니다. 약한 모델이 사실을 누락한 저장소에 강한 답변 모델을 붙여 일부 성능이 개선되어도, 강한 모델이 직접 만든 저장소의 성능에는 도달하지 못했습니다. 이는 검색 이후의 추론 능력뿐 아니라 질문이 오기 전에 무엇을 버렸는지가 답변을 제약한다는 근거입니다.
셋째, 코딩 에이전트를 원문 검색기로 활용하는 비교를 포함합니다. Pi는 Claude Opus 5.5 조건에서 표에 반올림된 정답률 99%, 전체 평가 비용 6.95달러를 기록했습니다. 다만 이 결과를 이해하려면 캡션의 정보 비대칭, 잘못된 정답 키, 실패 실행을 제외한 비용 집계를 함께 읽어야 합니다. 이 연구의 가치는 하나의 우승 제품을 선언하는 데 있기보다, 메모리 시스템을 비교할 때 빠뜨리기 쉬운 평가 조건을 드러내는 데 있습니다.
기술적 세부사항
비교 단위는 질문 하나가 아니라 구축부터 답변까지입니다
논문에서 rollout은 메모리 구축 한 번과 152개 질문에 대한 답변을 합친 단위입니다. Full context는 질문마다 대화 전체를 넣습니다. BM25는 단어 기반 관련도 검색으로 상위 8개 turn과 각 turn의 앞뒤 2개 이웃을 가져옵니다. Mem0는 추출된 사실 중 상위 200개, Zep은 시간적 관계 그래프의 상위 20개 edge를 제공합니다. Pi·Codex·Claude Code는 원본 JSON 파일을 읽는 도구를 사용하고, 읽을 범위는 에이전트가 결정합니다.
메모리 저장소의 writer는 정보를 추출해 기록하는 모델이며, reader는 검색 결과로 답하는 모델입니다. 기본 실험에서는 둘이 같지만, 교차 실험에서는 writer의 저장소와 검색 결과를 유지한 채 reader를 바꿉니다. 따라서 교차표는 답변 모델의 향상이 이미 손실된 정보를 얼마나 보완하는지 살펴봅니다.
원문 보존과 입력의 동등성은 다른 문제입니다
에이전트는 공식 대화 JSON에 들어 있는 사진의 텍스트 캡션까지 읽을 수 있지만, 네 메모리 방법에는 turn 본문만 주어졌습니다. 이는 사진 자체를 보는 시각 모델 실험이 아닙니다. 419개 turn 중 사진 공유 turn은 116개이며, 152개 질문 중 64개는 그러한 turn에 답변 근거가 있습니다. 나머지 88개는 사진 공유 turn에 근거가 없는 질문입니다.
이 88개 부분집합은 캡션이 결과에 미친 영향을 점검하는 데 유용합니다. 그러나 에이전트 입력에서 캡션을 제거하고 전체 152문제를 다시 수행한 동일 입력 실험은 아닙니다. 따라서 전체 정답률 차이를 순수한 메모리 아키텍처 차이로 읽지 않습니다.
이 논문은 새로운 수식보다 측정 정의가 중요합니다
v1은 새로운 목적함수나 정리의 수식을 제안하지 않습니다. 임의의 메모리 성능 공식을 추가하는 대신, 정답률의 분모·구축비 포함 여부·토큰과 호출의 정의를 구분하는 것이 원문에 충실합니다. 정답 판정은 GPT-4o-mini가 수행하며, 무응답은 오답입니다. 비용에는 LLM 및 임베딩 호출을 포함하고 채점 호출은 제외합니다. 토큰 수에는 캐시된 입력을 포함한 입력·출력 토큰이 들어가지만 임베딩 토큰은 포함하지 않습니다. 실패하거나 답변 없이 끝난 trial은 재실행하고 채택된 trial만 집계하므로, 보고된 비용을 실패·재시도까지 포함한 운영 총비용으로 해석할 수 없습니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
챕터의 위치와 역할: 도입부는 이후의 실험을 메모리 라이브러리 간 비교보다 넓은 문제로 설정합니다. 무엇을 기억할지 미리 정하는 방식과, 질문을 받은 모델이 원문을 찾아 읽는 방식 중 어느 쪽에 시스템 설계의 무게를 둘 것인지가 출발점입니다.
저자의 서술 순서를 따른 상세 내용:
-
메모리는 질문보다 먼저 만들어집니다. Mem0와 Zep 같은 시스템은 새로운 질문을 아직 모르는 상태에서 대화를 사실이나 관계로 변환합니다. 이후 모델은 원문 전체가 아니라 저장소가 보존하고 검색한 정보를 받아 답합니다. 메모리를 잘 설계했다는 주장은 미래 질문에 필요한 정보를 얼마나 남겼는지와 연결됩니다.
-
코딩 에이전트는 원문을 보관하고 도구로 읽습니다. 저자는 이 방식을 대안으로 제시합니다. 정보 추출 구조를 먼저 고정하는 대신, 에이전트가 질문을 보고 원문에서 필요한 내용을 탐색합니다. 여기서 harness는 모델을 감싸는 도구·실행 루프·세션 등의 실행 체계를 뜻합니다. 같은 모델을 사용해도 harness가 다르면 읽는 분량과 호출 횟수가 달라질 수 있습니다.
-
모델이 강해진 뒤에도 전용 메모리가 필요한지 묻습니다. 논문 제목의 Bitter Lesson은 일반적인 계산과 학습의 발전이 사람이 설계한 특수한 구조의 이점을 바꿀 수 있다는 관점입니다. 저자는 일곱 방법과 세 모델을 교차해, 메모리 방식의 이점이 모델 능력에 따라 유지되는지 확인합니다. 이 관점은 연구의 가설이며, 한 대화의 결과가 그 관점을 보편적으로 증명하는 것은 아닙니다.
챕터의 핵심 기여: 메모리의 품질을 저장 구조 자체의 정교함으로 판단하지 않고, 기반 모델이 강해질 때의 상대적 효용으로 묻습니다.
다음 챕터로의 연결: 이러한 비교가 성립하려면 무엇을 저장하고, 무엇을 모델에 보여주며, 비용을 어디까지 합산했는지 먼저 정해야 합니다. Section 2가 그 조건을 정의합니다.
📖 Chapter 2: Setup
챕터의 위치와 역할: 전체 결과를 해석하는 기준입니다. 특히 대화 규모, 캡션 접근 여부, 측정 단위는 뒤의 숫자보다 먼저 확인해야 합니다.
저자의 서술 순서를 따른 상세 내용:
-
데이터는 LoCoMo 전체가 아닌 conv-26 한 개입니다. 이 대화에는 19개 세션, 419개 turn, 152개 질문이 있습니다. 질문은 single-hop 70개, multi-hop 32개, temporal 37개, open-domain 13개입니다. Single-hop은 한 근거로 답하는 유형, multi-hop은 여러 근거를 연결하는 유형이며, temporal은 시점이나 순서를 다루는 유형입니다. Adversarial 질문은 Mem0 평가를 따라 제외합니다. 대화 전체가 모든 실험 모델의 context window 안에 들어가므로 Full context는 언제나 가능한 선택지입니다.
-
일곱 방법이 모델에 주는 정보가 다릅니다. 원문 Table 1의 차이를 정리하면 다음과 같습니다.
| 방법 | 보관하는 내용 | 답변 시 모델이 받는 내용 |
|---|---|---|
| Full context | 대화 원문 | 전체 대화 본문 |
| BM25 | 원본 turn | 상위 8개 turn과 앞뒤 2개 이웃 |
| Mem0 | 추출된 사실 | 상위 200개 사실 |
| Zep | 시간적 관계 그래프 | 상위 20개 edge |
| Pi·Codex·Claude Code | 원문 JSON 한 파일 | 실행 중 도구로 읽은 내용 |
Mem0는 OSS 2.1.0, Zep은 Graphiti OSS 0.30.2를 사용합니다. 에이전트 버전은 Pi 1.1.0, Codex 0.159.2, Claude Code 2.1.295입니다. 네 메모리 방법은 Mem0의 2025년 답변 템플릿으로 질문을 처리합니다. 에이전트는 질문마다 새로운 세션과 컨테이너를 시작하므로, 앞선 질문에서 생긴 에이전트 세션 기억이 다음 질문으로 이어지지 않습니다.
-
세 모델과 기본 writer/reader를 정합니다. GPT-4o-mini, GPT-6 Luna, Claude Opus 5.5를 비교하며 뒤의 두 모델은 reasoning effort를 high로 둡니다. GPT-4o-mini에는 해당 설정이 없습니다. 기본 21개 조합에서는 같은 모델이 메모리를 구축하고 답변하거나 에이전트를 구동합니다. 따라서 기본 결과에는 저장 능력과 답변 능력이 함께 반영됩니다.
-
Photos: 캡션 접근의 비대칭을 밝힙니다. 공식 파일에는 사진 공유 turn의 본문 옆에 캡션이 있습니다. 에이전트는 그 파일을 그대로 받고, 네 메모리 방법은 turn 본문만 받습니다. 64개 질문의 근거가 사진 공유 turn에 있고 나머지는 88개입니다. 캡션을 더 읽을 수 있다는 이점은 에이전트와 메모리 방법의 비교에 영향을 주지만, 동일하게 캡션을 받지 않은 네 메모리 방법 상호 비교와는 구분됩니다.
-
Measurement: 비용·호출·토큰을 각각 정의합니다. Rollout에는 저장소 구축과 152개 답변이 포함됩니다. 비용은 논문이 사용한 공급자 정가를 기준으로 LLM 및
text-embedding-3-small임베딩 호출을 합산하고 judge 비용은 제외합니다. Turn은 LLM 호출 한 번입니다. 메모리 방법은 질문당 답변 호출 한 번에 구축 호출이 추가되고, 에이전트는 루프의 단계마다 호출이 발생할 수 있습니다. 토큰에는 캐시된 입력도 들어가며 임베딩 토큰은 빠집니다. 조합마다 채택 실행은 한 번뿐입니다.
챕터의 핵심 기여: 단순 정답률표에서 사라지기 쉬운 데이터·정보·비용 경계를 공개합니다. 다만 이를 입력이 완전히 통제된 비교라고 부를 수는 없습니다.
다음 챕터로의 연결: 이 조건 위에서 모델이 강해질수록 메모리의 상대적 이점이 어떻게 바뀌는지 Section 3이 비교합니다.
📖 Chapter 3: Agent memory is a costly patch for a weak model
챕터의 위치와 역할: 논문의 첫 번째 실험적 주장입니다. 메모리 방식이 약한 모델의 답변을 돕는지, 그 이점이 더 강한 모델과 비용 측면에서도 유지되는지 차례로 살펴봅니다.
저자의 서술 순서를 따른 상세 내용:
-
GPT-4o-mini에서는 Mem0가 전체 문맥보다 높습니다. Mem0의 정답률은 78%, Full context와 BM25는 각각 74%입니다. 다만 모든 메모리 구조가 도움이 된 것은 아니어서 Zep은 43%입니다. 에이전트는 Pi 63%, Codex 28%, Claude Code 29%였습니다. 저자는 Codex가 약 4분의 3의 질문에서 대화 파일을 열고 Claude Code는 거의 열지 않는 실행 양상을 설명합니다. 도구를 부여하는 것과 실제로 적절하게 사용하는 것은 다른 능력입니다.
-
GPT-6 Luna에서는 전체 문맥의 이점이 커집니다. Full context는 92%, BM25는 82%, Mem0는 80%, Zep은 51%입니다. 이 조합에서는 사실 추출을 거친 메모리가 원문 전체를 읽는 방식보다 낮습니다. Zep 그래프가 GPT-6 Luna에서 128개 사실, Claude Opus 5.5에서 195개 사실을 남겼다는 관찰도 나옵니다. 같은 저장 구조여도 모델에 따라 보존하는 정보가 달라지므로, 결과를 라이브러리 이름 하나의 효과로 볼 수 없습니다.
-
Claude Opus 5.5에서는 Mem0와 전체 문맥이 같아집니다. 두 방법은 각각 95%이며 Zep은 87%입니다. Pi 99%, Codex 98%, Claude Code 97%라는 에이전트 수치도 제시됩니다. 이때의 99%는 원문 표의 정수 반올림 값입니다. 특히 에이전트의 전체 결과에는 추가 캡션 접근이 있으므로, 저장 구조만으로 차이를 설명할 수 없습니다.
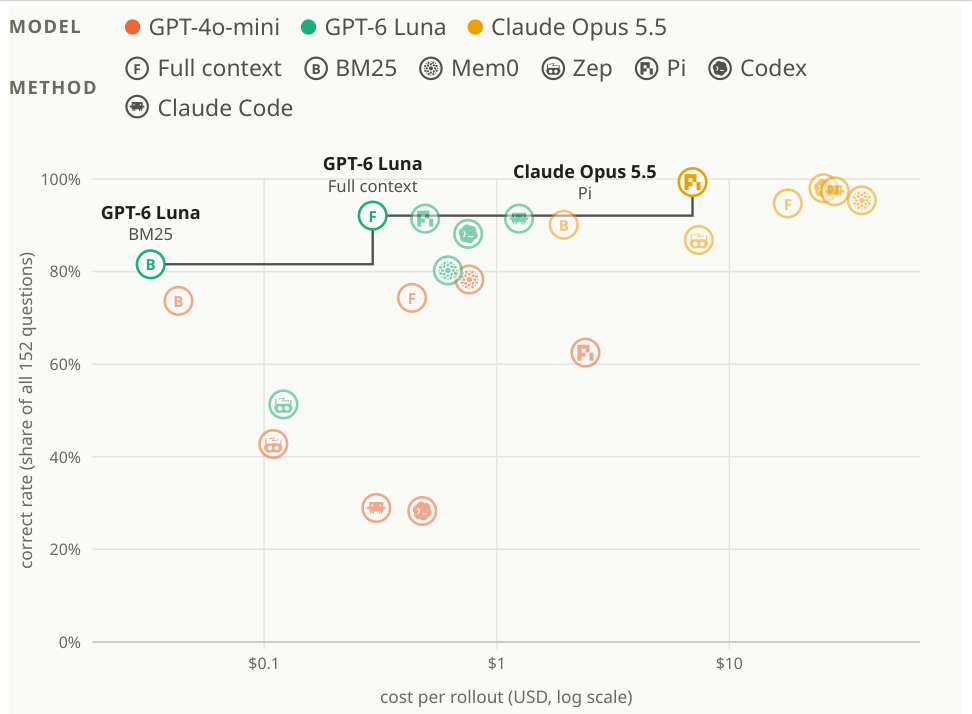
Figure 1, PDF 2쪽. 색은 모델, 배지는 방법을 나타냅니다. 가로축은 구축과 152개 답변을 합친 USD 비용의 로그 축이며, 세로축은 정답률입니다. 계단선은 주어진 비용 이하에서 도달한 최고 정답률을 표시합니다. 축·범례를 포함한 전체 그림 영역을 보존했습니다. 원문 PDF
- 질문당 비용이 낮아도 구축비를 회수하지 못할 수 있습니다. Mem0의 구축 비용만 보면 GPT-4o-mini 0.56달러, GPT-6 Luna 0.45달러, Claude Opus 5.5 25.88달러입니다. 대응하는 Full context의 152개 질문 전체 비용은 각각 0.43·0.29·17.84달러입니다. 즉 이 사례에서는 메모리 구축만으로도 전체 문맥 방식의 전체 평가 비용을 넘습니다. 이후 질문당 답변이 더 저렴해도 152개 질문 안에서는 그 선행 비용을 모두 회수하지 못합니다.
| 모델 | Mem0 구축비 | Full context 전체 평가 비용 | 저자가 보고한 손익분기 질문 수 |
|---|---|---|---|
| GPT-4o-mini | 약 0.56달러 | 약 0.43달러 | 372개 |
| GPT-6 Luna | 약 0.45달러 | 약 0.29달러 | 545개 |
| Claude Opus 5.5 | 약 25.88달러 | 약 17.84달러 | 596개 |
손익분기점은 같은 이력에 질문을 반복해 구축비를 나누어 부담한다는 조건의 값입니다. 이력이 계속 늘거나 저장소를 다시 만들어야 하는 상황의 보편적 기준이 아닙니다. 원문 비용표는 반올림되어 있으므로 표시된 질문당 비용만으로 위 숫자를 정확히 역산하려고 해서도 안 됩니다.
- Figure 2는 비용을 먼저 쓴 순서의 누적 결과입니다. 저자는 구축비를 먼저 놓고 질문을 저렴한 것부터 비싼 것까지 정렬합니다. 누적 정답 수를 152로 나누므로 세로축의 분모는 항상 전체 질문 수입니다. 오답은 비용만 늘리고 누적 정답 수는 늘리지 않습니다. 같은 비용은 묶고 곡선에 9점 이동평균을 적용하며, 마지막 배지는 평활화하지 않은 전체 결과입니다.
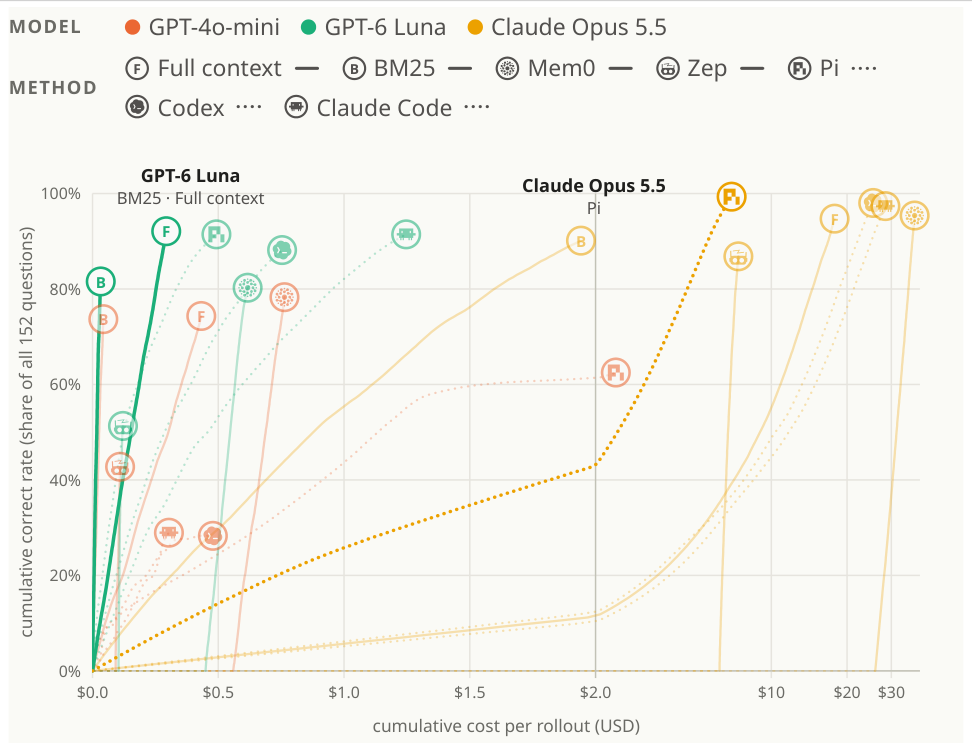
Figure 2, PDF 4쪽. 가로축은 2달러까지 선형이고 그 이후는 로그 축입니다. 굵은 선은 비용과 정답 수 양쪽에서 다른 조합에 지배되지 않는 결과입니다. 질문 순서를 비용 기준으로 재배열한 그림이므로, 시간에 따라 학습하거나 기억이 개선되는 곡선이 아닙니다. 원문 PDF
이 결과에서 비용·정답률의 경계는 GPT-6 Luna의 BM25와 Full context, Claude Opus 5.5의 Pi를 거칩니다. Mem0와 Zep은 이 연구의 비용·정답률 경계에 포함되지 않습니다. 이는 관측된 조합과 집계 정의 아래의 결과이며, 메모리가 모든 사용량에서 경제적으로 불리하다는 뜻은 아닙니다.
챕터의 핵심 기여: 메모리의 효과를 모델 능력과 구축비까지 연결합니다. 특히 질문당 비용과 전체 평가 비용을 분리한 점이 실용적으로 중요합니다.
다음 챕터로의 연결: 더 강한 모델이 답변만 맡으면 약한 모델의 메모리를 보완할 수 있는지, Section 4가 저장소 구축 능력과 읽기 능력을 분리합니다.
📖 Chapter 4: Agent memory has a ceiling
챕터의 위치와 역할: 앞 장에서 함께 움직이던 writer와 reader를 분리해, 정보 손실이 어디에서 생겼는지 좁힙니다.
저자의 서술 순서를 따른 상세 내용:
-
저장소와 검색 결과를 유지한 채 reader를 교체합니다. Mem0와 Zep의 검색 단계는 이 실험에서 LLM 호출을 필요로 하지 않으므로, 같은 writer가 만든 저장소와 그 검색 결과를 다른 답변 모델에 제공할 수 있습니다. 저장소를 더 강한 모델로 다시 만드는 실험과는 구분됩니다.
-
약한 writer의 저장소는 강한 reader로도 크게 개선되지 않습니다. 아래 값은 원문 Table 3의 정답률입니다. 각 행에서 왼쪽부터 reader가 강해지는 방향으로 읽습니다.
| 메모리 | 저장소 writer | GPT-4o-mini reader | GPT-6 Luna reader | Claude Opus 5.5 reader |
|---|---|---|---|---|
| Mem0 | GPT-4o-mini | 78% | 83% | 84% |
| Mem0 | GPT-6 Luna | 74% | 80% | 81% |
| Mem0 | Claude Opus 5.5 | 89% | 91% | 95% |
| Zep | GPT-4o-mini | 43% | 43% | 45% |
| Zep | GPT-6 Luna | 52% | 51% | 55% |
| Zep | Claude Opus 5.5 | 66% | 71% | 87% |
- 읽기 능력의 향상과 보존 정보의 향상을 구분합니다. Mem0의 GPT-4o-mini 저장소를 Claude Opus 5.5가 읽으면 84%이지만, Claude Opus 5.5가 만들고 읽으면 95%입니다. Zep에서도 같은 대비는 45%와 87%입니다. 더 강한 모델이 추론을 개선할 수 있어도, 저장 단계에서 빠진 근거를 검색 결과만으로 충분히 보완하지 못했다는 것이 이 실험에 대한 저자의 해석입니다. 여기서 ceiling은 관찰된 정보 병목에 대한 표현이며 수학적으로 증명된 상한 정리는 아닙니다.
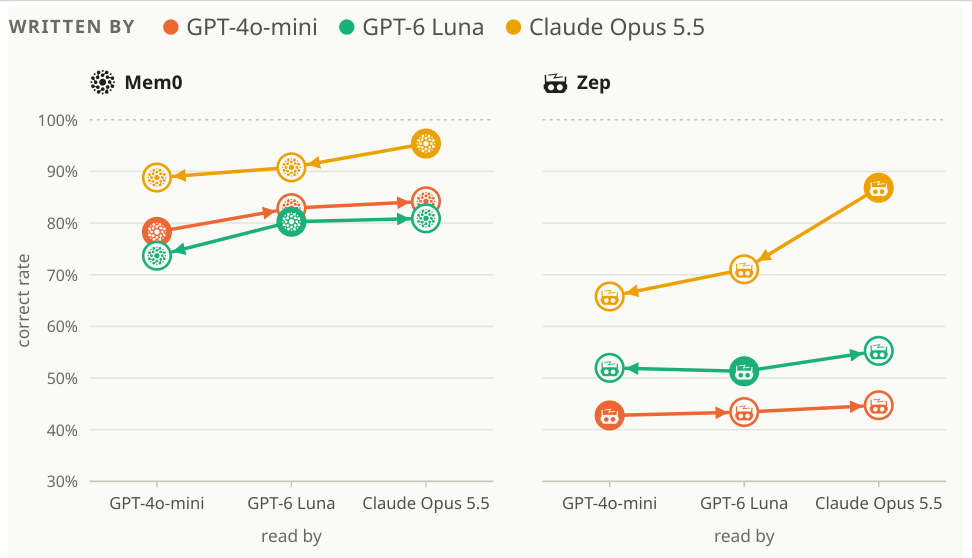
Figure 3, PDF 5쪽. 왼쪽은 Mem0, 오른쪽은 Zep입니다. 색은 저장소를 작성한 모델, 가로축은 읽는 모델을 나타내며, 채워진 배지는 writer가 자기 저장소를 읽는 조합입니다. 화살표는 reader를 교체한 결과를 연결합니다. 위 표로 수치도 함께 확인할 수 있습니다. 원문 PDF
챕터의 핵심 기여: 답변 모델만 업그레이드하면 기존 메모리의 문제가 해결된다는 가정을 실험적으로 분리합니다. 저장을 맡는 모델 선택도 시스템 품질의 일부입니다.
다음 챕터로의 연결: 이 병목을 피하기 위해 원문을 유지하고 도구로 읽을 때 어떤 결과가 나오는지, Section 5가 가장 높은 정답률의 조합을 자세히 살펴봅니다.
📖 Chapter 5: With Claude Opus 5.5, Pi tops the frontier
챕터의 위치와 역할: 가장 좋아 보이는 결과를 제시한 뒤, 잘못된 정답 키와 캡션 접근이라는 두 조건을 직접 점검합니다. 제목의 성능 주장을 그대로 인용하기 전에 읽어야 할 부분입니다.
저자의 서술 순서를 따른 상세 내용:
-
Pi는 이 실험에서 더 적은 비용으로 높은 정답률을 보입니다. Claude Opus 5.5의 Pi는 전체 평가에 6.95달러, Full context는 17.84달러를 사용했습니다. 정답률은 원문 정수 표기 기준 99%와 95%입니다. Pi는 질문당 약 10,000개의 입력 토큰을 사용했고 그중 약 7,900개가 캐시된 입력입니다. Full context는 약 28,900개의 입력 토큰을 사용합니다. 이 비교는 원문을 보관하는 방식이라도 매번 전부 넣을 필요가 없음을 보여줍니다.
-
같은 모델도 harness에 따라 비용이 다릅니다. Codex는 98%에 25.41달러, Claude Code는 97%에 28.41달러였습니다. 따라서 원문 접근과 강한 모델만으로 비용이 결정되지 않습니다. 다만 본 논문은 이 차이의 세부 원인을 모두 분해하는 연구가 아니며, 다른 작업에서도 Pi가 항상 저렴하다고 일반화할 수 없습니다.
-
Pi가 틀렸다고 판정된 한 문제에는 정답 키 오류가 있습니다. 질문은 2023년 10월 13일 Caroline이 Melanie에게 공유한 그림의 종류를 묻습니다. 정답 키는 파란 줄무늬가 있는 추상화를 가리키지만, 대화에서는 그 회화를 공유한 사람이 Melanie이며 Caroline은 drawing을 공유합니다. Pi는 이 전제의 차이를 지적해 오답 처리되었고 Full context·Codex·Claude Code도 같은 문제를 지적한 뒤 오답으로 판정되었습니다.
원래 채점 기준에서 Pi는 나머지 151개를 모두 맞혔으므로 151/152, 약 99.3%입니다. 원문의 표는 이를 99%로 반올림합니다. 저자가 그 한 문제의 정답 키를 교정해 읽으면 Pi가 모든 질문에 맞게 답했다고 분석한 것과, 보고된 채점값 99%는 구분해야 합니다. 이 리뷰에서는 공식 표의 값을 임의로 100%로 바꾸지 않습니다.
-
추가로 맞힌 문제 대부분에 캡션 정보가 있습니다. Pi는 Full context가 놓친 7개를 맞히고 Full context가 맞힌 문제를 놓치지 않았습니다. 그 7개 중 6개의 근거가 사진 공유 turn에 있습니다. Codex가 추가로 맞힌 6개와 Claude Code의 4개도 모두 해당 turn에 근거가 있습니다. 에이전트가 더 많은 정보를 받았다는 설명이 실제 차이와 맞물립니다.
-
사진 공유 turn에 근거가 없는 88문제에서는 차이가 작습니다. Claude Opus 5.5에서 Pi 100%, Full context·Mem0·Codex·Claude Code 각각 99%, BM25·Zep 각각 94%입니다. 88문제에서 한 문제는 약 1.14%p이므로, 100%와 99% 사이를 큰 성능 격차처럼 읽으면 안 됩니다. 또한 이 부분집합에서도 에이전트가 읽을 수 있는 전체 파일의 캡션을 제거한 것은 아닙니다. 캡션이 없는 동일 입력으로 모든 문제를 재평가했다는 뜻은 아닙니다.
챕터의 핵심 기여: 원문 검색의 비용상 이점을 보여주면서도, 전체 정답률 우위의 상당 부분에 입력 차이가 얽혀 있음을 드러냅니다. 저자는 검색이 원문 전체 읽기보다 정확한지까지 이 연구가 결론 내리지 못한다고 명시합니다.
다음 챕터로의 연결: 이 결과를 어디까지 적용할 수 있는지 Section 6에서 한계와 후속 방향을 정리합니다.
📖 Chapter 6: Discussion and limitations
챕터의 위치와 역할: 실험 결과에서 넓은 시스템 설계 시사점으로 이동하되, 저자가 직접 열거한 제약을 함께 제시합니다.
저자의 서술 순서를 따른 상세 내용:
-
먼저 세 가지 결과를 모읍니다. Mem0는 이 대화에서 GPT-4o-mini를 돕지만 강한 두 모델에서는 같은 이점을 보이지 않습니다. 더 강한 reader도 약한 writer의 정보 손실을 충분히 보완하지 못합니다. Claude Opus 5.5의 Pi는 전체 문맥보다 적은 비용으로 질문에 답합니다. 이 셋이 제목의 메모리 비용 문제를 구성합니다.
-
Scale: 대화 한 개와 채택 실행 한 번입니다. LoCoMo의 10개 대화 중 하나만 평가했으며 조합마다 한 번 실행했습니다. 저자는 몇 문제 정도의 차이가 다음 실행에서도 유지된다고 볼 수 없다고 밝힙니다. 신뢰구간이나 유의성 검정이 보고되지 않았으므로 리뷰에서도 통계적으로 유의하다고 단정하지 않습니다.
-
Grading: 관대한 LLM judge와 잘못된 정답 키입니다. GPT-4o-mini가 같은 주제를 다루거나 같은 시기를 가리키면 폭넓게 정답으로 인정하는 기준을 사용합니다. 적어도 한 정답 키가 잘못되었다는 관찰이 있습니다. 정답률은 이러한 평가 체계 아래의 값입니다.
-
Photo captions: 에이전트만 캡션을 받았습니다. 이 조건은 에이전트와 메모리 방법 사이 비교에 영향을 줍니다. 반면 네 메모리 방법 모두 캡션을 받지 않았으므로, 그 네 방법 사이의 차이에 같은 방식으로 적용되는 요인은 아닙니다.
-
Context length: 전체 문맥 입력이 가능한 길이입니다. 대화가 모든 모델의 입력 한도 안에 들어갑니다. 저자는 LongMemEval 등 다른 벤치마크나 입력 한도를 넘는 이력에서는 결과가 달라질 수 있다고 명시합니다. 매우 긴 기록에서 Full context를 사용할 수 없을 때의 결론으로 확장하지 않습니다.
-
Settings and prices: 기본값과 캐시 가격의 영향입니다. Mem0와 Zep은 기본 추출·검색 설정을 사용했으며 다른 설정은 더 나을 수 있습니다. 비용은 공급자 정가와 캐시 정책에 의존합니다. 그러므로 표의 USD 비용은 실험 조건의 비교값이지 장기적으로 고정된 가격표가 아닙니다.
-
후속 방향은 원문과 더 좋은 검색 도구입니다. 저자는 메모리나 harness를 자동 탐색하더라도 질문이 오기 전에 고정된다는 점을 지적합니다. 이어 원문 위에서 정확 일치·의미·벡터 검색을 모델이 직접 구동하는 방향을 제시합니다. grep에서 ripgrep, 다시 zvec-grep으로 이어지는 비유는 검색 도구의 발전을 뜻합니다. 동시에 같은 이력에 많은 질문을 던질 때에는 설계된 메모리가 비용 절충안으로 남을 수 있다고 열어 둡니다.
챕터의 핵심 기여: 주장의 적용 범위를 한정하고, 원문 보존·질문 시점 검색·반복 질의 비용의 관계를 후속 설계 문제로 연결합니다.
다음 구성으로의 연결: 원문은 여기서 References를 먼저 제시한 뒤, 상세 결과와 프로토콜·프롬프트를 부록으로 이어갑니다.
📚 References: 본문과 부록 사이의 참고문헌
참고문헌은 Mem0·Zep, 에이전트 문서, LoCoMo, Bitter Lesson, 모델·비용·harness 관련 자료, LongMemEval과 검색 도구·실행 환경으로 본문 주장을 연결합니다. 이 리뷰는 해당 참고문헌의 개별 논문과 소프트웨어를 모두 별도로 평가하지 않았습니다. 따라서 원문이 인용했다는 사실을 그 외부 자료의 독립 검증으로 표현하지 않습니다. 참고문헌 다음에는 전체 결과표를 제시하는 Appendix A가 나옵니다.
📖 Appendix A: Full results
부록의 위치와 역할: 본문의 요약 숫자를 모델·방법·질문 유형별로 확인하고, 캡션 관련 차이를 다시 살펴보는 근거입니다. HTML 원문 순서는 Table 2, Table 3, Table 4, Figure 4입니다. PDF에서는 Figure 4가 8쪽, Table 4가 9쪽에 배치되어 있어 화면상 순서가 다릅니다.
저자의 제시 순서를 따른 상세 내용:
- Table 2: 21개 조합의 전체 결과와 유형별 성능입니다. 먼저 전체 정답률을 전사하면 다음과 같습니다. 원문처럼 정수 반올림한 값입니다.
| 방법 | GPT-4o-mini | GPT-6 Luna | Claude Opus 5.5 |
|---|---|---|---|
| Full context | 74% | 92% | 95% |
| BM25 | 74% | 82% | 90% |
| Mem0 | 78% | 80% | 95% |
| Zep | 43% | 51% | 87% |
| Pi | 63% | 91% | 99% |
| Codex | 28% | 88% | 98% |
| Claude Code | 29% | 91% | 97% |
원문 Table 2는 여기에 구축비, 질문당 비용, 네 질문 유형의 정답률을 함께 제공합니다. 예를 들어 GPT-6 Luna의 Mem0는 single-hop 89%, multi-hop 88%, temporal 57%, open-domain 85%입니다. 같은 모델의 Full context는 각각 90·97·95·85%입니다. 전체 정답률의 12%p 차이만 보면 놓치기 쉬운 시간 관련 질문의 차이가 드러납니다. 유형별 표본은 70·32·37·13개로 서로 다르므로 작은 집단의 정수 퍼센트를 안정적인 순위로 해석하지 않습니다.
비용 열에서도 두 단위를 분리해야 합니다. Claude Opus 5.5의 Mem0는 구축비 25.876달러와 질문당 0.074달러, Zep은 구축비 6.224달러와 질문당 0.0077달러입니다. 구축이 없는 Full context의 질문당 비용은 0.117달러, Pi는 0.046달러입니다. 반올림된 질문당 비용에 질문 수를 곱한 값과 본문에 제시된 정확한 전체 비용이 소수점까지 일치한다고 가정하지 않습니다.
-
Table 3: writer와 reader의 교차표입니다. Section 4의 표는 이 부록을 전사한 것입니다. 대각선은 같은 모델이 쓰고 읽는 기본 조건이며, 나머지 값은 writer가 만든 저장소를 다른 reader가 읽은 조건입니다. 예컨대 Zep의 GPT-6 Luna writer에 GPT-4o-mini reader가 52%, GPT-6 Luna reader가 51%인 차이는 한 번의 실행에서 나온 값입니다. 모델 능력이 높아질 때 모든 셀이 엄격하게 증가한다는 법칙을 도출하지 않습니다.
-
Table 4: 사진 공유 turn 근거 유무에 따른 결과입니다. Photo 64개는 근거가 사진 공유 turn에 있는 문제이고, Other 88개는 그렇지 않은 문제입니다. 사진 자체를 보고 풀게 했다는 뜻이 아닙니다.
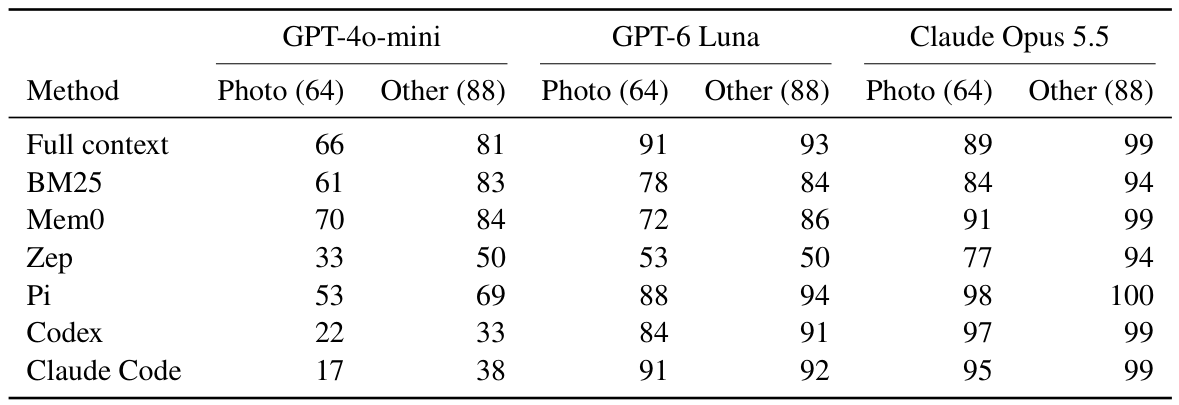
Table 4, PDF 9쪽. 열 묶음과 모든 행·수치를 보존한 표 크롭입니다. 에이전트만 사진 캡션을 읽을 수 있었다는 조건을 전제로 읽습니다. 아래에 Claude Opus 5.5 열을 한국어 표로 다시 제시합니다. 원문 PDF
| Claude Opus 5.5의 방법 | 사진 공유 turn 근거 64개 | 나머지 88개 |
|---|---|---|
| Full context | 89% | 99% |
| BM25 | 84% | 94% |
| Mem0 | 91% | 99% |
| Zep | 77% | 94% |
| Pi | 98% | 100% |
| Codex | 97% | 99% |
| Claude Code | 95% | 99% |
이 표는 전체 점수 차이의 해석을 좁혀 줍니다. 캡션 접근이 다른 상태에서의 전체 결과와, 사진 공유 turn에 근거가 없는 부분집합을 나누어 볼 수 있습니다. 그러나 캡션 유무만 조작한 전체 재실험이 아니므로 캡션의 독립적 인과 효과를 수치로 확정하지 않습니다.
- Figure 4: 비용 대신 호출·토큰을 사용한 누적 곡선입니다. 위 패널은 LLM 호출 수, 아래 패널은 토큰 수를 가로축으로 사용합니다. 원문 Figure 2와 같은 방식으로 질문을 해당 소모량 순서로 누적하며 축은 선형입니다. 호출 한 번이 소비하는 토큰도, 토큰의 캐시 단가도 다르기 때문에 비용·호출·토큰은 교환 가능한 효율성 지표가 아닙니다. 이 부록의 토큰에는 임베딩 토큰이 없지만 비용에는 임베딩 호출이 포함됩니다.
부록의 핵심 기여: 전체 점수의 이면에 있는 질문 유형·비용 단위·입력 조건을 확인하게 합니다. 이 리뷰는 Table 2의 모든 유형별 수치나 Figure 4의 모든 곡선 좌표를 재전사하지 않았으며, 필요하면 Appendix A 원문에서 확인할 수 있습니다.
다음 부록으로의 연결: 숫자를 재현하려면 저장과 실행 절차가 필요합니다. Appendix B가 그 조건을 제시합니다.
📖 Appendix B: Protocols
부록의 위치와 역할: 어떤 데이터를 어떤 단위로 저장하고, 에이전트가 어떤 환경에서 답했는지를 명시합니다. 보고 비용의 의미를 바꾸는 재시도 조건도 여기에 있습니다.
저자의 제시 순서를 따른 상세 내용:
-
메모리 구축·검색 프로토콜입니다. Mem0 OSS 2.1.0은 날짜를 본문 앞에 붙이고 시간순으로 한 turn씩 기록합니다. 검색은 상위 200개를 사용하며 reranking은 없습니다. Zep은 Kuzu 위의 Graphiti OSS 0.30.2를 사용하고 세션 하나를 episode 하나로 저장합니다. Hybrid edge search에서 상위 20개를 검색합니다. GPT-6 Luna와 Claude Opus 5.5의 reasoning effort는 high입니다.
-
에이전트 실행은 질문마다 격리됩니다. 각 질문은 Harbor 0.24.0 task이며 새로운 컨테이너에는 공식 대화 파일만 있고 질문·정답 데이터는 저장되어 있지 않습니다. 마지막 메시지가 답변입니다. 실행 중 네트워크 접근은 모델 endpoint로 제한됩니다. 에이전트와 모델 API가 직접 맞지 않으면 변환 proxy를 사용하고, 고급 두 모델은 같은 high 설정을 사용합니다.
-
도구와 시간 제한이 있습니다. Codex·Claude Code의 웹 검색은 꺼져 있고 Pi에는 웹 검색이 없습니다. 질문당 최대 20분이며 Pi와 Claude Code는 최대 100 turn입니다. GPT-6 Luna를 사용하는 Codex는 shell을 호출하는 JavaScript 도구 하나의 code mode를 선택합니다. 따라서 이 결과는 외부 검색으로 정답을 찾는 환경이 아니라 주어진 대화를 읽는 환경의 결과입니다.
-
실패 trial은 재실행하고 채택 trial만 집계합니다. 실행 실패나 최종 답변 부재가 발생하면 다시 수행합니다. 이 조건은 앞서 무응답을 오답으로 판정한다는 채점 정의와 구분해 읽어야 합니다. 여기서는 에이전트 실행 단계에서 실패하거나 답변 없이 끝난 trial을 어떻게 처리했는지 설명합니다. 특히 최종 보고된 비용에는 버려진 trial의 비용이 합산되었다고 볼 수 없습니다. 실제 배포 예산을 추정할 때에는 논문 표를 그대로 전체 운영 지출로 사용하지 않아야 한다는 해석이 이 프로토콜에서 나옵니다.
부록의 핵심 기여: 재현에 필요한 버전·검색량·실행 격리·모델 설정·재시도 기준을 공개합니다. 다만 이 리뷰는 저자의 실행을 독립 재현하거나 전체 trial 로그를 감사한 것이 아닙니다.
다음 부록으로의 연결: 같은 절차에도 지시문이 달라지면 답변·채점이 바뀔 수 있으므로 Appendix C가 실제 프롬프트를 제시합니다.
📖 Appendix C: Prompts
부록의 위치와 역할: 입력 형식과 판정 기준을 공개해, 정답률이 어떤 과업 지시에 대한 결과인지 설명합니다. 원문 순서대로 네 묶음을 살펴봅니다.
-
Answer, system message: 제공된 문맥으로 답하고, 시간 질문에는 대화 날짜를 기준으로 사용하도록 합니다. 가능한 짧게 답하며 가능하면 대화의 표현을 사용하고 주어를 덧붙이지 않게 지시합니다. 이는 장문의 설명 품질보다 짧은 사실 답변을 평가하는 설정입니다.
-
Answer, user message: 질문, 검색 또는 전체 문맥, 짧은 답변 위치를 구분해 제공합니다. Full context와 검색 메모리 방법의 차이는 이 문맥 칸에 무엇이 들어가는지에 있습니다. 모델의 일반 지식만으로 답하는 과업으로 바꾸지 않습니다.
-
Pi, Codex and Claude Code, user message: 대화가 담긴
conv-26/conv.json을 가리키고 같은 시간·간결성 규칙을 전달합니다. 최종 메시지를 답변으로 삼는다는 조건도 알립니다. 이로써 에이전트는 도구로 파일을 읽은 후 짧은 답을 내는 과업을 받습니다. -
Judge: 질문, gold answer, 생성 답변을 받아 정답·오답으로 분류합니다. 동일 주제를 포함하거나 같은 날짜·기간을 의미하면 표현이 길거나 형식이 달라도 관대하게 인정하도록 합니다. 마지막에는
label키의 JSON 출력을 지시합니다. 이 기준은 의미가 같은 답의 표면적 표현 차이를 줄이지만, gold answer 자체가 틀렸을 때의 문제를 없애지는 못합니다. Section 5의 사례가 그 차이를 보여줍니다.
부록의 핵심 기여: 답변 생성과 판정의 지시를 드러내어, 논문의 수치를 일반적인 대화 능력·장문 추론·이미지 이해 성능과 구분할 수 있게 합니다.
원문 구조의 마무리: Appendix C가 v1의 마지막 구성입니다. 본문 1–6, References, Appendix A–C를 이 순서대로 다루었으며, 참고문헌 전체의 재검증과 외부 소프트웨어의 별도 실행은 수행하지 않았습니다.
실험 결과 심층 분석
정확도 차이와 통계적 확실성은 구분해야 합니다
원문 정수 표기에서 GPT-4o-mini의 Mem0가 Full context보다 약 4%p 높고 GPT-6 Luna에서는 약 12%p 낮다는 대비는 메모리의 상대적 가치가 모델에 따라 바뀔 수 있다는 근거입니다. 그러나 원문은 신뢰구간·반복 실행 분산·유의성 검정을 보고하지 않습니다. 특히 152개 질문의 한 문제는 약 0.66%p이고, 88개 부분집합에서는 약 1.14%p입니다. 몇 문제 차이를 안정적인 제품 간 우열로 확대하기보다 해당 실행에서 관측한 차이로 읽어야 합니다.
비용 비교의 핵심은 구축·재사용·캐시입니다
Mem0는 질문당 답변이 저렴해도 구축비 때문에 152문제에서 불리했습니다. 반대로 같은 이력에 수백 개 이상의 질문이 반복되면 저자가 제시한 손익분기 조건이 의미를 가집니다. Pi의 낮은 비용에는 읽은 입력의 양과 캐시된 입력의 비중이 함께 관련됩니다. 이 두 사실을 합치면 비용 비교에서 중요한 질문은 “질문 한 번이 얼마인가”에 더해 “같은 기록을 얼마나 재사용하며 무엇을 캐시했는가”입니다.
여기에 Appendix B의 accepted trial 조건이 더해집니다. judge 비용과 실패·재시도의 폐기 비용을 포함한 운영 총액, 저장·호스팅·관측 시스템 등 전체 서비스 비용을 이 논문이 계산했다고 주장할 수 없습니다. 보고된 LLM·임베딩 비용을 해당 실험의 비교 단위로 유지해야 합니다.
정보 비대칭과 채점 오류는 서로 다른 문제입니다
캡션 접근 차이는 모델이 답을 찾을 수 있는 정보의 차이이고, 잘못된 gold answer는 찾은 답을 맞다고 판정하는 기준의 문제입니다. Pi의 전체 우위를 설명할 때에는 이 둘을 별도로 다뤄야 합니다. 정답 키 한 문제를 교정했다고 캡션 비대칭이 해결되는 것도 아니며, 88문제 부분집합을 살폈다고 전체 데이터의 채점 오류가 사라지는 것도 아닙니다.
재현성은 프로토콜 공개와 독립 재현을 나누어 봅니다
원문에는 데이터 ID, 버전, 검색량, 모델 설정, 프롬프트, 격리 환경과 재시도 기준이 있습니다. 이러한 정보는 재현의 출발점이 됩니다. 이 리뷰는 원문 HTML과 11쪽 PDF 및 표·그림을 대조한 문헌 분석이며, 21개 조합을 직접 실행한 재현 결과는 아닙니다. 따라서 저자 보고 결과와 리뷰어의 해석을 구분해 제시합니다.
기술적 함의와 응용
이 연구에서 읽을 수 있는 시스템 설계상의 함의는 메모리의 정교함만 보지 말고, 원문을 얼마나 보존하며 질문 시점에 무엇을 읽는지 함께 보아야 한다는 것입니다. 고객 상담 기록이나 연구 노트처럼 나중 질문이 바뀌는 업무에서는, 미리 추출한 사실만으로 충분한지 원문 근거를 통해 확인할 수 있어야 합니다. 이는 본 실험의 결과를 바탕으로 한 리뷰어의 적용 해석이며, 해당 산업 환경에서 성능이 검증되었다는 주장은 아닙니다.
또한 reader를 더 강한 모델로 바꾸는 계획이 있다면 writer가 남긴 저장소의 품질을 따로 확인해야 합니다. 질문별 정답률과 함께 어떤 근거가 저장·검색·답변의 어느 단계에서 빠졌는지를 보는 것이 교차 실험의 실용적 독해입니다. 저장소의 형태만 바꿨는지, 작성 모델도 바꿨는지, 검색 결과를 재사용했는지를 구분하면 비교의 원인을 더 분명히 읽을 수 있습니다.
저자가 제시한 후속 방향은 원문 위의 정확 일치·의미·벡터 검색을 모델이 직접 사용하는 도구의 발전입니다. 동시에 동일 기록의 반복 질의가 충분히 많다면 미리 만든 메모리의 구축비를 상각할 수 있다는 가능성도 남겨 둡니다. 따라서 이 논문은 모든 메모리를 폐기하라는 처방보다, 원문 보존·모델 능력·질의 반복량·정보 동등성을 함께 측정하는 비교 방식으로 읽는 편이 실험 범위에 맞습니다.
이 리뷰의 그림은 모두 MemoryTax v1 PDF에서 설명에 필요한 영역을 발췌한 것입니다. Figure 1–3은 축·범례·패널을 보존했고 Table 4는 표 전체를 보존했습니다. 출처의 라이선스는 arXiv의 perpetual non-exclusive 배포 조건이며, CC 라이선스로 표시하거나 재사용 허가가 확인되었다고 주장하지 않습니다.