논문 개요와 전체 구조
에이전트가 웹페이지를 검색하고 코드를 수정하는 과정은 질문과 답변 한 번으로 끝나지 않습니다. 추론, 도구 호출, 긴 도구 응답이 수십·수백 턴 쌓입니다. 언어 모델은 앞선 토큰을 다시 계산하지 않도록 KV 캐시(Key-Value cache)를 보관하지만, 긴 캐시를 매번 읽고 GPU 메모리에 유지하는 비용도 커집니다. 과거 대화를 요약하면 문맥은 짧아지지만, 앞부분이 바뀌어 남겨 둔 뒷부분의 캐시까지 다시 계산해야 할 수 있습니다.
Tianyu Fu 등 9명의 Cache Engineering for Agents는 이 문제를 대화 텍스트와 실제 attention에 참여하는 캐시를 분리하는 방식으로 다룹니다. 대화 이력은 보존한 채 오래된 도구 응답의 KV를 attention에서 제외하고, 남은 키의 위치 표현을 옮깁니다. 이때 같은 토큰이 남아 있어도 어떤 순서로 캐시를 만들고 제외했는지에 따라 내부 상태가 달라지므로, 이를 정확하게 공유·퇴거·복원하는 AKV 서빙 시스템을 함께 설계합니다.
이 리뷰는 2026년 10월 20일 제출된 arXiv 2610.28577v1의 HTML과 21쪽 PDF를 분석합니다. 모델의 가중치를 학습하는 논문과 구분해, 캐시 연산의 의미와 시스템 구현 원리, 에이전트 점수·추정 비용·서빙 지연의 서로 다른 평가 조건을 설명합니다. 원문 본문과 부록의 순서는 다음과 같습니다.
| 원문 순서 | 다루는 내용 |
|---|---|
| 1. Introduction | 긴 에이전트 실행의 비용과 텍스트 수정으로 인한 재계산 |
| 2. Related Work | 문맥 편집, KV 압축·퇴거·재사용, 서빙 시스템 |
| 3. Cache Engineering | 3.1 개념 → 3.2 설계 동기 → 3.3 세 연산 → 3.4 연산 이력 |
| 4. AKV Serving System | 4.1 API → 4.2 상태 관리 → drop 및 reposition 관리 |
| 5. Experiment | 5.1 설정 → 5.2 과제 성능 → 5.3 효율 → 5.4 ablation·정책 |
| 6. Conclusion | 성과와 명시된 향후 과제 |
| Acknowledgements / References | 지원 사항과 선행 연구 |
| Appendix A | A.1 시스템 상세 → A.2 실험 상세 → A.3 요금 산정 → A.4 추가 결과 → A.5 관련 연구 |
핵심 기여와 혁신성
해결하려는 문제는 긴 문맥을 유지하는 정확성과 캐시 비용의 충돌입니다. 오래된 대화를 지우거나 요약하면 앞으로 읽을 토큰 수는 줄어듭니다. 그러나 캐시는 앞선 문맥을 조건으로 계산된 결과이므로, 앞부분을 편집한 뒤 기존 뒷부분의 캐시를 그대로 쓰면 편집된 텍스트를 처음부터 계산한 결과와 달라질 수 있습니다. 일반적인 문맥 편집은 이 불일치를 피하려고 남은 뒷부분을 다시 prefill합니다. Prefill은 입력 토큰을 처리해 캐시를 만드는 단계입니다.
독창성은 이 불일치를 무시하는 대신, 캐시 연산 자체를 새로운 실행 의미로 명시한 데 있습니다. drop은 선택한 KV의 향후 attention 참여를 중단하고, repos는 남은 키의 위치 인코딩을 옮깁니다. 이후 캐시가 갖는 의미는 원래 텍스트만이 아니라 이런 연산의 이력으로 정해집니다. 논문은 이를 나타내는 연산 수열과, 그 이력까지 키로 사용하는 확장 radix tree를 함께 제안합니다.
핵심 결과로 논문은 세 모델·네 벤치마크에서 기본 요약 방식보다 평균 점수가 약 1.7점 높고 평균 추정 비용이 27.7% 감소했다고 보고합니다. 별도 서빙 실험의 최대 출력 처리량은 약 1.18배이며 P95 요청 지연의 속도 향상은 약 1.51배입니다. 모든 모델·과제에서 동시에 최고 점수를 얻었다는 뜻도, 실제 공급자 청구서를 같은 비율로 줄였다는 뜻도 아닙니다. 1·5절, PDF 1–10쪽
리뷰어 관점의 학습 가치는 정책의 효과와 시스템의 정확한 재사용 조건을 함께 읽을 수 있다는 점입니다. “무엇을 잊을까”라는 선택만으로는 충분하지 않습니다. 이미 계산된 상태를 언제 그대로 쓰고, 언제 별도 버전으로 복사하며, 사라진 상태를 어떻게 복원할지도 정의해야 합니다.
기술적 세부사항
텍스트 이력·활성 캐시·물리적 저장은 다릅니다
원문에서 trajectory는 프롬프트·assistant 메시지·도구 응답을 포함한 논리적 토큰 순서입니다. 활성 캐시는 다음 attention에서 읽을 수 있는 KV 상태이고, 물리적 상주는 그 상태가 서빙 엔진의 GPU 메모리에 실제 남아 있는지를 뜻합니다. drop은 첫 번째 의미의 제외이며, 다른 요청이 같은 상태를 사용하고 있으면 물리적 메모리는 곧바로 해제할 수 없습니다.
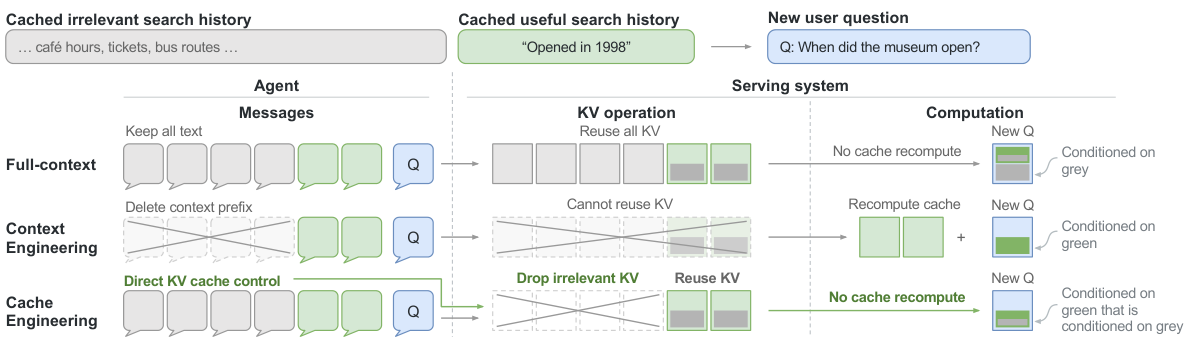
원문 Figure 1, PDF 2쪽의 그림 영역을 크롭했습니다. 중첩 색은 남은 캐시가 앞선 이력의 영향을 받아 계산됐음을 나타냅니다. 원문 그림·저작권: Tianyu Fu 외. arXiv 비독점 배포 라이선스이며 CC BY 자료로 표시하지 않습니다. 고정 버전 원문.
세 연산과 위치 인코딩
새 토큰을 처리하는 기본 연산은 다음과 같습니다.
$x_{t+1}$은 새 입력 또는 생성 토큰, $C_{t+1}$은 현재 활성 캐시를 조건으로 계산한 새 KV, $\mathcal C$는 논리적 순서의 활성 KV 열입니다. 대괄호 안의 세미콜론은 연결을 뜻합니다. 원문 식 (3)입니다.
$P$는 제외할 활성 토큰의 논리 인덱스 집합입니다. 식 (4)는 선택한 KV만 앞으로의 attention에서 빼며 남은 순서·값·위치 표현과 텍스트를 그대로 둡니다. 따라서 오래된 캐시를 제외해도 다음 토큰의 위치 번호가 자동으로 작아지지 않습니다.
RoPE(Rotary Position Embedding)는 토큰 위치에 따라 키와 쿼리를 회전시키는 표현입니다. 별도의 repos가 위치를 옮길 때 원문 식 (5)는 다음 변환을 사용합니다.
$K$는 기존 키, $p$는 현재 인코딩 위치, $q$는 목표 위치, $R(p)$는 해당 위치의 회전 행렬입니다. 기존 회전을 역으로 풀고 목표 회전을 적용합니다. 남은 항목이 $r$개이면 위치는 0부터 $r-1$까지 정리되고 다음 append 위치는 $r$이 됩니다. V와 hidden state를 다시 계산하는 연산은 아닙니다. 3.3절, PDF 5쪽
같은 토큰을 같은 캐시로 보면 안 됩니다
원문 식 (6)은 모든 상태를 결정하는 이력을 다음처럼 표현합니다.
$m$은 토큰 수가 아니라 연산 수입니다. 같은 모델에서 빈 캐시부터 이 수열을 수행하면 현재 상태가 정해집니다. A,B,C를 모두 계산한 뒤 A를 제외한 경우와, A,B 다음 A를 제외하고 C를 계산한 경우에는 B·C가 남는다는 사실은 같아도 C가 A를 보았는지가 다릅니다. 이후 D의 분포도 달라질 수 있습니다. AKV가 토큰 접두사와 함께 연산 이력을 추적하는 이유입니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
챕터의 위치와 역할: 긴 에이전트 실행에서 메모리·I/O 비용과 과제 정확성이 함께 문제가 되는 배경을 설명합니다.
저자의 서술 순서를 따른 상세 내용:
- 장기 실행의 비용: 도구와 환경을 오가며 수백 턴을 진행하면 과거 KV를 저장하고 읽는 비용이 누적됩니다. 저자는 BCP와 GPT-OSS-120B의 비용 사례에서 캐시 읽기가 전체 API 환산 비용의 82.4%라고 제시합니다. 이는 특정 분석 사례의 비율이며, 모든 에이전트 서비스의 보편적인 비용 구조는 아닙니다.
- 요약·삭제의 재계산 딜레마: 과거 텍스트를 편집하면 그 뒤에 남겨 둔 상태까지 무효화됩니다. 편집을 늦게 한꺼번에 하면 재계산 부담을 줄이기 위해 많은 정보를 버리기 쉽고, 작은 편집을 자주 하면 반복 prefill 비용이 커질 수 있습니다.
- 직접 캐시 제어: 텍스트를 바꾸지 않고 attention에 참여하는 KV를 선택합니다. 남은 캐시는 이미 오래된 이력의 영향을 반영할 수 있습니다. 이것은 삭제한 문장을 완벽하게 복원하거나 모든 정보를 기억한다는 보장이 아니라, 원래 문맥에서 계산된 상태를 유지하는 것입니다.
- 새로운 시스템 요구: 같은 토큰이 남아도 계산 이력이 다르면 캐시가 다릅니다. 토큰 접두사만으로 공유하는 시스템은 이들을 혼동할 수 있으므로, 캐시 연산을 포함하는 상태 표현과 복구가 필요합니다.
- 세 기여: 연산의 정식화, stateless API와 stateful 서버의 공동 설계, 에이전트 점수·비용과 서빙 성능의 실험을 차례로 예고합니다. 여기서 stateless는 서버가 상태를 갖지 않는다는 뜻이 아니라, 클라이언트가 특정 물리적 캐시의 잔존 여부에 의존하지 않아도 된다는 뜻입니다.
챕터의 핵심 기여: 문맥 압축의 정확도·재계산 문제를 캐시 연산과 서빙 상태의 문제로 확장합니다.
다음 챕터로의 연결: 기존 연구에서 텍스트·캐시·서빙의 어느 층을 바꾸었는지 구분합니다. 1절, PDF 1–3쪽
📖 Chapter 2: Related Work
챕터의 위치와 역할: 새로운 방식이 어떤 기존 기법과 함께 쓰이거나 구별되는지 세 축으로 정리합니다.
저자의 서술 순서를 따른 상세 내용:
- Agent context engineering: 휴리스틱 또는 에이전트 판단으로 과거를 요약하고, 학습으로 요약 품질을 높이거나 문맥을 직접 삭제하는 연구를 소개합니다. 공통적으로 앞선 텍스트를 바꾸면 남은 suffix의 prefill이 필요하다는 점을 강조합니다.
- KV compression·eviction·reuse: 저랭크·양자화·집계는 상태를 더 작은 표현으로 저장하는 접근입니다. 위치나 attention 중요도에 따른 eviction은 일부 항목을 제외하고, 위치 변환이나 부분 재계산 기반 reuse는 기존 상태를 다른 조건에 맞춥니다. 이 논문은 agent와 harness의 높은 수준 판단을 캐시 제외·재사용에 연결합니다. 낮은 정밀도 저장이나 모든 캐시 압축을 대신하는 하나의 기법으로 주장하지 않습니다.
- 서빙 시스템: 기존 접두사 캐시는 같은 prefix의 상태를 공유하고, 에이전트 시스템은 편집을 묶거나 prefill과 실행을 겹쳐 비용을 숨깁니다. AKV의 추가 과제는 연산 이력에 따라 달라진 상태를 요청 간 격리하면서 공유·관리하는 것입니다.
챕터의 핵심 기여: 어떤 정보를 줄일지 결정하는 정책과, 줄인 상태를 정확히 제공하는 엔진을 구분합니다.
다음 챕터로의 연결: 이 차이를 논리적 토큰·활성 KV·연산 수열로 정의합니다. 2절, PDF 3쪽
📖 Chapter 3: Cache Engineering
챕터의 위치와 역할: 이 논문의 알고리즘적 의미를 정의합니다. API나 성능 수치보다 먼저 무엇이 바뀌고 무엇이 보존되는지 읽어야 하는 부분입니다.
저자의 서술 순서를 따른 상세 내용:
3.1 Preliminaries
일반적인 자기회귀 모델은 앞선 토큰 열을 조건으로 다음 토큰의 확률을 계산합니다. 원문 식 (1)은 이 토큰 기반 조건을, 식 (2)는 현재 토큰과 이전 KV를 사용해 같은 추론을 효율적으로 수행하는 표현을 제시합니다. 기본 KV 캐시는 이전 토큰을 다시 처리하지 않으려는 계산 재사용입니다.
캐시 제어에서는 논리적 길이와 활성 길이가 달라집니다. 원문 텍스트가 100K 토큰이어도 일부를 attention에서 제외하면 활성 KV는 더 작을 수 있습니다. 반대로 active라는 말은 GPU에 물리적으로 보관되었다는 뜻이 아니므로, 메모리에서 퇴거된 활성 상태는 요청 시 복원해야 합니다. 논리적 인덱스와 RoPE 위치 인덱스도 분리됩니다.
이 구분 덕분에 “전체 messages를 보낸다”와 “모든 messages의 KV를 매번 attention한다”는 문장이 같은 의미가 아님을 알 수 있습니다. API의 텍스트는 상태를 기술하는 기록이고, 연산 이력이 실제 활성 상태를 정합니다.
3.2 Design Motivation
저자는 세 질문을 순서대로 다룹니다. 첫째, 왜 캐시를 직접 바꾸어야 할까요? GPT-OSS-120B로 BCP 앞의 100과제를 과제당 4회, 최대 100턴 수행한 동기 실험에서 최근 도구 응답 12라운드만 남기는 텍스트 trim은 full-context의 1.85배 비용이 들었습니다. 48K 임계 요약은 비용을 약 7% 줄였으나 정확도가 5%p 낮았습니다. 직접 KV를 제외하면 남은 상태를 재사용할 수 있어 이 딜레마를 줄일 수 있습니다. 이 수치는 주 결과 Table 1과 동일한 평가 집합 전체의 결과로 섞지 않습니다.
둘째, 어떤 KV를 남길까요? Figure 2는 선택한 BCP 요청 10개에서 토큰당 attention을 평균내면 오래된 도구 응답이 같은 정도로 오래된 assistant 메시지보다 적은 attention을 받는 경향을 보여줍니다. 이에 따라 추론 캐시는 모두 유지하고 최근 도구 응답의 KV만 남기는 rolling drop을 기본 예로 삼습니다. 이 관찰은 모든 오래된 도구 응답이 무의미하다는 판정은 아닙니다.
셋째, 위치 인코딩은 어떻게 관리할까요? 오래된 KV를 제외해도 논리적 위치가 계속 커지면 작은 활성 캐시가 모델의 위치 한계에 도달할 수 있습니다. repos를 별도 연산으로 두어 남은 키를 다시 회전시키고 다음 위치를 재설정합니다. 내용을 버리는 선택과 위치 범위를 조절하는 선택이 분리됩니다.
3.3 Cache Operations
append는 현재 활성 캐시를 조건으로 새 상태를 계산해 끝에 추가합니다. 프롬프트·도구 응답·모델 출력 어느 토큰에서나 같은 의미입니다. drop은 지정한 논리 인덱스의 상태를 향후 attention에서 제외하고, 남은 상태와 위치를 그대로 둡니다. 순서를 보존하는 제외 연산이므로 임의 순서의 집합처럼 캐시를 다시 배치하지 않습니다.
repos는 남은 항목을 논리적 순서로 0부터 배치합니다. RoPE 키를 이전 위치에서 목표 위치로 회전시키지만 값 V는 바꾸지 않습니다. 이전의 모든 hidden state를 새 압축 텍스트에서 계산한 결과와 같게 만드는 연산이 아닙니다. 따라서 이 연산 후 상태의 의미도 이전 연산 이력과 연결됩니다.
3.4 Cache Operation Sequence
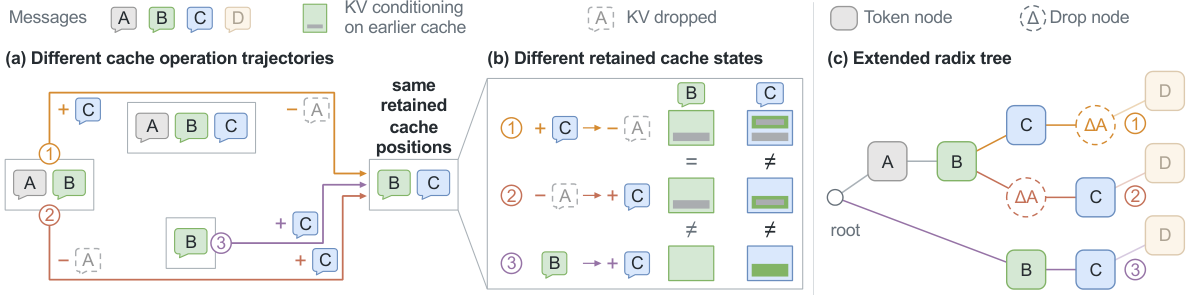
원문 Figure 5, PDF 5쪽. 세 경로와 색 범례를 보존한 크롭입니다. 그림·저작권: Tianyu Fu 외, arXiv 비독점 배포 라이선스. 원문.
원문 Figure 5의 경로 ①은 A와 B를 조건으로 C를 만든 뒤 A를 제외합니다. ②는 A와 B를 만든 뒤 A를 제외하고 C를 만듭니다. ③은 A 없이 B부터 만들어 C를 이어 붙입니다. 세 경우에 최종 B와 C가 남아도, ①·②의 B만 A를 조건으로 계산됐고 C는 세 경우 모두 다른 상태입니다.
즉 최종 토큰 목록과 최종 위치만으로 다음 확률을 복원할 수 없습니다. repos가 어느 토큰 이전에 실행됐는지도 이후 계산에 영향을 줍니다. 원문은 토큰과 연산의 공통 prefix가 있을 때만 그때까지의 계산을 공유해야 한다는 시스템 요구를 이 예시에서 도출합니다.
챕터의 핵심 기여: 같은 텍스트에서 다른 상태를 허용하되, 연산 이력을 명시해 그 상태를 결정적으로 기술합니다.
다음 챕터로의 연결: 이 수열을 요청에 표현하고, 공유 캐시를 정확히 찾고 복원하는 방법을 설계합니다. 3절·식 (1)–(6), PDF 3–5쪽
📖 Chapter 4: AKV Serving System
챕터의 위치와 역할: 연산의 의미를 실제 요청 간 캐시 공유·메모리 압력·상태 복원에 연결합니다.
저자의 서술 순서를 따른 상세 내용:
4.1 Serving Interface
클라이언트는 기존 API처럼 전체 messages를 전달하고, 선택적인 cache 필드에 연산 이력을 담습니다. 메시지 하나하나가 암묵적인 append이며, drop의 키는 어느 메시지를 처리한 뒤 실행할지, 값은 어느 메시지의 KV를 제외할지를 뜻합니다. reposition은 repos를 수행할 메시지 경계의 목록입니다. 인덱스는 0부터 시작하며 같은 경계에서는 drop 다음 repos입니다.
이 operate-after 문법은 현재 어떤 KV가 GPU에 남았는지를 클라이언트가 추측할 필요를 없앱니다. 서버가 턴 사이에 상태를 퇴거해도, 요청만으로 필요한 상태를 다시 구성해야 합니다. 다른 요청이 공유 prefix에서 drop을 실행했다고 현재 요청의 출력 분포가 바뀌어서는 안 됩니다.
원문 Figure 6은 메시지 경계와 연산을 함께 보여주는 설명용 요청 도식입니다. 여기서는 그 주석을 실행 가능한 JSON 예제로 재구성하지 않고 문법의 의미를 설명합니다. SDK 설치나 특정 호스팅 서비스에서의 즉시 사용 가능성을 이 논문만으로 검증하지는 않았습니다.
4.2 Cache State Management
4.2.1 Design Objectives and Challenges는 세 조건을 제시합니다. 필요한 상태와 동등할 때만 재사용하고, 요청 격리를 유지하며 쓰지 않는 상태를 퇴거하고, 퇴거한 상태를 한 번의 prefill로 복원합니다. 일반 causal prefill은 과거 drop·repos가 만든 계산을 그대로 재현하지 못하고, 모든 연산을 순서대로 별도 forward하면 여러 차례 모델을 지나야 하는 문제가 있습니다.
4.2.2 Drop-aware Cache Management는 먼저 radix tree에 drop node를 넣습니다. Radix tree는 공통 접두사를 공유하는 트리이며, 여기서는 drop을 실제 발동한 경계에 연산 노드를 둡니다. 연산 전까지 같은 상태는 공유하고, 그 이후 상태는 서로 다른 가지로 분리합니다. Figure 5의 ①·②는 A–B를 공유하지만 C의 가지가 갈라집니다.
메모리 퇴거에서는 진행 중인 계산이나 복원에 아무도 필요로 하지 않을 때 캐시를 해제합니다. 한 요청의 drop만으로 다른 요청이 사용하는 KV를 제거하지 않습니다. 저장 공간을 해제한 뒤에도 빈 트리 노드를 남겨, 그 뒤에 있는 캐시를 접두사 탐색으로 찾을 수 있게 합니다. 다음 턴 재사용 가능성을 고려해 완료 요청의 캐시보다 dropped 캐시를 먼저 퇴거합니다.
복원은 segment-batch attention을 사용합니다. Drop 경계마다 query를 나누고 각 구간이 원래 계산 당시 볼 수 있었던 이전 KV와 자신의 토큰에 causal attention을 적용합니다. 제외된 KV라도 과거 구간에서 필요했다면 그 구간에는 제공하고, 이후 구간에서는 숨깁니다. Attention만 분절하며 FFN은 전체 열을 한 batch로 처리해 구간마다 가중치를 다시 읽는 비용을 피합니다.
4.2.3 Reposition-aware Cache Management에서는 위치가 다른 버전을 구분합니다. 한 요청이 B·C를 낮은 위치로 옮기면 K를 재인코딩하고 V를 복사한 새 버전을 만듭니다. 원래 B를 사용하는 다른 요청은 기존 버전을 유지합니다. 트리는 바뀐 위치의 가지와 reposition node를 보관하며, 위치가 정확히 같으면 직접 재사용하고 호환되는 다른 위치이면 키를 회전시킵니다.
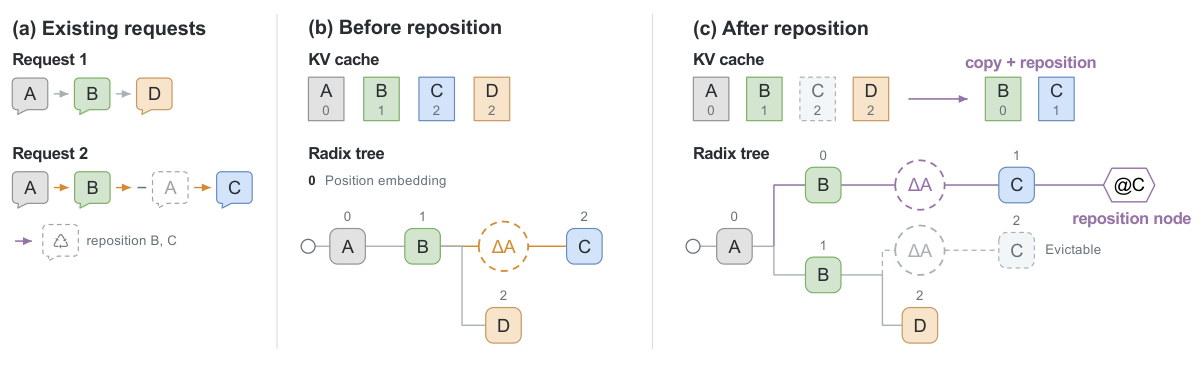
원문 Figure 8, PDF 7쪽. 세 패널과 위치 표기를 보존한 그림 영역 크롭입니다. 그림·저작권: Tianyu Fu 외, arXiv 비독점 배포 라이선스. 원문.
각 위치 버전은 독립적으로 사용 여부를 추적해 퇴거합니다. 복원 과정도 repos 경계에서 query를 나누고, 구간마다 원래 사용했던 위치의 임시 KV 버전을 제공합니다. 하나의 최종 위치로 모두 덮어쓰는 방법으로는 원래 hidden state를 복구할 수 없기 때문입니다.
챕터의 핵심 기여: 알고리즘적 제외와 물리적 해제, 직접 공유와 위치 변환, 전체 이력 기술과 서버 내부 상태를 구분하면서 연결합니다.
다음 챕터로의 연결: 이런 설계가 실제 과제 점수·비용과 서빙 처리량에 어떻게 나타나는지 분리해 평가합니다. 4절, PDF 6–8쪽
📖 Chapter 5: Experiment
챕터의 위치와 역할: 에이전트 정책의 품질, API 환산 비용, 서빙 속도를 각각 다른 실험으로 측정합니다.
저자의 서술 순서를 따른 상세 내용:
5.1 Setup
주 비교는 MiniMax-M2.7, GPT-OSS-120B, MiroThinker-1.7-Mini와 BCP·GAIA-Text·SWE-bench Verified·xbench-DeepSearch-2510의 조합입니다. GPT-OSS는 high reasoning effort, 다른 두 모델은 thinking mode를 사용합니다. GAIA는 텍스트만 있는 검증 부분집합 103과제입니다.
| 비교 방법 | 문맥 관리 | 임계값 / 보존 규칙 |
|---|---|---|
| Standard | 누적 이력을 요약 | GPT-OSS·MiniMax 96K, MiroThinker 192K |
| Text Engineering | 같은 요약 정책을 일찍 적용 | 세 모델 모두 48K |
| AKV | 오래된 도구 응답 KV를 rolling drop | 최근 도구 응답 12개 유지, 추론 KV 유지; repos 임계값은 Standard와 동일 |
비용은 주 에이전트와 요약 호출의 토큰을 공개 요율로 환산한 과제당 미국 센트 추정치입니다. 검색·웹페이지 판독·채점 등 모든 서비스 지출을 포괄한 운영 원가와 다릅니다. Cache miss·hit·출력을 다른 단가로 계산하고, AKV의 repos 대상 토큰에도 cache-hit 요금을 추가로 부과해 회전 비용을 보수적으로 잡습니다.
서빙은 SGLang 기반이고 NVIDIA A800-80GB 8개를 prefill 4개·decode 4개로 분리해 TP4로 사용합니다. A800에는 native MXFP4 지원이 없어 가중치를 BF16으로 설정합니다. 이 구성에서 측정한 지연을 임의의 GPU나 호스팅 API에 그대로 옮기면 안 됩니다.
5.2 Performance
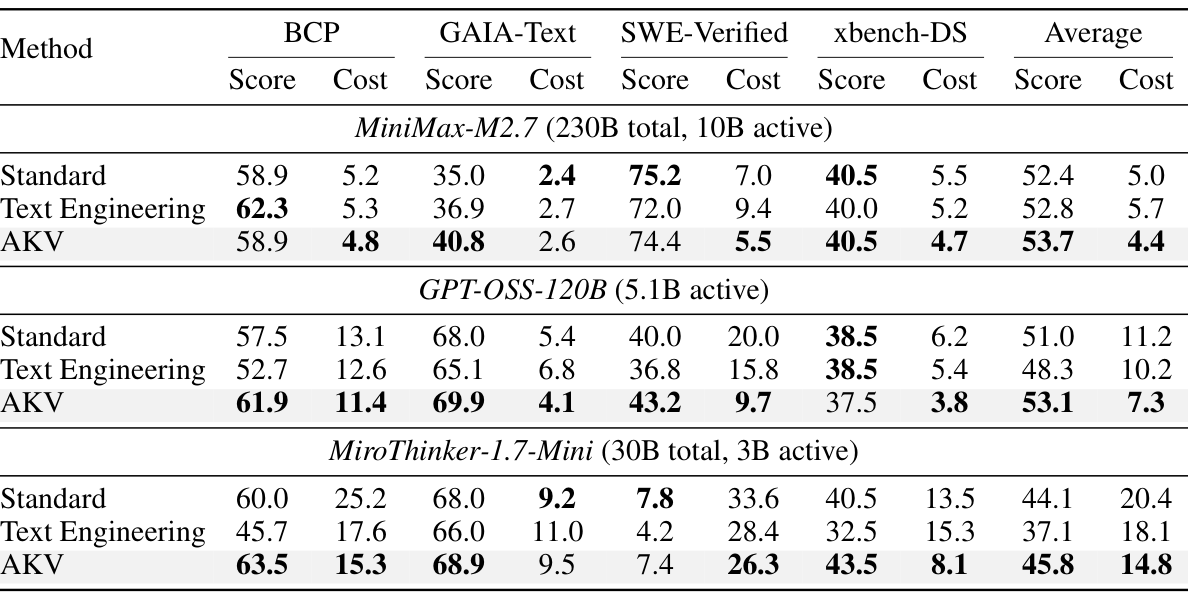
원문 Table 1, PDF 9쪽의 표 영역. Score는 pass rate(%), Cost는 미국 센트입니다. 아래에는 평균 열을 읽기 쉬운 표로 옮겼습니다. 표·저작권: Tianyu Fu 외, arXiv 비독점 배포 라이선스. 원문.
| 모델 | Standard 평균 점수 / 비용 | Text Engineering 평균 점수 / 비용 | AKV 평균 점수 / 비용 |
|---|---|---|---|
| MiniMax-M2.7 | 52.4 / 5.0 | 52.8 / 5.7 | 53.7 / 4.4 |
| GPT-OSS-120B | 51.0 / 11.2 | 48.3 / 10.2 | 53.1 / 7.3 |
| MiroThinker-1.7-Mini | 44.1 / 20.4 | 37.1 / 18.1 | 45.8 / 14.8 |
각 모델의 네 벤치마크 평균 점수는 AKV가 가장 높습니다. Standard 대비 차이는 1.3·2.1·1.7%p이며 평균 약 1.7점입니다. 과제 수가 다른 벤치마크를 모두 합쳐 계산한 하나의 총 성공률은 아닙니다. 논문은 세 모델·네 벤치마크에 걸친 평균 추정 비용이 Standard 대비 27.7%, Text Engineering 대비 21.9% 감소했다고 보고합니다. 집계 식을 별도로 명시하지 않고 표의 비용도 반올림되어 있으므로, 이 글에서 조합별 절감률의 단순 평균이라고 해석하거나 표로 정밀한 비율을 재산정해 단정하지 않습니다.
개별 셀에는 반대 결과도 있습니다. MiniMax의 SWE 점수는 Standard 75.2%와 AKV 74.4%, GPT-OSS-120B의 xbench는 38.5%와 37.5%입니다. MiniMax GAIA 비용도 2.4센트에서 2.6센트로 늘어납니다. 전체 경향과 각 업무의 최적 설정을 분리해 읽어야 합니다.
저자는 길이 구간별 BCP 분석에서, 48K 아래에는 세 방식의 정확도가 비슷하지만 48–96K에서 이른 요약이, 96K 초과에서 Standard가 낮아지는 패턴을 제시합니다. 각 임계값의 급격한 정보 축소와 일관되는 관찰이며, 모든 오답의 원인을 개별적으로 증명한 결과는 아닙니다.
5.3 Efficiency
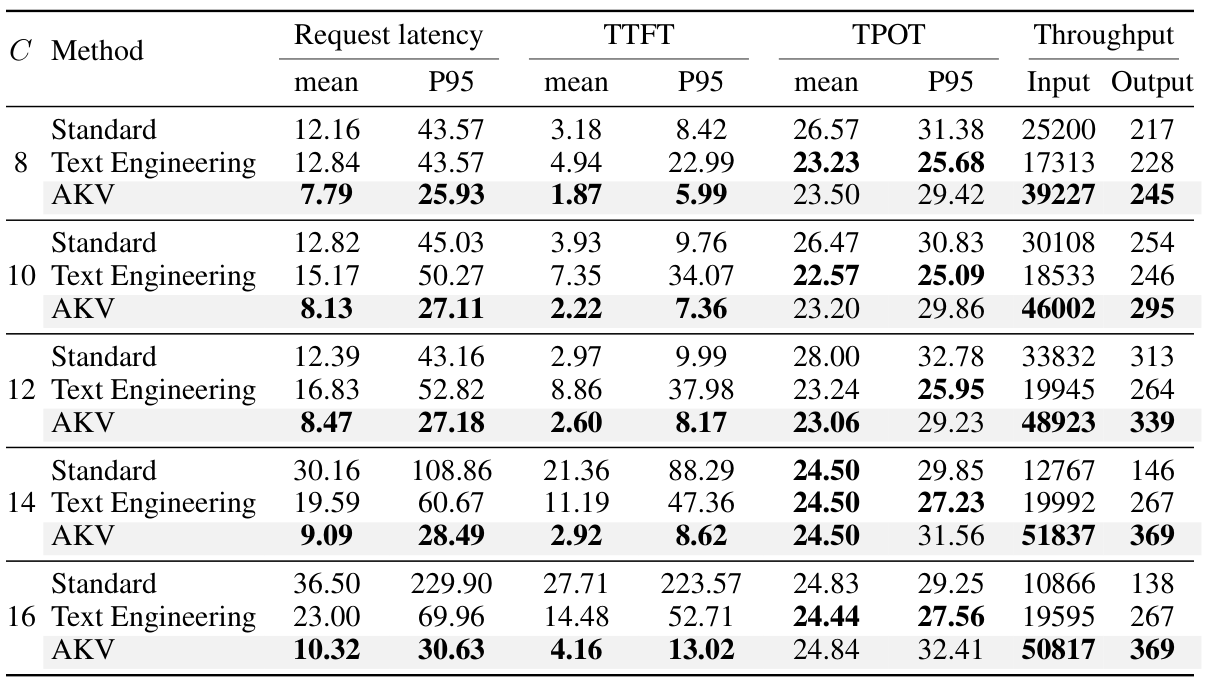
원문 Table 2, PDF 9쪽. 요청 지연·TTFT는 초, TPOT는 ms/token, throughput은 tokens/s입니다. 단위와 동시성 C를 보존한 크롭이며 주요 비교는 아래에 재작성했습니다. 표·저작권: Tianyu Fu 외, arXiv 비독점 배포 라이선스. 원문.
원문은 각 방식의 최대 출력 처리량 설정끼리 비교합니다. Standard는 동시성 12, AKV는 14입니다.
| 지표 | Standard, C=12 | AKV, C=14 | 비교 |
|---|---|---|---|
| 평균 요청 지연 | 12.39초 | 9.09초 | 약 1.36배 속도 향상 |
| P95 요청 지연 | 43.16초 | 28.49초 | 약 1.51배 속도 향상 |
| 입력 처리량 | 33,832 tokens/s | 51,837 tokens/s | 약 1.53배 |
| 출력 처리량 | 313 tokens/s | 369 tokens/s | 약 1.18배 |
입력 처리량은 제외한 캐시에 해당하는 토큰까지 포함한 논리 입력 토큰을 셉니다. 따라서 1.53배가 attention에서 실제 읽은 활성 KV 양이 늘었다는 뜻은 아닙니다. 또한 동시성 14에서 Standard의 P95 108.86초와 비교하는 수치는 이 최대 처리량 비교와 조건이 다릅니다.
동시성이 높아질수록 Standard는 KV 용량 압력으로 반복 prefill이 발생해 동시에 decode하는 요청 수가 줄어듭니다. AKV는 오래된 도구 KV를 읽지 않아 full-attention 계산과 메모리 접근이 줄어듭니다. 별도 online 실험은 SWE 앞의 100과제에서 방법마다 최대 처리량 동시성을 사용해 세 번 실행하고 평균 누적 pass rate와 ±1 표준편차를 표시합니다. 이 online 평가와 Table 2의 기록된 도구 응답을 재생하는 서빙 실험은 구분해야 합니다.
5.4 Ablations and Cache Engineering Policies
먼저 Table 3은 GPT-OSS-120B로 BCP·SWE 각각 첫 100과제에서 drop 대상과 repos를 분해합니다. 도구 KV를 제외하되 repos가 없으면 BCP 55.0%, repos를 더하면 62.0%입니다. 위치 한계 때문에 멈추던 실행을 더 이어갈 수 있다는 해석입니다. 추론만 제외하면 BCP/SWE 56.5/36.5%, 둘 다 제외하면 56.5/34.5%, 도구만 제외하면 62.0/41.0%입니다. 이 조건에서 추론 KV까지 제외하는 방식이 더 낫지는 않았습니다.
다음은 재귀적 자기 개선(RSI)입니다. MiniMax-M2.7으로 BCP 20과제에서 정책을 다듬고 100개 held-out 과제에서 평가합니다. 탐색 3·6회차 정책은 Standard와 비슷한 정확도를 유지하면서 비용을 각각 15.6%, 17.8% 줄입니다. 초록의 전문가 설계 대비 7.1% 추가 절감은 비교 대상이 Standard가 아니라 사람이 만든 K=12 정책입니다. 세 절감률을 같은 분모로 읽지 않습니다.
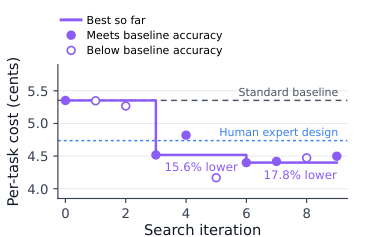
원문 Figure 4, PDF 4쪽. 기준 정확도 충족 여부와 비용 기준선을 그대로 보존한 크롭입니다. 그림·저작권: Tianyu Fu 외, arXiv 비독점 배포 라이선스. 원문.
마지막 Cache-As-Tool(CAT)은 에이전트가 도구로 캐시 감소 시점과 대상을 정하게 합니다. 별도 100과제 BCP 부분집합에서 GPT-OSS-120B와 MiniMax는 각각 61.0%, 64.0%로 해당 비교 중 가장 높은 pass rate를 얻습니다. GPT 비용은 13.4→12.1센트로 낮아지지만 MiniMax는 더 많은 턴을 실행해 5.4→5.9센트로 높아집니다. 높은 정확도가 항상 최저 비용과 함께 오지는 않습니다.
챕터의 핵심 기여: 평균 개선을 보고하면서도 모델·과제·정책·서빙 부하별 평가를 분리합니다. 캐시 정책 탐색과 엔진 효율은 서로 관련되지만 동일한 실험 결과가 아닙니다.
다음 챕터로의 연결: 확인한 성과와 원문이 남긴 후속 과제를 정리합니다. 5절·Tables 1–4, PDF 8–10쪽
📖 Chapter 6: Conclusion
챕터의 위치와 역할: 캐시 제어와 서빙 설계를 하나의 연구 결론으로 연결합니다.
저자의 서술 순서를 따른 상세 내용: 직접 활성 KV를 관리하고 남은 상태를 재사용하는 cache engineering을 제시한 뒤, stateless API·확장 radix tree·segment-batch attention을 요약합니다. 에이전트 성능과 환산 비용 개선을 AKV가 처리량·지연 개선으로 연결했다는 것이 결론입니다.
이 장 마지막의 Limitations에서 저자는 캐시 정책의 추가 탐색, 이 방식 아래에서 에이전트를 학습하는 연구, linear attention 모델로 서빙 지원을 확장하는 작업을 향후 과제로 적습니다. 이것이 원문이 명시한 범위이며, 리뷰어가 새 한계나 실패 조건을 덧붙인 목록은 아닙니다.
챕터의 핵심 기여: 정책과 시스템의 공동 설계를 정리하고 아직 수행하지 않은 방향을 명확히 남깁니다.
다음 내용으로의 연결: 지원 사항과 참고문헌 뒤에 시스템·평가의 상세 부록이 이어집니다. 6절, PDF 10쪽
📖 Chapter Acknowledgements / References: Acknowledgements / References
챕터의 위치와 역할: 연구 지원과 사용한 선행 연구·모델·시스템의 출처를 제공합니다.
저자의 서술 순서를 따른 상세 내용: 감사의 글은 연구비와 지원 기관을 명시하고, 참고문헌은 캐시 관리·문맥 처리·에이전트 평가·모델의 근거를 연결합니다. 이 리뷰는 원문에 서술된 비교 관계를 분석했으며 참고문헌 전체를 독립적으로 읽거나 모든 선행 결과를 재현한 것은 아닙니다.
챕터의 핵심 기여: 연구의 배경과 사용 자원을 추적할 수 있게 합니다.
다음 내용으로의 연결: 부록 A가 본문의 압축된 시스템 설명과 평가 조건을 자세히 제시합니다. PDF 10–14쪽
📖 Chapter A: Appendix
챕터의 위치와 역할: 한 번의 prefill로 이력을 복원하는 구체적 예, 위치 버전 매칭의 조건, 실험 프로토콜과 추가 결과를 제공합니다.
저자의 서술 순서를 따른 상세 내용:
A.1 AKV System Design Details
A.1.1 Restore with Segment-batch Attention은 drop·repos가 attention의 가시 범위나 위치 매핑을 바꾸는 곳에서 query를 나눕니다. 각 구간은 KV page 목록을 선택하고 표준 causal attention을 적용하므로, 조밀한 사용자 정의 attention mask를 만들 필요가 없습니다.
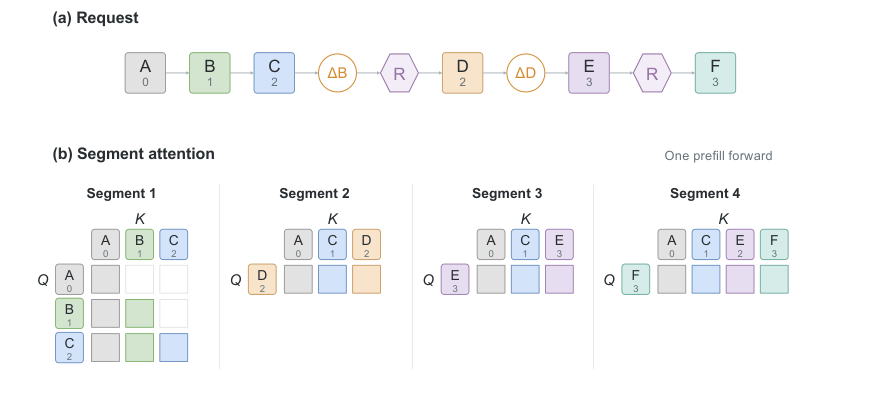
원문 Figure 10, PDF 15쪽. 요청 순서·네 attention 구간·Q/K 위치와 색 칸을 보존한 크롭입니다. 그림·저작권: Tianyu Fu 외, arXiv 비독점 배포 라이선스. 원문.
예시를 순서대로 보면, 첫 구간은 A0·B1·C2를 계산합니다. B를 제외하고 위치를 옮긴 다음 D2를 계산할 때는 A0·C1·D2를 봅니다. D를 제외한 세 번째 구간의 E3는 A0·C1·E3를 봅니다. Drop만으로 위치를 압축하지 않으므로 E의 인덱스가 3인 점이 중요합니다. 다시 repos하면 E가 2로 옮겨지고 네 번째 구간의 F3는 A0·C1·E2·F3를 봅니다.
이때 각 layer에서 C1·E2 같은 추가 위치 버전은 K를 회전시키고 V를 복사해 만듭니다. 구간별 query 범위와 page 목록을 함께 batch attention에 넣어 모델 forward는 한 번 수행합니다. 각 구간을 독립 모델 실행으로 되풀이하는 방법과 다릅니다.
A.1.2 Reposition Scheme은 같은 계산 상태의 위치 표현을 구별하는 정확 매칭과, 위치 변환이 가능한 더 긴 prefix를 찾는 retrigger matching을 설명합니다. 토큰 노드의 $T(x,p)$에서 $x$는 토큰 ID, $p$는 현재 저장된 K의 위치입니다. 처음 계산했던 위치와 반드시 같지는 않습니다.
이 정확 매칭은 토큰 ID·위치와 더불어 연산 노드·파라미터까지 같아야 합니다. 위치를 무시하는 투영은 다음과 같습니다.
$\phi$는 저장된 위치만 제거하는 투영이고, $\Delta P$는 해당 집합을 제외한 drop 기록, $R$은 repos 기록입니다. 두 prefix의 투영이 같으면 연산 이력은 유지하면서 위치 표현만 변환할 수 있는 후보가 됩니다. 시스템은 가장 긴 유효한 exact prefix로 시작하고, 엄밀히 더 긴 호환 prefix만 선택해 동률에서는 exact 결과를 유지합니다. 토큰 또는 연산이 처음 다르면 탐색을 멈춥니다.
원문 Figure 11은 최종 위치가 같아도 D를 계산하기 전에 repos를 했는지가 달라진 예를 보여줍니다. 나중에 다시 위치를 맞춰도 이미 다른 문맥·상대 거리에서 계산한 D의 hidden state 차이는 지워지지 않습니다. 따라서 연산 노드를 생략하고 최종 위치만 맞추면 안 됩니다. 저자의 재사용 논증은 모델·위치 설정 고정과 정확 산술을 전제로 하며, 유한 정밀도 회전의 반올림 때문에 재계산과 비트 단위 동일성을 보장하는 주장이 아닙니다.
A.1.3 Serving Configuration은 SGLang v0.5.20, BF16 GPT-OSS-120B, A800 8개를 기록합니다. Mooncake를 통한 노드 내부 NVLink 전송, Triton attention, triton_kernel MoE, static memory fraction 0.85, 토큰당 page 하나, prefill chunk와 최대 prefill 8,192토큰입니다. 양쪽 worker에서 radix cache를 켜고 baseline은 LRU, AKV는 drop-aware eviction을 사용합니다.
A.1.4 Workload Replay and Evaluation Protocol은 Table 2의 해석에 필요합니다. 요약 없는 trajectory의 최대 길이가 큰 SWE-bench Verified 80과제를 골라 고정 seed로 섞고 같은 과제 순서를 사용합니다. 각 방법은 자기 정책으로 수집한 궤적을 재생하므로 턴 수와 출력 예산은 다를 수 있습니다.
각 턴은 전체 기록에서 출력 토큰 예산을 복구하고 temperature 0·ignore_eos=True로 정한 수만큼 생성합니다. 새 assistant 응답은 다음 턴에 유지하지만 도구는 다시 실행하지 않고 기록된 도구 응답을 제공합니다. Assistant 응답이 없는 마지막 입력은 제외합니다. 따라서 이 재생을 실제 도구 환경의 성공률 재평가로 부르면 안 됩니다.
측정 창은 동시성을 유지하는 보충 과제의 요청도 포함합니다. 일반적인 과제 목표는 동시성의 3배와 30 중 큰 값입니다. AKV의 동시성 14·16은 완료 순서상 첫 30과제가 끝날 때 기록을 자르고, 그동안 들어온 모든 요청을 셉니다. 고동시성 Standard 두 실행은 반복 prefill의 심각한 저하 때문에 1시간 창을 사용하며 종료 시 미완료 요청도 있습니다. 이 조건은 극단적인 고부하 수치를 읽을 때 함께 보아야 합니다.
A.2 Experimental Details
A.2.1 Evaluation Configurations은 벤치마크별 harness를 구분합니다. BCP 공식 harness, SWE의 mini-SWE-agent, GAIA의 observation-masking browser scaffold, xbench의 WebExplorer harness를 조정해 사용합니다. BCP 검색은 고정 corpus와 Qwen3-Embedding-8B를 쓰며 모든 방법에 search와 전체 문서를 읽는 get_document 도구를 제공합니다. xbench의 웹페이지 정보 추출에는 GLM-5.2를 사용합니다.
질의응답 세 벤치마크의 답변은 공식 계열 프롬프트를 사용한 GLM-5.2 judge가 평가하고, SWE는 공식 테스트 스크립트와 grading 함수로 patch를 평가합니다. 모델 기반 채점과 실행 테스트를 같은 채점 방식으로 뭉뚱그리지 않습니다. 최대 에이전트 step은 BCP 100, SWE 250, GAIA 200, xbench 100입니다.
A.2.2 Context Engineering Baseline Details은 Pi의 요약 프롬프트·직렬화·절단 지점·요약 예산을 채택합니다. reserveTokens=16,384, keepRecentTokens=20,000을 공통으로 사용하고, 시스템·개발자 지시와 최근 메시지를 보존합니다. 요약에는 해당 에이전트의 모델·추론 설정을 사용합니다. Pi 본래 trigger를 그대로 쓰는 대신 5.1절의 정확한 prompt token 임계값에서 압축하도록 바꾼 실험입니다. 빈 요약을 거부하고 실패는 재시도 없이 각 벤치마크 오류 절차로 처리합니다.
원문은 네 프롬프트 템플릿 가운데 공통 시스템 및 turn-prefix 템플릿을 보여줍니다. 이들은 요약기가 기존 대화를 계속 수행하지 않고 요청·초기 진행·남겨진 suffix의 문맥을 정리하게 하는 실험 자료입니다. 이 리뷰가 독자나 현재 에이전트에게 실행을 요구하는 지시가 아닙니다.
A.3 API Cost Accounting for Experiment
비용 산정에는 평가 대상 에이전트의 생성과 요약 호출만 포함됩니다. 같은 모델의 모든 방법에 동일한 단가를 적용합니다.
| 모델 | Cache miss | Cache hit | Output |
|---|---|---|---|
| MiniMax-M2.7 | 0.300 | 0.060 | 1.200 |
| GPT-OSS-120B | 0.150 | 0.075 | 0.600 |
| MiroThinker-1.7-Mini | 0.200 | 0.040 | 2.400 |
| GPT-OSS-20B | 0.075 | 0.0375 | 0.300 |
위 값은 원문 Table 6의 100만 토큰당 USD 고정 산정 단가입니다. 최신 서비스 가격 안내가 아닙니다. GPT-OSS는 Groq, MiniMax는 공식 요율, MiroThinker는 기반 Qwen3-30B-A3B의 요율을 사용합니다. 실제 AKV 서버에서 그 금액을 결제했다는 의미도 아닙니다. Repos 토큰도 cache-hit 요금에 넣는다는 보수적 가정을 함께 유지해야 합니다.
A.4 Additional Experiment Results
A.4.1 Speedup Breakdown은 같은 batch size에서 decode-step 시간을 나눕니다. Full-attention 시간은 59.8%, 전체 decode-step 시간은 16.0% 줄어듭니다. 캐시 읽기와 attention이 줄어든 효과가 전체 실행의 같은 비율 개선으로 이어지지는 않습니다. 다른 연산은 여전히 필요하기 때문입니다.
A.4.2 Cost Breakdown and Active Context Length에서 BCP·GPT-OSS-120B의 cache-read 비용은 Standard 대비 약 17% 낮습니다. Text Engineering과 비교한 cache-miss 입력 비용은 약 48% 낮습니다. 두 수치는 비교 대상과 비용 항목이 다르며, 주 결과의 27.7%와 합쳐 더하는 값이 아닙니다.
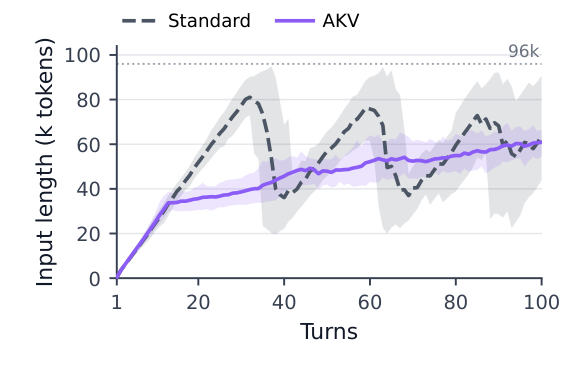
원문 Figure 14, PDF 20쪽. 턴·입력 길이 축, 96K 기준선, 두 방식과 음영을 보존한 크롭입니다. 그림·저작권: Tianyu Fu 외, arXiv 비독점 배포 라이선스. 원문.
추론 KV를 모두 남기므로 AKV의 활성 문맥도 계속 증가합니다. 최근 도구 응답만 제한했다고 전체 활성 캐시가 고정된 크기가 되는 것은 아닙니다. Figure 14는 성장 속도를 늦추는 rolling drop과 임계 요약으로 급감하는 Standard의 차이를 보여줍니다.
A.4.3 Attention Across Message History는 선택한 BCP 궤적 10개에서 layer·메시지별 토큰당 attention을 분석합니다. 대체로 오래된 도구 응답보다 오래된 추론, 둘보다 최근 이력에 attention이 많다는 관찰이 기본 정책의 근거입니다. Attention 값만으로 필요성을 완벽하게 판별했다고 주장하지 않습니다.
같은 소절의 Compatibility with Harness는 Pi에 AKV를 결합한 BCP 평가를 보고합니다. GPT-OSS-120B와 20B 모두에서 원래 Pi의 compaction 없는 설정보다 3%p, compaction 있는 설정보다 4%p 정확도가 높아집니다. 이것은 해당 결합 실험의 결과이지 모든 harness에 대한 보장은 아닙니다.
A.4.4 Additional Models는 high reasoning effort의 GPT-OSS-20B로 같은 종류의 비교를 확장합니다. Standard와 AKV repos는 96K, Text Engineering은 48K입니다. 평균 pass rate는 44.0→45.2%, 평균 비용은 6.2→4.8센트입니다. 다만 Text Engineering의 평균 비용 4.6센트보다 AKV가 더 비싸므로, 이 추가 모델에서도 정확도와 비용을 함께 봐야 합니다. 저자는 120B보다 이득이 작은 일부 결과를 남은 정보를 활용하는 모델 능력의 차이로 해석합니다.
A.5 Additional Related Works
마지막은 동시기 연구와의 경계를 설명합니다. AgentKV의 실행 단계별 query buffer, IntentKV의 cross-turn query memory·학습된 중요도, SideQuest의 보조 추론을 통한 오래된 도구 응답 삭제를 소개합니다. 이어 CLM의 편집 가능한 live context와 Suffix Cache Reuse를 설명합니다. 저자는 CLM의 session-local private buffer와 비교해, AKV가 정책에 독립적인 연산·공유 radix 색인·메모리 관리·복원을 통합한다는 차이를 강조합니다. 이는 원문이 제시한 비교이며 각 프로젝트의 최신 코드를 독립 감사한 결과는 아닙니다.
챕터의 핵심 기여: 상태 재사용의 수학적 조건과, 성능 수치의 실제 측정 창·요금·도구·judge 조건을 공개합니다.
원문 구조의 마무리: 본문 1–6절, 감사의 글·참고문헌, 부록 A.1.1–A.1.4·A.2.1–A.2.2·A.3·A.4.1–A.4.4·A.5를 순서대로 반영했습니다. 모든 참고문헌의 독립 검토, AKV 코드의 정적 감사, 모든 그림·프롬프트의 전사, 실제 모델 호출과 실험 재현은 수행하지 않았습니다. 본문 수치와 핵심 그림은 같은 버전 원문과 대조했습니다. Appendix A, PDF 15–21쪽
실험 결과 심층 분석
이 논문의 성과는 어떤 정책이 좋은가와 그 정책의 캐시를 올바르게 제공할 수 있는가라는 두 질문으로 나누어 읽으면 명확합니다. K=12 rolling drop은 과제 점수와 비용의 실험 대상이고, 확장 radix tree와 segment-batch attention은 그 연산 이력의 재사용·복원을 지원합니다. 엔진이 있다고 모든 캐시 정책이 좋아지는 것도 아니고, 유리한 정책이 있다고 임의의 prefix cache가 이를 정확히 실행하는 것도 아닙니다.
주 결과의 평균 향상과 개별 업무의 차이도 구분해야 합니다. 세 모델의 평균 pass rate는 오르지만 일부 SWE·xbench 점수는 낮아집니다. CAT는 MiniMax 정확도를 높이는 동시에 비용도 늘립니다. 따라서 저자의 실험은 캐시를 줄이면 언제나 더 정확하고 저렴해진다는 법칙보다 역할·최근성·실행 요구에 맞춰 제어할 수 있는 설계 공간을 뒷받침합니다.
정량 해석에서는 분모가 중요합니다. 1.7점은 벤치마크 점수의 평균 차이, 27.7%는 논문이 보고한 전체 평가의 평균 추정 비용 감소, 1.18배는 최대 출력 처리량, 1.51배는 최대 처리량 설정에서의 P95 요청 지연 비율입니다. 이들을 같은 평균이나 하나의 실험에서 동시에 얻은 수치처럼 연결하면 오해가 생깁니다. 비용에는 원문 고정 요율과 repos 보수적 과금 가정이 들어갑니다.
신뢰도 측면에서 Figure 9(a)는 세 실행 평균과 ±1 표준편차를 표시합니다. 그러나 주 결과 Table 1의 모든 비교에 대한 신뢰구간·유의성 검정은 보고되지 않았습니다. 이를 추정해 통계적으로 확정된 우열을 부여하지 않았습니다. 서빙 재생은 실제 도구를 다시 실행하지 않는 조건, 고동시성 측정은 방법별 시간 창의 차이까지 함께 해석해야 합니다.
기술적 함의와 응용
Cache engineering은 에이전트가 다루는 자원을 텍스트 문맥에서 계산된 상태의 참여와 위치까지 확장합니다. 긴 검색·코딩 업무에서 과거 기록을 그대로 보관하면서 다음 attention에서 사용할 상태를 달리 고를 수 있다는 것이 핵심입니다. 다만 논리 이력을 보존한다는 사실과 그 전체가 현재 attention에 보인다는 사실을 구분해야 합니다.
리뷰어 관점에서 더 넓은 함의는 실행 이력이 재사용의 정체성이 된다는 점입니다. 같은 최종 토큰·위치를 갖는 상태라도 계산 경로가 다르면 다르게 다뤄야 합니다. Prefix 공유, copy-on-transform에 해당하는 위치 버전 관리, 원래 가시 범위를 복원하는 구간 attention을 함께 설계한 이유가 여기에 있습니다. 이는 다른 시스템의 성능을 보증하는 주장이 아니라 원문의 설계를 이해하는 관점입니다.
저자는 정책 탐색 확대, 이 방식에서의 에이전트 학습, linear attention 지원을 후속 방향으로 남깁니다. 현재 결과의 의미는 모든 과거 정보를 없애거나 모든 비용을 없앴다는 데 있지 않습니다. 보관한 텍스트, attention에 참여할 상태, GPU에 남겨 둘 상태를 구분하고, 그 선택의 이력까지 시스템이 책임지는 방식을 실험 가능한 대상으로 만들었다는 데 있습니다.