논문 개요와 전체 구조
같은 언어 모델이 어떤 과제에서는 잘 작동하고 다른 과제에서는 필요한 작업을 끝내지 못하는 이유가 모델의 능력에만 있을까요? 에이전트는 프롬프트, 도구, 문맥 관리, 종료 조건을 구현한 하네스(harness) 안에서 실행됩니다. 보고서를 만드는 과제에는 올바른 파일 형식이 중요하고, 고객 관리 시스템을 수정하는 과제에는 실제 쓰기 작업이 수행됐는지 확인하는 절차가 중요합니다. 모든 과제에 하나의 실행 방식을 적용하면 이런 요구가 충돌할 수 있습니다.
Gaotang Li 등 12명의 Object-Oriented Harness: Evolving Agent Harnesses through Object-Oriented Design는 이 문제를 객체지향 프로그래밍의 상속과 다형성으로 다룹니다. OO-Harness는 실행 기록에서 과제들의 공통 요구를 찾고, 기존 하네스를 상속한 특화 클래스를 진화시킵니다. 배포할 때에는 새 과제와 기본 하네스의 관찰 가능한 실행 기록을 보고 적절한 클래스를 선택하거나 기본 결과를 그대로 재사용합니다. 모델 가중치를 학습하는 방법과 달리, 이 연구가 바꾸는 대상은 모델을 둘러싼 실행 코드와 선택에 쓰이는 저장된 근거입니다.
이 글은 2026년 10월 20일 제출된 arXiv 2610.28380v1의 HTML과 20쪽 PDF를 함께 읽은 리뷰입니다. 원문의 본문과 부록을 다음 순서대로 따라갑니다. 논문 초록의 “최대 15%”라는 표현은 결과표의 지표·분모를 확인하면서 해석하겠습니다.
| 원문 순서 | 핵심 내용 |
|---|---|
| 1. Introduction | 전역 하네스의 문제와 상속 기반 특화의 동기 |
| 2. Related Work | 자기 개선 에이전트·자동 하네스 진화와의 관계 |
| 3. Method | 3.1 문제 설정 → 3.2 계층 표현 → 3.3 초기화 → 3.4 진화 반복 → 3.5 테스트 선택·실행 |
| 4. Experiments | 4.1 데이터·지표·비교 조건 → 4.2 주 결과와 탐색 비교 |
| 5. Analysis | 5.1 라우팅·상속 ablation → 5.2 사례 분석 → 5.3 응용 도메인이 다른 OOD 평가 |
| 6. Conclusion / Limitations / References | 결론, 명시된 운영 의존성, 인용 문헌 |
| Appendix A | A.1 모델 → A.2 공통 학습 → A.3 벤치마크 → A.4 구현·프롬프트·상속 → A.5 기준선 → A.6 ablation → A.7 OOD → A.8 자료·자원 |
| Appendix B | B.1 Word 문서 → B.2 업무 완료 검사·라우팅 → B.3 도구 출력 압축·스프레드시트 검사 |
핵심 기여와 혁신성
문제의 중요성은 여러 종류의 과제에 서로 다른 실행 전략이 필요하다는 데 있습니다. 한 과제의 오류를 막기 위해 넣은 메모리나 검사 절차가 다른 과제에는 불필요한 간섭이 될 수 있습니다. 논문은 선행 연구의 결과를 근거로, 기능을 계속 추가한 하나의 전역 하네스가 항상 더 좋아진다고 가정하지 않습니다.
기존 접근과의 차이는 특화 구현을 보관하는 방식입니다. 여러 독립 하네스 중 하나를 고르는 것만으로는 공통 기능의 코드가 중복될 수 있습니다. OO-Harness는 부모의 메서드를 유지하면서 필요한 부분만 재정의하거나 새 메서드를 더합니다. 부모와 자식은 여러 에이전트가 차례로 수행하는 단계가 아니라, 선택된 하나의 완전한 실행 클래스를 구성합니다.
해결책의 독창성은 코드 계층과 과제 군집을 분리한 데 있습니다. 군집은 비슷한 실행 요구를 가진 과제와 평가 근거를 모으고, 상속 계층은 재사용할 코드를 조직합니다. 진화 과정은 대상 군집에서 후보를 평가하며 설계 교훈과 라우팅 교훈을 축적합니다. 테스트에서는 그 구조와 교훈을 고정합니다. 이를 통해 과제별 특화와 기존 기본 동작 보존을 함께 다루려 합니다.
주요 결과는 동일한 gemini-3.5-flash executor를 사용한 세 벤치마크에서 비교 방법 중 가장 높은 주 지표를 얻었다는 것입니다. 다만 부분 점수와 엄격한 과제 성공률은 다릅니다. 예를 들어 AutomationBench의 평균 부분 점수는 61.62%에서 77.41%로 높아지지만, 모든 요구를 충족한 PASS는 25.44%에서 37.22%입니다. 리뷰어 관점에서는 높은 숫자 하나보다 어떤 실행을 바꾸고, 어떤 실행은 보존했는지를 분석할 수 있다는 점이 학습 가치입니다. 1·3·4절, PDF 1–7쪽
기술적 세부사항
과제 군집·코드 계층·교훈은 각각 다른 것을 저장합니다
기본 하네스를 $H_0$, 고정된 과제 수행 모델을 $M$이라고 하겠습니다. 과제 군집 집합 $\mathcal C$는 발견용 과제의 실행 요구를 묶습니다. 군집 $c$의 발견 과제가 $\mathcal D_c$, 현재 그 군집에 선택된 하네스가 $H_c$입니다. 하네스 계층 $\mathcal T_H$는 클래스 사이의 상속 관계를 저장합니다. 한 군집의 분류와 한 클래스의 부모는 같은 개념이 아닙니다.
실행 기록에는 후보 코드, 수행 궤적, 결과, 성공·실패에 대한 성찰이 남습니다. 구현에서 교훈 저장소를 사용할 때, 설계 교훈은 다음 코드 수정에 유용한 변경과 실패를 요약하고, 라우팅 교훈은 어떤 조건에서 특화 하네스를 고를지 설명합니다. 라우터가 테스트 과제를 보면서 새 가중치를 학습하는 것이 아니라, 발견 단계에서 축적한 고정된 근거를 입력으로 받는 방식입니다.
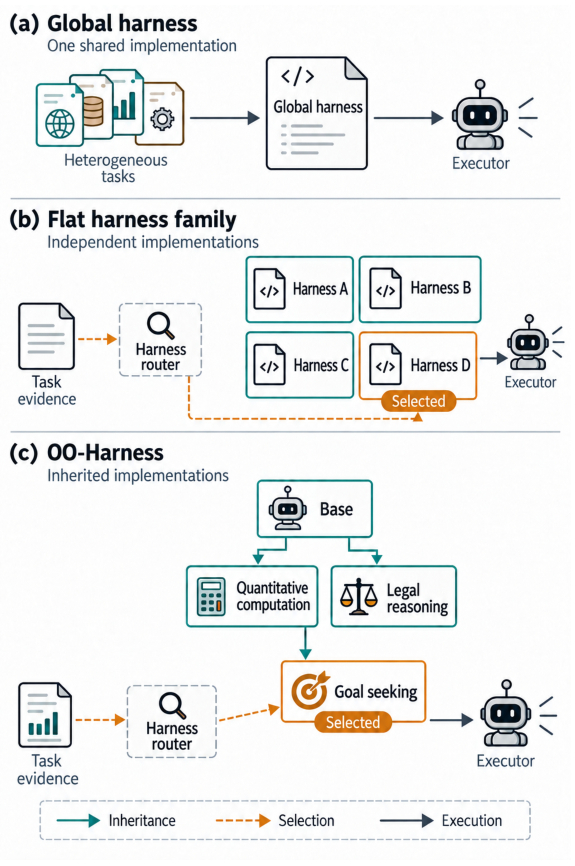
원문 Figure 1, PDF 2쪽. 청록색은 상속, 주황색 점선은 선택, 회색은 실행 경로입니다. 원문 영역만 크롭했으며 내용은 바꾸지 않았습니다. Gaotang Li 외, CC BY 4.0. 고정 버전 원문.
상속 구조만 크게 보면 다음과 같습니다. 아래 (c) 패널에서 선택된 주황색 자식은 조상의 코드를 물려받지만, 실행 화살표는 선택된 인스턴스 하나에서 executor로 이어집니다. 계층의 모든 노드를 차례로 실행하는 구조가 아닙니다.
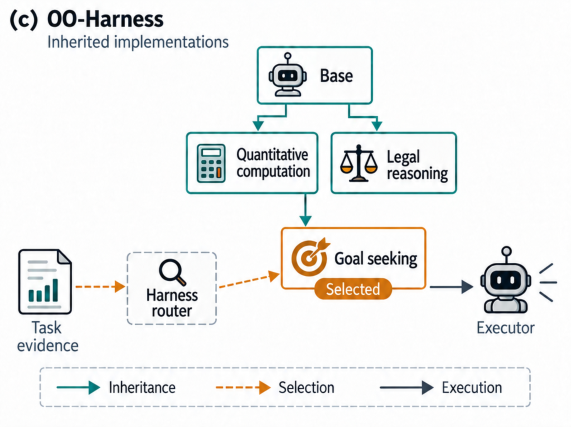
원문 Figure 1(c)와 범례의 상세 크롭, PDF 2쪽. 위의 전체 그림에서 해당 패널만 따로 제시했으며 배치나 내용을 바꾸지 않았습니다. Gaotang Li 외, CC BY 4.0. 원문.
후보 수용과 테스트 선택을 나누어 읽어야 합니다
진화 중 새 후보는 대상 군집에서 현재 점수보다 좋아야 하며, 벤치마크별 수용 검사도 통과해야 합니다. 원문의 조건을 그대로 쓰면 다음과 같습니다.
$H^{\prime}$는 새 하위 클래스, $S_c(H^{\prime})$는 그 후보를 군집 $c$의 발견 과제에 직접 실행한 점수, $S_c^{\mathrm{current}}$는 현재 할당의 저장된 점수입니다. 개선 요구는 대상 군집에 대한 조건이며, 전체 과제에서 동시에 개선돼야 한다는 뜻은 아닙니다. 이 부등식만으로 수용이 끝나는 것도 아닙니다. 과제별 결과와 실행 피드백을 검사하고, 구성된 경우 모호한 사례를 판정하는 에이전트도 사용합니다.
반면 배포 시 라우터의 선택식은 다음과 같습니다.
$t$는 새 과제, $\omega(t)$는 기본 하네스에서 관찰한 수행 궤적, $\rho$는 하네스 라우터, $\mathcal L_{\rho}$는 발견 단계에서 고정한 라우팅 교훈입니다. 선택지에는 기본 클래스와 군집별 활성 하네스가 들어갑니다. $H^{\star}=H_0$이면 이미 얻은 기본 결과를 재사용합니다. 특화 클래스를 선택하면 상속된 동작과 새 동작을 가진 인스턴스 하나를 실행합니다. 숨겨진 정답이나 테스트 채점 결과는 라우터 입력에 포함되지 않습니다. 3.4–3.5절, PDF 4–5쪽
챕터별 상세 리뷰
📖 Chapter 1: Introduction
챕터의 위치와 역할: 왜 동일한 모델 주위의 실행 코드를 과제별로 나눠야 하는지 문제를 설정하고, 상속이 제공하는 보존과 재사용의 의미를 설명합니다.
저자의 서술 순서를 따른 상세 내용:
- 다양한 에이전트 업무: 실제 사건 예측, 투자은행·컨설팅·법률의 여러 애플리케이션을 잇는 과제 등은 필요한 도구와 문맥, 완료 검사가 다릅니다. 하네스는 이런 선택을 실행 가능한 코드로 구현합니다. 따라서 일반화 문제는 언어 모델 자체뿐 아니라 실행 전략의 적합성과도 연결됩니다.
- 하나의 전역 변경이 만드는 간섭: 저자는 Meta-Harness처럼 발견 집합에서 선택한 하나의 하네스를 적용하는 방식과, 메모리·도구·전문가 추가가 항상 도움이 되지 않았던 선행 결과를 소개합니다. 발견 집합에서 유용한 변경도 분포가 달라지면 효과가 유지된다는 보장은 없습니다. 이 부분은 이 논문의 새 실험과 선행 연구 인용을 구분해 읽어야 합니다.
- 상속 기반 특화: OO-Harness는 기본 또는 기존 특화 클래스의 메서드를 재정의하거나 새 메서드를 더합니다. 진화 에이전트는 기본 실행 기록에서 공통 요구를 가진 과제를 묶고, 군집과 부모를 선택해 후보를 만들고 평가합니다. 성공과 실패는 이후 수정·선택의 근거로 남습니다.
- 효율성과 보존이라는 두 동기: 후보를 전체 발견 집합 대신 대상 군집에서 평가하면 반복 평가 범위를 줄일 수 있습니다. 또 특화 변경이 기본 하네스와 다른 가지를 그대로 남기므로, 새 과제에 무관한 변경을 강제로 적용하지 않을 수 있습니다. 논문은 이 두 가지를 효율성과 일반화의 동기로 설명합니다.
- 다형성과 고정된 배포 구조: 공통 실행 인터페이스로 선택된 클래스를 실행하고, 계층·교훈은 테스트 전에 고정합니다. executor 가중치는 발견 단계와 테스트 단계 모두 고정됩니다. 동시에 진행된 Adaptive Auto-Harness의 Git 브랜치 기반 특화와 비교하면서, 이 논문은 상속에 의한 코드 공유와 실행 근거를 반영한 라우팅을 강조합니다.
챕터의 핵심 기여: “더 많은 기능을 한 하네스에 추가한다”는 문제를, 공통 동작을 유지한 여러 실행 전략과 그 선택 문제로 바꿉니다.
다음 챕터로의 연결: 이러한 변화가 기존 자기 개선·자동 하네스 연구와 어떤 관계를 갖는지 정리합니다. 1절, PDF 1–2쪽
📖 Chapter 2: Related Work
챕터의 위치와 역할: 바꾸는 대상과 특화 구현을 조직하는 방식을 기준으로 선행 연구를 배치합니다.
저자의 서술 순서를 따른 상세 내용:
- Self-evolving agents: GEPA의 프롬프트 최적화, ReasoningBank의 실행 경험 메모리, A-Evolve의 지속 상태 갱신, HASP의 실행 가능한 스킬을 소개합니다. 이들은 하네스 진화의 재료가 될 수 있지만, OO-Harness의 중심 대상은 상속으로 연결된 특화 실행 클래스입니다.
- Automatic harness evolution: Meta-Harness·Agentic Harness Engineering·HarnessEvolve는 주로 전역 하네스 최적화로 정리합니다. HarnessDev와 EvoHarnessBench는 진화 및 기능 확장이 성능에 미치는 영향을 측정하는 맥락을 제공합니다. 여기서 나열된 결과를 이 리뷰가 모두 독립 재현한 것은 아닙니다.
- 특화·배포·프로그래밍 표현: Adaptive Auto-Harness의 Git 분기·rebase, EvolveNet의 배포 간 적응 통합, NOOA의 Python 객체 표현을 이어 설명합니다. OO-Harness는 부모 메서드 재사용, 재정의, 새 메서드를 통해 실행 계층을 만들고, 저장된 라우팅 교훈과 관찰 가능한 기본 실행을 함께 사용한다는 점을 구별합니다.
챕터의 핵심 기여: 자기 개선을 하나의 범주로 뭉뚱그리지 않고, 무엇을 고치며 어떻게 공유하고 선택하는지 비교할 축을 제공합니다.
다음 챕터로의 연결: 이 차이를 발견·테스트 분리와 구체적인 진화 절차로 정의합니다. 2절, PDF 2–3쪽
📖 Chapter 3: Method
챕터의 위치와 역할: 구조·학습·배포를 연결하는 핵심 장입니다. 모델 가중치 갱신과 실행 코드 진화를 혼동하지 않도록 먼저 고정된 요소를 정합니다.
저자의 서술 순서를 따른 상세 내용:
3.1 Problem setting and overview
발견용 과제에서 코드를 진화시키고, 겹치지 않는 held-out 과제에서 고정된 결과물을 평가합니다. Held-out은 탐색에 사용하지 않은 평가 집합을 뜻합니다. 저자는 탐색과 평가에 같은 과제를 사용한 선행 실험과 구분하며, 검색 집합 밖의 일반화를 측정하려면 이 분리가 필요하다고 설명합니다.
군집은 과제의 공통 실행 요구를 조직하고, 계층은 재사용할 실행 코드를 조직합니다. 실행 기록에는 성공한 후보뿐 아니라 실패한 후보의 코드·궤적·결과·성찰도 남습니다. 교훈 저장소를 쓰는 구현은 여기서 설계 교훈과 선택 교훈을 추출합니다. 라우터 가중치를 학습하는 것이 아니라 그 판단에 주는 근거가 누적됩니다.
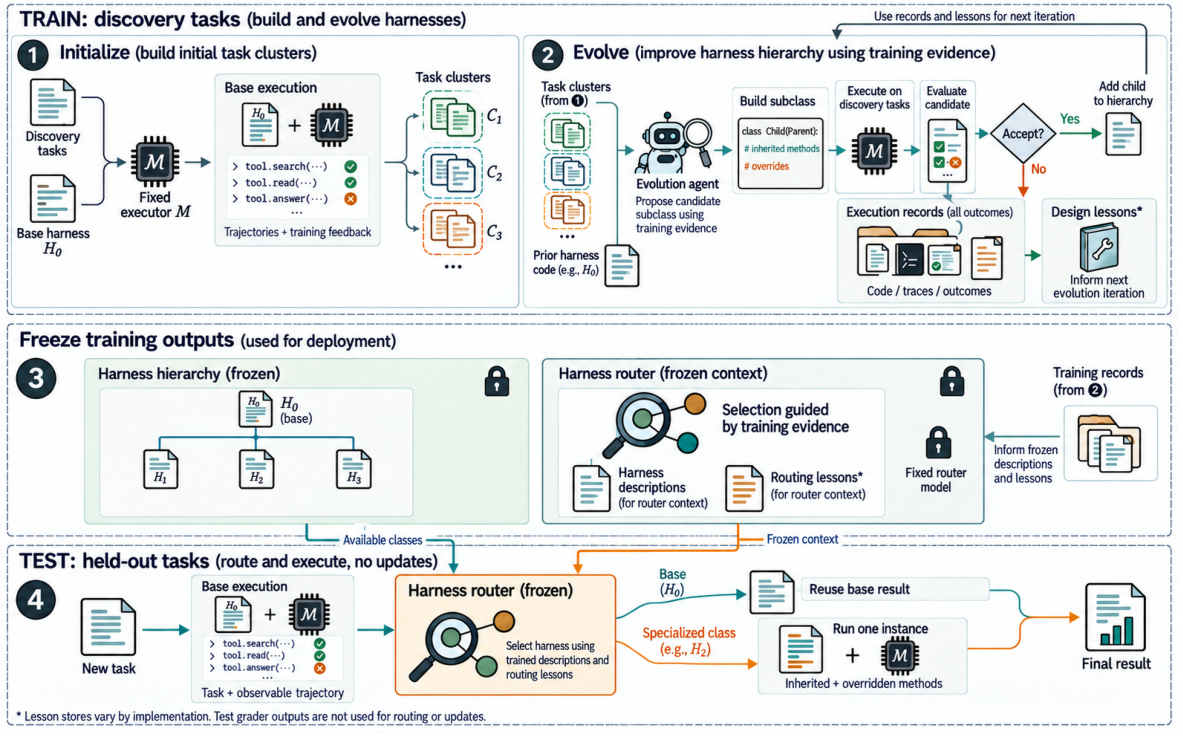
원문 Figure 3, PDF 4쪽. 위는 발견 단계, 아래는 고정된 테스트 단계입니다. 교훈 저장소의 사용은 구현별로 다르며 테스트 채점 결과로 라우터를 갱신하지 않습니다. 원문 크롭, Gaotang Li 외, CC BY 4.0. 원문.
3.2 Representing the harness hierarchy
하네스 진화는 클래스 정의와 보조 소스 파일을 대상으로 합니다. 프롬프트, 도구, 문맥 관리, 실행 제어와 새 메서드를 바꿀 수 있고, scaffold가 허용하는 경우 middleware·파일 backend·subagent 구성도 바꿉니다. Scaffold는 에이전트의 실행 인터페이스와 도구 연결을 제공하는 기반 틀입니다. 모든 벤치마크가 같은 수정 지점을 제공한다고 가정하지 않습니다.
하위 클래스는 필요 없는 메서드를 그대로 상속하고, 바꿀 메서드만 재정의합니다. 재정의한 메서드도 super()로 부모 동작을 먼저 수행할 수 있습니다. 중요한 실행 단위는 선택된 클래스 인스턴스 하나입니다. 조상 노드들이 독립적인 에이전트로 순서대로 실행되는 계층형 다중 에이전트와 다릅니다. 반복 도구 오류나 미완성 파일처럼 런타임에서 관찰한 상태에 따라 메서드가 동작할 수 있습니다.
3.3 Training initialization
먼저 발견 과제 전체를 기본 하네스로 실행해 궤적과 평가 피드백을 저장합니다. 비슷한 변경으로 도움을 받을 과제를 묶고, 각 군집은 기본 하네스를 현재 선택으로 시작합니다. 초기 코드 계층도 기본 클래스 하나입니다. “문서 작성”, “특정 API” 같은 고정된 분류표가 반드시 출발점인 것은 아닙니다. 기본 실행에서 드러난 요구가 군집화의 근거입니다.
3.4 Training iteration
진화 에이전트는 소스·군집·실행 기록을 읽을 수 있는 코드 작업 공간에서 대상 군집과 부모를 고릅니다. 필요한 변경을 기술한 뒤 하위 클래스를 쓰며, 근거 분석을 subagent에 나눌 수도 있습니다. 후보의 소스 부모가 현재 그 군집에 배정된 클래스와 반드시 같아야 하는 것은 일반 절차의 조건이 아닙니다.
후보는 대상 군집의 발견 과제에 라우팅 없이 직접 실행합니다. 앞서 설명한 점수 개선 부등식과 수용 검사를 통과하면 계층에 들어가고 군집의 선택 하네스가 될 수 있습니다. 이 방식은 후보 하나를 평가할 때마다 전체 발견 집합에 라우터를 다시 적용하는 비용을 피합니다. 부모는 상속 공급자로 남고, 활성 상태라면 독립적인 선택지로도 남을 수 있습니다.
거절도 기록합니다. 반복 거절은 그 군집의 탐색 우선순위를 낮추며, 실행 근거에 따라 과제를 재배치하거나 군집을 나누고 합칠 수 있습니다. Algorithm 1은 기본 실행 → 군집화 → 군집·부모 선택 → 하위 클래스 생성 → 평가 → 수용·기록 → 교훈 갱신을 반복한 뒤 결과를 고정하는 흐름입니다. 실패를 지운 뒤 새 후보만 남기는 방식과 다릅니다.
3.5 Test-time selection and execution
새 과제에 기본 실행을 먼저 얻고, 과제·관찰 가능한 궤적·하네스 설명·적용 조건·고정된 라우팅 교훈으로 실행 클래스를 선택합니다. 기본을 고르면 이미 얻은 결과를 사용하고, 특화를 고르면 그 인스턴스를 실행합니다. 기본 실행이 정답인지 채점기로 알아낸 뒤 선택하는 oracle routing은 아닙니다.
테스트 집합 전체에 걸쳐 계층과 저장 근거는 고정됩니다. Grader의 점수·성공 판정·숨겨진 참조 답안은 라우터와 executor가 볼 수 없습니다. 반면 발견 단계에서는 grader 피드백을 코드 진화에 사용합니다. 두 단계의 피드백 권한을 나누는 것이 결과 해석의 전제입니다.
챕터의 핵심 기여: 과제 근거, 코드 재사용, 클래스 선택을 분리하면서도 하나의 평가 가능한 과정으로 연결합니다.
다음 챕터로의 연결: 같은 executor와 분리된 과제 집합에서 이 구조가 어떤 효과를 내는지 측정합니다. 3절·Algorithm 1, PDF 3–5쪽
📖 Chapter 4: Experiments
챕터의 위치와 역할: 개선량을 해석하는 데 필요한 데이터 분할·점수 정의·기준선을 먼저 고정하고, 주 결과와 탐색 과정을 비교합니다.
저자의 서술 순서를 따른 상세 내용:
4.1 Evaluation setup
| 벤치마크 | 발견 / held-out 과제 수 | 평가 대상 | Mean의 의미 | 엄격한 PASS |
|---|---|---|---|---|
| AutomationBench | 300 / 300 | 시뮬레이션 앱의 업무 흐름·상태 변경 | 과제별 부분 점수의 평균 | 보상 0.999 이상 |
| Workspace-Bench | 288 / 100(Lite-100) | 문서·스프레드시트·프레젠테이션·코드 산출물 | 전체 rubric을 합친 micro pass | 해당 과제의 rubric 전부 충족 |
| Toolathlon-GYM | 251 / 252 | 여러 앱·도구를 결합한 완료 과제 | 과제 보상의 평균 | 보상 0.999 이상 |
주 지표는 앞의 두 벤치마크에서 Mean, Toolathlon-GYM에서 PASS입니다. Workspace의 micro 평균은 과제마다 동일 가중치로 성공 여부를 평균낸 값과 다릅니다. 요구 조건을 얼마나 충족했는지와 완전히 성공한 과제가 몇 개인지 함께 봐야 합니다.
기준선은 진화하지 않은 Base, 하나의 전역 하네스를 최적화하는 Meta-Harness와 AHE, 특화 하네스를 보관하는 AAH입니다. 이 논문의 AHE는 프레임워크 소스 중심 bundle에서 전역 구성요소를 고치는 적응 구현입니다. 따라서 원 논문의 모든 실험 조건을 그대로 재현한 것으로 부르면 안 됩니다.
OO-Harness는 기본 궤적을 추가로 사용하므로, 추가 추론 자체의 효과를 보기 위해 Base의 병렬 best-of-K(K=2·5)와 순차 자기 수정(K=2)도 비교합니다. 병렬 방식의 선택자와 순차 방식의 조언자는 관찰 가능한 궤적만 보며, held-out 채점 결과를 사용하지 않습니다. 진화 방법은 발견 과제의 평가 피드백을 쓰는 반면 이 테스트 시 확장 기준선은 그렇지 않다는 차이도 표에 표시됩니다.
모든 방법의 executor는 gemini-3.5-flash로 고정합니다. 하네스 진화는 Claude Opus 4.8을 사용해 최대 40회 반복하며, 필요한 테스트 궤적 선택·지도도 같은 모델을 사용합니다. 주 비교의 OO-Harness 라우터는 Claude Sonnet 5입니다. 각 방법·벤치마크에 대해 executor 실행을 세 번 수행한 평균±표준편차를 보고합니다. Steps는 최종 선택된 궤적의 단계 수이며, 버린 다른 rollout과 보조 선택 호출을 제외합니다. 따라서 이것만으로 전체 토큰·금액·지연이 줄었다고 계산할 수 없습니다.
4.2 Main results
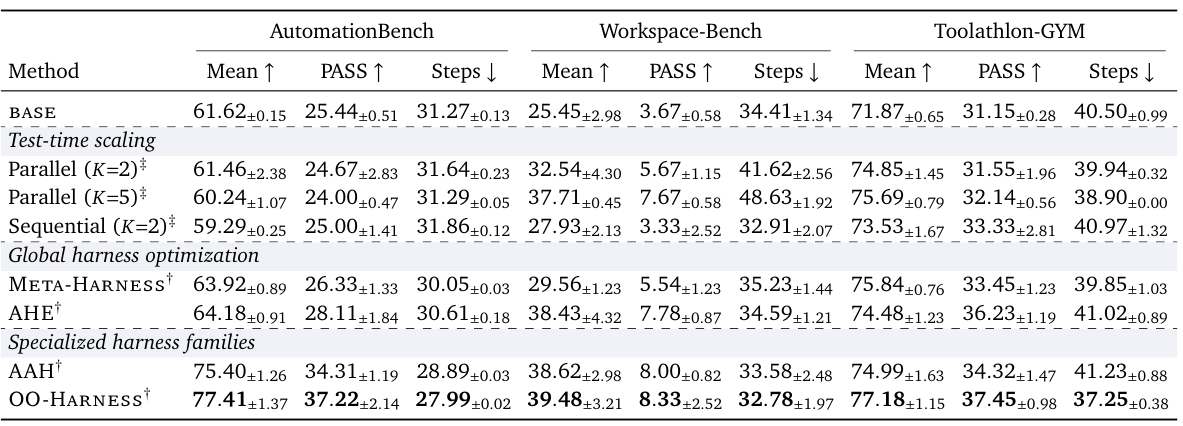
원문 Table 1, PDF 7쪽의 표 영역. 점수는 백분율이며 아래첨자는 독립 executor 실행 3회의 표준편차입니다. 표 전체를 크롭했으며 주요 지표는 아래에 큰 글씨의 Markdown 표로도 옮겼습니다. Gaotang Li 외, CC BY 4.0. 원문.
| 방법 | Automation Mean | Workspace Mean | Toolathlon PASS |
|---|---|---|---|
| Base | 61.62 ± 0.15 | 25.45 ± 2.98 | 31.15 ± 0.28 |
| Parallel K=2 | 61.46 ± 2.38 | 32.54 ± 4.30 | 31.55 ± 1.96 |
| Parallel K=5 | 60.24 ± 1.07 | 37.71 ± 0.45 | 32.14 ± 0.56 |
| Sequential K=2 | 59.29 ± 0.25 | 27.93 ± 2.13 | 33.33 ± 2.81 |
| Meta-Harness | 63.92 ± 0.89 | 29.56 ± 1.23 | 33.45 ± 1.23 |
| AHE | 64.18 ± 0.91 | 38.43 ± 4.32 | 36.23 ± 1.19 |
| AAH | 75.40 ± 1.26 | 38.62 ± 2.98 | 34.32 ± 1.47 |
| OO-Harness | 77.41 ± 1.37 | 39.48 ± 3.21 | 37.45 ± 0.98 |
OO-Harness의 Base 대비 주 지표 개선은 차례대로 15.79·14.03·6.30%p입니다. 이는 각 열의 백분율 점수를 뺀 절대 차이이며, 상대 개선율과 다릅니다. 또한 세 열의 지표 정의가 다르므로 하나의 같은 성공률이라고 부르지 않습니다. 초록의 “최대 15%” 표현을 정밀하게 해석할 때에는 이 표의 15.79%p와 구분하는 편이 정확합니다.
주 지표에서 모두 가장 높지만 근접한 방법과의 차이는 같은 크기가 아닙니다. 예를 들어 AAH 대비 Automation Mean은 2.01%p, Workspace Mean은 0.86%p입니다. 표준편차는 실행 변동을 보여주지만, 이 값만으로 모든 방법 간 차이에 통계적 유의성을 부여하지 않습니다. 논문은 주 결과의 모든 쌍에 대한 유의성 검정이나 신뢰구간을 제시하지 않습니다.
완전한 과제 성공률도 별도로 보면 OO-Harness는 Automation 37.22±2.14%, Workspace 8.33±2.52%, Toolathlon 37.45±0.98%입니다. 부분 점수가 높아졌다고 모든 요구를 안정적으로 충족한다는 뜻은 아닙니다. 최종 궤적의 Steps는 27.99·32.78·37.25로 표의 비교 방법 중 가장 낮지만, 앞서 설명한 제외 범위를 유지해야 합니다.
병렬·순차 재시도는 지표를 일관되게 높이지 못합니다. Workspace의 병렬 K=5는 좋아지지만 Automation에서는 Base보다 낮습니다. 논문이 주장하는 것은 “추가 추론은 효과가 없다”가 아니라, 추론량을 추가하는 것만으로 과제에 맞는 실행 전략을 학습한 효과가 자동으로 생기지는 않는다는 것입니다.
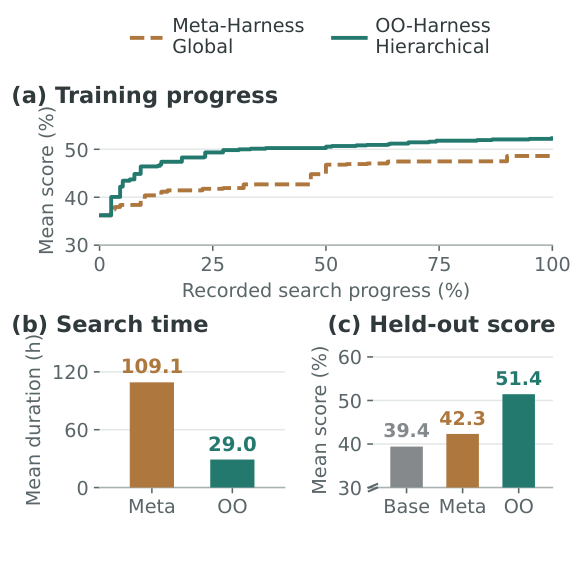
원문 Figure 4, PDF 6쪽. (a)의 가로축은 각 실행에서 기록된 갱신 진행 비율이며, (b)는 기록된 평균 탐색 시간입니다. 축·범례·값을 보존한 크롭입니다. Gaotang Li 외, CC BY 4.0. 원문.
Figure 4는 OO-Harness가 발견 곡선 초기에 더 크게 개선되고, 기록된 평균 탐색 시간이 109.1시간에서 29.0시간으로 짧아졌음을 보여줍니다. Held-out 요약 막대는 Base 39.4, Meta 42.3, OO 51.4입니다. 이는 개별 벤치마크의 모든 지표를 대체하는 단일 보편 점수가 아닙니다. 가로축도 동일한 과제 평가 횟수나 동일 누적 API 사용량이 아닌 기록된 갱신의 진행 비율로 맞췄다는 점이 중요합니다. 논문은 대상 군집만 평가하는 구조가 후보별 API 호출과 비용을 줄일 수 있다고 해석합니다. 전체 운영 비용의 완전한 분해표를 제공한 것으로 확대하지 않습니다.
챕터의 핵심 기여: 모델·과제·피드백 조건을 분리하고, 특화와 추가 추론을 같은 효과로 취급하지 않는 비교를 제공합니다.
다음 챕터로의 연결: 라우팅 근거와 상속이 각각 어떤 역할을 하는지 분해하고 실제 사례로 연결합니다. 4절·Table 1·Figure 4, PDF 5–7쪽
📖 Chapter 5: Analysis
챕터의 위치와 역할: 주 실험의 개선을 설명하기 위해 입력 근거, 코드 재사용 방식, 기본 결과 보존, 분포가 다른 과제를 차례로 살핍니다.
저자의 서술 순서를 따른 상세 내용:
5.1 Ablation studies
5.1.1 Harness routing에서는 같은 고정 하네스 catalogue·executor·grader·held-out 분할을 두고 라우팅 입력만 비교합니다. Task-only는 과제 설명과 메타데이터를 사용하며, 적합성에 대한 자기 보고 confidence가 0.7 이상일 때 특화를 고릅니다. 이 confidence는 보정된 성공 확률이나 채점 점수가 아닙니다. Task+trajectory는 여기에 관찰 가능한 기본 실행을 더합니다.
| 벤치마크 / 지표 | Base | Task-only | Task + trajectory |
|---|---|---|---|
| Automation / Mean | 61.30 | 64.88 | 77.52 |
| Workspace / Mean | 24.57 | 40.03 | 40.56 |
| Toolathlon / PASS | 31.35 | 33.33 | 37.70 |
이 Table 2는 단일 ablation 실행이며, 세 번 평균인 Table 1과 숫자가 같은 실험이라고 맞춰 읽으면 안 됩니다. 실행 근거 추가의 효과는 Automation 12.64%p, Toolathlon 4.37%p, Workspace 0.53%p입니다. Workspace에서는 요청된 문서나 스프레드시트 종류 자체가 필요한 특화의 단서가 될 수 있습니다. 반면 업무 흐름에서는 실제로 쓰기 작업을 빠뜨렸는지, API 오류가 반복됐는지 실행해야 드러나는 정보가 중요할 수 있습니다. 이는 저자의 군집·사례 분석에 근거한 해석입니다.
5.1.2 Hierarchical evolution structure에서는 Workspace에서 세 탐색을 따로 수행합니다. Base-reset은 과거 실행 근거와 성찰은 보지만 코드 구현은 매번 Base에서 새로 시작합니다. Flat은 앞서 수용된 동작을 복사해 Base 직계 클래스 안에 포함하지만, 다른 진화 노드를 상속·import·위임하지 못합니다. OO는 현재 군집의 하네스를 부모로 삼아 재정의하지 않은 메서드를 상속하고 super()로 동작을 합성합니다.
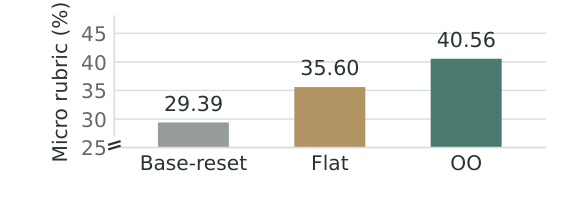
원문 Figure 5, PDF 8쪽. Base-reset 29.39%, Flat 35.60%, OO 40.56%입니다. 원문 그래프 영역 크롭, Gaotang Li 외, CC BY 4.0. 원문.
같은 발견 288과제, 초기 군집·기본 실행 기록, 명목 탐색 예산과 라우팅 절차를 사용하지만, 각 변형이 별도로 진화한 결과물을 Lite-100에서 한 번씩 평가합니다. Base-reset→Flat의 차이는 유용한 코드를 다음 개정에 가져가는 것, Flat→OO의 4.96%p 차이는 그 재사용을 상속으로 조직하는 것과 관련된 근거입니다. 동일한 최종 코드에 상속 문법만 바꾼 실험은 아니므로, 차이 전체를 언어 문법 자체의 인과 효과로 좁혀 말하지 않습니다.
5.2 Case studies
먼저 Automation의 300과제 실행 하나에서 134개(44.7%)는 기본 결과를 재사용하고, 166개는 특화를 선택합니다. Table 3은 특화 후 점수가 아니라 라우팅 목적지별 원래 Base 점수입니다. 재사용 집합의 Base Mean은 77.15%, PASS는 36.57%이고, 특화로 보내진 집합의 Base Mean은 44.40%, PASS는 14.25%입니다. 저자는 약한 기본 실행에 개입하고 강한 실행은 보존하는 방향으로 선택이 이뤄졌다고 해석합니다. 서로 다른 과제를 나눈 관측값이므로 이 표만으로 라우팅의 무작위 대조 인과 효과를 계산하지 않습니다.
다음으로 군집을 살핍니다. Automation의 commit-gate는 쓰기 누락, compute-verify는 다섯 업무 영역에 걸친 산술·시간 계산 요구를 묶습니다. Workspace의 여섯 군집은 문서·스프레드시트 같은 평가된 과제 유형과 잘 맞습니다. 군집이 언제나 기존 도메인 분류를 재발견하는 것도, 언제나 도메인과 무관한 오류만 묶는 것도 아닙니다. 공통 수정이 필요한 실행 요구에 따라 두 양상이 나타납니다.
Figure 6(c)의 예시는 기본 실행에서 쿼리 파싱 오류가 반복될 때 저장된 교훈을 찾아 API error-normalizer를 선택하는 흐름입니다. 이 특화는 오류를 쿼리 수정 지침으로 바꿉니다. 부록의 다른 사례에서는 연결 정보·자원 탐색 문제가 resource-manifest 특화를 고르게 하고, 쓰기가 성공한 깨끗한 실행은 Base를 유지하게 합니다.
마지막으로 구체적인 코드 변화는 공통 기능을 버리지 않는 확장으로 설명합니다. Automation의 missing-write 완료 검사에 예산 종료 근처의 알림과 오류 지침을 더하는 계보가 대표적입니다. 부모는 자식에게 코드를 공급하지만, 활성 상태라면 추가 개입이 불필요한 과제의 독립 선택지로도 남을 수 있습니다.
5.3 Base harness reuse in OOD settings
OOD는 발견 단계와 다른 분포를 뜻합니다. 저자는 응용 계열이 겹치지 않도록 Toolathlon-GYM 학습 254과제와 Toolathlon 테스트 49과제를 구성합니다. 이 수는 주 실험의 251/252 분할과 다릅니다. Meta-Harness는 학습한 전역 하네스를 적용하고, OO-Harness 라우터는 테스트 49과제 모두에서 Base를 선택합니다.
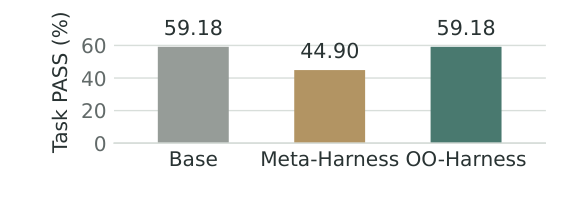
원문 Figure 7, PDF 9쪽. Task PASS는 Base 59.18%, Meta-Harness 44.90%, OO-Harness 59.18%입니다. 원문 크롭, Gaotang Li 외, CC BY 4.0. 원문.
이 결과의 의미는 OO-Harness가 새로운 도메인에서도 특화 실행으로 Base를 더 높였다는 것이 아닙니다. 이 설정에서는 적합하지 않은 특화를 강제하지 않고 기본 성능을 그대로 보존했습니다. 주 실험의 특화 성능 향상과 OOD의 보존 효과를 구분해야 합니다.
챕터의 핵심 기여: 추가 실행 근거가 필요한 업무와 요청만으로 특화가 드러나는 업무를 구분하고, 상속 재사용과 개입하지 않는 선택을 각각 분석합니다.
다음 챕터로의 연결: 확인한 결과를 결론으로 정리한 뒤 운영 의존성의 범위를 명시합니다. 5절·Tables 2–3·Figures 5–7, PDF 7–9쪽
📖 Chapter 6: Conclusion
챕터의 위치와 역할: 문제 설정과 실험을 다시 연결하는 원문의 결론입니다.
저자의 서술 순서를 따른 상세 내용:
- 상속으로 특화 하네스를 진화시키고 실행 근거를 사용해 과제별로 선택합니다.
- 군집은 공통 요구를 묶고 상속은 유용한 코드를 공유합니다.
- 비교 기준선 대비 주 지표 개선, 상속·궤적 기반 라우팅 ablation, 특화와 기본 재사용 사례를 결론의 근거로 요약합니다.
챕터의 핵심 기여: 모델을 추가 학습하지 않고 실행 전략을 구조화하는 접근을 정리합니다.
다음 내용으로의 연결: 일반적 성과 주장과 별개로 실제 운영에서 의존하는 API·실행 환경을 한계 절에서 설명합니다. 6절, PDF 9쪽
📖 Chapter Limitations: Limitations
챕터의 위치와 역할: 논문이 명시적으로 제한한 운영 조건을 제시합니다.
저자의 서술 순서를 따른 상세 내용:
- OO-Harness는 호스트가 제공하는 API와 실행 환경에 의존합니다. 서비스 중단과 요청 제한은 신뢰성에 영향을 줄 수 있습니다.
- 인터페이스가 바뀌면 진화된 하네스도 수정이 필요할 수 있습니다.
- 비공개·인증 서비스에는 안전한 인증 정보 취급과 권한 구성이 필요합니다. 저자는 이 의존성을 근거로 견고한 API 통합과 여러 환경의 배포를 향후 과제로 언급합니다.
챕터의 핵심 기여: 코드가 발견 과제에서 진화했다는 사실과, 외부 서비스 변화 속에서 운영된다는 조건을 분리합니다. 위 사항은 저자가 직접 적은 범위이며 리뷰어가 새로운 실패 조건을 추가한 목록이 아닙니다.
다음 내용으로의 연결: 참고문헌과 구현·평가 부록을 통해 결과를 해석할 세부 조건을 확인합니다. Limitations, PDF 10쪽
📖 Chapter References: References
챕터의 위치와 역할: 방법의 배경, 비교 방법, 벤치마크와 모델 출처를 제공합니다.
저자의 서술 순서를 따른 상세 내용: 원문에 나열된 인용 문헌은 전역 하네스 진화·과제별 특화·자기 개선·평가 환경에 대한 근거를 연결합니다. 이 리뷰는 OO-Harness 원문을 분석했으며 참고문헌 전체를 독립적으로 읽거나 그 결과를 재검증한 것은 아닙니다. 관련 연구의 성능을 이 논문의 실험 결과처럼 섞지 않았습니다.
챕터의 핵심 기여: 주장과 연구 계보를 추적할 수 있게 합니다.
다음 내용으로의 연결: 부록 A가 이 논문에서 실제 사용한 설정과 구현 차이를 설명합니다. References, PDF 10–12쪽
📖 Chapter A: Implementation and evaluation details
챕터의 위치와 역할: 본문의 추상적 절차를 벤치마크별 실행 인터페이스·프롬프트·비교 조건으로 구체화합니다. 재현 가능성을 평가할 때 특히 중요한 부분입니다.
저자의 서술 순서를 따른 상세 내용:
A.1 Model configuration
주 비교의 진화 모델은 Claude Opus 4.8, executor는 gemini-3.5-flash입니다. 각 벤치마크가 제공하는 scaffold·도구 환경·실행 제한·평가 절차는 유지합니다. 변경은 executor 가중치가 아니라 그 주변 코드에 적용합니다. 모델 제공자의 최신 제품 기능을 설명하는 글이 아니라, 원문에 적힌 실험 구성을 설명하는 것입니다.
A.2 Common training configuration
하네스 최적화 방법마다 벤치마크별 최대 40회 진화 예산을 설정합니다. 후보 평가와 선택에는 발견 과제만 사용하며 held-out 평가 전에 결과물을 고정합니다. “최대 40회”는 모든 실행이 정확히 같은 수의 API 요청·토큰·wall-clock을 썼다는 뜻은 아닙니다.
A.3 Benchmark implementations
AutomationBench는 초기화된 앱 상태를 API 검색·요청 도구로 읽고 바꾸며, 결정적 assertion으로 최종 상태를 채점합니다. Workspace-Bench는 DeepAgents와 로컬 shell·filesystem backend를 사용하고 agent-as-a-judge가 산출물의 과제별 rubric을 평가합니다. Toolathlon-GYM은 MCP 서버로 노출된 서비스·도구를 연결하고 컨테이너 기반 실행·평가 파이프라인을 유지합니다. 따라서 Mean과 PASS뿐 아니라 채점 방식도 세 환경에서 동일하지 않습니다.
A.4 OO-Harness implementation
A.4.1 Evolution workspace and code authoring: 진화 에이전트는 인터페이스·기존 코드·군집·발견 궤적·평가·성찰을 파일로 읽고, 지정된 위치에 하위 클래스를 씁니다. Automation과 Workspace는 공유 helper도 지원합니다. Workspace의 파일 읽기·검색·쓰기·편집·subagent 도구는 진화 과정의 도구이며, 하네스의 subagents()가 정의하는 과제 실행용 subagent와 역할을 구분해야 합니다.
A.4.2 Evolution and routing prompts: 진화 프롬프트는 공통적인 하네스 수정 가능 원인을 하나 찾고, 부모의 동작을 super()로 보존하며, 과제 ID·답안·파일명을 하드코딩하지 않도록 지시합니다. 이는 모델에 주는 규칙이며 그 자체가 모든 과적합을 방지했다는 별도 증명은 아닙니다. 구현은 manifest를 검증하고 발견 평가로 후보를 수용합니다. Automation·Workspace의 부모는 _Parent, Toolathlon은 _Base로 바인딩되며, 제안 가능한 수정 지점은 각각의 인터페이스가 정합니다.
Automation은 add·merge·split 제안과 교사의 군집 선택을 허용하고, Workspace는 대상 군집과 부모를 제공합니다. Toolathlon은 관찰 가능한 적용 gate를 요구합니다. 전달하는 교훈은 세 구현 모두 최대 6,000자이며, 기본 제안 timeout 2,400초는 executor rollout 예산과 별도입니다. 이런 세부사항은 하나의 추상 알고리즘과 실제 벤치마크별 정책을 구분하게 합니다.
라우터의 주 비교 모델은 Sonnet 5입니다. Automation은 기본 query와 도구 호출·결과 요약, 쓰기 횟수·실행 오류 패턴을 주고, 먼저 고정된 교훈을 검색한 뒤 선택합니다. Toolathlon은 도구 계열·이벤트 수·자주 나타난 도구·오류 분류를 요약하며 고정된 교훈도 받습니다. Workspace는 persona·난이도·출력 확장자·파일 의존성 간선 수와 기본 assistant-turn·tool-call 수를 사용합니다. Workspace의 입력을 모든 원문 궤적과 동일시하거나 모든 구현에 같은 교훈 저장소가 있다고 표현하면 안 됩니다. 준비된 레코드와 고정 문맥만 받고, 라우터의 에이전트 도구는 꺼져 있습니다.
참조 코드의 기본값은 본문 주 비교와 별도로 적혀 있습니다. Automation reference는 query 600자, 최대 60개 메시지의 digest, 최종 요약 5,000자, 교훈당 180자·하네스 설명당 120자 등을 둡니다. 검색 기본값은 Sonnet 5, 선택 기본값은 Opus 4.8이며 timeout은 400·1,200초입니다. Table 3 사례도 검색·선택에 Opus 4.8을 사용합니다. Toolathlon은 기본 25과제 batch와 최대 12개 규칙/총 4,000자, Workspace는 cohort feature table을 사용합니다. 이 reference default와 별도 사례 설정을 주 비교의 라우터 설정으로 덮어쓰지 않습니다.
A.4.3 Inheritance example: Toolathlon 계보의 부모 s7은 .xlsx에 수식처럼 보이는 문자열을 쓰는 상황을 감지해 계산된 값을 저장하라는 문맥 지침을 더합니다. 자식 s30은 그 manage_context를 재정의하지 않아 그대로 상속하고, verify_before_finish에서 부모 검사를 먼저 호출한 뒤 백분율 셀 검사를 추가합니다. 원문 Listing 1은 설명을 위해 표시 이름과 helper 호출을 축약했다고 명시합니다. 이를 완전한 설치·실행 예제로 제공한 것으로 오해하면 안 됩니다.
A.5 Baseline method implementations
Base는 기존 프롬프트·도구·실행 루프를 그대로 씁니다. Meta-Harness는 발견 평가에서 전역 후보를 탐색하고 하나를 고정합니다. AHE는 프레임워크 구성요소를 읽고 debugger의 실행 분석·변경 기록으로 전역 스냅샷을 수정하거나 되돌립니다.
AAH는 이 실험에서 Automation의 업무 도메인, Workspace의 출력·작업공간 요구, Toolathlon의 앱 계열로 그룹을 구성하고 독립 특화를 수정합니다. 배포에서는 설명·메타데이터로 선택하고 해당 특화가 없으면 Base를 씁니다. 따라서 OO-Harness와의 비교에는 코드 공유 방식뿐 아니라 군집을 만들고 선택하는 근거의 차이도 있습니다.
Parallel은 Base를 K번 독립 실행한 뒤 Opus 4.8이 궤적으로 하나를 고르고, Sequential은 첫 Base 궤적에서 보이는 과정 오류를 요약해 두 번째 Base 실행에 조언합니다. 둘 모두 테스트 정답·grader를 보지 못합니다. 이 차이를 알아야 추가 추론과 발견 단계의 감독된 진화를 공정하게 해석할 수 있습니다.
A.6 Ablation settings
A.6.1 Harness routing은 하네스 catalogue를 고정해 입력 근거를 바꿉니다. Task-only는 적합도 자기 보고 confidence 0.7 이상을 공통 gate로 사용하지만, 누락·잘못된 응답의 대체 규칙은 환경별로 다릅니다. Automation은 누락·미지 식별자를 Base로, 빠진 confidence는 0으로 처리합니다. Workspace는 잘못된 식별자에서 파일 유형·의존성 수 기반 metadata 대체 규칙을 사용할 수 있고, 누락 confidence 기본값은 1입니다. Toolathlon의 잘못된 선택은 leave-on-base입니다. 이 confidence를 실제 성공 확률로 읽지 않습니다.
A.6.2 Hierarchical structure은 Workspace의 발견 288과제와 Lite-100을 사용한 세 별도 탐색입니다. Base-reset도 진단 이력을 잊는 것은 아니며, 코드를 이어받지 않는다는 뜻입니다. Flat도 유용한 코드를 버리는 것이 아니라 복사로 이어받습니다. Flat과 Base-reset은 공유 helper를 읽기 전용으로 둬 후보 변경을 새 모듈에 쓰고, Flat은 다른 진화 노드를 import·위임·상속하지 못하게 합니다. OO는 부모 바인딩과 상속으로 그 기능을 유지합니다. 각 탐색의 최종 하네스와 실제 task assignment는 달라질 수 있습니다.
A.7 OOD evaluation configuration
훈련 앱 계열은 Google Workspace(Forms·Calendar·Sheets), HowToCook, Notion, Snowflake, WooCommerce입니다. 테스트는 Amazon·Canvas·Git/GitHub·Kubernetes·문헌 검색(arXiv·Scholarly/Google Scholar)·MySQL·12306·Redis·Yahoo Finance·YouTube입니다. 이름 붙은 앱 계열이 겹치지 않는 통제 설정이므로, 본문 5.3의 “모두 Base 선택”은 이 분할에 대해 해석해야 합니다. 가능한 모든 새로운 업무 분포를 검증한 것은 아닙니다.
A.8 Artifact sources and resource reporting
원문은 벤치마크 코드와 데이터의 조건을 나눕니다. AutomationBench의 원 기여는 MIT이지만 타사 API 구조 범위 고지가 별도이고, Workspace 코드 MIT와 full dataset Apache-2.0·별도 라이선스가 적히지 않은 Lite card를 구분합니다. Toolathlon-GYM 코드의 Apache-2.0과 원 Toolathlon 저장소·과제 데이터 카드의 표준 라이선스 부재도 따로 적습니다. 이 내용은 논문의 자료 범위를 설명하며 포괄적인 재배포 허가를 뜻하지 않습니다.
모델은 Google Cloud Vertex AI를 통한 hosted API로 접근했으며, 주 계산 지출은 과제 실행·진화·라우팅·모델 기반 평가의 API 사용이라고 기록합니다. 원문은 문장 수정·코드 점검·그림 준비에 AI 도구를 활용한 사실도 명시합니다. 이 리뷰는 제시된 설정을 분석했으며 모델 호출과 결과 재현을 수행하지 않았습니다.
챕터의 핵심 기여: 추상적인 OO-Harness가 실제로는 서로 다른 도구·입력 요약·허용 수정 지점·대체 규칙 위에 구현됐음을 드러냅니다.
다음 챕터로의 연결: 부록 B가 이 인터페이스에서 진화한 기능을 실제 출력과 검사 사례로 보여줍니다. Appendix A, PDF 13–18쪽
📖 Chapter B: Case studies of specialized harnesses
챕터의 위치와 역할: 특화 코드가 단순 프롬프트 이름이 아니라 실제 backend·검사·라우팅 동작이라는 점을 구체화합니다.
저자의 서술 순서를 따른 상세 내용:
B.1 Workspace-Bench: generating Word documents
.docx라는 확장자로 텍스트를 저장해도 Word 문서가 되지는 않습니다. office-doc-write는 파일 backend를 감싸 지원되는 텍스트를 실제 이진 Word 문서로 렌더링합니다. 직접 문서 쓰기뿐 아니라 요청한 문서가 없을 때 텍스트 초안으로 문서를 만들 수 있습니다. 후자의 경우 원래 텍스트 쓰기를 보존하고 이미 있는 대상 문서는 건드리지 않습니다. 렌더링에 실패하면 부모 backend로 대체합니다.
이 기능은 파일 형식을 처리하며 내용의 적합성은 별도 rubric이 평가합니다. 요청한 형식이 과제 설명에 드러나므로 task-only와 trajectory routing의 차이가 작았던 Workspace 결과를 이해하는 사례가 됩니다. 이 해석은 문서 생성 전체의 성공을 파일 형식 검사 하나로 환원하지 않습니다.
B.2 AutomationBench: inherited checks and routing lessons
업무가 상태 변경을 요구해도 에이전트는 검색·조회만 하고 종료할 수 있습니다. s9은 쓰기가 필요한 과제인데 변경 API 호출이 없으면 한 턴을 더 요청하는 완료 검사를 더합니다. s12는 성공한 쓰기가 없는 상태에서 turn limit 근처에 알림을 주고, s29는 그 두 기능을 유지하며 복구하기 어려운 오류·반복되는 무익한 도구 결과에 대한 지침을 더합니다.
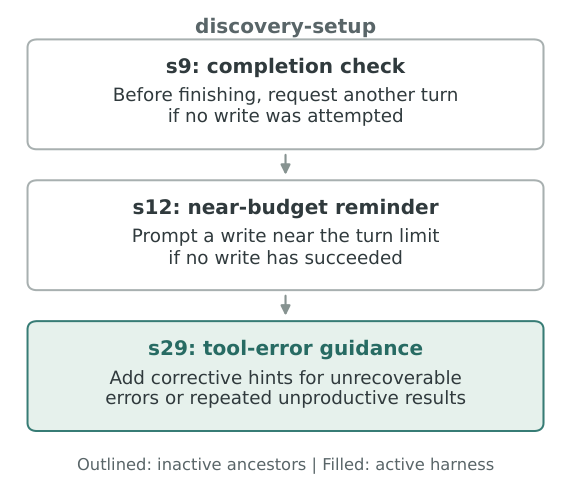
원문 Figure 9, PDF 19쪽. 테두리 노드 s9·s12는 비활성 조상으로 동작을 공급하고, 채워진 s29가 활성 하네스입니다. 원문 크롭, Gaotang Li 외, CC BY 4.0. 원문.
세 노드를 세 번 순차 실행하는 것이 아니라, 활성 자식 한 인스턴스가 상속된 검사와 자신의 지침을 함께 갖습니다. 따라서 비활성 조상도 코드상 역할이 사라지는 것은 아닙니다.
이어 Table 4는 라우팅 교훈과 실제 선택을 연결합니다. Lead scoring에서 쓰기는 없고 HubSpot·Intercom은 연결 계정 없는 401, Lead 조회는 404를 낸 실행은 연결 서비스·자원 정보를 제공하는 resource-manifest로 보냅니다. 반대로 세 번의 쓰기가 성공하고 오류 없이 끝난 실행은 Base를 재사용합니다. 파싱 오류를 오류 수정 지침으로 바꾸는 특화도 같은 방식으로 선택됩니다. 이 예시들은 과제 이름만이 아니라 관찰한 실행 문제가 선택에 들어간다는 것을 보여줍니다.
B.3 Toolathlon-GYM: refining when and what to check
먼저 Figure 10의 군집은 여러 앱에 걸칠 수 있습니다. completeness-finalize에는 Canvas·Notion·Snowflake·WooCommerce 과제가 함께 들어갑니다. 앱 이름 자체보다 미완료 방지처럼 공유하는 실행 요구가 중요할 수 있습니다.
두 번째 사례는 도구 출력 압축의 적용 시점입니다. 조상은 긴 응답을 줄여 기록 크기를 제한합니다. 자식은 그 기능을 유지하지만 한 번 이른 종료를 시도한 뒤의 도구 출력에는 압축을 건너뛰도록 조건을 좁힙니다. 상속은 기능을 계속 더하기만 하는 구조가 아니라, 관찰한 진행 상태를 바탕으로 언제 개입할지 조절할 수 있는 구조입니다.
마지막으로 excel-formula-literal은 저장한 workbook을 읽고, 백분율 표식이 있으면서 값이 0과 1 사이인 셀을 찾아 한 차례의 표적 수정 요청을 할 수 있습니다. 예를 들어 20%를 0.2가 아니라 20이라는 percentage point 값으로 요구하는 과제라는 전제에서 100배 값을 제안합니다. 일반적인 모든 스프레드시트에서 0.2가 오류라는 뜻은 아닙니다. 지침은 열거한 셀만 바꾸고 나머지는 보존하도록 합니다. 실행 전에 만든 막연한 규칙이 아니라 실제 산출물의 내용이 다음 수정 요청을 결정하는 사례입니다.
챕터의 핵심 기여: 파일 형식과 내용, 완료 판정과 실제 쓰기, 공통 검사와 표적 보정의 차이를 코드 수준의 사례로 설명합니다.
원문 구조의 마무리: 원문은 이 스프레드시트 사례로 끝납니다. 본문 1–6절, Limitations·References, 부록 A.1–A.8과 B.1–B.3을 모두 반영했습니다. 참고문헌 전체의 독립 검토, 모든 진화 노드의 소스 감사, 프롬프트·manifest의 전수 전사, 원문 그림 10개 전부의 상세 해설은 수행하지 않았습니다. 핵심 그림·결과·설정은 읽은 원문과 대조했습니다. Appendix B, PDF 19–20쪽
실험 결과 심층 분석
첫째, 고정된 모델에서 실행 코드의 적합성만으로도 결과가 달라집니다. 주 비교는 executor를 고정하고 발견 과제에서 진화한 구조를 held-out에 적용합니다. 따라서 이 논문의 성과는 더 큰 모델로 교체한 효과나 테스트 정답을 보고 경로를 고른 효과로 설명할 수 없습니다. 다만 방법마다 진화·선택 절차와 추가 추론이 다르므로, 같은 executor라는 사실만으로 총 운영 예산까지 동일하다고 보면 안 됩니다.
둘째, 부분 점수와 완전 성공은 함께 봐야 합니다. Automation의 Mean 77.41%와 PASS 37.22%, Workspace의 micro rubric 39.48%와 PASS 8.33%는 서로 다른 질문에 답합니다. 문서의 형식·내용·연결된 다른 산출물 등 여러 조건을 함께 맞혀야 완전 성공이 되므로, 주 지표 향상과 전체 업무를 완료하는 능력을 구분하는 것이 실용적으로 중요합니다.
셋째, 상속과 라우팅의 기여에 대한 실험 단위를 지켜야 합니다. 주 결과의 평균±표준편차는 executor 3회 실행이며, 라우팅 Table 2와 상속 Figure 5는 별도 단일 실험입니다. 상속 변형은 각각 다른 하네스를 탐색하므로 결과물과 배정이 달라집니다. 표준편차를 신뢰구간으로 바꾸거나 보고되지 않은 p값을 추정하지 않았습니다. 가까운 평균 차이는 확인된 수치 차이로 설명하고, 통계적으로 입증된 우열이라는 표현은 사용하지 않았습니다.
넷째, 관찰 가능한 실행은 유용하지만 grader와 다릅니다. 반복 401·404, 누락된 쓰기, 출력 확장자와 호출 수는 선택의 근거가 될 수 있습니다. 그러나 hidden reference나 실제 성공 판정을 제공하지는 않습니다. Table 3의 Base 재사용 집합과 특화 집합의 차이는 선택이 어떤 과제를 겨냥했는지 보여주는 사례이며, 무작위 대조 효과는 아닙니다.
다섯째, 적응과 보존은 다른 성과입니다. 주 실험에서는 특화가 높은 점수를 내고, OOD에서는 모든 과제가 Base를 선택해 59.18%를 유지합니다. 이 두 결과를 합쳐 모든 새 도메인에서 특화가 성공했다고 주장하면 원문의 근거를 넘어섭니다. 저자가 제시한 설계의 의미는 도움이 될 때 특화하고, 맞는 근거가 없을 때 기존 결과를 유지하는 선택지를 함께 보관한다는 데 있습니다.
기술적 함의와 응용
원문이 보여주는 기술적 성과는 에이전트의 실행 전략을 공유 코드가 있는 특화 클래스들과 고정된 선택 근거로 관리할 수 있다는 것입니다. “모델이 무엇을 알까”와 별개로 “어떤 backend로 파일을 만들고, 어떤 시점에 문맥을 줄이며, 무엇을 확인한 뒤 끝낼까”가 과제 수행을 바꿀 수 있습니다. 하네스 진화가 모델 가중치 갱신과 구별되는 연구 축이라는 점도 분명해집니다.
리뷰어 관점에서 데이터과학 실무와 연결되는 지점은 실험의 층위를 나누는 습관입니다. 과제별 지표, 부분·완전 성공, 최종 궤적 길이, 전체 탐색·추론 자원을 서로 다른 측정 대상으로 두어야 합니다. 좋은 변경을 전체 시스템에 일괄 적용하는 대신 해당 변경의 적용 조건과 기본 동작을 함께 보관한다는 발상도, 이 논문이 제공하는 구조적 관점입니다. 이는 새 응용에서 성능을 보증하는 주장이 아니라 결과를 읽고 설계를 이해하는 해석입니다.
저자는 서비스 중단·요청 제한·인터페이스 변경과 인증·권한 구성을 운영의 명시적 의존성으로 남깁니다. OO-Harness의 결론은 모든 기능을 계속 누적하면 좋아진다는 것이 아닙니다. 재사용할 코드, 특화가 필요한 과제, 개입하지 않고 보존할 기본 결과를 구분하는 일이 에이전트 실행 체계의 중요한 설계 대상이라는 것입니다.