논문 개요와 전체 구조
CANVAS: Continuity-Aware Narratives via Visual Agentic Storyboarding은 여러 장의 이미지가 하나의 이야기처럼 이어지도록 만드는 스토리보드 생성 연구입니다. Ishani Mondal 외 연구진이 제안한 핵심은 이전 그림을 참고하는 데서 더 나아가, 인물의 외형 상태·장소·소품의 변화를 명시적으로 계획하고 기억하는 것입니다. 여기서 스토리보드는 영상의 각 샷을 대표하는 정지 이미지의 순서이며, 연속성은 같은 것을 무조건 반복하는 성질이 아니라 이야기가 요구하는 변화와 유지되어야 하는 속성을 구분하는 성질입니다. 이 리뷰는 arXiv:2604.13452v1의 HTML과 동일 버전 PDF를 대상으로 합니다.
예를 들어 박물관에서 유물이 도난당했다면, 나중에 같은 전시실로 돌아왔을 때 방 구조는 유지되고 진열장은 비어 있어야 합니다. 인물이 변장했다가 원래 옷으로 갈아입는 경우에도 얼굴은 같고 옷은 서사에 맞게 달라져야 합니다. CANVAS는 이 문제를 전역 계획, 시각 메모리 검색, 후보 생성·질문 기반 선택, 메모리 갱신으로 분해합니다. 추가 모델 학습 없이 기존 이미지 생성 모델을 조율하는 추론 단계의 프레임워크이며, 자체 벤치마크 HardContinuityBench와 세분화된 평가 방식 ContinuityEval을 함께 제시합니다.
원문은 다음 순서로 전개됩니다. 참고문헌은 관련 연구의 근거 목록이며, 이 리뷰가 인용 논문 각각의 원문까지 독립 검증했다는 뜻은 아닙니다.
- 1 Introduction: 연속성 문제와 세계 상태 모델링의 필요성
- 2 Related Work: 2.1 Visual Story Generation from Text → 2.2 Multi-Turn Image Generation and Interactive Story Creation → 2.3 Memory-Based Narrative Generation
- 3 CANVAS: 3.1 Global Story Planning → 3.2 Sequential Generation with Memory
- 4 Experimental Setup: 데이터셋, 비교 방법, 자동 평가, 사람 선호도 평가
- 5 Main Results: ContinuityEval, ViStoryBench 표준 지표, 사람 평가
- 6 Further Analysis: 인물 메모리, 배경·소품 메모리, 후보 수 분석
- 7 Qualitative Analysis: 사례 비교와 구성 요소 제거
- 8 Conclusion and Future Work
- Limitations와 Use of AI assistants, Ethical Considerations와 Potential Risks and Harms, References
- Appendix A Appendix Organization: A.1 데이터셋 난도 → A.2 인물 연속성 평가 → A.3 계산 효율 → A.4 관련 연구와의 위치 → A.5 사람 평가 설정 → A.6 평가 지침 → A.7 자동 평가 검증 → A.8 영상 생성 → A.9 프롬프트와 구현 상세
핵심 기여와 혁신성
문제의 중요성은 개별 이미지 품질과 이야기 전체의 품질이 다르다는 데 있습니다. 아름다운 프레임도 이전 장면의 방 구조를 바꾸거나 사라진 물건을 되살리면 서사를 깨뜨립니다. 저자는 기존 접근의 상당수가 인물 참조 이미지나 이전 프레임의 특징을 전달하지만, 인물·장소·물체의 상태 변화를 독립적으로 다루지 않는다고 설명합니다. CANVAS는 장소의 동일성, 인물의 외형 버전, 소품의 현재 상태를 검색 가능한 조건으로 바꾸는 것을 해법으로 삼습니다. §1–3
차별점은 세 가지가 연결된다는 점입니다. 먼저 전체 샷을 읽어 미래 사건까지 고려한 계획을 만듭니다. 다음으로 현재 샷에 맞는 과거의 시각 앵커, 즉 외형이나 공간 배치의 기준 이미지를 검색합니다. 마지막으로 여러 후보를 질문·답변 방식으로 검사하고, 선택 결과에서 다음 샷에 필요한 메모리를 갱신합니다. 새로운 생성기 내부 구조보다 생성 전후의 상태 관리에 기여가 집중됩니다.
평가 측면에서는 인물의 얼굴·옷·몸, 연속 샷의 배경, 떨어져 있는 샷에서 재등장하는 배경, 이동 가능한 소품을 나누어 측정합니다. 리뷰어의 해석으로는 이러한 분해가 단일 유사도 점수보다 오류의 발생 위치를 이해하는 데 유용합니다. 다만 새로운 작은 벤치마크에서의 결과와 광범위한 일반화는 구분해야 하며, 그 크기는 아래에서 구체적으로 다룹니다.
기술적 세부사항
입력은 샷 설명의 순서이고 출력은 대응하는 이미지의 순서입니다. 시스템은 먼저 전역 계획을 만들고, 그 계획이 요구하는 상태에 따라 이미지 참조를 선택합니다. 핵심 구성 요소를 읽는 데 필요한 용어는 다음과 같습니다.
| 구성 요소 | 의미와 역할 |
|---|---|
| 전역 계획 | 모든 샷의 인물 외형, 장소 ID, 소품 상태를 미리 연결한 서사 조건입니다. |
| canonical anchor | 인물 정체성 또는 특정 외형 상태의 기준 이미지입니다. |
| recent anchor | 앞서 선택한 프레임에서 얻은 최근 외형 참조입니다. |
| 장소 메모리 | 같은 장소가 다시 등장할 때 공간 구조를 재사용하기 위한 배경 이미지입니다. |
| QA 선택기 | 샷 설명 부합도와 인물·배경·소품 조건을 질문으로 검사하는 시각언어모델입니다. |
| ContinuityEval | 생성 후 여러 프레임의 연속성을 평가하는 별도 절차입니다. 생성 중 후보 선택 점수와 구분해야 합니다. |
중요한 점은 계획과 시각 메모리의 역할이 다르다는 것입니다. 계획은 “지금 어떤 상태여야 하는가”를 알려 주고, 메모리는 “그 상태가 어떻게 생겼는가”를 제공합니다. 예컨대 옷을 갈아입었다는 텍스트만으로 같은 얼굴을 재현하기 어렵고, 옛 이미지 참조만으로는 옷을 바꿔야 한다는 사실을 강제하기 어렵습니다. 두 정보를 결합하는 것이 CANVAS의 동작 원리입니다. 수식과 검색 분기, 평가 집계는 원문의 해당 절 순서에 맞춰 아래에서 설명합니다.
실험은 Gemini-3-pro-image를 이미지 생성 백본으로 사용합니다. AutoStudio, Story-Iter, Story2Board도 같은 Gemini 백본으로 재구현해 비교하고, 이전 키프레임과 인물 앵커를 문맥으로 제공하는 Gemini-Contextual, 즉 Gemini-CT를 추가합니다. 따라서 본문의 주 비교는 각 원 논문의 원래 모델 성능을 그대로 모은 표가 아니라, 저자가 구성한 공통 백본 조건의 추론 파이프라인 비교입니다. §4
챕터별 상세 리뷰
📖 Chapter 1: Introduction
서론은 한 장의 이미지가 아니라 반복 등장하는 세계를 생성해야 한다는 요구에서 출발합니다. 인물은 얼굴과 머리 모양을 유지해야 하고, 같은 장소를 다시 보여줄 때 공간 구조가 보존되어야 하며, 물건은 사건에 따라 존재·도난·부재처럼 인과적으로 상태가 바뀌어야 합니다. 저자가 말하는 세계 상태 모델링은 이러한 대상과 변화를 명시적으로 표현하고 다음 생성에 반영하는 방식입니다. 물리 시뮬레이터를 학습했다는 의미로 사용하지 않습니다.
이어서 저자는 이전 프레임 또는 소수의 참조 이미지에 의존하는 방식에서 오차가 누적될 수 있다고 설명합니다. 특히 가까운 샷에서는 잘 작동하더라도 중간에 다른 장소나 클로즈업이 들어간 뒤 원래 장소로 돌아오는 경우를 강조합니다. CANVAS의 미래 조건부 계획은 나중에 필요한 배경 요소가 처음부터 장면 안에 존재하도록 만드는 역할도 합니다. 서론의 산타 작업실 예시는 이후 샷에 필요한 벽난로나 장난감 때문에 방이 갑자기 재구성되는 문제를 보여 줍니다.
마지막으로 서론은 측정의 문제로 이동합니다. 기존 벤치마크에 장소 재등장이나 물체 상태 전이가 드물면 장거리 연속성의 차이가 충분히 드러나지 않으므로 HardContinuityBench를 구성합니다. 이 장의 기여는 방법·데이터셋·평가를 같은 문제 정의로 묶는 데 있으며, 다음 장은 기존 방식이 어떤 정보를 유지하는지 비교합니다. §1
📖 Chapter 2: Related Work
2.1 Visual Story Generation from Text. 저자는 StoryGen의 자기회귀적 이미지 생성부터 설명합니다. 이전 이미지와 설명의 특징을 생성 과정에 전달하면 외형 유사성을 얻을 수 있지만, 서사의 대상별 상태가 독립적으로 표현되는 것은 아니라는 논리입니다. 이어 StoryDiffusion의 일관된 self-attention, 즉 프레임 사이 참조 토큰을 활용하는 주의집중 연산을 소개합니다. 이 접근 역시 인물 외형의 보존을 중심으로 논의됩니다. 마지막으로 Story2Board의 잠재 패널 앵커와 attention 값 혼합을 다루며, 패널의 표현력·배치 다양성과 지속적인 장소·소품 상태 관리를 구분합니다.
2.2 Multi-Turn Image Generation and Interactive Story Creation. AutoStudio는 피사체 관리자, 배치 생성기, 감독자, 이미지 생성기를 조합한 상호작용형 시스템으로 소개됩니다. TheaterGen은 대형언어모델이 인물과 배치의 프롬프트북을 만들고 참조 인물을 준비하는 방식입니다. 저자의 비교 기준은 에이전트의 유무 자체가 아니라, 여러 샷에 걸친 환경과 물체 상태를 지속적으로 관리하는지에 있습니다. 인물별 생성을 합성하는 방식의 상호작용·공간 관계 문제도 관련 연구 설명에 포함됩니다.
2.3 Memory-Based Narrative Generation. StoryMem은 과거 키프레임을 영상 생성의 기억으로 사용하고, VideoMemory는 인물·소품·배경의 개체 중심 동적 메모리를 둡니다. 저자는 이들과 비교해 CANVAS의 장점으로 서사 전역의 계획과 반복 장소의 기하 구조에 대한 명시적 조건을 제시합니다. Narrative Weaver, OneStory, HoloCine처럼 학습을 통해 장거리 문맥을 생성기에 통합한 방법은 강력한 참조가 될 수 있지만, CANVAS는 추가 학습 없이 사용할 수 있다는 위치를 취합니다. 이 비교는 저자의 문헌 분석이며, 모든 방법에 대한 같은 조건의 우열 실험으로 읽으면 안 됩니다. 다음 장에서는 이 차이를 실제 상태 구조와 알고리즘으로 구체화합니다. §2
📖 Chapter 3: CANVAS
이 장은 계획·검색·선택·갱신을 하나의 생성 순환으로 연결합니다. 박물관 사례에서 Lena는 파란 드레스에서 보안 재킷으로 바뀌었다가 다시 드레스로 돌아오며, 전시실의 유물은 도난 뒤 없어집니다. 인물의 과거 외형을 되찾는 문제와 배경을 최신 상태로 유지하는 문제를 동시에 보여 주는 예입니다.
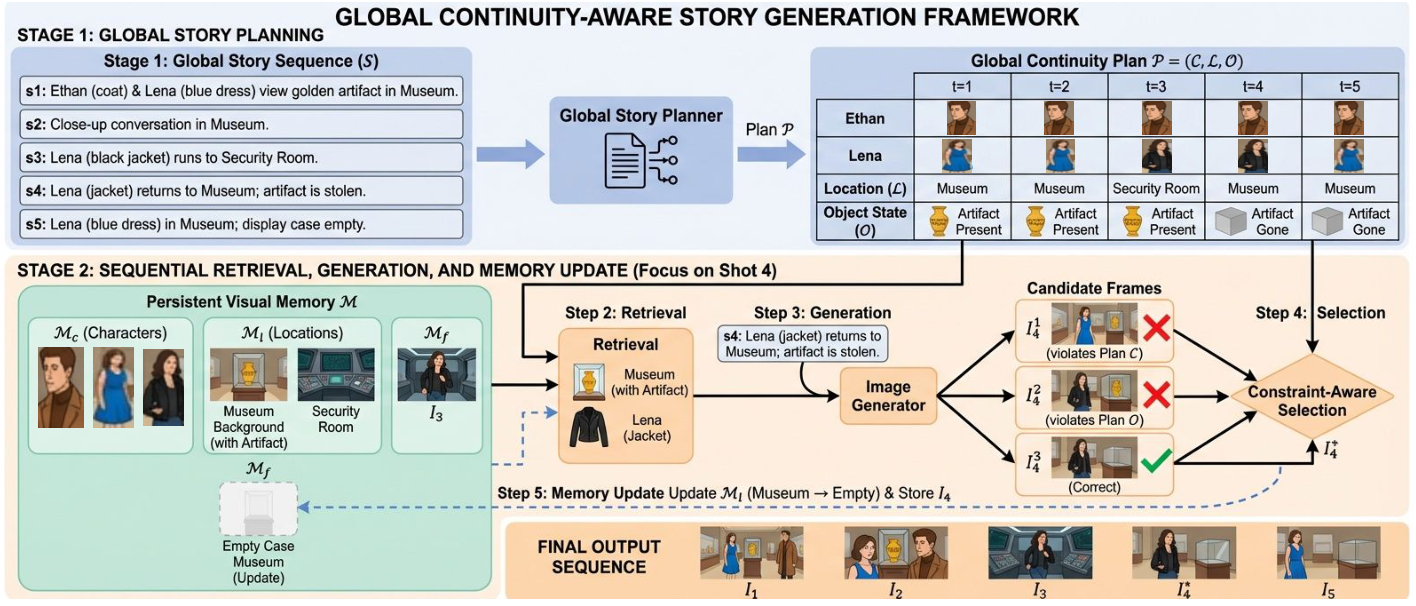
Figure 2, PDF 4쪽. 2604.13452v1 원문의 그림 영역을 크롭했습니다. 원문 영문과 배치를 유지했으며 번역·재구성하지 않았습니다. 아래 상세 그림은 같은 그림의 전역 계획 표와 시각 메모리 패널입니다.
3.1 Global Story Planning. 샷 설명의 집합 표기는 원문의 순서 있는 샷열을 가리킵니다. 전역 계획은 다음과 같습니다.
$T$는 샷 수, $s_t$는 현재 샷 설명입니다. $\mathcal C$는 인물 $c$가 샷 $t$에서 가져야 하는 외형 상태 $k$를, $\mathcal L$은 장소 ID $l$을, $\mathcal O$는 물체 $o$의 상태를 제공합니다. 같은 인물이 같은 옷으로 돌아오면 해당 외형의 기준을 재사용하고, 같은 장소는 표현이 달라도 같은 ID로 묶습니다. 소품은 보이는지뿐 아니라 운반 중인지, 이전 장소에서 사라졌는지까지 추적합니다. 이들은 새 학습 목적함수가 아니라 생성 조건을 구성하는 매핑입니다.
원문은 Character → Location → Object State 순서로 설명합니다. 인물 계획은 서사에 명시된 변화만 외형 변경으로 처리합니다. 장소 계획은 샷을 물리적 장소별로 묶고 미래 사건에 필요한 소품 배치를 예측합니다. 물체 계획은 도난당한 물건이 원래 자리에 다시 생성되는 오류를 막기 위한 상태 전이입니다. 현재 화면 밖에 있는 물체와 이야기 세계에서 제거된 물체를 구분하는 상세 규칙은 부록 A.9에 나옵니다.
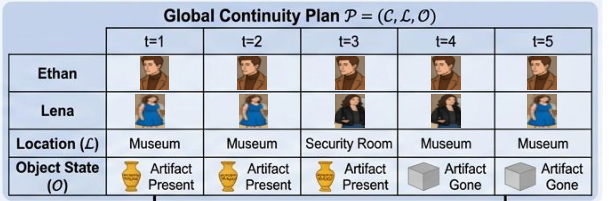
Figure 2 전역 계획 표 패널 상세, PDF 4쪽. 동일 버전 원문에서 추가 크롭했으며 번역하지 않았습니다. 인물 외형의 복귀와 유물 상태의 변화가 서로 다른 행으로 관리됩니다.
3.2 Sequential Generation with Memory — Visual State Memory. 본문은 인물·장소·프레임 메모리를 다음처럼 정의합니다.
$\mathcal M_c$는 인물 외형 앵커, $\mathcal M_l$은 장소 배경 앵커, $\mathcal M_f$는 생성된 프레임을 저장합니다. 같은 절의 갱신 설명과 부록 알고리즘에는 소품 메모리 $\mathcal M_o$도 등장합니다. 따라서 구현 설명을 읽을 때는 이 세 항의 초기 표기만으로 전체 저장 대상을 한정하면 안 됩니다. 원문의 표기 범위 차이를 그대로 구분한 것입니다.
Anchor Retrieval. 전역 계획으로 현재 인물·장소·소품 상태를 찾은 뒤 앵커 집합 $\mathcal A_t$를 구성합니다. 바로 이전 장면의 구도가 이어지면 이전 프레임과 인물 앵커를 사용합니다. 알려진 장소에 다른 시점으로 돌아오면 장소 배경과 현재 외형의 인물 앵커를 사용합니다. 처음 등장한 장소에는 재사용할 배경이 없으므로 인물 앵커와 샷 설명으로 생성합니다. 부록 알고리즘은 여기에 소품 검색과 canonical/recent 인물 참조 선택을 더 구체적으로 규정합니다.
Candidate Generation and Selection. 이미지 생성기는 같은 샷에 대해 $N$개의 후보를 만들고, 시각언어모델이 계획에서 유도한 질문으로 평가합니다. 선택은 가장 일관된 후보를 고르는 연산입니다.
$I_t^{(i)}$는 현재 샷의 $i$번째 후보이며, $i^*$는 가장 높은 점수를 얻은 후보 번호, $I_t^*$는 선택 이미지입니다. 원문의 선택식을 이미지와 인덱스의 관계가 드러나도록 두 줄로 풀어 썼습니다. 점수에는 샷 설명 부합도, 인물 외형, 배경 구조, 소품 상태가 들어가며 정확한 평균식은 부록 알고리즘 3에서 제시됩니다. 이 선택기는 생성 중 검사이고, 실험 결과를 측정하는 ContinuityEval과 동일한 점수라고 간주하지 않습니다.
Memory Update. 선택 이미지에서 명확히 보이는 인물의 현재 외형 앵커를 추출하고, 물체 변화가 환경에 영향을 주면 배경 앵커도 갱신합니다. 소품은 현재 상태의 시각 참조를 저장하고, 선택 프레임은 다음 연속 샷을 위해 보관합니다. 박물관으로 복귀한 장면에서 유물이 도난당하면 배경의 전시장은 빈 상태로 바뀌지만, 마지막 샷의 Lena는 드레스 상태의 인물 앵커를 검색합니다. 즉, 모든 메모리를 단순히 가장 최근 이미지 하나로 대체하는 구조가 아닙니다.
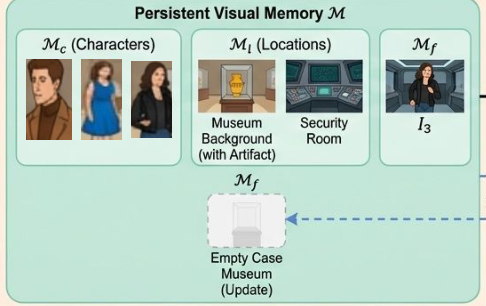
Figure 2 시각 메모리 패널 상세, PDF 4쪽. 동일 버전 원문의 부분 크롭이며 번역하지 않았습니다. 인물·장소·프레임을 별도로 저장하고, 유물 도난 뒤에는 전시실 배경을 빈 진열장 상태로 갱신합니다.
이 장의 핵심 기여는 생성 결과를 다음 생성의 조건으로 되돌리는 폐회로를 대상별 상태 계획과 결합한 것입니다. 다음 장은 이 구조를 어떻게 비교·평가했는지 설명합니다. §3
📖 Chapter 4: Experimental Setup
Datasets. 기존 데이터는 ViStoryBench-Lite 20개 이야기와 StoryMem에서 유래한 ST-Bench 30개 이야기입니다. HardContinuityBench는 GPT-5.2 프롬프팅으로 구성한 5개 이야기이며, 긴 간격 뒤의 장소 재등장, 외형 변화, 가림, 와이드 샷과 클로즈업의 전환을 강조합니다. 작은 크기는 저자도 명시합니다. 따라서 “장편”이라는 문제의식이 대규모 데이터셋을 의미하지 않습니다.
Baselines and Implementation. 공통 Gemini 백본의 세 재구현 방법과 Gemini-CT를 비교합니다. ViStoryBench-Lite에는 canonical 인물 이미지가 제공됩니다. ST-Bench와 HardContinuityBench에는 해당 참조가 없으므로 인물 설명으로 기준 이미지를 먼저 생성합니다. 기준 이미지의 제공 여부가 다르다는 조건을 함께 읽어야 합니다.
Automatic Evaluation Metrics. 첫 평가 축은 ContinuityEval입니다. 얼굴·의복·몸의 정체성, 고정된 건축 구조, 이동 가능한 소품을 따로 평가하며 배경은 연속 샷과 비연속 재등장을 나눕니다. 두 번째 축은 ViStoryBench의 표준 프로토콜로, 프롬프트 부합도와 이미지 품질 등을 평가합니다. 전자는 연속성에 집중하고 후자는 일반적인 스토리 이미지 품질을 보완합니다.
Human Preference User Study. 20개 이야기의 60개 장면을 샘플링하고, CANVAS와 네 비교 방법의 쌍대 비교 240개를 구성합니다. 15명의 평가자가 배경·소품·인물·전체 선호를 판단합니다. 240은 논문이 보고한 비교 쌍 수이며, 모든 평가자가 모든 쌍을 평가했다거나 독립 이야기 240개가 있다는 뜻은 아닙니다. 세부 모집·블라인드·판정 지침은 부록 A.5–A.6이 보완합니다. 이러한 설계 위에서 다음 장의 결과를 읽습니다. §4
📖 Chapter 5: Main Results
Evaluation on ContinuityEval. Table 2에서 CANVAS는 세 데이터셋 모두 배경·소품·인물 평균 점수에서 Gemini-CT보다 높습니다. 다음 표는 Gemini-2.5-Flash 평가자의 1–5 척도 결과 중 두 방법의 원점수를 전사한 것입니다. 각 셀은 Gemini-CT → CANVAS입니다.
| 데이터셋 | 연속 배경 | 비연속 배경 | 소품 | 인물 평균 |
|---|---|---|---|---|
| ViStoryBench-Lite | 4.52 → 4.83 | 4.00 → 4.83 | 4.56 → 4.88 | 4.05 → 4.30 |
| ST-Bench | 4.62 → 4.94 | 3.99 → 4.73 | 4.41 → 4.73 | 3.98 → 4.24 |
| HardContinuityBench | 4.48 → 4.88 | 3.83 → 4.88 | 4.06 → 4.19 | 4.39 → 4.91 |
Table 2의 중요한 패턴은 비연속 배경에서의 차이입니다. HardContinuityBench에서 1.05점의 차이가 나며, 직전 이미지만으로 복원하기 어려운 장소를 별도 메모리로 되찾는 설계와 방향이 일치합니다. 이는 결과에 대한 리뷰어의 해석이며, 점수 차이 자체가 특정 모듈의 인과 효과를 확정하지는 않습니다. 모듈 제거 실험은 다음 장에서 따로 봅니다.
원문의 §5는 일부 비연속 배경 개선율을 약 12–14%로 서술하지만, Table 2에서 Gemini-CT를 분모로 계산하면 각각 약 20.8%, 18.5%, 27.4%입니다. 이 리뷰는 표의 원점수와 분모를 우선합니다. 초록의 21.6%·9.6%·7.6%도 조건별 표의 모든 항목을 대표하는 단일 개선율로 재사용하지 않습니다.
Evaluation on Standard ViStoryBench Metrics. Table 3의 CANVAS는 CSD Cross/Self 0.49/0.72, CIDS Cross/Self 0.61/0.71, 평균 PA 3.60, CM 60.34, Aes 5.60입니다. PA는 Gemini-CT 3.61보다 조금 낮고 CIDS Self는 Story-Iter 0.71과 같습니다. 따라서 “모든 지표 단독 최고”라고 서술할 수 없습니다. CSD·CIDS·CM의 풀네임이 본문과 부록 표 캡션 사이에 다르게 적혀 있어 이 리뷰에서는 표의 약어와 비교 방향을 유지합니다. Inc도 Table 3의 13.89와 Table 16·19의 14.89가 달라, 해당 수치를 단정적인 결론에 사용하지 않습니다.
User Study Results. Figure 3은 자동 평가와 별개의 선호도 결과입니다. Gemini와 비교한 CANVAS의 승률은 배경 68.5%, 인물 70.0%, 전체 68.3%, 소품 66.5%입니다. AutoStudio 대비로는 같은 순서에서 90.9%, 86.7%, 86.7%, 90.9%입니다. 본문 §5의 그림 참조는 Figure 8로 적혀 있지만, 승률 그래프 자체는 Figure 3이며 Figure 8은 평가 인터페이스입니다.
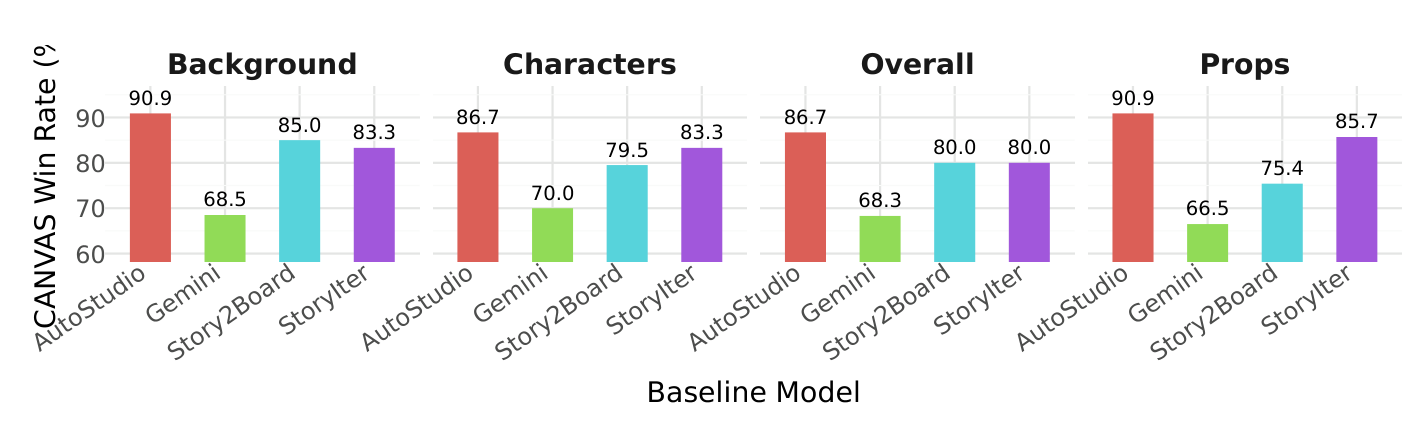
Figure 3, PDF 10쪽. 2604.13452v1 원문의 그래프 영역을 크롭했습니다. 축·방법명·막대 위 승률을 그대로 보존했으며 번역하지 않았습니다. 240개 장면 비교와 15명 평가자에 기반한 집계입니다.
이 장은 여러 평가에서 방향이 일치함을 보여 주지만, 통계적 유의성 검정이나 신뢰구간은 보고하지 않습니다. 다음 장은 각 메모리 요소를 제거했을 때의 변화를 통해 결과의 구조적 이유를 분석합니다. §5
📖 Chapter 6: Further Analysis
제거 실험은 HardContinuityBench를 포함한 20개 샘플 이야기에서 수행했다고 설명합니다. 하나의 모듈을 제거하고 나머지를 유지합니다. Table 4·5의 완전한 CANVAS 점수가 ST-Bench 행과 같더라도, 리뷰에서 실험 대상을 ST-Bench만으로 다시 정의하지 않습니다.
Character Memory. 기준 인물 앵커를 제거하면 얼굴은 4.18에서 2.55로, 의복은 4.45에서 2.76으로, 몸은 4.08에서 2.47로 내려갑니다. 인물 평균은 4.24에서 2.59입니다. 반면 인물 앵커 검색을 제거한 평균은 4.05, 메모리 갱신을 제거한 평균은 4.03입니다. 저자는 canonical 이미지가 고정된 정체성 기준을 제공하므로 가장 큰 영향을 준다고 해석합니다. 외형 기준의 존재, 적절한 검색, 최신 상태 갱신은 같은 기능의 반복이 아니라 서로 다른 역할입니다.
Background and Prop Memory. Table 5에서 장소 묶기를 제거하면 연속/비연속 배경이 4.94/4.73에서 2.45/3.34로 내려갑니다. 배경 재사용 제거에서는 2.12/2.44로 더 크게 하락합니다. 미래 계획 제거는 비연속 배경 4.11과 소품 3.55를 기록하고, 소품 상태 갱신 제거는 소품 3.76을 기록합니다. 완전한 모델의 소품 점수는 4.73입니다. 이 패턴은 장소 식별과 배경 참조가 공간 유지에, 사건을 고려한 계획과 갱신이 소품에 기여한다는 저자의 설명을 뒷받침합니다.
Effect of Candidate Variants. 후보 수를 늘리는 효과는 주로 인물 연속성에 나타나고 배경·소품은 비교적 안정적이라고 보고합니다. 저자는 $N=3$에서 성능이 포화되어 품질과 계산의 균형이 좋다고 판단합니다. 관련 곡선은 실제 Figure 6이며, §6의 Figure 7 참조와 구분해야 합니다. Table 12에서는 QA 선택을 제거해도 HardContinuityBench의 비연속 배경이 4.83으로 전체 모델의 4.88과 가깝지만, 인물 평균은 4.63으로 전체의 4.91보다 낮습니다. 후보 선택이 중요하되 전체 이득을 선택 단계 하나로 환원하기 어려운 결과입니다. 다음 장은 이러한 수치 패턴을 시각 사례로 설명합니다. §6
📖 Chapter 7: Qualitative Analysis
기차역 이야기의 Figure 4는 플랫폼 구조·표지판·조명과 주인공 외형의 유지 여부를 비교합니다. 저자는 Story2Board 등의 결과에서 역의 배치나 표시가 달라지는 반면 CANVAS가 이를 더 안정적으로 유지한다고 설명합니다. Figure 10의 실험실·복도 이야기에서는 장비와 로봇 외형, 복도 구조가 반복 등장할 때의 차이를 보여 줍니다. 이 사례의 로봇은 생성 이미지 속 소품·등장 대상이며, 논문의 연구 목적이나 주 평가는 로봇 제어·조작이 아닙니다.
Ablation. 배경 메모리와 계획을 제거한 결과에서는 장소가 바뀌고, 인물 메모리를 제거한 결과에서는 얼굴·옷이 바뀌며, 소품 갱신을 제거한 박물관 사례에서는 상태 연속성이 깨진다고 설명합니다. 이 장의 핵심은 특정 점수가 어떤 시각적 오류를 가리키는지 연결하는 데 있습니다. 예시 그림은 선택된 사례이므로 전체 실패율로 해석하지 않습니다. 다음 장은 연구의 결론과 저자가 명시한 후속 방향을 정리합니다. §7
📖 Chapter 8: Conclusion and Future Work
결론은 인물 정체성·배경·소품 상태라는 세 축을 명시적으로 유지하는 학습 없는 프레임워크라는 기여를 다시 묶습니다. HardContinuityBench와 ContinuityEval은 이러한 요구를 측정하기 위한 도구입니다. 저자가 제시한 향후 방향은 사용자가 자연어로 장면·인물을 반복 수정하거나 피드백을 주더라도 전역 연속성을 유지하는 human-in-the-loop 시각 스토리텔링입니다. 사람의 수정이 순환에 들어가는 상호작용형 확장이지, 현재 실험에서 이미 구현·검증한 기능은 아닙니다. 이후의 비번호 절은 이 성과의 적용 범위와 연구 절차를 설명합니다. §8
📖 Chapter 9: Limitations · Use of AI assistants · Ethical Considerations · References
Limitations. 저자는 네 가지 한계를 명시합니다. 첫째, 큰 이미지 생성 모델과 여러 후보의 QA 선택 때문에 추론 비용이 큽니다. 둘째, 세밀한 물리 상호작용과 복잡한 운동 동역학은 아직 충분히 모델링하지 않습니다. 셋째, 텍스트에서 인물·장소·물체를 안정적으로 추출할 수 있다고 가정하므로 모호하거나 추상적인 서사에서는 어려울 수 있습니다. 넷째, HardContinuityBench가 작으며 표본을 확장할 계획입니다. 이 네 항목이 논문이 직접 제시한 한계이며, 앞의 수치·표기 불일치는 리뷰어가 원문 대조 과정에서 확인한 보고상의 불확실성으로 구분합니다.
Use of AI assistants. 저자는 분석·시각화 코딩 지원과 간결한 표현을 위한 문장 재서술에 ChatGPT, Gemini, Claude를 사용했다고 밝히고, 실질적인 내용·분석·결론은 저자 책임이라고 설명합니다.
Ethical Considerations → Potential Risks and Harms. 크라우드소싱 플랫폼을 통한 수집은 없었고, 기관 윤리심의 절차가 연구 프로토콜을 승인했다고 기재합니다. 잠재 위험으로는 더 일관되고 사실적인 합성 콘텐츠가 허위정보, 딥페이크, 조작된 시각 증거에 이용될 수 있다는 점을 듭니다. 이어 참고문헌이 배치됩니다. 참고문헌 전체를 재요약하지 않고 관련 연구의 논리적 위치를 Chapter 2와 부록 A.4에 반영했습니다. 다음 부록은 데이터·평가·프롬프트를 상세화합니다. Limitations, Ethical Considerations
📖 Chapter A: Appendix Organization
부록은 본문 결과의 조건과 구현을 재구성하는 데 필요한 자료입니다. 아래는 A.1–A.9의 원래 순서를 유지합니다.
A.1 Why HardContinuityBench is Hard? Table 8의 구조 통계에서 장소 재등장 사이 평균 샷 간격은 ViStoryBench-Lite 1.4, ST-Bench 2.3, HardContinuityBench 5.6입니다. 이야기당 소품 상태 전이는 각각 0.8, 1.2, 3.6입니다. 이야기 수는 20, 30, 5입니다. 즉 난도는 단순한 표본 수 증가가 아니라, 참조가 멀어지고 외형·소품 상태가 더 자주 바뀌도록 만든 데서 나옵니다. Figure 5는 기차역 사례의 확대판으로 배경과 인물 메모리의 역할을 보여 줍니다. A.1
A.2 Character Consistency Evaluation. 먼저 텍스트에서 인물을 추출하고 같은 인물을 가리키는 표현을 정규화합니다. 인물별 등장 프레임열을 만든 뒤, 그 인물의 인접한 등장끼리 비교합니다. 전체 스토리보드에서 바로 붙은 프레임만 비교하는 것이 아닙니다. 서사가 외형 변화를 요구하는 경우는 그 요구를 고려합니다. 얼굴은 구조·비율·특징을, 옷은 종류·구조·색·패턴을, 머리와 몸은 머리 모양·체형·착용 액세서리를 평가합니다. 시점·표정·조명·가림으로 설명되는 차이를 정체성 오류로 세지 않도록 지시합니다.
집계식은 다음과 같습니다. $f_i$, $cl_i$, $hb_i$는 각각 인물의 인접 등장 쌍에서 얻은 얼굴·의복·머리/몸 점수입니다.
$k$는 해당 인물의 등장 프레임 수이고 $k-1$은 그 인물의 인접 등장 전이 수입니다. $C$는 이야기 속 인물 집합, $|C|$는 인물 수입니다. 보이지 않아 판단할 수 없는 속성은 null로 반환하고 평균에서 제외합니다. 따라서 가려진 얼굴을 낮은 점수로 강제하지 않습니다. 이 부록의 CIDS는 1–5 연속성 집계식이며, Table 3의 별도 ViStoryBench CIDS 열과 척도를 혼합하면 안 됩니다. 원문은 단일 등장 인물처럼 분모가 0이 되는 경우의 세부 처리까지 명시하지 않으므로 여기서 임의 규칙을 추가하지 않습니다.
이 절에 배치된 Table 9는 배경 구조 평가도 제공합니다. 벽·문·창·기둥처럼 고정된 구조물을 세고, 카메라 이동으로 설명되지 않는 등장·소실·배치 위반을 집계합니다. 원문의 문장형 계산을 수식으로 옮기면 다음과 같습니다.
$N_A,N_B$는 두 프레임의 건축 요소 수이고, $V$는 세 종류의 위반 수 합입니다. $G$를 0–100으로 제한한 뒤 90–100은 5점, 75–89는 4점, 55–74는 3점, 30–54는 2점, 0–29는 1점으로 바꿉니다. 고정 구조 평가에서 인물·작은 소품·조명 차이를 제외한다는 범위가 중요합니다.
Table 10의 소품 회수율은 형태·색·재질이 일치하는 이동 가능한 물체를 대응시킵니다.
이 식에서 $N_A,N_B$는 건축 요소가 아니라 각 프레임에 보이는 소품 수이며, $N_{\mathrm{match}}$는 동일 외형으로 대응된 소품 수입니다. $R$도 0–100으로 제한합니다. 가림이나 크롭 때문에 보이지 않는 대상을 있다고 추정하지 않도록 지시합니다. 따라서 이 가시성 기반 평가와, 도난 물체가 다시 나타나지 않아야 한다는 사람의 서사 상태 판정은 평가 범위를 구분해 이해해야 합니다. 원문은 이후 소품 비율을 1–5 점수로 변환한다고 설명하지만 Table 10에는 구간별 변환표나 빈 집합 처리 규칙이 없습니다.
뒤이어 Table 11은 머리·몸 점수의 1–5 기준, Table 12는 QA 선택 제거 결과, Figure 6은 후보 수 변화, Figure 7은 소품 추적 제거 사례를 제시합니다. 원문에서 떨어져 배치된 표와 그림도 해당 평가·분석 주제에 연결해 읽어야 합니다. A.2
A.3 Computational Efficiency. 비교 파이프라인은 호스팅된 멀티모달 API를 사용하므로 로컬에서는 프롬프트 구성·메모리 갱신·이미지 입출력이 중심이며, 저자는 로컬 GPU 없이 CPU 환경에서 동작한다고 설명합니다. 이는 이미지 생성 연산 자체가 저렴하다는 뜻이 아니라 비용의 중심이 원격 호출이라는 뜻입니다.
이 절의 $S$는 샷 수, $I$는 정제 반복 수, $K$는 샷당 후보 수, $C$는 canonical 초기화가 필요한 인물 수입니다. 앞 절의 샷 집합 $S$나 인물 집합 $C$와 문맥이 다릅니다. StoryIter는 최초 생성 뒤 반복 정제를 수행하고, CANVAS는 계획·초기화·샷별 추론·다중 후보와 평가 호출을 더합니다. 앞의 두 식은 이미지 생성 호출, 마지막 식은 총 API 호출의 근사치라 호출 종류도 같지 않습니다. 논문은 실측 초 단위 지연이나 금액 대신 이 호출량 설명을 제공합니다. A.3
A.4 Positioning of CANVAS. A.4.1은 텍스트 기반 StoryGen → StoryDiffusion → Story2Board를, A.4.2는 AutoStudio → TheaterGen을, A.4.3은 StoryMem → VideoMemory와 학습 기반 장거리 생성 방법을 다시 비교합니다. 본문의 관련 연구를 확장한 부분입니다. 이어 Table 13과 Comparison Criteria는 생성 방식, 인물 연속성, 환경 지속성, 물체 상태 추적, 상호작용 편집, 명시적 서사 모델링, 장거리 연속성의 축을 정의합니다. CANVAS는 상태 모델링과 환경·물체 지속성을 강조하지만 상호작용 편집은 지원 항목으로 표시하지 않습니다. 부분 지원과 명시적 지원을 구분한 저자의 분류표이며, 표의 체크 표시를 정량 성능으로 바꾸어 읽지 않습니다. A.4
A.5 Human Evaluation Setup. 자동 점수만으로는 서사적 자연스러움을 다 담기 어렵다는 이유로 사람 평가를 보완합니다. 참가자는 생성 모델 출력 평가 경험이 있는 연구 그룹 구성원 15명이며 자발적으로 참여했습니다. 지침과 예시를 제공했고 방법명은 숨겼으며 매 시행의 순서를 무작위화했습니다. 독립적인 일반 사용자 표본을 모집한 평가와는 모집 조건이 다릅니다. A.5
A.6 Human Annotation Instructions. 평가자는 같은 이야기를 생성한 두 전체 스토리보드를 보되, 지정된 대상 장면을 평가합니다. 나머지 장면은 맥락입니다. 선택지는 A·B·동률입니다. 배경은 공간 배치와 환경 요소의 지속성, 소품은 올바른 존재와 상태, 인물은 얼굴·머리·옷·몸, 전체 선호는 설명 부합도와 현실성·일관성을 함께 봅니다. 옷이 달라지는 사건이 설명에 있으면 그 변화는 허용합니다. 마지막 지침은 사소한 스타일보다 큰 불일치를 평가하고 비슷하면 동률을 고르도록 합니다. 사람용 배경 지침에는 조명도 들어가는 반면 자동 건축 구조 프롬프트는 조명을 제외하므로, 두 평가가 문자 그대로 동일한 척도는 아닙니다. A.6
A.7 ContinuityEval Validation. 전문가 3명이 프레임 쌍을 동일한 루브릭으로 독립 채점했고, 평가자 간 평균 일치도로 Fleiss’ $\kappa=0.74$를 보고합니다. 이는 사람 평가자끼리의 일치도이며 모델과 사람 사이의 상관계수가 아닙니다. 모델–사람 관계는 Pearson 상관계수로 별도 측정합니다. Gemini-2.5-Flash는 배경/인물/소품 0.71/0.68/0.67, GPT-5는 0.70/0.66/0.68을 기록합니다. Flash가 모든 축에서 가장 높은 것은 아니며 소품은 GPT-5가 조금 높습니다.
표본 수에는 원문 불일치가 있습니다. A.7 본문은 100개 무작위 전이, Table 14 캡션은 50개 전이라고 적습니다. 리뷰에서는 어느 쪽을 정답으로 임의 선택하지 않습니다. 평가 대상은 ViStoryBench와 ST-Bench라고 명시되어 있으며 HardContinuityBench까지 같은 상관 검증이 수행됐다고 확대하지 않습니다.
Table 15는 생성 모델 계열과 평가 모델을 달리하기 위해 GPT-5로 평가한 결과입니다. Gemini-CT 대비 CANVAS는 연속 배경 4.30→4.60, 비연속 배경 3.80→4.60, 소품 4.20→4.52, 인물 평균 3.82→4.18입니다. 평가 모델을 바꿔도 개선 방향이 유지된다는 근거이지만, 모든 평가 편향이 제거되었다는 증명은 아닙니다. 이어 Table 16은 표준 지표의 PA 하위 항목과 CP까지 확장합니다. 앞서 지적한 Inc 수치와 약어 정의 불일치 때문에 표 간 값을 조용히 합치지 않습니다. A.7
A.8 Storyboard Quality on Video Generation. 저자는 각 방식의 키프레임을 동일한 Veo-3.1-preview 이미지→영상 모델의 첫 프레임으로 제공하고 동일한 영상 프롬프트로 비교합니다. 짧은 클립을 연결해 약 1.5분의 영상을 만들며, 키프레임 조건이 최종 영상 품질에 미치는 영향을 봅니다. 이미지 생성 프레임워크 자체가 운동 동역학을 해결했다고 주장하는 실험은 아닙니다.
Table 17의 Gemini-2.5-Flash 평가는 대본 충실도(SF), 서사 일관성(NC), 시각 품질(VQ), 인물 일관성(CC), 물리 법칙 준수(PLC), 영화적 기법(CT), 몰입도(CD), 전체 품질(OQ)의 8축입니다. CANVAS+Veo의 평균은 4.03, Gemini-CT+Veo는 3.33, StoryIter+Veo는 3.13입니다. CANVAS의 NC/CC는 각각 4.00/4.00이지만, PLC 3.80은 StoryIter의 4.40보다 낮고 SF 3.40은 Story2Board의 3.60보다 낮습니다. 모든 영상 속성을 일괄 개선했다고 해석하지 않습니다.
Table 18은 Gemini-2.5-Pro 평가자의 별도 결과로, CANVAS의 NC 3.00, CC 4.00, CT 5.00, OQ 4.75를 제시합니다. 여기서도 물리 법칙 준수 3.25는 Story-Iter 3.75보다 낮습니다. Table 19는 ViStoryBench-Lite의 기존 방법 수치를 해당 벤치마크 논문에서 가져와 CANVAS와 함께 보여 줍니다. 이는 본문의 공통 Gemini 재구현 비교와 조건이 다른 문헌 수치 비교입니다. Copy-Paste의 높은 일부 유사성 관련 점수와 낮은 PA 1.28은 동일한 이미지를 유지하는 것만으로 이야기 부합도가 확보되지 않음을 읽는 사례입니다. Figure 9는 미래 배경 계획의 산타 사례, Figure 10은 실험실·복도 사례를 보완합니다. A.8
A.9 Prompts and Implementation Details for CANVAS. 이 절은 앞의 개념이 어떤 입출력 계약으로 실행되는지 보여 줍니다. 먼저 Table 20은 장소를 ID로 묶고 fresh_location, previous_frame_continuation, location_reappearance를 JSON으로 반환하게 합니다. Table 21은 현재·미래 사건을 함께 고려해 배경 소품, 반드시 나타날 대상, 나타나면 안 되는 대상, 인물이 운반 중인 물체를 구분합니다. 운반 중인 유물이 배경 진열장에도 중복 존재하지 않도록 하는 규칙입니다.
이어 Table 22는 한 인물의 외형 타임라인을 만들며 등장하지 않으면 not_present로 표시합니다. Table 23은 한 소품의 상태와 운반자를 추적하고, 이야기 세계에는 존재하지만 현재 화면에 보이지 않으면 not_visible을 사용합니다. 이 구분 덕분에 화면 밖으로 나갔다는 사실을 물체 소멸로 오해하지 않도록 계획할 수 있습니다. Table 24는 이전 프레임 재사용 여부를 단순한 장소 이름 일치가 아니라 즉시 이어지는 시간·공간 배치·카메라 전환으로 결정합니다. 소품 상태가 변해도 기본 공간이 연속되어야 한다면 이전 프레임을 사용할 수 있습니다.
그 다음 Algorithm 2는 빈 앵커 집합에서 출발해 현재 계획을 조회하고, 연속 장면이면 이전 프레임을 추가합니다. 인물 외형이 바뀌면 해당 상태의 canonical 앵커를, 유지되면 최근 앵커를 찾으며 최근 참조가 없으면 canonical로 돌아갑니다. 장소 배경을 조회하고 과거에 등장한 소품의 앵커를 더한 뒤, 샷 설명·앵커·인물 상태·소품 상태·배경 추론으로 생성 프롬프트를 구성합니다. Table 25는 생성기에 인물 정체성, 배경 구조, 소품 상태, 장면 부합도를 함께 지키도록 지시합니다.
Algorithm 3과 Table 26은 후보별 네 점수를 1–5로 평가해 평균을 냅니다.
$S_{\mathrm{align}}$은 샷 행동·설명과의 일치, $S_{\mathrm{char}}$는 계획된 인물 외형, $S_{\mathrm{bg}}$는 장소와 공간 연속성, $S_{\mathrm{prop}}$는 계획상 소품 상태의 정확성입니다. 가중치를 따로 학습하는 식이 아니라 네 항을 같은 비중으로 평균합니다. 점수와 이유를 JSON으로 반환하며 최고 후보를 선택합니다.
마지막으로 Algorithm 4는 선택 이미지와 계획을 바탕으로 인물·장소·소품 앵커를 추출하고 메모리에 저장하며 프레임도 추가합니다. Table 27은 명확히 보이는 인물의 외형, Table 28은 가능하면 큰 전경 인물을 피한 장소 배경, Table 29는 보이는 소품의 현재 상태를 추출하는 프롬프트입니다. 문서의 JSON 예시는 character_anchor_image 같은 표현을 사용합니다. 이것은 프롬프트 계약의 예시이며, 이 리뷰에서 이미지 추출 구현 코드까지 실행해 재현했다는 뜻은 아닙니다. 이 마지막 절의 기여는 계획·검색·선택·갱신에 필요한 정보가 무엇인지 구체적인 절차로 제시하는 데 있습니다. A.9
실험 결과 심층 분석
가장 설득력 있는 패턴은 먼 시점의 장소 재방문에서 나타나는 배경 점수 향상과 배경 참조를 제거했을 때의 큰 하락이 함께 관찰된다는 점입니다. Table 2의 HardContinuityBench 비연속 배경은 3.83→4.88로 1.05점 높고, Table 5의 배경 재사용 제거에서는 완전한 모델의 4.73이 2.44로 내려갑니다. 서로 다른 실험 조건의 두 숫자를 하나의 효과 크기로 합치지 않으면서도, 장소별 메모리라는 설계와 관측 결과의 관계를 이해할 수 있습니다.
소품 결과는 더 세심히 읽어야 합니다. HardContinuityBench에서 소품은 4.06→4.19로 0.13점 높아 인물 평균의 4.39→4.91보다 차이가 작습니다. 소품의 외형 매칭 점수, 생성 중 계획상 상태 정확성 검사, 사람이 판단하는 존재·도난·부재의 적절성은 측정 범위가 완전히 같지 않습니다. 따라서 “소품 점수가 높다”를 모든 인과 상태 전이가 해결되었다는 주장으로 바꾸지 않는 것이 타당합니다.
사람 평가의 전체 선호 68.3%는 강한 비교 방법에 대해서도 긍정적인 방향을 보여 줍니다. 그러나 참가자는 연구 그룹 구성원 15명이고, 평가가 무작위 순서·방법명 블라인드를 사용했다는 사실과 표본 대표성은 별개입니다. 승률의 신뢰구간, 유의성 검정, 반복 실행 변동성은 논문에 보고되지 않았습니다. Fleiss’ $\kappa=0.74$는 별도 전문가 3명의 루브릭 일치도이며 이 선호도 실험의 통계적 유의성을 대신하지 않습니다.
재현성 측면에서 전역 계획 프롬프트, 앵커 선택 분기, QA 평균식, 메모리 갱신 절차는 부록으로 공개되어 있어 방법을 이해하는 데 도움이 됩니다. 반면 원문의 표본 수·지표명·일부 숫자·그림 참조 불일치는 그대로 남아 있습니다. 이 리뷰는 모델 API를 호출하거나 실험 코드를 실행하지 않았으며, 표와 수식의 문헌 검토 범위에서 결과를 분석했습니다. Table 2, §6, A.7
기술적 함의와 응용
CANVAS가 보여 주는 기술적 의미는 이미지 생성기의 능력을 추가 학습 없이 활용하면서도, 서사 상태를 외부에서 명시적으로 관리할 수 있다는 점입니다. 리뷰어의 해석으로는 생성 시스템의 기억을 설계할 때 “무엇을 계속 보존할 것인가”와 “무엇을 사건에 따라 갱신할 것인가”를 함께 결정해야 한다는 사례입니다. 외형 변화 전의 인물 앵커는 나중에 다시 필요할 수 있고, 도난 전의 배경은 더 이상 현재 상태의 참조가 되어서는 안 됩니다.
응용 근거는 원문의 스토리보드와 영상 초기화 실험에 있습니다. 동일한 영상 모델과 프롬프트에서도 키프레임을 바꾸면 서사·인물 일관성 평가가 달라졌습니다. 따라서 영상 제작을 위한 사전 시각화에서 키프레임의 연속성을 관리하는 절차가 의미 있다는 해석이 가능합니다. 동시에 저자가 명시한 API 계산 비용, 미세 물리 상호작용의 미지원, 텍스트 개체 추출 가정, 작은 스트레스 테스트 데이터셋이라는 범위가 유지됩니다. 사람의 반복 수정과 전역 연속성을 결합하는 방향은 저자가 제시한 후속 과제입니다.
이 논문의 성과는 인물·공간·물체의 상태를 계획하고, 필요한 시각 참조를 검색하며, 결과를 검사해 다시 메모리에 반영하는 연결에 있습니다. 개별 프레임의 품질과 이야기 세계의 연속성을 분리해 설계하고 평가했다는 점이 핵심입니다.
검토 범위: v1의 본문 1–8절, 비번호 한계·윤리 절, 부록 A.1–A.9 및 알고리즘 1–4를 모두 반영했습니다. 긴 프롬프트와 모든 비교 표의 전 행을 그대로 번역하지는 않았으며, 입력·출력·판정 규칙과 주요 비교 조건을 설명했습니다. 참고문헌의 인용 원문 전체, 외부 구현 코드의 동작, 새 실험 재현은 검토 범위에 포함하지 않습니다.