논문 개요와 전체 구조
영상 생성 모델이 선명한 영상을 만들더라도, 사용자가 요청한 객체 수·행동·시간에 따른 변화를 모두 지키는 것은 별개의 문제입니다. Yiwen Song, Tomas Pfister, Yale Song의 VQQA(Video Quality Question Answering)는 영상 평가를 다음 생성의 입력을 고치는 작업으로 연결합니다. 시각 정보와 언어를 함께 처리하는 비전 언어 모델(VLM)이 질문을 만들고, 생성 영상을 보고 답변하며, 낮은 점수의 항목을 바탕으로 프롬프트를 수정합니다. 이 글은 2026년 3월 12일 공개된 arXiv 2603.12310v1 원문을 분석합니다.
핵심은 세부 오류를 고치는 피드백과 최종 영상을 고르는 기준을 분리하는 것입니다. 반복 중에는 “꽃봉오리가 실제로 열리는가?”처럼 구체적인 질문을 사용하고, 마지막에는 최초 사용자 요청을 기준으로 후보들을 평가합니다. 원문의 Test-Time Training(TTT)은 이산적인 텍스트 프롬프트의 최적화를 뜻합니다. 생성 모델의 가중치를 업데이트하는 학습으로 읽으면 방법을 오해하게 됩니다. 텍스트로 영상을 만드는 T2V와 참조 이미지도 사용하는 I2V에 같은 구조를 적용한다는 점에서, 영상 생성과 에이전트 설계를 함께 공부할 수 있는 논문입니다.
원문의 순서는 다음과 같습니다. 아래 챕터 리뷰도 이 순서를 유지합니다.
- Introduction
- Related Work: 2.1 Video Evaluation Frameworks, 2.2 Prompt Optimization for Video Generation, 2.3 Test-Time Scaling for Video Generation
- Methodology: 3.1 Problem Formulation(3.1.1 평가 시스템, 3.1.2 TTT), 3.2 The VQQA Framework(3.2.1 다중 에이전트, 3.2.2 전역 선택·수렴)
- Experiments: 4.1 Experimental Setup(Tasks, Baselines, Benchmarks), 4.2 Results(T2V-CompBench, VBench2, VBench-I2V), 4.3 Analysis(질문 품질, 수렴·효율), 4.4 Ablation Studies(상용 모델, 전역 선택, GS-in-the-loop)
- Conclusion, 이어 References
- 부록 A Limitations, B Inference Cost, C Experiment Details(Models, Video Generation Seeds, Parameters, Long-horizon runs)
- 부록 D Visualization(Side-by-Side Examples, Full Trajectory), E Analysis Prompts(Dataset Construction, Baseline Implementation, Metric Computation), F Agent Prompts(Question Generation, Question Answering, Prompt Refinement)
핵심 기여와 혁신성
기존 평가 점수는 영상이 좋거나 나쁘다는 순위를 알려 주더라도 무엇을 수정해야 하는지는 직접 설명하지 못합니다. 저자들은 고정된 평가 축만으로는 개별 영상에 나타난 특수한 오류를 충분히 진단하기 어렵다고 봅니다. 또한 무작위 후보를 많이 생성하는 탐색이나 모델 내부 상태를 조정하는 방법은 각각 계산량과 접근 권한의 제약을 갖습니다. VQQA는 생성 모델에 텍스트를 전달하는 인터페이스만으로 관찰·평가·수정을 이어 붙입니다. §1–2
독창성은 자연어 피드백 자체보다 그것을 운영하는 분업 구조에 있습니다. 질문 생성은 진단 항목을 정하고, 질문 답변은 항목별 상태를 수치화하며, 프롬프트 개선은 그 차이를 새로운 문장으로 바꿉니다. 저자들이 말하는 의미적 기울기(semantic gradient)는 미분값이 아니라 수정 방향을 알려 주는 언어적 진단입니다. 전역 선택은 수정 과정에서 원래 의도가 달라지는 의미적 표류(semantic drift)를 억제합니다. 최종 단계의 점수를 개선 에이전트에 다시 넣는 것이 항상 유리하지 않다는 절제 실험도 이 분리를 뒷받침합니다. §3, §4.4
리뷰어의 해석으로는, 이 연구는 “평가자를 추가하면 품질이 오른다”보다 어떤 피드백을 어느 단계에 전달할 것인가를 더 구체적으로 보여 줍니다. 다만 이 해석의 실험 근거는 원문이 평가한 생성기·벤치마크·VLM 조합에 한정됩니다.
기술적 세부사항
프레임워크의 입력은 텍스트 프롬프트와 선택적인 참조 이미지이며, 출력은 여러 반복에서 생성한 영상 중 하나입니다. 생성기와 평가·개선 에이전트는 별개입니다. 생성기 CogVideoX-5B가 영상을 만들고 Gemini-3-Pro 또는 GPT-4o가 진단·개선을 수행하는 식입니다. 질문별 0–100 점수는 개선할 위치를 알려 주고, 최초 요청에 대한 Global Score(GS)는 후보 선택과 종료 판단에 쓰입니다. 외부 벤치마크 점수는 다시 별도로 계산합니다.
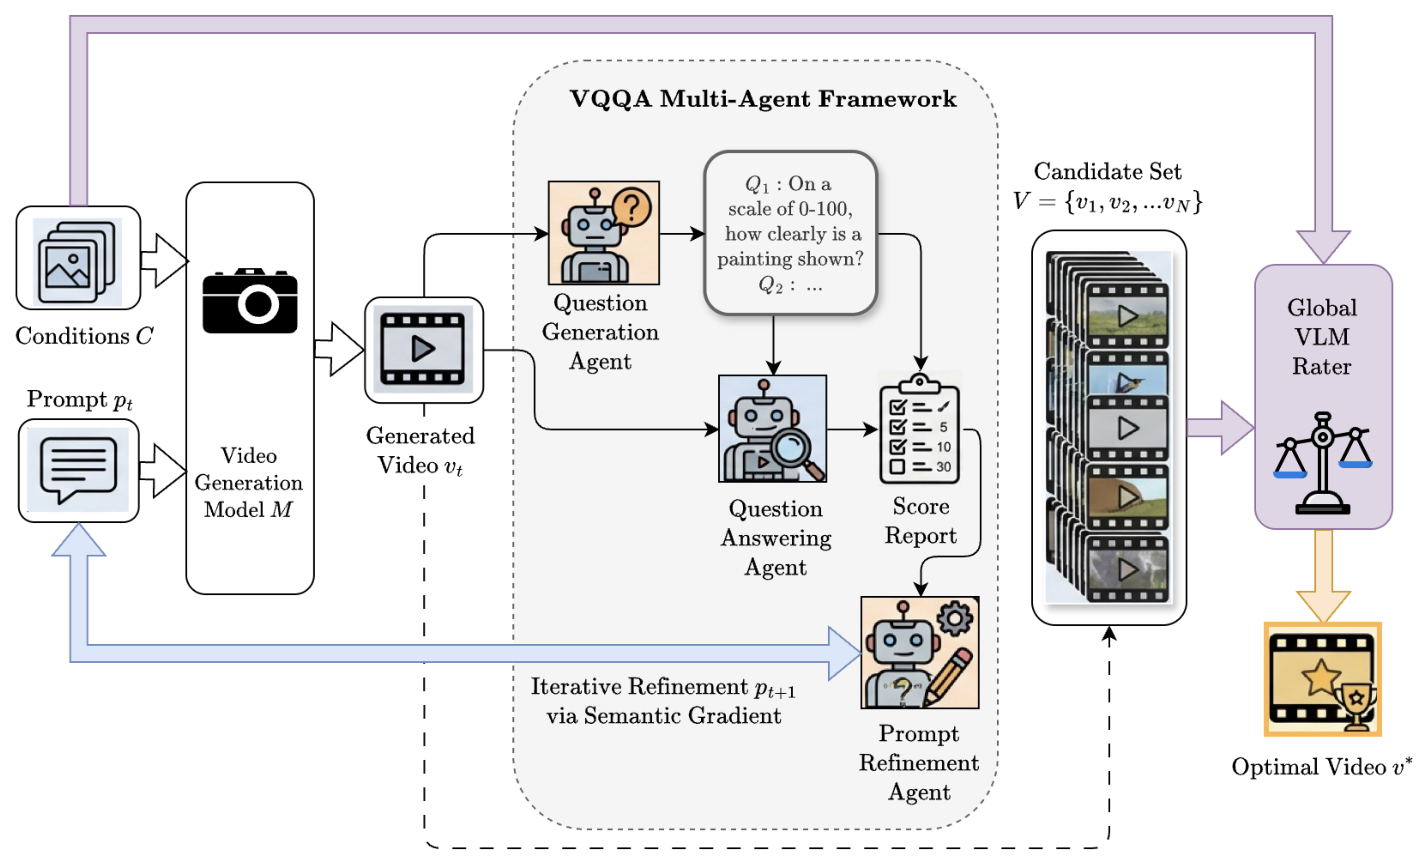
Figure 3, v1 PDF 6쪽. 그림 영역만 크롭했으며 번역·재배열 없이 원본 비율을 유지했습니다. 가운데 반복 경로와 오른쪽 후보 선택 경로를 구분해서 읽으면, QA 평균 점수와 GS의 역할이 다른 이유를 이해할 수 있습니다.
주요 비교는 Best-of-5의 후보 5개와 VQQA의 초기 생성 후 최대 4회 개선입니다. 두 방법 모두 최대 5개 영상을 갖지만, VQQA는 그 사이에 질문 생성·답변·개선 호출을 추가합니다. 따라서 영상 후보 수가 같다는 것과 VLM 호출 비용이나 지연 시간이 같다는 것은 다릅니다. 아래에서는 원문의 수식 (1)–(9), 표 1–7, 부록의 프롬프트 계약을 해당 챕터 안에서 설명합니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
서론은 확산 모델과 Transformer의 발전으로 영상의 시각 품질이 향상되었음에도 복합적인 사용자 의도와 출력 사이에 간극이 남는다는 문제에서 시작합니다. 객체·속성의 잘못된 결합, 시간적 불일치, 물리적으로 부자연스러운 현상 때문에 사용자는 프롬프트를 반복해서 고쳐야 합니다. 여기서 저자들은 생성 성능과 평가 기능의 발전 속도를 분리합니다. 분포 수준의 지표, 여러 전문 모델을 결합한 벤치마크, 인간 의견 점수를 예측하는 회귀기와 VLM은 서로 다른 장점을 갖지만, 점수를 다음 수정으로 연결하는 역할은 충분하지 않다는 설명입니다.
다음으로 에이전트가 자신의 출력을 검사하고 수정하는 작업 흐름을 도입합니다. 서론이 설정하는 요구 조건은 해석 가능한 진단, 닫힌 피드백 루프, 블랙박스 자연어 인터페이스입니다. VQQA는 질문 생성(QG), 질문 답변(QA), 프롬프트 개선(PR)의 세 역할을 제안하고, 최초 요청을 기준으로 하는 전역 선택과 동적 종료를 결합합니다. Figure 1은 수량·상호작용·동적 속성·공간 관계의 사례를, Figure 2는 낮은 QA 점수가 프롬프트 수정으로 이어지는 사례를 보여 줍니다.
이 장의 기여는 개선 목표를 단순한 시각적 아름다움에서 원래 요청을 유지한 채 오류를 수정하는 과정으로 정리한 것입니다. 관련 연구 장은 이 요구가 기존 평가·프롬프트 최적화·추론 시점 탐색과 어떻게 다른지를 이어서 설명합니다. §1
📖 Chapter 2: Related Work
2.1 Video Evaluation Frameworks
먼저 FVD, IS 같은 분포 기반 지표와 시간적 움직임을 보완하는 FVMD를 소개합니다. 이어 CLIPScore·BLIP-Score의 프레임-텍스트 일치, VQAScore의 긍정 답변 확률, T2VQA·LMM-VQA의 평균 의견 점수 예측으로 논의를 옮깁니다. VideoScore2는 점수 이전의 추론을 도입하지만, 저자들은 미리 정한 평가 축에 묶인다는 점을 구분합니다. 마지막으로 다차원 벤치마크와 Evaluation Agent를 살펴본 뒤, VQQA의 질문은 평가 결과를 후속 수정에 직접 전달하는 언어 인터페이스라는 차이를 강조합니다.
2.2 Prompt Optimization for Video Generation
APE·Promptist에서 시작해 Prompt-A-Video·VPO로 확장된 프롬프트 최적화를 설명합니다. VPO는 무해성·정확성·유용성을 고려하지만, 저자들의 비교 관점은 현재 생성 영상의 구체적 오류를 관찰하는가입니다. 데이터셋 수준의 사전 지식으로 프롬프트를 고치는 방식과 현재 출력의 진단을 입력으로 받는 방식은 피드백 경로가 다릅니다. Self-Refine·Reflexion의 언어 모델 자기 수정, 로봇 계획용 VideoAgent, 국소 영역을 고치는 VideoRepair를 차례로 언급한 뒤, VQQA는 전체 프롬프트를 갱신하여 국소 오류와 전역적 시간 흐름을 함께 다룬다고 설명합니다. 이 논문 자체의 주된 목적과 평가는 로봇 조작·제어가 아닙니다.
2.3 Test-Time Scaling for Video Generation
추론 시 계산량을 늘리는 방법을 후보 선택과 생성 경로 탐색으로 나눕니다. Video-T1·VISTA의 탐색, Video-TTT·EvoSearch의 내부 상태 또는 잠재 표현 조작을 비교한 뒤 TextGrad·Feedback Descent의 자연어 최적화 관점을 연결합니다. 여기서 “모델 불가지론적”이라는 표현은 내부 가중치나 잠재 상태에 접근하지 않고 프롬프트를 통해 생성기에 개입한다는 의미입니다. 모든 모델에서 같은 성능이 보장된다는 뜻은 아닙니다.
이 장은 기존 연구를 세 축으로 배치함으로써 방법 장의 설계 공간을 마련합니다. 다음 장에서는 점수 예측과 언어적 설명을 함께 출력하는 평가 함수를 정의하고, 그 설명을 프롬프트 갱신 연산으로 연결합니다. §2
📖 Chapter 3: Methodology
3.1 Problem Formulation — 3.1.1 Video Evaluation System
원문은 먼저 생성과 평가를 별도 함수로 씁니다. 다음은 식 (1)–(3)입니다.
$p$는 텍스트 프롬프트, $C=\{c_1,\ldots,c_n\}$는 참조 이미지 같은 추가 조건, $M$은 사전 학습된 영상 생성기, $v$는 생성 영상입니다. 평가 함수 $f$는 수치 점수 $S_f$와 언어적 근거 $R_f$를 함께 제공합니다. $g$는 인간 평균 의견 점수나 외부 벤치마크 평가기처럼 목표로 삼는 평가 시스템이며, $S_g$는 그 점수입니다. $\Delta$는 두 점수의 차이를 측정하는 함수, 기댓값은 평가할 입력들의 분포에 대한 평균을 나타냅니다. 원문은 여기서 특정 손실 함수나 학습 데이터 분포를 확정하지 않습니다.
따라서 식 (3)은 이 연구가 실제로 별도 평가 신경망을 학습했다는 절차가 아니라, 바람직한 평가 함수가 만족할 목표를 형식화합니다. 중요한 추가 요구는 해석 가능성입니다. 점수가 외부 평가와 가까운 것만으로는 부족하고, 설명이 다음 수정에 쓸 수 있어야 합니다. §3.1.1, 식 (1)–(3)
3.1.2 Iterative Refinement via Test-Time Training (TTT)
원문 식 (4)–(5)는 최적화 대상을 프롬프트 공간으로 옮깁니다.
$\mathcal{P}$는 가능한 텍스트 프롬프트의 공간이며, $p^*$는 목표 점수를 크게 만드는 프롬프트입니다. $t$는 반복 단계, $R_{f,t}$는 그 단계 영상에 대한 진단입니다. 외부 평가기 $g$를 추론 중 알거나 미분할 수 없으므로 $f$를 대리 평가기로 사용합니다. VLM은 문장을 갱신하는 연산자이며, 생성기 $M$의 파라미터는 업데이트하지 않습니다.
예를 들어 동작이 나타나지 않은 영상에 대해 “개화 동작이 거의 없다”는 진단을 얻으면, 개선 에이전트가 동작의 시작·진행·종료를 더 명시하는 프롬프트를 만듭니다. 이것이 의미적 기울기의 적용 방식입니다. 수학적 역전파나 수치 기울기의 크기를 계산하는 과정은 아닙니다. 또한 식 (4)는 수정되는 $p$를 목적함수 안에도 사용하지만, 실제 최종 선택은 아래 식 (6)처럼 고정된 최초 프롬프트 $p_0$를 사용한다는 점을 구분해야 합니다.
3.2 The VQQA Framework — 3.2.1 Multi-Agent Architecture
QG는 프롬프트 일치, 시각 품질, 추가 조건이 있을 때의 조건 충실도라는 세 범주로 질문을 생성합니다. QA는 영상을 검사해 질문별 정규화 점수 0–100을 매깁니다. PR은 낮은 점수의 여러 질문·답변 쌍을 종합하여 다음 프롬프트를 작성합니다. 이 역할 분리는 “무엇을 볼 것인가”, “관찰 결과가 어떤가”, “어떻게 다시 지시할 것인가”를 나눕니다.
세부 입력은 부록 F에서 더 정확히 드러납니다. 프롬프트 일치 질문은 텍스트에서, 시각 품질 질문은 영상과 텍스트에서, 조건 충실도 질문은 참조 이미지와 텍스트에서 생성됩니다. 따라서 모든 질문이 동일한 입력 조합을 반드시 보는 것으로 단순화해서는 안 됩니다. I2V에는 참조 대상의 정체성과 세부 무늬 보존 같은 질문이 추가되며, 생성기나 전체 반복 구조를 바꾸지 않고 평가 질문의 내용을 조정합니다. §3.2.1, 부록 F
3.2.2 Global Selection and Convergence
전역 평가자는 후보 영상이 최초 프롬프트와 참조 이미지에 얼마나 맞는지 0–100 숫자로 평가합니다. 원문 식 (6)은 다음과 같습니다.
$N$은 후보 집합의 크기, $v_i$는 그중 한 영상, $GS$는 전역 점수, $v^*$는 선택된 영상입니다. 프롬프트 개선은 탐색을 진행하지만, 최종 선택 기준은 $p_0$에 고정됩니다. 따라서 마지막 영상이 반드시 선택되지는 않습니다. QA 질문이 매 반복 달라질 수 있다는 점에서도 질문별 점수의 단순 평균과 동일한 기능이 아닙니다.
종료에는 지금까지의 최고 점수 $S_t^*$를 사용합니다. 원문 식 (7)–(8)의 조건을 함께 적으면 다음과 같습니다.
$\tau$는 이전 단계의 인덱스, $\gamma$는 목표 만족 임계값으로 원문은 100을 예로 듭니다. 여기서 $k$는 개선을 기다리는 patience window, $\epsilon$은 그 구간에서 허용하는 미미한 개선 폭입니다. 목표 점수를 넘거나, 최고 점수의 개선이 충분히 작으면 종료합니다. 이는 내부 평가에 따른 종료 기준입니다. GS가 100이라는 것이 외부 벤치마크나 인간 평가에서도 완벽하다는 보장은 아닙니다.
이 장의 핵심은 세부 진단을 이용한 탐색과 원래 의도를 기준으로 한 선택·종료를 연결하는 것입니다. 다음 실험 장은 같은 후보 수의 무작위 탐색보다 이러한 방향성 있는 수정이 유리한지, 그리고 전역 선택이 실제로 필요한지 검사합니다. §3.2.2, 식 (6)–(8)
📖 Chapter 4: Experiments
4.1 Experimental Setup — 4.1.1 Tasks
T2V는 텍스트의 의미와 시간적 내용을 영상에 반영하는 작업입니다. I2V는 여기에 참조 이미지의 정체성과 세부 속성 유지가 추가됩니다. 원문은 질문이 조건 집합에 맞게 바뀌므로 같은 반복 절차를 두 작업에 적용할 수 있다고 설명합니다. 주요 T2V 생성기는 CogVideoX-5B, I2V 생성기는 CogVideoX-5B-I2V입니다. 상용 생성기로의 확장은 뒤의 Veo 3.1 절제 실험에서 다룹니다.
4.1.2 Baselines
비교군 VPO는 프롬프트 자체를 개선하는 방법입니다. Best-of-N(BoN)은 최초 프롬프트로 후보를 여러 개 생성한 뒤 점수로 하나를 선택합니다. BoN의 선택기로는 VQAScore, VideoScore2, VLM-Rating을 사용합니다. VQAScore는 영상 프레임의 긍정 답변 신뢰도를 활용하고, VideoScore2는 시공간 표현에 기반한 품질·정합성 평가를 사용하며, VLM-Rating은 0–100 직접 평가입니다. VQQA와 같은 VLM을 BoN 평가에도 사용하는 비교는, 강한 평가 모델을 채택한 효과와 반복 수정의 효과를 구분하는 데 도움이 됩니다.
4.1.3 Benchmarks
T2V-CompBench는 1,400개 프롬프트와 일관 속성·동적 속성·공간·움직임·행동·상호작용·수량의 일곱 범주로 구성적 생성 능력을 평가합니다. VBench2는 창의성·상식·제어 가능성·인체 충실도·물리의 다섯 상위 차원을 평가합니다. VBench-I2V는 참조 이미지의 배경·대상 일치와 시간적 일관성·움직임을 평가합니다. 서로 다른 평가가 모두 하나의 “영상 품질”을 동일하게 측정하는 것으로 해석해서는 안 됩니다. 각 결과는 해당 벤치마크의 측정 대상에 대응합니다. §4.1
4.2 Results — 4.2.1 T2V-CompBench
다음은 원문 표 1을 전사한 결과입니다. 단위는 %이며 AVG는 원문 평균입니다. BoN은 후보 5개, VQQA는 4회 개선 조건입니다. Vanilla 수치는 공식 리더보드에서 가져왔다고 명시되어 있습니다.
| 방법·평가 VLM | 일관 속성 | 동적 속성 | 공간 | 움직임 | 행동 | 상호작용 | 수량 | AVG |
|---|---|---|---|---|---|---|---|---|
| Vanilla CogVideoX-5B | 61.64 | 2.19 | 51.72 | 26.58 | 53.33 | 60.69 | 37.06 | 41.89 |
| VPO | 76.43 | 4.52 | 54.18 | 26.07 | 64.09 | 68.83 | 45.72 | 48.55 |
| BoN / VQAScore | 80.83 | 2.48 | 56.62 | 26.24 | 64.31 | 65.96 | 44.48 | 48.70 |
| BoN / VideoScore2 | 80.86 | 1.99 | 56.90 | 26.82 | 58.24 | 61.54 | 39.53 | 46.55 |
| BoN / GPT-4o | 80.17 | 2.00 | 56.36 | 27.29 | 60.59 | 66.06 | 42.19 | 47.81 |
| BoN / Gemini-3-Pro | 79.00 | 2.34 | 58.36 | 28.63 | 60.31 | 58.97 | 43.42 | 47.29 |
| VQQA / GPT-4o | 82.96 | 4.88 | 58.73 | 28.51 | 66.72 | 69.57 | 47.75 | 51.30 |
| VQQA / Gemini-3-Pro | 84.58 | 7.92 | 66.03 | 27.73 | 68.50 | 68.54 | 50.91 | 53.46 |
Gemini-3-Pro 조합의 53.46은 Vanilla 41.89보다 11.57퍼센트포인트(pp) 높고, 가장 높은 비교군 평균 48.70보다 4.76pp 높습니다. 일관 속성은 22.94pp, 공간은 14.31pp, 수량은 13.85pp 개선됩니다. 평균의 우위와 범주별 우위는 구분해야 합니다. 움직임은 BoN/Gemini-3-Pro의 28.63이 VQQA/Gemini-3-Pro의 27.73보다 높고, VQQA의 상호작용 점수도 GPT-4o 조합이 더 높습니다. 동적 속성은 개선되었지만 절대 점수는 7.92입니다. 이는 높은 평균만으로 모든 구성 요소가 해결되었다고 표현할 수 없음을 보여 주는 원문 결과입니다. 표 1, §4.2.1
4.2.2 VBench2
원문 표 2에서 주요 비교를 전사하면 다음과 같습니다. 단위는 %이며 Total은 벤치마크가 보고한 총점입니다. 다섯 열의 단순 산술평균으로 새로 계산하지 않았습니다.
| 방법 | 창의성 | 상식 | 제어 가능성 | 인체 충실도 | 물리 | Total |
|---|---|---|---|---|---|---|
| Vanilla | 42.99 | 54.19 | 23.81 | 80.13 | 38.57 | 41.98 |
| VPO | 44.44 | 54.19 | 24.79 | 84.45 | 39.01 | 43.34 |
| BoN / VQAScore | 51.51 | 57.92 | 30.96 | 79.85 | 42.49 | 46.95 |
| BoN / VideoScore2 | 45.92 | 55.05 | 26.92 | 78.09 | 35.46 | 43.97 |
| BoN / GPT-5.1 | 48.34 | 56.49 | 29.81 | 78.83 | 33.88 | 45.28 |
| BoN / GPT-4o | 48.19 | 57.06 | 28.25 | 80.05 | 41.03 | 46.15 |
| BoN / Gemini-3-Pro | 47.96 | 57.64 | 28.79 | 79.69 | 31.05 | 44.76 |
| VQQA / GPT-4o | 55.47 | 57.92 | 30.41 | 79.95 | 46.92 | 48.18 |
| VQQA / Gemini-3-Pro | 54.85 | 58.21 | 31.50 | 81.23 | 54.26 | 50.41 |
VQQA/Gemini-3-Pro의 총점은 Vanilla보다 8.43pp, BoN/VQAScore보다 3.46pp 높습니다. 물리 점수 54.26은 Vanilla 38.57 대비 15.69pp 높습니다. 반면 인체 충실도는 VPO의 84.45가 가장 높고, 창의성은 VQQA/GPT-4o가 Gemini 조합보다 높습니다. 따라서 총점 우위는 각 차원에 대한 일률적 개선과 동일하지 않습니다. 표 2, §4.2.2
4.2.3 VBench-I2V
원문 표 3의 결과입니다. BoN은 후보 5개이며 VQQA의 보고 설정은 4회 개선입니다. Vanilla는 리더보드 값입니다.
| 방법 | I2V 배경 | 배경 일관성 | I2V 대상 | 대상 일관성 | 움직임 부드러움 | 평균 |
|---|---|---|---|---|---|---|
| Vanilla | 96.74 | 96.42 | 97.19 | 94.34 | 98.40 | 96.62 |
| BoN / VQAScore | 98.96 | 97.19 | 97.61 | 95.33 | 98.29 | 97.48 |
| BoN / Gemini-3-Pro | 99.03 | 97.37 | 97.77 | 95.68 | 98.32 | 97.63 |
| VQQA / Gemini-3-Pro | 99.08 | 97.40 | 98.09 | 96.29 | 98.44 | 97.86 |
평균 개선은 Vanilla 대비 1.24pp, 가장 높은 BoN 대비 0.23pp입니다. 저자들은 이 벤치마크가 이미 높은 점수에 포화되어 있다고 설명하며, 종료 기준을 만족하는 평균 반복 수는 1.6회라고 보고합니다. T2V의 큰 개선 폭과 I2V의 작은 개선 폭은 평가 척도·초기 점수·조건이 다르므로 그대로 능력 차이로 환산할 수 없습니다. 표 3, §4.2.3
4.3 Analysis — 4.3.1 Quality of Generated Questions
이 분석은 최종 영상 점수 이전에, 개선의 입력인 질문이 오류를 잘 포착하는지 검사합니다. VideoFeedback2 테스트 분할의 추론 기록에서 GPT-5.2가 구체적 결함 목록을 추출하고, 이를 GT로 사용합니다. 원문의 설명에 따르면 그 추론 기록은 Claude-4-Sonnet에서 유래합니다. 따라서 여기의 GT는 이 실험을 위해 사람이 영상을 직접 다시 주석한 정답 목록과는 다릅니다.
Q-Recall은 GT 결함 중 적어도 하나의 생성 질문이 다루는 비율입니다. E2E-Recall은 해당 질문이 QA 단계에서 임계값 60 미만의 점수까지 받는 비율입니다. Precision은 질문이 입력 영상·프롬프트에 관련되고 유효한지를 판단하는 비율이며, 실제 결함만을 검출했는지의 정밀도와 동일하지 않습니다. 저자들은 GT가 불완전할 수 있고 잠재적 오류를 묻는 질문도 유용하므로 이러한 관련성 정의를 택했다고 설명합니다.
| Gemini-3-Pro 기반 방법 | 질문/분석 관련성 Precision | Q-Recall | E2E-Recall |
|---|---|---|---|
| 직접 VLM 분석 | 99.94 | 해당 없음 | 70.18 |
| VQQA | 99.28 | 96.55 | 82.08 |
표 4의 판정 모델은 Gemini-3-Flash입니다. VQQA의 E2E-Recall은 11.90pp 높습니다. Q-Recall 96.55와 E2E-Recall 82.08의 차이는 관련 질문을 생성하는 단계와 실제로 낮은 점수를 부여하는 단계가 구분됨을 보여 줍니다. 저자들은 소수의 관련성 오류를 VLM의 환각과 연결합니다. 이 표를 인간 판정 정확도 99% 이상이라는 주장으로 바꾸어서는 안 됩니다. 표 4, §4.3.1
4.3.2 Convergence and Efficiency
10단계까지 확장한 분석에서 내부 최고 GS와 외부 T2V-CompBench 점수는 초기 몇 회에 빠르게 상승한 뒤 증가가 둔화합니다. Figure 4의 왼쪽 음영은 1,400개 표본에서 내부 최고 GS의 ±1 표준편차입니다. 외부 벤치마크 평균의 신뢰구간을 나타내는 것이 아닙니다. 오른쪽 민감도 분석은 patience window가 3일 때 임계값에 따라 평균 수렴 횟수가 3.80–4.22회임을 보여 줍니다.
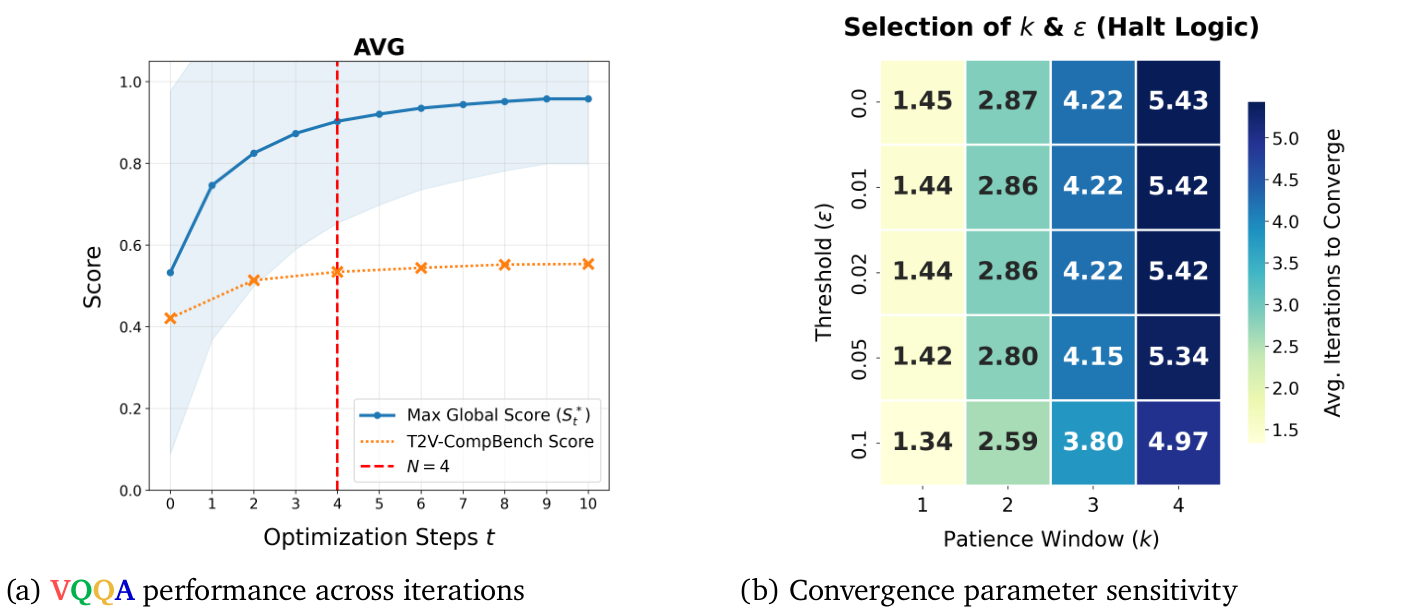
Figure 4, v1 PDF 11쪽. 두 패널을 함께 크롭했고 축·범례·단위·패널 표기를 보존했습니다. 원본은 번역하지 않았습니다. 오른쪽에서 patience가 3인 열은 임계값 0.0/0.01/0.02에서 4.22, 0.05에서 4.15, 0.1에서 3.80회입니다.
원문 부록 B는 최대 4회 설정의 T2V-CompBench에서 평균 개선 횟수 1.245를 별도로 보고합니다. 본문의 10단계 민감도 분석과 실험 범위가 다르며, 두 수치의 종료 설정을 완전히 대응시키는 설명은 제시되지 않습니다. 따라서 이 리뷰는 3.80–4.22와 1.245를 동일 조건의 수렴 횟수로 합치지 않습니다. 4회 안에 주요 개선이 나타난다는 관찰과 모든 설정이 평균 1.245회에 끝난다는 주장은 다릅니다. §4.3.2, 부록 B
4.4 Ablation Studies — 4.4.1 Generalizability to Proprietary Models
Veo 3.1은 내부 프롬프트 최적화가 필수로 켜진 상태에서도 VQQA를 적용했습니다. 표 5에서 평균은 Vanilla 55.93, BoN/VQAScore 59.51, BoN/VideoScore2 57.80, BoN/Gemini-3-Pro 59.01, VQQA/Gemini-3-Pro 61.81입니다. VQQA의 Vanilla 대비 개선은 5.88pp이며, 최상위 BoN/VQAScore보다 2.30pp 높습니다. 생성기 내부의 기존 최적화 위에서도 외부 진단 루프가 추가 효과를 보인 조건입니다.
범주별로는 VQQA가 일관 속성 82.00, 공간 65.73, 움직임 59.70, 상호작용 68.02, 수량 56.47로 우세하지만 모든 범주의 최고는 아닙니다. 동적 속성은 BoN/Gemini-3-Pro의 27.56이 VQQA의 26.44보다 높고, 행동은 BoN/VQAScore의 74.83이 VQQA의 74.31보다 높습니다. 이 절은 접근 방식의 이식 가능성을 입증하는 실험이며, 임의의 상용 모델에 대한 보편적 성능 보장은 아닙니다. 표 5
4.4.2 Global Selection Mechanism
마지막 반복의 영상을 무조건 선택하면 전역 선택보다 평균 1.02pp 낮아지고, 질문별 QA 점수의 평균으로 선택하면 1.86pp 낮아집니다. 전자는 마지막 수정이 원래 요청을 가장 잘 만족한다고 볼 수 없음을, 후자는 세부 항목 평균이 전체 정합성을 대신하지 못함을 보여 줍니다. 저자들은 이를 의미적 표류와 전체 장면의 정합성이라는 관점에서 해석합니다.
리뷰어의 해석으로는, 이 절의 중요한 근거는 반복이 진행되더라도 외부 품질이 단조 증가한다고 가정하지 않는 설계입니다. 이전 후보를 보존하고 최초 프롬프트로 다시 비교하면, 수정 과정에서 발생한 회귀를 최종 선택 단계에서 피할 수 있습니다. 이때 원문 식의 $v^*$는 생성된 후보 중 선택된 최선이며, 가능한 모든 영상 중 전역 최적해를 찾았다는 의미가 아닙니다. Figure 5, §4.4.2
4.4.3 Prompt Refinement: GS-in-the-loop (or not?)
GS를 개선 에이전트의 문맥 이력에 직접 넣는 변형을 비교합니다. 표 6에서 Gemini-3-Pro와 Gemini-2.5-Pro의 평균은 GS 포함 53.11, 표준 방식 53.77입니다. 수량은 각각 48.68과 52.29이며, 저자들은 전역 지표가 국소 병목 수정에 잡음을 줄 수 있다고 해석합니다.
모델별 결과에는 예외가 있습니다. Gemini-3-Pro 단독은 GS 포함 53.55, 표준 53.46으로 포함 쪽이 0.09pp 높습니다. Gemini-2.5-Pro는 52.66 대 54.07로 표준 방식이 높습니다. 따라서 정확한 결론은 평가한 두 모델의 평균에서 분리 구조가 우세했다는 것입니다. 모든 모델과 범주에서 GS를 넣으면 악화된다는 결론은 표를 넘어섭니다.
실험 장은 전체 성능, 피드백의 품질, 종료 동작, 모듈별 기여를 순서대로 연결합니다. 다음 결론 장은 이 결과를 블랙박스 영상 생성의 해석 가능한 개선이라는 하나의 주장으로 묶습니다. 표 6, §4.4.3
📖 Chapter 5: Conclusion
결론은 영상 평가를 수동적인 관찰에서 능동적인 닫힌 루프로 전환했다는 점을 다시 강조합니다. 질문을 통해 오류를 언어로 표현하고 이를 프롬프트 수정에 사용하면, 생성기 내부에 접근하지 않고도 T2V와 I2V를 개선할 수 있다는 정리입니다. 공개 가중치 모델과 상용 모델의 결과를 함께 제시해 적용 범위를 뒷받침합니다.
이 장에서 새로운 실험이나 별도의 향후 과제 목록은 추가하지 않습니다. 이어지는 References는 방법·평가·비교 연구의 서지 목록이며, 이 리뷰는 그 문헌을 모두 독립적으로 읽었다고 전제하지 않습니다. 이후 부록은 논문의 명시적 한계, 비용 계산, 구현 조건, 사례와 프롬프트를 보완합니다. §5
📖 Chapter A: Limitations
저자들이 명시한 첫 한계는 기반 모델 의존성입니다. 블랙박스 최적화는 VLM의 추론 능력과 영상 생성기의 능력에 묶이므로, 근본적인 아키텍처 문제를 고치거나 분포 밖 개념을 합성하거나 VLM 환각에서 생기는 잡음성 피드백을 완전히 없애지는 못한다고 설명합니다. 기반 모델의 발전으로 이런 제약이 줄어들 것이라는 문장은 저자의 전망으로 읽어야 합니다.
둘째는 순차 지연입니다. 질문·생성·수정이 순서대로 이어져, 병렬화할 수 있는 BoN보다 추론 지연이 커집니다. 저자들은 빠른 수렴과 정합성 향상으로 비용을 정당화하지만, 이 설명이 동일한 벽시계 실행 시간을 의미하지는 않습니다. 다음 부록은 이러한 비용을 VLM 호출 수로 구체화합니다. 부록 A
📖 Chapter B: Inference Cost
BoN은 이미 생성된 후보 $N$개를 평가하는 VLM 호출 $N$회가 필요합니다. VQQA는 한 번의 개선마다 T2V 질문 생성 2회, QA 1회, PR 1회를 사용하고, I2V에서는 참조 이미지마다 질문 생성 호출이 추가됩니다. 원문 표 7을 수식으로 정리하면 다음과 같습니다.
표시를 간결하게 하기 위해 생성 단계·평가 단계·전체 VLM 호출 수를 각각 $C_{\mathrm{gen}}$, $C_{\mathrm{eval}}$, $C_{\mathrm{total}}$로 표기했습니다. 여기서 $T$는 개선 횟수이고 이 부록의 $k$는 참조 이미지 수입니다. 본문 종료 식의 patience window와는 다른 기호 사용입니다. $T+1$은 초기 영상 1개와 개선 영상 $T$개의 전역 평가를 의미합니다. 이 식은 VLM 호출의 개수를 세며 영상 생성기의 연산량·토큰 길이·실행 시간·금액을 직접 합산한 식은 아닙니다.
표 7은 Gemini-3-Pro, T2V-CompBench, 최대 4회 개선 조건에서 평균 $T=1.245$를 보고합니다. T2V이므로 $k=0$을 대입하면 $5\times1.245+1=7.225$, 즉 약 7.23회입니다. Best-of-5의 평가 호출은 5회입니다. 저자들은 이를 비슷한 규모의 추론 사용량으로 설명하지만 호출 횟수가 같거나 VQQA가 더 적다는 결과는 아닙니다. 앞서 설명한 10단계 수렴 분석과 조건 대응이 불완전하다는 점도 함께 유지해야 합니다. 다음 부록의 모델·시드·파라미터는 이 비용 및 성능을 해석하는 실행 조건을 보완합니다. 부록 B, 표 7
📖 Chapter C: Experiment Details
C.1 Models
C.1.1은 Gemini API를 Vertex AI로, OpenAI 모델을 공식 API로 사용했다고 설명합니다. 구체적으로 gemini-3-pro-preview, gemini-3-flash-preview, gpt-4o-2024-08-06, gpt-5.1-2025-11-13, gpt-5.2-2025-12-11을 적습니다. 이는 원문 실험 당시의 식별자이며 현재 제공 상태를 확인했다는 뜻은 아닙니다.
C.1.2에서 CogVideoX-5B는 diffusers를 통해 추론 50단계, 41프레임, guidance scale 6.0을 사용합니다. CogVideoX-5B-I2V는 50단계, 49프레임, guidance scale 6.0입니다. Veo 3.1은 Vertex AI에서 16:9 비율과 기본 파라미터로 생성하며, 안전 필터에 걸린 출력은 배치 일관성을 위해 빈 영상으로 대체합니다. 이 조건은 상용 생성기 결과를 읽을 때 빠뜨리면 안 되는 처리 규칙입니다.
C.1.3은 VPO에 CCCCCC/VPO-5B, VQAScore에 t2v_metrics와 llava-onevision-qwen2-7b-ov, VideoScore2에 TIGER-Lab/VideoScore2를 사용했다고 밝힙니다. BoN에서 VideoScore2는 텍스트-영상 정합성 점수를 보상으로 사용합니다. 따라서 “VideoScore2를 사용했다”는 설명만으로 여러 출력 점수 중 어떤 것을 선택에 사용했는지 생략하지 않아야 합니다.
C.2 Video Generation Seeds
시드를 받는 CogVideoX 계열은 초기 생성 시드 17을 BoN과 VQQA에 공통 적용합니다. 두 번째 이후 생성의 시드 $s$는 원문 식 (9)에 따라 균등 추출합니다.
$\mathcal{U}$는 표시된 범위의 균등 분포이고, $s$는 영상 생성의 난수 시드입니다. VBench2와 VBench-I2V처럼 한 프롬프트에 여러 표본이 있으면 최적화도 표본별로 수행합니다. 초기 표본 인덱스 $k$의 시드는 $17+100k$로 정하고 이후에는 무작위 시드를 사용합니다. 이 문맥의 $k$는 표본 인덱스입니다. VPO 단일 생성에는 무작위 시드를 쓰며, Veo 3.1은 해당 실험 인터페이스에서 시드 입력을 받지 않는다고 적습니다.
C.3 Parameters
질문 생성·답변·영상 분석·프롬프트 최적화의 생성 temperature는 모두 0.0입니다. 저자들은 응답 안정성과 재현성을 위한 설정이라고 설명합니다. 영상 생성의 후속 시드는 무작위라는 앞 절의 조건과 구분해야 합니다. 따라서 이 설정을 전체 영상 실험이 완전히 결정적이라는 설명으로 확장하지 않습니다.
C.4 Long-horizon runs
Figure 6은 CogVideoX-5B/Gemini-3-Pro의 10회 반복을 T2V-CompBench 범주별로 펼칩니다. 대다수 범주의 의미적 성능 개선이 첫 4회 안에 집중된다는 관찰로 본문의 4회 실험 설정을 뒷받침합니다. 이 부록의 역할은 모델·샘플링·종료 분석 조건을 명시하는 것이며, 다음 부록은 점수의 변화를 실제 영상 사례와 수정 문장으로 보여 줍니다. 부록 C
📖 Chapter D: Visualization
D.1 Side-by-Side Examples
Figure 7–10은 직접 프롬프트, VPO, VQQA의 출력을 나란히 비교합니다. VPO가 CogVideoX-5B에 맞추어 학습되었기 때문에 생성기를 CogVideoX-5B로 고정합니다. 이 통제는 시각 차이를 생성기 교체의 효과로 혼동하지 않게 합니다. 사례 이미지는 논문의 정성적 설명 자료이며, 전체 데이터에서의 성공률을 대신하는 통계는 아닙니다.
D.2 VQQA Full Trajectory
Figure 11–13의 꽃 개화 사례는 반복의 내부 논리를 구체적으로 보여 줍니다. 초기 영상은 꽃봉오리의 질감과 안정성은 좋지만 거의 정지 영상이며, 개화와 마지막에 완전히 핀 꽃이 나타나는 항목은 각각 5점입니다. 첫 수정은 꽃잎이 갈라지고 펼쳐지고 바깥으로 확장되는 동작을 명시합니다.
첫 개선 이후에도 핵심 개화 점수는 5점이고, 꽃잎 분리·움직임 항목은 25점입니다. 분석 기록은 정적인 “꽃봉오리” 명사와 부드러운 움직임 표현이 충분한 변화를 유도하지 못했다고 해석합니다. 다음 수정은 시작의 닫힌 녹색 봉오리와 마지막의 노란색·주황색 꽃잎을 대비시키고, 강한 움직임과 급격한 형태 변화를 강조합니다. 원문은 두 번의 개선 후 내부 최고 GS 100에 도달했다고 설명합니다.
이 사례의 학습 가치는 일반적인 품질 수식어를 추가하는 것보다 실패한 동작을 관찰하고 표현을 바꾸는 과정을 추적할 수 있다는 데 있습니다. 프롬프트 원인에 대한 문장들은 에이전트의 진단이며, 생성기 내부의 인과 관계를 별도 실험으로 입증한 결과는 아닙니다. 다음 부록은 이러한 질문 진단 자체를 평가한 분석용 프롬프트를 공개합니다. 부록 D
📖 Chapter E: Analysis Prompts
E.0.1 Dataset Construction
GT 추출 프롬프트는 전문가 분석에 명시된 구체적이고 관찰 가능한 결함만 추출하고, 추측·모호한 평·중복을 제외하라고 지시합니다. 출력은 problems 배열이 있는 JSON입니다. 이 형식은 여러 표현을 개별 결함 단위로 정리하여 질문과 대응시키기 위한 것입니다. 원문의 “전문가 분석”이라는 프롬프트 역할 문구가 GT의 모든 항목을 사람이 직접 새로 주석했다는 증거는 아닙니다.
E.0.2 Baseline Implementation
직접 VLM 분석 비교군은 영상과 텍스트를 보고 시각 품질, 텍스트 정합성, 물리·상식 일관성에 관한 결함을 바로 나열합니다. 동일한 problems JSON을 사용하므로 질문을 경유하는 VQQA와 직접 결함을 쓰는 접근을 비교할 수 있습니다. VQQA가 생성 질문을 거쳐야만 얻을 수 있는 진단 범위가 있는지 확인하는 설계입니다.
E.0.3 Metric Computation
Precision 프롬프트는 특정 질문이 영상·프롬프트에 관련되고 유효한지 is_relevant 불리언으로 출력하게 합니다. Q-Recall 프롬프트는 주어진 GT 결함을 검사하거나 드러낼 질문의 인덱스를 indices로 반환하며, 대응 질문이 없으면 빈 배열입니다. 이를 통해 질문의 범위와 QA 점수의 검출 여부를 별도로 계산할 수 있습니다.
주의할 점은 부록의 “E2E-Recall for VLM Direct Analysis”라는 제목 아래 공개된 프롬프트가 검출 결함의 관련성을 묻는 형식이라는 것입니다. 해당 프롬프트에는 GT 결함과의 대응 입력이 명시되어 있지 않습니다. 따라서 공개된 프롬프트만으로 직접 분석 비교군의 GT 매칭 집계 절차 전체를 복원했다고 할 수는 없습니다. 이는 원문 설명의 확인 범위이며, 이 리뷰가 새로운 평가 절차를 보충해 넣지는 않습니다. 다음 부록은 분석용 판정기와 구분되는 실제 VQQA 에이전트의 입력·출력 규칙을 제시합니다. 부록 E
📖 Chapter F: Agent Prompts
F.1 Question Generation Agent
먼저 Video-Prompt Alignment 질문은 프롬프트 복잡도에 따라 5–10개를 생성합니다. 주체·핵심 속성에서 시작해 행동·관계·스타일로 진행하며, 영상 품질이나 미학 자체를 묻지 않도록 범위를 제한합니다. 두 번째 Visual Quality 질문은 영상과 텍스트를 보고 8–10개를 만듭니다. 비전문가도 이해할 수 있는 짧은 문장으로 객체 지속성, 물리적 개연성, 왜곡·깜박임, 부자연스러운 움직임을 우선하고 미적 매력은 낮은 우선순위로 둡니다.
세 번째 Condition Fidelity 질문은 참조 이미지마다 5–10개입니다. 대상의 정체성·재질·무늬·얼굴·의상·배경 구조 등을 점검하되, 제공된 참조 이미지의 내용만 다루게 합니다. 참조가 인물이나 물체라면 배경 질문을 만들지 않고, 텍스트와 충돌하는 시각 속성은 질문에서 제외합니다. 정체성, 세부 특징, 장면과의 자연스러운 통합, 표현 품질의 순서로 구성합니다. 모든 범주는 점수가 높을수록 좋은 0–100 질문과 questions 배열을 사용합니다.
원문 프롬프트 예시를 그대로 구현 사양으로 사용할 때 확인할 지점도 있습니다. 첫 범주의 복잡한 프롬프트 예시에는 NATO 깃발을 묘사한 입력과 독수리·곰·강에 관한 출력 질문이 함께 실려 있습니다. 이는 이 리뷰가 임의로 바로잡은 예시가 아니라 원문에 보이는 입력·출력 불일치입니다. 전체 방법의 효과와 별개로, 공개 예시가 모두 일관된다고 단정하지 않습니다.
F.2 Question Answering Agent
T2V와 I2V의 QA는 질문마다 정수 점수를 반환합니다. 0–20은 대상 부재 또는 심각한 실패, 21–40은 심한 결함, 41–60은 눈에 띄는 결함, 61–80은 작은 결함만 남은 상태, 81–99는 거의 완벽, 100은 매우 드물게 사용하도록 한 완벽 기준입니다. I2V는 참조 이미지 문맥에서 같은 기준을 적용하며 모든 질문에 답해야 합니다.
출력은 질문과 점수를 담은 answers 목록입니다. 여기서 QA 출력 자체는 장문의 자유 서술 비평이 아니라 구조화된 수치 응답입니다. 낮은 점수와 구체적인 질문의 결합이 진단 신호가 되고, 다음 PR 단계에서 결함·원인 추정·수정 전략을 언어화합니다. 본문의 “언어적 근거”를 모든 QA가 별도의 긴 해설을 출력한다는 뜻으로 읽지 않아야 합니다.
F.3 Prompt Refinement Agent
T2V 개선 프롬프트는 최초 요청, 현재 프롬프트, 현재 영상, QA 쌍, 선택적인 과거 이력을 입력으로 받습니다. 핵심 원칙은 높은 점수를 얻기 위해 주체·행동·배경을 삭제하거나 바꾸지 않는 것입니다. 달리는 자동차가 어렵다고 주차된 자동차로 바꾸지 말라는 예가 그 의도를 보여 줍니다. QA 분석, 결함 식별, 프롬프트와의 관련성 추정, 과거 수정의 성공·회귀 요약, 수정 전략, 새로운 프롬프트 작성의 순서로 진행합니다. 세부 추가·부정 제약·상충 표현 단순화·강조·순서 변경을 가능한 전략으로 제시합니다.
T2V 출력은 analysis 안에 과거 요약과 결함 식별 목록을 담고, refinement_strategy와 refined_prompt를 반환합니다. I2V는 참조 이미지 충실도, 최초 요청 준수, 영상 품질이라는 세 목표를 명시합니다. 결함을 세 범주로 분류하여 참조 특징이 사라지면 텍스트로 특징을 보강하고, 행동이 빠지면 동사를 바꾸거나 강조하며, 영상 아티팩트에는 품질·부정 제약을 추가합니다. 분석 목록은 vqa_failure_analysis로 제공됩니다.
이 부록은 같은 VLM을 여러 번 호출한다는 설명을 실제 역할 계약으로 구체화합니다. 질문별 점수와 이력을 개선 전략으로 바꾸되 최초 의도를 보존하고, 최종 후보의 비교는 별도 GS에 맡기는 구조가 논문 전체의 설계와 맞물립니다. 부록 F
실험 결과 심층 분석
가장 강한 근거는 동일한 생성기에서 최대 후보 수를 맞춘 BoN과의 비교입니다. CogVideoX-5B의 T2V-CompBench에서 VQQA/Gemini-3-Pro는 53.46으로 BoN/VQAScore 48.70보다 4.76pp 높습니다. 같은 Gemini-3-Pro를 선택기로 사용한 BoN의 47.29와 비교해도 높습니다. 이는 강한 VLM을 단순히 선택에 쓰는 것에 더해, 영상 관찰을 다음 프롬프트에 연결하는 것이 도움이 된 조건입니다. Vanilla와의 차이는 리더보드 출처라는 실험 설계도 함께 고려해야 합니다. 표 1
다만 품질·비용·지연은 서로 다른 축입니다. 영상 후보 최대 수를 5개로 맞추어도 VQQA에는 여러 VLM 호출이 추가됩니다. 표 7의 약 7.23회는 보고된 평균 개선 횟수를 비용식에 대입한 값이며, 실제 토큰 비용이나 초 단위 지연의 비교가 아닙니다. 논문은 순차 지연을 명시적인 한계로 인정합니다. 또한 본문 수렴 분석과 부록 비용 분석의 평균 횟수를 같은 조건으로 설명할 자료는 충분하지 않습니다. 부록 A–B
질문 분석은 실패를 찾는 과정의 어느 단계가 기여하는지 보여 주지만, 모델이 추출한 GT와 모델 판정에 기반합니다. 99.28이라는 Precision을 인간 결함 검출 정확도로 해석하지 않고, 질문 관련성이라는 정의를 유지해야 합니다. 원문에는 주요 방법 간 차이에 대한 유의성 검정이나 신뢰구간이 보고되지 않았습니다. Figure 4의 표준편차 음영은 이 공백을 대신하지 않습니다. 따라서 이 글은 관측된 점수 차이와 통계적으로 입증된 우위를 구분합니다.
재현성 자료로는 모델 식별자, 생성 프레임 수·추론 단계·guidance scale, 시드 규칙, temperature, 에이전트·분석 프롬프트가 제공됩니다. 이 리뷰는 해당 설정과 원문 표를 분석했으며, 생성 실험을 재실행하지 않았습니다. 부록 E의 직접 분석 recall 집계와 F의 예시 불일치는 확인 범위로 남깁니다. 논문에 프로젝트 페이지 링크가 있지만, 이 원문 분석만으로 코드·데이터의 현재 공개 상태까지 검증했다고 주장하지 않습니다.
기술적 함의와 응용
저자들이 제시하는 직접적인 응용은 공개 가중치 생성기와 상용 API를 아우르는 T2V·I2V 개선입니다. 생성기의 내부를 바꾸지 않고도 질문을 조건에 맞추고 텍스트를 수정할 수 있으므로, 영상 생성 앞뒤의 작업 흐름으로 적용할 수 있습니다. 실제 사용에서의 판단은 원문이 인정한 기반 모델의 능력 한계와 순차 지연을 포함해야 합니다. §5, 부록 A
리뷰어의 해석으로 가장 일반화하기 좋은 설계 원리는 국소적인 수정 신호와 최종 성공 기준의 분리입니다. 무엇이 잘못되었는지 알려 주는 세부 질문은 다음 행동을 정하는 데 유용하고, 원래 목표를 기준으로 한 전체 평가는 후보 간 선택에 유용합니다. 다만 표 6의 모델별 예외가 보여 주듯, 이러한 분리가 모든 모델에 무조건 우월하다고 일반화할 수는 없습니다.
VQQA는 영상 품질을 단일 점수로 압축하는 데서 한 걸음 더 나아가, 평가를 수정 가능한 언어적 정보로 조직합니다. 이 연구의 성과는 평가·수정·선택을 연결한 구조와 그 실험 근거에 있으며, 질문별 점수·전역 점수·외부 벤치마크를 구분해서 읽을 때 그 의미가 분명해집니다.
검토 범위: 본문 §1–5와 부록 A–F의 모든 절을 원문 순서로 반영했습니다. 부록 D의 정성적 영상 사례는 비교 설계와 전체 개화 궤적을 해설했으며, Figure 7–13의 모든 영상 프레임을 재게시하지 않았습니다. 부록 E–F의 프롬프트는 역할·입력·출력·규칙과 확인된 불일치를 설명했으며 예시 전문을 모두 전사하지 않았습니다. 참고문헌으로 연결된 다른 연구의 원문을 모두 검토한 것은 아닙니다.